Cliente de terminal en Go para conversar con modelos alojados localmente a través de Ollama. Un cliente simple en terminal que soporta entradas multimodales y gestión de contexto.
- Go 1.25 o superior (definido en
go.mod). - Ollama instalado y accesible en el
PATHdel sistema (dicho servidor también puede correr de forma remota). - Al menos un modelo descargado en Ollama que soporte la modalidad deseada (texto, imágenes, etc.).
- Una terminal que soporte secuencias ANSI (en Windows el propio binario habilita el modo virtual terminal al iniciar).
El cliente no inicia Ollama por sí mismo: solo se conecta a un servidor que ya debe estar corriendo.
-
Instalar Ollama siguiendo la guía oficial para tu sistema operativo.
-
Iniciar el servidor:
ollama serve
Por defecto Ollama escucha en
127.0.0.1:11434. Si ya lo instalaste como servicio del sistema, es posible que ya esté corriendo en segundo plano y este paso no sea necesario. -
Descargar al menos un modelo (en otra terminal, con el servidor ya corriendo):
ollama pull llama3
Podés reemplazar
llama3por cualquier modelo disponible en ollama.com/search. -
Verificar que el servidor responde:
curl http://localhost:11434/api/tags
Si devuelve un JSON con la lista de modelos, el servidor está listo para que el cliente se conecte.
Clonar el repositorio y compilar con Go:
git clone https://github.com/Urban20/LLM-Chat.git
cd LLM-Chat
go build .
Esto genera un binario llm-chat (o llm-chat.exe en Windows) en el directorio actual.
Ejecución básica, asumiendo que Ollama corre en localhost:11434:
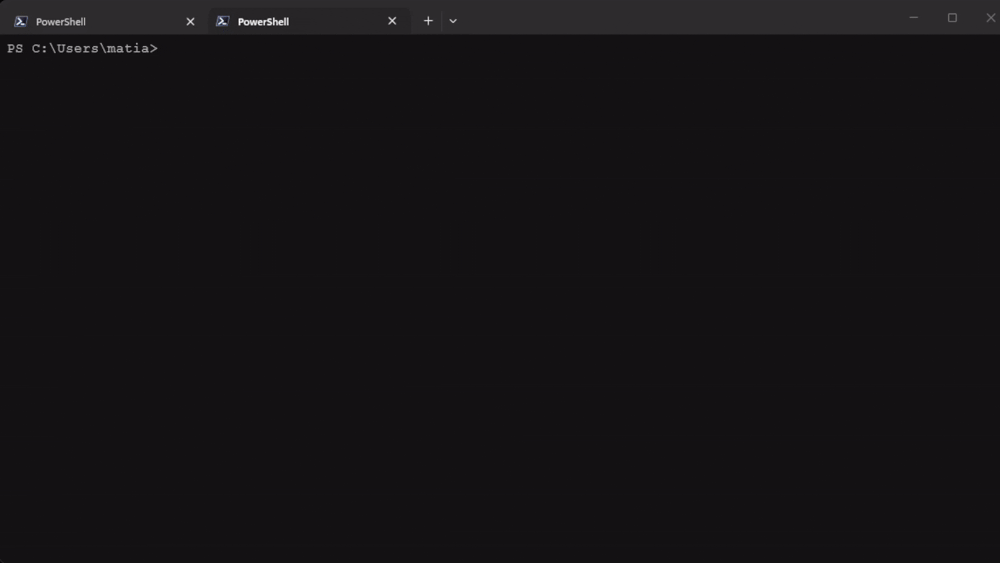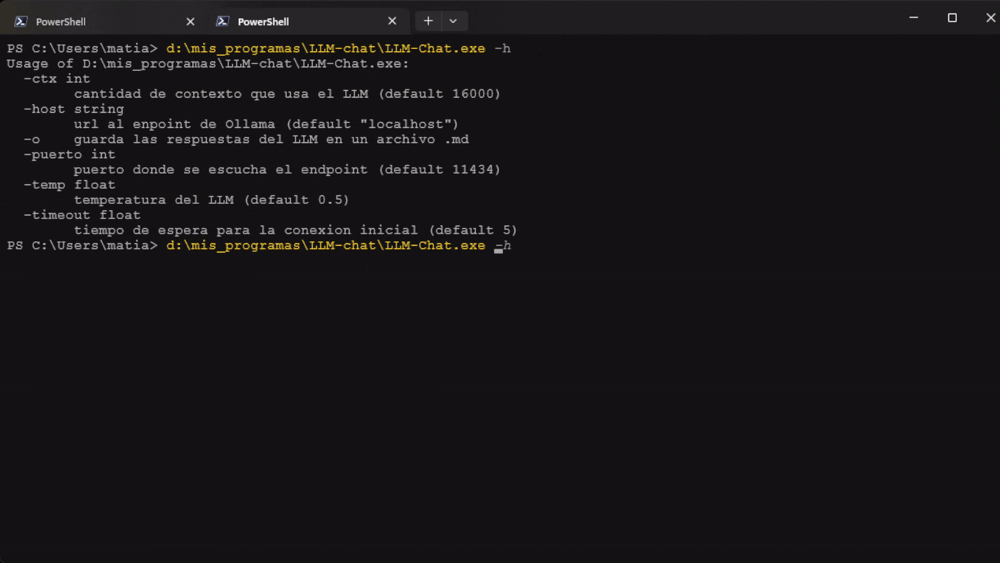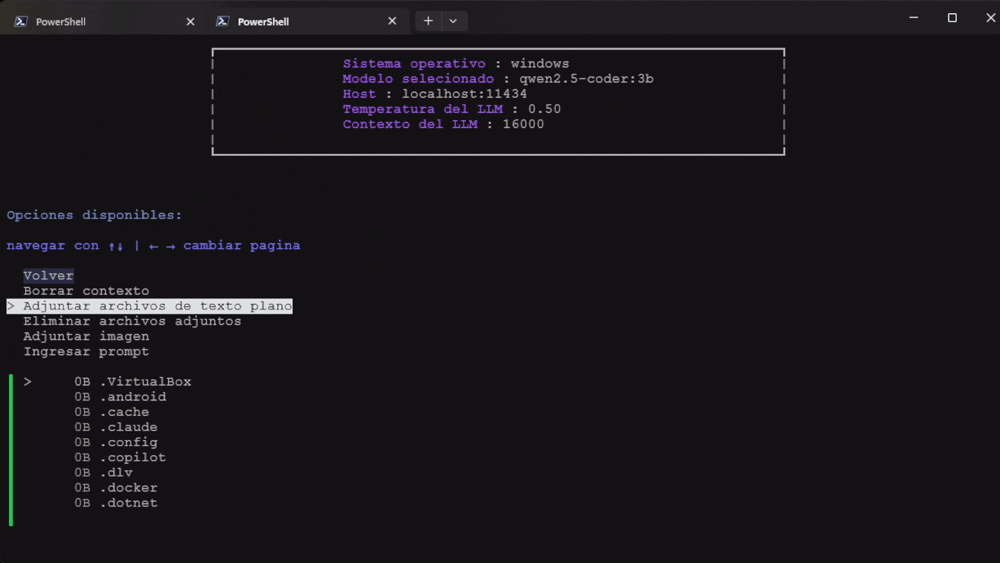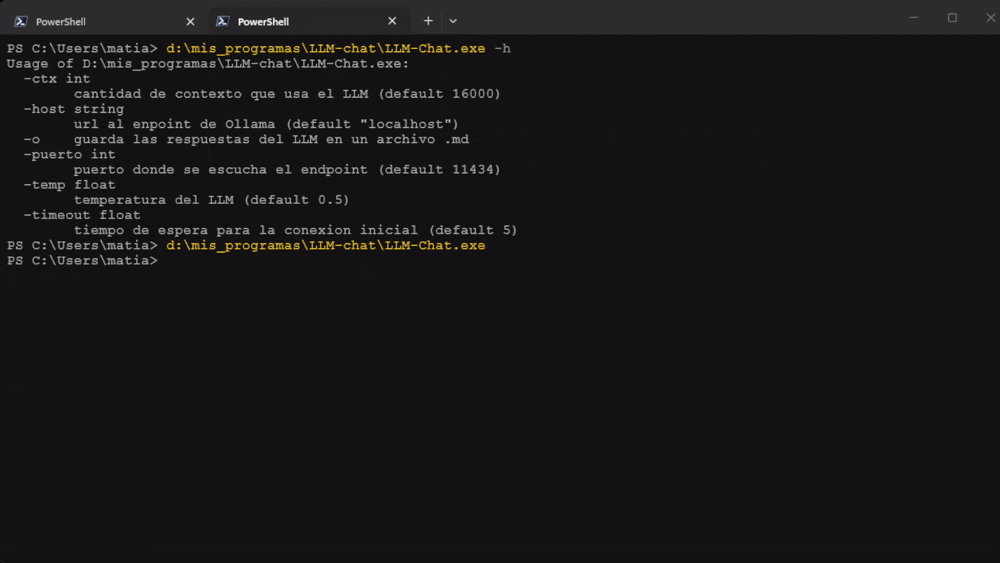
./llm-chat| Flag | Valor por defecto | Descripción |
|---|---|---|
-h |
vacio | despliega la ayuda |
-host |
localhost |
Host/URL donde escucha el endpoint de Ollama |
-puerto |
11434 |
Puerto del endpoint de Ollama |
-ctx |
16000 |
Cantidad de contexto (tokens) que usará el LLM. Nota: Este límite ahora incluye los tokens generados por documentos adjuntos. |
-temp |
0.5 |
Temperatura del modelo (creatividad de las respuestas). |
-o |
false |
Guarda las respuestas en un archivo Markdown (.md) al finalizar la sesión. |
Ejemplo avanzado: Apuntando a un servidor remoto con gran contexto, temperatura baja y guardando resultados:
./llm-chat -host 192.168.1.50 -puerto 11434 -ctx 32000 -temp 0.2 -oAl iniciar, el programa realiza las siguientes verificaciones:
- Verifica si Ollama está en las variables de entorno del sistema (advierte si no lo encuentra, pero continúa).
- Verifica que el servidor responda en la URL configurada.
- Lista los modelos ya descargados en el servidor. Si no hay ninguno, te pedirá ejecutar
ollama pull (modelo)y terminará la ejecución.
Este readme fue generado parcialmente con gemma4:e4b utilizando esta herramienta