- Понимание архитектуры сети в ядре Linux
- Приобретение практических навыков управления IP-пакетами с использованием пакетного фильтра или межсетевого экрана
- Знакомство с тем, как использовать сокеты на уровне ядра Linux
Развитие интернета привело к экспоненциальному росту сетевых приложений и, как следствие, к росту требований к скорости и производительности сетевой подсистемы операционной системы. Сетевая подсистема не является обязательным компонентом ядра операционной системы (ядро Linux может быть скомпилировано без поддержки сети). Однако крайне маловероятно, что вычислительная система (или даже встраиваемое устройство) будет работать под управлением несетевой операционной системы из-за потребности в связности. Современные операционные системы используют стек TCP/IP. Их ядро реализует протоколы до транспортного уровня, тогда как протоколы уровня приложений обычно реализуются в пользовательском пространстве (HTTP, FTP, SSH и т.д.).
В пользовательском пространстве абстракцией сетевого взаимодействия является сокет. Сокет абстрагирует канал связи и представляет собой интерфейс взаимодействия с основанным на ядре стеком TCP/IP. IP-сокет ассоциирован с IP-адресом, используемым протоколом транспортного уровня (TCP, UDP и т.д.) и портом. Общие вызовы функций, использующие сокеты: создание (socket), инициализация (bind), подключение (connect), ожидание соединения (listen, accept), закрытие сокета (close).
Сетевое взаимодействие осуществляется через вызовы read/write или recv/send для TCP-сокетов и recvfrom/sendto для UDP-сокетов. Операции передачи и приёма прозрачны для приложения, оставляя инкапсуляцию и передачу по сети на усмотрение ядра. Однако возможно реализовать стек TCP/IP в пользовательском пространстве с помощью raw-сокетов (опция PF_PACKET при создании сокета) или реализовать протокол уровня приложений в ядре (веб-сервер TUX).
Подробнее о программировании в пользовательском пространстве с использованием сокетов смотрите в Beej's Guide to Network Programming Using Internet Sockets.
Ядро Linux предоставляет три базовые структуры для работы с сетевыми пакетами: struct socket, struct sock и struct sk_buff.
Первые две — это абстракции сокета:
struct socket— абстракция, очень близкая к пользовательскому пространству, то есть сокеты BSD, используемые для программирования сетевых приложений;struct sockили INET-сокет в терминологии Linux — это сетевое представление сокета.
Обе структуры связаны: struct socket содержит поле INET-сокета, а struct sock имеет BSD-сокет, который его держит.
Структура struct sk_buff — это представление сетевого пакета и его состояния. Структура создаётся при получении пакета ядром — либо из пользовательского пространства, либо из сетевого интерфейса.
Структура struct socket — это представление BSD-сокета в ядре; операции, которые можно выполнять над ней, схожи с теми, что предлагает ядро (через системные вызовы). Общие операции с сокетами (создание, инициализация/bind, закрытие и т.д.) приводят к конкретным системным вызовам; они работают со структурой struct socket.
Операции struct socket описаны в net/socket.c и не зависят от типа протокола. Таким образом, структура struct socket — это общий интерфейс над конкретными реализациями сетевых операций. Обычно имена этих операций начинаются с префикса sock_.
Операции с сокетами:
Создание похоже на вызов функции socket() в пользовательском пространстве, но созданный struct socket будет сохранён в параметре res:
int sock_create(int family, int type, int protocol, struct socket **res)создаёт сокет после системного вызоваsocket();int sock_create_kern(struct net *net, int family, int type, int protocol, struct socket **res)создаёт сокет ядра;int sock_create_lite(int family, int type, int protocol, struct socket **res)создаёт сокет ядра без проверок корректности параметров.
Параметры этих вызовов следующие:
net, где присутствует, используется как ссылка на используемое сетевое namespace; обычно мы будем инициализировать его значениемinit_net;familyпредставляет семейство протоколов, используемых при передаче информации; они обычно начинаются со строкиPF_(Protocol Family); константы, представляющие семейство используемых протоколов, находятся вlinux/socket.h, из которых наиболее часто используемая —PF_INET, для протоколов TCP/IP;type— это тип сокета; константы для этого параметра находятся вlinux/net.h, из которых наиболее используемые —SOCK_STREAMдля соединяемой связи «источник-получатель» иSOCK_DGRAMдля несоединяемой связи;protocolпредставляет используемый протокол и тесно связан с параметромtype; константы для этого параметра находятся вlinux/in.h, из которых наиболее используемые —IPPROTO_TCPдля TCP иIPPROTO_UDPдля UDP.
Чтобы создать TCP-сокет в пространстве ядра, нужно вызвать:
struct socket *sock;
int err;

err = sock_create_kern(&init_net, PF_INET, SOCK_STREAM, IPPROTO_TCP, &sock);
if (err < 0) {
        /* handle error */
}
а для создания UDP-сокетов:
struct socket *sock;
int err;

err = sock_create_kern(&init_net, PF_INET, SOCK_DGRAM, IPPROTO_UDP, &sock);
if (err < 0) {
        /* handle error */
}
Пример использования является частью обработчика системного вызова sys_socket():
SYSCALL_DEFINE3(socket, int, family, int, type, int, protocol)
{
      int retval;
      struct socket *sock;
      int flags;

      /* Check the SOCK_* constants for consistency.  */
      BUILD_BUG_ON(SOCK_CLOEXEC != O_CLOEXEC);
      BUILD_BUG_ON((SOCK_MAX | SOCK_TYPE_MASK) != SOCK_TYPE_MASK);
      BUILD_BUG_ON(SOCK_CLOEXEC & SOCK_TYPE_MASK);
      BUILD_BUG_ON(SOCK_NONBLOCK & SOCK_TYPE_MASK);

      flags = type & ~SOCK_TYPE_MASK;
      if (flags & ~(SOCK_CLOEXEC | SOCK_NONBLOCK))
              return -EINVAL;
      type &= SOCK_TYPE_MASK;

      if (SOCK_NONBLOCK != O_NONBLOCK && (flags & SOCK_NONBLOCK))
              flags = (flags & ~SOCK_NONBLOCK) | O_NONBLOCK;

      retval = sock_create(family, type, protocol, &sock);
      if (retval < 0)
              goto out;

      return sock_map_fd(sock, flags & (O_CLOEXEC | O_NONBLOCK));
}Закрыть соединение (для сокетов, использующих соединение) и освободить связанные ресурсы:
void sock_release(struct socket *sock)вызывает функциюreleaseв полеopsструктуры сокета:
void sock_release(struct socket *sock)
{
      if (sock->ops) {
              struct module *owner = sock->ops->owner;

              sock->ops->release(sock);
              sock->ops = NULL;
              module_put(owner);
      }
      //...
}Сообщения отправляются/получаются с помощью следующих функций:
int sock_recvmsg(struct socket *sock, struct msghdr *msg, int flags);int kernel_recvmsg(struct socket *sock, struct msghdr *msg, struct kvec *vec, size_t num, size_t size, int flags);int sock_sendmsg(struct socket *sock, struct msghdr *msg);int kernel_sendmsg(struct socket *sock, struct msghdr *msg, struct kvec *vec, size_t num, size_t size);
Функции отправки/получения сообщений затем вызывают функцию sendmsg/recvmsg в поле ops сокета. Функции с префиксом kernel_ используются, когда сокет используется в ядре.
Параметры:
msg— структураstruct msghdr, содержащая сообщение для отправки/получения. Среди важных компонентов этой структуры —msg_nameиmsg_namelen, которые для UDP-сокетов должны быть заполнены адресом, на который отправляется сообщение (struct sockaddr_in);vec— структураstruct kvec, содержащая указатель на буфер с его данными и размером; как видно, она похожа по структуре наstruct iovec(структураstruct iovecсоответствует данным пользовательского пространства, а структураstruct kvec— данным пространства ядра).
Пример использования можно увидеть в обработчике системного вызова sys_sendto():
SYSCALL_DEFINE6(sendto, int, fd, void __user *, buff, size_t, len,
              unsigned int, flags, struct sockaddr __user *, addr,
              int, addr_len)
{
      struct socket *sock;
      struct sockaddr_storage address;
      int err;
      struct msghdr msg;
      struct iovec iov;
      int fput_needed;

      err = import_single_range(WRITE, buff, len, &iov, &msg.msg_iter);
      if (unlikely(err))
              return err;
      sock = sockfd_lookup_light(fd, &err, &fput_needed);
      if (!sock)
              goto out;

      msg.msg_name = NULL;
      msg.msg_control = NULL;
      msg.msg_controllen = 0;
      msg.msg_namelen = 0;
      if (addr) {
              err = move_addr_to_kernel(addr, addr_len, &address);
              if (err < 0)
                      goto out_put;
              msg.msg_name = (struct sockaddr *)&address;
              msg.msg_namelen = addr_len;
      }
      if (sock->file->f_flags & O_NONBLOCK)
              flags |= MSG_DONTWAIT;
      msg.msg_flags = flags;
      err = sock_sendmsg(sock, &msg);

out_put:
      fput_light(sock->file, fput_needed);
out:
      return err;
}/**
* struct socket - general BSD socket
* @state: socket state (%SS_CONNECTED, etc)
* @type: socket type (%SOCK_STREAM, etc)
* @flags: socket flags (%SOCK_NOSPACE, etc)
* @ops: protocol specific socket operations
* @file: File back pointer for gc
* @sk: internal networking protocol agnostic socket representation
* @wq: wait queue for several uses
*/
struct socket {
socket_state state;
short type;
unsigned long flags;
struct socket_wq __rcu *wq;
struct file *file;
struct sock *sk;
const struct proto_ops *ops;
};Достойные внимания поля:
ops— структура, хранящая указатели на специфичные для протокола функции;sk— ассоциированный с нимINET-сокет.
Структура struct proto_ops содержит реализации специфичных операций (TCP, UDP и т.д.); эти функции будут вызываться из общих функций через struct socket (sock_release(), sock_sendmsg() и т.д.)
Таким образом, структура struct proto_ops содержит ряд указателей на функции для специфичных реализаций протоколов:
struct proto_ops {
      int             family;
      struct module   *owner;
      int             (*release)   (struct socket *sock);
      int             (*bind)      (struct socket *sock,
                                    struct sockaddr *myaddr,
                                    int sockaddr_len);
      int             (*connect)   (struct socket *sock,
                                    struct sockaddr *vaddr,
                                    int sockaddr_len, int flags);
      int             (*socketpair)(struct socket *sock1,
                                    struct socket *sock2);
      int             (*accept)    (struct socket *sock,
                                    struct socket *newsock, int flags, bool kern);
      int             (*getname)   (struct socket *sock,
                                    struct sockaddr *addr,
                                    int peer);
      //...
}
Инициализация поля ops из struct socket выполняется в функции __sock_create() вызовом функции create(), специфичной для каждого протокола; эквивалентный вызов — это реализация функции __sock_create():
//...
      err = pf->create(net, sock, protocol, kern);
      if (err < 0)
              goto out_module_put;
//...
Это инстанцирует указатели на функции вызовами, специфичными для типа протокола, ассоциированного с сокетом. Вызовы sock_register() и sock_unregister() используются для заполнения вектора net_families.
Для остальных операций сокета (кроме создания, закрытия и отправки/получения сообщения, как описано выше в разделе Операции над структурой сокета) будут вызываться функции, переданные через указатели в этой структуре. Например, для bind, который ассоциирует сокет с сокетом на локальной машине, у нас будет следующая последовательность кода:
#define MY_PORT 60000

struct sockaddr_in addr = {
      .sin_family = AF_INET,
      .sin_port = htons (MY_PORT),
      .sin_addr = { htonl (INADDR_LOOPBACK) }
};

//...
      err = sock->ops->bind (sock, (struct sockaddr *) &addr, sizeof(addr));
      if (err < 0) {
              /* handle error */
      }
//...
Как видите, для передачи адреса и информации о порте, которые будут ассоциированы с сокетом, заполняется struct sockaddr_in.
struct sock описывает INET-сокет. Такая структура ассоциирована с сокетом пользовательского пространства и неявно со структурой struct socket. Структура используется для хранения информации о состоянии соединения. Поля структуры и ассоциированные операции обычно начинаются со строки sk_. Некоторые поля перечислены ниже:
struct sock {
      //...
      unsigned int            sk_padding : 1,
                              sk_no_check_tx : 1,
                              sk_no_check_rx : 1,
                              sk_userlocks : 4,
                              sk_protocol  : 8,
                              sk_type      : 16;
      //...
      struct socket           *sk_socket;
      //...
      struct sk_buff          *sk_send_head;
      //...
      void                    (*sk_state_change)(struct sock *sk);
      void                    (*sk_data_ready)(struct sock *sk);
      void                    (*sk_write_space)(struct sock *sk);
      void                    (*sk_error_report)(struct sock *sk);
      int                     (*sk_backlog_rcv)(struct sock *sk,
                                                struct sk_buff *skb);
      void                    (*sk_destruct)(struct sock *sk);
};sk_protocol— тип протокола, используемого сокетом;sk_type— тип сокета (SOCK_STREAM,SOCK_DGRAMи т.д.);sk_socket— держащий его BSD-сокет;sk_send_head— список структурstruct sk_buffдля передачи;- указатели на функции в конце — это колбэки для разных ситуаций.
Инициализация struct sock и прикрепление его к BSD-сокету выполняется с помощью колбэка, созданного из net_families (вызывается __sock_create()). Вот как инициализируется структура struct sock для протокола IP в функции inet_create():
/*
 *    Create an inet socket.
 */

static int inet_create(struct net *net, struct socket *sock, int protocol,
                     int kern)
{
      struct sock *sk;

      //...
      err = -ENOBUFS;
      sk = sk_alloc(net, PF_INET, GFP_KERNEL, answer_prot, kern);
      if (!sk)
              goto out;

      err = 0;
      if (INET_PROTOSW_REUSE & answer_flags)
              sk->sk_reuse = SK_CAN_REUSE;

      //...
      sock_init_data(sock, sk);

      sk->sk_destruct    = inet_sock_destruct;
      sk->sk_protocol    = protocol;
      sk->sk_backlog_rcv = sk->sk_prot->backlog_rcv;
      //...
}struct sk_buff (сокетный буфер, socket buffer) описывает сетевой пакет. Поля структуры содержат информацию как о заголовке, так и о содержимом пакета, используемых протоколах, используемом сетевом устройстве и указателях на другие struct sk_buff. Краткое описание содержимого структуры представлено ниже:
struct sk_buff {
      union {
              struct {
                      /* These two members must be first. */
                      struct sk_buff          *next;
                      struct sk_buff          *prev;

                      union {
                              struct net_device       *dev;
                              /* Some protocols might use this space to store information,
                               * while device pointer would be NULL.
                               * UDP receive path is one user.
                               */
                              unsigned long           dev_scratch;
                      };
              };

              struct rb_node  rbnode; /* used in netem & tcp stack */
      };
      struct sock             *sk;

        union {
              ktime_t         tstamp;
              u64             skb_mstamp;
      };

      /*
       * This is the control buffer. It is free to use for every
       * layer. Please put your private variables there. If you
       * want to keep them across layers you have to do a skb_clone()
       * first. This is owned by whoever has the skb queued ATM.
       */
      char                    cb[48] __aligned(8);

      unsigned long           _skb_refdst;
      void                    (*destructor)(struct sk_buff *skb);
        union {
              struct {
                      unsigned long   _skb_refdst;
                      void            (*destructor)(struct sk_buff *skb);
              };
              struct list_head        tcp_tsorted_anchor;
      };
      /* ... */

      unsigned int            len,
                              data_len;
      __u16                   mac_len,
                              hdr_len;

         /* ... */

      __be16                  protocol;
      __u16                   transport_header;
      __u16                   network_header;
      __u16                   mac_header;

      /* private: */
      __u32                   headers_end[0];
      /* public: */

      /* These elements must be at the end, see alloc_skb() for details.  */
      sk_buff_data_t          tail;
      sk_buff_data_t          end;
      unsigned char           *head,
                              *data;
      unsigned int            truesize;
      refcount_t              users;
};
где:
nextиprev— указатели на следующий и предыдущий элемент в списке буферов;dev— устройство, которое отправляет или принимает буфер;sk— сокет, ассоциированный с буфером;destructor— колбэк, освобождающий буфер;transport_header,network_headerиmac_header— смещения между началом пакета и началом различных заголовков в пакетах. Они внутренне поддерживаются различными слоями обработки, через которые проходит пакет. Чтобы получить указатели на заголовки, используйте одну из следующих функций:tcp_hdr(),udp_hdr(),ip_hdr()и т.д. В принципе, каждый протокол предоставляет функцию для получения ссылки на заголовок этого протокола внутри полученного пакета. Имейте в виду, что полеnetwork_headerне устанавливается, пока пакет не достигнет сетевого уровня, а полеtransport_header— пока пакет не достигнет транспортного уровня.
Структура IP-заголовка (struct iphdr) имеет следующие поля:
struct iphdr {
#if defined(__LITTLE_ENDIAN_BITFIELD)
      __u8    ihl:4,
              version:4;
#elif defined (__BIG_ENDIAN_BITFIELD)
      __u8    version:4,
              ihl:4;
#else
#error        "Please fix <asm/byteorder.h>"
#endif
      __u8    tos;
      __be16  tot_len;
      __be16  id;
      __be16  frag_off;
      __u8    ttl;
      __u8    protocol;
      __sum16 check;
      __be32  saddr;
      __be32  daddr;
      /*The options start here. */
};
где:
protocol— используемый протокол транспортного уровня;saddr— IP-адрес источника;daddr— IP-адрес назначения.
Структура TCP-заголовка (struct tcphdr) имеет следующие поля:
struct tcphdr {
      __be16  source;
      __be16  dest;
      __be32  seq;
      __be32  ack_seq;
#if defined(__LITTLE_ENDIAN_BITFIELD)
      __u16   res1:4,
              doff:4,
              fin:1,
              syn:1,
              rst:1,
              psh:1,
              ack:1,
              urg:1,
              ece:1,
              cwr:1;
#elif defined(__BIG_ENDIAN_BITFIELD)
      __u16   doff:4,
              res1:4,
              cwr:1,
              ece:1,
              urg:1,
              ack:1,
              psh:1,
              rst:1,
              syn:1,
              fin:1;
#else
#error        "Adjust your <asm/byteorder.h> defines"
#endif
      __be16  window;
      __sum16 check;
      __be16  urg_ptr;
};
где:
source— порт источника;dest— порт назначения;syn,ack,fin— используемые TCP-флаги; для более детального представления смотрите эту диаграмму.
Структура UDP-заголовка (struct udphdr) имеет следующие поля:
struct udphdr {
      __be16  source;
      __be16  dest;
      __be16  len;
      __sum16 check;
};
где:
source— порт источника;dest— порт назначения.
Пример доступа к информации, присутствующей в заголовках сетевого пакета:
struct sk_buff *skb;

struct iphdr *iph = ip_hdr(skb);                 /* IP header */
/* iph->saddr  - source IP address */
/* iph->daddr  - destination IP address */
if (iph->protocol == IPPROTO_TCP) {              /* TCP protocol */
        struct tcphdr *tcph = tcp_hdr(skb);      /* TCP header */
        /* tcph->source  - source TCP port */
        /* tcph->dest    - destination TCP port */
} else if (iph->protocol == IPPROTO_UDP) {       /* UDP protocol */
        struct udphdr *udph = udp_hdr(skb);      /* UDP header */
        /* udph->source  - source UDP port */
        /* udph->dest    - destination UDP port */
}В разных системах существует несколько способов упорядочивания байтов в слове (Endianness), включая: Big Endian (наиболее значимый байт первым) и Little Endian (наименее значимый байт первым). Поскольку сеть объединяет системы с разными платформами, интернет навязал стандартную последовательность для хранения числовых данных, называемую сетевым порядком байтов (network byte-order). Напротив, последовательность байтов для представления числовых данных на хост-компьютере называется порядком байтов хоста (host byte-order). Данные, получаемые/отправляемые из/в сеть, имеют формат сетевого порядка байтов и должны преобразовываться между этим форматом и порядком байтов хоста.
Для преобразования мы используем следующие макросы:
u16 htons(u16 x)преобразует 16-битное целое из порядка байтов хоста в сетевой порядок байтов (host to network short);u32 htonl(u32 x)преобразует 32-битное целое из порядка байтов хоста в сетевой порядок байтов (host to network long);u16 ntohs(u16 x)преобразует 16-битное целое из сетевого порядка байтов в порядок байтов хоста (network to host short);u32 ntohl(u32 x)преобразует 32-битное целое из сетевого порядка байтов в порядок байтов хоста (network to host long).
Netfilter — это имя интерфейса ядра для перехвата сетевых пакетов с целью их изменения/анализа (для фильтрации, NAT и т.д.). Интерфейс netfilter используется в пользовательском пространстве с помощью iptables.
В ядре Linux перехват пакетов с использованием netfilter выполняется подключением хуков. Хуки могут быть указаны в разных местах пути, который проходит сетевой пакет в ядре, по мере необходимости. Организационную диаграмму с маршрутом, которым следует пакет, и возможными областями для хука можно найти здесь.
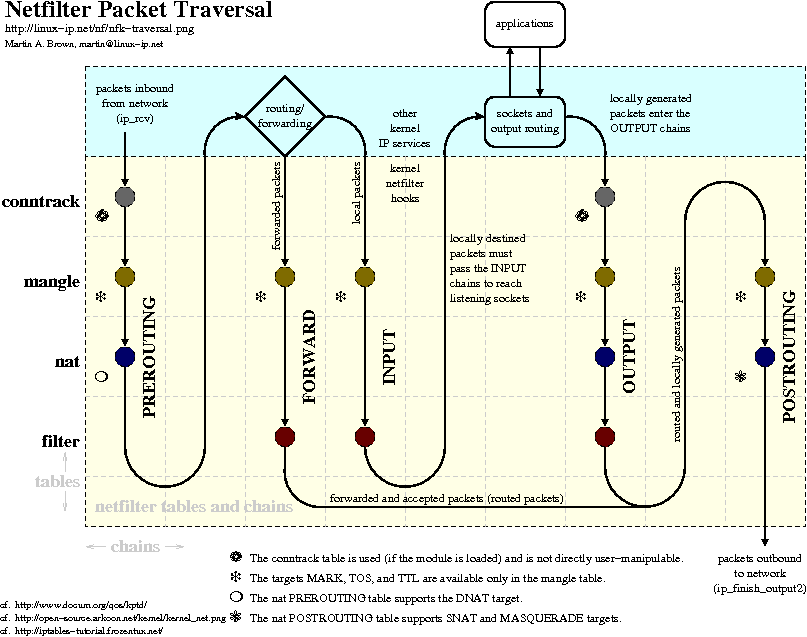
Заголовок, подключаемый при использовании netfilter, — linux/netfilter.h.
Хук определяется через структуру struct nf_hook_ops:
struct nf_hook_ops {
      /* User fills in from here down. */
      nf_hookfn               *hook;
      struct net_device       *dev;
      void                    *priv;
      u_int8_t                pf;
      unsigned int            hooknum;
      /* Hooks are ordered in ascending priority. */
      int                     priority;
};
где:
pf— тип пакета (PF_INETи т.д.);priority— приоритет; приоритеты определены вuapi/linux/netfilter_ipv4.hследующим образом:
enum nf_ip_hook_priorities {
      NF_IP_PRI_FIRST = INT_MIN,
      NF_IP_PRI_CONNTRACK_DEFRAG = -400,
      NF_IP_PRI_RAW = -300,
      NF_IP_PRI_SELINUX_FIRST = -225,
      NF_IP_PRI_CONNTRACK = -200,
      NF_IP_PRI_MANGLE = -150,
      NF_IP_PRI_NAT_DST = -100,
      NF_IP_PRI_FILTER = 0,
      NF_IP_PRI_SECURITY = 50,
      NF_IP_PRI_NAT_SRC = 100,
      NF_IP_PRI_SELINUX_LAST = 225,
      NF_IP_PRI_CONNTRACK_HELPER = 300,
      NF_IP_PRI_CONNTRACK_CONFIRM = INT_MAX,
      NF_IP_PRI_LAST = INT_MAX,
};
dev— устройство (сетевой интерфейс), на котором предполагается перехват;hooknum— тип используемого хука. Когда пакет перехвачен, режим обработки определяется полямиhooknumиhook. Для IP типы хуков определены вlinux/netfilter.h:
enum nf_inet_hooks {
      NF_INET_PRE_ROUTING,
      NF_INET_LOCAL_IN,
      NF_INET_FORWARD,
      NF_INET_LOCAL_OUT,
      NF_INET_POST_ROUTING,
      NF_INET_NUMHOOKS
};
hook— обработчик, вызываемый при перехвате сетевого пакета (пакет передаётся как структураstruct sk_buff). Полеprivate— это приватная информация, передаваемая обработчику. Прототип обработчика перехвата определён типомnf_hookfn:
struct nf_hook_state {
      unsigned int hook;
      u_int8_t pf;
      struct net_device *in;
      struct net_device *out;
      struct sock *sk;
      struct net *net;
      int (*okfn)(struct net *, struct sock *, struct sk_buff *);
};

typedef unsigned int nf_hookfn(void *priv,
                             struct sk_buff *skb,
                             const struct nf_hook_state *state);
Для функции перехвата nf_hookfn() параметр priv — это приватная информация, с которой был инициализирован struct nf_hook_ops. skb — указатель на перехваченный сетевой пакет. На основе информации skb принимаются решения о фильтрации пакетов. Параметр state функции — это информация о состоянии, связанная с перехватом пакета, включая входной интерфейс, выходной интерфейс, приоритет, номер хука. Приоритет и номер хука полезны, чтобы позволить одной и той же функции вызываться несколькими хуками.
Обработчик перехвата может вернуть одну из констант NF_*:
/* Responses from hook functions. */
#define NF_DROP 0
#define NF_ACCEPT 1
#define NF_STOLEN 2
#define NF_QUEUE 3
#define NF_REPEAT 4
#define NF_STOP 5
#define NF_MAX_VERDICT NF_STOP
NF_DROP используется для фильтрации (игнорирования) пакета, а NF_ACCEPT — для принятия пакета и его передачи дальше.
Регистрация/разрегистрация хука выполняется с помощью функций, определённых в linux/netfilter.h:
/* Function to register/unregister hook points. */
int nf_register_net_hook(struct net *net, const struct nf_hook_ops *ops);
void nf_unregister_net_hook(struct net *net, const struct nf_hook_ops *ops);
int nf_register_net_hooks(struct net *net, const struct nf_hook_ops *reg,
                        unsigned int n);
void nf_unregister_net_hooks(struct net *net, const struct nf_hook_ops *reg,
                           unsigned int n);
Внимание
До версии 3.11-rc2 ядра Linux существуют некоторые ограничения, связанные с использованием функций извлечения заголовков из структуры struct sk_buff, установленной как параметр в хуке netfilter. В то время как IP-заголовок можно получать каждый раз с помощью ip_hdr(), TCP- и UDP-заголовки могут быть получены с помощью tcp_hdr() и udp_hdr() только для пакетов, которые приходят изнутри системы, а не для тех, что получены извне системы. В последнем случае нужно вручную вычислить смещение заголовка в пакете:
// For TCP packets (iph->protocol == IPPROTO_TCP)
tcph = (struct tcphdr*)((__u32*)iph + iph->ihl);
// For UDP packets (iph->protocol == IPPROTO_UDP)
udph = (struct udphdr*)((__u32*)iph + iph->ihl);
Этот код работает во всех ситуациях фильтрации, поэтому рекомендуется использовать именно его вместо функций доступа к заголовкам.
Пример использования хука netfilter показан ниже:
#include <linux/netfilter.h>
#include <linux/netfilter_ipv4.h>
#include <linux/net.h>
#include <linux/in.h>
#include <linux/skbuff.h>
#include <linux/ip.h>
#include <linux/tcp.h>

static unsigned int my_nf_hookfn(void *priv,
              struct sk_buff *skb,
              const struct nf_hook_state *state)
{
      /* process packet */
      //...

      return NF_ACCEPT;
}

static struct nf_hook_ops my_nfho = {
      .hook        = my_nf_hookfn,
      .hooknum     = NF_INET_LOCAL_OUT,
      .pf          = PF_INET,
      .priority    = NF_IP_PRI_FIRST
};

int __init my_hook_init(void)
{
      return nf_register_net_hook(&init_net, &my_nfho);
}

void __exit my_hook_exit(void)
{
      nf_unregister_net_hook(&init_net, &my_nfho);
}

module_init(my_hook_init);
module_exit(my_hook_exit);При разработке приложений, включающих сетевой код, один из наиболее используемых инструментов — netcat. Также имеет прозвище «швейцарский нож для TCP/IP». Он позволяет:
- Инициировать TCP-соединения;
- Ожидать TCP-соединение;
- Отправлять и принимать UDP-пакеты;
- Отображать трафик в формате hexdump;
- Запустить программу после установления соединения (например, оболочку);
- Задавать специальные опции в отправляемых пакетах.
Инициирование TCP-соединений:
nc hostname port
Прослушивание TCP-порта:
nc -l -p port
Отправка и приём UDP-пакетов выполняется добавлением параметра командной строки -u.
Примечание
Команда называется nc; часто netcat — это алиас этой команды. Существуют и другие реализации команды netcat, некоторые из которых имеют слегка отличающиеся параметры от классической реализации. Запустите man nc или nc -h, чтобы проверить, как ею пользоваться.
Больше информации о netcat — в этом туториале.
- Understanding Linux Network Internals
- Linux IP networking
- The TUX Web Server
- Beej's Guide to Network Programming Using Internet Sockets
- Kernel Korner - Network Programming in the Kernel
- Hacking the Linux Kernel Network Stack
- The netfilter.org project
- A Deep Dive Into Iptables and Netfilter Architecture
- Linux Foundation Networking Page
Важно
Мы настоятельно рекомендуем использовать окружение из этого репозитория.
Для решения упражнений вам нужно выполнить эти шаги:
- подготовить скелеты из шаблонов
- собрать модули
- запустить виртуальную машину и протестировать модуль в ней.
Имя текущей лабораторной — networking. Имя задания смотрите в упражнениях.
Скелетный код генерируется из полных исходных примеров, расположенных в tools/labs/templates. Для решения задач начните с генерации скелетного кода для полной лабораторной:
tools/labs $ make clean
tools/labs $ LABS=<lab name> make skels
Можно также сгенерировать скелет для одного задания, используя
tools/labs $ LABS=<lab name>/<task name> make skels
Когда скелетные драйверы сгенерированы, соберите исходники:
tools/labs $ make build
Затем запустите виртуальную машину:
tools/labs $ make console
Модули размещаются в /home/root/skels/networking/<task_name>.
Вам НЕ нужно останавливать виртуальную машину при пересборке модулей! Локальный каталог skels разделяется с виртуальной машиной.
Смотрите раздел Exercises для более детальной информации.
Предупреждение
Перед началом упражнений или генерацией скелетов, пожалуйста, выполните git pull внутри Linux-репозитория, чтобы убедиться, что у вас последняя версия упражнений.
Если у вас есть локальные изменения, команда pull завершится ошибкой. Проверьте локальные изменения с помощью git status. Если вы хотите их сохранить, выполните git stash перед pull и git stash pop после. Чтобы отбросить изменения, выполните git reset --hard master.
Если вы уже сгенерировали скелет до git pull, вам нужно будет сгенерировать его снова.
Важно
Вам нужно убедиться, что поддержка netfilter активна в ядре. Она включается через CONFIG_NETFILTER. Чтобы активировать её, запустите make menuconfig в каталоге linux и проверьте опцию Network packet filtering framework (Netfilter) в Networking support -> Networking options. Если она не была включена, включите её (как builtin, а не внешний модуль — она должна быть помечена *).
Напишите модуль ядра, который отображает адрес источника и порт для TCP-пакетов, инициирующих исходящее соединение. Начните с кода в 1-2-netfilter и заполните области, помеченные TODO 1, принимая во внимание комментарии ниже.
Вам нужно зарегистрировать хук netfilter типа NF_INET_LOCAL_OUT, как объяснено в разделе netfilter.
Структура struct sk_buff позволяет получить доступ к заголовкам пакета с помощью специфичных функций. Функция ip_hdr() возвращает IP-заголовок как указатель на структуру struct iphdr. Функция tcp_hdr() возвращает TCP-заголовок как указатель на структуру struct tcphdr.
Диаграмма объясняет, как устанавливается TCP-соединение. Пакет инициализации соединения имеет установленный флаг SYN в TCP-заголовке и сброшенный флаг ACK.
Примечание
Для отображения IP-адреса источника используйте формат %pI4 функции printk. Детали можно найти в документации ядра (раздел IPv4 addresses). Ниже пример фрагмента кода, использующего %pI4:
printk("IP address is %pI4\n", &iph->saddr);При использовании формата %pI4 аргумент printk — это указатель. Отсюда конструкция &iph->saddr (с оператором & — амперсандом) вместо iph->saddr.
Исходный TCP-порт находится в TCP-заголовке в формате сетевого порядка байтов. Прочитайте раздел Преобразования. Используйте ntohs() для преобразования.
Для тестирования используйте файл 1-2-netfilter/user/test-1.sh. Тест создаёт соединение с localhost — соединение, которое будет перехвачено и отображено модулем ядра. Скрипт копируется на виртуальную машину командой make copy, только если он помечен как исполняемый. Скрипт использует статически скомпилированный инструмент netcat, хранящийся в skels/networking/netcat; эта программа должна иметь права на исполнение.
После запуска проверщика вывод должен быть похож на приведённый ниже:
# ./test-1.sh
[  229.783512] TCP connection initiated from 127.0.0.1:44716
Should show up in filter.
Check dmesg output.
Расширьте модуль из упражнения 1 так, чтобы можно было указать адрес назначения с помощью вызова ioctl MY_IOCTL_FILTER_ADDRESS. Вы будете показывать только пакеты, содержащие указанный адрес назначения. Для решения этой задачи заполните области, помеченные TODO 2, и следуйте спецификациям ниже.
Для реализации процедуры ioctl вы должны заполнить функцию my_ioctl. Повторите раздел про ioctl. Адрес, отправленный из пользовательского пространства, находится в сетевом порядке байтов, так что преобразование НЕ потребуется.
Примечание
IP-адрес, отправленный через ioctl, передаётся по адресу, а не по значению. Адрес должен храниться в переменной ioctl_set_addr. Для копирования используйте copy_from_user().
Для сравнения адресов заполните функцию test_daddr. Адреса в сетевом порядке байтов будут использоваться без необходимости преобразования адресов (если они равны слева направо, они будут равны и в обратном порядке).
Функция test_daddr должна вызываться из хука netfilter для отображения пакетов инициализации соединения, адрес назначения которых — тот, что отправлен через процедуру ioctl. Пакет инициализации соединения имеет установленный флаг SYN в TCP-заголовке и сброшенный флаг ACK. Вам нужно проверить две вещи:
- TCP-флаги;
- адрес назначения пакета (используя
test_addr).
Для тестирования используйте скрипт 1-2-netfilter/user/test-2.sh. Этот скрипт требует компиляции файла 1-2-netfilter/user/test.c в тестовый исполняемый файл. Компиляция выполняется автоматически на физической системе при запуске команды make build. Тестовый скрипт копируется на виртуальную машину, только если он помечен как исполняемый. Скрипт использует статически скомпилированный инструмент netcat в skels/networking/netcat; этот исполняемый файл должен иметь права на исполнение.
После запуска проверщика вывод должен быть похож на приведённый ниже:
# ./test-2.sh
[  797.673535] TCP connection initiated from 127.0.0.1:44721
Should show up in filter.
Should NOT show up in filter.
Check dmesg output.
Тест запрашивает фильтрацию пакетов сначала для IP-адреса 127.0.0.1, а затем для IP-адреса 127.0.0.2. Первый пакет инициализации соединения (к 127.0.0.1) перехватывается и отображается фильтром, а второй (к 127.0.0.2) не перехватывается.
Напишите модуль ядра, который создаёт TCP-сокет, прослушивающий соединения на порту 60000 на loopback-интерфейсе (в init_module). Начните с кода в 3-4-tcp-sock, заполните области, помеченные TODO 1, принимая во внимание замечания ниже.
Прочитайте разделы Операции над структурой сокета и Структура struct proto_ops.
Сокет sock — это серверный сокет, и он должен быть переведён в состояние прослушивания. То есть к сокету должны быть применены операции bind и listen. Для эквивалентов bind и listen в пространстве ядра вам нужно будет вызывать sock->ops->...; примеры таких функций, которые вы можете вызвать, — sock->ops->bind, sock->ops->listen и т.д.
Примечание
Например, для вызова функций sock->ops->bind или sock->ops->listen посмотрите, как они вызываются в обработчиках системных вызовов sys_bind() и sys_listen().
Ищите обработчики системных вызовов в файле net/socket.c в дереве исходного кода ядра Linux.
Примечание
Для второго аргумента вызова listen (backlog) используйте LISTEN_BACKLOG.
Не забудьте освободить сокет в функции выхода модуля и в области, помеченной метками ошибок; используйте sock_release().
Для тестирования запустите скрипт 3-4-tcp_sock/test-3.sh. Скрипт копируется на виртуальную машину командой make copy, только если он помечен как исполняемый.
После запуска теста TCP-сокет будет отображён прослушивающим соединения на порту 60000.
Расширьте модуль из предыдущего упражнения, чтобы разрешить внешнее соединение (не нужно отправлять сообщения, только принимать новые соединения). Заполните области, помеченные TODO 2.
Прочитайте разделы Операции над структурой сокета и Структура struct proto_ops.
Для эквивалента accept в пространстве ядра смотрите обработчик системного вызова sys_accept4(). Следуйте реализации lnet_sock_accept и тому, как используется вызов sock->ops->accept. Используйте 0 как значение для второго с конца аргумента (flags) и true для последнего аргумента (kern).
Примечание
Ищите обработчики системных вызовов в файле net/socket.c в дереве исходного кода ядра Linux.
Примечание
Новый сокет (new_sock) должен быть создан с помощью функции sock_create_lite(), а затем его операции должны быть настроены с помощью
newsock->ops = sock->ops;Напечатайте адрес и порт сокета назначения. Чтобы узнать имя peer'а сокета (его адрес), обратитесь к обработчику системного вызова sys_getpeername().
Примечание
Первым аргументом функции sock->ops->getname будет сокет соединения, то есть new_sock — тот, что инициализирован вызовом accept.
Последним аргументом функции sock->ops->getname будет 1, что означает, что мы хотим узнать о конечной точке или peer'е (remote end или peer).
Отобразите адрес peer'а (указанный переменной raddr), используя макрос print_sock_address, определённый в файле.
Освободите вновь созданный сокет (после принятия соединения) в функции выхода модуля и после метки ошибки. После добавления кода accept в функцию инициализации модуля операция insmod заблокируется до установления соединения. Разблокировать можно с помощью netcat на этом порту. Следовательно, тестовый скрипт из предыдущего упражнения не сработает.
Для тестирования запустите скрипт 3-4-tcp_sock/test-4.sh. Скрипт копируется на виртуальную машину командой make copy, только если он помечен как исполняемый.
Ничего особенного не отобразится (в буфере ядра). Успех теста будет определён установлением соединения. Затем используйте Ctrl+c для остановки тестового скрипта, после чего вы можете удалить модуль ядра.
Напишите модуль ядра, который создаёт UDP-сокет и отправляет сообщение из макроса MY_TEST_MESSAGE через сокет на loopback-адрес на порт 60001.
Начните с кода в 5-udp-sock.
Прочитайте разделы Операции над структурой сокета и Структура struct proto_ops.
Чтобы увидеть, как отправлять сообщения в пространстве ядра, смотрите обработчик системного вызова sys_send() или раздел Отправка/получение сообщений.
Подсказка
Поле msg_name структуры struct msghdr должно быть инициализировано адресом назначения (указатель на struct sockaddr), а поле msg_namelen — размером адреса.
Инициализируйте поле msg_flags структуры struct msghdr значением 0.
Инициализируйте поля msg_control и msg_controllen структуры struct msghdr значениями NULL и 0 соответственно.
Для отправки сообщения используйте kernel_sendmsg().
Параметры передачи сообщения извлекаются из пространства ядра. Приведите указатель структуры struct iovec к указателю struct kvec в вызове kernel_sendmsg().
Подсказка
Последние два параметра kernel_sendmsg() — это 1 (количество векторов ввода-вывода) и len (размер сообщения).
Для тестирования используйте файл test-5.sh. Скрипт копируется на виртуальную машину командой make copy, только если он помечен как исполняемый. Скрипт использует статически скомпилированный инструмент netcat, хранящийся в skels/networking/netcat; этот исполняемый файл должен иметь права на исполнение.
При корректной реализации запуск скрипта test-5.sh приведёт к отображению сообщения kernelsocket, как в выводе ниже:
/root # ./test-5.sh
+ pid=1059
+ sleep 1
+ nc -l -u -p 60001
+ insmod udp_sock.ko
kernelsocket
+ rmmod udp_sock
+ kill 1059