diff --git a/.github/dependabot.yml b/.github/dependabot.yml
deleted file mode 100644
index d3553db6584..00000000000
--- a/.github/dependabot.yml
+++ /dev/null
@@ -1,9 +0,0 @@
-version: 2
-updates:
- - package-ecosystem: "pip"
- directory: "/"
- schedule:
- interval: "weekly"
- timezone: "Asia/Shanghai"
- day: "friday"
- target-branch: "v3"
\ No newline at end of file
diff --git a/.github/workflows/build-and-push-python-pg.yml b/.github/workflows/build-and-push-python-pg.yml
index b0d9eb4ccce..fda7b40110c 100644
--- a/.github/workflows/build-and-push-python-pg.yml
+++ b/.github/workflows/build-and-push-python-pg.yml
@@ -4,9 +4,9 @@ on:
workflow_dispatch:
inputs:
architecture:
- description: 'Architecture'
+ description: "Architecture"
required: true
- default: 'linux/amd64'
+ default: "linux/amd64"
type: choice
options:
- linux/amd64
@@ -25,15 +25,15 @@ jobs:
run: |
DOCKER_IMAGE=ghcr.io/1panel-dev/maxkb-base
DOCKER_PLATFORMS=${{ github.event.inputs.architecture }}
- TAG_NAME=python3.11-pg17.10-20260525
+ TAG_NAME=python3.13-pg17.11-20260902
DOCKER_IMAGE_TAGS="--tag ${DOCKER_IMAGE}:${TAG_NAME}"
- echo ::set-output name=docker_image::${DOCKER_IMAGE}
- echo ::set-output name=version::${TAG_NAME}
- echo ::set-output name=buildx_args::--platform ${DOCKER_PLATFORMS} --no-cache \
+ echo "docker_image=${DOCKER_IMAGE}" >> $GITHUB_OUTPUT
+ echo "version=${TAG_NAME}" >> $GITHUB_OUTPUT
+ echo "buildx_args=--platform ${DOCKER_PLATFORMS} --no-cache \
--build-arg VERSION=${TAG_NAME} \
--build-arg BUILD_DATE=$(date -u +'%Y-%m-%dT%H:%M:%SZ') \
--build-arg VCS_REF=${GITHUB_SHA::8} \
- ${DOCKER_IMAGE_TAGS} .
+ ${DOCKER_IMAGE_TAGS} ." >> $GITHUB_OUTPUT
- name: Set up QEMU
uses: docker/setup-qemu-action@v4
with:
@@ -48,4 +48,4 @@ jobs:
password: ${{ secrets.GH_TOKEN }}
- name: Docker Buildx (build-and-push)
run: |
- docker buildx build --output "type=image,push=true" ${{ steps.prepare.outputs.buildx_args }} -f installer/Dockerfile-base
\ No newline at end of file
+ docker buildx build --output "type=image,push=true" ${{ steps.prepare.outputs.buildx_args }} -f installer/Dockerfile-base
diff --git a/.github/workflows/build-and-push-vector-model.yml b/.github/workflows/build-and-push-vector-model.yml
index cbf6a5204c9..0a7c1e5524b 100644
--- a/.github/workflows/build-and-push-vector-model.yml
+++ b/.github/workflows/build-and-push-vector-model.yml
@@ -4,13 +4,13 @@ on:
workflow_dispatch:
inputs:
dockerImageTag:
- description: 'Docker Image Tag'
- default: 'v2.0.3'
+ description: "Docker Image Tag"
+ default: "v2.0.3"
required: true
architecture:
- description: 'Architecture'
+ description: "Architecture"
required: true
- default: 'linux/amd64'
+ default: "linux/amd64"
type: choice
options:
- linux/amd64
@@ -32,13 +32,13 @@ jobs:
DOCKER_PLATFORMS=${{ github.event.inputs.architecture }}
TAG_NAME=${{ github.event.inputs.dockerImageTag }}
DOCKER_IMAGE_TAGS="--tag ${DOCKER_IMAGE}:${TAG_NAME} --tag ${DOCKER_IMAGE}:latest"
- echo ::set-output name=docker_image::${DOCKER_IMAGE}
- echo ::set-output name=version::${TAG_NAME}
- echo ::set-output name=buildx_args::--platform ${DOCKER_PLATFORMS} --no-cache \
+ echo "docker_image=${DOCKER_IMAGE}" >> $GITHUB_OUTPUT
+ echo "version=${TAG_NAME}" >> $GITHUB_OUTPUT
+ echo "buildx_args=--platform ${DOCKER_PLATFORMS} --no-cache \
--build-arg VERSION=${TAG_NAME} \
--build-arg BUILD_DATE=$(date -u +'%Y-%m-%dT%H:%M:%SZ') \
--build-arg VCS_REF=${GITHUB_SHA::8} \
- ${DOCKER_IMAGE_TAGS} .
+ ${DOCKER_IMAGE_TAGS} ." >> $GITHUB_OUTPUT
- name: Set up QEMU
uses: docker/setup-qemu-action@v4
with:
@@ -53,4 +53,4 @@ jobs:
password: ${{ secrets.GH_TOKEN }}
- name: Docker Buildx (build-and-push)
run: |
- docker buildx build --output "type=image,push=true" ${{ steps.prepare.outputs.buildx_args }} -f installer/Dockerfile-vector-model
\ No newline at end of file
+ docker buildx build --output "type=image,push=true" ${{ steps.prepare.outputs.buildx_args }} -f installer/Dockerfile-vector-model
diff --git a/.github/workflows/build-and-push.yml b/.github/workflows/build-and-push.yml
index 50b882fddc0..95b2368bd46 100644
--- a/.github/workflows/build-and-push.yml
+++ b/.github/workflows/build-and-push.yml
@@ -7,7 +7,7 @@ on:
inputs:
dockerImageTag:
description: 'Image Tag'
- default: 'v2.10.0-dev'
+ default: 'v3.0.0-dev'
required: true
dockerImageTagWithLatest:
description: '是否发布latest tag(正式发版时选择,测试版本切勿选择)'
diff --git a/.github/workflows/python-format-check.yml b/.github/workflows/python-format-check.yml
new file mode 100644
index 00000000000..d6634362adb
--- /dev/null
+++ b/.github/workflows/python-format-check.yml
@@ -0,0 +1,47 @@
+name: Python Format Check
+
+on:
+ pull_request:
+ types: [opened, reopened]
+
+jobs:
+ pre-commit:
+ name: Ruff format changed files
+ runs-on: ubuntu-latest
+ steps:
+ - name: Checkout repository
+ uses: actions/checkout@v6
+ with:
+ fetch-depth: 0
+
+ - name: Set up Python
+ uses: actions/setup-python@v5
+ with:
+ python-version: "3.13"
+
+ - name: Install pre-commit
+ run: python -m pip install pre-commit==4.6.1
+
+ - name: Check changed files
+ env:
+ BASE_SHA: ${{ github.event_name == 'pull_request' && github.event.pull_request.base.sha || github.event.before }}
+ HEAD_SHA: ${{ github.event_name == 'pull_request' && github.event.pull_request.head.sha || github.sha }}
+ DEFAULT_BRANCH: ${{ github.event.repository.default_branch }}
+ run: |
+ if ! git cat-file -e "${BASE_SHA}^{commit}" 2>/dev/null; then
+ if git show-ref --verify --quiet "refs/remotes/origin/${DEFAULT_BRANCH}"; then
+ BASE_SHA=$(git merge-base "$HEAD_SHA" "origin/${DEFAULT_BRANCH}")
+ elif git cat-file -e "${HEAD_SHA}^" 2>/dev/null; then
+ BASE_SHA=$(git rev-parse "${HEAD_SHA}^")
+ else
+ pre-commit run --all-files
+ git diff --cached --exit-code
+ exit 0
+ fi
+ fi
+
+ pre-commit run --from-ref "$BASE_SHA" --to-ref "$HEAD_SHA"
+
+ # The local hook formats and stages files. A clean index proves that
+ # every changed Python file was already formatted before CI ran.
+ git diff --cached --exit-code
diff --git a/.gitignore b/.gitignore
index 91e78cc6947..32f4aaf3ec9 100644
--- a/.gitignore
+++ b/.gitignore
@@ -4,6 +4,8 @@
# VS Code
.vscode
+.claude/
+.codex/
*.project
*.factorypath
@@ -190,4 +192,5 @@ apps/models_provider/impl/tencent_model_provider/model/stt.py
tmp/
config.yml
.SANDBOX_BANNED_HOSTS
-copilot-instructions.md
\ No newline at end of file
+copilot-instructions.md
+.ai/
\ No newline at end of file
diff --git a/.pre-commit-config.yaml b/.pre-commit-config.yaml
new file mode 100644
index 00000000000..3e75dd19aa1
--- /dev/null
+++ b/.pre-commit-config.yaml
@@ -0,0 +1,8 @@
+repos:
+ - repo: https://github.com/astral-sh/ruff-pre-commit
+ rev: v0.15.21
+ hooks:
+ - id: ruff-format
+ name: ruff format and stage
+ entry: bash -c 'ruff format "$@" && git add -- "$@"' --
+ require_serial: true
diff --git a/AGENTS.md b/AGENTS.md
new file mode 100644
index 00000000000..bea2e73223e
--- /dev/null
+++ b/AGENTS.md
@@ -0,0 +1,123 @@
+# MaxKB-v3
+
+MaxKB (Max Knowledge Brain) is an open-source platform for building enterprise AI agents with RAG pipelines, agentic workflows, and MCP tool-use capabilities.
+
+## Agent Instructions
+
+- This file is the shared source of repository instructions for all coding agents.
+- For changes under `ui/`, read and follow `ui/AGENTS.md` before editing or reviewing frontend code.
+- Keep tool-specific entry files such as `CLAUDE.md` small; shared project rules belong here or in the applicable nested `AGENTS.md`.
+
+## Tech Stack
+
+**Backend:** Python 3.13, Django 6.0, Django REST Framework, LangChain 1.3, LangGraph 1.2, Celery 5.6, uv (package manager)
+
+**Frontend:** Vue 3.5, TypeScript, Vite 8, Element Plus, Pinia, Vue Router
+
+**Infrastructure:** PostgreSQL 17.10 + pgvector, Redis 7
+
+## Project Structure
+
+```
+apps/ # Django backend
+ application/ # AI agents & applications
+ knowledge/ # Knowledge base & document management
+ chat/ # Chat functionality & MCP integration
+ models_provider/ # LLM provider integrations (OpenAI, Anthropic, etc.)
+ common/ # Shared utilities, auth, caching, chunking
+ maxkb/ # Django settings, URL routing, config
+ ops/ # Celery task queue configuration
+ users/ # User management
+ tools/ # Tool/function management
+ui/ # Vue.js frontend
+ src/
+ api/ # API client services
+ views/ # Page views
+ components/ # Vue components
+ workflow/ # Workflow UI
+installer/ # Docker build scripts and startup scripts
+main.py # Application entry point
+```
+
+## Development Setup
+
+### Backend
+
+```bash
+# Install dependencies (requires Python 3.13)
+python -m uv pip install -r pyproject.toml
+
+# Run database migrations
+cd apps && python manage.py migrate
+
+# Start dev server
+python main.py dev
+# or: cd apps && python manage.py runserver 0.0.0.0:8080
+```
+
+### Frontend
+
+```bash
+cd ui
+npm install
+npm run dev # dev server with hot reload
+npm run build # production build
+npm run type-check # TypeScript check
+npm run lint # ESLint
+npm run format # Prettier
+```
+
+### Service Management
+
+```bash
+python main.py start all -d # start all services (web + celery)
+python main.py start web -d # web only
+python main.py start task -d # celery worker
+python main.py start local_model -d # local model service
+```
+
+### Docker
+
+```bash
+docker build -f installer/Dockerfile -t maxkb:latest .
+```
+
+## Configuration
+
+Key environment variables (see `.env`):
+
+| Variable | Description |
+| ------------------------------------------------------- | ---------------------- |
+| `MAXKB_DB_HOST` / `MAXKB_DB_PORT` | PostgreSQL connection |
+| `MAXKB_DB_NAME` / `MAXKB_DB_USER` / `MAXKB_DB_PASSWORD` | PostgreSQL credentials |
+| `MAXKB_REDIS_HOST` / `MAXKB_REDIS_PORT` | Redis connection |
+
+Settings files:
+
+- `apps/maxkb/conf.py` — main config manager (reads env vars)
+- `apps/maxkb/settings/base/web.py` — Django settings
+- `apps/maxkb/settings/lib.py` — Celery/Redis settings
+
+## Testing
+
+```bash
+cd apps && python manage.py test
+```
+
+## Code Style
+
+- Python: Ruff linter, line length 120 (`pyproject.toml`)
+- TypeScript/Vue: ESLint + Prettier (`ui/`)
+- Migrations in `apps/*/migrations/`
+
+## Key Concepts
+
+- **Knowledge Base**: Documents are chunked, embedded, and stored in PostgreSQL with pgvector for semantic search.
+- **Applications/Agents**: Built on top of knowledge bases; support workflow-based and RAG-based configurations.
+- **Models Provider**: Abstraction layer in `apps/models_provider/` supporting 10+ LLM providers via LangChain.
+- **MCP**: Model Context Protocol tools integrated via `langchain-mcp-adapters` in `apps/chat/mcp/`.
+- **Task Queue**: Heavy document processing runs async via Celery workers.
+
+## Internationalization
+
+Translations in `apps/locales/` (zh_CN, en_US, zh_Hant) and `ui/src/locales/`.
diff --git a/CLAUDE.md b/CLAUDE.md
new file mode 100644
index 00000000000..7d0efdf7c9f
--- /dev/null
+++ b/CLAUDE.md
@@ -0,0 +1,3 @@
+@AGENTS.md
+
+
diff --git a/CONTRIBUTING.md b/CONTRIBUTING.md
index 7e0cfbc7770..c901d5efeb1 100644
--- a/CONTRIBUTING.md
+++ b/CONTRIBUTING.md
@@ -14,6 +14,18 @@ This [development guideline](https://github.com/1Panel-dev/MaxKB/wiki/3-%E5%BC%8
Note: If you split your pull request to small changes, please make sure any of the changes goes to master will not break anything. Otherwise, it can not be merged until this feature complete.
+## Code formatting
+
+This project uses [pre-commit](https://pre-commit.com/) and Ruff to format Python code. After cloning the repository and setting up the development environment, install the Git hook once:
+
+```bash
+uv sync --group dev
+uv run pre-commit install --install-hooks
+```
+
+
+The hook runs automatically on each `git commit` and stages files changed by the formatter. The same check also runs in CI for every pull request, so all formatting changes must be committed before the pull request can be merged.
+
## Report issues
It is a great way to contribute by reporting an issue. Well-written and complete bug reports are always welcome! Please open an issue and follow the template to fill in required information.
@@ -27,4 +39,4 @@ When reporting issues, always include:
* Snapshots or log files if needed
Because the issues are open to the public, when submitting files, be sure to remove any sensitive information, e.g. user name, password, IP address, and company name. You can
-replace those parts with "REDACTED" or other strings like "****".
\ No newline at end of file
+replace those parts with "REDACTED" or other strings like "****".
diff --git a/README.md b/README.md
index 93f8e95ea70..d5177bf8e37 100644
--- a/README.md
+++ b/README.md
@@ -54,10 +54,6 @@ Access MaxKB web interface at `http://your_server_ip:8080` with default admin cr
- LLM Framework:[LangChain](https://www.langchain.com/)
- Database:[PostgreSQL + pgvector](https://www.postgresql.org/)
-## Star History
-
-[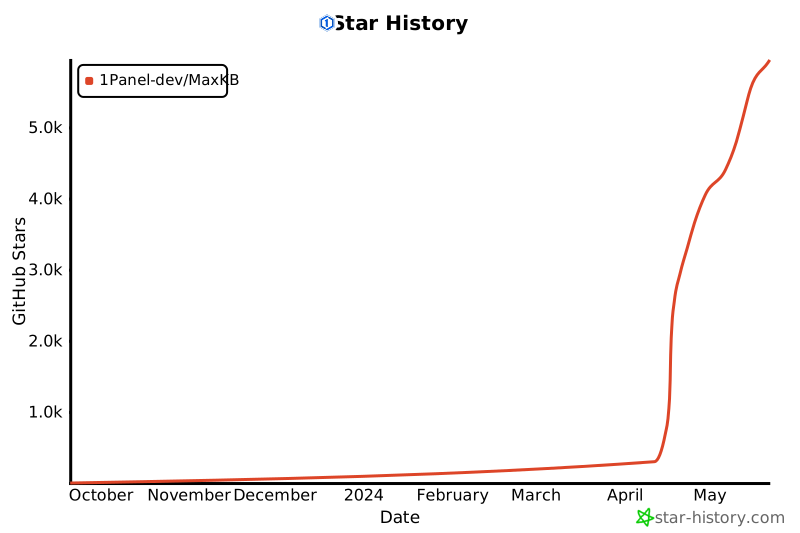](https://star-history.com/#1Panel-dev/MaxKB&Date)
-
## License
Licensed under The GNU General Public License version 3 (GPLv3) (the "License"); you may not use this file except in compliance with the License. You may obtain a copy of the License at
diff --git a/README_CN.md b/README_CN.md
index da5db24891d..fda3ab9b65a 100644
--- a/README_CN.md
+++ b/README_CN.md
@@ -4,7 +4,7 @@

-  +


 diff --git a/SECURITY.md b/SECURITY.md
index 22be037d008..88a06f8f61a 100644
--- a/SECURITY.md
+++ b/SECURITY.md
@@ -1,17 +1,15 @@
# 安全说明
-如果您发现安全问题,请直接联系我们:
+如果您发现安全问题,请[提交给我们](https://github.com/1Panel-dev/MaxKB/security/advisories/new)。
-- support@fit2cloud.com
-- 400-052-0755
+谢绝只有静态代码分析,未经完整PoC验证的安全建议。
感谢您的支持!
# Security Policy
-All security bugs should be reported to the contact as below:
+Any security issue please [submit a vulnerability report](https://github.com/1Panel-dev/MaxKB/security/advisories/new).
-- support@fit2cloud.com
-- 400-052-0755
+We do not accept security recommendations based solely on static code analysis without complete PoC validation.
-Thanks for your support!
\ No newline at end of file
+Thanks for your support!
diff --git a/apps/application/chat_pipeline/I_base_chat_pipeline.py b/apps/application/chat_pipeline/I_base_chat_pipeline.py
deleted file mode 100644
index f231c2c4514..00000000000
--- a/apps/application/chat_pipeline/I_base_chat_pipeline.py
+++ /dev/null
@@ -1,185 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: I_base_chat_pipeline.py
- @date:2024/1/9 17:25
- @desc:
-"""
-import time
-from abc import abstractmethod
-from typing import Type
-import uuid_utils.compat as uuid
-from rest_framework import serializers
-
-from knowledge.models import Paragraph
-
-
-class ParagraphPipelineModel:
-
- def __init__(self, _id: str, document_id: str, knowledge_id: str, content: str, title: str, status: str,
- is_active: bool, comprehensive_score: float, similarity: float, knowledge_name: str,
- document_name: str,
- hit_handling_method: str, directly_return_similarity: float, knowledge_type, meta: dict = None):
- self.id = _id
- self.document_id = document_id
- self.knowledge_id = knowledge_id
- self.content = content
- self.title = title
- self.status = status
- self.is_active = is_active
- self.comprehensive_score = comprehensive_score
- self.similarity = similarity
- self.knowledge_name = knowledge_name
- self.document_name = document_name
- self.hit_handling_method = hit_handling_method
- self.directly_return_similarity = directly_return_similarity
- self.meta = meta
- self.knowledge_type = knowledge_type
-
- def to_dict(self):
- return {
- 'id': self.id,
- 'document_id': self.document_id,
- 'knowledge_id': self.knowledge_id,
- 'content': self.content,
- 'title': self.title,
- 'status': self.status,
- 'is_active': self.is_active,
- 'comprehensive_score': self.comprehensive_score,
- 'similarity': self.similarity,
- 'knowledge_name': self.knowledge_name,
- 'document_name': self.document_name,
- 'knowledge_type': self.knowledge_type,
- 'meta': self.meta,
- }
-
- class builder:
- def __init__(self):
- self.similarity = None
- self.paragraph = {}
- self.comprehensive_score = None
- self.document_name = None
- self.knowledge_name = None
- self.knowledge_type = None
- self.hit_handling_method = None
- self.directly_return_similarity = 0.9
- self.meta = {}
-
- def add_paragraph(self, paragraph):
- if isinstance(paragraph, Paragraph):
- self.paragraph = {'id': paragraph.id,
- 'document_id': paragraph.document_id,
- 'knowledge_id': paragraph.knowledge_id,
- 'content': paragraph.content,
- 'title': paragraph.title,
- 'status': paragraph.status,
- 'is_active': paragraph.is_active,
- }
- else:
- self.paragraph = paragraph
- return self
-
- def add_knowledge_name(self, knowledge_name):
- self.knowledge_name = knowledge_name
- return self
-
- def add_knowledge_type(self, knowledge_type):
- self.knowledge_type = knowledge_type
- return self
-
- def add_document_name(self, document_name):
- self.document_name = document_name
- return self
-
- def add_hit_handling_method(self, hit_handling_method):
- self.hit_handling_method = hit_handling_method
- return self
-
- def add_directly_return_similarity(self, directly_return_similarity):
- self.directly_return_similarity = directly_return_similarity
- return self
-
- def add_comprehensive_score(self, comprehensive_score: float):
- self.comprehensive_score = comprehensive_score
- return self
-
- def add_similarity(self, similarity: float):
- self.similarity = similarity
- return self
-
- def add_meta(self, meta: dict):
- self.meta = meta
- return self
-
- def build(self):
- return ParagraphPipelineModel(str(self.paragraph.get('id')), str(self.paragraph.get('document_id')),
- str(self.paragraph.get('knowledge_id')),
- self.paragraph.get('content'), self.paragraph.get('title'),
- self.paragraph.get('status'),
- self.paragraph.get('is_active'),
- self.comprehensive_score, self.similarity, self.knowledge_name,
- self.document_name, self.hit_handling_method, self.directly_return_similarity,
- self.knowledge_type,
- self.meta)
-
-
-class IBaseChatPipelineStep:
- def __init__(self):
- # 当前步骤上下文,用于存储当前步骤信息
- self.context = {}
- self.status = 200
- self.err_message = ''
-
- @abstractmethod
- def get_step_serializer(self, manage) -> Type[serializers.Serializer]:
- pass
-
- def valid_args(self, manage):
- step_serializer_clazz = self.get_step_serializer(manage)
- step_serializer = step_serializer_clazz(data=manage.context)
- step_serializer.is_valid(raise_exception=True)
- self.context['step_args'] = step_serializer.data
-
- def run(self, manage):
- """
-
- :param manage: 步骤管理器
- :return: 执行结果
- """
- try:
- start_time = time.time()
- self.context['start_time'] = start_time
- # 校验参数,
- self.valid_args(manage)
- self._run(manage)
- self.context['run_time'] = time.time() - start_time
- except Exception as e:
- self.err_message = str(e)
- self.status = 500
- chat_record_id = manage.context.get('chat_record_id') or str(uuid.uuid7())
- manage.context['message_tokens'] = 0
- manage.context['answer_tokens'] = 0
- end_time = time.time()
- manage.context['run_time'] = end_time - (manage.context.get('start_time') or end_time)
- post_response_handler = manage.context.get('post_response_handler')
- post_response_handler.handler(manage.context.get('chat_id'), chat_record_id,
- manage.context.get('paragraph_list') or [],
- manage.context.get('problem_text'),
- str(e), manage, self, manage.context.get('padding_problem_text'),
- reasoning_content='')
-
- raise e
-
- def _run(self, manage):
- pass
-
- def execute(self, **kwargs):
- pass
-
- def get_details(self, manage, **kwargs):
- """
- 运行详情
- :return: 步骤详情
- """
- return None
diff --git a/apps/application/chat_pipeline/__init__.py b/apps/application/chat_pipeline/__init__.py
deleted file mode 100644
index 719a7e29c90..00000000000
--- a/apps/application/chat_pipeline/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/1/9 17:23
- @desc:
-"""
diff --git a/apps/application/chat_pipeline/pipeline_manage.py b/apps/application/chat_pipeline/pipeline_manage.py
deleted file mode 100644
index 206df8a399e..00000000000
--- a/apps/application/chat_pipeline/pipeline_manage.py
+++ /dev/null
@@ -1,66 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: pipeline_manage.py
- @date:2024/1/9 17:40
- @desc:
-"""
-import time
-from functools import reduce
-from typing import List, Type, Dict
-
-from application.chat_pipeline.I_base_chat_pipeline import IBaseChatPipelineStep
-from common.handle.base_to_response import BaseToResponse
-from common.handle.impl.response.system_to_response import SystemToResponse
-
-
-class PipelineManage:
- def __init__(self, step_list: List[Type[IBaseChatPipelineStep]],
- base_to_response: BaseToResponse = SystemToResponse(),
- debug=False):
- # 步骤执行器
- self.step_list = [step() for step in step_list]
- self.run_step_list = []
- # 上下文
- self.context = {'message_tokens': 0, 'answer_tokens': 0}
- self.base_to_response = base_to_response
- self.debug = debug
-
- def run(self, context: Dict = None):
- self.context['start_time'] = time.time()
- if context is not None:
- for key, value in context.items():
- self.context[key] = value
- for step in self.step_list:
- self.run_step_list.append(step)
- step.run(self)
-
- def get_details(self):
- return reduce(lambda x, y: {**x, **y}, [{item.get('step_type'): item} for item in
- filter(lambda r: r is not None,
- [row.get_details(self) for row in self.run_step_list])], {})
-
- def get_base_to_response(self):
- return self.base_to_response
-
- class builder:
- def __init__(self):
- self.step_list: List[Type[IBaseChatPipelineStep]] = []
- self.base_to_response = SystemToResponse()
- self.debug = False
-
- def append_step(self, step: Type[IBaseChatPipelineStep]):
- self.step_list.append(step)
- return self
-
- def add_base_to_response(self, base_to_response: BaseToResponse):
- self.base_to_response = base_to_response
- return self
-
- def add_debug(self, debug):
- self.debug = debug
- return self
-
- def build(self):
- return PipelineManage(step_list=self.step_list, base_to_response=self.base_to_response, debug=self.debug)
diff --git a/apps/application/chat_pipeline/step/__init__.py b/apps/application/chat_pipeline/step/__init__.py
deleted file mode 100644
index 5d9549cdc64..00000000000
--- a/apps/application/chat_pipeline/step/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/1/9 18:23
- @desc:
-"""
diff --git a/apps/application/chat_pipeline/step/chat_step/__init__.py b/apps/application/chat_pipeline/step/chat_step/__init__.py
deleted file mode 100644
index 5d9549cdc64..00000000000
--- a/apps/application/chat_pipeline/step/chat_step/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/1/9 18:23
- @desc:
-"""
diff --git a/apps/application/chat_pipeline/step/chat_step/i_chat_step.py b/apps/application/chat_pipeline/step/chat_step/i_chat_step.py
deleted file mode 100644
index 1c2ede64b40..00000000000
--- a/apps/application/chat_pipeline/step/chat_step/i_chat_step.py
+++ /dev/null
@@ -1,121 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_chat_step.py
- @date:2024/1/9 18:17
- @desc: 对话
-"""
-from abc import abstractmethod
-from typing import Type, List
-
-from django.utils.translation import gettext_lazy as _
-from langchain.chat_models.base import BaseChatModel
-from langchain_core.messages import BaseMessage
-from rest_framework import serializers
-
-from application.chat_pipeline.I_base_chat_pipeline import IBaseChatPipelineStep, ParagraphPipelineModel
-from application.chat_pipeline.pipeline_manage import PipelineManage
-from application.serializers.application import NoReferencesSetting
-from common.field.common import InstanceField
-
-
-class ModelField(serializers.Field):
- def to_internal_value(self, data):
- if not isinstance(data, BaseChatModel):
- self.fail(_('Model type error'), value=data)
- return data
-
- def to_representation(self, value):
- return value
-
-
-class MessageField(serializers.Field):
- def to_internal_value(self, data):
- if not isinstance(data, BaseMessage):
- self.fail(_('Message type error'), value=data)
- return data
-
- def to_representation(self, value):
- return value
-
-
-class PostResponseHandler:
- @abstractmethod
- def handler(self, chat_id, chat_record_id, paragraph_list: List[ParagraphPipelineModel], problem_text: str,
- answer_text,
- manage, step, padding_problem_text: str = None, **kwargs):
- pass
-
-
-class IChatStep(IBaseChatPipelineStep):
- class InstanceSerializer(serializers.Serializer):
- # 对话列表
- message_list = serializers.ListField(required=True, child=MessageField(required=True),
- label=_("Conversation list"))
- model_id = serializers.UUIDField(required=False, allow_null=True, label=_("Model id"))
- # 段落列表
- paragraph_list = serializers.ListField(label=_("Paragraph List"))
- # 对话id
- chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
- # 用户问题
- problem_text = serializers.CharField(required=True, label=_("User Questions"))
- # 后置处理器
- post_response_handler = InstanceField(model_type=PostResponseHandler,
- label=_("Post-processor"))
- # 补全问题
- padding_problem_text = serializers.CharField(required=False,
- label=_("Completion Question"))
- # 是否使用流的形式输出
- stream = serializers.BooleanField(required=False, label=_("Streaming Output"))
- chat_user_id = serializers.CharField(required=True, label=_("Chat user id"))
- chat_record_id = serializers.CharField(required=False, label=_("Chat record id"))
-
- chat_user_type = serializers.CharField(required=True, label=_("Chat user Type"))
- # 未查询到引用分段
- no_references_setting = NoReferencesSetting(required=True,
- label=_("No reference segment settings"))
-
- workspace_id = serializers.CharField(required=True, label=_("Workspace ID"))
-
- model_setting = serializers.DictField(required=True, allow_null=True,
- label=_("Model settings"))
-
- model_params_setting = serializers.DictField(required=False, allow_null=True,
- label=_("Model parameter settings"))
- mcp_tool_ids = serializers.JSONField(label="MCP工具ID列表", required=False, default=list)
- mcp_servers = serializers.JSONField(label="MCP服务列表", required=False, default=dict)
- mcp_source = serializers.CharField(label="MCP Source", required=False, default="referencing")
- tool_ids = serializers.JSONField(label="工具ID列表", required=False, default=list)
- application_ids = serializers.JSONField(label="应用ID列表", required=False, default=list)
- skill_tool_ids = serializers.JSONField(label="技能ID列表", required=False, default=list)
- mcp_output_enable = serializers.BooleanField(label="MCP输出是否启用", required=False, default=True)
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- message_list: List = self.initial_data.get('message_list')
- for message in message_list:
- if not isinstance(message, BaseMessage):
- raise Exception(_("message type error"))
-
- def get_step_serializer(self, manage: PipelineManage) -> Type[serializers.Serializer]:
- return self.InstanceSerializer
-
- def _run(self, manage: PipelineManage):
- chat_result = self.execute(**self.context['step_args'], manage=manage)
- manage.context['chat_result'] = chat_result
-
- @abstractmethod
- def execute(self, message_list: List[BaseMessage],
- chat_id, problem_text,
- post_response_handler: PostResponseHandler,
- model_id: str = None,
- workspace_id: str = None,
- paragraph_list=None,
- manage: PipelineManage = None,
- padding_problem_text: str = None, stream: bool = True, chat_user_id=None, chat_user_type=None,
- no_references_setting=None, model_params_setting=None, model_setting=None,
- mcp_tool_ids=None, mcp_servers='', mcp_source="referencing",
- tool_ids=None, application_ids=None, skill_tool_ids=None, mcp_output_enable=True,
- **kwargs):
- pass
diff --git a/apps/application/chat_pipeline/step/chat_step/impl/base_chat_step.py b/apps/application/chat_pipeline/step/chat_step/impl/base_chat_step.py
index 914f20b524e..e69de29bb2d 100644
--- a/apps/application/chat_pipeline/step/chat_step/impl/base_chat_step.py
+++ b/apps/application/chat_pipeline/step/chat_step/impl/base_chat_step.py
@@ -1,798 +0,0 @@
-# coding=utf-8
-"""
-@project: maxkb
-@Author:虎
-@file: base_chat_step.py
-@date:2024/1/9 18:25
-@desc: 对话step Base实现
-"""
-
-import json
-import time
-import traceback
-from typing import List
-
-import uuid_utils.compat as uuid
-from application.chat_pipeline.I_base_chat_pipeline import ParagraphPipelineModel
-from application.chat_pipeline.pipeline_manage import PipelineManage
-from application.chat_pipeline.step.chat_step.i_chat_step import IChatStep, PostResponseHandler
-from application.flow.tools import Reasoning, get_tools, mcp_response_generator
-from application.long_term_memory import extract_long_term_memory
-from application.models import (
- Application,
- ApplicationAccessToken,
- ApplicationApiKey,
- ApplicationChatUserStats,
- ApplicationLongTermMemory,
- ChatUserType,
-)
-from common.exception.app_exception import AppApiException
-from common.utils.logger import maxkb_logger
-from common.utils.rsa_util import rsa_long_decrypt
-from common.utils.shared_resource_auth import filter_authorized_ids
-from common.utils.tool_code import ToolExecutor
-from django.db.models import QuerySet
-from django.http import StreamingHttpResponse
-from django.utils.translation import gettext as _
-from langchain.chat_models.base import BaseChatModel
-from langchain_core.messages import AIMessage, AIMessageChunk, BaseMessage, HumanMessage, SystemMessage
-from models_provider.tools import get_model_instance_by_model_workspace_id
-from rest_framework import status
-from tools.models import Tool, ToolType
-
-
-def add_access_num(chat_user_id=None, chat_user_type=None, application_id=None):
- if [ChatUserType.ANONYMOUS_USER.value, ChatUserType.CHAT_USER.value].__contains__(
- chat_user_type
- ) and application_id is not None:
- application_public_access_client = (
- QuerySet(ApplicationChatUserStats)
- .filter(chat_user_id=chat_user_id, chat_user_type=chat_user_type, application_id=application_id)
- .first()
- )
- if application_public_access_client is not None:
- application_public_access_client.access_num = application_public_access_client.access_num + 1
- application_public_access_client.intraday_access_num = (
- application_public_access_client.intraday_access_num + 1
- )
- application_public_access_client.save()
-
-
-def write_context(step, manage, request_token, response_token, all_text):
- step.context["message_tokens"] = request_token
- step.context["answer_tokens"] = response_token
- current_time = time.time()
- step.context["answer_text"] = all_text
- step.context["run_time"] = current_time - step.context["start_time"]
- manage.context["run_time"] = current_time - manage.context["start_time"]
- manage.context["message_tokens"] = manage.context["message_tokens"] + request_token
- manage.context["answer_tokens"] = manage.context["answer_tokens"] + response_token
-
-
-def event_content(
- response,
- chat_id,
- chat_record_id,
- paragraph_list: List[ParagraphPipelineModel],
- post_response_handler: PostResponseHandler,
- manage,
- step,
- chat_model,
- message_list: List[BaseMessage],
- problem_text: str,
- padding_problem_text: str = None,
- chat_user_id=None,
- chat_user_type=None,
- is_ai_chat: bool = None,
- model_setting=None,
-):
- if model_setting is None:
- model_setting = {}
- reasoning_content_enable = model_setting.get("reasoning_content_enable", False)
- reasoning_content_start = model_setting.get("reasoning_content_start", "")
- reasoning_content_end = model_setting.get("reasoning_content_end", "")
- reasoning = Reasoning(reasoning_content_start, reasoning_content_end)
- all_text = ""
- reasoning_content = ""
- try:
- response_reasoning_content = False
- for chunk in response:
- reasoning_chunk = reasoning.get_reasoning_content(chunk)
- content_chunk = reasoning_chunk.get("content")
- if "reasoning_content" in chunk.additional_kwargs:
- response_reasoning_content = True
- reasoning_content_chunk = chunk.additional_kwargs.get("reasoning_content", "")
- else:
- reasoning_content_chunk = reasoning_chunk.get("reasoning_content")
- content_chunk = reasoning._normalize_content(content_chunk)
- all_text += content_chunk
- if reasoning_content_chunk is None:
- reasoning_content_chunk = ""
- reasoning_content += reasoning_content_chunk
- yield manage.get_base_to_response().to_stream_chunk_response(
- chat_id,
- str(chat_record_id),
- "ai-chat-node",
- [],
- content_chunk,
- False,
- 0,
- 0,
- {
- "node_is_end": False,
- "view_type": "many_view",
- "node_type": "ai-chat-node",
- "real_node_id": "ai-chat-node",
- "reasoning_content": reasoning_content_chunk if reasoning_content_enable else "",
- },
- )
- reasoning_chunk = reasoning.get_end_reasoning_content()
- all_text += reasoning_chunk.get("content")
- reasoning_content_chunk = ""
- if not response_reasoning_content:
- reasoning_content_chunk = reasoning_chunk.get("reasoning_content")
- yield manage.get_base_to_response().to_stream_chunk_response(
- chat_id,
- str(chat_record_id),
- "ai-chat-node",
- [],
- reasoning_chunk.get("content"),
- False,
- 0,
- 0,
- {
- "node_is_end": False,
- "view_type": "many_view",
- "node_type": "ai-chat-node",
- "real_node_id": "ai-chat-node",
- "reasoning_content": reasoning_content_chunk if reasoning_content_enable else "",
- },
- )
- # 获取token
- if is_ai_chat:
- try:
- request_token = chat_model.get_num_tokens_from_messages(message_list)
- response_token = chat_model.get_num_tokens(all_text)
- except Exception as e:
- request_token = 0
- response_token = 0
- else:
- request_token = 0
- response_token = 0
- write_context(step, manage, request_token, response_token, all_text)
- post_response_handler.handler(
- chat_id,
- chat_record_id,
- paragraph_list,
- problem_text,
- all_text,
- manage,
- step,
- padding_problem_text,
- reasoning_content=reasoning_content if reasoning_content_enable else "",
- )
- yield manage.get_base_to_response().to_stream_chunk_response(
- chat_id,
- str(chat_record_id),
- "ai-chat-node",
- [],
- "",
- True,
- request_token,
- response_token,
- {"node_is_end": True, "view_type": "many_view", "node_type": "ai-chat-node"},
- )
- if not manage.debug:
- add_access_num(chat_user_id, chat_user_type, manage.context.get("application_id"))
- except BaseException as e:
- if isinstance(e, GeneratorExit):
- maxkb_logger.error(f"Generator was closed (client disconnected)")
- else:
- maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
- all_text = "Exception:" + str(e)
- write_context(step, manage, 0, 0, all_text)
- post_response_handler.handler(
- chat_id,
- chat_record_id,
- paragraph_list,
- problem_text,
- all_text,
- manage,
- step,
- padding_problem_text,
- reasoning_content=reasoning_content if reasoning_content_enable else "",
- )
- if not manage.debug:
- add_access_num(chat_user_id, chat_user_type, manage.context.get("application_id"))
- yield manage.get_base_to_response().to_stream_chunk_response(
- chat_id,
- str(chat_record_id),
- "ai-chat-node",
- [],
- all_text,
- False,
- 0,
- 0,
- {
- "node_is_end": False,
- "view_type": "many_view",
- "node_type": "ai-chat-node",
- "real_node_id": "ai-chat-node",
- "reasoning_content": "",
- },
- )
-
-
-class BaseChatStep(IChatStep):
- def execute(
- self,
- message_list: List[BaseMessage],
- chat_id,
- problem_text,
- post_response_handler: PostResponseHandler,
- model_id: str = None,
- workspace_id: str = None,
- paragraph_list=None,
- manage: PipelineManage = None,
- padding_problem_text: str = None,
- stream: bool = True,
- chat_user_id=None,
- chat_user_type=None,
- no_references_setting=None,
- model_params_setting=None,
- model_setting=None,
- mcp_tool_ids=None,
- mcp_servers="",
- mcp_source="referencing",
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- mcp_output_enable=True,
- **kwargs,
- ):
- chat_model = (
- get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
- if model_id is not None
- else None
- )
- if stream:
- return self.execute_stream(
- message_list,
- chat_id,
- problem_text,
- post_response_handler,
- chat_model,
- paragraph_list,
- manage,
- padding_problem_text,
- chat_user_id,
- chat_user_type,
- no_references_setting,
- model_setting,
- mcp_tool_ids,
- mcp_servers,
- mcp_source,
- tool_ids,
- application_ids,
- skill_tool_ids,
- workspace_id,
- mcp_output_enable,
- )
- else:
- return self.execute_block(
- message_list,
- chat_id,
- problem_text,
- post_response_handler,
- chat_model,
- paragraph_list,
- manage,
- padding_problem_text,
- chat_user_id,
- chat_user_type,
- no_references_setting,
- model_setting,
- mcp_tool_ids,
- mcp_servers,
- mcp_source,
- tool_ids,
- application_ids,
- skill_tool_ids,
- workspace_id,
- mcp_output_enable,
- )
-
- def get_details(self, manage, **kwargs):
- # 提取长期记忆
- extract_long_term_memory.apply_async(
- args=(
- manage.context.get("workspace_id"),
- manage.context.get("application_id"),
- manage.context.get("chat_user_id"),
- ),
- countdown=1,
- )
- return {
- "status": self.status,
- "err_message": self.err_message,
- "step_type": "chat_step",
- "run_time": self.context.get("run_time") or 0,
- "model_id": str(manage.context["model_id"]),
- "message_list": self.reset_message_list(
- self.context["step_args"].get("message_list"), self.context.get("answer_text")
- ),
- "message_tokens": self.context.get("message_tokens"),
- "answer_tokens": self.context.get("answer_tokens"),
- "cost": 0,
- }
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [
- {
- "role": "user"
- if isinstance(message, HumanMessage)
- else ("system" if isinstance(message, SystemMessage) else "ai"),
- "content": message.content,
- }
- for message in message_list
- ]
- result.append({"role": "ai", "content": answer_text})
- return result
-
- def _handle_mcp_request(
- self,
- mcp_source,
- mcp_servers,
- mcp_tool_ids,
- tool_ids,
- application_ids,
- skill_tool_ids,
- mcp_output_enable,
- chat_model,
- system_prompt,
- message_list,
- agent_id,
- chat_id,
- workspace_id,
- ):
-
- mcp_servers_config = {}
-
- # 迁移过来mcp_source是None
- if mcp_source is None:
- mcp_source = "custom"
- # 兼容老数据
- if not mcp_tool_ids:
- mcp_tool_ids = []
- if mcp_source == "custom" and mcp_servers:
- mcp_servers_config = json.loads(mcp_servers)
- elif mcp_tool_ids:
- mcp_tools = QuerySet(Tool).filter(id__in=mcp_tool_ids).values()
- for mcp_tool in mcp_tools:
- if mcp_tool and mcp_tool["is_active"]:
- mcp_servers_config = {**mcp_servers_config, **json.loads(mcp_tool["code"])}
- # 校验代码是否包括禁止的关键字
- ToolExecutor().validate_mcp_transport(json.dumps(mcp_servers_config))
-
- tool_init_params = {}
- tools = get_tools("APPLICATION", agent_id, tool_ids, workspace_id)
- if tool_ids and len(tool_ids) > 0: # 如果有工具ID,则将其转换为MCP
- self.context["tool_ids"] = tool_ids
- for tool_id in tool_ids:
- tool = QuerySet(Tool).filter(id=tool_id, tool_type=ToolType.CUSTOM).first()
- if tool is None or tool.is_active is False:
- continue
- executor = ToolExecutor()
- if tool.init_params is not None:
- tool_init_params = json.loads(rsa_long_decrypt(tool.init_params))
- else:
- tool_init_params = {i["field"]: i.get("default_value") for i in tool.init_field_list}
- tool_config = executor.get_tool_mcp_config(tool, tool_init_params)
-
- mcp_servers_config[str(tool.id)] = tool_config
-
- if application_ids and len(application_ids) > 0:
- self.context["application_ids"] = application_ids
- for application_id in application_ids:
- app = QuerySet(Application).filter(id=application_id, is_publish=True).first()
- if app is None:
- continue
- app_key = QuerySet(ApplicationApiKey).filter(application_id=application_id, is_active=True).first()
- if app_key is not None:
- api_key = app_key.secret_key
- application_access_token = (
- QuerySet(ApplicationAccessToken).filter(application_id=app_key.application_id).first()
- )
- if application_access_token is not None and application_access_token.authentication:
- raise AppApiException(
- 500,
- _("Agent 【{name}】 access token authentication is not supported for agent tool").format(
- name=app.name
- ),
- )
- else:
- raise AppApiException(
- 500, _("Agent Key is required for agent tool 【{name}】").format(name=app.name)
- )
- executor = ToolExecutor()
- app_config = executor.get_app_mcp_config(api_key)
- mcp_servers_config[app.name] = app_config
-
- if skill_tool_ids and len(skill_tool_ids) > 0:
- self.context["skill_tool_ids"] = skill_tool_ids
- skill_file_items = []
-
- for tool_id in skill_tool_ids:
- tool = QuerySet(Tool).filter(id=tool_id, is_active=True).first()
- if tool is None or tool.is_active is False:
- continue
- init_params_default_value = {i["field"]: i.get("default_value") for i in tool.init_field_list}
- if tool.init_params is not None:
- params = init_params_default_value | json.loads(rsa_long_decrypt(tool.init_params))
- else:
- params = init_params_default_value
-
- skill_file_items.append({"tool_id": str(tool.id), "file_id": tool.code, "params": params})
- mcp_servers_config["skills"] = skill_file_items
-
- if len(mcp_servers_config) > 0 or len(tools) > 0:
- source_id = agent_id
- source_type = "APPLICATION"
- return mcp_response_generator(
- chat_model,
- system_prompt,
- message_list,
- json.dumps(mcp_servers_config),
- mcp_output_enable,
- tool_init_params,
- source_id,
- source_type,
- chat_id,
- tools,
- )
-
- return None
-
- def get_stream_result(
- self,
- message_list: List[BaseMessage],
- chat_model: BaseChatModel = None,
- paragraph_list=None,
- no_references_setting=None,
- problem_text=None,
- mcp_tool_ids=None,
- mcp_servers="",
- mcp_source="referencing",
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- workspace_id=None,
- mcp_output_enable=True,
- agent_id=None,
- chat_id=None,
- chat_user_id=None,
- chat_user_type=None,
- ):
- if paragraph_list is None:
- paragraph_list = []
- directly_return_chunk_list = [
- AIMessageChunk(content=paragraph.content)
- for paragraph in paragraph_list
- if (
- paragraph.hit_handling_method == "directly_return"
- and paragraph.similarity >= paragraph.directly_return_similarity
- )
- ]
- if directly_return_chunk_list is not None and len(directly_return_chunk_list) > 0:
- return iter(directly_return_chunk_list), False
- elif len(paragraph_list) == 0 and no_references_setting.get("status") == "designated_answer":
- return iter(
- [AIMessageChunk(content=no_references_setting.get("value").replace("{question}", problem_text))]
- ), False
- if chat_model is None:
- return iter(
- [
- AIMessageChunk(
- _(
- "Sorry, the AI model is not configured. Please go to the application to set up the AI model first."
- )
- )
- ]
- ), False
- else:
- user_system_prompt = None
- filtered_message_list = []
- long_term_memory = (
- QuerySet(ApplicationLongTermMemory).filter(chat_user_id=chat_user_id, application_id=agent_id).first()
- )
- if long_term_memory is not None:
- memory = long_term_memory.memory
- else:
- memory = ""
-
- # print(chat_user_id, chat_user_type)
- for msg in message_list:
- if isinstance(msg, SystemMessage):
- if isinstance(msg.content, str):
- user_system_prompt = msg.content.replace("{memory}", memory)
- msg.content = user_system_prompt
- elif isinstance(msg.content, list):
- user_system_prompt = "".join(
- item.get("text", "") if isinstance(item, dict) else str(item) for item in msg.content
- )
- else:
- user_system_prompt = str(msg.content)
- else:
- filtered_message_list.append(msg)
- # 过滤tool_id
- all_tool_ids = list(set((mcp_tool_ids or []) + (tool_ids or []) + (skill_tool_ids or [])))
- authorized_set = set(filter_authorized_ids("tool", all_tool_ids, workspace_id))
-
- mcp_tool_ids = [i for i in (mcp_tool_ids or []) if i in authorized_set]
- tool_ids = [i for i in (tool_ids or []) if i in authorized_set]
- skill_tool_ids = [i for i in (skill_tool_ids or []) if i in authorized_set]
- # 处理 MCP 请求
- mcp_result = self._handle_mcp_request(
- mcp_source,
- mcp_servers,
- mcp_tool_ids,
- tool_ids,
- application_ids,
- skill_tool_ids,
- mcp_output_enable,
- chat_model,
- user_system_prompt,
- filtered_message_list,
- agent_id,
- chat_id,
- workspace_id,
- )
- if mcp_result:
- return mcp_result, True
- return chat_model.stream(message_list), True
-
- def execute_stream(
- self,
- message_list: List[BaseMessage],
- chat_id,
- problem_text,
- post_response_handler: PostResponseHandler,
- chat_model: BaseChatModel = None,
- paragraph_list=None,
- manage: PipelineManage = None,
- padding_problem_text: str = None,
- chat_user_id=None,
- chat_user_type=None,
- no_references_setting=None,
- model_setting=None,
- mcp_tool_ids=None,
- mcp_servers="",
- mcp_source="referencing",
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- workspace_id=None,
- mcp_output_enable=True,
- ):
- chat_result, is_ai_chat = self.get_stream_result(
- message_list,
- chat_model,
- paragraph_list,
- no_references_setting,
- problem_text,
- mcp_tool_ids,
- mcp_servers,
- mcp_source,
- tool_ids,
- application_ids,
- skill_tool_ids,
- workspace_id,
- mcp_output_enable,
- manage.context.get("application_id"),
- chat_id,
- chat_user_id,
- chat_user_type,
- )
- chat_record_id = (
- self.context.get("step_args", {}).get("chat_record_id")
- if self.context.get("step_args", {}).get("chat_record_id")
- else uuid.uuid7()
- )
- r = StreamingHttpResponse(
- streaming_content=event_content(
- chat_result,
- chat_id,
- chat_record_id,
- paragraph_list,
- post_response_handler,
- manage,
- self,
- chat_model,
- message_list,
- problem_text,
- padding_problem_text,
- chat_user_id,
- chat_user_type,
- is_ai_chat,
- model_setting,
- ),
- content_type="text/event-stream;charset=utf-8",
- )
-
- r["Cache-Control"] = "no-cache"
- return r
-
- def get_block_result(
- self,
- message_list: List[BaseMessage],
- chat_model: BaseChatModel = None,
- paragraph_list=None,
- no_references_setting=None,
- problem_text=None,
- mcp_tool_ids=None,
- mcp_servers="",
- mcp_source="referencing",
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- workspace_id=None,
- mcp_output_enable=True,
- application_id=None,
- chat_id=None,
- ):
- if paragraph_list is None:
- paragraph_list = []
- directly_return_chunk_list = [
- AIMessageChunk(content=paragraph.content)
- for paragraph in paragraph_list
- if (
- paragraph.hit_handling_method == "directly_return"
- and paragraph.similarity >= paragraph.directly_return_similarity
- )
- ]
- if directly_return_chunk_list is not None and len(directly_return_chunk_list) > 0:
- return directly_return_chunk_list[0], False
- elif len(paragraph_list) == 0 and no_references_setting.get("status") == "designated_answer":
- return AIMessage(no_references_setting.get("value").replace("{question}", problem_text)), False
- if chat_model is None:
- return AIMessage(
- _("Sorry, the AI model is not configured. Please go to the application to set up the AI model first.")
- ), False
- else:
- # 过滤tool_id
- all_tool_ids = list(set((mcp_tool_ids or []) + (tool_ids or []) + (skill_tool_ids or [])))
- authorized_set = set(filter_authorized_ids("tool", all_tool_ids, workspace_id))
-
- mcp_tool_ids = [i for i in (mcp_tool_ids or []) if i in authorized_set]
- tool_ids = [i for i in (tool_ids or []) if i in authorized_set]
- skill_tool_ids = [i for i in (skill_tool_ids or []) if i in authorized_set]
- # 处理 MCP 请求
- mcp_result = self._handle_mcp_request(
- mcp_source,
- mcp_servers,
- mcp_tool_ids,
- tool_ids,
- application_ids,
- skill_tool_ids,
- mcp_output_enable,
- chat_model,
- "",
- message_list,
- application_id,
- chat_id,
- workspace_id,
- )
- if mcp_result:
- return mcp_result, True
- return chat_model.invoke(message_list), True
-
- def execute_block(
- self,
- message_list: List[BaseMessage],
- chat_id,
- problem_text,
- post_response_handler: PostResponseHandler,
- chat_model: BaseChatModel = None,
- paragraph_list=None,
- manage: PipelineManage = None,
- padding_problem_text: str = None,
- chat_user_id=None,
- chat_user_type=None,
- no_references_setting=None,
- model_setting=None,
- mcp_tool_ids=None,
- mcp_servers="",
- mcp_source="referencing",
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- workspace_id=None,
- mcp_output_enable=True,
- ):
- reasoning_content_enable = model_setting.get("reasoning_content_enable", False)
- reasoning_content_start = model_setting.get("reasoning_content_start", "")
- reasoning_content_end = model_setting.get("reasoning_content_end", "")
- reasoning = Reasoning(reasoning_content_start, reasoning_content_end)
- chat_record_id = uuid.uuid7()
- # 调用模型
- try:
- chat_result, is_ai_chat = self.get_block_result(
- message_list,
- chat_model,
- paragraph_list,
- no_references_setting,
- problem_text,
- mcp_tool_ids,
- mcp_servers,
- mcp_source,
- tool_ids,
- application_ids,
- skill_tool_ids,
- workspace_id,
- mcp_output_enable,
- manage.context.get("application_id"),
- chat_id,
- )
- if is_ai_chat:
- request_token = chat_model.get_num_tokens_from_messages(message_list)
- response_token = chat_model.get_num_tokens(chat_result.content)
- else:
- request_token = 0
- response_token = 0
- write_context(self, manage, request_token, response_token, chat_result.content)
- reasoning_result = reasoning.get_reasoning_content(chat_result)
- reasoning_result_end = reasoning.get_end_reasoning_content()
- content = reasoning_result.get("content") + reasoning_result_end.get("content")
- if "reasoning_content" in chat_result.response_metadata:
- reasoning_content = chat_result.response_metadata.get("reasoning_content", "") or ""
- else:
- reasoning_content = (reasoning_result.get("reasoning_content") or "") + (
- reasoning_result_end.get("reasoning_content") or ""
- )
- post_response_handler.handler(
- chat_id,
- chat_record_id,
- paragraph_list,
- problem_text,
- content,
- manage,
- self,
- padding_problem_text,
- reasoning_content=reasoning_content,
- )
- if not manage.debug:
- add_access_num(chat_user_id, chat_user_type, manage.context.get("application_id"))
- return manage.get_base_to_response().to_block_response(
- str(chat_id),
- str(chat_record_id),
- content,
- True,
- request_token,
- response_token,
- {
- "reasoning_content": reasoning_content if reasoning_content_enable else "",
- "answer_list": [
- {"content": content, "reasoning_content": reasoning_content if reasoning_content_enable else ""}
- ],
- },
- )
- except Exception as e:
- all_text = "Exception:" + str(e)
- write_context(self, manage, 0, 0, all_text)
- post_response_handler.handler(
- chat_id,
- chat_record_id,
- paragraph_list,
- problem_text,
- all_text,
- manage,
- self,
- padding_problem_text,
- reasoning_content="",
- )
- if not manage.debug:
- add_access_num(chat_user_id, chat_user_type, manage.context.get("application_id"))
- return manage.get_base_to_response().to_block_response(
- str(chat_id), str(chat_record_id), all_text, True, 0, 0, _status=status.HTTP_500_INTERNAL_SERVER_ERROR
- )
diff --git a/apps/application/chat_pipeline/step/generate_human_message_step/__init__.py b/apps/application/chat_pipeline/step/generate_human_message_step/__init__.py
deleted file mode 100644
index 5d9549cdc64..00000000000
--- a/apps/application/chat_pipeline/step/generate_human_message_step/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/1/9 18:23
- @desc:
-"""
diff --git a/apps/application/chat_pipeline/step/generate_human_message_step/i_generate_human_message_step.py b/apps/application/chat_pipeline/step/generate_human_message_step/i_generate_human_message_step.py
deleted file mode 100644
index 0d49e9a5e2f..00000000000
--- a/apps/application/chat_pipeline/step/generate_human_message_step/i_generate_human_message_step.py
+++ /dev/null
@@ -1,82 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_generate_human_message_step.py
- @date:2024/1/9 18:15
- @desc: 生成对话模板
-"""
-from abc import abstractmethod
-from typing import Type, List
-
-from django.utils.translation import gettext_lazy as _
-from langchain_core.messages import BaseMessage
-from rest_framework import serializers
-
-from application.chat_pipeline.I_base_chat_pipeline import IBaseChatPipelineStep, ParagraphPipelineModel
-from application.chat_pipeline.pipeline_manage import PipelineManage
-from application.models import ChatRecord
-from application.serializers.application import NoReferencesSetting
-from common.field.common import InstanceField
-
-
-class IGenerateHumanMessageStep(IBaseChatPipelineStep):
- class InstanceSerializer(serializers.Serializer):
- # 问题
- problem_text = serializers.CharField(required=True, label=_("question"))
- # 段落列表
- paragraph_list = serializers.ListField(child=InstanceField(model_type=ParagraphPipelineModel, required=True),
- label=_("Paragraph List"))
- # 历史对答
- history_chat_record = serializers.ListField(child=InstanceField(model_type=ChatRecord, required=True),
- label=_("History Questions"))
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
- # 最大携带知识库段落长度
- max_paragraph_char_number = serializers.IntegerField(required=True,
- label=_("Maximum length of the knowledge base paragraph"))
- # 模板
- prompt = serializers.CharField(required=True, label=_("Prompt word"))
- system = serializers.CharField(required=False, allow_null=True, allow_blank=True,
- label=_("System prompt words (role)"))
- # 补齐问题
- padding_problem_text = serializers.CharField(required=False,
- label=_("Completion problem"))
- # 未查询到引用分段
- no_references_setting = NoReferencesSetting(required=True,
- label=_("No reference segment settings"))
-
- def get_step_serializer(self, manage: PipelineManage) -> Type[serializers.Serializer]:
- return self.InstanceSerializer
-
- def _run(self, manage: PipelineManage):
- message_list = self.execute(**self.context['step_args'])
- manage.context['message_list'] = message_list
-
- @abstractmethod
- def execute(self,
- problem_text: str,
- paragraph_list: List[ParagraphPipelineModel],
- history_chat_record: List[ChatRecord],
- dialogue_number: int,
- max_paragraph_char_number: int,
- prompt: str,
- padding_problem_text: str = None,
- no_references_setting=None,
- system=None,
- **kwargs) -> List[BaseMessage]:
- """
-
- :param problem_text: 原始问题文本
- :param paragraph_list: 段落列表
- :param history_chat_record: 历史对话记录
- :param dialogue_number: 多轮对话数量
- :param max_paragraph_char_number: 最大段落长度
- :param prompt: 模板
- :param padding_problem_text 用户修改文本
- :param kwargs: 其他参数
- :param no_references_setting: 无引用分段设置
- :param system 系统提示称
- :return:
- """
- pass
diff --git a/apps/application/chat_pipeline/step/generate_human_message_step/impl/base_generate_human_message_step.py b/apps/application/chat_pipeline/step/generate_human_message_step/impl/base_generate_human_message_step.py
deleted file mode 100644
index 2fc62897eee..00000000000
--- a/apps/application/chat_pipeline/step/generate_human_message_step/impl/base_generate_human_message_step.py
+++ /dev/null
@@ -1,79 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_generate_human_message_step.py.py
- @date:2024/1/10 17:50
- @desc:
-"""
-from typing import List, Dict
-
-from langchain_core.messages import SystemMessage, BaseMessage, HumanMessage
-
-from application.chat_pipeline.I_base_chat_pipeline import ParagraphPipelineModel
-from application.chat_pipeline.step.generate_human_message_step.i_generate_human_message_step import \
- IGenerateHumanMessageStep
-from application.models import ChatRecord
-from common.utils.common import flat_map
-
-
-class BaseGenerateHumanMessageStep(IGenerateHumanMessageStep):
-
- def execute(self, problem_text: str,
- paragraph_list: List[ParagraphPipelineModel],
- history_chat_record: List[ChatRecord],
- dialogue_number: int,
- max_paragraph_char_number: int,
- prompt: str,
- padding_problem_text: str = None,
- no_references_setting=None,
- system=None,
- **kwargs) -> List[BaseMessage]:
- prompt = prompt if (paragraph_list is not None and len(paragraph_list) > 0) else no_references_setting.get(
- 'value')
- exec_problem_text = padding_problem_text if padding_problem_text is not None else problem_text
- start_index = len(history_chat_record) - dialogue_number
- history_message = [[history_chat_record[index].get_human_message(), history_chat_record[index].get_ai_message()]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))]
- if system is not None and len(system) > 0:
- return [SystemMessage(system), *flat_map(history_message),
- self.to_human_message(prompt, exec_problem_text, max_paragraph_char_number, paragraph_list,
- no_references_setting)]
-
- return [*flat_map(history_message),
- self.to_human_message(prompt, exec_problem_text, max_paragraph_char_number, paragraph_list,
- no_references_setting)]
-
- @staticmethod
- def to_human_message(prompt: str,
- problem: str,
- max_paragraph_char_number: int,
- paragraph_list: List[ParagraphPipelineModel],
- no_references_setting: Dict):
- if paragraph_list is None or len(paragraph_list) == 0:
- if no_references_setting.get('status') == 'ai_questioning':
- return HumanMessage(
- content=no_references_setting.get('value').replace('{question}', problem))
- else:
- return HumanMessage(content=prompt.replace('{data}', "").replace('{question}', problem))
- temp_len = 0
- data_list = []
- for p in paragraph_list:
- content = f"{p.title}:{p.content}"
- temp_len += len(content)
- if temp_len > max_paragraph_char_number:
- row_data = content[0:max_paragraph_char_number - temp_len]
- data_list.append(f"{row_data}")
- break
- else:
- data_list.append(f"{content}")
- data = "\n".join(data_list)
- return HumanMessage(content=prompt.replace('{data}', data).replace('{question}', problem))
-
- def get_details(self, manage, **kwargs):
- return {
- 'status': self.status,
- 'err_message': self.err_message,
- 'step_type': 'generate_human_message',
- }
diff --git a/apps/application/chat_pipeline/step/reset_problem_step/__init__.py b/apps/application/chat_pipeline/step/reset_problem_step/__init__.py
deleted file mode 100644
index 5d9549cdc64..00000000000
--- a/apps/application/chat_pipeline/step/reset_problem_step/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/1/9 18:23
- @desc:
-"""
diff --git a/apps/application/chat_pipeline/step/reset_problem_step/i_reset_problem_step.py b/apps/application/chat_pipeline/step/reset_problem_step/i_reset_problem_step.py
deleted file mode 100644
index a0e06204364..00000000000
--- a/apps/application/chat_pipeline/step/reset_problem_step/i_reset_problem_step.py
+++ /dev/null
@@ -1,55 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_reset_problem_step.py
- @date:2024/1/9 18:12
- @desc: 重写处理问题
-"""
-from abc import abstractmethod
-from typing import Type, List
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.chat_pipeline.I_base_chat_pipeline import IBaseChatPipelineStep
-from application.chat_pipeline.pipeline_manage import PipelineManage
-from application.models import ChatRecord
-from common.field.common import InstanceField
-
-
-class IResetProblemStep(IBaseChatPipelineStep):
- class InstanceSerializer(serializers.Serializer):
- # 问题文本
- problem_text = serializers.CharField(required=True, label=_("question"))
- # 历史对答
- history_chat_record = serializers.ListField(child=InstanceField(model_type=ChatRecord, required=True),
- label=_("History Questions"))
- # 大语言模型
- model_id = serializers.UUIDField(required=False, allow_null=True, label=_("Model id"))
- workspace_id = serializers.CharField(required=True, label=_("User ID"))
- problem_optimization_prompt = serializers.CharField(required=False, max_length=102400,
- label=_("Question completion prompt"))
-
- def get_step_serializer(self, manage: PipelineManage) -> Type[serializers.Serializer]:
- return self.InstanceSerializer
-
- def _run(self, manage: PipelineManage):
- padding_problem = self.execute(**self.context.get('step_args'))
- # 用户输入问题
- source_problem_text = self.context.get('step_args').get('problem_text')
- self.context['problem_text'] = source_problem_text
- self.context['padding_problem_text'] = padding_problem
- manage.context['problem_text'] = source_problem_text
- manage.context['padding_problem_text'] = padding_problem
- # 累加tokens
- manage.context['message_tokens'] = manage.context.get('message_tokens', 0) + self.context.get('message_tokens',
- 0)
- manage.context['answer_tokens'] = manage.context.get('answer_tokens', 0) + self.context.get('answer_tokens', 0)
-
- @abstractmethod
- def execute(self, problem_text: str, history_chat_record: List[ChatRecord] = None, model_id: str = None,
- problem_optimization_prompt=None,
- workspace_id=None,
- **kwargs):
- pass
diff --git a/apps/application/chat_pipeline/step/reset_problem_step/impl/base_reset_problem_step.py b/apps/application/chat_pipeline/step/reset_problem_step/impl/base_reset_problem_step.py
deleted file mode 100644
index 47368ae65f5..00000000000
--- a/apps/application/chat_pipeline/step/reset_problem_step/impl/base_reset_problem_step.py
+++ /dev/null
@@ -1,69 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_reset_problem_step.py
- @date:2024/1/10 14:35
- @desc:
-"""
-from typing import List
-
-from django.utils.translation import gettext as _
-from langchain_core.messages import HumanMessage
-
-from application.chat_pipeline.step.reset_problem_step.i_reset_problem_step import IResetProblemStep
-from application.models import ChatRecord
-from common.utils.split_model import flat_map
-from models_provider.tools import get_model_instance_by_model_workspace_id
-
-prompt = _(
- "() contains the user's question. Answer the guessed user's question based on the context ({question}) Requirement: Output a complete question and put it in the tag")
-
-
-class BaseResetProblemStep(IResetProblemStep):
- def execute(self, problem_text: str, history_chat_record: List[ChatRecord] = None, model_id: str = None,
- problem_optimization_prompt=None,
- workspace_id=None,
- **kwargs) -> str:
- chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id) if model_id is not None else None
- if chat_model is None:
- return problem_text
- start_index = len(history_chat_record) - 3
- history_message = [[history_chat_record[index].get_human_message(), history_chat_record[index].get_ai_message()]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))]
- reset_prompt = problem_optimization_prompt if problem_optimization_prompt else prompt
- message_list = [*flat_map(history_message),
- HumanMessage(content=reset_prompt.replace('{question}', problem_text))]
- response = chat_model.invoke(message_list)
- padding_problem = problem_text
- if response.content.__contains__("") and response.content.__contains__(''):
- padding_problem_data = response.content[
- response.content.index('') + 6:response.content.index('')]
- if padding_problem_data is not None and len(padding_problem_data.strip()) > 0:
- padding_problem = padding_problem_data
- elif len(response.content) > 0:
- padding_problem = response.content
-
- try:
- request_token = chat_model.get_num_tokens_from_messages(message_list)
- response_token = chat_model.get_num_tokens(padding_problem)
- except Exception as e:
- request_token = 0
- response_token = 0
- self.context['message_tokens'] = request_token
- self.context['answer_tokens'] = response_token
- return padding_problem
-
- def get_details(self, manage, **kwargs):
- return {'status': self.status,
- 'err_message': self.err_message,
- 'step_type': 'problem_padding',
- 'run_time': self.context['run_time'],
- 'model_id': str(manage.context['model_id']) if 'model_id' in manage.context else None,
- 'message_tokens': self.context.get('message_tokens', 0),
- 'answer_tokens': self.context.get('answer_tokens', 0),
- 'cost': 0,
- 'padding_problem_text': self.context.get('padding_problem_text'),
- 'problem_text': self.context.get("step_args").get('problem_text'),
- }
diff --git a/apps/application/chat_pipeline/step/search_dataset_step/__init__.py b/apps/application/chat_pipeline/step/search_dataset_step/__init__.py
deleted file mode 100644
index 023c4bc387d..00000000000
--- a/apps/application/chat_pipeline/step/search_dataset_step/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/1/9 18:24
- @desc:
-"""
diff --git a/apps/application/chat_pipeline/step/search_dataset_step/i_search_dataset_step.py b/apps/application/chat_pipeline/step/search_dataset_step/i_search_dataset_step.py
deleted file mode 100644
index 373dc33d44b..00000000000
--- a/apps/application/chat_pipeline/step/search_dataset_step/i_search_dataset_step.py
+++ /dev/null
@@ -1,77 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_search_dataset_step.py
- @date:2024/1/9 18:10
- @desc: 检索知识库
-"""
-import re
-from abc import abstractmethod
-from typing import List, Type
-
-from django.core import validators
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.chat_pipeline.I_base_chat_pipeline import IBaseChatPipelineStep, ParagraphPipelineModel
-from application.chat_pipeline.pipeline_manage import PipelineManage
-
-
-class ISearchDatasetStep(IBaseChatPipelineStep):
- class InstanceSerializer(serializers.Serializer):
- # 原始问题文本
- problem_text = serializers.CharField(required=True, label=_("question"))
- # 系统补全问题文本
- padding_problem_text = serializers.CharField(required=False,
- label=_("System completes question text"))
- # 需要查询的数据集id列表
- knowledge_id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True),
- label=_("Dataset id list"))
- # 需要排除的文档id
- exclude_document_id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True),
- label=_("List of document ids to exclude"))
- # 需要排除向量id
- exclude_paragraph_id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True),
- label=_("List of exclusion vector ids"))
- # 需要查询的条数
- top_n = serializers.IntegerField(required=True,
- label=_("Reference segment number"))
- # 相似度 0-1之间
- similarity = serializers.FloatField(required=True, max_value=1, min_value=0,
- label=_("Similarity"))
- search_mode = serializers.CharField(required=True, validators=[
- validators.RegexValidator(regex=re.compile("^embedding|keywords|blend$"),
- message=_("The type only supports embedding|keywords|blend"), code=500)
- ], label=_("Retrieval Mode"))
- workspace_id = serializers.CharField(required=True, label=_("Workspace ID"))
-
- def get_step_serializer(self, manage: PipelineManage) -> Type[InstanceSerializer]:
- return self.InstanceSerializer
-
- def _run(self, manage: PipelineManage):
- paragraph_list = self.execute(**self.context['step_args'], manage=manage)
- manage.context['paragraph_list'] = paragraph_list
- self.context['paragraph_list'] = paragraph_list
-
- @abstractmethod
- def execute(self, problem_text: str, knowledge_id_list: list[str], exclude_document_id_list: list[str],
- exclude_paragraph_id_list: list[str], top_n: int, similarity: float, padding_problem_text: str = None,
- search_mode: str = None,
- workspace_id=None,
- manage: PipelineManage = None,
- **kwargs) -> List[ParagraphPipelineModel]:
- """
- 关于 用户和补全问题 说明: 补全问题如果有就使用补全问题去查询 反之就用用户原始问题查询
- :param similarity: 相关性
- :param top_n: 查询多少条
- :param problem_text: 用户问题
- :param knowledge_id_list: 需要查询的数据集id列表
- :param exclude_document_id_list: 需要排除的文档id
- :param exclude_paragraph_id_list: 需要排除段落id
- :param padding_problem_text 补全问题
- :param search_mode 检索模式
- :param workspace_id 工作空间id
- :return: 段落列表
- """
- pass
diff --git a/apps/application/chat_pipeline/step/search_dataset_step/impl/base_search_dataset_step.py b/apps/application/chat_pipeline/step/search_dataset_step/impl/base_search_dataset_step.py
deleted file mode 100644
index e57eebd9f65..00000000000
--- a/apps/application/chat_pipeline/step/search_dataset_step/impl/base_search_dataset_step.py
+++ /dev/null
@@ -1,150 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_search_dataset_step.py
- @date:2024/1/10 10:33
- @desc:
-"""
-import os
-from typing import List, Dict
-
-from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
-from rest_framework.utils.formatting import lazy_format
-
-from application.chat_pipeline.I_base_chat_pipeline import ParagraphPipelineModel
-from application.chat_pipeline.step.search_dataset_step.i_search_dataset_step import ISearchDatasetStep
-from common.config.embedding_config import VectorStore, ModelManage
-from common.constants.permission_constants import RoleConstants
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.db.search import native_search
-from common.utils.common import get_file_content
-from knowledge.models import Paragraph, Knowledge
-from knowledge.models import SearchMode
-from maxkb.conf import PROJECT_DIR
-from models_provider.models import Model
-from models_provider.tools import get_model, get_model_by_id, get_model_default_params
-
-
-def reset_meta(meta):
- if not meta.get('allow_download', False):
- return {'allow_download': False}
- return meta
-
-
-def get_embedding_id(knowledge_id_list):
- knowledge_list = QuerySet(Knowledge).filter(id__in=knowledge_id_list)
- if len(set([knowledge.embedding_model_id for knowledge in knowledge_list])) > 1:
- raise Exception(
- _("The vector model of the associated knowledge base is inconsistent and the segmentation cannot be recalled."))
- if len(knowledge_list) == 0:
- raise Exception(_("The knowledge base setting is wrong, please reset the knowledge base"))
- return knowledge_list[0].embedding_model_id
-
-
-class BaseSearchDatasetStep(ISearchDatasetStep):
-
- def execute(self, problem_text: str, knowledge_id_list: list[str], exclude_document_id_list: list[str],
- exclude_paragraph_id_list: list[str], top_n: int, similarity: float, padding_problem_text: str = None,
- search_mode: str = None,
- workspace_id=None,
- manage=None,
- **kwargs) -> List[ParagraphPipelineModel]:
- get_knowledge_list_of_authorized = DatabaseModelManage.get_model('get_knowledge_list_of_authorized')
- chat_user_type = manage.context.get('chat_user_type')
- if get_knowledge_list_of_authorized is not None and RoleConstants.CHAT_USER.value.name == chat_user_type:
- knowledge_id_list = get_knowledge_list_of_authorized(manage.context.get('chat_user_id'),
- knowledge_id_list)
- if len(knowledge_id_list) == 0:
- return []
- exec_problem_text = padding_problem_text if padding_problem_text is not None else problem_text
- model_id = get_embedding_id(knowledge_id_list)
- model = get_model_by_id(model_id, workspace_id)
- if model.model_type != "EMBEDDING":
- raise Exception(_("Model does not exist"))
- self.context['model_name'] = model.name
- default_params = get_model_default_params(model)
- embedding_model = ModelManage.get_model(model_id, lambda _id: get_model(model, **{**default_params}))
- embedding_value = embedding_model.embed_query(exec_problem_text)
- vector = VectorStore.get_embedding_vector()
- embedding_list = vector.query(exec_problem_text, embedding_value, knowledge_id_list, None,
- exclude_document_id_list,
- exclude_paragraph_id_list, True, top_n, similarity, SearchMode(search_mode))
- if embedding_list is None:
- return []
- paragraph_list = self.list_paragraph(embedding_list, vector)
- result = [self.reset_paragraph(paragraph, embedding_list) for paragraph in paragraph_list]
- return result
-
- @staticmethod
- def reset_paragraph(paragraph: Dict, embedding_list: List) -> ParagraphPipelineModel:
- filter_embedding_list = [embedding for embedding in embedding_list if
- str(embedding.get('paragraph_id')) == str(paragraph.get('id'))]
- if filter_embedding_list is not None and len(filter_embedding_list) > 0:
- find_embedding = filter_embedding_list[-1]
- return (ParagraphPipelineModel.builder()
- .add_paragraph(paragraph)
- .add_similarity(find_embedding.get('similarity'))
- .add_comprehensive_score(find_embedding.get('comprehensive_score'))
- .add_knowledge_name(paragraph.get('knowledge_name'))
- .add_knowledge_type(paragraph.get('knowledge_type'))
- .add_document_name(paragraph.get('document_name'))
- .add_hit_handling_method(paragraph.get('hit_handling_method'))
- .add_directly_return_similarity(paragraph.get('directly_return_similarity'))
- .add_meta(reset_meta(paragraph.get('meta')))
- .build())
-
- @staticmethod
- def get_similarity(paragraph, embedding_list: List):
- filter_embedding_list = [embedding for embedding in embedding_list if
- str(embedding.get('paragraph_id')) == str(paragraph.get('id'))]
- if filter_embedding_list is not None and len(filter_embedding_list) > 0:
- find_embedding = filter_embedding_list[-1]
- return find_embedding.get('comprehensive_score')
- return 0
-
- @staticmethod
- def list_paragraph(embedding_list: List, vector):
- paragraph_id_list = [row.get('paragraph_id') for row in embedding_list]
- if paragraph_id_list is None or len(paragraph_id_list) == 0:
- return []
- paragraph_list = native_search(QuerySet(Paragraph).filter(id__in=paragraph_id_list),
- get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql',
- 'list_knowledge_paragraph_by_paragraph_id.sql')),
- with_table_name=True)
- # 如果向量库中存在脏数据 直接删除
- if len(paragraph_list) != len(paragraph_id_list):
- exist_paragraph_list = [row.get('id') for row in paragraph_list]
- for paragraph_id in paragraph_id_list:
- if not exist_paragraph_list.__contains__(paragraph_id):
- vector.delete_by_paragraph_id(paragraph_id)
- # 如果存在直接返回的则取直接返回段落
- hit_handling_method_paragraph = [paragraph for paragraph in paragraph_list if
- (paragraph.get(
- 'hit_handling_method') == 'directly_return' and BaseSearchDatasetStep.get_similarity(
- paragraph, embedding_list) >= paragraph.get(
- 'directly_return_similarity'))]
- if len(hit_handling_method_paragraph) > 0:
- # 找到评分最高的
- return [sorted(hit_handling_method_paragraph,
- key=lambda p: BaseSearchDatasetStep.get_similarity(p, embedding_list))[-1]]
- return paragraph_list
-
- def get_details(self, manage, **kwargs):
- step_args = self.context.get('step_args') or {}
-
- return {
- 'status': self.status,
- 'err_message': self.err_message,
- 'step_type': 'search_step',
- 'paragraph_list': [row.to_dict() for row in (self.context.get('paragraph_list') or [])],
- 'run_time': self.context.get('run_time') or 0,
- 'problem_text': step_args.get(
- 'padding_problem_text') if 'padding_problem_text' in step_args else step_args.get('problem_text'),
- 'model_name': self.context.get('model_name'),
- 'message_tokens': 0,
- 'answer_tokens': 0,
- 'cost': 0
- }
diff --git a/apps/application/flow/__init__.py b/apps/application/flow/__init__.py
deleted file mode 100644
index 328e8f8ec5f..00000000000
--- a/apps/application/flow/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/6/7 14:43
- @desc:
-"""
diff --git a/apps/application/flow/backend/sandbox_shell.py b/apps/application/flow/backend/sandbox_shell.py
deleted file mode 100644
index 6ed92781393..00000000000
--- a/apps/application/flow/backend/sandbox_shell.py
+++ /dev/null
@@ -1,75 +0,0 @@
-import getpass
-import os
-import re
-
-from deepagents.backends import LocalShellBackend
-from deepagents.backends.protocol import ExecuteResponse
-from maxkb.const import CONFIG
-
-_enable_sandbox = bool(int(CONFIG.get("SANDBOX", 0)))
-_run_user = "sandbox" if _enable_sandbox else getpass.getuser()
-_sandbox_python_sys_path = CONFIG.get_sandbox_python_package_paths().replace(",", ":")
-
-
-class SandboxShellBackend(LocalShellBackend):
- def __init__(self, root_dir: str, **kwargs):
- if "env" not in kwargs and not kwargs.get("inherit_env", False):
- env = os.environ.copy()
- python_path = env.get("PYTHONPATH", "")
-
- # 将 sandbox Python 包路径分解为列表,检查每个路径是否已存在
- existing_paths = set(python_path.split(os.pathsep))
- sandbox_paths = _sandbox_python_sys_path.split(os.pathsep) if _sandbox_python_sys_path else []
- new_paths = [p for p in sandbox_paths if p and p not in existing_paths]
-
- if new_paths:
- env["PYTHONPATH"] = (
- f"{os.pathsep.join(new_paths)}{os.pathsep}{python_path}"
- if python_path
- else os.pathsep.join(new_paths)
- )
-
- kwargs["env"] = env
- super().__init__(root_dir=root_dir, **kwargs)
-
- def _translate_virtual_paths(self, command: str) -> str:
- """Translate virtual absolute paths in the command to real filesystem paths.
-
- In virtual_mode=True, file tools (ls, glob, read_file) return virtual absolute
- paths like /skills/foo.py which map to {root_dir}/skills/foo.py. But execute()
- runs a real shell where /skills/foo.py does not exist. This method replaces
- any path token that exists under root_dir with its real path, while leaving
- genuine system paths (e.g. /usr/bin/python3) untouched.
- """
- root = str(self.cwd)
-
- def translate(m: re.Match) -> str:
- virtual_path = m.group(0)
- real_path = root + virtual_path
- return real_path if os.path.lexists(real_path) else virtual_path
-
- # Match absolute-path-like tokens: / followed by a non-whitespace sequence
- # that isn't clearly a flag (e.g. avoid matching -/something).
- # Only translate when virtual_mode is active.
- return re.sub(r'(?<:,]*', translate, command)
-
- def execute(
- self,
- command: str,
- *,
- timeout: int | None = None,
- ) -> ExecuteResponse:
- if self.virtual_mode:
- command = self._translate_virtual_paths(command)
-
- if _enable_sandbox:
- # 用 runuser 在子进程里切换用户,父进程凭据保持不变,
- # 避免父进程 ruid/euid 不一致导致 execve 报 Permission denied
- command = (
- "env -i LD_PRELOAD=/opt/maxkb-app/sandbox/lib/sandbox.so "
- f'PATH="${{PATH}}" PYTHONPATH="${{PYTHONPATH}}" gosu {_run_user} {command}'
- )
- # command = f"runuser -u {_run_user} -- env -i PATH=${{PATH}} {command}"
-
- # print(f"Executing command in sandbox: {command}")
- return super().execute(command=command, timeout=timeout)
diff --git a/apps/application/flow/common.py b/apps/application/flow/common.py
deleted file mode 100644
index d7520cf690c..00000000000
--- a/apps/application/flow/common.py
+++ /dev/null
@@ -1,284 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: common.py
- @date:2024/12/11 17:57
- @desc:
-"""
-from enum import Enum
-from typing import List, Dict
-
-from django.db.models import QuerySet
-from django.utils.translation import gettext as _
-from rest_framework.exceptions import ErrorDetail, ValidationError
-
-from common.exception.app_exception import AppApiException
-from common.utils.common import group_by
-from models_provider.models import Model
-from models_provider.tools import get_model_credential
-from tools.models.tool import Tool
-
-end_nodes = ['ai-chat-node', 'reply-node', 'function-node', 'function-lib-node', 'application-node',
- 'image-understand-node', 'speech-to-text-node', 'text-to-speech-node', 'image-generate-node',
- 'variable-assign-node']
-
-
-class Answer:
- def __init__(self, content, view_type, runtime_node_id, chat_record_id, child_node, real_node_id,
- reasoning_content):
- self.view_type = view_type
- self.content = content
- self.reasoning_content = reasoning_content
- self.runtime_node_id = runtime_node_id
- self.chat_record_id = chat_record_id
- self.child_node = child_node
- self.real_node_id = real_node_id
-
- def to_dict(self):
- return {'view_type': self.view_type, 'content': self.content, 'runtime_node_id': self.runtime_node_id,
- 'chat_record_id': self.chat_record_id,
- 'child_node': self.child_node,
- 'reasoning_content': self.reasoning_content,
- 'real_node_id': self.real_node_id}
-
-
-class NodeChunk:
- def __init__(self):
- self.status = 0
- self.chunk_list = []
-
- def add_chunk(self, chunk):
- self.chunk_list.append(chunk)
-
- def end(self, chunk=None):
- if chunk is not None:
- self.add_chunk(chunk)
- self.status = 200
-
- def is_end(self):
- return self.status == 200
-
-
-class Edge:
- def __init__(self, _id: str, _type: str, sourceNodeId: str, targetNodeId: str, **keywords):
- self.id = _id
- self.type = _type
- self.sourceNodeId = sourceNodeId
- self.targetNodeId = targetNodeId
- for keyword in keywords:
- self.__setattr__(keyword, keywords.get(keyword))
-
-
-class Node:
- def __init__(self, _id: str, _type: str, x: int, y: int, properties: dict, **kwargs):
- self.id = _id
- self.type = _type
- self.x = x
- self.y = y
- self.properties = properties
- for keyword in kwargs:
- self.__setattr__(keyword, kwargs.get(keyword))
-
-
-class EdgeNode:
- edge: Edge
- node: Node
-
- def __init__(self, edge, node):
- self.edge = edge
- self.node = node
-
-
-class WorkflowMode(Enum):
- APPLICATION = "application"
-
- APPLICATION_LOOP = "application-loop"
-
- KNOWLEDGE = "knowledge"
-
- KNOWLEDGE_LOOP = "knowledge-loop"
-
- TOOL = "tool"
-
- TOOL_LOOP = "tool-loop"
-
-
-class Workflow:
- """
- 节点列表
- """
- nodes: List[Node]
- """
- 线列表
- """
- edges: List[Edge]
- """
- 节点id:node
- """
- node_map: Dict[str, Node]
- """
- 节点id:当前节点id上面的所有节点
- """
- up_node_map: Dict[str, List[EdgeNode]]
- """
- 节点id:当前节点id下面的所有节点
- """
- next_node_map: Dict[str, List[EdgeNode]]
-
- workflow_mode: WorkflowMode
-
- def __init__(self, nodes: List[Node], edges: List[Edge],
- workflow_mode: WorkflowMode = WorkflowMode.APPLICATION.value):
- self.nodes = nodes
- self.edges = edges
- self.node_map = {node.id: node for node in nodes}
-
- self.up_node_map = {key: [EdgeNode(edge, self.node_map.get(edge.sourceNodeId)) for
- edge in edges] for
- key, edges in
- group_by(edges, key=lambda edge: edge.targetNodeId).items()}
-
- self.next_node_map = {key: [EdgeNode(edge, self.node_map.get(edge.targetNodeId)) for edge in edges] for
- key, edges in
- group_by(edges, key=lambda edge: edge.sourceNodeId).items()}
- self.workflow_mode = workflow_mode
-
- def get_node(self, node_id):
- """
- 根据node_id 获取节点信息
- @param node_id: node_id
- @return: 节点信息
- """
- return self.node_map.get(node_id)
-
- def get_up_edge_nodes(self, node_id) -> List[EdgeNode]:
- """
- 根据节点id 获取当前连接前置节点和连线
- @param node_id: 节点id
- @return: 节点连线列表
- """
- return self.up_node_map.get(node_id)
-
- def get_next_edge_nodes(self, node_id) -> List[EdgeNode]:
- """
- 根据节点id 获取当前连接目标节点和连线
- @param node_id: 节点id
- @return: 节点连线列表
- """
- return self.next_node_map.get(node_id)
-
- def get_up_nodes(self, node_id) -> List[Node]:
- """
- 根据节点id 获取当前连接前置节点
- @param node_id: 节点id
- @return: 节点列表
- """
- return [en.node for en in (self.up_node_map.get(node_id) or [])]
-
- def get_next_nodes(self, node_id) -> List[Node]:
- """
- 根据节点id 获取当前连接目标节点
- @param node_id: 节点id
- @return: 节点列表
- """
- return [en.node for en in self.next_node_map.get(node_id, [])]
-
- @staticmethod
- def new_instance(flow_obj: Dict, workflow_mode: WorkflowMode = WorkflowMode.APPLICATION):
- nodes = flow_obj.get('nodes')
- edges = flow_obj.get('edges')
- nodes = [Node(node.get('id'), node.get('type'), **node)
- for node in nodes]
- edges = [Edge(edge.get('id'), edge.get('type'), **edge) for edge in edges]
- return Workflow(nodes, edges, workflow_mode)
-
- def get_start_node(self):
- return self.get_node('start-node')
-
- def get_search_node(self):
- return [node for node in self.nodes if node.type == 'search-dataset-node']
-
- def is_valid(self):
- """
- 校验工作流数据
- """
- self.is_valid_model_params()
- self.is_valid_start_node()
- self.is_valid_base_node()
- self.is_valid_work_flow()
-
- def is_valid_node_params(self, node: Node):
- from application.flow.step_node import get_node
- get_node(node.type, self.workflow_mode)(node, None, None)
-
- def is_valid_node(self, node: Node):
- self.is_valid_node_params(node)
- if node.type == 'condition-node':
- branch_list = node.properties.get('node_data').get('branch')
- for branch in branch_list:
- source_anchor_id = f"{node.id}_{branch.get('id')}_right"
- edge_list = [edge for edge in self.edges if edge.sourceAnchorId == source_anchor_id]
- if len(edge_list) == 0:
- raise AppApiException(500,
- _('The branch {branch} of the {node} node needs to be connected').format(
- node=node.properties.get("stepName"), branch=branch.get("type")))
-
- else:
- edge_list = [edge for edge in self.edges if edge.sourceNodeId == node.id]
- if len(edge_list) == 0 and not end_nodes.__contains__(node.type):
- raise AppApiException(500, _("{node} Nodes cannot be considered as end nodes").format(
- node=node.properties.get("stepName")))
-
- def is_valid_work_flow(self, up_node=None):
- if up_node is None:
- up_node = self.get_start_node()
- self.is_valid_node(up_node)
- next_nodes = self.get_next_nodes(up_node)
- for next_node in next_nodes:
- self.is_valid_work_flow(next_node)
-
- def is_valid_start_node(self):
- start_node_list = [node for node in self.nodes if node.id == 'start-node']
- if len(start_node_list) == 0:
- raise AppApiException(500, _('The starting node is required'))
- if len(start_node_list) > 1:
- raise AppApiException(500, _('There can only be one starting node'))
-
- def is_valid_model_params(self):
- node_list = [node for node in self.nodes if (
- node.type == 'ai-chat-node' or node.type == 'question-node' or node.type == 'parameter-extraction-node')]
- for node in node_list:
- if (node.properties.get('node_data', {}).get('model_id_type') or 'custom') == 'reference':
- continue
- model = QuerySet(Model).filter(id=node.properties.get('node_data', {}).get('model_id')).first()
- if model is None:
- raise ValidationError(ErrorDetail(
- _('The node {node} model does not exist').format(node=node.properties.get("stepName"))))
- credential = get_model_credential(model.provider, model.model_type, model.model_name)
- model_params_setting = node.properties.get('node_data', {}).get('model_params_setting')
- model_params_setting_form = credential.get_model_params_setting_form(
- model.model_name)
- if model_params_setting is None:
- model_params_setting = model_params_setting_form.get_default_form_data()
- node.properties.get('node_data', {})['model_params_setting'] = model_params_setting
- if node.properties.get('status', 200) != 200:
- raise ValidationError(
- ErrorDetail(_("Node {node} is unavailable").format(node=node.properties.get("stepName"))))
- node_list = [node for node in self.nodes if (node.type == 'function-lib-node')]
- for node in node_list:
- function_lib_id = node.properties.get('node_data', {}).get('function_lib_id')
- if function_lib_id is None:
- raise ValidationError(ErrorDetail(
- _('The library ID of node {node} cannot be empty').format(node=node.properties.get("stepName"))))
- f_lib = QuerySet(Tool).filter(id=function_lib_id).first()
- if f_lib is None:
- raise ValidationError(ErrorDetail(_("The function library for node {node} is not available").format(
- node=node.properties.get("stepName"))))
-
- def is_valid_base_node(self):
- base_node_list = [node for node in self.nodes if node.id == 'base-node']
- if len(base_node_list) == 0:
- raise AppApiException(500, _('Basic information node is required'))
- if len(base_node_list) > 1:
- raise AppApiException(500, _('There can only be one basic information node'))
diff --git a/apps/application/flow/default_workflow.json b/apps/application/flow/default_workflow.json
deleted file mode 100644
index 48ac23c4dc6..00000000000
--- a/apps/application/flow/default_workflow.json
+++ /dev/null
@@ -1,451 +0,0 @@
-{
- "nodes": [
- {
- "id": "base-node",
- "type": "base-node",
- "x": 360,
- "y": 2810,
- "properties": {
- "config": {
-
- },
- "height": 825.6,
- "stepName": "基本信息",
- "node_data": {
- "desc": "",
- "name": "maxkbapplication",
- "prologue": "您好,我是 MaxKB 小助手,您可以向我提出 MaxKB 使用问题。\n- MaxKB 主要功能有什么?\n- MaxKB 支持哪些大语言模型?\n- MaxKB 支持哪些文档类型?"
- },
- "input_field_list": [
-
- ]
- }
- },
- {
- "id": "start-node",
- "type": "start-node",
- "x": 430,
- "y": 3660,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "用户问题",
- "value": "question"
- }
- ],
- "globalFields": [
- {
- "label": "当前时间",
- "value": "time"
- }
- ]
- },
- "fields": [
- {
- "label": "用户问题",
- "value": "question"
- }
- ],
- "height": 276,
- "stepName": "开始",
- "globalFields": [
- {
- "label": "当前时间",
- "value": "time"
- }
- ]
- }
- },
- {
- "id": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "type": "search-dataset-node",
- "x": 840,
- "y": 3210,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "检索结果的分段列表",
- "value": "paragraph_list"
- },
- {
- "label": "满足直接回答的分段列表",
- "value": "is_hit_handling_method_list"
- },
- {
- "label": "检索结果",
- "value": "data"
- },
- {
- "label": "满足直接回答的分段内容",
- "value": "directly_return"
- }
- ]
- },
- "height": 794,
- "stepName": "知识库检索",
- "node_data": {
- "dataset_id_list": [
-
- ],
- "dataset_setting": {
- "top_n": 3,
- "similarity": 0.6,
- "search_mode": "embedding",
- "max_paragraph_char_number": 5000
- },
- "question_reference_address": [
- "start-node",
- "question"
- ],
- "source_dataset_id_list": [
-
- ]
- }
- }
- },
- {
- "id": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "type": "condition-node",
- "x": 1490,
- "y": 3210,
- "properties": {
- "width": 600,
- "config": {
- "fields": [
- {
- "label": "分支名称",
- "value": "branch_name"
- }
- ]
- },
- "height": 543.675,
- "stepName": "判断器",
- "node_data": {
- "branch": [
- {
- "id": "1009",
- "type": "IF",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "is_hit_handling_method_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "4908",
- "type": "ELSE IF 1",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "paragraph_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "161",
- "type": "ELSE",
- "condition": "and",
- "conditions": [
-
- ]
- }
- ]
- },
- "branch_condition_list": [
- {
- "index": 0,
- "height": 121.225,
- "id": "1009"
- },
- {
- "index": 1,
- "height": 121.225,
- "id": "4908"
- },
- {
- "index": 2,
- "height": 44,
- "id": "161"
- }
- ]
- }
- },
- {
- "id": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "type": "reply-node",
- "x": 2170,
- "y": 2480,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "内容",
- "value": "answer"
- }
- ]
- },
- "height": 378,
- "stepName": "指定回复",
- "node_data": {
- "fields": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "directly_return"
- ],
- "content": "",
- "reply_type": "referencing",
- "is_result": true
- }
- }
- },
- {
- "id": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3200,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI 回答内容",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI 对话",
- "node_data": {
- "prompt": "已知信息:\n{{知识库检索.data}}\n问题:\n{{开始.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- },
- {
- "id": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3970,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI 回答内容",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI 对话1",
- "node_data": {
- "prompt": "{{开始.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- }
- ],
- "edges": [
- {
- "id": "7d0f166f-c472-41b2-b9a2-c294f4c83d73",
- "type": "app-edge",
- "sourceNodeId": "start-node",
- "targetNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "startPoint": {
- "x": 590,
- "y": 3660
- },
- "endPoint": {
- "x": 680,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 590,
- "y": 3660
- },
- {
- "x": 700,
- "y": 3660
- },
- {
- "x": 570,
- "y": 3210
- },
- {
- "x": 680,
- "y": 3210
- }
- ],
- "sourceAnchorId": "start-node_right",
- "targetAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_left"
- },
- {
- "id": "35cb86dd-f328-429e-a973-12fd7218b696",
- "type": "app-edge",
- "sourceNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "targetNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "startPoint": {
- "x": 1000,
- "y": 3210
- },
- "endPoint": {
- "x": 1200,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1000,
- "y": 3210
- },
- {
- "x": 1110,
- "y": 3210
- },
- {
- "x": 1090,
- "y": 3210
- },
- {
- "x": 1200,
- "y": 3210
- }
- ],
- "sourceAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_right",
- "targetAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_left"
- },
- {
- "id": "e8f6cfe6-7e48-41cd-abd3-abfb5304d0d8",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "startPoint": {
- "x": 1780,
- "y": 3073.775
- },
- "endPoint": {
- "x": 2010,
- "y": 2480
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3073.775
- },
- {
- "x": 1890,
- "y": 3073.775
- },
- {
- "x": 1900,
- "y": 2480
- },
- {
- "x": 2010,
- "y": 2480
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_1009_right",
- "targetAnchorId": "4ffe1086-25df-4c85-b168-979b5bbf0a26_left"
- },
- {
- "id": "994ff325-6f7a-4ebc-b61b-10e15519d6d2",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "startPoint": {
- "x": 1780,
- "y": 3203
- },
- "endPoint": {
- "x": 2000,
- "y": 3200
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3200
- },
- {
- "x": 2000,
- "y": 3200
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_4908_right",
- "targetAnchorId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb_left"
- },
- {
- "id": "19270caf-bb9f-4ba7-9bf8-200aa70fecd5",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "startPoint": {
- "x": 1780,
- "y": 3293.6124999999997
- },
- "endPoint": {
- "x": 2000,
- "y": 3970
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3970
- },
- {
- "x": 2000,
- "y": 3970
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_161_right",
- "targetAnchorId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7_left"
- }
- ]
-}
\ No newline at end of file
diff --git a/apps/application/flow/default_workflow_en.json b/apps/application/flow/default_workflow_en.json
deleted file mode 100644
index 17c397306b9..00000000000
--- a/apps/application/flow/default_workflow_en.json
+++ /dev/null
@@ -1,451 +0,0 @@
-{
- "nodes": [
- {
- "id": "base-node",
- "type": "base-node",
- "x": 360,
- "y": 2810,
- "properties": {
- "config": {
-
- },
- "height": 825.6,
- "stepName": "Base",
- "node_data": {
- "desc": "",
- "name": "maxkbapplication",
- "prologue": "Hello, I am the MaxKB assistant. You can ask me about MaxKB usage issues.\n-What are the main functions of MaxKB?\n-What major language models does MaxKB support?\n-What document types does MaxKB support?"
- },
- "input_field_list": [
-
- ]
- }
- },
- {
- "id": "start-node",
- "type": "start-node",
- "x": 430,
- "y": 3660,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "User Question",
- "value": "question"
- }
- ],
- "globalFields": [
- {
- "label": "Current Time",
- "value": "time"
- }
- ]
- },
- "fields": [
- {
- "label": "User Question",
- "value": "question"
- }
- ],
- "height": 276,
- "stepName": "Start",
- "globalFields": [
- {
- "label": "Current Time",
- "value": "time"
- }
- ]
- }
- },
- {
- "id": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "type": "search-dataset-node",
- "x": 840,
- "y": 3210,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "List of Retrieved Paragraphs",
- "value": "paragraph_list"
- },
- {
- "label": "List of Paragraphs Satisfying Direct Answer",
- "value": "is_hit_handling_method_list"
- },
- {
- "label": "Search Results",
- "value": "data"
- },
- {
- "label": "Content of Paragraphs Satisfying Direct Answer",
- "value": "directly_return"
- }
- ]
- },
- "height": 794,
- "stepName": "Knowledge Search",
- "node_data": {
- "dataset_id_list": [
-
- ],
- "dataset_setting": {
- "top_n": 3,
- "similarity": 0.6,
- "search_mode": "embedding",
- "max_paragraph_char_number": 5000
- },
- "question_reference_address": [
- "start-node",
- "question"
- ],
- "source_dataset_id_list": [
-
- ]
- }
- }
- },
- {
- "id": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "type": "condition-node",
- "x": 1490,
- "y": 3210,
- "properties": {
- "width": 600,
- "config": {
- "fields": [
- {
- "label": "Branch Name",
- "value": "branch_name"
- }
- ]
- },
- "height": 543.675,
- "stepName": "Conditional Branch",
- "node_data": {
- "branch": [
- {
- "id": "1009",
- "type": "IF",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "is_hit_handling_method_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "4908",
- "type": "ELSE IF 1",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "paragraph_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "161",
- "type": "ELSE",
- "condition": "and",
- "conditions": [
-
- ]
- }
- ]
- },
- "branch_condition_list": [
- {
- "index": 0,
- "height": 121.225,
- "id": "1009"
- },
- {
- "index": 1,
- "height": 121.225,
- "id": "4908"
- },
- {
- "index": 2,
- "height": 44,
- "id": "161"
- }
- ]
- }
- },
- {
- "id": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "type": "reply-node",
- "x": 2170,
- "y": 2480,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "Content",
- "value": "answer"
- }
- ]
- },
- "height": 378,
- "stepName": "Specified Reply",
- "node_data": {
- "fields": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "directly_return"
- ],
- "content": "",
- "reply_type": "referencing",
- "is_result": true
- }
- }
- },
- {
- "id": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3200,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI Answer Content",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI Chat",
- "node_data": {
- "prompt": "Known information:\n{{Knowledge Search.data}}\nQuestion:\n{{Start.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- },
- {
- "id": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3970,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI Answer Content",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI Chat1",
- "node_data": {
- "prompt": "{{Start.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- }
- ],
- "edges": [
- {
- "id": "7d0f166f-c472-41b2-b9a2-c294f4c83d73",
- "type": "app-edge",
- "sourceNodeId": "start-node",
- "targetNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "startPoint": {
- "x": 590,
- "y": 3660
- },
- "endPoint": {
- "x": 680,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 590,
- "y": 3660
- },
- {
- "x": 700,
- "y": 3660
- },
- {
- "x": 570,
- "y": 3210
- },
- {
- "x": 680,
- "y": 3210
- }
- ],
- "sourceAnchorId": "start-node_right",
- "targetAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_left"
- },
- {
- "id": "35cb86dd-f328-429e-a973-12fd7218b696",
- "type": "app-edge",
- "sourceNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "targetNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "startPoint": {
- "x": 1000,
- "y": 3210
- },
- "endPoint": {
- "x": 1200,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1000,
- "y": 3210
- },
- {
- "x": 1110,
- "y": 3210
- },
- {
- "x": 1090,
- "y": 3210
- },
- {
- "x": 1200,
- "y": 3210
- }
- ],
- "sourceAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_right",
- "targetAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_left"
- },
- {
- "id": "e8f6cfe6-7e48-41cd-abd3-abfb5304d0d8",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "startPoint": {
- "x": 1780,
- "y": 3073.775
- },
- "endPoint": {
- "x": 2010,
- "y": 2480
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3073.775
- },
- {
- "x": 1890,
- "y": 3073.775
- },
- {
- "x": 1900,
- "y": 2480
- },
- {
- "x": 2010,
- "y": 2480
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_1009_right",
- "targetAnchorId": "4ffe1086-25df-4c85-b168-979b5bbf0a26_left"
- },
- {
- "id": "994ff325-6f7a-4ebc-b61b-10e15519d6d2",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "startPoint": {
- "x": 1780,
- "y": 3203
- },
- "endPoint": {
- "x": 2000,
- "y": 3200
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3200
- },
- {
- "x": 2000,
- "y": 3200
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_4908_right",
- "targetAnchorId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb_left"
- },
- {
- "id": "19270caf-bb9f-4ba7-9bf8-200aa70fecd5",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "startPoint": {
- "x": 1780,
- "y": 3293.6124999999997
- },
- "endPoint": {
- "x": 2000,
- "y": 3970
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3970
- },
- {
- "x": 2000,
- "y": 3970
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_161_right",
- "targetAnchorId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7_left"
- }
- ]
-}
\ No newline at end of file
diff --git a/apps/application/flow/default_workflow_zh.json b/apps/application/flow/default_workflow_zh.json
deleted file mode 100644
index 48ac23c4dc6..00000000000
--- a/apps/application/flow/default_workflow_zh.json
+++ /dev/null
@@ -1,451 +0,0 @@
-{
- "nodes": [
- {
- "id": "base-node",
- "type": "base-node",
- "x": 360,
- "y": 2810,
- "properties": {
- "config": {
-
- },
- "height": 825.6,
- "stepName": "基本信息",
- "node_data": {
- "desc": "",
- "name": "maxkbapplication",
- "prologue": "您好,我是 MaxKB 小助手,您可以向我提出 MaxKB 使用问题。\n- MaxKB 主要功能有什么?\n- MaxKB 支持哪些大语言模型?\n- MaxKB 支持哪些文档类型?"
- },
- "input_field_list": [
-
- ]
- }
- },
- {
- "id": "start-node",
- "type": "start-node",
- "x": 430,
- "y": 3660,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "用户问题",
- "value": "question"
- }
- ],
- "globalFields": [
- {
- "label": "当前时间",
- "value": "time"
- }
- ]
- },
- "fields": [
- {
- "label": "用户问题",
- "value": "question"
- }
- ],
- "height": 276,
- "stepName": "开始",
- "globalFields": [
- {
- "label": "当前时间",
- "value": "time"
- }
- ]
- }
- },
- {
- "id": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "type": "search-dataset-node",
- "x": 840,
- "y": 3210,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "检索结果的分段列表",
- "value": "paragraph_list"
- },
- {
- "label": "满足直接回答的分段列表",
- "value": "is_hit_handling_method_list"
- },
- {
- "label": "检索结果",
- "value": "data"
- },
- {
- "label": "满足直接回答的分段内容",
- "value": "directly_return"
- }
- ]
- },
- "height": 794,
- "stepName": "知识库检索",
- "node_data": {
- "dataset_id_list": [
-
- ],
- "dataset_setting": {
- "top_n": 3,
- "similarity": 0.6,
- "search_mode": "embedding",
- "max_paragraph_char_number": 5000
- },
- "question_reference_address": [
- "start-node",
- "question"
- ],
- "source_dataset_id_list": [
-
- ]
- }
- }
- },
- {
- "id": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "type": "condition-node",
- "x": 1490,
- "y": 3210,
- "properties": {
- "width": 600,
- "config": {
- "fields": [
- {
- "label": "分支名称",
- "value": "branch_name"
- }
- ]
- },
- "height": 543.675,
- "stepName": "判断器",
- "node_data": {
- "branch": [
- {
- "id": "1009",
- "type": "IF",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "is_hit_handling_method_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "4908",
- "type": "ELSE IF 1",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "paragraph_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "161",
- "type": "ELSE",
- "condition": "and",
- "conditions": [
-
- ]
- }
- ]
- },
- "branch_condition_list": [
- {
- "index": 0,
- "height": 121.225,
- "id": "1009"
- },
- {
- "index": 1,
- "height": 121.225,
- "id": "4908"
- },
- {
- "index": 2,
- "height": 44,
- "id": "161"
- }
- ]
- }
- },
- {
- "id": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "type": "reply-node",
- "x": 2170,
- "y": 2480,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "内容",
- "value": "answer"
- }
- ]
- },
- "height": 378,
- "stepName": "指定回复",
- "node_data": {
- "fields": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "directly_return"
- ],
- "content": "",
- "reply_type": "referencing",
- "is_result": true
- }
- }
- },
- {
- "id": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3200,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI 回答内容",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI 对话",
- "node_data": {
- "prompt": "已知信息:\n{{知识库检索.data}}\n问题:\n{{开始.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- },
- {
- "id": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3970,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI 回答内容",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI 对话1",
- "node_data": {
- "prompt": "{{开始.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- }
- ],
- "edges": [
- {
- "id": "7d0f166f-c472-41b2-b9a2-c294f4c83d73",
- "type": "app-edge",
- "sourceNodeId": "start-node",
- "targetNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "startPoint": {
- "x": 590,
- "y": 3660
- },
- "endPoint": {
- "x": 680,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 590,
- "y": 3660
- },
- {
- "x": 700,
- "y": 3660
- },
- {
- "x": 570,
- "y": 3210
- },
- {
- "x": 680,
- "y": 3210
- }
- ],
- "sourceAnchorId": "start-node_right",
- "targetAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_left"
- },
- {
- "id": "35cb86dd-f328-429e-a973-12fd7218b696",
- "type": "app-edge",
- "sourceNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "targetNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "startPoint": {
- "x": 1000,
- "y": 3210
- },
- "endPoint": {
- "x": 1200,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1000,
- "y": 3210
- },
- {
- "x": 1110,
- "y": 3210
- },
- {
- "x": 1090,
- "y": 3210
- },
- {
- "x": 1200,
- "y": 3210
- }
- ],
- "sourceAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_right",
- "targetAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_left"
- },
- {
- "id": "e8f6cfe6-7e48-41cd-abd3-abfb5304d0d8",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "startPoint": {
- "x": 1780,
- "y": 3073.775
- },
- "endPoint": {
- "x": 2010,
- "y": 2480
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3073.775
- },
- {
- "x": 1890,
- "y": 3073.775
- },
- {
- "x": 1900,
- "y": 2480
- },
- {
- "x": 2010,
- "y": 2480
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_1009_right",
- "targetAnchorId": "4ffe1086-25df-4c85-b168-979b5bbf0a26_left"
- },
- {
- "id": "994ff325-6f7a-4ebc-b61b-10e15519d6d2",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "startPoint": {
- "x": 1780,
- "y": 3203
- },
- "endPoint": {
- "x": 2000,
- "y": 3200
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3200
- },
- {
- "x": 2000,
- "y": 3200
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_4908_right",
- "targetAnchorId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb_left"
- },
- {
- "id": "19270caf-bb9f-4ba7-9bf8-200aa70fecd5",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "startPoint": {
- "x": 1780,
- "y": 3293.6124999999997
- },
- "endPoint": {
- "x": 2000,
- "y": 3970
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3970
- },
- {
- "x": 2000,
- "y": 3970
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_161_right",
- "targetAnchorId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7_left"
- }
- ]
-}
\ No newline at end of file
diff --git a/apps/application/flow/default_workflow_zh_Hant.json b/apps/application/flow/default_workflow_zh_Hant.json
deleted file mode 100644
index 9cac9a54dc6..00000000000
--- a/apps/application/flow/default_workflow_zh_Hant.json
+++ /dev/null
@@ -1,451 +0,0 @@
-{
- "nodes": [
- {
- "id": "base-node",
- "type": "base-node",
- "x": 360,
- "y": 2810,
- "properties": {
- "config": {
-
- },
- "height": 825.6,
- "stepName": "基本資訊",
- "node_data": {
- "desc": "",
- "name": "maxkbapplication",
- "prologue": "您好,我是 MaxKB 小助手,您可以向我提出 MaxKB 使用問題。\n- MaxKB 主要功能有哪些?\n- MaxKB 支援哪些大型語言模型?\n- MaxKB 支援哪些文件類型?"
- },
- "input_field_list": [
-
- ]
- }
- },
- {
- "id": "start-node",
- "type": "start-node",
- "x": 430,
- "y": 3660,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "用戶問題",
- "value": "question"
- }
- ],
- "globalFields": [
- {
- "label": "當前時間",
- "value": "time"
- }
- ]
- },
- "fields": [
- {
- "label": "用戶問題",
- "value": "question"
- }
- ],
- "height": 276,
- "stepName": "開始",
- "globalFields": [
- {
- "label": "當前時間",
- "value": "time"
- }
- ]
- }
- },
- {
- "id": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "type": "search-dataset-node",
- "x": 840,
- "y": 3210,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "檢索結果的分段列表",
- "value": "paragraph_list"
- },
- {
- "label": "滿足直接回答的分段列表",
- "value": "is_hit_handling_method_list"
- },
- {
- "label": "檢索結果",
- "value": "data"
- },
- {
- "label": "滿足直接回答的分段內容",
- "value": "directly_return"
- }
- ]
- },
- "height": 794,
- "stepName": "知識庫檢索",
- "node_data": {
- "dataset_id_list": [
-
- ],
- "dataset_setting": {
- "top_n": 3,
- "similarity": 0.6,
- "search_mode": "embedding",
- "max_paragraph_char_number": 5000
- },
- "question_reference_address": [
- "start-node",
- "question"
- ],
- "source_dataset_id_list": [
-
- ]
- }
- }
- },
- {
- "id": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "type": "condition-node",
- "x": 1490,
- "y": 3210,
- "properties": {
- "width": 600,
- "config": {
- "fields": [
- {
- "label": "分支名稱",
- "value": "branch_name"
- }
- ]
- },
- "height": 543.675,
- "stepName": "判斷器",
- "node_data": {
- "branch": [
- {
- "id": "1009",
- "type": "IF",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "is_hit_handling_method_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "4908",
- "type": "ELSE IF 1",
- "condition": "and",
- "conditions": [
- {
- "field": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "paragraph_list"
- ],
- "value": "1",
- "compare": "len_ge"
- }
- ]
- },
- {
- "id": "161",
- "type": "ELSE",
- "condition": "and",
- "conditions": [
-
- ]
- }
- ]
- },
- "branch_condition_list": [
- {
- "index": 0,
- "height": 121.225,
- "id": "1009"
- },
- {
- "index": 1,
- "height": 121.225,
- "id": "4908"
- },
- {
- "index": 2,
- "height": 44,
- "id": "161"
- }
- ]
- }
- },
- {
- "id": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "type": "reply-node",
- "x": 2170,
- "y": 2480,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "內容",
- "value": "answer"
- }
- ]
- },
- "height": 378,
- "stepName": "指定回覆",
- "node_data": {
- "fields": [
- "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "directly_return"
- ],
- "content": "",
- "reply_type": "referencing",
- "is_result": true
- }
- }
- },
- {
- "id": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3200,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI 回答內容",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI 對話",
- "node_data": {
- "prompt": "已知資訊:\n{{知識庫檢索.data}}\n問題:\n{{開始.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- },
- {
- "id": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "type": "ai-chat-node",
- "x": 2160,
- "y": 3970,
- "properties": {
- "config": {
- "fields": [
- {
- "label": "AI 回答內容",
- "value": "answer"
- }
- ]
- },
- "height": 763,
- "stepName": "AI 對話1",
- "node_data": {
- "prompt": "{{開始.question}}",
- "system": "",
- "model_id": "",
- "dialogue_number": 0,
- "is_result": true
- }
- }
- }
- ],
- "edges": [
- {
- "id": "7d0f166f-c472-41b2-b9a2-c294f4c83d73",
- "type": "app-edge",
- "sourceNodeId": "start-node",
- "targetNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "startPoint": {
- "x": 590,
- "y": 3660
- },
- "endPoint": {
- "x": 680,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 590,
- "y": 3660
- },
- {
- "x": 700,
- "y": 3660
- },
- {
- "x": 570,
- "y": 3210
- },
- {
- "x": 680,
- "y": 3210
- }
- ],
- "sourceAnchorId": "start-node_right",
- "targetAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_left"
- },
- {
- "id": "35cb86dd-f328-429e-a973-12fd7218b696",
- "type": "app-edge",
- "sourceNodeId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5",
- "targetNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "startPoint": {
- "x": 1000,
- "y": 3210
- },
- "endPoint": {
- "x": 1200,
- "y": 3210
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1000,
- "y": 3210
- },
- {
- "x": 1110,
- "y": 3210
- },
- {
- "x": 1090,
- "y": 3210
- },
- {
- "x": 1200,
- "y": 3210
- }
- ],
- "sourceAnchorId": "b931efe5-5b66-46e0-ae3b-0160cb18eeb5_right",
- "targetAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_left"
- },
- {
- "id": "e8f6cfe6-7e48-41cd-abd3-abfb5304d0d8",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "4ffe1086-25df-4c85-b168-979b5bbf0a26",
- "startPoint": {
- "x": 1780,
- "y": 3073.775
- },
- "endPoint": {
- "x": 2010,
- "y": 2480
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3073.775
- },
- {
- "x": 1890,
- "y": 3073.775
- },
- {
- "x": 1900,
- "y": 2480
- },
- {
- "x": 2010,
- "y": 2480
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_1009_right",
- "targetAnchorId": "4ffe1086-25df-4c85-b168-979b5bbf0a26_left"
- },
- {
- "id": "994ff325-6f7a-4ebc-b61b-10e15519d6d2",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb",
- "startPoint": {
- "x": 1780,
- "y": 3203
- },
- "endPoint": {
- "x": 2000,
- "y": 3200
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3203
- },
- {
- "x": 1890,
- "y": 3200
- },
- {
- "x": 2000,
- "y": 3200
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_4908_right",
- "targetAnchorId": "f1f1ee18-5a02-46f6-b4e6-226253cdffbb_left"
- },
- {
- "id": "19270caf-bb9f-4ba7-9bf8-200aa70fecd5",
- "type": "app-edge",
- "sourceNodeId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b",
- "targetNodeId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7",
- "startPoint": {
- "x": 1780,
- "y": 3293.6124999999997
- },
- "endPoint": {
- "x": 2000,
- "y": 3970
- },
- "properties": {
-
- },
- "pointsList": [
- {
- "x": 1780,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3293.6124999999997
- },
- {
- "x": 1890,
- "y": 3970
- },
- {
- "x": 2000,
- "y": 3970
- }
- ],
- "sourceAnchorId": "fc60863a-dec2-4854-9e5a-7a44b7187a2b_161_right",
- "targetAnchorId": "309d0eef-c597-46b5-8d51-b9a28aaef4c7_left"
- }
- ]
-}
\ No newline at end of file
diff --git a/apps/application/flow/i_step_node.py b/apps/application/flow/i_step_node.py
deleted file mode 100644
index c0fb5e68ef9..00000000000
--- a/apps/application/flow/i_step_node.py
+++ /dev/null
@@ -1,380 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_step_node.py
- @date:2024/6/3 14:57
- @desc:
-"""
-import time
-import uuid
-from abc import abstractmethod
-from hashlib import sha1
-from typing import Type, Dict, List
-
-from django.core import cache
-from django.db.models import QuerySet
-from rest_framework import serializers
-from rest_framework.exceptions import ValidationError, ErrorDetail
-
-from application.flow.common import Answer, NodeChunk
-from application.long_term_memory import extract_long_term_memory
-from application.models import ApplicationChatUserStats
-from application.models import ChatRecord, ChatUserType
-from common.field.common import InstanceField
-from knowledge.models.knowledge_action import KnowledgeAction, State
-from tools.models import ToolRecord
-
-chat_cache = cache
-
-
-def write_context(step_variable: Dict, global_variable: Dict, node, workflow):
- if step_variable is not None:
- for key in step_variable:
- node.context[key] = step_variable[key]
- if workflow.is_result(node, NodeResult(step_variable, global_variable)) and 'answer' in step_variable:
- answer = step_variable['answer']
- yield answer
- node.answer_text = answer
- if global_variable is not None:
- for key in global_variable:
- workflow.context[key] = global_variable[key]
- node.context['run_time'] = time.time() - node.context['start_time']
-
-
-def is_interrupt(node, step_variable: Dict, global_variable: Dict):
- return node.type == 'form-node' and not node.context.get('is_submit', False)
-
-
-class WorkFlowPostHandler:
- def __init__(self, chat_info):
- self.chat_info = chat_info
-
- def handler(self, workflow):
- workflow_body = workflow.get_body()
- question = workflow_body.get('question')
- chat_record_id = workflow_body.get('chat_record_id')
- chat_id = workflow_body.get('chat_id')
- details = workflow.get_runtime_details()
- message_tokens = sum([row.get('message_tokens') for row in details.values() if
- 'message_tokens' in row and row.get('message_tokens') is not None])
- answer_tokens = sum([row.get('answer_tokens') for row in details.values() if
- 'answer_tokens' in row and row.get('answer_tokens') is not None])
- answer_text_list = workflow.get_answer_text_list()
- answer_text = '\n\n'.join(
- '\n\n'.join([a.get('content') for a in answer]) for answer in
- answer_text_list)
- if workflow.chat_record is not None:
- chat_record = workflow.chat_record
- chat_record.problem_text = question
- chat_record.answer_text = answer_text
- chat_record.details = details
- chat_record.message_tokens = message_tokens
- chat_record.answer_tokens = answer_tokens
- chat_record.answer_text_list = answer_text_list
- chat_record.run_time = time.time() - workflow.context['start_time']
- else:
- chat_record = ChatRecord(id=chat_record_id,
- chat_id=chat_id,
- problem_text=question,
- answer_text=answer_text,
- details=details,
- message_tokens=message_tokens,
- answer_tokens=answer_tokens,
- answer_text_list=answer_text_list,
- run_time=time.time() - workflow.context.get('start_time') if workflow.context.get(
- 'start_time') is not None else 0,
- index=0,
- ip_address=self.chat_info.ip_address,
- source=self.chat_info.source)
-
- self.chat_info.append_chat_record(chat_record)
- self.chat_info.set_cache()
-
- if not self.chat_info.debug and [ChatUserType.ANONYMOUS_USER.value, ChatUserType.CHAT_USER.value].__contains__(
- workflow_body.get('chat_user_type')):
- application_public_access_client = (QuerySet(ApplicationChatUserStats)
- .filter(chat_user_id=workflow_body.get('chat_user_id'),
- chat_user_type=workflow_body.get('chat_user_type'),
- application_id=self.chat_info.application_id).first())
- if application_public_access_client is not None:
- application_public_access_client.access_num = application_public_access_client.access_num + 1
- application_public_access_client.intraday_access_num = application_public_access_client.intraday_access_num + 1
- application_public_access_client.save()
- self.chat_info = None
-
- extract_long_term_memory.apply_async(
- args=(
- workflow_body.get('workspace_id'),
- workflow_body.get('application_id'),
- workflow_body.get('chat_user_id'),
- ),
- countdown=1,
- )
-
-
-class KnowledgeWorkflowPostHandler(WorkFlowPostHandler):
- def __init__(self, chat_info, knowledge_action_id):
- super().__init__(chat_info)
- self.knowledge_action_id = knowledge_action_id
-
- def handler(self, workflow):
- state = get_workflow_state(workflow)
- QuerySet(KnowledgeAction).filter(id=self.knowledge_action_id).update(
- state=state,
- run_time=time.time() - workflow.context.get('start_time') if workflow.context.get(
- 'start_time') is not None else 0)
-
-
-def get_tool_workflow_state(workflow):
- if workflow.is_the_task_interrupted():
- return State.REVOKED
- details = workflow.get_runtime_details()
- node_list = details.values()
- all_node = [*node_list, *get_loop_workflow_node(node_list)]
- err = any([True for value in all_node if value.get('status') == 500 and not value.get('enableException')])
- if err:
- return State.FAILURE
- return State.SUCCESS
-
-
-class ToolWorkflowCallPostHandler(WorkFlowPostHandler):
- def __init__(self, chat_info, tool_id):
- super().__init__(chat_info)
- self.tool_id = tool_id
-
- def handler(self, workflow):
- self.chat_info = None
- self.tool_id = None
-
-
-class ToolWorkflowPostHandler(WorkFlowPostHandler):
- def __init__(self, chat_info, tool_id):
- super().__init__(chat_info)
- self.tool_id = tool_id
-
- def handler(self, workflow):
- state = get_tool_workflow_state(workflow)
- record = ToolRecord(id=self.chat_info.tool_record_id, tool_id=self.tool_id,
- workspace_id=self.chat_info.workspace_id,
- source_type=self.chat_info.source_type,
- source_id=self.chat_info.source_id,
- state=state,
- run_time=time.time() - workflow.context.get('start_time') if workflow.context.get(
- 'start_time') is not None else 0,
- meta={
- 'input_field_list': workflow.get_input_field_list(),
- 'output_field_list': workflow.get_output_field_list(),
- 'input': workflow.get_input(),
- 'output': workflow.out_context,
- 'details': workflow.get_runtime_details(),
- 'answer_text_list': workflow.get_answer_text_list()
- })
- self.chat_info.set_record(record)
- self.chat_info = None
- self.tool_id = None
-
-
-def get_loop_workflow_node(node_list):
- result = []
- for item in node_list:
- if item.get('type') == 'loop-node':
- for loop_item in item.get('loop_node_data') or []:
- for inner_item in loop_item.values():
- result.append(inner_item)
- return result
-
-
-def get_workflow_state(workflow):
- if workflow.is_the_task_interrupted():
- return State.REVOKED
- details = workflow.get_runtime_details()
- node_list = details.values()
- all_node = [*node_list, *get_loop_workflow_node(node_list)]
- err = any([True for value in all_node if value.get('status') == 500 and not value.get('enableException')])
- if err:
- return State.FAILURE
- write_is_exist = any([True for value in all_node if value.get('type') == 'knowledge-write-node'])
- if not write_is_exist:
- return State.FAILURE
- return State.SUCCESS
-
-
-class NodeResult:
- def __init__(self, node_variable: Dict, workflow_variable: Dict,
- _write_context=write_context, _is_interrupt=is_interrupt):
- self._write_context = _write_context
- self.node_variable = node_variable
- self.workflow_variable = workflow_variable
- self._is_interrupt = _is_interrupt
-
- def write_context(self, node, workflow):
- return self._write_context(self.node_variable, self.workflow_variable, node, workflow)
-
- def is_assertion_result(self):
- return 'branch_id' in self.node_variable
-
- def is_interrupt_exec(self, current_node):
- """
- 是否中断执行
- @param current_node:
- @return:
- """
- return self._is_interrupt(current_node, self.node_variable, self.workflow_variable)
-
-
-class ReferenceAddressSerializer(serializers.Serializer):
- node_id = serializers.CharField(required=True, label="节点id")
- fields = serializers.ListField(
- child=serializers.CharField(required=True, label="节点字段"), required=True,
- label="节点字段数组")
-
-
-class FlowParamsSerializer(serializers.Serializer):
- # 历史对答
- history_chat_record = serializers.ListField(child=InstanceField(model_type=ChatRecord, required=True),
- label="历史对答")
-
- question = serializers.CharField(required=True, label="用户问题")
-
- chat_id = serializers.CharField(required=True, label="对话id")
-
- chat_record_id = serializers.CharField(required=True, label="对话记录id")
-
- stream = serializers.BooleanField(required=True, label="流式输出")
-
- chat_user_id = serializers.CharField(required=False, label="对话用户id")
-
- chat_user_type = serializers.CharField(required=False, label="对话用户类型")
-
- workspace_id = serializers.CharField(required=True, label="工作空间id")
-
- application_id = serializers.CharField(required=True, label="应用id")
-
- re_chat = serializers.BooleanField(required=True, label="换个答案")
-
- debug = serializers.BooleanField(required=True, label="是否debug")
-
-
-class KnowledgeFlowParamsSerializer(serializers.Serializer):
- knowledge_id = serializers.UUIDField(required=True, label="知识库id")
- workspace_id = serializers.CharField(required=True, label="工作空间id")
- knowledge_action_id = serializers.UUIDField(required=True, label="知识库任务执行器id")
- data_source = serializers.DictField(required=True, label="数据源")
- knowledge_base = serializers.DictField(required=False, label="知识库设置")
- user_id = serializers.UUIDField(required=False, label="创建人")
-
-
-class ToolFlowParamsSerializer(serializers.Serializer):
- tool_id = serializers.UUIDField(required=True, label="工具id")
- workspace_id = serializers.CharField(required=True, label="工作空间id")
-
-
-class INode:
- view_type = 'many_view'
-
- @abstractmethod
- def save_context(self, details, workflow_manage):
- pass
-
- def get_answer_list(self) -> List[Answer] | None:
- if self.answer_text is None:
- return None
- reasoning_content_enable = self.context.get('model_setting', {}).get('reasoning_content_enable', False)
- return [
- Answer(self.answer_text, self.view_type, self.runtime_node_id, self.workflow_params.get('chat_record_id'),
- {},
- self.runtime_node_id, self.context.get('reasoning_content', '') if reasoning_content_enable else '')]
-
- def __init__(self, node, workflow_params, workflow_manage, up_node_id_list=None,
- get_node_params=lambda node: node.properties.get('node_data'), salt=None):
- # 当前步骤上下文,用于存储当前步骤信息
- self.status = 200
- self.err_message = ''
- self.node = node
- self.node_params = get_node_params(node)
- self.workflow_params = workflow_params
- self.workflow_manage = workflow_manage
- self.node_params_serializer = None
- self.flow_params_serializer = None
- self.context = {}
- self.answer_text = None
- self.id = node.id
- if up_node_id_list is None:
- up_node_id_list = []
- self.up_node_id_list = up_node_id_list
- self.node_chunk = NodeChunk()
- self.runtime_node_id = sha1(uuid.NAMESPACE_DNS.bytes + bytes(str(uuid.uuid5(uuid.NAMESPACE_DNS,
- "".join([*sorted(up_node_id_list),
- node.id]))),
- "utf-8")).hexdigest() + (
- "__" + str(salt) if salt is not None else '')
- self.extra = {}
-
- def valid_args(self, node_params, flow_params):
- flow_params_serializer_class = self.get_flow_params_serializer_class()
- node_params_serializer_class = self.get_node_params_serializer_class()
- if flow_params_serializer_class is not None and flow_params is not None:
- self.flow_params_serializer = flow_params_serializer_class(data=flow_params)
- self.flow_params_serializer.is_valid(raise_exception=True)
- if node_params_serializer_class is not None:
- self.node_params_serializer = node_params_serializer_class(data=node_params)
- self.node_params_serializer.is_valid(raise_exception=True)
- if self.node.properties.get('status', 200) != 200:
- raise ValidationError(ErrorDetail(f'节点{self.node.properties.get("stepName")} 不可用'))
-
- def get_reference_field(self, fields: List[str]):
- return self.get_field(self.context, fields)
-
- @staticmethod
- def get_field(obj, fields: List[str]):
- for field in fields:
- value = obj.get(field)
- if value is None:
- return None
- else:
- obj = value
- return obj
-
- @abstractmethod
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- pass
-
- def get_flow_params_serializer_class(self) -> Type[serializers.Serializer]:
- return self.workflow_manage.get_params_serializer_class()
-
- def get_write_error_context(self, e):
- self.status = 500
- self.answer_text = str(e)
- self.err_message = str(e)
- current_time = time.time()
- self.context['run_time'] = current_time - (self.context.get('start_time') or current_time)
-
- def write_error_context(answer, status=200):
- pass
-
- return write_error_context
-
- def run(self) -> NodeResult:
- """
- :return: 执行结果
- """
- start_time = time.time()
- self.context['start_time'] = start_time
- result = self._run()
- self.context['run_time'] = time.time() - start_time
- return result
-
- def _run(self):
- result = self.execute()
- return result
-
- def execute(self, **kwargs) -> NodeResult:
- pass
-
- def get_details(self, index: int, **kwargs):
- """
- 运行详情
- :return: 步骤详情
- """
- return {}
diff --git a/apps/application/flow/knowledge_loop_workflow_manage.py b/apps/application/flow/knowledge_loop_workflow_manage.py
deleted file mode 100644
index 31d3ab4df25..00000000000
--- a/apps/application/flow/knowledge_loop_workflow_manage.py
+++ /dev/null
@@ -1,21 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: workflow_manage.py
- @date:2024/1/9 17:40
- @desc:
-"""
-from application.flow.i_step_node import KnowledgeFlowParamsSerializer
-from application.flow.loop_workflow_manage import LoopWorkflowManage
-
-
-class KnowledgeLoopWorkflowManage(LoopWorkflowManage):
- def get_params_serializer_class(self):
- return KnowledgeFlowParamsSerializer
-
- def get_source_type(self):
- return "KNOWLEDGE"
-
- def get_source_id(self):
- return self.params.get('knowledge_id')
diff --git a/apps/application/flow/knowledge_workflow_manage.py b/apps/application/flow/knowledge_workflow_manage.py
deleted file mode 100644
index 98212c9ee5a..00000000000
--- a/apps/application/flow/knowledge_workflow_manage.py
+++ /dev/null
@@ -1,130 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: Knowledge_workflow_manage.py
- @date:2025/11/13 19:02
- @desc:
-"""
-import time
-import traceback
-from concurrent.futures import ThreadPoolExecutor
-
-from django.db.models import QuerySet
-from django.utils.translation import get_language
-
-from application.flow.common import Workflow
-from application.flow.i_step_node import WorkFlowPostHandler, KnowledgeFlowParamsSerializer, NodeResult
-from application.flow.workflow_manage import WorkflowManage
-from common.handle.base_to_response import BaseToResponse
-from common.handle.impl.response.system_to_response import SystemToResponse
-from knowledge.models.knowledge_action import KnowledgeAction, State
-
-executor = ThreadPoolExecutor(max_workers=200)
-
-
-class KnowledgeWorkflowManage(WorkflowManage):
-
- def __init__(self, flow: Workflow,
- params,
- work_flow_post_handler: WorkFlowPostHandler,
- base_to_response: BaseToResponse = SystemToResponse(),
- start_node_id=None,
- start_node_data=None, chat_record=None, child_node=None, is_the_task_interrupted=lambda: False):
- super().__init__(flow, params, work_flow_post_handler, base_to_response, None, None, None,
- None,
- None, None, start_node_id, start_node_data, chat_record, child_node, is_the_task_interrupted)
-
- def get_params_serializer_class(self):
- return KnowledgeFlowParamsSerializer
-
- def get_start_node(self):
- start_node_list = [node for node in self.flow.nodes if
- self.params.get('data_source', {}).get('node_id') == node.id]
- return start_node_list[0]
-
- def run(self):
- self.context['start_time'] = time.time()
- executor.submit(self._run)
-
- def _run(self):
- QuerySet(KnowledgeAction).filter(id=self.params.get('knowledge_action_id')).update(
- state=State.STARTED)
- language = get_language()
- self.run_chain_async(self.start_node, None, language)
- while self.is_run():
- pass
- self.work_flow_post_handler.handler(self)
-
- @staticmethod
- def get_node_details(current_node, node, index):
- if current_node == node:
- return {
- 'name': node.node.properties.get('stepName'),
- "index": index,
- 'run_time': 0,
- 'type': node.type,
- 'status': 202,
- 'err_message': ""
- }
-
- return node.get_details(index)
-
- def run_chain(self, current_node, node_result_future=None):
- QuerySet(KnowledgeAction).filter(id=self.params.get('knowledge_action_id')).update(
- details=self.get_runtime_details(lambda node, index: self.get_node_details(current_node, node, index)))
- if node_result_future is None:
- node_result_future = self.run_node_future(current_node)
- try:
- result = self.hand_node_result(current_node, node_result_future)
- return result
- except Exception as e:
- traceback.print_exc()
- return None
-
- def hand_node_result(self, current_node, node_result_future):
- try:
- current_result = node_result_future.result()
- result = current_result.write_context(current_node, self)
- if result is not None:
- # 阻塞获取结果
- list(result)
- if current_node.status == 500:
- enableException = current_node.node.properties.get('enableException')
- if not enableException:
- return None
- current_node.context['exception_message'] = current_node.err_message
- current_node.context['branch_id'] = 'exception'
- r = NodeResult({'branch_id': 'exception', 'exception': current_node.err_message}, {},
- _is_interrupt=lambda node, step_variable, global_variable: False)
- r.write_context(current_node, self)
- return r
- if self.is_the_task_interrupted():
- current_node.status = 201
- return None
- return current_result
- except Exception as e:
- traceback.print_exc()
- self.status = 500
- current_node.get_write_error_context(e)
- self.answer += str(e)
- if self.is_the_task_interrupted():
- current_node.status = 201
- return None
- enableException = current_node.node.properties.get('enableException')
- if enableException:
- current_node.context['exception_message'] = current_node.err_message
- current_node.context['branch_id'] = 'exception'
- return NodeResult({'branch_id': 'exception', 'exception': current_node.err_message}, {},
- _is_interrupt=lambda node, step_variable, global_variable: False)
- QuerySet(KnowledgeAction).filter(id=self.params.get('knowledge_action_id')).update(state=State.FAILURE)
- finally:
- current_node.node_chunk.end()
- QuerySet(KnowledgeAction).filter(id=self.params.get('knowledge_action_id')).update(
- details=self.get_runtime_details())
-
- def get_source_type(self):
- return "KNOWLEDGE"
-
- def get_source_id(self):
- return self.params.get('knowledge_id')
diff --git a/apps/application/flow/loop_workflow_manage.py b/apps/application/flow/loop_workflow_manage.py
deleted file mode 100644
index c236b15dcc5..00000000000
--- a/apps/application/flow/loop_workflow_manage.py
+++ /dev/null
@@ -1,199 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: workflow_manage.py
- @date:2024/1/9 17:40
- @desc:
-"""
-from concurrent.futures import ThreadPoolExecutor
-from typing import List
-
-from django.db import close_old_connections
-from django.utils.translation import get_language
-from langchain_core.prompts import PromptTemplate
-
-from application.flow.common import Workflow
-from application.flow.i_step_node import WorkFlowPostHandler, INode
-from application.flow.step_node import get_node
-from application.flow.workflow_manage import WorkflowManage
-from common.handle.base_to_response import BaseToResponse
-from common.handle.impl.response.system_to_response import SystemToResponse
-
-executor = ThreadPoolExecutor(max_workers=200)
-
-
-class NodeResultFuture:
- def __init__(self, r, e, status=200):
- self.r = r
- self.e = e
- self.status = status
-
- def result(self):
- if self.status == 200:
- return self.r
- else:
- raise self.e
-
-
-def await_result(result, timeout=1):
- try:
- result.result(timeout)
- return False
- except Exception as e:
- return True
-
-
-class NodeChunkManage:
-
- def __init__(self, work_flow):
- self.node_chunk_list = []
- self.current_node_chunk = None
- self.work_flow = work_flow
-
- def add_node_chunk(self, node_chunk):
- self.node_chunk_list.append(node_chunk)
-
- def contains(self, node_chunk):
- return self.node_chunk_list.__contains__(node_chunk)
-
- def pop(self):
- if self.current_node_chunk is None:
- try:
- current_node_chunk = self.node_chunk_list.pop(0)
- self.current_node_chunk = current_node_chunk
- except IndexError as e:
- pass
- if self.current_node_chunk is not None:
- try:
- chunk = self.current_node_chunk.chunk_list.pop(0)
- return chunk
- except IndexError as e:
- if self.current_node_chunk.is_end():
- self.current_node_chunk = None
- if self.work_flow.answer_is_not_empty():
- chunk = self.work_flow.base_to_response.to_stream_chunk_response(
- self.work_flow.params['chat_id'],
- self.work_flow.params['chat_record_id'],
- '\n\n', False, 0, 0)
- self.work_flow.append_answer('\n\n')
- return chunk
- return self.pop()
- return None
-
-
-class LoopWorkflowManage(WorkflowManage):
-
- def __init__(self, flow: Workflow,
- params,
- work_flow_post_handler: WorkFlowPostHandler,
- parentWorkflowManage,
- loop_params,
- get_loop_context,
- base_to_response: BaseToResponse = SystemToResponse(),
- start_node_id=None,
- start_node_data=None, chat_record=None, child_node=None, is_the_task_interrupted=lambda: False):
- self.parentWorkflowManage = parentWorkflowManage
- self.loop_params = loop_params
- self.get_loop_context = get_loop_context
- self.loop_field_list = []
- super().__init__(flow, params, work_flow_post_handler, base_to_response, None, None, None,
- None,
- None, None, start_node_id, start_node_data, chat_record, child_node, is_the_task_interrupted)
-
- def get_node_cls_by_id(self, node_id, up_node_id_list=None,
- get_node_params=lambda node: node.properties.get('node_data')):
- for node in self.flow.nodes:
- if node.id == node_id:
- node_instance = get_node(node.type, self.flow.workflow_mode)(node,
- self.params, self, up_node_id_list,
- get_node_params,
- salt=self.get_index())
- return node_instance
- return None
-
- def stream(self):
- close_old_connections()
- language = get_language()
- self.run_chain_async(self.start_node, None, language)
- return self.await_result(is_cleanup=False)
-
- def get_index(self):
- return self.loop_params.get('index')
-
- def get_start_node(self):
- start_node_list = [node for node in self.flow.nodes if
- ['loop-start-node'].__contains__(node.type)]
- return start_node_list[0]
-
- def get_reference_field(self, node_id: str, fields: List[str]):
- """
- @param node_id: 节点id
- @param fields: 字段
- @return:
- """
- if node_id == 'global':
- return self.parentWorkflowManage.get_reference_field(node_id, fields)
- elif node_id == 'chat':
- return self.parentWorkflowManage.get_reference_field(node_id, fields)
- elif node_id == 'loop':
- loop_context = self.get_loop_context()
- return INode.get_field(loop_context, fields)
- else:
- node = self.get_node_by_id(node_id)
- if node:
- return node.get_reference_field(fields)
- return self.parentWorkflowManage.get_reference_field(node_id, fields)
-
- def get_workflow_content(self):
- context = {
- 'global': self.context,
- 'chat': self.chat_context,
- 'loop': self.get_loop_context(),
- }
-
- for node in self.node_context:
- context[node.id] = node.context
- return context
-
- def init_fields(self):
- super().init_fields()
- loop_field_list = []
- loop_start_node = self.flow.get_node('loop-start-node')
- loop_input_field_list = loop_start_node.properties.get('loop_input_field_list')
- node_name = loop_start_node.properties.get('stepName')
- node_id = loop_start_node.id
- if loop_input_field_list is not None:
- for f in loop_input_field_list:
- loop_field_list.append(
- {'label': f.get('label'), 'value': f.get('field'), 'node_id': node_id, 'node_name': node_name})
- self.loop_field_list = loop_field_list
-
- def reset_prompt(self, prompt: str):
- prompt = super().reset_prompt(prompt)
- for field in self.loop_field_list:
- chatLabel = f"loop.{field.get('value')}"
- chatValue = f"context.get('loop').get('{field.get('value', '')}','')"
- prompt = prompt.replace(chatLabel, chatValue)
-
- prompt = self.parentWorkflowManage.reset_prompt(prompt)
- return prompt
-
- def generate_prompt(self, prompt: str):
- """
- 格式化生成提示词
- @param prompt: 提示词信息
- @return: 格式化后的提示词
- """
-
- context = {**self.get_workflow_content(), **self.parentWorkflowManage.get_workflow_content()}
- prompt = self.reset_prompt(prompt)
- prompt_template = PromptTemplate.from_template(prompt, template_format='jinja2')
- value = prompt_template.format(context=context)
- return value
-
- def get_source_type(self):
- return "APPLICATION"
-
- def get_source_id(self):
- return self.params.get('application_id')
diff --git a/apps/application/flow/step_node/__init__.py b/apps/application/flow/step_node/__init__.py
deleted file mode 100644
index 4c38020771e..00000000000
--- a/apps/application/flow/step_node/__init__.py
+++ /dev/null
@@ -1,63 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/6/7 14:43
- @desc:
-"""
-from .ai_chat_step_node import *
-from .application_node import BaseApplicationNode
-from .condition_node import *
-from .data_source_local_node.impl.base_data_source_local_node import BaseDataSourceLocalNode
-from .data_source_web_node.impl.base_data_source_web_node import BaseDataSourceWebNode
-from .direct_reply_node import *
-from .document_extract_node import *
-from .form_node import *
-from .image_generate_step_node import *
-from .image_to_video_step_node import BaseImageToVideoNode
-from .image_understand_step_node import *
-from .intent_node import *
-from .knowledge_write_node.impl.base_knowledge_write_node import BaseKnowledgeWriteNode
-from .loop_break_node import BaseLoopBreakNode
-from .loop_continue_node import BaseLoopContinueNode
-from .loop_node import *
-from .loop_start_node import *
-from .mcp_node import BaseMcpNode
-from .parameter_extraction_node import BaseParameterExtractionNode
-from .question_node import *
-from .reranker_node import *
-from .search_document_node import BaseSearchDocumentNode
-from .search_knowledge_node import *
-from .speech_to_text_step_node import BaseSpeechToTextNode
-from .start_node import *
-from .text_to_speech_step_node.impl.base_text_to_speech_node import BaseTextToSpeechNode
-from .text_to_video_step_node.impl.base_text_to_video_node import BaseTextToVideoNode
-from .tool_lib_node import *
-from .tool_node import *
-from .tool_workflow_lib_node import BaseToolWorkflowLibNodeNode
-from .variable_aggregation_node.impl.base_variable_aggregation_node import BaseVariableAggregationNode
-from .variable_assign_node import BaseVariableAssignNode
-from .variable_splitting_node import BaseVariableSplittingNode
-from .video_understand_step_node import BaseVideoUnderstandNode
-from .document_split_node import BaseDocumentSplitNode
-from .tool_start_node import BaseToolStartStepNode
-
-node_list = [BaseStartStepNode, BaseChatNode, BaseSearchKnowledgeNode, BaseSearchDocumentNode, BaseQuestionNode,
- BaseConditionNode, BaseReplyNode,
- BaseToolNodeNode, BaseToolLibNodeNode, BaseRerankerNode, BaseApplicationNode,
- BaseDocumentExtractNode,
- BaseImageUnderstandNode, BaseFormNode, BaseSpeechToTextNode, BaseTextToSpeechNode,
- BaseImageGenerateNode, BaseVariableAssignNode, BaseMcpNode, BaseTextToVideoNode, BaseImageToVideoNode,
- BaseVideoUnderstandNode,
- BaseIntentNode, BaseLoopNode, BaseLoopStartStepNode,
- BaseLoopContinueNode,
- BaseLoopBreakNode, BaseVariableSplittingNode, BaseParameterExtractionNode, BaseVariableAggregationNode,
- BaseDataSourceLocalNode, BaseDataSourceWebNode, BaseKnowledgeWriteNode, BaseDocumentSplitNode,
- BaseToolStartStepNode, BaseToolWorkflowLibNodeNode]
-
-node_map = {n.type: {w: n for w in n.support} for n in node_list}
-
-
-def get_node(node_type, workflow_model):
- return node_map.get(node_type).get(workflow_model)
diff --git a/apps/application/flow/step_node/ai_chat_step_node/__init__.py b/apps/application/flow/step_node/ai_chat_step_node/__init__.py
deleted file mode 100644
index 1929ae2af49..00000000000
--- a/apps/application/flow/step_node/ai_chat_step_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:29
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/ai_chat_step_node/i_chat_node.py b/apps/application/flow/step_node/ai_chat_step_node/i_chat_node.py
deleted file mode 100644
index 0483c9cb5e7..00000000000
--- a/apps/application/flow/step_node/ai_chat_step_node/i_chat_node.py
+++ /dev/null
@@ -1,92 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_chat_node.py
- @date:2024/6/4 13:58
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class ChatNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- system = serializers.CharField(required=False, allow_blank=True, allow_null=True,
- label=_("Role Setting"))
- prompt = serializers.CharField(required=True, label=_("Prompt word"))
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- model_params_setting = serializers.DictField(required=False,
- label=_("Model parameter settings"))
- model_setting = serializers.DictField(required=False,
- label='Model settings')
- dialogue_type = serializers.CharField(required=False, allow_blank=True, allow_null=True,
- label=_("Context Type"))
- mcp_servers = serializers.JSONField(required=False, label=_("MCP Server"))
- mcp_tool_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("MCP Tool ID"))
- mcp_tool_ids = serializers.ListField(child=serializers.UUIDField(), required=False, allow_empty=True,
- label=_("MCP Tool IDs"), )
- mcp_source = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("MCP Source"))
-
- tool_ids = serializers.ListField(child=serializers.UUIDField(), required=False, allow_empty=True,
- label=_("Tool IDs"), )
- application_ids = serializers.ListField(child=serializers.UUIDField(), required=False, allow_empty=True,
- label=_("App IDs"), )
- skill_tool_ids = serializers.ListField(child=serializers.UUIDField(), required=False, allow_empty=True,
- label=_("Skill IDs"), )
- mcp_output_enable = serializers.BooleanField(required=False, default=True, label=_("Whether to enable MCP output"))
-
- video_list = serializers.ListField(required=False, label=_("video"))
-
- image_list = serializers.ListField(required=False, label=_("picture"))
-
- vision = serializers.BooleanField(required=False, default=False, label=_("vision"))
-
-
-class IChatNode(INode):
- type = 'ai-chat-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP,
- WorkflowMode.KNOWLEDGE, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ChatNodeSerializer
-
- def _run(self):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, system, prompt, dialogue_number, history_chat_record, stream, chat_id,
- chat_record_id,
- model_params_setting=None,
- model_id_type=None,
- model_id_reference=None,
- dialogue_type=None,
- model_setting=None,
- mcp_servers=None,
- mcp_tool_id=None,
- mcp_tool_ids=None,
- mcp_source=None,
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- mcp_output_enable=True,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/ai_chat_step_node/impl/__init__.py b/apps/application/flow/step_node/ai_chat_step_node/impl/__init__.py
deleted file mode 100644
index 79051a999fb..00000000000
--- a/apps/application/flow/step_node/ai_chat_step_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:34
- @desc:
-"""
-from .base_chat_node import BaseChatNode
diff --git a/apps/application/flow/step_node/ai_chat_step_node/impl/base_chat_node.py b/apps/application/flow/step_node/ai_chat_step_node/impl/base_chat_node.py
deleted file mode 100644
index 5e2b94ade0c..00000000000
--- a/apps/application/flow/step_node/ai_chat_step_node/impl/base_chat_node.py
+++ /dev/null
@@ -1,500 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_question_node.py
- @date:2024/6/4 14:30
- @desc:
-"""
-import base64
-import json
-import re
-import time
-from functools import reduce
-from imghdr import what
-from typing import List, Dict
-
-from django.db.models import QuerySet
-from django.utils.translation import gettext as _
-from langchain_core.messages import BaseMessage, AIMessage, HumanMessage, SystemMessage
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult, INode
-from application.flow.step_node.ai_chat_step_node.i_chat_node import IChatNode
-from application.flow.tools import Reasoning, mcp_response_generator, get_tools
-from application.models import Application, ApplicationApiKey, ApplicationAccessToken
-from common.exception.app_exception import AppApiException
-from common.utils.rsa_util import rsa_long_decrypt
-from common.utils.shared_resource_auth import filter_authorized_ids
-from common.utils.tool_code import ToolExecutor
-from knowledge.models import File
-from models_provider.models import Model
-from models_provider.tools import get_model_credential, get_model_instance_by_model_workspace_id
-from tools.models import Tool, ToolType
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str,
- reasoning_content: str):
- chat_model = node_variable.get('chat_model')
- message_tokens = chat_model.get_num_tokens_from_messages(node_variable.get('message_list'))
- answer_tokens = chat_model.get_num_tokens(answer)
- node.context['message_tokens'] = message_tokens
- node.context['answer_tokens'] = answer_tokens
- node.context['answer'] = answer
- node.context['question'] = node_variable['question']
- node.context['run_time'] = time.time() - node.context['start_time']
- node.context['reasoning_content'] = reasoning_content
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- answer = ''
- reasoning_content = ''
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start', ''),
- model_setting.get('reasoning_content_end', ''))
- response_reasoning_content = False
-
- for chunk in response:
- if workflow.is_the_task_interrupted():
- break
- reasoning_chunk = reasoning.get_reasoning_content(chunk)
- content_chunk = reasoning_chunk.get('content')
- if 'reasoning_content' in chunk.additional_kwargs:
- response_reasoning_content = True
- reasoning_content_chunk = chunk.additional_kwargs.get('reasoning_content', '')
- else:
- reasoning_content_chunk = reasoning_chunk.get('reasoning_content')
- answer += content_chunk
- if reasoning_content_chunk is None:
- reasoning_content_chunk = ''
- reasoning_content += reasoning_content_chunk
- yield {'content': content_chunk,
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
-
- reasoning_chunk = reasoning.get_end_reasoning_content()
- answer += reasoning_chunk.get('content')
- reasoning_content_chunk = ""
- if not response_reasoning_content:
- reasoning_content_chunk = reasoning_chunk.get(
- 'reasoning_content')
- yield {'content': reasoning_chunk.get('content'),
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
- _write_context(node_variable, workflow_variable, node, workflow, answer, reasoning_content)
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点实例对象
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start'), model_setting.get('reasoning_content_end'))
- reasoning_result = reasoning.get_reasoning_content(response)
- reasoning_result_end = reasoning.get_end_reasoning_content()
- content = reasoning_result.get('content') + reasoning_result_end.get('content')
- meta = {**response.response_metadata, **response.additional_kwargs}
- if 'reasoning_content' in meta:
- reasoning_content = (meta.get('reasoning_content', '') or '')
- else:
- reasoning_content = (reasoning_result.get('reasoning_content') or '') + (
- reasoning_result_end.get('reasoning_content') or '')
- _write_context(node_variable, workflow_variable, node, workflow, content, reasoning_content)
-
-
-def get_default_model_params_setting(model_id):
- model = QuerySet(Model).filter(id=model_id).first()
- credential = get_model_credential(model.provider, model.model_type, model.model_name)
- model_params_setting = credential.get_model_params_setting_form(
- model.model_name).get_default_form_data()
- return model_params_setting
-
-
-def get_node_message(chat_record, runtime_node_id):
- node_details = chat_record.get_node_details_runtime_node_id(runtime_node_id)
- if node_details is None:
- return []
- return [HumanMessage(node_details.get('question')), AIMessage(node_details.get('answer'))]
-
-
-def get_workflow_message(chat_record):
- return [chat_record.get_human_message(), chat_record.get_ai_message()]
-
-
-def get_message(chat_record, dialogue_type, runtime_node_id):
- return get_node_message(chat_record, runtime_node_id) if dialogue_type == 'NODE' else get_workflow_message(
- chat_record)
-
-
-class BaseChatNode(IChatNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['question'] = details.get('question')
- self.context['reasoning_content'] = details.get('reasoning_content')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, system, prompt, dialogue_number, history_chat_record, stream, chat_id, chat_record_id,
- model_params_setting=None,
- model_id_type=None,
- model_id_reference=None,
- dialogue_type=None,
- model_setting=None,
- mcp_servers=None,
- mcp_tool_id=None,
- mcp_tool_ids=None,
- mcp_source=None,
- tool_ids=None,
- application_ids=None,
- skill_tool_ids=None,
- mcp_output_enable=True,
- **kwargs) -> NodeResult:
- if dialogue_type is None:
- dialogue_type = 'WORKFLOW'
-
- if model_id_type == 'reference' and model_id_reference:
-
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
-
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
- if model_id is None or model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
-
- if model_params_setting is None and model_id:
- model_params_setting = get_default_model_params_setting(model_id)
-
- if model_setting is None:
- model_setting = {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''}
- self.context['model_setting'] = model_setting
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- history_message = self.get_history_message(history_chat_record, dialogue_number, dialogue_type,
- self.runtime_node_id)
- self.context['history_message'] = [{'content': message.content, 'role': message.type} for message in
- (history_message if history_message is not None else [])]
- question = self.generate_prompt_question(prompt, chat_model)
- self.context['question'] = question.content
- system = self.workflow_manage.generate_prompt(system)
- self.context['system'] = system
- message_list = self.generate_message_list(question, history_message)
- self.context['message_list'] = message_list
-
- # 过滤tool_id
- all_tool_ids = list(set(
- (mcp_tool_ids or []) +
- (tool_ids or []) +
- (skill_tool_ids or []) +
- ([mcp_tool_id] if mcp_tool_id else [])
- ))
- authorized_set = set(filter_authorized_ids('tool', all_tool_ids, workspace_id))
-
- mcp_tool_ids = [i for i in (mcp_tool_ids or []) if i in authorized_set]
- tool_ids = [i for i in (tool_ids or []) if i in authorized_set]
- skill_tool_ids = [i for i in (skill_tool_ids or []) if i in authorized_set]
- mcp_tool_id = mcp_tool_id if (mcp_tool_id and mcp_tool_id in authorized_set) else None
- # 处理 MCP 请求
- mcp_result = self._handle_mcp_request(
- mcp_source, mcp_servers, mcp_tool_id, mcp_tool_ids, tool_ids,
- application_ids, skill_tool_ids, mcp_output_enable,
- chat_model, SystemMessage(system), message_list, history_message, question, chat_id, workspace_id
- )
- if mcp_result:
- return mcp_result
- message_list = [SystemMessage(system)] + message_list
- if stream:
- r = chat_model.stream(message_list)
- return NodeResult({'result': r, 'chat_model': chat_model, 'message_list': message_list,
- 'question': question.content}, {},
- _write_context=write_context_stream)
- else:
- r = chat_model.invoke(message_list)
- return NodeResult({'result': r, 'chat_model': chat_model, 'message_list': message_list,
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (history_message if history_message is not None else [])],
- 'question': question.content}, {},
- _write_context=write_context)
-
- def _handle_mcp_request(self, mcp_source, mcp_servers, mcp_tool_id, mcp_tool_ids, tool_ids,
- application_ids, skill_tool_ids,
- mcp_output_enable, chat_model, system_prompt, message_list, history_message, question,
- chat_id, workspace_id):
-
- mcp_servers_config = {}
-
- # 迁移过来mcp_source是None
- if mcp_source is None:
- mcp_source = 'custom'
- # 兼容老数据
- if not mcp_tool_ids:
- mcp_tool_ids = []
- if mcp_tool_id:
- mcp_tool_ids = list(set(mcp_tool_ids + [mcp_tool_id]))
- if mcp_source == 'custom' and mcp_servers:
- mcp_servers_config = json.loads(mcp_servers)
- mcp_servers_config = self.handle_variables(mcp_servers_config)
- elif mcp_tool_ids:
- mcp_tools = QuerySet(Tool).filter(id__in=mcp_tool_ids).values()
- for mcp_tool in mcp_tools:
- if mcp_tool and mcp_tool['is_active']:
- mcp_servers_config = {**mcp_servers_config, **json.loads(mcp_tool['code'])}
- mcp_servers_config = self.handle_variables(mcp_servers_config)
- # 校验代码是否包括禁止的关键字
- ToolExecutor().validate_mcp_transport(json.dumps(mcp_servers_config))
-
- tool_init_params = {}
- tools = get_tools(self.workflow_manage.get_source_type(), self.workflow_manage.get_source_id(), tool_ids,
- workspace_id)
- if tool_ids and len(tool_ids) > 0: # 如果有工具ID,则将其转换为MCP
- self.context['tool_ids'] = tool_ids
- custom_tools_map = {str(t.id): t for t in
- QuerySet(Tool).filter(id__in=tool_ids, tool_type=ToolType.CUSTOM, is_active=True)}
- for tool_id in tool_ids:
- tool = custom_tools_map.get(str(tool_id))
- if tool is None:
- continue
- executor = ToolExecutor()
- if tool.init_params is not None:
- tool_init_params = json.loads(rsa_long_decrypt(tool.init_params))
- else:
- tool_init_params = {i["field"]: i.get('default_value') for i in tool.init_field_list}
- tool_config = executor.get_tool_mcp_config(tool, tool_init_params)
-
- mcp_servers_config[str(tool.id)] = tool_config
-
- if application_ids and len(application_ids) > 0:
- self.context['application_ids'] = application_ids
- apps_map = {str(a.id): a for a in
- QuerySet(Application).filter(id__in=application_ids, is_publish=True)}
- app_keys_map = {str(ak.application_id): ak for ak in
- QuerySet(ApplicationApiKey).filter(application_id__in=application_ids, is_active=True)}
- app_access_tokens_map = {str(at.application_id): at for at in
- QuerySet(ApplicationAccessToken).filter(
- application_id__in=application_ids)}
- for application_id in application_ids:
- app = apps_map.get(str(application_id))
- if app is None:
- continue
- app_key = app_keys_map.get(str(application_id))
- if app_key is not None:
- api_key = app_key.secret_key
- application_access_token = app_access_tokens_map.get(str(app_key.application_id))
- if application_access_token is not None and application_access_token.authentication:
- raise AppApiException(
- 500,
- _('Agent 【{name}】 access token authentication is not supported for agent tool').format(
- name=app.name)
- )
- else:
- raise AppApiException(
- 500,
- _('Agent Key is required for agent tool 【{name}】').format(name=app.name)
- )
- executor = ToolExecutor()
- app_config = executor.get_app_mcp_config(api_key)
- mcp_servers_config[app.name] = app_config
-
- if skill_tool_ids and len(skill_tool_ids) > 0:
- self.context['skill_tool_ids'] = skill_tool_ids
- skill_file_items = []
- skill_tools_map = {str(t.id): t for t in
- QuerySet(Tool).filter(id__in=skill_tool_ids, is_active=True)}
- for tool_id in skill_tool_ids:
- tool = skill_tools_map.get(str(tool_id))
- if tool is None:
- continue
- init_params_default_value = {i["field"]: i.get('default_value') for i in tool.init_field_list}
- if tool.init_params is not None:
- params = init_params_default_value | json.loads(rsa_long_decrypt(tool.init_params))
- else:
- params = init_params_default_value
-
- skill_file_items.append({
- 'tool_id': str(tool.id),
- 'file_id': tool.code,
- 'params': params
- })
- mcp_servers_config['skills'] = skill_file_items
-
- if len(mcp_servers_config) > 0 or len(tools) > 0:
- # 安全获取 application
- application_id = None
- tool_id = None
- knowledge_id = None
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- knowledge_id = self.workflow_params.get('knowledge_id')
- elif [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- application_id = self.workflow_manage.work_flow_post_handler.chat_info.application.id
- elif [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- tool_id = self.workflow_params.get('tool_id')
-
- source_id = application_id or knowledge_id or tool_id
- source_type = 'APPLICATION' if application_id else 'KNOWLEDGE' if knowledge_id else 'TOOL'
- r = mcp_response_generator(chat_model, system_prompt, message_list, json.dumps(mcp_servers_config),
- mcp_output_enable,
- tool_init_params, source_id, source_type, chat_id, tools)
- return NodeResult(
- {'result': r, 'chat_model': chat_model, 'message_list': message_list,
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (history_message if history_message is not None else [])],
- 'question': question.content}, {},
- _write_context=write_context_stream)
-
- return None
-
- def handle_variables(self, tool_params):
- # 处理参数中的变量
- for k, v in tool_params.items():
- if type(v) == str:
- tool_params[k] = self.workflow_manage.generate_prompt(tool_params[k])
- elif type(v) == dict:
- self.handle_variables(v)
- elif (type(v) == list) and len(v) > 0 and (type(v[0]) == str):
- tool_params[k] = self.get_reference_content(v)
- return tool_params
-
- def get_reference_content(self, fields: List[str]):
- return str(self.workflow_manage.get_reference_field(
- fields[0],
- fields[1:])) if fields else ''
-
- @staticmethod
- def get_history_message(history_chat_record, dialogue_number, dialogue_type, runtime_node_id):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- get_message(history_chat_record[index], dialogue_type, runtime_node_id)
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- for message in history_message:
- if isinstance(message.content, str):
- message.content = re.sub(r'.*?<\/form_rander>', '', message.content, flags=re.DOTALL)
- return history_message
-
- def generate_prompt_question(self, prompt, model):
- image = self.get_image()
- video = self.get_video()
- vision = self.is_vision()
- videos = []
- images = []
- if image and vision:
- images = self._process_images(image)
- if video and vision:
- videos = self._process_videos(video, model)
- return HumanMessage(
- content=[*videos, *images, {'type': 'text', 'text': self.workflow_manage.generate_prompt(prompt)}])
-
- def is_vision(self):
- if 'vision' in self.node_params_serializer.data:
- return self.node_params_serializer.data.get('vision')
- return False
-
- def get_image(self):
- if 'image_list' in self.node_params_serializer.data:
- image = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('image_list')[0],
- self.node_params_serializer.data.get('image_list')[1:])
- return image
- return None
-
- def get_video(self):
- if 'video_list' in self.node_params_serializer.data:
- video = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('video_list')[0],
- self.node_params_serializer.data.get('video_list')[1:])
- return video
- return None
-
- def _process_videos(self, image, video_model):
- videos = []
- if isinstance(image, str) and image.startswith('http'):
- videos.append({'type': 'video_url', 'video_url': {'url': image}})
- elif image is not None and len(image) > 0:
- for img in image:
- if 'file_id' in img:
- file_id = img['file_id']
- file = QuerySet(File).filter(id=file_id).first()
- url = video_model.upload_file_and_get_url(file.get_bytes(), file.file_name)
- videos.append(
- {'type': 'video_url', 'video_url': {'url': url}})
- elif 'url' in img and img['url'].startswith('http'):
- videos.append(
- {'type': 'video_url', 'video_url': {'url': img['url']}})
- return videos
-
- def _process_images(self, image):
- """
- 处理图像数据,转换为模型可识别的格式
- """
- images = []
- if isinstance(image, str) and image.startswith('http'):
- images.append({'type': 'image_url', 'image_url': {'url': image}})
- elif image is not None and len(image) > 0:
- for img in image:
- if 'file_id' in img:
- file_id = img['file_id']
- file = QuerySet(File).filter(id=file_id).first()
- image_bytes = file.get_bytes()
- base64_image = base64.b64encode(image_bytes).decode("utf-8")
- image_format = what(None, image_bytes)
- images.append(
- {'type': 'image_url', 'image_url': {'url': f'data:image/{image_format};base64,{base64_image}'}})
- elif 'url' in img and img['url'].startswith('http'):
- images.append(
- {'type': 'image_url', 'image_url': {'url': img["url"]}})
- return images
-
- def generate_message_list(self, question, history_message):
- return [*history_message, question]
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'system': self.context.get('system'),
- 'history_message': self.context.get('history_message'),
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'reasoning_content': self.context.get('reasoning_content'),
- 'enableException': self.node.properties.get('enableException'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message
- }
diff --git a/apps/application/flow/step_node/application_node/__init__.py b/apps/application/flow/step_node/application_node/__init__.py
deleted file mode 100644
index d1ea91ca7f8..00000000000
--- a/apps/application/flow/step_node/application_node/__init__.py
+++ /dev/null
@@ -1,2 +0,0 @@
-# coding=utf-8
-from .impl import *
diff --git a/apps/application/flow/step_node/application_node/i_application_node.py b/apps/application/flow/step_node/application_node/i_application_node.py
deleted file mode 100644
index 30cfd8632fc..00000000000
--- a/apps/application/flow/step_node/application_node/i_application_node.py
+++ /dev/null
@@ -1,106 +0,0 @@
-# coding=utf-8
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-from django.utils.translation import gettext_lazy as _
-
-from application.models import ChatSourceChoices
-
-
-class ApplicationNodeSerializer(serializers.Serializer):
- application_id = serializers.CharField(required=True, label=_("Application ID"))
- question_reference_address = serializers.ListField(required=True,
- label=_("User Questions"))
- api_input_field_list = serializers.ListField(required=False, label=_("API Input Fields"))
- user_input_field_list = serializers.ListField(required=False,
- label=_("User Input Fields"))
- image_list = serializers.ListField(required=False, label=_("picture"))
- document_list = serializers.ListField(required=False, label=_("document"))
- audio_list = serializers.ListField(required=False, label=_("Audio"))
- video_list = serializers.ListField(required=False, label=_("Video"))
- child_node = serializers.DictField(required=False, allow_null=True,
- label=_("Child Nodes"))
- node_data = serializers.DictField(required=False, allow_null=True, label=_("Form Data"))
-
-
-class IApplicationNode(INode):
- type = 'application-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ApplicationNodeSerializer
-
- def _run(self):
- question = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('question_reference_address')[0],
- self.node_params_serializer.data.get('question_reference_address')[1:])
- kwargs = {}
- for api_input_field in self.node_params_serializer.data.get('api_input_field_list', []):
- value = api_input_field.get('value', [''])[0] if api_input_field.get('value') else ''
- kwargs[api_input_field['variable']] = self.workflow_manage.get_reference_field(value,
- api_input_field['value'][
- 1:]) if value != '' else ''
-
- for user_input_field in self.node_params_serializer.data.get('user_input_field_list', []):
- value = user_input_field.get('value', [''])[0] if user_input_field.get('value') else ''
- kwargs[user_input_field['field']] = self.workflow_manage.get_reference_field(value,
- user_input_field['value'][
- 1:]) if value != '' else ''
- # 判断是否包含这个属性
- app_document_list = self.node_params_serializer.data.get('document_list', [])
- if app_document_list and len(app_document_list) > 0:
- app_document_list = self.workflow_manage.get_reference_field(
- app_document_list[0],
- app_document_list[1:])
- for document in app_document_list:
- if 'file_id' not in document:
- raise ValueError(
- _("Parameter value error: The uploaded document lacks file_id, and the document upload fails"))
- app_image_list = self.node_params_serializer.data.get('image_list', [])
- if app_image_list and len(app_image_list) > 0:
- app_image_list = self.workflow_manage.get_reference_field(
- app_image_list[0],
- app_image_list[1:])
- for image in app_image_list:
- if 'file_id' not in image:
- raise ValueError(
- _("Parameter value error: The uploaded image lacks file_id, and the image upload fails"))
-
- app_audio_list = self.node_params_serializer.data.get('audio_list', [])
- if app_audio_list and len(app_audio_list) > 0:
- app_audio_list = self.workflow_manage.get_reference_field(
- app_audio_list[0],
- app_audio_list[1:])
- for audio in app_audio_list:
- if 'file_id' not in audio:
- raise ValueError(
- _("Parameter value error: The uploaded audio lacks file_id, and the audio upload fails."))
- app_video_list = self.node_params_serializer.data.get('video_list', [])
- if app_video_list and len(app_video_list) > 0:
- app_video_list = self.workflow_manage.get_reference_field(
- app_video_list[0],
- app_video_list[1:]
- )
- for video in app_video_list:
- if 'file_id' not in video:
- raise ValueError(
- _("Parameter value error: The uploaded video lacks file_id, and the video upload fails."))
- return self.execute(**{**self.flow_params_serializer.data, **self.node_params_serializer.data},
- app_document_list=app_document_list, app_image_list=app_image_list,
- app_audio_list=app_audio_list,
- app_video_list=app_video_list,
- ip_address=self.workflow_params.get('ip_address') or '-',
- source=self.workflow_params.get('source') or {"type": ChatSourceChoices.ONLINE.value},
- message=str(question), **kwargs)
-
- def execute(self, application_id, message, chat_id, chat_record_id, stream, re_chat, client_id, client_type,
- app_document_list=None, app_image_list=None, app_audio_list=None, app_video_list=None, child_node=None,
- node_data=None,
- ip_address=None,
- source=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/application_node/impl/__init__.py b/apps/application/flow/step_node/application_node/impl/__init__.py
deleted file mode 100644
index e31a8d885cd..00000000000
--- a/apps/application/flow/step_node/application_node/impl/__init__.py
+++ /dev/null
@@ -1,2 +0,0 @@
-# coding=utf-8
-from .base_application_node import BaseApplicationNode
diff --git a/apps/application/flow/step_node/application_node/impl/base_application_node.py b/apps/application/flow/step_node/application_node/impl/base_application_node.py
deleted file mode 100644
index 7622de3a75f..00000000000
--- a/apps/application/flow/step_node/application_node/impl/base_application_node.py
+++ /dev/null
@@ -1,299 +0,0 @@
-# coding=utf-8
-import json
-import re
-import time
-import uuid
-from typing import Dict, List
-from django.utils.translation import gettext as _
-from application.flow.common import Answer
-from application.flow.i_step_node import NodeResult, INode
-from application.flow.step_node.application_node.i_application_node import IApplicationNode
-from common.utils.logger import maxkb_logger
-from application.models import Chat, ChatSourceChoices
-
-
-def string_to_uuid(input_str):
- return str(uuid.uuid5(uuid.NAMESPACE_DNS, input_str))
-
-
-def _is_interrupt_exec(node, node_variable: Dict, workflow_variable: Dict):
- return node_variable.get('is_interrupt_exec', False)
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str,
- reasoning_content: str):
- result = node_variable.get('result')
- node.context['application_node_dict'] = node_variable.get('application_node_dict')
- node.context['node_dict'] = node_variable.get('node_dict', {})
- node.context['is_interrupt_exec'] = node_variable.get('is_interrupt_exec')
- node.context['message_tokens'] = result.get('usage', {}).get('prompt_tokens', 0)
- node.context['answer_tokens'] = result.get('usage', {}).get('completion_tokens', 0)
- node.context['answer'] = answer
- node.context['result'] = answer
- node.context['reasoning_content'] = reasoning_content
- node.context['question'] = node_variable['question']
- node.context['run_time'] = time.time() - node.context['start_time']
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- answer = ''
- reasoning_content = ''
- usage = {}
- node_child_node = {}
- application_node_dict = node.context.get('application_node_dict', {})
- is_interrupt_exec = False
- for chunk in response:
- # 先把流转成字符串
- response_content = chunk.decode('utf-8')[6:]
- response_content = json.loads(response_content)
- content = (response_content.get('content', '') or '')
- runtime_node_id = response_content.get('runtime_node_id', '')
- chat_record_id = response_content.get('chat_record_id', '')
- child_node = response_content.get('child_node')
- view_type = response_content.get('view_type')
- node_type = response_content.get('node_type')
- real_node_id = response_content.get('real_node_id')
- node_is_end = response_content.get('node_is_end', False)
- _reasoning_content = (response_content.get('reasoning_content', '') or '')
- if node_type == 'form-node':
- is_interrupt_exec = True
- answer += content
- reasoning_content += _reasoning_content
- node_child_node = {'runtime_node_id': runtime_node_id, 'chat_record_id': chat_record_id,
- 'child_node': child_node}
-
- if real_node_id is not None:
- real_node_id = real_node_id + '__' + node.runtime_node_id
- application_node = application_node_dict.get(real_node_id, None)
- if application_node is None:
-
- application_node_dict[real_node_id] = {'content': content,
- 'runtime_node_id': runtime_node_id,
- 'chat_record_id': chat_record_id,
- 'child_node': child_node,
- 'index': len(application_node_dict),
- 'view_type': view_type,
- 'reasoning_content': _reasoning_content}
- else:
- application_node['content'] += content
- application_node['reasoning_content'] += _reasoning_content
-
- yield {'content': content,
- 'node_type': node_type,
- 'runtime_node_id': runtime_node_id, 'chat_record_id': chat_record_id,
- 'reasoning_content': _reasoning_content,
- 'child_node': child_node,
- 'real_node_id': real_node_id,
- 'node_is_end': node_is_end,
- 'view_type': view_type}
- usage = response_content.get('usage', {})
- node_variable['result'] = {'usage': usage}
- node_variable['is_interrupt_exec'] = is_interrupt_exec
- node_variable['child_node'] = node_child_node
- node_variable['application_node_dict'] = application_node_dict
- _write_context(node_variable, workflow_variable, node, workflow, answer, reasoning_content)
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点实例对象
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result', {}).get('data', {})
- node_variable['result'] = {'usage': {'completion_tokens': response.get('completion_tokens'),
- 'prompt_tokens': response.get('prompt_tokens')}}
- answer = response.get('content', '') or "抱歉,没有查找到相关内容,请重新描述您的问题或提供更多信息。"
- reasoning_content = response.get('reasoning_content', '')
- answer_list = response.get('answer_list', [])
- node_variable['application_node_dict'] = {answer.get('real_node_id'): {**answer, 'index': index} for answer, index
- in
- zip(answer_list, range(len(answer_list)))}
- _write_context(node_variable, workflow_variable, node, workflow, answer, reasoning_content)
-
-
-def reset_application_node_dict(application_node_dict, runtime_node_id, node_data):
- try:
- if application_node_dict is None:
- return
- for key in application_node_dict:
- application_node = application_node_dict[key]
- if application_node.get('runtime_node_id') == runtime_node_id:
- content: str = application_node.get('content')
- match = re.search(r'.*?<\/form_rander>', content, flags=re.DOTALL)
- if match:
- form_setting_str = match.group().replace('', '').replace('', '')
- form_setting = json.loads(form_setting_str)
- form_setting['is_submit'] = True
- form_setting['form_data'] = node_data
- value = f'{json.dumps(form_setting)}'
- res = re.sub(r'.*?<\/form_rander>', '${value}', content, flags=re.DOTALL)
- application_node['content'] = res.replace('${value}', value)
- except Exception as e:
- maxkb_logger.warning(f'reset_application_node_dict error: {e}', exc_info=True)
-
-
-class BaseApplicationNode(IApplicationNode):
- def get_answer_list(self) -> List[Answer] | None:
- if self.answer_text is None:
- return None
- application_node_dict = self.context.get('application_node_dict')
- if application_node_dict is None or len(application_node_dict) == 0:
- return [
- Answer(self.answer_text, self.view_type, self.runtime_node_id, self.workflow_params['chat_record_id'],
- self.context.get('child_node'), self.runtime_node_id, '')]
- else:
- return [Answer(n.get('content'), n.get('view_type'), self.runtime_node_id,
- self.workflow_params['chat_record_id'], {'runtime_node_id': n.get('runtime_node_id'),
- 'chat_record_id': n.get('chat_record_id')
- , 'child_node': n.get('child_node')}, n.get('real_node_id'),
- n.get('reasoning_content', ''))
- for n in
- sorted(application_node_dict.values(), key=lambda item: item.get('index'))]
-
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['result'] = details.get('answer')
- self.context['question'] = details.get('question')
- self.context['type'] = details.get('type')
- self.context['reasoning_content'] = details.get('reasoning_content')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def get_chat_asker(self, kwargs):
- asker = kwargs.get('asker')
- if asker:
- if isinstance(asker, dict):
- return asker
- return {'username': asker}
- return self.workflow_manage.work_flow_post_handler.chat_info.get_chat_user()
-
- def execute(self, application_id, message, chat_id, chat_record_id, stream, re_chat,
- chat_user_id,
- chat_user_type,
- app_document_list=None, app_image_list=None, app_audio_list=None, app_video_list=None, child_node=None,
- node_data=None,
- ip_address=None,
- source=None,
- **kwargs) -> NodeResult:
- from chat.serializers.chat import ChatSerializers
- if application_id == self.workflow_manage.get_body().get('application_id'):
- raise Exception(_("The sub application cannot use the current node"))
- # 生成嵌入应用的chat_id
- current_chat_id = string_to_uuid(chat_id + application_id)
- Chat.objects.get_or_create(id=current_chat_id, defaults={
- 'application_id': application_id,
- 'abstract': message[0:1024],
- 'chat_user_id': chat_user_id,
- 'chat_user_type': chat_user_type,
- 'ip_address': ip_address,
- 'source': source,
- 'asker': self.get_chat_asker(kwargs)
- })
- if app_document_list is None:
- app_document_list = []
- if app_image_list is None:
- app_image_list = []
- if app_audio_list is None:
- app_audio_list = []
- if app_video_list is None:
- app_video_list = []
- runtime_node_id = None
- record_id = None
- child_node_value = None
- if child_node is not None:
- runtime_node_id = child_node.get('runtime_node_id')
- record_id = child_node.get('chat_record_id')
- child_node_value = child_node.get('child_node')
- application_node_dict = self.context.get('application_node_dict')
- reset_application_node_dict(application_node_dict, runtime_node_id, node_data)
- response = ChatSerializers(data={
- "chat_id": current_chat_id,
- "chat_user_id": chat_user_id,
- 'chat_user_type': chat_user_type,
- 'application_id': application_id,
- 'ip_address': ip_address,
- 'source': source,
- 'debug': False
- }).chat(instance=
- {'message': message,
- 're_chat': re_chat,
- 'stream': stream,
- 'document_list': [*app_document_list],
- 'image_list': [*app_image_list],
- 'audio_list': [*app_audio_list],
- 'video_list': [*app_video_list],
- 'runtime_node_id': runtime_node_id,
- 'chat_record_id': record_id,
- 'child_node': child_node_value,
- 'node_data': node_data,
- 'form_data': kwargs}
- )
-
- if response.status_code == 200:
- if stream:
- content_generator = response.streaming_content
- return NodeResult({'result': content_generator, 'question': message}, {},
- _write_context=write_context_stream, _is_interrupt=_is_interrupt_exec)
- else:
- data = json.loads(response.content)
- return NodeResult({'result': data, 'question': message}, {},
- _write_context=write_context, _is_interrupt=_is_interrupt_exec)
-
- def get_details(self, index: int, **kwargs):
- global_fields = []
- for api_input_field in self.node_params_serializer.data.get('api_input_field_list', []):
- value = api_input_field.get('value', [''])[0] if api_input_field.get('value') else ''
- global_fields.append({
- 'label': api_input_field['variable'],
- 'key': api_input_field['variable'],
- 'value': self.workflow_manage.get_reference_field(
- value,
- api_input_field['value'][1:]
- ) if value != '' else ''
- })
-
- for user_input_field in self.node_params_serializer.data.get('user_input_field_list', []):
- value = user_input_field.get('value', [''])[0] if user_input_field.get('value') else ''
- global_fields.append({
- 'label': user_input_field['label'],
- 'key': user_input_field['field'],
- 'value': self.workflow_manage.get_reference_field(
- value,
- user_input_field['value'][1:]
- ) if value != '' else ''
- })
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "info": self.node.properties.get('node_data'),
- 'run_time': self.context.get('run_time'),
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'reasoning_content': self.context.get('reasoning_content'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'global_fields': global_fields,
- 'document_list': self.workflow_manage.document_list,
- 'image_list': self.workflow_manage.image_list,
- 'audio_list': self.workflow_manage.audio_list,
- 'video_list': self.workflow_manage.video_list,
- 'application_node_dict': self.context.get('application_node_dict'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/condition_node/__init__.py b/apps/application/flow/step_node/condition_node/__init__.py
deleted file mode 100644
index 57638504c9e..00000000000
--- a/apps/application/flow/step_node/condition_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/6/7 14:43
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/condition_node/i_condition_node.py b/apps/application/flow/step_node/condition_node/i_condition_node.py
deleted file mode 100644
index 664ee91baff..00000000000
--- a/apps/application/flow/step_node/condition_node/i_condition_node.py
+++ /dev/null
@@ -1,42 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_condition_node.py
- @date:2024/6/7 9:54
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode
-
-
-class ConditionSerializer(serializers.Serializer):
- compare = serializers.CharField(required=True, label=_("Comparator"))
- value = serializers.CharField(required=True, label=_("value"))
- field = serializers.ListField(required=True, label=_("Fields"))
-
-
-class ConditionBranchSerializer(serializers.Serializer):
- id = serializers.CharField(required=True, label=_("Branch id"))
- type = serializers.CharField(required=True, label=_("Branch Type"))
- condition = serializers.CharField(required=True, label=_("Condition or|and"))
- conditions = ConditionSerializer(many=True)
-
-
-class ConditionNodeParamsSerializer(serializers.Serializer):
- branch = ConditionBranchSerializer(many=True)
-
-
-class IConditionNode(INode):
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ConditionNodeParamsSerializer
-
- type = 'condition-node'
-
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
diff --git a/apps/application/flow/step_node/condition_node/impl/__init__.py b/apps/application/flow/step_node/condition_node/impl/__init__.py
deleted file mode 100644
index c21cd3ebb37..00000000000
--- a/apps/application/flow/step_node/condition_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:35
- @desc:
-"""
-from .base_condition_node import BaseConditionNode
diff --git a/apps/application/flow/step_node/condition_node/impl/base_condition_node.py b/apps/application/flow/step_node/condition_node/impl/base_condition_node.py
deleted file mode 100644
index e0da03ace4c..00000000000
--- a/apps/application/flow/step_node/condition_node/impl/base_condition_node.py
+++ /dev/null
@@ -1,47 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_condition_node.py
- @date:2024/6/7 11:29
- @desc:
-"""
-from typing import List
-
-from application.flow.i_step_node import NodeResult
-from application.flow.compare import do_assertion
-from application.flow.step_node.condition_node.i_condition_node import IConditionNode
-
-
-class BaseConditionNode(IConditionNode):
- def save_context(self, details, workflow_manage):
- self.context['branch_id'] = details.get('branch_id')
- self.context['branch_name'] = details.get('branch_name')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, **kwargs) -> NodeResult:
- branch_list = self.node_params_serializer.data['branch']
- branch = self._execute(branch_list)
- r = NodeResult({'branch_id': branch.get('id'), 'branch_name': branch.get('type')}, {})
- return r
-
- def _execute(self, branch_list: List):
- for branch in branch_list:
- if self.branch_assertion(branch):
- return branch
-
- def branch_assertion(self, branch):
- return do_assertion(self.workflow_manage, branch.get('condition'), branch.get('conditions'))
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'branch_id': self.context.get('branch_id'),
- 'branch_name': self.context.get('branch_name'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/data_source_local_node/__init__.py b/apps/application/flow/step_node/data_source_local_node/__init__.py
deleted file mode 100644
index bbf804a7079..00000000000
--- a/apps/application/flow/step_node/data_source_local_node/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/11/11 10:06
- @desc:
-"""
diff --git a/apps/application/flow/step_node/data_source_local_node/i_data_source_local_node.py b/apps/application/flow/step_node/data_source_local_node/i_data_source_local_node.py
deleted file mode 100644
index e6b39f686fa..00000000000
--- a/apps/application/flow/step_node/data_source_local_node/i_data_source_local_node.py
+++ /dev/null
@@ -1,42 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: i_data_source_local_node.py
- @date:2025/11/11 10:06
- @desc:
-"""
-from abc import abstractmethod
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class DataSourceLocalNodeParamsSerializer(serializers.Serializer):
- file_type_list = serializers.ListField(child=serializers.CharField(label=('')), label='')
- file_size_limit = serializers.IntegerField(required=True, label=_("Number of uploaded files"))
- file_count_limit = serializers.IntegerField(required=True, label=_("Upload file size"))
-
-
-class IDataSourceLocalNode(INode):
- type = 'data-source-local-node'
-
- @staticmethod
- @abstractmethod
- def get_form_list(node):
- pass
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return DataSourceLocalNodeParamsSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, file_type_list, file_size_limit, file_count_limit, **kwargs) -> NodeResult:
- pass
-
- support = [WorkflowMode.KNOWLEDGE]
diff --git a/apps/application/flow/step_node/data_source_local_node/impl/__init__.py b/apps/application/flow/step_node/data_source_local_node/impl/__init__.py
deleted file mode 100644
index 6f830151971..00000000000
--- a/apps/application/flow/step_node/data_source_local_node/impl/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/11/11 10:08
- @desc:
-"""
diff --git a/apps/application/flow/step_node/data_source_local_node/impl/base_data_source_local_node.py b/apps/application/flow/step_node/data_source_local_node/impl/base_data_source_local_node.py
deleted file mode 100644
index c2f69b6f21a..00000000000
--- a/apps/application/flow/step_node/data_source_local_node/impl/base_data_source_local_node.py
+++ /dev/null
@@ -1,52 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: base_data_source_local_node.py
- @date:2025/11/11 10:30
- @desc:
-"""
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.data_source_local_node.i_data_source_local_node import IDataSourceLocalNode
-from common import forms
-from common.forms import BaseForm
-
-
-class BaseDataSourceLocalNodeForm(BaseForm):
- api_key = forms.PasswordInputField('API Key', required=True)
-
-
-class BaseDataSourceLocalNode(IDataSourceLocalNode):
- def save_context(self, details, workflow_manage):
- self.context['exception_message'] = details.get('err_message')
-
- @staticmethod
- def get_form_list(node):
- node_data = node.get('properties').get('node_data')
- return [{
- 'field': 'file_list',
- 'input_type': 'LocalFileUpload',
- 'attrs': {
- 'file_count_limit': node_data.get('file_count_limit') or 10,
- 'file_size_limit': node_data.get('file_size_limit') or 100,
- 'file_type_list': node_data.get('file_type_list'),
- },
- 'label': '',
- }]
-
- def execute(self, file_type_list, file_size_limit, file_count_limit, **kwargs) -> NodeResult:
- return NodeResult({'file_list': self.workflow_manage.params.get('data_source', {}).get('file_list')},
- self.workflow_manage.params.get('knowledge_base') or {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'file_list': self.context.get('file_list'),
- 'knowledge_base': self.workflow_params.get('knowledge_base'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/data_source_web_node/__init__.py b/apps/application/flow/step_node/data_source_web_node/__init__.py
deleted file mode 100644
index 461bab6fc12..00000000000
--- a/apps/application/flow/step_node/data_source_web_node/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/11/12 13:43
- @desc:
-"""
diff --git a/apps/application/flow/step_node/data_source_web_node/i_data_source_web_node.py b/apps/application/flow/step_node/data_source_web_node/i_data_source_web_node.py
deleted file mode 100644
index ee5dc990b84..00000000000
--- a/apps/application/flow/step_node/data_source_web_node/i_data_source_web_node.py
+++ /dev/null
@@ -1,28 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: i_data_source_web_node.py
- @date:2025/11/12 13:47
- @desc:
-"""
-from abc import abstractmethod
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class IDataSourceWebNode(INode):
- type = 'data-source-web-node'
- support = [WorkflowMode.KNOWLEDGE]
-
- @staticmethod
- @abstractmethod
- def get_form_list(node):
- pass
-
- def _run(self):
- return self.execute(**self.flow_params_serializer.data)
-
- def execute(self, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/data_source_web_node/impl/__init__.py b/apps/application/flow/step_node/data_source_web_node/impl/__init__.py
deleted file mode 100644
index b7541b12df1..00000000000
--- a/apps/application/flow/step_node/data_source_web_node/impl/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py
- @date:2025/11/12 13:44
- @desc:
-"""
diff --git a/apps/application/flow/step_node/data_source_web_node/impl/base_data_source_web_node.py b/apps/application/flow/step_node/data_source_web_node/impl/base_data_source_web_node.py
deleted file mode 100644
index 0a9ec336036..00000000000
--- a/apps/application/flow/step_node/data_source_web_node/impl/base_data_source_web_node.py
+++ /dev/null
@@ -1,98 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: base_data_source_web_node.py
- @date:2025/11/12 13:47
- @desc:
-"""
-import traceback
-
-from django.utils.translation import gettext_lazy as _
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.data_source_web_node.i_data_source_web_node import IDataSourceWebNode
-from common import forms
-from common.forms import BaseForm
-from common.utils.fork import ForkManage, Fork, ChildLink
-from common.utils.logger import maxkb_logger
-
-
-class BaseDataSourceWebNodeForm(BaseForm):
- source_url = forms.TextInputField(_('Web source url'), required=True, attrs={
- 'placeholder': _('Please enter the Web root address')})
- selector = forms.TextInputField(_('Web knowledge selector'), required=False, attrs={
- 'placeholder': _('The default is body, you can enter .classname/#idname/tagname')})
-
-
-class InterruptedTaskException(Exception):
- def __init__(self, *args, **kwargs): # real signature unknown
- pass
-
-
-def get_collect_handler(workflow_manage):
- results = []
-
- def handler(child_link: ChildLink, response: Fork.Response):
- if response.status == 200:
- try:
- document_name = child_link.tag.text if child_link.tag is not None and len(
- child_link.tag.text.strip()) > 0 else child_link.url
- results.append({
- "name": document_name.strip(),
- "content": response.content,
- })
-
- except Exception as e:
- maxkb_logger.error(f'{str(e)}:{traceback.format_exc()}')
- if workflow_manage.is_the_task_interrupted():
- raise InterruptedTaskException('Task interrupted')
-
- return handler, results
-
-
-class BaseDataSourceWebNode(IDataSourceWebNode):
- def save_context(self, details, workflow_manage):
- self.context['exception_message'] = details.get('err_message')
-
- @staticmethod
- def get_form_list(node):
- return BaseDataSourceWebNodeForm().to_form_list()
-
- def execute(self, **kwargs) -> NodeResult:
- BaseDataSourceWebNodeForm().valid_form(self.workflow_params.get("data_source"))
-
- data_source = self.workflow_params.get("data_source")
-
- node_id = data_source.get("node_id")
- source_url = data_source.get("source_url")
- selector = data_source.get("selector") or "body"
-
- collect_handler, document_list = get_collect_handler(self.workflow_manage)
-
- try:
- ForkManage(source_url, selector.split(" ") if selector is not None else []).fork(3, set(), collect_handler)
-
- return NodeResult({'document_list': document_list, 'source_url': source_url, 'selector': selector},
- self.workflow_manage.params.get('knowledge_base') or {})
-
- except Exception as e:
- if isinstance(e, InterruptedTaskException):
- return NodeResult({'document_list': document_list, 'source_url': source_url, 'selector': selector},
- self.workflow_manage.params.get('knowledge_base') or {})
- maxkb_logger.error(_('data source web node:{node_id} error{error}{traceback}').format(
- node_id=node_id, error=str(e), traceback=traceback.format_exc()))
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'input_params': {"source_url": self.context.get("source_url"), "selector": self.context.get('selector')},
- 'output_params': self.context.get('document_list'),
- 'knowledge_base': self.workflow_params.get('knowledge_base'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/direct_reply_node/__init__.py b/apps/application/flow/step_node/direct_reply_node/__init__.py
deleted file mode 100644
index cf360f95685..00000000000
--- a/apps/application/flow/step_node/direct_reply_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 17:50
- @desc:
-"""
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/direct_reply_node/i_reply_node.py b/apps/application/flow/step_node/direct_reply_node/i_reply_node.py
deleted file mode 100644
index 1a963d76a58..00000000000
--- a/apps/application/flow/step_node/direct_reply_node/i_reply_node.py
+++ /dev/null
@@ -1,58 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_reply_node.py
- @date:2024/6/11 16:25
- @desc:
-"""
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-from common.exception.app_exception import AppApiException
-
-from django.utils.translation import gettext_lazy as _
-
-
-class ReplyNodeParamsSerializer(serializers.Serializer):
- reply_type = serializers.CharField(required=True, label=_("Response Type"))
- fields = serializers.ListField(required=False, label=_("Reference Field"))
- content = serializers.CharField(required=False, allow_blank=True, allow_null=True,
- label=_("Direct answer content"))
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- if self.data.get('reply_type') == 'referencing':
- if 'fields' not in self.data:
- raise AppApiException(500, _("Reference field cannot be empty"))
- if len(self.data.get('fields')) < 2:
- raise AppApiException(500, _("Reference field error"))
- else:
- if 'content' not in self.data or self.data.get('content') is None:
- raise AppApiException(500, _("Content cannot be empty"))
-
-
-class IReplyNode(INode):
- type = 'reply-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP,
- WorkflowMode.KNOWLEDGE, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ReplyNodeParamsSerializer
-
- def _run(self):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'stream': True})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, reply_type, stream, fields=None, content=None, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/direct_reply_node/impl/__init__.py b/apps/application/flow/step_node/direct_reply_node/impl/__init__.py
deleted file mode 100644
index 3307e90899e..00000000000
--- a/apps/application/flow/step_node/direct_reply_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 17:49
- @desc:
-"""
-from .base_reply_node import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/direct_reply_node/impl/base_reply_node.py b/apps/application/flow/step_node/direct_reply_node/impl/base_reply_node.py
deleted file mode 100644
index e70c45afd07..00000000000
--- a/apps/application/flow/step_node/direct_reply_node/impl/base_reply_node.py
+++ /dev/null
@@ -1,47 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_reply_node.py
- @date:2024/6/11 17:25
- @desc:
-"""
-from typing import List
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.direct_reply_node.i_reply_node import IReplyNode
-
-
-class BaseReplyNode(IReplyNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, reply_type, stream, fields=None, content=None, **kwargs) -> NodeResult:
- if reply_type == 'referencing':
- result = self.get_reference_content(fields)
- else:
- result = self.generate_reply_content(content)
- return NodeResult({'answer': result}, {})
-
- def generate_reply_content(self, prompt):
- return self.workflow_manage.generate_prompt(prompt)
-
- def get_reference_content(self, fields: List[str]):
- return str(self.workflow_manage.get_reference_field(
- fields[0],
- fields[1:])) if fields else ''
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'answer': self.context.get('answer'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/document_extract_node/__init__.py b/apps/application/flow/step_node/document_extract_node/__init__.py
deleted file mode 100644
index ce8f10f3e24..00000000000
--- a/apps/application/flow/step_node/document_extract_node/__init__.py
+++ /dev/null
@@ -1 +0,0 @@
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/document_extract_node/i_document_extract_node.py b/apps/application/flow/step_node/document_extract_node/i_document_extract_node.py
deleted file mode 100644
index d2cf43e0238..00000000000
--- a/apps/application/flow/step_node/document_extract_node/i_document_extract_node.py
+++ /dev/null
@@ -1,30 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class DocumentExtractNodeSerializer(serializers.Serializer):
- document_list = serializers.ListField(required=False, label=_("document"))
-
-
-class IDocumentExtractNode(INode):
- type = 'document-extract-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP,
- WorkflowMode.KNOWLEDGE, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return DocumentExtractNodeSerializer
-
- def _run(self):
- res = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('document_list')[0],
- self.node_params_serializer.data.get('document_list')[1:])
- return self.execute(document=res, **self.flow_params_serializer.data)
-
- def execute(self, document, chat_id=None, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/document_extract_node/impl/__init__.py b/apps/application/flow/step_node/document_extract_node/impl/__init__.py
deleted file mode 100644
index cf9d55ecde8..00000000000
--- a/apps/application/flow/step_node/document_extract_node/impl/__init__.py
+++ /dev/null
@@ -1 +0,0 @@
-from .base_document_extract_node import BaseDocumentExtractNode
diff --git a/apps/application/flow/step_node/document_extract_node/impl/base_document_extract_node.py b/apps/application/flow/step_node/document_extract_node/impl/base_document_extract_node.py
deleted file mode 100644
index 7bd910c31f3..00000000000
--- a/apps/application/flow/step_node/document_extract_node/impl/base_document_extract_node.py
+++ /dev/null
@@ -1,95 +0,0 @@
-# coding=utf-8
-import ast
-import io
-
-import uuid_utils.compat as uuid
-from django.db.models import QuerySet
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.document_extract_node.i_document_extract_node import IDocumentExtractNode
-from knowledge.models import File, FileSourceType
-from knowledge.serializers.document import split_handles, parse_table_handle_list, FileBufferHandle
-
-splitter = '\n`-----------------------------------`\n'
-
-
-class BaseDocumentExtractNode(IDocumentExtractNode):
- def save_context(self, details, workflow_manage):
- self.context['content'] = details.get('content')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, document, chat_id=None, **kwargs):
- get_buffer = FileBufferHandle().get_buffer
-
- self.context['document_list'] = document
- content = []
- if document is None or not isinstance(document, list):
- return NodeResult({'content': '', 'document_list': []}, {})
-
- # 安全获取 application
- application_id = None
- tool_id = None
- knowledge_id = None
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- knowledge_id = self.workflow_params.get('knowledge_id')
- elif [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- application_id = self.workflow_manage.work_flow_post_handler.chat_info.application.id
- elif [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- tool_id = self.workflow_params.get('tool_id')
-
- # doc文件中的图片保存
- def save_image(image_list):
- for image in image_list:
- meta = {
- 'debug': False if (application_id or knowledge_id or tool_id) else True,
- 'chat_id': chat_id,
- 'application_id': str(application_id) if application_id else None,
- 'knowledge_id': str(knowledge_id) if knowledge_id else None,
- 'tool_id': str(tool_id) if tool_id else None,
- 'file_id': str(image.id)
- }
- file_bytes = image.meta.pop('content')
- new_file = File(
- id=meta['file_id'],
- file_name=image.file_name,
- file_size=len(file_bytes),
- source_type=FileSourceType.APPLICATION.value if application_id else FileSourceType.KNOWLEDGE.value if knowledge_id else FileSourceType.TOOL.value,
- source_id=application_id or knowledge_id or tool_id,
- meta=meta
- )
- if not QuerySet(File).filter(id=new_file.id).exists():
- new_file.save(file_bytes)
-
- document_list = []
- for doc in document:
- file = QuerySet(File).filter(id=doc['file_id']).first()
- buffer = io.BytesIO(file.get_bytes())
- buffer.name = doc['name'] # this is the important line
-
- for split_handle in (parse_table_handle_list + split_handles):
- if split_handle.support(buffer, get_buffer):
- # 回到文件头
- buffer.seek(0)
- file_content = split_handle.get_content(buffer, save_image)
- content.append('### ' + doc['name'] + '\n' + file_content)
- document_list.append({'id': str(file.id), 'name': doc['name'], 'content': file_content})
- break
-
- return NodeResult({'content': splitter.join(content), 'document_list': document_list}, {})
-
- def get_details(self, index: int, **kwargs):
- content = self.context.get('content', '').split(splitter)
- # 不保存content全部内容,因为content内容可能会很大
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'content': [file_content[:500] for file_content in content],
- 'status': self.status,
- 'err_message': self.err_message,
- 'document_list': self.context.get('document_list'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/document_split_node/__init__.py b/apps/application/flow/step_node/document_split_node/__init__.py
deleted file mode 100644
index ce8f10f3e24..00000000000
--- a/apps/application/flow/step_node/document_split_node/__init__.py
+++ /dev/null
@@ -1 +0,0 @@
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/document_split_node/i_document_split_node.py b/apps/application/flow/step_node/document_split_node/i_document_split_node.py
deleted file mode 100644
index 7b13d2d405d..00000000000
--- a/apps/application/flow/step_node/document_split_node/i_document_split_node.py
+++ /dev/null
@@ -1,97 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class DocumentSplitNodeSerializer(serializers.Serializer):
- document_list = serializers.ListField(required=False, label=_("document list"))
- split_strategy = serializers.ChoiceField(
- choices=['auto', 'custom', 'qa'], required=False, label=_("split strategy"), default='auto'
- )
- paragraph_title_relate_problem_type = serializers.ChoiceField(
- choices=['custom', 'referencing'], required=False, label=_("paragraph title relate problem type"),
- default='custom'
- )
- paragraph_title_relate_problem = serializers.BooleanField(
- required=False, label=_("paragraph title relate problem"), default=False
- )
- paragraph_title_relate_problem_reference = serializers.ListField(
- required=False, label=_("paragraph title relate problem reference"), child=serializers.CharField(), default=[]
- )
- document_name_relate_problem_type = serializers.ChoiceField(
- choices=['custom', 'referencing'], required=False, label=_("document name relate problem type"),
- default='custom'
- )
- document_name_relate_problem = serializers.BooleanField(
- required=False, label=_("document name relate problem"), default=False
- )
- document_name_relate_problem_reference = serializers.ListField(
- required=False, label=_("document name relate problem reference"), child=serializers.CharField(), default=[]
- )
- limit = serializers.IntegerField(required=False, label=_("limit"), default=4096)
- limit_type = serializers.ChoiceField(
- choices=['custom', 'referencing'], required=False, label=_("document name relate problem type"),
- default='custom'
- )
- limit_reference = serializers.ListField(
- required=False, label=_("limit reference"), child=serializers.CharField(), default=[]
- )
- chunk_size = serializers.IntegerField(required=False, label=_("chunk size"), default=256)
- chunk_size_type = serializers.ChoiceField(
- choices=['custom', 'referencing'], required=False, label=_("chunk size type"), default='custom'
- )
- chunk_size_reference = serializers.ListField(
- required=False, label=_("chunk size reference"), child=serializers.CharField(), default=[]
- )
- patterns = serializers.ListField(
- required=False, label=_("patterns"), child=serializers.CharField(), default=[]
- )
- patterns_type = serializers.ChoiceField(
- choices=['custom', 'referencing'], required=False, label=_("patterns type"), default='custom'
- )
- patterns_reference = serializers.ListField(
- required=False, label=_("patterns reference"), child=serializers.CharField(), default=[]
- )
- with_filter = serializers.BooleanField(
- required=False, label=_("with filter"), default=False
- )
- with_filter_type = serializers.ChoiceField(
- choices=['custom', 'referencing'], required=False, label=_("with filter type"), default='custom'
- )
- with_filter_reference = serializers.ListField(
- required=False, label=_("with filter reference"), child=serializers.CharField(), default=[]
- )
-
-
-class IDocumentSplitNode(INode):
- type = 'document-split-node'
- support = [
- WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP
- ]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return DocumentSplitNodeSerializer
-
- def _run(self):
- if [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'knowledge_id': None})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, document_list, knowledge_id, split_strategy, paragraph_title_relate_problem_type,
- paragraph_title_relate_problem, paragraph_title_relate_problem_reference,
- document_name_relate_problem_type, document_name_relate_problem,
- document_name_relate_problem_reference, limit, limit_type, limit_reference, chunk_size, chunk_size_type,
- chunk_size_reference, patterns, patterns_type, patterns_reference, with_filter, with_filter_type,
- with_filter_reference, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/document_split_node/impl/__init__.py b/apps/application/flow/step_node/document_split_node/impl/__init__.py
deleted file mode 100644
index cc7dc7dda90..00000000000
--- a/apps/application/flow/step_node/document_split_node/impl/__init__.py
+++ /dev/null
@@ -1 +0,0 @@
-from .base_document_split_node import BaseDocumentSplitNode
diff --git a/apps/application/flow/step_node/document_split_node/impl/base_document_split_node.py b/apps/application/flow/step_node/document_split_node/impl/base_document_split_node.py
deleted file mode 100644
index 5e71cdd50a1..00000000000
--- a/apps/application/flow/step_node/document_split_node/impl/base_document_split_node.py
+++ /dev/null
@@ -1,192 +0,0 @@
-# coding=utf-8
-import io
-import mimetypes
-from typing import List
-
-from django.core.files.uploadedfile import InMemoryUploadedFile
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.document_split_node.i_document_split_node import IDocumentSplitNode
-from common.chunk import text_to_chunk
-from knowledge.serializers.document import default_split_handle, FileBufferHandle, md_qa_split_handle
-
-
-def bytes_to_uploaded_file(file_bytes, file_name="file.txt"):
- if file_name.startswith("http"):
- file_name = "file.txt"
- content_type, _ = mimetypes.guess_type(file_name)
- if content_type is None:
- # 如果未能识别,设置为默认的二进制文件类型
- content_type = "application/octet-stream"
- # 创建一个内存中的字节流对象
- file_stream = io.BytesIO(file_bytes)
-
- # 获取文件大小
- file_size = len(file_bytes)
-
- # 创建 InMemoryUploadedFile 对象
- uploaded_file = InMemoryUploadedFile(
- file=file_stream,
- field_name=None,
- name=file_name,
- content_type=content_type,
- size=file_size,
- charset=None,
- )
- return uploaded_file
-
-
-class BaseDocumentSplitNode(IDocumentSplitNode):
- def save_context(self, details, workflow_manage):
- self.context['content'] = details.get('content')
- self.context['exception_message'] = details.get('err_message')
-
- def get_reference_content(self, fields: List[str]):
- return self.workflow_manage.get_reference_field(fields[0], fields[1:]) if fields else None
-
- def execute(self, document_list, knowledge_id, split_strategy, paragraph_title_relate_problem_type,
- paragraph_title_relate_problem, paragraph_title_relate_problem_reference,
- document_name_relate_problem_type, document_name_relate_problem,
- document_name_relate_problem_reference, limit, limit_type, limit_reference, chunk_size, chunk_size_type,
- chunk_size_reference, patterns, patterns_type, patterns_reference, with_filter, with_filter_type,
- with_filter_reference, **kwargs) -> NodeResult:
- self.context['knowledge_id'] = knowledge_id
- file_list = self.get_reference_content(document_list)
-
- # 处理引用类型的参数
- if patterns_type == 'referencing':
- patterns = self.get_reference_content(patterns_reference)
- if limit_type == 'referencing':
- limit = self.get_reference_content(limit_reference)
- if chunk_size_type == 'referencing':
- chunk_size = self.get_reference_content(chunk_size_reference)
- if with_filter_type == 'referencing':
- with_filter = self.get_reference_content(with_filter_reference)
-
- paragraph_list = []
- for doc in file_list:
- get_buffer = FileBufferHandle().get_buffer
-
- file_mem = bytes_to_uploaded_file(doc['content'].encode('utf-8'), doc['name'])
- if split_strategy == 'qa':
- result = md_qa_split_handle.handle(file_mem, get_buffer, self._save_image)
- else:
- result = default_split_handle.handle(file_mem, patterns, with_filter, limit, get_buffer,
- self._save_image)
- # 统一处理结果为列表
- results = result if isinstance(result, list) else [result]
-
- for item in results:
- self._process_split_result(
- item, knowledge_id, doc.get('id'), doc.get('name'),
- split_strategy, paragraph_title_relate_problem_type,
- paragraph_title_relate_problem, paragraph_title_relate_problem_reference,
- document_name_relate_problem_type, document_name_relate_problem,
- document_name_relate_problem_reference, chunk_size
- )
-
- paragraph_list += results
-
- self.context['paragraph_list'] = paragraph_list
- self.context['document_list'] = file_list
- self.context['limit'] = limit
- self.context['chunk_size'] = chunk_size
- self.context['with_filter'] = with_filter
- self.context['patterns'] = patterns
- self.context['split_strategy'] = split_strategy
-
- return NodeResult({'paragraph_list': paragraph_list}, {})
-
- def _save_image(self, image_list):
- pass
-
- def _process_split_result(
- self, item, knowledge_id, source_file_id, file_name,
- split_strategy, paragraph_title_relate_problem_type,
- paragraph_title_relate_problem, paragraph_title_relate_problem_reference,
- document_name_relate_problem_type, document_name_relate_problem,
- document_name_relate_problem_reference, chunk_size
- ):
- """处理文档分割结果"""
- item['meta'] = {
- 'knowledge_id': knowledge_id,
- 'source_file_id': source_file_id,
- 'source_url': file_name,
- }
- if item.get('name', 'file.txt') == 'file.txt':
- item['name'] = file_name
- item['source_file_id'] = source_file_id
- item['paragraphs'] = item.pop('content', item.get('paragraphs', []))
-
- for paragraph in item['paragraphs']:
- paragraph['problem_list'] = self._generate_problem_list(
- paragraph, file_name,
- split_strategy, paragraph_title_relate_problem_type,
- paragraph_title_relate_problem, paragraph_title_relate_problem_reference,
- document_name_relate_problem_type, document_name_relate_problem,
- document_name_relate_problem_reference
- )
- paragraph['is_active'] = True
- paragraph['chunks'] = text_to_chunk(paragraph['content'], chunk_size)
-
- def _generate_problem_list(
- self, paragraph, document_name, split_strategy, paragraph_title_relate_problem_type,
- paragraph_title_relate_problem, paragraph_title_relate_problem_reference,
- document_name_relate_problem_type, document_name_relate_problem,
- document_name_relate_problem_reference
- ):
- if paragraph_title_relate_problem_type == 'referencing':
- paragraph_title_relate_problem = self.get_reference_content(paragraph_title_relate_problem_reference)
- if document_name_relate_problem_type == 'referencing':
- document_name_relate_problem = self.get_reference_content(document_name_relate_problem_reference)
-
- problem_list = [
- item for p in paragraph.get('problem_list', []) for item in p.get('content', '').split('
')
- if item.strip()
- ]
-
- if split_strategy == 'auto':
- if paragraph_title_relate_problem and paragraph.get('title'):
- problem_list.append(paragraph.get('title'))
- if document_name_relate_problem and document_name:
- problem_list.append(document_name)
- elif split_strategy == 'custom':
- if paragraph_title_relate_problem and paragraph.get('title'):
- problem_list.append(paragraph.get('title'))
- if document_name_relate_problem and document_name:
- problem_list.append(document_name)
- elif split_strategy == 'qa':
- if document_name_relate_problem and document_name:
- problem_list.append(document_name)
-
- return list(set(problem_list))
-
- def get_details(self, index: int, **kwargs):
- paragraph_list = self.context.get('paragraph_list', [])
- # 每个文档保留前5个分段
- limited_paragraph_list = []
- for doc in paragraph_list:
- if doc.get('paragraphs'):
- doc_copy = doc.copy()
- doc_copy['paragraphs'] = doc['paragraphs'][:5]
- limited_paragraph_list.append(doc_copy)
- else:
- limited_paragraph_list.append(doc)
- paragraph_list = limited_paragraph_list
-
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'paragraph_list': paragraph_list,
- 'limit': self.context.get('limit'),
- 'chunk_size': self.context.get('chunk_size'),
- 'with_filter': self.context.get('with_filter'),
- 'patterns': self.context.get('patterns'),
- 'split_strategy': self.context.get('split_strategy'),
- 'enableException': self.node.properties.get('enableException'),
- # 'document_list': self.context.get('document_list', []),
- }
diff --git a/apps/application/flow/step_node/form_node/__init__.py b/apps/application/flow/step_node/form_node/__init__.py
deleted file mode 100644
index ce04b64aea8..00000000000
--- a/apps/application/flow/step_node/form_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py.py
- @date:2024/11/4 14:48
- @desc:
-"""
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/form_node/i_form_node.py b/apps/application/flow/step_node/form_node/i_form_node.py
deleted file mode 100644
index 9be117f857f..00000000000
--- a/apps/application/flow/step_node/form_node/i_form_node.py
+++ /dev/null
@@ -1,37 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: i_form_node.py
- @date:2024/11/4 14:48
- @desc:
-"""
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-from django.utils.translation import gettext_lazy as _
-
-
-class FormNodeParamsSerializer(serializers.Serializer):
- form_field_list = serializers.ListField(required=True, label=_("Form Configuration"))
- form_content_format = serializers.CharField(required=True, label=_('Form output content'))
- form_data = serializers.DictField(required=False, allow_null=True, label=_("Form Data"))
-
-
-class IFormNode(INode):
- type = 'form-node'
- view_type = 'single_view'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return FormNodeParamsSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, form_field_list, form_content_format, form_data, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/form_node/impl/__init__.py b/apps/application/flow/step_node/form_node/impl/__init__.py
deleted file mode 100644
index 4cea85e1d9e..00000000000
--- a/apps/application/flow/step_node/form_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py.py
- @date:2024/11/4 14:49
- @desc:
-"""
-from .base_form_node import BaseFormNode
diff --git a/apps/application/flow/step_node/form_node/impl/base_form_node.py b/apps/application/flow/step_node/form_node/impl/base_form_node.py
deleted file mode 100644
index 710811f1505..00000000000
--- a/apps/application/flow/step_node/form_node/impl/base_form_node.py
+++ /dev/null
@@ -1,238 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: base_form_node.py
- @date:2024/11/4 14:52
- @desc:
-"""
-import copy
-import json
-import time
-from typing import Dict, List
-
-from langchain_core.prompts import PromptTemplate
-
-from application.flow.common import Answer
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.form_node.i_form_node import IFormNode
-import re
-
-_TEMPLATE_RE = re.compile(r'\{\{([^.\s}]+)\.([^.\s}]+)\}\}')
-multi_select_list = [
- 'MultiSelect',
- 'MultiRow'
-]
-
-
-def get_default_option(option_list, _type, value_field):
- try:
- if option_list is not None and isinstance(option_list, list) and len(option_list) > 0:
- default_value_list = [o.get(value_field) for o in option_list if o.get('default')]
- if len(default_value_list) == 0:
- return [option_list[0].get(
- value_field)] if multi_select_list.__contains__(_type) else option_list[0].get(
- value_field)
- else:
- if multi_select_list.__contains__(_type):
- return default_value_list
- else:
- return default_value_list[0]
- except Exception as _:
- pass
- return []
-
-
-def write_context(step_variable: Dict, global_variable: Dict, node, workflow):
- if step_variable is not None:
- for key in step_variable:
- node.context[key] = step_variable[key]
- if workflow.is_result(node, NodeResult(step_variable, global_variable)) and 'result' in step_variable:
- result = step_variable['result']
- yield result
- node.answer_text = result
- node.context['run_time'] = time.time() - node.context['start_time']
-
-
-def generate_prompt(workflow_manage, _value):
- try:
- return workflow_manage.generate_prompt(_value)
- except Exception as e:
- return _value
-
-
-class BaseFormNode(IFormNode):
- def save_context(self, details, workflow_manage):
- form_data = details.get('form_data', None)
- self.context['result'] = details.get('result')
- self.context['form_content_format'] = details.get('form_content_format')
- self.context['form_field_list'] = details.get('form_field_list')
- self.context['run_time'] = details.get('run_time')
- self.context['start_time'] = details.get('start_time')
- self.context['form_data'] = form_data
- self.context['is_submit'] = details.get('is_submit')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('result')
- if form_data is not None:
- for key in form_data:
- self.context[key] = form_data[key]
-
- def reset_field(self, field):
- field = copy.copy(field)
- reset_field = ['field', 'label', 'default_value']
- for f in reset_field:
- _value = field[f]
- if _value is None:
- continue
- if isinstance(_value, str):
- field[f] = generate_prompt(self.workflow_manage, _value)
- elif f == 'label':
- _label_value = _value.get('label')
- _value['label'] = generate_prompt(self.workflow_manage, _label_value)
- tooltip = _value.get('attrs').get('tooltip')
- if tooltip is not None:
- _value.get('attrs')['tooltip'] = generate_prompt(self.workflow_manage, tooltip)
-
- if ['SingleSelect', 'MultiSelect', 'RadioCard', 'RadioRow', 'MultiRow'].__contains__(field.get('input_type')):
- if field.get('assignment_method') == 'ref_variables':
- option_list = self.workflow_manage.get_reference_field(field.get('option_list')[0],
- field.get('option_list')[1:])
- option_list = option_list if isinstance(option_list, list) else []
- field['option_list'] = option_list
- field['default_value'] = get_default_option(option_list, field.get('input_type'),
- field.get('value_field'))
-
- if ['JsonInput'].__contains__(field.get('input_type')):
- if field.get('default_value_assignment_method') == 'ref_variables':
- field['default_value'] = self.workflow_manage.get_reference_field(field.get('default_value')[0],
- field.get('default_value')[1:])
-
- visibility_rules = field.get('visibility_rules')
- if visibility_rules and isinstance(visibility_rules.get('conditions'), list):
- for cond in visibility_rules['conditions']:
- cond_field = cond.get('field')
- if not cond_field or len(cond_field) < 2 or not cond_field[0] or not cond_field[1]:
- continue
-
- # cross node -------> _left
- if cond_field[0] != self.node.id:
- cond['_left'] = self.workflow_manage.get_reference_field(cond_field[0], cond_field[1:])
- # 右值 {{}}
- cond_value = cond.get("value")
- if isinstance(cond_value, str) and _TEMPLATE_RE.search(cond_value):
- cond['value'] = self._render_cond_value(cond_value)
-
- return field
-
- def _render_cond_value(self, value):
- """
- render cross-node/global/chat {{}} to literal, preserve same-form {{}}
- match.group(0) → "{{开始.question}}" # 完整匹配
- match.group(1) → "开始" # 第一个 () 捕获的
- match.group(2) → "question" # 第二个 () 捕获的
- match.start() → 3 # 匹配起始位置
- match.end() → 16 # 匹配结束位置
- """
- def replacer(match):
- node_display = match.group(1)
- field_name = match.group(2)
-
- # field_list: cross_node
- for f in self.workflow_manage.field_list:
- if f.get('node_name') == node_display and f.get('value') == field_name:
- if f.get('node_id') == self.node.id:
- return match.group(0) # same node
- ref = self.workflow_manage.get_reference_field(f.get('node_id'),[field_name])
- return str(ref) if ref is not None else ''
-
- # global
- if node_display in ('全局变量', 'global'):
- for f in self.workflow_manage.global_field_list:
- if f.get('value') == field_name:
- ref = self.workflow_manage.get_reference_field('global', [field_name])
- return str(ref) if ref is not None else ''
-
- # chat
- if node_display == 'chat':
- for f in self.workflow_manage.chat_field_list:
- if f.get("value") == field_name:
- ref = self.workflow_manage.get_reference_field('chat', [field_name])
- return str(ref) if ref is not None else ''
- return match.group(0)
- try:
- return _TEMPLATE_RE.sub(replacer, value)
- except Exception:
- return value
-
- def execute(self, form_field_list, form_content_format, form_data, **kwargs) -> NodeResult:
- if form_data is not None:
- self.context['is_submit'] = True
- self.context['form_data'] = form_data
- for key in form_data:
- self.context[key] = form_data.get(key)
- else:
- self.context['is_submit'] = False
- form_field_list = [self.reset_field(field) for field in form_field_list]
- form_setting = {"form_field_list": form_field_list, "runtime_node_id": self.runtime_node_id,
- "chat_record_id": self.flow_params_serializer.data.get("chat_record_id"),
- "is_submit": self.context.get("is_submit", False)}
- form = f'{json.dumps(form_setting, ensure_ascii=False)}'
- context = self.workflow_manage.get_workflow_content()
- form_content_format = self.workflow_manage.reset_prompt(form_content_format)
- prompt_template = PromptTemplate.from_template(form_content_format, template_format='jinja2')
- value = prompt_template.format(form=form, context=context, runtime_node_id=self.runtime_node_id,
- chat_record_id=self.flow_params_serializer.data.get("chat_record_id"),
- form_field_list=form_field_list)
-
- return NodeResult(
- {'result': value, 'form_field_list': form_field_list, 'form_content_format': form_content_format}, {},
- _write_context=write_context)
-
- def get_answer_list(self) -> List[Answer] | None:
- form_content_format = self.context.get('form_content_format')
- form_field_list = self.context.get('form_field_list')
- form_setting = {"form_field_list": form_field_list, "runtime_node_id": self.runtime_node_id,
- "chat_record_id": self.flow_params_serializer.data.get("chat_record_id"),
- 'form_data': self.context.get('form_data', {}),
- "is_submit": self.context.get("is_submit", False)}
- form = f'{json.dumps(form_setting, ensure_ascii=False)}'
- context = self.workflow_manage.get_workflow_content()
- form_content_format = self.workflow_manage.reset_prompt(form_content_format)
- prompt_template = PromptTemplate.from_template(form_content_format, template_format='jinja2')
- value = prompt_template.format(form=form, context=context, runtime_node_id=self.runtime_node_id,
- chat_record_id=self.flow_params_serializer.data.get("chat_record_id"),
- form_field_list=form_field_list)
- return [
- Answer(value, self.view_type, self.runtime_node_id, self.workflow_params.get('chat_record_id') or '', None,
- self.runtime_node_id, '')]
-
- def get_details(self, index: int, **kwargs):
- form_content_format = self.context.get('form_content_format')
- form_field_list = self.context.get('form_field_list')
- form_setting = {"form_field_list": form_field_list, "runtime_node_id": self.runtime_node_id,
- "chat_record_id": self.flow_params_serializer.data.get("chat_record_id"),
- 'form_data': self.context.get('form_data', {}),
- "is_submit": self.context.get("is_submit", False)}
- form = f'{json.dumps(form_setting, ensure_ascii=False)}'
- context = self.workflow_manage.get_workflow_content()
- form_content_format = self.workflow_manage.reset_prompt(form_content_format)
- prompt_template = PromptTemplate.from_template(form_content_format, template_format='jinja2')
- value = prompt_template.format(form=form, context=context, runtime_node_id=self.runtime_node_id,
- chat_record_id=self.flow_params_serializer.data.get("chat_record_id"),
- form_field_list=form_field_list)
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "result": value,
- "form_content_format": self.context.get('form_content_format'),
- "form_field_list": self.context.get('form_field_list'),
- 'form_data': self.context.get('form_data'),
- 'start_time': self.context.get('start_time'),
- 'is_submit': self.context.get('is_submit'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/image_generate_step_node/__init__.py b/apps/application/flow/step_node/image_generate_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/image_generate_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/image_generate_step_node/i_image_generate_node.py b/apps/application/flow/step_node/image_generate_step_node/i_image_generate_node.py
deleted file mode 100644
index 834c842fd14..00000000000
--- a/apps/application/flow/step_node/image_generate_step_node/i_image_generate_node.py
+++ /dev/null
@@ -1,56 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class ImageGenerateNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- prompt = serializers.CharField(required=True, label=_("Prompt word (positive)"))
-
- negative_prompt = serializers.CharField(required=False, label=_("Prompt word (negative)"),
- allow_null=True, allow_blank=True, )
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=False, default=0,
- label=_("Number of multi-round conversations"))
-
- dialogue_type = serializers.CharField(required=False, default='NODE',
- label=_("Conversation storage type"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- model_params_setting = serializers.JSONField(required=False, default=dict,
- label=_("Model parameter settings"))
-
-
-class IImageGenerateNode(INode):
- type = 'image-generate-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ImageGenerateNodeSerializer
-
- def _run(self):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, prompt, negative_prompt, dialogue_number, dialogue_type, history_chat_record,
- model_params_setting,
- chat_record_id, model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/image_generate_step_node/impl/__init__.py b/apps/application/flow/step_node/image_generate_step_node/impl/__init__.py
deleted file mode 100644
index 14a21a9159c..00000000000
--- a/apps/application/flow/step_node/image_generate_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_image_generate_node import BaseImageGenerateNode
diff --git a/apps/application/flow/step_node/image_generate_step_node/impl/base_image_generate_node.py b/apps/application/flow/step_node/image_generate_step_node/impl/base_image_generate_node.py
deleted file mode 100644
index 281122364be..00000000000
--- a/apps/application/flow/step_node/image_generate_step_node/impl/base_image_generate_node.py
+++ /dev/null
@@ -1,199 +0,0 @@
-# coding=utf-8
-from functools import reduce
-from typing import List
-
-import requests
-from langchain_core.messages import BaseMessage, HumanMessage, AIMessage
-from django.utils.translation import gettext_lazy as _
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.image_generate_step_node.i_image_generate_node import IImageGenerateNode
-from common.utils.common import bytes_to_uploaded_file
-from knowledge.models import FileSourceType
-from models_provider.tools import get_model_instance_by_model_workspace_id
-from oss.serializers.file import FileSerializer
-
-
-class BaseImageGenerateNode(IImageGenerateNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['question'] = details.get('question')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, prompt, negative_prompt, dialogue_number, dialogue_type, history_chat_record,
- model_params_setting,
- chat_record_id,
- model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
-
- if model_id is None or model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
-
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- tti_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- history_message = self.get_history_message(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
- question = self.generate_prompt_question(prompt)
- self.context['question'] = question
- message_list = self.generate_message_list(question, history_message)
- self.context['message_list'] = message_list
- self.context['dialogue_type'] = dialogue_type
- self.context['negative_prompt'] = self.generate_prompt_question(negative_prompt)
- image_urls = tti_model.generate_image(question, negative_prompt)
- # 保存图片
- file_urls = []
- for image_url in image_urls:
- file_name = 'generated_image.png'
- if isinstance(image_url, str):
- if image_url.startswith('http'):
- # HTTP URL 情况
- image_url = requests.get(image_url).content
- elif image_url.startswith('data:image'):
- # Data URL 格式 (data:image/png;base64,...)
- import base64
- header, encoded = image_url.split(',', 1)
- image_url = base64.b64decode(encoded)
- else:
- import base64
- image_url = base64.b64decode(image_url)
- file = bytes_to_uploaded_file(image_url, file_name)
- file_url = self.upload_file(file)
- file_urls.append(file_url)
- self.context['image_list'] = [{'file_id': path.split('/')[-1], 'url': path} for path in file_urls]
- answer = ' '.join([f"" for path in file_urls])
- return NodeResult({'answer': answer, 'chat_model': tti_model, 'message_list': message_list,
- 'image': [{'file_id': path.split('/')[-1], 'url': path} for path in file_urls],
- 'history_message': history_message, 'question': question}, {})
-
- def generate_history_ai_message(self, chat_record):
- for val in chat_record.details.values():
- if self.node.id == val['node_id'] and 'image_list' in val:
- if val['dialogue_type'] == 'WORKFLOW':
- return chat_record.get_ai_message()
- image_list = val['image_list']
- return AIMessage(content=[
- *[{'type': 'image_url', 'image_url': {'url': f'{file_url}'}} for file_url in image_list]
- ])
- return chat_record.get_ai_message()
-
- def get_history_message(self, history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message(history_chat_record[index]),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_human_message(self, chat_record):
-
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'image_list' in data:
- image_list = data['image_list']
- if len(image_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
- return HumanMessage(content=data['question'])
- return HumanMessage(content=chat_record.problem_text)
-
- def generate_prompt_question(self, prompt):
- return self.workflow_manage.generate_prompt(prompt)
-
- def generate_message_list(self, question: str, history_message):
- return [
- *history_message,
- question
- ]
-
- def upload_file(self, file):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.upload_knowledge_file(file)
- if [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- return self.upload_tool_file(file)
- return self.upload_application_file(file)
-
- def upload_knowledge_file(self, file):
- knowledge_id = self.workflow_params.get('knowledge_id')
- meta = {
- 'debug': False,
- 'knowledge_id': knowledge_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': knowledge_id,
- 'source_type': FileSourceType.KNOWLEDGE.value
- }).upload()
- return file_url
-
- def upload_tool_file(self, file):
- tool_id = self.workflow_params.get('tool_id')
- meta = {
- 'debug': False,
- 'tool_id': tool_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': tool_id,
- 'source_type': FileSourceType.TOOL.value
- }).upload()
- return file_url
-
- def upload_application_file(self, file):
- application = self.workflow_manage.work_flow_post_handler.chat_info.application
- chat_id = self.workflow_params.get('chat_id')
- meta = {
- 'debug': False if application.id else True,
- 'chat_id': chat_id,
- 'application_id': str(application.id) if application.id else None,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': meta['application_id'],
- 'source_type': FileSourceType.APPLICATION.value
- }).upload()
- return file_url
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (self.context.get('history_message') if self.context.get(
- 'history_message') is not None else [])],
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'image_list': self.context.get('image_list'),
- 'dialogue_type': self.context.get('dialogue_type'),
- 'negative_prompt': self.context.get('negative_prompt'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/image_to_video_step_node/__init__.py b/apps/application/flow/step_node/image_to_video_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/image_to_video_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/image_to_video_step_node/i_image_to_video_node.py b/apps/application/flow/step_node/image_to_video_step_node/i_image_to_video_node.py
deleted file mode 100644
index 846f4e90d8f..00000000000
--- a/apps/application/flow/step_node/image_to_video_step_node/i_image_to_video_node.py
+++ /dev/null
@@ -1,78 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class ImageToVideoNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
-
- prompt = serializers.CharField(required=True, label=_("Prompt word (positive)"))
-
- negative_prompt = serializers.CharField(required=False, label=_("Prompt word (negative)"),
- allow_null=True, allow_blank=True, )
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=False, default=0,
- label=_("Number of multi-round conversations"))
-
- dialogue_type = serializers.CharField(required=False, default='NODE',
- label=_("Conversation storage type"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- model_params_setting = serializers.JSONField(required=False, default=dict,
- label=_("Model parameter settings"))
-
- first_frame_url = serializers.ListField(required=True, label=_("First frame url"))
- last_frame_url = serializers.ListField(required=False, label=_("Last frame url"))
-
-
-class IImageToVideoNode(INode):
- type = 'image-to-video-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ImageToVideoNodeSerializer
-
- def _run(self):
- first_frame_url = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('first_frame_url')[0],
- self.node_params_serializer.data.get('first_frame_url')[1:])
- if first_frame_url is []:
- raise ValueError(
- _("First frame url cannot be empty"))
- last_frame_url = None
- if self.node_params_serializer.data.get('last_frame_url') is not None and self.node_params_serializer.data.get(
- 'last_frame_url') != []:
- last_frame_url = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('last_frame_url')[0],
- self.node_params_serializer.data.get('last_frame_url')[1:])
- node_params_data = {k: v for k, v in self.node_params_serializer.data.items()
- if k not in ['first_frame_url', 'last_frame_url']}
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(first_frame_url=first_frame_url, last_frame_url=last_frame_url, **node_params_data,
- **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None})
- else:
- return self.execute(first_frame_url=first_frame_url, last_frame_url=last_frame_url,
- **node_params_data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, prompt, negative_prompt, dialogue_number, dialogue_type, history_chat_record,
- model_params_setting,
- chat_record_id,
- first_frame_url, last_frame_url,
- model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/image_to_video_step_node/impl/__init__.py b/apps/application/flow/step_node/image_to_video_step_node/impl/__init__.py
deleted file mode 100644
index 95be14851cb..00000000000
--- a/apps/application/flow/step_node/image_to_video_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_image_to_video_node import BaseImageToVideoNode
diff --git a/apps/application/flow/step_node/image_to_video_step_node/impl/base_image_to_video_node.py b/apps/application/flow/step_node/image_to_video_step_node/impl/base_image_to_video_node.py
deleted file mode 100644
index 97acad76337..00000000000
--- a/apps/application/flow/step_node/image_to_video_step_node/impl/base_image_to_video_node.py
+++ /dev/null
@@ -1,214 +0,0 @@
-# coding=utf-8
-import base64
-from functools import reduce
-from typing import List
-
-import requests
-from django.db.models import QuerySet
-from langchain_core.messages import BaseMessage, HumanMessage, AIMessage
-from django.utils.translation import gettext_lazy as _
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.image_to_video_step_node.i_image_to_video_node import IImageToVideoNode
-from common.utils.common import bytes_to_uploaded_file
-from knowledge.models import FileSourceType, File
-from oss.serializers.file import FileSerializer, mime_types
-from models_provider.tools import get_model_instance_by_model_workspace_id
-from django.utils.translation import gettext
-
-
-class BaseImageToVideoNode(IImageToVideoNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['question'] = details.get('question')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, prompt, negative_prompt, dialogue_number, dialogue_type, history_chat_record,
- model_params_setting,
- chat_record_id,
- first_frame_url, last_frame_url=None,
- model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
- if model_id is None or model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- ttv_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- history_message = self.get_history_message(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
- question = self.generate_prompt_question(prompt)
- self.context['question'] = question
- message_list = self.generate_message_list(question, history_message)
- self.context['message_list'] = message_list
- self.context['dialogue_type'] = dialogue_type
- self.context['negative_prompt'] = self.generate_prompt_question(negative_prompt)
- self.context['first_frame_url'] = first_frame_url
- self.context['last_frame_url'] = last_frame_url
- # 处理首尾帧图片 这块可以是url 也可以是file_id 如果是url 可以直接传递给模型 如果是file_id 需要传base64
- # 判断是不是 url
- first_frame_url = self.get_file_base64(first_frame_url)
- last_frame_url = self.get_file_base64(last_frame_url)
- video_urls = ttv_model.generate_video(question, negative_prompt, first_frame_url, last_frame_url)
- # 保存图片
- if video_urls is None or video_urls == '':
- return NodeResult({'answer': gettext('Failed to generate video')}, {})
- file_name = 'generated_video.mp4'
- if isinstance(video_urls, str) and video_urls.startswith('http'):
- video_urls = requests.get(video_urls).content
- file = bytes_to_uploaded_file(video_urls, file_name)
- file_url = self.upload_file(file)
- video_label = f''
- video_list = [{'file_id': file_url.split('/')[-1], 'file_name': file_name, 'url': file_url}]
- return NodeResult({'answer': video_label, 'chat_model': ttv_model, 'message_list': message_list,
- 'video': video_list,
- 'history_message': history_message, 'question': question}, {})
-
- def get_file_base64(self, image_url):
- try:
- if isinstance(image_url, list):
- image_url = image_url[0].get('file_id') if 'file_id' in image_url[0] else image_url[0].get('url')
- if isinstance(image_url, str) and not image_url.startswith('http'):
- file = QuerySet(File).filter(id=image_url).first()
- file_bytes = file.get_bytes()
- # 如果我不知道content_type 可以用 magic 库去检测
- file_type = file.file_name.split(".")[-1].lower()
- content_type = mime_types.get(file_type, 'application/octet-stream')
- encoded_bytes = base64.b64encode(file_bytes)
- return f'data:{content_type};base64,{encoded_bytes.decode()}'
- return image_url
- except Exception as e:
- raise ValueError(
- gettext("Failed to obtain the image"))
-
- def upload_file(self, file):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.upload_knowledge_file(file)
- if [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- return self.upload_tool_file(file)
- return self.upload_application_file(file)
-
- def upload_knowledge_file(self, file):
- knowledge_id = self.workflow_params.get('knowledge_id')
- meta = {
- 'debug': False,
- 'knowledge_id': knowledge_id
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': knowledge_id,
- 'source_type': FileSourceType.KNOWLEDGE.value
- }).upload()
- return file_url
-
- def upload_tool_file(self, file):
- tool_id = self.workflow_params.get('tool_id')
- meta = {
- 'debug': False,
- 'tool_id': tool_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': tool_id,
- 'source_type': FileSourceType.TOOL.value
- }).upload()
- return file_url
-
- def upload_application_file(self, file):
- application = self.workflow_manage.work_flow_post_handler.chat_info.application
- chat_id = self.workflow_params.get('chat_id')
- meta = {
- 'debug': False if application.id else True,
- 'chat_id': chat_id,
- 'application_id': str(application.id) if application.id else None,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': meta['application_id'],
- 'source_type': FileSourceType.APPLICATION.value
- }).upload()
- return file_url
-
- def generate_history_ai_message(self, chat_record):
- for val in chat_record.details.values():
- if self.node.id == val['node_id'] and 'image_list' in val:
- if val['dialogue_type'] == 'WORKFLOW':
- return chat_record.get_ai_message()
- image_list = val['image_list']
- return AIMessage(content=[
- *[{'type': 'image_url', 'image_url': {'url': f'{file_url}'}} for file_url in image_list]
- ])
- return chat_record.get_ai_message()
-
- def get_history_message(self, history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message(history_chat_record[index]),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_human_message(self, chat_record):
-
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'image_list' in data:
- image_list = data['image_list']
- if len(image_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
- return HumanMessage(content=data['question'])
- return HumanMessage(content=chat_record.problem_text)
-
- def generate_prompt_question(self, prompt):
- return self.workflow_manage.generate_prompt(prompt)
-
- def generate_message_list(self, question: str, history_message):
- return [
- *history_message,
- question
- ]
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (self.context.get('history_message') if self.context.get(
- 'history_message') is not None else [])],
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'first_frame_url': self.context.get('first_frame_url'),
- 'last_frame_url': self.context.get('last_frame_url'),
- 'dialogue_type': self.context.get('dialogue_type'),
- 'negative_prompt': self.context.get('negative_prompt'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/image_understand_step_node/__init__.py b/apps/application/flow/step_node/image_understand_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/image_understand_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/image_understand_step_node/i_image_understand_node.py b/apps/application/flow/step_node/image_understand_step_node/i_image_understand_node.py
deleted file mode 100644
index 907ad019a33..00000000000
--- a/apps/application/flow/step_node/image_understand_step_node/i_image_understand_node.py
+++ /dev/null
@@ -1,63 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-from django.utils.translation import gettext_lazy as _
-
-
-class ImageUnderstandNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- system = serializers.CharField(required=False, allow_blank=True, allow_null=True,
- label=_("Role Setting"))
- prompt = serializers.CharField(required=True, label=_("Prompt word"))
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
-
- dialogue_type = serializers.CharField(required=True, label=_("Conversation storage type"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- image_list = serializers.ListField(required=False, label=_("picture"))
-
- model_params_setting = serializers.JSONField(required=False, default=dict,
- label=_("Model parameter settings"))
- model_setting = serializers.DictField(required=False,
- label='Model settings')
-
-
-class IImageUnderstandNode(INode):
- type = 'image-understand-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ImageUnderstandNodeSerializer
-
- def _run(self):
- res = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('image_list')[0],
- self.node_params_serializer.data.get('image_list')[1:])
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(image=res, **self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_record_id': None})
- else:
- return self.execute(image=res, **self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, system, prompt, dialogue_number, dialogue_type, history_chat_record, stream,
- model_params_setting,
- chat_record_id,
- image,
- model_id_type=None, model_id_reference=None,
- model_setting=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/image_understand_step_node/impl/__init__.py b/apps/application/flow/step_node/image_understand_step_node/impl/__init__.py
deleted file mode 100644
index ba251283921..00000000000
--- a/apps/application/flow/step_node/image_understand_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_image_understand_node import BaseImageUnderstandNode
diff --git a/apps/application/flow/step_node/image_understand_step_node/impl/base_image_understand_node.py b/apps/application/flow/step_node/image_understand_step_node/impl/base_image_understand_node.py
deleted file mode 100644
index 43ad363d106..00000000000
--- a/apps/application/flow/step_node/image_understand_step_node/impl/base_image_understand_node.py
+++ /dev/null
@@ -1,340 +0,0 @@
-# coding=utf-8
-import base64
-import time
-from functools import reduce
-from imghdr import what
-from typing import List, Dict
-
-from django.db.models import QuerySet
-from langchain_core.messages import BaseMessage, HumanMessage, SystemMessage, AIMessage
-from django.utils.translation import gettext_lazy as _
-from application.flow.i_step_node import NodeResult, INode
-from application.flow.step_node.image_understand_step_node.i_image_understand_node import IImageUnderstandNode
-from application.flow.tools import Reasoning
-from knowledge.models import File
-from models_provider.tools import get_model_instance_by_model_workspace_id
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str,
- reasoning_content: str):
- chat_model = node_variable.get('chat_model')
- message_tokens = chat_model.get_num_tokens_from_messages(node_variable.get('message_list'))
- answer_tokens = chat_model.get_num_tokens(answer)
- node.context['message_tokens'] = message_tokens
- node.context['answer_tokens'] = answer_tokens
- node.context['answer'] = answer
- node.context['history_message'] = node_variable['history_message']
- node.context['question'] = node_variable['question']
- node.context['run_time'] = time.time() - node.context['start_time']
- node.context['reasoning_content'] = reasoning_content
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- answer = ''
- reasoning_content = ''
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start', ''),
- model_setting.get('reasoning_content_end', ''))
- response_reasoning_content = False
-
- for chunk in response:
- if workflow.is_the_task_interrupted():
- break
-
- # 处理 reasoning content
- reasoning_chunk = reasoning.get_reasoning_content(chunk)
- content_chunk = reasoning_chunk.get('content')
- if 'reasoning_content' in chunk.additional_kwargs:
- response_reasoning_content = True
- reasoning_content_chunk = chunk.additional_kwargs.get('reasoning_content', '')
- else:
- reasoning_content_chunk = reasoning_chunk.get('reasoning_content')
-
- answer += content_chunk
- if reasoning_content_chunk is None:
- reasoning_content_chunk = ''
- reasoning_content += reasoning_content_chunk
-
- # 处理 chunk.content 为 list 的情况
- if isinstance(chunk.content, list):
- for chunk_item in chunk.content:
- text = chunk_item.get("text", "")
- yield {'content': text,
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
- else:
- text = chunk.content or ""
- yield {'content': text,
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
-
- reasoning_chunk = reasoning.get_end_reasoning_content()
- answer += reasoning_chunk.get('content')
- reasoning_content_chunk = ""
- if not response_reasoning_content:
- reasoning_content_chunk = reasoning_chunk.get(
- 'reasoning_content')
- yield {'content': reasoning_chunk.get('content'),
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
- _write_context(node_variable, workflow_variable, node, workflow, answer, reasoning_content)
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点实例对象
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start'), model_setting.get('reasoning_content_end'))
- reasoning_result = reasoning.get_reasoning_content(response)
- reasoning_result_end = reasoning.get_end_reasoning_content()
- content = reasoning_result.get('content') + reasoning_result_end.get('content')
- meta = {**response.response_metadata, **response.additional_kwargs}
- if 'reasoning_content' in meta:
- reasoning_content = (meta.get('reasoning_content', '') or '')
- else:
- reasoning_content = (reasoning_result.get('reasoning_content') or '') + (
- reasoning_result_end.get('reasoning_content') or '')
- _write_context(node_variable, workflow_variable, node, workflow, content, reasoning_content)
-
-
-def file_id_to_base64(file_id: str):
- file = QuerySet(File).filter(id=file_id).first()
- file_bytes = file.get_bytes()
- base64_image = base64.b64encode(file_bytes).decode("utf-8")
- return [base64_image, what(None, file_bytes)]
-
-
-class BaseImageUnderstandNode(IImageUnderstandNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['question'] = details.get('question')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, system, prompt, dialogue_number, dialogue_type, history_chat_record, stream,
- model_params_setting,
- chat_record_id,
- image,
- model_id_type=None, model_id_reference=None,
- model_setting=None,
- **kwargs) -> NodeResult:
- if model_setting is None:
- model_setting = {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''}
- self.context['model_setting'] = model_setting
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
-
- if model_id is None or model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
- # 处理不正确的参数
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- image_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- # 执行详情中的历史消息不需要图片内容
- history_message = self.get_history_message_for_details(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
- question = self.generate_prompt_question(prompt)
- self.context['question'] = question.content
- system = self.workflow_manage.generate_prompt(system)
- self.context['system'] = system
- # 生成消息列表, 真实的history_message
- message_list = self.generate_message_list(image_model, system, prompt,
- self.get_history_message(history_chat_record, dialogue_number), image)
- self.context['message_list'] = message_list
- self.generate_context_image(image)
- self.context['dialogue_type'] = dialogue_type
- if stream:
- r = image_model.stream(message_list)
- return NodeResult({'result': r, 'chat_model': image_model, 'message_list': message_list,
- 'history_message': history_message, 'question': question.content}, {},
- _write_context=write_context_stream)
- else:
- r = image_model.invoke(message_list)
- return NodeResult({'result': r, 'chat_model': image_model, 'message_list': message_list,
- 'history_message': history_message, 'question': question.content}, {},
- _write_context=write_context)
-
- def generate_context_image(self, image):
- if isinstance(image, str) and image.startswith('http'):
- self.context['image_list'] = [{'url': image}]
- elif image is not None and len(image) > 0:
- self.context['image_list'] = image
-
- def get_history_message_for_details(self, history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message_for_details(history_chat_record[index]),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_ai_message(self, chat_record):
- for val in chat_record.details.values():
- if self.node.id == val['node_id'] and 'image_list' in val:
- if val['dialogue_type'] == 'WORKFLOW':
- return chat_record.get_ai_message()
- return AIMessage(content=val['answer'])
- return chat_record.get_ai_message()
-
- def generate_history_human_message_for_details(self, chat_record):
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'image_list' in data:
- image_list = data['image_list'] or []
- if len(image_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
-
- file_id_list = []
- url_list = []
- for image in image_list:
- if 'file_id' in image:
- file_id_list.append(image.get('file_id'))
- elif 'url' in image:
- url_list.append(image.get('url'))
- return HumanMessage(content=[
- {'type': 'text', 'text': data['question']},
- *[{'type': 'image_url', 'image_url': {'url': f'./oss/file/{file_id}'}} for file_id in file_id_list],
- *[{'type': 'image_url', 'image_url': {'url': url}} for url in url_list]
- ])
- return HumanMessage(content=chat_record.problem_text)
-
- def get_history_message(self, history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message(history_chat_record[index]),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_human_message(self, chat_record):
-
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'image_list' in data:
- image_list = data['image_list'] or []
- if len(image_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
- file_id_list = []
- url_list = []
- for image in image_list:
- if 'file_id' in image:
- file_id_list.append(image.get('file_id'))
- elif 'url' in image:
- url_list.append(image.get('url'))
- image_base64_list = [file_id_to_base64(file_id) for file_id in file_id_list]
-
- return HumanMessage(
- content=[
- {'type': 'text', 'text': data['question']},
- *[{'type': 'image_url',
- 'image_url': {'url': f'data:image/{base64_image[1]};base64,{base64_image[0]}'}} for
- base64_image in image_base64_list],
- *[{'type': 'image_url', 'image_url': {'url': url}} for url in url_list]
- ])
- return HumanMessage(content=chat_record.problem_text)
-
- def generate_prompt_question(self, prompt):
- return HumanMessage(self.workflow_manage.generate_prompt(prompt))
-
- def _process_images(self, image):
- """
- 处理图像数据,转换为模型可识别的格式
- """
- images = []
- if isinstance(image, str) and image.startswith('http'):
- images.append({'type': 'image_url', 'image_url': {'url': image}})
- elif image is not None and len(image) > 0:
- for img in image:
- if 'file_id' in img:
- file_id = img['file_id']
- file = QuerySet(File).filter(id=file_id).first()
- image_bytes = file.get_bytes()
- base64_image = base64.b64encode(image_bytes).decode("utf-8")
- image_format = what(None, image_bytes)
- images.append(
- {'type': 'image_url', 'image_url': {'url': f'data:image/{image_format};base64,{base64_image}'}})
- elif 'url' in img and img['url'].startswith('http'):
- images.append(
- {'type': 'image_url', 'image_url': {'url': img["url"]}})
- return images
-
- def generate_message_list(self, image_model, system: str, prompt: str, history_message, image):
- prompt_text = self.workflow_manage.generate_prompt(prompt)
- images = self._process_images(image)
-
- if images:
- messages = [HumanMessage(content=[{'type': 'text', 'text': prompt_text}, *images])]
- else:
- messages = [HumanMessage(prompt_text)]
-
- if system is not None and len(system) > 0:
- return [
- SystemMessage(system),
- *history_message,
- *messages
- ]
- else:
- return [
- *history_message,
- *messages
- ]
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'system': self.context.get('system'),
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (self.context.get('history_message') if self.context.get(
- 'history_message') is not None else [])],
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'reasoning_content': self.context.get('reasoning_content'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'image_list': self.context.get('image_list'),
- 'dialogue_type': self.context.get('dialogue_type'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/intent_node/__init__.py b/apps/application/flow/step_node/intent_node/__init__.py
deleted file mode 100644
index 4b372238e7d..00000000000
--- a/apps/application/flow/step_node/intent_node/__init__.py
+++ /dev/null
@@ -1,6 +0,0 @@
-# coding=utf-8
-
-
-
-
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/intent_node/i_intent_node.py b/apps/application/flow/step_node/intent_node/i_intent_node.py
deleted file mode 100644
index d22d321c842..00000000000
--- a/apps/application/flow/step_node/intent_node/i_intent_node.py
+++ /dev/null
@@ -1,59 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class IntentBranchSerializer(serializers.Serializer):
- id = serializers.CharField(required=True, label=_("Branch id"))
- content = serializers.CharField(required=True, label=_("content"))
- isOther = serializers.BooleanField(required=True, label=_("Branch Type"))
-
-
-class IntentNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- content_list = serializers.ListField(required=True, label=_("Text content"))
- dialogue_number = serializers.IntegerField(required=True, label=
- _("Number of multi-round conversations"))
- model_params_setting = serializers.DictField(required=False,
- label=_("Model parameter settings"))
- branch = IntentBranchSerializer(many=True)
-
-
-class IIntentNode(INode):
- type = 'intent-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def save_context(self, details, workflow_manage):
- pass
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return IntentNodeSerializer
-
- def _run(self):
- question = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('content_list')[0],
- self.node_params_serializer.data.get('content_list')[1:],
- )
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None,
- 'user_input': str(question)})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- user_input=str(question))
-
- def execute(self, model_id, dialogue_number, history_chat_record, user_input, branch,
- model_params_setting=None, model_id_type=None, model_id_reference=None, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/intent_node/impl/__init__.py b/apps/application/flow/step_node/intent_node/impl/__init__.py
deleted file mode 100644
index 56954da75d4..00000000000
--- a/apps/application/flow/step_node/intent_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-
-
-from .base_intent_node import BaseIntentNode
\ No newline at end of file
diff --git a/apps/application/flow/step_node/intent_node/impl/base_intent_node.py b/apps/application/flow/step_node/intent_node/impl/base_intent_node.py
deleted file mode 100644
index b3f1608acc2..00000000000
--- a/apps/application/flow/step_node/intent_node/impl/base_intent_node.py
+++ /dev/null
@@ -1,265 +0,0 @@
-# coding=utf-8
-import json
-import re
-import time
-from typing import List, Dict, Any
-from functools import reduce
-
-from django.db.models import QuerySet
-from langchain_core.messages import HumanMessage, SystemMessage
-
-from application.flow.i_step_node import INode, NodeResult
-from application.flow.step_node.intent_node.i_intent_node import IIntentNode
-from models_provider.models import Model
-from models_provider.tools import get_model_instance_by_model_workspace_id, get_model_credential
-from .prompt_template import PROMPT_TEMPLATE
-
-
-def get_default_model_params_setting(model_id):
- model = QuerySet(Model).filter(id=model_id).first()
- credential = get_model_credential(model.provider, model.model_type, model.model_name)
- model_params_setting = credential.get_model_params_setting_form(
- model.model_name).get_default_form_data()
- return model_params_setting
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str):
- chat_model = node_variable.get('chat_model')
- message_tokens = chat_model.get_num_tokens_from_messages(node_variable.get('message_list'))
- answer_tokens = chat_model.get_num_tokens(answer)
-
- node.context['message_tokens'] = message_tokens
- node.context['answer_tokens'] = answer_tokens
- node.context['answer'] = answer
- node.context['history_message'] = node_variable['history_message']
- node.context['user_input'] = node_variable['user_input']
- node.context['branch_id'] = node_variable.get('branch_id')
- node.context['reason'] = node_variable.get('reason')
- node.context['category'] = node_variable.get('category')
- node.context['run_time'] = time.time() - node.context['start_time']
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- response = node_variable.get('result')
- answer = response.content
- _write_context(node_variable, workflow_variable, node, workflow, answer)
-
-
-class BaseIntentNode(IIntentNode):
-
- def save_context(self, details, workflow_manage):
- self.context['exception_message'] = details.get('err_message')
- self.context['branch_id'] = details.get('branch_id')
- self.context['category'] = details.get('category')
-
- def execute(self, model_id, dialogue_number, history_chat_record, user_input, branch,
- model_params_setting=None, model_id_type=None, model_id_reference=None, **kwargs) -> NodeResult:
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
- if not model_id:
- raise Exception(_('Model is not allowed to be empty'))
-
- # 设置默认模型参数
- if model_params_setting is None and model_id:
- model_params_setting = get_default_model_params_setting(model_id)
-
- # 获取模型实例
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- chat_model = get_model_instance_by_model_workspace_id(
- model_id, workspace_id, **(model_params_setting or {})
- )
-
- # 获取历史对话
- history_message = self.get_history_message(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
-
- # 保存问题到上下文
- self.context['user_input'] = user_input
-
- # 构建分类提示词
- prompt = self.build_classification_prompt(user_input, branch)
-
- # 生成消息列表
- system = self.build_system_prompt()
- message_list = self.generate_message_list(system, prompt, history_message)
- self.context['message_list'] = message_list
-
- # 调用模型进行分类
- try:
- r = chat_model.invoke(message_list)
- classification_result = r.content.strip()
- # 解析分类结果获取分支信息
- matched_branch = self.parse_classification_result(classification_result, branch)
-
- # 返回结果
- return NodeResult({
- 'result': r,
- 'chat_model': chat_model,
- 'message_list': message_list,
- 'history_message': history_message,
- 'user_input': user_input,
- 'branch_id': matched_branch['id'],
- 'reason': self.parse_result_reason(r.content),
- 'category': matched_branch.get('content', matched_branch['id'])
- }, {}, _write_context=write_context)
-
- except Exception as e:
- # 错误处理:返回"其他"分支
- other_branch = self.find_other_branch(branch)
- if other_branch:
- return NodeResult({
- 'branch_id': other_branch['id'],
- 'category': other_branch.get('content', other_branch['id']),
- 'error': str(e)
- }, {})
- else:
- raise Exception(f"error: {str(e)}")
-
- @staticmethod
- def get_history_message(history_chat_record, dialogue_number):
- """获取历史消息"""
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [history_chat_record[index].get_human_message(), history_chat_record[index].get_ai_message()]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
-
- for message in history_message:
- if isinstance(message.content, str):
- message.content = re.sub(r'.*?<\/form_rander>', '', message.content, flags=re.DOTALL)
- return history_message
-
- def build_system_prompt(self) -> str:
- """构建系统提示词"""
- return "你是一个专业的意图识别助手,请根据用户输入和意图选项,准确识别用户的真实意图。"
-
- def build_classification_prompt(self, user_input: str, branch: List[Dict]) -> str:
- """构建分类提示词"""
-
- classification_list = []
-
- other_branch = self.find_other_branch(branch)
- # 添加其他分支
- if other_branch:
- classification_list.append({
- "classificationId": 0,
- "content": other_branch.get('content')
- })
- # 添加正常分支
- classification_id = 1
- for b in branch:
- if not b.get('isOther'):
- classification_list.append({
- "classificationId": classification_id,
- "content": b['content']
- })
- classification_id += 1
-
- return PROMPT_TEMPLATE.format(
- classification_list=classification_list,
- user_input=user_input
- )
-
- def generate_message_list(self, system: str, prompt: str, history_message):
- """生成消息列表"""
- if system is None or len(system) == 0:
- return [*history_message, HumanMessage(self.workflow_manage.generate_prompt(prompt))]
- else:
- return [SystemMessage(self.workflow_manage.generate_prompt(system)), *history_message,
- HumanMessage(self.workflow_manage.generate_prompt(prompt))]
-
- def parse_classification_result(self, result: str, branch: List[Dict]) -> Dict[str, Any]:
- """解析分类结果"""
-
- other_branch = self.find_other_branch(branch)
- normal_intents = [
- b
- for b in branch
- if not b.get('isOther')
- ]
-
- def get_branch_by_id(category_id: int):
- if category_id == 0:
- return other_branch
- elif 1 <= category_id <= len(normal_intents):
- return normal_intents[category_id - 1]
- return None
-
- try:
- result_json = json.loads(result)
- classification_id = result_json.get('classificationId')
- # 如果是 0 ,返回其他分支
- matched_branch = get_branch_by_id(classification_id)
- if matched_branch:
- return matched_branch
-
- except Exception as e:
- # json 解析失败,re 提取
- numbers = re.findall(r'"classificationId":\s*(\d+)', result)
- if numbers:
- classification_id = int(numbers[0])
-
- matched_branch = get_branch_by_id(classification_id)
- if matched_branch:
- return matched_branch
-
- # 如果都解析失败,返回“other”
- return other_branch or (normal_intents[0] if normal_intents else {'id': 'unknown', 'content': 'unknown'})
-
- def parse_result_reason(self, result: str):
- """解析分类的原因"""
- try:
- result_json = json.loads(result)
- return result_json.get('reason', '')
- except Exception as e:
- reason_patterns = [
- r'"reason":\s*"([^"]*)"', # 标准格式
- r'"reason":\s*"([^"]*)', # 缺少结束引号
- r'"reason":\s*([^,}\n]*)', # 没有引号包围的内容
- ]
- for pattern in reason_patterns:
- match = re.search(pattern, result, re.DOTALL)
- if match:
- reason = match.group(1).strip()
- # 清理可能的尾部字符
- reason = re.sub(r'["\s]*$', '', reason)
- return reason
-
- return ''
-
- def find_other_branch(self, branch: List[Dict]) -> Dict[str, Any] | None:
- """查找其他分支"""
- for b in branch:
- if b.get('isOther'):
- return b
- return None
-
- def get_details(self, index: int, **kwargs):
- """获取节点执行详情"""
- return {
- 'name': self.node.properties.get('stepName'),
- 'index': index,
- 'run_time': self.context.get('run_time'),
- 'system': self.context.get('system'),
- 'history_message': [
- {'content': message.content, 'role': message.type}
- for message in (self.context.get('history_message') or [])
- ],
- 'user_input': self.context.get('user_input'),
- 'answer': self.context.get('answer'),
- 'branch_id': self.context.get('branch_id'),
- 'category': self.context.get('category'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/knowledge_write_node/__init__.py b/apps/application/flow/step_node/knowledge_write_node/__init__.py
deleted file mode 100644
index ea50569d563..00000000000
--- a/apps/application/flow/step_node/knowledge_write_node/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/11/13 11:17
- @desc:
-"""
\ No newline at end of file
diff --git a/apps/application/flow/step_node/knowledge_write_node/i_knowledge_write_node.py b/apps/application/flow/step_node/knowledge_write_node/i_knowledge_write_node.py
deleted file mode 100644
index 2f5349fa613..00000000000
--- a/apps/application/flow/step_node/knowledge_write_node/i_knowledge_write_node.py
+++ /dev/null
@@ -1,43 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: i_knowledge_write_node.py
- @date:2025/11/13 11:19
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class KnowledgeWriteNodeParamSerializer(serializers.Serializer):
- document_list = serializers.ListField(required=True, child=serializers.CharField(required=True), allow_null=True,
- label=_('document list'))
-
-
-class IKnowledgeWriteNode(INode):
-
- def save_context(self, details, workflow_manage):
- pass
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return KnowledgeWriteNodeParamSerializer
-
- def _run(self):
- documents = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('document_list')[0],
- self.node_params_serializer.data.get('document_list')[1:],
- )
-
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data, documents=documents)
-
- def execute(self, documents, user_id, **kwargs) -> NodeResult:
- pass
-
- type = 'knowledge-write-node'
- support = [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP]
diff --git a/apps/application/flow/step_node/knowledge_write_node/impl/__init__.py b/apps/application/flow/step_node/knowledge_write_node/impl/__init__.py
deleted file mode 100644
index 077d7432575..00000000000
--- a/apps/application/flow/step_node/knowledge_write_node/impl/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/11/13 11:18
- @desc:
-"""
diff --git a/apps/application/flow/step_node/knowledge_write_node/impl/base_knowledge_write_node.py b/apps/application/flow/step_node/knowledge_write_node/impl/base_knowledge_write_node.py
deleted file mode 100644
index aebf9d009d1..00000000000
--- a/apps/application/flow/step_node/knowledge_write_node/impl/base_knowledge_write_node.py
+++ /dev/null
@@ -1,343 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:niu
- @file: base_knowledge_write_node.py
- @date:2025/11/13 11:19
- @desc:
-"""
-from functools import reduce
-from typing import Any, Dict, List
-
-import uuid_utils.compat as uuid
-from common.chunk import text_to_chunk
-from common.utils.common import bulk_create_in_batches, filter_special_character
-from django.db.models import QuerySet
-from django.db.models.aggregates import Max
-from django.utils.translation import gettext_lazy as _
-from knowledge.models import (
- Document,
- DocumentTag,
- File,
- FileSourceType,
- KnowledgeType,
- Paragraph,
- Problem,
- ProblemParagraphMapping,
- Tag,
-)
-from knowledge.serializers.common import ProblemParagraphManage, ProblemParagraphObject
-from knowledge.serializers.document import DocumentSerializers
-from rest_framework import serializers
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.knowledge_write_node.i_knowledge_write_node import IKnowledgeWriteNode
-
-
-class ParagraphInstanceSerializer(serializers.Serializer):
- content = serializers.CharField(required=True, label=_('content'), max_length=102400, min_length=1, allow_null=True,
- allow_blank=True)
- title = serializers.CharField(required=False, max_length=256, label=_('section title'), allow_null=True,
- allow_blank=True)
- problem_list = serializers.ListField(required=False, child=serializers.CharField(required=False, allow_blank=True))
- is_active = serializers.BooleanField(required=False, label=_('Is active'))
- chunks = serializers.ListField(required=False, child=serializers.CharField(required=True))
-
-
-class TagInstanceSerializer(serializers.Serializer):
- key = serializers.CharField(required=True, max_length=64, label=_('Tag Key'))
- value = serializers.CharField(required=True, max_length=128, label=_('Tag Value'))
-
-
-class KnowledgeWriteParamSerializer(serializers.Serializer):
- name = serializers.CharField(required=True, label=_('document name'), max_length=128, min_length=1,
- source=_('document name'))
- meta = serializers.DictField(required=False)
- tags = serializers.ListField(required=False, label=_('Tags'), child=TagInstanceSerializer())
- paragraphs = ParagraphInstanceSerializer(required=False, many=True, allow_null=True)
- source_file_id = serializers.UUIDField(required=False, allow_null=True)
- user_id = serializers.UUIDField(required=False, allow_null=True)
-
-
-def convert_uuid_to_str(obj):
- if isinstance(obj, dict):
- return {k: convert_uuid_to_str(v) for k, v in obj.items()}
- elif isinstance(obj, list):
- return [convert_uuid_to_str(i) for i in obj]
- elif isinstance(obj, uuid.UUID):
- return str(obj)
- else:
- return obj
-
-
-def link_file(source_file_id, document_id):
- if source_file_id is None:
- return
- source_file = QuerySet(File).filter(id=source_file_id).first()
- if source_file:
- file_content = source_file.get_bytes()
-
- new_file = File(
- id=uuid.uuid7(),
- file_name=source_file.file_name,
- file_size=source_file.file_size,
- source_type=FileSourceType.DOCUMENT,
- source_id=document_id, # 更新为当前知识库ID
- meta=source_file.meta.copy() if source_file.meta else {}
- )
-
- # 保存文件内容和元数据
- new_file.save(file_content)
-
-
-def get_paragraph_problem_model(knowledge_id: str, document_id: str, instance: Dict):
- paragraph = Paragraph(
- id=uuid.uuid7(),
- document_id=document_id,
- content=filter_special_character(instance.get("content")),
- knowledge_id=knowledge_id,
- title=instance.get("title") if 'title' in instance else '',
- chunks=[filter_special_character(c) for c in (instance.get('chunks') if 'chunks' in instance else text_to_chunk(
- instance.get("content")))],
- )
-
- problem_paragraph_object_list = [ProblemParagraphObject(
- knowledge_id, document_id, str(paragraph.id), problem
- ) for problem in (instance.get('problem_list') if 'problem_list' in instance else [])]
-
- return {
- 'paragraph': paragraph,
- 'problem_paragraph_object_list': problem_paragraph_object_list,
- }
-
-
-def get_paragraph_model(document_model, paragraph_list: List):
- knowledge_id = document_model.knowledge_id
- paragraph_model_dict_list = [
- get_paragraph_problem_model(knowledge_id, document_model.id, paragraph)
- for paragraph in paragraph_list
- ]
-
- paragraph_model_list = []
- problem_paragraph_object_list = []
- for paragraphs in paragraph_model_dict_list:
- paragraph = paragraphs.get('paragraph')
- for problem_model in paragraphs.get('problem_paragraph_object_list'):
- problem_paragraph_object_list.append(problem_model)
- paragraph_model_list.append(paragraph)
-
- return {
- 'document': document_model,
- 'paragraph_model_list': paragraph_model_list,
- 'problem_paragraph_object_list': problem_paragraph_object_list,
- }
-
-
-def get_document_paragraph_model(knowledge_id: str, instance: Dict):
- source_meta = {'source_file_id': instance.get("source_file_id")} if instance.get("source_file_id") else {}
- meta = {**instance.get('meta'), **source_meta} if instance.get('meta') is not None else source_meta
- meta = {**convert_uuid_to_str(meta), 'allow_download': True}
-
- document_model = Document(
- **{
- 'knowledge_id': knowledge_id,
- 'id': uuid.uuid7(),
- 'name': instance.get('name'),
- 'char_length': reduce(
- lambda x, y: x + y,
- [len(p.get('content')) for p in instance.get('paragraphs', [])],
- 0),
- 'meta': meta,
- 'type': instance.get('type') if instance.get('type') is not None else KnowledgeType.WORKFLOW,
- "user_id": instance.get("user_id"),
- }
- )
-
- return get_paragraph_model(
- document_model,
- instance.get('paragraphs') if 'paragraphs' in instance else []
- )
-
-
-def save_knowledge_tags(knowledge_id: str, tags: List[Dict[str, Any]]):
- existed_tags_dict = {
- (key, value): str(tag_id)
- for key, value, tag_id in QuerySet(Tag).filter(knowledge_id=knowledge_id).values_list("key", "value", "id")
- }
-
- tag_model_list = []
- new_tag_dict = {}
- for tag in tags:
- key = tag.get("key")
- value = tag.get("value")
-
- if (key, value) not in existed_tags_dict:
- tag_model = Tag(
- id=uuid.uuid7(),
- knowledge_id=knowledge_id,
- key=key,
- value=value
- )
- tag_model_list.append(tag_model)
- new_tag_dict[(key, value)] = str(tag_model.id)
-
- if tag_model_list:
- Tag.objects.bulk_create(tag_model_list)
-
- all_tag_dict = {**existed_tags_dict, **new_tag_dict}
-
- return all_tag_dict, new_tag_dict
-
-
-def batch_add_document_tag(document_tag_map: Dict[str, List[str]]):
- """
- 批量添加文档-标签关联
- document_tag_map: {document_id: [tag_id1, tag_id2, ...]}
- """
- all_document_ids = list(document_tag_map.keys())
- all_tag_ids = list(set(tag_id for tag_ids in document_tag_map.values() for tag_id in tag_ids))
-
- # 查询已存在的文档-标签关联
- existed_relations = set(
- QuerySet(DocumentTag).filter(
- document_id__in=all_document_ids,
- tag_id__in=all_tag_ids
- ).values_list('document_id', 'tag_id')
- )
-
- new_relations = [
- DocumentTag(
- id=uuid.uuid7(),
- document_id=doc_id,
- tag_id=tag_id,
- )
- for doc_id, tag_ids in document_tag_map.items()
- for tag_id in tag_ids
- if (doc_id, tag_id) not in existed_relations
- ]
-
- if new_relations:
- QuerySet(DocumentTag).bulk_create(new_relations)
-
-
-class BaseKnowledgeWriteNode(IKnowledgeWriteNode):
-
- def save_context(self, details, workflow_manage):
- self.context['exception_message'] = details.get('err_message')
-
- def save(self, document_list, user_id):
- serializer = KnowledgeWriteParamSerializer(data=document_list, many=True)
- serializer.is_valid(raise_exception=True)
- document_list = serializer.data
-
- knowledge_id = self.workflow_params.get("knowledge_id")
- workspace_id = self.workflow_params.get("workspace_id")
-
- document_model_list = []
- paragraph_model_list = []
- problem_paragraph_object_list = []
- # 所有标签
- knowledge_tag_list = []
- # 文档标签映射关系
- document_tags_map = {}
- knowledge_tag_dict = {}
-
- for document in document_list:
- document["user_id"] = user_id
- document_paragraph_dict_model = get_document_paragraph_model(
- knowledge_id,
- document
- )
- document_instance = document_paragraph_dict_model.get('document')
- link_file(document.get("source_file_id"), document_instance.id)
- document_model_list.append(document_instance)
- # 收集标签
- single_document_tag_list = document.get("tags", [])
- # 去重传入的标签
- for tag in single_document_tag_list:
- tag_key = (tag['key'], tag['value'])
- if tag_key not in knowledge_tag_dict:
- knowledge_tag_dict[tag_key] = tag
-
- if single_document_tag_list:
- document_tags_map[str(document_instance.id)] = single_document_tag_list
-
- for paragraph in document_paragraph_dict_model.get("paragraph_model_list"):
- paragraph_model_list.append(paragraph)
- for problem_paragraph_object in document_paragraph_dict_model.get("problem_paragraph_object_list"):
- problem_paragraph_object_list.append(problem_paragraph_object)
- knowledge_tag_list = list(knowledge_tag_dict.values())
- # 保存所有文档中含有的标签到知识库
- if knowledge_tag_list:
- all_tag_dict, new_tag_dict = save_knowledge_tags(knowledge_id, knowledge_tag_list)
- # 构建文档-标签ID映射
- document_tag_id_map = {}
- # 为每个文档添加其对应的标签
- for doc_id, doc_tags in document_tags_map.items():
- doc_tag_ids = [
- all_tag_dict[(tag.get("key"), tag.get("value"))]
- for tag in doc_tags
- if (tag.get("key"), tag.get("value")) in all_tag_dict
- ]
- if doc_tag_ids:
- document_tag_id_map[doc_id] = doc_tag_ids
- if document_tag_id_map:
- batch_add_document_tag(document_tag_id_map)
-
- problem_model_list, problem_paragraph_mapping_list = (
- ProblemParagraphManage(problem_paragraph_object_list, knowledge_id).to_problem_model_list()
- )
-
- QuerySet(Document).bulk_create(document_model_list) if len(document_model_list) > 0 else None
-
- if len(paragraph_model_list) > 0:
- for document in document_model_list:
- max_position = Paragraph.objects.filter(document_id=document.id).aggregate(
- max_position=Max('position')
- )['max_position'] or 0
- sub_list = [p for p in paragraph_model_list if p.document_id == document.id]
- for i, paragraph in enumerate(sub_list):
- paragraph.position = max_position + i + 1
- QuerySet(Paragraph).bulk_create(sub_list if len(sub_list) > 0 else [])
-
- bulk_create_in_batches(Problem, problem_model_list, batch_size=1000)
-
- bulk_create_in_batches(ProblemParagraphMapping, problem_paragraph_mapping_list, batch_size=1000)
-
- return document_model_list, knowledge_id, workspace_id
-
- @staticmethod
- def post_embedding(document_model_list, knowledge_id, workspace_id):
- for document in document_model_list:
- DocumentSerializers.Operate(data={
- 'knowledge_id': knowledge_id,
- 'document_id': document.id,
- 'workspace_id': workspace_id
- }).refresh()
-
- def execute(self, documents, user_id, **kwargs) -> NodeResult:
-
- document_model_list, knowledge_id, workspace_id = self.save(documents, user_id)
- self.post_embedding(document_model_list, knowledge_id, workspace_id)
-
- write_content_list = [{
- "name": document.get("name"),
- "paragraphs": [{
- "title": p.get("title"),
- "content": p.get("content"),
- } for p in document.get("paragraphs")[0:5]]
- } for document in documents]
-
- return NodeResult({'write_content': write_content_list}, {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'write_content': self.context.get("write_content"),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/loop_break_node/__init__.py b/apps/application/flow/step_node/loop_break_node/__init__.py
deleted file mode 100644
index ee45b3ee837..00000000000
--- a/apps/application/flow/step_node/loop_break_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/9/15 12:08
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/loop_break_node/i_loop_break_node.py b/apps/application/flow/step_node/loop_break_node/i_loop_break_node.py
deleted file mode 100644
index 07edf227b53..00000000000
--- a/apps/application/flow/step_node/loop_break_node/i_loop_break_node.py
+++ /dev/null
@@ -1,41 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: i_loop_break_node.py
- @date:2025/9/15 12:14
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode
-from application.flow.i_step_node import NodeResult
-
-
-class ConditionSerializer(serializers.Serializer):
- compare = serializers.CharField(required=True, label=_("Comparator"))
- value = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("value"))
- field = serializers.ListField(required=True, label=_("Fields"))
-
-
-class LoopBreakNodeSerializer(serializers.Serializer):
- condition = serializers.CharField(required=True, label=_("Condition or|and"))
- condition_list = ConditionSerializer(many=True)
-
-
-class ILoopBreakNode(INode):
- type = 'loop-break-node'
- support = [WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return LoopBreakNodeSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data)
-
- def execute(self, condition, condition_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/loop_break_node/impl/__init__.py b/apps/application/flow/step_node/loop_break_node/impl/__init__.py
deleted file mode 100644
index 0ed3e008022..00000000000
--- a/apps/application/flow/step_node/loop_break_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/9/15 12:16
- @desc:
-"""
-from .base_loop_break_node import BaseLoopBreakNode
diff --git a/apps/application/flow/step_node/loop_break_node/impl/base_loop_break_node.py b/apps/application/flow/step_node/loop_break_node/impl/base_loop_break_node.py
deleted file mode 100644
index f82289729da..00000000000
--- a/apps/application/flow/step_node/loop_break_node/impl/base_loop_break_node.py
+++ /dev/null
@@ -1,47 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: base_loop_break_node.py
- @date:2025/9/15 12:17
- @desc:
-"""
-import time
-from typing import Dict
-
-from application.flow.compare import do_assertion
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.loop_break_node.i_loop_break_node import ILoopBreakNode
-
-
-def _write_context(step_variable: Dict, global_variable: Dict, node, workflow):
- if step_variable.get("is_break"):
- yield "BREAK"
-
- node.context['run_time'] = time.time() - node.context['start_time']
-
-
-class BaseLoopBreakNode(ILoopBreakNode):
- def save_context(self, details, workflow_manage):
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, condition, condition_list, **kwargs) -> NodeResult:
- is_break = do_assertion(self.workflow_manage, condition, condition_list)
- if is_break:
- self.node_params['is_result'] = True
- self.context['is_break'] = is_break
- return NodeResult({'is_break': is_break}, {},
- _write_context=_write_context,
- _is_interrupt=lambda n, v, w: is_break)
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'is_break': self.context.get('is_break'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/loop_continue_node/__init__.py b/apps/application/flow/step_node/loop_continue_node/__init__.py
deleted file mode 100644
index 9f7f1729d5c..00000000000
--- a/apps/application/flow/step_node/loop_continue_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/9/15 12:08
- @desc:
-"""
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/loop_continue_node/i_loop_continue_node.py b/apps/application/flow/step_node/loop_continue_node/i_loop_continue_node.py
deleted file mode 100644
index 00b6aa04c39..00000000000
--- a/apps/application/flow/step_node/loop_continue_node/i_loop_continue_node.py
+++ /dev/null
@@ -1,40 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: i_loop_continue_node.py
- @date:2025/9/15 12:13
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class ConditionSerializer(serializers.Serializer):
- compare = serializers.CharField(required=True, label=_("Comparator"))
- value = serializers.CharField(required=True, label=_("value"))
- field = serializers.ListField(required=True, label=_("Fields"))
-
-
-class LoopContinueNodeSerializer(serializers.Serializer):
- condition = serializers.CharField(required=True, label=_("Condition or|and"))
- condition_list = ConditionSerializer(many=True)
-
-
-class ILoopContinueNode(INode):
- type = 'loop-continue-node'
- support = [WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return LoopContinueNodeSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data)
-
- def execute(self, condition, condition_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/loop_continue_node/impl/__init__.py b/apps/application/flow/step_node/loop_continue_node/impl/__init__.py
deleted file mode 100644
index 3aca2f827de..00000000000
--- a/apps/application/flow/step_node/loop_continue_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/9/15 12:13
- @desc:
-"""
-from .base_loop_continue_node import BaseLoopContinueNode
\ No newline at end of file
diff --git a/apps/application/flow/step_node/loop_continue_node/impl/base_loop_continue_node.py b/apps/application/flow/step_node/loop_continue_node/impl/base_loop_continue_node.py
deleted file mode 100644
index 3c0393217c5..00000000000
--- a/apps/application/flow/step_node/loop_continue_node/impl/base_loop_continue_node.py
+++ /dev/null
@@ -1,35 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: base_loop_continue_node.py
- @date:2025/9/15 12:13
- @desc:
-"""
-from application.flow.compare import do_assertion
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.loop_continue_node.i_loop_continue_node import ILoopContinueNode
-
-
-class BaseLoopContinueNode(ILoopContinueNode):
- def save_context(self, details, workflow_manage):
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, condition, condition_list, **kwargs) -> NodeResult:
- is_continue = do_assertion(self.workflow_manage, condition, condition_list)
- self.context['is_continue'] = is_continue
- if is_continue:
- return NodeResult({'is_continue': is_continue, 'branch_id': 'continue'}, {})
- return NodeResult({'is_continue': is_continue}, {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "is_continue": self.context.get('is_continue'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/loop_node/__init__.py b/apps/application/flow/step_node/loop_node/__init__.py
deleted file mode 100644
index a5f59372be7..00000000000
--- a/apps/application/flow/step_node/loop_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2025/3/11 18:24
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/loop_node/i_loop_node.py b/apps/application/flow/step_node/loop_node/i_loop_node.py
deleted file mode 100644
index e16dbebc059..00000000000
--- a/apps/application/flow/step_node/loop_node/i_loop_node.py
+++ /dev/null
@@ -1,58 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: i_loop_node.py
- @date:2025/3/11 18:19
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-from common.exception.app_exception import AppApiException
-
-
-class ILoopNodeSerializer(serializers.Serializer):
- loop_type = serializers.CharField(required=True, label=_("loop_type"))
- array = serializers.ListField(required=False, allow_null=True,
- label=_("array"))
- number = serializers.IntegerField(required=False, allow_null=True,
- label=_("number"))
- loop_body = serializers.DictField(required=True, label="循环体")
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- loop_type = self.data.get('loop_type')
- if loop_type == 'ARRAY':
- array = self.data.get('array')
- if array is None or len(array) == 0:
- message = _('{field}, this field is required.', field='array')
- raise AppApiException(500, message)
- elif loop_type == 'NUMBER':
- number = self.data.get('number')
- if number is None:
- message = _('{field}, this field is required.', field='number')
- raise AppApiException(500, message)
-
-
-class ILoopNode(INode):
- type = 'loop-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.KNOWLEDGE, WorkflowMode.TOOL]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return ILoopNodeSerializer
-
- def _run(self):
- array = self.node_params_serializer.data.get('array')
- if self.node_params_serializer.data.get('loop_type') == 'ARRAY':
- array = self.workflow_manage.get_reference_field(
- array[0],
- array[1:])
- return self.execute(**{**self.node_params_serializer.data, "array": array}, **self.flow_params_serializer.data)
-
- def execute(self, loop_type, array, number, loop_body, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/loop_node/impl/__init__.py b/apps/application/flow/step_node/loop_node/impl/__init__.py
deleted file mode 100644
index 3cd082322a1..00000000000
--- a/apps/application/flow/step_node/loop_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py.py
- @date:2025/3/11 18:24
- @desc:
-"""
-from .base_loop_node import BaseLoopNode
diff --git a/apps/application/flow/step_node/loop_node/impl/base_loop_node.py b/apps/application/flow/step_node/loop_node/impl/base_loop_node.py
deleted file mode 100644
index e3f3cfa4e31..00000000000
--- a/apps/application/flow/step_node/loop_node/impl/base_loop_node.py
+++ /dev/null
@@ -1,332 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: base_loop_node.py
- @date:2025/3/11 18:24
- @desc:
-"""
-import time
-import uuid
-from typing import Dict, List
-
-from django.utils.translation import gettext as _
-
-from application.flow.common import Answer, WorkflowMode
-from application.flow.i_step_node import NodeResult, WorkFlowPostHandler, INode
-from application.flow.step_node.loop_node.i_loop_node import ILoopNode
-from application.flow.tools import Reasoning
-from application.models import ChatRecord
-from common.handle.impl.response.loop_to_response import LoopToResponse
-from maxkb.const import CONFIG
-
-max_loop_count = int(CONFIG.get("WORKFLOW_LOOP_NODE_MAX_LOOP_COUNT", 500))
-
-
-def _is_interrupt_exec(node, node_variable: Dict, workflow_variable: Dict):
- return node.context.get('is_interrupt_exec', False)
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str,
- reasoning_content: str):
- node.context['answer'] = answer
- node.context['run_time'] = time.time() - node.context['start_time']
- node.context['reasoning_content'] = reasoning_content
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
-
- response = node_variable.get('result')
- workflow_manage = node_variable.get('workflow_manage')
- answer = ''
- reasoning_content = ''
- for chunk in response:
- content_chunk = chunk.get('content', '')
- reasoning_content_chunk = chunk.get('reasoning_content', '')
- reasoning_content += reasoning_content_chunk
- answer += content_chunk
- yield {'content': content_chunk,
- 'reasoning_content': reasoning_content_chunk}
- runtime_details = workflow_manage.get_runtime_details()
- _write_context(node_variable, workflow_variable, node, workflow, answer, reasoning_content)
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点实例对象
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start'), model_setting.get('reasoning_content_end'))
- reasoning_result = reasoning.get_reasoning_content(response)
- reasoning_result_end = reasoning.get_end_reasoning_content()
- content = reasoning_result.get('content') + reasoning_result_end.get('content')
- if 'reasoning_content' in response.response_metadata:
- reasoning_content = response.response_metadata.get('reasoning_content', '')
- else:
- reasoning_content = reasoning_result.get('reasoning_content') + reasoning_result_end.get('reasoning_content')
- _write_context(node_variable, workflow_variable, node, workflow, content, reasoning_content)
-
-
-def get_answer_list(instance, child_node_node_dict, runtime_node_id):
- answer_list = instance.get_record_answer_list()
- for a in answer_list:
- _v = child_node_node_dict.get(a.get('runtime_node_id'))
- if _v:
- a['runtime_node_id'] = runtime_node_id
- a['child_node'] = _v
- return answer_list
-
-
-def insert_or_replace(arr, index, value):
- if index < len(arr):
- arr[index] = value # 替换
- else:
- # 在末尾插入足够多的None,然后替换最后一个
- arr.extend([None] * (index - len(arr) + 1))
- arr[index] = value
- return arr
-
-
-def generate_loop_number(number: int):
- def i(current_index: int):
- return iter([(index, index) for index in range(current_index, number)])
-
- return i
-
-
-def generate_loop_array(array):
- def i(current_index: int):
- return iter([(array[index], index) for index in range(current_index, len(array))])
-
- return i
-
-
-def generate_while_loop(current_index: int):
- index = current_index
- while True:
- yield index, index
- index += 1
-
-
-def loop(workflow_manage_new_instance, node: INode, generate_loop):
- loop_global_data = {}
- break_outer = False
- is_interrupt_exec = False
- loop_node_data = node.context.get('loop_node_data') or []
- loop_answer_data = node.context.get("loop_answer_data") or []
- start_index = node.context.get("current_index") or 0
- current_index = start_index
- node_params = node.node_params
- start_node_id = node_params.get('child_node', {}).get('runtime_node_id')
- loop_type = node_params.get('loop_type')
- start_node_data = None
- chat_record = None
- child_node = None
- if start_node_id:
- chat_record_id = node_params.get('child_node', {}).get('chat_record_id')
- child_node = node_params.get('child_node', {}).get('child_node')
- start_node_data = node_params.get('node_data')
- chat_record = ChatRecord(id=chat_record_id, answer_text_list=[], answer_text='',
- details=loop_node_data[current_index])
-
- for item, index in generate_loop(current_index):
- if 0 < max_loop_count <= index - start_index and loop_type == 'LOOP':
- raise Exception(_('Exceeding the maximum number of cycles'))
- """
- 指定次数循环
- @return:
- """
- instance = workflow_manage_new_instance({'index': index, 'item': item}, loop_global_data, start_node_id,
- start_node_data, chat_record, child_node)
- response = instance.stream()
- answer = ''
- current_index = index
- reasoning_content = ''
- child_node_node_dict = {}
- for chunk in response:
- if chunk.get('node_type') == 'loop-break-node' and chunk.get('content', '') == 'BREAK':
- break_outer = True
- continue
- child_node = chunk.get('child_node')
- runtime_node_id = chunk.get('runtime_node_id', '')
- chat_record_id = chunk.get('chat_record_id', '')
- child_node_node_dict[runtime_node_id] = {
- 'runtime_node_id': runtime_node_id,
- 'chat_record_id': chat_record_id,
- 'child_node': child_node}
- content_chunk = (chunk.get('content', '') or '')
- reasoning_content_chunk = (chunk.get('reasoning_content', '') or '')
- if chunk.get('real_node_id'):
- chunk['real_node_id'] = chunk['real_node_id'] + '__' + node.runtime_node_id + '__' + str(index)
- reasoning_content += reasoning_content_chunk
- answer += content_chunk
- yield chunk
- if chunk.get('node_status', "SUCCESS") == 'ERROR':
- insert_or_replace(loop_node_data, index, instance.get_runtime_details())
- insert_or_replace(loop_answer_data, index,
- get_answer_list(instance, child_node_node_dict, node.runtime_node_id))
- node.context['is_interrupt_exec'] = is_interrupt_exec
- node.context['loop_node_data'] = loop_node_data
- node.context['loop_answer_data'] = loop_answer_data
- node.context["index"] = current_index
- node.context["item"] = current_index
- node.status = 500
- node.err_message = chunk.get('content')
- return
- node_type = chunk.get('node_type')
- if node_type == 'form-node':
- break_outer = True
- is_interrupt_exec = True
- start_node_id = None
- start_node_data = None
- chat_record = None
- child_node = None
- insert_or_replace(loop_node_data, index, instance.get_runtime_details())
- insert_or_replace(loop_answer_data, index,
- get_answer_list(instance, child_node_node_dict, node.runtime_node_id))
- instance._cleanup()
- if break_outer:
- break
- if instance.is_the_task_interrupted():
- break
- node.context['is_interrupt_exec'] = is_interrupt_exec
- node.context['loop_node_data'] = loop_node_data
- node.context['loop_answer_data'] = loop_answer_data
- node.context["index"] = current_index
- node.context["item"] = current_index
- node.context['run_time'] = time.time() - node.context.get("start_time")
-
-
-def get_tokens(loop_node_data):
- message_tokens = 0
- answer_tokens = 0
- for details in (loop_node_data or {}):
- message_tokens += sum([row.get('message_tokens') or 0 for row in details.values() if
- 'message_tokens' in row and row.get('message_tokens') is not None])
- answer_tokens += sum([row.get('answer_tokens') or 0 for row in details.values() if
- 'answer_tokens' in row and row.get('answer_tokens') is not None])
- return {'message_tokens': message_tokens, 'answer_tokens': answer_tokens}
-
-
-def get_write_context(loop_type, array, number, loop_body):
- def inner_write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- if loop_type == 'ARRAY':
- return loop(node_variable['workflow_manage_new_instance'], node, generate_loop_array(array))
- if loop_type == 'LOOP':
- return loop(node_variable['workflow_manage_new_instance'], node, generate_while_loop)
- return loop(node_variable['workflow_manage_new_instance'], node, generate_loop_number(number))
-
- return inner_write_context
-
-
-class LoopWorkFlowPostHandler(WorkFlowPostHandler):
- def handler(self, workflow):
- pass
-
-
-class BaseLoopNode(ILoopNode):
- def save_context(self, details, workflow_manage):
- self.context['loop_context_data'] = details.get('loop_context_data')
- self.context['loop_answer_data'] = details.get('loop_answer_data')
- self.context['loop_node_data'] = details.get('loop_node_data')
- self.context['result'] = details.get('result')
- self.context['params'] = details.get('params')
- self.context['run_time'] = details.get('run_time')
- self.context['index'] = details.get('current_index')
- self.context['item'] = details.get('current_item')
- for key, value in (details.get('loop_context_data') or {}).items():
- self.context[key] = value
- self.answer_text = ""
-
- def get_answer_list(self) -> List[Answer] | None:
- result = []
- for answer_list in (self.context.get("loop_answer_data") or []):
- for a in answer_list:
- if isinstance(a, dict):
- result.append(Answer(**a))
-
- return result
-
- def get_loop_context(self):
- return self.context
-
- def execute(self, loop_type, array, number, loop_body, **kwargs) -> NodeResult:
- from application.flow.loop_workflow_manage import LoopWorkflowManage, Workflow
- from application.flow.knowledge_loop_workflow_manage import KnowledgeLoopWorkflowManage
- from application.flow.tool_loop_workflow_manage import ToolLoopWorkflowManage
- self.node_params['is_result'] = True
-
- def workflow_manage_new_instance(loop_data, global_data, start_node_id=None,
- start_node_data=None, chat_record=None, child_node=None):
- workflow_mode = {WorkflowMode.APPLICATION: WorkflowMode.APPLICATION_LOOP,
- WorkflowMode.KNOWLEDGE: WorkflowMode.KNOWLEDGE_LOOP,
- WorkflowMode.TOOL: WorkflowMode.TOOL_LOOP}.get(
- self.workflow_manage.flow.workflow_mode) or WorkflowMode.APPLICATION
- c = {WorkflowMode.APPLICATION_LOOP: LoopWorkflowManage,
- WorkflowMode.KNOWLEDGE_LOOP: KnowledgeLoopWorkflowManage,
- WorkflowMode.TOOL_LOOP: ToolLoopWorkflowManage}.get(workflow_mode) or LoopWorkflowManage
- workflow_manage = c(Workflow.new_instance(loop_body, workflow_mode),
- self.workflow_manage.params,
- LoopWorkFlowPostHandler(
- self.workflow_manage.work_flow_post_handler.chat_info),
- self.workflow_manage,
- loop_data,
- self.get_loop_context,
- base_to_response=LoopToResponse(),
- start_node_id=start_node_id,
- start_node_data=start_node_data,
- chat_record=chat_record,
- child_node=child_node,
- is_the_task_interrupted=self.workflow_manage.is_the_task_interrupted
- )
-
- return workflow_manage
-
- return NodeResult({'workflow_manage_new_instance': workflow_manage_new_instance}, {},
- _write_context=get_write_context(loop_type, array, number, loop_body),
- _is_interrupt=_is_interrupt_exec)
-
- def get_loop_context_data(self):
- fields = self.node.properties.get('config', {}).get('fields', []) or []
- return {f.get('value'): self.context.get(f.get('value')) for f in fields if
- self.context.get(f.get('value')) is not None}
-
- def get_details(self, index: int, **kwargs):
- tokens = get_tokens(self.context.get("loop_node_data"))
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "result": self.context.get('result'),
- 'array': self.node_params_serializer.data.get('array'),
- 'number': self.node_params_serializer.data.get('number'),
- "params": self.context.get('params'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'current_index': self.context.get("index"),
- "current_item": self.context.get("item"),
- 'loop_type': self.node_params_serializer.data.get('loop_type'),
- 'status': self.status,
- 'loop_context_data': self.get_loop_context_data(),
- 'loop_node_data': self.context.get("loop_node_data"),
- 'loop_answer_data': self.context.get("loop_answer_data"),
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- 'message_tokens': tokens.get('message_tokens') or 0,
- 'answer_tokens': tokens.get('answer_tokens') or 0,
- }
diff --git a/apps/application/flow/step_node/loop_start_node/__init__.py b/apps/application/flow/step_node/loop_start_node/__init__.py
deleted file mode 100644
index 98a1afcd904..00000000000
--- a/apps/application/flow/step_node/loop_start_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:30
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/loop_start_node/i_loop_start_node.py b/apps/application/flow/step_node/loop_start_node/i_loop_start_node.py
deleted file mode 100644
index 7c3ffa31413..00000000000
--- a/apps/application/flow/step_node/loop_start_node/i_loop_start_node.py
+++ /dev/null
@@ -1,21 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_start_node.py
- @date:2024/6/3 16:54
- @desc:
-"""
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class ILoopStarNode(INode):
- type = 'loop-start-node'
- support = [WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL_LOOP]
-
- def _run(self):
- return self.execute(**self.flow_params_serializer.data)
-
- def execute(self, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/loop_start_node/impl/__init__.py b/apps/application/flow/step_node/loop_start_node/impl/__init__.py
deleted file mode 100644
index 76f972fcedb..00000000000
--- a/apps/application/flow/step_node/loop_start_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:36
- @desc:
-"""
-from .base_start_node import BaseLoopStartStepNode
diff --git a/apps/application/flow/step_node/loop_start_node/impl/base_start_node.py b/apps/application/flow/step_node/loop_start_node/impl/base_start_node.py
deleted file mode 100644
index 8058e098b20..00000000000
--- a/apps/application/flow/step_node/loop_start_node/impl/base_start_node.py
+++ /dev/null
@@ -1,59 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_start_node.py
- @date:2024/6/3 17:17
- @desc:
-"""
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.loop_start_node.i_loop_start_node import ILoopStarNode
-
-
-class BaseLoopStartStepNode(ILoopStarNode):
- def save_context(self, details, workflow_manage):
- self.context['index'] = details.get('current_index')
- self.context['item'] = details.get('current_item')
- self.context['exception_message'] = details.get('err_message')
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- pass
-
- def execute(self, **kwargs) -> NodeResult:
- """
- 开始节点 初始化全局变量
- """
- loop_params = self.workflow_manage.loop_params
- node_variable = {
- 'index': loop_params.get("index"),
- 'item': loop_params.get("item")
- }
- if WorkflowMode.APPLICATION_LOOP == self.workflow_manage.flow.workflow_mode:
- self.workflow_manage.chat_context = self.workflow_manage.get_chat_info().get_chat_variable()
- return NodeResult(node_variable, {})
-
- def get_details(self, index: int, **kwargs):
- global_fields = []
- for field in self.node.properties.get('config')['globalFields']:
- key = field['value']
- global_fields.append({
- 'label': field['label'],
- 'key': key,
- 'value': self.workflow_manage.context[key] if key in self.workflow_manage.context else ''
- })
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "current_index": self.context.get('index'),
- "current_item": self.context.get('item'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/mcp_node/__init__.py b/apps/application/flow/step_node/mcp_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/mcp_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/mcp_node/i_mcp_node.py b/apps/application/flow/step_node/mcp_node/i_mcp_node.py
deleted file mode 100644
index 6dd3827d640..00000000000
--- a/apps/application/flow/step_node/mcp_node/i_mcp_node.py
+++ /dev/null
@@ -1,33 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class McpNodeSerializer(serializers.Serializer):
- mcp_servers = serializers.JSONField(required=True, label=_("Mcp servers"))
- mcp_server = serializers.CharField(required=True, label=_("Mcp server"))
- mcp_tool = serializers.CharField(required=True, label=_("Mcp tool"))
- mcp_tool_id = serializers.CharField(required=False, label=_("Mcp tool"), allow_null=True, allow_blank=True)
- mcp_source = serializers.CharField(required=False, label=_("Mcp source"), allow_blank=True, allow_null=True)
- tool_params = serializers.DictField(required=True, label=_("Tool parameters"))
-
-
-class IMcpNode(INode):
- type = 'mcp-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return McpNodeSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, mcp_servers, mcp_server, mcp_tool, mcp_tool_id, mcp_source, tool_params, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/mcp_node/impl/__init__.py b/apps/application/flow/step_node/mcp_node/impl/__init__.py
deleted file mode 100644
index 8c9a5ee197c..00000000000
--- a/apps/application/flow/step_node/mcp_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_mcp_node import BaseMcpNode
diff --git a/apps/application/flow/step_node/mcp_node/impl/base_mcp_node.py b/apps/application/flow/step_node/mcp_node/impl/base_mcp_node.py
deleted file mode 100644
index 82dd8a8a545..00000000000
--- a/apps/application/flow/step_node/mcp_node/impl/base_mcp_node.py
+++ /dev/null
@@ -1,77 +0,0 @@
-# coding=utf-8
-import asyncio
-import json
-from typing import List
-
-from django.db.models import QuerySet
-from langchain_mcp_adapters.client import MultiServerMCPClient
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.mcp_node.i_mcp_node import IMcpNode
-from tools.models import Tool
-from common.utils.tool_code import ToolExecutor
-
-
-class BaseMcpNode(IMcpNode):
- def save_context(self, details, workflow_manage):
- self.context['result'] = details.get('result')
- self.context['tool_params'] = details.get('tool_params')
- self.context['mcp_tool'] = details.get('mcp_tool')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, mcp_servers, mcp_server, mcp_tool, mcp_tool_id, mcp_source, tool_params, **kwargs) -> NodeResult:
- if mcp_source == 'referencing':
- if not mcp_tool_id:
- raise ValueError("MCP tool ID is required when mcp_source is 'referencing'.")
- tool = QuerySet(Tool).filter(id=mcp_tool_id).first()
- if not tool:
- raise ValueError(f"Tool with ID {mcp_tool_id} not found.")
- if not tool.is_active:
- raise ValueError(f"Tool with ID {mcp_tool_id} is inactive.")
- servers = json.loads(tool.code)
- else:
- servers = json.loads(mcp_servers)
-
- servers = self.handle_variables(servers) # 处理servers中的变量
- ToolExecutor().validate_mcp_transport(json.dumps(servers))
- params = json.loads(json.dumps(tool_params))
- params = self.handle_variables(params)
-
- async def call_tool(t, a):
- client = MultiServerMCPClient(servers)
- async with client.session(mcp_server) as s:
- return await s.call_tool(t, a)
-
- res = asyncio.run(call_tool(mcp_tool, params))
- return NodeResult(
- {'result': [content.text for content in res.content], 'tool_params': params, 'mcp_tool': mcp_tool}, {})
-
- def handle_variables(self, tool_params):
- # 处理参数中的变量
- for k, v in tool_params.items():
- if type(v) == str:
- tool_params[k] = self.workflow_manage.generate_prompt(tool_params[k])
- elif type(v) == dict:
- self.handle_variables(v)
- elif (type(v) == list) and len(v) > 0 and (type(v[0]) == str):
- tool_params[k] = self.get_reference_content(v)
- return tool_params
-
- def get_reference_content(self, fields: List[str]):
- return self.workflow_manage.get_reference_field(
- fields[0],
- fields[1:]) if fields else None
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'type': self.node.type,
- 'mcp_tool': self.context.get('mcp_tool'),
- 'tool_params': self.context.get('tool_params'),
- 'result': self.context.get('result'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/parameter_extraction_node/__init__.py b/apps/application/flow/step_node/parameter_extraction_node/__init__.py
deleted file mode 100644
index c93d71e9ed1..00000000000
--- a/apps/application/flow/step_node/parameter_extraction_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/10/13 14:56
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/parameter_extraction_node/i_parameter_extraction_node.py b/apps/application/flow/step_node/parameter_extraction_node/i_parameter_extraction_node.py
deleted file mode 100644
index 54c60bb096c..00000000000
--- a/apps/application/flow/step_node/parameter_extraction_node/i_parameter_extraction_node.py
+++ /dev/null
@@ -1,58 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class VariableSplittingNodeParamsSerializer(serializers.Serializer):
- input_variable = serializers.ListField(required=True,
- label=_("input variable"))
-
- variable_list = serializers.ListField(required=True,
- label=_("Split variables"))
-
- model_params_setting = serializers.DictField(required=False,
- label=_("Model parameter settings"))
-
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
-
-
-class IParameterExtractionNode(INode):
- type = 'parameter-extraction-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return VariableSplittingNodeParamsSerializer
-
- def _run(self):
- model_id_type = self.node_params_serializer.data.get('model_id_type')
- model_id_reference = self.node_params_serializer.data.get('model_id_reference')
- model_id = self.node_params_serializer.data.get('model_id')
- model_params_setting = self.node_params_serializer.data.get('model_params_setting')
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
-
- input_variable = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('input_variable')[0],
- self.node_params_serializer.data.get('input_variable')[1:])
- return self.execute(input_variable, self.node_params_serializer.data['variable_list'],
- model_params_setting, model_id)
-
- def execute(self, input_variable, variable_list, model_params_setting, model_id, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/parameter_extraction_node/impl/__init__.py b/apps/application/flow/step_node/parameter_extraction_node/impl/__init__.py
deleted file mode 100644
index a0d23a10454..00000000000
--- a/apps/application/flow/step_node/parameter_extraction_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/10/13 15:01
- @desc:
-"""
-from .base_parameter_extraction_node import *
diff --git a/apps/application/flow/step_node/parameter_extraction_node/impl/base_parameter_extraction_node.py b/apps/application/flow/step_node/parameter_extraction_node/impl/base_parameter_extraction_node.py
deleted file mode 100644
index 2e686743b69..00000000000
--- a/apps/application/flow/step_node/parameter_extraction_node/impl/base_parameter_extraction_node.py
+++ /dev/null
@@ -1,123 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: base_variable_splitting_node.py
- @date:2025/10/13 15:02
- @desc:
-"""
-import json
-import re
-
-from django.db.models import QuerySet
-from langchain_core.messages import HumanMessage
-from langchain_core.prompts import PromptTemplate
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.parameter_extraction_node.i_parameter_extraction_node import IParameterExtractionNode
-from models_provider.models import Model
-from models_provider.tools import get_model_instance_by_model_workspace_id, get_model_credential
-
-prompt = """
-Please strictly process the text according to the following requirements:
-**Task**:
-Extract specified field information from given text
-
-**Enter text**:
-{{question}}
-
-**Extract configuration**:
-{{properties}}
-
-**Rule**:
-- Strictly follow the data and field of Extract configuration
-- If not found, use null value
-- Only return pure JSON without additional text
-- Keep the string format neat
-"""
-
-
-def get_default_model_params_setting(model_id):
- model = QuerySet(Model).filter(id=model_id).first()
- credential = get_model_credential(model.provider, model.model_type, model.model_name)
- model_params_setting = credential.get_model_params_setting_form(
- model.model_name).get_default_form_data()
- return model_params_setting
-
-
-def generate_properties(variable_list):
- return {variable['field']: {'type': variable['parameter_type'], 'description': (variable.get('desc') or ""),
- 'title': variable['label']} for variable in
- variable_list}
-
-
-def generate_example(variable_list):
- return {variable['field']: None for variable in variable_list}
-
-
-def generate_content(input_variable, variable_list):
- properties = generate_properties(variable_list)
- prompt_template = PromptTemplate.from_template(prompt, template_format='jinja2')
- value = prompt_template.format(properties=properties, question=input_variable)
- return value
-
-
-def json_loads(response, variable_list):
- if not response or not isinstance(response, str):
- return generate_example(variable_list)
-
- cleaned = response.strip()
-
- extraction_strategies = [
- lambda: json.loads(cleaned),
- lambda: json.loads(re.search(r'```(?:json)?\s*(\{.*?\})\s*```', cleaned, re.DOTALL).group(1)),
- lambda: json.loads(re.search(r'(\{.*\})', cleaned, flags=re.DOTALL).group(1)),
- ]
- for strategy in extraction_strategies:
- try:
- result = strategy()
- return result
- except:
- continue
- return generate_example(variable_list)
-
-
-class BaseParameterExtractionNode(IParameterExtractionNode):
-
- def save_context(self, details, workflow_manage):
- for key, value in details.get('result').items():
- self.context[key] = value
- self.context['result'] = details.get('result')
- self.context['request'] = details.get('request')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, input_variable, variable_list, model_params_setting, model_id, **kwargs) -> NodeResult:
- input_variable = str(input_variable)
- self.context['request'] = input_variable
-
- if not model_id:
- raise Exception(_('Model is not allowed to be empty'))
-
- if model_params_setting is None and model_id:
- model_params_setting = get_default_model_params_setting(model_id)
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
-
- content = generate_content(input_variable, variable_list)
- response = chat_model.invoke([HumanMessage(content=content)])
- result = json_loads(response.content, variable_list)
- return NodeResult({'result': result, **result}, {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'request': self.context.get('request'),
- 'result': self.context.get('result'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/question_node/__init__.py b/apps/application/flow/step_node/question_node/__init__.py
deleted file mode 100644
index 98a1afcd904..00000000000
--- a/apps/application/flow/step_node/question_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:30
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/question_node/i_question_node.py b/apps/application/flow/step_node/question_node/i_question_node.py
deleted file mode 100644
index 2e58b31ea01..00000000000
--- a/apps/application/flow/step_node/question_node/i_question_node.py
+++ /dev/null
@@ -1,55 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_chat_node.py
- @date:2024/6/4 13:58
- @desc:
-"""
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class QuestionNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- system = serializers.CharField(required=False, allow_blank=True, allow_null=True,
- label=_("Role Setting"))
- prompt = serializers.CharField(required=True, label=_("Prompt word"))
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=True, label=
- _("Number of multi-round conversations"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
- model_params_setting = serializers.DictField(required=False,
- label=_("Model parameter settings"))
-
-
-class IQuestionNode(INode):
- type = 'question-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return QuestionNodeSerializer
-
- def _run(self):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, system, prompt, dialogue_number, history_chat_record, stream, chat_id, chat_record_id,
- model_params_setting=None, model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/question_node/impl/__init__.py b/apps/application/flow/step_node/question_node/impl/__init__.py
deleted file mode 100644
index d85aa8724ac..00000000000
--- a/apps/application/flow/step_node/question_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:35
- @desc:
-"""
-from .base_question_node import BaseQuestionNode
diff --git a/apps/application/flow/step_node/question_node/impl/base_question_node.py b/apps/application/flow/step_node/question_node/impl/base_question_node.py
deleted file mode 100644
index 34000542db3..00000000000
--- a/apps/application/flow/step_node/question_node/impl/base_question_node.py
+++ /dev/null
@@ -1,172 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_question_node.py
- @date:2024/6/4 14:30
- @desc:
-"""
-import re
-import time
-from functools import reduce
-from typing import List, Dict
-
-from django.db.models import QuerySet
-from langchain_core.messages import BaseMessage, HumanMessage, SystemMessage
-
-from application.flow.i_step_node import NodeResult, INode
-from application.flow.step_node.question_node.i_question_node import IQuestionNode
-from models_provider.models import Model
-from models_provider.tools import get_model_instance_by_model_workspace_id, get_model_credential
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str):
- chat_model = node_variable.get('chat_model')
- message_tokens = chat_model.get_num_tokens_from_messages(node_variable.get('message_list'))
- answer_tokens = chat_model.get_num_tokens(answer)
- node.context['message_tokens'] = message_tokens
- node.context['answer_tokens'] = answer_tokens
- node.context['answer'] = answer
- node.context['history_message'] = node_variable['history_message']
- node.context['question'] = node_variable['question']
- node.context['run_time'] = time.time() - node.context['start_time']
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- answer = ''
- for chunk in response:
- answer += chunk.content
- yield chunk.content
- _write_context(node_variable, workflow_variable, node, workflow, answer)
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点实例对象
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- answer = response.content
- _write_context(node_variable, workflow_variable, node, workflow, answer)
-
-
-def get_default_model_params_setting(model_id):
- model = QuerySet(Model).filter(id=model_id).first()
- credential = get_model_credential(model.provider, model.model_type, model.model_name)
- model_params_setting = credential.get_model_params_setting_form(
- model.model_name).get_default_form_data()
- return model_params_setting
-
-
-class BaseQuestionNode(IQuestionNode):
- def save_context(self, details, workflow_manage):
- self.context['run_time'] = details.get('run_time')
- self.context['question'] = details.get('question')
- self.context['answer'] = details.get('answer')
- self.context['message_tokens'] = details.get('message_tokens')
- self.context['answer_tokens'] = details.get('answer_tokens')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, system, prompt, dialogue_number, history_chat_record, stream, chat_id, chat_record_id,
- model_params_setting=None, model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
- if not model_id:
- raise Exception(_('Model is not allowed to be empty'))
-
- if model_params_setting is None and model_id:
- model_params_setting = get_default_model_params_setting(model_id)
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- history_message = self.get_history_message(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
- question = self.generate_prompt_question(prompt)
- self.context['question'] = question.content
- system = self.workflow_manage.generate_prompt(system)
- self.context['system'] = system
- message_list = self.generate_message_list(system, prompt, history_message)
- self.context['message_list'] = message_list
- if stream:
- r = chat_model.stream(message_list)
- return NodeResult({'result': r, 'chat_model': chat_model, 'message_list': message_list,
- 'history_message': history_message, 'question': question.content}, {},
- _write_context=write_context_stream)
- else:
- r = chat_model.invoke(message_list)
- return NodeResult({'result': r, 'chat_model': chat_model, 'message_list': message_list,
- 'history_message': history_message, 'question': question.content}, {},
- _write_context=write_context)
-
- @staticmethod
- def get_history_message(history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [history_chat_record[index].get_human_message(), history_chat_record[index].get_ai_message()]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- for message in history_message:
- if isinstance(message.content, str):
- message.content = re.sub(r'.*?<\/form_rander>', '', message.content, flags=re.DOTALL)
- return history_message
-
- def generate_prompt_question(self, prompt):
- return HumanMessage(self.workflow_manage.generate_prompt(prompt))
-
- def generate_message_list(self, system: str, prompt: str, history_message):
- if system is not None and len(system) > 0:
- return [SystemMessage(self.workflow_manage.generate_prompt(system)), *history_message,
- HumanMessage(self.workflow_manage.generate_prompt(prompt))]
- else:
- return [*history_message, HumanMessage(self.workflow_manage.generate_prompt(prompt))]
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'system': self.context.get('system'),
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (self.context.get('history_message') if self.context.get(
- 'history_message') is not None else [])],
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/reranker_node/__init__.py b/apps/application/flow/step_node/reranker_node/__init__.py
deleted file mode 100644
index 881d0f8a393..00000000000
--- a/apps/application/flow/step_node/reranker_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2024/9/4 11:37
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/reranker_node/i_reranker_node.py b/apps/application/flow/step_node/reranker_node/i_reranker_node.py
deleted file mode 100644
index af87a6f2003..00000000000
--- a/apps/application/flow/step_node/reranker_node/i_reranker_node.py
+++ /dev/null
@@ -1,84 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: i_reranker_node.py
- @date:2024/9/4 10:40
- @desc:
-"""
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-from django.utils.translation import gettext_lazy as _
-
-
-class RerankerSettingSerializer(serializers.Serializer):
- # 需要查询的条数
- top_n = serializers.IntegerField(required=True,
- label=_("Reference segment number"))
- # 相似度 0-1之间
- similarity = serializers.FloatField(required=True, max_value=2, min_value=0,
- label=_("Reference segment number"))
- max_paragraph_char_number = serializers.IntegerField(required=True,
- label=_("Maximum number of words in a quoted segment"))
-
-
-class RerankerStepNodeSerializer(serializers.Serializer):
- reranker_setting = RerankerSettingSerializer(required=True)
-
- question_reference_address = serializers.ListField(required=True)
- reranker_model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True)
- reranker_model_id_type = serializers.CharField(required=False, default='custom')
- reranker_model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True)
- reranker_reference_list = serializers.ListField(required=True, child=serializers.ListField(required=True))
- show_knowledge = serializers.BooleanField(required=True,
- label=_("The results are displayed in the knowledge sources"))
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
-
-
-class IRerankerNode(INode):
- type = 'reranker-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return RerankerStepNodeSerializer
-
- def _run(self):
- question = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('question_reference_address')[0],
- self.node_params_serializer.data.get('question_reference_address')[1:])
- reranker_list = [self.workflow_manage.get_reference_field(
- reference[0],
- reference[1:]) for reference in
- self.node_params_serializer.data.get('reranker_reference_list')]
-
- node_params_data = dict(self.node_params_serializer.data)
-
- reranker_model_id_type = node_params_data.pop('reranker_model_id_type', None)
- reranker_model_id_reference = node_params_data.pop('reranker_model_id_reference', None)
- reranker_model_id = node_params_data.pop('reranker_model_id', None)
-
- # 处理引用类型
- if reranker_model_id_type == 'reference' and reranker_model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- reranker_model_id_reference[0],
- reranker_model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- reranker_model_id = reference_data.get('reranker_model_id',
- reference_data.get('model_id', reranker_model_id))
- if reranker_model_id is None or reranker_model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
-
- return self.execute(**node_params_data, question=str(question),
- reranker_list=reranker_list, reranker_model_id=reranker_model_id)
-
- def execute(self, question, reranker_setting, reranker_list, reranker_model_id, show_knowledge,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/reranker_node/impl/__init__.py b/apps/application/flow/step_node/reranker_node/impl/__init__.py
deleted file mode 100644
index ef5ca80585b..00000000000
--- a/apps/application/flow/step_node/reranker_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2024/9/4 11:39
- @desc:
-"""
-from .base_reranker_node import *
diff --git a/apps/application/flow/step_node/reranker_node/impl/base_reranker_node.py b/apps/application/flow/step_node/reranker_node/impl/base_reranker_node.py
deleted file mode 100644
index 36dd2144aee..00000000000
--- a/apps/application/flow/step_node/reranker_node/impl/base_reranker_node.py
+++ /dev/null
@@ -1,129 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: base_reranker_node.py
- @date:2024/9/4 11:41
- @desc:
-"""
-from typing import List
-
-from langchain_core.documents import Document
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.reranker_node.i_reranker_node import IRerankerNode
-from models_provider.tools import get_model_instance_by_model_workspace_id
-
-
-def merge_reranker_list(reranker_list, result=None):
- if result is None:
- result = []
- for document in reranker_list:
- if isinstance(document, list):
- merge_reranker_list(document, result)
- elif isinstance(document, dict):
- content = document.get('title', '') + document.get('content', '')
- title = document.get("title")
- result.append(
- Document(page_content=str(document) if len(content) == 0 else content,
- metadata={'title': title, **document}))
- else:
- result.append(Document(page_content=str(document), metadata={}))
- return result
-
-
-def filter_result(document_list: List[Document], max_paragraph_char_number, top_n, similarity):
- use_len = 0
- result = []
- for index in range(len(document_list)):
- document = document_list[index]
- if use_len >= max_paragraph_char_number or index >= top_n or document.metadata.get(
- 'relevance_score') < similarity:
- break
- content = document.page_content[0:max_paragraph_char_number - use_len]
- use_len = use_len + len(content)
- result.append({'page_content': content, 'metadata': document.metadata})
- return result
-
-
-def reset_result_list(result_list: List[Document], document_list: List[Document]):
- r = []
- document_list = document_list.copy()
- for result in result_list:
- filter_result_list = [document for document in document_list if document.page_content == result.page_content]
- if len(filter_result_list) > 0:
- item = filter_result_list[0]
- document_list.remove(item)
- r.append(Document(page_content=item.page_content,
- metadata={**item.metadata, 'relevance_score': result.metadata.get('relevance_score')}))
- else:
- r.append(result)
- return r
-
-
-def get_none_result(question):
- return NodeResult(
- {'document_list': [], 'question': question,
- 'result_list': [], 'result': ''}, {})
-
-
-def reset_metadata(metadata):
- meta = metadata.get('meta')
- if isinstance(metadata.get('meta'), dict):
- if not meta.get('allow_download', False):
- metadata['meta'] = {'allow_download': False}
- return metadata
-
-
-class BaseRerankerNode(IRerankerNode):
- def save_context(self, details, workflow_manage):
- self.context['document_list'] = details.get('document_list', [])
- self.context['question'] = details.get('question')
- self.context['run_time'] = details.get('run_time')
- self.context['result_list'] = details.get('result_list')
- self.context['result'] = details.get('result')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, question, reranker_setting, reranker_list, reranker_model_id, show_knowledge,
- **kwargs) -> NodeResult:
- self.context['show_knowledge'] = show_knowledge
- documents = merge_reranker_list(reranker_list)
- documents = [d for d in documents if d.page_content and len(d.page_content) > 0]
- if len(documents) == 0:
- return get_none_result(question)
- top_n = reranker_setting.get('top_n', 3)
- self.context['document_list'] = [
- {'page_content': document.page_content, 'metadata': reset_metadata(document.metadata)} for
- document in documents]
- self.context['question'] = question
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- reranker_model = get_model_instance_by_model_workspace_id(reranker_model_id,
- workspace_id,
- top_n=top_n)
- result = reranker_model.compress_documents(
- documents,
- question)
- similarity = reranker_setting.get('similarity', 0.6)
- max_paragraph_char_number = reranker_setting.get('max_paragraph_char_number', 5000)
- result = reset_result_list(result, documents)
- r = filter_result(result, max_paragraph_char_number, top_n, similarity)
- return NodeResult({'result_list': r, 'result': ''.join([item.get('page_content') for item in r]),
- 'is_hit_handling_method_list': [r for row in r if
- row.get('metadata').get('is_hit_handling_method')]}, {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'show_knowledge': self.context.get('show_knowledge'),
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'document_list': self.context.get('document_list'),
- "question": self.context.get('question'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'reranker_setting': self.node_params_serializer.data.get('reranker_setting'),
- 'result_list': self.context.get('result_list'),
- 'result': self.context.get('result'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/search_document_node/__init__.py b/apps/application/flow/step_node/search_document_node/__init__.py
deleted file mode 100644
index ce8f10f3e24..00000000000
--- a/apps/application/flow/step_node/search_document_node/__init__.py
+++ /dev/null
@@ -1 +0,0 @@
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/search_document_node/i_search_document_node.py b/apps/application/flow/step_node/search_document_node/i_search_document_node.py
deleted file mode 100644
index 0a2c99a1e71..00000000000
--- a/apps/application/flow/step_node/search_document_node/i_search_document_node.py
+++ /dev/null
@@ -1,58 +0,0 @@
-# coding=utf-8
-from typing import Type, List
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class SearchDocumentStepNodeSerializer(serializers.Serializer):
- knowledge_id_list = serializers.ListField(
- required=False, child=serializers.UUIDField(required=True),
- label=_("knowledge id list"), default=list
- )
- search_mode = serializers.ChoiceField(
- required=False, choices=['auto', 'custom'], label=_("search mode"), default='auto'
- )
- search_scope_type = serializers.ChoiceField(
- required=False, choices=['custom', 'referencing'], label=_("search scope type"),
- allow_null=True, default='custom'
- )
- search_scope_source = serializers.ChoiceField(
- required=False, choices=['document', 'knowledge'],
- label=_("search scope variable type"), default='knowledge'
- )
- search_scope_reference = serializers.ListField(
- required=False, label=_("search scope variable"), default=list
- )
- question_reference = serializers.ListField(
- required=False, label=_("question reference address"), default=list
- )
- search_condition_type = serializers.ChoiceField(
- required=False, choices=['AND', 'OR'], label=_("search condition type"), default='AND'
- )
- search_condition_list = serializers.ListField(
- required=False, label=_("search condition list"), default=list
- )
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
-
-
-class ISearchDocumentStepNode(INode):
- type = 'search-document-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return SearchDocumentStepNodeSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, knowledge_id_list: List, search_mode: str, search_scope_type: str, search_scope_source: str,
- search_scope_reference: List, question_reference: List, search_condition_type: str,
- search_condition_list: List,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/search_document_node/impl/__init__.py b/apps/application/flow/step_node/search_document_node/impl/__init__.py
deleted file mode 100644
index 74a1aa384a7..00000000000
--- a/apps/application/flow/step_node/search_document_node/impl/__init__.py
+++ /dev/null
@@ -1 +0,0 @@
-from .base_search_document_node import BaseSearchDocumentNode
diff --git a/apps/application/flow/step_node/search_document_node/impl/base_search_document_node.py b/apps/application/flow/step_node/search_document_node/impl/base_search_document_node.py
deleted file mode 100644
index 1d85cff5331..00000000000
--- a/apps/application/flow/step_node/search_document_node/impl/base_search_document_node.py
+++ /dev/null
@@ -1,212 +0,0 @@
-# coding=utf-8
-from typing import List
-
-import jieba
-from django.db.models import Q
-from django.db.models import QuerySet
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.search_document_node.i_search_document_node import ISearchDocumentStepNode
-from common.constants.permission_constants import RoleConstants
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.utils.shared_resource_auth import filter_authorized_ids
-from knowledge.models import Document, DocumentTag, Knowledge
-
-
-class BaseSearchDocumentNode(ISearchDocumentStepNode):
- def save_context(self, details, workflow_manage):
- self.context['document_list'] = details.get('document_list')
- self.context['knowledge_list'] = details.get('knowledge_list')
- self.context['document_items'] = details.get('document_items')
- self.context['knowledge_items'] = details.get('knowledge_items')
- self.context['question'] = details.get('question')
- self.context['run_time'] = details.get('run_time')
- self.context['exception_message'] = details.get('err_message')
-
- def get_reference_content(self, fields: List[str]):
- return self.workflow_manage.get_reference_field(fields[0], fields[1:]) if fields else None
-
- def execute(self, knowledge_id_list: List, search_mode: str, search_scope_type: str, search_scope_source: str,
- search_scope_reference: List, question_reference: List, search_condition_type: str,
- search_condition_list: List,
- **kwargs) -> NodeResult:
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
-
- if search_scope_type == 'custom': # 手动选择知识库
- knowledge_id_list = filter_authorized_ids('knowledge', knowledge_id_list, workspace_id)
- document_id_list = QuerySet(Document).filter(
- knowledge_id__in=knowledge_id_list
- ).values_list('id', flat=True)
- else: # 引用上一步知识库/文档
- if search_scope_source == 'document': # 文档
- document_id_list = self.get_reference_content(search_scope_reference)
- else: # 知识库
- ref_knowledge_ids = filter_authorized_ids('knowledge',
- self.get_reference_content(search_scope_reference),
- workspace_id)
- document_id_list = QuerySet(Document).filter(
- knowledge_id__in=ref_knowledge_ids
- ).values_list('id', flat=True)
-
- # 权限过滤
- get_knowledge_list_of_authorized = DatabaseModelManage.get_model('get_knowledge_list_of_authorized')
- chat_user_type = self.workflow_manage.get_body().get('chat_user_type')
-
- if get_knowledge_list_of_authorized is not None and RoleConstants.CHAT_USER.value.name == chat_user_type:
- actual_knowledge_ids = list(
- QuerySet(Document).filter(id__in=document_id_list)
- .values_list('knowledge_id', flat=True).distinct()
- )
- authorized_knowledge_ids = get_knowledge_list_of_authorized(
- self.workflow_manage.get_body().get('chat_user_id'),
- [str(k_id) for k_id in actual_knowledge_ids]
- )
- document_id_list = QuerySet(Document).filter(
- id__in=document_id_list,
- knowledge_id__in=authorized_knowledge_ids
- ).values_list('id', flat=True)
-
- if search_mode == 'auto': # 通过问题自动检索
- matched_doc_ids = self.handle_auto_tags(document_id_list, question_reference)
-
- final_document_ids = list(matched_doc_ids)
- else: # 自定义检索条件
- matched_document_ids = self.handle_custom_tags(
- document_id_list, search_condition_list, search_condition_type
- )
-
- final_document_ids = list(matched_document_ids)
-
- # UUID to str
- final_document_ids = [str(doc_id) for doc_id in final_document_ids]
- document_items = QuerySet(Document).filter(id__in=final_document_ids).values()
- final_knowledge_ids = list(set(str(doc['knowledge_id']) for doc in document_items))
- knowledge_items = QuerySet(Knowledge).filter(id__in=final_knowledge_ids).values()
-
- return NodeResult({
- 'document_list': final_document_ids,
- 'document_items': list(document_items),
- 'knowledge_list': final_knowledge_ids,
- 'knowledge_items': list(knowledge_items)
- }, {})
-
- def handle_auto_tags(self, document_id_list: list, question_reference: list):
- question = self.get_reference_content(question_reference)
-
- # 使用jieba分词
- keywords = jieba.lcut(question)
- if not keywords:
- return set()
-
- # 构建OR查询,一次性获取所有匹配的文档
- q_objects = Q()
- for keyword in keywords:
- q_objects |= Q(tag__value__icontains=keyword)
-
- # 单次数据库查询
- matched_doc_ids = set(
- QuerySet(DocumentTag)
- .filter(document_id__in=document_id_list)
- .filter(q_objects)
- .values_list('document_id', flat=True)
- .distinct()
- )
-
- return matched_doc_ids
-
- def handle_custom_tags(self, document_id_list: List, search_condition_list: list, search_condition_type: str):
-
- if not search_condition_list:
- return set(document_id_list)
-
- if search_condition_type == 'AND':
- # AND逻辑:使用子查询和聚合
- matched_doc_ids = set(document_id_list)
-
- for condition in search_condition_list:
- tag_key = condition['key']
- field_value = self.workflow_manage.generate_prompt(condition['value'])
- compare_type = condition['compare']
-
- if not field_value or field_value == 'None' or len(field_value) == 0:
- continue
-
- # 构建查询条件
- if compare_type == 'not_contain':
- # 反向查询:找出包含该标签的文档,然后排除
- exclude_docs = set(QuerySet(DocumentTag).filter(
- document_id__in=matched_doc_ids,
- tag__key=tag_key,
- tag__value__icontains=field_value
- ).values_list('document_id', flat=True).distinct())
-
- matched_doc_ids = matched_doc_ids - exclude_docs
- else:
- if compare_type == 'contain':
- q_filter = Q(tag__key=tag_key, tag__value__icontains=field_value)
- elif compare_type == 'eq':
- q_filter = Q(tag__key=tag_key, tag__value=field_value)
- else:
- continue
-
- # 单次查询获取符合条件的文档
- tag_docs = set(QuerySet(DocumentTag).filter(
- document_id__in=matched_doc_ids
- ).filter(q_filter).values_list('document_id', flat=True).distinct())
-
- matched_doc_ids = matched_doc_ids.intersection(tag_docs)
-
- return matched_doc_ids
-
- else:
- # OR逻辑
- matched_docs = set()
-
- for condition in search_condition_list:
- tag_key = condition['key']
- field_value = self.workflow_manage.generate_prompt(condition['value'])
- compare_type = condition['compare']
-
- if not field_value or field_value == 'None' or len(field_value) == 0:
- continue
-
- if compare_type == 'not_contain':
- # 反向查询:找出包含该标签的文档,然后用全集减去
- exclude_docs = set(QuerySet(DocumentTag).filter(
- document_id__in=document_id_list,
- tag__key=tag_key,
- tag__value__icontains=field_value
- ).values_list('document_id', flat=True).distinct())
-
- matched_docs = matched_docs.union(set(document_id_list) - exclude_docs)
- else:
- if compare_type == 'contain':
- q_filter = Q(tag__key=tag_key, tag__value__icontains=field_value)
- elif compare_type == 'eq':
- q_filter = Q(tag__key=tag_key, tag__value=field_value)
- else:
- continue
-
- docs = set(QuerySet(DocumentTag).filter(
- document_id__in=document_id_list
- ).filter(q_filter).values_list('document_id', flat=True).distinct())
-
- matched_docs = matched_docs.union(docs)
-
- return matched_docs
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- 'question': self.context.get('question'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'document_list': self.context.get('document_list'),
- 'knowledge_list': self.context.get('knowledge_list'),
- 'document_items': self.context.get('document_items'),
- 'knowledge_items': self.context.get('knowledge_items'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/search_knowledge_node/__init__.py b/apps/application/flow/step_node/search_knowledge_node/__init__.py
deleted file mode 100644
index 98a1afcd904..00000000000
--- a/apps/application/flow/step_node/search_knowledge_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:30
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/search_knowledge_node/i_search_knowledge_node.py b/apps/application/flow/step_node/search_knowledge_node/i_search_knowledge_node.py
deleted file mode 100644
index 0cf23cb5e5d..00000000000
--- a/apps/application/flow/step_node/search_knowledge_node/i_search_knowledge_node.py
+++ /dev/null
@@ -1,96 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_search_dataset_node.py
- @date:2024/6/3 17:52
- @desc:
-"""
-import re
-from typing import Type
-
-from django.core import validators
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-from common.utils.common import flat_map
-
-
-class DatasetSettingSerializer(serializers.Serializer):
- # 需要查询的条数
- top_n = serializers.IntegerField(required=True,
- label=_("Reference segment number"))
- # 相似度 0-1之间
- similarity = serializers.FloatField(required=True, max_value=2, min_value=0,
- label=_('similarity'))
- search_mode = serializers.CharField(required=True, validators=[
- validators.RegexValidator(regex=re.compile("^embedding|keywords|blend$"),
- message=_("The type only supports embedding|keywords|blend"), code=500)
- ], label=_("Retrieval Mode"))
- max_paragraph_char_number = serializers.IntegerField(required=True,
- label=_("Maximum number of words in a quoted segment"))
-
-
-class SearchDatasetStepNodeSerializer(serializers.Serializer):
- # 需要查询的数据集id列表
- knowledge_id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True),
- label=_("Dataset id list"))
- knowledge_setting = DatasetSettingSerializer(required=True)
-
- question_reference_address = serializers.ListField(required=True)
-
- show_knowledge = serializers.BooleanField(required=True,
- label=_("The results are displayed in the knowledge sources"))
- search_scope_type = serializers.ChoiceField(
- required=False, choices=['custom', 'referencing'], label=_("search scope type"),
- allow_null=True, default='custom'
- )
- search_scope_source = serializers.ChoiceField(
- required=False, choices=['document', 'knowledge'],
- label=_("search scope variable type"), default='knowledge'
- )
- search_scope_reference = serializers.ListField(
- required=False, label=_("search scope variable"), default=list
- )
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
-
-
-def get_paragraph_list(chat_record, node_id):
- return flat_map([chat_record.details[key].get('paragraph_list', []) for key in chat_record.details if
- (chat_record.details[
- key].get('type', '') == 'search-dataset-node') and chat_record.details[key].get(
- 'paragraph_list', []) is not None and key == node_id])
-
-
-class ISearchKnowledgeStepNode(INode):
- type = 'search-knowledge-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return SearchDatasetStepNodeSerializer
-
- def _run(self):
- question = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('question_reference_address')[0],
- self.node_params_serializer.data.get('question_reference_address')[1:])
- exclude_paragraph_id_list = []
- if self.flow_params_serializer.data.get('re_chat', False):
- history_chat_record = self.flow_params_serializer.data.get('history_chat_record', [])
- paragraph_id_list = [p.get('id') for p in flat_map(
- [get_paragraph_list(chat_record, self.runtime_node_id) for chat_record in history_chat_record if
- chat_record.problem_text == question])]
- exclude_paragraph_id_list = list(set(paragraph_id_list))
-
- return self.execute(**self.node_params_serializer.data, question=str(question),
- exclude_paragraph_id_list=exclude_paragraph_id_list)
-
- def execute(self, dataset_id_list, dataset_setting, question, show_knowledge, search_scope_type,
- search_scope_source,
- search_scope_reference,
- exclude_paragraph_id_list=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/search_knowledge_node/impl/__init__.py b/apps/application/flow/step_node/search_knowledge_node/impl/__init__.py
deleted file mode 100644
index 76a70567714..00000000000
--- a/apps/application/flow/step_node/search_knowledge_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:35
- @desc:
-"""
-from .base_search_knowledge_node import BaseSearchKnowledgeNode
diff --git a/apps/application/flow/step_node/search_knowledge_node/impl/base_search_knowledge_node.py b/apps/application/flow/step_node/search_knowledge_node/impl/base_search_knowledge_node.py
deleted file mode 100644
index 35a6fbd19b3..00000000000
--- a/apps/application/flow/step_node/search_knowledge_node/impl/base_search_knowledge_node.py
+++ /dev/null
@@ -1,187 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_search_dataset_node.py
- @date:2024/6/4 11:56
- @desc:
-"""
-import os
-from typing import List, Dict
-
-from django.db import connection
-from django.db.models import QuerySet
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.search_knowledge_node.i_search_knowledge_node import ISearchKnowledgeStepNode
-from common.config.embedding_config import VectorStore
-from common.constants.permission_constants import RoleConstants
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.db.search import native_search
-from common.utils.common import get_file_content
-from common.utils.shared_resource_auth import filter_authorized_ids
-from knowledge.models import Document, Paragraph, Knowledge, SearchMode
-from maxkb.conf import PROJECT_DIR
-from models_provider.tools import get_model_instance_by_model_workspace_id
-
-
-def get_embedding_id(dataset_id_list):
- dataset_list = QuerySet(Knowledge).filter(id__in=dataset_id_list)
- if len(set([dataset.embedding_model_id for dataset in dataset_list])) > 1:
- raise Exception("关联知识库的向量模型不一致,无法召回分段。")
- if len(dataset_list) == 0:
- raise Exception("知识库设置错误,请重新设置知识库")
- return dataset_list[0].embedding_model_id
-
-
-def get_none_result(question):
- return NodeResult(
- {'paragraph_list': [], 'is_hit_handling_method': [], 'question': question, 'data': '',
- 'directly_return': ''}, {})
-
-
-def reset_title(title):
- if title is None or len(title.strip()) == 0:
- return ""
- else:
- return f"#### {title}\n"
-
-
-def reset_meta(meta):
- if not meta.get('allow_download', False):
- return {'allow_download': False}
- return meta
-
-
-class BaseSearchKnowledgeNode(ISearchKnowledgeStepNode):
- def save_context(self, details, workflow_manage):
- result = details.get('paragraph_list', [])
- knowledge_setting = self.node_params_serializer.data.get('knowledge_setting')
- directly_return = '\n'.join(
- [f"{paragraph.get('title', '')}:{paragraph.get('content')}" for paragraph in result if
- paragraph.get('is_hit_handling_method')])
- self.context['paragraph_list'] = result
- self.context['question'] = details.get('question')
- self.context['run_time'] = details.get('run_time')
- self.context['is_hit_handling_method_list'] = [row for row in result if row.get('is_hit_handling_method')]
- self.context['data'] = '\n'.join(
- [f"{paragraph.get('title', '')}:{paragraph.get('content')}" for paragraph in
- result])[0:knowledge_setting.get('max_paragraph_char_number', 5000)]
- self.context['directly_return'] = directly_return
- self.context['exception_message'] = details.get('err_message')
-
- def get_reference_content(self, fields: List[str]):
- return self.workflow_manage.get_reference_field(fields[0], fields[1:]) if fields else None
-
- def execute(self, knowledge_id_list, knowledge_setting, question, show_knowledge, search_scope_type,
- search_scope_source,
- search_scope_reference,
- exclude_paragraph_id_list=None,
- **kwargs) -> NodeResult:
- self.context['question'] = question
- self.context['show_knowledge'] = show_knowledge
-
- document_id_list = None
- if search_scope_type == 'referencing': # 引用上一步知识库/文档
- if search_scope_source == 'knowledge': # 知识库
- knowledge_id_list = self.get_reference_content(search_scope_reference)
- else: # 文档
- document_id_list = self.get_reference_content(search_scope_reference)
- knowledge_id_list = [str(k) for k in QuerySet(Document).filter(
- id__in=document_id_list
- ).values_list(
- 'knowledge_id', flat=True
- ).distinct()]
-
- get_knowledge_list_of_authorized = DatabaseModelManage.get_model('get_knowledge_list_of_authorized')
- chat_user_type = self.workflow_manage.get_body().get('chat_user_type')
- if get_knowledge_list_of_authorized is not None and RoleConstants.CHAT_USER.value.name == chat_user_type:
- knowledge_id_list = get_knowledge_list_of_authorized(self.workflow_manage.get_body().get('chat_user_id'),
- knowledge_id_list)
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- knowledge_id_list = filter_authorized_ids('knowledge', knowledge_id_list, workspace_id)
- if len(knowledge_id_list) == 0:
- return get_none_result(question)
- model_id = get_embedding_id(knowledge_id_list)
- embedding_model = get_model_instance_by_model_workspace_id(model_id, workspace_id)
- embedding_value = embedding_model.embed_query(question)
- vector = VectorStore.get_embedding_vector()
- exclude_document_id_list = [str(document.id) for document in
- QuerySet(Document).filter(
- knowledge_id__in=knowledge_id_list,
- is_active=False)]
- embedding_list = vector.query(question, embedding_value, knowledge_id_list, document_id_list,
- exclude_document_id_list,
- exclude_paragraph_id_list, True, knowledge_setting.get('top_n'),
- knowledge_setting.get('similarity'),
- SearchMode(knowledge_setting.get('search_mode')))
- # 手动关闭数据库连接
- connection.close()
- if embedding_list is None:
- return get_none_result(question)
- paragraph_list = self.list_paragraph(embedding_list, vector)
- result = [self.reset_paragraph(paragraph, embedding_list) for paragraph in paragraph_list]
- result = sorted(result, key=lambda p: p.get('similarity'), reverse=True)
- return NodeResult({'paragraph_list': result,
- 'is_hit_handling_method_list': [row for row in result if row.get('is_hit_handling_method')],
- 'data': '\n'.join(
- [f"{reset_title(paragraph.get('title', ''))}{paragraph.get('content')}" for paragraph in
- result])[0:knowledge_setting.get('max_paragraph_char_number', 5000)],
- 'directly_return': '\n'.join(
- [paragraph.get('content') for paragraph in
- result if
- paragraph.get('is_hit_handling_method')]),
- 'question': question},
-
- {})
-
- @staticmethod
- def reset_paragraph(paragraph: Dict, embedding_list: List):
- filter_embedding_list = [embedding for embedding in embedding_list if
- str(embedding.get('paragraph_id')) == str(paragraph.get('id'))]
- if filter_embedding_list is not None and len(filter_embedding_list) > 0:
- find_embedding = filter_embedding_list[-1]
- return {
- **paragraph,
- 'similarity': find_embedding.get('similarity'),
- 'is_hit_handling_method': find_embedding.get('similarity') > paragraph.get(
- 'directly_return_similarity') and paragraph.get('hit_handling_method') == 'directly_return',
- 'update_time': paragraph.get('update_time').strftime("%Y-%m-%d %H:%M:%S"),
- 'create_time': paragraph.get('create_time').strftime("%Y-%m-%d %H:%M:%S"),
- 'id': str(paragraph.get('id')),
- 'knowledge_id': str(paragraph.get('knowledge_id')),
- 'document_id': str(paragraph.get('document_id')),
- 'meta': reset_meta(paragraph.get('meta'))
- }
-
- @staticmethod
- def list_paragraph(embedding_list: List, vector):
- paragraph_id_list = [row.get('paragraph_id') for row in embedding_list]
- if paragraph_id_list is None or len(paragraph_id_list) == 0:
- return []
- paragraph_list = native_search(QuerySet(Paragraph).filter(id__in=paragraph_id_list),
- get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql',
- 'list_knowledge_paragraph_by_paragraph_id.sql')),
- with_table_name=True)
- # 如果向量库中存在脏数据 直接删除
- if len(paragraph_list) != len(paragraph_id_list):
- exist_paragraph_list = [row.get('id') for row in paragraph_list]
- for paragraph_id in paragraph_id_list:
- if not exist_paragraph_list.__contains__(paragraph_id):
- vector.delete_by_paragraph_id(paragraph_id)
- return paragraph_list
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- 'show_knowledge': self.context.get('show_knowledge'),
- 'question': self.context.get('question'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'paragraph_list': self.context.get('paragraph_list'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/speech_to_text_step_node/__init__.py b/apps/application/flow/step_node/speech_to_text_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/speech_to_text_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/speech_to_text_step_node/i_speech_to_text_node.py b/apps/application/flow/step_node/speech_to_text_step_node/i_speech_to_text_node.py
deleted file mode 100644
index 32e1bb752fd..00000000000
--- a/apps/application/flow/step_node/speech_to_text_step_node/i_speech_to_text_node.py
+++ /dev/null
@@ -1,47 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class SpeechToTextNodeSerializer(serializers.Serializer):
- stt_model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- stt_model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- stt_model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- audio_list = serializers.ListField(required=True,
- label=_("The audio file cannot be empty"))
- model_params_setting = serializers.DictField(required=False,
- label=_("Model parameter settings"))
-
-
-class ISpeechToTextNode(INode):
- type = 'speech-to-text-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP,WorkflowMode.TOOL,WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return SpeechToTextNodeSerializer
-
- def _run(self):
- res = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('audio_list')[0],
- self.node_params_serializer.data.get('audio_list')[1:])
- for audio in res:
- if 'file_id' not in audio:
- raise ValueError(
- _("Parameter value error: The uploaded audio lacks file_id, and the audio upload fails"))
-
- return self.execute(audio=res, **self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, stt_model_id,
- audio, model_params_setting=None, stt_model_id_type=None, stt_model_id_reference=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/speech_to_text_step_node/impl/__init__.py b/apps/application/flow/step_node/speech_to_text_step_node/impl/__init__.py
deleted file mode 100644
index 9d2da615820..00000000000
--- a/apps/application/flow/step_node/speech_to_text_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_speech_to_text_node import BaseSpeechToTextNode
diff --git a/apps/application/flow/step_node/speech_to_text_step_node/impl/base_speech_to_text_node.py b/apps/application/flow/step_node/speech_to_text_step_node/impl/base_speech_to_text_node.py
deleted file mode 100644
index 1df3f85cdeb..00000000000
--- a/apps/application/flow/step_node/speech_to_text_step_node/impl/base_speech_to_text_node.py
+++ /dev/null
@@ -1,89 +0,0 @@
-# coding=utf-8
-import os
-import tempfile
-from concurrent.futures import ThreadPoolExecutor
-
-from django.db.models import QuerySet
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.speech_to_text_step_node.i_speech_to_text_node import ISpeechToTextNode
-from common.utils.common import split_and_transcribe, any_to_mp3
-from knowledge.models import File
-from models_provider.tools import get_model_instance_by_model_workspace_id
-
-
-class BaseSpeechToTextNode(ISpeechToTextNode):
-
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['result'] = details.get('answer')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, stt_model_id, audio, model_params_setting=None, stt_model_id_type=None, stt_model_id_reference=None,**kwargs) -> NodeResult:
-
- # 处理引用类型
- if stt_model_id_type == 'reference' and stt_model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- stt_model_id_reference[0],
- stt_model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- stt_model_id = reference_data.get('stt_model_id', reference_data.get('model_id', stt_model_id))
- model_params_setting = reference_data.get('model_params_setting')
-
- from django.utils.translation import gettext_lazy as _
-
- if stt_model_id is None or stt_model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- stt_model = get_model_instance_by_model_workspace_id(stt_model_id, workspace_id, **(model_params_setting or {}))
- audio_list = audio
- self.context['audio_list'] = audio
-
- def process_audio_item(audio_item, model):
- file = QuerySet(File).filter(id=audio_item['file_id']).first()
- # 根据file_name 吧文件转成mp3格式
- file_format = file.file_name.split('.')[-1]
- with tempfile.NamedTemporaryFile(delete=False, suffix=f'.{file_format}') as temp_file:
- temp_file.write(file.get_bytes())
- temp_file_path = temp_file.name
- with tempfile.NamedTemporaryFile(delete=False, suffix='.mp3') as temp_amr_file:
- temp_mp3_path = temp_amr_file.name
- any_to_mp3(temp_file_path, temp_mp3_path)
- try:
- transcription = split_and_transcribe(temp_mp3_path, model)
- return {file.file_name: transcription}
- finally:
- os.remove(temp_file_path)
- os.remove(temp_mp3_path)
-
- def process_audio_items(audio_list, model):
- with ThreadPoolExecutor(max_workers=5) as executor:
- results = list(executor.map(lambda item: process_audio_item(item, model), audio_list))
- return results
-
- result = process_audio_items(audio_list, stt_model)
- content = []
- result_content = []
- for item in result:
- for key, value in item.items():
- content.append(f'### {key}\n{value}')
- result_content.append(value)
- return NodeResult({'answer': '\n'.join(result_content), 'result': '\n'.join(result_content),
- 'content': content}, {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'answer': self.context.get('answer'),
- 'content': self.context.get('content'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'audio_list': self.context.get('audio_list'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/start_node/__init__.py b/apps/application/flow/step_node/start_node/__init__.py
deleted file mode 100644
index 98a1afcd904..00000000000
--- a/apps/application/flow/step_node/start_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:30
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/start_node/i_start_node.py b/apps/application/flow/step_node/start_node/i_start_node.py
deleted file mode 100644
index 40caf0199bf..00000000000
--- a/apps/application/flow/step_node/start_node/i_start_node.py
+++ /dev/null
@@ -1,21 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_start_node.py
- @date:2024/6/3 16:54
- @desc:
-"""
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class IStarNode(INode):
- type = 'start-node'
- support = [WorkflowMode.APPLICATION]
-
- def _run(self):
- return self.execute(**self.flow_params_serializer.data)
-
- def execute(self, question, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/start_node/impl/__init__.py b/apps/application/flow/step_node/start_node/impl/__init__.py
deleted file mode 100644
index b68a92d021f..00000000000
--- a/apps/application/flow/step_node/start_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:36
- @desc:
-"""
-from .base_start_node import BaseStartStepNode
diff --git a/apps/application/flow/step_node/start_node/impl/base_start_node.py b/apps/application/flow/step_node/start_node/impl/base_start_node.py
deleted file mode 100644
index 81a23eb25e4..00000000000
--- a/apps/application/flow/step_node/start_node/impl/base_start_node.py
+++ /dev/null
@@ -1,121 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_start_node.py
- @date:2024/6/3 17:17
- @desc:
-"""
-import time
-from datetime import datetime
-from typing import List, Type
-
-from django.db.models import QuerySet
-from django.utils import timezone
-from rest_framework import serializers
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.start_node.i_start_node import IStarNode
-from application.models import ApplicationLongTermMemory
-
-
-def get_default_global_variable(input_field_list: List):
- return {
- item.get('variable') or item.get('field'): item.get('default_value')
- for item in input_field_list
- if item.get('default_value', None) is not None
- }
-
-
-def get_global_variable(node):
- body = node.workflow_manage.get_body()
- history_chat_record = node.flow_params_serializer.data.get('history_chat_record', [])
- history_context = [{'question': chat_record.problem_text, 'answer': chat_record.answer_text} for chat_record in
- history_chat_record]
- chat_id = node.flow_params_serializer.data.get('chat_id')
- return {'time': timezone.localtime(timezone.now()).strftime('%Y-%m-%d %H:%M:%S'), 'start_time': time.time(),
- 'history_context': history_context, 'chat_id': str(chat_id), **node.workflow_manage.form_data,
- 'chat_user_id': body.get('chat_user_id'),
- 'chat_user_type': body.get('chat_user_type'),
- 'chat_user': body.get('chat_user'),
- 'chat_user_group': body.get('chat_user_group')
- }
-
-
-class BaseStartStepNode(IStarNode):
- def save_context(self, details, workflow_manage):
- base_node = self.workflow_manage.get_base_node()
- default_global_variable = get_default_global_variable(base_node.properties.get('user_input_field_list', []))
- default_api_global_variable = get_default_global_variable(base_node.properties.get('api_input_field_list', []))
- workflow_variable = {**default_global_variable, **default_api_global_variable, **get_global_variable(self)}
- self.context['question'] = details.get('question')
- self.context['run_time'] = details.get('run_time')
- self.context['document'] = details.get('document_list')
- self.context['image'] = details.get('image_list')
- self.context['audio'] = details.get('audio_list')
- self.context['video'] = details.get('video_list')
- self.context['other'] = details.get('other_list')
- self.context['exception_message'] = details.get('err_message')
- self.status = details.get('status')
- self.err_message = details.get('err_message')
- for key, value in workflow_variable.items():
- workflow_manage.context[key] = value
- for item in details.get('global_fields', []):
- workflow_manage.context[item.get('key')] = item.get('value')
- self.workflow_manage.chat_context = self.workflow_manage.get_chat_info().get_chat_variable()
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- pass
-
- def execute(self, question, **kwargs) -> NodeResult:
- base_node = self.workflow_manage.get_base_node()
- default_global_variable = get_default_global_variable(base_node.properties.get('user_input_field_list', []))
- default_api_global_variable = get_default_global_variable(base_node.properties.get('api_input_field_list', []))
- workflow_variable = {**default_global_variable, **default_api_global_variable, **get_global_variable(self)}
- chat_user_id = workflow_variable.get('chat_user_id')
- long_term_memory = None
- if chat_user_id:
- long_term_memory = QuerySet(ApplicationLongTermMemory).filter(
- chat_user_id=chat_user_id, application_id=self.workflow_params.get('application_id')
- ).first()
- """
- 开始节点 初始化全局变量
- """
- node_variable = {
- 'question': question,
- 'image': self.workflow_manage.image_list,
- 'document': self.workflow_manage.document_list,
- 'audio': self.workflow_manage.audio_list,
- 'video': self.workflow_manage.video_list,
- 'other': self.workflow_manage.other_list,
- 'memory': long_term_memory.memory if long_term_memory else ''
- }
- workflow_variable['memory'] = node_variable['memory']
- self.workflow_manage.chat_context = self.workflow_manage.get_chat_info().get_chat_variable()
- return NodeResult(node_variable, workflow_variable)
-
- def get_details(self, index: int, **kwargs):
- global_fields = []
- for field in self.node.properties.get('config')['globalFields']:
- key = field['value']
- global_fields.append({
- 'label': field['label'],
- 'key': key,
- 'value': self.workflow_manage.context[key] if key in self.workflow_manage.context else ''
- })
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "question": self.context.get('question'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'image_list': self.context.get('image'),
- 'video_list': self.context.get('video'),
- 'document_list': self.context.get('document'),
- 'audio_list': self.context.get('audio'),
- 'other_list': self.context.get('other'),
- 'global_fields': global_fields,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/text_to_speech_step_node/__init__.py b/apps/application/flow/step_node/text_to_speech_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/text_to_speech_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/text_to_speech_step_node/i_text_to_speech_node.py b/apps/application/flow/step_node/text_to_speech_step_node/i_text_to_speech_node.py
deleted file mode 100644
index 0dde27fea51..00000000000
--- a/apps/application/flow/step_node/text_to_speech_step_node/i_text_to_speech_node.py
+++ /dev/null
@@ -1,42 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-from django.utils.translation import gettext_lazy as _
-
-
-class TextToSpeechNodeSerializer(serializers.Serializer):
- tts_model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- tts_model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- tts_model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- content_list = serializers.ListField(required=True, label=_("Text content"))
- model_params_setting = serializers.DictField(required=False,
- label=_("Model parameter settings"))
-
-
-class ITextToSpeechNode(INode):
- type = 'text-to-speech-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return TextToSpeechNodeSerializer
-
- def _run(self):
- content = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('content_list')[0],
- self.node_params_serializer.data.get('content_list')[1:])
- return self.execute(content=content, **self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, tts_model_id,
- content, model_params_setting=None, tts_model_id_type=None, tts_model_id_reference=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/text_to_speech_step_node/impl/__init__.py b/apps/application/flow/step_node/text_to_speech_step_node/impl/__init__.py
deleted file mode 100644
index 385b9718f6e..00000000000
--- a/apps/application/flow/step_node/text_to_speech_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_text_to_speech_node import BaseTextToSpeechNode
diff --git a/apps/application/flow/step_node/text_to_speech_step_node/impl/base_text_to_speech_node.py b/apps/application/flow/step_node/text_to_speech_step_node/impl/base_text_to_speech_node.py
deleted file mode 100644
index 6e740c5971a..00000000000
--- a/apps/application/flow/step_node/text_to_speech_step_node/impl/base_text_to_speech_node.py
+++ /dev/null
@@ -1,178 +0,0 @@
-# coding=utf-8
-import io
-import mimetypes
-
-from django.core.files.uploadedfile import InMemoryUploadedFile
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.text_to_speech_step_node.i_text_to_speech_node import ITextToSpeechNode
-from common.utils.common import _remove_empty_lines
-from knowledge.models import FileSourceType
-from models_provider.tools import get_model_instance_by_model_workspace_id
-from oss.serializers.file import FileSerializer
-from pydub import AudioSegment
-
-
-def bytes_to_uploaded_file(file_bytes, file_name="generated_audio.mp3"):
- content_type, _ = mimetypes.guess_type(file_name)
- if content_type is None:
- # 如果未能识别,设置为默认的二进制文件类型
- content_type = "application/octet-stream"
- # 创建一个内存中的字节流对象
- file_stream = io.BytesIO(file_bytes)
-
- # 获取文件大小
- file_size = len(file_bytes)
-
- uploaded_file = InMemoryUploadedFile(
- file=file_stream,
- field_name=None,
- name=file_name,
- content_type=content_type,
- size=file_size,
- charset=None,
- )
- return uploaded_file
-
-
-class BaseTextToSpeechNode(ITextToSpeechNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['result'] = details.get('result')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, tts_model_id,
- content, model_params_setting=None, tts_model_id_type=None, tts_model_id_reference=None,
- max_length=1024, **kwargs) -> NodeResult:
- # 处理引用类型
- if tts_model_id_type == 'reference' and tts_model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- tts_model_id_reference[0],
- tts_model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- tts_model_id = reference_data.get('tts_model_id', reference_data.get('model_id', tts_model_id))
- model_params_setting = reference_data.get('model_params_setting')
-
- from django.utils.translation import gettext_lazy as _
-
- if tts_model_id is None or tts_model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
- # 分割文本为合理片段
- content = _remove_empty_lines(content)
- content_chunks = [content[i:i + max_length]
- for i in range(0, len(content), max_length)]
-
- # 生成并收集所有音频片段
- audio_segments = []
- temp_files = []
-
- for i, chunk in enumerate(content_chunks):
- self.context['content'] = chunk
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- model = get_model_instance_by_model_workspace_id(
- tts_model_id, workspace_id, **(model_params_setting or {}))
-
- audio_byte = model.text_to_speech(chunk)
-
- # 保存为临时音频文件用于合并
- temp_file = io.BytesIO(audio_byte)
- audio_segment = AudioSegment.from_file(temp_file)
- audio_segments.append(audio_segment)
- temp_files.append(temp_file)
-
- # 合并所有音频片段
- combined_audio = AudioSegment.empty()
- for segment in audio_segments:
- combined_audio += segment
-
- # 将合并后的音频转为字节流
- output_buffer = io.BytesIO()
- combined_audio.export(output_buffer, format="mp3")
- combined_bytes = output_buffer.getvalue()
- file_name = 'combined_audio.mp3'
- file = bytes_to_uploaded_file(combined_bytes, file_name)
- # 存储合并后的音频文件
- file_url = self.upload_file(file)
- # 生成音频标签
- audio_label = f''
- file_id = file_url.split('/')[-1]
- audio_list = [{'file_id': file_id, 'file_name': file_name, 'url': file_url}]
-
- # 关闭所有临时文件
- for temp_file in temp_files:
- temp_file.close()
- output_buffer.close()
-
- return NodeResult({
- 'answer': audio_label,
- 'result': audio_list
- }, {})
-
- def upload_file(self, file):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.upload_knowledge_file(file)
- if [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- return self.upload_tool_file(file)
- return self.upload_application_file(file)
-
- def upload_knowledge_file(self, file):
- knowledge_id = self.workflow_params.get('knowledge_id')
- meta = {
- 'debug': False,
- 'knowledge_id': knowledge_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': knowledge_id,
- 'source_type': FileSourceType.KNOWLEDGE.value
- }).upload()
- return file_url
-
- def upload_tool_file(self, file):
- tool_id = self.workflow_params.get('tool_id')
- meta = {
- 'debug': False,
- 'tool_id': tool_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': tool_id,
- 'source_type': FileSourceType.TOOL.value
- }).upload()
- return file_url
-
- def upload_application_file(self, file):
- application = self.workflow_manage.work_flow_post_handler.chat_info.application
- chat_id = self.workflow_params.get('chat_id')
- meta = {
- 'debug': False if application.id else True,
- 'chat_id': chat_id,
- 'application_id': str(application.id) if application.id else None,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': meta['application_id'],
- 'source_type': FileSourceType.APPLICATION.value
- }).upload()
- return file_url
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'content': self.context.get('content'),
- 'err_message': self.err_message,
- 'answer': self.context.get('answer'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/text_to_video_step_node/__init__.py b/apps/application/flow/step_node/text_to_video_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/text_to_video_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/text_to_video_step_node/i_text_to_video_node.py b/apps/application/flow/step_node/text_to_video_step_node/i_text_to_video_node.py
deleted file mode 100644
index cf0f0252332..00000000000
--- a/apps/application/flow/step_node/text_to_video_step_node/i_text_to_video_node.py
+++ /dev/null
@@ -1,57 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class TextToVideoNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- prompt = serializers.CharField(required=True, label=_("Prompt word (positive)"))
-
- negative_prompt = serializers.CharField(required=False, label=_("Prompt word (negative)"),
- allow_null=True, allow_blank=True, )
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=False, default=0,
- label=_("Number of multi-round conversations"))
-
- dialogue_type = serializers.CharField(required=False, default='NODE',
- label=_("Conversation storage type"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- model_params_setting = serializers.JSONField(required=False, default=dict,
- label=_("Model parameter settings"))
-
-
-class ITextToVideoNode(INode):
- type = 'text-to-video-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return TextToVideoNodeSerializer
-
- def _run(self):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None})
- else:
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, prompt, negative_prompt, dialogue_number, dialogue_type, history_chat_record,
- model_params_setting,
- chat_record_id,
- model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/text_to_video_step_node/impl/__init__.py b/apps/application/flow/step_node/text_to_video_step_node/impl/__init__.py
deleted file mode 100644
index be03d57a2fa..00000000000
--- a/apps/application/flow/step_node/text_to_video_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_text_to_video_node import BaseTextToVideoNode
diff --git a/apps/application/flow/step_node/text_to_video_step_node/impl/base_text_to_video_node.py b/apps/application/flow/step_node/text_to_video_step_node/impl/base_text_to_video_node.py
deleted file mode 100644
index fd4ae5ad2f3..00000000000
--- a/apps/application/flow/step_node/text_to_video_step_node/impl/base_text_to_video_node.py
+++ /dev/null
@@ -1,190 +0,0 @@
-# coding=utf-8
-from functools import reduce
-from typing import List
-
-import requests
-from langchain_core.messages import BaseMessage, HumanMessage, AIMessage
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.text_to_video_step_node.i_text_to_video_node import ITextToVideoNode
-from common.utils.common import bytes_to_uploaded_file
-from knowledge.models import FileSourceType
-from oss.serializers.file import FileSerializer
-from models_provider.tools import get_model_instance_by_model_workspace_id
-from django.utils.translation import gettext
-
-
-class BaseTextToVideoNode(ITextToVideoNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['exception_message'] = details.get('err_message')
- self.context['question'] = details.get('question')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, prompt, negative_prompt, dialogue_number, dialogue_type, history_chat_record,
- model_params_setting,
- chat_record_id,
- model_id_type=None, model_id_reference=None,
- **kwargs) -> NodeResult:
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
-
- from django.utils.translation import gettext_lazy as _
-
- if model_id is None or model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- ttv_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- history_message = self.get_history_message(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
- question = self.generate_prompt_question(prompt)
- self.context['question'] = question
- message_list = self.generate_message_list(question, history_message)
- self.context['message_list'] = message_list
- self.context['dialogue_type'] = dialogue_type
- self.context['negative_prompt'] = self.generate_prompt_question(negative_prompt)
- video_urls = ttv_model.generate_video(question, negative_prompt)
- # 保存图片
- if video_urls is None:
- return NodeResult({'answer': gettext('Failed to generate video')}, {})
- file_name = 'generated_video.mp4'
- if isinstance(video_urls, str) and video_urls.startswith('http'):
- video_urls = requests.get(video_urls).content
- file = bytes_to_uploaded_file(video_urls, file_name)
- file_url = self.upload_file(file)
- video_label = f''
- video_list = [{'file_id': file_url.split('/')[-1], 'file_name': file_name, 'url': file_url}]
- return NodeResult({'answer': video_label, 'chat_model': ttv_model, 'message_list': message_list,
- 'video': video_list,
- 'history_message': history_message, 'question': question}, {})
-
- def upload_file(self, file):
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.upload_knowledge_file(file)
- if [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- return self.upload_tool_file(file)
- return self.upload_application_file(file)
-
- def upload_knowledge_file(self, file):
- knowledge_id = self.workflow_params.get('knowledge_id')
- meta = {
- 'debug': False,
- 'knowledge_id': knowledge_id
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': knowledge_id,
- 'source_type': FileSourceType.KNOWLEDGE.value
- }).upload()
- return file_url
-
- def upload_tool_file(self, file):
- tool_id = self.workflow_params.get('tool_id')
- meta = {
- 'debug': False,
- 'tool_id': tool_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': tool_id,
- 'source_type': FileSourceType.TOOL.value
- }).upload()
- return file_url
-
- def upload_application_file(self, file):
- application = self.workflow_manage.work_flow_post_handler.chat_info.application
- chat_id = self.workflow_params.get('chat_id')
- meta = {
- 'debug': False if application.id else True,
- 'chat_id': chat_id,
- 'application_id': str(application.id) if application.id else None,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': meta['application_id'],
- 'source_type': FileSourceType.APPLICATION.value
- }).upload()
- return file_url
-
- def generate_history_ai_message(self, chat_record):
- for val in chat_record.details.values():
- if self.node.id == val['node_id'] and 'image_list' in val:
- if val['dialogue_type'] == 'WORKFLOW':
- return chat_record.get_ai_message()
- image_list = val['image_list']
- return AIMessage(content=[
- *[{'type': 'image_url', 'image_url': {'url': f'{file_url}'}} for file_url in image_list]
- ])
- return chat_record.get_ai_message()
-
- def get_history_message(self, history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message(history_chat_record[index]),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_human_message(self, chat_record):
-
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'image_list' in data:
- image_list = data['image_list']
- if len(image_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
- return HumanMessage(content=data['question'])
- return HumanMessage(content=chat_record.problem_text)
-
- def generate_prompt_question(self, prompt):
- return self.workflow_manage.generate_prompt(prompt)
-
- def generate_message_list(self, question: str, history_message):
- return [
- *history_message,
- question
- ]
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (self.context.get('history_message') if self.context.get(
- 'history_message') is not None else [])],
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'image_list': self.context.get('image_list'),
- 'dialogue_type': self.context.get('dialogue_type'),
- 'negative_prompt': self.context.get('negative_prompt'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/tool_lib_node/__init__.py b/apps/application/flow/step_node/tool_lib_node/__init__.py
deleted file mode 100644
index 7422965c365..00000000000
--- a/apps/application/flow/step_node/tool_lib_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2024/8/8 17:45
- @desc:
-"""
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/tool_lib_node/i_tool_lib_node.py b/apps/application/flow/step_node/tool_lib_node/i_tool_lib_node.py
deleted file mode 100644
index 08f3e3a845d..00000000000
--- a/apps/application/flow/step_node/tool_lib_node/i_tool_lib_node.py
+++ /dev/null
@@ -1,54 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: i_function_lib_node.py
- @date:2024/8/8 16:21
- @desc:
-"""
-from typing import Type
-
-from django.db import connection
-from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-from common.field.common import ObjectField
-from tools.models.tool import Tool
-
-
-class InputField(serializers.Serializer):
- name = serializers.CharField(required=True, label=_('Variable Name'))
- value = ObjectField(required=True, label=_("Variable Value"), model_type_list=[str, list])
-
-
-class FunctionLibNodeParamsSerializer(serializers.Serializer):
- tool_lib_id = serializers.UUIDField(required=True, label=_('Library ID'))
- input_field_list = InputField(required=True, many=True)
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- f_lib = QuerySet(Tool).filter(id=self.data.get('tool_lib_id')).first()
- # 归还链接到连接池
- connection.close()
- if f_lib is None:
- raise Exception(_('The function has been deleted'))
-
-
-class IToolLibNode(INode):
- type = 'tool-lib-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return FunctionLibNodeParamsSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, tool_lib_id, input_field_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/tool_lib_node/impl/__init__.py b/apps/application/flow/step_node/tool_lib_node/impl/__init__.py
deleted file mode 100644
index c6c0d832175..00000000000
--- a/apps/application/flow/step_node/tool_lib_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2024/8/8 17:48
- @desc:
-"""
-from .base_tool_lib_node import BaseToolLibNodeNode
diff --git a/apps/application/flow/step_node/tool_lib_node/impl/base_tool_lib_node.py b/apps/application/flow/step_node/tool_lib_node/impl/base_tool_lib_node.py
deleted file mode 100644
index 3cd056b9534..00000000000
--- a/apps/application/flow/step_node/tool_lib_node/impl/base_tool_lib_node.py
+++ /dev/null
@@ -1,311 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: base_function_lib_node.py
- @date:2024/8/8 17:49
- @desc:
-"""
-
-import base64
-import io
-import json
-import mimetypes
-import time
-import traceback
-from typing import Dict
-
-import uuid_utils.compat as uuid
-from django.core.files.uploadedfile import InMemoryUploadedFile
-from django.db.models import QuerySet
-from django.utils.translation import gettext as _
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.tool_lib_node.i_tool_lib_node import IToolLibNode
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.exception.app_exception import AppApiException
-from common.utils.common import common_convert_value
-from common.utils.logger import maxkb_logger
-from common.utils.rsa_util import rsa_long_decrypt
-from common.utils.tool_code import ToolExecutor
-from knowledge.models import FileSourceType
-from knowledge.models.knowledge_action import State
-from oss.serializers.file import FileSerializer
-from tools.models import Tool, ToolRecord, ToolTaskTypeChoices
-
-function_executor = ToolExecutor()
-
-
-def write_context(step_variable: Dict, global_variable: Dict, node, workflow):
- if step_variable is not None:
- for key in step_variable:
- node.context[key] = step_variable[key]
- if workflow.is_result(node, NodeResult(step_variable, global_variable)) and 'result' in step_variable:
- result = str(step_variable['result']) + '\n'
- yield result
- node.answer_text = result
- node.context['run_time'] = time.time() - node.context['start_time']
-
-
-def get_field_value(debug_field_list, name, is_required):
- result = [field for field in debug_field_list if field.get('name') == name]
- if len(result) > 0:
- return result[-1]['value']
- if is_required:
- raise AppApiException(500, _('Field: {name} No value set').format(name=name))
- return None
-
-
-def valid_reference_value(_type, value, name):
- if _type == 'int':
- instance_type = int | float
- elif _type == 'boolean':
- instance_type = bool
- elif _type == 'float':
- instance_type = float | int
- elif _type == 'dict':
- value = json.loads(value) if isinstance(value, str) else value
- instance_type = dict
- elif _type == 'array':
- value = json.loads(value) if isinstance(value, str) else value
- instance_type = list
- elif _type == 'string':
- instance_type = str
- else:
- maxkb_logger.error(_(
- 'Field: {name} Type: {_type} Value: {value} Unsupported this type'
- ).format(name=name, _type=_type, value=value))
- return value
- if not isinstance(value, instance_type):
- raise Exception(_(
- 'Field: {name} Type: {_type} Value: {value} Type error'
- ).format(name=name, _type=_type, value=value))
- return value
-
-
-def convert_value(name: str, value, _type, is_required, source, node):
- if not is_required and (value is None or ((isinstance(value, str) or isinstance(value, list)) and len(value) == 0)):
- return None
- if source == 'reference':
- value = node.workflow_manage.get_reference_field(
- value[0],
- value[1:])
- if value is None:
- if not is_required:
- return None
- else:
- raise Exception(_(
- 'Field: {name} Type: {_type} is required'
- ).format(name=name, _type=_type))
- value = valid_reference_value(_type, value, name)
- if _type == 'int':
- return int(value)
- if _type == 'float':
- return float(value)
- return value
- try:
- value = node.workflow_manage.generate_prompt(value)
- return common_convert_value(_type, value)
- except Exception as e:
- raise Exception(
- _('Field: {name} Type: {_type} Value: {value} Type error').format(name=name, _type=_type,
- value=value))
-
-
-def valid_function(tool_lib, workspace_id):
- if tool_lib is None:
- raise Exception(_('Tool does not exist'))
- get_authorized_tool = DatabaseModelManage.get_model("get_authorized_tool")
- if tool_lib and tool_lib.workspace_id != workspace_id and get_authorized_tool is not None:
- tool_lib = get_authorized_tool(QuerySet(Tool).filter(id=tool_lib.id), workspace_id).first()
- if tool_lib is None:
- raise Exception(_("Tool does not exist"))
- if not tool_lib.is_active:
- raise Exception(_("Tool is not active"))
-
-
-def _filter_file_bytes(data):
- """递归过滤掉所有层级的 file_bytes"""
- if isinstance(data, dict):
- return {k: _filter_file_bytes(v) for k, v in data.items() if k != 'file_bytes'}
- elif isinstance(data, list):
- return [_filter_file_bytes(item) for item in data]
- else:
- return data
-
-
-def bytes_to_uploaded_file(file_bytes, file_name="unknown"):
- content_type, _ = mimetypes.guess_type(file_name)
- if content_type is None:
- # 如果未能识别,设置为默认的二进制文件类型
- content_type = "application/octet-stream"
- # 创建一个内存中的字节流对象
- file_stream = io.BytesIO(file_bytes)
-
- # 获取文件大小
- file_size = len(file_bytes)
-
- uploaded_file = InMemoryUploadedFile(
- file=file_stream,
- field_name=None,
- name=file_name,
- content_type=content_type,
- size=file_size,
- charset=None,
- )
- return uploaded_file
-
-
-def _get_result_detail(result):
- if isinstance(result, dict):
- result_dict = {k: (str(v)[:500] if len(str(v)) > 500 else v) for k, v in result.items()}
- elif isinstance(result, list):
- result_dict = [str(item)[:500] if len(str(item)) > 500 else item for item in result]
- elif isinstance(result, str):
- result_dict = result[:500] if len(result) > 500 else result
- else:
- result_dict = result
- return result_dict
-
-
-class BaseToolLibNodeNode(IToolLibNode):
- def save_context(self, details, workflow_manage):
- self.context['result'] = details.get('result')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result'):
- self.answer_text = str(details.get('result'))
-
- def execute(self, tool_lib_id, input_field_list, **kwargs) -> NodeResult:
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- tool_lib = QuerySet(Tool).filter(id=tool_lib_id).first()
- valid_function(tool_lib, workspace_id)
- params = {
- field.get('name'): convert_value(
- field.get('name'), field.get('value'), field.get('type'),
- field.get('is_required'),
- field.get('source'), self
- )
- for field in [
- {
- 'value': get_field_value(input_field_list, field.get('name'), field.get('is_required'), ), **field
- } for field in tool_lib.input_field_list
- ]
- }
-
- self.context['params'] = params
- # 合并初始化参数
- init_params_default_value = {i["field"]: i.get('default_value') for i in tool_lib.init_field_list}
- if tool_lib.init_params is not None:
- all_params = init_params_default_value | json.loads(rsa_long_decrypt(tool_lib.init_params)) | params
- else:
- all_params = init_params_default_value | params
- if self.node.properties.get('kind') == 'data-source':
- exist = function_executor.exec_code(
- f'{tool_lib.code}\ndef function_exist(function_name): return callable(globals().get(function_name))',
- {'function_name': 'get_download_file_list'})
- all_params = {**all_params, **self.workflow_params.get('data_source')}
- if exist:
- download_file_list = []
- download_list = function_executor.exec_code(tool_lib.code,
- all_params,
- function_name='get_download_file_list')
- for item in download_list:
- result = function_executor.exec_code(tool_lib.code,
- {**all_params, 'download_item': item},
- function_name='download')
- file_bytes = result.get('file_bytes', [])
- chunks = []
- for chunk in file_bytes:
- chunks.append(base64.b64decode(chunk))
- file = bytes_to_uploaded_file(b''.join(chunks), result.get('name'))
- file_url = self.upload_knowledge_file(file)
- download_file_list.append({'file_id': file_url.split('/')[-1], 'name': result.get('name')})
- result = download_file_list
- else:
- result = function_executor.exec_code(tool_lib.code, all_params)
- else:
- result = self.tool_exec_record(tool_lib, all_params)
- return NodeResult({'result': result},
- (self.workflow_manage.params.get('knowledge_base') or {}) if self.node.properties.get(
- 'kind') == 'data-source' else {}, _write_context=write_context)
-
- def tool_exec_record(self, tool_lib, all_params):
- task_record_id = uuid.uuid7()
- start_time = time.time()
- filtered_args = all_params
- try:
- # 过滤掉 tool_init_params 中的参数
- tool_init_params = json.loads(rsa_long_decrypt(tool_lib.init_params)) if tool_lib.init_params else {}
- if tool_init_params:
- filtered_args = {
- k: v for k, v in all_params.items()
- if k not in tool_init_params
- }
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- source_id = self.workflow_manage.params.get('knowledge_id')
- source_type = ToolTaskTypeChoices.KNOWLEDGE.value
- elif [WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP].__contains__(self.workflow_manage.flow.workflow_mode):
- source_id = self.workflow_manage.params.get('tool_id')
- source_type = ToolTaskTypeChoices.TOOL.value
- else:
- source_id = self.workflow_manage.params.get('application_id')
- source_type = ToolTaskTypeChoices.APPLICATION.value
-
- ToolRecord(
- id=task_record_id,
- workspace_id=tool_lib.workspace_id,
- tool_id=tool_lib.id,
- source_type=source_type,
- source_id=source_id,
- meta={'input': filtered_args, 'output': {}},
- state=State.STARTED
- ).save()
-
- result = function_executor.exec_code(tool_lib.code, all_params)
- result_dict = _get_result_detail(result)
- QuerySet(ToolRecord).filter(id=task_record_id).update(
- state=State.SUCCESS,
- run_time=time.time() - start_time,
- meta={'input': filtered_args, 'output': result_dict}
- )
-
- return result
- except Exception as e:
- maxkb_logger.error(f"Tool execution error: {traceback.format_exc()}")
- QuerySet(ToolRecord).filter(id=task_record_id).update(
- state=State.FAILURE,
- run_time=time.time() - start_time,
- meta={'input': filtered_args, 'output': 'Error: ' + str(e)}
- )
-
- def upload_knowledge_file(self, file):
- knowledge_id = self.workflow_params.get('knowledge_id')
- meta = {
- 'debug': False,
- 'knowledge_id': knowledge_id,
- }
- file_url = FileSerializer(data={
- 'file': file,
- 'meta': meta,
- 'source_id': knowledge_id,
- 'source_type': FileSourceType.KNOWLEDGE.value
- }).upload().replace("./oss/file/", '')
- file.close()
- return file_url
-
- def get_details(self, index: int, **kwargs):
- result = _filter_file_bytes(self.context.get('result'))
-
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "result": result,
- "params": self.context.get('params'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/tool_node/__init__.py b/apps/application/flow/step_node/tool_node/__init__.py
deleted file mode 100644
index ebfbe8d8bb4..00000000000
--- a/apps/application/flow/step_node/tool_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py.py
- @date:2024/8/13 10:43
- @desc:
-"""
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/tool_node/i_tool_node.py b/apps/application/flow/step_node/tool_node/i_tool_node.py
deleted file mode 100644
index 4f8343a67db..00000000000
--- a/apps/application/flow/step_node/tool_node/i_tool_node.py
+++ /dev/null
@@ -1,66 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: i_function_lib_node.py
- @date:2024/8/8 16:21
- @desc:
-"""
-import re
-from typing import Type
-
-from django.core import validators
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-from rest_framework.utils.formatting import lazy_format
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-from common.exception.app_exception import AppApiException
-from common.field.common import ObjectField
-
-
-class InputField(serializers.Serializer):
- name = serializers.CharField(required=True, label=_('Variable Name'))
- is_required = serializers.BooleanField(required=True, label=_("Is this field required"))
- type = serializers.CharField(required=True, label=_("type"), validators=[
- validators.RegexValidator(regex=re.compile("^string|int|dict|array|float|boolean$"),
- message=_("The field only supports string|int|dict|array|float"), code=500)
- ])
- source = serializers.CharField(required=True, label=_("source"), validators=[
- validators.RegexValidator(regex=re.compile("^custom|reference$"),
- message=_("The field only supports custom|reference"), code=500)
- ])
- value = ObjectField(required=True, label=_("Variable Value"), model_type_list=[str, list])
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- is_required = self.data.get('is_required')
- if is_required and self.data.get('value') is None:
- message = lazy_format(_('{field}, this field is required.'), field=self.data.get("name"))
- raise AppApiException(500, message)
-
-
-class FunctionNodeParamsSerializer(serializers.Serializer):
- input_field_list = InputField(required=True, many=True)
- code = serializers.CharField(required=True, label=_("function"))
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
-
-
-class IToolNode(INode):
- type = 'tool-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return FunctionNodeParamsSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, input_field_list, code, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/tool_node/impl/__init__.py b/apps/application/flow/step_node/tool_node/impl/__init__.py
deleted file mode 100644
index 0ef86c3b687..00000000000
--- a/apps/application/flow/step_node/tool_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py.py
- @date:2024/8/13 11:19
- @desc:
-"""
-from .base_tool_node import BaseToolNodeNode
diff --git a/apps/application/flow/step_node/tool_node/impl/base_tool_node.py b/apps/application/flow/step_node/tool_node/impl/base_tool_node.py
deleted file mode 100644
index c5595bc805e..00000000000
--- a/apps/application/flow/step_node/tool_node/impl/base_tool_node.py
+++ /dev/null
@@ -1,118 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: base_function_lib_node.py
- @date:2024/8/8 17:49
- @desc:
-"""
-import json
-import time
-from typing import Dict
-
-from django.utils.translation import gettext as _
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.tool_node.i_tool_node import IToolNode
-from common.utils.common import common_convert_value
-from common.utils.logger import maxkb_logger
-from common.utils.tool_code import ToolExecutor
-from maxkb.const import CONFIG
-
-function_executor = ToolExecutor()
-
-
-def write_context(step_variable: Dict, global_variable: Dict, node, workflow):
- if step_variable is not None:
- for key in step_variable:
- node.context[key] = step_variable[key]
- if workflow.is_result(node, NodeResult(step_variable, global_variable)) and 'result' in step_variable:
- result = str(step_variable['result']) + '\n'
- yield result
- node.answer_text = result
- node.context['run_time'] = time.time() - node.context['start_time']
-
-
-def valid_reference_value(_type, value, name):
- if _type == 'int':
- instance_type = int | float
- elif _type == 'boolean':
- instance_type = bool
- elif _type == 'float':
- instance_type = float | int
- elif _type == 'dict':
- value = json.loads(value) if isinstance(value, str) else value
- instance_type = dict
- elif _type == 'array':
- value = json.loads(value) if isinstance(value, str) else value
- instance_type = list
- elif _type == 'string':
- instance_type = str
- else:
- maxkb_logger.error(_(
- 'Field: {name} Type: {_type} Value: {value} Unsupported this type'
- ).format(name=name, _type=_type, value=value))
- return value
- if not isinstance(value, instance_type):
- raise Exception(_(
- 'Field: {name} Type: {_type} Value: {value} Type error'
- ).format(name=name, _type=_type, value=value))
- return value
-
-
-def convert_value(name: str, value, _type, is_required, source, node):
- if not is_required and (value is None or ((isinstance(value, str) or isinstance(value, list)) and len(value) == 0)):
- return None
- if source == 'reference':
- value = node.workflow_manage.get_reference_field(
- value[0],
- value[1:])
- if value is None:
- if not is_required:
- return None
- else:
- raise Exception(_(
- 'Field: {name} Type: {_type} is required'
- ).format(name=name, _type=_type))
- value = valid_reference_value(_type, value, name)
- if _type == 'int':
- return int(value)
- if _type == 'float':
- return float(value)
- return value
- try:
- value = node.workflow_manage.generate_prompt(value)
- return common_convert_value(_type, value)
- except Exception as e:
- raise Exception(
- _('Field: {name} Type: {_type} Value: {value} Type error').format(name=name, _type=_type,
- value=value))
-
-
-class BaseToolNodeNode(IToolNode):
- def save_context(self, details, workflow_manage):
- self.context['result'] = details.get('result')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = str(details.get('result'))
-
- def execute(self, input_field_list, code, **kwargs) -> NodeResult:
- params = {field.get('name'): convert_value(field.get('name'), field.get('value'), field.get('type'),
- field.get('is_required'), field.get('source'), self)
- for field in input_field_list}
- result = function_executor.exec_code(code, params)
- self.context['params'] = params
- return NodeResult({'result': result}, {}, _write_context=write_context)
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "result": self.context.get('result'),
- "params": self.context.get('params'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/tool_start_node/__init__.py b/apps/application/flow/step_node/tool_start_node/__init__.py
deleted file mode 100644
index 98a1afcd904..00000000000
--- a/apps/application/flow/step_node/tool_start_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:30
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/tool_start_node/i_tool_start_node.py b/apps/application/flow/step_node/tool_start_node/i_tool_start_node.py
deleted file mode 100644
index ca313277376..00000000000
--- a/apps/application/flow/step_node/tool_start_node/i_tool_start_node.py
+++ /dev/null
@@ -1,21 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: i_start_node.py
- @date:2024/6/3 16:54
- @desc:
-"""
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class IToolStartNode(INode):
- type = 'tool-start-node'
- support = [WorkflowMode.TOOL]
-
- def _run(self):
- return self.execute(**self.flow_params_serializer.data)
-
- def execute(self, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/tool_start_node/impl/__init__.py b/apps/application/flow/step_node/tool_start_node/impl/__init__.py
deleted file mode 100644
index 6fcd243dc5c..00000000000
--- a/apps/application/flow/step_node/tool_start_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 15:36
- @desc:
-"""
-from .base_tool_start_node import BaseToolStartStepNode
diff --git a/apps/application/flow/step_node/tool_start_node/impl/base_tool_start_node.py b/apps/application/flow/step_node/tool_start_node/impl/base_tool_start_node.py
deleted file mode 100644
index 5b24722f76e..00000000000
--- a/apps/application/flow/step_node/tool_start_node/impl/base_tool_start_node.py
+++ /dev/null
@@ -1,66 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: base_start_node.py
- @date:2024/6/3 17:17
- @desc:
-"""
-from typing import Type
-
-from rest_framework import serializers
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.tool_start_node.i_tool_start_node import IToolStartNode
-
-
-class BaseToolStartStepNode(IToolStartNode):
- def save_context(self, details, workflow_manage):
- base_node = self.workflow_manage.get_base_node()
- workflow_variable = {}
- self.context['exception_message'] = details.get('err_message')
- self.status = details.get('status')
- self.err_message = details.get('err_message')
- for key, value in workflow_variable.items():
- workflow_manage.context[key] = value
- for item in details.get('global_fields', []):
- workflow_manage.context[item.get('key')] = item.get('value')
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- pass
-
- def execute(self, **kwargs) -> NodeResult:
- base_node = self.workflow_manage.get_base_node()
- global_value = {}
- params = self.workflow_manage.get_body()
- for item in base_node.properties.get('user_input_field_list', []):
- global_value[item.get('field')] = params.get(item.get('field'))
-
- self.workflow_manage.out_context = {
- item.get('field'): None
- for item in base_node.properties.get('user_output_field_list', [])
- if item.get('default_value', None) is not None
- }
- return NodeResult({}, global_value)
-
- def get_details(self, index: int, **kwargs):
- global_fields = []
- for field in self.node.properties.get('config')['globalFields']:
- key = field['value']
- global_fields.append({
- 'label': field.get('label'),
- 'key': key,
- 'value': self.workflow_manage.context[key] if key in self.workflow_manage.context else ''
- })
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "question": self.context.get('question'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'err_message': self.err_message,
- 'global_fields': global_fields,
- '': '',
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/tool_workflow_lib_node/__init__.py b/apps/application/flow/step_node/tool_workflow_lib_node/__init__.py
deleted file mode 100644
index d417d531251..00000000000
--- a/apps/application/flow/step_node/tool_workflow_lib_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2026/3/16 13:53
- @desc:
-"""
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/tool_workflow_lib_node/i_tool_workflow_lib_node.py b/apps/application/flow/step_node/tool_workflow_lib_node/i_tool_workflow_lib_node.py
deleted file mode 100644
index 82b73d0904b..00000000000
--- a/apps/application/flow/step_node/tool_workflow_lib_node/i_tool_workflow_lib_node.py
+++ /dev/null
@@ -1,57 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: i_function_lib_node.py
- @date:2024/8/8 16:21
- @desc:
-"""
-from typing import Type
-
-from django.db import connection
-from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-from common.field.common import ObjectField
-from tools.models.tool import Tool, ToolType
-
-
-class InputField(serializers.Serializer):
- field = serializers.CharField(required=True, label=_('Variable Name'))
- label = serializers.CharField(required=True, label=_('Variable Label'))
- source = serializers.CharField(required=True, label=_('Variable Source'))
- type = serializers.CharField(required=True, label=_('Variable Type'))
- value = ObjectField(required=True, label=_("Variable Value"), model_type_list=[str, list, bool, dict, int, float])
-
-
-class FunctionLibNodeParamsSerializer(serializers.Serializer):
- tool_lib_id = serializers.UUIDField(required=True, label=_('Library ID'))
- input_field_list = InputField(required=True, many=True)
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- f_lib = QuerySet(Tool).filter(id=self.data.get('tool_lib_id'), tool_type=ToolType.WORKFLOW).first()
- # 归还链接到连接池
- connection.close()
- if f_lib is None:
- raise Exception(_('The function has been deleted'))
-
-
-class IToolWorkflowLibNode(INode):
- type = 'tool-workflow-lib-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return FunctionLibNodeParamsSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, tool_lib_id, input_field_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/tool_workflow_lib_node/impl/__init__.py b/apps/application/flow/step_node/tool_workflow_lib_node/impl/__init__.py
deleted file mode 100644
index 0b593554784..00000000000
--- a/apps/application/flow/step_node/tool_workflow_lib_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2026/3/16 13:53
- @desc:
-"""
-from .base_tool_workflow_lib_node import *
diff --git a/apps/application/flow/step_node/tool_workflow_lib_node/impl/base_tool_workflow_lib_node.py b/apps/application/flow/step_node/tool_workflow_lib_node/impl/base_tool_workflow_lib_node.py
deleted file mode 100644
index d158878454e..00000000000
--- a/apps/application/flow/step_node/tool_workflow_lib_node/impl/base_tool_workflow_lib_node.py
+++ /dev/null
@@ -1,245 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: base_tool_workflow_lib_node.py.py
- @date:2026/3/16 13:55
- @desc:
-"""
-
-import time
-from typing import Dict
-
-import uuid_utils.compat as uuid
-from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
-
-from application.flow.common import WorkflowMode, Workflow
-from application.flow.i_step_node import NodeResult, ToolWorkflowPostHandler, INode
-from application.flow.step_node.tool_workflow_lib_node.i_tool_workflow_lib_node import IToolWorkflowLibNode
-from application.models import ChatRecord
-from application.serializers.common import ToolExecute
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.exception.app_exception import ChatException
-from common.handle.impl.response.loop_to_response import LoopToResponse
-from tools.models import ToolWorkflowVersion, Tool
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str,
- reasoning_content: str):
- result = node_variable.get('result')
- node.context['application_node_dict'] = node_variable.get('application_node_dict')
- node.context['node_dict'] = node_variable.get('node_dict', {})
- node.context['is_interrupt_exec'] = node_variable.get('is_interrupt_exec')
- node.context['message_tokens'] = result.get('usage', {}).get('prompt_tokens', 0)
- node.context['answer_tokens'] = result.get('usage', {}).get('completion_tokens', 0)
- node.context['answer'] = answer
- node.context['result'] = answer
- node.context['reasoning_content'] = reasoning_content
- node.context['run_time'] = time.time() - node.context['start_time']
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def get_answer_list(instance, child_node_node_dict, runtime_node_id):
- answer_list = instance.get_record_answer_list()
- for a in answer_list:
- _v = child_node_node_dict.get(a.get('runtime_node_id'))
- if _v:
- a['runtime_node_id'] = runtime_node_id
- a['child_node'] = _v
- return answer_list
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
- workflow_manage_new_instance = node_variable.get('workflow_manage_new_instance')
- node_params = node.node_params
- start_node_id = node_params.get('child_node', {}).get('runtime_node_id')
- child_node_data = node.context.get('child_node_data') or []
- start_node_data = None
- chat_record = None
- child_node = None
- if start_node_id:
- chat_record_id = node_params.get('child_node', {}).get('chat_record_id')
- child_node = node_params.get('child_node', {}).get('child_node')
- start_node_data = node_params.get('node_data')
- chat_record = ChatRecord(id=chat_record_id, answer_text_list=[], answer_text='',
- details=child_node_data)
- instance = workflow_manage_new_instance(start_node_id,
- start_node_data, chat_record, child_node)
- answer = ''
- reasoning_content = ''
- usage = {}
- node_child_node = {}
- is_interrupt_exec = False
- response = instance.stream()
- child_node_node_dict = {}
- for chunk in response:
- response_content = chunk
- content = (response_content.get('content', '') or '')
- runtime_node_id = response_content.get('runtime_node_id', '')
- chat_record_id = response_content.get('chat_record_id', '')
- child_node = response_content.get('child_node')
- node_type = response_content.get('node_type')
- _reasoning_content = (response_content.get('reasoning_content', '') or '')
- if node_type == 'form-node':
- is_interrupt_exec = True
- answer += content
- reasoning_content += _reasoning_content
- node_child_node = {'runtime_node_id': runtime_node_id, 'chat_record_id': chat_record_id,
- 'child_node': child_node}
-
- child_node = chunk.get('child_node')
- runtime_node_id = chunk.get('runtime_node_id', '')
- chat_record_id = chunk.get('chat_record_id', '')
- child_node_node_dict[runtime_node_id] = {
- 'runtime_node_id': runtime_node_id,
- 'chat_record_id': chat_record_id,
- 'child_node': child_node}
- content_chunk = (chunk.get('content', '') or '')
- reasoning_content_chunk = (chunk.get('reasoning_content', '') or '')
- reasoning_content += reasoning_content_chunk
- answer += content_chunk
- yield chunk
- if chunk.get('node_status', "SUCCESS") == 'ERROR':
- is_interrupt_exec = True
- node.status = 500
- node.err_message = chunk.get('content')
- usage = response_content.get('usage', {})
- child_answer_data = get_answer_list(instance, child_node_node_dict, node.runtime_node_id)
- node.context['usage'] = {'usage': usage}
- node.context['child_node'] = node_child_node
- node.context['details'] = instance.get_runtime_details()
- node.context['is_interrupt_exec'] = is_interrupt_exec
- node.context['child_answer_data'] = child_answer_data
- node.context['run_time'] = time.time() - node.context.get("start_time")
- node.extra['input_field_list'] = instance.get_input_field_list()
- node.extra['output_field_list'] = instance.get_output_field_list()
- node.extra['input'] = instance.get_input()
- node.extra['output'] = instance.out_context
- for key, value in instance.out_context.items():
- node.context[key] = value
-
-
-def _is_interrupt_exec(node, node_variable: Dict, workflow_variable: Dict):
- return node.context.get('is_interrupt_exec', False)
-
-
-def valid_function(tool_lib, workspace_id):
- if tool_lib is None:
- raise Exception(_('Tool does not exist'))
- get_authorized_tool = DatabaseModelManage.get_model("get_authorized_tool")
- if tool_lib and tool_lib.workspace_id != workspace_id and get_authorized_tool is not None:
- tool_lib = get_authorized_tool(QuerySet(Tool).filter(id=tool_lib.id), workspace_id).first()
- if tool_lib is None:
- raise Exception(_("Tool does not exist"))
- if not tool_lib.is_active:
- raise Exception(_("Tool is not active"))
-
-
-class BaseToolWorkflowLibNodeNode(IToolWorkflowLibNode):
- def get_parameters(self, input_field_list):
- result = {}
- for input in input_field_list:
- source = input.get('source')
- value = input.get('value')
- if source == 'reference':
- value = self.workflow_manage.get_reference_field(
- value[0],
- value[1:])
- result[input.get('field')] = value
-
- return result
-
- def save_context(self, details, workflow_manage):
- self.context['child_answer_data'] = details.get('child_answer_data')
- self.context['details'] = details.get('details')
- self.extra['input_field_list'] = details.get('input_field_list')
- self.extra['output_field_list'] = details.get('output_field_list')
- self.extra['input'] = details.get('input')
- self.extra['output'] = details.get('output')
- self.context['result'] = details.get('result')
- self.context['exception_message'] = details.get('err_message')
- for key, value in (details.get('output') or {}).items():
- self.context[key] = value
- if self.node_params.get('is_result'):
- self.answer_text = str(details.get('result'))
-
- @staticmethod
- def to_chat_record(record):
- if record is None:
- return None
- return ChatRecord(
- answer_text_list=record.meta.get('answer_text_list'),
- details=record.meta.get('details'),
- answer_text='',
- )
-
- def execute(self, tool_lib_id, input_field_list, **kwargs) -> NodeResult:
- from application.flow.tool_workflow_manage import ToolWorkflowManage
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- tool_workflow_version = QuerySet(ToolWorkflowVersion).filter(tool_id=tool_lib_id).order_by(
- '-create_time')[0:1].first()
- if tool_workflow_version is None:
- raise ChatException(500, _("The tool has not been published. Please use it after publishing."))
- tool_lib = QuerySet(Tool).filter(id=tool_lib_id).first()
- valid_function(tool_lib, workspace_id)
- parameters = self.get_parameters(input_field_list)
- tool_record_id = (self.node_params.get('child_node') or {}).get('chat_record_id') or str(uuid.uuid7())
- took_execute = ToolExecute(tool_lib_id, tool_record_id,
- workspace_id,
- self.workflow_manage.get_source_type(),
- self.workflow_manage.get_source_id(),
- False)
-
- def workflow_manage_new_instance(start_node_id=None,
- start_node_data=None, chat_record=None, child_node=None):
- work_flow_manage = ToolWorkflowManage(
- Workflow.new_instance(tool_workflow_version.work_flow, WorkflowMode.TOOL),
- {
- 'chat_record_id': tool_record_id,
- 'tool_id': tool_lib_id,
- 'stream': True,
- 'workspace_id': workspace_id,
- **parameters},
- ToolWorkflowPostHandler(took_execute, tool_lib_id),
- base_to_response=LoopToResponse(),
- start_node_id=start_node_id,
- start_node_data=start_node_data,
- child_node=child_node,
- chat_record=self.to_chat_record(took_execute.get_record()),
- is_the_task_interrupted=lambda: False)
-
- return work_flow_manage
-
- return NodeResult({'workflow_manage_new_instance': workflow_manage_new_instance},
- {}, _write_context=write_context_stream,
- _is_interrupt=_is_interrupt_exec)
-
- def get_details(self, index: int, **kwargs):
- result = self.context.get('result')
-
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- "result": result,
- "params": self.context.get('params'),
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'status': self.status,
- 'input': self.extra.get('input'),
- 'output': self.extra.get('output'),
- 'input_field_list': self.extra.get('input_field_list'),
- 'output_field_list': self.extra.get('output_field_list'),
- 'details': self.context.get("details"),
- 'child_answer_data': self.context.get("child_answer_data"),
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/variable_aggregation_node/i_variable_aggregation_node.py b/apps/application/flow/step_node/variable_aggregation_node/i_variable_aggregation_node.py
deleted file mode 100644
index 86a38778292..00000000000
--- a/apps/application/flow/step_node/variable_aggregation_node/i_variable_aggregation_node.py
+++ /dev/null
@@ -1,42 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class VariableListSerializer(serializers.Serializer):
- v_id = serializers.CharField(required=True, label=_("Variable id"))
- key = serializers.CharField(required=False, label=_("Key"), allow_null=True, allow_blank=True, )
- variable = serializers.ListField(required=True, label=_("Variable"))
-
-
-class VariableGroupSerializer(serializers.Serializer):
- id = serializers.CharField(required=True, label=_("Group id"))
- field = serializers.CharField(required=True, label=_("group_name"))
- label = serializers.CharField(required=True)
- variable_list = VariableListSerializer(many=True)
-
-
-class VariableAggregationNodeSerializer(serializers.Serializer):
- strategy = serializers.CharField(required=True, label=_("Strategy"))
- group_list = VariableGroupSerializer(many=True)
-
-
-class IVariableAggregation(INode):
- type = 'variable-aggregation-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return VariableAggregationNodeSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, strategy, group_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/variable_aggregation_node/impl/base_variable_aggregation_node.py b/apps/application/flow/step_node/variable_aggregation_node/impl/base_variable_aggregation_node.py
deleted file mode 100644
index 341f2e0eab9..00000000000
--- a/apps/application/flow/step_node/variable_aggregation_node/impl/base_variable_aggregation_node.py
+++ /dev/null
@@ -1,98 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎²
- @file: base_variable_aggregation_node.py
- @date:2025/10/23 17:42
- @desc:
-"""
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.variable_aggregation_node.i_variable_aggregation_node import IVariableAggregation
-
-
-def _filter_file_bytes(data):
- """递归过滤掉所有层级的 file_bytes"""
- if isinstance(data, dict):
- return {k: _filter_file_bytes(v) for k, v in data.items() if k != 'file_bytes'}
- elif isinstance(data, list):
- return [_filter_file_bytes(item) for item in data]
- else:
- return data
-
-
-class BaseVariableAggregationNode(IVariableAggregation):
-
- def save_context(self, details, workflow_manage):
- for key, value in details.get('result').items():
- self.context[key] = value
- self.context['result'] = details.get('result')
- self.context['strategy'] = details.get('strategy')
- self.context['group_list'] = details.get('group_list')
- self.context['exception_message'] = details.get('err_message')
-
- def get_first_non_null(self, variable_list):
- for variable in variable_list:
- v = self.workflow_manage.get_reference_field(
- variable.get('variable')[0],
- variable.get('variable')[1:])
- if v is not None and not (isinstance(v, (str, list, dict)) and len(v) == 0):
- return v
- return None
-
- def set_variable_to_array(self, variable_list):
- return [self.workflow_manage.get_reference_field(
- variable.get('variable')[0],
- variable.get('variable')[1:]) for variable in variable_list]
-
- def set_variable_to_dict(self, variable_list):
- return {(variable.get('key') or variable.get('variable')[-1]): self.workflow_manage.get_reference_field(
- variable.get('variable')[0],
- variable.get('variable')[1:]) for variable in variable_list}
-
- def reset_variable(self, variable):
- value = self.workflow_manage.get_reference_field(
- variable.get('variable')[0],
- variable.get('variable')[1:])
- node_id = variable.get('variable')[0]
- node = self.workflow_manage.flow.get_node(node_id)
- return {"value": value, 'node_name': node.properties.get('stepName') if node is not None else node_id,
- 'field': variable.get('variable')[1]}
-
- def reset_group_list(self, group_list):
- result = []
- for g in group_list:
- b = {'label': g.get('label'),
- 'variable_list': [self.reset_variable(variable) for variable in g.get('variable_list')]}
- result.append(b)
- return result
-
- def execute(self, strategy, group_list, **kwargs) -> NodeResult:
- strategy_map = {'first_non_null': self.get_first_non_null,
- 'variable_to_array': self.set_variable_to_array,
- 'variable_to_dict': self.set_variable_to_dict,
- }
-
- # 向下兼容
- if strategy == 'variable_to_json':
- strategy = 'variable_to_array'
-
- result = {item.get('field'): strategy_map[strategy](item.get('variable_list')) for item in group_list}
-
- return NodeResult(
- {'result': result, 'strategy': strategy, 'group_list': self.reset_group_list(group_list), **result}, {})
-
- def get_details(self, index: int, **kwargs):
- result = _filter_file_bytes(self.context.get('result'))
- group_list = _filter_file_bytes(self.context.get('group_list'))
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'result': result,
- 'strategy': self.context.get('strategy'),
- 'group_list': group_list,
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/variable_assign_node/__init__.py b/apps/application/flow/step_node/variable_assign_node/__init__.py
deleted file mode 100644
index 2d231e6066d..00000000000
--- a/apps/application/flow/step_node/variable_assign_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/variable_assign_node/i_variable_assign_node.py b/apps/application/flow/step_node/variable_assign_node/i_variable_assign_node.py
deleted file mode 100644
index 6652cbe9e9a..00000000000
--- a/apps/application/flow/step_node/variable_assign_node/i_variable_assign_node.py
+++ /dev/null
@@ -1,29 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class VariableAssignNodeParamsSerializer(serializers.Serializer):
- variable_list = serializers.ListField(required=True,
- label=_("Reference Field"))
-
-
-class IVariableAssignNode(INode):
- type = 'variable-assign-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return VariableAssignNodeParamsSerializer
-
- def _run(self):
- return self.execute(**self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, variable_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/variable_assign_node/impl/__init__.py b/apps/application/flow/step_node/variable_assign_node/impl/__init__.py
deleted file mode 100644
index 7585cdd8fe4..00000000000
--- a/apps/application/flow/step_node/variable_assign_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/6/11 17:49
- @desc:
-"""
-from .base_variable_assign_node import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/variable_assign_node/impl/base_variable_assign_node.py b/apps/application/flow/step_node/variable_assign_node/impl/base_variable_assign_node.py
deleted file mode 100644
index b9572805acf..00000000000
--- a/apps/application/flow/step_node/variable_assign_node/impl/base_variable_assign_node.py
+++ /dev/null
@@ -1,125 +0,0 @@
-# coding=utf-8
-import json
-from typing import List
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.variable_assign_node.i_variable_assign_node import IVariableAssignNode
-
-
-class BaseVariableAssignNode(IVariableAssignNode):
- def save_context(self, details, workflow_manage):
- self.context['variable_list'] = details.get('variable_list')
- self.context['result_list'] = details.get('result_list')
- self.context['exception_message'] = details.get('err_message')
-
- def global_evaluation(self, variable, value):
- from application.flow.loop_workflow_manage import LoopWorkflowManage
- if isinstance(self.workflow_manage, LoopWorkflowManage):
- self.workflow_manage.parentWorkflowManage.context[variable['fields'][1]] = value
- else:
- self.workflow_manage.context[variable['fields'][1]] = value
-
- def loop_evaluation(self, variable, value):
- from application.flow.loop_workflow_manage import LoopWorkflowManage
- if isinstance(self.workflow_manage, LoopWorkflowManage):
- self.workflow_manage.get_loop_context()[variable['fields'][1]] = value
-
- def chat_evaluation(self, variable, value):
- from application.flow.loop_workflow_manage import LoopWorkflowManage
- if isinstance(self.workflow_manage, LoopWorkflowManage):
- self.workflow_manage.parentWorkflowManage.chat_context[variable['fields'][1]] = value
- else:
- self.workflow_manage.chat_context[variable['fields'][1]] = value
-
- def out_evaluation(self, variable, value):
- from application.flow.loop_workflow_manage import LoopWorkflowManage
- if isinstance(self.workflow_manage, LoopWorkflowManage):
- self.workflow_manage.parentWorkflowManage.out_context[variable['fields'][1]] = value
- else:
- self.workflow_manage.out_context[variable['fields'][1]] = value
-
- def handle(self, variable, evaluation):
- result = {
- 'name': variable['name'],
- 'input_value': self.get_reference_content(variable['fields']),
- }
- if variable['source'] == 'custom':
- if variable['type'] == 'json':
- if isinstance(variable['value'], dict) or isinstance(variable['value'], list):
- val = variable['value']
- else:
- val = json.loads(variable['value'])
- evaluation(variable, val)
- result['output_value'] = variable['value'] = val
- elif variable['type'] == 'string':
- # 变量解析 例如:{{global.xxx}}
- val = self.workflow_manage.generate_prompt(variable['value'])
- evaluation(variable, val)
- result['output_value'] = val
- else:
- val = variable['value']
- evaluation(variable, val)
- result['output_value'] = val
- elif variable['source'] == 'referencing':
- reference = self.get_reference_content(variable['reference'])
- evaluation(variable, reference)
- result['output_value'] = reference
- else:
- val = None
- evaluation(variable, val)
- result['output_value'] = val
-
- # 获取输入输出值的类型,用于显示在执行详情页面中
- result['input_type'] = type(result.get('input_value')).__name__ if result.get('input_value') is not None else 'null'
- result['output_type'] = type(result.get('output_value')).__name__ if result.get('output_value') is not None else 'null'
-
- return result
-
- def execute(self, variable_list, **kwargs) -> NodeResult:
- result_list = []
- contains_chat_variable = False
- for variable in variable_list:
- if not variable.get('fields'):
- continue
-
- field0 = variable['fields'][0]
- if 'global' == field0:
- result = self.handle(variable, self.global_evaluation)
- result_list.append(result)
- elif 'chat' == field0:
- result = self.handle(variable, self.chat_evaluation)
- result_list.append(result)
- contains_chat_variable = True
- elif 'loop' == field0:
- result = self.handle(variable, self.loop_evaluation)
- result_list.append(result)
- elif 'output' == field0:
- result = self.handle(variable, self.out_evaluation)
- result_list.append(result)
-
- if contains_chat_variable:
- from application.flow.loop_workflow_manage import LoopWorkflowManage
- if isinstance(self.workflow_manage, LoopWorkflowManage):
- self.workflow_manage.parentWorkflowManage.get_chat_info().set_chat_variable(
- self.workflow_manage.parentWorkflowManage.chat_context)
- else:
- self.workflow_manage.get_chat_info().set_chat_variable(self.workflow_manage.chat_context)
- return NodeResult({'variable_list': variable_list, 'result_list': result_list}, {})
-
- def get_reference_content(self, fields: List[str]):
- return self.workflow_manage.get_reference_field(
- fields[0],
- fields[1:]) if fields else None
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'variable_list': self.context.get('variable_list'),
- 'result_list': self.context.get('result_list'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/variable_splitting_node/__init__.py b/apps/application/flow/step_node/variable_splitting_node/__init__.py
deleted file mode 100644
index c93d71e9ed1..00000000000
--- a/apps/application/flow/step_node/variable_splitting_node/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/10/13 14:56
- @desc:
-"""
-from .impl import *
diff --git a/apps/application/flow/step_node/variable_splitting_node/i_variable_splitting_node.py b/apps/application/flow/step_node/variable_splitting_node/i_variable_splitting_node.py
deleted file mode 100644
index 39c48f817be..00000000000
--- a/apps/application/flow/step_node/variable_splitting_node/i_variable_splitting_node.py
+++ /dev/null
@@ -1,35 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class VariableSplittingNodeParamsSerializer(serializers.Serializer):
- input_variable = serializers.ListField(required=True,
- label=_("input variable"))
-
- variable_list = serializers.ListField(required=True,
- label=_("Split variables"))
-
-
-class IVariableSplittingNode(INode):
- type = 'variable-splitting-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return VariableSplittingNodeParamsSerializer
-
- def _run(self):
- input_variable = self.workflow_manage.get_reference_field(
- self.node_params_serializer.data.get('input_variable')[0],
- self.node_params_serializer.data.get('input_variable')[1:])
- return self.execute(input_variable, self.node_params_serializer.data['variable_list'])
-
- def execute(self, input_variable, variable_list, **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/variable_splitting_node/impl/__init__.py b/apps/application/flow/step_node/variable_splitting_node/impl/__init__.py
deleted file mode 100644
index 1ef0d7ac519..00000000000
--- a/apps/application/flow/step_node/variable_splitting_node/impl/__init__.py
+++ /dev/null
@@ -1,9 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/10/13 15:01
- @desc:
-"""
-from .base_variable_splitting_node import *
\ No newline at end of file
diff --git a/apps/application/flow/step_node/variable_splitting_node/impl/base_variable_splitting_node.py b/apps/application/flow/step_node/variable_splitting_node/impl/base_variable_splitting_node.py
deleted file mode 100644
index 274604e2328..00000000000
--- a/apps/application/flow/step_node/variable_splitting_node/impl/base_variable_splitting_node.py
+++ /dev/null
@@ -1,80 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: base_variable_splitting_node.py
- @date:2025/10/13 15:02
- @desc:
-"""
-import json
-from jsonpath_ng.ext import parse
-from common.cache.mem_cache import MemCache
-
-from application.flow.i_step_node import NodeResult
-from application.flow.step_node.variable_splitting_node.i_variable_splitting_node import IVariableSplittingNode
-
-jsonpath_expr_cache = MemCache('parse_path', {
- 'TIMEOUT': 3600, # 缓存有效期为 1 小时
- 'OPTIONS': {
- 'MAX_ENTRIES': 1000, # 最多缓存 1000 个条目
- 'CULL_FREQUENCY': 10, # 达到上限时,删除约 1/10 的缓存
- },
-})
-
-def parse_and_cache(path):
- jsonpath_expr = jsonpath_expr_cache.get(path)
- if not jsonpath_expr:
- jsonpath_expr = parse(path)
- jsonpath_expr_cache.set(path, jsonpath_expr)
- return jsonpath_expr
-
-def smart_jsonpath_search(data: dict, path: str):
- """
- 智能JSON Path搜索
- 返回:
- - 单个匹配: 直接返回值
- - 多个匹配: 返回值的列表
- - 无匹配: 返回None
- """
- jsonpath_expr = parse_and_cache(path)
- matches = jsonpath_expr.find(data)
-
- if not matches:
- return None
- elif len(matches) == 1:
- return matches[0].value
- else:
- return [match.value for match in matches]
-
-
-class BaseVariableSplittingNode(IVariableSplittingNode):
- def save_context(self, details, workflow_manage):
- for key, value in details.get('result').items():
- self.context[key] = value
- self.context['result'] = details.get('result')
- self.context['request'] = details.get('request')
- self.context['exception_message'] = details.get('err_message')
-
- def execute(self, input_variable, variable_list, **kwargs) -> NodeResult:
- if isinstance(input_variable, str):
- try:
- input_variable = json.loads(input_variable)
- except Exception:
- pass
-
- self.context['request'] = input_variable
- response = {v['field']: smart_jsonpath_search(input_variable, v['expression']) for v in variable_list}
- return NodeResult({'result': response, **response}, {})
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'type': self.node.type,
- 'request': self.context.get('request'),
- 'result': self.context.get('result'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/step_node/video_understand_step_node/__init__.py b/apps/application/flow/step_node/video_understand_step_node/__init__.py
deleted file mode 100644
index f3feecc9ce2..00000000000
--- a/apps/application/flow/step_node/video_understand_step_node/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .impl import *
diff --git a/apps/application/flow/step_node/video_understand_step_node/i_video_understand_node.py b/apps/application/flow/step_node/video_understand_step_node/i_video_understand_node.py
deleted file mode 100644
index 8d854291686..00000000000
--- a/apps/application/flow/step_node/video_understand_step_node/i_video_understand_node.py
+++ /dev/null
@@ -1,63 +0,0 @@
-# coding=utf-8
-
-from typing import Type
-
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
-from application.flow.common import WorkflowMode
-from application.flow.i_step_node import INode, NodeResult
-
-
-class VideoUnderstandNodeSerializer(serializers.Serializer):
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
- model_id_type = serializers.CharField(required=False, default='custom', label=_("Model id type"))
- model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True,
- label=_("Reference Field"))
- system = serializers.CharField(required=False, allow_blank=True, allow_null=True,
- label=_("Role Setting"))
- prompt = serializers.CharField(required=True, label=_("Prompt word"))
- # 多轮对话数量
- dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
-
- dialogue_type = serializers.CharField(required=True, label=_("Conversation storage type"))
-
- is_result = serializers.BooleanField(required=False,
- label=_('Whether to return content'))
-
- video_list = serializers.ListField(required=False, label=_("video"))
-
- model_params_setting = serializers.JSONField(required=False, default=dict,
- label=_("Model parameter settings"))
- model_setting = serializers.DictField(required=False,
- label='Model settings')
-
-
-class IVideoUnderstandNode(INode):
- type = 'video-understand-node'
- support = [WorkflowMode.APPLICATION, WorkflowMode.APPLICATION_LOOP, WorkflowMode.KNOWLEDGE,
- WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL, WorkflowMode.TOOL_LOOP]
-
- def get_node_params_serializer_class(self) -> Type[serializers.Serializer]:
- return VideoUnderstandNodeSerializer
-
- def _run(self):
- res = self.workflow_manage.get_reference_field(self.node_params_serializer.data.get('video_list')[0],
- self.node_params_serializer.data.get('video_list')[1:])
-
- if [WorkflowMode.KNOWLEDGE, WorkflowMode.KNOWLEDGE_LOOP, WorkflowMode.TOOL,
- WorkflowMode.TOOL_LOOP].__contains__(
- self.workflow_manage.flow.workflow_mode):
- return self.execute(video=res, **self.node_params_serializer.data, **self.flow_params_serializer.data,
- **{'history_chat_record': [], 'stream': True, 'chat_id': None, 'chat_record_id': None})
- else:
- return self.execute(video=res, **self.node_params_serializer.data, **self.flow_params_serializer.data)
-
- def execute(self, model_id, system, prompt, dialogue_number, dialogue_type, history_chat_record, stream,
- model_params_setting,
- chat_record_id,
- video,
- model_id_type=None, model_id_reference=None,
- model_setting=None,
- **kwargs) -> NodeResult:
- pass
diff --git a/apps/application/flow/step_node/video_understand_step_node/impl/__init__.py b/apps/application/flow/step_node/video_understand_step_node/impl/__init__.py
deleted file mode 100644
index 555faa26b66..00000000000
--- a/apps/application/flow/step_node/video_understand_step_node/impl/__init__.py
+++ /dev/null
@@ -1,3 +0,0 @@
-# coding=utf-8
-
-from .base_video_understand_node import BaseVideoUnderstandNode
diff --git a/apps/application/flow/step_node/video_understand_step_node/impl/base_video_understand_node.py b/apps/application/flow/step_node/video_understand_step_node/impl/base_video_understand_node.py
deleted file mode 100644
index ea497be27d0..00000000000
--- a/apps/application/flow/step_node/video_understand_step_node/impl/base_video_understand_node.py
+++ /dev/null
@@ -1,335 +0,0 @@
-# coding=utf-8
-
-import time
-from functools import reduce
-from typing import List, Dict
-
-from django.db.models import QuerySet
-from langchain_core.messages import BaseMessage, HumanMessage, SystemMessage, AIMessage
-
-from application.flow.i_step_node import NodeResult, INode
-from application.flow.step_node.video_understand_step_node.i_video_understand_node import IVideoUnderstandNode
-from application.flow.tools import Reasoning
-from knowledge.models import File
-from models_provider.tools import get_model_instance_by_model_workspace_id
-
-
-def _write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow, answer: str,
- reasoning_content: str):
- chat_model = node_variable.get('chat_model')
- message_tokens = node_variable['usage_metadata']['output_tokens'] if 'usage_metadata' in node_variable else 0
- answer_tokens = chat_model.get_num_tokens(answer)
- node.context['message_tokens'] = message_tokens
- node.context['answer_tokens'] = answer_tokens
- node.context['answer'] = answer
- node.context['history_message'] = node_variable['history_message']
- node.context['question'] = node_variable['question']
- node.context['run_time'] = time.time() - node.context['start_time']
- node.context['reasoning_content'] = reasoning_content
- if workflow.is_result(node, NodeResult(node_variable, workflow_variable)):
- node.answer_text = answer
-
-
-def write_context_stream(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据 (流式)
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- answer = ''
- reasoning_content = ''
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start', ''),
- model_setting.get('reasoning_content_end', ''))
- response_reasoning_content = False
-
- for chunk in response:
- if workflow.is_the_task_interrupted():
- break
-
- # 处理 reasoning content
- reasoning_chunk = reasoning.get_reasoning_content(chunk)
- content_chunk = reasoning_chunk.get('content')
- if 'reasoning_content' in chunk.additional_kwargs:
- response_reasoning_content = True
- reasoning_content_chunk = chunk.additional_kwargs.get('reasoning_content', '')
- else:
- reasoning_content_chunk = reasoning_chunk.get('reasoning_content')
-
- answer += content_chunk
- if reasoning_content_chunk is None:
- reasoning_content_chunk = ''
- reasoning_content += reasoning_content_chunk
-
- # 处理 chunk.content 为 list 的情况
- if isinstance(chunk.content, list):
- for chunk_item in chunk.content:
- text = chunk_item.get("text", "")
- yield {'content': text,
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
- else:
- text = chunk.content or ""
- yield {'content': text,
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
-
- reasoning_chunk = reasoning.get_end_reasoning_content()
- answer += reasoning_chunk.get('content')
- reasoning_content_chunk = ""
- if not response_reasoning_content:
- reasoning_content_chunk = reasoning_chunk.get(
- 'reasoning_content')
- yield {'content': reasoning_chunk.get('content'),
- 'reasoning_content': reasoning_content_chunk if model_setting.get('reasoning_content_enable',
- False) else ''}
- _write_context(node_variable, workflow_variable, node, workflow, answer, reasoning_content)
-
-
-def write_context(node_variable: Dict, workflow_variable: Dict, node: INode, workflow):
- """
- 写入上下文数据
- @param node_variable: 节点数据
- @param workflow_variable: 全局数据
- @param node: 节点实例对象
- @param workflow: 工作流管理器
- """
- response = node_variable.get('result')
- model_setting = node.context.get('model_setting',
- {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''})
- reasoning = Reasoning(model_setting.get('reasoning_content_start'), model_setting.get('reasoning_content_end'))
- reasoning_result = reasoning.get_reasoning_content(response)
- reasoning_result_end = reasoning.get_end_reasoning_content()
- content = reasoning_result.get('content') + reasoning_result_end.get('content')
- meta = {**response.response_metadata, **response.additional_kwargs}
- if 'reasoning_content' in meta:
- reasoning_content = (meta.get('reasoning_content', '') or '')
- else:
- reasoning_content = (reasoning_result.get('reasoning_content') or '') + (
- reasoning_result_end.get('reasoning_content') or '')
- _write_context(node_variable, workflow_variable, node, workflow, content, reasoning_content)
-
-
-def file_id_to_base64(file_id: str, video_model):
- file = QuerySet(File).filter(id=file_id).first()
- file_bytes = file.get_bytes()
- url = video_model.upload_file_and_get_url(file_bytes, file.file_name)
- return url
-
-
-class BaseVideoUnderstandNode(IVideoUnderstandNode):
- def save_context(self, details, workflow_manage):
- self.context['answer'] = details.get('answer')
- self.context['question'] = details.get('question')
- self.context['exception_message'] = details.get('err_message')
- if self.node_params.get('is_result', False):
- self.answer_text = details.get('answer')
-
- def execute(self, model_id, system, prompt, dialogue_number, dialogue_type, history_chat_record, stream,
- model_params_setting,
- chat_record_id,
- video,
- model_id_type=None, model_id_reference=None,
- model_setting=None,
- **kwargs) -> NodeResult:
- # 处理引用类型
- if model_id_type == 'reference' and model_id_reference:
- reference_data = self.workflow_manage.get_reference_field(
- model_id_reference[0],
- model_id_reference[1:],
- )
- if reference_data and isinstance(reference_data, dict):
- model_id = reference_data.get('model_id', model_id)
- model_params_setting = reference_data.get('model_params_setting')
-
- from django.utils.translation import gettext_lazy as _
-
- if model_id is None or model_id == '':
- raise Exception(_('Model is not allowed to be empty'))
-
- workspace_id = self.workflow_manage.get_body().get('workspace_id')
- if model_setting is None:
- model_setting = {'reasoning_content_enable': False, 'reasoning_content_end': '',
- 'reasoning_content_start': ''}
- self.context['model_setting'] = model_setting
- video_model = get_model_instance_by_model_workspace_id(model_id, workspace_id,
- **(model_params_setting or {}))
- # 执行详情中的历史消息不需要图片内容
- history_message = self.get_history_message_for_details(history_chat_record, dialogue_number)
- self.context['history_message'] = history_message
- system = self.workflow_manage.generate_prompt(system)
- self.context['system'] = system
- question = self.generate_prompt_question(prompt)
- self.context['question'] = question.content
- # 生成消息列表, 真实的history_message
- message_list = self.generate_message_list(video_model, system, prompt,
- self.get_history_message(history_chat_record, dialogue_number,
- video_model), video)
- self.context['message_list'] = message_list
- self.generate_context_video(video)
- self.context['dialogue_type'] = dialogue_type
- if stream:
- r = video_model.stream(message_list)
- return NodeResult({'result': r, 'chat_model': video_model, 'message_list': message_list,
- 'history_message': history_message, 'question': question.content}, {},
- _write_context=write_context_stream)
- else:
- r = video_model.invoke(message_list)
- return NodeResult({'result': r, 'chat_model': video_model, 'message_list': message_list,
- 'history_message': history_message, 'question': question.content}, {},
- _write_context=write_context)
-
- def generate_context_video(self, video):
- if isinstance(video, str) and video.startswith('http'):
- self.context['video_list'] = [{'url': video}]
- elif video is not None and len(video) > 0:
- self.context['video_list'] = video
-
- def get_history_message_for_details(self, history_chat_record, dialogue_number):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message_for_details(history_chat_record[index]),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_ai_message(self, chat_record):
- for val in chat_record.details.values():
- if self.node.id == val['node_id'] and 'video_list' in val:
- if val['dialogue_type'] == 'WORKFLOW':
- return chat_record.get_ai_message()
- return AIMessage(content=val.get('answer') or val.get('err_message') or '')
- return chat_record.get_ai_message()
-
- def generate_history_human_message_for_details(self, chat_record):
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'video_list' in data:
- video_list = data['video_list'] or []
- # 增加对 None 和空列表的检查
- if not video_list or len(video_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
- file_id_list = []
- url_list = []
- for image in video_list:
- if 'file_id' in image:
- file_id_list.append(image.get('file_id'))
- elif 'url' in image:
- url_list.append(image.get('url'))
- return HumanMessage(content=[
- {'type': 'text', 'text': data['question']},
- *[{'type': 'video_url', 'video_url': {'url': f'./oss/file/{file_id}'}} for file_id in file_id_list],
- *[{'type': 'video_url', 'video_url': {'url': url}} for url in url_list],
- ])
- return HumanMessage(content=chat_record.problem_text)
-
- def get_history_message(self, history_chat_record, dialogue_number, video_model):
- start_index = len(history_chat_record) - dialogue_number
- history_message = reduce(lambda x, y: [*x, *y], [
- [self.generate_history_human_message(history_chat_record[index], video_model),
- self.generate_history_ai_message(history_chat_record[index])]
- for index in
- range(start_index if start_index > 0 else 0, len(history_chat_record))], [])
- return history_message
-
- def generate_history_human_message(self, chat_record, video_model):
-
- for data in chat_record.details.values():
- if self.node.id == data['node_id'] and 'video_list' in data:
- video_list = data['video_list'] or []
- if video_list is None or len(video_list) == 0 or data['dialogue_type'] == 'WORKFLOW':
- return HumanMessage(content=chat_record.problem_text)
- file_id_list = []
- url_list = []
- for image in video_list:
- if 'file_id' in image:
- file_id_list.append(image.get('file_id'))
- elif 'url' in image:
- url_list.append(image.get('url'))
- video_base64_list = [file_id_to_base64(video.get('file_id'), video_model) for video in video_list]
- return HumanMessage(
- content=[
- {'type': 'text', 'text': data['question']},
- *[{'type': 'video_url',
- 'video_url': {'url': f'{base64_video}'}} for
- base64_video in video_base64_list]
- ])
- return HumanMessage(content=chat_record.problem_text)
-
- def generate_prompt_question(self, prompt):
- return HumanMessage(self.workflow_manage.generate_prompt(prompt))
-
- def _process_videos(self, image, video_model):
- videos = []
- if isinstance(image, str) and image.startswith('http'):
- videos.append({'type': 'video_url', 'video_url': {'url': image}})
- elif image is not None and len(image) > 0:
- for img in image:
- if 'file_id' in img:
- file_id = img['file_id']
- file = QuerySet(File).filter(id=file_id).first()
- url = video_model.upload_file_and_get_url(file.get_bytes(), file.file_name)
- videos.append(
- {'type': 'video_url', 'video_url': {'url': url}})
- elif 'url' in img and img['url'].startswith('http'):
- videos.append(
- {'type': 'video_url', 'video_url': {'url': img['url']}})
- return videos
-
- def generate_message_list(self, video_model, system: str, prompt: str, history_message, video):
- prompt_text = self.workflow_manage.generate_prompt(prompt)
- videos = self._process_videos(video, video_model)
-
- if videos:
- messages = [HumanMessage(content=[{'type': 'text', 'text': prompt_text}, *videos])]
- else:
- messages = [HumanMessage(prompt_text)]
-
- if system is not None and len(system) > 0:
- return [
- SystemMessage(system),
- *history_message,
- *messages
- ]
- else:
- return [
- *history_message,
- *messages
- ]
-
- @staticmethod
- def reset_message_list(message_list: List[BaseMessage], answer_text):
- result = [{'role': 'user' if isinstance(message, HumanMessage) else 'ai', 'content': message.content} for
- message
- in
- message_list]
- result.append({'role': 'ai', 'content': answer_text})
- return result
-
- def get_details(self, index: int, **kwargs):
- return {
- 'name': self.node.properties.get('stepName'),
- "index": index,
- 'run_time': self.context.get('run_time'),
- 'system': self.context.get('system'),
- 'history_message': [{'content': message.content, 'role': message.type} for message in
- (self.context.get('history_message') if self.context.get(
- 'history_message') is not None else [])],
- 'question': self.context.get('question'),
- 'answer': self.context.get('answer'),
- 'reasoning_content': self.context.get('reasoning_content'),
- 'type': self.node.type,
- 'message_tokens': self.context.get('message_tokens'),
- 'answer_tokens': self.context.get('answer_tokens'),
- 'status': self.status,
- 'err_message': self.err_message,
- 'video_list': self.context.get('video_list'),
- 'dialogue_type': self.context.get('dialogue_type'),
- 'enableException': self.node.properties.get('enableException'),
- }
diff --git a/apps/application/flow/tool_loop_workflow_manage.py b/apps/application/flow/tool_loop_workflow_manage.py
deleted file mode 100644
index 9fc2425f014..00000000000
--- a/apps/application/flow/tool_loop_workflow_manage.py
+++ /dev/null
@@ -1,21 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: workflow_manage.py
- @date:2024/1/9 17:40
- @desc:
-"""
-from application.flow.i_step_node import ToolFlowParamsSerializer
-from application.flow.loop_workflow_manage import LoopWorkflowManage
-
-
-class ToolLoopWorkflowManage(LoopWorkflowManage):
- def get_params_serializer_class(self):
- return ToolFlowParamsSerializer
-
- def get_source_type(self):
- return "TOOL"
-
- def get_source_id(self):
- return self.params.get('tool_id')
diff --git a/apps/application/flow/tool_workflow_manage.py b/apps/application/flow/tool_workflow_manage.py
deleted file mode 100644
index be63ca45e12..00000000000
--- a/apps/application/flow/tool_workflow_manage.py
+++ /dev/null
@@ -1,88 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: tool_workflow_manage.py
- @date:2026/3/12 15:17
- @desc:
-"""
-import time
-from concurrent.futures import ThreadPoolExecutor
-
-from django.db import close_old_connections
-from django.utils.translation import get_language
-
-from application.flow.common import Workflow
-from application.flow.i_step_node import WorkFlowPostHandler, ToolFlowParamsSerializer
-from application.flow.workflow_manage import WorkflowManage
-from common.handle.base_to_response import BaseToResponse
-from common.handle.impl.response.system_to_response import SystemToResponse
-
-executor = ThreadPoolExecutor(max_workers=200)
-
-
-class ToolWorkflowManage(WorkflowManage):
- def __init__(self, flow: Workflow, params, work_flow_post_handler: WorkFlowPostHandler,
- base_to_response: BaseToResponse = SystemToResponse(), form_data=None,
- start_node_id=None,
- start_node_data=None, chat_record=None, child_node=None, is_the_task_interrupted=lambda: False):
- super().__init__(flow, params, work_flow_post_handler, base_to_response, form_data, None, None, None,
- None, None, start_node_id, start_node_data, chat_record, child_node, is_the_task_interrupted)
- self.out_context = {}
-
- def get_params_serializer_class(self):
- return ToolFlowParamsSerializer
-
- def run(self):
- self.context['start_time'] = time.time()
- close_old_connections()
- language = get_language()
- if self.params.get('stream'):
- return self.run_stream(self.start_node, None, language)
- return self.run_block(language)
-
- def stream(self):
- close_old_connections()
- language = get_language()
- self.run_chain_async(self.start_node, None, language)
- return self.await_result(is_cleanup=False)
-
- def get_start_node(self):
- return self.flow.get_node('tool-start-node')
-
- def get_base_node(self):
- """
- 获取基础节点
- @return:
- """
- return self.flow.get_node('tool-base-node')
-
- def get_input_field_list(self):
- """
- 获取输入字段列表
- @return: 输入字段配置
- """
- base_node = self.get_base_node()
- return base_node.properties.get("user_input_field_list") or []
-
- def get_output_field_list(self):
- """
- 获取输出字段列表配置
- @return: 输出字段列表配置
- """
- base_node = self.get_base_node()
- return base_node.properties.get("user_output_field_list") or []
-
- def get_input(self):
- """
- 获取用户输入
- @return: 用户输入
- """
- input_field_list = self.get_input_field_list()
- return {f.get('field'): self.params.get(f.get('field')) for f in input_field_list}
-
- def get_source_type(self):
- return "TOOL"
-
- def get_source_id(self):
- return self.params.get('tool_id')
diff --git a/apps/application/flow/tools.py b/apps/application/flow/tools.py
deleted file mode 100644
index 7ee3bd7b1b5..00000000000
--- a/apps/application/flow/tools.py
+++ /dev/null
@@ -1,1100 +0,0 @@
-# coding=utf-8
-"""
-@project: maxkb
-@Author:虎
-@file: utils.py
-@date:2024/6/6 15:15
-@desc:
-"""
-
-import asyncio
-import io
-import json
-import os
-import queue
-import re
-import shutil
-import threading
-import zipfile
-from functools import reduce
-from typing import Iterator
-
-# ---------------------------------------------------------------------------
-# Fix: qwen's OpenAI-compatible streaming sends id='' (empty string) for
-# intermediate tool_call_chunks while only the first chunk carries the real
-# id ('call_xxx...'). langchain-core's merge_lists treats '' != 'call_xxx' as
-# an ID conflict and _appends_ instead of merging → the accumulated AIMessage
-# ends up with two separate tool_calls (one with empty args, one with empty
-# id) instead of one correct entry. This causes the Qwen API to reject the
-# next request with "function.arguments must be in JSON format".
-#
-# Patch: normalise id='' → None for items that have an 'index' key
-# (i.e. tool_call_chunk dicts). merge_lists treats None as "no id" and will
-# merge with any existing entry, keeping the real id from the first chunk.
-# ---------------------------------------------------------------------------
-import langchain_core.messages.ai as _lc_ai_module
-import uuid_utils.compat as uuid
-from asgiref.sync import sync_to_async
-from common.result import result
-from common.utils.logger import maxkb_logger
-from common.utils.tool_code import ToolExecutor
-from deepagents import create_deep_agent
-from django.db.models import OuterRef, QuerySet, Subquery
-from django.http import StreamingHttpResponse
-from knowledge.models import File
-from knowledge.models.knowledge_action import State
-from langchain_core.messages import AIMessageChunk, BaseMessage, BaseMessageChunk, ToolMessage
-from langchain_core.tools import StructuredTool
-from langchain_core.utils._merge import merge_lists as _original_merge_lists
-from langchain_mcp_adapters.client import MultiServerMCPClient
-from langgraph.checkpoint.memory import MemorySaver
-from maxkb.const import CONFIG
-from pydantic import Field, create_model
-from tools.models import Tool, ToolRecord, ToolScope, ToolType, ToolWorkflowVersion
-
-from application.flow.backend.sandbox_shell import SandboxShellBackend
-from application.flow.common import Workflow, WorkflowMode
-from application.flow.i_step_node import ToolWorkflowPostHandler, WorkFlowPostHandler
-from application.serializers.common import ToolExecute
-
-
-def _merge_lists_normalize_empty_tool_chunk_ids(left, *others):
- """Wrapper around merge_lists that normalises empty-string IDs to None in
- tool_call_chunk items (those with an 'index' key) so that qwen streaming
- chunks with id='' are merged correctly by index."""
-
- def _norm(lst):
- if lst is None:
- return lst
- result = []
- for item in lst:
- if isinstance(item, dict) and "index" in item and item.get("id") == "":
- item = {**item, "id": None}
- result.append(item)
- return result
-
- return _original_merge_lists(
- _norm(left),
- *[_norm(o) for o in others],
- )
-
-
-# Replace the module-level reference used by add_ai_message_chunks in ai.py
-_lc_ai_module.merge_lists = _merge_lists_normalize_empty_tool_chunk_ids
-
-
-class Reasoning:
- def __init__(self, reasoning_content_start, reasoning_content_end):
- self.content = ""
- self.reasoning_content = ""
- self.all_content = ""
- self.reasoning_content_start_tag = reasoning_content_start
- self.reasoning_content_end_tag = reasoning_content_end
- self.reasoning_content_start_tag_len = (
- len(reasoning_content_start) if reasoning_content_start is not None else 0
- )
- self.reasoning_content_end_tag_len = len(reasoning_content_end) if reasoning_content_end is not None else 0
- self.reasoning_content_end_tag_prefix = (
- reasoning_content_end[0] if self.reasoning_content_end_tag_len > 0 else ""
- )
- self.reasoning_content_is_start = False
- self.reasoning_content_is_end = False
- self.reasoning_content_chunk = ""
-
- def get_end_reasoning_content(self):
- if not self.reasoning_content_is_start and not self.reasoning_content_is_end:
- r = {"content": self.all_content, "reasoning_content": ""}
- self.reasoning_content_chunk = ""
- return r
- if self.reasoning_content_is_start and not self.reasoning_content_is_end:
- r = {"content": "", "reasoning_content": self.reasoning_content_chunk}
- self.reasoning_content_chunk = ""
- return r
- return {"content": "", "reasoning_content": ""}
-
- def _normalize_content(self, content):
- """将不同类型的内容统一转换为字符串"""
- if isinstance(content, str):
- return content
- elif isinstance(content, list):
- # 处理包含多种内容类型的列表
- normalized_parts = []
- for item in content:
- if isinstance(item, dict):
- if item.get("type") == "text":
- normalized_parts.append(item.get("text", ""))
- return "".join(normalized_parts)
- else:
- return str(content)
-
- def get_reasoning_content(self, chunk):
- # 如果没有开始思考过程标签那么就全是结果
- if self.reasoning_content_start_tag is None or len(self.reasoning_content_start_tag) == 0:
- self.content += chunk.content
- return {"content": chunk.content, "reasoning_content": ""}
- # 如果没有结束思考过程标签那么就全部是思考过程
- if self.reasoning_content_end_tag is None or len(self.reasoning_content_end_tag) == 0:
- return {"content": "", "reasoning_content": chunk.content}
- chunk.content = self._normalize_content(chunk.content)
- self.all_content += chunk.content
- if not self.reasoning_content_is_start and len(self.all_content) >= self.reasoning_content_start_tag_len:
- if self.all_content.startswith(self.reasoning_content_start_tag):
- self.reasoning_content_is_start = True
- self.reasoning_content_chunk = self.all_content[self.reasoning_content_start_tag_len :]
- else:
- if not self.reasoning_content_is_end:
- self.reasoning_content_is_end = True
- self.content += self.all_content
- return {
- "content": self.all_content,
- "reasoning_content": chunk.additional_kwargs.get("reasoning_content", "")
- if chunk.additional_kwargs
- else "",
- }
- else:
- if self.reasoning_content_is_start:
- self.reasoning_content_chunk += chunk.content
- reasoning_content_end_tag_prefix_index = self.reasoning_content_chunk.find(
- self.reasoning_content_end_tag_prefix
- )
- if self.reasoning_content_is_end:
- self.content += chunk.content
- return {
- "content": chunk.content,
- "reasoning_content": chunk.additional_kwargs.get("reasoning_content", "")
- if chunk.additional_kwargs
- else "",
- }
- # 是否包含结束
- if reasoning_content_end_tag_prefix_index > -1:
- if (
- len(self.reasoning_content_chunk) - reasoning_content_end_tag_prefix_index
- >= self.reasoning_content_end_tag_len
- ):
- reasoning_content_end_tag_index = self.reasoning_content_chunk.find(self.reasoning_content_end_tag)
- if reasoning_content_end_tag_index > -1:
- reasoning_content_chunk = self.reasoning_content_chunk[0:reasoning_content_end_tag_index]
- content_chunk = self.reasoning_content_chunk[
- reasoning_content_end_tag_index + self.reasoning_content_end_tag_len :
- ]
- self.reasoning_content += reasoning_content_chunk
- self.content += content_chunk
- self.reasoning_content_chunk = ""
- self.reasoning_content_is_end = True
- return {"content": content_chunk, "reasoning_content": reasoning_content_chunk}
- else:
- reasoning_content_chunk = self.reasoning_content_chunk[
- 0 : reasoning_content_end_tag_prefix_index + 1
- ]
- self.reasoning_content_chunk = self.reasoning_content_chunk.replace(reasoning_content_chunk, "")
- self.reasoning_content += reasoning_content_chunk
- return {"content": "", "reasoning_content": reasoning_content_chunk}
- else:
- return {"content": "", "reasoning_content": ""}
-
- else:
- if self.reasoning_content_is_end:
- self.content += chunk.content
- return {
- "content": chunk.content,
- "reasoning_content": chunk.additional_kwargs.get("reasoning_content", "")
- if chunk.additional_kwargs
- else "",
- }
- else:
- # aaa
- result = {"content": "", "reasoning_content": self.reasoning_content_chunk}
- self.reasoning_content += self.reasoning_content_chunk
- self.reasoning_content_chunk = ""
- return result
-
-
-def event_content(chat_id, chat_record_id, response, workflow, write_context, post_handler: WorkFlowPostHandler):
- """
- 用于处理流式输出
- @param chat_id: 会话id
- @param chat_record_id: 对话记录id
- @param response: 响应数据
- @param workflow: 工作流管理器
- @param write_context 写入节点上下文
- @param post_handler: 后置处理器
- """
- answer = ""
- try:
- for chunk in response:
- answer += chunk.content
- yield (
- "data: "
- + json.dumps(
- {
- "chat_id": str(chat_id),
- "id": str(chat_record_id),
- "operate": True,
- "content": chunk.content,
- "is_end": False,
- },
- ensure_ascii=False,
- )
- + "\n\n"
- )
- write_context(answer, 200)
- post_handler.handler(chat_id, chat_record_id, answer, workflow)
- yield (
- "data: "
- + json.dumps(
- {"chat_id": str(chat_id), "id": str(chat_record_id), "operate": True, "content": "", "is_end": True},
- ensure_ascii=False,
- )
- + "\n\n"
- )
- except Exception as e:
- answer = str(e)
- write_context(answer, 500)
- post_handler.handler(chat_id, chat_record_id, answer, workflow)
- yield (
- "data: "
- + json.dumps(
- {
- "chat_id": str(chat_id),
- "id": str(chat_record_id),
- "operate": True,
- "content": answer,
- "is_end": True,
- },
- ensure_ascii=False,
- )
- + "\n\n"
- )
-
-
-def to_stream_response(
- chat_id, chat_record_id, response: Iterator[BaseMessageChunk], workflow, write_context, post_handler
-):
- """
- 将结果转换为服务流输出
- @param chat_id: 会话id
- @param chat_record_id: 对话记录id
- @param response: 响应数据
- @param workflow: 工作流管理器
- @param write_context 写入节点上下文
- @param post_handler: 后置处理器
- @return: 响应
- """
- r = StreamingHttpResponse(
- streaming_content=event_content(chat_id, chat_record_id, response, workflow, write_context, post_handler),
- content_type="text/event-stream;charset=utf-8",
- charset="utf-8",
- )
-
- r["Cache-Control"] = "no-cache"
- return r
-
-
-def to_response(
- chat_id, chat_record_id, response: BaseMessage, workflow, write_context, post_handler: WorkFlowPostHandler
-):
- """
- 将结果转换为服务输出
-
- @param chat_id: 会话id
- @param chat_record_id: 对话记录id
- @param response: 响应数据
- @param workflow: 工作流管理器
- @param write_context 写入节点上下文
- @param post_handler: 后置处理器
- @return: 响应
- """
- answer = response.content
- write_context(answer)
- post_handler.handler(chat_id, chat_record_id, answer, workflow)
- return result.success(
- {"chat_id": str(chat_id), "id": str(chat_record_id), "operate": True, "content": answer, "is_end": True}
- )
-
-
-def to_response_simple(chat_id, chat_record_id, response: BaseMessage, workflow, post_handler: WorkFlowPostHandler):
- answer = response.content
- post_handler.handler(chat_id, chat_record_id, answer, workflow)
- return result.success(
- {"chat_id": str(chat_id), "id": str(chat_record_id), "operate": True, "content": answer, "is_end": True}
- )
-
-
-def to_stream_response_simple(stream_event):
- r = StreamingHttpResponse(
- streaming_content=stream_event, content_type="text/event-stream;charset=utf-8", charset="utf-8"
- )
-
- r["Cache-Control"] = "no-cache"
- return r
-
-
-def generate_tool_message_complete(icon, name, input_content, output_content):
- """生成包含输入和输出的工具消息模版"""
- # 确保输入内容是字符串,如果不是则尝试转换为 JSON 字符串
- if not isinstance(input_content, str):
- input_content = json.dumps(input_content, ensure_ascii=False)
- # 格式化输出
- if not isinstance(output_content, str):
- output_content = json.dumps(output_content, ensure_ascii=False)
- content = {
- "icon": icon,
- "title": name,
- "type": "simple-tool-calls",
- "content": {"input": input_content, "output": output_content},
- }
- return f"{json.dumps(content, ensure_ascii=False)}"
-
-
-# 全局单例事件循环
-_global_loop = None
-_loop_thread = None
-_loop_lock = threading.Lock()
-
-
-def get_global_loop():
- """获取全局共享的事件循环"""
- global _global_loop, _loop_thread
-
- with _loop_lock:
- if _global_loop is None:
- _global_loop = asyncio.new_event_loop()
-
- def run_forever():
- asyncio.set_event_loop(_global_loop)
- _global_loop.run_forever()
-
- _loop_thread = threading.Thread(target=run_forever, daemon=True, name="GlobalAsyncLoop")
- _loop_thread.start()
-
- return _global_loop
-
-
-def _extract_tool_id(raw_id):
- """从 raw_id 中提取最后一个符合 call_... 模式的 id,若无匹配则返回原值或 None"""
- if not raw_id:
- return None
- if not isinstance(raw_id, str):
- raw_id = str(raw_id)
-
- s = raw_id
- prefix = "call_"
- positions = [m.start() for m in re.finditer(re.escape(prefix), s)]
- if not positions:
- return raw_id
-
- # 取最后一个前缀位置,截到下一个前缀或结尾
- start = positions[-1]
- end = len(s)
- for pos in positions:
- if pos > start:
- end = pos
- break
-
- tool_id = s[start:end]
- return tool_id or raw_id
-
-
-async def _initialize_skills(mcp_servers, temp_dir):
- skills_dir = os.path.join(temp_dir, "skills")
- mcp_config = json.loads(mcp_servers)
- if "skills" in mcp_config:
- skill_file_items = mcp_config.pop("skills")
- for skill_file in skill_file_items:
- # 使用 sync_to_async 包装 ORM 查询
- file = await sync_to_async(lambda: QuerySet(File).filter(id=skill_file["file_id"]).first())()
- if not file:
- continue
- # get_bytes 可能也涉及 IO,也用 sync_to_async 包装
- file_bytes = await sync_to_async(file.get_bytes)()
- params = skill_file.get("params", {})
- with zipfile.ZipFile(io.BytesIO(file_bytes), "r") as zip_ref:
- members = [m for m in zip_ref.namelist() if not m.startswith("__MACOSX/") and "__MACOSX" not in m]
- for member in members:
- if ".." in member or member.startswith("/"):
- raise ValueError(f"非法路径: {member}")
- zip_ref.extractall(skills_dir, members=members)
-
- # 获取技能解压后的顶级目录名
- top_level_dirs = set()
- for member in members:
- parts = member.split("/")
- if parts[0]:
- top_level_dirs.add(parts[0])
-
- # 将 params 写入每个顶级目录下的 .env 文件
- if params:
- env_lines = []
- for key, value in params.items():
- # 对含空格或特殊字符的值加引号
- env_lines.append(f"{key}={value}")
- env_content = "\n".join(env_lines) + "\n"
- for top_dir in top_level_dirs:
- env_path = os.path.join(skills_dir, top_dir, ".env")
- with open(env_path, "w", encoding="utf-8") as f:
- f.write(env_content)
-
- os.system("chmod -R g+rx " + temp_dir) # 确保技能目录可访问
-
- client = MultiServerMCPClient(mcp_config)
-
- return client
-
-
-async def _yield_mcp_response(
- chat_model,
- system_prompt,
- message_list,
- mcp_servers,
- mcp_output_enable=True,
- tool_init_params={},
- source_id=None,
- source_type=None,
- temp_dir=None,
- chat_id=None,
- extra_tools=None,
-):
- try:
- checkpointer = MemorySaver()
- client = await _initialize_skills(mcp_servers, temp_dir)
- tools = await client.get_tools()
- for tool in tools:
- tool.handle_tool_error = True
- if extra_tools:
- for tool in extra_tools:
- tools.append(tool)
-
- agent = create_deep_agent(
- model=chat_model,
- backend=SandboxShellBackend(root_dir=temp_dir, virtual_mode=True),
- skills=["/skills"],
- tools=tools,
- system_prompt=system_prompt,
- interrupt_on={"write_file": False, "read_file": False, "edit_file": False},
- checkpointer=checkpointer,
- )
- recursion_limit = int(CONFIG.get("LANGCHAIN_GRAPH_RECURSION_LIMIT", "100"))
- response = agent.astream(
- {"messages": message_list},
- config={"recursion_limit": recursion_limit, "configurable": {"thread_id": chat_id}},
- stream_mode="messages",
- )
-
- tool_calls_info = {} # tool_id -> {'name': ..., 'input': ...}
- # key(index/id) -> {'id': ..., 'name': ..., 'arguments': ...}
- _tool_fragments = {}
-
- def _merge_arguments(entry, part_args):
- if not isinstance(part_args, str):
- try:
- part_args = json.dumps(part_args, ensure_ascii=False)
- except Exception:
- part_args = str(part_args) if part_args else ""
- if not part_args:
- return
-
- # Some providers first emit placeholder args like "{}" and then
- # stream the real JSON fragments via later chunks. Prefer fragments.
- if entry["arguments"] in ("{}", "[]") and part_args.startswith("{"):
- entry["arguments"] = part_args
- return
-
- if entry["arguments"]:
- try:
- existing_obj = json.loads(entry["arguments"])
- new_obj = json.loads(part_args)
- if isinstance(existing_obj, dict) and isinstance(new_obj, dict):
- merged = {**existing_obj, **new_obj}
- entry["arguments"] = json.dumps(merged, ensure_ascii=False)
- else:
- entry["arguments"] += part_args
- except (json.JSONDecodeError, ValueError):
- entry["arguments"] += part_args
- else:
- entry["arguments"] = part_args
-
- def _get_fragment_key(idx, raw_id):
- if idx is not None:
- return f"idx:{idx}"
- if raw_id and str(raw_id).strip():
- return f"id:{_extract_tool_id(str(raw_id).strip())}"
- return None
-
- def _upsert_fragment(key, raw_id, func_name, part_args):
- if key is None:
- return
- entry = _tool_fragments.setdefault(key, {"id": "", "name": "", "arguments": ""})
-
- if raw_id and str(raw_id).strip():
- new_id = str(raw_id).strip()
- if entry.get("completed") and entry.get("id") and entry["id"] != new_id:
- maxkb_logger.debug(f"Resetting completed fragment {key}: old ID {entry['id']} -> new ID {new_id}")
- entry.clear()
- entry.update({"id": "", "name": "", "arguments": ""})
- entry["id"] = new_id
-
- if func_name:
- entry["name"] = func_name
-
- _merge_arguments(entry, part_args)
-
- async for chunk in response:
- # print(chunk)
- if isinstance(chunk[0], AIMessageChunk):
- # ----------------------------------------------------------------
- # 1. 从 tool_call_chunks 中聚合工具调用片段
- # (qwen/OpenAI streaming 通过 tool_call_chunks 传递,
- # additional_kwargs['tool_calls'] 在流式时通常为空)
- # ----------------------------------------------------------------
- for tc_chunk in chunk[0].tool_call_chunks or []:
- raw_id = tc_chunk.get("id")
- key = _get_fragment_key(tc_chunk.get("index"), raw_id)
- _upsert_fragment(key, raw_id, tc_chunk.get("name"), tc_chunk.get("args", ""))
-
- # ----------------------------------------------------------------
- # 1.1 兼容部分模型将工具调用放在 chunk.tool_calls,且 tool_call_chunks
- # 的 index 为空(例如 ollama/qwen)
- # ----------------------------------------------------------------
- has_tool_call_chunks = bool(chunk[0].tool_call_chunks)
- for tool_call in chunk[0].tool_calls or []:
- raw_id = tool_call.get("id")
- part_args = tool_call.get("args", "")
- # qwen-plus often emits {} here as a placeholder while
- # the real args are split in tool_call_chunks/invalid_tool_calls.
- if has_tool_call_chunks and (part_args == "" or part_args == {} or part_args == []):
- part_args = ""
- key = _get_fragment_key(tool_call.get("index"), raw_id)
- _upsert_fragment(key, raw_id, tool_call.get("name"), part_args)
-
- # ----------------------------------------------------------------
- # 1.2 兼容 invalid_tool_calls 分片(部分模型会把中间 JSON 片段放这里)
- # ----------------------------------------------------------------
- for invalid_tool_call in chunk[0].invalid_tool_calls or []:
- raw_id = invalid_tool_call.get("id")
- key = _get_fragment_key(invalid_tool_call.get("index"), raw_id)
- _upsert_fragment(key, raw_id, invalid_tool_call.get("name"), invalid_tool_call.get("args", ""))
-
- # ----------------------------------------------------------------
- # 2. 兼容 additional_kwargs['tool_calls'] 方式(旧格式/非流式情况)
- # ----------------------------------------------------------------
- legacy_tool_calls = chunk[0].additional_kwargs.get("tool_calls", [])
- for tool_call in legacy_tool_calls:
- raw_id = tool_call.get("id")
- func = tool_call.get("function", {})
- if isinstance(func, dict):
- func_name = func.get("name")
- part_args = func.get("arguments", "")
- else:
- func_name = tool_call.get("name")
- part_args = tool_call.get("arguments", "")
- key = _get_fragment_key(tool_call.get("index"), raw_id)
- _upsert_fragment(key, raw_id, func_name, part_args)
-
- # ----------------------------------------------------------------
- # 3. 检测工具调用结束,更新 tool_calls_info
- # ----------------------------------------------------------------
- is_finish_chunk = (
- chunk[0].response_metadata.get("finish_reason") == "tool_calls" or chunk[0].chunk_position == "last"
- )
-
- if is_finish_chunk:
- # 在 finish chunk 时,将所有未完成的 fragment 标记完成并更新 tool_calls_info
- maxkb_logger.debug(f"Processing finish chunk. Tool fragments: {_tool_fragments}")
- for idx, entry in _tool_fragments.items():
- if entry.get("completed"):
- maxkb_logger.debug(f"Skipping fragment {idx}: already completed")
- continue
- if not entry.get("id"):
- maxkb_logger.debug(f"Skipping fragment {idx}: missing id. Fragment: {entry}")
- continue
- if not entry.get("arguments"):
- maxkb_logger.debug(f"Skipping fragment {idx}: missing arguments. Fragment: {entry}")
- continue
-
- if not entry.get("completed") and entry.get("id") and entry.get("arguments"):
- try:
- parsed_args = json.loads(entry["arguments"])
- filtered_args = (
- {k: v for k, v in parsed_args.items() if k not in tool_init_params}
- if tool_init_params
- else parsed_args
- )
- normalized_id = _extract_tool_id(entry["id"])
- info = {"name": entry["name"], "input": json.dumps(filtered_args, ensure_ascii=False)}
- tool_calls_info[entry["id"]] = info
- if normalized_id and normalized_id != entry["id"]:
- tool_calls_info[normalized_id] = info
- entry["completed"] = True
- maxkb_logger.debug(f"Added tool call {entry['id']} to tool_calls_info")
- except (json.JSONDecodeError, ValueError) as e:
- # JSON parsing failed, but still add to tool_calls_info with raw arguments
- # to prevent "Tool ID not found" errors when ToolMessage arrives
- maxkb_logger.warning(
- f"Failed to parse tool arguments at finish for tool {entry.get('id', 'unknown')}: "
- f"{entry['arguments']}, error: {e}. Using raw arguments."
- )
- normalized_id = _extract_tool_id(entry["id"])
- info = {
- "name": entry["name"],
- # Use raw arguments
- "input": entry["arguments"],
- }
- tool_calls_info[entry["id"]] = info
- if normalized_id and normalized_id != entry["id"]:
- tool_calls_info[normalized_id] = info
- entry["completed"] = True
-
- # ----------------------------------------------------------------
- # 4. 修复 tool_call_chunks 中的空 id(回填已知 id)
- # ----------------------------------------------------------------
- if chunk[0].tool_call_chunks:
- for tc_chunk in chunk[0].tool_call_chunks:
- key = _get_fragment_key(tc_chunk.get("index"), tc_chunk.get("id"))
- if key is not None:
- frag = _tool_fragments.get(key)
- if frag and frag.get("id") and not tc_chunk.get("id"):
- tc_chunk["id"] = frag["id"]
-
- # ----------------------------------------------------------------
- # 5. 修复 additional_kwargs['tool_calls'](兼容旧格式)
- # 仅在 finish chunk 时写入完整参数,避免污染中间 chunk 的
- # additional_kwargs(中间 chunk 会被 ainvoke 累积,如果写入
- # 不完整 JSON 会导致下一轮 API 调用出现 arguments 非 JSON 格式错误)
- # ----------------------------------------------------------------
- if legacy_tool_calls and is_finish_chunk:
- fixed_tool_calls = []
- for tool_call in legacy_tool_calls:
- key = _get_fragment_key(tool_call.get("index"), tool_call.get("id"))
- frag = _tool_fragments.get(key) if key is not None else None
- tc = dict(tool_call)
- if frag and frag.get("id") and not tc.get("id"):
- tc["id"] = frag["id"]
- if frag and isinstance(tc.get("function"), dict):
- tc["function"] = dict(tc["function"])
- if frag.get("completed"):
- tc["function"]["arguments"] = frag["arguments"]
- fixed_tool_calls.append(tc)
- chunk[0].additional_kwargs["tool_calls"] = fixed_tool_calls
-
- yield chunk[0]
-
- if mcp_output_enable and isinstance(chunk[0], ToolMessage):
- tool_id = chunk[0].tool_call_id
- normalized_tool_id = _extract_tool_id(tool_id)
- tool_info = tool_calls_info.get(tool_id) or tool_calls_info.get(normalized_tool_id)
-
- if tool_info:
- try:
- if isinstance(chunk[0].content, str):
- tool_result = json.loads(chunk[0].content)
- elif isinstance(chunk[0].content, dict):
- tool_result = chunk[0].content
- elif isinstance(chunk[0].content, list):
- tool_result = chunk[0].content[0] if len(chunk[0].content) > 0 else {}
- else:
- tool_result = {}
- text = tool_result.get("text") if "text" in tool_result else None
- text_result = json.loads(text) if text else tool_result
- if text:
- tool_lib_id = text_result.pop("tool_id") if "tool_id" in text_result else None
- else:
- tool_lib_id = tool_result.pop("tool_id") if "tool_id" in tool_result else None
- if tool_lib_id:
- await save_tool_record(tool_lib_id, tool_info, tool_result, source_id, source_type)
- tool_result = json.dumps(text_result, ensure_ascii=False)
- except Exception as e:
- tool_result = chunk[0].content
- content = generate_tool_message_complete(
- tool_info.get("icon", ""), tool_info["name"], tool_info["input"], tool_result
- )
- chunk[0].content = content
- else:
- maxkb_logger.warning(
- f"Tool ID {tool_id} not found in tool_calls_info. "
- f"Normalized Tool ID: {normalized_tool_id}. "
- f"Available IDs: {list(tool_calls_info.keys())}. "
- f"Tool fragments at this point: {_tool_fragments}"
- )
-
- yield chunk[0]
-
- except ExceptionGroup as eg:
-
- def get_real_error(exc):
- if isinstance(exc, ExceptionGroup):
- return get_real_error(exc.exceptions[0])
- return exc
-
- real_error = get_real_error(eg)
- error_msg = f"{type(real_error).__name__}: {str(real_error)}"
- raise RuntimeError(error_msg) from None
-
- except Exception as e:
- error_msg = f"{type(e).__name__}: {str(e)}"
- raise RuntimeError(error_msg) from None
-
-
-async def save_tool_record(tool_id, tool_info, tool_result, source_id, source_type):
- tool = await sync_to_async(lambda: QuerySet(Tool).filter(id=tool_id).first())()
- tool_info["icon"] = tool.icon
- tool_record = ToolRecord(
- id=uuid.uuid7(),
- workspace_id=tool.workspace_id,
- tool_id=tool_id,
- source_type=source_type,
- source_id=source_id,
- meta={"input": tool_info["input"], "output": tool_result},
- state=State.SUCCESS,
- )
- await sync_to_async(tool_record.save)()
-
-
-def mcp_response_generator(
- chat_model,
- system_prompt,
- message_list,
- mcp_servers,
- mcp_output_enable=True,
- tool_init_params={},
- source_id=None,
- source_type=None,
- chat_id=None,
- extra_tools=None,
-):
- """使用全局事件循环,不创建新实例"""
- result_queue = queue.Queue()
- loop = get_global_loop() # 使用共享循环
- # 创建临时文件夹
- if chat_id:
- temp_dir = os.path.join("/tmp", chat_id)
- else:
- temp_dir = os.path.join("/tmp", str(uuid.uuid7()))
- skills_dir = os.path.join(temp_dir, "skills")
- os.makedirs(skills_dir, exist_ok=True)
-
- # print(f"Initializing skills in temporary directory: {skills_dir}")
-
- async def _run():
- try:
- async_gen = _yield_mcp_response(
- chat_model,
- system_prompt,
- message_list,
- mcp_servers,
- mcp_output_enable,
- tool_init_params,
- source_id,
- source_type,
- temp_dir,
- chat_id,
- extra_tools,
- )
- async for chunk in async_gen:
- result_queue.put(("data", chunk))
- except Exception as e:
- maxkb_logger.error(f"Exception: {e}", exc_info=True)
- result_queue.put(("error", e))
- finally:
- result_queue.put(("done", None))
-
- # 在全局循环中调度任务
- asyncio.run_coroutine_threadsafe(_run(), loop)
-
- while True:
- msg_type, data = result_queue.get()
- if msg_type == "done":
- # 清理临时文件夹
- shutil.rmtree(temp_dir, ignore_errors=True)
- break
- if msg_type == "error":
- # 清理临时文件夹
- shutil.rmtree(temp_dir, ignore_errors=True)
- raise data
- yield data
-
-
-async def anext_async(agen):
- return await agen.__anext__()
-
-
-target_source_node_mapping = {
- "TOOL": {
- "tool-lib-node": lambda n: [n.get("properties").get("node_data").get("tool_lib_id")],
- "ai-chat-node": lambda n: [
- *(n.get("properties").get("node_data").get("mcp_tool_ids") or []),
- *(n.get("properties").get("node_data").get("tool_ids") or []),
- *(n.get("properties").get("node_data").get("skill_tool_ids") or []),
- ],
- "mcp-node": lambda n: [n.get("properties").get("node_data").get("mcp_tool_id")],
- "tool-workflow-lib-node": lambda n: [n.get("properties").get("node_data").get("tool_lib_id")],
- },
- "MODEL": {
- "ai-chat-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "question-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "speech-to-text-node": lambda n: [n.get("properties").get("node_data").get("stt_model_id")],
- "text-to-speech-node": lambda n: [n.get("properties").get("node_data").get("tts_model_id")],
- "image-to-video-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "image-generate-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "intent-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "image-understand-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "parameter-extraction-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "video-understand-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
- "reranker-node": lambda n: [n.get("properties").get("node_data").get("reranker_model_id")],
- },
- "KNOWLEDGE": {
- "search-knowledge-node": lambda n: n.get("properties").get("node_data").get("knowledge_id_list"),
- "search-document-node": lambda n: n.get("properties").get("node_data").get("knowledge_id_list"),
- },
- "APPLICATION": {
- "application-node": lambda n: [n.get("properties").get("node_data").get("application_id")],
- "ai-chat-node": lambda n: [*(n.get("properties").get("node_data").get("application_ids") or [])],
- },
-}
-
-
-def get_node_handle_callback(source_type, source_id):
- def node_handle_callback(node):
- from system_manage.models.resource_mapping import ResourceMapping
-
- response = []
- for key, value in target_source_node_mapping.items():
- if node.get("type") in value:
- call = value.get(node.get("type"))
- target_source_id_list = call(node)
- for target_source_id in target_source_id_list:
- if target_source_id:
- response.append(
- ResourceMapping(
- source_type=source_type,
- target_type=key,
- source_id=source_id,
- target_id=target_source_id,
- )
- )
- return response
-
- return node_handle_callback
-
-
-def get_workflow_resource(workflow, node_handle):
- response = []
- if "nodes" in workflow:
- for node in workflow.get("nodes"):
- rs = node_handle(node)
- if rs:
- for r in rs:
- response.append(r)
- if node.get("type") == "loop-node":
- r = get_workflow_resource(node.get("properties", {}).get("node_data", {}).get("loop_body"), node_handle)
- for rn in r:
- response.append(rn)
- return list({(str(item.target_type) + str(item.target_id)): item for item in response}.values())
- return []
-
-
-application_instance_field_call_dict = {
- "TOOL": [
- lambda instance: instance.mcp_tool_ids or [],
- lambda instance: instance.skill_tool_ids or [],
- lambda instance: instance.tool_ids or [],
- ],
- "APPLICATION": [
- lambda instance: instance.application_ids or [],
- ],
- "MODEL": [
- lambda instance: [instance.model_id] if instance.model_id else [],
- lambda instance: [instance.long_term_model_id] if instance.long_term_model_id else [],
- lambda instance: [instance.tts_model_id] if instance.tts_model_id else [],
- lambda instance: [instance.stt_model_id] if instance.stt_model_id else [],
- ],
-}
-knowledge_instance_field_call_dict = {
- "MODEL": [lambda instance: [instance.embedding_model_id] if instance.embedding_model_id else []],
-}
-
-
-def get_instance_resource(instance, source_type, source_id, instance_field_call_dict):
- response = []
- from system_manage.models.resource_mapping import ResourceMapping
-
- for target_type, call_list in instance_field_call_dict.items():
- target_id_list = reduce(lambda x, y: [*x, *y], [call(instance) for call in call_list], [])
- if target_id_list:
- for target_id in target_id_list:
- response.append(
- ResourceMapping(
- source_type=source_type, target_type=target_type, source_id=source_id, target_id=target_id
- )
- )
- return response
-
-
-def save_workflow_mapping(workflow, source_type, source_id, other_resource_mapping=None):
- if not other_resource_mapping:
- other_resource_mapping = []
- from django.db.models import QuerySet
- from system_manage.models.resource_mapping import ResourceMapping
-
- QuerySet(ResourceMapping).filter(source_type=source_type, source_id=source_id).delete()
- resource_mapping_list = get_workflow_resource(workflow, get_node_handle_callback(source_type, source_id))
- resource_mapping_list += other_resource_mapping
- if resource_mapping_list:
- QuerySet(ResourceMapping).bulk_create(
- {(str(item.target_type) + str(item.target_id)): item for item in resource_mapping_list}.values()
- )
-
-
-def get_tool_id_list(workflow, with_deep=False):
- from tools.models import ToolType, ToolWorkflow
-
- _result = []
- for node in workflow.get("nodes", []):
- if node.get("type") == "tool-lib-node":
- tool_id = node.get("properties", {}).get("node_data", {}).get("tool_lib_id")
- if tool_id:
- _result.append(tool_id)
- elif node.get("type") == "loop-node":
- r = get_tool_id_list(node.get("properties", {}).get("node_data", {}).get("loop_body", {}))
- for item in r:
- _result.append(item)
- elif node.get("type") == "tool-workflow-lib-node":
- tool_id = node.get("properties", {}).get("node_data", {}).get("tool_lib_id")
- if tool_id:
- _result.append(tool_id)
- elif node.get("type") == "ai-chat-node":
- node_data = node.get("properties", {}).get("node_data", {})
- mcp_tool_ids = node_data.get("mcp_tool_ids") or []
- skill_tool_ids = node_data.get("skill_tool_ids") or []
- tool_ids = node_data.get("tool_ids") or []
- for _id in mcp_tool_ids + tool_ids + skill_tool_ids:
- _result.append(_id)
- elif node.get("type") == "mcp-node":
- mcp_tool_id = node.get("properties", {}).get("node_data", {}).get("mcp_tool_id")
- if mcp_tool_id:
- _result.append(mcp_tool_id)
- if with_deep:
- workflow_list = QuerySet(Tool).filter(id__in=_result, tool_type=ToolType.WORKFLOW)
- tool_work_flow_list = QuerySet(ToolWorkflow).filter(tool_id__in=[wl.id for wl in workflow_list])
- for tool_work_flow in tool_work_flow_list:
- child_tool_id_list = get_child_tool_id_list(tool_work_flow.work_flow, [])
- for c in child_tool_id_list:
- _result.append(c)
- return _result
-
-
-def get_child_tool_id_list(work_flow, response):
- from tools.models import ToolType, ToolWorkflow
-
- tool_id_list = get_tool_id_list(work_flow, False)
- tool_id_list = [tool_id for tool_id in tool_id_list if len([r for r in response if r == tool_id]) == 0]
- tool_list = []
- if len(tool_id_list) > 0:
- tool_list = QuerySet(Tool).filter(id__in=tool_id_list).exclude(scope=ToolScope.SHARED)
- work_flow_tools = [tool for tool in tool_list if tool.tool_type == ToolType.WORKFLOW]
- if len(work_flow_tools) > 0:
- work_flow_tool_dict = {
- tw.tool_id: tw for tw in QuerySet(ToolWorkflow).filter(tool_id__in=[t.id for t in work_flow_tools])
- }
- for tool in tool_list:
- response.append(str(tool.id))
- if tool.tool_type == ToolType.WORKFLOW:
- get_child_tool_id_list(work_flow_tool_dict.get(tool.id).work_flow, response)
- else:
- for tool in tool_list:
- response.append(str(tool.id))
- return response
-
-
-def build_schema(fields: dict):
- return create_model("dynamicSchema", **fields)
-
-
-def get_type(_type: str):
- if _type == "float":
- return float
- if _type == "string":
- return str
- if _type == "int":
- return int
- if _type == "dict":
- return dict
- if _type == "array":
- return list
- if _type == "boolean":
- return bool
- return object
-
-
-def get_workflow_args(tool, qv):
- for node in qv.work_flow.get("nodes"):
- if node.get("type") == "tool-base-node":
- input_field_list = node.get("properties").get("user_input_field_list")
- return build_schema(
- {
- field.get("field"): (
- get_type(field.get("type")),
- Field(..., required=True, description=field.get("desc")) if field.get("is_required") else Field(default=None, required=False, description=field.get("desc"))
- )
- for field in input_field_list
- }
- )
-
- return build_schema({})
-
-
-def get_workflow_func(source_type, source_id, tool, qv, workspace_id):
- tool_id = tool.id
- tool_record_id = str(uuid.uuid7())
- took_execute = ToolExecute(tool_id, tool_record_id, workspace_id, source_type, source_id, False)
-
- def inner(**kwargs):
- from application.flow.tool_workflow_manage import ToolWorkflowManage
-
- work_flow_manage = ToolWorkflowManage(
- Workflow.new_instance(qv.work_flow, WorkflowMode.TOOL),
- {
- "chat_record_id": tool_record_id,
- "tool_id": tool_id,
- "stream": True,
- "workspace_id": workspace_id,
- **kwargs,
- },
- ToolWorkflowPostHandler(took_execute, tool_id),
- is_the_task_interrupted=lambda: False,
- child_node=None,
- start_node_id=None,
- start_node_data=None,
- chat_record=None,
- )
- res = work_flow_manage.run()
- for r in res:
- pass
- return work_flow_manage.out_context
-
- return inner
-
-
-def get_tools(source_type, source_id, tool_workflow_ids, workspace_id):
- tools = QuerySet(Tool).filter(
- id__in=tool_workflow_ids, is_active=True, tool_type=ToolType.WORKFLOW, workspace_id=workspace_id
- )
- latest_subquery = ToolWorkflowVersion.objects.filter(tool_id=OuterRef("tool_id")).order_by("-create_time")
-
- qs = ToolWorkflowVersion.objects.filter(
- tool_id__in=[t.id for t in tools], id=Subquery(latest_subquery.values("id")[:1])
- )
- qd = {q.tool_id: q for q in qs}
- results = []
- for tool in tools:
- qv = qd.get(tool.id)
- func = get_workflow_func(source_type, source_id, tool, qv, workspace_id)
- args = get_workflow_args(tool, qv)
- tool = StructuredTool.from_function(
- func=func,
- name=tool.name,
- description=tool.desc,
- args_schema=args,
- )
- results.append(tool)
-
- return results
diff --git a/apps/application/flow/workflow_manage.py b/apps/application/flow/workflow_manage.py
deleted file mode 100644
index f1323c6d4b7..00000000000
--- a/apps/application/flow/workflow_manage.py
+++ /dev/null
@@ -1,833 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: workflow_manage.py
- @date:2024/1/9 17:40
- @desc:
-"""
-import concurrent
-import json
-import threading
-from concurrent.futures import ThreadPoolExecutor
-from functools import reduce
-from typing import List, Dict
-
-from django.db import close_old_connections, connection
-from django.utils import translation
-from django.utils.translation import get_language
-from langchain_core.prompts import PromptTemplate
-from rest_framework import status
-
-from application.flow import tools
-from application.flow.common import Workflow
-from application.flow.i_step_node import INode, WorkFlowPostHandler, NodeResult, FlowParamsSerializer
-from application.flow.step_node import get_node
-from common.handle.base_to_response import BaseToResponse
-from common.handle.impl.response.system_to_response import SystemToResponse
-from common.utils.logger import maxkb_logger
-
-executor = ThreadPoolExecutor(max_workers=200)
-
-
-class NodeResultFuture:
- def __init__(self, r, e, status=200):
- self.r = r
- self.e = e
- self.status = status
-
- def result(self):
- if self.status == 200:
- return self.r
- else:
- raise self.e
-
-
-def await_result(result, timeout=1):
- try:
- result.result(timeout)
- return False
- except Exception as e:
- return True
-
-
-class NodeChunkManage:
-
- def __init__(self, work_flow):
- self.node_chunk_list = []
- self.current_node_chunk = None
- self.work_flow = work_flow
-
- def add_node_chunk(self, node_chunk):
- self.node_chunk_list.append(node_chunk)
-
- def contains(self, node_chunk):
- return self.node_chunk_list.__contains__(node_chunk)
-
- def pop(self):
- if self.current_node_chunk is None:
- try:
- current_node_chunk = self.node_chunk_list.pop(0)
- self.current_node_chunk = current_node_chunk
- except IndexError as e:
- pass
- if self.current_node_chunk is not None:
- try:
- chunk = self.current_node_chunk.chunk_list.pop(0)
- return chunk
- except IndexError as e:
- if self.current_node_chunk.is_end():
- self.current_node_chunk = None
- if self.work_flow.answer_is_not_empty():
- chunk = self.work_flow.base_to_response.to_stream_chunk_response(
- self.work_flow.params['chat_id'],
- self.work_flow.params['chat_record_id'],
- '\n\n', False, 0, 0)
- self.work_flow.append_answer('\n\n')
- return chunk
- return self.pop()
- return None
-
-
-class WorkflowManage:
- def __init__(self, flow: Workflow, params, work_flow_post_handler: WorkFlowPostHandler,
- base_to_response: BaseToResponse = SystemToResponse(), form_data=None, image_list=None,
- document_list=None,
- audio_list=None,
- video_list=None,
- other_list=None,
- start_node_id=None,
- start_node_data=None, chat_record=None, child_node=None, is_the_task_interrupted=lambda: False):
- if form_data is None:
- form_data = {}
- if image_list is None:
- image_list = []
- if document_list is None:
- document_list = []
- if audio_list is None:
- audio_list = []
- if video_list is None:
- video_list = []
- if other_list is None:
- other_list = []
- self.start_node_id = start_node_id
- self.start_node = None
- self.form_data = form_data
- self.image_list = image_list
- self.video_list = video_list
- self.document_list = document_list
- self.audio_list = audio_list
- self.other_list = other_list
- self.params = params
- self.flow = flow
- self.context = {}
- self.chat_context = {}
- self.node_chunk_manage = NodeChunkManage(self)
- self.work_flow_post_handler = work_flow_post_handler
- self.current_node = None
- self.current_result = None
- self.answer = ""
- self.answer_list = ['']
- self.status = 200
- self.base_to_response = base_to_response
- self.chat_record = chat_record
- self.child_node = child_node
- self.future_list = []
- self.lock = threading.Lock()
- self.field_list = []
- self.global_field_list = []
- self.chat_field_list = []
- self.init_fields()
- self.is_the_task_interrupted = is_the_task_interrupted
- if start_node_id is not None:
- self.load_node(chat_record, start_node_id, start_node_data)
- else:
- self.node_context = []
-
- def init_fields(self):
- field_list = []
- global_field_list = []
- chat_field_list = []
- for node in self.flow.nodes:
- properties = node.properties
- node_name = properties.get('stepName')
- node_id = node.id
- node_config = properties.get('config')
- field_list.append(
- {'label': '异常信息', 'value': 'exception_message', 'node_id': node_id, 'node_name': node_name})
- if node_config is not None:
- fields = node_config.get('fields')
- if fields is not None:
- for field in fields:
- field_list.append({**field, 'node_id': node_id, 'node_name': node_name})
- global_fields = node_config.get('globalFields')
- if global_fields is not None:
- for global_field in global_fields:
- global_field_list.append({**global_field, 'node_id': node_id, 'node_name': node_name})
- chat_fields = node_config.get('chatFields')
- if chat_fields is not None:
- for chat_field in chat_fields:
- chat_field_list.append({**chat_field, 'node_id': node_id, 'node_name': node_name})
- field_list.sort(key=lambda f: len(f.get('node_name') + f.get('value')), reverse=True)
- global_field_list.sort(key=lambda f: len(f.get('node_name') + f.get('value')), reverse=True)
- chat_field_list.sort(key=lambda f: len(f.get('node_name') + f.get('value')), reverse=True)
- self.field_list = field_list
- self.global_field_list = global_field_list
- self.chat_field_list = chat_field_list
-
- def append_answer(self, content):
- self.answer += content
- self.answer_list[-1] += content
-
- def answer_is_not_empty(self):
- return len(self.answer_list[-1]) > 0
-
- def load_node(self, chat_record, start_node_id, start_node_data):
- self.node_context = []
- self.answer = chat_record.answer_text
- self.answer_list = chat_record.answer_text_list
- self.answer_list.append('')
- for node_details in sorted(chat_record.details.values(), key=lambda d: d.get('index')):
- node_id = node_details.get('node_id')
- if node_details.get('runtime_node_id') == start_node_id:
- def get_node_params(n):
- is_result = False
- if ['application-node', 'loop-node', 'tool-workflow-lib-node'].__contains__(n.type):
- is_result = True
- return {**n.properties.get('node_data'), 'form_data': start_node_data, 'node_data': start_node_data,
- 'child_node': self.child_node, 'is_result': is_result}
-
- self.start_node = self.get_node_cls_by_id(node_id, node_details.get('up_node_id_list'),
- get_node_params=get_node_params)
- self.start_node.valid_args(
- {**self.start_node.node_params, 'form_data': start_node_data}, self.start_node.workflow_params)
- if self.start_node.type == 'loop-node':
- loop_node_data = node_details.get('loop_node_data', {})
- for k, v in node_details.get('loop_context_data').items():
- if v is not None:
- self.start_node.context[k] = v
- self.start_node.context['loop_node_data'] = loop_node_data
- self.start_node.context['current_index'] = node_details.get('current_index')
- self.start_node.context['current_item'] = node_details.get('current_item')
- self.start_node.context['loop_answer_data'] = node_details.get('loop_answer_data', {})
- if self.start_node.type == 'application-node':
- application_node_dict = node_details.get('application_node_dict', {})
- self.start_node.context['application_node_dict'] = application_node_dict
- self.node_context.append(self.start_node)
- continue
-
- node_id = node_details.get('node_id')
- node = self.get_node_cls_by_id(node_id, node_details.get('up_node_id_list'))
- node.valid_args(node.node_params, node.workflow_params)
- node.save_context(node_details, self)
- node.node_chunk.end()
- self.node_context.append(node)
-
- def run(self):
- close_old_connections()
- language = get_language()
- if self.params.get('stream'):
- return self.run_stream(self.start_node, None, language)
- return self.run_block(language)
-
- def run_block(self, language='zh'):
- """
- 非流式响应
- @return: 结果
- """
- try:
- self.params['stream'] = True
- self.run_chain_async(None, None, language)
- while self.is_run():
- pass
- details = self.get_runtime_details()
- message_tokens = sum([row.get('message_tokens') for row in details.values() if
- 'message_tokens' in row and row.get('message_tokens') is not None])
- answer_tokens = sum([row.get('answer_tokens') for row in details.values() if
- 'answer_tokens' in row and row.get('answer_tokens') is not None])
- answer_text_list = self.get_answer_text_list()
- answer_text = '\n\n'.join(
- '\n\n'.join([a.get('content') for a in answer]) for answer in
- answer_text_list)
- answer_list = reduce(lambda pre, _n: [*pre, *_n], answer_text_list, [])
- self.work_flow_post_handler.handler(self)
-
- res = self.base_to_response.to_block_response(self.params['chat_id'],
- self.params['chat_record_id'], answer_text, True
- , message_tokens, answer_tokens,
- _status=status.HTTP_200_OK if self.status == 200 else status.HTTP_500_INTERNAL_SERVER_ERROR,
- other_params={'answer_list': answer_list})
- finally:
- self._cleanup()
- return res
-
- def _cleanup(self):
- """清理所有对象引用"""
- # 清理列表
- self.future_list.clear()
- self.field_list.clear()
- self.global_field_list.clear()
- self.chat_field_list.clear()
- self.image_list.clear()
- self.video_list.clear()
- self.document_list.clear()
- self.audio_list.clear()
- self.other_list.clear()
- if hasattr(self, 'node_context'):
- self.node_context.clear()
-
- # 清理字典
- self.context.clear()
- self.chat_context.clear()
- self.form_data.clear()
-
- # 清理对象引用
- self.node_chunk_manage = None
- self.work_flow_post_handler = None
- self.flow = None
- self.start_node = None
- self.current_node = None
- self.current_result = None
- self.chat_record = None
- self.base_to_response = None
- self.params = None
- self.lock = None
-
- def run_stream(self, current_node, node_result_future, language='zh'):
- """
- 流式响应
- @return:
- """
- self.run_chain_async(current_node, node_result_future, language)
- return tools.to_stream_response_simple(self.await_result())
-
- def get_body(self):
- return self.params
-
- def is_run(self, timeout=0.5):
- future_list_len = len(self.future_list)
- try:
- r = concurrent.futures.wait(self.future_list, timeout)
- if len(r.not_done) > 0:
- return True
- else:
- if future_list_len == len(self.future_list):
- return False
- else:
- return True
- except Exception as e:
- return True
-
- def await_result(self, is_cleanup=True):
- try:
- while self.is_run():
- while True:
- chunk = self.node_chunk_manage.pop()
- if chunk is not None:
- yield chunk
- else:
- break
- while True:
- chunk = self.node_chunk_manage.pop()
- if chunk is None:
- break
- yield chunk
- finally:
- while self.is_run():
- pass
- details = self.get_runtime_details()
- message_tokens = sum([row.get('message_tokens') for row in details.values() if
- 'message_tokens' in row and row.get('message_tokens') is not None])
- answer_tokens = sum([row.get('answer_tokens') for row in details.values() if
- 'answer_tokens' in row and row.get('answer_tokens') is not None])
- self.work_flow_post_handler.handler(self)
- yield self.base_to_response.to_stream_chunk_response(self.params.get('chat_id'),
- self.params.get('chat_record_id'),
- '',
- [],
- '', True, message_tokens, answer_tokens, {})
- if is_cleanup:
- self._cleanup()
-
- def run_chain_async(self, current_node, node_result_future, language='zh'):
- future = executor.submit(self.run_chain_manage, current_node, node_result_future, language)
- self.future_list.append(future)
-
- def run_chain_manage(self, current_node, node_result_future, language='zh'):
- translation.activate(language)
- if current_node is None:
- start_node = self.get_start_node()
- current_node = get_node(start_node.type, self.flow.workflow_mode)(start_node, self.params, self)
- self.node_chunk_manage.add_node_chunk(current_node.node_chunk)
- # 添加节点
- self.append_node(current_node)
- result = self.run_chain(current_node, node_result_future)
- if result is None:
- return
- node_list = self.get_next_node_list(current_node, result)
- if len(node_list) == 1:
- self.run_chain_manage(node_list[0], None, language)
- elif len(node_list) > 1:
- sorted_node_run_list = sorted(node_list, key=lambda n: n.node.y)
- # 获取到可执行的子节点
- result_list = [{'node': node, 'future': executor.submit(self.run_chain_manage, node, None, language)} for
- node in
- sorted_node_run_list]
- for r in result_list:
- self.future_list.append(r.get('future'))
-
- def run_chain(self, current_node, node_result_future=None):
- if node_result_future is None:
- node_result_future = self.run_node_future(current_node)
- try:
- is_stream = self.params.get('stream', True)
- result = self.hand_event_node_result(current_node,
- node_result_future) if is_stream else self.hand_node_result(
- current_node, node_result_future)
- return result
- except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- return None
-
- def hand_node_result(self, current_node, node_result_future):
- try:
- current_result = node_result_future.result()
- result = current_result.write_context(current_node, self)
- if result is not None:
- # 阻塞获取结果
- list(result)
- return current_result
- except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- self.status = 500
- current_node.get_write_error_context(e)
- self.answer += str(e)
- finally:
- current_node.node_chunk.end()
-
- def append_node(self, current_node):
- for index in range(len(self.node_context)):
- n = self.node_context[index]
- if current_node.id == n.node.id and current_node.runtime_node_id == n.runtime_node_id:
- self.node_context[index] = current_node
- return
- self.node_context.append(current_node)
-
- def hand_event_node_result(self, current_node, node_result_future):
- runtime_node_id = current_node.runtime_node_id
- real_node_id = current_node.runtime_node_id
- child_node = {}
- view_type = current_node.view_type
- try:
- self.send_progress(current_node)
- current_result = node_result_future.result()
- result = current_result.write_context(current_node, self)
- if result is not None:
- if self.is_result(current_node, current_result):
- for r in result:
- reasoning_content = ''
- content = r
- child_node = {}
- node_is_end = False
- view_type = current_node.view_type
- node_type = current_node.type
- node_name = current_node.node.properties.get('stepName')
- if isinstance(r, dict):
- content = r.get('content')
- child_node = {'runtime_node_id': r.get('runtime_node_id'),
- 'chat_record_id': r.get('chat_record_id')
- , 'child_node': r.get('child_node')}
- if r.__contains__('real_node_id'):
- real_node_id = r.get('real_node_id')
- if r.__contains__('node_is_end'):
- node_is_end = r.get('node_is_end')
- if r.__contains__('node_type'):
- node_type = r.get("node_type")
- if r.__contains__('node_name'):
- node_name = r.get('node_name')
- view_type = r.get('view_type')
- reasoning_content = r.get('reasoning_content')
- chunk = self.base_to_response.to_stream_chunk_response(self.params.get('chat_id'),
- self.params.get('chat_record_id'),
- current_node.id,
- current_node.up_node_id_list,
- content, False, 0, 0,
- {'node_type': node_type,
- 'runtime_node_id': runtime_node_id,
- 'node_name': node_name,
- 'view_type': view_type,
- 'child_node': child_node,
- 'node_is_end': node_is_end,
- 'real_node_id': real_node_id,
- 'reasoning_content': reasoning_content,
- 'node_status': "SUCCESS"})
- current_node.node_chunk.add_chunk(chunk)
- chunk = (self.base_to_response
- .to_stream_chunk_response(self.params.get('chat_id'),
- self.params.get('chat_record_id'),
- current_node.id,
- current_node.up_node_id_list,
- '', False, 0, 0, {'node_is_end': True,
- 'runtime_node_id': runtime_node_id,
- 'node_type': current_node.type,
- 'view_type': view_type,
- 'child_node': child_node,
- 'real_node_id': real_node_id,
- 'reasoning_content': '',
- 'node_status': "SUCCESS"}))
- current_node.node_chunk.add_chunk(chunk)
- else:
- list(result)
- if current_node.status == 500:
- enableException = current_node.node.properties.get('enableException')
- if not enableException:
- return None
- current_node.context['exception_message'] = current_node.err_message
- current_node.context['branch_id'] = 'exception'
- r = NodeResult({'branch_id': 'exception', 'exception': current_node.err_message}, {},
- _is_interrupt=lambda node, step_variable, global_variable: False)
- r.write_context(current_node, self)
- return r
- if self.is_the_task_interrupted():
- current_node.status = 201
- return None
- return current_result
- except Exception as e:
- # 添加节点
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- enableException = current_node.node.properties.get('enableException')
- current_node.get_write_error_context(e)
- self.status = 500
- if self.is_the_task_interrupted():
- current_node.status = 201
- return None
- if not enableException:
- chunk = self.base_to_response.to_stream_chunk_response(self.params.get('chat_id'),
- self.params.get('chat_record_id'),
- current_node.id,
- current_node.up_node_id_list,
- 'Exception:' + str(e), False, 0, 0,
- {'node_is_end': True,
- 'runtime_node_id': current_node.runtime_node_id,
- 'node_type': current_node.type,
- 'view_type': current_node.view_type,
- 'child_node': {},
- 'real_node_id': real_node_id,
- 'node_status': 'ERROR'})
- current_node.node_chunk.add_chunk(chunk)
- return None
- else:
- current_node.context['exception_message'] = current_node.err_message
- current_node.context['branch_id'] = 'exception'
- return NodeResult({'branch_id': 'exception', 'exception': current_node.err_message}, {},
- _is_interrupt=lambda node, step_variable, global_variable: False)
- finally:
- current_node.node_chunk.end()
- # 归还链接到连接池
- connection.close()
-
- def send_progress(self, current_node):
- runtime_node_id = current_node.runtime_node_id
- real_node_id = current_node.runtime_node_id
- child_node = {}
- view_type = current_node.view_type
- if 'form-node' != current_node.type:
- chunk = self.base_to_response.to_stream_chunk_response(self.params.get('chat_id'),
- self.params.get('chat_record_id'),
- current_node.id,
- current_node.up_node_id_list,
- '', False, 0, 0,
- {'node_type': current_node.type,
- 'runtime_node_id': runtime_node_id,
- 'node_name': current_node.node.properties.get(
- 'stepName'),
- 'view_type': view_type,
- 'child_node': child_node,
- 'node_is_end': True,
- 'real_node_id': real_node_id,
- 'reasoning_content': '',
- 'node_status': "SUCCESS"})
- current_node.node_chunk.add_chunk(chunk)
-
- def run_node_async(self, node):
- future = executor.submit(self.run_node, node)
- return future
-
- def run_node_future(self, node):
- try:
- node.valid_args(node.node_params, node.workflow_params)
- self.send_progress(node)
- result = self.run_node(node)
- return NodeResultFuture(result, None, 200)
- except Exception as e:
- return NodeResultFuture(None, e, 500)
-
- def run_node(self, node):
- result = node.run()
- return result
-
- def is_result(self, current_node, current_node_result):
- return current_node.node_params.get('is_result', not self._has_next_node(
- current_node, current_node_result)) if current_node.node_params is not None else False
-
- def get_chat_info(self):
- return self.work_flow_post_handler.chat_info
-
- def get_chunk_content(self, chunk, is_end=False):
- return 'data: ' + json.dumps(
- {'chat_id': self.params['chat_id'], 'id': self.params['chat_record_id'], 'operate': True,
- 'content': chunk, 'is_end': is_end}, ensure_ascii=False) + "\n\n"
-
- def _has_next_node(self, current_node, node_result: NodeResult | None):
- """
- 是否有下一个可运行的节点
- """
- next_edge_node_list = self.flow.get_next_edge_nodes(current_node.id) or []
- for next_edge_node in next_edge_node_list:
- if node_result is not None and node_result.is_assertion_result():
- edge = next_edge_node.edge
- if (edge.sourceNodeId == current_node.id and
- f"{edge.sourceNodeId}_{node_result.node_variable.get('branch_id')}_right" == edge.sourceAnchorId):
- return True
- return len(next_edge_node_list) > 0
-
- def has_next_node(self, node_result: NodeResult | None):
- """
- 是否有下一个可运行的节点
- """
- return self._has_next_node(self.get_start_node() if self.current_node is None else self.current_node,
- node_result)
-
- def get_runtime_details(self, get_details=lambda n, index: n.get_details(index)):
- details_result = {}
- for index in range(len(self.node_context)):
- node = self.node_context[index]
- if self.chat_record is not None and self.chat_record.details is not None and self.start_node:
- details = self.chat_record.details.get(node.runtime_node_id)
- if details is not None and self.start_node.runtime_node_id != node.runtime_node_id:
- details_result[node.runtime_node_id] = details
- continue
- details = get_details(node, index)
- details['node_id'] = node.id
- details['up_node_id_list'] = node.up_node_id_list
- details['runtime_node_id'] = node.runtime_node_id
- details_result[node.runtime_node_id] = details
- return details_result
-
- def get_record_answer_list(self):
- answer_text_list = self.get_answer_text_list()
- return reduce(lambda pre, _n: [*pre, *_n], answer_text_list, [])
-
- def get_answer_text_list(self):
- result = []
- answer_list = reduce(lambda x, y: [*x, *y],
- [n.get_answer_list() for n in self.node_context if n.get_answer_list() is not None],
- [])
- up_node = None
- for index in range(len(answer_list)):
- current_answer = answer_list[index]
- if len(current_answer.content) > 0:
- if up_node is None or current_answer.view_type == 'single_view' or (
- current_answer.view_type == 'many_view' and up_node.view_type == 'single_view'):
- result.append([current_answer])
- else:
- if len(result) > 0:
- exec_index = len(result) - 1
- if isinstance(result[exec_index], list):
- result[exec_index].append(current_answer)
- else:
- result.insert(0, [current_answer])
- up_node = current_answer
- if len(result) == 0:
- # 如果没有响应 就响应一个空数据
- return [[]]
- return [[item.to_dict() for item in r] for r in result]
-
- @staticmethod
- def dependent_node(edge, node):
- up_node_id = edge.sourceNodeId
- if not node.node_chunk.is_end():
- return False
- if node.id == up_node_id:
- if node.context.get('branch_id', None):
- if edge.sourceAnchorId == f"{node.id}_{node.context.get('branch_id', None)}_right":
- return True
- else:
- return False
- if node.type == 'form-node':
- if node.context.get('form_data', None) is not None:
- return True
- return False
- return True
-
- def dependent_node_been_executed(self, node_id):
- """
- 判断依赖节点是否都已执行
- @param node_id: 需要判断的节点id
- @return:
- """
- up_edge_list = [edge for edge in self.flow.edges if edge.targetNodeId == node_id]
- return all(
- [any([self.dependent_node(edge, node) for node in self.node_context if node.id == edge.sourceNodeId]) for
- edge in
- up_edge_list])
-
- def get_next_node_list(self, current_node, current_node_result):
- """
- 获取下一个可执行节点列表
- @param current_node: 当前可执行节点
- @param current_node_result: 当前可执行节点结果
- @return: 可执行节点列表
- """
- # 判断是否中断执行
- if current_node_result.is_interrupt_exec(current_node):
- return []
- node_list = []
- next_edge_node_list = self.flow.get_next_edge_nodes(current_node.id) or []
- if current_node_result is not None and current_node_result.is_assertion_result():
- for edge_node in next_edge_node_list:
- edge = edge_node.edge
- next_node = edge_node.node
- if (
- f"{edge.sourceNodeId}_{current_node_result.node_variable.get('branch_id')}_right" == edge.sourceAnchorId):
- if next_node.properties.get('condition', "AND") == 'AND':
- if self.dependent_node_been_executed(edge.targetNodeId):
- up_nodes = self.flow.get_up_nodes(edge.targetNodeId)
- up_node_id_list = [*current_node.up_node_id_list, current_node.node.id]
- if up_nodes and len(up_nodes) > 1:
- up_nodes.sort(key=lambda node: node.id)
- first = up_nodes[0]
- up_node_id_list = [n_c for n_c in self.node_context if n_c.node.id == first.id][
- 0].up_node_id_list
- up_node_id_list = [*up_node_id_list, first.id]
- node_list.append(
- self.get_node_cls_by_id(edge.targetNodeId,
- up_node_id_list))
- else:
- node_list.append(
- self.get_node_cls_by_id(edge.targetNodeId,
- [*current_node.up_node_id_list, current_node.node.id]))
- else:
- for edge_node in next_edge_node_list:
- edge = edge_node.edge
- if edge.sourceNodeId + '_right' == edge.sourceAnchorId:
- next_node = edge_node.node
- if next_node.properties.get('condition', "AND") == 'AND':
- if self.dependent_node_been_executed(edge.targetNodeId):
- up_nodes = self.flow.get_up_nodes(edge.targetNodeId)
- up_node_id_list = [*current_node.up_node_id_list, current_node.node.id]
- if up_nodes and len(up_nodes) > 1:
- up_nodes.sort(key=lambda node: node.id)
- first = up_nodes[0]
- up_node_id_list = [n_c for n_c in self.node_context if n_c.node.id == first.id][
- 0].up_node_id_list
- up_node_id_list = [*up_node_id_list, first.id]
- node_list.append(
- self.get_node_cls_by_id(edge.targetNodeId,
- up_node_id_list))
- else:
- node_list.append(
- self.get_node_cls_by_id(edge.targetNodeId,
- [*current_node.up_node_id_list, current_node.node.id]))
- return [node for node in node_list if not node.node.properties.get('disabled')]
-
- def get_reference_field(self, node_id: str, fields: List[str]):
- """
- @param node_id: 节点id
- @param fields: 字段
- @return:
- """
- if node_id == 'global':
- return INode.get_field(self.context, fields)
- elif node_id == 'chat':
- return INode.get_field(self.chat_context, fields)
- else:
- node = self.get_node_by_id(node_id)
- if node:
- return node.get_reference_field(fields)
- return None
-
- def get_workflow_content(self):
- context = {
- 'global': self.context,
- 'chat': self.chat_context
- }
-
- for node in self.node_context:
- context[node.id] = node.context
- return context
-
- def reset_prompt(self, prompt: str):
- placeholder = "{}"
- for field in self.field_list:
- globeLabel = f"{field.get('node_name')}.{field.get('value')}"
- globeValue = f"context.get('{field.get('node_id')}',{placeholder}).get('{field.get('value', '')}','')"
- prompt = prompt.replace(globeLabel, globeValue)
- for field in self.global_field_list:
- globeLabel = f"全局变量.{field.get('value')}"
- globeLabelNew = f"global.{field.get('value')}"
- globeValue = f"context.get('global').get('{field.get('value', '')}','')"
- prompt = prompt.replace(globeLabel, globeValue).replace(globeLabelNew, globeValue)
- for field in self.chat_field_list:
- chatLabel = f"chat.{field.get('value')}"
- chatValue = f"context.get('chat').get('{field.get('value', '')}','')"
- prompt = prompt.replace(chatLabel, chatValue)
-
- return prompt
-
- def generate_prompt(self, prompt: str):
- """
- 格式化生成提示词
- @param prompt: 提示词信息
- @return: 格式化后的提示词
- """
- context = self.get_workflow_content()
- prompt = self.reset_prompt(prompt)
- prompt_template = PromptTemplate.from_template(prompt, template_format='jinja2')
- value = prompt_template.format(context=context)
- return value
-
- def get_start_node(self):
- """
- 获取启动节点
- @return:
- """
- start_node_list = [node for node in self.flow.nodes if node.type == 'start-node']
- return start_node_list[0]
-
- def get_base_node(self):
- """
- 获取基础节点
- @return:
- """
- base_node_list = [node for node in self.flow.nodes if node.type == 'base-node']
- return base_node_list[0]
-
- def get_node_cls_by_id(self, node_id, up_node_id_list=None,
- get_node_params=lambda node: node.properties.get('node_data')):
- for node in self.flow.nodes:
- if node.id == node_id:
- node_instance = get_node(node.type, self.flow.workflow_mode)(node,
- self.params, self, up_node_id_list,
- get_node_params)
- return node_instance
- return None
-
- def get_node_by_id(self, node_id):
- for node in self.node_context:
- if node.id == node_id:
- return node
- return None
-
- def get_node_reference(self, reference_address: Dict):
- node = self.get_node_by_id(reference_address.get('node_id'))
- return node.context[reference_address.get('node_field')]
-
- def get_params_serializer_class(self):
- return FlowParamsSerializer
-
- def get_source_type(self):
- return "APPLICATION"
-
- def get_source_id(self):
- return self.params.get('application_id')
diff --git a/apps/application/long_term_memory/__init__.py b/apps/application/long_term_memory/__init__.py
index ea03cf58bcc..ba2419d6bce 100644
--- a/apps/application/long_term_memory/__init__.py
+++ b/apps/application/long_term_memory/__init__.py
@@ -270,7 +270,7 @@ def _run_extract(workspace_id, application_id, chat_user_id, config, history_lim
]):
content += chunk.content
- content = re.sub(r'.*?<\/think>', '', content, flags=re.DOTALL).strip()
+ content = re.sub(r'.*?', '', content, flags=re.DOTALL).strip()
if long_term_memory:
long_term_memory.memory = content
diff --git a/apps/application/mcp_tools.py b/apps/application/mcp_tools.py
new file mode 100644
index 00000000000..d48d6480b26
--- /dev/null
+++ b/apps/application/mcp_tools.py
@@ -0,0 +1,8 @@
+"""Shared MCP tool loading helpers."""
+
+from langchain_mcp_adapters.client import MultiServerMCPClient
+
+
+async def get_mcp_tools(servers):
+ client = MultiServerMCPClient(servers)
+ return await client.get_tools()
diff --git a/apps/application/migrations/0014_applicationversion_knowledge_ids.py b/apps/application/migrations/0014_applicationversion_knowledge_ids.py
new file mode 100644
index 00000000000..9457355f724
--- /dev/null
+++ b/apps/application/migrations/0014_applicationversion_knowledge_ids.py
@@ -0,0 +1,61 @@
+# Generated by Django 5.2.15 on 2026-07-29 02:42
+
+from django.db import migrations, models
+
+
+def forwards(apps, schema_editor):
+ Application = apps.get_model("application", "Application")
+ ResourceMapping = apps.get_model("system_manage", "ResourceMapping")
+ ApplicationVersion = apps.get_model("application", "ApplicationVersion")
+
+ APPLICATION = "APPLICATION"
+ KNOWLEDGE = "KNOWLEDGE"
+ SIMPLE = "SIMPLE"
+ db_alias = schema_editor.connection.alias
+ simple_application_ids = {
+ str(app_id)
+ for app_id in Application.objects.using(db_alias)
+ .filter(type=SIMPLE)
+ .values_list("id", flat=True)
+ }
+ mapping = {}
+ qs = (
+ ResourceMapping.objects.using(db_alias)
+ .filter(source_type=APPLICATION, target_type=KNOWLEDGE)
+ .values_list("source_id", "target_id")
+ )
+ for source_id, target_id in qs.iterator():
+ if source_id in simple_application_ids:
+ mapping.setdefault(source_id, []).append(target_id)
+ mapping = {k: list(dict.fromkeys(v)) for k, v in mapping.items()}
+
+ updates = []
+ for obj in ApplicationVersion.objects.using(db_alias).iterator():
+ app_id = str(obj.application_id)
+ if app_id not in simple_application_ids:
+ continue
+ knowledge_ids = mapping.get(app_id)
+ if knowledge_ids:
+ obj.knowledge_ids = knowledge_ids
+ updates.append(obj)
+ if updates:
+ ApplicationVersion.objects.using(db_alias).bulk_update(
+ updates, ["knowledge_ids"], batch_size=500
+ )
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('application', '0013_application_long_term_enable_and_more'),
+ ('system_manage', '0005_resourcemapping'),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="applicationversion",
+ name="knowledge_ids",
+ field=models.JSONField(default=list, verbose_name="数据集id列表"),
+ ),
+ migrations.RunPython(forwards, migrations.RunPython.noop),
+ ]
diff --git a/apps/application/migrations/0015_chat_execute_type.py b/apps/application/migrations/0015_chat_execute_type.py
new file mode 100644
index 00000000000..9f0e446d4f9
--- /dev/null
+++ b/apps/application/migrations/0015_chat_execute_type.py
@@ -0,0 +1,23 @@
+# Generated by Django 5.2.14 on 2026-07-21 08:57
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('application', '0014_applicationversion_knowledge_ids'),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name='chat',
+ name='execute_type',
+ field=models.CharField(choices=[('ANONYMOUS_USER', '匿名用户'), ('CHAT_USER', '对话用户'), ('SYSTEM_API_KEY', '系统API_KEY'), ('APPLICATION_API_KEY', '应用API_KEY'), ('PLATFORM_USER', '平台用户')], default='CHAT', max_length=64, verbose_name='执行类型'),
+ ),
+ migrations.AddField(
+ model_name="chatrecord",
+ name="workflow_context",
+ field=models.JSONField(blank=True, default=dict, null=True, verbose_name="工作流上下文"),
+ ),
+ ]
diff --git a/apps/application/migrations/0016_chatrecord_messages_chatrecord_question_and_more.py b/apps/application/migrations/0016_chatrecord_messages_chatrecord_question_and_more.py
new file mode 100644
index 00000000000..bf835deb315
--- /dev/null
+++ b/apps/application/migrations/0016_chatrecord_messages_chatrecord_question_and_more.py
@@ -0,0 +1,30 @@
+# Generated by Django 5.2.14 on 2026-07-22 08:33
+
+import common.encoder.encoder
+import django.contrib.postgres.fields
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('application', '0015_chat_execute_type'),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name='chatrecord',
+ name='messages',
+ field=django.contrib.postgres.fields.ArrayField(base_field=models.JSONField(), default=list, size=None, verbose_name='响应message'),
+ ),
+ migrations.AddField(
+ model_name='chatrecord',
+ name='question',
+ field=models.JSONField(default=dict, encoder=common.encoder.encoder.SystemEncoder, verbose_name='用户的消息'),
+ ),
+ migrations.AddField(
+ model_name='chatrecord',
+ name='version',
+ field=models.IntegerField(default=1, verbose_name='版本号'),
+ ),
+ ]
diff --git a/apps/application/migrations/0017_application_is_portal_and_more.py b/apps/application/migrations/0017_application_is_portal_and_more.py
new file mode 100644
index 00000000000..8b4dd159ddc
--- /dev/null
+++ b/apps/application/migrations/0017_application_is_portal_and_more.py
@@ -0,0 +1,17 @@
+# Generated by Django 6.1 on 2026-08-24 08:29
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("application", "0016_chatrecord_messages_chatrecord_question_and_more"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="application",
+ name="is_portal",
+ field=models.BooleanField(default=False, verbose_name="是否在门户上架"),
+ )
+ ]
diff --git a/apps/application/migrations/0018_application_default_model_setting_and_more.py b/apps/application/migrations/0018_application_default_model_setting_and_more.py
new file mode 100644
index 00000000000..ff25649f8ae
--- /dev/null
+++ b/apps/application/migrations/0018_application_default_model_setting_and_more.py
@@ -0,0 +1,73 @@
+# Generated by Django 6.1 on 2026-09-09 09:28
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("application", "0017_application_is_portal_and_more"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="application",
+ name="default_model_setting",
+ field=models.JSONField(default=dict, verbose_name="默认模型"),
+ ),
+ migrations.AddField(
+ model_name="applicationversion",
+ name="default_model_setting",
+ field=models.JSONField(default=dict, verbose_name="默认模型"),
+ ),
+ migrations.AlterField(
+ model_name="applicationchatuserstats",
+ name="chat_user_type",
+ field=models.CharField(
+ choices=[
+ ("ANONYMOUS_USER", "匿名用户"),
+ ("CHAT_USER", "对话用户"),
+ ("SYSTEM_API_KEY", "系统API_KEY"),
+ ("APPLICATION_API_KEY", "应用API_KEY"),
+ ("PLATFORM_USER", "平台用户"),
+ ("SYSTEM_USER", "系统用户"),
+ ],
+ default="ANONYMOUS_USER",
+ max_length=64,
+ verbose_name="对话用户类型",
+ ),
+ ),
+ migrations.AlterField(
+ model_name="chat",
+ name="chat_user_type",
+ field=models.CharField(
+ choices=[
+ ("ANONYMOUS_USER", "匿名用户"),
+ ("CHAT_USER", "对话用户"),
+ ("SYSTEM_API_KEY", "系统API_KEY"),
+ ("APPLICATION_API_KEY", "应用API_KEY"),
+ ("PLATFORM_USER", "平台用户"),
+ ("SYSTEM_USER", "系统用户"),
+ ],
+ default="ANONYMOUS_USER",
+ max_length=64,
+ verbose_name="客户端类型",
+ ),
+ ),
+ migrations.AlterField(
+ model_name="chat",
+ name="execute_type",
+ field=models.CharField(
+ choices=[
+ ("ANONYMOUS_USER", "匿名用户"),
+ ("CHAT_USER", "对话用户"),
+ ("SYSTEM_API_KEY", "系统API_KEY"),
+ ("APPLICATION_API_KEY", "应用API_KEY"),
+ ("PLATFORM_USER", "平台用户"),
+ ("SYSTEM_USER", "系统用户"),
+ ],
+ default="CHAT",
+ max_length=64,
+ verbose_name="执行类型",
+ ),
+ ),
+ ]
diff --git a/apps/application/migrations/0019_applicationversion_publish_desc.py b/apps/application/migrations/0019_applicationversion_publish_desc.py
new file mode 100644
index 00000000000..f9c071ff985
--- /dev/null
+++ b/apps/application/migrations/0019_applicationversion_publish_desc.py
@@ -0,0 +1,17 @@
+# Generated by Django 6.1 on 2026-09-16 08:54
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("application", "0018_application_default_model_setting_and_more"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="applicationversion",
+ name="publish_desc",
+ field=models.CharField(default="", max_length=1024, verbose_name="更新说明"),
+ ),
+ ]
diff --git a/apps/application/models/application.py b/apps/application/models/application.py
index 34824b29eee..f81e48cad33 100644
--- a/apps/application/models/application.py
+++ b/apps/application/models/application.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application.py
- @date:2025/5/7 15:29
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application.py
+@date:2025/5/7 15:29
+@desc:
"""
+
import uuid_utils.compat as uuid
from django.db import models
from mptt.fields import TreeForeignKey
@@ -23,45 +24,50 @@ class ApplicationFolder(MPTTModel, AppModelMixin):
desc = models.CharField(max_length=200, null=True, blank=True, verbose_name="描述")
user = models.ForeignKey(User, on_delete=models.SET_NULL, db_constraint=False, blank=True, null=True)
workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", default="default", db_index=True)
- parent = TreeForeignKey('self', on_delete=models.DO_NOTHING, null=True, blank=True, related_name='children')
+ parent = TreeForeignKey("self", on_delete=models.DO_NOTHING, null=True, blank=True, related_name="children")
class Meta:
db_table = "application_folder"
class MPTTMeta:
- order_insertion_by = ['name']
+ order_insertion_by = ["name"]
class ApplicationTypeChoices(models.TextChoices):
"""订单类型"""
- SIMPLE = 'SIMPLE', '简易'
- WORK_FLOW = 'WORK_FLOW', '工作流'
+
+ SIMPLE = "SIMPLE", "简易"
+ WORK_FLOW = "WORK_FLOW", "工作流"
def get_dataset_setting_dict():
- return {'top_n': 3, 'similarity': 0.6, 'max_paragraph_char_number': 5000, 'search_mode': 'embedding',
- 'no_references_setting': {
- 'status': 'ai_questioning',
- 'value': '{question}'
- }}
+ return {
+ "top_n": 3,
+ "similarity": 0.6,
+ "max_paragraph_char_number": 5000,
+ "search_mode": "embedding",
+ "no_references_setting": {"status": "ai_questioning", "value": "{question}"},
+ }
def get_model_setting_dict():
return {
- 'prompt': Application.get_default_model_prompt(),
- 'no_references_prompt': '{question}',
- 'reasoning_content_start': '',
- 'reasoning_content_end': '',
- 'reasoning_content_enable': False,
+ "prompt": Application.get_default_model_prompt(),
+ "no_references_prompt": "{question}",
+ "reasoning_content_start": "",
+ "reasoning_content_end": "",
+ "reasoning_content_enable": False,
}
class Application(AppModelMixin):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", default="default", db_index=True)
- folder = models.ForeignKey(ApplicationFolder, on_delete=models.DO_NOTHING, verbose_name="文件夹id",
- default='default')
+ folder = models.ForeignKey(
+ ApplicationFolder, on_delete=models.DO_NOTHING, verbose_name="文件夹id", default="default"
+ )
is_publish = models.BooleanField(verbose_name="是否发布", default=False)
+ is_portal = models.BooleanField(verbose_name="是否在门户上架", default=False)
name = models.CharField(max_length=128, verbose_name="应用名称", db_index=True)
desc = models.CharField(max_length=512, verbose_name="引用描述", default="")
prologue = models.CharField(max_length=40960, verbose_name="开场白", default="")
@@ -76,15 +82,25 @@ class Application(AppModelMixin):
problem_optimization = models.BooleanField(verbose_name="问题优化", default=False)
icon = models.CharField(max_length=256, verbose_name="应用icon", default="./favicon.ico")
work_flow = models.JSONField(verbose_name="工作流数据", default=dict)
- type = models.CharField(verbose_name="应用类型", choices=ApplicationTypeChoices.choices,
- default=ApplicationTypeChoices.SIMPLE, max_length=256)
- problem_optimization_prompt = models.CharField(verbose_name="问题优化提示词", max_length=102400, blank=True,
- null=True,
- default="()里面是用户问题,根据上下文回答揣测用户问题({question}) 要求: 输出一个补全问题,并且放在标签中")
- tts_model = models.ForeignKey(Model, related_name='tts_model_id', on_delete=models.SET_NULL, db_constraint=False,
- blank=True, null=True)
- stt_model = models.ForeignKey(Model, related_name='stt_model_id', on_delete=models.SET_NULL, db_constraint=False,
- blank=True, null=True)
+ type = models.CharField(
+ verbose_name="应用类型",
+ choices=ApplicationTypeChoices.choices,
+ default=ApplicationTypeChoices.SIMPLE,
+ max_length=256,
+ )
+ problem_optimization_prompt = models.CharField(
+ verbose_name="问题优化提示词",
+ max_length=102400,
+ blank=True,
+ null=True,
+ default="()里面是用户问题,根据上下文回答揣测用户问题({question}) 要求: 输出一个补全问题,并且放在标签中",
+ )
+ tts_model = models.ForeignKey(
+ Model, related_name="tts_model_id", on_delete=models.SET_NULL, db_constraint=False, blank=True, null=True
+ )
+ stt_model = models.ForeignKey(
+ Model, related_name="stt_model_id", on_delete=models.SET_NULL, db_constraint=False, blank=True, null=True
+ )
tts_model_enable = models.BooleanField(verbose_name="语音合成模型是否启用", default=False)
stt_model_enable = models.BooleanField(verbose_name="语音识别模型是否启用", default=False)
tts_type = models.CharField(verbose_name="语音播放类型", max_length=20, default="BROWSER")
@@ -105,26 +121,30 @@ class Application(AppModelMixin):
skill_tool_ids = models.JSONField(verbose_name="技能ID列表", default=list)
mcp_output_enable = models.BooleanField(verbose_name="MCP输出是否启用", default=True)
file_clean_time = models.IntegerField(verbose_name="文件清理时间", default=180)
- long_term_enable = models.BooleanField(verbose_name='长期记忆是否开启', default=False)
- long_term_model = models.ForeignKey(Model, related_name='long_term_model_id', on_delete=models.SET_NULL,
- db_constraint=False, blank=True, null=True)
+ long_term_enable = models.BooleanField(verbose_name="长期记忆是否开启", default=False)
+ long_term_model = models.ForeignKey(
+ Model, related_name="long_term_model_id", on_delete=models.SET_NULL, db_constraint=False, blank=True, null=True
+ )
long_term_model_params_setting = models.JSONField(verbose_name="长期记忆模型参数相关设置", default=dict)
- long_term_trigger_type = models.CharField(verbose_name='长期记忆触发类型', default='ROUND')
- long_term_trigger_setting = models.JSONField(verbose_name='长期记忆触发配置', default=dict)
+ long_term_trigger_type = models.CharField(verbose_name="长期记忆触发类型", default="ROUND")
+ long_term_trigger_setting = models.JSONField(verbose_name="长期记忆触发配置", default=dict)
+ default_model_setting = models.JSONField(verbose_name="默认模型", default=dict)
@staticmethod
def get_default_model_prompt():
- return ('已知信息:'
- '\n{data}'
- '\n回答要求:'
- '\n- 如果你不知道答案或者没有从获取答案,请回答“没有在知识库中查找到相关信息,建议咨询相关技术支持或参考官方文档进行操作”。'
- '\n- 避免提及你是从中获得的知识。'
- '\n- 请保持答案与中描述的一致。'
- '\n- 请使用markdown 语法优化答案的格式。'
- '\n- 中的图片链接、链接地址和脚本语言请完整返回。'
- '\n- 请使用与问题相同的语言来回答。'
- '\n问题:'
- '\n{question}')
+ return (
+ "已知信息:"
+ "\n{data}"
+ "\n回答要求:"
+ "\n- 如果你不知道答案或者没有从获取答案,请回答“没有在知识库中查找到相关信息,建议咨询相关技术支持或参考官方文档进行操作”。"
+ "\n- 避免提及你是从中获得的知识。"
+ "\n- 请保持答案与中描述的一致。"
+ "\n- 请使用markdown 语法优化答案的格式。"
+ "\n- 中的图片链接、链接地址和脚本语言请完整返回。"
+ "\n- 请使用与问题相同的语言来回答。"
+ "\n问题:"
+ "\n{question}"
+ )
class Meta:
db_table = "application"
@@ -145,6 +165,7 @@ class ApplicationVersion(AppModelMixin):
name = models.CharField(verbose_name="版本名称", max_length=128, default="")
publish_user_id = models.UUIDField(verbose_name="发布者id", max_length=128, default=None, null=True)
publish_user_name = models.CharField(verbose_name="发布者名称", max_length=128, default="")
+ publish_desc = models.CharField(verbose_name="更新说明", max_length=1024, default="")
workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", default="default", db_index=True)
application_name = models.CharField(max_length=128, verbose_name="应用名称")
desc = models.CharField(max_length=512, verbose_name="引用描述", default="")
@@ -160,15 +181,21 @@ class ApplicationVersion(AppModelMixin):
problem_optimization = models.BooleanField(verbose_name="问题优化", default=False)
icon = models.CharField(max_length=256, verbose_name="应用icon", default="./favicon.ico")
work_flow = models.JSONField(verbose_name="工作流数据", default=dict)
- type = models.CharField(verbose_name="应用类型", choices=ApplicationTypeChoices.choices,
- default=ApplicationTypeChoices.SIMPLE, max_length=256)
- problem_optimization_prompt = models.CharField(verbose_name="问题优化提示词", max_length=102400, blank=True,
- null=True,
- default="()里面是用户问题,根据上下文回答揣测用户问题({question}) 要求: 输出一个补全问题,并且放在标签中")
- tts_model_id = models.UUIDField(verbose_name="文本转语音模型id",
- blank=True, null=True)
- stt_model_id = models.UUIDField(verbose_name="语音转文本模型id",
- blank=True, null=True)
+ type = models.CharField(
+ verbose_name="应用类型",
+ choices=ApplicationTypeChoices.choices,
+ default=ApplicationTypeChoices.SIMPLE,
+ max_length=256,
+ )
+ problem_optimization_prompt = models.CharField(
+ verbose_name="问题优化提示词",
+ max_length=102400,
+ blank=True,
+ null=True,
+ default="()里面是用户问题,根据上下文回答揣测用户问题({question}) 要求: 输出一个补全问题,并且放在标签中",
+ )
+ tts_model_id = models.UUIDField(verbose_name="文本转语音模型id", blank=True, null=True)
+ stt_model_id = models.UUIDField(verbose_name="语音转文本模型id", blank=True, null=True)
tts_model_enable = models.BooleanField(verbose_name="语音合成模型是否启用", default=False)
stt_model_enable = models.BooleanField(verbose_name="语音识别模型是否启用", default=False)
tts_type = models.CharField(verbose_name="语音播放类型", max_length=20, default="BROWSER")
@@ -187,11 +214,13 @@ class ApplicationVersion(AppModelMixin):
application_ids = models.JSONField(verbose_name="应用ID列表", default=list)
skill_tool_ids = models.JSONField(verbose_name="技能ID列表", default=list)
mcp_output_enable = models.BooleanField(verbose_name="MCP输出是否启用", default=True)
- long_term_enable = models.BooleanField(verbose_name='长期记忆是否开启', default=False)
+ long_term_enable = models.BooleanField(verbose_name="长期记忆是否开启", default=False)
long_term_model_id = models.UUIDField(verbose_name="长期记忆模型id", blank=True, null=True)
long_term_model_params_setting = models.JSONField(verbose_name="长期记忆模型参数相关设置", default=dict)
- long_term_trigger_type = models.CharField(verbose_name='长期记忆触发类型', default='ROUND')
- long_term_trigger_setting = models.JSONField(verbose_name='长期记忆触发配置', default=dict)
+ long_term_trigger_type = models.CharField(verbose_name="长期记忆触发类型", default="ROUND")
+ long_term_trigger_setting = models.JSONField(verbose_name="长期记忆触发配置", default=dict)
+ knowledge_ids = models.JSONField(verbose_name="数据集id列表", default=list)
+ default_model_setting = models.JSONField(verbose_name="默认模型", default=dict)
class Meta:
db_table = "application_version"
diff --git a/apps/application/models/application_chat.py b/apps/application/models/application_chat.py
index e9a3efbc697..fea35d311f7 100644
--- a/apps/application/models/application_chat.py
+++ b/apps/application/models/application_chat.py
@@ -1,33 +1,39 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_chat_log.py
- @date:2025/5/29 17:12
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application_chat_log.py
+@date:2025/5/29 17:12
+@desc:
"""
+
import uuid_utils.compat as uuid
from django.contrib.postgres.fields import ArrayField
from django.db import models
-from django.utils.translation import gettext as _
-from langchain_core.messages import HumanMessage, AIMessage
from application.models import Application
from common.encoder.encoder import SystemEncoder
from common.mixins.app_model_mixin import AppModelMixin
+from common.utils.messages_util import to_ai_message_list, to_human_message_list
from users.models import User
class ChatUserType(models.TextChoices):
- ANONYMOUS_USER = "ANONYMOUS_USER", '匿名用户'
+ ANONYMOUS_USER = "ANONYMOUS_USER", "匿名用户"
CHAT_USER = "CHAT_USER", "对话用户"
SYSTEM_API_KEY = "SYSTEM_API_KEY", "系统API_KEY"
APPLICATION_API_KEY = "APPLICATION_API_KEY", "应用API_KEY"
PLATFORM_USER = "PLATFORM_USER", "平台用户"
+ SYSTEM_USER = "SYSTEM_USER", "系统用户"
+
+
+class ExecuteType(models.TextChoices):
+ DEBUG = "DEBUG"
+ CHAT = "CHAT"
def default_asker():
- return {'username': '游客'}
+ return {"username": "游客"}
class Chat(AppModelMixin):
@@ -35,8 +41,12 @@ class Chat(AppModelMixin):
application = models.ForeignKey(Application, on_delete=models.CASCADE)
abstract = models.CharField(max_length=1024, verbose_name="摘要")
chat_user_id = models.CharField(verbose_name="对话用户id", default=None, null=True)
- chat_user_type = models.CharField(max_length=64, verbose_name="客户端类型", choices=ChatUserType.choices,
- default=ChatUserType.ANONYMOUS_USER)
+ chat_user_type = models.CharField(
+ max_length=64, verbose_name="客户端类型", choices=ChatUserType.choices, default=ChatUserType.ANONYMOUS_USER
+ )
+ execute_type = models.CharField(
+ max_length=64, verbose_name="执行类型", choices=ChatUserType.choices, default=ExecuteType.CHAT
+ )
is_deleted = models.BooleanField(verbose_name="逻辑删除", default=False)
asker = models.JSONField(verbose_name="访问者", default=default_asker, encoder=SystemEncoder)
meta = models.JSONField(verbose_name="元数据", default=dict)
@@ -45,7 +55,7 @@ class Chat(AppModelMixin):
chat_record_count = models.IntegerField(verbose_name="对话次数", default=0)
mark_sum = models.IntegerField(verbose_name="标记数量", default=0)
source = models.JSONField(verbose_name="来源", default=dict)
- ip_address = models.CharField(max_length=128, verbose_name="ip地址", default='')
+ ip_address = models.CharField(max_length=128, verbose_name="ip地址", default="")
class Meta:
db_table = "application_chat"
@@ -53,21 +63,24 @@ class Meta:
class VoteChoices(models.TextChoices):
"""订单类型"""
- UN_VOTE = "-1", '未投票'
- STAR = "0", '赞同'
- TRAMPLE = "1", '反对'
+
+ UN_VOTE = "-1", "未投票"
+ STAR = "0", "赞同"
+ TRAMPLE = "1", "反对"
class VoteReasonChoices(models.TextChoices):
- ACCURATE = 'accurate', '内容准确'
- COMPLETE = 'complete', '内容完善'
- INACCURATE = 'inaccurate', '内容不准确'
- INCOMPLETE = 'incomplete', '内容不完善'
- OTHER = 'other', '其他'
+ ACCURATE = "accurate", "内容准确"
+ COMPLETE = "complete", "内容完善"
+ INACCURATE = "inaccurate", "内容不准确"
+ INCOMPLETE = "incomplete", "内容不完善"
+ OTHER = "other", "其他"
+
class ShareLinkType(models.TextChoices):
- PUBLIC = "PUBLIC", 'public'
- PRIVATE = "PRIVATE", 'private'
+ PUBLIC = "PUBLIC", "public"
+ PRIVATE = "PRIVATE", "private"
+
class ChatSourceChoices(models.TextChoices):
ONLINE = "ONLINE", "线上使用"
@@ -85,44 +98,47 @@ class ChatRecord(AppModelMixin):
"""
对话日志 详情
"""
+
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
chat = models.ForeignKey(Chat, on_delete=models.CASCADE)
- vote_status = models.CharField(verbose_name='投票', max_length=10, choices=VoteChoices.choices,
- default=VoteChoices.UN_VOTE)
- vote_reason = models.CharField(verbose_name='投票原因', max_length=50, choices=VoteReasonChoices.choices, null=True,
- blank=True)
- vote_other_content = models.CharField(verbose_name='其他原因', max_length=1024, default='')
+ vote_status = models.CharField(
+ verbose_name="投票", max_length=10, choices=VoteChoices.choices, default=VoteChoices.UN_VOTE
+ )
+ vote_reason = models.CharField(
+ verbose_name="投票原因", max_length=50, choices=VoteReasonChoices.choices, null=True, blank=True
+ )
+ vote_other_content = models.CharField(verbose_name="其他原因", max_length=1024, default="")
problem_text = models.CharField(max_length=10240, verbose_name="问题")
answer_text = models.CharField(max_length=40960, verbose_name="答案")
- answer_text_list = ArrayField(verbose_name="改进标注列表",
- base_field=models.JSONField()
- , default=list)
+ answer_text_list = ArrayField(verbose_name="改进标注列表", base_field=models.JSONField(), default=list)
message_tokens = models.IntegerField(verbose_name="请求token数量", default=0)
answer_tokens = models.IntegerField(verbose_name="响应token数量", default=0)
const = models.IntegerField(verbose_name="总费用", default=0)
details = models.JSONField(verbose_name="对话详情", default=dict, encoder=SystemEncoder)
- improve_paragraph_id_list = ArrayField(verbose_name="改进标注列表",
- base_field=models.UUIDField(max_length=128, blank=True)
- , default=list)
+ improve_paragraph_id_list = ArrayField(
+ verbose_name="改进标注列表", base_field=models.UUIDField(max_length=128, blank=True), default=list
+ )
run_time = models.FloatField(verbose_name="运行时长", default=0)
index = models.IntegerField(verbose_name="对话下标")
source = models.JSONField(verbose_name="来源", default=dict)
- ip_address = models.CharField(max_length=128, verbose_name="ip地址", default='')
+ ip_address = models.CharField(max_length=128, verbose_name="ip地址", default="")
+ version = models.IntegerField(verbose_name="版本号", default=1)
+ question = models.JSONField(verbose_name="用户的消息", default=dict, encoder=SystemEncoder)
+ messages = ArrayField(verbose_name="响应message", base_field=models.JSONField(), default=list)
+
+ workflow_context = models.JSONField(verbose_name="工作流上下文", default=dict, null=True, blank=True)
def get_human_message(self):
- if 'problem_padding' in self.details:
- return HumanMessage(content=self.details.get('problem_padding').get('padding_problem_text'))
- return HumanMessage(content=self.problem_text)
+ return to_human_message_list(self.question)
def get_ai_message(self):
- answer_text = self.answer_text
- if answer_text is None or len(str(answer_text).strip()) == 0:
- answer_text = _(
- 'Sorry, no relevant content was found. Please re-describe your problem or provide more information. ')
- return AIMessage(content=answer_text)
+ return to_ai_message_list(self.messages)
def get_node_details_runtime_node_id(self, runtime_node_id):
- return self.details.get(runtime_node_id, None)
+ for node_details in self.details:
+ if node_details.get("node_id") == runtime_node_id:
+ return node_details
+ return None
class Meta:
db_table = "application_chat_record"
@@ -131,8 +147,9 @@ class Meta:
class ApplicationChatUserStats(AppModelMixin):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
chat_user_id = models.UUIDField(max_length=128, default=uuid.uuid7, verbose_name="对话用户id")
- chat_user_type = models.CharField(max_length=64, verbose_name="对话用户类型", choices=ChatUserType.choices,
- default=ChatUserType.ANONYMOUS_USER)
+ chat_user_type = models.CharField(
+ max_length=64, verbose_name="对话用户类型", choices=ChatUserType.choices, default=ChatUserType.ANONYMOUS_USER
+ )
application = models.ForeignKey(Application, on_delete=models.CASCADE, verbose_name="应用id")
access_num = models.IntegerField(default=0, verbose_name="访问总次数次数")
intraday_access_num = models.IntegerField(default=0, verbose_name="当日访问次数")
@@ -140,13 +157,14 @@ class ApplicationChatUserStats(AppModelMixin):
class Meta:
db_table = "application_chat_user_stats"
indexes = [
- models.Index(fields=['application_id', 'chat_user_id']),
+ models.Index(fields=["application_id", "chat_user_id"]),
]
+
class ChatShareLink(AppModelMixin):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
chat = models.ForeignKey(Chat, on_delete=models.CASCADE)
- application = models.ForeignKey(Application,on_delete=models.CASCADE)
+ application = models.ForeignKey(Application, on_delete=models.CASCADE)
share_type = models.CharField(max_length=20, choices=ShareLinkType.choices, default=ShareLinkType.PUBLIC)
user = models.ForeignKey(User, on_delete=models.SET_NULL, db_constraint=False, blank=True, null=True)
chat_record_ids = ArrayField(base_field=models.UUIDField(max_length=128))
@@ -155,16 +173,15 @@ class Meta:
db_table = "application_chat_share_link"
-
class ApplicationLongTermMemory(AppModelMixin):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
application = models.ForeignKey(Application, on_delete=models.CASCADE, db_constraint=False, verbose_name="所属应用")
- chat_user_id = models.CharField( max_length=128, verbose_name="对话用户id", db_index=True)
+ chat_user_id = models.CharField(max_length=128, verbose_name="对话用户id", db_index=True)
memory = models.TextField(verbose_name="长期记忆内容", default="")
class Meta:
db_table = "application_long_term_memory"
- unique_together = [('application', 'chat_user_id')]
+ unique_together = [("application", "chat_user_id")]
indexes = [
- models.Index(fields=['application_id', 'chat_user_id']),
+ models.Index(fields=["application_id", "chat_user_id"]),
]
diff --git a/apps/application/serializers/application.py b/apps/application/serializers/application.py
index 5c74570911b..e0edf3e8a70 100644
--- a/apps/application/serializers/application.py
+++ b/apps/application/serializers/application.py
@@ -21,6 +21,11 @@
import requests
import uuid_utils.compat as uuid
+from application.workflow.common import new_instance, WorkflowType
+from application.long_term_memory import schedule_extract_long_term_memory
+from application.models.application import Application, ApplicationFolder, ApplicationTypeChoices, ApplicationVersion
+from application.models.application_access_token import ApplicationAccessToken
+from application.serializers.common import update_resource_mapping_by_application
from common import result
from common.cache_data.application_access_token_cache import del_application_access_token
from common.database_model_manage.database_model_manage import DatabaseModelManage
@@ -36,6 +41,7 @@
)
from common.utils.logger import maxkb_logger
from common.utils.tool_code import ToolExecutor
+from common.utils.url_validator import ALLOWED_CALLBACK_HOSTS, ALLOWED_DOWNLOAD_HOSTS, validate_trusted_url
from django.core import validators
from django.db import models, transaction
from django.db.models import Q, QuerySet
@@ -45,14 +51,14 @@
from knowledge.models import File, FileSourceType, Knowledge, KnowledgeScope
from knowledge.serializers.common import BatchMoveSerializer, BatchSerializer
from knowledge.serializers.knowledge import KnowledgeModelSerializer, KnowledgeSerializer
-from langchain_mcp_adapters.client import MultiServerMCPClient
+from application.workflow.backend.sandbox_mcp import SandboxMCPBackend
from maxkb.conf import PROJECT_DIR
from maxkb.const import CONFIG
from models_provider.models import Model
from models_provider.tools import get_model_instance_by_model_workspace_id
from rest_framework import serializers, status
from rest_framework.utils.formatting import lazy_format
-from system_manage.models import AuthTargetType, WorkspaceUserResourcePermission
+from system_manage.models import AuthTargetType, WorkspaceUserResourcePermission, WorkspaceUserGroupResourcePermission
from system_manage.models.resource_mapping import ResourceMapping
from system_manage.serializers.resource_mapping_serializers import ResourceMappingSerializer
from system_manage.serializers.user_resource_permission import UserResourcePermissionSerializer
@@ -62,11 +68,133 @@
from users.models import User
from users.serializers.user import is_workspace_manage, is_workspace_manage_permission_read
-from application.flow.common import Workflow
-from application.long_term_memory import schedule_extract_long_term_memory
-from application.models.application import Application, ApplicationFolder, ApplicationTypeChoices, ApplicationVersion
-from application.models.application_access_token import ApplicationAccessToken
-from application.serializers.common import update_resource_mapping_by_application
+
+def _walk_workflow_nodes(work_flow, collector):
+ """遍历工作流节点(含 loop-node 嵌套),对每个节点的 node_data 调用 collector。"""
+ if not work_flow:
+ return
+ for node in work_flow.get("nodes", []) or []:
+ node_data = (node.get("properties") or {}).get("node_data") or {}
+ collector(node_data)
+ if node.get("type") == "loop-node":
+ _walk_workflow_nodes(node_data.get("loop_body"), collector)
+
+
+def get_bound_tool_ids(instance: Dict) -> List[str]:
+ """
+ 收集应用配置(含工作流节点)中引用的所有工具id,用于绑定前的权限校验
+ """
+ tool_ids = set()
+ for key in ("tool_ids", "skill_tool_ids", "mcp_tool_ids"):
+ for tool_id in instance.get(key) or []:
+ tool_ids.add(str(tool_id))
+ if instance.get("mcp_tool_id"):
+ tool_ids.add(str(instance.get("mcp_tool_id")))
+
+ def collect(node_data):
+ for key in ("tool_lib_id", "mcp_tool_id"):
+ if node_data.get(key):
+ tool_ids.add(str(node_data.get(key)))
+ for key in ("mcp_tool_ids", "tool_ids", "skill_tool_ids"):
+ for tool_id in node_data.get(key) or []:
+ tool_ids.add(str(tool_id))
+
+ _walk_workflow_nodes(instance.get("work_flow"), collect)
+ return list(tool_ids)
+
+
+def get_bound_application_ids(instance: Dict) -> List[str]:
+ """
+ 收集应用配置(含工作流节点)中引用的所有 application_id,用于绑定前的权限校验。
+ ai-chat-node 的 node_data 包含 application_ids 列表。
+ """
+ application_ids = set()
+ for app_id in instance.get("application_ids") or []:
+ application_ids.add(str(app_id))
+
+ def collect(node_data):
+ for app_id in node_data.get("application_ids") or []:
+ application_ids.add(str(app_id))
+
+ _walk_workflow_nodes(instance.get("work_flow"), collect)
+ return list(application_ids)
+
+
+def get_authorized_tool_ids(user_id: str, workspace_id: str, tool_ids: List[str]) -> List[str]:
+ """
+ 返回 tool_ids 中当前用户被授权绑定/使用的工具id。
+ 工作空间管理员默认拥有全部工具权限;其他用户必须在 workspace_user_resource_permission
+ 中存在针对该工具的显式授权记录(默认拒绝)。
+ """
+ if not tool_ids:
+ return []
+ tool_ids = list({str(t) for t in tool_ids})
+ if is_workspace_manage(user_id, workspace_id):
+ return tool_ids
+ granted_tool_ids = {
+ str(permission.target)
+ for permission in QuerySet(WorkspaceUserResourcePermission).filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type=AuthTargetType.TOOL.value,
+ target__in=tool_ids,
+ )
+ if "VIEW" in permission.permission_list or "ROLE" in permission.permission_list
+ }
+ return [tool_id for tool_id in tool_ids if tool_id in granted_tool_ids]
+
+
+def get_authorized_application_ids(user_id: str, workspace_id: str, application_ids: List[str]) -> List[str]:
+ """
+ 返回 application_ids 中当前用户被授权绑定/使用的应用id。
+ 工作空间管理员默认拥有全部应用权限;其他用户必须在 workspace_user_resource_permission
+ 中存在针对该应用的显式授权记录(默认拒绝)。
+ """
+ if not application_ids:
+ return []
+ application_ids = list({str(a) for a in application_ids})
+ if is_workspace_manage(user_id, workspace_id):
+ return application_ids
+ granted_application_ids = {
+ str(permission.target)
+ for permission in QuerySet(WorkspaceUserResourcePermission).filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type=AuthTargetType.APPLICATION.value,
+ target__in=application_ids,
+ )
+ if "VIEW" in permission.permission_list or "ROLE" in permission.permission_list
+ }
+ return [app_id for app_id in application_ids if app_id in granted_application_ids]
+
+
+def validate_bound_tool_permissions(user_id: str, workspace_id: str, instance: Dict):
+ """
+ 校验应用/工作流中绑定的工具和子应用,当前用户是否都有权限使用,防止低权限成员
+ 绑定自己被禁止访问的资源,并通过应用/工作流执行绕过单独授权控制。
+ """
+ tool_ids = get_bound_tool_ids(instance)
+ if tool_ids:
+ authorized_tool_ids = set(get_authorized_tool_ids(user_id, workspace_id, tool_ids))
+ unauthorized_tool_ids = [tool_id for tool_id in tool_ids if tool_id not in authorized_tool_ids]
+ if unauthorized_tool_ids:
+ message = lazy_format(
+ _("No permission to use tool(s): {tool_ids}"), tool_ids=", ".join(unauthorized_tool_ids)
+ )
+ raise AppApiException(403, str(message))
+
+ application_ids = get_bound_application_ids(instance)
+ if application_ids:
+ authorized_application_ids = set(get_authorized_application_ids(user_id, workspace_id, application_ids))
+ unauthorized_application_ids = [
+ app_id for app_id in application_ids if app_id not in authorized_application_ids
+ ]
+ if unauthorized_application_ids:
+ message = lazy_format(
+ _("No permission to use application(s): {application_ids}"),
+ application_ids=", ".join(unauthorized_application_ids),
+ )
+ raise AppApiException(403, str(message))
def get_base_node_work_flow(work_flow):
@@ -103,6 +231,42 @@ def hand_node(node, update_tool_map):
node.get("properties", {}).get("node_data", {})["tool_lib_id"] = update_tool_map.get(tool_lib_id, tool_lib_id)
+def update_form_knowledge_fields(workflow):
+ if workflow is None:
+ return
+ for node in workflow.get("nodes", []):
+ if node.get("type") == "form-node":
+ form_field_list = node.get("properties", {}).get("node_data", {}).get("form_field_list", [])
+ for field in form_field_list:
+ if field.get("input_type") != "Knowledge":
+ continue
+ knowledge_list = field.get("attrs", {}).get("knowledge_list", [])
+ knowledge_id_list = [
+ str(knowledge.get("id")) for knowledge in knowledge_list if knowledge.get("id") is not None
+ ]
+ current_knowledge_dict = {
+ str(knowledge.id): knowledge
+ for knowledge in QuerySet(Knowledge).filter(id__in=list(set(knowledge_id_list)))
+ }
+ refreshed_knowledge_list = []
+ for knowledge in knowledge_list:
+ current_knowledge = current_knowledge_dict.get(str(knowledge.get("id")))
+ if current_knowledge is None:
+ refreshed_knowledge_list.append(knowledge)
+ else:
+ refreshed_knowledge_list.append(
+ {
+ **knowledge,
+ "name": current_knowledge.name,
+ "type": current_knowledge.type,
+ "embedding_model_id": current_knowledge.embedding_model_id,
+ }
+ )
+ field.setdefault("attrs", {})["knowledge_list"] = refreshed_knowledge_list
+ if node.get("type") == "loop-node":
+ update_form_knowledge_fields(node.get("properties", {}).get("node_data", {}).get("loop_body") or {})
+
+
class MKInstance:
def __init__(self, application: dict, function_lib_list: List[dict], version: str, tool_list: List[dict]):
self.application = application
@@ -262,6 +426,7 @@ def to_application_model(user_id: str, workspace_id: str, application: Dict):
file_upload_enable=application.get("file_upload_enable", False),
file_upload_setting=application.get("file_upload_setting", {}),
work_flow=default_workflow,
+ default_model_setting=application.get("default_model_setting", {}),
)
class SimplateRequest(serializers.Serializer):
@@ -393,6 +558,9 @@ class ApplicationListResponse(serializers.Serializer):
required=True, label=_("Application Description"), help_text=_("Application Description")
)
is_publish = serializers.BooleanField(required=True, label=_("Model id"), help_text=_("Model id"))
+ is_portal = serializers.BooleanField(
+ required=True, label=_("Whether to publish on portal"), help_text=_("Whether to publish on portal")
+ )
type = serializers.CharField(required=True, label=_("Application type"), help_text=_("Application type"))
resource_type = serializers.CharField(required=True, label=_("Resource type"), help_text=_("Resource type"))
user_id = serializers.CharField(required=True, label=_("Affiliation user"), help_text=_("Affiliation user"))
@@ -437,11 +605,15 @@ def get_query_set(self, instance: Dict, workspace_manage: bool, is_x_pack_ee: bo
resource_and_folder_query_set = QuerySet(WorkspaceUserResourcePermission).filter(
auth_target_type="APPLICATION", workspace_id=workspace_id, user_id=user_id
)
+ resource_and_group_query_set = self.get_workspace_user_group_resource_permission_query_set(
+ workspace_id, user_id
+ )
return (
{
"application_query_set": application_query_set,
"workspace_user_resource_permission_query_set": resource_and_folder_query_set,
+ "workspace_user_group_resource_permission_query_set": resource_and_group_query_set,
}
if (not workspace_manage)
else {
@@ -456,6 +628,14 @@ def is_x_pack_ee():
role_permission_mapping_model = DatabaseModelManage.get_model("role_permission_mapping_model")
return workspace_user_role_mapping_model is not None and role_permission_mapping_model is not None
+ @staticmethod
+ def get_workspace_user_group_resource_permission_query_set(workspace_id, user_id):
+ return QuerySet(WorkspaceUserGroupResourcePermission).filter(
+ auth_target_type="APPLICATION",
+ workspace_id=workspace_id,
+ user_group__user_relations__user_id=user_id,
+ )
+
def list(self, instance: Dict):
self.is_valid(raise_exception=True)
workspace_id = self.data.get("workspace_id")
@@ -514,6 +694,7 @@ class ApplicationImportRequest(serializers.Serializer):
class ApplicationEditSerializer(serializers.Serializer):
name = serializers.CharField(required=False, max_length=64, min_length=1, label=_("Application Name"))
+ is_portal = serializers.BooleanField(required=False, label=_("Whether to publish on portal"))
desc = serializers.CharField(
required=False,
max_length=256,
@@ -534,6 +715,9 @@ class ApplicationEditSerializer(serializers.Serializer):
)
# 数据集相关设置
knowledge_setting = KnowledgeSettingSerializer(required=False, allow_null=True, label=_("Dataset settings"))
+
+ default_model_setting = serializers.DictField(required=False, label=_("Default model setting"))
+
# 模型相关设置
model_setting = ModelSettingSerializer(required=False, allow_null=True, label=_("Model setup"))
# 问题补全
@@ -586,10 +770,10 @@ def insert_template_workflow(self, instance: Dict):
self.is_valid(raise_exception=True)
work_flow_template = instance.get("work_flow_template")
download_url = work_flow_template.get("downloadUrl")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
app = ApplicationSerializer(
data={"user_id": self.data.get("user_id"), "workspace_id": self.data.get("workspace_id")}
).import_(
@@ -610,9 +794,9 @@ def insert_template_workflow(self, instance: Dict):
)
try:
download_callback_url = work_flow_template.get("downloadCallbackUrl", "")
- if not download_callback_url.startswith("https://apps.fit2cloud.com"):
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
raise AppApiException(500, _("Illegal download callback url"))
- requests.get(download_callback_url, timeout=5)
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
return app
@@ -623,6 +807,7 @@ def insert_workflow(self, instance: Dict):
workspace_id = self.data.get("workspace_id")
wq = ApplicationCreateSerializer.WorkflowRequest(data=instance)
wq.is_valid(raise_exception=True)
+ validate_bound_tool_permissions(user_id, workspace_id, instance)
application_model = wq.to_application_model(user_id, workspace_id, instance)
application_model.save()
# 插入认证信息
@@ -675,7 +860,7 @@ def import_(self, instance: dict, is_import_tool, with_valid=True):
mk_instance_bytes = instance.get("file").read()
try:
mk_instance = restricted_loads(mk_instance_bytes)
- except Exception as e:
+ except Exception:
raise AppApiException(1001, _("Unsupported file format"))
application = mk_instance.application
tool_list = mk_instance.get_tool_list()
@@ -703,6 +888,20 @@ def import_(self, instance: dict, is_import_tool, with_valid=True):
if not exits_tool_id_list.__contains__(tool.get("id"))
and not exits_tool_id_list.__contains__(generate_uuid((tool.get("id") + workspace_id or "")))
]
+ # 导入包内新建的工具由导入者本人持有,无需校验;仅需校验绑定到已存在工具的引用
+ existing_bound_tool_ids = [
+ tool_id for tool_id in get_bound_tool_ids(application) if tool_id not in update_tool_map
+ ]
+ if existing_bound_tool_ids:
+ authorized_tool_ids = set(get_authorized_tool_ids(user_id, workspace_id, existing_bound_tool_ids))
+ unauthorized_tool_ids = [
+ tool_id for tool_id in existing_bound_tool_ids if tool_id not in authorized_tool_ids
+ ]
+ if unauthorized_tool_ids:
+ message = lazy_format(
+ _("No permission to use tool(s): {tool_ids}"), tool_ids=", ".join(unauthorized_tool_ids)
+ )
+ raise AppApiException(403, str(message))
application_model = self.to_application(application, workspace_id, user_id, update_tool_map, folder_id)
tool_model_list = [self.to_tool(f, workspace_id, user_id) for f in tool_list]
application_model.save()
@@ -896,8 +1095,8 @@ class PlayDemoTextRequest(serializers.Serializer):
async def get_mcp_tools(servers):
- client = MultiServerMCPClient(servers)
- return await client.get_tools()
+ backend = SandboxMCPBackend(servers)
+ return await backend.get_tools()
class McpServersSerializer(serializers.Serializer):
@@ -908,6 +1107,12 @@ class ApplicationOperateSerializer(serializers.Serializer):
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
+ publish_name = serializers.CharField(
+ required=False, max_length=128, allow_null=True, allow_blank=True, label=_("Publish Name")
+ )
+ publish_desc = serializers.CharField(
+ required=False, max_length=1024, allow_null=True, allow_blank=True, label=_("Publish Desc")
+ )
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
@@ -923,9 +1128,7 @@ def get_mcp_servers(self, instance, with_valid=True):
self.is_valid(raise_exception=True)
McpServersSerializer(data=instance).is_valid(raise_exception=True)
servers = json.loads(instance.get("mcp_servers"))
- for server, config in servers.items():
- if config.get("transport") not in ["sse", "streamable_http"]:
- raise AppApiException(500, _("Only support transport=sse or transport=streamable_http"))
+ ToolExecutor().validate_mcp_transport(json.dumps(servers))
tools = []
for server in servers:
tools += [
@@ -971,7 +1174,7 @@ def export(self, with_valid=True):
self.is_valid()
application_id = self.data.get("application_id")
application = QuerySet(Application).filter(id=application_id).first()
- from application.flow.tools import get_tool_id_list
+ from system_manage.services.resource_mapping import get_tool_id_list
tool_id_list = get_tool_id_list(application.work_flow, True)
if len(tool_id_list) > 0:
@@ -1050,6 +1253,7 @@ def reset_application_version(application_version, application):
"skill_tool_ids": "skill_tool_ids",
"mcp_output_enable": "mcp_output_enable",
"type": "type",
+ "default_model_setting": "default_model_setting",
}
for version_field, app_field in update_field_dict.items():
@@ -1062,6 +1266,10 @@ def publish(self, instance, with_valid=True):
self.is_valid()
user_id = self.data.get("user_id")
workspace_id = self.data.get("workspace_id")
+ name = (instance or {}).get("publish_name")
+ if not name or not str(name).strip():
+ raise AppApiException(500, _("publish_name is required"))
+ publish_desc = (instance or {}).get("publish_desc") or ""
user = QuerySet(User).filter(id=user_id).first()
application = (
QuerySet(Application).filter(id=self.data.get("application_id"), workspace_id=workspace_id).first()
@@ -1070,7 +1278,7 @@ def publish(self, instance, with_valid=True):
work_flow = application.work_flow
if work_flow is None:
raise AppApiException(500, _("work_flow is a required field"))
- Workflow.new_instance(work_flow).is_valid()
+ new_instance(work_flow).is_valid(workflow_type=WorkflowType.APPLICATION)
base_node = get_base_node_work_flow(work_flow)
if base_node is not None:
node_data = base_node.get("properties").get("node_data")
@@ -1085,12 +1293,21 @@ def publish(self, instance, with_valid=True):
work_flow_version = ApplicationVersion(
work_flow=application.work_flow,
application=application,
- name=timezone.localtime(timezone.now()).strftime("%Y-%m-%d %H:%M:%S"),
+ name=name,
publish_user_id=user_id,
publish_user_name=user.username,
+ publish_desc=publish_desc,
workspace_id=workspace_id,
)
self.reset_application_version(work_flow_version, application)
+ # 如果是简易应用 需要存入 knowledge_ids
+ if application.type == ApplicationTypeChoices.SIMPLE:
+ work_flow_version.knowledge_ids = [
+ str(row.target_id)
+ for row in QuerySet(ResourceMapping).filter(
+ source_id=str(application.id), source_type="APPLICATION", target_type="KNOWLEDGE"
+ )
+ ]
work_flow_version.save()
access_token = hashlib.md5(str(uuid.uuid7()).encode()).hexdigest()[8:24]
application_access_token = QuerySet(ApplicationAccessToken).filter(application_id=application.id).first()
@@ -1190,6 +1407,8 @@ def edit(self, instance: Dict, with_valid=True):
if "work_flow_template" in instance:
return self.update_template_workflow(instance, application)
+ validate_bound_tool_permissions(self.data.get("user_id"), self.data.get("workspace_id"), instance)
+
if instance.get("model_id") is None or len(instance.get("model_id")) == 0:
application.model_id = None
else:
@@ -1221,6 +1440,7 @@ def edit(self, instance: Dict, with_valid=True):
ToolExecutor().validate_mcp_transport(json.dumps(instance.get("mcp_servers")))
update_keys = [
"name",
+ "is_portal",
"desc",
"model_id",
"multiple_rounds_dialogue",
@@ -1264,6 +1484,7 @@ def edit(self, instance: Dict, with_valid=True):
"clean_time",
"file_clean_time",
"folder_id",
+ "default_model_setting",
]
for update_key in update_keys:
if update_key in instance and instance.get(update_key) is not None:
@@ -1304,13 +1525,13 @@ def update_template_workflow(self, instance: Dict, app: Application):
self.is_valid(raise_exception=True)
work_flow_template = instance.get("work_flow_template")
download_url = work_flow_template.get("downloadUrl")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
try:
mk_instance = restricted_loads(res.content)
- except Exception as e:
+ except Exception:
raise AppApiException(1001, _("Unsupported file format"))
application = mk_instance.application
tool_list = mk_instance.get_tool_list()
@@ -1363,9 +1584,9 @@ def update_template_workflow(self, instance: Dict, app: Application):
).auth_resource_batch([t.id for t in tool_model_list])
try:
download_callback_url = work_flow_template.get("downloadCallbackUrl", "")
- if not download_callback_url.startswith("https://apps.fit2cloud.com"):
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
raise AppApiException(500, _("Illegal download callback url"))
- requests.get(download_callback_url, timeout=5)
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
@@ -1408,6 +1629,7 @@ def one(self, with_valid=True):
knowledge_id_list = [k.get("id") for k in knowledge_list]
else:
self.update_knowledge_node(application.work_flow, available_knowledge_dict)
+ update_form_knowledge_fields(application.work_flow)
return {
**ApplicationSerializerModel(application).data,
@@ -1600,6 +1822,9 @@ def batch_delete(self, instance: Dict, with_valid=True):
self.is_valid(raise_exception=True)
id_list = instance.get("id_list")
workspace_id = self.data.get("workspace_id")
+ id_list = list(
+ QuerySet(Application).filter(id__in=id_list, workspace_id=workspace_id).values_list("id", flat=True)
+ )
QuerySet(ApplicationVersion).filter(application_id__in=id_list).delete()
QuerySet(ResourceMapping).filter(Q(target_id__in=id_list) | Q(source_id__in=id_list)).delete()
@@ -1657,9 +1882,7 @@ def batch_clean_time(self, instance: Dict, with_valid=True):
class BatchCleanTimeSerializer(BatchSerializer):
clean_time = serializers.IntegerField(required=True, min_value=1, max_value=100000, label=_("Clean time"))
- file_clean_time = serializers.IntegerField(
- required=True, min_value=1, max_value=100000, label=_("File clean time")
- )
+ file_clean_time = serializers.IntegerField(required=True, min_value=1, max_value=100000, label=_("File clean time"))
def is_valid(self, *, model=None, raise_exception=False):
super().is_valid(model=model, raise_exception=True)
diff --git a/apps/application/serializers/application_chat.py b/apps/application/serializers/application_chat.py
index dd9464a9ba5..0236b178eb5 100644
--- a/apps/application/serializers/application_chat.py
+++ b/apps/application/serializers/application_chat.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_chat.py
- @date:2025/6/10 11:06
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application_chat.py
+@date:2025/6/10 11:06
+@desc:
"""
+
import datetime
import os
import re
@@ -45,80 +46,90 @@ class ApplicationChatResponseSerializers(serializers.Serializer):
class ApplicationChatRecordExportRequest(serializers.Serializer):
- select_ids = serializers.ListField(required=True, label=_("Chat ID List"),
- child=serializers.UUIDField(required=True, label=_("Chat ID")))
+ select_ids = serializers.ListField(
+ required=True, label=_("Chat ID List"), child=serializers.UUIDField(required=True, label=_("Chat ID"))
+ )
class ApplicationChatQuerySerializers(serializers.Serializer):
workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
abstract = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("summary"))
username = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("username"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
- min_star = serializers.IntegerField(required=False, min_value=0,
- label=_("Minimum number of likes"))
- min_trample = serializers.IntegerField(required=False, min_value=0,
- label=_("Minimum number of clicks"))
- comparer = serializers.CharField(required=False, label=_("Comparator"), validators=[
- validators.RegexValidator(regex=re.compile("^and|or$"),
- message=_("Only supports and|or"), code=500)
- ])
+ min_star = serializers.IntegerField(required=False, min_value=0, label=_("Minimum number of likes"))
+ min_trample = serializers.IntegerField(required=False, min_value=0, label=_("Minimum number of clicks"))
+ comparer = serializers.CharField(
+ required=False,
+ label=_("Comparator"),
+ validators=[
+ validators.RegexValidator(regex=re.compile("^and|or$"), message=_("Only supports and|or"), code=500)
+ ],
+ )
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
+ raise AppApiException(500, _("Application id does not exist"))
def get_end_time(self):
- d = datetime.datetime.strptime(self.data.get('end_time'), '%Y-%m-%d').date()
+ d = datetime.datetime.strptime(self.data.get("end_time"), "%Y-%m-%d").date()
naive = datetime.datetime.combine(d, datetime.time.max)
return timezone.make_aware(naive, timezone.get_default_timezone())
def get_start_time(self):
- d = datetime.datetime.strptime(self.data.get('start_time'), '%Y-%m-%d').date()
+ d = datetime.datetime.strptime(self.data.get("start_time"), "%Y-%m-%d").date()
naive = datetime.datetime.combine(d, datetime.time.min)
return timezone.make_aware(naive, timezone.get_default_timezone())
def get_query_set(self, select_ids=None):
end_time = self.get_end_time()
start_time = self.get_start_time()
- query_set = QuerySet(model=get_dynamics_model(
- {'application_chat.application_id': models.CharField(),
- 'application_chat.abstract': models.CharField(),
- 'application_chat.asker': models.JSONField(),
- "star_num": models.IntegerField(),
- 'trample_num': models.IntegerField(),
- 'comparer': models.CharField(),
- 'application_chat.update_time': models.DateTimeField(),
- 'application_chat.id': models.UUIDField(),
- 'application_chat_record_temp.id': models.UUIDField()}))
-
- base_query_dict = {'application_chat.application_id': self.data.get("application_id"),
- 'application_chat.update_time__gte': start_time,
- 'application_chat.update_time__lte': end_time,
- }
- if 'abstract' in self.data and self.data.get('abstract') is not None:
- base_query_dict['application_chat.abstract__icontains'] = self.data.get('abstract')
- if 'username' in self.data and self.data.get('username') is not None:
- base_query_dict['application_chat.asker__username__icontains'] = self.data.get('username')
-
+ query_set = QuerySet(
+ model=get_dynamics_model(
+ {
+ "application_chat.application_id": models.CharField(),
+ "application_chat.abstract": models.CharField(),
+ "application_chat.asker": models.JSONField(),
+ "star_num": models.IntegerField(),
+ "trample_num": models.IntegerField(),
+ "comparer": models.CharField(),
+ "application_chat.update_time": models.DateTimeField(),
+ "application_chat.id": models.UUIDField(),
+ "application_chat_record_temp.id": models.UUIDField(),
+ }
+ )
+ )
+
+ base_query_dict = {
+ "application_chat.application_id": self.data.get("application_id"),
+ "application_chat.update_time__gte": start_time,
+ "application_chat.update_time__lte": end_time,
+ }
+ if "abstract" in self.data and self.data.get("abstract") is not None:
+ base_query_dict["application_chat.abstract__icontains"] = self.data.get("abstract")
if select_ids is not None and len(select_ids) > 0:
- base_query_dict['application_chat.id__in'] = select_ids
+ base_query_dict["application_chat.id__in"] = select_ids
base_condition = Q(**base_query_dict)
+ if "username" in self.data and self.data.get("username") is not None:
+ username = self.data.get("username")
+ base_condition = base_condition & (
+ Q(**{"application_chat.asker__username__icontains": username})
+ | Q(**{"application_chat.asker__nick_name__icontains": username})
+ )
min_star_query = None
min_trample_query = None
- if 'min_star' in self.data and self.data.get('min_star') is not None:
- min_star_query = Q(star_num__gte=self.data.get('min_star'))
- if 'min_trample' in self.data and self.data.get('min_trample') is not None:
- min_trample_query = Q(trample_num__gte=self.data.get('min_trample'))
+ if "min_star" in self.data and self.data.get("min_star") is not None:
+ min_star_query = Q(star_num__gte=self.data.get("min_star"))
+ if "min_trample" in self.data and self.data.get("min_trample") is not None:
+ min_trample_query = Q(trample_num__gte=self.data.get("min_trample"))
if min_star_query is not None and min_trample_query is not None:
- if self.data.get(
- 'comparer') is not None and self.data.get('comparer') == 'or':
+ if self.data.get("comparer") is not None and self.data.get("comparer") == "or":
condition = base_condition & (min_star_query | min_trample_query)
else:
condition = base_condition & (min_star_query & min_trample_query)
@@ -129,71 +140,113 @@ def get_query_set(self, select_ids=None):
else:
condition = base_condition
- return {
- 'default_queryset': query_set.filter(condition).order_by("-application_chat.update_time")
- }
+ return {"default_queryset": query_set.filter(condition).order_by("-application_chat.update_time")}
def list(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- return native_search(self.get_query_set(), select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql',
- ('list_application_chat_ee.sql' if ['PE', 'EE'].__contains__(
- edition) else 'list_application_chat.sql'))),
- with_table_name=False)
+ return native_search(
+ self.get_query_set(),
+ select_string=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "application",
+ "sql",
+ (
+ "list_application_chat_ee.sql"
+ if ["PE", "EE"].__contains__(edition)
+ else "list_application_chat.sql"
+ ),
+ )
+ ),
+ with_table_name=False,
+ )
@staticmethod
def paragraph_list_to_string(paragraph_list):
return "\n**********\n".join(
- [f"{paragraph.get('title')}:\n{paragraph.get('content')}" for paragraph in
- paragraph_list] if paragraph_list is not None else '')
+ [f"{paragraph.get('title')}:\n{paragraph.get('content')}" for paragraph in paragraph_list]
+ if paragraph_list is not None
+ else ""
+ )
@staticmethod
def to_row(row: Dict):
- details = row.get('details') or {}
- padding_problem_text = ' '.join((node.get("answer", "") or "") for key, node in details.items() if
- node.get("type") == 'question-node')
- search_dataset_node_list = [(key, node) for key, node in details.items() if
- node.get("type") == 'search-dataset-node' or node.get(
- "step_type") == 'search_step' or node.get("type") == 'search-knowledge-node']
- reference_paragraph_len = '\n'.join([str(len(node.get('paragraph_list',
- []))) if key == 'search_step' else node.get(
- 'name') + ':' + str(
- len(node.get('paragraph_list', [])) if node.get('paragraph_list', []) is not None else '0') for
- key, node in search_dataset_node_list])
- reference_paragraph = '\n----------\n'.join(
- [ApplicationChatQuerySerializers.paragraph_list_to_string(node.get('paragraph_list',
- [])) if key == 'search_step' else node.get(
- 'name') + ':\n' + ApplicationChatQuerySerializers.paragraph_list_to_string(node.get('paragraph_list',
- [])) for
- key, node in search_dataset_node_list])
- improve_paragraph_list = row.get('improve_paragraph_list') or []
- vote_status_map = {'-1': '未投票', '0': '赞同', '1': '反对'}
- vote_reason_map = {'accurate': gettext('accurate'), 'complete': gettext('complete'),
- 'inaccurate': gettext('inaccurate'), 'incomplete': gettext('incomplete'),
- 'other': gettext('Other'), }
- return [str(row.get('chat_id')), row.get('abstract'), row.get('problem_text'), padding_problem_text,
- row.get('answer_text'), vote_status_map.get(row.get('vote_status')),
- vote_reason_map.get(row.get('vote_reason')),
- row.get('vote_other_content'),
- reference_paragraph_len,
- reference_paragraph,
- "\n".join([
+ details = row.get("details") or {}
+ padding_problem_text = " ".join(
+ (node.get("answer", "") or "") for key, node in details.items() if node.get("type") == "question-node"
+ )
+ search_dataset_node_list = [
+ (key, node)
+ for key, node in details.items()
+ if node.get("type") == "search-dataset-node"
+ or node.get("step_type") == "search_step"
+ or node.get("type") == "search-knowledge-node"
+ ]
+ reference_paragraph_len = "\n".join(
+ [
+ str(len(node.get("paragraph_list", [])))
+ if key == "search_step"
+ else node.get("name")
+ + ":"
+ + str(len(node.get("paragraph_list", [])) if node.get("paragraph_list", []) is not None else "0")
+ for key, node in search_dataset_node_list
+ ]
+ )
+ reference_paragraph = "\n----------\n".join(
+ [
+ ApplicationChatQuerySerializers.paragraph_list_to_string(node.get("paragraph_list", []))
+ if key == "search_step"
+ else node.get("name")
+ + ":\n"
+ + ApplicationChatQuerySerializers.paragraph_list_to_string(node.get("paragraph_list", []))
+ for key, node in search_dataset_node_list
+ ]
+ )
+ improve_paragraph_list = row.get("improve_paragraph_list") or []
+ vote_status_map = {"-1": "未投票", "0": "赞同", "1": "反对"}
+ vote_reason_map = {
+ "accurate": gettext("accurate"),
+ "complete": gettext("complete"),
+ "inaccurate": gettext("inaccurate"),
+ "incomplete": gettext("incomplete"),
+ "other": gettext("Other"),
+ }
+ return [
+ str(row.get("chat_id")),
+ row.get("abstract"),
+ row.get("problem_text"),
+ padding_problem_text,
+ row.get("answer_text"),
+ vote_status_map.get(row.get("vote_status")),
+ vote_reason_map.get(row.get("vote_reason")),
+ row.get("vote_other_content"),
+ reference_paragraph_len,
+ reference_paragraph,
+ "\n".join(
+ [
f"{improve_paragraph_list[index].get('title')}\n{improve_paragraph_list[index].get('content')}"
- for index in range(len(improve_paragraph_list))]),
- row.get('asker').get('username'),
- (row.get('message_tokens') or 0) + (row.get('answer_tokens') or 0),
- row.get('ip_address') or '-',
- get_source_display(row.get('source')),
- row.get('run_time'),
- str(row.get('create_time').astimezone(pytz.timezone(TIME_ZONE)).strftime('%Y-%m-%d %H:%M:%S')
- if row.get('create_time') is not None else None)]
+ for index in range(len(improve_paragraph_list))
+ ]
+ ),
+ row.get("asker").get("username"),
+ (row.get("message_tokens") or 0) + (row.get("answer_tokens") or 0),
+ row.get("ip_address") or "-",
+ get_source_display(row.get("source")),
+ row.get("run_time"),
+ str(
+ row.get("create_time").astimezone(pytz.timezone(TIME_ZONE)).strftime("%Y-%m-%d %H:%M:%S")
+ if row.get("create_time") is not None
+ else None
+ ),
+ ]
@staticmethod
def reset_value(value):
if isinstance(value, str):
- value = re.sub(ILLEGAL_CHARACTERS_RE, '', value)
- if value.startswith(('=', '+', '-', '@')):
+ value = re.sub(ILLEGAL_CHARACTERS_RE, "", value)
+ if value.startswith(("=", "+", "-", "@")):
value = "'" + value
if isinstance(value, datetime.datetime):
eastern = pytz.timezone(TIME_ZONE)
@@ -208,31 +261,50 @@ def export(self, data, with_valid=True):
def stream_response():
workbook = openpyxl.Workbook(write_only=True)
- worksheet = workbook.create_sheet(title='Sheet1')
+ worksheet = workbook.create_sheet(title="Sheet1")
current_page = 1
page_size = 500
- headers = [gettext('Conversation ID'), gettext('summary'), gettext('User Questions'),
- gettext('Problem after optimization'),
- gettext('answer'), gettext('User feedback'), gettext('Feedback reason'),
- gettext('Other reason content'),
- gettext('Reference segment number'),
- gettext('Section title + content'),
- gettext('Annotation'), gettext('User'), gettext('Consuming tokens'),
- gettext('Ip Address'), gettext('source'),
- gettext('Time consumed (s)'),
- gettext('Question Time')]
+ headers = [
+ gettext("Conversation ID"),
+ gettext("summary"),
+ gettext("User Questions"),
+ gettext("Problem after optimization"),
+ gettext("answer"),
+ gettext("User feedback"),
+ gettext("Feedback reason"),
+ gettext("Other reason content"),
+ gettext("Reference segment number"),
+ gettext("Section title + content"),
+ gettext("Annotation"),
+ gettext("User"),
+ gettext("Consuming tokens"),
+ gettext("Ip Address"),
+ gettext("source"),
+ gettext("Time consumed (s)"),
+ gettext("Question Time"),
+ ]
worksheet.append(headers)
- for data_list in native_page_handler(page_size, self.get_query_set(data.get('select_ids')),
- primary_key='application_chat_record_temp.id',
- primary_queryset='default_queryset',
- get_primary_value=lambda item: item.get('id'),
- select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql',
- ('export_application_chat_ee.sql' if ['PE',
- 'EE'].__contains__(
- edition) else 'export_application_chat.sql'))),
- with_table_name=False):
-
+ for data_list in native_page_handler(
+ page_size,
+ self.get_query_set(data.get("select_ids")),
+ primary_key="application_chat_record_temp.id",
+ primary_queryset="default_queryset",
+ get_primary_value=lambda item: item.get("id"),
+ select_string=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "application",
+ "sql",
+ (
+ "export_application_chat_ee.sql"
+ if ["PE", "EE"].__contains__(edition)
+ else "export_application_chat.sql"
+ ),
+ )
+ ),
+ with_table_name=False,
+ ):
for item in data_list:
row = [self.reset_value(v) for v in self.to_row(item)]
worksheet.append(row)
@@ -244,56 +316,74 @@ def stream_response():
output.close()
workbook.close()
- response = StreamingHttpResponse(stream_response(),
- content_type='application/vnd.open.xmlformats-officedocument.spreadsheetml.sheet')
- response['Content-Disposition'] = 'attachment; filename="data.xlsx"'
+ response = StreamingHttpResponse(
+ stream_response(), content_type="application/vnd.open.xmlformats-officedocument.spreadsheetml.sheet"
+ )
+ response["Content-Disposition"] = 'attachment; filename="data.xlsx"'
return response
def page(self, current_page: int, page_size: int, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- return native_page_search(current_page, page_size, self.get_query_set(), select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql',
- ('list_application_chat_ee.sql' if ['PE', 'EE'].__contains__(
- edition) else 'list_application_chat.sql'))),
- with_table_name=False)
+ return native_page_search(
+ current_page,
+ page_size,
+ self.get_query_set(),
+ select_string=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "application",
+ "sql",
+ (
+ "list_application_chat_ee.sql"
+ if ["PE", "EE"].__contains__(edition)
+ else "list_application_chat.sql"
+ ),
+ )
+ ),
+ with_table_name=False,
+ )
class ChatCountSerializer(serializers.Serializer):
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
def get_query_set(self):
- return QuerySet(ChatRecord).filter(chat_id=self.data.get('chat_id'))
+ return QuerySet(ChatRecord).filter(chat_id=self.data.get("chat_id"))
def update_chat(self):
self.is_valid(raise_exception=True)
- count_chat_record = native_search(self.get_query_set(), get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql', 'count_chat_record.sql')), with_search_one=True)
- QuerySet(Chat).filter(id=self.data.get('chat_id')).update(star_num=count_chat_record.get('star_num', 0) or 0,
- trample_num=count_chat_record.get('trample_num',
- 0) or 0,
- chat_record_count=count_chat_record.get(
- 'chat_record_count', 0) or 0,
- mark_sum=count_chat_record.get('mark_sum', 0) or 0)
+ count_chat_record = native_search(
+ self.get_query_set(),
+ get_file_content(os.path.join(PROJECT_DIR, "apps", "application", "sql", "count_chat_record.sql")),
+ with_search_one=True,
+ )
+ QuerySet(Chat).filter(id=self.data.get("chat_id")).update(
+ star_num=count_chat_record.get("star_num", 0) or 0,
+ trample_num=count_chat_record.get("trample_num", 0) or 0,
+ chat_record_count=count_chat_record.get("chat_record_count", 0) or 0,
+ mark_sum=count_chat_record.get("mark_sum", 0) or 0,
+ )
return True
def get_source_display(source):
- if not source or not isinstance(source, dict) or 'type' not in source:
- return '-'
- source_type = source.get('type')
+ if not source or not isinstance(source, dict) or "type" not in source:
+ return "-"
+ source_type = source.get("type")
# 定义映射关系
source_mapping = {
- ChatSourceChoices.ONLINE.value: gettext('Online Usage'),
- ChatSourceChoices.API_CALL.value: gettext('API Call'),
- ChatSourceChoices.ENTERPRISE_WECHAT.value: gettext('Enterprise WeChat'),
- ChatSourceChoices.WECHAT_PUBLIC_ACCOUNT.value: gettext('WeChat Public Account'),
- ChatSourceChoices.LARK.value: gettext('Lark'),
- ChatSourceChoices.DINGTALK.value: gettext('DingTalk'),
- ChatSourceChoices.ENTERPRISE_WECHAT_ROBOT.value: gettext('Enterprise WeChat Robot'),
- ChatSourceChoices.TRIGGER.value: gettext('Trigger'),
- ChatSourceChoices.SLACK.value: gettext('Slack'),
+ ChatSourceChoices.ONLINE.value: gettext("Online Usage"),
+ ChatSourceChoices.API_CALL.value: gettext("API Call"),
+ ChatSourceChoices.ENTERPRISE_WECHAT.value: gettext("Enterprise WeChat"),
+ ChatSourceChoices.WECHAT_PUBLIC_ACCOUNT.value: gettext("WeChat Public Account"),
+ ChatSourceChoices.LARK.value: gettext("Lark"),
+ ChatSourceChoices.DINGTALK.value: gettext("DingTalk"),
+ ChatSourceChoices.ENTERPRISE_WECHAT_ROBOT.value: gettext("Enterprise WeChat Robot"),
+ ChatSourceChoices.TRIGGER.value: gettext("Trigger"),
+ ChatSourceChoices.SLACK.value: gettext("Slack"),
}
return source_mapping.get(source_type, str(source_type))
diff --git a/apps/application/serializers/application_chat_link.py b/apps/application/serializers/application_chat_link.py
index a283d264f9b..f295d823406 100644
--- a/apps/application/serializers/application_chat_link.py
+++ b/apps/application/serializers/application_chat_link.py
@@ -5,18 +5,21 @@
@date: 2026/2/9 10:50
@desc:
"""
+import re
+
from django.utils.translation import gettext_lazy as _
from rest_framework import serializers
from application.models import Chat, ChatShareLink, ShareLinkType, ChatRecord
from common.exception.app_exception import AppApiException
from common.utils.chat_link_code import UUIDEncoder
+from knowledge.models import PublicFileAccess
import uuid_utils.compat as uuid
class ShareChatRecordModelSerializer(serializers.ModelSerializer):
-
execution_details = serializers.SerializerMethodField()
+
class Meta:
model = ChatRecord
fields = ['id', 'problem_text', 'answer_text', 'answer_text_list',
@@ -38,6 +41,7 @@ def get_execution_details(chat_record):
for v in details.values() if v.get('type') == 'start-node'
]
+
class ChatRecordShareLinkRequestSerializer(serializers.Serializer):
chat_record_ids = serializers.ListSerializer(
child=serializers.UUIDField(),
@@ -52,6 +56,53 @@ def validate(self, attrs):
raise serializers.ValidationError(_('Chat record ids can not be empty'))
return attrs
+
+def extract_oss_file_urls(answer_text_list):
+ """从 answer_text_list 中提取所有 ./oss/file/ 开头的链接"""
+ file_urls = []
+ for answer_group in answer_text_list:
+ if not isinstance(answer_group, list):
+ answer_group = [answer_group]
+ for item in answer_group:
+ content = item.get('content', '')
+ urls = re.findall(r'\./oss/file/[\w-]+', content)
+ file_urls.extend(urls)
+ return file_urls
+
+
+def save_public_file_access(chat_record_list):
+ """提取聊天记录中的所有文件ID并入库 PublicFileAccess"""
+ file_ids = set()
+ for chat_record in chat_record_list:
+ urls = extract_oss_file_urls(chat_record.answer_text_list)
+ for url in urls:
+ file_id = url.replace('./oss/file/', '')
+ if file_id:
+ file_ids.add(file_id)
+
+ if not file_ids:
+ return
+
+ existing = set(
+ PublicFileAccess.objects.filter(
+ source_type='FILE',
+ source_id__in=list(file_ids)
+ ).values_list('source_id', flat=True)
+ )
+
+ new_records = [
+ PublicFileAccess(
+ id=uuid.uuid7(),
+ source_type='FILE',
+ source_id=file_id
+ )
+ for file_id in file_ids if file_id not in existing
+ ]
+
+ if new_records:
+ PublicFileAccess.objects.bulk_create(new_records)
+
+
class ChatRecordShareLinkSerializer(serializers.Serializer):
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
@@ -61,8 +112,11 @@ def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
chat_id = self.data.get('chat_id')
application_id = self.data.get('application_id')
+ user_id = self.data.get('user_id')
- chat_query_set = Chat.objects.filter(id=chat_id, application_id=application_id, is_deleted=False)
+ chat_query_set = Chat.objects.filter(
+ id=chat_id, application_id=application_id, chat_user_id=user_id, is_deleted=False
+ )
if not chat_query_set.exists():
raise AppApiException(500, _('Chat id does not exist'))
@@ -74,7 +128,8 @@ def generate_link(self, instance, with_valid=True):
if not instance.get('is_current_all', False):
chat_record_ids: list[str] = instance.get('chat_record_ids')
- record_count = ChatRecord.objects.filter(id__in=chat_record_ids, chat_id=self.data.get('chat_id')).count()
+ record_count = ChatRecord.objects.filter(id__in=chat_record_ids,
+ chat_id=self.data.get('chat_id')).count()
if record_count != len(chat_record_ids):
raise AppApiException(500, _('Invalid chat record ids'))
chat_id = self.data.get('chat_id')
@@ -99,7 +154,8 @@ def generate_link(self, instance, with_valid=True):
if existing:
return {'link': UUIDEncoder.encode(existing.id)}
-
+ chat_record_list = ChatRecord.objects.filter(id__in=sorted_ids)
+ save_public_file_access(chat_record_list)
chat_share_link_model = ChatShareLink(
id=uuid.uuid7(),
chat_id=chat_id,
diff --git a/apps/application/serializers/application_chat_record.py b/apps/application/serializers/application_chat_record.py
index b2f21f72008..08a5fcfdb6e 100644
--- a/apps/application/serializers/application_chat_record.py
+++ b/apps/application/serializers/application_chat_record.py
@@ -1,44 +1,65 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_chat_record.py
- @date:2025/6/10 15:10
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application_chat_record.py
+@date:2025/6/10 15:10
+@desc:
"""
+
from functools import reduce
from typing import Dict
import uuid_utils.compat as uuid
-from django.db import transaction
-from django.db.models import QuerySet
-from django.db.models.aggregates import Max, Min
-from django.utils.translation import gettext_lazy as _, gettext
-from rest_framework import serializers
-from rest_framework.utils.formatting import lazy_format
-
-from application.models import ChatRecord, ApplicationAccessToken, Application
+from application.models import Application, ApplicationAccessToken, ChatRecord, Chat
from application.serializers.application_chat import ChatCountSerializer
from application.serializers.common import ChatInfo
from common.auth.authentication import get_is_permissions
from common.chunk import text_to_chunk
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.db.search import page_search
from common.exception.app_exception import AppApiException, AppUnauthorizedFailed
from common.utils.common import post
-from knowledge.models import Paragraph, Document, Problem, ProblemParagraphMapping, Knowledge
+from django.db import transaction
+from django.db.models import QuerySet
+from django.db.models.aggregates import Max, Min
+from django.utils.translation import gettext
+from django.utils.translation import gettext_lazy as _
+from knowledge.models import Document, Knowledge, Paragraph, Problem, ProblemParagraphMapping
from knowledge.serializers.common import get_embedding_model_id_by_knowledge_id, update_document_char_length
from knowledge.serializers.paragraph import ParagraphSerializers
from knowledge.task.embedding import embedding_by_paragraph, embedding_by_paragraph_list
+from rest_framework import serializers
+from rest_framework.utils.formatting import lazy_format
class ChatRecordSerializerModel(serializers.ModelSerializer):
class Meta:
model = ChatRecord
- fields = ['id', 'chat_id', 'vote_status','vote_reason','vote_other_content', 'problem_text', 'answer_text',
- 'message_tokens', 'answer_tokens', 'const', 'improve_paragraph_id_list', 'run_time', 'index',
- 'answer_text_list',
- 'create_time', 'update_time']
+ fields = [
+ "id",
+ "chat_id",
+ "vote_status",
+ "vote_reason",
+ "vote_other_content",
+ "problem_text",
+ "answer_text",
+ "message_tokens",
+ "answer_tokens",
+ "const",
+ "improve_paragraph_id_list",
+ "run_time",
+ "index",
+ "answer_text_list",
+ "create_time",
+ "update_time",
+ "version",
+ "question",
+ "messages",
+ ]
class ChatRecordOperateSerializer(serializers.Serializer):
@@ -49,42 +70,57 @@ class ChatRecordOperateSerializer(serializers.Serializer):
def is_valid(self, *, debug=False, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
- application_access_token = QuerySet(ApplicationAccessToken).filter(
- application_id=self.data.get('application_id')).first()
+ raise AppApiException(500, _("Application id does not exist"))
+ if (
+ not ChatRecord.objects.filter(
+ chat_id=self.data.get("chat_id"), chat__application_id=self.data.get("application_id")
+ ).exists()
+ and not debug
+ ):
+ raise AppApiException(500, _("Chat records for the application do not exist"))
+ application_access_token = (
+ QuerySet(ApplicationAccessToken).filter(application_id=self.data.get("application_id")).first()
+ )
if application_access_token is None:
- raise AppApiException(500, gettext('Application authentication information does not exist'))
+ raise AppApiException(500, gettext("Application authentication information does not exist"))
def get_chat_record(self):
- chat_record_id = self.data.get('chat_record_id')
- chat_id = self.data.get('chat_id')
+ chat_record_id = self.data.get("chat_record_id")
+ chat_id = self.data.get("chat_id")
chat_info: ChatInfo = ChatInfo.get_cache(chat_id)
if chat_info is not None:
- chat_record_list = [chat_record for chat_record in chat_info.chat_record_list if
- str(chat_record.id) == str(chat_record_id)]
+ chat_record_list = [
+ chat_record for chat_record in chat_info.chat_record_list if str(chat_record.id) == str(chat_record_id)
+ ]
if chat_record_list is not None and len(chat_record_list):
return chat_record_list[-1]
- return QuerySet(ChatRecord).filter(id=chat_record_id, chat_id=chat_id).first()
+ return (
+ QuerySet(ChatRecord)
+ .filter(id=chat_record_id, chat_id=chat_id, chat__application_id=self.data.get("application_id"))
+ .first()
+ )
def one(self, debug):
self.is_valid(debug=debug, raise_exception=True)
chat_record = self.get_chat_record()
if chat_record is None:
raise AppApiException(500, gettext("Conversation does not exist"))
- application_access_token = QuerySet(ApplicationAccessToken).filter(
- application_id=self.data.get('application_id')).first()
+ application_access_token = (
+ QuerySet(ApplicationAccessToken).filter(application_id=self.data.get("application_id")).first()
+ )
show_source = False
show_exec = False
if application_access_token is not None:
show_exec = application_access_token.show_exec
show_source = application_access_token.show_source
return ApplicationChatRecordQuerySerializers.reset_chat_record(
- chat_record, True if debug else show_source, True if debug else show_exec)
+ chat_record, True if debug else show_source, True if debug else show_exec
+ )
class ApplicationChatRecordQuerySerializers(serializers.Serializer):
@@ -95,28 +131,35 @@ class ApplicationChatRecordQuerySerializers(serializers.Serializer):
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
+ raise AppApiException(500, _("Application id does not exist"))
+ if not Chat.objects.filter(
+ id=self.data.get("chat_id"), application_id=self.data.get("application_id")
+ ).exists():
+ raise AppApiException(500, _("Chat records for the application do not exist"))
def list(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- QuerySet(ChatRecord).filter(chat_id=self.data.get('chat_id'))
- order_by = 'create_time' if self.data.get('order_asc') is None or self.data.get(
- 'order_asc') else '-create_time'
- return [ChatRecordSerializerModel(chat_record).data for chat_record in
- QuerySet(ChatRecord).filter(chat_id=self.data.get('chat_id')).order_by(order_by)]
+ order_by = "create_time" if self.data.get("order_asc") is None or self.data.get("order_asc") else "-create_time"
+ return [
+ ChatRecordSerializerModel(chat_record).data
+ for chat_record in QuerySet(ChatRecord)
+ .filter(chat_id=self.data.get("chat_id"), chat__application_id=self.data.get("application_id"))
+ .order_by(order_by)
+ ]
@staticmethod
def get_loop_workflow_node(details):
result = []
- for item in details.values():
- if item.get('type') == 'loop-node':
- for loop_item in item.get('loop_node_data') or []:
+
+ for item in details.values() if isinstance(details, dict) else details:
+ if item.get("type") == "loop-node":
+ for loop_item in item.get("loop_node_data") or []:
for inner_item in loop_item.values():
result.append(inner_item)
return result
@@ -125,67 +168,97 @@ def get_loop_workflow_node(details):
def reset_chat_record(chat_record, show_source, show_exec):
knowledge_list = []
paragraph_list = []
- if 'search_step' in chat_record.details and chat_record.details.get('search_step').get(
- 'paragraph_list') is not None:
- paragraph_list = chat_record.details.get('search_step').get(
- 'paragraph_list')
-
- for item in [*chat_record.details.values(),
- *ApplicationChatRecordQuerySerializers.get_loop_workflow_node(chat_record.details)]:
- if item.get('type') == 'search-knowledge-node' and item.get('show_knowledge', False):
- paragraph_list = paragraph_list + (item.get(
- 'paragraph_list') or [])
-
- if item.get('type') == 'reranker-node' and item.get('show_knowledge', False):
- paragraph_list = paragraph_list + [rl.get('metadata') for rl in (item.get('result_list') or []) if
- 'document_id' in (rl.get('metadata') or {}) and 'knowledge_id' in (
- rl.get(
- 'metadata') or {})]
- paragraph_list = list({p.get('id'): p for p in paragraph_list}.values())
- knowledge_list = knowledge_list + [{'id': knowledge_id, **knowledge} for knowledge_id, knowledge in
- reduce(lambda x, y: {**x, **y},
- [{row.get(
- 'knowledge_id'): {'knowledge_name': row.get(
- "knowledge_name"),
- 'knowledge_type': row.get('knowledge_type')}} for
- row in
- paragraph_list],
- {}).items()]
+ if (
+ "search_step" in chat_record.details
+ and chat_record.details.get("search_step").get("paragraph_list") is not None
+ ):
+ paragraph_list = chat_record.details.get("search_step").get("paragraph_list")
+
+ for item in [
+ *(chat_record.details.values() if isinstance(chat_record.details, dict) else chat_record.details),
+ *ApplicationChatRecordQuerySerializers.get_loop_workflow_node(chat_record.details),
+ ]:
+ if item.get("type") == "search-knowledge-node" and item.get("show_knowledge", False):
+ paragraph_list = paragraph_list + (item.get("paragraph_list") or [])
+
+ if item.get("type") == "reranker-node" and item.get("show_knowledge", False):
+ paragraph_list = paragraph_list + [
+ rl.get("metadata")
+ for rl in (item.get("result_list") or [])
+ if "document_id" in (rl.get("metadata") or {}) and "knowledge_id" in (rl.get("metadata") or {})
+ ]
+ paragraph_list = list({p.get("id"): p for p in paragraph_list}.values())
+ knowledge_list = knowledge_list + [
+ {"id": knowledge_id, **knowledge}
+ for knowledge_id, knowledge in reduce(
+ lambda x, y: {**x, **y},
+ [
+ {
+ row.get("knowledge_id"): {
+ "knowledge_name": row.get("knowledge_name"),
+ "knowledge_type": row.get("knowledge_type"),
+ }
+ }
+ for row in paragraph_list
+ ],
+ {},
+ ).items()
+ ]
if len(chat_record.improve_paragraph_id_list) > 0:
paragraph_model_list = QuerySet(Paragraph).filter(id__in=chat_record.improve_paragraph_id_list)
if len(paragraph_model_list) < len(chat_record.improve_paragraph_id_list):
paragraph_model_id_list = [str(p.id) for p in paragraph_model_list]
chat_record.improve_paragraph_id_list = list(
- filter(lambda p_id: paragraph_model_id_list.__contains__(p_id),
- chat_record.improve_paragraph_id_list))
+ filter(
+ lambda p_id: paragraph_model_id_list.__contains__(p_id), chat_record.improve_paragraph_id_list
+ )
+ )
chat_record.save()
- show_source_dict = {'knowledge_list': knowledge_list,
- 'paragraph_list': paragraph_list, }
- show_exec_dict = {'execution_details': [chat_record.details[key] for key in chat_record.details if
- (True if show_exec else chat_record.details[key].get(
- 'type') == 'start-node')]}
+ show_source_dict = {
+ "knowledge_list": knowledge_list,
+ "paragraph_list": paragraph_list,
+ }
+ if isinstance(chat_record.details, dict):
+ show_exec_dict = {
+ "execution_details": [
+ chat_record.details[key]
+ for key in chat_record.details
+ if (True if show_exec else chat_record.details[key].get("type") == "start-node")
+ ]
+ }
+ else:
+ show_exec_dict = {
+ "execution_details": [
+ item for item in chat_record.details if (True if show_exec else item.get("type") == "start-node")
+ ]
+ }
+
return {
**ChatRecordSerializerModel(chat_record).data,
- 'padding_problem_text': chat_record.details.get('problem_padding').get(
- 'padding_problem_text') if 'problem_padding' in chat_record.details else None,
+ "padding_problem_text": chat_record.details.get("problem_padding").get("padding_problem_text")
+ if "problem_padding" in chat_record.details
+ else None,
**(show_source_dict if show_source else {}),
- **(show_exec_dict if show_exec else show_exec_dict)
+ **(show_exec_dict if show_exec else show_exec_dict),
}
def page(self, current_page: int, page_size: int, with_valid=True, show_source=None, show_exec=None):
if with_valid:
self.is_valid(raise_exception=True)
- order_by = '-create_time' if self.data.get('order_asc') is None or self.data.get(
- 'order_asc') else 'create_time'
+ order_by = "-create_time" if self.data.get("order_asc") is None or self.data.get("order_asc") else "create_time"
if show_source is None:
show_source = True
if show_exec is None:
show_exec = True
- page = page_search(current_page, page_size,
- QuerySet(ChatRecord).filter(chat_id=self.data.get('chat_id')).order_by(order_by),
- post_records_handler=lambda chat_record: self.reset_chat_record(chat_record, show_source,
- show_exec))
+ page = page_search(
+ current_page,
+ page_size,
+ QuerySet(ChatRecord)
+ .filter(chat_id=self.data.get("chat_id"), chat__application_id=self.data.get("application_id"))
+ .order_by(order_by),
+ post_records_handler=lambda chat_record: self.reset_chat_record(chat_record, show_source, show_exec),
+ )
return page
@@ -202,26 +275,25 @@ class ChatRecordImproveSerializer(serializers.Serializer):
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
- chat_record_id = serializers.UUIDField(required=True,
- label=_("Conversation record id"))
+ chat_record_id = serializers.UUIDField(required=True, label=_("Conversation record id"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
+ raise AppApiException(500, _("Application id does not exist"))
def get(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- chat_record_id = self.data.get('chat_record_id')
- chat_id = self.data.get('chat_id')
+ chat_record_id = self.data.get("chat_record_id")
+ chat_id = self.data.get("chat_id")
chat_record = QuerySet(ChatRecord).filter(id=chat_record_id, chat_id=chat_id).first()
if chat_record is None:
- raise AppApiException(500, gettext('Conversation record does not exist'))
+ raise AppApiException(500, gettext("Conversation record does not exist"))
if chat_record.improve_paragraph_id_list is None or len(chat_record.improve_paragraph_id_list) == 0:
return []
@@ -229,19 +301,21 @@ def get(self, with_valid=True):
if len(paragraph_model_list) < len(chat_record.improve_paragraph_id_list):
paragraph_model_id_list = [str(p.id) for p in paragraph_model_list]
chat_record.improve_paragraph_id_list = list(
- filter(lambda p_id: paragraph_model_id_list.__contains__(p_id),
- chat_record.improve_paragraph_id_list))
+ filter(lambda p_id: paragraph_model_id_list.__contains__(p_id), chat_record.improve_paragraph_id_list)
+ )
chat_record.save()
return [ParagraphModel(p).data for p in paragraph_model_list]
class ApplicationChatRecordImproveInstanceSerializer(serializers.Serializer):
- title = serializers.CharField(required=False, max_length=256, allow_null=True, allow_blank=True,
- label=_("Section title"))
+ title = serializers.CharField(
+ required=False, max_length=256, allow_null=True, allow_blank=True, label=_("Section title")
+ )
content = serializers.CharField(required=True, label=_("Paragraph content"))
- problem_text = serializers.CharField(required=False, max_length=256, allow_null=True, allow_blank=True,
- label=_("question"))
+ problem_text = serializers.CharField(
+ required=False, max_length=256, allow_null=True, allow_blank=True, label=_("question")
+ )
class ApplicationChatRecordAddKnowledgeSerializer(serializers.Serializer):
@@ -249,19 +323,22 @@ class ApplicationChatRecordAddKnowledgeSerializer(serializers.Serializer):
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
knowledge_id = serializers.UUIDField(required=True, label=_("Knowledge base id"))
document_id = serializers.UUIDField(required=True, label=_("Document id"))
- chat_ids = serializers.ListSerializer(child=serializers.UUIDField(), required=True,
- label=_("Conversation ID"))
+ chat_ids = serializers.ListSerializer(child=serializers.UUIDField(), required=True, label=_("Conversation ID"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
- if not Document.objects.filter(id=self.data['document_id'], knowledge_id=self.data['knowledge_id']).exists():
+ raise AppApiException(500, _("Application id does not exist"))
+ if not Document.objects.filter(id=self.data["document_id"], knowledge_id=self.data["knowledge_id"]).exists():
raise AppApiException(500, gettext("The document id is incorrect"))
+ if not ChatRecord.objects.filter(
+ chat_id__in=self.data["chat_ids"], chat__application_id=self.data["application_id"]
+ ).exists():
+ raise AppApiException(500, gettext("The chat id is incorrect"))
@staticmethod
def post_embedding_paragraph(paragraph_ids, knowledge_id):
@@ -270,31 +347,33 @@ def post_embedding_paragraph(paragraph_ids, knowledge_id):
@post(post_function=post_embedding_paragraph)
@transaction.atomic
- def post_improve(self, instance: Dict, request=None, scope='WORKSPACE', with_valid=True):
+ def post_improve(self, instance: Dict, request=None, scope="WORKSPACE", with_valid=True):
if with_valid:
ApplicationChatRecordAddKnowledgeSerializer(data=instance).is_valid(raise_exception=True)
self.is_valid(raise_exception=True)
- if scope == 'WORKSPACE':
- is_permission = get_is_permissions(request=request, workspace_id=self.data.get('workspace_id'),
- knowledge_id=self.data.get("knowledge_id"))(
+ if scope == "WORKSPACE":
+ is_permission = get_is_permissions(
+ request=request, workspace_id=self.data.get("workspace_id"), knowledge_id=self.data.get("knowledge_id")
+ )(
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
else:
- is_permission = get_is_permissions(request=request, workspace_id=self.data.get('workspace_id'),
- knowledge_id=self.data.get("knowledge_id"))(
- PermissionConstants.RESOURCE_KNOWLEDGE_DOCUMENT_EDIT, RoleConstants.ADMIN
- )
+ is_permission = get_is_permissions(
+ request=request, workspace_id=self.data.get("workspace_id"), knowledge_id=self.data.get("knowledge_id")
+ )(PermissionConstants.RESOURCE_KNOWLEDGE_DOCUMENT_EDIT, RoleConstants.ADMIN)
if not is_permission:
- raise AppUnauthorizedFailed(403, gettext('No permission to access'))
+ raise AppUnauthorizedFailed(403, gettext("No permission to access"))
- chat_ids = instance['chat_ids']
- document_id = instance['document_id']
- knowledge_id = instance['knowledge_id']
+ chat_ids = instance["chat_ids"]
+ document_id = instance["document_id"]
+ knowledge_id = instance["knowledge_id"]
# 获取所有聊天记录
chat_record_list = list(ChatRecord.objects.filter(chat_id__in=chat_ids))
@@ -312,7 +391,7 @@ def post_improve(self, instance: Dict, request=None, scope='WORKSPACE', with_val
content=chat_record.answer_text,
knowledge_id=knowledge_id,
title=chat_record.problem_text,
- chunks=text_to_chunk(chat_record.answer_text)
+ chunks=text_to_chunk(chat_record.answer_text),
)
problem, _ = Problem.objects.get_or_create(content=chat_record.problem_text, knowledge_id=knowledge_id)
problem_paragraph_mapping = ProblemParagraphMapping(
@@ -320,7 +399,7 @@ def post_improve(self, instance: Dict, request=None, scope='WORKSPACE', with_val
knowledge_id=knowledge_id,
document_id=document_id,
problem_id=problem.id,
- paragraph_id=paragraph.id
+ paragraph_id=paragraph.id,
)
paragraphs.append(paragraph)
paragraph_ids.append(paragraph.id)
@@ -335,19 +414,17 @@ def post_improve(self, instance: Dict, request=None, scope='WORKSPACE', with_val
ProblemParagraphMapping.objects.bulk_create(problem_paragraph_mappings)
# 批量保存聊天记录
- ChatRecord.objects.bulk_update(chat_record_list, ['improve_paragraph_id_list'])
+ ChatRecord.objects.bulk_update(chat_record_list, ["improve_paragraph_id_list"])
update_document_char_length(document_id)
for chat_id in chat_ids:
- ChatCountSerializer(data={'chat_id': chat_id}).update_chat()
+ ChatCountSerializer(data={"chat_id": chat_id}).update_chat()
return paragraph_ids, knowledge_id
@staticmethod
def prepend_paragraphs(document_id, paragraphs):
# 获取所有现有段落
- existing_paragraphs = list(Paragraph.objects.filter(
- document_id=document_id
- ).order_by('position'))
+ existing_paragraphs = list(Paragraph.objects.filter(document_id=document_id).order_by("position"))
# 计算新段落数量
new_count = len(paragraphs)
@@ -360,7 +437,7 @@ def prepend_paragraphs(document_id, paragraphs):
# 批量更新现有段落位置
if existing_paragraphs:
- Paragraph.objects.bulk_update(existing_paragraphs, ['position'])
+ Paragraph.objects.bulk_update(existing_paragraphs, ["position"])
# 为新段落分配位置,从1开始
for i, paragraph in enumerate(paragraphs):
@@ -370,8 +447,7 @@ def prepend_paragraphs(document_id, paragraphs):
class ApplicationChatRecordImproveSerializer(serializers.Serializer):
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
- chat_record_id = serializers.UUIDField(required=True,
- label=_("Conversation record id"))
+ chat_record_id = serializers.UUIDField(required=True, label=_("Conversation record id"))
knowledge_id = serializers.UUIDField(required=True, label=_("Knowledge base id"))
@@ -382,21 +458,24 @@ class ApplicationChatRecordImproveSerializer(serializers.Serializer):
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
+ raise AppApiException(500, _("Application id does not exist"))
- query_set = QuerySet(Knowledge).filter(id=self.data.get('knowledge_id'))
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Knowledge id does not exist'))
+ raise AppApiException(500, _("Knowledge id does not exist"))
- if not QuerySet(Document).filter(id=self.data.get('document_id'),
- knowledge_id=self.data.get('knowledge_id')).exists():
+ if (
+ not QuerySet(Document)
+ .filter(id=self.data.get("document_id"), knowledge_id=self.data.get("knowledge_id"))
+ .exists()
+ ):
raise AppApiException(500, gettext("The document id is incorrect"))
@staticmethod
@@ -408,38 +487,41 @@ def post_embedding_paragraph(chat_record, paragraph_id, knowledge_id):
@post(post_function=post_embedding_paragraph)
@transaction.atomic
- def improve(self, instance: Dict, request=None, scope='WORKSPACE', with_valid=True):
+ def improve(self, instance: Dict, request=None, scope="WORKSPACE", with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- if scope == 'WORKSPACE':
- is_permission = get_is_permissions(request, workspace_id=self.data.get('workspace_id'),
- knowledge_id=self.data.get("knowledge_id"))(
+ if scope == "WORKSPACE":
+ is_permission = get_is_permissions(
+ request, workspace_id=self.data.get("workspace_id"), knowledge_id=self.data.get("knowledge_id")
+ )(
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
else:
- is_permission = get_is_permissions(request, workspace_id=self.data.get('workspace_id'),
- knowledge_id=self.data.get("knowledge_id"))(
- PermissionConstants.RESOURCE_KNOWLEDGE_DOCUMENT_EDIT, RoleConstants.ADMIN
- )
+ is_permission = get_is_permissions(
+ request, workspace_id=self.data.get("workspace_id"), knowledge_id=self.data.get("knowledge_id")
+ )(PermissionConstants.RESOURCE_KNOWLEDGE_DOCUMENT_EDIT, RoleConstants.ADMIN)
if not is_permission:
- raise AppUnauthorizedFailed(403, gettext('No permission to access'))
+ raise AppUnauthorizedFailed(403, gettext("No permission to access"))
ApplicationChatRecordImproveInstanceSerializer(data=instance).is_valid(raise_exception=True)
- chat_record_id = self.data.get('chat_record_id')
- chat_id = self.data.get('chat_id')
+ chat_record_id = self.data.get("chat_record_id")
+ chat_id = self.data.get("chat_id")
chat_record = QuerySet(ChatRecord).filter(id=chat_record_id, chat_id=chat_id).first()
if chat_record is None:
- raise AppApiException(500, gettext('Conversation record does not exist'))
+ raise AppApiException(500, gettext("Conversation record does not exist"))
document_id = self.data.get("document_id")
knowledge_id = self.data.get("knowledge_id")
- max_position = Paragraph.objects.filter(document_id=document_id).aggregate(
- max_position=Max('position')
- )['max_position'] or 0
+ max_position = (
+ Paragraph.objects.filter(document_id=document_id).aggregate(max_position=Max("position"))["max_position"]
+ or 0
+ )
paragraph = Paragraph(
id=uuid.uuid7(),
document_id=document_id,
@@ -449,13 +531,17 @@ def improve(self, instance: Dict, request=None, scope='WORKSPACE', with_valid=Tr
position=max_position + 1,
chunks=text_to_chunk(instance.get("content", "")),
)
- problem_text = instance.get('problem_text') if instance.get(
- 'problem_text') is not None else chat_record.problem_text
+ problem_text = (
+ instance.get("problem_text") if instance.get("problem_text") is not None else chat_record.problem_text
+ )
problem, _ = QuerySet(Problem).get_or_create(content=problem_text, knowledge_id=knowledge_id)
- problem_paragraph_mapping = ProblemParagraphMapping(id=uuid.uuid7(), knowledge_id=knowledge_id,
- document_id=document_id,
- problem_id=problem.id,
- paragraph_id=paragraph.id)
+ problem_paragraph_mapping = ProblemParagraphMapping(
+ id=uuid.uuid7(),
+ knowledge_id=knowledge_id,
+ document_id=document_id,
+ problem_id=problem.id,
+ paragraph_id=paragraph.id,
+ )
# 插入段落
paragraph.save()
# 插入关联问题
@@ -464,14 +550,13 @@ def improve(self, instance: Dict, request=None, scope='WORKSPACE', with_valid=Tr
update_document_char_length(document_id)
# 添加标注
chat_record.save()
- ChatCountSerializer(data={'chat_id': chat_id}).update_chat()
+ ChatCountSerializer(data={"chat_id": chat_id}).update_chat()
return ChatRecordSerializerModel(chat_record).data, paragraph.id, knowledge_id
class Operate(serializers.Serializer):
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
- chat_record_id = serializers.UUIDField(required=True,
- label=_("Conversation record id"))
+ chat_record_id = serializers.UUIDField(required=True, label=_("Conversation record id"))
knowledge_id = serializers.UUIDField(required=True, label=_("Knowledge base id"))
@@ -481,49 +566,63 @@ class Operate(serializers.Serializer):
workspace_id = serializers.CharField(required=True, label=_("Workspace ID"))
- def delete(self, request=None, scope='WORKSPACE', with_valid=True):
+ def delete(self, request=None, scope="WORKSPACE", with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- if scope == 'WORKSPACE':
- is_permission = get_is_permissions(request=request, workspace_id=self.data.get('workspace_id'),
- knowledge_id=self.data.get("knowledge_id"))(
+ if scope == "WORKSPACE":
+ is_permission = get_is_permissions(
+ request=request,
+ workspace_id=self.data.get("workspace_id"),
+ knowledge_id=self.data.get("knowledge_id"),
+ )(
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
else:
- is_permission = get_is_permissions(request=request, workspace_id=self.data.get('workspace_id'),
- knowledge_id=self.data.get("knowledge_id"))(
- PermissionConstants.RESOURCE_KNOWLEDGE_DOCUMENT_EDIT, RoleConstants.ADMIN
- )
+ is_permission = get_is_permissions(
+ request=request,
+ workspace_id=self.data.get("workspace_id"),
+ knowledge_id=self.data.get("knowledge_id"),
+ )(PermissionConstants.RESOURCE_KNOWLEDGE_DOCUMENT_EDIT, RoleConstants.ADMIN)
if not is_permission:
- raise AppUnauthorizedFailed(403, gettext('No permission to access'))
-
- workspace_id = self.data.get('workspace_id')
- chat_record_id = self.data.get('chat_record_id')
- chat_id = self.data.get('chat_id')
- knowledge_id = self.data.get('knowledge_id')
- document_id = self.data.get('document_id')
- paragraph_id = self.data.get('paragraph_id')
+ raise AppUnauthorizedFailed(403, gettext("No permission to access"))
+
+ workspace_id = self.data.get("workspace_id")
+ chat_record_id = self.data.get("chat_record_id")
+ chat_id = self.data.get("chat_id")
+ knowledge_id = self.data.get("knowledge_id")
+ document_id = self.data.get("document_id")
+ paragraph_id = self.data.get("paragraph_id")
chat_record = QuerySet(ChatRecord).filter(id=chat_record_id, chat_id=chat_id).first()
if chat_record is None:
- raise AppApiException(500, gettext('Conversation record does not exist'))
+ raise AppApiException(500, gettext("Conversation record does not exist"))
if not chat_record.improve_paragraph_id_list.__contains__(uuid.UUID(paragraph_id)):
message = lazy_format(
gettext(
- 'The paragraph id is wrong. The current conversation record does not exist. [{paragraph_id}] paragraph id'),
- paragraph_id=paragraph_id)
+ "The paragraph id is wrong. The current conversation record does not exist. [{paragraph_id}] paragraph id"
+ ),
+ paragraph_id=paragraph_id,
+ )
raise AppApiException(500, message.__str__())
- chat_record.improve_paragraph_id_list = [row for row in chat_record.improve_paragraph_id_list if
- str(row) != paragraph_id]
+ chat_record.improve_paragraph_id_list = [
+ row for row in chat_record.improve_paragraph_id_list if str(row) != paragraph_id
+ ]
chat_record.save()
o = ParagraphSerializers.Operate(
- data={"workspace_id": workspace_id, "knowledge_id": knowledge_id, 'document_id': document_id,
- "paragraph_id": paragraph_id})
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ "document_id": document_id,
+ "paragraph_id": paragraph_id,
+ }
+ )
o.is_valid(raise_exception=True)
o.delete()
return True
diff --git a/apps/application/serializers/application_version.py b/apps/application/serializers/application_version.py
index 5856220336f..ac0fcf49de8 100644
--- a/apps/application/serializers/application_version.py
+++ b/apps/application/serializers/application_version.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_version.py
- @date:2025/6/3 16:25
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application_version.py
+@date:2025/6/3 16:25
+@desc:
"""
+
from typing import Dict
from django.db.models import QuerySet
@@ -19,21 +20,33 @@
class ApplicationVersionQuerySerializer(serializers.Serializer):
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
- name = serializers.CharField(required=False, allow_null=True, allow_blank=True,
- label=_("summary"))
+ name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("summary"))
class ApplicationVersionModelSerializer(serializers.ModelSerializer):
class Meta:
model = ApplicationVersion
- fields = ['id', 'name', 'workspace_id', 'application_id', 'work_flow', 'publish_user_id', 'publish_user_name',
- 'create_time',
- 'update_time']
+ fields = [
+ "id",
+ "name",
+ "publish_desc",
+ "workspace_id",
+ "application_id",
+ "work_flow",
+ "publish_user_id",
+ "publish_user_name",
+ "create_time",
+ "update_time",
+ ]
class ApplicationVersionEditSerializer(serializers.Serializer):
- name = serializers.CharField(required=False, max_length=128, allow_null=True, allow_blank=True,
- label=_("Version Name"))
+ name = serializers.CharField(
+ required=False, max_length=128, allow_null=True, allow_blank=True, label=_("Version Name")
+ )
+ publish_desc = serializers.CharField(
+ required=False, max_length=1024, allow_null=True, allow_blank=True, label=_("Publish Description")
+ )
class ApplicationVersionSerializer(serializers.Serializer):
@@ -43,11 +56,11 @@ class Query(serializers.Serializer):
workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
def get_query_set(self, query):
- query_set = QuerySet(ApplicationVersion).filter(application_id=query.get('application_id'))
- if 'name' in query and query.get('name') is not None:
- query_set = query_set.filter(name__contains=query.get('name'))
- if 'workspace_id' in self.data and self.data.get('workspace_id') is not None:
- query_set = query_set.filter(workspace_id=self.data.get('workspace_id'))
+ query_set = QuerySet(ApplicationVersion).filter(application_id=query.get("application_id"))
+ if "name" in query and query.get("name") is not None:
+ query_set = query_set.filter(name__contains=query.get("name"))
+ if "workspace_id" in self.data and self.data.get("workspace_id") is not None:
+ query_set = query_set.filter(workspace_id=self.data.get("workspace_id"))
return query_set.order_by("-create_time")
def list(self, query, with_valid=True):
@@ -60,48 +73,57 @@ def list(self, query, with_valid=True):
def page(self, query, current_page, page_size, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- return page_search(current_page, page_size,
- self.get_query_set(query),
- post_records_handler=lambda v: ApplicationVersionModelSerializer(v).data)
+ return page_search(
+ current_page,
+ page_size,
+ self.get_query_set(query),
+ post_records_handler=lambda v: ApplicationVersionModelSerializer(v).data,
+ )
class Operate(serializers.Serializer):
workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
- application_version_id = serializers.UUIDField(required=True,
- label=_("Application version ID"))
+ application_version_id = serializers.UUIDField(required=True, label=_("Application version ID"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Application id does not exist'))
+ raise AppApiException(500, _("Application id does not exist"))
def one(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- application_version = QuerySet(ApplicationVersion).filter(application_id=self.data.get('application_id'),
- id=self.data.get(
- 'application_version_id')).first()
+ application_version = (
+ QuerySet(ApplicationVersion)
+ .filter(application_id=self.data.get("application_id"), id=self.data.get("application_version_id"))
+ .first()
+ )
if application_version is not None:
return ApplicationVersionModelSerializer(application_version).data
else:
- raise AppApiException(500, _('Workflow version does not exist'))
+ raise AppApiException(500, _("Workflow version does not exist"))
def edit(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
ApplicationVersionEditSerializer(data=instance).is_valid(raise_exception=True)
- application_version = QuerySet(ApplicationVersion).filter(application_id=self.data.get('application_id'),
- id=self.data.get(
- 'application_version_id')).first()
+ application_version = (
+ QuerySet(ApplicationVersion)
+ .filter(application_id=self.data.get("application_id"), id=self.data.get("application_version_id"))
+ .first()
+ )
if application_version is not None:
- name = instance.get('name', None)
+ name = instance.get("name", None)
+ publish_desc = instance.get("publish_desc", None)
if name is not None and len(name) > 0:
application_version.name = name
+ if publish_desc is not None and len(publish_desc) > 0:
+ application_version.publish_desc = publish_desc
application_version.save()
return ApplicationVersionModelSerializer(application_version).data
else:
- raise AppApiException(500, _('Workflow version does not exist'))
+ raise AppApiException(500, _("Workflow version does not exist"))
diff --git a/apps/application/serializers/common.py b/apps/application/serializers/common.py
index b41ce79e470..c1da528f3dc 100644
--- a/apps/application/serializers/common.py
+++ b/apps/application/serializers/common.py
@@ -1,19 +1,35 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: common.py
- @date:2025/6/9 13:42
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: common.py
+@date:2025/6/9 13:42
+@desc:
"""
+
from typing import List
+from application.models import Application, ApplicationTypeChoices, ApplicationVersion, Chat, ChatRecord, ChatUserType
+from application.serializers.application_chat import ChatCountSerializer
+from common.constants.cache_version import Cache_Version
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.exception.app_exception import ChatException
from django.core.cache import cache
from django.db.models import QuerySet
from django.utils import timezone
from django.utils.translation import gettext_lazy as _
-from application.models import Application, ChatRecord, Chat, ApplicationVersion, ChatUserType, ApplicationTypeChoices
+from system_manage.models.chat_user_token_quota import ChatUserTokenQuota
+
+from application.models import (
+ Application,
+ ChatRecord,
+ Chat,
+ ApplicationVersion,
+ ChatUserType,
+ ApplicationTypeChoices,
+ ExecuteType,
+)
from application.serializers.application_chat import ChatCountSerializer
from common.constants.cache_version import Cache_Version
from common.database_model_manage.database_model_manage import DatabaseModelManage
@@ -26,12 +42,7 @@
class ToolExecute:
- def __init__(self, tool_id: str,
- tool_record_id: str,
- workspace_id: str,
- source_type,
- source_id,
- debug=False):
+ def __init__(self, tool_id: str, tool_record_id: str, workspace_id: str, source_type, source_id, debug=False):
self.tool_id = tool_id
self.workspace_id = workspace_id
self.source_type = source_type
@@ -42,8 +53,12 @@ def __init__(self, tool_id: str,
def get_record(self):
if self.tool_record_id:
if self.debug:
- return self.to_record(cache.get(Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=self.tool_record_id),
- version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version()))
+ return self.to_record(
+ cache.get(
+ Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=self.tool_record_id),
+ version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version(),
+ )
+ )
else:
return QuerySet(ToolRecord).filter(tool_id=self.tool_id, id=self.tool_record_id).first()
return None
@@ -51,61 +66,136 @@ def get_record(self):
def to_record(self, tool_record_dict):
if tool_record_dict is None:
return None
- return ToolRecord(id=tool_record_dict.get('id'),
- tool_id=tool_record_dict.get('tool_id'),
- workspace_id=tool_record_dict.get('workspace_id'),
- source_type=tool_record_dict.get('source_type'),
- source_id=tool_record_dict.get('source_id'),
- meta=tool_record_dict.get('meta'),
- state=tool_record_dict.get('state'),
- run_time=tool_record_dict.get('run_time'))
+ return ToolRecord(
+ id=tool_record_dict.get("id"),
+ tool_id=tool_record_dict.get("tool_id"),
+ workspace_id=tool_record_dict.get("workspace_id"),
+ source_type=tool_record_dict.get("source_type"),
+ source_id=tool_record_dict.get("source_id"),
+ meta=tool_record_dict.get("meta"),
+ state=tool_record_dict.get("state"),
+ run_time=tool_record_dict.get("run_time"),
+ )
def to_dict(self, tool_record):
- return {'id': tool_record.id,
- 'tool_id': tool_record.tool_id,
- 'workspace_id': tool_record.workspace_id,
- 'source_type': tool_record.source_type,
- 'source_id': tool_record.source_id,
- 'meta': tool_record.meta,
- 'state': tool_record.state,
- 'run_time': tool_record.run_time}
+ return {
+ "id": tool_record.id,
+ "tool_id": tool_record.tool_id,
+ "workspace_id": tool_record.workspace_id,
+ "source_type": tool_record.source_type,
+ "source_id": tool_record.source_id,
+ "meta": tool_record.meta,
+ "state": tool_record.state,
+ "run_time": tool_record.run_time,
+ }
def set_record(self, tool_record):
- cache.set(Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=self.tool_record_id), self.to_dict(tool_record),
- version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version(),
- timeout=60 * 30)
+ cache.set(
+ Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=self.tool_record_id),
+ self.to_dict(tool_record),
+ version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version(),
+ timeout=60 * 30,
+ )
if not self.debug:
- QuerySet(ToolRecord).update_or_create(id=tool_record.id,
- create_defaults={'id': tool_record.id,
- 'tool_id': tool_record.tool_id,
- 'state': tool_record.state,
- 'workspace_id': tool_record.workspace_id,
- "source_type": tool_record.source_type,
- 'source_id': tool_record.source_id,
- 'meta': tool_record.meta,
- 'run_time': tool_record.run_time},
- defaults={
- 'workspace_id': tool_record.workspace_id,
- 'tool_id': tool_record.tool_id,
- "source_type": tool_record.source_type,
- 'source_id': tool_record.source_id,
- 'state': tool_record.state,
- 'meta': tool_record.meta,
- 'run_time': tool_record.run_time
- })
+ QuerySet(ToolRecord).update_or_create(
+ id=tool_record.id,
+ create_defaults={
+ "id": tool_record.id,
+ "tool_id": tool_record.tool_id,
+ "state": tool_record.state,
+ "workspace_id": tool_record.workspace_id,
+ "source_type": tool_record.source_type,
+ "source_id": tool_record.source_id,
+ "meta": tool_record.meta,
+ "run_time": tool_record.run_time,
+ },
+ defaults={
+ "workspace_id": tool_record.workspace_id,
+ "tool_id": tool_record.tool_id,
+ "source_type": tool_record.source_type,
+ "source_id": tool_record.source_id,
+ "state": tool_record.state,
+ "meta": tool_record.meta,
+ "run_time": tool_record.run_time,
+ },
+ )
+
+
+def load_debug_workflow_context(chat_record_id):
+ """
+ 按记录 id 解析历史工作流 context:优先 Redis 调试缓存 DEBUG_WORKFLOW_CONTEXT,其次 DB ChatRecord.workflow_context。
+ 属业务层逻辑(依赖 ChatRecord),供基于 ChatRecord 的续跑场景(应用对话、子应用节点)复用,
+ 作为 WorkflowManage.from_context 的 get_context 回调传入;引擎本身不关心 context 来源。
+ """
+ try:
+ cache_key = Cache_Version.DEBUG_WORKFLOW_CONTEXT.get_key(chat_record_id=str(chat_record_id))
+ context_data = cache.get(cache_key)
+ if not context_data:
+ chat_record = ChatRecord.objects.filter(id=chat_record_id).first()
+ if not chat_record or not chat_record.workflow_context:
+ return None
+ context_data = chat_record.workflow_context
+ return context_data
+ except Exception:
+ import traceback
+
+ traceback.print_exc()
+ return None
+
+
+def resolve_chat_user(chat_user_id, chat_user_type, asker=None):
+ """
+ 根据对话用户 id / 类型解析出对话用户信息。
+ - 登录的对话用户(CHAT_USER):从 ChatUser 表取真实信息
+ - 匿名/其他:优先用 asker(dict 或用户名),否则回退为“游客”
+ """
+ from system_manage.models import ChatUser
+
+ if chat_user_type == ChatUserType.CHAT_USER.value:
+ chat_user = QuerySet(ChatUser).filter(id=chat_user_id).first()
+ return {
+ "id": str(chat_user.id),
+ "email": chat_user.email,
+ "phone": chat_user.phone,
+ "nick_name": chat_user.nick_name,
+ "username": chat_user.username,
+ "source": chat_user.source,
+ }
+ if asker:
+ if isinstance(asker, dict):
+ return asker
+ return {"username": asker}
+ return {"username": "游客"}
+
+
+def resolve_chat_user_group(chat_user):
+ chat_user_id = chat_user.get("id")
+ if not chat_user_id:
+ return []
+ user_group_relation_model = DatabaseModelManage.get_model("user_group_relation")
+ if user_group_relation_model:
+ return [
+ {"id": user_group_relation.group_id, "name": user_group_relation.group.name}
+ for user_group_relation in QuerySet(user_group_relation_model)
+ .select_related("group")
+ .filter(user_id=chat_user_id)
+ ]
+ return []
class ChatInfo:
- def __init__(self,
- chat_id: str,
- chat_user_id: str,
- chat_user_type: str,
- ip_address: str,
- source: {},
- knowledge_id_list: List[str],
- exclude_document_id_list: list[str],
- application_id: str,
- debug=False):
+ def __init__(
+ self,
+ chat_id: str,
+ chat_user_id: str,
+ chat_user_type: str,
+ ip_address: str,
+ source: {},
+ knowledge_id_list: List[str],
+ exclude_document_id_list: list[str],
+ application_id: str,
+ debug=False,
+ ):
"""
:param chat_id: 对话id
:param chat_user_id 对话用户id
@@ -133,36 +223,44 @@ def __init__(self,
@staticmethod
def get_no_references_setting(knowledge_setting, model_setting):
no_references_setting = knowledge_setting.get(
- 'no_references_setting', {
- 'status': 'ai_questioning',
- 'value': '{question}'})
- if no_references_setting.get('status') == 'ai_questioning':
- no_references_prompt = model_setting.get('no_references_prompt', '{question}')
- no_references_setting['value'] = no_references_prompt if len(no_references_prompt) > 0 else "{question}"
+ "no_references_setting", {"status": "ai_questioning", "value": "{question}"}
+ )
+ if no_references_setting.get("status") == "ai_questioning":
+ no_references_prompt = model_setting.get("no_references_prompt", "{question}")
+ no_references_setting["value"] = no_references_prompt if len(no_references_prompt) > 0 else "{question}"
return no_references_setting
def get_application(self):
if self.debug:
application = QuerySet(Application).filter(id=self.application_id).first()
if not application:
- raise ChatException(500, _('The application does not exist'))
+ raise ChatException(500, _("The application does not exist"))
else:
- application = QuerySet(ApplicationVersion).filter(application_id=self.application_id).order_by(
- '-create_time')[0:1].first()
+ application = (
+ QuerySet(ApplicationVersion)
+ .filter(application_id=self.application_id)
+ .order_by("-create_time")[0:1]
+ .first()
+ )
if not application:
raise ChatException(500, _("The application has not been published. Please use it after publishing."))
if application.type == ApplicationTypeChoices.SIMPLE.value:
- # 数据集id列表
- knowledge_id_list = [str(row.target_id) for row in
- QuerySet(ResourceMapping).filter(source_id=self.application_id,
- source_type='APPLICATION',
- target_type='KNOWLEDGE')]
+ # 数据集id列表 这里需要从application中获取知识库 不能从关联表获取
+ if self.debug:
+ knowledge_id_list = [
+ str(row.target_id)
+ for row in QuerySet(ResourceMapping).filter(
+ source_id=self.application_id, source_type="APPLICATION", target_type="KNOWLEDGE"
+ )
+ ]
+ else:
+ knowledge_id_list = application.knowledge_ids
# 需要排除的文档
- exclude_document_id_list = [str(document.id) for document in
- QuerySet(Document).filter(
- knowledge_id__in=knowledge_id_list,
- is_active=False)]
+ exclude_document_id_list = [
+ str(document.id)
+ for document in QuerySet(Document).filter(knowledge_id__in=knowledge_id_list, is_active=False)
+ ]
self.knowledge_id_list = knowledge_id_list
self.exclude_document_id_list = exclude_document_id_list
self.application = application
@@ -171,42 +269,14 @@ def get_application(self):
def get_chat_user(self, asker=None):
if self.chat_user:
return self.chat_user
- chat_user_model = DatabaseModelManage.get_model("chat_user")
- if self.chat_user_type == ChatUserType.CHAT_USER.value and chat_user_model:
- chat_user = QuerySet(chat_user_model).filter(id=self.chat_user_id).first()
- return {
- 'id': str(chat_user.id),
- 'email': chat_user.email,
- 'phone': chat_user.phone,
- 'nick_name': chat_user.nick_name,
- 'username': chat_user.username,
- 'source': chat_user.source
- }
- else:
- if asker:
- if isinstance(asker, dict):
- self.chat_user = asker
- else:
- self.chat_user = {'username': asker}
- else:
- self.chat_user = {'username': '游客'}
- return self.chat_user
+ chat_user = resolve_chat_user(self.chat_user_id, self.chat_user_type, asker=asker)
+ # 保持原有语义:仅非登录用户缓存到实例上
+ if self.chat_user_type != ChatUserType.CHAT_USER.value:
+ self.chat_user = chat_user
+ return chat_user
def get_chat_user_group(self, asker=None):
- chat_user = self.get_chat_user(asker=asker)
- chat_user_id = chat_user.get('id')
-
- if not chat_user_id:
- return []
-
- user_group_relation_model = DatabaseModelManage.get_model("user_group_relation")
- if user_group_relation_model:
- return [{
- 'id': user_group_relation.group_id,
- 'name': user_group_relation.group.name
- } for user_group_relation in
- QuerySet(user_group_relation_model).select_related('group').filter(user_id=chat_user_id)]
- return []
+ return resolve_chat_user_group(self.get_chat_user(asker=asker))
def to_base_pipeline_manage_params(self):
self.get_application()
@@ -217,66 +287,107 @@ def to_base_pipeline_manage_params(self):
model_params_setting = None
if model_id is not None:
model = QuerySet(Model).filter(id=model_id).first()
+ if model is None:
+ raise Exception(_("Model does not exist"))
credential = get_model_credential(model.provider, model.model_type, model.model_name)
model_params_setting = credential.get_model_params_setting_form(model.model_name).get_default_form_data()
return {
- 'knowledge_id_list': self.knowledge_id_list,
- 'exclude_document_id_list': self.exclude_document_id_list,
- 'exclude_paragraph_id_list': [],
- 'top_n': 3 if knowledge_setting.get('top_n') is None else knowledge_setting.get('top_n'),
- 'similarity': 0.6 if knowledge_setting.get('similarity') is None else knowledge_setting.get('similarity'),
- 'max_paragraph_char_number': knowledge_setting.get('max_paragraph_char_number') or 5000,
- 'history_chat_record': self.chat_record_list,
- 'chat_id': self.chat_id,
- 'dialogue_number': self.application.dialogue_number,
- 'problem_optimization_prompt': self.application.problem_optimization_prompt if self.application.problem_optimization_prompt is not None and len(
- self.application.problem_optimization_prompt) > 0 else _(
- "() contains the user's question. Answer the guessed user's question based on the context ({question}) Requirement: Output a complete question and put it in the tag"),
- 'prompt': model_setting.get(
- 'prompt') if 'prompt' in model_setting and len(model_setting.get(
- 'prompt')) > 0 else Application.get_default_model_prompt(),
- 'system': model_setting.get(
- 'system', None),
- 'model_id': model_id,
- 'problem_optimization': self.application.problem_optimization,
- 'stream': True,
- 'model_setting': model_setting,
- 'model_params_setting': model_params_setting if self.application.model_params_setting is None or len(
- self.application.model_params_setting.keys()) == 0 else self.application.model_params_setting,
- 'search_mode': self.application.knowledge_setting.get('search_mode') or 'embedding',
- 'no_references_setting': self.get_no_references_setting(self.application.knowledge_setting, model_setting),
- 'workspace_id': self.application.workspace_id,
- 'application_id': self.application_id,
- 'mcp_enable': self.application.mcp_enable,
- 'mcp_tool_ids': self.application.mcp_tool_ids,
- 'mcp_servers': self.application.mcp_servers,
- 'mcp_source': self.application.mcp_source,
- 'tool_enable': self.application.tool_enable,
- 'tool_ids': self.application.tool_ids,
- 'application_enable': self.application.application_enable,
- 'application_ids': self.application.application_ids,
- 'skill_tool_ids': self.application.skill_tool_ids,
- 'mcp_output_enable': self.application.mcp_output_enable,
+ "knowledge_id_list": self.knowledge_id_list,
+ "exclude_document_id_list": self.exclude_document_id_list,
+ "exclude_paragraph_id_list": [],
+ "top_n": 3 if knowledge_setting.get("top_n") is None else knowledge_setting.get("top_n"),
+ "similarity": 0.6 if knowledge_setting.get("similarity") is None else knowledge_setting.get("similarity"),
+ "max_paragraph_char_number": knowledge_setting.get("max_paragraph_char_number") or 5000,
+ "history_chat_record": self.chat_record_list,
+ "chat_id": self.chat_id,
+ "dialogue_number": self.application.dialogue_number,
+ "problem_optimization_prompt": self.application.problem_optimization_prompt
+ if self.application.problem_optimization_prompt is not None
+ and len(self.application.problem_optimization_prompt) > 0
+ else _(
+ "() contains the user's question. Answer the guessed user's question based on the context ({question}) Requirement: Output a complete question and put it in the tag"
+ ),
+ "prompt": model_setting.get("prompt")
+ if "prompt" in model_setting and len(model_setting.get("prompt")) > 0
+ else Application.get_default_model_prompt(),
+ "system": model_setting.get("system", None),
+ "model_id": model_id,
+ "problem_optimization": self.application.problem_optimization,
+ "stream": True,
+ "model_setting": model_setting,
+ "model_params_setting": model_params_setting
+ if self.application.model_params_setting is None or len(self.application.model_params_setting.keys()) == 0
+ else self.application.model_params_setting,
+ "search_mode": self.application.knowledge_setting.get("search_mode") or "embedding",
+ "no_references_setting": self.get_no_references_setting(self.application.knowledge_setting, model_setting),
+ "workspace_id": self.application.workspace_id,
+ "application_id": self.application_id,
+ "mcp_enable": self.application.mcp_enable,
+ "mcp_tool_ids": self.application.mcp_tool_ids,
+ "mcp_servers": self.application.mcp_servers,
+ "mcp_source": self.application.mcp_source,
+ "tool_enable": self.application.tool_enable,
+ "tool_ids": self.application.tool_ids,
+ "application_enable": self.application.application_enable,
+ "application_ids": self.application.application_ids,
+ "skill_tool_ids": self.application.skill_tool_ids,
+ "mcp_output_enable": self.application.mcp_output_enable,
}
- def to_pipeline_manage_params(self, problem_text: str, post_response_handler,
- exclude_paragraph_id_list, chat_user_id: str, chat_user_type, ip_address, source,
- stream=True,
- form_data=None):
+ def to_pipeline_manage_params(
+ self,
+ problem_text: str,
+ post_response_handler,
+ exclude_paragraph_id_list,
+ chat_user_id: str,
+ chat_user_type,
+ ip_address,
+ source,
+ stream=True,
+ form_data=None,
+ ):
if form_data is None:
form_data = {}
params = self.to_base_pipeline_manage_params()
- return {**params, 'problem_text': problem_text, 'post_response_handler': post_response_handler,
- 'exclude_paragraph_id_list': exclude_paragraph_id_list, 'stream': stream, 'chat_user_id': chat_user_id,
- 'chat_user_type': chat_user_type, 'ip_address': ip_address, 'source': source, 'form_data': form_data}
+ return {
+ **params,
+ "problem_text": problem_text,
+ "post_response_handler": post_response_handler,
+ "exclude_paragraph_id_list": exclude_paragraph_id_list,
+ "stream": stream,
+ "chat_user_id": chat_user_id,
+ "chat_user_type": chat_user_type,
+ "ip_address": ip_address,
+ "source": source,
+ "form_data": form_data,
+ }
def set_chat(self, question):
if not self.debug:
if not QuerySet(Chat).filter(id=self.chat_id).exists():
- Chat(id=self.chat_id, application_id=self.application_id, abstract=question[0:1024],
- chat_user_id=self.chat_user_id, chat_user_type=self.chat_user_type,
- ip_address=self.ip_address, source=self.source,
- asker=self.get_chat_user()).save()
+ Chat(
+ id=self.chat_id,
+ application_id=self.application_id,
+ abstract=question[0:1024],
+ chat_user_id=self.chat_user_id,
+ chat_user_type=self.chat_user_type,
+ ip_address=self.ip_address,
+ source=self.source,
+ asker=self.get_chat_user(),
+ ).save()
+
+ def save_chat(self):
+ Chat(
+ id=self.chat_id,
+ application_id=self.application_id,
+ abstract="新建对话",
+ execute_type=ExecuteType.DEBUG if self.debug else ExecuteType.CHAT,
+ chat_user_id=self.chat_user_id,
+ chat_user_type=self.chat_user_type,
+ ip_address=self.ip_address,
+ source=self.source,
+ asker=self.get_chat_user(),
+ ).save()
def set_chat_variable(self, chat_context):
if not self.debug:
@@ -285,9 +396,12 @@ def set_chat_variable(self, chat_context):
chat.meta = {**(chat.meta if isinstance(chat.meta, dict) else {}), **chat_context}
chat.save()
else:
- cache.set(Cache_Version.CHAT_VARIABLE.get_key(key=self.chat_id), chat_context,
- version=Cache_Version.CHAT_VARIABLE.get_version(),
- timeout=60 * 30)
+ cache.set(
+ Cache_Version.CHAT_VARIABLE.get_key(key=self.chat_id),
+ chat_context,
+ version=Cache_Version.CHAT_VARIABLE.get_version(),
+ timeout=60 * 30,
+ )
def get_chat_variable(self):
if not self.debug:
@@ -296,8 +410,13 @@ def get_chat_variable(self):
return chat.meta
return {}
else:
- return cache.get(Cache_Version.CHAT_VARIABLE.get_key(key=self.chat_id),
- version=Cache_Version.CHAT_VARIABLE.get_version()) or {}
+ return (
+ cache.get(
+ Cache_Version.CHAT_VARIABLE.get_key(key=self.chat_id),
+ version=Cache_Version.CHAT_VARIABLE.get_version(),
+ )
+ or {}
+ )
def append_chat_record(self, chat_record: ChatRecord):
chat_record.problem_text = chat_record.problem_text[0:10240] if chat_record.problem_text is not None else ""
@@ -312,137 +431,172 @@ def append_chat_record(self, chat_record: ChatRecord):
break
if is_save:
self.chat_record_list.append(chat_record)
- if not self.debug:
- if not QuerySet(Chat).filter(id=self.chat_id).exists():
- Chat(id=self.chat_id, application_id=self.application_id, abstract=chat_record.problem_text[0:1024],
- chat_user_id=self.chat_user_id, chat_user_type=self.chat_user_type,
- ip_address=self.ip_address, source=self.source,
- asker=self.get_chat_user()).save()
- else:
- QuerySet(Chat).filter(id=self.chat_id).update(update_time=timezone.now())
- # 插入会话记录
- QuerySet(ChatRecord).update_or_create(id=chat_record.id,
- create_defaults={'id': chat_record.id,
- 'chat_id': chat_record.chat_id,
- "vote_status": chat_record.vote_status,
- 'problem_text': chat_record.problem_text,
- 'answer_text': chat_record.answer_text,
- 'answer_text_list': chat_record.answer_text_list,
- 'message_tokens': chat_record.message_tokens,
- 'answer_tokens': chat_record.answer_tokens,
- 'const': chat_record.const,
- 'details': chat_record.details,
- 'improve_paragraph_id_list': chat_record.improve_paragraph_id_list,
- 'run_time': chat_record.run_time,
- 'source': chat_record.source,
- 'ip_address': chat_record.ip_address or '',
- 'index': chat_record.index},
- defaults={
- "vote_status": chat_record.vote_status,
- 'problem_text': chat_record.problem_text,
- 'answer_text': chat_record.answer_text,
- 'answer_text_list': chat_record.answer_text_list,
- 'message_tokens': chat_record.message_tokens,
- 'answer_tokens': chat_record.answer_tokens,
- 'const': chat_record.const,
- 'details': chat_record.details,
- 'improve_paragraph_id_list': chat_record.improve_paragraph_id_list,
- 'run_time': chat_record.run_time,
- 'index': chat_record.index,
- 'source': chat_record.source,
- 'ip_address': chat_record.ip_address or '',
- })
- ChatCountSerializer(data={'chat_id': self.chat_id}).update_chat()
+ if not QuerySet(Chat).filter(id=self.chat_id).exists():
+ Chat(
+ id=self.chat_id,
+ application_id=self.application_id,
+ abstract=chat_record.problem_text[0:1024],
+ chat_user_id=self.chat_user_id,
+ chat_user_type=self.chat_user_type,
+ ip_address=self.ip_address,
+ source=self.source,
+ asker=self.get_chat_user(),
+ ).save()
+ else:
+ QuerySet(Chat).filter(id=self.chat_id).update(update_time=timezone.now())
+ # 记录Token消耗
+ total_tokens = (chat_record.message_tokens or 0) + (chat_record.answer_tokens or 0)
+ if total_tokens > 0:
+ ChatUserTokenQuota.consume(self.chat_user_id, total_tokens)
+ # 插入会话记录
+ QuerySet(ChatRecord).update_or_create(
+ id=chat_record.id,
+ create_defaults={
+ "id": chat_record.id,
+ "chat_id": chat_record.chat_id,
+ "vote_status": chat_record.vote_status,
+ "problem_text": chat_record.problem_text,
+ "answer_text": chat_record.answer_text,
+ "answer_text_list": chat_record.answer_text_list,
+ "message_tokens": chat_record.message_tokens,
+ "answer_tokens": chat_record.answer_tokens,
+ "const": chat_record.const,
+ "details": chat_record.details,
+ "improve_paragraph_id_list": chat_record.improve_paragraph_id_list,
+ "run_time": chat_record.run_time,
+ "source": chat_record.source,
+ "ip_address": chat_record.ip_address or "",
+ "index": chat_record.index,
+ },
+ defaults={
+ "vote_status": chat_record.vote_status,
+ "problem_text": chat_record.problem_text,
+ "answer_text": chat_record.answer_text,
+ "answer_text_list": chat_record.answer_text_list,
+ "message_tokens": chat_record.message_tokens,
+ "answer_tokens": chat_record.answer_tokens,
+ "const": chat_record.const,
+ "details": chat_record.details,
+ "improve_paragraph_id_list": chat_record.improve_paragraph_id_list,
+ "run_time": chat_record.run_time,
+ "index": chat_record.index,
+ "source": chat_record.source,
+ "ip_address": chat_record.ip_address or "",
+ },
+ )
+ ChatCountSerializer(data={"chat_id": self.chat_id}).update_chat()
def to_dict(self):
return {
- 'chat_id': self.chat_id,
- 'chat_user_id': self.chat_user_id,
- 'chat_user_type': self.chat_user_type,
- 'ip_address': self.ip_address,
- 'source': self.source,
- 'knowledge_id_list': self.knowledge_id_list,
- 'exclude_document_id_list': self.exclude_document_id_list,
- 'application_id': self.application_id,
- 'chat_record_list': [self.chat_record_to_map(c) for c in self.chat_record_list][-20:],
- 'debug': self.debug
+ "chat_id": self.chat_id,
+ "chat_user_id": self.chat_user_id,
+ "chat_user_type": self.chat_user_type,
+ "ip_address": self.ip_address,
+ "source": self.source,
+ "knowledge_id_list": self.knowledge_id_list,
+ "exclude_document_id_list": self.exclude_document_id_list,
+ "application_id": self.application_id,
+ "chat_record_list": [self.chat_record_to_map(c) for c in self.chat_record_list][-20:],
+ "debug": self.debug,
}
def chat_record_to_map(self, chat_record):
- return {'id': chat_record.id,
- 'chat_id': chat_record.chat_id,
- 'vote_status': chat_record.vote_status,
- 'problem_text': chat_record.problem_text,
- 'answer_text': chat_record.answer_text,
- 'answer_text_list': chat_record.answer_text_list,
- 'message_tokens': chat_record.message_tokens,
- 'answer_tokens': chat_record.answer_tokens,
- 'const': chat_record.const,
- 'details': chat_record.details,
- 'improve_paragraph_id_list': chat_record.improve_paragraph_id_list,
- 'run_time': chat_record.run_time,
- 'source': chat_record.source,
- 'ip_address': chat_record.ip_address,
- 'index': chat_record.index}
+ return {
+ "id": chat_record.id,
+ "chat_id": chat_record.chat_id,
+ "vote_status": chat_record.vote_status,
+ "problem_text": chat_record.problem_text,
+ "answer_text": chat_record.answer_text,
+ "answer_text_list": chat_record.answer_text_list,
+ "message_tokens": chat_record.message_tokens,
+ "answer_tokens": chat_record.answer_tokens,
+ "const": chat_record.const,
+ "details": chat_record.details,
+ "improve_paragraph_id_list": chat_record.improve_paragraph_id_list,
+ "run_time": chat_record.run_time,
+ "source": chat_record.source,
+ "ip_address": chat_record.ip_address,
+ "index": chat_record.index,
+ }
@staticmethod
def map_to_chat_record(chat_record_dict):
- return ChatRecord(id=chat_record_dict.get('id'),
- chat_id=chat_record_dict.get('chat_id'),
- vote_status=chat_record_dict.get('vote_status'),
- problem_text=chat_record_dict.get('problem_text'),
- answer_text=chat_record_dict.get('answer_text'),
- answer_text_list=chat_record_dict.get('answer_text_list'),
- message_tokens=chat_record_dict.get('message_tokens'),
- answer_tokens=chat_record_dict.get('answer_tokens'),
- const=chat_record_dict.get('const'),
- details=chat_record_dict.get('details'),
- improve_paragraph_id_list=chat_record_dict.get('improve_paragraph_id_list'),
- run_time=chat_record_dict.get('run_time'),
- index=chat_record_dict.get('index'),
- source=chat_record_dict.get('source'),
- ip_address=chat_record_dict.get('ip_address'))
+ return ChatRecord(
+ id=chat_record_dict.get("id"),
+ chat_id=chat_record_dict.get("chat_id"),
+ vote_status=chat_record_dict.get("vote_status"),
+ problem_text=chat_record_dict.get("problem_text"),
+ answer_text=chat_record_dict.get("answer_text"),
+ answer_text_list=chat_record_dict.get("answer_text_list"),
+ message_tokens=chat_record_dict.get("message_tokens"),
+ answer_tokens=chat_record_dict.get("answer_tokens"),
+ const=chat_record_dict.get("const"),
+ details=chat_record_dict.get("details"),
+ improve_paragraph_id_list=chat_record_dict.get("improve_paragraph_id_list"),
+ run_time=chat_record_dict.get("run_time"),
+ index=chat_record_dict.get("index"),
+ source=chat_record_dict.get("source"),
+ ip_address=chat_record_dict.get("ip_address"),
+ )
def set_cache(self):
- cache.set(Cache_Version.CHAT.get_key(key=self.chat_id), self.to_dict(),
- version=Cache_Version.CHAT_INFO.get_version(),
- timeout=60 * 30)
+ cache.set(
+ Cache_Version.CHAT.get_key(key=self.chat_id),
+ self.to_dict(),
+ version=Cache_Version.CHAT_INFO.get_version(),
+ timeout=60 * 30,
+ )
@staticmethod
def map_to_chat_info(chat_info_dict):
- c = ChatInfo(chat_info_dict.get('chat_id'), chat_info_dict.get('chat_user_id'),
- chat_info_dict.get('chat_user_type'), chat_info_dict.get('ip_address'),
- chat_info_dict.get('source'),
- chat_info_dict.get('knowledge_id_list'),
- chat_info_dict.get('exclude_document_id_list'),
- chat_info_dict.get('application_id'),
- debug=chat_info_dict.get('debug'))
- c.chat_record_list = [ChatInfo.map_to_chat_record(c_r) for c_r in chat_info_dict.get('chat_record_list')]
+ c = ChatInfo(
+ chat_info_dict.get("chat_id"),
+ chat_info_dict.get("chat_user_id"),
+ chat_info_dict.get("chat_user_type"),
+ chat_info_dict.get("ip_address"),
+ chat_info_dict.get("source"),
+ chat_info_dict.get("knowledge_id_list"),
+ chat_info_dict.get("exclude_document_id_list"),
+ chat_info_dict.get("application_id"),
+ debug=chat_info_dict.get("debug"),
+ )
+ c.chat_record_list = [ChatInfo.map_to_chat_record(c_r) for c_r in chat_info_dict.get("chat_record_list")]
return c
@staticmethod
def get_cache(chat_id):
- chat_info_dict = cache.get(Cache_Version.CHAT.get_key(key=chat_id),
- version=Cache_Version.CHAT_INFO.get_version())
+ chat_info_dict = cache.get(
+ Cache_Version.CHAT.get_key(key=chat_id), version=Cache_Version.CHAT_INFO.get_version()
+ )
if chat_info_dict:
return ChatInfo.map_to_chat_info(chat_info_dict)
return None
def update_resource_mapping_by_application(application_id: str, other_resource_mapping=None):
- from application.flow.tools import get_instance_resource, save_workflow_mapping, \
- application_instance_field_call_dict
+ from system_manage.services.resource_mapping import (
+ application_instance_field_call_dict,
+ get_instance_resource,
+ save_workflow_mapping,
+ )
from system_manage.models.resource_mapping import ResourceType
+
if other_resource_mapping is None:
other_resource_mapping = []
application = QuerySet(Application).filter(id=application_id).first()
- instance_mapping = get_instance_resource(application, ResourceType.APPLICATION, str(application.id),
- application_instance_field_call_dict)
- if application.type == 'WORK_FLOW':
- save_workflow_mapping(application.work_flow, ResourceType.APPLICATION, str(application_id),
- instance_mapping + other_resource_mapping)
+ instance_mapping = get_instance_resource(
+ application, ResourceType.APPLICATION, str(application.id), application_instance_field_call_dict
+ )
+ if application.type == "WORK_FLOW":
+ save_workflow_mapping(
+ application.work_flow,
+ ResourceType.APPLICATION,
+ str(application_id),
+ instance_mapping + other_resource_mapping,
+ )
return
else:
- save_workflow_mapping({}, ResourceType.APPLICATION, str(application_id),
- instance_mapping + other_resource_mapping)
+ save_workflow_mapping(
+ {}, ResourceType.APPLICATION, str(application_id), instance_mapping + other_resource_mapping
+ )
diff --git a/apps/application/sql/list_application.sql b/apps/application/sql/list_application.sql
index 3b6e863fd97..c26218223d7 100644
--- a/apps/application/sql/list_application.sql
+++ b/apps/application/sql/list_application.sql
@@ -2,6 +2,7 @@ select *
from (select application."id"::text, application."name",
application."desc",
application."is_publish",
+ application."is_portal",
application."type",
'application' as "resource_type",
application."workspace_id",
diff --git a/apps/application/sql/list_application_user.sql b/apps/application/sql/list_application_user.sql
index ecffcd93daf..cc25dab288f 100644
--- a/apps/application/sql/list_application_user.sql
+++ b/apps/application/sql/list_application_user.sql
@@ -2,6 +2,7 @@ select *
from (select application."id"::text, application."name",
application."desc",
application."is_publish",
+ application."is_portal",
application."type",
'application' as "resource_type",
application."workspace_id",
@@ -16,5 +17,13 @@ from (select application."id"::text, application."name",
left join "user" on user_id = "user".id
where application."id"::text in (select target
from workspace_user_resource_permission ${workspace_user_resource_permission_query_set}
- and 'VIEW' = any (permission_list))) temp
-${application_query_set}
\ No newline at end of file
+ and 'VIEW' = any (permission_list)
+ union
+ select distinct target
+ from workspace_user_group_resource_permission
+ inner join system_user_group_relation
+ on system_user_group_relation.group_id =
+ workspace_user_group_resource_permission.user_group_id
+ ${workspace_user_group_resource_permission_query_set}
+ and 'VIEW' = any (permission_list))) temp
+${application_query_set}
diff --git a/apps/application/sql/list_application_user_ee.sql b/apps/application/sql/list_application_user_ee.sql
index 0fe61a1402c..da5c356d5e6 100644
--- a/apps/application/sql/list_application_user_ee.sql
+++ b/apps/application/sql/list_application_user_ee.sql
@@ -2,6 +2,7 @@ select *
from (select application."id"::text, application."name",
application."desc",
application."is_publish",
+ application."is_portal",
application."type",
'application' as "resource_type",
application."workspace_id",
@@ -33,5 +34,33 @@ from (select application."id"::text, application."name",
else
'VIEW' = any (permission_list)
- end)) temp
-${application_query_set}
\ No newline at end of file
+ end
+ union
+ select distinct target
+ from workspace_user_group_resource_permission
+ inner join system_user_group_relation
+ on system_user_group_relation.group_id =
+ workspace_user_group_resource_permission.user_group_id
+ ${workspace_user_group_resource_permission_query_set}
+ and (
+ 'VIEW' = any (permission_list)
+ or (
+ auth_type = 'ROLE'
+ and 'ROLE' = any (permission_list)
+ and 'APPLICATION:READ' in (select (case
+ when user_role_relation.role_id =
+ any (array['USER'])
+ then 'APPLICATION:READ'
+ else
+ role_permission.permission_id end)
+ from role_permission role_permission
+ right join user_role_relation user_role_relation
+ on user_role_relation.role_id =
+ role_permission.role_id
+ where user_role_relation.user_id =
+ system_user_group_relation.user_id
+ and user_role_relation.workspace_id =
+ workspace_user_group_resource_permission.workspace_id)
+ )
+ ))) temp
+${application_query_set}
diff --git a/apps/application/tests.py b/apps/application/tests.py
index 7ce503c2dd9..d3acbc933ae 100644
--- a/apps/application/tests.py
+++ b/apps/application/tests.py
@@ -1,3 +1,143 @@
-from django.test import TestCase
+from datetime import datetime
+from types import SimpleNamespace
+from unittest.mock import MagicMock, patch
-# Create your tests here.
+from django.test import SimpleTestCase
+
+from application.workflow.nodes.ai_chat_node.ai_chat_node import AIChatNode, _get_upstream_knowledge_images
+from application.workflow.nodes.search_knowledge_node.search_knowledge_node import (
+ _get_recalled_image_list,
+ _record_recalled_items,
+ _reset_paragraph,
+)
+from knowledge.models import SourceType
+
+
+class SearchKnowledgeNodeTests(SimpleTestCase):
+ def test_image_hit_metadata_is_attached_to_recalled_paragraph(self):
+ paragraph_id = "00000000-0000-0000-0000-000000000001"
+ asset_id = "00000000-0000-0000-0000-000000000002"
+ file_id = "00000000-0000-0000-0000-000000000003"
+ created_at = datetime(2026, 9, 3, 10, 0, 0)
+ paragraph = {
+ "id": paragraph_id,
+ "knowledge_id": "00000000-0000-0000-0000-000000000004",
+ "document_id": "00000000-0000-0000-0000-000000000005",
+ "directly_return_similarity": 0.8,
+ "hit_handling_method": "normal",
+ "update_time": created_at,
+ "create_time": created_at,
+ "meta": {},
+ }
+ embedding = {
+ "paragraph_id": paragraph_id,
+ "similarity": 0.91,
+ "comprehensive_score": 0.93,
+ "source_id": asset_id,
+ "source_type": SourceType.IMAGE.value,
+ "query_unit_type": "text",
+ "query_unit_index": 0,
+ }
+ asset = {"id": asset_id, "file_id": file_id, "file_name": "chart.png"}
+
+ result = _reset_paragraph(paragraph, [embedding], {asset_id: asset})
+
+ self.assertEqual(result["hit_unit_type"], "image")
+ self.assertEqual(result["hit_asset"], asset)
+ self.assertEqual(result["comprehensive_score"], 0.93)
+ self.assertEqual(_get_recalled_image_list([result, result]), [asset])
+
+ def test_image_text_hit_adds_visual_text_to_retrieval_context(self):
+ paragraph_id = "00000000-0000-0000-0000-000000000001"
+ asset_id = "00000000-0000-0000-0000-000000000002"
+ created_at = datetime(2026, 9, 3, 10, 0, 0)
+ paragraph = {
+ "id": paragraph_id,
+ "knowledge_id": "00000000-0000-0000-0000-000000000004",
+ "document_id": "00000000-0000-0000-0000-000000000005",
+ "content": "paragraph text",
+ "directly_return_similarity": 0.8,
+ "hit_handling_method": "normal",
+ "update_time": created_at,
+ "create_time": created_at,
+ "meta": {},
+ }
+ embedding = {
+ "paragraph_id": paragraph_id,
+ "similarity": 0.91,
+ "comprehensive_score": 0.93,
+ "source_id": asset_id,
+ "source_type": SourceType.IMAGE.value,
+ "meta": {"unit_type": "text", "content_type": "image_description"},
+ }
+ asset = {
+ "id": asset_id,
+ "file_id": "00000000-0000-0000-0000-000000000003",
+ "caption": "chart",
+ "ocr_text": "revenue 100",
+ "description": "an upward trend",
+ }
+
+ result = _reset_paragraph(paragraph, [embedding], {asset_id: asset})
+
+ self.assertEqual(result["hit_unit_type"], "text")
+ self.assertEqual(result["retrieval_content"], "paragraph text\nchart\nrevenue 100\nan upward trend")
+
+ @patch("application.workflow.nodes.search_knowledge_node.search_knowledge_node.record_recall_safely")
+ @patch("application.workflow.nodes.search_knowledge_node.search_knowledge_node.get_recall_tracker")
+ def test_records_only_embeddings_returned_to_the_user(self, get_tracker, record_recall):
+ workflow_manage = MagicMock()
+ tracker = {}
+ get_tracker.return_value = tracker
+ embedding_list = [
+ {"paragraph_id": "paragraph-1", "source_type": SourceType.PARAGRAPH.value},
+ {"paragraph_id": "paragraph-2", "source_type": SourceType.PARAGRAPH.value},
+ ]
+
+ _record_recalled_items(embedding_list, [{"id": "paragraph-2"}], workflow_manage)
+
+ record_recall.assert_called_once_with([embedding_list[1]], tracker=tracker)
+
+ @patch("application.workflow.nodes.search_knowledge_node.search_knowledge_node.record_recall_safely")
+ def test_does_not_record_recall_in_debug_mode(self, record_recall):
+ _record_recalled_items([{"paragraph_id": "paragraph-1"}], [{"id": "paragraph-1"}], MagicMock(), True)
+
+ record_recall.assert_not_called()
+
+
+class AIChatKnowledgeImageTests(SimpleTestCase):
+ def setUp(self):
+ search_node = SimpleNamespace(id="search", type="search-knowledge-node")
+ condition_node = SimpleNamespace(id="condition", type="condition-node")
+ start_node = SimpleNamespace(id="start", type="start-node")
+ self.workflow_manage = MagicMock()
+ self.workflow_manage.workflow.up_node_map = {
+ "ai": [SimpleNamespace(node=condition_node)],
+ "condition": [SimpleNamespace(node=search_node)],
+ "search": [SimpleNamespace(node=start_node)],
+ }
+ self.asset = {
+ "file_id": "00000000-0000-0000-0000-000000000006",
+ "file_name": "chart.png",
+ }
+ self.workflow_manage.get_context.side_effect = lambda node_id, key: (
+ [self.asset, self.asset] if node_id == "search" and key == "image_list" else None
+ )
+
+ def test_collects_deduplicated_images_from_upstream_knowledge_searches(self):
+ self.assertEqual(_get_upstream_knowledge_images(self.workflow_manage, "ai"), [self.asset])
+
+ @patch("application.workflow.nodes.ai_chat_node.ai_chat_node._process_images")
+ def test_vision_chat_receives_recalled_knowledge_images(self, process_images):
+ processed_image = {"type": "image_url", "image_url": {"url": "data:image/png;base64,image"}}
+ process_images.return_value = [processed_image]
+ self.workflow_manage.generate_prompt.return_value = "answer with the recalled context"
+ node = AIChatNode.__new__(AIChatNode)
+ node.node = SimpleNamespace(id="ai")
+ node.workflow_manage = self.workflow_manage
+
+ question = node._generate_prompt_question("prompt", MagicMock(), True, None, None)
+
+ process_images.assert_called_once_with([self.asset])
+ self.assertEqual(question.content[0], processed_image)
+ self.assertEqual(question.content[-1]["text"], "answer with the recalled context")
diff --git a/apps/application/urls.py b/apps/application/urls.py
index 1c473b63935..05707a9f48f 100644
--- a/apps/application/urls.py
+++ b/apps/application/urls.py
@@ -43,5 +43,10 @@
path('workspace//application//play_demo_text', views.PlayDemoText.as_view()),
path('workspace//application//mcp_tools', views.McpServers.as_view()),
path('workspace//application//model//prompt_generate', views.PromptGenerateView.as_view()),
- path('chat_message/', views.ChatView.as_view()),
+ path('workspace//application//chat//chat_message', views.ChatView.as_view()),
+ path('workspace//application//chat//cancel_chat_message', views.CancelWorkflowView.as_view()),
+ path('workspace//application//chat//chat_record//resume_chat_message', views.ResumeStreamView.as_view()),
+ path('workspace//application//historical_conversation//', views.DebugHistoricalConversation.PageView.as_view()),
+ path('workspace//application//historical_conversation/', views.DebugHistoricalConversation.Operate.as_view()),
+ path('workspace//application//historical_conversation_record///', views.DebugHistoricalConversation.RecordPageView.as_view()),
]
diff --git a/apps/application/views/application.py b/apps/application/views/application.py
index 5f5058bca4d..6bb977ab75c 100644
--- a/apps/application/views/application.py
+++ b/apps/application/views/application.py
@@ -23,7 +23,10 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions, get_is_permissions, check_batch_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from tools.api.tool import GetInternalToolAPI
@@ -151,7 +154,7 @@ class Export(APIView):
PermissionConstants.APPLICATION_EXPORT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate="Export Application",
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')),
@@ -178,7 +181,7 @@ class Operate(APIView):
PermissionConstants.APPLICATION_DELETE.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate='Deleting application',
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')),
@@ -204,7 +207,7 @@ def delete(self, request: Request, workspace_id: str, application_id: str):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate="Modify the application",
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')),
@@ -230,7 +233,7 @@ def put(self, request: Request, workspace_id: str, application_id: str):
PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str):
return result.success(ApplicationOperateSerializer(
@@ -254,7 +257,7 @@ class Move(APIView):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate='Move an application',
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')))
@@ -281,7 +284,7 @@ class Publish(APIView):
PermissionConstants.APPLICATION_PUBLISH.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate='Publishing an application',
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')))
@@ -315,11 +318,11 @@ class BatchDelete(APIView):
methods=['PUT'],
description=_("Batch delete applications"),
summary=_("Batch delete applications"),
- operation_id=_("Batch delete applications"),
+ operation_id=_("Batch delete applications"), # type: ignore
parameters=ApplicationBatchOperateAPI.get_parameters(),
request=ApplicationBatchOperateAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Application')]
+ tags=[_('Application')] # type: ignore
)
@has_permissions(PermissionConstants.APPLICATION_BATCH_DELETE.get_workspace_permission(),
RoleConstants.USER.get_workspace_role(),
@@ -333,17 +336,18 @@ def put(self, request: Request, workspace_id: str):
PermissionConstants.APPLICATION_DELETE.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role()), workspace_id=workspace_id
)
+
@log(menu='Application', operate='Batch delete applications',
get_operation_object=lambda r, k: get_application_operation_object_batch(permitted_ids))
- def inner(view,r, **kwargs):
+ def inner(view, r, **kwargs):
return ApplicationBatchOperateSerializer(
data={'workspace_id': workspace_id, 'user_id': request.user.id}
).batch_delete({'id_list': permitted_ids})
- return result.success(inner(self,request, workspace_id=workspace_id))
+ return result.success(inner(self, request, workspace_id=workspace_id))
class BatchMove(APIView):
authentication_classes = [TokenAuth]
@@ -352,11 +356,11 @@ class BatchMove(APIView):
methods=['PUT'],
description=_("Batch move applications"),
summary=_("Batch move applications"),
- operation_id=_("Batch move applications"),
+ operation_id=_("Batch move applications"), # type: ignore
parameters=ApplicationBatchOperateAPI.get_parameters(),
request=ApplicationBatchOperateAPI.get_move_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Application')]
+ tags=[_('Application')] # type: ignore
)
@has_permissions(PermissionConstants.APPLICATION_BATCH_MOVE.get_workspace_permission(),
RoleConstants.USER.get_workspace_role(),
@@ -370,19 +374,19 @@ def put(self, request: Request, workspace_id: str):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role()),
workspace_id=workspace_id
)
@log(menu='Application', operate='Batch move applications',
get_operation_object=lambda r, k: get_application_operation_object_batch(permitted_ids))
- def inner(view,r, **kwargs):
+ def inner(view, r, **kwargs):
return ApplicationBatchOperateSerializer(
data={'workspace_id': workspace_id, 'user_id': request.user.id}
).batch_move({'id_list': permitted_ids, 'folder_id': request.data.get('folder_id')})
- return result.success(inner(self,request, workspace_id=workspace_id))
+ return result.success(inner(self, request, workspace_id=workspace_id))
class BatchCleanTime(APIView):
authentication_classes = [TokenAuth]
@@ -391,11 +395,11 @@ class BatchCleanTime(APIView):
methods=['PUT'],
description=_("Batch update application chat log clear policy"),
summary=_("Batch update application chat log clear policy"),
- operation_id=_("Batch update application chat log clear policy"),
+ operation_id=_("Batch update application chat log clear policy"), # type: ignore
parameters=ApplicationBatchOperateAPI.get_parameters(),
request=ApplicationBatchOperateAPI.get_clean_time_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Application')]
+ tags=[_('Application')] # type: ignore
)
@has_permissions(PermissionConstants.APPLICATION_READ.get_workspace_permission(),
RoleConstants.USER.get_workspace_role(),
@@ -409,14 +413,14 @@ def put(self, request: Request, workspace_id: str):
PermissionConstants.APPLICATION_CHAT_LOG_CLEAR_POLICY.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role()),
workspace_id=workspace_id
)
@log(menu='Application', operate='Batch update application chat log clear policy',
get_operation_object=lambda r, k: get_application_operation_object_batch(permitted_ids))
- def inner(view,r, **kwargs):
+ def inner(view, r, **kwargs):
return ApplicationBatchOperateSerializer(
data={'workspace_id': workspace_id, 'user_id': request.user.id}
).batch_clean_time({
@@ -425,7 +429,8 @@ def inner(view,r, **kwargs):
'file_clean_time': request.data.get('file_clean_time')
})
- return result.success(inner(self,request, workspace_id=workspace_id))
+ return result.success(inner(self, request, workspace_id=workspace_id))
+
class McpServers(APIView):
authentication_classes = [TokenAuth]
@@ -444,7 +449,7 @@ class McpServers(APIView):
PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def post(self, request: Request, workspace_id, application_id: str):
return result.success(ApplicationOperateSerializer(
@@ -470,7 +475,7 @@ class SpeechToText(APIView):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def post(self, request: Request, workspace_id: str, application_id: str):
return result.success(
@@ -496,7 +501,7 @@ class TextToSpeech(APIView):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def post(self, request: Request, workspace_id: str, application_id: str):
byte_data = ApplicationOperateSerializer(
@@ -523,7 +528,7 @@ class PlayDemoText(APIView):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate="trial listening",
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')))
diff --git a/apps/application/views/application_access_token.py b/apps/application/views/application_access_token.py
index f7dc6bcaf83..ebf7da12e9f 100644
--- a/apps/application/views/application_access_token.py
+++ b/apps/application/views/application_access_token.py
@@ -18,7 +18,10 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
def get_application_operation_object(application_id):
@@ -49,7 +52,7 @@ class AccessToken(APIView):
PermissionConstants.APPLICATION_OVERVIEW_ACCESS.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def put(self, request: Request, workspace_id: str, application_id: str):
return result.success(
@@ -68,7 +71,7 @@ def put(self, request: Request, workspace_id: str, application_id: str):
PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
)
def get(self, request: Request, workspace_id: str, application_id: str):
diff --git a/apps/application/views/application_api_key.py b/apps/application/views/application_api_key.py
index 213c8fe7221..bd07d07a44f 100644
--- a/apps/application/views/application_api_key.py
+++ b/apps/application/views/application_api_key.py
@@ -9,7 +9,11 @@
from application.serializers.application_api_key import ApplicationKeySerializer
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+
from common.log.log import log
from common.result import result, DefaultResultSerializer
@@ -42,8 +46,9 @@ class ApplicationKey(APIView):
@has_permissions(PermissionConstants.APPLICATION_OVERVIEW_API_KEY.get_workspace_application_permission(),
PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ [
+ PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
)
def post(self, request: Request, workspace_id: str, application_id: str):
@@ -67,7 +72,7 @@ class Page(APIView):
PermissionConstants.APPLICATION_OVERVIEW_API_KEY.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, current_page: int, page_size: int):
return result.success(ApplicationKeySerializer(
@@ -92,7 +97,7 @@ class Operate(APIView):
PermissionConstants.APPLICATION_OVERVIEW_API_KEY.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate="Modify application API_KEY",
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')),
@@ -118,7 +123,7 @@ def put(self, request: Request, workspace_id: str, application_id: str, api_key_
PermissionConstants.APPLICATION_OVERVIEW_API_KEY.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate="Delete application API_KEY",
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')),
diff --git a/apps/application/views/application_chat.py b/apps/application/views/application_chat.py
index d60206ded5a..01dbcb464ec 100644
--- a/apps/application/views/application_chat.py
+++ b/apps/application/views/application_chat.py
@@ -1,179 +1,407 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_chat.py
- @date:2025/6/10 11:00
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application_chat.py
+@date:2025/6/10 11:00
+@desc:
"""
-import uuid_utils.compat as uuid
-from django.db.models import QuerySet
+from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
from rest_framework.request import Request
from rest_framework.views import APIView
-from application.api.application_chat import ApplicationChatQueryAPI, ApplicationChatQueryPageAPI, \
- ApplicationChatExportAPI
-from application.models import ChatUserType, Application
+from application.api.application_chat import (
+ ApplicationChatQueryAPI,
+ ApplicationChatQueryPageAPI,
+ ApplicationChatExportAPI,
+)
+from application.models import ChatUserType, Application, ChatSourceChoices
from application.serializers.application_chat import ApplicationChatQuerySerializers
-from chat.api.chat_api import ChatAPI, PromptGenerateAPI
+from chat.api.chat_api import ChatAPI, PromptGenerateAPI, PageHistoricalConversationAPI, HistoricalConversationRecordAPI
from chat.api.chat_authentication_api import ChatOpenAPI
-from chat.serializers.chat import OpenChatSerializers, ChatSerializers, DebugChatSerializers, PromptGenerateSerializer
+from chat.serializers.chat import DebugChatSerializers, OpenChatSerializers, PromptGenerateSerializer, ResumeSerializers
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
-from common.log.log import log
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.log.log import log, _get_ip_address
from common.result import result
from common.utils.common import query_params_to_single_dict
+
def get_application_operation_object(application_id):
application_model = QuerySet(model=Application).filter(id=application_id).first()
if application_model is not None:
- return {
- 'name': application_model.name
- }
+ return {"name": application_model.name}
return {}
+
class ApplicationChat(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get the conversation list"),
summary=_("Get the conversation list"),
operation_id=_("Get the conversation list"), # type: ignore
request=ApplicationChatQueryAPI.get_request(),
parameters=ApplicationChatQueryAPI.get_parameters(),
responses=ApplicationChatQueryAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str):
- return result.success(ApplicationChatQuerySerializers(
- data={**query_params_to_single_dict(request.query_params), 'workspace_id': workspace_id,
- 'application_id': application_id,
- }).list())
+ return result.success(
+ ApplicationChatQuerySerializers(
+ data={
+ **query_params_to_single_dict(request.query_params),
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ }
+ ).list()
+ )
class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get the conversation list by page"),
summary=_("Get the conversation list by page"),
operation_id=_("Get the conversation list by page"), # type: ignore
request=ApplicationChatQueryPageAPI.get_request(),
parameters=ApplicationChatQueryPageAPI.get_parameters(),
responses=ApplicationChatQueryPageAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, current_page: int, page_size: int):
- return result.success(ApplicationChatQuerySerializers(
- data={**query_params_to_single_dict(request.query_params), 'workspace_id': workspace_id,
- 'application_id': application_id,
- }).page(current_page=current_page,
- page_size=page_size))
+ return result.success(
+ ApplicationChatQuerySerializers(
+ data={
+ **query_params_to_single_dict(request.query_params),
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ }
+ ).page(current_page=current_page, page_size=page_size)
+ )
class Export(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Export conversation"),
summary=_("Export conversation"),
operation_id=_("Export conversation"), # type: ignore
request=ApplicationChatExportAPI.get_request(),
parameters=ApplicationChatExportAPI.get_parameters(),
responses=ApplicationChatExportAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_EXPORT.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_EXPORT.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_EXPORT.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_EXPORT.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def post(self, request: Request, workspace_id: str, application_id: str):
return ApplicationChatQuerySerializers(
- data={**query_params_to_single_dict(request.query_params), 'workspace_id': workspace_id,
- 'application_id': application_id,
- }).export(request.data)
+ data={
+ **query_params_to_single_dict(request.query_params),
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ }
+ ).export(request.data)
class OpenView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get a temporary session id based on the application id"),
summary=_("Get a temporary session id based on the application id"),
operation_id=_("Get a temporary session id based on the application id"), # type: ignore
parameters=ChatOpenAPI.get_parameters(),
responses=None,
- tags=[_('Application')] # type: ignore
+ tags=[_("Application")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str):
- return result.success(OpenChatSerializers(
- data={'workspace_id': workspace_id, 'application_id': application_id,
- 'chat_user_id': str(uuid.uuid7()), 'chat_user_type': ChatUserType.ANONYMOUS_USER,
- 'debug': True}).open())
+ ip_address = _get_ip_address(request)
+ return result.success(
+ OpenChatSerializers(
+ data={
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_user_id": str(request.user.id),
+ "chat_user_type": ChatUserType.SYSTEM_USER,
+ "ip_address": ip_address,
+ "source": {"type": ChatSourceChoices.ONLINE.value},
+ "debug": True,
+ }
+ ).open()
+ )
class ChatView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("dialogue"),
summary=_("dialogue"),
operation_id=_("dialogue"), # type: ignore
request=ChatAPI.get_request(),
parameters=ChatAPI.get_parameters(),
responses=None,
- tags=[_('Application')] # type: ignore
+ tags=[_("Application")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- def post(self, request: Request, chat_id: str):
- return DebugChatSerializers(data={'chat_id': chat_id}).chat(request.data)
+ def post(self, request: Request, workspace_id: str, application_id: str, chat_id: str):
+ # 携带 open 上下文:前端本地生成 chat_id 首次发消息时,缓存缺失则按该 id 现开会话。
+ return DebugChatSerializers(
+ data={
+ "chat_id": chat_id,
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_user_id": str(request.user.id),
+ "chat_user_type": ChatUserType.SYSTEM_USER,
+ "ip_address": _get_ip_address(request),
+ "source": {"type": ChatSourceChoices.ONLINE.value},
+ }
+ ).chat(request.data)
+
+
+class CancelWorkflowView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Cancel running workflow"),
+ summary=_("Cancel running workflow"),
+ operation_id=_("Cancel running workflow"), # type: ignore
+ tags=[_("Application")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def post(self, request: Request, workspace_id: str, application_id: str, chat_id: str):
+ from application.workflow.workflow_run_registry import WorkflowRunRegistry, CancelResult
+
+ result_enum = WorkflowRunRegistry.cancel_by_chat_id(chat_id)
+ if result_enum == CancelResult.CANCELLED:
+ return result.success({"status": "cancelled", "chat_id": chat_id})
+ elif result_enum == CancelResult.NOT_FOUND:
+ return result.success({"status": "not_found", "chat_id": chat_id})
+ else:
+ return result.error(_("Failed to cancel workflow"))
+
+
+class ResumeStreamView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Resume stream for workflow"),
+ summary=_("Resume stream for workflow"),
+ operation_id=_("Resume stream for workflow"), # type: ignore
+ tags=[_("Application")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def post(self, request: Request, workspace_id: str, application_id: str, chat_id: str, chat_record_id: str):
+ return ResumeSerializers(data={"chat_id": chat_id, "chat_record_id": chat_record_id}).resume(request)
+
class PromptGenerateView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("generate prompt"),
summary=_("generate prompt"),
operation_id=_("generate prompt"), # type: ignore
request=PromptGenerateAPI.get_request(),
parameters=PromptGenerateAPI.get_parameters(),
responses=None,
- tags=[_('Application')] # type: ignore
+ tags=[_("Application")], # type: ignore
)
- @has_permissions(PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
- @log(menu='Application', operate='Generate prompt',
- get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')))
- def post(self, request: Request, workspace_id: str, model_id:str, application_id: str):
- return PromptGenerateSerializer(data={'workspace_id': workspace_id, 'model_id': model_id, 'application_id': application_id}).generate_prompt(instance=request.data)
\ No newline at end of file
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ @log(
+ menu="Application",
+ operate="Generate prompt",
+ get_operation_object=lambda r, k: get_application_operation_object(k.get("application_id")),
+ )
+ def post(self, request: Request, workspace_id: str, model_id: str, application_id: str):
+ return PromptGenerateSerializer(
+ data={"workspace_id": workspace_id, "model_id": model_id, "application_id": application_id}
+ ).generate_prompt(instance=request.data)
+
+
+class DebugHistoricalConversation(APIView):
+ authentication_classes = [TokenAuth]
+
+ class PageView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation by page"),
+ summary=_("Get historical conversation by page"),
+ operation_id=_("Get historical conversation by page"), # type: ignore
+ parameters=PageHistoricalConversationAPI.get_parameters(),
+ responses=PageHistoricalConversationAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(self, request: Request, workspace_id: str, application_id: str, current_page: int, page_size: int):
+ from chat.serializers.chat_record import HistoricalConversationSerializer
+
+ return result.success(
+ HistoricalConversationSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": str(request.user.id),
+ }
+ ).page(current_page, page_size)
+ )
+
+ class RecordPageView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation records"),
+ summary=_("Get historical conversation records"),
+ operation_id=_("Get historical conversation records"), # type: ignore
+ parameters=HistoricalConversationRecordAPI.get_parameters(),
+ responses=HistoricalConversationRecordAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(
+ self,
+ request: Request,
+ workspace_id: str,
+ application_id: str,
+ chat_id: str,
+ current_page: int,
+ page_size: int,
+ ):
+ from chat.serializers.chat_record import HistoricalConversationRecordSerializer
+
+ serializer = HistoricalConversationRecordSerializer(
+ data={
+ "application_id": application_id,
+ "chat_id": chat_id,
+ "chat_user_id": str(request.user.id),
+ }
+ )
+ return result.success(serializer.page(current_page, page_size))
+
+ class Operate(APIView):
+ authentication_classes = [TokenAuth]
+
+ def delete(self, request: Request, workspace_id: str, application_id: str, chat_id: str):
+ from django.db.models import QuerySet
+ from application.models import Chat
+
+ QuerySet(Chat).filter(id=chat_id, application_id=application_id).update(is_deleted=True)
+ return result.success(True)
+
+ def put(self, request: Request, workspace_id: str, application_id: str, chat_id: str):
+ from django.db.models import QuerySet
+ from application.models import Chat
+
+ abstract = request.data.get("abstract", "")
+ QuerySet(Chat).filter(id=chat_id, application_id=application_id).update(abstract=abstract)
+ return result.success(True)
diff --git a/apps/application/views/application_chat_link.py b/apps/application/views/application_chat_link.py
index d410ef392a6..2ed46cbae2d 100644
--- a/apps/application/views/application_chat_link.py
+++ b/apps/application/views/application_chat_link.py
@@ -1,10 +1,11 @@
"""
- @project: MaxKB
- @Author: niu
- @file: application_chat_link.py
- @date: 2026/2/9 10:44
- @desc:
+@project: MaxKB
+@Author: niu
+@file: application_chat_link.py
+@date: 2026/2/9 10:44
+@desc:
"""
+
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
from rest_framework.request import Request
@@ -20,36 +21,32 @@ class ChatRecordLinkView(APIView):
authentication_classes = [ChatTokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Generate share link"),
summary=_("Generate share link"),
operation_id=_("Generate share link"), # type: ignore
request=ChatRecordLinkAPI.get_request(),
parameters=ChatRecordLinkAPI.get_parameters(),
responses=ChatRecordLinkAPI.get_response(),
- tags=[_("Chat record link")] # type: ignore
+ tags=[_("Chat record link")], # type: ignore
)
-
def post(self, request: Request, application_id: str, chat_id: str):
- return result.success(ChatRecordShareLinkSerializer(data={
- "application_id": application_id,
- "chat_id": chat_id,
- "user_id": request.auth.chat_user_id
- }).generate_link(request.data))
+ return result.success(
+ ChatRecordShareLinkSerializer(
+ data={"application_id": application_id, "chat_id": chat_id, "user_id": request.user.id}
+ ).generate_link(request.data)
+ )
class ChatRecordDetailView(APIView):
-
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get chat record by share link"),
summary=_("Get chat record by share link"),
operation_id=_("Get chat record by share link"), # type: ignore
parameters=ChatRecordDetailShareAPI.get_parameters(),
responses=ChatRecordDetailShareAPI.get_response(),
- tags=[_("Chat record link")] # type: ignore
+ tags=[_("Chat record link")], # type: ignore
)
def get(self, request, link: str):
- return result.success(
- ChatShareLinkDetailSerializer(data={'link':link}).get_record_list()
- )
+ return result.success(ChatShareLinkDetailSerializer(data={"link": link}).get_record_list())
diff --git a/apps/application/views/application_chat_record.py b/apps/application/views/application_chat_record.py
index 0d59146b29d..91213efcc32 100644
--- a/apps/application/views/application_chat_record.py
+++ b/apps/application/views/application_chat_record.py
@@ -1,217 +1,313 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_chat_record.py
- @date:2025/6/10 15:08
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: application_chat_record.py
+@date:2025/6/10 15:08
+@desc:
"""
-from django.utils.translation import gettext_lazy as _
-from drf_spectacular.utils import extend_schema
-from rest_framework.request import Request
-from rest_framework.views import APIView
-from application.api.application_chat_record import ApplicationChatRecordQueryAPI, \
- ApplicationChatRecordImproveParagraphAPI, ApplicationChatRecordAddKnowledgeAPI
-from application.serializers.application_chat_record import ApplicationChatRecordQuerySerializers, \
- ApplicationChatRecordImproveSerializer, ChatRecordImproveSerializer, ApplicationChatRecordAddKnowledgeSerializer, \
- ChatRecordOperateSerializer
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.utils.common import query_params_to_single_dict
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from application.api.application_chat_record import (
+ ApplicationChatRecordAddKnowledgeAPI,
+ ApplicationChatRecordImproveParagraphAPI,
+ ApplicationChatRecordQueryAPI,
+)
+from application.serializers.application_chat_record import (
+ ApplicationChatRecordAddKnowledgeSerializer,
+ ApplicationChatRecordImproveSerializer,
+ ApplicationChatRecordQuerySerializers,
+ ChatRecordImproveSerializer,
+ ChatRecordOperateSerializer,
+)
class ApplicationChatRecord(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get the conversation record list"),
summary=_("Get the conversation record list"),
operation_id=_("Get the conversation record list"), # type: ignore
request=ApplicationChatRecordQueryAPI.get_request(),
parameters=ApplicationChatRecordQueryAPI.get_parameters(),
responses=ApplicationChatRecordQueryAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, chat_id: str):
- return result.success(ApplicationChatRecordQuerySerializers(
- data={**query_params_to_single_dict(request.query_params), 'workspace_id': workspace_id,
- 'application_id': application_id,
- 'chat_id': chat_id
- }).list())
+ return result.success(
+ ApplicationChatRecordQuerySerializers(
+ data={
+ **query_params_to_single_dict(request.query_params),
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_id": chat_id,
+ }
+ ).list()
+ )
class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get the conversation record list by page"),
summary=_("Get the conversation record list by page"),
operation_id=_("Get the conversation record list by page"), # type: ignore
request=ApplicationChatRecordQueryAPI.get_request(),
parameters=ApplicationChatRecordQueryAPI.get_parameters(),
responses=ApplicationChatRecordQueryAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
- def get(self, request: Request, workspace_id: str, application_id: str, chat_id: str, current_page: int,
- page_size: int):
- return result.success(ApplicationChatRecordQuerySerializers(
- data={**query_params_to_single_dict(request.query_params), 'workspace_id': workspace_id,
- 'application_id': application_id,
- 'chat_id': chat_id}).page(
- current_page=current_page,
- page_size=page_size))
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND, ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ def get(
+ self,
+ request: Request,
+ workspace_id: str,
+ application_id: str,
+ chat_id: str,
+ current_page: int,
+ page_size: int,
+ ):
+ return result.success(
+ ApplicationChatRecordQuerySerializers(
+ data={
+ **query_params_to_single_dict(request.query_params),
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_id": chat_id,
+ }
+ ).page(current_page=current_page, page_size=page_size)
+ )
class ApplicationChatRecordOperateAPI(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get conversation record details"),
summary=_("Get conversation record details"),
operation_id=_("Get conversation record details"), # type: ignore
request=ApplicationChatRecordQueryAPI.get_request(),
parameters=ApplicationChatRecordQueryAPI.get_parameters(),
responses=ApplicationChatRecordQueryAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_READ.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.APPLICATION_READ.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, chat_id: str, chat_record_id: str):
- return result.success(ChatRecordOperateSerializer(
- data={
- 'workspace_id': workspace_id,
- 'application_id': application_id,
- 'chat_id': chat_id,
- 'chat_record_id': chat_record_id}).one(True))
+ return result.success(
+ ChatRecordOperateSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ }
+ ).one(True)
+ )
class ApplicationChatRecordAddKnowledge(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Add to Knowledge Base"),
summary=_("Add to Knowledge Base"),
operation_id=_("Add to Knowledge Base"), # type: ignore
request=ApplicationChatRecordAddKnowledgeAPI.get_request(),
parameters=ApplicationChatRecordAddKnowledgeAPI.get_parameters(),
responses=ApplicationChatRecordAddKnowledgeAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_ADD_KNOWLEDGE.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_ADD_KNOWLEDGE.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_ADD_KNOWLEDGE.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_ADD_KNOWLEDGE.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def post(self, request: Request, workspace_id: str, application_id: str):
- return result.success(ApplicationChatRecordAddKnowledgeSerializer(data = {'workspace_id': workspace_id, 'application_id': application_id, **request.data}).post_improve(
- {'workspace_id': workspace_id, 'application_id': application_id, **request.data}, request=request))
+ return result.success(
+ ApplicationChatRecordAddKnowledgeSerializer(
+ data={"workspace_id": workspace_id, "application_id": application_id, **request.data}
+ ).post_improve(
+ {"workspace_id": workspace_id, "application_id": application_id, **request.data}, request=request
+ )
+ )
class ApplicationChatRecordImprove(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get the list of marked paragraphs"),
summary=_("Get the list of marked paragraphs"),
operation_id=_("Get the list of marked paragraphs"), # type: ignore
request=ApplicationChatRecordQueryAPI.get_request(),
parameters=ApplicationChatRecordQueryAPI.get_parameters(),
responses=ApplicationChatRecordQueryAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, chat_id: str, chat_record_id: str):
- return result.success(ChatRecordImproveSerializer(
- data={'workspace_id': workspace_id, 'application_id': application_id, 'chat_id': chat_id,
- 'chat_record_id': chat_record_id}).get())
+ return result.success(
+ ChatRecordImproveSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ }
+ ).get()
+ )
class ApplicationChatRecordImproveParagraph(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
description=_("Annotation"),
summary=_("Annotation"),
operation_id=_("Annotation"), # type: ignore
request=ApplicationChatRecordImproveParagraphAPI.get_request(),
parameters=ApplicationChatRecordImproveParagraphAPI.get_parameters(),
responses=ApplicationChatRecordImproveParagraphAPI.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
- def put(self, request: Request,
+ def put(
+ self,
+ request: Request,
workspace_id: str,
application_id: str,
chat_id: str,
chat_record_id: str,
knowledge_id: str,
- document_id: str):
- return result.success(ApplicationChatRecordImproveSerializer(
- data={'workspace_id': workspace_id, 'application_id': application_id, 'chat_id': chat_id,
- 'chat_record_id': chat_record_id,
- 'knowledge_id': knowledge_id, 'document_id': document_id}).improve(request.data, request=request))
+ document_id: str,
+ ):
+ return result.success(
+ ApplicationChatRecordImproveSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ "knowledge_id": knowledge_id,
+ "document_id": document_id,
+ }
+ ).improve(request.data, request=request)
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['DELETE'],
+ methods=["DELETE"],
description=_("Delete a Annotation"),
summary=_("Delete a Annotation"),
operation_id=_("Delete a Annotation"), # type: ignore
request=ApplicationChatRecordImproveParagraphAPI.Operate.get_request(),
parameters=ApplicationChatRecordImproveParagraphAPI.Operate.get_parameters(),
responses=ApplicationChatRecordImproveParagraphAPI.Operate.get_response(),
- tags=[_("Application/Conversation Log")] # type: ignore
+ tags=[_("Application/Conversation Log")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_application_permission(),
+ PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.APPLICATION.get_workspace_application_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_application_permission(),
- PermissionConstants.APPLICATION_CHAT_LOG_ANNOTATION.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
- def delete(self, request: Request, workspace_id: str, application_id: str, chat_id: str, chat_record_id: str,
- knowledge_id: str,
- document_id: str, paragraph_id: str):
- return result.success(ApplicationChatRecordImproveSerializer.Operate(
- data={'chat_id': chat_id, 'chat_record_id': chat_record_id, 'workspace_id': workspace_id,
- 'application_id': application_id,
- 'knowledge_id': knowledge_id, 'document_id': document_id,
- 'paragraph_id': paragraph_id}).delete(request=request))
+ def delete(
+ self,
+ request: Request,
+ workspace_id: str,
+ application_id: str,
+ chat_id: str,
+ chat_record_id: str,
+ knowledge_id: str,
+ document_id: str,
+ paragraph_id: str,
+ ):
+ return result.success(
+ ApplicationChatRecordImproveSerializer.Operate(
+ data={
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ "workspace_id": workspace_id,
+ "application_id": application_id,
+ "knowledge_id": knowledge_id,
+ "document_id": document_id,
+ "paragraph_id": paragraph_id,
+ }
+ ).delete(request=request)
+ )
diff --git a/apps/application/views/application_stats.py b/apps/application/views/application_stats.py
index 4567156175e..c4fbe65bf9b 100644
--- a/apps/application/views/application_stats.py
+++ b/apps/application/views/application_stats.py
@@ -17,7 +17,10 @@
from django.utils.translation import gettext_lazy as _
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
class ApplicationStats(APIView):
@@ -36,7 +39,7 @@ class ApplicationStats(APIView):
PermissionConstants.APPLICATION_OVERVIEW_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str):
return result.success(
@@ -64,7 +67,7 @@ class TokenUsageStatistics(APIView):
PermissionConstants.APPLICATION_OVERVIEW_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str):
return result.success(
@@ -91,7 +94,7 @@ class TopQuestionsStatistics(APIView):
PermissionConstants.APPLICATION_OVERVIEW_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str):
return result.success(
diff --git a/apps/application/views/application_version.py b/apps/application/views/application_version.py
index 3a87a1533f0..ad3c3db9797 100644
--- a/apps/application/views/application_version.py
+++ b/apps/application/views/application_version.py
@@ -18,7 +18,10 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
@@ -38,7 +41,7 @@ class ApplicationVersionView(APIView):
PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id, application_id: str):
return result.success(
@@ -62,7 +65,7 @@ class Page(APIView):
PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, current_page: int, page_size: int):
return result.success(
@@ -87,7 +90,7 @@ class Operate(APIView):
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, application_id: str, application_version_id: str):
return result.success(
@@ -109,7 +112,7 @@ def get(self, request: Request, workspace_id: str, application_id: str, applicat
PermissionConstants.APPLICATION_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.APPLICATION.get_workspace_application_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Application', operate="Modify application version information",
get_operation_object=lambda r, k: get_application_operation_object(k.get('application_id')),
diff --git a/apps/application/workflow/__init__.py b/apps/application/workflow/__init__.py
new file mode 100644
index 00000000000..c4f90ff4f38
--- /dev/null
+++ b/apps/application/workflow/__init__.py
@@ -0,0 +1,8 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/6/29 16:15
+ @desc:
+"""
diff --git a/apps/application/flow/backend/__init__.py b/apps/application/workflow/backend/__init__.py
similarity index 100%
rename from apps/application/flow/backend/__init__.py
rename to apps/application/workflow/backend/__init__.py
diff --git a/apps/application/workflow/backend/sandbox_mcp.py b/apps/application/workflow/backend/sandbox_mcp.py
new file mode 100644
index 00000000000..12f0780248a
--- /dev/null
+++ b/apps/application/workflow/backend/sandbox_mcp.py
@@ -0,0 +1,47 @@
+"""MCP backend honoring the application's sandbox switch."""
+
+from langchain_mcp_adapters.client import MultiServerMCPClient
+from mcp.types import CallToolResult
+
+from common.mcp.config import InternalMCPConfig, remote_connection, validate_mcp_servers
+from common.mcp.sandbox import sandbox_connection
+from maxkb.const import CONFIG
+
+
+class SandboxMCPBackend(MultiServerMCPClient):
+ """Provide MCP tools and sessions using the configured sandbox mode.
+
+ With SANDBOX enabled, inherited get_tools() creates tools whose later
+ invocations also open sandbox workers. When explicitly disabled, use remote
+ SDK connections directly for local development. This backend supplies the
+ agent's tools; SandboxShellBackend handles skill files and shell commands.
+ """
+
+ def __init__(self, servers: dict):
+ super().__init__(connections=self._build_connections(servers))
+
+ @staticmethod
+ def _build_connections(servers: dict) -> dict:
+ if not isinstance(servers, dict):
+ raise ValueError("MCP servers must be an object")
+ connections = {}
+ for name, config in servers.items():
+ if not isinstance(config, dict):
+ raise ValueError("MCP server configuration must be an object")
+ internal = isinstance(config, InternalMCPConfig)
+ if internal and config.get("transport") == "stdio":
+ connections[name] = dict(config)
+ continue
+ validate_mcp_servers({name: config})
+ if internal:
+ connections[name] = dict(config)
+ elif bool(int(CONFIG.get("SANDBOX", 1))):
+ connections[name] = sandbox_connection(config)
+ else:
+ connections[name] = remote_connection(config)
+ return connections
+
+ async def call_tool(self, server_name: str, tool_name: str, arguments: dict | None = None) -> CallToolResult:
+ """Call one tool and close its session/worker, preserving the MCP result."""
+ async with self.session(server_name) as session:
+ return await session.call_tool(tool_name, arguments)
diff --git a/apps/application/workflow/backend/sandbox_shell.py b/apps/application/workflow/backend/sandbox_shell.py
new file mode 100644
index 00000000000..7dac1f90376
--- /dev/null
+++ b/apps/application/workflow/backend/sandbox_shell.py
@@ -0,0 +1,311 @@
+import getpass
+import os
+import re
+import shlex
+
+from deepagents.backends import LocalShellBackend
+from deepagents.backends.protocol import ExecuteResponse
+
+from common.utils.logger import maxkb_logger
+from maxkb.const import CONFIG
+
+_enable_sandbox = bool(int(CONFIG.get("SANDBOX", 1)))
+_run_user = "sandbox" if _enable_sandbox else getpass.getuser()
+_sandbox_python_sys_path = CONFIG.get_sandbox_python_package_paths().replace(",", ":")
+
+
+class SandboxShellBackend(LocalShellBackend):
+ def __init__(self, root_dir: str, **kwargs):
+ if "env" not in kwargs and not kwargs.get("inherit_env", False):
+ env = os.environ.copy()
+ python_path = env.get("PYTHONPATH", "")
+
+ # 将 sandbox Python 包路径分解为列表,检查每个路径是否已存在
+ existing_paths = set(python_path.split(os.pathsep))
+ sandbox_paths = _sandbox_python_sys_path.split(os.pathsep) if _sandbox_python_sys_path else []
+ new_paths = [p for p in sandbox_paths if p and p not in existing_paths]
+
+ if new_paths:
+ env["PYTHONPATH"] = (
+ f"{os.pathsep.join(new_paths)}{os.pathsep}{python_path}"
+ if python_path
+ else os.pathsep.join(new_paths)
+ )
+
+ kwargs["env"] = env
+ super().__init__(root_dir=root_dir, **kwargs)
+
+ def _translate_virtual_paths(self, command: str) -> str:
+ """Translate virtual absolute paths in the command to real filesystem paths.
+
+ In virtual_mode=True, file tools (ls, glob, read_file) return virtual absolute
+ paths like /skills/foo.py which map to {root_dir}/skills/foo.py. But execute()
+ runs a real shell where /skills/foo.py does not exist. This method replaces
+ any path token that exists under root_dir with its real path, while leaving
+ genuine system paths (e.g. /usr/bin/python3) untouched.
+ """
+ root = str(self.cwd)
+
+ def translate(m: re.Match) -> str:
+ virtual_path = m.group(0)
+ real_path = root + virtual_path
+ return real_path if os.path.lexists(real_path) else virtual_path
+
+ # Match absolute-path-like tokens: / followed by a non-whitespace sequence
+ # that isn't clearly a flag (e.g. avoid matching -/something).
+ # Only translate when virtual_mode is active.
+ return re.sub(r'(?<:,]*', translate, command)
+
+ def _consume_group(self, command: str, start_index: int) -> tuple[str, int]:
+ current = []
+ in_single_quote = False
+ in_double_quote = False
+ in_backticks = False
+ escaped = False
+ substitution_depth = 0
+ group_depth = 1
+ index = start_index + 1
+
+ while index < len(command):
+ char = command[index]
+
+ if escaped:
+ current.append(char)
+ escaped = False
+ index += 1
+ continue
+
+ if char == "\\" and not in_single_quote:
+ current.append(char)
+ escaped = True
+ index += 1
+ continue
+
+ if char == "`" and not in_single_quote:
+ in_backticks = not in_backticks
+ current.append(char)
+ index += 1
+ continue
+
+ if in_backticks:
+ current.append(char)
+ index += 1
+ continue
+
+ if char == "'" and not in_double_quote:
+ in_single_quote = not in_single_quote
+ current.append(char)
+ index += 1
+ continue
+
+ if char == '"' and not in_single_quote:
+ in_double_quote = not in_double_quote
+ current.append(char)
+ index += 1
+ continue
+
+ if in_single_quote or in_double_quote:
+ current.append(char)
+ index += 1
+ continue
+
+ if command.startswith("$(", index):
+ substitution_depth += 1
+ current.append("$(")
+ index += 2
+ continue
+
+ if substitution_depth:
+ if char == ")":
+ substitution_depth -= 1
+ current.append(char)
+ index += 1
+ continue
+
+ if char == "(":
+ group_depth += 1
+ current.append(char)
+ index += 1
+ continue
+
+ if char == ")":
+ group_depth -= 1
+ if group_depth == 0:
+ return "".join(current).strip(), index + 1
+ current.append(char)
+ index += 1
+ continue
+
+ current.append(char)
+ index += 1
+
+ raise ValueError("unclosed command group")
+
+ def _append_pending_command_part(self, parts: list[str | tuple[str, str]], current: list[str]) -> None:
+ part = "".join(current).strip()
+ if part:
+ parts.append(part)
+ return
+
+ if not parts:
+ parts.append("")
+ return
+
+ last_part = parts[-1]
+ if isinstance(last_part, str) and last_part in {";", "&&", "||", "|", "&"}:
+ parts.append("")
+
+ def _split_shell_command_list(self, command: str) -> list[str | tuple[str, str]]:
+ parts = []
+ current = []
+ in_single_quote = False
+ in_double_quote = False
+ in_backticks = False
+ escaped = False
+ substitution_depth = 0
+ index = 0
+
+ while index < len(command):
+ char = command[index]
+
+ if escaped:
+ current.append(char)
+ escaped = False
+ index += 1
+ continue
+
+ if char == "\\" and not in_single_quote:
+ current.append(char)
+ escaped = True
+ index += 1
+ continue
+
+ if char == "`" and not in_single_quote:
+ in_backticks = not in_backticks
+ current.append(char)
+ index += 1
+ continue
+
+ if in_backticks:
+ current.append(char)
+ index += 1
+ continue
+
+ if char == "'" and not in_double_quote:
+ in_single_quote = not in_single_quote
+ current.append(char)
+ index += 1
+ continue
+
+ if char == '"' and not in_single_quote:
+ in_double_quote = not in_double_quote
+ current.append(char)
+ index += 1
+ continue
+
+ if not in_single_quote and not in_double_quote:
+ if command.startswith("$(", index):
+ substitution_depth += 1
+ current.append("$(")
+ index += 2
+ continue
+
+ if substitution_depth:
+ if char == ")":
+ substitution_depth -= 1
+ current.append(char)
+ index += 1
+ continue
+
+ if char == "(" and not "".join(current).strip():
+ group_content, index = self._consume_group(command, index)
+ parts.append(("group", group_content))
+ current = []
+ continue
+
+ if command.startswith("&&", index) or command.startswith("||", index):
+ self._append_pending_command_part(parts, current)
+ parts.append(command[index : index + 2])
+ current = []
+ index += 2
+ continue
+
+ if char in {";", "|", "&"}:
+ self._append_pending_command_part(parts, current)
+ parts.append(char)
+ current = []
+ index += 1
+ continue
+
+ if char == "\n":
+ self._append_pending_command_part(parts, current)
+ parts.append(";")
+ current = []
+ index += 1
+ continue
+
+ current.append(char)
+ index += 1
+
+ self._append_pending_command_part(parts, current)
+ return parts
+
+ def _build_sandbox_command(self, command: str) -> str:
+ prefix = (
+ "env -i LD_PRELOAD=/opt/maxkb-app/sandbox/lib/sandbox.so "
+ f'PATH="${{PATH}}" PYTHONPATH="${{PYTHONPATH}}" gosu {_run_user} '
+ )
+ parts = self._split_shell_command_list(command)
+ sandboxed_parts = []
+ expect_command = True
+
+ for part in parts:
+ if expect_command:
+ if isinstance(part, tuple):
+ group_kind, group_content = part
+ if group_kind != "group":
+ raise ValueError(f"unsupported command part: {group_kind}")
+ if not group_content:
+ raise ValueError("empty command group")
+ sandboxed_parts.append(f"( {self._build_sandbox_command(group_content)} )")
+ elif not part:
+ raise ValueError("empty command")
+ else:
+ tokens = shlex.split(part)
+ if not tokens:
+ raise ValueError("empty command")
+ sandboxed_parts.append(prefix + " ".join(shlex.quote(token) for token in tokens))
+ else:
+ if part not in {";", "&&", "||", "|", "&"}:
+ raise ValueError(f"unsupported shell operator: {part}")
+ sandboxed_parts.append(part)
+
+ expect_command = not expect_command
+
+ if expect_command:
+ raise ValueError("command cannot end with a shell operator")
+
+ return " ".join(sandboxed_parts)
+
+ def execute(
+ self,
+ command: str,
+ *,
+ timeout: int | None = None,
+ ) -> ExecuteResponse:
+ if self.virtual_mode:
+ command = self._translate_virtual_paths(command)
+
+ if _enable_sandbox:
+ # 用 runuser 在子进程里切换用户,父进程凭据保持不变,
+ # 避免父进程 ruid/euid 不一致导致 execve 报 Permission denied
+ try:
+ # 将命令列表拆成多个简单命令,并分别在 sandbox 用户下执行。
+ # 每个简单命令仍按 argv 重新 quote,避免 $()、反引号等在父 shell 中展开。
+ command = self._build_sandbox_command(command)
+ except ValueError as e:
+ return ExecuteResponse(output=f"Invalid command: {e}", exit_code=1)
+ # command = f"runuser -u {_run_user} -- env -i PATH=${{PATH}} {command}"
+
+ maxkb_logger.debug(f"Executing command in sandbox: {command}")
+ return super().execute(command=command, timeout=timeout)
diff --git a/apps/application/workflow/common.py b/apps/application/workflow/common.py
new file mode 100644
index 00000000000..802b2a4ee39
--- /dev/null
+++ b/apps/application/workflow/common.py
@@ -0,0 +1,248 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: workflow.py
+@date:2026/6/29 10:58
+@desc:
+"""
+
+from enum import Enum
+from typing import List, Dict
+
+from django.utils.translation import gettext as _
+from common.exception.app_exception import AppApiException
+from common.utils.common import group_by
+
+
+class Node:
+ def __init__(self, _id: str, _type: str, x: int, y: int, properties: dict, **kwargs):
+ """
+
+ @param _id: 节点id
+ @param _type: 类型
+ @param x: 节点x轴位置
+ @param y: 节点y轴位置
+ @param properties:
+ @param kwargs:
+ """
+ self.id = _id
+ self.type = _type
+ self.x = x
+ self.y = y
+ self.properties = properties
+ for keyword in kwargs:
+ self.__setattr__(keyword, kwargs.get(keyword))
+
+
+class Edge:
+ def __init__(self, _id: str, _type: str, sourceNodeId: str, targetNodeId: str, **keywords):
+ """
+ 线
+ @param _id: 线id
+ @param _type: 线类型
+ @param sourceNodeId:
+ @param targetNodeId:
+ @param keywords:
+ """
+ self.id = _id
+ self.type = _type
+ self.sourceNodeId = sourceNodeId
+ self.targetNodeId = targetNodeId
+ for keyword in keywords:
+ self.__setattr__(keyword, keywords.get(keyword))
+
+
+class EdgeNode:
+ edge: Edge
+ node: Node
+
+ def __init__(self, edge, node):
+ self.edge = edge
+ self.node = node
+
+
+def init_fields(workflow):
+ result = []
+ for node in workflow.nodes:
+ properties = node.properties
+ node_name = properties.get("stepName")
+ node_id = node.id
+ node_config = properties.get("config")
+ result.append(NodeField(node_id, node_name, "异常信息", "exception_message"))
+ if node_config is not None:
+ fields = node_config.get("fields")
+ if fields is not None:
+ for field in fields:
+ result.append(NodeField(node_id, node_name, field.get("label"), field.get("value")))
+ global_fields = node_config.get("globalFields")
+ if global_fields is not None:
+ for global_field in global_fields:
+ result.append(NodeField("global", "全局变量", global_field.get("label"), global_field.get("value")))
+ chat_fields = node_config.get("chatFields")
+ if chat_fields is not None:
+ for chat_field in chat_fields:
+ result.append(NodeField("chat", "chat", chat_field.get("label"), chat_field.get("value")))
+ result.sort(key=lambda f: len(f.node_name + f.value), reverse=True)
+ return result
+
+
+def get_node_parameters(node):
+ return node.properties.get("node_data", {})
+
+
+class NodeField:
+ def __init__(self, node_id, node_name, label, value):
+ self.node_id = node_id
+ self.node_name = node_name
+ self.label = label
+ self.value = value
+
+ def reset_variable(self, prompt: str):
+ userVariable = self.node_name + "." + self.value
+ systemVariable = f"context.get('{self.node_id}').get('{self.value}','')"
+ prompt = prompt.replace(userVariable, systemVariable)
+ # 全局变量:前端用 global.xxx 引用,也要能解析到 context['global']
+ if self.node_id == "global":
+ prompt = prompt.replace(f"global.{self.value}", systemVariable)
+ return prompt
+
+
+class WorkflowType(Enum):
+ # 应用
+ APPLICATION = "APPLICATION"
+ # 知识库
+ KNOWLEDGE = "KNOWLEDGE"
+ # 工具
+ TOOL = "TOOL"
+
+
+class Workflow:
+ """
+ 节点列表
+ """
+
+ nodes: List[Node]
+ """
+ 线列表
+ """
+ edges: List[Edge]
+ """
+ 节点id:node
+ """
+ node_map: Dict[str, Node]
+ """
+ 节点id:当前节点id上面的所有节点
+ """
+ up_node_map: Dict[str, List[EdgeNode]]
+ """
+ 节点id:当前节点id下面的所有节点
+ """
+ next_node_map: Dict[str, List[EdgeNode]]
+ """
+ 节点字段
+ """
+ node_field_list: List[NodeField]
+
+ def __init__(self, nodes: List[Node], edges: List[Edge]):
+ self.nodes = nodes
+ self.edges = edges
+ self.node_map = {node.id: node for node in nodes}
+
+ self.up_node_map = {
+ key: [EdgeNode(edge, self.node_map.get(edge.sourceNodeId)) for edge in edges]
+ for key, edges in group_by(edges, key=lambda edge: edge.targetNodeId).items()
+ }
+
+ self.next_node_map = {
+ key: [EdgeNode(edge, self.node_map.get(edge.targetNodeId)) for edge in edges]
+ for key, edges in group_by(edges, key=lambda edge: edge.sourceNodeId).items()
+ }
+ self.node_field_list = init_fields(self)
+
+ def get_node(self, node_id):
+ """
+ 根据node_id 获取节点信息
+ @param node_id: node_id
+ @return: 节点信息
+ """
+ return self.node_map.get(node_id)
+
+ def get_up_edge_nodes(self, node_id) -> List[EdgeNode]:
+ """
+ 根据节点id 获取当前连接前置节点和连线
+ @param node_id: 节点id
+ @return: 节点连线列表
+ """
+ return self.up_node_map.get(node_id)
+
+ def get_next_edge_nodes(self, node_id) -> List[EdgeNode]:
+ """
+ 根据节点id 获取当前连接目标节点和连线
+ @param node_id: 节点id
+ @return: 节点连线列表
+ """
+ return self.next_node_map.get(node_id)
+
+ def get_up_nodes(self, node_id) -> List[Node]:
+ """
+ 根据节点id 获取当前连接前置节点
+ @param node_id: 节点id
+ @return: 节点列表
+ """
+ return [en.node for en in self.up_node_map.get(node_id)]
+
+ def get_next_nodes(self, node_id) -> List[Node]:
+ """
+ 根据节点id 获取当前连接目标节点
+ @param node_id: 节点id
+ @return: 节点列表
+ """
+ return [en.node for en in self.next_node_map.get(node_id, [])]
+
+ def reset_prompt(self, prompt):
+ for node_field in self.node_field_list:
+ prompt = node_field.reset_variable(prompt)
+ return prompt
+
+ def is_valid(self, workflow_type: WorkflowType):
+ """
+ 校验工作流数据:一趟遍历同时统计节点id出现次数、校验每个节点的参数
+ """
+ start_node_list = []
+ for node in self.nodes:
+ if node.id == "start-node":
+ start_node_list.append(node)
+ self.is_valid_node(node, workflow_type)
+ self.is_valid_start_node(start_node_list)
+
+ def is_valid_start_node(self, start_node_list: List[Node]):
+ """
+ 校验开始节点:有且只有一个 start-node
+ """
+ if len(start_node_list) == 0:
+ raise AppApiException(500, _("The starting node is required"))
+ if len(start_node_list) > 1:
+ raise AppApiException(500, _("There can only be one starting node"))
+
+ def is_valid_node(self, node: Node, workflow_type: WorkflowType = WorkflowType.APPLICATION):
+ """
+ 校验单个节点:交给该节点类型对应的序列化器
+ """
+ from application.workflow.nodes import node_map
+
+ node_class = node_map.get(node.type, {}).get(workflow_type)
+ if node_class is None or node_class.serializer_class is None:
+ return
+ try:
+ node_class.serializer_class(data=get_node_parameters(node)).is_valid(raise_exception=True)
+ except AppApiException as e:
+ raise AppApiException(500, f"{node.properties.get('stepName')}:{e.message}")
+
+
+def new_instance(flow_obj: Dict, workflow_type: WorkflowType = WorkflowType.APPLICATION):
+ nodes = flow_obj.get("nodes")
+ edges = flow_obj.get("edges")
+ nodes = [Node(node.get("id"), node.get("type"), **node) for node in nodes]
+ edges = [Edge(edge.get("id"), edge.get("type"), **edge) for edge in edges]
+ return Workflow(nodes, edges)
diff --git a/apps/application/flow/compare/__init__.py b/apps/application/workflow/compare/__init__.py
similarity index 100%
rename from apps/application/flow/compare/__init__.py
rename to apps/application/workflow/compare/__init__.py
diff --git a/apps/application/flow/compare/compare.py b/apps/application/workflow/compare/compare.py
similarity index 100%
rename from apps/application/flow/compare/compare.py
rename to apps/application/workflow/compare/compare.py
diff --git a/apps/application/flow/compare/contain_compare.py b/apps/application/workflow/compare/contain_compare.py
similarity index 100%
rename from apps/application/flow/compare/contain_compare.py
rename to apps/application/workflow/compare/contain_compare.py
diff --git a/apps/application/flow/compare/end_with.py b/apps/application/workflow/compare/end_with.py
similarity index 100%
rename from apps/application/flow/compare/end_with.py
rename to apps/application/workflow/compare/end_with.py
diff --git a/apps/application/flow/compare/equal_compare.py b/apps/application/workflow/compare/equal_compare.py
similarity index 100%
rename from apps/application/flow/compare/equal_compare.py
rename to apps/application/workflow/compare/equal_compare.py
diff --git a/apps/application/flow/compare/ge_compare.py b/apps/application/workflow/compare/ge_compare.py
similarity index 100%
rename from apps/application/flow/compare/ge_compare.py
rename to apps/application/workflow/compare/ge_compare.py
diff --git a/apps/application/flow/compare/gt_compare.py b/apps/application/workflow/compare/gt_compare.py
similarity index 100%
rename from apps/application/flow/compare/gt_compare.py
rename to apps/application/workflow/compare/gt_compare.py
diff --git a/apps/application/flow/compare/is_not_null_compare.py b/apps/application/workflow/compare/is_not_null_compare.py
similarity index 100%
rename from apps/application/flow/compare/is_not_null_compare.py
rename to apps/application/workflow/compare/is_not_null_compare.py
diff --git a/apps/application/flow/compare/is_not_true.py b/apps/application/workflow/compare/is_not_true.py
similarity index 100%
rename from apps/application/flow/compare/is_not_true.py
rename to apps/application/workflow/compare/is_not_true.py
diff --git a/apps/application/flow/compare/is_null_compare.py b/apps/application/workflow/compare/is_null_compare.py
similarity index 100%
rename from apps/application/flow/compare/is_null_compare.py
rename to apps/application/workflow/compare/is_null_compare.py
diff --git a/apps/application/flow/compare/is_true.py b/apps/application/workflow/compare/is_true.py
similarity index 100%
rename from apps/application/flow/compare/is_true.py
rename to apps/application/workflow/compare/is_true.py
diff --git a/apps/application/flow/compare/le_compare.py b/apps/application/workflow/compare/le_compare.py
similarity index 100%
rename from apps/application/flow/compare/le_compare.py
rename to apps/application/workflow/compare/le_compare.py
diff --git a/apps/application/flow/compare/len_equal_compare.py b/apps/application/workflow/compare/len_equal_compare.py
similarity index 100%
rename from apps/application/flow/compare/len_equal_compare.py
rename to apps/application/workflow/compare/len_equal_compare.py
diff --git a/apps/application/flow/compare/len_ge_compare.py b/apps/application/workflow/compare/len_ge_compare.py
similarity index 100%
rename from apps/application/flow/compare/len_ge_compare.py
rename to apps/application/workflow/compare/len_ge_compare.py
diff --git a/apps/application/flow/compare/len_gt_compare.py b/apps/application/workflow/compare/len_gt_compare.py
similarity index 100%
rename from apps/application/flow/compare/len_gt_compare.py
rename to apps/application/workflow/compare/len_gt_compare.py
diff --git a/apps/application/flow/compare/len_le_compare.py b/apps/application/workflow/compare/len_le_compare.py
similarity index 100%
rename from apps/application/flow/compare/len_le_compare.py
rename to apps/application/workflow/compare/len_le_compare.py
diff --git a/apps/application/flow/compare/len_lt_compare.py b/apps/application/workflow/compare/len_lt_compare.py
similarity index 100%
rename from apps/application/flow/compare/len_lt_compare.py
rename to apps/application/workflow/compare/len_lt_compare.py
diff --git a/apps/application/flow/compare/lt_compare.py b/apps/application/workflow/compare/lt_compare.py
similarity index 100%
rename from apps/application/flow/compare/lt_compare.py
rename to apps/application/workflow/compare/lt_compare.py
diff --git a/apps/application/flow/compare/not_contain_compare.py b/apps/application/workflow/compare/not_contain_compare.py
similarity index 100%
rename from apps/application/flow/compare/not_contain_compare.py
rename to apps/application/workflow/compare/not_contain_compare.py
diff --git a/apps/application/flow/compare/not_equal_compare.py b/apps/application/workflow/compare/not_equal_compare.py
similarity index 100%
rename from apps/application/flow/compare/not_equal_compare.py
rename to apps/application/workflow/compare/not_equal_compare.py
diff --git a/apps/application/flow/compare/regex_compare.py b/apps/application/workflow/compare/regex_compare.py
similarity index 100%
rename from apps/application/flow/compare/regex_compare.py
rename to apps/application/workflow/compare/regex_compare.py
diff --git a/apps/application/flow/compare/start_with.py b/apps/application/workflow/compare/start_with.py
similarity index 100%
rename from apps/application/flow/compare/start_with.py
rename to apps/application/workflow/compare/start_with.py
diff --git a/apps/application/flow/compare/wildcard_compare.py b/apps/application/workflow/compare/wildcard_compare.py
similarity index 100%
rename from apps/application/flow/compare/wildcard_compare.py
rename to apps/application/workflow/compare/wildcard_compare.py
diff --git a/apps/application/workflow/content_type.py b/apps/application/workflow/content_type.py
new file mode 100644
index 00000000000..193cf713cd2
--- /dev/null
+++ b/apps/application/workflow/content_type.py
@@ -0,0 +1,21 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: content_type.py
+@date:2026/6/30 15:57
+@desc:
+"""
+
+from enum import Enum
+
+
+class ContentType(Enum):
+ TEXT = "TEXT"
+ REASONING = "REASONING"
+ FAILURE = "FAILURE"
+ TOOL = "TOOL"
+ CONTINUE = "CONTINUE"
+ BREAK = "BREAK"
+ FORM = "FORM"
+ PROGRESS = "PROGRESS"
diff --git a/apps/application/workflow/i_node.py b/apps/application/workflow/i_node.py
new file mode 100644
index 00000000000..0b3a17c0c94
--- /dev/null
+++ b/apps/application/workflow/i_node.py
@@ -0,0 +1,259 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: i_node.py
+@date:2026/6/29 16:41
+@desc:
+"""
+
+import time
+import traceback
+from enum import Enum
+from typing import Optional, Type, Callable
+
+from rest_framework import serializers
+
+from application.workflow.common import Node
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.message.struct.progress_content import ProgressContent
+from application.workflow.status import Status
+from common.utils.logger import maxkb_logger
+
+
+class CancelledException(Exception):
+ """工作流取消异常"""
+
+ pass
+
+
+class Signal(str, Enum):
+ BREAK = "BREAK"
+ CONTINUE = "CONTINUE"
+ FORM = "FORM"
+ CANCELLED = "CANCELLED"
+
+
+class INode:
+ # 当前节点支持的工作流类型
+ supported_workflow_type_list = []
+ # 节点类型
+ type = None
+ # 序列化校验器
+ serializer_class: Optional[Type[serializers.Serializer]] = None
+
+ @classmethod
+ def is_valid(cls, data):
+ if cls.serializer_class:
+ cls.serializer_class(data=data).is_valid(raise_exception=True)
+
+ def __init__(self, node, workflow_manage, get_node_parameters: Callable[[Node], dict]):
+ self.node = node
+ self.status = Status.BEFORE_RUNNING
+ self.workflow_manage = workflow_manage
+ # 节点参数
+ self.parameters = get_node_parameters(node)
+ # 节点运行时产生的数据
+ self.data = {}
+ self._completed = False
+ # ---- 锚点构造,全项目唯一的拼接点 ----
+
+ def anchor(self, *parts):
+ """
+ 通用锚点: anchor('right') → '{id}_right',
+ anchor(branch_id, 'right') → '{id}_{branch_id}_right'
+ """
+ return "_".join([self.node.id, *map(str, parts)])
+
+ def success_anchor(self):
+ """
+ 成功锚点
+ @return: 成功锚点
+ """
+ return self.anchor("right")
+
+ def fail_anchor(self):
+ """
+ 失败锚点
+ @return: 失败锚点
+ """
+ return self.branch_anchor("exception")
+
+ def branch_anchor(self, branch_id):
+ """
+ 自定义锚点
+ @param branch_id: 自定义分支id
+ @return: 自定义锚点
+ """
+ return self.anchor(branch_id, "right")
+
+ def execute(self):
+ pass
+
+ def run(self):
+ """
+ 运行节点
+ @return: 不响应数据
+ """
+ self.data["start_time"] = time.time()
+ self.status = Status.RUNNING
+ try:
+ self._run()
+ except CancelledException:
+ self.complete(Status.CANCELLED)
+ except Exception as e:
+ traceback.print_exc()
+ self.complete(Status.FAIL, error=e)
+
+ def _run(self):
+ """
+ 执行节点
+ @return:
+ """
+ self.write(
+ ProgressContent(
+ self.node.id,
+ Status.BEFORE_RUNNING,
+ NodeInfo(self.get_node_id(), self.get_node_name(), Status.BEFORE_RUNNING),
+ Position(self.get_node_id()),
+ )
+ )
+ self.execute()
+ self.complete(Status.SUCCESS)
+
+ def complete(self, status, anchors=None, error=None, signal: Optional[Signal] = None):
+ """
+ 节点结束调用函数
+
+ @param status: 状态
+ @param anchors 锚点信息
+ @param error: 错误信息
+ @param signal: 信号
+ @return:
+ """
+ if self._completed:
+ return
+ self._completed = True
+ self.status = status
+ if error:
+ self.data["error"] = str(error)
+ self.data["run_time"] = time.time() - self.data["start_time"]
+ if signal:
+ self.workflow_manage.signal = signal
+ anchors = []
+ if anchors is None:
+ anchors = [
+ self.success_anchor() if [Status.SUCCESS, Status.CANCELLED].__contains__(status) else self.fail_anchor()
+ ]
+ self._dispatch(anchors)
+ self.workflow_manage.assertion_end(error)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ """
+ 获取节点运行详情
+ @param index: 节点索引
+ @param position: 位置信息,用于表单节点等断点续跑场景
+ @param old_details: 旧的详情数据,用于表单节点等断点续跑场景
+ @return: 节点详情字典
+ """
+ return {
+ "node_id": self.node.id,
+ "name": self.get_node_name(),
+ "index": index,
+ "run_time": self.data.get("run_time"),
+ "type": self.type,
+ "status": self.status.value if self.status else None,
+ "error": self.data.get("error"),
+ }
+
+ def _dispatch(self, anchors):
+ """
+ 根据锚点执行下一个节点
+ @param anchors: 锚点列表
+ @return:不返回
+ """
+ edge_node_list = self.workflow_manage.workflow.get_next_edge_nodes(self.node.id) or []
+ known = {en.edge.sourceAnchorId for en in edge_node_list}
+ unknown = set(anchors) - known
+ if unknown and known:
+ maxkb_logger.warning(f"node {self.node.id}: anchors {unknown} matched no edges, known={known}")
+ self.workflow_manage.next_nodes([en.node for en in edge_node_list if en.edge.sourceAnchorId in anchors])
+
+ def get_node_id(self):
+ """
+ 获取节点id
+ @return: 节点id
+ """
+ return self.node.id
+
+ def get_node_name(self):
+ """
+ 获取节点名称
+ @return: 节点名称
+ """
+ return self.node.properties.get("stepName")
+
+ def write_context(self, key, value, append=False):
+ """
+ 将数据写入节点上下文
+ @param key: 数据key
+ @param value: 数据value
+ @param append: 是否追加
+ @return: None
+ """
+ self.workflow_manage.write_context(self.node.id, key, value, append)
+
+ def get_context(self, key):
+ """
+ 获取上下文数据 根据key
+ @param key: key
+ @return: 数据
+ """
+ return self.workflow_manage.get_context(self.node.id, key)
+
+ def get_workflow_type(self):
+ """
+ 获取工作流类型
+ @return: 工作流类型
+ """
+ return self.workflow_manage.workflow_type
+
+ def get_workflow_parameters(self):
+ """
+ 获取工作流body
+ @return: 工作流body数据
+ """
+ return self.workflow_manage.get_parameters()
+
+ def get_parameters(self):
+ """
+ 获取节点参数数据
+ @return: 节点参数数据
+ """
+ return self.parameters
+
+ def get_next_nodes(self, wf):
+ """
+ 获取下n个基点
+ @param wf: 工作流对象
+ @return: 下n个节点
+ """
+ return wf.get_next_nodes(self.get_node_id())
+
+ def write(self, message: Content):
+ self.workflow_manage.write(message)
+
+ def cancel(self):
+ """
+ 取消运行
+ @return:
+ """
+ self.status = Status.CANCELLED
+
+ def _check_cancelled(self):
+ """
+ 检查是否已取消,如果已取消则抛出 CancelledException
+ @return:
+ """
+ if self.status == Status.CANCELLED or self.workflow_manage.signal == Signal.CANCELLED:
+ raise CancelledException()
diff --git a/apps/application/workflow/loop_workflow_manage.py b/apps/application/workflow/loop_workflow_manage.py
new file mode 100644
index 00000000000..9a3ef30351d
--- /dev/null
+++ b/apps/application/workflow/loop_workflow_manage.py
@@ -0,0 +1,81 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: loop_workflow_manage.py
+@date:2026/7/2 10:00
+@desc:
+"""
+
+from typing import Dict, Callable
+
+from application.workflow.common import Workflow, WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.workflow_manage import WorkflowManage, CallBack
+from common.utils.prompt_template import render_prompt
+
+
+class LoopWorkFlowManage(WorkflowManage):
+ def __init__(
+ self,
+ workflow: Workflow,
+ parameters: Dict,
+ workflow_type: WorkflowType,
+ call_back: CallBack,
+ get_start_node: Callable[[Workflow, WorkflowManage], INode],
+ parent_workflow_manage: WorkflowManage,
+ ):
+ self.parent_workflow_manage = parent_workflow_manage
+ super().__init__(workflow, parameters, workflow_type, call_back, get_start_node)
+
+ def get_parameters(self):
+ return self.parameters
+
+ def get_parent_context(self, node_id, key):
+ return self.parent_workflow_manage.get_context(node_id, key)
+
+ def generate_prompt(self, prompt):
+ input_template = self.workflow.reset_prompt(prompt)
+ input_template = self.parent_workflow_manage.workflow.reset_prompt(input_template)
+ context = {**self.context, **self.parent_workflow_manage.context}
+ return render_prompt(input_template, context)
+
+ def get_reference_field(self, node_id, fields):
+ """
+ 获取引用字段,先从当前工作流获取,获取不到再从父工作流获取
+ @param node_id: 节点id
+ @param fields: 字段
+ @return: 引用数据
+ """
+ # 先从当前工作流获取
+ result = super().get_reference_field(node_id, fields)
+ if result is not None:
+ return result
+
+ # 从父工作流获取
+ return self.parent_workflow_manage.get_reference_field(node_id, fields)
+
+ @classmethod
+ def from_context(
+ cls, get_context, workflow, parameters, workflow_type, call_back, get_start_node, parent_workflow_manage=None
+ ):
+ try:
+ context = get_context()
+
+ instance = cls(
+ workflow=workflow,
+ parameters=parameters,
+ workflow_type=workflow_type,
+ call_back=call_back,
+ get_start_node=get_start_node,
+ parent_workflow_manage=parent_workflow_manage,
+ )
+ if context:
+ instance.context = context
+
+ return instance
+ except Exception:
+ import traceback
+
+ traceback.print_exc()
+ return None
diff --git a/apps/application/workflow/message/aggregator/__init__.py b/apps/application/workflow/message/aggregator/__init__.py
new file mode 100644
index 00000000000..82b549143e2
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/__init__.py
@@ -0,0 +1,12 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @date:2026/7/22 16:24
+ @desc: 内容聚合器模块
+"""
+from application.workflow.message.aggregator.content_aggregator import ContentAggregator
+from application.workflow.message.aggregator.aggregator_factory import AggregatorFactory
+from application.workflow.message.aggregator.aggregation_manager import AggregationManager
+
+__all__ = ['ContentAggregator', 'AggregatorFactory', 'AggregationManager']
diff --git a/apps/application/workflow/message/aggregator/aggregation_manager.py b/apps/application/workflow/message/aggregator/aggregation_manager.py
new file mode 100644
index 00000000000..5f3c1c7441e
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/aggregation_manager.py
@@ -0,0 +1,62 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: aggregation_manager.py
+@date:2026/7/22 16:24
+@desc: 聚合管理器
+"""
+
+from typing import Dict, List
+
+from application.workflow.message.struct.content import Content
+from application.workflow.message.aggregator.aggregator_factory import AggregatorFactory
+
+
+class AggregationManager:
+ """
+ 聚合管理器
+ 管理内容块的聚合,将相同id和类型的内容合并
+ """
+
+ def __init__(self):
+ self._key_to_index: Dict[str, int] = {}
+ self._contents: List[Content] = []
+
+ @property
+ def contents(self) -> List[Content]:
+ """获取聚合后的内容列表"""
+ return self._contents
+
+ def aggregate(self, chunk: Content) -> None:
+ """
+ 聚合内容块
+
+ @param chunk: 内容块
+ """
+ if not AggregatorFactory.is_aggregatable(chunk):
+ return
+ key = f"{chunk.id}_{chunk.type.value if hasattr(chunk.type, 'value') else chunk.type}"
+
+ idx = self._key_to_index.get(key)
+ if idx is None:
+ # 新key
+ self._key_to_index[key] = len(self._contents)
+ self._contents.append(chunk)
+ else:
+ # 已存在,聚合
+ prev = self._contents[idx]
+ aggregator = AggregatorFactory.get_aggregator(type(prev))
+ self._contents[idx] = aggregator.aggregate(prev, chunk)
+
+ def clear(self) -> None:
+ """清空聚合器"""
+ self._contents.clear()
+ self._key_to_index.clear()
+
+ def get_contents(self) -> List[Dict]:
+ """
+ 获取所有聚合后的内容(字典格式)
+
+ @return: 内容字典列表
+ """
+ return [content.to_dict() for content in self._contents]
diff --git a/apps/application/workflow/message/aggregator/aggregator_factory.py b/apps/application/workflow/message/aggregator/aggregator_factory.py
new file mode 100644
index 00000000000..7f79d6ee1fc
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/aggregator_factory.py
@@ -0,0 +1,70 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: aggregator_factory.py
+@date:2026/7/22 16:24
+@desc: 聚合器工厂
+"""
+
+from typing import Dict, Type, Optional
+
+from application.workflow.message.aggregator.content_aggregator import ContentAggregator
+from application.workflow.message.aggregator.impl import FormAggregator
+from application.workflow.message.aggregator.impl.reasoning_aggregator import ReasoningAggregator
+from application.workflow.message.aggregator.impl.text_aggregator import TextAggregator
+from application.workflow.message.aggregator.impl.tool_aggregator import ToolAggregator
+from application.workflow.message.struct.content import Content
+from application.workflow.message.struct.form_content import FormContent
+from application.workflow.message.struct.reasoning_content import ReasoningContent
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.message.struct.tool_content import ToolContent
+
+
+class AggregatorFactory:
+ """
+ 聚合器工厂
+ 根据内容类型获取对应的聚合器
+ """
+
+ _aggregators: Dict[Type[Content], ContentAggregator] = {
+ TextContent: TextAggregator(),
+ ReasoningContent: ReasoningAggregator(),
+ ToolContent: ToolAggregator(),
+ FormContent: FormAggregator(),
+ }
+
+ @classmethod
+ def get_aggregator(cls, content_class: Type[Content]) -> ContentAggregator:
+ """
+ 获取聚合器
+
+ @param content_class: 内容类型
+ @return: 聚合器实例
+ @raises ValueError: 如果找不到对应的聚合器
+ """
+ aggregator = cls._aggregators.get(content_class)
+ if aggregator is None:
+ raise ValueError(f"No aggregator found for class: {content_class.__name__}")
+ return aggregator
+
+ @classmethod
+ def get_aggregator_optional(cls, content_class: Type[Content]) -> Optional[ContentAggregator]:
+ """
+ 获取聚合器(可选)
+
+ @param content_class: 内容类型
+ @return: 聚合器实例或None
+ """
+ return cls._aggregators.get(content_class)
+
+ @classmethod
+ def is_aggregatable(cls, chunk: Content) -> bool:
+ """
+ 判断给定的内容对象是否可以被聚合
+
+ @param chunk: 内容对象实例
+ @return: True 表示有对应的聚合器,False 表示没有
+ """
+ if chunk is None:
+ return False
+ return type(chunk) in cls._aggregators
diff --git a/apps/application/workflow/message/aggregator/content_aggregator.py b/apps/application/workflow/message/aggregator/content_aggregator.py
new file mode 100644
index 00000000000..fb3def1f997
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/content_aggregator.py
@@ -0,0 +1,45 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: content_aggregator.py
+ @date:2026/7/22 16:24
+ @desc: 内容聚合器接口
+"""
+from abc import ABC, abstractmethod
+from typing import TypeVar, Generic
+
+from application.workflow.message.struct.content import Content
+
+T = TypeVar('T', bound=Content)
+
+
+class ContentAggregator(ABC, Generic[T]):
+ """
+ 内容聚合器接口
+ 用于合并相同类型的流式内容块
+ """
+
+ @abstractmethod
+ def aggregate(self, prev: T, chunk: T) -> T:
+ """
+ 聚合两个内容块
+
+ @param prev: 之前的内容
+ @param chunk: 新的内容块
+ @return: 合并后的内容
+ """
+ pass
+
+ def merge_base_fields(self, prev: T, chunk: T, result: T) -> None:
+ """
+ 合并基础字段
+
+ @param prev: 之前的内容
+ @param chunk: 新的内容块
+ @param result: 结果对象
+ """
+ result.id = chunk.id if chunk.id else prev.id
+ result.status = chunk.status if chunk.status else prev.status
+ result.node_info = chunk.node_info if chunk.node_info else prev.node_info
+ result.position = chunk.position if chunk.position else prev.position
+ result.extra = chunk.extra if chunk.extra else prev.extra
diff --git a/apps/application/workflow/message/aggregator/impl/__init__.py b/apps/application/workflow/message/aggregator/impl/__init__.py
new file mode 100644
index 00000000000..34a83e07003
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/impl/__init__.py
@@ -0,0 +1,14 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: __init__.py
+@date:2026/7/22 16:24
+@desc: 聚合器实现模块
+"""
+
+from application.workflow.message.aggregator.impl.text_aggregator import TextAggregator
+from application.workflow.message.aggregator.impl.reasoning_aggregator import ReasoningAggregator
+from application.workflow.message.aggregator.impl.tool_aggregator import ToolAggregator
+from application.workflow.message.aggregator.impl.form_aggregator import FormAggregator
+
+__all__ = ["TextAggregator", "ReasoningAggregator", "ToolAggregator", "FormAggregator"]
diff --git a/apps/application/workflow/message/aggregator/impl/form_aggregator.py b/apps/application/workflow/message/aggregator/impl/form_aggregator.py
new file mode 100644
index 00000000000..663fef26bd2
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/impl/form_aggregator.py
@@ -0,0 +1,49 @@
+"""
+@project: MaxKB
+@file: form_aggregator.py
+@date:2026/9/16
+@desc:
+"""
+
+from application.workflow.message.aggregator.content_aggregator import ContentAggregator
+from application.workflow.message.struct.form_content import FormContent
+
+
+class FormAggregator(ContentAggregator[FormContent]):
+ """
+ 推理内容聚合器
+ 用于合并流式推理内容块
+ """
+
+ def aggregate(self, prev: FormContent, chunk: FormContent) -> FormContent:
+ """
+ 聚合推理内容
+
+ @param prev: 之前的内容
+ @param chunk: 新的内容块
+ @return: 合并后的内容
+ """
+ if prev is None:
+ return chunk
+
+ # 合并 status: 优先使用 chunk 的,否则使用 prev 的
+ merged_status = chunk.status if chunk.status else prev.status
+ form_field_list = chunk.form_field_list if chunk.form_field_list else prev.form_field_list
+ form_content_format = chunk.form_content_format if chunk.form_content_format else prev.form_content_format
+ is_submit = chunk.is_submit if chunk.is_submit else prev.is_submit
+ form_data = chunk.form_data if chunk.form_data else prev.form_data
+ # 合并基础字段
+ merged_id = chunk.id if chunk.id else prev.id
+ merged_node_info = chunk.node_info if chunk.node_info else prev.node_info
+ merged_position = chunk.position if chunk.position else prev.position
+ result = FormContent(
+ merged_id,
+ form_field_list,
+ form_content_format,
+ is_submit,
+ merged_status,
+ merged_node_info,
+ merged_position,
+ form_data,
+ )
+ return result
diff --git a/apps/application/workflow/message/aggregator/impl/reasoning_aggregator.py b/apps/application/workflow/message/aggregator/impl/reasoning_aggregator.py
new file mode 100644
index 00000000000..c278f6a6887
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/impl/reasoning_aggregator.py
@@ -0,0 +1,44 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: reasoning_aggregator.py
+ @date:2026/7/22 16:24
+ @desc: ReasoningContent 聚合器
+"""
+from application.workflow.message.aggregator.content_aggregator import ContentAggregator
+from application.workflow.message.struct.reasoning_content import ReasoningContent
+
+
+class ReasoningAggregator(ContentAggregator[ReasoningContent]):
+ """
+ 推理内容聚合器
+ 用于合并流式推理内容块
+ """
+
+ def aggregate(self, prev: ReasoningContent, chunk: ReasoningContent) -> ReasoningContent:
+ """
+ 聚合推理内容
+
+ @param prev: 之前的内容
+ @param chunk: 新的内容块
+ @return: 合并后的内容
+ """
+ if prev is None:
+ return chunk
+
+ # 合并 content
+ prev_content = prev.content if prev.content else ""
+ chunk_content = chunk.content if chunk.content else ""
+ merged_content = prev_content + chunk_content
+
+ # 合并 status: 优先使用 chunk 的,否则使用 prev 的
+ merged_status = chunk.status if chunk.status else prev.status
+
+ # 合并基础字段
+ merged_id = chunk.id if chunk.id else prev.id
+ merged_node_info = chunk.node_info if chunk.node_info else prev.node_info
+ merged_position = chunk.position if chunk.position else prev.position
+
+ result = ReasoningContent(merged_id, merged_content, merged_status, merged_node_info, merged_position)
+
+ return result
diff --git a/apps/application/workflow/message/aggregator/impl/text_aggregator.py b/apps/application/workflow/message/aggregator/impl/text_aggregator.py
new file mode 100644
index 00000000000..af519bad38e
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/impl/text_aggregator.py
@@ -0,0 +1,44 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: text_aggregator.py
+ @date:2026/7/22 16:24
+ @desc: TextContent 聚合器
+"""
+from application.workflow.message.aggregator.content_aggregator import ContentAggregator
+from application.workflow.message.struct.text_content import TextContent
+
+
+class TextAggregator(ContentAggregator[TextContent]):
+ """
+ 文本内容聚合器
+ 用于合并流式文本内容块
+ """
+
+ def aggregate(self, prev: TextContent, chunk: TextContent) -> TextContent:
+ """
+ 聚合文本内容
+
+ @param prev: 之前的内容
+ @param chunk: 新的内容块
+ @return: 合并后的内容
+ """
+ if prev is None:
+ return chunk
+
+ # 合并 content
+ prev_content = prev.content if prev.content else ""
+ chunk_content = chunk.content if chunk.content else ""
+ merged_content = prev_content + chunk_content
+
+ # 合并 status: 优先使用 chunk 的,否则使用 prev 的
+ merged_status = chunk.status if chunk.status else prev.status
+
+ # 合并基础字段
+ merged_id = chunk.id if chunk.id else prev.id
+ merged_node_info = chunk.node_info if chunk.node_info else prev.node_info
+ merged_position = chunk.position if chunk.position else prev.position
+
+ result = TextContent(merged_id, merged_content, merged_status, merged_node_info, merged_position)
+
+ return result
diff --git a/apps/application/workflow/message/aggregator/impl/tool_aggregator.py b/apps/application/workflow/message/aggregator/impl/tool_aggregator.py
new file mode 100644
index 00000000000..f2b5a5b1e85
--- /dev/null
+++ b/apps/application/workflow/message/aggregator/impl/tool_aggregator.py
@@ -0,0 +1,56 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: tool_aggregator.py
+@date:2026/7/22 16:24
+@desc: ToolContent 聚合器
+"""
+
+from application.workflow.message.aggregator.content_aggregator import ContentAggregator
+from application.workflow.message.struct.tool_content import ToolContent
+
+
+class ToolAggregator(ContentAggregator[ToolContent]):
+ """
+ 工具内容聚合器
+ 用于合并流式工具调用内容块
+ """
+
+ def aggregate(self, prev: ToolContent, chunk: ToolContent) -> ToolContent:
+ """
+ 聚合工具内容
+
+ @param prev: 之前的内容
+ @param chunk: 新的内容块
+ @return: 合并后的内容
+ """
+ if prev is None:
+ return chunk
+
+ # 合并 name (tool_name):取新回退旧
+ prev_name = prev.name if prev.name else ""
+ chunk_name = chunk.name if chunk.name else ""
+ merged_name = chunk_name if chunk_name else prev_name
+
+ # 合并 arguments:拼接
+ prev_arguments = prev.arguments if prev.arguments else ""
+ chunk_arguments = chunk.arguments if chunk.arguments else ""
+ merged_arguments = prev_arguments + chunk_arguments
+
+ # 合并 content(即 result 结果):拼接
+ prev_content = prev.content if prev.content else ""
+ chunk_content = chunk.content if chunk.content else ""
+ merged_content = prev_content + chunk_content
+
+ # 合并基础字段
+ merged_id = chunk.id if chunk.id else prev.id
+ merged_status = chunk.status if chunk.status else prev.status
+ merged_node_info = chunk.node_info if chunk.node_info else prev.node_info
+ merged_position = chunk.position if chunk.position else prev.position
+
+ # ToolContent(_id, tool_name, arguments, result, status, node_info, position)
+ result = ToolContent(
+ merged_id, merged_name, merged_arguments, merged_content, merged_status, merged_node_info, merged_position
+ )
+
+ return result
diff --git a/apps/application/workflow/message/struct/content.py b/apps/application/workflow/message/struct/content.py
new file mode 100644
index 00000000000..ed57f6bd8a3
--- /dev/null
+++ b/apps/application/workflow/message/struct/content.py
@@ -0,0 +1,63 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: content.py
+ @date:2026/6/30 15:38
+ @desc:
+"""
+from enum import Enum
+from typing import Optional
+
+from application.workflow.content_type import ContentType
+from application.workflow.status import Status
+
+
+class NodeInfo:
+ def __init__(self, _id: str, name: str, status: Status):
+ self.id = _id
+ self.name = name
+ self.status = status
+
+ def to_dict(self):
+ return {
+ 'id': self.id,
+ 'name': self.name,
+ 'status': self.status.value if hasattr(self.status, 'value') else str(self.status),
+ }
+
+
+class Position:
+ def __init__(self, _id: str, index: Optional[int] = None, children: Optional['Position'] = None):
+ self.id = _id
+ self.index = index
+ self.children = children
+
+ def to_dict(self):
+ return {
+ 'id': self.id,
+ 'index': self.index,
+ 'children': self.children.to_dict() if self.children else None,
+ }
+
+
+class Content:
+ def __init__(self, _id, status: Status, _type: ContentType, node_info: NodeInfo, position: Position, **kwargs):
+ self.id = _id
+ self.status = status
+ self.type = _type
+ self.node_info = node_info
+ self.position = position
+ self.extra = kwargs
+
+ def to_dict(self):
+ result = {
+ 'id': self.id,
+ 'type': self.type.value if hasattr(self.type, 'value') else str(self.type),
+ 'status': self.status.value if hasattr(self.status, 'value') else str(self.status),
+ 'node_info': self.node_info.to_dict() if self.node_info else None,
+ 'position': self.position.to_dict() if self.position else None,
+ }
+ if self.extra:
+ result.update(self.extra)
+ return result
diff --git a/apps/application/workflow/message/struct/failure_content.py b/apps/application/workflow/message/struct/failure_content.py
new file mode 100644
index 00000000000..b867c21c967
--- /dev/null
+++ b/apps/application/workflow/message/struct/failure_content.py
@@ -0,0 +1,25 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: failure_content.py
+ @date:2026/7/27 11:14
+ @desc:
+"""
+from typing import Optional
+
+from application.workflow.content_type import ContentType
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.status import Status
+
+
+class FailureContent(Content):
+ def __init__(self, _id, content: str, status: Status, node_info: Optional[NodeInfo], position: Optional[Position],
+ **kwargs):
+ self.content = content
+ super().__init__(_id, status, ContentType.FAILURE, node_info, position, **kwargs)
+
+ def to_dict(self):
+ result = super().to_dict()
+ result['content'] = self.content
+ return result
diff --git a/apps/application/workflow/message/struct/form_content.py b/apps/application/workflow/message/struct/form_content.py
new file mode 100644
index 00000000000..080837d409c
--- /dev/null
+++ b/apps/application/workflow/message/struct/form_content.py
@@ -0,0 +1,32 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: form_content.py
+ @date:2026/7/6 15:30
+ @desc:
+"""
+from typing import List, Dict, Optional
+
+from application.workflow.content_type import ContentType
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.status import Status
+
+
+class FormContent(Content):
+ def __init__(self, _id, form_field_list: List[Dict], form_content_format: str,
+ is_submit: bool, status: Status, node_info: NodeInfo, position: Position,
+ form_data: Optional[Dict] = None, **kwargs):
+ self.form_field_list = form_field_list
+ self.form_content_format = form_content_format
+ self.is_submit = is_submit
+ self.form_data = form_data or {}
+ super().__init__(_id, status, ContentType.FORM, node_info, position, **kwargs)
+
+ def to_dict(self):
+ result = super().to_dict()
+ result['form_field_list'] = self.form_field_list
+ result['form_content_format'] = self.form_content_format
+ result['is_submit'] = self.is_submit
+ result['form_data'] = self.form_data
+ return result
diff --git a/apps/application/workflow/message/struct/progress_content.py b/apps/application/workflow/message/struct/progress_content.py
new file mode 100644
index 00000000000..cb19d50465c
--- /dev/null
+++ b/apps/application/workflow/message/struct/progress_content.py
@@ -0,0 +1,21 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: reasoning_content.py
+@date:2026/6/30 16:07
+@desc:
+"""
+
+from application.workflow.content_type import ContentType
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.status import Status
+
+
+class ProgressContent(Content):
+ def __init__(self, _id, status: Status, node_info: NodeInfo, position: Position, **kwargs):
+ super().__init__(_id, status, ContentType.PROGRESS, node_info, position, **kwargs)
+
+ def to_dict(self):
+ result = super().to_dict()
+ return result
diff --git a/apps/application/workflow/message/struct/reasoning_content.py b/apps/application/workflow/message/struct/reasoning_content.py
new file mode 100644
index 00000000000..e7903d2e188
--- /dev/null
+++ b/apps/application/workflow/message/struct/reasoning_content.py
@@ -0,0 +1,22 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: reasoning_content.py
+ @date:2026/6/30 16:07
+ @desc:
+"""
+from application.workflow.content_type import ContentType
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.status import Status
+
+
+class ReasoningContent(Content):
+ def __init__(self, _id, content: str, status: Status, node_info: NodeInfo, position: Position, **kwargs):
+ self.content = content
+ super().__init__(_id, status, ContentType.REASONING, node_info, position, **kwargs)
+
+ def to_dict(self):
+ result = super().to_dict()
+ result['content'] = self.content
+ return result
diff --git a/apps/application/workflow/message/struct/text_content.py b/apps/application/workflow/message/struct/text_content.py
new file mode 100644
index 00000000000..a2691778ac4
--- /dev/null
+++ b/apps/application/workflow/message/struct/text_content.py
@@ -0,0 +1,22 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: text_content.py
+ @date:2026/6/30 16:03
+ @desc:
+"""
+from application.workflow.content_type import ContentType
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.status import Status
+
+
+class TextContent(Content):
+ def __init__(self, _id, content: str, status: Status, node_info: NodeInfo, position: Position, **kwargs):
+ self.content = content
+ super().__init__(_id, status, ContentType.TEXT, node_info, position, **kwargs)
+
+ def to_dict(self):
+ result = super().to_dict()
+ result['content'] = self.content
+ return result
diff --git a/apps/application/workflow/message/struct/tool_content.py b/apps/application/workflow/message/struct/tool_content.py
new file mode 100644
index 00000000000..e632df00406
--- /dev/null
+++ b/apps/application/workflow/message/struct/tool_content.py
@@ -0,0 +1,37 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: tool_content.py
+@date:2026/6/30 16:17
+@desc:
+"""
+
+from application.workflow.content_type import ContentType
+from application.workflow.message.struct.content import Content, NodeInfo, Position
+from application.workflow.status import Status
+
+
+class ToolContent(Content):
+ def __init__(
+ self,
+ _id,
+ tool_name: str,
+ arguments: str,
+ result: str,
+ status: Status,
+ node_info: NodeInfo,
+ position: Position,
+ **kwargs,
+ ):
+ self.name = tool_name
+ self.arguments = arguments
+ self.content = result
+ super().__init__(_id, status, ContentType.TOOL, node_info, position, **kwargs)
+
+ def to_dict(self):
+ result = super().to_dict()
+ result["content"] = self.content
+ result["arguments"] = self.arguments
+ result["name"] = self.name
+ return result
diff --git a/apps/application/workflow/message_queue.py b/apps/application/workflow/message_queue.py
new file mode 100644
index 00000000000..d0ae940e314
--- /dev/null
+++ b/apps/application/workflow/message_queue.py
@@ -0,0 +1,724 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: message_queue.py
+@date:2026/7/27 10:10
+@desc: 消息队列管理,用于流式响应的消息存储和消费
+支持多消费者、断线重连、消息持久化
+"""
+
+import bisect
+import fnmatch
+import json
+import os
+import socket
+import threading
+import time
+from abc import ABC, abstractmethod
+from collections import deque
+from concurrent.futures import ThreadPoolExecutor
+from enum import Enum
+from typing import Any, Callable, List, Optional, Tuple
+
+from common.utils.logger import maxkb_logger
+
+DEFAULT_TTL = 3600
+DEFAULT_BATCH_SIZE = 100
+DEFAULT_BLOCK_TIMEOUT_MS = 5000
+MAX_CONSECUTIVE_ERRORS = 5
+# XREAD block 窗口相对 socket_timeout 的安全比例,保证服务端先返回、客户端后超时
+BLOCK_SAFETY_RATIO = 0.6
+
+
+def _benign_timeouts() -> tuple:
+ """
+ 阻塞读读空窗口时的超时属于正常现象,不能计入故障预算。
+ redis.exceptions.TimeoutError 与内建 TimeoutError/socket.timeout 都要覆盖。
+ """
+ candidates = [TimeoutError, socket.timeout]
+ try:
+ from redis.exceptions import TimeoutError as RedisTimeoutError
+
+ candidates.append(RedisTimeoutError)
+ except ImportError:
+ pass
+ return tuple({c for c in candidates if isinstance(c, type)})
+
+
+BENIGN_TIMEOUTS = _benign_timeouts()
+
+
+class MessageQueueError(Exception):
+ """
+ 队列后端不可用。
+
+ 刻意与"队列不存在"区分开:Redis 抖动不应该被上层误判成会话已失效。
+ """
+
+
+class MessageStatus(str, Enum):
+ RUNNING = "RUNNING"
+ SUCCESS = "SUCCESS"
+ FAIL = "FAIL"
+ CANCELLED = "CANCELLED"
+
+
+def parse_stream_id(value: Any) -> Tuple[int, int]:
+ """
+ 把 Redis Stream ID ("1699999999999-0") 解析成可比较的元组。
+ 非法值一律退化成 (0, 0),即"从头开始"。
+ """
+ if value is None:
+ return 0, 0
+ if isinstance(value, (bytes, bytearray)):
+ value = value.decode("utf-8")
+ value = str(value)
+ if not value or value == "0":
+ return 0, 0
+ if value == "$":
+ return (1 << 63) - 1, 0
+ parts = value.split("-", 1)
+ try:
+ ms = int(parts[0])
+ seq = int(parts[1]) if len(parts) > 1 and parts[1] else 0
+ return ms, seq
+ except (TypeError, ValueError):
+ return 0, 0
+
+
+class IMessageQueue(ABC):
+ """消息队列接口"""
+
+ @abstractmethod
+ def exists(self, queue_id: str) -> bool:
+ pass
+
+ @abstractmethod
+ def produce(self, queue_id: str, message: Any, ttl: int = None) -> None:
+ pass
+
+ @abstractmethod
+ def produce_done(self, queue_id: str, ttl: int = None) -> None:
+ pass
+
+ @abstractmethod
+ def is_done(self, queue_id: str) -> bool:
+ pass
+
+ @abstractmethod
+ def consume(
+ self,
+ queue_id: str,
+ start_id: str = "0",
+ on_message: Optional[Callable[[str, str], None]] = None,
+ on_done: Optional[Callable[[], None]] = None,
+ timeout: float = 300,
+ should_stop: Optional[Callable[[], bool]] = None,
+ ) -> None:
+ """
+ 消费消息,阻塞直到队列结束 / 超时 / 被取消。
+
+ @param start_id: 起始消息ID,"0" 表示从头;语义为"返回 ID 严格大于 start_id 的消息"
+ @param on_message: 回调 (message_id, message_data)
+ @param on_done: 结束回调,保证有且只调用一次
+ @param timeout: 最长消费时间(秒)
+ @param should_stop: 取消钩子,返回 True 则立即结束消费
+ """
+ pass
+
+ @abstractmethod
+ def get_messages(self, queue_id: str, start_id: str = "0", count: int = 100) -> list:
+ """拉取 ID 严格大于 start_id 的历史消息,用于断线重连补发。"""
+ pass
+
+ @abstractmethod
+ def delete(self, queue_id: str) -> None:
+ pass
+
+ @abstractmethod
+ def clear_by_pattern(self, pattern: str) -> int:
+ pass
+
+
+_instances: dict[str, IMessageQueue] = {}
+_instances_lock = threading.Lock()
+
+
+class InMemoryMessageQueue(IMessageQueue):
+ """内存消息队列,仅适用于单进程环境(多 worker 下生产者和消费者可能不在同一进程)"""
+
+ def __init__(self, default_ttl: int = DEFAULT_TTL):
+ # queue_id -> (sort_keys, items),两个列表下标一一对应,便于 bisect 定位游标
+ self._sort_keys: dict[str, List[Tuple[int, int]]] = {}
+ self._items: dict[str, List[Tuple[str, str]]] = {}
+ self._done_flags: dict[str, bool] = {}
+ self._last_id: dict[str, Tuple[int, int]] = {}
+ self._expire_at: dict[str, float] = {}
+ self._default_ttl = default_ttl
+ # 用 RLock,避免 clear_by_pattern -> delete 这类内部复用造成自死锁
+ self._cond = threading.Condition(threading.RLock())
+
+ # ---------- 内部工具 ----------
+
+ def _next_id(self, queue_id: str) -> str:
+ """生成与 Redis Stream 同构的 ID,保证两种实现的 start_id 可以互换。"""
+ now = int(time.time() * 1000)
+ last_ms, last_seq = self._last_id.get(queue_id, (0, 0))
+ new_id = (now, 0) if now > last_ms else (last_ms, last_seq + 1)
+ self._last_id[queue_id] = new_id
+ return f"{new_id[0]}-{new_id[1]}"
+
+ def _drop(self, queue_id: str) -> None:
+ """调用方必须已持有锁。"""
+ self._sort_keys.pop(queue_id, None)
+ self._items.pop(queue_id, None)
+ self._done_flags.pop(queue_id, None)
+ self._last_id.pop(queue_id, None)
+ self._expire_at.pop(queue_id, None)
+
+ def _purge_if_expired(self, queue_id: str) -> None:
+ """调用方必须已持有锁。"""
+ expire_at = self._expire_at.get(queue_id)
+ if expire_at is not None and expire_at <= time.time():
+ self._drop(queue_id)
+
+ def _read_after(self, cursor: Tuple[int, int], queue_id: str) -> Tuple[List[Tuple[str, str]], bool]:
+ """
+ 原子地返回 (游标之后的消息, 是否已结束)。
+
+ 两个值必须在同一次加锁内读取:生产者是先 produce 再 produce_done,
+ 所以只要读到 done=True,就说明所有消息在本次快照里已经全部可见,
+ 不存在"最后一条消息还没写进来就判定结束"的竞态。
+ """
+ with self._cond:
+ self._purge_if_expired(queue_id)
+ keys = self._sort_keys.get(queue_id)
+ done = self._done_flags.get(queue_id, False)
+ if not keys:
+ return [], done
+ start = bisect.bisect_right(keys, cursor)
+ return list(self._items[queue_id][start:]), done
+
+ def purge_expired(self) -> int:
+ """惰性清理兜底:建议由定时任务周期调用,防止用户关页面后队列常驻内存。"""
+ now = time.time()
+ with self._cond:
+ expired = [k for k, exp in self._expire_at.items() if exp <= now]
+ for k in expired:
+ self._drop(k)
+ return len(expired)
+
+ # ---------- 接口实现 ----------
+
+ def exists(self, queue_id: str) -> bool:
+ with self._cond:
+ self._purge_if_expired(queue_id)
+ return queue_id in self._items
+
+ def produce(self, queue_id: str, message: Any, ttl: int = None) -> None:
+ data = message if isinstance(message, str) else json.dumps(message, ensure_ascii=False)
+ with self._cond:
+ self._purge_if_expired(queue_id)
+ if queue_id not in self._items:
+ self._items[queue_id] = []
+ self._sort_keys[queue_id] = []
+ msg_id = self._next_id(queue_id)
+ self._sort_keys[queue_id].append(parse_stream_id(msg_id))
+ self._items[queue_id].append((msg_id, data))
+ # 滑动过期,长会话不会中途被清掉
+ self._expire_at[queue_id] = time.time() + (ttl or self._default_ttl)
+ self._cond.notify_all()
+
+ def produce_done(self, queue_id: str, ttl: int = None) -> None:
+ with self._cond:
+ self._done_flags[queue_id] = True
+ self._expire_at[queue_id] = time.time() + (ttl or self._default_ttl)
+ self._cond.notify_all()
+
+ def is_done(self, queue_id: str) -> bool:
+ with self._cond:
+ return self._done_flags.get(queue_id, False)
+
+ def consume(
+ self,
+ queue_id: str,
+ start_id: str = "0",
+ on_message: Optional[Callable[[str, str], None]] = None,
+ on_done: Optional[Callable[[], None]] = None,
+ timeout: float = 300,
+ should_stop: Optional[Callable[[], bool]] = None,
+ ) -> None:
+ deadline = time.monotonic() + timeout
+ cursor = parse_stream_id(start_id)
+ try:
+ while True:
+ if should_stop is not None and should_stop():
+ break
+
+ remaining = deadline - time.monotonic()
+ if remaining <= 0:
+ maxkb_logger.warning(f"MessageQueue consume timeout: {queue_id}")
+ break
+
+ batch, done = self._read_after(cursor, queue_id)
+ if batch:
+ for msg_id, msg_data in batch:
+ if on_message:
+ on_message(msg_id, msg_data)
+ cursor = parse_stream_id(msg_id)
+ continue
+ if done:
+ break
+
+ # 等待生产者唤醒,而不是固定 sleep,降低首字延迟
+ with self._cond:
+ self._cond.wait(min(0.05, remaining))
+ finally:
+ if on_done:
+ on_done()
+
+ def get_messages(self, queue_id: str, start_id: str = "0", count: int = 100) -> list:
+ batch, _ = self._read_after(parse_stream_id(start_id), queue_id)
+ return [{"id": mid, "data": data} for mid, data in batch[:count]]
+
+ def delete(self, queue_id: str) -> None:
+ with self._cond:
+ self._drop(queue_id)
+ self._cond.notify_all()
+
+ def clear_by_pattern(self, pattern: str) -> int:
+ with self._cond:
+ keys = [k for k in self._items if fnmatch.fnmatch(k, pattern)]
+ for k in keys:
+ self._drop(k)
+ self._cond.notify_all()
+ return len(keys)
+
+
+class RedisStreamMessageQueue(IMessageQueue):
+ """
+ Redis Stream 消息队列
+ 支持多消费者、断线重连、消息持久化
+ """
+
+ def __init__(self, namespace: str = "mq", redis_client=None, alias: str = "default"):
+ self._namespace = namespace
+ self._redis = redis_client
+ self._alias = alias
+ self._resolved = None
+ self._default_ttl = DEFAULT_TTL
+ self._batch_size = DEFAULT_BATCH_SIZE
+ self._block_timeout = DEFAULT_BLOCK_TIMEOUT_MS
+ self._block_limit = None
+
+ # ---------- 连接 ----------
+
+ def _resolve_redis(self):
+ """
+ django-redis 的 cache.client 是 DefaultClient 包装层,没有 xadd/xread,
+ 必须取出底层 redis-py 连接。
+ """
+ try:
+ from django_redis import get_redis_connection
+
+ return get_redis_connection(self._alias)
+ except ImportError:
+ pass
+ except Exception as e:
+ maxkb_logger.warning(f"get_redis_connection({self._alias}) failed: {e}")
+
+ from django.core.cache import cache
+
+ client = getattr(cache, "client", None)
+ if client is not None and hasattr(client, "get_client"):
+ return client.get_client(write=True)
+ if client is not None and hasattr(client, "xadd"):
+ return client
+ raise MessageQueueError("当前 CACHES 后端不是 django-redis,无法使用 RedisStreamMessageQueue")
+
+ def _get_redis(self):
+ if self._redis is not None:
+ return self._redis
+ if self._resolved is None:
+ self._resolved = self._resolve_redis()
+ return self._resolved
+
+ def ping(self) -> bool:
+ """真实探活,不吞异常,供 create_message_queue 判断是否降级。"""
+ return bool(self._get_redis().ping())
+
+ def _block_limit_ms(self, redis) -> int:
+ """
+ XREAD 的 block 是让服务端挂起的时长,而客户端等响应用的是连接的 socket_timeout。
+ 一旦 block >= socket_timeout,空窗口必然先触发 "Timeout reading from socket"
+ 并导致 redis-py 断连重建。这里按连接实际配置反推一个安全上限。
+ """
+ if self._block_limit is not None:
+ return self._block_limit
+
+ limit = self._block_timeout
+ try:
+ kwargs = getattr(getattr(redis, "connection_pool", None), "connection_kwargs", None) or {}
+ socket_timeout = kwargs.get("socket_timeout")
+ if socket_timeout:
+ safe = int(float(socket_timeout) * 1000 * BLOCK_SAFETY_RATIO)
+ limit = max(100, min(limit, safe))
+ if limit < self._block_timeout:
+ maxkb_logger.info(f"MessageQueue: socket_timeout={socket_timeout}s,XREAD block 收敛到 {limit}ms")
+ except Exception as e:
+ maxkb_logger.warning(f"MessageQueue: 无法读取 socket_timeout,沿用默认 block: {e}")
+
+ self._block_limit = limit
+ return limit
+
+ # ---------- 编解码 ----------
+
+ def _key(self, queue_id: str) -> str:
+ return f"{self._namespace}:{queue_id}"
+
+ def _done_key(self, queue_id: str) -> str:
+ return f"{self._namespace}:{queue_id}:done"
+
+ def _encode(self, value: Any) -> str:
+ if isinstance(value, str):
+ return value
+ return json.dumps(value, ensure_ascii=False)
+
+ @staticmethod
+ def _decode_bytes(data: Any) -> str:
+ return data.decode("utf-8") if isinstance(data, (bytes, bytearray)) else str(data)
+
+ def _decode_field(self, fields: dict, name: str = "data") -> str:
+ """同时兼容 decode_responses=True / False 两种 client 配置。"""
+ if not fields:
+ return ""
+ val = fields.get(name)
+ if val is None:
+ val = fields.get(name.encode("utf-8"))
+ if val is None:
+ return ""
+ return self._decode_bytes(val)
+
+ def _emit(self, messages, on_message) -> Optional[str]:
+ last_id = None
+ for msg_id_raw, fields in messages:
+ msg_id = self._decode_bytes(msg_id_raw)
+ if on_message:
+ on_message(msg_id, self._decode_field(fields))
+ last_id = msg_id
+ return last_id
+
+ # ---------- 接口实现 ----------
+
+ def exists(self, queue_id: str) -> bool:
+ try:
+ return self._get_redis().exists(self._key(queue_id)) > 0
+ except Exception as e:
+ raise MessageQueueError(f"exists({queue_id}) failed: {e}") from e
+
+ def produce(self, queue_id: str, message: Any, ttl: int = None) -> None:
+ key = self._key(queue_id)
+ try:
+ # pipeline 合并 xadd + expire,流式场景每个 token 少一次 RTT;
+ # 同时每次都续期,避免长会话中途整条 stream 过期
+ pipe = self._get_redis().pipeline(transaction=False)
+ pipe.xadd(key, {"data": self._encode(message)})
+ pipe.expire(key, ttl or self._default_ttl)
+ pipe.execute()
+ except Exception as e:
+ maxkb_logger.error(f"MessageQueue produce error [{queue_id}]: {e}")
+ raise MessageQueueError(f"produce({queue_id}) failed: {e}") from e
+
+ def produce_done(self, queue_id: str, ttl: int = None) -> None:
+ try:
+ self._get_redis().set(self._done_key(queue_id), "1", ex=ttl or self._default_ttl)
+ except Exception as e:
+ maxkb_logger.error(f"MessageQueue produce_done error [{queue_id}]: {e}")
+ raise MessageQueueError(f"produce_done({queue_id}) failed: {e}") from e
+
+ def is_done(self, queue_id: str) -> bool:
+ try:
+ return self._get_redis().exists(self._done_key(queue_id)) > 0
+ except Exception as e:
+ raise MessageQueueError(f"is_done({queue_id}) failed: {e}") from e
+
+ def consume(
+ self,
+ queue_id: str,
+ start_id: str = "0",
+ on_message: Optional[Callable[[str, str], None]] = None,
+ on_done: Optional[Callable[[], None]] = None,
+ timeout: float = 300,
+ should_stop: Optional[Callable[[], bool]] = None,
+ ) -> None:
+ key = self._key(queue_id)
+ deadline = time.monotonic() + timeout
+ current_id = start_id or "0"
+ errors = 0
+
+ try:
+ redis = self._get_redis()
+ while True:
+ if should_stop is not None and should_stop():
+ break
+
+ remaining = deadline - time.monotonic()
+ if remaining <= 0:
+ maxkb_logger.warning(f"MessageQueue consume timeout: {queue_id}")
+ break
+
+ try:
+ # block 必须 >= 1:block=0 在 Redis 里是"无限阻塞",会挂死消费线程
+ block_ms = max(1, min(int(remaining * 1000), self._block_limit_ms(redis)))
+ result = redis.xread({key: current_id}, count=self._batch_size, block=block_ms)
+ errors = 0
+ except BENIGN_TIMEOUTS:
+ # 阻塞窗口内没有新消息而已,不是故障:不计入熔断预算,也不退避。
+ # 游标未推进,Stream 可重复读,不会丢消息。
+ result = None
+ except Exception as e:
+ errors += 1
+ maxkb_logger.error(
+ f"MessageQueue consume error [{queue_id}] ({errors}/{MAX_CONSECUTIVE_ERRORS}): {e}"
+ )
+ if errors >= MAX_CONSECUTIVE_ERRORS:
+ break
+ time.sleep(min(0.1 * errors, 1.0))
+ continue
+
+ if result:
+ for _, messages in result:
+ last_id = self._emit(messages, on_message)
+ if last_id:
+ current_id = last_id
+ continue
+
+ # 阻塞窗口内没有新消息,检查是否已结束
+ try:
+ finished = self.is_done(queue_id)
+ except MessageQueueError:
+ continue
+ if finished:
+ # done 标记是在所有 produce 之后写的,这里把尾部残留全部读干净
+ self._flush_remaining(redis, key, current_id, on_message)
+ break
+ except MessageQueueError as e:
+ maxkb_logger.error(f"MessageQueue consume aborted [{queue_id}]: {e}")
+ finally:
+ if on_done:
+ on_done()
+
+ def _flush_remaining(self, redis, key: str, current_id: str, on_message: Optional[Callable]) -> str:
+ """
+ 用非阻塞 xread 循环读完尾部消息。
+ 不传 block 参数即为非阻塞,且 xread 天然是"ID 严格大于游标"的语义,
+ 无需依赖 Redis 6.2+ 的 "(" 排他区间写法。
+ """
+ cursor = current_id
+ while True:
+ try:
+ result = redis.xread({key: cursor}, count=self._batch_size)
+ except Exception as e:
+ maxkb_logger.error(f"MessageQueue flush error [{key}]: {e}")
+ break
+ if not result:
+ break
+ total = 0
+ for _, messages in result:
+ total += len(messages)
+ last_id = self._emit(messages, on_message)
+ if last_id:
+ cursor = last_id
+ if total < self._batch_size:
+ break
+ return cursor
+
+ def get_messages(self, queue_id: str, start_id: str = "0", count: int = 100) -> list:
+ try:
+ result = self._get_redis().xread({self._key(queue_id): start_id or "0"}, count=count)
+ except Exception as e:
+ raise MessageQueueError(f"get_messages({queue_id}) failed: {e}") from e
+ return [
+ {"id": self._decode_bytes(mid), "data": self._decode_field(fields)}
+ for _, messages in (result or [])
+ for mid, fields in messages
+ ]
+
+ def delete(self, queue_id: str) -> None:
+ try:
+ self._get_redis().delete(self._key(queue_id), self._done_key(queue_id))
+ except Exception as e:
+ maxkb_logger.error(f"MessageQueue delete error [{queue_id}]: {e}")
+ raise MessageQueueError(f"delete({queue_id}) failed: {e}") from e
+
+ def clear_by_pattern(self, pattern: str) -> int:
+ """返回删除的 stream 数量;对应的 :done 标记也会一并清理。"""
+ try:
+ redis = self._get_redis()
+ count = 0
+ for full_pattern, counted in (
+ (f"{self._namespace}:{pattern}", True),
+ (f"{self._namespace}:{pattern}:done", False),
+ ):
+ cursor = 0
+ while True:
+ cursor, keys = redis.scan(cursor, match=full_pattern, count=500)
+ if keys:
+ redis.delete(*keys)
+ if counted:
+ count += len(keys)
+ if cursor == 0:
+ break
+ return count
+ except Exception as e:
+ maxkb_logger.error(f"MessageQueue clear_by_pattern error [{pattern}]: {e}")
+ return 0
+
+
+class _ProducerLane:
+ """单个 queue_id 的写入通道:一个 FIFO 缓冲 + 是否已有 flush 任务在跑的标记。"""
+
+ __slots__ = ("buffer", "active")
+
+ def __init__(self):
+ self.buffer: deque = deque()
+ self.active = False
+
+
+class AsyncMessageQueue(IMessageQueue):
+ """
+ 给后端队列套一层"异步写入 + 单会话保序"的生产侧包装。
+
+ 流式场景每 token 都要 produce 一次,若同步写后端(Redis)会让调用线程逐 token 等一次网络 RTT,
+ 进而拖慢整个工作流。这里把 produce / produce_done 交给共享线程池执行,调用方只做一次进程内入队后立即返回:
+ - 每个 queue_id 同一时刻至多一个 flush 任务在跑,消息按 deque FIFO 顺序写出,
+ 断线重连用的 Stream ID 顺序不受影响;
+ - produce_done 走同一条通道,保证在全部消息写完之后才落 done 标记;
+ - 会话写空后回收该 queue_id 的通道,避免长期占用内存;
+ - 读操作(exists / consume / get_messages / is_done 等)直接委托后端,语义不变。
+ 后端写入异常只记日志、不抛回业务线程(业务线程此时早已返回)。
+ """
+
+ _DONE = object()
+
+ def __init__(self, backend: IMessageQueue, max_workers: int = None):
+ self._backend = backend
+ self._lanes: dict[str, _ProducerLane] = {}
+ self._lock = threading.Lock()
+ self._pool = ThreadPoolExecutor(
+ max_workers=max_workers or int(os.getenv("MAXKB_MQ_PRODUCE_WORKERS", "8")),
+ thread_name_prefix="mq-produce",
+ )
+
+ # ---------- 生产侧:异步 + 保序 ----------
+
+ def produce(self, queue_id: str, message: Any, ttl: int = None) -> None:
+ self._enqueue(queue_id, (message, ttl))
+
+ def produce_done(self, queue_id: str, ttl: int = None) -> None:
+ self._enqueue(queue_id, (self._DONE, ttl))
+
+ def _enqueue(self, queue_id: str, item: Tuple[Any, Optional[int]]) -> None:
+ with self._lock:
+ lane = self._lanes.get(queue_id)
+ if lane is None:
+ lane = _ProducerLane()
+ self._lanes[queue_id] = lane
+ lane.buffer.append(item)
+ if lane.active:
+ return
+ lane.active = True
+ self._pool.submit(self._flush, queue_id)
+
+ def _flush(self, queue_id: str) -> None:
+ while True:
+ with self._lock:
+ lane = self._lanes.get(queue_id)
+ if lane is None:
+ return
+ if not lane.buffer:
+ # 写空即回收:新消息到来时 _enqueue 会重建通道并重新提交任务
+ self._lanes.pop(queue_id, None)
+ return
+ message, ttl = lane.buffer.popleft()
+ try:
+ if message is self._DONE:
+ self._backend.produce_done(queue_id, ttl=ttl)
+ else:
+ self._backend.produce(queue_id, message, ttl=ttl)
+ except Exception as e:
+ maxkb_logger.error(f"AsyncMessageQueue flush error [{queue_id}]: {e}")
+
+ def _drop_lane(self, queue_id: str) -> None:
+ with self._lock:
+ self._lanes.pop(queue_id, None)
+
+ # ---------- 读操作 / 清理:委托后端 ----------
+
+ def exists(self, queue_id: str) -> bool:
+ return self._backend.exists(queue_id)
+
+ def is_done(self, queue_id: str) -> bool:
+ return self._backend.is_done(queue_id)
+
+ def consume(
+ self,
+ queue_id: str,
+ start_id: str = "0",
+ on_message: Optional[Callable[[str, str], None]] = None,
+ on_done: Optional[Callable[[], None]] = None,
+ timeout: float = 300,
+ should_stop: Optional[Callable[[], bool]] = None,
+ ) -> None:
+ return self._backend.consume(queue_id, start_id, on_message, on_done, timeout, should_stop)
+
+ def get_messages(self, queue_id: str, start_id: str = "0", count: int = 100) -> list:
+ return self._backend.get_messages(queue_id, start_id, count)
+
+ def delete(self, queue_id: str) -> None:
+ # 先丢掉尚未 flush 的缓冲,避免删除后又把残留写回后端
+ self._drop_lane(queue_id)
+ self._backend.delete(queue_id)
+
+ def clear_by_pattern(self, pattern: str) -> int:
+ with self._lock:
+ for queue_id in [q for q in self._lanes if fnmatch.fnmatch(q, pattern)]:
+ self._lanes.pop(queue_id, None)
+ return self._backend.clear_by_pattern(pattern)
+
+
+def create_message_queue(namespace: str = "mq", use_redis: bool = True) -> IMessageQueue:
+ """
+ 创建消息队列实例
+ @param namespace: 命名空间
+ @param use_redis: 是否使用Redis(False则使用内存实现)
+ """
+ if use_redis:
+ try:
+ queue = RedisStreamMessageQueue(namespace=namespace)
+ queue.ping()
+ return queue
+ except Exception as e:
+ maxkb_logger.warning(f"Redis 不可用,降级为 InMemoryMessageQueue(多 worker 部署下跨进程消费将失效): {e}")
+ return InMemoryMessageQueue()
+
+
+def get_message_queue(namespace: str = "chat") -> IMessageQueue:
+ """进程内按 namespace 复用队列实例。禁止在业务代码里直接调 create_message_queue。"""
+ instance = _instances.get(namespace) # 快路径,GIL 下 dict.get 原子
+ if instance is not None:
+ return instance
+ with _instances_lock:
+ instance = _instances.get(namespace) # 双检
+ if instance is None:
+ from django.conf import settings
+
+ backend = create_message_queue(
+ namespace=namespace,
+ use_redis=getattr(settings, "MESSAGE_QUEUE_USE_REDIS", True),
+ )
+ # 套异步写入层:produce/produce_done 不再阻塞业务线程(逐 token 的 Redis RTT 拖慢工作流)
+ instance = AsyncMessageQueue(backend)
+ _instances[namespace] = instance
+ return instance
diff --git a/apps/application/workflow/nodes/__init__.py b/apps/application/workflow/nodes/__init__.py
new file mode 100644
index 00000000000..3f6eeb92644
--- /dev/null
+++ b/apps/application/workflow/nodes/__init__.py
@@ -0,0 +1,78 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py.py
+ @date:2026/6/29 16:15
+ @desc:
+"""
+import pkgutil
+import importlib
+import inspect
+from pathlib import Path
+
+from application.workflow.i_node import INode
+
+node_list: list[type[INode]] = []
+_seen: set[type] = set()
+
+for _, module_name, _ in pkgutil.iter_modules([str(Path(__file__).parent)]):
+ module = importlib.import_module(f".{module_name}", __package__)
+ for _, obj in inspect.getmembers(module, inspect.isclass):
+ if (
+ issubclass(obj, INode)
+ and obj is not INode
+ and obj.__module__.startswith(__package__)
+ and obj not in _seen
+ ):
+ _seen.add(obj)
+ node_list.append(obj)
+
+if not node_list:
+ raise RuntimeError(f"未发现任何节点,检查各子包 __init__.py 是否导出了 INode 子类: {Path(__file__).parent}")
+
+node_map = {n.type: {workflow_type: n for workflow_type in n.supported_workflow_type_list} for n in node_list}
+
+
+def get_node_class(_type, workflow_type):
+ """
+ 根据节点类型 获取此类型的处理器
+ @param _type: 节点类型
+ @param workflow_type: 工作流类型
+ @return: 节点处理器
+ """
+ node_class = node_map.get(_type, {}).get(workflow_type)
+ if node_class is None:
+ raise ValueError(f"节点不存在: type={_type}, workflow_type={workflow_type}")
+ return node_class
+
+
+def get_start_node(workflow, workflow_manage, workflow_type, position=None):
+ """
+ 获取开始节点实例
+ @param workflow: 工作流对象
+ @param workflow_manage 工作流管理器
+ @param workflow_type: 工作流类型
+ @param position: 位置信息(可选)
+ @return: 开始节点实例
+ """
+ # 如果有 position,根据 position 确定开始节点
+ if position and position.get('id'):
+ node_id = position.get('id')
+ node = workflow.get_node(node_id)
+ if node:
+ node_class = get_node_class(node.type, workflow_type)
+ def get_node_parameters(n):
+ return n.properties.get('node_data', {})
+ return node_class(node, workflow_manage, get_node_parameters)
+
+ # 默认返回开始节点
+ start_node = workflow.get_node('start-node')
+ if start_node is None:
+ raise ValueError("开始节点不存在")
+ node_class = get_node_class(start_node.type, workflow_type)
+
+ def get_node_parameters(node):
+ return node.properties.get('node_data', {})
+
+ return node_class(start_node, workflow_manage, get_node_parameters)
diff --git a/apps/application/workflow/nodes/ai_chat_node/__init__.py b/apps/application/workflow/nodes/ai_chat_node/__init__.py
new file mode 100644
index 00000000000..0682df52ea0
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/1 16:59
+ @desc:
+"""
+from .ai_chat_node import AIChatNode
diff --git a/apps/application/workflow/nodes/ai_chat_node/agent.py b/apps/application/workflow/nodes/ai_chat_node/agent.py
new file mode 100644
index 00000000000..9e8a561bd83
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/agent.py
@@ -0,0 +1,209 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: agent.py
+@date: 2026/9/14 16:59
+@desc: AI 对话节点的 Agent(MCP / deepagents)执行逻辑。
+
+从 application/flow/tools.py 抽离,供新工作流引擎的 ai_chat_node 使用,
+避免新引擎反向依赖旧引擎的 flow.tools 模块。
+"""
+
+import asyncio
+import json
+import os
+import re
+import shutil
+
+import langchain_core.messages.ai as _lc_ai_module
+import uuid_utils.compat as uuid
+from deepagents import create_deep_agent
+from langchain_core.utils._merge import merge_lists as _original_merge_lists
+from langchain_mcp_adapters.client import MultiServerMCPClient
+from langgraph.checkpoint.memory import MemorySaver
+
+from application.workflow.backend.sandbox_shell import SandboxShellBackend
+from application.workflow.i_node import CancelledException
+from application.workflow.nodes.ai_chat_node.tools.skill import init_skills
+from maxkb.const import CONFIG
+
+
+# ---------------------------------------------------------------------------
+# Fix: qwen's OpenAI-compatible streaming sends id='' (empty string) for
+# intermediate tool_call_chunks while only the first chunk carries the real
+# id ('call_xxx...'). langchain-core's merge_lists treats '' != 'call_xxx' as
+# an ID conflict and _appends_ instead of merging → the accumulated AIMessage
+# ends up with two separate tool_calls (one with empty args, one with empty
+# id) instead of one correct entry. This causes the Qwen API to reject the
+# next request with "function.arguments must be in JSON format".
+#
+# Patch: normalise id='' → None for items that have an 'index' key
+# (i.e. tool_call_chunk dicts). merge_lists treats None as "no id" and will
+# merge with any existing entry, keeping the real id from the first chunk.
+# ---------------------------------------------------------------------------
+def _merge_lists_normalize_empty_tool_chunk_ids(left, *others):
+ """Wrapper around merge_lists that normalises empty-string IDs to None in
+ tool_call_chunk items (those with an 'index' key) so that qwen streaming
+ chunks with id='' are merged correctly by index."""
+
+ def _norm(lst):
+ if lst is None:
+ return lst
+ result = []
+ for item in lst:
+ if isinstance(item, dict) and "index" in item and item.get("id") == "":
+ item = {**item, "id": None}
+ result.append(item)
+ return result
+
+ return _original_merge_lists(
+ _norm(left),
+ *[_norm(o) for o in others],
+ )
+
+
+# Replace the module-level reference used by add_ai_message_chunks in ai.py
+_lc_ai_module.merge_lists = _merge_lists_normalize_empty_tool_chunk_ids
+
+
+def _get_tool_call_id(raw_id):
+ if not raw_id:
+ return None
+ if not isinstance(raw_id, str):
+ raw_id = str(raw_id)
+
+ s = raw_id
+ prefix = "call_"
+ positions = [m.start() for m in re.finditer(re.escape(prefix), s)]
+ if not positions:
+ return raw_id
+
+ # 取最后一个前缀位置,截到下一个前缀或结尾
+ start = positions[-1]
+ end = len(s)
+ for pos in positions:
+ if pos > start:
+ end = pos
+ break
+
+ tool_id = s[start:end]
+ return tool_id or raw_id
+
+
+class ToolCallStreamManagement:
+ def __init__(self):
+ self.index_id_map = {}
+ self.id_name_map = {}
+ self.tool_uuid_map = {}
+ self.use_tool_id_list = set()
+
+ @staticmethod
+ def get_fallback_tool_calls(msg):
+ source = msg.tool_calls or msg.invalid_tool_calls
+ if source:
+ return [(tc.get("index"), tc.get("id"), tc.get("name"), tc.get("args", "")) for tc in source]
+ result = []
+ for tc in msg.additional_kwargs.get("tool_calls", []):
+ func = tc.get("function")
+ if isinstance(func, dict):
+ result.append((tc.get("index"), tc.get("id"), func.get("name"), func.get("arguments", "")))
+ else:
+ result.append((tc.get("index"), tc.get("id"), tc.get("name"), tc.get("arguments", "")))
+ return result
+
+ def get_tool_id(self, index, raw_id):
+ if raw_id and str(raw_id).strip():
+ tool_id = _get_tool_call_id(str(raw_id).strip())
+ if index is not None:
+ self.index_id_map[index] = tool_id
+ return tool_id
+ if index is not None:
+ return self.index_id_map.get(index)
+ return None
+
+ def get_tool_name(self, tool_id, default=None):
+ return self.id_name_map.get(tool_id, default)
+
+ def add_tool_id(self, tool_id):
+ self.use_tool_id_list.add(tool_id)
+
+ def get_tool_uuid(self, tool_id):
+ if tool_id not in self.tool_uuid_map:
+ self.tool_uuid_map[tool_id] = str(uuid.uuid7())
+ return self.tool_uuid_map.get(tool_id)
+
+ def tool_id_is_used(self, tool_id):
+ return tool_id in self.use_tool_id_list
+
+ def set_tool_id_name(self, tool_id, name):
+ self.id_name_map[tool_id] = name
+
+
+def create_agent(
+ chat_model,
+ system_prompt,
+ message_list,
+ mcp_servers,
+ call_back,
+ chat_id=None,
+ skill_tool_ids=None,
+ extra_tools=None,
+):
+ # 创建临时文件夹
+ if chat_id:
+ temp_dir = os.path.join("/tmp", chat_id)
+ else:
+ temp_dir = os.path.join("/tmp", str(uuid.uuid7()))
+ skills_dir = os.path.join(temp_dir, "skills")
+ os.makedirs(skills_dir, exist_ok=True)
+
+ async def _run():
+ checkpointer = MemorySaver()
+ await init_skills(skill_tool_ids, temp_dir)
+ client = MultiServerMCPClient(json.loads(mcp_servers))
+ tools = await client.get_tools()
+ for tool in tools:
+ tool.handle_tool_error = True
+ if extra_tools:
+ for tool in extra_tools:
+ tools.append(tool)
+
+ agent = create_deep_agent(
+ model=chat_model,
+ backend=SandboxShellBackend(root_dir=temp_dir, virtual_mode=True),
+ skills=["/skills"],
+ tools=tools,
+ system_prompt=system_prompt,
+ interrupt_on={"write_file": False, "read_file": False, "edit_file": False},
+ checkpointer=checkpointer,
+ )
+ recursion_limit = int(CONFIG.get("LANGCHAIN_GRAPH_RECURSION_LIMIT", "100"))
+ response = agent.astream(
+ {"messages": message_list},
+ config={"recursion_limit": recursion_limit, "configurable": {"thread_id": chat_id}},
+ stream_mode="messages",
+ )
+
+ async for chunk in response:
+ msg = chunk[0]
+ call_back.on_next(msg)
+
+ def _classify_error(e):
+ # 取消:原样保留(保持节点取消语义);MCP TaskGroup 的 ExceptionGroup:展开取真实异常并包成 RuntimeError
+ if isinstance(e, CancelledException):
+ return e
+ if isinstance(e, ExceptionGroup):
+ while isinstance(e, ExceptionGroup):
+ e = e.exceptions[0]
+ return RuntimeError(f"{type(e).__name__}: {str(e)}")
+
+ error = None
+ try:
+ asyncio.run(_run())
+ except Exception as e:
+ error = _classify_error(e)
+ finally:
+ # 清理临时文件夹
+ shutil.rmtree(temp_dir, ignore_errors=True)
+ call_back.on_complete(error)
diff --git a/apps/application/workflow/nodes/ai_chat_node/ai_chat_node.py b/apps/application/workflow/nodes/ai_chat_node/ai_chat_node.py
new file mode 100644
index 00000000000..ae744850396
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/ai_chat_node.py
@@ -0,0 +1,666 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: ai_chat_node.py
+@date:2026/7/1 16:59
+@desc:
+"""
+
+import base64
+import json
+import re
+from functools import reduce
+from typing import Callable, Optional
+
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import AIMessage, HumanMessage, SystemMessage, ToolMessage, AIMessageChunk
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.aggregator import AggregationManager
+from application.workflow.message.struct.content import NodeInfo, Position, Content
+from application.workflow.message.struct.reasoning_content import ReasoningContent
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.message.struct.tool_content import ToolContent
+from application.workflow.nodes.ai_chat_node.agent import create_agent, ToolCallStreamManagement, _get_tool_call_id
+from application.workflow.nodes.ai_chat_node.tools import (
+ get_application_tools,
+ get_mcp_servers,
+ get_tool_tools,
+)
+from application.workflow.status import Status
+from application.workflow.tools import Reasoning
+from common.utils.common import guess_image_format
+from common.utils.messages_util import to_ai_message_list, to_human_message_list
+from common.utils.shared_resource_auth import filter_authorized_ids
+from common.utils.tool_code import ToolExecutor
+from knowledge.models import File
+from models_provider.models import Model
+from models_provider.tools import get_model_credential, get_model_instance_by_model_workspace_id
+from common.exception.app_exception import AppApiException
+
+
+class AgentCallBack:
+ def __init__(
+ self,
+ on_next: Callable[[any], None],
+ on_complete: Callable[[Optional[Exception]], None],
+ ):
+ self.on_next = on_next
+ self.on_complete = on_complete
+
+
+class ChatNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ system = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Role Setting"))
+ prompt = serializers.CharField(required=True, label=_("Prompt word"))
+ dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ model_params_setting = serializers.DictField(required=False, label=_("Model parameter settings"))
+ model_setting = serializers.DictField(required=False, label="Model settings")
+ dialogue_type = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Context Type"))
+ mcp_servers = serializers.JSONField(required=False, label=_("MCP Server"))
+ mcp_tool_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("MCP Tool ID"))
+ mcp_tool_ids = serializers.ListField(
+ child=serializers.UUIDField(),
+ required=False,
+ allow_empty=True,
+ label=_("MCP Tool IDs"),
+ )
+ mcp_source = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("MCP Source"))
+ tool_ids = serializers.ListField(
+ child=serializers.UUIDField(),
+ required=False,
+ allow_empty=True,
+ label=_("Tool IDs"),
+ )
+ application_ids = serializers.ListField(
+ child=serializers.UUIDField(),
+ required=False,
+ allow_empty=True,
+ label=_("App IDs"),
+ )
+ skill_tool_ids = serializers.ListField(
+ child=serializers.UUIDField(),
+ required=False,
+ allow_empty=True,
+ label=_("Skill IDs"),
+ )
+ mcp_output_enable = serializers.BooleanField(required=False, default=True, label=_("Whether to enable MCP output"))
+ video_list = serializers.ListField(required=False, label=_("video"))
+ image_list = serializers.ListField(required=False, label=_("picture"))
+ vision = serializers.BooleanField(required=False, default=False, label=_("vision"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _get_default_model_params_setting(model_id):
+ model = QuerySet(Model).filter(id=model_id).first()
+ credential = get_model_credential(model.provider, model.model_type, model.model_name)
+ model_params_setting = credential.get_model_params_setting_form(model.model_name).get_default_form_data()
+ return model_params_setting
+
+
+def _get_node_message(chat_record, runtime_node_id):
+ node_details = chat_record.get_node_details_runtime_node_id(runtime_node_id)
+ if node_details is None:
+ return []
+ return [*to_human_message_list(node_details.get("question")), *to_ai_message_list(node_details.get("messages"))]
+ return [HumanMessage(node_details.get("question")), AIMessage(node_details.get("messages"))]
+
+
+def _get_workflow_message(chat_record):
+ return [*chat_record.get_human_message(), *chat_record.get_ai_message()]
+
+
+def _get_message(chat_record, dialogue_type, runtime_node_id):
+ if dialogue_type == "NODE":
+ return _get_node_message(chat_record, runtime_node_id)
+ return _get_workflow_message(chat_record)
+
+
+def _get_history_message(history_chat_record, dialogue_number, dialogue_type, runtime_node_id):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ _get_message(history_chat_record[index], dialogue_type, runtime_node_id)
+ for index in range(max(start_index, 0), len(history_chat_record))
+ ],
+ [],
+ )
+ for message in history_message:
+ if isinstance(message.content, str):
+ message.content = re.sub(r".*?", "", message.content, flags=re.DOTALL)
+ return history_message
+
+
+def _process_images(image):
+ images = []
+ if isinstance(image, str) and image.startswith("http"):
+ images.append({"type": "image_url", "image_url": {"url": image}})
+ elif image is not None and len(image) > 0:
+ for img in image:
+ if "file_id" in img:
+ file_id = img["file_id"]
+ file = QuerySet(File).filter(id=file_id).first()
+ image_bytes = file.get_bytes()
+ base64_image = base64.b64encode(image_bytes).decode("utf-8")
+ image_format = guess_image_format(image_bytes)
+ images.append(
+ {"type": "image_url", "image_url": {"url": f"data:image/{image_format};base64,{base64_image}"}}
+ )
+ elif "url" in img and img["url"].startswith("http"):
+ images.append({"type": "image_url", "image_url": {"url": img["url"]}})
+ return images
+
+
+def _get_upstream_knowledge_images(workflow_manage, node_id):
+ """Collect image hits produced by executed upstream knowledge-search nodes."""
+ workflow = workflow_manage.workflow
+ pending_node_ids = [node_id]
+ visited_node_ids = set()
+ image_list = []
+ seen_file_ids = set()
+
+ while pending_node_ids:
+ current_node_id = pending_node_ids.pop()
+ if current_node_id in visited_node_ids:
+ continue
+ visited_node_ids.add(current_node_id)
+ for edge_node in workflow.up_node_map.get(current_node_id, []):
+ upstream_node = edge_node.node
+ pending_node_ids.append(upstream_node.id)
+ if upstream_node.type != "search-knowledge-node":
+ continue
+ for image in workflow_manage.get_context(upstream_node.id, "image_list") or []:
+ file_id = str(image.get("file_id") or "")
+ if not file_id or file_id in seen_file_ids:
+ continue
+ seen_file_ids.add(file_id)
+ image_list.append(image)
+ return image_list
+
+
+def _process_videos(video, video_model):
+ videos = []
+ if isinstance(video, str) and video.startswith("http"):
+ videos.append({"type": "video_url", "video_url": {"url": video}})
+ elif video is not None and len(video) > 0:
+ for v in video:
+ if "file_id" in v:
+ file_id = v["file_id"]
+ file = QuerySet(File).filter(id=file_id).first()
+ url = video_model.upload_file_and_get_url(file.get_bytes(), file.file_name)
+ videos.append({"type": "video_url", "video_url": {"url": url}})
+ elif "url" in v and v["url"].startswith("http"):
+ videos.append({"type": "video_url", "video_url": {"url": v["url"]}})
+ return videos
+
+
+class AIChatNode(INode):
+ serializer_class = ChatNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "ai-chat-node"
+
+ def write(self, message: Content):
+ super().write(message)
+ if not self.data.get("messages"):
+ self.data["messages"] = []
+ self.data["messages"].append(message)
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ node_params = self.get_parameters()
+ reasoning_content_id = str(uuid.uuid7())
+ text_content_id = str(uuid.uuid7())
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ model_params_setting = node_params.get("model_params_setting")
+ model_setting = node_params.get("model_setting")
+ system = node_params.get("system", "")
+ prompt = node_params.get("prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ dialogue_type = node_params.get("dialogue_type", "WORKFLOW") or "WORKFLOW"
+ is_result = node_params.get("is_result", False)
+ vision = node_params.get("vision", False)
+ image_list = node_params.get("image_list")
+ video_list = node_params.get("video_list")
+ stream = node_params.get("stream", True)
+
+ mcp_servers = node_params.get("mcp_servers")
+ mcp_tool_id = node_params.get("mcp_tool_id")
+ mcp_tool_ids = node_params.get("mcp_tool_ids")
+ mcp_source = node_params.get("mcp_source")
+ tool_ids = node_params.get("tool_ids")
+ application_ids = node_params.get("application_ids")
+ skill_tool_ids = node_params.get("skill_tool_ids")
+ mcp_output_enable = node_params.get("mcp_output_enable", True)
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ chat_id = None
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ chat_id = workflow_params.get("chat_id")
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("LLM") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ if model_params_setting is None and model_id:
+ model_params_setting = _get_default_model_params_setting(model_id)
+
+ if model_setting is None:
+ model_setting = {
+ "reasoning_content_enable": False,
+ "reasoning_content_end": "",
+ "reasoning_content_start": "",
+ }
+ self.data["model_setting"] = model_setting
+
+ chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message = _get_history_message(history_chat_record, dialogue_number, dialogue_type, self.get_node_id())
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message or [])],
+ )
+ question_str = self.workflow_manage.generate_prompt(prompt)
+ question = self._generate_prompt_question(question_str, chat_model, vision, image_list, video_list)
+ self.data["question"] = {"content": question_str, "image_list": image_list, "video_list": video_list}
+
+ system = self.workflow_manage.generate_prompt(system)
+ self.data["system"] = system
+
+ message_list = [*history_message, question]
+
+ all_tool_ids = list(
+ set(
+ (mcp_tool_ids or [])
+ + (tool_ids or [])
+ + (skill_tool_ids or [])
+ + ([mcp_tool_id] if mcp_tool_id else [])
+ )
+ )
+ authorized_set = set(filter_authorized_ids("tool", all_tool_ids, workspace_id))
+ mcp_tool_ids = [i for i in (mcp_tool_ids or []) if i in authorized_set]
+ tool_ids = [i for i in (tool_ids or []) if i in authorized_set]
+ skill_tool_ids = [i for i in (skill_tool_ids or []) if i in authorized_set]
+ mcp_tool_id = mcp_tool_id if (mcp_tool_id and mcp_tool_id in authorized_set) else None
+
+ mcp_handled = self._handle_mcp(
+ mcp_source,
+ mcp_servers,
+ mcp_tool_id,
+ mcp_tool_ids,
+ tool_ids,
+ application_ids,
+ skill_tool_ids,
+ mcp_output_enable,
+ chat_model,
+ SystemMessage(system),
+ message_list,
+ question,
+ chat_id,
+ workspace_id,
+ workflow_type,
+ is_result,
+ )
+ if not mcp_handled:
+ message_list_with_system = [SystemMessage(system)] + message_list
+
+ if stream:
+ r = chat_model.stream(message_list_with_system)
+ self._stream_response(
+ r, chat_model, message_list_with_system, question.content, reasoning_content_id, text_content_id
+ )
+ else:
+ r = chat_model.invoke(message_list_with_system)
+ self._invoke_response(
+ r, chat_model, message_list_with_system, question.content, is_result, text_content_id
+ )
+
+ def _generate_prompt_question(self, question_str, model, vision, image_list, video_list):
+ images = []
+ videos = []
+ if vision:
+ if image_list:
+ image = self.workflow_manage.get_reference_field(image_list[0], image_list[1:])
+ images = _process_images(image)
+ recalled_images = _get_upstream_knowledge_images(self.workflow_manage, self.get_node_id())
+ if recalled_images:
+ images.extend(_process_images(recalled_images))
+ if video_list:
+ video = self.workflow_manage.get_reference_field(video_list[0], video_list[1:])
+ videos = _process_videos(video, model)
+ return HumanMessage(content=[*videos, *images, {"type": "text", "text": question_str}])
+
+ def _stream_response(self, response, chat_model, message_list, question, reasoning_content_id, text_content_id):
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.RUNNING)
+ model_setting = self.get_context("model_setting") or {}
+ reasoning = Reasoning(
+ model_setting.get("reasoning_content_start", ""),
+ model_setting.get("reasoning_content_end", ""),
+ )
+ answer = ""
+ reasoning_content = ""
+ response_reasoning_content = False
+
+ for chunk in response:
+ self._check_cancelled()
+ reasoning_chunk = reasoning.get_reasoning_content(chunk)
+ content_chunk = reasoning_chunk.get("content")
+ if "reasoning_content" in chunk.additional_kwargs:
+ response_reasoning_content = True
+ reasoning_content_chunk = chunk.additional_kwargs.get("reasoning_content", "")
+ else:
+ reasoning_content_chunk = reasoning_chunk.get("reasoning_content")
+ answer += content_chunk
+ if reasoning_content_chunk is None:
+ reasoning_content_chunk = ""
+ reasoning_content += reasoning_content_chunk
+ reasoning_end = False
+ if content_chunk:
+ if not reasoning_end:
+ self.write(
+ ReasoningContent(
+ reasoning_content_id, "", Status.SUCCESS, node_info, Position(self.get_node_id())
+ )
+ )
+ self.write(
+ TextContent(text_content_id, content_chunk, Status.RUNNING, node_info, Position(self.get_node_id()))
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ reasoning_end = reasoning.get_end_reasoning_content()
+ answer += reasoning_end.get("content")
+ reasoning_content_chunk = ""
+ if not response_reasoning_content:
+ reasoning_content_chunk = reasoning_end.get("reasoning_content")
+ if reasoning_end.get("content"):
+ self.write(
+ TextContent(
+ text_content_id,
+ reasoning_end.get("content"),
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ self._write_final_context(chat_model, message_list, question, answer, reasoning_content)
+
+ def _invoke_response(self, response, chat_model, message_list, question, is_result=False, text_content_id=None):
+ model_setting = self.get_context("model_setting") or {}
+ reasoning = Reasoning(
+ model_setting.get("reasoning_content_start", ""),
+ model_setting.get("reasoning_content_end", ""),
+ )
+ reasoning_result = reasoning.get_reasoning_content(response)
+ reasoning_result_end = reasoning.get_end_reasoning_content()
+ content = reasoning_result.get("content") + reasoning_result_end.get("content")
+ meta = {**response.response_metadata, **response.additional_kwargs}
+ if "reasoning_content" in meta:
+ reasoning_content = meta.get("reasoning_content", "") or ""
+ else:
+ reasoning_content = (reasoning_result.get("reasoning_content") or "") + (
+ reasoning_result_end.get("reasoning_content") or ""
+ )
+ self._write_final_context(chat_model, message_list, question, content, reasoning_content)
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(TextContent(text_content_id, content, Status.SUCCESS, node_info, Position(self.get_node_id())))
+
+ def _write_final_context(self, chat_model, message_list, question, answer, reasoning_content):
+ message_tokens = chat_model.get_num_tokens_from_messages(message_list)
+ answer_tokens = chat_model.get_num_tokens(answer)
+ self.data["message_tokens"] = message_tokens
+ self.data["answer_tokens"] = answer_tokens
+ self.write_context("answer", answer)
+ self.data["reasoning_content"] = reasoning_content
+
+ def _handle_mcp(
+ self,
+ mcp_source,
+ mcp_servers,
+ mcp_tool_id,
+ mcp_tool_ids,
+ tool_ids,
+ application_ids,
+ skill_tool_ids,
+ mcp_output_enable,
+ chat_model,
+ system_prompt,
+ message_list,
+ question,
+ chat_id,
+ workspace_id,
+ workflow_type,
+ text_content_id,
+ is_result=False,
+ ):
+ # 工具记录来源(source_type / source_id)
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ source_id = self.get_workflow_parameters().get("knowledge_id")
+ source_type = "KNOWLEDGE"
+ elif workflow_type == WorkflowType.TOOL:
+ source_id = self.get_workflow_parameters().get("tool_id")
+ source_type = "TOOL"
+ else:
+ source_id = self.get_workflow_parameters().get("application_id")
+ source_type = "APPLICATION"
+
+ # 工具(workflow/custom) + 智能体(子应用) → LangChain tools;
+ # MCP(自定义/库内) → mcp_servers 配置;技能 → 交给引擎侧 init_skills 初始化
+ tools = get_tool_tools(
+ source_type, source_id, tool_ids, workspace_id, self.get_workflow_parameters()
+ ) + get_application_tools(source_type, source_id, application_ids, workspace_id, self.get_workflow_parameters())
+ mcp_servers_config = get_mcp_servers(mcp_source, mcp_servers, mcp_tool_id, mcp_tool_ids, self._handle_variables)
+ ToolExecutor().validate_mcp_transport(json.dumps(mcp_servers_config))
+
+ if tools or mcp_servers_config or skill_tool_ids:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.RUNNING)
+ # 使用可变状态在回调间共享(answer 累积、当前文本 content id、工具 content id 映射)
+ state = {"answer": "", "text_id": text_content_id, "tool_id_map": {}}
+ tool_stream = ToolCallStreamManagement()
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.RUNNING)
+
+ def on_next(chunk):
+ self._check_cancelled()
+ if mcp_output_enable and isinstance(chunk, AIMessageChunk):
+ if chunk.tool_call_chunks:
+ for tc in chunk.tool_call_chunks:
+ tool_id = tool_stream.get_tool_id(tc.get("index"), tc.get("id"))
+ if not tool_id:
+ continue
+ tool_stream.add_tool_id(tool_id)
+ if tc.get("name") or tc.get("args"):
+ tool_stream.set_tool_id_name(tool_id, tc.get("name"))
+ self.write(
+ ToolContent(
+ tool_stream.get_tool_uuid(tool_id),
+ tc.get("name"),
+ tc.get("args"),
+ "",
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+ else:
+ for index, raw_id, name, args in tool_stream.get_fallback_tool_calls(chunk):
+ tool_id = tool_stream.get_tool_id(index, raw_id)
+ if not tool_id or not tool_stream.add_tool_id(tool_id):
+ continue
+ self.write(
+ ToolContent(
+ tool_stream.get_tool_uuid(tool_id),
+ name,
+ args,
+ "",
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ if mcp_output_enable and isinstance(chunk, ToolMessage):
+ tool_id = _get_tool_call_id(chunk.tool_call_id) or chunk.tool_call_id
+ chunk.name = tool_stream.get_tool_name(tool_id, chunk.name)
+ try:
+ if isinstance(chunk.content, str):
+ tool_result = json.loads(chunk.content)
+ elif isinstance(chunk.content, dict):
+ tool_result = chunk.content
+ elif isinstance(chunk.content, list):
+ tool_result = chunk.content[0] if len(chunk.content) > 0 else {}
+ else:
+ tool_result = {}
+ text = tool_result.get("text") if "text" in tool_result else None
+ text_result = json.loads(text) if text else tool_result
+ tool_result = (
+ text_result if isinstance(text_result, str) else json.dumps(text_result, ensure_ascii=False)
+ )
+ except Exception:
+ tool_result = chunk.content
+ result = (
+ tool_result if isinstance(tool_result, str) else json.dumps(tool_result, ensure_ascii=False)
+ )
+ self.write(
+ ToolContent(
+ tool_stream.get_tool_uuid(tool_id),
+ "",
+ "",
+ result,
+ Status.SUCCESS,
+ NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS),
+ Position(self.get_node_id()),
+ )
+ )
+ else:
+ if is_result and chunk.content:
+ self.write(
+ TextContent(
+ tool_stream.get_tool_uuid(chunk.id),
+ chunk.content,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ def on_complete(error):
+ if error:
+ raise error
+ self._write_final_context(chat_model, message_list, question.content, state["answer"], "")
+ self.write(
+ TextContent(
+ tool_stream.get_tool_uuid("text"),
+ "",
+ Status.SUCCESS,
+ NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS),
+ Position(self.get_node_id()),
+ )
+ )
+
+ create_agent(
+ chat_model,
+ system_prompt,
+ message_list,
+ json.dumps(mcp_servers_config),
+ AgentCallBack(on_next, on_complete),
+ chat_id,
+ skill_tool_ids,
+ tools,
+ )
+ return True
+
+ return False
+
+ def _handle_variables(self, tool_params):
+ for k, v in tool_params.items():
+ if isinstance(v, str):
+ tool_params[k] = self.workflow_manage.generate_prompt(v)
+ elif isinstance(v, dict):
+ self._handle_variables(v)
+ elif isinstance(v, list) and len(v) > 0 and isinstance(v[0], str):
+ tool_params[k] = self._get_reference_content(v)
+ return tool_params
+
+ def _get_reference_content(self, fields):
+ if fields:
+ return str(self.workflow_manage.get_reference_field(fields[0], fields[1:]))
+ return ""
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ aggregation = AggregationManager()
+ for m in self.data.get("messages") or []:
+ aggregation.aggregate(m)
+ messages = aggregation.get_contents()
+ details.update(
+ {
+ "question": self.data.get("question"),
+ "answer": self.get_context("answer"),
+ "reasoning_content": self.get_context("reasoning_content"),
+ "message_tokens": self.get_context("message_tokens"),
+ "answer_tokens": self.get_context("answer_tokens"),
+ "history_message": self.get_context("history_message"),
+ "messages": messages,
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/__init__.py b/apps/application/workflow/nodes/ai_chat_node/tools/__init__.py
new file mode 100644
index 00000000000..03482beb2cd
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/__init__.py
@@ -0,0 +1,15 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/15 16:58
+@desc:
+"""
+
+from .application import get_application_tools
+from .mcp import get_mcp_servers
+from .skill import init_skills
+from .tool import get_tool_tools
+
+__all__ = ["get_tool_tools", "get_application_tools", "get_mcp_servers", "init_skills"]
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/application.py b/apps/application/workflow/nodes/ai_chat_node/tools/application.py
new file mode 100644
index 00000000000..272b1f70220
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/application.py
@@ -0,0 +1,191 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: application.py
+@date: 2026/9/15 16:10
+@desc:
+"""
+
+import re
+import threading
+
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+from langchain_core.tools import StructuredTool
+from pydantic import Field
+
+from .base import build_schema
+
+
+def _application_string_to_uuid(input_str):
+ return str(uuid.uuid5(uuid.NAMESPACE_DNS, input_str))
+
+
+def get_application_args():
+ """
+ 应用(Agent)工具对模型暴露的入参:固定单个必填 message。
+
+ 与 chat.mcp.tools.MCPToolHandler.list_tools 的 inputSchema 保持一致,
+ 这样从远端 MCP 代理切换为进程内直调时,模型侧契约不变。
+ """
+ return build_schema(
+ {
+ "message": (str, Field(..., required=True, description="The message to send to the AI.")),
+ }
+ )
+
+
+def get_application_func(source_type, source_id, application, workflow_params, workspace_id):
+ """
+ 构建应用(Agent)工具的执行函数。
+
+ 工具调用是同步的,不支持子应用表单中断,命中表单时返回已累积文本。
+ """
+ application_id = str(application.id)
+
+ def inner(message: str = ""):
+ from application.models import Application, ApplicationVersion, Chat, ChatRecord, ChatSourceChoices
+ from application.workflow.common import WorkflowType, new_instance
+ from application.workflow.content_type import ContentType
+ from application.workflow.nodes import get_start_node
+ from application.workflow.workflow_manage import CallBack, WorkflowManage
+ from chat.serializers.chat import get_work_flow
+ from chat.serializers.chat_history import ChatHistory
+
+ question = str(message or "")
+ chat_id = workflow_params.get("chat_id")
+ chat_user_id = workflow_params.get("chat_user_id")
+ chat_user_type = workflow_params.get("chat_user_type")
+ ip_address = workflow_params.get("ip_address") or "-"
+ source = workflow_params.get("source") or {"type": ChatSourceChoices.ONLINE.value}
+ debug = workflow_params.get("debug", False)
+
+ # 自引用守卫:子应用不能是当前应用本身
+ if application_id == str(workflow_params.get("application_id") or ""):
+ raise Exception("The sub application cannot use the current agent")
+
+ # 派生子应用聊天 id(父对话 + 子应用稳定映射),与 application_node 一致
+ current_chat_id = _application_string_to_uuid(str(chat_id) + application_id)
+ asker = workflow_params.get("chat_user")
+ Chat.objects.get_or_create(
+ id=current_chat_id,
+ defaults={
+ "application_id": application_id,
+ "abstract": question[0:1024],
+ "chat_user_id": chat_user_id,
+ "chat_user_type": chat_user_type,
+ "ip_address": ip_address,
+ "source": source,
+ "asker": asker,
+ },
+ )
+
+ # 解析子应用工作流(debug 取本体,否则取最新发布版本)
+ if debug:
+ sub_application = QuerySet(Application).filter(id=application_id).first()
+ else:
+ sub_application = (
+ QuerySet(ApplicationVersion).filter(application_id=application_id).order_by("-create_time")[0:1].first()
+ )
+ if sub_application is None:
+ raise Exception("The application has not been published. Please use it after publishing.")
+
+ sub_workflow = new_instance(get_work_flow(sub_application), WorkflowType.APPLICATION)
+
+ # 生成子应用记录 id 并建 ChatRecord(子对话可追溯)
+ sub_chat_record_id = str(uuid.uuid7())
+ QuerySet(ChatRecord).create(
+ id=sub_chat_record_id,
+ chat_id=current_chat_id,
+ problem_text=question[0:1024],
+ answer_text="",
+ details={},
+ message_tokens=0,
+ answer_tokens=0,
+ answer_text_list=[[]],
+ index=0,
+ ip_address=ip_address or "",
+ source=source,
+ workflow_context={},
+ question={"content": question},
+ messages=[],
+ )
+
+ # 组装子应用参数(复制父工作流参数并覆盖子应用相关字段)
+ sub_parameters = dict(workflow_params)
+ sub_parameters.update(
+ {
+ "chat_id": current_chat_id,
+ "chat_record_id": sub_chat_record_id,
+ "application_id": application_id,
+ "question": question,
+ "stream": True,
+ "form_data": {},
+ "position": None,
+ "history_chat_record": ChatHistory(current_chat_id).load(exclude_record_id=sub_chat_record_id),
+ "image_list": [],
+ "document_list": [],
+ "audio_list": [],
+ "video_list": [],
+ "default_model_setting": sub_application.default_model_setting or {},
+ }
+ )
+
+ done_event = threading.Event()
+ result_holder = {"answer": "", "error": None}
+
+ def on_next(wf_manage, content):
+ # 逐块聚合子应用文本回答(不直接转发给上游,作为工具结果一次性返回)
+ if content.type == ContentType.TEXT:
+ result_holder["answer"] += content.content or ""
+
+ def on_complete(wf_manage, error):
+ try:
+ # 持久化子应用上下文,供后续追溯
+ QuerySet(ChatRecord).filter(id=sub_chat_record_id).update(workflow_context=wf_manage.context)
+ finally:
+ result_holder["error"] = error
+ done_event.set()
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_start_node_fn(wf, wm):
+ return get_start_node(wf, wm, WorkflowType.APPLICATION, None)
+
+ sub_manage = WorkflowManage(
+ sub_workflow, sub_parameters, WorkflowType.APPLICATION, call_back, get_start_node_fn
+ )
+ sub_manage.start_node.workflow_manage = sub_manage
+ sub_manage.run()
+ done_event.wait()
+ if result_holder["error"]:
+ raise result_holder["error"]
+
+ answer = result_holder["answer"]
+ # 去除 标签(与 MCPToolHandler.call_tool 一致)
+ answer = re.sub(r".*?", "", answer, flags=re.DOTALL)
+ return answer
+
+ return inner
+
+
+def get_application_tools(source_type, source_id, application_ids, workspace_id, workflow_params):
+ if not application_ids:
+ return []
+ from application.models import Application
+
+ applications = QuerySet(Application).filter(id__in=application_ids, is_publish=True)
+ results = []
+ for application in applications:
+ func = get_application_func(source_type, source_id, application, workflow_params, workspace_id)
+ args = get_application_args()
+ structured_tool = StructuredTool.from_function(
+ func=func,
+ name=application.name,
+ description=f"{application.name} {application.desc or ''}".strip(),
+ args_schema=args,
+ )
+ results.append(structured_tool)
+
+ return results
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/base.py b/apps/application/workflow/nodes/ai_chat_node/tools/base.py
new file mode 100644
index 00000000000..ac13933f716
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/base.py
@@ -0,0 +1,30 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: base.py
+@date: 2026/9/15
+@desc:
+"""
+
+from pydantic import create_model
+
+
+def build_schema(fields: dict):
+ return create_model("dynamicSchema", **fields)
+
+
+def get_type(_type: str):
+ if _type == "float":
+ return float
+ if _type == "string":
+ return str
+ if _type == "int":
+ return int
+ if _type == "dict":
+ return dict
+ if _type == "array":
+ return list
+ if _type == "boolean":
+ return bool
+ return object
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/mcp.py b/apps/application/workflow/nodes/ai_chat_node/tools/mcp.py
new file mode 100644
index 00000000000..9f3c44e4708
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/mcp.py
@@ -0,0 +1,37 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: mcp.py
+@date: 2026/9/15
+@desc:
+"""
+
+import json
+
+from django.db.models import QuerySet
+
+from tools.models import Tool
+
+
+def get_mcp_servers(mcp_source, mcp_servers, mcp_tool_id, mcp_tool_ids, handle_variables):
+ """
+ tool-mcp-custom:mcp_source == "custom" 时用节点传入的自定义 MCP JSON。
+ tool-mcp:否则用库内 MCP 工具(Tool.code 存 MCP server 配置)。
+ """
+ if mcp_source is None:
+ mcp_source = "custom"
+ if not mcp_tool_ids:
+ mcp_tool_ids = []
+ if mcp_tool_id:
+ mcp_tool_ids = list(set(mcp_tool_ids + [mcp_tool_id]))
+
+ mcp_servers_config = {}
+ if mcp_source == "custom" and mcp_servers:
+ mcp_servers_config = handle_variables(json.loads(mcp_servers))
+ elif mcp_tool_ids:
+ mcp_tools = QuerySet(Tool).filter(id__in=mcp_tool_ids).values()
+ for mcp_tool in mcp_tools:
+ if mcp_tool and mcp_tool["is_active"]:
+ mcp_servers_config = handle_variables({**mcp_servers_config, **json.loads(mcp_tool["code"])})
+ return mcp_servers_config
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/skill.py b/apps/application/workflow/nodes/ai_chat_node/tools/skill.py
new file mode 100644
index 00000000000..42d362ed48d
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/skill.py
@@ -0,0 +1,66 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: skill.py
+@date: 2026/9/15
+@desc:
+"""
+
+import io
+import json
+import os
+import zipfile
+
+from asgiref.sync import sync_to_async
+from django.db.models import QuerySet
+
+from common.utils.rsa_util import rsa_long_decrypt
+from knowledge.models import File
+from tools.models import Tool
+
+
+async def init_skills(skill_tool_ids, temp_dir):
+ if not skill_tool_ids:
+ return
+ skills_dir = os.path.join(temp_dir, "skills")
+ tools = await sync_to_async(lambda: list(QuerySet(Tool).filter(id__in=skill_tool_ids, is_active=True)))()
+ if not tools:
+ return
+
+ for tool in tools:
+ init_params_default_value = {i["field"]: i.get("default_value") for i in (tool.init_field_list or [])}
+ if tool.init_params is not None:
+ params = init_params_default_value | json.loads(rsa_long_decrypt(tool.init_params))
+ else:
+ params = init_params_default_value
+
+ file = await sync_to_async(lambda t=tool: QuerySet(File).filter(id=t.code).first())()
+ if not file:
+ continue
+ file_bytes = await sync_to_async(file.get_bytes)()
+
+ with zipfile.ZipFile(io.BytesIO(file_bytes), "r") as zip_ref:
+ members = [m for m in zip_ref.namelist() if not m.startswith("__MACOSX/") and "__MACOSX" not in m]
+ for member in members:
+ if ".." in member or member.startswith("/"):
+ raise ValueError(f"非法路径: {member}")
+ zip_ref.extractall(skills_dir, members=members)
+
+ # 获取技能解压后的顶级目录名
+ top_level_dirs = set()
+ for member in members:
+ parts = member.split("/")
+ if parts[0]:
+ top_level_dirs.add(parts[0])
+
+ # 将 params 写入每个顶级目录下的 .env 文件
+ if params:
+ env_lines = [f"{key}={value}" for key, value in params.items()]
+ env_content = "\n".join(env_lines) + "\n"
+ for top_dir in top_level_dirs:
+ env_path = os.path.join(skills_dir, top_dir, ".env")
+ with open(env_path, "w", encoding="utf-8") as f:
+ f.write(env_content)
+
+ os.system("chmod -R g+rx " + temp_dir) # 确保技能目录可访问
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/tool/__init__.py b/apps/application/workflow/nodes/ai_chat_node/tools/tool/__init__.py
new file mode 100644
index 00000000000..0138298dbd0
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/tool/__init__.py
@@ -0,0 +1,26 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/15
+@desc:
+"""
+
+from .custom import get_custom_tools
+from .workflow import get_workflow_tools
+
+__all__ = ["get_tool_tools", "get_workflow_tools", "get_custom_tools"]
+
+
+def get_tool_tools(source_type, source_id, tool_ids, workspace_id, workflow_params=None):
+ """
+ 构建工具(Tool)类工具:内部按 tool_type 拆分 workflow / custom,合并返回 LangChain tools。
+
+ 节点只需传入混合的 tool_ids,各构建器各自按 tool_type 过滤。
+ """
+ if not tool_ids:
+ return []
+ return get_workflow_tools(source_type, source_id, tool_ids, workspace_id, workflow_params) + get_custom_tools(
+ source_type, source_id, tool_ids, workspace_id
+ )
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/tool/custom.py b/apps/application/workflow/nodes/ai_chat_node/tools/tool/custom.py
new file mode 100644
index 00000000000..a665f4b132a
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/tool/custom.py
@@ -0,0 +1,117 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: custom.py
+@date: 2026/9/15
+@desc:
+"""
+
+import json
+import time
+
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+from langchain_core.tools import StructuredTool
+from pydantic import Field
+
+from knowledge.models.knowledge_action import State
+from tools.models import Tool, ToolRecord, ToolType
+
+from ..base import build_schema, get_type
+
+
+def get_custom_args(tool):
+ """
+ 从 CUSTOM 工具的 input_field_list 显式构建给模型的 args_schema。
+
+ input_field_list 项结构:{name, is_required, type(string|int|dict|array|float), source}
+ """
+ input_field_list = tool.input_field_list or []
+ return build_schema(
+ {
+ field.get("name"): (
+ get_type(field.get("type")),
+ Field(..., required=True, description=field.get("desc"))
+ if field.get("is_required")
+ else Field(default=None, required=False, description=field.get("desc")),
+ )
+ for field in input_field_list
+ }
+ )
+
+
+def _save_custom_tool_record(tool_id, workspace_id, source_type, source_id, input_params, output, start_time, error):
+ """
+ CUSTOM 工具执行结束后落库执行记录(替代原 MCP 路径的 save_tool_record)。
+
+ input 仅记录业务入参(不含 init 参数),避免密文/密钥进入记录。
+ """
+ state = State.FAILURE if error else State.SUCCESS
+ ToolRecord(
+ id=uuid.uuid7(),
+ tool_id=tool_id,
+ workspace_id=workspace_id,
+ source_type=source_type,
+ source_id=source_id,
+ state=state,
+ run_time=time.time() - start_time,
+ meta={
+ "input": input_params,
+ "output": str(error) if error else output,
+ },
+ ).save()
+
+
+def get_custom_func(source_type, source_id, tool, workspace_id):
+ tool_id = tool.id
+ code = tool.code
+ init_field_list = tool.init_field_list or []
+ init_params_ciphertext = tool.init_params
+
+ def inner(**kwargs):
+ # 在进程内直接跑沙箱代码(无 MCP 子进程),方式与工具调试执行 ToolExecutor.exec_code 一致。
+ from common.utils.rsa_util import rsa_long_decrypt
+ from common.utils.tool_code import ToolExecutor
+
+ start_time = time.time()
+ # 合并初始化参数(默认值 → 已保存的启动参数),服务端注入,模型不可见
+ init_params_default_value = {i["field"]: i.get("default_value") for i in init_field_list}
+ if init_params_ciphertext is not None:
+ init_params = init_params_default_value | json.loads(rsa_long_decrypt(init_params_ciphertext))
+ else:
+ init_params = init_params_default_value
+ all_params = init_params | kwargs
+
+ error = None
+ result = None
+ try:
+ result = ToolExecutor().exec_code(code, all_params)
+ except Exception as e:
+ error = e
+ finally:
+ _save_custom_tool_record(tool_id, workspace_id, source_type, source_id, kwargs, result, start_time, error)
+ if error:
+ raise error
+ return result
+
+ return inner
+
+
+def get_custom_tools(source_type, source_id, tool_ids, workspace_id):
+ if not tool_ids:
+ return []
+ tools = QuerySet(Tool).filter(id__in=tool_ids, is_active=True, tool_type=ToolType.CUSTOM)
+ results = []
+ for tool in tools:
+ func = get_custom_func(source_type, source_id, tool, workspace_id)
+ args = get_custom_args(tool)
+ structured_tool = StructuredTool.from_function(
+ func=func,
+ name=tool.name,
+ description=tool.desc,
+ args_schema=args,
+ )
+ results.append(structured_tool)
+
+ return results
diff --git a/apps/application/workflow/nodes/ai_chat_node/tools/tool/workflow.py b/apps/application/workflow/nodes/ai_chat_node/tools/tool/workflow.py
new file mode 100644
index 00000000000..e70fc25e0fe
--- /dev/null
+++ b/apps/application/workflow/nodes/ai_chat_node/tools/tool/workflow.py
@@ -0,0 +1,186 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: workflow.py
+@date: 2026/9/15
+@desc:
+"""
+
+import threading
+import time
+
+import uuid_utils.compat as uuid
+from django.db.models import OuterRef, QuerySet, Subquery
+from langchain_core.tools import StructuredTool
+from pydantic import Field
+
+from application.workflow.message.aggregator import AggregationManager
+from application.workflow.status import Status
+from knowledge.models.knowledge_action import State
+from tools.models import Tool, ToolRecord, ToolType, ToolWorkflowVersion
+
+from ..base import build_schema, get_type
+
+
+def get_workflow_args(tool, qv):
+ for node in qv.work_flow.get("nodes"):
+ if node.get("type") == "tool-base-node":
+ input_field_list = node.get("properties").get("user_input_field_list")
+ return build_schema(
+ {
+ field.get("field"): (
+ get_type(field.get("type")),
+ Field(..., required=True, description=field.get("desc"))
+ if field.get("is_required")
+ else Field(default=None, required=False, description=field.get("desc")),
+ )
+ for field in input_field_list
+ }
+ )
+
+ return build_schema({})
+
+
+def _save_workflow_tool_record(
+ tool_record_id, tool_id, workspace_id, source_type, source_id, wf_manage, aggregation, parameters, start_time, error
+):
+ """
+ 工具工作流执行结束后落库执行记录(替代旧引擎 ToolWorkflowPostHandler.handler)。
+ 实实行(非调试)直接插入 ToolRecord,字段与工具记录查询端点保持一致。
+ """
+ workflow = wf_manage.workflow
+ base_node = workflow.get_node("tool-base-node")
+ input_field_list = base_node.properties.get("user_input_field_list", []) if base_node else []
+ output_field_list = base_node.properties.get("user_output_field_list", []) if base_node else []
+ input_data = {f.get("field"): parameters.get(f.get("field")) for f in input_field_list}
+ # 新引擎工具输出统一收口于全局 output 上下文(tool-start-node 初始化、变量赋值节点写入)
+ output = wf_manage.context.get("output", {})
+ details = wf_manage.get_details()
+ if error:
+ state = State.FAILURE
+ else:
+ has_fail = any((d or {}).get("status") == Status.FAIL.value for d in (details or []))
+ state = State.FAILURE if has_fail else State.SUCCESS
+ ToolRecord(
+ id=tool_record_id,
+ tool_id=tool_id,
+ workspace_id=workspace_id,
+ source_type=source_type,
+ source_id=source_id,
+ state=state,
+ run_time=time.time() - start_time,
+ meta={
+ "input_field_list": input_field_list,
+ "output_field_list": output_field_list,
+ "input": input_data,
+ "output": output,
+ "details": details,
+ "answer_text_list": aggregation.get_contents(),
+ },
+ ).save()
+
+
+def get_workflow_func(source_type, source_id, tool, qv, workspace_id, workflow_params=None):
+ from knowledge.services.retrieval_access import inherited_retrieval_context
+
+ tool_id = tool.id
+
+ def inner(**kwargs):
+ # 使用新工作流引擎执行工具工作流,方式与 tool_workflow_lib_node 保持一致。
+ from application.workflow.common import WorkflowType, new_instance
+ from application.workflow.nodes import get_node_class
+ from application.workflow.workflow_manage import CallBack, WorkflowManage
+
+ tool_record_id = str(uuid.uuid7())
+ sub_workflow = new_instance(qv.work_flow, WorkflowType.TOOL)
+ start_time = time.time()
+ sub_parameters = {
+ "chat_record_id": tool_record_id,
+ "tool_id": str(tool_id),
+ "stream": True,
+ "workspace_id": workspace_id,
+ "default_model_setting": qv.default_model_setting or {},
+ **kwargs,
+ **inherited_retrieval_context({"workspace_id": workspace_id, **(workflow_params or {})}),
+ }
+
+ # WorkflowManage.run() 在后台线程异步执行节点,完成时机由 on_complete 回调驱动,
+ # 而 inner 作为 LangChain 同步工具函数必须阻塞到子工作流结束再返回其输出。
+ aggregation = AggregationManager()
+ done_event = threading.Event()
+ result_holder = {"output": {}, "error": None}
+
+ def on_next(wf_manage, content):
+ # 逐块聚合,用于执行记录的 answer_text_list(不直接转发给上游)
+ aggregation.aggregate(content)
+
+ def on_complete(wf_manage, error):
+ try:
+ # 工具工作流输出统一写入 context['output']
+ result_holder["output"] = dict(wf_manage.context.get("output", {}) or {})
+ # 执行结束落库工具执行记录
+ _save_workflow_tool_record(
+ tool_record_id,
+ tool_id,
+ workspace_id,
+ source_type,
+ source_id,
+ wf_manage,
+ aggregation,
+ sub_parameters,
+ start_time,
+ error,
+ )
+ finally:
+ result_holder["error"] = error
+ done_event.set()
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_start_node_fn(wf, wm):
+ start_node = wf.get_node("tool-start-node")
+ node_class = get_node_class("tool-start-node", WorkflowType.TOOL)
+ return node_class(start_node, wm, lambda n: n.properties.get("node_data", {}))
+
+ sub_manage = WorkflowManage(
+ workflow=sub_workflow,
+ parameters=sub_parameters,
+ workflow_type=WorkflowType.TOOL,
+ call_back=call_back,
+ get_start_node=get_start_node_fn,
+ )
+ sub_manage.start_node.workflow_manage = sub_manage
+ sub_manage.run()
+ done_event.wait()
+ if result_holder["error"]:
+ raise result_holder["error"]
+ return result_holder["output"]
+
+ return inner
+
+
+def get_workflow_tools(source_type, source_id, tool_workflow_ids, workspace_id, workflow_params=None):
+ tools = QuerySet(Tool).filter(
+ id__in=tool_workflow_ids, is_active=True, tool_type=ToolType.WORKFLOW, workspace_id=workspace_id
+ )
+ latest_subquery = ToolWorkflowVersion.objects.filter(tool_id=OuterRef("tool_id")).order_by("-create_time")
+
+ qs = ToolWorkflowVersion.objects.filter(
+ tool_id__in=[t.id for t in tools], id=Subquery(latest_subquery.values("id")[:1])
+ )
+ qd = {q.tool_id: q for q in qs}
+ results = []
+ for tool in tools:
+ qv = qd.get(tool.id)
+ func = get_workflow_func(source_type, source_id, tool, qv, workspace_id, workflow_params)
+ args = get_workflow_args(tool, qv)
+ tool = StructuredTool.from_function(
+ func=func,
+ name=tool.name,
+ description=tool.desc,
+ args_schema=args,
+ )
+ results.append(tool)
+
+ return results
diff --git a/apps/application/workflow/nodes/application_node/__init__.py b/apps/application/workflow/nodes/application_node/__init__.py
new file mode 100644
index 00000000000..fb099b7fed4
--- /dev/null
+++ b/apps/application/workflow/nodes/application_node/__init__.py
@@ -0,0 +1,4 @@
+# coding=utf-8
+from .application_node import ApplicationNode
+
+__all__ = ["ApplicationNode"]
diff --git a/apps/application/workflow/nodes/application_node/application_node.py b/apps/application/workflow/nodes/application_node/application_node.py
new file mode 100644
index 00000000000..e94f1d8186d
--- /dev/null
+++ b/apps/application/workflow/nodes/application_node/application_node.py
@@ -0,0 +1,295 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: application_node.py
+@date:2026/9/3
+@desc: 智能体节点
+"""
+
+import uuid_utils.compat as uuid
+from django.db import connection
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.models import Application, ApplicationVersion, Chat, ChatRecord, ChatSourceChoices
+from application.workflow.common import WorkflowType, new_instance
+from application.workflow.content_type import ContentType
+from application.workflow.i_node import INode, Signal
+from application.workflow.message.struct.content import Position
+from application.workflow.status import Status
+from application.workflow.workflow_manage import WorkflowManage, CallBack
+from chat.serializers.chat_history import ChatHistory
+from common.exception.app_exception import AppApiException
+
+
+def string_to_uuid(input_str):
+ return str(uuid.uuid5(uuid.NAMESPACE_DNS, input_str))
+
+
+class ApplicationNodeSerializer(serializers.Serializer):
+ application_id = serializers.CharField(required=True, label=_("Application ID"))
+ question_reference_address = serializers.ListField(required=True, label=_("User Questions"))
+ api_input_field_list = serializers.ListField(required=False, label=_("API Input Fields"))
+ user_input_field_list = serializers.ListField(required=False, label=_("User Input Fields"))
+ image_list = serializers.ListField(required=False, label=_("picture"))
+ document_list = serializers.ListField(required=False, label=_("document"))
+ audio_list = serializers.ListField(required=False, label=_("Audio"))
+ video_list = serializers.ListField(required=False, label=_("Video"))
+ node_data = serializers.DictField(required=False, allow_null=True, label=_("Form Data"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ application_id = self.data.get("application_id")
+ f_app = QuerySet(Application).filter(id=application_id).first()
+ if f_app is None:
+ raise AppApiException(500, _("The application has been deleted"))
+
+
+class ApplicationNode(INode):
+ serializer_class = ApplicationNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION]
+ type = "application-node"
+
+ def _run(self):
+ # 完成时机由子应用 on_complete 回调驱动,这里不自动 complete
+ self.execute()
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ application_id = node_params.get("application_id")
+ chat_id = workflow_params.get("chat_id")
+ chat_user_id = workflow_params.get("chat_user_id")
+ chat_user_type = workflow_params.get("chat_user_type")
+ ip_address = workflow_params.get("ip_address") or "-"
+ source = workflow_params.get("source") or {"type": ChatSourceChoices.ONLINE.value}
+ debug = workflow_params.get("debug", False)
+
+ # 父工作流 position 指向本节点 → 子工作流表单提交,需恢复续跑
+ position = workflow_params.get("position") or {}
+ is_submit = position.get("id") == self.get_node_id()
+ sub_chat_record_id = self.get_context("sub_chat_record_id")
+ # 表单暂停点:前端回传的 position 是一个嵌套链(id=本节点, children=子工作流暂停点)。
+ # 恢复时用 position.children 逐级下传,才能把深层锚点(子子工作流表单)完整带下去。
+ sub_position = position.get("children") or self.get_context("sub_position")
+
+ # 自引用守卫
+ if application_id == workflow_params.get("application_id"):
+ raise Exception(_("The sub application cannot use the current node"))
+
+ # 解析用户问题
+ question_address = node_params.get("question_reference_address") or []
+ if question_address:
+ question = self.workflow_manage.get_reference_field(question_address[0], question_address[1:])
+ else:
+ question = ""
+ question = str(question or "")
+ self.write_context("question", question)
+
+ # 解析 api 输入 / 用户输入 → form_data
+ form_data = {}
+ for api_input_field in node_params.get("api_input_field_list", []):
+ value = api_input_field.get("value", [""])[0] if api_input_field.get("value") else ""
+ form_data[api_input_field["variable"]] = (
+ self.workflow_manage.get_reference_field(value, api_input_field["value"][1:]) if value != "" else ""
+ )
+ for user_input_field in node_params.get("user_input_field_list", []):
+ value = user_input_field.get("value", [""])[0] if user_input_field.get("value") else ""
+ form_data[user_input_field["field"]] = (
+ self.workflow_manage.get_reference_field(value, user_input_field["value"][1:]) if value != "" else ""
+ )
+
+ # 解析文件列表(校验 file_id)
+ app_document_list = self._resolve_file_list(node_params.get("document_list", []), "document")
+ app_image_list = self._resolve_file_list(node_params.get("image_list", []), "image")
+ app_audio_list = self._resolve_file_list(node_params.get("audio_list", []), "audio")
+ app_video_list = self._resolve_file_list(node_params.get("video_list", []), "video")
+
+ # 派生子应用聊天 id
+ current_chat_id = string_to_uuid(chat_id + application_id)
+ Chat.objects.get_or_create(
+ id=current_chat_id,
+ defaults={
+ "application_id": application_id,
+ "abstract": question[0:1024],
+ "chat_user_id": chat_user_id,
+ "chat_user_type": chat_user_type,
+ "ip_address": ip_address,
+ "source": source,
+ "asker": self._get_chat_asker(workflow_params),
+ },
+ )
+
+ # 解析子应用工作流(debug 取本体,否则取最新发布版本),与 chat_work_flow 的 get_application 一致
+ if debug:
+ sub_application = QuerySet(Application).filter(id=application_id).first()
+ else:
+ sub_application = (
+ QuerySet(ApplicationVersion).filter(application_id=application_id).order_by("-create_time")[0:1].first()
+ )
+ if sub_application is None:
+ raise Exception(_("The application has not been published. Please use it after publishing."))
+ from chat.serializers.chat import get_work_flow
+
+ sub_workflow = new_instance(get_work_flow(sub_application), WorkflowType.APPLICATION)
+
+ # 首次运行:生成子应用记录 id 并建 ChatRecord;恢复时沿用已持久化的 id
+ if not is_submit:
+ sub_chat_record_id = str(uuid.uuid7())
+ self.write_context("sub_chat_record_id", sub_chat_record_id)
+ self.write_context("sub_position", sub_position)
+ QuerySet(ChatRecord).create(
+ id=sub_chat_record_id,
+ chat_id=current_chat_id,
+ problem_text=question[0:1024],
+ answer_text="",
+ details={},
+ message_tokens=0,
+ answer_tokens=0,
+ answer_text_list=[[]],
+ index=0,
+ ip_address=ip_address or "",
+ source=source,
+ workflow_context={},
+ question={"content": question},
+ messages=[],
+ )
+ sub_position = None
+
+ # 组装子应用参数(复制父工作流参数并覆盖子应用相关字段)
+ sub_parameters = dict(workflow_params)
+ sub_parameters.update(
+ {
+ "chat_id": current_chat_id,
+ "chat_record_id": sub_chat_record_id,
+ "application_id": application_id,
+ "question": question,
+ "stream": True,
+ "form_data": workflow_params.get("form_data") if is_submit else form_data,
+ "position": sub_position if is_submit else None,
+ "chunk_id": workflow_params.get("chunk_id"),
+ "history_chat_record": ChatHistory(current_chat_id).load(exclude_record_id=sub_chat_record_id),
+ "image_list": app_image_list,
+ "document_list": app_document_list,
+ "audio_list": app_audio_list,
+ "video_list": app_video_list,
+ "default_model_setting": sub_application.default_model_setting or {},
+ }
+ )
+
+ # 内联回调:转发子应用输出、嵌套 position、传播表单暂停信号
+ self._answer = ""
+ self._reasoning_content = ""
+
+ def on_next(wf_manage, content):
+ if content.type == ContentType.FORM:
+ # 已提交表单的回显块不转发,避免前端出现重复的已填表单
+ if content.is_submit:
+ return
+ # 记录子工作流表单节点位置(保留嵌套链),供父工作流恢复时透传回子工作流续跑
+ self.write_context("sub_position", content.position.to_dict())
+ content.position = Position(self.get_node_id(), None, content.position)
+ self.write(content)
+ return
+ content.position = Position(self.get_node_id(), None, content.position)
+ if content.type == ContentType.TEXT:
+ self._answer += content.content
+ elif content.type == ContentType.REASONING:
+ self._reasoning_content += content.content
+ self.write(content)
+
+ def on_complete(wf_manage, error):
+ # 持久化子应用上下文,供后续 resume 的 from_context 读取
+ QuerySet(ChatRecord).filter(id=sub_chat_record_id).update(workflow_context=wf_manage.context)
+ usage = self._usage_from_context(wf_manage.context)
+ self._write_final_context(self._answer, self._reasoning_content, usage)
+ if error:
+ self.complete(Status.FAIL, error=error)
+ return
+ # 子应用命中表单(Signal.FORM):向上传播中断,暂停父工作流,等用户提交后恢复
+ if wf_manage.signal == Signal.FORM:
+ self.complete(Status.SUCCESS, signal=Signal.FORM)
+ return
+ self.complete(Status.SUCCESS)
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_start_node_fn(wf, wm):
+ from application.workflow.nodes import get_start_node
+
+ return get_start_node(wf, wm, WorkflowType.APPLICATION, sub_position if is_submit else None)
+
+ # 表单提交:从历史 context 恢复子应用;否则全新运行
+ if is_submit:
+ from application.serializers.common import load_debug_workflow_context
+
+ sub_manage = WorkflowManage.from_context(
+ get_context=lambda: load_debug_workflow_context(sub_chat_record_id),
+ workflow=sub_workflow,
+ parameters=sub_parameters,
+ workflow_type=WorkflowType.APPLICATION,
+ call_back=call_back,
+ get_start_node=get_start_node_fn,
+ )
+ if sub_manage is None:
+ sub_manage = WorkflowManage(
+ sub_workflow, sub_parameters, WorkflowType.APPLICATION, call_back, get_start_node_fn
+ )
+ else:
+ sub_manage = WorkflowManage(
+ sub_workflow, sub_parameters, WorkflowType.APPLICATION, call_back, get_start_node_fn
+ )
+
+ sub_manage.start_node.workflow_manage = sub_manage
+ sub_manage.run()
+
+ def _resolve_file_list(self, field_list, name):
+ if not field_list or len(field_list) == 0:
+ return []
+ values = self.workflow_manage.get_reference_field(field_list[0], field_list[1:]) or []
+ for item in values:
+ if "file_id" not in item:
+ raise ValueError(
+ _("Parameter value error: The uploaded {name} lacks file_id, and the {name} upload fails").format(
+ name=name
+ )
+ )
+ return list(values)
+
+ def _get_chat_asker(self, workflow_params):
+ asker = (workflow_params.get("form_data") or {}).get("asker")
+ if asker:
+ return asker if isinstance(asker, dict) else {"username": asker}
+ return workflow_params.get("chat_user")
+
+ @staticmethod
+ def _usage_from_context(workflow_context):
+ prompt_tokens = 0
+ completion_tokens = 0
+ for node_context in (workflow_context or {}).values():
+ if isinstance(node_context, dict):
+ prompt_tokens += node_context.get("message_tokens", 0) or 0
+ completion_tokens += node_context.get("answer_tokens", 0) or 0
+ return {"prompt_tokens": prompt_tokens, "completion_tokens": completion_tokens}
+
+ def _write_final_context(self, answer, reasoning_content, usage):
+ self.write_context("answer", answer)
+ self.write_context("result", answer)
+ self.write_context("reasoning_content", reasoning_content)
+ self.write_context("message_tokens", usage.get("prompt_tokens", 0))
+ self.write_context("answer_tokens", usage.get("completion_tokens", 0))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "reasoning_content": self.get_context("reasoning_content"),
+ "message_tokens": self.get_context("message_tokens"),
+ "answer_tokens": self.get_context("answer_tokens"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/condition_node/__init__.py b/apps/application/workflow/nodes/condition_node/__init__.py
new file mode 100644
index 00000000000..c1c44f4f7ca
--- /dev/null
+++ b/apps/application/workflow/nodes/condition_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/2 10:00
+ @desc:
+"""
+from .condition_node import ConditionNode
diff --git a/apps/application/workflow/nodes/condition_node/condition_node.py b/apps/application/workflow/nodes/condition_node/condition_node.py
new file mode 100644
index 00000000000..d04b1fddcd1
--- /dev/null
+++ b/apps/application/workflow/nodes/condition_node/condition_node.py
@@ -0,0 +1,72 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: condition_node.py
+@date:2026/7/2 10:00
+@desc:
+"""
+
+from typing import List
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.compare import do_assertion
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.status import Status
+
+
+class ConditionSerializer(serializers.Serializer):
+ compare = serializers.CharField(required=True, label=_("Comparator"))
+ value = serializers.CharField(required=True, label=_("value"))
+ field = serializers.ListField(required=True, label=_("Fields"))
+
+
+class ConditionBranchSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label=_("Branch id"))
+ type = serializers.CharField(required=True, label=_("Branch Type"))
+ condition = serializers.CharField(required=True, label=_("Condition or|and"))
+ conditions = ConditionSerializer(many=True)
+
+
+class ConditionNodeSerializer(serializers.Serializer):
+ branch = ConditionBranchSerializer(many=True)
+
+
+class ConditionNode(INode):
+ serializer_class = ConditionNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "condition-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ branch_list = node_params.get("branch", [])
+ branch = self._evaluate_branches(branch_list)
+ branch_id = branch.get("id")
+ branch_name = branch.get("type")
+
+ self.write_context("branch_id", branch_id)
+ self.write_context("branch_name", branch_name)
+
+ self.complete(Status.SUCCESS, [self.branch_anchor(branch_id)])
+
+ def _evaluate_branches(self, branch_list: List):
+ for branch in branch_list:
+ if self._branch_assertion(branch):
+ return branch
+ return branch_list[-1] if branch_list else {}
+
+ def _branch_assertion(self, branch):
+ return do_assertion(self.workflow_manage, branch.get("condition"), branch.get("conditions"))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "branch_id": self.get_context("branch_id"),
+ "branch_name": self.get_context("branch_name"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/data_source_local_node/__init__.py b/apps/application/workflow/nodes/data_source_local_node/__init__.py
new file mode 100644
index 00000000000..dc72f858db7
--- /dev/null
+++ b/apps/application/workflow/nodes/data_source_local_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/11
+@desc: 本地文件数据源节点(知识库工作流起始节点之一)
+"""
+
+from .data_source_local_node import DataSourceLocalNode
diff --git a/apps/application/workflow/nodes/data_source_local_node/data_source_local_node.py b/apps/application/workflow/nodes/data_source_local_node/data_source_local_node.py
new file mode 100644
index 00000000000..8d55aff2f27
--- /dev/null
+++ b/apps/application/workflow/nodes/data_source_local_node/data_source_local_node.py
@@ -0,0 +1,59 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: data_source_local_node.py
+@date: 2026/9/11
+@desc: 本地文件数据源节点:知识库工作流的起始节点之一,把上传的文件列表写入节点输出供下游读取
+"""
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+
+
+class DataSourceLocalNodeParamsSerializer(serializers.Serializer):
+ file_type_list = serializers.ListField(child=serializers.CharField(label=_("")), label=_(""))
+ file_size_limit = serializers.IntegerField(required=True, label=_("Upload file size"))
+ file_count_limit = serializers.IntegerField(required=True, label=_("Number of uploaded files"))
+
+
+class DataSourceLocalNode(INode):
+ serializer_class = DataSourceLocalNodeParamsSerializer
+ supported_workflow_type_list = [WorkflowType.KNOWLEDGE]
+ type = "data-source-local-node"
+
+ @staticmethod
+ def get_form_list(node):
+ node_data = node.get("properties").get("node_data")
+ return [
+ {
+ "field": "file_list",
+ "input_type": "LocalFileUpload",
+ "attrs": {
+ "file_count_limit": node_data.get("file_count_limit") or 10,
+ "file_size_limit": node_data.get("file_size_limit") or 100,
+ "file_type_list": node_data.get("file_type_list"),
+ },
+ "label": "",
+ }
+ ]
+
+ def execute(self):
+ # 文件列表来自工作流入参 data_source.file_list,写入本节点输出供下游节点引用
+ workflow_params = self.get_workflow_parameters()
+ file_list = (workflow_params.get("data_source") or {}).get("file_list")
+ self.write_context("file_list", file_list)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "file_list": self.get_context("file_list"),
+ "knowledge_base": self.get_workflow_parameters().get("knowledge_base"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/data_source_web_node/__init__.py b/apps/application/workflow/nodes/data_source_web_node/__init__.py
new file mode 100644
index 00000000000..2887a81f640
--- /dev/null
+++ b/apps/application/workflow/nodes/data_source_web_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/16
+@desc: Web 站点数据源节点(知识库工作流起始节点之一)
+"""
+
+from .data_source_web_node import DataSourceWebNode
diff --git a/apps/application/workflow/nodes/data_source_web_node/data_source_web_node.py b/apps/application/workflow/nodes/data_source_web_node/data_source_web_node.py
new file mode 100644
index 00000000000..f6c7ab0a444
--- /dev/null
+++ b/apps/application/workflow/nodes/data_source_web_node/data_source_web_node.py
@@ -0,0 +1,107 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: data_source_web_node.py
+@date: 2026/9/16
+@desc: Web 站点数据源节点:知识库工作流的起始节点之一,按根地址抓取站点内容写入 document_list 供下游读取
+"""
+
+import traceback
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import CancelledException, INode
+from common.utils.fork import ChildLink, Fork, ForkManage
+from common.utils.logger import maxkb_logger
+
+
+class DataSourceWebNodeParamsSerializer(serializers.Serializer):
+ source_url = serializers.CharField(required=True, label=_("Web source url"))
+ selector = serializers.CharField(
+ required=False, allow_blank=True, allow_null=True, label=_("Web knowledge selector")
+ )
+
+
+class DataSourceWebNode(INode):
+ serializer_class = DataSourceWebNodeParamsSerializer
+ supported_workflow_type_list = [WorkflowType.KNOWLEDGE]
+ type = "data-source-web-node"
+
+ @staticmethod
+ def get_form_list(node):
+ return [
+ {
+ "field": "source_url",
+ "input_type": "TextInput",
+ "attrs": {"placeholder": _("Please enter the Web root address")},
+ "label": _("Web source url"),
+ "required": True,
+ },
+ {
+ "field": "selector",
+ "input_type": "TextInput",
+ "attrs": {"placeholder": _("The default is body, you can enter .classname/#idname/tagname")},
+ "label": _("Web knowledge selector"),
+ "required": False,
+ },
+ ]
+
+ def _get_collect_handler(self, document_list):
+ def handler(child_link: ChildLink, response: Fork.Response):
+ if response.status == 200:
+ try:
+ document_name = (
+ child_link.tag.text
+ if child_link.tag is not None and len(child_link.tag.text.strip()) > 0
+ else child_link.url
+ )
+ document_list.append({"name": document_name.strip(), "content": response.content})
+ except Exception as e:
+ maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
+ # 已取消则抛出 CancelledException,由引擎结束流程
+ self._check_cancelled()
+
+ return handler
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ data_source = workflow_params.get("data_source") or {}
+
+ serializer = self.serializer_class(data=data_source)
+ serializer.is_valid(raise_exception=True)
+ source_url = serializer.validated_data.get("source_url")
+ selector = serializer.validated_data.get("selector") or "body"
+
+ document_list = []
+ collect_handler = self._get_collect_handler(document_list)
+
+ try:
+ ForkManage(source_url, selector.split(" ") if selector else []).fork(3, set(), collect_handler)
+ except CancelledException:
+ raise
+ except Exception as e:
+ maxkb_logger.error(
+ _("data source web node:{node_id} error{error}{traceback}").format(
+ node_id=self.get_node_id(), error=str(e), traceback=traceback.format_exc()
+ )
+ )
+
+ self.write_context("document_list", document_list)
+ self.write_context("source_url", source_url)
+ self.write_context("selector", selector)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "document_list": self.get_context("document_list"),
+ "source_url": self.get_context("source_url"),
+ "selector": self.get_context("selector"),
+ "knowledge_base": self.get_workflow_parameters().get("knowledge_base"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/document_extract_node/__init__.py b/apps/application/workflow/nodes/document_extract_node/__init__.py
new file mode 100644
index 00000000000..ec08b854e4d
--- /dev/null
+++ b/apps/application/workflow/nodes/document_extract_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/11
+@desc: 文档内容提取节点
+"""
+
+from .document_extract_node import DocumentExtractNode
diff --git a/apps/application/workflow/nodes/document_extract_node/document_extract_node.py b/apps/application/workflow/nodes/document_extract_node/document_extract_node.py
new file mode 100644
index 00000000000..225fdb7e18a
--- /dev/null
+++ b/apps/application/workflow/nodes/document_extract_node/document_extract_node.py
@@ -0,0 +1,119 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: document_extract_node.py
+@date: 2026/9/11
+@desc: 文档内容提取节点:把引用到的文件解析为文本内容,并保存文档内嵌图片
+"""
+
+import io
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from knowledge.models import File, FileSourceType
+from knowledge.serializers.document import FileBufferHandle, parse_table_handle_list, split_handles
+
+splitter = "\n`-----------------------------------`\n"
+
+
+class DocumentExtractNodeSerializer(serializers.Serializer):
+ document_list = serializers.ListField(required=False, label=_("document"))
+
+
+class DocumentExtractNode(INode):
+ serializer_class = DocumentExtractNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "document-extract-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+ document_reference = node_params.get("document_list") or []
+ document = (
+ self.workflow_manage.get_reference_field(document_reference[0], document_reference[1:])
+ if document_reference
+ else None
+ )
+ chat_id = workflow_params.get("chat_id")
+
+ self.write_context("document_list", document)
+ if document is None or not isinstance(document, list):
+ self.write_context("content", "")
+ self.write_context("document_list", [])
+ return
+
+ # 按工作流类型确定归属资源 id(知识库/应用/工具),均取自工作流入参
+ application_id = None
+ tool_id = None
+ knowledge_id = None
+ workflow_type = self.get_workflow_type()
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ knowledge_id = workflow_params.get("knowledge_id")
+ elif workflow_type == WorkflowType.APPLICATION:
+ application_id = workflow_params.get("application_id")
+ elif workflow_type == WorkflowType.TOOL:
+ tool_id = workflow_params.get("tool_id")
+
+ # doc 文件中内嵌的图片另存为文件
+ def save_image(image_list):
+ for image in image_list:
+ meta = {
+ "debug": False if (application_id or knowledge_id or tool_id) else True,
+ "chat_id": chat_id,
+ "application_id": str(application_id) if application_id else None,
+ "knowledge_id": str(knowledge_id) if knowledge_id else None,
+ "tool_id": str(tool_id) if tool_id else None,
+ "file_id": str(image.id),
+ }
+ file_bytes = image.meta.pop("content")
+ new_file = File(
+ id=meta["file_id"],
+ file_name=image.file_name,
+ file_size=len(file_bytes),
+ source_type=FileSourceType.APPLICATION.value
+ if application_id
+ else FileSourceType.KNOWLEDGE.value
+ if knowledge_id
+ else FileSourceType.TOOL.value,
+ source_id=application_id or knowledge_id or tool_id,
+ meta=meta,
+ )
+ if not QuerySet(File).filter(id=new_file.id).exists():
+ new_file.save(file_bytes)
+
+ get_buffer = FileBufferHandle().get_buffer
+ content = []
+ document_list = []
+ for doc in document:
+ file = QuerySet(File).filter(id=doc["file_id"]).first()
+ buffer = io.BytesIO(file.get_bytes())
+ buffer.name = doc["name"] # this is the important line
+
+ for split_handle in parse_table_handle_list + split_handles:
+ if split_handle.support(buffer, get_buffer):
+ buffer.seek(0)
+ file_content = split_handle.get_content(buffer, save_image)
+ content.append("### " + doc["name"] + "\n" + file_content)
+ document_list.append({"id": str(file.id), "name": doc["name"], "content": file_content})
+ break
+
+ self.write_context("content", splitter.join(content))
+ self.write_context("document_list", document_list)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ content = (self.get_context("content") or "").split(splitter)
+ details.update(
+ {
+ # 不保存 content 全部内容,因为 content 可能非常大
+ "content": [file_content[:500] for file_content in content],
+ "document_list": self.get_context("document_list"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/document_split_node/__init__.py b/apps/application/workflow/nodes/document_split_node/__init__.py
new file mode 100644
index 00000000000..fb048472596
--- /dev/null
+++ b/apps/application/workflow/nodes/document_split_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/11
+@desc: 文档分段节点
+"""
+
+from .document_split_node import DocumentSplitNode
diff --git a/apps/application/workflow/nodes/document_split_node/document_split_node.py b/apps/application/workflow/nodes/document_split_node/document_split_node.py
new file mode 100644
index 00000000000..89d11721ac6
--- /dev/null
+++ b/apps/application/workflow/nodes/document_split_node/document_split_node.py
@@ -0,0 +1,311 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: document_split_node.py
+@date: 2026/9/11
+@desc: 文档分段节点:把提取出的文档内容按策略切分为段落,供知识库写入
+"""
+
+import io
+import mimetypes
+from typing import List
+
+from django.core.files.uploadedfile import InMemoryUploadedFile
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from common.chunk import text_to_chunk
+from knowledge.serializers.document import FileBufferHandle, default_split_handle, md_qa_split_handle
+
+
+class DocumentSplitNodeSerializer(serializers.Serializer):
+ document_list = serializers.ListField(required=False, label=_("document list"))
+ split_strategy = serializers.ChoiceField(
+ choices=["auto", "custom", "qa"], required=False, label=_("split strategy"), default="auto"
+ )
+ paragraph_title_relate_problem_type = serializers.ChoiceField(
+ choices=["custom", "referencing"],
+ required=False,
+ label=_("paragraph title relate problem type"),
+ default="custom",
+ )
+ paragraph_title_relate_problem = serializers.BooleanField(
+ required=False, label=_("paragraph title relate problem"), default=False
+ )
+ paragraph_title_relate_problem_reference = serializers.ListField(
+ required=False, label=_("paragraph title relate problem reference"), child=serializers.CharField(), default=[]
+ )
+ document_name_relate_problem_type = serializers.ChoiceField(
+ choices=["custom", "referencing"],
+ required=False,
+ label=_("document name relate problem type"),
+ default="custom",
+ )
+ document_name_relate_problem = serializers.BooleanField(
+ required=False, label=_("document name relate problem"), default=False
+ )
+ document_name_relate_problem_reference = serializers.ListField(
+ required=False, label=_("document name relate problem reference"), child=serializers.CharField(), default=[]
+ )
+ limit = serializers.IntegerField(required=False, label=_("limit"), default=4096)
+ limit_type = serializers.ChoiceField(
+ choices=["custom", "referencing"],
+ required=False,
+ label=_("document name relate problem type"),
+ default="custom",
+ )
+ limit_reference = serializers.ListField(
+ required=False, label=_("limit reference"), child=serializers.CharField(), default=[]
+ )
+ chunk_size = serializers.IntegerField(required=False, label=_("chunk size"), default=256)
+ chunk_size_type = serializers.ChoiceField(
+ choices=["custom", "referencing"], required=False, label=_("chunk size type"), default="custom"
+ )
+ chunk_size_reference = serializers.ListField(
+ required=False, label=_("chunk size reference"), child=serializers.CharField(), default=[]
+ )
+ patterns = serializers.ListField(required=False, label=_("patterns"), child=serializers.CharField(), default=[])
+ patterns_type = serializers.ChoiceField(
+ choices=["custom", "referencing"], required=False, label=_("patterns type"), default="custom"
+ )
+ patterns_reference = serializers.ListField(
+ required=False, label=_("patterns reference"), child=serializers.CharField(), default=[]
+ )
+ with_filter = serializers.BooleanField(required=False, label=_("with filter"), default=False)
+ with_filter_type = serializers.ChoiceField(
+ choices=["custom", "referencing"], required=False, label=_("with filter type"), default="custom"
+ )
+ with_filter_reference = serializers.ListField(
+ required=False, label=_("with filter reference"), child=serializers.CharField(), default=[]
+ )
+
+
+def bytes_to_uploaded_file(file_bytes, file_name="file.txt"):
+ if file_name.startswith("http"):
+ file_name = "file.txt"
+ content_type, _unused = mimetypes.guess_type(file_name)
+ if content_type is None:
+ # 如果未能识别,设置为默认的二进制文件类型
+ content_type = "application/octet-stream"
+ # 创建一个内存中的字节流对象
+ file_stream = io.BytesIO(file_bytes)
+ # 获取文件大小
+ file_size = len(file_bytes)
+ # 创建 InMemoryUploadedFile 对象
+ uploaded_file = InMemoryUploadedFile(
+ file=file_stream,
+ field_name=None,
+ name=file_name,
+ content_type=content_type,
+ size=file_size,
+ charset=None,
+ )
+ return uploaded_file
+
+
+class DocumentSplitNode(INode):
+ serializer_class = DocumentSplitNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "document-split-node"
+
+ def get_reference_content(self, fields: List[str]):
+ return self.workflow_manage.get_reference_field(fields[0], fields[1:]) if fields else None
+
+ def execute(self):
+ # 通过 serializer 应用默认值(新引擎不会对 node_data 自动校验/填默认)
+ serializer = DocumentSplitNodeSerializer(data=self.get_parameters())
+ serializer.is_valid(raise_exception=True)
+ params = serializer.data
+
+ knowledge_id = (
+ self.get_workflow_parameters().get("knowledge_id")
+ if self.get_workflow_type() == WorkflowType.KNOWLEDGE
+ else None
+ )
+
+ document_list = params.get("document_list")
+ split_strategy = params.get("split_strategy")
+ paragraph_title_relate_problem_type = params.get("paragraph_title_relate_problem_type")
+ paragraph_title_relate_problem = params.get("paragraph_title_relate_problem")
+ paragraph_title_relate_problem_reference = params.get("paragraph_title_relate_problem_reference")
+ document_name_relate_problem_type = params.get("document_name_relate_problem_type")
+ document_name_relate_problem = params.get("document_name_relate_problem")
+ document_name_relate_problem_reference = params.get("document_name_relate_problem_reference")
+ limit = params.get("limit")
+ limit_type = params.get("limit_type")
+ limit_reference = params.get("limit_reference")
+ chunk_size = params.get("chunk_size")
+ chunk_size_type = params.get("chunk_size_type")
+ chunk_size_reference = params.get("chunk_size_reference")
+ patterns = params.get("patterns")
+ patterns_type = params.get("patterns_type")
+ patterns_reference = params.get("patterns_reference")
+ with_filter = params.get("with_filter")
+ with_filter_type = params.get("with_filter_type")
+ with_filter_reference = params.get("with_filter_reference")
+
+ self.write_context("knowledge_id", knowledge_id)
+ file_list = self.get_reference_content(document_list)
+
+ # 处理引用类型的参数
+ if patterns_type == "referencing":
+ patterns = self.get_reference_content(patterns_reference)
+ if limit_type == "referencing":
+ limit = self.get_reference_content(limit_reference)
+ if chunk_size_type == "referencing":
+ chunk_size = self.get_reference_content(chunk_size_reference)
+ if with_filter_type == "referencing":
+ with_filter = self.get_reference_content(with_filter_reference)
+
+ paragraph_list = []
+ for doc in file_list:
+ get_buffer = FileBufferHandle().get_buffer
+
+ file_mem = bytes_to_uploaded_file(doc["content"].encode("utf-8"), doc["name"])
+ if split_strategy == "qa":
+ result = md_qa_split_handle.handle(file_mem, get_buffer, self._save_image)
+ else:
+ result = default_split_handle.handle(
+ file_mem, patterns, with_filter, limit, get_buffer, self._save_image
+ )
+ # 统一处理结果为列表
+ results = result if isinstance(result, list) else [result]
+
+ for item in results:
+ self._process_split_result(
+ item,
+ knowledge_id,
+ doc.get("id"),
+ doc.get("name"),
+ split_strategy,
+ paragraph_title_relate_problem_type,
+ paragraph_title_relate_problem,
+ paragraph_title_relate_problem_reference,
+ document_name_relate_problem_type,
+ document_name_relate_problem,
+ document_name_relate_problem_reference,
+ chunk_size,
+ )
+
+ paragraph_list += results
+
+ self.write_context("paragraph_list", paragraph_list)
+ self.write_context("document_list", file_list)
+ self.write_context("limit", limit)
+ self.write_context("chunk_size", chunk_size)
+ self.write_context("with_filter", with_filter)
+ self.write_context("patterns", patterns)
+ self.write_context("split_strategy", split_strategy)
+
+ def _save_image(self, image_list):
+ pass
+
+ def _process_split_result(
+ self,
+ item,
+ knowledge_id,
+ source_file_id,
+ file_name,
+ split_strategy,
+ paragraph_title_relate_problem_type,
+ paragraph_title_relate_problem,
+ paragraph_title_relate_problem_reference,
+ document_name_relate_problem_type,
+ document_name_relate_problem,
+ document_name_relate_problem_reference,
+ chunk_size,
+ ):
+ """处理文档分割结果"""
+ item["meta"] = {
+ "knowledge_id": knowledge_id,
+ "source_file_id": source_file_id,
+ "source_url": file_name,
+ }
+ if item.get("name", "file.txt") == "file.txt":
+ item["name"] = file_name
+ item["source_file_id"] = source_file_id
+ item["paragraphs"] = item.pop("content", item.get("paragraphs", []))
+
+ for paragraph in item["paragraphs"]:
+ paragraph["problem_list"] = self._generate_problem_list(
+ paragraph,
+ file_name,
+ split_strategy,
+ paragraph_title_relate_problem_type,
+ paragraph_title_relate_problem,
+ paragraph_title_relate_problem_reference,
+ document_name_relate_problem_type,
+ document_name_relate_problem,
+ document_name_relate_problem_reference,
+ )
+ paragraph["is_active"] = True
+ paragraph["chunks"] = text_to_chunk(paragraph["content"], chunk_size)
+
+ def _generate_problem_list(
+ self,
+ paragraph,
+ document_name,
+ split_strategy,
+ paragraph_title_relate_problem_type,
+ paragraph_title_relate_problem,
+ paragraph_title_relate_problem_reference,
+ document_name_relate_problem_type,
+ document_name_relate_problem,
+ document_name_relate_problem_reference,
+ ):
+ if paragraph_title_relate_problem_type == "referencing":
+ paragraph_title_relate_problem = self.get_reference_content(paragraph_title_relate_problem_reference)
+ if document_name_relate_problem_type == "referencing":
+ document_name_relate_problem = self.get_reference_content(document_name_relate_problem_reference)
+
+ problem_list = [
+ item
+ for p in paragraph.get("problem_list", [])
+ for item in p.get("content", "").split("
")
+ if item.strip()
+ ]
+
+ if split_strategy == "auto":
+ if paragraph_title_relate_problem and paragraph.get("title"):
+ problem_list.append(paragraph.get("title"))
+ if document_name_relate_problem and document_name:
+ problem_list.append(document_name)
+ elif split_strategy == "custom":
+ if paragraph_title_relate_problem and paragraph.get("title"):
+ problem_list.append(paragraph.get("title"))
+ if document_name_relate_problem and document_name:
+ problem_list.append(document_name)
+ elif split_strategy == "qa":
+ if document_name_relate_problem and document_name:
+ problem_list.append(document_name)
+
+ return list(set(problem_list))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ paragraph_list = self.get_context("paragraph_list") or []
+ # 每个文档保留前 5 个分段
+ limited_paragraph_list = []
+ for doc in paragraph_list:
+ if doc.get("paragraphs"):
+ doc_copy = doc.copy()
+ doc_copy["paragraphs"] = doc["paragraphs"][:5]
+ limited_paragraph_list.append(doc_copy)
+ else:
+ limited_paragraph_list.append(doc)
+
+ details.update(
+ {
+ "paragraph_list": limited_paragraph_list,
+ "limit": self.get_context("limit"),
+ "chunk_size": self.get_context("chunk_size"),
+ "with_filter": self.get_context("with_filter"),
+ "patterns": self.get_context("patterns"),
+ "split_strategy": self.get_context("split_strategy"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/form_node/__init__.py b/apps/application/workflow/nodes/form_node/__init__.py
new file mode 100644
index 00000000000..261db05100c
--- /dev/null
+++ b/apps/application/workflow/nodes/form_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/6 15:30
+ @desc:
+"""
+from .form_node import FormNode
diff --git a/apps/application/workflow/nodes/form_node/form_node.py b/apps/application/workflow/nodes/form_node/form_node.py
new file mode 100644
index 00000000000..0ec16624e43
--- /dev/null
+++ b/apps/application/workflow/nodes/form_node/form_node.py
@@ -0,0 +1,199 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: form_node.py
+@date:2026/7/6 15:30
+@desc:
+"""
+
+import copy
+import re
+
+import uuid_utils.compat as uuid
+from rest_framework import serializers
+
+from django.utils.translation import gettext_lazy as _
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode, Signal
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.form_content import FormContent
+from application.workflow.status import Status
+
+_TEMPLATE_RE = re.compile(r"\{\{([^.\s}]+)\.([^.\s}]+)\}\}")
+
+_MULTI_SELECT_TYPES = {"MultiSelect", "MultiRow"}
+
+
+def _get_default_option(option_list, _type, value_field):
+ try:
+ if option_list and isinstance(option_list, list) and len(option_list) > 0:
+ default_value_list = [o.get(value_field) for o in option_list if o.get("default")]
+ if len(default_value_list) == 0:
+ return (
+ [option_list[0].get(value_field)]
+ if _type in _MULTI_SELECT_TYPES
+ else option_list[0].get(value_field)
+ )
+ else:
+ return default_value_list if _type in _MULTI_SELECT_TYPES else default_value_list[0]
+ except Exception:
+ pass
+ return []
+
+
+class FormNodeSerializer(serializers.Serializer):
+ form_field_list = serializers.ListField(required=True, label=_("Form Configuration"))
+ form_content_format = serializers.CharField(required=True, label=_("Form output content"))
+ form_data = serializers.DictField(required=False, allow_null=True, label=_("Form Data"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+
+
+class FormNode(INode):
+ serializer_class = FormNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "form-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.workflow_manage.get_parameters()
+
+ # 判断是否是表单提交
+ position = workflow_params.get("position") or {}
+ is_form_submit = position.get("id") == self.node.id
+
+ form_field_list = node_params.get("form_field_list", [])
+ form_content_format = node_params.get("form_content_format", "")
+
+ if is_form_submit:
+ # 表单提交:从 workflow_params 获取前端提交的 form_data
+ form_data = workflow_params.get("form_data") or {}
+ is_submit = True
+ # 复用前端传来的 chunk_id
+ chunk_id = workflow_params.get("chunk_id") or str(uuid.uuid7())
+ else:
+ # 首次执行:从节点参数获取
+ form_data = node_params.get("form_data")
+ is_submit = form_data is not None
+ # 生成新 chunk_id
+ chunk_id = str(uuid.uuid7())
+
+ # 写入 context
+ self.write_context("is_submit", is_submit)
+ self.write_context("form_content_format", form_content_format)
+
+ if is_submit:
+ self.write_context("form_data", form_data)
+ for key in form_data:
+ self.write_context(key, form_data.get(key))
+
+ form_field_list = [self._reset_field(field) for field in form_field_list]
+ self.write_context("form_field_list", form_field_list)
+
+ # 输出表单内容
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(
+ FormContent(
+ chunk_id,
+ form_field_list,
+ form_content_format,
+ is_submit,
+ Status.SUCCESS,
+ node_info,
+ Position(self.get_node_id()),
+ form_data=form_data,
+ )
+ )
+
+ # 如果未提交,中断工作流等待用户提交
+ if not is_submit:
+ self.complete(Status.SUCCESS, signal=Signal.FORM)
+ return
+
+ # 已提交,继续执行后续节点
+ self.complete(Status.SUCCESS)
+
+ def _generate_prompt(self, prompt):
+ try:
+ return self.workflow_manage.generate_prompt(prompt)
+ except Exception:
+ return prompt
+
+ def _reset_field(self, field):
+ field = copy.copy(field)
+ for f in ["field", "label", "default_value"]:
+ _value = field.get(f)
+ if _value is None:
+ continue
+ if isinstance(_value, str):
+ field[f] = self._generate_prompt(_value)
+ elif f == "label" and isinstance(_value, dict):
+ _label_value = _value.get("label")
+ _value["label"] = self._generate_prompt(_label_value)
+ tooltip = _value.get("attrs", {}).get("tooltip")
+ if tooltip is not None:
+ _value["attrs"]["tooltip"] = self._generate_prompt(tooltip)
+
+ input_type = field.get("input_type")
+ if input_type in {"SingleSelect", "MultiSelect", "RadioCard", "RadioRow", "MultiRow"}:
+ if field.get("assignment_method") == "ref_variables":
+ option_list_ref = field.get("option_list")
+ if option_list_ref and len(option_list_ref) >= 2:
+ option_list = self.workflow_manage.get_reference_field(option_list_ref[0], option_list_ref[1:])
+ option_list = option_list if isinstance(option_list, list) else []
+ field["option_list"] = option_list
+ field["default_value"] = _get_default_option(option_list, input_type, field.get("value_field"))
+
+ if input_type == "JsonInput":
+ if field.get("default_value_assignment_method") == "ref_variables":
+ default_ref = field.get("default_value")
+ if default_ref and isinstance(default_ref, list) and len(default_ref) >= 2:
+ field["default_value"] = self.workflow_manage.get_reference_field(default_ref[0], default_ref[1:])
+
+ self._reset_visibility_rules(field)
+ return field
+
+ def _reset_visibility_rules(self, field):
+ visibility_rules = field.get("visibility_rules")
+ if not visibility_rules or not isinstance(visibility_rules.get("conditions"), list):
+ return
+ for cond in visibility_rules["conditions"]:
+ cond_field = cond.get("field")
+ if not cond_field or len(cond_field) < 2 or not cond_field[0] or not cond_field[1]:
+ continue
+ if cond_field[0] != self.node.id:
+ cond["_left"] = self.workflow_manage.get_reference_field(cond_field[0], cond_field[1:])
+ cond_value = cond.get("value")
+ if isinstance(cond_value, str) and _TEMPLATE_RE.search(cond_value):
+ cond["value"] = self._render_cond_value(cond_value)
+
+ def _render_cond_value(self, value):
+ def replacer(match):
+ node_display = match.group(1)
+ field_name = match.group(2)
+ workflow = self.workflow_manage.workflow
+ for f in workflow.node_field_list:
+ if f.node_name == node_display and f.value == field_name:
+ if f.node_id == self.node.id:
+ return match.group(0)
+ ref = self.workflow_manage.get_reference_field(f.node_id, [field_name])
+ return str(ref) if ref is not None else ""
+ return match.group(0)
+
+ try:
+ return _TEMPLATE_RE.sub(replacer, value)
+ except Exception:
+ return value
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "form_field_list": self.get_context("form_field_list"),
+ "form_data": self.get_context("form_data"),
+ "is_submit": self.get_context("is_submit"),
+ "form_content_format": self.get_context("form_content_format"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/image_generate_node/__init__.py b/apps/application/workflow/nodes/image_generate_node/__init__.py
new file mode 100644
index 00000000000..b915a23112f
--- /dev/null
+++ b/apps/application/workflow/nodes/image_generate_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/6 16:00
+ @desc:
+"""
+from .image_generate_node import ImageGenerateNode
diff --git a/apps/application/workflow/nodes/image_generate_node/image_generate_node.py b/apps/application/workflow/nodes/image_generate_node/image_generate_node.py
new file mode 100644
index 00000000000..c2776a1c50d
--- /dev/null
+++ b/apps/application/workflow/nodes/image_generate_node/image_generate_node.py
@@ -0,0 +1,231 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: image_generate_node.py
+@date:2026/7/6 16:00
+@desc:
+"""
+
+import base64
+from functools import reduce
+
+import requests
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage, AIMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+from common.utils.common import bytes_to_uploaded_file
+from knowledge.models import FileSourceType
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+from oss.serializers.file import FileSerializer
+
+
+class ImageGenerateNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ prompt = serializers.CharField(required=True, label=_("Prompt word (positive)"))
+ negative_prompt = serializers.CharField(
+ required=False, label=_("Prompt word (negative)"), allow_null=True, allow_blank=True
+ )
+ dialogue_number = serializers.IntegerField(
+ required=False, default=0, label=_("Number of multi-round conversations")
+ )
+ dialogue_type = serializers.CharField(required=False, default="NODE", label=_("Conversation storage type"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ model_params_setting = serializers.JSONField(required=False, default=dict, label=_("Model parameter settings"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+class ImageGenerateNode(INode):
+ serializer_class = ImageGenerateNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "image-generate-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ prompt = node_params.get("prompt", "")
+ negative_prompt = node_params.get("negative_prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ dialogue_type = node_params.get("dialogue_type", "NODE")
+ is_result = node_params.get("is_result", False)
+ model_params_setting = node_params.get("model_params_setting")
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("TTI") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ workspace_id = workflow_params.get("workspace_id")
+ tti_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message = self._get_history_message(history_chat_record, dialogue_number)
+ self.write_context("history_message", [{"content": m.content, "role": m.type} for m in (history_message or [])])
+
+ question = self.workflow_manage.generate_prompt(prompt)
+ self.write_context("question", question)
+ self.write_context("negative_prompt", self.workflow_manage.generate_prompt(negative_prompt or ""))
+ self.write_context("dialogue_type", dialogue_type)
+
+ self._check_cancelled()
+ image_urls = tti_model.generate_image(question, negative_prompt)
+
+ file_urls = []
+ for image_url in image_urls:
+ file_name = "generated_image.png"
+ if isinstance(image_url, str):
+ if image_url.startswith("http"):
+ image_url = requests.get(image_url).content
+ elif image_url.startswith("data:image"):
+ header, encoded = image_url.split(",", 1)
+ image_url = base64.b64decode(encoded)
+ else:
+ image_url = base64.b64decode(image_url)
+ file = bytes_to_uploaded_file(image_url, file_name)
+ file_url = self._upload_file(file, workflow_params, workflow_type)
+ file_urls.append(file_url)
+
+ image_list = [{"file_id": path.split("/")[-1], "url": path} for path in file_urls]
+ self.write_context("image_list", image_list)
+
+ answer = " ".join([f"" for path in file_urls])
+ self.write_context("answer", answer)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(
+ TextContent(str(uuid.uuid7()), answer, Status.SUCCESS, node_info, position=Position(self.get_node_id()))
+ )
+
+ def _get_history_message(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ return reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message(history_chat_record[index]),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(max(start_index, 0), len(history_chat_record))
+ ],
+ [],
+ )
+
+ def _generate_history_human_message(self, chat_record):
+ for data in chat_record.details.values():
+ if self.node.id == data.get("node_id") and "image_list" in data:
+ image_list = data["image_list"]
+ if len(image_list) == 0 or data.get("dialogue_type") == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ return HumanMessage(content=data.get("question", chat_record.problem_text))
+ return HumanMessage(content=chat_record.problem_text)
+
+ def _generate_history_ai_message(self, chat_record):
+ for val in chat_record.details.values():
+ if self.node.id == val.get("node_id") and "image_list" in val:
+ if val.get("dialogue_type") == "WORKFLOW":
+ return chat_record.get_ai_message()
+ image_list = val["image_list"]
+ return [
+ AIMessage(
+ content=[{"type": "image_url", "image_url": {"url": f"{file_url}"}} for file_url in image_list]
+ )
+ ]
+ return chat_record.get_ai_message()
+
+ def _upload_file(self, file, workflow_params, workflow_type):
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ return self._upload_knowledge_file(file, workflow_params)
+ if workflow_type == WorkflowType.TOOL:
+ return self._upload_tool_file(file, workflow_params)
+ return self._upload_application_file(file, workflow_params)
+
+ def _upload_knowledge_file(self, file, workflow_params):
+ knowledge_id = workflow_params.get("knowledge_id")
+ return FileSerializer(
+ data={
+ "file": file,
+ "meta": {"debug": False, "knowledge_id": knowledge_id},
+ "source_id": knowledge_id,
+ "source_type": FileSourceType.KNOWLEDGE.value,
+ }
+ ).upload()
+
+ def _upload_tool_file(self, file, workflow_params):
+ tool_id = workflow_params.get("tool_id")
+ return FileSerializer(
+ data={
+ "file": file,
+ "meta": {"debug": False, "tool_id": tool_id},
+ "source_id": tool_id,
+ "source_type": FileSourceType.TOOL.value,
+ }
+ ).upload()
+
+ def _upload_application_file(self, file, workflow_params):
+ application_id = workflow_params.get("application_id")
+ chat_id = workflow_params.get("chat_id")
+ return FileSerializer(
+ data={
+ "file": file,
+ "meta": {"debug": False, "chat_id": chat_id, "application_id": application_id},
+ "source_id": application_id,
+ "source_type": FileSourceType.APPLICATION.value,
+ }
+ ).upload()
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "image_list": self.get_context("image_list"),
+ "negative_prompt": self.get_context("negative_prompt"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/image_to_video_node/__init__.py b/apps/application/workflow/nodes/image_to_video_node/__init__.py
new file mode 100644
index 00000000000..2a6d404093b
--- /dev/null
+++ b/apps/application/workflow/nodes/image_to_video_node/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .image_to_video_node import ImageToVideoNode
diff --git a/apps/application/workflow/nodes/image_to_video_node/image_to_video_node.py b/apps/application/workflow/nodes/image_to_video_node/image_to_video_node.py
new file mode 100644
index 00000000000..624a71ab0e9
--- /dev/null
+++ b/apps/application/workflow/nodes/image_to_video_node/image_to_video_node.py
@@ -0,0 +1,287 @@
+# coding=utf-8
+import base64
+import uuid_utils.compat as uuid
+import requests
+from functools import reduce
+from typing import List
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _, gettext
+from langchain_core.messages import BaseMessage, HumanMessage, AIMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.utils.common import bytes_to_uploaded_file
+from knowledge.models import FileSourceType, File
+from oss.serializers.file import FileSerializer, mime_types
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+from common.exception.app_exception import AppApiException
+from common.utils.logger import maxkb_logger
+
+
+class ImageToVideoNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ prompt = serializers.CharField(required=True, label=_("Prompt word (positive)"))
+ negative_prompt = serializers.CharField(
+ required=False, label=_("Prompt word (negative)"), allow_null=True, allow_blank=True
+ )
+ dialogue_number = serializers.IntegerField(
+ required=False, default=0, label=_("Number of multi-round conversations")
+ )
+ dialogue_type = serializers.CharField(required=False, default="NODE", label=_("Conversation storage type"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ model_params_setting = serializers.JSONField(required=False, default=dict, label=_("Model parameter settings"))
+ first_frame_url = serializers.ListField(required=True, label=_("First frame url"))
+ last_frame_url = serializers.ListField(required=False, label=_("Last frame url"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+class ImageToVideoNode(INode):
+ serializer_class = ImageToVideoNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "image-to-video-node"
+
+ def execute(self):
+ maxkb_logger.info(f"[ImageToVideoNode] execute START, node_id={self.get_node_id()}")
+ workflow_params = self.get_workflow_parameters()
+ node_params = self.get_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ prompt = node_params.get("prompt", "")
+ negative_prompt = node_params.get("negative_prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ dialogue_type = node_params.get("dialogue_type", "NODE")
+ is_result = node_params.get("is_result", False)
+ model_params_setting = node_params.get("model_params_setting")
+ first_frame_url_ref = node_params.get("first_frame_url")
+ last_frame_url_ref = node_params.get("last_frame_url")
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ chat_id = None
+ chat_record_id = None
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ chat_id = workflow_params.get("chat_id")
+ chat_record_id = workflow_params.get("chat_record_id")
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("ITV") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ if first_frame_url_ref is None or first_frame_url_ref == []:
+ raise ValueError(_("First frame url cannot be empty"))
+
+ first_frame_url = self.workflow_manage.get_reference_field(first_frame_url_ref[0], first_frame_url_ref[1:])
+
+ last_frame_url = None
+ if last_frame_url_ref is not None and last_frame_url_ref != []:
+ last_frame_url = self.workflow_manage.get_reference_field(last_frame_url_ref[0], last_frame_url_ref[1:])
+
+ ttv_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message = self._get_history_message(history_chat_record, dialogue_number)
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message or [])],
+ )
+
+ question = self.workflow_manage.generate_prompt(prompt)
+ self.write_context("question", question)
+
+ message_list = [*history_message, question]
+ self.write_context("message_list", message_list)
+ self.write_context("dialogue_type", dialogue_type)
+ self.write_context("negative_prompt", self.workflow_manage.generate_prompt(negative_prompt))
+ self.write_context("first_frame_url", first_frame_url)
+ self.write_context("last_frame_url", last_frame_url)
+
+ first_frame_url = self._get_file_base64(first_frame_url)
+ last_frame_url = self._get_file_base64(last_frame_url)
+
+ self._check_cancelled()
+ video_urls = ttv_model.generate_video(question, negative_prompt, first_frame_url, last_frame_url)
+ maxkb_logger.info(
+ f"[ImageToVideoNode] generate_video result: {video_urls is not None}, node_id={self.get_node_id()}"
+ )
+
+ if video_urls is None or video_urls == "":
+ raise Exception(gettext("Failed to generate video"))
+
+ file_name = "generated_video.mp4"
+ if isinstance(video_urls, str) and video_urls.startswith("http"):
+ video_urls = requests.get(video_urls).content
+
+ file = bytes_to_uploaded_file(video_urls, file_name)
+ file_url = self._upload_file(file, workflow_type, workflow_params)
+
+ video_label = f''
+ video_list = [{"file_id": file_url.split("/")[-1], "file_name": file_name, "url": file_url}]
+
+ self.write_context("answer", video_label)
+ self.write_context("video", video_list)
+ self.write_context("chat_model", ttv_model)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(
+ TextContent(str(uuid.uuid7()), video_label, Status.SUCCESS, node_info, Position(self.get_node_id()))
+ )
+
+ def _get_file_base64(self, image_url):
+ try:
+ if isinstance(image_url, list):
+ image_url = image_url[0].get("file_id") if "file_id" in image_url[0] else image_url[0].get("url")
+ if isinstance(image_url, str) and not image_url.startswith("http"):
+ file = QuerySet(File).filter(id=image_url).first()
+ file_bytes = file.get_bytes()
+ file_type = file.file_name.split(".")[-1].lower()
+ content_type = mime_types.get(file_type, "application/octet-stream")
+ encoded_bytes = base64.b64encode(file_bytes)
+ return f"data:{content_type};base64,{encoded_bytes.decode()}"
+ return image_url
+ except Exception as e:
+ raise ValueError(gettext("Failed to obtain the image"))
+
+ def _upload_file(self, file, workflow_type, workflow_params):
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ return self._upload_knowledge_file(file, workflow_params)
+ if workflow_type == WorkflowType.TOOL:
+ return self._upload_tool_file(file, workflow_params)
+ return self._upload_application_file(file, workflow_params)
+
+ def _upload_knowledge_file(self, file, workflow_params):
+ knowledge_id = workflow_params.get("knowledge_id")
+ meta = {"debug": False, "knowledge_id": knowledge_id}
+ file_url = FileSerializer(
+ data={"file": file, "meta": meta, "source_id": knowledge_id, "source_type": FileSourceType.KNOWLEDGE.value}
+ ).upload()
+ return file_url
+
+ def _upload_tool_file(self, file, workflow_params):
+ tool_id = workflow_params.get("tool_id")
+ meta = {
+ "debug": False,
+ "tool_id": tool_id,
+ }
+ file_url = FileSerializer(
+ data={"file": file, "meta": meta, "source_id": tool_id, "source_type": FileSourceType.TOOL.value}
+ ).upload()
+ return file_url
+
+ def _upload_application_file(self, file, workflow_params):
+ application_id = workflow_params.get("application_id")
+ chat_id = workflow_params.get("chat_id")
+ debug = workflow_params.get("debug", False)
+ meta = {
+ "debug": debug,
+ "chat_id": chat_id,
+ "application_id": application_id,
+ }
+ file_url = FileSerializer(
+ data={
+ "file": file,
+ "meta": meta,
+ "source_id": application_id,
+ "source_type": FileSourceType.APPLICATION.value,
+ }
+ ).upload()
+ return file_url
+
+ def _generate_history_ai_message(self, chat_record):
+ for val in chat_record.details.values():
+ if self.node.id == val["node_id"] and "image_list" in val:
+ if val["dialogue_type"] == "WORKFLOW":
+ return chat_record.get_ai_message()
+ image_list = val["image_list"]
+ return [
+ AIMessage(
+ content=[
+ *[{"type": "image_url", "image_url": {"url": f"{file_url}"}} for file_url in image_list]
+ ]
+ )
+ ]
+ return chat_record.get_ai_message()
+
+ def _get_history_message(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message(history_chat_record[index]),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ return history_message
+
+ def _generate_history_human_message(self, chat_record):
+ for data in chat_record.details.values():
+ if self.node.id == data["node_id"] and "image_list" in data:
+ image_list = data["image_list"]
+ if len(image_list) == 0 or data["dialogue_type"] == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ return HumanMessage(content=data["question"])
+ return HumanMessage(content=chat_record.problem_text)
+
+ @staticmethod
+ def reset_message_list(message_list: List[BaseMessage], answer_text):
+ result = [
+ {"role": "user" if isinstance(message, HumanMessage) else "ai", "content": message.content}
+ for message in message_list
+ ]
+ result.append({"role": "ai", "content": answer_text})
+ return result
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "video": self.get_context("video"),
+ "first_frame_url": self.get_context("first_frame_url"),
+ "last_frame_url": self.get_context("last_frame_url"),
+ "negative_prompt": self.get_context("negative_prompt"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/image_understand_node/__init__.py b/apps/application/workflow/nodes/image_understand_node/__init__.py
new file mode 100644
index 00000000000..d6242aeec4b
--- /dev/null
+++ b/apps/application/workflow/nodes/image_understand_node/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .image_understand_node import ImageUnderstandNode
diff --git a/apps/application/workflow/nodes/image_understand_node/image_understand_node.py b/apps/application/workflow/nodes/image_understand_node/image_understand_node.py
new file mode 100644
index 00000000000..20df7753c4e
--- /dev/null
+++ b/apps/application/workflow/nodes/image_understand_node/image_understand_node.py
@@ -0,0 +1,397 @@
+# coding=utf-8
+import base64
+import uuid_utils.compat as uuid
+from functools import reduce
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage, SystemMessage, AIMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.reasoning_content import ReasoningContent
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from application.workflow.tools import Reasoning
+from common.utils.common import guess_image_format
+from common.exception.app_exception import AppApiException
+from knowledge.models import File
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+
+
+class ImageUnderstandNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ system = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Role Setting"))
+ prompt = serializers.CharField(required=True, label=_("Prompt word"))
+ dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
+ dialogue_type = serializers.CharField(required=True, label=_("Conversation storage type"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ image_list = serializers.ListField(required=False, label=_("picture"))
+ model_params_setting = serializers.JSONField(required=False, default=dict, label=_("Model parameter settings"))
+ model_setting = serializers.DictField(required=False, label="Model settings")
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+class ImageUnderstandNode(INode):
+ serializer_class = ImageUnderstandNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "image-understand-node"
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ node_params = self.get_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ system = node_params.get("system", "")
+ prompt = node_params.get("prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ dialogue_type = node_params.get("dialogue_type", "WORKFLOW")
+ is_result = node_params.get("is_result", False)
+ image_list_ref = node_params.get("image_list")
+ model_params_setting = node_params.get("model_params_setting")
+ model_setting = node_params.get("model_setting")
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ chat_id = None
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ chat_id = workflow_params.get("chat_id")
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_setting is None:
+ model_setting = {
+ "reasoning_content_enable": False,
+ "reasoning_content_end": "",
+ "reasoning_content_start": "",
+ }
+ self.write_context("model_setting", model_setting)
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("IMAGE") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ image = None
+ if image_list_ref:
+ image = self.workflow_manage.get_reference_field(image_list_ref[0], image_list_ref[1:])
+
+ chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message_for_details = self._get_history_message_for_details(history_chat_record, dialogue_number)
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message_for_details or [])],
+ )
+
+ question = self.workflow_manage.generate_prompt(prompt)
+ self.write_context("question", question)
+
+ system = self.workflow_manage.generate_prompt(system)
+ self.write_context("system", system)
+
+ history_message = self._get_history_message(history_chat_record, dialogue_number)
+ message_list = self._generate_message_list(chat_model, system, prompt, history_message, image)
+ self.write_context(
+ "message_list",
+ [{"content": m.content, "role": m.type} for m in message_list],
+ )
+
+ self._generate_context_image(image)
+ self.write_context("dialogue_type", dialogue_type)
+
+ reasoning_content_id = str(uuid.uuid7())
+ text_content_id = str(uuid.uuid7())
+
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.RUNNING)
+
+ r = chat_model.stream(message_list)
+ self._stream_response(
+ r, chat_model, message_list, question, reasoning_content_id, text_content_id, node_info, is_result
+ )
+
+ def _stream_response(
+ self, response, chat_model, message_list, question, reasoning_content_id, text_content_id, node_info, is_result
+ ):
+ model_setting = self.get_context("model_setting") or {}
+ reasoning = Reasoning(
+ model_setting.get("reasoning_content_start", ""),
+ model_setting.get("reasoning_content_end", ""),
+ )
+ answer = ""
+ reasoning_content = ""
+ response_reasoning_content = False
+
+ for chunk in response:
+ self._check_cancelled()
+ reasoning_chunk = reasoning.get_reasoning_content(chunk)
+ content_chunk = reasoning_chunk.get("content")
+ if "reasoning_content" in chunk.additional_kwargs:
+ response_reasoning_content = True
+ reasoning_content_chunk = chunk.additional_kwargs.get("reasoning_content", "")
+ else:
+ reasoning_content_chunk = reasoning_chunk.get("reasoning_content")
+ answer += content_chunk
+ if reasoning_content_chunk is None:
+ reasoning_content_chunk = ""
+ reasoning_content += reasoning_content_chunk
+
+ if is_result:
+ if isinstance(chunk.content, list):
+ for chunk_item in chunk.content:
+ text = chunk_item.get("text", "")
+ if text:
+ self.write(
+ TextContent(
+ text_content_id, text, Status.RUNNING, node_info, Position(self.get_node_id())
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+ else:
+ if content_chunk:
+ self.write(
+ TextContent(
+ text_content_id, content_chunk, Status.RUNNING, node_info, Position(self.get_node_id())
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ reasoning_end = reasoning.get_end_reasoning_content()
+ answer += reasoning_end.get("content")
+ reasoning_content_chunk = ""
+ if not response_reasoning_content:
+ reasoning_content_chunk = reasoning_end.get("reasoning_content")
+ if is_result:
+ if reasoning_end.get("content"):
+ self.write(
+ TextContent(
+ text_content_id,
+ reasoning_end.get("content"),
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ self._write_final_context(chat_model, message_list, question, answer, reasoning_content)
+
+ def _write_final_context(self, chat_model, message_list, question, answer, reasoning_content):
+ message_tokens = chat_model.get_num_tokens_from_messages(message_list)
+ answer_tokens = chat_model.get_num_tokens(answer)
+ self.write_context("message_tokens", message_tokens)
+ self.write_context("answer_tokens", answer_tokens)
+ self.write_context("answer", answer)
+ self.write_context("question", question)
+ self.write_context("reasoning_content", reasoning_content)
+
+ def _generate_context_image(self, image):
+ if isinstance(image, str) and image.startswith("http"):
+ self.write_context("image_list", [{"url": image}])
+ elif image is not None and len(image) > 0:
+ self.write_context("image_list", image)
+
+ def _get_history_message_for_details(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message_for_details(history_chat_record[index]),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ return history_message
+
+ def _generate_history_ai_message(self, chat_record):
+ for val in chat_record.details.values():
+ if self.node.id == val["node_id"] and "image_list" in val:
+ if val["dialogue_type"] == "WORKFLOW":
+ return chat_record.get_ai_message()
+ return [AIMessage(content=val["answer"])]
+ return chat_record.get_ai_message()
+
+ def _generate_history_human_message_for_details(self, chat_record):
+ for data in chat_record.details.values():
+ if self.node.id == data["node_id"] and "image_list" in data:
+ image_list = data["image_list"] or []
+ if len(image_list) == 0 or data["dialogue_type"] == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ file_id_list = []
+ url_list = []
+ for image in image_list:
+ if "file_id" in image:
+ file_id_list.append(image.get("file_id"))
+ elif "url" in image:
+ url_list.append(image.get("url"))
+ return HumanMessage(
+ content=[
+ {"type": "text", "text": data["question"]},
+ *[
+ {"type": "image_url", "image_url": {"url": f"./oss/file/{file_id}"}}
+ for file_id in file_id_list
+ ],
+ *[{"type": "image_url", "image_url": {"url": url}} for url in url_list],
+ ]
+ )
+ return HumanMessage(content=chat_record.problem_text)
+
+ def _get_history_message(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message(history_chat_record[index]),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ return history_message
+
+ def _generate_history_human_message(self, chat_record):
+ for data in chat_record.details.values():
+ if self.node.id == data["node_id"] and "image_list" in data:
+ image_list = data["image_list"] or []
+ if len(image_list) == 0 or data["dialogue_type"] == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ file_id_list = []
+ url_list = []
+ for image in image_list:
+ if "file_id" in image:
+ file_id_list.append(image.get("file_id"))
+ elif "url" in image:
+ url_list.append(image.get("url"))
+ image_base64_list = [self._file_id_to_base64(file_id) for file_id in file_id_list]
+ return HumanMessage(
+ content=[
+ {"type": "text", "text": data["question"]},
+ *[
+ {
+ "type": "image_url",
+ "image_url": {"url": f"data:image/{base64_image[1]};base64,{base64_image[0]}"},
+ }
+ for base64_image in image_base64_list
+ ],
+ *[{"type": "image_url", "image_url": {"url": url}} for url in url_list],
+ ]
+ )
+ return HumanMessage(content=chat_record.problem_text)
+
+ @staticmethod
+ def _file_id_to_base64(file_id: str):
+ file = QuerySet(File).filter(id=file_id).first()
+ file_bytes = file.get_bytes()
+ base64_image = base64.b64encode(file_bytes).decode("utf-8")
+ return [base64_image, guess_image_format(file_bytes, file.file_name)]
+
+ def _process_images(self, image):
+ images = []
+ if isinstance(image, str) and image.startswith("http"):
+ images.append({"type": "image_url", "image_url": {"url": image}})
+ elif image is not None and len(image) > 0:
+ for img in image:
+ if "file_id" in img:
+ file_id = img["file_id"]
+ file = QuerySet(File).filter(id=file_id).first()
+ image_bytes = file.get_bytes()
+ base64_image = base64.b64encode(image_bytes).decode("utf-8")
+ image_format = guess_image_format(image_bytes, file.file_name)
+ images.append(
+ {"type": "image_url", "image_url": {"url": f"data:image/{image_format};base64,{base64_image}"}}
+ )
+ elif "url" in img and img["url"].startswith("http"):
+ images.append({"type": "image_url", "image_url": {"url": img["url"]}})
+ return images
+
+ def _generate_message_list(self, image_model, system: str, prompt: str, history_message, image):
+ prompt_text = self.workflow_manage.generate_prompt(prompt)
+ images = self._process_images(image)
+
+ if images:
+ messages = [HumanMessage(content=[{"type": "text", "text": prompt_text}, *images])]
+ else:
+ messages = [HumanMessage(prompt_text)]
+
+ if system is not None and len(system) > 0:
+ return [SystemMessage(system), *history_message, *messages]
+ else:
+ return [*history_message, *messages]
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "image_list": self.get_context("image_list"),
+ "reasoning_content": self.get_context("reasoning_content"),
+ "message_tokens": self.get_context("message_tokens"),
+ "answer_tokens": self.get_context("answer_tokens"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/intent_node/__init__.py b/apps/application/workflow/nodes/intent_node/__init__.py
new file mode 100644
index 00000000000..87587caeb24
--- /dev/null
+++ b/apps/application/workflow/nodes/intent_node/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .intent_node import IntentNode
diff --git a/apps/application/workflow/nodes/intent_node/intent_node.py b/apps/application/workflow/nodes/intent_node/intent_node.py
new file mode 100644
index 00000000000..bb0e884c2f6
--- /dev/null
+++ b/apps/application/workflow/nodes/intent_node/intent_node.py
@@ -0,0 +1,254 @@
+# coding=utf-8
+import json
+import re
+from typing import List, Dict, Any
+from functools import reduce
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage, SystemMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id, get_model_credential
+from .prompt_template import PROMPT_TEMPLATE
+
+
+class IntentBranchSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label=_("Branch id"))
+ content = serializers.CharField(required=True, label=_("content"))
+ isOther = serializers.BooleanField(required=True, label=_("Branch Type"))
+
+
+class IntentNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ content_list = serializers.ListField(required=True, label=_("Text content"))
+ dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
+ model_params_setting = serializers.DictField(required=False, label=_("Model parameter settings"))
+ branch = IntentBranchSerializer(many=True)
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _get_default_model_params_setting(model_id):
+ model = QuerySet(Model).filter(id=model_id).first()
+ credential = get_model_credential(model.provider, model.model_type, model.model_name)
+ model_params_setting = credential.get_model_params_setting_form(model.model_name).get_default_form_data()
+ return model_params_setting
+
+
+class IntentNode(INode):
+ serializer_class = IntentNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "intent-node"
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ node_params = self.get_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ content_list_ref = node_params.get("content_list")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ model_params_setting = node_params.get("model_params_setting")
+ branch = node_params.get("branch", [])
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("LLM") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ if model_params_setting is None and model_id:
+ model_params_setting = _get_default_model_params_setting(model_id)
+
+ user_input = self.workflow_manage.get_reference_field(content_list_ref[0], content_list_ref[1:])
+
+ chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message = self._get_history_message(history_chat_record, dialogue_number)
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message or [])],
+ )
+
+ self.write_context("user_input", str(user_input))
+
+ prompt = self._build_classification_prompt(str(user_input), branch)
+ system = self._build_system_prompt()
+ message_list = self._generate_message_list(system, prompt, history_message)
+ self.write_context(
+ "message_list",
+ [{"content": m.content, "role": m.type} for m in message_list],
+ )
+
+ try:
+ self._check_cancelled()
+ r = chat_model.invoke(message_list)
+ classification_result = r.content.strip()
+ matched_branch = self._parse_classification_result(classification_result, branch)
+
+ message_tokens = chat_model.get_num_tokens_from_messages(message_list)
+ answer_tokens = chat_model.get_num_tokens(r.content)
+ self.write_context("message_tokens", message_tokens)
+ self.write_context("answer_tokens", answer_tokens)
+ self.write_context("answer", r.content)
+ self.write_context("branch_id", matched_branch["id"])
+ self.write_context("reason", self._parse_result_reason(r.content))
+ self.write_context("category", matched_branch.get("content", matched_branch["id"]))
+
+ self.complete(Status.SUCCESS, [self.branch_anchor(matched_branch["id"])])
+
+ except Exception as e:
+ other_branch = self._find_other_branch(branch)
+ if other_branch:
+ self.write_context("branch_id", other_branch["id"])
+ self.write_context("category", other_branch.get("content", other_branch["id"]))
+ self.write_context("error", str(e))
+ self.complete(Status.SUCCESS, [self.branch_anchor(other_branch["id"])])
+ else:
+ raise Exception(f"error: {str(e)}")
+
+ def _get_history_message(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [*history_chat_record[index].get_human_message(), *history_chat_record[index].get_ai_message()]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+
+ for message in history_message:
+ if isinstance(message.content, str):
+ message.content = re.sub(r".*?", "", message.content, flags=re.DOTALL)
+ return history_message
+
+ def _build_system_prompt(self) -> str:
+ return "你是一个专业的意图识别助手,请根据用户输入和意图选项,准确识别用户的真实意图。"
+
+ def _build_classification_prompt(self, user_input: str, branch: List[Dict]) -> str:
+ classification_list = []
+ other_branch = self._find_other_branch(branch)
+ if other_branch:
+ classification_list.append({"classificationId": 0, "content": other_branch.get("content")})
+ classification_id = 1
+ for b in branch:
+ if not b.get("isOther"):
+ classification_list.append({"classificationId": classification_id, "content": b["content"]})
+ classification_id += 1
+
+ return PROMPT_TEMPLATE.format(classification_list=classification_list, user_input=user_input)
+
+ def _generate_message_list(self, system: str, prompt: str, history_message):
+ if system is None or len(system) == 0:
+ return [*history_message, HumanMessage(self.workflow_manage.generate_prompt(prompt))]
+ else:
+ return [
+ SystemMessage(self.workflow_manage.generate_prompt(system)),
+ *history_message,
+ HumanMessage(self.workflow_manage.generate_prompt(prompt)),
+ ]
+
+ def _parse_classification_result(self, result: str, branch: List[Dict]) -> Dict[str, Any]:
+ other_branch = self._find_other_branch(branch)
+ normal_intents = [b for b in branch if not b.get("isOther")]
+
+ def get_branch_by_id(category_id: int):
+ if category_id == 0:
+ return other_branch
+ elif 1 <= category_id <= len(normal_intents):
+ return normal_intents[category_id - 1]
+ return None
+
+ try:
+ result_json = json.loads(result)
+ classification_id = result_json.get("classificationId")
+ matched_branch = get_branch_by_id(classification_id)
+ if matched_branch:
+ return matched_branch
+ except Exception as e:
+ numbers = re.findall(r'"classificationId":\s*(\d+)', result)
+ if numbers:
+ classification_id = int(numbers[0])
+ matched_branch = get_branch_by_id(classification_id)
+ if matched_branch:
+ return matched_branch
+
+ return other_branch or (normal_intents[0] if normal_intents else {"id": "unknown", "content": "unknown"})
+
+ def _parse_result_reason(self, result: str):
+ try:
+ result_json = json.loads(result)
+ return result_json.get("reason", "")
+ except Exception as e:
+ reason_patterns = [
+ r'"reason":\s*"([^"]*)"',
+ r'"reason":\s*"([^"]*)',
+ r'"reason":\s*([^,}\n]*)',
+ ]
+ for pattern in reason_patterns:
+ match = re.search(pattern, result, re.DOTALL)
+ if match:
+ reason = match.group(1).strip()
+ reason = re.sub(r'["\s]*$', "", reason)
+ return reason
+ return ""
+
+ def _find_other_branch(self, branch: List[Dict]) -> Dict[str, Any] | None:
+ for b in branch:
+ if b.get("isOther"):
+ return b
+ return None
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "user_input": self.get_context("user_input"),
+ "answer": self.get_context("answer"),
+ "branch_id": self.get_context("branch_id"),
+ "category": self.get_context("category"),
+ "reason": self.get_context("reason"),
+ "message_tokens": self.get_context("message_tokens"),
+ "answer_tokens": self.get_context("answer_tokens"),
+ }
+ )
+ return details
diff --git a/apps/application/flow/step_node/intent_node/impl/prompt_template.py b/apps/application/workflow/nodes/intent_node/prompt_template.py
similarity index 100%
rename from apps/application/flow/step_node/intent_node/impl/prompt_template.py
rename to apps/application/workflow/nodes/intent_node/prompt_template.py
diff --git a/apps/application/workflow/nodes/knowledge_write_node/__init__.py b/apps/application/workflow/nodes/knowledge_write_node/__init__.py
new file mode 100644
index 00000000000..e81dda631fb
--- /dev/null
+++ b/apps/application/workflow/nodes/knowledge_write_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/11
+@desc: 知识库写入节点
+"""
+
+from .knowledge_write_node import KnowledgeWriteNode
diff --git a/apps/application/workflow/nodes/knowledge_write_node/knowledge_write_node.py b/apps/application/workflow/nodes/knowledge_write_node/knowledge_write_node.py
new file mode 100644
index 00000000000..1a10e33558f
--- /dev/null
+++ b/apps/application/workflow/nodes/knowledge_write_node/knowledge_write_node.py
@@ -0,0 +1,392 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: knowledge_write_node.py
+@date: 2026/9/11
+@desc: 知识库写入节点:把上游产出的文档/段落写入知识库并触发向量化
+"""
+
+from functools import reduce
+from typing import Any, Dict, List
+
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+from django.db.models.aggregates import Max
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from common.chunk import text_to_chunk
+from common.utils.common import bulk_create_in_batches, filter_special_character
+from knowledge.models import (
+ ContentOrigin,
+ Document,
+ DocumentResourceType,
+ DocumentTag,
+ File,
+ FileSourceType,
+ KnowledgeType,
+ Paragraph,
+ Problem,
+ ProblemParagraphMapping,
+ Tag,
+)
+from knowledge.serializers.common import ProblemParagraphManage, ProblemParagraphObject
+from knowledge.serializers.document import DocumentSerializers
+from knowledge.serializers.document_strategy import DocumentStrategySerializer
+from knowledge.services.document_strategy import (
+ document_source_hash,
+ normalize_document_strategy,
+ strategy_hashes,
+)
+from knowledge.services.incremental_sync import prepare_remote_paragraphs
+
+
+class ParagraphInstanceSerializer(serializers.Serializer):
+ content = serializers.CharField(
+ required=True, label=_("content"), max_length=102400, min_length=1, allow_null=True, allow_blank=True
+ )
+ title = serializers.CharField(
+ required=False, max_length=256, label=_("section title"), allow_null=True, allow_blank=True
+ )
+ problem_list = serializers.ListField(required=False, child=serializers.CharField(required=False, allow_blank=True))
+ is_active = serializers.BooleanField(required=False, label=_("Is active"))
+ chunks = serializers.ListField(required=False, child=serializers.CharField(required=True))
+
+
+class TagInstanceSerializer(serializers.Serializer):
+ key = serializers.CharField(required=True, max_length=64, label=_("Tag Key"))
+ value = serializers.CharField(required=True, max_length=128, label=_("Tag Value"))
+
+
+class KnowledgeWriteParamSerializer(serializers.Serializer):
+ name = serializers.CharField(
+ required=True, label=_("document name"), max_length=128, min_length=1, source=_("document name")
+ )
+ meta = serializers.DictField(required=False)
+ tags = serializers.ListField(required=False, label=_("Tags"), child=TagInstanceSerializer())
+ paragraphs = ParagraphInstanceSerializer(required=False, many=True, allow_null=True)
+ source_file_id = serializers.UUIDField(required=False, allow_null=True)
+ user_id = serializers.UUIDField(required=False, allow_null=True)
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
+
+
+class KnowledgeWriteNodeParamSerializer(serializers.Serializer):
+ document_list = serializers.ListField(
+ required=True, child=serializers.CharField(required=True), allow_null=True, label=_("document list")
+ )
+
+
+def convert_uuid_to_str(obj):
+ if isinstance(obj, dict):
+ return {k: convert_uuid_to_str(v) for k, v in obj.items()}
+ elif isinstance(obj, list):
+ return [convert_uuid_to_str(i) for i in obj]
+ elif isinstance(obj, uuid.UUID):
+ return str(obj)
+ else:
+ return obj
+
+
+def link_file(source_file_id, document_id):
+ if source_file_id is None:
+ return
+ source_file = QuerySet(File).filter(id=source_file_id).first()
+ if source_file:
+ file_content = source_file.get_bytes()
+
+ new_file = File(
+ id=uuid.uuid7(),
+ file_name=source_file.file_name,
+ file_size=source_file.file_size,
+ source_type=FileSourceType.DOCUMENT,
+ source_id=document_id, # 更新为当前知识库ID
+ meta=source_file.meta.copy() if source_file.meta else {},
+ )
+
+ # 保存文件内容和元数据
+ new_file.save(file_content)
+
+
+def get_paragraph_problem_model(knowledge_id: str, document_id: str, instance: Dict):
+ content = filter_special_character(instance.get("content"))
+ paragraph = Paragraph(
+ id=uuid.uuid7(),
+ document_id=document_id,
+ content=content,
+ knowledge_id=knowledge_id,
+ title=instance.get("title") if "title" in instance else "",
+ chunks=[
+ filter_special_character(c)
+ for c in (
+ instance.get("chunks")
+ if "chunks" in instance
+ else text_to_chunk(content, instance.get("child_length", 256))
+ )
+ ],
+ origin=instance.get("origin", ContentOrigin.SYNCED),
+ source_key=instance.get("source_key", ""),
+ source_hash=instance.get("source_hash", ""),
+ source_snapshot=instance.get("source_snapshot")
+ or {
+ "title": instance.get("title") or "",
+ "content": content,
+ },
+ source_updated_at=instance.get("source_updated_at"),
+ )
+
+ problem_paragraph_object_list = [
+ ProblemParagraphObject(knowledge_id, document_id, str(paragraph.id), problem)
+ for problem in (instance.get("problem_list") if "problem_list" in instance else [])
+ ]
+
+ return {
+ "paragraph": paragraph,
+ "problem_paragraph_object_list": problem_paragraph_object_list,
+ }
+
+
+def get_paragraph_model(document_model, paragraph_list: List):
+ knowledge_id = document_model.knowledge_id
+ paragraph_model_dict_list = [
+ get_paragraph_problem_model(knowledge_id, document_model.id, paragraph) for paragraph in paragraph_list
+ ]
+
+ paragraph_model_list = []
+ problem_paragraph_object_list = []
+ for paragraphs in paragraph_model_dict_list:
+ paragraph = paragraphs.get("paragraph")
+ for problem_model in paragraphs.get("problem_paragraph_object_list"):
+ problem_paragraph_object_list.append(problem_model)
+ paragraph_model_list.append(paragraph)
+
+ return {
+ "document": document_model,
+ "paragraph_model_list": paragraph_model_list,
+ "problem_paragraph_object_list": problem_paragraph_object_list,
+ }
+
+
+def get_document_paragraph_model(knowledge_id: str, instance: Dict):
+ source_meta = {"source_file_id": instance.get("source_file_id")} if instance.get("source_file_id") else {}
+ meta = {**instance.get("meta"), **source_meta} if instance.get("meta") is not None else source_meta
+ meta = {**convert_uuid_to_str(meta), "allow_download": True}
+
+ strategy = normalize_document_strategy(instance.get("doc_strategy"))
+ normalized_paragraphs = prepare_remote_paragraphs(
+ [
+ {
+ **paragraph,
+ "content": filter_special_character(paragraph.get("content")),
+ "origin": ContentOrigin.SYNCED,
+ "child_length": strategy["split"]["child_length"],
+ }
+ for paragraph in instance.get("paragraphs", [])
+ ]
+ )
+ document_model = Document(
+ **{
+ "knowledge_id": knowledge_id,
+ "id": uuid.uuid7(),
+ "name": instance.get("name"),
+ "char_length": reduce(lambda x, y: x + y, [len(p.get("content")) for p in normalized_paragraphs], 0),
+ "meta": meta,
+ "type": instance.get("type") if instance.get("type") is not None else KnowledgeType.WORKFLOW,
+ "resource_type": DocumentResourceType.DOCUMENT,
+ "doc_strategy": strategy,
+ "source_hash": document_source_hash(normalized_paragraphs),
+ "user_id": instance.get("user_id"),
+ **strategy_hashes(strategy),
+ }
+ )
+
+ return get_paragraph_model(document_model, normalized_paragraphs)
+
+
+def save_knowledge_tags(knowledge_id: str, tags: List[Dict[str, Any]]):
+ existed_tags_dict = {
+ (key, value): str(tag_id)
+ for key, value, tag_id in QuerySet(Tag).filter(knowledge_id=knowledge_id).values_list("key", "value", "id")
+ }
+
+ tag_model_list = []
+ new_tag_dict = {}
+ for tag in tags:
+ key = tag.get("key")
+ value = tag.get("value")
+
+ if (key, value) not in existed_tags_dict:
+ tag_model = Tag(id=uuid.uuid7(), knowledge_id=knowledge_id, key=key, value=value)
+ tag_model_list.append(tag_model)
+ new_tag_dict[(key, value)] = str(tag_model.id)
+
+ if tag_model_list:
+ Tag.objects.bulk_create(tag_model_list)
+
+ all_tag_dict = {**existed_tags_dict, **new_tag_dict}
+
+ return all_tag_dict, new_tag_dict
+
+
+def batch_add_document_tag(document_tag_map: Dict[str, List[str]]):
+ """
+ 批量添加文档-标签关联
+ document_tag_map: {document_id: [tag_id1, tag_id2, ...]}
+ """
+ all_document_ids = list(document_tag_map.keys())
+ all_tag_ids = list(set(tag_id for tag_ids in document_tag_map.values() for tag_id in tag_ids))
+
+ # 查询已存在的文档-标签关联
+ existed_relations = set(
+ QuerySet(DocumentTag)
+ .filter(document_id__in=all_document_ids, tag_id__in=all_tag_ids)
+ .values_list("document_id", "tag_id")
+ )
+
+ new_relations = [
+ DocumentTag(
+ id=uuid.uuid7(),
+ document_id=doc_id,
+ tag_id=tag_id,
+ )
+ for doc_id, tag_ids in document_tag_map.items()
+ for tag_id in tag_ids
+ if (doc_id, tag_id) not in existed_relations
+ ]
+
+ if new_relations:
+ QuerySet(DocumentTag).bulk_create(new_relations)
+
+
+class KnowledgeWriteNode(INode):
+ serializer_class = KnowledgeWriteNodeParamSerializer
+ supported_workflow_type_list = [WorkflowType.KNOWLEDGE]
+ type = "knowledge-write-node"
+
+ def save(self, document_list, user_id):
+ serializer = KnowledgeWriteParamSerializer(data=document_list, many=True)
+ serializer.is_valid(raise_exception=True)
+ document_list = serializer.data
+
+ workflow_params = self.get_workflow_parameters()
+ knowledge_id = workflow_params.get("knowledge_id")
+ workspace_id = workflow_params.get("workspace_id")
+
+ document_model_list = []
+ paragraph_model_list = []
+ problem_paragraph_object_list = []
+ # 文档标签映射关系
+ document_tags_map = {}
+ knowledge_tag_dict = {}
+
+ for document in document_list:
+ document["user_id"] = user_id
+ document_paragraph_dict_model = get_document_paragraph_model(knowledge_id, document)
+ document_instance = document_paragraph_dict_model.get("document")
+ link_file(document.get("source_file_id"), document_instance.id)
+ document_model_list.append(document_instance)
+ # 收集标签
+ single_document_tag_list = document.get("tags", [])
+ # 去重传入的标签
+ for tag in single_document_tag_list:
+ tag_key = (tag["key"], tag["value"])
+ if tag_key not in knowledge_tag_dict:
+ knowledge_tag_dict[tag_key] = tag
+
+ if single_document_tag_list:
+ document_tags_map[str(document_instance.id)] = single_document_tag_list
+
+ for paragraph in document_paragraph_dict_model.get("paragraph_model_list"):
+ paragraph_model_list.append(paragraph)
+ for problem_paragraph_object in document_paragraph_dict_model.get("problem_paragraph_object_list"):
+ problem_paragraph_object_list.append(problem_paragraph_object)
+ knowledge_tag_list = list(knowledge_tag_dict.values())
+ # 保存所有文档中含有的标签到知识库
+ if knowledge_tag_list:
+ all_tag_dict, new_tag_dict = save_knowledge_tags(knowledge_id, knowledge_tag_list)
+ # 构建文档-标签ID映射
+ document_tag_id_map = {}
+ # 为每个文档添加其对应的标签
+ for doc_id, doc_tags in document_tags_map.items():
+ doc_tag_ids = [
+ all_tag_dict[(tag.get("key"), tag.get("value"))]
+ for tag in doc_tags
+ if (tag.get("key"), tag.get("value")) in all_tag_dict
+ ]
+ if doc_tag_ids:
+ document_tag_id_map[doc_id] = doc_tag_ids
+ if document_tag_id_map:
+ batch_add_document_tag(document_tag_id_map)
+
+ problem_model_list, problem_paragraph_mapping_list = ProblemParagraphManage(
+ problem_paragraph_object_list, knowledge_id
+ ).to_problem_model_list()
+
+ QuerySet(Document).bulk_create(document_model_list) if len(document_model_list) > 0 else None
+
+ if len(paragraph_model_list) > 0:
+ for document in document_model_list:
+ max_position = (
+ Paragraph.objects.filter(document_id=document.id).aggregate(max_position=Max("position"))[
+ "max_position"
+ ]
+ or 0
+ )
+ sub_list = [p for p in paragraph_model_list if p.document_id == document.id]
+ for i, paragraph in enumerate(sub_list):
+ paragraph.position = max_position + i + 1
+ QuerySet(Paragraph).bulk_create(sub_list if len(sub_list) > 0 else [])
+
+ bulk_create_in_batches(Problem, problem_model_list, batch_size=1000)
+
+ bulk_create_in_batches(ProblemParagraphMapping, problem_paragraph_mapping_list, batch_size=1000)
+
+ return document_model_list, knowledge_id, workspace_id
+
+ @staticmethod
+ def post_embedding(document_model_list, knowledge_id, workspace_id):
+ for document in document_model_list:
+ DocumentSerializers.Operate(
+ data={"knowledge_id": knowledge_id, "document_id": document.id, "workspace_id": workspace_id}
+ ).refresh()
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+ document_reference = node_params.get("document_list") or []
+ documents = (
+ self.workflow_manage.get_reference_field(document_reference[0], document_reference[1:])
+ if document_reference
+ else []
+ )
+ user_id = workflow_params.get("user_id")
+
+ document_model_list, knowledge_id, workspace_id = self.save(documents, user_id)
+ self.post_embedding(document_model_list, knowledge_id, workspace_id)
+
+ write_content_list = [
+ {
+ "name": document.get("name"),
+ "paragraphs": [
+ {
+ "title": p.get("title"),
+ "content": p.get("content"),
+ }
+ for p in document.get("paragraphs")[0:5]
+ ],
+ }
+ for document in documents
+ ]
+ self.write_context("write_content", write_content_list)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "write_content": self.get_context("write_content"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/loop_break_node/__init__.py b/apps/application/workflow/nodes/loop_break_node/__init__.py
new file mode 100644
index 00000000000..8bc0177353d
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_break_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/6 15:00
+ @desc:
+"""
+from .loop_break_node import LoopBreakNode
diff --git a/apps/application/workflow/nodes/loop_break_node/loop_break_node.py b/apps/application/workflow/nodes/loop_break_node/loop_break_node.py
new file mode 100644
index 00000000000..4e19ed8901b
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_break_node/loop_break_node.py
@@ -0,0 +1,55 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: loop_break_node.py
+@date:2026/7/6 15:00
+@desc:
+"""
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.compare import do_assertion
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode, Signal
+from application.workflow.status import Status
+
+
+class ConditionSerializer(serializers.Serializer):
+ compare = serializers.CharField(required=True, label=_("Comparator"))
+ value = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("value"))
+ field = serializers.ListField(required=True, label=_("Fields"))
+
+
+class LoopBreakNodeSerializer(serializers.Serializer):
+ condition = serializers.CharField(required=True, label=_("Condition or|and"))
+ condition_list = ConditionSerializer(many=True)
+
+
+class LoopBreakNode(INode):
+ serializer_class = LoopBreakNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "loop-break-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ condition = node_params.get("condition")
+ condition_list = node_params.get("condition_list", [])
+
+ is_break = do_assertion(self.workflow_manage, condition, condition_list)
+ self.write_context("is_break", is_break)
+
+ if is_break:
+ self.complete(Status.SUCCESS, signal=Signal.BREAK)
+ return
+ self.complete(Status.SUCCESS)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "is_break": self.get_context("is_break"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/loop_continue_node/__init__.py b/apps/application/workflow/nodes/loop_continue_node/__init__.py
new file mode 100644
index 00000000000..a7733ae87d4
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_continue_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/6 15:10
+ @desc:
+"""
+from .loop_continue_node import LoopContinueNode
diff --git a/apps/application/workflow/nodes/loop_continue_node/loop_continue_node.py b/apps/application/workflow/nodes/loop_continue_node/loop_continue_node.py
new file mode 100644
index 00000000000..aabab104314
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_continue_node/loop_continue_node.py
@@ -0,0 +1,55 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: loop_continue_node.py
+@date:2026/7/6 15:10
+@desc:
+"""
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.compare import do_assertion
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode, Signal
+from application.workflow.status import Status
+
+
+class ConditionSerializer(serializers.Serializer):
+ compare = serializers.CharField(required=True, label=_("Comparator"))
+ value = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("value"))
+ field = serializers.ListField(required=True, label=_("Fields"))
+
+
+class LoopContinueNodeSerializer(serializers.Serializer):
+ condition = serializers.CharField(required=True, label=_("Condition or|and"))
+ condition_list = ConditionSerializer(many=True)
+
+
+class LoopContinueNode(INode):
+ serializer_class = LoopContinueNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "loop-continue-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ condition = node_params.get("condition")
+ condition_list = node_params.get("condition_list", [])
+
+ is_continue = do_assertion(self.workflow_manage, condition, condition_list)
+ self.write_context("is_continue", is_continue)
+
+ if is_continue:
+ self.complete(Status.SUCCESS, signal=Signal.CONTINUE)
+ return
+ self.complete(Status.SUCCESS)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "is_continue": self.get_context("is_continue"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/loop_node/__init__.py b/apps/application/workflow/nodes/loop_node/__init__.py
new file mode 100644
index 00000000000..826ece19728
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/2 10:00
+ @desc:
+"""
+from .loop_node import LoopNode
diff --git a/apps/application/workflow/nodes/loop_node/loop_node.py b/apps/application/workflow/nodes/loop_node/loop_node.py
new file mode 100644
index 00000000000..c33e4449bcf
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_node/loop_node.py
@@ -0,0 +1,226 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: loop_node.py
+@date:2026/7/2 10:00
+@desc:
+"""
+
+import time
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType, new_instance
+from application.workflow.i_node import INode, Signal
+from application.workflow.message.struct.content import Position
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+
+MAX_LOOP_COUNT = 500
+
+
+class LoopNodeSerializer(serializers.Serializer):
+ loop_type = serializers.CharField(required=True, label=_("loop_type"))
+ array = serializers.ListField(required=False, allow_null=True, label=_("array"))
+ number = serializers.IntegerField(required=False, allow_null=True, label=_("number"))
+ loop_body = serializers.DictField(required=True, label="循环体")
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ loop_type = self.data.get("loop_type")
+ if loop_type == "ARRAY":
+ array = self.data.get("array")
+ if array is None or len(array) == 0:
+ message = _("{field}, this field is required.", field="array")
+ raise AppApiException(500, message)
+ elif loop_type == "NUMBER":
+ number = self.data.get("number")
+ if number is None:
+ message = _("{field}, this field is required.", field="number")
+ raise AppApiException(500, message)
+
+
+def _generate_loop_number(number, start_index=0):
+ return iter([(i, i) for i in range(start_index, number)])
+
+
+def _generate_loop_array(array, start_index=0):
+ return iter([(item, i) for i, item in enumerate(array) if i >= start_index])
+
+
+def _generate_while_loop(number, start_index=0):
+ return iter([(i, i) for i in range(start_index, number)])
+
+
+class LoopNode(INode):
+ serializer_class = LoopNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "loop-node"
+ _workflow_params = None
+ _iterator = None
+
+ def _run(self):
+ self.execute()
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ loop_type = node_params.get("loop_type")
+ array = node_params.get("array")
+ number = node_params.get("number")
+ loop_body = node_params.get("loop_body")
+
+ # 从 position 获取 start_index
+ position = workflow_params.get("position") or {}
+ start_index = position.get("index") or 0 if position.get("id") == self.node.id else 0
+
+ if loop_type == "ARRAY" and isinstance(array, list) and len(array) >= 2:
+ array = self.workflow_manage.get_reference_field(array[0], array[1:])
+
+ self.data["params"] = {"loop_type": loop_type, "array": array, "number": number}
+
+ # 根据 start_index 构建迭代器
+ if loop_type == "ARRAY":
+ iterator = _generate_loop_array(array, start_index=start_index)
+ elif loop_type == "LOOP":
+ iterator = _generate_while_loop(number or MAX_LOOP_COUNT, start_index=start_index)
+ else:
+ iterator = _generate_loop_number(number, start_index=start_index)
+ self._workflow_params = workflow_params
+ self.data["loop_body"] = loop_body
+ self._iterator = iterator
+
+ self._run_next()
+
+ def _run_next(self):
+ try:
+ item, index = next(self._iterator)
+ except StopIteration:
+ self.data["run_time"] = time.time() - self.data.get("start_time", time.time())
+ self.complete(Status.SUCCESS)
+ return
+ workflow = new_instance(self.data["loop_body"], self.get_workflow_type())
+
+ chunk_list = []
+
+ def on_next(wf_manage, content):
+ chunk_list.append(content)
+ content.position = Position(self.get_node_id(), index, content.position)
+ self.write(content)
+
+ def on_complete(wf_manage, error):
+ loop_details_list = self.data.setdefault("loop_details_list", [])
+ loop_details_list.append(wf_manage.get_details())
+ self.write_context("index", index)
+ self.write_context("item", item)
+ last_context = self.workflow_manage.get_context(self.node.id, "last_context")
+ if last_context:
+ self.write_context("last_context", {**last_context, **wf_manage.context})
+ else:
+ self.write_context("last_context", wf_manage.context)
+
+ if wf_manage.signal == Signal.BREAK or wf_manage.signal == Signal.FORM:
+ self.data["run_time"] = time.time() - self.data.get("start_time", time.time())
+ self.complete(Status.SUCCESS)
+ return
+
+ if wf_manage.signal == Signal.CONTINUE:
+ self._run_next()
+ return
+
+ if error:
+ self.write_context("error_message", str(error))
+ self.complete(Status.FAIL, error=error)
+ return
+
+ self._run_next()
+
+ from application.workflow.workflow_manage import CallBack
+ from application.workflow.loop_workflow_manage import LoopWorkFlowManage
+ from application.workflow.nodes import get_node_class
+
+ call_back = CallBack(on_next, on_complete)
+
+ loop_start_class = get_node_class("loop-start-node", self.get_workflow_type())
+
+ # 获取 position,当前 index 和 position.index 一致时传入 children
+ position = self._workflow_params.get("position") or {}
+ child_position = None
+ if position.get("id") == self.node.id and position.get("index") == index:
+ child_position = position.get("children")
+
+ def get_start_node_fn(wf, wf_manage):
+ # 如果有 child_position,从指定节点开始
+ if child_position and child_position.get("id"):
+ node_id = child_position.get("id")
+ node = wf.get_node(node_id)
+ if node:
+ node_class = get_node_class(node.type, self.get_workflow_type())
+ return node_class(node, wf_manage, lambda n: n.properties.get("node_data", {}))
+
+ # 默认从 loop-start-node 开始
+ start_node = wf.get_node("loop-start-node")
+ return loop_start_class(start_node, wf_manage, lambda n: n.properties.get("node_data", {}))
+
+ def get_context():
+ last_context = self.workflow_manage.get_context(self.node.id, "last_context") or {}
+ if last_context:
+ return last_context
+ return {}
+
+ # 构建子工作流参数,第一次迭代传入 child_position
+ loop_workflow_params = dict(self._workflow_params)
+ if child_position:
+ loop_workflow_params["position"] = child_position
+ else:
+ loop_workflow_params.pop("position", None)
+ loop_workflow_params["index"] = index
+ loop_workflow_params["item"] = item
+ loop_manage = LoopWorkFlowManage.from_context(
+ workflow=workflow,
+ parameters=loop_workflow_params,
+ workflow_type=self.get_workflow_type(),
+ call_back=call_back,
+ get_start_node=get_start_node_fn,
+ parent_workflow_manage=self.workflow_manage,
+ get_context=get_context,
+ )
+ loop_manage.run()
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {"params": self.data.get("params"), "index": self.get_context("index"), "item": self.get_context("item")}
+ )
+ loop_details = []
+ position_index = 0
+ loop_position_index = 0
+ if old_details and position:
+ for index, item in enumerate(old_details.get("children") or []):
+ loop_position_index = index
+ loop_details.append(item)
+ current_details = loop_details[loop_position_index]
+ for index, value in enumerate(current_details):
+ if position.get("children").get("id") == value.get("node_id"):
+ position_index = index
+
+ for index, _loop_details in enumerate(self.data.get("loop_details_list")):
+ if position and index == 0:
+ for inner_index, item in enumerate(_loop_details):
+ if position is not None and inner_index == 0 and index == 0:
+ loop_details[loop_position_index][position_index] = item
+ else:
+ _child = []
+ if len(loop_details) > loop_position_index:
+ _child = loop_details[loop_position_index]
+ else:
+ loop_details.insert(loop_position_index, _child)
+ _child.append(item)
+ else:
+ loop_details.append(_loop_details)
+
+ details["children"] = loop_details
+ return details
diff --git a/apps/application/workflow/nodes/loop_start_node/__init__.py b/apps/application/workflow/nodes/loop_start_node/__init__.py
new file mode 100644
index 00000000000..7d1dbb5f046
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_start_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/2 10:00
+ @desc:
+"""
+from .loop_start_node import LoopStartNode
diff --git a/apps/application/workflow/nodes/loop_start_node/loop_start_node.py b/apps/application/workflow/nodes/loop_start_node/loop_start_node.py
new file mode 100644
index 00000000000..d0b25af9188
--- /dev/null
+++ b/apps/application/workflow/nodes/loop_start_node/loop_start_node.py
@@ -0,0 +1,47 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: loop_start_node.py
+@date:2026/7/2 10:00
+@desc:
+"""
+
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+
+
+class LoopStartNodeSerializer(serializers.Serializer):
+ pass
+
+
+class LoopStartNode(INode):
+ serializer_class = LoopStartNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "loop-start-node"
+
+ def execute(self):
+ loop = self.workflow_manage.context.get("loop")
+ if loop is None:
+ self.write_context("loop", {})
+ parameters = self.workflow_manage.get_parameters()
+ if parameters is not None:
+ index = parameters.get("index", 0)
+ item = parameters.get("item", 0)
+ self.write_context("index", index)
+ self.write_context("item", item)
+ else:
+ self.write_context("index", 0)
+ self.write_context("item", 0)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "index": self.get_context("index"),
+ "item": self.get_context("item"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/mcp_node/__init__.py b/apps/application/workflow/nodes/mcp_node/__init__.py
new file mode 100644
index 00000000000..cd0b0387c40
--- /dev/null
+++ b/apps/application/workflow/nodes/mcp_node/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .mcp_node import McpNode
diff --git a/apps/application/workflow/nodes/mcp_node/mcp_node.py b/apps/application/workflow/nodes/mcp_node/mcp_node.py
new file mode 100644
index 00000000000..0155d36ee98
--- /dev/null
+++ b/apps/application/workflow/nodes/mcp_node/mcp_node.py
@@ -0,0 +1,101 @@
+# coding=utf-8
+import asyncio
+import json
+from typing import List, Dict, Any
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_mcp_adapters.client import MultiServerMCPClient
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.status import Status
+from common.utils.tool_code import ToolExecutor
+from tools.models import Tool
+
+
+class McpNodeSerializer(serializers.Serializer):
+ mcp_servers = serializers.JSONField(required=True, label=_("Mcp servers"))
+ mcp_server = serializers.CharField(required=True, label=_("Mcp server"))
+ mcp_tool = serializers.CharField(required=True, label=_("Mcp tool"))
+ mcp_tool_id = serializers.CharField(required=False, label=_("Mcp tool"), allow_null=True, allow_blank=True)
+ mcp_source = serializers.CharField(required=False, label=_("Mcp source"), allow_blank=True, allow_null=True)
+ tool_params = serializers.DictField(required=True, label=_("Tool parameters"))
+
+
+class McpNode(INode):
+ serializer_class = McpNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "mcp-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+
+ mcp_servers = node_params.get("mcp_servers")
+ mcp_server = node_params.get("mcp_server")
+ mcp_tool = node_params.get("mcp_tool")
+ mcp_tool_id = node_params.get("mcp_tool_id")
+ mcp_source = node_params.get("mcp_source")
+ tool_params = node_params.get("tool_params", {})
+
+ if mcp_source == "referencing":
+ if not mcp_tool_id:
+ raise ValueError("MCP tool ID is required when mcp_source is 'referencing'.")
+ tool = QuerySet(Tool).filter(id=mcp_tool_id).first()
+ if not tool:
+ raise ValueError(f"Tool with ID {mcp_tool_id} not found.")
+ if not tool.is_active:
+ raise ValueError(f"Tool with ID {mcp_tool_id} is inactive.")
+ servers = json.loads(tool.code)
+ else:
+ servers = json.loads(mcp_servers) if isinstance(mcp_servers, str) else mcp_servers
+
+ servers = self._handle_variables(servers)
+ ToolExecutor().validate_mcp_transport(json.dumps(servers))
+
+ params = json.loads(json.dumps(tool_params))
+ params = self._handle_variables(params)
+
+ self._check_cancelled()
+
+ async def call_tool(t, a):
+ client = MultiServerMCPClient(servers)
+ async with client.session(mcp_server) as s:
+ return await s.call_tool(t, a)
+
+ res = asyncio.run(call_tool(mcp_tool, params))
+ result = [content.text for content in res.content]
+
+ self.write_context("result", result)
+ self.write_context("tool_params", params)
+ self.write_context("mcp_tool", mcp_tool)
+
+ def _handle_variables(self, tool_params: Any) -> Any:
+ if isinstance(tool_params, dict):
+ for k, v in tool_params.items():
+ tool_params[k] = self._handle_variables(v)
+ return tool_params
+ elif isinstance(tool_params, list):
+ if len(tool_params) > 0 and isinstance(tool_params[0], str):
+ return self._get_reference_content(tool_params)
+ return [self._handle_variables(item) for item in tool_params]
+ elif isinstance(tool_params, str):
+ return self.workflow_manage.generate_prompt(tool_params)
+ return tool_params
+
+ def _get_reference_content(self, fields: List[str]) -> Any:
+ if fields:
+ return self.workflow_manage.get_reference_field(fields[0], fields[1:])
+ return None
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "mcp_tool": self.get_context("mcp_tool"),
+ "tool_params": self.get_context("tool_params"),
+ "result": self.get_context("result"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/parameter_extraction_node/__init__.py b/apps/application/workflow/nodes/parameter_extraction_node/__init__.py
new file mode 100644
index 00000000000..e695c85c365
--- /dev/null
+++ b/apps/application/workflow/nodes/parameter_extraction_node/__init__.py
@@ -0,0 +1,7 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @desc:
+"""
+from .parameter_extraction_node import ParameterExtractionNode
diff --git a/apps/application/workflow/nodes/parameter_extraction_node/parameter_extraction_node.py b/apps/application/workflow/nodes/parameter_extraction_node/parameter_extraction_node.py
new file mode 100644
index 00000000000..ce3ea8f63f6
--- /dev/null
+++ b/apps/application/workflow/nodes/parameter_extraction_node/parameter_extraction_node.py
@@ -0,0 +1,173 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: parameter_extraction_node.py
+@desc:
+"""
+
+import json
+import re
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage
+from langchain_core.prompts import PromptTemplate
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id, get_model_credential
+from common.exception.app_exception import AppApiException
+
+prompt = """
+Please strictly process the text according to the following requirements:
+**Task**:
+Extract specified field information from given text
+
+**Enter text**:
+{{question}}
+
+**Extract configuration**:
+{{properties}}
+
+**Rule**:
+- Strictly follow the data and field of Extract configuration
+- If not found, use null value
+- Only return pure JSON without additional text
+- Keep the string format neat
+"""
+
+
+class ParameterExtractionNodeSerializer(serializers.Serializer):
+ input_variable = serializers.ListField(required=True, label=_("input variable"))
+ variable_list = serializers.ListField(required=True, label=_("Split variables"))
+ model_params_setting = serializers.DictField(required=False, label=_("Model parameter settings"))
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _get_default_model_params_setting(model_id):
+ model = QuerySet(Model).filter(id=model_id).first()
+ credential = get_model_credential(model.provider, model.model_type, model.model_name)
+ model_params_setting = credential.get_model_params_setting_form(model.model_name).get_default_form_data()
+ return model_params_setting
+
+
+def _generate_properties(variable_list):
+ return {
+ variable["field"]: {
+ "type": variable["parameter_type"],
+ "description": (variable.get("desc") or ""),
+ "title": variable["label"],
+ }
+ for variable in variable_list
+ }
+
+
+def _generate_example(variable_list):
+ return {variable["field"]: None for variable in variable_list}
+
+
+def _generate_content(input_variable, variable_list):
+ properties = _generate_properties(variable_list)
+ prompt_template = PromptTemplate.from_template(prompt, template_format="jinja2")
+ value = prompt_template.format(properties=properties, question=input_variable)
+ return value
+
+
+def _json_loads(response, variable_list):
+ if not response or not isinstance(response, str):
+ return _generate_example(variable_list)
+
+ cleaned = response.strip()
+
+ extraction_strategies = [
+ lambda: json.loads(cleaned),
+ lambda: json.loads(re.search(r"```(?:json)?\s*(\{.*?\})\s*```", cleaned, re.DOTALL).group(1)),
+ lambda: json.loads(re.search(r"(\{.*\})", cleaned, flags=re.DOTALL).group(1)),
+ ]
+ for strategy in extraction_strategies:
+ try:
+ result = strategy()
+ return result
+ except:
+ continue
+ return _generate_example(variable_list)
+
+
+class ParameterExtractionNode(INode):
+ serializer_class = ParameterExtractionNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "parameter-extraction-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ model_params_setting = node_params.get("model_params_setting")
+ input_variable_ref = node_params.get("input_variable")
+ variable_list = node_params.get("variable_list")
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("LLM") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ if model_params_setting is None and model_id:
+ model_params_setting = _get_default_model_params_setting(model_id)
+
+ workspace_id = workflow_params.get("workspace_id")
+ chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ input_variable = self.workflow_manage.get_reference_field(input_variable_ref[0], input_variable_ref[1:])
+
+ input_variable_str = str(input_variable)
+ self.write_context("request", input_variable_str)
+
+ content = _generate_content(input_variable_str, variable_list)
+ self._check_cancelled()
+ response = chat_model.invoke([HumanMessage(content=content)])
+ result = _json_loads(response.content, variable_list)
+
+ self.write_context("result", result)
+ for key, value in result.items():
+ self.write_context(key, value)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "request": self.get_context("request"),
+ "result": self.get_context("result"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/question_node/__init__.py b/apps/application/workflow/nodes/question_node/__init__.py
new file mode 100644
index 00000000000..e8ddbf43989
--- /dev/null
+++ b/apps/application/workflow/nodes/question_node/__init__.py
@@ -0,0 +1,7 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @desc:
+"""
+from .question_node import QuestionNode
diff --git a/apps/application/workflow/nodes/question_node/question_node.py b/apps/application/workflow/nodes/question_node/question_node.py
new file mode 100644
index 00000000000..7313a1a9f07
--- /dev/null
+++ b/apps/application/workflow/nodes/question_node/question_node.py
@@ -0,0 +1,170 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: question_node.py
+@desc:
+"""
+
+import re
+from functools import reduce
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage, SystemMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id, get_model_credential
+
+
+class QuestionNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ system = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Role Setting"))
+ prompt = serializers.CharField(required=True, label=_("Prompt word"))
+ dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ model_params_setting = serializers.DictField(required=False, label=_("Model parameter settings"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _get_default_model_params_setting(model_id):
+ model = QuerySet(Model).filter(id=model_id).first()
+ credential = get_model_credential(model.provider, model.model_type, model.model_name)
+ model_params_setting = credential.get_model_params_setting_form(model.model_name).get_default_form_data()
+ return model_params_setting
+
+
+def _get_history_message(history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [*history_chat_record[index].get_human_message(), *history_chat_record[index].get_ai_message()]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ for message in history_message:
+ if isinstance(message.content, str):
+ message.content = re.sub(r".*?", "", message.content, flags=re.DOTALL)
+ return history_message
+
+
+class QuestionNode(INode):
+ serializer_class = QuestionNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "question-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ model_params_setting = node_params.get("model_params_setting")
+ system = node_params.get("system", "")
+ prompt = node_params.get("prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ is_result = node_params.get("is_result", False)
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("LLM") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ if model_params_setting is None and model_id:
+ model_params_setting = _get_default_model_params_setting(model_id)
+
+ chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message = _get_history_message(history_chat_record, dialogue_number)
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message or [])],
+ )
+
+ question = HumanMessage(self.workflow_manage.generate_prompt(prompt))
+ self.write_context("question", question.content)
+
+ system = self.workflow_manage.generate_prompt(system)
+ self.write_context("system", system)
+
+ if system and len(system) > 0:
+ message_list = [SystemMessage(system), *history_message, question]
+ else:
+ message_list = [*history_message, question]
+ self.write_context(
+ "message_list",
+ [{"content": m.content, "role": m.type} for m in message_list],
+ )
+
+ response = chat_model.stream(message_list)
+ answer = ""
+
+ for chunk in response:
+ self._check_cancelled()
+ answer += chunk.content
+
+ message_tokens = chat_model.get_num_tokens_from_messages(message_list)
+ answer_tokens = chat_model.get_num_tokens(answer)
+ self.write_context("message_tokens", message_tokens)
+ self.write_context("answer_tokens", answer_tokens)
+ self.write_context("answer", answer)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(TextContent(self.get_node_id(), answer, Status.SUCCESS, node_info, Position(self.get_node_id())))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "system": self.get_context("system"),
+ "message_tokens": self.get_context("message_tokens"),
+ "answer_tokens": self.get_context("answer_tokens"),
+ "history_message": self.get_context("history_message"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/reply_node/__init__.py b/apps/application/workflow/nodes/reply_node/__init__.py
new file mode 100644
index 00000000000..5bdd7388bc7
--- /dev/null
+++ b/apps/application/workflow/nodes/reply_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/2 10:00
+ @desc:
+"""
+from .reply_node import ReplyNode
diff --git a/apps/application/workflow/nodes/reply_node/reply_node.py b/apps/application/workflow/nodes/reply_node/reply_node.py
new file mode 100644
index 00000000000..f40b8f53373
--- /dev/null
+++ b/apps/application/workflow/nodes/reply_node/reply_node.py
@@ -0,0 +1,71 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: reply_node.py
+@date:2026/7/2 10:00
+@desc:
+"""
+
+from typing import List
+import uuid_utils.compat as uuid
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+
+
+class ReplyNodeSerializer(serializers.Serializer):
+ reply_type = serializers.CharField(required=True, label=_("Response Type"))
+ fields = serializers.ListField(required=False, label=_("Reference Field"))
+ content = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Direct answer content"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+
+
+class ReplyNode(INode):
+ serializer_class = ReplyNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "reply-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ chunk_id = uuid.uuid7()
+
+ reply_type = node_params.get("reply_type")
+ fields = node_params.get("fields")
+ content = node_params.get("content")
+ is_result = node_params.get("is_result", False)
+
+ if reply_type == "referencing":
+ result = self._get_reference_content(fields)
+ else:
+ result = self._generate_reply_content(content)
+
+ self.write_context("answer", result)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(TextContent(str(chunk_id), result, Status.SUCCESS, node_info, Position(self.get_node_id())))
+
+ def _generate_reply_content(self, prompt):
+ if prompt is None:
+ return ""
+ return self.workflow_manage.generate_prompt(prompt)
+
+ def _get_reference_content(self, fields: List[str]):
+ if fields and len(fields) >= 2:
+ return str(self.workflow_manage.get_reference_field(fields[0], fields[1:]))
+ return ""
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "answer": self.get_context("answer"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/reranker_node/__init__.py b/apps/application/workflow/nodes/reranker_node/__init__.py
new file mode 100644
index 00000000000..e6adc8ee183
--- /dev/null
+++ b/apps/application/workflow/nodes/reranker_node/__init__.py
@@ -0,0 +1,7 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @desc:
+"""
+from .reranker_node import RerankerNode
diff --git a/apps/application/workflow/nodes/reranker_node/reranker_node.py b/apps/application/workflow/nodes/reranker_node/reranker_node.py
new file mode 100644
index 00000000000..87802a36941
--- /dev/null
+++ b/apps/application/workflow/nodes/reranker_node/reranker_node.py
@@ -0,0 +1,205 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: reranker_node.py
+@desc:
+"""
+
+from typing import List
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.documents import Document
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from common.exception.app_exception import AppApiException
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+
+
+class RerankerSettingSerializer(serializers.Serializer):
+ top_n = serializers.IntegerField(required=True, label=_("Reference segment number"))
+ similarity = serializers.FloatField(required=True, max_value=2, min_value=0, label=_("Reference segment number"))
+ max_paragraph_char_number = serializers.IntegerField(
+ required=True, label=_("Maximum number of words in a quoted segment")
+ )
+
+
+class RerankerNodeSerializer(serializers.Serializer):
+ reranker_setting = RerankerSettingSerializer(required=True)
+ question_reference_address = serializers.ListField(required=True)
+ reranker_model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True)
+ reranker_model_id_type = serializers.CharField(required=False, default="custom")
+ reranker_model_id_reference = serializers.ListField(required=False, child=serializers.CharField(), allow_empty=True)
+ reranker_reference_list = serializers.ListField(required=True, child=serializers.ListField(required=True))
+ show_knowledge = serializers.BooleanField(
+ required=True, label=_("The results are displayed in the knowledge sources")
+ )
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("reranker_model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("reranker_model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _merge_reranker_list(reranker_list, result=None):
+ if result is None:
+ result = []
+ for document in reranker_list:
+ if isinstance(document, list):
+ _merge_reranker_list(document, result)
+ elif isinstance(document, dict):
+ content = document.get("title", "") + document.get("content", "")
+ title = document.get("title")
+ result.append(
+ Document(
+ page_content=str(document) if len(content) == 0 else content, metadata={"title": title, **document}
+ )
+ )
+ else:
+ result.append(Document(page_content=str(document), metadata={}))
+ return result
+
+
+def _filter_result(document_list: List[Document], max_paragraph_char_number, top_n, similarity):
+ use_len = 0
+ result = []
+ for index in range(len(document_list)):
+ document = document_list[index]
+ if (
+ use_len >= max_paragraph_char_number
+ or index >= top_n
+ or document.metadata.get("relevance_score") < similarity
+ ):
+ break
+ content = document.page_content[0 : max_paragraph_char_number - use_len]
+ use_len = use_len + len(content)
+ result.append({"page_content": content, "metadata": document.metadata})
+ return result
+
+
+def _reset_result_list(result_list: List[Document], document_list: List[Document]):
+ r = []
+ document_list = document_list.copy()
+ for result in result_list:
+ filter_result_list = [document for document in document_list if document.page_content == result.page_content]
+ if len(filter_result_list) > 0:
+ item = filter_result_list[0]
+ document_list.remove(item)
+ r.append(
+ Document(
+ page_content=item.page_content,
+ metadata={**item.metadata, "relevance_score": result.metadata.get("relevance_score")},
+ )
+ )
+ else:
+ r.append(result)
+ return r
+
+
+def _reset_metadata(metadata):
+ meta = metadata.get("meta")
+ if isinstance(metadata.get("meta"), dict):
+ if not meta.get("allow_download", False):
+ metadata["meta"] = {"allow_download": False}
+ return metadata
+
+
+class RerankerNode(INode):
+ serializer_class = RerankerNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.TOOL]
+ type = "reranker-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ question_ref = node_params.get("question_reference_address")
+ reranker_reference_list = node_params.get("reranker_reference_list")
+ reranker_setting = node_params.get("reranker_setting")
+ reranker_model_id = node_params.get("reranker_model_id")
+ reranker_model_id_type = node_params.get("reranker_model_id_type", "custom")
+ reranker_model_id_reference = node_params.get("reranker_model_id_reference")
+ show_knowledge = node_params.get("show_knowledge", False)
+
+ question = self.workflow_manage.get_reference_field(question_ref[0], question_ref[1:])
+ question = str(question)
+
+ reranker_list = [self.workflow_manage.get_reference_field(ref[0], ref[1:]) for ref in reranker_reference_list]
+
+ if reranker_model_id_type == "reference" and reranker_model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ reranker_model_id_reference[0],
+ reranker_model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ reranker_model_id = reference_data.get(
+ "reranker_model_id", reference_data.get("model_id", reranker_model_id)
+ )
+
+ if reranker_model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("RERANKER") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ reranker_model_id = default_model_setting.get("model_id", reranker_model_id)
+
+ if not reranker_model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ self.write_context("show_knowledge", show_knowledge)
+
+ documents = _merge_reranker_list(reranker_list)
+ documents = [d for d in documents if d.page_content and len(d.page_content) > 0]
+
+ if len(documents) == 0:
+ self.write_context("document_list", [])
+ self.write_context("question", question)
+ self.write_context("result_list", [])
+ self.write_context("result", "")
+ return
+
+ top_n = reranker_setting.get("top_n", 3)
+ self.write_context(
+ "document_list",
+ [
+ {"page_content": document.page_content, "metadata": _reset_metadata(document.metadata)}
+ for document in documents
+ ],
+ )
+ self.write_context("question", question)
+
+ workspace_id = workflow_params.get("workspace_id")
+ reranker_model = get_model_instance_by_model_workspace_id(reranker_model_id, workspace_id, top_n=top_n)
+
+ self._check_cancelled()
+ result = reranker_model.compress_documents(documents, question)
+
+ similarity = reranker_setting.get("similarity", 0.6)
+ max_paragraph_char_number = reranker_setting.get("max_paragraph_char_number", 5000)
+
+ result = _reset_result_list(result, documents)
+ r = _filter_result(result, max_paragraph_char_number, top_n, similarity)
+
+ self.write_context("result_list", r)
+ self.write_context("result", "".join([item.get("page_content") for item in r]))
+ self.write_context(
+ "is_hit_handling_method_list", [row for row in r if row.get("metadata").get("is_hit_handling_method")]
+ )
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "result_list": self.get_context("result_list"),
+ "result": self.get_context("result"),
+ "document_list": self.get_context("document_list"),
+ "show_knowledge": self.get_context("show_knowledge"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/search_document_node/__init__.py b/apps/application/workflow/nodes/search_document_node/__init__.py
new file mode 100644
index 00000000000..822ff4d9c8d
--- /dev/null
+++ b/apps/application/workflow/nodes/search_document_node/__init__.py
@@ -0,0 +1,7 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @desc:
+"""
+from .search_document_node import SearchDocumentNode
diff --git a/apps/application/workflow/nodes/search_document_node/search_document_node.py b/apps/application/workflow/nodes/search_document_node/search_document_node.py
new file mode 100644
index 00000000000..2424e96390a
--- /dev/null
+++ b/apps/application/workflow/nodes/search_document_node/search_document_node.py
@@ -0,0 +1,265 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: search_document_node.py
+@desc:
+"""
+
+import jieba
+from django.db.models import Q
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from common.utils.shared_resource_auth import filter_authorized_ids
+from knowledge.models import Document, DocumentTag, Knowledge
+from knowledge.services.retrieval_access import filter_workflow_knowledge
+
+
+class SearchDocumentNodeSerializer(serializers.Serializer):
+ knowledge_id_list = serializers.ListField(
+ required=False, child=serializers.UUIDField(required=True), label=_("knowledge id list"), default=list
+ )
+ search_mode = serializers.ChoiceField(
+ required=False, choices=["auto", "custom"], label=_("search mode"), default="auto"
+ )
+ search_scope_type = serializers.ChoiceField(
+ required=False,
+ choices=["custom", "referencing"],
+ label=_("search scope type"),
+ allow_null=True,
+ default="custom",
+ )
+ search_scope_source = serializers.ChoiceField(
+ required=False, choices=["document", "knowledge"], label=_("search scope variable type"), default="knowledge"
+ )
+ search_scope_reference = serializers.ListField(required=False, label=_("search scope variable"), default=list)
+ question_reference = serializers.ListField(required=False, label=_("question reference address"), default=list)
+ search_condition_type = serializers.ChoiceField(
+ required=False, choices=["AND", "OR"], label=_("search condition type"), default="AND"
+ )
+ search_condition_list = serializers.ListField(required=False, label=_("search condition list"), default=list)
+
+
+def _to_jsonable(value):
+ """将 ORM values() 行中的非 JSON 可序列化类型转为可序列化值。"""
+ import datetime
+ import decimal
+ import uuid
+
+ if isinstance(value, (datetime.datetime, datetime.date)):
+ return value.strftime("%Y-%m-%d %H:%M:%S")
+ if isinstance(value, decimal.Decimal):
+ return float(value)
+ if isinstance(value, uuid.UUID):
+ return str(value)
+ if isinstance(value, bytes):
+ return value.decode("utf-8", errors="ignore")
+ if isinstance(value, dict):
+ return {k: _to_jsonable(v) for k, v in value.items()}
+ if isinstance(value, (list, tuple)):
+ return [_to_jsonable(v) for v in value]
+ return value
+
+
+def _serialize_items(rows):
+ """把 ORM values() 列表转成干净的可 JSON 序列化列表。"""
+ return [_to_jsonable(row) for row in rows]
+
+
+def _handle_auto_tags(workflow_manage, document_id_list, question_reference):
+ question = (
+ workflow_manage.get_reference_field(question_reference[0], question_reference[1:]) if question_reference else ""
+ )
+ keywords = jieba.lcut(str(question))
+ if not keywords:
+ return set()
+
+ q_objects = Q()
+ for keyword in keywords:
+ q_objects |= Q(tag__value__icontains=keyword)
+
+ matched_doc_ids = set(
+ QuerySet(DocumentTag)
+ .filter(document_id__in=document_id_list)
+ .filter(q_objects)
+ .values_list("document_id", flat=True)
+ .distinct()
+ )
+ return matched_doc_ids
+
+
+def _handle_custom_tags(workflow_manage, document_id_list, search_condition_list, search_condition_type):
+ if not search_condition_list:
+ return set(document_id_list)
+
+ if search_condition_type == "AND":
+ matched_doc_ids = set(document_id_list)
+ for condition in search_condition_list:
+ tag_key = condition["key"]
+ field_value = workflow_manage.generate_prompt(condition["value"])
+ compare_type = condition["compare"]
+
+ if not field_value or field_value == "None" or len(field_value) == 0:
+ continue
+
+ if compare_type == "not_contain":
+ exclude_docs = set(
+ QuerySet(DocumentTag)
+ .filter(document_id__in=matched_doc_ids, tag__key=tag_key, tag__value__icontains=field_value)
+ .values_list("document_id", flat=True)
+ .distinct()
+ )
+ matched_doc_ids = matched_doc_ids - exclude_docs
+ else:
+ if compare_type == "contain":
+ q_filter = Q(tag__key=tag_key, tag__value__icontains=field_value)
+ elif compare_type == "eq":
+ q_filter = Q(tag__key=tag_key, tag__value=field_value)
+ else:
+ continue
+
+ tag_docs = set(
+ QuerySet(DocumentTag)
+ .filter(document_id__in=matched_doc_ids)
+ .filter(q_filter)
+ .values_list("document_id", flat=True)
+ .distinct()
+ )
+ matched_doc_ids = matched_doc_ids.intersection(tag_docs)
+
+ return matched_doc_ids
+ else:
+ matched_docs = set()
+ for condition in search_condition_list:
+ tag_key = condition["key"]
+ field_value = workflow_manage.generate_prompt(condition["value"])
+ compare_type = condition["compare"]
+
+ if not field_value or field_value == "None" or len(field_value) == 0:
+ continue
+
+ if compare_type == "not_contain":
+ exclude_docs = set(
+ QuerySet(DocumentTag)
+ .filter(document_id__in=document_id_list, tag__key=tag_key, tag__value__icontains=field_value)
+ .values_list("document_id", flat=True)
+ .distinct()
+ )
+ matched_docs = matched_docs.union(set(document_id_list) - exclude_docs)
+ else:
+ if compare_type == "contain":
+ q_filter = Q(tag__key=tag_key, tag__value__icontains=field_value)
+ elif compare_type == "eq":
+ q_filter = Q(tag__key=tag_key, tag__value=field_value)
+ else:
+ continue
+
+ docs = set(
+ QuerySet(DocumentTag)
+ .filter(document_id__in=document_id_list)
+ .filter(q_filter)
+ .values_list("document_id", flat=True)
+ .distinct()
+ )
+ matched_docs = matched_docs.union(docs)
+
+ return matched_docs
+
+
+class SearchDocumentNode(INode):
+ serializer_class = SearchDocumentNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.TOOL]
+ type = "search-document-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ knowledge_id_list = node_params.get("knowledge_id_list", [])
+ search_mode = node_params.get("search_mode", "auto")
+ search_scope_type = node_params.get("search_scope_type", "custom")
+ search_scope_source = node_params.get("search_scope_source", "knowledge")
+ search_scope_reference = node_params.get("search_scope_reference", [])
+ question_reference = node_params.get("question_reference", [])
+ search_condition_type = node_params.get("search_condition_type", "AND")
+ search_condition_list = node_params.get("search_condition_list", [])
+
+ workspace_id = workflow_params.get("workspace_id")
+
+ if search_scope_type == "custom":
+ knowledge_id_list = filter_authorized_ids("knowledge", knowledge_id_list, workspace_id)
+ document_id_list = list(
+ QuerySet(Document).filter(knowledge_id__in=knowledge_id_list).values_list("id", flat=True)
+ )
+ else:
+ if search_scope_source == "document":
+ document_id_list = (
+ self.workflow_manage.get_reference_field(search_scope_reference[0], search_scope_reference[1:])
+ if search_scope_reference
+ else []
+ )
+ else:
+ ref_knowledge_ids = (
+ self.workflow_manage.get_reference_field(search_scope_reference[0], search_scope_reference[1:])
+ if search_scope_reference
+ else []
+ )
+ ref_knowledge_ids = filter_authorized_ids("knowledge", ref_knowledge_ids, workspace_id)
+ document_id_list = list(
+ QuerySet(Document).filter(knowledge_id__in=ref_knowledge_ids).values_list("id", flat=True)
+ )
+
+ actual_knowledge_ids = list(
+ QuerySet(Document)
+ .filter(id__in=document_id_list or [], is_active=True)
+ .values_list("knowledge_id", flat=True)
+ .distinct()
+ )
+ authorized_knowledge_ids = filter_workflow_knowledge(
+ filter_authorized_ids("knowledge", actual_knowledge_ids, workspace_id), workflow_params
+ )
+ document_id_list = list(
+ QuerySet(Document)
+ .filter(id__in=document_id_list or [], knowledge_id__in=authorized_knowledge_ids, is_active=True)
+ .values_list("id", flat=True)
+ )
+
+ if search_mode == "auto":
+ matched_doc_ids = _handle_auto_tags(self.workflow_manage, document_id_list, question_reference)
+ final_document_ids = list(matched_doc_ids)
+ else:
+ matched_document_ids = _handle_custom_tags(
+ self.workflow_manage, document_id_list, search_condition_list, search_condition_type
+ )
+ final_document_ids = list(matched_document_ids)
+
+ final_document_ids = [str(doc_id) for doc_id in final_document_ids]
+ authorized_knowledge_ids = filter_workflow_knowledge(authorized_knowledge_ids, workflow_params)
+ document_items = list(
+ QuerySet(Document)
+ .filter(id__in=final_document_ids, knowledge_id__in=authorized_knowledge_ids, is_active=True)
+ .values()
+ )
+ final_document_ids = [str(doc["id"]) for doc in document_items]
+ final_knowledge_ids = list(set(str(doc["knowledge_id"]) for doc in document_items))
+ knowledge_items = list(QuerySet(Knowledge).filter(id__in=final_knowledge_ids).values())
+
+ self.write_context("document_list", final_document_ids)
+ self.write_context("document_items", _serialize_items(document_items))
+ self.write_context("knowledge_list", final_knowledge_ids)
+ self.write_context("knowledge_items", _serialize_items(knowledge_items))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "document_list": self.get_context("document_list"),
+ "document_items": self.get_context("document_items"),
+ "knowledge_list": self.get_context("knowledge_list"),
+ "knowledge_items": self.get_context("knowledge_items"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/search_knowledge_node/__init__.py b/apps/application/workflow/nodes/search_knowledge_node/__init__.py
new file mode 100644
index 00000000000..2ce5f1602b2
--- /dev/null
+++ b/apps/application/workflow/nodes/search_knowledge_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: __init__.py
+ @date:2026/7/2 10:00
+ @desc:
+"""
+from .search_knowledge_node import SearchKnowledgeNode
diff --git a/apps/application/workflow/nodes/search_knowledge_node/search_knowledge_node.py b/apps/application/workflow/nodes/search_knowledge_node/search_knowledge_node.py
new file mode 100644
index 00000000000..ebcadfd528b
--- /dev/null
+++ b/apps/application/workflow/nodes/search_knowledge_node/search_knowledge_node.py
@@ -0,0 +1,361 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: search_knowledge_node.py
+@date:2026/7/2 10:00
+@desc:
+"""
+
+import os
+import re
+from typing import List, Dict
+
+from django.core import validators
+from django.db import connection
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from common.config.embedding_config import VectorStore
+from common.db.search import native_search
+from common.utils.common import flat_map, get_file_content
+from common.utils.shared_resource_auth import filter_authorized_ids
+from knowledge.models import Document, Paragraph, Knowledge, SearchMode, SourceType
+from knowledge.services.multimodal_retrieval import get_hit_asset_map
+from knowledge.services.retrieval_stats import get_recall_tracker, record_recall_safely
+from knowledge.services.retrieval_access import filter_workflow_knowledge
+from maxkb.conf import PROJECT_DIR
+from models_provider.tools import get_model_instance_by_model_workspace_id
+
+
+class DatasetSettingSerializer(serializers.Serializer):
+ top_n = serializers.IntegerField(required=True, label=_("Reference segment number"))
+ similarity = serializers.FloatField(required=True, max_value=2, min_value=0, label=_("similarity"))
+ search_mode = serializers.CharField(
+ required=True,
+ validators=[
+ validators.RegexValidator(
+ regex=re.compile("^embedding|keywords|blend$"),
+ message=_("The type only supports embedding|keywords|blend"),
+ code=500,
+ )
+ ],
+ label=_("Retrieval Mode"),
+ )
+ max_paragraph_char_number = serializers.IntegerField(
+ required=True, label=_("Maximum number of words in a quoted segment")
+ )
+
+
+class SearchKnowledgeNodeSerializer(serializers.Serializer):
+ knowledge_id_list = serializers.ListField(
+ required=True, child=serializers.UUIDField(required=True), label=_("Dataset id list")
+ )
+ knowledge_setting = DatasetSettingSerializer(required=True)
+ question_reference_address = serializers.ListField(required=True)
+ show_knowledge = serializers.BooleanField(
+ required=True, label=_("The results are displayed in the knowledge sources")
+ )
+ search_scope_type = serializers.ChoiceField(
+ required=False,
+ choices=["custom", "referencing"],
+ label=_("search scope type"),
+ allow_null=True,
+ default="custom",
+ )
+ search_scope_source = serializers.ChoiceField(
+ required=False, choices=["document", "knowledge"], label=_("search scope variable type"), default="knowledge"
+ )
+ search_scope_reference = serializers.ListField(required=False, label=_("search scope variable"), default=list)
+
+
+def _get_paragraph_list(chat_record, node_id):
+ return flat_map(
+ [
+ chat_record.details[key].get("paragraph_list", [])
+ for key in chat_record.details
+ if (chat_record.details[key].get("type", "") == "search-dataset-node")
+ and chat_record.details[key].get("paragraph_list", []) is not None
+ and key == node_id
+ ]
+ )
+
+
+def _get_embedding_id(dataset_id_list):
+ dataset_list = QuerySet(Knowledge).filter(id__in=dataset_id_list)
+ if len(set([dataset.embedding_model_id for dataset in dataset_list])) > 1:
+ raise Exception("关联知识库的向量模型不一致,无法召回分段。")
+ if len(dataset_list) == 0:
+ raise Exception("知识库设置错误,请重新设置知识库")
+ return dataset_list[0].embedding_model_id
+
+
+def _reset_title(title):
+ if title is None or len(title.strip()) == 0:
+ return ""
+ else:
+ return f"#### {title}\n"
+
+
+def _reset_meta(meta):
+ if not meta.get("allow_download", False):
+ return {"allow_download": False}
+ return meta
+
+
+def _asset_retrieval_text(asset: Dict | None) -> str:
+ if not asset:
+ return ""
+ return "\n".join(
+ str(value).strip()
+ for value in (asset.get("caption"), asset.get("ocr_text"), asset.get("description"))
+ if value and str(value).strip()
+ )
+
+
+def _reset_paragraph(paragraph: Dict, embedding_list: List, hit_asset_map: Dict = None):
+ filter_embedding_list = [
+ embedding for embedding in embedding_list if str(embedding.get("paragraph_id")) == str(paragraph.get("id"))
+ ]
+ if filter_embedding_list is not None and len(filter_embedding_list) > 0:
+ find_embedding = filter_embedding_list[-1]
+ source_id = find_embedding.get("source_id")
+ source_type = find_embedding.get("source_type")
+ is_image_hit = str(source_type) == str(SourceType.IMAGE.value)
+ embedding_meta = find_embedding.get("meta") or {}
+ hit_unit_type = embedding_meta.get("unit_type") or ("image" if is_image_hit else "text")
+ hit_asset = (hit_asset_map or {}).get(str(source_id)) if is_image_hit else None
+ asset_text = _asset_retrieval_text(hit_asset)
+ retrieval_content = "\n".join(value for value in (paragraph.get("content") or "", asset_text) if value)
+ return {
+ **paragraph,
+ "similarity": find_embedding.get("similarity"),
+ "comprehensive_score": find_embedding.get("comprehensive_score"),
+ "source_id": source_id,
+ "source_type": source_type,
+ "hit_unit_type": hit_unit_type,
+ "query_unit_type": find_embedding.get("query_unit_type"),
+ "query_unit_index": find_embedding.get("query_unit_index"),
+ "hit_asset": hit_asset,
+ "retrieval_content": retrieval_content,
+ "is_hit_handling_method": find_embedding.get("similarity") > paragraph.get("directly_return_similarity")
+ and paragraph.get("hit_handling_method") == "directly_return",
+ "update_time": paragraph.get("update_time").strftime("%Y-%m-%d %H:%M:%S"),
+ "create_time": paragraph.get("create_time").strftime("%Y-%m-%d %H:%M:%S"),
+ "id": str(paragraph.get("id")),
+ "knowledge_id": str(paragraph.get("knowledge_id")),
+ "document_id": str(paragraph.get("document_id")),
+ "meta": _reset_meta(paragraph.get("meta")),
+ }
+
+
+def _get_recalled_image_list(paragraph_list: List[Dict]) -> List[Dict]:
+ image_list = []
+ seen_file_ids = set()
+ for paragraph in paragraph_list:
+ hit_asset = paragraph.get("hit_asset")
+ if not hit_asset:
+ continue
+ file_id = str(hit_asset.get("file_id") or "")
+ if not file_id or file_id in seen_file_ids:
+ continue
+ seen_file_ids.add(file_id)
+ image_list.append(hit_asset)
+ return image_list
+
+
+def _record_recalled_items(embedding_list: List[Dict], paragraph_list: List[Dict], workflow_manage, debug=False):
+ if debug:
+ return
+ recalled_paragraph_ids = {str(paragraph.get("id")) for paragraph in paragraph_list}
+ recalled_items = [
+ embedding for embedding in embedding_list if str(embedding.get("paragraph_id")) in recalled_paragraph_ids
+ ]
+ record_recall_safely(recalled_items, tracker=get_recall_tracker(workflow_manage))
+
+
+def _list_paragraph(embedding_list: List, vector, knowledge_ids=None, document_ids=None):
+ paragraph_id_list = [row.get("paragraph_id") for row in embedding_list]
+ if paragraph_id_list is None or len(paragraph_id_list) == 0:
+ return []
+ query = QuerySet(Paragraph).filter(id__in=paragraph_id_list)
+ if knowledge_ids is not None:
+ query = query.filter(
+ knowledge_id__in=knowledge_ids,
+ is_active=True,
+ document_id__in=QuerySet(Document).filter(knowledge_id__in=knowledge_ids, is_active=True).values("id"),
+ )
+ if document_ids is not None:
+ query = query.filter(document_id__in=document_ids)
+ paragraph_list = native_search(
+ query,
+ get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "application", "sql", "list_knowledge_paragraph_by_paragraph_id.sql")
+ ),
+ with_table_name=True,
+ )
+ if knowledge_ids is None and len(paragraph_list) != len(paragraph_id_list):
+ exist_paragraph_list = [row.get("id") for row in paragraph_list]
+ for paragraph_id in paragraph_id_list:
+ if paragraph_id not in exist_paragraph_list:
+ vector.delete_by_paragraph_id(paragraph_id)
+ return paragraph_list
+
+
+class SearchKnowledgeNode(INode):
+ serializer_class = SearchKnowledgeNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.TOOL]
+ type = "search-knowledge-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ knowledge_id_list = node_params.get("knowledge_id_list", [])
+ knowledge_setting = node_params.get("knowledge_setting", {})
+ question_reference_address = node_params.get("question_reference_address", [])
+ show_knowledge = node_params.get("show_knowledge", False)
+ search_scope_type = node_params.get("search_scope_type", "custom")
+ search_scope_source = node_params.get("search_scope_source", "knowledge")
+ search_scope_reference = node_params.get("search_scope_reference", [])
+
+ question = str(
+ self.workflow_manage.get_reference_field(question_reference_address[0], question_reference_address[1:])
+ )
+
+ exclude_paragraph_id_list = []
+ if workflow_params.get("re_chat", False):
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ paragraph_id_list = [
+ p.get("id")
+ for p in flat_map(
+ [
+ _get_paragraph_list(chat_record, self.get_node_id())
+ for chat_record in history_chat_record
+ if chat_record.problem_text == question
+ ]
+ )
+ ]
+ exclude_paragraph_id_list = list(set(paragraph_id_list))
+
+ self.write_context("question", question)
+ self.write_context("show_knowledge", show_knowledge)
+
+ document_id_list = None
+ if search_scope_type == "referencing":
+ if search_scope_source == "knowledge":
+ knowledge_id_list = self._get_reference_content(search_scope_reference)
+ else:
+ document_id_list = self._get_reference_content(search_scope_reference)
+ knowledge_id_list = [
+ str(k)
+ for k in QuerySet(Document)
+ .filter(id__in=document_id_list)
+ .values_list("knowledge_id", flat=True)
+ .distinct()
+ ]
+
+ workspace_id = workflow_params.get("workspace_id")
+ knowledge_id_list = filter_authorized_ids("knowledge", knowledge_id_list, workspace_id)
+ knowledge_id_list = filter_workflow_knowledge(knowledge_id_list, workflow_params)
+
+ if len(knowledge_id_list) == 0 or document_id_list == []:
+ self._write_empty_result(question)
+ return
+
+ model_id = _get_embedding_id(knowledge_id_list)
+ self._check_cancelled()
+ embedding_model = get_model_instance_by_model_workspace_id(model_id, workspace_id)
+ embedding_value = embedding_model.embed_query(question)
+ vector = VectorStore.get_embedding_vector()
+
+ exclude_document_id_list = [
+ str(document.id)
+ for document in QuerySet(Document).filter(knowledge_id__in=knowledge_id_list, is_active=False)
+ ]
+
+ self._check_cancelled()
+ embedding_list = vector.query(
+ question,
+ embedding_value,
+ knowledge_id_list,
+ document_id_list,
+ exclude_document_id_list,
+ exclude_paragraph_id_list,
+ True,
+ knowledge_setting.get("top_n"),
+ knowledge_setting.get("similarity"),
+ SearchMode(knowledge_setting.get("search_mode")),
+ )
+
+ connection.close()
+
+ if embedding_list is None:
+ self._write_empty_result(question)
+ return
+
+ knowledge_id_list = filter_workflow_knowledge(knowledge_id_list, workflow_params)
+ paragraph_list = _list_paragraph(embedding_list, vector, knowledge_id_list, document_id_list)
+ hit_asset_map = get_hit_asset_map(embedding_list)
+ result = [
+ reset_paragraph
+ for paragraph in paragraph_list
+ if (reset_paragraph := _reset_paragraph(paragraph, embedding_list, hit_asset_map)) is not None
+ ]
+ result = sorted(result, key=lambda p: p.get("similarity"), reverse=True)
+ image_list = _get_recalled_image_list(result)
+
+ _record_recalled_items(embedding_list, result, self.workflow_manage, workflow_params.get("debug", False))
+
+ self.write_context("paragraph_list", result)
+ self.write_context("image_list", image_list)
+ self.write_context("is_hit_handling_method_list", [row for row in result if row.get("is_hit_handling_method")])
+ self.write_context(
+ "data",
+ "\n".join(
+ [
+ f"{_reset_title(paragraph.get('title', ''))}"
+ f"{paragraph.get('retrieval_content', paragraph.get('content'))}"
+ for paragraph in result
+ ]
+ )[0 : knowledge_setting.get("max_paragraph_char_number", 5000)],
+ )
+ self.write_context(
+ "directly_return",
+ "\n".join(
+ [
+ paragraph.get("retrieval_content", paragraph.get("content"))
+ for paragraph in result
+ if paragraph.get("is_hit_handling_method")
+ ]
+ ),
+ )
+
+ def _write_empty_result(self, question):
+ self.write_context("paragraph_list", [])
+ self.write_context("image_list", [])
+ self.write_context("is_hit_handling_method_list", [])
+ self.write_context("data", "")
+ self.write_context("directly_return", "")
+ self.write_context("question", question)
+
+ def _get_reference_content(self, fields: List[str]):
+ if fields:
+ return self.workflow_manage.get_reference_field(fields[0], fields[1:])
+ return None
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "paragraph_list": self.get_context("paragraph_list"),
+ "image_list": self.get_context("image_list"),
+ "data": self.get_context("data"),
+ "show_knowledge": self.get_context("show_knowledge"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/speech_to_text_node/__init__.py b/apps/application/workflow/nodes/speech_to_text_node/__init__.py
new file mode 100644
index 00000000000..ffbe9f1673b
--- /dev/null
+++ b/apps/application/workflow/nodes/speech_to_text_node/__init__.py
@@ -0,0 +1,7 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @desc:
+"""
+from .speech_to_text_node import SpeechToTextNode
diff --git a/apps/application/workflow/nodes/speech_to_text_node/speech_to_text_node.py b/apps/application/workflow/nodes/speech_to_text_node/speech_to_text_node.py
new file mode 100644
index 00000000000..37b194d5535
--- /dev/null
+++ b/apps/application/workflow/nodes/speech_to_text_node/speech_to_text_node.py
@@ -0,0 +1,145 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: speech_to_text_node.py
+@desc:
+"""
+
+import os
+import tempfile
+from concurrent.futures import ThreadPoolExecutor
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.utils.common import split_and_transcribe, any_to_mp3
+from common.exception.app_exception import AppApiException
+from knowledge.models import File
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+
+
+class SpeechToTextNodeSerializer(serializers.Serializer):
+ stt_model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ stt_model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ stt_model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ audio_list = serializers.ListField(required=True, label=_("The audio file cannot be empty"))
+ model_params_setting = serializers.DictField(required=False, label=_("Model parameter settings"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("stt_model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("stt_model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _process_audio_item(audio_item, model):
+ file = QuerySet(File).filter(id=audio_item["file_id"]).first()
+ file_format = file.file_name.split(".")[-1]
+ with tempfile.NamedTemporaryFile(delete=False, suffix=f".{file_format}") as temp_file:
+ temp_file.write(file.get_bytes())
+ temp_file_path = temp_file.name
+ with tempfile.NamedTemporaryFile(delete=False, suffix=".mp3") as temp_amr_file:
+ temp_mp3_path = temp_amr_file.name
+ any_to_mp3(temp_file_path, temp_mp3_path)
+ try:
+ transcription = split_and_transcribe(temp_mp3_path, model)
+ return {file.file_name: transcription}
+ finally:
+ os.remove(temp_file_path)
+ os.remove(temp_mp3_path)
+
+
+def _process_audio_items(audio_list, model):
+ with ThreadPoolExecutor(max_workers=5) as executor:
+ results = list(executor.map(lambda item: _process_audio_item(item, model), audio_list))
+ return results
+
+
+class SpeechToTextNode(INode):
+ serializer_class = SpeechToTextNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "speech-to-text-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+
+ stt_model_id = node_params.get("stt_model_id")
+ stt_model_id_type = node_params.get("stt_model_id_type", "custom")
+ stt_model_id_reference = node_params.get("stt_model_id_reference")
+ model_params_setting = node_params.get("model_params_setting")
+ audio_list_ref = node_params.get("audio_list")
+ is_result = node_params.get("is_result", False)
+
+ audio_list = self.workflow_manage.get_reference_field(audio_list_ref[0], audio_list_ref[1:])
+ for audio in audio_list:
+ if "file_id" not in audio:
+ raise ValueError(
+ _("Parameter value error: The uploaded audio lacks file_id, and the audio upload fails")
+ )
+
+ if stt_model_id_type == "reference" and stt_model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ stt_model_id_reference[0],
+ stt_model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ stt_model_id = reference_data.get("stt_model_id", reference_data.get("model_id", stt_model_id))
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if stt_model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("STT") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ stt_model_id = default_model_setting.get("model_id", stt_model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not stt_model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ workspace_id = workflow_params.get("workspace_id")
+ stt_model = get_model_instance_by_model_workspace_id(stt_model_id, workspace_id, **(model_params_setting or {}))
+
+ self.write_context("audio_list", audio_list)
+
+ self._check_cancelled()
+ result = _process_audio_items(audio_list, stt_model)
+ content = []
+ result_content = []
+ for item in result:
+ for key, value in item.items():
+ content.append(f"### {key}\n{value}")
+ result_content.append(value)
+
+ answer = "\n".join(result_content)
+ self.write_context("answer", answer)
+ self.write_context("result", answer)
+ self.write_context("content", content)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(TextContent(self.get_node_id(), answer, Status.SUCCESS, node_info, Position(self.get_node_id())))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "answer": self.get_context("answer"),
+ "result": self.get_context("result"),
+ "content": self.get_context("content"),
+ "audio_list": self.get_context("audio_list"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/start_node/__init__.py b/apps/application/workflow/nodes/start_node/__init__.py
new file mode 100644
index 00000000000..21960a776ac
--- /dev/null
+++ b/apps/application/workflow/nodes/start_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: __init__.py.py
+ @date:2026/6/29 10:59
+ @desc:
+"""
+from .start_node import StarNode
diff --git a/apps/application/workflow/nodes/start_node/start_node.py b/apps/application/workflow/nodes/start_node/start_node.py
new file mode 100644
index 00000000000..e9a863aef76
--- /dev/null
+++ b/apps/application/workflow/nodes/start_node/start_node.py
@@ -0,0 +1,117 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: start_node.py
+@date:2026/7/1 16:59
+@desc:
+"""
+
+import time
+from typing import List
+
+from django.db.models import QuerySet
+from django.utils import timezone
+from rest_framework import serializers
+
+from application.models.application_chat import ApplicationLongTermMemory
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.status import Status
+
+
+def get_default_global_variable(input_field_list: List):
+ return {
+ item.get("variable") or item.get("field"): item.get("default_value")
+ for item in input_field_list
+ if item.get("default_value", None) is not None
+ }
+
+
+class ApplicationSerializer(serializers.Serializer):
+ chat_id = serializers.UUIDField(required=True, label="对话id")
+ user_id = serializers.UUIDField(required=True, label="用户id")
+ chat_record_id = serializers.UUIDField(required=True, label="对话记录id")
+ messages = serializers.ListField(required=True, label="上下文数据")
+
+
+class StarNode(INode):
+ supported_workflow_type_list = [WorkflowType.APPLICATION]
+ type = "start-node"
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ base_node = self.workflow_manage.workflow.get_node("base-node")
+
+ user_input_field_list = base_node.properties.get("user_input_field_list", []) if base_node else []
+ api_input_field_list = base_node.properties.get("api_input_field_list", []) if base_node else []
+ default_global = get_default_global_variable(user_input_field_list)
+ default_api_global = get_default_global_variable(api_input_field_list)
+
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ history_context = [{"question": r.problem_text, "answer": r.answer_text} for r in history_chat_record]
+
+ chat_id = workflow_params.get("chat_id")
+ chat_user_id = workflow_params.get("chat_user_id")
+
+ memory = ""
+ if chat_user_id:
+ long_term_memory = (
+ QuerySet(ApplicationLongTermMemory)
+ .filter(chat_user_id=chat_user_id, application_id=workflow_params.get("application_id"))
+ .first()
+ )
+ if long_term_memory:
+ memory = long_term_memory.memory
+
+ workflow_variable = {
+ **default_global,
+ **default_api_global,
+ "time": timezone.localtime(timezone.now()).strftime("%Y-%m-%d %H:%M:%S"),
+ "start_time": time.time(),
+ "history_context": history_context,
+ "chat_id": str(chat_id) if chat_id else None,
+ "chat_user_id": chat_user_id,
+ "chat_user_type": workflow_params.get("chat_user_type"),
+ "chat_user": workflow_params.get("chat_user"),
+ "chat_user_group": workflow_params.get("chat_user_group"),
+ "memory": memory,
+ }
+
+ question = workflow_params.get("question", "")
+ node_variable = {
+ "question": question,
+ "image": workflow_params.get("image_list", []),
+ "document": workflow_params.get("document_list", []),
+ "audio": workflow_params.get("audio_list", []),
+ "video": workflow_params.get("video_list", []),
+ "other": workflow_params.get("other_list", []),
+ "memory": memory,
+ }
+
+ for key, value in node_variable.items():
+ self.write_context(key, value)
+
+ # 全局变量统一放进 context['global'],与 reset_variable / get_reference_field 的引用约定一致
+ for key, value in workflow_variable.items():
+ self.workflow_manage.write_context("global", key, value)
+
+ config = self.node.properties.get("config", {})
+ if config:
+ for field in config.get("globalFields", []):
+ key = field.get("value")
+ if key:
+ self.workflow_manage.write_context("global", key, workflow_variable.get(key, ""))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "image": self.get_context("image"),
+ "document": self.get_context("document"),
+ "audio": self.get_context("audio"),
+ "video": self.get_context("video"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/text_to_speech_node/__init__.py b/apps/application/workflow/nodes/text_to_speech_node/__init__.py
new file mode 100644
index 00000000000..37c432059c0
--- /dev/null
+++ b/apps/application/workflow/nodes/text_to_speech_node/__init__.py
@@ -0,0 +1,7 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: __init__.py
+ @desc:
+"""
+from .text_to_speech_node import TextToSpeechNode
diff --git a/apps/application/workflow/nodes/text_to_speech_node/text_to_speech_node.py b/apps/application/workflow/nodes/text_to_speech_node/text_to_speech_node.py
new file mode 100644
index 00000000000..79e2ad9d8cc
--- /dev/null
+++ b/apps/application/workflow/nodes/text_to_speech_node/text_to_speech_node.py
@@ -0,0 +1,204 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: text_to_speech_node.py
+@desc:
+"""
+
+import io
+import mimetypes
+
+from django.core.files.uploadedfile import InMemoryUploadedFile
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from pydub import AudioSegment
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+from common.utils.common import _remove_empty_lines
+from knowledge.models import FileSourceType
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+from oss.serializers.file import FileSerializer
+
+
+class TextToSpeechNodeSerializer(serializers.Serializer):
+ tts_model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ tts_model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ tts_model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ content_list = serializers.ListField(required=True, label=_("Text content"))
+ model_params_setting = serializers.DictField(required=False, label=_("Model parameter settings"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("tts_model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("tts_model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+def _bytes_to_uploaded_file(file_bytes, file_name="generated_audio.mp3"):
+ content_type, _ = mimetypes.guess_type(file_name)
+ if content_type is None:
+ content_type = "application/octet-stream"
+ file_stream = io.BytesIO(file_bytes)
+ file_size = len(file_bytes)
+ uploaded_file = InMemoryUploadedFile(
+ file=file_stream,
+ field_name=None,
+ name=file_name,
+ content_type=content_type,
+ size=file_size,
+ charset=None,
+ )
+ return uploaded_file
+
+
+class TextToSpeechNode(INode):
+ serializer_class = TextToSpeechNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "text-to-speech-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+ workflow_type = self.get_workflow_type()
+
+ tts_model_id = node_params.get("tts_model_id")
+ tts_model_id_type = node_params.get("tts_model_id_type", "custom")
+ tts_model_id_reference = node_params.get("tts_model_id_reference")
+ model_params_setting = node_params.get("model_params_setting")
+ content_list_ref = node_params.get("content_list")
+ is_result = node_params.get("is_result", False)
+
+ content = (
+ self.workflow_manage.get_reference_field(content_list_ref[0], content_list_ref[1:])
+ if content_list_ref
+ else ""
+ )
+
+ if tts_model_id_type == "reference" and tts_model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ tts_model_id_reference[0],
+ tts_model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ tts_model_id = reference_data.get("tts_model_id", reference_data.get("model_id", tts_model_id))
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if tts_model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("TTS") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ tts_model_id = default_model_setting.get("model_id", tts_model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not tts_model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ content = _remove_empty_lines(str(content))
+ max_length = 1024
+ content_chunks = [content[i : i + max_length] for i in range(0, len(content), max_length)]
+
+ audio_segments = []
+ temp_files = []
+
+ for chunk in content_chunks:
+ self._check_cancelled()
+ self.write_context("content", chunk)
+ workspace_id = workflow_params.get("workspace_id")
+ model = get_model_instance_by_model_workspace_id(tts_model_id, workspace_id, **(model_params_setting or {}))
+ audio_byte = model.text_to_speech(chunk)
+ temp_file = io.BytesIO(audio_byte)
+ audio_segment = AudioSegment.from_file(temp_file)
+ audio_segments.append(audio_segment)
+ temp_files.append(temp_file)
+
+ combined_audio = AudioSegment.empty()
+ for segment in audio_segments:
+ combined_audio += segment
+
+ output_buffer = io.BytesIO()
+ combined_audio.export(output_buffer, format="mp3")
+ combined_bytes = output_buffer.getvalue()
+ file_name = "combined_audio.mp3"
+ file = _bytes_to_uploaded_file(combined_bytes, file_name)
+ file_url = self._upload_file(file, workflow_params, workflow_type)
+
+ file_id = file_url.split("/")[-1]
+ audio_list = [{"file_id": file_id, "file_name": file_name, "url": file_url}]
+
+ for temp_file in temp_files:
+ temp_file.close()
+ output_buffer.close()
+
+ audio_label = f''
+ self.write_context("answer", audio_label)
+ self.write_context("result", audio_list)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(
+ TextContent(self.get_node_id(), audio_label, Status.SUCCESS, node_info, Position(self.get_node_id()))
+ )
+
+ def _upload_file(self, file, workflow_params, workflow_type):
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ return self._upload_knowledge_file(file, workflow_params)
+ if workflow_type == WorkflowType.TOOL:
+ return self._upload_tool_file(file, workflow_params)
+ return self._upload_application_file(file, workflow_params)
+
+ def _upload_knowledge_file(self, file, workflow_params):
+ knowledge_id = workflow_params.get("knowledge_id")
+ return FileSerializer(
+ data={
+ "file": file,
+ "meta": {"debug": False, "knowledge_id": knowledge_id},
+ "source_id": knowledge_id,
+ "source_type": FileSourceType.KNOWLEDGE.value,
+ }
+ ).upload()
+
+ def _upload_tool_file(self, file, workflow_params):
+ tool_id = workflow_params.get("tool_id")
+ return FileSerializer(
+ data={
+ "file": file,
+ "meta": {"debug": False, "tool_id": tool_id},
+ "source_id": tool_id,
+ "source_type": FileSourceType.TOOL.value,
+ }
+ ).upload()
+
+ def _upload_application_file(self, file, workflow_params):
+ application_id = workflow_params.get("application_id")
+ chat_id = workflow_params.get("chat_id")
+ return FileSerializer(
+ data={
+ "file": file,
+ "meta": {"debug": False, "chat_id": chat_id, "application_id": application_id},
+ "source_id": application_id,
+ "source_type": FileSourceType.APPLICATION.value,
+ }
+ ).upload()
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "content": self.get_context("content"),
+ "answer": self.get_context("answer"),
+ "result": self.get_context("result"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/text_to_video_node/__init__.py b/apps/application/workflow/nodes/text_to_video_node/__init__.py
new file mode 100644
index 00000000000..3c4dac4c599
--- /dev/null
+++ b/apps/application/workflow/nodes/text_to_video_node/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .text_to_video_node import TextToVideoNode
diff --git a/apps/application/workflow/nodes/text_to_video_node/text_to_video_node.py b/apps/application/workflow/nodes/text_to_video_node/text_to_video_node.py
new file mode 100644
index 00000000000..c4ad6b989db
--- /dev/null
+++ b/apps/application/workflow/nodes/text_to_video_node/text_to_video_node.py
@@ -0,0 +1,251 @@
+# coding=utf-8
+import uuid_utils.compat as uuid
+import requests
+from functools import reduce
+from typing import List
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _, gettext
+from langchain_core.messages import BaseMessage, HumanMessage, AIMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+from common.utils.common import bytes_to_uploaded_file
+from knowledge.models import FileSourceType
+from oss.serializers.file import FileSerializer
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+from common.utils.logger import maxkb_logger
+
+
+class TextToVideoNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ prompt = serializers.CharField(required=True, label=_("Prompt word (positive)"))
+ negative_prompt = serializers.CharField(
+ required=False, label=_("Prompt word (negative)"), allow_null=True, allow_blank=True
+ )
+ dialogue_number = serializers.IntegerField(
+ required=False, default=0, label=_("Number of multi-round conversations")
+ )
+ dialogue_type = serializers.CharField(required=False, default="NODE", label=_("Conversation storage type"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ model_params_setting = serializers.JSONField(required=False, default=dict, label=_("Model parameter settings"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+class TextToVideoNode(INode):
+ serializer_class = TextToVideoNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "text-to-video-node"
+
+ def execute(self):
+ maxkb_logger.info(f"[TextToVideoNode] execute START, node_id={self.get_node_id()}")
+ workflow_params = self.get_workflow_parameters()
+ node_params = self.get_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ prompt = node_params.get("prompt", "")
+ negative_prompt = node_params.get("negative_prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ dialogue_type = node_params.get("dialogue_type", "NODE")
+ is_result = node_params.get("is_result", False)
+ model_params_setting = node_params.get("model_params_setting")
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ chat_id = None
+ chat_record_id = None
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ chat_id = workflow_params.get("chat_id")
+ chat_record_id = workflow_params.get("chat_record_id")
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("TTV") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ ttv_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message = self._get_history_message(history_chat_record, dialogue_number)
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message or [])],
+ )
+
+ question = self.workflow_manage.generate_prompt(prompt)
+ self.write_context("question", question)
+
+ # message_list = [*history_message, question]
+ # self.write_context("message_list", [{"content": m.content, "role": m.type} for m in message_list],)
+ self.write_context("dialogue_type", dialogue_type)
+ self.write_context("negative_prompt", self.workflow_manage.generate_prompt(negative_prompt))
+
+ self._check_cancelled()
+ video_urls = ttv_model.generate_video(question, negative_prompt)
+ maxkb_logger.info(
+ f"[TextToVideoNode] generate_video result: {video_urls is not None}, node_id={self.get_node_id()}"
+ )
+
+ if video_urls is None or video_urls == "":
+ raise Exception(gettext("Failed to generate video"))
+
+ file_name = "generated_video.mp4"
+ if isinstance(video_urls, str) and video_urls.startswith("http"):
+ video_urls = requests.get(video_urls).content
+
+ file = bytes_to_uploaded_file(video_urls, file_name)
+ file_url = self._upload_file(file, workflow_type, workflow_params)
+
+ video_label = f''
+ video_list = [{"file_id": file_url.split("/")[-1], "file_name": file_name, "url": file_url}]
+
+ self.write_context("answer", video_label)
+ self.write_context("video", video_list)
+ # self.write_context("chat_model", ttv_model)
+
+ if is_result:
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(
+ TextContent(str(uuid.uuid7()), video_label, Status.SUCCESS, node_info, Position(self.get_node_id()))
+ )
+
+ def _upload_file(self, file, workflow_type, workflow_params):
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ return self._upload_knowledge_file(file, workflow_params)
+ if workflow_type == WorkflowType.TOOL:
+ return self._upload_tool_file(file, workflow_params)
+ return self._upload_application_file(file, workflow_params)
+
+ def _upload_knowledge_file(self, file, workflow_params):
+ knowledge_id = workflow_params.get("knowledge_id")
+ meta = {"debug": False, "knowledge_id": knowledge_id}
+ file_url = FileSerializer(
+ data={"file": file, "meta": meta, "source_id": knowledge_id, "source_type": FileSourceType.KNOWLEDGE.value}
+ ).upload()
+ return file_url
+
+ def _upload_tool_file(self, file, workflow_params):
+ tool_id = workflow_params.get("tool_id")
+ meta = {
+ "debug": False,
+ "tool_id": tool_id,
+ }
+ file_url = FileSerializer(
+ data={"file": file, "meta": meta, "source_id": tool_id, "source_type": FileSourceType.TOOL.value}
+ ).upload()
+ return file_url
+
+ def _upload_application_file(self, file, workflow_params):
+ application_id = workflow_params.get("application_id")
+ chat_id = workflow_params.get("chat_id")
+ debug = workflow_params.get("debug", False)
+ meta = {
+ "debug": debug,
+ "chat_id": chat_id,
+ "application_id": application_id,
+ }
+ file_url = FileSerializer(
+ data={
+ "file": file,
+ "meta": meta,
+ "source_id": application_id,
+ "source_type": FileSourceType.APPLICATION.value,
+ }
+ ).upload()
+ return file_url
+
+ def _generate_history_ai_message(self, chat_record):
+ for val in chat_record.details.values():
+ if self.node.id == val["node_id"] and "image_list" in val:
+ if val["dialogue_type"] == "WORKFLOW":
+ return chat_record.get_ai_message()
+ image_list = val["image_list"]
+ return [
+ AIMessage(
+ content=[
+ *[{"type": "image_url", "image_url": {"url": f"{file_url}"}} for file_url in image_list]
+ ]
+ )
+ ]
+ return chat_record.get_ai_message()
+
+ def _get_history_message(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message(history_chat_record[index]),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ return history_message
+
+ def _generate_history_human_message(self, chat_record):
+ for data in chat_record.details.values():
+ if self.node.id == data["node_id"] and "image_list" in data:
+ image_list = data["image_list"]
+ if len(image_list) == 0 or data["dialogue_type"] == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ return HumanMessage(content=data["question"])
+ return HumanMessage(content=chat_record.problem_text)
+
+ @staticmethod
+ def reset_message_list(message_list: List[BaseMessage], answer_text):
+ result = [
+ {"role": "user" if isinstance(message, HumanMessage) else "ai", "content": message.content}
+ for message in message_list
+ ]
+ result.append({"role": "ai", "content": answer_text})
+ return result
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "video": self.get_context("video"),
+ "negative_prompt": self.get_context("negative_prompt"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/tool_lib_node/__init__.py b/apps/application/workflow/nodes/tool_lib_node/__init__.py
new file mode 100644
index 00000000000..09bdd257c52
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_lib_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: __init__.py
+@date:2026/9/3 16:21
+@desc:
+"""
+
+from .tool_lib_node import ToolLibNode
diff --git a/apps/application/workflow/nodes/tool_lib_node/tool_lib_node.py b/apps/application/workflow/nodes/tool_lib_node/tool_lib_node.py
new file mode 100644
index 00000000000..c71d2bf0b3c
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_lib_node/tool_lib_node.py
@@ -0,0 +1,339 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: tool_lib_node.py
+@date:2026/9/3 16:21
+@desc:
+"""
+
+import base64
+import io
+import json
+import mimetypes
+import traceback
+
+import uuid_utils.compat as uuid
+from django.core.files.uploadedfile import InMemoryUploadedFile
+from django.db import connection
+from django.db.models import QuerySet
+from django.utils.translation import gettext
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.exception.app_exception import AppApiException
+from common.field.common import ObjectField
+from common.utils.common import common_convert_value
+from common.utils.logger import maxkb_logger
+from common.utils.rsa_util import rsa_long_decrypt
+from common.utils.tool_code import ToolExecutor
+from knowledge.models import FileSourceType
+from knowledge.models.knowledge_action import State
+from oss.serializers.file import FileSerializer
+from tools.models import Tool, ToolRecord, ToolTaskTypeChoices
+
+function_executor = ToolExecutor()
+
+
+class InputField(serializers.Serializer):
+ name = serializers.CharField(required=True, label=_("Variable Name"))
+ value = ObjectField(required=True, label=_("Variable Value"), model_type_list=[str, list])
+
+
+class ToolLibNodeSerializer(serializers.Serializer):
+ tool_lib_id = serializers.UUIDField(required=True, label=_("Library ID"))
+ input_field_list = InputField(required=True, many=True)
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ f_lib = QuerySet(Tool).filter(id=self.data.get("tool_lib_id")).first()
+ # 归还链接到连接池
+ connection.close()
+ if f_lib is None:
+ raise AppApiException(500, _("Tool has been deleted"))
+ if not f_lib.is_active:
+ raise AppApiException(500, _("Tool is not active"))
+
+
+def get_field_value(debug_field_list, name, is_required):
+ result = [field for field in debug_field_list if field.get("name") == name]
+ if len(result) > 0:
+ return result[-1]["value"]
+ if is_required:
+ raise AppApiException(500, gettext("Field: {name} No value set").format(name=name))
+ return None
+
+
+def valid_reference_value(_type, value, name):
+ if _type == "int":
+ instance_type = int | float
+ elif _type == "boolean":
+ instance_type = bool
+ elif _type == "float":
+ instance_type = float | int
+ elif _type == "dict":
+ value = json.loads(value) if isinstance(value, str) else value
+ instance_type = dict
+ elif _type == "array":
+ value = json.loads(value) if isinstance(value, str) else value
+ instance_type = list
+ elif _type == "string":
+ instance_type = str
+ else:
+ maxkb_logger.error(
+ gettext("Field: {name} Type: {_type} Value: {value} Unsupported this type").format(
+ name=name, _type=_type, value=value
+ )
+ )
+ return value
+ if not isinstance(value, instance_type):
+ raise Exception(
+ gettext("Field: {name} Type: {_type} Value: {value} Type error").format(name=name, _type=_type, value=value)
+ )
+ return value
+
+
+def convert_value(name: str, value, _type, is_required, source, node):
+ if not is_required and (value is None or ((isinstance(value, str) or isinstance(value, list)) and len(value) == 0)):
+ return None
+ if source == "reference":
+ value = node.workflow_manage.get_reference_field(value[0], value[1:])
+ if value is None:
+ if not is_required:
+ return None
+ else:
+ raise Exception(gettext("Field: {name} Type: {_type} is required").format(name=name, _type=_type))
+ value = valid_reference_value(_type, value, name)
+ if _type == "int":
+ return int(value)
+ if _type == "float":
+ return float(value)
+ return value
+ try:
+ value = node.workflow_manage.generate_prompt(value)
+ return common_convert_value(_type, value)
+ except Exception:
+ raise Exception(
+ gettext("Field: {name} Type: {_type} Value: {value} Type error").format(name=name, _type=_type, value=value)
+ )
+
+
+def valid_function(tool_lib, workspace_id):
+ if tool_lib is None:
+ raise Exception(gettext("Tool does not exist"))
+ get_authorized_tool = DatabaseModelManage.get_model("get_authorized_tool")
+ if tool_lib and tool_lib.workspace_id != workspace_id and get_authorized_tool is not None:
+ tool_lib = get_authorized_tool(QuerySet(Tool).filter(id=tool_lib.id), workspace_id).first()
+ if tool_lib is None:
+ raise Exception(gettext("Tool does not exist"))
+ if not tool_lib.is_active:
+ raise Exception(gettext("Tool is not active"))
+
+
+def _filter_file_bytes(data):
+ """递归过滤掉所有层级的 file_bytes"""
+ if isinstance(data, dict):
+ return {k: _filter_file_bytes(v) for k, v in data.items() if k != "file_bytes"}
+ elif isinstance(data, list):
+ return [_filter_file_bytes(item) for item in data]
+ else:
+ return data
+
+
+def bytes_to_uploaded_file(file_bytes, file_name="unknown"):
+ content_type, _ = mimetypes.guess_type(file_name)
+ if content_type is None:
+ # 如果未能识别,设置为默认的二进制文件类型
+ content_type = "application/octet-stream"
+ # 创建一个内存中的字节流对象
+ file_stream = io.BytesIO(file_bytes)
+
+ # 获取文件大小
+ file_size = len(file_bytes)
+
+ uploaded_file = InMemoryUploadedFile(
+ file=file_stream,
+ field_name=None,
+ name=file_name,
+ content_type=content_type,
+ size=file_size,
+ charset=None,
+ )
+ return uploaded_file
+
+
+def _get_result_detail(result):
+ if isinstance(result, dict):
+ result_dict = {k: (str(v)[:500] if len(str(v)) > 500 else v) for k, v in result.items()}
+ elif isinstance(result, list):
+ result_dict = [str(item)[:500] if len(str(item)) > 500 else item for item in result]
+ elif isinstance(result, str):
+ result_dict = result[:500] if len(result) > 500 else result
+ else:
+ result_dict = result
+ return result_dict
+
+
+class ToolLibNode(INode):
+ serializer_class = ToolLibNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "tool-lib-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+ tool_lib_id = node_params.get("tool_lib_id")
+ input_field_list = node_params.get("input_field_list", [])
+ is_result = node_params.get("is_result", False)
+
+ workspace_id = workflow_params.get("workspace_id")
+ tool_lib = QuerySet(Tool).filter(id=tool_lib_id).first()
+ valid_function(tool_lib, workspace_id)
+ params = {
+ field.get("name"): convert_value(
+ field.get("name"),
+ field.get("value"),
+ field.get("type"),
+ field.get("is_required"),
+ field.get("source"),
+ self,
+ )
+ for field in [
+ {"value": get_field_value(input_field_list, field.get("name"), field.get("is_required")), **field}
+ for field in tool_lib.input_field_list
+ ]
+ }
+
+ self.write_context("params", params)
+ # 合并初始化参数
+ init_params_default_value = {i["field"]: i.get("default_value") for i in tool_lib.init_field_list}
+ if tool_lib.init_params is not None:
+ all_params = init_params_default_value | json.loads(rsa_long_decrypt(tool_lib.init_params)) | params
+ else:
+ all_params = init_params_default_value | params
+
+ if self.node.properties.get("kind") == "data-source":
+ exist = function_executor.exec_code(
+ f"{tool_lib.code}\ndef function_exist(function_name): return callable(globals().get(function_name))",
+ {"function_name": "get_download_file_list"},
+ )
+ all_params = {**all_params, **(workflow_params.get("data_source") or {})}
+ if exist:
+ download_file_list = []
+ download_list = function_executor.exec_code(
+ tool_lib.code, all_params, function_name="get_download_file_list"
+ )
+ for item in download_list:
+ self._check_cancelled()
+ file_result = function_executor.exec_code(
+ tool_lib.code, {**all_params, "download_item": item}, function_name="download"
+ )
+ file_bytes = file_result.get("file_bytes", [])
+ chunks = []
+ for chunk in file_bytes:
+ chunks.append(base64.b64decode(chunk))
+ file = bytes_to_uploaded_file(b"".join(chunks), file_result.get("name"))
+ file_url = self.upload_knowledge_file(file)
+ download_file_list.append({"file_id": file_url.split("/")[-1], "name": file_result.get("name")})
+ result = download_file_list
+ else:
+ result = function_executor.exec_code(tool_lib.code, all_params)
+ else:
+ result = self.tool_exec_record(tool_lib, all_params)
+
+ self.write_context("result", result)
+
+ if is_result:
+ chunk_id = str(uuid.uuid7())
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(TextContent(chunk_id, str(result), Status.SUCCESS, node_info, Position(self.get_node_id())))
+
+ def tool_exec_record(self, tool_lib, all_params):
+ import time
+
+ task_record_id = uuid.uuid7()
+ start_time = time.time()
+ filtered_args = all_params
+ try:
+ # 过滤掉 tool_init_params 中的参数
+ tool_init_params = json.loads(rsa_long_decrypt(tool_lib.init_params)) if tool_lib.init_params else {}
+ if tool_init_params:
+ filtered_args = {k: v for k, v in all_params.items() if k not in tool_init_params}
+ workflow_params = self.get_workflow_parameters()
+ workflow_type = self.get_workflow_type()
+ if workflow_type == WorkflowType.KNOWLEDGE:
+ source_id = workflow_params.get("knowledge_id")
+ source_type = ToolTaskTypeChoices.KNOWLEDGE.value
+ elif workflow_type == WorkflowType.TOOL:
+ source_id = workflow_params.get("tool_id")
+ source_type = ToolTaskTypeChoices.TOOL.value
+ else:
+ source_id = workflow_params.get("application_id")
+ source_type = ToolTaskTypeChoices.APPLICATION.value
+
+ ToolRecord(
+ id=task_record_id,
+ workspace_id=tool_lib.workspace_id,
+ tool_id=tool_lib.id,
+ source_type=source_type,
+ source_id=source_id,
+ meta={"input": filtered_args, "output": {}},
+ state=State.STARTED,
+ ).save()
+
+ result = function_executor.exec_code(tool_lib.code, all_params)
+ result_dict = _get_result_detail(result)
+ QuerySet(ToolRecord).filter(id=task_record_id).update(
+ state=State.SUCCESS,
+ run_time=time.time() - start_time,
+ meta={"input": filtered_args, "output": result_dict},
+ )
+
+ return result
+ except Exception as e:
+ maxkb_logger.error(f"Tool execution error: {traceback.format_exc()}")
+ QuerySet(ToolRecord).filter(id=task_record_id).update(
+ state=State.FAILURE,
+ run_time=time.time() - start_time,
+ meta={"input": filtered_args, "output": "Error: " + str(e)},
+ )
+ raise e
+
+ def upload_knowledge_file(self, file):
+ knowledge_id = self.get_workflow_parameters().get("knowledge_id")
+ meta = {
+ "debug": False,
+ "knowledge_id": knowledge_id,
+ }
+ file_url = (
+ FileSerializer(
+ data={
+ "file": file,
+ "meta": meta,
+ "source_id": knowledge_id,
+ "source_type": FileSourceType.KNOWLEDGE.value,
+ }
+ )
+ .upload()
+ .replace("./oss/file/", "")
+ )
+ file.close()
+ return file_url
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "result": _filter_file_bytes(self.get_context("result")),
+ "params": self.get_context("params"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/tool_node/__init__.py b/apps/application/workflow/nodes/tool_node/__init__.py
new file mode 100644
index 00000000000..20020915128
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: __init__.py
+@date:2026/6/29 16:21
+@desc:
+"""
+
+from .tool_node import ToolNode
diff --git a/apps/application/workflow/nodes/tool_node/tool_node.py b/apps/application/workflow/nodes/tool_node/tool_node.py
new file mode 100644
index 00000000000..a43d561042c
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_node/tool_node.py
@@ -0,0 +1,182 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: tool_node.py
+@date:2026/9/3 15:09
+@desc:
+"""
+
+import json
+import re
+
+import uuid_utils.compat as uuid
+from django.core import validators
+from django.utils.translation import gettext_lazy as _
+from django.utils.translation import gettext
+from rest_framework import serializers
+from rest_framework.utils.formatting import lazy_format
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from common.exception.app_exception import AppApiException
+from common.field.common import ObjectField
+from common.utils.common import common_convert_value
+from common.utils.logger import maxkb_logger
+from common.utils.tool_code import ToolExecutor
+
+function_executor = ToolExecutor()
+
+
+class InputField(serializers.Serializer):
+ name = serializers.CharField(required=True, label=_("Variable Name"))
+ is_required = serializers.BooleanField(required=True, label=_("Is this field required"))
+ type = serializers.CharField(
+ required=True,
+ label=_("type"),
+ validators=[
+ validators.RegexValidator(
+ regex=re.compile("^string|int|dict|array|float|boolean$"),
+ message=_("The field only supports string|int|dict|array|float"),
+ code=500,
+ )
+ ],
+ )
+ source = serializers.CharField(
+ required=True,
+ label=_("source"),
+ validators=[
+ validators.RegexValidator(
+ regex=re.compile("^custom|reference$"),
+ message=_("The field only supports custom|reference"),
+ code=500,
+ )
+ ],
+ )
+ value = ObjectField(required=True, label=_("Variable Value"), model_type_list=[str, list])
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ is_required = self.data.get("is_required")
+ if is_required and self.data.get("value") is None:
+ message = lazy_format(_("{field}, this field is required."), field=self.data.get("name"))
+ raise AppApiException(500, message)
+
+
+class ToolNodeSerializer(serializers.Serializer):
+ input_field_list = InputField(required=True, many=True)
+ code = serializers.CharField(required=True, label=_("function"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+
+
+def valid_reference_value(_type, value, name):
+ if _type == "int":
+ instance_type = int | float
+ elif _type == "boolean":
+ instance_type = bool
+ elif _type == "float":
+ instance_type = float | int
+ elif _type == "dict":
+ value = json.loads(value) if isinstance(value, str) else value
+ instance_type = dict
+ elif _type == "array":
+ value = json.loads(value) if isinstance(value, str) else value
+ instance_type = list
+ elif _type == "string":
+ instance_type = str
+ else:
+ maxkb_logger.error(
+ gettext("Field: {name} Type: {_type} Value: {value} Unsupported this type").format(
+ name=name, _type=_type, value=value
+ )
+ )
+ return value
+ if not isinstance(value, instance_type):
+ raise Exception(
+ gettext("Field: {name} Type: {_type} Value: {value} Type error").format(name=name, _type=_type, value=value)
+ )
+ return value
+
+
+def convert_value(name: str, value, _type, is_required, source, node):
+ if not is_required and (value is None or ((isinstance(value, str) or isinstance(value, list)) and len(value) == 0)):
+ return None
+ if source == "reference":
+ value = node.workflow_manage.get_reference_field(value[0], value[1:])
+ if value is None:
+ if not is_required:
+ return None
+ else:
+ raise Exception(gettext("Field: {name} Type: {_type} is required").format(name=name, _type=_type))
+ value = valid_reference_value(_type, value, name)
+ if _type == "int":
+ return int(value)
+ if _type == "float":
+ return float(value)
+ return value
+ try:
+ value = node.workflow_manage.generate_prompt(value)
+ return common_convert_value(_type, value)
+ except Exception:
+ raise Exception(
+ gettext("Field: {name} Type: {_type} Value: {value} Type error").format(name=name, _type=_type, value=value)
+ )
+
+
+class ToolNode(INode):
+ serializer_class = ToolNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "tool-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ input_field_list = node_params.get("input_field_list", [])
+ code = node_params.get("code")
+ is_result = node_params.get("is_result", False)
+
+ params = {
+ field.get("name"): convert_value(
+ field.get("name"),
+ field.get("value"),
+ field.get("type"),
+ field.get("is_required"),
+ field.get("source"),
+ self,
+ )
+ for field in input_field_list
+ }
+
+ # 合并启动参数默认值(如果有 init_field_list 定义)
+ init_field_list = node_params.get("init_field_list", [])
+ if init_field_list:
+ init_params_default_value = {i["field"]: i.get("default_value") for i in init_field_list}
+ init_params = self.get_workflow_parameters().get("init_params")
+ if init_params is not None:
+ all_params = init_params_default_value | init_params | params
+ else:
+ all_params = init_params_default_value | params
+ else:
+ all_params = params
+
+ result = function_executor.exec_code(code, all_params)
+ self.write_context("params", all_params)
+ self.write_context("result", result)
+
+ if is_result:
+ chunk_id = str(uuid.uuid7())
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.SUCCESS)
+ self.write(TextContent(chunk_id, str(result), Status.SUCCESS, node_info, Position(self.get_node_id())))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "result": self.get_context("result"),
+ "params": self.get_context("params"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/tool_start_node/__init__.py b/apps/application/workflow/nodes/tool_start_node/__init__.py
new file mode 100644
index 00000000000..bb9f7dc8336
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_start_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/3 17:20
+@desc:
+"""
+
+from .tool_start_node import ToolStartNode
diff --git a/apps/application/workflow/nodes/tool_start_node/tool_start_node.py b/apps/application/workflow/nodes/tool_start_node/tool_start_node.py
new file mode 100644
index 00000000000..efb746f0211
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_start_node/tool_start_node.py
@@ -0,0 +1,54 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: tool_start_node.py
+@date: 2026/9/3 17:20
+@desc: 工具工作流的起始节点,负责把工具入参写入全局变量、初始化输出字段
+"""
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+
+
+class ToolStartNode(INode):
+ supported_workflow_type_list = [WorkflowType.TOOL]
+ type = "tool-start-node"
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ base_node = self.workflow_manage.workflow.get_node("tool-base-node")
+ user_input_field_list = base_node.properties.get("user_input_field_list", []) if base_node else []
+ user_output_field_list = base_node.properties.get("user_output_field_list", []) if base_node else []
+
+ # 入参 -> 全局变量(引用约定 global.)
+ for item in user_input_field_list:
+ field = item.get("field")
+ self.workflow_manage.write_context("global", field, workflow_params.get(field))
+
+ # 初始化输出字段默认值 -> output(工作流内由变量赋值节点覆写)
+ for item in user_output_field_list:
+ if item.get("default_value", None) is not None:
+ self.workflow_manage.write_context("output", item.get("field"), item.get("default_value"))
+
+ self.write_context("question", workflow_params.get("question", ""))
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ global_fields = []
+ for field in (self.node.properties.get("config") or {}).get("globalFields", []) or []:
+ key = field.get("value")
+ global_fields.append(
+ {
+ "label": field.get("label"),
+ "key": key,
+ "value": self.workflow_manage.get_context("global", key) or "",
+ }
+ )
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "global_fields": global_fields,
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/tool_workflow_lib_node/__init__.py b/apps/application/workflow/nodes/tool_workflow_lib_node/__init__.py
new file mode 100644
index 00000000000..ddfc1fe47ac
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_workflow_lib_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/3 17:20
+@desc:
+"""
+
+from .tool_workflow_lib_node import ToolWorkflowLibNode
diff --git a/apps/application/workflow/nodes/tool_workflow_lib_node/tool_workflow_lib_node.py b/apps/application/workflow/nodes/tool_workflow_lib_node/tool_workflow_lib_node.py
new file mode 100644
index 00000000000..ac1d4d1967d
--- /dev/null
+++ b/apps/application/workflow/nodes/tool_workflow_lib_node/tool_workflow_lib_node.py
@@ -0,0 +1,215 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: tool_workflow_lib_node.py
+@date: 2026/9/3 17:20
+@desc:
+"""
+
+import uuid_utils.compat as uuid
+from django.db import connection
+from django.db.models import QuerySet
+from django.utils.translation import gettext
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType, new_instance
+from application.workflow.i_node import INode, Signal
+from application.workflow.message.struct.content import Position
+from application.workflow.status import Status
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.exception.app_exception import ChatException, AppApiException
+from common.field.common import ObjectField
+from tools.models import Tool, ToolType, ToolWorkflowVersion
+from knowledge.services.retrieval_access import inherited_retrieval_context
+
+
+class InputField(serializers.Serializer):
+ field = serializers.CharField(required=True, label=_("Variable Name"))
+ label = serializers.CharField(required=True, label=_("Variable Label"))
+ source = serializers.CharField(required=True, label=_("Variable Source"))
+ type = serializers.CharField(required=True, label=_("Variable Type"))
+ value = ObjectField(required=True, label=_("Variable Value"), model_type_list=[str, list, bool, dict, int, float])
+
+
+class ToolWorkflowLibNodeSerializer(serializers.Serializer):
+ tool_lib_id = serializers.UUIDField(required=True, label=_("Library ID"))
+ input_field_list = InputField(required=True, many=True)
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ f_lib = QuerySet(Tool).filter(id=self.data.get("tool_lib_id"), tool_type=ToolType.WORKFLOW).first()
+ # 归还链接到连接池
+ connection.close()
+ if f_lib is None:
+ raise AppApiException(500, _("Tool has been deleted"))
+ if not f_lib.is_active:
+ raise AppApiException(500, _("Tool is not active"))
+
+
+def valid_function(tool_lib, workspace_id):
+ if tool_lib is None:
+ raise Exception(gettext("Tool does not exist"))
+ get_authorized_tool = DatabaseModelManage.get_model("get_authorized_tool")
+ if tool_lib and tool_lib.workspace_id != workspace_id and get_authorized_tool is not None:
+ tool_lib = get_authorized_tool(QuerySet(Tool).filter(id=tool_lib.id), workspace_id).first()
+ if tool_lib is None:
+ raise Exception(gettext("Tool does not exist"))
+ if not tool_lib.is_active:
+ raise Exception(gettext("Tool is not active"))
+
+
+def _sum_tokens(context, key):
+ total = 0
+ for node_context in (context or {}).values():
+ if isinstance(node_context, dict) and isinstance(node_context.get(key), (int, float)):
+ total += node_context.get(key)
+ return total
+
+
+class ToolWorkflowLibNode(INode):
+ serializer_class = ToolWorkflowLibNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "tool-workflow-lib-node"
+
+ def _run(self):
+ # 完成时机由子工作流的 on_complete 回调驱动,这里不自动 complete
+ self.execute()
+
+ def execute(self):
+ node_params = self.get_parameters()
+ workflow_params = self.get_workflow_parameters()
+ tool_lib_id = node_params.get("tool_lib_id")
+ input_field_list = node_params.get("input_field_list", [])
+ workspace_id = workflow_params.get("workspace_id")
+ position = workflow_params.get("position")
+ tool_workflow_version = (
+ QuerySet(ToolWorkflowVersion).filter(tool_id=tool_lib_id).order_by("-create_time")[0:1].first()
+ )
+ if tool_workflow_version is None:
+ raise ChatException(500, _("The tool has not been published. Please use it after publishing."))
+ tool_lib = QuerySet(Tool).filter(id=tool_lib_id).first()
+ valid_function(tool_lib, workspace_id)
+
+ parameters = self._resolve_parameters(input_field_list)
+ # 入参映射属于调试数据,不需要给下游引用
+ self.data["params"] = parameters
+
+ sub_workflow = new_instance(tool_workflow_version.work_flow, WorkflowType.TOOL)
+ tool_record_id = str(uuid.uuid7())
+ sub_parameters = {
+ "chat_record_id": tool_record_id,
+ "tool_id": str(tool_lib_id),
+ "stream": True,
+ "workspace_id": workspace_id,
+ "position": position.get("children") if position else None,
+ "chunk_id": workflow_params.get("chunk_id"),
+ "form_data": workflow_params.get("form_data"),
+ "default_model_setting": tool_workflow_version.default_model_setting or {},
+ **parameters,
+ **inherited_retrieval_context(workflow_params),
+ }
+
+ node_id = self.get_node_id()
+
+ def on_next(wf_manage, content):
+ # 把子工作流的输出位置嵌套到当前节点下,再转发给父工作流
+ content.position = Position(node_id, None, content.position)
+ self.write(content)
+
+ def on_complete(wf_manage, error):
+ # 收集工具工作流输出(tool-start-node 初始化、变量赋值节点覆写)
+ output = dict(wf_manage.context.get("output", {}) or {})
+ # 只有需要给下游引用的数据才写 context:各输出字段
+ for key, value in output.items():
+ self.write_context(key, value)
+ # 调试/详情数据放 self.data,不进可引用 context(run_time 由基类 complete 写入)
+ self.data["output"] = output
+ self.data["details"] = wf_manage.get_details()
+ self.data["message_tokens"] = _sum_tokens(wf_manage.context, "message_tokens")
+ self.data["answer_tokens"] = _sum_tokens(wf_manage.context, "answer_tokens")
+
+ if error:
+ self.complete(Status.FAIL, error=error)
+ return
+ # 子工作流命中表单:向上传播中断,暂停父工作流
+ if wf_manage.signal == Signal.FORM:
+ self.complete(Status.SUCCESS, signal=Signal.FORM)
+ return
+ self.complete(Status.SUCCESS)
+
+ from application.workflow.nodes import get_node_class
+ from application.workflow.workflow_manage import CallBack, WorkflowManage
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_start_node_fn(wf, wm):
+ # 如果有 position,根据 position 确定开始节点
+ _position = wm.get_parameters().get("position")
+ if _position and _position.get("id"):
+ _node_id = _position.get("id")
+ node = wf.get_node(_node_id)
+ if node:
+ node_class = get_node_class(node.type, WorkflowType.TOOL)
+ return node_class(node, wm, lambda n: n.properties.get("node_data", {}))
+ # 默认返回工具工作流开始节点
+ start_node = wf.get_node("tool-start-node")
+ node_class = get_node_class("tool-start-node", WorkflowType.TOOL)
+ return node_class(start_node, wm, lambda n: n.properties.get("node_data", {}))
+
+ sub_manage = WorkflowManage(
+ workflow=sub_workflow,
+ parameters=sub_parameters,
+ workflow_type=WorkflowType.TOOL,
+ call_back=call_back,
+ get_start_node=get_start_node_fn,
+ )
+ sub_manage.start_node.workflow_manage = sub_manage
+ # 子工作流的输出已在 on_next 中逐块转发给父工作流,无需按 is_result 重复输出
+ sub_manage.run()
+
+ def _resolve_parameters(self, input_field_list):
+ result = {}
+ for item in input_field_list:
+ source = item.get("source")
+ value = item.get("value")
+ if source == "reference" and isinstance(value, list) and len(value) >= 2:
+ value = self.workflow_manage.get_reference_field(value[0], value[1:])
+ result[item.get("field")] = value
+ return result
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "params": self.data.get("params"),
+ "output": self.data.get("output"),
+ "message_tokens": self.data.get("message_tokens"),
+ "answer_tokens": self.data.get("answer_tokens"),
+ "enableException": self.node.properties.get("enableException"),
+ }
+ )
+
+ # 子工作流节点详情。工具工作流只运行一遍,children 是扁平的一层节点列表;
+ # 循环节点因每个迭代多一层,children 结构为 [[节点...], [节点...]]。
+ node_details = []
+ position_index = 0
+ if old_details and position:
+ # 用旧详情作为底,定位续跑点(子工作流表单节点)
+ old_node_list = old_details.get("children") or []
+ node_details = list(old_node_list)
+ for node_index, value in enumerate(node_details):
+ if position.get("children", {}).get("id") == value.get("node_id"):
+ position_index = node_index
+
+ for index, item in enumerate(self.data.get("details") or []):
+ if position is not None and node_details and index == 0:
+ # 续跑点:子工作流从表单节点恢复,当前运行的首个节点覆盖旧详情中的同一点
+ node_details[position_index] = item
+ else:
+ node_details.append(item)
+
+ details["children"] = node_details
+ return details
diff --git a/apps/application/workflow/nodes/variable_aggregation_node/__init__.py b/apps/application/workflow/nodes/variable_aggregation_node/__init__.py
new file mode 100644
index 00000000000..1ddb052c0d4
--- /dev/null
+++ b/apps/application/workflow/nodes/variable_aggregation_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@desc:
+"""
+
+from .variable_aggregation_node import VariableAggregationNode
diff --git a/apps/application/workflow/nodes/variable_aggregation_node/variable_aggregation_node.py b/apps/application/workflow/nodes/variable_aggregation_node/variable_aggregation_node.py
new file mode 100644
index 00000000000..5e02c9c27a3
--- /dev/null
+++ b/apps/application/workflow/nodes/variable_aggregation_node/variable_aggregation_node.py
@@ -0,0 +1,133 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: variable_aggregation_node.py
+@desc: 变量聚合节点
+"""
+
+from typing import Callable, List
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+
+
+class VariableListSerializer(serializers.Serializer):
+ v_id = serializers.CharField(required=True, label=_("Variable id"))
+ key = serializers.CharField(required=False, label=_("Key"), allow_null=True, allow_blank=True)
+ variable = serializers.ListField(required=True, label=_("Variable"))
+
+
+class VariableGroupSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label=_("Group id"))
+ field = serializers.CharField(required=True, label=_("group_name"))
+ label = serializers.CharField(required=True)
+ variable_list = VariableListSerializer(many=True)
+
+
+class VariableAggregationNodeSerializer(serializers.Serializer):
+ strategy = serializers.CharField(required=True, label=_("Strategy"))
+ group_list = VariableGroupSerializer(many=True)
+
+
+def _filter_file_bytes(data):
+ """递归过滤掉所有层级的 file_bytes"""
+ if isinstance(data, dict):
+ return {k: _filter_file_bytes(v) for k, v in data.items() if k != "file_bytes"}
+ elif isinstance(data, list):
+ return [_filter_file_bytes(item) for item in data]
+ else:
+ return data
+
+
+class VariableAggregationNode(INode):
+ serializer_class = VariableAggregationNodeSerializer
+ supported_workflow_type_list = [
+ WorkflowType.APPLICATION,
+ WorkflowType.KNOWLEDGE,
+ WorkflowType.TOOL,
+ ]
+ type = "variable-aggregation-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ strategy = node_params.get("strategy")
+ group_list = node_params.get("group_list", [])
+
+ strategy_map = {
+ "first_non_null": self.get_first_non_null,
+ "variable_to_array": self.set_variable_to_array,
+ "variable_to_dict": self.set_variable_to_dict,
+ }
+
+ # 向下兼容
+ if strategy == "variable_to_json":
+ strategy = "variable_to_array"
+
+ result = {
+ item.get("field"): strategy_map[strategy](item.get("variable_list")) if item.get("variable_list") else []
+ for item in group_list
+ }
+
+ self.write_context("result", result)
+ self.write_context("strategy", strategy)
+ self.write_context("group_list", self.reset_group_list(group_list))
+ for key, value in result.items():
+ self.write_context(key, value)
+
+ def get_first_non_null(self, variable_list) -> Callable:
+ for variable in variable_list:
+ v = self.get_reference_content(variable.get("variable"))
+ if v is not None and not (isinstance(v, (str, list, dict)) and len(v) == 0):
+ return v
+ return None
+
+ def set_variable_to_array(self, variable_list) -> List:
+ return [self.get_reference_content(variable.get("variable")) for variable in variable_list]
+
+ def set_variable_to_dict(self, variable_list) -> dict:
+ return {
+ (variable.get("key") or variable.get("variable")[-1]): self.get_reference_content(variable.get("variable"))
+ for variable in variable_list
+ }
+
+ def reset_variable(self, variable):
+ value = self.get_reference_content(variable.get("variable"))
+ node_id = variable.get("variable")[0]
+ node = self.workflow_manage.workflow.get_node(node_id)
+ return {
+ "value": value,
+ "node_name": node.properties.get("stepName") if node is not None else node_id,
+ "field": variable.get("variable")[1],
+ }
+
+ def reset_group_list(self, group_list):
+ return [
+ {
+ "label": g.get("label"),
+ "variable_list": [self.reset_variable(variable) for variable in g.get("variable_list")],
+ }
+ for g in group_list
+ ]
+
+ def get_reference_content(self, variable):
+ return (
+ self.workflow_manage.get_reference_field(variable[0], variable[1:])
+ if variable and len(variable) >= 2
+ else None
+ )
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "result": _filter_file_bytes(self.get_context("result")),
+ "strategy": self.get_context("strategy"),
+ "group_list": _filter_file_bytes(self.get_context("group_list")),
+ "status": self.status.value if self.status else None,
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/variable_assign_node/__init__.py b/apps/application/workflow/nodes/variable_assign_node/__init__.py
new file mode 100644
index 00000000000..6f3c30b088a
--- /dev/null
+++ b/apps/application/workflow/nodes/variable_assign_node/__init__.py
@@ -0,0 +1,10 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@date: 2026/9/3
+@desc:
+"""
+
+from .variable_assign_node import VariableAssignNode
diff --git a/apps/application/workflow/nodes/variable_assign_node/variable_assign_node.py b/apps/application/workflow/nodes/variable_assign_node/variable_assign_node.py
new file mode 100644
index 00000000000..ea54bb8cd65
--- /dev/null
+++ b/apps/application/workflow/nodes/variable_assign_node/variable_assign_node.py
@@ -0,0 +1,129 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: variable_assign_node.py
+@desc: 变量赋值节点
+"""
+
+import json
+from typing import Callable, List
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.loop_workflow_manage import LoopWorkFlowManage
+
+
+class VariableAssignNodeParamsSerializer(serializers.Serializer):
+ variable_list = serializers.ListField(required=True, label=_("Reference Field"))
+
+
+class VariableAssignNode(INode):
+ serializer_class = VariableAssignNodeParamsSerializer
+ supported_workflow_type_list = [
+ WorkflowType.APPLICATION,
+ WorkflowType.KNOWLEDGE,
+ WorkflowType.TOOL,
+ ]
+ type = "variable-assign-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+ result_list = []
+ for variable in node_params.get("variable_list", []):
+ if not variable.get("fields"):
+ continue
+
+ field0 = variable["fields"][0]
+ if field0 == "global":
+ result = self.handle(variable, self.global_evaluation)
+ result_list.append(result)
+ elif field0 == "chat":
+ result = self.handle(variable, self.chat_evaluation)
+ result_list.append(result)
+ elif field0 == "loop":
+ result = self.handle(variable, self.loop_evaluation)
+ result_list.append(result)
+ elif field0 == "output":
+ result = self.handle(variable, self.output_evaluation)
+ result_list.append(result)
+
+ self.write_context("variable_list", node_params.get("variable_list", []))
+ self.write_context("result_list", result_list)
+
+ def _target_manage(self):
+ return (
+ self.workflow_manage.parent_workflow_manage
+ if isinstance(self.workflow_manage, LoopWorkFlowManage)
+ else self.workflow_manage
+ )
+
+ def global_evaluation(self, variable, value):
+ self._target_manage().write_context("global", variable["fields"][1], value)
+
+ def loop_evaluation(self, variable, value):
+ self.workflow_manage.write_context("loop", variable["fields"][1], value)
+
+ def chat_evaluation(self, variable, value):
+ self._target_manage().write_context("chat", variable["fields"][1], value)
+
+ def output_evaluation(self, variable, value):
+ self._target_manage().write_context("output", variable["fields"][1], value)
+
+ def handle(self, variable, evaluation: Callable):
+ result = {
+ "name": variable["name"],
+ "input_value": self.get_reference_content(variable["fields"]),
+ }
+ if variable["source"] == "custom":
+ if variable["type"] == "json":
+ if isinstance(variable["value"], dict) or isinstance(variable["value"], list):
+ val = variable["value"]
+ else:
+ val = json.loads(variable["value"])
+ evaluation(variable, val)
+ result["output_value"] = variable["value"] = val
+ elif variable["type"] == "string":
+ # 变量解析 例如:{{global.xxx}}
+ val = self.workflow_manage.generate_prompt(variable["value"])
+ evaluation(variable, val)
+ result["output_value"] = val
+ else:
+ val = variable["value"]
+ evaluation(variable, val)
+ result["output_value"] = val
+ elif variable["source"] == "referencing":
+ reference = self.get_reference_content(variable["reference"])
+ evaluation(variable, reference)
+ result["output_value"] = reference
+ else:
+ val = None
+ evaluation(variable, val)
+ result["output_value"] = val
+
+ # 获取输入输出值的类型,用于显示在执行详情页面中
+ result["input_type"] = (
+ type(result.get("input_value")).__name__ if result.get("input_value") is not None else "null"
+ )
+ result["output_type"] = (
+ type(result.get("output_value")).__name__ if result.get("output_value") is not None else "null"
+ )
+
+ return result
+
+ def get_reference_content(self, fields: List[str]):
+ return self.workflow_manage.get_reference_field(fields[0], fields[1:]) if fields else None
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "variable_list": self.get_context("variable_list"),
+ "result_list": self.get_context("result_list"),
+ "status": self.status.value if self.status else None,
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/variable_splitting_node/__init__.py b/apps/application/workflow/nodes/variable_splitting_node/__init__.py
new file mode 100644
index 00000000000..18bc38f55df
--- /dev/null
+++ b/apps/application/workflow/nodes/variable_splitting_node/__init__.py
@@ -0,0 +1,9 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: __init__.py
+@desc:
+"""
+
+from .variable_splitting_node import VariableSplittingNode
diff --git a/apps/application/workflow/nodes/variable_splitting_node/variable_splitting_node.py b/apps/application/workflow/nodes/variable_splitting_node/variable_splitting_node.py
new file mode 100644
index 00000000000..051cbb2c831
--- /dev/null
+++ b/apps/application/workflow/nodes/variable_splitting_node/variable_splitting_node.py
@@ -0,0 +1,101 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: variable_splitting_node.py
+@desc: 变量拆分节点
+"""
+
+import json
+
+from django.utils.translation import gettext_lazy as _
+from jsonpath_ng.ext import parse
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from common.cache.mem_cache import MemCache
+
+jsonpath_expr_cache = MemCache(
+ "parse_path",
+ {
+ "TIMEOUT": 3600, # 缓存有效期为 1 小时
+ "OPTIONS": {
+ "MAX_ENTRIES": 1000, # 最多缓存 1000 个条目
+ "CULL_FREQUENCY": 10, # 达到上限时,删除约 1/10 的缓存
+ },
+ },
+)
+
+
+class VariableSplittingNodeParamsSerializer(serializers.Serializer):
+ input_variable = serializers.ListField(required=True, label=_("input variable"))
+ variable_list = serializers.ListField(required=True, label=_("Split variables"))
+
+
+def parse_and_cache(path):
+ jsonpath_expr = jsonpath_expr_cache.get(path)
+ if not jsonpath_expr:
+ jsonpath_expr = parse(path)
+ jsonpath_expr_cache.set(path, jsonpath_expr)
+ return jsonpath_expr
+
+
+def smart_jsonpath_search(data: dict, path: str):
+ """智能 JSON Path 搜索。
+
+ - 单个匹配: 直接返回值
+ - 多个匹配: 返回值的列表
+ - 无匹配: 返回 None
+ """
+ jsonpath_expr = parse_and_cache(path)
+ matches = jsonpath_expr.find(data)
+
+ if not matches:
+ return None
+ elif len(matches) == 1:
+ return matches[0].value
+ else:
+ return [match.value for match in matches]
+
+
+class VariableSplittingNode(INode):
+ serializer_class = VariableSplittingNodeParamsSerializer
+ supported_workflow_type_list = [
+ WorkflowType.APPLICATION,
+ WorkflowType.KNOWLEDGE,
+ WorkflowType.TOOL,
+ ]
+ type = "variable-splitting-node"
+
+ def execute(self):
+ node_params = self.get_parameters()
+
+ input_variable = self.workflow_manage.get_reference_field(
+ node_params.get("input_variable")[0],
+ node_params.get("input_variable")[1:],
+ )
+ variable_list = node_params.get("variable_list", [])
+
+ if isinstance(input_variable, str):
+ try:
+ input_variable = json.loads(input_variable)
+ except Exception:
+ pass
+
+ self.write_context("request", input_variable)
+ response = {v["field"]: smart_jsonpath_search(input_variable, v["expression"]) for v in variable_list}
+ self.write_context("result", response)
+ for key, value in response.items():
+ self.write_context(key, value)
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "request": self.get_context("request"),
+ "result": self.get_context("result"),
+ "status": self.status.value if self.status else None,
+ }
+ )
+ return details
diff --git a/apps/application/workflow/nodes/video_understand_node/__init__.py b/apps/application/workflow/nodes/video_understand_node/__init__.py
new file mode 100644
index 00000000000..5bb3385963d
--- /dev/null
+++ b/apps/application/workflow/nodes/video_understand_node/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .video_understand_node import VideoUnderstandNode
diff --git a/apps/application/workflow/nodes/video_understand_node/video_understand_node.py b/apps/application/workflow/nodes/video_understand_node/video_understand_node.py
new file mode 100644
index 00000000000..8f9d3b3b8ac
--- /dev/null
+++ b/apps/application/workflow/nodes/video_understand_node/video_understand_node.py
@@ -0,0 +1,387 @@
+# coding=utf-8
+import uuid_utils.compat as uuid
+from functools import reduce
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage, SystemMessage, AIMessage
+from rest_framework import serializers
+
+from application.workflow.common import WorkflowType
+from application.workflow.i_node import INode
+from application.workflow.message.struct.content import NodeInfo, Position
+from application.workflow.message.struct.reasoning_content import ReasoningContent
+from application.workflow.message.struct.text_content import TextContent
+from application.workflow.status import Status
+from application.workflow.tools import Reasoning
+from common.exception.app_exception import AppApiException
+from knowledge.models import File
+from models_provider.models import Model
+from models_provider.tools import get_model_instance_by_model_workspace_id
+
+
+class VideoUnderstandNodeSerializer(serializers.Serializer):
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model id"))
+ model_id_type = serializers.CharField(required=False, default="custom", label=_("Model id type"))
+ model_id_reference = serializers.ListField(
+ required=False, child=serializers.CharField(), allow_empty=True, label=_("Reference Field")
+ )
+ system = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Role Setting"))
+ prompt = serializers.CharField(required=True, label=_("Prompt word"))
+ dialogue_number = serializers.IntegerField(required=True, label=_("Number of multi-round conversations"))
+ dialogue_type = serializers.CharField(required=True, label=_("Conversation storage type"))
+ is_result = serializers.BooleanField(required=False, label=_("Whether to return content"))
+ video_list = serializers.ListField(required=False, label=_("video"))
+ model_params_setting = serializers.JSONField(required=False, default=dict, label=_("Model parameter settings"))
+ model_setting = serializers.DictField(required=False, label="Model settings")
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ # reference / default 在运行时才解析,此处只校验自定义模型
+ if (self.data.get("model_id_type") or "custom") in ("reference", "default"):
+ return
+ model_id = self.data.get("model_id")
+ if not model_id or not QuerySet(Model).filter(id=model_id).exists():
+ raise AppApiException(500, _("The model of the node does not exist"))
+
+
+class VideoUnderstandNode(INode):
+ serializer_class = VideoUnderstandNodeSerializer
+ supported_workflow_type_list = [WorkflowType.APPLICATION, WorkflowType.KNOWLEDGE, WorkflowType.TOOL]
+ type = "video-understand-node"
+
+ def execute(self):
+ workflow_params = self.get_workflow_parameters()
+ node_params = self.get_parameters()
+
+ model_id = node_params.get("model_id")
+ model_id_type = node_params.get("model_id_type", "custom")
+ model_id_reference = node_params.get("model_id_reference")
+ system = node_params.get("system", "")
+ prompt = node_params.get("prompt", "")
+ dialogue_number = node_params.get("dialogue_number", 0)
+ dialogue_type = node_params.get("dialogue_type", "WORKFLOW")
+ is_result = node_params.get("is_result", False)
+ video_list_ref = node_params.get("video_list")
+ model_params_setting = node_params.get("model_params_setting")
+ model_setting = node_params.get("model_setting")
+
+ workflow_type = self.get_workflow_type()
+ if workflow_type in (WorkflowType.KNOWLEDGE, WorkflowType.TOOL):
+ history_chat_record = []
+ chat_id = None
+ workspace_id = workflow_params.get("workspace_id")
+ else:
+ history_chat_record = workflow_params.get("history_chat_record", [])
+ chat_id = workflow_params.get("chat_id")
+ workspace_id = workflow_params.get("workspace_id")
+
+ if model_setting is None:
+ model_setting = {
+ "reasoning_content_enable": False,
+ "reasoning_content_end": "",
+ "reasoning_content_start": "",
+ }
+ self.write_context("model_setting", model_setting)
+
+ if model_id_type == "reference" and model_id_reference:
+ reference_data = self.workflow_manage.get_reference_field(
+ model_id_reference[0],
+ model_id_reference[1:],
+ )
+ if reference_data and isinstance(reference_data, dict):
+ model_id = reference_data.get("model_id", model_id)
+ model_params_setting = reference_data.get("model_params_setting")
+
+ if model_id_type == "default":
+ default_model_setting = workflow_params.get("default_model_setting").get("IMAGE") or {}
+ if default_model_setting and isinstance(default_model_setting, dict):
+ model_id = default_model_setting.get("model_id", model_id)
+ model_params_setting = default_model_setting.get("model_params_setting")
+
+ if not model_id:
+ raise Exception(_("Model is not allowed to be empty"))
+
+ video = None
+ if video_list_ref:
+ video = self.workflow_manage.get_reference_field(video_list_ref[0], video_list_ref[1:])
+
+ chat_model = get_model_instance_by_model_workspace_id(model_id, workspace_id, **(model_params_setting or {}))
+
+ history_message_for_details = self._get_history_message_for_details(history_chat_record, dialogue_number)
+ self.write_context(
+ "history_message",
+ [{"content": message.content, "role": message.type} for message in (history_message_for_details or [])],
+ )
+
+ question = self.workflow_manage.generate_prompt(prompt)
+ self.write_context("question", question)
+
+ system = self.workflow_manage.generate_prompt(system)
+ self.write_context("system", system)
+
+ history_message = self._get_history_message(history_chat_record, dialogue_number, chat_model)
+ message_list = self._generate_message_list(chat_model, system, prompt, history_message, video)
+ self.write_context(
+ "message_list",
+ [{"content": m.content, "role": m.type} for m in message_list],
+ )
+
+ self._generate_context_video(video)
+ self.write_context("dialogue_type", dialogue_type)
+
+ reasoning_content_id = str(uuid.uuid7())
+ text_content_id = str(uuid.uuid7())
+
+ node_info = NodeInfo(self.get_node_id(), self.get_node_name(), Status.RUNNING)
+
+ r = chat_model.stream(message_list)
+ self._stream_response(
+ r, chat_model, message_list, question, reasoning_content_id, text_content_id, node_info, is_result
+ )
+
+ def _stream_response(
+ self, response, chat_model, message_list, question, reasoning_content_id, text_content_id, node_info, is_result
+ ):
+ model_setting = self.get_context("model_setting") or {}
+ reasoning = Reasoning(
+ model_setting.get("reasoning_content_start", ""),
+ model_setting.get("reasoning_content_end", ""),
+ )
+ answer = ""
+ reasoning_content = ""
+ response_reasoning_content = False
+
+ for chunk in response:
+ self._check_cancelled()
+ reasoning_chunk = reasoning.get_reasoning_content(chunk)
+ content_chunk = reasoning_chunk.get("content")
+ if "reasoning_content" in chunk.additional_kwargs:
+ response_reasoning_content = True
+ reasoning_content_chunk = chunk.additional_kwargs.get("reasoning_content", "")
+ else:
+ reasoning_content_chunk = reasoning_chunk.get("reasoning_content")
+ answer += content_chunk
+ if reasoning_content_chunk is None:
+ reasoning_content_chunk = ""
+ reasoning_content += reasoning_content_chunk
+
+ if is_result:
+ if isinstance(chunk.content, list):
+ for chunk_item in chunk.content:
+ text = chunk_item.get("text", "")
+ if text:
+ self.write(
+ TextContent(
+ text_content_id, text, Status.RUNNING, node_info, Position(self.get_node_id())
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+ else:
+ if content_chunk:
+ self.write(
+ TextContent(
+ text_content_id, content_chunk, Status.RUNNING, node_info, Position(self.get_node_id())
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ reasoning_end = reasoning.get_end_reasoning_content()
+ answer += reasoning_end.get("content")
+ reasoning_content_chunk = ""
+ if not response_reasoning_content:
+ reasoning_content_chunk = reasoning_end.get("reasoning_content")
+ if is_result:
+ if reasoning_end.get("content"):
+ self.write(
+ TextContent(
+ text_content_id,
+ reasoning_end.get("content"),
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+ if reasoning_content_chunk and model_setting.get("reasoning_content_enable", False):
+ self.write(
+ ReasoningContent(
+ reasoning_content_id,
+ reasoning_content_chunk,
+ Status.RUNNING,
+ node_info,
+ Position(self.get_node_id()),
+ )
+ )
+
+ self._write_final_context(chat_model, message_list, question, answer, reasoning_content)
+
+ def _write_final_context(self, chat_model, message_list, question, answer, reasoning_content):
+ message_tokens = chat_model.get_num_tokens_from_messages(message_list)
+ answer_tokens = chat_model.get_num_tokens(answer)
+ self.write_context("message_tokens", message_tokens)
+ self.write_context("answer_tokens", answer_tokens)
+ self.write_context("answer", answer)
+ self.write_context("question", question)
+ self.write_context("reasoning_content", reasoning_content)
+
+ def _generate_context_video(self, video):
+ if isinstance(video, str) and video.startswith("http"):
+ self.write_context("video_list", [{"url": video}])
+ elif video is not None and len(video) > 0:
+ self.write_context("video_list", video)
+
+ def _get_history_message_for_details(self, history_chat_record, dialogue_number):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message_for_details(history_chat_record[index]),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ return history_message
+
+ def _generate_history_ai_message(self, chat_record):
+ for val in chat_record.details.values():
+ if self.node.id == val["node_id"] and "video_list" in val:
+ if val["dialogue_type"] == "WORKFLOW":
+ return chat_record.get_ai_message()
+ return [AIMessage(content=val["answer"])]
+ return chat_record.get_ai_message()
+
+ def _generate_history_human_message_for_details(self, chat_record):
+ for data in chat_record.details.values():
+ if self.node.id == data["node_id"] and "video_list" in data:
+ video_list = data["video_list"] or []
+ if len(video_list) == 0 or data["dialogue_type"] == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ file_id_list = []
+ url_list = []
+ for video in video_list:
+ if "file_id" in video:
+ file_id_list.append(video.get("file_id"))
+ elif "url" in video:
+ url_list.append(video.get("url"))
+ return HumanMessage(
+ content=[
+ {"type": "text", "text": data["question"]},
+ *[
+ {"type": "video_url", "video_url": {"url": f"./oss/file/{file_id}"}}
+ for file_id in file_id_list
+ ],
+ *[{"type": "video_url", "video_url": {"url": url}} for url in url_list],
+ ]
+ )
+ return HumanMessage(content=chat_record.problem_text)
+
+ def _get_history_message(self, history_chat_record, dialogue_number, video_model):
+ start_index = len(history_chat_record) - dialogue_number
+ history_message = reduce(
+ lambda x, y: [*x, *y],
+ [
+ [
+ self._generate_history_human_message(history_chat_record[index], video_model),
+ *self._generate_history_ai_message(history_chat_record[index]),
+ ]
+ for index in range(start_index if start_index > 0 else 0, len(history_chat_record))
+ ],
+ [],
+ )
+ return history_message
+
+ def _generate_history_human_message(self, chat_record, video_model):
+ for data in chat_record.details.values():
+ if self.node.id == data["node_id"] and "video_list" in data:
+ video_list = data["video_list"] or []
+ if len(video_list) == 0 or data["dialogue_type"] == "WORKFLOW":
+ return HumanMessage(content=chat_record.problem_text)
+ file_id_list = []
+ url_list = []
+ for video in video_list:
+ if "file_id" in video:
+ file_id_list.append(video.get("file_id"))
+ elif "url" in video:
+ url_list.append(video.get("url"))
+ video_base64_list = [self._file_id_to_base64(file_id, video_model) for file_id in file_id_list]
+ return HumanMessage(
+ content=[
+ {"type": "text", "text": data["question"]},
+ *[
+ {"type": "video_url", "video_url": {"url": base64_video}}
+ for base64_video in video_base64_list
+ ],
+ *[{"type": "video_url", "video_url": {"url": url}} for url in url_list],
+ ]
+ )
+ return HumanMessage(content=chat_record.problem_text)
+
+ @staticmethod
+ def _file_id_to_base64(file_id: str, video_model):
+ file = QuerySet(File).filter(id=file_id).first()
+ file_bytes = file.get_bytes()
+ return video_model.upload_file_and_get_url(file_bytes, file.file_name)
+
+ def _process_videos(self, video, video_model):
+ videos = []
+ if isinstance(video, str) and video.startswith("http"):
+ videos.append({"type": "video_url", "video_url": {"url": video}})
+ elif video is not None and len(video) > 0:
+ for v in video:
+ if "file_id" in v:
+ file_id = v["file_id"]
+ file = QuerySet(File).filter(id=file_id).first()
+ url = video_model.upload_file_and_get_url(file.get_bytes(), file.file_name)
+ videos.append({"type": "video_url", "video_url": {"url": url}})
+ elif "url" in v and v["url"].startswith("http"):
+ videos.append({"type": "video_url", "video_url": {"url": v["url"]}})
+ return videos
+
+ def _generate_message_list(self, video_model, system: str, prompt: str, history_message, video):
+ prompt_text = self.workflow_manage.generate_prompt(prompt)
+ videos = self._process_videos(video, video_model)
+
+ if videos:
+ messages = [HumanMessage(content=[{"type": "text", "text": prompt_text}, *videos])]
+ else:
+ messages = [HumanMessage(prompt_text)]
+
+ if system is not None and len(system) > 0:
+ return [SystemMessage(system), *history_message, *messages]
+ else:
+ return [*history_message, *messages]
+
+ def get_details(self, index: int = 0, position: dict = None, old_details: dict = None, **kwargs):
+ details = super().get_details(index, position, old_details, **kwargs)
+ details.update(
+ {
+ "question": self.get_context("question"),
+ "answer": self.get_context("answer"),
+ "video_list": self.get_context("video_list"),
+ "reasoning_content": self.get_context("reasoning_content"),
+ "message_tokens": self.get_context("message_tokens"),
+ "answer_tokens": self.get_context("answer_tokens"),
+ }
+ )
+ return details
diff --git a/apps/application/workflow/status.py b/apps/application/workflow/status.py
new file mode 100644
index 00000000000..3bb2b0db594
--- /dev/null
+++ b/apps/application/workflow/status.py
@@ -0,0 +1,22 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: status.py
+ @date:2026/6/30 15:47
+ @desc:
+"""
+from enum import Enum
+
+
+class Status(Enum):
+ # 成功
+ SUCCESS = "SUCCESS"
+ # 失败
+ FAIL = "FAIL"
+ # 运行中
+ RUNNING = "RUNNING"
+ # 运行前
+ BEFORE_RUNNING = "BEFORE_RUNNING"
+ # 取消
+ CANCELLED = "CANCELLED"
diff --git a/apps/application/workflow/tools.py b/apps/application/workflow/tools.py
new file mode 100644
index 00000000000..c5e6db6fb87
--- /dev/null
+++ b/apps/application/workflow/tools.py
@@ -0,0 +1,94 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: tools.py
+ @date:2026/6/29 18:44
+ @desc:
+"""
+
+
+class Reasoning:
+ def __init__(self, reasoning_content_start, reasoning_content_end):
+ self.content = ""
+ self.reasoning_content = ""
+ self.all_content = ""
+ self.reasoning_content_start_tag = reasoning_content_start
+ self.reasoning_content_end_tag = reasoning_content_end
+ self.reasoning_content_start_tag_len = len(
+ reasoning_content_start) if reasoning_content_start is not None else 0
+ self.reasoning_content_end_tag_len = len(reasoning_content_end) if reasoning_content_end is not None else 0
+ self.reasoning_content_end_tag_prefix = reasoning_content_end[
+ 0] if self.reasoning_content_end_tag_len > 0 else ''
+ self.reasoning_content_is_start = False
+ self.reasoning_content_is_end = False
+ self.reasoning_content_chunk = ""
+
+ def get_end_reasoning_content(self):
+ if not self.reasoning_content_is_start and not self.reasoning_content_is_end:
+ r = {'content': self.all_content, 'reasoning_content': ''}
+ self.reasoning_content_chunk = ""
+ return r
+ if self.reasoning_content_is_start and not self.reasoning_content_is_end:
+ r = {'content': '', 'reasoning_content': self.reasoning_content_chunk}
+ self.reasoning_content_chunk = ""
+ return r
+ return {'content': '', 'reasoning_content': ''}
+
+ def get_reasoning_content(self, chunk):
+ # 如果没有开始思考过程标签那么就全是结果
+ if self.reasoning_content_start_tag is None or len(self.reasoning_content_start_tag) == 0:
+ self.content += chunk.content
+ return {'content': chunk.content, 'reasoning_content': ''}
+ # 如果没有结束思考过程标签那么就全部是思考过程
+ if self.reasoning_content_end_tag is None or len(self.reasoning_content_end_tag) == 0:
+ return {'content': '', 'reasoning_content': chunk.content}
+ self.all_content += chunk.content
+ if not self.reasoning_content_is_start and len(self.all_content) >= self.reasoning_content_start_tag_len:
+ if self.all_content.startswith(self.reasoning_content_start_tag):
+ self.reasoning_content_is_start = True
+ self.reasoning_content_chunk = self.all_content[self.reasoning_content_start_tag_len:]
+ else:
+ if not self.reasoning_content_is_end:
+ self.reasoning_content_is_end = True
+ self.content += self.all_content
+ return {'content': self.all_content, 'reasoning_content': ''}
+ else:
+ if self.reasoning_content_is_start:
+ self.reasoning_content_chunk += chunk.content
+ reasoning_content_end_tag_prefix_index = self.reasoning_content_chunk.find(
+ self.reasoning_content_end_tag_prefix)
+ if self.reasoning_content_is_end:
+ self.content += chunk.content
+ return {'content': chunk.content, 'reasoning_content': ''}
+ # 是否包含结束
+ if reasoning_content_end_tag_prefix_index > -1:
+ if len(self.reasoning_content_chunk) - reasoning_content_end_tag_prefix_index >= self.reasoning_content_end_tag_len:
+ reasoning_content_end_tag_index = self.reasoning_content_chunk.find(self.reasoning_content_end_tag)
+ if reasoning_content_end_tag_index > -1:
+ reasoning_content_chunk = self.reasoning_content_chunk[0:reasoning_content_end_tag_index]
+ content_chunk = self.reasoning_content_chunk[
+ reasoning_content_end_tag_index + self.reasoning_content_end_tag_len:]
+ self.reasoning_content += reasoning_content_chunk
+ self.content += content_chunk
+ self.reasoning_content_chunk = ""
+ self.reasoning_content_is_end = True
+ return {'content': content_chunk, 'reasoning_content': reasoning_content_chunk}
+ else:
+ reasoning_content_chunk = self.reasoning_content_chunk[0:reasoning_content_end_tag_prefix_index + 1]
+ self.reasoning_content_chunk = self.reasoning_content_chunk.replace(reasoning_content_chunk, '')
+ self.reasoning_content += reasoning_content_chunk
+ return {'content': '', 'reasoning_content': reasoning_content_chunk}
+ else:
+ return {'content': '', 'reasoning_content': ''}
+
+ else:
+ if self.reasoning_content_is_end:
+ self.content += chunk.content
+ return {'content': chunk.content, 'reasoning_content': ''}
+ else:
+ # aaa
+ result = {'content': '', 'reasoning_content': self.reasoning_content_chunk}
+ self.reasoning_content += self.reasoning_content_chunk
+ self.reasoning_content_chunk = ""
+ return result
diff --git a/apps/application/workflow/workflow_manage.py b/apps/application/workflow/workflow_manage.py
new file mode 100644
index 00000000000..5360ccc2480
--- /dev/null
+++ b/apps/application/workflow/workflow_manage.py
@@ -0,0 +1,276 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: workflow_manage.py
+@date:2026/6/29 10:30
+@desc:
+"""
+
+from __future__ import annotations
+
+import threading
+from typing import List, Dict, Optional, Callable
+
+from application.workflow.common import Workflow, WorkflowType, Node, get_node_parameters
+from application.workflow.i_node import INode, Signal
+from application.workflow.message.struct.content import Content
+
+from application.workflow.status import Status
+from common.utils.prompt_template import render_prompt
+
+
+class CallBack:
+ def __init__(
+ self,
+ on_next: Callable[[WorkflowManage, Content], None],
+ on_complete: Callable[[WorkflowManage, Optional[Exception]], None],
+ ):
+ self.on_next = on_next
+ self.on_complete = on_complete
+
+
+class WorkflowManage:
+ # 工作流节点数据
+ context: Dict[Dict[str, any]]
+ # 运行的节点
+ nodes: List[INode]
+ # 是否结束
+ done: bool
+
+ def __init__(
+ self,
+ workflow: Workflow,
+ parameters: Dict,
+ workflow_type: WorkflowType,
+ call_back: CallBack,
+ get_start_node: Callable[[Workflow, WorkflowManage], INode],
+ ):
+ """
+
+ @param workflow: 工作流对象
+ @param workflow_type: 工作流类型
+ @param parameters: 工作流使用到的其他数据
+ """
+ self._lock = threading.Lock()
+ self.done = False
+ self.call_back = call_back
+ self.workflow = workflow
+ self.workflow_type = workflow_type
+ self.parameters = parameters
+ self.context = {}
+ self.nodes = []
+ self.node_dict = {}
+ self.signal = None
+ self.details = {"position": {}, "details": {}}
+ self.start_node = get_start_node(workflow, self)
+
+ def run(self):
+ """
+ 工作流执行
+ @return: None
+ """
+ self.nodes.append(self.start_node)
+ self.node_dict = {node.node.id: node for node in self.nodes}
+ self._run_async(self.start_node)
+
+ def _run(self, node):
+ node.run()
+
+ def next_nodes(self, nodes: Optional[List[Node]]):
+ """
+ 继续执行下面的节点
+ @param nodes: 执行下面要执行的节点
+ @return:
+ """
+ if [Signal.FORM, Signal.CANCELLED].__contains__(self.signal):
+ return
+ if nodes is None or len(nodes) == 0:
+ return
+ # 需要校验是否可执行
+ for n in nodes:
+ condition = n.properties.get("condition")
+ if condition == "AND":
+ up_nodes = self.workflow.get_up_nodes(n.id)
+ # 如果是AND就是前面所有节点都执行结束
+ unfinished = {Status.BEFORE_RUNNING, Status.RUNNING}
+ end = all(
+ [
+ self.node_dict.get(node.id) and self.node_dict.get(node.id).status not in unfinished
+ for node in up_nodes
+ ]
+ )
+ if not end:
+ return
+
+ with self._lock:
+ from application.workflow.nodes import get_node_class
+
+ instances = [get_node_class(n.type, self.workflow_type)(n, self, get_node_parameters) for n in nodes]
+ self.nodes.extend(instances)
+ for node in instances:
+ self.node_dict[node.node.id] = node
+ for inst in instances:
+ self._run_async(inst)
+
+ def assertion_end(self, error=None):
+ with self._lock:
+ if self.done:
+ return
+ if not self.is_end():
+ return
+ self.done = True # 锁内抢占,保证只有一个线程能往下走
+ self.end(error) # 回调放到锁外,避免回调里再触碰本 manage 造成重入/死锁
+
+ def is_end(self):
+ """
+ 工作流是否执行结束
+ @return: 是否执行结束
+ """
+ unfinished = {Status.BEFORE_RUNNING, Status.RUNNING}
+ return not any(node.status in unfinished for node in self.nodes)
+
+ def write_context(self, node_id, key, value, append=False):
+ """
+ 写入上下文
+ @param node_id: 节点id
+ @param key: 数据key
+ @param value: 数据value
+ @param append: 是否追加
+ @return: None
+ """
+ node_context = self.context.setdefault(node_id, {})
+ if append and key in node_context:
+ node_context[key] += value
+ else:
+ node_context[key] = value
+
+ def get_context(self, node_id, key):
+ """
+ 获取节点上下文的指定key的内容
+ @param node_id: 节点id
+ @param key: key
+ @return: 数据
+ """
+ node_context = self.context.get(node_id)
+ if node_context is None:
+ return None
+ return node_context.get(key)
+
+ def _run_async(self, node):
+ t = threading.Thread(target=lambda: self._run(node))
+ t.start()
+ return t
+
+ def invoke(self):
+ """
+ 非流式响应
+ @return: 没个节点的 块数据
+ """
+ self.run()
+
+ def write(self, message: Content):
+ """
+ 写入数据
+ @param message: 节点输出内容
+ @return: None
+ """
+ self.call_back.on_next(self, message)
+
+ def end(self, error=None):
+ """
+ 工作流输出结束的时候调用
+ @return: None
+ """
+ self.call_back.on_complete(self, error)
+
+ def get_parameters(self):
+ """
+ 获取工作流的参数信息
+ @return: 工作流参数信息
+ """
+ return self.parameters
+
+ def get_details(self, position: Dict = None, old_details=None):
+ """
+ 获取所有节点的运行详情
+ @param position: 位置信息,用于表单节点等需要断点续跑的场景
+ @param old_details: 旧的详情数据,用于表单节点等断点续跑场景
+ @return: 包含position和details的字典
+ """
+ details_result = []
+ position_index = 0
+ if old_details and position:
+ for index, value in enumerate(old_details):
+ details_result.append(value)
+ if position.get("id") == value.get("node_id"):
+ position_index = index
+ for index, node in enumerate(self.nodes):
+ if position is not None and node.node.id == position.get("id") and index == 0:
+ details = node.get_details(
+ index + position_index, position=position, old_details=old_details[position_index]
+ )
+ details_result[position_index] = details
+ else:
+ details = node.get_details(index + position_index)
+ details_result.append(details)
+ return details_result
+
+ def generate_prompt(self, prompt):
+ """
+ 处理提示词
+ @param prompt: 提示词
+ @return: 处理后的提示词
+ """
+ input_template = self.workflow.reset_prompt(prompt)
+ return render_prompt(input_template, self.context)
+
+ def get_reference_field(self, node_id, fields):
+ """
+ 获取引用字段
+ @param node_id: 节点id
+ @param fields: 字段
+ @return: 引用数据
+ """
+ node_context = self.context.get(node_id)
+ if node_context is None:
+ return None
+ obj = node_context
+ for field in fields:
+ if isinstance(obj, dict):
+ obj = obj.get(field)
+ else:
+ return None
+ return obj
+
+ @classmethod
+ def from_context(cls, get_context, workflow, parameters, workflow_type, call_back, get_start_node):
+ """
+ 恢复 WorkflowManage:调用 get_context() 拿到历史 context 并用它重建实例。
+ context 从何而来(DB、缓存或其它)由调用方通过 get_context 决定,引擎不关心其业务来源;
+ get_context 返回空或抛异常则返回 None,调用方可据此回退为全新执行。
+ """
+ try:
+ context = get_context()
+ if not context:
+ return None
+ instance = cls(
+ workflow=workflow,
+ parameters=parameters,
+ workflow_type=workflow_type,
+ call_back=call_back,
+ get_start_node=get_start_node,
+ )
+ # 恢复全局 context
+ instance.context = context
+ return instance
+ except Exception:
+ import traceback
+
+ traceback.print_exc()
+ return None
+
+ def cancel(self):
+ self.signal = Signal.CANCELLED
+ for node in self.nodes:
+ node.cancel()
diff --git a/apps/application/workflow/workflow_run_registry.py b/apps/application/workflow/workflow_run_registry.py
new file mode 100644
index 00000000000..5e240eb84c4
--- /dev/null
+++ b/apps/application/workflow/workflow_run_registry.py
@@ -0,0 +1,168 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @file: workflow_run_registry.py
+ @desc: 工作流运行注册表,用于管理和取消正在运行的工作流实例
+"""
+import threading
+from enum import Enum
+
+from common.utils.logger import maxkb_logger
+
+
+class CancelResult(Enum):
+ """取消操作结果"""
+ CANCELLED = "CANCELLED"
+ NOT_FOUND = "NOT_FOUND"
+ FAILED = "FAILED"
+
+
+class WorkflowRunRegistry:
+ _lock = threading.Lock()
+ _running = {} # {chat_record_id: WorkflowManage}
+ _chat_to_records = {} # {chat_id: set[chat_record_id]}
+
+ @classmethod
+ def register(cls, chat_record_id: str, chat_id: str, workflow_manage) -> None:
+ """
+ 注册一个正在运行的工作流实例
+ @param chat_record_id: 聊天记录ID
+ @param chat_id: 聊天ID
+ @param workflow_manage: WorkflowManage 实例
+ """
+ if not chat_record_id or not workflow_manage:
+ return
+ with cls._lock:
+ cls._running[str(chat_record_id)] = workflow_manage
+ if chat_id:
+ if chat_id not in cls._chat_to_records:
+ cls._chat_to_records[chat_id] = set()
+ cls._chat_to_records[chat_id].add(str(chat_record_id))
+ maxkb_logger.debug(f"Workflow registered: {chat_record_id}, total running: {len(cls._running)}")
+
+ @classmethod
+ def unregister(cls, chat_record_id: str, chat_id: str = None) -> None:
+ """
+ 注销一个工作流实例(无论成功/失败/取消都应调用)
+ @param chat_record_id: 聊天记录ID
+ @param chat_id: 聊天ID
+ """
+ if not chat_record_id:
+ return
+ with cls._lock:
+ removed = cls._running.pop(str(chat_record_id), None)
+ if chat_id and chat_id in cls._chat_to_records:
+ cls._chat_to_records[chat_id].discard(str(chat_record_id))
+ if not cls._chat_to_records[chat_id]:
+ del cls._chat_to_records[chat_id]
+ if removed is not None:
+ maxkb_logger.debug(f"Workflow unregistered: {chat_record_id}, total running: {len(cls._running)}")
+
+ @classmethod
+ def cancel_by_chat_id(cls, chat_id: str) -> CancelResult:
+ """
+ 取消某个聊天下所有运行中的工作流
+ @param chat_id: 聊天ID
+ @return: CancelResult
+ """
+ if not chat_id:
+ return CancelResult.NOT_FOUND
+
+ with cls._lock:
+ record_ids = list(cls._chat_to_records.get(chat_id, set()))
+
+ if not record_ids:
+ maxkb_logger.info(f"Cancel requested but no running workflow found for chat: {chat_id}")
+ return CancelResult.NOT_FOUND
+
+ cancelled_count = 0
+ failed_count = 0
+ for record_id in record_ids:
+ with cls._lock:
+ wm = cls._running.get(record_id)
+ if wm:
+ try:
+ wm.cancel()
+ cancelled_count += 1
+ maxkb_logger.info(f"Cancel signal sent to workflow: {record_id}")
+ except Exception as e:
+ failed_count += 1
+ maxkb_logger.error(f"Failed to cancel workflow: {record_id}, error: {e}")
+
+ if failed_count > 0 and cancelled_count == 0:
+ return CancelResult.FAILED
+ return CancelResult.CANCELLED
+
+ @classmethod
+ def cancel_by_record_id(cls, chat_record_id: str) -> CancelResult:
+ """
+ 取消某个特定的工作流
+ @param chat_record_id: 聊天记录ID
+ @return: CancelResult
+ """
+ if not chat_record_id:
+ return CancelResult.NOT_FOUND
+
+ with cls._lock:
+ wm = cls._running.get(str(chat_record_id))
+
+ if wm is None:
+ maxkb_logger.info(f"Cancel requested but workflow not found (may already finished): {chat_record_id}")
+ return CancelResult.NOT_FOUND
+
+ try:
+ wm.cancel()
+ maxkb_logger.info(f"Cancel signal sent to workflow: {chat_record_id}")
+ return CancelResult.CANCELLED
+ except Exception as e:
+ maxkb_logger.error(f"Failed to cancel workflow: {chat_record_id}, error: {e}")
+ return CancelResult.FAILED
+
+ @classmethod
+ def get(cls, chat_record_id: str):
+ """
+ 获取正在运行的工作流实例
+ @param chat_record_id: 聊天记录ID
+ @return: WorkflowManage 实例或 None
+ """
+ if not chat_record_id:
+ return None
+ return cls._running.get(str(chat_record_id))
+
+ @classmethod
+ def is_running(cls, chat_record_id: str) -> bool:
+ """
+ 检查工作流是否正在运行
+ @param chat_record_id: 聊天记录ID
+ @return: 是否正在运行
+ """
+ return chat_record_id is not None and str(chat_record_id) in cls._running
+
+ @classmethod
+ def is_chat_running(cls, chat_id: str) -> bool:
+ """
+ 检查某个聊天是否有正在运行的工作流
+ @param chat_id: 聊天ID
+ @return: 是否有正在运行的工作流
+ """
+ if not chat_id:
+ return False
+ with cls._lock:
+ return chat_id in cls._chat_to_records and len(cls._chat_to_records[chat_id]) > 0
+
+ @classmethod
+ def running_count(cls) -> int:
+ """
+ 获取正在运行的工作流数量
+ @return: 数量
+ """
+ return len(cls._running)
+
+ @classmethod
+ def running_ids(cls) -> list:
+ """
+ 获取所有正在运行的工作流ID列表
+ @return: ID列表
+ """
+ with cls._lock:
+ return list(cls._running.keys())
diff --git a/apps/chat/api/chat_authentication_api.py b/apps/chat/api/chat_authentication_api.py
index 6f6b1b1a835..c344931a1bc 100644
--- a/apps/chat/api/chat_authentication_api.py
+++ b/apps/chat/api/chat_authentication_api.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: chat_authentication_api.py
- @date:2025/6/6 19:59
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: chat_authentication_api.py
+@date:2025/6/6 19:59
+@desc:
"""
from django.utils.translation import gettext_lazy as _
@@ -25,31 +25,62 @@ def get_request():
class ChatAuthenticationAPI(APIMixin):
@staticmethod
def get_request():
- return AnonymousAuthenticationSerializer
+ return None
@staticmethod
def get_parameters():
- pass
+ return [
+ OpenApiParameter(
+ name="application_id",
+ description=_("Application ID"),
+ type=OpenApiTypes.UUID,
+ location="query",
+ required=False,
+ )
+ ]
@staticmethod
def get_response():
pass
-class ChatAuthenticationProfileAPI(APIMixin):
+class ChatAuthenticationProfileAPIV2(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name="access_token",
+ description=_("access_token"),
+ type=OpenApiTypes.STR,
+ location="query",
+ required=True,
+ )
+ ]
+
+class ChatAuthenticationProfileAPI(APIMixin):
@staticmethod
def get_parameters():
- return [OpenApiParameter(
- name="access_token",
- description=_("access_token"),
- type=OpenApiTypes.STR,
- location='query',
- required=True,
- )]
+ return [
+ OpenApiParameter(
+ name="application_id",
+ description=_("Application ID"),
+ type=OpenApiTypes.UUID,
+ location="query",
+ required=True,
+ )
+ ]
class ChatOpenAPI(APIMixin):
@staticmethod
def get_parameters():
- return []
+ return [
+ OpenApiParameter(
+ name="application_id",
+ description=_("Application ID"),
+ type=OpenApiTypes.UUID,
+ location=OpenApiParameter.PATH,
+ required=True,
+ )
+ ]
diff --git a/apps/chat/api/portal_api.py b/apps/chat/api/portal_api.py
new file mode 100644
index 00000000000..db9b1d6fb03
--- /dev/null
+++ b/apps/chat/api/portal_api.py
@@ -0,0 +1,128 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:MaxKB
+@file: portal.py
+@date:2026/8/14
+@desc: 门户API文档
+"""
+
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+
+from common.mixins.api_mixin import APIMixin
+from common.result import DefaultResultSerializer
+from users.serializers.login import LoginRequest
+
+
+class PortalAPI(APIMixin):
+ class Get(APIMixin):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Save(APIMixin):
+ @staticmethod
+ def get_request():
+ return {
+ "multipart/form-data": {
+ "type": "object",
+ "properties": {
+ "name": {"type": "string", "description": "门户名称"},
+ "description": {"type": "string", "description": "门户描述"},
+ "logo": {"type": "string", "format": "binary", "description": "门户Logo"},
+ "tab_logo": {"type": "string", "format": "binary", "description": "浏览器Tab Logo"},
+ "enable_public_access": {"type": "boolean", "description": "是否开启公开访问"},
+ "enable_api": {"type": "boolean", "description": "是否开启API服务"},
+ "enable_auth": {"type": "boolean", "description": "是否开启身份认证"},
+ "auth_config": {"type": "object", "description": "身份认证配置"},
+ "enable_cors": {"type": "boolean", "description": "是否开启跨域设置"},
+ "cors_config": {"type": "object", "description": "跨域配置"},
+ },
+ }
+ }
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Application(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name="current_page",
+ description="当前页码",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="page_size",
+ description="每页数量",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="name",
+ description="应用名称搜索",
+ type=OpenApiTypes.STR,
+ location="query",
+ required=False,
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Login(APIMixin):
+ @staticmethod
+ def get_request():
+ return LoginRequest
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Info(APIMixin):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Logout(APIMixin):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Conversation(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name="current_page",
+ description="当前页码",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="page_size",
+ description="每页数量",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="name",
+ description="应用名称搜索",
+ type=OpenApiTypes.STR,
+ location="query",
+ required=False,
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
diff --git a/apps/chat/mcp/knowledge.py b/apps/chat/mcp/knowledge.py
new file mode 100644
index 00000000000..223b40a1f40
--- /dev/null
+++ b/apps/chat/mcp/knowledge.py
@@ -0,0 +1,66 @@
+"""Knowledge equivalent of the application's MCPToolHandler."""
+
+import json
+
+from rest_framework.exceptions import ValidationError
+
+from knowledge.services.external_retrieval import retrieve
+from knowledge.services.retrieval_access import RetrievalError
+
+PROTOCOL_VERSIONS = ("2025-03-26", "2025-06-18", "2025-11-25")
+
+
+class KnowledgeMCPToolHandler:
+ def __init__(self, knowledge, identity):
+ self.knowledge, self.identity = knowledge, identity
+ self.tool_name = f"knowledge_{knowledge.id}"
+
+ def initialize(self, params):
+ version = params.get("protocolVersion")
+ if (
+ not isinstance(version, str)
+ or not isinstance(params.get("capabilities"), dict)
+ or not isinstance(params.get("clientInfo"), dict)
+ ):
+ raise ValidationError("Invalid initialization parameters.")
+ return {
+ "protocolVersion": version if version in PROTOCOL_VERSIONS else "2025-06-18",
+ "serverInfo": {"name": "maxkb-knowledge-mcp", "version": "1.0.0"},
+ "capabilities": {"tools": {}},
+ }
+
+ def list_tools(self):
+ return {
+ "tools": [
+ {
+ "name": self.tool_name,
+ "description": f"检索知识库:{self.knowledge.name}",
+ "inputSchema": {
+ "type": "object",
+ "additionalProperties": False,
+ "required": ["query_text"],
+ "properties": {
+ "query_text": {"type": "string", "minLength": 1, "maxLength": 8000},
+ "top_number": {"type": "integer", "minimum": 1, "maximum": 50, "default": 5},
+ "similarity": {"type": "number", "minimum": 0, "maximum": 1, "default": 0},
+ "search_mode": {
+ "type": "string",
+ "enum": ["embedding", "keywords", "blend"],
+ "default": "embedding",
+ },
+ },
+ },
+ }
+ ]
+ }
+
+ def call_tool(self, params):
+ if params.get("name") != self.tool_name:
+ raise ValidationError("Unknown tool.")
+ try:
+ output = retrieve(self.knowledge.id, self.identity, params.get("arguments", {}))
+ except (RetrievalError, ValidationError):
+ raise
+ except Exception:
+ return {"isError": True, "content": [{"type": "text", "text": "Knowledge retrieval failed."}]}
+ return {"content": [{"type": "text", "text": json.dumps(output, ensure_ascii=False)}]}
diff --git a/apps/chat/mcp/tools.py b/apps/chat/mcp/tools.py
index 4a3ff972388..ea9ea8ea9d6 100644
--- a/apps/chat/mcp/tools.py
+++ b/apps/chat/mcp/tools.py
@@ -1,87 +1,174 @@
+import base64
import json
import re
import uuid_utils.compat as uuid
+from application.models import Application, ApplicationApiKey, ChatSourceChoices, ChatUserType
from django.db.models import QuerySet
+from django.utils import timezone
-from application.models import ApplicationApiKey, Application, ChatUserType, ChatSourceChoices
from chat.serializers.chat import ChatSerializers
+CHAT_FILE_LIST_FIELDS = ("image_list", "document_list", "audio_list", "video_list", "other_list")
+
+CHAT_FILE_TYPE_LABELS = {
+ "image_list": "image",
+ "document_list": "document",
+ "audio_list": "audio",
+ "video_list": "video",
+ "other_list": "file",
+}
+
class MCPToolHandler:
- def __init__(self, auth_header):
+ def __init__(self, auth_header, chat_files_header=None, form_data=None):
app_key = QuerySet(ApplicationApiKey).filter(secret_key=auth_header, is_active=True).first()
if not app_key:
raise PermissionError("Invalid API Key")
+ if app_key.is_permanent is False and app_key.expire_time < timezone.now():
+ raise PermissionError("API Key is expired")
self.application = QuerySet(Application).filter(id=app_key.application_id, is_publish=True).first()
if not self.application:
raise PermissionError("Application is not found or not published")
+ self.chat_files = self.decode_chat_files(chat_files_header)
+ self.form_data = self.decode_form_data(form_data)
+
+ @staticmethod
+ def decode_chat_files(chat_files_header):
+ """
+ 解析上层应用透传过来的文件列表
+ """
+ if not chat_files_header:
+ return {}
+ try:
+ chat_files = json.loads(base64.b64decode(chat_files_header).decode("utf-8"))
+ except Exception:
+ return {}
+ if not isinstance(chat_files, dict):
+ return {}
+ return {
+ key: value
+ for key, value in chat_files.items()
+ if key in CHAT_FILE_LIST_FIELDS and isinstance(value, list) and len(value) > 0
+ }
+
+ @staticmethod
+ def decode_form_data(form_data):
+ """
+ 解析上层应用透传过来的表单数据
+ """
+ if not form_data:
+ return {}
+ try:
+ form_data = json.loads(base64.b64decode(form_data).decode("utf-8"))
+ except Exception:
+ return {}
+ if not isinstance(form_data, dict):
+ return {}
+ return form_data
def initialize(self):
return {
"protocolVersion": "2025-06-18",
- "serverInfo": {
- "name": "maxkb-mcp",
- "version": "1.0.0"
- },
- "capabilities": {
- "tools": {}
- }
+ "serverInfo": {"name": "maxkb-mcp", "version": "1.0.0"},
+ "capabilities": {"tools": {}},
}
+ def build_description(self):
+ """
+ 工具描述中带上当前对话已上传的文件, 否则上层模型不知道子应用可以处理这些文件
+ """
+ description = f"{self.application.name} {self.application.desc}"
+ file_desc_list = []
+ for field, file_list in self.chat_files.items():
+ name_list = [
+ str(file.get("name") or file.get("file_id"))
+ for file in file_list
+ if isinstance(file, dict) and (file.get("name") or file.get("file_id"))
+ ]
+ if name_list:
+ file_desc_list.append(f"{CHAT_FILE_TYPE_LABELS.get(field, 'file')}: {', '.join(name_list)}")
+ if not file_desc_list:
+ return description
+ return (
+ f"{description}\n"
+ "The user has attached the following files to the current conversation. "
+ "They are forwarded to this AI automatically, so it can read and process them directly "
+ "and you do NOT need to pass them as arguments: "
+ f"{'; '.join(file_desc_list)}."
+ )
+
def list_tools(self):
return {
"tools": [
{
- "name": f'agent_{str(self.application.id)[:8]}',
- "description": f'{self.application.name} {self.application.desc}',
+ "name": f"agent_{str(self.application.id)}",
+ "description": self.build_description(),
"inputSchema": {
"type": "object",
"properties": {
"message": {"type": "string", "description": "The message to send to the AI."},
},
- "required": ["message"]
- }
+ "required": ["message"],
+ },
}
]
}
def _get_chat_id(self):
from application.models import ChatUserType
- from chat.serializers.chat import OpenChatSerializers
from common.init import init_template
+ from chat.serializers.chat import OpenChatSerializers
+
init_template.run()
- return OpenChatSerializers(data={
- 'application_id': self.application.id,
- 'chat_user_id': str(uuid.uuid7()),
- 'chat_user_type': ChatUserType.ANONYMOUS_USER,
- 'ip_address': '-',
- 'source': {"type": ChatSourceChoices.ONLINE.value},
- 'debug': False
- }).open()
+ return OpenChatSerializers(
+ data={
+ "application_id": self.application.id,
+ "chat_user_id": str(uuid.uuid7()),
+ "chat_user_type": ChatUserType.ANONYMOUS_USER,
+ "ip_address": "-",
+ "source": {"type": ChatSourceChoices.ONLINE.value},
+ "debug": False,
+ }
+ ).open()
+
+ def build_form_data(self, message):
+ """
+ 合并父应用透传参数与提示词中的 JSON 参数,提示词参数优先。
+ """
+ try:
+ message_form_data = json.loads(message or "{}")
+ except (TypeError, json.JSONDecodeError):
+ message_form_data = {}
+ if not isinstance(message_form_data, dict):
+ message_form_data = {}
+ return {**self.form_data, **message_form_data}
def call_tool(self, params):
- name = params["name"]
args = params.get("arguments", {})
- # print(params)
+ message = args.get("message")
payload = {
- 'message': args.get('message'),
- 'stream': True,
- 're_chat': False
+ "message": message,
+ "stream": True,
+ "re_chat": False,
+ "form_data": self.build_form_data(message),
+ **self.chat_files,
}
- resp = ChatSerializers(data={
- 'chat_id': self._get_chat_id(),
- 'chat_user_id': str(uuid.uuid7()),
- 'chat_user_type': ChatUserType.ANONYMOUS_USER,
- 'application_id': self.application.id,
- 'ip_address': '-',
- 'source': {"type": ChatSourceChoices.ONLINE.value},
- 'debug': False,
- }).chat(payload)
+ resp = ChatSerializers(
+ data={
+ "chat_id": self._get_chat_id(),
+ "chat_user_id": str(uuid.uuid7()),
+ "chat_user_type": ChatUserType.ANONYMOUS_USER,
+ "application_id": self.application.id,
+ "ip_address": "-",
+ "source": {"type": ChatSourceChoices.ONLINE.value},
+ "debug": False,
+ }
+ ).chat(payload)
chunks = []
for raw_line in resp:
line = raw_line.decode("utf-8", errors="replace").rstrip("\r\n")
@@ -99,7 +186,7 @@ def call_tool(self, params):
if event.get("is_end"):
break
- data = ''.join(chunks)
+ data = "".join(chunks)
# 排除标签
- data = re.sub(r'.*?', '', data, flags=re.DOTALL)
+ data = re.sub(r".*?", "", data, flags=re.DOTALL)
return {"content": [{"type": "text", "text": data}]}
diff --git a/apps/chat/serializers/chat.py b/apps/chat/serializers/chat.py
index 58f23136638..ffe5d60ef79 100644
--- a/apps/chat/serializers/chat.py
+++ b/apps/chat/serializers/chat.py
@@ -1,210 +1,442 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: chat.py
- @date:2025/6/9 11:23
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: chat.py
+@date:2025/6/9 11:23
+@desc: 对话新实现(统一走 workflow 引擎、去除 ChatInfo 与 Redis 会话缓存)。
"""
+
import json
import os
-from gettext import gettext
-from typing import List, Dict
+import queue
+import queue as thread_queue
+import threading
+import uuid_utils
import uuid_utils.compat as uuid
from django.db.models import QuerySet
+from django.http import StreamingHttpResponse
+from django.utils import timezone
from django.utils.translation import gettext_lazy as _
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage
from rest_framework import serializers
-
-from application.chat_pipeline.pipeline_manage import PipelineManage
-from application.chat_pipeline.step.chat_step.i_chat_step import PostResponseHandler
-from application.chat_pipeline.step.chat_step.impl.base_chat_step import BaseChatStep
-from application.chat_pipeline.step.generate_human_message_step.impl.base_generate_human_message_step import \
- BaseGenerateHumanMessageStep
-from application.chat_pipeline.step.reset_problem_step.impl.base_reset_problem_step import BaseResetProblemStep
-from application.chat_pipeline.step.search_dataset_step.impl.base_search_dataset_step import BaseSearchDatasetStep
-from application.flow.common import Answer, Workflow
-from application.flow.i_step_node import WorkFlowPostHandler
-from application.flow.tools import to_stream_response_simple
-from application.flow.workflow_manage import WorkflowManage
-from application.models import Application, ApplicationTypeChoices, \
- ChatUserType, ApplicationChatUserStats, ApplicationAccessToken, ChatRecord, Chat, ApplicationVersion
+from rest_framework.request import Request
+
+from common.utils.common import to_stream_response_simple
+from application.models import (
+ Application,
+ ApplicationVersion,
+ ApplicationAccessToken,
+ ApplicationChatUserStats,
+ Chat,
+ ChatRecord,
+ ChatUserType,
+ ExecuteType,
+)
from application.serializers.application import ApplicationOperateSerializer
-from application.serializers.common import ChatInfo
-from common.database_model_manage.database_model_manage import DatabaseModelManage
+from application.serializers.application_chat import ChatCountSerializer
+from application.serializers.common import load_debug_workflow_context, resolve_chat_user, resolve_chat_user_group
+from chat.serializers.chat_history import ChatHistory
+from application.workflow.common import WorkflowType, new_instance
+from application.workflow.message.aggregator import AggregationManager
+from application.workflow.message.struct.failure_content import FailureContent
+from application.workflow.message_queue import get_message_queue
+from application.workflow.nodes import get_start_node
+from application.workflow.workflow_manage import WorkflowManage, CallBack
+from application.workflow.workflow_run_registry import WorkflowRunRegistry
+from knowledge.services.retrieval_access import identity_from_server
+from chat.template.agent_simple import build_workflow
+from common import result
from common.exception.app_exception import AppApiException, AppChatNumOutOfBoundsFailed, ChatException
from common.handle.base_to_response import BaseToResponse
from common.handle.impl.response.openai_to_response import OpenaiToResponse
from common.handle.impl.response.system_to_response import SystemToResponse
-from common.utils.common import flat_map, get_file_content, is_valid_uuid
-from knowledge.models import Document, Paragraph
+from common.utils.common import get_file_content
+from common.utils.logger import maxkb_logger
from maxkb.conf import PROJECT_DIR
from models_provider.models import Model, Status
from models_provider.tools import get_model_instance_by_model_workspace_id
-from system_manage.models.resource_mapping import ResourceMapping
+from system_manage.models.chat_user_token_quota import ChatUserTokenQuota
+_CHAT_UNSET = object()
-class ChatMessagesSerializers(serializers.Serializer):
- role = serializers.CharField(required=True, label=_("Role"))
- content = serializers.CharField(required=True, label=_("Content"))
-
-class GeneratePromptSerializers(serializers.Serializer):
- prompt = serializers.CharField(required=True, label=_("Prompt template"))
- messages = serializers.ListSerializer(child=ChatMessagesSerializers(), required=True, label=_("Chat context"))
-
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- messages = self.data.get("messages")
-
- if len(messages) > 30:
- raise AppApiException(400, _("Too many messages"))
-
- for index in range(len(messages)):
- role = messages[index].get('role')
- if role == 'ai' and index % 2 != 1:
- raise AppApiException(400, _("Authentication failed. Please verify that the parameters are correct."))
- if role == 'user' and index % 2 != 0:
- raise AppApiException(400, _("Authentication failed. Please verify that the parameters are correct."))
- if role not in ['user', 'ai']:
- raise AppApiException(400, _("Authentication failed. Please verify that the parameters are correct."))
+def get_work_flow(application):
+ if application.type == "WORK_FLOW":
+ return application.work_flow
+ return build_workflow(application)
class ChatMessageSerializers(serializers.Serializer):
- message = serializers.CharField(required=True, label=_("User Questions"))
- stream = serializers.BooleanField(required=True,
- label=_("Is the answer in streaming mode"))
- re_chat = serializers.BooleanField(required=True, label=_("Do you want to reply again"))
- chat_record_id = serializers.UUIDField(required=False, allow_null=True,
- label=_("Conversation record id"))
-
- node_id = serializers.CharField(required=False, allow_null=True, allow_blank=True,
- label=_("Node id"))
-
- runtime_node_id = serializers.CharField(required=False, allow_null=True, allow_blank=True,
- label=_("Runtime node id"))
-
- node_data = serializers.DictField(required=False, allow_null=True,
- label=_("Node parameters"))
+ """新流程的对话入参(去掉旧工作流调试字段 node_id/runtime_node_id/node_data/child_node)。"""
+ message = serializers.DictField(required=True, label=_("User Questions"))
+ stream = serializers.BooleanField(required=False, default=True, label=_("Is the answer in streaming mode"))
+ re_chat = serializers.BooleanField(required=False, default=False, label=_("Do you want to reply again"))
+ chat_record_id = serializers.UUIDField(required=False, allow_null=True, label=_("Conversation record id"))
form_data = serializers.DictField(required=False, label=_("Global variables"))
- image_list = serializers.ListField(required=False, label=_("picture"))
- document_list = serializers.ListField(required=False, label=_("document"))
- audio_list = serializers.ListField(required=False, label=_("Audio"))
- other_list = serializers.ListField(required=False, label=_("Other"))
- child_node = serializers.DictField(required=False, allow_null=True,
- label=_("Child Nodes"))
-
-
-def get_post_handler(chat_info: ChatInfo):
- class PostHandler(PostResponseHandler):
-
- def handler(self,
- chat_id,
- chat_record_id,
- paragraph_list: List[Paragraph],
- problem_text: str,
- answer_text,
- manage: PipelineManage,
- step: BaseChatStep,
- padding_problem_text: str = None,
- **kwargs):
- answer_list = [[Answer(answer_text, 'ai-chat-node', 'ai-chat-node', 'ai-chat-node', {}, 'ai-chat-node',
- kwargs.get('reasoning_content', '')).to_dict()]]
- chat_record = ChatRecord(id=chat_record_id,
- chat_id=chat_id,
- problem_text=problem_text,
- answer_text=answer_text,
- details=manage.get_details(),
- message_tokens=manage.context['message_tokens'],
- answer_tokens=manage.context['answer_tokens'],
- answer_text_list=answer_list,
- run_time=manage.context['run_time'],
- index=len(chat_info.chat_record_list) + 1,
- ip_address=chat_info.ip_address,
- source=chat_info.source
- )
- chat_info.append_chat_record(chat_record)
- # 重新设置缓存
- chat_info.set_cache()
-
- return PostHandler()
+ # Form 提交时的定位信息 {id, index, children}
+ position = serializers.DictField(required=False, allow_null=True, label=_("Form position"))
+ chunk_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Chunk id"))
class DebugChatSerializers(serializers.Serializer):
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
+ workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
+ application_id = serializers.UUIDField(required=True, label=_("Application ID"))
+ chat_user_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Client id"))
+ chat_user_type = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Client Type"))
+ ip_address = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("IP Address"))
+ source = serializers.JSONField(required=False, allow_null=True, label=_("Source"))
def chat(self, instance: dict, base_to_response: BaseToResponse = SystemToResponse()):
self.is_valid(raise_exception=True)
- chat_id = self.data.get('chat_id')
- chat_info: ChatInfo = ChatInfo.get_cache(chat_id)
- application = QuerySet(Application).filter(id=chat_info.application_id).first()
- chat_info.application = application
- return ChatSerializers(data={
- 'chat_id': chat_id, "chat_user_id": chat_info.chat_user_id,
- "chat_user_type": chat_info.chat_user_type,
- "application_id": chat_info.application.id, "debug": True
- }).chat(instance, base_to_response)
+ return ChatSerializers(
+ data={
+ "chat_id": self.data.get("chat_id"),
+ "chat_user_id": self.data.get("chat_user_id"),
+ "chat_user_type": self.data.get("chat_user_type"),
+ "application_id": self.data.get("application_id"),
+ "ip_address": self.data.get("ip_address"),
+ "source": self.data.get("source"),
+ "debug": True,
+ }
+ ).chat(instance, base_to_response)
-SYSTEM_ROLE = get_file_content(os.path.join(PROJECT_DIR, "apps", "chat", 'template', 'generate_prompt_system'))
+class ChatSerializers(serializers.Serializer):
+ chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
+ chat_user_id = serializers.CharField(required=True, label=_("Client id"))
+ chat_user_type = serializers.CharField(required=True, label=_("Client Type"))
+ application_id = serializers.UUIDField(required=True, allow_null=True, label=_("Application ID"))
+ debug = serializers.BooleanField(required=False, label=_("Debug"))
+ ip_address = serializers.CharField(required=False, label=_("IP Address"), allow_null=True, allow_blank=True)
+ source = serializers.JSONField(required=False, label=_("Source"))
+ # ---------- 会话行(一次查询,全程复用) ----------
+ def get_chat(self):
+ """查询 Chat 行并缓存到实例,全流程只查一次(区分未查询/不存在)。"""
+ cached = getattr(self, "_chat_cache", _CHAT_UNSET)
+ if cached is _CHAT_UNSET:
+ cached = QuerySet(Chat).filter(id=self.data.get("chat_id")).first()
+ self._chat_cache = cached
+ return cached
+
+ # ---------- 校验 ----------
+ def is_valid_chat(self):
+ """
+ 会话不存在 → 视为新会话,后续 ensure_chat_row 惰性创建,无需前端传标记;
+ 会话已存在 → 校验归属(必须属于当前应用与当前对话用户),防止越权写入。
+ debug 会话同样落库(execute_type=DEBUG)、同样按此校验,不再特殊放行。
+ """
+ chat = self.get_chat()
+ if chat is None:
+ return
+ if str(chat.application_id) != str(self.data.get("application_id")) or str(chat.chat_user_id) != str(
+ self.data.get("chat_user_id")
+ ):
+ raise ChatException(500, _("Conversation does not exist"))
-class PromptGenerateSerializer(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
- model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model"))
- application_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Application"))
+ def is_valid_intraday_access_num(self):
+ if not self.data.get("debug") and [
+ ChatUserType.ANONYMOUS_USER.value,
+ ChatUserType.CHAT_USER.value,
+ ].__contains__(self.data.get("chat_user_type")):
+ access_client = (
+ QuerySet(ApplicationChatUserStats)
+ .filter(chat_user_id=self.data.get("chat_user_id"), application_id=self.data.get("application_id"))
+ .first()
+ )
+ if access_client is None:
+ access_client = ApplicationChatUserStats(
+ chat_user_id=self.data.get("chat_user_id"),
+ chat_user_type=self.data.get("chat_user_type"),
+ application_id=self.data.get("application_id"),
+ access_num=0,
+ intraday_access_num=0,
+ )
+ access_client.save()
- def is_valid(self, *, raise_exception=False):
- super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Application).filter(id=self.data.get('application_id'))
- if workspace_id:
- query_set = query_set.filter(workspace_id=workspace_id)
- application = query_set.first()
- if application is None:
- raise AppApiException(500, _('Application id does not exist'))
- return application
+ application_access_token = (
+ QuerySet(ApplicationAccessToken).filter(application_id=self.data.get("application_id")).first()
+ )
+ if application_access_token.access_num <= access_client.intraday_access_num:
+ raise AppChatNumOutOfBoundsFailed(1002, _("The number of visits exceeds today's visits"))
- def generate_prompt(self, instance: dict):
- application = self.is_valid(raise_exception=True)
- GeneratePromptSerializers(data=instance).is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- model_id = self.data.get('model_id')
- prompt = instance.get('prompt')
- messages = instance.get('messages')
+ # ---------- application ----------
+ def get_application(self):
+ """debug 取 Application 本体;非 debug 取最新发布的 ApplicationVersion。"""
+ application_id = self.data.get("application_id")
+ if self.data.get("debug"):
+ application = QuerySet(Application).filter(id=application_id).first()
+ if application is None:
+ raise ChatException(500, _("The application does not exist"))
+ else:
+ application = (
+ QuerySet(ApplicationVersion).filter(application_id=application_id).order_by("-create_time")[0:1].first()
+ )
+ if application is None:
+ raise ChatException(500, _("The application has not been published. Please use it after publishing."))
+ return application
- message = messages[-1]['content']
- q = prompt.replace("{userInput}", message)
+ def ensure_chat_row(self, question, asker):
+ """Chat 行不存在则创建(debug 记为 DEBUG 类型),返回该行。复用 get_chat 的一次查询。"""
+ chat = self.get_chat()
+ if chat is not None:
+ return chat
+ chat = Chat(
+ id=self.data.get("chat_id"),
+ application_id=self.data.get("application_id"),
+ abstract=(question or "")[0:1024],
+ execute_type=ExecuteType.DEBUG if self.data.get("debug") else ExecuteType.CHAT,
+ chat_user_id=self.data.get("chat_user_id"),
+ chat_user_type=self.data.get("chat_user_type"),
+ ip_address=self.data.get("ip_address"),
+ source=self.data.get("source"),
+ asker=asker,
+ )
+ chat.save()
+ self._chat_cache = chat
+ return chat
+
+ def get_defaults_record(self, question):
+ """构造一条占位 ChatRecord 的字段(workflow 完成后由 update_chat_record 回填)。"""
+ return {
+ "chat_id": self.data.get("chat_id"),
+ "problem_text": "",
+ "answer_text": "",
+ "details": {},
+ "message_tokens": 0,
+ "answer_tokens": 0,
+ "answer_text_list": [[]],
+ "run_time": 0,
+ # index 现在用不上,字段 NOT NULL 故给常量 0
+ "index": 0,
+ "ip_address": self.data.get("ip_address") or "",
+ "source": self.data.get("source"),
+ "workflow_context": {},
+ "question": question,
+ "messages": [],
+ }
- messages[-1]['content'] = q
- SUPPORTED_MODEL_TYPES = ["LLM", "IMAGE"]
- model_exist = QuerySet(Model).filter(
- id=model_id,
- model_type__in=SUPPORTED_MODEL_TYPES
- ).exists()
- if not model_exist:
- raise Exception(_("Model does not exists or is not an LLM model"))
+ @staticmethod
+ def _usage_from_context(workflow_context):
+ """从 workflow_context 汇总 token 用量:prompt=message_tokens, completion=answer_tokens。"""
+ prompt_tokens = sum(
+ v.get("message_tokens", 0)
+ for v in workflow_context.values()
+ if isinstance(v, dict) and "message_tokens" in v
+ )
+ completion_tokens = sum(
+ v.get("answer_tokens", 0) for v in workflow_context.values() if isinstance(v, dict) and "answer_tokens" in v
+ )
+ return {"prompt_tokens": prompt_tokens, "completion_tokens": completion_tokens}
- def process():
- model = get_model_instance_by_model_workspace_id(model_id=model_id, workspace_id=workspace_id,
- **application.model_params_setting)
- try:
- for r in model.stream([SystemMessage(content=SYSTEM_ROLE),
- *[HumanMessage(content=m.get('content')) if m.get(
- 'role') == 'user' else AIMessage(
- content=m.get('content')) for m in messages]]):
- yield 'data: ' + json.dumps({'content': r.content}) + '\n\n'
- except Exception as e:
- yield 'data: ' + json.dumps({'error': str(e)}) + '\n\n'
+ @staticmethod
+ def update_chat_record(chat_user_id, chat_record_id, workflow_context, messages, details):
+ usage = ChatSerializers._usage_from_context(workflow_context)
+ message_tokens = usage["prompt_tokens"]
+ answer_tokens = usage["completion_tokens"]
+ ChatUserTokenQuota.consume(chat_user_id, message_tokens + answer_tokens)
+ QuerySet(ChatRecord).filter(id=chat_record_id).update(
+ workflow_context=workflow_context,
+ messages=messages,
+ message_tokens=message_tokens,
+ answer_tokens=answer_tokens,
+ details=details,
+ )
+
+ # ---------- 执行 ----------
+ def chat_work_flow(self, application, instance: dict, base_to_response):
+ message_dict = instance.get("message")
+ message = message_dict.get("content", "") if isinstance(message_dict, dict) else message_dict
+ re_chat = instance.get("re_chat")
+ stream = instance.get("stream")
+ chat_id = self.data.get("chat_id")
+ chat_user_id = self.data.get("chat_user_id")
+ chat_user_type = self.data.get("chat_user_type")
+ ip_address = self.data.get("ip_address")
+ source = self.data.get("source")
+ form_data = instance.get("form_data") or {}
+ image_list = message_dict.get("image_list", []) if isinstance(message_dict, dict) else []
+ video_list = message_dict.get("video_list", []) if isinstance(message_dict, dict) else []
+ document_list = message_dict.get("document_list", []) if isinstance(message_dict, dict) else []
+ audio_list = message_dict.get("audio_list", []) if isinstance(message_dict, dict) else []
+ other_list = message_dict.get("other_list", []) if isinstance(message_dict, dict) else []
+ workspace_id = application.workspace_id
+ chat_record_id = instance.get("chat_record_id")
+ position = instance.get("position")
+ chunk_id = instance.get("chunk_id")
+ debug = self.data.get("debug", False)
+ default_model_setting = application.default_model_setting or {}
+
+ # 对话用户信息(asker 取自 form_data)
+ chat_user = resolve_chat_user(chat_user_id, chat_user_type, asker=form_data.get("asker"))
+ chat_user_group = resolve_chat_user_group(chat_user)
+
+ history_chat_record = ChatHistory(chat_id).load(exclude_record_id=chat_record_id)
+
+ work_flow = get_work_flow(application)
+ workflow = new_instance(work_flow, WorkflowType.APPLICATION)
+
+ chat_record_id_str = str(uuid.uuid7()) if chat_record_id is None else str(chat_record_id)
+ self.ensure_chat_row(message, chat_user)
+ if chat_record_id is None:
+ ChatRecord(id=chat_record_id_str, **self.get_defaults_record(message_dict)).save(force_insert=True)
+
+ parameters = {
+ "retrieval_identity": identity_from_server(chat_user_id, chat_user_type, debug),
+ "history_chat_record": history_chat_record,
+ "question": message,
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id_str,
+ "stream": stream,
+ "re_chat": re_chat,
+ "chat_user_id": chat_user_id,
+ "chat_user_type": chat_user_type,
+ "ip_address": ip_address,
+ "source": source,
+ "workspace_id": workspace_id,
+ "debug": debug,
+ "chat_user": chat_user,
+ "chat_user_group": chat_user_group,
+ "application_id": str(self.data.get("application_id")),
+ "form_data": form_data,
+ "position": position,
+ "chunk_id": chunk_id,
+ "image_list": image_list or [],
+ "document_list": document_list or [],
+ "audio_list": audio_list or [],
+ "video_list": video_list or [],
+ "other_list": other_list or [],
+ "default_model_setting": default_model_setting,
+ }
+
+ result_queue = queue.Queue()
+ aggregation = AggregationManager()
+
+ def on_next(wf_manage, content):
+ aggregation.aggregate(content)
+ block = content.to_dict()
+ get_message_queue().produce(chat_record_id_str, block)
+ result_queue.put(("chunk", block))
+
+ def on_complete(wf_manage, error):
+ WorkflowRunRegistry.unregister(chat_record_id_str, str(chat_id))
+ message_queue = get_message_queue()
+ if error:
+ result_queue.put(("error", error))
+ message_queue.produce(
+ chat_record_id_str,
+ FailureContent(str(uuid_utils.uuid7()), str(error), Status.SUCCESS, None, None).to_dict(),
+ )
+ messages = aggregation.get_contents()
+ old_details = None
+ chat_record = None
+ if chat_record_id is not None:
+ chat_record = QuerySet(ChatRecord).filter(id=chat_record_id).first()
+ if chat_record:
+ old_details = chat_record.details
+ if position and chat_record.messages:
+ messages = list({m.get("id"): m for m in [*chat_record.messages, *messages]}.values())
+ details = wf_manage.get_details(position=position, old_details=old_details)
+ self.update_chat_record(chat_user_id, chat_record_id_str, wf_manage.context, messages, details)
+ ChatCountSerializer(data={"chat_id": chat_id}).update_chat()
+ # 表单续跑时 message_dict.content 为空;保留原记录里的用户问题,避免 WORKFLOW 历史丢问题
+ question = chat_record.question if (chat_record and chat_record.question) else message_dict
+ ChatHistory(chat_id).append(
+ ChatRecord(
+ id=chat_record_id_str,
+ chat_id=chat_id,
+ question=question,
+ messages=messages,
+ details=details,
+ create_time=timezone.now(),
+ )
+ )
+ result_queue.put(("done", None))
+ message_queue.produce_done(chat_record_id_str)
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_start_node_fn(wf, wm):
+ return get_start_node(wf, wm, WorkflowType.APPLICATION, position)
+
+ # Form 提交(有 position 和 chat_record_id):从历史 context 恢复
+ if position and chat_record_id:
+ work_flow_manage = WorkflowManage.from_context(
+ get_context=lambda: load_debug_workflow_context(chat_record_id),
+ workflow=workflow,
+ parameters=parameters,
+ workflow_type=WorkflowType.APPLICATION,
+ call_back=call_back,
+ get_start_node=get_start_node_fn,
+ )
+ if work_flow_manage is None:
+ work_flow_manage = WorkflowManage(
+ workflow, parameters, WorkflowType.APPLICATION, call_back, get_start_node_fn
+ )
+ else:
+ work_flow_manage = WorkflowManage(
+ workflow, parameters, WorkflowType.APPLICATION, call_back, get_start_node_fn
+ )
+
+ work_flow_manage.start_node.workflow_manage = work_flow_manage
+ WorkflowRunRegistry.register(chat_record_id_str, str(chat_id), work_flow_manage)
+
+ if stream:
+
+ def generate():
+ work_flow_manage.run()
+ while True:
+ msg_type, data = result_queue.get()
+ if msg_type == "done":
+ end_frame = base_to_response.to_stream_end(
+ chat_id,
+ chat_record_id_str,
+ usage=self._usage_from_context(work_flow_manage.context),
+ )
+ if end_frame is not None:
+ yield "data: " + end_frame + "\n\n"
+ yield "data: [DONE]\n\n"
+ break
+ if msg_type == "error":
+ error_block = {"id": str(uuid.uuid7()), "type": "FAILURE", "content": str(data)}
+ frame = base_to_response.to_stream(chat_id, chat_record_id_str, error_block)
+ if frame is not None:
+ yield "data: " + frame + "\n\n"
+ yield "data: [DONE]\n\n"
+ break
+ if msg_type == "chunk":
+ frame = base_to_response.to_stream(chat_id, chat_record_id_str, data)
+ if frame is not None:
+ yield "data: " + frame + "\n\n"
+
+ return to_stream_response_simple(generate())
+ else:
+ work_flow_manage.run()
+ while True:
+ msg_type, data = result_queue.get()
+ if msg_type == "done":
+ break
+ if msg_type == "error":
+ raise data
+ usage = self._usage_from_context(work_flow_manage.context)
+ return base_to_response.to_block(chat_id, chat_record_id_str, aggregation.get_contents(), usage)
- return to_stream_response_simple(process())
+ def chat(self, instance: dict, base_to_response: BaseToResponse = SystemToResponse()):
+ self.is_valid(raise_exception=True)
+ ChatMessageSerializers(data=instance).is_valid(raise_exception=True)
+ self.is_valid_chat()
+ application = self.get_application()
+ self.is_valid_intraday_access_num()
+ return self.chat_work_flow(application, instance, base_to_response)
class OpenAIMessage(serializers.Serializer):
- content = serializers.CharField(required=True, label=_('content'))
- role = serializers.CharField(required=True, label=_('Role'))
+ content = serializers.CharField(required=True, label=_("content"))
+ role = serializers.CharField(required=True, label=_("Role"))
class OpenAIInstanceSerializer(serializers.Serializer):
@@ -215,6 +447,8 @@ class OpenAIInstanceSerializer(serializers.Serializer):
class OpenAIChatSerializer(serializers.Serializer):
+ """OpenAI 兼容入口:走新 ChatSerializers + OpenaiToResponse,无 ChatInfo/缓存。"""
+
application_id = serializers.UUIDField(required=True, label=_("Application ID"))
chat_user_id = serializers.CharField(required=True, label=_("Client id"))
chat_user_type = serializers.CharField(required=True, label=_("Client Type"))
@@ -223,382 +457,316 @@ class OpenAIChatSerializer(serializers.Serializer):
@staticmethod
def get_message(instance):
- return instance.get('messages')[-1].get('content')
+ return instance.get("messages")[-1].get("content")
- @staticmethod
- def generate_chat(chat_id, application_id, message, chat_user_id, chat_user_type, ip_address, source):
- if chat_id is None:
- chat_id = str(uuid.uuid1())
- chat_info = ChatInfo(chat_id, chat_user_id, chat_user_type, ip_address, source, [], [],
- application_id)
- chat_info.set_cache()
- else:
- chat_info = ChatInfo.get_cache(chat_id)
- if chat_info is None:
- open_chat = ChatSerializers(data={
- 'chat_id': chat_id,
- 'chat_user_id': chat_user_id,
- 'chat_user_type': chat_user_type,
- 'application_id': application_id,
- 'ip_address': ip_address,
- 'source': source,
- })
- open_chat.is_valid(raise_exception=True)
- chat_info = open_chat.re_open_chat(chat_id)
- chat_info.set_cache()
- return chat_id
-
- def chat(self, instance: Dict, with_valid=True):
+ def chat(self, instance: dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
OpenAIInstanceSerializer(data=instance).is_valid(raise_exception=True)
- chat_id = instance.get('chat_id')
+ # 会话不存在则新开:新 ChatSerializers 会按 chat_id 惰性建 Chat 行,无需缓存
+ chat_id = instance.get("chat_id") or str(uuid.uuid7())
message = self.get_message(instance)
- re_chat = instance.get('re_chat', False)
- stream = instance.get('stream', False)
- application_id = self.data.get('application_id')
- chat_user_id = self.data.get('chat_user_id')
- chat_user_type = self.data.get('chat_user_type')
- ip_address = self.data.get('ip_address')
- source = self.data.get('source')
- chat_id = self.generate_chat(chat_id, application_id, message, chat_user_id, chat_user_type, ip_address, source)
return ChatSerializers(
data={
- 'chat_id': chat_id,
- 'chat_user_id': chat_user_id,
- 'chat_user_type': chat_user_type,
- 'application_id': application_id,
- 'ip_address': ip_address,
- 'source': source,
+ "chat_id": chat_id,
+ "chat_user_id": self.data.get("chat_user_id"),
+ "chat_user_type": self.data.get("chat_user_type"),
+ "application_id": self.data.get("application_id"),
+ "ip_address": self.data.get("ip_address"),
+ "source": self.data.get("source"),
}
- ).chat({'message': message,
- 're_chat': re_chat,
- 'stream': stream,
- 'form_data': instance.get('form_data', {}),
- 'image_list': instance.get('image_list', []),
- 'document_list': instance.get('document_list', []),
- 'audio_list': instance.get('audio_list', []),
- 'other_list': instance.get('other_list', [])},
- base_to_response=OpenaiToResponse())
+ ).chat(
+ {
+ "message": {
+ "content": message,
+ "image_list": instance.get("image_list", []),
+ "document_list": instance.get("document_list", []),
+ "audio_list": instance.get("audio_list", []),
+ "video_list": instance.get("video_list", []),
+ "other_list": instance.get("other_list", []),
+ },
+ "re_chat": instance.get("re_chat", False),
+ "stream": instance.get("stream", False),
+ "form_data": instance.get("form_data", {}),
+ },
+ base_to_response=OpenaiToResponse(),
+ )
+
+
+# ==================== 会话创建 ====================
-class ChatSerializers(serializers.Serializer):
- chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
+class OpenChatSerializers(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
+ application_id = serializers.UUIDField(required=True)
chat_user_id = serializers.CharField(required=True, label=_("Client id"))
chat_user_type = serializers.CharField(required=True, label=_("Client Type"))
- application_id = serializers.UUIDField(required=True, allow_null=True,
- label=_("Application ID"))
- debug = serializers.BooleanField(required=False, label=_("Debug"))
- ip_address = serializers.CharField(required=False, label=_("IP Address"), allow_null=True, allow_blank=True)
+ debug = serializers.BooleanField(required=True, label=_("Debug"))
+ ip_address = serializers.CharField(required=False, label=_("IP Address"))
source = serializers.JSONField(required=False, label=_("Source"))
- def is_valid_application_workflow(self, *, raise_exception=False):
- self.is_valid_intraday_access_num()
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ application_id = self.data.get("application_id")
+ query_set = QuerySet(Application).filter(id=application_id)
+ if workspace_id:
+ query_set = query_set.filter(workspace_id=workspace_id)
+ if not query_set.exists():
+ raise AppApiException(500, _("Application does not exist"))
- def is_valid_chat_id(self, chat_info: ChatInfo):
- if self.data.get('application_id') is not None and self.data.get('application_id') != str(
- chat_info.application_id):
- raise ChatException(500, _("Conversation does not exist"))
+ def open(self, chat_id=None):
+ """新建会话:直接建 Chat 行(cache-free,无 ChatInfo)。SIMPLE/WORK_FLOW 一视同仁。"""
+ self.is_valid(raise_exception=True)
+ application_id = self.data.get("application_id")
+ debug = self.data.get("debug")
+ if not debug:
+ published = (
+ QuerySet(ApplicationVersion).filter(application_id=application_id).order_by("-create_time")[0:1].first()
+ )
+ if published is None:
+ raise AppApiException(500, _("The application has not been published. Please use it after publishing."))
+ chat_id = chat_id or str(uuid.uuid7())
+ Chat(
+ id=chat_id,
+ application_id=application_id,
+ abstract="新建对话",
+ execute_type=ExecuteType.DEBUG if debug else ExecuteType.CHAT,
+ chat_user_id=self.data.get("chat_user_id"),
+ chat_user_type=self.data.get("chat_user_type"),
+ ip_address=self.data.get("ip_address"),
+ source=self.data.get("source"),
+ asker=resolve_chat_user(self.data.get("chat_user_id"), self.data.get("chat_user_type")),
+ ).save()
+ return chat_id
- def is_valid_intraday_access_num(self):
- if not self.data.get('debug') and [ChatUserType.ANONYMOUS_USER.value,
- ChatUserType.CHAT_USER.value].__contains__(
- self.data.get('chat_user_type')):
- access_client = QuerySet(ApplicationChatUserStats).filter(chat_user_id=self.data.get('chat_user_id'),
- application_id=self.data.get(
- 'application_id')).first()
- if access_client is None:
- access_client = ApplicationChatUserStats(chat_user_id=self.data.get('chat_user_id'),
- chat_user_type=self.data.get('chat_user_type'),
- application_id=self.data.get('application_id'),
- access_num=0,
- intraday_access_num=0)
- access_client.save()
- application_access_token = QuerySet(ApplicationAccessToken).filter(
- application_id=self.data.get('application_id')).first()
- if application_access_token.access_num <= access_client.intraday_access_num:
- raise AppChatNumOutOfBoundsFailed(1002, _("The number of visits exceeds today's visits"))
+# ==================== 断点续传 ====================
- def is_valid_application_simple(self, *, chat_info: ChatInfo, raise_exception=False):
- self.is_valid_intraday_access_num()
- model_id = chat_info.application.model_id
- if model_id is None:
- return chat_info
- model = QuerySet(Model).filter(id=model_id).first()
- if model is None:
- return chat_info
- if model.status == Status.ERROR:
- raise ChatException(500, _("The current model is not available"))
- if model.status == Status.DOWNLOAD:
- raise ChatException(500, _("The model is downloading, please try again later"))
- return chat_info
-
- def chat_simple(self, chat_info: ChatInfo, instance, base_to_response):
- message = instance.get('message')
- re_chat = instance.get('re_chat')
- stream = instance.get('stream')
- chat_user_id = self.data.get('chat_user_id')
- chat_user_type = self.data.get('chat_user_type')
- ip_address = self.data.get('ip_address')
- source = self.data.get('source')
- form_data = instance.get("form_data")
- chat_record_id = instance.get('chat_record_id')
- pipeline_manage_builder = PipelineManage.builder()
- # 如果开启了问题优化,则添加上问题优化步骤
- if chat_info.application.problem_optimization:
- pipeline_manage_builder.append_step(BaseResetProblemStep)
- # 构建流水线管理器
- pipeline_message = (pipeline_manage_builder.append_step(BaseSearchDatasetStep)
- .append_step(BaseGenerateHumanMessageStep)
- .append_step(BaseChatStep)
- .add_base_to_response(base_to_response)
- .add_debug(self.data.get('debug', False))
- .build())
- exclude_paragraph_id_list = []
- # 相同问题是否需要排除已经查询到的段落
- if re_chat:
- paragraph_id_list = flat_map(
- [[paragraph.get('id') for paragraph in chat_record.details['search_step']['paragraph_list']] for
- chat_record in chat_info.chat_record_list if
- chat_record.problem_text == message and 'search_step' in chat_record.details and 'paragraph_list' in
- chat_record.details['search_step']])
- exclude_paragraph_id_list = list(set(paragraph_id_list))
- # 构建运行参数
- params = chat_info.to_pipeline_manage_params(message, get_post_handler(chat_info), exclude_paragraph_id_list,
- chat_user_id, chat_user_type, ip_address, source, stream,
- form_data)
- if chat_record_id:
- params['chat_record_id'] = chat_record_id
- chat_info.set_chat(message)
- # 运行流水线作业
- pipeline_message.run(params)
- return pipeline_message.context['chat_result']
+# consume 桥接队列的上限:满了会反压 pump 线程,防止慢客户端把消息全堆进内存
+_BRIDGE_MAXSIZE = 1000
+# 消费上限(秒),与桥接 get 的超时保持一致的量级
+_CONSUME_TIMEOUT = 300
- @staticmethod
- def get_chat_record(chat_info, chat_record_id):
- if chat_info is not None:
- chat_record_list = [chat_record for chat_record in chat_info.chat_record_list if
- str(chat_record.id) == str(chat_record_id)]
- if chat_record_list is not None and len(chat_record_list):
- return chat_record_list[-1]
- chat_record = QuerySet(ChatRecord).filter(id=chat_record_id, chat_id=chat_info.chat_id).first()
- if chat_record is None:
- raise ChatException(500, _("Conversation record does not exist"))
-
- return chat_record
- chat_record = QuerySet(ChatRecord).filter(id=chat_record_id).first()
- return chat_record
-
- def chat_work_flow(self, chat_info: ChatInfo, instance: dict, base_to_response):
- message = instance.get('message')
- re_chat = instance.get('re_chat')
- stream = instance.get('stream')
- chat_user_id = self.data.get("chat_user_id")
- chat_user_type = self.data.get('chat_user_type')
- ip_address = self.data.get('ip_address')
- source = self.data.get('source')
- form_data = instance.get('form_data')
- image_list = instance.get('image_list')
- video_list = instance.get('video_list')
- document_list = instance.get('document_list')
- audio_list = instance.get('audio_list')
- other_list = instance.get('other_list')
- workspace_id = chat_info.application.workspace_id
- chat_record_id = instance.get('chat_record_id')
- debug = self.data.get('debug', False)
- chat_record = None
- history_chat_record = chat_info.chat_record_list
- if chat_record_id is not None:
- chat_record = self.get_chat_record(chat_info, chat_record_id)
- if chat_record:
- history_chat_record = [r for r in chat_info.chat_record_list if str(r.id) != chat_record_id]
- work_flow = chat_info.application.work_flow
- work_flow_manage = WorkflowManage(Workflow.new_instance(work_flow),
- {'history_chat_record': history_chat_record, 'question': message,
- 'chat_id': chat_info.chat_id, 'chat_record_id': str(
- uuid.uuid7()) if chat_record_id is None else str(chat_record_id),
- 'stream': stream,
- 're_chat': re_chat,
- 'chat_user_id': chat_user_id,
- 'chat_user_type': chat_user_type,
- 'ip_address': ip_address,
- 'source': source,
- 'workspace_id': workspace_id,
- 'debug': debug,
- 'chat_user': chat_info.get_chat_user(),
- 'chat_user_group': chat_info.get_chat_user_group(),
- 'application_id': str(chat_info.application_id)},
- WorkFlowPostHandler(chat_info),
- base_to_response, form_data, image_list, document_list, audio_list,
- video_list,
- other_list,
- instance.get('runtime_node_id'),
- instance.get('node_data'), chat_record, instance.get('child_node'))
- chat_info.set_chat(message)
- r = work_flow_manage.run()
- return r
-
- def is_valid_chat_user(self):
- chat_user_id = self.data.get('chat_user_id')
- application_id = self.data.get('application_id')
- chat_user_type = self.data.get('chat_user_type')
- is_auth_chat_user = DatabaseModelManage.get_model("is_auth_chat_user")
- application_access_token = QuerySet(ApplicationAccessToken).filter(application_id=application_id).first()
- if application_access_token and application_access_token.authentication and application_access_token.authentication_value.get(
- 'type') == 'login':
- if chat_user_type == ChatUserType.ANONYMOUS_USER.value:
- raise ChatException(500, _("The chat user is not authorized."))
- if chat_user_type == ChatUserType.CHAT_USER.value and is_auth_chat_user:
- is_auth = is_auth_chat_user(chat_user_id, application_id)
- if not is_auth:
- raise ChatException(500, _("The chat user is not authorized."))
- def chat(self, instance: dict, base_to_response: BaseToResponse = SystemToResponse()):
- super().is_valid(raise_exception=True)
- ChatMessageSerializers(data=instance).is_valid(raise_exception=True)
- chat_info = self.get_chat_info()
- chat_info.get_application()
- chat_info.get_chat_user(asker=(instance.get('form_data') or {}).get('asker'))
- self.is_valid_chat_id(chat_info)
- if not self.data.get('debug'):
- self.is_valid_chat_user()
- if chat_info.application.type == ApplicationTypeChoices.SIMPLE:
- self.is_valid_application_simple(raise_exception=True, chat_info=chat_info)
- return self.chat_simple(chat_info, instance, base_to_response)
- else:
- self.is_valid_application_workflow(raise_exception=True)
- return self.chat_work_flow(chat_info, instance, base_to_response)
+class ResumeSerializers(serializers.Serializer):
+ chat_id = serializers.UUIDField(required=True)
+ chat_record_id = serializers.UUIDField(required=True)
- def get_chat_info(self):
+ def resume(self, request):
self.is_valid(raise_exception=True)
- chat_id = self.data.get('chat_id')
- chat_info: ChatInfo = ChatInfo.get_cache(chat_id)
- if chat_info is None:
- chat_info: ChatInfo = self.re_open_chat(chat_id)
- chat_info.set_cache()
- return chat_info
-
- def re_open_chat(self, chat_id: str):
- chat = QuerySet(Chat).filter(id=chat_id).first()
- if chat is None:
- raise ChatException(500, _("Conversation does not exist"))
- application = QuerySet(Application).filter(id=chat.application_id).first()
- if application is None:
- raise ChatException(500, _("Application does not exist"))
- application_version = QuerySet(ApplicationVersion).filter(application_id=application.id).order_by(
- '-create_time')[0:1].first()
- if application_version is None:
- raise ChatException(500, _("The application has not been published. Please use it after publishing."))
- if application.type == ApplicationTypeChoices.SIMPLE:
- return self.re_open_chat_simple(chat_id, application)
+ chat_record_id = self.data.get("chat_record_id")
+ mq = get_message_queue()
+
+ start_id = self._resolve_start_id(request)
+
+ is_running = mq.exists(chat_record_id) and not mq.is_done(chat_record_id)
+
+ if is_running:
+ generator = self._stream_from_queue(mq, chat_record_id, start_id)
else:
- return self.re_open_chat_work_flow(chat_id, application)
-
- def re_open_chat_simple(self, chat_id, application):
- # 数据集id列表
- knowledge_id_list = [str(row.target_id) for row in
- QuerySet(ResourceMapping).filter(source_id=str(application.id),
- source_type='APPLICATION',
- target_type='KNOWLEDGE')]
-
- # 需要排除的文档
- exclude_document_id_list = [str(document.id) for document in
- QuerySet(Document).filter(
- knowledge_id__in=knowledge_id_list,
- is_active=False)]
- chat_info = ChatInfo(chat_id, self.data.get('chat_user_id'), self.data.get('chat_user_type'),
- self.data.get('ip_address'),
- self.data.get('source'), knowledge_id_list,
- exclude_document_id_list, application.id)
- chat_record_list = list(QuerySet(ChatRecord).filter(chat_id=chat_id).order_by('-create_time')[0:5])
- chat_record_list.sort(key=lambda r: r.create_time)
- for chat_record in chat_record_list:
- chat_info.chat_record_list.append(chat_record)
- return chat_info
-
- def re_open_chat_work_flow(self, chat_id, application):
- chat_info = ChatInfo(chat_id, self.data.get('chat_user_id'), self.data.get('chat_user_type'),
- self.data.get('ip_address'),
- self.data.get('source'), [], [],
- application.id)
- chat_record_list = list(QuerySet(ChatRecord).filter(chat_id=chat_id).order_by('-create_time')[0:5])
- chat_record_list.sort(key=lambda r: r.create_time)
- for chat_record in chat_record_list:
- chat_info.chat_record_list.append(chat_record)
- return chat_info
+ chat_record = ChatRecord.objects.filter(id=chat_record_id).first()
+ if not chat_record:
+ return result.error(_("Chat record not found"))
+ generator = self._stream_from_db(chat_record, start_id)
+
+ response = StreamingHttpResponse(
+ generator,
+ content_type="text/event-stream;charset=utf-8",
+ )
+ response["Cache-Control"] = "no-cache"
+ response["X-Accel-Buffering"] = "no"
+ return response
+ @staticmethod
+ def _resolve_start_id(request: Request) -> str:
+ """
+ 优先取 SSE 标准的 Last-Event-ID 头(浏览器 EventSource 断线重连会自动带上),
+ 兼容 body / query 里显式传的 last_event_id。取不到则从头开始。
+ """
+ candidate = (
+ request.META.get("HTTP_LAST_EVENT_ID")
+ or (request.data.get("last_event_id") if hasattr(request, "data") else None)
+ or request.query_params.get("last_event_id")
+ )
+ candidate = (candidate or "").strip()
+ return candidate or "0"
-class OpenChatSerializers(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Workspace ID"))
- application_id = serializers.UUIDField(required=True)
- chat_user_id = serializers.CharField(required=True, label=_("Client id"))
- chat_user_type = serializers.CharField(required=True, label=_("Client Type"))
- debug = serializers.BooleanField(required=True, label=_("Debug"))
- ip_address = serializers.CharField(required=False, label=_("IP Address"))
- source = serializers.JSONField(required=False, label=_("Source"))
+ @staticmethod
+ def _sse(msg_id: str, msg_data: str) -> str:
+ """
+ 带 id 字段的 SSE 帧:浏览器会把最后收到的 id 存进 Last-Event-ID,
+ 下次重连自动回传,从而实现断点续传。
+ """
+ return f"id: {msg_id}\ndata: {msg_data}\n\n"
+
+ def _stream_from_queue(self, mq, chat_record_id: str, start_id: str):
+ """
+ 用后台线程跑阻塞式 consume,把回调桥接成 generator。
+ 复用 consume 已经处理好的 done 标记 / 尾部残留竞态,视图层不再重写收尾。
+ """
+ bridge: thread_queue.Queue = thread_queue.Queue(maxsize=_BRIDGE_MAXSIZE)
+ done_sentinel = object()
+ stop_event = threading.Event()
+
+ def pump():
+ try:
+ mq.consume(
+ queue_id=chat_record_id,
+ start_id=start_id,
+ # bridge.put 无 timeout:队列满时在此反压,等 generator 消费腾位
+ on_message=lambda mid, data: bridge.put((mid, data)),
+ on_done=lambda: bridge.put(done_sentinel), # 契约保证有且仅一次
+ timeout=_CONSUME_TIMEOUT,
+ should_stop=stop_event.is_set, # 客户端断开时提前结束,省掉空转
+ )
+ except Exception as e:
+ maxkb_logger.error(f"ResumeStream pump error [{chat_record_id}]: {e}")
+ # 兜底:即使 consume 内部异常也要放哨兵,避免 generator 永久阻塞
+ try:
+ bridge.put_nowait(done_sentinel)
+ except thread_queue.Full:
+ pass
+
+ worker = threading.Thread(target=pump, name=f"resume-{chat_record_id}", daemon=True)
+ worker.start()
+
+ try:
+ while True:
+ try:
+ # 略大于 consume timeout:正常情况下哨兵会先到,这里只防线程异常挂死
+ item = bridge.get(timeout=_CONSUME_TIMEOUT + 5)
+ except thread_queue.Empty:
+ maxkb_logger.warning(f"ResumeStream bridge idle timeout [{chat_record_id}]")
+ break
+ if item is done_sentinel:
+ break
+ msg_id, msg_data = item
+ yield self._sse(msg_id, msg_data)
+ yield "data: [DONE]\n\n"
+ finally:
+ # 客户端提前关闭连接会在 yield 处抛 GeneratorExit,落到这里;
+ # 通知 consume 线程停止,不必再等到 300s 超时
+ stop_event.set()
+
+ def _stream_from_db(self, chat_record, start_id: str):
+ """
+ 已完成 / 不存在于队列:从库里读。
+ 若带了 Last-Event-ID,则跳过已发送过的部分(按落库时的消息 id 对齐)。
+ """
+ try:
+ messages = chat_record.messages or []
+ resuming = start_id and start_id != "0"
+ passed = not resuming # 无续传点则全部下发
+
+ for msg in messages:
+ msg_id = str(msg.get("id", "")) if isinstance(msg, dict) else ""
+
+ if not passed:
+ # 尚未越过续传点:命中该 id 后,从下一条开始发
+ if msg_id and msg_id == start_id:
+ passed = True
+ continue
+
+ yield self._sse(msg_id, json.dumps(msg, ensure_ascii=False))
+
+ # 续传点在库里没匹配到(比如 id 体系不一致):退化为整段重放,别让客户端收到空流
+ if not passed:
+ for msg in messages:
+ msg_id = str(msg.get("id", "")) if isinstance(msg, dict) else ""
+ yield self._sse(msg_id, json.dumps(msg, ensure_ascii=False))
+ finally:
+ yield "data: [DONE]\n\n"
+
+
+# ==================== 提示词生成 ====================
+
+SYSTEM_ROLE = get_file_content(os.path.join(PROJECT_DIR, "apps", "chat", "template", "generate_prompt_system"))
+
+
+class ChatMessagesSerializers(serializers.Serializer):
+ role = serializers.CharField(required=True, label=_("Role"))
+ content = serializers.CharField(required=True, label=_("Content"))
+
+
+class GeneratePromptSerializers(serializers.Serializer):
+ prompt = serializers.CharField(required=True, label=_("Prompt template"))
+ messages = serializers.ListSerializer(child=ChatMessagesSerializers(), required=True, label=_("Chat context"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- application_id = self.data.get('application_id')
- query_set = QuerySet(Application).filter(id=application_id)
+ messages = self.data.get("messages")
+
+ if len(messages) > 30:
+ raise AppApiException(400, _("Too many messages"))
+
+ for index in range(len(messages)):
+ role = messages[index].get("role")
+ if role == "ai" and index % 2 != 1:
+ raise AppApiException(400, _("Authentication failed. Please verify that the parameters are correct."))
+ if role == "user" and index % 2 != 0:
+ raise AppApiException(400, _("Authentication failed. Please verify that the parameters are correct."))
+ if role not in ["user", "ai"]:
+ raise AppApiException(400, _("Authentication failed. Please verify that the parameters are correct."))
+
+
+class PromptGenerateSerializer(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
+ model_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Model"))
+ application_id = serializers.CharField(required=False, allow_blank=True, allow_null=True, label=_("Application"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Application).filter(id=self.data.get("application_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
- if not query_set.exists():
- raise AppApiException(500, gettext('Application does not exist'))
+ application = query_set.first()
+ if application is None:
+ raise AppApiException(500, _("Application id does not exist"))
+ return application
- def open(self):
- self.is_valid(raise_exception=True)
- application_id = self.data.get('application_id')
- application = QuerySet(Application).get(id=application_id)
- debug = self.data.get("debug")
- if not debug:
- application_version = QuerySet(ApplicationVersion).filter(application_id=application_id).order_by(
- '-create_time')[0:1].first()
- if application_version is None:
- raise AppApiException(500,
- _("The application has not been published. Please use it after publishing."))
- if application.type == ApplicationTypeChoices.SIMPLE:
- return self.open_simple(application)
- else:
- return self.open_work_flow(application)
+ def generate_prompt(self, instance: dict):
+ application = self.is_valid(raise_exception=True)
+ GeneratePromptSerializers(data=instance).is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ model_id = self.data.get("model_id")
+ prompt = instance.get("prompt")
+ messages = instance.get("messages")
- def open_work_flow(self, application):
- self.is_valid(raise_exception=True)
- application_id = self.data.get('application_id')
- chat_user_id = self.data.get("chat_user_id")
- chat_user_type = self.data.get("chat_user_type")
- ip_address = self.data.get("ip_address")
- source = self.data.get("source")
- debug = self.data.get("debug")
- chat_id = str(uuid.uuid7())
- ChatInfo(chat_id, chat_user_id, chat_user_type, ip_address, source, [],
- [],
- application_id, debug).set_cache()
- return chat_id
+ message = messages[-1]["content"]
+ q = prompt.replace("{userInput}", message)
- def open_simple(self, application):
- application_id = self.data.get('application_id')
- chat_user_id = self.data.get("chat_user_id")
- chat_user_type = self.data.get("chat_user_type")
- ip_address = self.data.get("ip_address")
- source = self.data.get("source")
- debug = self.data.get("debug")
- knowledge_id_list = [str(row.target_id) for row in
- QuerySet(ResourceMapping).filter(source_id=str(application_id),
- source_type='APPLICATION',
- target_type='KNOWLEDGE')]
-
- chat_id = str(uuid.uuid7())
- ChatInfo(chat_id, chat_user_id, chat_user_type, ip_address, source, knowledge_id_list,
- [str(document.id) for document in
- QuerySet(Document).filter(
- knowledge_id__in=knowledge_id_list,
- is_active=False)],
- application_id,
- debug=debug).set_cache()
- return chat_id
+ messages[-1]["content"] = q
+ SUPPORTED_MODEL_TYPES = ["LLM", "IMAGE"]
+ model_exist = QuerySet(Model).filter(id=model_id, model_type__in=SUPPORTED_MODEL_TYPES).exists()
+ if not model_exist:
+ raise Exception(_("Model does not exists or is not an LLM model"))
+
+ def process():
+ model = get_model_instance_by_model_workspace_id(
+ model_id=model_id, workspace_id=workspace_id, **application.model_params_setting
+ )
+ try:
+ for r in model.stream(
+ [
+ SystemMessage(content=SYSTEM_ROLE),
+ *[
+ HumanMessage(content=m.get("content"))
+ if m.get("role") == "user"
+ else AIMessage(content=m.get("content"))
+ for m in messages
+ ],
+ ]
+ ):
+ yield "data: " + json.dumps({"content": r.content}) + "\n\n"
+ except Exception as e:
+ yield "data: " + json.dumps({"error": str(e)}) + "\n\n"
+
+ return to_stream_response_simple(process())
+
+
+# ==================== 语音 ====================
class TextToSpeechSerializers(serializers.Serializer):
@@ -606,11 +774,11 @@ class TextToSpeechSerializers(serializers.Serializer):
def text_to_speech(self, instance):
self.is_valid(raise_exception=True)
- application_id = self.data.get('application_id')
+ application_id = self.data.get("application_id")
application = QuerySet(Application).filter(id=application_id).first()
return ApplicationOperateSerializer(
- data={'application_id': application_id,
- 'user_id': application.user_id}).text_to_speech(instance, False)
+ data={"application_id": application_id, "user_id": application.user_id}
+ ).text_to_speech(instance, False)
class SpeechToTextSerializers(serializers.Serializer):
@@ -618,8 +786,8 @@ class SpeechToTextSerializers(serializers.Serializer):
def speech_to_text(self, instance):
self.is_valid(raise_exception=True)
- application_id = self.data.get('application_id')
+ application_id = self.data.get("application_id")
application = QuerySet(Application).filter(id=application_id).first()
return ApplicationOperateSerializer(
- data={'application_id': application_id,
- 'user_id': application.user_id}).speech_to_text(instance, False)
+ data={"application_id": application_id, "user_id": application.user_id}
+ ).speech_to_text(instance, False)
diff --git a/apps/chat/serializers/chat_authentication.py b/apps/chat/serializers/chat_authentication.py
index b6c801b4a9c..7db073c478f 100644
--- a/apps/chat/serializers/chat_authentication.py
+++ b/apps/chat/serializers/chat_authentication.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: ChatAuthentication.py
- @date:2025/6/6 13:48
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: ChatAuthentication.py
+@date:2025/6/6 13:48
+@desc:
"""
+
import uuid_utils.compat as uuid
from django.core import signing
from django.core.cache import cache
@@ -13,80 +14,119 @@
from django.utils.translation import gettext_lazy as _
from rest_framework import serializers
-from application.models import ApplicationAccessToken, ChatUserType, Application, ApplicationVersion
-from application.serializers.application import ApplicationSerializerModel
-from common.auth.common import ChatUserToken, ChatAuthentication
+from application.models import ApplicationAccessToken, Application, ApplicationVersion
+from common.auth.common import ChatToken
+from common.auth.constants.operate_constants import Operate
from common.constants.authentication_type import AuthenticationType
from common.constants.cache_version import Cache_Version
from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.exception.app_exception import NotFound404, AppUnauthorizedFailed
+from common.exception.app_exception import NotFound404, AppUnauthorizedFailed, AppApiException
from common.utils.rsa_util import get_key_pair_by_sql
class AnonymousAuthenticationSerializer(serializers.Serializer):
+ """v3 匿名认证:application_id 为可选 query 参数。
+ 传入时颁发应用级令牌,未传入时颁发全局令牌。"""
+
+ application_id = serializers.UUIDField(required=False, label=_("application_id"))
+
+ def auth(self, request):
+ token = request.META.get("HTTP_AUTHORIZATION")
+ token_details = {}
+ try:
+ # 校验token
+ if token is not None:
+ token_details = signing.loads(token[7:])
+ except Exception:
+ pass
+ chat_user_id = token_details.get("id") or str(uuid.uuid7())
+ _type = AuthenticationType.CHAT_USER
+
+ application_id = self.validated_data.get("application_id")
+ if application_id:
+ application_access_token = QuerySet(ApplicationAccessToken).filter(application_id=application_id).first()
+ if application_access_token is None or not application_access_token.is_active:
+ raise AppApiException(500, _("Invalid application_id"))
+ application_id = str(application_id)
+ return ChatToken(
+ chat_user_id, _type, str(Operate.ANNOTATION_AUTH), application_id=application_id
+ ).to_token()
+ return (ChatToken(chat_user_id, _type, str(Operate.ANNOTATION_AUTH)).to_token(),)
+
+
+class AnonymousAuthenticationV2Serializer(serializers.Serializer):
+ """v2 匿名认证:application_id 不在 path,从 access_token 解出并写进 token,
+ 供 ChatUserToken handler 收窄到该应用。"""
+
access_token = serializers.CharField(required=True, label=_("access_token"))
def auth(self, request, with_valid=True):
- token = request.META.get('HTTP_AUTHORIZATION')
+ token = request.META.get("HTTP_AUTHORIZATION")
token_details = {}
try:
# 校验token
if token is not None:
token_details = signing.loads(token[7:])
- except Exception as e:
+ except Exception:
pass
if with_valid:
self.is_valid(raise_exception=True)
access_token = self.data.get("access_token")
application_access_token = QuerySet(ApplicationAccessToken).filter(access_token=access_token).first()
- if application_access_token is not None and application_access_token.is_active:
- chat_user_id = token_details.get('chat_user_id') or str(uuid.uuid7())
- _type = AuthenticationType.CHAT_ANONYMOUS_USER
- return ChatUserToken(application_access_token.application_id, None, access_token, _type,
- ChatUserType.ANONYMOUS_USER,
- chat_user_id, ChatAuthentication(None)).to_token()
- else:
+ if application_access_token is None or not application_access_token.is_active:
raise NotFound404(404, _("Invalid access_token"))
+ chat_user_id = token_details.get("user_id") or token_details.get("id") or str(uuid.uuid7())
+ _type = AuthenticationType.CHAT_USER
+ application_id = str(application_access_token.application_id)
+ return ChatToken(
+ chat_user_id, _type, str(Operate.ANNOTATION_AUTH), application_id=application_id
+ ).to_token(), FileToken(chat_user_id, _type, application_id=application_id).to_token()
class AuthProfileSerializer(serializers.Serializer):
+ """v3: 直接通过 application_id 获取认证 profile"""
+
+ application_id = serializers.UUIDField(required=True, label=_("application_id"))
+
+ def profile(self):
+ self.is_valid(raise_exception=True)
+ application_id = self.validated_data.get("application_id")
+ application_access_token = QuerySet(ApplicationAccessToken).filter(application_id=application_id).first()
+ if application_access_token is None:
+ raise NotFound404(404, _("Invalid application_id"))
+ if not application_access_token.is_active:
+ raise NotFound404(404, _("Invalid application_id"))
+ login_value = application_access_token.authentication_value.get("login_value", [])
+ chat_platform = DatabaseModelManage.get_model("chat_platform")
+ if chat_platform is not None:
+ types = QuerySet(chat_platform).filter(is_active=True, is_valid=True).values_list("auth_type", flat=True)
+ login_value = list(set(login_value) & set(types))
+ if "LOCAL" in application_access_token.authentication_value.get("login_value", []):
+ login_value.insert(0, "LOCAL")
+ return {
+ "application_name": application_access_token.application.name,
+ "authentication": application_access_token.authentication,
+ "authentication_type": application_access_token.authentication_value.get("type", "password"),
+ "max_attempts": application_access_token.authentication_value.get("max_attempts", 1),
+ "login_value": login_value,
+ "rsaKey": get_key_pair_by_sql().get("key"),
+ }
+
+
+class AuthProfileV2Serializer(serializers.Serializer):
+ """v2: 通过 access_token 查表得到 application_id,委托给 AuthProfileSerializer"""
+
access_token = serializers.CharField(required=True, label=_("access_token"))
def profile(self):
self.is_valid(raise_exception=True)
- access_token = self.data.get("access_token")
+ access_token = self.validated_data.get("access_token")
application_access_token = QuerySet(ApplicationAccessToken).filter(access_token=access_token).first()
if application_access_token is None:
raise NotFound404(404, _("Invalid access_token"))
if not application_access_token.is_active:
raise NotFound404(404, _("Invalid access_token"))
- application_id = application_access_token.application_id
- profile = {
- 'authentication': False
- }
- application_setting_model = DatabaseModelManage.get_model('application_setting')
- chat_platform = DatabaseModelManage.get_model('chat_platform')
- if application_setting_model and chat_platform:
- application_setting = QuerySet(application_setting_model).filter(application_id=application_id).first()
- types = QuerySet(chat_platform).filter(is_active=True, is_valid=True).values_list('auth_type', flat=True)
- login_value = application_access_token.authentication_value.get('login_value', [])
- max_attempts = application_access_token.authentication_value.get('max_attempts', 1)
- final_login_value = list(set(login_value) & set(types))
- if 'LOCAL' in login_value:
- final_login_value.insert(0, 'LOCAL')
- if application_setting is not None:
- profile = {
- 'icon': application_setting.application.icon,
- 'application_name': application_setting.application.name,
- 'bg_icon': application_setting.chat_background,
- 'authentication': application_access_token.authentication,
- 'authentication_type': application_access_token.authentication_value.get(
- 'type', 'password'),
- 'max_attempts': max_attempts,
- 'login_value': final_login_value,
- 'rsaKey' : get_key_pair_by_sql().get('key')
- }
- return profile
+ return AuthProfileSerializer(data={"application_id": application_access_token.application_id}).profile()
class ApplicationProfileSerializer(serializers.Serializer):
@@ -95,18 +135,30 @@ class ApplicationProfileSerializer(serializers.Serializer):
@staticmethod
def reset_application(application, application_version):
update_field_dict = {
- 'application_name': 'name', 'desc': 'desc', 'prologue': 'prologue', 'dialogue_number': 'dialogue_number',
- 'user_id': 'user_id', 'model_id': 'model_id', 'knowledge_setting': 'knowledge_setting',
- 'model_setting': 'model_setting', 'model_params_setting': 'model_params_setting',
- 'tts_model_params_setting': 'tts_model_params_setting',
- 'problem_optimization': 'problem_optimization', 'work_flow': 'work_flow',
- 'problem_optimization_prompt': 'problem_optimization_prompt', 'tts_model_id': 'tts_model_id',
- 'stt_model_id': 'stt_model_id', 'tts_model_enable': 'tts_model_enable',
- 'stt_model_enable': 'stt_model_enable', 'tts_type': 'tts_type',
- 'tts_autoplay': 'tts_autoplay', 'stt_autosend': 'stt_autosend', 'file_upload_enable': 'file_upload_enable',
- 'file_upload_setting': 'file_upload_setting'
+ "application_name": "name",
+ "desc": "desc",
+ "prologue": "prologue",
+ "dialogue_number": "dialogue_number",
+ "user_id": "user_id",
+ "model_id": "model_id",
+ "knowledge_setting": "knowledge_setting",
+ "model_setting": "model_setting",
+ "model_params_setting": "model_params_setting",
+ "tts_model_params_setting": "tts_model_params_setting",
+ "problem_optimization": "problem_optimization",
+ "work_flow": "work_flow",
+ "problem_optimization_prompt": "problem_optimization_prompt",
+ "tts_model_id": "tts_model_id",
+ "stt_model_id": "stt_model_id",
+ "tts_model_enable": "tts_model_enable",
+ "stt_model_enable": "stt_model_enable",
+ "tts_type": "tts_type",
+ "tts_autoplay": "tts_autoplay",
+ "stt_autosend": "stt_autosend",
+ "file_upload_enable": "file_upload_enable",
+ "file_upload_setting": "file_upload_setting",
}
- for (version_field, app_field) in update_field_dict.items():
+ for version_field, app_field in update_field_dict.items():
_v = getattr(application_version, version_field)
setattr(application, app_field, _v)
@@ -118,60 +170,74 @@ def profile(self, with_valid=True):
application_access_token = QuerySet(ApplicationAccessToken).filter(application_id=application.id).first()
if application_access_token is None:
raise AppUnauthorizedFailed(500, _("Illegal User"))
- application_setting_model = DatabaseModelManage.get_model('application_setting')
- application_version = QuerySet(ApplicationVersion).filter(application_id=application.id).order_by(
- '-create_time').first()
+ application_setting_model = DatabaseModelManage.get_model("application_setting")
+ application_version = (
+ QuerySet(ApplicationVersion).filter(application_id=application.id).order_by("-create_time").first()
+ )
if application_version is not None:
self.reset_application(application, application_version)
- license_is_valid = cache.get(Cache_Version.SYSTEM.get_key(key='license_is_valid'),
- version=Cache_Version.SYSTEM.get_version())
+ license_is_valid = cache.get(
+ Cache_Version.SYSTEM.get_key(key="license_is_valid"), version=Cache_Version.SYSTEM.get_version()
+ )
application_setting_dict = {}
if application_setting_model is not None and license_is_valid:
- application_setting = QuerySet(application_setting_model).filter(
- application_id=application_access_token.application_id).first()
+ application_setting = (
+ QuerySet(application_setting_model)
+ .filter(application_id=application_access_token.application_id)
+ .first()
+ )
if application_setting is not None:
- custom_theme = getattr(application_setting, 'custom_theme', {})
- float_location = getattr(application_setting, 'float_location', {})
+ custom_theme = getattr(application_setting, "custom_theme", {})
+ float_location = getattr(application_setting, "float_location", {})
if not custom_theme:
- application_setting.custom_theme = {
- 'theme_color': '',
- 'header_font_color': ''
- }
+ application_setting.custom_theme = {"theme_color": "", "header_font_color": ""}
if not float_location:
application_setting.float_location = {
- 'x': {'type': '', 'value': ''},
- 'y': {'type': '', 'value': ''}
+ "x": {"type": "", "value": ""},
+ "y": {"type": "", "value": ""},
}
- application_setting_dict = {'show_source': application_access_token.show_source,
- 'show_history': application_setting.show_history,
- 'draggable': application_setting.draggable,
- 'show_guide': application_setting.show_guide,
- 'avatar': application_setting.avatar,
- 'show_avatar': application_setting.show_avatar,
- 'float_icon': application_setting.float_icon,
- 'disclaimer': application_setting.disclaimer,
- 'disclaimer_value': application_setting.disclaimer_value,
- 'custom_theme': application_setting.custom_theme,
- 'user_avatar': application_setting.user_avatar,
- 'show_user_avatar': application_setting.show_user_avatar,
- 'show_share': application_setting.show_share,
- 'float_location': application_setting.float_location,
- 'chat_background': application_setting.chat_background}
- base_node = [node for node in ((application.work_flow or {}).get('nodes', []) or []) if
- node.get('id') == 'base-node']
- return {**ApplicationSerializerModel(application).data,
- 'stt_model_id': application.stt_model_id,
- 'tts_model_id': application.tts_model_id,
- 'stt_model_enable': application.stt_model_enable,
- 'tts_model_enable': application.tts_model_enable,
- 'tts_type': application.tts_type,
- 'tts_autoplay': application.tts_autoplay,
- 'stt_autosend': application.stt_autosend,
- 'file_upload_enable': application.file_upload_enable,
- 'file_upload_setting': application.file_upload_setting,
- 'work_flow': {'nodes': base_node} if base_node else None,
- 'show_source': application_access_token.show_source,
- 'show_exec': application_access_token.show_exec,
- 'show_share': True,
- 'language': application_access_token.language,
- **application_setting_dict}
+ application_setting_dict = {
+ "show_source": application_access_token.show_source,
+ "show_history": application_setting.show_history,
+ "draggable": application_setting.draggable,
+ "show_guide": application_setting.show_guide,
+ "avatar": application_setting.avatar,
+ "show_avatar": application_setting.show_avatar,
+ "float_icon": application_setting.float_icon,
+ "disclaimer": application_setting.disclaimer,
+ "disclaimer_value": application_setting.disclaimer_value,
+ "custom_theme": application_setting.custom_theme,
+ "user_avatar": application_setting.user_avatar,
+ "show_user_avatar": application_setting.show_user_avatar,
+ "show_share": application_setting.show_share,
+ "float_location": application_setting.float_location,
+ "chat_background": application_setting.chat_background,
+ }
+ base_node = [
+ node for node in ((application.work_flow or {}).get("nodes", []) or []) if node.get("id") == "base-node"
+ ]
+ return {
+ "id": application.id,
+ "name": application.name,
+ "desc": application.desc,
+ "prologue": application.prologue,
+ "icon": application.icon,
+ "type": application.type,
+ "dialogue_number": application.dialogue_number,
+ "problem_optimization": application.problem_optimization,
+ "stt_model_id": application.stt_model_id,
+ "tts_model_id": application.tts_model_id,
+ "stt_model_enable": application.stt_model_enable,
+ "tts_model_enable": application.tts_model_enable,
+ "tts_type": application.tts_type,
+ "tts_autoplay": application.tts_autoplay,
+ "stt_autosend": application.stt_autosend,
+ "file_upload_enable": application.file_upload_enable,
+ "file_upload_setting": application.file_upload_setting,
+ "work_flow": {"nodes": base_node} if base_node else None,
+ "show_source": application_access_token.show_source,
+ "show_exec": application_access_token.show_exec,
+ "show_share": True,
+ "language": application_access_token.language,
+ **application_setting_dict,
+ }
diff --git a/apps/chat/serializers/chat_history.py b/apps/chat/serializers/chat_history.py
new file mode 100644
index 00000000000..f103f532bf5
--- /dev/null
+++ b/apps/chat/serializers/chat_history.py
@@ -0,0 +1,92 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: chat_history.py
+@date:2025/6/9 11:23
+@desc: 会话历史的滚动窗口缓存(Redis,跨 worker 共享)。
+
+- 历史是 append-only:每轮末尾追加一条已完成记录,旧记录不再变。
+- 只缓存最近 LIMIT 条,且只存历史真正要用的字段:question + messages
+ (新流程用 question/messages 构造 Human/AI message,不再用 problem_text/answer_text)。
+- 缓存缺失时回落 DB 并回填;记录定稿(on_complete)后 append/按 id upsert;清历史时失效。
+"""
+
+from django.core.cache import cache
+from django.db.models import QuerySet
+
+from application.models import ChatRecord
+from common.constants.cache_version import Cache_Version
+
+
+class ChatHistory:
+ # 最近多少条历史进上下文(注意:若节点 dialogue_number 超过该值会喂不够)
+ LIMIT = 5
+ TIMEOUT = 60 * 30
+
+ def __init__(self, chat_id):
+ self.chat_id = str(chat_id)
+
+ def _key(self):
+ return Cache_Version.CHAT_HISTORY.get_key(key=self.chat_id)
+
+ def _version(self):
+ return Cache_Version.CHAT_HISTORY.get_version()
+
+ @staticmethod
+ def _to_map(r):
+ return {
+ "id": str(r.id),
+ "chat_id": str(r.chat_id),
+ "question": r.question,
+ "messages": r.messages,
+ "details": r.details,
+ "create_time": r.create_time,
+ }
+
+ @staticmethod
+ def _from_map(d):
+ return ChatRecord(
+ id=d.get("id"),
+ chat_id=d.get("chat_id"),
+ question=d.get("question"),
+ messages=d.get("messages"),
+ details=d.get("details"),
+ create_time=d.get("create_time"),
+ )
+
+ def _load_from_db(self):
+ records = list(QuerySet(ChatRecord).filter(chat_id=self.chat_id).order_by("-create_time")[0 : self.LIMIT])
+ records.sort(key=lambda r: r.create_time)
+ return records
+
+ def load(self, exclude_record_id=None):
+ """
+ 读历史:命中缓存则还原,未命中从 DB 取最近 N 条并回填。
+ exclude_record_id:重答/Form 提交时把当前这条从历史上下文里剔掉。
+ """
+ cached = cache.get(self._key(), version=self._version())
+ if cached is None:
+ records = self._load_from_db()
+ cache.set(self._key(), [self._to_map(r) for r in records], version=self._version(), timeout=self.TIMEOUT)
+ else:
+ records = [self._from_map(d) for d in cached]
+ if exclude_record_id is not None:
+ records = [r for r in records if str(r.id) != str(exclude_record_id)]
+ return records
+
+ def append(self, chat_record):
+ """
+ 记录定稿后追加进缓存(按 create_time 天然排在最后)。
+ re_chat 复用同一 id → 先按 id 去重再追加,等价 upsert。
+ 未预热(缓存为空)则跳过,下次 load 会从 DB 重建。
+ """
+ cached = cache.get(self._key(), version=self._version())
+ if cached is None:
+ return
+ cached = [d for d in cached if str(d.get("id")) != str(chat_record.id)]
+ cached.append(self._to_map(chat_record))
+ cache.set(self._key(), cached[-self.LIMIT :], version=self._version(), timeout=self.TIMEOUT)
+
+ def clear(self):
+ cache.delete(self._key(), version=self._version())
diff --git a/apps/chat/serializers/chat_record.py b/apps/chat/serializers/chat_record.py
index ee6d446dd57..de0db6fcf77 100644
--- a/apps/chat/serializers/chat_record.py
+++ b/apps/chat/serializers/chat_record.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: chat_record.py
- @date:2025/6/23 11:16
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: chat_record.py
+@date:2025/6/23 11:16
+@desc:
"""
+
from typing import Dict
from django.db import transaction
@@ -15,18 +16,20 @@
from application.models import VoteChoices, ChatRecord, Chat, ApplicationAccessToken, VoteReasonChoices
from application.serializers.application_chat import ChatCountSerializer
-from application.serializers.application_chat_record import ChatRecordSerializerModel, \
- ApplicationChatRecordQuerySerializers
+from application.serializers.application_chat_record import (
+ ChatRecordSerializerModel,
+ ApplicationChatRecordQuerySerializers,
+)
from common.db.search import page_search
from common.exception.app_exception import AppApiException
from common.utils.lock import RedisLock
class VoteRequest(serializers.Serializer):
- vote_status = serializers.ChoiceField(choices=VoteChoices.choices,
- label=_("Bidding Status"))
- vote_reason = serializers.ChoiceField(choices=VoteReasonChoices.choices, label=_("Vote Reason"), required=False,
- allow_null=True)
+ vote_status = serializers.ChoiceField(choices=VoteChoices.choices, label=_("Bidding Status"))
+ vote_reason = serializers.ChoiceField(
+ choices=VoteReasonChoices.choices, label=_("Vote Reason"), required=False, allow_null=True
+ )
vote_other_content = serializers.CharField(required=False, allow_blank=True, label=_("Vote other content"))
@@ -34,18 +37,14 @@ class VoteRequest(serializers.Serializer):
class HistoryChatModel(serializers.ModelSerializer):
class Meta:
model = Chat
- fields = ['id',
- 'application_id',
- 'abstract',
- 'create_time',
- 'update_time']
+ fields = ["id", "application_id", "abstract", "create_time", "update_time"]
class VoteSerializer(serializers.Serializer):
+ application_id = serializers.UUIDField(required=True, label=_("Application ID"))
chat_id = serializers.UUIDField(required=True, label=_("Conversation ID"))
- chat_record_id = serializers.UUIDField(required=True,
- label=_("Conversation record id"))
+ chat_record_id = serializers.UUIDField(required=True, label=_("Conversation record id"))
@transaction.atomic
def vote(self, instance: Dict, with_valid=True):
@@ -53,13 +52,16 @@ def vote(self, instance: Dict, with_valid=True):
self.is_valid(raise_exception=True)
VoteRequest(data=instance).is_valid(raise_exception=True)
rlock = RedisLock()
- if not rlock.try_lock(self.data.get('chat_record_id')):
- raise AppApiException(500,
- gettext(
- "Voting on the current session minutes, please do not send repeated requests"))
+ if not rlock.try_lock(self.data.get("chat_record_id")):
+ raise AppApiException(
+ 500, gettext("Voting on the current session minutes, please do not send repeated requests")
+ )
try:
- chat_record_details_model = QuerySet(ChatRecord).get(id=self.data.get('chat_record_id'),
- chat_id=self.data.get('chat_id'))
+ chat_record_details_model = QuerySet(ChatRecord).get(
+ id=self.data.get("chat_record_id"),
+ chat_id=self.data.get("chat_id"),
+ chat__application_id=self.data.get("application_id"),
+ )
if chat_record_details_model is None:
raise AppApiException(500, gettext("Non-existent conversation chat_record_id"))
vote_status = instance.get("vote_status")
@@ -68,7 +70,7 @@ def vote(self, instance: Dict, with_valid=True):
if chat_record_details_model.vote_status == VoteChoices.UN_VOTE:
# 投票时获取字段
vote_reason = instance.get("vote_reason")
- vote_other_content = instance.get("vote_other_content") or ''
+ vote_other_content = instance.get("vote_other_content") or ""
if vote_status == VoteChoices.STAR:
# 点赞
@@ -88,25 +90,28 @@ def vote(self, instance: Dict, with_valid=True):
# 取消点赞
chat_record_details_model.vote_status = VoteChoices.UN_VOTE
chat_record_details_model.vote_reason = None
- chat_record_details_model.vote_other_content = ''
+ chat_record_details_model.vote_other_content = ""
chat_record_details_model.save()
else:
raise AppApiException(500, gettext("Already voted, please cancel first and then vote again"))
finally:
- rlock.un_lock(self.data.get('chat_record_id'))
- ChatCountSerializer(data={'chat_id': self.data.get('chat_id')}).update_chat()
+ rlock.un_lock(self.data.get("chat_record_id"))
+ ChatCountSerializer(data={"chat_id": self.data.get("chat_id")}).update_chat()
return True
class HistoricalConversationSerializer(serializers.Serializer):
- application_id = serializers.UUIDField(required=True, label=_('Application ID'))
- chat_user_id = serializers.UUIDField(required=True, label=_('Chat User ID'))
+ application_id = serializers.UUIDField(required=True, label=_("Application ID"))
+ chat_user_id = serializers.UUIDField(required=True, label=_("Chat User ID"))
def get_queryset(self):
- chat_user_id = self.data.get('chat_user_id')
+ chat_user_id = self.data.get("chat_user_id")
application_id = self.data.get("application_id")
- return QuerySet(Chat).filter(application_id=application_id, chat_user_id=chat_user_id,
- is_deleted=False).order_by('-update_time', 'id')
+ return (
+ QuerySet(Chat)
+ .filter(application_id=application_id, chat_user_id=chat_user_id, is_deleted=False)
+ .order_by("-update_time", "id")
+ )
def list(self):
self.is_valid(raise_exception=True)
@@ -119,67 +124,90 @@ def page(self, current_page, page_size):
class EditAbstractSerializer(serializers.Serializer):
- abstract = serializers.CharField(required=True, label=_('Abstract'))
+ abstract = serializers.CharField(required=True, label=_("Abstract"))
class HistoricalConversationOperateSerializer(serializers.Serializer):
- application_id = serializers.UUIDField(required=True, label=_('Application ID'))
- chat_user_id = serializers.UUIDField(required=True, label=_('Chat User ID'))
- chat_id = serializers.UUIDField(required=True, label=_('Chat ID'))
+ application_id = serializers.UUIDField(required=True, label=_("Application ID"))
+ chat_user_id = serializers.UUIDField(required=True, label=_("Chat User ID"))
+ chat_id = serializers.UUIDField(required=True, label=_("Chat ID"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- e = QuerySet(Chat).filter(id=self.data.get('chat_id'), application_id=self.data.get('application_id'),
- chat_user_id=self.data.get('chat_user_id')).exists()
+ e = (
+ QuerySet(Chat)
+ .filter(
+ id=self.data.get("chat_id"),
+ application_id=self.data.get("application_id"),
+ chat_user_id=self.data.get("chat_user_id"),
+ )
+ .exists()
+ )
if not e:
- raise AppApiException(500, _('Chat is not exist'))
+ raise AppApiException(500, _("Chat is not exist"))
def edit_abstract(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
EditAbstractSerializer(data=instance).is_valid(raise_exception=True)
- QuerySet(Chat).filter(id=self.data.get('chat_id'), application_id=self.data.get('application_id'),
- chat_user_id=self.data.get('chat_user_id')).update(abstract=instance.get('abstract'))
+ chat = (
+ QuerySet(Chat)
+ .filter(
+ id=self.data.get("chat_id"),
+ application_id=self.data.get("application_id"),
+ chat_user_id=self.data.get("chat_user_id"),
+ )
+ .first()
+ )
+ if chat.is_deleted:
+ raise AppApiException(500, _("Chat has been deleted"))
+ chat.abstract = instance.get("abstract")
+ chat.save()
return True
def logic_delete(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- QuerySet(Chat).filter(id=self.data.get('chat_id'), application_id=self.data.get('application_id'),
- chat_user_id=self.data.get('chat_user_id')).update(is_deleted=True)
+ QuerySet(Chat).filter(
+ id=self.data.get("chat_id"),
+ application_id=self.data.get("application_id"),
+ chat_user_id=self.data.get("chat_user_id"),
+ ).update(is_deleted=True)
return True
class Clear(serializers.Serializer):
- application_id = serializers.UUIDField(required=True, label=_('Application ID'))
- chat_user_id = serializers.UUIDField(required=True, label=_('Chat User ID'))
+ application_id = serializers.UUIDField(required=True, label=_("Application ID"))
+ chat_user_id = serializers.UUIDField(required=True, label=_("Chat User ID"))
def batch_logic_delete(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- QuerySet(Chat).filter(application_id=self.data.get('application_id'),
- chat_user_id=self.data.get('chat_user_id')).update(is_deleted=True)
+ QuerySet(Chat).filter(
+ application_id=self.data.get("application_id"), chat_user_id=self.data.get("chat_user_id")
+ ).update(is_deleted=True)
return True
class HistoricalConversationRecordSerializer(serializers.Serializer):
- application_id = serializers.UUIDField(required=True, label=_('Application ID'))
- chat_id = serializers.UUIDField(required=True, label=_('Chat ID'))
- chat_user_id = serializers.UUIDField(required=True, label=_('Chat User ID'))
+ application_id = serializers.UUIDField(required=True, label=_("Application ID"))
+ chat_id = serializers.UUIDField(required=True, label=_("Chat ID"))
+ chat_user_id = serializers.UUIDField(required=True, label=_("Chat User ID"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- chat_user_id = self.data.get('chat_user_id')
+ chat_user_id = self.data.get("chat_user_id")
application_id = self.data.get("application_id")
- chat_id = self.data.get('chat_id')
- chat_exist = QuerySet(Chat).filter(application_id=application_id, chat_user_id=chat_user_id,
- id=chat_id).exists()
+ chat_id = self.data.get("chat_id")
+ chat_exist = (
+ QuerySet(Chat).filter(application_id=application_id, chat_user_id=chat_user_id, id=chat_id).exists()
+ )
if not chat_exist:
- raise AppApiException(500, _('Non-existent chatID'))
+ raise AppApiException(500, _("Non-existent chatID"))
def get_queryset(self):
- chat_id = self.data.get('chat_id')
- return QuerySet(ChatRecord).filter(chat_id=chat_id).order_by('-create_time')
+ chat_id = self.data.get("chat_id")
+ return QuerySet(ChatRecord).filter(chat_id=chat_id).order_by("-create_time")
def list(self):
self.is_valid(raise_exception=True)
@@ -188,13 +216,14 @@ def list(self):
def page(self, current_page, page_size):
self.is_valid(raise_exception=True)
- application_access_token = QuerySet(ApplicationAccessToken).filter(
- application_id=self.data.get('application_id')).first()
+ application_access_token = (
+ QuerySet(ApplicationAccessToken).filter(application_id=self.data.get("application_id")).first()
+ )
show_source = False
show_exec = False
if application_access_token is not None:
show_exec = application_access_token.show_exec
show_source = application_access_token.show_source
return ApplicationChatRecordQuerySerializers(
- data={'application_id': self.data.get('application_id'), 'chat_id': self.data.get('chat_id')}).page(
- current_page, page_size, show_source=show_source, show_exec=show_exec)
+ data={"application_id": self.data.get("application_id"), "chat_id": self.data.get("chat_id")}
+ ).page(current_page, page_size, show_source=show_source, show_exec=show_exec)
diff --git a/apps/chat/serializers/chat_user_api_key_serializers.py b/apps/chat/serializers/chat_user_api_key_serializers.py
new file mode 100644
index 00000000000..ab0d7bce1f5
--- /dev/null
+++ b/apps/chat/serializers/chat_user_api_key_serializers.py
@@ -0,0 +1,56 @@
+# coding=utf-8
+
+import hashlib
+
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from common.db.search import page_search
+from system_manage.models import ChatUserApiKey
+
+
+class ChatUserApiKeyModelSerializer(serializers.ModelSerializer):
+ class Meta:
+ model = ChatUserApiKey
+ fields = ['id', 'secret_key', 'is_active', 'create_time', 'user_id']
+
+
+class ChatUserApiKeySerializer(serializers.Serializer):
+ user_id = serializers.UUIDField(required=True, label=_('user id'))
+ order_by = serializers.CharField(required=False, label=_('order by'), allow_null=True, allow_blank=True)
+
+ def generate(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ api_key = ChatUserApiKey(
+ id=uuid.uuid7(),
+ secret_key=hashlib.md5(uuid.uuid7().bytes).hexdigest(),
+ user_id=self.data.get('user_id')
+ )
+ api_key.save()
+ return ChatUserApiKeyModelSerializer(api_key).data
+
+ def page(self, current_page: int, page_size: int, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ user_id = self.data.get('user_id')
+ query_set = QuerySet(ChatUserApiKey).filter(user_id=user_id)
+ order_by = '-create_time' if self.data.get('order_by') is None or self.data.get('order_by') == '' else self.data.get('order_by')
+ query_set = query_set.order_by(order_by)
+ return page_search(current_page, page_size,
+ query_set,
+ post_records_handler=lambda u: ChatUserApiKeyModelSerializer(u).data)
+
+ class Operate(serializers.Serializer):
+ id = serializers.UUIDField(required=True, label=_('api key id'))
+ user_id = serializers.UUIDField(required=True, label=_('user id'))
+
+ def destroy(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ QuerySet(ChatUserApiKey).filter(
+ id=self.data.get('id'), user_id=self.data.get('user_id')
+ ).delete()
+ return True
\ No newline at end of file
diff --git a/apps/chat/serializers/chat_user_serializer.py b/apps/chat/serializers/chat_user_serializer.py
new file mode 100644
index 00000000000..ee9c6f76dc6
--- /dev/null
+++ b/apps/chat/serializers/chat_user_serializer.py
@@ -0,0 +1,96 @@
+import json
+
+from django.core.cache import cache
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.models import ApplicationAccessToken
+from common.constants.cache_version import Cache_Version
+from common.exception.app_exception import AppApiException
+from common.utils.common import password_encrypt
+from common.utils.common import password_verify, needs_password_upgrade
+from common.utils.rsa_util import decrypt
+from system_manage.models import ChatUser
+from users.serializers.login import LoginRequest
+
+system_version, system_get_key = Cache_Version.SYSTEM.value
+
+
+class ChatUserAccessTokenV3Serializer(serializers.Serializer):
+ @staticmethod
+ def get_auth_setting():
+ application_access_token = ApplicationAccessToken.objects.filter(is_active=True).first()
+
+ if not application_access_token:
+ raise AppApiException(1005, _("Invalid access token"))
+
+ return application_access_token.authentication_value
+
+ @staticmethod
+ def local_login(instance):
+ username = instance.get("username", "")
+ encryptedData = instance.get("encryptedData", "")
+ if encryptedData:
+ json_data = json.loads(decrypt(encryptedData))
+ instance.update(json_data)
+ try:
+ LoginRequest(data=instance).is_valid(raise_exception=True)
+ except Exception as e:
+ raise e
+ auth_setting = ChatUserAccessTokenV3Serializer.get_auth_setting()
+
+ max_attempts = auth_setting.get("max_attempts", 1)
+ password = instance.get("password")
+ captcha = instance.get("captcha", "")
+
+ # 判断是否需要验证码
+ need_captcha = True
+ if max_attempts == -1:
+ need_captcha = False
+ elif max_attempts > 0:
+ fail_count = cache.get(system_get_key(f"chat_{username}"), version=system_version) or 0
+ need_captcha = fail_count >= max_attempts
+
+ if need_captcha:
+ ChatUserAccessTokenV3Serializer._validate_captcha(username, captcha)
+
+ user = ChatUser.objects.filter(username=username).first()
+
+ if not user or not password_verify(password, user.password):
+ record_login_fail(username)
+ raise AppApiException(500, _("The username or password is incorrect"))
+
+ if needs_password_upgrade(user.password):
+ user.password = password_encrypt(password)
+ user.save(update_fields=["password"])
+ if not user.is_active:
+ raise AppApiException(1005, _("The user has been disabled, please contact the administrator!"))
+ cache.delete(system_get_key(f"chat_{username}"), version=system_version)
+ return user
+
+ @staticmethod
+ def _validate_captcha(username: str, captcha: str) -> None:
+ """验证验证码(一次性消费)"""
+ if not captcha:
+ raise AppApiException(1005, _("Captcha is required"))
+
+ captcha_key = Cache_Version.CAPTCHA.get_key(captcha=f"chat_{username}")
+ captcha_cache = cache.get(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+
+ if captcha_cache is None or captcha.lower() != captcha_cache:
+ record_login_fail(username)
+ raise AppApiException(1005, _("Captcha code error or expiration"))
+
+ # 校验通过即销毁,保证验证码一次性使用
+ cache.delete(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+
+
+def record_login_fail(username: str, expire: int = 600):
+ """记录登录失败次数(原子递增)"""
+ if not username:
+ return
+ fail_key = system_get_key(f"chat_{username}")
+ try:
+ cache.incr(fail_key, 1, version=system_version)
+ except ValueError:
+ cache.set(fail_key, 1, timeout=expire, version=system_version)
diff --git a/apps/chat/serializers/portal.py b/apps/chat/serializers/portal.py
new file mode 100644
index 00000000000..c5a2cd7648b
--- /dev/null
+++ b/apps/chat/serializers/portal.py
@@ -0,0 +1,199 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:MaxKB
+@file: portal.py
+@date:2026/8/14
+@desc: 门户配置序列化器
+"""
+
+from django.core.cache import cache
+from django.db.models import Exists, OuterRef
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.models import Application, Chat
+from application.models.application_access_token import ApplicationAccessToken
+from common.constants.cache_version import Cache_Version
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.db.search import page_search
+from system_manage.models.chat_user import (
+ ChatUser,
+ ResourceChatUserAuthorize,
+ ResourceChatUserGroupAuthorize,
+ ResourceType,
+ UserGroupRelation,
+)
+
+
+def build_application_setting_dict(setting, show_source):
+ return {
+ "show_source": show_source,
+ "show_history": setting.show_history,
+ "draggable": setting.draggable,
+ "show_guide": setting.show_guide,
+ "avatar": setting.avatar,
+ "show_avatar": setting.show_avatar,
+ "float_icon": setting.float_icon,
+ "disclaimer": setting.disclaimer,
+ "disclaimer_value": setting.disclaimer_value,
+ "custom_theme": setting.custom_theme or {"theme_color": "", "header_font_color": ""},
+ "user_avatar": setting.user_avatar,
+ "show_user_avatar": setting.show_user_avatar,
+ "show_share": setting.show_share,
+ "float_location": setting.float_location or {"x": {"type": "", "value": ""}, "y": {"type": "", "value": ""}},
+ "chat_background": setting.chat_background,
+ }
+
+
+def get_application_settings_map(application_ids):
+ """批量返回 application_id -> 门户设置信息;license 无效或模型缺失时返回空 dict"""
+ application_setting_model = DatabaseModelManage.get_model("application_setting")
+ if application_setting_model is None or not application_ids:
+ return {}
+ license_is_valid = cache.get(
+ Cache_Version.SYSTEM.get_key(key="license_is_valid"), version=Cache_Version.SYSTEM.get_version()
+ )
+ if not license_is_valid:
+ return {}
+ settings = application_setting_model.objects.filter(application_id__in=application_ids)
+ access_tokens = ApplicationAccessToken.objects.filter(application_id__in=application_ids).values_list(
+ "application_id", "show_source"
+ )
+ token_map = {str(application_id): show_source for application_id, show_source in access_tokens}
+ return {
+ str(setting.application_id): build_application_setting_dict(
+ setting, token_map.get(str(setting.application_id), False)
+ )
+ for setting in settings
+ }
+
+
+class PortalApplicationAuthMixin:
+ """门户应用授权过滤公共逻辑"""
+
+ @staticmethod
+ def get_authorized_application_ids(user_id):
+ public_apps = ApplicationAccessToken.objects.filter(application_id=OuterRef("id"), authentication=False)
+ if not ChatUser.objects.filter(id=user_id).exists():
+ return (
+ Application.objects.filter(is_publish=True, is_portal=True)
+ .filter(Exists(public_apps))
+ .values_list("id", flat=True)
+ )
+ authed_token_exists = ApplicationAccessToken.objects.filter(application_id=OuterRef("id"), authentication=True)
+ direct_auth = ResourceChatUserAuthorize.objects.filter(
+ resource_id=OuterRef("id"), resource_type=ResourceType.APPLICATION.value, is_auth=True, user_id=user_id
+ )
+ user_groups = UserGroupRelation.objects.filter(user_id=user_id).values_list("group_id", flat=True)
+ group_auth = ResourceChatUserGroupAuthorize.objects.filter(
+ resource_id=OuterRef("id"),
+ resource_type=ResourceType.APPLICATION.value,
+ is_auth=True,
+ user_group_id__in=user_groups,
+ )
+ return (
+ Application.objects.filter(is_publish=True, is_portal=True)
+ .filter(Exists(public_apps) | (Exists(authed_token_exists) & (Exists(direct_auth) | Exists(group_auth))))
+ .values_list("id", flat=True)
+ )
+
+
+class ApplicationResponseSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True)
+ name = serializers.CharField(required=True)
+ desc = serializers.CharField(required=True)
+ icon = serializers.CharField(required=True)
+ type = serializers.CharField(required=True)
+ dialogue_number = serializers.IntegerField(required=True)
+ prologue = serializers.CharField(required=True)
+ is_publish = serializers.BooleanField(required=True)
+ is_portal = serializers.BooleanField(required=True)
+
+
+class PortalApplicationSerializer(serializers.Serializer):
+ class Query(PortalApplicationAuthMixin, serializers.Serializer):
+ name = serializers.CharField(
+ required=False, allow_blank=True, label=_("Application Name"), help_text=_("Application name")
+ )
+
+ def get_query_set(self):
+ queryset = Application.objects.filter(is_publish=True, is_portal=True)
+ name = self.data.get("name")
+ if name:
+ queryset = queryset.filter(name__icontains=name)
+ return queryset.order_by("-create_time")
+
+ def page(self, current_page, page_size, user_id, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ queryset = self.get_query_set()
+ queryset = queryset.filter(id__in=self.get_authorized_application_ids(user_id))
+ return page_search(
+ current_page,
+ page_size,
+ queryset,
+ post_records_handler=lambda app: ApplicationResponseSerializer(app).data,
+ )
+
+
+def get_recent_chats_map(user_id, application_ids, limit=5):
+ """批量返回 application_id -> 该应用最近的 limit 条历史会话;show_history=false 的应用不在此表里"""
+ chats = Chat.objects.filter(chat_user_id=user_id, is_deleted=False, application_id__in=application_ids).order_by(
+ "application_id", "-update_time", "id"
+ )
+ result = {}
+ for chat in chats:
+ key = str(chat.application_id)
+ if len(result.get(key, [])) >= limit:
+ continue
+ result.setdefault(key, []).append(
+ {
+ "id": str(chat.id),
+ "abstract": chat.abstract,
+ "create_time": str(chat.create_time),
+ "update_time": str(chat.update_time),
+ }
+ )
+ return result
+
+
+class PortalHistoricalConversationSerializer(serializers.Serializer):
+ class Query(PortalApplicationAuthMixin, serializers.Serializer):
+ name = serializers.CharField(
+ required=False, allow_blank=True, label=_("Application Name"), help_text=_("Application name")
+ )
+
+ def get_query_set(self, user_id):
+ # 主表是应用:返回用户有权限访问的已发布门户应用
+ queryset = Application.objects.filter(
+ is_publish=True,
+ is_portal=True,
+ id__in=self.get_authorized_application_ids(user_id),
+ )
+ name = self.data.get("name")
+ if name:
+ queryset = queryset.filter(name__icontains=name)
+ return queryset.order_by("-create_time")
+
+ def page(self, current_page, page_size, user_id, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ result = page_search(
+ current_page,
+ page_size,
+ self.get_query_set(user_id),
+ post_records_handler=lambda app: {
+ "id": str(app.id),
+ "name": app.name,
+ "icon": app.icon,
+ },
+ )
+ app_ids = [record["id"] for record in result["records"]]
+ settings_map = get_application_settings_map(app_ids)
+ show_history_ids = [aid for aid in app_ids if settings_map.get(aid, {}).get("show_history")]
+ chat_map = get_recent_chats_map(user_id, show_history_ids) if show_history_ids else {}
+ for record in result["records"]:
+ record.update(settings_map.get(record["id"], {}))
+ record["conversations"] = chat_map.get(record["id"], [])
+ return result
diff --git a/apps/chat/template/agent_simple.py b/apps/chat/template/agent_simple.py
new file mode 100644
index 00000000000..45db39983e4
--- /dev/null
+++ b/apps/chat/template/agent_simple.py
@@ -0,0 +1,655 @@
+from django.db.models import QuerySet
+
+template = {
+ "edges": [
+ {
+ "id": "6a8d23d9-5179-424e-80c2-f08d37cdb8d4",
+ "type": "app-edge",
+ "endPoint": {"x": 2760, "y": 1054.125},
+ "pointsList": [
+ {"x": 2620, "y": 1054.125},
+ {"x": 2730, "y": 1054.125},
+ {"x": 2650, "y": 1054.125},
+ {"x": 2760, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 2620, "y": 1054.125},
+ "sourceNodeId": "fd0324fc-f5e4-4fa6-a2d9-cb251b467605",
+ "targetNodeId": "420a6e4f-44ff-4847-bb81-0923630846b5",
+ "sourceAnchorId": "fd0324fc-f5e4-4fa6-a2d9-cb251b467605_right",
+ "targetAnchorId": "420a6e4f-44ff-4847-bb81-0923630846b5_left",
+ },
+ {
+ "id": "56006748-d9fe-491b-a14b-04fd568cac08",
+ "type": "app-edge",
+ "endPoint": {"x": 3610, "y": 149.25},
+ "pointsList": [
+ {"x": 3340, "y": 913.75},
+ {"x": 3450, "y": 913.75},
+ {"x": 3500, "y": 149.25},
+ {"x": 3610, "y": 149.25},
+ ],
+ "properties": {},
+ "startPoint": {"x": 3340, "y": 913.75},
+ "sourceNodeId": "420a6e4f-44ff-4847-bb81-0923630846b5",
+ "targetNodeId": "36a440a9-5b00-4d82-b13a-8e7819112918",
+ "sourceAnchorId": "420a6e4f-44ff-4847-bb81-0923630846b5_7887_right",
+ "targetAnchorId": "36a440a9-5b00-4d82-b13a-8e7819112918_left",
+ },
+ {
+ "id": "9bc8721b-07aa-4730-9347-910ed64e26b9",
+ "type": "app-edge",
+ "endPoint": {"x": 3610, "y": 1054.125},
+ "pointsList": [
+ {"x": 3340, "y": 1043.125},
+ {"x": 3450, "y": 1043.125},
+ {"x": 3500, "y": 1054.125},
+ {"x": 3610, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 3340, "y": 1043.125},
+ "sourceNodeId": "420a6e4f-44ff-4847-bb81-0923630846b5",
+ "targetNodeId": "f7c3b4a2-cb80-4e47-b050-7fef0315daaf",
+ "sourceAnchorId": "420a6e4f-44ff-4847-bb81-0923630846b5_6847_right",
+ "targetAnchorId": "f7c3b4a2-cb80-4e47-b050-7fef0315daaf_left",
+ },
+ {
+ "id": "e4b4bb4e-35ed-40a4-b4e7-b86f77131d92",
+ "type": "app-edge",
+ "endPoint": {"x": 550, "y": 1054.125},
+ "pointsList": [
+ {"x": 280, "y": 1054.125},
+ {"x": 390, "y": 1054.125},
+ {"x": 440, "y": 1054.125},
+ {"x": 550, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 280, "y": 1054.125},
+ "sourceNodeId": "start-node",
+ "targetNodeId": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94",
+ "sourceAnchorId": "start-node_right",
+ "targetAnchorId": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94_left",
+ },
+ {
+ "id": "0ea723ab-bebd-4058-98af-74b6c5f03260",
+ "type": "app-edge",
+ "endPoint": {"x": 1270, "y": 1054.125},
+ "pointsList": [
+ {"x": 1130, "y": 978.4375},
+ {"x": 1240, "y": 978.4375},
+ {"x": 1160, "y": 1054.125},
+ {"x": 1270, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 1130, "y": 978.4375},
+ "sourceNodeId": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94",
+ "targetNodeId": "a0089772-3821-474f-bb4f-9bfe32c1d95f",
+ "sourceAnchorId": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94_gWldyeZ3CMPKS9teLWQeI_right",
+ "targetAnchorId": "a0089772-3821-474f-bb4f-9bfe32c1d95f_left",
+ },
+ {
+ "id": "c0c675d3-cb0b-4b67-8009-16951303791d",
+ "type": "app-edge",
+ "endPoint": {"x": 1730, "y": 1054.125},
+ "pointsList": [
+ {"x": 1130, "y": 1069.125},
+ {"x": 1240, "y": 1069.125},
+ {"x": 1620, "y": 1054.125},
+ {"x": 1730, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 1130, "y": 1069.125},
+ "sourceNodeId": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94",
+ "targetNodeId": "124fe8a0-70fa-42cb-b854-4b6c02ebb836",
+ "sourceAnchorId": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94_TvdY3NQkSdYbC8A15VrId_right",
+ "targetAnchorId": "124fe8a0-70fa-42cb-b854-4b6c02ebb836_left",
+ },
+ {
+ "id": "0c1d5fc1-6ab2-431e-afdc-9f332ce8b466",
+ "type": "app-edge",
+ "endPoint": {"x": 1730, "y": 1054.125},
+ "pointsList": [
+ {"x": 1590, "y": 1054.125},
+ {"x": 1700, "y": 1054.125},
+ {"x": 1620, "y": 1054.125},
+ {"x": 1730, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 1590, "y": 1054.125},
+ "sourceNodeId": "a0089772-3821-474f-bb4f-9bfe32c1d95f",
+ "targetNodeId": "124fe8a0-70fa-42cb-b854-4b6c02ebb836",
+ "sourceAnchorId": "a0089772-3821-474f-bb4f-9bfe32c1d95f_right",
+ "targetAnchorId": "124fe8a0-70fa-42cb-b854-4b6c02ebb836_left",
+ },
+ {
+ "id": "422564a4-2b0a-469b-be86-ded4204e7742",
+ "type": "app-edge",
+ "endPoint": {"x": 2300, "y": 1054.125},
+ "pointsList": [
+ {"x": 2160, "y": 1054.125},
+ {"x": 2270, "y": 1054.125},
+ {"x": 2190, "y": 1054.125},
+ {"x": 2300, "y": 1054.125},
+ ],
+ "properties": {},
+ "startPoint": {"x": 2160, "y": 1054.125},
+ "sourceNodeId": "124fe8a0-70fa-42cb-b854-4b6c02ebb836",
+ "targetNodeId": "fd0324fc-f5e4-4fa6-a2d9-cb251b467605",
+ "sourceAnchorId": "124fe8a0-70fa-42cb-b854-4b6c02ebb836_right",
+ "targetAnchorId": "fd0324fc-f5e4-4fa6-a2d9-cb251b467605_left",
+ },
+ {
+ "id": "a0cee2ac-4d0d-4b68-8cb2-ca2cb39993e9",
+ "type": "app-edge",
+ "endPoint": {"x": 3480, "y": 1973.375},
+ "pointsList": [
+ {"x": 3340, "y": 1133.8125},
+ {"x": 3450, "y": 1133.8125},
+ {"x": 3370, "y": 1973.375},
+ {"x": 3480, "y": 1973.375},
+ ],
+ "properties": {},
+ "startPoint": {"x": 3340, "y": 1133.8125},
+ "sourceNodeId": "420a6e4f-44ff-4847-bb81-0923630846b5",
+ "targetNodeId": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4",
+ "sourceAnchorId": "420a6e4f-44ff-4847-bb81-0923630846b5_2794_right",
+ "targetAnchorId": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4_left",
+ },
+ {
+ "id": "cd66759a-bcb9-4d61-806b-7bde23ae4582",
+ "type": "app-edge",
+ "endPoint": {"x": 4200, "y": 1001.5},
+ "pointsList": [
+ {"x": 4060, "y": 1897.6875},
+ {"x": 4170, "y": 1897.6875},
+ {"x": 4090, "y": 1001.5},
+ {"x": 4200, "y": 1001.5},
+ ],
+ "properties": {},
+ "startPoint": {"x": 4060, "y": 1897.6875},
+ "sourceNodeId": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4",
+ "targetNodeId": "dd02a0d8-0ea1-41c4-8b64-0cb7d8963fd9",
+ "sourceAnchorId": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4_Iu8b0BMQU9xXWy5JbcTnz_right",
+ "targetAnchorId": "dd02a0d8-0ea1-41c4-8b64-0cb7d8963fd9_left",
+ },
+ {
+ "id": "7113c5b7-d9d6-4f49-a030-24eaeee00e7d",
+ "type": "app-edge",
+ "endPoint": {"x": 4200, "y": 1973.375},
+ "pointsList": [
+ {"x": 4060, "y": 1988.375},
+ {"x": 4170, "y": 1988.375},
+ {"x": 4090, "y": 1973.375},
+ {"x": 4200, "y": 1973.375},
+ ],
+ "properties": {},
+ "startPoint": {"x": 4060, "y": 1988.375},
+ "sourceNodeId": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4",
+ "targetNodeId": "04dd6c1e-95f9-4757-bb3e-134d503fce54",
+ "sourceAnchorId": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4_s-groW06vt6a7B-aqDqnX_right",
+ "targetAnchorId": "04dd6c1e-95f9-4757-bb3e-134d503fce54_left",
+ },
+ ],
+ "nodes": [
+ {
+ "x": 120,
+ "y": 120,
+ "id": "base-node",
+ "type": "base-node",
+ "properties": {
+ "config": {},
+ "height": 984.25,
+ "showNode": True,
+ "stepName": "基本信息",
+ "node_data": {
+ "desc": "www",
+ "name": "www",
+ "prologue": "您好,我是 XXX 小助手,您可以向我提出 XXX 使用问题。\n- XXX 主要功能有什么?\n- XXX 如何收费?\n- 需要转人工服务",
+ "tts_type": "BROWSER",
+ "stt_model_id_type": "default",
+ "long_term_model_id_type": "default",
+ },
+ "enableException": False,
+ "input_field_list": [],
+ "user_input_config": {"title": "用户输入"},
+ "api_input_field_list": [],
+ "chat_input_field_list": [],
+ "user_input_field_list": [
+ {
+ "attrs": {},
+ "field": "problem_optimization",
+ "label": {
+ "attrs": {"tooltip": "是否需要问题优化"},
+ "label": "问题优化",
+ "input_type": "TooltipLabel",
+ "props_info": {},
+ },
+ "required": True,
+ "input_type": "SwitchInput",
+ "default_value": False,
+ "visibility_rules": {
+ "action": "show",
+ "node_id": "base-node",
+ "condition": "and",
+ "node_name": "基本信息",
+ "conditions": [],
+ },
+ "show_default_value": True,
+ },
+ {
+ "attrs": {},
+ "field": "ai_questioning",
+ "label": {
+ "attrs": {"tooltip": "是否ai回复"},
+ "label": "是否ai回复",
+ "input_type": "TooltipLabel",
+ "props_info": {},
+ },
+ "required": True,
+ "input_type": "SwitchInput",
+ "default_value": False,
+ "visibility_rules": {
+ "action": "show",
+ "node_id": "base-node",
+ "condition": "and",
+ "node_name": "基本信息",
+ "conditions": [],
+ },
+ "show_default_value": True,
+ },
+ ],
+ },
+ },
+ {
+ "x": 120,
+ "y": 1054.125,
+ "id": "start-node",
+ "type": "start-node",
+ "properties": {
+ "config": {
+ "fields": [{"label": "用户问题", "value": "question"}],
+ "chatFields": [],
+ "globalFields": [
+ {"label": "当前时间", "value": "time"},
+ {"label": "历史聊天记录", "value": "history_context"},
+ {"label": "对话 ID", "value": "chat_id"},
+ {"label": "对话用户 ID", "value": "chat_user_id"},
+ {"label": "对话用户类型", "value": "chat_user_type"},
+ {"label": "对话用户组", "value": "chat_user_group"},
+ {"label": "对话用户", "value": "chat_user"},
+ {"label": "问题优化", "value": "problem_optimization"},
+ {"label": "是否ai回复", "value": "ai_questioning"},
+ ],
+ },
+ "fields": [{"label": "用户问题", "value": "question"}],
+ "height": 644,
+ "showNode": True,
+ "stepName": "开始",
+ "globalFields": [{"label": "当前时间", "value": "time"}],
+ "enableException": False,
+ },
+ },
+ {
+ "x": 2460,
+ "y": 1054.125,
+ "id": "fd0324fc-f5e4-4fa6-a2d9-cb251b467605",
+ "type": "search-knowledge-node",
+ "properties": {
+ "config": {
+ "fields": [
+ {"label": "检索结果的分段列表", "value": "paragraph_list"},
+ {"label": "满足直接回答的分段列表", "value": "is_hit_handling_method_list"},
+ {"label": "检索结果", "value": "data"},
+ {"label": "满足直接回答的分段内容", "value": "directly_return"},
+ ]
+ },
+ "height": 806.375,
+ "showNode": True,
+ "stepName": "知识库检索",
+ "condition": "AND",
+ "node_data": {
+ "knowledge_list": [],
+ "show_knowledge": True,
+ "knowledge_id_list": [],
+ "knowledge_setting": {
+ "top_n": 3,
+ "similarity": 0.6,
+ "search_mode": "embedding",
+ "max_paragraph_char_number": 5000,
+ },
+ "search_scope_type": "custom",
+ "search_scope_source": "knowledge",
+ "all_knowledge_id_list": [],
+ "question_reference_address": ["124fe8a0-70fa-42cb-b854-4b6c02ebb836", "Group1"],
+ "no_permission_knowledge_id_list": [],
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 3050,
+ "y": 1054.125,
+ "id": "420a6e4f-44ff-4847-bb81-0923630846b5",
+ "type": "condition-node",
+ "properties": {
+ "width": 600,
+ "config": {"fields": [{"label": "分支名称", "value": "branch_name"}]},
+ "height": 552.125,
+ "showNode": True,
+ "stepName": "判断器",
+ "condition": "AND",
+ "node_data": {
+ "branch": [
+ {
+ "id": "7887",
+ "type": "IF",
+ "condition": "and",
+ "conditions": [
+ {
+ "field": ["fd0324fc-f5e4-4fa6-a2d9-cb251b467605", "is_hit_handling_method_list"],
+ "value": 1,
+ "compare": "is_not_None",
+ }
+ ],
+ },
+ {
+ "id": "6847",
+ "type": "ELSE IF 1",
+ "condition": "and",
+ "conditions": [
+ {
+ "field": ["fd0324fc-f5e4-4fa6-a2d9-cb251b467605", "paragraph_list"],
+ "value": 1,
+ "compare": "is_not_None",
+ }
+ ],
+ },
+ {"id": "2794", "type": "ELSE", "condition": "and", "conditions": []},
+ ]
+ },
+ "enableException": False,
+ "branch_condition_list": [
+ {"id": "7887", "index": 0, "height": 121.375},
+ {"id": "6847", "index": 1, "height": 121.375},
+ {"id": "2794", "index": 2, "height": 44},
+ ],
+ },
+ },
+ {
+ "x": 3770,
+ "y": 149.25,
+ "id": "36a440a9-5b00-4d82-b13a-8e7819112918",
+ "type": "reply-node",
+ "properties": {
+ "config": {"fields": [{"label": "内容", "value": "answer"}]},
+ "height": 394,
+ "showNode": True,
+ "stepName": "指定回复",
+ "condition": "AND",
+ "node_data": {
+ "fields": ["fd0324fc-f5e4-4fa6-a2d9-cb251b467605", "directly_return"],
+ "content": "",
+ "is_result": True,
+ "reply_type": "referencing",
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 3770,
+ "y": 1054.125,
+ "id": "f7c3b4a2-cb80-4e47-b050-7fef0315daaf",
+ "type": "ai-chat-node",
+ "properties": {
+ "config": {
+ "fields": [
+ {"label": "AI 回答内容", "value": "answer"},
+ {"label": "思考过程", "value": "reasoning_content"},
+ {"label": "历史聊天记录", "value": "history_message"},
+ ]
+ },
+ "height": 1175.75,
+ "showNode": True,
+ "stepName": "AI 对话",
+ "condition": "AND",
+ "node_data": {
+ "prompt": "已知信息:\n{{知识库检索.data}}\n问题:\n{{开始.question}}",
+ "system": "",
+ "model_id": "",
+ "is_result": True,
+ "max_tokens": None,
+ "temperature": None,
+ "dialogue_type": "WORKFLOW",
+ "model_id_type": "custom",
+ "model_setting": {
+ "reasoning_content_end": "",
+ "reasoning_content_start": "",
+ "reasoning_content_enable": False,
+ },
+ "dialogue_number": 1,
+ "mcp_output_enable": True,
+ "model_id_reference": [],
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 4360,
+ "y": 1973.375,
+ "id": "04dd6c1e-95f9-4757-bb3e-134d503fce54",
+ "type": "reply-node",
+ "properties": {
+ "config": {"fields": [{"label": "内容", "value": "answer"}]},
+ "height": 512,
+ "showNode": True,
+ "stepName": "指定回复1",
+ "condition": "AND",
+ "node_data": {
+ "fields": [],
+ "content": "抱歉,没有在知识库查询到相关内容,请提供更详细的信息。",
+ "is_result": True,
+ "reply_type": "content",
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 840,
+ "y": 1054.125,
+ "id": "b4dd9d45-25f0-4b01-9ec3-557a46a97d94",
+ "type": "condition-node",
+ "properties": {
+ "width": 600,
+ "config": {"fields": [{"label": "分支名称", "value": "branch_name"}]},
+ "height": 422.75,
+ "showNode": True,
+ "stepName": "判断器1",
+ "condition": "AND",
+ "node_data": {
+ "branch": [
+ {
+ "id": "gWldyeZ3CMPKS9teLWQeI",
+ "type": "IF",
+ "condition": "and",
+ "conditions": [
+ {"field": ["global", "problem_optimization"], "value": 1, "compare": "is_True"}
+ ],
+ },
+ {"id": "TvdY3NQkSdYbC8A15VrId", "type": "ELSE", "condition": "and", "conditions": []},
+ ]
+ },
+ "enableException": False,
+ "branch_condition_list": [
+ {"id": "gWldyeZ3CMPKS9teLWQeI", "index": 0, "height": 121.375},
+ {"id": "TvdY3NQkSdYbC8A15VrId", "index": 1, "height": 44},
+ ],
+ },
+ },
+ {
+ "x": 1430,
+ "y": 1054.125,
+ "id": "a0089772-3821-474f-bb4f-9bfe32c1d95f",
+ "type": "question-node",
+ "properties": {
+ "config": {"fields": [{"label": "问题优化结果", "value": "answer"}]},
+ "height": 842,
+ "showNode": True,
+ "stepName": "问题优化",
+ "condition": "AND",
+ "node_data": {
+ "prompt": "{{开始.question}}",
+ "system": "# 角色\n你是一位问题优化大师,擅长根据上下文精准揣测用户意图,并对用户提出的问题进行优化。\n\n## 技能\n### 技能 1: 优化问题\n2. 接收用户输入的问题。\n3. 依据上下文仔细分析问题含义。\n4. 输出优化后的问题。\n\n## 限制:\n- 仅返回优化后的问题,不进行额外解释或说明。\n- 确保优化后的问题准确反映原始问题意图,不得改变原意。",
+ "model_id": "",
+ "is_result": False,
+ "model_id_type": "default",
+ "dialogue_number": 0,
+ "model_id_reference": [],
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 1945,
+ "y": 1054.125,
+ "id": "124fe8a0-70fa-42cb-b854-4b6c02ebb836",
+ "type": "variable-aggregation-node",
+ "properties": {
+ "config": {"fields": [{"label": "Group1", "value": "Group1"}]},
+ "height": 530.75,
+ "showNode": True,
+ "stepName": "变量聚合",
+ "condition": "AND",
+ "node_data": {
+ "strategy": "first_non_None",
+ "is_result": True,
+ "group_list": [
+ {
+ "id": "A5aBuBrQJ5hq12mKSJNiQ",
+ "field": "Group1",
+ "label": "Group1",
+ "variable_list": [
+ {
+ "v_id": "0bmeMSbo9696jwbfp3jDX",
+ "variable": ["a0089772-3821-474f-bb4f-9bfe32c1d95f", "answer"],
+ },
+ {"v_id": "1YHRj-fr3_IQpELv_HAdC", "variable": ["start-node", "question"]},
+ ],
+ }
+ ],
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 4360,
+ "y": 1001.5,
+ "id": "dd02a0d8-0ea1-41c4-8b64-0cb7d8963fd9",
+ "type": "ai-chat-node",
+ "properties": {
+ "config": {
+ "fields": [
+ {"label": "AI 回答内容", "value": "answer"},
+ {"label": "思考过程", "value": "reasoning_content"},
+ {"label": "历史聊天记录", "value": "history_message"},
+ ]
+ },
+ "height": 1191.75,
+ "showNode": True,
+ "stepName": "AI 对话1",
+ "condition": "AND",
+ "node_data": {
+ "prompt": "{{开始.question}}",
+ "system": "",
+ "model_id": "",
+ "is_result": True,
+ "max_tokens": None,
+ "temperature": None,
+ "dialogue_type": "WORKFLOW",
+ "model_id_type": "custom",
+ "model_setting": {
+ "reasoning_content_end": "",
+ "reasoning_content_start": "",
+ "reasoning_content_enable": False,
+ },
+ "dialogue_number": 0,
+ "mcp_output_enable": True,
+ "model_id_reference": [],
+ },
+ "enableException": False,
+ },
+ },
+ {
+ "x": 3770,
+ "y": 1973.375,
+ "id": "f9ae6300-5b07-4244-9b88-2a5e7329e1d4",
+ "type": "condition-node",
+ "properties": {
+ "width": 600,
+ "config": {"fields": [{"label": "分支名称", "value": "branch_name"}]},
+ "height": 422.75,
+ "showNode": True,
+ "stepName": "判断器2",
+ "condition": "AND",
+ "node_data": {
+ "branch": [
+ {
+ "id": "Iu8b0BMQU9xXWy5JbcTnz",
+ "type": "IF",
+ "condition": "and",
+ "conditions": [{"field": ["global", "ai_questioning"], "value": 1, "compare": "is_True"}],
+ },
+ {"id": "s-groW06vt6a7B-aqDqnX", "type": "ELSE", "condition": "and", "conditions": []},
+ ]
+ },
+ "enableException": False,
+ "branch_condition_list": [
+ {"id": "Iu8b0BMQU9xXWy5JbcTnz", "index": 0, "height": 121.375},
+ {"id": "s-groW06vt6a7B-aqDqnX", "index": 1, "height": 44},
+ ],
+ },
+ },
+ ],
+}
+
+
+def build_workflow(application):
+ from system_manage.models.resource_mapping import ResourceMapping, ResourceType
+
+ data = template.copy()
+ if application.knowledge_ids:
+ knowledge_ids = application.knowledge_ids
+ else:
+ knowledge_ids = (
+ QuerySet(ResourceMapping)
+ .filter(source_type=ResourceType.APPLICATION, source_id=application.id, target_type=ResourceType.KNOWLEDGE)
+ .values_list("target_id", flat=True)
+ )
+
+ data["nodes"][0]["properties"]["user_input_field_list"][0]["default_value"] = application.problem_optimization
+
+ data["nodes"][0]["properties"]["user_input_field_list"][1]["default_value"] = (
+ application.knowledge_setting.no_references_setting.status == "ai_questioning"
+ )
+ model_id = application.model
+ model_params_setting = application.model_params_setting or {}
+ ## 问题优化设置
+ data["nodes"][8]["properties"]["node_data"]["model_id"] = model_id
+ data["nodes"][8]["properties"]["node_data"]["prompt"] = application.problem_optimization_prompt.replace(
+ "{question}", "{{开始.question}}"
+ )
+ data["nodes"][8]["properties"]["node_data"]["model_params_setting"] = model_params_setting
+ ## 知识库检索
+ data["nodes"][2]["properties"]["node_data"]["knowledge_id_list"] = knowledge_ids
+ data["nodes"][2]["properties"]["node_data"]["knowledge_setting"] = application.knowledge_setting
+ ## ai对话
+ data["nodes"][5]["properties"]["node_data"]["model_id"] = model_id
+ data["nodes"][5]["properties"]["node_data"]["model_params_setting"] = model_params_setting
+ data["nodes"][5]["properties"]["node_data"]["prompt"] = application.model_setting.prompt
+ ## 未查询到知识库ai 回复
+ data["nodes"][10]["properties"]["node_data"]["model_id"] = model_id
+ data["nodes"][10]["properties"]["node_data"]["model_params_setting"] = model_params_setting
+ ## 未查询到知识库指定回复
+ if application.knowledge_setting.no_references_setting.status == "designated_answer":
+ data["nodes"][6]["properties"]["node_data"]["content"] = application.knowledge_setting.value
+
+ return data
diff --git a/apps/chat/urls.py b/apps/chat/urls.py
index 5fb3dc23fa0..b898adf6b66 100644
--- a/apps/chat/urls.py
+++ b/apps/chat/urls.py
@@ -1,32 +1,77 @@
-from django.urls import path
+from django.urls import path, include
from application.views import ChatRecordDetailView, ChatRecordLinkView
-from chat.views.mcp import mcp_view
-from . import views
+from chat.views import v2 as v2_views, v3 as v3_views
+from chat.views.v3.knowledge import knowledge_mcp_view, retrieve_view
-app_name = 'chat'
+app_name = "chat"
# @formatter:off
# fmt: off
-urlpatterns = [
- path('embed', views.ChatEmbedView.as_view()),
- path('mcp', mcp_view),
- path('auth/anonymous', views.AnonymousAuthentication.as_view()),
- path('profile', views.AuthProfile.as_view()),
- path('application/profile', views.ApplicationProfile.as_view(), name='profile'),
- path('chat_message/', views.ChatView.as_view(), name='chat'),
- path('open', views.OpenView.as_view(), name='open'),
- path('text_to_speech', views.TextToSpeech.as_view()),
- path('speech_to_text', views.SpeechToText.as_view()),
- path('captcha', views.CaptchaView.as_view(), name='captcha'),
- path('/chat/completions', views.OpenAIView.as_view(), name='application/chat_completions'),
- path('vote/chat//chat_record/', views.VoteView.as_view(), name='vote'),
- path('historical_conversation', views.HistoricalConversationView.as_view(), name='historical_conversation'),
- path('historical_conversation//record/',views.ChatRecordView.as_view(),name='conversation_details'),
- path('historical_conversation//', views.HistoricalConversationView.PageView.as_view(), name='historical_conversation'),
- path('historical_conversation/clear',views.HistoricalConversationView.BatchDelete.as_view(), name='historical_conversation_clear'),
- path('historical_conversation/',views.HistoricalConversationView.Operate.as_view(), name='historical_conversation_operate'),
- path('historical_conversation_record/', views.HistoricalConversationRecordView.as_view(), name='historical_conversation_record'),
- path('historical_conversation_record///', views.HistoricalConversationRecordView.PageView.as_view(), name='historical_conversation_record'),
+
+v3=[
+ # ---- application 作用域:application_id 从 path 获取 ----
+ path('application//', include([
+ path("profile",v3_views.ApplicationProfile.as_view(), name='v3_profile'),
+ path('open', v3_views.OpenView.as_view(), name='v3_open'),
+ path('text_to_speech',v3_views.TextToSpeech.as_view(),name='v3_text_to_speech'),
+ path('speech_to_text',v3_views.SpeechToText.as_view(),name='v3_speech_to_text'),
+ path('chat/completions',v3_views.OpenAIView.as_view(), name='v3_chat_completions'),
+ path('chat/clear',v3_views.HistoricalConversationView.BatchDelete.as_view(), name='v3_historical_conversation_clear'),
+ path('chat',v3_views.HistoricalConversationView.as_view(), name='v3_historical_conversation'),
+ path('chat//',v3_views.HistoricalConversationView.PageView.as_view(),name='v3_historical_conversation_page'),
+ path('chat//chat_message',v3_views.ChatView.as_view(), name='v3_chat'),
+ path('chat//chat_record',v3_views.HistoricalConversationRecordView.as_view(), name='v3_historical_conversation_record'),
+ path('chat//chat_record//', v3_views.HistoricalConversationRecordView.PageView.as_view(), name='v3_historical_conversation_record_page'),
+ path('chat//chat_record/',v3_views.ChatRecordView.as_view(),name='v3_conversation_details'),
+ path('chat//chat_record//vote',v3_views.VoteView.as_view(), name='v3_vote'),
+ path('chat//share_chat',ChatRecordLinkView.as_view(),name='v3_share_chat'),
+ path('chat/',v3_views.HistoricalConversationView.Operate.as_view(), name='v3_historical_conversation_operate'),
+ ])),
+ # ---- 全局(非 application 作用域)----
+ path('embed', v3_views.ChatEmbedView.as_view()),
+ path('mcp', v3_views.mcp_view),
+ path('auth/anonymous', v3_views.AnonymousAuthentication.as_view()),
+ path('auth/login', v3_views.LocalLoginView.as_view()),
+ path('auth/logout', v3_views.Logout.as_view(), name='v3_logout'),
+ path('profile', v3_views.AuthProfile.as_view()),
+ path('captcha', v3_views.CaptchaView.as_view(), name='v3_captcha'),
+ path('share/', ChatRecordDetailView.as_view()),
+ path('chat_message//cancel', v3_views.CancelWorkflowView.as_view(), name='v3_cancel_workflow'),
+ path('chat_user/profile', v3_views.ChatUserProfileView.as_view(), name='v3_chat_user_profile'),
+ path('chat_user/current/reset_password', v3_views.ResetCurrentUserPasswordView.as_view(), name='v3_reset_password_current'),
+ path('api_key', v3_views.ChatUserApiKeyView.as_view()),
+ path('api_key//', v3_views.ChatUserApiKeyView.Page.as_view()),
+ path('api_key/', v3_views.ChatUserApiKeyView.Operate.as_view()),
+ path('portal/application//', v3_views.PortalApplicationView.as_view(), name='v3_portal_application'),
+ path('portal/chat//', v3_views.PortalHistoricalConversationView.as_view(), name='v3_portal_historical_conversation'),
+ path('knowledge//retrieve', retrieve_view),
+ path('knowledge//mcp', knowledge_mcp_view),
+]
+v2=[
+ path('embed', v2_views.ChatEmbedView.as_view()),
+ path('mcp', v2_views.mcp_view),
+ path('auth/anonymous', v2_views.AnonymousAuthentication.as_view(), name='anonymous'),
+ path('profile', v2_views.AuthProfile.as_view()),
+ path('application/profile', v2_views.ApplicationProfile.as_view(), name='profile'),
+ path('chat_message/', v2_views.ChatView.as_view(), name='chat'),
+ path('open', v2_views.OpenView.as_view(), name='open'),
+ path('text_to_speech', v2_views.TextToSpeech.as_view()),
+ path('speech_to_text', v2_views.SpeechToText.as_view()),
+ path('captcha', v2_views.CaptchaView.as_view(), name='captcha'),
+ path('/chat/completions', v2_views.OpenAIView.as_view(), name='application/chat_completions'),
+ path('vote/chat//chat_record/', v2_views.VoteView.as_view(), name='vote'),
+ path('historical_conversation', v2_views.HistoricalConversationView.as_view(), name='historical_conversation'),
+ path('historical_conversation//record/',v2_views.ChatRecordView.as_view(),name='conversation_details'),
+ path('historical_conversation//', v2_views.HistoricalConversationView.PageView.as_view(), name='historical_conversation'),
+ path('historical_conversation/clear',v2_views.HistoricalConversationView.BatchDelete.as_view(), name='historical_conversation_clear'),
+ path('historical_conversation/',v2_views.HistoricalConversationView.Operate.as_view(), name='historical_conversation_operate'),
+ path('historical_conversation_record/', v2_views.HistoricalConversationRecordView.as_view(), name='historical_conversation_record'),
+ path('historical_conversation_record///', v2_views.HistoricalConversationRecordView.PageView.as_view(), name='historical_conversation_record'),
path('share/', ChatRecordDetailView.as_view()),
path('/chat//share_chat', ChatRecordLinkView.as_view()),
+
+]
+urlpatterns = [
+ *v2,
+ path('v3/',include(v3))
]
diff --git a/apps/chat/views/__init__.py b/apps/chat/views/__init__.py
index fa38335c952..da273c43822 100644
--- a/apps/chat/views/__init__.py
+++ b/apps/chat/views/__init__.py
@@ -6,6 +6,5 @@
@date:2025/5/29 16:08
@desc:
"""
-from .chat_embed import *
-from .chat import *
-from .chat_record import *
+from . import v2
+from . import v3
diff --git a/apps/chat/views/chat.py b/apps/chat/views/chat.py
deleted file mode 100644
index a18a5ad95dc..00000000000
--- a/apps/chat/views/chat.py
+++ /dev/null
@@ -1,274 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: chat.py
- @date:2025/6/6 11:18
- @desc:
-"""
-import requests
-from django.http import HttpResponse, StreamingHttpResponse
-from django.utils.translation import gettext_lazy as _
-from drf_spectacular.utils import extend_schema
-from rest_framework.parsers import MultiPartParser
-from rest_framework.request import Request
-from rest_framework.views import APIView
-
-from application.api.application_api import SpeechToTextAPI, TextToSpeechAPI
-from application.models import ChatUserType, ChatSourceChoices
-from chat.api.chat_api import ChatAPI
-from chat.api.chat_authentication_api import ChatAuthenticationAPI, ChatAuthenticationProfileAPI, ChatOpenAPI, OpenAIAPI
-from chat.serializers.chat import OpenChatSerializers, ChatSerializers, SpeechToTextSerializers, \
- TextToSpeechSerializers, OpenAIChatSerializer
-from chat.serializers.chat_authentication import AnonymousAuthenticationSerializer, ApplicationProfileSerializer, \
- AuthProfileSerializer
-from common.auth import ChatTokenAuth
-from common.constants.permission_constants import ChatAuth
-from common.exception.app_exception import AppAuthenticationFailed
-from common.log.log import _get_ip_address
-from common.result import result
-from knowledge.models import FileSourceType
-from oss.serializers.file import FileSerializer
-from users.api import CaptchaAPI
-from users.serializers.login import CaptchaSerializer
-
-
-def stream_image(response):
- """生成器函数,用于流式传输图片数据"""
- for chunk in response.iter_content(chunk_size=4096):
- if chunk: # 过滤掉保持连接的空块
- yield chunk
-
-
-class ResourceProxy(APIView):
- def get(self, request: Request):
- image_url = request.query_params.get("url")
- if not image_url:
- return result.error("Missing 'url' parameter")
- try:
-
- # 发送GET请求,流式获取图片内容
- response = requests.get(
- image_url,
- stream=True, # 启用流式响应
- allow_redirects=True,
- timeout=10
- )
- content_type = response.headers.get('Content-Type', '').split(';')[0]
- # 创建Django流式响应
- django_response = StreamingHttpResponse(
- stream_image(response), # 使用生成器
- content_type=content_type
- )
-
- return django_response
- except Exception as e:
- return result.error(f"Image request failed: {str(e)}")
-
-
-class OpenAIView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['POST'],
- description=_('OpenAI Interface Dialogue'),
- summary=_('OpenAI Interface Dialogue'),
- operation_id=_('OpenAI Interface Dialogue'), # type: ignore
- request=OpenAIAPI.get_request(),
- responses=None,
- tags=[_('Chat')] # type: ignore
- )
- def post(self, request: Request, application_id: str):
- ip_address = _get_ip_address(request)
- if application_id != str(request.auth.application_id):
- raise AppAuthenticationFailed(500, _('Secret key is invalid'))
- return OpenAIChatSerializer(
- data={'application_id': application_id, 'chat_user_id': request.auth.chat_user_id,
- 'chat_user_type': request.auth.chat_user_type,
- 'ip_address': ip_address,
- 'source': {"type": ChatSourceChoices.API_CALL.value}}).chat(request.data)
-
-
-class AnonymousAuthentication(APIView):
- def options(self, request, *args, **kwargs):
- return HttpResponse(
- headers={"Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": "true",
- "Access-Control-Allow-Methods": "POST",
- "Access-Control-Allow-Headers": "Origin,Content-Type,Cookie,Accept,Token"}, )
-
- @extend_schema(
- methods=['POST'],
- description=_('Application Anonymous Certification'),
- summary=_('Application Anonymous Certification'),
- operation_id=_('Application Anonymous Certification'), # type: ignore
- request=ChatAuthenticationAPI.get_request(),
- responses=None,
- tags=[_('Chat')] # type: ignore
- )
- def post(self, request: Request):
- return result.success(
- AnonymousAuthenticationSerializer(data={'access_token': request.data.get("access_token")}).auth(
- request),
- headers={"Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": "true",
- "Access-Control-Allow-Methods": "POST",
- "Access-Control-Allow-Headers": "Origin,Content-Type,Cookie,Accept,Token"}
- )
-
-
-class ApplicationProfile(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get application related information"),
- summary=_("Get application related information"),
- operation_id=_("Get application related information"), # type: ignore
- request=None,
- responses=None,
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request):
- if isinstance(request.auth, ChatAuth):
- return result.success(ApplicationProfileSerializer(
- data={'application_id': request.auth.application_id}).profile())
- raise AppAuthenticationFailed(401, "身份异常")
-
-
-class AuthProfile(APIView):
- @extend_schema(
- methods=['GET'],
- description=_("Get application authentication information"),
- summary=_("Get application authentication information"),
- operation_id=_("Get application authentication information"), # type: ignore
- parameters=ChatAuthenticationProfileAPI.get_parameters(),
- responses=None,
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request):
- return result.success(
- AuthProfileSerializer(data={'access_token': request.query_params.get("access_token")}).profile())
-
-
-class ChatView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['POST'],
- description=_("dialogue"),
- summary=_("dialogue"),
- operation_id=_("dialogue"), # type: ignore
- request=ChatAPI.get_request(),
- parameters=ChatAPI.get_parameters(),
- responses=None,
- tags=[_('Chat')] # type: ignore
- )
- def post(self, request: Request, chat_id: str):
- ip_address = _get_ip_address(request)
- return ChatSerializers(data={'chat_id': chat_id,
- 'chat_user_id': request.auth.chat_user_id,
- 'chat_user_type': request.auth.chat_user_type,
- 'application_id': request.auth.application_id,
- 'debug': False,
- 'ip_address': ip_address,
- 'source': {
- 'type': ChatSourceChoices.API_CALL.value if request.auth.chat_user_type == ChatUserType.APPLICATION_API_KEY.value else ChatSourceChoices.ONLINE.value}
- }
- ).chat(request.data)
-
-
-class OpenView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get the session id according to the application id"),
- summary=_("Get the session id according to the application id"),
- operation_id=_("Get the session id according to the application id"), # type: ignore
- parameters=ChatOpenAPI.get_parameters(),
- responses=None,
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request):
- ip_address = _get_ip_address(request)
- return result.success(OpenChatSerializers(
- data={'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id, 'chat_user_type': request.auth.chat_user_type,
- 'ip_address': ip_address,
- 'source': {
- 'type': ChatSourceChoices.API_CALL.value if request.auth.chat_user_type == ChatUserType.APPLICATION_API_KEY.value else ChatSourceChoices.ONLINE.value},
- 'debug': False}).open())
-
-
-class CaptchaView(APIView):
- @extend_schema(methods=['GET'],
- summary=_("Get Chat captcha"),
- description=_("Get Chat captcha"),
- operation_id=_("Get Chat captcha"), # type: ignore
- tags=[_("Chat")], # type: ignore
- responses=CaptchaAPI.get_response())
- def get(self, request: Request):
- username = request.query_params.get('username', None)
- accessToken = request.query_params.get('accessToken', None)
- return result.success(CaptchaSerializer().chat_generate(username, 'chat', accessToken))
-
-
-class SpeechToText(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['POST'],
- description=_("speech to text"),
- summary=_("speech to text"),
- operation_id=_("speech to text"), # type: ignore
- request=SpeechToTextAPI.get_request(),
- responses=SpeechToTextAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def post(self, request: Request):
- return result.success(
- SpeechToTextSerializers(
- data={'application_id': request.auth.application_id})
- .speech_to_text({'file': request.FILES.get('file')}))
-
-
-class TextToSpeech(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['POST'],
- description=_("text to speech"),
- summary=_("text to speech"),
- operation_id=_("text to speech"), # type: ignore
- request=TextToSpeechAPI.get_request(),
- responses=TextToSpeechAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def post(self, request: Request):
- byte_data = TextToSpeechSerializers(
- data={'application_id': request.auth.application_id}).text_to_speech(request.data)
- return HttpResponse(byte_data, status=200, headers={'Content-Type': 'audio/mp3',
- 'Content-Disposition': 'attachment; filename="abc.mp3"'})
-
-
-class UploadFile(APIView):
- authentication_classes = [ChatTokenAuth]
- parser_classes = [MultiPartParser]
-
- @extend_schema(
- methods=['POST'],
- description=_("Upload files"),
- summary=_("Upload files"),
- operation_id=_("Upload files"), # type: ignore
- request=TextToSpeechAPI.get_request(),
- responses=TextToSpeechAPI.get_response(),
- tags=[_('Application')] # type: ignore
- )
- def post(self, request: Request, chat_id: str):
- files = request.FILES.getlist('file')
- file_ids = []
- meta = {}
- for file in files:
- file_url = FileSerializer(
- data={'file': file, 'meta': meta, 'source_id': chat_id, 'source_type': FileSourceType.CHAT, }).upload()
- file_ids.append({'name': file.name, 'url': file_url, 'file_id': file_url.split('/')[-1]})
- return result.success(file_ids)
diff --git a/apps/chat/views/chat_record.py b/apps/chat/views/chat_record.py
deleted file mode 100644
index c50d95b6437..00000000000
--- a/apps/chat/views/chat_record.py
+++ /dev/null
@@ -1,200 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: chat_record.py
- @date:2025/6/23 10:42
- @desc:
-"""
-from django.utils.translation import gettext_lazy as _
-from drf_spectacular.utils import extend_schema
-from rest_framework.request import Request
-from rest_framework.views import APIView
-
-from application.serializers.application_chat_record import ChatRecordOperateSerializer
-from chat.api.chat_api import HistoricalConversationAPI, PageHistoricalConversationAPI, \
- PageHistoricalConversationRecordAPI, HistoricalConversationRecordAPI, HistoricalConversationOperateAPI
-from chat.api.vote_api import VoteAPI
-from chat.serializers.chat_record import VoteSerializer, HistoricalConversationSerializer, \
- HistoricalConversationRecordSerializer, HistoricalConversationOperateSerializer
-from common import result
-from common.auth import ChatTokenAuth
-
-
-class VoteView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['PUT'],
- description=_("Like, Dislike"),
- summary=_("Like, Dislike"),
- operation_id=_("Like, Dislike"), # type: ignore
- parameters=VoteAPI.get_parameters(),
- request=VoteAPI.get_request(),
- responses=VoteAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def put(self, request: Request, chat_id: str, chat_record_id: str):
- return result.success(VoteSerializer(
- data={'chat_id': chat_id,
- 'chat_record_id': chat_record_id
- }).vote(request.data))
-
-
-class HistoricalConversationView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get historical conversation"),
- summary=_("Get historical conversation"),
- operation_id=_("Get historical conversation"), # type: ignore
- parameters=HistoricalConversationAPI.get_parameters(),
- responses=HistoricalConversationAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request):
- return result.success(HistoricalConversationSerializer(
- data={
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- }).list())
-
- class Operate(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['PUT'],
- description=_("Modify conversation about"),
- summary=_("Modify conversation about"),
- operation_id=_("Modify conversation about"), # type: ignore
- parameters=HistoricalConversationOperateAPI.get_parameters(),
- request=HistoricalConversationOperateAPI.get_request(),
- responses=HistoricalConversationOperateAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def put(self, request: Request, chat_id: str):
- return result.success(HistoricalConversationOperateSerializer(
- data={
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- 'chat_id': chat_id,
- }).edit_abstract(request.data)
- )
-
- @extend_schema(
- methods=['DELETE'],
- description=_("Delete history conversation"),
- summary=_("Delete history conversation"),
- operation_id=_("Delete history conversation"), # type: ignore
- parameters=HistoricalConversationOperateAPI.get_parameters(),
- responses=HistoricalConversationOperateAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def delete(self, request: Request, chat_id: str):
- return result.success(HistoricalConversationOperateSerializer(
- data={
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- 'chat_id': chat_id,
- }).logic_delete())
-
- class BatchDelete(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['DELETE'],
- description=_("Batch delete history conversation"),
- summary=_("Batch delete history conversation"),
- operation_id=_("Batch delete history conversation"), # type: ignore
- parameters=HistoricalConversationOperateAPI.get_parameters(),
- responses=HistoricalConversationOperateAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def delete(self, request: Request):
- return result.success(HistoricalConversationOperateSerializer.Clear(data={
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- }).batch_logic_delete())
-
- class PageView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get historical conversation by page"),
- summary=_("Get historical conversation by page"),
- operation_id=_("Get historical conversation by page"), # type: ignore
- parameters=PageHistoricalConversationAPI.get_parameters(),
- responses=PageHistoricalConversationAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request, current_page: int, page_size: int):
- return result.success(HistoricalConversationSerializer(
- data={
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- }).page(current_page, page_size))
-
-
-class HistoricalConversationRecordView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get historical conversation records"),
- summary=_("Get historical conversation records"),
- operation_id=_("Get historical conversation records"), # type: ignore
- parameters=HistoricalConversationRecordAPI.get_parameters(),
- responses=HistoricalConversationRecordAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request, chat_id: str):
- return result.success(HistoricalConversationRecordSerializer(
- data={
- 'chat_id': chat_id,
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- }).list())
-
- class PageView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get historical conversation records by page "),
- summary=_("Get historical conversation records by page"),
- operation_id=_("Get historical conversation records by page"), # type: ignore
- parameters=PageHistoricalConversationRecordAPI.get_parameters(),
- responses=PageHistoricalConversationRecordAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request, chat_id: str, current_page: int, page_size: int):
- return result.success(HistoricalConversationRecordSerializer(
- data={
- 'chat_id': chat_id,
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- }).page(current_page, page_size))
-
-
-class ChatRecordView(APIView):
- authentication_classes = [ChatTokenAuth]
-
- @extend_schema(
- methods=['GET'],
- description=_("Get conversation details"),
- summary=_("Get conversation details"),
- operation_id=_("Get conversation details"), # type: ignore
- parameters=PageHistoricalConversationRecordAPI.get_parameters(),
- responses=PageHistoricalConversationRecordAPI.get_response(),
- tags=[_('Chat')] # type: ignore
- )
- def get(self, request: Request, chat_id: str, chat_record_id: str):
- return result.success(ChatRecordOperateSerializer(
- data={
- 'chat_id': chat_id,
- 'chat_record_id': chat_record_id,
- 'application_id': request.auth.application_id,
- 'chat_user_id': request.auth.chat_user_id,
- }).one(False))
diff --git a/apps/chat/views/v2/__init__.py b/apps/chat/views/v2/__init__.py
new file mode 100644
index 00000000000..4cedec9c1d3
--- /dev/null
+++ b/apps/chat/views/v2/__init__.py
@@ -0,0 +1,12 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: __init__.py.py
+ @date:2025/5/29 16:08
+ @desc:
+"""
+from .chat_embed import *
+from .chat import *
+from .chat_record import *
+from .mcp import mcp_view
diff --git a/apps/chat/views/v2/chat.py b/apps/chat/views/v2/chat.py
new file mode 100644
index 00000000000..df7add2982f
--- /dev/null
+++ b/apps/chat/views/v2/chat.py
@@ -0,0 +1,496 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: chat.py
+@date:2025/6/6 11:18
+@desc:
+"""
+
+import json
+
+import requests
+from django.core.cache import cache
+from django.http import HttpResponse, StreamingHttpResponse
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+from rest_framework.parsers import MultiPartParser
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from application.api.application_api import SpeechToTextAPI, TextToSpeechAPI
+from application.models import ChatUserType, ChatSourceChoices
+from chat.api.chat_api import ChatAPI
+from chat.api.chat_authentication_api import (
+ ChatAuthenticationAPI,
+ ChatAuthenticationProfileAPIV2,
+ ChatOpenAPI,
+ OpenAIAPI,
+)
+from chat.serializers.chat import (
+ ChatSerializers,
+ OpenAIChatSerializer,
+ OpenChatSerializers,
+ SpeechToTextSerializers,
+ TextToSpeechSerializers,
+)
+from chat.serializers.chat_authentication import (
+ AnonymousAuthenticationV2Serializer,
+ ApplicationProfileSerializer,
+ AuthProfileV2Serializer,
+)
+from common.auth import ChatTokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.chat_permission_constants import ChatPermissionConstants
+from common.constants.authentication_type import AuthenticationType
+from common.constants.cache_version import Cache_Version
+from common.exception.app_exception import AppAuthenticationFailed, AppApiException
+from common.log.log import _get_ip_address, log
+from common.result import result
+from common.utils.rsa_util import decrypt
+from knowledge.models import FileSourceType
+from maxkb.const import CONFIG
+from models_provider.api.model import DefaultModelResponse
+from oss.serializers.file import FileSerializer
+from system_manage.serializers.chat_user import RePasswordSerializer, ChatUserProfileSerializer
+from system_manage.serializers.chat_user_serializer import ChatUserAccessTokenSerializer
+from users.api import CaptchaAPI, LoginAPI
+from users.api.user import ResetPasswordAPI, UserProfileAPI
+from users.serializers.login import CaptchaSerializer
+from users.views import get_re_password_details
+
+
+def stream_image(response):
+ """生成器函数,用于流式传输图片数据"""
+ for chunk in response.iter_content(chunk_size=4096):
+ if chunk: # 过滤掉保持连接的空块
+ yield chunk
+
+
+class ResourceProxy(APIView):
+ def get(self, request: Request):
+ image_url = request.query_params.get("url")
+ if not image_url:
+ return result.error("Missing 'url' parameter")
+ try:
+ # 发送GET请求,流式获取图片内容
+ response = requests.get(
+ image_url,
+ stream=True, # 启用流式响应
+ allow_redirects=True,
+ timeout=10,
+ )
+ content_type = response.headers.get("Content-Type", "").split(";")[0]
+ # 创建Django流式响应
+ django_response = StreamingHttpResponse(
+ stream_image(response), # 使用生成器
+ content_type=content_type,
+ )
+
+ return django_response
+ except Exception as e:
+ return result.error(f"Image request failed: {str(e)}")
+
+
+class OpenAIView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("OpenAI Interface Dialogue"),
+ summary=_("OpenAI Interface Dialogue"),
+ operation_id=_("OpenAI Interface Dialogue"), # type: ignore
+ request=OpenAIAPI.get_request(),
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ def post(self, request: Request, application_id: str):
+ ip_address = _get_ip_address(request)
+ if application_id != str(request.user.kwargs.get("application_id")):
+ raise AppAuthenticationFailed(500, _("Secret key is invalid"))
+ return OpenAIChatSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ "chat_user_type": request.user.type,
+ "ip_address": ip_address,
+ "source": {"type": ChatSourceChoices.API_CALL.value},
+ }
+ ).chat(request.data)
+
+
+class AnonymousAuthentication(APIView):
+ def options(self, request, *args, **kwargs):
+ return HttpResponse(
+ headers={
+ "Access-Control-Allow-Origin": "*",
+ "Access-Control-Allow-Credentials": "true",
+ "Access-Control-Allow-Methods": "POST",
+ "Access-Control-Allow-Headers": "Origin,Content-Type,Cookie,Accept,Token",
+ },
+ )
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Application Anonymous Certification"),
+ summary=_("Application Anonymous Certification"),
+ operation_id=_("Application Anonymous Certification"), # type: ignore
+ request=AnonymousAuthenticationV2Serializer,
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ def post(self, request: Request):
+ token, f_token = AnonymousAuthenticationV2Serializer(data=request.data).auth(request)
+ response = result.success(
+ token,
+ headers={
+ "Access-Control-Allow-Origin": "*",
+ "Access-Control-Allow-Credentials": "true",
+ "Access-Control-Allow-Methods": "POST",
+ "Access-Control-Allow-Headers": "Origin,Content-Type,Cookie,Accept,Token",
+ },
+ )
+ is_https = request.scheme == "https"
+
+ response.set_cookie(
+ key="mk_file_auth",
+ value=f_token,
+ max_age=7 * 24 * 3600,
+ path=f"{CONFIG.get_chat_path()}/{request.data.get('access_token')}",
+ secure=is_https,
+ httponly=True,
+ samesite="None" if is_https else "Lax",
+ )
+ return response
+
+
+class ApplicationProfile(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get application related information"),
+ summary=_("Get application related information"),
+ operation_id=_("Get application related information"), # type: ignore
+ request=None,
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request):
+ return result.success(
+ ApplicationProfileSerializer(data={"application_id": request.user.kwargs.get("application_id")}).profile()
+ )
+
+
+class AuthProfile(APIView):
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get application authentication information"),
+ summary=_("Get application authentication information"),
+ operation_id=_("Get application authentication information"), # type: ignore
+ parameters=ChatAuthenticationProfileAPIV2.get_parameters(),
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request):
+ return result.success(
+ AuthProfileV2Serializer(data={"access_token": request.query_params.get("access_token")}).profile()
+ )
+
+
+class ChatView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("dialogue"),
+ summary=_("dialogue"),
+ operation_id=_("dialogue"), # type: ignore
+ request=ChatAPI.get_request(),
+ parameters=ChatAPI.get_parameters(),
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ def post(self, request: Request, chat_id: str):
+ ip_address = _get_ip_address(request)
+ return ChatSerializers(
+ data={
+ "chat_id": chat_id,
+ "chat_user_id": request.user.id,
+ "chat_user_type": request.user.type,
+ "application_id": request.user.kwargs.get("application_id"),
+ "debug": False,
+ "ip_address": ip_address,
+ "source": {
+ "type": ChatSourceChoices.API_CALL.value
+ if request.user.type == ChatUserType.APPLICATION_API_KEY.value
+ else ChatSourceChoices.ONLINE.value
+ },
+ }
+ ).chat(request.data)
+
+
+class OpenView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get the session id according to the application id"),
+ summary=_("Get the session id according to the application id"),
+ operation_id=_("Get the session id according to the application id"), # type: ignore
+ parameters=ChatOpenAPI.get_parameters(),
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request):
+ ip_address = _get_ip_address(request)
+ return result.success(
+ OpenChatSerializers(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ "chat_user_type": request.user.type,
+ "ip_address": ip_address,
+ "source": {
+ "type": ChatSourceChoices.API_CALL.value
+ if request.user.type == ChatUserType.APPLICATION_API_KEY.value
+ else ChatSourceChoices.ONLINE.value
+ },
+ "debug": False,
+ }
+ ).open()
+ )
+
+
+class CancelWorkflowView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Cancel running workflow"),
+ summary=_("Cancel running workflow"),
+ operation_id=_("Cancel running workflow"), # type: ignore
+ parameters=[
+ OpenApiParameter(
+ name="chat_id", type=OpenApiTypes.UUID, location=OpenApiParameter.PATH, description=_("Chat ID")
+ ),
+ ],
+ responses=None,
+ tags=[_("Chat")], # type: ignore
+ )
+ def post(self, request: Request, chat_id: str):
+ from application.workflow.workflow_run_registry import WorkflowRunRegistry, CancelResult
+
+ result_enum = WorkflowRunRegistry.cancel_by_chat_id(chat_id)
+ if result_enum == CancelResult.CANCELLED:
+ return result.success({"status": "cancelled", "chat_id": chat_id})
+ elif result_enum == CancelResult.NOT_FOUND:
+ return result.success({"status": "not_found", "chat_id": chat_id})
+ else:
+ return result.fail(500, _("Failed to cancel workflow"))
+
+
+class CaptchaView(APIView):
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get Chat captcha"),
+ description=_("Get Chat captcha"),
+ operation_id=_("Get Chat captcha"), # type: ignore
+ tags=[_("Chat")], # type: ignore
+ responses=CaptchaAPI.get_response(),
+ )
+ def get(self, request: Request):
+ username = request.query_params.get("username", None)
+ accessToken = request.query_params.get("accessToken", None)
+ return result.success(CaptchaSerializer().chat_generate(username, "chat", accessToken))
+
+
+class SpeechToText(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("speech to text"),
+ summary=_("speech to text"),
+ operation_id=_("speech to text"), # type: ignore
+ request=SpeechToTextAPI.get_request(),
+ responses=SpeechToTextAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def post(self, request: Request):
+ return result.success(
+ SpeechToTextSerializers(data={"application_id": request.user.kwargs.get("application_id")}).speech_to_text(
+ {"file": request.FILES.get("file")}
+ )
+ )
+
+
+class TextToSpeech(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("text to speech"),
+ summary=_("text to speech"),
+ operation_id=_("text to speech"), # type: ignore
+ request=TextToSpeechAPI.get_request(),
+ responses=TextToSpeechAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def post(self, request: Request):
+ byte_data = TextToSpeechSerializers(
+ data={"application_id": request.user.kwargs.get("application_id")}
+ ).text_to_speech(request.data)
+ return HttpResponse(
+ byte_data,
+ status=200,
+ headers={"Content-Type": "audio/mp3", "Content-Disposition": 'attachment; filename="abc.mp3"'},
+ )
+
+
+class UploadFile(APIView):
+ authentication_classes = [ChatTokenAuth]
+ parser_classes = [MultiPartParser]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Upload files"),
+ summary=_("Upload files"),
+ operation_id=_("Upload files"), # type: ignore
+ request=TextToSpeechAPI.get_request(),
+ responses=TextToSpeechAPI.get_response(),
+ tags=[_("Application")], # type: ignore
+ )
+ def post(self, request: Request, chat_id: str):
+ files = request.FILES.getlist("file")
+ file_ids = []
+ meta = {}
+ for file in files:
+ file_url = FileSerializer(
+ data={
+ "file": file,
+ "meta": meta,
+ "source_id": chat_id,
+ "source_type": FileSourceType.CHAT,
+ }
+ ).upload(request.user.id)
+ file_ids.append({"name": file.name, "url": file_url, "file_id": file_url.split("/")[-1]})
+ return result.success(file_ids)
+
+
+class ResetCurrentUserPasswordView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Modify current user password"),
+ description=_("Modify current user password"),
+ operation_id=_("Modify current user password"), # type: ignore
+ tags=[_("Chat User")], # type: ignore
+ request=ResetPasswordAPI.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(
+ menu="Chat User",
+ operate="Modify current user password",
+ get_operation_object=lambda r, k: {"name": r.user.username},
+ get_details=get_re_password_details,
+ )
+ def post(self, request: Request):
+ request_data = request.data
+ encrypted_data = request_data.get("encryptedData", "")
+ if encrypted_data:
+ try:
+ decrypted_raw = decrypt(encrypted_data)
+ # decrypt 可能返回非 JSON 字符串,防护解析异常
+ decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
+ if isinstance(decrypted_data, dict):
+ request_data = decrypted_data
+ except Exception as e:
+ raise AppApiException(500, _("Invalid encrypted data"))
+ serializer_obj = RePasswordSerializer(data=request_data)
+ if serializer_obj.reset_password(request.user.id):
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ auth = request.META.get("HTTP_AUTHORIZATION")
+ cache.delete(get_key(token=auth), version=version)
+ return result.success(True)
+ return result.error(_("Failed to change password"))
+
+
+class ChatUserProfileView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get current user information"),
+ description=_("Get current user information"),
+ operation_id=_("Get current user information"), # type: ignore
+ tags=[_("Chat User")], # type: ignore
+ responses=UserProfileAPI.get_response(),
+ )
+ def get(self, request: Request):
+ return result.success(ChatUserProfileSerializer().profile(request.user))
+
+
+class BaseAuthView(APIView):
+ @staticmethod
+ def create_token_and_cache(access_token, user, request):
+ token = ChatUserAccessTokenSerializer.create_token_and_cache(access_token, user, request)
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ cache.set(get_key(token), user, timeout=60 * 60 * 2, version=version)
+ return token
+
+ @classmethod
+ def generate(self, request, f_token: str, response: HttpResponse, path: str = "/chat"):
+ secure = request.is_secure()
+ response.set_cookie(
+ "mk_file_auth",
+ value=f_token,
+ max_age=7 * 24 * 3600,
+ path=path,
+ domain=None,
+ secure=secure,
+ httponly=True,
+ samesite="Lax",
+ )
+ return response
+
+
+class LocalLoginView(BaseAuthView):
+ @extend_schema(
+ methods=["POST"],
+ description=_("Log in"),
+ summary=_("Log in"),
+ operation_id=_("Log in"), # type: ignore
+ tags=[_("Chat User/login")], # type: ignore
+ request=LoginAPI.get_request(),
+ responses=LoginAPI.get_response(),
+ )
+ def post(self, request: Request, access_token: str = None):
+ user = ChatUserAccessTokenSerializer.local_login(request.data, access_token)
+ user.source = "LOCAL"
+ token = self.create_token_and_cache(access_token, user, request)
+ response = result.success({"token": token})
+ return self.generate(request, token, response, path=f"/chat/{access_token}/")
+
+
+class Logout(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Sign out"),
+ description=_("Sign out"),
+ operation_id=_("Sign out"), # type: ignore
+ tags=[_("Chat User")], # type: ignore
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(menu="Chat User/logout", operate="Sign out", get_operation_object=lambda r, k: {"name": r.user.username})
+ def post(self, request: Request):
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ auth = request.META.get("HTTP_AUTHORIZATION")
+ cache.delete(get_key(token=auth[7:]), version=version)
+ return result.success(True)
diff --git a/apps/chat/views/chat_embed.py b/apps/chat/views/v2/chat_embed.py
similarity index 100%
rename from apps/chat/views/chat_embed.py
rename to apps/chat/views/v2/chat_embed.py
diff --git a/apps/chat/views/v2/chat_record.py b/apps/chat/views/v2/chat_record.py
new file mode 100644
index 00000000000..38456f977ef
--- /dev/null
+++ b/apps/chat/views/v2/chat_record.py
@@ -0,0 +1,239 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: chat_record.py
+@date:2025/6/23 10:42
+@desc:
+"""
+
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from application.serializers.application_chat_record import ChatRecordOperateSerializer
+from chat.api.chat_api import (
+ HistoricalConversationAPI,
+ PageHistoricalConversationAPI,
+ PageHistoricalConversationRecordAPI,
+ HistoricalConversationRecordAPI,
+ HistoricalConversationOperateAPI,
+)
+from chat.api.vote_api import VoteAPI
+from chat.serializers.chat_record import (
+ VoteSerializer,
+ HistoricalConversationSerializer,
+ HistoricalConversationRecordSerializer,
+ HistoricalConversationOperateSerializer,
+)
+from common import result
+from common.auth import ChatTokenAuth
+
+
+class VoteView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Like, Dislike"),
+ summary=_("Like, Dislike"),
+ operation_id=_("Like, Dislike"), # type: ignore
+ parameters=VoteAPI.get_parameters(),
+ request=VoteAPI.get_request(),
+ responses=VoteAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def put(self, request: Request, chat_id: str, chat_record_id: str):
+ return result.success(
+ VoteSerializer(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ }
+ ).vote(request.data)
+ )
+
+
+class HistoricalConversationView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation"),
+ summary=_("Get historical conversation"),
+ operation_id=_("Get historical conversation"), # type: ignore
+ parameters=HistoricalConversationAPI.get_parameters(),
+ responses=HistoricalConversationAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request):
+ return result.success(
+ HistoricalConversationSerializer(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ }
+ ).list()
+ )
+
+ class Operate(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Modify conversation about"),
+ summary=_("Modify conversation about"),
+ operation_id=_("Modify conversation about"), # type: ignore
+ parameters=HistoricalConversationOperateAPI.get_parameters(),
+ request=HistoricalConversationOperateAPI.get_request(),
+ responses=HistoricalConversationOperateAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def put(self, request: Request, chat_id: str):
+ return result.success(
+ HistoricalConversationOperateSerializer(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ "chat_id": chat_id,
+ }
+ ).edit_abstract(request.data)
+ )
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Delete history conversation"),
+ summary=_("Delete history conversation"),
+ operation_id=_("Delete history conversation"), # type: ignore
+ parameters=HistoricalConversationOperateAPI.get_parameters(),
+ responses=HistoricalConversationOperateAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def delete(self, request: Request, chat_id: str):
+ return result.success(
+ HistoricalConversationOperateSerializer(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ "chat_id": chat_id,
+ }
+ ).logic_delete()
+ )
+
+ class BatchDelete(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Batch delete history conversation"),
+ summary=_("Batch delete history conversation"),
+ operation_id=_("Batch delete history conversation"), # type: ignore
+ parameters=[],
+ responses=HistoricalConversationOperateAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def delete(self, request: Request):
+ return result.success(
+ HistoricalConversationOperateSerializer.Clear(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ }
+ ).batch_logic_delete()
+ )
+
+ class PageView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation by page"),
+ summary=_("Get historical conversation by page"),
+ operation_id=_("Get historical conversation by page"), # type: ignore
+ parameters=PageHistoricalConversationAPI.get_parameters(),
+ responses=PageHistoricalConversationAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request, current_page: int, page_size: int):
+ return result.success(
+ HistoricalConversationSerializer(
+ data={
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ }
+ ).page(current_page, page_size)
+ )
+
+
+class HistoricalConversationRecordView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation records"),
+ summary=_("Get historical conversation records"),
+ operation_id=_("Get historical conversation records"), # type: ignore
+ parameters=HistoricalConversationRecordAPI.get_parameters(),
+ responses=HistoricalConversationRecordAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request, chat_id: str):
+ return result.success(
+ HistoricalConversationRecordSerializer(
+ data={
+ "chat_id": chat_id,
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ }
+ ).list()
+ )
+
+ class PageView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation records by page "),
+ summary=_("Get historical conversation records by page"),
+ operation_id=_("Get historical conversation records by page"), # type: ignore
+ parameters=PageHistoricalConversationRecordAPI.get_parameters(),
+ responses=PageHistoricalConversationRecordAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request, chat_id: str, current_page: int, page_size: int):
+ return result.success(
+ HistoricalConversationRecordSerializer(
+ data={
+ "chat_id": chat_id,
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ }
+ ).page(current_page, page_size)
+ )
+
+
+class ChatRecordView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get conversation details"),
+ summary=_("Get conversation details"),
+ operation_id=_("Get conversation details"), # type: ignore
+ parameters=PageHistoricalConversationRecordAPI.get_parameters(),
+ responses=PageHistoricalConversationRecordAPI.get_response(),
+ tags=[_("Chat")], # type: ignore
+ )
+ def get(self, request: Request, chat_id: str, chat_record_id: str):
+ return result.success(
+ ChatRecordOperateSerializer(
+ data={
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ "application_id": request.user.kwargs.get("application_id"),
+ "chat_user_id": request.user.id,
+ }
+ ).one(False)
+ )
diff --git a/apps/chat/views/v2/mcp.py b/apps/chat/views/v2/mcp.py
new file mode 100644
index 00000000000..f4733a8c050
--- /dev/null
+++ b/apps/chat/views/v2/mcp.py
@@ -0,0 +1,53 @@
+import json
+
+from django.http import HttpResponse, JsonResponse
+from django.views.decorators.csrf import csrf_exempt
+
+from chat.mcp.tools import MCPToolHandler
+
+
+@csrf_exempt
+def mcp_view(request):
+ request_id = None
+ try:
+ data = json.loads(request.body)
+ method = data.get("method")
+ params = data.get("params", {})
+ request_id = data.get("id")
+
+ if request_id is None:
+ return HttpResponse(status=204)
+
+ auth_header = request.headers.get("Authorization", "").replace("Bearer ", "")
+ handler = MCPToolHandler(
+ auth_header,
+ request.headers.get("X-MaxKB-Chat-Files", ""),
+ request.headers.get("X-MaxKB-Form-Data", ""),
+ )
+
+ # 路由方法
+ if method == "initialize":
+ result = handler.initialize()
+
+ elif method == "tools/list":
+ result = handler.list_tools()
+
+ elif method == "tools/call":
+ result = handler.call_tool(params)
+
+ else:
+ return JsonResponse(
+ {
+ "jsonrpc": "2.0",
+ "id": request_id,
+ "error": {"code": -32601, "message": f"Method not found: {method}"},
+ }
+ )
+
+ # 成功响应
+ return JsonResponse({"jsonrpc": "2.0", "id": request_id, "result": result})
+
+ except Exception as e:
+ return JsonResponse(
+ {"jsonrpc": "2.0", "id": request_id, "error": {"code": -32603, "message": f"Internal error: {str(e)}"}}
+ )
diff --git a/apps/chat/views/v3/__init__.py b/apps/chat/views/v3/__init__.py
new file mode 100644
index 00000000000..7220a4c91e4
--- /dev/null
+++ b/apps/chat/views/v3/__init__.py
@@ -0,0 +1,15 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: __init__.py
+@date:2025/6/6 11:18
+@desc:
+"""
+
+from .chat_embed import *
+from .chat import *
+from .chat_record import *
+from .chat_user_api_key import *
+from .portal import *
+from .mcp import mcp_view
diff --git a/apps/chat/views/v3/chat.py b/apps/chat/views/v3/chat.py
new file mode 100644
index 00000000000..6a8083ec679
--- /dev/null
+++ b/apps/chat/views/v3/chat.py
@@ -0,0 +1,506 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: chat.py
+@date:2025/6/6 11:18
+@desc:
+"""
+
+import json
+
+import requests
+from django.core.cache import cache
+from django.http import HttpResponse, StreamingHttpResponse
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+from rest_framework.parsers import MultiPartParser
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from application.api.application_api import SpeechToTextAPI, TextToSpeechAPI
+from application.models import ChatUserType, ChatSourceChoices, ApplicationAccessToken
+from chat.api.chat_api import ChatAPI
+from chat.api.chat_authentication_api import ChatAuthenticationAPI, ChatAuthenticationProfileAPI, ChatOpenAPI, OpenAIAPI
+from chat.serializers.chat import (
+ OpenAIChatSerializer,
+ ChatSerializers,
+ OpenChatSerializers,
+ SpeechToTextSerializers,
+ TextToSpeechSerializers,
+)
+from chat.serializers.chat_authentication import (
+ AnonymousAuthenticationSerializer,
+ ApplicationProfileSerializer,
+ AuthProfileSerializer,
+)
+from common.auth import ChatTokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.common import ChatToken
+from common.auth.constants.chat_permission_constants import ChatPermissionConstants
+from common.auth.constants.operate_constants import Operate
+from common.constants.authentication_type import AuthenticationType
+from common.constants.cache_version import Cache_Version
+from common.exception.app_exception import AppApiException
+from common.log.log import _get_ip_address, log
+from common.result import result
+from common.utils.rsa_util import decrypt
+from knowledge.models import FileSourceType
+from maxkb.const import CONFIG
+from models_provider.api.model import DefaultModelResponse
+from oss.serializers.file import FileSerializer
+from system_manage.serializers.chat_user import RePasswordSerializer, ChatUserProfileSerializer
+from chat.serializers.chat_user_serializer import ChatUserAccessTokenV3Serializer
+from users.api import CaptchaAPI, LoginAPI
+from users.api.user import ResetPasswordAPI, UserProfileAPI
+from users.serializers.login import CaptchaSerializer
+from users.views import get_re_password_details
+
+
+def stream_image(response):
+ """生成器函数,用于流式传输图片数据"""
+ for chunk in response.iter_content(chunk_size=4096):
+ if chunk: # 过滤掉保持连接的空块
+ yield chunk
+
+
+class ResourceProxy(APIView):
+ def get(self, request: Request):
+ image_url = request.query_params.get("url")
+ if not image_url:
+ return result.error("Missing 'url' parameter")
+ try:
+ # 发送GET请求,流式获取图片内容
+ response = requests.get(
+ image_url,
+ stream=True, # 启用流式响应
+ allow_redirects=True,
+ timeout=10,
+ )
+ content_type = response.headers.get("Content-Type", "").split(";")[0]
+ # 创建Django流式响应
+ django_response = StreamingHttpResponse(
+ stream_image(response), # 使用生成器
+ content_type=content_type,
+ )
+
+ return django_response
+ except Exception as e:
+ return result.error(f"Image request failed: {str(e)}")
+
+
+class OpenAIView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("OpenAI Interface Dialogue"),
+ summary=_("OpenAI Interface Dialogue"),
+ operation_id=_("V3 OpenAI Interface Dialogue"), # type: ignore
+ request=OpenAIAPI.get_request(),
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ def post(self, request: Request, application_id: str):
+ ip_address = _get_ip_address(request)
+ return OpenAIChatSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ "chat_user_type": request.user.type,
+ "ip_address": ip_address,
+ "source": {"type": ChatSourceChoices.API_CALL.value},
+ }
+ ).chat(request.data)
+
+
+class AnonymousAuthentication(APIView):
+ def options(self, request, *args, **kwargs):
+ return HttpResponse(
+ headers={
+ "Access-Control-Allow-Origin": "*",
+ "Access-Control-Allow-Credentials": "true",
+ "Access-Control-Allow-Methods": "POST",
+ "Access-Control-Allow-Headers": "Origin,Content-Type,Cookie,Accept,Token",
+ },
+ )
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Application Anonymous Certification"),
+ summary=_("Application Anonymous Certification"),
+ operation_id=_("V3 Application Anonymous Certification"), # type: ignore
+ request=ChatAuthenticationAPI.get_request(),
+ parameters=ChatAuthenticationAPI.get_parameters(),
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ def post(self, request: Request):
+ serializer = AnonymousAuthenticationSerializer(data=request.query_params)
+ serializer.is_valid(raise_exception=True)
+ token = serializer.auth(request)
+ response = result.success(
+ token,
+ headers={
+ "Access-Control-Allow-Origin": "*",
+ "Access-Control-Allow-Credentials": "true",
+ "Access-Control-Allow-Methods": "POST",
+ "Access-Control-Allow-Headers": "Origin,Content-Type,Cookie,Accept,Token",
+ },
+ )
+ is_https = request.scheme == "https"
+
+ application_id = serializer.validated_data.get("application_id")
+ cookie_path = f"{CONFIG.get_chat_path()}/{application_id}" if application_id else CONFIG.get_chat_path()
+ response.set_cookie(
+ key="mk_file_auth",
+ value=token,
+ max_age=7 * 24 * 3600,
+ path=cookie_path,
+ secure=is_https,
+ httponly=True,
+ samesite="None" if is_https else "Lax",
+ )
+ return response
+
+
+class ApplicationProfile(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get application related information"),
+ summary=_("Get application related information"),
+ operation_id=_("V3 Get application related information"), # type: ignore
+ request=None,
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str):
+ return result.success(ApplicationProfileSerializer(data={"application_id": application_id}).profile())
+
+
+class AuthProfile(APIView):
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get application authentication information"),
+ summary=_("Get application authentication information"),
+ operation_id=_("V3 Get application authentication information"), # type: ignore
+ parameters=ChatAuthenticationProfileAPI.get_parameters(),
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ def get(self, request: Request):
+ return result.success(
+ AuthProfileSerializer(data={"application_id": request.query_params.get("application_id")}).profile()
+ )
+
+
+class ChatView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("dialogue"),
+ summary=_("dialogue"),
+ operation_id=_("V3 dialogue"), # type: ignore
+ request=ChatAPI.get_request(),
+ parameters=ChatAPI.get_parameters(),
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def post(self, request: Request, application_id: str, chat_id: str):
+ ip_address = _get_ip_address(request)
+ return ChatSerializers(
+ data={
+ "chat_id": chat_id,
+ "chat_user_id": request.user.id,
+ "chat_user_type": request.user.type,
+ "application_id": application_id,
+ "debug": False,
+ "ip_address": ip_address,
+ "source": {
+ "type": ChatSourceChoices.API_CALL.value
+ if request.user.type == ChatUserType.APPLICATION_API_KEY.value
+ else ChatSourceChoices.ONLINE.value
+ },
+ }
+ ).chat(request.data)
+
+
+class OpenView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get the session id according to the application id"),
+ summary=_("Get the session id according to the application id"),
+ operation_id=_("V3 Get the session id according to the application id"), # type: ignore
+ parameters=ChatOpenAPI.get_parameters(),
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str):
+ ip_address = _get_ip_address(request)
+ return result.success(
+ OpenChatSerializers(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ "chat_user_type": request.user.type,
+ "ip_address": ip_address,
+ "source": {
+ "type": ChatSourceChoices.API_CALL.value
+ if request.user.type == ChatUserType.APPLICATION_API_KEY.value
+ else ChatSourceChoices.ONLINE.value
+ },
+ "debug": False,
+ }
+ ).open()
+ )
+
+
+class CancelWorkflowView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Cancel running workflow"),
+ summary=_("Cancel running workflow"),
+ operation_id=_("V3 Cancel running workflow"), # type: ignore
+ parameters=[
+ OpenApiParameter(
+ name="chat_id", type=OpenApiTypes.UUID, location=OpenApiParameter.PATH, description=_("Chat ID")
+ ),
+ ],
+ responses=None,
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ def post(self, request: Request, chat_id: str):
+ from application.workflow.workflow_run_registry import WorkflowRunRegistry, CancelResult
+
+ result_enum = WorkflowRunRegistry.cancel_by_chat_id(chat_id)
+ if result_enum == CancelResult.CANCELLED:
+ return result.success({"status": "cancelled", "chat_id": chat_id})
+ elif result_enum == CancelResult.NOT_FOUND:
+ return result.success({"status": "not_found", "chat_id": chat_id})
+ else:
+ return result.fail(500, _("Failed to cancel workflow"))
+
+
+class CaptchaView(APIView):
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get Chat captcha"),
+ description=_("Get Chat captcha"),
+ operation_id=_("V3 Get Chat captcha"), # type: ignore
+ tags=[_("V3 Chat")], # type: ignore
+ responses=CaptchaAPI.get_response(),
+ )
+ def get(self, request: Request):
+ username = request.query_params.get("username", None)
+ application_id = request.query_params.get("application_id", None)
+ return result.success(CaptchaSerializer().chat_generate(username, "chat", application_id))
+
+
+class SpeechToText(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("speech to text"),
+ summary=_("speech to text"),
+ operation_id=_("V3 speech to text"), # type: ignore
+ request=SpeechToTextAPI.get_request(),
+ responses=SpeechToTextAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def post(self, request: Request, application_id: str):
+ return result.success(
+ SpeechToTextSerializers(data={"application_id": application_id}).speech_to_text(
+ {"file": request.FILES.get("file")}
+ )
+ )
+
+
+class TextToSpeech(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("text to speech"),
+ summary=_("text to speech"),
+ operation_id=_("V3 text to speech"), # type: ignore
+ request=TextToSpeechAPI.get_request(),
+ responses=TextToSpeechAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def post(self, request: Request, application_id: str):
+ byte_data = TextToSpeechSerializers(data={"application_id": application_id}).text_to_speech(request.data)
+ return HttpResponse(
+ byte_data,
+ status=200,
+ headers={"Content-Type": "audio/mp3", "Content-Disposition": 'attachment; filename="abc.mp3"'},
+ )
+
+
+class UploadFile(APIView):
+ authentication_classes = [ChatTokenAuth]
+ parser_classes = [MultiPartParser]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Upload files"),
+ summary=_("Upload files"),
+ operation_id=_("V3 Upload files"), # type: ignore
+ request=TextToSpeechAPI.get_request(),
+ responses=TextToSpeechAPI.get_response(),
+ tags=[_("V3 Application")], # type: ignore
+ )
+ def post(self, request: Request, chat_id: str):
+ files = request.FILES.getlist("file")
+ file_ids = []
+ meta = {}
+ for file in files:
+ file_url = FileSerializer(
+ data={
+ "file": file,
+ "meta": meta,
+ "source_id": chat_id,
+ "source_type": FileSourceType.CHAT,
+ }
+ ).upload(request.user.id)
+ file_ids.append({"name": file.name, "url": file_url, "file_id": file_url.split("/")[-1]})
+ return result.success(file_ids)
+
+
+class ResetCurrentUserPasswordView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Modify current user password"),
+ description=_("Modify current user password"),
+ operation_id=_("V3 Modify current user password"), # type: ignore
+ tags=[_("V3 Chat User")], # type: ignore
+ request=ResetPasswordAPI.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(
+ menu="Chat User",
+ operate="Modify current user password",
+ get_operation_object=lambda r, k: {"name": r.user.username},
+ get_details=get_re_password_details,
+ )
+ def post(self, request: Request):
+ request_data = request.data
+ encrypted_data = request_data.get("encryptedData", "")
+ if encrypted_data:
+ try:
+ decrypted_raw = decrypt(encrypted_data)
+ # decrypt 可能返回非 JSON 字符串,防护解析异常
+ decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
+ if isinstance(decrypted_data, dict):
+ request_data = decrypted_data
+ except Exception:
+ raise AppApiException(500, _("Invalid encrypted data"))
+ serializer_obj = RePasswordSerializer(data=request_data)
+ if serializer_obj.reset_password(request.user.id):
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ auth = request.META.get("HTTP_AUTHORIZATION")
+ cache.delete(get_key(token=auth), version=version)
+ return result.success(True)
+ return result.error(_("Failed to change password"))
+
+
+class ChatUserProfileView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get current user information"),
+ description=_("Get current user information"),
+ operation_id=_("V3 Get current user information"), # type: ignore
+ tags=[_("V3 Chat User")], # type: ignore
+ responses=UserProfileAPI.get_response(),
+ )
+ def get(self, request: Request):
+ return result.success(ChatUserProfileSerializer().profile(request.user.profile))
+
+
+class BaseAuthView(APIView):
+ @staticmethod
+ def create_token_and_cache(user, access_token, operate):
+ application_id = None
+ if access_token:
+ application_id = (
+ ApplicationAccessToken.objects.filter(access_token=access_token, is_active=True)
+ .values_list("application_id", flat=True)
+ .first()
+ )
+ token = ChatToken(
+ str(user.id), AuthenticationType.CHAT_USER, str(operate), application_id=application_id
+ ).to_token()
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ cache.set(get_key(token), user, timeout=60 * 60 * 2, version=version)
+ return token
+
+ @classmethod
+ def generate(self, request, token: str, response: HttpResponse, path: str = "/chat"):
+ secure = request.is_secure()
+ response.set_cookie(
+ "mk_file_auth",
+ value=token,
+ max_age=7 * 24 * 3600,
+ path=path,
+ domain=None,
+ secure=secure,
+ httponly=True,
+ samesite="Lax",
+ )
+ return response
+
+
+class LocalLoginView(BaseAuthView):
+ @extend_schema(
+ methods=["POST"],
+ description=_("Log in"),
+ summary=_("Log in"),
+ operation_id=_("V3 Log in"), # type: ignore
+ tags=[_("V3 Chat User/login")], # type: ignore
+ request=LoginAPI.get_request(),
+ responses=LoginAPI.get_response(),
+ )
+ def post(self, request: Request):
+ user = ChatUserAccessTokenV3Serializer.local_login(request.data)
+ user.source = "LOCAL"
+ access_token = request.query_params.get("accessToken")
+ token = self.create_token_and_cache(user, access_token, Operate.LOCAL)
+ response = result.success({"token": token})
+ return self.generate(request, token, response, path=f"/chat/{access_token + '/' if access_token else ''}")
+
+
+class Logout(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Sign out"),
+ description=_("Sign out"),
+ operation_id=_("V3 Sign out"), # type: ignore
+ tags=[_("V3 Chat User")], # type: ignore
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(menu="Chat User/logout", operate="Sign out", get_operation_object=lambda r, k: {"name": r.user.username})
+ def post(self, request: Request):
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ auth = request.META.get("HTTP_AUTHORIZATION")
+ cache.delete(get_key(token=auth[7:]), version=version)
+ return result.success(True)
diff --git a/apps/chat/views/v3/chat_embed.py b/apps/chat/views/v3/chat_embed.py
new file mode 100644
index 00000000000..4e5310214b0
--- /dev/null
+++ b/apps/chat/views/v3/chat_embed.py
@@ -0,0 +1,32 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: chat_embed.py
+ @date:2025/5/30 15:22
+ @desc:
+"""
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from chat.api.chat_embed_api import ChatEmbedAPI
+from chat.serializers.chat_embed_serializers import ChatEmbedSerializer
+
+
+class ChatEmbedView(APIView):
+
+ @extend_schema(
+ methods=['GET'],
+ description=_('Get embedded js'),
+ summary=_('Get embedded js'),
+ operation_id=_('V3 Get embedded js'), # type: ignore
+ parameters=ChatEmbedAPI.get_parameters(),
+ responses=ChatEmbedAPI.get_response(),
+ tags=[_('V3 Chat')] # type: ignore
+ )
+ def get(self, request: Request):
+ return ChatEmbedSerializer(
+ data={'protocol': request.query_params.get('protocol'), 'token': request.query_params.get('token'),
+ 'host': request.query_params.get('host'), }).get_embed(params=request.query_params)
diff --git a/apps/chat/views/v3/chat_record.py b/apps/chat/views/v3/chat_record.py
new file mode 100644
index 00000000000..38539992d66
--- /dev/null
+++ b/apps/chat/views/v3/chat_record.py
@@ -0,0 +1,246 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: chat_record.py
+@date:2025/6/23 10:42
+@desc: v3 chat record views —— application_id 从 path 获取,用户身份从 request.user(Principal) 获取
+"""
+
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from application.serializers.application_chat_record import ChatRecordOperateSerializer
+from chat.api.chat_api import (
+ HistoricalConversationAPI,
+ PageHistoricalConversationAPI,
+ PageHistoricalConversationRecordAPI,
+ HistoricalConversationRecordAPI,
+ HistoricalConversationOperateAPI,
+)
+from chat.api.vote_api import VoteAPI
+from chat.serializers.chat_record import (
+ VoteSerializer,
+ HistoricalConversationSerializer,
+ HistoricalConversationRecordSerializer,
+ HistoricalConversationOperateSerializer,
+)
+from common import result
+from common.auth import ChatTokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.chat_permission_constants import ChatPermissionConstants
+
+
+class VoteView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Like, Dislike"),
+ summary=_("Like, Dislike"),
+ operation_id=_("V3 Like, Dislike"), # type: ignore
+ parameters=VoteAPI.get_parameters(),
+ request=VoteAPI.get_request(),
+ responses=VoteAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def put(self, request: Request, application_id: str, chat_id: str, chat_record_id: str):
+ return result.success(
+ VoteSerializer(
+ data={"application_id": application_id, "chat_id": chat_id, "chat_record_id": chat_record_id}
+ ).vote(request.data)
+ )
+
+
+class HistoricalConversationView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation"),
+ summary=_("Get historical conversation"),
+ operation_id=_("V3 Get historical conversation"), # type: ignore
+ parameters=HistoricalConversationAPI.get_parameters(),
+ responses=HistoricalConversationAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str):
+ return result.success(
+ HistoricalConversationSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ }
+ ).list()
+ )
+
+ class Operate(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Modify conversation about"),
+ summary=_("Modify conversation about"),
+ operation_id=_("V3 Modify conversation about"), # type: ignore
+ parameters=HistoricalConversationOperateAPI.get_parameters(),
+ request=HistoricalConversationOperateAPI.get_request(),
+ responses=HistoricalConversationOperateAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def put(self, request: Request, application_id: str, chat_id: str):
+ return result.success(
+ HistoricalConversationOperateSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ "chat_id": chat_id,
+ }
+ ).edit_abstract(request.data)
+ )
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Delete history conversation"),
+ summary=_("Delete history conversation"),
+ operation_id=_("V3 Delete history conversation"), # type: ignore
+ parameters=HistoricalConversationOperateAPI.get_parameters(),
+ responses=HistoricalConversationOperateAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def delete(self, request: Request, application_id: str, chat_id: str):
+ return result.success(
+ HistoricalConversationOperateSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ "chat_id": chat_id,
+ }
+ ).logic_delete()
+ )
+
+ class BatchDelete(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Batch delete history conversation"),
+ summary=_("Batch delete history conversation"),
+ operation_id=_("V3 Batch delete history conversation"), # type: ignore
+ parameters=[],
+ responses=HistoricalConversationOperateAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def delete(self, request: Request, application_id: str):
+ return result.success(
+ HistoricalConversationOperateSerializer.Clear(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ }
+ ).batch_logic_delete()
+ )
+
+ class PageView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation by page"),
+ summary=_("Get historical conversation by page"),
+ operation_id=_("V3 Get historical conversation by page"), # type: ignore
+ parameters=PageHistoricalConversationAPI.get_parameters(),
+ responses=PageHistoricalConversationAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str, current_page: int, page_size: int):
+ return result.success(
+ HistoricalConversationSerializer(
+ data={
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ }
+ ).page(current_page, page_size)
+ )
+
+
+class HistoricalConversationRecordView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation records"),
+ summary=_("Get historical conversation records"),
+ operation_id=_("V3 Get historical conversation records"), # type: ignore
+ parameters=HistoricalConversationRecordAPI.get_parameters(),
+ responses=HistoricalConversationRecordAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str, chat_id: str):
+ return result.success(
+ HistoricalConversationRecordSerializer(
+ data={
+ "chat_id": chat_id,
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ }
+ ).list()
+ )
+
+ class PageView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get historical conversation records by page "),
+ summary=_("Get historical conversation records by page"),
+ operation_id=_("V3 Get historical conversation records by page"), # type: ignore
+ parameters=PageHistoricalConversationRecordAPI.get_parameters(),
+ responses=PageHistoricalConversationRecordAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str, chat_id: str, current_page: int, page_size: int):
+ return result.success(
+ HistoricalConversationRecordSerializer(
+ data={
+ "chat_id": chat_id,
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ }
+ ).page(current_page, page_size)
+ )
+
+
+class ChatRecordView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get conversation details"),
+ summary=_("Get conversation details"),
+ operation_id=_("V3 Get conversation details"), # type: ignore
+ parameters=PageHistoricalConversationRecordAPI.get_parameters(),
+ responses=PageHistoricalConversationRecordAPI.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ @has_permissions(ChatPermissionConstants.get_aggregate_permissions())
+ def get(self, request: Request, application_id: str, chat_id: str, chat_record_id: str):
+ return result.success(
+ ChatRecordOperateSerializer(
+ data={
+ "chat_id": chat_id,
+ "chat_record_id": chat_record_id,
+ "application_id": application_id,
+ "chat_user_id": request.user.id,
+ }
+ ).one(False)
+ )
diff --git a/apps/chat/views/v3/chat_user_api_key.py b/apps/chat/views/v3/chat_user_api_key.py
new file mode 100644
index 00000000000..6be48db3dc9
--- /dev/null
+++ b/apps/chat/views/v3/chat_user_api_key.py
@@ -0,0 +1,69 @@
+from common.auth import ChatTokenAuth
+from common.log.log import log
+from common.result import result
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+
+from chat.serializers.chat_user_api_key_serializers import ChatUserApiKeySerializer
+
+
+class ChatUserApiKeyView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Create ChatUserAPIKey"),
+ summary=_("Create ChatUserAPIKey"),
+ operation_id="V3 Create ChatUserAPIKey",
+ responses=None,
+ tags=[_("V3 Chat User API Key")], # type: ignore
+ )
+ @log(menu="Chat User API Key", operate="Add chat user API key")
+ def post(self, request: Request):
+ return result.success(ChatUserApiKeySerializer(data={"user_id": request.user.id}).generate())
+
+ class Page(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get ChatUserAPIKey List"),
+ summary=_("Get ChatUserAPIKey List"),
+ operation_id="V3 Get ChatUserAPIKey List",
+ parameters=[
+ OpenApiParameter(name='order_by', type=OpenApiTypes.STR, location=OpenApiParameter.QUERY,
+ description=_('order by'), required=False),
+ ],
+ responses=None,
+ tags=[_("V3 Chat User API Key")], # type: ignore
+ )
+ def get(self, request: Request, current_page, page_size):
+ return result.success(
+ ChatUserApiKeySerializer(
+ data={"user_id": request.user.id, "order_by": request.query_params.get("order_by")}
+ ).page(current_page, page_size)
+ )
+
+ class Operate(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Delete ChatUserAPIKey"),
+ summary=_("Delete ChatUserAPIKey"),
+ operation_id="V3 Delete ChatUserAPIKey",
+ responses=None,
+ parameters=None,
+ tags=[_("V3 Chat User API Key")], # type: ignore
+ )
+ @log(menu="Chat User API Key", operate="Delete chat user API key")
+ def delete(self, request: Request, api_key_id: str):
+ return result.success(
+ ChatUserApiKeySerializer.Operate(
+ data={"id": api_key_id, "user_id": request.user.id}
+ ).destroy()
+ )
diff --git a/apps/chat/views/v3/knowledge.py b/apps/chat/views/v3/knowledge.py
new file mode 100644
index 00000000000..34cdade3f4a
--- /dev/null
+++ b/apps/chat/views/v3/knowledge.py
@@ -0,0 +1,115 @@
+"""Public knowledge API/MCP endpoints, following the existing application MCP endpoint."""
+
+import json
+from urllib.parse import urlsplit
+
+from django.http import HttpResponse, JsonResponse
+from django.views.decorators.csrf import csrf_exempt
+from django.views.decorators.http import require_POST
+from rest_framework.exceptions import ValidationError
+
+from chat.mcp.knowledge import KnowledgeMCPToolHandler, PROTOCOL_VERSIONS
+from knowledge.services.external_retrieval import retrieve
+from knowledge.services.retrieval_access import RetrievalError, authenticate_key, authorize_external
+
+
+def response_headers(response):
+ response["Cache-Control"] = "no-store"
+ response["X-Content-Type-Options"] = "nosniff"
+ if response.status_code == 401:
+ response["WWW-Authenticate"] = "Bearer"
+ return response
+
+
+def read_request(request, knowledge_id):
+ origin = request.headers.get("Origin")
+ if origin:
+ expected = urlsplit(request.build_absolute_uri("/"))
+ if origin != f"{expected.scheme}://{expected.netloc}":
+ raise RetrievalError("invalid_origin", "Origin is not allowed.", 403)
+ identity = authenticate_key(request.headers.get("Authorization"))
+ knowledge = authorize_external(knowledge_id, identity)
+ if request.content_type != "application/json":
+ raise RetrievalError("invalid_content_type", "Use application/json.", 415)
+ if int(request.META.get("CONTENT_LENGTH") or 0) > 65536:
+ raise RetrievalError("request_too_large", "Request body is too large.", 413)
+ body = request.body
+ if len(body) > 65536:
+ raise RetrievalError("request_too_large", "Request body is too large.", 413)
+ return knowledge, identity, json.loads(body)
+
+
+def error_response(error):
+ return response_headers(
+ JsonResponse({"error": {"code": error.code, "message": error.message}}, status=error.status)
+ )
+
+
+@csrf_exempt
+@require_POST
+def retrieve_view(request, knowledge_id):
+ try:
+ knowledge, identity, data = read_request(request, knowledge_id)
+ return response_headers(JsonResponse(retrieve(knowledge.id, identity, data)))
+ except RetrievalError as error:
+ return error_response(error)
+ except (ValueError, UnicodeError, ValidationError):
+ return error_response(RetrievalError("invalid_request", "Invalid retrieval request."))
+ except Exception:
+ return error_response(RetrievalError("retrieval_failed", "Knowledge retrieval failed.", 503))
+
+
+def rpc_response(request_id, result=None, code=None, message=None, status=200):
+ data = {"jsonrpc": "2.0", "id": request_id}
+ data.update({"error": {"code": code, "message": message}} if code is not None else {"result": result})
+ return response_headers(JsonResponse(data, status=status))
+
+
+@csrf_exempt
+@require_POST
+def knowledge_mcp_view(request, knowledge_id):
+ request_id = None
+ try:
+ knowledge, identity, data = read_request(request, knowledge_id)
+ accept = request.headers.get("Accept", "")
+ if not all(value in accept for value in ("application/json", "text/event-stream")):
+ return rpc_response(
+ None, code=-32600, message="Accept must include application/json and text/event-stream.", status=406
+ )
+ if request.headers.get("MCP-Protocol-Version", "2025-03-26") not in PROTOCOL_VERSIONS:
+ return rpc_response(None, code=-32600, message="Unsupported protocol version.", status=400)
+ if not isinstance(data, dict) or data.get("jsonrpc") != "2.0" or not isinstance(data.get("method"), str):
+ return rpc_response(None, code=-32600, message="Invalid Request")
+ request_id = data.get("id")
+ if "id" in data and (isinstance(request_id, bool) or not isinstance(request_id, (str, int))):
+ return rpc_response(None, code=-32600, message="Invalid request ID.")
+ params = data.get("params", {})
+ if not isinstance(params, dict):
+ return (
+ rpc_response(request_id, code=-32602, message="Invalid params.")
+ if "id" in data
+ else HttpResponse(status=400)
+ )
+ if "id" not in data:
+ return response_headers(HttpResponse(status=202))
+ handler = KnowledgeMCPToolHandler(knowledge, identity)
+ method = data["method"]
+ if method == "initialize":
+ output = handler.initialize(params)
+ elif method == "ping":
+ output = {}
+ elif method == "tools/list":
+ output = handler.list_tools()
+ elif method == "tools/call":
+ output = handler.call_tool(params)
+ else:
+ return rpc_response(request_id, code=-32601, message="Method not found.")
+ return rpc_response(request_id, result=output)
+ except RetrievalError as error:
+ return error_response(error)
+ except (ValueError, UnicodeError):
+ return rpc_response(None, code=-32700, message="Parse error.", status=400)
+ except ValidationError:
+ return rpc_response(request_id, code=-32602, message="Invalid params.")
+ except Exception:
+ return rpc_response(request_id, code=-32603, message="Knowledge retrieval failed.", status=503)
diff --git a/apps/chat/views/mcp.py b/apps/chat/views/v3/mcp.py
similarity index 100%
rename from apps/chat/views/mcp.py
rename to apps/chat/views/v3/mcp.py
diff --git a/apps/chat/views/v3/portal.py b/apps/chat/views/v3/portal.py
new file mode 100644
index 00000000000..18a6479ce4b
--- /dev/null
+++ b/apps/chat/views/v3/portal.py
@@ -0,0 +1,63 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:MaxKB
+@file: portal.py
+@date:2026/8/14
+@desc: 门户视图
+"""
+
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from common import result
+from common.auth import ChatTokenAuth
+from common.utils.common import query_params_to_single_dict
+
+from chat.api.portal_api import PortalAPI
+from chat.serializers.portal import (
+ PortalApplicationSerializer,
+ PortalHistoricalConversationSerializer,
+)
+
+
+class PortalApplicationView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get published application list by page"),
+ summary=_("Get published application list by page"),
+ operation_id=_("Get published application list by page"), # type: ignore
+ parameters=PortalAPI.Application.get_parameters(),
+ responses=PortalAPI.Application.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ def get(self, request: Request, current_page: int, page_size: int):
+ return result.success(
+ PortalApplicationSerializer.Query(data={**query_params_to_single_dict(request.query_params)}).page(
+ current_page, page_size, str(request.user.id)
+ )
+ )
+
+
+class PortalHistoricalConversationView(APIView):
+ authentication_classes = [ChatTokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get portal historical conversation by page"),
+ summary=_("Get portal historical conversation by page"),
+ operation_id=_("Get portal historical conversation by page"), # type: ignore
+ parameters=PortalAPI.Conversation.get_parameters(),
+ responses=PortalAPI.Conversation.get_response(),
+ tags=[_("V3 Chat")], # type: ignore
+ )
+ def get(self, request: Request, current_page: int, page_size: int):
+ return result.success(
+ PortalHistoricalConversationSerializer.Query(
+ data={**query_params_to_single_dict(request.query_params)}
+ ).page(current_page, page_size, str(request.user.id))
+ )
diff --git a/apps/common/auth/authenticate.py b/apps/common/auth/authenticate.py
index 71ee51bf1f6..9bf27c420aa 100644
--- a/apps/common/auth/authenticate.py
+++ b/apps/common/auth/authenticate.py
@@ -50,9 +50,30 @@ def new_instance_by_class_path(class_path: str):
return HandlerClass()
-handles = [new_instance_by_class_path(class_path) for class_path in settings.AUTH_HANDLES]
-chat_handles = [new_instance_by_class_path(class_path) for class_path in settings.CHAT_AUTH_HANDLES]
-all_handles = handles + chat_handles
+handles = None
+chat_handles = None
+all_handles = None
+
+
+def get_handles():
+ global handles
+ if handles is None:
+ handles = [new_instance_by_class_path(class_path) for class_path in settings.AUTH_HANDLES]
+ return handles
+
+
+def get_chat_handles():
+ global chat_handles
+ if chat_handles is None:
+ chat_handles = [new_instance_by_class_path(class_path) for class_path in settings.CHAT_AUTH_HANDLES]
+ return chat_handles
+
+
+def get_all_handles():
+ global all_handles
+ if all_handles is None:
+ all_handles = get_handles() + get_chat_handles()
+ return all_handles
class TokenDetails:
@@ -85,7 +106,7 @@ def authenticate(self, request):
try:
token = auth[7:]
token_details = TokenDetails(token)
- for handle in handles:
+ for handle in get_handles():
if handle.support(request, token, token_details.get_token_details):
return handle.handle(request, token, token_details.get_token_details)
raise AppAuthenticationFailed(1002, _('Authentication information is incorrect! illegal user'))
@@ -111,7 +132,7 @@ def authenticate(self, request):
try:
token = auth[7:]
token_details = TokenDetails(token)
- for handle in chat_handles:
+ for handle in get_chat_handles():
if handle.support(request, token, token_details.get_token_details):
return handle.handle(request, token, token_details.get_token_details)
raise AppAuthenticationFailed(1002, _('Authentication information is incorrect! illegal user'))
@@ -137,7 +158,7 @@ def authenticate(self, request):
try:
token = auth[7:]
token_details = TokenDetails(token)
- for handle in all_handles:
+ for handle in get_all_handles():
if handle.support(request, token, token_details.get_token_details):
return handle.handle(request, token, token_details.get_token_details)
raise AppAuthenticationFailed(1002, _('Authentication information is incorrect! illegal user'))
diff --git a/apps/common/auth/authentication.py b/apps/common/auth/authentication.py
index 8ee80f324f5..c3b1c8b5d74 100644
--- a/apps/common/auth/authentication.py
+++ b/apps/common/auth/authentication.py
@@ -1,142 +1,63 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: authentication.py
- @date:2025/4/15 20:12
- @desc:
+@project: MaxKB
+@file: authentication.py
+@desc: 适配层,复用 AggregatePermission
"""
-from typing import List
from django.utils.translation import gettext_lazy as _
-from rest_framework.request import Request
-
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants, \
- Permission, Role
-from common.exception.app_exception import AppUnauthorizedFailed
-
-
-def exist_permissions_by_permission_constants(user_permission: List[PermissionConstants],
- permission_list: List[PermissionConstants]):
- """
- 用户是否拥有 permission_list的权限
- :param user_permission: 用户权限
- :param permission_list: 需要的权限
- :return: 是否拥有
- """
- return any(list(map(lambda up: permission_list.__contains__(up), user_permission)))
-
-
-def exist_role_by_role_constants(user_role: List[RoleConstants],
- role_list: List[RoleConstants]):
- """
- 用户是否拥有这个角色
- :param user_role: 用户角色
- :param role_list: 需要拥有的角色
- :return: 是否拥有
- """
- return any([True for role in role_list if user_role.__contains__(role.value.__str__())])
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import AggregatePermission
+from common.auth.struct.permission import Role
-def exist_permissions_by_view_permission(user_role: List[RoleConstants],
- user_permission: List[PermissionConstants | object],
- permission: ViewPermission, request, **kwargs):
- """
- 用户是否存在这些权限
- :param request:
- :param user_role: 用户角色
- :param user_permission: 用户权限
- :param permission: 所属权限
- :return: 是否存在 True False
- """
-
- role_list = [user_r(request, kwargs) if callable(user_r) else user_r for user_r in
- permission.roleList]
- role_ok = any(list(map(lambda up: role_list.__contains__(up),
- user_role)))
- permission_list = [user_p(request, kwargs) if callable(user_p) else user_p for user_p in
- permission.permissionList
- ]
- permission_ok = any(list(map(lambda up: permission_list.__contains__(up),
- user_permission)))
- return role_ok | permission_ok if permission.compare == CompareConstants.OR else role_ok & permission_ok
-
-
-def exist_permissions(user_role: List[RoleConstants], user_permission: List[PermissionConstants], permission, request,
- **kwargs):
- if isinstance(permission, ViewPermission):
- return exist_permissions_by_view_permission(user_role, user_permission, permission, request, **kwargs)
- if isinstance(permission, RoleConstants):
- return exist_role_by_role_constants(user_role, [permission])
- if isinstance(permission, PermissionConstants):
- return exist_permissions_by_permission_constants(user_permission, [permission])
- if isinstance(permission, Permission):
- return user_permission.__contains__(permission)
- if isinstance(permission, Role):
- return user_role.__contains__(permission.__str__())
- return False
+from common.exception.app_exception import AppUnauthorizedFailed
-def exist(user_role: List[RoleConstants], user_permission: List[PermissionConstants], permission, request, **kwargs):
- if callable(permission):
- p = permission(request, kwargs)
- return exist_permissions(user_role, user_permission, p, request, **kwargs)
- return exist_permissions(user_role, user_permission, permission, request, **kwargs)
+def _build(items, request, kwargs, compare) -> AggregatePermission:
+ roles, permissions, aggregates = [], [], []
+ for it in items:
+ if callable(it) and not isinstance(it, AggregatePermission):
+ it = it(request, kwargs)
+ if isinstance(it, AggregatePermission):
+ aggregates.append(it)
+ elif isinstance(it, (RoleConstants, Role)):
+ roles.append(it)
+ else:
+ permissions.append(it)
+ return AggregatePermission(roles=roles, permissions=permissions, aggregatePermissions=aggregates, compare=compare)
def get_is_permissions(request, **kwargs):
def is_permissions(*permission, compare=CompareConstants.OR):
- exit_list = list(
- map(lambda p: exist(request.auth.role_list, request.auth.permission_list, p, request, **kwargs),
- permission))
- return any(exit_list) if compare == CompareConstants.OR else all(exit_list)
+ return _build(permission, request, kwargs, compare).hasPermission(request, **kwargs)
return is_permissions
-def check_batch_permissions(request: Request, id_list: List[str], id_key: str, permissions: tuple,
- compare=CompareConstants.OR, **kwargs) -> List[str]:
+def check_batch_permissions(request, id_list, id_key, permissions, compare=CompareConstants.OR, **kwargs):
if not id_list:
return []
-
- # workspace manager 直接放行
- # 预检
- kwargs[id_key] = '__workspace_level_pre_check__'
- pre_check = list(
- map(lambda p: exist(request.auth.role_list, request.auth.permission_list, p, request, **kwargs),
- permissions)
- )
- if any(pre_check) if compare == CompareConstants.OR else all(pre_check):
+ kwargs[id_key] = "__workspace_level_pre_check__"
+ if _build(permissions, request, kwargs, compare).hasPermission(request, **kwargs):
return list(id_list)
- # 逐个资源校验
result_list = []
for resource_id in id_list:
kwargs[id_key] = resource_id
- exit_list = list(
- map(lambda p: exist(request.auth.role_list, request.auth.permission_list, p, request, **kwargs),
- permissions)
- )
- if any(exit_list) if compare == CompareConstants.OR else all(exit_list):
+ if _build(permissions, request, kwargs, compare).hasPermission(request, **kwargs):
result_list.append(resource_id)
return result_list
+
def has_permissions(*permission, compare=CompareConstants.OR):
- """
- 权限 role or permission
- :param compare: 比较符号
- :param permission: 如果是角色 role:roleId
- :return: 权限装饰器函数,用于判断用户是否有权限访问当前接口
- """
+ """接口权限装饰器"""
def inner(func):
def run(view, request, **kwargs):
- exit_list = list(
- map(lambda p: exist(request.auth.role_list, request.auth.permission_list, p, request, **kwargs),
- permission))
- # 判断是否有权限
- if any(exit_list) if compare == CompareConstants.OR else all(exit_list):
+ if _build(permission, request, kwargs, compare).hasPermission(request, **kwargs):
return func(view, request, **kwargs)
- raise AppUnauthorizedFailed(403, _('No permission to access'))
+ raise AppUnauthorizedFailed(403, _("No permission to access"))
return run
diff --git a/apps/common/auth/common.py b/apps/common/auth/common.py
index ad8e0e50a48..98832c885ef 100644
--- a/apps/common/auth/common.py
+++ b/apps/common/auth/common.py
@@ -1,87 +1,63 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: common.py
- @date:2025/6/6 19:55
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: common.py
+@date:2025/6/6 19:55
+@desc:
"""
-import hashlib
-import json
-import threading
-from django.core import signing, cache
+from django.core import signing
-from common.constants.cache_version import Cache_Version
-from common.utils.rsa_util import encrypt, decrypt
+from common.constants.authentication_type import AuthenticationType
+from common.exception.app_exception import AppAuthenticationFailed
-authentication_cache = cache.cache
-lock = threading.Lock()
-
-def _decrypt(authentication: str):
- cache_key = hashlib.sha256(authentication.encode()).hexdigest()
- result = authentication_cache.get(key=cache_key, version=Cache_Version.CHAT.value)
- if result is None:
- with lock:
- result = authentication_cache.get(cache_key, version=Cache_Version.CHAT.value)
- if result is None:
- result = decrypt(authentication)
- authentication_cache.set(cache_key, result, version=Cache_Version.CHAT.value, timeout=60 * 60 * 2)
-
- return result
-
-
-class ChatAuthentication:
- def __init__(self, auth_type: str | None, **kwargs):
- self.auth_type = auth_type
- for k, v in kwargs.items():
- self.__setattr__(k, v)
+class SystemToken:
+ def __init__(self, user_id, _type: AuthenticationType, **kwargs):
+ self.id = user_id
+ self.type = _type
+ self.kwargs = kwargs
def to_dict(self):
- return self.__dict__
+ if self.kwargs:
+ return {"user_id": self.id, "type": str(self.type.value), "kwargs": self.kwargs}
+ return {"id": str(self.id), "type": str(self.type.value)}
- def to_string(self):
- value = json.dumps(self.to_dict())
- authentication = encrypt(value)
- cache_key = hashlib.sha256(authentication.encode()).hexdigest()
- authentication_cache.set(cache_key, value, version=Cache_Version.CHAT.get_version(), timeout=60 * 60 * 2)
- return authentication
-
- @staticmethod
- def new_instance(authentication: str):
- auth = json.loads(_decrypt(authentication))
- return ChatAuthentication(**auth)
+ def to_token(self):
+ return signing.dumps(self.to_dict())
-class ChatUserToken:
- def __init__(self, application_id, user_id, access_token, _type, chat_user_type, chat_user_id,
- authentication: ChatAuthentication):
- self.application_id = application_id
- self.user_id = user_id
- self.access_token = access_token
+class ChatToken:
+ def __init__(self, user_id, _type: AuthenticationType, login_type: str, **kwargs):
+ self.id = user_id
self.type = _type
- self.chat_user_type = chat_user_type
- self.chat_user_id = chat_user_id
- self.authentication = authentication
+ self.login_type = login_type
+ self.kwargs = kwargs
def to_dict(self):
+ if self.kwargs:
+ return {
+ "id": str(self.id),
+ "type": str(self.type.value),
+ "login_type": str(self.login_type),
+ "kwargs": self.kwargs,
+ }
return {
- 'application_id': str(self.application_id),
- 'user_id': str(self.user_id),
- 'access_token': self.access_token,
- 'type': str(self.type.value),
- 'chat_user_type': str(self.chat_user_type),
- 'chat_user_id': str(self.chat_user_id),
- 'authentication': self.authentication.to_string()
+ "id": str(self.id),
+ "type": str(self.type.value),
+ "login_type": str(self.login_type),
}
def to_token(self):
return signing.dumps(self.to_dict())
- @staticmethod
- def new_instance(token_dict):
- return ChatUserToken(token_dict.get('application_id'), token_dict.get('user_id'),
- token_dict.get('access_token'), token_dict.get('type'), token_dict.get('chat_user_type'),
- token_dict.get('chat_user_id'),
- ChatAuthentication.new_instance(token_dict.get('authentication')))
+
+def parse_token(token):
+ details = signing.loads(token)
+ _type = details.get("type")
+ if _type:
+ if _type == AuthenticationType.SYSTEM_USER.value:
+ return SystemToken(details.get("id"), details.get("type"), **details.get("kwargs", {}))
+ return ChatToken(details.get("id"), details.get("type"), details.get("login_type"), **details.get("kwargs", {}))
+ raise AppAuthenticationFailed(1001, "")
diff --git a/apps/common/auth/constants/category_constants.py b/apps/common/auth/constants/category_constants.py
new file mode 100644
index 00000000000..734a2cefb20
--- /dev/null
+++ b/apps/common/auth/constants/category_constants.py
@@ -0,0 +1,36 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: category_constants.py
+ @date:2026/8/3 17:31
+ @desc: 一级目录分类常量(最顶层分类)
+"""
+from enum import Enum
+from django.utils.translation import gettext_lazy as _
+
+
+class Category(Enum):
+ """
+ 一级目录(最顶层分类),用于在 parent_group 之上再加一层分类
+ """
+ # 身份与权限
+ IAM = ("IAM", _("IAM"))
+ # 资源管理
+ RESOURCE = ("RESOURCE", _("Resource"))
+ # 共享资源
+ SHARED = ("SHARED", _("Shared"))
+ # 对话客户端
+ CHAT_CLIENT = ("CHAT_CLIENT", _("Chat Client"))
+ # 操作日志
+ OPERATION_LOG = ("OPERATION_LOG", _("Operation Log"))
+ # 系统设置
+ SYSTEM_SETTING = ("SYSTEM_SETTING", _("System Setting"))
+ # 工作空间
+ WORKSPACE = ("WORKSPACE", _("Workspace"))
+ # 其他
+ OTHER = ("OTHER", _("Other"))
+
+ def __init__(self, value, label):
+ self._value_ = value
+ self.label = label
diff --git a/apps/common/auth/constants/chat_permission_constants.py b/apps/common/auth/constants/chat_permission_constants.py
new file mode 100644
index 00000000000..160639d386a
--- /dev/null
+++ b/apps/common/auth/constants/chat_permission_constants.py
@@ -0,0 +1,53 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: chat_permission_constants.py
+@date:2026/8/6 16:38
+@desc:
+"""
+
+from enum import Enum
+
+from common.auth.constants.group_constants import Group
+from common.auth.constants.operate_constants import Operate
+from common.auth.struct.aggregate_permission import AggregatePermission
+from common.auth.struct.permission import Permission
+
+
+class ChatPermissionConstants(Enum):
+ CHAT_USER_ANONYMOUS = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.ANNOTATION_AUTH, 0)
+ CHAT_USER_LOCAL = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.LOCAL, 1)
+ CHAT_USER_CAS = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.CAS, 2)
+ CHAT_USER_DINGTALK = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.DINGTALK, 3)
+ CHAT_USER_WECOM = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.WECOM, 4)
+ CHAT_USER_LARK = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.LARK, 5)
+ CHAT_USER_OIDC = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.OIDC, 6)
+ CHAT_USER_LDAP = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.LDAP, 7)
+ CHAT_USER_OAUTH2 = Permission(Group.CHAT_USER, Group.CHAT_USER, Operate.OAUTH2, 8)
+
+ def get_permission(self):
+ return self._build_workspace_permission("application_id")
+
+ def _build_workspace_permission(self, resource_id_key=None):
+ def permission_factory(_, **kwargs):
+ return Permission(
+ group=self.value.group,
+ sub_group=self.value.sub_group,
+ operate=self.value.operate,
+ bit_index=self.value.bit_index,
+ workspace_id=kwargs.get("workspace_id"),
+ resource_id=kwargs.get(resource_id_key) if resource_id_key else None,
+ )
+
+ return permission_factory
+
+ @staticmethod
+ def get_aggregate_permissions():
+ return AggregatePermission(
+ permissions=[_permission.get_permission() for _permission in ChatPermissionConstants]
+ )
+
+
+# 权限字符串与权限对象的Map
+CHAT_PERMISSION_STR_MAP = {_permission.value.__str__(): _permission for _permission in ChatPermissionConstants}
diff --git a/apps/common/auth/constants/compare_constants.py b/apps/common/auth/constants/compare_constants.py
new file mode 100644
index 00000000000..7c6a34dd0c7
--- /dev/null
+++ b/apps/common/auth/constants/compare_constants.py
@@ -0,0 +1,16 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: compare_constants.py
+ @date:2026/8/5 10:42
+ @desc:
+"""
+from enum import Enum
+
+
+class CompareConstants(Enum):
+ # 或者
+ OR = "OR"
+ # 并且
+ AND = "AND"
diff --git a/apps/common/auth/constants/group_constants.py b/apps/common/auth/constants/group_constants.py
new file mode 100644
index 00000000000..beaeb226d9a
--- /dev/null
+++ b/apps/common/auth/constants/group_constants.py
@@ -0,0 +1,126 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: group_constants.py
+@date:2026/8/3 17:31
+@desc: 权限分组常量,用于菜单和权限分类
+"""
+
+from enum import Enum
+
+from django.utils.translation import gettext_lazy as _
+
+
+class Group(Enum):
+ """
+ 权限组 一个组一般对应前端一个菜单
+ 使用方式:
+ - 无子分组: group=Group.TOOL, sub_group=Group.TOOL
+ - 有子分组: group=Group.TOOL, sub_group=Group.FOLDER
+ """
+
+ # 用户管理
+ USER = ("USER_MANAGEMENT", _("User Management"))
+
+ # 资源主分组
+ APPLICATION = ("APPLICATION", _("Application"))
+ KNOWLEDGE = ("KNOWLEDGE", _("Knowledge"))
+ MODEL = ("MODEL", _("Model"))
+ TOOL = ("TOOL", _("Tool"))
+ TRIGGER = ("TRIGGER", _("Trigger"))
+
+ # 子分组 - 文件夹
+ FOLDER = ("FOLDER", _("Folder"))
+
+ # 子分组 - 知识库
+ DOCUMENT = ("DOCUMENT", _("Document"))
+ WORKFLOW = ("WORKFLOW", _("Workflow"))
+ TAG = ("TAG", _("Tag"))
+ PROBLEM = ("PROBLEM", _("Problem"))
+ TERMBASE = ("TERMBASE", _("Termbase"))
+ HIT_TEST = ("HIT_TEST", _("Hit-Test"))
+
+ # 子分组 - 应用
+ OVERVIEW = ("OVERVIEW", _("Overview"))
+ ACCESS = ("ACCESS", _("Application Access"))
+ CHAT_LOG = ("CHAT_LOG", _("Conversation log"))
+ CHAT_USER = ("CHAT_USER", _("Dialogue users"))
+
+ # 子分组 - 对话用户(知识库)
+ KNOWLEDGE_CHAT_USER = ("KNOWLEDGE_CHAT_USER", _("Dialogue users"))
+
+ # 系统功能分组
+ ROLE = ("ROLE", _("Role Management"))
+ WORKSPACE = ("WORKSPACE", _("Workspace"))
+ USER_GROUP = ("USER_GROUP", _("User Group"))
+ EMAIL_SETTING = ("EMAIL_SETTING", _("Email Setting"))
+ LOGIN_AUTH = ("LOGIN_AUTH", _("Login Auth"))
+ APPEARANCE_SETTINGS = ("APPEARANCE_SETTINGS", _("Appearance Settings"))
+ DISPLAY_SETTINGS = ("DISPLAY_SETTINGS", _("Display Settings"))
+
+ # 对话相关
+ CHAT_USER_GROUP = ("CHAT_USER_GROUP", _("Chat User Group"))
+ CHAT_USER_AUTH = ("CHAT_USER_AUTH", _("Chat User Auth"))
+ PORTAL = ("PORTAL", _("portal"))
+ # 其他
+ OTHER = ("OTHER", _("Other"))
+ HOMEPAGE = ("HOMEPAGE", _("Home page"))
+ OPERATION_LOG = ("OPERATION_LOG", _("Operation Log"))
+
+ # 资源授权分组
+ RESOURCE_PERMISSION = ("RESOURCE_PERMISSION", _("Resource Permission"))
+ APPLICATION_RESOURCE_PERMISSION = (
+ "APPLICATION_RESOURCE_PERMISSION",
+ _("Application"),
+ )
+ KNOWLEDGE_RESOURCE_PERMISSION = ("KNOWLEDGE_RESOURCE_PERMISSION", _("Knowledge"))
+ TOOL_RESOURCE_PERMISSION = ("TOOL_RESOURCE_PERMISSION", _("Tool"))
+ MODEL_RESOURCE_PERMISSION = ("MODEL_RESOURCE_PERMISSION", _("Model"))
+
+ # 工作空间分组
+ WORKSPACE_ROLE = ("WORKSPACE_ROLE", _("Role Management"))
+ WORKSPACE_WORKSPACE = ("WORKSPACE_WORKSPACE", _("Workspace"))
+ WORKSPACE_USER_GROUP = ("WORKSPACE_USER_GROUP", _("User Group"))
+ WORKSPACE_RESOURCE_PERMISSION = ("WORKSPACE_RESOURCE_PERMISSION", _("Resource Permission"))
+ WORKSPACE_CHAT_USER = ("WORKSPACE_CHAT_USER", _("Chat User"))
+ WORKSPACE_CHAT_USER_GROUP = ("WORKSPACE_CHAT_USER_GROUP", _("Chat User Group"))
+
+ # 用户级分组
+ USER_HOMEPAGE = ("USER_HOMEPAGE", _("Home page"))
+ USER_APPLICATION = ("USER_APPLICATION", _("Application"))
+ USER_KNOWLEDGE = ("USER_KNOWLEDGE", _("Knowledge"))
+ USER_MODEL = ("USER_MODEL", _("Model"))
+ USER_TOOL = ("USER_TOOL", _("Tool"))
+ USER_OTHER = ("USER_OTHER", _("Other"))
+
+ # 共享资源分组
+ SYSTEM_KNOWLEDGE = ("SYSTEM_KNOWLEDGE", _("Knowledge"))
+ SYSTEM_MODEL = ("SYSTEM_MODEL", _("Model"))
+ SYSTEM_TOOL = ("SYSTEM_TOOL", _("Tool"))
+
+ # 资源管理分组
+ SYSTEM_RES_APPLICATION = ("SYSTEM_RESOURCE_APPLICATION", _("Application"))
+ SYSTEM_RES_KNOWLEDGE = ("SYSTEM_RESOURCE_KNOWLEDGE", _("Knowledge"))
+ SYSTEM_RES_TOOL = ("SYSTEM_RESOURCE_TOOL", _("Tool"))
+ SYSTEM_RES_MODEL = ("SYSTEM_RESOURCE_MODEL", _("Model"))
+
+ # 系统资源子分组
+ SYSTEM_DOCUMENT = ("SYSTEM_DOCUMENT", _("Document"))
+ SYSTEM_WORKFLOW = ("SYSTEM_WORKFLOW", _("Workflow"))
+ SYSTEM_TAG = ("SYSTEM_TAG", _("Tag"))
+ SYSTEM_PROBLEM = ("SYSTEM_PROBLEM", _("Problem"))
+ SYSTEM_TERMBASE = ("SYSTEM_TERMBASE", _("Termbase"))
+ SYSTEM_HIT_TEST = ("SYSTEM_HIT_TEST", _("Hit-Test"))
+ SYSTEM_CHAT_USER = ("SYSTEM_CHAT_USER", _("Dialogue users"))
+ SYSTEM_OVERVIEW = ("SYSTEM_OVERVIEW", _("Overview"))
+ SYSTEM_ACCESS = ("SYSTEM_ACCESS", _("Application Access"))
+ SYSTEM_CHAT_LOG = ("SYSTEM_CHAT_LOG", _("Conversation log"))
+ CHAT = ("CHAT", _("Chat"))
+
+ def __init__(self, value, label):
+ self._value_ = value
+ self.label = label
+
+ def __str__(self):
+ return self.value
diff --git a/apps/common/auth/constants/operate_constants.py b/apps/common/auth/constants/operate_constants.py
new file mode 100644
index 00000000000..835c5e86935
--- /dev/null
+++ b/apps/common/auth/constants/operate_constants.py
@@ -0,0 +1,96 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: operate_constants.py
+@date:2026/8/3 17:32
+@desc: 操作权限常量
+"""
+
+from enum import Enum
+from django.utils.translation import gettext_lazy as _
+
+
+class Operate(Enum):
+ """
+ 一个权限组的操作权限
+ """
+
+ SELF = ("", "")
+ READ = ("READ", _("Read"))
+ EDIT = ("READ+EDIT", _("Edit"))
+ CREATE = ("READ+CREATE", _("Create"))
+ DELETE = ("READ+DELETE", _("Delete"))
+ """
+ 使用权限
+ """
+ USE = ("USE", _("Use"))
+ IMPORT = ("READ+IMPORT", _("Import"))
+ EXPORT = ("READ+EXPORT", _("Export"))
+ PUBLISH = ("READ+PUBLISH", _("Publish"))
+ SYNC = ("READ+SYNC", _("Sync"))
+ GENERATE = ("READ+GENERATE", _("Generate"))
+ ADD_MEMBER = ("READ+ADD_MEMBER", _("Add Member"))
+ REMOVE_MEMBER = ("READ+REMOVE_MEMBER", _("Remove Member"))
+ VECTOR = ("READ+VECTOR", _("Vector"))
+ MIGRATE = ("READ+MIGRATE", _("Migrate"))
+ RELATE = ("READ+RELATE", _("Relate"))
+ USER_GROUP = ("READ+USER_GROUP", _("User Group"))
+ ANNOTATION = ("READ+ANNOTATION", _("Annotation"))
+ CLEAR_POLICY = ("READ+CLEAR_POLICY", _("Clear Policy"))
+ EMBED = ("READ+EMBED", _("Embed third party"))
+ ACCESS = ("READ+ACCESS", _("Access restrictions"))
+ DISPLAY = ("READ+DISPLAY", _("Display Settings"))
+ API_KEY = ("READ+API_KEY", _("API KEY"))
+ PUBLIC_ACCESS = ("READ+PUBLIC_ACCESS", _("Public access link"))
+ Q_WEIXIN = ("READ+Q_WEIXIN", _("Enterprise WeiXin"))
+ FEISHU = ("READ+FEISHU", _("Feishu"))
+ DD = ("READ+DD", _("Dingding"))
+ WEIXIN_PUBLIC_ACCOUNT = ("READ+WEIXIN_PUBLIC_ACCOUNT", _("Weixin Public Account"))
+ SLACK = ("READ+SLACK", _("Slack"))
+ ADD_KNOWLEDGE = ("READ+ADD_KNOWLEDGE", _("Add to Knowledge Base"))
+ TO_CHAT = ("READ+TO_CHAT", _("To Chat"))
+ SETTING = ("READ+SETTING", _("Setting"))
+ DOWNLOAD = ("READ+DOWNLOAD", _("Download Original Document"))
+ COPY = ("READ+COPY", _("Copy"))
+ AUTH = ("READ+AUTH", _("resource authorization"))
+ TAG = ("READ+TAG", _("Tag Setting"))
+ REPLACE = ("READ+REPLACE", _("Replace Original Document"))
+ UPDATE = ("READ+UPDATE", _("Update License"))
+ RELATE_VIEW = ("READ+RELATE_VIEW", _("View related resources"))
+ RECORD = ("READ+RECORD", _("Read execute record"))
+ TRIGGER_READ = ("READ+TRIGGER_READ", _("Read Trigger"))
+ TRIGGER_EDIT = ("READ+TRIGGER_EDIT", _("Edit Trigger"))
+ TRIGGER_CREATE = ("READ+TRIGGER_CREATE", _("Create Trigger"))
+ TRIGGER_DELETE = ("READ+TRIGGER_DELETE", _("Delete Trigger"))
+ BATCH_DELETE = ("READ+BATCH_DELETE", _("Batch delete"))
+ BATCH_MOVE = ("READ+BATCH_MOVE", _("Batch move"))
+ TOKEN = ("READ+TOKEN", _("Token Index"))
+ TO_WORKSPACE = ("READ+TO_WORKSPACE", _("Authorize to Workspace"))
+ SET_ROLE = ("READ+SET_ROLE", _("Set Role"))
+ QUOTA_SETTING = ("READ+QUOTA_SETTING", _("Quota Setting"))
+
+ ABOUT = ("READ", _("About"))
+ LICENSE = ("READ+UPDATE", _("Update License"))
+ SWITCH_LANGUAGE = ("READ+EDIT", _("Switch Language"))
+ CHANGE_PASSWORD = ("READ+CREATE", _("Change Password"))
+ SYSTEM_API_KEY = ("READ+DELETE", _("System API Key"))
+ PORTAL = ("READ+PORTAL", _("Portal"))
+
+ ANNOTATION_AUTH = ('ANNOTATION', _("Annotation"))
+ PASSWORD = ("PASSWORD", _("Password verification"))
+ LOCAL = ("LOCAL", _("Account login"))
+ CAS = ("CAS", _("CAS"))
+ DINGTALK = ("DINGTALK", _("dingtalk"))
+ WECOM = ("WECOM", _("WeCom"))
+ LARK = ("LARK", _("lark"))
+ OIDC = ("OIDC", _("OIDC"))
+ LDAP = ("LDAP", _("LDAP"))
+ OAUTH2 = ("OAUTH2", _("OAUTH2"))
+
+ def __init__(self, value, label):
+ self._value_ = value
+ self.label = label
+
+ def __str__(self):
+ return self.value
diff --git a/apps/common/auth/constants/permission_constants.py b/apps/common/auth/constants/permission_constants.py
new file mode 100644
index 00000000000..ca7858badd1
--- /dev/null
+++ b/apps/common/auth/constants/permission_constants.py
@@ -0,0 +1,3713 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: permission_constants.py
+@date:2026/8/3 17:28
+@desc: 权限枚举常量(新格式)
+"""
+
+from enum import Enum
+from typing import List, Dict
+
+from common.auth.constants.category_constants import Category
+from common.auth.constants.group_constants import Group
+from common.auth.constants.operate_constants import Operate
+from common.auth.constants.permission_scope_constants import PermissionScopeConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.permission import Permission, PermissionMeta
+
+
+class ResourcePermissionGroup:
+ """资源权限组"""
+
+ def __init__(self, resource: Group, permission: str):
+ self.resource = resource
+ self.permission = permission
+
+ def __eq__(self, other):
+ return str(self.permission) == str(other.permission) and str(self.resource) == str(other.resource)
+
+ def __str__(self):
+ return f"{self.resource}_{self.permission}"
+
+ def __hash__(self):
+ return hash((self.resource, self.permission))
+
+
+class ResourcePermissionConst:
+ """资源权限常量"""
+
+ # 知识库
+ KNOWLEDGE_VIEW = ResourcePermissionGroup(Group.KNOWLEDGE, "VIEW")
+ KNOWLEDGE_MANAGE = ResourcePermissionGroup(Group.KNOWLEDGE, "MANAGE")
+ KNOWLEDGE_FOLDER_VIEW = ResourcePermissionGroup(Group.KNOWLEDGE, "FOLDER_VIEW")
+ KNOWLEDGE_FOLDER_MANAGE = ResourcePermissionGroup(Group.KNOWLEDGE, "FOLDER_MANAGE")
+
+ # 应用
+ APPLICATION_VIEW = ResourcePermissionGroup(Group.APPLICATION, "VIEW")
+ APPLICATION_MANAGE = ResourcePermissionGroup(Group.APPLICATION, "MANAGE")
+ APPLICATION_FOLDER_VIEW = ResourcePermissionGroup(Group.APPLICATION, "FOLDER_VIEW")
+ APPLICATION_FOLDER_MANAGE = ResourcePermissionGroup(Group.APPLICATION, "FOLDER_MANAGE")
+
+ # 工具
+ TOOL_VIEW = ResourcePermissionGroup(Group.TOOL, "VIEW")
+ TOOL_MANAGE = ResourcePermissionGroup(Group.TOOL, "MANAGE")
+ TOOL_FOLDER_VIEW = ResourcePermissionGroup(Group.TOOL, "FOLDER_VIEW")
+ TOOL_FOLDER_MANAGE = ResourcePermissionGroup(Group.TOOL, "FOLDER_MANAGE")
+
+ # 模型
+ MODEL_VIEW = ResourcePermissionGroup(Group.MODEL, "VIEW")
+ MODEL_MANAGE = ResourcePermissionGroup(Group.MODEL, "MANAGE")
+
+
+from maxkb import settings
+
+is_ee: bool = settings.edition == "EE"
+
+
+class PermissionConstants(Enum):
+ """
+ 权限枚举
+ """
+
+ # ==================== 首页 ====================
+ HOMEPAGE_READ = (
+ Permission(group=Group.HOMEPAGE, sub_group=Group.HOMEPAGE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ HOMEPAGE_EXPORT = (
+ Permission(group=Group.HOMEPAGE, sub_group=Group.HOMEPAGE, operate=Operate.EXPORT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ SYSTEM_HOMEPAGE_READ = (
+ Permission(group=Group.HOMEPAGE, sub_group=Group.HOMEPAGE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ SYSTEM_HOMEPAGE_EXPORT = (
+ Permission(group=Group.HOMEPAGE, sub_group=Group.HOMEPAGE, operate=Operate.EXPORT, bit_index=1),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ # ==================== 资源主分组(无子分组) ====================
+ KNOWLEDGE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.SELF, bit_index=0),
+ PermissionMeta(
+ role_list=[],
+ category=Category.RESOURCE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ APPLICATION = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.SELF, bit_index=0),
+ PermissionMeta(
+ role_list=[],
+ category=Category.RESOURCE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ MODEL = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.SELF, bit_index=0),
+ PermissionMeta(role_list=[], category=Category.RESOURCE),
+ )
+
+ TOOL = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.SELF, bit_index=0),
+ PermissionMeta(role_list=[], category=Category.RESOURCE),
+ )
+
+ # ==================== 用户管理 ====================
+ USER_READ = (
+ Permission(group=Group.USER, sub_group=Group.USER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ USER_CREATE = (
+ Permission(group=Group.USER, sub_group=Group.USER, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ USER_EDIT = (
+ Permission(group=Group.USER, sub_group=Group.USER, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ USER_DELETE = (
+ Permission(group=Group.USER, sub_group=Group.USER, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ USER_SET_ROLE = (
+ Permission(group=Group.USER, sub_group=Group.USER, operate=Operate.SET_ROLE, bit_index=4),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ USER_IMPORT = (
+ Permission(group=Group.USER, sub_group=Group.USER, operate=Operate.IMPORT, bit_index=5),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ # ==================== 系统用户组 ====================
+ SYSTEM_USER_GROUP_READ = (
+ Permission(group=Group.USER_GROUP, sub_group=Group.USER_GROUP, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SYSTEM_USER_GROUP_CREATE = (
+ Permission(group=Group.USER_GROUP, sub_group=Group.USER_GROUP, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SYSTEM_USER_GROUP_EDIT = (
+ Permission(group=Group.USER_GROUP, sub_group=Group.USER_GROUP, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SYSTEM_USER_GROUP_DELETE = (
+ Permission(group=Group.USER_GROUP, sub_group=Group.USER_GROUP, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SYSTEM_USER_GROUP_ADD_MEMBER = (
+ Permission(group=Group.USER_GROUP, sub_group=Group.USER_GROUP, operate=Operate.ADD_MEMBER, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SYSTEM_USER_GROUP_REMOVE_MEMBER = (
+ Permission(group=Group.USER_GROUP, sub_group=Group.USER_GROUP, operate=Operate.REMOVE_MEMBER, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 模型 ====================
+ MODEL_READ = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.READ, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.MODEL_VIEW],
+ ),
+ )
+
+ MODEL_CREATE = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.CREATE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ resource_permission_group_list=[ResourcePermissionConst.MODEL_MANAGE],
+ ),
+ )
+
+ MODEL_EDIT = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.EDIT, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.MODEL_MANAGE],
+ ),
+ )
+
+ MODEL_DELETE = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.DELETE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.MODEL_MANAGE],
+ ),
+ )
+
+ MODEL_RESOURCE_AUTHORIZATION = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.AUTH, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.MODEL_MANAGE],
+ ),
+ )
+
+ MODEL_RELATE_RESOURCE_VIEW = (
+ Permission(group=Group.MODEL, sub_group=Group.MODEL, operate=Operate.RELATE_VIEW, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.MODEL_MANAGE],
+ ),
+ )
+
+ # ==================== 触发器 ====================
+ TRIGGER_READ = (
+ Permission(group=Group.TRIGGER, sub_group=Group.TRIGGER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TRIGGER_CREATE = (
+ Permission(group=Group.TRIGGER, sub_group=Group.TRIGGER, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ TRIGGER_EDIT = (
+ Permission(group=Group.TRIGGER, sub_group=Group.TRIGGER, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TRIGGER_DELETE = (
+ Permission(group=Group.TRIGGER, sub_group=Group.TRIGGER, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TRIGGER_RECORD = (
+ Permission(group=Group.TRIGGER, sub_group=Group.TRIGGER, operate=Operate.RECORD, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 工具 ====================
+ TOOL_READ = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.READ, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_CREATE = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.CREATE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ TOOL_BATCH_MOVE = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.BATCH_MOVE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_BATCH_DELETE = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.BATCH_DELETE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_EDIT = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.EDIT, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_DELETE = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.DELETE, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_IMPORT = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.IMPORT, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_EXPORT = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.EXPORT, bit_index=8),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_RESOURCE_AUTHORIZATION = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.AUTH, bit_index=9),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_RELATE_RESOURCE_VIEW = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.RELATE_VIEW, bit_index=10),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_PUBLISH = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.PUBLISH, bit_index=11),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_EXECUTE_RECORD = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.RECORD, bit_index=12),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # 工具触发器
+ TOOL_TRIGGER_READ = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.TRIGGER_READ, bit_index=13),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_TRIGGER_CREATE = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.TRIGGER_CREATE, bit_index=14),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_TRIGGER_EDIT = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.TRIGGER_EDIT, bit_index=15),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_TRIGGER_DELETE = (
+ Permission(group=Group.TOOL, sub_group=Group.TOOL, operate=Operate.TRIGGER_DELETE, bit_index=16),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 工具文件夹 ====================
+ TOOL_FOLDER_READ = (
+ Permission(group=Group.TOOL, sub_group=Group.FOLDER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_FOLDER_CREATE = (
+ Permission(group=Group.TOOL, sub_group=Group.FOLDER, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ TOOL_FOLDER_EDIT = (
+ Permission(group=Group.TOOL, sub_group=Group.FOLDER, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_FOLDER_DELETE = (
+ Permission(group=Group.TOOL, sub_group=Group.FOLDER, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ TOOL_FOLDER_AUTH = (
+ Permission(group=Group.TOOL, sub_group=Group.FOLDER, operate=Operate.AUTH, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.TOOL_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 知识库 ====================
+ KNOWLEDGE_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.READ, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ ),
+ )
+
+ KNOWLEDGE_CREATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.CREATE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ ),
+ )
+
+ KNOWLEDGE_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.EDIT, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.DELETE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_SYNC = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.SYNC, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_EXPORT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.EXPORT, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_VECTOR = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.VECTOR, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_GENERATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.GENERATE, bit_index=8),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_BATCH_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.BATCH_DELETE, bit_index=9),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_BATCH_MOVE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.BATCH_MOVE, bit_index=10),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_RESOURCE_AUTHORIZATION = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.AUTH, bit_index=11),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_RELATE_RESOURCE_VIEW = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.KNOWLEDGE, operate=Operate.RELATE_VIEW, bit_index=12),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ # ==================== 知识库文件夹 ====================
+ KNOWLEDGE_FOLDER_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.FOLDER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ ),
+ )
+
+ KNOWLEDGE_FOLDER_CREATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.FOLDER, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_FOLDER_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.FOLDER, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_FOLDER_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.FOLDER, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_FOLDER_AUTH = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.FOLDER, operate=Operate.AUTH, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ # ==================== 知识库工作流 ====================
+ KNOWLEDGE_WORKFLOW_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.WORKFLOW, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ ),
+ )
+
+ KNOWLEDGE_WORKFLOW_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.WORKFLOW, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_WORKFLOW_EXPORT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.WORKFLOW, operate=Operate.EXPORT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ KNOWLEDGE_WORKFLOW_PUBLISH = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.WORKFLOW, operate=Operate.PUBLISH, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ ),
+ )
+
+ # ==================== 知识库文档 ====================
+ KNOWLEDGE_DOCUMENT_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_CREATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_SYNC = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.SYNC, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_EXPORT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.EXPORT, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_DOWNLOAD_SOURCE_FILE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.DOWNLOAD, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_GENERATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.GENERATE, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_VECTOR = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.VECTOR, bit_index=8),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_MIGRATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.MIGRATE, bit_index=9),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_TAG = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.TAG, bit_index=10),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_REPLACE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.REPLACE, bit_index=11),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_DOCUMENT_TOKEN = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.DOCUMENT, operate=Operate.TOKEN, bit_index=12),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 知识库命中测试 ====================
+ KNOWLEDGE_HIT_TEST = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.HIT_TEST, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 知识库问题 ====================
+ KNOWLEDGE_PROBLEM_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.PROBLEM, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_PROBLEM_CREATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.PROBLEM, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ KNOWLEDGE_PROBLEM_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.PROBLEM, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_PROBLEM_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.PROBLEM, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_PROBLEM_RELATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.PROBLEM, operate=Operate.RELATE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 知识库术语库 ====================
+ KNOWLEDGE_TERMBASE_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TERMBASE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_TERMBASE_CREATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TERMBASE, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ KNOWLEDGE_TERMBASE_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TERMBASE, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_TERMBASE_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TERMBASE, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 知识库标签 ====================
+ KNOWLEDGE_TAG_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TAG, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_TAG_CREATE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TAG, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ KNOWLEDGE_TAG_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TAG, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_TAG_DELETE = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.TAG, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 知识库对话用户 ====================
+ KNOWLEDGE_CHAT_USER_READ = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.CHAT_USER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ KNOWLEDGE_CHAT_USER_EDIT = (
+ Permission(group=Group.KNOWLEDGE, sub_group=Group.CHAT_USER, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANAGE],
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 资源授权 ====================
+ APPLICATION_RESOURCE_PERMISSION_READ = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.APPLICATION_RESOURCE_PERMISSION,
+ operate=Operate.READ,
+ bit_index=0,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ APPLICATION_RESOURCE_PERMISSION_EDIT = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.APPLICATION_RESOURCE_PERMISSION,
+ operate=Operate.EDIT,
+ bit_index=1,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ KNOWLEDGE_RESOURCE_PERMISSION_READ = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.KNOWLEDGE_RESOURCE_PERMISSION,
+ operate=Operate.READ,
+ bit_index=2,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ KNOWLEDGE_RESOURCE_PERMISSION_EDIT = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.KNOWLEDGE_RESOURCE_PERMISSION,
+ operate=Operate.EDIT,
+ bit_index=3,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ TOOL_RESOURCE_PERMISSION_READ = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION, sub_group=Group.TOOL_RESOURCE_PERMISSION, operate=Operate.READ, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ TOOL_RESOURCE_PERMISSION_EDIT = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.TOOL_RESOURCE_PERMISSION,
+ operate=Operate.EDIT,
+ bit_index=5,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ MODEL_RESOURCE_PERMISSION_READ = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.MODEL_RESOURCE_PERMISSION,
+ operate=Operate.READ,
+ bit_index=6,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ MODEL_RESOURCE_PERMISSION_EDIT = (
+ Permission(
+ group=Group.RESOURCE_PERMISSION,
+ sub_group=Group.MODEL_RESOURCE_PERMISSION,
+ operate=Operate.EDIT,
+ bit_index=7,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 邮件设置 ====================
+ EMAIL_SETTING_READ = (
+ Permission(group=Group.EMAIL_SETTING, sub_group=Group.EMAIL_SETTING, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.SYSTEM_SETTING, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ EMAIL_SETTING_EDIT = (
+ Permission(group=Group.EMAIL_SETTING, sub_group=Group.EMAIL_SETTING, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.SYSTEM_SETTING, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ # ==================== 角色管理 ====================
+ ROLE_READ = (
+ Permission(group=Group.ROLE, sub_group=Group.ROLE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ ROLE_CREATE = (
+ Permission(group=Group.ROLE, sub_group=Group.ROLE, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ ROLE_EDIT = (
+ Permission(group=Group.ROLE, sub_group=Group.ROLE, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ ROLE_DELETE = (
+ Permission(group=Group.ROLE, sub_group=Group.ROLE, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], category=Category.IAM, scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ ROLE_ADD_MEMBER = (
+ Permission(group=Group.ROLE, sub_group=Group.ROLE, operate=Operate.ADD_MEMBER, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ ROLE_REMOVE_MEMBER = (
+ Permission(group=Group.ROLE, sub_group=Group.ROLE, operate=Operate.REMOVE_MEMBER, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 工作空间管理 ====================
+ WORKSPACE_READ = (
+ Permission(group=Group.WORKSPACE, sub_group=Group.WORKSPACE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ WORKSPACE_CREATE = (
+ Permission(group=Group.WORKSPACE, sub_group=Group.WORKSPACE, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.IAM, is_ee=is_ee, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ WORKSPACE_EDIT = (
+ Permission(group=Group.WORKSPACE, sub_group=Group.WORKSPACE, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.IAM, is_ee=is_ee, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ WORKSPACE_DELETE = (
+ Permission(group=Group.WORKSPACE, sub_group=Group.WORKSPACE, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.IAM, is_ee=is_ee, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ WORKSPACE_ADD_MEMBER = (
+ Permission(group=Group.WORKSPACE, sub_group=Group.WORKSPACE, operate=Operate.ADD_MEMBER, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ WORKSPACE_REMOVE_MEMBER = (
+ Permission(group=Group.WORKSPACE, sub_group=Group.WORKSPACE, operate=Operate.REMOVE_MEMBER, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.IAM,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 登录认证 ====================
+ LOGIN_AUTH_READ = (
+ Permission(group=Group.LOGIN_AUTH, sub_group=Group.LOGIN_AUTH, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.SYSTEM_SETTING, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ LOGIN_AUTH_EDIT = (
+ Permission(group=Group.LOGIN_AUTH, sub_group=Group.LOGIN_AUTH, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.SYSTEM_SETTING, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ # ==================== 应用 ====================
+ APPLICATION_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.READ, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
+ ),
+ )
+
+ APPLICATION_CREATE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.CREATE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_COPY = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.COPY, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_EDIT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.EDIT, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_DELETE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.DELETE, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_IMPORT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.IMPORT, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_EXPORT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.EXPORT, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_PUBLISH = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.PUBLISH, bit_index=8),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_BATCH_DELETE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.BATCH_DELETE, bit_index=9),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_BATCH_MOVE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.BATCH_MOVE, bit_index=10),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_RESOURCE_AUTHORIZATION = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.AUTH, bit_index=11),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_RELATE_RESOURCE_VIEW = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.RELATE_VIEW, bit_index=12),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ # 应用触发器
+ APPLICATION_TRIGGER_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.TRIGGER_READ, bit_index=13),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ APPLICATION_TRIGGER_CREATE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.TRIGGER_CREATE, bit_index=14),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ ),
+ )
+
+ APPLICATION_TRIGGER_EDIT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.TRIGGER_EDIT, bit_index=15),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ APPLICATION_TRIGGER_DELETE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.APPLICATION, operate=Operate.TRIGGER_DELETE, bit_index=16),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ ),
+ )
+
+ # ==================== 应用文件夹 ====================
+ APPLICATION_FOLDER_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.FOLDER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
+ ),
+ )
+
+ APPLICATION_FOLDER_CREATE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.FOLDER, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_FOLDER_EDIT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.FOLDER, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_FOLDER_DELETE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.FOLDER, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_FOLDER_AUTH = (
+ Permission(group=Group.APPLICATION, sub_group=Group.FOLDER, operate=Operate.AUTH, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ # ==================== 应用概览 ====================
+ APPLICATION_OVERVIEW_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.OVERVIEW, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
+ ),
+ )
+
+ APPLICATION_OVERVIEW_EMBED = (
+ Permission(group=Group.APPLICATION, sub_group=Group.OVERVIEW, operate=Operate.EMBED, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_OVERVIEW_ACCESS = (
+ Permission(group=Group.APPLICATION, sub_group=Group.OVERVIEW, operate=Operate.ACCESS, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_OVERVIEW_DISPLAY = (
+ Permission(group=Group.APPLICATION, sub_group=Group.OVERVIEW, operate=Operate.DISPLAY, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_OVERVIEW_API_KEY = (
+ Permission(group=Group.APPLICATION, sub_group=Group.OVERVIEW, operate=Operate.API_KEY, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_OVERVIEW_PUBLIC = (
+ Permission(group=Group.APPLICATION, sub_group=Group.OVERVIEW, operate=Operate.PUBLIC_ACCESS, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ # ==================== 应用接入 ====================
+ APPLICATION_ACCESS_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.ACCESS, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
+ ),
+ )
+
+ APPLICATION_ACCESS_EDIT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.ACCESS, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ # ==================== 应用对话用户 ====================
+ APPLICATION_CHAT_USER_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_USER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
+ ),
+ )
+
+ APPLICATION_CHAT_USER_EDIT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_USER, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ # ==================== 应用对话日志 ====================
+ APPLICATION_CHAT_LOG_READ = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_LOG, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
+ ),
+ )
+
+ APPLICATION_CHAT_LOG_ANNOTATION = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_LOG, operate=Operate.ANNOTATION, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_CHAT_LOG_EXPORT = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_LOG, operate=Operate.EXPORT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_CHAT_LOG_CLEAR_POLICY = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_LOG, operate=Operate.CLEAR_POLICY, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ APPLICATION_CHAT_LOG_ADD_KNOWLEDGE = (
+ Permission(group=Group.APPLICATION, sub_group=Group.CHAT_LOG, operate=Operate.ADD_KNOWLEDGE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER],
+ category=Category.WORKSPACE,
+ scope=[PermissionScopeConstants.WORKSPACE_RESOURCE],
+ resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANAGE],
+ ),
+ )
+
+ # ==================== 其他 ====================
+ ABOUT_READ = (
+ Permission(group=Group.OTHER, sub_group=Group.OTHER, operate=Operate.ABOUT, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.SYSTEM_SETTING,
+ scope=[PermissionScopeConstants.SYSTEM],
+ role_category_map={
+ RoleConstants.ADMIN.name: Category.SYSTEM_SETTING,
+ RoleConstants.USER.name: Category.OTHER,
+ RoleConstants.WORKSPACE_MANAGE.name: Category.OTHER,
+ },
+ ),
+ )
+
+ LICENSE_UPDATE = (
+ Permission(group=Group.OTHER, sub_group=Group.OTHER, operate=Operate.LICENSE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SYSTEM_SETTING,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SWITCH_LANGUAGE = (
+ Permission(group=Group.OTHER, sub_group=Group.OTHER, operate=Operate.SWITCH_LANGUAGE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.SYSTEM_SETTING,
+ scope=[PermissionScopeConstants.SYSTEM],
+ role_category_map={
+ RoleConstants.ADMIN.name: Category.SYSTEM_SETTING,
+ RoleConstants.USER.name: Category.OTHER,
+ RoleConstants.WORKSPACE_MANAGE.name: Category.OTHER,
+ },
+ ),
+ )
+
+ CHANGE_PASSWORD = (
+ Permission(group=Group.OTHER, sub_group=Group.OTHER, operate=Operate.CHANGE_PASSWORD, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.SYSTEM_SETTING,
+ scope=[PermissionScopeConstants.SYSTEM],
+ role_category_map={
+ RoleConstants.ADMIN.name: Category.SYSTEM_SETTING,
+ RoleConstants.USER.name: Category.OTHER,
+ RoleConstants.WORKSPACE_MANAGE.name: Category.OTHER,
+ },
+ ),
+ )
+
+ SYSTEM_API_KEY_EDIT = (
+ Permission(group=Group.OTHER, sub_group=Group.OTHER, operate=Operate.SYSTEM_API_KEY, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.SYSTEM_SETTING,
+ scope=[PermissionScopeConstants.SYSTEM],
+ role_category_map={
+ RoleConstants.ADMIN.name: Category.SYSTEM_SETTING,
+ RoleConstants.USER.name: Category.OTHER,
+ RoleConstants.WORKSPACE_MANAGE.name: Category.OTHER,
+ },
+ ),
+ )
+
+ PORTAL = (
+ Permission(group=Group.OTHER, sub_group=Group.OTHER, operate=Operate.PORTAL, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.SYSTEM_SETTING,
+ scope=[PermissionScopeConstants.SYSTEM],
+ role_category_map={
+ RoleConstants.ADMIN.name: Category.SYSTEM_SETTING,
+ RoleConstants.USER.name: Category.OTHER,
+ RoleConstants.WORKSPACE_MANAGE.name: Category.OTHER,
+ },
+ ),
+ )
+
+ # ==================== 外观设置 ====================
+ APPEARANCE_SETTINGS_READ = (
+ Permission(
+ group=Group.APPEARANCE_SETTINGS, sub_group=Group.APPEARANCE_SETTINGS, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.SYSTEM_SETTING, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ APPEARANCE_SETTINGS_EDIT = (
+ Permission(
+ group=Group.APPEARANCE_SETTINGS, sub_group=Group.APPEARANCE_SETTINGS, operate=Operate.EDIT, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.SYSTEM_SETTING, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ # ==================== 对话用户 ====================
+ CHAT_USER_READ = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ CHAT_USER_CREATE = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ CHAT_USER_SYNC = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.SYNC, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ CHAT_USER_EDIT = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.EDIT, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ CHAT_USER_DELETE = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.DELETE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ CHAT_USER_GROUP = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.USER_GROUP, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ CHAT_USER_QUOTA_SETTING = (
+ Permission(group=Group.CHAT_USER, sub_group=Group.CHAT_USER, operate=Operate.QUOTA_SETTING, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 对话用户组 ====================
+ USER_GROUP_READ = (
+ Permission(group=Group.CHAT_USER_GROUP, sub_group=Group.CHAT_USER_GROUP, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ USER_GROUP_CREATE = (
+ Permission(group=Group.CHAT_USER_GROUP, sub_group=Group.CHAT_USER_GROUP, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ USER_GROUP_EDIT = (
+ Permission(group=Group.CHAT_USER_GROUP, sub_group=Group.CHAT_USER_GROUP, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ USER_GROUP_DELETE = (
+ Permission(group=Group.CHAT_USER_GROUP, sub_group=Group.CHAT_USER_GROUP, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ USER_GROUP_ADD_MEMBER = (
+ Permission(
+ group=Group.CHAT_USER_GROUP, sub_group=Group.CHAT_USER_GROUP, operate=Operate.ADD_MEMBER, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ USER_GROUP_REMOVE_MEMBER = (
+ Permission(
+ group=Group.CHAT_USER_GROUP, sub_group=Group.CHAT_USER_GROUP, operate=Operate.REMOVE_MEMBER, bit_index=5
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
+ category=Category.CHAT_CLIENT,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 对话用户认证 ====================
+ CHAT_USER_AUTH_READ = (
+ Permission(group=Group.CHAT_USER_AUTH, sub_group=Group.CHAT_USER_AUTH, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.CHAT_CLIENT, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ CHAT_USER_AUTH_EDIT = (
+ Permission(group=Group.CHAT_USER_AUTH, sub_group=Group.CHAT_USER_AUTH, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.CHAT_CLIENT, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ PORTAL_READ = (
+ Permission(group=Group.PORTAL, sub_group=Group.PORTAL, operate=Operate.READ, bit_index=0),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ PORTAL_EDIT = (
+ Permission(group=Group.PORTAL, sub_group=Group.PORTAL, operate=Operate.EDIT, bit_index=0),
+ PermissionMeta(role_list=[RoleConstants.ADMIN], scope=[PermissionScopeConstants.SYSTEM]),
+ )
+
+ # ==================== 共享工具 ====================
+ SHARED_TOOL_READ = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_CREATE = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_EDIT = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_DELETE = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_IMPORT = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.IMPORT, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_EXPORT = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.EXPORT, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_PUBLISH = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.PUBLISH, bit_index=6),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_RELATE_RESOURCE_VIEW = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.RELATE_VIEW, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_EXECUTE_RECORD = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.RECORD, bit_index=8),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_TOOL_TO_WORKSPACE = (
+ Permission(group=Group.SYSTEM_TOOL, sub_group=Group.SYSTEM_TOOL, operate=Operate.TO_WORKSPACE, bit_index=9),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 共享知识库 ====================
+ SHARED_KNOWLEDGE_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_CREATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_SYNC = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.SYNC, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_VECTOR = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.VECTOR, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_EXPORT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.EXPORT, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_GENERATE = (
+ Permission(
+ group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.GENERATE, bit_index=6
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DELETE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.DELETE, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_RELATE_RESOURCE_VIEW = (
+ Permission(
+ group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.RELATE_VIEW, bit_index=8
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TO_WORKSPACE = (
+ Permission(
+ group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_KNOWLEDGE, operate=Operate.TO_WORKSPACE, bit_index=9
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库工作流
+ SHARED_KNOWLEDGE_WORKFLOW_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_WORKFLOW_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_WORKFLOW_EXPORT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.EXPORT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_WORKFLOW_PUBLISH = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.PUBLISH, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库文档
+ SHARED_KNOWLEDGE_DOCUMENT_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_CREATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_DELETE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_SYNC = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.SYNC, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_EXPORT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.EXPORT, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_DOWNLOAD_SOURCE_FILE = (
+ Permission(
+ group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.DOWNLOAD, bit_index=6
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_GENERATE = (
+ Permission(
+ group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.GENERATE, bit_index=7
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_VECTOR = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.VECTOR, bit_index=8),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_MIGRATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.MIGRATE, bit_index=9),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_TAG = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.TAG, bit_index=10),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_REPLACE = (
+ Permission(
+ group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.REPLACE, bit_index=11
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_DOCUMENT_TOKEN = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.TOKEN, bit_index=12),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库标签
+ SHARED_KNOWLEDGE_TAG_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TAG_CREATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TAG_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TAG_DELETE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库问题
+ SHARED_KNOWLEDGE_PROBLEM_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_PROBLEM_CREATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_PROBLEM_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_PROBLEM_DELETE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_PROBLEM_RELATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.RELATE, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库术语库
+ SHARED_KNOWLEDGE_TERMBASE_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TERMBASE_CREATE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TERMBASE_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TERMBASE_DELETE = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_TERMBASE_EXPORT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.EXPORT, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库命中测试
+ SHARED_KNOWLEDGE_HIT_TEST = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_HIT_TEST, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 共享知识库对话用户
+ SHARED_KNOWLEDGE_CHAT_USER_READ = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_CHAT_USER, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_KNOWLEDGE_CHAT_USER_EDIT = (
+ Permission(group=Group.SYSTEM_KNOWLEDGE, sub_group=Group.SYSTEM_CHAT_USER, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 共享模型 ====================
+ SHARED_MODEL_READ = (
+ Permission(group=Group.SYSTEM_MODEL, sub_group=Group.SYSTEM_MODEL, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_MODEL_CREATE = (
+ Permission(group=Group.SYSTEM_MODEL, sub_group=Group.SYSTEM_MODEL, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_MODEL_EDIT = (
+ Permission(group=Group.SYSTEM_MODEL, sub_group=Group.SYSTEM_MODEL, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_MODEL_DELETE = (
+ Permission(group=Group.SYSTEM_MODEL, sub_group=Group.SYSTEM_MODEL, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_MODEL_RELATE_RESOURCE_VIEW = (
+ Permission(group=Group.SYSTEM_MODEL, sub_group=Group.SYSTEM_MODEL, operate=Operate.RELATE_VIEW, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ SHARED_MODEL_TO_WORKSPACE = (
+ Permission(group=Group.SYSTEM_MODEL, sub_group=Group.SYSTEM_MODEL, operate=Operate.TO_WORKSPACE, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.SHARED,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 资源管理 - 应用 ====================
+ RESOURCE_APPLICATION_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.READ,
+ bit_index=0,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.EDIT,
+ bit_index=1,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.DELETE,
+ bit_index=2,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_EXPORT = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.EXPORT,
+ bit_index=3,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_COPY = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.COPY,
+ bit_index=4,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_AUTH = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.AUTH,
+ bit_index=5,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_PUBLISH = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.PUBLISH,
+ bit_index=6,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_TRIGGER_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.TRIGGER_READ,
+ bit_index=7,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_TRIGGER_CREATE = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.TRIGGER_CREATE,
+ bit_index=8,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_TRIGGER_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.TRIGGER_EDIT,
+ bit_index=9,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_TRIGGER_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.TRIGGER_DELETE,
+ bit_index=10,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_RELATE_RESOURCE_VIEW = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_RES_APPLICATION,
+ operate=Operate.RELATE_VIEW,
+ bit_index=11,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 应用概览
+ RESOURCE_APPLICATION_OVERVIEW_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_OVERVIEW, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_OVERVIEW_EMBED = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_OVERVIEW, operate=Operate.EMBED, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_OVERVIEW_ACCESS = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_OVERVIEW, operate=Operate.ACCESS, bit_index=2
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_OVERVIEW_DISPLAY = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_OVERVIEW, operate=Operate.DISPLAY, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_OVERVIEW_API_KEY = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_OVERVIEW, operate=Operate.API_KEY, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_OVERVIEW_PUBLIC = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_OVERVIEW,
+ operate=Operate.PUBLIC_ACCESS,
+ bit_index=5,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 应用接入
+ RESOURCE_APPLICATION_ACCESS_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_ACCESS, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_ACCESS_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_ACCESS, operate=Operate.EDIT, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 应用对话用户
+ RESOURCE_APPLICATION_CHAT_USER_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_CHAT_USER, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_CHAT_USER_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_CHAT_USER, operate=Operate.EDIT, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 应用对话日志
+ RESOURCE_APPLICATION_CHAT_LOG_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_CHAT_LOG, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_CHAT_LOG_ADD_KNOWLEDGE = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_CHAT_LOG,
+ operate=Operate.ADD_KNOWLEDGE,
+ bit_index=1,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_CHAT_LOG_ANNOTATION = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_CHAT_LOG, operate=Operate.ANNOTATION, bit_index=2
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_CHAT_LOG_EXPORT = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION, sub_group=Group.SYSTEM_CHAT_LOG, operate=Operate.EXPORT, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_APPLICATION_CHAT_LOG_CLEAR_POLICY = (
+ Permission(
+ group=Group.SYSTEM_RES_APPLICATION,
+ sub_group=Group.SYSTEM_CHAT_LOG,
+ operate=Operate.CLEAR_POLICY,
+ bit_index=4,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 资源管理 - 知识库 ====================
+ RESOURCE_KNOWLEDGE_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.EDIT, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.DELETE, bit_index=2
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_SYNC = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.SYNC, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_EXPORT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.EXPORT, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_PUBLISH = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.PUBLISH, bit_index=5
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_VECTOR = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.VECTOR, bit_index=6
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_GENERATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE,
+ sub_group=Group.SYSTEM_RES_KNOWLEDGE,
+ operate=Operate.GENERATE,
+ bit_index=7,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_AUTH = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.AUTH, bit_index=8
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_RELATE_RESOURCE_VIEW = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE,
+ sub_group=Group.SYSTEM_RES_KNOWLEDGE,
+ operate=Operate.RELATE_VIEW,
+ bit_index=9,
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库工作流
+ RESOURCE_KNOWLEDGE_WORKFLOW_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_WORKFLOW_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.EDIT, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_WORKFLOW_EXPORT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.EXPORT, bit_index=2
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_WORKFLOW_PUBLISH = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_WORKFLOW, operate=Operate.PUBLISH, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库文档
+ RESOURCE_KNOWLEDGE_DOCUMENT_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_CREATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.CREATE, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.EDIT, bit_index=2
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.DELETE, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_SYNC = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.SYNC, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_EXPORT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.EXPORT, bit_index=5
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_DOWNLOAD_SOURCE_FILE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.DOWNLOAD, bit_index=6
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_GENERATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.GENERATE, bit_index=7
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_VECTOR = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.VECTOR, bit_index=8
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_MIGRATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.MIGRATE, bit_index=9
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_TAG = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.TAG, bit_index=10
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_REPLACE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.REPLACE, bit_index=11
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_DOCUMENT_TOKEN = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_DOCUMENT, operate=Operate.TOKEN, bit_index=12
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库命中测试
+ RESOURCE_KNOWLEDGE_HIT_TEST = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_HIT_TEST, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库问题
+ RESOURCE_KNOWLEDGE_PROBLEM_READ = (
+ Permission(group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_PROBLEM_CREATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.CREATE, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_PROBLEM_EDIT = (
+ Permission(group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_PROBLEM_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.DELETE, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_PROBLEM_RELATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_PROBLEM, operate=Operate.RELATE, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库术语库
+ RESOURCE_KNOWLEDGE_TERMBASE_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TERMBASE_CREATE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.CREATE, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TERMBASE_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.EDIT, bit_index=2
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TERMBASE_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.DELETE, bit_index=3
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TERMBASE_EXPORT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TERMBASE, operate=Operate.EXPORT, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库标签
+ RESOURCE_KNOWLEDGE_TAG_READ = (
+ Permission(group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TAG_CREATE = (
+ Permission(group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.CREATE, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TAG_EDIT = (
+ Permission(group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.EDIT, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_TAG_DELETE = (
+ Permission(group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_TAG, operate=Operate.DELETE, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # 资源管理 - 知识库对话用户
+ RESOURCE_KNOWLEDGE_CHAT_USER_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_CHAT_USER, operate=Operate.READ, bit_index=0
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_KNOWLEDGE_CHAT_USER_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_KNOWLEDGE, sub_group=Group.SYSTEM_CHAT_USER, operate=Operate.EDIT, bit_index=1
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 资源管理 - 工具 ====================
+ RESOURCE_TOOL_READ = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_EDIT = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_DELETE = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.DELETE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_EXPORT = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.EXPORT, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_PUBLISH = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.PUBLISH, bit_index=4),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_AUTH = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.AUTH, bit_index=5),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_RELATE_RESOURCE_VIEW = (
+ Permission(
+ group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.RELATE_VIEW, bit_index=6
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_EXECUTE_RECORD = (
+ Permission(group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.RECORD, bit_index=7),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_TRIGGER_READ = (
+ Permission(
+ group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_READ, bit_index=8
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_TRIGGER_CREATE = (
+ Permission(
+ group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_CREATE, bit_index=9
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_TRIGGER_EDIT = (
+ Permission(
+ group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_EDIT, bit_index=10
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_TOOL_TRIGGER_DELETE = (
+ Permission(
+ group=Group.SYSTEM_RES_TOOL, sub_group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_DELETE, bit_index=11
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 资源管理 - 模型 ====================
+ RESOURCE_MODEL_READ = (
+ Permission(group=Group.SYSTEM_RES_MODEL, sub_group=Group.SYSTEM_RES_MODEL, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_MODEL_EDIT = (
+ Permission(group=Group.SYSTEM_RES_MODEL, sub_group=Group.SYSTEM_RES_MODEL, operate=Operate.EDIT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_MODEL_DELETE = (
+ Permission(group=Group.SYSTEM_RES_MODEL, sub_group=Group.SYSTEM_RES_MODEL, operate=Operate.DELETE, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_MODEL_AUTH = (
+ Permission(group=Group.SYSTEM_RES_MODEL, sub_group=Group.SYSTEM_RES_MODEL, operate=Operate.AUTH, bit_index=3),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ RESOURCE_MODEL_RELATE_RESOURCE_VIEW = (
+ Permission(
+ group=Group.SYSTEM_RES_MODEL, sub_group=Group.SYSTEM_RES_MODEL, operate=Operate.RELATE_VIEW, bit_index=4
+ ),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN],
+ category=Category.RESOURCE,
+ is_ee=is_ee,
+ scope=[PermissionScopeConstants.SYSTEM],
+ ),
+ )
+
+ # ==================== 操作日志 ====================
+ OPERATION_LOG_READ = (
+ Permission(group=Group.OPERATION_LOG, sub_group=Group.OPERATION_LOG, operate=Operate.READ, bit_index=0),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.OPERATION_LOG, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ OPERATION_LOG_EXPORT = (
+ Permission(group=Group.OPERATION_LOG, sub_group=Group.OPERATION_LOG, operate=Operate.EXPORT, bit_index=1),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.OPERATION_LOG, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ OPERATION_LOG_CLEAR_POLICY = (
+ Permission(group=Group.OPERATION_LOG, sub_group=Group.OPERATION_LOG, operate=Operate.CLEAR_POLICY, bit_index=2),
+ PermissionMeta(
+ role_list=[RoleConstants.ADMIN], category=Category.OPERATION_LOG, scope=[PermissionScopeConstants.SYSTEM]
+ ),
+ )
+
+ def __init__(self, value, meta):
+ self._value_ = value
+ self.meta = meta
+
+ def _build_workspace_permission(self, resource_id_key=None):
+ def permission_factory(_, kwargs):
+ return Permission(
+ group=self.value.group,
+ sub_group=self.value.sub_group,
+ operate=self.value.operate,
+ bit_index=self.value.bit_index,
+ workspace_id=kwargs.get("workspace_id"),
+ resource_id=kwargs.get(resource_id_key) if resource_id_key else None,
+ )
+
+ return permission_factory
+
+ def get_workspace_application_permission(self):
+ return self._build_workspace_permission(resource_id_key="application_id")
+
+ def get_workspace_knowledge_permission(self):
+ return self._build_workspace_permission(resource_id_key="knowledge_id")
+
+ def get_workspace_model_permission(self):
+ return self._build_workspace_permission(resource_id_key="model_id")
+
+ def get_workspace_tool_permission(self):
+ return self._build_workspace_permission(resource_id_key="tool_id")
+
+ def get_workspace_permission(self):
+ return self._build_workspace_permission()
+
+ def get_workspace_permission_workspace_manage_role(self):
+ """
+ 工作空间管理员的特权权限
+ @return: 工作空间管理员特权权限
+ """
+
+ def permission_factory(_, kwargs):
+ return Permission(
+ group=self.value.group,
+ sub_group=self.value.sub_group,
+ operate=self.value.operate,
+ bit_index=self.value.bit_index,
+ workspace_id=kwargs.get("workspace_id"),
+ flag=RoleConstants.WORKSPACE_MANAGE.value,
+ )
+
+ return permission_factory
+
+
+def group_by_all_resource_permissions() -> Dict[str, List[Permission]]:
+ grouped = {}
+
+ for _permission in PermissionConstants:
+ meta = _permission.meta
+ if meta.resource_permission_group_list:
+ for group in meta.resource_permission_group_list:
+ _array = grouped.get(str(group)) or []
+ _array.append(_permission)
+ grouped[str(group)] = _array
+ return dict(grouped)
+
+
+def group_permissions_by_scope() -> Dict[str, List[Permission]]:
+ grouped = {}
+
+ for _permission in PermissionConstants:
+ permission = _permission.value
+ meta = _permission.meta
+ if meta.scope:
+ for scope_item in meta.scope:
+ _array = grouped.get(scope_item) or []
+ _array.append(_permission)
+ grouped[scope_item] = _array
+ return dict(grouped)
+
+
+# 权限字符串与权限对象的Map
+PERMISSION_STR_MAP = {_permission.value.__str__(): _permission for _permission in PermissionConstants}
+
+# 资源组Map
+RESOURCE_PERMISSION_MAP = group_by_all_resource_permissions()
+
+# 权限 SCOPE Map
+SCOPE_PERMISSION_MAP = group_permissions_by_scope()
diff --git a/apps/common/auth/constants/permission_scope_constants.py b/apps/common/auth/constants/permission_scope_constants.py
new file mode 100644
index 00000000000..122057f7825
--- /dev/null
+++ b/apps/common/auth/constants/permission_scope_constants.py
@@ -0,0 +1,15 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: permission_scope_constants.py
+ @date:2026/8/4 11:50
+ @desc:
+"""
+from enum import Enum
+
+
+class PermissionScopeConstants(Enum):
+ SYSTEM = 'SYSTEM'
+ WORKSPACE = 'WORKSPACE'
+ WORKSPACE_RESOURCE = 'WORKSPACE_RESOURCE'
diff --git a/apps/common/auth/constants/resource_auth_type_constants.py b/apps/common/auth/constants/resource_auth_type_constants.py
new file mode 100644
index 00000000000..c8079fa0eca
--- /dev/null
+++ b/apps/common/auth/constants/resource_auth_type_constants.py
@@ -0,0 +1,21 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: resource_auth_type_constants.py
+ @date:2026/8/4 15:31
+ @desc:
+"""
+
+from django.db import models
+
+
+class ResourceAuthType(models.TextChoices):
+ """
+ 资源授权类型
+ """
+ "当授权类型是Role时候"
+ ROLE = "ROLE"
+
+ """资源权限组"""
+ RESOURCE_PERMISSION_GROUP = "RESOURCE_PERMISSION_GROUP"
diff --git a/apps/common/auth/constants/role_constants.py b/apps/common/auth/constants/role_constants.py
new file mode 100644
index 00000000000..94b250b9522
--- /dev/null
+++ b/apps/common/auth/constants/role_constants.py
@@ -0,0 +1,34 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: role_constants.py
+ @date:2026/8/4 9:50
+ @desc:
+"""
+from enum import Enum
+
+from common.auth.constants.role_group import RoleGroup
+from common.auth.struct.permission import Role, RoleMeta
+
+
+class RoleConstants(Enum):
+ ADMIN = (Role("ADMIN"), RoleMeta('系统管理员', RoleGroup.SYSTEM_USER))
+ WORKSPACE_MANAGE = (Role("WORKSPACE_MANAGE"), RoleMeta('工作空间管理员', RoleGroup.SYSTEM_USER))
+ USER = (Role("USER"), RoleMeta('普通用户', RoleGroup.SYSTEM_USER))
+ EXTENDS_ADMIN = (Role("EXTENDS_ADMIN"), RoleMeta('继承系统管理员', RoleGroup.SYSTEM_USER))
+ EXTENDS_WORKSPACE_MANAGE = (Role("EXTENDS_WORKSPACE_MANAGE"), RoleMeta('继承工作空间管理员', RoleGroup.SYSTEM_USER))
+ EXTENDS_USER = (Role("EXTENDS_USER"), RoleMeta('继承普通用户', RoleGroup.SYSTEM_USER))
+
+ CHAT_ANONYMOUS_USER = (Role("CHAT_ANONYMOUS_USER"), RoleMeta('对话匿名用户', RoleGroup.CHAT_USER))
+ CHAT_USER = (Role("CHAT_USER"), RoleMeta('对话用户', RoleGroup.CHAT_USER))
+
+ def __init__(self, value, meta):
+ self._value_ = value
+ self.meta = meta
+
+ def __str__(self):
+ return self.value.__str__()
+
+ def get_workspace_role(self):
+ return lambda r, kwargs: Role(self.value.name, kwargs.get('workspace_id'))
diff --git a/apps/common/auth/constants/role_group.py b/apps/common/auth/constants/role_group.py
new file mode 100644
index 00000000000..95abccd2ef1
--- /dev/null
+++ b/apps/common/auth/constants/role_group.py
@@ -0,0 +1,16 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: role_group.py
+ @date:2026/8/4 9:57
+ @desc:
+"""
+from enum import Enum
+
+
+class RoleGroup(Enum):
+ # 系统用户
+ SYSTEM_USER = "SYSTEM_USER"
+ # 对话用户
+ CHAT_USER = "CHAT_USER"
diff --git a/apps/common/auth/handle/impl/application_key.py b/apps/common/auth/handle/impl/application_key.py
index 259f21b872d..661f3b5ca98 100644
--- a/apps/common/auth/handle/impl/application_key.py
+++ b/apps/common/auth/handle/impl/application_key.py
@@ -1,18 +1,20 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: application_key.py
- @date:2025/7/10 03:02
- @desc: 应用api key认证
+@project: MaxKB
+@Author:虎虎
+@file: application_key.py
+@date:2025/7/10 03:02
+@desc: 应用api key认证
"""
+
from django.db.models import QuerySet
from django.utils import timezone
from django.utils.translation import gettext_lazy as _
from application.models import ApplicationApiKey, ChatUserType, ApplicationAccessToken
+from common.auth.constants.group_constants import Group
from common.auth.handle.auth_base_handle import AuthBaseHandle
-from common.constants.permission_constants import Permission, Group, Operate, RoleConstants, ChatAuth
+from common.auth.struct.auth import Principal, Auth
from common.exception.app_exception import AppAuthenticationFailed
@@ -20,26 +22,25 @@ class ApplicationKey(AuthBaseHandle):
def handle(self, request, token: str, get_token_details):
application_api_key = QuerySet(ApplicationApiKey).filter(secret_key=token).first()
if application_api_key is None:
- raise AppAuthenticationFailed(500, _('Secret key is invalid'))
+ raise AppAuthenticationFailed(500, _("Secret key is invalid"))
if not application_api_key.is_active:
- raise AppAuthenticationFailed(500, _('Secret key is invalid'))
+ raise AppAuthenticationFailed(500, _("Secret key is invalid"))
if application_api_key.is_permanent is False and application_api_key.expire_time < timezone.now():
- raise AppAuthenticationFailed(500, _('Secret key is expired'))
- application_access_token = QuerySet(ApplicationAccessToken).filter(
- application_id=application_api_key.application_id).first()
+ raise AppAuthenticationFailed(500, _("Secret key is expired"))
+ application_access_token = (
+ QuerySet(ApplicationAccessToken).filter(application_id=application_api_key.application_id).first()
+ )
if application_access_token is not None:
if application_access_token.authentication:
- if application_access_token.authentication_value.get('type',
- 'password') != 'password':
- raise AppAuthenticationFailed(1002, _('Authentication information is incorrect'))
- return None, ChatAuth(
- current_role_list=[RoleConstants.CHAT_ANONYMOUS_USER],
- permission_list=[
- Permission(group=Group.APPLICATION,
- operate=Operate.READ)],
- application_id=application_api_key.application_id,
- chat_user_id=str(application_api_key.id),
- chat_user_type=ChatUserType.APPLICATION_API_KEY.value)
+ if application_access_token.authentication_value.get("type", "password") != "password":
+ raise AppAuthenticationFailed(1002, _("Authentication information is incorrect"))
+
+ k = f"{Group.CHAT_USER}:r:{application_access_token.application_id}"
+ return Principal(
+ str(application_api_key.id),
+ ChatUserType.APPLICATION_API_KEY,
+ application_id=str(application_api_key.application_id),
+ ), Auth(set(), {k: 1})
def support(self, request, token: str, get_token_details):
- return str(token).startswith("application-") or str(token).startswith('agent-')
+ return str(token).startswith("application-") or str(token).startswith("agent-")
diff --git a/apps/common/auth/handle/impl/chat_anonymous_user_token.py b/apps/common/auth/handle/impl/chat_anonymous_user_token.py
deleted file mode 100644
index 7d8cc56e533..00000000000
--- a/apps/common/auth/handle/impl/chat_anonymous_user_token.py
+++ /dev/null
@@ -1,56 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎虎
- @file: chat_anonymous_user_token.py
- @date:2025/6/6 15:08
- @desc:
-"""
-from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
-
-from application.models import ApplicationAccessToken
-from common.auth.common import ChatUserToken
-from common.auth.handle.auth_base_handle import AuthBaseHandle
-from common.constants.authentication_type import AuthenticationType
-from common.constants.permission_constants import RoleConstants, Permission, Group, Operate, ChatAuth
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from common.exception.app_exception import AppAuthenticationFailed
-from maxkb.settings import edition
-
-
-class ChatAnonymousUserToken(AuthBaseHandle):
- def support(self, request, token: str, get_token_details):
- token_details = get_token_details()
- if token_details is None:
- return False
- return (
- 'application_id' in token_details and
- 'access_token' in token_details and
- token_details.get('type') == AuthenticationType.CHAT_ANONYMOUS_USER.value)
-
- def handle(self, request, token: str, get_token_details):
- auth_details = get_token_details()
- chat_user_token = ChatUserToken.new_instance(auth_details)
- application_id = chat_user_token.application_id
- access_token = chat_user_token.access_token
- application_access_token = QuerySet(ApplicationAccessToken).filter(
- application_id=application_id).first()
- if application_access_token is None:
- raise AppAuthenticationFailed(1002, _('Authentication information is incorrect'))
- if not application_access_token.is_active:
- raise AppAuthenticationFailed(1002, _('Authentication information is incorrect'))
- if not application_access_token.access_token == access_token:
- raise AppAuthenticationFailed(1002, _('Authentication information is incorrect'))
- if application_access_token.authentication and ['PE', 'EE'].__contains__(edition):
- if chat_user_token.authentication.auth_type != application_access_token.authentication_value.get('type',
- ''):
- raise AppAuthenticationFailed(1002, _('Authentication information is incorrect'))
- return None, ChatAuth(
- current_role_list=[RoleConstants.CHAT_ANONYMOUS_USER],
- permission_list=[
- Permission(group=Group.APPLICATION,
- operate=Operate.USE)],
- application_id=application_access_token.application_id,
- chat_user_id=chat_user_token.chat_user_id,
- chat_user_type=chat_user_token.chat_user_type)
diff --git a/apps/common/auth/handle/impl/chat_user_token.py b/apps/common/auth/handle/impl/chat_user_token.py
new file mode 100644
index 00000000000..2dbc91d3edd
--- /dev/null
+++ b/apps/common/auth/handle/impl/chat_user_token.py
@@ -0,0 +1,130 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: chat_anonymous_user_token.py
+@date:2025/6/6 15:08
+@desc:
+"""
+
+from functools import reduce
+
+from django.db.models import QuerySet, Q
+from django.utils.translation import gettext_lazy as _
+
+from application.models import ApplicationAccessToken, ChatUserType
+from common.auth.constants.chat_permission_constants import ChatPermissionConstants, CHAT_PERMISSION_STR_MAP
+from common.auth.constants.group_constants import Group
+from common.auth.constants.operate_constants import Operate
+from common.auth.handle.auth_base_handle import AuthBaseHandle
+from common.auth.struct.auth import Principal, Auth
+from common.constants.authentication_type import AuthenticationType
+from common.exception.app_exception import AppUnauthorizedFailed
+from system_manage.models import (
+ ResourceChatUserGroupAuthorize,
+ ResourceType,
+ ResourceChatUserAuthorize,
+ UserGroupRelation,
+ ChatUser,
+)
+
+login_type_list = [
+ Operate.LOCAL.value,
+ Operate.CAS.value,
+ Operate.DINGTALK.value,
+ Operate.WECOM.value,
+ Operate.LARK.value,
+ Operate.OIDC.value,
+ Operate.LDAP.value,
+ Operate.OAUTH2.value,
+]
+
+
+def get_auth(login_type, user_id, application_id):
+ application_access_token_list = QuerySet(ApplicationAccessToken).filter(is_active=True)
+ if login_type.upper() == str(Operate.ANNOTATION_AUTH):
+ application_access_token_list = application_access_token_list.filter(authentication=False)
+ elif login_type.upper() == str(Operate.PASSWORD):
+ application_access_token_list = application_access_token_list.filter(
+ authentication=True, authentication_value__type="password"
+ )
+
+ elif login_type_list.__contains__(login_type.upper()):
+ user_group_ids = (
+ QuerySet(UserGroupRelation)
+ .filter(
+ user_id=user_id,
+ )
+ .values_list("group_id", flat=True)
+ )
+
+ group_qs = (
+ QuerySet(ResourceChatUserGroupAuthorize)
+ .filter(
+ resource_type=ResourceType.APPLICATION,
+ is_auth=True,
+ user_group_id__in=user_group_ids,
+ )
+ .values_list("resource_id", flat=True)
+ )
+
+ user_qs = (
+ QuerySet(ResourceChatUserAuthorize)
+ .filter(
+ resource_type=ResourceType.APPLICATION,
+ is_auth=True,
+ user_id=user_id,
+ )
+ .values_list("resource_id", flat=True)
+ )
+ application_access_token_list = application_access_token_list.filter(
+ Q(authentication_value__type="login"),
+ Q(authentication_value__login_value__contains=login_type),
+ Q(application_id__in=group_qs) | Q(application_id__in=user_qs),
+ )
+ if application_id:
+ application_access_token_list = application_access_token_list.filter(application_id=application_id)
+ permissions = {}
+ for application_access_token in application_access_token_list:
+ permission_list = []
+ if application_access_token.authentication:
+ authentication_value = application_access_token.authentication_value
+ if authentication_value.get("type") == "login":
+ login_value = authentication_value.get("login_value") or []
+ for _value in login_value:
+ permission_str = f"{Group.CHAT_USER}_{_value.upper()}"
+ permission = CHAT_PERMISSION_STR_MAP.get(permission_str)
+ if permission:
+ permission_list.append(permission.value)
+
+ else:
+ permission_list.append(ChatPermissionConstants.CHAT_USER_ANONYMOUS.value)
+ k = f"{Group.CHAT_USER}:r:{application_access_token.application_id}"
+ permissions[k] = reduce(lambda x, y: x | y, [p.bit() for p in permission_list], 0)
+ return Auth(set(), permissions)
+
+
+class ChatUserToken(AuthBaseHandle):
+ def support(self, request, token: str, get_token_details):
+ token_details = get_token_details()
+ if token_details is None:
+ return False
+ return token_details.get("type") == AuthenticationType.CHAT_USER.value
+
+ def handle(self, request, token: str, get_token_details):
+ auth_details = get_token_details()
+ login_type = auth_details.get("login_type")
+ user_id = auth_details.get("id")
+ application_id = (auth_details.get("kwargs") or {}).get("application_id")
+ _type = (
+ ChatUserType.CHAT_USER if login_type_list.__contains__(login_type.upper()) else ChatUserType.ANONYMOUS_USER
+ )
+ auth = get_auth(login_type, user_id, application_id)
+ chat_user = QuerySet(ChatUser).filter(id=user_id).first()
+ if application_id:
+ # 指定了 application_id(v2 流程)时,直接校验该应用是否有权限,无权限直接抛错,
+ # 避免返回一个空权限的 Principal 造成静默失败。
+ if not auth.permissions.get(f"{Group.CHAT_USER}:r:{application_id}"):
+ raise AppUnauthorizedFailed(403, _("No permission to access"))
+ return Principal(user_id, _type, application_id=application_id, profile=chat_user), auth
+ return Principal(user_id, _type, profile=chat_user), auth
diff --git a/apps/common/auth/handle/impl/user_token.py b/apps/common/auth/handle/impl/user_token.py
index 18dd9d074df..cd65515dfab 100644
--- a/apps/common/auth/handle/impl/user_token.py
+++ b/apps/common/auth/handle/impl/user_token.py
@@ -1,233 +1,192 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: authenticate.py
- @date:2024/3/14 03:02
- @desc: 用户认证
+@project: MaxKB
+@Author:虎虎
+@file: authenticate.py
+@date:2024/3/14 03:02
+@desc: 用户认证
"""
+
from functools import reduce
-from typing import List
from django.core.cache import cache
from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
+from common.auth.constants.permission_constants import RESOURCE_PERMISSION_MAP, PERMISSION_STR_MAP
+from common.auth.constants.permission_scope_constants import PermissionScopeConstants
+from common.constants.resource_permission_constants import ResourceAuthType
+from common.auth.constants.role_constants import RoleConstants
from common.auth.handle.auth_base_handle import AuthBaseHandle
-from common.constants.authentication_type import AuthenticationType
+from common.auth.struct.auth import Auth, Principal
+from common.constants.authentication_type import AuthenticationType, UserType
from common.constants.cache_version import Cache_Version
-from common.constants.permission_constants import Auth, PermissionConstants, ResourcePermissionGroup, \
- get_permission_list_by_resource_group, ResourceAuthType, \
- ResourcePermissionRole, get_default_role_permission_mapping_list, get_default_workspace_user_role_mapping_list, \
- RoleConstants, ResourcePermission, Resource, WorkspaceGroup
+
from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.exception.app_exception import AppAuthenticationFailed
-from common.utils.common import group_by
+from common.utils.common import group_by, flat_map
from maxkb.const import CONFIG
+from system_manage.models.workspace_user_group_permission import WorkspaceUserGroupResourcePermission
from system_manage.models.workspace_user_permission import WorkspaceUserResourcePermission
from users.models import User
-permission_constants_dict = {p.value.__str__(): p for p in PermissionConstants}
-
-def get_permission(permission_id):
- """
- 获取权限字符串
- @param permission_id: 权限id
- @return: 权限字符串
- """
- if isinstance(permission_id, PermissionConstants):
- permission_id = permission_id.value
- return f"{permission_id}"
-
-
-def get_workspace_permission(permission_id, workspace_id, role=None):
- """
- 获取工作空间权限字符串
- @param permission_id: 权限id
- @param workspace_id: 工作空间id
- @param role: 角色
- @return:
- """
- if isinstance(permission_id, PermissionConstants):
- permission_id = permission_id.value
- if role and role.type == RoleConstants.WORKSPACE_MANAGE.value.__str__():
- return [f"{permission_id}:/WORKSPACE/{workspace_id}:ROLE/{role.type}",
- f"{permission_id}:/WORKSPACE/{workspace_id}"]
- return [f"{permission_id}:/WORKSPACE/{workspace_id}"]
-
-
-def get_role_permission(role, workspace_id):
- """
- 获取工作空间角色
- @param role: 角色
- @param workspace_id: 工作空间id
- @return:
- """
- if isinstance(role, RoleConstants):
- role = role.value
- return f"{role}:/WORKSPACE/{workspace_id}"
-
-
-def get_workspace_permission_list(role_permission_mapping_dict, workspace_user_role_mapping_list, role_model_dict):
- """
- 获取工作空间下所有的权限
- @param role_permission_mapping_dict: 角色权限关联字典
- @param workspace_user_role_mapping_list: 工作空间用户角色关联列表
- @param role_model_dict: 角色字典
- @return: 工作空间下的权限
- """
- workspace_permission_list = [
- [get_workspace_permission(role_permission_mapping.permission_id, w_u_r.workspace_id,
- role_model_dict.get(w_u_r.role_id, None)) for role_permission_mapping
- in
- role_permission_mapping_dict.get(w_u_r.role_id, [])] for w_u_r in workspace_user_role_mapping_list]
- return reduce(lambda x, y: [*x, *y], reduce(lambda x, y: [*x, *y], workspace_permission_list, []), [])
-
-
-def get_workspace_resource_permission_list(
- workspace_user_resource_permission_list: List[WorkspaceUserResourcePermission],
- role_permission_mapping_dict,
- workspace_user_role_mapping_dict):
- """
-
- @param workspace_user_resource_permission_list: 工作空间用户资源权限列表
- @param role_permission_mapping_dict: 角色权限关联字典 key为role_id
- @param workspace_user_role_mapping_dict: 工作空间用户角色映射字典 key为role_id
- @return: 工作空间资源权限列表
- """
- resource_permission_list = [
- get_workspace_resource_permission_list_by_workspace_user_permission(workspace_user_resource_permission,
- role_permission_mapping_dict,
- workspace_user_role_mapping_dict) for
- workspace_user_resource_permission in workspace_user_resource_permission_list]
- # 将二维数组扁平为一维
- return reduce(lambda x, y: [*x, *y], resource_permission_list, [])
-
-
-def get_workspace_resource_permission_list_by_workspace_user_permission(
- workspace_user_resource_permission: WorkspaceUserResourcePermission,
- role_permission_mapping_dict,
- workspace_user_role_mapping_dict):
- """
-
- @param workspace_user_resource_permission: 工作空间用户资源权限对象
- @param role_permission_mapping_dict: 角色权限关联字典 key为role_id
- @param workspace_user_role_mapping_dict: 工作空间用户角色关联字典 key为role_id
- @return: 工作空间用户资源的权限列表
- """
- # 判断用户在当前工作空间是否为内置USER
- workspace_role_ids = [
- wur.role_id
- for wur in
- workspace_user_role_mapping_dict.get(workspace_user_resource_permission.workspace_id,[])
- ]
- is_builtin_user = RoleConstants.USER.value.__str__() in workspace_role_ids
-
- role_permission_mapping_list = [role_permission_mapping_dict.get(workspace_user_role_mapping.role_id, []) for
- workspace_user_role_mapping in
- workspace_user_role_mapping_dict.get(
- workspace_user_resource_permission.workspace_id)]
- role_permission_mapping_list = reduce(lambda x, y: [*x, *y], role_permission_mapping_list, [])
- # 如果是根据角色
- if (workspace_user_resource_permission.auth_type == ResourceAuthType.ROLE
- and workspace_user_resource_permission.permission_list.__contains__(
- ResourcePermissionRole.ROLE)):
- per_op_permissions = [
- f"{role_permission_mapping.permission_id}:/WORKSPACE/{workspace_user_resource_permission.workspace_id}/{workspace_user_resource_permission.auth_target_type}/{workspace_user_resource_permission.target}"
- for role_permission_mapping in role_permission_mapping_list if (permission_constants_dict.get(role_permission_mapping.permission_id).value.parent_group or []).__contains__(
- WorkspaceGroup(workspace_user_resource_permission.auth_target_type))]
- if is_builtin_user:
- per_op_permissions.append(
- f"{workspace_user_resource_permission.auth_target_type}:/WORKSPACE/{workspace_user_resource_permission.workspace_id}/{workspace_user_resource_permission.auth_target_type}/{workspace_user_resource_permission.target}"
- )
- return per_op_permissions
- elif workspace_user_resource_permission.auth_type == ResourceAuthType.RESOURCE_PERMISSION_GROUP:
- resource_permission_list = [
- [
- f"{permission}:/WORKSPACE/{workspace_user_resource_permission.workspace_id}/{workspace_user_resource_permission.auth_target_type}/{workspace_user_resource_permission.target}"
- for permission in get_permission_list_by_resource_group(
- ResourcePermissionGroup(Resource(workspace_user_resource_permission.auth_target_type),
- ResourcePermission(resource_permission)))]
- for resource_permission in workspace_user_resource_permission.permission_list if
- ResourcePermission.values.__contains__(resource_permission)]
- # 将二维数组扁平为一维
- return reduce(lambda x, y: [*x, *y], resource_permission_list, [])
- return []
-
-def get_permission_list(user,
- workspace_user_role_mapping_model,
- workspace_model,
- role_model,
- role_permission_mapping_model):
+def get_permissions(
+ user, workspace_user_role_mapping_model, workspace_model, role_model, role_permission_mapping_model
+):
user_id = user.id
version = Cache_Version.PERMISSION_LIST.get_version()
key = Cache_Version.PERMISSION_LIST.get_key(user_id=user_id)
# 获取权限列表
- is_query_model = workspace_user_role_mapping_model is not None and workspace_model is not None and role_model is not None and role_permission_mapping_model is not None
- permission_list = cache.get(key, version=version)
- if permission_list is None:
+ is_query_model = (
+ workspace_user_role_mapping_model is not None
+ and workspace_model is not None
+ and role_model is not None
+ and role_permission_mapping_model is not None
+ )
+ permission_map = cache.get(key, version=version)
+ if permission_map is None:
+ permission_map = {}
if is_query_model:
# 获取工作空间 用户 角色映射数据
workspace_user_role_mapping_list = QuerySet(workspace_user_role_mapping_model).filter(user_id=user_id)
- workspace_user_role_mapping_dict = group_by(workspace_user_role_mapping_list,
- lambda item: item.workspace_id)
- role_id_list = list(set([workspace_user_role_mapping.role_id for workspace_user_role_mapping in
- workspace_user_role_mapping_list]))
+
+ role_id_list = list(
+ set(
+ [
+ workspace_user_role_mapping.role_id
+ for workspace_user_role_mapping in workspace_user_role_mapping_list
+ ]
+ )
+ )
# 获取角色权限映射数据
- role_permission_mapping_list = QuerySet(role_permission_mapping_model).filter(
- role_id__in=role_id_list)
+ role_permission_mapping_list = QuerySet(role_permission_mapping_model).filter(role_id__in=role_id_list)
role_model_list = QuerySet(role_model).filter(id__in=role_id_list)
role_model_dict = {role_model.id: role_model for role_model in role_model_list}
- role_permission_mapping_dict = group_by(
- role_permission_mapping_list, lambda item: item.role_id)
+ role_permission_mapping_dict = group_by(role_permission_mapping_list, lambda item: str(item.role_id))
workspace_user_permission_list = QuerySet(WorkspaceUserResourcePermission).filter(
- workspace_id__in=[workspace_user_role.workspace_id for workspace_user_role in
- workspace_user_role_mapping_list if
- (role_model_dict.get(workspace_user_role.role_id).type == 'USER' if
- role_model_dict.get(workspace_user_role.role_id) else False)],
- user_id=user_id)
-
- # 资源权限
- workspace_resource_permission_list = get_workspace_resource_permission_list(workspace_user_permission_list,
- role_permission_mapping_dict,
- workspace_user_role_mapping_dict)
+ workspace_id__in=[
+ workspace_user_role.workspace_id
+ for workspace_user_role in workspace_user_role_mapping_list
+ if (
+ role_model_dict.get(workspace_user_role.role_id).type == "USER"
+ if role_model_dict.get(workspace_user_role.role_id)
+ else False
+ )
+ ],
+ user_id=user_id,
+ )
- workspace_permission_list = get_workspace_permission_list(role_permission_mapping_dict,
- workspace_user_role_mapping_list, role_model_dict)
- # 系统权限
- system_permission_list = [role_permission_mapping.permission_id for role_permission_mapping in
- role_permission_mapping_list]
- # 合并权限
- permission_list = system_permission_list + workspace_permission_list + workspace_resource_permission_list
- permission_list = list(set(permission_list))
- cache.set(key, permission_list, version=version)
+ workspace_user_group_resource_permission_list = (
+ QuerySet(WorkspaceUserGroupResourcePermission)
+ .filter(user_group__user_relations__user_id=user_id)
+ .select_related("user_group")
+ .distinct()
+ )
+ "----------------------处理资源权限--------------------------------------------------"
+ for _ in list(workspace_user_permission_list) + list(workspace_user_group_resource_permission_list):
+ if _.auth_type == ResourceAuthType.RESOURCE_PERMISSION_GROUP:
+ all_permissions = flat_map(
+ [
+ RESOURCE_PERMISSION_MAP.get(f"{_.auth_target_type}_{_resource_permission}")
+ for _resource_permission in _.permission_list
+ if _resource_permission in ["VIEW", "MANAGE"]
+ ]
+ )
+ all_permissions = [_permission for _permission in all_permissions if _permission is not None]
+ for group, permissions in group_by(
+ all_permissions, lambda _permission: _permission.value.group
+ ).items():
+ k = f"{group}:{_.workspace_id}:{_.target}"
+ bits = reduce(lambda x, y: x | y, [_permission.value.bit() for _permission in permissions], 0)
+ permission_map[k] = permission_map.get(k, 0) | bits
+ elif _.auth_type == ResourceAuthType.ROLE:
+ role_ids = [m.role_id for m in workspace_user_role_mapping_list if m.workspace_id == _.workspace_id]
+
+ permissions = []
+ for role_id in role_ids:
+ for m in role_permission_mapping_dict.get(str(role_id)) or []:
+ p = PERMISSION_STR_MAP.get(m.permission_id)
+ if p is not None and PermissionScopeConstants.WORKSPACE in p.meta.scope:
+ permissions.append(p)
+
+ for group, ps in group_by(permissions, lambda p: p.value.group).items():
+ k = f"{group}:w:{_.workspace_id}:r:{_.target}"
+ bits = reduce(lambda x, y: x | y, [p.value.bit() for p in ps], 0)
+ permission_map[k] = permission_map.get(k, 0) | bits
+
+ "----------------------处理工作空间权限--------------------------------------------------"
+ for _ in workspace_user_role_mapping_list:
+ _role_permission_mapping_list = role_permission_mapping_dict.get(str(_.role_id)) or []
+ permissions = [
+ PERMISSION_STR_MAP.get(_role_permission_mapping.permission_id)
+ for _role_permission_mapping in _role_permission_mapping_list
+ ]
+ # 过滤工作空间权限
+ permissions = [
+ _permission
+ for _permission in permissions
+ if _permission is not None and PermissionScopeConstants.WORKSPACE in _permission.meta.scope
+ ]
+ for group, ps in group_by(permissions, lambda p: p.value.group).items():
+ k = f"{group}:w:{_.workspace_id}"
+ bits = reduce(lambda x, y: x | y, [p.value.bit() for p in ps], 0)
+ permission_map[k] = permission_map.get(k, 0) | bits
+ "----------------------处理系统权限--------------------------------------------------"
+ system_permissions = [
+ PERMISSION_STR_MAP.get(_role_permission_mapping.permission_id)
+ for _role_permission_mapping in role_permission_mapping_list
+ ]
+ system_permissions = [
+ _permission
+ for _permission in system_permissions
+ if _permission is not None and PermissionScopeConstants.SYSTEM in _permission.meta.scope
+ ]
+ for group, permissions in group_by(system_permissions, lambda _permission: _permission.value.group).items():
+ permission_map[f"{group}"] = reduce(
+ lambda x, y: x | y, [_permission.value.bit() for _permission in permissions], 0
+ )
+ cache.set(key, permission_map, version=version)
else:
- workspace_id_list = ['default']
- workspace_user_resource_permission_list = QuerySet(WorkspaceUserResourcePermission).filter(
- workspace_id__in=workspace_id_list, user_id=user_id)
- role_permission_mapping_list = get_default_role_permission_mapping_list()
- role_permission_mapping_dict = group_by(role_permission_mapping_list, lambda item: item.role_id)
- workspace_user_role_mapping_list = get_default_workspace_user_role_mapping_list([user.role])
- workspace_user_role_mapping_dict = group_by(workspace_user_role_mapping_list,
- lambda item: item.workspace_id)
- # 资源权限
- workspace_resource_permission_list = get_workspace_resource_permission_list(
- workspace_user_resource_permission_list,
- role_permission_mapping_dict,
- workspace_user_role_mapping_dict)
- # 合并权限
- permission_list = workspace_resource_permission_list
- permission_list = list(set(permission_list))
- cache.set(key, permission_list, version=version)
- return permission_list
-
+ workspace_id_list = ["default"]
+ workspace_user_permission_list = QuerySet(WorkspaceUserResourcePermission).filter(
+ workspace_id__in=workspace_id_list, user_id=user_id
+ )
+ workspace_user_group_resource_permission_list = (
+ QuerySet(WorkspaceUserGroupResourcePermission)
+ .filter(user_group__user_relations__user_id=user_id)
+ .select_related("user_group")
+ .distinct()
+ )
-system_role_list = [RoleConstants.ADMIN.value.name, RoleConstants.WORKSPACE_MANAGE.value.name,
- RoleConstants.USER.value.name]
+ for _ in list(workspace_user_permission_list) + list(workspace_user_group_resource_permission_list):
+ if _.auth_type == ResourceAuthType.RESOURCE_PERMISSION_GROUP:
+ all_permissions = flat_map(
+ [
+ RESOURCE_PERMISSION_MAP.get(f"{_.auth_target_type}_{_resource_permission}")
+ for _resource_permission in _.permission_list
+ if _resource_permission in ["VIEW", "MANAGE"]
+ ]
+ )
+ for group, permissions in group_by(
+ all_permissions, lambda _permission: _permission.value.group
+ ).items():
+ permission_map[f"{group}:w:{_.workspace_id}:r:{_.target}"] = reduce(
+ lambda x, y: x | y, [_permission.value.bit() for _permission in permissions], 0
+ )
+ cache.set(key, permission_map, version=version)
+
+ return permission_map
+
+
+system_role_list = [
+ RoleConstants.ADMIN.value.name,
+ RoleConstants.WORKSPACE_MANAGE.value.name,
+ RoleConstants.USER.value.name,
+]
system_role = RoleConstants.ADMIN.value.name
@@ -237,22 +196,18 @@ def reset_workspace_role(role_id, workspace_id, role_dict):
if system_role == role_id:
return [role_id]
else:
- return [f"{role_id}:/WORKSPACE/{workspace_id}", role_id]
+ return [f"{role_id}:w:{workspace_id}", role_id]
else:
r = role_dict.get(role_id)
if r is None:
- return ''
+ return []
role_type = role_dict.get(role_id).type
if system_role == role_type:
return [RoleConstants.EXTENDS_ADMIN.value.name]
- return [f"EXTENDS_{role_type}:/WORKSPACE/{workspace_id}", f"EXTENDS_{role_type}"]
+ return [f"EXTENDS_{role_type}:w:{workspace_id}"]
-def get_role_list(user,
- workspace_user_role_mapping_model,
- workspace_model,
- role_model,
- role_permission_mapping_model):
+def get_role_list(user, workspace_user_role_mapping_model, workspace_model, role_model, role_permission_mapping_model):
"""
获取当前用户的角色列表
"""
@@ -260,7 +215,12 @@ def get_role_list(user,
key = Cache_Version.ROLE_LIST.get_key(user_id=user.id)
role_list = cache.get(key, version=version)
# 获取权限列表
- is_query_model = workspace_user_role_mapping_model is not None and workspace_model is not None and role_model is not None and role_permission_mapping_model is not None
+ is_query_model = (
+ workspace_user_role_mapping_model is not None
+ and workspace_model is not None
+ and role_model is not None
+ and role_permission_mapping_model is not None
+ )
if role_list is None:
if is_query_model:
# 获取工作空间 用户 角色映射数据
@@ -268,18 +228,25 @@ def get_role_list(user,
role_list = QuerySet(role_model).filter(id__in=[wurm.role_id for wurm in workspace_user_role_mapping_list])
role_dict = {r.id: r for r in role_list}
role_list = list(
- set(reduce(lambda x, y: [*x, *y], [reset_workspace_role(workspace_user_role_mapping.role_id,
- workspace_user_role_mapping.workspace_id,
- role_dict)
- for
- workspace_user_role_mapping in
- workspace_user_role_mapping_list], [])))
+ set(
+ reduce(
+ lambda x, y: [*x, *y],
+ [
+ reset_workspace_role(
+ workspace_user_role_mapping.role_id, workspace_user_role_mapping.workspace_id, role_dict
+ )
+ for workspace_user_role_mapping in workspace_user_role_mapping_list
+ ],
+ [],
+ )
+ )
+ )
cache.set(key, role_list, version=version)
else:
if user.role == RoleConstants.ADMIN.value.__str__():
- role_list = [user.role, get_role_permission(RoleConstants.WORKSPACE_MANAGE, 'default')]
+ role_list = [user.role, f"{RoleConstants.WORKSPACE_MANAGE}:w:default"]
else:
- role_list = [user.role, get_role_permission(RoleConstants.USER, 'default')]
+ role_list = [user.role, f"{RoleConstants.USER}:w:default"]
cache.set(key, role_list, version=version)
return role_list
@@ -290,11 +257,13 @@ def get_auth(user):
role_model = DatabaseModelManage.get_model("role_model")
role_permission_mapping_model = DatabaseModelManage.get_model("role_permission_mapping_model")
- permission_list = get_permission_list(user, workspace_user_role_mapping_model, workspace_model,
- role_model, role_permission_mapping_model)
- role_list = get_role_list(user, workspace_user_role_mapping_model, workspace_model,
- role_model, role_permission_mapping_model)
- return Auth(role_list, permission_list)
+ permissions = get_permissions(
+ user, workspace_user_role_mapping_model, workspace_model, role_model, role_permission_mapping_model
+ )
+ role_list = get_role_list(
+ user, workspace_user_role_mapping_model, workspace_model, role_model, role_permission_mapping_model
+ )
+ return Auth(set(role_list), permissions)
class UserToken(AuthBaseHandle):
@@ -302,18 +271,18 @@ def support(self, request, token: str, get_token_details):
auth_details = get_token_details()
if auth_details is None:
return False
- return 'id' in auth_details and auth_details.get('type') == AuthenticationType.SYSTEM_USER.value
+ return "id" in auth_details and auth_details.get("type") == AuthenticationType.SYSTEM_USER.value
def handle(self, request, token: str, get_token_details):
version, get_key = Cache_Version.TOKEN.value
cache_token = cache.get(get_key(token), version=version)
if cache_token is None:
- raise AppAuthenticationFailed(1002, _('Login expired'))
+ raise AppAuthenticationFailed(1002, _("Login expired"))
auth_details = get_token_details()
timeout = CONFIG.get_session_timeout()
cache.touch(token, timeout=timeout, version=version)
- user = QuerySet(User).get(id=auth_details['id'])
+ user = QuerySet(User).get(id=auth_details["id"])
if not user.is_active or user.password != cache_token.password:
- raise AppAuthenticationFailed(1002, _('Authentication information is incorrect'))
+ raise AppAuthenticationFailed(1002, _("Authentication information is incorrect"))
auth = get_auth(user)
- return user, auth
+ return Principal(user.id, UserType.SYSTEM_USER, user), auth
diff --git a/apps/common/auth/struct/aggregate_permission.py b/apps/common/auth/struct/aggregate_permission.py
new file mode 100644
index 00000000000..cb1c7e92098
--- /dev/null
+++ b/apps/common/auth/struct/aggregate_permission.py
@@ -0,0 +1,85 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: aggregate_permission.py
+@date:2026/8/5 10:11
+@desc:
+"""
+
+from typing import Protocol, List, Union
+
+from rest_framework.request import Request
+
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.permission import Role, Permission
+
+
+class RoleFunc(Protocol):
+ def __call__(self, request: Request, kwargs) -> RoleConstants | Role: ...
+
+
+class PermissionFunc(Protocol):
+ def __call__(self, request: Request, kwargs) -> PermissionConstants | Permission: ...
+
+
+class AggregatePermission:
+ def __init__(
+ self,
+ roles: List[Union[RoleConstants, RoleFunc]] = None,
+ permissions: List[Union[PermissionConstants, PermissionFunc]] = None,
+ aggregatePermissions: List["AggregatePermission"] = None,
+ compare: CompareConstants = CompareConstants.OR,
+ ):
+ # 不能用可变默认值;原 stub 的 `= list` 其实是把类型对象赋进去了
+ self.roles = roles if roles is not None else []
+ self.permissions = permissions if permissions is not None else []
+ self.aggregatePermissions = aggregatePermissions if aggregatePermissions is not None else []
+ self.compare = compare
+
+ def hasPermission(self, request: Request, **kwargs) -> bool:
+ user_roles = request.auth.roles
+ user_permissions = request.auth.permissions
+
+ # 无任何约束 => 放行(对应 Java 里五个集合全空的判断)
+ if not (self.roles or self.permissions or self.aggregatePermissions):
+ return True
+
+ is_and = self.compare == CompareConstants.AND
+
+ # 惰性产出每一项的命中结果,保证 OR/AND 的短路语义
+ # (return 后生成器不再前进,后面的 permission/role 不会被求值)
+ def results():
+ for role in self.roles:
+ resolved = role(request, kwargs) if callable(role) else role
+ yield self._match_role(resolved, user_roles)
+ for permission in self.permissions:
+ resolved = permission(request, kwargs) if callable(permission) else permission
+ yield self._match_permission(resolved, user_permissions)
+ for aggregate in self.aggregatePermissions:
+ yield aggregate.hasPermission(request, **kwargs)
+
+ for has in results():
+ if has and not is_and: # OR:命中一个即通过
+ return True
+ if not has and is_and: # AND:缺一个即失败
+ return False
+
+ # AND 全部通过 => True;OR 一个都没命中 => False
+ return is_and
+
+ @staticmethod
+ def _match_permission(permission: Union[PermissionConstants, Permission], user_permissions: dict) -> bool:
+ p = permission.value if isinstance(permission, PermissionConstants) else permission
+ key = p.get_resource_permission_key(p.resource_id) if p.resource_id else str(p)
+ return key in user_permissions and (user_permissions[key] & p.bit()) > 0
+
+ @staticmethod
+ def _match_role(role: Union[RoleConstants, Role], user_roles) -> bool:
+ r = role.value if isinstance(role, RoleConstants) else role
+ return str(r) in user_roles
+
+
+ViewPermission = AggregatePermission
diff --git a/apps/common/auth/struct/auth.py b/apps/common/auth/struct/auth.py
new file mode 100644
index 00000000000..2c87af82a19
--- /dev/null
+++ b/apps/common/auth/struct/auth.py
@@ -0,0 +1,41 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: auth.py
+ @date:2026/8/5 9:45
+ @desc:
+"""
+from typing import Dict
+
+from application.models import ChatUserType
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.permission import Role
+from common.constants.authentication_type import UserType
+
+
+class Auth:
+ """
+ 用于存储当前用户的角色和权限
+ """
+
+ def __init__(self,
+ roles: set[RoleConstants | Role | str],
+ permissions: Dict[str, int],
+ **kwargs):
+ # 权限列表
+ self.permissions = permissions
+ # 角色列表
+ self.roles = roles
+ self.kwargs = kwargs
+
+
+class Principal:
+ def __init__(self, _id,
+ _type: ChatUserType | UserType,
+ profile=None,
+ **kwargs):
+ self.id = _id
+ self.type = _type
+ self.profile = profile
+ self.kwargs = kwargs
diff --git a/apps/common/auth/struct/permission.py b/apps/common/auth/struct/permission.py
new file mode 100644
index 00000000000..5f3de1bac59
--- /dev/null
+++ b/apps/common/auth/struct/permission.py
@@ -0,0 +1,75 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎虎
+@file: permission.py
+@date:2026/8/3 17:29
+@desc:
+"""
+
+from dataclasses import dataclass, field
+from typing import Optional
+
+from common.auth.constants.category_constants import Category
+from common.auth.constants.group_constants import Group
+from common.auth.constants.operate_constants import Operate
+from common.auth.constants.permission_scope_constants import PermissionScopeConstants
+from common.auth.constants.role_group import RoleGroup
+
+
+@dataclass(frozen=True)
+class Permission:
+ """
+ 权限信息
+ """
+
+ group: Group | str
+ sub_group: Group | str
+ operate: Operate
+ bit_index: int
+ workspace_id: Optional[str] = None
+ resource_id: Optional[str] = None
+ flag: str = None
+
+ def bit(self):
+ return 1 << self.bit_index
+
+ def get_resource_permission_key(self, resource_id):
+ workspace = f":w:{self.workspace_id}" if self.workspace_id else ""
+ resource = f":r:{self.resource_id}" if self.resource_id else ""
+ return f"{self.group}{workspace}{resource}"
+
+ def __str__(self):
+ sub = f"_{self.sub_group}" if self.sub_group != self.group else ""
+ flag = f"_{self.flag}" if self.flag else ""
+ operate = f":{self.operate}" if self.operate else ""
+ return f"{self.group}{sub}{operate}{flag}"
+
+
+@dataclass
+class PermissionMeta:
+ role_list: list = field(default_factory=list)
+ category: Optional[Category] = None
+ resource_permission_group_list: Optional[list] = None
+ scope: list[PermissionScopeConstants] = field(default_factory=list)
+ is_ee: bool = True
+ # 角色 -> 分类 覆盖表;未列出的角色默认归入 OTHER
+ role_category_map: Optional[dict] = None
+
+
+@dataclass(frozen=True)
+class Role:
+ name: str
+ workspace_id: str = None
+
+ def __str__(self):
+ return f"{self.name}{(':w:' + self.workspace_id) if self.workspace_id else ''}"
+
+ def __eq__(self, other):
+ return str(self) == str(other)
+
+
+@dataclass(frozen=True)
+class RoleMeta:
+ desc: str
+ group: RoleGroup
diff --git a/apps/common/constants/authentication_type.py b/apps/common/constants/authentication_type.py
index 1880fe4d3cd..fe0696363ad 100644
--- a/apps/common/constants/authentication_type.py
+++ b/apps/common/constants/authentication_type.py
@@ -8,13 +8,15 @@
"""
from enum import Enum
+from django.db import models
+
class AuthenticationType(Enum):
# 系统用户
SYSTEM_USER = "SYSTEM_USER"
# 对话用户
CHAT_USER = "CHAT_USER"
- # 对话匿名用户
- CHAT_ANONYMOUS_USER = "CHAT_ANONYMOUS_USER"
- # APIKEY
- API_KEY = "API_KEY"
+
+
+class UserType(models.TextChoices):
+ SYSTEM_USER = "SYSTEM_USER", '系统用户'
diff --git a/apps/common/constants/cache_version.py b/apps/common/constants/cache_version.py
index 0aed4715e2e..64c29498515 100644
--- a/apps/common/constants/cache_version.py
+++ b/apps/common/constants/cache_version.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: cache_version.py
- @date:2025/4/14 19:09
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: cache_version.py
+@date:2025/4/14 19:09
+@desc:
"""
+
from enum import Enum
@@ -32,6 +33,9 @@ class Cache_Version(Enum):
CHAT_INFO = "CHAT_INFO", lambda key: key
+ # 会话历史滚动窗口缓存(只存最近 N 条已完成记录,append-only)
+ CHAT_HISTORY = "CHAT_HISTORY", lambda key: key
+
CHAT_VARIABLE = "CHAT_VARIABLE", lambda key: key
# 应用API KEY
@@ -41,6 +45,8 @@ class Cache_Version(Enum):
TOOL_WORKFLOW_EXECUTE = "TOOL_WORKFLOW_EXECUTE", lambda key: key
+ DEBUG_WORKFLOW_CONTEXT = "DEBUG_WORKFLOW_CONTEXT", lambda chat_record_id: chat_record_id
+
def get_version(self):
return self.value[0]
diff --git a/apps/common/constants/permission_constants.py b/apps/common/constants/permission_constants.py
deleted file mode 100644
index b1d40debdbc..00000000000
--- a/apps/common/constants/permission_constants.py
+++ /dev/null
@@ -1,2134 +0,0 @@
-"""
- @project: qabot
- @Author:虎虎
- @file: permission_constants.py
- @date:2023/9/13 18:23
- @desc: 权限,角色 常量
-"""
-from enum import Enum
-from functools import reduce
-from typing import List
-
-from django.db import models
-from django.utils.translation import gettext_lazy as _
-
-from maxkb import settings
-
-
-class Group(Enum):
- """
- 权限组 一个组一般对应前端一个菜单
- """
-
- USER = "USER_MANAGEMENT"
- # 应用
- APPLICATION = "APPLICATION"
- # 应用概览
- APPLICATION_OVERVIEW = "APPLICATION_OVERVIEW"
- # 应用接入
- APPLICATION_ACCESS = "APPLICATION_ACCESS"
- # 应用 对话用户
- APPLICATION_CHAT_USER = "APPLICATION_CHAT_USER"
- # 知识库 对话用户
- KNOWLEDGE_CHAT_USER = "KNOWLEDGE_CHAT_USER"
- # 应用对话日志
- APPLICATION_CHAT_LOG = "APPLICATION_CHAT_LOG"
-
- KNOWLEDGE = "KNOWLEDGE"
- SYSTEM_KNOWLEDGE = "SYSTEM_KNOWLEDGE"
- SYSTEM_RES_KNOWLEDGE = "SYSTEM_RESOURCE_KNOWLEDGE"
- KNOWLEDGE_HIT_TEST = "KNOWLEDGE_HIT_TEST"
- KNOWLEDGE_DOCUMENT = "KNOWLEDGE_DOCUMENT"
- KNOWLEDGE_WORKFLOW = "KNOWLEDGE_WORKFLOW"
- KNOWLEDGE_TAG = "KNOWLEDGE_TAG"
- SYSTEM_KNOWLEDGE_DOCUMENT = "SYSTEM_KNOWLEDGE_DOCUMENT"
- SYSTEM_KNOWLEDGE_WORKFLOW = "SYSTEM_KNOWLEDGE_WORKFLOW"
- SYSTEM_RES_KNOWLEDGE_DOCUMENT = "SYSTEM_RESOURCE_KNOWLEDGE_DOCUMENT"
- SYSTEM_RES_KNOWLEDGE_WORKFLOW = "SYSTEM_RESOURCE_KNOWLEDGE_WORKFLOW"
- SYSTEM_RES_KNOWLEDGE_TAG = "SYSTEM_RES_KNOWLEDGE_TAG"
- SYSTEM_KNOWLEDGE_TAG = "SYSTEM_KNOWLEDGE_TAG"
-
- KNOWLEDGE_PROBLEM = "KNOWLEDGE_PROBLEM"
- KNOWLEDGE_TERMBASE = "KNOWLEDGE_TERMBASE"
- SYSTEM_KNOWLEDGE_PROBLEM = "SYSTEM_KNOWLEDGE_PROBLEM"
- SYSTEM_KNOWLEDGE_TERMBASE = "SYSTEM_KNOWLEDGE_TERMBASE"
- SYSTEM_RES_KNOWLEDGE_PROBLEM = "SYSTEM_RESOURCE_KNOWLEDGE_PROBLEM"
- SYSTEM_RES_KNOWLEDGE_TERMBASE = "SYSTEM_RESOURCE_KNOWLEDGE_TERMBASE"
-
- SYSTEM_KNOWLEDGE_HIT_TEST = "SYSTEM_KNOWLEDGE_HIT_TEST"
- SYSTEM_RES_KNOWLEDGE_HIT_TEST = "SYSTEM_RESOURCE_KNOWLEDGE_HIT_TEST"
- SYSTEM_KNOWLEDGE_CHAT_USER = "SYSTEM_KNOWLEDGE_CHAT_USER"
- SYSTEM_RES_KNOWLEDGE_CHAT_USER = "SYSTEM_RESOURCE_KNOWLEDGE_CHAT_USER"
-
- MODEL = "MODEL"
- SYSTEM_MODEL = "SYSTEM_MODEL"
- SYSTEM_RES_MODEL = "SYSTEM_RESOURCE_MODEL"
- SYSTEM_RES_APPLICATION = "SYSTEM_RESOURCE_APPLICATION"
- SYSTEM_RES_APPLICATION_OVERVIEW = "SYSTEM_RESOURCE_APPLICATION_OVERVIEW"
- SYSTEM_RES_APPLICATION_ACCESS = "SYSTEM_RESOURCE_APPLICATION_ACCESS"
- SYSTEM_RES_APPLICATION_CHAT_USER = "SYSTEM_RESOURCE_APPLICATION_CHAT_USER"
- SYSTEM_RES_APPLICATION_CHAT_LOG = "SYSTEM_RESOURCE_APPLICATION_CHAT_LOG"
-
- TOOL = "TOOL"
- SYSTEM_TOOL = "SYSTEM_TOOL"
- SYSTEM_RES_TOOL = "SYSTEM_RESOURCE_TOOL"
-
- TRIGGER = "TRIGGER"
-
- APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION = "APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION"
- KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION = "KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION"
- TOOL_WORKSPACE_USER_RESOURCE_PERMISSION = "TOOL_WORKSPACE_USER_RESOURCE_PERMISSION"
- MODEL_WORKSPACE_USER_RESOURCE_PERMISSION = "MODEL_WORKSPACE_USER_RESOURCE_PERMISSION"
-
- EMAIL_SETTING = "EMAIL_SETTING"
- ROLE = "ROLE"
- WORKSPACE_ROLE = "WORKSPACE_ROLE"
- WORKSPACE = "WORKSPACE"
- WORKSPACE_WORKSPACE = "WORKSPACE_WORKSPACE"
-
- DISPLAY_SETTINGS = "DISPLAY_SETTINGS"
- LOGIN_AUTH = "LOGIN_AUTH"
- SYSTEM_API_KEY = "SYSTEM_API_KEY"
- APPEARANCE_SETTINGS = "APPEARANCE_SETTINGS"
- CHAT_USER = "CHAT_USER"
- WORKSPACE_CHAT_USER = "WORKSPACE_CHAT_USER"
- USER_GROUP = "USER_GROUP"
- WORKSPACE_USER_GROUP = "WORKSPACE_USER_GROUP"
- CHAT_USER_AUTH = "CHAT_USER_AUTH"
- OTHER = "OTHER"
- OVERVIEW = "OVERVIEW"
- OPERATION_LOG = "OPERATION_LOG"
-
- APPLICATION_FOLDER = "APPLICATION_FOLDER"
- KNOWLEDGE_FOLDER = "KNOWLEDGE_FOLDER"
- TOOL_FOLDER = "TOOL_FOLDER"
-
-
-class SystemGroup(Enum):
- """
- 一级菜单
- """
- USER_MANAGEMENT = "USER_MANAGEMENT"
- ROLE = "ROLE"
- WORKSPACE = "WORKSPACE"
- # RESOURCE = "RESOURCE"
- RESOURCE_APPLICATION = "RESOURCE_APPLICATION"
- RESOURCE_KNOWLEDGE = "RESOURCE_KNOWLEDGE"
- RESOURCE_TOOL = "RESOURCE_TOOL"
- RESOURCE_MODEL = "RESOURCE_MODEL"
- RESOURCE_PERMISSION = "RESOURCE_PERMISSION"
- SHARED_KNOWLEDGE = "SHARED_KNOWLEDGE"
- SHARED_MODEL = "SHARED_MODEL"
- SHARED_TOOL = "SHARED_TOOL"
- CHAT_USER = "CHAT_USER"
- SYSTEM_SETTING = "SYSTEM_SETTING"
- OPERATION_LOG = "OPERATION_LOG"
- OTHER = "OTHER"
-
-
-class WorkspaceGroup(Enum):
- SYSTEM_MANAGEMENT = "SYSTEM_MANAGEMENT"
- APPLICATION = "APPLICATION"
- KNOWLEDGE = "KNOWLEDGE"
- MODEL = "MODEL"
- TOOL = "TOOL"
- TRIGGER = "TRIGGER"
- RESOURCE_PERMISSION = "RESOURCE_PERMISSION"
- OTHER = "OTHER"
-
-
-class UserGroup(Enum):
- APPLICATION = "APPLICATION"
- KNOWLEDGE = "KNOWLEDGE"
- MODEL = "MODEL"
- TOOL = "TOOL"
- OTHER = "OTHER"
-
-
-class Operate(Enum):
- """
- 一个权限组的操作权限
- """
- SELF = ""
- READ = 'READ'
- EDIT = "READ+EDIT"
- CREATE = "READ+CREATE"
- DELETE = "READ+DELETE"
- """
- 使用权限
- """
- USE = "USE"
- IMPORT = "READ+IMPORT"
- EXPORT = "READ+EXPORT" # 导入导出
- PUBLISH = "READ+PUBLISH" # 发布
- SYNC = "READ+SYNC" # 同步
- GENERATE = "READ+GENERATE" # 生成
- ADD_MEMBER = "READ+ADD_MEMBER" # 添加成员
- REMOVE_MEMBER = "READ+REMOVE_MEMBER" # 添加成员
- VECTOR = "READ+VECTOR" # 向量化
- MIGRATE = "READ+MIGRATE" # 迁移
- RELATE = "READ+RELATE" # 关联
- USER_GROUP = "READ+USER_GROUP" # 用户组
- ANNOTATION = "READ+ANNOTATION" # 标注
- CLEAR_POLICY = "READ+CLEAR_POLICY"
- EMBED = "READ+EMBED" # 嵌入
- ACCESS = "READ+ACCESS" # 访问限制
- DISPLAY = "READ+DISPLAY" # 显示设置
- API_KEY = "READ+API_KEY" # API_KEY
- PUBLIC_ACCESS = "READ+PUBLIC_ACCESS" # 公共访问链接
- Q_WEIXIN = "READ+Q_WEIXIN" # 企业微信
- FEISHU = "READ+FEISHU" # 飞书
- DD = "READ+DD" # 钉钉
- WEIXIN_PUBLIC_ACCOUNT = "READ+WEIXIN_PUBLIC_ACCOUNT" # 微信公众号
- SLACK = "READ+SLACK" # SLACK
- ADD_KNOWLEDGE = "READ+ADD_KNOWLEDGE" # 添加到知识库
- TO_CHAT = "READ+TO_CHAT" # 去对话
- SETTING = "READ+SETTING" # 管理
- DOWNLOAD = "READ+DOWNLOAD" # 下载
- COPY = "READ+COPY"
- AUTH = "READ+AUTH" # 资源授权
- TAG = "READ+TAG" # 标签设置
- REPLACE = "READ+REPLACE" # 标签设置
- UPDATE = "READ+UPDATE" # 更新license
- RELATE_VIEW = "READ+RELATE_VIEW"
- RECORD = "READ+RECORD"
- TRIGGER_READ = "READ+TRIGGER_READ"
- TRIGGER_EDIT = "READ+TRIGGER_EDIT"
- TRIGGER_CREATE = "READ+TRIGGER_CREATE"
- TRIGGER_DELETE = "READ+TRIGGER_DELETE"
- BATCH_DELETE = "READ+BATCH_DELETE"
- BATCH_MOVE = "READ+BATCH_MOVE"
-
-
-class RoleGroup(Enum):
- # 系统用户
- SYSTEM_USER = "SYSTEM_USER"
- # 对话用户
- CHAT_USER = "CHAT_USER"
-
-
-class ResourcePermissionRole(models.TextChoices):
- """
- 资源权限根据角色
- """
- ROLE = "ROLE"
-
- def __eq__(self, other):
- return str(self) == str(other)
-
-
-class ResourcePermission(models.TextChoices):
- """
- 资源权限组
- """
- # 查看
- VIEW = "VIEW"
- # 管理
- MANAGE = "MANAGE"
-
- def __eq__(self, other):
- return str(self) == str(other)
-
-
-class Resource(models.TextChoices):
- KNOWLEDGE = Group.KNOWLEDGE.value
- KNOWLEDGE_FOLDER = Group.KNOWLEDGE_FOLDER.value
- APPLICATION = Group.APPLICATION.value
- APPLICATION_FOLDER = Group.APPLICATION_FOLDER.value
- TOOL = Group.TOOL.value
- TOOL_FOLDER = Group.TOOL_FOLDER.value
- MODEL = Group.MODEL.value
-
- def __eq__(self, other):
- return str(self) == str(other)
-
-
-class ResourcePermissionGroup:
- def __init__(self, resource: Resource, permission: ResourcePermission):
- self.permission = permission
- self.resource = resource
-
- def __eq__(self, other):
- return str(self.permission) == str(other.permission) and str(self.resource) == str(other.resource)
-
-
-class ResourcePermissionConst:
- KNOWLEDGE_MANGE = ResourcePermissionGroup(Resource.KNOWLEDGE, ResourcePermission.MANAGE)
- KNOWLEDGE_FOLDER_MANGE = ResourcePermissionGroup(Resource.KNOWLEDGE_FOLDER, ResourcePermission.MANAGE)
- KNOWLEDGE_FOLDER_VIEW = ResourcePermissionGroup(Resource.KNOWLEDGE_FOLDER, ResourcePermission.VIEW)
- KNOWLEDGE_VIEW = ResourcePermissionGroup(Resource.KNOWLEDGE, ResourcePermission.VIEW)
- APPLICATION_MANGE = ResourcePermissionGroup(Resource.APPLICATION, ResourcePermission.MANAGE)
- APPLICATION_FOLDER_MANGE = ResourcePermissionGroup(Resource.APPLICATION_FOLDER, ResourcePermission.MANAGE)
- APPLICATION_FOLDER_VIEW = ResourcePermissionGroup(Resource.APPLICATION_FOLDER, ResourcePermission.VIEW)
- APPLICATION_VIEW = ResourcePermissionGroup(Resource.APPLICATION, ResourcePermission.VIEW)
- TOOL_MANGE = ResourcePermissionGroup(Resource.TOOL, ResourcePermission.MANAGE)
- TOOL_FOLDER_MANGE = ResourcePermissionGroup(Resource.TOOL_FOLDER, ResourcePermission.MANAGE)
- TOOL_FOLDER_VIEW = ResourcePermissionGroup(Resource.TOOL_FOLDER, ResourcePermission.VIEW)
- TOOL_VIEW = ResourcePermissionGroup(Resource.TOOL, ResourcePermission.VIEW)
- MODEL_MANGE = ResourcePermissionGroup(Resource.MODEL, ResourcePermission.MANAGE)
- MODEL_VIEW = ResourcePermissionGroup(Resource.MODEL, ResourcePermission.VIEW)
-
-
-class ResourceAuthType(models.TextChoices):
- """
- 资源授权类型
- """
- "当授权类型是Role时候"
- ROLE = "ROLE"
-
- """资源权限组"""
- RESOURCE_PERMISSION_GROUP = "RESOURCE_PERMISSION_GROUP"
-
-
-class Role:
- def __init__(self, name: str, decs: str, group: RoleGroup, resource_path=None):
- self.name = name
- self.decs = decs
- self.group = group
- self.resource_path = resource_path
-
- def __str__(self):
- return self.name + (
- (":" + self.resource_path) if self.resource_path is not None else '')
-
- def __eq__(self, other):
- return str(self) == str(other)
-
- def get_workspace_role(self):
- return lambda r, kwargs: Role(self.name, self.decs, self.group,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}")
-
-
-class RoleConstants(Enum):
- ADMIN = Role("ADMIN", '超级管理员', RoleGroup.SYSTEM_USER)
- WORKSPACE_MANAGE = Role("WORKSPACE_MANAGE", '工作空间管理员', RoleGroup.SYSTEM_USER)
- USER = Role("USER", '普通用户', RoleGroup.SYSTEM_USER)
- CHAT_ANONYMOUS_USER = Role("CHAT_ANONYMOUS_USER", "对话匿名用户", RoleGroup.CHAT_USER)
- CHAT_USER = Role("CHAT_USER", "对话用户", RoleGroup.CHAT_USER)
-
- EXTENDS_ADMIN = Role("EXTENDS_ADMIN", '继承超级管理员', RoleGroup.SYSTEM_USER)
- EXTENDS_WORKSPACE_MANAGE = Role("EXTENDS_WORKSPACE_MANAGE", "继承工作空间管理员", RoleGroup.CHAT_USER)
- EXTENDS_USER = Role("EXTENDS_USER", "继承普通用户", RoleGroup.CHAT_USER)
-
- def get_workspace_role(self):
- return lambda r, kwargs: Role(name=self.value.name,
- decs=self.value.decs,
- group=self.value.group,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}")
-
-
-Permission_Label = {
- SystemGroup.SYSTEM_SETTING.value: _("System Setting"),
- SystemGroup.USER_MANAGEMENT.value: _("User Management"),
- SystemGroup.ROLE.value: _("Role"),
- SystemGroup.WORKSPACE.value: _("Workspace"),
- SystemGroup.RESOURCE_APPLICATION.value: _("Resource Application"),
- SystemGroup.RESOURCE_KNOWLEDGE.value: _("Resource Knowledge"),
- SystemGroup.RESOURCE_TOOL.value: _("Resource Tool"),
- SystemGroup.RESOURCE_MODEL.value: _("Resource Model"),
- SystemGroup.RESOURCE_PERMISSION.value: _("Resource Permission"),
- SystemGroup.SHARED_KNOWLEDGE.value: _("Shared Knowledge"),
- SystemGroup.SHARED_MODEL.value: _("Shared Model"),
- SystemGroup.SHARED_TOOL.value: _("Shared Tool"),
- SystemGroup.OPERATION_LOG.value: _("Operation Log"),
- SystemGroup.OTHER.value: _("Other"),
- WorkspaceGroup.SYSTEM_MANAGEMENT.value: _("System Management"),
- WorkspaceGroup.APPLICATION.value: _("Application"),
- WorkspaceGroup.KNOWLEDGE.value: _("Knowledge"),
- WorkspaceGroup.MODEL.value: _("Model"),
- WorkspaceGroup.TOOL.value: _("Tool"),
- WorkspaceGroup.TRIGGER.value: _("Trigger"),
- WorkspaceGroup.OTHER.value: _("Other"),
- Operate.READ.value: _("Read"),
- Operate.EDIT.value: _("Edit"),
- Operate.COPY.value: _('Copy'),
- Operate.PUBLISH.value: _("Publish"),
- Operate.CREATE.value: _("Create"),
- Operate.DELETE.value: _("Delete"),
- Group.EMAIL_SETTING.value: _("Email Setting"),
- Group.APPLICATION.value: _("Application"),
- Group.KNOWLEDGE.value: _("Knowledge"),
- Group.KNOWLEDGE_DOCUMENT.value: _("Document"),
- Group.KNOWLEDGE_TERMBASE.value: _("Termbase"),
- Group.KNOWLEDGE_WORKFLOW.value: _("Workflow"),
- Group.KNOWLEDGE_TAG.value: _("Tag"),
- Group.KNOWLEDGE_PROBLEM.value: _("Problem"),
- Group.KNOWLEDGE_HIT_TEST.value: _("Hit-Test"),
- Operate.IMPORT.value: _("Import"),
- Operate.EXPORT.value: _("Export"),
- Operate.SYNC.value: _("Sync"),
- Operate.GENERATE.value: _("Generate"),
- Operate.ADD_MEMBER.value: _("Add Member"),
- Operate.REMOVE_MEMBER.value: _("Remove Member"),
- Operate.VECTOR.value: _("Vector"),
- Operate.MIGRATE.value: _("Migrate"),
- Operate.RELATE.value: _("Relate"),
- Operate.ANNOTATION.value: _("Annotation"),
- Operate.CLEAR_POLICY.value: _("Clear Policy"),
- Operate.DOWNLOAD.value: _('Download Original Document'),
- Operate.EMBED.value: _('Embed third party'),
- Operate.ACCESS.value: _('Access restrictions'),
- Operate.DISPLAY.value: _('Display Settings'),
- Operate.API_KEY.value: _('API KEY'),
- Operate.PUBLIC_ACCESS.value: _('Public access link'),
- Operate.Q_WEIXIN.value: _('Enterprise WeiXin'),
- Operate.FEISHU.value: _('Feishu'),
- Operate.DD.value: _('Dingding'),
- Operate.WEIXIN_PUBLIC_ACCOUNT.value: _('Weixin Public Account'),
- Operate.ADD_KNOWLEDGE.value: _('Add to Knowledge Base'),
- Operate.AUTH.value: _('resource authorization'),
- Operate.TAG.value: _('Tag Setting'),
- Operate.REPLACE.value: _('Replace Original Document'),
- Operate.RELATE_VIEW.value: _('View related resources'),
- Operate.TRIGGER_READ.value: _('Read Trigger'),
- Operate.TRIGGER_CREATE.value: _('Create Trigger'),
- Operate.TRIGGER_EDIT.value: _('Edit Trigger'),
- Operate.TRIGGER_DELETE.value: _('Delete Trigger'),
- Operate.RECORD.value: _('Read execute record'),
- Operate.BATCH_DELETE.value: _('Batch delete'),
- Operate.BATCH_MOVE.value: _('Batch move'),
-
- Group.APPLICATION_OVERVIEW.value: _('Overview'),
- Group.APPLICATION_ACCESS.value: _('Application Access'),
- Group.APPLICATION_CHAT_USER.value: _('Dialogue users'),
- Group.APPLICATION_CHAT_LOG.value: _('Conversation log'),
- Group.KNOWLEDGE_CHAT_USER.value: _('Dialogue users'),
-
- Group.LOGIN_AUTH.value: _("Login Auth"),
- Group.DISPLAY_SETTINGS.value: _("Display Settings"),
- Group.SYSTEM_API_KEY.value: _("System API Key"),
- Group.APPEARANCE_SETTINGS.value: _("Appearance Settings"),
- Group.CHAT_USER.value: _("Chat User"),
- Group.USER_GROUP.value: _("User Group"),
- Group.CHAT_USER_AUTH.value: _("Chat User Auth"),
- Group.OVERVIEW.value: _("Overview"),
- Group.SYSTEM_TOOL.value: _("Tool"),
- Group.SYSTEM_MODEL.value: _("Model"),
- Group.SYSTEM_KNOWLEDGE.value: _("Knowledge"),
- Group.SYSTEM_KNOWLEDGE_DOCUMENT.value: _("Document"),
- Group.SYSTEM_KNOWLEDGE_TERMBASE.value: _("Termbase"),
- Group.SYSTEM_KNOWLEDGE_WORKFLOW.value: _("Workflow"),
- Group.SYSTEM_KNOWLEDGE_TAG.value: _("Tag"),
- Group.SYSTEM_KNOWLEDGE_PROBLEM.value: _("Problem"),
- Group.SYSTEM_KNOWLEDGE_HIT_TEST.value: _("Hit-Test"),
- Group.SYSTEM_KNOWLEDGE_CHAT_USER.value: _("Dialogue users"),
- Group.SYSTEM_RES_TOOL.value: _("Tool"),
- Group.SYSTEM_RES_MODEL.value: _("Model"),
- Group.SYSTEM_RES_KNOWLEDGE.value: _("Knowledge"),
- Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT.value: _("Document"),
- Group.SYSTEM_RES_KNOWLEDGE_TERMBASE.value: _("Termbase"),
- Group.SYSTEM_RES_KNOWLEDGE_WORKFLOW.value: _("Workflow"),
- Group.SYSTEM_RES_KNOWLEDGE_TAG.value: _("Tag"),
- Group.SYSTEM_RES_KNOWLEDGE_PROBLEM.value: _("Problem"),
- Group.SYSTEM_RES_KNOWLEDGE_HIT_TEST.value: _("Hit-Test"),
- Group.SYSTEM_RES_KNOWLEDGE_CHAT_USER.value: _("Dialogue users"),
- Group.WORKSPACE_USER_GROUP.value: _("User Group"),
- Group.WORKSPACE_CHAT_USER.value: _("Chat User"),
- Group.WORKSPACE_WORKSPACE.value: _("Workspace"),
- Group.WORKSPACE_ROLE.value: _("Role"),
- Group.APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION.value: _("Application"),
- Group.KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION.value: _("Knowledge"),
- Group.MODEL_WORKSPACE_USER_RESOURCE_PERMISSION.value: _("Model"),
- Group.TOOL_WORKSPACE_USER_RESOURCE_PERMISSION.value: _("Tool"),
- Group.SYSTEM_RES_APPLICATION.value: _("Application"),
- Group.SYSTEM_RES_APPLICATION_OVERVIEW.value: _("Overview"),
- Group.SYSTEM_RES_APPLICATION_ACCESS.value: _("Application Access"),
- Group.SYSTEM_RES_APPLICATION_CHAT_USER.value: _("Dialogue users"),
- Group.SYSTEM_RES_APPLICATION_CHAT_LOG.value: _("Conversation log"),
- Group.APPLICATION_FOLDER.value: _("Folder"),
- Group.KNOWLEDGE_FOLDER.value: _("Folder"),
- Group.TOOL_FOLDER.value: _("Folder"),
- # SystemGroup.RESOURCE.value: _("Resource"),
-}
-
-
-class Permission:
- """
- 权限信息
- """
-
- def __init__(self, group: Group, operate: Operate, resource_path=None, role_list=None,
- resource_permission_group_list=None, parent_group=None, label=None, is_ee=True):
- if role_list is None:
- role_list = []
- if resource_permission_group_list is None:
- resource_permission_group_list = []
- self.group = group
- self.operate = operate
- self.resource_path = resource_path
- # 用于获取角色与权限的关系,只适用于没有权限管理的
- self.role_list = role_list
- # 用于资源权限权限分组
- self.resource_permission_group_list = resource_permission_group_list
- self.parent_group = parent_group # 新增字段:父级组
- self.label = label
- self.is_ee = is_ee # 是否是企业版权限
-
- @staticmethod
- def new_instance(permission_str: str):
- permission_split = permission_str.split(":")
- group = Group[permission_split[0]]
- operate = Operate[permission_split[1]]
- if len(permission_split) > 2:
- dynamic_tag = ":".join(permission_split[2:])
- return Permission(group, operate, dynamic_tag)
- return Permission(group, operate)
-
- def __str__(self):
-
- return self.group.value + (
- (":" + self.operate.value) if self.operate.value else '') + (
- (":" + self.resource_path) if self.resource_path is not None else '')
-
- def __eq__(self, other):
- return str(self) == str(other)
-
-
-class PermissionConstants(Enum):
- """
- 权限枚举
- """
- KNOWLEDGE = Permission(
- group=Group.KNOWLEDGE, operate=Operate.SELF, role_list=[RoleConstants.ADMIN, RoleConstants.USER]
- )
- APPLICATION = Permission(
- group=Group.APPLICATION, operate=Operate.SELF, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- )
- MODEL = Permission(
- group=Group.MODEL, operate=Operate.SELF, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- )
- TOOL = Permission(
- group=Group.TOOL, operate=Operate.SELF, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- )
- USER_READ = Permission(
- group=Group.USER, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.USER_MANAGEMENT]
- )
-
- USER_CREATE = Permission(
- group=Group.USER, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.USER_MANAGEMENT]
- )
-
- USER_EDIT = Permission(
- group=Group.USER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.USER_MANAGEMENT]
- )
-
- USER_DELETE = Permission(
- group=Group.USER, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.USER_MANAGEMENT]
- )
-
- MODEL_READ = Permission(
- group=Group.MODEL, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.MODEL, UserGroup.MODEL],
- resource_permission_group_list=[ResourcePermissionConst.MODEL_VIEW]
- )
-
- MODEL_CREATE = Permission(
- group=Group.MODEL, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.MODEL, UserGroup.MODEL],
- resource_permission_group_list=[ResourcePermissionConst.MODEL_MANGE]
- )
-
- MODEL_EDIT = Permission(
- group=Group.MODEL, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.MODEL, UserGroup.MODEL],
- resource_permission_group_list=[ResourcePermissionConst.MODEL_MANGE]
- )
- MODEL_DELETE = Permission(
- group=Group.MODEL, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.MODEL, UserGroup.MODEL],
- resource_permission_group_list=[ResourcePermissionConst.MODEL_MANGE]
- )
- MODEL_RESOURCE_AUTHORIZATION = Permission(
- group=Group.MODEL, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.MODEL, UserGroup.MODEL],
- resource_permission_group_list=[ResourcePermissionConst.MODEL_MANGE]
- )
- MODEL_RELATE_RESOURCE_VIEW = Permission(
- group=Group.MODEL, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.MODEL, UserGroup.MODEL],
- resource_permission_group_list=[ResourcePermissionConst.MODEL_MANGE]
- )
- # trigger
- TRIGGER_READ = Permission(
- group=Group.TRIGGER, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.TRIGGER],
- )
- TRIGGER_CREATE = Permission(
- group=Group.TRIGGER, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.TRIGGER],
- )
- TRIGGER_EDIT = Permission(
- group=Group.TRIGGER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.TRIGGER],
- )
- TRIGGER_DELETE = Permission(
- group=Group.TRIGGER, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.TRIGGER],
- )
- TRIGGER_RECORD = Permission(
- group=Group.TRIGGER, operate=Operate.RECORD, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.TRIGGER],
- )
- TOOL_READ = Permission(
- group=Group.TOOL, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW]
- )
-
- TOOL_CREATE = Permission(
- group=Group.TOOL, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_BATCH_MOVE = Permission(
- group=Group.TOOL, operate=Operate.BATCH_MOVE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_BATCH_DELETE = Permission(
- group=Group.TOOL, operate=Operate.BATCH_DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_EDIT = Permission(
- group=Group.TOOL, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
-
- TOOL_DELETE = Permission(
- group=Group.TOOL, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_IMPORT = Permission(
- group=Group.TOOL, operate=Operate.IMPORT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_EXPORT = Permission(
- group=Group.TOOL, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_RESOURCE_AUTHORIZATION = Permission(
- group=Group.TOOL, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_RELATE_RESOURCE_VIEW = Permission(
- group=Group.TOOL, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_PUBLISH = Permission(
- group=Group.TOOL, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_EXECUTE_RECORD = Permission(
- group=Group.TOOL, operate=Operate.RECORD, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- # source point trigger
- TOOL_TRIGGER_READ = Permission(
- group=Group.TOOL, operate=Operate.TRIGGER_READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_TRIGGER_CREATE = Permission(
- group=Group.TOOL, operate=Operate.TRIGGER_CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW]
- )
- TOOL_TRIGGER_EDIT = Permission(
- group=Group.TOOL, operate=Operate.TRIGGER_EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW]
- )
- TOOL_TRIGGER_DELETE = Permission(
- group=Group.TOOL, operate=Operate.TRIGGER_DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW]
- )
- TOOL_FOLDER_READ = Permission(
- group=Group.TOOL_FOLDER, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_VIEW]
- )
- TOOL_FOLDER_CREATE = Permission(
- group=Group.TOOL_FOLDER, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_FOLDER_EDIT = Permission(
- group=Group.TOOL_FOLDER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_FOLDER_DELETE = Permission(
- group=Group.TOOL_FOLDER, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- TOOL_FOLDER_AUTH = Permission(
- group=Group.TOOL_FOLDER, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.TOOL, UserGroup.TOOL],
- resource_permission_group_list=[ResourcePermissionConst.TOOL_MANGE]
- )
- KNOWLEDGE_READ = Permission(
- group=Group.KNOWLEDGE, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_CREATE = Permission(
- group=Group.KNOWLEDGE, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_EDIT = Permission(
- group=Group.KNOWLEDGE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DELETE = Permission(
- group=Group.KNOWLEDGE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_SYNC = Permission(
- group=Group.KNOWLEDGE, operate=Operate.SYNC, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_EXPORT = Permission(
- group=Group.KNOWLEDGE, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_VECTOR = Permission(
- group=Group.KNOWLEDGE, operate=Operate.VECTOR, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_GENERATE = Permission(
- group=Group.KNOWLEDGE, operate=Operate.GENERATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_BATCH_DELETE = Permission(group=Group.KNOWLEDGE, operate=Operate.BATCH_DELETE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE],
- )
- KNOWLEDGE_BATCH_MOVE = Permission(group=Group.KNOWLEDGE, operate=Operate.BATCH_MOVE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE],
- )
- KNOWLEDGE_RESOURCE_AUTHORIZATION = Permission(
- group=Group.KNOWLEDGE, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_RELATE_RESOURCE_VIEW = Permission(
- group=Group.KNOWLEDGE, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE]
- )
- KNOWLEDGE_FOLDER_READ = Permission(
- group=Group.KNOWLEDGE_FOLDER, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_FOLDER_CREATE = Permission(
- group=Group.KNOWLEDGE_FOLDER, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_FOLDER_EDIT = Permission(
- group=Group.KNOWLEDGE_FOLDER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_FOLDER_DELETE = Permission(
- group=Group.KNOWLEDGE_FOLDER, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_FOLDER_AUTH = Permission(
- group=Group.KNOWLEDGE_FOLDER, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_WORKFLOW_READ = Permission(
- group=Group.KNOWLEDGE_WORKFLOW, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_WORKFLOW_EDIT = Permission(
- group=Group.KNOWLEDGE_WORKFLOW, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_WORKFLOW_EXPORT = Permission(
- group=Group.KNOWLEDGE_WORKFLOW, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_WORKFLOW_PUBLISH = Permission(
- group=Group.KNOWLEDGE_WORKFLOW, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_READ = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_CREATE = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_EDIT = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_DELETE = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_SYNC = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.SYNC, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_EXPORT = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.EXPORT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_DOWNLOAD_SOURCE_FILE = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.DOWNLOAD,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_GENERATE = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.GENERATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_VECTOR = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.VECTOR,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_MIGRATE = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.MIGRATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_TAG = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.TAG,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_DOCUMENT_REPLACE = Permission(
- group=Group.KNOWLEDGE_DOCUMENT, operate=Operate.REPLACE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_HIT_TEST = Permission(
- group=Group.KNOWLEDGE_HIT_TEST, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_PROBLEM_READ = Permission(
- group=Group.KNOWLEDGE_PROBLEM, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_PROBLEM_CREATE = Permission(
- group=Group.KNOWLEDGE_PROBLEM, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_PROBLEM_EDIT = Permission(
- group=Group.KNOWLEDGE_PROBLEM, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_PROBLEM_DELETE = Permission(
- group=Group.KNOWLEDGE_PROBLEM, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_PROBLEM_RELATE = Permission(
- group=Group.KNOWLEDGE_PROBLEM, operate=Operate.RELATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TERMBASE_READ = Permission(
- group=Group.KNOWLEDGE_TERMBASE, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TERMBASE_CREATE = Permission(
- group=Group.KNOWLEDGE_TERMBASE, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TERMBASE_EDIT = Permission(
- group=Group.KNOWLEDGE_TERMBASE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TERMBASE_DELETE = Permission(
- group=Group.KNOWLEDGE_TERMBASE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TAG_READ = Permission(
- group=Group.KNOWLEDGE_TAG, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TAG_CREATE = Permission(
- group=Group.KNOWLEDGE_TAG, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TAG_EDIT = Permission(
- group=Group.KNOWLEDGE_TAG, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- KNOWLEDGE_TAG_DELETE = Permission(
- group=Group.KNOWLEDGE_TAG, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE]
- )
- APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION_READ = Permission(
- group=Group.APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
- APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION_EDIT = Permission(
- group=Group.APPLICATION_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
- KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION_READ = Permission(
- group=Group.KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
- KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION_EDIT = Permission(
- group=Group.KNOWLEDGE_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
- TOOL_WORKSPACE_USER_RESOURCE_PERMISSION_READ = Permission(
- group=Group.TOOL_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
- TOOL_WORKSPACE_USER_RESOURCE_PERMISSION_EDIT = Permission(
- group=Group.TOOL_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
-
- )
- MODEL_WORKSPACE_USER_RESOURCE_PERMISSION_READ = Permission(
- group=Group.MODEL_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
- MODEL_WORKSPACE_USER_RESOURCE_PERMISSION_EDIT = Permission(
- group=Group.MODEL_WORKSPACE_USER_RESOURCE_PERMISSION, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE],
- parent_group=[SystemGroup.RESOURCE_PERMISSION, WorkspaceGroup.RESOURCE_PERMISSION]
- )
-
- EMAIL_SETTING_READ = Permission(
- group=Group.EMAIL_SETTING, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SYSTEM_SETTING]
- )
- EMAIL_SETTING_EDIT = Permission(
- group=Group.EMAIL_SETTING, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SYSTEM_SETTING]
- )
-
- ROLE_READ = Permission(
- group=Group.ROLE, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.ROLE]
- )
- ROLE_CREATE = Permission(
- group=Group.ROLE, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.ROLE]
- )
- ROLE_EDIT = Permission(
- group=Group.ROLE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.ROLE]
- )
- ROLE_DELETE = Permission(
- group=Group.ROLE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.ROLE]
- )
- ROLE_ADD_MEMBER = Permission(
- group=Group.ROLE, operate=Operate.ADD_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.ROLE]
- )
- ROLE_REMOVE_MEMBER = Permission(
- group=Group.ROLE, operate=Operate.REMOVE_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.ROLE]
- )
- WORKSPACE_ROLE_READ = Permission(
- group=Group.WORKSPACE_ROLE, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_ROLE_ADD_MEMBER = Permission(
- group=Group.WORKSPACE_ROLE, operate=Operate.ADD_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_ROLE_REMOVE_MEMBER = Permission(
- group=Group.WORKSPACE_ROLE, operate=Operate.REMOVE_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
-
- WORKSPACE_READ = Permission(
- group=Group.WORKSPACE, operate=Operate.READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.WORKSPACE], is_ee=settings.edition == "EE"
- )
- WORKSPACE_CREATE = Permission(
- group=Group.WORKSPACE, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.WORKSPACE], is_ee=settings.edition == "EE"
- )
- WORKSPACE_EDIT = Permission(
- group=Group.WORKSPACE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.WORKSPACE], is_ee=settings.edition == "EE"
- )
- WORKSPACE_DELETE = Permission(
- group=Group.WORKSPACE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.WORKSPACE], is_ee=settings.edition == "EE"
- )
- WORKSPACE_ADD_MEMBER = Permission(
- group=Group.WORKSPACE, operate=Operate.ADD_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.WORKSPACE], is_ee=settings.edition == "EE"
- )
- WORKSPACE_REMOVE_MEMBER = Permission(
- group=Group.WORKSPACE, operate=Operate.REMOVE_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.WORKSPACE], is_ee=settings.edition == "EE"
- )
- WORKSPACE_WORKSPACE_READ = Permission(
- group=Group.WORKSPACE_WORKSPACE, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT], is_ee=settings.edition == "EE"
- )
- WORKSPACE_WORKSPACE_ADD_MEMBER = Permission(
- group=Group.WORKSPACE_WORKSPACE, operate=Operate.ADD_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT], is_ee=settings.edition == "EE"
- )
- WORKSPACE_WORKSPACE_REMOVE_MEMBER = Permission(
- group=Group.WORKSPACE_WORKSPACE, operate=Operate.REMOVE_MEMBER, role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT], is_ee=settings.edition == "EE"
- )
- LOGIN_AUTH_READ = Permission(
- group=Group.LOGIN_AUTH, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SYSTEM_SETTING]
- )
- LOGIN_AUTH_EDIT = Permission(
- group=Group.LOGIN_AUTH, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SYSTEM_SETTING]
- )
- APPLICATION_READ = Permission(group=Group.APPLICATION, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
- )
- APPLICATION_CREATE = Permission(group=Group.APPLICATION, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- )
- APPLICATION_COPY = Permission(group=Group.APPLICATION, operate=Operate.COPY,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- )
- APPLICATION_EDIT = Permission(group=Group.APPLICATION, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- )
- APPLICATION_DELETE = Permission(group=Group.APPLICATION, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- )
- APPLICATION_IMPORT = Permission(group=Group.APPLICATION, operate=Operate.IMPORT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_EXPORT = Permission(group=Group.APPLICATION, operate=Operate.EXPORT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- )
- APPLICATION_PUBLISH = Permission(group=Group.APPLICATION, operate=Operate.PUBLISH,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- )
- APPLICATION_BATCH_DELETE = Permission(group=Group.APPLICATION, operate=Operate.BATCH_DELETE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- )
- APPLICATION_BATCH_MOVE = Permission(group=Group.APPLICATION, operate=Operate.BATCH_MOVE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- )
- APPLICATION_RESOURCE_AUTHORIZATION = Permission(group=Group.APPLICATION, operate=Operate.AUTH,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[
- ResourcePermissionConst.APPLICATION_MANGE],
- )
- APPLICATION_RELATE_RESOURCE_VIEW = Permission(
- group=Group.APPLICATION, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_TRIGGER_READ = Permission(
- group=Group.APPLICATION, operate=Operate.TRIGGER_READ, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_TRIGGER_CREATE = Permission(
- group=Group.APPLICATION, operate=Operate.TRIGGER_CREATE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_TRIGGER_EDIT = Permission(
- group=Group.APPLICATION, operate=Operate.TRIGGER_EDIT, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_TRIGGER_DELETE = Permission(
- group=Group.APPLICATION, operate=Operate.TRIGGER_DELETE, role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_FOLDER_READ = Permission(group=Group.APPLICATION_FOLDER, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW]
- )
- APPLICATION_FOLDER_CREATE = Permission(group=Group.APPLICATION_FOLDER, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_FOLDER_EDIT = Permission(group=Group.APPLICATION_FOLDER, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_FOLDER_DELETE = Permission(group=Group.APPLICATION_FOLDER, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_FOLDER_AUTH = Permission(group=Group.APPLICATION_FOLDER, operate=Operate.AUTH,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE]
- )
- APPLICATION_OVERVIEW_READ = Permission(group=Group.APPLICATION_OVERVIEW, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
- )
-
- APPLICATION_OVERVIEW_EMBED = Permission(group=Group.APPLICATION_OVERVIEW, operate=Operate.EMBED,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
-
- )
-
- APPLICATION_OVERVIEW_ACCESS = Permission(group=Group.APPLICATION_OVERVIEW, operate=Operate.ACCESS,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
-
- )
- APPLICATION_OVERVIEW_DISPLAY = Permission(group=Group.APPLICATION_OVERVIEW, operate=Operate.DISPLAY,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[
- ResourcePermissionConst.APPLICATION_MANGE],
-
- )
- APPLICATION_OVERVIEW_API_KEY = Permission(group=Group.APPLICATION_OVERVIEW, operate=Operate.API_KEY,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[
- ResourcePermissionConst.APPLICATION_MANGE],
-
- )
- APPLICATION_OVERVIEW_PUBLIC = Permission(group=Group.APPLICATION_OVERVIEW, operate=Operate.PUBLIC_ACCESS,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
-
- )
- # 应用接入
- APPLICATION_ACCESS_READ = Permission(group=Group.APPLICATION_ACCESS, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
-
- )
- APPLICATION_ACCESS_EDIT = Permission(group=Group.APPLICATION_ACCESS, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE])
-
- APPLICATION_CHAT_USER_READ = Permission(group=Group.APPLICATION_CHAT_USER, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
- )
- APPLICATION_CHAT_USER_EDIT = Permission(group=Group.APPLICATION_CHAT_USER, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- )
- KNOWLEDGE_CHAT_USER_READ = Permission(group=Group.KNOWLEDGE_CHAT_USER, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_VIEW],
- )
-
- KNOWLEDGE_CHAT_USER_EDIT = Permission(group=Group.KNOWLEDGE_CHAT_USER, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.KNOWLEDGE, UserGroup.KNOWLEDGE],
- resource_permission_group_list=[ResourcePermissionConst.KNOWLEDGE_MANGE],
- )
-
- APPLICATION_CHAT_LOG_READ = Permission(group=Group.APPLICATION_CHAT_LOG, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_VIEW],
- )
-
- APPLICATION_CHAT_LOG_ANNOTATION = Permission(group=Group.APPLICATION_CHAT_LOG, operate=Operate.ANNOTATION,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[
- ResourcePermissionConst.APPLICATION_MANGE],
- )
-
- APPLICATION_CHAT_LOG_EXPORT = Permission(group=Group.APPLICATION_CHAT_LOG, operate=Operate.EXPORT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[ResourcePermissionConst.APPLICATION_MANGE],
- )
-
- APPLICATION_CHAT_LOG_CLEAR_POLICY = Permission(group=Group.APPLICATION_CHAT_LOG, operate=Operate.CLEAR_POLICY,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[
- ResourcePermissionConst.APPLICATION_MANGE],
- )
- APPLICATION_CHAT_LOG_ADD_KNOWLEDGE = Permission(group=Group.APPLICATION_CHAT_LOG, operate=Operate.ADD_KNOWLEDGE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[WorkspaceGroup.APPLICATION, UserGroup.APPLICATION],
- resource_permission_group_list=[
- ResourcePermissionConst.APPLICATION_MANGE],
- )
-
- ABOUT_READ = Permission(group=Group.OTHER, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.OTHER, WorkspaceGroup.OTHER, UserGroup.OTHER],
- label=_('About')
- )
- ABOUT_UPDATE = Permission(group=Group.OTHER, operate=Operate.UPDATE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.OTHER],
- label=_('Update License')
- )
- SWITCH_LANGUAGE = Permission(group=Group.OTHER, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.OTHER, WorkspaceGroup.OTHER, UserGroup.OTHER],
- label=_('Switch Language')
- )
- CHANGE_PASSWORD = Permission(group=Group.OTHER, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.OTHER, WorkspaceGroup.OTHER, UserGroup.OTHER],
- label=_('Change Password')
- )
-
- SYSTEM_API_KEY_EDIT = Permission(group=Group.OTHER, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN, RoleConstants.USER],
- parent_group=[SystemGroup.OTHER, WorkspaceGroup.OTHER, UserGroup.OTHER],
- label=_('System API Key')
- )
-
- APPEARANCE_SETTINGS_READ = Permission(group=Group.APPEARANCE_SETTINGS, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SYSTEM_SETTING]
- )
- APPEARANCE_SETTINGS_EDIT = Permission(group=Group.APPEARANCE_SETTINGS, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SYSTEM_SETTING]
- )
- CHAT_USER_READ = Permission(group=Group.CHAT_USER, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER],
- )
- CHAT_USER_CREATE = Permission(group=Group.CHAT_USER, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- CHAT_USER_SYNC = Permission(group=Group.CHAT_USER, operate=Operate.SYNC,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- CHAT_USER_EDIT = Permission(group=Group.CHAT_USER, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- CHAT_USER_DELETE = Permission(group=Group.CHAT_USER, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- CHAT_USER_GROUP = Permission(group=Group.CHAT_USER, operate=Operate.USER_GROUP,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER],
- label=_('Set up user groups')
- )
- USER_GROUP_READ = Permission(group=Group.USER_GROUP, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- USER_GROUP_CREATE = Permission(group=Group.USER_GROUP, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- USER_GROUP_EDIT = Permission(group=Group.USER_GROUP, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- USER_GROUP_DELETE = Permission(group=Group.USER_GROUP, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- USER_GROUP_ADD_MEMBER = Permission(group=Group.USER_GROUP, operate=Operate.ADD_MEMBER,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- USER_GROUP_REMOVE_MEMBER = Permission(group=Group.USER_GROUP, operate=Operate.REMOVE_MEMBER,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- CHAT_USER_AUTH_READ = Permission(group=Group.CHAT_USER_AUTH, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- CHAT_USER_AUTH_EDIT = Permission(group=Group.CHAT_USER_AUTH, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.CHAT_USER]
- )
- WORKSPACE_CHAT_USER_READ = Permission(group=Group.WORKSPACE_CHAT_USER, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_CHAT_USER_CREATE = Permission(group=Group.WORKSPACE_CHAT_USER, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_CHAT_USER_EDIT = Permission(group=Group.WORKSPACE_CHAT_USER, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_CHAT_USER_DELETE = Permission(group=Group.WORKSPACE_CHAT_USER, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_CHAT_USER_GROUP = Permission(group=Group.WORKSPACE_CHAT_USER, operate=Operate.USER_GROUP,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT],
- label=_('Set up user groups')
- )
- WORKSPACE_USER_GROUP_READ = Permission(group=Group.WORKSPACE_USER_GROUP, operate=Operate.READ,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_USER_GROUP_CREATE = Permission(group=Group.WORKSPACE_USER_GROUP, operate=Operate.CREATE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_USER_GROUP_EDIT = Permission(group=Group.WORKSPACE_USER_GROUP, operate=Operate.EDIT,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_USER_GROUP_DELETE = Permission(group=Group.WORKSPACE_USER_GROUP, operate=Operate.DELETE,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_USER_GROUP_ADD_MEMBER = Permission(group=Group.WORKSPACE_USER_GROUP, operate=Operate.ADD_MEMBER,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
- WORKSPACE_USER_GROUP_REMOVE_MEMBER = Permission(group=Group.WORKSPACE_USER_GROUP, operate=Operate.REMOVE_MEMBER,
- role_list=[RoleConstants.ADMIN],
- parent_group=[WorkspaceGroup.SYSTEM_MANAGEMENT]
- )
-
- SHARED_TOOL_READ = Permission(group=Group.SYSTEM_TOOL, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
-
- SHARED_TOOL_CREATE = Permission(group=Group.SYSTEM_TOOL, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
-
- SHARED_TOOL_EDIT = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
-
- SHARED_TOOL_DELETE = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
- SHARED_TOOL_IMPORT = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.IMPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
- SHARED_TOOL_EXPORT = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
- SHARED_TOOL_PUBLISH = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
- SHARED_TOOL_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
- SHARED_TOOL_EXECUTE_RECORD = Permission(
- group=Group.SYSTEM_TOOL, operate=Operate.RECORD, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_TOOL], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_CREATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_SYNC = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.SYNC, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_VECTOR = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.VECTOR, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_EXPORT = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_GENERATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.GENERATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DELETE = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_KNOWLEDGE, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_WORKFLOW_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE_WORKFLOW, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_WORKFLOW_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_WORKFLOW, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_WORKFLOW_EXPORT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_WORKFLOW, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_WORKFLOW_PUBLISH = Permission(
- group=Group.SYSTEM_KNOWLEDGE_WORKFLOW, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_CREATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_DELETE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_SYNC = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.SYNC, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_EXPORT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_DOWNLOAD_SOURCE_FILE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.DOWNLOAD, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_GENERATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.GENERATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_VECTOR = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.VECTOR, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_MIGRATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.MIGRATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_TAG = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.TAG, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_DOCUMENT_REPLACE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_DOCUMENT, operate=Operate.REPLACE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TAG_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TAG, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TAG_CREATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TAG, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TAG_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TAG, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TAG_DELETE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TAG, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_PROBLEM_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE_PROBLEM, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_PROBLEM_CREATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_PROBLEM, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_PROBLEM_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_PROBLEM, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_PROBLEM_DELETE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_PROBLEM, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_PROBLEM_RELATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_PROBLEM, operate=Operate.RELATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TERMBASE_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TERMBASE, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TERMBASE_CREATE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TERMBASE, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TERMBASE_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TERMBASE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TERMBASE_DELETE = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TERMBASE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_TERMBASE_EXPORT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_TERMBASE, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_HIT_TEST = Permission(
- group=Group.SYSTEM_KNOWLEDGE_HIT_TEST, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_CHAT_USER_READ = Permission(
- group=Group.SYSTEM_KNOWLEDGE_CHAT_USER, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_KNOWLEDGE_CHAT_USER_EDIT = Permission(
- group=Group.SYSTEM_KNOWLEDGE_CHAT_USER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- SHARED_MODEL_READ = Permission(
- group=Group.SYSTEM_MODEL, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_MODEL], is_ee=settings.edition == "EE"
- )
- SHARED_MODEL_CREATE = Permission(
- group=Group.SYSTEM_MODEL, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_MODEL], is_ee=settings.edition == "EE"
- )
-
- SHARED_MODEL_EDIT = Permission(
- group=Group.SYSTEM_MODEL, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_MODEL], is_ee=settings.edition == "EE"
- )
- SHARED_MODEL_DELETE = Permission(
- group=Group.SYSTEM_MODEL, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_MODEL], is_ee=settings.edition == "EE"
- )
- SHARED_MODEL_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_MODEL, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.SHARED_MODEL], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_READ = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_EDIT = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_DELETE = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_EXPORT = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_COPY = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.COPY,
- role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_AUTH = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_PUBLISH = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_TRIGGER_READ = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.TRIGGER_READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_TRIGGER_CREATE = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.TRIGGER_CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_TRIGGER_EDIT = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.TRIGGER_EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_TRIGGER_DELETE = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.TRIGGER_DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_RES_APPLICATION, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_OVERVIEW_READ = Permission(
- group=Group.SYSTEM_RES_APPLICATION_OVERVIEW, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_OVERVIEW_EMBED = Permission(
- group=Group.SYSTEM_RES_APPLICATION_OVERVIEW, operate=Operate.EMBED, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_OVERVIEW_ACCESS = Permission(
- group=Group.SYSTEM_RES_APPLICATION_OVERVIEW, operate=Operate.ACCESS, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_OVERVIEW_DISPLAY = Permission(
- group=Group.SYSTEM_RES_APPLICATION_OVERVIEW, operate=Operate.DISPLAY, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_OVERVIEW_API_KEY = Permission(
- group=Group.SYSTEM_RES_APPLICATION_OVERVIEW, operate=Operate.API_KEY, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_OVERVIEW_PUBLIC = Permission(
- group=Group.SYSTEM_RES_APPLICATION_OVERVIEW, operate=Operate.PUBLIC_ACCESS, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- # 应用接入
- RESOURCE_APPLICATION_ACCESS_READ = Permission(
- group=Group.SYSTEM_RES_APPLICATION_ACCESS, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_ACCESS_EDIT = Permission(
- group=Group.SYSTEM_RES_APPLICATION_ACCESS, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_USER_READ = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_USER, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_USER_EDIT = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_USER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_LOG_READ = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_LOG, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_LOG_ADD_KNOWLEDGE = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_LOG, operate=Operate.ADD_KNOWLEDGE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_LOG_ANNOTATION = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_LOG, operate=Operate.ANNOTATION, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_LOG_EXPORT = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_LOG, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- RESOURCE_APPLICATION_CHAT_LOG_CLEAR_POLICY = Permission(
- group=Group.SYSTEM_RES_APPLICATION_CHAT_LOG, operate=Operate.CLEAR_POLICY, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_APPLICATION], is_ee=settings.edition == "EE"
- )
- # 知识库
- RESOURCE_KNOWLEDGE_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DELETE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_SYNC = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.SYNC, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_EXPORT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_PUBLISH = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_VECTOR = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.VECTOR, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_GENERATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.GENERATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_AUTH = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- # 文档
- RESOURCE_KNOWLEDGE_WORKFLOW_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_WORKFLOW, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_WORKFLOW_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_WORKFLOW, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_WORKFLOW_EXPORT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_WORKFLOW, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_WORKFLOW_PUBLISH = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_WORKFLOW, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_CREATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_DELETE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_SYNC = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.SYNC, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_EXPORT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_DOWNLOAD_SOURCE_FILE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.DOWNLOAD, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_GENERATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.GENERATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_VECTOR = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.VECTOR, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_MIGRATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.MIGRATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_TAG = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.TAG, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_DOCUMENT_REPLACE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_DOCUMENT, operate=Operate.REPLACE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_HIT_TEST = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_HIT_TEST, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_PROBLEM_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_PROBLEM, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_PROBLEM_CREATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_PROBLEM, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_PROBLEM_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_PROBLEM, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_PROBLEM_DELETE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_PROBLEM, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_PROBLEM_RELATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_PROBLEM, operate=Operate.RELATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TERMBASE_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TERMBASE, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TERMBASE_CREATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TERMBASE, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TERMBASE_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TERMBASE, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TERMBASE_DELETE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TERMBASE, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TERMBASE_EXPORT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TERMBASE, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TAG_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TAG, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TAG_CREATE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TAG, operate=Operate.CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TAG_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TAG, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_TAG_DELETE = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_TAG, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_CHAT_USER_READ = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_CHAT_USER, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_KNOWLEDGE_CHAT_USER_EDIT = Permission(
- group=Group.SYSTEM_RES_KNOWLEDGE_CHAT_USER, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_KNOWLEDGE], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_READ = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_EDIT = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_DELETE = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_EXPORT = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_PUBLISH = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.PUBLISH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_AUTH = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_EXECUTE_RECORD = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.RECORD, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_TRIGGER_READ = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_TRIGGER_CREATE = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_CREATE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_TRIGGER_EDIT = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_TOOL_TRIGGER_DELETE = Permission(
- group=Group.SYSTEM_RES_TOOL, operate=Operate.TRIGGER_DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_TOOL], is_ee=settings.edition == "EE"
- )
- RESOURCE_MODEL_READ = Permission(
- group=Group.SYSTEM_RES_MODEL, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_MODEL], is_ee=settings.edition == "EE"
- )
- RESOURCE_MODEL_EDIT = Permission(
- group=Group.SYSTEM_RES_MODEL, operate=Operate.EDIT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_MODEL], is_ee=settings.edition == "EE"
- )
- RESOURCE_MODEL_DELETE = Permission(
- group=Group.SYSTEM_RES_MODEL, operate=Operate.DELETE, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_MODEL], is_ee=settings.edition == "EE"
- )
- RESOURCE_MODEL_AUTH = Permission(
- group=Group.SYSTEM_RES_MODEL, operate=Operate.AUTH, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_MODEL], is_ee=settings.edition == "EE"
- )
- RESOURCE_MODEL_RELATE_RESOURCE_VIEW = Permission(
- group=Group.SYSTEM_RES_MODEL, operate=Operate.RELATE_VIEW, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.RESOURCE_MODEL], is_ee=settings.edition == "EE"
- )
- OPERATION_LOG_READ = Permission(
- group=Group.OPERATION_LOG, operate=Operate.READ, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.OPERATION_LOG]
- )
- OPERATION_LOG_EXPORT = Permission(
- group=Group.OPERATION_LOG, operate=Operate.EXPORT, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.OPERATION_LOG]
- )
- OPERATION_LOG_CLEAR_POLICY = Permission(
- group=Group.OPERATION_LOG, operate=Operate.CLEAR_POLICY, role_list=[RoleConstants.ADMIN],
- parent_group=[SystemGroup.OPERATION_LOG]
- )
-
- def get_workspace_application_permission(self):
- return lambda r, kwargs: Permission(group=self.value.group, operate=self.value.operate,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}/APPLICATION/{kwargs.get('application_id')}")
-
- def get_workspace_knowledge_permission(self):
- return lambda r, kwargs: Permission(group=self.value.group, operate=self.value.operate,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}/KNOWLEDGE/{kwargs.get('knowledge_id')}")
-
- def get_workspace_model_permission(self):
- return lambda r, kwargs: Permission(group=self.value.group, operate=self.value.operate,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}/MODEL/{kwargs.get('model_id')}")
-
- def get_workspace_tool_permission(self):
- return lambda r, kwargs: Permission(group=self.value.group, operate=self.value.operate,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}/TOOL/{kwargs.get('tool_id')}")
-
- def get_workspace_permission(self):
- return lambda r, kwargs: Permission(group=self.value.group, operate=self.value.operate,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}")
-
- def get_workspace_permission_workspace_manage_role(self):
- return lambda r, kwargs: Permission(group=self.value.group, operate=self.value.operate,
- resource_path=
- f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/{RoleConstants.WORKSPACE_MANAGE.value.__str__()}")
-
- def __eq__(self, other):
- if isinstance(other, PermissionConstants):
- return other == self
- else:
- return self.value == other
-
-
-def get_default_permission_list_by_role(role: RoleConstants):
- """
- 根据角色 获取角色对应的权限
- :param role: 角色
- :return: 权限
- """
- return list(map(lambda k: PermissionConstants[k],
- list(filter(lambda k: PermissionConstants[k].value.role_list.__contains__(role),
- PermissionConstants.__members__))))
-
-
-class RolePermissionMapping:
- def __init__(self, role_id, permission_id):
- self.role_id = role_id
- self.permission_id = permission_id
-
-
-class WorkspaceUserRoleMapping:
- def __init__(self, workspace_id, role_id, user_id):
- self.workspace_id = workspace_id
- self.role_id = role_id
- self.user_id = user_id
-
-
-def get_default_role_permission_mapping_list():
- role_permission_mapping_list = [
- [RolePermissionMapping(role.value.name, PermissionConstants[k].value.__str__()) for role in
- PermissionConstants[k].value.role_list] for k in PermissionConstants.__members__]
- return reduce(lambda x, y: [*x, *y], role_permission_mapping_list, [])
-
-
-def get_default_workspace_user_role_mapping_list(user_role_list: list):
- return [WorkspaceUserRoleMapping('default', role.value.name, 'default') for role in RoleConstants if
- user_role_list.__contains__(role.value.name)]
-
-
-def get_permission_list_by_resource_group(resource_group: ResourcePermissionGroup):
- """
- 根据资源组获取权限
- """
- return [PermissionConstants[k].value for k in PermissionConstants.__members__ if
- PermissionConstants[k].value.resource_permission_group_list.__contains__(resource_group)]
-
-
-class ChatAuth:
- def __init__(self,
- current_role_list: List[RoleConstants | Role],
- permission_list: List[PermissionConstants | Permission],
- chat_user_id,
- chat_user_type,
- application_id):
- # 权限列表
- self.permission_list = permission_list
- # 角色列表
- self.role_list = current_role_list
- self.chat_user_id = chat_user_id
- self.chat_user_type = chat_user_type
- self.application_id = application_id
-
-
-class Auth:
- """
- 用于存储当前用户的角色和权限
- """
-
- def __init__(self,
- current_role_list: List[RoleConstants | Role],
- permission_list: List[PermissionConstants | Permission],
- **keywords):
- # 权限列表
- self.permission_list = permission_list
- # 角色列表
- self.role_list = current_role_list
- self.keywords = keywords
-
-
-class CompareConstants(Enum):
- # 或者
- OR = "OR"
- # 并且
- AND = "AND"
-
-
-class ViewPermission:
- def __init__(self, roleList: List[RoleConstants], permissionList: List[PermissionConstants | object],
- compare=CompareConstants.OR):
- self.roleList = roleList
- self.permissionList = permissionList
- self.compare = compare
diff --git a/apps/common/constants/resource_permission_constants.py b/apps/common/constants/resource_permission_constants.py
new file mode 100644
index 00000000000..a692f72d5f4
--- /dev/null
+++ b/apps/common/constants/resource_permission_constants.py
@@ -0,0 +1,43 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎虎
+ @file: resource_permission_constants.py
+ @date:2026/8/4 15:38
+ @desc:
+"""
+from django.db import models
+
+
+class ResourcePermissionConstants(models.TextChoices):
+ """
+ 资源权限组
+ """
+ # 查看
+ VIEW = "VIEW"
+ # 管理
+ MANAGE = "MANAGE"
+ # 角色
+ ROLE = "ROLE"
+
+ def __eq__(self, other):
+ return str(self) == str(other)
+
+
+class ResourceAuthType(models.TextChoices):
+ """
+ 资源授权类型
+ """
+ "当授权类型是Role时候"
+ ROLE = "ROLE"
+
+ """资源权限组"""
+ RESOURCE_PERMISSION_GROUP = "RESOURCE_PERMISSION_GROUP"
+
+
+class AuthTargetType(models.TextChoices):
+ """授权目标"""
+ KNOWLEDGE = 'KNOWLEDGE', '知识库'
+ APPLICATION = 'APPLICATION', '应用'
+ TOOL = 'TOOL', '工具'
+ MODEL = 'MODEL', '模型'
diff --git a/apps/common/event/listener_manage.py b/apps/common/event/listener_manage.py
index f9617bbb417..74fbad95a8c 100644
--- a/apps/common/event/listener_manage.py
+++ b/apps/common/event/listener_manage.py
@@ -31,8 +31,9 @@
Termbase,
)
from knowledge.serializers.common import create_knowledge_index
-from langchain_core.embeddings import Embeddings
+from knowledge.services.paragraph_assets import embed_paragraph_assets
from maxkb.conf import PROJECT_DIR
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
from common.config.embedding_config import VectorStore
from common.db.search import get_dynamics_model, native_search, native_update
@@ -61,7 +62,7 @@ def __init__(self, source_url_list: List[str], selector: str, handler):
class UpdateProblemArgs:
- def __init__(self, problem_id: str, problem_content: str, embedding_model: Embeddings):
+ def __init__(self, problem_id: str, problem_content: str, embedding_model: MaxKBBaseEmbeddingModel):
self.problem_id = problem_id
self.problem_content = problem_content
self.embedding_model = embedding_model
@@ -79,7 +80,7 @@ def __init__(
paragraph_id_list: List[str],
target_document_id: str,
target_knowledge_id: str,
- target_embedding_model: Embeddings = None,
+ target_embedding_model: MaxKBBaseEmbeddingModel = None,
):
self.paragraph_id_list = paragraph_id_list
self.target_document_id = target_document_id
@@ -89,11 +90,11 @@ def __init__(
class ListenerManagement:
@staticmethod
- def embedding_by_problem(args, embedding_model: Embeddings):
+ def embedding_by_problem(args, embedding_model: MaxKBBaseEmbeddingModel):
VectorStore.get_embedding_vector().save(**args, embedding=embedding_model)
@staticmethod
- def embedding_by_paragraph_list(paragraph_id_list, embedding_model: Embeddings):
+ def embedding_by_paragraph_list(paragraph_id_list, embedding_model: MaxKBBaseEmbeddingModel):
try:
data_list = native_search(
{
@@ -117,7 +118,7 @@ def embedding_by_paragraph_list(paragraph_id_list, embedding_model: Embeddings):
)
@staticmethod
- def embedding_by_paragraph_data_list(data_list, paragraph_id_list, embedding_model: Embeddings):
+ def embedding_by_paragraph_data_list(data_list, paragraph_id_list, embedding_model: MaxKBBaseEmbeddingModel):
maxkb_logger.info(
_("Start--->Embedding paragraph: {paragraph_id_list}").format(paragraph_id_list=paragraph_id_list)
)
@@ -130,6 +131,7 @@ def is_save_function():
# 批量向量化
VectorStore.get_embedding_vector().batch_save(data_list, embedding_model, is_save_function)
+ embed_paragraph_assets(paragraph_id_list, embedding_model)
ListenerManagement.update_status(
QuerySet(Paragraph).filter(id__in=paragraph_id_list), TaskType.EMBEDDING, State.SUCCESS
)
@@ -148,7 +150,7 @@ def is_save_function():
)
@staticmethod
- def embedding_by_paragraph(paragraph_id, embedding_model: Embeddings):
+ def embedding_by_paragraph(paragraph_id, embedding_model: MaxKBBaseEmbeddingModel):
"""
向量化段落 根据段落id
@param paragraph_id: 段落id
@@ -180,6 +182,7 @@ def is_the_task_interrupted():
# 批量向量化
VectorStore.get_embedding_vector().batch_save(data_list, embedding_model, is_the_task_interrupted)
+ embed_paragraph_assets([paragraph_id], embedding_model)
# 更新到开始状态
ListenerManagement.update_status(
QuerySet(Paragraph).filter(id=paragraph_id), TaskType.EMBEDDING, State.SUCCESS
@@ -197,7 +200,7 @@ def is_the_task_interrupted():
maxkb_logger.info(_("End--->Embedding paragraph: {paragraph_id}").format(paragraph_id=paragraph_id))
@staticmethod
- def embedding_by_data_list(data_list: List, embedding_model: Embeddings):
+ def embedding_by_data_list(data_list: List, embedding_model: MaxKBBaseEmbeddingModel):
# 批量向量化
VectorStore.get_embedding_vector().batch_save(data_list, embedding_model, lambda: False)
@@ -224,13 +227,11 @@ def tokenize_by_paragraph(paragraph_id):
chunks = paragraph.chunks
# 提前查询一次用户词汇,避免循环内重复查询
user_words = list(
- QuerySet(Termbase)
- .filter(knowledge_id=paragraph.knowledge_id)
- .values_list("content", flat=True)
+ QuerySet(Termbase).filter(knowledge_id=paragraph.knowledge_id).values_list("content", flat=True)
)
data_list = list(QuerySet(Embedding).filter(paragraph_id=paragraph_id))
for data, chunk in zip(data_list, chunks):
- data.search_vector = SearchVector(Value(to_ts_vector(chunk, user_words=user_words)), config='simple')
+ data.search_vector = SearchVector(Value(to_ts_vector(chunk, user_words=user_words)), config="simple")
# 批量保存,减少数据库写入次数
QuerySet(Embedding).filter(paragraph_id=paragraph_id).bulk_update(data_list, ["search_vector"])
@@ -351,7 +352,7 @@ def update_status(query_set: QuerySet, taskType: TaskType, state: State):
lock.release()
@staticmethod
- def embedding_by_document(document_id, embedding_model: Embeddings, state_list=None):
+ def embedding_by_document(document_id, embedding_model: MaxKBBaseEmbeddingModel, state_list=None):
"""
向量化文档
@param state_list:
@@ -412,7 +413,7 @@ def is_the_task_interrupted():
rlock.un_lock("embedding:" + str(document_id))
@staticmethod
- def embedding_by_knowledge(knowledge_id, embedding_model: Embeddings):
+ def embedding_by_knowledge(knowledge_id, embedding_model: MaxKBBaseEmbeddingModel):
"""
向量化知识库
@param knowledge_id: 知识库id
@@ -509,10 +510,18 @@ def hit_test(
top_number: int,
similarity: float,
search_mode: SearchMode,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
+ image_list: list[str] | None = None,
):
return VectorStore.get_embedding_vector().hit_test(
- query_text, knowledge_id, exclude_document_id_list, top_number, similarity, search_mode, embedding
+ query_text,
+ knowledge_id,
+ exclude_document_id_list,
+ top_number,
+ similarity,
+ search_mode,
+ embedding,
+ image_list,
)
@staticmethod
@@ -544,8 +553,8 @@ def is_the_task_interrupted():
.annotate(
reversed_status=Reverse("status"),
task_type_status=Coalesce(
- NullIf(Substr("reversed_status", TaskType.TOKENIZE.value, 1), Value('')),
- Value('n'),
+ NullIf(Substr("reversed_status", TaskType.TOKENIZE.value, 1), Value("")),
+ Value("n"),
),
)
.filter(task_type_status__in=state_list, document_id=document_id)
diff --git a/apps/common/handle/base_to_response.py b/apps/common/handle/base_to_response.py
index 376d1a9ddd7..8f03a68f7f2 100644
--- a/apps/common/handle/base_to_response.py
+++ b/apps/common/handle/base_to_response.py
@@ -1,30 +1,40 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: base_to_response.py
- @date:2024/9/6 16:04
- @desc:
+@project: MaxKB
+@Author:虎
+@file: base_to_response.py
+@date:2024/9/6 16:04
+@desc:
"""
+
from abc import ABC, abstractmethod
from rest_framework import status
class BaseToResponse(ABC):
+ @abstractmethod
+ def to_stream(self, chat_id, chat_record_id, block: dict):
+ """
+ 把一个内容块(content.to_dict())格式化成一帧 SSE 的 data 载荷(JSON 字符串)。
+ 返回 None 表示该块类型在此格式下不表达(消费方跳过)。
+ 只返回 data 载荷,不含 'data:'/'id:' 帧壳,帧壳由消费方拼。
+ """
+ pass
@abstractmethod
- def to_block_response(self, chat_id, chat_record_id, content, is_end, completion_tokens,
- prompt_tokens, other_params: dict = None,
- _status=status.HTTP_200_OK):
+ def to_stream_end(self, chat_id, chat_record_id, usage: dict = None):
+ """
+ 流结束帧(如 OpenAI 的空 delta + finish_reason=stop + 最终用量)。
+ 返回 None 表示该格式无需单独结束帧(如系统格式以 [DONE] 收尾)。
+ """
pass
@abstractmethod
- def to_stream_chunk_response(self, chat_id, chat_record_id, node_id, up_node_id_list, content, is_end,
- completion_tokens,
- prompt_tokens, other_params: dict = None):
+ def to_block(self, chat_id, chat_record_id, contents: list, usage: dict = None, _status=status.HTTP_200_OK):
+ """从聚合后的内容块列表(content.to_dict() 的 list)构造非流式响应。"""
pass
@staticmethod
def format_stream_chunk(response_str):
- return 'data: ' + response_str + '\n\n'
+ return "data: " + response_str + "\n\n"
diff --git a/apps/common/handle/impl/common_handle.py b/apps/common/handle/impl/common_handle.py
index 16c647a9626..99cab6f63c6 100644
--- a/apps/common/handle/impl/common_handle.py
+++ b/apps/common/handle/impl/common_handle.py
@@ -1,14 +1,14 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: tools.py
- @date:2024/9/11 16:41
- @desc:
+@project: MaxKB
+@Author:虎
+@file: tools.py
+@date:2024/9/11 16:41
+@desc:
"""
+
import io
import traceback
-from functools import reduce
from io import BytesIO
from xml.etree.ElementTree import fromstring
from zipfile import ZipFile
@@ -23,8 +23,42 @@
from knowledge.models import File
from PIL import ImageFile
+
ImageFile.LOAD_TRUNCATED_IMAGES = True
-PILImage.MAX_IMAGE_PIXELS = None
+
+# 全局图片解码像素上限(不再禁用 Pillow 的解压炸弹保护)。
+# 超过该上限 Pillow 会告警,超过 2 倍会直接抛错,避免超大图片耗尽 worker 内存。
+PILImage.MAX_IMAGE_PIXELS = 50_000_000
+
+# 内嵌图片解码保护(防解压炸弹 / 超大尺寸图片导致共享 worker OOM)。
+MAX_EMBED_IMAGE_PIXELS = 16_000_000
+MAX_EMBED_IMAGE_AGGREGATE_PIXELS = 64_000_000
+
+# XLSX(zip) 压缩包防护,限制成员数 / 解压后总大小 / 解压膨胀比。
+MAX_EMBED_ARCHIVE_MEMBERS = 10_000
+MAX_EMBED_ARCHIVE_UNCOMPRESSED_BYTES = 1024 * 1024 * 1024
+MAX_EMBED_ARCHIVE_EXPANSION_RATIO = 50
+
+
+def validate_xlsx_archive(archive: ZipFile):
+ infolist = archive.infolist()
+ if len(infolist) > MAX_EMBED_ARCHIVE_MEMBERS:
+ raise ValueError(f"XLSX archive member count exceeds limit: {len(infolist)}")
+ total_uncompressed = sum(info.file_size for info in infolist)
+ total_compressed = sum(info.compress_size for info in infolist)
+ if total_uncompressed > MAX_EMBED_ARCHIVE_UNCOMPRESSED_BYTES:
+ raise ValueError("XLSX archive uncompressed size exceeds limit")
+ if total_compressed > 0 and total_uncompressed > total_compressed * MAX_EMBED_ARCHIVE_EXPANSION_RATIO:
+ raise ValueError("XLSX archive expansion ratio exceeds limit")
+
+
+def validate_xlsx_buffer(buffer):
+ archive = ZipFile(buffer)
+ try:
+ validate_xlsx_archive(archive)
+ finally:
+ archive.close()
+
def parse_element(element) -> {}:
data = {}
@@ -87,15 +121,16 @@ def handle_images(deps, archive: ZipFile) -> []:
def xlsx_embed_cells_images(buffer) -> {}:
archive = ZipFile(buffer)
+ validate_xlsx_archive(archive)
# 解析cellImage.xml文件
deps = get_dependents(archive, get_rels_path("xl/cellimages.xml"))
image_rel = handle_images(deps=deps, archive=archive)
# 工作表及其中图片ID
sheet_list = {}
for item in archive.namelist():
- if not item.startswith('xl/worksheets/sheet'):
+ if not item.startswith("xl/worksheets/sheet"):
continue
- key = item.split('/')[-1].split('.')[0].split('sheet')[-1]
+ key = item.split("/")[-1].split(".")[0].split("sheet")[-1]
sheet_list[key] = parse_element_sheet_xml(fromstring(archive.read(item)))
cell_images_xml = parse_element(fromstring(archive.read("xl/cellimages.xml")))
cell_images_rel = {}
@@ -104,18 +139,11 @@ def xlsx_embed_cells_images(buffer) -> {}:
for cnv, embed in cell_images_xml.items():
cell_images_xml[cnv] = cell_images_rel.get(embed)
result = {}
+ total_pixels = 0
for key, img in cell_images_xml.items():
- all_cells = [
- cell
- for _sheet_id, sheet in sheet_list.items()
- if sheet is not None
- for cell in sheet or []
- ]
-
- image_excel_id_list = [
- cell for cell in all_cells
- if isinstance(cell, str) and key in cell
- ]
+ all_cells = [cell for _sheet_id, sheet in sheet_list.items() if sheet is not None for cell in sheet or []]
+
+ image_excel_id_list = [cell for cell in all_cells if isinstance(cell, str) and key in cell]
# print(key, img)
if img is None:
continue
@@ -123,9 +151,24 @@ def xlsx_embed_cells_images(buffer) -> {}:
image_excel_id = image_excel_id_list[-1]
f = archive.open(img.target)
img_byte = io.BytesIO()
- im = PILImage.open(f).convert('RGB')
- im.save(img_byte, format='JPEG')
- image = File(id=uuid.uuid7(), file_name=img.path, meta={'debug': False, 'content': img_byte.getvalue()})
- result['=' + image_excel_id] = image
+ try:
+ with PILImage.open(f) as im:
+ width, height = im.size
+ pixels = width * height
+ if pixels > MAX_EMBED_IMAGE_PIXELS:
+ maxkb_logger.warning(
+ f"Skip oversized embedded image {img.path}: {width}x{height} pixels exceeds limit"
+ )
+ continue
+ total_pixels += pixels
+ if total_pixels > MAX_EMBED_IMAGE_AGGREGATE_PIXELS:
+ maxkb_logger.warning("Skip embedded images in archive: aggregate pixels exceed limit")
+ break
+ im.convert("RGB").save(img_byte, format="JPEG")
+ except Exception as e:
+ maxkb_logger.error(f"Error decoding image {img.target}: {e}, {traceback.format_exc()}")
+ continue
+ image = File(id=uuid.uuid7(), file_name=img.path, meta={"debug": False, "content": img_byte.getvalue()})
+ result["=" + image_excel_id] = image
archive.close()
return result
diff --git a/apps/common/handle/impl/qa/xlsx_parse_qa_handle.py b/apps/common/handle/impl/qa/xlsx_parse_qa_handle.py
index 71332b1b9e1..ff5987763f6 100644
--- a/apps/common/handle/impl/qa/xlsx_parse_qa_handle.py
+++ b/apps/common/handle/impl/qa/xlsx_parse_qa_handle.py
@@ -1,18 +1,19 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: xlsx_parse_qa_handle.py
- @date:2024/5/21 14:59
- @desc:
+@project: maxkb
+@Author:虎
+@file: xlsx_parse_qa_handle.py
+@date:2024/5/21 14:59
+@desc:
"""
+
import io
import traceback
import openpyxl
from common.handle.base_parse_qa_handle import BaseParseQAHandle, get_title_row_index_dict, get_row_value
-from common.handle.impl.common_handle import xlsx_embed_cells_images
+from common.handle.impl.common_handle import xlsx_embed_cells_images, validate_xlsx_buffer
from common.utils.logger import maxkb_logger
@@ -22,28 +23,26 @@ def handle_sheet(file_name, sheet, image_dict):
title_row_list = next(rows)
title_row_list = [row.value for row in title_row_list]
except Exception as e:
- return {'name': file_name, 'paragraphs': []}
+ return {"name": file_name, "paragraphs": []}
if len(title_row_list) == 0:
- return {'name': file_name, 'paragraphs': []}
+ return {"name": file_name, "paragraphs": []}
title_row_index_dict = get_title_row_index_dict(title_row_list)
paragraph_list = []
for row in rows:
- content = get_row_value(row, title_row_index_dict, 'content')
+ content = get_row_value(row, title_row_index_dict, "content")
if content is None or content.value is None:
continue
- problem = get_row_value(row, title_row_index_dict, 'problem_list')
- problem = str(problem.value) if problem is not None and problem.value is not None else ''
- problem_list = [{'content': p[0:255]} for p in problem.split('\n') if len(p.strip()) > 0]
- title = get_row_value(row, title_row_index_dict, 'title')
- title = str(title.value) if title is not None and title.value is not None else ''
+ problem = get_row_value(row, title_row_index_dict, "problem_list")
+ problem = str(problem.value) if problem is not None and problem.value is not None else ""
+ problem_list = [{"content": p[0:255]} for p in problem.split("\n") if len(p.strip()) > 0]
+ title = get_row_value(row, title_row_index_dict, "title")
+ title = str(title.value) if title is not None and title.value is not None else ""
content = str(content.value)
image = image_dict.get(content, None)
if image is not None:
- content = f''
- paragraph_list.append({'title': title[0:255],
- 'content': content[0:102400],
- 'problem_list': problem_list})
- return {'name': file_name, 'paragraphs': paragraph_list}
+ content = f""
+ paragraph_list.append({"title": title[0:255], "content": content[0:102400], "problem_list": problem_list})
+ return {"name": file_name, "paragraphs": paragraph_list}
class XlsxParseQAHandle(BaseParseQAHandle):
@@ -56,6 +55,7 @@ def support(self, file, get_buffer):
def handle(self, file, get_buffer, save_image):
buffer = get_buffer(file)
try:
+ validate_xlsx_buffer(io.BytesIO(buffer))
workbook = openpyxl.load_workbook(io.BytesIO(buffer))
try:
image_dict: dict = xlsx_embed_cells_images(io.BytesIO(buffer))
@@ -64,12 +64,16 @@ def handle(self, file, get_buffer, save_image):
image_dict = {}
worksheets = workbook.worksheets
worksheets_size = len(worksheets)
- return [row for row in
- [handle_sheet(file.name,
- sheet,
- image_dict) if worksheets_size == 1 and sheet.title == 'Sheet1' else handle_sheet(
- sheet.title, sheet, image_dict) for sheet
- in worksheets] if row is not None]
+ return [
+ row
+ for row in [
+ handle_sheet(file.name, sheet, image_dict)
+ if worksheets_size == 1 and sheet.title == "Sheet1"
+ else handle_sheet(sheet.title, sheet, image_dict)
+ for sheet in worksheets
+ ]
+ if row is not None
+ ]
except Exception as e:
maxkb_logger.error(f"Error processing XLSX file {file.name}: {e}, {traceback.format_exc()}")
- return [{'name': file.name, 'paragraphs': []}]
+ return [{"name": file.name, "paragraphs": []}]
diff --git a/apps/common/handle/impl/qa/zip_parse_qa_handle.py b/apps/common/handle/impl/qa/zip_parse_qa_handle.py
index cdf56ef1524..02b135c368e 100644
--- a/apps/common/handle/impl/qa/zip_parse_qa_handle.py
+++ b/apps/common/handle/impl/qa/zip_parse_qa_handle.py
@@ -20,7 +20,7 @@
from common.handle.impl.qa.csv_parse_qa_handle import CsvParseQAHandle
from common.handle.impl.qa.xls_parse_qa_handle import XlsParseQAHandle
from common.handle.impl.qa.xlsx_parse_qa_handle import XlsxParseQAHandle
-from common.utils.common import parse_md_image
+from common.utils.common import parse_md_image, parse_md_file_link
from knowledge.models import File
@@ -70,42 +70,39 @@ def is_valid_uuid(uuid_str: str):
def get_image_list(result_list: list, zip_files: List[str]):
- """
- 获取图片文件列表
- @param result_list:
- @param zip_files:
- @return:
- """
image_file_list = []
for result in result_list:
for p in result.get('paragraphs', []):
content: str = p.get('content', '')
- image_list = parse_md_image(content)
- for image in image_list:
- search = re.search("\(.*\)", image)
- if search:
- new_image_id = str(uuid.uuid7())
- source_image_path = search.group().replace('(', '').replace(')', '')
- image_path = urljoin(result.get('name'), '.' + source_image_path if source_image_path.startswith(
- '/') else source_image_path)
- if not zip_files.__contains__(image_path):
- continue
- if image_path.startswith('oss/file/') or image_path.startswith('oss/image/'):
- image_id = image_path.replace('oss/file/', '')
- if is_valid_uuid(image_id):
- image_file_list.append({'source_file': image_path,
- 'image_id': image_id})
- else:
- image_file_list.append({'source_file': image_path,
- 'image_id': new_image_id})
- content = content.replace(source_image_path, f'./oss/file/{new_image_id}')
- p['content'] = content
+ tokens = parse_md_image(content) + parse_md_file_link(content)
+ for token in tokens:
+ src_match = re.search(r'\bsrc=["\']([^"\']+)["\']', token)
+ paren_match = re.search(r'\(([^)]*)\)', token)
+ if src_match:
+ source_path = src_match.group(1).strip()
+ elif paren_match:
+ source_path = paren_match.group(1).strip().split(" ")[0]
+ else:
+ continue
+ new_image_id = str(uuid.uuid7())
+ image_path = urljoin(result.get('name'), '.' + source_path if source_path.startswith(
+ '/') else source_path)
+ if image_path not in zip_files:
+ continue
+ if image_path.startswith('oss/file/') or image_path.startswith('oss/image/'):
+ image_id = image_path.replace('oss/file/', '').replace('oss/image/', '')
+ if is_valid_uuid(image_id):
+ image_file_list.append({"source_file": image_path, "image_id": new_image_id})
+ content = content.replace(source_path, f"./oss/file/{new_image_id}")
+ p['content'] = content
else:
- image_file_list.append({'source_file': image_path,
- 'image_id': new_image_id})
- content = content.replace(source_image_path, f'./oss/file/{new_image_id}')
+ image_file_list.append({'source_file': image_path, 'image_id': new_image_id})
+ content = content.replace(source_path, f'./oss/file/{new_image_id}')
p['content'] = content
-
+ else:
+ image_file_list.append({'source_file': image_path, 'image_id': new_image_id})
+ content = content.replace(source_path, f'./oss/file/{new_image_id}')
+ p['content'] = content
return image_file_list
diff --git a/apps/common/handle/impl/response/openai_to_response.py b/apps/common/handle/impl/response/openai_to_response.py
index b4eda362555..98023aef364 100644
--- a/apps/common/handle/impl/response/openai_to_response.py
+++ b/apps/common/handle/impl/response/openai_to_response.py
@@ -1,12 +1,11 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: openai_to_response.py
- @date:2024/9/6 16:08
- @desc:
+@project: MaxKB
+@Author:虎
+@file: openai_to_response.py
+@date:2024/9/6 16:08
+@desc:
"""
-import datetime
from django.http import JsonResponse
from django.utils import timezone
@@ -20,34 +19,102 @@
class OpenaiToResponse(BaseToResponse):
- def to_block_response(self, chat_id, chat_record_id, content, is_end, prompt_tokens, completion_tokens,
- other_params: dict = None,
- _status=status.HTTP_200_OK):
- if other_params is None:
- other_params = {}
- data = ChatCompletion(id=chat_record_id, choices=[
- BlockChoice(finish_reason='stop', index=0, chat_id=chat_id,
- answer_list=other_params.get('answer_list', ""),
- message=ChatCompletionMessage(role='assistant', content=content))],
- created=timezone.now().second, model='', object='chat.completion',
- usage=CompletionUsage(completion_tokens=completion_tokens,
- prompt_tokens=prompt_tokens,
- total_tokens=completion_tokens + prompt_tokens)
- ).dict()
- return JsonResponse(data=data, status=_status)
+ def __init__(self):
+ # per-response 状态:tool_id -> index,逐帧分配,客户端按 index 累加 arguments
+ self._tool_index = {}
+
+ def _to_tool_call_delta(self, block: dict) -> dict:
+ """把一个 ToolContent 块转成 OpenAI 的 delta.tool_calls 项;靠稳定 id 分帧、不缓冲。"""
+ tool_id = block.get("id")
+ first = tool_id not in self._tool_index
+ if first:
+ self._tool_index[tool_id] = len(self._tool_index)
+ index = self._tool_index[tool_id]
+ function = {"arguments": block.get("arguments") or ""}
+ if first:
+ function["name"] = block.get("content") or "" # ToolContent.content = 工具名
+ tool_call = {"index": index, "type": "function", "function": function}
+ if first:
+ tool_call["id"] = tool_id
+ # 非标扩展:result(与 reasoning_content/chat_id 一致),标准客户端忽略、自家客户端读
+ if block.get("result"):
+ tool_call["result"] = block.get("result")
+ return tool_call
+
+ def to_stream(self, chat_id, chat_record_id, block: dict):
+ block_type = block.get("type")
+ delta_kwargs = {"chat_id": chat_id}
+ if block_type == "TEXT":
+ delta_kwargs["content"] = block.get("content", "")
+ elif block_type == "REASONING":
+ delta_kwargs["reasoning_content"] = block.get("content", "")
+ elif block_type == "TOOL":
+ delta_kwargs["tool_calls"] = [self._to_tool_call_delta(block)]
+ else:
+ # FORM / FAILURE 等:OpenAI 流不表达,跳过
+ return None
+ # 内容帧:finish_reason=None、usage=None(用量只在结束帧给,符合 OpenAI 规范)
+ return ChatCompletionChunk(
+ id=str(chat_record_id),
+ model="",
+ object="chat.completion.chunk",
+ created=int(timezone.now().timestamp()),
+ choices=[Choice(delta=ChoiceDelta(**delta_kwargs), finish_reason=None, index=0)],
+ ).json()
- def to_stream_chunk_response(self, chat_id, chat_record_id, node_id, up_node_id_list, content, is_end,
- prompt_tokens,
- completion_tokens, other_params: dict = None):
- if other_params is None:
- other_params = {}
- chunk = ChatCompletionChunk(id=chat_record_id, model='', object='chat.completion.chunk',
- created=timezone.now().second, choices=[
- Choice(delta=ChoiceDelta(content=content, reasoning_content=other_params.get('reasoning_content', ""),
- chat_id=chat_id),
- finish_reason='stop' if is_end else None,
- index=0)],
- usage=CompletionUsage(completion_tokens=completion_tokens,
- prompt_tokens=prompt_tokens,
- total_tokens=completion_tokens + prompt_tokens)).json()
- return super().format_stream_chunk(chunk)
+ def to_stream_end(self, chat_id, chat_record_id, usage: dict = None):
+ # 结束帧:空 delta + finish_reason=stop + 最终用量
+ usage = usage or {}
+ completion_tokens = usage.get("completion_tokens", 0)
+ prompt_tokens = usage.get("prompt_tokens", 0)
+ return ChatCompletionChunk(
+ id=str(chat_record_id),
+ model="",
+ object="chat.completion.chunk",
+ created=int(timezone.now().timestamp()),
+ choices=[Choice(delta=ChoiceDelta(chat_id=chat_id), finish_reason="stop", index=0)],
+ usage=CompletionUsage(
+ completion_tokens=completion_tokens,
+ prompt_tokens=prompt_tokens,
+ total_tokens=completion_tokens + prompt_tokens,
+ ),
+ ).json()
+
+ def to_block(self, chat_id, chat_record_id, contents: list, usage: dict = None, _status=status.HTTP_200_OK):
+ usage = usage or {}
+ answer = "".join(c.get("content", "") for c in (contents or []) if c.get("type") == "TEXT")
+ tool_calls = []
+ for c in contents or []:
+ if c.get("type") != "TOOL":
+ continue
+ tc = {
+ "index": len(tool_calls),
+ "id": c.get("id"),
+ "type": "function",
+ "function": {"name": c.get("content") or "", "arguments": c.get("arguments") or ""},
+ }
+ if c.get("result"):
+ tc["result"] = c.get("result")
+ tool_calls.append(tc)
+ message_kwargs = {"role": "assistant", "content": answer}
+ if tool_calls:
+ message_kwargs["tool_calls"] = tool_calls
+ completion_tokens = usage.get("completion_tokens", 0)
+ prompt_tokens = usage.get("prompt_tokens", 0)
+ data = ChatCompletion(
+ id=str(chat_record_id),
+ choices=[
+ BlockChoice(
+ finish_reason="stop", index=0, chat_id=chat_id, message=ChatCompletionMessage(**message_kwargs)
+ )
+ ],
+ created=int(timezone.now().timestamp()),
+ model="",
+ object="chat.completion",
+ usage=CompletionUsage(
+ completion_tokens=completion_tokens,
+ prompt_tokens=prompt_tokens,
+ total_tokens=completion_tokens + prompt_tokens,
+ ),
+ ).dict()
+ return JsonResponse(data=data, status=_status)
diff --git a/apps/common/handle/impl/response/system_to_response.py b/apps/common/handle/impl/response/system_to_response.py
index a1a530dba08..daabc6cc1b5 100644
--- a/apps/common/handle/impl/response/system_to_response.py
+++ b/apps/common/handle/impl/response/system_to_response.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: system_to_response.py
- @date:2024/9/6 18:03
- @desc:
+@project: MaxKB
+@Author:虎
+@file: system_to_response.py
+@date:2024/9/6 18:03
+@desc:
"""
+
import json
from rest_framework import status
@@ -15,27 +16,35 @@
class SystemToResponse(BaseToResponse):
- def to_block_response(self, chat_id, chat_record_id, content, is_end, completion_tokens,
- prompt_tokens, other_params: dict = None,
- _status=status.HTTP_200_OK):
- if other_params is None:
- other_params = {}
- return result.success({'chat_id': str(chat_id), 'id': str(chat_record_id), 'operate': True,
- 'content': content, 'is_end': is_end, **other_params,
- 'completion_tokens': completion_tokens, 'prompt_tokens': prompt_tokens},
- response_status=_status,
- code=_status)
+ def to_stream(self, chat_id, chat_record_id, block: dict):
+ # 沿用前端在解析的信封 shape:{chat_id, chat_record_id, content:[block]}
+ # 系统格式所有块类型都原样下发(block 即 content.to_dict())
+ return json.dumps(
+ {
+ "chat_id": str(chat_id),
+ "chat_record_id": str(chat_record_id),
+ "content": [{**block, "chat_id": str(chat_id), "chat_record_id": str(chat_record_id)}],
+ },
+ ensure_ascii=False,
+ )
+
+ def to_stream_end(self, chat_id, chat_record_id, usage: dict = None):
+ # 系统格式以 [DONE] 收尾,无需单独结束帧
+ return None
- def to_stream_chunk_response(self, chat_id, chat_record_id, node_id, up_node_id_list, content, is_end,
- completion_tokens,
- prompt_tokens, other_params: dict = None):
- if other_params is None:
- other_params = {}
- chunk = json.dumps({'chat_id': str(chat_id), 'chat_record_id': str(chat_record_id), 'operate': True,
- 'content': content, 'node_id': node_id, 'up_node_id_list': up_node_id_list,
- 'is_end': is_end,
- 'usage': {'completion_tokens': completion_tokens,
- 'prompt_tokens': prompt_tokens,
- 'total_tokens': completion_tokens + prompt_tokens},
- **other_params})
- return super().format_stream_chunk(chunk)
+ def to_block(self, chat_id, chat_record_id, contents: list, usage: dict = None, _status=status.HTTP_200_OK):
+ usage = usage or {}
+ answer = "".join(c.get("content", "") for c in (contents or []) if c.get("type") == "TEXT")
+ return result.success(
+ {
+ "chat_id": str(chat_id),
+ "id": str(chat_record_id),
+ "operate": True,
+ "content": answer,
+ "is_end": True,
+ "completion_tokens": usage.get("completion_tokens", 0),
+ "prompt_tokens": usage.get("prompt_tokens", 0),
+ },
+ response_status=_status,
+ code=_status,
+ )
diff --git a/apps/common/handle/impl/table/xlsx_parse_table_handle.py b/apps/common/handle/impl/table/xlsx_parse_table_handle.py
index 2acf5aa1a95..fb76678b282 100644
--- a/apps/common/handle/impl/table/xlsx_parse_table_handle.py
+++ b/apps/common/handle/impl/table/xlsx_parse_table_handle.py
@@ -6,14 +6,15 @@
from openpyxl import load_workbook
from common.handle.base_parse_table_handle import BaseParseTableHandle
-from common.handle.impl.common_handle import xlsx_embed_cells_images
+from common.handle.impl.common_handle import xlsx_embed_cells_images, validate_xlsx_buffer
+from common.handle.impl.xlsx_utils import iter_sheet_content_rows
from common.utils.logger import maxkb_logger
class XlsxParseTableHandle(BaseParseTableHandle):
def support(self, file, get_buffer):
file_name: str = file.name.lower()
- if file_name.endswith('.xlsx'):
+ if file_name.endswith(".xlsx"):
return True
return False
@@ -22,14 +23,19 @@ def fill_merged_cells(self, sheet, image_dict):
# 获取第一行作为标题行
headers = []
- for idx, cell in enumerate(sheet[1]):
+ rows = iter_sheet_content_rows(sheet)
+ try:
+ title_row = next(rows)
+ except StopIteration:
+ return data
+ for idx, cell in enumerate(title_row):
if cell.value is None:
- headers.append(' ' * (idx + 1))
+ headers.append(" " * (idx + 1))
else:
headers.append(cell.value)
# 从第二行开始遍历每一行
- for row in sheet.iter_rows(min_row=2, values_only=False):
+ for row in rows:
row_data = {}
for col_idx, cell in enumerate(row):
cell_value = cell.value
@@ -41,10 +47,10 @@ def fill_merged_cells(self, sheet, image_dict):
cell_value = sheet[merged_range.min_row][merged_range.min_col - 1].value
break
if cell_value is None:
- cell_value = ''
+ cell_value = ""
image = image_dict.get(cell_value, None)
if image is not None:
- cell_value = f''
+ cell_value = f""
# 使用标题作为键,单元格的值作为值存入字典
row_data[headers[col_idx]] = cell_value
@@ -55,6 +61,7 @@ def fill_merged_cells(self, sheet, image_dict):
def handle(self, file, get_buffer, save_image):
buffer = get_buffer(file)
try:
+ validate_xlsx_buffer(io.BytesIO(buffer))
wb = load_workbook(io.BytesIO(buffer))
try:
image_dict: dict = xlsx_embed_cells_images(io.BytesIO(buffer))
@@ -70,13 +77,13 @@ def handle(self, file, get_buffer, save_image):
for row in data:
row_output = "; ".join([f"{key}: {value}" for key, value in row.items()])
# print(row_output)
- paragraphs.append({'title': '', 'content': row_output})
+ paragraphs.append({"title": "", "content": row_output})
- result.append({'name': sheetname, 'paragraphs': paragraphs})
+ result.append({"name": sheetname, "paragraphs": paragraphs})
except BaseException as e:
maxkb_logger.error(f"Error processing XLSX file {file.name}: {e}, {traceback.format_exc()}")
- return [{'name': file.name, 'paragraphs': []}]
+ return [{"name": file.name, "paragraphs": []}]
return result
def get_content(self, file, save_image):
@@ -88,9 +95,9 @@ def get_content(self, file, save_image):
if len(image_dict) > 0:
save_image(image_dict.values())
except Exception as e:
- maxkb_logger.error(f'Exception: {e}')
+ maxkb_logger.error(f"Exception: {e}")
image_dict = {}
- md_tables = ''
+ md_tables = ""
# 遍历所有工作表
for sheetname in workbook.sheetnames:
sheet = workbook[sheetname]
@@ -99,22 +106,25 @@ def get_content(self, file, save_image):
continue
# 添加 sheet 名称作为标题
- md_tables += f'## {sheetname}\n\n'
+ md_tables += f"## {sheetname}\n\n"
# 提取表头和内容
headers = [f"{key}" for key, value in rows[0].items()]
# 构建 Markdown 表格
- md_table = '| ' + ' | '.join(headers) + ' |\n'
- md_table += '| ' + ' | '.join(['---'] * len(headers)) + ' |\n'
+ md_table = "| " + " | ".join(headers) + " |\n"
+ md_table += "| " + " | ".join(["---"] * len(headers)) + " |\n"
for row in rows:
- r = [f'{value}' for key, value in row.items()]
- md_table += '| ' + ' | '.join(
- [str(cell).replace('\n', '
') if cell is not None else '' for cell in r]) + ' |\n'
+ r = [f"{value}" for key, value in row.items()]
+ md_table += (
+ "| "
+ + " | ".join([str(cell).replace("\n", "
") if cell is not None else "" for cell in r])
+ + " |\n"
+ )
- md_tables += md_table + '\n\n'
+ md_tables += md_table + "\n\n"
return md_tables
except Exception as e:
- maxkb_logger.error(f'excel split handle error: {e}')
- return f'error: {e}'
+ maxkb_logger.error(f"excel split handle error: {e}")
+ return f"error: {e}"
diff --git a/apps/common/handle/impl/text/pdf_split_handle.py b/apps/common/handle/impl/text/pdf_split_handle.py
index dde048887a1..3e416285b94 100644
--- a/apps/common/handle/impl/text/pdf_split_handle.py
+++ b/apps/common/handle/impl/text/pdf_split_handle.py
@@ -14,13 +14,15 @@
import traceback
from typing import List
+import uuid_utils.compat as uuid
+from django.utils.translation import gettext_lazy as _
from pypdf import PdfReader
from pypdf.generic import Destination
-from django.utils.translation import gettext_lazy as _
from common.handle.base_split_handle import BaseSplitHandle
from common.utils.logger import maxkb_logger
from common.utils.split_model import SplitModel, smart_split_paragraph
+from knowledge.models import File
default_pattern_list = [
re.compile("(?<=^)# .*|(?<=\\n)# .*"),
@@ -76,25 +78,19 @@ def handle(
return {"name": file.name, "content": result}
# 没目录但是有链接的pdf
- result = self.handle_links(
- pdf_document, pattern_list, with_filter, limit
- )
+ result = self.handle_links(pdf_document, pattern_list, with_filter, limit)
if result is not None and len(result) > 0:
return {"name": file.name, "content": result}
# 没有目录的pdf
- content = self.handle_pdf_content(file, pdf_document)
+ content = self.handle_pdf_content(file, pdf_document, save_image)
if pattern_list is not None and len(pattern_list) > 0:
split_model = SplitModel(pattern_list, with_filter, limit)
else:
- split_model = SplitModel(
- default_pattern_list, with_filter=with_filter, limit=limit
- )
+ split_model = SplitModel(default_pattern_list, with_filter=with_filter, limit=limit)
except BaseException as e:
- maxkb_logger.error(
- f"File: {file.name}, error: {e}, {traceback.format_exc()}"
- )
+ maxkb_logger.error(f"File: {file.name}, error: {e}, {traceback.format_exc()}")
return {"name": file.name, "content": []}
finally:
# 处理完后可以删除临时文件
@@ -103,7 +99,7 @@ def handle(
return {"name": file.name, "content": split_model.parse(content)}
@staticmethod
- def handle_pdf_content(file, pdf_document):
+ def handle_pdf_content(file, pdf_document, save_image):
# 第一步:收集所有字体大小
font_sizes = []
page_lines = []
@@ -124,6 +120,7 @@ def handle_pdf_content(file, pdf_document):
# 第二步:提取内容
content = ""
+ image_list = []
for page_num, page in enumerate(pdf_document.pages):
start_time = time.time()
@@ -142,15 +139,22 @@ def handle_pdf_content(file, pdf_document):
content += f"{text}\n"
for image_index in range(PdfSplitHandle.get_page_image_count(page)):
- content += f"\n\n"
+ try:
+ image = page.images[image_index]
+ except Exception as e:
+ maxkb_logger.warning(f"File: {file.name}, Page: {page_num + 1}, Image: {image_index}, error: {e}")
+ continue
+ image_id = uuid.uuid7()
+ image_list.append(File(id=image_id, file_name=image.name, meta={"debug": False, "content": image.data}))
+ content += f"\n\n"
content = content.replace("\0", "")
elapsed_time = time.time() - start_time
- maxkb_logger.debug(
- f"File: {file.name}, Page: {page_num + 1}, Time: {elapsed_time:.3f}s"
- )
+ maxkb_logger.debug(f"File: {file.name}, Page: {page_num + 1}, Time: {elapsed_time:.3f}s")
+ if image_list:
+ save_image(image_list)
return content
@staticmethod
@@ -228,7 +232,80 @@ def collect_toc(doc, outline, level, toc):
title = item.get("/Title")
if title is None:
title = str(item)
- toc.append((level, str(title).replace("\0", ""), page_number))
+ toc.append(
+ (
+ level,
+ str(title).replace("\0", ""),
+ page_number,
+ PdfSplitHandle.get_destination_top(item),
+ )
+ )
+
+ @staticmethod
+ def get_destination_top(destination):
+ top = getattr(destination, "top", None)
+ try:
+ return float(top)
+ except (TypeError, ValueError):
+ return None
+
+ @staticmethod
+ def extract_page_text_by_position(page, top=None, bottom=None):
+ if top is None and bottom is None:
+ return PdfSplitHandle.extract_page_text(page)
+
+ text_parts = []
+
+ def visitor_text(text, cm, tm, font_dict, font_size):
+ if not text:
+ return
+
+ # Text matrix coordinates can be relative to a page-level transform.
+ # Convert the text origin to PDF user-space coordinates before comparing
+ # it with the outline destination's /Top value.
+ x = tm[4] if len(tm) > 4 else 0
+ y = tm[5] if len(tm) > 5 else 0
+ if len(cm) > 5:
+ y = x * cm[1] + y * cm[3] + cm[5]
+
+ if top is not None and y > top:
+ return
+ if bottom is not None and y <= bottom:
+ return
+ text_parts.append(text)
+
+ try:
+ page.extract_text(visitor_text=visitor_text)
+ except BaseException:
+ return PdfSplitHandle.extract_page_text(page)
+ return "".join(text_parts).replace("\0", "")
+
+ @staticmethod
+ def remove_leading_title(text, *titles):
+ for title in titles:
+ title = title.strip()
+ if not title:
+ continue
+ pattern = r"^\s*" + r"\s*".join(re.escape(char) for char in title)
+ stripped_text, count = re.subn(pattern, "", text, count=1)
+ if count:
+ return stripped_text
+ return text
+
+ @staticmethod
+ def discard_ambiguous_destination_tops(toc):
+ position_counts = {}
+ for _level, _title, page_number, top in toc:
+ if top is not None:
+ position = (page_number, top)
+ position_counts[position] = position_counts.get(position, 0) + 1
+
+ ambiguous_tops = {top for (_page_number, top), count in position_counts.items() if count > 1}
+
+ return [
+ (level, title, page_number, None if top in ambiguous_tops else top)
+ for level, title, page_number, top in toc
+ ]
@staticmethod
def handle_toc(doc, limit):
@@ -236,19 +313,29 @@ def handle_toc(doc, limit):
toc = PdfSplitHandle.get_toc(doc)
if toc is None or len(toc) == 0:
return None
+ # Some PDF generators assign the same default position to every bookmark
+ # on a page. Such coordinates cannot define chapter boundaries, so preserve
+ # the title-based behavior for those entries.
+ toc = PdfSplitHandle.discard_ambiguous_destination_tops(toc)
# 创建存储章节内容的数组
chapters = []
# 遍历目录并按章节提取文本
for i, entry in enumerate(toc):
- level, title, start_page = entry
+ level, title, start_page, start_top = entry
chapter_title = title
# 确定结束页码,如果是最后一个章节则到文档末尾
if i + 1 < len(toc):
- end_page = toc[i + 1][2] - 1
+ _next_level, next_title, next_start_page, next_top = toc[i + 1]
+ # A positioned bookmark can start partway down a page. Include that
+ # page and keep only the text above the next bookmark for this chapter.
+ end_page = next_start_page if next_top is not None else next_start_page - 1
else:
end_page = len(doc.pages) - 1
+ next_title = None
+ next_start_page = None
+ next_top = None
end_page = max(start_page, end_page)
# 去掉标题中的符号
@@ -257,20 +344,23 @@ def handle_toc(doc, limit):
# 提取该章节的文本内容
chapter_text = ""
for page_num in range(start_page, end_page + 1):
- text = PdfSplitHandle.extract_page_text(doc.pages[page_num])
+ page_top = start_top if page_num == start_page else None
+ page_bottom = next_top if page_num == next_start_page else None
+ text = PdfSplitHandle.extract_page_text_by_position(doc.pages[page_num], page_top, page_bottom)
text = re.sub(r"(? -1:
- text = text[idx + len(title) :]
+ if page_num == start_page:
+ if start_top is not None:
+ text = PdfSplitHandle.remove_leading_title(text, chapter_title, title)
+ else:
+ idx = text.find(title)
+ if idx > -1:
+ text = text[idx + len(title) :]
- if i + 1 < len(toc):
- _level, next_title, next_start_page = toc[i + 1]
- next_title = PdfSplitHandle.handle_chapter_title(next_title)
- # print(f'next_title: {next_title}')
- idx = text.find(next_title)
+ if next_title is not None and next_top is None:
+ handled_next_title = PdfSplitHandle.handle_chapter_title(next_title)
+ idx = text.find(handled_next_title)
if idx > -1:
text = text[:idx]
@@ -284,12 +374,16 @@ def handle_toc(doc, limit):
if 0 < limit < len(chapter_text):
split_text = smart_split_paragraph(chapter_text, limit)
for text in split_text:
- chapters.append({"title": real_chapter_title, "content": text})
+ chapters.append(
+ {"title": real_chapter_title, "content": text.encode("utf-8", "ignore").decode("utf-8")}
+ )
else:
chapters.append(
{
"title": real_chapter_title,
- "content": chapter_text if chapter_text else real_chapter_title,
+ "content": (chapter_text if chapter_text else real_chapter_title)
+ .encode("utf-8", "ignore")
+ .decode("utf-8"),
}
)
# 保存章节内容和章节标题
@@ -334,13 +428,9 @@ def handle_links(doc, pattern_list, with_filter, limit):
next_link = links[num + 1] if num + 1 < len(links) else None
next_link_title = None
if next_link is not None:
- next_link_title = PdfSplitHandle.extract_link_title(
- page, next_link["from"]
- )
+ next_link_title = PdfSplitHandle.extract_link_title(page, next_link["from"])
if not next_link_title:
- next_link_title = PdfSplitHandle.extract_first_line(
- doc.pages[next_link["page"]]
- )
+ next_link_title = PdfSplitHandle.extract_first_line(doc.pages[next_link["page"]])
end_page = next_link["page"]
# 提取章节内容
@@ -383,24 +473,14 @@ def handle_links(doc, pattern_list, with_filter, limit):
else:
pre_toc[-1]["content"] += line
for i in range(len(pre_toc)):
- pre_toc[i]["content"] = re.sub(
- r"(? 0:
split_model = SplitModel(pattern_list, with_filter, limit)
else:
- split_model = SplitModel(
- default_pattern_list, with_filter=with_filter, limit=limit
- )
+ split_model = SplitModel(default_pattern_list, with_filter=with_filter, limit=limit)
# 插入目录前的部分
page_content = re.sub(r"(?= len(doc.pages):
continue
rect = annotation.get("/Rect")
- links.append(
- {"page": dest_page, "from": PdfSplitHandle.normalize_rect(rect)}
- )
+ links.append({"page": dest_page, "from": PdfSplitHandle.normalize_rect(rect)})
return links
@staticmethod
@@ -465,9 +541,7 @@ def get_destination_page_number(doc, destination):
return PdfSplitHandle.get_page_number_by_reference(doc, destination[0])
if hasattr(destination, "get") and destination.get("/D") is not None:
- return PdfSplitHandle.get_destination_page_number(
- doc, destination.get("/D")
- )
+ return PdfSplitHandle.get_destination_page_number(doc, destination.get("/D"))
return None
@@ -511,8 +585,7 @@ def visitor_text(text, cm, tm, font_dict, font_size):
text_top = y + (float(font_size) if font_size else 0)
in_horizontal_range = left - tolerance <= x <= right + tolerance
in_vertical_range = (
- bottom - tolerance <= y <= top + tolerance
- or bottom - tolerance <= text_top <= top + tolerance
+ bottom - tolerance <= y <= top + tolerance or bottom - tolerance <= text_top <= top + tolerance
)
if in_horizontal_range and in_vertical_range:
text_parts.append(text)
@@ -552,7 +625,7 @@ def get_content(self, file, save_image):
try:
with open(temp_file_path, "rb") as pdf_file:
pdf_document = PdfReader(pdf_file)
- return self.handle_pdf_content(file, pdf_document)
+ return self.handle_pdf_content(file, pdf_document, save_image)
except BaseException as e:
traceback.print_exception(e)
return f"{e}"
diff --git a/apps/common/handle/impl/text/xlsx_split_handle.py b/apps/common/handle/impl/text/xlsx_split_handle.py
index 13f9c41d17b..4da581c0e93 100644
--- a/apps/common/handle/impl/text/xlsx_split_handle.py
+++ b/apps/common/handle/impl/text/xlsx_split_handle.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: xlsx_parse_qa_handle.py
- @date:2024/5/21 14:59
- @desc:
+@project: maxkb
+@Author:虎
+@file: xlsx_parse_qa_handle.py
+@date:2024/5/21 14:59
+@desc:
"""
+
import io
import traceback
from typing import List
@@ -14,39 +15,46 @@
from openpyxl import load_workbook
from common.handle.base_split_handle import BaseSplitHandle
-from common.handle.impl.common_handle import xlsx_embed_cells_images
+from common.handle.impl.common_handle import xlsx_embed_cells_images, validate_xlsx_buffer
+from common.handle.impl.xlsx_utils import iter_sheet_content_rows
from common.utils.logger import maxkb_logger
-splitter = '\n`-----------------------------------`\n'
+splitter = "\n`-----------------------------------`\n"
def post_cell(image_dict, cell_value):
image = image_dict.get(cell_value, None)
if image is not None:
- return f''
- return cell_value.replace('\n', '
').replace('|', '|')
+ return f""
+ return cell_value.replace("\n", "
").replace("|", "|")
def row_to_md(row, image_dict):
- return '| ' + ' | '.join(
- [post_cell(image_dict, str(cell.value if cell.value is not None else '')) if cell is not None else '' for cell
- in row]) + ' |\n'
+ return (
+ "| "
+ + " | ".join(
+ [
+ post_cell(image_dict, str(cell.value if cell.value is not None else "")) if cell is not None else ""
+ for cell in row
+ ]
+ )
+ + " |\n"
+ )
def handle_sheet(file_name, sheet, image_dict, limit: int):
- rows = sheet.rows
+ rows = iter_sheet_content_rows(sheet)
paragraphs = []
- result = {'name': file_name, 'content': paragraphs}
+ result = {"name": file_name, "content": paragraphs}
try:
title_row_list = next(rows)
title_md_content = row_to_md(title_row_list, image_dict)
- title_md_content += '| ' + ' | '.join(
- ['---' if cell is not None else '' for cell in title_row_list]) + ' |\n'
+ title_md_content += "| " + " | ".join(["---" if cell is not None else "" for cell in title_row_list]) + " |\n"
except Exception as e:
return result
if len(title_row_list) == 0:
return result
- result_item_content = ''
+ result_item_content = ""
for row in rows:
next_md_content = row_to_md(row, image_dict)
next_md_content_len = len(next_md_content)
@@ -58,10 +66,10 @@ def handle_sheet(file_name, sheet, image_dict, limit: int):
if result_item_content_len + next_md_content_len < limit:
result_item_content += next_md_content
else:
- paragraphs.append({'content': result_item_content, 'title': ''})
+ paragraphs.append({"content": result_item_content, "title": ""})
result_item_content = title_md_content + next_md_content
if len(result_item_content) > 0:
- paragraphs.append({'content': result_item_content, 'title': ''})
+ paragraphs.append({"content": result_item_content, "title": ""})
return result
@@ -71,14 +79,19 @@ def fill_merged_cells(self, sheet, image_dict):
# 获取第一行作为标题行
headers = []
- for idx, cell in enumerate(sheet[1]):
+ rows = iter_sheet_content_rows(sheet)
+ try:
+ title_row = next(rows)
+ except StopIteration:
+ return data
+ for idx, cell in enumerate(title_row):
if cell.value is None:
- headers.append(' ' * (idx + 1))
+ headers.append(" " * (idx + 1))
else:
headers.append(cell.value)
# 从第二行开始遍历每一行
- for row in sheet.iter_rows(min_row=2, values_only=False):
+ for row in rows:
row_data = {}
for col_idx, cell in enumerate(row):
cell_value = cell.value
@@ -92,7 +105,7 @@ def fill_merged_cells(self, sheet, image_dict):
image = image_dict.get(cell_value, None)
if image is not None:
- cell_value = f''
+ cell_value = f""
# 使用标题作为键,单元格的值作为值存入字典
row_data[headers[col_idx]] = cell_value
@@ -103,6 +116,7 @@ def fill_merged_cells(self, sheet, image_dict):
def handle(self, file, pattern_list: List, with_filter: bool, limit: int, get_buffer, save_image):
buffer = get_buffer(file)
try:
+ validate_xlsx_buffer(io.BytesIO(buffer))
if type(limit) is str:
limit = int(limit)
workbook = openpyxl.load_workbook(io.BytesIO(buffer))
@@ -113,16 +127,19 @@ def handle(self, file, pattern_list: List, with_filter: bool, limit: int, get_bu
image_dict = {}
worksheets = workbook.worksheets
worksheets_size = len(worksheets)
- return [row for row in
- [handle_sheet(file.name,
- sheet,
- image_dict,
- limit) if worksheets_size == 1 and sheet.title == 'Sheet1' else handle_sheet(
- sheet.title, sheet, image_dict, limit) for sheet
- in worksheets] if row is not None]
+ return [
+ row
+ for row in [
+ handle_sheet(file.name, sheet, image_dict, limit)
+ if worksheets_size == 1 and sheet.title == "Sheet1"
+ else handle_sheet(sheet.title, sheet, image_dict, limit)
+ for sheet in worksheets
+ ]
+ if row is not None
+ ]
except Exception as e:
maxkb_logger.error(f"Error processing XLSX file {file.name}: {e}, {traceback.format_exc()}")
- return [{'name': file.name, 'content': []}]
+ return [{"name": file.name, "content": []}]
def get_content(self, file, save_image):
try:
@@ -133,9 +150,9 @@ def get_content(self, file, save_image):
if len(image_dict) > 0:
save_image(image_dict.values())
except Exception as e:
- maxkb_logger.error(f'Exception: {e}')
+ maxkb_logger.error(f"Exception: {e}")
image_dict = {}
- md_tables = ''
+ md_tables = ""
# 遍历所有工作表
for sheetname in workbook.sheetnames:
sheet = workbook[sheetname]
@@ -144,41 +161,41 @@ def get_content(self, file, save_image):
continue
# 添加 sheet 名称作为标题
- md_tables += f'## {sheetname}\n\n'
+ md_tables += f"## {sheetname}\n\n"
# 提取表头和内容
headers = [f"{key}" for key, value in rows[0].items()]
# 构建 Markdown 表格
- md_table = '| ' + ' | '.join(headers) + ' |\n'
- md_table += '| ' + ' | '.join(['---'] * len(headers)) + ' |\n'
+ md_table = "| " + " | ".join(headers) + " |\n"
+ md_table += "| " + " | ".join(["---"] * len(headers)) + " |\n"
for row in rows:
r = [self._escape_cell_content(value) for key, value in row.items()]
- md_table += '| ' + ' | '.join(r) + ' |\n'
+ md_table += "| " + " | ".join(r) + " |\n"
- md_tables += md_table + '\n\n'
+ md_tables += md_table + "\n\n"
return md_tables
except Exception as e:
- maxkb_logger.error(f'excel split handle error: {e}')
- return f'error: {e}'
+ maxkb_logger.error(f"excel split handle error: {e}")
+ return f"error: {e}"
def _escape_cell_content(self, cell_value):
"""转义单元格内容,避免破坏 Markdown 表格结构"""
if cell_value is None:
- return ''
+ return ""
cell_str = str(cell_value)
# 替换换行符为
- cell_str = cell_str.replace('\n', '
')
+ cell_str = cell_str.replace("\n", "
")
# 转义管道符 | 为 HTML 实体
- cell_str = cell_str.replace('|', '|')
+ cell_str = cell_str.replace("|", "|")
# 如果内容包含反引号,需要转义
- if '`' in cell_str:
- cell_str = cell_str.replace('`', '`')
+ if "`" in cell_str:
+ cell_str = cell_str.replace("`", "`")
return cell_str
diff --git a/apps/common/handle/impl/text/zip_split_handle.py b/apps/common/handle/impl/text/zip_split_handle.py
index 75e418665d9..14f1b7c310a 100644
--- a/apps/common/handle/impl/text/zip_split_handle.py
+++ b/apps/common/handle/impl/text/zip_split_handle.py
@@ -91,7 +91,8 @@ def _collect_file_refs(tokens: list, base_name: str, zip_files: List[str], conte
if file_path.startswith("oss/file/") or file_path.startswith("oss/image/"):
file_id = file_path.replace("oss/file/", "").replace("oss/image/", "")
if is_valid_uuid(file_id):
- file_list.append({"source_file": file_path, "image_id": file_id})
+ file_list.append({"source_file": file_path, "image_id": new_id})
+ content = update_content(content, source_path, f"./oss/file/{new_id}")
else:
file_list.append({"source_file": file_path, "image_id": new_id})
content = update_content(content, source_path, f"./oss/file/{new_id}")
diff --git a/apps/common/handle/impl/xlsx_utils.py b/apps/common/handle/impl/xlsx_utils.py
new file mode 100644
index 00000000000..3cd99defe96
--- /dev/null
+++ b/apps/common/handle/impl/xlsx_utils.py
@@ -0,0 +1,15 @@
+# coding=utf-8
+
+
+def get_sheet_content_max_column(sheet):
+ return max(
+ (cell.column for cell in sheet._cells.values() if cell.value is not None),
+ default=0,
+ )
+
+
+def iter_sheet_content_rows(sheet, min_row=1):
+ max_column = get_sheet_content_max_column(sheet)
+ if max_column == 0:
+ return iter(())
+ return sheet.iter_rows(min_row=min_row, max_col=max_column)
diff --git a/apps/common/init/init_doc.py b/apps/common/init/init_doc.py
index 156275e4ae6..09154e4fed1 100644
--- a/apps/common/init/init_doc.py
+++ b/apps/common/init/init_doc.py
@@ -1,51 +1,91 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: init_doc.py
- @date:2024/5/24 14:11
- @desc:
+@project: maxkb
+@Author:虎
+@file: init_doc.py
+@date:2024/5/24 14:11
+@desc:
"""
+
import hashlib
-from django.urls import path, URLPattern
+from django.urls import path, URLPattern, URLResolver
from drf_spectacular.views import SpectacularAPIView, SpectacularSwaggerView, SpectacularRedocView
from maxkb.const import CONFIG
-chat_api_prefix = CONFIG.get_chat_path()[1:] + '/api/'
+chat_api_prefix = CONFIG.get_chat_path()[1:] + "/api/"
+
+
+def flatten_url_patterns(patterns, prefix=""):
+ """
+ 递归展开 urlpatterns,遇到 include() 产生的 URLResolver 时向下钻取,
+ 累加各层路由前缀,最终产出 (完整路由字符串, URLPattern) 元组。
+ """
+ for entry in patterns:
+ if isinstance(entry, URLResolver):
+ yield from flatten_url_patterns(entry.url_patterns, prefix + str(entry.pattern))
+ elif isinstance(entry, URLPattern):
+ yield prefix + str(entry.pattern), entry
def init_app_doc(system_urlpatterns):
system_urlpatterns += [
- path(f'{CONFIG.get_admin_path()[1:]}/api-doc/schema/', SpectacularAPIView.as_view(), name='schema'),
+ path(f"{CONFIG.get_admin_path()[1:]}/api-doc/schema/", SpectacularAPIView.as_view(), name="schema"),
# schema的配置文件的路由,下面两个ui也是根据这个配置文件来生成的
- path(f'{CONFIG.get_admin_path()[1:]}/api-doc/', SpectacularSwaggerView.as_view(url_name='schema'),
- name='swagger-ui'), # swagger-ui的路由
+ path(
+ f"{CONFIG.get_admin_path()[1:]}/api-doc/",
+ SpectacularSwaggerView.as_view(url_name="schema"),
+ name="swagger-ui",
+ ), # swagger-ui的路由
]
class ChatSpectacularSwaggerView(SpectacularSwaggerView):
@staticmethod
def _swagger_ui_resource(filename):
- return f'{CONFIG.get_chat_path()}/api-doc/swagger-ui-dist/{filename}'
+ return f"{CONFIG.get_chat_path()}/api-doc/swagger-ui-dist/{filename}"
@staticmethod
def _swagger_ui_favicon():
- return f'{CONFIG.get_chat_path()}/api-doc/swagger-ui-dist/favicon-32x32.png'
+ return f"{CONFIG.get_chat_path()}/api-doc/swagger-ui-dist/favicon-32x32.png"
+
+
+def build_curated_patterns(chat_urlpatterns, doc_names):
+ """按 name 集合从(递归展开后的)chat 路由里挑出 curated 端点,重建为带完整 path 的 URLPattern。"""
+ return [
+ URLPattern(
+ pattern=f"{chat_api_prefix}{full_path}", callback=url.callback, default_args=url.default_args, name=url.name
+ )
+ for full_path, url in flatten_url_patterns(chat_urlpatterns)
+ if doc_names.__contains__(getattr(url, "name", None))
+ ]
def init_chat_doc(system_urlpatterns, chat_urlpatterns):
+ chat_path = CONFIG.get_chat_path()[1:]
+ v3_patterns = build_curated_patterns(
+ chat_urlpatterns,
+ ["v3_chat", "v3_open", "v3_profile", "v3_portal_application", "v3_portal_historical_conversation"],
+ )
+ v2_patterns = build_curated_patterns(chat_urlpatterns, ["chat", "open", "profile", "anonymous"])
system_urlpatterns += [
- path(f'{CONFIG.get_chat_path()[1:]}/api-doc/schema/',
- SpectacularAPIView.as_view(patterns=[
- URLPattern(pattern=f'{chat_api_prefix}{str(url.pattern)}', callback=url.callback,
- default_args=url.default_args,
- name=url.name) for url in chat_urlpatterns if
- ['chat', 'open', 'profile'].__contains__(url.name)]),
- name='chat_schema'), # schema的配置文件的路由,下面两个ui也是根据这个配置文件来生成的
- path(f'{CONFIG.get_chat_path()[1:]}/api-doc/', ChatSpectacularSwaggerView.as_view(url_name='chat_schema'),
- name='swagger-ui'), # swagger-ui的路由
+ # v3 curated 文档(主路径)
+ path(
+ f"{chat_path}/api-doc/schema/", SpectacularAPIView.as_view(patterns=v3_patterns), name="chat_schema"
+ ), # schema的配置文件的路由,下面ui根据它生成
+ path(
+ f"{chat_path}/api-doc/", ChatSpectacularSwaggerView.as_view(url_name="chat_schema"), name="swagger-ui"
+ ), # swagger-ui的路由
+ # v2 curated 文档(保留)
+ path(
+ f"{chat_path}/api-doc/v2/schema/", SpectacularAPIView.as_view(patterns=v2_patterns), name="chat_schema_v2"
+ ),
+ path(
+ f"{chat_path}/api-doc/v2/",
+ ChatSpectacularSwaggerView.as_view(url_name="chat_schema_v2"),
+ name="swagger-ui-v2",
+ ),
]
@@ -58,23 +98,40 @@ def encrypt(text):
def get_call(application_urlpatterns, patterns, params, func):
def run():
- if params['valid']():
- func(*params['get_params'](application_urlpatterns, patterns))
+ if params["valid"]():
+ func(*params["get_params"](application_urlpatterns, patterns))
return run
-init_list = [(init_app_doc, {'valid': lambda: CONFIG.get('DOC_PASSWORD') is not None and encrypt(
- CONFIG.get('DOC_PASSWORD')) == 'd4fc097197b4b90a122b92cbd5bbe867',
- 'get_call': get_call,
- 'get_params': lambda application_urlpatterns, patterns: (application_urlpatterns,)}),
- (init_chat_doc, {'valid': lambda: CONFIG.get('DOC_PASSWORD') is not None and encrypt(
- CONFIG.get('DOC_PASSWORD')) == 'd4fc097197b4b90a122b92cbd5bbe867' or True, 'get_call': get_call,
- 'get_params': lambda application_urlpatterns, patterns: (
- application_urlpatterns, patterns)})]
+init_list = [
+ (
+ init_app_doc,
+ {
+ "valid": lambda: (
+ CONFIG.get("DOC_PASSWORD") is not None
+ and encrypt(CONFIG.get("DOC_PASSWORD")) == "d4fc097197b4b90a122b92cbd5bbe867"
+ ),
+ "get_call": get_call,
+ "get_params": lambda application_urlpatterns, patterns: (application_urlpatterns,),
+ },
+ ),
+ (
+ init_chat_doc,
+ {
+ "valid": lambda: (
+ CONFIG.get("DOC_PASSWORD") is not None
+ and encrypt(CONFIG.get("DOC_PASSWORD")) == "d4fc097197b4b90a122b92cbd5bbe867"
+ or True
+ ),
+ "get_call": get_call,
+ "get_params": lambda application_urlpatterns, patterns: (application_urlpatterns, patterns),
+ },
+ ),
+]
def init_doc(system_urlpatterns, chat_patterns):
for init, params in init_list:
- if params['valid']():
+ if params["valid"]():
get_call(system_urlpatterns, chat_patterns, params, init)()
diff --git a/apps/common/job/__init__.py b/apps/common/job/__init__.py
index 4984886b423..8b4aa3542c1 100644
--- a/apps/common/job/__init__.py
+++ b/apps/common/job/__init__.py
@@ -1,14 +1,16 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py
- @date:2024/3/14 11:54
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py
+@date:2024/3/14 11:54
+@desc:
"""
+
from .clean_chat_job import *
from .clean_debug_file_job import *
from .client_access_num_job import *
+from knowledge.services.knowledge_sync_schedule import restore_knowledge_sync_jobs
def run():
@@ -16,3 +18,4 @@ def run():
clean_chat_job.run()
clean_debug_file_job.run()
client_access_num_job.run()
+ restore_knowledge_sync_jobs()
diff --git a/apps/common/job/clean_chat_job.py b/apps/common/job/clean_chat_job.py
index eab82630dac..e90d5e58c7f 100644
--- a/apps/common/job/clean_chat_job.py
+++ b/apps/common/job/clean_chat_job.py
@@ -3,10 +3,11 @@
import datetime
from django.db import transaction
-from django.db.models import Q, Max
+from django.db.models import CharField, Q, Max
+from django.db.models.functions import Cast
from django.utils import timezone
-from application.models import Application, Chat, ChatRecord
+from application.models import Application, Chat, ChatRecord, ApplicationChatUserStats
from common.job.scheduler import scheduler
from common.utils.lock import lock, RedisLock
from common.utils.logger import maxkb_logger
@@ -17,19 +18,17 @@ def clean_chat_log_job():
clean_chat_log_job_lock()
-@lock(lock_key='clean_chat_log_job_execute', timeout=30)
+@lock(lock_key="clean_chat_log_job_execute", timeout=30)
def clean_chat_log_job_lock():
from django.utils.translation import gettext_lazy as _
- maxkb_logger.info(_('start clean chat log'))
+
+ maxkb_logger.info(_("start clean chat log"))
now = timezone.now()
- applications = Application.objects.all().values('id', 'clean_time', 'file_clean_time')
- cutoff_dates = {
- app['id']: now - datetime.timedelta(days=app['clean_time'] or 180)
- for app in applications
- }
+ applications = Application.objects.all().values("id", "clean_time", "file_clean_time")
+ cutoff_dates = {app["id"]: now - datetime.timedelta(days=app["clean_time"] or 180) for app in applications}
file_cutoff_dates = {
- app['id']: now - datetime.timedelta(days=app['file_clean_time'] or app['clean_time'] or 180)
+ app["id"]: now - datetime.timedelta(days=app["file_clean_time"] or app["clean_time"] or 180)
for app in applications
}
file_conditions = Q()
@@ -42,69 +41,132 @@ def clean_chat_log_job_lock():
query_conditions |= Q(chat__application_id=app_id, create_time__lt=cutoff_date)
clean_method(query_conditions)
- maxkb_logger.info(_('end clean chat log'))
+ maxkb_logger.info(_("end clean chat log"))
+
+
+def delete_orphan_chats(orphan_chat_ids):
+ if not orphan_chat_ids:
+ return
+
+ orphan_chats = list(Chat.objects.filter(id__in=orphan_chat_ids))
+
+ # 按 (application_id, chat_user_id) 收集孤儿会话的用户,
+ # 仅当该用户在该应用下不再有其它会话时才删除其访问统计,避免误删其他应用或仍活跃用户的统计
+ app_user_ids = {}
+ for chat in orphan_chats:
+ if chat.chat_user_id:
+ chat_user_id = str(chat.chat_user_id)
+ app_user_ids.setdefault(chat.application_id, set()).add(chat_user_id)
+
+ if app_user_ids:
+ all_user_ids = set()
+ for user_ids in app_user_ids.values():
+ all_user_ids.update(user_ids)
+
+ remaining_keys = (
+ Chat.objects.filter(
+ application_id__in=app_user_ids.keys(),
+ chat_user_id__in=all_user_ids,
+ )
+ .exclude(id__in=orphan_chat_ids)
+ .values_list("application_id", "chat_user_id")
+ .distinct()
+ )
+
+ remaining_app_user_ids = {}
+ for app_id, user_id in remaining_keys:
+ remaining_app_user_ids.setdefault(app_id, set()).add(user_id)
+
+ for app_id, user_ids in app_user_ids.items():
+ user_ids_to_delete = user_ids - remaining_app_user_ids.get(app_id, set())
+ if user_ids_to_delete:
+ ApplicationChatUserStats.objects.annotate(
+ chat_user_id_str=Cast("chat_user_id", output_field=CharField(max_length=128))
+ ).filter(
+ application_id=app_id,
+ chat_user_id_str__in=user_ids_to_delete,
+ ).delete()
+
+ deleted_chat_count, _ = Chat.objects.filter(id__in=orphan_chat_ids).delete()
+ maxkb_logger.info(f"[clean_chat_log] delete orphan chats, count={deleted_chat_count}")
def clean_method(query_conditions, clean_log=True):
batch_size = 500
+ last_record_id = None
while True:
with transaction.atomic():
- chat_records = ChatRecord.objects.filter(query_conditions).select_related('chat').only('id', 'chat_id',
- 'create_time')[
- :batch_size]
+ records = ChatRecord.objects.filter(query_conditions)
+ if last_record_id is not None:
+ records = records.filter(id__gt=last_record_id)
+ chat_records = list(records.order_by("id").only("id", "chat_id", "create_time")[:batch_size])
if not chat_records:
break
+ last_record_id = chat_records[-1].id
chat_record_ids = [record.id for record in chat_records]
chat_ids = {record.chat_id for record in chat_records}
# 计算每个 chat_id 的最大 create_time
- max_create_times = ChatRecord.objects.filter(id__in=chat_record_ids).values('chat_id').annotate(
- max_create_time=Max('create_time'))
+ max_create_times = (
+ ChatRecord.objects.filter(id__in=chat_record_ids)
+ .values("chat_id")
+ .annotate(max_create_time=Max("create_time"))
+ )
# 收集需要删除的文件
files_to_delete = []
- for record in chat_records:
- max_create_time = next(
- (item['max_create_time'] for item in max_create_times if
- str(item['chat_id']) == str(record.chat_id)), None)
- if max_create_time:
- files_to_delete.extend(
- File.objects.filter(source_id=str(record.chat_id), create_time__lt=max_create_time)
- )
+ for item in max_create_times:
+ files_to_delete.extend(
+ File.objects.filter(source_id=str(item["chat_id"]), create_time__lt=item["max_create_time"])
+ )
# 删除 ChatRecord
- deleted_count = 0
if clean_log:
deleted_count = ChatRecord.objects.filter(id__in=chat_record_ids).delete()[0]
+ maxkb_logger.info(f"[clean_chat_log] delete chat_records, count={deleted_count}")
from django.db.models import Count
- updated_counts = ChatRecord.objects.filter(chat_id__in=chat_ids) \
- .values('chat_id') \
- .annotate(count=Count('id'))
- count_map = {item['chat_id']: item['count'] for item in updated_counts}
+ updated_counts = (
+ ChatRecord.objects.filter(chat_id__in=chat_ids).values("chat_id").annotate(count=Count("id"))
+ )
+
+ count_map = {item["chat_id"]: item["count"] for item in updated_counts}
for chat_id in chat_ids:
count = count_map.get(chat_id, 0) # 如果没有记录则为0
Chat.objects.filter(id=chat_id).update(chat_record_count=count)
- # 删除没有关联 ChatRecord 的 Chat
- Chat.objects.filter(chatrecord__isnull=True, id__in=chat_ids).delete()
- File.objects.filter(loid__in=[file.loid for file in files_to_delete]).delete()
+ # 删除已经没有关联 ChatRecord 的 Chat
+ orphan_chat_ids = [chat_id for chat_id in chat_ids if count_map.get(chat_id, 0) == 0]
+ delete_orphan_chats(orphan_chat_ids)
+ File.objects.filter(id__in=[file.id for file in files_to_delete]).delete()
- if deleted_count < batch_size:
+ if len(chat_records) < batch_size:
break
+ if clean_log:
+ orphan_chat_ids = list(Chat.objects.filter(chatrecord__isnull=True).values_list("id", flat=True))
+ maxkb_logger.info(f"[clean_chat_log] final orphan_chat_count={len(orphan_chat_ids)}")
+ delete_orphan_chats(orphan_chat_ids)
+
def run():
rlock = RedisLock()
- if rlock.try_lock('clean_chat_log_job', 30 * 30):
+ if rlock.try_lock("clean_chat_log_job", 30 * 30):
try:
- maxkb_logger.debug('get lock clean_chat_log_job')
+ maxkb_logger.debug("get lock clean_chat_log_job")
- existing_job = scheduler.get_job(job_id='clean_chat_log')
+ existing_job = scheduler.get_job(job_id="clean_chat_log")
if existing_job is not None:
existing_job.remove()
- scheduler.add_job(clean_chat_log_job, 'cron', hour='0', minute='5', id='clean_chat_log',
- misfire_grace_time=300, max_instances=1)
+ scheduler.add_job(
+ clean_chat_log_job,
+ "cron",
+ hour="0",
+ minute="5",
+ id="clean_chat_log",
+ misfire_grace_time=300,
+ max_instances=1,
+ )
finally:
- rlock.un_lock('clean_chat_log_job')
+ rlock.un_lock("clean_chat_log_job")
diff --git a/apps/common/log/log.py b/apps/common/log/log.py
index faca1cdf881..272acef689d 100644
--- a/apps/common/log/log.py
+++ b/apps/common/log/log.py
@@ -1,12 +1,11 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: log.py
- @date:2025/6/4 14:13
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: log.py
+@date:2025/6/4 14:13
+@desc:
"""
-from qianfan.utils.utils import get_ip_address
from system_manage.models.log_management import Log
@@ -17,11 +16,11 @@ def _get_ip_address(request):
@param request:
@return:
"""
- x_forwarded_for = request.META.get('HTTP_X_FORWARDED_FOR')
+ x_forwarded_for = request.META.get("HTTP_X_FORWARDED_FOR")
if x_forwarded_for:
- ip = x_forwarded_for.split(',')[0]
+ ip = x_forwarded_for.split(",")[0]
else:
- ip = request.META.get('REMOTE_ADDR')
+ ip = request.META.get("REMOTE_ADDR")
return ip
@@ -33,9 +32,9 @@ def _get_user(request):
"""
user = request.user
if user is None:
- return {
-
- }
+ return {}
+ if hasattr(user, 'profile') and user.profile is not None:
+ user = user.profile
user_info = {
"id": str(user.id),
"email": user.email,
@@ -43,9 +42,8 @@ def _get_user(request):
"nick_name": user.nick_name,
"username": user.username,
}
- # 如果是 User 模型且有 role 属性
- if hasattr(user, 'role'):
- user_info['role'] = user.role
+ if hasattr(user, "role"):
+ user_info["role"] = user.role
return user_info
@@ -53,28 +51,31 @@ def _get_details(request):
path = request.path
body = request.data
- sensitive_fields = {'password', 're_password'}
+ sensitive_fields = {"password", "re_password"}
- body_copy = dict(body) if hasattr(body, 'items') else body
+ body_copy = dict(body) if hasattr(body, "items") else body
if isinstance(body_copy, dict):
for field in sensitive_fields:
body_copy.pop(field, None)
query = request.query_params
- return {
- 'path': path,
- 'body': body_copy,
- 'query': query
- }
+ return {"path": path, "body": body_copy, "query": query}
def _get_workspace_id(request, kwargs):
- return kwargs.get('workspace_id', 'None')
-
-
-def log(menu: str, operate, get_user=_get_user, get_ip_address=_get_ip_address, get_details=_get_details,
- get_operation_object=None, get_workspace_id=_get_workspace_id):
+ return kwargs.get("workspace_id", "None")
+
+
+def log(
+ menu: str,
+ operate,
+ get_user=_get_user,
+ get_ip_address=_get_ip_address,
+ get_details=_get_details,
+ get_operation_object=None,
+ get_workspace_id=_get_workspace_id,
+):
"""
记录审计日志
@param menu: 操作菜单 str
@@ -110,17 +111,33 @@ def run(view, request, **kwargs):
if callable(operate):
_operate = operate(request)
# 插入审计日志
- Log(menu=menu, operate=_operate, user=user, status=status, ip_address=ip, details=details,
- operation_object=operation_object, workspace_id=workspace_id).save()
+ Log(
+ menu=menu,
+ operate=_operate,
+ user=user,
+ status=status,
+ ip_address=ip,
+ details=details,
+ operation_object=operation_object,
+ workspace_id=workspace_id,
+ ).save()
return run
return inner
-def record_log(menu: str, operate: str, request, user: dict = None, status: int = 200,
- get_details=_get_details, get_operation_object=None, workspace_id: str = 'default',
- operation_object: dict = None):
+def record_log(
+ menu: str,
+ operate: str,
+ request,
+ user: dict = None,
+ status: int = 200,
+ get_details=_get_details,
+ get_operation_object=None,
+ workspace_id: str = "default",
+ operation_object: dict = None,
+):
"""
手动记录审计日志(适用于无法使用装饰器的场景,如第三方登录回调)
@@ -154,7 +171,7 @@ def record_log(menu: str, operate: str, request, user: dict = None, status: int
ip_address=ip,
details=details,
operation_object=operation_object or {},
- workspace_id=workspace_id
+ workspace_id=workspace_id,
).save()
except Exception as e:
# 日志记录失败不应影响主业务流程
diff --git a/apps/common/mcp/__init__.py b/apps/common/mcp/__init__.py
new file mode 100644
index 00000000000..7e622b56dc7
--- /dev/null
+++ b/apps/common/mcp/__init__.py
@@ -0,0 +1 @@
+"""Shared MCP configuration and sandbox workers."""
diff --git a/apps/common/mcp/client.py b/apps/common/mcp/client.py
new file mode 100644
index 00000000000..767af83f15b
--- /dev/null
+++ b/apps/common/mcp/client.py
@@ -0,0 +1,12 @@
+"""Compatibility exports and client factory for the dedicated MCP backend."""
+
+from application.workflow.backend.sandbox_mcp import SandboxMCPBackend
+from common.mcp.config import InternalMCPConfig, validate_mcp_servers
+
+
+__all__ = ["InternalMCPConfig", "validate_mcp_servers", "create_mcp_client"]
+
+
+def create_mcp_client(servers):
+ """Keep existing callers compatible with the dedicated MCP backend."""
+ return SandboxMCPBackend(servers)
diff --git a/apps/common/mcp/config.py b/apps/common/mcp/config.py
new file mode 100644
index 00000000000..868f4947496
--- /dev/null
+++ b/apps/common/mcp/config.py
@@ -0,0 +1,32 @@
+"""Shared MCP configuration types and validation."""
+
+import json
+
+
+REMOTE_FIELDS = {"transport", "url", "headers", "timeout", "sse_read_timeout", "terminate_on_close"}
+
+
+class InternalMCPConfig(dict):
+ """In-memory provenance for configurations generated by ToolExecutor.
+
+ Never deserialize user input into this type. JSON round trips deliberately
+ lose this privilege; keep runtime configurations in memory instead.
+ """
+
+
+def validate_mcp_servers(servers):
+ if not isinstance(servers, dict):
+ raise ValueError("MCP servers must be an object")
+ for config in servers.values():
+ if not isinstance(config, dict) or config.get("transport") not in ("sse", "streamable_http"):
+ raise ValueError("Only support transport=sse or transport=streamable_http")
+ if not isinstance(config.get("url"), str) or not config["url"].strip():
+ raise ValueError("MCP server URL must be a non-empty string")
+
+
+def remote_connection(config):
+ """Copy serializable transport data, excluding commands and SDK callbacks."""
+ remote = {key: value for key, value in config.items() if key in REMOTE_FIELDS}
+ if remote.get("transport") == "sse":
+ remote.pop("terminate_on_close", None)
+ return json.loads(json.dumps(remote, allow_nan=False))
diff --git a/apps/common/mcp/sandbox.py b/apps/common/mcp/sandbox.py
new file mode 100644
index 00000000000..65c936f1929
--- /dev/null
+++ b/apps/common/mcp/sandbox.py
@@ -0,0 +1,66 @@
+"""Build fixed stdio worker connections; user configuration never selects code."""
+
+import json
+import pwd
+import sys
+from datetime import timedelta
+from importlib.machinery import PathFinder
+from pathlib import Path
+
+from mcp.types import Implementation
+
+from common.mcp.config import remote_connection
+from maxkb.const import CONFIG
+
+
+BOOTSTRAP_KEY = "maxkbSandbox"
+
+
+def sandbox_settings():
+ if not bool(int(CONFIG.get("SANDBOX", 1))):
+ raise ValueError("MCP sandbox is disabled")
+ if not sys.platform.startswith("linux"):
+ raise ValueError("MCP sandbox requires Linux; set SANDBOX=0 for local development")
+ account = pwd.getpwnam("sandbox")
+ sandbox_home = Path(CONFIG.get("SANDBOX_HOME", "/opt/maxkb-app/sandbox"))
+ library = sandbox_home / "lib/sandbox.so"
+ if not library.is_file() or not library.with_name(".sandbox.conf").is_file():
+ raise ValueError("MCP sandbox library or configuration is missing")
+ return {
+ "uid": account.pw_uid,
+ "gid": account.pw_gid,
+ "library": str(library),
+ "cwd": str(sandbox_home),
+ "python_paths": CONFIG.get_sandbox_python_package_paths().split(","),
+ "memory_mb": int(CONFIG.get("SANDBOX_PYTHON_PROCESS_LIMIT_MEM_MB", "256")),
+ "cpu_cores": int(CONFIG.get("SANDBOX_PYTHON_PROCESS_LIMIT_CPU_CORES", "1")),
+ "timeout": int(CONFIG.get("SANDBOX_PYTHON_PROCESS_LIMIT_TIMEOUT_SECONDS", "3600")),
+ }
+
+
+def sandbox_connection(config):
+ settings = sandbox_settings()
+ # Release builds replace source files with adjacent, sourceless .pyc files.
+ # Search only our installed directory, never a user-controlled module path.
+ worker = PathFinder.find_spec("sandbox_worker", [str(Path(__file__).parent)])
+ if worker is None or worker.origin is None or Path(worker.origin).suffix not in (".py", ".pyc"):
+ raise RuntimeError("MCP sandbox worker is missing or has an unsupported format")
+ # Only transport data goes to the remote client. In particular, ignore user
+ # command/env/factory/session_kwargs fields and never deserialize Python code.
+ bootstrap = {"connection": remote_connection(config)}
+ return {
+ "transport": "stdio",
+ "command": sys.executable,
+ "args": ["-I", worker.origin],
+ "cwd": settings["cwd"],
+ "env": {
+ "LD_PRELOAD": settings["library"],
+ "MAXKB_MCP_WORKER_SETTINGS": json.dumps(settings),
+ },
+ "session_kwargs": {
+ "read_timeout_seconds": timedelta(seconds=settings["timeout"]),
+ # This field travels only over the child's stdio pipe. The worker
+ # removes it before forwarding initialize to the remote server.
+ "client_info": Implementation(name="maxkb-sandbox", version="1", **{BOOTSTRAP_KEY: bootstrap}),
+ },
+ }
diff --git a/apps/common/mcp/sandbox_proxy.py b/apps/common/mcp/sandbox_proxy.py
new file mode 100644
index 00000000000..7b4e7928bff
--- /dev/null
+++ b/apps/common/mcp/sandbox_proxy.py
@@ -0,0 +1,162 @@
+"""Forward MCP messages without converting tools, results or notifications."""
+
+from contextlib import asynccontextmanager
+import logging
+import os
+import socket
+import ssl
+import sys
+
+import anyio
+import httpx
+from mcp.client.sse import sse_client
+from mcp.client.streamable_http import streamable_http_client
+from mcp.server.stdio import stdio_server
+from mcp.shared._httpx_utils import create_mcp_http_client
+from mcp.types import JSONRPCRequest
+
+
+def sandbox_failure_message(error):
+ # SDK exception groups and chained HTTP errors can embed credentials. Only
+ # report numeric HTTP statuses or fixed descriptions, never exception text.
+ errors, pending, seen = [], [error], set()
+ while pending:
+ current = pending.pop()
+ if id(current) in seen:
+ continue
+ seen.add(id(current))
+ errors.append(current)
+ if isinstance(current, BaseExceptionGroup):
+ pending.extend(current.exceptions)
+ if current.__cause__ is not None:
+ pending.append(current.__cause__)
+ for current in errors:
+ if isinstance(current, httpx.HTTPStatusError):
+ return f"MCP endpoint returned HTTP {current.response.status_code}; check endpoint and credentials"
+ for exception_type, message in (
+ (ssl.SSLCertVerificationError, "MCP TLS certificate verification failed"),
+ (socket.gaierror, "MCP hostname resolution failed; check container DNS"),
+ (PermissionError, "MCP access denied; check sandbox file and network policy"),
+ ((httpx.TimeoutException, TimeoutError), "MCP connection timed out"),
+ (httpx.TooManyRedirects, "MCP endpoint returned too many redirects"),
+ (httpx.ConnectError, "MCP connection failed; check container connectivity and sandbox network policy"),
+ ):
+ if any(isinstance(current, exception_type) for current in errors):
+ return message
+ return "MCP session failed; check endpoint, sandbox setup and network policy"
+
+
+class PipeInput:
+ """Cancellable pipe reads; a blocked readline thread would delay shutdown."""
+
+ def __init__(self):
+ self.fd = sys.stdin.fileno()
+ os.set_blocking(self.fd, False)
+ self.buffer = b""
+
+ def __aiter__(self):
+ return self
+
+ async def __anext__(self):
+ while b"\n" not in self.buffer:
+ await anyio.wait_readable(self.fd)
+ try:
+ chunk = os.read(self.fd, 65536)
+ except BlockingIOError:
+ continue
+ if not chunk:
+ raise StopAsyncIteration
+ self.buffer += chunk
+ if len(self.buffer) > 32 * 1024 * 1024:
+ raise ValueError("MCP message exceeds sandbox limit")
+ line, self.buffer = self.buffer.split(b"\n", 1)
+ return line.decode("utf-8")
+
+
+class PipeOutput:
+ def __init__(self):
+ self.fd = sys.stdout.fileno()
+ os.set_blocking(self.fd, False)
+
+ async def write(self, value):
+ remaining = value.encode("utf-8")
+ while remaining:
+ await anyio.wait_writable(self.fd)
+ try:
+ written = os.write(self.fd, remaining)
+ except BlockingIOError:
+ continue
+ remaining = remaining[written:]
+
+ async def flush(self):
+ pass
+
+
+def extract_bootstrap(message):
+ request = message.message.root
+ if not isinstance(request, JSONRPCRequest) or request.method != "initialize":
+ raise ValueError("MCP sandbox requires initialize first")
+ params = dict(request.params or {})
+ client_info = dict(params.get("clientInfo") or {})
+ bootstrap = client_info.pop("maxkbSandbox", None)
+ if not isinstance(bootstrap, dict):
+ raise ValueError("Missing MCP sandbox bootstrap")
+ params["clientInfo"] = client_info
+ request.params = params
+ return bootstrap
+
+
+@asynccontextmanager
+async def remote_transport(bootstrap):
+ config = bootstrap["connection"]
+ if config.get("transport") not in ("sse", "streamable_http"):
+ raise ValueError("Unsupported external MCP transport")
+ timeout = config.get("timeout", 5 if config["transport"] == "sse" else 30)
+ read_timeout = config.get("sse_read_timeout", 300)
+ if config["transport"] == "sse":
+ async with sse_client(
+ config["url"],
+ headers=config.get("headers"),
+ timeout=timeout,
+ sse_read_timeout=read_timeout,
+ ) as streams:
+ yield streams
+ else:
+ async with create_mcp_http_client(
+ headers=config.get("headers"),
+ timeout=httpx.Timeout(timeout, read=read_timeout),
+ ) as client:
+ async with streamable_http_client(
+ config["url"],
+ http_client=client,
+ terminate_on_close=config.get("terminate_on_close", True),
+ ) as (read, write, _):
+ yield read, write
+
+
+async def forward(source, destination, cancel_scope):
+ try:
+ async for message in source:
+ if isinstance(message, Exception):
+ raise message
+ await destination.send(message)
+ finally:
+ cancel_scope.cancel()
+
+
+async def proxy():
+ async with stdio_server(stdin=PipeInput(), stdout=PipeOutput()) as (local_read, local_write):
+ with anyio.fail_after(30):
+ first = await local_read.receive()
+ bootstrap = extract_bootstrap(first)
+ async with remote_transport(bootstrap) as (remote_read, remote_write):
+ async with anyio.create_task_group() as tasks:
+ tasks.start_soon(forward, remote_read, local_write, tasks.cancel_scope)
+ await remote_write.send(first)
+ tasks.start_soon(forward, local_read, remote_write, tasks.cancel_scope)
+
+
+def run():
+ # Remote SDK exceptions may contain authorization headers or URL parameters.
+ logging.disable(logging.CRITICAL)
+ anyio.run(proxy)
diff --git a/apps/common/mcp/sandbox_worker.py b/apps/common/mcp/sandbox_worker.py
new file mode 100644
index 00000000000..9c069a8850a
--- /dev/null
+++ b/apps/common/mcp/sandbox_worker.py
@@ -0,0 +1,201 @@
+"""Fixed Linux entry point for the stdio-to-HTTP MCP sandbox proxy."""
+
+import ctypes
+from contextlib import contextmanager
+import errno
+import importlib.machinery
+import importlib.util
+import ipaddress
+import json
+import os
+from pathlib import Path
+import pwd
+import resource
+import signal
+import socket
+import struct
+import sys
+
+
+class MCPWorkerFailure(Exception):
+ """A failure whose message was sanitized by the protocol proxy."""
+
+
+class DlInfo(ctypes.Structure):
+ _fields_ = [
+ ("filename", ctypes.c_char_p),
+ ("base", ctypes.c_void_p),
+ ("symbol", ctypes.c_char_p),
+ ("address", ctypes.c_void_p),
+ ]
+
+
+class AddrInfo(ctypes.Structure):
+ pass
+
+
+AddrInfo._fields_ = [
+ ("flags", ctypes.c_int),
+ ("family", ctypes.c_int),
+ ("socktype", ctypes.c_int),
+ ("protocol", ctypes.c_int),
+ ("addrlen", ctypes.c_uint),
+ ("addr", ctypes.c_void_p),
+ ("canonname", ctypes.c_char_p),
+ ("next", ctypes.POINTER(AddrInfo)),
+]
+
+
+@contextmanager
+def quiet_probe():
+ # The C hook logs denied connections. Suppress only our synthetic startup
+ # probes, before any remote connection or concurrent task has been started.
+ saved = os.dup(2)
+ try:
+ with open(os.devnull, "w") as sink:
+ os.dup2(sink.fileno(), 2)
+ yield
+ finally:
+ os.dup2(saved, 2)
+ os.close(saved)
+
+
+class SandboxNetworkCheck:
+ """Verify the existing interposer without requiring a new C export."""
+
+ def __init__(self, library):
+ # Resolve process-global symbols only: loading a library here would not
+ # prove LD_PRELOAD actually installed the interposed network functions.
+ process = ctypes.CDLL(None, use_errno=True)
+ dladdr = process.dladdr
+ dladdr.argtypes = [ctypes.c_void_p, ctypes.POINTER(DlInfo)]
+ dladdr.restype = ctypes.c_int
+ self.connect = process.connect
+ self.connect.argtypes = [ctypes.c_int, ctypes.c_void_p, ctypes.c_uint]
+ self.connect.restype = ctypes.c_int
+ self.getaddrinfo = process.getaddrinfo
+ self.getaddrinfo.argtypes = [
+ ctypes.c_char_p,
+ ctypes.c_char_p,
+ ctypes.POINTER(AddrInfo),
+ ctypes.POINTER(ctypes.POINTER(AddrInfo)),
+ ]
+ self.getaddrinfo.restype = ctypes.c_int
+ self.freeaddrinfo = process.freeaddrinfo
+ self.freeaddrinfo.argtypes = [ctypes.POINTER(AddrInfo)]
+ self.freeaddrinfo.restype = None
+ for function in (self.connect, self.getaddrinfo):
+ info = DlInfo()
+ if not dladdr(ctypes.cast(function, ctypes.c_void_p), ctypes.byref(info)) or not info.filename:
+ raise RuntimeError("Cannot locate MCP sandbox network hooks")
+ loaded_path = Path(os.fsdecode(info.filename))
+ if not os.path.samefile(loaded_path, library):
+ raise RuntimeError("MCP sandbox network hooks are not preloaded")
+ self.policy_path = loaded_path.with_name(".sandbox.conf")
+
+ def verify(self):
+ rules = ""
+ # Read as the sandbox user, from the same path used by the C interposer.
+ # Reject a truncated policy rather than relying on its first 511 bytes.
+ for line in self.policy_path.read_text().splitlines(keepends=True):
+ key, separator, value = line.partition("=")
+ if separator and key.strip() == "SANDBOX_PYTHON_BANNED_HOSTS":
+ if len(line.encode()) > 511:
+ raise RuntimeError("MCP sandbox network policy is too long")
+ rules = value.strip()
+ if not rules:
+ raise RuntimeError("MCP sandbox network policy is empty")
+ for rule in filter(None, (value.strip() for value in rules.split(","))):
+ try:
+ ip = ipaddress.ip_network(rule, strict=False).network_address
+ except ValueError:
+ # Numeric-only flags prevent this self-check from sending DNS
+ # traffic, even if the rule is ineffective or the hook is broken.
+ hints = AddrInfo(flags=socket.AI_NUMERICHOST | socket.AI_NUMERICSERV)
+ result = ctypes.POINTER(AddrInfo)()
+ ctypes.set_errno(0)
+ with quiet_probe():
+ status = self.getaddrinfo(rule.encode(), b"0", ctypes.byref(hints), ctypes.byref(result))
+ error = ctypes.get_errno()
+ if result:
+ self.freeaddrinfo(result)
+ if status == socket.EAI_SYSTEM and error == errno.EACCES:
+ return
+ else:
+ if ip.version == 4:
+ address = struct.pack("=H", socket.AF_INET) + b"\0\0" + ip.packed + b"\0" * 8
+ else:
+ address = struct.pack("=H", socket.AF_INET6) + b"\0" * 6 + ip.packed + b"\0" * 4
+ buffer = ctypes.create_string_buffer(address)
+ ctypes.set_errno(0)
+ # -1 can never send a packet: libc returns EBADF, while the
+ # active sandbox must reject a configured banned IP with EACCES.
+ with quiet_probe():
+ status = self.connect(-1, buffer, len(address))
+ if status == -1 and ctypes.get_errno() == errno.EACCES:
+ return
+ raise RuntimeError("MCP sandbox network policy self-check failed")
+
+
+def enter_sandbox(settings):
+ if not sys.platform.startswith("linux"):
+ raise RuntimeError("MCP sandbox requires Linux")
+ account = pwd.getpwnam("sandbox")
+ if settings["uid"] != account.pw_uid or settings["gid"] != account.pw_gid or account.pw_uid == 0:
+ raise RuntimeError("Invalid MCP sandbox identity")
+ network_check = SandboxNetworkCheck(settings["library"])
+ timeout = settings["timeout"]
+ memory = settings["memory_mb"] * 1024 * 1024
+ cores = settings["cpu_cores"]
+ if timeout <= 0 or memory <= 0 or cores <= 0:
+ raise RuntimeError("Invalid MCP sandbox resource limits")
+ resource.setrlimit(resource.RLIMIT_AS, (memory, memory))
+ resource.setrlimit(resource.RLIMIT_CPU, (timeout, timeout))
+ resource.setrlimit(resource.RLIMIT_CORE, (0, 0))
+ os.sched_setaffinity(0, sorted(os.sched_getaffinity(0))[:cores])
+ # The SDK closes stdin, then terminates/kills the child when a session ends.
+ # This independent wall deadline also bounds a hung handshake or orphan.
+ signal.signal(signal.SIGALRM, signal.SIG_DFL)
+ signal.signal(signal.SIGTERM, signal.SIG_DFL)
+ signal.alarm(timeout)
+ os.setgroups([])
+ os.setgid(account.pw_gid)
+ os.setuid(account.pw_uid)
+ os.environ.clear()
+ if os.getuid() != account.pw_uid or os.geteuid() != account.pw_uid:
+ raise RuntimeError("MCP sandbox identity was not applied")
+ network_check.verify()
+
+
+def main():
+ settings = json.loads(os.environ.pop("MAXKB_MCP_WORKER_SETTINGS"))
+ # Load the fixed proxy before dropping access to the app tree. It does not
+ # import Django or read application configuration. The loader supports both
+ # source and sourceless release layouts, only from our installed directory.
+ spec = importlib.machinery.PathFinder.find_spec("sandbox_proxy", [str(Path(__file__).parent)])
+ if spec is None or spec.loader is None:
+ raise RuntimeError("MCP sandbox dependency is missing")
+ proxy = importlib.util.module_from_spec(spec)
+ spec.loader.exec_module(proxy)
+ # Remove the application directory while retaining approved package paths.
+ app_path = str(Path(__file__).resolve().parents[2])
+ sys.path = [p for p in sys.path if p != app_path]
+ sys.path.extend(p for p in settings["python_paths"] if p and p not in sys.path)
+ enter_sandbox(settings)
+ try:
+ proxy.run()
+ except Exception as exc:
+ raise MCPWorkerFailure(proxy.sandbox_failure_message(exc)) from None
+
+
+if __name__ == "__main__":
+ try:
+ main()
+ except MCPWorkerFailure as exc:
+ sys.stderr.write(f"MCP sandbox worker failed: {exc}.\n")
+ sys.exit(1)
+ except BaseException:
+ # URLs/headers may contain secrets: keep failures off stdout and do not
+ # dump exceptions or bootstrap data inherited from the remote SDK.
+ sys.stderr.write("MCP sandbox worker failed; check sandbox setup and network policy.\n")
+ sys.exit(1)
diff --git a/apps/common/middleware/doc_headers_middleware.py b/apps/common/middleware/doc_headers_middleware.py
index 5f1884e7731..5afa66a523c 100644
--- a/apps/common/middleware/doc_headers_middleware.py
+++ b/apps/common/middleware/doc_headers_middleware.py
@@ -10,7 +10,7 @@
from django.http import HttpResponse
from django.utils.deprecation import MiddlewareMixin
-from common.auth import TokenDetails, handles
+from common.auth import TokenDetails, get_handles
from maxkb.const import CONFIG
content = """
@@ -126,7 +126,7 @@ def process_response(self, request, response):
try:
token = auth[7:]
token_details = TokenDetails(token)
- for handle in handles:
+ for handle in get_handles():
if handle.support(request, token, token_details.get_token_details):
handle.handle(request, token, token_details.get_token_details)
return response
diff --git a/apps/common/sql/list_embedding_text.sql b/apps/common/sql/list_embedding_text.sql
index 8f4f14dfd6d..431b8857458 100644
--- a/apps/common/sql/list_embedding_text.sql
+++ b/apps/common/sql/list_embedding_text.sql
@@ -20,10 +20,19 @@ SELECT
paragraph."id" AS paragraph_id,
paragraph.knowledge_id AS knowledge_id,
1 AS source_type,
- concat_ws(E'\n',paragraph.title,paragraph."content") AS "text",
+ concat_ws(
+ E'\n',
+ paragraph.title,
+ paragraph."content",
+ (
+ SELECT string_agg(concat_ws(E'\n', asset.caption, asset.ocr_text, asset.description), E'\n' ORDER BY asset.position)
+ FROM paragraph_asset asset
+ WHERE asset.paragraph_id = paragraph."id" AND asset.sync_state = 'active'
+ )
+ ) AS "text",
paragraph.is_active AS is_active,
paragraph.chunks AS chunks
FROM
paragraph paragraph
- ${paragraph}
\ No newline at end of file
+ ${paragraph}
diff --git a/apps/application/flow/step_node/variable_aggregation_node/__init__.py b/apps/common/storage/__init__.py
similarity index 100%
rename from apps/application/flow/step_node/variable_aggregation_node/__init__.py
rename to apps/common/storage/__init__.py
diff --git a/apps/common/storage/seaweedfs.py b/apps/common/storage/seaweedfs.py
new file mode 100644
index 00000000000..d3e57dbce57
--- /dev/null
+++ b/apps/common/storage/seaweedfs.py
@@ -0,0 +1,25 @@
+import boto3
+from botocore.client import Config
+from maxkb.const import CONFIG
+
+
+def is_seaweedfs_enabled() -> bool:
+ return bool(CONFIG.get("S3_ENDPOINT"))
+
+
+def get_bucket() -> str:
+ return CONFIG.get("S3_BUCKET") or "maxkb"
+
+
+def get_s3_client():
+ addr = CONFIG.get("S3_ENDPOINT") or ""
+ if addr and not addr.startswith(("http://", "https://")):
+ addr = f"http://{addr}"
+ return boto3.client(
+ "s3",
+ endpoint_url=addr,
+ aws_access_key_id=CONFIG.get("S3_ACCESS_KEY"),
+ aws_secret_access_key=CONFIG.get("S3_SECRET_KEY"),
+ config=Config(signature_version="s3v4"),
+ region_name="us-east-1",
+ )
diff --git a/apps/common/test_clean_chat_job.py b/apps/common/test_clean_chat_job.py
new file mode 100644
index 00000000000..1641f49d43c
--- /dev/null
+++ b/apps/common/test_clean_chat_job.py
@@ -0,0 +1,96 @@
+from contextlib import nullcontext
+from datetime import timedelta
+from types import SimpleNamespace
+from unittest.mock import MagicMock, call, patch
+from uuid import UUID
+
+from django.db.models import Q
+from django.test import SimpleTestCase
+from django.utils import timezone
+
+
+class CleanChatPaginationTests(SimpleTestCase):
+ def run_cleanup(self, count, clean_log=False):
+ # Importing common.job normally starts the scheduler; keep tests isolated from background jobs.
+ with patch("apscheduler.schedulers.background.BackgroundScheduler.start"):
+ from common.job.clean_chat_job import clean_method
+
+ now = timezone.now()
+ chat_id = UUID(int=9999)
+ records = [SimpleNamespace(id=UUID(int=i + 1), chat_id=chat_id, create_time=now) for i in range(count)]
+ pages = [records[i : i + 500] for i in range(0, count, 500)]
+ if count % 500 == 0:
+ pages.append([])
+ page_queries = []
+ for page in pages:
+ query = MagicMock()
+ query.filter.return_value = query
+ query.order_by.return_value.only.return_value.__getitem__.return_value = page
+ page_queries.append(query)
+ aggregate_query = MagicMock()
+ aggregate_query.values.return_value.annotate.return_value = [{"chat_id": chat_id, "max_create_time": now}]
+ # Cascaded delete counts can exceed the number of ChatRecords; they must not control pagination.
+ aggregate_query.delete.return_value = (9999, {})
+ count_query = MagicMock()
+ count_query.values.return_value.annotate.return_value = [{"chat_id": chat_id, "count": 1}]
+ remaining_queries = iter(page_queries)
+ conditions = Q(create_time__lt=now + timedelta(days=1))
+
+ def filter_records(*args, **kwargs):
+ if args:
+ self.assertEqual(args, (conditions,))
+ return next(remaining_queries)
+ if "chat_id__in" in kwargs:
+ return count_query
+ return aggregate_query
+
+ with (
+ patch("common.job.clean_chat_job.transaction.atomic", return_value=nullcontext()),
+ patch("common.job.clean_chat_job.ChatRecord.objects") as manager,
+ patch("common.job.clean_chat_job.Chat.objects") as chats,
+ patch("common.job.clean_chat_job.File.objects") as files,
+ patch("common.job.clean_chat_job.delete_orphan_chats") as delete_chats,
+ patch("common.job.clean_chat_job.maxkb_logger"),
+ ):
+ manager.filter.side_effect = filter_records
+ file = SimpleNamespace(id=UUID(int=99999))
+ file_query = MagicMock()
+ file_query.__iter__.return_value = [file]
+ files.filter.return_value = file_query
+ clean_method(conditions, clean_log=clean_log)
+
+ self.assertEqual(sum(bool(c.args) for c in manager.filter.call_args_list), len(pages))
+ for index, query in enumerate(page_queries):
+ query.order_by.assert_called_once_with("id")
+ if index:
+ query.filter.assert_called_once_with(id__gt=pages[index - 1][-1].id)
+ else:
+ query.filter.assert_not_called()
+ nonempty_pages = sum(bool(page) for page in pages)
+ # One file lookup per chat per batch, rather than one per record in the chat.
+ lookups = [c for c in files.filter.call_args_list if "source_id" in c.kwargs]
+ self.assertEqual(len(lookups), nonempty_pages)
+ self.assertTrue(all(c.kwargs["create_time__lt"] == now for c in lookups))
+ deletions = [c for c in files.filter.call_args_list if "id__in" in c.kwargs]
+ self.assertEqual(deletions, [call(id__in=[file.id])] * nonempty_pages)
+ if not clean_log:
+ aggregate_query.delete.assert_not_called()
+ chats.filter.assert_not_called()
+ delete_chats.assert_not_called()
+ else:
+ self.assertEqual(aggregate_query.delete.call_count, nonempty_pages)
+
+ def test_files_only_processes_all_pages(self):
+ self.run_cleanup(1201)
+
+ def test_files_only_exact_batch_boundary(self):
+ self.run_cleanup(500)
+
+ def test_files_only_one_record_after_boundary(self):
+ self.run_cleanup(501)
+
+ def test_empty_queryset(self):
+ self.run_cleanup(0)
+
+ def test_log_deletion_uses_same_cursor_without_offset_skips(self):
+ self.run_cleanup(1001, clean_log=True)
diff --git a/apps/common/tests.py b/apps/common/tests.py
new file mode 100644
index 00000000000..113d6ec6279
--- /dev/null
+++ b/apps/common/tests.py
@@ -0,0 +1,16 @@
+from django.test import SimpleTestCase
+
+from common.utils.common import markdown_to_plain_text
+
+
+class MarkdownToPlainTextTestCase(SimpleTestCase):
+ def test_removes_embedded_markup_contents(self):
+ cases = {
+ 'before after': "before after",
+ 'before after': "before after",
+ 'before {"label":"private"} after': "before after",
+ }
+
+ for markup, expected in cases.items():
+ with self.subTest(markup=markup):
+ self.assertEqual(markdown_to_plain_text(markup), expected)
diff --git a/apps/common/utils/common.py b/apps/common/utils/common.py
index 43370db2ef1..df589b220bb 100644
--- a/apps/common/utils/common.py
+++ b/apps/common/utils/common.py
@@ -13,8 +13,8 @@
import json
import mimetypes
import pickle
-import random
import re
+import secrets
import shutil
import uuid
from functools import reduce
@@ -24,6 +24,7 @@
from django.contrib.auth.hashers import check_password, make_password
from django.core.files.uploadedfile import InMemoryUploadedFile
from django.db.models import QuerySet
+from django.http import StreamingHttpResponse
from django.utils.translation import gettext as _
from maxkb.settings import TIME_ZONE
from openpyxl.cell.cell import ILLEGAL_CHARACTERS_RE
@@ -117,7 +118,7 @@ def group_by(list_source: List, key):
def get_random_chars(number=4):
if number <= 0:
return ""
- return "".join(random.choices(SAFE_CHAR_SET, k=number))
+ return "".join(secrets.choice(SAFE_CHAR_SET) for _ in range(number))
def encryption(message: str):
@@ -159,8 +160,18 @@ def _remove_empty_lines(text):
def markdown_to_plain_text(md: str) -> str:
+ # 先移除特定媒体标签(优先级高于通用 Markdown 和 HTML 处理)
+ text = re.sub(
+ r"<(audio|video)(?:\s+[^>]*)?>.*?",
+ "",
+ md,
+ flags=re.DOTALL | re.IGNORECASE,
+ )
+ text = re.sub(r"]*>", "", text) # 匹配图片标签
+ # 去除表单渲染
+ text = re.sub(r".*?", "", text, flags=re.DOTALL)
# 移除图片 
- text = re.sub(r"!\[.*?\]\(.*?\)", "", md)
+ text = re.sub(r"!\[.*?\]\(.*?\)", "", text)
# 移除链接 [text](url)
text = re.sub(r"\[([^\]]+)\]\([^)]+\)", r"\1", text)
# 移除 Markdown 标题符号 (#, ##, ###)
@@ -179,15 +190,8 @@ def markdown_to_plain_text(md: str) -> str:
text = re.sub(r"\n{2,}", "\n", text)
# 使用正则表达式去除所有 HTML 标签
text = re.sub(r"<[^>]+>", "", text)
- # 先移除特定媒体标签(优先级高于通用HTML标签移除)
- text = re.sub(
- r"<(?:audio|video)(?:\s+[^>]*)?>.*?(?:)?", "", text, flags=re.DOTALL | re.IGNORECASE
- )
- text = re.sub(r"]*>", "", text) # 匹配图片标签
# 去除多余的空白字符(包括换行符、制表符等)
text = re.sub(r"\s+", " ", text)
- # 去除表单渲染
- text = re.sub(r".*?<\/form_rander>", "", text, flags=re.DOTALL)
# 去除首尾空格
text = text.strip()
return text
@@ -235,6 +239,33 @@ def bytes_to_uploaded_file(file_bytes, file_name="file.txt"):
return uploaded_file
+def guess_image_format(file_bytes: bytes, file_name: str = "") -> str:
+ content_type, _ = mimetypes.guess_type(file_name)
+ if content_type and content_type.startswith("image/"):
+ return content_type.split("/", 1)[1]
+
+ if file_bytes.startswith(b"\xff\xd8\xff"):
+ return "jpeg"
+ if file_bytes.startswith(b"\x89PNG\r\n\x1a\n"):
+ return "png"
+ if file_bytes.startswith((b"GIF87a", b"GIF89a")):
+ return "gif"
+ if file_bytes.startswith(b"RIFF") and file_bytes[8:12] == b"WEBP":
+ return "webp"
+ if file_bytes.startswith(b"BM"):
+ return "bmp"
+ if file_bytes.startswith((b"II*\x00", b"MM\x00*")):
+ return "tiff"
+ if file_bytes.startswith(b"\x00\x00\x01\x00"):
+ return "x-icon"
+
+ stripped = file_bytes.lstrip()
+ if stripped.startswith(b"
+ for m in re.finditer(r'<\w+[^>]+\bsrc=["\'](\./oss/(?:image|file)/[^"\']+)["\']', content):
+ results.append(m.group())
+ return results
+
+
def generate_uuid(tag: str):
return str(uuid.uuid5(uuid.NAMESPACE_DNS, tag))
@@ -482,3 +525,12 @@ def reset_value(value):
c = datetime.timezone(eastern._utcoffset)
value = value.astimezone(c)
return value
+
+
+def to_stream_response_simple(stream_event):
+ r = StreamingHttpResponse(
+ streaming_content=stream_event, content_type="text/event-stream;charset=utf-8", charset="utf-8"
+ )
+
+ r["Cache-Control"] = "no-cache"
+ return r
diff --git a/apps/common/utils/fork.py b/apps/common/utils/fork.py
index b4c47ab1114..fa652b42675 100644
--- a/apps/common/utils/fork.py
+++ b/apps/common/utils/fork.py
@@ -1,19 +1,28 @@
+import base64
import copy
import re
import traceback
from functools import reduce
from typing import List, Set
-from urllib.parse import urljoin, urlparse, ParseResult, urlsplit, urlunparse
+from urllib.parse import ParseResult, urljoin, urlparse, urlsplit, urlunparse
-from markdownify import markdownify
import requests
from bs4 import BeautifulSoup
+from markdownify import markdownify
from common.utils.logger import maxkb_logger
requests.packages.urllib3.disable_warnings()
+class SandboxFetchResponse:
+ def __init__(self, status_code: int, content: bytes, encoding: str | None, apparent_encoding: str | None):
+ self.status_code = status_code
+ self.content = content
+ self.encoding = encoding
+ self.apparent_encoding = apparent_encoding
+
+
class ChildLink:
def __init__(self, url, tag):
self.url = url
@@ -29,27 +38,34 @@ def fork(self, level: int, exclude_link_url: Set[str], fork_handler):
self.fork_child(ChildLink(self.base_url, None), self.selector_list, level, exclude_link_url, fork_handler)
@staticmethod
- def fork_child(child_link: ChildLink, selector_list: List[str], level: int, exclude_link_url: Set[str],
- fork_handler):
+ def fork_child(
+ child_link: ChildLink, selector_list: List[str], level: int, exclude_link_url: Set[str], fork_handler
+ ):
if level < 0:
return
else:
child_link.url = remove_fragment(child_link.url)
- child_url = child_link.url[:-1] if child_link.url.endswith('/') else child_link.url
+ child_url = child_link.url[:-1] if child_link.url.endswith("/") else child_link.url
if not exclude_link_url.__contains__(child_url):
exclude_link_url.add(child_url)
response = Fork(child_link.url, selector_list).fork()
fork_handler(child_link, response)
for child_link in response.child_link_list:
- child_url = child_link.url[:-1] if child_link.url.endswith('/') else child_link.url
+ child_url = child_link.url[:-1] if child_link.url.endswith("/") else child_link.url
if not exclude_link_url.__contains__(child_url):
ForkManage.fork_child(child_link, selector_list, level - 1, exclude_link_url, fork_handler)
def remove_fragment(url: str) -> str:
parsed_url = urlparse(url)
- modified_url = ParseResult(scheme=parsed_url.scheme, netloc=parsed_url.netloc, path=parsed_url.path,
- params=parsed_url.params, query=parsed_url.query, fragment=None)
+ modified_url = ParseResult(
+ scheme=parsed_url.scheme,
+ netloc=parsed_url.netloc,
+ path=parsed_url.path,
+ params=parsed_url.params,
+ query=parsed_url.query,
+ fragment=None,
+ )
return urlunparse(modified_url)
@@ -63,54 +79,67 @@ def __init__(self, content: str, child_link_list: List[ChildLink], status, messa
@staticmethod
def success(html_content: str, child_link_list: List[ChildLink]):
- return Fork.Response(html_content, child_link_list, 200, '')
+ return Fork.Response(html_content, child_link_list, 200, "")
@staticmethod
def error(message: str):
- return Fork.Response('', [], 500, message)
+ return Fork.Response("", [], 500, message)
def __init__(self, base_fork_url: str, selector_list: List[str]):
base_fork_url = remove_fragment(base_fork_url)
parsed = urlparse(base_fork_url)
- path = parsed.path.rstrip('/')
- self.base_fork_url = urlunparse((
- parsed.scheme,
- parsed.netloc,
- path,
- None,
- None,
- None # fragment
- ))
+ path = parsed.path.rstrip("/")
+ self.base_fork_url = urlunparse(
+ (
+ parsed.scheme,
+ parsed.netloc,
+ path,
+ None,
+ None,
+ None, # fragment
+ )
+ )
parsed = urlsplit(base_fork_url)
query = parsed.query
if query is not None and len(query) > 0:
- self.base_fork_url = self.base_fork_url + '?' + query
+ self.base_fork_url = self.base_fork_url + "?" + query
self.selector_list = [selector for selector in selector_list if selector is not None and len(selector) > 0]
self.urlparse = urlparse(self.base_fork_url)
- self.base_url = ParseResult(scheme=self.urlparse.scheme, netloc=self.urlparse.netloc, path='', params='',
- query='',
- fragment='').geturl()
+ self.base_url = ParseResult(
+ scheme=self.urlparse.scheme, netloc=self.urlparse.netloc, path="", params="", query="", fragment=""
+ ).geturl()
def get_child_link_list(self, bf: BeautifulSoup):
# Compute the crawl prefix: parent directory when base_fork_url is an HTML file
crawl_prefix = self.base_fork_url
- if crawl_prefix.endswith(('.html', '.htm')):
- crawl_prefix = crawl_prefix.rsplit('/', 1)[0]
+ if crawl_prefix.endswith((".html", ".htm")):
+ crawl_prefix = crawl_prefix.rsplit("/", 1)[0]
pattern = "^((?!(http:|https:|tel:/|#|mailto:|javascript:))|" + crawl_prefix + "|/).*"
- link_list = bf.find_all(name='a', href=re.compile(pattern))
- result = [ChildLink(link.get('href'), link) if link.get('href').startswith(self.base_url) else ChildLink(
- self.base_url + link.get('href'), link) for link in link_list]
+ link_list = bf.find_all(name="a", href=re.compile(pattern))
+ result = [
+ ChildLink(link.get("href"), link)
+ if link.get("href").startswith(self.base_url)
+ else ChildLink(self.base_url + link.get("href"), link)
+ for link in link_list
+ ]
result = [row for row in result if row.url.startswith(crawl_prefix)]
return result
def get_content_html(self, bf: BeautifulSoup):
if self.selector_list is None or len(self.selector_list) == 0:
return str(bf)
- params = reduce(lambda x, y: {**x, **y},
- [{'class_': selector.replace('.', '')} if selector.startswith('.') else
- {'id': selector.replace("#", "")} if selector.startswith("#") else {'name': selector} for
- selector in
- self.selector_list], {})
+ params = reduce(
+ lambda x, y: {**x, **y},
+ [
+ {"class_": selector.replace(".", "")}
+ if selector.startswith(".")
+ else {"id": selector.replace("#", "")}
+ if selector.startswith("#")
+ else {"name": selector}
+ for selector in self.selector_list
+ ],
+ {},
+ )
f = bf.find_all(**params)
return "\n".join([str(row) for row in f])
@@ -119,94 +148,146 @@ def reset_url(tag, field, base_fork_url):
field_value: str = tag[field]
if field_value.startswith("/"):
result = urlparse(base_fork_url)
- result_url = ParseResult(scheme=result.scheme, netloc=result.netloc, path=field_value, params='', query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=result.scheme, netloc=result.netloc, path=field_value, params="", query="", fragment=""
+ ).geturl()
else:
# When base_fork_url is an HTML file (not a directory), resolve relative
# links against its parent directory to avoid broken paths like
# /en/index.html/about_dolphindb.html
- if base_fork_url.endswith(('.html', '.htm')):
- base = base_fork_url.rsplit('/', 1)[0] + '/'
+ if base_fork_url.endswith((".html", ".htm")):
+ base = base_fork_url.rsplit("/", 1)[0] + "/"
else:
- base = base_fork_url + '/'
+ base = base_fork_url + "/"
result_url = urljoin(base, field_value)
- result_url = result_url[:-1] if result_url.endswith('/') else result_url
+ result_url = result_url[:-1] if result_url.endswith("/") else result_url
tag[field] = result_url
def reset_beautiful_soup(self, bf: BeautifulSoup):
reset_config_list = [
{
- 'field': 'href',
+ "field": "href",
},
{
- 'field': 'src',
- }
+ "field": "src",
+ },
]
for reset_config in reset_config_list:
- field = reset_config.get('field')
- tag_list = bf.find_all(**{field: re.compile('^(?!(http:|https:|tel:/|#|mailto:|javascript:)).*')})
+ field = reset_config.get("field")
+ tag_list = bf.find_all(**{field: re.compile("^(?!(http:|https:|tel:/|#|mailto:|javascript:)).*")})
for tag in tag_list:
self.reset_url(tag, field, self.base_fork_url)
# 去掉 href 以 # 开头的锚点链接,保留文字
- for a in bf.find_all('a', href=re.compile('^#')):
+ for a in bf.find_all("a", href=re.compile("^#")):
a.unwrap()
return bf
@staticmethod
def get_beautiful_soup(response):
- encoding = response.encoding if response.encoding is not None and response.encoding != 'ISO-8859-1' else response.apparent_encoding
- html_content = response.content.decode(encoding)
- beautiful_soup = BeautifulSoup(html_content, "html.parser")
- meta_list = beautiful_soup.find_all('meta')
- charset_list = Fork.get_charset_list(meta_list)
- if len(charset_list) > 0:
- charset = charset_list[0]
- if charset != encoding:
- try:
- html_content = response.content.decode(charset, errors='replace')
- except Exception as e:
- maxkb_logger.error(f'{e}: {traceback.format_exc()}')
- return BeautifulSoup(html_content, "html.parser")
- return beautiful_soup
+ encoding_list = Fork.get_encoding_list(response)
+ for encoding in encoding_list:
+ try:
+ return BeautifulSoup(response.content.decode(encoding), "html.parser")
+ except (LookupError, UnicodeDecodeError):
+ continue
+
+ fallback_encoding = encoding_list[0] if len(encoding_list) > 0 else "utf-8"
+ html_content = response.content.decode(fallback_encoding, errors="replace")
+ return BeautifulSoup(html_content, "html.parser")
+
+ @staticmethod
+ def get_encoding_list(response):
+ charset_list = Fork.get_charset_list(response.content)
+ if response.encoding is not None and response.encoding != "ISO-8859-1":
+ charset_list.append(response.encoding)
+ if response.apparent_encoding is not None:
+ charset_list.append(response.apparent_encoding)
+ result = []
+ for charset in charset_list:
+ normalized_charset = Fork.normalize_charset(charset)
+ if normalized_charset is not None and normalized_charset not in result:
+ result.append(normalized_charset)
+ return result
@staticmethod
- def get_charset_list(meta_list):
+ def get_charset_list(content):
charset_list = []
- for meta in meta_list:
- if meta.attrs is not None:
- if 'charset' in meta.attrs:
- charset_list.append(meta.attrs.get('charset'))
- elif meta.attrs.get('http-equiv', '').lower() == 'content-type' and 'content' in meta.attrs:
- match = re.search(r'charset=([^\s;]+)', meta.attrs['content'], re.I)
- if match:
- charset_list.append(match.group(1))
- return charset_list
+ content_head = content[:8192]
+ charset_list.extend(re.findall(rb"]+charset=['\"]?\s*([a-zA-Z0-9._-]+)", content_head, re.I))
+ charset_list.extend(
+ re.findall(rb"]+content=['\"][^'\"]*charset=([a-zA-Z0-9._-]+)", content_head, re.I)
+ )
+ return [
+ charset.decode("ascii", errors="ignore")
+ for charset in charset_list
+ if len(charset) > 0
+ ]
+
+ @staticmethod
+ def normalize_charset(charset):
+ if charset is None:
+ return None
+ normalized_charset = charset.strip().strip("\"'").lower()
+ return normalized_charset if len(normalized_charset) > 0 else None
+
+ @staticmethod
+ def _sandbox_requests_get(base_fork_url: str, headers: dict):
+ from common.utils.tool_code import ToolExecutor
+
+ response = ToolExecutor().exec_code(
+ """
+def fetch_url(url, headers):
+ import base64
+ import requests
+
+ requests.packages.urllib3.disable_warnings()
+ response = requests.get(url, verify=False, headers=headers)
+ return {
+ "status_code": response.status_code,
+ "content": base64.b64encode(response.content).decode("ascii"),
+ "encoding": response.encoding,
+ "apparent_encoding": response.apparent_encoding,
+ }
+""",
+ {"url": base_fork_url, "headers": headers},
+ function_name="fetch_url",
+ )
+ return SandboxFetchResponse(
+ response.get("status_code"),
+ base64.b64decode(response.get("content")),
+ response.get("encoding"),
+ response.get("apparent_encoding"),
+ )
+
+ @staticmethod
+ def requests_get(base_fork_url: str, headers: dict):
+ return Fork._sandbox_requests_get(base_fork_url, headers)
def fork(self):
try:
-
headers = {
- 'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.51 Safari/537.36'
+ "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.51 Safari/537.36"
}
- maxkb_logger.info(f'fork:{self.base_fork_url}')
- response = requests.get(self.base_fork_url, verify=False, headers=headers)
+ maxkb_logger.info(f"fork:{self.base_fork_url}")
+ response = self.requests_get(self.base_fork_url, headers)
if response.status_code != 200:
maxkb_logger.error(f"url: {self.base_fork_url} code:{response.status_code}")
return Fork.Response.error(f"url: {self.base_fork_url} code:{response.status_code}")
bf = self.get_beautiful_soup(response)
except Exception as e:
- maxkb_logger.error(f'{str(e)}:{traceback.format_exc()}')
+ maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
return Fork.Response.error(str(e))
bf = self.reset_beautiful_soup(bf)
link_list = self.get_child_link_list(bf)
content = self.get_content_html(bf)
- r = markdownify(content, heading_style='ATX')
+ r = markdownify(content, heading_style="ATX")
return Fork.Response.success(r, link_list)
def handler(base_url, response: Fork.Response):
maxkb_logger.info(base_url.url, base_url.tag.text if base_url.tag else None, response.content)
+
# ForkManage('https://bbs.fit2cloud.com/c/de/6', ['.md-content']).fork(3, set(), handler)
diff --git a/apps/common/utils/messages_util.py b/apps/common/utils/messages_util.py
new file mode 100644
index 00000000000..b29645df1d3
--- /dev/null
+++ b/apps/common/utils/messages_util.py
@@ -0,0 +1,72 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: messages_util.py
+@date: 2023/9/11 11:45
+@desc: ChatRecord 存储的 question / messages 与 LangChain 消息之间的转换工具
+"""
+
+import json
+
+import uuid_utils.compat as uuid
+from django.utils.translation import gettext as _
+from langchain_core.messages import AIMessage, HumanMessage, ToolMessage
+
+
+def to_human_message_list(question):
+ """
+ 将用户消息转换为 HumanMessage 列表。
+ question 为 {content, image_list, ...} 结构,历史上下文只取文本部分。
+ """
+ question = question if isinstance(question, dict) else {"content": question or ""}
+ return [HumanMessage(content=question.get("content", "") or "")]
+
+
+def to_ai_message_list(messages):
+ """
+ 将 messages 中的 TEXT / TOOL 内容块转换为 LangChain 消息列表。
+ REASONING/FORM/FAILURE 不进历史;按顺序保留交错。
+ 注意:type 用字面量,避免对 application.workflow.ContentType 产生反向依赖。
+ """
+ ai_message_list = []
+ for m in messages or []:
+ if not isinstance(m, dict):
+ continue
+ m_type = m.get("type")
+ if m_type == "TEXT":
+ if m.get("content"):
+ ai_message_list.append(AIMessage(content=m.get("content")))
+ elif m_type == "TOOL":
+ # 工具调用按 OpenAI/LangChain 协议拆成两条消息:
+ # 1. AIMessage 携带 tool_calls(名称 + 入参)
+ # 2. ToolMessage 携带结果,通过 tool_call_id 与上一条对应
+ tool_name = m.get("content")
+ if not tool_name:
+ continue
+ # arguments 存储为 JSON 字符串,需还原为 dict 供 tool_calls 使用
+ raw_arguments = m.get("arguments")
+ try:
+ args = json.loads(raw_arguments) if isinstance(raw_arguments, str) and raw_arguments else {}
+ except (json.JSONDecodeError, ValueError):
+ args = {}
+ if not isinstance(args, dict):
+ args = {"arguments": args}
+ # tool_call_id 必须让 AIMessage 与 ToolMessage 一一对应,否则模型侧会报错
+ tool_call_id = m.get("id") or str(uuid.uuid7())
+ ai_message_list.append(
+ AIMessage(
+ content="",
+ tool_calls=[{"name": tool_name, "args": args, "id": tool_call_id, "type": "tool_call"}],
+ )
+ )
+ ai_message_list.append(ToolMessage(content=m.get("result") or "", tool_call_id=tool_call_id))
+ if len(ai_message_list) == 0:
+ ai_message_list = [
+ AIMessage(
+ content=_(
+ "Sorry, no relevant content was found. Please re-describe your problem or provide more information. "
+ )
+ )
+ ]
+ return ai_message_list
diff --git a/apps/common/utils/prompt_template.py b/apps/common/utils/prompt_template.py
new file mode 100644
index 00000000000..30b686d5c45
--- /dev/null
+++ b/apps/common/utils/prompt_template.py
@@ -0,0 +1,34 @@
+# coding=utf-8
+
+import hashlib
+
+from jinja2.sandbox import SandboxedEnvironment
+
+from common.cache.mem_cache import MemCache
+
+# 缓存 reset_prompt 后的模板编译产物(只依赖配置,同一工作流运行期间恒定)
+template_cache = MemCache(
+ "workflow_template_cache",
+ {
+ "TIMEOUT": 3600, # 缓存有效期为 1 小时
+ "OPTIONS": {
+ "MAX_ENTRIES": 1000, # 最多缓存 1000 个条目
+ "CULL_FREQUENCY": 10, # 达到上限时,删除约 1/10 的缓存
+ },
+ },
+)
+
+
+def render_prompt(input_template, context):
+ """
+ 渲染提示词,编译一次后缓存编译产物,之后每轮仅渲染
+ @param input_template: reset_prompt 处理后的模板字符串
+ @param context: 渲染模板所需的上下文数据
+ @return: 渲染后的提示词字符串
+ """
+ key = f"workflow_template::{hashlib.sha256(input_template.encode('utf-8')).hexdigest()}"
+ template = template_cache.get(key)
+ if template is None:
+ template = SandboxedEnvironment().from_string(input_template)
+ template_cache.set(key, template)
+ return template.render(context=context)
diff --git a/apps/common/utils/shared_resource_auth.py b/apps/common/utils/shared_resource_auth.py
index 9e8f3a14bf5..38c0edc9558 100644
--- a/apps/common/utils/shared_resource_auth.py
+++ b/apps/common/utils/shared_resource_auth.py
@@ -12,6 +12,14 @@
from common.database_model_manage.database_model_manage import DatabaseModelManage
from knowledge.models import Knowledge
from tools.models import Tool
+from users.serializers.user import is_workspace_manage
+
+
+def get_runtime_user_id(user_id=None, chat_user_id=None, chat_user_type=None):
+ if user_id:
+ return str(user_id)
+ return None
+
def filter_authorized_ids(resource_type: str, ids: List[str], workspace_id: str) -> List[str]:
diff --git a/apps/common/utils/tool_code.py b/apps/common/utils/tool_code.py
index 9a115576054..b95612c24e2 100644
--- a/apps/common/utils/tool_code.py
+++ b/apps/common/utils/tool_code.py
@@ -20,9 +20,10 @@
from django.utils.translation import gettext_lazy as _
from maxkb.const import BASE_DIR, CONFIG, PROJECT_DIR
+from common.mcp.config import InternalMCPConfig, validate_mcp_servers
from common.utils.logger import maxkb_logger
-_enable_sandbox = bool(int(CONFIG.get("SANDBOX", 0)))
+_enable_sandbox = bool(int(CONFIG.get("SANDBOX", 1)))
_run_user = "sandbox" if _enable_sandbox else getpass.getuser()
_sandbox_path = (
CONFIG.get("SANDBOX_HOME", "/opt/maxkb-app/sandbox")
@@ -76,6 +77,11 @@ def init_sandbox_dir():
allow_dl_open = CONFIG.get("SANDBOX_PYTHON_ALLOW_DL_OPEN", "0")
allow_subprocess = CONFIG.get("SANDBOX_PYTHON_ALLOW_SUBPROCESS", "0")
allow_syscall = CONFIG.get("SANDBOX_PYTHON_ALLOW_SYSCALL", "0")
+ import _ctypes
+
+ ctypes_so_mode = os.stat(_ctypes.__file__).st_mode
+ # 如果不允许打开动态链接库,则去掉sandbox用户对ctypes动态链接库文件的读权限
+ os.chmod(_ctypes.__file__, ctypes_so_mode & ~0o040 if allow_dl_open == "0" else ctypes_so_mode | 0o040)
if banned_hosts:
hostname = socket.gethostname()
local_ip = socket.gethostbyname(hostname)
@@ -112,7 +118,7 @@ def exec_code(self, code_str, keywords, function_name=None):
try:
import os, sys, json
from contextlib import redirect_stdout
- path_to_exclude = ['/opt/py3/lib/python3.11/site-packages', '/opt/maxkb-app/apps']
+ path_to_exclude = ['/opt/py3/lib/python3.13/site-packages', '/opt/maxkb-app/apps']
sys.path = [p for p in sys.path if p not in path_to_exclude]
sys.path += {_sandbox_python_sys_path}
_id = os.environ.get("_ID")
@@ -312,7 +318,7 @@ def generate_mcp_server_code(self, code_str, params, name, description, tool_id)
logging.basicConfig(level=logging.WARNING)
logging.getLogger("mcp").setLevel(logging.ERROR)
logging.getLogger("mcp.server").setLevel(logging.ERROR)
-path_to_exclude = ['/opt/py3/lib/python3.11/site-packages', '/opt/maxkb-app/apps']
+path_to_exclude = ['/opt/py3/lib/python3.13/site-packages', '/opt/maxkb-app/apps']
sys.path = [p for p in sys.path if p not in path_to_exclude]
sys.path += {_sandbox_python_sys_path}
{set_run_user}
@@ -336,17 +342,50 @@ def get_tool_mcp_config(self, tool, params):
},
"transport": "stdio",
}
- return tool_config
+ return InternalMCPConfig(tool_config)
- def get_app_mcp_config(self, api_key):
+ def get_app_mcp_config(self, api_key, chat_files=None, form_data=None):
+ headers = {
+ "Authorization": f"Bearer {api_key}",
+ }
+ # 将外层应用本次对话上传的文件透传给被嵌套的应用
+ chat_files_header = self.encode_chat_files(chat_files)
+ if chat_files_header:
+ headers["X-MaxKB-Chat-Files"] = chat_files_header
+ if form_data:
+ headers["X-MaxKB-Form-Data"] = base64.b64encode(
+ json.dumps(form_data, ensure_ascii=False).encode("utf-8")
+ ).decode()
app_config = {
"url": f"http://127.0.0.1:8080{CONFIG.get_chat_path()}/api/mcp",
"transport": "streamable_http",
- "headers": {
- "Authorization": f"Bearer {api_key}",
- },
+ "headers": headers,
+ }
+ return InternalMCPConfig(app_config)
+
+ @staticmethod
+ def encode_chat_files(chat_files, max_size=6000):
+ """
+ 将文件列表编码为可放入 HTTP 头的字符串(base64), 超出长度限制时逐步裁剪
+ """
+ if not chat_files:
+ return None
+
+ def encode(data):
+ return base64.b64encode(json.dumps(data, ensure_ascii=False).encode("utf-8")).decode()
+
+ encoded = encode(chat_files)
+ if len(encoded) <= max_size:
+ return encoded
+ # 去掉 url, 仅保留 file_id/name, 下游节点通过 file_id 读取文件
+ simplified = {
+ key: [{k: v for k, v in item.items() if k != "url"} for item in value] for key, value in chat_files.items()
}
- return app_config
+ encoded = encode(simplified)
+ if len(encoded) <= max_size:
+ return encoded
+ maxkb_logger.warning("Chat files are too large to be passed to the nested agent, skipped")
+ return None
def _exec(self, execute_file, _id):
kwargs = {
@@ -376,13 +415,10 @@ def _set_resource_limit():
)
return subprocess_result
except subprocess.TimeoutExpired:
- raise Exception(_(f"Process execution timed out after {_process_limit_timeout_seconds} seconds."))
+ raise Exception(_("Process execution timed out after {} seconds.").format(_process_limit_timeout_seconds))
def validate_mcp_transport(self, code_str):
- servers = json.loads(code_str)
- for server, config in servers.items():
- if config.get("transport") not in ["sse", "streamable_http"]:
- raise Exception(_("Only support transport=sse or transport=streamable_http"))
+ validate_mcp_servers(json.loads(code_str))
@contextmanager
diff --git a/apps/common/utils/ts_vecto_util.py b/apps/common/utils/ts_vecto_util.py
index e40c019a699..1294de7080f 100644
--- a/apps/common/utils/ts_vecto_util.py
+++ b/apps/common/utils/ts_vecto_util.py
@@ -114,5 +114,16 @@ def to_ts_vector(text: str, user_words: List[str] = None):
def to_query(text: str, user_words: List[str] = None):
tokenizer = _build_tokenizer(user_words) if user_words else jieba
extract_tags = tokenizer.lcut(text, cut_all=True)
- result = " ".join(extract_tags)
+ query_tokens = []
+ previous_token_is_negation = False
+ for token in extract_tags:
+ if token == '-':
+ # PostgreSQL treats each standalone '-' as a nested NOT operator.
+ if previous_token_is_negation:
+ continue
+ previous_token_is_negation = True
+ elif token.strip():
+ previous_token_is_negation = False
+ query_tokens.append(token)
+ result = " ".join(query_tokens)
return result
diff --git a/apps/common/utils/url_validator.py b/apps/common/utils/url_validator.py
new file mode 100644
index 00000000000..73c6782968c
--- /dev/null
+++ b/apps/common/utils/url_validator.py
@@ -0,0 +1,42 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: url_validator.py
+@date:2025/7/27
+@desc: Shared URL validation utilities to prevent SSRF (CWE-918)
+"""
+from urllib.parse import urlparse
+
+# Allowlist for template/tool/knowledge download asset URLs
+ALLOWED_DOWNLOAD_HOSTS = {"apps-assets.fit2cloud.com"}
+
+# Allowlist for download-callback notification URLs
+ALLOWED_CALLBACK_HOSTS = {"apps.fit2cloud.com"}
+
+
+def validate_trusted_url(url, allowed_hosts):
+ """Return True only if *url* is a safe HTTPS URL whose hostname is an
+ exact (case-insensitive) match against *allowed_hosts*.
+
+ Rejects:
+ - Non-string or empty values.
+ - Non-HTTPS schemes.
+ - URLs containing userinfo (user:pass@host).
+ - URLs with an explicit port number.
+ - Hostnames not present in *allowed_hosts*.
+ """
+ if not url or not isinstance(url, str):
+ return False
+ try:
+ parsed = urlparse(url)
+ except (ValueError, TypeError):
+ return False
+ if parsed.scheme != "https":
+ return False
+ if parsed.username or parsed.password:
+ return False
+ if parsed.port is not None:
+ return False
+ hostname = (parsed.hostname or "").lower()
+ return hostname in allowed_hosts
diff --git a/apps/folders/serializers/folder.py b/apps/folders/serializers/folder.py
index b95ce53d7b2..9d27b42a135 100644
--- a/apps/folders/serializers/folder.py
+++ b/apps/folders/serializers/folder.py
@@ -10,7 +10,9 @@
from application.models.application import Application, ApplicationFolder
from application.serializers.application import ApplicationOperateSerializer
from application.serializers.application_folder import ApplicationFolderTreeSerializer
-from common.constants.permission_constants import Group, ResourcePermission, ResourcePermissionRole, RoleConstants
+from common.auth.constants.group_constants import Group
+from common.auth.constants.role_constants import RoleConstants
+from common.constants.resource_permission_constants import ResourcePermissionConstants
from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.exception.app_exception import AppApiException
from folders.api.folder import FolderCreateRequest
@@ -178,12 +180,20 @@ class Operate(serializers.Serializer):
source = serializers.CharField(required=True, label=_('source'))
user_id = serializers.UUIDField(required=True, label=_('user id'))
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ Folder = get_folder_type(self.data.get('source')) # noqa
+ if Folder is None or not QuerySet(Folder).filter(
+ id=self.data.get('id'), workspace_id=self.data.get('workspace_id')
+ ).exists():
+ raise serializers.ValidationError(_('Folder does not exist'))
+
@transaction.atomic
def edit(self, instance):
self.is_valid(raise_exception=True)
Folder = get_folder_type(self.data.get('source')) # noqa
current_id = self.data.get('id')
- current_node = Folder.objects.get(id=current_id)
+ current_node = Folder.objects.get(id=current_id, workspace_id=self.data.get('workspace_id'))
if current_node is None:
raise serializers.ValidationError(_('Folder does not exist'))
# 模块间的移动
@@ -232,7 +242,7 @@ def edit(self, instance):
def one(self):
self.is_valid(raise_exception=True)
Folder = get_folder_type(self.data.get('source')) # noqa
- folder = QuerySet(Folder).filter(id=self.data.get('id')).first()
+ folder = QuerySet(Folder).filter(id=self.data.get('id'), workspace_id=self.data.get('workspace_id')).first()
return FolderSerializer(folder).data
@transaction.atomic
@@ -240,7 +250,7 @@ def delete(self):
self.is_valid(raise_exception=True)
Folder = get_folder_type(self.data.get('source')) # noqa
Source = get_source_type(self.data.get('source')) # noqa
- folder = Folder.objects.filter(id=self.data.get('id')).first()
+ folder = Folder.objects.filter(id=self.data.get('id'), workspace_id=self.data.get('workspace_id')).first()
if not folder:
raise serializers.ValidationError(_('Folder does not exist'))
if folder.id == folder.workspace_id:
@@ -270,7 +280,7 @@ def delete(self):
Q(user_id=self.data.get('user_id')) &
Q(auth_target_type=self.data.get('source')) &
Q(target__in=source_ids) &
- Q(permission_list__overlap=[ResourcePermission.MANAGE, ResourcePermissionRole.ROLE])
+ Q(permission_list__overlap=[ResourcePermissionConstants.MANAGE, ResourcePermissionConstants.ROLE])
).count()
if auth_list != len(source_ids):
raise AppApiException(500, _('This folder contains resources that you dont have permission'))
diff --git a/apps/folders/views/folder.py b/apps/folders/views/folder.py
index 942137e5ae9..287148c8dce 100644
--- a/apps/folders/views/folder.py
+++ b/apps/folders/views/folder.py
@@ -6,8 +6,11 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import Permission, Group, Operate, RoleConstants, ViewPermission, \
- PermissionConstants, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission, PermissionFunc
+from common.auth.struct.permission import Permission
from common.log.log import log
from common.result import result
from folders.api.folder import FolderCreateAPI, FolderEditAPI, FolderReadAPI, FolderTreeReadAPI, FolderDeleteAPI
@@ -18,9 +21,7 @@ def get_folder_operation_object(folder_id, source):
Folder = get_folder_type(source)
folder_model = QuerySet(model=Folder).filter(id=folder_id).first()
if folder_model is not None:
- return {
- 'name': folder_model.name
- }
+ return {"name": folder_model.name}
return {}
@@ -28,147 +29,168 @@ class FolderView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Create folder'),
- summary=_('Create folder'),
- operation_id=_('Create folder'), # type: ignore
+ methods=["POST"],
+ description=_("Create folder"),
+ summary=_("Create folder"),
+ operation_id=_("Create folder"), # type: ignore
parameters=FolderCreateAPI.get_parameters(),
request=FolderCreateAPI.get_request(),
responses=FolderCreateAPI.get_response(),
- tags=[_('Folder')] # type: ignore
+ tags=[_("Folder")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_FOLDER"), operate=Operate.CREATE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source')}/{r.data.get('parent_id')}"),
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_FOLDER"), operate=Operate.CREATE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: ViewPermission([RoleConstants.USER.get_workspace_role()],
- [Permission(group=Group(kwargs.get('source')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source')}/{r.data.get('parent_id')}"
- )], CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source')}_FOLDER_CREATE"].get_workspace_permission(),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source')}_FOLDER_CREATE"
+ ].get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: Permission(
+ group=PermissionConstants[kwargs.get("source")].value.group,
+ sub_group=PermissionConstants[kwargs.get("source")].value.sub_group,
+ operate=PermissionConstants[kwargs.get("source")].value.operate,
+ bit_index=PermissionConstants[kwargs.get("source")].value.bit_index,
+ workspace_id=kwargs.get("workspace_id"),
+ resource_id=r.data.get("parent_id"),
+ )
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu='folder', operate='Create folder',
- get_operation_object=lambda r, k: {'name': r.data.get('name')},
-
+ menu="folder",
+ operate="Create folder",
+ get_operation_object=lambda r, k: {"name": r.data.get("name")},
)
def post(self, request: Request, workspace_id: str, source: str):
- return result.success(FolderSerializer.Create(
- data={'user_id': request.user.id,
- 'source': source,
- 'workspace_id': workspace_id}
- ).insert(request.data))
+ return result.success(
+ FolderSerializer.Create(
+ data={"user_id": request.user.id, "source": source, "workspace_id": workspace_id}
+ ).insert(request.data)
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get folder tree'),
- summary=_('Get folder tree'),
- operation_id=_('Get folder tree'), # type: ignore
+ methods=["GET"],
+ description=_("Get folder tree"),
+ summary=_("Get folder tree"),
+ operation_id=_("Get folder tree"), # type: ignore
parameters=FolderTreeReadAPI.get_parameters(),
responses=FolderTreeReadAPI.get_response(),
- tags=[_('Folder')] # type: ignore
+ tags=[_("Folder")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_WORKSPACE_USER_RESOURCE_PERMISSION"),
- operate=Operate.READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}"),
- lambda r, kwargs: Permission(group=Group(kwargs.get('source')), operate=Operate.READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}"),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role(),
- RoleConstants.ADMIN, RoleConstants.EXTENDS_ADMIN
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source')}_FOLDER_READ"].get_workspace_permission(),
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source')}_READ"].get_workspace_permission(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str, source: str):
- return result.success(FolderTreeSerializer(
- data={'workspace_id': workspace_id, 'source': source}
- ).get_folder_tree(request.user, request.query_params.get('name')))
+ return result.success(
+ FolderTreeSerializer(data={"workspace_id": workspace_id, "source": source}).get_folder_tree(
+ request.user, request.query_params.get("name")
+ )
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- description=_('Update folder'),
- summary=_('Update folder'),
- operation_id=_('Update folder'), # type: ignore
+ methods=["PUT"],
+ description=_("Update folder"),
+ summary=_("Update folder"),
+ operation_id=_("Update folder"), # type: ignore
parameters=FolderEditAPI.get_parameters(),
request=FolderEditAPI.get_request(),
responses=FolderEditAPI.get_response(),
- tags=[_('Folder')] # type: ignore
+ tags=[_("Folder")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_FOLDER"), operate=Operate.EDIT,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_FOLDER"), operate=Operate.EDIT,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source')}/{kwargs.get('folder_id')}"
- ),
- lambda r, kwargs: ViewPermission([RoleConstants.USER.get_workspace_role()],
- [Permission(group=Group(kwargs.get('source')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source')}/{kwargs.get('folder_id')}"
- )], CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source')}_FOLDER_EDIT"]._build_workspace_permission(
+ resource_id_key="folder_id"
+ ),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source')}_FOLDER_EDIT"
+ ].get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("source")]._build_workspace_permission(
+ resource_id_key="folder_id"
+ )(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu='folder', operate='Edit folder',
- get_operation_object=lambda r, k: get_folder_operation_object(k.get('folder_id'), k.get('source')),
+ menu="folder",
+ operate="Edit folder",
+ get_operation_object=lambda r, k: get_folder_operation_object(k.get("folder_id"), k.get("source")),
)
def put(self, request: Request, workspace_id: str, source: str, folder_id: str):
- return result.success(FolderSerializer.Operate(
- data={'id': folder_id, 'workspace_id': workspace_id, 'source': source, 'user_id': request.user.id}
- ).edit(request.data))
+ return result.success(
+ FolderSerializer.Operate(
+ data={"id": folder_id, "workspace_id": workspace_id, "source": source, "user_id": request.user.id}
+ ).edit(request.data)
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get folder'),
- summary=_('Get folder'),
- operation_id=_('Get folder'), # type: ignore
+ methods=["GET"],
+ description=_("Get folder"),
+ summary=_("Get folder"),
+ operation_id=_("Get folder"), # type: ignore
parameters=FolderReadAPI.get_parameters(),
responses=FolderReadAPI.get_response(),
- tags=[_('Folder')] # type: ignore
+ tags=[_("Folder")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('source')), operate=Operate.READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}"),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role(),
- RoleConstants.ADMIN, RoleConstants.EXTENDS_ADMIN
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source')}_READ"].get_workspace_permission(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.EXTENDS_ADMIN,
)
def get(self, request: Request, workspace_id: str, source: str, folder_id: str):
- return result.success(FolderSerializer.Operate(
- data={'id': folder_id, 'workspace_id': workspace_id, 'source': source, 'user_id': request.user.id}
- ).one())
+ return result.success(
+ FolderSerializer.Operate(
+ data={"id": folder_id, "workspace_id": workspace_id, "source": source, "user_id": request.user.id}
+ ).one()
+ )
@extend_schema(
- methods=['DELETE'],
- description=_('Delete folder'),
- summary=_('Delete folder'),
- operation_id=_('Delete folder'), # type: ignore
+ methods=["DELETE"],
+ description=_("Delete folder"),
+ summary=_("Delete folder"),
+ operation_id=_("Delete folder"), # type: ignore
parameters=FolderDeleteAPI.get_parameters(),
responses=FolderDeleteAPI.get_response(),
- tags=[_('Folder')] # type: ignore
+ tags=[_("Folder")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_FOLDER"), operate=Operate.DELETE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(f"{kwargs.get('source')}_FOLDER"), operate=Operate.DELETE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source')}/{kwargs.get('folder_id')}"
- ),
- lambda r, kwargs: ViewPermission([RoleConstants.USER.get_workspace_role()],
- [Permission(group=Group(kwargs.get('source')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source')}/{kwargs.get('folder_id')}"
- )], CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source')}_FOLDER_DELETE"]._build_workspace_permission(
+ resource_id_key="folder_id"
+ ),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source')}_FOLDER_DELETE"
+ ].get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("source")]._build_workspace_permission(
+ resource_id_key="folder_id"
+ )(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu='folder', operate='Delete folder',
- get_operation_object=lambda r, k: get_folder_operation_object(k.get('folder_id'), k.get('source')),
+ menu="folder",
+ operate="Delete folder",
+ get_operation_object=lambda r, k: get_folder_operation_object(k.get("folder_id"), k.get("source")),
)
def delete(self, request: Request, workspace_id: str, source: str, folder_id: str):
- return result.success(FolderSerializer.Operate(
- data={'id': folder_id, 'workspace_id': workspace_id, 'source': source, 'user_id': request.user.id}
- ).delete())
+ return result.success(
+ FolderSerializer.Operate(
+ data={"id": folder_id, "workspace_id": workspace_id, "source": source, "user_id": request.user.id}
+ ).delete()
+ )
diff --git a/apps/homepage/api/home_page_api.py b/apps/homepage/api/home_page_api.py
index 8afba490fa1..22f5b852ca5 100644
--- a/apps/homepage/api/home_page_api.py
+++ b/apps/homepage/api/home_page_api.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: home_page_api.py
- @date:2026/5/18 16:02
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: home_page_api.py
+@date:2026/5/18 16:02
+@desc:
"""
from django.utils.translation import gettext_lazy as _
@@ -22,13 +22,14 @@
class ApplicationMonitoringAPI(APIMixin):
@staticmethod
def get_parameters():
- return [OpenApiParameter(
- name="workspace_id",
- description="工作空间id",
- type=OpenApiTypes.STR,
- location='path',
- required=True,
- ),
+ return [
+ OpenApiParameter(
+ name="workspace_id",
+ description="工作空间id",
+ type=OpenApiTypes.STR,
+ location="path",
+ required=True,
+ ),
OpenApiParameter(
name="application_id",
description="application ID",
@@ -55,7 +56,6 @@ def get_response():
class RankingBaseAPI(APIMixin):
-
@staticmethod
def get_request():
return None
@@ -106,7 +106,6 @@ def get_parameters():
class RankingBaseExportAPI(APIMixin):
-
@staticmethod
def get_request():
return None
@@ -143,7 +142,6 @@ def get_parameters():
class ApplicationTokensRankingAPI(RankingBaseAPI):
-
@staticmethod
def get_response():
return inline_serializer(
@@ -173,7 +171,6 @@ def get_response():
class ApplicationQuestionRankingAPI(RankingBaseAPI):
-
@staticmethod
def get_response():
return inline_serializer(
@@ -203,33 +200,39 @@ def get_response():
class UserTokensRankingAPI(RankingBaseAPI):
-
@staticmethod
- def get_response(serializer=inline_serializer(name="UserTokensRankingResponse", fields={
- "code": serializers.IntegerField(help_text=_("Response code")),
- "message": serializers.CharField(help_text=_("Response message")),
- "data": inline_serializer(name="UserTokensRankingPage",
- fields={"total": serializers.IntegerField(help_text=_("Total count")),
- "records": serializers.ListField(help_text=_("User tokens ranking list"),
- child=inline_serializer(
- name="UserTokensRankingItem", fields={
- "chat_user_id": serializers.CharField(
- help_text=_("Chat user ID")),
- "chat_user_type": serializers.CharField(
- help_text=_("Chat user type")),
- "total_tokens": serializers.IntegerField(
- help_text=_(
- "Total consumed tokens")),
- "chat_record_count": serializers.IntegerField(
- help_text=_("Question count")),
- "asker": serializers.JSONField(
- help_text=_(
- "Asker user information")), }, ), ), }, ), }, )):
+ def get_response(
+ serializer=inline_serializer(
+ name="UserTokensRankingResponse",
+ fields={
+ "code": serializers.IntegerField(help_text=_("Response code")),
+ "message": serializers.CharField(help_text=_("Response message")),
+ "data": inline_serializer(
+ name="UserTokensRankingPage",
+ fields={
+ "total": serializers.IntegerField(help_text=_("Total count")),
+ "records": serializers.ListField(
+ help_text=_("User tokens ranking list"),
+ child=inline_serializer(
+ name="UserTokensRankingItem",
+ fields={
+ "chat_user_id": serializers.CharField(help_text=_("Chat user ID")),
+ "chat_user_type": serializers.CharField(help_text=_("Chat user type")),
+ "total_tokens": serializers.IntegerField(help_text=_("Total consumed tokens")),
+ "chat_record_count": serializers.IntegerField(help_text=_("Question count")),
+ "asker": serializers.JSONField(help_text=_("Asker user information")),
+ },
+ ),
+ ),
+ },
+ ),
+ },
+ ),
+ ):
return serializer
class ApplicationAggregationAPI(APIMixin):
-
@staticmethod
def get_request():
return None
@@ -292,7 +295,6 @@ def get_parameters():
class KnowledgeAggregationAPI(APIMixin):
-
@staticmethod
def get_request():
return None
@@ -329,7 +331,6 @@ def get_parameters():
class ToolAggregationAPI(APIMixin):
-
@staticmethod
def get_request():
return None
@@ -366,7 +367,6 @@ def get_parameters():
class ModelAggregationAPI(APIMixin):
-
@staticmethod
def get_request():
return None
@@ -400,3 +400,28 @@ def get_parameters():
description=_("Workspace ID"),
),
]
+
+
+def system_parameters(api_class):
+ """系统管理端点参数:workspace_id 由 PATH 必填改为可选 query 参数(传了查指定工作空间,缺省查全局)"""
+ params = api_class.get_parameters()
+ return [
+ (
+ OpenApiParameter(
+ name="workspace_id",
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ description=_("Workspace ID (optional; omit to query across all workspaces)"),
+ )
+ if _param_name(p) == "workspace_id"
+ else p
+ )
+ for p in params
+ ]
+
+
+def _param_name(param):
+ if isinstance(param, dict):
+ return param.get("name")
+ return getattr(param, "name", None)
diff --git a/apps/homepage/serializers/homepage.py b/apps/homepage/serializers/homepage.py
index 4a415790ed9..75d87810229 100644
--- a/apps/homepage/serializers/homepage.py
+++ b/apps/homepage/serializers/homepage.py
@@ -1,28 +1,41 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: homepage.py
- @date:2026/5/13 14:34
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: homepage.py
+@date:2026/5/13 14:34
+@desc:
"""
+
import datetime
import os
from typing import List, Dict
import openpyxl
from django.db import models
-from django.db.models import QuerySet, Count, Q, UUIDField, Sum, F, BigIntegerField, Value, ExpressionWrapper, \
- IntegerField, Window
+from django.db.models import (
+ QuerySet,
+ Count,
+ Q,
+ UUIDField,
+ Sum,
+ F,
+ BigIntegerField,
+ Value,
+ ExpressionWrapper,
+ IntegerField,
+ Window,
+)
from django.db.models.functions import Cast, Coalesce, RowNumber
-from django.forms import CharField
from django.http import HttpResponse
from django.utils import timezone
from django.utils.translation import gettext_lazy as _, gettext
from rest_framework import serializers
from application.models import Application, ApplicationChatUserStats, Chat, ChatRecord
-from common.constants.permission_constants import RoleConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.permission import Permission, Role
from common.db.search import native_search, get_dynamics_model, page_search
from common.utils.common import get_file_content
from knowledge.models import Knowledge
@@ -31,6 +44,7 @@
from models_provider.models import Model
from system_manage.models import WorkspaceUserResourcePermission
from tools.models import Tool, ToolType
+from users.serializers.user import get_workspace_list_by_user
_PERM_WITH_ROLE = ["VIEW", "MANAGE", "ROLE"]
_PERM_DEFAULT = ["VIEW", "MANAGE"]
@@ -38,58 +52,680 @@
def hasPermission(auth, permission):
- if 'USER' in auth.role_list:
- return True
- if permission in auth.permission_list:
+ if "USER" in auth.roles:
return True
- return False
+ key = permission.get_resource_permission_key(permission.resource_id) if permission.resource_id else str(permission)
+ return (auth.permissions.get(key, 0) & permission.bit()) > 0
def has_extends_workspace_manage_permission(auth, permission, workspace_id):
- return hasPermission(auth, f"{permission}:/WORKSPACE/{workspace_id}:ROLE/WORKSPACE_MANAGE")
+ p = Permission(
+ group=permission.group,
+ sub_group=permission.sub_group,
+ operate=permission.operate,
+ bit_index=permission.bit_index,
+ workspace_id=workspace_id,
+ flag=RoleConstants.WORKSPACE_MANAGE.value,
+ )
+ return hasPermission(auth, p)
def has_user_permission(auth, permission, workspace_id):
- return hasPermission(auth, f"{permission}:/WORKSPACE/{workspace_id}")
+ p = Permission(
+ group=permission.group,
+ sub_group=permission.sub_group,
+ operate=permission.operate,
+ bit_index=permission.bit_index,
+ workspace_id=workspace_id,
+ )
+ return hasPermission(auth, p)
def has_all_permission(auth, permission, workspace_id):
- return (has_user_permission(auth, permission, workspace_id)
- or has_extends_workspace_manage_permission(auth,
- permission,
- workspace_id)
- or hasPermission(auth,
- permission)
- or RoleConstants.USER.name + f':/WORKSPACE/{workspace_id}' in auth.role_list
- or RoleConstants.WORKSPACE_MANAGE.name + f':/WORKSPACE/{workspace_id}' in auth.role_list)
+ return (
+ has_user_permission(auth, permission, workspace_id)
+ or has_extends_workspace_manage_permission(auth, permission, workspace_id)
+ or hasPermission(auth, permission)
+ or str(Role(RoleConstants.USER.value.name, workspace_id)) in auth.roles
+ or str(Role(RoleConstants.WORKSPACE_MANAGE.value.name, workspace_id)) in auth.roles
+ )
def is_workspace_manage(auth, workspace_id):
- return RoleConstants.WORKSPACE_MANAGE.value.__str__() + ":/WORKSPACE/" + workspace_id in auth.role_list
+ return str(Role(RoleConstants.WORKSPACE_MANAGE.value.name, workspace_id)) in auth.roles
def is_extends_workspace_manage(auth, workspace_id):
- return RoleConstants.EXTENDS_WORKSPACE_MANAGE.value.__str__() + ":/WORKSPACE/" + workspace_id in auth.role_list
+ return str(Role(RoleConstants.EXTENDS_WORKSPACE_MANAGE.value.name, workspace_id)) in auth.roles
def get_start_time(date_time):
- d = datetime.datetime.strptime(date_time, '%Y-%m-%d').date()
+ d = datetime.datetime.strptime(date_time, "%Y-%m-%d").date()
naive = datetime.datetime.combine(d, datetime.time.min)
return timezone.make_aware(naive, timezone.get_default_timezone())
def get_end_time(date_time):
- d = datetime.datetime.strptime(date_time, '%Y-%m-%d').date()
+ d = datetime.datetime.strptime(date_time, "%Y-%m-%d").date()
naive = datetime.datetime.combine(d, datetime.time.max)
return timezone.make_aware(naive, timezone.get_default_timezone())
+def _get_authorized_resource_query_set(auth, user_id, model, auth_target_type, read_permission, workspace_id=None):
+ """返回当前用户授权可访问的资源 QuerySet。
+ workspace_id 缺省 => 跨所有授权工作空间(全局);给出 => 仅该工作空间"""
+ permission_list = _PERM_WITH_ROLE if hasPermission(auth, read_permission) else _PERM_DEFAULT
+ if workspace_id:
+ # 指定工作空间:复用现有单工作空间授权逻辑
+ if is_workspace_manage(auth, workspace_id):
+ return QuerySet(model).filter(workspace_id=workspace_id)
+ if is_extends_workspace_manage(auth, workspace_id):
+ if has_extends_workspace_manage_permission(auth, read_permission, workspace_id):
+ return QuerySet(model).filter(workspace_id=workspace_id)
+ if not has_all_permission(auth, read_permission, workspace_id):
+ return QuerySet(model).none()
+ return QuerySet(model).filter(
+ id__in=QuerySet(WorkspaceUserResourcePermission)
+ .filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type=auth_target_type,
+ permission_list__overlap=permission_list,
+ )
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
+ .values_list("target_uuid", flat=True)
+ )
+ # 全局:跨所有授权工作空间,单条查询
+ manage_ws_ids = [
+ w["id"]
+ for w in get_workspace_list_by_user(user_id)
+ if is_workspace_manage(auth, w["id"])
+ or (
+ is_extends_workspace_manage(auth, w["id"])
+ and has_extends_workspace_manage_permission(auth, read_permission, w["id"])
+ )
+ ]
+ perm_ids = (
+ QuerySet(WorkspaceUserResourcePermission)
+ .filter(user_id=user_id, auth_target_type=auth_target_type, permission_list__overlap=permission_list)
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
+ .values_list("target_uuid", flat=True)
+ )
+ return QuerySet(model).filter(Q(workspace_id__in=manage_ws_ids) | Q(id__in=perm_ids))
+
+
+def _get_authorized_application_query_set(auth, user_id, workspace_id=None):
+ return _get_authorized_resource_query_set(
+ auth, user_id, Application, "APPLICATION", PermissionConstants.APPLICATION_READ.value, workspace_id
+ )
+
+
+class SystemHomePageSerializer(serializers.Serializer):
+ """系统管理首页:跨所有授权工作空间的资源数据(不绑定单个工作空间)"""
+
+ class Application(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+
+ def aggregation(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ query_set = _get_authorized_application_query_set(auth, self.data["user_id"], self.data.get("workspace_id"))
+ result = query_set.aggregate(
+ total=Count("id"),
+ publish_count=Count("id", filter=Q(is_publish=True)),
+ un_publish_count=Count("id", filter=Q(is_publish=False)),
+ )
+ return {
+ "total": result["total"],
+ "publish_count": result["publish_count"],
+ "un_publish_count": result["un_publish_count"],
+ }
+
+ class Knowledge(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+
+ def aggregation(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ query_set = _get_authorized_resource_query_set(
+ auth,
+ self.data["user_id"],
+ Knowledge,
+ "KNOWLEDGE",
+ PermissionConstants.KNOWLEDGE_READ.value,
+ self.data.get("workspace_id"),
+ )
+ result = query_set.aggregate(
+ total=Count("id", distinct=True),
+ document_count=Count("document", distinct=True),
+ failure_count=Count(
+ "document",
+ filter=Q(document__status__contains="3"),
+ distinct=True,
+ ),
+ )
+ return {
+ "total": result["total"] or 0,
+ "document_count": result["document_count"] or 0,
+ "failure_count": result["failure_count"] or 0,
+ }
+
+ class Tool(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+
+ def aggregation(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ query_set = _get_authorized_resource_query_set(
+ auth,
+ self.data["user_id"],
+ Tool,
+ "TOOL",
+ PermissionConstants.TOOL_READ.value,
+ self.data.get("workspace_id"),
+ )
+ result = query_set.aggregate(
+ total=Count("id"),
+ custom_count=Count("id", filter=Q(tool_type=ToolType.CUSTOM)),
+ skill_count=Count("id", filter=Q(tool_type=ToolType.SKILL)),
+ mcp_count=Count("id", filter=Q(tool_type=ToolType.MCP)),
+ workflow_count=Count("id", filter=Q(tool_type=ToolType.WORKFLOW)),
+ data_source_count=Count("id", filter=Q(tool_type=ToolType.DATA_SOURCE)),
+ )
+ return {
+ "total": result["total"] or 0,
+ "custom_count": result["custom_count"] or 0,
+ "skill_count": result["skill_count"] or 0,
+ "mcp_count": result["mcp_count"] or 0,
+ "workflow_count": result["workflow_count"] or 0,
+ "data_source_count": result["data_source_count"] or 0,
+ }
+
+ class Model(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+
+ def aggregation(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ query_set = _get_authorized_resource_query_set(
+ auth,
+ self.data["user_id"],
+ Model,
+ "MODEL",
+ PermissionConstants.MODEL_READ.value,
+ self.data.get("workspace_id"),
+ )
+ result = query_set.aggregate(
+ total=Count("id"),
+ embedding_count=Count("id", filter=Q(model_type=ModelTypeConst.EMBEDDING.name)),
+ llm_count=Count("id", filter=Q(model_type=ModelTypeConst.LLM.name)),
+ )
+ return {
+ "total": result["total"] or 0,
+ "embedding_count": result["embedding_count"] or 0,
+ "llm_count": result["llm_count"] or 0,
+ }
+
+ class TokensAggregation(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
+
+ def aggregation(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.data
+ query = ChatRecord.objects.filter(
+ create_time__gte=get_start_time(data["start_time"]),
+ create_time__lte=get_end_time(data["end_time"]),
+ chat__application_id__in=_get_authorized_application_query_set(
+ auth, data["user_id"], data.get("workspace_id")
+ ),
+ )
+ return {
+ "total_tokens": query.aggregate(
+ total_tokens=Coalesce(Sum(F("message_tokens") + F("answer_tokens"), output_field=IntegerField()), 0)
+ )["total_tokens"]
+ }
+
+ class ChatRecordAggregation(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
+
+ def aggregation(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.data
+ query = ChatRecord.objects.filter(
+ create_time__gte=get_start_time(data["start_time"]),
+ create_time__lte=get_end_time(data["end_time"]),
+ chat__application_id__in=_get_authorized_application_query_set(
+ auth, data["user_id"], data.get("workspace_id")
+ ),
+ )
+ return {"total_count": query.aggregate(total_count=Count("id"))["total_count"]}
+
+ class ApplicationTokensRanking(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+ name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Application Name"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
+
+ def get_queryset(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.data
+ record_time_filter = (
+ Q(chat__is_deleted=False)
+ & Q(chat__chatrecord__create_time__gte=get_start_time(data["start_time"]))
+ & Q(chat__chatrecord__create_time__lte=get_end_time(data["end_time"]))
+ )
+ token_expr = ExpressionWrapper(
+ F("chat__chatrecord__message_tokens") + F("chat__chatrecord__answer_tokens"),
+ output_field=BigIntegerField(),
+ )
+ queryset = _get_authorized_application_query_set(auth, data["user_id"], data.get("workspace_id"))
+ if data.get("name"):
+ queryset = queryset.filter(name__contains=data["name"])
+ return queryset.annotate(
+ total_tokens=Coalesce(
+ Sum(token_expr, filter=record_time_filter), Value(0), output_field=BigIntegerField()
+ ),
+ chat_record_count_total=Count(
+ "chat__chatrecord__id", filter=record_time_filter, output_field=IntegerField()
+ ),
+ chat_user_count=Count(
+ "chat__chat_user_id",
+ filter=(record_time_filter & Q(chat__chat_user_id__isnull=False) & ~Q(chat__chat_user_id="")),
+ distinct=True,
+ ),
+ ).order_by("-total_tokens")
+
+ def ranking(self, auth, current_page, page_size, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ queryset = self.get_queryset(auth, with_valid=False)
+ return page_search(
+ current_page,
+ page_size,
+ queryset,
+ lambda a: {
+ "id": a.id,
+ "name": a.name,
+ "total_tokens": a.total_tokens,
+ "chat_record_count": a.chat_record_count_total,
+ "chat_user_count": a.chat_user_count,
+ },
+ )
+
+ def export(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ tokens_total = SystemHomePageSerializer.TokensAggregation(data=self.data).aggregation(auth)["total_tokens"]
+ queryset = self.get_queryset(auth, with_valid=False)
+ workbook = openpyxl.Workbook(write_only=True)
+ worksheet = workbook.create_sheet(title="Sheet1")
+ headers = [
+ gettext("ranking"),
+ gettext("Application Name"),
+ gettext("Token consumption"),
+ gettext("proportion"),
+ gettext("number of questions"),
+ gettext("active users"),
+ gettext("Average tokens per request"),
+ ]
+ worksheet.append(headers)
+ index = 0
+ for item in queryset:
+ index += 1
+ total_tokens = item.total_tokens
+ chat_record_count_total = item.chat_record_count_total
+ row = [
+ index,
+ item.name,
+ total_tokens,
+ total_tokens / tokens_total if tokens_total else 0,
+ item.chat_user_count,
+ chat_record_count_total,
+ total_tokens / chat_record_count_total if chat_record_count_total else 0,
+ ]
+ worksheet.append(row)
+ response = HttpResponse(content_type="application/vnd.ms-excel")
+ response["Content-Disposition"] = f'attachment; filename="data.xlsx"'
+ workbook.save(response)
+ return response
+
+ class ApplicationQuestionRanking(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+ name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Application Name"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
+
+ def get_queryset(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.data
+ record_time_filter = (
+ Q(chat__is_deleted=False)
+ & Q(chat__chatrecord__create_time__gte=get_start_time(data["start_time"]))
+ & Q(chat__chatrecord__create_time__lte=get_end_time(data["end_time"]))
+ )
+ queryset = _get_authorized_application_query_set(auth, data["user_id"], data.get("workspace_id"))
+ if data.get("name"):
+ queryset = queryset.filter(name__contains=data["name"])
+ return queryset.annotate(
+ chat_record_count_total=Coalesce(
+ Count("chat__chatrecord__id", filter=record_time_filter), Value(0), output_field=BigIntegerField()
+ ),
+ chat_user_count=Count(
+ "chat__chat_user_id",
+ filter=(record_time_filter & Q(chat__chat_user_id__isnull=False) & ~Q(chat__chat_user_id="")),
+ distinct=True,
+ ),
+ ).order_by("-chat_record_count_total")
+
+ def ranking(self, auth, current_page, page_size, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ queryset = self.get_queryset(auth, with_valid=False)
+ return page_search(
+ current_page,
+ page_size,
+ queryset,
+ lambda a: {
+ "id": a.id,
+ "name": a.name,
+ "chat_record_count": a.chat_record_count_total,
+ "chat_user_count": a.chat_user_count,
+ },
+ )
+
+ def export(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ chat_record_number = SystemHomePageSerializer.ChatRecordAggregation(data=self.data).aggregation(auth)[
+ "total_count"
+ ]
+ queryset = self.get_queryset(auth, with_valid=False)
+ workbook = openpyxl.Workbook(write_only=True)
+ worksheet = workbook.create_sheet(title="Sheet1")
+ headers = [
+ gettext("ranking"),
+ gettext("Application Name"),
+ gettext("number of questions"),
+ gettext("proportion"),
+ gettext("active users"),
+ gettext("Average Number of Conversation Turns per Person"),
+ ]
+ worksheet.append(headers)
+ index = 0
+ for item in queryset:
+ index += 1
+ row = [
+ index,
+ item.name,
+ item.chat_record_count_total,
+ item.chat_record_count_total / chat_record_number if chat_record_number != 0 else 0,
+ item.chat_user_count,
+ item.chat_user_count / item.chat_record_count_total if item.chat_record_count_total != 0 else 0,
+ ]
+ worksheet.append(row)
+ response = HttpResponse(content_type="application/vnd.ms-excel")
+ response["Content-Disposition"] = f'attachment; filename="data.xlsx"'
+ workbook.save(response)
+ return response
+
+ class ApplicationUserTokenRanking(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+ name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("User Name"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
+
+ def get_queryset(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.data
+ start_time = get_start_time(data["start_time"])
+ end_time = get_end_time(data["end_time"])
+ name = data.get("name")
+
+ base_queryset = Chat.objects.filter(
+ is_deleted=False,
+ chat_user_id__isnull=False,
+ ).exclude(chat_user_id="")
+
+ if name:
+ base_queryset = base_queryset.filter(asker__username__contains=name)
+
+ base_queryset = base_queryset.filter(
+ application_id__in=_get_authorized_application_query_set(
+ auth, data["user_id"], data.get("workspace_id")
+ )
+ )
+
+ asker_map = self._build_asker_map(base_queryset)
+
+ record_time_filter = Q(
+ chatrecord__create_time__gte=start_time,
+ chatrecord__create_time__lte=end_time,
+ )
+
+ queryset = (
+ base_queryset.filter(record_time_filter)
+ .values("chat_user_id", "chat_user_type")
+ .annotate(
+ total_tokens=Coalesce(
+ Sum(TOKEN_EXPR, filter=record_time_filter),
+ Value(0),
+ output_field=BigIntegerField(),
+ ),
+ chat_record_count=Count(
+ "chatrecord__id",
+ filter=record_time_filter,
+ distinct=True,
+ ),
+ )
+ .order_by("-total_tokens")
+ )
+ return queryset, asker_map
+
+ def ranking(self, auth, current_page, page_size, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ queryset, asker_map = self.get_queryset(auth, with_valid=False)
+ return page_search(
+ current_page,
+ page_size,
+ queryset,
+ lambda item: {
+ "chat_user_id": item["chat_user_id"],
+ "chat_user_type": item["chat_user_type"],
+ "asker": asker_map.get((item["chat_user_id"], item["chat_user_type"])),
+ "total_tokens": item["total_tokens"],
+ "chat_record_count": item["chat_record_count"],
+ },
+ )
+
+ def export(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ token_count = SystemHomePageSerializer.TokensAggregation(data=self.data).aggregation(auth)["total_tokens"]
+ queryset, asker_map = self.get_queryset(auth, with_valid=False)
+ workbook = openpyxl.Workbook(write_only=True)
+ worksheet = workbook.create_sheet(title="Sheet1")
+ headers = [
+ gettext("ranking"),
+ gettext("User Name"),
+ gettext("Token consumption"),
+ gettext("proportion"),
+ gettext("number of questions"),
+ gettext("Average tokens per request"),
+ ]
+ worksheet.append(headers)
+ index = 0
+ for item in queryset:
+ index += 1
+ user_info = asker_map.get((item["chat_user_id"], item["chat_user_type"])) or {}
+ username = user_info.get("username", "")
+ total_tokens = item.get("total_tokens", 0)
+ chat_record_count = item.get("chat_record_count", 0)
+ row = [
+ index,
+ username,
+ total_tokens,
+ total_tokens / token_count if token_count else 0,
+ chat_record_count,
+ total_tokens / chat_record_count if chat_record_count else 0,
+ ]
+ worksheet.append(row)
+ response = HttpResponse(content_type="application/vnd.ms-excel")
+ response["Content-Disposition"] = f'attachment; filename="data.xlsx"'
+ workbook.save(response)
+ return response
+
+ @staticmethod
+ def _build_asker_map(base_queryset):
+ latest_rows = (
+ base_queryset.annotate(
+ _rn=Window(
+ expression=RowNumber(),
+ partition_by=[F("chat_user_id"), F("chat_user_type")],
+ order_by=F("create_time").desc(),
+ )
+ )
+ .filter(_rn=1)
+ .values("chat_user_id", "chat_user_type", "asker")
+ )
+
+ return {(row["chat_user_id"], row["chat_user_type"]): row["asker"] for row in latest_rows}
+
+ class ApplicationMonitoring(serializers.Serializer):
+ workspace_id = serializers.CharField(required=False, allow_null=True, label=_("Workspace ID"))
+ user_id = serializers.UUIDField(required=True, label=_("User ID"))
+ application_id = serializers.UUIDField(required=False, allow_null=True, label=_("Application ID"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
+
+ def get_customer_count_trend(self, application_queryset, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ start_time = get_start_time(self.data.get("start_time"))
+ end_time = get_end_time(self.data.get("end_time"))
+ query_set = QuerySet(ApplicationChatUserStats).filter(
+ create_time__gte=start_time, create_time__lte=end_time
+ )
+ application_id = self.data.get("application_id")
+ if application_id:
+ query_set = query_set.filter(application_id=application_id)
+ else:
+ query_set = query_set.filter(application_id__in=application_queryset)
+ return native_search(
+ {"default_sql": query_set},
+ select_string=get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "application", "sql", "customer_count_trend.sql")
+ ),
+ )
+
+ def get_chat_record_aggregate_trend(self, auth, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.data
+ start_time = get_start_time(data["start_time"])
+ end_time = get_end_time(data["end_time"])
+ application_id = data.get("application_id")
+ application_query_set = _get_authorized_application_query_set(
+ auth, data["user_id"], data.get("workspace_id")
+ )
+ chat_record_aggregate_trend = native_search(
+ {
+ "default_sql": QuerySet(
+ model=get_dynamics_model(
+ {
+ "application_chat.application_id": models.UUIDField(),
+ "application_chat_record.create_time": models.DateTimeField(),
+ }
+ )
+ ).filter(
+ **{
+ **(
+ {"application_chat.application_id": application_id}
+ if application_id
+ else {"application_chat.application_id__in": application_query_set}
+ ),
+ "application_chat_record.create_time__gte": start_time,
+ "application_chat_record.create_time__lte": end_time,
+ }
+ )
+ },
+ select_string=get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "application", "sql", "chat_record_count_trend.sql")
+ ),
+ )
+ customer_count_trend = self.get_customer_count_trend(application_query_set, with_valid=False)
+ return self.merge_customer_chat_record(chat_record_aggregate_trend, customer_count_trend)
+
+ def merge_customer_chat_record(self, chat_record_aggregate_trend: List[Dict], customer_count_trend: List[Dict]):
+
+ return [
+ {
+ **self.find(
+ chat_record_aggregate_trend,
+ lambda c: c.get("day").strftime("%Y-%m-%d") == day,
+ {
+ "star_num": 0,
+ "trample_num": 0,
+ "tokens_num": 0,
+ "chat_record_count": 0,
+ "customer_num": 0,
+ "day": day,
+ },
+ ),
+ **self.find(
+ customer_count_trend,
+ lambda c: c.get("day").strftime("%Y-%m-%d") == day,
+ {"customer_added_count": 0},
+ ),
+ }
+ for day in self.get_days_between_dates(self.data.get("start_time"), self.data.get("end_time"))
+ ]
+
+ @staticmethod
+ def find(source_list, condition, default):
+ value_list = [row for row in source_list if condition(row)]
+ if len(value_list) > 0:
+ return value_list[0]
+ return default
+
+ @staticmethod
+ def get_days_between_dates(start_date, end_date):
+ start_date = datetime.datetime.strptime(start_date, "%Y-%m-%d")
+ end_date = datetime.datetime.strptime(end_date, "%Y-%m-%d")
+ days = []
+ current_date = start_date
+ while current_date <= end_date:
+ days.append(current_date.strftime("%Y-%m-%d"))
+ current_date += datetime.timedelta(days=1)
+ return days
+
+
class HomePageSerializer(serializers.Serializer):
class ChatRecordAggregation(serializers.Serializer):
workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
def aggregation(self, auth, with_valid=True):
if with_valid:
@@ -97,60 +733,47 @@ def aggregation(self, auth, with_valid=True):
data = self.data
user_id = data["user_id"]
workspace_id = data.get("workspace_id")
- start_time = get_start_time(data.get('start_time'))
- end_time = get_end_time(data.get('end_time'))
- workspace_manage = is_workspace_manage(auth, workspace_id)
- extends_workspace_manage = is_extends_workspace_manage(auth, workspace_id)
+ start_time = get_start_time(data.get("start_time"))
+ end_time = get_end_time(data.get("end_time"))
query = ChatRecord.objects.filter(
create_time__gte=start_time,
create_time__lte=end_time,
)
- if workspace_manage:
- query = query.filter(
- chat__application__workspace_id=workspace_id
- )
- elif extends_workspace_manage:
- if hasPermission(auth, f"APPLICATION:READ:/WORKSPACE/{workspace_id}"):
- query = query.filter(
- chat__application__workspace_id=workspace_id
- )
+ if is_workspace_manage(auth, workspace_id):
+ query = query.filter(chat__application__workspace_id=workspace_id)
+ elif is_extends_workspace_manage(auth, workspace_id):
+ if has_extends_workspace_manage_permission(
+ auth, PermissionConstants.APPLICATION_READ.value, workspace_id
+ ):
+ query = query.filter(chat__application__workspace_id=workspace_id)
else:
return 0
else:
permission_list = (
["VIEW", "MANAGE", "ROLE"]
- if hasPermission(auth, "APPLICATION:READ")
+ if hasPermission(auth, PermissionConstants.APPLICATION_READ.value)
else ["VIEW", "MANAGE"]
)
permission_subquery = (
- WorkspaceUserResourcePermission.objects
- .filter(
+ WorkspaceUserResourcePermission.objects.filter(
workspace_id=workspace_id,
user_id=user_id,
auth_target_type="APPLICATION",
- permission_list__overlap=permission_list
- ).exclude(target='default')
- .annotate(
- target_uuid=Cast(
- "target",
- output_field=UUIDField()
- )
+ permission_list__overlap=permission_list,
)
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
.values("target_uuid")
)
- query = query.filter(
- chat__application_id__in=permission_subquery
- )
+ query = query.filter(chat__application_id__in=permission_subquery)
- return query.aggregate(
- total_count=Count("id")
- )["total_count"]
+ return query.aggregate(total_count=Count("id"))["total_count"]
class TokensAggregation(serializers.Serializer):
workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
def aggregation(self, auth, with_valid=True):
if with_valid:
@@ -160,63 +783,46 @@ def aggregation(self, auth, with_valid=True):
workspace_id = data.get("workspace_id")
start_time = get_start_time(data["start_time"])
end_time = get_end_time(data["end_time"])
- workspace_manage = is_workspace_manage(auth, workspace_id)
- extends_workspace_manage = is_extends_workspace_manage(auth, workspace_id)
query = ChatRecord.objects.filter(
create_time__gte=start_time,
create_time__lte=end_time,
)
- if workspace_manage:
- query = query.filter(
- chat__application__workspace_id=workspace_id
- )
- elif extends_workspace_manage and has_extends_workspace_manage_permission(auth, 'APPLICATION:READ',
- workspace_id):
- query = query.filter(
- chat__application__workspace_id=workspace_id
- )
+ if is_workspace_manage(auth, workspace_id):
+ query = query.filter(chat__application__workspace_id=workspace_id)
+ elif is_extends_workspace_manage(auth, workspace_id):
+ if has_extends_workspace_manage_permission(
+ auth, PermissionConstants.APPLICATION_READ.value, workspace_id
+ ):
+ query = query.filter(chat__application__workspace_id=workspace_id)
else:
permission_list = (
["VIEW", "MANAGE", "ROLE"]
- if hasPermission(auth, "APPLICATION:READ")
+ if hasPermission(auth, PermissionConstants.APPLICATION_READ.value)
else ["VIEW", "MANAGE"]
)
permission_subquery = (
- WorkspaceUserResourcePermission.objects
- .filter(
+ WorkspaceUserResourcePermission.objects.filter(
workspace_id=workspace_id,
user_id=user_id,
auth_target_type="APPLICATION",
- permission_list__overlap=permission_list
- ).exclude(target='default')
- .annotate(
- target_uuid=Cast(
- "target",
- output_field=UUIDField()
- )
+ permission_list__overlap=permission_list,
)
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
.values("target_uuid")
)
- query = query.filter(
- chat__application_id__in=permission_subquery
- )
+ query = query.filter(chat__application_id__in=permission_subquery)
return query.aggregate(
- total_tokens=Coalesce(
- Sum(
- F("message_tokens") + F("answer_tokens"),
- output_field=IntegerField()
- ),
- 0
- )
+ total_tokens=Coalesce(Sum(F("message_tokens") + F("answer_tokens"), output_field=IntegerField()), 0)
)["total_tokens"]
class ApplicationUserTokenRanking(serializers.Serializer):
workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("User Name"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
def get_queryset(self, auth):
workspace_id = self.data.get("workspace_id")
@@ -226,21 +832,16 @@ def get_queryset(self, auth):
name = self.data.get("name")
# ---- 基础查询:不再按 Chat.create_time 过滤 ----
- base_queryset = (
- Chat.objects.filter(
- is_deleted=False,
- chat_user_id__isnull=False,
- )
- .exclude(chat_user_id="")
- )
+ base_queryset = Chat.objects.filter(
+ is_deleted=False,
+ chat_user_id__isnull=False,
+ ).exclude(chat_user_id="")
if name:
base_queryset = base_queryset.filter(asker__username__contains=name)
# ---- 权限过滤 ----
- base_queryset = self._apply_permission_filter(
- base_queryset, auth, workspace_id, user_id
- )
+ base_queryset = self._apply_permission_filter(base_queryset, auth, workspace_id, user_id)
# ---- 窗口函数:一次查询拿到每个用户最新的 asker ----
asker_map = self._build_asker_map(base_queryset)
@@ -253,8 +854,7 @@ def get_queryset(self, auth):
# ---- 聚合统计 ----
queryset = (
- base_queryset
- .filter(record_time_filter)
+ base_queryset.filter(record_time_filter)
.values("chat_user_id", "chat_user_type")
.annotate(
total_tokens=Coalesce(
@@ -283,9 +883,7 @@ def ranking(self, auth, current_page, page_size, with_valid=True):
lambda item: {
"chat_user_id": item["chat_user_id"],
"chat_user_type": item["chat_user_type"],
- "asker": asker_map.get(
- (item["chat_user_id"], item["chat_user_type"])
- ),
+ "asker": asker_map.get((item["chat_user_id"], item["chat_user_type"])),
"total_tokens": item["total_tokens"],
"chat_record_count": item["chat_record_count"],
},
@@ -297,21 +895,20 @@ def export(self, auth, with_valid=True):
token_count = HomePageSerializer.TokensAggregation(data=self.data).aggregation(auth)
queryset, asker_map = self.get_queryset(auth)
workbook = openpyxl.Workbook(write_only=True)
- worksheet = workbook.create_sheet(title='Sheet1')
- headers = [gettext('ranking'),
- gettext('User Name'),
- gettext('Token consumption'),
- gettext('proportion'),
- gettext('number of questions'),
- gettext('Average tokens per request'),
- ]
+ worksheet = workbook.create_sheet(title="Sheet1")
+ headers = [
+ gettext("ranking"),
+ gettext("User Name"),
+ gettext("Token consumption"),
+ gettext("proportion"),
+ gettext("number of questions"),
+ gettext("Average tokens per request"),
+ ]
worksheet.append(headers)
index = 0
for item in queryset:
index += 1
- user_info = asker_map.get(
- (item["chat_user_id"], item["chat_user_type"])
- ) or {}
+ user_info = asker_map.get((item["chat_user_id"], item["chat_user_type"])) or {}
username = user_info.get("username", "")
total_tokens = item.get("total_tokens", 0)
chat_record_count = item.get("chat_record_count", 0)
@@ -334,15 +931,15 @@ def _apply_permission_filter(self, queryset, auth, workspace_id, user_id):
if is_workspace_manage(auth, workspace_id):
return queryset.filter(application__workspace_id=workspace_id)
elif is_extends_workspace_manage(auth, workspace_id):
- if hasPermission(auth, f"APPLICATION:READ:/WORKSPACE/{workspace_id}"):
+ if has_extends_workspace_manage_permission(
+ auth, PermissionConstants.APPLICATION_READ.value, workspace_id
+ ):
return queryset.filter(application__workspace_id=workspace_id)
- if not has_all_permission(auth, 'APPLICATION:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.APPLICATION_READ.value, workspace_id):
return queryset.none()
permission_list = (
- _PERM_WITH_ROLE
- if hasPermission(auth, "APPLICATION:READ")
- else _PERM_DEFAULT
+ _PERM_WITH_ROLE if hasPermission(auth, PermissionConstants.APPLICATION_READ.value) else _PERM_DEFAULT
)
allowed_app_ids = (
@@ -352,7 +949,8 @@ def _apply_permission_filter(self, queryset, auth, workspace_id, user_id):
user_id=user_id,
auth_target_type="APPLICATION",
permission_list__overlap=permission_list,
- ).exclude(target='default')
+ )
+ .exclude(target="default")
.annotate(target_uuid=Cast("target", output_field=UUIDField()))
.values_list("target_uuid", flat=True)
)
@@ -366,8 +964,7 @@ def _build_asker_map(base_queryset):
替代原来每行一次的 Subquery。
"""
latest_rows = (
- base_queryset
- .annotate(
+ base_queryset.annotate(
_rn=Window(
expression=RowNumber(),
partition_by=[F("chat_user_id"), F("chat_user_type")],
@@ -378,17 +975,14 @@ def _build_asker_map(base_queryset):
.values("chat_user_id", "chat_user_type", "asker")
)
- return {
- (row["chat_user_id"], row["chat_user_type"]): row["asker"]
- for row in latest_rows
- }
+ return {(row["chat_user_id"], row["chat_user_type"]): row["asker"] for row in latest_rows}
class ApplicationQuestionRanking(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Application Name"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
def get_queryset(self, auth):
workspace_id = self.data.get("workspace_id")
@@ -396,25 +990,25 @@ def get_queryset(self, auth):
name = self.data.get("name")
start_time = get_start_time(self.data.get("start_time"))
end_time = get_end_time(self.data.get("end_time"))
- workspace_manage = is_workspace_manage(auth, workspace_id)
queryset = QuerySet(Application)
is_resource_filter = True
if name:
queryset = queryset.filter(name__contains=name)
- is_resource_filter = False
- if workspace_manage:
+ if is_workspace_manage(auth, workspace_id):
queryset = queryset.filter(workspace_id=workspace_id)
elif is_extends_workspace_manage(auth, workspace_id):
- if has_extends_workspace_manage_permission(auth, "APPLICATION:READ", workspace_id):
+ if has_extends_workspace_manage_permission(
+ auth, PermissionConstants.APPLICATION_READ.value, workspace_id
+ ):
queryset = queryset.filter(workspace_id=workspace_id)
is_resource_filter = False
- if not has_all_permission(auth, 'APPLICATION:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.APPLICATION_READ.value, workspace_id):
queryset = queryset.none()
is_resource_filter = False
if is_resource_filter:
permission_list = (
["VIEW", "MANAGE", "ROLE"]
- if hasPermission(auth, "APPLICATION:READ")
+ if hasPermission(auth, PermissionConstants.APPLICATION_READ.value)
else ["VIEW", "MANAGE"]
)
@@ -425,17 +1019,16 @@ def get_queryset(self, auth):
user_id=user_id,
auth_target_type="APPLICATION",
permission_list__overlap=permission_list,
- ).exclude(target='default')
- .annotate(
- target_uuid=Cast("target", output_field=UUIDField())
)
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
.values_list("target_uuid", flat=True)
)
record_time_filter = (
- Q(chat__is_deleted=False)
- & Q(chat__chatrecord__create_time__gte=start_time)
- & Q(chat__chatrecord__create_time__lte=end_time)
+ Q(chat__is_deleted=False)
+ & Q(chat__chatrecord__create_time__gte=start_time)
+ & Q(chat__chatrecord__create_time__lte=end_time)
)
return queryset.annotate(
# 问题数(按 ChatRecord 条数统计)
@@ -447,20 +1040,13 @@ def get_queryset(self, auth):
Value(0),
output_field=BigIntegerField(),
),
-
# 对话用户数量,按 chat_user_id 去重
chat_user_count=Count(
"chat__chat_user_id",
- filter=(
- record_time_filter
- & Q(chat__chat_user_id__isnull=False)
- & ~Q(chat__chat_user_id="")
- ),
+ filter=(record_time_filter & Q(chat__chat_user_id__isnull=False) & ~Q(chat__chat_user_id="")),
distinct=True,
),
- ).order_by(
- "-chat_record_count_total"
- )
+ ).order_by("-chat_record_count_total")
def ranking(self, auth, current_page, page_size, with_valid=True):
if with_valid:
@@ -484,14 +1070,15 @@ def export(self, auth, with_valid=True):
chat_record_number = HomePageSerializer.ChatRecordAggregation(data=self.data).aggregation(auth)
queryset = self.get_queryset(auth)
workbook = openpyxl.Workbook(write_only=True)
- worksheet = workbook.create_sheet(title='Sheet1')
- headers = [gettext('ranking'),
- gettext('Application Name'),
- gettext('number of questions'),
- gettext('proportion'),
- gettext('active users'),
- gettext('Average Number of Conversation Turns per Person')
- ]
+ worksheet = workbook.create_sheet(title="Sheet1")
+ headers = [
+ gettext("ranking"),
+ gettext("Application Name"),
+ gettext("number of questions"),
+ gettext("proportion"),
+ gettext("active users"),
+ gettext("Average Number of Conversation Turns per Person"),
+ ]
worksheet.append(headers)
index = 0
for item in queryset:
@@ -502,7 +1089,7 @@ def export(self, auth, with_valid=True):
item.chat_record_count_total,
item.chat_record_count_total / chat_record_number if chat_record_number != 0 else 0,
item.chat_user_count,
- item.chat_user_count / item.chat_record_count_total if item.chat_record_count_total != 0 else 0
+ item.chat_user_count / item.chat_record_count_total if item.chat_record_count_total != 0 else 0,
]
worksheet.append(row)
response = HttpResponse(content_type="application/vnd.ms-excel")
@@ -511,54 +1098,53 @@ def export(self, auth, with_valid=True):
return response
class ApplicationTokensRanking(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Application Name"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
def get_queryset(self, auth):
- start_time = get_start_time(self.data.get('start_time'))
- end_time = get_end_time(self.data.get('end_time'))
+ start_time = get_start_time(self.data.get("start_time"))
+ end_time = get_end_time(self.data.get("end_time"))
name = self.data.get("name")
workspace_id = self.data.get("workspace_id")
user_id = self.data.get("user_id")
token_expr = ExpressionWrapper(
F("chat__chatrecord__message_tokens") + F("chat__chatrecord__answer_tokens"),
- output_field=BigIntegerField()
+ output_field=BigIntegerField(),
)
# 时间条件针对 ChatRecord
record_time_filter = (
- Q(chat__is_deleted=False)
- & Q(chat__chatrecord__create_time__gte=start_time)
- & Q(chat__chatrecord__create_time__lte=end_time)
+ Q(chat__is_deleted=False)
+ & Q(chat__chatrecord__create_time__gte=start_time)
+ & Q(chat__chatrecord__create_time__lte=end_time)
)
is_resource_filter = True
- workspace_manage = is_workspace_manage(auth, workspace_id)
queryset = QuerySet(Application)
if name:
queryset = queryset.filter(name__contains=name)
- if workspace_manage:
+ if is_workspace_manage(auth, workspace_id):
queryset = queryset.filter(workspace_id=workspace_id)
is_resource_filter = False
elif is_extends_workspace_manage(auth, workspace_id):
if has_extends_workspace_manage_permission(
- auth,
- "APPLICATION:READ", workspace_id
+ auth, PermissionConstants.APPLICATION_READ.value, workspace_id
):
queryset = queryset.filter(workspace_id=workspace_id)
is_resource_filter = False
- if not has_all_permission(auth, 'APPLICATION:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.APPLICATION_READ.value, workspace_id):
queryset = queryset.none()
is_resource_filter = False
if is_resource_filter:
- permission_list = ["VIEW", "MANAGE", "ROLE"] if hasPermission(
- auth,
- "APPLICATION:READ"
- ) else ["VIEW", "MANAGE"]
+ permission_list = (
+ ["VIEW", "MANAGE", "ROLE"]
+ if hasPermission(auth, PermissionConstants.APPLICATION_READ.value)
+ else ["VIEW", "MANAGE"]
+ )
queryset = queryset.filter(
id__in=QuerySet(WorkspaceUserResourcePermission)
@@ -566,33 +1152,23 @@ def get_queryset(self, auth):
workspace_id=workspace_id,
user_id=user_id,
auth_target_type="APPLICATION",
- permission_list__overlap=permission_list
- ).exclude(target='default')
+ permission_list__overlap=permission_list,
+ )
+ .exclude(target="default")
.annotate(target_uuid=Cast("target", output_field=UUIDField()))
.values_list("target_uuid", flat=True)
)
return queryset.annotate(
total_tokens=Coalesce(
- Sum(
- token_expr,
- filter=record_time_filter
- ),
- Value(0),
- output_field=BigIntegerField()
+ Sum(token_expr, filter=record_time_filter), Value(0), output_field=BigIntegerField()
),
chat_record_count_total=Count(
- "chat__chatrecord__id",
- filter=record_time_filter,
- output_field=IntegerField()
+ "chat__chatrecord__id", filter=record_time_filter, output_field=IntegerField()
),
chat_user_count=Count(
"chat__chat_user_id",
- filter=(
- record_time_filter
- & Q(chat__chat_user_id__isnull=False)
- & ~Q(chat__chat_user_id="")
- ),
+ filter=(record_time_filter & Q(chat__chat_user_id__isnull=False) & ~Q(chat__chat_user_id="")),
distinct=True,
),
).order_by("-total_tokens")
@@ -610,8 +1186,8 @@ def ranking(self, auth, current_page, page_size, with_valid=True):
"name": a.name,
"total_tokens": a.total_tokens,
"chat_record_count": a.chat_record_count_total,
- "chat_user_count": a.chat_user_count
- }
+ "chat_user_count": a.chat_user_count,
+ },
)
def export(self, auth, with_valid=True):
@@ -620,15 +1196,16 @@ def export(self, auth, with_valid=True):
tokens_total = HomePageSerializer.TokensAggregation(data=self.data).aggregation(auth)
queryset = self.get_queryset(auth)
workbook = openpyxl.Workbook(write_only=True)
- worksheet = workbook.create_sheet(title='Sheet1')
- headers = [gettext('ranking'),
- gettext('Application Name'),
- gettext('Token consumption'),
- gettext('proportion'),
- gettext('number of questions'),
- gettext('active users'),
- gettext('Average tokens per request'),
- ]
+ worksheet = workbook.create_sheet(title="Sheet1")
+ headers = [
+ gettext("ranking"),
+ gettext("Application Name"),
+ gettext("Token consumption"),
+ gettext("proportion"),
+ gettext("number of questions"),
+ gettext("active users"),
+ gettext("Average tokens per request"),
+ ]
worksheet.append(headers)
index = 0
for item in queryset:
@@ -651,11 +1228,11 @@ def export(self, auth, with_valid=True):
return response
class ApplicationMonitoring(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
application_id = serializers.UUIDField(required=False, allow_null=True, label=_("Application ID"))
- start_time = serializers.DateField(format='%Y-%m-%d', label=_("Start time"))
- end_time = serializers.DateField(format='%Y-%m-%d', label=_("End time"))
+ start_time = serializers.DateField(format="%Y-%m-%d", label=_("Start time"))
+ end_time = serializers.DateField(format="%Y-%m-%d", label=_("End time"))
def get_customer_count_trend(self, application_queryset, with_valid=True):
if with_valid:
@@ -663,17 +1240,19 @@ def get_customer_count_trend(self, application_queryset, with_valid=True):
start_time = get_start_time(self.data.get("start_time"))
end_time = get_end_time(self.data.get("end_time"))
query_set = QuerySet(ApplicationChatUserStats).filter(
- create_time__gte=start_time,
- create_time__lte=end_time)
- application_id = self.data.get('application_id')
+ create_time__gte=start_time, create_time__lte=end_time
+ )
+ application_id = self.data.get("application_id")
if application_id:
query_set = query_set.filter(application_id=application_id)
else:
query_set = query_set.filter(application_id__in=application_queryset)
return native_search(
- {'default_sql': query_set},
+ {"default_sql": query_set},
select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql', 'customer_count_trend.sql')))
+ os.path.join(PROJECT_DIR, "apps", "application", "sql", "customer_count_trend.sql")
+ ),
+ )
def get_chat_record_aggregate_trend(self, auth, with_valid=True):
if with_valid:
@@ -682,37 +1261,64 @@ def get_chat_record_aggregate_trend(self, auth, with_valid=True):
workspace_id = self.data.get("workspace_id")
start_time = get_start_time(self.data.get("start_time"))
end_time = get_end_time(self.data.get("end_time"))
- application_id = self.data.get('application_id')
+ application_id = self.data.get("application_id")
applicationSerializer = HomePageSerializer.Application(
- data={"user_id": user_id, 'workspace_id': workspace_id})
+ data={"user_id": user_id, "workspace_id": workspace_id}
+ )
applicationSerializer.is_valid(raise_exception=True)
- application_query_set = applicationSerializer.get_aggregation_query_set(
- auth)
+ application_query_set = applicationSerializer.get_aggregation_query_set(auth)
chat_record_aggregate_trend = native_search(
- {'default_sql': QuerySet(model=get_dynamics_model(
- {'application_chat.application_id': models.UUIDField(),
- 'application_chat_record.create_time': models.DateTimeField()})).filter(
- **{**({'application_chat.application_id': application_id} if application_id else {
- 'application_chat.application_id__in': application_query_set}),
- 'application_chat_record.create_time__gte': start_time,
- 'application_chat_record.create_time__lte': end_time}
- )},
+ {
+ "default_sql": QuerySet(
+ model=get_dynamics_model(
+ {
+ "application_chat.application_id": models.UUIDField(),
+ "application_chat_record.create_time": models.DateTimeField(),
+ }
+ )
+ ).filter(
+ **{
+ **(
+ {"application_chat.application_id": application_id}
+ if application_id
+ else {"application_chat.application_id__in": application_query_set}
+ ),
+ "application_chat_record.create_time__gte": start_time,
+ "application_chat_record.create_time__lte": end_time,
+ }
+ )
+ },
select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "application", 'sql', 'chat_record_count_trend.sql')))
+ os.path.join(PROJECT_DIR, "apps", "application", "sql", "chat_record_count_trend.sql")
+ ),
+ )
customer_count_trend = self.get_customer_count_trend(application_query_set, with_valid=False)
return self.merge_customer_chat_record(chat_record_aggregate_trend, customer_count_trend)
def merge_customer_chat_record(self, chat_record_aggregate_trend: List[Dict], customer_count_trend: List[Dict]):
- return [{**self.find(chat_record_aggregate_trend, lambda c: c.get('day').strftime('%Y-%m-%d') == day,
- {'star_num': 0, 'trample_num': 0, 'tokens_num': 0, 'chat_record_count': 0,
- 'customer_num': 0,
- 'day': day}),
- **self.find(customer_count_trend, lambda c: c.get('day').strftime('%Y-%m-%d') == day,
- {'customer_added_count': 0})}
- for
- day in
- self.get_days_between_dates(self.data.get('start_time'), self.data.get('end_time'))]
+ return [
+ {
+ **self.find(
+ chat_record_aggregate_trend,
+ lambda c: c.get("day").strftime("%Y-%m-%d") == day,
+ {
+ "star_num": 0,
+ "trample_num": 0,
+ "tokens_num": 0,
+ "chat_record_count": 0,
+ "customer_num": 0,
+ "day": day,
+ },
+ ),
+ **self.find(
+ customer_count_trend,
+ lambda c: c.get("day").strftime("%Y-%m-%d") == day,
+ {"customer_added_count": 0},
+ ),
+ }
+ for day in self.get_days_between_dates(self.data.get("start_time"), self.data.get("end_time"))
+ ]
@staticmethod
def find(source_list, condition, default):
@@ -723,40 +1329,48 @@ def find(source_list, condition, default):
@staticmethod
def get_days_between_dates(start_date, end_date):
- start_date = datetime.datetime.strptime(start_date, '%Y-%m-%d')
- end_date = datetime.datetime.strptime(end_date, '%Y-%m-%d')
+ start_date = datetime.datetime.strptime(start_date, "%Y-%m-%d")
+ end_date = datetime.datetime.strptime(end_date, "%Y-%m-%d")
days = []
current_date = start_date
while current_date <= end_date:
- days.append(current_date.strftime('%Y-%m-%d'))
+ days.append(current_date.strftime("%Y-%m-%d"))
current_date += datetime.timedelta(days=1)
return days
class Application(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
def get_aggregation_query_set(self, auth):
workspace_id = self.data.get("workspace_id")
user_id = self.data.get("user_id")
- workspace_manage = is_workspace_manage(auth, workspace_id)
- if workspace_manage:
+ if is_workspace_manage(auth, workspace_id):
return QuerySet(Application).filter(workspace_id=workspace_id)
if is_extends_workspace_manage(auth, workspace_id):
- if has_extends_workspace_manage_permission(auth, "APPLICATION:READ", workspace_id):
+ if has_extends_workspace_manage_permission(
+ auth, PermissionConstants.APPLICATION_READ.value, workspace_id
+ ):
return QuerySet(Application).filter(workspace_id=workspace_id)
- if not has_all_permission(auth, 'APPLICATION:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.APPLICATION_READ.value, workspace_id):
return QuerySet(Application).none()
- permission_list = ["VIEW", "MANAGE", "ROLE"] if hasPermission(auth, "APPLICATION:READ") else ['VIEW',
- 'MANAGE']
+ permission_list = (
+ ["VIEW", "MANAGE", "ROLE"]
+ if hasPermission(auth, PermissionConstants.APPLICATION_READ.value)
+ else ["VIEW", "MANAGE"]
+ )
return QuerySet(Application).filter(
id__in=QuerySet(WorkspaceUserResourcePermission)
- .filter(workspace_id=workspace_id,
- user_id=user_id,
- auth_target_type="APPLICATION",
- permission_list__overlap=permission_list
- ).exclude(target='default').annotate(target_uuid=Cast("target", output_field=UUIDField()))
- .values_list("target_uuid", flat=True))
+ .filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type="APPLICATION",
+ permission_list__overlap=permission_list,
+ )
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
+ .values_list("target_uuid", flat=True)
+ )
def aggregation(self, auth, with_valid=True):
if with_valid:
@@ -774,7 +1388,7 @@ def aggregation(self, auth, with_valid=True):
}
class Knowledge(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
def get_aggregation_query_set(self, auth):
@@ -783,20 +1397,29 @@ def get_aggregation_query_set(self, auth):
if is_workspace_manage(auth, workspace_id):
return QuerySet(Knowledge).filter(workspace_id=workspace_id)
if is_extends_workspace_manage(auth, workspace_id):
- if has_extends_workspace_manage_permission(auth, "KNOWLEDGE:READ", workspace_id):
+ if has_extends_workspace_manage_permission(
+ auth, PermissionConstants.KNOWLEDGE_READ.value, workspace_id
+ ):
return QuerySet(Knowledge).filter(workspace_id=workspace_id)
- if not has_all_permission(auth, 'KNOWLEDGE:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.KNOWLEDGE_READ.value, workspace_id):
return QuerySet(Knowledge).none()
- permission_list = ["VIEW", "MANAGE", "ROLE"] if hasPermission(auth, "KNOWLEDGE:READ") else ['VIEW',
- 'MANAGE']
+ permission_list = (
+ ["VIEW", "MANAGE", "ROLE"]
+ if hasPermission(auth, PermissionConstants.KNOWLEDGE_READ.value)
+ else ["VIEW", "MANAGE"]
+ )
return QuerySet(Knowledge).filter(
- id__in=QuerySet(WorkspaceUserResourcePermission).filter(workspace_id=workspace_id,
- user_id=user_id,
- auth_target_type="KNOWLEDGE",
- permission_list__overlap=permission_list
- ).exclude(target='default').annotate(
- target_uuid=Cast("target", output_field=UUIDField()))
- .values_list("target_uuid", flat=True))
+ id__in=QuerySet(WorkspaceUserResourcePermission)
+ .filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type="KNOWLEDGE",
+ permission_list__overlap=permission_list,
+ )
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
+ .values_list("target_uuid", flat=True)
+ )
def aggregation(self, auth, with_valid=True):
if with_valid:
@@ -823,7 +1446,7 @@ def aggregation(self, auth, with_valid=True):
}
class Tool(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
def get_aggregation_query_set(self, auth):
@@ -832,21 +1455,27 @@ def get_aggregation_query_set(self, auth):
if is_workspace_manage(auth, workspace_id):
return QuerySet(Tool).filter(workspace_id=workspace_id)
if is_extends_workspace_manage(auth, workspace_id):
- if has_extends_workspace_manage_permission(auth, "TOOL:READ", workspace_id):
+ if has_extends_workspace_manage_permission(auth, PermissionConstants.TOOL_READ.value, workspace_id):
return QuerySet(Tool).filter(workspace_id=workspace_id)
- if not has_all_permission(auth, 'TOOL:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.TOOL_READ.value, workspace_id):
return QuerySet(Tool).none()
- permission_list = ["VIEW", "MANAGE", "ROLE"] if hasPermission(auth, "TOOL:READ") else ['VIEW',
- 'MANAGE']
+ permission_list = (
+ ["VIEW", "MANAGE", "ROLE"]
+ if hasPermission(auth, PermissionConstants.TOOL_READ.value)
+ else ["VIEW", "MANAGE"]
+ )
return QuerySet(Tool).filter(
- id__in=QuerySet(WorkspaceUserResourcePermission).filter(workspace_id=workspace_id,
- user_id=user_id,
- auth_target_type="TOOL",
- permission_list__overlap=permission_list
- )
- .exclude(target='default').annotate(
- target_uuid=Cast("target", output_field=UUIDField()))
- .values_list("target_uuid", flat=True))
+ id__in=QuerySet(WorkspaceUserResourcePermission)
+ .filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type="TOOL",
+ permission_list__overlap=permission_list,
+ )
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
+ .values_list("target_uuid", flat=True)
+ )
def aggregation(self, auth, with_valid=True):
if with_valid:
@@ -870,7 +1499,7 @@ def aggregation(self, auth, with_valid=True):
}
class Model(serializers.Serializer):
- workspace_id = serializers.CharField(required=False, label=_('Workspace ID'))
+ workspace_id = serializers.CharField(required=False, label=_("Workspace ID"))
user_id = serializers.UUIDField(required=True, label=_("User ID"))
def get_aggregation_query_set(self, auth):
@@ -879,20 +1508,27 @@ def get_aggregation_query_set(self, auth):
if is_workspace_manage(auth, workspace_id):
return QuerySet(Model).filter(workspace_id=workspace_id)
if is_extends_workspace_manage(auth, workspace_id):
- if has_extends_workspace_manage_permission(auth, "MODEL:READ", workspace_id):
+ if has_extends_workspace_manage_permission(auth, PermissionConstants.MODEL_READ.value, workspace_id):
return QuerySet(Model).filter(workspace_id=workspace_id)
- if not has_all_permission(auth, 'MODEL:READ', workspace_id):
+ if not has_all_permission(auth, PermissionConstants.MODEL_READ.value, workspace_id):
return QuerySet(Model).none()
- permission_list = ["VIEW", "MANAGE", "ROLE"] if hasPermission(auth, "MODEL:READ") else ['VIEW',
- 'MANAGE']
+ permission_list = (
+ ["VIEW", "MANAGE", "ROLE"]
+ if hasPermission(auth, PermissionConstants.MODEL_READ.value)
+ else ["VIEW", "MANAGE"]
+ )
return QuerySet(Model).filter(
- id__in=QuerySet(WorkspaceUserResourcePermission).filter(workspace_id=workspace_id,
- user_id=user_id,
- auth_target_type="MODEL",
- permission_list__overlap=permission_list
- ).exclude(target='default').annotate(
- target_uuid=Cast("target", output_field=UUIDField()))
- .values_list("target_uuid", flat=True))
+ id__in=QuerySet(WorkspaceUserResourcePermission)
+ .filter(
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type="MODEL",
+ permission_list__overlap=permission_list,
+ )
+ .exclude(target="default")
+ .annotate(target_uuid=Cast("target", output_field=UUIDField()))
+ .values_list("target_uuid", flat=True)
+ )
def aggregation(self, auth, with_valid=True):
if with_valid:
@@ -906,8 +1542,4 @@ def aggregation(self, auth, with_valid=True):
total = result["total"] or 0
embedding_count = result["embedding_count"] or 0
llm_count = result["llm_count"] or 0
- return {
- "total": total,
- "embedding_count": embedding_count,
- "llm_count": llm_count
- }
+ return {"total": total, "embedding_count": embedding_count, "llm_count": llm_count}
diff --git a/apps/homepage/urls.py b/apps/homepage/urls.py
index a6cd75fd662..6026bee5417 100644
--- a/apps/homepage/urls.py
+++ b/apps/homepage/urls.py
@@ -19,5 +19,19 @@
path("workspace//homepage/chat_record/aggregation",views.HomePageAPI.ChatRecordAggregation.as_view()),
path("workspace//homepage/question_ranking/export",views.HomePageAPI.ApplicationQuestionRankingExport.as_view()),
path("workspace//homepage/tokens_ranking/export",views.HomePageAPI.ApplicationTokensRankingExport.as_view()),
- path("workspace//homepage/user_tokens_ranking/export",views.HomePageAPI.UserTokensRankingExport.as_view())
+ path("workspace//homepage/user_tokens_ranking/export",views.HomePageAPI.UserTokensRankingExport.as_view()),
+
+ path("system/homepage/application/aggregation",views.SystemHomePageAPI.ApplicationAggregation.as_view()),
+ path("system/homepage/knowledge/aggregation",views.SystemHomePageAPI.KnowledgeAggregation.as_view()),
+ path("system/homepage/tool/aggregation",views.SystemHomePageAPI.ToolAggregation.as_view()),
+ path("system/homepage/model/aggregation",views.SystemHomePageAPI.ModelAggregation.as_view()),
+ path("system/homepage/tokens/aggregation",views.SystemHomePageAPI.TokensAggregation.as_view()),
+ path("system/homepage/chat_record/aggregation",views.SystemHomePageAPI.ChatRecordAggregation.as_view()),
+ path("system/homepage/application/tokens_ranking//",views.SystemHomePageAPI.ApplicationTokensRanking.as_view()),
+ path("system/homepage/application/question_ranking//",views.SystemHomePageAPI.ApplicationQuestionRanking.as_view()),
+ path("system/homepage/application/user_tokens_ranking//",views.SystemHomePageAPI.UserTokensRanking.as_view()),
+ path("system/homepage/monitoring/aggregation",views.SystemHomePageAPI.ApplicationMonitoring.as_view()),
+ path("system/homepage/question_ranking/export",views.SystemHomePageAPI.ApplicationQuestionRankingExport.as_view()),
+ path("system/homepage/tokens_ranking/export",views.SystemHomePageAPI.ApplicationTokensRankingExport.as_view()),
+ path("system/homepage/user_tokens_ranking/export",views.SystemHomePageAPI.UserTokensRankingExport.as_view())
]
diff --git a/apps/homepage/views/homepage.py b/apps/homepage/views/homepage.py
index 1dea5cf8d47..fc9bddbdc72 100644
--- a/apps/homepage/views/homepage.py
+++ b/apps/homepage/views/homepage.py
@@ -1,22 +1,37 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: homepage.py
- @date:2026/5/13 16:40
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: homepage.py
+@date:2026/5/13 16:40
+@desc:
"""
+
from drf_spectacular.utils import extend_schema
from rest_framework.request import Request
from rest_framework.views import APIView
-from application.api.application_stats import ApplicationStatsAPI
from common import result
from common.auth import TokenAuth
-from homepage.api.home_page_api import ApplicationTokensRankingAPI, ApplicationQuestionRankingAPI, UserTokensRankingAPI, \
- ApplicationAggregationAPI, KnowledgeAggregationAPI, ToolAggregationAPI, ModelAggregationAPI, \
- ApplicationMonitoringAPI, RankingBaseAPI, TokensAggregationAPI, RankingBaseExportAPI
-from homepage.serializers.homepage import HomePageSerializer
+from common.auth.authentication import has_permissions
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import AggregatePermission, ViewPermission
+from homepage.api.home_page_api import (
+ ApplicationTokensRankingAPI,
+ ApplicationQuestionRankingAPI,
+ UserTokensRankingAPI,
+ ApplicationAggregationAPI,
+ KnowledgeAggregationAPI,
+ ToolAggregationAPI,
+ ModelAggregationAPI,
+ ApplicationMonitoringAPI,
+ TokensAggregationAPI,
+ RankingBaseExportAPI,
+ system_parameters,
+)
+from homepage.serializers.homepage import HomePageSerializer, SystemHomePageSerializer
from django.utils.translation import gettext_lazy as _
@@ -33,17 +48,24 @@ class ChatRecordAggregation(APIView):
operation_id="homepage_chat_count_aggregation",
parameters=TokensAggregationAPI.get_parameters(),
responses=TokensAggregationAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
HomePageSerializer.ChatRecordAggregation(
- data={'workspace_id': workspace_id, 'user_id': request.user.id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time')}).aggregation(
- request.auth))
+ data={
+ "workspace_id": workspace_id,
+ "user_id": request.user.id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).aggregation(request.auth)
+ )
class TokensAggregation(APIView):
authentication_classes = [TokenAuth]
@@ -55,17 +77,24 @@ class TokensAggregation(APIView):
operation_id="homepage_tokens_aggregation",
parameters=TokensAggregationAPI.get_parameters(),
responses=TokensAggregationAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
HomePageSerializer.TokensAggregation(
- data={'workspace_id': workspace_id, 'user_id': request.user.id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time')}).aggregation(
- request.auth))
+ data={
+ "workspace_id": workspace_id,
+ "user_id": request.user.id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).aggregation(request.auth)
+ )
class ApplicationTokensRankingExport(APIView):
authentication_classes = [TokenAuth]
@@ -77,17 +106,23 @@ class ApplicationTokensRankingExport(APIView):
operation_id="homepage_application_tokens_ranking_export",
parameters=RankingBaseExportAPI.get_parameters(),
responses=RankingBaseExportAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_EXPORT.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return HomePageSerializer.ApplicationTokensRanking(
- data={'user_id': request.user.id, 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time'),
- "name": request.query_params.get("name")
- }).export(request.auth)
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ "name": request.query_params.get("name"),
+ }
+ ).export(request.auth)
class ApplicationTokensRanking(APIView):
authentication_classes = [TokenAuth]
@@ -99,17 +134,25 @@ class ApplicationTokensRanking(APIView):
operation_id="homepage_application_tokens_ranking",
parameters=ApplicationTokensRankingAPI.get_parameters(),
responses=ApplicationTokensRankingAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str, current_page: int, page_size: int):
- return result.success(HomePageSerializer.ApplicationTokensRanking(
- data={'user_id': request.user.id, 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time'),
- "name": request.query_params.get("name")
- }).ranking(request.auth, current_page, page_size))
+ return result.success(
+ HomePageSerializer.ApplicationTokensRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ "name": request.query_params.get("name"),
+ }
+ ).ranking(request.auth, current_page, page_size)
+ )
class ApplicationQuestionRankingExport(APIView):
authentication_classes = [TokenAuth]
@@ -121,17 +164,23 @@ class ApplicationQuestionRankingExport(APIView):
operation_id="homepage_application_question_ranking_export",
parameters=RankingBaseExportAPI.get_parameters(),
responses=RankingBaseExportAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_EXPORT.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return HomePageSerializer.ApplicationQuestionRanking(
- data={'user_id': request.user.id, 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time'),
- "name": request.query_params.get("name")
- }).export(request.auth)
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ "name": request.query_params.get("name"),
+ }
+ ).export(request.auth)
class ApplicationQuestionRanking(APIView):
authentication_classes = [TokenAuth]
@@ -143,17 +192,25 @@ class ApplicationQuestionRanking(APIView):
operation_id="homepage_application_question_ranking",
parameters=ApplicationQuestionRankingAPI.get_parameters(),
responses=ApplicationQuestionRankingAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str, current_page: int, page_size: int):
- return result.success(HomePageSerializer.ApplicationQuestionRanking(
- data={'user_id': request.user.id, 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time'),
- "name": request.query_params.get("name")
- }).ranking(request.auth, current_page, page_size))
+ return result.success(
+ HomePageSerializer.ApplicationQuestionRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ "name": request.query_params.get("name"),
+ }
+ ).ranking(request.auth, current_page, page_size)
+ )
class UserTokensRankingExport(APIView):
authentication_classes = [TokenAuth]
@@ -165,16 +222,23 @@ class UserTokensRankingExport(APIView):
operation_id="homepage_user_tokens_ranking_export",
parameters=RankingBaseExportAPI.get_parameters(),
responses=RankingBaseExportAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_EXPORT.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return HomePageSerializer.ApplicationUserTokenRanking(
- data={'user_id': request.user.id, 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time'),
- "name": request.query_params.get("name")}).export(request.auth)
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ "name": request.query_params.get("name"),
+ }
+ ).export(request.auth)
class UserTokensRanking(APIView):
authentication_classes = [TokenAuth]
@@ -186,41 +250,55 @@ class UserTokensRanking(APIView):
operation_id="homepage_user_tokens_ranking",
parameters=UserTokensRankingAPI.get_parameters(),
responses=UserTokensRankingAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str, current_page: int, page_size: int):
- return result.success(HomePageSerializer.ApplicationUserTokenRanking(
- data={'user_id': request.user.id, 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time'),
- "name": request.query_params.get("name")})
- .ranking(request.auth, current_page, page_size))
+ return result.success(
+ HomePageSerializer.ApplicationUserTokenRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ "name": request.query_params.get("name"),
+ }
+ ).ranking(request.auth, current_page, page_size)
+ )
class ApplicationMonitoring(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Dialogue-related statistical trends'),
- summary=_('Dialogue-related statistical trends'),
- operation_id='Dialogue-related statistical trends', # type: ignore
+ methods=["GET"],
+ description=_("Dialogue-related statistical trends"),
+ summary=_("Dialogue-related statistical trends"),
+ operation_id="Dialogue-related statistical trends", # type: ignore
parameters=ApplicationMonitoringAPI.get_parameters(),
responses=ApplicationMonitoringAPI.get_response(),
- tags=[_('Home page')] # type: ignore
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
HomePageSerializer.ApplicationMonitoring(
- data={'application_id': request.query_params.get("application_id"),
- "user_id": request.user.id,
- 'workspace_id': workspace_id,
- 'start_time': request.query_params.get(
- 'start_time'),
- 'end_time': request.query_params.get(
- 'end_time')
- }).get_chat_record_aggregate_trend(request.auth))
+ data={
+ "application_id": request.query_params.get("application_id"),
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).get_chat_record_aggregate_trend(request.auth)
+ )
class ApplicationAggregation(APIView):
authentication_classes = [TokenAuth]
@@ -232,13 +310,19 @@ class ApplicationAggregation(APIView):
operation_id="homepage_application_aggregation",
parameters=ApplicationAggregationAPI.get_parameters(),
responses=ApplicationAggregationAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
HomePageSerializer.Application(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}).aggregation(
- request.auth))
+ data={"workspace_id": workspace_id, "user_id": request.user.id}
+ ).aggregation(request.auth)
+ )
class KnowledgeAggregation(APIView):
authentication_classes = [TokenAuth]
@@ -250,13 +334,19 @@ class KnowledgeAggregation(APIView):
operation_id="homepage_knowledge_aggregation",
parameters=KnowledgeAggregationAPI.get_parameters(),
responses=KnowledgeAggregationAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
HomePageSerializer.Knowledge(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}).aggregation(
- request.auth))
+ data={"workspace_id": workspace_id, "user_id": request.user.id}
+ ).aggregation(request.auth)
+ )
class ToolAggregation(APIView):
authentication_classes = [TokenAuth]
@@ -268,13 +358,19 @@ class ToolAggregation(APIView):
operation_id="homepage_tool_aggregation",
parameters=ToolAggregationAPI.get_parameters(),
responses=ToolAggregationAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
- HomePageSerializer.Tool(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}).aggregation(
- request.auth))
+ HomePageSerializer.Tool(data={"workspace_id": workspace_id, "user_id": request.user.id}).aggregation(
+ request.auth
+ )
+ )
class ModelAggregation(APIView):
authentication_classes = [TokenAuth]
@@ -286,10 +382,417 @@ class ModelAggregation(APIView):
operation_id="homepage_model_aggregation",
parameters=ModelAggregationAPI.get_parameters(),
responses=ModelAggregationAPI.get_response(),
- tags=[_("Home page")],
+ tags=[_("Home page")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.HOMEPAGE_READ.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
return result.success(
- HomePageSerializer.Model(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}).aggregation(
- request.auth))
+ HomePageSerializer.Model(data={"workspace_id": workspace_id, "user_id": request.user.id}).aggregation(
+ request.auth
+ )
+ )
+
+
+class SystemHomePageAPI(APIView):
+ authentication_classes = [TokenAuth]
+
+ class ApplicationAggregation(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide application data aggregation across all workspaces"),
+ summary=_("System application aggregation"),
+ operation_id="system_homepage_application_aggregation",
+ parameters=system_parameters(ApplicationAggregationAPI),
+ responses=ApplicationAggregationAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.Application(
+ data={"user_id": request.user.id, "workspace_id": request.query_params.get("workspace_id") or None}
+ ).aggregation(request.auth)
+ )
+
+ class KnowledgeAggregation(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide knowledge data aggregation across all workspaces"),
+ summary=_("System knowledge aggregation"),
+ operation_id="system_homepage_knowledge_aggregation",
+ parameters=system_parameters(KnowledgeAggregationAPI),
+ responses=KnowledgeAggregationAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.Knowledge(
+ data={"user_id": request.user.id, "workspace_id": request.query_params.get("workspace_id") or None}
+ ).aggregation(request.auth)
+ )
+
+ class ToolAggregation(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide tool data aggregation across all workspaces"),
+ summary=_("System tool aggregation"),
+ operation_id="system_homepage_tool_aggregation",
+ parameters=system_parameters(ToolAggregationAPI),
+ responses=ToolAggregationAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.Tool(
+ data={"user_id": request.user.id, "workspace_id": request.query_params.get("workspace_id") or None}
+ ).aggregation(request.auth)
+ )
+
+ class ModelAggregation(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide model data aggregation across all workspaces"),
+ summary=_("System model aggregation"),
+ operation_id="system_homepage_model_aggregation",
+ parameters=system_parameters(ModelAggregationAPI),
+ responses=ModelAggregationAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.Model(
+ data={"user_id": request.user.id, "workspace_id": request.query_params.get("workspace_id") or None}
+ ).aggregation(request.auth)
+ )
+
+ class TokensAggregation(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide tokens aggregation across all workspaces"),
+ summary=_("System tokens aggregation"),
+ operation_id="system_homepage_tokens_aggregation",
+ parameters=system_parameters(TokensAggregationAPI),
+ responses=TokensAggregationAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.TokensAggregation(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).aggregation(request.auth)
+ )
+
+ class ChatRecordAggregation(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide chat record aggregation across all workspaces"),
+ summary=_("System chat record aggregation"),
+ operation_id="system_homepage_chat_record_aggregation",
+ parameters=system_parameters(TokensAggregationAPI),
+ responses=TokensAggregationAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.ChatRecordAggregation(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).aggregation(request.auth)
+ )
+
+ class ApplicationTokensRanking(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide top applications by token consumption across all workspaces"),
+ summary=_("System application tokens ranking"),
+ operation_id="system_homepage_application_tokens_ranking",
+ parameters=system_parameters(ApplicationTokensRankingAPI),
+ responses=ApplicationTokensRankingAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request, current_page: int, page_size: int):
+ return result.success(
+ SystemHomePageSerializer.ApplicationTokensRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "name": request.query_params.get("name"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).ranking(request.auth, current_page, page_size)
+ )
+
+ class ApplicationQuestionRanking(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide top applications by question count across all workspaces"),
+ summary=_("System application question ranking"),
+ operation_id="system_homepage_application_question_ranking",
+ parameters=system_parameters(ApplicationQuestionRankingAPI),
+ responses=ApplicationQuestionRankingAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request, current_page: int, page_size: int):
+ return result.success(
+ SystemHomePageSerializer.ApplicationQuestionRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "name": request.query_params.get("name"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).ranking(request.auth, current_page, page_size)
+ )
+
+ class UserTokensRanking(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide top users by token consumption across all workspaces"),
+ summary=_("System user tokens ranking"),
+ operation_id="system_homepage_user_tokens_ranking",
+ parameters=system_parameters(UserTokensRankingAPI),
+ responses=UserTokensRankingAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request, current_page: int, page_size: int):
+ return result.success(
+ SystemHomePageSerializer.ApplicationUserTokenRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "name": request.query_params.get("name"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).ranking(request.auth, current_page, page_size)
+ )
+
+ class UserTokensRankingExport(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide top users by token consumption export across all workspaces"),
+ summary=_("System user tokens ranking export"),
+ operation_id="system_homepage_user_tokens_ranking_export",
+ parameters=system_parameters(RankingBaseExportAPI),
+ responses=RankingBaseExportAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_EXPORT.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return SystemHomePageSerializer.ApplicationUserTokenRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "name": request.query_params.get("name"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).export(request.auth)
+
+ class ApplicationQuestionRankingExport(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide top applications by question count export across all workspaces"),
+ summary=_("System application question ranking export"),
+ operation_id="system_homepage_application_question_ranking_export",
+ parameters=system_parameters(RankingBaseExportAPI),
+ responses=RankingBaseExportAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_EXPORT.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return SystemHomePageSerializer.ApplicationQuestionRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "name": request.query_params.get("name"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).export(request.auth)
+
+ class ApplicationTokensRankingExport(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide top applications by token consumption export across all workspaces"),
+ summary=_("System application tokens ranking export"),
+ operation_id="system_homepage_application_tokens_ranking_export",
+ parameters=system_parameters(RankingBaseExportAPI),
+ responses=RankingBaseExportAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_EXPORT.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return SystemHomePageSerializer.ApplicationTokensRanking(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "name": request.query_params.get("name"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).export(request.auth)
+
+ class ApplicationMonitoring(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("System-wide dialogue monitoring trends across all workspaces"),
+ summary=_("System application monitoring"),
+ operation_id="system_homepage_application_monitoring",
+ parameters=system_parameters(ApplicationMonitoringAPI),
+ responses=ApplicationMonitoringAPI.get_response(),
+ tags=[_("System home page")], # type: ignore
+ )
+ @has_permissions(
+ RoleConstants.ADMIN,
+ ViewPermission(
+ roles=[RoleConstants.EXTENDS_ADMIN],
+ permissions=[PermissionConstants.SYSTEM_HOMEPAGE_READ.value],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request):
+ return result.success(
+ SystemHomePageSerializer.ApplicationMonitoring(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": request.query_params.get("workspace_id") or None,
+ "application_id": request.query_params.get("application_id"),
+ "start_time": request.query_params.get("start_time"),
+ "end_time": request.query_params.get("end_time"),
+ }
+ ).get_chat_record_aggregate_trend(request.auth)
+ )
diff --git a/apps/knowledge/EXTERNAL_RETRIEVAL.md b/apps/knowledge/EXTERNAL_RETRIEVAL.md
new file mode 100644
index 00000000000..64cdc3c6e53
--- /dev/null
+++ b/apps/knowledge/EXTERNAL_RETRIEVAL.md
@@ -0,0 +1,73 @@
+# 知识库外部检索服务
+
+本次仅实现后端配置与检索接口,供「知识库 → 授权与集成 → 外部检索服务」页面接入。
+MCP 沿用智能体的 Django HTTP 入口与 ToolHandler 结构,
+支持 Streamable HTTP 的 JSON 响应;不新增服务进程、队列或生产依赖,不改动 ChatUserApiKey。
+
+## 配置与兼容
+
+`Knowledge.external_service` 保存两个开关:`enabled`(外部 API/MCP)和 `authentication`(身份认证)。
+新知识库的外部服务和身份认证均默认关闭:`enabled=false, authentication=false`。迁移 `0015_knowledge_external_service`
+给旧库写入空配置:外部服务关闭,内部检索继续原有规则;管理员显式修改身份认证后采用新开关规则。
+只切换外部服务不会改变旧库内部鉴权。迁移需按项目部署流程执行,开发时不自动应用。
+
+管理接口为 `GET/PUT /admin/api/workspace/{workspace_id}/knowledge/{knowledge_id}/external_service`,
+使用现有管理员 Token 和知识库读/编辑权限。PUT 只提交本次修改的开关,例如 `{"enabled":true}`;
+其他配置保留。响应中的地址使用当前部署前缀,MCP 配置仅包含 Key 占位符。
+
+外部服务关闭时,两种入口都返回 404。身份认证开启时,需要有效且启用的对话用户 API Key、
+启用的用户和现有用户/用户组知识库授权;关闭时允许匿名。显式传入无效 Key 返回 401。
+Key 创建、查询、删除仍用原有 `/chat/api/v3/api_key` 接口。检索期间再次检查撤权及服务关闭。
+
+身份认证开关同样覆盖应用内知识库检索、文档检索和工具工作流。身份取自后端认证结果,
+不使用 `form_data.asker`,子工具参数不能覆盖它。管理员调试仍检查后台资源权限。
+外部服务开关不影响内部检索。
+
+## REST
+
+`POST /chat/api/v3/knowledge/{knowledge_id}/retrieve`
+
+```bash
+curl "$BASE_URL/chat/api/v3/knowledge/$KNOWLEDGE_ID/retrieve" \
+ -H "Authorization: Bearer $CHAT_USER_API_KEY" \
+ -H 'Content-Type: application/json' \
+ -d '{"query_text":"如何使用知识库?","top_number":5,"similarity":0,"search_mode":"embedding"}'
+```
+
+身份认证关闭时可省略 Authorization。文本最长 8000 字符,top_number 为 1–50(默认 5),
+similarity 为 0–1(默认 0),search_mode 支持 embedding、keywords、blend(默认 embedding)。
+检索限定当前知识库,返回 `knowledge_id` 和 `hits`,命中包含段落正文(最多 8000 字符)、
+分数、来源与 `citation`(知识库、文档、段落 ID 和名称);不生成回答。
+过滤跨库、停用或失效段落,仅对实际返回命中累计原有召回统计。正文中的附件沿用现有文件访问规则。
+
+请求体最大 64 KiB。400 为参数错误、401 为缺少/无效凭据、403 为无权限/不允许的 Origin、
+404 为服务不可用、413 为请求超限、415 为媒体类型错误、503 为检索依赖失败。
+错误不会返回内部异常或模型凭据。响应设置 `Cache-Control: no-store`。
+
+## MCP
+
+`POST /chat/api/v3/knowledge/{knowledge_id}/mcp`,与智能体 `/chat/api/v3/mcp` 并存。
+工具名为 `knowledge_{knowledge_id}`,输入与 REST 相同,返回文本 content 内的同一份 JSON 结果。
+配置接口返回的 `mcp_config` 可直接用于 MaxKB 的 MCP 工具配置,认证开启时替换 Key 占位符。
+
+```json
+{
+ "knowledge_example": {
+ "url": "https://example.com/chat/api/v3/knowledge/KNOWLEDGE_ID/mcp",
+ "transport": "streamable_http",
+ "headers": {"Authorization": "Bearer "}
+ }
+}
+```
+
+遵循 [Streamable HTTP](https://modelcontextprotocol.io/specification/2025-11-25/basic/transports):
+客户端发送 `Accept: application/json, text/event-stream`、`Content-Type: application/json`;
+初始化后携带协商的 `MCP-Protocol-Version`。支持 2025-03-26、2025-06-18、2025-11-25,
+提供 initialize、ping、tools/list、tools/call;通知返回 202,不执行工具。不建立持久会话,
+GET/DELETE 返回 405。不提供旧 SSE 或 OAuth 自动发现。带 Origin 的请求须与当前服务同源。
+
+## 验证
+
+`python apps/manage.py test knowledge.test_external_retrieval` 包含两开关规则、旧库兼容、
+原有 Key、授权撤销、跨库过滤、管理员调试、JSON-RPC 和真实 MCP Python SDK 的内存 HTTP 往返测试。
+真实 PostgreSQL/pgvector、模型供应商和外部客户端仍需在配置好的测试环境完成部署验收。
diff --git a/apps/knowledge/api/document.py b/apps/knowledge/api/document.py
index 8ba9d3b4fd3..cb4e6920897 100644
--- a/apps/knowledge/api/document.py
+++ b/apps/knowledge/api/document.py
@@ -1,12 +1,25 @@
-from drf_spectacular.types import OpenApiTypes
-from drf_spectacular.utils import OpenApiParameter
-
from common.mixins.api_mixin import APIMixin
from common.result import DefaultResultSerializer
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
from knowledge.serializers.common import BatchSerializer
-from knowledge.serializers.document import DocumentInstanceSerializer, DocumentWebInstanceSerializer, \
- CancelInstanceSerializer, BatchCancelInstanceSerializer, DocumentRefreshSerializer, BatchEditHitHandlingSerializer, \
- DocumentBatchRefreshSerializer, DocumentBatchGenerateRelatedSerializer, DocumentMigrateSerializer
+from knowledge.serializers.document import (
+ BatchCancelInstanceSerializer,
+ BatchEditHitHandlingSerializer,
+ CancelInstanceSerializer,
+ DocumentBatchAddTagSerializer,
+ DocumentBatchGenerateRelatedSerializer,
+ DocumentBatchRefreshSerializer,
+ DocumentInstanceSerializer,
+ DocumentMigrateSerializer,
+ DocumentRefreshSerializer,
+ DocumentWebInstanceSerializer,
+)
+from knowledge.serializers.document_strategy import DocumentSyncStrategySerializer
+from knowledge.serializers.image_document import (
+ ImagePreviewBatchCreateRequest,
+ ImagePreviewUpdateRequest,
+)
class DocumentSplitAPI(APIMixin):
@@ -17,7 +30,7 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -25,29 +38,90 @@ def get_parameters():
@staticmethod
def get_request():
return {
- 'multipart/form-data': {
- 'type': 'object',
- 'properties': {
- 'file': {
- 'type': 'string',
- 'format': 'binary' # Tells Swagger it's a file
+ "multipart/form-data": {
+ "type": "object",
+ "required": ["file"],
+ "properties": {
+ "file": {
+ "type": "array",
+ "items": {"type": "string", "format": "binary"},
},
- 'limit': {
- 'type': 'integer',
- 'description': '分段长度'
+ "limit": {"type": "integer", "description": "分段长度"},
+ "patterns": {
+ "type": "array",
+ "items": {"type": "string"},
+ "description": "分段正则列表",
},
- 'patterns': {
- 'type': 'string',
- 'description': '分段正则列表'
+ "with_filter": {"type": "boolean", "description": "是否清除特殊字符"},
+ "doc_strategy": {"type": "object", "description": "文档处理策略(multipart 中传 JSON)"},
+ },
+ }
+ }
+
+
+class ImagePreviewAPI(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return DocumentBatchAPI.get_parameters()
+
+ @staticmethod
+ def get_request():
+ return {
+ "multipart/form-data": {
+ "type": "object",
+ "required": ["file"],
+ "properties": {
+ "file": {
+ "type": "array",
+ "items": {"type": "string", "format": "binary"},
+ "description": "jpg/jpeg/png/webp/bmp, at most 50 files",
},
- 'with_filter': {
- 'type': 'boolean',
- 'description': '是否清除特殊字符'
- }
- }
+ "doc_strategy": {"type": "object", "description": "document processing strategy"},
+ },
}
}
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+
+class ImagePreviewOperateAPI(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ *DocumentBatchAPI.get_parameters(),
+ OpenApiParameter(
+ name="preview_id",
+ description="图片预览id",
+ type=OpenApiTypes.UUID,
+ location="path",
+ required=True,
+ ),
+ ]
+
+ @staticmethod
+ def get_request():
+ return ImagePreviewUpdateRequest
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+
+class ImageBatchCreateAPI(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return DocumentBatchAPI.get_parameters()
+
+ @staticmethod
+ def get_request():
+ return ImagePreviewBatchCreateRequest
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
class DocumentBatchAPI(APIMixin):
@staticmethod
@@ -57,14 +131,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -86,14 +160,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -115,14 +189,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -144,21 +218,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="document_id",
description="文档id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -186,30 +260,29 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
-
]
@staticmethod
def get_request():
return {
- 'multipart/form-data': {
- 'type': 'object',
- 'properties': {
- 'file': {
- 'type': 'string',
- 'format': 'binary' # Tells Swagger it's a file
+ "multipart/form-data": {
+ "type": "object",
+ "properties": {
+ "file": {
+ "type": "string",
+ "format": "binary", # Tells Swagger it's a file
}
- }
+ },
}
}
@@ -241,7 +314,9 @@ def get_request():
class SyncWebAPI(DocumentReadAPI):
- pass
+ @staticmethod
+ def get_request():
+ return DocumentSyncStrategySerializer
class RefreshAPI(DocumentReadAPI):
@@ -258,14 +333,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -283,42 +358,49 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="folder_id",
description="文件夹id",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
OpenApiParameter(
name="user_id",
description="用户id",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
OpenApiParameter(
name="name",
description="名称",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
OpenApiParameter(
name="desc",
description="描述",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
+ required=False,
+ ),
+ OpenApiParameter(
+ name="resource_type",
+ description="资源类型: document|image",
+ type=OpenApiTypes.STR,
+ location="query",
required=False,
),
]
@@ -332,14 +414,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -357,14 +439,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -382,14 +464,14 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -407,21 +489,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="type",
description="Export template type csv|excel",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=True,
),
]
@@ -439,21 +521,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="document_id",
description="文档id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -471,21 +553,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="target_knowledge_id",
description="目标知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -503,21 +585,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="document_id",
description="文档id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -535,21 +617,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="document_id",
description="文档id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -560,4 +642,18 @@ def get_request():
@staticmethod
def get_response():
- return DefaultResultSerializer
\ No newline at end of file
+ return DefaultResultSerializer
+
+
+class DocumentBatchAddTagAPI(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return DocumentBatchAPI.get_parameters()
+
+ @staticmethod
+ def get_request():
+ return DocumentBatchAddTagSerializer
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
diff --git a/apps/knowledge/api/knowledge.py b/apps/knowledge/api/knowledge.py
index e7d7207c2a4..ca2a1ae5422 100644
--- a/apps/knowledge/api/knowledge.py
+++ b/apps/knowledge/api/knowledge.py
@@ -2,11 +2,18 @@
from drf_spectacular.utils import OpenApiParameter
from common.mixins.api_mixin import APIMixin
-from common.result import ResultSerializer, DefaultResultSerializer
+from common.result import DefaultResultSerializer, ResultPageSerializer, ResultSerializer
from knowledge.serializers.common import BatchSerializer, BatchMoveSerializer
from knowledge.serializers.common import GenerateRelatedSerializer
-from knowledge.serializers.knowledge import KnowledgeBaseCreateRequest, KnowledgeModelSerializer, KnowledgeEditRequest, \
- KnowledgeWebCreateRequest, HitTestSerializer, KnowledgeImportRequest
+from knowledge.serializers.knowledge import (
+ KnowledgeBaseCreateRequest,
+ KnowledgeModelSerializer,
+ KnowledgeEditRequest,
+ KnowledgeWebCreateRequest,
+ HitTestSerializer,
+ KnowledgeImportRequest,
+)
+from knowledge.serializers.knowledge_sync import KnowledgeSyncLogSerializer, KnowledgeSyncSettingRequest
class KnowledgeCreateResponse(ResultSerializer):
@@ -22,16 +29,16 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
- )
+ ),
]
@staticmethod
@@ -47,7 +54,7 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
)
]
@@ -69,7 +76,7 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
)
]
@@ -91,16 +98,16 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
- )
+ ),
]
@staticmethod
@@ -120,35 +127,35 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="folder_id",
description="文件夹id",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=True,
),
OpenApiParameter(
name="user_id",
description="用户id",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
OpenApiParameter(
name="name",
description="名称",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
OpenApiParameter(
name="desc",
description="描述",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
]
@@ -162,42 +169,42 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="current_page",
description="当前页码",
type=OpenApiTypes.INT,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="page_size",
description="每页条数",
type=OpenApiTypes.INT,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="folder_id",
description="文件夹id",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=True,
),
OpenApiParameter(
name="name",
description="名称",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
OpenApiParameter(
name="desc",
description="描述",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=False,
),
]
@@ -211,21 +218,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="sync_type",
- description="同步类型 (replace: 替换同步, complete: 完整同步)",
+ description="同步类型 (incremental: 增量同步, replace: 替换同步, complete: 完整同步)",
type=OpenApiTypes.STR,
- location='query',
+ location="query",
required=True,
),
]
@@ -235,6 +242,52 @@ def get_response():
return DefaultResultSerializer
+class KnowledgeSyncSettingResponse(ResultSerializer):
+ def get_data(self):
+ return KnowledgeSyncSettingRequest()
+
+
+class KnowledgeSyncSettingAPI(SyncWebAPI):
+ @staticmethod
+ def get_request():
+ return KnowledgeSyncSettingRequest
+
+ @staticmethod
+ def get_response():
+ return KnowledgeSyncSettingResponse
+
+
+class KnowledgeSyncLogResponse(ResultPageSerializer):
+ def get_data(self):
+ return KnowledgeSyncLogSerializer(many=True)
+
+
+class KnowledgeSyncLogAPI(SyncWebAPI):
+ @staticmethod
+ def get_parameters():
+ return [
+ *SyncWebAPI.get_parameters()[:2],
+ OpenApiParameter(
+ name="current_page",
+ description="当前页码",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="page_size",
+ description="每页条数",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return KnowledgeSyncLogResponse
+
+
class GenerateRelatedAPI(SyncWebAPI):
@staticmethod
def get_request():
@@ -251,6 +304,12 @@ class EmbeddingAPI(SyncWebAPI):
pass
+class TokenizeAPI(KnowledgeReadAPI):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+
class GetModelAPI(SyncWebAPI):
@staticmethod
def get_parameters():
@@ -259,7 +318,7 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
@@ -268,6 +327,7 @@ def get_parameters():
def get_response():
return DefaultResultSerializer
+
class KnowledgeExportAPI(APIMixin):
@staticmethod
def get_parameters():
@@ -276,21 +336,21 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="knowledge_id",
description="知识库id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
OpenApiParameter(
name="with_source_file",
description="是否导出原始文件",
type=OpenApiTypes.BOOL,
- location='query',
+ location="query",
required=False,
),
]
@@ -308,7 +368,7 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
)
]
@@ -330,7 +390,7 @@ def get_parameters():
name="workspace_id",
description="工作空间id",
type=OpenApiTypes.STR,
- location='path',
+ location="path",
required=True,
),
]
diff --git a/apps/knowledge/migrations/0010_file_storage_type.py b/apps/knowledge/migrations/0010_file_storage_type.py
new file mode 100644
index 00000000000..905e3450723
--- /dev/null
+++ b/apps/knowledge/migrations/0010_file_storage_type.py
@@ -0,0 +1,20 @@
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("knowledge", "0009_document_user"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="file",
+ name="storage_type",
+ field=models.CharField(db_index=True, default="pg", max_length=16),
+ ),
+ migrations.AlterField(
+ model_name="file",
+ name="loid",
+ field=models.IntegerField(blank=True, null=True, verbose_name="loid"),
+ ),
+ ]
diff --git a/apps/knowledge/migrations/0011_publicfileaccess.py b/apps/knowledge/migrations/0011_publicfileaccess.py
new file mode 100644
index 00000000000..fc19f4eb9b3
--- /dev/null
+++ b/apps/knowledge/migrations/0011_publicfileaccess.py
@@ -0,0 +1,28 @@
+# Generated by Django 5.2.14 on 2026-07-10 10:44
+
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('knowledge', '0010_file_storage_type'),
+ ]
+
+ operations = [
+ migrations.CreateModel(
+ name='PublicFileAccess',
+ fields=[
+ ('create_time', models.DateTimeField(auto_now_add=True, db_index=True, verbose_name='创建时间')),
+ ('update_time', models.DateTimeField(auto_now=True, db_index=True, verbose_name='修改时间')),
+ ('id', models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False, verbose_name='主键id')),
+ ('source_type', models.CharField(choices=[('FILE', '文件'), ('APPLICATION', '应用'), ('KNOWLEDGE', '知识库')], db_index=True, max_length=20, verbose_name='资源类型')),
+ ('source_id', models.CharField(db_index=True, max_length=128, verbose_name='资源ID')),
+ ],
+ options={
+ 'db_table': 'public_file_access',
+ 'indexes': [models.Index(fields=['source_type', 'source_id'], name='public_file_source__a961f4_idx')],
+ },
+ ),
+ ]
diff --git a/apps/knowledge/migrations/0012_multimodal_knowledge_sync.py b/apps/knowledge/migrations/0012_multimodal_knowledge_sync.py
new file mode 100644
index 00000000000..9db376e8b6e
--- /dev/null
+++ b/apps/knowledge/migrations/0012_multimodal_knowledge_sync.py
@@ -0,0 +1,386 @@
+# Generated by Django 6.1 on 2026-08-13 08:39
+
+import django.db.models.deletion
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("knowledge", "0011_publicfileaccess"),
+ ]
+
+ operations = [
+ migrations.CreateModel(
+ name="KnowledgeSyncLog",
+ fields=[
+ ("create_time", models.DateTimeField(auto_now_add=True, db_index=True, verbose_name="创建时间")),
+ ("update_time", models.DateTimeField(auto_now=True, db_index=True, verbose_name="修改时间")),
+ (
+ "id",
+ models.UUIDField(
+ default=uuid_utils.compat.uuid7,
+ editable=False,
+ primary_key=True,
+ serialize=False,
+ verbose_name="主键id",
+ ),
+ ),
+ ("workspace_id", models.CharField(db_index=True, max_length=64, verbose_name="工作空间id")),
+ (
+ "sync_type",
+ models.CharField(
+ choices=[("incremental", "增量同步"), ("replace", "替换同步"), ("complete", "完整同步")],
+ default="incremental",
+ max_length=16,
+ verbose_name="同步方式",
+ ),
+ ),
+ (
+ "trigger_type",
+ models.CharField(
+ choices=[("manual", "手动同步"), ("scheduled", "定时同步")],
+ default="manual",
+ max_length=16,
+ verbose_name="触发方式",
+ ),
+ ),
+ (
+ "status",
+ models.CharField(
+ choices=[("running", "同步中"), ("success", "同步成功"), ("failure", "同步失败")],
+ db_index=True,
+ default="running",
+ max_length=16,
+ verbose_name="同步状态",
+ ),
+ ),
+ ("total_count", models.PositiveIntegerField(default=0, verbose_name="文档总数")),
+ ("synced_count", models.PositiveIntegerField(default=0, verbose_name="已同步数")),
+ ("skipped_count", models.PositiveIntegerField(default=0, verbose_name="跳过数")),
+ ("deleted_count", models.PositiveIntegerField(default=0, verbose_name="删除数")),
+ ("failed_count", models.PositiveIntegerField(default=0, verbose_name="失败数")),
+ ("duration_ms", models.PositiveBigIntegerField(default=0, verbose_name="耗时毫秒")),
+ ("message", models.TextField(blank=True, default="", verbose_name="结果信息")),
+ ],
+ options={
+ "db_table": "knowledge_sync_log",
+ "ordering": ["-create_time"],
+ },
+ ),
+ migrations.CreateModel(
+ name="ParagraphAsset",
+ fields=[
+ ("create_time", models.DateTimeField(auto_now_add=True, db_index=True, verbose_name="创建时间")),
+ ("update_time", models.DateTimeField(auto_now=True, db_index=True, verbose_name="修改时间")),
+ (
+ "id",
+ models.UUIDField(
+ default=uuid_utils.compat.uuid7,
+ editable=False,
+ primary_key=True,
+ serialize=False,
+ verbose_name="主键id",
+ ),
+ ),
+ (
+ "asset_type",
+ models.CharField(db_index=True, default="image", max_length=16, verbose_name="资产类型"),
+ ),
+ ("position", models.PositiveIntegerField(default=0, verbose_name="段落内位置")),
+ (
+ "origin",
+ models.CharField(
+ choices=[("manual", "手工创建"), ("synced", "外部同步")],
+ default="synced",
+ max_length=16,
+ verbose_name="内容来源",
+ ),
+ ),
+ (
+ "source_asset_key",
+ models.CharField(db_index=True, default="", max_length=512, verbose_name="远端资产稳定键"),
+ ),
+ (
+ "source_hash",
+ models.CharField(db_index=True, default="", max_length=64, verbose_name="远端资产哈希"),
+ ),
+ ("caption", models.TextField(default="", verbose_name="图片标题")),
+ ("ocr_text", models.TextField(default="", verbose_name="OCR 文本")),
+ ("description", models.TextField(default="", verbose_name="图片描述")),
+ (
+ "local_state",
+ models.CharField(
+ choices=[("clean", "未修改"), ("modified", "本地已修改"), ("deleted", "本地已删除")],
+ default="clean",
+ max_length=16,
+ verbose_name="本地状态",
+ ),
+ ),
+ (
+ "sync_state",
+ models.CharField(
+ choices=[("active", "正常"), ("remote_deleted", "远端已删除"), ("conflict", "同步冲突")],
+ default="active",
+ max_length=24,
+ verbose_name="同步状态",
+ ),
+ ),
+ (
+ "process_status",
+ models.CharField(
+ choices=[
+ ("pending", "待处理"),
+ ("success", "处理成功"),
+ ("failure", "处理失败"),
+ ("skipped", "未启用"),
+ ],
+ default="pending",
+ max_length=16,
+ verbose_name="处理状态",
+ ),
+ ),
+ ("process_error", models.TextField(default="", verbose_name="处理错误")),
+ ("visual_strategy_hash", models.CharField(default="", max_length=64, verbose_name="图片处理策略哈希")),
+ ("meta", models.JSONField(default=dict, verbose_name="元数据")),
+ ],
+ options={
+ "db_table": "paragraph_asset",
+ },
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="doc_strategy",
+ field=models.JSONField(default=dict, verbose_name="文档处理策略"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="hit_num",
+ field=models.IntegerField(db_index=True, default=0, verbose_name="召回次数"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="index_strategy_hash",
+ field=models.CharField(default="", max_length=64, verbose_name="索引增强策略哈希"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="last_hit_time",
+ field=models.DateTimeField(blank=True, db_index=True, null=True, verbose_name="最后一次召回时间"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="last_sync_time",
+ field=models.DateTimeField(blank=True, db_index=True, null=True, verbose_name="最后同步时间"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="resource_type",
+ field=models.CharField(
+ choices=[("document", "文档"), ("image", "图片")],
+ db_index=True,
+ default="document",
+ max_length=16,
+ verbose_name="资源类型",
+ ),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="source_hash",
+ field=models.CharField(db_index=True, default="", max_length=64, verbose_name="远端文档内容哈希"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="split_strategy_hash",
+ field=models.CharField(default="", max_length=64, verbose_name="分段策略哈希"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="sync_version",
+ field=models.PositiveIntegerField(default=0, verbose_name="同步版本"),
+ ),
+ migrations.AddField(
+ model_name="document",
+ name="visual_strategy_hash",
+ field=models.CharField(default="", max_length=64, verbose_name="图片处理策略哈希"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="anchor_paragraph",
+ field=models.ForeignKey(
+ blank=True,
+ db_constraint=False,
+ null=True,
+ on_delete=django.db.models.deletion.SET_NULL,
+ related_name="anchored_paragraphs",
+ to="knowledge.paragraph",
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="content_schema",
+ field=models.JSONField(default=list, verbose_name="结构化内容"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="last_hit_time",
+ field=models.DateTimeField(blank=True, db_index=True, null=True, verbose_name="最后一次召回时间"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="local_state",
+ field=models.CharField(
+ choices=[("clean", "未修改"), ("modified", "本地已修改"), ("deleted", "本地已删除")],
+ db_index=True,
+ default="clean",
+ max_length=16,
+ verbose_name="本地状态",
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="origin",
+ field=models.CharField(
+ choices=[("manual", "手工创建"), ("synced", "外部同步")],
+ db_index=True,
+ default="manual",
+ max_length=16,
+ verbose_name="内容来源",
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="placement",
+ field=models.CharField(default="after", max_length=8, verbose_name="相对锚点位置"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="source_hash",
+ field=models.CharField(db_index=True, default="", max_length=64, verbose_name="远端内容哈希"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="source_key",
+ field=models.CharField(db_index=True, default="", max_length=512, verbose_name="远端稳定键"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="source_snapshot",
+ field=models.JSONField(default=dict, verbose_name="上次同步快照"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="source_updated_at",
+ field=models.DateTimeField(blank=True, null=True, verbose_name="远端更新时间"),
+ ),
+ migrations.AddField(
+ model_name="paragraph",
+ name="sync_state",
+ field=models.CharField(
+ choices=[("active", "正常"), ("remote_deleted", "远端已删除"), ("conflict", "同步冲突")],
+ db_index=True,
+ default="active",
+ max_length=24,
+ verbose_name="同步状态",
+ ),
+ ),
+ migrations.AddField(
+ model_name="problem",
+ name="last_hit_time",
+ field=models.DateTimeField(blank=True, db_index=True, null=True, verbose_name="最后一次召回时间"),
+ ),
+ migrations.AddField(
+ model_name="problemparagraphmapping",
+ name="meta",
+ field=models.JSONField(default=dict, verbose_name="元数据"),
+ ),
+ migrations.AlterField(
+ model_name="embedding",
+ name="source_type",
+ field=models.CharField(
+ choices=[(0, "问题"), (1, "段落"), (2, "标题"), (3, "图片")],
+ db_index=True,
+ default=0,
+ max_length=5,
+ verbose_name="资源类型",
+ ),
+ ),
+ migrations.AlterField(
+ model_name="paragraph",
+ name="hit_num",
+ field=models.IntegerField(db_index=True, default=0, verbose_name="召回次数"),
+ ),
+ migrations.AlterField(
+ model_name="problem",
+ name="hit_num",
+ field=models.IntegerField(db_index=True, default=0, verbose_name="召回次数"),
+ ),
+ migrations.AddConstraint(
+ model_name="paragraph",
+ constraint=models.UniqueConstraint(
+ condition=models.Q(("source_key", ""), _negated=True),
+ fields=("document", "source_key"),
+ name="uniq_document_paragraph_source_key",
+ ),
+ ),
+ migrations.AddField(
+ model_name="knowledgesynclog",
+ name="knowledge",
+ field=models.ForeignKey(
+ db_constraint=False,
+ on_delete=django.db.models.deletion.CASCADE,
+ related_name="sync_logs",
+ to="knowledge.knowledge",
+ verbose_name="知识库",
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraphasset",
+ name="document",
+ field=models.ForeignKey(
+ db_constraint=False,
+ on_delete=django.db.models.deletion.CASCADE,
+ related_name="assets",
+ to="knowledge.document",
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraphasset",
+ name="file",
+ field=models.ForeignKey(
+ db_constraint=False,
+ on_delete=django.db.models.deletion.DO_NOTHING,
+ related_name="paragraph_assets",
+ to="knowledge.file",
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraphasset",
+ name="knowledge",
+ field=models.ForeignKey(
+ db_constraint=False, on_delete=django.db.models.deletion.DO_NOTHING, to="knowledge.knowledge"
+ ),
+ ),
+ migrations.AddField(
+ model_name="paragraphasset",
+ name="paragraph",
+ field=models.ForeignKey(
+ db_constraint=False,
+ on_delete=django.db.models.deletion.CASCADE,
+ related_name="assets",
+ to="knowledge.paragraph",
+ ),
+ ),
+ migrations.AddIndex(
+ model_name="knowledgesynclog",
+ index=models.Index(fields=["knowledge", "-create_time"], name="knowledge_s_knowled_9f3ba4_idx"),
+ ),
+ migrations.AddConstraint(
+ model_name="paragraphasset",
+ constraint=models.UniqueConstraint(
+ condition=models.Q(("source_asset_key", ""), _negated=True),
+ fields=("document", "source_asset_key"),
+ name="uniq_document_asset_source_key",
+ ),
+ ),
+ ]
diff --git a/apps/knowledge/migrations/0013_paragraph_asset_recall.py b/apps/knowledge/migrations/0013_paragraph_asset_recall.py
new file mode 100644
index 00000000000..5e4444c67e2
--- /dev/null
+++ b/apps/knowledge/migrations/0013_paragraph_asset_recall.py
@@ -0,0 +1,22 @@
+# Generated by Django 6.1 on 2026-09-03
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("knowledge", "0012_multimodal_knowledge_sync"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="paragraphasset",
+ name="hit_num",
+ field=models.IntegerField(db_index=True, default=0, verbose_name="召回次数"),
+ ),
+ migrations.AddField(
+ model_name="paragraphasset",
+ name="last_hit_time",
+ field=models.DateTimeField(blank=True, db_index=True, null=True, verbose_name="最后一次召回时间"),
+ ),
+ ]
diff --git a/apps/knowledge/migrations/0014_knowledgeworkflow_default_model_setting_and_more.py b/apps/knowledge/migrations/0014_knowledgeworkflow_default_model_setting_and_more.py
new file mode 100644
index 00000000000..b9cd3220a11
--- /dev/null
+++ b/apps/knowledge/migrations/0014_knowledgeworkflow_default_model_setting_and_more.py
@@ -0,0 +1,43 @@
+# Generated by Django 6.1 on 2026-09-11 06:34
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("knowledge", "0013_paragraph_asset_recall"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="knowledgeworkflow",
+ name="default_model_setting",
+ field=models.JSONField(default=dict, verbose_name="默认模型"),
+ ),
+ migrations.AddField(
+ model_name="knowledgeworkflowversion",
+ name="default_model_setting",
+ field=models.JSONField(default=dict, verbose_name="默认模型"),
+ ),
+ migrations.AlterField(
+ model_name="file",
+ name="source_type",
+ field=models.CharField(
+ choices=[
+ ("KNOWLEDGE", "Knowledge"),
+ ("APPLICATION", "Application"),
+ ("TOOL", "Tool"),
+ ("DOCUMENT", "Document"),
+ ("CHAT", "Chat"),
+ ("SYSTEM", "System"),
+ ("TEMPORARY_30_MINUTE", "Temporary 30 Minute"),
+ ("TEMPORARY_120_MINUTE", "Temporary 120 Minute"),
+ ("TEMPORARY_1_DAY", "Temporary 1 Day"),
+ ("APPLICATION_SETTINGS", "Application Settings"),
+ ],
+ db_index=True,
+ default="TEMPORARY_120_MINUTE",
+ verbose_name="资源类型",
+ ),
+ ),
+ ]
diff --git a/apps/knowledge/migrations/0015_knowledge_external_service.py b/apps/knowledge/migrations/0015_knowledge_external_service.py
new file mode 100644
index 00000000000..3410b389d05
--- /dev/null
+++ b/apps/knowledge/migrations/0015_knowledge_external_service.py
@@ -0,0 +1,21 @@
+from django.db import migrations, models
+
+from knowledge.models.knowledge import default_external_service
+
+
+class Migration(migrations.Migration):
+ dependencies = [("knowledge", "0014_knowledgeworkflow_default_model_setting_and_more")]
+
+ operations = [
+ # An absent authentication setting preserves existing internal access rules.
+ migrations.AddField(
+ model_name="knowledge",
+ name="external_service",
+ field=models.JSONField(default=dict, verbose_name="外部检索服务"),
+ ),
+ migrations.AlterField(
+ model_name="knowledge",
+ name="external_service",
+ field=models.JSONField(default=default_external_service, verbose_name="外部检索服务"),
+ ),
+ ]
diff --git a/apps/knowledge/models/knowledge.py b/apps/knowledge/models/knowledge.py
index 3a74ff2d0b8..967a67b68eb 100644
--- a/apps/knowledge/models/knowledge.py
+++ b/apps/knowledge/models/knowledge.py
@@ -5,12 +5,13 @@
import uuid_utils.compat as uuid
from common.db.sql_execute import select_one
from common.mixins.app_model_mixin import AppModelMixin
+from common.storage.seaweedfs import get_bucket, get_s3_client, is_seaweedfs_enabled
from common.utils.common import get_sha256_hash
from django.contrib.postgres.fields import ArrayField
from django.contrib.postgres.search import SearchVectorField
-from django.db import models
+from django.db import connections, models, transaction
from django.db.models import QuerySet
-from django.db.models.signals import pre_delete
+from django.db.models.signals import post_delete
from django.dispatch import receiver
from models_provider.models import Model
from mptt.fields import TreeForeignKey
@@ -64,6 +65,52 @@ class HitHandlingMethod(models.TextChoices):
directly_return = "directly_return", "直接返回"
+class ContentOrigin(models.TextChoices):
+ MANUAL = "manual", "手工创建"
+ SYNCED = "synced", "外部同步"
+
+
+class DocumentResourceType(models.TextChoices):
+ DOCUMENT = "document", "文档"
+ IMAGE = "image", "图片"
+
+
+class LocalState(models.TextChoices):
+ CLEAN = "clean", "未修改"
+ MODIFIED = "modified", "本地已修改"
+ DELETED = "deleted", "本地已删除"
+
+
+class SyncState(models.TextChoices):
+ ACTIVE = "active", "正常"
+ REMOTE_DELETED = "remote_deleted", "远端已删除"
+ CONFLICT = "conflict", "同步冲突"
+
+
+class KnowledgeSyncType(models.TextChoices):
+ INCREMENTAL = "incremental", "增量同步"
+ REPLACE = "replace", "替换同步"
+ COMPLETE = "complete", "完整同步"
+
+
+class KnowledgeSyncStatus(models.TextChoices):
+ RUNNING = "running", "同步中"
+ SUCCESS = "success", "同步成功"
+ FAILURE = "failure", "同步失败"
+
+
+class KnowledgeSyncTrigger(models.TextChoices):
+ MANUAL = "manual", "手动同步"
+ SCHEDULED = "scheduled", "定时同步"
+
+
+class AssetProcessStatus(models.TextChoices):
+ PENDING = "pending", "待处理"
+ SUCCESS = "success", "处理成功"
+ FAILURE = "failure", "处理失败"
+ SKIPPED = "skipped", "未启用"
+
+
class Status:
type_cls = TaskType
state_cls = State
@@ -115,6 +162,10 @@ class MPTTMeta:
order_insertion_by = ["name"]
+def default_external_service():
+ return {"enabled": False, "authentication": False}
+
+
class Knowledge(AppModelMixin):
"""
知识库表
@@ -139,12 +190,58 @@ class Knowledge(AppModelMixin):
embedding_model = models.ForeignKey(Model, on_delete=models.SET_NULL, db_constraint=False, blank=True, null=True)
file_size_limit = models.IntegerField(verbose_name="文件大小限制", default=100)
file_count_limit = models.IntegerField(verbose_name="文件数量限制", default=50)
+ external_service = models.JSONField(default=default_external_service, verbose_name="外部检索服务")
meta = models.JSONField(verbose_name="元数据", default=dict)
class Meta:
db_table = "knowledge"
+class KnowledgeSyncLog(AppModelMixin):
+ """Execution history for manual and scheduled external knowledge synchronization."""
+
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+ knowledge = models.ForeignKey(
+ Knowledge,
+ on_delete=models.CASCADE,
+ db_constraint=False,
+ related_name="sync_logs",
+ verbose_name="知识库",
+ )
+ workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", db_index=True)
+ sync_type = models.CharField(
+ max_length=16,
+ choices=KnowledgeSyncType.choices,
+ default=KnowledgeSyncType.INCREMENTAL,
+ verbose_name="同步方式",
+ )
+ trigger_type = models.CharField(
+ max_length=16,
+ choices=KnowledgeSyncTrigger.choices,
+ default=KnowledgeSyncTrigger.MANUAL,
+ verbose_name="触发方式",
+ )
+ status = models.CharField(
+ max_length=16,
+ choices=KnowledgeSyncStatus.choices,
+ default=KnowledgeSyncStatus.RUNNING,
+ db_index=True,
+ verbose_name="同步状态",
+ )
+ total_count = models.PositiveIntegerField(default=0, verbose_name="文档总数")
+ synced_count = models.PositiveIntegerField(default=0, verbose_name="已同步数")
+ skipped_count = models.PositiveIntegerField(default=0, verbose_name="跳过数")
+ deleted_count = models.PositiveIntegerField(default=0, verbose_name="删除数")
+ failed_count = models.PositiveIntegerField(default=0, verbose_name="失败数")
+ duration_ms = models.PositiveBigIntegerField(default=0, verbose_name="耗时毫秒")
+ message = models.TextField(default="", blank=True, verbose_name="结果信息")
+
+ class Meta:
+ db_table = "knowledge_sync_log"
+ ordering = ["-create_time"]
+ indexes = [models.Index(fields=["knowledge", "-create_time"])]
+
+
class KnowledgeWorkflow(AppModelMixin):
"""
知识库工作流表
@@ -158,6 +255,7 @@ class KnowledgeWorkflow(AppModelMixin):
work_flow = models.JSONField(verbose_name="工作流数据", default=dict)
is_publish = models.BooleanField(verbose_name="是否发布", default=False, db_index=True)
publish_time = models.DateTimeField(verbose_name="发布时间", null=True, blank=True)
+ default_model_setting = models.JSONField(verbose_name="默认模型", default=dict)
class Meta:
db_table = "knowledge_workflow"
@@ -175,6 +273,7 @@ class KnowledgeWorkflowVersion(AppModelMixin):
work_flow = models.JSONField(verbose_name="工作流数据", default=dict)
publish_user_id = models.UUIDField(verbose_name="发布者id", max_length=128, default=None, null=True)
publish_user_name = models.CharField(verbose_name="发布者名称", max_length=128, default="")
+ default_model_setting = models.JSONField(verbose_name="默认模型", default=dict)
class Meta:
db_table = "knowledge_workflow_version"
@@ -200,6 +299,13 @@ class Document(AppModelMixin):
type = models.IntegerField(
verbose_name="类型", choices=KnowledgeType.choices, default=KnowledgeType.BASE, db_index=True
)
+ resource_type = models.CharField(
+ verbose_name="资源类型",
+ max_length=16,
+ choices=DocumentResourceType.choices,
+ default=DocumentResourceType.DOCUMENT,
+ db_index=True,
+ )
hit_handling_method = models.CharField(
verbose_name="命中处理方式",
max_length=20,
@@ -207,6 +313,17 @@ class Document(AppModelMixin):
default=HitHandlingMethod.optimization,
)
directly_return_similarity = models.FloatField(verbose_name="直接回答相似度", default=0.9)
+ hit_num = models.IntegerField(verbose_name="召回次数", default=0, db_index=True)
+ last_hit_time = models.DateTimeField(verbose_name="最后一次召回时间", null=True, blank=True, db_index=True)
+
+ # 导入/同步策略必须跟随文档保存,后续同步使用同一份策略,避免重新分段造成全量抖动。
+ doc_strategy = models.JSONField(verbose_name="文档处理策略", default=dict)
+ source_hash = models.CharField(verbose_name="远端文档内容哈希", max_length=64, default="", db_index=True)
+ split_strategy_hash = models.CharField(verbose_name="分段策略哈希", max_length=64, default="")
+ visual_strategy_hash = models.CharField(verbose_name="图片处理策略哈希", max_length=64, default="")
+ index_strategy_hash = models.CharField(verbose_name="索引增强策略哈希", max_length=64, default="")
+ sync_version = models.PositiveIntegerField(verbose_name="同步版本", default=0)
+ last_sync_time = models.DateTimeField(verbose_name="最后同步时间", null=True, blank=True, db_index=True)
meta = models.JSONField(verbose_name="元数据", default=dict)
@@ -258,13 +375,92 @@ class Paragraph(AppModelMixin):
title = models.CharField(max_length=256, verbose_name="标题", default="", db_index=True)
status = models.CharField(verbose_name="状态", max_length=20, default=get_default_status, db_index=True)
status_meta = models.JSONField(verbose_name="状态数据", default=default_status_meta)
- hit_num = models.IntegerField(verbose_name="命中次数", default=0)
+ hit_num = models.IntegerField(verbose_name="召回次数", default=0, db_index=True)
+ last_hit_time = models.DateTimeField(verbose_name="最后一次召回时间", null=True, blank=True, db_index=True)
is_active = models.BooleanField(default=True, db_index=True)
position = models.IntegerField(verbose_name="段落顺序", default=0, db_index=True)
chunks = ArrayField(verbose_name="块", base_field=models.CharField(), default=list)
+ content_schema = models.JSONField(verbose_name="结构化内容", default=list)
+ origin = models.CharField(
+ verbose_name="内容来源",
+ max_length=16,
+ choices=ContentOrigin.choices,
+ default=ContentOrigin.MANUAL,
+ db_index=True,
+ )
+ source_key = models.CharField(verbose_name="远端稳定键", max_length=512, default="", db_index=True)
+ source_hash = models.CharField(verbose_name="远端内容哈希", max_length=64, default="", db_index=True)
+ source_snapshot = models.JSONField(verbose_name="上次同步快照", default=dict)
+ source_updated_at = models.DateTimeField(verbose_name="远端更新时间", null=True, blank=True)
+ local_state = models.CharField(
+ verbose_name="本地状态", max_length=16, choices=LocalState.choices, default=LocalState.CLEAN, db_index=True
+ )
+ sync_state = models.CharField(
+ verbose_name="同步状态", max_length=24, choices=SyncState.choices, default=SyncState.ACTIVE, db_index=True
+ )
+ anchor_paragraph = models.ForeignKey(
+ "self",
+ on_delete=models.SET_NULL,
+ db_constraint=False,
+ blank=True,
+ null=True,
+ related_name="anchored_paragraphs",
+ )
+ placement = models.CharField(verbose_name="相对锚点位置", max_length=8, default="after")
class Meta:
db_table = "paragraph"
+ constraints = [
+ models.UniqueConstraint(
+ fields=["document", "source_key"],
+ condition=~models.Q(source_key=""),
+ name="uniq_document_paragraph_source_key",
+ )
+ ]
+
+
+class ParagraphAsset(AppModelMixin):
+ """段落内的图片等资产;资产属于文档生命周期,不是独立知识类型。"""
+
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+ knowledge = models.ForeignKey(Knowledge, on_delete=models.DO_NOTHING, db_constraint=False)
+ document = models.ForeignKey(Document, on_delete=models.CASCADE, db_constraint=False, related_name="assets")
+ paragraph = models.ForeignKey(Paragraph, on_delete=models.CASCADE, db_constraint=False, related_name="assets")
+ file = models.ForeignKey("File", on_delete=models.DO_NOTHING, db_constraint=False, related_name="paragraph_assets")
+ asset_type = models.CharField(verbose_name="资产类型", max_length=16, default="image", db_index=True)
+ position = models.PositiveIntegerField(verbose_name="段落内位置", default=0)
+ origin = models.CharField(
+ verbose_name="内容来源", max_length=16, choices=ContentOrigin.choices, default=ContentOrigin.SYNCED
+ )
+ source_asset_key = models.CharField(verbose_name="远端资产稳定键", max_length=512, default="", db_index=True)
+ source_hash = models.CharField(verbose_name="远端资产哈希", max_length=64, default="", db_index=True)
+ caption = models.TextField(verbose_name="图片标题", default="")
+ ocr_text = models.TextField(verbose_name="OCR 文本", default="")
+ description = models.TextField(verbose_name="图片描述", default="")
+ hit_num = models.IntegerField(verbose_name="召回次数", default=0, db_index=True)
+ last_hit_time = models.DateTimeField(verbose_name="最后一次召回时间", null=True, blank=True, db_index=True)
+ local_state = models.CharField(
+ verbose_name="本地状态", max_length=16, choices=LocalState.choices, default=LocalState.CLEAN
+ )
+ sync_state = models.CharField(
+ verbose_name="同步状态", max_length=24, choices=SyncState.choices, default=SyncState.ACTIVE
+ )
+ process_status = models.CharField(
+ verbose_name="处理状态", max_length=16, choices=AssetProcessStatus.choices, default=AssetProcessStatus.PENDING
+ )
+ process_error = models.TextField(verbose_name="处理错误", default="")
+ visual_strategy_hash = models.CharField(verbose_name="图片处理策略哈希", max_length=64, default="")
+ meta = models.JSONField(verbose_name="元数据", default=dict)
+
+ class Meta:
+ db_table = "paragraph_asset"
+ constraints = [
+ models.UniqueConstraint(
+ fields=["document", "source_asset_key"],
+ condition=~models.Q(source_asset_key=""),
+ name="uniq_document_asset_source_key",
+ )
+ ]
class Problem(AppModelMixin):
@@ -275,7 +471,8 @@ class Problem(AppModelMixin):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
knowledge = models.ForeignKey(Knowledge, on_delete=models.DO_NOTHING, db_constraint=False)
content = models.CharField(max_length=256, verbose_name="问题内容", db_index=True)
- hit_num = models.IntegerField(verbose_name="命中次数", default=0)
+ hit_num = models.IntegerField(verbose_name="召回次数", default=0, db_index=True)
+ last_hit_time = models.DateTimeField(verbose_name="最后一次召回时间", null=True, blank=True, db_index=True)
class Meta:
db_table = "problem"
@@ -287,6 +484,7 @@ class ProblemParagraphMapping(AppModelMixin):
document = models.ForeignKey(Document, on_delete=models.DO_NOTHING, db_constraint=False)
problem = models.ForeignKey(Problem, on_delete=models.DO_NOTHING, db_constraint=False)
paragraph = models.ForeignKey(Paragraph, on_delete=models.DO_NOTHING, db_constraint=False)
+ meta = models.JSONField(verbose_name="元数据", default=dict)
class Meta:
db_table = "problem_paragraph_mapping"
@@ -311,6 +509,7 @@ class SourceType(models.IntegerChoices):
PROBLEM = 0, "问题"
PARAGRAPH = 1, "段落"
TITLE = 2, "标题"
+ IMAGE = 3, "图片"
class SearchMode(models.TextChoices):
@@ -337,6 +536,8 @@ class FileSourceType(models.TextChoices):
TEMPORARY_120_MINUTE = "TEMPORARY_120_MINUTE"
# 临时1天 数据1天后被清理 source_id为TEMPORARY_1_DAY
TEMPORARY_1_DAY = "TEMPORARY_1_DAY"
+ # 应用的icon 背景图等 用户的icon
+ APPLICATION_SETTINGS = "APPLICATION_SETTINGS"
class VectorField(models.Field):
@@ -376,7 +577,8 @@ class File(AppModelMixin):
source_id = models.CharField(
verbose_name="资源id", default=FileSourceType.TEMPORARY_120_MINUTE.value, db_index=True
)
- loid = models.IntegerField(verbose_name="loid")
+ loid = models.IntegerField(verbose_name="loid", null=True, blank=True)
+ storage_type = models.CharField(max_length=16, default="pg", db_index=True)
meta = models.JSONField(verbose_name="文件关联数据", default=dict)
class Meta:
@@ -392,15 +594,27 @@ def save(self, bytea=None, force_insert=False, force_update=False, using=None, u
if existing_file:
self.loid = existing_file.loid
self.file_size = existing_file.file_size
+ self.storage_type = existing_file.storage_type
+ if existing_file.storage_type == "seaweedfs":
+ # Point to the canonical S3 key; this file has no object of its own
+ canonical_key = existing_file.meta.get("seaweedfs_key", f"files/{existing_file.id}")
+ self.meta = {**self.meta, "seaweedfs_key": canonical_key}
return super().save()
- compressed_data = self._compress_data(bytea)
- self.file_size = len(compressed_data)
-
- self.loid = self._create_large_object()
+ if is_seaweedfs_enabled():
+ self.storage_type = "seaweedfs"
+ self.file_size = len(bytea)
+ self.loid = None
+ self.meta = {**self.meta, "seaweedfs_key": f"files/{self.id}"}
+ get_s3_client().put_object(Bucket=get_bucket(), Key=f"files/{self.id}", Body=bytea)
+ else:
+ self.storage_type = "pg"
+ compressed_data = self._compress_data(bytea)
+ self.file_size = len(compressed_data)
+ self.loid = self._create_large_object()
+ self.meta = {**self.meta, "original_size": len(bytea)}
+ self._write_compressed_data(compressed_data)
- self._write_compressed_data(compressed_data)
- # 调用父类保存
return super().save()
def _compress_data(self, data, compression_level=9):
@@ -432,6 +646,11 @@ def _write_compressed_data(self, data, block_size=64 * 1024):
)
def get_bytes(self):
+ if self.storage_type == "seaweedfs":
+ key = self.meta.get("seaweedfs_key", f"files/{self.id}")
+ resp = get_s3_client().get_object(Bucket=get_bucket(), Key=key)
+ return resp["Body"].read()
+
buffer = io.BytesIO()
for chunk in self.get_bytes_stream():
buffer.write(chunk)
@@ -450,12 +669,37 @@ def get_bytes(self):
return data
def get_bytes_stream(self, start=0, end=None, chunk_size=64 * 1024):
+ if self.storage_type == "seaweedfs":
+ key = self.meta.get("seaweedfs_key", f"files/{self.id}")
+ kwargs = {}
+ byte_range = []
+ if start:
+ byte_range.append(f"bytes={start}-")
+ if end is not None:
+ byte_range = [f"bytes={start}-{end - 1}"]
+ if byte_range:
+ kwargs["Range"] = byte_range[0]
+ resp = get_s3_client().get_object(Bucket=get_bucket(), Key=key, **kwargs)
+ body = resp["Body"]
+ while True:
+ chunk = body.read(chunk_size)
+ if not chunk:
+ break
+ yield chunk
+ return
+
def _read_with_offset():
offset = start
while True:
+ read_size = chunk_size
+ if end is not None:
+ remaining = end - offset
+ if remaining <= 0:
+ break
+ read_size = min(chunk_size, remaining)
result = select_one(
"SELECT lo_get(%s::oid, %s, %s) as chunk",
- [self.loid, offset, end - offset if end and (end - offset) < chunk_size else chunk_size],
+ [self.loid, offset, read_size],
)
chunk = result["chunk"] if result else None
if not chunk:
@@ -464,14 +708,50 @@ def _read_with_offset():
offset += len(chunk)
if len(chunk) < chunk_size:
break
- if end and offset > end:
- break
- return _read_with_offset()
+ yield from _read_with_offset()
+
+
+@receiver(post_delete, sender=File)
+def on_delete_file(sender, instance, using, **kwargs):
+ if instance.storage_type == "seaweedfs":
+ from knowledge.services.file_cleanup import delete_file_object
+
+ bucket = get_bucket()
+ key = instance.meta.get("seaweedfs_key", f"files/{instance.id}")
+ file_id = instance.id
+ transaction.on_commit(lambda: delete_file_object(bucket, key, file_id, using), using=using, robust=True)
+ elif instance.loid is not None:
+ # post_delete sees the complete batch removed; unlink remains in the same PG transaction.
+ shared = File.objects.using(using).filter(storage_type="pg", loid=instance.loid).exists()
+ if not shared:
+ with connections[using].cursor() as cursor:
+ # Multiple deleted rows may refer to the same large object.
+ cursor.execute("SELECT lo_unlink(oid) FROM pg_largeobject_metadata WHERE oid = %s", [instance.loid])
-@receiver(pre_delete, sender=File)
-def on_delete_file(sender, instance, **kwargs):
- exist = QuerySet(File).filter(loid=instance.loid).exclude(id=instance.id).exists()
- if not exist:
- select_one(f"SELECT lo_unlink({instance.loid})", [])
+class PublicFileAccess(AppModelMixin):
+ """
+ 公共文件访问控制表
+ 记录哪些文件允许公开访问
+ """
+
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+
+ source_type = models.CharField(
+ max_length=20,
+ choices=[
+ ("FILE", "文件"),
+ ("APPLICATION", "应用"),
+ ("KNOWLEDGE", "知识库"),
+ ],
+ db_index=True,
+ verbose_name="资源类型",
+ )
+ source_id = models.CharField(max_length=128, db_index=True, verbose_name="资源ID")
+
+ class Meta:
+ db_table = "public_file_access"
+ indexes = [
+ models.Index(fields=["source_type", "source_id"]),
+ ]
diff --git a/apps/knowledge/serializers/common.py b/apps/knowledge/serializers/common.py
index 398a63edc63..4ba863e8576 100644
--- a/apps/knowledge/serializers/common.py
+++ b/apps/knowledge/serializers/common.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: common_serializers.py
- @date:2023/11/17 11:00
- @desc:
+@project: maxkb
+@Author:虎
+@file: common_serializers.py
+@date:2023/11/17 11:00
+@desc:
"""
+
import os
import re
import zipfile
@@ -16,7 +17,11 @@
from django.utils.translation import gettext_lazy as _
from rest_framework import serializers
-from application.flow.tools import save_workflow_mapping, get_instance_resource, knowledge_instance_field_call_dict
+from system_manage.services.resource_mapping import (
+ save_workflow_mapping,
+ get_instance_resource,
+ knowledge_instance_field_call_dict,
+)
from common.config.embedding_config import ModelManage
from common.db.search import native_search
from common.db.sql_execute import sql_execute, update_execute
@@ -24,8 +29,9 @@
from common.utils.common import get_file_content
from common.utils.fork import Fork
from common.utils.logger import maxkb_logger
-from knowledge.models import Document, KnowledgeWorkflow, KnowledgeWorkflowVersion, KnowledgeType
+from knowledge.models import Document, DocumentResourceType, KnowledgeWorkflow, KnowledgeWorkflowVersion, KnowledgeType
from knowledge.models import Paragraph, Problem, ProblemParagraphMapping, Knowledge, File
+from knowledge.serializers.document_strategy import DocumentStrategySerializer
from maxkb.conf import PROJECT_DIR
from models_provider.tools import get_model, get_model_default_params
from system_manage.models.resource_mapping import ResourceMapping, ResourceType
@@ -33,15 +39,17 @@
class MetaSerializer(serializers.Serializer):
class WebMeta(serializers.Serializer):
- source_url = serializers.CharField(required=True, label=_('source url'))
- selector = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_('selector'))
+ source_url = serializers.CharField(required=True, label=_("source url"))
+ selector = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("selector"))
+ embedding_model_id = serializers.CharField(required=False, allow_null=True)
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- source_url = self.data.get('source_url')
+ source_url = self.data.get("source_url")
response = Fork(source_url, []).fork()
if response.status == 500:
- raise AppApiException(500, _('URL error, cannot parse [{source_url}]').format(source_url=source_url))
+ raise AppApiException(500, _("URL error, cannot parse [{source_url}]").format(source_url=source_url))
class BaseMeta(serializers.Serializer):
def is_valid(self, *, raise_exception=False):
@@ -49,21 +57,30 @@ def is_valid(self, *, raise_exception=False):
class BatchSerializer(serializers.Serializer):
- id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True), label=_('id list'))
+ id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True), label=_("id list"))
+ resource_type = serializers.ChoiceField(
+ required=False,
+ default=DocumentResourceType.DOCUMENT,
+ choices=DocumentResourceType.choices,
+ label=_("resource type"),
+ )
def is_valid(self, *, model=None, raise_exception=False):
super().is_valid(raise_exception=True)
if model is not None:
- id_list = self.data.get('id_list')
+ id_list = self.data.get("id_list")
model_list = QuerySet(model).filter(id__in=id_list)
if len(model_list) != len(id_list):
model_id_list = [str(m.id) for m in model_list]
error_id_list = list(filter(lambda row_id: not model_id_list.__contains__(row_id), id_list))
- raise AppApiException(500, _('The following id does not exist: {error_id_list}').format(
- error_id_list=error_id_list))
+ raise AppApiException(
+ 500, _("The following id does not exist: {error_id_list}").format(error_id_list=error_id_list)
+ )
+
class BatchMoveSerializer(BatchSerializer):
- folder_id = serializers.CharField(required=True, label=_('folder id'))
+ folder_id = serializers.CharField(required=True, label=_("folder id"))
+
class ProblemParagraphObject:
def __init__(self, knowledge_id: str, document_id: str, paragraph_id: str, problem_content: str):
@@ -74,10 +91,11 @@ def __init__(self, knowledge_id: str, document_id: str, paragraph_id: str, probl
class GenerateRelatedSerializer(serializers.Serializer):
- model_id = serializers.UUIDField(required=True, label=_('Model id'))
- prompt = serializers.CharField(required=True, label=_('Prompt word'))
- state_list = serializers.ListField(required=False, child=serializers.CharField(required=True),
- label=_("state list"))
+ model_id = serializers.UUIDField(required=True, label=_("Model id"))
+ prompt = serializers.CharField(required=True, label=_("Prompt word"))
+ state_list = serializers.ListField(
+ required=False, child=serializers.CharField(required=True), label=_("state list")
+ )
class ProblemParagraphManage:
@@ -90,8 +108,9 @@ def to_problem_model_list(self):
exists_problem_list = []
if len(self.problem_paragraph_object_list) > 0:
# 查询到已存在的问题列表
- exists_problem_list = QuerySet(Problem).filter(knowledge_id=self.knowledge_id,
- content__in=problem_list).all()
+ exists_problem_list = (
+ QuerySet(Problem).filter(knowledge_id=self.knowledge_id, content__in=problem_list).all()
+ )
problem_content_dict = {}
problem_model_list = [
or_get(
@@ -99,8 +118,11 @@ def to_problem_model_list(self):
problemParagraphObject.problem_content,
problemParagraphObject.knowledge_id,
problemParagraphObject.document_id,
- problemParagraphObject.paragraph_id, problem_content_dict
- ) for problemParagraphObject in self.problem_paragraph_object_list]
+ problemParagraphObject.paragraph_id,
+ problem_content_dict,
+ )
+ for problemParagraphObject in self.problem_paragraph_object_list
+ ]
problem_paragraph_mapping_list = [
ProblemParagraphMapping(
@@ -108,65 +130,70 @@ def to_problem_model_list(self):
document_id=document_id,
problem_id=problem_model.id,
paragraph_id=paragraph_id,
- knowledge_id=self.knowledge_id
- ) for problem_model, document_id, paragraph_id in problem_model_list]
-
- result = [
- problem_model for problem_model, is_create in problem_content_dict.values() if is_create
- ], problem_paragraph_mapping_list
+ knowledge_id=self.knowledge_id,
+ )
+ for problem_model, document_id, paragraph_id in problem_model_list
+ ]
+
+ result = (
+ [problem_model for problem_model, is_create in problem_content_dict.values() if is_create],
+ problem_paragraph_mapping_list,
+ )
return result
def get_embedding_model_by_knowledge_id_list(knowledge_id_list: List):
knowledge_list = QuerySet(Knowledge).filter(id__in=knowledge_id_list)
if len(set([knowledge.embedding_model_id for knowledge in knowledge_list])) > 1:
- raise Exception(_('The knowledge base is inconsistent with the vector model'))
+ raise Exception(_("The knowledge base is inconsistent with the vector model"))
if len(knowledge_list) == 0:
- raise Exception(_('Knowledge base setting error, please reset the knowledge base'))
+ raise Exception(_("Knowledge base setting error, please reset the knowledge base"))
default_params = get_model_default_params(knowledge_list[0].embedding_model)
return ModelManage.get_model(
str(knowledge_list[0].embedding_model_id),
- lambda _id: get_model(knowledge_list[0].embedding_model, **{**default_params})
+ lambda _id: get_model(knowledge_list[0].embedding_model, **{**default_params}),
)
def get_embedding_model_by_knowledge_id(knowledge_id: str):
- knowledge = QuerySet(Knowledge).select_related('embedding_model').filter(id=knowledge_id).first()
+ knowledge = QuerySet(Knowledge).select_related("embedding_model").filter(id=knowledge_id).first()
default_params = get_model_default_params(knowledge.embedding_model)
- return ModelManage.get_model(str(knowledge.embedding_model_id),
- lambda _id: get_model(knowledge.embedding_model, **{**default_params}))
+ return ModelManage.get_model(
+ str(knowledge.embedding_model_id), lambda _id: get_model(knowledge.embedding_model, **{**default_params})
+ )
def get_embedding_model_by_knowledge(knowledge):
default_params = get_model_default_params(knowledge.embedding_model)
- return ModelManage.get_model(str(knowledge.embedding_model_id),
- lambda _id: get_model(knowledge.embedding_model, **{**default_params}))
+ return ModelManage.get_model(
+ str(knowledge.embedding_model_id), lambda _id: get_model(knowledge.embedding_model, **{**default_params})
+ )
def get_embedding_model_id_by_knowledge_id(knowledge_id):
- knowledge = QuerySet(Knowledge).select_related('embedding_model').filter(id=knowledge_id).first()
+ knowledge = QuerySet(Knowledge).select_related("embedding_model").filter(id=knowledge_id).first()
return str(knowledge.embedding_model_id)
def get_embedding_model_id_by_knowledge_id_list(knowledge_id_list: List):
knowledge_list = QuerySet(Knowledge).filter(id__in=knowledge_id_list)
if len(set([knowledge.embedding_model_id for knowledge in knowledge_list])) > 1:
- raise Exception(_('The knowledge base is inconsistent with the vector model'))
+ raise Exception(_("The knowledge base is inconsistent with the vector model"))
if len(knowledge_list) == 0:
- raise Exception(_('Knowledge base setting error, please reset the knowledge base'))
+ raise Exception(_("Knowledge base setting error, please reset the knowledge base"))
return str(knowledge_list[0].embedding_model_id)
def zip_dir(zip_path, output=None):
- output = output or os.path.basename(zip_path) + '.zip'
- zip = zipfile.ZipFile(output, 'w', zipfile.ZIP_DEFLATED)
+ output = output or os.path.basename(zip_path) + ".zip"
+ zip = zipfile.ZipFile(output, "w", zipfile.ZIP_DEFLATED)
for root, dirs, files in os.walk(zip_path):
- relative_root = '' if root == zip_path else root.replace(zip_path, '') + os.sep
+ relative_root = "" if root == zip_path else root.replace(zip_path, "") + os.sep
for filename in files:
zip.write(os.path.join(root, filename), relative_root + filename)
zip.close()
@@ -182,36 +209,43 @@ def is_valid_uuid(s):
def write_image(zip_path: str, image_list: List[str]):
for image in image_list:
- search = re.search("\(.*\)", image)
- if search:
- text = search.group()
- if text.startswith('(./oss/file/'):
- image_id = text.replace('(./oss/file/', '').replace(')', '')
- image_id = image_id.strip().split(" ")[0]
- if not is_valid_uuid(image_id):
- continue
- file = QuerySet(File).filter(id=image_id).first()
- if file is None:
- continue
- zip_inner_path = os.path.join('oss', 'file', image_id)
- file_path = os.path.join(zip_path, zip_inner_path)
- if not os.path.exists(os.path.dirname(file_path)):
- os.makedirs(os.path.dirname(file_path))
- with open(os.path.join(zip_path, file_path), 'wb') as f:
- f.write(file.get_bytes())
+ # Match (./oss/file/) from both image syntax and regular links/HTML src
+ src_match = re.search(r'\bsrc=["\'](\./oss/(?:file|image)/[^"\']+)["\']', image)
+ paren_match = re.search(r"\(\./oss/(?:file|image)/([^)]+)\)", image)
+ if src_match:
+ oss_path = src_match.group(1)
+ image_id = re.sub(r"^\./oss/(file|image)/", "", oss_path).strip().split(" ")[0]
+ elif paren_match:
+ image_id = paren_match.group(1).strip().split(" ")[0]
+ else:
+ continue
+ if not is_valid_uuid(image_id):
+ continue
+ file = QuerySet(File).filter(id=image_id).first()
+ if file is None:
+ continue
+ zip_inner_path = os.path.join("oss", "file", image_id)
+ file_path = os.path.join(zip_path, zip_inner_path)
+ if not os.path.exists(os.path.dirname(file_path)):
+ os.makedirs(os.path.dirname(file_path))
+ with open(file_path, "wb") as f:
+ f.write(file.get_bytes())
def update_document_char_length(document_id: str):
- update_execute(get_file_content(
- os.path.join(PROJECT_DIR, "apps", "knowledge", 'sql', 'update_document_char_length.sql')),
- (document_id, document_id))
+ update_execute(
+ get_file_content(os.path.join(PROJECT_DIR, "apps", "knowledge", "sql", "update_document_char_length.sql")),
+ (document_id, document_id),
+ )
def list_paragraph(paragraph_list: List[str]):
if paragraph_list is None or len(paragraph_list) == 0:
return []
- return native_search(QuerySet(Paragraph).filter(id__in=paragraph_list), get_file_content(
- os.path.join(PROJECT_DIR, "apps", "knowledge", 'sql', 'list_paragraph.sql')))
+ return native_search(
+ QuerySet(Paragraph).filter(id__in=paragraph_list),
+ get_file_content(os.path.join(PROJECT_DIR, "apps", "knowledge", "sql", "list_paragraph.sql")),
+ )
def or_get(exists_problem_list, content, knowledge_id, document_id, paragraph_id, problem_content_dict):
@@ -235,14 +269,14 @@ def get_knowledge_operation_object(knowledge_id: str):
"desc": knowledge_model.desc,
"type": knowledge_model.type,
"create_time": knowledge_model.create_time,
- "update_time": knowledge_model.update_time
+ "update_time": knowledge_model.update_time,
}
return {}
def create_knowledge_index(knowledge_id=None, document_id=None):
if knowledge_id is None and document_id is None:
- raise AppApiException(500, _('Knowledge ID or Document ID must be provided'))
+ raise AppApiException(500, _("Knowledge ID or Document ID must be provided"))
if knowledge_id is not None:
k_id = knowledge_id
@@ -257,17 +291,17 @@ def create_knowledge_index(knowledge_id=None, document_id=None):
result = sql_execute(sql, [])
if len(result) == 0:
return
- dims = result[0]['dims']
+ dims = result[0]["dims"]
# 超过2000维度不创建索引,pgvector hnsw索引不支持超过2000维度
if dims < 2000:
sql = f"""CREATE INDEX "embedding_hnsw_idx_{k_id}" ON embedding USING hnsw ((embedding::vector({dims})) vector_cosine_ops) WHERE knowledge_id = '{k_id}'"""
update_execute(sql, [])
- maxkb_logger.info(f'Created index for knowledge ID: {k_id}')
+ maxkb_logger.info(f"Created index for knowledge ID: {k_id}")
def drop_knowledge_index(knowledge_id=None, document_id=None):
if knowledge_id is None and document_id is None:
- raise AppApiException(500, _('Knowledge ID or Document ID must be provided'))
+ raise AppApiException(500, _("Knowledge ID or Document ID must be provided"))
if knowledge_id is not None:
k_id = knowledge_id
@@ -280,21 +314,22 @@ def drop_knowledge_index(knowledge_id=None, document_id=None):
if index:
sql = f'DROP INDEX "embedding_hnsw_idx_{k_id}"'
update_execute(sql, [])
- maxkb_logger.info(f'Dropped index for knowledge ID: {k_id}')
+ maxkb_logger.info(f"Dropped index for knowledge ID: {k_id}")
def update_resource_mapping_by_knowledge(knowledge_id: str):
knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first()
- instance_mapping = get_instance_resource(knowledge, ResourceType.KNOWLEDGE, str(knowledge.id),
- knowledge_instance_field_call_dict)
+ instance_mapping = get_instance_resource(
+ knowledge, ResourceType.KNOWLEDGE, str(knowledge.id), knowledge_instance_field_call_dict
+ )
if knowledge.type == KnowledgeType.WORKFLOW:
- knowledge_workflow = QuerySet(KnowledgeWorkflow).filter(
- knowledge_id=knowledge_id).order_by(
- '-create_time')[0:1].first()
+ knowledge_workflow = (
+ QuerySet(KnowledgeWorkflow).filter(knowledge_id=knowledge_id).order_by("-create_time")[0:1].first()
+ )
if knowledge_workflow:
- save_workflow_mapping(knowledge_workflow.work_flow, ResourceType.KNOWLEDGE,
- str(knowledge_id), instance_mapping)
+ save_workflow_mapping(
+ knowledge_workflow.work_flow, ResourceType.KNOWLEDGE, str(knowledge_id), instance_mapping
+ )
return
else:
- save_workflow_mapping({}, ResourceType.KNOWLEDGE,
- str(knowledge_id), instance_mapping)
+ save_workflow_mapping({}, ResourceType.KNOWLEDGE, str(knowledge_id), instance_mapping)
diff --git a/apps/knowledge/serializers/document.py b/apps/knowledge/serializers/document.py
index d392b0f583c..66b0bc09af9 100644
--- a/apps/knowledge/serializers/document.py
+++ b/apps/knowledge/serializers/document.py
@@ -4,7 +4,7 @@
import re
import traceback
from collections import defaultdict
-from functools import reduce
+from functools import partial, reduce
from tempfile import TemporaryDirectory
from typing import Dict, List
@@ -32,10 +32,10 @@
from common.handle.impl.text.xls_split_handle import XlsSplitHandle
from common.handle.impl.text.xlsx_split_handle import XlsxSplitHandle
from common.handle.impl.text.zip_split_handle import ZipSplitHandle
-from common.utils.common import bulk_create_in_batches, get_file_content, parse_image, post
+from common.utils.common import bulk_create_in_batches, get_file_content, parse_file_link, parse_image, post
from common.utils.fork import Fork
from common.utils.logger import maxkb_logger
-from common.utils.split_model import flat_map, get_split_model
+from common.utils.split_model import flat_map
from django.contrib.postgres.fields import JSONField
from django.core import validators
from django.db import models, transaction
@@ -44,23 +44,20 @@
from django.db.models.functions import Coalesce, NullIf, Reverse, Substr
from django.db.models.query_utils import Q
from django.http import HttpResponse
-from django.utils.translation import get_language, gettext, to_locale
+from django.utils import timezone
+from django.utils.translation import get_language, gettext
from django.utils.translation import gettext_lazy as _
-from maxkb.const import PROJECT_DIR
-from models_provider.models import Model
-from openpyxl.cell.cell import ILLEGAL_CHARACTERS_RE
-from oss.serializers.file import FileSerializer
-from rest_framework import serializers
-from xlwt import Utils
-
from knowledge.models import (
+ ContentOrigin,
Document,
+ DocumentResourceType,
DocumentTag,
File,
FileSourceType,
Knowledge,
KnowledgeType,
Paragraph,
+ ParagraphAsset,
Problem,
ProblemParagraphMapping,
State,
@@ -75,22 +72,44 @@
write_image,
zip_dir,
)
+from knowledge.serializers.document_strategy import (
+ DocumentStrategySerializer,
+ DocumentSyncStrategySerializer,
+ WebSourceURLField,
+)
from knowledge.serializers.paragraph import (
ParagraphInstanceSerializer,
ParagraphSerializers,
delete_problems_and_mappings,
)
+from knowledge.services.document_cleanup import delete_document_data
+from knowledge.services.document_strategy import (
+ apply_length_strategy,
+ document_source_hash,
+ normalize_document_strategy,
+ parse_web_content,
+ strategy_hashes,
+)
+from knowledge.services.incremental_sync import IncrementalDocumentSync, prepare_remote_paragraphs
+from knowledge.services.paragraph_assets import process_visual_assets, sync_paragraph_assets
from knowledge.task.embedding import (
- delete_embedding_by_document,
delete_embedding_by_document_list,
delete_embedding_by_paragraph_ids,
embedding_by_document,
embedding_by_document_list,
+ embedding_by_paragraph_list,
tokenize_by_document,
update_embedding_knowledge_id,
)
from knowledge.task.generate import generate_related_by_document_id
-from knowledge.task.sync import sync_web_document
+from knowledge.web_assets import internalize_web_images
+from maxkb.const import PROJECT_DIR
+from models_provider.models import Model
+from openpyxl.cell.cell import ILLEGAL_CHARACTERS_RE
+from ops import celery_app
+from oss.serializers.file import FileSerializer
+from rest_framework import serializers
+from xlwt import Utils
default_split_handle = TextSplitHandle()
split_handles = [
@@ -123,6 +142,9 @@ def convert_uuid_to_str(obj):
class BatchCancelInstanceSerializer(serializers.Serializer):
id_list = serializers.ListField(required=True, child=serializers.UUIDField(required=True), label=_("id list"))
type = serializers.IntegerField(required=True, label=_("task type"))
+ resource_type = serializers.ChoiceField(
+ required=False, default=DocumentResourceType.DOCUMENT, choices=DocumentResourceType.choices
+ )
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
@@ -139,6 +161,9 @@ class DocumentInstanceSerializer(serializers.Serializer):
)
paragraphs = ParagraphInstanceSerializer(required=False, many=True, allow_null=True)
source_file_id = serializers.UUIDField(required=False, allow_null=True, label=_("source file id"))
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
+ meta = serializers.DictField(required=False)
+ type = serializers.IntegerField(required=False)
class CancelInstanceSerializer(serializers.Serializer):
@@ -200,15 +225,27 @@ class DocumentSplitRequest(serializers.Serializer):
required=False, child=serializers.CharField(required=True, label=_("patterns")), label=_("patterns")
)
with_filter = serializers.BooleanField(required=False, label=_("Auto Clean"))
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
class DocumentWebInstanceSerializer(serializers.Serializer):
source_url_list = serializers.ListField(
required=True,
label=_("document url list"),
- child=serializers.CharField(required=True, label=_("document url list")),
+ allow_empty=False,
+ child=WebSourceURLField(required=True, max_length=2048, label=_("document url list")),
)
selector = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("selector"))
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
+
+ def validate_source_url_list(self, source_url_list):
+ # Keep request order while preventing the same page from being imported more than once in one task.
+ return list(dict.fromkeys(source_url.strip() for source_url in source_url_list))
+
+ def validate(self, attrs):
+ attrs["selector"] = (attrs.get("selector") or "body").strip() or "body"
+ attrs["doc_strategy"] = normalize_document_strategy(attrs.get("doc_strategy"))
+ return attrs
class DocumentInstanceQASerializer(serializers.Serializer):
@@ -230,6 +267,9 @@ class DocumentRefreshSerializer(serializers.Serializer):
class DocumentBatchRefreshSerializer(serializers.Serializer):
id_list = serializers.ListField(required=True, label=_("id list"))
state_list = serializers.ListField(required=True, label=_("state list"))
+ resource_type = serializers.ChoiceField(
+ required=False, default=DocumentResourceType.DOCUMENT, choices=DocumentResourceType.choices
+ )
class DocumentBatchGenerateRelatedSerializer(serializers.Serializer):
@@ -237,6 +277,19 @@ class DocumentBatchGenerateRelatedSerializer(serializers.Serializer):
model_id = serializers.UUIDField(required=True, label=_("model id"))
prompt = serializers.CharField(required=True, label=_("prompt"))
state_list = serializers.ListField(required=True, label=_("state list"))
+ resource_type = serializers.ChoiceField(
+ required=False, default=DocumentResourceType.DOCUMENT, choices=DocumentResourceType.choices
+ )
+
+
+class DocumentBatchAddTagSerializer(serializers.Serializer):
+ document_ids = serializers.ListField(
+ required=True, child=serializers.UUIDField(required=True), label=_("document id list")
+ )
+ tag_ids = serializers.ListField(required=True, child=serializers.UUIDField(required=True), label=_("tag id list"))
+ resource_type = serializers.ChoiceField(
+ required=False, default=DocumentResourceType.DOCUMENT, choices=DocumentResourceType.choices
+ )
class DocumentMigrateSerializer(serializers.Serializer):
@@ -249,6 +302,9 @@ class BatchEditHitHandlingSerializer(serializers.Serializer):
directly_return_similarity = serializers.FloatField(
required=False, max_value=2, min_value=0, label=_("directly return similarity")
)
+ resource_type = serializers.ChoiceField(
+ required=False, default=DocumentResourceType.DOCUMENT, choices=DocumentResourceType.choices
+ )
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
@@ -274,9 +330,7 @@ def export(self, with_valid=True):
language = get_language()
if self.data.get("type") == "csv":
file = open(
- os.path.join(
- PROJECT_DIR, "apps", "knowledge", "template", f"csv_template_{language}.csv"
- ),
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "template", f"csv_template_{language}.csv"),
"rb",
)
content = file.read()
@@ -291,9 +345,7 @@ def export(self, with_valid=True):
)
elif self.data.get("type") == "excel":
file = open(
- os.path.join(
- PROJECT_DIR, "apps", "knowledge", "template", f"excel_template_{language}.xlsx"
- ),
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "template", f"excel_template_{language}.xlsx"),
"rb",
)
content = file.read()
@@ -315,9 +367,7 @@ def table_export(self, with_valid=True):
language = get_language()
if self.data.get("type") == "csv":
file = open(
- os.path.join(
- PROJECT_DIR, "apps", "knowledge", "template", f"table_template_{language}.csv"
- ),
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "template", f"table_template_{language}.csv"),
"rb",
)
content = file.read()
@@ -332,9 +382,7 @@ def table_export(self, with_valid=True):
)
elif self.data.get("type") == "excel":
file = open(
- os.path.join(
- PROJECT_DIR, "apps", "knowledge", "template", f"table_template_{language}.xlsx"
- ),
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "template", f"table_template_{language}.xlsx"),
"rb",
)
content = file.read()
@@ -382,6 +430,11 @@ def migrate(self, with_valid=True):
target_knowledge = QuerySet(Knowledge).filter(id=target_knowledge_id).first()
document_id_list = self.data.get("document_id_list")
document_list = QuerySet(Document).filter(knowledge_id=knowledge_id, id__in=document_id_list)
+ if (
+ document_list.filter(resource_type=DocumentResourceType.IMAGE).exists()
+ and target_knowledge.type != KnowledgeType.BASE
+ ):
+ raise AppApiException(500, _("Image documents can only be migrated to a general knowledge base"))
paragraph_list = QuerySet(Paragraph).filter(knowledge_id=knowledge_id, document_id__in=document_id_list)
problem_paragraph_mapping_list = QuerySet(ProblemParagraphMapping).filter(paragraph__in=paragraph_list)
@@ -427,6 +480,7 @@ def migrate(self, with_valid=True):
pid_list = [paragraph.id for paragraph in paragraph_list]
# 修改段落信息
paragraph_list.update(knowledge_id=target_knowledge_id)
+ QuerySet(ParagraphAsset).filter(document_id__in=document_id_list).update(knowledge_id=target_knowledge_id)
# 修改向量信息
if model_id:
delete_embedding_by_paragraph_ids(pid_list)
@@ -488,6 +542,13 @@ class Query(serializers.Serializer):
no_tag = serializers.BooleanField(required=False, default=False, allow_null=True)
tag_exclude = serializers.BooleanField(required=False, default=False, allow_null=True)
create_user = serializers.UUIDField(required=False, allow_null=True)
+ resource_type = serializers.ChoiceField(
+ choices=DocumentResourceType.choices,
+ required=False,
+ allow_null=True,
+ allow_blank=True,
+ default=DocumentResourceType.DOCUMENT,
+ )
def get_query_set(self):
query_set = QuerySet(model=Document)
@@ -543,12 +604,15 @@ def get_query_set(self):
query_set = query_set.filter(id__in=document_id_list)
if "create_user" in self.data and self.data.get("create_user") is not None:
query_set = query_set.filter(**{"user_id": self.data.get("create_user")})
+ query_set = query_set.filter(resource_type=self.data.get("resource_type") or DocumentResourceType.DOCUMENT)
order_by = self.data.get("order_by", "")
order_by_query_set = QuerySet(
model=get_dynamics_model(
{
"char_length": models.CharField(),
"paragraph_count": models.IntegerField(),
+ "hit_num": models.IntegerField(),
+ "last_hit_time": models.DateTimeField(),
"update_time": models.IntegerField(),
"create_time": models.DateTimeField(),
}
@@ -586,9 +650,19 @@ class Sync(serializers.Serializer):
workspace_id = serializers.CharField(required=False, label=_("workspace id"))
knowledge_id = serializers.UUIDField(required=False, label=_("knowledge id"))
document_id = serializers.UUIDField(required=True, label=_("document id"))
+ strategy_mode = serializers.ChoiceField(
+ choices=["default", "custom"], required=False, default="default", label=_("document strategy mode")
+ )
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
+ DocumentSyncStrategySerializer(
+ data={
+ "strategy_mode": self.validated_data.get("strategy_mode", "default"),
+ "doc_strategy": self.validated_data.get("doc_strategy"),
+ }
+ ).is_valid(raise_exception=True)
workspace_id = self.data.get("workspace_id")
query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
if workspace_id:
@@ -596,20 +670,22 @@ def is_valid(self, *, raise_exception=False):
if not query_set.exists():
raise AppApiException(500, _("Knowledge id does not exist"))
document_id = self.data.get("document_id")
- first = QuerySet(Document).filter(id=document_id).first()
+ first = QuerySet(Document).filter(id=document_id, knowledge_id=self.data.get("knowledge_id")).first()
if first is None:
raise AppApiException(500, _("document id not exist"))
- if first.type != KnowledgeType.WEB:
+ if first.type != KnowledgeType.WEB or first.resource_type != DocumentResourceType.DOCUMENT:
raise AppApiException(500, _("Synchronization is only supported for web site types"))
@transaction.atomic
- def sync(self, with_valid=True, with_embedding=True):
+ def sync(self, with_valid=True, with_embedding=True, response: Fork.Response | None = None):
if with_valid:
self.is_valid(raise_exception=True)
- document_id = self.data.get("document_id")
- document = QuerySet(Document).filter(id=document_id).first()
+ document_id = self.initial_data.get("document_id")
+ document = (
+ QuerySet(Document).filter(id=document_id, knowledge_id=self.initial_data.get("knowledge_id")).first()
+ )
state = State.SUCCESS
- if document.type != KnowledgeType.WEB:
+ if document.type != KnowledgeType.WEB or document.resource_type != DocumentResourceType.DOCUMENT:
return True
try:
ListenerManagement.update_status(
@@ -622,53 +698,45 @@ def sync(self, with_valid=True, with_embedding=True):
if "selector" in document.meta and document.meta.get("selector") is not None
else []
)
- result = Fork(source_url, selector_list).fork()
+ result = response or Fork(source_url, selector_list).fork()
if result.status == 200:
- # 删除段落
- QuerySet(model=Paragraph).filter(document_id=document_id).delete()
- # 删除问题
- QuerySet(model=ProblemParagraphMapping).filter(document_id=document_id).delete()
- delete_problems_and_mappings([document_id])
- # 删除向量库
- delete_embedding_by_document(document_id)
- paragraphs = get_split_model("web.md").parse(result.content)
- char_length = reduce(lambda x, y: x + y, [len(p.get("content")) for p in paragraphs], 0)
- QuerySet(Document).filter(id=document_id).update(char_length=char_length)
- document_paragraph_model = DocumentSerializers.Create.get_paragraph_model(document, paragraphs)
-
- paragraph_model_list = document_paragraph_model.get("paragraph_model_list")
- problem_paragraph_object_list = document_paragraph_model.get("problem_paragraph_object_list")
- problem_model_list, problem_paragraph_mapping_list = ProblemParagraphManage(
- problem_paragraph_object_list, document.knowledge_id
- ).to_problem_model_list()
- # 批量插入段落
- if len(paragraph_model_list) > 0:
- max_position = (
- Paragraph.objects.filter(document_id=document_id).aggregate(max_position=Max("position"))[
- "max_position"
- ]
- or 0
- )
- for i, paragraph in enumerate(paragraph_model_list):
- paragraph.position = max_position + i + 1
- QuerySet(Paragraph).bulk_create(paragraph_model_list)
- # 批量插入问题
- QuerySet(Problem).bulk_create(problem_model_list) if len(problem_model_list) > 0 else None
- # 插入关联问题
- QuerySet(ProblemParagraphMapping).bulk_create(problem_paragraph_mapping_list) if len(
- problem_paragraph_mapping_list
- ) > 0 else None
- # 向量化
- if with_embedding:
+ strategy_mode = self.validated_data.get("strategy_mode", "default") if with_valid else "default"
+ split_strategy = normalize_document_strategy(
+ self.validated_data.get("doc_strategy") if strategy_mode == "custom" else document.doc_strategy
+ )
+ content = internalize_web_images(result.content, document.knowledge_id)
+ paragraphs = parse_web_content(content, split_strategy)
+ incoming_source_hash = document_source_hash(prepare_remote_paragraphs(paragraphs))
+ incoming_strategy_hashes = strategy_hashes(split_strategy)
+ strategy_unchanged = all(
+ getattr(document, key) == value for key, value in incoming_strategy_hashes.items()
+ )
+ if document.source_hash == incoming_source_hash and strategy_unchanged:
+ document.last_sync_time = timezone.now()
+ document.save(update_fields=["last_sync_time", "update_time"])
+ merge_result = None
+ else:
+ merge_result = IncrementalDocumentSync(document, split_strategy).merge(paragraphs)
+ if merge_result is None:
+ changed_paragraphs = QuerySet(Paragraph).none()
+ else:
+ changed_paragraphs = QuerySet(Paragraph).filter(id__in=merge_result.reembed_ids)
+ assets = sync_paragraph_assets(changed_paragraphs, document.visual_strategy_hash)
+ process_visual_assets(assets, split_strategy)
+ if merge_result is not None and merge_result.disabled_ids:
+ delete_embedding_by_paragraph_ids(merge_result.disabled_ids)
+ # 只重建新增或有效内容变化的向量,稳定段落 ID 与问题关联都保持不变。
+ if with_embedding and merge_result is not None and merge_result.reembed_ids:
embedding_model_id = get_embedding_model_id_by_knowledge_id(document.knowledge_id)
- ListenerManagement.update_status(
- QuerySet(Document).filter(id=document_id), TaskType.EMBEDDING, State.PENDING
- )
- ListenerManagement.update_status(
- QuerySet(Paragraph).filter(document_id=document_id), TaskType.EMBEDDING, State.PENDING
- )
+ ListenerManagement.update_status(changed_paragraphs, TaskType.EMBEDDING, State.PENDING)
ListenerManagement.get_aggregation_document_status(document_id)()
- embedding_by_document.delay(document_id, embedding_model_id)
+ transaction.on_commit(
+ partial(
+ embedding_by_paragraph_list.delay,
+ list(merge_result.reembed_ids),
+ embedding_model_id,
+ )
+ )
else:
state = State.FAILURE
@@ -694,7 +762,8 @@ def is_valid(self, *, raise_exception=False):
if not query_set.exists():
raise AppApiException(500, _("Knowledge id does not exist"))
document_id = self.data.get("document_id")
- if not QuerySet(Document).filter(id=document_id).exists():
+ knowledge_id = self.data.get("knowledge_id")
+ if not QuerySet(Document).filter(id=document_id, knowledge_id=knowledge_id).exists():
raise AppApiException(500, _("document id not exist"))
def export(self, with_valid=True):
@@ -741,7 +810,10 @@ def export_zip(self, with_valid=True):
with_table_name=True,
)
data_dict, document_dict = self.merge_problem(paragraph_list, problem_mapping_list, [document])
- res = [parse_image(paragraph.get("content")) for paragraph in paragraph_list]
+ res = [
+ parse_image(paragraph.get("content")) + parse_file_link(paragraph.get("content"))
+ for paragraph in paragraph_list
+ ]
workbook = DocumentSerializers.Operate.get_workbook(data_dict, document_dict)
response = HttpResponse(content_type="application/zip")
@@ -756,12 +828,12 @@ def export_zip(self, with_valid=True):
response.write(zip_buffer.getvalue())
return response
- def download_source_file(self):
+ def download_source_file(self, mk_file_auth=None):
self.is_valid(raise_exception=True)
file = QuerySet(File).filter(source_id=self.data.get("document_id")).first()
if not file:
raise AppApiException(500, _("File not exist. Only manually uploaded documents are supported"))
- return FileSerializer.Operate(data={"id": file.id}).get(with_valid=True)
+ return FileSerializer.Operate(data={"id": file.id}).get(mk_file_auth=mk_file_auth, with_valid=True)
def one(self, with_valid=False):
self.is_valid(raise_exception=True)
@@ -786,6 +858,16 @@ def edit(self, instance: Dict, with_valid=False):
if update_key in instance and instance.get(update_key) is not None:
_document.__setattr__(update_key, instance.get(update_key))
_document.save()
+ if (
+ _document.resource_type == DocumentResourceType.IMAGE
+ and "name" in instance
+ and instance.get("name") is not None
+ ):
+ source_file_ids = [_document.meta.get("source_file_id")] if _document.meta else []
+ QuerySet(File).filter(
+ Q(source_id=str(_document.id), source_type=FileSourceType.DOCUMENT)
+ | Q(id__in=[file_id for file_id in source_file_ids if file_id])
+ ).update(file_name=instance.get("name"))
return self.one()
def cancel(self, instance, with_valid=True):
@@ -822,21 +904,7 @@ def cancel(self, instance, with_valid=True):
@transaction.atomic
def delete(self):
self.is_valid(raise_exception=True)
- document_id = self.data.get("document_id")
- source_file_ids = [
- doc["meta"].get("source_file_id") for doc in Document.objects.filter(id=document_id).values("meta")
- ]
- QuerySet(File).filter(id__in=source_file_ids).delete()
- QuerySet(File).filter(source_id=document_id, source_type=FileSourceType.DOCUMENT).delete()
- paragraph_ids = QuerySet(model=Paragraph).filter(document_id=document_id).values_list("id", flat=True)
- # 删除问题
- delete_problems_and_mappings(paragraph_ids)
- # 删除段落
- QuerySet(model=Paragraph).filter(document_id=document_id).delete()
- # 删除向量库
- delete_embedding_by_document(document_id)
- QuerySet(model=DocumentTag).filter(document_id=document_id).delete()
- QuerySet(model=Document).filter(id=document_id).delete()
+ delete_document_data([self.data.get("document_id")])
return True
def refresh(self, state_list=None, with_valid=True):
@@ -1047,6 +1115,13 @@ def save(self, instance: Dict, with_valid=True, **kwargs):
QuerySet(ProblemParagraphMapping).bulk_create(problem_paragraph_mapping_list) if len(
problem_paragraph_mapping_list
) > 0 else None
+ IncrementalDocumentSync(document_model, document_model.doc_strategy)._sync_title_questions(
+ list(QuerySet(Paragraph).filter(document_id=document_model.id))
+ )
+ assets = sync_paragraph_assets(
+ QuerySet(Paragraph).filter(document_id=document_model.id), document_model.visual_strategy_hash
+ )
+ process_visual_assets(assets, document_model.doc_strategy)
document_id = str(document_model.id)
return (
DocumentSerializers.Operate(data={"knowledge_id": knowledge_id, "document_id": document_id}).one(
@@ -1086,33 +1161,66 @@ def get_document_paragraph_model(knowledge_id, user_id, instance: Dict):
meta = {**instance.get("meta"), **source_meta} if instance.get("meta") is not None else source_meta
meta = {**convert_uuid_to_str(meta), "allow_download": True}
+ strategy = normalize_document_strategy(instance.get("doc_strategy"))
+ hashes = strategy_hashes(strategy)
+ paragraphs = instance.get("paragraphs", [])
+ origin = (
+ ContentOrigin.SYNCED
+ if instance.get("source_file_id") or instance.get("type") in [KnowledgeType.WEB, KnowledgeType.LARK]
+ else ContentOrigin.MANUAL
+ )
+ normalized_paragraphs = [
+ {
+ **paragraph,
+ "origin": paragraph.get("origin", origin),
+ "child_length": strategy["split"]["child_length"],
+ }
+ for paragraph in paragraphs
+ ]
+ if origin == ContentOrigin.SYNCED:
+ normalized_paragraphs = prepare_remote_paragraphs(normalized_paragraphs)
document_model = Document(
**{
"knowledge_id": knowledge_id,
"id": uuid.uuid7(),
"name": instance.get("name"),
"char_length": reduce(
- lambda x, y: x + y, [len(p.get("content")) for p in instance.get("paragraphs", [])], 0
+ lambda x, y: x + y, [len(p.get("content")) for p in normalized_paragraphs], 0
),
"meta": meta,
+ "doc_strategy": strategy,
+ "source_hash": document_source_hash(normalized_paragraphs),
+ **hashes,
"type": instance.get("type") if instance.get("type") is not None else KnowledgeType.BASE,
+ # Standalone images must go through ImageDocumentService so that file validation,
+ # visual processing and ParagraphAsset creation cannot be bypassed.
+ "resource_type": DocumentResourceType.DOCUMENT,
"user_id": user_id,
}
)
- return DocumentSerializers.Create.get_paragraph_model(
- document_model, instance.get("paragraphs") if "paragraphs" in instance else []
- )
+ return DocumentSerializers.Create.get_paragraph_model(document_model, normalized_paragraphs)
def save_web(self, instance: Dict, with_valid=True):
+ request_serializer = DocumentWebInstanceSerializer(data=instance)
if with_valid:
- DocumentWebInstanceSerializer(data=instance).is_valid(raise_exception=True)
+ request_serializer.is_valid(raise_exception=True)
self.is_valid(raise_exception=True)
+ instance = request_serializer.validated_data
+ else:
+ instance = {
+ **instance,
+ "selector": (instance.get("selector") or "body").strip() or "body",
+ "doc_strategy": normalize_document_strategy(instance.get("doc_strategy")),
+ }
knowledge_id = self.data.get("knowledge_id")
user_id = self.data.get("user_id")
source_url_list = instance.get("source_url_list")
selector = instance.get("selector")
- sync_web_document.delay(knowledge_id, user_id, source_url_list, selector)
+ celery_app.send_task(
+ "celery:sync_web_document",
+ args=[knowledge_id, user_id, source_url_list, selector, instance.get("doc_strategy")],
+ )
def save_qa(self, instance: Dict, with_valid=True):
if with_valid:
@@ -1224,22 +1332,37 @@ def is_valid(self, *, instance=None, raise_exception=True):
def parse(self, instance):
self.is_valid(instance=instance, raise_exception=True)
- DocumentSplitRequest(data=instance).is_valid(raise_exception=True)
-
- file_list = instance.get("file")
- return reduce(
+ request_serializer = DocumentSplitRequest(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ validated_data = request_serializer.validated_data
+
+ file_list = validated_data.get("file")
+ strategy_input = validated_data.get("doc_strategy") or {
+ "split": {
+ "patterns": validated_data.get("patterns"),
+ "max_length": validated_data.get("limit", 4096),
+ "auto_clean": validated_data.get("with_filter", False),
+ }
+ }
+ strategy = normalize_document_strategy(strategy_input)
+ parse_limit = 100000 if strategy["split"].get("patterns") == [] else strategy["split"]["max_length"]
+ documents = reduce(
lambda x, y: [*x, *y],
[
self.file_to_paragraph(
f,
- instance.get("patterns", None),
- instance.get("with_filter", None),
- instance.get("limit", 4096),
+ strategy["split"].get("patterns"),
+ strategy["split"].get("auto_clean", False),
+ parse_limit,
)
for f in file_list
],
[],
)
+ for document in documents:
+ document["content"] = apply_length_strategy(document.get("content", []), strategy)
+ document["doc_strategy"] = strategy
+ return documents
def save_image(self, image_list):
if image_list is not None and len(image_list) > 0:
@@ -1314,6 +1437,27 @@ class Batch(serializers.Serializer):
knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
user_id = serializers.UUIDField(required=False, label=_("user id"), allow_null=True)
+ def validate_document_ids(self, instance: Dict, field_name="id_list") -> List[str]:
+ document_ids = [str(document_id) for document_id in instance.get(field_name) or []]
+ if not document_ids:
+ raise AppApiException(500, _("Document id list cannot be empty"))
+ resource_type = instance.get("resource_type") or DocumentResourceType.DOCUMENT
+ if resource_type not in DocumentResourceType.values:
+ raise AppApiException(500, _("Unsupported document resource type"))
+ matched_ids = {
+ str(document_id)
+ for document_id in QuerySet(Document)
+ .filter(
+ id__in=document_ids,
+ knowledge_id=self.initial_data.get("knowledge_id"),
+ resource_type=resource_type,
+ )
+ .values_list("id", flat=True)
+ }
+ if matched_ids != set(document_ids):
+ raise AppApiException(500, _("Document does not belong to the requested resource type"))
+ return document_ids
+
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
workspace_id = self.data.get("workspace_id")
@@ -1404,6 +1548,14 @@ def batch_save(self, instance_list: List[Dict], with_valid=True):
bulk_create_in_batches(Problem, problem_model_list, batch_size=1000)
# 批量插入关联问题
bulk_create_in_batches(ProblemParagraphMapping, problem_paragraph_mapping_list, batch_size=1000)
+ for document in document_model_list:
+ IncrementalDocumentSync(document, document.doc_strategy)._sync_title_questions(
+ list(QuerySet(Paragraph).filter(document_id=document.id))
+ )
+ assets = sync_paragraph_assets(
+ QuerySet(Paragraph).filter(document_id=document.id), document.visual_strategy_hash
+ )
+ process_visual_assets(assets, document.doc_strategy)
# 查询文档
query_set = QuerySet(model=Document)
if len(document_model_list) == 0:
@@ -1428,6 +1580,7 @@ def batch_sync(self, instance: Dict, with_valid=True):
if with_valid:
BatchSerializer(data=instance).is_valid(model=Document, raise_exception=True)
self.is_valid(raise_exception=True)
+ self.validate_document_ids(instance)
# 异步同步
work_thread_pool.submit(
lambda doc_ids: [
@@ -1449,7 +1602,9 @@ def batch_delete(self, instance: Dict, with_valid=True):
if with_valid:
BatchSerializer(data=instance).is_valid(model=Document, raise_exception=True)
self.is_valid(raise_exception=True)
- document_id_list = instance.get("id_list")
+ document_id_list = self.validate_document_ids(instance)
+ else:
+ document_id_list = instance.get("id_list")
source_file_ids = [
doc["meta"].get("source_file_id")
for doc in Document.objects.filter(id__in=document_id_list).values("meta")
@@ -1470,7 +1625,9 @@ def batch_cancel(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
BatchCancelInstanceSerializer(data=instance).is_valid(raise_exception=True)
- document_id_list = instance.get("id_list")
+ document_id_list = self.validate_document_ids(instance)
+ else:
+ document_id_list = instance.get("id_list")
ListenerManagement.update_status(
QuerySet(Paragraph)
.annotate(
@@ -1505,7 +1662,9 @@ def batch_edit_hit_handling(self, instance: Dict, with_valid=True):
if hit_handling_method != "optimization" and hit_handling_method != "directly_return":
raise AppApiException(500, _("The hit processing method must be directly_return|optimization"))
self.is_valid(raise_exception=True)
- document_id_list = instance.get("id_list")
+ document_id_list = self.validate_document_ids(instance)
+ else:
+ document_id_list = instance.get("id_list")
hit_handling_method = instance.get("hit_handling_method")
directly_return_similarity = instance.get("directly_return_similarity")
update_dict = {"hit_handling_method": hit_handling_method}
@@ -1529,7 +1688,9 @@ def batch_edit_hit_handling(self, instance: Dict, with_valid=True):
def batch_refresh(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- document_id_list = instance.get("id_list")
+ document_id_list = self.validate_document_ids(instance)
+ else:
+ document_id_list = instance.get("id_list")
state_list = instance.get("state_list")
knowledge_id = self.data.get("knowledge_id")
for document_id in document_id_list:
@@ -1543,7 +1704,9 @@ def batch_refresh(self, instance: Dict, with_valid=True):
def batch_tokenize(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- document_id_list = instance.get("id_list")
+ document_id_list = self.validate_document_ids(instance)
+ else:
+ document_id_list = instance.get("id_list")
state_list = instance.get("state_list")
knowledge_id = self.data.get("knowledge_id")
for document_id in document_id_list:
@@ -1556,8 +1719,13 @@ def batch_tokenize(self, instance: Dict, with_valid=True):
def batch_add_tag(self, instance: Dict, with_valid=True):
if with_valid:
+ request_serializer = DocumentBatchAddTagSerializer(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ instance = request_serializer.validated_data
self.is_valid(raise_exception=True)
- document_id_list = instance.get("document_ids")
+ document_id_list = self.validate_document_ids(instance, "document_ids")
+ else:
+ document_id_list = instance.get("document_ids")
tag_id_list = instance.get("tag_ids")
# 批量查询已存在的标签关联关系
existing_relations = {
@@ -1590,7 +1758,9 @@ def batch_export(self, instance: Dict, with_valid=True):
if with_valid:
BatchSerializer(data=instance).is_valid(model=Document, raise_exception=True)
self.is_valid(raise_exception=True)
- document_ids = instance.get("id_list")
+ document_ids = self.validate_document_ids(instance)
+ else:
+ document_ids = instance.get("id_list")
document_list = QuerySet(Document).filter(id__in=document_ids)
paragraph_list = native_search(
QuerySet(Paragraph).filter(document_id__in=document_ids),
@@ -1615,8 +1785,10 @@ def batch_export_zip(self, instance: Dict, with_valid=True):
if with_valid:
BatchSerializer(data=instance).is_valid(model=Document, raise_exception=True)
self.is_valid(raise_exception=True)
+ document_ids = self.validate_document_ids(instance)
knowledge = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id")).first()
- document_ids = instance.get("id_list")
+ if not with_valid:
+ document_ids = instance.get("id_list")
document_list = QuerySet(Document).filter(id__in=document_ids)
paragraph_list = native_search(
QuerySet(Paragraph).filter(document_id__in=document_ids),
@@ -1632,7 +1804,10 @@ def batch_export_zip(self, instance: Dict, with_valid=True):
data_dict, document_dict = DocumentSerializers.Operate.merge_problem(
paragraph_list, problem_mapping_list, document_list
)
- res = [parse_image(paragraph.get("content")) for paragraph in paragraph_list]
+ res = [
+ parse_image(paragraph.get("content")) + parse_file_link(paragraph.get("content"))
+ for paragraph in paragraph_list
+ ]
workbook = DocumentSerializers.Operate.get_workbook(data_dict, document_dict)
response = HttpResponse(content_type="application/zip")
@@ -1662,7 +1837,20 @@ def is_valid(self, *, raise_exception=False):
def batch_generate_related(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- document_id_list = instance.get("document_id_list")
+ document_id_list = [str(document_id) for document_id in instance.get("document_id_list") or []]
+ resource_type = instance.get("resource_type") or DocumentResourceType.DOCUMENT
+ valid_ids = {
+ str(document_id)
+ for document_id in QuerySet(Document)
+ .filter(
+ id__in=document_id_list,
+ knowledge_id=self.data.get("knowledge_id"),
+ resource_type=resource_type,
+ )
+ .values_list("id", flat=True)
+ }
+ if valid_ids != set(document_id_list):
+ raise AppApiException(500, _("Document does not belong to the requested resource type"))
model_id = instance.get("model_id")
prompt = instance.get("prompt")
model_params_setting = instance.get("model_params_setting")
diff --git a/apps/knowledge/serializers/document_strategy.py b/apps/knowledge/serializers/document_strategy.py
new file mode 100644
index 00000000000..8f6467afe7e
--- /dev/null
+++ b/apps/knowledge/serializers/document_strategy.py
@@ -0,0 +1,103 @@
+"""Request serializers for document processing strategies."""
+
+import re
+from urllib.parse import urlsplit
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from knowledge.services.document_strategy import normalize_document_strategy
+
+
+class WebSourceURLField(serializers.CharField):
+ """HTTP(S) URL field that also accepts single-label intranet hosts."""
+
+ default_error_messages = {"invalid": _("Enter a valid HTTP or HTTPS URL")}
+
+ def to_internal_value(self, data):
+ value = super().to_internal_value(data).strip()
+ parsed = urlsplit(value)
+ if parsed.scheme.lower() not in {"http", "https"} or not parsed.netloc:
+ self.fail("invalid")
+ return value
+
+
+class DocumentSplitStrategySerializer(serializers.Serializer):
+ mode = serializers.ChoiceField(choices=["smart", "advanced"], required=False)
+ patterns = serializers.ListField(child=serializers.CharField(allow_blank=False), required=False, allow_null=True)
+ min_length = serializers.IntegerField(min_value=0, max_value=100000, required=False)
+ max_length = serializers.IntegerField(min_value=50, max_value=100000, required=False)
+ child_length = serializers.IntegerField(min_value=50, max_value=2048, required=False)
+ auto_clean = serializers.BooleanField(required=False)
+
+ def validate_patterns(self, patterns):
+ if patterns is None:
+ return None
+ for pattern in patterns:
+ try:
+ re.compile(pattern)
+ except re.error as exc:
+ raise serializers.ValidationError(
+ _("Invalid paragraph identifier: {error}").format(error=str(exc))
+ ) from exc
+ return patterns
+
+ def validate(self, attrs):
+ minimum = attrs.get("min_length", 0)
+ maximum = attrs.get("max_length", 4096)
+ if minimum > maximum:
+ raise serializers.ValidationError(
+ {"min_length": _("The minimum paragraph length cannot exceed the maximum paragraph length")}
+ )
+ if "patterns" in attrs and "mode" not in attrs:
+ attrs["mode"] = "advanced"
+ if attrs.get("mode") == "smart" and attrs.get("patterns") is not None:
+ raise serializers.ValidationError(
+ {"patterns": _("Paragraph identifiers are only supported in advanced split mode")}
+ )
+ return attrs
+
+
+class DocumentVisualStrategySerializer(serializers.Serializer):
+ enabled = serializers.BooleanField(required=False)
+ strategy = serializers.ChoiceField(choices=["model", "tool"], required=False)
+ model_id = serializers.UUIDField(required=False, allow_null=True)
+ tool_id = serializers.UUIDField(required=False, allow_null=True)
+
+ def validate(self, attrs):
+ if not attrs.get("enabled", False):
+ return attrs
+ strategy = attrs.get("strategy", "model")
+ selected = attrs.get("model_id") if strategy == "model" else attrs.get("tool_id")
+ if selected is None:
+ field = "model_id" if strategy == "model" else "tool_id"
+ raise serializers.ValidationError({field: _("This field is required when visual enhancement is enabled")})
+ return attrs
+
+
+class DocumentIndexStrategySerializer(serializers.Serializer):
+ title_as_question = serializers.BooleanField(required=False)
+
+
+class DocumentStrategySerializer(serializers.Serializer):
+ split = DocumentSplitStrategySerializer(required=False)
+ visual = DocumentVisualStrategySerializer(required=False)
+ index = DocumentIndexStrategySerializer(required=False)
+
+ def validate(self, attrs):
+ try:
+ return normalize_document_strategy(attrs)
+ except (TypeError, ValueError) as exc:
+ raise serializers.ValidationError(str(exc)) from exc
+
+
+class DocumentSyncStrategySerializer(serializers.Serializer):
+ strategy_mode = serializers.ChoiceField(choices=["default", "custom"], required=False, default="default")
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
+
+ def validate(self, attrs):
+ if attrs.get("strategy_mode") == "custom" and attrs.get("doc_strategy") is None:
+ raise serializers.ValidationError(
+ {"doc_strategy": _("This field is required when the custom document strategy is selected")}
+ )
+ return attrs
diff --git a/apps/knowledge/serializers/external_retrieval.py b/apps/knowledge/serializers/external_retrieval.py
new file mode 100644
index 00000000000..cdccbc55b60
--- /dev/null
+++ b/apps/knowledge/serializers/external_retrieval.py
@@ -0,0 +1,87 @@
+import math
+
+from django.db import transaction
+from rest_framework import serializers
+
+from knowledge.models import Knowledge
+from maxkb.const import CONFIG
+
+
+class StrictSerializer(serializers.Serializer):
+ def to_internal_value(self, data):
+ if not isinstance(data, dict) or set(data) - set(self.fields):
+ raise serializers.ValidationError("Invalid or unknown fields.")
+ return super().to_internal_value(data)
+
+
+class ExternalServiceSettings(StrictSerializer):
+ enabled = serializers.BooleanField(required=False)
+ authentication = serializers.BooleanField(required=False)
+
+ def validate(self, attrs):
+ if not attrs:
+ raise serializers.ValidationError("At least one setting is required.")
+ return attrs
+
+
+class RetrievalRequest(StrictSerializer):
+ query_text = serializers.CharField(max_length=8000, allow_blank=False)
+ top_number = serializers.IntegerField(default=5, min_value=1, max_value=50)
+ similarity = serializers.FloatField(default=0.0, min_value=0.0, max_value=1.0)
+ search_mode = serializers.ChoiceField(choices=["embedding", "keywords", "blend"], default="embedding")
+
+ def to_internal_value(self, data):
+ if isinstance(data, dict) and not isinstance(data.get("query_text"), str):
+ raise serializers.ValidationError("query_text must be a string.")
+ return super().to_internal_value(data)
+
+ def validate_similarity(self, value):
+ if not math.isfinite(value):
+ raise serializers.ValidationError("similarity must be finite.")
+ return value
+
+
+def service_settings(knowledge, request=None):
+ prefix = f"{CONFIG.get_chat_path()}/api/v3/knowledge/{knowledge.id}"
+ absolute = request.build_absolute_uri if request else lambda path: path
+ mcp_url = absolute(f"{prefix}/mcp")
+ authentication = knowledge.external_service.get("authentication", False)
+ connection = {"url": mcp_url, "transport": "streamable_http"}
+ if authentication:
+ connection["headers"] = {"Authorization": "Bearer "}
+ return {
+ "enabled": knowledge.external_service.get("enabled", False),
+ "authentication": authentication,
+ "api_url": absolute(f"{prefix}/retrieve"),
+ "mcp_url": mcp_url,
+ "mcp_config": {f"knowledge_{knowledge.id}": connection},
+ }
+
+
+class ExternalServiceSerializer(serializers.Serializer):
+ workspace_id = serializers.CharField()
+ knowledge_id = serializers.UUIDField()
+
+ def get_knowledge(self, lock=False):
+ self.is_valid(raise_exception=True)
+ query = Knowledge.objects.select_for_update() if lock else Knowledge.objects.all()
+ knowledge = query.filter(
+ id=self.validated_data["knowledge_id"], workspace_id=self.validated_data["workspace_id"]
+ ).first()
+ if knowledge is None:
+ from common.exception.app_exception import NotFound404
+
+ raise NotFound404(404, "Knowledge does not exist.")
+ return knowledge
+
+ def get_settings(self):
+ return service_settings(self.get_knowledge(), self.context.get("request"))
+
+ @transaction.atomic
+ def update_settings(self, data):
+ settings = ExternalServiceSettings(data=data)
+ settings.is_valid(raise_exception=True)
+ knowledge = self.get_knowledge(lock=True)
+ knowledge.external_service = {**knowledge.external_service, **settings.validated_data}
+ knowledge.save(update_fields=["external_service"])
+ return service_settings(knowledge, self.context.get("request"))
diff --git a/apps/knowledge/serializers/image_document.py b/apps/knowledge/serializers/image_document.py
new file mode 100644
index 00000000000..fca6a987e12
--- /dev/null
+++ b/apps/knowledge/serializers/image_document.py
@@ -0,0 +1,83 @@
+"""API serializers for standalone image documents."""
+
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from knowledge.serializers.document import DocumentSerializers
+from knowledge.serializers.document_strategy import DocumentStrategySerializer
+from knowledge.services.image_documents import ImageDocumentService
+
+
+class ImagePreviewUploadRequest(serializers.Serializer):
+ file = serializers.ListField(child=serializers.FileField(), allow_empty=False, max_length=50)
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
+
+
+class ImagePreviewUpdateRequest(serializers.Serializer):
+ name = serializers.CharField(required=False, min_length=1, max_length=150)
+ caption = serializers.CharField(required=False, allow_blank=True, max_length=1024)
+ ocr_text = serializers.CharField(required=False, allow_blank=True, max_length=102400)
+ description = serializers.CharField(required=False, allow_blank=True, max_length=102400)
+
+ def validate(self, attrs):
+ if not attrs:
+ raise serializers.ValidationError(_("At least one field must be provided"))
+ return attrs
+
+
+class ImagePreviewBatchCreateRequest(serializers.Serializer):
+ preview_ids = serializers.ListField(
+ child=serializers.UUIDField(), allow_empty=False, max_length=50, label=_("image preview ids")
+ )
+
+
+class ImageDocumentSerializers:
+ class Preview(serializers.Serializer):
+ workspace_id = serializers.CharField(required=True)
+ knowledge_id = serializers.UUIDField(required=True)
+ user_id = serializers.UUIDField(required=False, allow_null=True)
+
+ def _service(self) -> ImageDocumentService:
+ self.is_valid(raise_exception=True)
+ return ImageDocumentService(
+ self.validated_data["workspace_id"],
+ self.validated_data["knowledge_id"],
+ self.validated_data.get("user_id"),
+ )
+
+ def upload(self, instance):
+ request_serializer = ImagePreviewUploadRequest(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ return self._service().create_previews(
+ request_serializer.validated_data["file"],
+ request_serializer.validated_data.get("doc_strategy"),
+ )
+
+ def one(self, preview_id):
+ return self._service().get_preview(preview_id)
+
+ def edit(self, preview_id, instance):
+ request_serializer = ImagePreviewUpdateRequest(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ return self._service().update_preview(preview_id, request_serializer.validated_data)
+
+ def delete(self, preview_id):
+ return self._service().delete_preview(preview_id)
+
+ def batch_create(self, instance):
+ request_serializer = ImagePreviewBatchCreateRequest(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ service = self._service()
+ document_ids = service.import_previews(request_serializer.validated_data["preview_ids"])
+ result = []
+ for document_id in document_ids:
+ operate = DocumentSerializers.Operate(
+ data={
+ "workspace_id": self.validated_data["workspace_id"],
+ "knowledge_id": self.validated_data["knowledge_id"],
+ "document_id": document_id,
+ }
+ )
+ result.append(operate.one(with_valid=True))
+ operate.refresh(with_valid=False)
+ return result
diff --git a/apps/knowledge/serializers/knowledge.py b/apps/knowledge/serializers/knowledge.py
index c6cf4f087ff..9f4b82eaa72 100644
--- a/apps/knowledge/serializers/knowledge.py
+++ b/apps/knowledge/serializers/knowledge.py
@@ -4,16 +4,16 @@
import pickle
import re
import tempfile
-import traceback
import zipfile
from collections import defaultdict
-from functools import reduce
+from functools import partial, reduce
from tempfile import TemporaryDirectory
from typing import Dict, List
from urllib.parse import quote
import requests
import uuid_utils.compat as uuid
+import openpyxl
from celery_once import AlreadyQueued
from common.chunk import text_to_chunk
from common.config.embedding_config import VectorStore
@@ -24,21 +24,18 @@
from common.exception.app_exception import AppApiException
from common.field.common import UploadedFileField
from common.utils.common import bulk_create_in_batches, get_file_content, parse_image, post
-from common.utils.fork import ChildLink, Fork
from common.utils.logger import maxkb_logger
-from common.utils.split_model import get_split_model
-from django.core import validators
from django.core.files.uploadedfile import SimpleUploadedFile
from django.db import models, transaction
from django.db.models import QuerySet
from django.db.models.functions import Reverse, Substr
from django.db.models.query_utils import Q
from django.http import HttpResponse
-from django.utils.translation import gettext
-from django.utils.translation import gettext_lazy as _
+from django.utils.translation import gettext_lazy as _, gettext
from maxkb.conf import PROJECT_DIR
from maxkb.const import CONFIG
from models_provider.models import Model
+from openpyxl.cell.cell import ILLEGAL_CHARACTERS_RE
from rest_framework import serializers
from system_manage.models import AuthTargetType, WorkspaceUserResourcePermission
from system_manage.models.resource_mapping import ResourceMapping
@@ -54,17 +51,26 @@
Knowledge,
KnowledgeFolder,
KnowledgeScope,
+ KnowledgeSyncTrigger,
KnowledgeType,
KnowledgeWorkflow,
Paragraph,
Problem,
ProblemParagraphMapping,
SearchMode,
+ SourceType,
State,
Tag,
TaskType,
Termbase,
)
+from knowledge.services.document_strategy import normalize_document_strategy
+from knowledge.services.knowledge_sync_schedule import remove_knowledge_sync_job
+from knowledge.services.multimodal_retrieval import (
+ MAX_QUERY_IMAGE_COUNT,
+ get_hit_asset_map,
+ load_image_query_inputs,
+)
from knowledge.serializers.common import (
BatchMoveSerializer,
BatchSerializer,
@@ -81,28 +87,18 @@
zip_dir,
)
from knowledge.serializers.document import DocumentSerializers
-from knowledge.task.embedding import delete_embedding_by_knowledge, embedding_by_knowledge
+from knowledge.serializers.document_strategy import DocumentStrategySerializer, WebSourceURLField
+from knowledge.serializers.knowledge_model import KnowledgeModelSerializer
+from knowledge.serializers.knowledge_workflow import (
+ KBWFInstance,
+ KnowledgeWorkflowModelSerializer,
+ KnowledgeWorkflowSerializer,
+)
+from knowledge.task.embedding import delete_embedding_by_knowledge, embedding_by_knowledge, tokenize_by_knowledge
from knowledge.task.generate import generate_related_by_knowledge_id
from knowledge.task.sync import sync_replace_web_knowledge, sync_web_knowledge
-
-
-class KnowledgeModelSerializer(serializers.ModelSerializer):
- class Meta:
- model = Knowledge
- fields = [
- "id",
- "name",
- "desc",
- "meta",
- "folder_id",
- "type",
- "workspace_id",
- "create_time",
- "update_time",
- "file_size_limit",
- "file_count_limit",
- "embedding_model_id",
- ]
+from system_manage.services.resource_mapping import get_tool_id_list
+from tools.models import Tool, ToolScope, ToolType, ToolWorkflow
class KnowledgeBaseCreateRequest(serializers.Serializer):
@@ -121,8 +117,14 @@ class KnowledgeWebCreateRequest(serializers.Serializer):
folder_id = serializers.CharField(required=True, label=_("folder id"))
desc = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("knowledge description"))
embedding_model_id = serializers.CharField(required=True, label=_("knowledge embedding"))
- source_url = serializers.CharField(required=True, label=_("source url"))
+ source_url = WebSourceURLField(required=True, max_length=2048, label=_("source url"))
selector = serializers.CharField(required=False, label=_("knowledge selector"), allow_null=True, allow_blank=True)
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
+
+ def validate(self, attrs):
+ attrs["selector"] = (attrs.get("selector") or "body").strip() or "body"
+ attrs["doc_strategy"] = normalize_document_strategy(attrs.get("doc_strategy"))
+ return attrs
class KnowledgeEditRequest(serializers.Serializer):
@@ -136,6 +138,7 @@ class KnowledgeEditRequest(serializers.Serializer):
)
file_size_limit = serializers.IntegerField(required=False, label=_("file size limit"))
file_count_limit = serializers.IntegerField(required=False, label=_("file count limit"))
+ doc_strategy = DocumentStrategySerializer(required=False, allow_null=True)
@staticmethod
def get_knowledge_meta_valid_map():
@@ -147,27 +150,61 @@ def get_knowledge_meta_valid_map():
def is_valid(self, *, knowledge: Knowledge = None):
super().is_valid(raise_exception=True)
- if "meta" in self.data and self.data.get("meta") is not None:
+ if knowledge.type != KnowledgeType.WEB:
+ if self.validated_data.get("doc_strategy") is not None:
+ raise serializers.ValidationError(
+ {
+ "doc_strategy": _(
+ "Knowledge-base-level default document processing strategies are only supported for Web knowledge bases. "
+ "Configure document-level strategies through the document import or synchronization API."
+ )
+ }
+ )
+ # Non-Web detail responses contain null; do not treat it as a strategy update.
+ self.validated_data.pop("doc_strategy", None)
+ if "meta" in self.validated_data and self.validated_data.get("meta") is not None:
knowledge_meta_valid_map = self.get_knowledge_meta_valid_map()
valid_class = knowledge_meta_valid_map.get(knowledge.type)
- valid_class(data=self.data.get("meta")).is_valid(raise_exception=True)
+ meta_serializer = valid_class(data=self.validated_data.get("meta"))
+ meta_serializer.is_valid(raise_exception=True)
+ self._validated_data["meta"] = meta_serializer.validated_data
+
+
+class HitTestImageSerializer(serializers.Serializer):
+ file_id = serializers.UUIDField(required=True, label=_("file id"))
+ name = serializers.CharField(required=False, allow_blank=True, label=_("file name"))
+ url = serializers.CharField(required=False, allow_blank=True, label=_("file url"))
class HitTestSerializer(serializers.Serializer):
- query_text = serializers.CharField(required=True, label=_("query text"))
+ query_text = serializers.CharField(
+ required=False,
+ allow_blank=True,
+ allow_null=True,
+ default="",
+ label=_("query text"),
+ )
+ image_list = serializers.ListSerializer(
+ child=HitTestImageSerializer(),
+ required=False,
+ default=list,
+ max_length=MAX_QUERY_IMAGE_COUNT,
+ label=_("query image list"),
+ )
top_number = serializers.IntegerField(required=True, max_value=10000, min_value=1, label=_("top number"))
similarity = serializers.FloatField(required=True, max_value=2, min_value=0, label=_("similarity"))
- search_mode = serializers.CharField(
- required=True,
- label=_("search mode"),
- validators=[
- validators.RegexValidator(
- regex=re.compile("^embedding|keywords|blend$"),
- message=_("The type only supports embedding|keywords|blend"),
- code=500,
+ search_mode = serializers.ChoiceField(required=True, choices=SearchMode.choices, label=_("search mode"))
+
+ def validate(self, attrs):
+ attrs["query_text"] = (attrs.get("query_text") or "").strip()
+ image_list = attrs.get("image_list") or []
+ if not attrs["query_text"] and not image_list:
+ raise serializers.ValidationError(_("Query text and query images cannot both be empty"))
+ if image_list and attrs.get("search_mode") == SearchMode.keywords.value:
+ raise serializers.ValidationError(
+ {"search_mode": _("Image queries only support embedding or blend search")}
)
- ],
- )
+ return attrs
class KnowledgeSerializer(serializers.Serializer):
@@ -354,9 +391,18 @@ def embedding(self, with_valid=True):
embedding_model_id = get_embedding_model_id_by_knowledge_id(self.data.get("knowledge_id"))
try:
embedding_by_knowledge.delay(knowledge_id, embedding_model_id)
- except AlreadyQueued as e:
+ except AlreadyQueued:
raise AppApiException(500, _("Failed to send the vectorization task, please try again later!"))
+ def tokenize(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ knowledge_id = self.data.get("knowledge_id")
+ try:
+ tokenize_by_knowledge.delay(knowledge_id)
+ except AlreadyQueued:
+ raise AppApiException(500, _("The task is being executed, please do not send it repeatedly."))
+
def generate_related(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
@@ -383,7 +429,7 @@ def generate_related(self, instance: Dict, with_valid=True):
ListenerManagement.get_aggregation_document_status_by_knowledge_id(knowledge_id)()
try:
generate_related_by_knowledge_id.delay(knowledge_id, model_id, model_params_setting, prompt, state_list)
- except AlreadyQueued as e:
+ except AlreadyQueued:
raise AppApiException(500, _("Failed to send the vectorization task, please try again later!"))
def list_application(self, with_valid=True):
@@ -445,17 +491,22 @@ def one(self):
workflow = {}
if knowledge_dict.get("type") == 4:
- from knowledge.models import KnowledgeWorkflow
-
k = QuerySet(KnowledgeWorkflow).filter(knowledge_id=knowledge_dict.get("id")).first()
if k:
workflow["work_flow"] = k.work_flow
workflow["is_publish"] = k.is_publish
workflow["publish_time"] = k.publish_time
+ workflow["default_model_setting"] = k.default_model_setting
+ meta = json.loads(knowledge_dict.get("meta", "{}"))
return {
**knowledge_dict,
**workflow,
- "meta": json.loads(knowledge_dict.get("meta", "{}")),
+ "meta": meta,
+ "doc_strategy": (
+ normalize_document_strategy(meta.get("doc_strategy"))
+ if knowledge_dict.get("type") == KnowledgeType.WEB
+ else None
+ ),
"application_id_list": list(
filter(
lambda application_id: all_application_list.__contains__(application_id),
@@ -475,7 +526,9 @@ def one(self):
def edit(self, instance: Dict, select_one=True):
self.is_valid()
knowledge = QuerySet(Knowledge).get(id=self.data.get("knowledge_id"))
- KnowledgeEditRequest(data=instance).is_valid(knowledge=knowledge)
+ request_serializer = KnowledgeEditRequest(data=instance)
+ request_serializer.is_valid(knowledge=knowledge)
+ validated_data = request_serializer.validated_data
if "embedding_model_id" in instance:
knowledge.embedding_model_id = instance.get("embedding_model_id")
if "name" in instance:
@@ -483,7 +536,12 @@ def edit(self, instance: Dict, select_one=True):
if "desc" in instance:
knowledge.desc = instance.get("desc")
if "meta" in instance:
- knowledge.meta = instance.get("meta")
+ knowledge.meta = validated_data.get("meta")
+ if "doc_strategy" in validated_data:
+ knowledge.meta = {
+ **(knowledge.meta or {}),
+ "doc_strategy": normalize_document_strategy(validated_data.get("doc_strategy")),
+ }
if "folder_id" in instance:
knowledge.folder_id = instance.get("folder_id")
if "file_size_limit" in instance:
@@ -500,16 +558,19 @@ def edit(self, instance: Dict, select_one=True):
def delete(self):
self.is_valid()
knowledge = QuerySet(Knowledge).get(id=self.data.get("knowledge_id"))
- QuerySet(Document).filter(knowledge=knowledge).delete()
+ document_query_set = QuerySet(Document).filter(knowledge=knowledge)
QuerySet(ProblemParagraphMapping).filter(knowledge=knowledge).delete()
QuerySet(Paragraph).filter(knowledge=knowledge).delete()
QuerySet(Problem).filter(knowledge=knowledge).delete()
QuerySet(WorkspaceUserResourcePermission).filter(target=knowledge.id).delete()
drop_knowledge_index(knowledge_id=knowledge.id)
knowledge.delete()
- File.objects.filter(
- source_id=knowledge.id,
+ transaction.on_commit(partial(remove_knowledge_sync_job, str(self.data.get("knowledge_id"))))
+ QuerySet(File).filter(source_id=self.data.get("knowledge_id")).delete()
+ QuerySet(File).filter(
+ source_id__in=[str(i) for i in document_query_set.values_list("id", flat=True)]
).delete()
+ document_query_set.delete()
QuerySet(ResourceMapping).filter(
Q(target_id=self.data.get("knowledge_id")) | Q(source_id=self.data.get("knowledge_id"))
).delete()
@@ -703,15 +764,6 @@ def export_knowledge(self, with_source_file=False, with_valid=True):
if knowledge.type == KnowledgeType.WORKFLOW:
knowledge_workflow = QuerySet(KnowledgeWorkflow).filter(knowledge_id=knowledge_id).first()
if knowledge_workflow:
- from application.flow.tools import get_tool_id_list
- from tools.models import Tool, ToolScope, ToolType, ToolWorkflow
-
- from knowledge.serializers.knowledge_workflow import (
- KBWFInstance,
- KnowledgeWorkflowModelSerializer,
- KnowledgeWorkflowSerializer,
- )
-
tool_id_list = get_tool_id_list(knowledge_workflow.work_flow, True)
tool_list = []
if len(tool_id_list) > 0:
@@ -741,9 +793,6 @@ def export_knowledge(self, with_source_file=False, with_valid=True):
def _get_knowledge_workbook(
data_dict: dict, document_dict: dict, doc_tag_map: dict, doc_obj_map: dict, paragraph_active_map: dict
):
- import openpyxl
- from openpyxl.cell.cell import ILLEGAL_CHARACTERS_RE
-
workbook = openpyxl.Workbook()
workbook.remove(workbook.active)
if len(data_dict.keys()) == 0:
@@ -954,8 +1003,6 @@ def import_knowledge(self, file, is_import_tool=False, with_valid=True):
old_to_new_file_map[old_id] = str(new_file.id)
# knowledge.xlsx -> doc + para + problem
- import openpyxl
-
xlsx_bytes = io.BytesIO(zf.read("knowledge.xlsx"))
workbook = openpyxl.load_workbook(xlsx_bytes)
@@ -1107,8 +1154,6 @@ def import_knowledge(self, file, is_import_tool=False, with_valid=True):
# 工作流导入
if "workflow.kbwf" in namelist:
workflow_bytes = zf.read("workflow.kbwf")
- from knowledge.serializers.knowledge_workflow import KnowledgeWorkflowSerializer
-
workflow_file = SimpleUploadedFile("workflow.kbwf", workflow_bytes)
KnowledgeWorkflowSerializer.Import(
data={"knowledge_id": str(knowledge_id), "user_id": user_id, "workspace_id": workspace_id}
@@ -1210,11 +1255,21 @@ def save_base(self, instance, with_valid=True):
}, knowledge_id
def save_web(self, instance: Dict, with_valid=True):
+ request_serializer = KnowledgeWebCreateRequest(data=instance)
if with_valid:
self.is_valid(raise_exception=True)
- KnowledgeWebCreateRequest(data=instance).is_valid(raise_exception=True)
+ request_serializer.is_valid(raise_exception=True)
+ instance = request_serializer.validated_data
+ else:
+ instance = {
+ **instance,
+ "selector": (instance.get("selector") or "body").strip() or "body",
+ "doc_strategy": normalize_document_strategy(instance.get("doc_strategy")),
+ }
folder_id = instance.get("folder_id", self.data.get("workspace_id"))
+ selector = instance.get("selector")
+ doc_strategy = instance.get("doc_strategy")
knowledge_id = uuid.uuid7()
knowledge = Knowledge(
@@ -1229,8 +1284,9 @@ def save_web(self, instance: Dict, with_valid=True):
embedding_model_id=instance.get("embedding_model_id"),
meta={
"source_url": instance.get("source_url"),
- "selector": instance.get("selector", "body"),
+ "selector": selector,
"embedding_model_id": instance.get("embedding_model_id"),
+ "doc_strategy": doc_strategy,
},
)
knowledge.save()
@@ -1244,7 +1300,7 @@ def save_web(self, instance: Dict, with_valid=True):
).auth_resource(str(knowledge_id))
sync_web_knowledge.delay(
- str(knowledge_id), self.data.get("user_id"), instance.get("source_url"), instance.get("selector")
+ str(knowledge_id), self.data.get("user_id"), instance.get("source_url"), selector, doc_strategy
)
update_resource_mapping_by_knowledge(str(knowledge_id))
return {**KnowledgeModelSerializer(knowledge).data, "document_list": []}
@@ -1253,16 +1309,10 @@ class SyncWeb(serializers.Serializer):
workspace_id = serializers.CharField(required=True, label=_("workspace id"))
knowledge_id = serializers.CharField(required=True, label=_("knowledge id"))
user_id = serializers.UUIDField(required=False, label=_("user id"), allow_null=True)
- sync_type = serializers.CharField(
+ sync_type = serializers.ChoiceField(
required=True,
label=_("sync type"),
- validators=[
- validators.RegexValidator(
- regex=re.compile("^replace|complete$"),
- message=_("The synchronization type only supports:replace|complete"),
- code=500,
- )
- ],
+ choices=["incremental", "replace", "complete"],
)
def is_valid(self, *, raise_exception=False):
@@ -1282,135 +1332,107 @@ def is_valid(self, *, raise_exception=False):
def sync(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- sync_type = self.data.get("sync_type")
- knowledge_id = self.data.get("knowledge_id")
+ payload = self.validated_data if with_valid else self.initial_data
+ sync_type = payload.get("sync_type")
+ knowledge_id = payload.get("knowledge_id")
knowledge = QuerySet(Knowledge).get(id=knowledge_id)
self.__getattribute__(sync_type + "_sync")(knowledge)
return True
- @staticmethod
- def get_sync_handler(knowledge):
- def handler(child_link: ChildLink, response: Fork.Response):
- if response.status == 200:
- try:
- document_name = (
- child_link.tag.text
- if child_link.tag is not None and len(child_link.tag.text.strip()) > 0
- else child_link.url
- )
- paragraphs = get_split_model("web.md").parse(response.content)
- maxkb_logger.info(child_link.url.strip())
- first = (
- QuerySet(Document)
- .filter(meta__source_url=child_link.url.strip(), knowledge=knowledge)
- .first()
- )
- if first is not None:
- # 如果存在,使用文档同步
- DocumentSerializers.Sync(data={"document_id": first.id}).sync()
- else:
- # 插入
- DocumentSerializers.Create(data={"knowledge_id": knowledge.id}).save(
- {
- "name": document_name,
- "paragraphs": paragraphs,
- "meta": {
- "source_url": child_link.url.strip(),
- "selector": knowledge.meta.get("selector"),
- },
- "type": KnowledgeType.WEB,
- },
- with_valid=True,
- )
- except Exception as e:
- maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
+ def _enqueue_sync(self, knowledge, sync_type):
+ meta = knowledge.meta or {}
+ url = meta.get("source_url")
+ selector = meta.get("selector")
+ doc_strategy = normalize_document_strategy((knowledge.meta or {}).get("doc_strategy"))
+ user_id = self.initial_data.get("user_id")
+ sync_replace_web_knowledge.delay(
+ str(knowledge.id),
+ user_id,
+ url,
+ selector,
+ doc_strategy,
+ sync_type,
+ record_log=True,
+ trigger_type=KnowledgeSyncTrigger.MANUAL,
+ )
- return handler
+ def incremental_sync(self, knowledge):
+ self._enqueue_sync(knowledge, "incremental")
def replace_sync(self, knowledge):
- """
- 替换同步
- :return:
- """
- url = knowledge.meta.get("source_url")
- selector = knowledge.meta.get("selector") if "selector" in knowledge.meta else None
- user_id = self.data.get("user_id")
- sync_replace_web_knowledge.delay(str(knowledge.id), user_id, url, selector)
+ self._enqueue_sync(knowledge, "replace")
def complete_sync(self, knowledge):
- """
- 完整同步 删掉当前数据集下所有的文档,再进行同步
- :return:
- """
- # 删除关联问题
- QuerySet(ProblemParagraphMapping).filter(knowledge=knowledge).delete()
- # 删除文档
- QuerySet(Document).filter(knowledge=knowledge).delete()
- # 删除段落
- QuerySet(Paragraph).filter(knowledge=knowledge).delete()
- # 删除向量
- delete_embedding_by_knowledge(self.data.get("knowledge_id"))
- # 同步
- self.replace_sync(knowledge)
+ self._enqueue_sync(knowledge, "complete")
- class HitTest(serializers.Serializer):
+ class HitTest(HitTestSerializer):
workspace_id = serializers.CharField(required=True, label=_("workspace id"))
knowledge_id = serializers.UUIDField(required=True, label=_("id"))
user_id = serializers.UUIDField(required=False, label=_("user id"))
- query_text = serializers.CharField(required=True, label=_("query text"))
- top_number = serializers.IntegerField(required=True, max_value=10000, min_value=1, label=_("top number"))
- similarity = serializers.FloatField(required=True, max_value=2, min_value=0, label=_("similarity"))
- search_mode = serializers.CharField(
- required=True,
- label=_("search mode"),
- validators=[
- validators.RegexValidator(
- regex=re.compile("^embedding|keywords|blend$"),
- message=_("The type only supports embedding|keywords|blend"),
- code=500,
- )
- ],
- )
- def is_valid(self, *, raise_exception=True):
- super().is_valid(raise_exception=True)
- workspace_id = self.data.get("workspace_id")
- query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
+ def validate(self, attrs):
+ attrs = super().validate(attrs)
+ workspace_id = attrs.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=attrs.get("knowledge_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
raise AppApiException(500, _("Knowledge id does not exist"))
- if not QuerySet(Knowledge).filter(id=self.data.get("knowledge_id")).exists():
- raise AppApiException(300, _("id does not exist"))
+ return attrs
def hit_test(self):
- self.is_valid()
+ self.is_valid(raise_exception=True)
+ data = self.validated_data
vector = VectorStore.get_embedding_vector()
exclude_document_id_list = [
str(document.id)
- for document in QuerySet(Document).filter(knowledge_id=self.data.get("knowledge_id"), is_active=False)
+ for document in QuerySet(Document).filter(knowledge_id=data.get("knowledge_id"), is_active=False)
]
- model = get_embedding_model_by_knowledge_id(self.data.get("knowledge_id"))
+ model = get_embedding_model_by_knowledge_id(data.get("knowledge_id"))
+ image_items = data.get("image_list") or []
+ if image_items and not model.supports_image_embedding():
+ raise AppApiException(500, _("The current embedding model does not support image embedding"))
+ image_inputs = load_image_query_inputs(image_items, data.get("user_id"))
# 向量库检索
hit_list = vector.hit_test(
- self.data.get("query_text"),
- [self.data.get("knowledge_id")],
+ data.get("query_text"),
+ [data.get("knowledge_id")],
exclude_document_id_list,
- self.data.get("top_number"),
- self.data.get("similarity"),
- SearchMode(self.data.get("search_mode")),
+ data.get("top_number"),
+ data.get("similarity"),
+ SearchMode(data.get("search_mode")),
model,
+ image_inputs,
)
- hit_dict = reduce(lambda x, y: {**x, **y}, [{hit.get("paragraph_id"): hit} for hit in hit_list], {})
- p_list = list_paragraph([h.get("paragraph_id") for h in hit_list])
- return [
- {
- **p,
- "similarity": hit_dict.get(p.get("id")).get("similarity"),
- "comprehensive_score": hit_dict.get(p.get("id")).get("comprehensive_score"),
- }
- for p in p_list
- ]
+ paragraph_dict = {
+ str(paragraph.get("id")): paragraph
+ for paragraph in list_paragraph([hit.get("paragraph_id") for hit in hit_list])
+ }
+ hit_asset_map = get_hit_asset_map(hit_list)
+ result_list = []
+ for hit in hit_list:
+ paragraph = paragraph_dict.get(str(hit.get("paragraph_id")))
+ if paragraph is None:
+ continue
+ current_hit = hit
+ source_id = current_hit.get("source_id")
+ source_type = current_hit.get("source_type")
+ is_image_hit = str(source_type) == str(SourceType.IMAGE.value)
+ embedding_meta = current_hit.get("meta") or {}
+ result_list.append(
+ {
+ **paragraph,
+ "similarity": current_hit.get("similarity"),
+ "comprehensive_score": current_hit.get("comprehensive_score"),
+ "source_id": source_id,
+ "source_type": source_type,
+ "hit_unit_type": embedding_meta.get("unit_type") or ("image" if is_image_hit else "text"),
+ "query_unit_type": current_hit.get("query_unit_type"),
+ "query_unit_index": current_hit.get("query_unit_index"),
+ "hit_asset": hit_asset_map.get(str(source_id)) if is_image_hit else None,
+ }
+ )
+ return result_list
class StoreKnowledge(serializers.Serializer):
user_id = serializers.UUIDField(required=True, label=_("User ID"))
@@ -1568,7 +1590,7 @@ def batch_delete(self, instance: Dict, with_valid=True):
knowledge_query_set = QuerySet(Knowledge).filter(id__in=id_list, workspace_id=workspace_id)
# 删除所有关联
- QuerySet(Document).filter(knowledge__in=knowledge_query_set).delete()
+ document_query_set = QuerySet(Document).filter(knowledge__in=knowledge_query_set)
QuerySet(ProblemParagraphMapping).filter(knowledge__in=knowledge_query_set).delete()
QuerySet(Paragraph).filter(knowledge__in=knowledge_query_set).delete()
QuerySet(Problem).filter(knowledge__in=knowledge_query_set).delete()
@@ -1578,7 +1600,9 @@ def batch_delete(self, instance: Dict, with_valid=True):
drop_knowledge_index(knowledge_id=k_id)
delete_embedding_by_knowledge(k_id)
- File.objects.filter(source_id__in=id_list).delete()
+ QuerySet(File).filter(source_id__in=id_list).delete()
+ QuerySet(File).filter(source_id__in=[str(i) for i in document_query_set.values_list("id", flat=True)]).delete()
+ document_query_set.delete()
QuerySet(ResourceMapping).filter(Q(target_id__in=id_list) | Q(source_id__in=id_list)).delete()
knowledge_query_set.delete()
diff --git a/apps/knowledge/serializers/knowledge_model.py b/apps/knowledge/serializers/knowledge_model.py
new file mode 100644
index 00000000000..a1c56d7987e
--- /dev/null
+++ b/apps/knowledge/serializers/knowledge_model.py
@@ -0,0 +1,24 @@
+"""Model serializers shared by knowledge and workflow modules."""
+
+from rest_framework import serializers
+
+from knowledge.models import Knowledge
+
+
+class KnowledgeModelSerializer(serializers.ModelSerializer):
+ class Meta:
+ model = Knowledge
+ fields = [
+ "id",
+ "name",
+ "desc",
+ "meta",
+ "folder_id",
+ "type",
+ "workspace_id",
+ "create_time",
+ "update_time",
+ "file_size_limit",
+ "file_count_limit",
+ "embedding_model_id",
+ ]
diff --git a/apps/knowledge/serializers/knowledge_sync.py b/apps/knowledge/serializers/knowledge_sync.py
new file mode 100644
index 00000000000..34af00366e0
--- /dev/null
+++ b/apps/knowledge/serializers/knowledge_sync.py
@@ -0,0 +1,125 @@
+"""Request and response serializers for external knowledge synchronization."""
+
+from functools import partial
+
+from common.db.search import page_search
+from common.exception.app_exception import AppApiException
+from common.result import Page
+from django.db import transaction
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from knowledge.models import Knowledge, KnowledgeSyncLog, KnowledgeSyncType
+from knowledge.services.knowledge_sync_schedule import (
+ SCHEDULED_KNOWLEDGE_TYPES,
+ deploy_knowledge_sync_job,
+ normalize_knowledge_sync_setting,
+)
+
+
+class KnowledgeSyncSettingRequest(serializers.Serializer):
+ enabled = serializers.BooleanField(required=True, label=_("Enable scheduled synchronization"))
+ schedule_type = serializers.ChoiceField(
+ required=True,
+ choices=["daily", "cron"],
+ label=_("Schedule type"),
+ )
+ time = serializers.RegexField(
+ required=False,
+ regex=r"^([01]\d|2[0-3]):([0-5]\d)$",
+ label=_("Daily synchronization time"),
+ )
+ cron_expression = serializers.CharField(required=False, allow_blank=False, label=_("Cron expression"))
+ sync_type = serializers.ChoiceField(
+ required=True,
+ choices=KnowledgeSyncType.choices,
+ label=_("Synchronization type"),
+ )
+
+ def validate(self, attrs):
+ if attrs["schedule_type"] == "daily" and not attrs.get("time"):
+ raise serializers.ValidationError({"time": _("This field is required for a daily schedule")})
+ if attrs["schedule_type"] == "cron" and not attrs.get("cron_expression"):
+ raise serializers.ValidationError({"cron_expression": _("This field is required for a Cron schedule")})
+ try:
+ return normalize_knowledge_sync_setting(attrs)
+ except ValueError as exc:
+ raise serializers.ValidationError(str(exc)) from exc
+
+
+class KnowledgeSyncSettingOperationSerializer(serializers.Serializer):
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
+
+ def validate(self, attrs):
+ knowledge = (
+ QuerySet(Knowledge)
+ .filter(
+ id=attrs["knowledge_id"],
+ workspace_id=attrs["workspace_id"],
+ type__in=SCHEDULED_KNOWLEDGE_TYPES,
+ )
+ .first()
+ )
+ if knowledge is None:
+ raise AppApiException(404, _("Scheduled synchronization is not supported for this knowledge base"))
+ attrs["knowledge"] = knowledge
+ return attrs
+
+ def get_setting(self):
+ self.is_valid(raise_exception=True)
+ return normalize_knowledge_sync_setting((self.validated_data["knowledge"].meta or {}).get("sync_setting"))
+
+ def update_setting(self, setting):
+ self.is_valid(raise_exception=True)
+ setting_serializer = KnowledgeSyncSettingRequest(data=setting)
+ setting_serializer.is_valid(raise_exception=True)
+ knowledge_id = self.validated_data["knowledge"].id
+ with transaction.atomic():
+ knowledge = QuerySet(Knowledge).select_for_update().get(id=knowledge_id)
+ knowledge.meta = {**(knowledge.meta or {}), "sync_setting": setting_serializer.validated_data}
+ knowledge.save(update_fields=["meta", "update_time"])
+ transaction.on_commit(partial(deploy_knowledge_sync_job, str(knowledge.id)))
+ return setting_serializer.validated_data
+
+
+class KnowledgeSyncLogSerializer(serializers.ModelSerializer):
+ duration_seconds = serializers.SerializerMethodField()
+
+ class Meta:
+ model = KnowledgeSyncLog
+ fields = [
+ "id",
+ "create_time",
+ "update_time",
+ "sync_type",
+ "trigger_type",
+ "status",
+ "total_count",
+ "synced_count",
+ "skipped_count",
+ "deleted_count",
+ "failed_count",
+ "duration_ms",
+ "duration_seconds",
+ "message",
+ ]
+
+ def get_duration_seconds(self, instance):
+ return round(instance.duration_ms / 1000, 3)
+
+
+class KnowledgeSyncLogQuerySerializer(KnowledgeSyncSettingOperationSerializer):
+ def page(self, current_page, page_size):
+ self.is_valid(raise_exception=True)
+ query_set = (
+ QuerySet(KnowledgeSyncLog).filter(knowledge_id=self.validated_data["knowledge"].id).order_by("-create_time")
+ )
+ page = page_search(
+ current_page,
+ page_size,
+ query_set,
+ lambda item: KnowledgeSyncLogSerializer(item).data,
+ )
+ return Page(page["total"], page["records"], page["current"], page["size"])
diff --git a/apps/knowledge/serializers/knowledge_workflow.py b/apps/knowledge/serializers/knowledge_workflow.py
index 73d4714e984..e58a08e060d 100644
--- a/apps/knowledge/serializers/knowledge_workflow.py
+++ b/apps/knowledge/serializers/knowledge_workflow.py
@@ -3,12 +3,13 @@
import base64
import json
import pickle
+import time
+from copy import deepcopy
from functools import reduce
from typing import Dict, List
import requests
import uuid_utils.compat as uuid
-from django.core.cache import cache
from django.db import transaction
from django.db.models import QuerySet
from django.http import HttpResponse
@@ -16,13 +17,14 @@
from django.utils.translation import gettext_lazy as _
from rest_framework import serializers, status
-from application.flow.common import Workflow, WorkflowMode
-from application.flow.i_step_node import KnowledgeWorkflowPostHandler
-from application.flow.knowledge_workflow_manage import KnowledgeWorkflowManage
-from application.flow.step_node import get_node
-from application.flow.tools import save_workflow_mapping
-from application.serializers.application import get_mcp_tools
-from common.constants.cache_version import Cache_Version
+from application.workflow.common import WorkflowType, new_instance
+from application.workflow.i_node import Signal
+from application.workflow.nodes import get_node_class
+from system_manage.services.resource_mapping import get_tool_id_list, save_workflow_mapping
+from application.workflow.status import Status
+from application.workflow.workflow_manage import CallBack, WorkflowManage
+from application.workflow.workflow_run_registry import WorkflowRunRegistry
+from application.mcp_tools import get_mcp_tools
from common.db.search import page_search
from common.exception.app_exception import AppApiException
from common.field.common import UploadedFileField
@@ -32,6 +34,7 @@
from common.utils.logger import maxkb_logger
from common.utils.rsa_util import rsa_long_decrypt
from common.utils.tool_code import ToolExecutor
+from common.utils.url_validator import ALLOWED_CALLBACK_HOSTS, ALLOWED_DOWNLOAD_HOSTS, validate_trusted_url
from knowledge.models import (
KnowledgeScope,
Knowledge,
@@ -40,10 +43,17 @@
KnowledgeWorkflowVersion,
File,
FileSourceType,
+ Document,
+ DocumentResourceType,
+ KnowledgeSyncLog,
+ KnowledgeSyncStatus,
+ KnowledgeSyncType,
)
from knowledge.models.knowledge_action import KnowledgeAction, State
from knowledge.serializers.common import update_resource_mapping_by_knowledge
-from knowledge.serializers.knowledge import KnowledgeModelSerializer
+from knowledge.serializers.knowledge_model import KnowledgeModelSerializer
+from knowledge.services.document_cleanup import delete_document_data
+from knowledge.services.workflow_sync import merge_workflow_incremental_snapshot
from system_manage.models import AuthTargetType
from system_manage.models.resource_mapping import ResourceType
from system_manage.serializers.user_resource_permission import UserResourcePermissionSerializer
@@ -78,6 +88,56 @@ def hand_node(node, update_tool_map):
node.get("properties", {}).get("node_data", {})["tool_lib_id"] = update_tool_map.get(tool_lib_id, tool_lib_id)
+def finalize_knowledge_action(knowledge_action_id, state, run_time, sync_log_id=None, document_cleanup=None):
+ """
+ 知识库工作流执行结束后的收尾:更新 KnowledgeAction 的最终状态/耗时,并在同步场景下收尾 KnowledgeSyncLog。
+ 与具体执行引擎解耦——state/run_time 由调用方按各自引擎算好传入。
+ """
+ QuerySet(KnowledgeAction).filter(id=knowledge_action_id).update(state=state, run_time=run_time)
+ if sync_log_id is not None:
+ sync_log = QuerySet(KnowledgeSyncLog).filter(id=sync_log_id).first()
+ if sync_log is not None:
+ if (
+ state == State.SUCCESS
+ and sync_log.sync_type == KnowledgeSyncType.INCREMENTAL
+ and document_cleanup is not None
+ ):
+ stats = merge_workflow_incremental_snapshot(sync_log)
+ else:
+ stats = {
+ "total_count": QuerySet(Document)
+ .filter(
+ knowledge_id=sync_log.knowledge_id,
+ resource_type=DocumentResourceType.DOCUMENT,
+ )
+ .count(),
+ "synced_count": QuerySet(Document)
+ .filter(
+ knowledge_id=sync_log.knowledge_id,
+ type=KnowledgeType.WORKFLOW,
+ resource_type=DocumentResourceType.DOCUMENT,
+ create_time__gte=sync_log.create_time,
+ )
+ .count(),
+ "skipped_count": 0,
+ "deleted_count": sync_log.deleted_count,
+ "failed_count": 0 if state == State.SUCCESS else 1,
+ }
+ is_success = state == State.SUCCESS
+ QuerySet(KnowledgeSyncLog).filter(id=sync_log.id).update(
+ status=KnowledgeSyncStatus.SUCCESS
+ if is_success and not stats["failed_count"]
+ else KnowledgeSyncStatus.FAILURE,
+ total_count=stats["total_count"],
+ synced_count=stats["synced_count"],
+ skipped_count=stats["skipped_count"],
+ deleted_count=stats["deleted_count"],
+ failed_count=stats["failed_count"],
+ duration_ms=max(0, round(run_time * 1000)),
+ message=f"Workflow action {knowledge_action_id}: {state}",
+ )
+
+
class KnowledgeWorkflowModelSerializer(serializers.ModelSerializer):
class Meta:
model = KnowledgeWorkflow
@@ -113,6 +173,15 @@ class KnowledgeWorkflowActionSerializer(serializers.Serializer):
workspace_id = serializers.CharField(required=True, label=_("workspace id"))
knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
+ if workspace_id:
+ query_set = query_set.filter(workspace_id=workspace_id)
+ if not query_set.exists():
+ raise AppApiException(500, _("Knowledge id does not exist"))
+
def get_query_set(self, instance: Dict):
query_set = (
QuerySet(KnowledgeAction)
@@ -159,7 +228,7 @@ def page(self, current_page, page_size, instance: Dict, is_valid=True):
},
)
- def action(self, instance: Dict, user, with_valid=True):
+ def action(self, instance: Dict, user, with_valid=True, sync_log_id=None):
if with_valid:
self.is_valid(raise_exception=True)
knowledge_workflow = QuerySet(KnowledgeWorkflow).filter(knowledge_id=self.data.get("knowledge_id")).first()
@@ -169,6 +238,15 @@ def action(self, instance: Dict, user, with_valid=True):
id=knowledge_action_id, knowledge_id=self.data.get("knowledge_id"), state=State.STARTED, meta=meta
).save()
knowledge = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id")).first()
+ if sync_log_id is None:
+ knowledge.meta = {
+ **(knowledge.meta or {}),
+ "workflow_sync_input": {
+ "data_source": deepcopy(instance.get("data_source") or {}),
+ "knowledge_base": deepcopy(instance.get("knowledge_base") or {}),
+ },
+ }
+ knowledge.save(update_fields=["meta", "update_time"])
instance["knowledge_base"] = {
**(instance.get("knowledge_base") or {}),
"knowledge": {
@@ -178,26 +256,26 @@ def action(self, instance: Dict, user, with_valid=True):
"workspace_id": knowledge.workspace_id,
},
}
- work_flow_manage = KnowledgeWorkflowManage(
- Workflow.new_instance(knowledge_workflow.work_flow, WorkflowMode.KNOWLEDGE),
- {
- "knowledge_id": self.data.get("knowledge_id"),
- "knowledge_action_id": knowledge_action_id,
- "stream": True,
- "workspace_id": self.data.get("workspace_id"),
- "user_id": str(user.id),
- **instance,
- },
- KnowledgeWorkflowPostHandler(None, knowledge_action_id),
- is_the_task_interrupted=lambda: (
- cache.get(
- Cache_Version.KNOWLEDGE_WORKFLOW_INTERRUPTED.get_key(action_id=knowledge_action_id),
- version=Cache_Version.KNOWLEDGE_WORKFLOW_INTERRUPTED.get_version(),
- )
- or False
- ),
+ self._launch_knowledge_workflow(
+ instance,
+ user,
+ knowledge_action_id,
+ knowledge_workflow.work_flow,
+ knowledge_workflow.default_model_setting,
+ sync_log_id,
)
- work_flow_manage.run()
+ # 需要把文件改成永久文件
+ data_source = instance.get("data_source") or {}
+ file_ids = [item.get("file_id") for item in data_source.get("file_list") or [] if item.get("file_id")]
+ knowledge_id = str(self.data.get("knowledge_id"))
+ file_list = list(QuerySet(File).filter(id__in=file_ids))
+ for file in file_list:
+ meta = dict(file.meta or {})
+ meta.update(debug=False, knowledge_id=knowledge_id)
+ file.source_type = FileSourceType.KNOWLEDGE.value
+ file.source_id = knowledge_id
+ file.meta = meta
+ QuerySet(File).bulk_update(file_list, ["source_type", "source_id", "meta"])
return {
"id": knowledge_action_id,
"knowledge_id": self.data.get("knowledge_id"),
@@ -206,6 +284,69 @@ def action(self, instance: Dict, user, with_valid=True):
"meta": meta,
}
+ def _launch_knowledge_workflow(
+ self, instance: Dict, user, knowledge_action_id, work_flow, default_model_setting={}, sync_log_id=None
+ ):
+ """
+ 在新引擎上异步启动知识库工作流(action/upload_document 共用):
+ 动态解析数据源起点 -> 注册到运行注册表(供停止)-> run() 每节点起线程立即返回,
+ 最终状态由 on_complete 通过 finalize_knowledge_action 落库。
+ """
+ parameters = {
+ "knowledge_id": self.data.get("knowledge_id"),
+ "knowledge_action_id": knowledge_action_id,
+ "stream": True,
+ "workspace_id": self.data.get("workspace_id"),
+ "user_id": str(user.id),
+ **instance,
+ "default_model_setting": default_model_setting,
+ }
+ workflow = new_instance(work_flow, WorkflowType.KNOWLEDGE)
+ start_time = time.time()
+
+ def get_node_parameters(node):
+ return node.properties.get("node_data", {})
+
+ def get_start_node_fn(wf, wm):
+ # 知识库起点是数据源节点,由 data_source.node_id 指定(动态,非固定 start-node)
+ node_id = (instance.get("data_source") or {}).get("node_id")
+ node = wf.get_node(node_id) if node_id else None
+ if node is None:
+ raise AppApiException(500, _("The start node does not exist"))
+ return get_node_class(node.type, WorkflowType.KNOWLEDGE)(node, wm, get_node_parameters)
+
+ def on_next(wf_manage, content):
+ # 实时刷新节点详情,供前端轮询 KnowledgeAction 展示进度
+ QuerySet(KnowledgeAction).filter(id=knowledge_action_id).update(details=wf_manage.get_details())
+
+ def on_complete(wf_manage, error):
+ WorkflowRunRegistry.unregister(str(knowledge_action_id))
+ details = wf_manage.get_details()
+ cancelled = wf_manage.signal == Signal.CANCELLED
+ state = self.compute_knowledge_state(details, error, cancelled)
+ run_time = time.time() - start_time
+ QuerySet(KnowledgeAction).filter(id=knowledge_action_id).update(details=details)
+ finalize_knowledge_action(knowledge_action_id, state, run_time, sync_log_id, delete_document_data)
+
+ call_back = CallBack(on_next, on_complete)
+ work_flow_manage = WorkflowManage(workflow, parameters, WorkflowType.KNOWLEDGE, call_back, get_start_node_fn)
+ WorkflowRunRegistry.register(str(knowledge_action_id), None, work_flow_manage)
+ work_flow_manage.run()
+ return work_flow_manage
+
+ @staticmethod
+ def compute_knowledge_state(details, error, cancelled):
+ if cancelled:
+ return State.REVOKED
+ details = details or []
+ has_fail = any(d.get("status") == Status.FAIL.value and not d.get("enableException") for d in details)
+ if error or has_fail:
+ return State.FAILURE
+ write_exist = any(d.get("type") == "knowledge-write-node" for d in details)
+ if not write_exist:
+ return State.FAILURE
+ return State.SUCCESS
+
def upload_document(self, instance: Dict, user, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
@@ -233,26 +374,14 @@ def upload_document(self, instance: Dict, user, with_valid=True):
"workspace_id": knowledge.workspace_id,
},
}
- work_flow_manage = KnowledgeWorkflowManage(
- Workflow.new_instance(knowledge_workflow_version.work_flow, WorkflowMode.KNOWLEDGE),
- {
- "knowledge_id": self.data.get("knowledge_id"),
- "knowledge_action_id": knowledge_action_id,
- "stream": True,
- "workspace_id": self.data.get("workspace_id"),
- "user_id": str(user.id),
- **instance,
- },
- KnowledgeWorkflowPostHandler(None, knowledge_action_id),
- is_the_task_interrupted=lambda: (
- cache.get(
- Cache_Version.KNOWLEDGE_WORKFLOW_INTERRUPTED.get_key(action_id=knowledge_action_id),
- version=Cache_Version.KNOWLEDGE_WORKFLOW_INTERRUPTED.get_version(),
- )
- or False
- ),
+ # 线上上传走已发布版本的 work_flow,执行链路与 action 一致(新引擎异步执行)
+ self._launch_knowledge_workflow(
+ instance,
+ user,
+ knowledge_action_id,
+ knowledge_workflow_version.work_flow,
+ knowledge_workflow_version.default_model_setting,
)
- work_flow_manage.run()
return {
"id": knowledge_action_id,
"knowledge_id": self.data.get("knowledge_id"),
@@ -266,11 +395,30 @@ class Operate(serializers.Serializer):
knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
id = serializers.UUIDField(required=True, label=_("knowledge action id"))
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
+ if workspace_id:
+ query_set = query_set.filter(workspace_id=workspace_id)
+ if not query_set.exists():
+ raise AppApiException(500, _("Knowledge id does not exist"))
+ if (
+ not QuerySet(KnowledgeAction)
+ .filter(id=self.data.get("id"), knowledge_id=self.data.get("knowledge_id"))
+ .exists()
+ ):
+ raise AppApiException(500, _("Knowledge action does not exist"))
+
def one(self, is_valid=True):
if is_valid:
self.is_valid(raise_exception=True)
knowledge_action_id = self.data.get("id")
- knowledge_action = QuerySet(KnowledgeAction).filter(id=knowledge_action_id).first()
+ knowledge_action = (
+ QuerySet(KnowledgeAction)
+ .filter(id=knowledge_action_id, knowledge_id=self.data.get("knowledge_id"))
+ .first()
+ )
return {
"id": knowledge_action_id,
"knowledge_id": knowledge_action.knowledge_id,
@@ -283,14 +431,13 @@ def cancel(self, is_valid=True):
if is_valid:
self.is_valid(raise_exception=True)
knowledge_action_id = self.data.get("id")
- cache.set(
- Cache_Version.KNOWLEDGE_WORKFLOW_INTERRUPTED.get_key(action_id=knowledge_action_id),
- True,
- version=Cache_Version.KNOWLEDGE_WORKFLOW_INTERRUPTED.get_version(),
- )
- QuerySet(KnowledgeAction).filter(id=knowledge_action_id, state__in=[State.STARTED, State.PENDING]).update(
- state=State.REVOKE
- )
+ # action / upload_document 均在新引擎执行,统一向运行注册表发送停止信号
+ WorkflowRunRegistry.cancel_by_record_id(str(knowledge_action_id))
+ QuerySet(KnowledgeAction).filter(
+ id=knowledge_action_id,
+ knowledge_id=self.data.get("knowledge_id"),
+ state__in=[State.STARTED, State.PENDING],
+ ).update(state=State.REVOKE)
return True
@@ -304,8 +451,9 @@ class Datasource(serializers.Serializer):
def action(self):
self.is_valid(raise_exception=True)
if self.data.get("type") == "local":
- node = get_node(self.data.get("id"), WorkflowMode.KNOWLEDGE)
- return node.__getattribute__(node, self.data.get("function_name"))(**self.data.get("params"))
+ # self.data["id"] 为数据源节点类型,取新引擎该节点类上的同名静态方法(如 get_form_list)
+ node_class = get_node_class(self.data.get("id"), WorkflowType.KNOWLEDGE)
+ return getattr(node_class, self.data.get("function_name"))(**self.data.get("params"))
elif self.data.get("type") == "tool":
tool = QuerySet(Tool).filter(id=self.data.get("id")).first()
init_params = json.loads(rsa_long_decrypt(tool.init_params))
@@ -363,10 +511,10 @@ def save_workflow(self, instance: Dict):
if instance.get("work_flow_template") is not None:
template_instance = instance.get("work_flow_template")
download_url = template_instance.get("downloadUrl")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
KnowledgeWorkflowSerializer.Import(
data={
"user_id": self.data.get("user_id"),
@@ -377,9 +525,9 @@ def save_workflow(self, instance: Dict):
try:
download_callback_url = template_instance.get("downloadCallbackUrl", "")
- if not download_callback_url.startswith("https://apps.fit2cloud.com"):
- raise AppApiException(500, _("Illegal download callback url"))
- requests.get(download_callback_url, timeout=5)
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
+ raise AppApiException(500, _("Illegal download callback url"))
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
@@ -401,7 +549,7 @@ def import_(self, instance: dict, is_import_tool, with_valid=True):
kbwf_instance_bytes = instance.get("file").read()
try:
kbwf_instance = restricted_loads(kbwf_instance_bytes)
- except Exception as e:
+ except Exception:
raise AppApiException(1001, _("Unsupported file format"))
knowledge_workflow = kbwf_instance.knowledge_workflow
tool_list = kbwf_instance.get_tool_list()
@@ -524,8 +672,6 @@ def export(self, with_valid=True):
knowledge_id = self.data.get("knowledge_id")
knowledge_workflow = QuerySet(KnowledgeWorkflow).filter(knowledge_id=knowledge_id).first()
knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first()
- from application.flow.tools import get_tool_id_list
-
tool_id_list = get_tool_id_list(knowledge_workflow.work_flow, True)
tool_list = []
if len(tool_id_list) > 0:
@@ -585,6 +731,7 @@ def publish(self, with_valid=True):
publish_user_id=user_id,
publish_user_name=user.username,
workspace_id=workspace_id,
+ default_model_setting=knowledge_workflow.default_model_setting,
)
work_flow_version.save()
QuerySet(KnowledgeWorkflow).filter(knowledge_id=self.data.get("knowledge_id")).update(
@@ -602,18 +749,22 @@ def edit(self, instance: Dict):
"knowledge_id": self.data.get("knowledge_id"),
"workspace_id": self.data.get("workspace_id"),
"work_flow": instance.get("work_flow", {}),
+ "default_model_setting": instance.get("default_model_setting", {}),
+ },
+ defaults={
+ "work_flow": instance.get("work_flow"),
+ "default_model_setting": instance.get("default_model_setting", {}),
},
- defaults={"work_flow": instance.get("work_flow")},
)
update_resource_mapping_by_knowledge(self.data.get("knowledge_id"))
return self.one()
if instance.get("work_flow_template"):
template_instance = instance.get("work_flow_template")
download_url = template_instance.get("downloadUrl")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
KnowledgeWorkflowSerializer.Import(
data={
"user_id": self.data.get("user_id"),
@@ -624,9 +775,9 @@ def edit(self, instance: Dict):
try:
download_callback_url = template_instance.get("downloadCallbackUrl", "")
- if not download_callback_url.startswith("https://apps.fit2cloud.com"):
- raise AppApiException(500, _("Illegal download callback url"))
- requests.get(download_callback_url, timeout=5)
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
+ raise AppApiException(500, _("Illegal download callback url"))
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
diff --git a/apps/knowledge/serializers/paragraph.py b/apps/knowledge/serializers/paragraph.py
index 09a30242c77..f81cffd0bb9 100644
--- a/apps/knowledge/serializers/paragraph.py
+++ b/apps/knowledge/serializers/paragraph.py
@@ -15,15 +15,18 @@
from rest_framework import serializers
from knowledge.models import (
+ ContentOrigin,
Document,
Knowledge,
Paragraph,
+ LocalState,
Problem,
ProblemParagraphMapping,
SourceType,
State,
TaskType,
)
+from knowledge.services.document_strategy import stable_hash
from knowledge.serializers.common import (
BatchSerializer,
ProblemParagraphManage,
@@ -56,9 +59,46 @@ def to_internal_value(self, data):
class ParagraphSerializer(serializers.ModelSerializer):
+ assets = serializers.SerializerMethodField()
+
+ @staticmethod
+ def get_assets(obj):
+ return list(
+ obj.assets.order_by("position").values(
+ "id",
+ "file_id",
+ "position",
+ "caption",
+ "ocr_text",
+ "description",
+ "hit_num",
+ "last_hit_time",
+ "process_status",
+ "process_error",
+ "sync_state",
+ )
+ )
+
class Meta:
model = Paragraph
- fields = ["id", "content", "is_active", "document_id", "title", "create_time", "update_time", "position"]
+ fields = [
+ "id",
+ "content",
+ "is_active",
+ "document_id",
+ "title",
+ "create_time",
+ "update_time",
+ "position",
+ "hit_num",
+ "last_hit_time",
+ "content_schema",
+ "assets",
+ "origin",
+ "local_state",
+ "sync_state",
+ ]
+ read_only_fields = ["hit_num", "last_hit_time"]
class ParagraphInstanceSerializer(serializers.Serializer):
@@ -117,7 +157,15 @@ def is_valid(self, *, raise_exception=False):
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
raise AppApiException(500, _("Knowledge id does not exist"))
- if not QuerySet(Paragraph).filter(id=self.data.get("paragraph_id")).exists():
+ if (
+ not QuerySet(Paragraph)
+ .filter(
+ id=self.data.get("paragraph_id"),
+ document_id=self.data.get("document_id"),
+ knowledge_id=self.data.get("knowledge_id"),
+ )
+ .exists()
+ ):
raise AppApiException(500, _("Paragraph id does not exist"))
def list(self, with_valid=False):
@@ -209,7 +257,15 @@ def is_valid(self, *, raise_exception=True):
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
raise AppApiException(500, _("Knowledge id does not exist"))
- if not QuerySet(Paragraph).filter(id=self.data.get("paragraph_id")).exists():
+ if (
+ not QuerySet(Paragraph)
+ .filter(
+ id=self.data.get("paragraph_id"),
+ document_id=self.data.get("document_id"),
+ knowledge_id=self.data.get("knowledge_id"),
+ )
+ .exists()
+ ):
raise AppApiException(500, _("Paragraph id does not exist"))
@staticmethod
@@ -238,6 +294,9 @@ def edit(self, instance: Dict):
if instance.get("content") is not None:
_paragraph.chunks = text_to_chunk(instance.get("content", ""))
+ if _paragraph.origin == ContentOrigin.SYNCED and any(key in instance for key in ["title", "content"]):
+ _paragraph.local_state = LocalState.MODIFIED
+
if "problem_list" in instance:
update_problem_list = list(
filter(lambda row: "id" in row and row.get("id") is not None, instance.get("problem_list"))
@@ -320,8 +379,14 @@ def delete(self, with_valid=False):
if with_valid:
self.is_valid(raise_exception=True)
paragraph_id = self.data.get("paragraph_id")
- Paragraph.objects.filter(id=paragraph_id).delete()
- delete_problems_and_mappings([paragraph_id])
+ paragraph = Paragraph.objects.filter(id=paragraph_id).first()
+ if paragraph and paragraph.origin == ContentOrigin.SYNCED:
+ paragraph.local_state = LocalState.DELETED
+ paragraph.is_active = False
+ paragraph.save(update_fields=["local_state", "is_active", "update_time"])
+ else:
+ Paragraph.objects.filter(id=paragraph_id).delete()
+ delete_problems_and_mappings([paragraph_id])
update_document_char_length(self.data.get("document_id"))
delete_embedding_by_paragraph(paragraph_id)
@@ -401,13 +466,25 @@ def save(self, instance: Dict, with_valid=True, with_embedding=True):
@staticmethod
def get_paragraph_problem_model(knowledge_id: str, document_id: str, instance: Dict):
+ origin = instance.get("origin", ContentOrigin.MANUAL)
+ title = instance.get("title") if "title" in instance else ""
+ content = instance.get("content") or ""
+ source_key = instance.get("source_key", "")
+ source_hash = instance.get("source_hash") or (
+ stable_hash({"title": title or "", "content": content}) if origin == ContentOrigin.SYNCED else ""
+ )
paragraph = Paragraph(
id=uuid.uuid7(),
document_id=document_id,
- content=instance.get("content"),
+ content=content,
knowledge_id=knowledge_id,
- title=instance.get("title") if "title" in instance else "",
- chunks=text_to_chunk(instance.get("content", "")),
+ title=title,
+ chunks=text_to_chunk(content, instance.get("child_length", 256)),
+ origin=origin,
+ source_key=source_key,
+ source_hash=source_hash,
+ source_snapshot=instance.get("source_snapshot")
+ or ({"title": title or "", "content": content} if origin == ContentOrigin.SYNCED else {}),
)
problem_paragraph_object_list = [
ProblemParagraphObject(knowledge_id, document_id, str(paragraph.id), problem.get("content"))
@@ -560,8 +637,15 @@ def batch_delete(self, instance: Dict, with_valid=True):
BatchSerializer(data=instance).is_valid(model=Paragraph, raise_exception=True)
self.is_valid(raise_exception=True)
paragraph_id_list = instance.get("id_list")
- QuerySet(Paragraph).filter(id__in=paragraph_id_list).delete()
- delete_problems_and_mappings(paragraph_id_list)
+ synced_ids = list(
+ QuerySet(Paragraph)
+ .filter(id__in=paragraph_id_list, origin=ContentOrigin.SYNCED)
+ .values_list("id", flat=True)
+ )
+ manual_ids = [paragraph_id for paragraph_id in paragraph_id_list if paragraph_id not in synced_ids]
+ QuerySet(Paragraph).filter(id__in=synced_ids).update(local_state=LocalState.DELETED, is_active=False)
+ QuerySet(Paragraph).filter(id__in=manual_ids).delete()
+ delete_problems_and_mappings(manual_ids)
update_document_char_length(self.data.get("document_id"))
# 删除向量库
delete_embedding_by_paragraph_ids(paragraph_id_list)
@@ -586,7 +670,7 @@ def batch_generate_related(self, instance: Dict, with_valid=True):
generate_related_by_paragraph_id_list.delay(
document_id, paragraph_id_list, model_id, model_params_setting, prompt
)
- except AlreadyQueued as e:
+ except AlreadyQueued:
raise AppApiException(500, _("The task is being executed, please do not send it again."))
class Migrate(serializers.Serializer):
@@ -793,22 +877,49 @@ def adjust_position(self, new_position):
except (TypeError, ValueError):
raise serializers.ValidationError(_("new_position must be an integer"))
# 获取当前段落
- paragraph = Paragraph.objects.get(id=self.data.get("paragraph_id"))
+ paragraph = Paragraph.objects.get(
+ id=self.data.get("paragraph_id"),
+ knowledge_id=self.data.get("knowledge_id"),
+ document_id=self.data.get("document_id"),
+ )
old_position = paragraph.position
if old_position < new_position:
# 如果新顺序在当前顺序之后,更新受影响段落的顺序
- Paragraph.objects.filter(position__gt=old_position, position__lte=new_position).update(
- position=F("position") - 1
- )
+ Paragraph.objects.filter(
+ position__gt=old_position, position__lte=new_position, document_id=paragraph.document_id
+ ).update(position=F("position") - 1)
elif old_position > new_position:
# 如果新顺序在当前顺序之前,更新受影响段落的顺序
- Paragraph.objects.filter(position__lt=old_position, position__gte=new_position).update(
- position=F("position") + 1
- )
+ Paragraph.objects.filter(
+ position__lt=old_position, position__gte=new_position, document_id=paragraph.document_id
+ ).update(position=F("position") + 1)
# 更新当前段落的顺序
paragraph.position = new_position
+ if paragraph.origin == ContentOrigin.MANUAL:
+ previous = (
+ Paragraph.objects.filter(
+ document_id=paragraph.document_id,
+ origin=ContentOrigin.SYNCED,
+ is_active=True,
+ position__lt=new_position,
+ )
+ .order_by("-position")
+ .first()
+ )
+ following = (
+ Paragraph.objects.filter(
+ document_id=paragraph.document_id,
+ origin=ContentOrigin.SYNCED,
+ is_active=True,
+ position__gt=new_position,
+ )
+ .order_by("position")
+ .first()
+ )
+ paragraph.anchor_paragraph = previous or following
+ paragraph.placement = "after" if previous else "before"
paragraph.save()
diff --git a/apps/knowledge/serializers/problem.py b/apps/knowledge/serializers/problem.py
index 533258fca06..fae2133a5ee 100644
--- a/apps/knowledge/serializers/problem.py
+++ b/apps/knowledge/serializers/problem.py
@@ -20,68 +20,76 @@
class ProblemSerializer(serializers.ModelSerializer):
class Meta:
model = Problem
- fields = ['id', 'content', 'knowledge_id', 'create_time', 'update_time']
+ fields = ["id", "content", "knowledge_id", "hit_num", "last_hit_time", "create_time", "update_time"]
+ read_only_fields = ["hit_num", "last_hit_time"]
class ProblemInstanceSerializer(serializers.Serializer):
- id = serializers.CharField(required=False, label=_('problem id'))
- content = serializers.CharField(required=True, max_length=256, label=_('content'))
+ id = serializers.CharField(required=False, label=_("problem id"))
+ content = serializers.CharField(required=True, max_length=256, label=_("content"))
+ hit_num = serializers.IntegerField(read_only=True, label=_("recall count"))
+ last_hit_time = serializers.DateTimeField(read_only=True, allow_null=True, label=_("last recall time"))
class ProblemEditSerializer(serializers.Serializer):
- content = serializers.CharField(required=True, max_length=256, label=_('content'))
+ content = serializers.CharField(required=True, max_length=256, label=_("content"))
class ProblemMappingSerializer(serializers.Serializer):
- paragraph_id = serializers.UUIDField(required=True, label=_('paragraph id'))
- document_id = serializers.UUIDField(required=True, label=_('document id'))
+ paragraph_id = serializers.UUIDField(required=True, label=_("paragraph id"))
+ document_id = serializers.UUIDField(required=True, label=_("document id"))
class ProblemBatchSerializer(serializers.Serializer):
- problem_list = serializers.ListField(required=True, label=_('problem list'),
- child=serializers.CharField(required=True, max_length=256, label=_('problem')))
+ problem_list = serializers.ListField(
+ required=True,
+ label=_("problem list"),
+ child=serializers.CharField(required=True, max_length=256, label=_("problem")),
+ )
class ProblemBatchDeleteSerializer(serializers.Serializer):
- problem_id_list = serializers.ListField(required=True, label=_('problem id list'),
- child=serializers.UUIDField(required=True, label=_('problem id')))
+ problem_id_list = serializers.ListField(
+ required=True, label=_("problem id list"), child=serializers.UUIDField(required=True, label=_("problem id"))
+ )
class AssociationParagraph(serializers.Serializer):
- paragraph_id = serializers.UUIDField(required=True, label=_('paragraph id'))
- document_id = serializers.UUIDField(required=True, label=_('document id'))
+ paragraph_id = serializers.UUIDField(required=True, label=_("paragraph id"))
+ document_id = serializers.UUIDField(required=True, label=_("document id"))
class BatchAssociation(serializers.Serializer):
- problem_id_list = serializers.ListField(required=True, label=_('problem id list'),
- child=serializers.UUIDField(required=True, label=_('problem id')))
+ problem_id_list = serializers.ListField(
+ required=True, label=_("problem id list"), child=serializers.UUIDField(required=True, label=_("problem id"))
+ )
paragraph_list = AssociationParagraph(many=True)
class ProblemSerializers(serializers.Serializer):
class BatchOperate(serializers.Serializer):
- workspace_id = serializers.CharField(required=True, label=_('workspace id'))
- knowledge_id = serializers.UUIDField(required=True, label=_('knowledge id'))
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Knowledge).filter(id=self.data.get('knowledge_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Knowledge id does not exist'))
+ raise AppApiException(500, _("Knowledge id does not exist"))
def delete(self, problem_id_list: List, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- knowledge_id = self.data.get('knowledge_id')
+ knowledge_id = self.data.get("knowledge_id")
problem_paragraph_mapping_list = QuerySet(ProblemParagraphMapping).filter(
- knowledge_id=knowledge_id,
- problem_id__in=problem_id_list)
+ knowledge_id=knowledge_id, problem_id__in=problem_id_list
+ )
source_ids = [row.id for row in problem_paragraph_mapping_list]
problem_paragraph_mapping_list.delete()
- QuerySet(Problem).filter(id__in=problem_id_list).delete()
+ QuerySet(Problem).filter(id__in=problem_id_list, knowledge_id=knowledge_id).delete()
delete_embedding_by_source_ids(source_ids)
return True
@@ -89,30 +97,41 @@ def association(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
BatchAssociation(data=instance).is_valid(raise_exception=True)
- knowledge_id = self.data.get('knowledge_id')
- paragraph_list = instance.get('paragraph_list')
- problem_id_list = instance.get('problem_id_list')
- problem_list = QuerySet(Problem).filter(id__in=problem_id_list)
-
- exits_problem_paragraph_mapping = QuerySet(
- ProblemParagraphMapping
- ).filter(problem_id__in=problem_id_list, paragraph_id__in=[p.get('paragraph_id') for p in paragraph_list])
+ knowledge_id = self.data.get("knowledge_id")
+ paragraph_list = instance.get("paragraph_list") or []
+ problem_id_list = instance.get("problem_id_list") or []
+ paragraph_id_list = [p.get("paragraph_id") for p in paragraph_list]
+
+ # 校验目标段落都属于当前知识库, 防止跨知识库关联并回读他人内容
+ if QuerySet(Paragraph).filter(id__in=paragraph_id_list, knowledge_id=knowledge_id).count() != len(
+ set(paragraph_id_list)
+ ):
+ raise AppApiException(500, _("Paragraph does not exist"))
+ # 仅允许关联当前知识库下的问题
+ problem_list = QuerySet(Problem).filter(id__in=problem_id_list, knowledge_id=knowledge_id)
+ if problem_list.count() != len(set(problem_id_list)):
+ raise AppApiException(500, _("Problem does not exist"))
+
+ exits_problem_paragraph_mapping = QuerySet(ProblemParagraphMapping).filter(
+ problem_id__in=problem_id_list, paragraph_id__in=paragraph_id_list
+ )
problem_paragraph_mapping_list = [
- (problem_paragraph_mapping, problem) for problem_paragraph_mapping, problem in
- reduce(
+ (problem_paragraph_mapping, problem)
+ for problem_paragraph_mapping, problem in reduce(
lambda x, y: [*x, *y],
[
[
to_problem_paragraph_mapping(
- problem, paragraph.get('document_id'),
- paragraph.get('paragraph_id'),
- knowledge_id
- ) for paragraph in paragraph_list
- ] for problem in problem_list
+ problem, paragraph.get("document_id"), paragraph.get("paragraph_id"), knowledge_id
+ )
+ for paragraph in paragraph_list
+ ]
+ for problem in problem_list
],
- []
- ) if not is_exits(exits_problem_paragraph_mapping, problem_paragraph_mapping)
+ [],
+ )
+ if not is_exits(exits_problem_paragraph_mapping, problem_paragraph_mapping)
]
QuerySet(ProblemParagraphMapping).bulk_create(
@@ -121,61 +140,70 @@ def association(self, instance: Dict, with_valid=True):
data_list = [
{
- 'text': problem.content,
- 'is_active': True,
- 'source_type': SourceType.PROBLEM,
- 'source_id': str(problem_paragraph_mapping.id),
- 'document_id': str(problem_paragraph_mapping.document_id),
- 'paragraph_id': str(problem_paragraph_mapping.paragraph_id),
- 'knowledge_id': knowledge_id,
- } for problem_paragraph_mapping, problem in problem_paragraph_mapping_list
+ "text": problem.content,
+ "is_active": True,
+ "source_type": SourceType.PROBLEM,
+ "source_id": str(problem_paragraph_mapping.id),
+ "document_id": str(problem_paragraph_mapping.document_id),
+ "paragraph_id": str(problem_paragraph_mapping.paragraph_id),
+ "knowledge_id": knowledge_id,
+ }
+ for problem_paragraph_mapping, problem in problem_paragraph_mapping_list
]
- model_id = get_embedding_model_id_by_knowledge_id(self.data.get('knowledge_id'))
+ model_id = get_embedding_model_id_by_knowledge_id(self.data.get("knowledge_id"))
embedding_by_data_list(data_list, model_id=model_id)
class Operate(serializers.Serializer):
- workspace_id = serializers.CharField(required=True, label=_('workspace id'))
- knowledge_id = serializers.UUIDField(required=True, label=_('knowledge id'))
- problem_id = serializers.UUIDField(required=True, label=_('problem id'))
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
+ problem_id = serializers.UUIDField(required=True, label=_("problem id"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Knowledge).filter(id=self.data.get('knowledge_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Knowledge id does not exist'))
+ raise AppApiException(500, _("Knowledge id does not exist"))
def list_paragraph(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
problem_paragraph_mapping = QuerySet(ProblemParagraphMapping).filter(
- knowledge_id=self.data.get("knowledge_id"),
- problem_id=self.data.get("problem_id")
+ knowledge_id=self.data.get("knowledge_id"), problem_id=self.data.get("problem_id")
)
if problem_paragraph_mapping is None or len(problem_paragraph_mapping) == 0:
return []
return native_search(
- QuerySet(Paragraph).filter(id__in=[row.paragraph_id for row in problem_paragraph_mapping]),
+ QuerySet(Paragraph).filter(
+ knowledge_id=self.data.get("knowledge_id"),
+ id__in=[row.paragraph_id for row in problem_paragraph_mapping],
+ ),
select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "knowledge", 'sql', 'list_paragraph.sql')))
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "sql", "list_paragraph.sql")
+ ),
+ )
def one(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- return ProblemInstanceSerializer(QuerySet(Problem).get(**{'id': self.data.get('problem_id')})).data
+ return ProblemInstanceSerializer(
+ QuerySet(Problem).get(id=self.data.get("problem_id"), knowledge_id=self.data.get("knowledge_id"))
+ ).data
@transaction.atomic
def delete(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
problem_paragraph_mapping_list = QuerySet(ProblemParagraphMapping).filter(
- knowledge_id=self.data.get('knowledge_id'),
- problem_id=self.data.get('problem_id'))
+ knowledge_id=self.data.get("knowledge_id"), problem_id=self.data.get("problem_id")
+ )
source_ids = [row.id for row in problem_paragraph_mapping_list]
problem_paragraph_mapping_list.delete()
- QuerySet(Problem).filter(id=self.data.get('problem_id')).delete()
+ QuerySet(Problem).filter(
+ id=self.data.get("problem_id"), knowledge_id=self.data.get("knowledge_id")
+ ).delete()
delete_embedding_by_source_ids(source_ids)
return True
@@ -183,9 +211,9 @@ def delete(self, with_valid=True):
def edit(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- problem_id = self.data.get('problem_id')
- knowledge_id = self.data.get('knowledge_id')
- content = instance.get('content')
+ problem_id = self.data.get("problem_id")
+ knowledge_id = self.data.get("knowledge_id")
+ content = instance.get("content")
problem = QuerySet(Problem).filter(id=problem_id, knowledge_id=knowledge_id).first()
QuerySet(Knowledge).filter(id=knowledge_id)
problem.content = content
@@ -194,36 +222,35 @@ def edit(self, instance: Dict, with_valid=True):
update_problem_embedding(problem_id, content, model_id)
class Create(serializers.Serializer):
- workspace_id = serializers.CharField(required=True, label=_('workspace id'))
- knowledge_id = serializers.UUIDField(required=True, label=_('knowledge id'))
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Knowledge).filter(id=self.data.get('knowledge_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Knowledge id does not exist'))
+ raise AppApiException(500, _("Knowledge id does not exist"))
def batch(self, problem_list, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- ProblemBatchSerializer(data={'problem_list': problem_list}).is_valid(raise_exception=True)
+ ProblemBatchSerializer(data={"problem_list": problem_list}).is_valid(raise_exception=True)
problem_list = list(set(problem_list))
- knowledge_id = self.data.get('knowledge_id')
+ knowledge_id = self.data.get("knowledge_id")
exists_problem_content_list = [
- problem.content for problem in QuerySet(
- Problem
- ).filter(knowledge_id=knowledge_id, content__in=problem_list)
+ problem.content
+ for problem in QuerySet(Problem).filter(knowledge_id=knowledge_id, content__in=problem_list)
]
problem_instance_list = [
- Problem(
- id=uuid.uuid7(), knowledge_id=knowledge_id, content=problem_content
- ) for problem_content in problem_list if (
- not exists_problem_content_list.__contains__(
- problem_content
- ) if len(exists_problem_content_list) > 0 else True
+ Problem(id=uuid.uuid7(), knowledge_id=knowledge_id, content=problem_content)
+ for problem_content in problem_list
+ if (
+ not exists_problem_content_list.__contains__(problem_content)
+ if len(exists_problem_content_list) > 0
+ else True
)
]
@@ -231,46 +258,57 @@ def batch(self, problem_list, with_valid=True):
return [ProblemSerializer(problem_instance).data for problem_instance in problem_instance_list]
class Query(serializers.Serializer):
- workspace_id = serializers.CharField(required=True, label=_('workspace id'))
- knowledge_id = serializers.UUIDField(required=True, label=_('knowledge id'))
- content = serializers.CharField(required=False, label=_('content'))
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ knowledge_id = serializers.UUIDField(required=True, label=_("knowledge id"))
+ content = serializers.CharField(required=False, label=_("content"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
- query_set = QuerySet(Knowledge).filter(id=self.data.get('knowledge_id'))
+ workspace_id = self.data.get("workspace_id")
+ query_set = QuerySet(Knowledge).filter(id=self.data.get("knowledge_id"))
if workspace_id:
query_set = query_set.filter(workspace_id=workspace_id)
if not query_set.exists():
- raise AppApiException(500, _('Knowledge id does not exist'))
+ raise AppApiException(500, _("Knowledge id does not exist"))
def get_query_set(self):
self.is_valid()
query_set = QuerySet(model=Problem)
- query_set = query_set.filter(
- **{'knowledge_id': self.data.get('knowledge_id')})
- if 'content' in self.data:
- query_set = query_set.filter(**{'content__icontains': self.data.get('content')})
+ query_set = query_set.filter(**{"knowledge_id": self.data.get("knowledge_id")})
+ if "content" in self.data:
+ query_set = query_set.filter(**{"content__icontains": self.data.get("content")})
query_set = query_set.order_by("-create_time")
return query_set
def list(self):
query_set = self.get_query_set()
- return native_search(query_set, select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "knowledge", 'sql', 'list_problem.sql')))
+ return native_search(
+ query_set,
+ select_string=get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "sql", "list_problem.sql")
+ ),
+ )
def page(self, current_page, page_size):
query_set = self.get_query_set()
- return native_page_search(current_page, page_size, query_set, select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "knowledge", 'sql', 'list_problem.sql')))
+ return native_page_search(
+ current_page,
+ page_size,
+ query_set,
+ select_string=get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "knowledge", "sql", "list_problem.sql")
+ ),
+ )
def is_exits(exits_problem_paragraph_mapping_list, new_paragraph_mapping):
- filter_list = [exits_problem_paragraph_mapping for exits_problem_paragraph_mapping in
- exits_problem_paragraph_mapping_list if
- str(exits_problem_paragraph_mapping.paragraph_id) == new_paragraph_mapping.paragraph_id
- and str(exits_problem_paragraph_mapping.problem_id) == new_paragraph_mapping.problem_id
- and str(exits_problem_paragraph_mapping.knowledge_id) == new_paragraph_mapping.knowledge_id]
+ filter_list = [
+ exits_problem_paragraph_mapping
+ for exits_problem_paragraph_mapping in exits_problem_paragraph_mapping_list
+ if str(exits_problem_paragraph_mapping.paragraph_id) == new_paragraph_mapping.paragraph_id
+ and str(exits_problem_paragraph_mapping.problem_id) == new_paragraph_mapping.problem_id
+ and str(exits_problem_paragraph_mapping.knowledge_id) == new_paragraph_mapping.knowledge_id
+ ]
return len(filter_list) > 0
@@ -280,5 +318,5 @@ def to_problem_paragraph_mapping(problem, document_id: str, paragraph_id: str, k
document_id=document_id,
paragraph_id=paragraph_id,
knowledge_id=knowledge_id,
- problem_id=str(problem.id)
+ problem_id=str(problem.id),
), problem
diff --git a/apps/knowledge/serializers/tag.py b/apps/knowledge/serializers/tag.py
index 562e539f4fb..72f5d38ea63 100644
--- a/apps/knowledge/serializers/tag.py
+++ b/apps/knowledge/serializers/tag.py
@@ -106,7 +106,7 @@ def is_valid(self, *, raise_exception=False):
@transaction.atomic
def edit(self, instance: Dict):
self.is_valid(raise_exception=True)
- tag = QuerySet(Tag).get(id=self.data.get('tag_id'))
+ tag = QuerySet(Tag).filter(id=self.data.get('tag_id'), knowledge_id=self.data.get('knowledge_id')).first()
if tag is None:
raise AppApiException(500, _('Tag id does not exist'))
@@ -150,7 +150,9 @@ def delete(self, delete_type: str):
self.is_valid(raise_exception=True)
if delete_type == 'key':
# 删除同一knowledge_id下相同key的所有标签
- tag = QuerySet(Tag).get(id=self.data.get('tag_id'))
+ tag = QuerySet(Tag).filter(
+ id=self.data.get('tag_id'), knowledge_id=self.data.get('knowledge_id')
+ ).first()
if tag is None:
raise AppApiException(500, _('Tag id does not exist'))
QuerySet(Tag).filter(
@@ -160,7 +162,7 @@ def delete(self, delete_type: str):
QuerySet(DocumentTag).filter(tag_id=tag.id).delete()
else:
# 仅删除当前标签
- QuerySet(Tag).filter(id=self.data.get('tag_id')).delete()
+ QuerySet(Tag).filter(id=self.data.get('tag_id'), knowledge_id=self.data.get('knowledge_id')).delete()
QuerySet(DocumentTag).filter(tag_id=self.data.get('tag_id')).delete()
class BatchDelete(serializers.Serializer):
@@ -185,7 +187,7 @@ def batch_delete(self):
return
# 获取要删除的标签的key
- tags_to_delete = QuerySet(Tag).filter(id__in=tag_ids)
+ tags_to_delete = QuerySet(Tag).filter(id__in=tag_ids, knowledge_id=self.data.get('knowledge_id'))
keys_to_delete = set(tags_to_delete.values_list('key', flat=True))
# 删除具有相同key的所有标签
diff --git a/apps/knowledge/serializers/termbase.py b/apps/knowledge/serializers/termbase.py
index 7f994539541..d955ea0b560 100644
--- a/apps/knowledge/serializers/termbase.py
+++ b/apps/knowledge/serializers/termbase.py
@@ -47,7 +47,7 @@ def is_valid(self, *, raise_exception=False):
def delete(self, problem_id_list: List, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- QuerySet(Termbase).filter(id__in=problem_id_list).delete()
+ QuerySet(Termbase).filter(id__in=problem_id_list, knowledge_id=self.data.get("knowledge_id")).delete()
return True
def export(self, problem_id_list: List, with_valid=True):
@@ -55,7 +55,7 @@ def export(self, problem_id_list: List, with_valid=True):
self.is_valid(raise_exception=True)
terms = (
QuerySet(Termbase)
- .filter(id__in=problem_id_list)
+ .filter(id__in=problem_id_list, knowledge_id=self.data.get("knowledge_id"))
.order_by("-create_time")
.values_list("content", flat=True)
)
@@ -78,13 +78,16 @@ def is_valid(self, *, raise_exception=False):
def one(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- return TermbaseInstanceSerializer(QuerySet(Termbase).get(**{"id": self.data.get("termbase_id")})).data
+ return TermbaseInstanceSerializer(QuerySet(Termbase).get(
+ id=self.data.get("termbase_id"), knowledge_id=self.data.get("knowledge_id"))).data
@transaction.atomic
def delete(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- QuerySet(Termbase).filter(id=self.data.get("termbase_id")).delete()
+ QuerySet(Termbase).filter(
+ id=self.data.get("termbase_id"), knowledge_id=self.data.get("knowledge_id")
+ ).delete()
return True
@transaction.atomic
diff --git a/apps/knowledge/services/__init__.py b/apps/knowledge/services/__init__.py
new file mode 100644
index 00000000000..830677a75ad
--- /dev/null
+++ b/apps/knowledge/services/__init__.py
@@ -0,0 +1 @@
+"""Knowledge domain services."""
diff --git a/apps/knowledge/services/document_cleanup.py b/apps/knowledge/services/document_cleanup.py
new file mode 100644
index 00000000000..b4c051fda4f
--- /dev/null
+++ b/apps/knowledge/services/document_cleanup.py
@@ -0,0 +1,97 @@
+"""Shared cleanup operations for document replacement and deletion."""
+
+from collections.abc import Iterable
+
+from django.db import transaction
+from django.db.models import QuerySet
+
+from knowledge.models import (
+ ContentOrigin,
+ Document,
+ DocumentTag,
+ File,
+ FileSourceType,
+ Paragraph,
+ Problem,
+ ProblemParagraphMapping,
+)
+from knowledge.task.embedding import delete_embedding_by_document_list, delete_embedding_by_paragraph_ids
+
+
+def _delete_problems_and_mappings(paragraph_ids: list[str]) -> None:
+ mappings = QuerySet(ProblemParagraphMapping).filter(paragraph_id__in=paragraph_ids)
+ problem_ids = set(mappings.values_list("problem_id", flat=True))
+ mappings.delete()
+ if not problem_ids:
+ return
+ remaining_problem_ids = set(
+ QuerySet(ProblemParagraphMapping).filter(problem_id__in=problem_ids).values_list("problem_id", flat=True)
+ )
+ QuerySet(Problem).filter(id__in=problem_ids - remaining_problem_ids).delete()
+
+
+def delete_synced_paragraph_data(document_id, paragraph_ids: Iterable[str]) -> list[str]:
+ """Delete missing source paragraphs inside the caller's document-sync transaction.
+
+ Asset rows cascade with paragraphs. Keep the underlying files, which may also
+ be referenced by retained paragraphs or other documents.
+ """
+ paragraphs = QuerySet(Paragraph).filter(
+ document_id=document_id, id__in=list(paragraph_ids), origin=ContentOrigin.SYNCED
+ )
+ existing_ids = [str(paragraph_id) for paragraph_id in paragraphs.values_list("id", flat=True)]
+ if not existing_ids:
+ return []
+ _delete_problems_and_mappings(existing_ids)
+ delete_embedding_by_paragraph_ids(existing_ids)
+ paragraphs.delete()
+ return existing_ids
+
+
+@transaction.atomic
+def reset_document_content(document_ids: Iterable[str]) -> list[str]:
+ """Remove generated content while retaining document identity and external-source metadata."""
+ normalized_ids = [str(document_id) for document_id in document_ids]
+ if not normalized_ids:
+ return []
+ existing_ids = [
+ str(document_id)
+ for document_id in QuerySet(Document).filter(id__in=normalized_ids).values_list("id", flat=True)
+ ]
+ if not existing_ids:
+ return []
+ paragraph_ids = list(QuerySet(Paragraph).filter(document_id__in=existing_ids).values_list("id", flat=True))
+ _delete_problems_and_mappings(paragraph_ids)
+ QuerySet(Paragraph).filter(id__in=paragraph_ids).delete()
+ delete_embedding_by_document_list(existing_ids)
+ QuerySet(Document).filter(id__in=existing_ids).update(char_length=0, source_hash="")
+ return existing_ids
+
+
+@transaction.atomic
+def delete_document_data(document_ids: Iterable[str]) -> list[str]:
+ """Delete documents and every relation managed by the regular document API."""
+ normalized_ids = [str(document_id) for document_id in document_ids]
+ if not normalized_ids:
+ return []
+
+ documents = list(QuerySet(Document).filter(id__in=normalized_ids).values("id", "meta"))
+ existing_ids = [str(document["id"]) for document in documents]
+ if not existing_ids:
+ return []
+
+ source_file_ids = [
+ document["meta"].get("source_file_id")
+ for document in documents
+ if (document.get("meta") or {}).get("source_file_id")
+ ]
+ QuerySet(File).filter(id__in=source_file_ids).delete()
+ QuerySet(File).filter(source_id__in=existing_ids, source_type=FileSourceType.DOCUMENT).delete()
+
+ paragraph_ids = list(QuerySet(Paragraph).filter(document_id__in=existing_ids).values_list("id", flat=True))
+ _delete_problems_and_mappings(paragraph_ids)
+ QuerySet(Paragraph).filter(id__in=paragraph_ids).delete()
+ delete_embedding_by_document_list(existing_ids)
+ QuerySet(DocumentTag).filter(document_id__in=existing_ids).delete()
+ QuerySet(Document).filter(id__in=existing_ids).delete()
+ return existing_ids
diff --git a/apps/knowledge/services/document_strategy.py b/apps/knowledge/services/document_strategy.py
new file mode 100644
index 00000000000..6804d2b2aea
--- /dev/null
+++ b/apps/knowledge/services/document_strategy.py
@@ -0,0 +1,128 @@
+"""Document import strategy normalization and deterministic fingerprints."""
+
+import hashlib
+import json
+from copy import deepcopy
+from typing import Dict, Iterable, List
+
+from common.utils.split_model import SplitModel, get_split_model
+
+DEFAULT_DOCUMENT_STRATEGY = {
+ "split": {
+ "mode": "smart",
+ "patterns": None,
+ "min_length": 0,
+ "max_length": 4096,
+ "child_length": 256,
+ "auto_clean": False,
+ },
+ "visual": {
+ "enabled": False,
+ "strategy": "model",
+ "model_id": None,
+ "tool_id": None,
+ },
+ "index": {"title_as_question": False},
+}
+
+
+def _deep_merge(base: Dict, override: Dict) -> Dict:
+ result = deepcopy(base)
+ for key, value in (override or {}).items():
+ if isinstance(value, dict) and isinstance(result.get(key), dict):
+ result[key] = _deep_merge(result[key], value)
+ else:
+ result[key] = value
+ return result
+
+
+def normalize_document_strategy(strategy: Dict | None) -> Dict:
+ result = _deep_merge(DEFAULT_DOCUMENT_STRATEGY, strategy or {})
+ split = result["split"]
+ provided_split = (strategy or {}).get("split") or {}
+ if "mode" not in provided_split and "patterns" in provided_split:
+ split["mode"] = "advanced"
+ if split.get("mode") not in {"smart", "advanced"}:
+ split["mode"] = "smart"
+ split["min_length"] = max(0, int(split.get("min_length") or 0))
+ split["max_length"] = min(100000, max(50, int(split.get("max_length") or 4096)))
+ if split["min_length"] > split["max_length"]:
+ split["min_length"] = split["max_length"]
+ split["child_length"] = min(2048, max(50, int(split.get("child_length") or 256)))
+ patterns = split.get("patterns")
+ if patterns is not None:
+ split["patterns"] = [str(item) for item in patterns if item is not None]
+
+ visual = result["visual"]
+ visual["enabled"] = bool(visual.get("enabled", False))
+ if visual.get("strategy") not in {"model", "tool"}:
+ visual["strategy"] = "model"
+ if visual["enabled"]:
+ selected = visual.get("model_id") if visual["strategy"] == "model" else visual.get("tool_id")
+ if not selected:
+ raise ValueError("visual enhancement requires the selected model or tool")
+ visual["model_id"] = str(visual["model_id"]) if visual.get("model_id") else None
+ visual["tool_id"] = str(visual["tool_id"]) if visual.get("tool_id") else None
+ result["index"]["title_as_question"] = bool(result["index"].get("title_as_question", False))
+ return result
+
+
+def parse_web_content(content: str, strategy: Dict | None) -> List[Dict]:
+ """Parse Web content with the exact split strategy captured when the document was imported."""
+ normalized = normalize_document_strategy(strategy)
+ split = normalized["split"]
+ patterns = split.get("patterns")
+ parse_limit = 100000 if patterns == [] else split["max_length"]
+ if patterns:
+ split_model = SplitModel(patterns, with_filter=split["auto_clean"], limit=parse_limit)
+ else:
+ split_model = get_split_model("web.md", with_filter=split["auto_clean"], limit=parse_limit)
+ return apply_length_strategy(split_model.parse(content), normalized)
+
+
+def stable_hash(value) -> str:
+ payload = json.dumps(value, ensure_ascii=False, sort_keys=True, separators=(",", ":"), default=str)
+ return hashlib.sha256(payload.encode("utf-8")).hexdigest()
+
+
+def strategy_hashes(strategy: Dict | None) -> Dict[str, str]:
+ normalized = normalize_document_strategy(strategy)
+ return {
+ "split_strategy_hash": stable_hash(normalized["split"]),
+ "visual_strategy_hash": stable_hash(normalized["visual"]),
+ "index_strategy_hash": stable_hash(normalized["index"]),
+ }
+
+
+def document_source_hash(paragraphs: Iterable[Dict]) -> str:
+ return stable_hash([{"title": p.get("title") or "", "content": p.get("content") or ""} for p in paragraphs])
+
+
+def apply_length_strategy(paragraphs: List[Dict], strategy: Dict | None) -> List[Dict]:
+ """Apply max/min rules after structural parsing; a short tail merges into its predecessor."""
+ split = normalize_document_strategy(strategy)["split"]
+ if split.get("patterns") == []:
+ parts = []
+ for paragraph in paragraphs:
+ title, content = paragraph.get("title") or "", paragraph.get("content") or ""
+ value = "\n".join(item for item in [title, content] if item)
+ if value.strip():
+ parts.append(value)
+ return [{"title": "", "content": "\n".join(parts)}] if parts else []
+ maximum, minimum = split["max_length"], split["min_length"]
+ result: List[Dict] = []
+ for paragraph in paragraphs:
+ content = paragraph.get("content") or ""
+ if not content.strip():
+ continue
+ pieces = [content[i : i + maximum] for i in range(0, len(content), maximum)] or [content]
+ for index, piece in enumerate(pieces):
+ item = {**paragraph, "content": piece}
+ if index:
+ item["title"] = ""
+ result.append(item)
+ if minimum and len(result) > 1 and len(result[-1]["content"]) < minimum:
+ tail = result.pop()
+ separator = "\n" if result[-1]["content"] else ""
+ result[-1]["content"] += separator + tail["content"]
+ return result
diff --git a/apps/knowledge/services/external_retrieval.py b/apps/knowledge/services/external_retrieval.py
new file mode 100644
index 00000000000..a6ef0e6d67e
--- /dev/null
+++ b/apps/knowledge/services/external_retrieval.py
@@ -0,0 +1,87 @@
+"""Shared REST/MCP retrieval using the existing vector search and recall statistics."""
+
+import math
+
+from common.config.embedding_config import VectorStore
+from knowledge.models import Document, Paragraph, ParagraphAsset, ProblemParagraphMapping, SearchMode, SourceType
+from knowledge.serializers.common import get_embedding_model_by_knowledge_id
+from knowledge.serializers.external_retrieval import RetrievalRequest
+from knowledge.services.retrieval_access import authorize_external, refresh_identity
+from knowledge.services.retrieval_stats import record_recall_safely
+
+
+def valid_source(hit, paragraph):
+ source_id, source_type = str(hit.get("source_id")), str(hit.get("source_type"))
+ if source_type in {str(SourceType.PARAGRAPH.value), str(SourceType.TITLE.value)}:
+ return source_id == str(paragraph.id)
+ filters = dict(knowledge_id=paragraph.knowledge_id, document_id=paragraph.document_id, paragraph_id=paragraph.id)
+ if source_type == str(SourceType.IMAGE.value):
+ return ParagraphAsset.objects.filter(id=source_id, **filters).exists()
+ if source_type == str(SourceType.PROBLEM.value):
+ return ProblemParagraphMapping.objects.filter(id=source_id, **filters).exists()
+ return False
+
+
+def score(value):
+ value = float(value or 0)
+ return value if math.isfinite(value) else 0.0
+
+
+def retrieve(knowledge_id, identity, data):
+ request = RetrievalRequest(data=data)
+ request.is_valid(raise_exception=True)
+ data = request.validated_data
+ knowledge = authorize_external(knowledge_id, refresh_identity(identity))
+ excluded = list(Document.objects.filter(knowledge_id=knowledge.id, is_active=False).values_list("id", flat=True))
+ mode = SearchMode(data["search_mode"])
+ model = get_embedding_model_by_knowledge_id(knowledge.id) if mode != SearchMode.keywords else None
+ matches = VectorStore.get_embedding_vector().hit_test(
+ data["query_text"],
+ [str(knowledge.id)],
+ list(map(str, excluded)),
+ data["top_number"],
+ data["similarity"],
+ mode,
+ model,
+ )
+ # Check current credentials and publication again after the potentially slow model call.
+ knowledge = authorize_external(knowledge_id, refresh_identity(identity))
+ paragraphs = {
+ str(p.id): p
+ for p in Paragraph.objects.select_related("document").filter(
+ id__in=[row["paragraph_id"] for row in matches],
+ knowledge_id=knowledge.id,
+ document__knowledge_id=knowledge.id,
+ is_active=True,
+ document__is_active=True,
+ )
+ }
+ hits, recalled, seen = [], [], set()
+ for match in matches:
+ paragraph = paragraphs.get(str(match["paragraph_id"]))
+ if paragraph is None or paragraph.id in seen or not valid_source(match, paragraph):
+ continue
+ seen.add(paragraph.id)
+ hits.append(
+ {
+ "paragraph_id": str(paragraph.id),
+ "document_id": str(paragraph.document_id),
+ "title": paragraph.title,
+ "content": paragraph.content[:8000],
+ "similarity": score(match.get("similarity")),
+ "comprehensive_score": score(match.get("comprehensive_score")),
+ "source_type": match.get("source_type"),
+ "source_id": str(match.get("source_id")),
+ "citation": {
+ "knowledge_id": str(knowledge.id),
+ "knowledge_name": knowledge.name,
+ "document_id": str(paragraph.document_id),
+ "document_name": paragraph.document.name,
+ "paragraph_id": str(paragraph.id),
+ },
+ }
+ )
+ recalled.append(match)
+ authorize_external(knowledge_id, refresh_identity(identity))
+ record_recall_safely(recalled)
+ return {"knowledge_id": str(knowledge.id), "hits": hits}
diff --git a/apps/knowledge/services/file_cleanup.py b/apps/knowledge/services/file_cleanup.py
new file mode 100644
index 00000000000..c0da54e838b
--- /dev/null
+++ b/apps/knowledge/services/file_cleanup.py
@@ -0,0 +1,34 @@
+"""Best-effort cleanup of unreferenced S3 objects after database commit."""
+
+from uuid import UUID
+
+from common.storage.seaweedfs import get_s3_client
+from common.utils.logger import maxkb_logger
+from django.db.models import Q
+from knowledge.models import File
+
+
+def object_is_referenced(key, using):
+ references = Q(meta__seaweedfs_key=key)
+ if key.startswith("files/"):
+ try:
+ file_id = UUID(key.removeprefix("files/"))
+ except ValueError:
+ pass
+ else:
+ references |= Q(id=file_id) & ~Q(meta__has_key="seaweedfs_key")
+ return File.objects.using(using).filter(references, storage_type="seaweedfs").exists()
+
+
+def delete_file_object(bucket, key, file_id, using="default"):
+ try:
+ if not object_is_referenced(key, using):
+ # S3 deletion is idempotent when a batch contains multiple references to the same key.
+ get_s3_client().delete_object(Bucket=bucket, Key=key)
+ except Exception as exc:
+ # Avoid logging object keys or credentials from SDK error messages.
+ maxkb_logger.warning(
+ "Failed to clean up OSS object for deleted File %s (%s); manual cleanup may be required",
+ file_id,
+ type(exc).__name__,
+ )
diff --git a/apps/knowledge/services/image_documents.py b/apps/knowledge/services/image_documents.py
new file mode 100644
index 00000000000..466218fc3ff
--- /dev/null
+++ b/apps/knowledge/services/image_documents.py
@@ -0,0 +1,342 @@
+"""Standalone image resources for general knowledge bases."""
+
+from pathlib import Path
+from typing import Dict, Iterable, List
+
+import uuid_utils.compat as uuid
+from common.chunk import text_to_chunk
+from common.exception.app_exception import AppApiException
+from django.db import transaction
+from django.db.models import QuerySet
+from django.utils import timezone
+from django.utils.translation import gettext_lazy as _
+from PIL import Image, UnidentifiedImageError
+
+from knowledge.models import (
+ AssetProcessStatus,
+ ContentOrigin,
+ Document,
+ DocumentResourceType,
+ File,
+ FileSourceType,
+ Knowledge,
+ KnowledgeType,
+ Paragraph,
+ ParagraphAsset,
+ SyncState,
+)
+from knowledge.services.document_strategy import (
+ document_source_hash,
+ normalize_document_strategy,
+ strategy_hashes,
+)
+from knowledge.services.incremental_sync import IncrementalDocumentSync
+from knowledge.services.paragraph_assets import resolve_visual_processor
+
+
+SUPPORTED_IMAGE_EXTENSIONS = {".jpg", ".jpeg", ".png", ".webp", ".bmp"}
+IMAGE_FORMAT_EXTENSIONS = {
+ "JPEG": {".jpg", ".jpeg"},
+ "PNG": {".png"},
+ "WEBP": {".webp"},
+ "BMP": {".bmp"},
+}
+
+
+def _preview_meta(file: File) -> Dict:
+ return (file.meta or {}).get("image_preview") or {}
+
+
+def _display_text(file_name: str, preview: Dict) -> str:
+ values = [preview.get("caption"), preview.get("ocr_text"), preview.get("description")]
+ content = "\n".join(str(value).strip() for value in values if value and str(value).strip()).strip()
+ return content or Path(file_name).stem
+
+
+class ImageDocumentService:
+ def __init__(self, workspace_id: str, knowledge_id: str, user_id=None):
+ self.workspace_id = workspace_id
+ self.knowledge_id = str(knowledge_id)
+ self.user_id = user_id
+
+ def get_knowledge(self) -> Knowledge:
+ knowledge = QuerySet(Knowledge).filter(id=self.knowledge_id, workspace_id=self.workspace_id).first()
+ if knowledge is None:
+ raise AppApiException(500, _("Knowledge id does not exist"))
+ if knowledge.type != KnowledgeType.BASE:
+ raise AppApiException(500, _("Image files are only supported by general knowledge bases"))
+ return knowledge
+
+ @staticmethod
+ def _validate_image(file, knowledge: Knowledge) -> None:
+ extension = Path(file.name).suffix.lower()
+ if extension not in SUPPORTED_IMAGE_EXTENSIONS:
+ raise AppApiException(
+ 500,
+ _("Unsupported image format. Supported formats: jpg, jpeg, png, webp, bmp"),
+ )
+ size_limit = min(100, knowledge.file_size_limit)
+ if file.size > 1024 * 1024 * size_limit:
+ raise AppApiException(
+ 500,
+ _("The maximum size of the uploaded file cannot exceed {}MB").format(size_limit),
+ )
+ position = file.tell()
+ try:
+ image = Image.open(file)
+ image_format = image.format
+ image.verify()
+ if extension not in IMAGE_FORMAT_EXTENSIONS.get(image_format, set()):
+ raise AppApiException(500, _("The image content does not match its file extension"))
+ except (UnidentifiedImageError, OSError, Image.DecompressionBombError) as exc:
+ raise AppApiException(500, _("The uploaded file is not a valid image")) from exc
+ finally:
+ file.seek(position)
+
+ @staticmethod
+ def _run_visual_processor(file: File, strategy: Dict, workspace_id: str) -> Dict:
+ visual = strategy["visual"]
+ if not visual["enabled"]:
+ return {
+ "caption": "",
+ "ocr_text": "",
+ "description": "",
+ "process_status": AssetProcessStatus.SKIPPED,
+ "process_error": "",
+ "meta": {},
+ }
+ try:
+ processor = resolve_visual_processor(visual, workspace_id)
+ if processor is None:
+ raise ValueError("visual processor adapter is unavailable")
+ asset = ParagraphAsset(file=file, file_id=file.id, position=1)
+ output = processor(asset, visual) or {}
+ caption = str(output.get("caption") or "")
+ return {
+ "caption": caption,
+ "ocr_text": str(output.get("ocr_text") or ""),
+ "description": str(output.get("description") or caption or Path(file.file_name).stem),
+ "process_status": AssetProcessStatus.SUCCESS,
+ "process_error": "",
+ "meta": output.get("meta") if isinstance(output.get("meta"), dict) else {},
+ }
+ except Exception as exc:
+ original_text = Path(file.file_name).stem
+ return {
+ "caption": "",
+ "ocr_text": "",
+ "description": original_text,
+ "process_status": AssetProcessStatus.FAILURE,
+ "process_error": str(exc)[:2000],
+ "meta": {},
+ }
+
+ @staticmethod
+ def serialize_preview(file: File) -> Dict:
+ preview = _preview_meta(file)
+ content = _display_text(file.file_name, preview)
+ original_size = (file.meta or {}).get("upload_size")
+ if original_size is None:
+ original_size = (file.meta or {}).get("original_size", file.file_size)
+ return {
+ "id": str(file.id),
+ "preview_id": str(file.id),
+ "file_id": str(file.id),
+ "name": file.file_name,
+ "file_name": file.file_name,
+ "file_size": original_size,
+ "url": f"./oss/file/{file.id}",
+ "caption": preview.get("caption", ""),
+ "ocr_text": preview.get("ocr_text", ""),
+ "description": preview.get("description", ""),
+ "content": content,
+ "char_length": len(content),
+ "process_status": preview.get("process_status", AssetProcessStatus.PENDING),
+ "process_error": preview.get("process_error", ""),
+ "doc_strategy": preview.get("doc_strategy", {}),
+ "imported": bool(preview.get("imported", False)),
+ "document_id": preview.get("document_id"),
+ }
+
+ def _get_preview_file(self, preview_id) -> File:
+ file = (
+ QuerySet(File)
+ .filter(
+ id=preview_id,
+ source_type=FileSourceType.KNOWLEDGE,
+ source_id=self.knowledge_id,
+ )
+ .first()
+ )
+ if file is None or not _preview_meta(file):
+ raise AppApiException(500, _("Image preview does not exist"))
+ if _preview_meta(file).get("imported"):
+ raise AppApiException(500, _("Image preview has already been imported"))
+ return file
+
+ def create_previews(self, files: Iterable, strategy: Dict | None = None) -> List[Dict]:
+ knowledge = self.get_knowledge()
+ file_list = list(files)
+ if not file_list:
+ raise AppApiException(500, _("Please upload at least one image"))
+ count_limit = min(50, knowledge.file_count_limit)
+ if len(file_list) > count_limit:
+ raise AppApiException(
+ 500,
+ _("A maximum of {} files can be uploaded at a time").format(count_limit),
+ )
+ normalized_strategy = normalize_document_strategy(strategy)
+ for upload in file_list:
+ self._validate_image(upload, knowledge)
+ previews = []
+ for upload in file_list:
+ content = upload.read()
+ upload.seek(0)
+ file = File(
+ id=uuid.uuid7(),
+ file_name=upload.name,
+ file_size=upload.size,
+ source_type=FileSourceType.KNOWLEDGE,
+ source_id=self.knowledge_id,
+ meta={"knowledge_id": self.knowledge_id, "upload_size": upload.size},
+ )
+ file.save(content)
+ processed = self._run_visual_processor(file, normalized_strategy, self.workspace_id)
+ preview = {
+ **processed,
+ "doc_strategy": normalized_strategy,
+ "imported": False,
+ "document_id": None,
+ }
+ meta = {**(file.meta or {}), "image_preview": preview}
+ QuerySet(File).filter(id=file.id).update(meta=meta)
+ file.meta = meta
+ previews.append(self.serialize_preview(file))
+ return previews
+
+ def get_preview(self, preview_id) -> Dict:
+ self.get_knowledge()
+ return self.serialize_preview(self._get_preview_file(preview_id))
+
+ def update_preview(self, preview_id, values: Dict) -> Dict:
+ self.get_knowledge()
+ file = self._get_preview_file(preview_id)
+ file_name = values.get("name", file.file_name)
+ if Path(file_name).suffix.lower() not in SUPPORTED_IMAGE_EXTENSIONS:
+ raise AppApiException(500, _("The image name must retain a supported file extension"))
+ preview = {**_preview_meta(file)}
+ for field in ("caption", "ocr_text", "description"):
+ if field in values:
+ preview[field] = values[field] or ""
+ meta = {**(file.meta or {}), "image_preview": preview}
+ QuerySet(File).filter(id=file.id).update(file_name=file_name, meta=meta)
+ file.file_name = file_name
+ file.meta = meta
+ return self.serialize_preview(file)
+
+ def delete_preview(self, preview_id) -> bool:
+ self.get_knowledge()
+ file = self._get_preview_file(preview_id)
+ file.delete()
+ return True
+
+ @transaction.atomic
+ def import_previews(self, preview_ids: Iterable) -> List[str]:
+ knowledge = self.get_knowledge()
+ ordered_ids = list(dict.fromkeys(str(preview_id) for preview_id in preview_ids))
+ if not ordered_ids:
+ raise AppApiException(500, _("Please select at least one image preview"))
+ preview_files = (
+ QuerySet(File)
+ .filter(
+ id__in=ordered_ids,
+ source_type=FileSourceType.KNOWLEDGE,
+ source_id=self.knowledge_id,
+ )
+ .select_for_update()
+ )
+ files_by_id = {str(file.id): file for file in preview_files}
+ if len(files_by_id) != len(ordered_ids):
+ raise AppApiException(500, _("One or more image previews do not exist"))
+
+ document_ids = []
+ for preview_id in ordered_ids:
+ file = files_by_id[preview_id]
+ preview = _preview_meta(file)
+ if not preview or preview.get("imported"):
+ raise AppApiException(500, _("One or more image previews cannot be imported"))
+ strategy = normalize_document_strategy(preview.get("doc_strategy"))
+ hashes = strategy_hashes(strategy)
+ content = _display_text(file.file_name, preview)
+ document = Document(
+ id=uuid.uuid7(),
+ knowledge_id=knowledge.id,
+ name=file.file_name,
+ char_length=len(content),
+ user_id=self.user_id,
+ type=KnowledgeType.BASE,
+ resource_type=DocumentResourceType.IMAGE,
+ doc_strategy=strategy,
+ source_hash=document_source_hash([{"title": Path(file.file_name).stem, "content": content}]),
+ meta={
+ "source_file_id": str(file.id),
+ "allow_download": True,
+ "image_file_id": str(file.id),
+ },
+ **hashes,
+ )
+ document.save()
+ paragraph = Paragraph(
+ id=uuid.uuid7(),
+ document_id=document.id,
+ knowledge_id=knowledge.id,
+ title=preview.get("caption") or Path(file.file_name).stem,
+ content=content,
+ chunks=text_to_chunk(content, strategy["split"]["child_length"]),
+ content_schema=[
+ {
+ "type": "image",
+ "file_id": str(file.id),
+ "caption": preview.get("caption", ""),
+ "ocr_text": preview.get("ocr_text", ""),
+ "description": preview.get("description", ""),
+ }
+ ],
+ origin=ContentOrigin.MANUAL,
+ position=1,
+ )
+ paragraph.save()
+ ParagraphAsset.objects.create(
+ id=uuid.uuid7(),
+ knowledge_id=knowledge.id,
+ document_id=document.id,
+ paragraph_id=paragraph.id,
+ file_id=file.id,
+ position=1,
+ origin=ContentOrigin.MANUAL,
+ source_asset_key=f"standalone:{file.sha256_hash or file.id}",
+ source_hash=file.sha256_hash,
+ caption=preview.get("caption", ""),
+ ocr_text=preview.get("ocr_text", ""),
+ description=preview.get("description", ""),
+ sync_state=SyncState.ACTIVE,
+ process_status=preview.get("process_status", AssetProcessStatus.PENDING),
+ process_error=preview.get("process_error", ""),
+ visual_strategy_hash=hashes["visual_strategy_hash"],
+ meta=preview.get("meta") if isinstance(preview.get("meta"), dict) else {},
+ )
+ IncrementalDocumentSync(document, strategy)._sync_title_questions([paragraph])
+ imported_preview = {
+ **preview,
+ "imported": True,
+ "document_id": str(document.id),
+ "imported_at": timezone.now().isoformat(),
+ }
+ file_meta = {**(file.meta or {}), "image_preview": imported_preview}
+ QuerySet(File).filter(id=file.id).update(
+ source_type=FileSourceType.DOCUMENT,
+ source_id=str(document.id),
+ meta=file_meta,
+ )
+ document_ids.append(str(document.id))
+ return document_ids
diff --git a/apps/knowledge/services/incremental_sync.py b/apps/knowledge/services/incremental_sync.py
new file mode 100644
index 00000000000..a500aec004f
--- /dev/null
+++ b/apps/knowledge/services/incremental_sync.py
@@ -0,0 +1,400 @@
+"""Stable-ID, three-way paragraph synchronization for external documents."""
+
+from collections import defaultdict
+from dataclasses import dataclass, field
+from typing import Dict, Iterable, List, Optional
+
+import uuid_utils.compat as uuid
+from common.chunk import text_to_chunk
+from django.db import transaction
+from django.utils import timezone
+
+from knowledge.models import (
+ ContentOrigin,
+ Document,
+ LocalState,
+ Paragraph,
+ Problem,
+ ProblemParagraphMapping,
+ SyncState,
+)
+from knowledge.services.document_cleanup import delete_synced_paragraph_data
+from knowledge.services.document_strategy import (
+ document_source_hash,
+ normalize_document_strategy,
+ stable_hash,
+ strategy_hashes,
+)
+
+
+def paragraph_hash(title: str, content: str) -> str:
+ return stable_hash({"title": title or "", "content": content or ""})
+
+
+def _normalized_title(value: str) -> str:
+ return " ".join((value or "").strip().lower().split())[:240]
+
+
+def prepare_remote_paragraphs(paragraphs: Iterable[Dict]) -> List[Dict]:
+ """Fill stable keys when a connector cannot provide a native block id."""
+ occurrences = defaultdict(int)
+ source_key_occurrences = defaultdict(int)
+ result = []
+ for position, raw in enumerate(paragraphs, 1):
+ title, content = raw.get("title") or "", raw.get("content") or ""
+ identity = _normalized_title(title) or "untitled"
+ occurrences[identity] += 1
+ source_key = str(raw.get("source_key") or f"heading:{identity}:{occurrences[identity]}")[:480]
+ source_key_occurrences[source_key] += 1
+ if source_key_occurrences[source_key] > 1:
+ source_key = f"{source_key}:duplicate:{source_key_occurrences[source_key]}"
+ result.append(
+ {
+ **raw,
+ "title": title,
+ "content": content,
+ "position": position,
+ "source_key": source_key,
+ "source_hash": paragraph_hash(title, content),
+ }
+ )
+ return result
+
+
+@dataclass
+class MergeResult:
+ created_ids: List[str] = field(default_factory=list)
+ updated_ids: List[str] = field(default_factory=list)
+ disabled_ids: List[str] = field(default_factory=list)
+ deleted_ids: List[str] = field(default_factory=list)
+ conflict_ids: List[str] = field(default_factory=list)
+ unchanged_ids: List[str] = field(default_factory=list)
+
+ @property
+ def reembed_ids(self) -> List[str]:
+ return [*self.created_ids, *self.updated_ids]
+
+
+class IncrementalDocumentSync:
+ def __init__(self, document: Document, strategy: Optional[Dict] = None, *, source_authoritative: bool = False):
+ self.document = document
+ self.strategy = normalize_document_strategy(strategy if strategy is not None else document.doc_strategy)
+ # Lark follows source updates/deletes; other connectors retain three-way conflict handling.
+ # Neither policy may overwrite manually created paragraphs.
+ self.source_authoritative = source_authoritative
+
+ @staticmethod
+ def _snapshot(item: Dict) -> Dict:
+ return {"title": item.get("title") or "", "content": item.get("content") or ""}
+
+ def _match(self, remote: Dict, unmatched: List[Paragraph]) -> Optional[Paragraph]:
+ unmatched = [p for p in unmatched if p.origin == ContentOrigin.SYNCED]
+ if self.source_authoritative:
+ by_hash = next(
+ (
+ p
+ for p in unmatched
+ if (p.source_hash or paragraph_hash(p.title, p.content)) == remote["source_hash"]
+ ),
+ None,
+ )
+ if by_hash is not None:
+ return by_hash
+ by_title = [p for p in unmatched if _normalized_title(p.title) == _normalized_title(remote["title"])]
+ # Repeated headings are paired in source order after unchanged chunks are reserved.
+ return next(
+ (p for p in by_title if p.source_key == remote["source_key"]), by_title[0] if by_title else None
+ )
+ exact = next((p for p in unmatched if p.source_key and p.source_key == remote["source_key"]), None)
+ if exact:
+ return exact
+ # Legacy paragraphs have no stable key. Exact content is safe; title/position is only used when unique.
+ by_hash = [
+ p for p in unmatched if (p.source_hash or paragraph_hash(p.title, p.content)) == remote["source_hash"]
+ ]
+ if len(by_hash) == 1:
+ return by_hash[0]
+ by_title = [p for p in unmatched if _normalized_title(p.title) == _normalized_title(remote["title"])]
+ if len(by_title) == 1 and abs((by_title[0].position or 0) - remote["position"]) <= 2:
+ return by_title[0]
+ return None
+
+ def _merge_matched(self, paragraph: Paragraph, remote: Dict, result: MergeResult):
+ if self.source_authoritative:
+ # An unchanged source chunk must not overwrite a user's local edits.
+ if (paragraph.source_hash or paragraph_hash(paragraph.title, paragraph.content)) == remote[
+ "source_hash"
+ ] and paragraph.sync_state != SyncState.REMOTE_DELETED:
+ updated_fields = []
+ if paragraph.source_key != remote["source_key"]:
+ paragraph.source_key = remote["source_key"]
+ updated_fields.append("source_key")
+ old_split = normalize_document_strategy(self.document.doc_strategy)["split"]
+ if old_split["child_length"] != self.strategy["split"]["child_length"]:
+ paragraph.chunks = text_to_chunk(paragraph.content, self.strategy["split"]["child_length"])
+ updated_fields.append("chunks")
+ result.updated_ids.append(str(paragraph.id))
+ else:
+ result.unchanged_ids.append(str(paragraph.id))
+ if updated_fields:
+ paragraph.save(update_fields=[*updated_fields, "update_time"])
+ return
+ paragraph.title, paragraph.content = remote["title"], remote["content"]
+ paragraph.chunks = text_to_chunk(paragraph.content, self.strategy["split"]["child_length"])
+ paragraph.source_key = remote["source_key"]
+ paragraph.source_hash = remote["source_hash"]
+ paragraph.source_snapshot = self._snapshot(remote)
+ paragraph.source_updated_at = remote.get("source_updated_at")
+ paragraph.local_state = LocalState.CLEAN
+ paragraph.sync_state = SyncState.ACTIVE
+ paragraph.is_active = True
+ paragraph.save(
+ update_fields=[
+ "title",
+ "content",
+ "chunks",
+ "source_key",
+ "source_hash",
+ "source_snapshot",
+ "source_updated_at",
+ "local_state",
+ "sync_state",
+ "is_active",
+ "update_time",
+ ]
+ )
+ result.updated_ids.append(str(paragraph.id))
+ return
+ base = paragraph.source_snapshot or {"title": paragraph.title, "content": paragraph.content}
+ local = {"title": paragraph.title or "", "content": paragraph.content or ""}
+ incoming = self._snapshot(remote)
+ local_changed = paragraph.local_state == LocalState.MODIFIED or local != base
+ remote_changed = incoming != base
+
+ paragraph.source_key = remote["source_key"]
+ paragraph.source_hash = remote["source_hash"]
+ paragraph.source_updated_at = remote.get("source_updated_at")
+ paragraph.source_snapshot = incoming
+ paragraph.origin = ContentOrigin.SYNCED
+
+ if paragraph.local_state == LocalState.DELETED:
+ paragraph.sync_state = SyncState.CONFLICT if remote_changed else SyncState.ACTIVE
+ paragraph.is_active = False
+ (result.conflict_ids if remote_changed else result.unchanged_ids).append(str(paragraph.id))
+ elif local_changed and remote_changed and local != incoming:
+ paragraph.sync_state = SyncState.CONFLICT
+ paragraph.local_state = LocalState.MODIFIED
+ paragraph.is_active = True
+ result.conflict_ids.append(str(paragraph.id))
+ elif not local_changed:
+ changed = local != incoming or paragraph.sync_state != SyncState.ACTIVE or not paragraph.is_active
+ paragraph.title, paragraph.content = incoming["title"], incoming["content"]
+ paragraph.chunks = text_to_chunk(paragraph.content, self.strategy["split"]["child_length"])
+ paragraph.local_state = LocalState.CLEAN
+ paragraph.sync_state = SyncState.ACTIVE
+ paragraph.is_active = True
+ (result.updated_ids if changed else result.unchanged_ids).append(str(paragraph.id))
+ else:
+ # Only local changed (or both arrived at the same value): keep local and advance the base snapshot.
+ paragraph.sync_state = SyncState.ACTIVE
+ paragraph.is_active = True
+ result.unchanged_ids.append(str(paragraph.id))
+ paragraph.save(
+ update_fields=[
+ "title",
+ "content",
+ "chunks",
+ "origin",
+ "source_key",
+ "source_hash",
+ "source_snapshot",
+ "source_updated_at",
+ "local_state",
+ "sync_state",
+ "is_active",
+ "update_time",
+ ]
+ )
+
+ def _create(self, remote: Dict, result: MergeResult) -> Paragraph:
+ paragraph = Paragraph.objects.create(
+ id=uuid.uuid7(),
+ document=self.document,
+ knowledge=self.document.knowledge,
+ title=remote["title"],
+ content=remote["content"],
+ chunks=text_to_chunk(remote["content"], self.strategy["split"]["child_length"]),
+ position=remote["position"],
+ origin=ContentOrigin.SYNCED,
+ source_key=remote["source_key"],
+ source_hash=remote["source_hash"],
+ source_snapshot=self._snapshot(remote),
+ source_updated_at=remote.get("source_updated_at"),
+ local_state=LocalState.CLEAN,
+ sync_state=SyncState.ACTIVE,
+ )
+ result.created_ids.append(str(paragraph.id))
+ return paragraph
+
+ def _handle_remote_deletes(self, unmatched: List[Paragraph], result: MergeResult):
+ if self.source_authoritative:
+ missing_ids = [p.id for p in unmatched if p.origin == ContentOrigin.SYNCED]
+ if missing_ids:
+ result.deleted_ids.extend(delete_synced_paragraph_data(self.document.id, missing_ids))
+ return
+ for paragraph in unmatched:
+ if paragraph.origin != ContentOrigin.SYNCED:
+ continue
+ if paragraph.local_state == LocalState.MODIFIED:
+ paragraph.sync_state = SyncState.CONFLICT
+ paragraph.is_active = True
+ result.conflict_ids.append(str(paragraph.id))
+ else:
+ paragraph.sync_state = SyncState.REMOTE_DELETED
+ paragraph.is_active = False
+ result.disabled_ids.append(str(paragraph.id))
+ paragraph.save(update_fields=["sync_state", "is_active", "update_time"])
+
+ def _reorder(self, ordered_synced: List[Paragraph], all_existing: List[Paragraph]):
+ active_synced = [p for p in ordered_synced if p.sync_state != SyncState.REMOTE_DELETED]
+ manual = [p for p in all_existing if p.origin == ContentOrigin.MANUAL and p.local_state != LocalState.DELETED]
+ sequence = list(active_synced)
+ for item in sorted(manual, key=lambda p: p.position):
+ if item.anchor_paragraph_id:
+ anchor_index = next((i for i, p in enumerate(sequence) if p.id == item.anchor_paragraph_id), None)
+ if anchor_index is not None:
+ sequence.insert(anchor_index + (1 if item.placement == "after" else 0), item)
+ continue
+ sequence.append(item)
+ for position, paragraph in enumerate(sequence, 1):
+ if paragraph.position != position:
+ paragraph.position = position
+ paragraph.save(update_fields=["position", "update_time"])
+
+ def _sync_title_questions(self, paragraphs: List[Paragraph]):
+ auto_mappings = ProblemParagraphMapping.objects.filter(
+ document_id=self.document.id, meta__index_source="paragraph_title"
+ )
+ if self.source_authoritative:
+ auto_mappings = auto_mappings.filter(paragraph__origin=ContentOrigin.SYNCED)
+ if not self.strategy["index"]["title_as_question"]:
+ problem_ids = list(auto_mappings.values_list("problem_id", flat=True))
+ auto_mappings.delete()
+ Problem.objects.filter(id__in=problem_ids, problemparagraphmapping__isnull=True).delete()
+ return
+ for paragraph in paragraphs:
+ title = (paragraph.title or "").strip()
+ stale = auto_mappings.filter(paragraph_id=paragraph.id).exclude(problem__content=title[:256])
+ stale_problem_ids = list(stale.values_list("problem_id", flat=True))
+ stale.delete()
+ Problem.objects.filter(id__in=stale_problem_ids, problemparagraphmapping__isnull=True).delete()
+ if not title:
+ continue
+ problem, _ = Problem.objects.get_or_create(
+ knowledge_id=self.document.knowledge_id,
+ content=title[:256],
+ defaults={"id": uuid.uuid7()},
+ )
+ mapping, created = ProblemParagraphMapping.objects.get_or_create(
+ knowledge_id=self.document.knowledge_id,
+ document_id=self.document.id,
+ paragraph_id=paragraph.id,
+ problem_id=problem.id,
+ defaults={"id": uuid.uuid7()},
+ )
+ if created:
+ mapping.meta = {**mapping.meta, "index_source": "paragraph_title"}
+ mapping.save(update_fields=["meta", "update_time"])
+
+ @transaction.atomic
+ def merge(self, paragraphs: Iterable[Dict]) -> MergeResult:
+ remote_list = prepare_remote_paragraphs(paragraphs)
+ # Serialize all synchronizations for the same document. Locking only the existing
+ # paragraphs does not protect an initially empty document or concurrent inserts.
+ self.document = Document.objects.select_for_update().get(id=self.document.id)
+ existing = list(Paragraph.objects.select_for_update().filter(document=self.document).order_by("position"))
+ if not remote_list and any(
+ paragraph.origin == ContentOrigin.SYNCED and paragraph.sync_state != SyncState.REMOTE_DELETED
+ for paragraph in existing
+ ):
+ raise ValueError("Remote synchronization returned an empty paragraph snapshot")
+ unmatched = [paragraph for paragraph in existing if paragraph.origin == ContentOrigin.SYNCED]
+ ordered_synced, result = [], MergeResult()
+ matches = [None] * len(remote_list)
+ if self.source_authoritative:
+ # Reserve every unchanged chunk before matching changed chunks by title. Otherwise
+ # an inserted chunk under a repeated heading could consume an unchanged old chunk.
+ for index, remote in enumerate(remote_list):
+ paragraph = next(
+ (
+ p
+ for p in unmatched
+ if (p.source_hash or paragraph_hash(p.title, p.content)) == remote["source_hash"]
+ ),
+ None,
+ )
+ if paragraph is not None:
+ matches[index] = paragraph
+ unmatched.remove(paragraph)
+ for index, remote in enumerate(remote_list):
+ if matches[index] is None:
+ paragraph = self._match(remote, unmatched)
+ if paragraph is not None:
+ matches[index] = paragraph
+ unmatched.remove(paragraph)
+
+ if self.source_authoritative:
+ self._handle_remote_deletes(unmatched, result)
+ # Release changing keys together before a heading reorder swaps unique source keys.
+ rekey_ids = [
+ paragraph.id
+ for remote, paragraph in zip(remote_list, matches)
+ if paragraph is not None and paragraph.source_key != remote["source_key"]
+ ]
+ if rekey_ids:
+ Paragraph.objects.filter(document=self.document, id__in=rekey_ids).update(source_key="")
+ for remote, paragraph in zip(remote_list, matches):
+ if paragraph is None:
+ paragraph = self._create(remote, result)
+ else:
+ self._merge_matched(paragraph, remote, result)
+ ordered_synced.append(paragraph)
+ if not self.source_authoritative:
+ self._handle_remote_deletes(unmatched, result)
+ self._reorder(ordered_synced, existing)
+ self._sync_title_questions(ordered_synced)
+
+ hashes = strategy_hashes(self.strategy)
+ if (
+ self.document.split_strategy_hash != hashes["split_strategy_hash"]
+ or self.document.visual_strategy_hash != hashes["visual_strategy_hash"]
+ or self.document.index_strategy_hash != hashes["index_strategy_hash"]
+ ):
+ active_paragraphs = Paragraph.objects.filter(document=self.document, is_active=True)
+ if self.source_authoritative:
+ active_paragraphs = active_paragraphs.filter(origin=ContentOrigin.SYNCED)
+ for paragraph_id in active_paragraphs.values_list("id", flat=True):
+ value = str(paragraph_id)
+ if value not in result.reembed_ids:
+ result.updated_ids.append(value)
+ self.document.doc_strategy = self.strategy
+ self.document.source_hash = document_source_hash(remote_list)
+ self.document.char_length = sum(len(item["content"]) for item in remote_list)
+ self.document.sync_version += 1
+ self.document.last_sync_time = timezone.now()
+ for key, value in hashes.items():
+ setattr(self.document, key, value)
+ self.document.save(
+ update_fields=[
+ "doc_strategy",
+ "source_hash",
+ "char_length",
+ "sync_version",
+ "last_sync_time",
+ "split_strategy_hash",
+ "visual_strategy_hash",
+ "index_strategy_hash",
+ "update_time",
+ ]
+ )
+ return result
diff --git a/apps/knowledge/services/knowledge_sync_schedule.py b/apps/knowledge/services/knowledge_sync_schedule.py
new file mode 100644
index 00000000000..5a7d87b1e87
--- /dev/null
+++ b/apps/knowledge/services/knowledge_sync_schedule.py
@@ -0,0 +1,116 @@
+"""APScheduler integration for scheduled external knowledge synchronization."""
+
+import importlib
+import re
+
+from apscheduler.triggers.cron import CronTrigger
+from django.db.models import QuerySet
+
+from common.utils.logger import maxkb_logger
+from knowledge.models import Knowledge, KnowledgeType
+from knowledge.task.sync import scheduled_sync_knowledge
+
+
+KNOWLEDGE_SYNC_JOB_PREFIX = "knowledge:sync:"
+LEGACY_WEB_SYNC_JOB_PREFIX = "knowledge:web-sync:"
+DEFAULT_KNOWLEDGE_SYNC_SETTING = {
+ "enabled": False,
+ "schedule_type": "daily",
+ "time": "01:00",
+ "cron_expression": "0 1 * * *",
+ "sync_type": "incremental",
+}
+KNOWLEDGE_SYNC_TYPES = {"incremental", "replace", "complete"}
+SCHEDULED_KNOWLEDGE_TYPES = {KnowledgeType.WEB, KnowledgeType.LARK, KnowledgeType.WORKFLOW}
+TIME_PATTERN = re.compile(r"^([01]\d|2[0-3]):([0-5]\d)$")
+
+
+def _get_scheduler():
+ """Load the scheduler only when a job is deployed, not during API module import."""
+ return importlib.import_module("common.job.scheduler").scheduler
+
+
+def knowledge_sync_job_id(knowledge_id) -> str:
+ return f"{KNOWLEDGE_SYNC_JOB_PREFIX}{knowledge_id}"
+
+
+def normalize_knowledge_sync_setting(setting=None) -> dict:
+ value = {**DEFAULT_KNOWLEDGE_SYNC_SETTING, **(setting or {})}
+ value["enabled"] = bool(value.get("enabled", False))
+ if value.get("schedule_type") not in {"daily", "cron"}:
+ raise ValueError("schedule_type must be daily or cron")
+ if value.get("sync_type") not in KNOWLEDGE_SYNC_TYPES:
+ raise ValueError("sync_type must be incremental, replace or complete")
+ if value["schedule_type"] == "daily":
+ time_value = str(value.get("time") or "").strip()
+ match = TIME_PATTERN.fullmatch(time_value)
+ if match is None:
+ raise ValueError("time must use HH:MM format")
+ value["time"] = time_value
+ value["cron_expression"] = f"{int(match.group(2))} {int(match.group(1))} * * *"
+ else:
+ expression = str(value.get("cron_expression") or "").strip()
+ if not expression:
+ raise ValueError("cron_expression is required")
+ CronTrigger.from_crontab(expression)
+ value["cron_expression"] = expression
+ return value
+
+
+def enqueue_scheduled_knowledge_sync(knowledge_id: str):
+ scheduled_sync_knowledge.delay(str(knowledge_id))
+
+
+def remove_knowledge_sync_job(knowledge_id) -> None:
+ scheduler = _get_scheduler()
+ for job_id in [knowledge_sync_job_id(knowledge_id), f"{LEGACY_WEB_SYNC_JOB_PREFIX}{knowledge_id}"]:
+ job = scheduler.get_job(job_id)
+ if job is not None:
+ job.remove()
+
+
+def deploy_knowledge_sync_job(knowledge_id) -> bool:
+ scheduler = _get_scheduler()
+ remove_knowledge_sync_job(knowledge_id)
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id, type__in=SCHEDULED_KNOWLEDGE_TYPES).first()
+ if knowledge is None:
+ return False
+ try:
+ setting = normalize_knowledge_sync_setting((knowledge.meta or {}).get("sync_setting"))
+ except ValueError as exc:
+ maxkb_logger.warning(f"Invalid knowledge sync setting, knowledge_id={knowledge_id}: {exc}")
+ return False
+ if not setting["enabled"]:
+ return False
+ scheduler.add_job(
+ enqueue_scheduled_knowledge_sync,
+ trigger=CronTrigger.from_crontab(setting["cron_expression"]),
+ id=knowledge_sync_job_id(knowledge.id),
+ args=[str(knowledge.id)],
+ replace_existing=True,
+ misfire_grace_time=300,
+ max_instances=1,
+ coalesce=True,
+ )
+ return True
+
+
+def restore_knowledge_sync_jobs() -> None:
+ scheduler = _get_scheduler()
+ active_ids = {
+ str(knowledge_id)
+ for knowledge_id in QuerySet(Knowledge)
+ .filter(type__in=SCHEDULED_KNOWLEDGE_TYPES, meta__sync_setting__enabled=True)
+ .values_list("id", flat=True)
+ }
+ for job in scheduler.get_jobs():
+ job_id = getattr(job, "id", "")
+ if (
+ job_id.startswith(KNOWLEDGE_SYNC_JOB_PREFIX)
+ and job_id.removeprefix(KNOWLEDGE_SYNC_JOB_PREFIX) not in active_ids
+ ):
+ job.remove()
+ elif job_id.startswith(LEGACY_WEB_SYNC_JOB_PREFIX):
+ job.remove()
+ for knowledge_id in active_ids:
+ deploy_knowledge_sync_job(knowledge_id)
diff --git a/apps/knowledge/services/multimodal_retrieval.py b/apps/knowledge/services/multimodal_retrieval.py
new file mode 100644
index 00000000000..7114ff4e7c9
--- /dev/null
+++ b/apps/knowledge/services/multimodal_retrieval.py
@@ -0,0 +1,83 @@
+"""Helpers shared by multimodal knowledge retrieval entry points."""
+
+import base64
+import mimetypes
+from typing import Iterable
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+
+from common.exception.app_exception import AppApiException
+from knowledge.models import File, ParagraphAsset, SourceType
+
+
+MAX_QUERY_IMAGE_COUNT = 10
+MAX_QUERY_IMAGE_SIZE = 20 * 1024 * 1024
+
+
+def load_image_query_inputs(image_items: Iterable[dict], user_id=None) -> list[str]:
+ """Resolve uploaded file references into provider-neutral image data URLs."""
+ items = list(image_items or [])
+ if not items:
+ return []
+ if len(items) > MAX_QUERY_IMAGE_COUNT:
+ raise AppApiException(
+ 500,
+ _("A maximum of {count} images can be queried at a time").format(count=MAX_QUERY_IMAGE_COUNT),
+ )
+
+ file_ids = [str(item.get("file_id")) for item in items]
+ files = {str(file.id): file for file in QuerySet(File).filter(id__in=file_ids)}
+ image_inputs = []
+ for file_id in file_ids:
+ file = files.get(file_id)
+ if file is None:
+ raise AppApiException(500, _("Query image does not exist: {file_id}").format(file_id=file_id))
+
+ owner_id = str((file.meta or {}).get("user_id") or "")
+ if owner_id and user_id and owner_id != str(user_id):
+ raise AppApiException(403, _("No permission to access the query image"))
+
+ mime_type = mimetypes.guess_type(file.file_name)[0] or ""
+ if not mime_type.startswith("image/"):
+ raise AppApiException(500, _("Only image files can be used for image queries"))
+
+ content = file.get_bytes()
+ if len(content) > MAX_QUERY_IMAGE_SIZE:
+ raise AppApiException(
+ 500,
+ _("The maximum size of a query image cannot exceed {size}MB").format(
+ size=MAX_QUERY_IMAGE_SIZE // 1024 // 1024
+ ),
+ )
+ encoded = base64.b64encode(content).decode("ascii")
+ image_inputs.append(f"data:{mime_type};base64,{encoded}")
+ return image_inputs
+
+
+def get_hit_asset_map(hit_list: Iterable[dict]) -> dict[str, dict]:
+ """Return display metadata for image vectors that won a paragraph hit."""
+ asset_ids = {
+ str(hit.get("source_id"))
+ for hit in hit_list or []
+ if str(hit.get("source_type")) == str(SourceType.IMAGE.value) and hit.get("source_id")
+ }
+ if not asset_ids:
+ return {}
+
+ assets = ParagraphAsset.objects.select_related("file").filter(id__in=asset_ids)
+ return {
+ str(asset.id): {
+ "id": str(asset.id),
+ "file_id": str(asset.file_id),
+ "file_name": asset.file.file_name,
+ "url": f"./oss/file/{asset.file_id}",
+ "position": asset.position,
+ "caption": asset.caption,
+ "ocr_text": asset.ocr_text,
+ "description": asset.description,
+ "hit_num": asset.hit_num,
+ "last_hit_time": asset.last_hit_time.isoformat() if asset.last_hit_time else None,
+ }
+ for asset in assets
+ }
diff --git a/apps/knowledge/services/paragraph_assets.py b/apps/knowledge/services/paragraph_assets.py
new file mode 100644
index 00000000000..fd7311d3d7b
--- /dev/null
+++ b/apps/knowledge/services/paragraph_assets.py
@@ -0,0 +1,415 @@
+"""Extract and process inline paragraph images without turning them into standalone paragraphs."""
+
+import base64
+import json
+import mimetypes
+import re
+from typing import Callable, Dict, Iterable, List, Optional
+
+import uuid_utils.compat as uuid
+from common.config.embedding_config import ModelManage
+from common.exception.app_exception import AppApiException
+from common.utils.shared_resource_auth import filter_authorized_ids
+from common.utils.tool_code import ToolExecutor
+from common.utils.ts_vecto_util import to_ts_vector
+from django.contrib.postgres.search import SearchVector
+from django.db import transaction
+from django.db.models import Value
+from django.utils.translation import gettext_lazy as _
+from langchain_core.messages import HumanMessage
+from models_provider.base_model_provider import ModelTypeConst
+from models_provider.tools import get_model, get_model_by_id
+from tools.models import Tool
+
+from knowledge.models import (
+ AssetProcessStatus,
+ ContentOrigin,
+ Embedding,
+ File,
+ Paragraph,
+ ParagraphAsset,
+ SourceType,
+ SyncState,
+)
+from knowledge.services.document_strategy import normalize_document_strategy, strategy_hashes
+
+
+IMAGE_PATTERN = re.compile(r"!\[(?P[^\]]*)\]\([^)]*/oss/file/(?P[0-9a-fA-F-]{32,36})[^)]*\)")
+
+
+def paragraph_asset_source_key(paragraph: Paragraph, position: int) -> str:
+ return f"{paragraph.source_key or paragraph.id}:image:{position}"
+
+
+def paragraph_content_schema(content: str) -> List[Dict]:
+ blocks, cursor = [], 0
+ for match in IMAGE_PATTERN.finditer(content or ""):
+ if match.start() > cursor:
+ blocks.append({"type": "text", "content": content[cursor : match.start()]})
+ blocks.append(
+ {
+ "type": "image",
+ "file_id": match.group("file_id"),
+ "caption": match.group("caption") or "",
+ "description": "",
+ "raw": match.group(0),
+ }
+ )
+ cursor = match.end()
+ if cursor < len(content or ""):
+ blocks.append({"type": "text", "content": content[cursor:]})
+ return blocks or [{"type": "text", "content": content or ""}]
+
+
+@transaction.atomic
+def sync_paragraph_assets(paragraphs: Iterable[Paragraph], visual_strategy_hash: str = "") -> List[ParagraphAsset]:
+ paragraphs = list(paragraphs)
+ if not paragraphs:
+ return []
+
+ document_ids = {paragraph.document_id for paragraph in paragraphs}
+ touched_paragraph_ids = {paragraph.id for paragraph in paragraphs}
+ existing_assets = list(
+ ParagraphAsset.objects.select_for_update()
+ .select_related("paragraph")
+ .filter(document_id__in=document_ids)
+ .order_by("document_id", "paragraph_id", "position", "id")
+ )
+ existing_keys = {(asset.document_id, asset.source_asset_key) for asset in existing_assets if asset.source_asset_key}
+ claimed_ids = set()
+ plans = []
+ schemas = {}
+
+ def available_assets(paragraph, origin):
+ return [
+ asset
+ for asset in existing_assets
+ if asset.document_id == paragraph.document_id
+ and asset.origin == origin
+ and asset.id not in claimed_ids
+ and (
+ asset.paragraph_id == paragraph.id
+ or (
+ origin == ContentOrigin.SYNCED
+ and (
+ asset.paragraph_id in touched_paragraph_ids
+ or not asset.paragraph.is_active
+ or asset.paragraph.sync_state == SyncState.REMOTE_DELETED
+ )
+ )
+ )
+ ]
+
+ def unique_source_key(paragraph, desired_key, file_hash):
+ candidate = desired_key[:512]
+ index = 1
+ while (paragraph.document_id, candidate) in existing_keys:
+ suffix = f":{(file_hash or 'asset')[:12]}:{index}"
+ candidate = f"{desired_key[: 512 - len(suffix)]}{suffix}"
+ index += 1
+ existing_keys.add((paragraph.document_id, candidate))
+ return candidate
+
+ # Match every image before applying remote-delete markers. This allows an image to move
+ # between changed paragraphs while retaining its ParagraphAsset id and recall history.
+ for paragraph in paragraphs:
+ schema = paragraph_content_schema(paragraph.content)
+ schemas[paragraph.id] = schema
+ image_position = 0
+ for block in schema:
+ if block["type"] != "image":
+ continue
+ image_position += 1
+ file = File.objects.filter(id=block["file_id"]).first()
+ if file is None:
+ continue
+ origin = ContentOrigin.SYNCED if paragraph.origin == ContentOrigin.SYNCED else ContentOrigin.MANUAL
+ candidates = available_assets(paragraph, origin)
+ desired_key = str(block.get("source_asset_key") or paragraph_asset_source_key(paragraph, image_position))
+ file_hash = file.sha256_hash or ""
+
+ # Original bytes are the safest fallback when a connector cannot expose a native
+ # block/image id. The one-to-one claim prevents duplicate images sharing an asset.
+ hash_matches = [asset for asset in candidates if file_hash and asset.source_hash == file_hash]
+ asset = hash_matches[0] if len(hash_matches) == 1 else None
+ if asset is None:
+ asset = next((item for item in candidates if item.source_asset_key == desired_key), None)
+ if asset is None and origin == ContentOrigin.MANUAL:
+ asset = next(
+ (item for item in candidates if item.paragraph_id == paragraph.id and item.file_id == file.id),
+ None,
+ )
+
+ if asset is not None:
+ claimed_ids.add(asset.id)
+ source_key = asset.source_asset_key or unique_source_key(paragraph, desired_key, file_hash)
+ else:
+ source_key = unique_source_key(paragraph, desired_key, file_hash)
+ plans.append((paragraph, block, image_position, file, origin, source_key, asset))
+
+ active_assets = []
+ for paragraph, block, image_position, file, origin, source_key, asset in plans:
+ if asset is None:
+ asset = ParagraphAsset(
+ document_id=paragraph.document_id,
+ source_asset_key=source_key,
+ origin=origin,
+ )
+ asset.knowledge_id = paragraph.knowledge_id
+ asset.paragraph_id = paragraph.id
+ asset.file_id = file.id
+ asset.position = image_position
+ asset.source_hash = file.sha256_hash
+ asset.caption = block["caption"]
+ asset.sync_state = SyncState.ACTIVE
+ asset.visual_strategy_hash = visual_strategy_hash
+ asset.save()
+ claimed_ids.add(asset.id)
+ block["asset_id"] = str(asset.id)
+ block["source_asset_key"] = asset.source_asset_key
+ block["caption"] = asset.caption
+ block["ocr_text"] = asset.ocr_text
+ block["description"] = asset.description
+ active_assets.append(asset)
+
+ ParagraphAsset.objects.filter(
+ paragraph_id__in=touched_paragraph_ids,
+ origin=ContentOrigin.SYNCED,
+ ).exclude(id__in=claimed_ids).update(sync_state=SyncState.REMOTE_DELETED)
+ for paragraph in paragraphs:
+ schema = schemas[paragraph.id]
+ paragraph.content_schema = schema
+ paragraph.save(update_fields=["content_schema", "update_time"])
+ return active_assets
+
+
+def process_visual_assets(
+ assets: Iterable[ParagraphAsset],
+ strategy: Dict | None,
+ processor: Optional[Callable[[ParagraphAsset, Dict], Dict]] = None,
+ workspace_id: str | None = None,
+) -> None:
+ """Run a model/tool adapter. Errors are isolated per image and never abort document import."""
+ assets = list(assets)
+ normalized = normalize_document_strategy(strategy)
+ visual = normalized["visual"]
+ visual_hash = strategy_hashes(normalized)["visual_strategy_hash"]
+ resolver_error = ""
+ if visual["enabled"] and processor is None:
+ try:
+ processor = resolve_visual_processor(visual, workspace_id or _get_asset_workspace_id(assets))
+ except Exception as exc:
+ resolver_error = str(exc)[:2000]
+ for asset in assets:
+ asset.visual_strategy_hash = visual_hash
+ if not visual["enabled"]:
+ asset.process_status = AssetProcessStatus.SKIPPED
+ asset.process_error = ""
+ elif processor is None:
+ asset.process_status = AssetProcessStatus.FAILURE
+ asset.process_error = resolver_error or "visual processor adapter is unavailable"
+ asset.description = asset.description or asset.caption
+ else:
+ try:
+ output = processor(asset, visual) or {}
+ asset.caption = str(output.get("caption") or asset.caption)
+ asset.ocr_text = str(output.get("ocr_text") or asset.ocr_text)
+ asset.description = str(output.get("description") or asset.description or asset.caption)
+ output_meta = output.get("meta") if isinstance(output.get("meta"), dict) else {}
+ asset.meta = {**(asset.meta or {}), **output_meta}
+ asset.process_status = AssetProcessStatus.SUCCESS
+ asset.process_error = ""
+ except Exception as exc: # Image failure must not interrupt the remaining document.
+ asset.process_status = AssetProcessStatus.FAILURE
+ asset.process_error = str(exc)[:2000]
+ asset.description = asset.description or asset.caption
+ asset.save(
+ update_fields=[
+ "caption",
+ "ocr_text",
+ "description",
+ "meta",
+ "process_status",
+ "process_error",
+ "visual_strategy_hash",
+ "update_time",
+ ]
+ )
+ _write_asset_description(asset)
+
+
+def _write_asset_description(asset: ParagraphAsset) -> None:
+ paragraph = Paragraph.objects.filter(id=asset.paragraph_id).first()
+ if paragraph is None:
+ return
+ schema = paragraph.content_schema or paragraph_content_schema(paragraph.content)
+ images = [block for block in schema if block.get("type") == "image"]
+ index = asset.position - 1
+ if index < 0 or index >= len(images):
+ return
+ images[index]["caption"] = asset.caption
+ images[index]["ocr_text"] = asset.ocr_text
+ images[index]["description"] = asset.description
+ paragraph.content_schema = schema
+ paragraph.save(update_fields=["content_schema", "update_time"])
+
+
+def _image_data_url(asset: ParagraphAsset) -> str:
+ mime = mimetypes.guess_type(asset.file.file_name)[0] or "application/octet-stream"
+ encoded = base64.b64encode(asset.file.get_bytes()).decode("ascii")
+ return f"data:{mime};base64,{encoded}"
+
+
+def _get_asset_workspace_id(assets: List[ParagraphAsset]) -> str | None:
+ if not assets:
+ return None
+ asset = assets[0]
+ knowledge = getattr(asset, "knowledge", None)
+ return str(knowledge.workspace_id) if knowledge is not None else None
+
+
+def _get_llm_model(model_id, workspace_id: str | None):
+ if not workspace_id:
+ raise AppApiException(500, _("Workspace id is required for visual model validation"))
+ model = get_model_by_id(model_id, workspace_id)
+ if model.model_type != ModelTypeConst.IMAGE.name:
+ raise AppApiException(500, _("The selected model is not a vision model"))
+ return ModelManage.get_model(model_id, lambda _id: get_model(model))
+
+
+def resolve_visual_processor(
+ visual: Dict, workspace_id: str | None = None
+) -> Optional[Callable[[ParagraphAsset, Dict], Dict]]:
+ if visual.get("strategy") == "model":
+ model = _get_llm_model(visual["model_id"], workspace_id)
+
+ def model_processor(asset: ParagraphAsset, _config: Dict) -> Dict:
+ prompt = (
+ "请识别图片中的文字并描述图片。只返回 JSON:"
+ '{"description":"图片描述","ocr_text":"识别文字","caption":"简短标题"}'
+ )
+ response = model.invoke(
+ [
+ HumanMessage(
+ content=[
+ {"type": "text", "text": prompt},
+ {"type": "image_url", "image_url": {"url": _image_data_url(asset)}},
+ ]
+ )
+ ]
+ )
+ content = response.content if hasattr(response, "content") else response
+ if isinstance(content, list):
+ content = "".join(
+ str(item.get("text", item)) if isinstance(item, dict) else str(item) for item in content
+ )
+ text = str(content).strip().removeprefix("```json").removesuffix("```").strip()
+ try:
+ return json.loads(text)
+ except json.JSONDecodeError:
+ return {"description": text}
+
+ return model_processor
+
+ if visual.get("strategy") == "tool":
+ if not workspace_id:
+ raise AppApiException(500, _("Workspace id is required for visual tool validation"))
+ authorized_ids = filter_authorized_ids("tool", [str(visual["tool_id"])], workspace_id)
+ tool = Tool.objects.filter(id__in=authorized_ids, is_active=True).first()
+ if tool is None:
+ raise AppApiException(500, _("The selected visual tool does not exist or is not authorized"))
+
+ def tool_processor(asset: ParagraphAsset, _config: Dict) -> Dict:
+ data_url = _image_data_url(asset)
+ available = {
+ "file_id": str(asset.file_id),
+ "image": data_url,
+ "image_url": data_url,
+ "image_base64": data_url.split(",", 1)[1],
+ }
+ params = {
+ field.get("name"): available.get(field.get("name"))
+ for field in (tool.input_field_list or [])
+ if field.get("name") in available
+ }
+ init_params = tool.init_params
+ if isinstance(init_params, str) and init_params.strip():
+ init_params = json.loads(init_params)
+ output = ToolExecutor().exec_code(tool.code, {**(init_params or {}), **params})
+ if isinstance(output, dict):
+ return output
+ return {"description": str(output)}
+
+ return tool_processor
+ return None
+
+
+def embed_paragraph_assets(paragraph_ids: Iterable[str], embedding_model) -> int:
+ """Create text units for image descriptions and image units when the model supports them."""
+ assets = list(
+ ParagraphAsset.objects.select_related("file", "paragraph")
+ .filter(paragraph_id__in=paragraph_ids, sync_state=SyncState.ACTIVE)
+ .order_by("paragraph_id", "position")
+ )
+ if not assets:
+ return 0
+ rows = []
+
+ text_assets = []
+ text_inputs = []
+ for asset in assets:
+ text = "\n".join(
+ value.strip() for value in (asset.caption, asset.ocr_text, asset.description) if value and value.strip()
+ )
+ if text:
+ text_assets.append(asset)
+ text_inputs.append(text)
+ if text_inputs:
+ text_vectors = embedding_model.embed_documents(text_inputs)
+ if len(text_vectors) != len(text_inputs):
+ raise AppApiException(500, _("The image description embedding model returned an incomplete result"))
+ for asset, text, vector in zip(text_assets, text_inputs, text_vectors):
+ rows.append(
+ Embedding(
+ id=uuid.uuid7(),
+ knowledge_id=asset.knowledge_id,
+ document_id=asset.document_id,
+ paragraph_id=asset.paragraph_id,
+ source_id=str(asset.id),
+ source_type=SourceType.IMAGE,
+ is_active=asset.paragraph.is_active,
+ embedding=[float(item) for item in vector],
+ search_vector=SearchVector(Value(to_ts_vector(text)), config="simple"),
+ meta={
+ "unit_type": "text",
+ "content_type": "image_description",
+ "asset_id": str(asset.id),
+ "position": asset.position,
+ },
+ )
+ )
+
+ if embedding_model.supports_image_embedding():
+ image_inputs = [_image_data_url(asset) for asset in assets]
+ image_vectors = embedding_model.embed_images(image_inputs)
+ if len(image_vectors) != len(image_inputs):
+ raise AppApiException(500, _("The image embedding model returned an incomplete result"))
+ for asset, vector in zip(assets, image_vectors):
+ rows.append(
+ Embedding(
+ id=uuid.uuid7(),
+ knowledge_id=asset.knowledge_id,
+ document_id=asset.document_id,
+ paragraph_id=asset.paragraph_id,
+ source_id=str(asset.id),
+ source_type=SourceType.IMAGE,
+ is_active=asset.paragraph.is_active,
+ embedding=[float(item) for item in vector],
+ search_vector="",
+ meta={"unit_type": "image", "asset_id": str(asset.id), "position": asset.position},
+ )
+ )
+
+ if rows:
+ Embedding.objects.bulk_create(rows)
+ return len(rows)
diff --git a/apps/knowledge/services/problem_service.py b/apps/knowledge/services/problem_service.py
new file mode 100644
index 00000000000..e57af43d8bf
--- /dev/null
+++ b/apps/knowledge/services/problem_service.py
@@ -0,0 +1,78 @@
+"""Problem association services shared by generation tasks."""
+
+import re
+
+import uuid_utils.compat as uuid
+from django.db import transaction
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+
+from common.utils.logger import maxkb_logger
+from knowledge.models import Knowledge, Paragraph, Problem, ProblemParagraphMapping, SourceType
+from knowledge.task.embedding import embedding_by_problem
+
+
+@transaction.atomic
+def save_problem(knowledge_id, document_id, paragraph_id, generated_text) -> None:
+ """Persist one generated question and build its embedding."""
+ generated_text = re.sub(r"^\d+\.\s*", "", generated_text)
+ match = re.search(r"(.*?)", generated_text, flags=re.DOTALL)
+ content = match.group(1) if match else None
+ if not content:
+ return
+
+ try:
+ paragraph_exists = (
+ QuerySet(Paragraph)
+ .filter(
+ id=paragraph_id,
+ document_id=document_id,
+ knowledge_id=knowledge_id,
+ )
+ .exists()
+ )
+ if not paragraph_exists:
+ return
+
+ problem = QuerySet(Problem).filter(knowledge_id=knowledge_id, content=content).first()
+ if problem is None:
+ problem = Problem(id=uuid.uuid7(), knowledge_id=knowledge_id, content=content)
+ problem.save()
+
+ mapping = (
+ QuerySet(ProblemParagraphMapping)
+ .filter(
+ knowledge_id=knowledge_id,
+ problem_id=problem.id,
+ paragraph_id=paragraph_id,
+ )
+ .first()
+ )
+ if mapping is not None:
+ return
+
+ mapping = ProblemParagraphMapping(
+ id=uuid.uuid7(),
+ problem_id=problem.id,
+ document_id=document_id,
+ paragraph_id=paragraph_id,
+ knowledge_id=knowledge_id,
+ )
+ mapping.save()
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first()
+ if knowledge is None or knowledge.embedding_model_id is None:
+ return
+ embedding_by_problem(
+ {
+ "text": problem.content,
+ "is_active": True,
+ "source_type": SourceType.PROBLEM,
+ "source_id": mapping.id,
+ "document_id": document_id,
+ "paragraph_id": paragraph_id,
+ "knowledge_id": knowledge_id,
+ },
+ str(knowledge.embedding_model_id),
+ )
+ except Exception as exc:
+ maxkb_logger.error(_("Association problem failed {error}").format(error=str(exc)))
diff --git a/apps/knowledge/services/retrieval_access.py b/apps/knowledge/services/retrieval_access.py
new file mode 100644
index 00000000000..1954a02d317
--- /dev/null
+++ b/apps/knowledge/services/retrieval_access.py
@@ -0,0 +1,129 @@
+"""Knowledge retrieval authorization using existing chat users and API keys."""
+
+from dataclasses import dataclass
+
+from django.db.models import QuerySet
+
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from knowledge.models import Knowledge
+from system_manage.models import ChatUser, ChatUserApiKey
+
+
+class RetrievalError(Exception):
+ def __init__(self, code, message, status=400):
+ super().__init__(message)
+ self.code, self.message, self.status = code, message, status
+
+
+@dataclass(frozen=True)
+class RetrievalIdentity:
+ user_id: str | None = None
+ api_key_id: str | None = None
+ admin_user_id: str | None = None
+
+
+def key_identity(key):
+ if key is None or not key.is_active or not key.user.is_active:
+ raise RetrievalError("invalid_api_key", "Invalid API key.", 401)
+ return RetrievalIdentity(user_id=str(key.user_id), api_key_id=str(key.id))
+
+
+def authenticate_key(authorization):
+ if authorization is None:
+ return RetrievalIdentity()
+ parts = authorization.split()
+ if len(parts) != 2 or parts[0].lower() != "bearer" or not 16 <= len(parts[1]) <= 1024:
+ raise RetrievalError("invalid_api_key", "Invalid API key.", 401)
+ return key_identity(QuerySet(ChatUserApiKey).select_related("user").filter(secret_key=parts[1]).first())
+
+
+def refresh_identity(identity):
+ if identity.api_key_id:
+ return key_identity(QuerySet(ChatUserApiKey).select_related("user").filter(id=identity.api_key_id).first())
+ return identity
+
+
+def authorized_ids(user_id, ids):
+ if not user_id or not QuerySet(ChatUser).filter(id=user_id, is_active=True).exists():
+ return set()
+ handler = DatabaseModelManage.get_model("get_knowledge_list_of_authorized")
+ return set(map(str, handler(user_id, ids))) if handler else set()
+
+
+def authorize_external(knowledge_id, identity):
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first()
+ if knowledge is None or knowledge.external_service.get("enabled") is not True:
+ raise RetrievalError("service_unavailable", "Retrieval service is unavailable.", 404)
+ if knowledge.external_service.get("authentication", False):
+ if not identity.user_id:
+ raise RetrievalError("authentication_required", "A chat user API key is required.", 401)
+ if str(knowledge.id) not in authorized_ids(identity.user_id, [str(knowledge.id)]):
+ raise RetrievalError("access_denied", "Knowledge access denied.", 403)
+ return knowledge
+
+
+def identity_from_server(user_id, user_type, debug=False):
+ """Use authenticated server fields; form_data.asker is not an authorization identity."""
+ return RetrievalIdentity(
+ user_id=str(user_id) if user_id and user_type == "CHAT_USER" else None,
+ admin_user_id=str(user_id) if user_id and debug and user_type in {"SYSTEM_USER", "ADMIN"} else None,
+ )
+
+
+def inherited_retrieval_context(parameters):
+ return {
+ key: parameters.get(key)
+ for key in ("retrieval_identity", "chat_user_id", "chat_user_type", "workspace_id", "debug")
+ }
+
+
+def filter_admin_knowledge(knowledge, user_id):
+ from common.auth.handle.impl.user_token import get_auth
+ from common.exception.app_exception import AppUnauthorizedFailed
+ from oss.serializers.file import _check_workspace_resource_permission
+ from users.models import User
+
+ user = QuerySet(User).filter(id=user_id, is_active=True).first()
+ if user is None:
+ return []
+ auth = get_auth(user)
+ allowed = []
+ for item in knowledge:
+ try:
+ _check_workspace_resource_permission(
+ auth,
+ user.id,
+ workspace_id=item.workspace_id,
+ target_id=str(item.id),
+ auth_target_type="KNOWLEDGE",
+ read_permission="KNOWLEDGE:READ",
+ )
+ allowed.append(str(item.id))
+ except AppUnauthorizedFailed:
+ pass
+ return allowed
+
+
+def filter_workflow_knowledge(knowledge_ids, parameters):
+ knowledge = list(QuerySet(Knowledge).filter(id__in=knowledge_ids))
+ identity = parameters.get("retrieval_identity")
+ if not isinstance(identity, RetrievalIdentity):
+ identity = RetrievalIdentity()
+ if identity.admin_user_id:
+ return filter_admin_knowledge(knowledge, identity.admin_user_id)
+ allowed, restricted, legacy = set(), [], []
+ for item in knowledge:
+ setting = item.external_service
+ if "authentication" not in setting:
+ legacy.append(str(item.id))
+ elif setting["authentication"]:
+ restricted.append(str(item.id))
+ else:
+ allowed.add(str(item.id))
+ allowed.update(authorized_ids(identity.user_id, restricted) if restricted else [])
+ # Preserve the pre-feature behavior for migrated, unconfigured knowledge bases.
+ handler = DatabaseModelManage.get_model("get_knowledge_list_of_authorized")
+ if legacy and handler and parameters.get("chat_user_type") == "CHAT_USER":
+ legacy = handler(parameters.get("chat_user_id"), legacy)
+ allowed.update(map(str, legacy))
+ return [str(i) for i in knowledge_ids if str(i) in allowed]
diff --git a/apps/knowledge/services/retrieval_stats.py b/apps/knowledge/services/retrieval_stats.py
new file mode 100644
index 00000000000..78c56b87111
--- /dev/null
+++ b/apps/knowledge/services/retrieval_stats.py
@@ -0,0 +1,113 @@
+import threading
+from contextlib import nullcontext
+from typing import Iterable
+
+from django.db import transaction
+from django.db.models import F, QuerySet
+from django.utils import timezone
+
+from common.utils.logger import maxkb_logger
+from knowledge.models import Document, Paragraph, ParagraphAsset, Problem, ProblemParagraphMapping, SourceType
+
+
+def _value(item, key):
+ return item.get(key) if isinstance(item, dict) else getattr(item, key, None)
+
+
+def collect_recall_source_ids(recall_items: Iterable) -> tuple[set[str], set[str]]:
+ """收集本次召回中的分段和问题映射 ID。
+
+ 向量查询会对每个分段保留得分最高的可检索单元;只有该单元来自问题时,
+ 才将对应问题计为本次召回。
+ """
+ paragraph_ids = set()
+ problem_mapping_ids = set()
+ for item in recall_items or []:
+ paragraph_id = _value(item, "paragraph_id")
+ if paragraph_id is not None:
+ paragraph_ids.add(str(paragraph_id))
+ if str(_value(item, "source_type")) == str(SourceType.PROBLEM.value):
+ source_id = _value(item, "source_id")
+ if source_id is not None:
+ problem_mapping_ids.add(str(source_id))
+ return paragraph_ids, problem_mapping_ids
+
+
+def collect_recall_asset_ids(recall_items: Iterable) -> set[str]:
+ """收集最终命中图片检索单元对应的资产 ID。"""
+ return {
+ str(source_id)
+ for item in recall_items or []
+ if str(_value(item, "source_type")) == str(SourceType.IMAGE.value)
+ and (source_id := _value(item, "source_id")) is not None
+ }
+
+
+def _only_new_ids(tracker: dict | None, key: str, ids: set[str]) -> set[str]:
+ if tracker is None:
+ return ids
+ seen_ids = tracker.setdefault(key, set())
+ new_ids = ids - seen_ids
+ seen_ids.update(ids)
+ return new_ids
+
+
+def get_recall_tracker(owner) -> dict:
+ tracker = getattr(owner, "_knowledge_recall_tracker", None)
+ if tracker is None:
+ tracker = {}
+ setattr(owner, "_knowledge_recall_tracker", tracker)
+ return tracker
+
+
+def record_recall(recall_items: Iterable, tracker: dict | None = None, recalled_at=None) -> None:
+ recall_items = list(recall_items or [])
+ paragraph_ids, problem_mapping_ids = collect_recall_source_ids(recall_items)
+ asset_ids = collect_recall_asset_ids(recall_items)
+ if not paragraph_ids:
+ return
+
+ paragraph_document_pairs = QuerySet(Paragraph).filter(id__in=paragraph_ids).values_list("id", "document_id")
+ existing_paragraph_ids = {str(paragraph_id) for paragraph_id, _ in paragraph_document_pairs}
+ recalled_paragraph_ids = existing_paragraph_ids
+ document_ids = {str(document_id) for _, document_id in paragraph_document_pairs}
+
+ problem_ids = set()
+ if problem_mapping_ids:
+ problem_ids = {
+ str(problem_id)
+ for problem_id in QuerySet(ProblemParagraphMapping)
+ .filter(id__in=problem_mapping_ids, paragraph_id__in=existing_paragraph_ids)
+ .values_list("problem_id", flat=True)
+ }
+
+ tracker_lock = tracker.setdefault("_lock", threading.Lock()) if tracker is not None else nullcontext()
+ with tracker_lock:
+ existing_paragraph_ids = _only_new_ids(tracker, "paragraph_ids", existing_paragraph_ids)
+ document_ids = _only_new_ids(tracker, "document_ids", document_ids)
+ problem_ids = _only_new_ids(tracker, "problem_ids", problem_ids)
+ asset_ids = _only_new_ids(tracker, "asset_ids", asset_ids)
+ recalled_at = recalled_at or timezone.now()
+
+ with transaction.atomic():
+ if existing_paragraph_ids:
+ QuerySet(Paragraph).filter(id__in=existing_paragraph_ids).update(
+ hit_num=F("hit_num") + 1, last_hit_time=recalled_at
+ )
+ if document_ids:
+ QuerySet(Document).filter(id__in=document_ids).update(hit_num=F("hit_num") + 1, last_hit_time=recalled_at)
+ if problem_ids:
+ QuerySet(Problem).filter(id__in=problem_ids).update(hit_num=F("hit_num") + 1, last_hit_time=recalled_at)
+ if asset_ids:
+ QuerySet(ParagraphAsset).filter(
+ id__in=asset_ids,
+ paragraph_id__in=recalled_paragraph_ids,
+ ).update(hit_num=F("hit_num") + 1, last_hit_time=recalled_at)
+
+
+def record_recall_safely(recall_items: Iterable, tracker: dict | None = None) -> None:
+ try:
+ record_recall(recall_items, tracker=tracker)
+ except Exception:
+ # 统计失败不应中断用户的检索和对话。
+ maxkb_logger.exception("Failed to update knowledge recall statistics")
diff --git a/apps/knowledge/services/workflow_sync.py b/apps/knowledge/services/workflow_sync.py
new file mode 100644
index 00000000000..b2bcd0332b5
--- /dev/null
+++ b/apps/knowledge/services/workflow_sync.py
@@ -0,0 +1,220 @@
+"""Stable document and paragraph reconciliation for scheduled workflow knowledge runs."""
+
+from collections import defaultdict
+from django.db import transaction
+from django.db.models import QuerySet
+
+from common.utils.logger import maxkb_logger
+from knowledge.models import (
+ Document,
+ DocumentResourceType,
+ DocumentTag,
+ Embedding,
+ File,
+ FileSourceType,
+ Knowledge,
+ KnowledgeSyncLog,
+ KnowledgeType,
+ Paragraph,
+ Problem,
+ ProblemParagraphMapping,
+)
+from knowledge.services.incremental_sync import IncrementalDocumentSync, prepare_remote_paragraphs
+from knowledge.services.paragraph_assets import process_visual_assets, sync_paragraph_assets
+from ops import celery_app
+
+
+DOCUMENT_IDENTITY_FIELDS = ("source_key", "source_id", "token", "source_url", "url")
+
+
+def _delete_problems_and_mappings(paragraph_ids) -> None:
+ mappings = QuerySet(ProblemParagraphMapping).filter(paragraph_id__in=paragraph_ids)
+ problem_ids = set(mappings.values_list("problem_id", flat=True))
+ mappings.delete()
+ if problem_ids:
+ QuerySet(Problem).filter(id__in=problem_ids, problemparagraphmapping__isnull=True).delete()
+
+
+def _delete_workflow_documents(document_ids) -> list[str]:
+ document_ids = [str(document_id) for document_id in document_ids]
+ if not document_ids:
+ return []
+ existing_ids = [
+ str(document_id) for document_id in QuerySet(Document).filter(id__in=document_ids).values_list("id", flat=True)
+ ]
+ if not existing_ids:
+ return []
+ source_file_ids = [
+ source_file_id
+ for source_file_id in QuerySet(Document)
+ .filter(id__in=existing_ids)
+ .values_list("meta__source_file_id", flat=True)
+ if source_file_id
+ ]
+ QuerySet(File).filter(id__in=source_file_ids).delete()
+ QuerySet(File).filter(source_type=FileSourceType.DOCUMENT, source_id__in=existing_ids).delete()
+ paragraph_ids = list(QuerySet(Paragraph).filter(document_id__in=existing_ids).values_list("id", flat=True))
+ _delete_problems_and_mappings(paragraph_ids)
+ QuerySet(Embedding).filter(document_id__in=existing_ids).delete()
+ QuerySet(Paragraph).filter(id__in=paragraph_ids).delete()
+ QuerySet(DocumentTag).filter(document_id__in=existing_ids).delete()
+ QuerySet(Document).filter(id__in=existing_ids).delete()
+ return existing_ids
+
+
+def workflow_document_identity(document: Document) -> str:
+ meta = document.meta or {}
+ for field in DOCUMENT_IDENTITY_FIELDS:
+ value = str(meta.get(field) or "").strip()
+ if value:
+ return f"{field}:{value}"
+ return f"name:{' '.join((document.name or '').strip().lower().split())}"
+
+
+def _copy_document_relations(source: Document, target: Document, source_paragraphs, remote_paragraphs) -> None:
+ target_paragraphs = {
+ paragraph.source_key: paragraph
+ for paragraph in QuerySet(Paragraph).filter(document_id=target.id)
+ if paragraph.source_key
+ }
+ source_key_by_id = {
+ str(paragraph.id): remote["source_key"] for paragraph, remote in zip(source_paragraphs, remote_paragraphs)
+ }
+ for mapping in QuerySet(ProblemParagraphMapping).filter(document_id=source.id):
+ target_paragraph = target_paragraphs.get(source_key_by_id.get(str(mapping.paragraph_id), ""))
+ if target_paragraph is None:
+ continue
+ QuerySet(ProblemParagraphMapping).get_or_create(
+ knowledge_id=target.knowledge_id,
+ document_id=target.id,
+ paragraph_id=target_paragraph.id,
+ problem_id=mapping.problem_id,
+ defaults={"meta": mapping.meta or {}},
+ )
+ for tag_id in QuerySet(DocumentTag).filter(document_id=source.id).values_list("tag_id", flat=True):
+ QuerySet(DocumentTag).get_or_create(document_id=target.id, tag_id=tag_id)
+ QuerySet(File).filter(source_type=FileSourceType.DOCUMENT, source_id=str(source.id)).update(
+ source_id=str(target.id)
+ )
+
+
+@transaction.atomic
+def merge_workflow_incremental_snapshot(sync_log: KnowledgeSyncLog) -> dict:
+ """Merge newly generated workflow documents into the previous stable snapshot."""
+ new_documents = list(
+ QuerySet(Document).filter(
+ knowledge_id=sync_log.knowledge_id,
+ type=KnowledgeType.WORKFLOW,
+ resource_type=DocumentResourceType.DOCUMENT,
+ create_time__gte=sync_log.create_time,
+ )
+ )
+ old_documents = list(
+ QuerySet(Document).filter(
+ knowledge_id=sync_log.knowledge_id,
+ type=KnowledgeType.WORKFLOW,
+ resource_type=DocumentResourceType.DOCUMENT,
+ create_time__lt=sync_log.create_time,
+ )
+ )
+ old_by_identity = defaultdict(list)
+ for document in old_documents:
+ old_by_identity[workflow_document_identity(document)].append(document)
+
+ matched_old_ids = set()
+ synced_count = 0
+ skipped_count = 0
+ failed_count = 0
+ for new_document in new_documents:
+ candidates = [
+ document
+ for document in old_by_identity.get(workflow_document_identity(new_document), [])
+ if document.id not in matched_old_ids
+ ]
+ if not candidates:
+ synced_count += 1
+ continue
+ old_document = candidates[0]
+ # Reserve the old identity before merging so a per-document failure can never cause the
+ # last good version to be removed as a stale document.
+ matched_old_ids.add(old_document.id)
+ try:
+ source_paragraphs = list(QuerySet(Paragraph).filter(document_id=new_document.id).order_by("position", "id"))
+ remote_paragraphs = prepare_remote_paragraphs(
+ [
+ {
+ "title": paragraph.title,
+ "content": paragraph.content,
+ "source_key": paragraph.source_key,
+ "source_updated_at": paragraph.source_updated_at,
+ }
+ for paragraph in source_paragraphs
+ ]
+ )
+ result = IncrementalDocumentSync(old_document, new_document.doc_strategy).merge(remote_paragraphs)
+ changed_paragraphs = QuerySet(Paragraph).filter(id__in=result.reembed_ids)
+ assets = sync_paragraph_assets(changed_paragraphs, old_document.visual_strategy_hash)
+ process_visual_assets(assets, old_document.doc_strategy)
+ if result.disabled_ids:
+ QuerySet(Embedding).filter(paragraph_id__in=result.disabled_ids).delete()
+
+ old_document.name = new_document.name
+ old_document.meta = {**(old_document.meta or {}), **(new_document.meta or {})}
+ old_document.save(update_fields=["name", "meta", "update_time"])
+ _copy_document_relations(new_document, old_document, source_paragraphs, remote_paragraphs)
+
+ # Preserve files transferred to the stable document. The temporary output document
+ # must not delete an input/source file now referenced by the stable document.
+ new_document.meta = {
+ key: value for key, value in (new_document.meta or {}).items() if key != "source_file_id"
+ }
+ new_document.save(update_fields=["meta", "update_time"])
+ _delete_workflow_documents([str(new_document.id)])
+ if result.reembed_ids:
+ model_id = (
+ QuerySet(Knowledge)
+ .filter(id=old_document.knowledge_id)
+ .values_list("embedding_model_id", flat=True)
+ .first()
+ )
+ if model_id:
+ transaction.on_commit(
+ lambda paragraph_ids=list(result.reembed_ids), embedding_model_id=str(model_id): (
+ celery_app.send_task(
+ "celery:embedding_by_paragraph_list",
+ args=[paragraph_ids, embedding_model_id],
+ )
+ )
+ )
+ synced_count += 1
+ else:
+ skipped_count += 1
+ except Exception:
+ maxkb_logger.exception(
+ f"Failed to merge workflow document snapshot: knowledge_id={sync_log.knowledge_id}, "
+ f"document_id={new_document.id}"
+ )
+ failed_count += 1
+
+ # A successful workflow run represents a complete output snapshot. Remove old generated
+ # documents that were not emitted this time, but never touch standalone image resources.
+ deleted_count = 0
+ if new_documents and failed_count == 0:
+ stale_ids = [str(document.id) for document in old_documents if document.id not in matched_old_ids]
+ if stale_ids:
+ deleted_count = len(_delete_workflow_documents(stale_ids))
+ total_count = (
+ QuerySet(Document)
+ .filter(
+ knowledge_id=sync_log.knowledge_id,
+ resource_type=DocumentResourceType.DOCUMENT,
+ )
+ .count()
+ )
+ return {
+ "total_count": total_count,
+ "synced_count": synced_count,
+ "skipped_count": skipped_count,
+ "deleted_count": deleted_count,
+ "failed_count": failed_count,
+ }
diff --git a/apps/knowledge/sql/blend_search.sql b/apps/knowledge/sql/blend_search.sql
index 10e0ccbd7a5..5e2d3a27f2e 100644
--- a/apps/knowledge/sql/blend_search.sql
+++ b/apps/knowledge/sql/blend_search.sql
@@ -8,12 +8,18 @@ WITH vector_top AS (
)
SELECT
paragraph_id,
+ source_id,
+ source_type,
+ meta,
comprehensive_score,
comprehensive_score AS similarity
FROM
(
SELECT DISTINCT ON
(vc.paragraph_id) vc.paragraph_id,
+ e.source_id,
+ e.source_type,
+ e.meta,
(1 - vc.distance + COALESCE(ts_rank_cd(e.search_vector, websearch_to_tsquery('simple', %s), 32), 0)) AS comprehensive_score
FROM
vector_top vc
diff --git a/apps/knowledge/sql/embedding_search.sql b/apps/knowledge/sql/embedding_search.sql
index 5abb6fa6378..fd91eb0f78b 100644
--- a/apps/knowledge/sql/embedding_search.sql
+++ b/apps/knowledge/sql/embedding_search.sql
@@ -1,5 +1,8 @@
WITH vector_top AS (
SELECT paragraph_id,
+ source_id,
+ source_type,
+ meta,
(embedding::vector(%s) <=> %s) AS distance
FROM embedding ${embedding_query}
ORDER BY (embedding::vector(%s) <=> %s)
@@ -7,12 +10,18 @@ WITH vector_top AS (
)
SELECT
paragraph_id,
+ source_id,
+ source_type,
+ meta,
comprehensive_score,
comprehensive_score as similarity
FROM
(
SELECT DISTINCT ON
(vc.paragraph_id) vc.paragraph_id,
+ vc.source_id,
+ vc.source_type,
+ vc.meta,
(1 - vc.distance) AS comprehensive_score
FROM
vector_top vc
diff --git a/apps/knowledge/sql/keywords_search.sql b/apps/knowledge/sql/keywords_search.sql
index e47bd4e9f44..f548301a842 100644
--- a/apps/knowledge/sql/keywords_search.sql
+++ b/apps/knowledge/sql/keywords_search.sql
@@ -1,5 +1,8 @@
SELECT
paragraph_id,
+ source_id,
+ source_type,
+ meta,
comprehensive_score,
comprehensive_score as similarity
FROM
diff --git a/apps/knowledge/sql/list_knowledge.sql b/apps/knowledge/sql/list_knowledge.sql
index b8ff5a1ff86..de9d7fccc44 100644
--- a/apps/knowledge/sql/list_knowledge.sql
+++ b/apps/knowledge/sql/list_knowledge.sql
@@ -17,10 +17,14 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
WHEN
"app_knowledge_temp"."count" IS NULL THEN 0
ELSE "app_knowledge_temp"."count" END AS application_mapping_count,
- "document_temp".document_count
+ "document_temp".document_count,
+ "document_temp".image_count
FROM (SELECT knowledge.*
FROM knowledge knowledge ${knowledge_custom_sql}) temp_knowledge
- LEFT JOIN (SELECT "count"("id") AS document_count, "sum"("char_length") "char_length", knowledge_id
+ LEFT JOIN (SELECT "count"("id") FILTER (WHERE "resource_type" = 'document') AS document_count,
+ "count"("id") FILTER (WHERE "resource_type" = 'image') AS image_count,
+ "sum"("char_length") "char_length",
+ knowledge_id
FROM "document"
GROUP BY knowledge_id) "document_temp" ON temp_knowledge."id" = "document_temp".knowledge_id
LEFT JOIN (SELECT "count"("id"), knowledge_id
@@ -29,4 +33,4 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
ON temp_knowledge."id" = "app_knowledge_temp".knowledge_id
left join "user" on "user".id = temp_knowledge.user_id
) temp
- ${default_sql}
\ No newline at end of file
+ ${default_sql}
diff --git a/apps/knowledge/sql/list_knowledge_user.sql b/apps/knowledge/sql/list_knowledge_user.sql
index a9114be64d2..646c12ffb29 100644
--- a/apps/knowledge/sql/list_knowledge_user.sql
+++ b/apps/knowledge/sql/list_knowledge_user.sql
@@ -19,13 +19,17 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
WHEN
"app_knowledge_temp"."count" IS NULL THEN 0
ELSE "app_knowledge_temp"."count" END AS application_mapping_count,
- "document_temp".document_count
+ "document_temp".document_count,
+ "document_temp".image_count
FROM (SELECT knowledge.*
FROM knowledge knowledge ${knowledge_custom_sql}
AND id::text in (select target
from workspace_user_resource_permission ${workspace_user_resource_permission_query_set}
and 'VIEW' = any (permission_list))) temp_knowledge
- LEFT JOIN (SELECT "count"("id") AS document_count, "sum"("char_length") "char_length", knowledge_id
+ LEFT JOIN (SELECT "count"("id") FILTER (WHERE "resource_type" = 'document') AS document_count,
+ "count"("id") FILTER (WHERE "resource_type" = 'image') AS image_count,
+ "sum"("char_length") "char_length",
+ knowledge_id
FROM "document"
GROUP BY knowledge_id) "document_temp" ON temp_knowledge."id" = "document_temp".knowledge_id
LEFT JOIN (SELECT "count"("id"), knowledge_id
@@ -34,4 +38,4 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
ON temp_knowledge."id" = "app_knowledge_temp".knowledge_id
left join "user" on "user".id = temp_knowledge.user_id
) temp
- ${default_sql}
\ No newline at end of file
+ ${default_sql}
diff --git a/apps/knowledge/sql/list_knowledge_user_ee.sql b/apps/knowledge/sql/list_knowledge_user_ee.sql
index cc43c88ea7d..09a1c72b12e 100644
--- a/apps/knowledge/sql/list_knowledge_user_ee.sql
+++ b/apps/knowledge/sql/list_knowledge_user_ee.sql
@@ -19,7 +19,8 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
WHEN
"app_knowledge_temp"."count" IS NULL THEN 0
ELSE "app_knowledge_temp"."count" END AS application_mapping_count,
- "document_temp".document_count
+ "document_temp".document_count,
+ "document_temp".image_count
FROM (SELECT knowledge.*
FROM knowledge knowledge ${knowledge_custom_sql}
AND "knowledge".id::text in (select target
@@ -39,7 +40,10 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
'VIEW' = any (permission_list)
end
)) temp_knowledge
- LEFT JOIN (SELECT "count"("id") AS document_count, "sum"("char_length") "char_length", knowledge_id
+ LEFT JOIN (SELECT "count"("id") FILTER (WHERE "resource_type" = 'document') AS document_count,
+ "count"("id") FILTER (WHERE "resource_type" = 'image') AS image_count,
+ "sum"("char_length") "char_length",
+ knowledge_id
FROM "document"
GROUP BY knowledge_id) "document_temp" ON temp_knowledge."id" = "document_temp".knowledge_id
LEFT JOIN (SELECT "count"("id"), knowledge_id
@@ -48,4 +52,4 @@ FROM (SELECT "temp_knowledge".id::text, "temp_knowledge".name,
ON temp_knowledge."id" = "app_knowledge_temp".knowledge_id
left join "user" on "user".id = temp_knowledge.user_id
) temp
- ${default_sql}
\ No newline at end of file
+ ${default_sql}
diff --git a/apps/knowledge/task/embedding.py b/apps/knowledge/task/embedding.py
index 76efc2e28fb..265166fb15d 100644
--- a/apps/knowledge/task/embedding.py
+++ b/apps/knowledge/task/embedding.py
@@ -3,7 +3,7 @@
import traceback
from typing import List
-from celery_once import QueueOnce
+from celery_once import AlreadyQueued, QueueOnce
from common.config.embedding_config import ModelManage
from common.event.listener_manage import (
ListenerManagement,
@@ -12,13 +12,14 @@
UpdateProblemArgs,
)
from common.utils.logger import maxkb_logger
+from django.db import transaction
from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
from models_provider.models import Model
from models_provider.tools import get_model, get_model_default_params
from ops import celery_app
-from knowledge.models import Document, State, TaskType
+from knowledge.models import Document, Paragraph, State, TaskType
from knowledge.serializers.common import drop_knowledge_index
@@ -158,6 +159,27 @@ def tokenize_by_document(document_id, state_list):
ListenerManagement.tokenize_by_document(document_id, state_list)
+@celery_app.task(base=QueueOnce, once={"keys": ["knowledge_id"]}, name="celery:tokenize_by_knowledge")
+def tokenize_by_knowledge(knowledge_id):
+ """为知识库全部文档提交分词任务,复用文档任务的状态管理和锁。"""
+ # 先提交状态更新,再分发文档任务,避免 worker 读到未提交的状态。
+ with transaction.atomic():
+ ListenerManagement.update_status(
+ QuerySet(Document).filter(knowledge_id=knowledge_id), TaskType.TOKENIZE, State.PENDING
+ )
+ ListenerManagement.update_status(
+ QuerySet(Paragraph).filter(knowledge_id=knowledge_id), TaskType.TOKENIZE, State.PENDING
+ )
+ ListenerManagement.get_aggregation_document_status_by_knowledge_id(knowledge_id)()
+ document_ids = QuerySet(Document).filter(knowledge_id=knowledge_id).values_list("id", flat=True)
+ state_list = [state.value for state in State]
+ for document_id in document_ids.iterator():
+ try:
+ tokenize_by_document.delay(document_id, state_list)
+ except AlreadyQueued:
+ continue
+
+
def delete_embedding_by_document(document_id):
"""
删除指定文档id的向量
diff --git a/apps/knowledge/task/generate.py b/apps/knowledge/task/generate.py
index bf89122a524..57870d40cbf 100644
--- a/apps/knowledge/task/generate.py
+++ b/apps/knowledge/task/generate.py
@@ -11,7 +11,7 @@
from common.utils.logger import maxkb_logger
from common.utils.page_utils import page, page_desc
from knowledge.models import Paragraph, Document, Status, TaskType, State
-from knowledge.task.handler import save_problem
+from knowledge.services.problem_service import save_problem
from models_provider.models import Model
from models_provider.tools import get_model
from ops import celery_app
@@ -24,20 +24,24 @@ def get_llm_model(model_id, model_params_setting=None):
def generate_problem_by_paragraph(paragraph, llm_model, prompt):
try:
- ListenerManagement.update_status(QuerySet(Paragraph).filter(id=paragraph.id), TaskType.GENERATE_PROBLEM,
- State.STARTED)
+ ListenerManagement.update_status(
+ QuerySet(Paragraph).filter(id=paragraph.id), TaskType.GENERATE_PROBLEM, State.STARTED
+ )
res = llm_model.invoke(
- [HumanMessage(content=prompt.replace('{data}', paragraph.content).replace('{title}', paragraph.title))])
+ [HumanMessage(content=prompt.replace("{data}", paragraph.content).replace("{title}", paragraph.title))]
+ )
if (res.content is None) or (len(res.content) == 0):
return
- problems = res.content.split('\n')
+ problems = res.content.split("\n")
for problem in problems:
save_problem(paragraph.knowledge_id, paragraph.document_id, paragraph.id, problem)
- ListenerManagement.update_status(QuerySet(Paragraph).filter(id=paragraph.id), TaskType.GENERATE_PROBLEM,
- State.SUCCESS)
+ ListenerManagement.update_status(
+ QuerySet(Paragraph).filter(id=paragraph.id), TaskType.GENERATE_PROBLEM, State.SUCCESS
+ )
except Exception as e:
- ListenerManagement.update_status(QuerySet(Paragraph).filter(id=paragraph.id), TaskType.GENERATE_PROBLEM,
- State.FAILURE)
+ ListenerManagement.update_status(
+ QuerySet(Paragraph).filter(id=paragraph.id), TaskType.GENERATE_PROBLEM, State.FAILURE
+ )
def get_generate_problem(llm_model, prompt, post_apply=lambda: None, is_the_task_interrupted=lambda: False):
@@ -61,8 +65,7 @@ def is_the_task_interrupted():
return is_the_task_interrupted
-@celery_app.task(base=QueueOnce, once={'keys': ['knowledge_id']},
- name='celery:generate_related_by_knowledge')
+@celery_app.task(base=QueueOnce, once={"keys": ["knowledge_id"]}, name="celery:generate_related_by_knowledge")
def generate_related_by_knowledge_id(knowledge_id, model_id, model_params_setting, prompt, state_list=None):
document_list = QuerySet(Document).filter(knowledge_id=knowledge_id)
for document in document_list:
@@ -72,58 +75,69 @@ def generate_related_by_knowledge_id(knowledge_id, model_id, model_params_settin
pass
-@celery_app.task(base=QueueOnce, once={'keys': ['document_id']},
- name='celery:generate_related_by_document')
+@celery_app.task(base=QueueOnce, once={"keys": ["document_id"]}, name="celery:generate_related_by_document")
def generate_related_by_document_id(document_id, model_id, model_params_setting, prompt, state_list=None):
if state_list is None:
- state_list = [State.PENDING.value, State.STARTED.value, State.SUCCESS.value, State.FAILURE.value,
- State.REVOKE.value,
- State.REVOKED.value, State.IGNORED.value]
+ state_list = [
+ State.PENDING.value,
+ State.STARTED.value,
+ State.SUCCESS.value,
+ State.FAILURE.value,
+ State.REVOKE.value,
+ State.REVOKED.value,
+ State.IGNORED.value,
+ ]
try:
is_the_task_interrupted = get_is_the_task_interrupted(document_id)
if is_the_task_interrupted():
return
- ListenerManagement.update_status(QuerySet(Document).filter(id=document_id),
- TaskType.GENERATE_PROBLEM,
- State.STARTED)
+ ListenerManagement.update_status(
+ QuerySet(Document).filter(id=document_id), TaskType.GENERATE_PROBLEM, State.STARTED
+ )
llm_model = get_llm_model(model_id, model_params_setting)
# 生成问题函数
- generate_problem = get_generate_problem(llm_model, prompt,
- ListenerManagement.get_aggregation_document_status(
- document_id), is_the_task_interrupted)
- query_set = QuerySet(Paragraph).annotate(
- reversed_status=Reverse('status'),
- task_type_status=Substr('reversed_status', TaskType.GENERATE_PROBLEM.value,
- 1),
- ).filter(task_type_status__in=state_list, document_id=document_id)
+ generate_problem = get_generate_problem(
+ llm_model, prompt, ListenerManagement.get_aggregation_document_status(document_id), is_the_task_interrupted
+ )
+ query_set = (
+ QuerySet(Paragraph)
+ .annotate(
+ reversed_status=Reverse("status"),
+ task_type_status=Substr("reversed_status", TaskType.GENERATE_PROBLEM.value, 1),
+ )
+ .filter(task_type_status__in=state_list, document_id=document_id)
+ )
page_desc(query_set, 10, generate_problem, is_the_task_interrupted)
except Exception as e:
- maxkb_logger.error(f'根据文档生成问题:{document_id}出现错误{str(e)}{traceback.format_exc()}')
- maxkb_logger.error(_('Generate issue based on document: {document_id} error {error}{traceback}').format(
- document_id=document_id, error=str(e), traceback=traceback.format_exc()))
+ maxkb_logger.error(f"根据文档生成问题:{document_id}出现错误{str(e)}{traceback.format_exc()}")
+ maxkb_logger.error(
+ _("Generate issue based on document: {document_id} error {error}{traceback}").format(
+ document_id=document_id, error=str(e), traceback=traceback.format_exc()
+ )
+ )
finally:
ListenerManagement.post_update_document_status(document_id, TaskType.GENERATE_PROBLEM)
- maxkb_logger.info(_('End--->Generate problem: {document_id}').format(document_id=document_id))
+ maxkb_logger.info(_("End--->Generate problem: {document_id}").format(document_id=document_id))
-@celery_app.task(base=QueueOnce, once={'keys': ['paragraph_id_list']},
- name='celery:generate_related_by_paragraph_list')
+@celery_app.task(base=QueueOnce, once={"keys": ["paragraph_id_list"]}, name="celery:generate_related_by_paragraph_list")
def generate_related_by_paragraph_id_list(document_id, paragraph_id_list, model_id, model_params_setting, prompt):
try:
is_the_task_interrupted = get_is_the_task_interrupted(document_id)
if is_the_task_interrupted():
- ListenerManagement.update_status(QuerySet(Document).filter(id=document_id),
- TaskType.GENERATE_PROBLEM,
- State.REVOKED)
+ ListenerManagement.update_status(
+ QuerySet(Document).filter(id=document_id), TaskType.GENERATE_PROBLEM, State.REVOKED
+ )
return
- ListenerManagement.update_status(QuerySet(Document).filter(id=document_id),
- TaskType.GENERATE_PROBLEM,
- State.STARTED)
+ ListenerManagement.update_status(
+ QuerySet(Document).filter(id=document_id), TaskType.GENERATE_PROBLEM, State.STARTED
+ )
llm_model = get_llm_model(model_id, model_params_setting)
# 生成问题函数
- generate_problem = get_generate_problem(llm_model, prompt, ListenerManagement.get_aggregation_document_status(
- document_id))
+ generate_problem = get_generate_problem(
+ llm_model, prompt, ListenerManagement.get_aggregation_document_status(document_id)
+ )
def is_the_task_interrupted():
document = QuerySet(Document).filter(id=document_id).first()
diff --git a/apps/knowledge/task/handler.py b/apps/knowledge/task/handler.py
index 36abd1d3fd4..46a60859b3a 100644
--- a/apps/knowledge/task/handler.py
+++ b/apps/knowledge/task/handler.py
@@ -1,88 +1,174 @@
# coding=utf-8
-import re
import traceback
+from urllib.parse import urlsplit, urlunsplit
-from common.utils.fork import ChildLink, Fork
+from common.utils.fork import ChildLink, Fork, remove_fragment
from common.utils.logger import maxkb_logger
-from common.utils.split_model import get_split_model
from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
+from knowledge.models import State, Status, TaskType
+from knowledge.models.knowledge import Document, DocumentResourceType, Knowledge, KnowledgeType
+from knowledge.serializers.document import DocumentSerializers
+from knowledge.services.document_cleanup import delete_document_data
+from knowledge.services.document_strategy import (
+ normalize_document_strategy,
+ parse_web_content,
+ strategy_hashes,
+)
+from knowledge.web_assets import internalize_web_images
-from knowledge.models import State
-from knowledge.models.knowledge import Document, Knowledge, KnowledgeType
+def normalize_web_url(source_url: str) -> str:
+ """Return the URL identity used to match crawl results with stored documents."""
+ value = remove_fragment((source_url or "").strip())
+ parsed = urlsplit(value)
+ path = parsed.path.rstrip("/")
+ return urlunsplit((parsed.scheme.lower(), parsed.netloc.lower(), path, parsed.query, ""))
-def get_save_handler(knowledge_id, user_id, selector):
- from knowledge.serializers.document import DocumentSerializers
+
+def _document_name(child_link: ChildLink) -> str:
+ tag_text = getattr(child_link.tag, "text", "") if child_link.tag is not None else ""
+ return tag_text.strip() if tag_text and tag_text.strip() else child_link.url
+
+
+def _increment_stats(stats, field, amount=1):
+ if stats is not None:
+ stats[field] = stats.get(field, 0) + amount
+
+
+def get_save_handler(knowledge_id, user_id, selector, doc_strategy=None, stats=None):
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first()
+ strategy = normalize_document_strategy(
+ doc_strategy
+ if doc_strategy is not None
+ else ((knowledge.meta or {}).get("doc_strategy") if knowledge else None)
+ )
def handler(child_link: ChildLink, response: Fork.Response):
if response.status == 200:
try:
- document_name = (
- child_link.tag.text
- if child_link.tag is not None and len(child_link.tag.text.strip()) > 0
- else child_link.url
- )
- paragraphs = get_split_model("web.md").parse(response.content)
+ document_name = _document_name(child_link)
+ content = internalize_web_images(response.content, knowledge_id)
+ paragraphs = parse_web_content(content, strategy)
DocumentSerializers.Create(data={"knowledge_id": knowledge_id, "user_id": user_id}).save(
{
"name": document_name,
"paragraphs": paragraphs,
"meta": {"source_url": child_link.url, "selector": selector},
"type": KnowledgeType.WEB,
+ "doc_strategy": strategy,
},
with_valid=True,
)
+ _increment_stats(stats, "synced_count")
except Exception as e:
+ _increment_stats(stats, "failed_count")
maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
+ else:
+ _increment_stats(stats, "failed_count")
return handler
-def get_sync_handler(knowledge_id, user_id):
- from knowledge.serializers.document import DocumentSerializers
-
+def get_sync_handler(
+ knowledge_id,
+ user_id,
+ doc_strategy=None,
+ sync_type="incremental",
+ successful_urls=None,
+ stats=None,
+):
knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first()
+ if knowledge is None:
+ raise ValueError(f"Knowledge does not exist: {knowledge_id}")
+ if sync_type not in {"incremental", "replace"}:
+ raise ValueError(f"Unsupported Web knowledge synchronization type: {sync_type}")
+ strategy = normalize_document_strategy(
+ doc_strategy
+ if doc_strategy is not None
+ else ((knowledge.meta or {}).get("doc_strategy") if knowledge else None)
+ )
+ document_by_url = {
+ normalize_web_url((document.meta or {}).get("source_url", "")): document
+ for document in QuerySet(Document).filter(
+ knowledge=knowledge,
+ type=KnowledgeType.WEB,
+ resource_type=DocumentResourceType.DOCUMENT,
+ )
+ if (document.meta or {}).get("source_url")
+ }
def handler(child_link: ChildLink, response: Fork.Response):
if response.status == 200:
+ source_url = normalize_web_url(child_link.url)
+ if successful_urls is not None:
+ successful_urls.add(source_url)
try:
- document_name = (
- child_link.tag.text
- if child_link.tag is not None and len(child_link.tag.text.strip()) > 0
- else child_link.url
- )
- paragraphs = get_split_model("web.md").parse(response.content)
- first = QuerySet(Document).filter(meta__source_url=child_link.url.strip(), knowledge=knowledge).first()
- if first is not None:
- # 如果存在,使用文档同步
- DocumentSerializers.Sync(data={"document_id": first.id}).sync()
- else:
- # 插入
- DocumentSerializers.Create(data={"knowledge_id": knowledge.id, "user_id": user_id}).save(
- {
- "name": document_name,
- "paragraphs": paragraphs,
- "meta": {"source_url": child_link.url.strip(), "selector": knowledge.meta.get("selector")},
- "type": KnowledgeType.WEB,
- },
- with_valid=True,
+ document_name = _document_name(child_link)
+ existing = document_by_url.get(source_url)
+ if existing is not None and sync_type == "incremental":
+ # 增量同步使用文档自身策略,并复用本次爬取结果,避免重复请求。
+ previous_sync_version = existing.sync_version
+ DocumentSerializers.Sync(data={"knowledge_id": knowledge.id, "document_id": existing.id}).sync(
+ response=response
)
+ if stats is not None:
+ refreshed = QuerySet(Document).filter(id=existing.id).first()
+ sync_state = Status.of(refreshed.status)[TaskType.SYNC] if refreshed is not None else None
+ if sync_state == State.FAILURE:
+ _increment_stats(stats, "failed_count")
+ elif refreshed.sync_version == previous_sync_version:
+ _increment_stats(stats, "skipped_count")
+ else:
+ _increment_stats(stats, "synced_count")
+ return
+
+ selected_strategy = (
+ normalize_document_strategy(existing.doc_strategy) if existing is not None else strategy
+ )
+ selected_selector = (
+ (existing.meta or {}).get("selector")
+ if existing is not None
+ else (knowledge.meta or {}).get("selector")
+ )
+ content = internalize_web_images(response.content, knowledge.id)
+ paragraphs = parse_web_content(content, selected_strategy)
+ created = DocumentSerializers.Create(data={"knowledge_id": knowledge.id, "user_id": user_id}).save(
+ {
+ "name": document_name,
+ "paragraphs": paragraphs,
+ "meta": {"source_url": source_url, "selector": selected_selector},
+ "type": KnowledgeType.WEB,
+ "doc_strategy": selected_strategy,
+ },
+ with_valid=True,
+ )
+ if existing is not None:
+ # 新文档完整落库后再删除旧文档,避免解析或向量化失败造成数据丢失。
+ delete_document_data([existing.id])
+ _increment_stats(stats, "deleted_count")
+ created_id = created.get("id") if isinstance(created, dict) else None
+ if created_id:
+ document_by_url[source_url] = QuerySet(Document).filter(id=created_id).first()
+ _increment_stats(stats, "synced_count")
except Exception as e:
+ _increment_stats(stats, "failed_count")
maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
+ else:
+ _increment_stats(stats, "failed_count")
return handler
-def get_sync_web_document_handler(knowledge_id, user_id):
- from knowledge.serializers.document import DocumentSerializers
+def get_sync_web_document_handler(knowledge_id, user_id, doc_strategy=None):
+ strategy = normalize_document_strategy(doc_strategy)
def handler(source_url: str, selector, response: Fork.Response):
if response.status == 200:
try:
- paragraphs = get_split_model("web.md").parse(response.content)
+ content = internalize_web_images(response.content, knowledge_id)
+ paragraphs = parse_web_content(content, strategy)
# 插入
DocumentSerializers.Create(data={"knowledge_id": knowledge_id, "user_id": user_id}).save(
{
@@ -90,12 +176,14 @@ def handler(source_url: str, selector, response: Fork.Response):
"paragraphs": paragraphs,
"meta": {"source_url": source_url, "selector": selector},
"type": KnowledgeType.WEB,
+ "doc_strategy": strategy,
},
with_valid=True,
)
except Exception as e:
maxkb_logger.error(f"{str(e)}:{traceback.format_exc()}")
else:
+ hashes = strategy_hashes(strategy)
Document(
name=source_url[0:128],
knowledge_id=knowledge_id,
@@ -103,32 +191,9 @@ def handler(source_url: str, selector, response: Fork.Response):
type=KnowledgeType.WEB,
char_length=0,
status=State.FAILURE,
+ user_id=user_id,
+ doc_strategy=strategy,
+ **hashes,
).save()
return handler
-
-
-def save_problem(knowledge_id, document_id, paragraph_id, problem):
- from knowledge.serializers.paragraph import ParagraphSerializers
-
- # print(f"knowledge_id: {knowledge_id}")
- # print(f"document_id: {document_id}")
- # print(f"paragraph_id: {paragraph_id}")
- # print(f"problem: {problem}")
- problem = re.sub(r"^\d+\.\s*", "", problem)
- match = re.search(r"(.*?)<\/question>", problem, flags=re.DOTALL)
- problem = match.group(1) if match else None
- if problem is None or len(problem) == 0:
- return
- try:
- workspace_id = QuerySet(Knowledge).filter(id=knowledge_id).first().workspace_id
- ParagraphSerializers.Problem(
- data={
- "workspace_id": workspace_id,
- "knowledge_id": knowledge_id,
- "document_id": document_id,
- "paragraph_id": paragraph_id,
- }
- ).save(instance={"content": problem}, with_valid=True)
- except Exception as e:
- maxkb_logger.error(_("Association problem failed {error}").format(error=str(e)))
diff --git a/apps/knowledge/task/sync.py b/apps/knowledge/task/sync.py
index 623688587af..699ff5484b1 100644
--- a/apps/knowledge/task/sync.py
+++ b/apps/knowledge/task/sync.py
@@ -8,25 +8,64 @@
"""
import traceback
+from copy import deepcopy
+from time import perf_counter
from typing import List
from celery_once import QueueOnce
from common.utils.fork import Fork, ForkManage
from common.utils.logger import maxkb_logger
+from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
+from knowledge.models import (
+ Document,
+ DocumentResourceType,
+ File,
+ FileSourceType,
+ Knowledge,
+ KnowledgeSyncLog,
+ KnowledgeSyncStatus,
+ KnowledgeSyncTrigger,
+ KnowledgeSyncType,
+ KnowledgeType,
+)
+from knowledge.serializers.knowledge_workflow import KnowledgeWorkflowActionSerializer
+from knowledge.services.document_cleanup import delete_document_data
+from knowledge.task.handler import (
+ get_save_handler,
+ get_sync_handler,
+ get_sync_web_document_handler,
+ normalize_web_url,
+)
from ops import celery_app
+WEB_SYNC_TYPES = {"incremental", "replace", "complete"}
+SCHEDULED_KNOWLEDGE_TYPES = {KnowledgeType.WEB, KnowledgeType.LARK, KnowledgeType.WORKFLOW}
-@celery_app.task(base=QueueOnce, once={"keys": ["knowledge_id"]}, name="celery:sync_web_knowledge")
-def sync_web_knowledge(knowledge_id: str, user_id, url: str, selector: str):
- from knowledge.task.handler import get_save_handler
+def get_selector_list(selector: str | None) -> List[str]:
+ return [item for item in (selector or "").split(" ") if item]
+
+
+def _new_sync_stats():
+ return {
+ "total_count": 0,
+ "synced_count": 0,
+ "skipped_count": 0,
+ "deleted_count": 0,
+ "failed_count": 0,
+ "message": "",
+ }
+
+
+@celery_app.task(base=QueueOnce, once={"keys": ["knowledge_id"]}, name="celery:sync_web_knowledge")
+def sync_web_knowledge(knowledge_id: str, user_id, url: str, selector: str, doc_strategy=None):
try:
maxkb_logger.info(
_("Start--->Start synchronization web knowledge base:{knowledge_id}").format(knowledge_id=knowledge_id)
)
- ForkManage(url, selector.split(" ") if selector is not None else []).fork(
- 2, set(), get_save_handler(knowledge_id, user_id, selector)
+ ForkManage(url, get_selector_list(selector)).fork(
+ 2, set(), get_save_handler(knowledge_id, user_id, selector, doc_strategy)
)
maxkb_logger.info(
@@ -41,35 +80,260 @@ def sync_web_knowledge(knowledge_id: str, user_id, url: str, selector: str):
@celery_app.task(base=QueueOnce, once={"keys": ["knowledge_id"]}, name="celery:sync_replace_web_knowledge")
-def sync_replace_web_knowledge(knowledge_id: str, user_id, url: str, selector: str):
- from knowledge.task.handler import get_sync_handler
-
+def sync_replace_web_knowledge(
+ knowledge_id: str,
+ user_id,
+ url: str,
+ selector: str,
+ doc_strategy=None,
+ sync_type: str = "incremental",
+ record_log: bool = False,
+ trigger_type: str = KnowledgeSyncTrigger.MANUAL,
+):
+ started_at = perf_counter()
+ stats = _new_sync_stats()
+ sync_log = None
try:
+ if sync_type not in WEB_SYNC_TYPES:
+ raise ValueError(f"Unsupported Web knowledge synchronization type: {sync_type}")
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id, type=KnowledgeType.WEB).first()
+ if knowledge is None:
+ raise ValueError(f"Web knowledge does not exist: {knowledge_id}")
+ initial_total = (
+ QuerySet(Document)
+ .filter(
+ knowledge_id=knowledge_id,
+ type=KnowledgeType.WEB,
+ resource_type=DocumentResourceType.DOCUMENT,
+ )
+ .count()
+ )
+ stats["total_count"] = initial_total if isinstance(initial_total, int) else 0
+ if record_log:
+ sync_log = KnowledgeSyncLog.objects.create(
+ knowledge=knowledge,
+ workspace_id=knowledge.workspace_id,
+ sync_type=sync_type,
+ trigger_type=trigger_type,
+ )
maxkb_logger.info(
- _("Start--->Start synchronization web knowledge base:{knowledge_id}").format(knowledge_id=knowledge_id)
+ _("Start--->Start synchronization web knowledge base:{knowledge_id}, type:{sync_type}").format(
+ knowledge_id=knowledge_id, sync_type=sync_type
+ )
)
- ForkManage(url, selector.split(" ") if selector is not None else []).fork(
- 2, set(), get_sync_handler(knowledge_id, user_id)
+ if sync_type == "complete":
+ document_ids = list(
+ QuerySet(Document)
+ .filter(knowledge_id=knowledge_id, resource_type=DocumentResourceType.DOCUMENT)
+ .values_list("id", flat=True)
+ )
+ delete_document_data(document_ids)
+ QuerySet(File).filter(
+ source_type=FileSourceType.KNOWLEDGE,
+ source_id=str(knowledge_id),
+ meta__source_url__isnull=False,
+ ).delete()
+ ForkManage(url, get_selector_list(selector)).fork(
+ 2,
+ set(),
+ get_save_handler(knowledge_id, user_id, selector, doc_strategy, stats),
+ )
+ stats["deleted_count"] = len(document_ids)
+ else:
+ visited_urls, successful_urls = set(), set()
+ ForkManage(url, get_selector_list(selector)).fork(
+ 2,
+ visited_urls,
+ get_sync_handler(knowledge_id, user_id, doc_strategy, sync_type, successful_urls, stats),
+ )
+ if sync_type == "incremental" and normalize_web_url(url) in successful_urls:
+ crawled_urls = {normalize_web_url(item) for item in visited_urls}
+ stale_document_ids = [
+ document.id
+ for document in QuerySet(Document).filter(
+ knowledge_id=knowledge_id,
+ type=KnowledgeType.WEB,
+ resource_type=DocumentResourceType.DOCUMENT,
+ )
+ if (document.meta or {}).get("source_url")
+ and normalize_web_url(document.meta["source_url"]) not in crawled_urls
+ ]
+ delete_document_data(stale_document_ids)
+ stats["deleted_count"] += len(stale_document_ids)
+ stats["total_count"] = max(
+ stats["total_count"],
+ stats["synced_count"] + stats["skipped_count"] + stats["failed_count"],
+ stats["deleted_count"],
)
maxkb_logger.info(
_("End--->End synchronization web knowledge base:{knowledge_id}").format(knowledge_id=knowledge_id)
)
except Exception as e:
+ stats["failed_count"] += 1
+ stats["message"] = str(e)
maxkb_logger.error(
_("Synchronize web knowledge base:{knowledge_id} error{error}{traceback}").format(
knowledge_id=knowledge_id, error=str(e), traceback=traceback.format_exc()
)
)
+ finally:
+ stats["duration_ms"] = max(0, round((perf_counter() - started_at) * 1000))
+ stats["status"] = KnowledgeSyncStatus.FAILURE if stats["failed_count"] else KnowledgeSyncStatus.SUCCESS
+ if sync_log is not None:
+ QuerySet(KnowledgeSyncLog).filter(id=sync_log.id).update(
+ status=stats["status"],
+ total_count=stats["total_count"],
+ synced_count=stats["synced_count"],
+ skipped_count=stats["skipped_count"],
+ deleted_count=stats["deleted_count"],
+ failed_count=stats["failed_count"],
+ duration_ms=stats["duration_ms"],
+ message=stats["message"],
+ )
+ return stats
-@celery_app.task(name="celery:sync_web_document")
-def sync_web_document(knowledge_id, user_id, source_url_list: List[str], selector: str):
- from knowledge.task.handler import get_sync_web_document_handler
+@celery_app.task(name="celery:scheduled_sync_web_knowledge")
+def scheduled_sync_web_knowledge(knowledge_id: str, sync_type: str = "incremental"):
+ """Unified entry point for a scheduler to synchronize a Web knowledge base."""
+ if sync_type not in WEB_SYNC_TYPES:
+ maxkb_logger.warning(f"Scheduled Web knowledge synchronization type is invalid: {sync_type}")
+ return False
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id, type=KnowledgeType.WEB).first()
+ if knowledge is None:
+ maxkb_logger.warning(f"Scheduled Web knowledge synchronization skipped: {knowledge_id}")
+ return False
+ meta = knowledge.meta or {}
+ sync_setting = meta.get("sync_setting") or {}
+ if not sync_setting.get("enabled", False):
+ maxkb_logger.info(f"Scheduled Web knowledge synchronization is disabled: {knowledge_id}")
+ return False
+ sync_type = sync_setting.get("sync_type", sync_type)
+ if sync_type not in WEB_SYNC_TYPES:
+ maxkb_logger.warning(f"Scheduled Web knowledge synchronization type is invalid: {sync_type}")
+ return False
+ if not meta.get("source_url"):
+ maxkb_logger.warning(f"Scheduled Web knowledge synchronization has no source URL: {knowledge_id}")
+ return False
+ sync_replace_web_knowledge.delay(
+ str(knowledge.id),
+ knowledge.user_id,
+ meta.get("source_url"),
+ meta.get("selector"),
+ meta.get("doc_strategy"),
+ sync_type,
+ record_log=True,
+ trigger_type=KnowledgeSyncTrigger.SCHEDULED,
+ )
+ return True
+
- handler = get_sync_web_document_handler(knowledge_id, user_id)
+@celery_app.task(
+ base=QueueOnce,
+ once={"keys": ["knowledge_id"]},
+ name="celery:scheduled_sync_workflow_knowledge",
+)
+def scheduled_sync_workflow_knowledge(knowledge_id: str):
+ """Run a workflow knowledge base with the most recently saved input snapshot."""
+ started_at = perf_counter()
+ sync_log = None
+ try:
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id, type=KnowledgeType.WORKFLOW).first()
+ if knowledge is None:
+ raise ValueError(f"Workflow knowledge does not exist: {knowledge_id}")
+ meta = knowledge.meta or {}
+ setting = meta.get("sync_setting") or {}
+ if not setting.get("enabled", False):
+ maxkb_logger.info(f"Scheduled workflow knowledge synchronization is disabled: {knowledge_id}")
+ return False
+ if (
+ QuerySet(KnowledgeSyncLog)
+ .filter(
+ knowledge_id=knowledge.id,
+ status=KnowledgeSyncStatus.RUNNING,
+ )
+ .exists()
+ ):
+ maxkb_logger.info(f"Scheduled workflow knowledge synchronization is already running: {knowledge_id}")
+ return False
+ sync_type = setting.get("sync_type", KnowledgeSyncType.INCREMENTAL)
+ if sync_type not in WEB_SYNC_TYPES:
+ raise ValueError(f"Unsupported workflow knowledge synchronization type: {sync_type}")
+ sync_log = KnowledgeSyncLog.objects.create(
+ knowledge=knowledge,
+ workspace_id=knowledge.workspace_id,
+ sync_type=sync_type,
+ trigger_type=KnowledgeSyncTrigger.SCHEDULED,
+ total_count=QuerySet(Document)
+ .filter(knowledge_id=knowledge.id, resource_type=DocumentResourceType.DOCUMENT)
+ .count(),
+ )
+ workflow_input = deepcopy(meta.get("workflow_sync_input") or {})
+ if not workflow_input.get("data_source"):
+ raise ValueError("Workflow knowledge has no saved synchronization input")
+ if knowledge.user is None:
+ raise ValueError("Workflow knowledge has no owner available for scheduled synchronization")
+ if sync_type in {KnowledgeSyncType.REPLACE, KnowledgeSyncType.COMPLETE}:
+ document_ids = list(
+ QuerySet(Document)
+ .filter(knowledge_id=knowledge.id, resource_type=DocumentResourceType.DOCUMENT)
+ .values_list("id", flat=True)
+ )
+ delete_document_data(document_ids)
+ QuerySet(KnowledgeSyncLog).filter(id=sync_log.id).update(deleted_count=len(document_ids))
+ action = KnowledgeWorkflowActionSerializer(
+ data={"workspace_id": knowledge.workspace_id, "knowledge_id": str(knowledge.id)}
+ ).action(workflow_input, knowledge.user, True, str(sync_log.id))
+ QuerySet(KnowledgeSyncLog).filter(id=sync_log.id).update(message=f"Workflow action started: {action['id']}")
+ return True
+ except Exception as exc:
+ maxkb_logger.error(
+ f"Scheduled workflow knowledge synchronization failed, knowledge_id={knowledge_id}: "
+ f"{exc}\n{traceback.format_exc()}"
+ )
+ if sync_log is not None:
+ QuerySet(KnowledgeSyncLog).filter(id=sync_log.id).update(
+ status=KnowledgeSyncStatus.FAILURE,
+ failed_count=1,
+ duration_ms=max(0, round((perf_counter() - started_at) * 1000)),
+ message=str(exc),
+ )
+ return False
+
+
+@celery_app.task(
+ base=QueueOnce,
+ once={"keys": ["knowledge_id"]},
+ name="celery:scheduled_sync_knowledge",
+)
+def scheduled_sync_knowledge(knowledge_id: str):
+ """Dispatch one scheduled synchronization according to the knowledge source type."""
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id, type__in=SCHEDULED_KNOWLEDGE_TYPES).first()
+ if knowledge is None:
+ maxkb_logger.warning(f"Scheduled knowledge synchronization skipped: {knowledge_id}")
+ return False
+ if not ((knowledge.meta or {}).get("sync_setting") or {}).get("enabled", False):
+ maxkb_logger.info(f"Scheduled knowledge synchronization is disabled: {knowledge_id}")
+ return False
+ if knowledge.type == KnowledgeType.WEB:
+ scheduled_sync_web_knowledge.delay(str(knowledge.id))
+ elif knowledge.type == KnowledgeType.LARK:
+ celery_app.send_task("celery:scheduled_sync_lark_knowledge", args=[str(knowledge.id)])
+ elif knowledge.type == KnowledgeType.WORKFLOW:
+ scheduled_sync_workflow_knowledge.delay(str(knowledge.id))
+ return True
+
+
+@celery_app.task(name="celery:sync_web_document")
+def sync_web_document(knowledge_id, user_id, source_url_list: List[str], selector: str, doc_strategy=None):
+ handler = get_sync_web_document_handler(knowledge_id, user_id, doc_strategy)
for source_url in source_url_list:
try:
- result = Fork(base_fork_url=source_url, selector_list=selector.split(" ")).fork()
+ result = Fork(base_fork_url=source_url, selector_list=get_selector_list(selector)).fork()
handler(source_url, selector, result)
except Exception as e:
- pass
+ maxkb_logger.error(
+ _("Synchronize web document:{source_url} error{error}{traceback}").format(
+ source_url=source_url, error=str(e), traceback=traceback.format_exc()
+ )
+ )
diff --git a/apps/knowledge/test_external_retrieval.py b/apps/knowledge/test_external_retrieval.py
new file mode 100644
index 00000000000..975476660bb
--- /dev/null
+++ b/apps/knowledge/test_external_retrieval.py
@@ -0,0 +1,386 @@
+import importlib
+import json
+from contextlib import ExitStack
+from types import SimpleNamespace
+from unittest.mock import Mock, patch
+from uuid import UUID
+
+from django.test import RequestFactory, SimpleTestCase
+from django.urls import resolve
+
+from chat.views.v3 import knowledge as views
+from knowledge.models import Knowledge, SourceType
+from knowledge.serializers.external_retrieval import (
+ ExternalServiceSerializer,
+ ExternalServiceSettings,
+ RetrievalRequest,
+ service_settings,
+)
+from knowledge.services import external_retrieval as core
+from knowledge.services import retrieval_access as access
+
+KID = "10000000-0000-0000-0000-000000000001"
+DID = "20000000-0000-0000-0000-000000000001"
+PID = "30000000-0000-0000-0000-000000000001"
+UID = "40000000-0000-0000-0000-000000000001"
+KEY = "50000000-0000-0000-0000-000000000001"
+
+
+def knowledge(**settings):
+ return SimpleNamespace(id=KID, name="manual", workspace_id="default", external_service=settings)
+
+
+class RetrievalSettingsTests(SimpleTestCase):
+ def test_new_default_and_existing_migration_default_differ(self):
+ self.assertEqual(Knowledge().external_service, {"enabled": False, "authentication": False})
+ migration = importlib.import_module("knowledge.migrations.0015_knowledge_external_service").Migration
+ self.assertEqual(migration.operations[0].field.get_default(), {})
+ self.assertEqual(migration.operations[1].field.get_default(), Knowledge().external_service)
+ self.assertFalse(service_settings(knowledge())["enabled"])
+ self.assertFalse(service_settings(Knowledge())["authentication"])
+
+ def test_only_two_settings_can_be_changed(self):
+ self.assertTrue(ExternalServiceSettings(data={"enabled": True}).is_valid())
+ for data in ({}, [], {"knowledge_id": KID}, {"authentication": None}):
+ self.assertFalse(ExternalServiceSettings(data=data).is_valid())
+
+ def test_enabling_old_service_preserves_legacy_auth_until_explicitly_changed(self):
+ item = knowledge()
+ item.save = Mock()
+ serializer = ExternalServiceSerializer(data={"workspace_id": "default", "knowledge_id": KID})
+ with patch.object(serializer, "get_knowledge", return_value=item) as get_knowledge:
+ # Exercise the update without opening a database transaction in this isolated unit test.
+ update = ExternalServiceSerializer.update_settings.__wrapped__
+ settings = update(serializer, {"enabled": True})
+ self.assertEqual(item.external_service, {"enabled": True})
+ self.assertTrue(settings["enabled"])
+ self.assertFalse(settings["authentication"])
+ get_knowledge.assert_called_once_with(lock=True)
+ settings = update(serializer, {"authentication": True})
+ self.assertEqual(item.external_service, {"enabled": True, "authentication": True})
+ self.assertTrue(settings["enabled"])
+ self.assertTrue(settings["authentication"])
+ item.save.assert_called_with(update_fields=["external_service"])
+
+ @patch("knowledge.serializers.external_retrieval.Knowledge.objects")
+ def test_settings_cannot_cross_workspace_boundary(self, manager):
+ from common.exception.app_exception import NotFound404
+
+ manager.all.return_value.filter.return_value.first.return_value = None
+ serializer = ExternalServiceSerializer(data={"workspace_id": "other", "knowledge_id": KID})
+ with self.assertRaises(NotFound404):
+ serializer.get_settings()
+ manager.all.return_value.filter.assert_called_once_with(id=UUID(KID), workspace_id="other")
+
+ def test_request_validation(self):
+ self.assertTrue(RetrievalRequest(data={"query_text": "hello"}).is_valid())
+ for extra in (
+ {"query_text": 5},
+ {"query_text": " "},
+ {"query_text": "x" * 8001},
+ {"top_number": 0},
+ {"top_number": 51},
+ {"similarity": float("nan")},
+ {"knowledge_id": KID},
+ {"user_id": UID},
+ {"debug": True},
+ {"search_mode": "bad"},
+ ):
+ with self.subTest(extra=extra):
+ self.assertFalse(RetrievalRequest(data={"query_text": "hello", **extra}).is_valid())
+
+ def test_config_uses_deployment_prefix_and_key_placeholder(self):
+ with patch("knowledge.serializers.external_retrieval.CONFIG.get_chat_path", return_value="/custom/chat"):
+ settings = service_settings(
+ knowledge(authentication=True), RequestFactory().get("/", HTTP_HOST="testserver")
+ )
+ self.assertIn("/custom/chat/api/v3/knowledge/", settings["api_url"])
+ connection = settings["mcp_config"][f"knowledge_{KID}"]
+ self.assertEqual(connection["transport"], "streamable_http")
+ self.assertEqual(connection["headers"]["Authorization"], "Bearer ")
+ self.assertNotIn("headers", service_settings(knowledge())["mcp_config"][f"knowledge_{KID}"])
+
+ def test_routes_resolve_to_knowledge_and_preserve_application_mcp(self):
+ self.assertIs(resolve(f"/chat/api/v3/knowledge/{KID}/mcp").func, views.knowledge_mcp_view)
+ self.assertIs(resolve(f"/chat/api/v3/knowledge/{KID}/retrieve").func, views.retrieve_view)
+ self.assertEqual(
+ resolve(f"/admin/api/workspace/default/knowledge/{KID}/external_service").kwargs["workspace_id"], "default"
+ )
+ self.assertEqual(resolve("/chat/api/v3/mcp").func.__module__, "chat.views.v3.mcp")
+
+
+class RetrievalAccessTests(SimpleTestCase):
+ def setUp(self):
+ self.key = SimpleNamespace(id=KEY, user_id=UID, is_active=True, user=SimpleNamespace(is_active=True))
+
+ @patch.object(access, "QuerySet")
+ def test_existing_api_key_uses_original_secret_without_writes(self, queryset):
+ queryset.return_value.select_related.return_value.filter.return_value.first.return_value = self.key
+ raw = "0123456789abcdef0123456789abcdef"
+ self.assertEqual(access.authenticate_key("Bearer " + raw), access.RetrievalIdentity(UID, KEY))
+ queryset.return_value.select_related.return_value.filter.assert_called_once_with(secret_key=raw)
+ queryset.return_value.update.assert_not_called()
+
+ def test_invalid_credentials_never_become_anonymous(self):
+ self.assertIsNone(access.authenticate_key(None).user_id)
+ for header in ("", "Basic x", "Bearer short", "Bearer a b"):
+ with self.assertRaises(access.RetrievalError):
+ access.authenticate_key(header)
+ for key in (
+ None,
+ SimpleNamespace(**{**vars(self.key), "is_active": False}),
+ SimpleNamespace(**{**vars(self.key), "user": SimpleNamespace(is_active=False)}),
+ ):
+ with self.assertRaises(access.RetrievalError):
+ access.key_identity(key)
+
+ @patch.object(access, "QuerySet")
+ def test_refresh_rechecks_revoked_key(self, queryset):
+ queryset.return_value.select_related.return_value.filter.return_value.first.return_value = None
+ with self.assertRaises(access.RetrievalError):
+ access.refresh_identity(access.RetrievalIdentity(UID, KEY))
+ queryset.return_value.select_related.return_value.filter.assert_called_once_with(id=KEY)
+
+ @patch.object(access, "authorized_ids", return_value={KID})
+ @patch.object(access, "QuerySet")
+ def test_external_switch_and_authorization_matrix(self, queryset, authorized):
+ for enabled, authentication in ((False, False), (False, True), (True, False), (True, True)):
+ queryset.return_value.filter.return_value.first.return_value = knowledge(
+ enabled=enabled, authentication=authentication
+ )
+ for identity in (access.RetrievalIdentity(), access.RetrievalIdentity(UID, KEY)):
+ denied = not enabled or (authentication and not identity.user_id)
+ if denied:
+ with self.assertRaises(access.RetrievalError) as error:
+ access.authorize_external(KID, identity)
+ self.assertEqual(error.exception.status, 404 if not enabled else 401)
+ else:
+ self.assertEqual(access.authorize_external(KID, identity).id, KID)
+ authorized.return_value = set()
+ with self.assertRaises(access.RetrievalError) as error:
+ access.authorize_external(KID, access.RetrievalIdentity(UID))
+ self.assertEqual(error.exception.status, 403)
+
+ @patch.object(access.DatabaseModelManage, "get_model", return_value=None)
+ @patch.object(access, "QuerySet")
+ def test_missing_handler_or_inactive_user_denies(self, queryset, handler):
+ queryset.return_value.filter.return_value.exists.return_value = True
+ self.assertEqual(access.authorized_ids(UID, [KID]), set())
+ handler.return_value = lambda *a: [KID]
+ queryset.return_value.filter.return_value.exists.return_value = False
+ self.assertEqual(access.authorized_ids(UID, [KID]), set())
+
+ @patch.object(access.DatabaseModelManage, "get_model")
+ @patch.object(access, "authorized_ids", return_value={KID})
+ @patch.object(access, "QuerySet")
+ def test_old_rules_new_auth_and_anonymous_setting(self, queryset, authorized, handler):
+ queryset.return_value.filter.return_value = [knowledge()]
+ self.assertEqual(access.filter_workflow_knowledge([KID], {}), [KID])
+ handler.return_value.return_value = []
+ self.assertEqual(
+ access.filter_workflow_knowledge([KID], {"chat_user_id": UID, "chat_user_type": "CHAT_USER"}), []
+ )
+ queryset.return_value.filter.return_value = [knowledge(enabled=False, authentication=True)]
+ identity = access.identity_from_server(UID, "CHAT_USER")
+ self.assertEqual(access.filter_workflow_knowledge([KID], {"retrieval_identity": identity}), [KID])
+ authorized.return_value = set()
+ self.assertEqual(
+ access.filter_workflow_knowledge(
+ [KID], {"form_data": {"asker": {"id": UID}}, "retrieval_identity": {"user_id": UID}}
+ ),
+ [],
+ )
+ authorized.assert_called_with(None, [KID])
+ queryset.return_value.filter.return_value = [knowledge(authentication=False)]
+ self.assertEqual(access.filter_workflow_knowledge([KID], {}), [KID])
+
+ def test_child_tools_cannot_override_trusted_identity(self):
+ parent = {
+ "retrieval_identity": access.identity_from_server(UID, "CHAT_USER"),
+ "workspace_id": "default",
+ "debug": False,
+ }
+ child = {
+ "retrieval_identity": {"admin_user_id": UID},
+ "debug": True,
+ **access.inherited_retrieval_context(parent),
+ }
+ self.assertEqual(child["retrieval_identity"].user_id, UID)
+ self.assertFalse(child["debug"])
+ self.assertIsNone(access.identity_from_server(UID, "APPLICATION_API_KEY", True).admin_user_id)
+
+ @patch("oss.serializers.file._check_workspace_resource_permission")
+ @patch("common.auth.handle.impl.user_token.get_auth")
+ @patch.object(access, "QuerySet")
+ def test_admin_debug_uses_resource_permissions(self, queryset, get_auth, check):
+ from common.exception.app_exception import AppUnauthorizedFailed
+
+ queryset.return_value.filter.return_value.first.return_value = SimpleNamespace(id=UID)
+ self.assertEqual(access.filter_admin_knowledge([knowledge()], UID), [KID])
+ self.assertEqual(check.call_args.kwargs["read_permission"], "KNOWLEDGE:READ")
+ check.side_effect = AppUnauthorizedFailed(403, "denied")
+ self.assertEqual(access.filter_admin_knowledge([knowledge()], UID), [])
+
+
+class RetrievalCoreTests(SimpleTestCase):
+ def setUp(self):
+ self.stack = ExitStack()
+ self.addCleanup(self.stack.close)
+ self.authorize = self.stack.enter_context(
+ patch.object(core, "authorize_external", return_value=knowledge(enabled=True))
+ )
+ self.stack.enter_context(patch.object(core, "refresh_identity", side_effect=lambda i: i))
+ self.model = self.stack.enter_context(patch.object(core, "get_embedding_model_by_knowledge_id"))
+ self.vector = self.stack.enter_context(patch.object(core.VectorStore, "get_embedding_vector"))
+ self.documents = self.stack.enter_context(patch.object(core.Document, "objects"))
+ self.paragraphs = self.stack.enter_context(patch.object(core.Paragraph, "objects"))
+ self.paragraphs.select_related.return_value.filter.return_value = [
+ SimpleNamespace(
+ id=PID,
+ document_id=DID,
+ knowledge_id=KID,
+ title="title",
+ content="answer",
+ document=SimpleNamespace(name="document"),
+ )
+ ]
+ self.match = {"paragraph_id": PID, "source_type": SourceType.PARAGRAPH, "source_id": PID, "similarity": 0.9}
+ self.vector.return_value.hit_test.return_value = [self.match]
+ self.stats = self.stack.enter_context(patch.object(core, "record_recall_safely"))
+
+ def retrieve(self, **data):
+ return core.retrieve(KID, access.RetrievalIdentity(), {"query_text": "hello", **data})
+
+ def test_keyword_search_and_scoped_citations(self):
+ result = self.retrieve(search_mode="keywords")
+ self.model.assert_not_called()
+ self.assertEqual(result["hits"][0]["citation"]["document_name"], "document")
+ self.assertEqual(self.vector.return_value.hit_test.call_args.args[1], [KID])
+ self.paragraphs.select_related.return_value.filter.assert_called_once_with(
+ id__in=[PID], knowledge_id=KID, document__knowledge_id=KID, is_active=True, document__is_active=True
+ )
+ self.stats.assert_called_once_with([self.match])
+
+ def test_stale_foreign_or_inactive_paragraph_not_returned(self):
+ self.paragraphs.select_related.return_value.filter.return_value = []
+ self.assertEqual(self.retrieve()["hits"], [])
+ self.stats.assert_called_once_with([])
+
+ def test_foreign_source_not_returned_or_counted(self):
+ self.match["source_id"] = DID
+ self.assertEqual(self.retrieve()["hits"], [])
+ self.stats.assert_called_once_with([])
+
+ def test_revoke_or_close_while_model_runs_discards_result(self):
+ self.authorize.side_effect = [knowledge(), access.RetrievalError("access_denied", "denied", 403)]
+ with self.assertRaises(access.RetrievalError):
+ self.retrieve()
+ self.stats.assert_not_called()
+
+
+class RetrievalTransportTests(SimpleTestCase):
+ def setUp(self):
+ self.factory = RequestFactory()
+ self.stack = ExitStack()
+ self.addCleanup(self.stack.close)
+ self.auth = self.stack.enter_context(
+ patch.object(views, "authenticate_key", return_value=access.RetrievalIdentity())
+ )
+ self.authorize = self.stack.enter_context(
+ patch.object(views, "authorize_external", return_value=knowledge(enabled=True))
+ )
+ self.output = {"knowledge_id": KID, "hits": [{"content": "answer"}]}
+ self.rest = self.stack.enter_context(patch.object(views, "retrieve", return_value=self.output))
+ self.mcp = self.stack.enter_context(patch("chat.mcp.knowledge.retrieve", return_value=self.output))
+
+ def rpc(self, data, **headers):
+ request = self.factory.post(
+ "/mcp",
+ json.dumps(data),
+ content_type="application/json",
+ HTTP_ACCEPT="application/json, text/event-stream",
+ **headers,
+ )
+ return views.knowledge_mcp_view(request, KID)
+
+ def test_rest_mcp_share_retrieval_output(self):
+ rest = views.retrieve_view(
+ self.factory.post("/retrieve", '{"query_text":"hello"}', content_type="application/json"), KID
+ )
+ mcp = self.rpc(
+ {
+ "jsonrpc": "2.0",
+ "id": 1,
+ "method": "tools/call",
+ "params": {"name": f"knowledge_{KID}", "arguments": {"query_text": "hello"}},
+ }
+ )
+ self.assertEqual(json.loads(json.loads(mcp.content)["result"]["content"][0]["text"]), json.loads(rest.content))
+ self.assertEqual(rest["Cache-Control"], "no-store")
+
+ def test_notifications_do_not_execute_tools(self):
+ response = self.rpc({"jsonrpc": "2.0", "method": "tools/call", "params": {"name": f"knowledge_{KID}"}})
+ self.assertEqual(response.status_code, 202)
+ self.mcp.assert_not_called()
+
+ def test_mcp_rechecks_auth_on_every_request(self):
+ self.assertEqual(self.rpc({"jsonrpc": "2.0", "id": 1, "method": "tools/list"}).status_code, 200)
+ self.auth.side_effect = access.RetrievalError("invalid_api_key", "Invalid API key.", 401)
+ response = self.rpc({"jsonrpc": "2.0", "id": 2, "method": "tools/list"})
+ self.assertEqual(response.status_code, 401)
+ self.assertEqual(response["WWW-Authenticate"], "Bearer")
+
+ def test_protocol_validation(self):
+ for data, code in (
+ ([], -32600),
+ ({"jsonrpc": "2.0", "method": "ping", "id": True}, -32600),
+ ({"jsonrpc": "2.0", "method": "unknown", "id": 1}, -32601),
+ ({"jsonrpc": "2.0", "method": "initialize", "id": 1}, -32602),
+ ):
+ self.assertEqual(json.loads(self.rpc(data).content)["error"]["code"], code)
+ self.assertEqual(
+ self.rpc({"jsonrpc": "2.0", "method": "ping", "id": 1}, HTTP_MCP_PROTOCOL_VERSION="bad").status_code, 400
+ )
+
+ def test_origin_size_content_type_and_method(self):
+ self.assertEqual(self.rpc({}, HTTP_ORIGIN="https://foreign.example").status_code, 403)
+ for request, status in (
+ (self.factory.post("/", "x" * 65537, content_type="application/json"), 413),
+ (self.factory.post("/", "{}", content_type="text/plain"), 415),
+ (self.factory.get("/"), 405),
+ ):
+ self.assertEqual(views.retrieve_view(request, KID).status_code, status)
+
+ def test_errors_do_not_leak_provider_details(self):
+ self.rest.side_effect = RuntimeError("private credentials")
+ response = views.retrieve_view(
+ self.factory.post("/", '{"query_text":"hello"}', content_type="application/json"), KID
+ )
+ self.assertEqual(response.status_code, 503)
+ self.assertNotIn(b"private", response.content)
+ self.mcp.side_effect = RuntimeError("private credentials")
+ response = self.rpc({"jsonrpc": "2.0", "id": 1, "method": "tools/call", "params": {"name": f"knowledge_{KID}"}})
+ self.assertTrue(json.loads(response.content)["result"]["isError"])
+ self.assertNotIn(b"private", response.content)
+
+ async def test_real_mcp_sdk_initialize_discover_and_call(self):
+ import httpx
+ from mcp import ClientSession
+ from mcp.client.streamable_http import streamable_http_client
+
+ async def dispatch(request):
+ django_request = self.factory.generic(
+ request.method, "/mcp", request.content, content_type="application/json", headers=dict(request.headers)
+ )
+ response = views.knowledge_mcp_view(django_request, KID)
+ return httpx.Response(response.status_code, headers=dict(response.headers), content=response.content)
+
+ async with httpx.AsyncClient(transport=httpx.MockTransport(dispatch)) as client:
+ async with streamable_http_client("http://testserver/mcp", http_client=client) as (read, write, _):
+ async with ClientSession(read, write) as session:
+ initialized = await session.initialize()
+ self.assertEqual(initialized.serverInfo.name, "maxkb-knowledge-mcp")
+ tools = await session.list_tools()
+ self.assertEqual(tools.tools[0].name, f"knowledge_{KID}")
+ result = await session.call_tool(tools.tools[0].name, {"query_text": "hello"})
+ self.assertEqual(json.loads(result.content[0].text), self.output)
diff --git a/apps/knowledge/test_file_cleanup.py b/apps/knowledge/test_file_cleanup.py
new file mode 100644
index 00000000000..f7767336f75
--- /dev/null
+++ b/apps/knowledge/test_file_cleanup.py
@@ -0,0 +1,131 @@
+from unittest.mock import patch
+from uuid import uuid4
+
+from django.db import transaction
+from django.test import SimpleTestCase, TestCase
+from knowledge.models import File
+from knowledge.models.knowledge import on_delete_file
+from knowledge.services.file_cleanup import delete_file_object, object_is_referenced
+
+
+class FileCleanupTests(SimpleTestCase):
+ def test_pg_unlinks_only_after_last_reference_and_uses_database_alias(self):
+ for shared in (False, True):
+ with self.subTest(shared=shared):
+ with (
+ patch("knowledge.models.knowledge.File.objects") as files,
+ patch("knowledge.models.knowledge.connections") as connections,
+ ):
+ files.using.return_value.filter.return_value.exists.return_value = shared
+ on_delete_file(File, File(storage_type="pg", loid=42), using="archive")
+ files.using.assert_called_once_with("archive")
+ cursor = connections.__getitem__.return_value.cursor.return_value.__enter__.return_value
+ if shared:
+ cursor.execute.assert_not_called()
+ else:
+ cursor.execute.assert_called_once_with(
+ "SELECT lo_unlink(oid) FROM pg_largeobject_metadata WHERE oid = %s", [42]
+ )
+
+ def test_pg_without_large_object_does_nothing(self):
+ with patch("knowledge.models.knowledge.connections") as connections:
+ on_delete_file(File, File(storage_type="pg", loid=None), using="default")
+ connections.__getitem__.assert_not_called()
+
+ def test_oss_deletion_runs_only_after_commit(self):
+ with (
+ patch("knowledge.models.knowledge.transaction.on_commit") as on_commit,
+ patch("knowledge.services.file_cleanup.delete_file_object") as delete,
+ patch("knowledge.models.knowledge.get_bucket", return_value="bucket"),
+ ):
+ file = File(storage_type="seaweedfs", meta={"seaweedfs_key": "shared"})
+ on_delete_file(File, file, using="archive")
+ delete.assert_not_called()
+ on_commit.call_args.args[0]()
+ delete.assert_called_once_with("bucket", "shared", file.id, "archive")
+ self.assertTrue(on_commit.call_args.kwargs["robust"])
+
+ def test_shared_key_and_legacy_key_reference_lookup(self):
+ with patch("knowledge.services.file_cleanup.File.objects") as files:
+ files.using.return_value.filter.return_value.exists.return_value = True
+ self.assertTrue(object_is_referenced(f"files/{uuid4()}", "archive"))
+ files.using.assert_called_once_with("archive")
+ condition = files.using.return_value.filter.call_args.args[0]
+ self.assertIn("seaweedfs_key", str(condition))
+ self.assertIn("has_key", str(condition))
+ self.assertEqual(files.using.return_value.filter.call_args.kwargs, {"storage_type": "seaweedfs"})
+
+ def test_cleanup_failure_is_logged_without_raising(self):
+ with (
+ patch("knowledge.services.file_cleanup.object_is_referenced", return_value=False),
+ patch("knowledge.services.file_cleanup.get_s3_client", side_effect=RuntimeError("private details")),
+ patch("knowledge.services.file_cleanup.maxkb_logger") as logger,
+ ):
+ delete_file_object("bucket", "key", "file-id")
+ logger.warning.assert_called_once()
+ self.assertEqual(logger.warning.call_args.args[1:], ("file-id", "RuntimeError"))
+
+
+class FileCleanupDatabaseTests(TestCase):
+ def setUp(self):
+ self.client_patch = patch("knowledge.services.file_cleanup.get_s3_client")
+ self.client = self.client_patch.start().return_value
+ self.addCleanup(self.client_patch.stop)
+ self.bucket_patch = patch("knowledge.models.knowledge.get_bucket", return_value="bucket")
+ self.bucket_patch.start()
+ self.addCleanup(self.bucket_patch.stop)
+
+ def create_files(self):
+ files = [
+ File(storage_type="seaweedfs", sha256_hash="same", meta={"seaweedfs_key": "shared"}),
+ File(storage_type="seaweedfs", sha256_hash="same", meta={"seaweedfs_key": "shared"}),
+ ]
+ File.objects.bulk_create(files)
+ return files
+
+ def test_bulk_delete_shared_object_after_commit(self):
+ files = self.create_files()
+ with self.captureOnCommitCallbacks(execute=True):
+ File.objects.filter(pk__in=[file.pk for file in files]).delete()
+ self.client.delete_object.assert_not_called()
+ self.assertTrue(self.client.delete_object.called)
+ for call in self.client.delete_object.call_args_list:
+ self.assertEqual(call.kwargs, {"Bucket": "bucket", "Key": "shared"})
+
+ def test_single_reference_then_last_reference(self):
+ first, last = self.create_files()
+ with self.captureOnCommitCallbacks(execute=True):
+ first.delete()
+ self.client.delete_object.assert_not_called()
+ with self.captureOnCommitCallbacks(execute=True):
+ last.delete()
+ self.client.delete_object.assert_called_once()
+
+ def test_rollback_restores_files_and_discards_callback(self):
+ files = self.create_files()
+ with self.captureOnCommitCallbacks(execute=True):
+ try:
+ with transaction.atomic():
+ File.objects.filter(pk__in=[file.pk for file in files]).delete()
+ raise RuntimeError("rollback")
+ except RuntimeError:
+ pass
+ self.assertEqual(File.objects.count(), 2)
+ self.client.delete_object.assert_not_called()
+
+ def test_oss_failure_does_not_undo_file_deletion(self):
+ files = self.create_files()
+ self.client.delete_object.side_effect = RuntimeError("offline")
+ with patch("knowledge.services.file_cleanup.maxkb_logger") as logger:
+ with self.captureOnCommitCallbacks(execute=True):
+ File.objects.filter(pk__in=[file.pk for file in files]).delete()
+ self.assertTrue(logger.warning.called)
+ self.assertFalse(File.objects.exists())
+
+ def test_same_hash_different_object_does_not_prevent_deletion(self):
+ first, last = self.create_files()
+ File.objects.filter(pk=last.pk).update(meta={"seaweedfs_key": "different"})
+ with self.captureOnCommitCallbacks(execute=True):
+ first.delete()
+ self.client.delete_object.assert_called_once_with(Bucket="bucket", Key="shared")
+ self.assertTrue(File.objects.filter(pk=last.pk).exists())
diff --git a/apps/knowledge/test_tokenize.py b/apps/knowledge/test_tokenize.py
new file mode 100644
index 00000000000..fb7bb55f6cc
--- /dev/null
+++ b/apps/knowledge/test_tokenize.py
@@ -0,0 +1,113 @@
+from contextlib import nullcontext
+from unittest.mock import MagicMock, call, patch
+
+from celery_once import AlreadyQueued
+from common.exception.app_exception import AppApiException
+from django.test import SimpleTestCase
+from django.urls import resolve
+from knowledge.models import Document, Paragraph, State, TaskType
+from knowledge.serializers.knowledge import KnowledgeSerializer
+from knowledge.task.embedding import tokenize_by_knowledge
+from knowledge.views.knowledge import KnowledgeView
+
+
+class KnowledgeTokenizeTests(SimpleTestCase):
+ knowledge_id = "00000000-0000-0000-0000-000000000001"
+ user_id = "00000000-0000-0000-0000-000000000002"
+
+ def serializer(self, workspace_id="workspace-1"):
+ return KnowledgeSerializer.Operate(
+ data={"knowledge_id": self.knowledge_id, "workspace_id": workspace_id, "user_id": self.user_id}
+ )
+
+ @patch("knowledge.serializers.knowledge.tokenize_by_knowledge.delay")
+ @patch("knowledge.serializers.knowledge.QuerySet")
+ def test_submit_validates_workspace_without_loading_embedding_model(self, query_set, delay):
+ for workspace_id in ("workspace-1", "None"):
+ with self.subTest(workspace_id=workspace_id):
+ query_set.reset_mock()
+ delay.reset_mock()
+ self.serializer(workspace_id).tokenize()
+
+ query_set.assert_called_once()
+ query_set.return_value.filter.assert_called_once_with(id=self.knowledge_id)
+ query_set.return_value.filter.return_value.filter.assert_called_once_with(workspace_id=workspace_id)
+ delay.assert_called_once_with(self.knowledge_id)
+
+ @patch("knowledge.serializers.knowledge.tokenize_by_knowledge.delay")
+ @patch("knowledge.serializers.knowledge.QuerySet")
+ def test_missing_or_other_workspace_knowledge_is_not_queued(self, query_set, delay):
+ query_set.return_value.filter.return_value.filter.return_value.exists.return_value = False
+ with self.assertRaises(AppApiException):
+ self.serializer().tokenize()
+ delay.assert_not_called()
+
+ @patch("knowledge.serializers.knowledge.tokenize_by_knowledge.delay", side_effect=AlreadyQueued(10))
+ @patch("knowledge.serializers.knowledge.QuerySet")
+ def test_duplicate_knowledge_task_returns_api_error(self, _query_set, _delay):
+ with self.assertRaises(AppApiException):
+ self.serializer().tokenize()
+
+ def test_workspace_route_uses_tokenize_view(self):
+ match = resolve(f"/workspace/workspace-1/knowledge/{self.knowledge_id}/tokenize", urlconf="knowledge.urls")
+ self.assertIs(match.func.view_class, KnowledgeView.Tokenize)
+
+
+class KnowledgeTokenizeTaskTests(SimpleTestCase):
+ def setUp(self):
+ self.query_patch = patch("knowledge.task.embedding.QuerySet")
+ self.query_set = self.query_patch.start()
+ self.addCleanup(self.query_patch.stop)
+ self.listener_patch = patch("knowledge.task.embedding.ListenerManagement")
+ self.listener = self.listener_patch.start()
+ self.addCleanup(self.listener_patch.stop)
+ self.atomic_patch = patch("knowledge.task.embedding.transaction.atomic", side_effect=nullcontext)
+ self.atomic_patch.start()
+ self.addCleanup(self.atomic_patch.stop)
+ self.delay_patch = patch("knowledge.task.embedding.tokenize_by_document.delay")
+ self.delay = self.delay_patch.start()
+ self.addCleanup(self.delay_patch.stop)
+ self.documents, self.paragraphs = MagicMock(), MagicMock()
+ self.query_set.side_effect = {Document: self.documents, Paragraph: self.paragraphs}.__getitem__
+
+ def set_documents(self, document_ids):
+ self.documents.filter.return_value.values_list.return_value.iterator.return_value = iter(document_ids)
+
+ def test_rebuilds_all_document_states_and_only_tokenize_status(self):
+ self.set_documents(["doc-1", "doc-2"])
+
+ tokenize_by_knowledge.run("knowledge-1")
+
+ self.documents.filter.assert_has_calls([call(knowledge_id="knowledge-1")])
+ self.paragraphs.filter.assert_called_once_with(knowledge_id="knowledge-1")
+ self.listener.update_status.assert_has_calls(
+ [
+ call(self.documents.filter.return_value, TaskType.TOKENIZE, State.PENDING),
+ call(self.paragraphs.filter.return_value, TaskType.TOKENIZE, State.PENDING),
+ ]
+ )
+ self.assertEqual(self.listener.update_status.call_count, 2)
+ self.listener.get_aggregation_document_status_by_knowledge_id.assert_called_once_with("knowledge-1")
+ state_list = [state.value for state in State]
+ self.assertIn(State.IGNORED.value, state_list)
+ self.delay.assert_has_calls([call("doc-1", state_list), call("doc-2", state_list)])
+
+ def test_duplicate_document_does_not_block_remaining_documents(self):
+ self.set_documents(["doc-1", "doc-2"])
+ self.delay.side_effect = [AlreadyQueued(10), None]
+
+ tokenize_by_knowledge.run("knowledge-1")
+
+ self.assertEqual(self.delay.call_count, 2)
+ self.assertEqual(self.delay.call_args.args[0], "doc-2")
+
+ def test_empty_knowledge_does_not_queue_document_tasks(self):
+ self.set_documents([])
+ tokenize_by_knowledge.run("empty-knowledge")
+ self.delay.assert_not_called()
+
+ def test_broker_errors_are_not_silently_ignored(self):
+ self.set_documents(["doc-1"])
+ self.delay.side_effect = RuntimeError("broker unavailable")
+ with self.assertRaises(RuntimeError):
+ tokenize_by_knowledge.run("knowledge-1")
diff --git a/apps/knowledge/tests.py b/apps/knowledge/tests.py
index 7ce503c2dd9..359a15212e4 100644
--- a/apps/knowledge/tests.py
+++ b/apps/knowledge/tests.py
@@ -1,3 +1,1905 @@
-from django.test import TestCase
+from contextlib import nullcontext
+from io import BytesIO
+from unittest.mock import MagicMock, patch
-# Create your tests here.
+from common.exception.app_exception import AppApiException
+from django.core.files.uploadedfile import SimpleUploadedFile
+from django.test import SimpleTestCase
+from django.utils import timezone
+from django.utils.datastructures import MultiValueDict
+from knowledge.api.document import DocumentBatchAddTagAPI, DocumentSplitAPI
+from knowledge.models import (
+ AssetProcessStatus,
+ ContentOrigin,
+ Document,
+ DocumentResourceType,
+ FileSourceType,
+ Knowledge,
+ KnowledgeSyncLog,
+ KnowledgeSyncStatus,
+ KnowledgeSyncTrigger,
+ KnowledgeSyncType,
+ KnowledgeType,
+ LocalState,
+ Paragraph,
+ ParagraphAsset,
+ Problem,
+ ProblemParagraphMapping,
+ SearchMode,
+ SourceType,
+ SyncState,
+)
+from knowledge.models.knowledge_action import State as KnowledgeActionState
+from knowledge.serializers.document import (
+ DocumentBatchAddTagSerializer,
+ DocumentSerializers,
+ DocumentWebInstanceSerializer,
+)
+from knowledge.serializers.document_strategy import DocumentSyncStrategySerializer
+from knowledge.serializers.image_document import ImagePreviewUpdateRequest
+from knowledge.serializers.knowledge import (
+ HitTestSerializer,
+ KnowledgeEditRequest,
+ KnowledgeSerializer,
+ KnowledgeWebCreateRequest,
+)
+from knowledge.serializers.knowledge_sync import (
+ KnowledgeSyncSettingOperationSerializer,
+ KnowledgeSyncSettingRequest,
+)
+from knowledge.serializers.knowledge_workflow import KnowledgeWorkflowActionSerializer, finalize_knowledge_action
+from knowledge.serializers.problem import ProblemInstanceSerializer, ProblemSerializer
+from knowledge.services.document_cleanup import delete_synced_paragraph_data
+from knowledge.services.document_strategy import (
+ apply_length_strategy,
+ document_source_hash,
+ normalize_document_strategy,
+ parse_web_content,
+ strategy_hashes,
+)
+from knowledge.services.image_documents import ImageDocumentService
+from knowledge.services.incremental_sync import IncrementalDocumentSync, MergeResult, prepare_remote_paragraphs
+from knowledge.services.knowledge_sync_schedule import (
+ deploy_knowledge_sync_job,
+ normalize_knowledge_sync_setting,
+)
+from knowledge.services.multimodal_retrieval import get_hit_asset_map, load_image_query_inputs
+from knowledge.services.paragraph_assets import (
+ embed_paragraph_assets,
+ paragraph_asset_source_key,
+ paragraph_content_schema,
+ process_visual_assets,
+ resolve_visual_processor,
+ sync_paragraph_assets,
+)
+from knowledge.services.retrieval_stats import (
+ collect_recall_asset_ids,
+ collect_recall_source_ids,
+ get_recall_tracker,
+ record_recall,
+)
+from knowledge.services.workflow_sync import merge_workflow_incremental_snapshot, workflow_document_identity
+from knowledge.task.handler import get_save_handler, get_sync_handler, normalize_web_url
+from knowledge.task.sync import (
+ get_selector_list,
+ scheduled_sync_knowledge,
+ scheduled_sync_web_knowledge,
+ scheduled_sync_workflow_knowledge,
+ sync_replace_web_knowledge,
+)
+from knowledge.vector.pg_vector import PGVector
+from knowledge.views.document import _get_document_split_payload
+from knowledge.web_assets import internalize_web_images
+from PIL import Image
+from rest_framework.exceptions import ValidationError
+
+
+class ProblemRecallSerializerTests(SimpleTestCase):
+ def test_problem_serializers_include_recall_statistics(self):
+ recalled_at = timezone.now()
+ problem = Problem(
+ id="00000000-0000-0000-0000-000000000040",
+ knowledge_id="00000000-0000-0000-0000-000000000041",
+ content="How does image retrieval work?",
+ hit_num=7,
+ last_hit_time=recalled_at,
+ )
+
+ model_data = ProblemSerializer(problem).data
+ instance_data = ProblemInstanceSerializer(problem).data
+
+ self.assertEqual(model_data["hit_num"], 7)
+ self.assertIsNotNone(model_data["last_hit_time"])
+ self.assertEqual(instance_data["hit_num"], 7)
+ self.assertIsNotNone(instance_data["last_hit_time"])
+
+
+class MultimodalHitTestTests(SimpleTestCase):
+ request_data = {
+ "top_number": 5,
+ "similarity": 0.6,
+ "search_mode": SearchMode.embedding.value,
+ }
+
+ def test_accepts_an_image_only_query(self):
+ serializer = HitTestSerializer(
+ data={
+ **self.request_data,
+ "image_list": [
+ {
+ "file_id": "00000000-0000-0000-0000-000000000001",
+ "name": "query.png",
+ "url": "./oss/file/00000000-0000-0000-0000-000000000001",
+ }
+ ],
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ self.assertEqual(serializer.validated_data["query_text"], "")
+
+ def test_requires_text_or_at_least_one_image(self):
+ serializer = HitTestSerializer(data=self.request_data)
+
+ self.assertFalse(serializer.is_valid())
+ self.assertIn("non_field_errors", serializer.errors)
+
+ def test_rejects_images_in_keyword_search(self):
+ serializer = HitTestSerializer(
+ data={
+ **self.request_data,
+ "query_text": "breakfast",
+ "search_mode": SearchMode.keywords.value,
+ "image_list": [{"file_id": "00000000-0000-0000-0000-000000000001"}],
+ }
+ )
+
+ self.assertFalse(serializer.is_valid())
+ self.assertIn("search_mode", serializer.errors)
+
+ @patch("knowledge.services.multimodal_retrieval.QuerySet")
+ def test_uploaded_image_is_converted_to_a_data_url(self, query_set):
+ file = MagicMock(
+ id="00000000-0000-0000-0000-000000000001",
+ file_name="query.png",
+ meta={"user_id": "00000000-0000-0000-0000-000000000002"},
+ )
+ file.get_bytes.return_value = b"image-content"
+ query_set.return_value.filter.return_value = [file]
+
+ image_inputs = load_image_query_inputs(
+ [{"file_id": file.id}],
+ user_id="00000000-0000-0000-0000-000000000002",
+ )
+
+ self.assertEqual(image_inputs, ["data:image/png;base64,aW1hZ2UtY29udGVudA=="])
+
+ @patch("knowledge.services.multimodal_retrieval.ParagraphAsset.objects.select_related")
+ def test_image_hit_includes_asset_recall_statistics(self, select_related):
+ recalled_at = timezone.now()
+ asset = MagicMock(
+ id="00000000-0000-0000-0000-000000000004",
+ file_id="00000000-0000-0000-0000-000000000005",
+ position=1,
+ caption="chart",
+ ocr_text="revenue 100",
+ description="upward trend",
+ hit_num=7,
+ last_hit_time=recalled_at,
+ )
+ asset.file.file_name = "chart.png"
+ select_related.return_value.filter.return_value = [asset]
+
+ result = get_hit_asset_map(
+ [
+ {
+ "source_id": str(asset.id),
+ "source_type": SourceType.IMAGE.value,
+ }
+ ]
+ )
+
+ self.assertEqual(result[str(asset.id)]["hit_num"], 7)
+ self.assertEqual(result[str(asset.id)]["last_hit_time"], recalled_at.isoformat())
+
+
+class ImageDocumentTests(SimpleTestCase):
+ def test_document_list_defaults_to_document_resources(self):
+ serializer = DocumentSerializers.Query(
+ data={
+ "workspace_id": "workspace",
+ "knowledge_id": "00000000-0000-0000-0000-000000000037",
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ self.assertEqual(serializer.validated_data["resource_type"], DocumentResourceType.DOCUMENT)
+
+ def test_generic_document_creation_cannot_forge_an_image_resource(self):
+ result = DocumentSerializers.Create.get_document_paragraph_model(
+ "00000000-0000-0000-0000-000000000039",
+ "user-id",
+ {
+ "name": "forged-image.png",
+ "paragraphs": [],
+ "resource_type": DocumentResourceType.IMAGE,
+ },
+ )
+
+ self.assertEqual(result["document"].resource_type, DocumentResourceType.DOCUMENT)
+
+ @patch("knowledge.services.image_documents.QuerySet")
+ def test_standalone_images_are_rejected_for_external_knowledge_bases(self, query_set):
+ query_set.return_value.filter.return_value.first.return_value = Knowledge(
+ id="00000000-0000-0000-0000-000000000038",
+ workspace_id="workspace",
+ name="web",
+ desc="",
+ type=KnowledgeType.WEB,
+ )
+
+ with self.assertRaises(AppApiException):
+ ImageDocumentService("workspace", "00000000-0000-0000-0000-000000000038").get_knowledge()
+
+ def test_preview_edit_accepts_name_and_description(self):
+ serializer = ImagePreviewUpdateRequest(data={"name": "renamed.png", "description": "updated"})
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+
+ @patch("knowledge.services.image_documents.QuerySet")
+ @patch("knowledge.services.image_documents.File")
+ def test_upload_creates_an_editable_preview_without_visual_processing(self, file_model, query_set):
+ knowledge = Knowledge(
+ id="00000000-0000-0000-0000-000000000040",
+ workspace_id="workspace",
+ name="base",
+ desc="",
+ type=KnowledgeType.BASE,
+ file_size_limit=100,
+ file_count_limit=50,
+ )
+ service = ImageDocumentService("workspace", str(knowledge.id))
+ service.get_knowledge = MagicMock(return_value=knowledge)
+ stored_file = MagicMock(
+ id="00000000-0000-0000-0000-000000000041",
+ file_name="scene.png",
+ file_size=3,
+ meta={"knowledge_id": str(knowledge.id), "upload_size": 3},
+ )
+ file_model.return_value = stored_file
+ query_set.return_value.filter.return_value.update.return_value = 1
+ image_buffer = BytesIO()
+ Image.new("RGB", (1, 1)).save(image_buffer, format="PNG")
+ image_bytes = image_buffer.getvalue()
+ upload = SimpleUploadedFile("scene.png", image_bytes, content_type="image/png")
+
+ previews = service.create_previews([upload])
+
+ self.assertEqual(previews[0]["name"], "scene.png")
+ self.assertEqual(previews[0]["process_status"], "skipped")
+ stored_file.save.assert_called_once_with(image_bytes)
+ file_model.assert_called_once()
+
+ @patch("knowledge.services.image_documents.IncrementalDocumentSync")
+ @patch("knowledge.services.image_documents.ParagraphAsset.objects.create")
+ @patch("knowledge.services.image_documents.Paragraph")
+ @patch("knowledge.services.image_documents.Document")
+ @patch("knowledge.services.image_documents.QuerySet")
+ def test_import_creates_an_image_document_and_moves_the_source_file(
+ self,
+ query_set,
+ document_model,
+ paragraph_model,
+ create_asset,
+ incremental_sync,
+ ):
+ knowledge = Knowledge(
+ id="00000000-0000-0000-0000-000000000042",
+ workspace_id="workspace",
+ name="base",
+ desc="",
+ type=KnowledgeType.BASE,
+ )
+ file = MagicMock(
+ id="00000000-0000-0000-0000-000000000043",
+ file_name="scene.png",
+ sha256_hash="image-hash",
+ meta={
+ "image_preview": {
+ "caption": "风景",
+ "ocr_text": "",
+ "description": "群山与草地",
+ "process_status": "success",
+ "process_error": "",
+ "doc_strategy": normalize_document_strategy(None),
+ "imported": False,
+ }
+ },
+ )
+ file_query = MagicMock()
+ file_query.filter.return_value.select_for_update.return_value = [file]
+ update_query = MagicMock()
+ query_set.side_effect = [file_query, update_query]
+ document = MagicMock(id="00000000-0000-0000-0000-000000000044")
+ paragraph = MagicMock(id="00000000-0000-0000-0000-000000000045")
+ document_model.return_value = document
+ paragraph_model.return_value = paragraph
+ service = ImageDocumentService("workspace", str(knowledge.id), "user-id")
+ service.get_knowledge = MagicMock(return_value=knowledge)
+
+ document_ids = ImageDocumentService.import_previews.__wrapped__(service, [file.id])
+
+ self.assertEqual(document_ids, [str(document.id)])
+ self.assertEqual(document_model.call_args.kwargs["resource_type"], DocumentResourceType.IMAGE)
+ self.assertEqual(document_model.call_args.kwargs["char_length"], len("风景\n群山与草地"))
+ self.assertEqual(paragraph_model.call_args.kwargs["content_schema"][0]["file_id"], str(file.id))
+ self.assertEqual(create_asset.call_args.kwargs["file_id"], file.id)
+ update_query.filter.return_value.update.assert_called_once()
+ update_values = update_query.filter.return_value.update.call_args.kwargs
+ self.assertEqual(update_values["source_type"], FileSourceType.DOCUMENT)
+ self.assertEqual(update_values["source_id"], str(document.id))
+ incremental_sync.return_value._sync_title_questions.assert_called_once_with([paragraph])
+
+
+class MultimodalVectorSearchTests(SimpleTestCase):
+ @patch("knowledge.vector.pg_vector.search_handle_list", new_callable=list)
+ @patch("knowledge.vector.pg_vector.QuerySet")
+ def test_text_and_images_are_searched_independently_and_fused_by_best_score(self, query_set, search_handles):
+ query_set.return_value.filter.return_value.exclude.return_value = MagicMock()
+ search_handle = MagicMock()
+ search_handle.support.return_value = True
+ search_handle.handle.side_effect = [
+ [
+ {
+ "paragraph_id": "paragraph-1",
+ "source_id": "paragraph-1",
+ "source_type": SourceType.PARAGRAPH.value,
+ "similarity": 0.7,
+ "comprehensive_score": 0.7,
+ },
+ {
+ "paragraph_id": "paragraph-2",
+ "source_id": "paragraph-2",
+ "source_type": SourceType.PARAGRAPH.value,
+ "similarity": 0.6,
+ "comprehensive_score": 0.6,
+ },
+ ],
+ [
+ {
+ "paragraph_id": "paragraph-1",
+ "source_id": "asset-1",
+ "source_type": SourceType.IMAGE.value,
+ "similarity": 0.8,
+ "comprehensive_score": 0.8,
+ }
+ ],
+ ]
+ search_handles[:] = [search_handle]
+ embedding_model = MagicMock()
+ embedding_model.supports_image_embedding.return_value = True
+ embedding_model.embed_query.return_value = [1.0, 0.0]
+ embedding_model.embed_images.return_value = [[0.0, 1.0]]
+
+ result = PGVector().hit_test(
+ "breakfast",
+ ["knowledge-1"],
+ [],
+ 5,
+ 0.6,
+ SearchMode.embedding,
+ embedding_model,
+ ["data:image/png;base64,AA=="],
+ )
+
+ self.assertEqual([item["paragraph_id"] for item in result], ["paragraph-1", "paragraph-2"])
+ self.assertEqual(result[0]["source_type"], SourceType.IMAGE.value)
+ self.assertEqual(result[0]["query_unit_type"], "image")
+ self.assertEqual(search_handle.handle.call_count, 2)
+
+ @patch("knowledge.vector.pg_vector.QuerySet")
+ def test_rejects_image_query_when_embedding_model_has_no_image_capability(self, query_set):
+ embedding_model = MagicMock()
+ embedding_model.supports_image_embedding.return_value = False
+
+ with self.assertRaises(AppApiException):
+ PGVector().hit_test(
+ "",
+ ["knowledge-1"],
+ [],
+ 5,
+ 0.6,
+ SearchMode.embedding,
+ embedding_model,
+ ["data:image/png;base64,AA=="],
+ )
+
+ query_set.assert_not_called()
+
+
+class RecallStatisticsTests(SimpleTestCase):
+ def test_collects_unique_paragraph_and_winning_problem_mapping_ids(self):
+ recall_items = [
+ {"paragraph_id": "paragraph-1", "source_type": SourceType.PROBLEM.value, "source_id": "mapping-1"},
+ {"paragraph_id": "paragraph-1", "source_type": SourceType.PROBLEM.value, "source_id": "mapping-1"},
+ {"paragraph_id": "paragraph-2", "source_type": SourceType.PARAGRAPH.value, "source_id": "paragraph-2"},
+ ]
+
+ paragraph_ids, problem_mapping_ids = collect_recall_source_ids(recall_items)
+
+ self.assertEqual(paragraph_ids, {"paragraph-1", "paragraph-2"})
+ self.assertEqual(problem_mapping_ids, {"mapping-1"})
+
+ def test_collects_unique_winning_image_asset_ids(self):
+ recall_items = [
+ {"paragraph_id": "paragraph-1", "source_type": SourceType.IMAGE.value, "source_id": "asset-1"},
+ {"paragraph_id": "paragraph-1", "source_type": SourceType.IMAGE.value, "source_id": "asset-1"},
+ {"paragraph_id": "paragraph-2", "source_type": SourceType.PARAGRAPH.value, "source_id": "asset-2"},
+ ]
+
+ self.assertEqual(collect_recall_asset_ids(recall_items), {"asset-1"})
+
+ def test_ignores_problem_mapping_when_paragraph_content_wins(self):
+ paragraph_ids, problem_mapping_ids = collect_recall_source_ids(
+ [{"paragraph_id": "paragraph-1", "source_type": SourceType.PARAGRAPH.value, "source_id": "mapping-1"}]
+ )
+
+ self.assertEqual(paragraph_ids, {"paragraph-1"})
+ self.assertEqual(problem_mapping_ids, set())
+
+ def test_reuses_one_tracker_for_the_same_retrieval_owner(self):
+ owner = object.__new__(type("RecallOwner", (), {}))
+
+ tracker = get_recall_tracker(owner)
+ tracker["paragraph_ids"] = {"paragraph-1"}
+
+ self.assertIs(get_recall_tracker(owner), tracker)
+ self.assertEqual(get_recall_tracker(owner)["paragraph_ids"], {"paragraph-1"})
+
+ @patch("knowledge.services.retrieval_stats.transaction.atomic", side_effect=lambda: nullcontext())
+ @patch("knowledge.services.retrieval_stats.QuerySet")
+ def test_updates_each_resource_once_and_deduplicates_with_tracker(self, query_set, _atomic):
+ paragraph_query = MagicMock()
+ paragraph_filter = paragraph_query.filter.return_value
+ paragraph_filter.values_list.return_value = [
+ ("paragraph-1", "document-1"),
+ ("paragraph-2", "document-1"),
+ ]
+ mapping_query = MagicMock()
+ mapping_query.filter.return_value.values_list.return_value = ["problem-1", "problem-1"]
+ document_query = MagicMock()
+ problem_query = MagicMock()
+ asset_query = MagicMock()
+ queries = {
+ Paragraph: paragraph_query,
+ ProblemParagraphMapping: mapping_query,
+ Document: document_query,
+ Problem: problem_query,
+ ParagraphAsset: asset_query,
+ }
+ query_set.side_effect = lambda model: queries[model]
+ recall_items = [
+ {"paragraph_id": "paragraph-1", "source_type": SourceType.PROBLEM.value, "source_id": "mapping-1"},
+ {"paragraph_id": "paragraph-2", "source_type": SourceType.PARAGRAPH.value, "source_id": "paragraph-2"},
+ {"paragraph_id": "paragraph-2", "source_type": SourceType.IMAGE.value, "source_id": "asset-1"},
+ ]
+ recalled_at = timezone.now()
+ tracker = {}
+
+ record_recall(recall_items, tracker=tracker, recalled_at=recalled_at)
+ record_recall(recall_items, tracker=tracker, recalled_at=recalled_at)
+
+ self.assertEqual(paragraph_filter.update.call_count, 1)
+ self.assertEqual(document_query.filter.return_value.update.call_count, 1)
+ self.assertEqual(problem_query.filter.return_value.update.call_count, 1)
+ self.assertEqual(asset_query.filter.return_value.update.call_count, 1)
+ self.assertEqual(paragraph_filter.update.call_args.kwargs["last_hit_time"], recalled_at)
+ self.assertEqual(document_query.filter.return_value.update.call_args.kwargs["last_hit_time"], recalled_at)
+ self.assertEqual(problem_query.filter.return_value.update.call_args.kwargs["last_hit_time"], recalled_at)
+ self.assertEqual(asset_query.filter.return_value.update.call_args.kwargs["last_hit_time"], recalled_at)
+
+
+class DocumentStrategyTests(SimpleTestCase):
+ def test_visual_enhancement_is_disabled_by_default_and_hashes_are_stable(self):
+ strategy = normalize_document_strategy(None)
+
+ self.assertFalse(strategy["visual"]["enabled"])
+ self.assertEqual(strategy_hashes(strategy), strategy_hashes(strategy))
+
+ def test_enabled_visual_strategy_requires_selected_model_or_tool(self):
+ with self.assertRaises(ValueError):
+ normalize_document_strategy({"visual": {"enabled": True, "strategy": "model"}})
+
+ def test_short_tail_is_merged_into_previous_paragraph(self):
+ paragraphs = [{"content": "a" * 10}, {"content": "tail"}]
+ result = apply_length_strategy(paragraphs, {"split": {"min_length": 5, "max_length": 10}})
+
+ self.assertEqual(len(result), 1)
+ self.assertEqual(result[0]["content"], "a" * 10 + "\ntail")
+
+ def test_empty_patterns_keep_whole_paragraph(self):
+ content = "x" * 200
+ result = apply_length_strategy(
+ [{"content": content}], {"split": {"patterns": [], "min_length": 0, "max_length": 50}}
+ )
+
+ self.assertEqual(result, [{"title": "", "content": content}])
+
+ def test_web_parser_applies_empty_pattern_no_split_strategy(self):
+ content = "x" * 200
+
+ result = parse_web_content(content, {"split": {"patterns": [], "max_length": 50}})
+
+ self.assertEqual(result, [{"title": "", "content": content}])
+
+
+class WebDocumentStrategyRequestTests(SimpleTestCase):
+ def test_document_split_multipart_payload_includes_json_strategy(self):
+ request = MagicMock()
+ request.FILES.getlist.return_value = [SimpleUploadedFile("example.txt", b"content")]
+ request.data = MultiValueDict(
+ {
+ "doc_strategy": ['{"split":{"max_length":1024}}'],
+ "patterns": ["# ", "## "],
+ }
+ )
+
+ payload = _get_document_split_payload(request)
+
+ self.assertEqual(payload["doc_strategy"]["split"]["max_length"], 1024)
+ self.assertEqual(payload["patterns"], ["# ", "## "])
+
+ def test_document_split_openapi_describes_strategy_and_file_list(self):
+ schema = DocumentSplitAPI.get_request()["multipart/form-data"]
+
+ self.assertIn("doc_strategy", schema["properties"])
+ self.assertEqual(schema["properties"]["file"]["type"], "array")
+ self.assertEqual(schema["properties"]["patterns"]["type"], "array")
+
+ def test_batch_add_tag_request_exposes_resource_type(self):
+ serializer = DocumentBatchAddTagSerializer(
+ data={
+ "document_ids": ["00000000-0000-0000-0000-000000000001"],
+ "tag_ids": ["00000000-0000-0000-0000-000000000002"],
+ "resource_type": DocumentResourceType.IMAGE,
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ self.assertEqual(serializer.validated_data["resource_type"], DocumentResourceType.IMAGE)
+ self.assertIs(DocumentBatchAddTagAPI.get_request(), DocumentBatchAddTagSerializer)
+ self.assertEqual(len(DocumentBatchAddTagAPI.get_parameters()), 2)
+
+ def test_web_document_request_uses_normalized_defaults(self):
+ serializer = DocumentWebInstanceSerializer(
+ data={
+ "source_url_list": ["https://example.com/a", "https://example.com/a"],
+ "selector": "",
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ self.assertEqual(serializer.validated_data["source_url_list"], ["https://example.com/a"])
+ self.assertEqual(serializer.validated_data["selector"], "body")
+ self.assertEqual(serializer.validated_data["doc_strategy"], normalize_document_strategy(None))
+
+ def test_web_document_request_accepts_single_label_intranet_host(self):
+ serializer = DocumentWebInstanceSerializer(data={"source_url_list": ["http://wiki/docs"]})
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+
+ def test_web_document_request_normalizes_custom_strategy(self):
+ model_id = "00000000-0000-0000-0000-000000000001"
+ serializer = DocumentWebInstanceSerializer(
+ data={
+ "source_url_list": ["https://example.com/a"],
+ "doc_strategy": {
+ "split": {
+ "patterns": [r"(?m)^# .*"],
+ "min_length": 100,
+ "max_length": 2000,
+ "child_length": 512,
+ "auto_clean": True,
+ },
+ "visual": {"enabled": True, "strategy": "model", "model_id": model_id},
+ "index": {"title_as_question": True},
+ },
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ strategy = serializer.validated_data["doc_strategy"]
+ self.assertEqual(strategy["split"]["mode"], "advanced")
+ self.assertEqual(strategy["split"]["child_length"], 512)
+ self.assertEqual(strategy["visual"]["model_id"], model_id)
+ self.assertTrue(strategy["index"]["title_as_question"])
+
+ def test_web_document_request_rejects_invalid_custom_strategy(self):
+ serializer = DocumentWebInstanceSerializer(
+ data={
+ "source_url_list": ["not-a-url"],
+ "doc_strategy": {
+ "split": {"min_length": 500, "max_length": 100},
+ "visual": {"enabled": True, "strategy": "tool"},
+ },
+ }
+ )
+
+ self.assertFalse(serializer.is_valid())
+ self.assertIn("source_url_list", serializer.errors)
+ self.assertIn("doc_strategy", serializer.errors)
+
+ def test_smart_split_rejects_advanced_paragraph_identifiers(self):
+ serializer = DocumentWebInstanceSerializer(
+ data={
+ "source_url_list": ["https://example.com"],
+ "doc_strategy": {"split": {"mode": "smart", "patterns": [r"(?m)^# .* "]}},
+ }
+ )
+
+ self.assertFalse(serializer.is_valid())
+ self.assertIn("doc_strategy", serializer.errors)
+
+ def test_web_knowledge_request_captures_strategy_for_later_sync(self):
+ serializer = KnowledgeWebCreateRequest(
+ data={
+ "name": "docs",
+ "folder_id": "folder-id",
+ "embedding_model_id": "embedding-id",
+ "source_url": "https://example.com",
+ "doc_strategy": {"split": {"max_length": 1024}},
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ self.assertEqual(serializer.validated_data["selector"], "body")
+ self.assertEqual(serializer.validated_data["doc_strategy"]["split"]["max_length"], 1024)
+
+ def test_custom_document_sync_requires_a_strategy(self):
+ serializer = DocumentSyncStrategySerializer(data={"strategy_mode": "custom"})
+
+ self.assertFalse(serializer.is_valid())
+ self.assertIn("doc_strategy", serializer.errors)
+
+ def test_web_knowledge_edit_normalizes_top_level_strategy_without_replacing_meta(self):
+ knowledge = MagicMock(type=KnowledgeType.WEB)
+ serializer = KnowledgeEditRequest(data={"doc_strategy": {"split": {"max_length": 2048}}})
+
+ serializer.is_valid(knowledge=knowledge)
+
+ self.assertEqual(serializer.validated_data["doc_strategy"]["split"]["max_length"], 2048)
+
+ def test_non_web_knowledge_rejects_document_strategy_settings(self):
+ for knowledge_type in KnowledgeType:
+ if knowledge_type == KnowledgeType.WEB:
+ continue
+ for strategy in ({}, {"split": {"max_length": 2048}}):
+ with self.subTest(knowledge_type=knowledge_type, strategy=strategy):
+ serializer = KnowledgeEditRequest(data={"doc_strategy": strategy})
+
+ with self.assertRaises(ValidationError):
+ serializer.is_valid(knowledge=MagicMock(type=knowledge_type))
+
+ def test_knowledge_sync_type_supports_all_three_modes(self):
+ field = KnowledgeSerializer.SyncWeb().fields["sync_type"]
+
+ self.assertEqual(field.run_validation("incremental"), "incremental")
+ self.assertEqual(field.run_validation("replace"), "replace")
+ self.assertEqual(field.run_validation("complete"), "complete")
+
+ @patch("knowledge.serializers.knowledge.sync_replace_web_knowledge.delay")
+ def test_knowledge_sync_dispatches_selected_mode(self, delay):
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000011",
+ meta={"source_url": "https://example.com", "selector": "body", "doc_strategy": {}},
+ )
+ serializer = KnowledgeSerializer.SyncWeb(data={"user_id": "00000000-0000-0000-0000-000000000012"})
+
+ serializer.incremental_sync(knowledge)
+
+ self.assertEqual(delay.call_args.args[-1], "incremental")
+ self.assertTrue(delay.call_args.kwargs["record_log"])
+ self.assertEqual(delay.call_args.kwargs["trigger_type"], KnowledgeSyncTrigger.MANUAL)
+
+ def test_selector_list_ignores_extra_spaces(self):
+ self.assertEqual(get_selector_list("body .article "), ["body", ".article"])
+
+ def test_web_url_identity_ignores_fragment_trailing_slash_and_host_case(self):
+ self.assertEqual(
+ normalize_web_url("HTTPS://EXAMPLE.COM/docs/#section"),
+ "https://example.com/docs",
+ )
+
+ @patch("knowledge.serializers.document.DocumentSerializers.Create")
+ @patch("knowledge.task.handler.internalize_web_images", side_effect=lambda content, _knowledge_id: content)
+ @patch("knowledge.task.handler.QuerySet")
+ def test_legacy_task_call_falls_back_to_strategy_saved_on_knowledge(
+ self, query_set, _internalize_web_images, create_document
+ ):
+ knowledge = MagicMock(meta={"doc_strategy": {"split": {"max_length": 777}}})
+ query_set.return_value.filter.return_value.first.return_value = knowledge
+ response = MagicMock(status=200, content="content")
+ child_link = MagicMock(tag=None, url="https://example.com/docs")
+
+ get_save_handler("knowledge-id", "user-id", "body")(child_link, response)
+
+ instance = create_document.return_value.save.call_args.args[0]
+ self.assertEqual(instance["doc_strategy"]["split"]["max_length"], 777)
+
+ @patch("knowledge.serializers.document.DocumentSerializers.Sync")
+ @patch("knowledge.task.handler.QuerySet")
+ def test_incremental_crawl_reuses_response_and_document_strategy(self, query_set, sync_document):
+ knowledge = MagicMock(id="knowledge-id", meta={"doc_strategy": {}})
+ existing = MagicMock(
+ id="document-id",
+ type=KnowledgeType.WEB,
+ meta={"source_url": "https://example.com/docs/"},
+ )
+ knowledge_query = MagicMock()
+ knowledge_query.filter.return_value.first.return_value = knowledge
+ document_query = MagicMock()
+ document_query.filter.return_value.__iter__.return_value = [existing]
+ query_set.side_effect = lambda model: knowledge_query if model is Knowledge else document_query
+ response = MagicMock(status=200, content="updated")
+ successful_urls = set()
+
+ handler = get_sync_handler("knowledge-id", "user-id", successful_urls=successful_urls)
+ handler(MagicMock(tag=None, url="https://example.com/docs#top"), response)
+
+ sync_document.return_value.sync.assert_called_once_with(response=response)
+ self.assertEqual(successful_urls, {"https://example.com/docs"})
+
+ @patch("knowledge.task.handler.delete_document_data")
+ @patch("knowledge.serializers.document.DocumentSerializers.Create")
+ @patch("knowledge.task.handler.internalize_web_images", side_effect=lambda content, _knowledge_id: content)
+ @patch("knowledge.task.handler.QuerySet")
+ def test_replace_crawl_creates_new_document_before_deleting_old(
+ self, query_set, _internalize_web_images, create_document, delete_document_data
+ ):
+ knowledge = MagicMock(id="knowledge-id", meta={"selector": "body", "doc_strategy": {}})
+ existing = MagicMock(
+ id="old-document-id",
+ type=KnowledgeType.WEB,
+ meta={"source_url": "https://example.com/docs", "selector": ".content"},
+ doc_strategy={"split": {"max_length": 777}},
+ )
+ knowledge_query = MagicMock()
+ knowledge_query.filter.return_value.first.return_value = knowledge
+ document_query = MagicMock()
+ document_query.filter.return_value.__iter__.return_value = [existing]
+ query_set.side_effect = lambda model: knowledge_query if model is Knowledge else document_query
+ create_document.return_value.save.return_value = {"id": "new-document-id"}
+
+ handler = get_sync_handler("knowledge-id", "user-id", sync_type="replace")
+ handler(MagicMock(tag=None, url="https://example.com/docs"), MagicMock(status=200, content="updated"))
+
+ instance = create_document.return_value.save.call_args.args[0]
+ self.assertEqual(instance["doc_strategy"]["split"]["max_length"], 777)
+ self.assertEqual(instance["meta"]["selector"], ".content")
+ delete_document_data.assert_called_once_with(["old-document-id"])
+
+ @patch("knowledge.task.handler.delete_document_data")
+ @patch("knowledge.serializers.document.DocumentSerializers.Create")
+ @patch("knowledge.task.handler.internalize_web_images", side_effect=lambda content, _knowledge_id: content)
+ @patch("knowledge.task.handler.QuerySet")
+ def test_replace_crawl_keeps_old_document_when_new_document_creation_fails(
+ self, query_set, _internalize_web_images, create_document, delete_document_data
+ ):
+ knowledge = MagicMock(id="knowledge-id", meta={"selector": "body", "doc_strategy": {}})
+ existing = MagicMock(
+ id="old-document-id",
+ type=KnowledgeType.WEB,
+ meta={"source_url": "https://example.com/docs"},
+ doc_strategy={},
+ )
+ knowledge_query = MagicMock()
+ knowledge_query.filter.return_value.first.return_value = knowledge
+ document_query = MagicMock()
+ document_query.filter.return_value.__iter__.return_value = [existing]
+ query_set.side_effect = lambda model: knowledge_query if model is Knowledge else document_query
+ create_document.return_value.save.side_effect = RuntimeError("create failed")
+
+ handler = get_sync_handler("knowledge-id", "user-id", sync_type="replace")
+ handler(MagicMock(tag=None, url="https://example.com/docs"), MagicMock(status=200, content="updated"))
+
+ delete_document_data.assert_not_called()
+
+
+class KnowledgeModelUpdateTests(SimpleTestCase):
+ @patch("knowledge.serializers.knowledge.update_resource_mapping_by_knowledge")
+ @patch("knowledge.serializers.knowledge.QuerySet")
+ def test_model_update_preserves_meta_when_strategy_is_omitted_or_inapplicable_null(self, query_set, update_mapping):
+ knowledge_id = "00000000-0000-0000-0000-000000000011"
+ model_id = "00000000-0000-0000-0000-000000000012"
+ for knowledge_type in KnowledgeType:
+ payloads = [{"embedding_model_id": model_id}]
+ if knowledge_type != KnowledgeType.WEB:
+ payloads.append({"embedding_model_id": model_id, "doc_strategy": None})
+ for payload in payloads:
+ with self.subTest(knowledge_type=knowledge_type, payload=payload):
+ original_meta = {"sync_setting": {"enabled": True}}
+ if knowledge_type == KnowledgeType.WEB:
+ original_meta["doc_strategy"] = normalize_document_strategy({"split": {"max_length": 1024}})
+ knowledge = MagicMock(id=knowledge_id, type=knowledge_type, meta=original_meta.copy())
+ query_set.return_value.get.return_value = knowledge
+ operation = KnowledgeSerializer.Operate(
+ data={
+ "user_id": "00000000-0000-0000-0000-000000000013",
+ "workspace_id": "workspace-id",
+ "knowledge_id": knowledge_id,
+ }
+ )
+
+ # Exercise the edit path with mocked persistence, without opening a database transaction.
+ KnowledgeSerializer.Operate.edit.__wrapped__(operation, payload, select_one=False)
+
+ self.assertEqual(knowledge.embedding_model_id, model_id)
+ self.assertEqual(knowledge.meta, original_meta)
+ knowledge.save.assert_called_once_with()
+ update_mapping.assert_called_with(knowledge_id)
+
+ @patch("knowledge.serializers.knowledge.update_resource_mapping_by_knowledge")
+ @patch("knowledge.serializers.knowledge.QuerySet")
+ def test_web_knowledge_explicit_null_strategy_still_resets_to_defaults(self, query_set, _update_mapping):
+ knowledge = MagicMock(
+ type=KnowledgeType.WEB,
+ meta={"selector": "body", "doc_strategy": {"split": {"max_length": 1024}}},
+ )
+ query_set.return_value.get.return_value = knowledge
+ operation = KnowledgeSerializer.Operate(
+ data={
+ "user_id": "00000000-0000-0000-0000-000000000013",
+ "workspace_id": "workspace-id",
+ "knowledge_id": "00000000-0000-0000-0000-000000000011",
+ }
+ )
+
+ KnowledgeSerializer.Operate.edit.__wrapped__(operation, {"doc_strategy": None}, select_one=False)
+
+ self.assertEqual(knowledge.meta, {"selector": "body", "doc_strategy": normalize_document_strategy(None)})
+ knowledge.save.assert_called_once_with()
+
+
+class WebKnowledgeSyncTaskTests(SimpleTestCase):
+ @patch("knowledge.task.sync.delete_document_data")
+ @patch("knowledge.task.sync.KnowledgeSyncLog.objects.create")
+ @patch("knowledge.task.sync.QuerySet")
+ @patch("knowledge.task.sync.get_sync_handler")
+ @patch("knowledge.task.sync.ForkManage")
+ def test_recorded_sync_persists_counts_and_duration(
+ self, fork_manage, get_handler, query_set, create_log, _delete_document_data
+ ):
+ root_url = "https://example.com"
+ knowledge = MagicMock(id="knowledge-id", workspace_id="workspace-id")
+ knowledge_query = MagicMock()
+ knowledge_query.filter.return_value.first.return_value = knowledge
+ document_query = MagicMock()
+ document_query.filter.return_value.count.return_value = 2
+ document_query.filter.return_value.__iter__.return_value = []
+ log_query = MagicMock()
+ query_set.side_effect = lambda model: {
+ Knowledge: knowledge_query,
+ Document: document_query,
+ }.get(model, log_query)
+ sync_log = MagicMock(id="log-id")
+ create_log.return_value = sync_log
+
+ def handler_factory(_knowledge_id, _user_id, _strategy, _sync_type, successful_urls, stats):
+ successful_urls.add(root_url)
+ stats["synced_count"] = 1
+ stats["skipped_count"] = 1
+ return MagicMock()
+
+ get_handler.side_effect = handler_factory
+ fork_manage.return_value.fork.side_effect = lambda _level, visited, _handler: visited.add(root_url)
+
+ result = sync_replace_web_knowledge.run(
+ "knowledge-id",
+ "user-id",
+ root_url,
+ "body",
+ {},
+ "incremental",
+ record_log=True,
+ )
+
+ self.assertEqual(result["status"], "success")
+ self.assertEqual(result["total_count"], 2)
+ log_query.filter.return_value.update.assert_called_once()
+ update = log_query.filter.return_value.update.call_args.kwargs
+ self.assertEqual(update["synced_count"], 1)
+ self.assertEqual(update["skipped_count"], 1)
+ self.assertGreaterEqual(update["duration_ms"], 0)
+
+ @patch("knowledge.task.sync.delete_document_data")
+ @patch("knowledge.task.sync.QuerySet")
+ @patch("knowledge.task.sync.get_sync_handler")
+ @patch("knowledge.task.sync.ForkManage")
+ def test_incremental_sync_deletes_urls_missing_from_successful_crawl(
+ self, fork_manage, get_handler, query_set, delete_document_data
+ ):
+ root_url = "https://example.com"
+ successful_urls = None
+
+ def handler_factory(_knowledge_id, _user_id, _strategy, _sync_type, success_set, _stats):
+ nonlocal successful_urls
+ successful_urls = success_set
+ return MagicMock()
+
+ get_handler.side_effect = handler_factory
+
+ def crawl(_level, visited, _handler):
+ visited.update({root_url, f"{root_url}/kept"})
+ successful_urls.add(root_url)
+
+ fork_manage.return_value.fork.side_effect = crawl
+ kept = MagicMock(id="kept-id", meta={"source_url": f"{root_url}/kept"})
+ stale = MagicMock(id="stale-id", meta={"source_url": f"{root_url}/removed"})
+ document_query = MagicMock()
+ document_query.filter.return_value.__iter__.return_value = [kept, stale]
+ query_set.side_effect = lambda model: document_query
+
+ sync_replace_web_knowledge.run("knowledge-id", "user-id", root_url, "body", {}, "incremental")
+
+ delete_document_data.assert_called_once_with(["stale-id"])
+
+ @patch("knowledge.task.sync.delete_document_data")
+ @patch("knowledge.task.sync.QuerySet")
+ @patch("knowledge.task.sync.get_sync_handler")
+ @patch("knowledge.task.sync.ForkManage")
+ def test_incremental_sync_does_not_prune_documents_when_root_fetch_fails(
+ self, fork_manage, get_handler, _query_set, delete_document_data
+ ):
+ root_url = "https://example.com"
+ get_handler.return_value = MagicMock()
+ fork_manage.return_value.fork.side_effect = lambda _level, visited, _handler: visited.add(root_url)
+
+ sync_replace_web_knowledge.run("knowledge-id", "user-id", root_url, "body", {}, "incremental")
+
+ delete_document_data.assert_not_called()
+
+ @patch("knowledge.task.sync.get_save_handler")
+ @patch("knowledge.task.sync.ForkManage")
+ @patch("knowledge.task.sync.delete_document_data")
+ @patch("knowledge.task.sync.QuerySet")
+ def test_complete_sync_cleans_documents_before_crawling(
+ self, query_set, delete_document_data, fork_manage, _get_save_handler
+ ):
+ events = []
+ document_query = MagicMock()
+ document_query.filter.return_value.values_list.return_value = ["document-id"]
+ file_query = MagicMock()
+ query_set.side_effect = lambda model: document_query if model is Document else file_query
+ delete_document_data.side_effect = lambda _document_ids: events.append("cleanup")
+ fork_manage.return_value.fork.side_effect = lambda *_args: events.append("crawl")
+
+ sync_replace_web_knowledge.run("knowledge-id", "user-id", "https://example.com", "body", {}, "complete")
+
+ delete_document_data.assert_called_once_with(["document-id"])
+ fork_manage.return_value.fork.assert_called_once()
+ self.assertEqual(events, ["cleanup", "crawl"])
+
+
+class KnowledgeScheduleTests(SimpleTestCase):
+ def test_daily_setting_is_normalized_to_cron(self):
+ serializer = KnowledgeSyncSettingRequest(
+ data={
+ "enabled": True,
+ "schedule_type": "daily",
+ "time": "01:30",
+ "sync_type": "incremental",
+ }
+ )
+
+ self.assertTrue(serializer.is_valid(), serializer.errors)
+ self.assertEqual(serializer.validated_data["cron_expression"], "30 1 * * *")
+
+ def test_custom_cron_is_validated(self):
+ self.assertEqual(
+ normalize_knowledge_sync_setting(
+ {
+ "enabled": True,
+ "schedule_type": "cron",
+ "cron_expression": "*/15 * * * *",
+ "sync_type": "replace",
+ }
+ )["cron_expression"],
+ "*/15 * * * *",
+ )
+ serializer = KnowledgeSyncSettingRequest(
+ data={
+ "enabled": True,
+ "schedule_type": "cron",
+ "cron_expression": "invalid",
+ "sync_type": "replace",
+ }
+ )
+ self.assertFalse(serializer.is_valid())
+ self.assertIn("non_field_errors", serializer.errors)
+
+ @patch("knowledge.services.knowledge_sync_schedule._get_scheduler")
+ @patch("knowledge.services.knowledge_sync_schedule.QuerySet")
+ def test_enabled_setting_deploys_one_replaceable_job(self, query_set, get_scheduler):
+ scheduler = get_scheduler.return_value
+ scheduler.get_job.return_value = None
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000021",
+ meta={
+ "sync_setting": {
+ "enabled": True,
+ "schedule_type": "daily",
+ "time": "02:00",
+ "sync_type": "incremental",
+ }
+ },
+ )
+ query_set.return_value.filter.return_value.first.return_value = knowledge
+
+ self.assertTrue(deploy_knowledge_sync_job(knowledge.id))
+
+ self.assertEqual(scheduler.add_job.call_count, 1)
+ self.assertTrue(scheduler.add_job.call_args.kwargs["replace_existing"])
+ self.assertEqual(scheduler.add_job.call_args.kwargs["id"], f"knowledge:sync:{knowledge.id}")
+
+ @patch("knowledge.task.sync.sync_replace_web_knowledge.delay")
+ @patch("knowledge.task.sync.QuerySet")
+ def test_scheduled_entry_uses_saved_sync_type_and_records_log(self, query_set, delay):
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000022",
+ user_id="00000000-0000-0000-0000-000000000023",
+ meta={
+ "source_url": "https://example.com",
+ "selector": "body",
+ "doc_strategy": {},
+ "sync_setting": {"enabled": True, "sync_type": "complete"},
+ },
+ )
+ query_set.return_value.filter.return_value.first.return_value = knowledge
+
+ self.assertTrue(scheduled_sync_web_knowledge.run(str(knowledge.id)))
+
+ self.assertEqual(delay.call_args.args[-1], "complete")
+ self.assertTrue(delay.call_args.kwargs["record_log"])
+ self.assertEqual(delay.call_args.kwargs["trigger_type"], KnowledgeSyncTrigger.SCHEDULED)
+
+ @patch("knowledge.serializers.knowledge_sync.QuerySet")
+ def test_setting_operation_accepts_lark_and_workflow_knowledge(self, query_set):
+ for knowledge_type in [KnowledgeType.LARK, KnowledgeType.WORKFLOW]:
+ with self.subTest(knowledge_type=knowledge_type):
+ knowledge = MagicMock(type=knowledge_type, meta={})
+ query_set.return_value.filter.return_value.first.return_value = knowledge
+ serializer = KnowledgeSyncSettingOperationSerializer(
+ data={
+ "workspace_id": "workspace-id",
+ "knowledge_id": "00000000-0000-0000-0000-000000000024",
+ }
+ )
+
+ self.assertFalse(serializer.get_setting()["enabled"])
+
+ @patch("knowledge.task.sync.celery_app.send_task")
+ @patch("knowledge.task.sync.QuerySet")
+ def test_generic_scheduled_entry_dispatches_lark_task(self, query_set, send_task):
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000025",
+ type=KnowledgeType.LARK,
+ meta={"sync_setting": {"enabled": True}},
+ )
+ query_set.return_value.filter.return_value.first.return_value = knowledge
+
+ self.assertTrue(scheduled_sync_knowledge.run(str(knowledge.id)))
+
+ send_task.assert_called_once_with("celery:scheduled_sync_lark_knowledge", args=[str(knowledge.id)])
+
+ @patch("knowledge.task.sync.scheduled_sync_workflow_knowledge.delay")
+ @patch("knowledge.task.sync.QuerySet")
+ def test_generic_scheduled_entry_dispatches_workflow_task(self, query_set, delay):
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000026",
+ type=KnowledgeType.WORKFLOW,
+ meta={"sync_setting": {"enabled": True}},
+ )
+ query_set.return_value.filter.return_value.first.return_value = knowledge
+
+ self.assertTrue(scheduled_sync_knowledge.run(str(knowledge.id)))
+
+ delay.assert_called_once_with(str(knowledge.id))
+
+
+class WorkflowKnowledgeScheduleTests(SimpleTestCase):
+ @patch("knowledge.serializers.knowledge_workflow.merge_workflow_incremental_snapshot")
+ @patch("knowledge.serializers.knowledge_workflow.QuerySet")
+ def test_incremental_workflow_uses_stable_snapshot_merge(self, query_set, merge_workflow_snapshot):
+ sync_log = MagicMock(
+ id="00000000-0000-0000-0000-000000000032",
+ knowledge_id="00000000-0000-0000-0000-000000000033",
+ create_time=timezone.now(),
+ sync_type=KnowledgeSyncType.INCREMENTAL,
+ )
+ action_query = MagicMock()
+ log_query = MagicMock()
+ log_query.filter.return_value.first.return_value = sync_log
+ query_set.side_effect = lambda model: log_query if model is KnowledgeSyncLog else action_query
+ merge_workflow_snapshot.return_value = {
+ "total_count": 1,
+ "synced_count": 0,
+ "skipped_count": 1,
+ "deleted_count": 0,
+ "failed_count": 0,
+ }
+ document_cleanup = MagicMock()
+
+ # 新引擎:完成收尾由 finalize_knowledge_action 内联处理,state/run_time 由调用方算好传入
+ finalize_knowledge_action(
+ "00000000-0000-0000-0000-000000000036",
+ KnowledgeActionState.SUCCESS,
+ 0.0,
+ str(sync_log.id),
+ document_cleanup,
+ )
+
+ merge_workflow_snapshot.assert_called_once_with(sync_log)
+ update = log_query.filter.return_value.update.call_args.kwargs
+ self.assertEqual(update["status"], KnowledgeSyncStatus.SUCCESS)
+ self.assertEqual(update["synced_count"], 0)
+ self.assertEqual(update["skipped_count"], 1)
+
+ @patch("knowledge.task.sync.KnowledgeWorkflowActionSerializer")
+ @patch("knowledge.task.sync.KnowledgeSyncLog.objects.create")
+ @patch("knowledge.task.sync.QuerySet")
+ def test_scheduled_workflow_uses_saved_input_and_starts_an_action(self, query_set, create_log, action_serializer):
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000027",
+ workspace_id="workspace-id",
+ type=KnowledgeType.WORKFLOW,
+ user=MagicMock(),
+ meta={
+ "sync_setting": {"enabled": True, "sync_type": "incremental"},
+ "workflow_sync_input": {
+ "data_source": {"node_id": "start-node"},
+ "knowledge_base": {},
+ },
+ },
+ )
+ knowledge_query = MagicMock()
+ knowledge_query.filter.return_value.first.return_value = knowledge
+ log_query = MagicMock()
+ log_query.filter.return_value.exists.return_value = False
+ document_query = MagicMock()
+ document_query.filter.return_value.count.return_value = 2
+ query_set.side_effect = lambda model: {
+ Knowledge: knowledge_query,
+ KnowledgeSyncLog: log_query,
+ }.get(model, document_query)
+ sync_log = MagicMock(id="00000000-0000-0000-0000-000000000028")
+ create_log.return_value = sync_log
+ action_serializer.return_value.action.return_value = {"id": "00000000-0000-0000-0000-000000000029"}
+
+ self.assertTrue(scheduled_sync_workflow_knowledge.run(str(knowledge.id)))
+
+ workflow_input = action_serializer.return_value.action.call_args.args[0]
+ self.assertEqual(workflow_input["data_source"], {"node_id": "start-node"})
+ action_serializer.return_value.action.assert_called_once_with(
+ workflow_input,
+ knowledge.user,
+ True,
+ str(sync_log.id),
+ )
+
+ @patch("knowledge.serializers.knowledge_workflow.WorkflowRunRegistry")
+ @patch("knowledge.serializers.knowledge_workflow.new_instance")
+ @patch("knowledge.serializers.knowledge_workflow.WorkflowManage")
+ @patch("knowledge.serializers.knowledge_workflow.KnowledgeAction.save")
+ @patch("knowledge.serializers.knowledge_workflow.QuerySet")
+ def test_manual_action_saves_input_for_later_scheduled_runs(
+ self, query_set, _save_action, workflow_manage, _new_instance, _registry
+ ):
+ workflow = MagicMock(work_flow={})
+ knowledge = MagicMock(
+ id="00000000-0000-0000-0000-000000000030",
+ name="workflow knowledge",
+ desc="desc",
+ workspace_id="workspace-id",
+ meta={"existing": True},
+ )
+
+ def query_for(model):
+ query = MagicMock()
+ query.filter.return_value.first.return_value = (
+ workflow if model.__name__ == "KnowledgeWorkflow" else knowledge
+ )
+ return query
+
+ query_set.side_effect = query_for
+ user = MagicMock(id="00000000-0000-0000-0000-000000000031", username="owner")
+ workflow_input = {
+ "data_source": {"node_id": "start-node", "files": ["a.docx"]},
+ "knowledge_base": {"custom": "value"},
+ }
+
+ serializer = KnowledgeWorkflowActionSerializer(
+ data={"workspace_id": knowledge.workspace_id, "knowledge_id": str(knowledge.id)}
+ )
+ serializer.is_valid(raise_exception=True)
+ serializer.action(workflow_input, user, with_valid=False)
+
+ self.assertEqual(
+ knowledge.meta["workflow_sync_input"],
+ {
+ "data_source": {"node_id": "start-node", "files": ["a.docx"]},
+ "knowledge_base": {"custom": "value"},
+ },
+ )
+ knowledge.save.assert_called_once_with(update_fields=["meta", "update_time"])
+ workflow_manage.return_value.run.assert_called_once_with()
+
+
+class WebImageAssetTests(SimpleTestCase):
+ @patch(
+ "knowledge.web_assets._cache_web_image",
+ return_value="00000000-0000-0000-0000-000000000001",
+ )
+ def test_remote_images_are_replaced_with_internal_references_and_deduplicated(self, cache_web_image):
+ source = "before  "
+
+ result = internalize_web_images(source, "knowledge-id")
+
+ self.assertEqual(cache_web_image.call_count, 1)
+ self.assertIn("", result)
+ self.assertIn("", result)
+
+ @patch("knowledge.web_assets._cache_web_image", return_value=None)
+ def test_remote_image_failure_does_not_block_document_content(self, _cache_web_image):
+ source = "before  after"
+
+ self.assertEqual(internalize_web_images(source, "knowledge-id"), source)
+
+
+class IncrementalSyncTests(SimpleTestCase):
+ def test_manual_paragraphs_never_match_remote_keys_hashes_or_titles(self):
+ service = IncrementalDocumentSync(Document())
+ remote = prepare_remote_paragraphs([{"title": "Title", "content": "remote"}])[0]
+ for fields in (
+ {"source_key": remote["source_key"]},
+ {"source_hash": remote["source_hash"]},
+ {},
+ ):
+ with self.subTest(fields=fields):
+ manual = Paragraph(title="Title", content="manual", position=1, origin=ContentOrigin.MANUAL, **fields)
+ self.assertIsNone(service._match(remote, [manual]))
+
+ def test_source_authoritative_update_overwrites_changed_imported_content(self):
+ service = IncrementalDocumentSync(Document(), source_authoritative=True)
+ paragraph = Paragraph(
+ title="Title",
+ content="local edit",
+ source_hash="old",
+ source_snapshot={"title": "Title", "content": "base"},
+ origin=ContentOrigin.SYNCED,
+ local_state=LocalState.MODIFIED,
+ hit_num=7,
+ )
+ original_id = paragraph.id
+ paragraph.save = MagicMock()
+ remote = prepare_remote_paragraphs([{"title": "Title", "content": "remote edit"}])[0]
+ result = MergeResult()
+
+ service._merge_matched(paragraph, remote, result)
+
+ self.assertEqual(paragraph.id, original_id)
+ self.assertEqual(paragraph.hit_num, 7)
+ self.assertEqual(paragraph.content, "remote edit")
+ self.assertEqual(paragraph.source_hash, remote["source_hash"])
+ self.assertEqual(paragraph.local_state, LocalState.CLEAN)
+ self.assertEqual(paragraph.sync_state, SyncState.ACTIVE)
+ self.assertEqual(result.updated_ids, [str(original_id)])
+ self.assertEqual(result.conflict_ids, [])
+
+ def test_source_authoritative_matches_titles_without_position_limit(self):
+ service = IncrementalDocumentSync(Document(), source_authoritative=True)
+ paragraph = Paragraph(title="Title", content="old", position=20, origin=ContentOrigin.SYNCED)
+ remote = prepare_remote_paragraphs([{"title": "Title", "content": "new"}])[0]
+
+ self.assertIs(service._match(remote, [paragraph]), paragraph)
+
+ def test_source_authoritative_new_title_does_not_reuse_an_old_key(self):
+ service = IncrementalDocumentSync(Document(), source_authoritative=True)
+ paragraph = Paragraph(title="Old", content="old", source_key="block-1", origin=ContentOrigin.SYNCED)
+ remote = prepare_remote_paragraphs([{"title": "New", "content": "new", "source_key": "block-1"}])[0]
+
+ self.assertIsNone(service._match(remote, [paragraph]))
+
+ @patch("knowledge.services.incremental_sync.Paragraph.objects")
+ @patch("knowledge.services.incremental_sync.Document.objects")
+ def test_source_authoritative_reserves_unchanged_duplicate_headings_before_updates(self, documents, paragraphs):
+ strategy = normalize_document_strategy(None)
+ document = Document(doc_strategy=strategy, sync_version=1, **strategy_hashes(strategy))
+ document.save = MagicMock()
+ originals = prepare_remote_paragraphs(
+ [
+ {"title": "Title", "content": "first"},
+ {"title": "Title", "content": "second"},
+ ]
+ )
+ first, second = [
+ Paragraph(
+ title=item["title"],
+ content=item["content"],
+ source_key=item["source_key"],
+ source_hash=item["source_hash"],
+ origin=ContentOrigin.SYNCED,
+ )
+ for item in originals
+ ]
+ first.save, second.save = MagicMock(), MagicMock()
+ documents.select_for_update.return_value.get.return_value = document
+ paragraphs.select_for_update.return_value.filter.return_value.order_by.return_value = [first, second]
+ service = IncrementalDocumentSync(document, source_authoritative=True)
+ with patch.object(service, "_reorder"), patch.object(service, "_sync_title_questions"):
+ result = IncrementalDocumentSync.merge.__wrapped__(
+ service,
+ [
+ {"title": "Title", "content": "changed"},
+ {"title": "Title", "content": "first"},
+ ],
+ )
+
+ self.assertEqual(result.unchanged_ids, [str(first.id)])
+ self.assertEqual(result.updated_ids, [str(second.id)])
+ self.assertEqual(first.content, "first")
+ self.assertEqual(second.content, "changed")
+ self.assertEqual(first.source_key, originals[1]["source_key"])
+ self.assertEqual(second.source_key, originals[0]["source_key"])
+ paragraphs.filter.assert_called_once_with(document=document, id__in=[second.id, first.id])
+ paragraphs.filter.return_value.update.assert_called_once_with(source_key="")
+ paragraphs.create.assert_not_called()
+
+ def test_source_authoritative_unchanged_chunk_preserves_local_content(self):
+ service = IncrementalDocumentSync(Document(), source_authoritative=True)
+ remote = prepare_remote_paragraphs([{"title": "Title", "content": "base"}])[0]
+ paragraph = Paragraph(
+ title="Title",
+ content="local edit",
+ source_key=remote["source_key"],
+ source_hash=remote["source_hash"],
+ origin=ContentOrigin.SYNCED,
+ local_state=LocalState.MODIFIED,
+ )
+ paragraph.save = MagicMock()
+ result = MergeResult()
+
+ service._merge_matched(paragraph, remote, result)
+
+ self.assertEqual(paragraph.content, "local edit")
+ paragraph.save.assert_not_called()
+ self.assertEqual(result.unchanged_ids, [str(paragraph.id)])
+
+ def test_source_authoritative_custom_child_length_rechunks_unchanged_content(self):
+ service = IncrementalDocumentSync(
+ Document(doc_strategy=normalize_document_strategy(None)),
+ {"split": {"child_length": 50}},
+ source_authoritative=True,
+ )
+ remote = prepare_remote_paragraphs([{"title": "Title", "content": "x" * 120}])[0]
+ paragraph = Paragraph(
+ title="Title",
+ content="x" * 120,
+ source_hash=remote["source_hash"],
+ chunks=["x" * 120],
+ origin=ContentOrigin.SYNCED,
+ )
+ paragraph.save = MagicMock()
+ result = MergeResult()
+
+ service._merge_matched(paragraph, remote, result)
+
+ self.assertGreater(len(paragraph.chunks), 1)
+ self.assertEqual("".join(paragraph.chunks), paragraph.content)
+ self.assertEqual(result.updated_ids, [str(paragraph.id)])
+
+ @patch("knowledge.services.incremental_sync.delete_synced_paragraph_data")
+ def test_source_authoritative_deletes_missing_imported_but_not_manual_paragraphs(self, cleanup):
+ document = Document()
+ service = IncrementalDocumentSync(document, source_authoritative=True)
+ synced = Paragraph(origin=ContentOrigin.SYNCED)
+ edited = Paragraph(origin=ContentOrigin.SYNCED, local_state=LocalState.MODIFIED)
+ manual = Paragraph(origin=ContentOrigin.MANUAL)
+ cleanup.return_value = [str(synced.id), str(edited.id)]
+ result = MergeResult()
+
+ service._handle_remote_deletes([synced, manual, edited], result)
+
+ cleanup.assert_called_once_with(document.id, [synced.id, edited.id])
+ self.assertEqual(result.deleted_ids, cleanup.return_value)
+ self.assertEqual(result.disabled_ids, [])
+ self.assertEqual(result.conflict_ids, [])
+
+ @patch("knowledge.services.incremental_sync.delete_synced_paragraph_data")
+ def test_three_way_policy_still_retains_remote_deleted_paragraphs(self, cleanup):
+ synced = Paragraph(origin=ContentOrigin.SYNCED)
+ synced.save = MagicMock()
+ result = MergeResult()
+
+ IncrementalDocumentSync(Document())._handle_remote_deletes([synced], result)
+
+ cleanup.assert_not_called()
+ self.assertFalse(synced.is_active)
+ self.assertEqual(synced.sync_state, SyncState.REMOTE_DELETED)
+ self.assertEqual(result.disabled_ids, [str(synced.id)])
+
+ @patch("knowledge.services.incremental_sync.delete_synced_paragraph_data")
+ @patch("knowledge.services.incremental_sync.Paragraph.objects")
+ @patch("knowledge.services.incremental_sync.Document.objects")
+ def test_authoritative_empty_snapshot_does_not_delete_existing_content(self, documents, paragraphs, cleanup):
+ document = Document()
+ documents.select_for_update.return_value.get.return_value = document
+ paragraphs.select_for_update.return_value.filter.return_value.order_by.return_value = [
+ Paragraph(origin=ContentOrigin.SYNCED),
+ ]
+ service = IncrementalDocumentSync(document, source_authoritative=True)
+
+ with self.assertRaisesRegex(ValueError, "empty paragraph snapshot"):
+ IncrementalDocumentSync.merge.__wrapped__(service, [])
+
+ cleanup.assert_not_called()
+
+ @patch("knowledge.services.incremental_sync.Paragraph.objects")
+ @patch("knowledge.services.incremental_sync.Document.objects")
+ def test_authoritative_merge_keeps_manual_content_and_saves_new_strategy(self, documents, paragraphs):
+ document = Document(knowledge=Knowledge(), doc_strategy=normalize_document_strategy(None), sync_version=1)
+ document.save = MagicMock()
+ manual = Paragraph(title="Title", content="manual", origin=ContentOrigin.MANUAL)
+ manual.save = MagicMock()
+ documents.select_for_update.return_value.get.return_value = document
+ paragraphs.select_for_update.return_value.filter.return_value.order_by.return_value = [manual]
+ created = Paragraph(title="Title", content="remote", origin=ContentOrigin.SYNCED)
+ paragraphs.create.return_value = created
+ active = paragraphs.filter.return_value.filter.return_value
+ active.values_list.return_value = [created.id]
+ service = IncrementalDocumentSync(document, {"split": {"child_length": 50}}, source_authoritative=True)
+ with patch.object(service, "_reorder"), patch.object(service, "_sync_title_questions"):
+ result = IncrementalDocumentSync.merge.__wrapped__(service, [{"title": "Title", "content": "remote"}])
+
+ self.assertEqual(result.created_ids, [str(created.id)])
+ self.assertEqual(manual.content, "manual")
+ manual.save.assert_not_called()
+ paragraphs.filter.return_value.filter.assert_called_once_with(origin=ContentOrigin.SYNCED)
+ self.assertEqual(document.doc_strategy["split"]["child_length"], 50)
+ self.assertEqual(document.sync_version, 2)
+
+ def test_fallback_source_key_survives_content_change(self):
+ first = prepare_remote_paragraphs([{"title": "Overview", "content": "v1"}])
+ second = prepare_remote_paragraphs([{"title": "Overview", "content": "v2"}])
+
+ self.assertEqual(first[0]["source_key"], second[0]["source_key"])
+ self.assertNotEqual(first[0]["source_hash"], second[0]["source_hash"])
+
+ def test_three_way_conflict_preserves_local_content(self):
+ document = Document(id="00000000-0000-0000-0000-000000000001", name="doc", char_length=0)
+ service = IncrementalDocumentSync(document)
+ paragraph = Paragraph(
+ id="00000000-0000-0000-0000-000000000002",
+ title="Title",
+ content="local edit",
+ source_snapshot={"title": "Title", "content": "base"},
+ source_key="block-1",
+ source_hash="old",
+ origin=ContentOrigin.SYNCED,
+ local_state=LocalState.MODIFIED,
+ )
+ paragraph.save = MagicMock()
+ result = MergeResult()
+
+ service._merge_matched(
+ paragraph,
+ {
+ "title": "Title",
+ "content": "remote edit",
+ "source_key": "block-1",
+ "source_hash": "new",
+ },
+ result,
+ )
+
+ self.assertEqual(paragraph.content, "local edit")
+ self.assertEqual(paragraph.sync_state, SyncState.CONFLICT)
+ self.assertEqual(result.conflict_ids, [str(paragraph.id)])
+
+ @patch("knowledge.services.incremental_sync.Paragraph.objects")
+ @patch("knowledge.services.incremental_sync.Document.objects")
+ def test_empty_remote_snapshot_keeps_existing_synced_paragraphs(self, document_objects, paragraph_objects):
+ document = Document(id="00000000-0000-0000-0000-000000000001", name="doc", char_length=4)
+ synced_paragraph = Paragraph(
+ id="00000000-0000-0000-0000-000000000002",
+ document=document,
+ knowledge_id="00000000-0000-0000-0000-000000000003",
+ title="Title",
+ content="body",
+ origin=ContentOrigin.SYNCED,
+ sync_state=SyncState.ACTIVE,
+ )
+ document_objects.select_for_update.return_value.get.return_value = document
+ paragraph_objects.select_for_update.return_value.filter.return_value.order_by.return_value = [synced_paragraph]
+ synced_paragraph.save = MagicMock()
+ service = IncrementalDocumentSync(document)
+
+ with self.assertRaisesRegex(ValueError, "empty paragraph snapshot"):
+ IncrementalDocumentSync.merge.__wrapped__(service, [])
+
+ document_objects.select_for_update.assert_called_once_with()
+ synced_paragraph.save.assert_not_called()
+
+ @patch("knowledge.serializers.document.IncrementalDocumentSync")
+ @patch("knowledge.serializers.document.process_visual_assets")
+ @patch("knowledge.serializers.document.sync_paragraph_assets", return_value=[])
+ @patch("knowledge.serializers.document.internalize_web_images", side_effect=lambda content, _knowledge_id: content)
+ @patch("knowledge.serializers.document.parse_web_content")
+ @patch("knowledge.serializers.document.ListenerManagement")
+ @patch("knowledge.serializers.document.QuerySet")
+ def test_document_hash_skips_paragraph_merge_and_embedding(
+ self,
+ query_set,
+ _listener,
+ parse_content,
+ _internalize_images,
+ _sync_assets,
+ _process_assets,
+ incremental_sync,
+ ):
+ paragraphs = [{"title": "Overview", "content": "unchanged"}]
+ strategy = normalize_document_strategy(None)
+ hashes = strategy_hashes(strategy)
+ document = Document(
+ id="00000000-0000-0000-0000-000000000021",
+ knowledge_id="00000000-0000-0000-0000-000000000022",
+ name="docs",
+ char_length=9,
+ type=KnowledgeType.WEB,
+ meta={"source_url": "https://example.com", "selector": "body"},
+ doc_strategy=strategy,
+ source_hash=document_source_hash(prepare_remote_paragraphs(paragraphs)),
+ **hashes,
+ )
+ document.save = MagicMock()
+ document_query = MagicMock()
+ document_query.filter.return_value.first.return_value = document
+ paragraph_query = MagicMock()
+ query_set.side_effect = lambda model: document_query if model is Document else paragraph_query
+ parse_content.return_value = paragraphs
+
+ serializer = DocumentSerializers.Sync(
+ data={"knowledge_id": str(document.knowledge_id), "document_id": str(document.id)}
+ )
+ DocumentSerializers.Sync.sync.__wrapped__(
+ serializer,
+ with_valid=False,
+ with_embedding=False,
+ response=MagicMock(status=200, content="unchanged"),
+ )
+
+ incremental_sync.assert_not_called()
+ document.save.assert_called_once_with(update_fields=["last_sync_time", "update_time"])
+
+
+class SyncedParagraphCleanupTests(SimpleTestCase):
+ @patch("knowledge.services.document_cleanup.delete_embedding_by_paragraph_ids")
+ @patch("knowledge.services.document_cleanup.QuerySet")
+ def test_cleanup_is_scoped_and_preserves_shared_problems(self, query_set, delete_vectors):
+ paragraph_query, mapping_query, problem_query = MagicMock(), MagicMock(), MagicMock()
+ query_set.side_effect = lambda model: {
+ Paragraph: paragraph_query,
+ ProblemParagraphMapping: mapping_query,
+ Problem: problem_query,
+ }[model]
+ paragraph_query.filter.return_value.values_list.return_value = ["synced-id"]
+ removed_mappings, remaining_mappings = MagicMock(), MagicMock()
+ mapping_query.filter.side_effect = [removed_mappings, remaining_mappings]
+ removed_mappings.values_list.return_value = ["shared-problem", "orphan-problem"]
+ remaining_mappings.values_list.return_value = ["shared-problem"]
+
+ result = delete_synced_paragraph_data("doc-id", ["synced-id", "manual-id", "other-doc-id"])
+
+ paragraph_query.filter.assert_called_once_with(
+ document_id="doc-id",
+ id__in=["synced-id", "manual-id", "other-doc-id"],
+ origin=ContentOrigin.SYNCED,
+ )
+ removed_mappings.delete.assert_called_once()
+ problem_query.filter.assert_called_once_with(id__in={"orphan-problem"})
+ delete_vectors.assert_called_once_with(["synced-id"])
+ paragraph_query.filter.return_value.delete.assert_called_once()
+ self.assertEqual(result, ["synced-id"])
+
+
+class ParagraphAssetTests(SimpleTestCase):
+ def test_image_is_kept_inside_paragraph_schema(self):
+ content = "before  after"
+ schema = paragraph_content_schema(content)
+
+ self.assertEqual([block["type"] for block in schema], ["text", "image", "text"])
+ self.assertEqual(schema[1]["caption"], "chart")
+
+ def test_asset_source_key_does_not_change_with_file_content(self):
+ paragraph = Paragraph(
+ id="00000000-0000-0000-0000-000000000001",
+ source_key="heading:overview:1",
+ )
+
+ source_key = paragraph_asset_source_key(paragraph, 1)
+
+ self.assertEqual(source_key, "heading:overview:1:image:1")
+ self.assertNotIn("hash", source_key)
+
+ @patch("knowledge.services.paragraph_assets.File.objects")
+ @patch("knowledge.services.paragraph_assets.ParagraphAsset.objects")
+ def test_synced_asset_moves_by_hash_without_changing_identity(self, asset_objects, file_objects):
+ old_asset = MagicMock(
+ id="00000000-0000-0000-0000-000000000061",
+ document_id="00000000-0000-0000-0000-000000000062",
+ paragraph_id="00000000-0000-0000-0000-000000000063",
+ origin=ContentOrigin.SYNCED,
+ source_asset_key="heading:old:1:image:1",
+ source_hash="same-image",
+ caption="old",
+ ocr_text="ocr",
+ description="description",
+ paragraph=MagicMock(is_active=False, sync_state=SyncState.REMOTE_DELETED),
+ )
+ asset_objects.select_for_update.return_value.select_related.return_value.filter.return_value.order_by.return_value = [
+ old_asset
+ ]
+ image_file = MagicMock(
+ id="00000000-0000-0000-0000-000000000064",
+ sha256_hash="same-image",
+ )
+ file_objects.filter.return_value.first.return_value = image_file
+ paragraph = Paragraph(
+ id="00000000-0000-0000-0000-000000000065",
+ document_id=old_asset.document_id,
+ knowledge_id="00000000-0000-0000-0000-000000000066",
+ title="new",
+ content=f"",
+ origin=ContentOrigin.SYNCED,
+ )
+ paragraph.save = MagicMock()
+
+ assets = sync_paragraph_assets.__wrapped__([paragraph])
+
+ self.assertEqual(assets, [old_asset])
+ self.assertEqual(old_asset.paragraph_id, paragraph.id)
+ self.assertEqual(old_asset.source_asset_key, "heading:old:1:image:1")
+ asset_objects.filter.assert_called_once_with(
+ paragraph_id__in={paragraph.id},
+ origin=ContentOrigin.SYNCED,
+ )
+
+ @patch("knowledge.services.paragraph_assets.ParagraphAsset.objects")
+ def test_remote_delete_cleanup_is_limited_to_synced_assets(self, asset_objects):
+ asset_objects.select_for_update.return_value.select_related.return_value.filter.return_value.order_by.return_value = []
+ paragraph = Paragraph(
+ id="00000000-0000-0000-0000-000000000067",
+ document_id="00000000-0000-0000-0000-000000000068",
+ knowledge_id="00000000-0000-0000-0000-000000000069",
+ title="manual",
+ content="text only",
+ origin=ContentOrigin.MANUAL,
+ )
+ paragraph.save = MagicMock()
+
+ sync_paragraph_assets.__wrapped__([paragraph])
+
+ asset_objects.filter.assert_called_once_with(
+ paragraph_id__in={paragraph.id},
+ origin=ContentOrigin.SYNCED,
+ )
+
+
+class DocumentResourceIsolationTests(SimpleTestCase):
+ @patch("knowledge.serializers.document.QuerySet")
+ def test_batch_document_operation_rejects_image_ids_by_default(self, query_set):
+ document_query = MagicMock()
+ document_query.filter.return_value.values_list.return_value = []
+ query_set.return_value = document_query
+ serializer = DocumentSerializers.Batch(
+ data={
+ "workspace_id": "workspace-id",
+ "knowledge_id": "00000000-0000-0000-0000-000000000071",
+ }
+ )
+
+ with self.assertRaises(AppApiException):
+ serializer.validate_document_ids({"id_list": ["00000000-0000-0000-0000-000000000072"]})
+
+ document_query.filter.assert_called_once_with(
+ id__in=["00000000-0000-0000-0000-000000000072"],
+ knowledge_id="00000000-0000-0000-0000-000000000071",
+ resource_type=DocumentResourceType.DOCUMENT,
+ )
+
+
+class WorkflowDocumentIdentityTests(SimpleTestCase):
+ def test_stable_source_metadata_takes_priority_over_document_name(self):
+ first = Document(name="Old name", meta={"source_key": "source-1"})
+ renamed = Document(name="New name", meta={"source_key": "source-1"})
+
+ self.assertEqual(workflow_document_identity(first), workflow_document_identity(renamed))
+
+ @patch("knowledge.services.workflow_sync._delete_workflow_documents")
+ @patch("knowledge.services.workflow_sync.process_visual_assets")
+ @patch("knowledge.services.workflow_sync.sync_paragraph_assets", return_value=[])
+ @patch("knowledge.services.workflow_sync.IncrementalDocumentSync")
+ @patch("knowledge.services.workflow_sync.QuerySet")
+ def test_incremental_snapshot_merges_into_old_document_id(
+ self,
+ query_set,
+ incremental_sync,
+ _sync_assets,
+ _process_assets,
+ delete_documents,
+ ):
+ sync_log = MagicMock(
+ knowledge_id="00000000-0000-0000-0000-000000000081",
+ create_time=timezone.now(),
+ )
+ old_document = MagicMock(
+ id="00000000-0000-0000-0000-000000000082",
+ knowledge_id=sync_log.knowledge_id,
+ name="Old",
+ meta={"source_key": "source-1"},
+ doc_strategy={},
+ visual_strategy_hash="visual",
+ )
+ new_document = MagicMock(
+ id="00000000-0000-0000-0000-000000000083",
+ knowledge_id=sync_log.knowledge_id,
+ name="Renamed",
+ meta={"source_key": "source-1"},
+ doc_strategy={},
+ )
+ source_paragraph = MagicMock(
+ id="00000000-0000-0000-0000-000000000084",
+ title="Title",
+ content="Content",
+ source_key="block-1",
+ source_updated_at=None,
+ )
+ target_paragraph = MagicMock(source_key="block-1")
+ document_query = MagicMock()
+
+ def filter_documents(**kwargs):
+ result = MagicMock()
+ if "create_time__gte" in kwargs:
+ result.__iter__.return_value = iter([new_document])
+ elif "create_time__lt" in kwargs:
+ result.__iter__.return_value = iter([old_document])
+ else:
+ result.count.return_value = 1
+ return result
+
+ document_query.filter.side_effect = filter_documents
+ paragraph_query = MagicMock()
+
+ def filter_paragraphs(**kwargs):
+ result = MagicMock()
+ if kwargs.get("document_id") == new_document.id:
+ result.order_by.return_value = [source_paragraph]
+ else:
+ result.__iter__.return_value = iter([target_paragraph])
+ return result
+
+ paragraph_query.filter.side_effect = filter_paragraphs
+ empty_relation_query = MagicMock()
+ empty_relation_query.filter.return_value.__iter__.return_value = iter([])
+ empty_relation_query.filter.return_value.values_list.return_value = []
+ file_query = MagicMock()
+ knowledge_query = MagicMock()
+ query_set.side_effect = lambda model: {
+ Document: document_query,
+ Paragraph: paragraph_query,
+ ProblemParagraphMapping: empty_relation_query,
+ FileSourceType: file_query,
+ Knowledge: knowledge_query,
+ }.get(model, empty_relation_query)
+ incremental_sync.return_value.merge.return_value = MergeResult()
+ delete_documents.return_value = [str(new_document.id)]
+
+ stats = merge_workflow_incremental_snapshot.__wrapped__(sync_log)
+
+ incremental_sync.assert_called_once_with(old_document, new_document.doc_strategy)
+ delete_documents.assert_called_once_with([str(new_document.id)])
+ self.assertEqual(old_document.id, "00000000-0000-0000-0000-000000000082")
+ self.assertEqual(stats["skipped_count"], 1)
+
+ @patch("knowledge.services.paragraph_assets._write_asset_description")
+ def test_visual_failure_preserves_existing_text_as_description(self, write_description):
+ asset = MagicMock()
+ asset.caption = "original caption"
+ asset.ocr_text = ""
+ asset.description = ""
+ asset.meta = {}
+
+ process_visual_assets(
+ [asset],
+ {"visual": {"enabled": True, "strategy": "model", "model_id": "model-id"}},
+ processor=MagicMock(side_effect=RuntimeError("vision failed")),
+ )
+
+ self.assertEqual(asset.process_status, AssetProcessStatus.FAILURE)
+ self.assertEqual(asset.description, "original caption")
+ asset.save.assert_called_once()
+ write_description.assert_called_once_with(asset)
+
+ @patch("knowledge.services.paragraph_assets.get_model_by_id")
+ def test_rejects_non_vision_model_for_visual_processing(self, get_model_by_id):
+ get_model_by_id.return_value.model_type = "LLM"
+
+ with self.assertRaises(AppApiException):
+ resolve_visual_processor(
+ {"strategy": "model", "model_id": "00000000-0000-0000-0000-000000000001"},
+ "workspace-1",
+ )
+
+ @patch("knowledge.services.paragraph_assets.Tool.objects.filter")
+ @patch("knowledge.services.paragraph_assets.filter_authorized_ids", return_value=[])
+ def test_rejects_unauthorized_visual_tool(self, filter_authorized_ids, tool_filter):
+ tool_filter.return_value.first.return_value = None
+ with self.assertRaises(AppApiException):
+ resolve_visual_processor(
+ {"strategy": "tool", "tool_id": "00000000-0000-0000-0000-000000000001"},
+ "workspace-1",
+ )
+
+ filter_authorized_ids.assert_called_once()
+ tool_filter.assert_called_once_with(id__in=[], is_active=True)
+
+ @patch("knowledge.services.paragraph_assets.Embedding.objects.bulk_create")
+ @patch("knowledge.services.paragraph_assets.ParagraphAsset.objects.select_related")
+ def test_text_only_embedding_model_indexes_image_description(self, select_related, bulk_create):
+ asset = MagicMock(spec=ParagraphAsset)
+ asset.id = "00000000-0000-0000-0000-000000000001"
+ asset.knowledge_id = "00000000-0000-0000-0000-000000000002"
+ asset.document_id = "00000000-0000-0000-0000-000000000003"
+ asset.paragraph_id = "00000000-0000-0000-0000-000000000004"
+ asset.position = 1
+ asset.caption = "chart"
+ asset.ocr_text = "revenue 100"
+ asset.description = "an upward trend"
+ asset.paragraph.is_active = True
+ select_related.return_value.filter.return_value.order_by.return_value = [asset]
+ embedding_model = MagicMock()
+ embedding_model.supports_image_embedding.return_value = False
+ embedding_model.embed_documents.return_value = [[0.1, 0.2]]
+
+ count = embed_paragraph_assets([asset.paragraph_id], embedding_model)
+
+ self.assertEqual(count, 1)
+ embedding_model.embed_documents.assert_called_once_with(["chart\nrevenue 100\nan upward trend"])
+ embedding_model.embed_images.assert_not_called()
+ row = bulk_create.call_args.args[0][0]
+ self.assertEqual(row.meta["unit_type"], "text")
+ self.assertEqual(row.meta["content_type"], "image_description")
+
+ @patch("knowledge.services.paragraph_assets.Embedding.objects.bulk_create")
+ @patch("knowledge.services.paragraph_assets.ParagraphAsset.objects.select_related")
+ def test_rejects_incomplete_image_embedding_result(self, select_related, bulk_create):
+ asset = MagicMock(spec=ParagraphAsset)
+ asset.id = "00000000-0000-0000-0000-000000000001"
+ asset.knowledge_id = "00000000-0000-0000-0000-000000000002"
+ asset.document_id = "00000000-0000-0000-0000-000000000003"
+ asset.paragraph_id = "00000000-0000-0000-0000-000000000004"
+ asset.position = 1
+ asset.caption = ""
+ asset.ocr_text = ""
+ asset.description = ""
+ asset.paragraph.is_active = True
+ asset.file.file_name = "chart.png"
+ asset.file.get_bytes.return_value = b"image"
+ select_related.return_value.filter.return_value.order_by.return_value = [asset]
+ embedding_model = MagicMock()
+ embedding_model.supports_image_embedding.return_value = True
+ embedding_model.embed_images.return_value = []
+
+ with self.assertRaises(AppApiException):
+ embed_paragraph_assets([asset.paragraph_id], embedding_model)
+
+ bulk_create.assert_not_called()
diff --git a/apps/knowledge/urls.py b/apps/knowledge/urls.py
index a8b715ec9ee..aee4dfdfe92 100644
--- a/apps/knowledge/urls.py
+++ b/apps/knowledge/urls.py
@@ -1,6 +1,7 @@
from django.urls import path
from . import views
+from knowledge.views.external_service import ExternalServiceView
app_name = "knowledge"
# @formatter:off
@@ -21,11 +22,15 @@
path('workspace//knowledge/import_knowledge', views.KnowledgeView.ImportKnowledge.as_view()),
path('workspace//knowledge/', views.KnowledgeView.Operate.as_view()),
path('workspace//knowledge//sync', views.KnowledgeView.SyncWeb.as_view()),
+ path('workspace//knowledge//sync_setting', views.KnowledgeView.KnowledgeSyncSetting.as_view()),
+ path('workspace//knowledge//sync_log//', views.KnowledgeView.KnowledgeSyncLog.as_view()),
path('workspace//knowledge//workflow', views.KnowledgeWorkflowView.Operate.as_view()),
path('workspace//knowledge//workflow/export', views.KnowledgeWorkflowView.Export.as_view()),
path('workspace//knowledge//workflow/import', views.KnowledgeWorkflowView.Import.as_view()),
path('workspace//knowledge//generate_related', views.KnowledgeView.GenerateRelated.as_view()),
path('workspace//knowledge//embedding', views.KnowledgeView.Embedding.as_view()),
+ path('workspace//knowledge//external_service', ExternalServiceView.as_view()),
+ path('workspace//knowledge//tokenize', views.KnowledgeView.Tokenize.as_view()),
path('workspace//knowledge//hit_test', views.KnowledgeView.HitTest.as_view()),
path('workspace//knowledge//export', views.KnowledgeView.Export.as_view()),
path('workspace//knowledge//export_zip', views.KnowledgeView.ExportZip.as_view()),
@@ -46,6 +51,9 @@
path('workspace//knowledge//document/batch_generate_related', views.DocumentView.BatchGenerateRelated.as_view()),
path('workspace//knowledge//document/batch_export', views.DocumentView.BatchExport.as_view()),
path('workspace//knowledge//document/batch_export_zip', views.DocumentView.BatchExportZip.as_view()),
+ path('workspace//knowledge//document/image/preview', views.ImageDocumentView.Preview.as_view()),
+ path('workspace//knowledge//document/image/preview/', views.ImageDocumentView.PreviewOperate.as_view()),
+ path('workspace//knowledge//document/image/batch_create', views.ImageDocumentView.BatchCreate.as_view()),
path('workspace//knowledge//document/web', views.WebDocumentView.as_view()),
path('workspace//knowledge//document/qa', views.QaDocumentView.as_view()),
path('workspace//knowledge//document/table', views.TableDocumentView.as_view()),
diff --git a/apps/knowledge/vector/base_vector.py b/apps/knowledge/vector/base_vector.py
index 32478f2c37a..99e087f09de 100644
--- a/apps/knowledge/vector/base_vector.py
+++ b/apps/knowledge/vector/base_vector.py
@@ -15,7 +15,7 @@
from common.chunk import text_to_chunk
from common.utils.common import sub_array
-from langchain_core.embeddings import Embeddings
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
from knowledge.models import SearchMode, SourceType
@@ -94,7 +94,7 @@ def save(
paragraph_id: str,
source_id: str,
is_active: bool,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
):
"""
插入向量数据
@@ -123,7 +123,7 @@ def save(
for child_array in result:
self._batch_save(child_array, embedding, lambda: False)
- def batch_save(self, data_list: List[Dict], embedding: Embeddings, is_the_task_interrupted):
+ def batch_save(self, data_list: List[Dict], embedding: MaxKBBaseEmbeddingModel, is_the_task_interrupted):
"""
批量插入
@param data_list: 数据列表
@@ -150,12 +150,12 @@ def _save(
paragraph_id: str,
source_id: str,
is_active: bool,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
):
pass
@abstractmethod
- def _batch_save(self, text_list: List[Dict], embedding: Embeddings, is_the_task_interrupted):
+ def _batch_save(self, text_list: List[Dict], embedding: MaxKBBaseEmbeddingModel, is_the_task_interrupted):
pass
def search(
@@ -165,17 +165,23 @@ def search(
exclude_document_id_list: list[str],
exclude_paragraph_list: list[str],
is_active: bool,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
):
if knowledge_id_list is None or len(knowledge_id_list) == 0:
return []
query_text = normalize_for_embedding(query_text)
query_embedding = embedding.embed_query(query_text)
result = self.query(
- query_text, query_embedding,
- knowledge_id_list, None,
- exclude_document_id_list, exclude_paragraph_list,
- is_active, 3, 0.65, SearchMode.embedding
+ query_text,
+ query_embedding,
+ knowledge_id_list,
+ None,
+ exclude_document_id_list,
+ exclude_paragraph_list,
+ is_active,
+ 3,
+ 0.65,
+ SearchMode.embedding,
)
return result[0] if result else None
@@ -204,7 +210,8 @@ def hit_test(
top_number: int,
similarity: float,
search_mode: SearchMode,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
+ image_list: list[str] | None = None,
):
pass
diff --git a/apps/knowledge/vector/pg_vector.py b/apps/knowledge/vector/pg_vector.py
index 0fc8ed96049..3fc03039eda 100644
--- a/apps/knowledge/vector/pg_vector.py
+++ b/apps/knowledge/vector/pg_vector.py
@@ -15,10 +15,12 @@
import uuid_utils.compat as uuid
from django.contrib.postgres.search import SearchVector
from django.db.models import QuerySet, Value
-from langchain_core.embeddings import Embeddings
+from django.utils.translation import gettext_lazy as _
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
from common.db.search import generate_sql_by_query_dict
from common.db.sql_execute import select_list
+from common.exception.app_exception import AppApiException
from common.utils.common import get_file_content
from common.utils.ts_vecto_util import to_ts_vector, to_query
from knowledge.models import Embedding, SearchMode, SourceType, Termbase
@@ -51,7 +53,7 @@ def _save(
paragraph_id: str,
source_id: str,
is_active: bool,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
):
text = normalize_for_embedding(text)
text_embedding = [float(x) for x in embedding.embed_query(text)]
@@ -71,14 +73,16 @@ def _save(
source_id=source_id,
embedding=text_embedding,
source_type=source_type,
- search_vector=SearchVector(Value(to_ts_vector(text, user_words=terms)), config='simple'),
+ search_vector=SearchVector(Value(to_ts_vector(text, user_words=terms)), config="simple"),
)
embedding.save()
return True
- def _batch_save(self, text_list: List[Dict], embedding: Embeddings, is_the_task_interrupted):
+ def _batch_save(self, text_list: List[Dict], embedding: MaxKBBaseEmbeddingModel, is_the_task_interrupted):
texts = [normalize_for_embedding(row.get("text")) for row in text_list]
embeddings = embedding.embed_documents(texts)
+ if len(embeddings) != len(texts):
+ raise AppApiException(500, _("The embedding model returned an incomplete result"))
embedding_list = [
Embedding(
id=uuid.uuid7(),
@@ -100,7 +104,7 @@ def _batch_save(self, text_list: List[Dict], embedding: Embeddings, is_the_task_
),
)
),
- config='simple',
+ config="simple",
),
)
for index in range(0, len(texts))
@@ -117,34 +121,94 @@ def hit_test(
top_number: int,
similarity: float,
search_mode: SearchMode,
- embedding: Embeddings,
+ embedding: MaxKBBaseEmbeddingModel,
+ image_list: list[str] | None = None,
):
if knowledge_id_list is None or len(knowledge_id_list) == 0:
return []
+ image_list = list(image_list or [])
exclude_dict = {}
query_text = normalize_for_embedding(query_text)
- embedding_query = embedding.embed_query(query_text)
if exclude_document_id_list is not None and len(exclude_document_id_list) > 0:
exclude_dict.__setitem__("document_id__in", exclude_document_id_list)
- for search_handle in search_handle_list:
- if search_handle.support(search_mode):
- # Query per knowledge base to leverage per-KB partial HNSW indexes
- # (WHERE knowledge_id = '{k_id}'), which won't be used with knowledge_id__in
- if len(knowledge_id_list) == 1:
- query_set = QuerySet(Embedding).filter(knowledge_id=knowledge_id_list[0], is_active=True).exclude(**exclude_dict)
- return search_handle.handle(
- query_set, query_text, embedding_query, top_number, similarity, search_mode, knowledge_id_list
- )
- else:
- all_results = []
- for kid in knowledge_id_list:
- query_set = QuerySet(Embedding).filter(knowledge_id=kid, is_active=True).exclude(**exclude_dict)
- results = search_handle.handle(
- query_set, query_text, embedding_query, top_number, similarity, search_mode, knowledge_id_list
- )
- all_results.extend(results)
- all_results.sort(key=lambda x: x.get("similarity", x.get("comprehensive_score", 0)), reverse=True)
- return all_results[:top_number]
+
+ if image_list and not embedding.supports_image_embedding():
+ raise AppApiException(500, _("The current embedding model does not support image embedding"))
+
+ query_units = []
+ if search_mode == SearchMode.keywords:
+ if not query_text:
+ return []
+ query_units.append({"type": "text", "embedding": []})
+ else:
+ if query_text:
+ query_units.append({"type": "text", "embedding": embedding.embed_query(query_text)})
+ if image_list:
+ image_embeddings = embedding.embed_images(image_list)
+ if len(image_embeddings) != len(image_list):
+ raise AppApiException(500, _("The image embedding model returned an incomplete result"))
+ query_units.extend({"type": "image", "embedding": value} for value in image_embeddings)
+
+ if not query_units:
+ return []
+
+ # Query each text/image vector independently and keep the best score for each
+ # paragraph. This avoids averaging unrelated images and preserves image-to-image
+ # retrieval in the provider's shared multimodal vector space.
+ all_results = []
+ for query_unit_index, query_unit in enumerate(query_units):
+ unit_search_mode = search_mode
+ if query_unit["type"] == "image" and search_mode == SearchMode.blend:
+ unit_search_mode = SearchMode.embedding
+ search_handle = next(
+ (handle for handle in search_handle_list if handle.support(unit_search_mode)),
+ None,
+ )
+ if search_handle is None:
+ continue
+
+ # Query per knowledge base to leverage per-KB partial HNSW indexes
+ # (WHERE knowledge_id = '{k_id}'), which won't be used with knowledge_id__in.
+ for knowledge_id in knowledge_id_list:
+ query_set = (
+ QuerySet(Embedding).filter(knowledge_id=knowledge_id, is_active=True).exclude(**exclude_dict)
+ )
+ results = search_handle.handle(
+ query_set,
+ query_text,
+ query_unit["embedding"],
+ top_number,
+ similarity,
+ unit_search_mode,
+ knowledge_id_list,
+ )
+ all_results.extend(
+ {
+ **result,
+ "query_unit_type": query_unit["type"],
+ "query_unit_index": query_unit_index,
+ }
+ for result in results
+ )
+
+ best_result_by_paragraph = {}
+ for result in all_results:
+ paragraph_id = str(result.get("paragraph_id"))
+ score = result.get("comprehensive_score", result.get("similarity", 0)) or 0
+ previous = best_result_by_paragraph.get(paragraph_id)
+ if previous is None:
+ best_result_by_paragraph[paragraph_id] = result
+ continue
+ previous_score = previous.get("comprehensive_score", previous.get("similarity", 0)) or 0
+ if score > previous_score:
+ best_result_by_paragraph[paragraph_id] = result
+
+ result_list = list(best_result_by_paragraph.values())
+ result_list.sort(
+ key=lambda item: item.get("comprehensive_score", item.get("similarity", 0)) or 0,
+ reverse=True,
+ )
+ return result_list[:top_number]
def query(
self,
@@ -176,6 +240,7 @@ def build_query_set(kid):
qs = qs.exclude(paragraph_id__in=exclude_paragraph_list)
qs = qs.exclude(**exclude_dict)
return qs
+
if len(knowledge_id_list) == 1:
query_set = build_query_set(knowledge_id_list[0])
return search_handle.handle(
@@ -265,7 +330,17 @@ def handle(
with_table_name=True,
)
embedding_model = select_list(
- exec_sql, [len(query_embedding), json.dumps(query_embedding), *exec_params, len(query_embedding), json.dumps(query_embedding), top_number, similarity, top_number]
+ exec_sql,
+ [
+ len(query_embedding),
+ json.dumps(query_embedding),
+ *exec_params,
+ len(query_embedding),
+ json.dumps(query_embedding),
+ top_number,
+ similarity,
+ top_number,
+ ],
)
return embedding_model
@@ -297,7 +372,14 @@ def handle(
else None
)
embedding_model = select_list(
- exec_sql, [to_query(query_text, user_words=terms), *exec_params, to_query(query_text, user_words=terms), similarity, top_number]
+ exec_sql,
+ [
+ to_query(query_text, user_words=terms),
+ *exec_params,
+ to_query(query_text, user_words=terms),
+ similarity,
+ top_number,
+ ],
)
return embedding_model
diff --git a/apps/knowledge/views/__init__.py b/apps/knowledge/views/__init__.py
index 54d9d0c12d7..9329e569ee0 100644
--- a/apps/knowledge/views/__init__.py
+++ b/apps/knowledge/views/__init__.py
@@ -6,3 +6,4 @@
from .tag import *
from .knowledge_workflow import *
from .knowledge_workflow_version import *
+from .image_document import *
diff --git a/apps/knowledge/views/document.py b/apps/knowledge/views/document.py
index db7694086a7..3757dfb41a5 100644
--- a/apps/knowledge/views/document.py
+++ b/apps/knowledge/views/document.py
@@ -1,20 +1,23 @@
+import json
+
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import CompareConstants, PermissionConstants, RoleConstants, ViewPermission
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.exception.app_exception import AppApiException
from common.log.log import log
from common.result import result
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
-from rest_framework.parsers import MultiPartParser
-from rest_framework.request import Request
-from rest_framework.views import APIView
-
from knowledge.api.document import (
BatchCancelTaskAPI,
BatchEditHitHandlingAPI,
BatchGenerateRelatedAPI,
BatchRefreshAPI,
CancelTaskAPI,
+ DocumentBatchAddTagAPI,
DocumentBatchAPI,
DocumentBatchCreateAPI,
DocumentCreateAPI,
@@ -43,6 +46,29 @@
get_document_operation_object_batch,
get_knowledge_document_operation_object,
)
+from rest_framework.parsers import MultiPartParser
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+
+def _get_document_split_payload(request: Request):
+ payload = {"file": request.FILES.getlist("file")}
+ request_data = request.data
+ if "patterns" in request_data and request_data.get("patterns") not in (None, ""):
+ payload["patterns"] = request_data.getlist("patterns")
+ if "limit" in request_data:
+ payload["limit"] = request_data.get("limit")
+ if "with_filter" in request_data:
+ payload["with_filter"] = request_data.get("with_filter")
+ raw_strategy = request_data.get("doc_strategy")
+ if raw_strategy not in (None, ""):
+ if isinstance(raw_strategy, str):
+ try:
+ raw_strategy = json.loads(raw_strategy)
+ except json.JSONDecodeError as exc:
+ raise AppApiException(500, _("Invalid document processing strategy")) from exc
+ payload["doc_strategy"] = raw_strategy
+ return payload
class DocumentView(APIView):
@@ -65,7 +91,7 @@ class DocumentView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -98,7 +124,7 @@ def post(self, request: Request, workspace_id: str, knowledge_id: str):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
@@ -116,6 +142,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str):
"no_tag": "NO_TAG" in raw_tags,
"desc": request.query_params.get("desc"),
"user_id": request.query_params.get("user_id"),
+ "resource_type": request.query_params.get("resource_type"),
}
).list()
)
@@ -138,7 +165,7 @@ class Operate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
@@ -164,7 +191,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str, document_i
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -197,7 +224,7 @@ def put(self, request: Request, workspace_id: str, knowledge_id: str, document_i
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -236,29 +263,17 @@ class Split(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str):
- split_data = {"file": request.FILES.getlist("file")}
- request_data = request.data
- if (
- "patterns" in request.data
- and request.data.get("patterns") is not None
- and len(request.data.get("patterns")) > 0
- ):
- split_data.__setitem__("patterns", request_data.getlist("patterns"))
- if "limit" in request.data:
- split_data.__setitem__("limit", request_data.get("limit"))
- if "with_filter" in request.data:
- split_data.__setitem__("with_filter", request_data.get("with_filter"))
return result.success(
DocumentSerializers.Split(
data={
"workspace_id": workspace_id,
"knowledge_id": knowledge_id,
}
- ).parse(split_data)
+ ).parse(_get_document_split_payload(request))
)
class SplitPattern(APIView):
@@ -299,7 +314,7 @@ class BatchEditHitHandling(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -337,7 +352,7 @@ class SyncWeb(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -351,7 +366,12 @@ class SyncWeb(APIView):
def put(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
return result.success(
DocumentSerializers.Sync(
- data={"document_id": document_id, "knowledge_id": knowledge_id, "workspace_id": workspace_id}
+ data={
+ **request.data,
+ "document_id": document_id,
+ "knowledge_id": knowledge_id,
+ "workspace_id": workspace_id,
+ }
).sync()
)
@@ -375,7 +395,7 @@ class Refresh(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -413,7 +433,7 @@ class Tokenize(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -450,7 +470,7 @@ class CancelTask(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -487,7 +507,7 @@ class BatchCancelTask(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -527,7 +547,7 @@ class BatchCreate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -567,7 +587,7 @@ class BatchSync(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -607,7 +627,7 @@ class BatchDelete(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -646,7 +666,7 @@ class BatchRefresh(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -677,15 +697,13 @@ class BatchTokenize(APIView):
tags=[_("Knowledge Base/Documentation")], # type: ignore
)
@has_permissions(
- PermissionConstants.KNOWLEDGE_DOCUMENT_VECTOR.get_workspace_knowledge_permission(),
- PermissionConstants.KNOWLEDGE_DOCUMENT_VECTOR.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_knowledge_permission(),
- PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.KNOWLEDGE_DOCUMENT_TOKEN.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_DOCUMENT_TOKEN.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -710,9 +728,9 @@ class BatchAddTag(APIView):
methods=["POST"],
summary=_("Batch add tags to documents"),
operation_id=_("Batch add tags to documents"), # type: ignore
- request=DocumentTagsAPI.get_request(),
- parameters=DocumentTagsAPI.get_parameters(),
- responses=DocumentTagsAPI.get_response(),
+ request=DocumentBatchAddTagAPI.get_request(),
+ parameters=DocumentBatchAddTagAPI.get_parameters(),
+ responses=DocumentBatchAddTagAPI.get_response(),
tags=[_("Knowledge Base/Documentation")], # type: ignore
)
@has_permissions(
@@ -722,7 +740,7 @@ class BatchAddTag(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -762,7 +780,7 @@ class BatchGenerateRelated(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -790,7 +808,7 @@ class BatchExport(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -816,7 +834,7 @@ class BatchExportZip(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -851,7 +869,7 @@ class Page(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, current_page: int, page_size: int):
@@ -875,6 +893,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str, current_pa
"hit_handling_method": request.query_params.get("hit_handling_method"),
"order_by": request.query_params.get("order_by"),
"create_user": request.query_params.get("create_user"),
+ "resource_type": request.query_params.get("resource_type"),
}
).page(current_page, page_size)
)
@@ -896,7 +915,7 @@ class Export(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -929,7 +948,7 @@ class ExportZip(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -962,13 +981,13 @@ class DownloadSourceFile(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
return DocumentSerializers.Operate(
data={"workspace_id": workspace_id, "document_id": document_id, "knowledge_id": knowledge_id}
- ).download_source_file()
+ ).download_source_file(mk_file_auth=request.COOKIES.get("mk_file_auth"))
class ReplaceSourceFile(APIView):
authentication_classes = [TokenAuth]
@@ -987,7 +1006,7 @@ class ReplaceSourceFile(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
@@ -1020,7 +1039,7 @@ class Tags(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
@@ -1050,7 +1069,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str, document_i
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
@@ -1084,7 +1103,7 @@ class BatchDelete(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -1125,7 +1144,7 @@ class BatchDeleteDocsTag(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -1165,7 +1184,7 @@ class Migrate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -1209,7 +1228,7 @@ class WebDocumentView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -1251,7 +1270,7 @@ class QaDocumentView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -1293,7 +1312,7 @@ class TableDocumentView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -1337,7 +1356,7 @@ class TableTemplate(APIView):
operation_id=_("Get form template"), # type: ignore
parameters=TemplateExportAPI.get_parameters(),
responses=TemplateExportAPI.get_response(),
- tags=[_("Knowledge Base/Documentation")],
+ tags=[_("Knowledge Base/Documentation")], # type: ignore
) # type: ignore
def get(self, request: Request):
return DocumentSerializers.Export(data={"type": request.query_params.get("type")}).table_export(with_valid=True)
diff --git a/apps/knowledge/views/external_service.py b/apps/knowledge/views/external_service.py
new file mode 100644
index 00000000000..31b0d6392a9
--- /dev/null
+++ b/apps/knowledge/views/external_service.py
@@ -0,0 +1,63 @@
+from rest_framework.views import APIView
+
+from common import result
+from common.auth import TokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.log.log import log
+from knowledge.serializers.common import get_knowledge_operation_object
+from knowledge.serializers.external_retrieval import ExternalServiceSerializer
+
+
+class ExternalServiceView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request, workspace_id, knowledge_id):
+ return result.success(
+ ExternalServiceSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ },
+ context={"request": request},
+ ).get_settings()
+ )
+
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_EDIT.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ @log(
+ menu="Knowledge Base",
+ operate="Modify external retrieval service",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
+ )
+ def put(self, request, workspace_id, knowledge_id):
+ return result.success(
+ ExternalServiceSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ },
+ context={"request": request},
+ ).update_settings(request.data)
+ )
diff --git a/apps/knowledge/views/image_document.py b/apps/knowledge/views/image_document.py
new file mode 100644
index 00000000000..f61096c3469
--- /dev/null
+++ b/apps/knowledge/views/image_document.py
@@ -0,0 +1,150 @@
+"""HTTP endpoints for standalone image documents."""
+
+import json
+
+from common.auth import TokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.exception.app_exception import AppApiException
+from common.result import result
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.parsers import MultiPartParser
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from knowledge.api.document import ImageBatchCreateAPI, ImagePreviewAPI, ImagePreviewOperateAPI
+from knowledge.serializers.image_document import ImageDocumentSerializers
+
+
+def _document_permissions(permission):
+ return has_permissions(
+ permission.get_workspace_knowledge_permission(),
+ permission.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+
+
+class ImageDocumentView:
+ class Preview(APIView):
+ authentication_classes = [TokenAuth]
+ parser_classes = [MultiPartParser]
+
+ @extend_schema(
+ methods=["POST"],
+ description=_("Upload images and generate editable previews"),
+ summary=_("Generate image previews"),
+ operation_id=_("Generate image previews"), # type: ignore
+ parameters=ImagePreviewAPI.get_parameters(),
+ request=ImagePreviewAPI.get_request(),
+ responses=ImagePreviewAPI.get_response(),
+ tags=[_("Knowledge Base/Images")], # type: ignore
+ )
+ @_document_permissions(PermissionConstants.KNOWLEDGE_DOCUMENT_CREATE)
+ def post(self, request: Request, workspace_id: str, knowledge_id: str):
+ payload = {"file": request.FILES.getlist("file")}
+ raw_strategy = request.data.get("doc_strategy")
+ if raw_strategy not in (None, ""):
+ if isinstance(raw_strategy, str):
+ try:
+ raw_strategy = json.loads(raw_strategy)
+ except json.JSONDecodeError as exc:
+ raise AppApiException(500, _("Invalid document processing strategy")) from exc
+ payload["doc_strategy"] = raw_strategy
+ return result.success(
+ ImageDocumentSerializers.Preview(
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ "user_id": request.user.id,
+ }
+ ).upload(payload)
+ )
+
+ class PreviewOperate(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get an image preview"),
+ summary=_("Get an image preview"),
+ operation_id=_("Get an image preview"), # type: ignore
+ parameters=ImagePreviewOperateAPI.get_parameters(),
+ responses=ImagePreviewOperateAPI.get_response(),
+ tags=[_("Knowledge Base/Images")], # type: ignore
+ )
+ @_document_permissions(PermissionConstants.KNOWLEDGE_DOCUMENT_READ)
+ def get(self, request: Request, workspace_id: str, knowledge_id: str, preview_id: str):
+ return result.success(
+ ImageDocumentSerializers.Preview(data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}).one(
+ preview_id
+ )
+ )
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Edit an image preview"),
+ summary=_("Edit an image preview"),
+ operation_id=_("Edit an image preview"), # type: ignore
+ parameters=ImagePreviewOperateAPI.get_parameters(),
+ request=ImagePreviewOperateAPI.get_request(),
+ responses=ImagePreviewOperateAPI.get_response(),
+ tags=[_("Knowledge Base/Images")], # type: ignore
+ )
+ @_document_permissions(PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT)
+ def put(self, request: Request, workspace_id: str, knowledge_id: str, preview_id: str):
+ return result.success(
+ ImageDocumentSerializers.Preview(
+ data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).edit(preview_id, request.data)
+ )
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Delete an image preview"),
+ summary=_("Delete an image preview"),
+ operation_id=_("Delete an image preview"), # type: ignore
+ parameters=ImagePreviewOperateAPI.get_parameters(),
+ responses=ImagePreviewOperateAPI.get_response(),
+ tags=[_("Knowledge Base/Images")], # type: ignore
+ )
+ @_document_permissions(PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT)
+ def delete(self, request: Request, workspace_id: str, knowledge_id: str, preview_id: str):
+ return result.success(
+ ImageDocumentSerializers.Preview(
+ data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).delete(preview_id)
+ )
+
+ class BatchCreate(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Import image previews as standalone image documents"),
+ summary=_("Import image documents"),
+ operation_id=_("Import image documents"), # type: ignore
+ parameters=ImageBatchCreateAPI.get_parameters(),
+ request=ImageBatchCreateAPI.get_request(),
+ responses=ImageBatchCreateAPI.get_response(),
+ tags=[_("Knowledge Base/Images")], # type: ignore
+ )
+ @_document_permissions(PermissionConstants.KNOWLEDGE_DOCUMENT_CREATE)
+ def put(self, request: Request, workspace_id: str, knowledge_id: str):
+ return result.success(
+ ImageDocumentSerializers.Preview(
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ "user_id": request.user.id,
+ }
+ ).batch_create(request.data)
+ )
diff --git a/apps/knowledge/views/knowledge.py b/apps/knowledge/views/knowledge.py
index ed69d88d7e9..3dc79210ec2 100644
--- a/apps/knowledge/views/knowledge.py
+++ b/apps/knowledge/views/knowledge.py
@@ -6,170 +6,224 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions, check_batch_permissions, get_is_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common import result
-from knowledge.api.knowledge import KnowledgeBaseCreateAPI, KnowledgeWebCreateAPI, KnowledgeTreeReadAPI, \
- KnowledgeEditAPI, KnowledgeReadAPI, KnowledgePageAPI, SyncWebAPI, GenerateRelatedAPI, HitTestAPI, EmbeddingAPI, \
- GetModelAPI, KnowledgeExportAPI, KnowledgeBatchOperateAPI, KnowledgeImportAPI
+from knowledge.api.knowledge import (
+ KnowledgeBaseCreateAPI,
+ KnowledgeWebCreateAPI,
+ KnowledgeTreeReadAPI,
+ KnowledgeEditAPI,
+ KnowledgeReadAPI,
+ KnowledgePageAPI,
+ SyncWebAPI,
+ KnowledgeSyncLogAPI,
+ KnowledgeSyncSettingAPI,
+ GenerateRelatedAPI,
+ HitTestAPI,
+ EmbeddingAPI,
+ TokenizeAPI,
+ GetModelAPI,
+ KnowledgeExportAPI,
+ KnowledgeBatchOperateAPI,
+ KnowledgeImportAPI,
+)
from knowledge.models import KnowledgeScope
from knowledge.serializers.common import get_knowledge_operation_object
from knowledge.serializers.knowledge import KnowledgeSerializer, KnowledgeBatchOperateSerializer
+from knowledge.serializers.knowledge_sync import (
+ KnowledgeSyncLogQuerySerializer,
+ KnowledgeSyncSettingOperationSerializer,
+)
from models_provider.serializers.model_serializer import ModelSerializer
from tools.api.tool import GetInternalToolAPI
from django.db.models import QuerySet
from knowledge.models import Knowledge
+
def get_knowledge_operation_object_batch(knowledge_id_list):
knowledge_model_list = QuerySet(model=Knowledge).filter(id__in=knowledge_id_list)
if knowledge_model_list is not None:
return {
- "name": f'[{",".join([app.name for app in knowledge_model_list])}]',
- 'knowledge_list': [{'name': app.name} for app in knowledge_model_list]
+ "name": f"[{','.join([app.name for app in knowledge_model_list])}]",
+ "knowledge_list": [{"name": app.name} for app in knowledge_model_list],
}
return {}
+
class KnowledgeView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get knowledge by folder'),
- summary=_('Get knowledge by folder'),
- operation_id=_('Get knowledge by folder'), # type: ignore
+ methods=["GET"],
+ description=_("Get knowledge by folder"),
+ summary=_("Get knowledge by folder"),
+ operation_id=_("Get knowledge by folder"), # type: ignore
parameters=KnowledgeTreeReadAPI.get_parameters(),
responses=KnowledgeTreeReadAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
- return result.success(KnowledgeSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'folder_id': request.query_params.get('folder_id'),
- 'name': request.query_params.get('name'),
- 'desc': request.query_params.get("desc"),
- 'scope': KnowledgeScope.WORKSPACE,
- 'user_id': request.user.id
- }
- ).list())
+ return result.success(
+ KnowledgeSerializer.Query(
+ data={
+ "workspace_id": workspace_id,
+ "folder_id": request.query_params.get("folder_id"),
+ "name": request.query_params.get("name"),
+ "desc": request.query_params.get("desc"),
+ "scope": KnowledgeScope.WORKSPACE,
+ "user_id": request.user.id,
+ }
+ ).list()
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- description=_('Edit knowledge'),
- summary=_('Edit knowledge'),
- operation_id=_('Edit knowledge'), # type: ignore
+ methods=["PUT"],
+ description=_("Edit knowledge"),
+ summary=_("Edit knowledge"),
+ operation_id=_("Edit knowledge"), # type: ignore
parameters=KnowledgeEditAPI.get_parameters(),
request=KnowledgeEditAPI.get_request(),
responses=KnowledgeEditAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_EDIT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Modify knowledge base information",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
-
+ menu="Knowledge Base",
+ operate="Modify knowledge base information",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def put(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.Operate(
- data={'user_id': request.user.id, 'workspace_id': workspace_id, 'knowledge_id': knowledge_id}
- ).edit(request.data))
+ return result.success(
+ KnowledgeSerializer.Operate(
+ data={"user_id": request.user.id, "workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).edit(request.data)
+ )
@extend_schema(
- methods=['DELETE'],
- description=_('Delete knowledge'),
- summary=_('Delete knowledge'),
- operation_id=_('Delete knowledge'), # type: ignore
+ methods=["DELETE"],
+ description=_("Delete knowledge"),
+ summary=_("Delete knowledge"),
+ operation_id=_("Delete knowledge"), # type: ignore
parameters=KnowledgeBaseCreateAPI.get_parameters(),
request=KnowledgeBaseCreateAPI.get_request(),
responses=KnowledgeBaseCreateAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_DELETE.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Delete knowledge base",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
-
+ menu="Knowledge Base",
+ operate="Delete knowledge base",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def delete(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.Operate(
- data={'user_id': request.user.id, 'workspace_id': workspace_id, 'knowledge_id': knowledge_id}
- ).delete())
+ return result.success(
+ KnowledgeSerializer.Operate(
+ data={"user_id": request.user.id, "workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).delete()
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get knowledge'),
- summary=_('Get knowledge'),
- operation_id=_('Get knowledge'), # type: ignore
+ methods=["GET"],
+ description=_("Get knowledge"),
+ summary=_("Get knowledge"),
+ operation_id=_("Get knowledge"), # type: ignore
parameters=KnowledgeReadAPI.get_parameters(),
responses=KnowledgeReadAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_READ.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.Operate(
- data={'user_id': request.user.id, 'workspace_id': workspace_id, 'knowledge_id': knowledge_id}
- ).one())
+ return result.success(
+ KnowledgeSerializer.Operate(
+ data={"user_id": request.user.id, "workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).one()
+ )
class BatchDelete(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
description=_("Batch delete knowledge"),
summary=_("Batch delete knowledge"),
- operation_id=_("Batch delete knowledge"),
+ operation_id=_("Batch delete knowledge"), # type: ignore
parameters=KnowledgeBatchOperateAPI.get_parameters(),
request=KnowledgeBatchOperateAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Knowledge Base')]
+ tags=[_("Knowledge Base")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_BATCH_DELETE.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.KNOWLEDGE_BATCH_DELETE.get_workspace_permission(),
- RoleConstants.USER.get_workspace_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
- )
def put(self, request: Request, workspace_id: str):
- id_list = request.data.get('id_list', [])
+ id_list = request.data.get("id_list", [])
permitted_ids = check_batch_permissions(
- request, id_list, 'knowledge_id',
- (PermissionConstants.KNOWLEDGE_DELETE.get_workspace_knowledge_permission(),
- PermissionConstants.KNOWLEDGE_DELETE.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()), workspace_id=workspace_id
+ request,
+ id_list,
+ "knowledge_id",
+ (
+ PermissionConstants.KNOWLEDGE_DELETE.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_DELETE.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ),
+ workspace_id=workspace_id,
)
- @log(menu='Knowledge Base', operate='Batch delete knowledge',
- get_operation_object=lambda r, k: get_knowledge_operation_object_batch(permitted_ids))
+ @log(
+ menu="Knowledge Base",
+ operate="Batch delete knowledge",
+ get_operation_object=lambda r, k: get_knowledge_operation_object_batch(permitted_ids),
+ )
def inner(view, r, **kwargs):
return KnowledgeBatchOperateSerializer(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}
- ).batch_delete({'id_list': permitted_ids})
+ data={"workspace_id": workspace_id, "user_id": request.user.id}
+ ).batch_delete({"id_list": permitted_ids})
return result.success(inner(self, request, workspace_id=workspace_id))
@@ -177,38 +231,48 @@ class BatchMove(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
description=_("Batch move knowledge"),
summary=_("Batch move knowledge"),
- operation_id=_("Batch move knowledge"),
+ operation_id=_("Batch move knowledge"), # type: ignore
parameters=KnowledgeBatchOperateAPI.get_parameters(),
request=KnowledgeBatchOperateAPI.get_move_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Knowledge Base')]
+ tags=[_("Knowledge Base")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_BATCH_MOVE.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.KNOWLEDGE_BATCH_MOVE.get_workspace_permission(),
- RoleConstants.USER.get_workspace_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
- )
def put(self, request: Request, workspace_id: str):
- id_list = request.data.get('id_list', [])
+ id_list = request.data.get("id_list", [])
permitted_ids = check_batch_permissions(
- request, id_list, 'knowledge_id',
- (PermissionConstants.KNOWLEDGE_EDIT.get_workspace_knowledge_permission(),
- PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()),
- workspace_id=workspace_id
+ request,
+ id_list,
+ "knowledge_id",
+ (
+ PermissionConstants.KNOWLEDGE_EDIT.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ),
+ workspace_id=workspace_id,
)
- @log(menu='Knowledge Base', operate='Batch move knowledge',
- get_operation_object=lambda r, k: get_knowledge_operation_object_batch(permitted_ids))
+ @log(
+ menu="Knowledge Base",
+ operate="Batch move knowledge",
+ get_operation_object=lambda r, k: get_knowledge_operation_object_batch(permitted_ids),
+ )
def inner(view, r, **kwargs):
return KnowledgeBatchOperateSerializer(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}
- ).batch_move({'id_list': permitted_ids, 'folder_id': request.data.get('folder_id')})
+ data={"workspace_id": workspace_id, "user_id": request.user.id}
+ ).batch_move({"id_list": permitted_ids, "folder_id": request.data.get("folder_id")})
return result.success(inner(self, request, workspace_id=workspace_id))
@@ -216,332 +280,506 @@ class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get the knowledge base paginated list'),
- summary=_('Get the knowledge base paginated list'),
- operation_id=_('Get the knowledge base paginated list'), # type: ignore
+ methods=["GET"],
+ description=_("Get the knowledge base paginated list"),
+ summary=_("Get the knowledge base paginated list"),
+ operation_id=_("Get the knowledge base paginated list"), # type: ignore
parameters=KnowledgePageAPI.get_parameters(),
responses=KnowledgePageAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str, current_page: int, page_size: int):
- return result.success(KnowledgeSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'folder_id': request.query_params.get('folder_id'),
- 'name': request.query_params.get('name'),
- 'desc': request.query_params.get("desc"),
- 'scope': KnowledgeScope.WORKSPACE,
- 'user_id': request.user.id,
- 'create_user': request.query_params.get('create_user'),
- }
- ).page(current_page, page_size))
+ return result.success(
+ KnowledgeSerializer.Query(
+ data={
+ "workspace_id": workspace_id,
+ "folder_id": request.query_params.get("folder_id"),
+ "name": request.query_params.get("name"),
+ "desc": request.query_params.get("desc"),
+ "scope": KnowledgeScope.WORKSPACE,
+ "user_id": request.user.id,
+ "create_user": request.query_params.get("create_user"),
+ }
+ ).page(current_page, page_size)
+ )
class SyncWeb(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
summary=_("Synchronize the knowledge base of the website"),
description=_("Synchronize the knowledge base of the website"),
operation_id=_("Synchronize the knowledge base of the website"), # type: ignore
parameters=SyncWebAPI.get_parameters(),
request=SyncWebAPI.get_request(),
responses=SyncWebAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_SYNC.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_SYNC.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Synchronize the knowledge base of the website",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
+ menu="Knowledge Base",
+ operate="Synchronize the knowledge base of the website",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
+ )
+ def put(self, request: Request, workspace_id: str, knowledge_id: str):
+ return result.success(
+ KnowledgeSerializer.SyncWeb(
+ data={
+ "workspace_id": workspace_id,
+ "sync_type": request.query_params.get("sync_type"),
+ "knowledge_id": knowledge_id,
+ "user_id": str(request.user.id),
+ }
+ ).sync()
+ )
+
+ class KnowledgeSyncSetting(APIView):
+ authentication_classes = [TokenAuth]
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get knowledge scheduled synchronization setting"),
+ description=_("Get knowledge scheduled synchronization setting"),
+ operation_id=_("Get knowledge scheduled synchronization setting"), # type: ignore
+ parameters=KnowledgeSyncSettingAPI.get_parameters()[:2],
+ responses=KnowledgeSyncSettingAPI.get_response(),
+ tags=[_("Knowledge Base")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(self, request: Request, workspace_id: str, knowledge_id: str):
+ return result.success(
+ KnowledgeSyncSettingOperationSerializer(
+ data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).get_setting()
+ )
+
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Update knowledge scheduled synchronization setting"),
+ description=_("Update knowledge scheduled synchronization setting"),
+ operation_id=_("Update knowledge scheduled synchronization setting"), # type: ignore
+ parameters=KnowledgeSyncSettingAPI.get_parameters()[:2],
+ request=KnowledgeSyncSettingAPI.get_request(),
+ responses=KnowledgeSyncSettingAPI.get_response(),
+ tags=[_("Knowledge Base")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_SYNC.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_SYNC.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ @log(
+ menu="Knowledge Base",
+ operate="Update knowledge scheduled synchronization setting",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def put(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.SyncWeb(
- data={
- 'workspace_id': workspace_id,
- 'sync_type': request.query_params.get('sync_type'),
- 'knowledge_id': knowledge_id,
- 'user_id': str(request.user.id)
- }
- ).sync())
+ return result.success(
+ KnowledgeSyncSettingOperationSerializer(
+ data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).update_setting(request.data)
+ )
+
+ class KnowledgeSyncLog(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get knowledge synchronization logs"),
+ description=_("Get knowledge synchronization logs"),
+ operation_id=_("Get knowledge synchronization logs"), # type: ignore
+ parameters=KnowledgeSyncLogAPI.get_parameters(),
+ responses=KnowledgeSyncLogAPI.get_response(),
+ tags=[_("Knowledge Base")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ def get(
+ self,
+ request: Request,
+ workspace_id: str,
+ knowledge_id: str,
+ current_page: int,
+ page_size: int,
+ ):
+ return result.success(
+ KnowledgeSyncLogQuerySerializer(data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}).page(
+ current_page, page_size
+ )
+ )
class HitTest(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- summary=_('Hit test list'),
- description=_('Hit test list'),
- operation_id=_('Hit test list'), # type: ignore
+ methods=["POST"],
+ summary=_("Hit test list"),
+ description=_("Hit test list"),
+ operation_id=_("Hit test list"), # type: ignore
parameters=HitTestAPI.get_parameters(),
request=HitTestAPI.get_request(),
responses=HitTestAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_HIT_TEST.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_HIT_TEST.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.HitTest(
- data={
- 'workspace_id': workspace_id,
- 'knowledge_id': knowledge_id,
- 'user_id': request.user.id,
- "query_text": request.data.get("query_text"),
- "top_number": request.data.get("top_number"),
- 'similarity': request.data.get('similarity'),
- 'search_mode': request.data.get('search_mode')
- }
- ).hit_test())
+ return result.success(
+ KnowledgeSerializer.HitTest(
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ "user_id": request.user.id,
+ "query_text": request.data.get("query_text") or "",
+ "image_list": request.data.get("image_list", []),
+ "top_number": request.data.get("top_number"),
+ "similarity": request.data.get("similarity"),
+ "search_mode": request.data.get("search_mode"),
+ }
+ ).hit_test()
+ )
class StoreKnowledge(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get Appstore tools"),
summary=_("Get Appstore tools"),
operation_id=_("Get Appstore tools"), # type: ignore
responses=GetInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
def get(self, request: Request):
- return result.success(KnowledgeSerializer.StoreKnowledge(data={
- 'user_id': request.user.id,
- 'name': request.query_params.get('name', ''),
- }).get_appstore_templates())
+ return result.success(
+ KnowledgeSerializer.StoreKnowledge(
+ data={
+ "user_id": request.user.id,
+ "name": request.query_params.get("name", ""),
+ }
+ ).get_appstore_templates()
+ )
class Embedding(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- summary=_('Re-vectorize'),
- description=_('Re-vectorize'),
- operation_id=_('Re-vectorize'), # type: ignore
+ methods=["PUT"],
+ summary=_("Re-vectorize"),
+ description=_("Re-vectorize"),
+ operation_id=_("Re-vectorize"), # type: ignore
parameters=EmbeddingAPI.get_parameters(),
request=EmbeddingAPI.get_request(),
responses=EmbeddingAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_VECTOR.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_VECTOR.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate='Re-vectorize',
- get_operation_object=lambda r, k: get_knowledge_operation_object(k.get('knowledge_id')),
+ menu="Knowledge Base",
+ operate="Re-vectorize",
+ get_operation_object=lambda r, k: get_knowledge_operation_object(k.get("knowledge_id")),
+ )
+ def put(self, request: Request, workspace_id: str, knowledge_id: str):
+ return result.success(
+ KnowledgeSerializer.Operate(
+ data={"knowledge_id": knowledge_id, "workspace_id": workspace_id, "user_id": request.user.id}
+ ).embedding()
+ )
+ class Tokenize(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Tokenize knowledge base"),
+ description=_("Tokenize knowledge base"),
+ operation_id=_("Tokenize knowledge base"), # type: ignore
+ parameters=TokenizeAPI.get_parameters(),
+ request=TokenizeAPI.get_request(),
+ responses=TokenizeAPI.get_response(),
+ tags=[_("Knowledge Base")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.KNOWLEDGE_DOCUMENT_TOKEN.get_workspace_knowledge_permission(),
+ PermissionConstants.KNOWLEDGE_DOCUMENT_TOKEN.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ @log(
+ menu="Knowledge Base",
+ operate="Tokenize knowledge base",
+ get_operation_object=lambda r, k: get_knowledge_operation_object(k.get("knowledge_id")),
)
def put(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.Operate(
- data={'knowledge_id': knowledge_id, 'workspace_id': workspace_id, 'user_id': request.user.id}
- ).embedding())
+ return result.success(
+ KnowledgeSerializer.Operate(
+ data={"knowledge_id": knowledge_id, "workspace_id": workspace_id, "user_id": request.user.id}
+ ).tokenize()
+ )
class Export(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- summary=_('Export knowledge base'),
- operation_id=_('Export knowledge base'), # type: ignore
+ summary=_("Export knowledge base"),
+ operation_id=_("Export knowledge base"), # type: ignore
parameters=KnowledgeExportAPI.get_parameters(),
responses=KnowledgeExportAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_EXPORT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_EXPORT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Export knowledge base",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
-
+ menu="Knowledge Base",
+ operate="Export knowledge base",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
- return KnowledgeSerializer.Operate(data={
- 'workspace_id': workspace_id, 'knowledge_id': knowledge_id, 'user_id': request.user.id
- }).export_excel()
+ return KnowledgeSerializer.Operate(
+ data={"workspace_id": workspace_id, "knowledge_id": knowledge_id, "user_id": request.user.id}
+ ).export_excel()
class ExportZip(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- summary=_('Export knowledge base containing images'),
- operation_id=_('Export knowledge base containing images'), # type: ignore
+ summary=_("Export knowledge base containing images"),
+ operation_id=_("Export knowledge base containing images"), # type: ignore
parameters=KnowledgeExportAPI.get_parameters(),
responses=KnowledgeExportAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_EXPORT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_EXPORT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Export knowledge base containing images",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
-
+ menu="Knowledge Base",
+ operate="Export knowledge base containing images",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
- return KnowledgeSerializer.Operate(data={
- 'workspace_id': workspace_id, 'knowledge_id': knowledge_id, 'user_id': request.user.id
- }).export_zip()
+ return KnowledgeSerializer.Operate(
+ data={"workspace_id": workspace_id, "knowledge_id": knowledge_id, "user_id": request.user.id}
+ ).export_zip()
class ExportKnowledge(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- summary=_('Export knowledge bundle'),
- operation_id=_('Export knowledge bundle'), # type: ignore
+ summary=_("Export knowledge bundle"),
+ operation_id=_("Export knowledge bundle"), # type: ignore
parameters=KnowledgeExportAPI.get_parameters(),
responses=KnowledgeExportAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_EXPORT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_EXPORT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Export knowledge bundle",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
+ menu="Knowledge Base",
+ operate="Export knowledge bundle",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
- return KnowledgeSerializer.Operate(data={
- 'workspace_id': workspace_id,
- 'knowledge_id': knowledge_id,
- 'user_id': request.user.id,
- }).export_knowledge(with_source_file=request.query_params.get("with_source_file"))
-
+ return KnowledgeSerializer.Operate(
+ data={
+ "workspace_id": workspace_id,
+ "knowledge_id": knowledge_id,
+ "user_id": request.user.id,
+ }
+ ).export_knowledge(with_source_file=request.query_params.get("with_source_file"))
class ImportKnowledge(APIView):
authentication_classes = [TokenAuth]
parser_classes = [MultiPartParser]
@extend_schema(
- methods=['POST'],
- description=_('Import knowledge bundle'),
- summary=_('Import knowledge bundle'),
- operation_id=_('Import knowledge bundle'),
+ methods=["POST"],
+ description=_("Import knowledge bundle"),
+ summary=_("Import knowledge bundle"),
+ operation_id=_("Import knowledge bundle"), # type: ignore
parameters=KnowledgeImportAPI.get_parameters(),
request=KnowledgeImportAPI.get_request(),
responses=KnowledgeImportAPI.get_response(),
- tags=[_('Knowledge Base')]
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_CREATE.get_workspace_permission(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- RoleConstants.USER.get_workspace_role()
+ RoleConstants.USER.get_workspace_role(),
)
@log(
- menu='Knowledge Base', operate="Import knowledge bundle",
+ menu="Knowledge Base",
+ operate="Import knowledge bundle",
)
def post(self, request: Request, workspace_id: str):
is_import_tool = get_is_permissions(request, workspace_id=workspace_id)(
PermissionConstants.TOOL_IMPORT.get_workspace_permission(),
PermissionConstants.TOOL_IMPORT.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
return result.success(
KnowledgeSerializer.ImportKnowledge(
- data={'workspace_id': workspace_id, 'user_id': request.user.id, 'folder_id': request.data.get('folder_id',workspace_id)}
- ).import_knowledge(request.FILES.get('file'), is_import_tool)
+ data={
+ "workspace_id": workspace_id,
+ "user_id": request.user.id,
+ "folder_id": request.data.get("folder_id", workspace_id),
+ }
+ ).import_knowledge(request.FILES.get("file"), is_import_tool)
)
-
class GenerateRelated(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- summary=_('Generate related'),
- description=_('Generate related'),
- operation_id=_('Generate related'), # type: ignore
+ methods=["PUT"],
+ summary=_("Generate related"),
+ description=_("Generate related"),
+ operation_id=_("Generate related"), # type: ignore
parameters=GenerateRelatedAPI.get_parameters(),
request=GenerateRelatedAPI.get_request(),
responses=GenerateRelatedAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_GENERATE.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_GENERATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='document', operate='Generate related documents',
- get_operation_object=lambda r, k: get_knowledge_operation_object(k.get('knowledge_id')),
-
+ menu="document",
+ operate="Generate related documents",
+ get_operation_object=lambda r, k: get_knowledge_operation_object(k.get("knowledge_id")),
)
def put(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.Operate(
- data={'knowledge_id': knowledge_id, 'workspace_id': workspace_id, 'user_id': request.user.id}
- ).generate_related(request.data))
+ return result.success(
+ KnowledgeSerializer.Operate(
+ data={"knowledge_id": knowledge_id, "workspace_id": workspace_id, "user_id": request.user.id}
+ ).generate_related(request.data)
+ )
class Model(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- summary=_('Get model for knowledge base'),
- description=_('Get model for knowledge base'),
- operation_id=_('Get model for knowledge base'), # type: ignore
+ methods=["GET"],
+ summary=_("Get model for knowledge base"),
+ description=_("Get model for knowledge base"),
+ operation_id=_("Get model for knowledge base"), # type: ignore
parameters=GetModelAPI.get_parameters(),
responses=GetModelAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
- return result.success(ModelSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'model_type': 'LLM'
- }
- ).list(workspace_id, True))
+ return result.success(
+ ModelSerializer.Query(data={"workspace_id": workspace_id, "model_type": "LLM"}).list(workspace_id, True)
+ )
class EmbeddingModel(APIView):
authentication_classes = [TokenAuth]
@has_permissions(
PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
- return result.success(ModelSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'model_type': 'EMBEDDING'
- }
- ).list(workspace_id, True))
+ return result.success(
+ ModelSerializer.Query(data={"workspace_id": workspace_id, "model_type": "EMBEDDING"}).list(
+ workspace_id, True
+ )
+ )
class TransformWorkflow(APIView):
authentication_classes = [TokenAuth]
@@ -550,97 +788,119 @@ class TransformWorkflow(APIView):
PermissionConstants.KNOWLEDGE_EDIT.get_workspace_knowledge_permission(),
PermissionConstants.KNOWLEDGE_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Knowledge Base', operate="Modify knowledge base information",
- get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get('knowledge_id')),
+ menu="Knowledge Base",
+ operate="Modify knowledge base information",
+ get_operation_object=lambda r, keywords: get_knowledge_operation_object(keywords.get("knowledge_id")),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str):
- return result.success(KnowledgeSerializer.TransformWorkflow(
- data={'user_id': request.user.id, 'workspace_id': workspace_id, 'knowledge_id': knowledge_id}
- ).transform(request.data))
+ return result.success(
+ KnowledgeSerializer.TransformWorkflow(
+ data={"user_id": request.user.id, "workspace_id": workspace_id, "knowledge_id": knowledge_id}
+ ).transform(request.data)
+ )
class Tags(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get all tags of knowledge base'),
- summary=_('Get all tags of knowledge base'),
- operation_id=_('Get all tags of knowledge base'), # type: ignore
+ methods=["GET"],
+ description=_("Get all tags of knowledge base"),
+ summary=_("Get all tags of knowledge base"),
+ operation_id=_("Get all tags of knowledge base"), # type: ignore
parameters=KnowledgeReadAPI.get_parameters(),
responses=KnowledgeReadAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
- return result.success(KnowledgeSerializer.Tags(data={
- 'user_id': request.user.id,
- 'workspace_id': workspace_id,
- 'knowledge_ids': request.query_params.getlist('knowledge_ids[]')
- }).list())
+ return result.success(
+ KnowledgeSerializer.Tags(
+ data={
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "knowledge_ids": request.query_params.getlist("knowledge_ids[]"),
+ }
+ ).list()
+ )
class KnowledgeBaseView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Create base knowledge'),
- summary=_('Create base knowledge'),
- operation_id=_('Create base knowledge'), # type: ignore
+ methods=["POST"],
+ description=_("Create base knowledge"),
+ summary=_("Create base knowledge"),
+ operation_id=_("Create base knowledge"), # type: ignore
parameters=KnowledgeBaseCreateAPI.get_parameters(),
request=KnowledgeBaseCreateAPI.get_request(),
responses=KnowledgeBaseCreateAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_CREATE.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
@log(
- menu='knowledge Base', operate='Create base knowledge',
- get_operation_object=lambda r, k: {'name': r.data.get('name'), 'desc': r.data.get('desc')},
-
+ menu="knowledge Base",
+ operate="Create base knowledge",
+ get_operation_object=lambda r, k: {"name": r.data.get("name"), "desc": r.data.get("desc")},
)
def post(self, request: Request, workspace_id: str):
- return result.success(KnowledgeSerializer.Create(
- data={'user_id': request.user.id, 'workspace_id': workspace_id}
- ).save_base(request.data))
+ return result.success(
+ KnowledgeSerializer.Create(data={"user_id": request.user.id, "workspace_id": workspace_id}).save_base(
+ request.data
+ )
+ )
class KnowledgeWebView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Create web knowledge'),
- summary=_('Create web knowledge'),
- operation_id=_('Create web knowledge'), # type: ignore
+ methods=["POST"],
+ description=_("Create web knowledge"),
+ summary=_("Create web knowledge"),
+ operation_id=_("Create web knowledge"), # type: ignore
parameters=KnowledgeWebCreateAPI.get_parameters(),
request=KnowledgeWebCreateAPI.get_request(),
responses=KnowledgeWebCreateAPI.get_response(),
- tags=[_('Knowledge Base')] # type: ignore
+ tags=[_("Knowledge Base")], # type: ignore
)
@has_permissions(
PermissionConstants.KNOWLEDGE_CREATE.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
@log(
- menu='Knowledge Base', operate="Create a web site knowledge base",
- get_operation_object=lambda r, k: {'name': r.data.get('name'), 'desc': r.data.get('desc'),
- 'first_list': r.FILES.getlist('file'),
- 'meta': {'source_url': r.data.get('source_url'),
- 'selector': r.data.get('selector'),
- 'embedding_model_id': r.data.get('embedding_model_id')}}
- ,
+ menu="Knowledge Base",
+ operate="Create a web site knowledge base",
+ get_operation_object=lambda r, k: {
+ "name": r.data.get("name"),
+ "desc": r.data.get("desc"),
+ "first_list": r.FILES.getlist("file"),
+ "meta": {
+ "source_url": r.data.get("source_url"),
+ "selector": r.data.get("selector"),
+ "embedding_model_id": r.data.get("embedding_model_id"),
+ },
+ },
)
def post(self, request: Request, workspace_id: str):
- return result.success(KnowledgeSerializer.Create(
- data={'user_id': request.user.id, 'workspace_id': workspace_id}
- ).save_web(request.data))
+ return result.success(
+ KnowledgeSerializer.Create(data={"user_id": request.user.id, "workspace_id": workspace_id}).save_web(
+ request.data
+ )
+ )
diff --git a/apps/knowledge/views/knowledge_workflow.py b/apps/knowledge/views/knowledge_workflow.py
index 8a6f23861f7..5c3ca434c3d 100644
--- a/apps/knowledge/views/knowledge_workflow.py
+++ b/apps/knowledge/views/knowledge_workflow.py
@@ -3,7 +3,10 @@
from application.api.application_api import SpeechToTextAPI
from common.auth import TokenAuth
from common.auth.authentication import get_is_permissions, has_permissions
-from common.constants.permission_constants import CompareConstants, PermissionConstants, RoleConstants, ViewPermission
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import DefaultResultSerializer, result
from django.utils.translation import gettext_lazy as _
@@ -36,7 +39,7 @@ class KnowledgeDatasourceFormListView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str, type: str, id: str):
@@ -57,7 +60,7 @@ class KnowledgeDatasourceView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str, type: str, id: str, function_name: str):
@@ -88,7 +91,7 @@ class KnowledgeWorkflowUploadDocumentView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str):
@@ -122,13 +125,13 @@ class KnowledgeWorkflowActionView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, knowledge_id: str):
return result.success(
KnowledgeWorkflowActionSerializer(data={"workspace_id": workspace_id, "knowledge_id": knowledge_id}).action(
- request.data, request.user, True
+ request.data, request.user.profile, True
)
)
@@ -152,7 +155,7 @@ class Page(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, current_page: int, page_size: int):
@@ -181,7 +184,7 @@ class Operate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request, workspace_id: str, knowledge_id: str, knowledge_action_id: str):
@@ -210,7 +213,7 @@ class Cancel(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request, workspace_id: str, knowledge_id: str, knowledge_action_id: str):
@@ -264,7 +267,7 @@ class Publish(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@@ -304,7 +307,7 @@ class Export(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -337,7 +340,7 @@ class Import(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -378,7 +381,7 @@ class Operate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -409,7 +412,7 @@ def put(self, request: Request, workspace_id: str, knowledge_id: str):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
@@ -439,7 +442,7 @@ class KnowledgeWorkflowVersionView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
@@ -469,7 +472,7 @@ class McpServers(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
diff --git a/apps/knowledge/views/knowledge_workflow_version.py b/apps/knowledge/views/knowledge_workflow_version.py
index 6202b7b8397..f976bada97c 100644
--- a/apps/knowledge/views/knowledge_workflow_version.py
+++ b/apps/knowledge/views/knowledge_workflow_version.py
@@ -15,7 +15,10 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from knowledge.api.knowledge_version import KnowledgeVersionListAPI, KnowledgeVersionPageAPI, \
KnowledgeVersionOperateAPI
@@ -48,7 +51,7 @@ class KnowledgeWorkflowVersionView(APIView):
PermissionConstants.KNOWLEDGE_WORKFLOW_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id, knowledge_id: str):
return result.success(
@@ -72,7 +75,7 @@ class Page(APIView):
PermissionConstants.KNOWLEDGE_WORKFLOW_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, knowledge_id: str, current_page: int, page_size: int):
return result.success(
@@ -97,7 +100,7 @@ class Operate(APIView):
PermissionConstants.KNOWLEDGE_WORKFLOW_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, knowledge_id: str, knowledge_version_id: str):
return result.success(
@@ -119,7 +122,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str, knowledge_
PermissionConstants.KNOWLEDGE_WORKFLOW_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Knowledge', operate="Modify knowledge version information",
get_operation_object=lambda r, k: get_knowledge_operation_object(k.get('knowledge_id')),
diff --git a/apps/knowledge/views/paragraph.py b/apps/knowledge/views/paragraph.py
index ada0883e300..5f48df5c2e1 100644
--- a/apps/knowledge/views/paragraph.py
+++ b/apps/knowledge/views/paragraph.py
@@ -5,7 +5,10 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import result
from common.utils.common import query_params_to_single_dict
@@ -33,7 +36,7 @@ class ParagraphView(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
q = ParagraphSerializers.Query(
@@ -59,7 +62,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str, document_i
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Create Paragraph',
@@ -91,7 +94,7 @@ class BatchDelete(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def put(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
return result.success(ParagraphSerializers.Batch(
@@ -114,7 +117,7 @@ class BatchMigrate(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Migrate paragraphs in batches',
@@ -153,7 +156,7 @@ class BatchGenerateRelated(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_GENERATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Batch generate related',
@@ -185,7 +188,7 @@ class Operate(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Modify paragraph data',
@@ -220,7 +223,7 @@ def put(self, request: Request, workspace_id: str, knowledge_id: str, document_i
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str, paragraph_id: str):
o = ParagraphSerializers.Operate(
@@ -247,7 +250,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str, document_i
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Delete paragraph',
@@ -286,7 +289,7 @@ class Problem(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Add associated questions',
@@ -319,7 +322,7 @@ def post(self, request: Request, workspace_id: str, knowledge_id: str, document_
PermissionConstants.KNOWLEDGE_PROBLEM_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str, paragraph_id: str):
return result.success(ParagraphSerializers.Problem(
@@ -349,7 +352,7 @@ class UnAssociation(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_RELATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Disassociation issue',
@@ -387,7 +390,7 @@ class Association(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_RELATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='Paragraph', operate='Related questions',
@@ -424,7 +427,7 @@ class Page(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request,
workspace_id: str, knowledge_id: str, document_id: str, current_page: int, page_size: int):
@@ -456,7 +459,7 @@ class AdjustPosition(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def put(self, request: Request, workspace_id: str, knowledge_id: str, document_id: str):
return result.success(ParagraphSerializers.AdjustPosition(
diff --git a/apps/knowledge/views/problem.py b/apps/knowledge/views/problem.py
index cfff9b4457d..0e2667a73f5 100644
--- a/apps/knowledge/views/problem.py
+++ b/apps/knowledge/views/problem.py
@@ -5,7 +5,10 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import result
from common.utils.common import query_params_to_single_dict
@@ -32,7 +35,7 @@ class ProblemView(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
q = ProblemSerializers.Query(
@@ -60,7 +63,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str):
PermissionConstants.KNOWLEDGE_PROBLEM_CREATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='problem', operate='Create question',
@@ -88,7 +91,7 @@ class Paragraph(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, problem_id: str):
return result.success(ProblemSerializers.Operate(
@@ -117,7 +120,7 @@ class BatchAssociation(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='problem', operate='Batch associated paragraphs',
@@ -147,7 +150,7 @@ class BatchDelete(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='problem', operate='Batch deletion issues',
@@ -176,7 +179,7 @@ class Operate(APIView):
PermissionConstants.KNOWLEDGE_PROBLEM_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='problem', operate='Delete question',
@@ -208,7 +211,7 @@ def delete(self, request: Request, workspace_id: str, knowledge_id: str, problem
PermissionConstants.KNOWLEDGE_PROBLEM_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='problem', operate='Modify question',
@@ -243,7 +246,7 @@ class Page(APIView):
PermissionConstants.KNOWLEDGE_DOCUMENT_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, current_page, page_size):
d = ProblemSerializers.Query(
diff --git a/apps/knowledge/views/tag.py b/apps/knowledge/views/tag.py
index 99bde42973e..2721dffbb60 100644
--- a/apps/knowledge/views/tag.py
+++ b/apps/knowledge/views/tag.py
@@ -5,7 +5,10 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import result
from knowledge.api.tag import TagCreateAPI, TagDeleteAPI, TagEditAPI
@@ -29,7 +32,7 @@ class KnowledgeTagView(APIView):
PermissionConstants.KNOWLEDGE_TAG_CREATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='tag', operate="Create a knowledge tag",
@@ -53,7 +56,7 @@ def post(self, request: Request, workspace_id: str, knowledge_id: str):
PermissionConstants.KNOWLEDGE_TAG_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='tag', operate="Create a knowledge tag",
@@ -82,7 +85,7 @@ class Operate(APIView):
PermissionConstants.KNOWLEDGE_TAG_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='tag', operate="Update a knowledge tag",
@@ -109,7 +112,7 @@ class Delete(APIView):
PermissionConstants.KNOWLEDGE_TAG_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='tag', operate="Delete a knowledge tag",
@@ -136,7 +139,7 @@ class BatchDelete(APIView):
PermissionConstants.KNOWLEDGE_TAG_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], CompareConstants.AND),
+ [PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()], compare=CompareConstants.AND),
)
@log(
menu='tag', operate="Batch Delete knowledge tag",
diff --git a/apps/knowledge/views/termbase.py b/apps/knowledge/views/termbase.py
index 1969dee3cde..53798e611cc 100644
--- a/apps/knowledge/views/termbase.py
+++ b/apps/knowledge/views/termbase.py
@@ -1,6 +1,9 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import CompareConstants, PermissionConstants, RoleConstants, ViewPermission
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import result
from common.utils.common import query_params_to_single_dict
@@ -39,7 +42,7 @@ class TermbaseView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str):
@@ -70,7 +73,7 @@ def get(self, request: Request, workspace_id: str, knowledge_id: str):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -105,7 +108,7 @@ class BatchDelete(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -140,7 +143,7 @@ class BatchExport(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -174,7 +177,7 @@ class Operate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -211,7 +214,7 @@ def delete(self, request: Request, workspace_id: str, knowledge_id: str, termbas
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -251,7 +254,7 @@ class Page(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.KNOWLEDGE.get_workspace_knowledge_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, knowledge_id: str, current_page, page_size):
diff --git a/apps/knowledge/web_assets.py b/apps/knowledge/web_assets.py
new file mode 100644
index 00000000000..39fd8c15390
--- /dev/null
+++ b/apps/knowledge/web_assets.py
@@ -0,0 +1,87 @@
+"""Persist remote images referenced by Web documents as knowledge assets."""
+
+import re
+from pathlib import PurePosixPath
+from urllib.parse import unquote, urlsplit
+
+import uuid_utils.compat as uuid
+from django.db.models import QuerySet
+
+from common.utils.common import get_sha256_hash, guess_image_format
+from common.utils.fork import Fork
+from common.utils.logger import maxkb_logger
+from knowledge.models import File, FileSourceType
+
+
+REMOTE_IMAGE_PATTERN = re.compile(
+ r'!\[(?P[^\]]*)\]\((?Phttps?://[^\s)]+)(?:\s+["\'][^"\']*["\'])?\)',
+ flags=re.IGNORECASE,
+)
+MAX_WEB_IMAGE_SIZE = 20 * 1024 * 1024
+MAX_WEB_IMAGES_PER_DOCUMENT = 100
+IMAGE_EXTENSION = {"jpeg": "jpg", "svg+xml": "svg", "x-icon": "ico"}
+
+
+def _file_name(source_url: str, image_format: str) -> str:
+ path_name = unquote(PurePosixPath(urlsplit(source_url).path).name)
+ extension = IMAGE_EXTENSION.get(image_format, image_format)
+ if not path_name or "." not in path_name:
+ path_name = f"web-image.{extension}"
+ return path_name[-256:]
+
+
+def _cache_web_image(source_url: str, knowledge_id) -> str | None:
+ try:
+ response = Fork.requests_get(
+ source_url,
+ {
+ "user-agent": (
+ "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
+ "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.51 Safari/537.36"
+ )
+ },
+ )
+ if response.status_code != 200 or not response.content or len(response.content) > MAX_WEB_IMAGE_SIZE:
+ return None
+ image_format = guess_image_format(response.content, source_url)
+ sha256_hash = get_sha256_hash(response.content)
+ existing = (
+ QuerySet(File)
+ .filter(
+ source_type=FileSourceType.KNOWLEDGE,
+ source_id=str(knowledge_id),
+ sha256_hash=sha256_hash,
+ meta__source_url=source_url,
+ )
+ .first()
+ )
+ if existing is not None:
+ return str(existing.id)
+ file = File(
+ id=uuid.uuid7(),
+ file_name=_file_name(source_url, image_format),
+ source_type=FileSourceType.KNOWLEDGE,
+ source_id=str(knowledge_id),
+ meta={"knowledge_id": str(knowledge_id), "source_url": source_url},
+ )
+ file.save(response.content)
+ return str(file.id)
+ except Exception as exc:
+ maxkb_logger.warning(f"Cache web image failed, url={source_url}, error={exc}")
+ return None
+
+
+def internalize_web_images(content: str, knowledge_id) -> str:
+ """Replace downloadable remote Markdown images with stable internal file references."""
+ cached: dict[str, str | None] = {}
+
+ def replace(match: re.Match) -> str:
+ source_url = match.group("url")
+ if source_url not in cached:
+ cached[source_url] = _cache_web_image(source_url, knowledge_id)
+ file_id = cached[source_url]
+ if file_id is None:
+ return match.group(0)
+ return f""
+
+ return REMOTE_IMAGE_PATTERN.sub(replace, content or "", count=MAX_WEB_IMAGES_PER_DOCUMENT)
diff --git a/apps/local_model/serializers/model_apply_serializers.py b/apps/local_model/serializers/model_apply_serializers.py
index 76c8792bbfa..a69e1a2a7ef 100644
--- a/apps/local_model/serializers/model_apply_serializers.py
+++ b/apps/local_model/serializers/model_apply_serializers.py
@@ -1,33 +1,32 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: model_apply_serializers.py
- @date:2024/8/20 20:39
- @desc:
+@project: MaxKB
+@Author:虎
+@file: model_apply_serializers.py
+@date:2024/8/20 20:39
+@desc:
"""
+
import json
import threading
import time
+from common.cache.mem_cache import MemCache
from django.db import connection
from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
from langchain_core.documents import Document
-from rest_framework import serializers
-
from local_model.models import Model
from local_model.serializers.rsa_util import rsa_long_decrypt
from models_provider.impl.local_model_provider.local_model_provider import LocalModelProvider
-
-from common.cache.mem_cache import MemCache
+from rest_framework import serializers
_lock = threading.Lock()
locks = {}
class ModelManage:
- cache = MemCache('model', {})
+ cache = MemCache("model", {})
up_clear_time = time.time()
@staticmethod
@@ -74,87 +73,100 @@ def delete_key(_id):
def get_local_model(model, **kwargs):
- return LocalModelProvider().get_model(model.model_type, model.model_name,
- json.loads(
- rsa_long_decrypt(model.credential)),
- model_id=model.id,
- streaming=True, **kwargs)
+ return LocalModelProvider().get_model(
+ model.model_type,
+ model.model_name,
+ json.loads(rsa_long_decrypt(model.credential)),
+ model_id=model.id,
+ streaming=True,
+ **kwargs,
+ )
def get_embedding_model(model_id):
model = QuerySet(Model).filter(id=model_id).first()
# 手动关闭数据库连接
connection.close()
- embedding_model = ModelManage.get_model(model_id,
- lambda _id: get_local_model(model, use_local=True))
+ embedding_model = ModelManage.get_model(model_id, lambda _id: get_local_model(model, use_local=True))
return embedding_model
class EmbedDocuments(serializers.Serializer):
- texts = serializers.ListField(required=True,
- child=serializers.CharField(required=True, label=_('vector text')),
- label=_('vector text list'))
+ texts = serializers.ListField(
+ required=True, child=serializers.CharField(required=True, label=_("vector text")), label=_("vector text list")
+ )
class EmbedQuery(serializers.Serializer):
- text = serializers.CharField(required=True, label=_('vector text'))
+ text = serializers.CharField(required=True, label=_("vector text"))
class CompressDocument(serializers.Serializer):
- page_content = serializers.CharField(required=True, label=_('text'))
- metadata = serializers.DictField(required=False, label=_('metadata'))
+ page_content = serializers.CharField(required=True, label=_("text"))
+ metadata = serializers.DictField(required=False, label=_("metadata"))
class CompressDocuments(serializers.Serializer):
documents = CompressDocument(required=True, many=True)
- query = serializers.CharField(required=True, label=_('query'))
+ query = serializers.CharField(required=True, label=_("query"))
class ValidateModelSerializers(serializers.Serializer):
- model_name = serializers.CharField(required=True, label=_('model_name'))
+ model_name = serializers.CharField(required=True, label=_("model_name"))
- model_type = serializers.CharField(required=True, label=_('model_type'))
+ model_type = serializers.CharField(required=True, label=_("model_type"))
model_credential = serializers.DictField(required=True, label="credential")
def validate_model(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- LocalModelProvider().is_valid_credential(self.data.get('model_type'), self.data.get('model_name'),
- self.data.get('model_credential'), model_params={},
- raise_exception=True)
+ LocalModelProvider().is_valid_credential(
+ self.data.get("model_type"),
+ self.data.get("model_name"),
+ self.data.get("model_credential"),
+ model_params={},
+ raise_exception=True,
+ )
class ModelApplySerializers(serializers.Serializer):
- model_id = serializers.UUIDField(required=True, label=_('model id'))
+ model_id = serializers.UUIDField(required=True, label=_("model id"))
def embed_documents(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
EmbedDocuments(data=instance).is_valid(raise_exception=True)
- model = get_embedding_model(self.data.get('model_id'))
- return model.embed_documents(instance.getlist('texts'))
+ model = get_embedding_model(self.data.get("model_id"))
+ return model.embed_documents(instance.getlist("texts"))
def embed_query(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
EmbedQuery(data=instance).is_valid(raise_exception=True)
- model = get_embedding_model(self.data.get('model_id'))
- return model.embed_query(instance.get('text'))
+ model = get_embedding_model(self.data.get("model_id"))
+ return model.embed_query(instance.get("text"))
def compress_documents(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
CompressDocuments(data=instance).is_valid(raise_exception=True)
- model = get_embedding_model(self.data.get('model_id'))
- return [{'page_content': d.page_content, 'metadata': d.metadata} for d in model.compress_documents(
- [Document(page_content=document.get('page_content'), metadata=document.get('metadata')) for document in
- instance.get('documents')], instance.get('query'))]
+ model = get_embedding_model(self.data.get("model_id"))
+ return [
+ {"page_content": d.page_content, "metadata": d.metadata}
+ for d in model.compress_documents(
+ [
+ Document(page_content=document.get("page_content"), metadata=document.get("metadata"))
+ for document in instance.get("documents")
+ ],
+ instance.get("query"),
+ )
+ ]
def unload(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- ModelManage.delete_key(self.data.get('model_id'))
+ ModelManage.delete_key(self.data.get("model_id"))
return True
diff --git a/apps/local_model/serializers/rsa_util.py b/apps/local_model/serializers/rsa_util.py
index df2cedba736..1bedd9c2994 100644
--- a/apps/local_model/serializers/rsa_util.py
+++ b/apps/local_model/serializers/rsa_util.py
@@ -1,21 +1,21 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: rsa_util.py
- @date:2023/11/3 11:13
- @desc:
+@project: maxkb
+@Author:虎
+@file: rsa_util.py
+@date:2023/11/3 11:13
+@desc:
"""
+
import base64
import threading
+from common.constants.cache_version import Cache_Version
from Crypto.Cipher import PKCS1_v1_5 as PKCS1_cipher
from Crypto.PublicKey import RSA
from django.core import cache
from django.db.models import QuerySet
-
-from common.constants.cache_version import Cache_Version
-from local_model.models.system_setting import SystemSetting, SettingType
+from local_model.models.system_setting import SettingType, SystemSetting
lock = threading.Lock()
rsa_cache = cache.cache
@@ -33,9 +33,8 @@ def generate():
key = RSA.generate(2048)
# 获取私钥
- encrypted_key = key.export_key(passphrase=secret_code, pkcs=8,
- protection="scryptAndAES128-CBC")
- return {'key': key.publickey().export_key(), 'value': encrypted_key}
+ encrypted_key = key.export_key(passphrase=secret_code, pkcs=8, protection="scryptAndAES128-CBC")
+ return {"key": key.publickey().export_key(), "value": encrypted_key}
def get_key_pair():
@@ -47,7 +46,7 @@ def get_key_pair():
return rsa_value
rsa_value = get_key_pair_by_sql()
version, get_key = Cache_Version.SYSTEM.value
- rsa_cache.set(get_key(key='rsa_key'), rsa_value, timeout=None, version=version)
+ rsa_cache.set(get_key(key="rsa_key"), rsa_value, timeout=None, version=version)
return rsa_value
@@ -55,8 +54,9 @@ def get_key_pair_by_sql():
system_setting = QuerySet(SystemSetting).filter(type=SettingType.RSA.value).first()
if system_setting is None:
kv = generate()
- system_setting = SystemSetting(type=SettingType.RSA.value,
- meta={'key': kv.get('key').decode(), 'value': kv.get('value').decode()})
+ system_setting = SystemSetting(
+ type=SettingType.RSA.value, meta={"key": kv.get("key").decode(), "value": kv.get("value").decode()}
+ )
system_setting.save()
return system_setting.meta
@@ -69,7 +69,7 @@ def encrypt(msg, public_key: str | None = None):
:return: 加密后的数据
"""
if public_key is None:
- public_key = get_key_pair().get('key')
+ public_key = get_key_pair().get("key")
cipher = PKCS1_cipher.new(RSA.importKey(public_key))
encrypt_msg = cipher.encrypt(msg.encode("utf-8"))
return base64.b64encode(encrypt_msg).decode()
@@ -83,7 +83,7 @@ def decrypt(msg, pri_key: str | None = None):
:return: 解密后数据
"""
if pri_key is None:
- pri_key = get_key_pair().get('value')
+ pri_key = get_key_pair().get("value")
cipher = PKCS1_cipher.new(RSA.importKey(pri_key, passphrase=secret_code))
decrypt_data = cipher.decrypt(base64.b64decode(msg), 0)
return decrypt_data.decode("utf-8")
@@ -100,22 +100,21 @@ def rsa_long_encrypt(message, public_key: str | None = None, length=200):
"""
# 读取公钥
if public_key is None:
- public_key = get_key_pair().get('key')
- cipher = PKCS1_cipher.new(RSA.importKey(extern_key=public_key,
- passphrase=secret_code))
+ public_key = get_key_pair().get("key")
+ cipher = PKCS1_cipher.new(RSA.importKey(extern_key=public_key, passphrase=secret_code))
# 处理:Plaintext is too long. 分段加密
if len(message) <= length:
# 对编码的数据进行加密,并通过base64进行编码
- result = base64.b64encode(cipher.encrypt(message.encode('utf-8')))
+ result = base64.b64encode(cipher.encrypt(message.encode("utf-8")))
else:
rsa_text = []
# 对编码后的数据进行切片,原因:加密长度不能过长
for i in range(0, len(message), length):
- cont = message[i:i + length]
+ cont = message[i : i + length]
# 对切片后的数据进行加密,并新增到text后面
- rsa_text.append(cipher.encrypt(cont.encode('utf-8')))
+ rsa_text.append(cipher.encrypt(cont.encode("utf-8")))
# 加密完进行拼接
- cipher_text = b''.join(rsa_text)
+ cipher_text = b"".join(rsa_text)
# base64进行编码
result = base64.b64encode(cipher_text)
return result.decode()
@@ -130,10 +129,10 @@ def rsa_long_decrypt(message, pri_key: str | None = None, length=256):
:return: 解密后的数据
"""
if pri_key is None:
- pri_key = get_key_pair().get('value')
+ pri_key = get_key_pair().get("value")
cipher = PKCS1_cipher.new(RSA.importKey(pri_key, passphrase=secret_code))
base64_de = base64.b64decode(message)
res = []
for i in range(0, len(base64_de), length):
- res.append(cipher.decrypt(base64_de[i:i + length], 0))
+ res.append(cipher.decrypt(base64_de[i : i + length], 0))
return b"".join(res).decode()
diff --git a/apps/local_model/views/model_apply.py b/apps/local_model/views/model_apply.py
index 98c07dd7493..4259c695db1 100644
--- a/apps/local_model/views/model_apply.py
+++ b/apps/local_model/views/model_apply.py
@@ -1,42 +1,35 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: model_apply.py
- @date:2024/8/20 20:38
- @desc:
+@project: MaxKB
+@Author:虎
+@file: model_apply.py
+@date:2024/8/20 20:38
+@desc:
"""
-from urllib.request import Request
-from rest_framework.views import APIView
+from urllib.request import Request
from common.result import result
from local_model.serializers.model_apply_serializers import ModelApplySerializers, ValidateModelSerializers
+from rest_framework.views import APIView
class LocalModelApply(APIView):
class EmbedDocuments(APIView):
-
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).embed_documents(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).embed_documents(request.data))
class EmbedQuery(APIView):
-
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).embed_query(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).embed_query(request.data))
class CompressDocuments(APIView):
-
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).compress_documents(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).compress_documents(request.data))
class Unload(APIView):
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).compress_documents(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).compress_documents(request.data))
class Validate(APIView):
def post(self, request: Request):
diff --git a/apps/locales/en_US/LC_MESSAGES/django.po b/apps/locales/en_US/LC_MESSAGES/django.po
index d07bf84fe63..448be2f7a8e 100644
--- a/apps/locales/en_US/LC_MESSAGES/django.po
+++ b/apps/locales/en_US/LC_MESSAGES/django.po
@@ -5644,6 +5644,14 @@ msgstr ""
#: apps/workspace/serializers/workspace_serializers.py:223
msgid "User relation does not exist"
msgstr ""
+#: apps/workspace/serializers/workspace_serializers.py:40
+msgid "No permission to manage this workspace members"
+msgstr ""
+#: apps/role_setting/serializers/role_setting_serializers.py:426
+msgid "No permission to operate this role"
+msgstr ""
+
+
#: apps/role_setting/serializers/role_setting_serializers.py:316
#: apps/workspace/serializers/workspace_serializers.py:226
@@ -6815,7 +6823,7 @@ msgstr ""
#: apps/users/views/user.py:120 apps/users/views/user.py:121
#: apps/users/views/user.py:122
msgid "Get all user"
-msgstr ""
+msgstr "Retrieve users by their names (up to 200 users)"
#: apps/users/views/user.py:133 apps/users/views/user.py:134
#: apps/users/views/user.py:135
@@ -6967,6 +6975,14 @@ msgstr ""
msgid "Remove member from system workspace"
msgstr ""
+#: apps/workspace/views/workspace.py:173
+msgid "Batch remove members from system workspace"
+msgstr ""
+
+#: apps/workspace/serializers/workspace_serializers.py:244
+msgid "User relation IDs"
+msgstr ""
+
#: apps/workspace/views/workspace.py:133 apps/workspace/views/workspace.py:134
#: apps/workspace/views/workspace.py:135
msgid "Get system workspace member list"
@@ -7565,6 +7581,14 @@ msgstr ""
msgid "Please analyze the content of the image."
msgstr ""
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:281
+msgid "Please analyze the content of the file."
+msgstr ""
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:283
+msgid "Please analyze the content of the video."
+msgstr ""
+
#: apps/xpack/serializers/channel/ding_talk.py:95
#, python-brace-format
msgid "DingTalk application: {user}"
@@ -7882,6 +7906,27 @@ msgstr ""
msgid "The platform configuration corresponding to {type} was not found"
msgstr ""
+#: apps/xpack/serializers/platform_serializer.py:56
+msgid "Bot ID is required"
+msgstr "Bot ID is required"
+
+#: apps/xpack/serializers/platform_serializer.py:166
+#, python-brace-format
+msgid ""
+"This bot_id is already bound to another application ({app}). "
+"Each bot_id can only correspond to one application."
+msgstr ""
+"This bot_id is already bound to another application ({app}). "
+"Each bot_id can only correspond to one application."
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:126
+msgid "Hello! I am an AI assistant. How can I help you?"
+msgstr "Hello! I am an AI assistant. How can I help you?"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:188
+msgid "Sorry, I have encountered some issues. Please try again later."
+msgstr "Sorry, I have encountered some issues. Please try again later."
+
#: apps/xpack/serializers/resource_chat_user.py:35
#: apps/xpack/serializers/resource_chat_user.py:111
#: apps/xpack/serializers/resource_chat_user_group.py:18
@@ -8695,7 +8740,6 @@ msgstr ""
msgid "generate prompt"
msgstr ""
-
msgid "Watermark"
msgstr ""
@@ -9381,4 +9425,319 @@ msgid "User Name"
msgstr "User Name"
msgid "New chat"
-msgstr "A new conversation has been generated. Please ask your question again!"
\ No newline at end of file
+msgstr "A new conversation has been generated. Please ask your question again!"
+
+msgid "Token Index"
+msgstr "Token Index"
+
+msgid "Authorize to Workspace"
+msgstr ""
+
+msgid "IAM"
+msgstr "IAM"
+
+msgid "Chat Client"
+msgstr "Chat Client"
+
+msgid "Shared"
+msgstr ""
+
+msgid "IAM/User Group"
+msgstr ""
+
+msgid "Create or update System User Group"
+msgstr ""
+
+msgid "Get System User Group list by workspace id"
+msgstr ""
+
+msgid "Delete System User Group"
+msgstr ""
+
+msgid "Add members to System User Group"
+msgstr ""
+
+msgid "Unauthorized users are present"
+msgstr ""
+
+msgid "Remove members from System User Group"
+msgstr ""
+
+msgid "One or more user groups do not exist"
+msgstr ""
+
+msgid "Role Management"
+msgstr ""
+
+msgid "Chat User Group"
+msgstr ""
+
+msgid "Get user group authorization status of resource"
+msgstr ""
+
+msgid "Edit user group authorization status of resource"
+msgstr ""
+
+msgid "Get user group authorization status of resource by page"
+msgstr ""
+
+msgid "Get portal configuration"
+msgstr ""
+
+msgid "Save portal configuration"
+msgstr ""
+
+msgid "Portal"
+msgstr ""
+
+msgid "Portal configuration does not exist"
+msgstr ""
+
+msgid "portal name"
+msgstr ""
+
+msgid "portal description"
+msgstr ""
+
+msgid "portal logo"
+msgstr ""
+
+msgid "tab logo"
+msgstr ""
+
+msgid "enable public access"
+msgstr ""
+
+msgid "enable api"
+msgstr ""
+
+msgid "enable auth"
+msgstr ""
+
+msgid "auth config"
+msgstr ""
+
+msgid "enable cors"
+msgstr ""
+
+msgid "cors config"
+msgstr ""
+
+msgid "Get published application list by page"
+msgstr ""
+
+msgid "Portal login"
+msgstr ""
+
+msgid "Invalid encrypted data"
+msgstr ""
+
+msgid "Portal authentication is not enabled"
+msgstr ""
+
+msgid "Portal authentication is not configured"
+msgstr ""
+
+msgid "Portal local login is not enabled"
+msgstr ""
+
+msgid "Get portal login info"
+msgstr ""
+
+msgid "Portal logout"
+msgstr ""
+
+msgid "Create ChatUserAPIKey"
+msgstr ""
+
+msgid "Get ChatUserAPIKey List"
+msgstr ""
+
+msgid "Delete ChatUserAPIKey"
+msgstr ""
+
+msgid "Chat User API Key"
+msgstr ""
+
+msgid "Add chat user API key"
+msgstr ""
+
+msgid "Get chat user API key list"
+msgstr ""
+
+msgid "Delete chat user API key"
+msgstr ""
+
+msgid "Quota Setting"
+msgstr "Quota Setting"
+
+#: apps/xpack/serializers/chat_user.py:746
+msgid "Quota mode"
+msgstr "Quota mode"
+
+#: apps/xpack/serializers/chat_user.py:750
+msgid "Period unit"
+msgstr "Period unit"
+
+#: apps/xpack/serializers/chat_user.py:754
+msgid "Period quantity"
+msgstr "Period quantity"
+
+#: apps/xpack/serializers/chat_user.py:758
+msgid "Token limit (K)"
+msgstr "Token limit (K)"
+
+#: apps/xpack/serializers/chat_user.py:765
+msgid "Period unit is required for periodic quota"
+msgstr "Period unit is required for periodic quota"
+
+#: apps/xpack/serializers/chat_user.py:767
+msgid "Period quantity is required for periodic quota"
+msgstr "Period quantity is required for periodic quota"
+
+#: apps/xpack/serializers/chat_user.py:769
+msgid "Token limit is required for periodic quota"
+msgstr "Token limit is required for periodic quota"
+
+#: apps/xpack/views/system_chat_user.py:73
+msgid "Get chat user quota"
+msgstr "Get chat user quota"
+
+#: apps/xpack/views/system_chat_user.py:82
+msgid "Set chat user quota"
+msgstr "Set chat user quota"
+
+msgid "The token quota for the current period has been exhausted. Please contact the administrator."
+msgstr ""
+
+msgid "Get portal historical conversation by page"
+msgstr ""
+
+msgid "Too many verification code attempts, please try again later"
+msgstr ""
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:18
+msgid "Recognition language"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:18
+msgid "Recognition language: zh / en, auto detected when omitted"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:22
+msgid "Auto detect"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:23
+msgid "Chinese"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:30
+msgid "Audio encoding"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:30
+msgid "pcm / wav / ogg / mp3, auto detected when omitted"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:34
+msgid "Auto"
+msgstr ""
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:76
+msgid "Tokenhub sync_transcribe endpoint"
+msgstr ""
+
+msgid "Add logo"
+msgstr "Add logo"
+
+msgid "Custom watermark content, at most 16 characters, drawn in the bottom-right."
+msgstr "Custom watermark content, at most 16 characters, drawn in the bottom-right."
+
+msgid "Designed for Agent workloads, using a MoE architecture that supports interleaved thinking, structured output, Function Calling and Cache caching."
+msgstr "Designed for Agent workloads, using a MoE architecture that supports interleaved thinking, structured output, Function Calling and Cache caching."
+
+msgid "Frame rate"
+msgstr "Frame rate"
+
+msgid "Hunyuan HY-Video 1.5 image-to-video model."
+msgstr "Hunyuan HY-Video 1.5 image-to-video model."
+
+msgid "Hunyuan HY-Video 1.5 text-to-video model."
+msgstr "Hunyuan HY-Video 1.5 text-to-video model."
+
+msgid "Hunyuan Hy-Image 3.0 text-to-image model."
+msgstr "Hunyuan Hy-Image 3.0 text-to-image model."
+
+msgid "Hunyuan's latest role-playing model based on the Hunyuan model with role-playing scene fine-tuning."
+msgstr "Hunyuan's latest role-playing model based on the Hunyuan model with role-playing scene fine-tuning."
+
+msgid "Hunyuan's role-playing model with better basic effects in role-playing scenarios."
+msgstr "Hunyuan's role-playing model with better basic effects in role-playing scenarios."
+
+msgid "Output video frame rate: 16, 24, 30."
+msgstr "Output video frame rate: 16, 24, 30."
+
+msgid "Output video resolution: 480p, 720p, 1080p."
+msgstr "Output video resolution: 480p, 720p, 1080p."
+
+msgid "Prompt rewrite"
+msgstr "Prompt rewrite"
+
+msgid "Tencent Hybrid multilingual translation model."
+msgstr "Tencent Hybrid multilingual translation model."
+
+msgid "Tencent TokenHub multimodal embedding model, 2048 dimensions."
+msgstr "Tencent TokenHub multimodal embedding model, 2048 dimensions."
+
+msgid "Tencent TokenHub multimodal embedding model, 4096 dimensions."
+msgstr "Tencent TokenHub multimodal embedding model, 4096 dimensions."
+
+msgid "Tencent TokenHub text embedding model, 1024 dimensions."
+msgstr "Tencent TokenHub text embedding model, 1024 dimensions."
+
+msgid "Tencent TokenHub text embedding model, 2560 dimensions."
+msgstr "Tencent TokenHub text embedding model, 2560 dimensions."
+
+msgid "Tencent YT-Video 2.0 image-to-video model."
+msgstr "Tencent YT-Video 2.0 image-to-video model."
+
+msgid "The latest generation productivity model with upgraded Agent and complex task execution capabilities."
+msgstr "The latest generation productivity model with upgraded Agent and complex task execution capabilities."
+
+msgid "TokenHub Hy-Image v3-generation endpoint"
+msgstr "TokenHub Hy-Image v3-generation endpoint"
+
+msgid "TokenHub OpenAI compatible embeddings endpoint"
+msgstr "TokenHub OpenAI compatible embeddings endpoint"
+
+msgid "TokenHub OpenAI compatible endpoint"
+msgstr "TokenHub OpenAI compatible endpoint"
+
+msgid "TokenHub video endpoint. Use the base (e.g. https://tokenhub.tencentmaas.com/v1) or a full submit/query URL."
+msgstr "TokenHub video endpoint. Use the base (e.g. https://tokenhub.tencentmaas.com/v1) or a full submit/query URL."
+
+msgid "Tuned on real business scenarios, balancing effectiveness and cost-effectiveness, with reinforced Coding, long-text, reasoning and Agent capabilities."
+msgstr "Tuned on real business scenarios, balancing effectiveness and cost-effectiveness, with reinforced Coding, long-text, reasoning and Agent capabilities."
+
+msgid "Watermark footnote"
+msgstr "Watermark footnote"
+
+msgid "Whether the model should rewrite and optimize the prompt before generation."
+msgstr "Whether the model should rewrite and optimize the prompt before generation."
+
+msgid "Whether to add the AI-generated logo to the video. 1: add logo; 0: no logo (requires console approval for independent control)."
+msgstr "Whether to add the AI-generated logo to the video. 1: add logo; 0: no logo (requires console approval for independent control)."
+
+msgid "Width and height must be in [512, 2048] and the area must not exceed 1024x1024. If not passed, the model auto-selects the closest preset size."
+msgstr "Width and height must be in [512, 2048] and the area must not exceed 1024x1024. If not passed, the model auto-selects the closest preset size."
+
+msgid "api_key is required"
+msgstr "api_key is required"
diff --git a/apps/locales/zh_CN/LC_MESSAGES/django.po b/apps/locales/zh_CN/LC_MESSAGES/django.po
index b768d7356c3..dcdc196b9f5 100644
--- a/apps/locales/zh_CN/LC_MESSAGES/django.po
+++ b/apps/locales/zh_CN/LC_MESSAGES/django.po
@@ -661,7 +661,7 @@ msgstr "字段仅支持自定义|引用"
#: apps/application/flow/step_node/function_node/i_function_node.py:40
msgid "{field}, this field is required."
-msgstr "{field_label} 字段是必填项"
+msgstr "{field} 字段是必填项"
#: apps/application/flow/step_node/function_node/i_function_node.py:46
msgid "function"
@@ -5763,6 +5763,14 @@ msgstr "成员集合"
#: apps/workspace/serializers/workspace_serializers.py:223
msgid "User relation does not exist"
msgstr "用户关系不存在"
+#: apps/workspace/serializers/workspace_serializers.py:40
+msgid "No permission to manage this workspace members"
+msgstr "没有权限管理该工作空间成员"
+#: apps/role_setting/serializers/role_setting_serializers.py:426
+msgid "No permission to operate this role"
+msgstr "没有权限操作该角色"
+
+
#: apps/role_setting/serializers/role_setting_serializers.py:316
#: apps/workspace/serializers/workspace_serializers.py:226
@@ -6935,7 +6943,7 @@ msgstr "获取当前用户信息"
#: apps/users/views/user.py:120 apps/users/views/user.py:121
#: apps/users/views/user.py:122
msgid "Get all user"
-msgstr "获取所有用户"
+msgstr "根据姓名获取用户(最多获取200个)"
#: apps/users/views/user.py:133 apps/users/views/user.py:134
#: apps/users/views/user.py:135
@@ -7086,6 +7094,14 @@ msgstr "系统工作空间添加成员"
msgid "Remove member from system workspace"
msgstr "系统工作空间移除成员"
+#: apps/workspace/views/workspace.py:173
+msgid "Batch remove members from system workspace"
+msgstr "批量移除系统工作空间成员"
+
+#: apps/workspace/serializers/workspace_serializers.py:244
+msgid "User relation IDs"
+msgstr "用户关系 ID 列表"
+
#: apps/workspace/views/workspace.py:133 apps/workspace/views/workspace.py:134
#: apps/workspace/views/workspace.py:135
msgid "Get system workspace member list"
@@ -7684,6 +7700,14 @@ msgstr "图片下载失败,请检查网络"
msgid "Please analyze the content of the image."
msgstr "请分析图片内容。"
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:281
+msgid "Please analyze the content of the file."
+msgstr "请分析文件内容。"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:283
+msgid "Please analyze the content of the video."
+msgstr "请分析视频内容。"
+
#: apps/xpack/serializers/channel/ding_talk.py:95
msgid "DingTalk application: {user}"
msgstr "钉钉智能体: {user}"
@@ -8002,6 +8026,27 @@ msgstr "检查字段是否正确"
msgid "The platform configuration corresponding to {type} was not found"
msgstr "未找到对应 {type} 的平台配置"
+#: apps/xpack/serializers/platform_serializer.py:56
+msgid "Bot ID is required"
+msgstr "Bot ID 是必填项"
+
+#: apps/xpack/serializers/platform_serializer.py:166
+#, python-brace-format
+msgid ""
+"This bot_id is already bound to another application ({app}). "
+"Each bot_id can only correspond to one application."
+msgstr ""
+"该 bot_id 已绑定到另一个应用 ({app}),"
+"每个 bot_id 只能对应一个应用。"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:126
+msgid "Hello! I am an AI assistant. How can I help you?"
+msgstr "您好!我是智能助手,有什么可以帮您的吗?"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:188
+msgid "Sorry, I have encountered some issues. Please try again later."
+msgstr "抱歉,我遇到了一些问题,请稍后再试。"
+
#: apps/xpack/serializers/resource_chat_user.py:35
#: apps/xpack/serializers/resource_chat_user.py:111
#: apps/xpack/serializers/resource_chat_user_group.py:18
@@ -8800,7 +8845,6 @@ msgstr "系统资源授权"
msgid "This folder contains resources that you dont have permission"
msgstr "此文件夹包含您没有权限的资源"
-
msgid "Text to Video"
msgstr "文生视频"
@@ -9504,4 +9548,366 @@ msgid "User Name"
msgstr "用户名称"
msgid "New chat"
-msgstr "已生成新对话,请重新提问!"
\ No newline at end of file
+msgstr "已生成新对话,请重新提问!"
+
+msgid "Token Index"
+msgstr "分词索引"
+
+msgid "Authorize to Workspace"
+msgstr "授权工作空间"
+
+msgid "IAM"
+msgstr "身份与权限"
+
+msgid "Chat Client"
+msgstr "对话端管理"
+
+msgid "Shared"
+msgstr "共享资源"
+
+msgid "IAM/User Group"
+msgstr "身份与权限/用户组"
+
+msgid "Create or update System User Group"
+msgstr "创建或更新系统用户组"
+
+msgid "Get System User Group list by workspace id"
+msgstr "通过工作空间 ID 获取系统用户组列表"
+
+msgid "Delete System User Group"
+msgstr "删除系统用户组"
+
+msgid "Add members to System User Group"
+msgstr "添加成员到系统用户组"
+
+msgid "Unauthorized users are present"
+msgstr "存在未授权的用户"
+
+msgid "Remove members from System User Group"
+msgstr "从系统用户组中移除成员"
+
+msgid "One or more user groups do not exist"
+msgstr "一个或多个用户组不存在"
+
+msgid "Role Management"
+msgstr "角色管理"
+
+msgid "Chat User Group"
+msgstr "对话用户组"
+
+msgid "Create or update Workspace User Group"
+msgstr "创建或更新工作空间用户组"
+
+msgid "Get Workspace User Group list by workspace id"
+msgstr "通过工作空间 ID 获取工作空间用户组列表"
+
+msgid "Delete Workspace User Group"
+msgstr "删除工作空间用户组"
+
+msgid "Add members to Workspace User Group"
+msgstr "添加成员到工作空间用户组"
+
+msgid "Remove members from Workspace User Group"
+msgstr "从工作空间用户组中移除成员"
+
+msgid "Get user group authorization status of resource"
+msgstr "获取用户组对资源的授权状态"
+
+msgid "Edit user group authorization status of resource"
+msgstr "编辑用户组对资源的授权状态"
+
+msgid "Get user group authorization status of resource by page"
+msgstr "分页获取用户组对资源的授权状态"
+
+msgid "Get portal configuration"
+msgstr "获取门户配置"
+
+msgid "Save portal configuration"
+msgstr "保存门户配置"
+
+msgid "Portal"
+msgstr "门户"
+
+msgid "Portal configuration does not exist"
+msgstr "门户配置不存在"
+
+msgid "portal name"
+msgstr "门户名称"
+
+msgid "portal description"
+msgstr "门户描述"
+
+msgid "portal logo"
+msgstr "门户Logo"
+
+msgid "tab logo"
+msgstr "浏览器Tab Logo"
+
+msgid "enable public access"
+msgstr "是否开启公开访问"
+
+msgid "enable api"
+msgstr "是否开启API服务"
+
+msgid "enable auth"
+msgstr "是否开启身份认证"
+
+msgid "auth config"
+msgstr "身份认证配置"
+
+msgid "enable cors"
+msgstr "是否开启跨域设置"
+
+msgid "cors config"
+msgstr "跨域配置"
+
+msgid "Get published application list by page"
+msgstr "分页获取已发布应用列表"
+
+msgid "Portal login"
+msgstr "门户登录"
+
+msgid "Invalid encrypted data"
+msgstr "无效的加密数据"
+
+msgid "Portal authentication is not enabled"
+msgstr "门户身份认证未开启"
+
+msgid "Portal authentication is not configured"
+msgstr "门户身份认证未配置"
+
+msgid "Portal local login is not enabled"
+msgstr "门户本地登录未开启"
+
+msgid "Get portal login info"
+msgstr "获取门户登录信息"
+
+msgid "Portal logout"
+msgstr "门户退出登录"
+
+msgid "Create ChatUserAPIKey"
+msgstr "创建对话用户 API 密钥"
+
+msgid "Get ChatUserAPIKey List"
+msgstr "获取对话用户 API 密钥列表"
+
+msgid "Delete ChatUserAPIKey"
+msgstr "删除对话用户 API 密钥"
+
+msgid "Chat User API Key"
+msgstr "对话用户 API 密钥"
+
+msgid "Add chat user API key"
+msgstr "添加对话用户 API 密钥"
+
+msgid "Get chat user API key list"
+msgstr "获取对话用户 API 密钥列表"
+
+msgid "Delete chat user API key"
+msgstr "删除对话用户 API 密钥"
+
+msgid "Quota Setting"
+msgstr "配额设置"
+
+#: apps/xpack/serializers/chat_user.py:746
+msgid "Quota mode"
+msgstr "配额模式"
+
+#: apps/xpack/serializers/chat_user.py:750
+msgid "Period unit"
+msgstr "周期单位"
+
+#: apps/xpack/serializers/chat_user.py:754
+msgid "Period quantity"
+msgstr "周期数量"
+
+#: apps/xpack/serializers/chat_user.py:758
+msgid "Token limit (K)"
+msgstr "Tokens 上限(K)"
+
+#: apps/xpack/serializers/chat_user.py:765
+msgid "Period unit is required for periodic quota"
+msgstr "按周期限制时,周期单位不能为空"
+
+#: apps/xpack/serializers/chat_user.py:767
+msgid "Period quantity is required for periodic quota"
+msgstr "按周期限制时,周期数量不能为空"
+
+#: apps/xpack/serializers/chat_user.py:769
+msgid "Token limit is required for periodic quota"
+msgstr "按周期限制时,Tokens 上限不能为空"
+
+#: apps/xpack/views/system_chat_user.py:73
+msgid "Get chat user quota"
+msgstr "获取对话用户配额"
+
+#: apps/xpack/views/system_chat_user.py:82
+msgid "Set chat user quota"
+msgstr "设置对话用户配额"
+
+msgid "The token quota for the current period has been exhausted. Please contact the administrator."
+msgstr "当前周期 Tokens 配额已用尽,请联系管理员。"
+
+msgid "Get portal historical conversation by page"
+msgstr "分页获取门户历史会话"
+
+#: apps/xpack/views/system_chat_user.py:101
+msgid "Batch set chat user quota"
+msgstr "批量设置对话用户配额"
+
+msgid "Too many verification code attempts, please try again later"
+msgstr "验证码尝试次数过多,请稍后重试"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:18
+msgid "Recognition language"
+msgstr "识别语言"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:18
+msgid "Recognition language: zh / en, auto detected when omitted"
+msgstr "识别语言:zh / en,缺省时自动检测"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:22
+msgid "Auto detect"
+msgstr "自动检测"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:23
+msgid "Chinese"
+msgstr "中文"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:30
+msgid "Audio encoding"
+msgstr "音频编码"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:30
+msgid "pcm / wav / ogg / mp3, auto detected when omitted"
+msgstr "pcm / wav / ogg / mp3,缺省时自动检测"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:34
+msgid "Auto"
+msgstr "自动"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:76
+msgid "Tokenhub sync_transcribe endpoint"
+msgstr "Tokenhub 同步转写接口地址"
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Add logo"
+msgstr "添加标识"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Custom watermark content, at most 16 characters, drawn in the bottom-right."
+msgstr "自定义水印内容,最多16个字符,绘制在右下角。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Designed for Agent workloads, using a MoE architecture that supports interleaved thinking, structured output, Function Calling and Cache caching."
+msgstr "专为 Agent 场景设计,采用 MoE 架构,支持交织思考、结构化输出、Function Calling 和 Cache 缓存。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Frame rate"
+msgstr "帧率"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan HY-Video 1.5 image-to-video model."
+msgstr "混元 HY-Video 1.5 图生视频模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan HY-Video 1.5 text-to-video model."
+msgstr "混元 HY-Video 1.5 文生视频模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan Hy-Image 3.0 text-to-image model."
+msgstr "混元 Hy-Image 3.0 文生图模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan's latest role-playing model based on the Hunyuan model with role-playing scene fine-tuning."
+msgstr "基于混元模型并在角色扮演场景微调的最新角色扮演模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan's role-playing model with better basic effects in role-playing scenarios."
+msgstr "在角色扮演场景中基础效果更优的混元角色扮演模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Output video frame rate: 16, 24, 30."
+msgstr "输出视频帧率:16、24、30。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Output video resolution: 480p, 720p, 1080p."
+msgstr "输出视频分辨率:480p、720p、1080p。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Prompt rewrite"
+msgstr "提示词改写"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent Hybrid multilingual translation model."
+msgstr "腾讯混元多语言翻译模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub multimodal embedding model, 2048 dimensions."
+msgstr "腾讯 TokenHub 多模态向量模型,2048 维。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub multimodal embedding model, 4096 dimensions."
+msgstr "腾讯 TokenHub 多模态向量模型,4096 维。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub text embedding model, 1024 dimensions."
+msgstr "腾讯 TokenHub 文本向量模型,1024 维。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub text embedding model, 2560 dimensions."
+msgstr "腾讯 TokenHub 文本向量模型,2560 维。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent YT-Video 2.0 image-to-video model."
+msgstr "腾讯 YT-Video 2.0 图生视频模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "The latest generation productivity model with upgraded Agent and complex task execution capabilities."
+msgstr "采用全新一代生产力模型,升级了 Agent 与复杂任务执行能力。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "TokenHub Hy-Image v3-generation endpoint"
+msgstr "TokenHub Hy-Image v3-generation 接口"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/embedding.py
+msgid "TokenHub OpenAI compatible embeddings endpoint"
+msgstr "TokenHub OpenAI 兼容向量接口"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/llm.py
+msgid "TokenHub OpenAI compatible endpoint"
+msgstr "TokenHub OpenAI 兼容接口"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "TokenHub video endpoint. Use the base (e.g. https://tokenhub.tencentmaas.com/v1) or a full submit/query URL."
+msgstr "TokenHub 视频接口。可使用根地址(如 https://tokenhub.tencentmaas.com/v1)或完整的 submit/query 地址。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tuned on real business scenarios, balancing effectiveness and cost-effectiveness, with reinforced Coding, long-text, reasoning and Agent capabilities."
+msgstr "针对真实业务场景调优,兼顾效果与成本,强化了 Coding、长文本、推理和 Agent 能力。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Watermark footnote"
+msgstr "水印角标"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Whether the model should rewrite and optimize the prompt before generation."
+msgstr "模型是否在生成前改写并优化提示词。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Whether to add the AI-generated logo to the video. 1: add logo; 0: no logo (requires console approval for independent control)."
+msgstr "是否为生成视频添加 AI 标识。1:添加标识;0:不添加标识(需在控制台申请开启独立控制)。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Width and height must be in [512, 2048] and the area must not exceed 1024x1024. If not passed, the model auto-selects the closest preset size."
+msgstr "宽和高必须在 [512, 2048] 之间,且面积不得超过 1024x1024。不传时由模型自动选择最接近的预设尺寸。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/embedding.py
+msgid "api_key is required"
+msgstr "api_key 必填"
diff --git a/apps/locales/zh_Hant/LC_MESSAGES/django.po b/apps/locales/zh_Hant/LC_MESSAGES/django.po
index 114ded37522..ef537cc0f81 100644
--- a/apps/locales/zh_Hant/LC_MESSAGES/django.po
+++ b/apps/locales/zh_Hant/LC_MESSAGES/django.po
@@ -661,7 +661,7 @@ msgstr "欄位僅支持自定義|引用"
#: apps/application/flow/step_node/function_node/i_function_node.py:40
msgid "{field}, this field is required."
-msgstr "{field_label} 欄位是必填項"
+msgstr "{field} 欄位是必填項"
#: apps/application/flow/step_node/function_node/i_function_node.py:46
msgid "function"
@@ -5763,6 +5763,14 @@ msgstr "成員集合"
#: apps/workspace/serializers/workspace_serializers.py:223
msgid "User relation does not exist"
msgstr "用戶關係不存在"
+#: apps/workspace/serializers/workspace_serializers.py:40
+msgid "No permission to manage this workspace members"
+msgstr "沒有權限管理該工作空間成員"
+#: apps/role_setting/serializers/role_setting_serializers.py:426
+msgid "No permission to operate this role"
+msgstr "沒有權限操作該角色"
+
+
#: apps/role_setting/serializers/role_setting_serializers.py:316
#: apps/workspace/serializers/workspace_serializers.py:226
@@ -6935,7 +6943,7 @@ msgstr "獲取當前用戶信息"
#: apps/users/views/user.py:120 apps/users/views/user.py:121
#: apps/users/views/user.py:122
msgid "Get all user"
-msgstr "獲取所有用戶"
+msgstr "根據姓名獲取用戶(最多獲取200個)"
#: apps/users/views/user.py:133 apps/users/views/user.py:134
#: apps/users/views/user.py:135
@@ -7086,6 +7094,14 @@ msgstr "系統工作空間添加成員"
msgid "Remove member from system workspace"
msgstr "系統工作空間移除成員"
+#: apps/workspace/views/workspace.py:173
+msgid "Batch remove members from system workspace"
+msgstr "批量移除系統工作空間成員"
+
+#: apps/workspace/serializers/workspace_serializers.py:244
+msgid "User relation IDs"
+msgstr "用戶關係 ID 列表"
+
#: apps/workspace/views/workspace.py:133 apps/workspace/views/workspace.py:134
#: apps/workspace/views/workspace.py:135
msgid "Get system workspace member list"
@@ -7684,6 +7700,14 @@ msgstr "圖片下載失敗,請檢查網絡"
msgid "Please analyze the content of the image."
msgstr "請分析圖片內容。"
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:281
+msgid "Please analyze the content of the file."
+msgstr "請分析文件內容。"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:283
+msgid "Please analyze the content of the video."
+msgstr "請分析視頻內容。"
+
#: apps/xpack/serializers/channel/ding_talk.py:95
msgid "DingTalk application: {user}"
msgstr "釘釘智能體: {user}"
@@ -8002,6 +8026,27 @@ msgstr "檢查欄位是否正確"
msgid "The platform configuration corresponding to {type} was not found"
msgstr "未找到對應 {type} 的平臺配置"
+#: apps/xpack/serializers/platform_serializer.py:56
+msgid "Bot ID is required"
+msgstr "Bot ID 為必填項"
+
+#: apps/xpack/serializers/platform_serializer.py:166
+#, python-brace-format
+msgid ""
+"This bot_id is already bound to another application ({app}). "
+"Each bot_id can only correspond to one application."
+msgstr ""
+"該 bot_id 已綁定到另一個應用 ({app}),"
+"每個 bot_id 只能對應一個應用。"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:126
+msgid "Hello! I am an AI assistant. How can I help you?"
+msgstr "您好!我是智能助手,有什麼可以幫您的嗎?"
+
+#: apps/xpack/serializers/channel/aibot/bot_manager.py:188
+msgid "Sorry, I have encountered some issues. Please try again later."
+msgstr "抱歉,我遇到了一些問題,請稍後再試。"
+
#: apps/xpack/serializers/resource_chat_user.py:35
#: apps/xpack/serializers/resource_chat_user.py:111
#: apps/xpack/serializers/resource_chat_user_group.py:18
@@ -8629,6 +8674,9 @@ msgstr "API KEY"
msgid "Download"
msgstr "下載"
+msgid "User"
+msgstr "用戶"
+
msgid "Delete personal system API_KEY"
msgstr "删除個人系統API KEY"
@@ -8797,7 +8845,6 @@ msgstr "系統資源授權"
msgid "This folder contains resources that you dont have permission"
msgstr "此資料夾包含您沒有許可權的資源"
-
msgid "Text to Video"
msgstr "文生視頻"
@@ -9501,4 +9548,364 @@ msgid "User Name"
msgstr "用戶名稱"
msgid "New chat"
-msgstr "已生成新對話,請重新提問!"
\ No newline at end of file
+msgstr "已生成新對話,請重新提問!"
+
+msgid "Token Index"
+msgstr "分詞索引"
+
+msgid "Authorize to Workspace"
+msgstr "授權工作空間"
+
+msgid "IAM"
+msgstr "身份與權限"
+
+msgid "Chat Client"
+msgstr "對話端管理"
+
+msgid "Shared"
+msgstr "共享資源"
+
+msgid "IAM/User Group"
+msgstr "身份與權限/用戶組"
+
+msgid "Create or update System User Group"
+msgstr "創建或更新系統用戶組"
+
+msgid "Get System User Group list by workspace id"
+msgstr "通過工作空間 ID 獲取系統用戶組列表"
+
+msgid "Delete System User Group"
+msgstr "刪除系統用戶組"
+
+msgid "Add members to System User Group"
+msgstr "添加成員到系統用戶組"
+
+msgid "Unauthorized users are present"
+msgstr "存在未授權的使用者"
+
+msgid "Remove members from System User Group"
+msgstr "從系統用戶組中移除成員"
+
+msgid "One or more user groups do not exist"
+msgstr "一個或多個用戶組不存在"
+
+msgid "Role Management"
+msgstr "角色管理"
+
+msgid "Chat User Group"
+msgstr "對話用戶組"
+
+msgid "Create or update Workspace User Group"
+msgstr "創建或更新工作空間用戶組"
+
+msgid "Get Workspace User Group list by workspace id"
+msgstr "通過工作空間 ID 獲取工作空間用戶組列表"
+
+msgid "Delete Workspace User Group"
+msgstr "刪除工作空間用戶組"
+
+msgid "Add members to Workspace User Group"
+msgstr "添加成員到工作空間用戶組"
+
+msgid "Remove members from Workspace User Group"
+msgstr "從工作空間用戶組中移除成員"
+
+msgid "Get user group authorization status of resource"
+msgstr "獲取用戶組對資源的授權狀態"
+
+msgid "Edit user group authorization status of resource"
+msgstr "編輯用戶組對資源的授權狀態"
+
+msgid "Get user group authorization status of resource by page"
+msgstr "分頁獲取用戶組對資源的授權狀態"
+
+msgid "Get portal configuration"
+msgstr "獲取門戶配置"
+
+msgid "Save portal configuration"
+msgstr "儲存門戶配置"
+
+msgid "Portal"
+msgstr "門戶"
+
+msgid "Portal configuration does not exist"
+msgstr "門戶配置不存在"
+
+msgid "portal name"
+msgstr "門戶名稱"
+
+msgid "portal description"
+msgstr "門戶描述"
+
+msgid "portal logo"
+msgstr "門戶Logo"
+
+msgid "tab logo"
+msgstr "瀏覽器Tab Logo"
+
+msgid "enable public access"
+msgstr "是否開啟公開訪問"
+
+msgid "enable api"
+msgstr "是否開啟API服務"
+
+msgid "enable auth"
+msgstr "是否開啟身份認證"
+
+msgid "auth config"
+msgstr "身份認證配置"
+
+msgid "enable cors"
+msgstr "是否開啟跨域設置"
+
+msgid "cors config"
+msgstr "跨域配置"
+
+msgid "Get published application list by page"
+msgstr "分頁獲取已發布應用列表"
+
+msgid "Portal login"
+msgstr "門戶登錄"
+
+msgid "Invalid encrypted data"
+msgstr "無效的加密數據"
+
+msgid "Portal authentication is not enabled"
+msgstr "門戶身份認證未開啟"
+
+msgid "Portal authentication is not configured"
+msgstr "門戶身份認證未配置"
+
+msgid "Portal local login is not enabled"
+msgstr "門戶本地登錄未開啟"
+
+msgid "Get portal login info"
+msgstr "獲取門戶登錄信息"
+
+msgid "Portal logout"
+msgstr "門戶退出登錄"
+
+msgid "Create ChatUserAPIKey"
+msgstr "創建對話用戶 API 密鑰"
+
+msgid "Get ChatUserAPIKey List"
+msgstr "獲取對話用戶 API 密鑰列表"
+
+msgid "Delete ChatUserAPIKey"
+msgstr "刪除對話用戶 API 密鑰"
+
+msgid "Chat User API Key"
+msgstr "對話用戶 API 密鑰"
+
+msgid "Add chat user API key"
+msgstr "添加對話用戶 API 密鑰"
+
+msgid "Get chat user API key list"
+msgstr "獲取對話用戶 API 密鑰列表"
+
+msgid "Delete chat user API key"
+msgstr "刪除對話用戶 API 密鑰"
+
+msgid "Quota Setting"
+msgstr "配額設置"
+
+#: apps/xpack/serializers/chat_user.py:746
+msgid "Quota mode"
+msgstr "配額模式"
+
+#: apps/xpack/serializers/chat_user.py:750
+msgid "Period unit"
+msgstr "週期單位"
+
+#: apps/xpack/serializers/chat_user.py:754
+msgid "Period quantity"
+msgstr "週期數量"
+
+#: apps/xpack/serializers/chat_user.py:758
+msgid "Token limit (K)"
+msgstr "Tokens 上限(K)"
+
+#: apps/xpack/serializers/chat_user.py:765
+msgid "Period unit is required for periodic quota"
+msgstr "按週期限制時,週期單位不能為空"
+
+#: apps/xpack/serializers/chat_user.py:767
+msgid "Period quantity is required for periodic quota"
+msgstr "按週期限制時,週期數量不能為空"
+
+#: apps/xpack/serializers/chat_user.py:769
+msgid "Token limit is required for periodic quota"
+msgstr "按週期限制時,Tokens 上限不能為空"
+
+#: apps/xpack/views/system_chat_user.py:73
+msgid "Get chat user quota"
+msgstr "獲取對話用戶配額"
+
+#: apps/xpack/views/system_chat_user.py:82
+msgid "Set chat user quota"
+msgstr "設置對話用戶配額"
+
+msgid "The token quota for the current period has been exhausted. Please contact the administrator."
+msgstr "當前週期 Tokens 配額已用盡,請聯繫管理員。"
+
+msgid "Get portal historical conversation by page"
+msgstr "分頁獲取門戶歷史會話"
+
+msgid "Too many verification code attempts, please try again later"
+msgstr "驗證碼嘗試次數過多,請稍後重試"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:18
+msgid "Recognition language"
+msgstr "識別語言"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:18
+msgid "Recognition language: zh / en, auto detected when omitted"
+msgstr "識別語言:zh / en,缺省時自動檢測"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:22
+msgid "Auto detect"
+msgstr "自動檢測"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:23
+msgid "Chinese"
+msgstr "中文"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:30
+msgid "Audio encoding"
+msgstr "音頻編碼"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:30
+msgid "pcm / wav / ogg / mp3, auto detected when omitted"
+msgstr "pcm / wav / ogg / mp3,缺省時自動檢測"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:34
+msgid "Auto"
+msgstr "自動"
+
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py:76
+msgid "Tokenhub sync_transcribe endpoint"
+msgstr "Tokenhub 同步轉寫接口地址"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Add logo"
+msgstr "加入標示"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Custom watermark content, at most 16 characters, drawn in the bottom-right."
+msgstr "自訂浮水印內容,最多16個字元,繪製在右下角。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Designed for Agent workloads, using a MoE architecture that supports interleaved thinking, structured output, Function Calling and Cache caching."
+msgstr "專為 Agent 場景設計,採用 MoE 架構,支援交織思考、結構化輸出、Function Calling 與 Cache 快取。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Frame rate"
+msgstr "幀率"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan HY-Video 1.5 image-to-video model."
+msgstr "混元 HY-Video 1.5 圖生影片模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan HY-Video 1.5 text-to-video model."
+msgstr "混元 HY-Video 1.5 文生影片模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan Hy-Image 3.0 text-to-image model."
+msgstr "混元 Hy-Image 3.0 文生圖模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan's latest role-playing model based on the Hunyuan model with role-playing scene fine-tuning."
+msgstr "基於混元模型並在角色扮演場景微調的最新角色扮演模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Hunyuan's role-playing model with better basic effects in role-playing scenarios."
+msgstr "在角色扮演場景中基礎效果更優的混元角色扮演模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Output video frame rate: 16, 24, 30."
+msgstr "輸出影片幀率:16、24、30。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Output video resolution: 480p, 720p, 1080p."
+msgstr "輸出影片解析度:480p、720p、1080p。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Prompt rewrite"
+msgstr "提示詞改寫"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent Hybrid multilingual translation model."
+msgstr "騰訊混元多語言翻譯模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub multimodal embedding model, 2048 dimensions."
+msgstr "騰訊 TokenHub 多模態向量模型,2048 維。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub multimodal embedding model, 4096 dimensions."
+msgstr "騰訊 TokenHub 多模態向量模型,4096 維。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub text embedding model, 1024 dimensions."
+msgstr "騰訊 TokenHub 文字向量模型,1024 維。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent TokenHub text embedding model, 2560 dimensions."
+msgstr "騰訊 TokenHub 文字向量模型,2560 維。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tencent YT-Video 2.0 image-to-video model."
+msgstr "騰訊 YT-Video 2.0 圖生影片模型。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "The latest generation productivity model with upgraded Agent and complex task execution capabilities."
+msgstr "採用全新一代生產力模型,升級了 Agent 與複雜任務執行能力。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "TokenHub Hy-Image v3-generation endpoint"
+msgstr "TokenHub Hy-Image v3-generation 介面"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/embedding.py
+msgid "TokenHub OpenAI compatible embeddings endpoint"
+msgstr "TokenHub OpenAI 相容向量介面"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/llm.py
+msgid "TokenHub OpenAI compatible endpoint"
+msgstr "TokenHub OpenAI 相容介面"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "TokenHub video endpoint. Use the base (e.g. https://tokenhub.tencentmaas.com/v1) or a full submit/query URL."
+msgstr "TokenHub 影片介面。可使用根位址(如 https://tokenhub.tencentmaas.com/v1)或完整的 submit/query 位址。"
+
+#: apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+msgid "Tuned on real business scenarios, balancing effectiveness and cost-effectiveness, with reinforced Coding, long-text, reasoning and Agent capabilities."
+msgstr "針對真實業務場景調優,兼顧效果與成本,強化了 Coding、長文本、推理和 Agent 能力。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Watermark footnote"
+msgstr "浮水印角標"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Whether the model should rewrite and optimize the prompt before generation."
+msgstr "模型是否在生成前改寫並最佳化提示詞。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/ttv.py
+msgid "Whether to add the AI-generated logo to the video. 1: add logo; 0: no logo (requires console approval for independent control)."
+msgstr "是否為生成影片加入 AI 標示。1:加入標示;0:不加入標示(需在控制台申請開啟獨立控制)。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/tti.py
+msgid "Width and height must be in [512, 2048] and the area must not exceed 1024x1024. If not passed, the model auto-selects the closest preset size."
+msgstr "寬和高必須在 [512, 2048] 之間,且面積不得超過 1024x1024。未傳時由模型自動選擇最接近的預設尺寸。"
+
+#: apps/models_provider/impl/tencent_model_provider/credential/embedding.py
+msgid "api_key is required"
+msgstr "api_key 必填"
diff --git a/apps/maxkb/conf.py b/apps/maxkb/conf.py
index 3f747418e8d..69c524c8519 100644
--- a/apps/maxkb/conf.py
+++ b/apps/maxkb/conf.py
@@ -47,6 +47,12 @@ class Config(dict):
"REDIS_MAX_CONNECTIONS": 100,
# 外置语言包路径
"EXTERNAL_LOCALE_PATH": "/opt/maxkb/local/locales",
+ "FILE_AUTH": "1",
+ # S3 配置
+ "S3_ACCESS_KEY": "seaweedfsadmin",
+ "S3_SECRET_KEY": "seaweedfsadmin",
+ "S3_ENDPOINT": "http://127.0.0.1:8333",
+ "S3_BUCKET_NAME": "maxkb",
}
def get_debug(self) -> bool:
@@ -129,7 +135,7 @@ def get_log_level(self):
def get_sandbox_python_package_paths(self):
return self.get(
"SANDBOX_PYTHON_PACKAGE_PATHS",
- "/opt/py3/lib/python3.11/site-packages,/opt/maxkb-app/sandbox/python-packages,/opt/maxkb/python-packages",
+ "/opt/py3/lib/python3.13/site-packages,/opt/maxkb-app/sandbox/python-packages,/opt/maxkb/python-packages",
)
def get_admin_path(self):
@@ -167,7 +173,7 @@ def from_mapping(self, *mapping, **kwargs):
"""Updates the config like :meth:`update` ignoring items with non-upper
keys.
- .. versionadded:: 0.11
+ ... versionadded:: 0.11
"""
mappings = []
if len(mapping) == 1:
diff --git a/apps/maxkb/settings/__init__.py b/apps/maxkb/settings/__init__.py
index e973afc3014..547d2f849a1 100644
--- a/apps/maxkb/settings/__init__.py
+++ b/apps/maxkb/settings/__init__.py
@@ -6,6 +6,10 @@
@date:2025/4/11 16:39
@desc:
"""
+import warnings
+
+warnings.filterwarnings("ignore", message="pkg_resources is deprecated as an API")
+
from .base import *
from .logging import *
from .auth import *
diff --git a/apps/maxkb/settings/auth/web.py b/apps/maxkb/settings/auth/web.py
index e7936ef2378..497bd1bc979 100644
--- a/apps/maxkb/settings/auth/web.py
+++ b/apps/maxkb/settings/auth/web.py
@@ -7,7 +7,7 @@
@desc:
"""
USER_TOKEN_AUTH = 'common.auth.handle.impl.user_token.UserToken'
-CHAT_ANONYMOUS_USER_AURH = 'common.auth.handle.impl.chat_anonymous_user_token.ChatAnonymousUserToken'
+CHAT_ANONYMOUS_USER_AURH = 'common.auth.handle.impl.chat_user_token.ChatUserToken'
APPLICATION_KEY_AUTH = 'common.auth.handle.impl.application_key.ApplicationKey'
AUTH_HANDLES = [
USER_TOKEN_AUTH
diff --git a/apps/maxkb/settings/base/web.py b/apps/maxkb/settings/base/web.py
index ec62d4b9902..7263dedbdc4 100644
--- a/apps/maxkb/settings/base/web.py
+++ b/apps/maxkb/settings/base/web.py
@@ -1,16 +1,19 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: web.py
- @date:2025/11/5 14:53
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: web.py
+@date:2025/11/5 14:53
+@desc:
"""
-from pathlib import Path
-from ...const import CONFIG, PROJECT_DIR
+
import os
+from pathlib import Path
+
from django.utils.translation import gettext_lazy as _
+from ...const import CONFIG, PROJECT_DIR
+
# Build paths inside the project like this: BASE_DIR / 'subdir'.
BASE_DIR = Path(__file__).resolve().parent.parent.parent
@@ -18,122 +21,124 @@
# See https://docs.djangoproject.com/en/4.2/howto/deployment/checklist/
# SECURITY WARNING: keep the secret key used in production secret!
-SECRET_KEY = CONFIG.get("SECRET_KEY") or 'django-insecure-zm^1_^i5)3gp^&0io6zg72&z!a*d=9kf9o2%uft+27l)+t(#3e'
+SECRET_KEY = CONFIG.get("SECRET_KEY") or "django-insecure-zm^1_^i5)3gp^&0io6zg72&z!a*d=9kf9o2%uft+27l)+t(#3e"
# SECURITY WARNING: don't run with debug turned on in production!
DEBUG = CONFIG.get_debug()
-ALLOWED_HOSTS = ['*']
+ALLOWED_HOSTS = ["*"]
# Application definition
INSTALLED_APPS = [
- 'django.contrib.contenttypes',
- 'django.contrib.messages',
- 'django.contrib.staticfiles',
- 'rest_framework',
- 'drf_spectacular',
- 'drf_spectacular_sidecar',
- 'users.apps.UsersConfig',
- 'tools.apps.ToolConfig',
- 'knowledge',
- 'common',
- 'system_manage',
- 'models_provider',
- 'django_celery_beat',
- 'application',
- 'chat',
- 'oss',
- 'trigger',
- 'django_apscheduler',
+ "django.contrib.contenttypes",
+ "django.contrib.messages",
+ "django.contrib.staticfiles",
+ "rest_framework",
+ "drf_spectacular",
+ "drf_spectacular_sidecar",
+ "users.apps.UsersConfig",
+ "tools.apps.ToolConfig",
+ "knowledge",
+ "common",
+ "system_manage",
+ "models_provider",
+ "application",
+ "chat",
+ "oss",
+ "trigger",
+ "django_apscheduler",
+ "portal",
+ "django.contrib.postgres",
]
MIDDLEWARE = [
- 'django.middleware.locale.LocaleMiddleware',
- 'django.middleware.security.SecurityMiddleware',
- 'django.contrib.sessions.middleware.SessionMiddleware',
- 'django.middleware.common.CommonMiddleware',
- 'common.middleware.gzip.GZipMiddleware',
- 'common.middleware.chat_headers_middleware.ChatHeadersMiddleware',
- 'common.middleware.cross_domain_middleware.CrossDomainMiddleware',
- 'common.middleware.doc_headers_middleware.DocHeadersMiddleware',
-
+ "django.middleware.locale.LocaleMiddleware",
+ "django.middleware.security.SecurityMiddleware",
+ "django.contrib.sessions.middleware.SessionMiddleware",
+ "django.middleware.common.CommonMiddleware",
+ "common.middleware.gzip.GZipMiddleware",
+ "common.middleware.chat_headers_middleware.ChatHeadersMiddleware",
+ "common.middleware.cross_domain_middleware.CrossDomainMiddleware",
+ "common.middleware.doc_headers_middleware.DocHeadersMiddleware",
]
REST_FRAMEWORK = {
- 'EXCEPTION_HANDLER': 'common.exception.handle_exception.handle_exception',
- 'DEFAULT_SCHEMA_CLASS': 'drf_spectacular.openapi.AutoSchema',
- 'DEFAULT_AUTHENTICATION_CLASSES': ['common.auth.authenticate.AnonymousAuthentication']
+ "EXCEPTION_HANDLER": "common.exception.handle_exception.handle_exception",
+ "DEFAULT_SCHEMA_CLASS": "drf_spectacular.openapi.AutoSchema",
+ "DEFAULT_AUTHENTICATION_CLASSES": ["common.auth.authenticate.AnonymousAuthentication"],
}
-STATICFILES_DIRS = [(os.path.join(PROJECT_DIR, 'ui', 'dist'))]
-STATIC_ROOT = os.path.join(BASE_DIR.parent, 'static')
-ROOT_URLCONF = 'maxkb.urls'
-APPS_DIR = os.path.join(PROJECT_DIR, 'apps')
+STATICFILES_DIRS = [(os.path.join(PROJECT_DIR, "ui", "dist"))]
+STATIC_ROOT = os.path.join(BASE_DIR.parent, "static")
+ROOT_URLCONF = "maxkb.urls"
+APPS_DIR = os.path.join(PROJECT_DIR, "apps")
TEMPLATES = [
{
- 'BACKEND': 'django.template.backends.django.DjangoTemplates',
- 'DIRS': ["apps/static/admin"],
- 'APP_DIRS': True,
- 'OPTIONS': {
- 'context_processors': [
- 'django.template.context_processors.debug',
- 'django.template.context_processors.request',
- 'django.contrib.auth.context_processors.auth',
- 'django.contrib.messages.context_processors.messages',
+ "BACKEND": "django.template.backends.django.DjangoTemplates",
+ "DIRS": ["apps/static/admin"],
+ "APP_DIRS": True,
+ "OPTIONS": {
+ "context_processors": [
+ "django.template.context_processors.debug",
+ "django.template.context_processors.request",
+ "django.contrib.auth.context_processors.auth",
+ "django.contrib.messages.context_processors.messages",
+ ],
+ },
+ },
+ {
+ "NAME": "CHAT",
+ "BACKEND": "django.template.backends.django.DjangoTemplates",
+ "DIRS": ["apps/static/chat"],
+ "APP_DIRS": True,
+ "OPTIONS": {
+ "context_processors": [
+ "django.template.context_processors.debug",
+ "django.template.context_processors.request",
+ "django.contrib.auth.context_processors.auth",
+ "django.contrib.messages.context_processors.messages",
+ ],
+ },
+ },
+ {
+ "NAME": "DOC",
+ "BACKEND": "django.template.backends.django.DjangoTemplates",
+ "DIRS": ["apps/static/drf_spectacular_sidecar"],
+ "APP_DIRS": True,
+ "OPTIONS": {
+ "context_processors": [
+ "django.template.context_processors.debug",
+ "django.template.context_processors.request",
+ "django.contrib.auth.context_processors.auth",
+ "django.contrib.messages.context_processors.messages",
],
},
},
- {"NAME": "CHAT",
- 'BACKEND': 'django.template.backends.django.DjangoTemplates',
- 'DIRS': ["apps/static/chat"],
- 'APP_DIRS': True,
- 'OPTIONS': {
- 'context_processors': [
- 'django.template.context_processors.debug',
- 'django.template.context_processors.request',
- 'django.contrib.auth.context_processors.auth',
- 'django.contrib.messages.context_processors.messages',
- ],
- },
- },
- {"NAME": "DOC",
- 'BACKEND': 'django.template.backends.django.DjangoTemplates',
- 'DIRS': ["apps/static/drf_spectacular_sidecar"],
- 'APP_DIRS': True,
- 'OPTIONS': {
- 'context_processors': [
- 'django.template.context_processors.debug',
- 'django.template.context_processors.request',
- 'django.contrib.auth.context_processors.auth',
- 'django.contrib.messages.context_processors.messages',
- ],
- },
- },
]
SPECTACULAR_SETTINGS = {
- 'TITLE': 'MaxKB API',
- 'DESCRIPTION': _('Intelligent customer service platform'),
- 'VERSION': 'v2',
- 'SERVE_INCLUDE_SCHEMA': False,
+ "TITLE": "MaxKB API",
+ "DESCRIPTION": _("Intelligent customer service platform"),
+ "VERSION": "v2",
+ "SERVE_INCLUDE_SCHEMA": False,
# OTHER SETTINGS
- 'SWAGGER_UI_DIST': f'{CONFIG.get_admin_path()}/api-doc/swagger-ui-dist', # shorthand to use the sidecar instead
- 'SWAGGER_UI_FAVICON_HREF': f'{CONFIG.get_admin_path()}/api-doc/swagger-ui-dist/favicon-32x32.png',
- 'REDOC_DIST': f'{CONFIG.get_admin_path()}/api-doc/redoc',
- 'SECURITY_DEFINITIONS': {
- 'Bearer': {
- 'type': 'apiKey',
- 'name': 'AUTHORIZATION',
- 'in': 'header',
+ "SWAGGER_UI_DIST": f"{CONFIG.get_admin_path()}/api-doc/swagger-ui-dist", # shorthand to use the sidecar instead
+ "SWAGGER_UI_FAVICON_HREF": f"{CONFIG.get_admin_path()}/api-doc/swagger-ui-dist/favicon-32x32.png",
+ "REDOC_DIST": f"{CONFIG.get_admin_path()}/api-doc/redoc",
+ "SECURITY_DEFINITIONS": {
+ "Bearer": {
+ "type": "apiKey",
+ "name": "AUTHORIZATION",
+ "in": "header",
}
- }
+ },
}
-WSGI_APPLICATION = 'maxkb.wsgi.application'
+WSGI_APPLICATION = "maxkb.wsgi.application"
# Database
# https://docs.djangoproject.com/en/4.2/ref/settings/#databases
-DATABASES = {'default': CONFIG.get_db_setting()}
+DATABASES = {"default": CONFIG.get_db_setting()}
CACHES = CONFIG.get_cache_setting()
@@ -142,16 +147,16 @@
AUTH_PASSWORD_VALIDATORS = [
{
- 'NAME': 'django.contrib.auth.password_validation.UserAttributeSimilarityValidator',
+ "NAME": "django.contrib.auth.password_validation.UserAttributeSimilarityValidator",
},
{
- 'NAME': 'django.contrib.auth.password_validation.MinimumLengthValidator',
+ "NAME": "django.contrib.auth.password_validation.MinimumLengthValidator",
},
{
- 'NAME': 'django.contrib.auth.password_validation.CommonPasswordValidator',
+ "NAME": "django.contrib.auth.password_validation.CommonPasswordValidator",
},
{
- 'NAME': 'django.contrib.auth.password_validation.NumericPasswordValidator',
+ "NAME": "django.contrib.auth.password_validation.NumericPasswordValidator",
},
]
@@ -168,25 +173,27 @@
# 文件上传配置
DATA_UPLOAD_MAX_NUMBER_FILES = 1000
+# 分段导入以 JSON 回传全文,默认允许 100 MiB,可通过 MAXKB_DATA_UPLOAD_MAX_MEMORY_SIZE(字节)调整。
+DATA_UPLOAD_MAX_MEMORY_SIZE = int(CONFIG.get("DATA_UPLOAD_MAX_MEMORY_SIZE", 100 * 1024 * 1024))
# 支持的语言
LANGUAGES = CONFIG.get_languages()
# 翻译文件路径
-LOCALE_PATHS = [
- os.path.join(BASE_DIR.parent, 'locales')
-]
+LOCALE_PATHS = [os.path.join(BASE_DIR.parent, "locales")]
# Static files (CSS, JavaScript, Images)
# https://docs.djangoproject.com/en/4.2/howto/static-files/
-STATIC_URL = 'static/'
+STATIC_URL = "static/"
# Default primary key field type
# https://docs.djangoproject.com/en/4.2/ref/settings/#default-auto-field
-DEFAULT_AUTO_FIELD = 'django.db.models.BigAutoField'
+DEFAULT_AUTO_FIELD = "django.db.models.BigAutoField"
+
+edition = "CE"
-edition = 'CE'
+SECURE_PROXY_SSL_HEADER = ("HTTP_X_FORWARDED_PROTO", "https")
-if os.environ.get('MAXKB_REDIS_SENTINEL_SENTINELS') is not None:
+if os.environ.get("MAXKB_REDIS_SENTINEL_SENTINELS") is not None:
DJANGO_REDIS_CONNECTION_FACTORY = "django_redis.pool.SentinelConnectionFactory"
diff --git a/apps/maxkb/urls/web.py b/apps/maxkb/urls/web.py
index f43983256fb..a3444cd8205 100644
--- a/apps/maxkb/urls/web.py
+++ b/apps/maxkb/urls/web.py
@@ -42,12 +42,13 @@
path(admin_api_prefix, include("system_manage.urls")),
path(admin_api_prefix, include("application.urls")),
path(admin_api_prefix, include("trigger.urls")),
- path(admin_api_prefix, include("oss.urls")),
+ path(admin_api_prefix, include("oss.urls", namespace="admin_oss")),
path(admin_api_prefix, include("homepage.urls")),
- path(chat_api_prefix, include("oss.urls")),
+ path(admin_api_prefix, include("portal.urls")),
+ path(chat_api_prefix, include("oss.urls", namespace="chat_oss")),
path(chat_api_prefix, include("chat.urls")),
- path(f'{admin_ui_prefix[1:]}/', include('oss.retrieval_urls')),
- path(f'{chat_ui_prefix[1:]}/', include('oss.retrieval_urls')),
+ path(f'{admin_ui_prefix[1:]}/', include('oss.retrieval_urls', namespace='admin_oss_retrieval')),
+ path(f'{chat_ui_prefix[1:]}/', include('oss.retrieval_urls', namespace='chat_oss_retrieval')),
]
init_doc(urlpatterns, chat_urlpatterns)
diff --git a/apps/maxkb/wsgi/web.py b/apps/maxkb/wsgi/web.py
index 4fedb7225f2..6e69dc43977 100644
--- a/apps/maxkb/wsgi/web.py
+++ b/apps/maxkb/wsgi/web.py
@@ -1,14 +1,14 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: web.py
- @date:2025/11/5 15:14
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: web.py
+@date:2025/11/5 15:14
+@desc:
"""
+
import builtins
import os
-import sys
from django.core.wsgi import get_wsgi_application
@@ -18,11 +18,9 @@ def __init__(self):
self.original_import = builtins.__import__
def __call__(self, name, *args, **kwargs):
- if len([True for i in
- ['torch']
- if
- i in name.lower()]) > 0:
+ if len([True for i in ["torch"] if i in name.lower()]) > 0:
import types
+
return types.ModuleType(name)
else:
return self.original_import(name, *args, **kwargs)
@@ -31,15 +29,16 @@ def __call__(self, name, *args, **kwargs):
# 安装导入拦截器
builtins.__import__ = TorchBlocker()
-os.environ.setdefault('DJANGO_SETTINGS_MODULE', 'maxkb.settings')
-os.environ['TIKTOKEN_CACHE_DIR'] = '/opt/maxkb-app/model/tokenizer/openai-tiktoken-cl100k-base'
+os.environ.setdefault("DJANGO_SETTINGS_MODULE", "maxkb.settings")
+os.environ["TIKTOKEN_CACHE_DIR"] = "/opt/maxkb-app/model/tokenizer/openai-tiktoken-cl100k-base"
application = get_wsgi_application()
def post_handler():
- from common.database_model_manage.database_model_manage import DatabaseModelManage
from common import event
+ from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.init import init_template
+
event.run()
DatabaseModelManage.init()
init_template.run()
diff --git a/apps/models_provider/api/model.py b/apps/models_provider/api/model.py
index d79849f4ab2..5d7fb2721c2 100644
--- a/apps/models_provider/api/model.py
+++ b/apps/models_provider/api/model.py
@@ -1,13 +1,12 @@
# coding=utf-8
+from common.mixins.api_mixin import APIMixin
+from common.result import DefaultResultSerializer, ResultSerializer
+from django.utils.translation import gettext_lazy as _
from drf_spectacular.types import OpenApiTypes
from drf_spectacular.utils import OpenApiParameter
+from models_provider.serializers.model_serializer import ModelCreateRequest, ModelModelSerializer
from rest_framework import serializers
-from common.mixins.api_mixin import APIMixin
-from common.result import ResultSerializer, DefaultResultSerializer
-from models_provider.serializers.model_serializer import ModelModelSerializer, ModelCreateRequest
-from django.utils.translation import gettext_lazy as _
-
class ModelCreateResponse(ResultSerializer):
def get_data(self):
@@ -25,48 +24,49 @@ def get_data(self):
@staticmethod
def get_parameters():
- return [OpenApiParameter(
- name="workspace_id",
- description=_("workspace id"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.PATH,
- required=True,
- ),
+ return [
+ OpenApiParameter(
+ name="workspace_id",
+ description=_("workspace id"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ ),
OpenApiParameter(
name="name",
description=_("model name"),
type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
+ location=OpenApiParameter.QUERY, # type: ignore
required=False,
),
OpenApiParameter(
name="model_type",
description=_("model type"),
type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
+ location=OpenApiParameter.QUERY, # type: ignore
required=False,
),
OpenApiParameter(
name="model_name",
description=_("base model"),
type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
+ location=OpenApiParameter.QUERY, # type: ignore
required=False,
),
OpenApiParameter(
name="provider",
description=_("provider"),
type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
+ location=OpenApiParameter.QUERY, # type: ignore
required=False,
),
OpenApiParameter(
name="create_user",
description=_("create user"),
type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
+ location=OpenApiParameter.QUERY, # type: ignore
required=False,
- )
+ ),
]
@@ -81,33 +81,37 @@ def get_response():
@classmethod
def get_parameters(cls):
- return [OpenApiParameter(
- name="workspace_id",
- description=_("workspace id"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.PATH,
- required=True,
- )]
+ return [
+ OpenApiParameter(
+ name="workspace_id",
+ description=_("workspace id"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ )
+ ]
class GetModelApi(APIMixin):
-
@staticmethod
def get_query_params_api():
- return [OpenApiParameter(
- name="workspace_id",
- description=_("workspace id"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.PATH,
- required=True,
- ), OpenApiParameter(
- name="model_id",
- description=_("model id"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.PATH,
- required=True,
- )
+ return [
+ OpenApiParameter(
+ name="workspace_id",
+ description=_("workspace id"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ ),
+ OpenApiParameter(
+ name="model_id",
+ description=_("model id"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ ),
]
+
@staticmethod
def get_request():
return []
diff --git a/apps/models_provider/api/provide.py b/apps/models_provider/api/provide.py
index 83d81a10603..9e0921dbbd3 100644
--- a/apps/models_provider/api/provide.py
+++ b/apps/models_provider/api/provide.py
@@ -1,11 +1,10 @@
# coding=utf-8
-from drf_spectacular.types import OpenApiTypes
-from drf_spectacular.utils import OpenApiParameter
-
from common.mixins.api_mixin import APIMixin
from common.result import ResultSerializer
-from rest_framework import serializers
from django.utils.translation import gettext_lazy as _
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+from rest_framework import serializers
class ProvideResponse(ResultSerializer):
@@ -65,25 +64,28 @@ class ProvideApi(APIMixin):
class ModelParamsForm(APIMixin):
@staticmethod
def get_query_params_api():
- return [OpenApiParameter(
- name="model_type",
- description=_("model type"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
- required=True,
- ), OpenApiParameter(
- name="provider",
- description=_("provider"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
- required=True,
- ), OpenApiParameter(
- name="model_name",
- description=_("model name"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
- required=True,
- )
+ return [
+ OpenApiParameter(
+ name="model_type",
+ description=_("model type"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY, # type: ignore
+ required=True,
+ ),
+ OpenApiParameter(
+ name="provider",
+ description=_("provider"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY, # type: ignore
+ required=True,
+ ),
+ OpenApiParameter(
+ name="model_name",
+ description=_("model name"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY, # type: ignore
+ required=True,
+ ),
]
@staticmethod
@@ -93,19 +95,21 @@ def get_response():
class ModelList(APIMixin):
@staticmethod
def get_query_params_api():
- return [OpenApiParameter(
- name="model_type",
- description=_("model type"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
- required=True,
- ), OpenApiParameter(
- name="provider",
- description=_("provider"),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
- required=True,
- )
+ return [
+ OpenApiParameter(
+ name="model_type",
+ description=_("model type"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY, # type: ignore
+ required=True,
+ ),
+ OpenApiParameter(
+ name="provider",
+ description=_("provider"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY, # type: ignore
+ required=True,
+ ),
]
@staticmethod
@@ -119,17 +123,19 @@ def get_response():
class ModelTypeList(APIMixin):
@staticmethod
def get_query_params_api():
- return [OpenApiParameter(
- # 参数的名称是done
- name="provider",
- # 对参数的备注
- description=_("provider"),
- # 指定参数的类型
- type=OpenApiTypes.STR,
- location=OpenApiParameter.QUERY,
- # 指定必须给
- required=True,
- )]
+ return [
+ OpenApiParameter(
+ # 参数的名称是done
+ name="provider",
+ # 对参数的备注
+ description=_("provider"),
+ # 指定参数的类型
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY, # type: ignore
+ # 指定必须给
+ required=True,
+ )
+ ]
@staticmethod
def get_response():
diff --git a/apps/models_provider/base_model_provider.py b/apps/models_provider/base_model_provider.py
index 77f5275cad2..c8562f58aaa 100644
--- a/apps/models_provider/base_model_provider.py
+++ b/apps/models_provider/base_model_provider.py
@@ -3,21 +3,19 @@
from abc import ABC, abstractmethod
from enum import Enum
from functools import reduce
-from typing import Dict, Iterator, Type, List
-
-from pydantic import BaseModel
+from typing import Dict, Iterator, List, Type
from common.exception.app_exception import AppApiException
-from django.utils.translation import gettext_lazy as _
-
from common.utils.common import encryption
+from django.utils.translation import gettext_lazy as _
+from pydantic import BaseModel
class DownModelChunkStatus(Enum):
success = "success"
error = "error"
pulling = "pulling"
- unknown = 'unknown'
+ unknown = "unknown"
class ValidCode(Enum):
@@ -39,7 +37,7 @@ def to_dict(self):
"status": self.status.value,
"digest": self.digest,
"progress": self.progress,
- "index": self.index
+ "index": self.index,
}
@@ -57,29 +55,42 @@ def get_model_type_list(self):
def get_model_list(self, model_type):
if model_type is None:
- raise AppApiException(500, _('Model type cannot be empty'))
+ raise AppApiException(500, _("Model type cannot be empty"))
return self.get_model_info_manage().get_model_list_by_model_type(model_type)
def get_model_credential(self, model_type, model_name):
model_info = self.get_model_info_manage().get_model_info(model_type, model_name)
model_credential = model_info.model_credential
- if model_type == 'TTI' and model_name.startswith(('qwen', 'wan2.6', 'wan')):
- if hasattr(model_credential, 'api_base'):
+ if model_type == "TTI" and model_name.startswith(("qwen", "wan2.6", "wan")):
+ if hasattr(model_credential, "api_base"):
+ api_base = model_credential.api_base
+ if hasattr(api_base, "default_value") and not api_base.default_value:
+ api_base.default_value = "https://dashscope.aliyuncs.com/api/v1"
+ # MiniMax H3 视频模型固定走 v2 API
+ if model_type in ("TTV", "ITV") and model_name.upper().startswith(("MiniMax-H3")):
+ if hasattr(model_credential, "api_base"):
api_base = model_credential.api_base
- if hasattr(api_base, 'default_value') and not api_base.default_value:
- api_base.default_value = 'https://dashscope.aliyuncs.com/api/v1'
+ if hasattr(api_base, "default_value"):
+ api_base.default_value = "https://api.minimaxi.com/v2"
return model_credential
def get_model_params(self, model_type, model_name):
model_info = self.get_model_info_manage().get_model_info(model_type, model_name)
return model_info.model_credential
- def is_valid_credential(self, model_type, model_name, model_credential: Dict[str, object],
- model_params: Dict[str, object], raise_exception=False):
+ def is_valid_credential(
+ self,
+ model_type,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params: Dict[str, object],
+ raise_exception=False,
+ ):
model_info = self.get_model_info_manage().get_model_info(model_type, model_name)
- return model_info.model_credential.is_valid(model_type, model_name, model_credential, model_params, self,
- raise_exception=raise_exception)
+ return model_info.model_credential.is_valid(
+ model_type, model_name, model_credential, model_params, self, raise_exception=raise_exception
+ )
def get_model(self, model_type, model_name, model_credential: Dict[str, object], **model_kwargs) -> BaseModel:
model_info = self.get_model_info_manage().get_model_info(model_type, model_name)
@@ -89,7 +100,7 @@ def get_dialogue_number(self):
return 3
def down_model(self, model_type: str, model_name, model_credential: Dict[str, object]) -> Iterator[DownModelChunk]:
- raise AppApiException(500, _('The current platform does not support downloading models'))
+ raise AppApiException(500, _("The current platform does not support downloading models"))
class MaxKBBaseModel(ABC):
@@ -106,16 +117,46 @@ def is_cache_model():
def filter_optional_params(model_kwargs):
optional_params = {}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming', 'show_ref_label', 'stream']:
+ if key not in ["model_id", "use_local", "streaming", "show_ref_label", "stream"]:
optional_params[key] = value
return optional_params
-class BaseModelCredential(ABC):
+class MaxKBBaseEmbeddingModel(MaxKBBaseModel):
+ """All embedding providers must explicitly declare whether they share a text/image vector space."""
@abstractmethod
- def is_valid(self, model_type: str, model_name, model: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def supports_image_embedding(self) -> bool:
+ """Return True only when image and text embeddings are comparable in the same vector space."""
+ pass
+
+ def embed_images(self, images: List[str]) -> List[List[float]]:
+ """Embed data URLs or provider-supported image URLs."""
+ raise AppApiException(500, _("The current embedding model does not support image embedding"))
+
+ @staticmethod
+ def normalize_image_input(url: str, keep_data_prefix: bool = False) -> str:
+ """归一化图片输入为上游接口可识别的字符串。
+
+ - http(s) URL:原样返回
+ - data:image/...;base64,xxx:keep_data_prefix=True 保留 data URI(阿里百炼等),
+ False 只返回 base64 内容(腾讯 TokenHub 等)
+ - 其它字符串:视为已是目标格式,原样返回
+ """
+ if url.startswith(("http://", "https://")):
+ return url
+ if url.startswith("data:") and ";base64," in url:
+ if keep_data_prefix:
+ return url
+ return url.split(";base64,", 1)[1]
+ return url
+
+
+class BaseModelCredential(ABC):
+ @abstractmethod
+ def is_valid(
+ self, model_type: str, model_name, model: Dict[str, object], model_params, provider, raise_exception=True
+ ):
pass
@abstractmethod
@@ -128,8 +169,8 @@ def encryption_dict(self, model_info: Dict[str, object]):
def get_model_params_setting_form(self, model_name):
"""
- 模型参数设置表单
- :return:
+ 模型参数设置表单
+ :return:
"""
pass
@@ -144,22 +185,28 @@ def encryption(message: str):
class ModelTypeConst(Enum):
- LLM = {'code': 'LLM', 'message': _('LLM')}
- EMBEDDING = {'code': 'EMBEDDING', 'message': _('Embedding Model')}
- STT = {'code': 'STT', 'message': _('Speech2Text')}
- TTS = {'code': 'TTS', 'message': _('TTS')}
- IMAGE = {'code': 'IMAGE', 'message': _('Vision Model')}
- TTI = {'code': 'TTI', 'message': _('Image Generation')}
- RERANKER = {'code': 'RERANKER', 'message': _('Rerank')}
+ LLM = {"code": "LLM", "message": _("LLM")}
+ EMBEDDING = {"code": "EMBEDDING", "message": _("Embedding Model")}
+ STT = {"code": "STT", "message": _("Speech2Text")}
+ TTS = {"code": "TTS", "message": _("TTS")}
+ IMAGE = {"code": "IMAGE", "message": _("Vision Model")}
+ TTI = {"code": "TTI", "message": _("Image Generation")}
+ RERANKER = {"code": "RERANKER", "message": _("Rerank")}
# 文生视频 图生视频
- TTV = {'code': 'TTV', 'message': _('Text to Video')}
- ITV = {'code': 'ITV', 'message': _('Image to Video')}
+ TTV = {"code": "TTV", "message": _("Text to Video")}
+ ITV = {"code": "ITV", "message": _("Image to Video")}
class ModelInfo:
- def __init__(self, name: str, desc: str, model_type: ModelTypeConst, model_credential: BaseModelCredential,
- model_class: Type[MaxKBBaseModel],
- **keywords):
+ def __init__(
+ self,
+ name: str,
+ desc: str,
+ model_type: ModelTypeConst,
+ model_credential: BaseModelCredential,
+ model_class: Type[MaxKBBaseModel],
+ **keywords,
+ ):
self.name = name
self.desc = desc
self.model_type = model_type.name
@@ -190,9 +237,15 @@ def get_model_class(self):
return self.model_class
def to_dict(self):
- return reduce(lambda x, y: {**x, **y},
- [{attr: self.__getattribute__(attr)} for attr in vars(self) if
- not attr.startswith("__") and not attr == 'model_credential' and not attr == 'model_class'], {})
+ return reduce(
+ lambda x, y: {**x, **y},
+ [
+ {attr: self.__getattribute__(attr)}
+ for attr in vars(self)
+ if not attr.startswith("__") and not attr == "model_credential" and not attr == "model_class"
+ ],
+ {},
+ )
class ModelInfoManage:
@@ -221,13 +274,16 @@ def get_model_list_by_model_type(self, model_type):
return [model.to_dict() for model in self.model_list if model.model_type == model_type]
def get_model_type_list(self):
- return [{'key': _type.value.get('message'), 'value': _type.value.get('code')} for _type in ModelTypeConst if
- len([model for model in self.model_list if model.model_type == _type.name]) > 0]
+ return [
+ {"key": _type.value.get("message"), "value": _type.value.get("code")}
+ for _type in ModelTypeConst
+ if len([model for model in self.model_list if model.model_type == _type.name]) > 0
+ ]
def get_model_info(self, model_type, model_name) -> ModelInfo:
model_info = self.model_dict.get(model_type, {}).get(model_name, self.default_model_dict.get(model_type))
if model_info is None:
- raise AppApiException(500, _('The model does not support'))
+ raise AppApiException(500, _("The model does not support"))
return model_info
class builder:
@@ -260,6 +316,8 @@ def __init__(self, provider: str, name: str, icon: str):
self.icon = icon
def to_dict(self):
- return reduce(lambda x, y: {**x, **y},
- [{attr: self.__getattribute__(attr)} for attr in vars(self) if
- not attr.startswith("__")], {})
+ return reduce(
+ lambda x, y: {**x, **y},
+ [{attr: self.__getattribute__(attr)} for attr in vars(self) if not attr.startswith("__")],
+ {},
+ )
diff --git a/apps/models_provider/constants/model_provider_constants.py b/apps/models_provider/constants/model_provider_constants.py
index 4533e0fca9b..1117204a1a0 100644
--- a/apps/models_provider/constants/model_provider_constants.py
+++ b/apps/models_provider/constants/model_provider_constants.py
@@ -1,8 +1,9 @@
# coding=utf-8
from enum import Enum
-from models_provider.impl.aliyun_bai_lian_model_provider.aliyun_bai_lian_model_provider import \
- AliyunBaiLianModelProvider
+from models_provider.impl.aliyun_bai_lian_model_provider.aliyun_bai_lian_model_provider import (
+ AliyunBaiLianModelProvider,
+)
from models_provider.impl.anthropic_model_provider.anthropic_model_provider import AnthropicModelProvider
from models_provider.impl.aws_bedrock_model_provider.aws_bedrock_model_provider import BedrockModelProvider
from models_provider.impl.azure_model_provider.azure_model_provider import AzureModelProvider
@@ -11,25 +12,25 @@
from models_provider.impl.gemini_model_provider.gemini_model_provider import GeminiModelProvider
from models_provider.impl.kimi_model_provider.kimi_model_provider import KimiModelProvider
from models_provider.impl.local_model_provider.local_model_provider import LocalModelProvider
+from models_provider.impl.minimax_model_provider.minimax_model_provider import MiniMaxModelProvider
from models_provider.impl.ollama_model_provider.ollama_model_provider import OllamaModelProvider
from models_provider.impl.openai_model_provider.openai_model_provider import OpenAIModelProvider
from models_provider.impl.regolo_model_provider.regolo_model_provider import RegoloModelProvider
from models_provider.impl.siliconCloud_model_provider.siliconCloud_model_provider import SiliconCloudModelProvider
-from models_provider.impl.tencent_cloud_model_provider.tencent_cloud_model_provider import TencentCloudModelProvider
from models_provider.impl.tencent_model_provider.tencent_model_provider import TencentModelProvider
from models_provider.impl.vllm_model_provider.vllm_model_provider import VllmModelProvider
-from models_provider.impl.volcanic_engine_model_provider.volcanic_engine_model_provider import \
- VolcanicEngineModelProvider
-from models_provider.impl.wenxin_model_provider.wenxin_model_provider import WenxinModelProvider
+from models_provider.impl.volcanic_engine_model_provider.volcanic_engine_model_provider import (
+ VolcanicEngineModelProvider,
+)
+from models_provider.impl.qianfan_model_provider.qianfan_model_provider import QianfanModelProvider
from models_provider.impl.xf_model_provider.xf_model_provider import XunFeiModelProvider
from models_provider.impl.xinference_model_provider.xinference_model_provider import XinferenceModelProvider
-from models_provider.impl.minimax_model_provider.minimax_model_provider import MiniMaxModelProvider
from models_provider.impl.zhipu_model_provider.zhipu_model_provider import ZhiPuModelProvider
class ModelProvideConstants(Enum):
model_azure_provider = AzureModelProvider()
- model_wenxin_provider = WenxinModelProvider()
+ model_qianfan_provider = QianfanModelProvider()
model_ollama_provider = OllamaModelProvider()
model_openai_provider = OpenAIModelProvider()
model_docker_ai_provider = DockerModelProvider()
@@ -40,7 +41,6 @@ class ModelProvideConstants(Enum):
model_gemini_provider = GeminiModelProvider()
model_volcanic_engine_provider = VolcanicEngineModelProvider()
model_tencent_provider = TencentModelProvider()
- model_tencent_cloud_provider = TencentCloudModelProvider()
model_aws_bedrock_provider = BedrockModelProvider()
model_local_provider = LocalModelProvider()
model_xinference_provider = XinferenceModelProvider()
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/__init__.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/__init__.py
index 3c10c5535f7..48aefc7635a 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/__init__.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2024/9/9 17:42
- @desc:
+@project: MaxKB
+@Author:虎
+@file: __init__.py
+@date:2024/9/9 17:42
+@desc:
"""
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/embedding.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/embedding.py
index 8646c17915e..cb881fc41ca 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/16 17:01
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/16 17:01
+@desc:
"""
+
from typing import Dict, Any
from django.utils.translation import gettext as _
@@ -20,63 +21,53 @@
class BaiLianEmbeddingModelParams(BaseForm):
dimensions = forms.SingleSelect(
- TooltipLabel(
- _('Dimensions'),
- _('')
- ),
+ TooltipLabel(_("Dimensions"), _("")),
required=True,
default_value=1024,
- value_field='value',
- text_field='label',
+ value_field="value",
+ text_field="label",
option_list=[
- {'label': '1024', 'value': '1024'},
- {'label': '768', 'value': '768'},
- {'label': '512', 'value': '512'},
- ]
+ {"label": "1024", "value": "1024"},
+ {"label": "768", "value": "768"},
+ {"label": "512", "value": "512"},
+ ],
)
class AliyunBaiLianEmbeddingCredential(BaseForm, BaseModelCredential):
-
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider: Any,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider: Any,
+ raise_exception: bool = False,
) -> bool:
"""
验证模型凭据是否有效
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
- raise AppApiException(
- ValidCode.valid_error.value,
- f"{model_type} Model type is not supported"
- )
- required_keys = ['dashscope_api_key', 'api_base']
+ if not any(mt.get("value") == model_type for mt in model_type_list):
+ raise AppApiException(ValidCode.valid_error.value, f"{model_type} Model type is not supported")
+ required_keys = ["dashscope_api_key", "api_base"]
missing_keys = [key for key in required_keys if key not in model_credential]
if missing_keys:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- f"{', '.join(missing_keys)} is required"
- )
+ raise AppApiException(ValidCode.valid_error.value, f"{', '.join(missing_keys)} is required")
return False
try:
model: AliyunBaiLianEmbedding = provider.get_model(model_type, model_name, model_credential)
model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- f"Verification failed, please check whether the parameters are correct: {e}"
+ f"Verification failed, please check whether the parameters are correct: {e}",
)
return False
@@ -86,12 +77,13 @@ def encryption_dict(self, model: Dict[str, Any]) -> Dict[str, Any]:
"""
加密敏感信息
"""
- api_key = model.get('dashscope_api_key', '')
- return {**model, 'dashscope_api_key': super().encryption(api_key)}
+ api_key = model.get("dashscope_api_key", "")
+ return {**model, "dashscope_api_key": super().encryption(api_key)}
def get_model_params_setting_form(self, model_name):
return BaiLianEmbeddingModelParams()
- api_base = forms.TextInputField(_('API URL'), required=True,
- default_value='https://dashscope.aliyuncs.com/compatible-mode/v1')
- dashscope_api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField(
+ _("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/compatible-mode/v1"
+ )
+ dashscope_api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/image.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/image.py
index 51a0719ca9b..c565eb40b4f 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/image.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/image.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:41
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:41
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -18,74 +19,80 @@
class QwenModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=1.0,
- _min=0.1,
- _max=1.9,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=1.0,
+ _min=0.1,
+ _max=1.9,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class QwenVLModelCredential(BaseForm, BaseModelCredential):
-
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, object],
- model_params: dict,
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, object],
+ model_params: dict,
+ provider,
+ raise_exception: bool = False,
) -> bool:
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.check_auth(model_credential.get('api_key'))
+ model.check_auth(model_credential.get("api_key"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext('Verification failed, please check whether the parameters are correct: {error}').format(
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
error=str(e)
- )
+ ),
)
return False
return True
def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField(_('API URL'), required=True, default_value='https://dashscope.aliyuncs.com/compatible-mode/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField(
+ _("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/compatible-mode/v1"
+ )
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return QwenModelParams()
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/itv.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/itv.py
index 3baa6fe9c9a..dfb5e378839 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/itv.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/itv.py
@@ -6,31 +6,33 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, SingleSelect, SliderField, TooltipLabel
+from common.forms import BaseForm, PasswordInputField, SingleSelect, TooltipLabel
from common.forms.switch_field import SwitchField
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class QwenModelParams(BaseForm):
"""
Parameters class for the Qwen Image-to-Video model.
Defines fields such as Video size, number of Videos, and style.
"""
+
resolution = SingleSelect(
- TooltipLabel(_('Resolution'), ''),
+ TooltipLabel(_("Resolution"), ""),
required=True,
- default_value='480P',
+ default_value="480P",
option_list=[
- {'value': '480P', 'label': '480P'},
- {'value': '720P', 'label': '720P'},
- {'value': '1080P', 'label': '1080P'},
+ {"value": "480P", "label": "480P"},
+ {"value": "720P", "label": "720P"},
+ {"value": "1080P", "label": "1080P"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
watermark = SwitchField(
- TooltipLabel(_('Watermark'), _('Whether to add watermark')),
+ TooltipLabel(_("Watermark"), _("Whether to add watermark")),
attrs={"active-value": True, "inactive-value": False},
default_value=False,
)
@@ -41,17 +43,18 @@ class ImageToVideoModelCredential(BaseForm, BaseModelCredential):
Credential class for the Qwen Image-to-Video model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField(_('API URL'), required=True, default_value='https://dashscope.aliyuncs.com/api/v1')
- api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/api/v1")
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -65,35 +68,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -106,10 +106,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/llm.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/llm.py
index 9511e2ef0de..5d6bd90d24a 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/llm.py
@@ -10,87 +10,84 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class BaiLianLLMModelParams(BaseForm):
temperature = forms.SliderField(
TooltipLabel(
- _('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
),
required=True,
default_value=0.7,
_min=0.1,
_max=1.0,
_step=0.01,
- precision=2
+ precision=2,
)
max_tokens = forms.SliderField(
TooltipLabel(
- _('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate.')
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate.")
),
required=True,
- default_value=800,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0
+ precision=0,
)
class BaiLianLLMModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField(_('API URL'), required=True)
- api_key = forms.PasswordInputField(_('API Key'), required=True)
+ api_base = forms.TextInputField(_("API URL"), required=True)
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, object],
- model_params: dict,
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, object],
+ model_params: dict,
+ provider,
+ raise_exception: bool = False,
) -> bool:
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- if model_params.get('stream'):
- for res in model.stream([HumanMessage(content=gettext('Hello'))]):
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ if model_params.get("stream"):
+ for res in model.stream([HumanMessage(content="1")]):
pass
else:
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext('Verification failed, please check whether the parameters are correct: {error}').format(
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
error=str(e)
- )
+ ),
)
return False
return True
def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str) -> BaiLianLLMModelParams:
return BaiLianLLMModelParams()
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/reranker.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/reranker.py
index 9b30aaf14c0..2ed3f07346f 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/reranker.py
@@ -14,13 +14,15 @@
class AliyunRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class AliyunBaiLianRerankerCredential(BaseForm, BaseModelCredential):
@@ -28,18 +30,18 @@ class AliyunBaiLianRerankerCredential(BaseForm, BaseModelCredential):
Credential class for the Aliyun BaiLian Reranker model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField(_('API URL'), required=True,
- default_value='https://dashscope.aliyuncs.com/api/v1')
- dashscope_api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/api/v1")
+ dashscope_api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -52,34 +54,31 @@ def is_valid(
:param raise_exception: Whether to raise an exception on validation failure.
:return: Boolean indicating whether the credentials are valid.
"""
- if model_type != 'RERANKER':
+ if model_type != "RERANKER":
raise AppApiException(
- ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type)
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
)
- required_keys = ['dashscope_api_key']
+ required_keys = ["dashscope_api_key"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- _('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
return False
try:
model: AliyunBaiLianReranker = provider.get_model(model_type, model_name, model_credential)
- model.compress_documents([Document(page_content=_('Hello'))], _('Hello'))
+ model.compress_documents([Document(page_content=_("Hello"))], _("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e))
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -92,10 +91,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'dashscope_api_key': super().encryption(model.get('dashscope_api_key', ''))
- }
+ return {**model, "dashscope_api_key": super().encryption(model.get("dashscope_api_key", ""))}
def get_model_params_setting_form(self, model_name: str) -> AliyunRerankerModelParams:
return AliyunRerankerModelParams()
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/__init__.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/__init__.py
index f6aabffea89..308da5df495 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/__init__.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/__init__.py
@@ -1,12 +1,13 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/12/5 15:11
- @desc:
+@project: MaxKB
+@Author:niu
+@file: __init__.py.py
+@date:2025/12/5 15:11
+@desc:
"""
+
from .stt import AliyunBaiLianSTTModelCredential
from .omni_stt import AliyunBaiLianOmiSTTModelCredential
from .default_stt import AliyunBaiLianDefaultSTTModelCredential
-from .asr_stt import AliyunBaiLianAsrSTTModelCredential
\ No newline at end of file
+from .asr_stt import AliyunBaiLianAsrSTTModelCredential
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/asr_stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/asr_stt.py
index 6ca485006fc..9ed67cc6ce5 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/asr_stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/asr_stt.py
@@ -10,56 +10,51 @@
class AliyunBaiLianAsrSTTModelCredential(BaseForm, BaseModelCredential):
- api_url = forms.TextInputField(_('API URL'), required=True)
- api_key = forms.PasswordInputField(_('API Key'), required=True)
-
- def is_valid(self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
- ) -> bool:
+ api_url = forms.TextInputField(_("API URL"), required=True)
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
+ ) -> bool:
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
- ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type)
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
)
- required_keys = ['api_key']
+ required_keys = ["api_key"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- _('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e))
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
return True
def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/default_stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/default_stt.py
index 85a1802e2ad..d7e3e32304e 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/default_stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/default_stt.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: default_stt.py
- @date:2025/12/5 15:12
- @desc:
+@project: MaxKB
+@Author:niu
+@file: default_stt.py
+@date:2025/12/5 15:12
+@desc:
"""
+
from typing import Dict, Any
from common import forms
@@ -16,68 +17,67 @@
from django.utils.translation import gettext as _
-
class AliyunBaiLianDefaultSTTModelCredential(BaseForm, BaseModelCredential):
- type = forms.SingleSelect(_("API"), required=True, text_field='label', default_value='qwen', provider='', method='',
- value_field='value', option_list=[
- {'label': _('Audio file recognition - Tongyi Qwen'),
- 'value': 'qwen'},
- {'label': _('Qwen-Omni'),
- 'value': 'omni'},
- {'label': _('Real-time speech recognition - Fun-ASR/Paraformer'),
- 'value': 'other'}
- ])
- api_url = forms.TextInputField(_('API URL'), required=True, relation_show_field_dict={'type': ['qwen', 'omni']})
- api_key = forms.PasswordInputField(_('API Key'), required=True)
+ type = forms.SingleSelect(
+ _("API"),
+ required=True,
+ text_field="label",
+ default_value="qwen",
+ provider="",
+ method="",
+ value_field="value",
+ option_list=[
+ {"label": _("Audio file recognition - Tongyi Qwen"), "value": "qwen"},
+ {"label": _("Qwen-Omni"), "value": "omni"},
+ {"label": _("Real-time speech recognition - Fun-ASR/Paraformer"), "value": "other"},
+ ],
+ )
+ api_url = forms.TextInputField(_("API URL"), required=True, relation_show_field_dict={"type": ["qwen", "omni"]})
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
- def is_valid(self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
- ) -> bool:
+ def is_valid(
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
+ ) -> bool:
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
- ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type)
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
)
- required_keys = ['api_key']
+ required_keys = ["api_key"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- _('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e))
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
return True
def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
- pass
\ No newline at end of file
+ pass
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/omni_stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/omni_stt.py
index 34c737017bc..f0027bd3f8c 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/omni_stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/omni_stt.py
@@ -3,72 +3,71 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, TooltipLabel
+from common.forms import BaseForm, TooltipLabel
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from django.utils.translation import gettext as _
from common.utils.logger import maxkb_logger
+
class AliyunBaiLianOmiSTTModelParams(BaseForm):
CueWord = forms.TextInputField(
- TooltipLabel(_('CueWord'), _('If not passed, the default value is What is this audio saying? Only answer the audio content')),
+ TooltipLabel(
+ _("CueWord"),
+ _("If not passed, the default value is What is this audio saying? Only answer the audio content"),
+ ),
required=True,
- default_value='这段音频在说什么,只回答音频的内容',
+ default_value="这段音频在说什么,只回答音频的内容",
)
class AliyunBaiLianOmiSTTModelCredential(BaseForm, BaseModelCredential):
- api_url = forms.TextInputField(_('API URL'), required=True)
- api_key = forms.PasswordInputField(_('API Key'), required=True)
+ api_url = forms.TextInputField(_("API URL"), required=True)
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
- def is_valid(self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
- ) -> bool:
+ def is_valid(
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
+ ) -> bool:
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
- ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type)
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
)
- required_keys = ['api_key']
+ required_keys = ["api_key"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- _('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
- ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(error=str(e))
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
return True
def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
-
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
- return AliyunBaiLianOmiSTTModelParams()
\ No newline at end of file
+ return AliyunBaiLianOmiSTTModelParams()
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/stt.py
index dd2f56c239a..0445d99abbd 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/stt/stt.py
@@ -10,14 +10,19 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class AliyunBaiLianSTTModelParams(BaseForm):
sample_rate = forms.SliderField(
- TooltipLabel(_('Sample Rate'), _('If not passed, the default value is 16000')),
+ TooltipLabel(_("Sample Rate"), _("If not passed, the default value is 16000")),
required=True,
default_value=16000,
- _step=4000, _min=0, _max=20000,precision=0
+ _step=4000,
+ _min=0,
+ _max=20000,
+ precision=0,
)
+
class AliyunBaiLianSTTModelCredential(BaseForm, BaseModelCredential):
"""
Credential class for the Aliyun BaiLian STT (Speech-to-Text) model.
@@ -33,7 +38,7 @@ def is_valid(
model_credential: Dict[str, Any],
model_params: Dict[str, Any],
provider,
- raise_exception: bool = False
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -47,33 +52,31 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
- ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type)
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
)
- required_keys = ['api_key']
+ required_keys = ["api_key"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- _('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
return False
try:
- model = provider.get_model(model_type, model_name, model_credential,**model_params)
+ model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(error=str(e))
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -86,10 +89,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tti.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tti.py
index 744ea3da2ec..2e57f1c36b0 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tti.py
@@ -17,48 +17,48 @@ class QwenModelParams(BaseForm):
"""
size = SingleSelect(
- TooltipLabel(_('Image size'), _('Specify the size of the generated image, such as: 1024x1024')),
+ TooltipLabel(_("Image size"), _("Specify the size of the generated image, such as: 1024x1024")),
required=True,
- default_value='1024*1024',
+ default_value="1024*1024",
option_list=[
- {'value': '1024*1024', 'label': '1024*1024'},
- {'value': '720*1280', 'label': '720*1280'},
- {'value': '768*1152', 'label': '768*1152'},
- {'value': '1280*720', 'label': '1280*720'},
+ {"value": "1024*1024", "label": "1024*1024"},
+ {"value": "720*1280", "label": "720*1280"},
+ {"value": "768*1152", "label": "768*1152"},
+ {"value": "1280*720", "label": "1280*720"},
],
- text_field='label',
- value_field='value',
- attrs={'allow-create': True, 'filterable': True}
+ text_field="label",
+ value_field="value",
+ attrs={"allow-create": True, "filterable": True},
)
n = SliderField(
- TooltipLabel(_('Number of pictures'), _('Specify the number of generated images')),
+ TooltipLabel(_("Number of pictures"), _("Specify the number of generated images")),
required=True,
default_value=1,
_min=1,
_max=4,
_step=1,
- precision=0
+ precision=0,
)
style = SingleSelect(
- TooltipLabel(_('Style'), _('Specify the style of generated images')),
+ TooltipLabel(_("Style"), _("Specify the style of generated images")),
required=True,
- default_value='',
+ default_value="",
option_list=[
- {'value': '', 'label': _('Default value, the image style is randomly output by the model')},
- {'value': '', 'label': _('photography')},
- {'value': '', 'label': _('Portraits')},
- {'value': '<3d cartoon>', 'label': _('3D cartoon')},
- {'value': '', 'label': _('animation')},
- {'value': '', 'label': _('painting')},
- {'value': '', 'label': _('watercolor')},
- {'value': '', 'label': _('sketch')},
- {'value': '', 'label': _('Chinese painting')},
- {'value': '', 'label': _('flat illustration')},
+ {"value": "", "label": _("Default value, the image style is randomly output by the model")},
+ {"value": "", "label": _("photography")},
+ {"value": "", "label": _("Portraits")},
+ {"value": "<3d cartoon>", "label": _("3D cartoon")},
+ {"value": "", "label": _("animation")},
+ {"value": "", "label": _("painting")},
+ {"value": "", "label": _("watercolor")},
+ {"value": "", "label": _("sketch")},
+ {"value": "", "label": _("Chinese painting")},
+ {"value": "", "label": _("flat illustration")},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
@@ -67,18 +67,18 @@ class QwenTextToImageModelCredential(BaseForm, BaseModelCredential):
Credential class for the Qwen Text-to-Image model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField(_('API URL'), required=True,
- default_value='https://dashscope.aliyuncs.com/api/v1')
- api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/api/v1")
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -92,35 +92,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -133,10 +130,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tts.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tts.py
index feafaa406d5..32434b9217e 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/tts.py
@@ -18,29 +18,29 @@ class AliyunBaiLianTTSModelGeneralParams(BaseForm):
"""
voice = SingleSelect(
- TooltipLabel(_('Timbre'), _('Chinese sounds can support mixed scenes of Chinese and English')),
+ TooltipLabel(_("Timbre"), _("Chinese sounds can support mixed scenes of Chinese and English")),
required=True,
- default_value='longxiaochun',
- text_field='value',
- value_field='value',
+ default_value="longxiaochun",
+ text_field="value",
+ value_field="value",
option_list=[
- {'label': _('Long Xiaochun'), 'value': 'longxiaochun'},
- {'label': _('Long Xiaoxia'), 'value': 'longxiaoxia'},
- {'label': _('Long Xiaochen'), 'value': 'longxiaocheng'},
- {'label': _('Long Xiaobai'), 'value': 'longxiaobai'},
- {'label': _('Long Laotie'), 'value': 'longlaotie'},
- {'label': _('Long Shu'), 'value': 'longshu'},
- ]
+ {"label": _("Long Xiaochun"), "value": "longxiaochun"},
+ {"label": _("Long Xiaoxia"), "value": "longxiaoxia"},
+ {"label": _("Long Xiaochen"), "value": "longxiaocheng"},
+ {"label": _("Long Xiaobai"), "value": "longxiaobai"},
+ {"label": _("Long Laotie"), "value": "longlaotie"},
+ {"label": _("Long Shu"), "value": "longshu"},
+ ],
)
speech_rate = SliderField(
- TooltipLabel(_('Speaking speed'), _('[0.5, 2], the default is 1, usually one decimal place is enough')),
+ TooltipLabel(_("Speaking speed"), _("[0.5, 2], the default is 1, usually one decimal place is enough")),
required=True,
default_value=1,
_min=0.5,
_max=2,
_step=0.1,
- precision=1
+ precision=1,
)
@@ -51,27 +51,27 @@ class AliyunBaiLianQwenTTSModelGeneralParams(BaseForm):
"""
voice = SingleSelect(
- TooltipLabel(_('Timbre'), _('Please select a system voice supported by Qwen-TTS')),
+ TooltipLabel(_("Timbre"), _("Please select a system voice supported by Qwen-TTS")),
required=True,
- default_value='Cherry',
- text_field='value',
- value_field='value',
+ default_value="Cherry",
+ text_field="value",
+ value_field="value",
option_list=[
- {'label': 'Cherry', 'value': 'Cherry'},
- {'label': 'Serena', 'value': 'Serena'},
- {'label': 'Ethan', 'value': 'Ethan'},
- {'label': 'Chelsie', 'value': 'Chelsie'},
- ]
+ {"label": "Cherry", "value": "Cherry"},
+ {"label": "Serena", "value": "Serena"},
+ {"label": "Ethan", "value": "Ethan"},
+ {"label": "Chelsie", "value": "Chelsie"},
+ ],
)
speech_rate = SliderField(
- TooltipLabel(_('Speaking speed'), _('[0.5, 2], the default is 1, usually one decimal place is enough')),
+ TooltipLabel(_("Speaking speed"), _("[0.5, 2], the default is 1, usually one decimal place is enough")),
required=True,
default_value=1,
_min=0.5,
_max=2,
_step=0.1,
- precision=1
+ precision=1,
)
@@ -80,18 +80,19 @@ class AliyunBaiLianTTSModelCredential(BaseForm, BaseModelCredential):
Credential class for the Aliyun BaiLian TTS (Text-to-Speech) model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField(_('API URL'), required=True, default_value='https://dashscope.aliyuncs.com/api/v1')
+
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/api/v1")
api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, object],
- model_params,
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -105,35 +106,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -146,10 +144,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
@@ -158,6 +153,6 @@ def get_model_params_setting_form(self, model_name: str):
:param model_name: Name of the model.
:return: Parameter setting form.
"""
- if 'qwen' in model_name and 'tts' in model_name:
+ if "qwen" in model_name and "tts" in model_name:
return AliyunBaiLianQwenTTSModelGeneralParams()
return AliyunBaiLianTTSModelGeneralParams()
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/ttv.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/ttv.py
index 0f544a5807d..3538dd01093 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/ttv.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/credential/ttv.py
@@ -6,7 +6,7 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, SingleSelect, SliderField, TooltipLabel
+from common.forms import BaseForm, PasswordInputField, SingleSelect, TooltipLabel
from common.forms.switch_field import SwitchField
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
@@ -19,21 +19,21 @@ class QwenModelParams(BaseForm):
"""
size = SingleSelect(
- TooltipLabel(_('Video size'), _('Specify the size of the generated Video, such as: 1024x1024')),
+ TooltipLabel(_("Video size"), _("Specify the size of the generated Video, such as: 1024x1024")),
required=True,
- default_value='1280*720',
+ default_value="1280*720",
option_list=[
- {'value': '832*480', 'label': '832*480'},
- {'value': '480*832', 'label': '480*832'},
- {'value': '1280*720', 'label': '1280*720'},
- {'value': '720*1280', 'label': '720*1280'},
+ {"value": "832*480", "label": "832*480"},
+ {"value": "480*832", "label": "480*832"},
+ {"value": "1280*720", "label": "1280*720"},
+ {"value": "720*1280", "label": "720*1280"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
watermark = SwitchField(
- TooltipLabel(_('Watermark'), _('Whether to add watermark')),
+ TooltipLabel(_("Watermark"), _("Whether to add watermark")),
attrs={"active-value": True, "inactive-value": False},
default_value=False,
)
@@ -44,17 +44,18 @@ class TextToVideoModelCredential(BaseForm, BaseModelCredential):
Credential class for the Qwen Text-to-Video model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField(_('API URL'), required=True, default_value='https://dashscope.aliyuncs.com/api/v1')
- api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://dashscope.aliyuncs.com/api/v1")
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -68,35 +69,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -109,10 +107,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/embedding.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/embedding.py
index 62118ae5534..e9920c57668 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/embedding.py
@@ -1,20 +1,22 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/16 16:34
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/16 16:34
+@desc:
"""
+
from http import HTTPStatus
from typing import Dict, List
+import dashscope
from openai import OpenAI
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
-class AliyunBaiLianEmbedding(MaxKBBaseModel):
+class AliyunBaiLianEmbedding(MaxKBBaseEmbeddingModel):
model_name: str
optional_params: dict
api_base: str
@@ -30,46 +32,66 @@ def __init__(self, api_key, model_name: str, api_base: str, optional_params: dic
def is_cache_model(self):
return False
+ @staticmethod
+ def _is_multimodal(model_name: str) -> bool:
+ """判断模型是否为多模态向量模型(支持图片/视频独立向量)。"""
+ return any(k in model_name for k in ("vl-embedding", "embedding-vision", "multimodal"))
+
+ def supports_image_embedding(self) -> bool:
+ return self._is_multimodal(self.model_name)
+
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return AliyunBaiLianEmbedding(
- api_key=model_credential.get('dashscope_api_key'),
+ api_key=model_credential.get("dashscope_api_key"),
model_name=model_name,
- api_base=model_credential.get('api_base') or 'https://dashscope.aliyuncs.com/compatible-mode/v1',
- optional_params=optional_params
+ api_base=model_credential.get("api_base") or "https://dashscope.aliyuncs.com/compatible-mode/v1",
+ optional_params=optional_params,
)
def embed_query(self, text: str):
res = self.embed_documents([text])
return res[0]
- def embed_documents(
- self, texts: List[str], chunk_size: int | None = None
- ) -> List[List[float]]:
+ def embed_documents(self, texts: List[str], chunk_size: int | None = None) -> List[List[float]]:
# 处理多模态的向量化
- if any(k in self.model_name for k in ("vl-embedding", "embedding-vision", "multimodal")):
- import dashscope
- dashscope.api_key = self.api_key
- dashscope.base_http_api_url = self.api_base
- multimodal_input = [{"text": text} for text in texts]
- resp = dashscope.MultiModalEmbedding.call(
- model=self.model_name,
- input=multimodal_input, # type: ignore
- **self.optional_params
- )
-
- if resp.status_code == HTTPStatus.OK:
- embeddings_data = resp.output.get('embeddings', [])
- return [item.get('embedding', []) for item in embeddings_data]
- else:
- raise Exception(f'MultiModalEmbedding call failed: status={resp.status_code}, message={resp.message}')
+ if self._is_multimodal(self.model_name):
+ return self._call_multimodal([{"text": text} for text in texts])
if len(self.optional_params) > 0:
res = self.client.create(
- input=texts, model=self.model_name, encoding_format="float",
- **self.optional_params
+ input=texts, model=self.model_name, encoding_format="float", **self.optional_params
)
else:
res = self.client.create(input=texts, model=self.model_name, encoding_format="float")
return [e.embedding for e in res.data]
+
+ def embed_images(self, images: List[str]) -> List[List[float]]:
+ """对图片 URL / data URL 做独立向量化(每张图生成一个向量)。"""
+ if not self.supports_image_embedding():
+ return []
+ return self._call_multimodal(
+ [{"image": self.normalize_image_input(image, keep_data_prefix=True)} for image in images]
+ )
+
+ def _multimodal_base_url(self) -> str:
+ """DashScope 原生多模态接口走 /api/v1,与 OpenAI 兼容地址区分开。"""
+ base = self.api_base or "https://dashscope.aliyuncs.com/api/v1"
+ if "/compatible-mode/" in base:
+ return base.split("/compatible-mode/")[0] + "/api/v1"
+ return base
+
+ def _call_multimodal(self, items: List[dict]) -> List[List[float]]:
+ dashscope.api_key = self.api_key
+ dashscope.base_http_api_url = self._multimodal_base_url()
+ resp = dashscope.MultiModalEmbedding.call(
+ model=self.model_name,
+ input=items, # type: ignore
+ **self.optional_params,
+ )
+
+ if resp.status_code == HTTPStatus.OK:
+ embeddings_data = resp.output.get("embeddings", [])
+ return [item.get("embedding", []) for item in embeddings_data]
+ raise Exception(f"MultiModalEmbedding call failed: status={resp.status_code}, message={resp.message}")
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/image.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/image.py
index 7d94a4cfa06..b6ed53f8f6d 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/image.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/image.py
@@ -1,19 +1,12 @@
# coding=utf-8
-import json
-import time
-from typing import Dict, Optional, Any, Iterator
+from typing import Dict
-import requests
-from langchain_core.language_models import LanguageModelInput
-from langchain_core.messages import BaseMessageChunk, AIMessage
-from langchain_core.runnables import RunnableConfig
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
class QwenVLChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -23,8 +16,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
chat_tong_yi = QwenVLChatModel(
model_name=model_name,
- openai_api_key=model_credential.get('api_key'),
- openai_api_base=model_credential.get('api_base') or 'https://dashscope.aliyuncs.com/compatible-mode/v1',
+ openai_api_key=model_credential.get("api_key"),
+ openai_api_base=model_credential.get("api_base") or "https://dashscope.aliyuncs.com/compatible-mode/v1",
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/llm.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/llm.py
index 28a242e32b3..d09311c882c 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/llm.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/llm.py
@@ -21,18 +21,18 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
# optional_params['streaming'] = True
return BaiLianChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
streaming=True,
**optional_params,
)
def _get_request_payload(
- self,
- input_: LanguageModelInput,
- *,
- stop: list[str] | None = None,
- **kwargs: Any,
+ self,
+ input_: LanguageModelInput,
+ *,
+ stop: list[str] | None = None,
+ **kwargs: Any,
) -> dict:
# Collect reasoning_content from AIMessages with tool_calls before base conversion.
# When enable_thinking=true, Bailian API requires reasoning_content on any assistant
@@ -40,12 +40,8 @@ def _get_request_payload(
messages = self._convert_input(input_).to_messages()
reasoning_content_map = {}
for i, msg in enumerate(messages):
- if (
- isinstance(msg, AIMessage)
- and (msg.tool_calls or msg.invalid_tool_calls)
- ):
- reasoning_content_map[i] = msg.additional_kwargs.get(
- "reasoning_content") or ""
+ if isinstance(msg, AIMessage) and (msg.tool_calls or msg.invalid_tool_calls):
+ reasoning_content_map[i] = msg.additional_kwargs.get("reasoning_content") or ""
payload = super()._get_request_payload(input_, stop=stop, **kwargs)
@@ -53,11 +49,7 @@ def _get_request_payload(
# Bailian deepseek thinking mode does not reject the request with a 400 error.
if "messages" in payload and reasoning_content_map:
for i, message in enumerate(payload["messages"]):
- if (
- i in reasoning_content_map
- and message.get("role") == "assistant"
- and message.get("tool_calls")
- ):
+ if i in reasoning_content_map and message.get("role") == "assistant" and message.get("tool_calls"):
message["reasoning_content"] = reasoning_content_map[i]
return payload
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/reranker.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/reranker.py
index 30e53bbfd95..030215da534 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/reranker.py
@@ -1,18 +1,18 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: reranker.py.py
- @date:2024/9/2 16:42
- @desc:
+@project: MaxKB
+@Author:虎
+@file: reranker.py.py
+@date:2024/9/2 16:42
+@desc:
"""
+
from http import HTTPStatus
-from typing import Sequence, Optional, Any, Dict
+from typing import Sequence, Optional, Dict
import dashscope
from langchain_core.callbacks import Callbacks
from langchain_core.documents import BaseDocumentCompressor, Document
-from langchain_core.documents import BaseDocumentCompressor
from models_provider.base_model_provider import MaxKBBaseModel
@@ -20,7 +20,7 @@
class AliyunBaiLianReranker(MaxKBBaseModel, BaseDocumentCompressor):
model: Optional[str]
api_key: Optional[str]
- base_url: str = ''
+ base_url: str = ""
top_n: Optional[int] = 3 # 取前 N 个最相关的结果
@@ -30,13 +30,16 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return AliyunBaiLianReranker(model=model_name,
- api_key=model_credential.get('dashscope_api_key'),
- base_url=model_credential.get('api_base') or 'https://dashscope.aliyuncs.com/api/v1',
- top_n=model_kwargs.get('top_n', 3))
+ return AliyunBaiLianReranker(
+ model=model_name,
+ api_key=model_credential.get("dashscope_api_key"),
+ base_url=model_credential.get("api_base") or "https://dashscope.aliyuncs.com/api/v1",
+ top_n=model_kwargs.get("top_n", 3),
+ )
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if not documents:
return []
dashscope.base_http_api_url = self.base_url
@@ -47,15 +50,15 @@ def compress_documents(self, documents: Sequence[Document], query: str, callback
documents=texts,
top_n=self.top_n,
api_key=self.api_key,
- return_documents=True
+ return_documents=True,
)
if resp.status_code == HTTPStatus.OK:
return [
Document(
- page_content=item.get('document', {}).get('text', ''),
- metadata={'relevance_score': item.get('relevance_score')}
+ page_content=item.get("document", {}).get("text", ""),
+ metadata={"relevance_score": item.get("relevance_score")},
)
- for item in resp.output.get('results', [])
+ for item in resp.output.get("results", [])
]
else:
- raise Exception(f'Failed, status_code: {resp.status_code}, message: {resp.message}')
+ raise Exception(f"Failed, status_code: {resp.status_code}, message: {resp.message}")
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/__init__.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/__init__.py
index 59db8ff9b74..e31fb6ddd1f 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/__init__.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/__init__.py
@@ -1,13 +1,13 @@
-#coding=utf-8
+# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/12/5 15:39
- @desc:
+@project: MaxKB
+@Author:niu
+@file: __init__.py.py
+@date:2025/12/5 15:39
+@desc:
"""
from .asr_stt import AliyunBaiLianAsrSpeechToText
from .default_stt import AliyunBaiLianDefaultSpeechToText
from .stt import AliyunBaiLianSpeechToText
-from .omni_stt import AliyunBaiLianOmiSpeechToText
\ No newline at end of file
+from .omni_stt import AliyunBaiLianOmiSpeechToText
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/asr_stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/asr_stt.py
index e13a46a16b9..63f56efe4db 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/asr_stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/asr_stt.py
@@ -18,10 +18,10 @@ class AliyunBaiLianAsrSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
- self.api_url = kwargs.get('api_url')
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
+ self.api_url = kwargs.get("api_url")
@staticmethod
def is_cache_model():
@@ -31,21 +31,20 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return AliyunBaiLianAsrSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
- api_url=model_credential.get('api_url'),
+ api_key=model_credential.get("api_key"),
+ api_url=model_credential.get("api_url"),
params=model_kwargs,
- **model_kwargs
+ **model_kwargs,
)
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as audio_file:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as audio_file:
self.speech_to_text(audio_file)
def speech_to_text(self, audio_file):
try:
-
base64_audio = base64.b64encode(audio_file.read()).decode("utf-8")
messages = [
@@ -53,21 +52,17 @@ def speech_to_text(self, audio_file):
"role": "user",
"content": [
{"audio": f"data:audio/mp3;base64,{base64_audio}"},
- ]
+ ],
}
]
response = dashscope.MultiModalConversation.call(
- api_key=self.api_key,
- model=self.model,
- messages=messages,
- result_format="message",
- **self.params
+ api_key=self.api_key, model=self.model, messages=messages, result_format="message", **self.params
)
if response.status_code == 200:
text = response["output"]["choices"][0]["message"].content[0]["text"]
return text
else:
- raise Exception('Error: ', response.message)
+ raise Exception("Error: ", response.message)
except Exception as err:
maxkb_logger.error(f":Error: {str(err)}: {traceback.format_exc()}")
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/default_stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/default_stt.py
index 6607345bb24..001ffbb7a74 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/default_stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/default_stt.py
@@ -1,12 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: default_stt.py
- @date:2025/12/5 15:40
- @desc:
+@project: MaxKB
+@Author:niu
+@file: default_stt.py
+@date:2025/12/5 15:40
+@desc:
"""
-import os
+
from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
@@ -27,42 +27,33 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- from models_provider.impl.aliyun_bai_lian_model_provider.model.stt import AliyunBaiLianOmiSpeechToText, \
- AliyunBaiLianSpeechToText, AliyunBaiLianAsrSpeechToText
- stt_type=model_credential.get('type')
- if stt_type == 'qwen':
+ from models_provider.impl.aliyun_bai_lian_model_provider.model.stt import (
+ AliyunBaiLianOmiSpeechToText,
+ AliyunBaiLianSpeechToText,
+ AliyunBaiLianAsrSpeechToText,
+ )
+
+ stt_type = model_credential.get("type")
+ if stt_type == "qwen":
return AliyunBaiLianAsrSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
- api_url=model_credential.get('api_url'),
+ api_key=model_credential.get("api_key"),
+ api_url=model_credential.get("api_url"),
params=model_kwargs,
- **model_kwargs
+ **model_kwargs,
)
- elif stt_type == 'omni':
+ elif stt_type == "omni":
return AliyunBaiLianOmiSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
- api_url=model_credential.get('api_url'),
+ api_key=model_credential.get("api_key"),
+ api_url=model_credential.get("api_url"),
params=model_kwargs,
- **model_kwargs
+ **model_kwargs,
)
else:
return AliyunBaiLianSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
params=model_kwargs,
**model_kwargs,
)
-
-
-
-
-
-
-
-
-
-
-
-
-
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/omni_stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/omni_stt.py
index 7860f82e8e1..6e55f7edec6 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/omni_stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/omni_stt.py
@@ -18,10 +18,10 @@ class AliyunBaiLianOmiSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
- self.api_url = kwargs.get('api_url')
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
+ self.api_url = kwargs.get("api_url")
@staticmethod
def is_cache_model():
@@ -31,20 +31,17 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return AliyunBaiLianOmiSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
- api_url=model_credential.get('api_url') ,
- params= model_kwargs,
- **model_kwargs
+ api_key=model_credential.get("api_key"),
+ api_url=model_credential.get("api_url"),
+ params=model_kwargs,
+ **model_kwargs,
)
-
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as audio_file:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as audio_file:
self.speech_to_text(audio_file)
-
-
def speech_to_text(self, audio_file):
try:
client = OpenAI(
@@ -68,7 +65,7 @@ def speech_to_text(self, audio_file):
"format": "mp3",
},
},
- {"type": "text", "text": self.params.get('CueWord') or '这段音频在说什么'},
+ {"type": "text", "text": self.params.get("CueWord") or "这段音频在说什么"},
],
},
],
@@ -77,11 +74,11 @@ def speech_to_text(self, audio_file):
# stream 必须设置为 True,否则会报错
stream=True,
stream_options={"include_usage": True},
- extra_body = {'enable_thinking': False, **self.params},
+ extra_body={"enable_thinking": False, **self.params},
)
result = []
for chunk in completion:
- if chunk.choices and hasattr(chunk.choices[0].delta, 'content'):
+ if chunk.choices and hasattr(chunk.choices[0].delta, "content"):
content = chunk.choices[0].delta.content
result.append(content)
return "".join(result)
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/stt.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/stt.py
index f48c0adf291..7cce6df7c32 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/stt.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/stt/stt.py
@@ -3,7 +3,7 @@
from typing import Dict
import dashscope
-from dashscope.audio.asr import (Recognition)
+from dashscope.audio.asr import Recognition
from pydub import AudioSegment
from models_provider.base_model_provider import MaxKBBaseModel
@@ -17,10 +17,9 @@ class AliyunBaiLianSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
-
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -29,34 +28,33 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return AliyunBaiLianSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
params=model_kwargs,
**optional_params,
)
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as f:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as f:
self.speech_to_text(f)
def speech_to_text(self, audio_file):
dashscope.api_key = self.api_key
recognition_params = {
- 'model': self.model,
- 'format': 'mp3',
- 'sample_rate': 16000,
- 'callback': None,
- **self.params
+ "model": self.model,
+ "format": "mp3",
+ "sample_rate": 16000,
+ "callback": None,
+ **self.params,
}
recognition = Recognition(**recognition_params)
-
with tempfile.NamedTemporaryFile(delete=False) as temp_file:
# 将上传的文件保存到临时文件中
temp_file.write(audio_file.read())
@@ -70,18 +68,18 @@ def speech_to_text(self, audio_file):
audio = audio.set_frame_rate(16000)
# 将转换后的音频文件保存到临时文件中
- audio.export(temp_file_path, format='mp3')
+ audio.export(temp_file_path, format="mp3")
# 识别临时文件
result = recognition.call(temp_file_path)
- text = ''
+ text = ""
if result.status_code == 200:
result_sentence = result.get_sentence()
if result_sentence is not None:
for sentence in result_sentence:
- text += sentence['text']
+ text += sentence["text"]
return text
else:
- raise Exception('Error: ', result.message)
+ raise Exception("Error: ", result.message)
finally:
# 删除临时文件
os.remove(temp_file_path)
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tti.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tti.py
index 6ad324c0f73..07d48796630 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tti.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tti.py
@@ -18,10 +18,10 @@ class QwenTextToImageModel(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model_name = kwargs.get('model_name')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -29,17 +29,17 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024*1024', 'n': 1}}
+ optional_params = {"params": {"size": "1024*1024", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
- api_base = model_credential.get('api_base')
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ api_base = model_credential.get("api_base")
if api_base is None:
- api_base = 'https://dashscope.aliyuncs.com/api/v1'
+ api_base = "https://dashscope.aliyuncs.com/api/v1"
chat_tong_yi = QwenTextToImageModel(
model_name=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
api_base=api_base,
**optional_params,
)
@@ -66,91 +66,90 @@ def check_auth(self):
def generate_image(self, prompt: str, negative_prompt: str = None):
import dashscope
+
dashscope.base_http_api_url = self.api_base
if self.model_name.startswith("wan2.6") or self.model_name.startswith("z"):
from dashscope.api_entities.dashscope_response import Message
+
# 以下为北京地域url,各地域的base_url不同
- message = Message(
- role="user",
- content=[
- {
- 'text': prompt
- }
- ]
- )
+ message = Message(role="user", content=[{"text": prompt}])
rsp = ImageGeneration.call(
model=self.model_name,
api_key=self.api_key,
messages=[message],
negative_prompt=negative_prompt,
- **self.params
+ **self.params,
)
file_urls = []
if rsp.status_code == HTTPStatus.OK:
for result in rsp.output.choices:
if isinstance(result.message.content, list):
for item in result.message.content:
- if isinstance(item, dict) and item.get('image'):
- file_urls.append(item.get('image'))
+ if isinstance(item, dict) and item.get("image"):
+ file_urls.append(item.get("image"))
elif isinstance(result.message.content, dict):
- if result.message.content.get('image'):
- file_urls.append(result.message.content.get('image'))
+ if result.message.content.get("image"):
+ file_urls.append(result.message.content.get("image"))
else:
- maxkb_logger.error('sync_call Failed, status_code: %s, code: %s, message: %s' %
- (rsp.status_code, rsp.code, rsp.message))
- raise Exception('sync_call Failed, status_code: %s, code: %s, message: %s' %
- (rsp.status_code, rsp.code, rsp.message))
+ maxkb_logger.error(
+ "sync_call Failed, status_code: %s, code: %s, message: %s"
+ % (rsp.status_code, rsp.code, rsp.message)
+ )
+ raise Exception(
+ "sync_call Failed, status_code: %s, code: %s, message: %s"
+ % (rsp.status_code, rsp.code, rsp.message)
+ )
return file_urls
elif self.model_name.startswith("wan") or self.model_name.startswith("qwen-image-plus"):
- rsp = ImageSynthesis.call(api_key=self.api_key,
- model=self.model_name,
- prompt=prompt,
- negative_prompt=negative_prompt,
- **self.params)
+ rsp = ImageSynthesis.call(
+ api_key=self.api_key,
+ model=self.model_name,
+ prompt=prompt,
+ negative_prompt=negative_prompt,
+ **self.params,
+ )
file_urls = []
if rsp.status_code == HTTPStatus.OK:
for result in rsp.output.results:
file_urls.append(result.url)
else:
- maxkb_logger.error('sync_call Failed, status_code: %s, code: %s, message: %s' %
- (rsp.status_code, rsp.code, rsp.message))
- raise Exception('sync_call Failed, status_code: %s, code: %s, message: %s' %
- (rsp.status_code, rsp.code, rsp.message))
+ maxkb_logger.error(
+ "sync_call Failed, status_code: %s, code: %s, message: %s"
+ % (rsp.status_code, rsp.code, rsp.message)
+ )
+ raise Exception(
+ "sync_call Failed, status_code: %s, code: %s, message: %s"
+ % (rsp.status_code, rsp.code, rsp.message)
+ )
return file_urls
elif self.model_name.startswith("qwen"):
- messages = [
- {
- "role": "user",
- "content": [
- {
- "type": "text",
- "text": prompt
- }
- ]
- }
- ]
+ messages = [{"role": "user", "content": [{"type": "text", "text": prompt}]}]
rsp = MultiModalConversation.call(
api_key=self.api_key,
model=self.model_name,
messages=messages,
- result_format='message',
+ result_format="message",
stream=False,
negative_prompt=negative_prompt,
- **self.params
+ **self.params,
)
file_urls = []
if rsp.status_code == HTTPStatus.OK:
for result in rsp.output.choices:
if isinstance(result.message.content, list):
for item in result.message.content:
- if isinstance(item, dict) and item.get('image'):
- file_urls.append(item.get('image'))
+ if isinstance(item, dict) and item.get("image"):
+ file_urls.append(item.get("image"))
elif isinstance(result.message.content, dict):
- if result.message.content.get('image'):
- file_urls.append(result.message.content.get('image'))
+ if result.message.content.get("image"):
+ file_urls.append(result.message.content.get("image"))
else:
- maxkb_logger.error('sync_call Failed, status_code: %s, code: %s, message: %s' %
- (rsp.status_code, rsp.code, rsp.message))
- raise Exception('sync_call Failed, status_code: %s, code: %s, message: %s' %
- (rsp.status_code, rsp.code, rsp.message))
+ maxkb_logger.error(
+ "sync_call Failed, status_code: %s, code: %s, message: %s"
+ % (rsp.status_code, rsp.code, rsp.message)
+ )
+ raise Exception(
+ "sync_call Failed, status_code: %s, code: %s, message: %s"
+ % (rsp.status_code, rsp.code, rsp.message)
+ )
return file_urls
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tts.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tts.py
index d23cddd3f8b..fa97f3ee764 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tts.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/tts.py
@@ -17,10 +17,10 @@ class AliyunBaiLianTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.base_url = kwargs.get('base_url')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.base_url = kwargs.get("base_url")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -28,69 +28,63 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return AliyunBaiLianTextToSpeech(
model=model_name,
- api_key=model_credential.get('api_key'),
- base_url=model_credential.get('api_base', "https://dashscope.aliyuncs.com/api/v1"),
+ api_key=model_credential.get("api_key"),
+ base_url=model_credential.get("api_base", "https://dashscope.aliyuncs.com/api/v1"),
**optional_params,
)
def check_auth(self):
- self.text_to_speech(_('Hello'))
+ self.text_to_speech(_("Hello"))
def text_to_speech(self, text):
global audio
dashscope.api_key = self.api_key
dashscope.base_http_api_url = self.base_url
text = _remove_empty_lines(text)
- if 'sambert' in self.model:
+ if "sambert" in self.model:
from dashscope.audio.tts import SpeechSynthesizer
+
audio = SpeechSynthesizer.call(model=self.model, text=text, **self.params).get_audio_data()
- elif 'qwen' in self.model:
+ elif "qwen" in self.model:
import requests
+
response = dashscope.MultiModalConversation.call(
# 如需使用指令控制功能,请将model替换为qwen3-tts-instruct-flash
model=self.model,
api_key=self.api_key,
text=text,
- **self.params
+ **self.params,
)
# 这个的接口返回格式和上面两个不太一样,直接返回了一个url地址,下载后就是音频文件
audio_url = response.output.audio.url
res = requests.get(audio_url)
audio = res.content
- elif 'MiniMax' in self.model:
+ elif "MiniMax" in self.model:
import requests
api_url = f"{self.base_url}/services/aigc/multimodal-generation/generation"
- headers = {
- "Authorization": f"Bearer {self.api_key}",
- "Content-Type": "application/json"
- }
- payload = {
- "model": self.model,
- "input": {
- "text": text,
- **self.params
- }
- }
+ headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}
+ payload = {"model": self.model, "input": {"text": text, **self.params}}
response = requests.post(api_url, headers=headers, json=payload)
audio_hex = response.json().get("output", {}).get("data", {}).get("audio")
if audio_hex:
audio = bytes.fromhex(audio_hex)
else:
- raise Exception('Failed to get audio data from response' + str(response.text))
+ raise Exception("Failed to get audio data from response" + str(response.text))
else:
from dashscope.audio.tts_v2 import SpeechSynthesizer
+
synthesizer = SpeechSynthesizer(model=self.model, **self.params)
audio = synthesizer.call(text)
if audio is None:
- raise Exception('Failed to generate audio')
+ raise Exception("Failed to generate audio")
if type(audio) == str:
raise Exception(audio)
return audio
diff --git a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/ttv.py b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/ttv.py
index 7abfdce8abf..be2b7a62100 100644
--- a/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/ttv.py
+++ b/apps/models_provider/impl/aliyun_bai_lian_model_provider/model/ttv.py
@@ -20,11 +20,11 @@ class GenerationVideoModel(MaxKBBaseModel, BaseGenerationVideo):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model_name = kwargs.get('model_name')
- self.params = kwargs.get('params', {})
- self.max_retries = kwargs.get('max_retries', 3)
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params", {})
+ self.max_retries = kwargs.get("max_retries", 3)
self.retry_delay = 5
@staticmethod
@@ -33,16 +33,16 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
- api_base = model_credential.get('api_base')
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ api_base = model_credential.get("api_base")
if api_base is None:
- api_base = 'https://dashscope.aliyuncs.com/api/v1'
+ api_base = "https://dashscope.aliyuncs.com/api/v1"
return GenerationVideoModel(
model_name=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
api_base=api_base,
**optional_params,
)
@@ -56,9 +56,11 @@ def _safe_call(self, func, **kwargs):
try:
rsp = func(**kwargs)
return rsp
- except (requests.exceptions.ProxyError,
- requests.exceptions.ConnectionError,
- requests.exceptions.Timeout) as e:
+ except (
+ requests.exceptions.ProxyError,
+ requests.exceptions.ConnectionError,
+ requests.exceptions.Timeout,
+ ) as e:
maxkb_logger.error(f"⚠️ 网络错误: {e},正在重试 {attempt + 1}/{self.max_retries}...")
time.sleep(self.retry_delay)
raise RuntimeError("多次重试后仍无法连接到 DashScope API,请检查代理或网络配置")
@@ -66,18 +68,19 @@ def _safe_call(self, func, **kwargs):
# --- 通用异步生成函数 ---
def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, last_frame_url=None, **kwargs):
"""
- prompt: 文本描述
- negative_prompt: 反向文本描述
- first_frame_url: 起始关键帧图片 URL (KF2V 必填)
- last_frame_url: 结束关键帧图片 URL (KF2V 必填)
- 如果没有提供last_frame_url,则表示只提供了first_frame_url,生成的是单关键帧视频(KFV) 参数是img_url
- """
+ prompt: 文本描述
+ negative_prompt: 反向文本描述
+ first_frame_url: 起始关键帧图片 URL (KF2V 必填)
+ last_frame_url: 结束关键帧图片 URL (KF2V 必填)
+ 如果没有提供last_frame_url,则表示只提供了first_frame_url,生成的是单关键帧视频(KFV) 参数是img_url
+ """
import dashscope
+
dashscope.base_http_api_url = self.api_base
- is_kf2v_model = 'kf2v' in self.model_name.lower()
+ is_kf2v_model = "kf2v" in self.model_name.lower()
- is_wan27_model = 'wan2.7' in self.model_name.lower()
+ is_wan27_model = "wan2.7" in self.model_name.lower()
if is_wan27_model:
# wan2.7 模型使用特殊的 media 参数结构
@@ -85,34 +88,32 @@ def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, las
# 添加首帧图片
if first_frame_url:
- media.append({
- "type": "first_frame",
- "url": first_frame_url
- })
+ media.append({"type": "first_frame", "url": first_frame_url})
# 添加尾帧图片(如果存在)
if last_frame_url:
- media.append({
- "type": "last_frame",
- "url": last_frame_url
- })
+ media.append({"type": "last_frame", "url": last_frame_url})
params = {
"api_key": self.api_key,
"model": self.model_name,
"prompt": prompt,
"media": media,
- "negative_prompt": negative_prompt
+ "negative_prompt": negative_prompt,
}
else:
# 构建基础参数
- params = {"api_key": self.api_key, "prompt": prompt, "model": self.model_name,
- "negative_prompt": negative_prompt}
+ params = {
+ "api_key": self.api_key,
+ "prompt": prompt,
+ "model": self.model_name,
+ "negative_prompt": negative_prompt,
+ }
if is_kf2v_model:
- params['first_frame_url'] = first_frame_url
- params['last_frame_url'] = last_frame_url
+ params["first_frame_url"] = first_frame_url
+ params["last_frame_url"] = last_frame_url
elif first_frame_url:
- params['img_url'] = first_frame_url
+ params["img_url"] = first_frame_url
# 合并所有额外参数
params.update(self.params)
@@ -120,8 +121,10 @@ def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, las
# --- 异步提交任务 ---
rsp = self._safe_call(VideoSynthesis.async_call, **params)
if rsp.status_code != HTTPStatus.OK:
- maxkb_logger.info(f'提交任务失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}')
- raise RuntimeError(f'提交任务失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}')
+ maxkb_logger.info(f"提交任务失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}")
+ raise RuntimeError(
+ f"提交任务失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}"
+ )
maxkb_logger.info("task_id:", rsp.output.task_id)
@@ -131,19 +134,21 @@ def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, las
maxkb_logger.info("当前任务状态:", status.output.task_status)
else:
maxkb_logger.error(
- f'获取任务状态失败,status_code: {status.status_code}, code: {status.code}, message: {status.message}')
+ f"获取任务状态失败,status_code: {status.status_code}, code: {status.code}, message: {status.message}"
+ )
raise RuntimeError(
- f'获取任务状态失败,status_code: {status.status_code}, code: {status.code}, message: {status.message}')
+ f"获取任务状态失败,status_code: {status.status_code}, code: {status.code}, message: {status.message}"
+ )
# --- 等待任务完成 ---
rsp = self._safe_call(VideoSynthesis.wait, task=rsp, api_key=self.api_key)
if rsp.status_code == HTTPStatus.OK:
if rsp.output.task_status == "SUCCEEDED":
- maxkb_logger.info(f'视频生成完成!视频 URL: {rsp.output.video_url}')
+ maxkb_logger.info(f"视频生成完成!视频 URL: {rsp.output.video_url}")
return rsp.output.video_url
else:
- maxkb_logger.error(f'视频生成失败: {rsp.output.message}')
- raise RuntimeError(f'视频生成失败, message: {rsp.output.message}')
+ maxkb_logger.error(f"视频生成失败: {rsp.output.message}")
+ raise RuntimeError(f"视频生成失败, message: {rsp.output.message}")
else:
- maxkb_logger.error(f'生成失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}')
- raise RuntimeError(f'生成失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}')
+ maxkb_logger.error(f"生成失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}")
+ raise RuntimeError(f"生成失败,status_code: {rsp.status_code}, code: {rsp.code}, message: {rsp.message}")
diff --git a/apps/models_provider/impl/anthropic_model_provider/__init__.py b/apps/models_provider/impl/anthropic_model_provider/__init__.py
index 2dc4ab10db4..906f7224d02 100644
--- a/apps/models_provider/impl/anthropic_model_provider/__init__.py
+++ b/apps/models_provider/impl/anthropic_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/28 16:25
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/3/28 16:25
+@desc:
"""
diff --git a/apps/models_provider/impl/anthropic_model_provider/anthropic_model_provider.py b/apps/models_provider/impl/anthropic_model_provider/anthropic_model_provider.py
index 33094337eb4..a3830de90a5 100644
--- a/apps/models_provider/impl/anthropic_model_provider/anthropic_model_provider.py
+++ b/apps/models_provider/impl/anthropic_model_provider/anthropic_model_provider.py
@@ -1,16 +1,22 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: openai_model_provider.py
- @date:2024/3/28 16:26
- @desc:
+@project: maxkb
+@Author:虎
+@file: openai_model_provider.py
+@date:2024/3/28 16:26
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.anthropic_model_provider.credential.image import AnthropicImageModelCredential
from models_provider.impl.anthropic_model_provider.credential.llm import AnthropicLLMModelCredential
from models_provider.impl.anthropic_model_provider.model.image import AnthropicImage
@@ -21,24 +27,16 @@
openai_image_model_credential = AnthropicImageModelCredential()
model_info_list = [
- ModelInfo('claude-3-opus-20240229', '', ModelTypeConst.LLM,
- openai_llm_model_credential, AnthropicChatModel
- ),
- ModelInfo('claude-3-sonnet-20240229', '', ModelTypeConst.LLM, openai_llm_model_credential,
- AnthropicChatModel),
- ModelInfo('claude-3-haiku-20240307', '', ModelTypeConst.LLM, openai_llm_model_credential,
- AnthropicChatModel),
- ModelInfo('claude-3-5-sonnet-20240620', '', ModelTypeConst.LLM, openai_llm_model_credential,
- AnthropicChatModel),
- ModelInfo('claude-3-5-haiku-20241022', '', ModelTypeConst.LLM, openai_llm_model_credential,
- AnthropicChatModel),
- ModelInfo('claude-3-5-sonnet-20241022', '', ModelTypeConst.LLM, openai_llm_model_credential,
- AnthropicChatModel),
+ ModelInfo("claude-3-opus-20240229", "", ModelTypeConst.LLM, openai_llm_model_credential, AnthropicChatModel),
+ ModelInfo("claude-3-sonnet-20240229", "", ModelTypeConst.LLM, openai_llm_model_credential, AnthropicChatModel),
+ ModelInfo("claude-3-haiku-20240307", "", ModelTypeConst.LLM, openai_llm_model_credential, AnthropicChatModel),
+ ModelInfo("claude-3-5-sonnet-20240620", "", ModelTypeConst.LLM, openai_llm_model_credential, AnthropicChatModel),
+ ModelInfo("claude-3-5-haiku-20241022", "", ModelTypeConst.LLM, openai_llm_model_credential, AnthropicChatModel),
+ ModelInfo("claude-3-5-sonnet-20241022", "", ModelTypeConst.LLM, openai_llm_model_credential, AnthropicChatModel),
]
image_model_info = [
- ModelInfo('claude-3-5-sonnet-20241022', '', ModelTypeConst.IMAGE, openai_image_model_credential,
- AnthropicImage),
+ ModelInfo("claude-3-5-sonnet-20241022", "", ModelTypeConst.IMAGE, openai_image_model_credential, AnthropicImage),
]
model_info_manage = (
@@ -52,11 +50,22 @@
class AnthropicModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_anthropic_provider', name='Anthropic', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'anthropic_model_provider', 'icon',
- 'anthropic_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_anthropic_provider",
+ name="Anthropic",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "impl",
+ "anthropic_model_provider",
+ "icon",
+ "anthropic_icon_svg",
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/anthropic_model_provider/credential/image.py b/apps/models_provider/impl/anthropic_model_provider/credential/image.py
index 9d0d01f0022..211e6381f60 100644
--- a/apps/models_provider/impl/anthropic_model_provider/credential/image.py
+++ b/apps/models_provider/impl/anthropic_model_provider/credential/image.py
@@ -12,39 +12,56 @@
class AnthropicImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class AnthropicImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField(_('API URL'), required=True)
- api_key = forms.PasswordInputField(_('API Key'), required=True)
+ api_base = forms.TextInputField(_("API URL"), required=True)
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
@@ -53,20 +70,22 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return AnthropicImageModelParams()
diff --git a/apps/models_provider/impl/anthropic_model_provider/credential/llm.py b/apps/models_provider/impl/anthropic_model_provider/credential/llm.py
index c90e8ff67e8..5dab629b138 100644
--- a/apps/models_provider/impl/anthropic_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/anthropic_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:32
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:32
+@desc:
"""
+
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -17,61 +18,80 @@
from django.utils.translation import gettext_lazy as _, gettext
from common.utils.logger import maxkb_logger
+
class AnthropicLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class AnthropicLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField(_('API URL'), required=True)
- api_key = forms.PasswordInputField(_('API Key'), required=True)
+ api_base = forms.TextInputField(_("API URL"), required=True)
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
def get_model_params_setting_form(self, model_name):
return AnthropicLLMModelParams()
diff --git a/apps/models_provider/impl/anthropic_model_provider/model/image.py b/apps/models_provider/impl/anthropic_model_provider/model/image.py
index 08cb0fd2b70..e612b495c3d 100644
--- a/apps/models_provider/impl/anthropic_model_provider/model/image.py
+++ b/apps/models_provider/impl/anthropic_model_provider/model/image.py
@@ -12,7 +12,6 @@ def custom_get_token_ids(text: str):
class AnthropicImage(MaxKBBaseModel, ChatAnthropic):
-
@staticmethod
def is_cache_model():
return False
@@ -22,8 +21,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return AnthropicImage(
model=model_name,
- anthropic_api_url=model_credential.get('api_base'),
- anthropic_api_key=model_credential.get('api_key'),
+ anthropic_api_url=model_credential.get("api_base"),
+ anthropic_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
**optional_params,
diff --git a/apps/models_provider/impl/anthropic_model_provider/model/llm.py b/apps/models_provider/impl/anthropic_model_provider/model/llm.py
index 1a297c46e44..8931725eba9 100644
--- a/apps/models_provider/impl/anthropic_model_provider/model/llm.py
+++ b/apps/models_provider/impl/anthropic_model_provider/model/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/18 15:28
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/4/18 15:28
+@desc:
"""
+
from typing import List, Dict
from langchain_anthropic import ChatAnthropic
@@ -21,7 +22,6 @@ def custom_get_token_ids(text: str):
class AnthropicChatModel(MaxKBBaseModel, ChatAnthropic):
-
@staticmethod
def is_cache_model():
return False
@@ -31,23 +31,23 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
azure_chat_open_ai = AnthropicChatModel(
model=model_name,
- anthropic_api_url=model_credential.get('api_base'),
- anthropic_api_key=model_credential.get('api_key'),
+ anthropic_api_url=model_credential.get("api_base"),
+ anthropic_api_key=model_credential.get("api_key"),
**optional_params,
- custom_get_token_ids=custom_get_token_ids
+ custom_get_token_ids=custom_get_token_ids,
)
return azure_chat_open_ai
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/aws_bedrock_model_provider.py b/apps/models_provider/impl/aws_bedrock_model_provider/aws_bedrock_model_provider.py
index 3ff8efa8383..4bc956e816a 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/aws_bedrock_model_provider.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/aws_bedrock_model_provider.py
@@ -4,7 +4,11 @@
import os
from common.utils.common import get_file_content
from models_provider.base_model_provider import (
- IModelProvider, ModelProvideInfo, ModelInfo, ModelTypeConst, ModelInfoManage
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
)
from models_provider.impl.aws_bedrock_model_provider.credential.embedding import BedrockEmbeddingCredential
from models_provider.impl.aws_bedrock_model_provider.credential.image import BedrockVLModelCredential
@@ -25,164 +29,190 @@ def _create_model_info(model_name, description, model_type, credential_class, mo
desc=description,
model_type=model_type,
model_credential=credential_class(),
- model_class=model_class
+ model_class=model_class,
)
def _get_aws_bedrock_icon_path():
- return os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'aws_bedrock_model_provider',
- 'icon', 'bedrock_icon_svg')
+ return os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "aws_bedrock_model_provider", "icon", "bedrock_icon_svg"
+ )
def _initialize_model_info():
model_info_list = [
_create_model_info(
- 'anthropic.claude-v2:1',
- _('An update to Claude 2 that doubles the context window and improves reliability, hallucination rates, and evidence-based accuracy in long documents and RAG contexts.'),
+ "anthropic.claude-v2:1",
+ _(
+ "An update to Claude 2 that doubles the context window and improves reliability, hallucination rates, and evidence-based accuracy in long documents and RAG contexts."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'anthropic.claude-v2',
- _('Anthropic is a powerful model that can handle a variety of tasks, from complex dialogue and creative content generation to detailed command obedience.'),
+ "anthropic.claude-v2",
+ _(
+ "Anthropic is a powerful model that can handle a variety of tasks, from complex dialogue and creative content generation to detailed command obedience."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'anthropic.claude-3-haiku-20240307-v1:0',
- _("The Claude 3 Haiku is Anthropic's fastest and most compact model, with near-instant responsiveness. The model can answer simple queries and requests quickly. Customers will be able to build seamless AI experiences that mimic human interactions. Claude 3 Haiku can process images and return text output, and provides 200K context windows."),
+ "anthropic.claude-3-haiku-20240307-v1:0",
+ _(
+ "The Claude 3 Haiku is Anthropic's fastest and most compact model, with near-instant responsiveness. The model can answer simple queries and requests quickly. Customers will be able to build seamless AI experiences that mimic human interactions. Claude 3 Haiku can process images and return text output, and provides 200K context windows."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'anthropic.claude-3-sonnet-20240229-v1:0',
- _("The Claude 3 Sonnet model from Anthropic strikes the ideal balance between intelligence and speed, especially when it comes to handling enterprise workloads. This model offers maximum utility while being priced lower than competing products, and it's been engineered to be a solid choice for deploying AI at scale."),
+ "anthropic.claude-3-sonnet-20240229-v1:0",
+ _(
+ "The Claude 3 Sonnet model from Anthropic strikes the ideal balance between intelligence and speed, especially when it comes to handling enterprise workloads. This model offers maximum utility while being priced lower than competing products, and it's been engineered to be a solid choice for deploying AI at scale."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'anthropic.claude-3-5-sonnet-20240620-v1:0',
- _('The Claude 3.5 Sonnet raises the industry standard for intelligence, outperforming competing models and the Claude 3 Opus in extensive evaluations, with the speed and cost-effectiveness of our mid-range models.'),
+ "anthropic.claude-3-5-sonnet-20240620-v1:0",
+ _(
+ "The Claude 3.5 Sonnet raises the industry standard for intelligence, outperforming competing models and the Claude 3 Opus in extensive evaluations, with the speed and cost-effectiveness of our mid-range models."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'anthropic.claude-instant-v1',
- _('A faster, more affordable but still very powerful model that can handle a range of tasks including casual conversation, text analysis, summarization and document question answering.'),
+ "anthropic.claude-instant-v1",
+ _(
+ "A faster, more affordable but still very powerful model that can handle a range of tasks including casual conversation, text analysis, summarization and document question answering."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'amazon.titan-text-premier-v1:0',
- _("Titan Text Premier is the most powerful and advanced model in the Titan Text series, designed to deliver exceptional performance for a variety of enterprise applications. With its cutting-edge features, it delivers greater accuracy and outstanding results, making it an excellent choice for organizations looking for a top-notch text processing solution."),
+ "amazon.titan-text-premier-v1:0",
+ _(
+ "Titan Text Premier is the most powerful and advanced model in the Titan Text series, designed to deliver exceptional performance for a variety of enterprise applications. With its cutting-edge features, it delivers greater accuracy and outstanding results, making it an excellent choice for organizations looking for a top-notch text processing solution."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel
+ BedrockModel,
),
_create_model_info(
- 'amazon.titan-text-lite-v1',
- _('Amazon Titan Text Lite is a lightweight, efficient model ideal for fine-tuning English-language tasks, including summarization and copywriting, where customers require smaller, more cost-effective, and highly customizable models.'),
+ "amazon.titan-text-lite-v1",
+ _(
+ "Amazon Titan Text Lite is a lightweight, efficient model ideal for fine-tuning English-language tasks, including summarization and copywriting, where customers require smaller, more cost-effective, and highly customizable models."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel),
+ BedrockModel,
+ ),
_create_model_info(
- 'amazon.titan-text-express-v1',
- _('Amazon Titan Text Express has context lengths of up to 8,000 tokens, making it ideal for a variety of high-level general language tasks, such as open-ended text generation and conversational chat, as well as support in retrieval-augmented generation (RAG). At launch, the model is optimized for English, but other languages are supported.'),
+ "amazon.titan-text-express-v1",
+ _(
+ "Amazon Titan Text Express has context lengths of up to 8,000 tokens, making it ideal for a variety of high-level general language tasks, such as open-ended text generation and conversational chat, as well as support in retrieval-augmented generation (RAG). At launch, the model is optimized for English, but other languages are supported."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel),
+ BedrockModel,
+ ),
_create_model_info(
- 'mistral.mistral-7b-instruct-v0:2',
- _('7B dense converter for rapid deployment and easy customization. Small in size yet powerful in a variety of use cases. Supports English and code, as well as 32k context windows.'),
+ "mistral.mistral-7b-instruct-v0:2",
+ _(
+ "7B dense converter for rapid deployment and easy customization. Small in size yet powerful in a variety of use cases. Supports English and code, as well as 32k context windows."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel),
+ BedrockModel,
+ ),
_create_model_info(
- 'mistral.mistral-large-2402-v1:0',
- _('Advanced Mistral AI large-scale language model capable of handling any language task, including complex multilingual reasoning, text understanding, transformation, and code generation.'),
+ "mistral.mistral-large-2402-v1:0",
+ _(
+ "Advanced Mistral AI large-scale language model capable of handling any language task, including complex multilingual reasoning, text understanding, transformation, and code generation."
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel),
+ BedrockModel,
+ ),
_create_model_info(
- 'meta.llama3-70b-instruct-v1:0',
- _('Ideal for content creation, conversational AI, language understanding, R&D, and enterprise applications'),
+ "meta.llama3-70b-instruct-v1:0",
+ _(
+ "Ideal for content creation, conversational AI, language understanding, R&D, and enterprise applications"
+ ),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel),
+ BedrockModel,
+ ),
_create_model_info(
- 'meta.llama3-8b-instruct-v1:0',
- _('Ideal for limited computing power and resources, edge devices, and faster training times.'),
+ "meta.llama3-8b-instruct-v1:0",
+ _("Ideal for limited computing power and resources, edge devices, and faster training times."),
ModelTypeConst.LLM,
BedrockLLMModelCredential,
- BedrockModel),
+ BedrockModel,
+ ),
]
embedded_model_info_list = [
_create_model_info(
- 'amazon.titan-embed-text-v1',
- _('Titan Embed Text is the largest embedding model in the Amazon Titan Embed series and can handle various text embedding tasks, such as text classification, text similarity calculation, etc.'),
+ "amazon.titan-embed-text-v1",
+ _(
+ "Titan Embed Text is the largest embedding model in the Amazon Titan Embed series and can handle various text embedding tasks, such as text classification, text similarity calculation, etc."
+ ),
ModelTypeConst.EMBEDDING,
BedrockEmbeddingCredential,
- BedrockEmbeddingModel
+ BedrockEmbeddingModel,
),
]
reranker_model_info_list = [
_create_model_info(
- 'amazon.rerank-v1:0',
- '',
- ModelTypeConst.RERANKER,
- BedrockRerankerCredential,
- BedrockRerankerModel
+ "amazon.rerank-v1:0", "", ModelTypeConst.RERANKER, BedrockRerankerCredential, BedrockRerankerModel
),
_create_model_info(
- 'cohere.rerank-v3-5:0',
- '',
- ModelTypeConst.RERANKER,
- BedrockRerankerCredential,
- BedrockRerankerModel
- )
+ "cohere.rerank-v3-5:0", "", ModelTypeConst.RERANKER, BedrockRerankerCredential, BedrockRerankerModel
+ ),
]
vl_model_info_list = [
-
_create_model_info(
- 'global.anthropic.claude-sonnet-4-5-20250929-v1:0',
- '',
+ "global.anthropic.claude-sonnet-4-5-20250929-v1:0",
+ "",
ModelTypeConst.IMAGE,
BedrockVLModelCredential,
- BedrockVLModel
+ BedrockVLModel,
),
_create_model_info(
- 'us.anthropic.claude-sonnet-4-5-20250929-v1:0',
- '',
+ "us.anthropic.claude-sonnet-4-5-20250929-v1:0",
+ "",
ModelTypeConst.IMAGE,
BedrockVLModelCredential,
- BedrockVLModel
+ BedrockVLModel,
),
_create_model_info(
- 'global.anthropic.claude-haiku-4-5-20251001-v1:0',
- '',
+ "global.anthropic.claude-haiku-4-5-20251001-v1:0",
+ "",
ModelTypeConst.IMAGE,
BedrockVLModelCredential,
- BedrockVLModel
+ BedrockVLModel,
),
]
- model_info_manage = ModelInfoManage.builder() \
- .append_model_info_list(model_info_list) \
- .append_default_model_info(model_info_list[0]) \
- .append_model_info_list(embedded_model_info_list) \
- .append_default_model_info(embedded_model_info_list[0]) \
- .append_model_info_list(vl_model_info_list) \
- .append_default_model_info(vl_model_info_list[0]) \
- .append_model_info_list(reranker_model_info_list) \
- .append_default_model_info(reranker_model_info_list[0]) \
+ model_info_manage = (
+ ModelInfoManage.builder()
+ .append_model_info_list(model_info_list)
+ .append_default_model_info(model_info_list[0])
+ .append_model_info_list(embedded_model_info_list)
+ .append_default_model_info(embedded_model_info_list[0])
+ .append_model_info_list(vl_model_info_list)
+ .append_default_model_info(vl_model_info_list[0])
+ .append_model_info_list(reranker_model_info_list)
+ .append_default_model_info(reranker_model_info_list[0])
.build()
+ )
return model_info_manage
@@ -197,8 +227,4 @@ def get_model_info_manage(self):
def get_model_provide_info(self):
icon_path = _get_aws_bedrock_icon_path()
icon_data = get_file_content(icon_path)
- return ModelProvideInfo(
- provider='model_aws_bedrock_provider',
- name='Amazon Bedrock',
- icon=icon_data
- )
+ return ModelProvideInfo(provider="model_aws_bedrock_provider", name="Amazon Bedrock", icon=icon_data)
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/credential/embedding.py b/apps/models_provider/impl/aws_bedrock_model_provider/credential/embedding.py
index 8c73af139e0..c661fc0e6da 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/credential/embedding.py
@@ -9,43 +9,56 @@
from models_provider.impl.aws_bedrock_model_provider.model.embedding import BedrockEmbeddingModel
from common.utils.logger import maxkb_logger
-class BedrockEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+class BedrockEmbeddingCredential(BaseForm, BaseModelCredential):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("{model_type} Model type is not supported").format(model_type=model_type),
+ )
return False
- required_keys = ['region_name', 'access_key_id', 'secret_access_key']
+ required_keys = ["region_name", "access_key_id", "secret_access_key"]
if not all(key in model_credential for key in required_keys):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('The following fields are required: {keys}').format(
- keys=", ".join(required_keys)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("The following fields are required: {keys}").format(keys=", ".join(required_keys)),
+ )
return False
try:
model: BedrockEmbeddingModel = provider.get_model(model_type, model_name, model_credential)
- aa = model.embed_query(_('Hello'))
+ aa = model.embed_query(_("Hello"))
except AppApiException:
raise
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'secret_access_key': super().encryption(model.get('secret_access_key', ''))}
+ return {**model, "secret_access_key": super().encryption(model.get("secret_access_key", ""))}
- region_name = forms.TextInputField('Region Name', required=True)
- access_key_id = forms.TextInputField('Access Key ID', required=True)
- secret_access_key = forms.PasswordInputField('Secret Access Key', required=True)
+ region_name = forms.TextInputField("Region Name", required=True)
+ access_key_id = forms.TextInputField("Access Key ID", required=True)
+ secret_access_key = forms.PasswordInputField("Secret Access Key", required=True)
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/credential/image.py b/apps/models_provider/impl/aws_bedrock_model_provider/credential/image.py
index a2bc3092c67..d4ca8c9aaa4 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/credential/image.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/credential/image.py
@@ -11,66 +11,85 @@
class BedrockImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class BedrockVLModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
return False
- required_keys = ['region_name', 'access_key_id', 'secret_access_key']
+ required_keys = ["region_name", "access_key_id", "secret_access_key"]
if not all(key in model_credential for key in required_keys):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('The following fields are required: {keys}').format(
- keys=", ".join(required_keys)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("The following fields are required: {keys}").format(keys=", ".join(required_keys)),
+ )
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model.invoke([HumanMessage(content="1")])
except AppApiException:
raise
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'secret_access_key': super().encryption(model.get('secret_access_key', ''))}
+ return {**model, "secret_access_key": super().encryption(model.get("secret_access_key", ""))}
- region_name = forms.TextInputField('Region Name', required=True)
- access_key_id = forms.TextInputField('Access Key ID', required=True)
- secret_access_key = forms.PasswordInputField('Secret Access Key', required=True)
- base_url = forms.TextInputField('Proxy URL', required=False)
+ region_name = forms.TextInputField("Region Name", required=True)
+ access_key_id = forms.TextInputField("Access Key ID", required=True)
+ secret_access_key = forms.PasswordInputField("Secret Access Key", required=True)
+ base_url = forms.TextInputField("Proxy URL", required=False)
def get_model_params_setting_form(self, model_name):
return BedrockImageModelParams()
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/credential/llm.py b/apps/models_provider/impl/aws_bedrock_model_provider/credential/llm.py
index 32527dac060..2b123b6e6d6 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/credential/llm.py
@@ -9,67 +9,87 @@
from models_provider.base_model_provider import ValidCode, BaseModelCredential
from common.utils.logger import maxkb_logger
+
class BedrockLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class BedrockLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
return False
- required_keys = ['region_name', 'access_key_id', 'secret_access_key']
+ required_keys = ["region_name", "access_key_id", "secret_access_key"]
if not all(key in model_credential for key in required_keys):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('The following fields are required: {keys}').format(
- keys=", ".join(required_keys)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("The following fields are required: {keys}").format(keys=", ".join(required_keys)),
+ )
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except AppApiException:
raise
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'secret_access_key': super().encryption(model.get('secret_access_key', ''))}
+ return {**model, "secret_access_key": super().encryption(model.get("secret_access_key", ""))}
- region_name = forms.TextInputField('Region Name', required=True)
- access_key_id = forms.TextInputField('Access Key ID', required=True)
- secret_access_key = forms.PasswordInputField('Secret Access Key', required=True)
- base_url = forms.TextInputField('Proxy URL', required=False)
+ region_name = forms.TextInputField("Region Name", required=True)
+ access_key_id = forms.TextInputField("Access Key ID", required=True)
+ secret_access_key = forms.PasswordInputField("Secret Access Key", required=True)
+ base_url = forms.TextInputField("Proxy URL", required=False)
def get_model_params_setting_form(self, model_name):
return BedrockLLMModelParams()
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/credential/reranker.py b/apps/models_provider/impl/aws_bedrock_model_provider/credential/reranker.py
index 46a3ed9e3a9..26f27fa6437 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/credential/reranker.py
@@ -1,7 +1,7 @@
import traceback
from typing import Dict
-from django.utils.translation import gettext_lazy as _, gettext
+from django.utils.translation import gettext_lazy as _
from langchain_core.documents import Document
from common import forms
@@ -11,57 +11,71 @@
class BedrockRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=20,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=20,
+ _step=1,
+ precision=0,
+ )
class BedrockRerankerCredential(BaseForm, BaseModelCredential):
- access_key_id = forms.PasswordInputField(_('Access Key ID'), required=True)
- secret_access_key = forms.PasswordInputField(_('Secret Access Key'), required=True)
- region_name = forms.TextInputField(_('Region Name'), required=True, default_value='us-east-1')
- base_url = forms.TextInputField(_('Base URL'), required=False)
+ access_key_id = forms.PasswordInputField(_("Access Key ID"), required=True)
+ secret_access_key = forms.PasswordInputField(_("Secret Access Key"), required=True)
+ region_name = forms.TextInputField(_("Region Name"), required=True, default_value="us-east-1")
+ base_url = forms.TextInputField(_("Base URL"), required=False)
- def is_valid(self, model_type: str, model_name: str, model_credential: Dict[str, object], model_params,
- provider,
- raise_exception: bool = False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception: bool = False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value, _('Model type is not supported'))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(ValidCode.valid_error.value, _("Model type is not supported"))
- for key in ['access_key_id', 'secret_access_key', 'region_name']:
+ for key in ["access_key_id", "secret_access_key", "region_name"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('%(key)s is required') % {'key': key})
+ raise AppApiException(ValidCode.valid_error.value, _("%(key)s is required") % {"key": key})
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
# Use top_n=1 for validation since we only have 1 test document
test_docs = [
- Document(page_content=str(_('Hello'))),
- Document(page_content=str(_('World'))),
- Document(page_content=str(_('Test')))
+ Document(page_content=str(_("Hello"))),
+ Document(page_content=str(_("World"))),
+ Document(page_content=str(_("Test"))),
]
- model.compress_documents(test_docs, str(_('Hello')))
+ model.compress_documents(test_docs, str(_("Hello")))
except Exception as e:
traceback.print_exc()
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: %(error)s') % {'error': str(e)})
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: %(error)s")
+ % {"error": str(e)},
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'access_key_id': super().encryption(model.get('access_key_id', '')),
- 'secret_access_key': super().encryption(model.get('secret_access_key', ''))}
+ return {
+ **model,
+ "access_key_id": super().encryption(model.get("access_key_id", "")),
+ "secret_access_key": super().encryption(model.get("secret_access_key", "")),
+ }
def get_model_params_setting_form(self, model_name):
return BedrockRerankerModelParams()
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/model/embedding.py b/apps/models_provider/impl/aws_bedrock_model_provider/model/embedding.py
index c6c658c7cdd..2748e4e9a85 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/model/embedding.py
@@ -1,26 +1,31 @@
from langchain_aws import BedrockEmbeddings
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
from typing import Dict, List
from models_provider.impl.aws_bedrock_model_provider.model.llm import _update_aws_credentials
-class BedrockEmbeddingModel(MaxKBBaseModel, BedrockEmbeddings):
- def __init__(self, model_id: str, region_name: str, credentials_profile_name: str,
- **kwargs):
- super().__init__(model_id=model_id, region_name=region_name,
- credentials_profile_name=credentials_profile_name, **kwargs)
+class BedrockEmbeddingModel(MaxKBBaseEmbeddingModel, BedrockEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
+
+ def __init__(self, model_id: str, region_name: str, credentials_profile_name: str, **kwargs):
+ super().__init__(
+ model_id=model_id, region_name=region_name, credentials_profile_name=credentials_profile_name, **kwargs
+ )
@classmethod
- def new_instance(cls, model_type: str, model_name: str, model_credential: Dict[str, str],
- **model_kwargs) -> 'BedrockModel':
- _update_aws_credentials(model_credential['access_key_id'], model_credential['access_key_id'],
- model_credential['secret_access_key'])
+ def new_instance(
+ cls, model_type: str, model_name: str, model_credential: Dict[str, str], **model_kwargs
+ ) -> "BedrockEmbeddingModel":
+ _update_aws_credentials(
+ model_credential["access_key_id"], model_credential["access_key_id"], model_credential["secret_access_key"]
+ )
return cls(
model_id=model_name,
- region_name=model_credential['region_name'],
- credentials_profile_name=model_credential['access_key_id'],
+ region_name=model_credential["region_name"],
+ credentials_profile_name=model_credential["access_key_id"],
)
def embed_documents(self, texts: List[str]) -> List[List[float]]:
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/model/image.py b/apps/models_provider/impl/aws_bedrock_model_provider/model/image.py
index 9ab812a5462..0766063bc8a 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/model/image.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/model/image.py
@@ -1,9 +1,10 @@
# coding=utf-8
"""
- @project: MaxKB
- @file: image.py
- @desc: AWS Bedrock Vision-Language Model Implementation
+@project: MaxKB
+@file: image.py
+@desc: AWS Bedrock Vision-Language Model Implementation
"""
+
from typing import Dict, List
from botocore.config import Config
@@ -25,47 +26,46 @@ class BedrockVLModel(MaxKBBaseModel, ChatBedrock):
def is_cache_model():
return False
- def __init__(self, model_id: str, region_name: str, credentials_profile_name: str,
- streaming: bool = False, config: Config = None, **kwargs):
+ def __init__(
+ self,
+ model_id: str,
+ region_name: str,
+ credentials_profile_name: str,
+ streaming: bool = False,
+ config: Config = None,
+ **kwargs,
+ ):
super().__init__(
model_id=model_id,
region_name=region_name,
credentials_profile_name=credentials_profile_name,
streaming=streaming,
config=config,
- **kwargs
+ **kwargs,
)
@classmethod
- def new_instance(cls, model_type: str, model_name: str, model_credential: Dict[str, str],
- **model_kwargs) -> 'BedrockVLModel':
+ def new_instance(
+ cls, model_type: str, model_name: str, model_credential: Dict[str, str], **model_kwargs
+ ) -> "BedrockVLModel":
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
config = {}
# Check if proxy URL is provided
- if 'base_url' in model_credential and model_credential['base_url']:
- proxy_url = model_credential['base_url']
- config = Config(
- proxies={
- 'http': proxy_url,
- 'https': proxy_url
- },
- connect_timeout=60,
- read_timeout=60
- )
+ if "base_url" in model_credential and model_credential["base_url"]:
+ proxy_url = model_credential["base_url"]
+ config = Config(proxies={"http": proxy_url, "https": proxy_url}, connect_timeout=60, read_timeout=60)
_update_aws_credentials(
- model_credential['access_key_id'],
- model_credential['access_key_id'],
- model_credential['secret_access_key']
+ model_credential["access_key_id"], model_credential["access_key_id"], model_credential["secret_access_key"]
)
return cls(
model_id=model_name,
- region_name=model_credential['region_name'],
- credentials_profile_name=model_credential['access_key_id'],
- streaming=model_kwargs.pop('streaming', True),
+ region_name=model_credential["region_name"],
+ credentials_profile_name=model_credential["access_key_id"],
+ streaming=model_kwargs.pop("streaming", True),
model_kwargs=optional_params,
- config=config
+ config=config,
)
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
@@ -75,7 +75,7 @@ def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
"""
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
@@ -86,6 +86,6 @@ def get_num_tokens(self, text: str) -> int:
"""
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/model/llm.py b/apps/models_provider/impl/aws_bedrock_model_provider/model/llm.py
index 50ee4abfe65..3bc9a5bca56 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/model/llm.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/model/llm.py
@@ -1,3 +1,4 @@
+import configparser
import os
import re
from typing import Dict, List
@@ -21,83 +22,118 @@ def get_max_tokens_keyword(model_name):
# max_tokens_to_sample = ["anthropic.claude-v2:1", "anthropic.claude-v2", "anthropic.claude-instant-v1"]
maxTokenCount = ["amazon.titan-text-lite-v1", "amazon.titan-text-express-v1"]
max_new_tokens = [
- "us.meta.llama3-2-1b-instruct-v1:0", "us.meta.llama3-2-3b-instruct-v1:0", "us.meta.llama3-2-11b-instruct-v1:0",
- "us.meta.llama3-2-90b-instruct-v1:0"]
+ "us.meta.llama3-2-1b-instruct-v1:0",
+ "us.meta.llama3-2-3b-instruct-v1:0",
+ "us.meta.llama3-2-11b-instruct-v1:0",
+ "us.meta.llama3-2-90b-instruct-v1:0",
+ ]
if model_name in maxTokens:
- return 'maxTokens'
+ return "maxTokens"
elif model_name in maxTokenCount:
- return 'maxTokenCount'
+ return "maxTokenCount"
elif model_name in max_new_tokens:
- return 'max_new_tokens'
+ return "max_new_tokens"
else:
- return 'max_tokens'
+ return "max_tokens"
class BedrockModel(MaxKBBaseModel, ChatBedrock):
-
@staticmethod
def is_cache_model():
return False
- def __init__(self, model_id: str, region_name: str, credentials_profile_name: str,
- streaming: bool = False, config: Config = None, **kwargs):
- super().__init__(model_id=model_id, region_name=region_name,
- credentials_profile_name=credentials_profile_name, streaming=streaming, config=config,
- **kwargs)
+ def __init__(
+ self,
+ model_id: str,
+ region_name: str,
+ credentials_profile_name: str,
+ streaming: bool = False,
+ config: Config = None,
+ **kwargs,
+ ):
+ super().__init__(
+ model_id=model_id,
+ region_name=region_name,
+ credentials_profile_name=credentials_profile_name,
+ streaming=streaming,
+ config=config,
+ **kwargs,
+ )
@classmethod
- def new_instance(cls, model_type: str, model_name: str, model_credential: Dict[str, str],
- **model_kwargs) -> 'BedrockModel':
+ def new_instance(
+ cls, model_type: str, model_name: str, model_credential: Dict[str, str], **model_kwargs
+ ) -> "BedrockModel":
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
config = {}
# 判断model_kwargs是否包含 base_url 且不为空
- if 'base_url' in model_credential and model_credential['base_url']:
- proxy_url = model_credential['base_url']
- config = Config(
- proxies={
- 'http': proxy_url,
- 'https': proxy_url
- },
- connect_timeout=60,
- read_timeout=60
- )
- _update_aws_credentials(model_credential['access_key_id'], model_credential['access_key_id'],
- model_credential['secret_access_key'])
+ if "base_url" in model_credential and model_credential["base_url"]:
+ proxy_url = model_credential["base_url"]
+ config = Config(proxies={"http": proxy_url, "https": proxy_url}, connect_timeout=60, read_timeout=60)
+ _update_aws_credentials(
+ model_credential["access_key_id"], model_credential["access_key_id"], model_credential["secret_access_key"]
+ )
return cls(
model_id=model_name,
- region_name=model_credential['region_name'],
- credentials_profile_name=model_credential['access_key_id'],
- streaming=model_kwargs.pop('streaming', True),
+ region_name=model_credential["region_name"],
+ credentials_profile_name=model_credential["access_key_id"],
+ streaming=model_kwargs.pop("streaming", True),
model_kwargs=optional_params,
- config=config
+ config=config,
)
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
+def _validate_aws_profile_name(profile_name: str):
+ if not profile_name:
+ raise ValueError("profile_name can not be empty")
+ if profile_name != profile_name.strip():
+ raise ValueError("profile_name can not contain leading or trailing spaces")
+ if re.search(r'[\x00-\x1f\x7f\[\]]', profile_name):
+ raise ValueError("profile_name contains invalid characters")
+
+
+def _validate_aws_credential_value(field_name: str, value: str):
+ if not value:
+ raise ValueError(f"{field_name} can not be empty")
+ if value.strip() != value:
+ raise ValueError(f"{field_name} can not contain leading or trailing spaces")
+ if re.search(r'[\x00-\x1f\x7f]', value):
+ raise ValueError(f"{field_name} contains invalid characters")
+
+
def _update_aws_credentials(profile_name, access_key_id, secret_access_key):
+ _validate_aws_profile_name(profile_name)
+ _validate_aws_credential_value("access_key_id", access_key_id)
+ _validate_aws_credential_value("secret_access_key", secret_access_key)
+
credentials_path = os.path.join(os.path.expanduser("~"), ".aws", "credentials")
os.makedirs(os.path.dirname(credentials_path), exist_ok=True)
+ config = configparser.RawConfigParser(strict=False)
+ config.optionxform = str
+ if os.path.exists(credentials_path):
+ config.read(credentials_path, encoding='utf-8')
- content = open(credentials_path, 'r').read() if os.path.exists(credentials_path) else ''
- pattern = rf'\n*\[{profile_name}\]\n*(aws_access_key_id = .*)\n*(aws_secret_access_key = .*)\n*'
- content = re.sub(pattern, '', content, flags=re.DOTALL)
+ if config.has_section(profile_name):
+ config.remove_section(profile_name)
- if not re.search(rf'\[{profile_name}\]', content):
- content += f"\n[{profile_name}]\naws_access_key_id = {access_key_id}\naws_secret_access_key = {secret_access_key}\n"
+ config.add_section(profile_name)
+ config.set(profile_name, "aws_access_key_id", access_key_id)
+ config.set(profile_name, "aws_secret_access_key", secret_access_key)
- with open(credentials_path, 'w') as file:
- file.write(content)
+ with open(credentials_path, 'w', encoding='utf-8') as file:
+ config.write(file)
diff --git a/apps/models_provider/impl/aws_bedrock_model_provider/model/reranker.py b/apps/models_provider/impl/aws_bedrock_model_provider/model/reranker.py
index fb4743f5f6f..4074dbf6c48 100644
--- a/apps/models_provider/impl/aws_bedrock_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/aws_bedrock_model_provider/model/reranker.py
@@ -1,6 +1,4 @@
-import os
-import re
-from typing import Dict, List, Sequence, Optional, Any
+from typing import Dict, Sequence, Optional, Any
from botocore.config import Config
from langchain_aws import BedrockRerank
@@ -29,40 +27,36 @@ def is_cache_model():
return False
@staticmethod
- def new_instance(model_type: str, model_name: str, model_credential: Dict[str, str],
- **model_kwargs) -> 'BedrockRerankerModel':
- top_n = model_kwargs.get('top_n', 3)
- region_name = model_credential['region_name']
+ def new_instance(
+ model_type: str, model_name: str, model_credential: Dict[str, str], **model_kwargs
+ ) -> "BedrockRerankerModel":
+ top_n = model_kwargs.get("top_n", 3)
+ region_name = model_credential["region_name"]
model_arn = f"arn:aws:bedrock:{region_name}::foundation-model/{model_name}"
config = None
- if 'base_url' in model_credential and model_credential['base_url']:
- proxy_url = model_credential['base_url']
- config = Config(
- proxies={
- 'http': proxy_url,
- 'https': proxy_url
- },
- connect_timeout=60,
- read_timeout=60
- )
+ if "base_url" in model_credential and model_credential["base_url"]:
+ proxy_url = model_credential["base_url"]
+ config = Config(proxies={"http": proxy_url, "https": proxy_url}, connect_timeout=60, read_timeout=60)
- _update_aws_credentials(model_credential['access_key_id'], model_credential['access_key_id'],
- model_credential['secret_access_key'])
+ _update_aws_credentials(
+ model_credential["access_key_id"], model_credential["access_key_id"], model_credential["secret_access_key"]
+ )
return BedrockRerankerModel(
model_id=model_name,
model_arn=model_arn,
region_name=region_name,
- credentials_profile_name=model_credential['access_key_id'],
- aws_access_key_id=model_credential['access_key_id'],
- aws_secret_access_key=model_credential['secret_access_key'],
+ credentials_profile_name=model_credential["access_key_id"],
+ aws_access_key_id=model_credential["access_key_id"],
+ aws_secret_access_key=model_credential["secret_access_key"],
config=config,
- top_n=top_n
+ top_n=top_n,
)
- def compress_documents(self, documents: Sequence[Document], query: str,
- callbacks: Optional[Callbacks] = None) -> Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
"""Compress documents using Bedrock reranking."""
if not documents:
return []
@@ -74,7 +68,6 @@ def compress_documents(self, documents: Sequence[Document], query: str,
aws_access_key_id=self.aws_access_key_id,
aws_secret_access_key=self.aws_secret_access_key,
config=self.config,
- top_n=self.top_n
+ top_n=self.top_n,
)
return reranker.compress_documents(documents, query, callbacks)
-
diff --git a/apps/models_provider/impl/azure_model_provider/__init__.py b/apps/models_provider/impl/azure_model_provider/__init__.py
index 53b7001e589..fd54226fe4c 100644
--- a/apps/models_provider/impl/azure_model_provider/__init__.py
+++ b/apps/models_provider/impl/azure_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2023/10/31 17:16
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2023/10/31 17:16
+@desc:
"""
diff --git a/apps/models_provider/impl/azure_model_provider/azure_model_provider.py b/apps/models_provider/impl/azure_model_provider/azure_model_provider.py
index 39cf44ced4c..1134b9f5d45 100644
--- a/apps/models_provider/impl/azure_model_provider/azure_model_provider.py
+++ b/apps/models_provider/impl/azure_model_provider/azure_model_provider.py
@@ -1,16 +1,22 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: azure_model_provider.py
- @date:2023/10/31 16:19
- @desc:
+@project: maxkb
+@Author:虎
+@file: azure_model_provider.py
+@date:2023/10/31 16:19
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.azure_model_provider.credential.embedding import AzureOpenAIEmbeddingCredential
from models_provider.impl.azure_model_provider.credential.image import AzureOpenAIImageModelCredential
from models_provider.impl.azure_model_provider.credential.llm import AzureLLMModelCredential
@@ -24,7 +30,6 @@
from models_provider.impl.azure_model_provider.model.tti import AzureOpenAITextToImage
from models_provider.impl.azure_model_provider.model.tts import AzureOpenAITextToSpeech
from maxkb.conf import PROJECT_DIR
-from django.utils.translation import gettext_lazy as _
base_azure_llm_model_credential = AzureLLMModelCredential()
base_azure_embedding_model_credential = AzureOpenAIEmbeddingCredential()
@@ -34,57 +39,117 @@
base_azure_stt_model_credential = AzureOpenAISTTModelCredential()
default_model_info = [
- ModelInfo('Azure OpenAI', '', ModelTypeConst.LLM,
- base_azure_llm_model_credential, AzureChatModel, api_version='2024-02-15-preview'
- ),
- ModelInfo('gpt-4', '', ModelTypeConst.LLM,
- base_azure_llm_model_credential, AzureChatModel, api_version='2024-02-15-preview'
- ),
- ModelInfo('gpt-4o', '', ModelTypeConst.LLM,
- base_azure_llm_model_credential, AzureChatModel, api_version='2024-02-15-preview'
- ),
- ModelInfo('gpt-4o-mini', '', ModelTypeConst.LLM,
- base_azure_llm_model_credential, AzureChatModel, api_version='2024-02-15-preview'
- ),
+ ModelInfo(
+ "Azure OpenAI",
+ "",
+ ModelTypeConst.LLM,
+ base_azure_llm_model_credential,
+ AzureChatModel,
+ api_version="2024-02-15-preview",
+ ),
+ ModelInfo(
+ "gpt-4",
+ "",
+ ModelTypeConst.LLM,
+ base_azure_llm_model_credential,
+ AzureChatModel,
+ api_version="2024-02-15-preview",
+ ),
+ ModelInfo(
+ "gpt-4o",
+ "",
+ ModelTypeConst.LLM,
+ base_azure_llm_model_credential,
+ AzureChatModel,
+ api_version="2024-02-15-preview",
+ ),
+ ModelInfo(
+ "gpt-4o-mini",
+ "",
+ ModelTypeConst.LLM,
+ base_azure_llm_model_credential,
+ AzureChatModel,
+ api_version="2024-02-15-preview",
+ ),
]
embedding_model_info = [
- ModelInfo('text-embedding-3-large', '', ModelTypeConst.EMBEDDING,
- base_azure_embedding_model_credential, AzureOpenAIEmbeddingModel, api_version='2023-05-15'
- ),
- ModelInfo('text-embedding-3-small', '', ModelTypeConst.EMBEDDING,
- base_azure_embedding_model_credential, AzureOpenAIEmbeddingModel, api_version='2023-05-15'
- ),
- ModelInfo('text-embedding-ada-002', '', ModelTypeConst.EMBEDDING,
- base_azure_embedding_model_credential, AzureOpenAIEmbeddingModel, api_version='2023-05-15'
- ),
+ ModelInfo(
+ "text-embedding-3-large",
+ "",
+ ModelTypeConst.EMBEDDING,
+ base_azure_embedding_model_credential,
+ AzureOpenAIEmbeddingModel,
+ api_version="2023-05-15",
+ ),
+ ModelInfo(
+ "text-embedding-3-small",
+ "",
+ ModelTypeConst.EMBEDDING,
+ base_azure_embedding_model_credential,
+ AzureOpenAIEmbeddingModel,
+ api_version="2023-05-15",
+ ),
+ ModelInfo(
+ "text-embedding-ada-002",
+ "",
+ ModelTypeConst.EMBEDDING,
+ base_azure_embedding_model_credential,
+ AzureOpenAIEmbeddingModel,
+ api_version="2023-05-15",
+ ),
]
image_model_info = [
- ModelInfo('gpt-4o', '', ModelTypeConst.IMAGE,
- base_azure_image_model_credential, AzureOpenAIImage, api_version='2023-05-15'
- ),
- ModelInfo('gpt-4o-mini', '', ModelTypeConst.IMAGE,
- base_azure_image_model_credential, AzureOpenAIImage, api_version='2023-05-15'
- ),
+ ModelInfo(
+ "gpt-4o",
+ "",
+ ModelTypeConst.IMAGE,
+ base_azure_image_model_credential,
+ AzureOpenAIImage,
+ api_version="2023-05-15",
+ ),
+ ModelInfo(
+ "gpt-4o-mini",
+ "",
+ ModelTypeConst.IMAGE,
+ base_azure_image_model_credential,
+ AzureOpenAIImage,
+ api_version="2023-05-15",
+ ),
]
tti_model_info = [
- ModelInfo('dall-e-3', '', ModelTypeConst.TTI,
- base_azure_tti_model_credential, AzureOpenAITextToImage, api_version='2023-05-15'
- ),
+ ModelInfo(
+ "dall-e-3",
+ "",
+ ModelTypeConst.TTI,
+ base_azure_tti_model_credential,
+ AzureOpenAITextToImage,
+ api_version="2023-05-15",
+ ),
]
tts_model_info = [
- ModelInfo('tts', '', ModelTypeConst.TTS,
- base_azure_tts_model_credential, AzureOpenAITextToSpeech, api_version='2023-05-15'
- ),
+ ModelInfo(
+ "tts",
+ "",
+ ModelTypeConst.TTS,
+ base_azure_tts_model_credential,
+ AzureOpenAITextToSpeech,
+ api_version="2023-05-15",
+ ),
]
stt_model_info = [
- ModelInfo('whisper', '', ModelTypeConst.STT,
- base_azure_stt_model_credential, AzureOpenAISpeechToText, api_version='2023-05-15'
- ),
+ ModelInfo(
+ "whisper",
+ "",
+ ModelTypeConst.STT,
+ base_azure_stt_model_credential,
+ AzureOpenAISpeechToText,
+ api_version="2023-05-15",
+ ),
]
model_info_manage = (
@@ -106,11 +171,16 @@
class AzureModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_azure_provider', name='Azure OpenAI', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'azure_model_provider', 'icon',
- 'azure_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_azure_provider",
+ name="Azure OpenAI",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "azure_model_provider", "icon", "azure_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/azure_model_provider/credential/embedding.py b/apps/models_provider/impl/azure_model_provider/credential/embedding.py
index c37f750b1e5..7bda526bdff 100644
--- a/apps/models_provider/impl/azure_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/azure_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 17:08
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 17:08
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,41 +17,51 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
-class AzureOpenAIEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+class AzureOpenAIEmbeddingCredential(BaseForm, BaseModelCredential):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key', 'api_version']:
+ for key in ["api_base", "api_key", "api_version"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct'))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct"),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
api_version = forms.TextInputField("Api Version", required=True)
- api_base = forms.TextInputField('Azure Endpoint', required=True)
+ api_base = forms.TextInputField("Azure Endpoint", required=True)
api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/azure_model_provider/credential/image.py b/apps/models_provider/impl/azure_model_provider/credential/image.py
index eefd0ea9822..817556ba43f 100644
--- a/apps/models_provider/impl/azure_model_provider/credential/image.py
+++ b/apps/models_provider/impl/azure_model_provider/credential/image.py
@@ -1,6 +1,4 @@
# coding=utf-8
-import base64
-import os
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -14,62 +12,81 @@
class AzureOpenAIImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class AzureOpenAIImageModelCredential(BaseForm, BaseModelCredential):
api_version = forms.TextInputField("API Version", required=True)
- api_base = forms.TextInputField('Azure Endpoint', required=True)
+ api_base = forms.TextInputField("Azure Endpoint", required=True)
api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key', 'api_version']:
+ for key in ["api_base", "api_key", "api_version"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return AzureOpenAIImageModelParams()
diff --git a/apps/models_provider/impl/azure_model_provider/credential/llm.py b/apps/models_provider/impl/azure_model_provider/credential/llm.py
index f9f3ad86baf..8e0da23a44c 100644
--- a/apps/models_provider/impl/azure_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/azure_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 17:08
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 17:08
+@desc:
"""
+
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -18,78 +19,100 @@
from django.utils.translation import gettext_lazy as _, gettext
from common.utils.logger import maxkb_logger
+
class AzureLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class o3MiniLLMModelParams(BaseForm):
max_completion_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=5000,
_step=1,
- precision=0)
+ precision=0,
+ )
class AzureLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key', 'deployment_name', 'api_version']:
+ for key in ["api_base", "api_key", "deployment_name", "api_version"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException) or isinstance(e, BadRequestError):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('Verification failed, please check whether the parameters are correct'))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct"),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
api_version = forms.TextInputField("API Version", required=True)
- api_base = forms.TextInputField('Azure Endpoint', required=True)
+ api_base = forms.TextInputField("Azure Endpoint", required=True)
api_key = forms.PasswordInputField("API Key", required=True)
deployment_name = forms.TextInputField("Deployment name", required=True)
def get_model_params_setting_form(self, model_name):
- if 'o3' in model_name or 'o1' in model_name:
+ if "o3" in model_name or "o1" in model_name:
return o3MiniLLMModelParams()
return AzureLLMModelParams()
diff --git a/apps/models_provider/impl/azure_model_provider/credential/stt.py b/apps/models_provider/impl/azure_model_provider/credential/stt.py
index ac82e00d4ac..826448bb8c3 100644
--- a/apps/models_provider/impl/azure_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/azure_model_provider/credential/stt.py
@@ -9,41 +9,53 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class AzureOpenAISTTModelCredential(BaseForm, BaseModelCredential):
api_version = forms.TextInputField("API Version", required=True)
- api_base = forms.TextInputField('Azure Endpoint', required=True)
+ api_base = forms.TextInputField("Azure Endpoint", required=True)
api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key', 'api_version']:
+ for key in ["api_base", "api_key", "api_version"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
pass
diff --git a/apps/models_provider/impl/azure_model_provider/credential/tti.py b/apps/models_provider/impl/azure_model_provider/credential/tti.py
index c370eaa4eb4..3d41a0176de 100644
--- a/apps/models_provider/impl/azure_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/azure_model_provider/credential/tti.py
@@ -9,77 +9,91 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class AzureOpenAITTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'), _('Specify the size of the generated image, such as: 1024x1024')),
+ TooltipLabel(_("Image size"), _("Specify the size of the generated image, such as: 1024x1024")),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '1024x1792', 'label': '1024x1792'},
- {'value': '1792x1024', 'label': '1792x1024'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1024x1792", "label": "1024x1792"},
+ {"value": "1792x1024", "label": "1792x1024"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
quality = forms.SingleSelect(
- TooltipLabel(_('Picture quality'), ''),
+ TooltipLabel(_("Picture quality"), ""),
required=True,
- default_value='standard',
+ default_value="standard",
option_list=[
- {'value': 'standard', 'label': 'standard'},
- {'value': 'hd', 'label': 'hd'},
+ {"value": "standard", "label": "standard"},
+ {"value": "hd", "label": "hd"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
n = forms.SliderField(
- TooltipLabel(_('Number of pictures'), _('Specify the number of generated images')),
- required=True, default_value=1,
+ TooltipLabel(_("Number of pictures"), _("Specify the number of generated images")),
+ required=True,
+ default_value=1,
_min=1,
_max=10,
_step=1,
- precision=0)
+ precision=0,
+ )
class AzureOpenAITextToImageModelCredential(BaseForm, BaseModelCredential):
api_version = forms.TextInputField("API Version", required=True)
- api_base = forms.TextInputField('Azure Endpoint', required=True)
+ api_base = forms.TextInputField("Azure Endpoint", required=True)
api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key', 'api_version']:
+ for key in ["api_base", "api_key", "api_version"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return AzureOpenAITTIModelParams()
diff --git a/apps/models_provider/impl/azure_model_provider/credential/tts.py b/apps/models_provider/impl/azure_model_provider/credential/tts.py
index c5e6318cf42..6807eb17363 100644
--- a/apps/models_provider/impl/azure_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/azure_model_provider/credential/tts.py
@@ -9,59 +9,78 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class AzureOpenAITTSModelGeneralParams(BaseForm):
# alloy, echo, fable, onyx, nova, shimmer
voice = forms.SingleSelect(
- TooltipLabel('Voice',
- _('Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English.')),
- required=True, default_value='alloy',
- text_field='value',
- value_field='value',
+ TooltipLabel(
+ "Voice",
+ _(
+ "Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English."
+ ),
+ ),
+ required=True,
+ default_value="alloy",
+ text_field="value",
+ value_field="value",
option_list=[
- {'text': 'alloy', 'value': 'alloy'},
- {'text': 'echo', 'value': 'echo'},
- {'text': 'fable', 'value': 'fable'},
- {'text': 'onyx', 'value': 'onyx'},
- {'text': 'nova', 'value': 'nova'},
- {'text': 'shimmer', 'value': 'shimmer'},
- ])
+ {"text": "alloy", "value": "alloy"},
+ {"text": "echo", "value": "echo"},
+ {"text": "fable", "value": "fable"},
+ {"text": "onyx", "value": "onyx"},
+ {"text": "nova", "value": "nova"},
+ {"text": "shimmer", "value": "shimmer"},
+ ],
+ )
class AzureOpenAITTSModelCredential(BaseForm, BaseModelCredential):
api_version = forms.TextInputField("API Version", required=True)
- api_base = forms.TextInputField('Azure Endpoint', required=True)
+ api_base = forms.TextInputField("Azure Endpoint", required=True)
api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key', 'api_version']:
+ for key in ["api_base", "api_key", "api_version"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return AzureOpenAITTSModelGeneralParams()
diff --git a/apps/models_provider/impl/azure_model_provider/model/azure_chat_model.py b/apps/models_provider/impl/azure_model_provider/model/azure_chat_model.py
index 36a12553a9c..edf8c1d6d01 100644
--- a/apps/models_provider/impl/azure_model_provider/model/azure_chat_model.py
+++ b/apps/models_provider/impl/azure_model_provider/model/azure_chat_model.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: azure_chat_model.py
- @date:2024/4/28 11:45
- @desc:
+@project: maxkb
+@Author:虎
+@file: azure_chat_model.py
+@date:2024/4/28 11:45
+@desc:
"""
from typing import List, Dict, Optional, Any
@@ -28,40 +28,40 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return AzureChatModel(
- azure_endpoint=model_credential.get('api_base'),
+ azure_endpoint=model_credential.get("api_base"),
model_name=model_name,
- openai_api_version=model_credential.get('api_version', '2024-02-15-preview'),
- deployment_name=model_credential.get('deployment_name'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_version=model_credential.get("api_version", "2024-02-15-preview"),
+ deployment_name=model_credential.get("deployment_name"),
+ openai_api_key=model_credential.get("api_key"),
openai_api_type="azure",
**optional_params,
streaming=True,
)
def get_last_generation_info(self) -> Optional[Dict[str, Any]]:
- return self.__dict__.get('_last_generation_info')
+ return self.__dict__.get("_last_generation_info")
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
- return self.get_last_generation_info().get('input_tokens', 0)
- except Exception as e:
+ return self.get_last_generation_info().get("input_tokens", 0)
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
- return self.get_last_generation_info().get('output_tokens', 0)
- except Exception as e:
+ return self.get_last_generation_info().get("output_tokens", 0)
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
def invoke(
- self,
- input: LanguageModelInput,
- config: Optional[RunnableConfig] = None,
- *,
- stop: Optional[list[str]] = None,
- **kwargs: Any,
+ self,
+ input: LanguageModelInput,
+ config: Optional[RunnableConfig] = None,
+ *,
+ stop: Optional[list[str]] = None,
+ **kwargs: Any,
) -> BaseMessage:
message = super().invoke(input, config, stop=stop, **kwargs)
if isinstance(message.content, str):
@@ -72,8 +72,8 @@ def invoke(
normalized_parts = []
for item in content:
if isinstance(item, dict):
- if item.get('type') == 'text':
- normalized_parts.append(item.get('text', ''))
- message.content = ''.join(normalized_parts)
- self.__dict__.setdefault('_last_generation_info', {}).update(message.usage_metadata)
+ if item.get("type") == "text":
+ normalized_parts.append(item.get("text", ""))
+ message.content = "".join(normalized_parts)
+ self.__dict__.setdefault("_last_generation_info", {}).update(message.usage_metadata)
return message
diff --git a/apps/models_provider/impl/azure_model_provider/model/embedding.py b/apps/models_provider/impl/azure_model_provider/model/embedding.py
index 8b16d11b5ac..bf6e388b8f5 100644
--- a/apps/models_provider/impl/azure_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/azure_model_provider/model/embedding.py
@@ -1,25 +1,29 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 17:44
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 17:44
+@desc:
"""
+
from typing import Dict
from langchain_openai import AzureOpenAIEmbeddings
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class AzureOpenAIEmbeddingModel(MaxKBBaseEmbeddingModel, AzureOpenAIEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
-class AzureOpenAIEmbeddingModel(MaxKBBaseModel, AzureOpenAIEmbeddings):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return AzureOpenAIEmbeddingModel(
model=model_name,
- openai_api_key=model_credential.get('api_key'),
- azure_endpoint=model_credential.get('api_base'),
- openai_api_version=model_credential.get('api_version'),
+ openai_api_key=model_credential.get("api_key"),
+ azure_endpoint=model_credential.get("api_base"),
+ openai_api_version=model_credential.get("api_version"),
openai_api_type="azure",
)
diff --git a/apps/models_provider/impl/azure_model_provider/model/image.py b/apps/models_provider/impl/azure_model_provider/model/image.py
index 4d086ec40fa..6bc335501ee 100644
--- a/apps/models_provider/impl/azure_model_provider/model/image.py
+++ b/apps/models_provider/impl/azure_model_provider/model/image.py
@@ -13,7 +13,6 @@ def custom_get_token_ids(text: str):
class AzureOpenAIImage(MaxKBBaseModel, AzureChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -23,9 +22,9 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return AzureOpenAIImage(
model_name=model_name,
- openai_api_key=model_credential.get('api_key'),
- azure_endpoint=model_credential.get('api_base'),
- openai_api_version=model_credential.get('api_version'),
+ openai_api_key=model_credential.get("api_key"),
+ azure_endpoint=model_credential.get("api_base"),
+ openai_api_version=model_credential.get("api_version"),
openai_api_type="azure",
streaming=True,
**optional_params,
@@ -34,13 +33,13 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/azure_model_provider/model/stt.py b/apps/models_provider/impl/azure_model_provider/model/stt.py
index c6364f37328..104994f8301 100644
--- a/apps/models_provider/impl/azure_model_provider/model/stt.py
+++ b/apps/models_provider/impl/azure_model_provider/model/stt.py
@@ -22,10 +22,10 @@ class AzureOpenAISpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.api_version = kwargs.get('api_version')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.api_version = kwargs.get("api_version")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -34,44 +34,32 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return AzureOpenAISpeechToText(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
- api_version=model_credential.get('api_version'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
+ api_version=model_credential.get("api_version"),
params=model_kwargs,
**optional_params,
)
def check_auth(self):
- client = AzureOpenAI(
- azure_endpoint=self.api_base,
- api_key=self.api_key,
- api_version=self.api_version
- )
+ client = AzureOpenAI(azure_endpoint=self.api_base, api_key=self.api_key, api_version=self.api_version)
response_list = client.models.with_raw_response.list()
# print(response_list)
def speech_to_text(self, audio_file):
- client = AzureOpenAI(
- azure_endpoint=self.api_base,
- api_key=self.api_key,
- api_version=self.api_version
- )
+ client = AzureOpenAI(azure_endpoint=self.api_base, api_key=self.api_key, api_version=self.api_version)
audio_data = audio_file.read()
buffer = io.BytesIO(audio_data)
buffer.name = "file.mp3" # this is the important line
- filter_params = {k: v for k, v in self.params.items() if k not in {'model_id', 'use_local', 'streaming'}}
- transcription_params = {
- 'model': self.model,
- 'file': buffer,
- 'language': 'zh'
- }
+ filter_params = {k: v for k, v in self.params.items() if k not in {"model_id", "use_local", "streaming"}}
+ transcription_params = {"model": self.model, "file": buffer, "language": "zh"}
res = client.audio.transcriptions.create(**transcription_params, extra_body=filter_params)
return res.text
diff --git a/apps/models_provider/impl/azure_model_provider/model/tti.py b/apps/models_provider/impl/azure_model_provider/model/tti.py
index 2f9b4cb7368..9a11d60b413 100644
--- a/apps/models_provider/impl/azure_model_provider/model/tti.py
+++ b/apps/models_provider/impl/azure_model_provider/model/tti.py
@@ -21,11 +21,11 @@ class AzureOpenAITextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.api_version = kwargs.get('api_version')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.api_version = kwargs.get("api_version")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -33,15 +33,15 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024x1024', 'quality': 'auto', 'n': 1}}
+ optional_params = {"params": {"size": "1024x1024", "quality": "auto", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return AzureOpenAITextToImage(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
- api_version=model_credential.get('api_version'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
+ api_version=model_credential.get("api_version"),
**optional_params,
)
@@ -66,5 +66,3 @@ def generate_image(self, prompt: str, negative_prompt: str = None):
return file_urls
except Exception as e:
raise e
-
-
diff --git a/apps/models_provider/impl/azure_model_provider/model/tts.py b/apps/models_provider/impl/azure_model_provider/model/tts.py
index 75fcf0d1948..53d7d0bf6e5 100644
--- a/apps/models_provider/impl/azure_model_provider/model/tts.py
+++ b/apps/models_provider/impl/azure_model_provider/model/tts.py
@@ -22,11 +22,11 @@ class AzureOpenAITextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.api_version = kwargs.get('api_version')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.api_version = kwargs.get("api_version")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -34,37 +34,27 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice': 'alloy'}}
+ optional_params = {"params": {"voice": "alloy"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return AzureOpenAITextToSpeech(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
- api_version=model_credential.get('api_version'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
+ api_version=model_credential.get("api_version"),
**optional_params,
)
def check_auth(self):
- client = AzureOpenAI(
- azure_endpoint=self.api_base,
- api_key=self.api_key,
- api_version=self.api_version
- )
+ client = AzureOpenAI(azure_endpoint=self.api_base, api_key=self.api_key, api_version=self.api_version)
response_list = client.models.with_raw_response.list()
# print(response_list)
def text_to_speech(self, text):
- client = AzureOpenAI(
- azure_endpoint=self.api_base,
- api_key=self.api_key,
- api_version=self.api_version
- )
+ client = AzureOpenAI(azure_endpoint=self.api_base, api_key=self.api_key, api_version=self.api_version)
text = _remove_empty_lines(text)
with client.audio.speech.with_streaming_response.create(
- model=self.model,
- input=text,
- **self.params
+ model=self.model, input=text, **self.params
) as response:
return response.read()
diff --git a/apps/models_provider/impl/base_chat_open_ai.py b/apps/models_provider/impl/base_chat_open_ai.py
index f0e717fd249..bc216c824a8 100644
--- a/apps/models_provider/impl/base_chat_open_ai.py
+++ b/apps/models_provider/impl/base_chat_open_ai.py
@@ -4,8 +4,16 @@
from typing import Dict, Optional, Any, Iterator, cast, Union, Sequence, Callable, Mapping, AsyncIterator
from langchain_core.language_models import LanguageModelInput
-from langchain_core.messages import BaseMessage, get_buffer_string, BaseMessageChunk, HumanMessageChunk, AIMessageChunk, \
- SystemMessageChunk, FunctionMessageChunk, ChatMessageChunk
+from langchain_core.messages import (
+ BaseMessage,
+ get_buffer_string,
+ BaseMessageChunk,
+ HumanMessageChunk,
+ AIMessageChunk,
+ SystemMessageChunk,
+ FunctionMessageChunk,
+ ChatMessageChunk,
+)
from langchain_core.messages.ai import UsageMetadata
from langchain_core.messages.tool import tool_call_chunk, ToolMessageChunk
from langchain_core.outputs import ChatGenerationChunk, ChatGeneration
@@ -25,15 +33,15 @@ def custom_get_token_ids(text: str):
def _convert_delta_to_message_chunk(
- _dict: Mapping[str, Any], default_class: type[BaseMessageChunk]
+ _dict: Mapping[str, Any], default_class: type[BaseMessageChunk]
) -> BaseMessageChunk:
"""Convert to a LangChain message chunk."""
id_ = _dict.get("id")
role = cast(str, _dict.get("role"))
content = cast(str, _dict.get("content") or "")
additional_kwargs: dict = {}
- if reasoning := _dict.get('reasoning_content') or _dict.get('reasoning'):
- additional_kwargs['reasoning_content'] = reasoning
+ if reasoning := _dict.get("reasoning_content") or _dict.get("reasoning"):
+ additional_kwargs["reasoning_content"] = reasoning
if _dict.get("function_call"):
function_call = dict(_dict["function_call"])
if "name" in function_call and function_call["name"] is None:
@@ -68,15 +76,11 @@ def _convert_delta_to_message_chunk(
additional_kwargs = {"__openai_role__": "developer"}
else:
additional_kwargs = {}
- return SystemMessageChunk(
- content=content, id=id_, additional_kwargs=additional_kwargs
- )
+ return SystemMessageChunk(content=content, id=id_, additional_kwargs=additional_kwargs)
if role == "function" or default_class == FunctionMessageChunk:
return FunctionMessageChunk(content=content, name=_dict["name"], id=id_)
if role == "tool" or default_class == ToolMessageChunk:
- return ToolMessageChunk(
- content=content, tool_call_id=_dict["tool_call_id"], id=id_
- )
+ return ToolMessageChunk(content=content, tool_call_id=_dict["tool_call_id"], id=id_)
if role or default_class == ChatMessageChunk:
return ChatMessageChunk(content=content, role=role, id=id_)
return default_class(content=content, id=id_) # type: ignore[call-arg]
@@ -90,15 +94,12 @@ def get_last_generation_info(self) -> Optional[Dict[str, Any]]:
return self.usage_metadata
def get_num_tokens_from_messages(
- self,
- messages: list[BaseMessage],
- tools: Optional[
- Sequence[Union[dict[str, Any], type, Callable, BaseTool]]
- ] = None,
- timeout: Optional[float] = 0.5,
+ self,
+ messages: list[BaseMessage],
+ tools: Optional[Sequence[Union[dict[str, Any], type, Callable, BaseTool]]] = None,
+ timeout: Optional[float] = 0.5,
) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
-
with ThreadPoolExecutor(max_workers=1) as executor:
future = executor.submit(super().get_num_tokens_from_messages, messages, tools)
try:
@@ -112,51 +113,48 @@ def get_num_tokens_from_messages(
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
- return self.usage_metadata.get('input_tokens', self.usage_metadata.get('prompt_tokens', 0))
+ return self.usage_metadata.get("input_tokens", self.usage_metadata.get("prompt_tokens", 0))
def get_num_tokens(self, text: str) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
- return self.get_last_generation_info().get('output_tokens',
- self.get_last_generation_info().get('completion_tokens', 0))
+ return self.get_last_generation_info().get(
+ "output_tokens", self.get_last_generation_info().get("completion_tokens", 0)
+ )
def _stream(self, *args: Any, **kwargs: Any) -> Iterator[ChatGenerationChunk]:
- kwargs['stream_usage'] = True
for chunk in super()._stream(*args, **kwargs):
if chunk.message.usage_metadata is not None:
self.usage_metadata = chunk.message.usage_metadata
yield chunk
async def _astream(self, *args: Any, **kwargs: Any) -> AsyncIterator[ChatGenerationChunk]:
- kwargs['stream_usage'] = True
async for chunk in super()._astream(*args, **kwargs):
if chunk.message.usage_metadata is not None:
self.usage_metadata = chunk.message.usage_metadata
yield chunk
def _convert_chunk_to_generation_chunk(
- self,
- chunk: dict,
- default_chunk_class: type,
- base_generation_info: dict | None,
+ self,
+ chunk: dict,
+ default_chunk_class: type,
+ base_generation_info: dict | None,
) -> ChatGenerationChunk | None:
if chunk.get("type") == "content.delta": # From beta.chat.completions.stream
return None
token_usage = chunk.get("usage")
choices = (
- chunk.get("choices", [])
- # From beta.chat.completions.stream
- or chunk.get("chunk", {}).get("choices", [])
+ chunk.get("choices", [])
+ # From beta.chat.completions.stream
+ or chunk.get("chunk", {}).get("choices", [])
)
usage_metadata: UsageMetadata | None = (
- _create_usage_metadata(token_usage, chunk.get("service_tier"))
- if token_usage
- else None
+ _create_usage_metadata(token_usage, chunk.get("service_tier")) if token_usage else None
)
if len(choices) == 0:
# logprobs is implicitly None
@@ -174,9 +172,7 @@ def _convert_chunk_to_generation_chunk(
if choice["delta"] is None:
return None
- message_chunk = _convert_delta_to_message_chunk(
- choice["delta"], default_chunk_class
- )
+ message_chunk = _convert_delta_to_message_chunk(choice["delta"], default_chunk_class)
generation_info = {**base_generation_info} if base_generation_info else {}
if finish_reason := choice.get("finish_reason"):
@@ -196,17 +192,15 @@ def _convert_chunk_to_generation_chunk(
message_chunk.usage_metadata = usage_metadata
message_chunk.response_metadata["model_provider"] = "openai"
- return ChatGenerationChunk(
- message=message_chunk, generation_info=generation_info or None
- )
+ return ChatGenerationChunk(message=message_chunk, generation_info=generation_info or None)
def invoke(
- self,
- input: LanguageModelInput,
- config: Optional[RunnableConfig] = None,
- *,
- stop: Optional[list[str]] = None,
- **kwargs: Any,
+ self,
+ input: LanguageModelInput,
+ config: Optional[RunnableConfig] = None,
+ *,
+ stop: Optional[list[str]] = None,
+ **kwargs: Any,
) -> BaseMessage:
config = ensure_config(config)
chat_result = cast(
@@ -221,26 +215,23 @@ def invoke(
run_id=config.pop("run_id", None),
**kwargs,
).generations[0][0],
-
).message
- self.usage_metadata = chat_result.response_metadata[
- 'token_usage'] if 'token_usage' in chat_result.response_metadata else chat_result.usage_metadata
+ self.usage_metadata = (
+ chat_result.response_metadata["token_usage"]
+ if "token_usage" in chat_result.response_metadata
+ else chat_result.usage_metadata
+ )
return chat_result
def upload_file_and_get_url(self, file_stream, file_name):
"""上传文件并获取文件URL"""
base64_video = base64.b64encode(file_stream).decode("utf-8")
video_format = get_video_format(file_name)
- return f'data:{video_format};base64,{base64_video}'
+ return f"data:{video_format};base64,{base64_video}"
def get_video_format(file_name):
- extension = file_name.split('.')[-1].lower()
- format_map = {
- 'mp4': 'video/mp4',
- 'avi': 'video/avi',
- 'mov': 'video/mov',
- 'wmv': 'video/x-ms-wmv'
- }
- return format_map.get(extension, 'video/mp4')
+ extension = file_name.split(".")[-1].lower()
+ format_map = {"mp4": "video/mp4", "avi": "video/avi", "mov": "video/mov", "wmv": "video/x-ms-wmv"}
+ return format_map.get(extension, "video/mp4")
diff --git a/apps/models_provider/impl/deepseek_model_provider/credential/llm.py b/apps/models_provider/impl/deepseek_model_provider/credential/llm.py
index 8961e92d391..79e42085556 100644
--- a/apps/models_provider/impl/deepseek_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/deepseek_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 17:51
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 17:51
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -19,61 +20,78 @@
class DeepSeekLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class DeepSeekLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField(_('API URL'), required=True,
- default_value='https://api.deepseek.com')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://api.deepseek.com")
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return DeepSeekLLMModelParams()
diff --git a/apps/models_provider/impl/deepseek_model_provider/model/llm.py b/apps/models_provider/impl/deepseek_model_provider/model/llm.py
index 6220d7074f9..4b429e4d448 100644
--- a/apps/models_provider/impl/deepseek_model_provider/model/llm.py
+++ b/apps/models_provider/impl/deepseek_model_provider/model/llm.py
@@ -1,11 +1,12 @@
#!/usr/bin/env python
# -*- coding: UTF-8 -*-
"""
-@Project :MaxKB
+@Project :MaxKB
@File :llm.py
@Author :Brian Yang
-@Date :5/12/24 7:44 AM
+@Date :5/12/24 7:44 AM
"""
+
import json
from typing import Dict, Any
@@ -17,7 +18,6 @@
class DeepSeekChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -28,18 +28,18 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
deepseek_chat_open_ai = DeepSeekChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base') or 'https://api.deepseek.com',
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base") or "https://api.deepseek.com",
+ openai_api_key=model_credential.get("api_key"),
**optional_params,
)
return deepseek_chat_open_ai
def _get_request_payload(
- self,
- input_: LanguageModelInput,
- *,
- stop: list[str] | None = None,
- **kwargs: Any,
+ self,
+ input_: LanguageModelInput,
+ *,
+ stop: list[str] | None = None,
+ **kwargs: Any,
) -> dict:
# Get original messages to preserve reasoning_content before base conversion
messages = self._convert_input(input_).to_messages()
@@ -50,9 +50,9 @@ def _get_request_payload(
reasoning_content_map = {}
for i, msg in enumerate(messages):
if (
- isinstance(msg, AIMessage)
- and (msg.tool_calls or msg.invalid_tool_calls)
- and (reasoning := msg.additional_kwargs.get("reasoning_content"))
+ isinstance(msg, AIMessage)
+ and (msg.tool_calls or msg.invalid_tool_calls)
+ and (reasoning := msg.additional_kwargs.get("reasoning_content"))
):
reasoning_content_map[i] = reasoning
@@ -62,20 +62,14 @@ def _get_request_payload(
# This is required by DeepSeek API - missing it causes 400 error
if "messages" in payload and reasoning_content_map:
for i, message in enumerate(payload["messages"]):
- if (
- i in reasoning_content_map
- and message.get("role") == "assistant"
- and message.get("tool_calls")
- ):
+ if i in reasoning_content_map and message.get("role") == "assistant" and message.get("tool_calls"):
message["reasoning_content"] = reasoning_content_map[i]
# Apply DeepSeek-specific message formatting
for message in payload["messages"]:
if message["role"] == "tool" and isinstance(message["content"], list):
message["content"] = json.dumps(message["content"])
- elif message["role"] == "assistant" and isinstance(
- message["content"], list
- ):
+ elif message["role"] == "assistant" and isinstance(message["content"], list):
# DeepSeek API expects assistant content to be a string, not a list.
# Extract text blocks and join them, or use empty string if none exist.
text_parts = [
diff --git a/apps/models_provider/impl/docker_ai_model_provider/__init__.py b/apps/models_provider/impl/docker_ai_model_provider/__init__.py
index 2dc4ab10db4..906f7224d02 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/__init__.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/28 16:25
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/3/28 16:25
+@desc:
"""
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/embedding.py b/apps/models_provider/impl/docker_ai_model_provider/credential/embedding.py
index 1305b40cd13..7b0e5026ff2 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,59 +17,68 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class DockerAIEmbeddingModelParams(BaseForm):
dimensions = forms.SingleSelect(
- TooltipLabel(
- _('Dimensions'),
- _('')
- ),
+ TooltipLabel(_("Dimensions"), _("")),
required=True,
default_value=1024,
- value_field='value',
- text_field='label',
+ value_field="value",
+ text_field="label",
option_list=[
- {'label': '1536', 'value': '1536'},
- {'label': '1024', 'value': '1024'},
- {'label': '768', 'value': '768'},
- {'label': '512', 'value': '512'},
- ]
+ {"label": "1536", "value": "1536"},
+ {"label": "1024", "value": "1024"},
+ {"label": "768", "value": "768"},
+ {"label": "512", "value": "512"},
+ ],
)
class DockerAIEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return DockerAIEmbeddingModelParams()
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/image.py b/apps/models_provider/impl/docker_ai_model_provider/credential/image.py
index ce3abcbbeb2..a2543d6ab03 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/image.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/image.py
@@ -1,6 +1,4 @@
# coding=utf-8
-import base64
-import os
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -14,61 +12,80 @@
class DockerAIImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class DockerAIImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return DockerAIImageModelParams()
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/llm.py b/apps/models_provider/impl/docker_ai_model_provider/credential/llm.py
index ed77af1a5c5..9c7f7387408 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:32
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:32
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -18,62 +19,80 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class DockerAILLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class DockerAILLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
-
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException) or isinstance(e, BadRequestError):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return DockerAILLMModelParams()
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/reranker.py b/apps/models_provider/impl/docker_ai_model_provider/credential/reranker.py
index 98ebbd252db..2ef8075cbc6 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/reranker.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: reranker.py
- @date:2024/9/9 17:51
- @desc:
+@project: MaxKB
+@Author:虎
+@file: reranker.py
+@date:2024/9/9 17:51
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -20,39 +21,51 @@
class DockerAIRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class DockerAIRerankerCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- if not model_type == 'RERANKER':
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['api_base']:
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ if not model_type == "RERANKER":
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
+ for key in ["api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model: DockerAIReranker = provider.get_model(model_type, model_name, model_credential)
- model.compress_documents([Document(page_content=_('Hello'))], _('Hello'))
+ model.compress_documents([Document(page_content=_("Hello"))], _("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
@@ -60,7 +73,7 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
def encryption_dict(self, model: Dict[str, object]):
return {**model}
- api_base = forms.TextInputField('API URL', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
def get_model_params_setting_form(self, model_name: str) -> DockerAIRerankerModelParams:
return DockerAIRerankerModelParams()
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/stt.py b/apps/models_provider/impl/docker_ai_model_provider/credential/stt.py
index 020837ed389..9ae316ac579 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/stt.py
@@ -9,47 +9,60 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class DockerAISTTModelParams(BaseForm):
language = forms.TextInputField(
- TooltipLabel(_('language'), _('If not passed, the default value is zh')),
+ TooltipLabel(_("language"), _("If not passed, the default value is zh")),
required=True,
- default_value='zh',
+ default_value="zh",
)
+
class DockerAISTTModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/tti.py b/apps/models_provider/impl/docker_ai_model_provider/credential/tti.py
index af5822f2ec3..38dd189986d 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/tti.py
@@ -9,80 +9,105 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class DockerAITTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('The image generation endpoint allows you to create raw images based on text prompts. When using the DALL·E 3, the image size can be 1024x1024, 1024x1792 or 1792x1024 pixels.')),
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "The image generation endpoint allows you to create raw images based on text prompts. When using the DALL·E 3, the image size can be 1024x1024, 1024x1792 or 1792x1024 pixels."
+ ),
+ ),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '1024x1792', 'label': '1024x1792'},
- {'value': '1792x1024', 'label': '1792x1024'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1024x1792", "label": "1024x1792"},
+ {"value": "1792x1024", "label": "1792x1024"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
quality = forms.SingleSelect(
- TooltipLabel(_('Picture quality'), _('''
+ TooltipLabel(
+ _("Picture quality"),
+ _("""
By default, images are produced in standard quality, but with DALL·E 3 you can set quality: "hd" to enhance detail. Square, standard quality images are generated fastest.
- ''')),
+ """),
+ ),
required=True,
- default_value='standard',
+ default_value="standard",
option_list=[
- {'value': 'standard', 'label': 'standard'},
- {'value': 'hd', 'label': 'hd'},
+ {"value": "standard", "label": "standard"},
+ {"value": "hd", "label": "hd"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
n = forms.SliderField(
- TooltipLabel(_('Number of pictures'),
- _('You can use DALL·E 3 to request 1 image at a time (requesting more images by issuing parallel requests), or use DALL·E 2 with the n parameter to request up to 10 images at a time.')),
- required=True, default_value=1,
+ TooltipLabel(
+ _("Number of pictures"),
+ _(
+ "You can use DALL·E 3 to request 1 image at a time (requesting more images by issuing parallel requests), or use DALL·E 2 with the n parameter to request up to 10 images at a time."
+ ),
+ ),
+ required=True,
+ default_value=1,
_min=1,
_max=10,
_step=1,
- precision=0)
+ precision=0,
+ )
class DockerAITextToImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return DockerAITTIModelParams()
diff --git a/apps/models_provider/impl/docker_ai_model_provider/credential/tts.py b/apps/models_provider/impl/docker_ai_model_provider/credential/tts.py
index 5eab8a9f689..c8051c087db 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/credential/tts.py
@@ -9,59 +9,77 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class DockerAITTSModelGeneralParams(BaseForm):
# alloy, echo, fable, onyx, nova, shimmer
voice = forms.SingleSelect(
- TooltipLabel('Voice',
- _('Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English.')),
- required=True, default_value='alloy',
- text_field='value',
- value_field='value',
+ TooltipLabel(
+ "Voice",
+ _(
+ "Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English."
+ ),
+ ),
+ required=True,
+ default_value="alloy",
+ text_field="value",
+ value_field="value",
option_list=[
- {'text': 'alloy', 'value': 'alloy'},
- {'text': 'echo', 'value': 'echo'},
- {'text': 'fable', 'value': 'fable'},
- {'text': 'onyx', 'value': 'onyx'},
- {'text': 'nova', 'value': 'nova'},
- {'text': 'shimmer', 'value': 'shimmer'},
- ])
+ {"text": "alloy", "value": "alloy"},
+ {"text": "echo", "value": "echo"},
+ {"text": "fable", "value": "fable"},
+ {"text": "onyx", "value": "onyx"},
+ {"text": "nova", "value": "nova"},
+ {"text": "shimmer", "value": "shimmer"},
+ ],
+ )
class DockerAITTSModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return DockerAITTSModelGeneralParams()
diff --git a/apps/models_provider/impl/docker_ai_model_provider/docker_ai_model_provider.py b/apps/models_provider/impl/docker_ai_model_provider/docker_ai_model_provider.py
index 10a496a39be..60ff1072cb9 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/docker_ai_model_provider.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/docker_ai_model_provider.py
@@ -1,16 +1,22 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: docker_ai_model_provider.py
- @date:2024/3/28 16:26
- @desc:
+@project: maxkb
+@Author:虎
+@file: docker_ai_model_provider.py
+@date:2024/3/28 16:26
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.docker_ai_model_provider.credential.embedding import DockerAIEmbeddingCredential
from models_provider.impl.docker_ai_model_provider.credential.image import DockerAIImageModelCredential
from models_provider.impl.docker_ai_model_provider.credential.llm import DockerAILLMModelCredential
@@ -19,12 +25,8 @@
from models_provider.impl.docker_ai_model_provider.credential.tti import DockerAITextToImageModelCredential
from models_provider.impl.docker_ai_model_provider.credential.tts import DockerAITTSModelCredential
from models_provider.impl.docker_ai_model_provider.model.embedding import DockerAIEmbeddingModel
-from models_provider.impl.docker_ai_model_provider.model.image import DockerAIImage
from models_provider.impl.docker_ai_model_provider.model.llm import DockerAIChatModel
from models_provider.impl.docker_ai_model_provider.model.reranker import DockerAIReranker
-from models_provider.impl.docker_ai_model_provider.model.stt import DockerAISpeechToText
-from models_provider.impl.docker_ai_model_provider.model.tti import DockerAITextToImage
-from models_provider.impl.docker_ai_model_provider.model.tts import DockerAITextToSpeech
from maxkb.conf import PROJECT_DIR
from django.utils.translation import gettext_lazy as _
@@ -34,15 +36,13 @@
docker_ai_image_model_credential = DockerAIImageModelCredential()
docker_ai_tti_model_credential = DockerAITextToImageModelCredential()
model_info_list = [
- ModelInfo('ai/qwen3-vl:8B', '', ModelTypeConst.LLM,
- docker_ai_llm_model_credential, DockerAIChatModel
- ),
+ ModelInfo("ai/qwen3-vl:8B", "", ModelTypeConst.LLM, docker_ai_llm_model_credential, DockerAIChatModel),
]
open_ai_embedding_credential = DockerAIEmbeddingCredential()
model_info_embedding_list = [
- ModelInfo('ai/qwen3-embedding-vllm', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- DockerAIEmbeddingModel),
+ ModelInfo(
+ "ai/qwen3-embedding-vllm", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, DockerAIEmbeddingModel
+ ),
]
# model_info_image_list = [
@@ -62,17 +62,22 @@
# ]
docker_ai_reranker_model_credential = DockerAIRerankerCredential()
model_info_rerank_list = [
- ModelInfo('ai/qwen3-reranker:0.6B', '',
- ModelTypeConst.RERANKER, docker_ai_reranker_model_credential,
- DockerAIReranker),
+ ModelInfo(
+ "ai/qwen3-reranker:0.6B", "", ModelTypeConst.RERANKER, docker_ai_reranker_model_credential, DockerAIReranker
+ ),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
.append_default_model_info(
- ModelInfo('gpt-3.5-turbo', _('The latest gpt-3.5-turbo, updated with DockerAI adjustments'), ModelTypeConst.LLM,
- docker_ai_llm_model_credential, DockerAIChatModel
- ))
+ ModelInfo(
+ "gpt-3.5-turbo",
+ _("The latest gpt-3.5-turbo, updated with DockerAI adjustments"),
+ ModelTypeConst.LLM,
+ docker_ai_llm_model_credential,
+ DockerAIChatModel,
+ )
+ )
.append_model_info_list(model_info_embedding_list)
.append_default_model_info(model_info_embedding_list[0])
# .append_model_info_list(model_info_image_list)
@@ -93,11 +98,22 @@
class DockerModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_docker_ai_provider', name='Docker AI', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'docker_ai_model_provider', 'icon',
- 'docker_ai_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_docker_ai_provider",
+ name="Docker AI",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "impl",
+ "docker_ai_model_provider",
+ "icon",
+ "docker_ai_icon_svg",
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/embedding.py b/apps/models_provider/impl/docker_ai_model_provider/model/embedding.py
index f3f94888be8..f7426f25a65 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/embedding.py
@@ -1,19 +1,23 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 17:44
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 17:44
+@desc:
"""
+
from typing import Dict, List
import openai
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class DockerAIEmbeddingModel(MaxKBBaseEmbeddingModel):
+ def supports_image_embedding(self) -> bool:
+ return False
-class DockerAIEmbeddingModel(MaxKBBaseModel):
model_name: str
optional_params: dict
@@ -27,25 +31,22 @@ def is_cache_model(self):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return DockerAIEmbeddingModel(
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
model_name=model_name,
- base_url=model_credential.get('api_base'),
- optional_params=optional_params
+ base_url=model_credential.get("api_base"),
+ optional_params=optional_params,
)
def embed_query(self, text: str):
res = self.embed_documents([text])
return res[0]
- def embed_documents(
- self, texts: List[str], chunk_size: int | None = None
- ) -> List[List[float]]:
+ def embed_documents(self, texts: List[str], chunk_size: int | None = None) -> List[List[float]]:
if len(self.optional_params) > 0:
res = self.client.create(
- input=texts, model=self.model_name, encoding_format="float",
- **self.optional_params
+ input=texts, model=self.model_name, encoding_format="float", **self.optional_params
)
else:
res = self.client.create(input=texts, model=self.model_name, encoding_format="float")
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/image.py b/apps/models_provider/impl/docker_ai_model_provider/model/image.py
index cf2563a6aa9..a2736e9f6c6 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/image.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/image.py
@@ -5,7 +5,6 @@
class DockerAIImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -15,8 +14,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return DockerAIImage(
model_name=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/llm.py b/apps/models_provider/impl/docker_ai_model_provider/model/llm.py
index 10c19a0640d..0a6292c2d00 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/llm.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/18 15:28
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/4/18 15:28
+@desc:
"""
+
from typing import List, Dict
from langchain_core.messages import BaseMessage, get_buffer_string
@@ -21,7 +22,6 @@ def custom_get_token_ids(text: str):
class DockerAIChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -29,13 +29,13 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- streaming = model_kwargs.get('streaming', True)
- if 'o1' in model_name:
+ streaming = model_kwargs.get("streaming", True)
+ if "o1" in model_name:
streaming = False
chat_open_ai = DockerAIChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
streaming=streaming,
custom_get_token_ids=custom_get_token_ids,
**optional_params,
@@ -45,13 +45,13 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/reranker.py b/apps/models_provider/impl/docker_ai_model_provider/model/reranker.py
index 788251ec23e..4be442d51dc 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/reranker.py
@@ -1,13 +1,14 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: siliconcloud_reranker.py
- @date:2024/9/10 9:45
- @desc: SiliconCloud 文档重排封装
+@project: MaxKB
+@Author:虎
+@file: siliconcloud_reranker.py
+@date:2024/9/10 9:45
+@desc: SiliconCloud 文档重排封装
"""
+
import json
-from typing import Sequence, Optional, Any, Dict
+from typing import Sequence, Optional, Dict
import requests
from langchain_core.callbacks import Callbacks
@@ -25,22 +26,19 @@ class DockerAIReranker(MaxKBBaseModel, BaseDocumentCompressor):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return DockerAIReranker(
- api_base=model_credential.get('api_base'),
- model=model_name,
- top_n=model_kwargs.get('top_n', 3)
+ api_base=model_credential.get("api_base"), model=model_name, top_n=model_kwargs.get("top_n", 3)
)
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if not documents:
return []
# 预处理文本
texts = [doc.page_content for doc in documents]
- headers = {
- "Content-Type": "application/json"
- }
+ headers = {"Content-Type": "application/json"}
payload = {
"model": self.model,
"query": query,
@@ -58,8 +56,8 @@ def compress_documents(self, documents: Sequence[Document], query: str, callback
# 解析返回结果
return [
Document(
- page_content=payload['documents'][item.get('index')],
- metadata={'relevance_score': item.get('relevance_score')}
+ page_content=payload["documents"][item.get("index")],
+ metadata={"relevance_score": item.get("relevance_score")},
)
- for item in res.get('results', [])
+ for item in res.get("results", [])
]
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/stt.py b/apps/models_provider/impl/docker_ai_model_provider/model/stt.py
index fa9950b9f04..8399a5fdb6e 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/stt.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/stt.py
@@ -1,4 +1,3 @@
-import asyncio
import io
from typing import Dict
@@ -26,50 +25,39 @@ def is_cache_model():
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return DockerAISpeechToText(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
- params = model_kwargs,
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
+ params=model_kwargs,
**optional_params,
)
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def speech_to_text(self, audio_file):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
audio_data = audio_file.read()
buffer = io.BytesIO(audio_data)
buffer.name = "file.mp3" # this is the important line
- filter_params = {k: v for k,v in self.params.items() if k not in {'model_id','use_local','streaming'}}
- transcription_params = {
- 'model': self.model,
- 'file': buffer,
- 'language': 'zh'
- }
+ filter_params = {k: v for k, v in self.params.items() if k not in {"model_id", "use_local", "streaming"}}
+ transcription_params = {"model": self.model, "file": buffer, "language": "zh"}
- res = client.audio.transcriptions.create(**transcription_params,extra_body=filter_params)
+ res = client.audio.transcriptions.create(**transcription_params, extra_body=filter_params)
return res.text
-
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/tti.py b/apps/models_provider/impl/docker_ai_model_provider/model/tti.py
index d8749690da0..c6614e49ff7 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/tti.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/tti.py
@@ -20,10 +20,10 @@ class DockerAITextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -31,14 +31,14 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024x1024', 'quality': 'standard', 'n': 1}}
+ optional_params = {"params": {"size": "1024x1024", "quality": "standard", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return DockerAITextToImage(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/docker_ai_model_provider/model/tts.py b/apps/models_provider/impl/docker_ai_model_provider/model/tts.py
index 15f9296ba37..08e913c6d3b 100644
--- a/apps/models_provider/impl/docker_ai_model_provider/model/tts.py
+++ b/apps/models_provider/impl/docker_ai_model_provider/model/tts.py
@@ -21,10 +21,10 @@ class DockerAITextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -32,34 +32,26 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice': 'alloy'}}
+ optional_params = {"params": {"voice": "alloy"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return DockerAITextToSpeech(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def text_to_speech(self, text):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
text = _remove_empty_lines(text)
with client.audio.speech.with_streaming_response.create(
- model=self.model,
- input=text,
- **self.params
+ model=self.model, input=text, **self.params
) as response:
return response.read()
diff --git a/apps/models_provider/impl/gemini_model_provider/__init__.py b/apps/models_provider/impl/gemini_model_provider/__init__.py
index 43fd3dd051c..f9c7cbcc8a1 100644
--- a/apps/models_provider/impl/gemini_model_provider/__init__.py
+++ b/apps/models_provider/impl/gemini_model_provider/__init__.py
@@ -1,8 +1,8 @@
#!/usr/bin/env python
# -*- coding: UTF-8 -*-
"""
-@Project :MaxKB
+@Project :MaxKB
@File :__init__.py.py
@Author :Brian Yang
-@Date :5/13/24 7:40 AM
+@Date :5/13/24 7:40 AM
"""
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/embedding.py b/apps/models_provider/impl/gemini_model_provider/credential/embedding.py
index 12639849583..dfc6ef6bb61 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,36 +17,48 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class GeminiEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_key']:
+ for key in ["api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/image.py b/apps/models_provider/impl/gemini_model_provider/credential/image.py
index 10ffc6a60ed..8d86e3b07da 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/image.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/image.py
@@ -12,61 +12,82 @@
class GeminiImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class GeminiImageModelCredential(BaseForm, BaseModelCredential):
- base_url = forms.TextInputField('Base URL', required=True, default_value='https://generativelanguage.googleapis.com')
- api_key = forms.PasswordInputField('API Key', required=True)
+ base_url = forms.TextInputField(
+ "Base URL", required=True, default_value="https://generativelanguage.googleapis.com"
+ )
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'base_url']:
+ for key in ["api_key", "base_url"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return GeminiImageModelParams()
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/itv.py b/apps/models_provider/impl/gemini_model_provider/credential/itv.py
index 7105472eb60..a335989d148 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/itv.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/itv.py
@@ -11,14 +11,15 @@
from common.utils.logger import maxkb_logger
-
class ImageToVideoModelCredential(BaseForm, BaseModelCredential):
"""
Credential class for the Qwen Image-to-Video model.
Provides validation and encryption for the model credentials.
"""
- base_url = forms.TextInputField(_("Base Url"), required=True, default_value="https://generativelanguage.googleapis.com")
+ base_url = forms.TextInputField(
+ _("Base Url"), required=True, default_value="https://generativelanguage.googleapis.com"
+ )
api_key = PasswordInputField("API Key", required=True)
def is_valid(
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/llm.py b/apps/models_provider/impl/gemini_model_provider/credential/llm.py
index 6e2ba6862b4..a5f479613a4 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 17:57
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 17:57
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -19,61 +20,80 @@
class GeminiLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class GeminiLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'base_url']:
+ for key in ["api_key", "base_url"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ res = model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- base_url = forms.TextInputField('Base URL', required=True,
- default_value='https://generativelanguage.googleapis.com')
- api_key = forms.PasswordInputField('API Key', required=True)
+ base_url = forms.TextInputField(
+ "Base URL", required=True, default_value="https://generativelanguage.googleapis.com"
+ )
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return GeminiLLMModelParams()
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/stt.py b/apps/models_provider/impl/gemini_model_provider/credential/stt.py
index 470185fa23d..e6e46ac381d 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/stt.py
@@ -9,39 +9,51 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class GeminiSTTModelCredential(BaseForm, BaseModelCredential):
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_key']:
+ for key in ["api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
pass
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/tti.py b/apps/models_provider/impl/gemini_model_provider/credential/tti.py
index dc26a03674c..f624936c282 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/tti.py
@@ -1,11 +1,11 @@
# coding=utf-8
from typing import Dict
-from django.utils.translation import gettext_lazy as _, gettext
+from django.utils.translation import gettext
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, TooltipLabel
+from common.forms import BaseForm
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
@@ -15,41 +15,53 @@ class GeminiTTIModelParams(BaseForm):
class GeminiTextToImageModelCredential(BaseForm, BaseModelCredential):
- base_url = forms.TextInputField('Base Url', required=True,
- default_value='https://generativelanguage.googleapis.com')
- api_key = forms.PasswordInputField('API Key', required=True)
+ base_url = forms.TextInputField(
+ "Base Url", required=True, default_value="https://generativelanguage.googleapis.com"
+ )
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['base_url', 'api_key']:
+ for key in ["base_url", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return GeminiTTIModelParams()
diff --git a/apps/models_provider/impl/gemini_model_provider/credential/ttv.py b/apps/models_provider/impl/gemini_model_provider/credential/ttv.py
index cf0e83b1d46..ea8fb1b0d68 100644
--- a/apps/models_provider/impl/gemini_model_provider/credential/ttv.py
+++ b/apps/models_provider/impl/gemini_model_provider/credential/ttv.py
@@ -6,29 +6,30 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, SingleSelect, SliderField, TooltipLabel
-from common.forms.switch_field import SwitchField
+from common.forms import BaseForm, PasswordInputField
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
-
class TextToVideoModelCredential(BaseForm, BaseModelCredential):
"""
Credential class for the Qwen Text-to-Video model.
Provides validation and encryption for the model credentials.
"""
- base_url = forms.TextInputField(_("Base Url"), required=True, default_value="https://generativelanguage.googleapis.com")
- api_key = PasswordInputField('API Key', required=True)
+
+ base_url = forms.TextInputField(
+ _("Base Url"), required=True, default_value="https://generativelanguage.googleapis.com"
+ )
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -42,35 +43,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'base_url']
+ required_keys = ["api_key", "base_url"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -83,10 +81,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
diff --git a/apps/models_provider/impl/gemini_model_provider/model/embedding.py b/apps/models_provider/impl/gemini_model_provider/model/embedding.py
index d5ceb93c2d6..f6143323a2e 100644
--- a/apps/models_provider/impl/gemini_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/gemini_model_provider/model/embedding.py
@@ -1,22 +1,26 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 17:44
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 17:44
+@desc:
"""
+
from typing import Dict
from langchain_google_genai import GoogleGenerativeAIEmbeddings
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class GeminiEmbeddingModel(MaxKBBaseEmbeddingModel, GoogleGenerativeAIEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
-class GeminiEmbeddingModel(MaxKBBaseModel, GoogleGenerativeAIEmbeddings):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return GeminiEmbeddingModel(
- google_api_key=model_credential.get('api_key'),
+ google_api_key=model_credential.get("api_key"),
model=model_name,
)
diff --git a/apps/models_provider/impl/gemini_model_provider/model/image.py b/apps/models_provider/impl/gemini_model_provider/model/image.py
index eef0a3c2933..abb0c3440dd 100644
--- a/apps/models_provider/impl/gemini_model_provider/model/image.py
+++ b/apps/models_provider/impl/gemini_model_provider/model/image.py
@@ -12,7 +12,6 @@ def custom_get_token_ids(text: str):
class GeminiImage(MaxKBBaseModel, ChatGoogleGenerativeAI):
-
@staticmethod
def is_cache_model():
return False
@@ -20,12 +19,12 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- base_url = model_credential.get('base_url', "https://generativelanguage.googleapis.com")
+ base_url = model_credential.get("base_url", "https://generativelanguage.googleapis.com")
if base_url:
optional_params.setdefault("model_kwargs", {})
optional_params["model_kwargs"]["http_options"] = {"base_url": base_url}
return GeminiImage(
model=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/gemini_model_provider/model/llm.py b/apps/models_provider/impl/gemini_model_provider/model/llm.py
index 522bfbf3ef4..733402376fe 100644
--- a/apps/models_provider/impl/gemini_model_provider/model/llm.py
+++ b/apps/models_provider/impl/gemini_model_provider/model/llm.py
@@ -1,11 +1,12 @@
#!/usr/bin/env python
# -*- coding: UTF-8 -*-
"""
-@Project :MaxKB
+@Project :MaxKB
@File :llm.py
@Author :Brian Yang
-@Date :5/13/24 7:40 AM
+@Date :5/13/24 7:40 AM
"""
+
from typing import List, Dict, Optional, Any
from langchain_core.messages import BaseMessage, get_buffer_string
@@ -16,7 +17,6 @@
class GeminiChatModel(MaxKBBaseModel, ChatGoogleGenerativeAI):
-
@staticmethod
def is_cache_model():
return False
@@ -24,30 +24,26 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- base_url = model_credential.get('base_url', "https://generativelanguage.googleapis.com")
+ base_url = model_credential.get("base_url", "https://generativelanguage.googleapis.com")
if base_url:
optional_params.setdefault("model_kwargs", {})
optional_params["model_kwargs"]["http_options"] = {"base_url": base_url}
- gemini_chat = GeminiChatModel(
- model=model_name,
- api_key=model_credential.get('api_key'),
- **optional_params
- )
+ gemini_chat = GeminiChatModel(model=model_name, api_key=model_credential.get("api_key"), **optional_params)
return gemini_chat
def get_last_generation_info(self) -> Optional[Dict[str, Any]]:
- return self.__dict__.get('_last_generation_info')
+ return self.__dict__.get("_last_generation_info")
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
- return self.get_last_generation_info().get('input_tokens', 0)
- except Exception as e:
+ return self.get_last_generation_info().get("input_tokens", 0)
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
- return self.get_last_generation_info().get('output_tokens', 0)
- except Exception as e:
+ return self.get_last_generation_info().get("output_tokens", 0)
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/gemini_model_provider/model/stt.py b/apps/models_provider/impl/gemini_model_provider/model/stt.py
index 500afaf1fb4..0da9d46e6c7 100644
--- a/apps/models_provider/impl/gemini_model_provider/model/stt.py
+++ b/apps/models_provider/impl/gemini_model_provider/model/stt.py
@@ -3,7 +3,6 @@
from django.utils.translation import gettext as _
from langchain_core.messages import HumanMessage
from langchain_google_genai import ChatGoogleGenerativeAI
-from openai import base_url
from common.config.tokenizer_manage_config import TokenizerManage
from models_provider.base_model_provider import MaxKBBaseModel
@@ -21,7 +20,7 @@ class GeminiSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
+ self.api_key = kwargs.get("api_key")
@staticmethod
def is_cache_model():
@@ -30,48 +29,43 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return GeminiSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- client = ChatGoogleGenerativeAI(
- model=self.model,
- google_api_key=self.api_key
- )
- response_list = client.invoke(_('Hello'))
+ client = ChatGoogleGenerativeAI(model=self.model, google_api_key=self.api_key)
+ response_list = client.invoke(_("Hello"))
# print(response_list)
def speech_to_text(self, audio_file):
- client = ChatGoogleGenerativeAI(
- model=self.model,
- google_api_key=self.api_key
- )
+ client = ChatGoogleGenerativeAI(model=self.model, google_api_key=self.api_key)
audio_data = audio_file.read()
system_instruction = """You are a professional speech-to-text assistant. Your task is to:
1. Transcribe the audio content accurately into text
2. Output ONLY the transcribed text without any additional comments..."""
- msg = HumanMessage(content=[
- {'type': 'text', 'text': system_instruction},
- {"type": "media", 'mime_type': 'audio/mp3', "data": audio_data}
- ])
+ msg = HumanMessage(
+ content=[
+ {"type": "text", "text": system_instruction},
+ {"type": "media", "mime_type": "audio/mp3", "data": audio_data},
+ ]
+ )
res = client.invoke([msg])
if isinstance(res.content, list):
for item in res.content:
- if isinstance(item, dict) and 'text' in item:
- return item['text'].strip()
- elif hasattr(item, 'text'):
+ if isinstance(item, dict) and "text" in item:
+ return item["text"].strip()
+ elif hasattr(item, "text"):
return item.text.strip()
- return ''
+ return ""
elif isinstance(res.content, dict):
- return res.content.get('text', '').strip()
+ return res.content.get("text", "").strip()
else:
- return str(res.content).strip() if res.content else ''
-
+ return str(res.content).strip() if res.content else ""
diff --git a/apps/models_provider/impl/gemini_model_provider/model/tti.py b/apps/models_provider/impl/gemini_model_provider/model/tti.py
index 1f5e17852b9..b3c0f915a50 100644
--- a/apps/models_provider/impl/gemini_model_provider/model/tti.py
+++ b/apps/models_provider/impl/gemini_model_provider/model/tti.py
@@ -1,7 +1,6 @@
import base64
from typing import Dict
-from openai import OpenAI
from common.config.tokenizer_manage_config import TokenizerManage
from common.utils.logger import maxkb_logger
@@ -22,10 +21,10 @@ class GeminiTextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.base_url = kwargs.get('base_url')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.base_url = kwargs.get("base_url")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -33,14 +32,14 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return GeminiTextToImage(
model=model_name,
- base_url=model_credential.get('base_url', "https://generativelanguage.googleapis.com"),
- api_key=model_credential.get('api_key'),
+ base_url=model_credential.get("base_url", "https://generativelanguage.googleapis.com"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
@@ -50,34 +49,24 @@ def check_auth(self):
def generate_image(self, prompt: str, negative_prompt: str = None):
from google import genai
from google.genai import types
- from PIL import Image
+
file_urls = []
client = genai.Client(api_key=self.api_key, http_options={"base_url": self.base_url})
- if self.model.startswith('imagen'):
+ if self.model.startswith("imagen"):
config = types.GenerateImagesConfig(**self.params)
# 如果有 negative_prompt 就加入
if negative_prompt:
config.negative_prompt = negative_prompt
- response = client.models.generate_images(
- model=self.model,
- prompt=prompt,
- config=config
- )
+ response = client.models.generate_images(model=self.model, prompt=prompt, config=config)
for generated_image in response.generated_images:
img_base64 = base64.b64encode(generated_image.image.image_bytes).decode("utf-8")
- file_urls.append(f'data:{generated_image.image.mime_type};base64,{img_base64}')
+ file_urls.append(f"data:{generated_image.image.mime_type};base64,{img_base64}")
else:
- config = types.GenerateContentConfig(image_config=types.ImageConfig(
- **self.params
- ))
+ config = types.GenerateContentConfig(image_config=types.ImageConfig(**self.params))
if negative_prompt:
config.negative_prompt = negative_prompt
- response = client.models.generate_content(
- model=self.model,
- contents=[prompt],
- config=config
- )
+ response = client.models.generate_content(model=self.model, contents=[prompt], config=config)
for part in response.parts:
if part.text is not None:
@@ -85,6 +74,6 @@ def generate_image(self, prompt: str, negative_prompt: str = None):
elif part.inline_data is not None:
image_bytes = part.inline_data.data
img_base64 = base64.b64encode(image_bytes).decode("utf-8")
- file_urls.append(f'data:{part.inline_data.mime_type};base64,{img_base64}')
+ file_urls.append(f"data:{part.inline_data.mime_type};base64,{img_base64}")
return file_urls
diff --git a/apps/models_provider/impl/gemini_model_provider/model/ttv.py b/apps/models_provider/impl/gemini_model_provider/model/ttv.py
index f3df1e50baf..3bb01934d29 100644
--- a/apps/models_provider/impl/gemini_model_provider/model/ttv.py
+++ b/apps/models_provider/impl/gemini_model_provider/model/ttv.py
@@ -44,6 +44,7 @@ def check_auth(self):
def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, last_frame_url=None, **kwargs):
from google import genai
from google.genai import types
+
client = genai.Client(api_key=self.api_key, http_options={"base_url": self.base_url})
# 1. 动态构建 Config 参数字典
diff --git a/apps/models_provider/impl/kimi_model_provider/__init__.py b/apps/models_provider/impl/kimi_model_provider/__init__.py
index 53b7001e589..fd54226fe4c 100644
--- a/apps/models_provider/impl/kimi_model_provider/__init__.py
+++ b/apps/models_provider/impl/kimi_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2023/10/31 17:16
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2023/10/31 17:16
+@desc:
"""
diff --git a/apps/models_provider/impl/kimi_model_provider/credential/llm.py b/apps/models_provider/impl/kimi_model_provider/credential/llm.py
index d451e39f31e..e8581ccd5e2 100644
--- a/apps/models_provider/impl/kimi_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/kimi_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:06
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:06
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,60 +18,80 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class KimiLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.3,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.3,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class KimiLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return KimiLLMModelParams()
diff --git a/apps/models_provider/impl/kimi_model_provider/kimi_model_provider.py b/apps/models_provider/impl/kimi_model_provider/kimi_model_provider.py
index e1ab6d7fad9..5cb4fbb9639 100644
--- a/apps/models_provider/impl/kimi_model_provider/kimi_model_provider.py
+++ b/apps/models_provider/impl/kimi_model_provider/kimi_model_provider.py
@@ -1,35 +1,43 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: kimi_model_provider.py
- @date:2024/3/28 16:26
- @desc:
+@project: maxkb
+@Author:虎
+@file: kimi_model_provider.py
+@date:2024/3/28 16:26
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.kimi_model_provider.credential.llm import KimiLLMModelCredential
from models_provider.impl.kimi_model_provider.model.llm import KimiChatModel
from maxkb.conf import PROJECT_DIR
kimi_llm_model_credential = KimiLLMModelCredential()
-moonshot_v1_8k = ModelInfo('moonshot-v1-8k', '', ModelTypeConst.LLM, kimi_llm_model_credential,
- KimiChatModel)
-moonshot_v1_32k = ModelInfo('moonshot-v1-32k', '', ModelTypeConst.LLM, kimi_llm_model_credential,
- KimiChatModel)
-moonshot_v1_128k = ModelInfo('moonshot-v1-128k', '', ModelTypeConst.LLM, kimi_llm_model_credential,
- KimiChatModel)
+moonshot_v1_8k = ModelInfo("moonshot-v1-8k", "", ModelTypeConst.LLM, kimi_llm_model_credential, KimiChatModel)
+moonshot_v1_32k = ModelInfo("moonshot-v1-32k", "", ModelTypeConst.LLM, kimi_llm_model_credential, KimiChatModel)
+moonshot_v1_128k = ModelInfo("moonshot-v1-128k", "", ModelTypeConst.LLM, kimi_llm_model_credential, KimiChatModel)
-model_info_manage = ModelInfoManage.builder().append_model_info(moonshot_v1_8k).append_model_info(
- moonshot_v1_32k).append_default_model_info(moonshot_v1_128k).append_default_model_info(moonshot_v1_8k).build()
+model_info_manage = (
+ ModelInfoManage.builder()
+ .append_model_info(moonshot_v1_8k)
+ .append_model_info(moonshot_v1_32k)
+ .append_default_model_info(moonshot_v1_128k)
+ .append_default_model_info(moonshot_v1_8k)
+ .build()
+)
class KimiModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
@@ -37,6 +45,12 @@ def get_dialogue_number(self):
return 3
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_kimi_provider', name='Kimi', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'kimi_model_provider', 'icon',
- 'kimi_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_kimi_provider",
+ name="Kimi",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "kimi_model_provider", "icon", "kimi_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/kimi_model_provider/model/llm.py b/apps/models_provider/impl/kimi_model_provider/model/llm.py
index b1607596e00..dd45f662b13 100644
--- a/apps/models_provider/impl/kimi_model_provider/model/llm.py
+++ b/apps/models_provider/impl/kimi_model_provider/model/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2023/11/10 17:45
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2023/11/10 17:45
+@desc:
"""
+
from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
@@ -13,7 +14,6 @@
class KimiChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -23,8 +23,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
kimi_chat_open_ai = KimiChatModel(
- openai_api_base=model_credential['api_base'],
- openai_api_key=model_credential['api_key'],
+ openai_api_base=model_credential["api_base"],
+ openai_api_key=model_credential["api_key"],
model=model_name,
**optional_params,
)
diff --git a/apps/models_provider/impl/local_model_provider/__init__.py b/apps/models_provider/impl/local_model_provider/__init__.py
index 90a8d72c352..f2d1408e123 100644
--- a/apps/models_provider/impl/local_model_provider/__init__.py
+++ b/apps/models_provider/impl/local_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: __init__.py
- @date:2024/7/10 17:48
- @desc:
+@project: MaxKB
+@Author:虎
+@file: __init__.py
+@date:2024/7/10 17:48
+@desc:
"""
diff --git a/apps/models_provider/impl/local_model_provider/credential/embedding/__init__.py b/apps/models_provider/impl/local_model_provider/credential/embedding/__init__.py
index 29828bb7401..253d109a6c0 100644
--- a/apps/models_provider/impl/local_model_provider/credential/embedding/__init__.py
+++ b/apps/models_provider/impl/local_model_provider/credential/embedding/__init__.py
@@ -1,14 +1,15 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/11/7 14:02
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: __init__.py.py
+@date:2025/11/7 14:02
+@desc:
"""
+
import os
-if os.environ.get('SERVER_NAME', 'web') == 'local_model':
+if os.environ.get("SERVER_NAME", "web") == "local_model":
from .model import *
else:
from .web import *
diff --git a/apps/models_provider/impl/local_model_provider/credential/embedding/model.py b/apps/models_provider/impl/local_model_provider/credential/embedding/model.py
index 402c48c1261..48805c8233e 100644
--- a/apps/models_provider/impl/local_model_provider/credential/embedding/model.py
+++ b/apps/models_provider/impl/local_model_provider/credential/embedding/model.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: model.py.py
- @date:2025/11/7 14:02
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: model.py.py
+@date:2025/11/7 14:02
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,31 +18,42 @@
from models_provider.impl.local_model_provider.model.embedding import LocalEmbedding
from common.utils.logger import maxkb_logger
-class LocalEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- if not model_type == 'EMBEDDING':
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['cache_folder']:
+class LocalEmbeddingCredential(BaseForm, BaseModelCredential):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ if not model_type == "EMBEDDING":
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
+ for key in ["cache_folder"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model: LocalEmbedding = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(gettext('Hello'))
+ model.embed_query(gettext("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
@@ -49,4 +61,4 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
def encryption_dict(self, model: Dict[str, object]):
return model
- cache_folder = forms.TextInputField(_('Model catalog'), required=True)
+ cache_folder = forms.TextInputField(_("Model catalog"), required=True)
diff --git a/apps/models_provider/impl/local_model_provider/credential/embedding/web.py b/apps/models_provider/impl/local_model_provider/credential/embedding/web.py
index 4695d141c6d..07f33e0ebb8 100644
--- a/apps/models_provider/impl/local_model_provider/credential/embedding/web.py
+++ b/apps/models_provider/impl/local_model_provider/credential/embedding/web.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: web.py
- @date:2025/11/7 14:03
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: web.py
+@date:2025/11/7 14:03
+@desc:
"""
+
from typing import Dict
import requests
@@ -18,20 +19,27 @@
class LocalEmbeddingCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- bind = f'{CONFIG.get("LOCAL_MODEL_HOST")}:{CONFIG.get("LOCAL_MODEL_PORT")}'
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ bind = f"{CONFIG.get('LOCAL_MODEL_HOST')}:{CONFIG.get('LOCAL_MODEL_PORT')}"
prefix = CONFIG.get_admin_path()
res = requests.post(
- f'{CONFIG.get("LOCAL_MODEL_PROTOCOL")}://{bind}{prefix}/api/model/validate',
- json={'model_name': model_name, 'model_type': model_type, 'model_credential': model_credential})
+ f"{CONFIG.get('LOCAL_MODEL_PROTOCOL')}://{bind}{prefix}/api/model/validate",
+ json={"model_name": model_name, "model_type": model_type, "model_credential": model_credential},
+ )
result = res.json()
- if result.get('code', 500) == 200:
- return result.get('data')
- raise Exception(result.get('message'))
+ if result.get("code", 500) == 200:
+ return result.get("data")
+ raise Exception(result.get("message"))
def encryption_dict(self, model: Dict[str, object]):
return model
- cache_folder = forms.TextInputField(_('Model catalog'), required=True)
+ cache_folder = forms.TextInputField(_("Model catalog"), required=True)
diff --git a/apps/models_provider/impl/local_model_provider/credential/reranker/__init__.py b/apps/models_provider/impl/local_model_provider/credential/reranker/__init__.py
index f9ec12bc56c..d670e667179 100644
--- a/apps/models_provider/impl/local_model_provider/credential/reranker/__init__.py
+++ b/apps/models_provider/impl/local_model_provider/credential/reranker/__init__.py
@@ -1,14 +1,15 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/11/7 14:22
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: __init__.py.py
+@date:2025/11/7 14:22
+@desc:
"""
+
import os
-if os.environ.get('SERVER_NAME', 'web') == 'local_model':
+if os.environ.get("SERVER_NAME", "web") == "local_model":
from .model import *
else:
from .web import *
diff --git a/apps/models_provider/impl/local_model_provider/credential/reranker/model.py b/apps/models_provider/impl/local_model_provider/credential/reranker/model.py
index 9d381747ba6..af11f163f11 100644
--- a/apps/models_provider/impl/local_model_provider/credential/reranker/model.py
+++ b/apps/models_provider/impl/local_model_provider/credential/reranker/model.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: model.py
- @date:2025/11/7 14:23
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: model.py
+@date:2025/11/7 14:23
+@desc:
"""
+
from typing import Dict
from langchain_core.documents import Document
@@ -20,40 +21,52 @@
class LocalRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class LocalRerankerCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- if not model_type == 'RERANKER':
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['cache_dir']:
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ if not model_type == "RERANKER":
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
+ for key in ["cache_dir"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model: LocalReranker = provider.get_model(model_type, model_name, model_credential)
- model.compress_documents([Document(page_content=gettext('Hello'))], gettext('Hello'))
+ model.compress_documents([Document(page_content=gettext("Hello"))], gettext("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
@@ -61,7 +74,7 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
def encryption_dict(self, model: Dict[str, object]):
return model
- cache_dir = forms.TextInputField(_('Model catalog'), required=True)
+ cache_dir = forms.TextInputField(_("Model catalog"), required=True)
def get_model_params_setting_form(self, model_name: str) -> LocalRerankerModelParams:
return LocalRerankerModelParams()
diff --git a/apps/models_provider/impl/local_model_provider/credential/reranker/web.py b/apps/models_provider/impl/local_model_provider/credential/reranker/web.py
index 3996c9df3c4..877488d450c 100644
--- a/apps/models_provider/impl/local_model_provider/credential/reranker/web.py
+++ b/apps/models_provider/impl/local_model_provider/credential/reranker/web.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: web.py
- @date:2025/11/7 14:23
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: web.py
+@date:2025/11/7 14:23
+@desc:
"""
+
from typing import Dict
import requests
@@ -18,20 +19,27 @@
class LocalRerankerCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- bind = f'{CONFIG.get("LOCAL_MODEL_HOST")}:{CONFIG.get("LOCAL_MODEL_PORT")}'
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ bind = f"{CONFIG.get('LOCAL_MODEL_HOST')}:{CONFIG.get('LOCAL_MODEL_PORT')}"
prefix = CONFIG.get_admin_path()
res = requests.post(
- f'{CONFIG.get("LOCAL_MODEL_PROTOCOL")}://{bind}{prefix}/api/model/validate',
- json={'model_name': model_name, 'model_type': model_type, 'model_credential': model_credential})
+ f"{CONFIG.get('LOCAL_MODEL_PROTOCOL')}://{bind}{prefix}/api/model/validate",
+ json={"model_name": model_name, "model_type": model_type, "model_credential": model_credential},
+ )
result = res.json()
- if result.get('code', 500) == 200:
- return result.get('data')
- raise Exception(result.get('message'))
+ if result.get("code", 500) == 200:
+ return result.get("data")
+ raise Exception(result.get("message"))
def encryption_dict(self, model: Dict[str, object]):
return model
- cache_dir = forms.TextInputField(_('Model catalog'), required=True)
+ cache_dir = forms.TextInputField(_("Model catalog"), required=True)
diff --git a/apps/models_provider/impl/local_model_provider/local_model_provider.py b/apps/models_provider/impl/local_model_provider/local_model_provider.py
index 342f585f4d4..c5461645f57 100644
--- a/apps/models_provider/impl/local_model_provider/local_model_provider.py
+++ b/apps/models_provider/impl/local_model_provider/local_model_provider.py
@@ -1,42 +1,58 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: zhipu_model_provider.py
- @date:2024/04/19 13:5
- @desc:
+@project: maxkb
+@Author:虎
+@file: zhipu_model_provider.py
+@date:2024/04/19 13:5
+@desc:
"""
+
import os
from django.utils.translation import gettext as _
from common.utils.common import get_file_content
from maxkb.conf import PROJECT_DIR
-from models_provider.base_model_provider import ModelProvideInfo, ModelTypeConst, ModelInfo, IModelProvider, \
- ModelInfoManage
+from models_provider.base_model_provider import (
+ ModelProvideInfo,
+ ModelTypeConst,
+ ModelInfo,
+ IModelProvider,
+ ModelInfoManage,
+)
from models_provider.impl.local_model_provider.credential.embedding import LocalEmbeddingCredential
from models_provider.impl.local_model_provider.credential.reranker import LocalRerankerCredential
from models_provider.impl.local_model_provider.model.embedding import LocalEmbedding
from models_provider.impl.local_model_provider.model.reranker import LocalReranker
-embedding_text2vec_base_chinese = ModelInfo('shibing624/text2vec-base-chinese', '', ModelTypeConst.EMBEDDING,
- LocalEmbeddingCredential(), LocalEmbedding)
-bge_reranker_v2_m3 = ModelInfo('BAAI/bge-reranker-v2-m3', '', ModelTypeConst.RERANKER,
- LocalRerankerCredential(), LocalReranker)
+embedding_text2vec_base_chinese = ModelInfo(
+ "shibing624/text2vec-base-chinese", "", ModelTypeConst.EMBEDDING, LocalEmbeddingCredential(), LocalEmbedding
+)
+bge_reranker_v2_m3 = ModelInfo(
+ "BAAI/bge-reranker-v2-m3", "", ModelTypeConst.RERANKER, LocalRerankerCredential(), LocalReranker
+)
-model_info_manage = (ModelInfoManage.builder().append_model_info(embedding_text2vec_base_chinese)
- .append_default_model_info(embedding_text2vec_base_chinese)
- .append_model_info(bge_reranker_v2_m3)
- .append_default_model_info(bge_reranker_v2_m3)
- .build())
+model_info_manage = (
+ ModelInfoManage.builder()
+ .append_model_info(embedding_text2vec_base_chinese)
+ .append_default_model_info(embedding_text2vec_base_chinese)
+ .append_model_info(bge_reranker_v2_m3)
+ .append_default_model_info(bge_reranker_v2_m3)
+ .build()
+)
class LocalModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_local_provider', name=_('local model'), icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'local_model_provider', 'icon',
- 'local_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_local_provider",
+ name=_("local model"),
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "local_model_provider", "icon", "local_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/local_model_provider/model/embedding/__init__.py b/apps/models_provider/impl/local_model_provider/model/embedding/__init__.py
index 840afa5afc4..aca7c79b253 100644
--- a/apps/models_provider/impl/local_model_provider/model/embedding/__init__.py
+++ b/apps/models_provider/impl/local_model_provider/model/embedding/__init__.py
@@ -1,14 +1,15 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py
- @date:2025/11/5 15:24
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: __init__.py
+@date:2025/11/5 15:24
+@desc:
"""
+
import os
-if os.environ.get('SERVER_NAME', 'web') == 'local_model':
+if os.environ.get("SERVER_NAME", "web") == "local_model":
from .model import *
else:
from .web import *
diff --git a/apps/models_provider/impl/local_model_provider/model/embedding/model.py b/apps/models_provider/impl/local_model_provider/model/embedding/model.py
index c2c2900679f..36818324a3d 100644
--- a/apps/models_provider/impl/local_model_provider/model/embedding/model.py
+++ b/apps/models_provider/impl/local_model_provider/model/embedding/model.py
@@ -1,22 +1,27 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: model.py
- @date:2025/11/5 15:26
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: model.py
+@date:2025/11/5 15:26
+@desc:
"""
+
+import time
from typing import Dict
from langchain_huggingface import HuggingFaceEmbeddings
from common.utils.logger import maxkb_logger
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
max_retries = 3
-class LocalEmbedding(MaxKBBaseModel, HuggingFaceEmbeddings):
+class LocalEmbedding(MaxKBBaseEmbeddingModel, HuggingFaceEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
+
@staticmethod
def is_cache_model():
return True
@@ -25,18 +30,20 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
for attempt in range(max_retries):
try:
- embedding = LocalEmbedding(model_name=model_name, cache_folder=model_credential.get('cache_folder'),
- model_kwargs={'device': model_credential.get('device')},
- encode_kwargs={'normalize_embeddings': True}
- )
+ embedding = LocalEmbedding(
+ model_name=model_name,
+ cache_folder=model_credential.get("cache_folder"),
+ model_kwargs={"device": model_credential.get("device")},
+ encode_kwargs={"normalize_embeddings": True},
+ )
# 测试一下是否真的能用
embedding.embed_query("test")
return embedding
except Exception as e:
- if 'meta tensor' in str(e).lower() and attempt < max_retries - 1:
+ if "meta tensor" in str(e).lower() and attempt < max_retries - 1:
maxkb_logger.warning(
- f"Test failed with meta tensor error, retrying... (attempt {attempt + 1}/{max_retries})")
- import time
+ f"Test failed with meta tensor error, retrying... (attempt {attempt + 1}/{max_retries})"
+ )
time.sleep(1)
continue
raise e
diff --git a/apps/models_provider/impl/local_model_provider/model/embedding/web.py b/apps/models_provider/impl/local_model_provider/model/embedding/web.py
index 42c780adc04..5ca2d1fde98 100644
--- a/apps/models_provider/impl/local_model_provider/model/embedding/web.py
+++ b/apps/models_provider/impl/local_model_provider/model/embedding/web.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: web.py
- @date:2025/11/5 15:24
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: web.py
+@date:2025/11/5 15:24
+@desc:
"""
from typing import Dict, List
@@ -14,41 +14,49 @@
from langchain_core.embeddings import Embeddings
from maxkb.const import CONFIG
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
-class LocalEmbedding(MaxKBBaseModel, BaseModel, Embeddings):
+class LocalEmbedding(MaxKBBaseEmbeddingModel, BaseModel, Embeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
+
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.model_id = kwargs.get('model_id', None)
+ self.model_id = kwargs.get("model_id", None)
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return LocalEmbedding(model_name=model_name, cache_folder=model_credential.get('cache_folder'),
- model_kwargs={'device': model_credential.get('device')},
- encode_kwargs={'normalize_embeddings': True},
- **model_kwargs)
+ return LocalEmbedding(
+ model_name=model_name,
+ cache_folder=model_credential.get("cache_folder"),
+ model_kwargs={"device": model_credential.get("device")},
+ encode_kwargs={"normalize_embeddings": True},
+ **model_kwargs,
+ )
model_id: str = None
def embed_query(self, text: str) -> List[float]:
- bind = f'{CONFIG.get("LOCAL_MODEL_HOST")}:{CONFIG.get("LOCAL_MODEL_PORT")}'
+ bind = f"{CONFIG.get('LOCAL_MODEL_HOST')}:{CONFIG.get('LOCAL_MODEL_PORT')}"
prefix = CONFIG.get_admin_path()
res = requests.post(
- f'{CONFIG.get("LOCAL_MODEL_PROTOCOL")}://{bind}{prefix}/api/model/{self.model_id}/embed_query',
- {'text': text})
+ f"{CONFIG.get('LOCAL_MODEL_PROTOCOL')}://{bind}{prefix}/api/model/{self.model_id}/embed_query",
+ {"text": text},
+ )
result = res.json()
- if result.get('code', 500) == 200:
- return result.get('data')
- raise Exception(result.get('message'))
+ if result.get("code", 500) == 200:
+ return result.get("data")
+ raise Exception(result.get("message"))
def embed_documents(self, texts: List[str]) -> List[List[float]]:
- bind = f'{CONFIG.get("LOCAL_MODEL_HOST")}:{CONFIG.get("LOCAL_MODEL_PORT")}'
+ bind = f"{CONFIG.get('LOCAL_MODEL_HOST')}:{CONFIG.get('LOCAL_MODEL_PORT')}"
prefix = CONFIG.get_admin_path()
res = requests.post(
- f'{CONFIG.get("LOCAL_MODEL_PROTOCOL")}://{bind}{prefix}/api/model/{self.model_id}/embed_documents',
- {'texts': texts})
+ f"{CONFIG.get('LOCAL_MODEL_PROTOCOL')}://{bind}{prefix}/api/model/{self.model_id}/embed_documents",
+ {"texts": texts},
+ )
result = res.json()
- if result.get('code', 500) == 200:
- return result.get('data')
- raise Exception(result.get('message'))
+ if result.get("code", 500) == 200:
+ return result.get("data")
+ raise Exception(result.get("message"))
diff --git a/apps/models_provider/impl/local_model_provider/model/reranker/__init__.py b/apps/models_provider/impl/local_model_provider/model/reranker/__init__.py
index 10d5b1bb68d..97148bd6fba 100644
--- a/apps/models_provider/impl/local_model_provider/model/reranker/__init__.py
+++ b/apps/models_provider/impl/local_model_provider/model/reranker/__init__.py
@@ -1,14 +1,15 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: __init__.py.py
- @date:2025/11/5 15:30
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: __init__.py.py
+@date:2025/11/5 15:30
+@desc:
"""
+
import os
-if os.environ.get('SERVER_NAME', 'web') == 'local_model':
+if os.environ.get("SERVER_NAME", "web") == "local_model":
from .model import *
else:
from .web import *
diff --git a/apps/models_provider/impl/local_model_provider/model/reranker/model.py b/apps/models_provider/impl/local_model_provider/model/reranker/model.py
index a66776101b4..892dad76e46 100644
--- a/apps/models_provider/impl/local_model_provider/model/reranker/model.py
+++ b/apps/models_provider/impl/local_model_provider/model/reranker/model.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: model.py
- @date:2025/11/5 15:30
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: model.py
+@date:2025/11/5 15:30
+@desc:
"""
from typing import Sequence, Optional, Dict, Any
@@ -25,12 +25,13 @@ class LocalReranker(MaxKBBaseModel, BaseDocumentCompressor):
def __init__(self, model_name, cache_dir=None, **model_kwargs):
super().__init__()
from transformers import AutoModelForSequenceClassification, AutoTokenizer
+
self.model = model_name
self.cache_dir = cache_dir
self.model_kwargs = model_kwargs
self.client = AutoModelForSequenceClassification.from_pretrained(self.model, cache_dir=self.cache_dir)
self.tokenizer = AutoTokenizer.from_pretrained(self.model, cache_dir=self.cache_dir)
- self.client = self.client.to(self.model_kwargs.get('device', 'cpu'))
+ self.client = self.client.to(self.model_kwargs.get("device", "cpu"))
self.client.eval()
@staticmethod
@@ -39,20 +40,34 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return LocalReranker(model_name, cache_dir=model_credential.get('cache_dir'))
+ return LocalReranker(model_name, cache_dir=model_credential.get("cache_dir"))
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if documents is None or len(documents) == 0:
return []
import torch
+
with torch.no_grad():
- inputs = self.tokenizer([[query, document.page_content] for document in documents], padding=True,
- truncation=True, return_tensors='pt', max_length=512)
- scores = [torch.sigmoid(s).float().item() for s in
- self.client(**inputs, return_dict=True).logits.view(-1, ).float()]
- result = [Document(page_content=documents[index].page_content, metadata={'relevance_score': scores[index]})
- for index
- in range(len(documents))]
- result.sort(key=lambda row: row.metadata.get('relevance_score'), reverse=True)
+ inputs = self.tokenizer(
+ [[query, document.page_content] for document in documents],
+ padding=True,
+ truncation=True,
+ return_tensors="pt",
+ max_length=512,
+ )
+ scores = [
+ torch.sigmoid(s).float().item()
+ for s in self.client(**inputs, return_dict=True)
+ .logits.view(
+ -1,
+ )
+ .float()
+ ]
+ result = [
+ Document(page_content=documents[index].page_content, metadata={"relevance_score": scores[index]})
+ for index in range(len(documents))
+ ]
+ result.sort(key=lambda row: row.metadata.get("relevance_score"), reverse=True)
return result
diff --git a/apps/models_provider/impl/local_model_provider/model/reranker/web.py b/apps/models_provider/impl/local_model_provider/model/reranker/web.py
index 8be3850be99..93248926293 100644
--- a/apps/models_provider/impl/local_model_provider/model/reranker/web.py
+++ b/apps/models_provider/impl/local_model_provider/model/reranker/web.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: web.py
- @date:2025/11/5 15:30
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: web.py
+@date:2025/11/5 15:30
+@desc:
"""
+
from typing import Sequence, Optional, Dict
import requests
@@ -18,34 +19,43 @@
class LocalReranker(MaxKBBaseModel, BaseModel, BaseDocumentCompressor):
-
@staticmethod
def is_cache_model():
return False
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return LocalReranker(model_type=model_type, model_name=model_name, model_credential=model_credential,
- **model_kwargs)
+ return LocalReranker(
+ model_type=model_type, model_name=model_name, model_credential=model_credential, **model_kwargs
+ )
model_id: str = None
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.model_id = kwargs.get('model_id', None)
+ self.model_id = kwargs.get("model_id", None)
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if documents is None or len(documents) == 0:
return []
prefix = CONFIG.get_admin_path()
- bind = f'{CONFIG.get("LOCAL_MODEL_HOST")}:{CONFIG.get("LOCAL_MODEL_PORT")}'
+ bind = f"{CONFIG.get('LOCAL_MODEL_HOST')}:{CONFIG.get('LOCAL_MODEL_PORT')}"
res = requests.post(
- f'{CONFIG.get("LOCAL_MODEL_PROTOCOL")}://{bind}{prefix}/api/model/{self.model_id}/compress_documents',
- json={'documents': [{'page_content': document.page_content, 'metadata': document.metadata} for document in
- documents], 'query': query}, headers={'Content-Type': 'application/json'})
+ f"{CONFIG.get('LOCAL_MODEL_PROTOCOL')}://{bind}{prefix}/api/model/{self.model_id}/compress_documents",
+ json={
+ "documents": [
+ {"page_content": document.page_content, "metadata": document.metadata} for document in documents
+ ],
+ "query": query,
+ },
+ headers={"Content-Type": "application/json"},
+ )
result = res.json()
- if result.get('code', 500) == 200:
- return [Document(page_content=document.get('page_content'), metadata=document.get('metadata')) for document
- in result.get('data')]
- raise Exception(result.get('message'))
+ if result.get("code", 500) == 200:
+ return [
+ Document(page_content=document.get("page_content"), metadata=document.get("metadata"))
+ for document in result.get("data")
+ ]
+ raise Exception(result.get("message"))
diff --git a/apps/models_provider/impl/minimax_model_provider/credential/itv.py b/apps/models_provider/impl/minimax_model_provider/credential/itv.py
index 2bbb01c5abb..695cdf38ae2 100644
--- a/apps/models_provider/impl/minimax_model_provider/credential/itv.py
+++ b/apps/models_provider/impl/minimax_model_provider/credential/itv.py
@@ -6,7 +6,7 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, SingleSelect, SliderField, TooltipLabel
+from common.forms import BaseForm, PasswordInputField, TooltipLabel
from common.forms.switch_field import SwitchField
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
@@ -14,34 +14,67 @@
class MiniMaxModelParams(BaseForm):
"""
- Parameters class for the Qwen Text-to-Video model.
- Defines fields such as Video size, number of Videos, and style.
+ Parameters class for the MiniMax V1 (legacy) Video model.
"""
aigc_watermark = SwitchField(
- TooltipLabel(_('Watermark'), _('Whether to add watermark')),
+ TooltipLabel(_("Watermark"), _("Whether to add watermark")),
attrs={"active-value": True, "inactive-value": False},
default_value=False,
)
+class MiniMaxH3ModelParams(BaseForm):
+ """
+ Parameters class for the MiniMax V2 (MiniMax-H3) Video model.
+ """
+
+ resolution = forms.SingleSelect(
+ TooltipLabel(_("Resolution"), _("Output video resolution.")),
+ required=True,
+ default_value="480P",
+ option_list=[{"value": value, "label": value} for value in ["480P", "768P", "2K"]],
+ text_field="label",
+ value_field="value",
+ )
+
+ duration = forms.SliderField(
+ TooltipLabel(_("Duration"), _("Video duration in seconds (4-15).")),
+ 4,
+ 15,
+ 1,
+ 0,
+ required=True,
+ default_value=10,
+ )
+
+ ratio = forms.SingleSelect(
+ TooltipLabel(_("Aspect ratio"), _("Output video aspect ratio.")),
+ required=False,
+ default_value="16:9",
+ option_list=[{"value": value, "label": value} for value in ["16:9", "9:16", "1:1", "4:3", "3:4"]],
+ text_field="label",
+ value_field="value",
+ )
+
+
class ImageToVideoModelCredential(BaseForm, BaseModelCredential):
"""
Credential class for the Qwen Text-to-Video model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField('API URL', required=True,
- default_value='https://api.minimaxi.com/v1')
- api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v1")
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -55,35 +88,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -96,10 +126,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
@@ -109,3 +136,17 @@ def get_model_params_setting_form(self, model_name: str):
:return: Parameter setting form.
"""
return MiniMaxModelParams()
+
+
+class MiniMaxH3ImageToVideoModelCredential(ImageToVideoModelCredential):
+ """
+ Credential for the MiniMax H3 / H3-Max (V2) image-to-video model.
+ Uses the V2 endpoint and requires resolution / duration / ratio.
+ """
+
+ # BaseForm 只收集本类的字段(vars(self.__class__) 不走 MRO),继承字段需重新声明
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v2")
+ api_key = PasswordInputField("API Key", required=True)
+
+ def get_model_params_setting_form(self, model_name: str):
+ return MiniMaxH3ModelParams()
diff --git a/apps/models_provider/impl/minimax_model_provider/credential/llm.py b/apps/models_provider/impl/minimax_model_provider/credential/llm.py
index 76283c7aad1..807e05edd59 100644
--- a/apps/models_provider/impl/minimax_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/minimax_model_provider/credential/llm.py
@@ -12,61 +12,78 @@
class MiniMaxLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=1.0,
- _min=0.01,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=1.0,
+ _min=0.01,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=192000,
_step=1,
- precision=0)
+ precision=0,
+ )
class MiniMaxLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True,
- default_value='https://api.minimaxi.com/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return MiniMaxLLMModelParams()
diff --git a/apps/models_provider/impl/minimax_model_provider/credential/tti.py b/apps/models_provider/impl/minimax_model_provider/credential/tti.py
index 71ea95a267c..755ec3a3ab3 100644
--- a/apps/models_provider/impl/minimax_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/minimax_model_provider/credential/tti.py
@@ -5,7 +5,7 @@
from django.utils.translation import gettext_lazy as _, gettext
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, SingleSelect, SliderField, TooltipLabel
+from common.forms import BaseForm, PasswordInputField, SliderField, TooltipLabel
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
@@ -17,13 +17,13 @@ class MiniMaxModelParams(BaseForm):
"""
n = SliderField(
- TooltipLabel(_('Number of pictures'), _('Specify the number of generated images')),
+ TooltipLabel(_("Number of pictures"), _("Specify the number of generated images")),
required=True,
default_value=1,
_min=1,
_max=4,
_step=1,
- precision=0
+ precision=0,
)
@@ -32,18 +32,18 @@ class MiniMaxTextToImageModelCredential(BaseForm, BaseModelCredential):
Credential class for the MiniMax Text-to-Image model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField('API URL', required=True,
- default_value='https://api.minimaxi.com/v1')
- api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v1")
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -57,35 +57,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -98,10 +95,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
diff --git a/apps/models_provider/impl/minimax_model_provider/credential/tts.py b/apps/models_provider/impl/minimax_model_provider/credential/tts.py
index 2d441a05374..c913afa8fe6 100644
--- a/apps/models_provider/impl/minimax_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/minimax_model_provider/credential/tts.py
@@ -5,58 +5,68 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, TooltipLabel
+from common.forms import BaseForm
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
class MiniMaxTTSModelGeneralParams(BaseForm):
voice_setting = forms.BaseField(
- input_type='JsonInput',
- label=_('Voice Setting'),
+ input_type="JsonInput",
+ label=_("Voice Setting"),
required=True,
default_value={
- 'voice_id': 'Chinese (Mandarin)_Lyrical_Voice',
- }
+ "voice_id": "Chinese (Mandarin)_Lyrical_Voice",
+ },
)
class MiniMaxTTSModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True,
- default_value='https://api.minimaxi.com/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return MiniMaxTTSModelGeneralParams()
diff --git a/apps/models_provider/impl/minimax_model_provider/credential/ttv.py b/apps/models_provider/impl/minimax_model_provider/credential/ttv.py
index c2765906f49..9a2d580b766 100644
--- a/apps/models_provider/impl/minimax_model_provider/credential/ttv.py
+++ b/apps/models_provider/impl/minimax_model_provider/credential/ttv.py
@@ -6,7 +6,7 @@
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, PasswordInputField, SingleSelect, SliderField, TooltipLabel
+from common.forms import BaseForm, PasswordInputField, TooltipLabel
from common.forms.switch_field import SwitchField
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
@@ -14,34 +14,67 @@
class MiniMaxModelParams(BaseForm):
"""
- Parameters class for the Qwen Text-to-Video model.
- Defines fields such as Video size, number of Videos, and style.
+ Parameters class for the MiniMax V1 (legacy) Video model.
"""
aigc_watermark = SwitchField(
- TooltipLabel(_('Watermark'), _('Whether to add watermark')),
+ TooltipLabel(_("Watermark"), _("Whether to add watermark")),
attrs={"active-value": True, "inactive-value": False},
default_value=False,
)
+class MiniMaxH3ModelParams(BaseForm):
+ """
+ Parameters class for the MiniMax V2 (MiniMax-H3) Video model.
+ """
+
+ resolution = forms.SingleSelect(
+ TooltipLabel(_("Resolution"), _("Output video resolution.")),
+ required=True,
+ default_value="480P",
+ option_list=[{"value": value, "label": value} for value in ["480P", "768P", "2K"]],
+ text_field="label",
+ value_field="value",
+ )
+
+ duration = forms.SliderField(
+ TooltipLabel(_("Duration"), _("Video duration in seconds (4-15).")),
+ 4,
+ 15,
+ 1,
+ 0,
+ required=True,
+ default_value=10,
+ )
+
+ ratio = forms.SingleSelect(
+ TooltipLabel(_("Aspect ratio"), _("Output video aspect ratio.")),
+ required=False,
+ default_value="16:9",
+ option_list=[{"value": value, "label": value} for value in ["16:9", "9:16", "1:1", "4:3", "3:4"]],
+ text_field="label",
+ value_field="value",
+ )
+
+
class TextToVideoModelCredential(BaseForm, BaseModelCredential):
"""
Credential class for the Qwen Text-to-Video model.
Provides validation and encryption for the model credentials.
"""
- api_base = forms.TextInputField('API URL', required=True,
- default_value='https://api.minimaxi.com/v1')
- api_key = PasswordInputField('API Key', required=True)
+
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v1")
+ api_key = PasswordInputField("API Key", required=True)
def is_valid(
- self,
- model_type: str,
- model_name: str,
- model_credential: Dict[str, Any],
- model_params: Dict[str, Any],
- provider,
- raise_exception: bool = False
+ self,
+ model_type: str,
+ model_name: str,
+ model_credential: Dict[str, Any],
+ model_params: Dict[str, Any],
+ provider,
+ raise_exception: bool = False,
) -> bool:
"""
Validate the model credentials.
@@ -55,35 +88,32 @@ def is_valid(
:return: Boolean indicating whether the credentials are valid.
"""
model_type_list = provider.get_model_type_list()
- if not any(mt.get('value') == model_type for mt in model_type_list):
+ if not any(mt.get("value") == model_type for mt in model_type_list):
raise AppApiException(
ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type)
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
)
- required_keys = ['api_key', 'api_base']
+ required_keys = ["api_key", "api_base"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- gettext('{key} is required').format(key=key)
- )
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}'
- ).format(error=str(e))
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
@@ -96,10 +126,7 @@ def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
:param model: Dictionary containing model details.
:return: Dictionary with encrypted sensitive fields.
"""
- return {
- **model,
- 'api_key': super().encryption(model.get('api_key', ''))
- }
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str):
"""
@@ -109,3 +136,17 @@ def get_model_params_setting_form(self, model_name: str):
:return: Parameter setting form.
"""
return MiniMaxModelParams()
+
+
+class MiniMaxH3TextToVideoModelCredential(TextToVideoModelCredential):
+ """
+ Credential for the MiniMax H3 / H3-Max (V2) text-to-video model.
+ Uses the V2 endpoint and requires resolution / duration / ratio.
+ """
+
+ # BaseForm 只收集本类的字段(vars(self.__class__) 不走 MRO),继承字段需重新声明
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.minimaxi.com/v2")
+ api_key = PasswordInputField("API Key", required=True)
+
+ def get_model_params_setting_form(self, model_name: str):
+ return MiniMaxH3ModelParams()
diff --git a/apps/models_provider/impl/minimax_model_provider/minimax_model_provider.py b/apps/models_provider/impl/minimax_model_provider/minimax_model_provider.py
index c9f1d7f90f1..53a8c8f24f6 100644
--- a/apps/models_provider/impl/minimax_model_provider/minimax_model_provider.py
+++ b/apps/models_provider/impl/minimax_model_provider/minimax_model_provider.py
@@ -9,11 +9,17 @@
ModelTypeConst,
ModelInfoManage,
)
-from models_provider.impl.minimax_model_provider.credential.itv import ImageToVideoModelCredential
+from models_provider.impl.minimax_model_provider.credential.itv import (
+ ImageToVideoModelCredential,
+ MiniMaxH3ImageToVideoModelCredential,
+)
from models_provider.impl.minimax_model_provider.credential.llm import MiniMaxLLMModelCredential
from models_provider.impl.minimax_model_provider.credential.tti import MiniMaxTextToImageModelCredential
from models_provider.impl.minimax_model_provider.credential.tts import MiniMaxTTSModelCredential
-from models_provider.impl.minimax_model_provider.credential.ttv import TextToVideoModelCredential
+from models_provider.impl.minimax_model_provider.credential.ttv import (
+ MiniMaxH3TextToVideoModelCredential,
+ TextToVideoModelCredential,
+)
from models_provider.impl.minimax_model_provider.model.llm import MiniMaxChatModel
from models_provider.impl.minimax_model_provider.model.tti import MiniMaxTextToImageModel
from models_provider.impl.minimax_model_provider.model.tts import MiniMaxTextToSpeech
@@ -27,6 +33,8 @@
minimax_tti_model_credential = MiniMaxTextToImageModelCredential()
minimax_ttv_model_credential = TextToVideoModelCredential()
minimax_itv_model_credential = ImageToVideoModelCredential()
+minimax_h3_ttv_model_credential = MiniMaxH3TextToVideoModelCredential()
+minimax_h3_itv_model_credential = MiniMaxH3ImageToVideoModelCredential()
minimax_m2_7 = ModelInfo(
"MiniMax-M2.7",
@@ -87,10 +95,14 @@
ModelInfo("image-01", _(""), ModelTypeConst.TTI, minimax_tti_model_credential, MiniMaxTextToImageModel),
]
minimax_ttv_list = [
+ ModelInfo("MiniMax-H3", _(""), ModelTypeConst.TTV, minimax_h3_ttv_model_credential, GenerationVideoModel),
+ ModelInfo("MiniMax-H3-Max", _(""), ModelTypeConst.TTV, minimax_h3_ttv_model_credential, GenerationVideoModel),
ModelInfo("MiniMax-Hailuo-2.3", _(""), ModelTypeConst.TTV, minimax_ttv_model_credential, GenerationVideoModel),
]
model_info_itv_list = [
+ ModelInfo("MiniMax-H3", _(""), ModelTypeConst.ITV, minimax_h3_itv_model_credential, GenerationVideoModel),
+ ModelInfo("MiniMax-H3-Max", _(""), ModelTypeConst.ITV, minimax_h3_itv_model_credential, GenerationVideoModel),
ModelInfo("MiniMax-Hailuo-2.3", _(""), ModelTypeConst.ITV, minimax_itv_model_credential, GenerationVideoModel),
]
model_info_manage = (
diff --git a/apps/models_provider/impl/minimax_model_provider/model/llm.py b/apps/models_provider/impl/minimax_model_provider/model/llm.py
index 981ba485478..ed11c4f9ece 100644
--- a/apps/models_provider/impl/minimax_model_provider/model/llm.py
+++ b/apps/models_provider/impl/minimax_model_provider/model/llm.py
@@ -6,7 +6,6 @@
class MiniMaxChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -14,15 +13,15 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- extra_body = optional_params.get('extra_body', {})
+ extra_body = optional_params.get("extra_body", {})
if not isinstance(extra_body, dict):
extra_body = {}
- if 'reasoning_split' not in extra_body:
- extra_body['reasoning_split'] = True
- optional_params['extra_body'] = extra_body
+ if "reasoning_split" not in extra_body:
+ extra_body["reasoning_split"] = True
+ optional_params["extra_body"] = extra_body
return MiniMaxChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base') or 'https://api.minimaxi.com/v1',
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base") or "https://api.minimaxi.com/v1",
+ openai_api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/minimax_model_provider/model/tti.py b/apps/models_provider/impl/minimax_model_provider/model/tti.py
index 5d2c3e0b4b7..4dff305080f 100644
--- a/apps/models_provider/impl/minimax_model_provider/model/tti.py
+++ b/apps/models_provider/impl/minimax_model_provider/model/tti.py
@@ -1,10 +1,7 @@
# coding=utf-8
-from http import HTTPStatus
from typing import Dict
import requests
-from dashscope import ImageSynthesis, MultiModalConversation
-from dashscope.aigc.image_generation import ImageGeneration
from common.utils.logger import maxkb_logger
from models_provider.base_model_provider import MaxKBBaseModel
@@ -19,10 +16,10 @@ class MiniMaxTextToImageModel(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model_name = kwargs.get('model_name')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -30,15 +27,15 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
- api_base = model_credential.get('api_base', "https://api.minimaxi.com/v1")
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ api_base = model_credential.get("api_base", "https://api.minimaxi.com/v1")
minimax_model = MiniMaxTextToImageModel(
model_name=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
api_base=api_base,
**optional_params,
)
@@ -56,7 +53,7 @@ def generate_image(self, prompt: str, negative_prompt: str = None):
**self.params,
}
try:
- response = requests.post(f'{self.api_base}/image_generation', headers=headers, json=payload)
+ response = requests.post(f"{self.api_base}/image_generation", headers=headers, json=payload)
response.raise_for_status()
file_urls = []
data = response.json().get("data", {})
@@ -67,5 +64,5 @@ def generate_image(self, prompt: str, negative_prompt: str = None):
file_urls.append(f"data:image/png;base64,{img}")
return file_urls
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
raise e
diff --git a/apps/models_provider/impl/minimax_model_provider/model/tts.py b/apps/models_provider/impl/minimax_model_provider/model/tts.py
index 50935e4c915..549118dac29 100644
--- a/apps/models_provider/impl/minimax_model_provider/model/tts.py
+++ b/apps/models_provider/impl/minimax_model_provider/model/tts.py
@@ -18,10 +18,10 @@ class MiniMaxTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -29,49 +29,51 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice_id': 'English_Graceful_Lady'}}
+ optional_params = {"params": {"voice_id": "English_Graceful_Lady"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return MiniMaxTextToSpeech(
model=model_name,
- api_base=model_credential.get('api_base') or 'https://api.minimaxi.com/v1',
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base") or "https://api.minimaxi.com/v1",
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- self.text_to_speech(_('Hello'))
+ self.text_to_speech(_("Hello"))
def text_to_speech(self, text):
text = _remove_empty_lines(text)
- api_base = self.api_base.rstrip('/')
- url = f'{api_base}/t2a_v2'
+ api_base = self.api_base.rstrip("/")
+ url = f"{api_base}/t2a_v2"
- if 'audio_setting' not in self.params:
- self.params['audio_setting'] = {'format': 'mp3', }
+ if "audio_setting" not in self.params:
+ self.params["audio_setting"] = {
+ "format": "mp3",
+ }
payload = {
- 'model': self.model,
- 'text': text,
- 'stream': False,
+ "model": self.model,
+ "text": text,
+ "stream": False,
**self.params,
}
headers = {
- 'Authorization': f'Bearer {self.api_key}',
- 'Content-Type': 'application/json',
+ "Authorization": f"Bearer {self.api_key}",
+ "Content-Type": "application/json",
}
response = requests.post(url, json=payload, headers=headers, timeout=60)
response.raise_for_status()
result = response.json()
- if result.get('base_resp', {}).get('status_code', 0) != 0:
- error_msg = result.get('base_resp', {}).get('status_msg', 'Unknown error')
- raise Exception(f'MiniMax TTS API error: {error_msg}')
+ if result.get("base_resp", {}).get("status_code", 0) != 0:
+ error_msg = result.get("base_resp", {}).get("status_msg", "Unknown error")
+ raise Exception(f"MiniMax TTS API error: {error_msg}")
- audio_hex = result.get('data', {}).get('audio', '')
+ audio_hex = result.get("data", {}).get("audio", "")
if not audio_hex:
- raise Exception('MiniMax TTS API returned empty audio data')
+ raise Exception("MiniMax TTS API returned empty audio data")
return bytes.fromhex(audio_hex)
diff --git a/apps/models_provider/impl/minimax_model_provider/model/ttv.py b/apps/models_provider/impl/minimax_model_provider/model/ttv.py
index 2aab0ce612f..4797c3751c2 100644
--- a/apps/models_provider/impl/minimax_model_provider/model/ttv.py
+++ b/apps/models_provider/impl/minimax_model_provider/model/ttv.py
@@ -1,6 +1,6 @@
-
+# coding=utf-8
import time
-from typing import Dict
+from typing import ClassVar, Dict, Optional
import requests
@@ -10,21 +10,34 @@
class GenerationVideoModel(MaxKBBaseModel, BaseGenerationVideo):
+ """MiniMax 视频生成模型,兼容 V1 与 V2 (MiniMax-H3) 两套接口。"""
+
api_key: str
api_base: str
model_name: str
- params: dict
+ params: dict = {}
max_retries: int = 3
- retry_delay: int = 10 # seconds
+ retry_delay: int = 10 # 秒
+
+ DEFAULT_API_BASE: ClassVar[str] = "https://api.minimaxi.com/v1"
+ REQUEST_TIMEOUT: ClassVar[tuple] = (10, 120) # (连接超时, 读取超时)
+ MAX_POLL_ATTEMPTS: ClassVar[int] = 60 # 最多轮询 60 次(约 10 分钟)
+
+ # V2 (MiniMax-H3) 专用参数
+ V2_EXTRA_FIELDS: ClassVar[tuple] = ("resolution", "duration", "ratio", "callback_url")
+ SUCCESS_STATUSES: ClassVar[frozenset] = frozenset({"succeeded", "Success"})
+ FAIL_STATUSES: ClassVar[frozenset] = frozenset({"failed", "Fail", "cancelled", "Cancel"})
+ ERROR_KEYS: ClassVar[tuple] = ("error_message", "error", "detail", "message", "msg")
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base', 'https://api.minimaxi.com/v1')
- self.model_name = kwargs.get('model_name')
- self.params = kwargs.get('params', {})
- self.max_retries = kwargs.get('max_retries', 3)
- self.retry_delay = 10
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base", self.DEFAULT_API_BASE)
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params", {}) or {}
+ self.max_retries = kwargs.get("max_retries", 3)
+ self.retry_delay = kwargs.get("retry_delay", 10)
+ self._session = self._build_session()
@staticmethod
def is_cache_model():
@@ -32,16 +45,16 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
- api_base = model_credential.get('api_base','https://api.minimaxi.com/v1')
+ api_base = model_credential.get("api_base", "https://api.minimaxi.com/v1")
return GenerationVideoModel(
model_name=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
api_base=api_base,
**optional_params,
)
@@ -49,35 +62,96 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
def check_auth(self):
return True
- def _safe_call(self, method, url, **kwargs):
- """带重试的请求封装"""
- headers = {"Authorization": f"Bearer {self.api_key}"}
-
- for attempt in range(self.max_retries):
+ def _build_session(self) -> requests.Session:
+ """创建带鉴权头与连接复用的请求会话。"""
+ session = requests.Session()
+ session.headers.update({"Authorization": f"Bearer {self.api_key}"})
+ return session
+
+ # ---------- API 版本探测 / URL 构建 ----------
+
+ def _detect_api_version(self) -> str:
+ """探测当前使用 V1 还是 V2 (MiniMax-H3)。"""
+ # 模型名包含 H3 -> V2
+ if self.model_name and "H3" in self.model_name.upper():
+ return "v2"
+ # api_base 路径包含 /v2 -> V2
+ base_path = self.api_base.split("://", 1)[-1] if "://" in self.api_base else self.api_base
+ if "/v2" in base_path:
+ return "v2"
+ return "v1"
+
+ def _base_url(self) -> str:
+ """去掉结尾的 /v1 或 /v2,返回纯净 base,便于拼装两套路径。"""
+ base = self.api_base.rstrip("/")
+ if base.endswith("/v1") or base.endswith("/v2"):
+ base = base[:-3]
+ return base.rstrip("/")
+
+ def _v2(self) -> bool:
+ return self._detect_api_version() == "v2"
+
+ # ---------- 底层请求 / 轮询 ----------
+
+ def _request(self, method: str, url: str, **kwargs) -> dict:
+ """带固定间隔重试的请求封装,成功返回 JSON 响应。"""
+ kwargs.setdefault("timeout", self.REQUEST_TIMEOUT)
+ for attempt in range(1, self.max_retries + 1):
try:
- if method.upper() == 'POST':
- response = requests.post(url, headers=headers, **kwargs)
- elif method.upper() == 'GET':
- response = requests.get(url, headers=headers, **kwargs)
- else:
- raise ValueError(f"Unsupported HTTP method: {method}")
-
+ response = self._session.request(method, url, **kwargs)
response.raise_for_status()
return response.json()
- except (requests.exceptions.ProxyError,
- requests.exceptions.ConnectionError,
- requests.exceptions.Timeout) as e:
- maxkb_logger.error(f"⚠️ 网络错误: {e},正在重试 {attempt + 1}/{self.max_retries}...")
- time.sleep(self.retry_delay)
- except requests.exceptions.HTTPError as e:
- maxkb_logger.error(f"HTTP 错误: {e}")
- raise RuntimeError(f"HTTP 请求失败: {e.response.text if hasattr(e, 'response') else str(e)}")
-
+ except (
+ requests.exceptions.ProxyError,
+ requests.exceptions.ConnectionError,
+ requests.exceptions.Timeout,
+ ) as exc:
+ if attempt < self.max_retries:
+ maxkb_logger.warning(f"网络错误: {exc},正在重试 {attempt + 1}/{self.max_retries}...")
+ time.sleep(self.retry_delay)
+ else:
+ raise RuntimeError("多次重试后仍无法连接到 MiniMax API,请检查代理或网络配置") from exc
+ except requests.exceptions.HTTPError as exc:
+ detail = exc.response.text if exc.response is not None else str(exc)
+ raise RuntimeError(f"HTTP 请求失败: {detail}") from exc
raise RuntimeError("多次重试后仍无法连接到 MiniMax API,请检查代理或网络配置")
+ def _wait_for_result(self, query_url: str, task_id: Optional[str] = None) -> dict:
+ """轮询任务状态直至成功/失败,成功时返回原始响应。"""
+ params = {"task_id": task_id} if task_id else None
+ for attempt in range(1, self.MAX_POLL_ATTEMPTS + 1):
+ response_data = self._request("GET", query_url, params=params)
+ task = response_data.get("task") or response_data
+ status = task.get("status")
+
+ maxkb_logger.info(f"当前任务状态 (尝试 {attempt}/{self.MAX_POLL_ATTEMPTS}): {status}")
+
+ if status in self.SUCCESS_STATUSES:
+ return response_data
+ if status in self.FAIL_STATUSES:
+ error_msg = self._extract_error(task, response_data)
+ raise RuntimeError(f"视频生成失败: {error_msg}")
+ # queued / running 等状态,继续轮询
+ time.sleep(self.retry_delay)
+
+ raise RuntimeError(f"任务超时:经过 {self.MAX_POLL_ATTEMPTS} 次轮询后仍未完成")
+
+ @staticmethod
+ def _extract_error(task: dict, response_data: dict) -> str:
+ for container in (task, response_data):
+ if not isinstance(container, dict):
+ continue
+ for key in GenerationVideoModel.ERROR_KEYS:
+ value = container.get(key)
+ if value:
+ return str(value)
+ return "未知错误"
+
+ # ---------- 对外入口 ----------
+
def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, last_frame_url=None, **kwargs):
"""
- 生成视频
+ 生成视频。
prompt: 文本描述
negative_prompt: 反向文本描述(MiniMax 暂不支持,保留参数以兼容接口)
first_frame_url: 起始关键帧图片 URL (图生视频或首尾帧模式)
@@ -85,89 +159,95 @@ def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, las
返回: 视频下载 URL
"""
- base_url = f"{self.api_base}/video_generation"
+ # 自动兼容 V1 / V2 (MiniMax-H3) 两套参数逻辑
+ if self._v2():
+ return self._generate_video_v2(prompt, first_frame_url, last_frame_url, **kwargs)
+ return self._generate_video_v1(prompt, first_frame_url, last_frame_url, **kwargs)
+
+ # ---------- V2 (MiniMax-H3) 流程 ----------
+
+ def _build_v2_payload(self, prompt, first_frame_url, last_frame_url) -> dict:
+ content = [{"type": "text", "text": prompt}]
+ if first_frame_url:
+ content.append(
+ {
+ "type": "image_url",
+ "image_url": {"url": first_frame_url},
+ "role": "first_frame",
+ }
+ )
+ if last_frame_url:
+ content.append(
+ {
+ "type": "image_url",
+ "image_url": {"url": last_frame_url},
+ "role": "last_frame",
+ }
+ )
+
+ payload = {"model": self.model_name, "content": content}
+ # V2 必需的 resolution / duration,以及可选的 ratio / callback_url 均来自 params
+ for key in self.V2_EXTRA_FIELDS:
+ if key in self.params:
+ payload[key] = self.params[key]
+ return payload
+
+ def _generate_video_v2(self, prompt, first_frame_url=None, last_frame_url=None, **kwargs) -> str:
+ base_url = f"{self._base_url()}/v2/video_generation"
+ payload = self._build_v2_payload(prompt, first_frame_url, last_frame_url)
+
+ maxkb_logger.info(f"提交视频生成任务(V2/H3),模型: {self.model_name}")
+ response_data = self._request("POST", base_url, json=payload)
+
+ task_id = response_data.get("task_id")
+ if not task_id:
+ raise RuntimeError(f"提交任务失败,未获取到 task_id: {response_data}")
- # 构建基础参数
- payload = {
- "prompt": prompt,
- "model": self.model_name,
- }
+ query_url = f"{self._base_url()}/v2/query/video_generation/{task_id}"
+ response_data = self._wait_for_result(query_url)
+
+ task = response_data.get("task") or response_data
+ video_url = (task.get("content") or {}).get("url")
+ if not video_url:
+ raise RuntimeError(f"任务成功但未获取到视频 URL: {response_data}")
+ return video_url
+ # ---------- V1 流程(兼容老接口) ----------
+
+ def _generate_video_v1(self, prompt, first_frame_url=None, last_frame_url=None, **kwargs) -> str:
+ base_url = f"{self._base_url()}/v1/video_generation"
+
+ payload = {"prompt": prompt, "model": self.model_name}
# 根据提供的参数判断生成模式
if first_frame_url and last_frame_url:
- # 模式三:首尾帧生成视频
- payload["first_frame_image"] = first_frame_url
- payload["last_frame_image"] = last_frame_url
- maxkb_logger.info("使用首尾帧模式生成视频")
+ payload.update(first_frame_image=first_frame_url, last_frame_image=last_frame_url)
elif first_frame_url:
- # 模式二:图生视频
payload["first_frame_image"] = first_frame_url
- maxkb_logger.info("使用图生视频模式")
- else:
- # 模式一:文生视频
- maxkb_logger.info("使用文生视频模式")
# 合并额外参数(duration, resolution 等)
payload.update(self.params)
- # --- 步骤 1: 提交任务 ---
- maxkb_logger.info(f"提交视频生成任务,模型: {self.model_name}")
- response_data = self._safe_call('POST', base_url, json=payload)
+ maxkb_logger.info(f"提交视频生成任务(V1),模型: {self.model_name}")
+ response_data = self._request("POST", base_url, json=payload)
task_id = response_data.get("task_id")
if not task_id:
raise RuntimeError(f"提交任务失败,未获取到 task_id: {response_data}")
- maxkb_logger.info(f"任务已提交,task_id: {task_id}")
+ query_url = f"{self._base_url()}/v1/query/video_generation"
+ response_data = self._wait_for_result(query_url, task_id=task_id)
- # --- 步骤 2: 轮询查询任务状态 ---
- query_url = f"{self.api_base}/query/video_generation"
- file_id = self._poll_task_status(query_url, task_id)
+ file_id = response_data.get("file_id")
+ if not file_id:
+ raise RuntimeError(f"任务成功但未获取到 file_id: {response_data}")
+ return self._get_video_download_url_v1(file_id)
- # --- 步骤 3: 获取视频下载链接 ---
- video_url = self._get_video_download_url(file_id)
-
- maxkb_logger.info(f"视频生成完成!视频 URL: {video_url}")
- return video_url
-
- def _poll_task_status(self, query_url: str, task_id: str) -> str:
- """轮询任务状态,直至成功或失败"""
- params = {"task_id": task_id}
- max_attempts = 60 # 最多轮询 60 次(约 10 分钟)
-
- for attempt in range(max_attempts):
- response_data = self._safe_call('GET', query_url, params=params)
- status = response_data.get("status")
-
- maxkb_logger.info(f"当前任务状态 (尝试 {attempt + 1}/{max_attempts}): {status}")
-
- if status == "Success":
- file_id = response_data.get("file_id")
- if not file_id:
- raise RuntimeError(f"任务成功但未获取到 file_id: {response_data}")
- maxkb_logger.info(f"任务处理成功,file_id: {file_id}")
- return file_id
- elif status == "Fail":
- error_msg = response_data.get("error_message", "未知错误")
- maxkb_logger.error(f"视频生成失败: {error_msg}")
- raise RuntimeError(f"视频生成失败: {error_msg}")
- else:
- # 任务仍在处理中,等待后继续轮询
- time.sleep(self.retry_delay)
-
- raise RuntimeError(f"任务超时:经过 {max_attempts} 次轮询后仍未完成")
-
- def _get_video_download_url(self, file_id: str) -> str:
- """根据 file_id 获取视频下载链接"""
- retrieve_url = f"{self.api_base}/files/retrieve"
- params = {"file_id": file_id}
-
- response_data = self._safe_call('GET', retrieve_url, params=params)
-
- file_info = response_data.get("file", {})
- download_url = file_info.get("download_url")
+ def _get_video_download_url_v1(self, file_id: str) -> str:
+ """根据 file_id 获取视频下载链接(V1)。"""
+ retrieve_url = f"{self._base_url()}/v1/files/retrieve"
+ response_data = self._request("GET", retrieve_url, params={"file_id": file_id})
+ download_url = (response_data.get("file") or {}).get("download_url")
if not download_url:
raise RuntimeError(f"获取下载链接失败: {response_data}")
-
return download_url
diff --git a/apps/models_provider/impl/ollama_model_provider/__init__.py b/apps/models_provider/impl/ollama_model_provider/__init__.py
index 6da6cdb69ad..bebd1ccd581 100644
--- a/apps/models_provider/impl/ollama_model_provider/__init__.py
+++ b/apps/models_provider/impl/ollama_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/5 17:20
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/3/5 17:20
+@desc:
"""
diff --git a/apps/models_provider/impl/ollama_model_provider/credential/embedding.py b/apps/models_provider/impl/ollama_model_provider/credential/embedding.py
index 15a869a45a4..99d29402306 100644
--- a/apps/models_provider/impl/ollama_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/ollama_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 15:10
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 15:10
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -18,32 +19,44 @@
class OllamaEmbeddingModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'))
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, _('API domain name is invalid'))
- exist = [model for model in (model_list.get('models') if model_list.get('models') is not None else []) if
- model.get('model') == model_name or model.get('model').replace(":latest", "") == model_name]
+ model_list = provider.get_base_model_list(model_credential.get("api_base"))
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, _("API domain name is invalid"))
+ exist = [
+ model
+ for model in (model_list.get("models") if model_list.get("models") is not None else [])
+ if model.get("model") == model_name or model.get("model").replace(":latest", "") == model_name
+ ]
if len(exist) == 0:
- raise AppApiException(ValidCode.model_not_fount,
- _('The model does not exist, please download the model first'))
+ raise AppApiException(
+ ValidCode.model_not_fount, _("The model does not exist, please download the model first")
+ )
model: LocalEmbedding = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
return True
def encryption_dict(self, model_info: Dict[str, object]):
return model_info
def build_model(self, model_info: Dict[str, object]):
- for key in ['model']:
+ for key in ["model"]:
if key not in model_info:
- raise AppApiException(500, _('{key} is required').format(key=key))
+ raise AppApiException(500, _("{key} is required").format(key=key))
return self
- api_base = forms.TextInputField('API URL', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
diff --git a/apps/models_provider/impl/ollama_model_provider/credential/image.py b/apps/models_provider/impl/ollama_model_provider/credential/image.py
index c3009154741..f4f19fd6414 100644
--- a/apps/models_provider/impl/ollama_model_provider/credential/image.py
+++ b/apps/models_provider/impl/ollama_model_provider/credential/image.py
@@ -9,48 +9,69 @@
class OllamaImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class OllamaImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'))
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, gettext('API domain name is invalid'))
- exist = [model for model in (model_list.get('models') if model_list.get('models') is not None else []) if
- model.get('model') == model_name or model.get('model').replace(":latest", "") == model_name]
+ model_list = provider.get_base_model_list(model_credential.get("api_base"))
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("API domain name is invalid"))
+ exist = [
+ model
+ for model in (model_list.get("models") if model_list.get("models") is not None else [])
+ if model.get("model") == model_name or model.get("model").replace(":latest", "") == model_name
+ ]
if len(exist) == 0:
- raise AppApiException(ValidCode.model_not_fount,
- gettext('The model does not exist, please download the model first'))
+ raise AppApiException(
+ ValidCode.model_not_fount, gettext("The model does not exist, please download the model first")
+ )
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return OllamaImageModelParams()
diff --git a/apps/models_provider/impl/ollama_model_provider/credential/llm.py b/apps/models_provider/impl/ollama_model_provider/credential/llm.py
index 02558b0b9fa..c908e553e3c 100644
--- a/apps/models_provider/impl/ollama_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/ollama_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:19
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:19
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,54 +18,75 @@
class OllamaLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.3,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.3,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
num_predict = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class OllamaLLMModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'))
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, gettext('API domain name is invalid'))
- exist = [model for model in (model_list.get('models') if model_list.get('models') is not None else []) if
- model.get('model') == model_name or model.get('model').replace(":latest", "") == model_name]
+ model_list = provider.get_base_model_list(model_credential.get("api_base"))
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("API domain name is invalid"))
+ exist = [
+ model
+ for model in (model_list.get("models") if model_list.get("models") is not None else [])
+ if model.get("model") == model_name or model.get("model").replace(":latest", "") == model_name
+ ]
if len(exist) == 0:
- raise AppApiException(ValidCode.model_not_fount,
- gettext('The model does not exist, please download the model first'))
+ raise AppApiException(
+ ValidCode.model_not_fount, gettext("The model does not exist, please download the model first")
+ )
return True
def encryption_dict(self, model_info: Dict[str, object]):
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
def build_model(self, model_info: Dict[str, object]):
- for key in ['api_key', 'model']:
+ for key in ["api_key", "model"]:
if key not in model_info:
- raise AppApiException(500, gettext('{key} is required').format(key=key))
- self.api_key = model_info.get('api_key')
+ raise AppApiException(500, gettext("{key} is required").format(key=key))
+ self.api_key = model_info.get("api_key")
return self
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return OllamaLLMModelParams()
diff --git a/apps/models_provider/impl/ollama_model_provider/credential/reranker.py b/apps/models_provider/impl/ollama_model_provider/credential/reranker.py
index 0fb0bd1e37c..d2101beadd3 100644
--- a/apps/models_provider/impl/ollama_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/ollama_model_provider/credential/reranker.py
@@ -1,14 +1,14 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 15:10
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 15:10
+@desc:
"""
+
from typing import Dict
-from django.utils.translation import gettext as _
from django.utils.translation import gettext_lazy as _, gettext
from langchain_core.documents import Document
@@ -20,46 +20,64 @@
class OllamaRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class OllamaReRankModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- if not model_type == 'RERANKER':
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ if not model_type == "RERANKER":
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'))
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, _('API domain name is invalid'))
- exist = [model for model in (model_list.get('models') if model_list.get('models') is not None else []) if
- model.get('model') == model_name or model.get('model').replace(":latest", "") == model_name]
+ model_list = provider.get_base_model_list(model_credential.get("api_base"))
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, _("API domain name is invalid"))
+ exist = [
+ model
+ for model in (model_list.get("models") if model_list.get("models") is not None else [])
+ if model.get("model") == model_name or model.get("model").replace(":latest", "") == model_name
+ ]
if len(exist) == 0:
- raise AppApiException(ValidCode.model_not_fount,
- _('The model does not exist, please download the model first'))
+ raise AppApiException(
+ ValidCode.model_not_fount, _("The model does not exist, please download the model first")
+ )
try:
model: OllamaReranker = provider.get_model(model_type, model_name, model_credential)
- model.compress_documents([Document(page_content=gettext('Hello'))], gettext('Hello'))
+ model.compress_documents([Document(page_content=gettext("Hello"))], gettext("Hello"))
except Exception as e:
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
@@ -68,12 +86,12 @@ def encryption_dict(self, model_info: Dict[str, object]):
return model_info
def build_model(self, model_info: Dict[str, object]):
- for key in ['model']:
+ for key in ["model"]:
if key not in model_info:
- raise AppApiException(500, _('{key} is required').format(key=key))
+ raise AppApiException(500, _("{key} is required").format(key=key))
return self
- api_base = forms.TextInputField('API URL', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
def get_model_params_setting_form(self, model_name: str) -> OllamaRerankerModelParams:
return OllamaRerankerModelParams()
diff --git a/apps/models_provider/impl/ollama_model_provider/model/embedding.py b/apps/models_provider/impl/ollama_model_provider/model/embedding.py
index 35bbbe4acfd..6974d2d75a4 100644
--- a/apps/models_provider/impl/ollama_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/ollama_model_provider/model/embedding.py
@@ -1,25 +1,29 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 15:02
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 15:02
+@desc:
"""
+
from typing import Dict, List
from langchain_ollama import OllamaEmbeddings
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class OllamaEmbedding(MaxKBBaseEmbeddingModel, OllamaEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
-class OllamaEmbedding(MaxKBBaseModel, OllamaEmbeddings):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return OllamaEmbedding(
model=model_name,
- base_url=model_credential.get('api_base'),
+ base_url=model_credential.get("api_base"),
)
def embed_documents(self, texts: List[str]) -> List[List[float]]:
@@ -31,9 +35,9 @@ def embed_documents(self, texts: List[str]) -> List[List[float]]:
Returns:
List of embeddings, one for each text.
"""
- return self._client.embed(
- self.model, texts, options=self._default_params, keep_alive=self.keep_alive
- )["embeddings"]
+ return self._client.embed(self.model, texts, options=self._default_params, keep_alive=self.keep_alive)[
+ "embeddings"
+ ]
def embed_query(self, text: str) -> List[float]:
"""Embed a query using a Ollama deployed embedding model.
diff --git a/apps/models_provider/impl/ollama_model_provider/model/image.py b/apps/models_provider/impl/ollama_model_provider/model/image.py
index f9e347cb30c..b0663cdeec7 100644
--- a/apps/models_provider/impl/ollama_model_provider/model/image.py
+++ b/apps/models_provider/impl/ollama_model_provider/model/image.py
@@ -7,28 +7,27 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
class OllamaImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- api_base = model_credential.get('api_base', '')
+ api_base = model_credential.get("api_base", "")
base_url = get_base_url(api_base)
- base_url = base_url if base_url.endswith('/v1') else (base_url + '/v1')
+ base_url = base_url if base_url.endswith("/v1") else (base_url + "/v1")
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return OllamaImage(
model_name=model_name,
openai_api_base=base_url,
- openai_api_key=model_credential.get('api_key'),
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/ollama_model_provider/model/llm.py b/apps/models_provider/impl/ollama_model_provider/model/llm.py
index 047582426c0..46934018b4c 100644
--- a/apps/models_provider/impl/ollama_model_provider/model/llm.py
+++ b/apps/models_provider/impl/ollama_model_provider/model/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/3/6 11:48
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/3/6 11:48
+@desc:
"""
+
from typing import List, Dict
from urllib.parse import urlparse, ParseResult
@@ -19,9 +20,9 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
@@ -32,12 +33,11 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- api_base = model_credential.get('api_base', '')
+ api_base = model_credential.get("api_base", "")
base_url = get_base_url(api_base)
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- return OllamaChatModel(model=model_name, base_url=base_url,
- stream=True, **optional_params)
+ return OllamaChatModel(model=model_name, base_url=base_url, stream=True, **optional_params)
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
tokenizer = TokenizerManage.get_tokenizer()
diff --git a/apps/models_provider/impl/ollama_model_provider/model/reranker.py b/apps/models_provider/impl/ollama_model_provider/model/reranker.py
index 00da46894d7..2531d77062c 100644
--- a/apps/models_provider/impl/ollama_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/ollama_model_provider/model/reranker.py
@@ -14,15 +14,13 @@ class OllamaReranker(MaxKBBaseModel, OllamaEmbeddings, BaseModel):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- return OllamaReranker(
- model=model_name,
- base_url=model_credential.get('api_base'),
- **optional_params
- )
-
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ return OllamaReranker(model=model_name, base_url=model_credential.get("api_base"), **optional_params)
+
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
from sklearn.metrics.pairwise import cosine_similarity
+
"""Rank documents based on their similarity to the query.
Args:
@@ -38,11 +36,11 @@ def compress_documents(self, documents: Sequence[Document], query: str, callback
document_embeddings = self.embed_documents(documents)
# 计算相似度
similarities = cosine_similarity([query_embedding], document_embeddings)[0]
- ranked_docs = [(doc, _) for _, doc in sorted(zip(similarities, documents), reverse=True)][:self.top_n]
+ ranked_docs = [(doc, _) for _, doc in sorted(zip(similarities, documents), reverse=True)][: self.top_n]
return [
Document(
page_content=doc, # 第一个值是文档内容
- metadata={'relevance_score': score} # 第二个值是相似度分数
+ metadata={"relevance_score": score}, # 第二个值是相似度分数
)
for doc, score in ranked_docs
]
diff --git a/apps/models_provider/impl/ollama_model_provider/ollama_model_provider.py b/apps/models_provider/impl/ollama_model_provider/ollama_model_provider.py
index 5bb8a54049f..37877ab5751 100644
--- a/apps/models_provider/impl/ollama_model_provider/ollama_model_provider.py
+++ b/apps/models_provider/impl/ollama_model_provider/ollama_model_provider.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: ollama_model_provider.py
- @date:2024/3/5 17:23
- @desc:
+@project: maxkb
+@Author:虎
+@file: ollama_model_provider.py
+@date:2024/3/5 17:23
+@desc:
"""
+
import json
import os
from typing import Dict, Iterator
@@ -13,8 +14,15 @@
import requests
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, ModelTypeConst, \
- BaseModelCredential, DownModelChunk, DownModelChunkStatus, ValidCode, ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ DownModelChunk,
+ DownModelChunkStatus,
+ ModelInfoManage,
+)
from models_provider.impl.ollama_model_provider.credential.embedding import OllamaEmbeddingModelCredential
from models_provider.impl.ollama_model_provider.credential.image import OllamaImageModelCredential
from models_provider.impl.ollama_model_provider.credential.llm import OllamaLLMModelCredential
@@ -30,172 +38,197 @@
ollama_llm_model_credential = OllamaLLMModelCredential()
model_info_list = [
- ModelInfo(
- 'deepseek-r1:1.5b',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'deepseek-r1:7b',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'deepseek-r1:8b',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'deepseek-r1:14b',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'deepseek-r1:32b',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
-
- ModelInfo(
- 'llama2',
- _('Llama 2 is a set of pretrained and fine-tuned generative text models ranging in size from 7 billion to 70 billion. This is a repository of 7B pretrained models. Links to other models can be found in the index at the bottom.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'llama2:13b',
- _('Llama 2 is a set of pretrained and fine-tuned generative text models ranging in size from 7 billion to 70 billion. This is a repository of 13B pretrained models. Links to other models can be found in the index at the bottom.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'llama2:70b',
- _('Llama 2 is a set of pretrained and fine-tuned generative text models ranging in size from 7 billion to 70 billion. This is a repository of 70B pretrained models. Links to other models can be found in the index at the bottom.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'llama2-chinese:13b',
- _('Since the Chinese alignment of Llama2 itself is weak, we use the Chinese instruction set to fine-tune meta-llama/Llama-2-13b-chat-hf with LoRA so that it has strong Chinese conversation capabilities.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'llama3:8b',
- _('Meta Llama 3: The most capable public product LLM to date. 8 billion parameters.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'llama3:70b',
- _('Meta Llama 3: The most capable public product LLM to date. 70 billion parameters.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:0.5b',
- _("Compared with previous versions, qwen 1.5 0.5b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 500 million parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:1.8b',
- _("Compared with previous versions, qwen 1.5 1.8b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 1.8 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:4b',
- _("Compared with previous versions, qwen 1.5 4b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 4 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
-
- ModelInfo(
- 'qwen:7b',
- _("Compared with previous versions, qwen 1.5 7b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 7 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:14b',
- _("Compared with previous versions, qwen 1.5 14b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 14 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:32b',
- _("Compared with previous versions, qwen 1.5 32b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 32 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:72b',
- _("Compared with previous versions, qwen 1.5 72b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 72 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen:110b',
- _("Compared with previous versions, qwen 1.5 110b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 110 billion parameters."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2:72b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2:57b-a14b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2:7b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:72b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:32b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:14b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:7b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:1.5b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:0.5b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'qwen2.5:3b-instruct',
- '',
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
- ModelInfo(
- 'phi3',
+ ModelInfo("deepseek-r1:1.5b", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("deepseek-r1:7b", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("deepseek-r1:8b", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("deepseek-r1:14b", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("deepseek-r1:32b", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo(
+ "llama2",
+ _(
+ "Llama 2 is a set of pretrained and fine-tuned generative text models ranging in size from 7 billion to 70 billion. This is a repository of 7B pretrained models. Links to other models can be found in the index at the bottom."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "llama2:13b",
+ _(
+ "Llama 2 is a set of pretrained and fine-tuned generative text models ranging in size from 7 billion to 70 billion. This is a repository of 13B pretrained models. Links to other models can be found in the index at the bottom."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "llama2:70b",
+ _(
+ "Llama 2 is a set of pretrained and fine-tuned generative text models ranging in size from 7 billion to 70 billion. This is a repository of 70B pretrained models. Links to other models can be found in the index at the bottom."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "llama2-chinese:13b",
+ _(
+ "Since the Chinese alignment of Llama2 itself is weak, we use the Chinese instruction set to fine-tune meta-llama/Llama-2-13b-chat-hf with LoRA so that it has strong Chinese conversation capabilities."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "llama3:8b",
+ _("Meta Llama 3: The most capable public product LLM to date. 8 billion parameters."),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "llama3:70b",
+ _("Meta Llama 3: The most capable public product LLM to date. 70 billion parameters."),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:0.5b",
+ _(
+ "Compared with previous versions, qwen 1.5 0.5b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 500 million parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:1.8b",
+ _(
+ "Compared with previous versions, qwen 1.5 1.8b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 1.8 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:4b",
+ _(
+ "Compared with previous versions, qwen 1.5 4b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 4 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:7b",
+ _(
+ "Compared with previous versions, qwen 1.5 7b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 7 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:14b",
+ _(
+ "Compared with previous versions, qwen 1.5 14b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 14 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:32b",
+ _(
+ "Compared with previous versions, qwen 1.5 32b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 32 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:72b",
+ _(
+ "Compared with previous versions, qwen 1.5 72b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 72 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo(
+ "qwen:110b",
+ _(
+ "Compared with previous versions, qwen 1.5 110b has significantly enhanced the model's alignment with human preferences and its multi-language processing capabilities. Models of all sizes support a context length of 32768 tokens. 110 billion parameters."
+ ),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
+ ModelInfo("qwen2:72b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2:57b-a14b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2:7b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:72b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:32b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:14b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:7b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:1.5b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:0.5b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo("qwen2.5:3b-instruct", "", ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelInfo(
+ "phi3",
_("Phi-3 Mini is Microsoft's 3.8B parameter, lightweight, state-of-the-art open model."),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ ),
]
ollama_embedding_model_credential = OllamaEmbeddingModelCredential()
ollama_image_model_credential = OllamaImageModelCredential()
ollama_reranker_model_credential = OllamaReRankModelCredential()
embedding_model_info = [
ModelInfo(
- 'nomic-embed-text',
- _('A high-performance open embedding model with a large token context window.'),
- ModelTypeConst.EMBEDDING, ollama_embedding_model_credential, OllamaEmbedding),
+ "nomic-embed-text",
+ _("A high-performance open embedding model with a large token context window."),
+ ModelTypeConst.EMBEDDING,
+ ollama_embedding_model_credential,
+ OllamaEmbedding,
+ ),
]
reranker_model_info = [
ModelInfo(
- 'linux6200/bge-reranker-v2-m3',
- '',
- ModelTypeConst.RERANKER, ollama_reranker_model_credential, OllamaReranker),
+ "linux6200/bge-reranker-v2-m3", "", ModelTypeConst.RERANKER, ollama_reranker_model_credential, OllamaReranker
+ ),
]
image_model_info = [
- ModelInfo(
- 'llava:7b',
- '',
- ModelTypeConst.IMAGE, ollama_image_model_credential, OllamaImage),
- ModelInfo(
- 'llava:13b',
- '',
- ModelTypeConst.IMAGE, ollama_image_model_credential, OllamaImage),
- ModelInfo(
- 'llava:34b',
- '',
- ModelTypeConst.IMAGE, ollama_image_model_credential, OllamaImage),
+ ModelInfo("llava:7b", "", ModelTypeConst.IMAGE, ollama_image_model_credential, OllamaImage),
+ ModelInfo("llava:13b", "", ModelTypeConst.IMAGE, ollama_image_model_credential, OllamaImage),
+ ModelInfo("llava:34b", "", ModelTypeConst.IMAGE, ollama_image_model_credential, OllamaImage),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
.append_model_info_list(embedding_model_info)
- .append_default_model_info(ModelInfo(
- 'phi3',
- _('Phi-3 Mini is Microsoft\'s 3.8B parameter, lightweight, state-of-the-art open model.'),
- ModelTypeConst.LLM, ollama_llm_model_credential, OllamaChatModel))
- .append_default_model_info(ModelInfo(
- 'nomic-embed-text',
- _('A high-performance open embedding model with a large token context window.'),
- ModelTypeConst.EMBEDDING, ollama_embedding_model_credential, OllamaEmbedding), )
+ .append_default_model_info(
+ ModelInfo(
+ "phi3",
+ _("Phi-3 Mini is Microsoft's 3.8B parameter, lightweight, state-of-the-art open model."),
+ ModelTypeConst.LLM,
+ ollama_llm_model_credential,
+ OllamaChatModel,
+ )
+ )
+ .append_default_model_info(
+ ModelInfo(
+ "nomic-embed-text",
+ _("A high-performance open embedding model with a large token context window."),
+ ModelTypeConst.EMBEDDING,
+ ollama_embedding_model_credential,
+ OllamaEmbedding,
+ ),
+ )
.append_model_info_list(image_model_info)
.append_default_model_info(image_model_info[0])
.append_model_info_list(reranker_model_info)
@@ -206,9 +239,9 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
@@ -217,18 +250,18 @@ def convert_to_down_model_chunk(row_str: str, chunk_index: int):
status = DownModelChunkStatus.unknown
digest = ""
progress = 100
- if 'status' in row:
- digest = row.get('status')
- if row.get('status') == 'success':
+ if "status" in row:
+ digest = row.get("status")
+ if row.get("status") == "success":
status = DownModelChunkStatus.success
- if row.get('status').__contains__("pulling"):
+ if row.get("status").__contains__("pulling"):
progress = 0
status = DownModelChunkStatus.pulling
- if 'total' in row and 'completed' in row and row.get('total'):
- progress = (row.get('completed') / row.get('total') * 100)
- elif 'error' in row:
+ if "total" in row and "completed" in row and row.get("total"):
+ progress = row.get("completed") / row.get("total") * 100
+ elif "error" in row:
status = DownModelChunkStatus.error
- digest = row.get('error')
+ digest = row.get("error")
return DownModelChunk(status=status, digest=digest, progress=progress, details=row_str, index=chunk_index)
@@ -239,7 +272,7 @@ def convert(response_stream) -> Iterator[DownModelChunk]:
index += 1
row_content = c.decode()
temp += row_content
- if row_content.endswith('}') or row_content.endswith('\n'):
+ if row_content.endswith("}") or row_content.endswith("\n"):
rows = [t for t in temp.split("\n") if len(t) > 0]
for row in rows:
yield convert_to_down_model_chunk(row, index)
@@ -256,9 +289,15 @@ def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_ollama_provider', name='Ollama', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'ollama_model_provider', 'icon',
- 'ollama_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_ollama_provider",
+ name="Ollama",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "ollama_model_provider", "icon", "ollama_icon_svg"
+ )
+ ),
+ )
@staticmethod
def get_base_model_list(api_base):
@@ -268,7 +307,7 @@ def get_base_model_list(api_base):
return r.json()
def down_model(self, model_type: str, model_name, model_credential: Dict[str, object]) -> Iterator[DownModelChunk]:
- api_base = model_credential.get('api_base', '')
+ api_base = model_credential.get("api_base", "")
base_url = get_base_url(api_base)
r = requests.request(
method="POST",
diff --git a/apps/models_provider/impl/openai_model_provider/__init__.py b/apps/models_provider/impl/openai_model_provider/__init__.py
index 2dc4ab10db4..906f7224d02 100644
--- a/apps/models_provider/impl/openai_model_provider/__init__.py
+++ b/apps/models_provider/impl/openai_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/28 16:25
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/3/28 16:25
+@desc:
"""
diff --git a/apps/models_provider/impl/openai_model_provider/credential/embedding.py b/apps/models_provider/impl/openai_model_provider/credential/embedding.py
index 4be5f32a8e8..068ac4661e6 100644
--- a/apps/models_provider/impl/openai_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/openai_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,59 +17,68 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class OpenAIEmbeddingModelParams(BaseForm):
dimensions = forms.SingleSelect(
- TooltipLabel(
- _('Dimensions'),
- _('')
- ),
+ TooltipLabel(_("Dimensions"), _("")),
required=True,
default_value=1024,
- value_field='value',
- text_field='label',
+ value_field="value",
+ text_field="label",
option_list=[
- {'label': '1536', 'value': '1536'},
- {'label': '1024', 'value': '1024'},
- {'label': '768', 'value': '768'},
- {'label': '512', 'value': '512'},
- ]
+ {"label": "1536", "value": "1536"},
+ {"label": "1024", "value": "1024"},
+ {"label": "768", "value": "768"},
+ {"label": "512", "value": "512"},
+ ],
)
class OpenAIEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return OpenAIEmbeddingModelParams()
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/openai_model_provider/credential/image.py b/apps/models_provider/impl/openai_model_provider/credential/image.py
index 071a8335b01..8f9bf94f5ab 100644
--- a/apps/models_provider/impl/openai_model_provider/credential/image.py
+++ b/apps/models_provider/impl/openai_model_provider/credential/image.py
@@ -1,6 +1,4 @@
# coding=utf-8
-import base64
-import os
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -14,61 +12,80 @@
class OpenAIImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class OpenAIImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return OpenAIImageModelParams()
diff --git a/apps/models_provider/impl/openai_model_provider/credential/llm.py b/apps/models_provider/impl/openai_model_provider/credential/llm.py
index a2db9fe688c..f52b5f43307 100644
--- a/apps/models_provider/impl/openai_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/openai_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:32
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:32
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -18,62 +19,80 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class OpenAILLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class OpenAILLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
-
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException) or isinstance(e, BadRequestError):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return OpenAILLMModelParams()
diff --git a/apps/models_provider/impl/openai_model_provider/credential/stt.py b/apps/models_provider/impl/openai_model_provider/credential/stt.py
index 1675835c1b7..0af3621fab5 100644
--- a/apps/models_provider/impl/openai_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/openai_model_provider/credential/stt.py
@@ -9,47 +9,60 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class OpenAISTTModelParams(BaseForm):
language = forms.TextInputField(
- TooltipLabel(_('language'), _('If not passed, the default value is zh')),
+ TooltipLabel(_("language"), _("If not passed, the default value is zh")),
required=True,
- default_value='zh',
+ default_value="zh",
)
+
class OpenAISTTModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
diff --git a/apps/models_provider/impl/openai_model_provider/credential/tti.py b/apps/models_provider/impl/openai_model_provider/credential/tti.py
index ba882674274..a4468fceb7b 100644
--- a/apps/models_provider/impl/openai_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/openai_model_provider/credential/tti.py
@@ -9,80 +9,105 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class OpenAITTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('The image generation endpoint allows you to create raw images based on text prompts. When using the DALL·E 3, the image size can be 1024x1024, 1024x1792 or 1792x1024 pixels.')),
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "The image generation endpoint allows you to create raw images based on text prompts. When using the DALL·E 3, the image size can be 1024x1024, 1024x1792 or 1792x1024 pixels."
+ ),
+ ),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '1024x1792', 'label': '1024x1792'},
- {'value': '1792x1024', 'label': '1792x1024'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1024x1792", "label": "1024x1792"},
+ {"value": "1792x1024", "label": "1792x1024"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
quality = forms.SingleSelect(
- TooltipLabel(_('Picture quality'), _('''
+ TooltipLabel(
+ _("Picture quality"),
+ _("""
By default, images are produced in standard quality, but with DALL·E 3 you can set quality: "hd" to enhance detail. Square, standard quality images are generated fastest.
- ''')),
+ """),
+ ),
required=True,
- default_value='standard',
+ default_value="standard",
option_list=[
- {'value': 'standard', 'label': 'standard'},
- {'value': 'hd', 'label': 'hd'},
+ {"value": "standard", "label": "standard"},
+ {"value": "hd", "label": "hd"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
n = forms.SliderField(
- TooltipLabel(_('Number of pictures'),
- _('You can use DALL·E 3 to request 1 image at a time (requesting more images by issuing parallel requests), or use DALL·E 2 with the n parameter to request up to 10 images at a time.')),
- required=True, default_value=1,
+ TooltipLabel(
+ _("Number of pictures"),
+ _(
+ "You can use DALL·E 3 to request 1 image at a time (requesting more images by issuing parallel requests), or use DALL·E 2 with the n parameter to request up to 10 images at a time."
+ ),
+ ),
+ required=True,
+ default_value=1,
_min=1,
_max=10,
_step=1,
- precision=0)
+ precision=0,
+ )
class OpenAITextToImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return OpenAITTIModelParams()
diff --git a/apps/models_provider/impl/openai_model_provider/credential/tts.py b/apps/models_provider/impl/openai_model_provider/credential/tts.py
index 6c70aca8755..70ad7879660 100644
--- a/apps/models_provider/impl/openai_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/openai_model_provider/credential/tts.py
@@ -9,59 +9,77 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class OpenAITTSModelGeneralParams(BaseForm):
# alloy, echo, fable, onyx, nova, shimmer
voice = forms.SingleSelect(
- TooltipLabel('Voice',
- _('Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English.')),
- required=True, default_value='alloy',
- text_field='value',
- value_field='value',
+ TooltipLabel(
+ "Voice",
+ _(
+ "Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English."
+ ),
+ ),
+ required=True,
+ default_value="alloy",
+ text_field="value",
+ value_field="value",
option_list=[
- {'text': 'alloy', 'value': 'alloy'},
- {'text': 'echo', 'value': 'echo'},
- {'text': 'fable', 'value': 'fable'},
- {'text': 'onyx', 'value': 'onyx'},
- {'text': 'nova', 'value': 'nova'},
- {'text': 'shimmer', 'value': 'shimmer'},
- ])
+ {"text": "alloy", "value": "alloy"},
+ {"text": "echo", "value": "echo"},
+ {"text": "fable", "value": "fable"},
+ {"text": "onyx", "value": "onyx"},
+ {"text": "nova", "value": "nova"},
+ {"text": "shimmer", "value": "shimmer"},
+ ],
+ )
class OpenAITTSModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return OpenAITTSModelGeneralParams()
diff --git a/apps/models_provider/impl/openai_model_provider/model/embedding.py b/apps/models_provider/impl/openai_model_provider/model/embedding.py
index 9b5a1c417b4..5dd7ea557e1 100644
--- a/apps/models_provider/impl/openai_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/openai_model_provider/model/embedding.py
@@ -1,19 +1,23 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 17:44
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 17:44
+@desc:
"""
+
from typing import Dict, List
import openai
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class OpenAIEmbeddingModel(MaxKBBaseEmbeddingModel):
+ def supports_image_embedding(self) -> bool:
+ return False
-class OpenAIEmbeddingModel(MaxKBBaseModel):
model_name: str
optional_params: dict
@@ -27,25 +31,22 @@ def is_cache_model(self):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return OpenAIEmbeddingModel(
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
model_name=model_name,
- base_url=model_credential.get('api_base'),
- optional_params=optional_params
+ base_url=model_credential.get("api_base"),
+ optional_params=optional_params,
)
def embed_query(self, text: str):
res = self.embed_documents([text])
return res[0]
- def embed_documents(
- self, texts: List[str], chunk_size: int | None = None
- ) -> List[List[float]]:
+ def embed_documents(self, texts: List[str], chunk_size: int | None = None) -> List[List[float]]:
if len(self.optional_params) > 0:
res = self.client.create(
- input=texts, model=self.model_name, encoding_format="float",
- **self.optional_params
+ input=texts, model=self.model_name, encoding_format="float", **self.optional_params
)
else:
res = self.client.create(input=texts, model=self.model_name, encoding_format="float")
diff --git a/apps/models_provider/impl/openai_model_provider/model/image.py b/apps/models_provider/impl/openai_model_provider/model/image.py
index de6ad8faff1..4d0c6398515 100644
--- a/apps/models_provider/impl/openai_model_provider/model/image.py
+++ b/apps/models_provider/impl/openai_model_provider/model/image.py
@@ -5,7 +5,6 @@
class OpenAIImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -15,8 +14,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return OpenAIImage(
model_name=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/openai_model_provider/model/llm.py b/apps/models_provider/impl/openai_model_provider/model/llm.py
index 3f405b5d17a..7603309a178 100644
--- a/apps/models_provider/impl/openai_model_provider/model/llm.py
+++ b/apps/models_provider/impl/openai_model_provider/model/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/18 15:28
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/4/18 15:28
+@desc:
"""
+
from typing import List, Dict
from langchain_core.messages import BaseMessage, get_buffer_string
@@ -21,7 +22,6 @@ def custom_get_token_ids(text: str):
class OpenAIChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -29,13 +29,13 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- streaming = model_kwargs.get('streaming', True)
- if 'o1' in model_name:
+ streaming = model_kwargs.get("streaming", True)
+ if "o1" in model_name:
streaming = False
chat_open_ai = OpenAIChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
streaming=streaming,
custom_get_token_ids=custom_get_token_ids,
**optional_params,
@@ -45,13 +45,13 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/openai_model_provider/model/stt.py b/apps/models_provider/impl/openai_model_provider/model/stt.py
index 32999855631..ea6b551b9a1 100644
--- a/apps/models_provider/impl/openai_model_provider/model/stt.py
+++ b/apps/models_provider/impl/openai_model_provider/model/stt.py
@@ -1,4 +1,3 @@
-import asyncio
import io
from typing import Dict
@@ -26,50 +25,39 @@ def is_cache_model():
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return OpenAISpeechToText(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
- params = model_kwargs,
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
+ params=model_kwargs,
**optional_params,
)
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def speech_to_text(self, audio_file):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
audio_data = audio_file.read()
buffer = io.BytesIO(audio_data)
buffer.name = "file.mp3" # this is the important line
- filter_params = {k: v for k,v in self.params.items() if k not in {'model_id','use_local','streaming'}}
- transcription_params = {
- 'model': self.model,
- 'file': buffer,
- 'language': 'zh'
- }
+ filter_params = {k: v for k, v in self.params.items() if k not in {"model_id", "use_local", "streaming"}}
+ transcription_params = {"model": self.model, "file": buffer, "language": "zh"}
- res = client.audio.transcriptions.create(**transcription_params,extra_body=filter_params)
+ res = client.audio.transcriptions.create(**transcription_params, extra_body=filter_params)
return res.text
-
diff --git a/apps/models_provider/impl/openai_model_provider/model/tti.py b/apps/models_provider/impl/openai_model_provider/model/tti.py
index ee3aff6ed18..b67b0ac499b 100644
--- a/apps/models_provider/impl/openai_model_provider/model/tti.py
+++ b/apps/models_provider/impl/openai_model_provider/model/tti.py
@@ -20,10 +20,10 @@ class OpenAITextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -31,14 +31,14 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024x1024', 'quality': 'standard', 'n': 1}}
+ optional_params = {"params": {"size": "1024x1024", "quality": "standard", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return OpenAITextToImage(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/openai_model_provider/model/tts.py b/apps/models_provider/impl/openai_model_provider/model/tts.py
index 1a37a236294..d5e55eb147c 100644
--- a/apps/models_provider/impl/openai_model_provider/model/tts.py
+++ b/apps/models_provider/impl/openai_model_provider/model/tts.py
@@ -21,10 +21,10 @@ class OpenAITextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -32,34 +32,26 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice': 'alloy'}}
+ optional_params = {"params": {"voice": "alloy"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return OpenAITextToSpeech(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def text_to_speech(self, text):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
text = _remove_empty_lines(text)
with client.audio.speech.with_streaming_response.create(
- model=self.model,
- input=text,
- **self.params
+ model=self.model, input=text, **self.params
) as response:
return response.read()
diff --git a/apps/models_provider/impl/openai_model_provider/openai_model_provider.py b/apps/models_provider/impl/openai_model_provider/openai_model_provider.py
index a9796d7f058..5a326b0c39d 100644
--- a/apps/models_provider/impl/openai_model_provider/openai_model_provider.py
+++ b/apps/models_provider/impl/openai_model_provider/openai_model_provider.py
@@ -1,16 +1,22 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: openai_model_provider.py
- @date:2024/3/28 16:26
- @desc:
+@project: maxkb
+@Author:虎
+@file: openai_model_provider.py
+@date:2024/3/28 16:26
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.openai_model_provider.credential.embedding import OpenAIEmbeddingCredential
from models_provider.impl.openai_model_provider.credential.image import OpenAIImageModelCredential
from models_provider.impl.openai_model_provider.credential.llm import OpenAILLMModelCredential
@@ -32,113 +38,173 @@
openai_image_model_credential = OpenAIImageModelCredential()
openai_tti_model_credential = OpenAITextToImageModelCredential()
model_info_list = [
- ModelInfo('gpt-3.5-turbo', _('The latest gpt-3.5-turbo, updated with OpenAI adjustments'), ModelTypeConst.LLM,
- openai_llm_model_credential, OpenAIChatModel
- ),
- ModelInfo('gpt-4', _('Latest gpt-4, updated with OpenAI adjustments'), ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4o', _('The latest GPT-4o, cheaper and faster than gpt-4-turbo, updated with OpenAI adjustments'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4o-mini', _('The latest gpt-4o-mini, cheaper and faster than gpt-4o, updated with OpenAI adjustments'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4-turbo', _('The latest gpt-4-turbo, updated with OpenAI adjustments'), ModelTypeConst.LLM,
- openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4-turbo-preview', _('The latest gpt-4-turbo-preview, updated with OpenAI adjustments'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-3.5-turbo-0125',
- _('gpt-3.5-turbo snapshot on January 25, 2024, supporting context length 16,385 tokens'), ModelTypeConst.LLM,
- openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-3.5-turbo-1106',
- _('gpt-3.5-turbo snapshot on November 6, 2023, supporting context length 16,385 tokens'), ModelTypeConst.LLM,
- openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-3.5-turbo-0613',
- _('[Legacy] gpt-3.5-turbo snapshot on June 13, 2023, will be deprecated on June 13, 2024'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4o-2024-05-13',
- _('gpt-4o snapshot on May 13, 2024, supporting context length 128,000 tokens'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4-turbo-2024-04-09',
- _('gpt-4-turbo snapshot on April 9, 2024, supporting context length 128,000 tokens'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4-0125-preview', _('gpt-4-turbo snapshot on January 25, 2024, supporting context length 128,000 tokens'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('gpt-4-1106-preview', _('gpt-4-turbo snapshot on November 6, 2023, supporting context length 128,000 tokens'),
- ModelTypeConst.LLM, openai_llm_model_credential,
- OpenAIChatModel),
- ModelInfo('whisper-1', '',
- ModelTypeConst.STT, openai_stt_model_credential,
- OpenAISpeechToText),
- ModelInfo('tts-1', '',
- ModelTypeConst.TTS, openai_tts_model_credential,
- OpenAITextToSpeech)
+ ModelInfo(
+ "gpt-3.5-turbo",
+ _("The latest gpt-3.5-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4",
+ _("Latest gpt-4, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4o",
+ _("The latest GPT-4o, cheaper and faster than gpt-4-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4o-mini",
+ _("The latest gpt-4o-mini, cheaper and faster than gpt-4o, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4-turbo",
+ _("The latest gpt-4-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4-turbo-preview",
+ _("The latest gpt-4-turbo-preview, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-3.5-turbo-0125",
+ _("gpt-3.5-turbo snapshot on January 25, 2024, supporting context length 16,385 tokens"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-3.5-turbo-1106",
+ _("gpt-3.5-turbo snapshot on November 6, 2023, supporting context length 16,385 tokens"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-3.5-turbo-0613",
+ _("[Legacy] gpt-3.5-turbo snapshot on June 13, 2023, will be deprecated on June 13, 2024"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4o-2024-05-13",
+ _("gpt-4o snapshot on May 13, 2024, supporting context length 128,000 tokens"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4-turbo-2024-04-09",
+ _("gpt-4-turbo snapshot on April 9, 2024, supporting context length 128,000 tokens"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4-0125-preview",
+ _("gpt-4-turbo snapshot on January 25, 2024, supporting context length 128,000 tokens"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo(
+ "gpt-4-1106-preview",
+ _("gpt-4-turbo snapshot on November 6, 2023, supporting context length 128,000 tokens"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ ),
+ ModelInfo("whisper-1", "", ModelTypeConst.STT, openai_stt_model_credential, OpenAISpeechToText),
+ ModelInfo("tts-1", "", ModelTypeConst.TTS, openai_tts_model_credential, OpenAITextToSpeech),
]
open_ai_embedding_credential = OpenAIEmbeddingCredential()
model_info_embedding_list = [
- ModelInfo('text-embedding-ada-002', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- OpenAIEmbeddingModel),
- ModelInfo('text-embedding-3-small', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- OpenAIEmbeddingModel),
- ModelInfo('text-embedding-3-large', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- OpenAIEmbeddingModel)
+ ModelInfo(
+ "text-embedding-ada-002", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, OpenAIEmbeddingModel
+ ),
+ ModelInfo(
+ "text-embedding-3-small", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, OpenAIEmbeddingModel
+ ),
+ ModelInfo(
+ "text-embedding-3-large", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, OpenAIEmbeddingModel
+ ),
]
model_info_image_list = [
- ModelInfo('gpt-4o', _('The latest GPT-4o, cheaper and faster than gpt-4-turbo, updated with OpenAI adjustments'),
- ModelTypeConst.IMAGE, openai_image_model_credential,
- OpenAIImage),
- ModelInfo('gpt-4o-mini', _('The latest gpt-4o-mini, cheaper and faster than gpt-4o, updated with OpenAI adjustments'),
- ModelTypeConst.IMAGE, openai_image_model_credential,
- OpenAIImage),
+ ModelInfo(
+ "gpt-4o",
+ _("The latest GPT-4o, cheaper and faster than gpt-4-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.IMAGE,
+ openai_image_model_credential,
+ OpenAIImage,
+ ),
+ ModelInfo(
+ "gpt-4o-mini",
+ _("The latest gpt-4o-mini, cheaper and faster than gpt-4o, updated with OpenAI adjustments"),
+ ModelTypeConst.IMAGE,
+ openai_image_model_credential,
+ OpenAIImage,
+ ),
]
model_info_tti_list = [
- ModelInfo('dall-e-3', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- OpenAITextToImage),
+ ModelInfo("dall-e-3", "", ModelTypeConst.TTI, openai_tti_model_credential, OpenAITextToImage),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
- .append_default_model_info(ModelInfo('gpt-3.5-turbo', _('The latest gpt-3.5-turbo, updated with OpenAI adjustments'), ModelTypeConst.LLM,
- openai_llm_model_credential, OpenAIChatModel
- ))
+ .append_default_model_info(
+ ModelInfo(
+ "gpt-3.5-turbo",
+ _("The latest gpt-3.5-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ OpenAIChatModel,
+ )
+ )
.append_model_info_list(model_info_embedding_list)
.append_default_model_info(model_info_embedding_list[0])
.append_model_info_list(model_info_image_list)
.append_default_model_info(model_info_image_list[0])
.append_model_info_list(model_info_tti_list)
.append_default_model_info(model_info_tti_list[0])
- .append_default_model_info(ModelInfo('whisper-1', '',
- ModelTypeConst.STT, openai_stt_model_credential,
- OpenAISpeechToText)
+ .append_default_model_info(
+ ModelInfo("whisper-1", "", ModelTypeConst.STT, openai_stt_model_credential, OpenAISpeechToText)
+ )
+ .append_default_model_info(
+ ModelInfo("tts-1", "", ModelTypeConst.TTS, openai_tts_model_credential, OpenAITextToSpeech)
)
- .append_default_model_info(ModelInfo('tts-1', '',
- ModelTypeConst.TTS, openai_tts_model_credential,
- OpenAITextToSpeech))
.build()
)
class OpenAIModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_openai_provider', name='OpenAI', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'openai_model_provider', 'icon',
- 'openai_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_openai_provider",
+ name="OpenAI",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "openai_model_provider", "icon", "openai_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/qianfan_model_provider/__init__.py b/apps/models_provider/impl/qianfan_model_provider/__init__.py
new file mode 100644
index 00000000000..fd54226fe4c
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/__init__.py
@@ -0,0 +1,8 @@
+# coding=utf-8
+"""
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2023/10/31 17:16
+@desc:
+"""
diff --git a/apps/application/flow/step_node/variable_aggregation_node/impl/__init__.py b/apps/models_provider/impl/qianfan_model_provider/credential/__init__.py
similarity index 100%
rename from apps/application/flow/step_node/variable_aggregation_node/impl/__init__.py
rename to apps/models_provider/impl/qianfan_model_provider/credential/__init__.py
diff --git a/apps/models_provider/impl/qianfan_model_provider/credential/embedding.py b/apps/models_provider/impl/qianfan_model_provider/credential/embedding.py
new file mode 100644
index 00000000000..d5e1c7b9e0c
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/credential/embedding.py
@@ -0,0 +1,58 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/17 15:40
+@desc:
+"""
+
+from typing import Dict
+
+from django.utils.translation import gettext as _
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class QianfanEmbeddingCredential(BaseForm, BaseModelCredential):
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://qianfan.baidubce.com/v2")
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ for key in ["api_base", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
+ return False
+
+ try:
+ model = provider.get_model(model_type, model_name, model_credential)
+ model.embed_query(_("Hello"))
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if isinstance(e, AppApiException):
+ raise e
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ return False
+ return True
+
+ def encryption_dict(self, model: Dict[str, object]):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
diff --git a/apps/models_provider/impl/qianfan_model_provider/credential/image.py b/apps/models_provider/impl/qianfan_model_provider/credential/image.py
new file mode 100644
index 00000000000..02faa0d5847
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/credential/image.py
@@ -0,0 +1,89 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: image.py
+@desc: 千帆视觉理解模型凭据
+"""
+
+from typing import Dict
+
+from django.utils.translation import gettext, gettext_lazy as _
+from langchain_core.messages import HumanMessage
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, TooltipLabel
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class QianfanImageModelParams(BaseForm):
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.95,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
+
+ max_tokens = forms.SliderField(
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
+ _min=1,
+ _max=100000,
+ _step=1,
+ precision=0,
+ )
+
+
+class QianfanImageModelCredential(BaseForm, BaseModelCredential):
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://qianfan.baidubce.com/v2")
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ for key in ["api_base", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
+ return False
+
+ try:
+ model = provider.get_model(model_type, model_name, model_credential, **model_params)
+ response = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
+ for _chunk in response:
+ break
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if isinstance(e, AppApiException):
+ raise e
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ return False
+ return True
+
+ def encryption_dict(self, model: Dict[str, object]):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
+
+ def get_model_params_setting_form(self, model_name):
+ return QianfanImageModelParams()
diff --git a/apps/models_provider/impl/qianfan_model_provider/credential/llm.py b/apps/models_provider/impl/qianfan_model_provider/credential/llm.py
new file mode 100644
index 00000000000..5cc2afb467b
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/credential/llm.py
@@ -0,0 +1,88 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/12 10:19
+@desc:
+"""
+
+from typing import Dict
+
+from django.utils.translation import gettext, gettext_lazy as _
+from langchain_core.messages import HumanMessage
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, TooltipLabel
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class QianfanLLMModelParams(BaseForm):
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.95,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
+
+ max_tokens = forms.SliderField(
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
+ _min=2,
+ _max=100000,
+ _step=1,
+ precision=0,
+ )
+
+
+class QianfanLLMModelCredential(BaseForm, BaseModelCredential):
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://qianfan.baidubce.com/v2")
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ for key in ["api_base", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
+ return False
+
+ try:
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ raise e
+ return True
+
+ def encryption_dict(self, model_info: Dict[str, object]):
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
+
+ def build_model(self, model_info: Dict[str, object]):
+ for key in ["api_base", "api_key", "model"]:
+ if key not in model_info:
+ raise AppApiException(500, gettext("{key} is required").format(key=key))
+ self.api_base = model_info.get("api_base")
+ self.api_key = model_info.get("api_key")
+ return self
+
+ def get_model_params_setting_form(self, model_name):
+ return QianfanLLMModelParams()
diff --git a/apps/models_provider/impl/qianfan_model_provider/credential/reranker.py b/apps/models_provider/impl/qianfan_model_provider/credential/reranker.py
new file mode 100644
index 00000000000..b1f81512388
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/credential/reranker.py
@@ -0,0 +1,74 @@
+from typing import Dict
+
+from langchain_core.documents import Document
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, TooltipLabel
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+from django.utils.translation import gettext_lazy as _
+from common.utils.logger import maxkb_logger
+from models_provider.impl.qianfan_model_provider.model.reranker import QfBgeReranker
+
+
+class QfRerankerModelParams(BaseForm):
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
+
+
+class QfRerankerCredential(BaseForm, BaseModelCredential):
+ api_url = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
+ model_type_list = provider.get_model_type_list()
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
+
+ for key in ["api_url", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
+ else:
+ return False
+ try:
+ model: QfBgeReranker = provider.get_model(model_type, model_name, model_credential)
+ test_text = str(_("Hello"))
+ model.compress_documents([Document(page_content=test_text)], test_text)
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if isinstance(e, AppApiException):
+ raise e
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ return False
+
+ return True
+
+ def encryption_dict(self, model_info: Dict[str, object]):
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
+
+ def get_model_params_setting_form(self, model_name: str) -> QfRerankerModelParams:
+ return QfRerankerModelParams()
diff --git a/apps/models_provider/impl/qianfan_model_provider/credential/tti.py b/apps/models_provider/impl/qianfan_model_provider/credential/tti.py
new file mode 100644
index 00000000000..27956275215
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/credential/tti.py
@@ -0,0 +1,106 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: tti.py
+@desc: 千帆文生图模型凭据
+"""
+
+from typing import Dict
+
+from django.utils.translation import gettext, gettext_lazy as _
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, TooltipLabel
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class QianfanTTIModelParams(BaseForm):
+ size = forms.SingleSelect(
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "The size of the generated image. Optional values: [1024x1024, 1280x720, 720x1280, 1152x864, 864x1152, "
+ "1328x1328, 1664x928, 928x1664, 1472x1104, 1104x1472], default is 1024x1024."
+ ),
+ ),
+ required=True,
+ default_value="1024x1024",
+ option_list=[
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1280x720", "label": "1280x720"},
+ {"value": "720x1280", "label": "720x1280"},
+ {"value": "1152x864", "label": "1152x864"},
+ {"value": "864x1152", "label": "864x1152"},
+ {"value": "1328x1328", "label": "1328x1328"},
+ {"value": "1664x928", "label": "1664x928"},
+ {"value": "928x1664", "label": "928x1664"},
+ {"value": "1472x1104", "label": "1472x1104"},
+ {"value": "1104x1472", "label": "1104x1472"},
+ ],
+ text_field="label",
+ value_field="value",
+ )
+
+ response_format = forms.SingleSelect(
+ TooltipLabel(
+ _("Response format"),
+ _("The format of the generated image. url returns a URL, b64_json returns base64-encoded data."),
+ ),
+ required=True,
+ default_value="url",
+ option_list=[
+ {"value": "url", "label": "url"},
+ {"value": "b64_json", "label": "b64_json"},
+ ],
+ text_field="label",
+ value_field="value",
+ )
+
+
+class QianfanTextToImageModelCredential(BaseForm, BaseModelCredential):
+ api_base = forms.TextInputField(
+ "API URL",
+ required=True,
+ default_value="https://qianfan.baidubce.com/v2/musesteamer/images/generations",
+ )
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ for key in ["api_base", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
+ return False
+
+ try:
+ model = provider.get_model(model_type, model_name, model_credential, **model_params)
+ model.check_auth()
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if isinstance(e, AppApiException):
+ raise e
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ return False
+ return True
+
+ def encryption_dict(self, model: Dict[str, object]):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
+
+ def get_model_params_setting_form(self, model_name):
+ return QianfanTTIModelParams()
diff --git a/apps/models_provider/impl/qianfan_model_provider/credential/ttv.py b/apps/models_provider/impl/qianfan_model_provider/credential/ttv.py
new file mode 100644
index 00000000000..3603a808b53
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/credential/ttv.py
@@ -0,0 +1,70 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: ttv.py
+@desc: 千帆视频生成模型凭据
+"""
+
+from typing import Dict, Any
+
+from django.utils.translation import gettext, gettext_lazy as _
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, SliderField, TooltipLabel
+from common.forms.switch_field import SwitchField
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class QianfanVideoModelParams(BaseForm):
+ duration = SliderField(
+ TooltipLabel(
+ _("Video duration"),
+ _("The duration of the generated video in seconds. Only supported values are accepted."),
+ ),
+ required=False,
+ default_value=None,
+ _min=1,
+ _max=30,
+ _step=1,
+ precision=0,
+ )
+
+ watermark = SwitchField(
+ TooltipLabel(_("Watermark"), _("Whether the generated video contains a watermark")),
+ attrs={"active-value": True, "inactive-value": False},
+ default_value=False,
+ )
+
+ prompt_extend = SwitchField(
+ TooltipLabel(_("Prompt extend"), _("Whether to use a large model to rewrite the prompt")),
+ attrs={"active-value": True, "inactive-value": False},
+ default_value=True,
+ )
+
+
+class QianfanVideoModelCredential(BaseForm, BaseModelCredential):
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://qianfan.baidubce.com/v2")
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, Any],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ for key in ["api_base", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
+ return False
+ return True
+
+ def encryption_dict(self, model: Dict[str, object]):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
+
+ def get_model_params_setting_form(self, model_name):
+ return QianfanVideoModelParams()
diff --git a/apps/models_provider/impl/qwen_model_provider/__init__.py b/apps/models_provider/impl/qianfan_model_provider/icon/__init__.py
similarity index 100%
rename from apps/models_provider/impl/qwen_model_provider/__init__.py
rename to apps/models_provider/impl/qianfan_model_provider/icon/__init__.py
diff --git a/apps/models_provider/impl/wenxin_model_provider/icon/azure_icon_svg b/apps/models_provider/impl/qianfan_model_provider/icon/qianfan_icon_svg
similarity index 100%
rename from apps/models_provider/impl/wenxin_model_provider/icon/azure_icon_svg
rename to apps/models_provider/impl/qianfan_model_provider/icon/qianfan_icon_svg
diff --git a/apps/models_provider/impl/qwen_model_provider/credential/__init__.py b/apps/models_provider/impl/qianfan_model_provider/model/__init__.py
similarity index 100%
rename from apps/models_provider/impl/qwen_model_provider/credential/__init__.py
rename to apps/models_provider/impl/qianfan_model_provider/model/__init__.py
diff --git a/apps/models_provider/impl/qianfan_model_provider/model/embedding.py b/apps/models_provider/impl/qianfan_model_provider/model/embedding.py
new file mode 100644
index 00000000000..3d1bd049988
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/model/embedding.py
@@ -0,0 +1,50 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/17 16:48
+@desc:
+"""
+
+from typing import Dict, List
+
+import openai
+
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+
+class QianfanEmbeddings(MaxKBBaseEmbeddingModel):
+ """千帆 OpenAI 兼容向量接口(v2)"""
+
+ model_name: str
+
+ def supports_image_embedding(self) -> bool:
+ return False
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ def __init__(self, api_key: str, base_url: str, model_name: str):
+ self.client = openai.OpenAI(api_key=api_key, base_url=base_url).embeddings
+ self.model_name = model_name
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ return QianfanEmbeddings(
+ api_key=model_credential.get("api_key"),
+ model_name=model_name,
+ base_url=model_credential.get("api_base"),
+ )
+
+ def embed_query(self, text: str):
+ res = self.embed_documents([text])
+ return res[0]
+
+ def embed_documents(
+ self,
+ texts: List[str],
+ ) -> List[List[float]]:
+ res = self.client.create(input=texts, model=self.model_name, encoding_format="float")
+ return [e.embedding for e in res.data]
diff --git a/apps/models_provider/impl/qianfan_model_provider/model/image.py b/apps/models_provider/impl/qianfan_model_provider/model/image.py
new file mode 100644
index 00000000000..bd99d8a5534
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/model/image.py
@@ -0,0 +1,27 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: image.py
+@desc: 千帆视觉理解模型(v2 OpenAI 兼容接口 /v2/chat/completions)
+"""
+
+from typing import Dict
+
+from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
+
+
+class QianfanVisionModel(MaxKBBaseModel, BaseChatOpenAI):
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ return QianfanVisionModel(
+ model=model_name,
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
+ extra_body=optional_params,
+ )
diff --git a/apps/models_provider/impl/qianfan_model_provider/model/llm.py b/apps/models_provider/impl/qianfan_model_provider/model/llm.py
new file mode 100644
index 00000000000..e08c404ba18
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/model/llm.py
@@ -0,0 +1,31 @@
+# coding=utf-8
+"""
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2023/11/10 17:45
+@desc:
+"""
+
+from typing import Dict
+
+from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
+
+
+class QianfanChatModel(MaxKBBaseModel, BaseChatOpenAI):
+ """千帆 OpenAI 兼容接口(v2)"""
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ return QianfanChatModel(
+ model=model_name,
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
+ extra_body=optional_params,
+ )
diff --git a/apps/models_provider/impl/qianfan_model_provider/model/reranker.py b/apps/models_provider/impl/qianfan_model_provider/model/reranker.py
new file mode 100644
index 00000000000..430d1f0f247
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/model/reranker.py
@@ -0,0 +1,60 @@
+from typing import Sequence, Optional, Dict
+
+import requests
+from langchain_core.callbacks import Callbacks
+from langchain_core.documents import BaseDocumentCompressor, Document
+
+from models_provider.base_model_provider import MaxKBBaseModel
+
+
+class QfBgeReranker(MaxKBBaseModel, BaseDocumentCompressor):
+ api_key: str
+ api_url: str
+ model: str
+ params: dict
+ top_n: int = 3
+
+ def __init__(self, **kwargs):
+ super().__init__(**kwargs)
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params", {})
+ self.api_url = kwargs.get("api_url")
+ self.top_n = self.params.get("top_n", 3)
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ return QfBgeReranker(
+ model=model_name,
+ api_key=model_credential.get("api_key"),
+ api_url=model_credential.get("api_url"),
+ params=model_kwargs,
+ )
+
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
+ if not documents:
+ return []
+
+ texts = [doc.page_content for doc in documents]
+
+ headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}
+ top_n = min(self.top_n, len(texts))
+ payload = {"model": self.model, "query": query, "documents": texts, "top_n": top_n}
+
+ response = requests.post(f"{self.api_url}/rerank", json=payload, headers=headers)
+
+ if response.status_code != 200:
+ raise RuntimeError(f"千帆 API 请求失败:{response.text}")
+
+ res = response.json()
+
+ return [
+ Document(page_content=item.get("document", ""), metadata={"relevance_score": item.get("relevance_score")})
+ for item in res.get("results", [])
+ ]
diff --git a/apps/models_provider/impl/qianfan_model_provider/model/tti.py b/apps/models_provider/impl/qianfan_model_provider/model/tti.py
new file mode 100644
index 00000000000..d4b27890970
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/model/tti.py
@@ -0,0 +1,74 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: tti.py
+@desc: 千帆文生图通用模型。api_base 即完整请求地址,直接使用。
+"""
+
+from typing import Dict
+
+import requests
+
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.impl.base_tti import BaseTextToImage
+
+
+class QianfanTextToImage(MaxKBBaseModel, BaseTextToImage):
+ api_key: str
+ api_base: str
+ model_name: str
+ params: dict = {}
+
+ def __init__(self, **kwargs):
+ super().__init__(**kwargs)
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params", {}) or {}
+ self._session = requests.Session()
+ self._session.headers.update({"Authorization": f"Bearer {self.api_key}"})
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ optional_params = {"params": {}}
+ for key, value in model_kwargs.items():
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ return QianfanTextToImage(
+ model_name=model_name,
+ api_key=model_credential.get("api_key"),
+ api_base=model_credential.get("api_base"),
+ **optional_params,
+ )
+
+ def check_auth(self):
+ self.generate_image("a green grass field with a blue sky")
+
+ def generate_image(self, prompt: str, negative_prompt: str = None):
+ payload = {"model": self.model_name, "prompt": prompt}
+ if negative_prompt:
+ payload["negative_prompt"] = negative_prompt
+ payload.update(self.params)
+
+ try:
+ response = self._session.post(self.api_base, json=payload)
+ response.raise_for_status()
+ file_urls = []
+ for item in response.json().get("data", []):
+ if not isinstance(item, dict):
+ continue
+ url = item.get("url") or item.get("b64_json")
+ if not url:
+ continue
+ if "://" not in url:
+ url = f"data:image/png;base64,{url}"
+ file_urls.append(url)
+ return file_urls
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ raise e
diff --git a/apps/models_provider/impl/qianfan_model_provider/model/ttv.py b/apps/models_provider/impl/qianfan_model_provider/model/ttv.py
new file mode 100644
index 00000000000..5137cdc80b0
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/model/ttv.py
@@ -0,0 +1,124 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: ttv.py
+@desc: 千帆视频生成模型(蒸汽机 Air,异步任务式接口 /video/generations)
+"""
+
+import time
+from typing import ClassVar, Dict
+
+import requests
+
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_ttv import BaseGenerationVideo
+
+
+class QianfanVideoModel(MaxKBBaseModel, BaseGenerationVideo):
+ api_key: str
+ api_base: str
+ model_name: str
+ params: dict = {}
+
+ REQUEST_TIMEOUT: ClassVar[tuple] = (10, 120)
+ MAX_POLL_ATTEMPTS: ClassVar[int] = 180
+ POLL_INTERVAL: ClassVar[int] = 5
+ SUCCESS_STATUSES: ClassVar[frozenset] = frozenset({"succeeded"})
+ FAIL_STATUSES: ClassVar[frozenset] = frozenset({"failed"})
+ # 任务失败时用于提取错误信息的字段
+ ERROR_KEYS: ClassVar[tuple] = ("error_msg", "error", "message", "msg", "detail", "description")
+
+ def __init__(self, **kwargs):
+ super().__init__(**kwargs)
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params", {}) or {}
+ # 需要关闭默认的 Authorization 头污染
+ self._session = requests.Session()
+ self._session.headers.update({"Authorization": f"Bearer {self.api_key}"})
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ optional_params = {"params": {}}
+ for key, value in model_kwargs.items():
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ return QianfanVideoModel(
+ model_name=model_name,
+ api_key=model_credential.get("api_key"),
+ api_base=model_credential.get("api_base", "https://qianfan.baidubce.com/v2"),
+ **optional_params,
+ )
+
+ def check_auth(self):
+ return True
+
+ def _base_url(self):
+ """接口路径为 /video/generations(无 v2 前缀),去掉 api_base 末尾的 /v2。"""
+ base = self.api_base.rstrip("/")
+ if base.endswith("/v2"):
+ base = base[:-3]
+ return base.rstrip("/")
+
+ def _request(self, method: str, url: str, **kwargs) -> dict:
+ kwargs.setdefault("timeout", self.REQUEST_TIMEOUT)
+ response = self._session.request(method, url, **kwargs)
+ try:
+ response.raise_for_status()
+ except requests.exceptions.HTTPError as e:
+ detail = e.response.text if e.response is not None else str(e)
+ maxkb_logger.error(f"千帆视频接口请求失败: {detail}", exc_info=True)
+ raise RuntimeError(f"HTTP 请求失败: {detail}") from e
+ return response.json()
+
+ @staticmethod
+ def _extract_error(data: dict) -> str:
+ for key in QianfanVideoModel.ERROR_KEYS:
+ value = data.get(key)
+ if value:
+ return str(value)
+ return str(data)
+
+ def _wait_for_result(self, task_id: str) -> dict:
+ query_url = f"{self._base_url()}/video/generations"
+ for attempt in range(1, self.MAX_POLL_ATTEMPTS + 1):
+ response_data = self._request("GET", query_url, params={"task_id": task_id})
+ status = response_data.get("status")
+ maxkb_logger.info(f"千帆视频任务状态 (尝试 {attempt}/{self.MAX_POLL_ATTEMPTS}): {status}")
+ if status in self.SUCCESS_STATUSES:
+ return response_data
+ if status in self.FAIL_STATUSES:
+ raise RuntimeError(f"视频生成失败: {self._extract_error(response_data)}")
+ time.sleep(self.POLL_INTERVAL)
+ raise RuntimeError(f"任务超时:经过 {self.MAX_POLL_ATTEMPTS} 次轮询后仍未完成")
+
+ def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, last_frame_url=None, **kwargs):
+ content = [{"type": "text", "text": prompt}]
+ if first_frame_url:
+ content.append({"type": "image_url", "image_url": {"url": first_frame_url}})
+ if not any(item.get("type") == "image_url" for item in content):
+ # 图生视频(musesteamer-air-i2v)必须包含图片信息
+ maxkb_logger.warning("千帆视频生成:未提供图片,文生视频接口可能不支持该模型")
+
+ payload = {"model": self.model_name, "content": content}
+ payload.update(self.params)
+
+ maxkb_logger.info(f"提交千帆视频生成任务,模型: {self.model_name}")
+ response_data = self._request("POST", f"{self._base_url()}/video/generations", json=payload)
+
+ task_id = response_data.get("task_id")
+ if not task_id:
+ raise RuntimeError(f"提交任务失败,未获取到 task_id: {response_data}")
+
+ response_data = self._wait_for_result(task_id)
+
+ video_url = (response_data.get("content") or {}).get("video_url")
+ if not video_url:
+ raise RuntimeError(f"任务成功但未获取到 video_url: {response_data}")
+ return video_url
diff --git a/apps/models_provider/impl/qianfan_model_provider/qianfan_model_provider.py b/apps/models_provider/impl/qianfan_model_provider/qianfan_model_provider.py
new file mode 100644
index 00000000000..049821911aa
--- /dev/null
+++ b/apps/models_provider/impl/qianfan_model_provider/qianfan_model_provider.py
@@ -0,0 +1,101 @@
+# coding=utf-8
+"""
+@project: maxkb
+@Author:虎
+@file: qianfan_model_provider.py
+@date:2023/10/31 16:19
+@desc:
+"""
+
+import os
+
+from common.utils.common import get_file_content
+from models_provider.base_model_provider import (
+ ModelProvideInfo,
+ ModelTypeConst,
+ ModelInfo,
+ IModelProvider,
+ ModelInfoManage,
+)
+from models_provider.impl.qianfan_model_provider.credential.embedding import QianfanEmbeddingCredential
+from models_provider.impl.qianfan_model_provider.credential.image import QianfanImageModelCredential
+from models_provider.impl.qianfan_model_provider.credential.llm import QianfanLLMModelCredential
+from models_provider.impl.qianfan_model_provider.credential.reranker import QfRerankerCredential
+from models_provider.impl.qianfan_model_provider.credential.tti import QianfanTextToImageModelCredential
+from models_provider.impl.qianfan_model_provider.credential.ttv import QianfanVideoModelCredential
+from models_provider.impl.qianfan_model_provider.model.embedding import QianfanEmbeddings
+from models_provider.impl.qianfan_model_provider.model.image import QianfanVisionModel
+from models_provider.impl.qianfan_model_provider.model.llm import QianfanChatModel
+from models_provider.impl.qianfan_model_provider.model.tti import QianfanTextToImage
+from models_provider.impl.qianfan_model_provider.model.ttv import QianfanVideoModel
+from maxkb.conf import PROJECT_DIR
+from django.utils.translation import gettext as _
+
+from models_provider.impl.qianfan_model_provider.model.reranker import QfBgeReranker
+
+qianfan_llm_model_credential = QianfanLLMModelCredential()
+qianfan_image_model_credential = QianfanImageModelCredential()
+qianfan_tti_model_credential = QianfanTextToImageModelCredential()
+qianfan_video_model_credential = QianfanVideoModelCredential()
+qianfan_embedding_credential = QianfanEmbeddingCredential()
+qf_reranker_credential = QfRerankerCredential()
+model_info_list = [
+ ModelInfo("ernie-5.1", "", ModelTypeConst.LLM, qianfan_llm_model_credential, QianfanChatModel),
+ ModelInfo("ernie-5.0", "", ModelTypeConst.LLM, qianfan_llm_model_credential, QianfanChatModel),
+ ModelInfo("ernie-4.5-turbo-128k", "", ModelTypeConst.LLM, qianfan_llm_model_credential, QianfanChatModel),
+ ModelInfo("deepseek-v4-pro", "", ModelTypeConst.LLM, qianfan_llm_model_credential, QianfanChatModel),
+ ModelInfo("ernie-4.5-turbo-32k", "", ModelTypeConst.LLM, qianfan_llm_model_credential, QianfanChatModel),
+]
+image_model_info_list = [
+ ModelInfo("qwen2.5-vl-7b-instruct", "", ModelTypeConst.IMAGE, qianfan_image_model_credential, QianfanVisionModel),
+ ModelInfo("ernie-4.5-vl-28b-a3b", "", ModelTypeConst.IMAGE, qianfan_image_model_credential, QianfanVisionModel),
+]
+tti_model_info_list = [
+ ModelInfo("musesteamer-air-image", "", ModelTypeConst.TTI, qianfan_tti_model_credential, QianfanTextToImage),
+ ModelInfo("qwen-image", "", ModelTypeConst.TTI, qianfan_tti_model_credential, QianfanTextToImage),
+ ModelInfo("ernie-image-turbo", "", ModelTypeConst.TTI, qianfan_tti_model_credential, QianfanTextToImage),
+]
+itv_model_info_list = [
+ ModelInfo("musesteamer-air-i2v", "", ModelTypeConst.ITV, qianfan_video_model_credential, QianfanVideoModel),
+]
+embedding_model_info_list = [
+ ModelInfo("Embedding-V1", "", ModelTypeConst.EMBEDDING, qianfan_embedding_credential, QianfanEmbeddings),
+ ModelInfo("bge-large-zh", "", ModelTypeConst.EMBEDDING, qianfan_embedding_credential, QianfanEmbeddings),
+]
+rerank_model_info_list = [
+ ModelInfo("bce-reranker-base", "", ModelTypeConst.RERANKER, qf_reranker_credential, QfBgeReranker),
+]
+model_info_manage = (
+ ModelInfoManage.builder()
+ .append_model_info_list(model_info_list)
+ .append_default_model_info(
+ ModelInfo("ernie-5.1", "", ModelTypeConst.LLM, qianfan_llm_model_credential, QianfanChatModel)
+ )
+ .append_model_info_list(image_model_info_list)
+ .append_default_model_info(image_model_info_list[0])
+ .append_model_info_list(tti_model_info_list)
+ .append_default_model_info(tti_model_info_list[0])
+ .append_model_info_list(itv_model_info_list)
+ .append_default_model_info(itv_model_info_list[0])
+ .append_model_info_list(embedding_model_info_list)
+ .append_default_model_info(embedding_model_info_list[0])
+ .append_model_info_list(rerank_model_info_list)
+ .append_default_model_info(rerank_model_info_list[0])
+ .build()
+)
+
+
+class QianfanModelProvider(IModelProvider):
+ def get_model_info_manage(self):
+ return model_info_manage
+
+ def get_model_provide_info(self):
+ return ModelProvideInfo(
+ provider="model_qianfan_provider",
+ name=_("Thousand sails large model"),
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "qianfan_model_provider", "icon", "qianfan_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/regolo_model_provider/__init__.py b/apps/models_provider/impl/regolo_model_provider/__init__.py
index 2dc4ab10db4..906f7224d02 100644
--- a/apps/models_provider/impl/regolo_model_provider/__init__.py
+++ b/apps/models_provider/impl/regolo_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/28 16:25
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/3/28 16:25
+@desc:
"""
diff --git a/apps/models_provider/impl/regolo_model_provider/credential/embedding.py b/apps/models_provider/impl/regolo_model_provider/credential/embedding.py
index 1be60e8c05a..081ea74baa5 100644
--- a/apps/models_provider/impl/regolo_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/regolo_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -18,37 +19,47 @@
class RegoloEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField(_('API URL'), required=True,
- default_value='https://api.regolo.ai/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField(_("API URL"), required=True, default_value="https://api.regolo.ai/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/regolo_model_provider/credential/image.py b/apps/models_provider/impl/regolo_model_provider/credential/image.py
index bb0d7aa402c..94c84aea3b5 100644
--- a/apps/models_provider/impl/regolo_model_provider/credential/image.py
+++ b/apps/models_provider/impl/regolo_model_provider/credential/image.py
@@ -1,6 +1,4 @@
# coding=utf-8
-import base64
-import os
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -15,59 +13,78 @@
class RegoloImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class RegoloImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True, default_value='https://api.regolo.ai/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.regolo.ai/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return RegoloImageModelParams()
diff --git a/apps/models_provider/impl/regolo_model_provider/credential/llm.py b/apps/models_provider/impl/regolo_model_provider/credential/llm.py
index 2e404964e8d..f3c648a9170 100644
--- a/apps/models_provider/impl/regolo_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/regolo_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:32
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:32
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -19,61 +20,78 @@
class RegoloLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class RegoloLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
-
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True, default_value='https://api.regolo.ai/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.regolo.ai/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return RegoloLLMModelParams()
diff --git a/apps/models_provider/impl/regolo_model_provider/credential/tti.py b/apps/models_provider/impl/regolo_model_provider/credential/tti.py
index a556b0258f8..a44e7f50cea 100644
--- a/apps/models_provider/impl/regolo_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/regolo_model_provider/credential/tti.py
@@ -9,80 +9,97 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class RegoloTTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('The image generation endpoint allows you to create raw images based on text prompts. ')),
+ TooltipLabel(
+ _("Image size"), _("The image generation endpoint allows you to create raw images based on text prompts. ")
+ ),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '1024x1792', 'label': '1024x1792'},
- {'value': '1792x1024', 'label': '1792x1024'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1024x1792", "label": "1024x1792"},
+ {"value": "1792x1024", "label": "1792x1024"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
quality = forms.SingleSelect(
- TooltipLabel(_('Picture quality'), _('''
+ TooltipLabel(
+ _("Picture quality"),
+ _("""
By default, images are produced in standard quality.
- ''')),
+ """),
+ ),
required=True,
- default_value='standard',
+ default_value="standard",
option_list=[
- {'value': 'standard', 'label': 'standard'},
- {'value': 'hd', 'label': 'hd'},
+ {"value": "standard", "label": "standard"},
+ {"value": "hd", "label": "hd"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
n = forms.SliderField(
- TooltipLabel(_('Number of pictures'),
- _('1 as default')),
- required=True, default_value=1,
+ TooltipLabel(_("Number of pictures"), _("1 as default")),
+ required=True,
+ default_value=1,
_min=1,
_max=10,
_step=1,
- precision=0)
+ precision=0,
+ )
class RegoloTextToImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True, default_value='https://api.regolo.ai/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://api.regolo.ai/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return RegoloTTIModelParams()
diff --git a/apps/models_provider/impl/regolo_model_provider/model/embedding.py b/apps/models_provider/impl/regolo_model_provider/model/embedding.py
index 471f23f859e..fa1a3e37547 100644
--- a/apps/models_provider/impl/regolo_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/regolo_model_provider/model/embedding.py
@@ -1,23 +1,27 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 17:44
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 17:44
+@desc:
"""
+
from typing import Dict
from langchain_openai import OpenAIEmbeddings
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class RegoloEmbeddingModel(MaxKBBaseEmbeddingModel, OpenAIEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
-class RegoloEmbeddingModel(MaxKBBaseModel, OpenAIEmbeddings):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return RegoloEmbeddingModel(
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
model=model_name,
- openai_api_base=model_credential.get('api_base') or "https://api.regolo.ai/v1",
+ openai_api_base=model_credential.get("api_base") or "https://api.regolo.ai/v1",
)
diff --git a/apps/models_provider/impl/regolo_model_provider/model/image.py b/apps/models_provider/impl/regolo_model_provider/model/image.py
index 7c268bd1c92..47c0e89e30d 100644
--- a/apps/models_provider/impl/regolo_model_provider/model/image.py
+++ b/apps/models_provider/impl/regolo_model_provider/model/image.py
@@ -5,7 +5,6 @@
class RegoloImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -15,8 +14,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return RegoloImage(
model_name=model_name,
- openai_api_base=model_credential.get('api_base') or "https://api.regolo.ai/v1",
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base") or "https://api.regolo.ai/v1",
+ openai_api_key=model_credential.get("api_key"),
streaming=True,
stream_usage=True,
**optional_params,
diff --git a/apps/models_provider/impl/regolo_model_provider/model/llm.py b/apps/models_provider/impl/regolo_model_provider/model/llm.py
index 7a9df564fac..30e1d0f06fa 100644
--- a/apps/models_provider/impl/regolo_model_provider/model/llm.py
+++ b/apps/models_provider/impl/regolo_model_provider/model/llm.py
@@ -1,15 +1,14 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/18 15:28
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/4/18 15:28
+@desc:
"""
-from typing import List, Dict
-from langchain_core.messages import BaseMessage, get_buffer_string
-from langchain_openai.chat_models import ChatOpenAI
+from typing import Dict
+
from common.config.tokenizer_manage_config import TokenizerManage
from models_provider.base_model_provider import MaxKBBaseModel
@@ -22,7 +21,6 @@ def custom_get_token_ids(text: str):
class RegoloChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -32,7 +30,7 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return RegoloChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base') or "https://api.regolo.ai/v1",
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base") or "https://api.regolo.ai/v1",
+ openai_api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/regolo_model_provider/model/tti.py b/apps/models_provider/impl/regolo_model_provider/model/tti.py
index e80d6e44316..d7528590f30 100644
--- a/apps/models_provider/impl/regolo_model_provider/model/tti.py
+++ b/apps/models_provider/impl/regolo_model_provider/model/tti.py
@@ -20,10 +20,10 @@ class RegoloTextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -31,14 +31,14 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024x1024', 'quality': 'standard', 'n': 1}}
+ optional_params = {"params": {"size": "1024x1024", "quality": "standard", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return RegoloTextToImage(
model=model_name,
- api_base=model_credential.get('api_base') or "https://api.regolo.ai/v1",
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base") or "https://api.regolo.ai/v1",
+ api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/regolo_model_provider/regolo_model_provider.py b/apps/models_provider/impl/regolo_model_provider/regolo_model_provider.py
index afcc406b676..1d756f0fb3a 100644
--- a/apps/models_provider/impl/regolo_model_provider/regolo_model_provider.py
+++ b/apps/models_provider/impl/regolo_model_provider/regolo_model_provider.py
@@ -1,19 +1,25 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: openai_model_provider.py
- @date:2024/3/28 16:26
- @desc:
+@project: maxkb
+@Author:虎
+@file: openai_model_provider.py
+@date:2024/3/28 16:26
+@desc:
"""
+
import os
from django.utils.translation import gettext as _
from common.utils.common import get_file_content
from maxkb.conf import PROJECT_DIR
-from models_provider.base_model_provider import ModelInfo, ModelTypeConst, ModelInfoManage, IModelProvider, \
- ModelProvideInfo
+from models_provider.base_model_provider import (
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+ IModelProvider,
+ ModelProvideInfo,
+)
from models_provider.impl.regolo_model_provider.credential.embedding import RegoloEmbeddingCredential
from models_provider.impl.regolo_model_provider.credential.llm import RegoloLLMModelCredential
from models_provider.impl.regolo_model_provider.credential.tti import RegoloTextToImageModelCredential
@@ -24,65 +30,53 @@
openai_llm_model_credential = RegoloLLMModelCredential()
openai_tti_model_credential = RegoloTextToImageModelCredential()
model_info_list = [
- ModelInfo('Phi-4', '', ModelTypeConst.LLM,
- openai_llm_model_credential, RegoloChatModel
- ),
- ModelInfo('DeepSeek-R1-Distill-Qwen-32B', '', ModelTypeConst.LLM,
- openai_llm_model_credential,
- RegoloChatModel),
- ModelInfo('maestrale-chat-v0.4-beta', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- RegoloChatModel),
- ModelInfo('Llama-3.3-70B-Instruct',
- '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- RegoloChatModel),
- ModelInfo('Llama-3.1-8B-Instruct',
- '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- RegoloChatModel),
- ModelInfo('DeepSeek-Coder-6.7B-Instruct', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- RegoloChatModel)
+ ModelInfo("Phi-4", "", ModelTypeConst.LLM, openai_llm_model_credential, RegoloChatModel),
+ ModelInfo("DeepSeek-R1-Distill-Qwen-32B", "", ModelTypeConst.LLM, openai_llm_model_credential, RegoloChatModel),
+ ModelInfo("maestrale-chat-v0.4-beta", "", ModelTypeConst.LLM, openai_llm_model_credential, RegoloChatModel),
+ ModelInfo("Llama-3.3-70B-Instruct", "", ModelTypeConst.LLM, openai_llm_model_credential, RegoloChatModel),
+ ModelInfo("Llama-3.1-8B-Instruct", "", ModelTypeConst.LLM, openai_llm_model_credential, RegoloChatModel),
+ ModelInfo("DeepSeek-Coder-6.7B-Instruct", "", ModelTypeConst.LLM, openai_llm_model_credential, RegoloChatModel),
]
open_ai_embedding_credential = RegoloEmbeddingCredential()
model_info_embedding_list = [
- ModelInfo('gte-Qwen2', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- RegoloEmbeddingModel),
+ ModelInfo("gte-Qwen2", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, RegoloEmbeddingModel),
]
model_info_tti_list = [
- ModelInfo('FLUX.1-dev', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- RegoloTextToImage),
- ModelInfo('sdxl-turbo', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- RegoloTextToImage),
+ ModelInfo("FLUX.1-dev", "", ModelTypeConst.TTI, openai_tti_model_credential, RegoloTextToImage),
+ ModelInfo("sdxl-turbo", "", ModelTypeConst.TTI, openai_tti_model_credential, RegoloTextToImage),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
.append_default_model_info(
- ModelInfo('gpt-3.5-turbo', _('The latest gpt-3.5-turbo, updated with OpenAI adjustments'), ModelTypeConst.LLM,
- openai_llm_model_credential, RegoloChatModel
- ))
+ ModelInfo(
+ "gpt-3.5-turbo",
+ _("The latest gpt-3.5-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ RegoloChatModel,
+ )
+ )
.append_model_info_list(model_info_embedding_list)
.append_default_model_info(model_info_embedding_list[0])
.append_model_info_list(model_info_tti_list)
.append_default_model_info(model_info_tti_list[0])
-
.build()
)
class RegoloModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_regolo_provider', name='Regolo', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'regolo_model_provider',
- 'icon',
- 'regolo_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_regolo_provider",
+ name="Regolo",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "regolo_model_provider", "icon", "regolo_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/__init__.py b/apps/models_provider/impl/siliconCloud_model_provider/__init__.py
index 2dc4ab10db4..906f7224d02 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/__init__.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/28 16:25
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/3/28 16:25
+@desc:
"""
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/embedding.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/embedding.py
index 92fa5778d5c..5da6b21e84f 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,37 +17,49 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class SiliconCloudEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/image.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/image.py
index 92b9f83e7d1..a1382505854 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/image.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/image.py
@@ -1,6 +1,4 @@
# coding=utf-8
-import base64
-import os
from typing import Dict
from langchain_core.messages import HumanMessage
@@ -14,61 +12,80 @@
class SiliconCloudImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class SiliconCloudImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return SiliconCloudImageModelParams()
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/llm.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/llm.py
index e096ba2bcc6..4fd82923c00 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:32
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:32
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,62 +18,80 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class SiliconCloudLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class SiliconCloudLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
-
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return SiliconCloudLLMModelParams()
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/reranker.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/reranker.py
index e49de9f583e..9cc1495ba4d 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/reranker.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: reranker.py
- @date:2024/9/9 17:51
- @desc:
+@project: MaxKB
+@Author:虎
+@file: reranker.py
+@date:2024/9/9 17:51
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -20,48 +21,60 @@
class SiliconCloudRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class SiliconCloudRerankerCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- if not model_type == 'RERANKER':
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['api_base', 'api_key']:
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ if not model_type == "RERANKER":
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model: SiliconCloudReranker = provider.get_model(model_type, model_name, model_credential)
- model.compress_documents([Document(page_content=_('Hello'))], _('Hello'))
+ model.compress_documents([Document(page_content=_("Hello"))], _("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name: str) -> SiliconCloudRerankerModelParams:
return SiliconCloudRerankerModelParams()
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/stt.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/stt.py
index 83efa7d0f63..636a4d5ab96 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/stt.py
@@ -9,40 +9,52 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class SiliconCloudSTTModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential,**model_params)
+ model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
pass
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/tti.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/tti.py
index 6c252b05c7c..168eb13ff1d 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/tti.py
@@ -9,80 +9,105 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class SiliconCloudTTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('The image generation endpoint allows you to create raw images based on text prompts. When using the DALL·E 3, the image size can be 1024x1024, 1024x1792 or 1792x1024 pixels.')),
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "The image generation endpoint allows you to create raw images based on text prompts. When using the DALL·E 3, the image size can be 1024x1024, 1024x1792 or 1792x1024 pixels."
+ ),
+ ),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '1024x1792', 'label': '1024x1792'},
- {'value': '1792x1024', 'label': '1792x1024'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1024x1792", "label": "1024x1792"},
+ {"value": "1792x1024", "label": "1792x1024"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
quality = forms.SingleSelect(
- TooltipLabel(_('Picture quality'), _('''
+ TooltipLabel(
+ _("Picture quality"),
+ _("""
By default, images are produced in standard quality, but with DALL·E 3 you can set quality: "hd" to enhance detail. Square, standard quality images are generated fastest.
- ''')),
+ """),
+ ),
required=True,
- default_value='standard',
+ default_value="standard",
option_list=[
- {'value': 'standard', 'label': 'standard'},
- {'value': 'hd', 'label': 'hd'},
+ {"value": "standard", "label": "standard"},
+ {"value": "hd", "label": "hd"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
n = forms.SliderField(
- TooltipLabel(_('Number of pictures'),
- _('You can use DALL·E 3 to request 1 image at a time (requesting more images by issuing parallel requests), or use DALL·E 2 with the n parameter to request up to 10 images at a time.')),
- required=True, default_value=1,
+ TooltipLabel(
+ _("Number of pictures"),
+ _(
+ "You can use DALL·E 3 to request 1 image at a time (requesting more images by issuing parallel requests), or use DALL·E 2 with the n parameter to request up to 10 images at a time."
+ ),
+ ),
+ required=True,
+ default_value=1,
_min=1,
_max=10,
_step=1,
- precision=0)
+ precision=0,
+ )
class SiliconCloudTextToImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return SiliconCloudTTIModelParams()
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/credential/tts.py b/apps/models_provider/impl/siliconCloud_model_provider/credential/tts.py
index 216b0f16024..f308ed57390 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/credential/tts.py
@@ -9,62 +9,79 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class SiliconCloudTTSModelGeneralParams(BaseForm):
# alloy, echo, fable, onyx, nova, shimmer
voice = forms.SingleSelect(
- TooltipLabel('Voice',
- _('Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English.')),
- required=True, default_value='fnlp/MOSS-TTSD-v0.5:alex',
- text_field='label',
- value_field='value',
+ TooltipLabel(
+ "Voice",
+ _(
+ "Try out the different sounds (Alloy, Echo, Fable, Onyx, Nova, and Sparkle) to find one that suits your desired tone and audience. The current voiceover is optimized for English."
+ ),
+ ),
+ required=True,
+ default_value="fnlp/MOSS-TTSD-v0.5:alex",
+ text_field="label",
+ value_field="value",
option_list=[
- {'label': 'alex', 'value': 'fnlp/MOSS-TTSD-v0.5:alex'},
- {'label': 'anna', 'value': 'fnlp/MOSS-TTSD-v0.5:anna'},
- {'label': 'bella', 'value': 'fnlp/MOSS-TTSD-v0.5:bella'},
- {'label': 'charles', 'value': 'fnlp/MOSS-TTSD-v0.5:charles'},
- {'label': 'benjamin', 'value': 'fnlp/MOSS-TTSD-v0.5:benjamin'},
- {'label': 'claire', 'value': 'fnlp/MOSS-TTSD-v0.5:claire'},
- {'label': 'david', 'value': 'fnlp/MOSS-TTSD-v0.5:david'},
- {'label': 'diana', 'value': 'fnlp/MOSS-TTSD-v0.5:diana'},
- ])
+ {"label": "alex", "value": "fnlp/MOSS-TTSD-v0.5:alex"},
+ {"label": "anna", "value": "fnlp/MOSS-TTSD-v0.5:anna"},
+ {"label": "bella", "value": "fnlp/MOSS-TTSD-v0.5:bella"},
+ {"label": "charles", "value": "fnlp/MOSS-TTSD-v0.5:charles"},
+ {"label": "benjamin", "value": "fnlp/MOSS-TTSD-v0.5:benjamin"},
+ {"label": "claire", "value": "fnlp/MOSS-TTSD-v0.5:claire"},
+ {"label": "david", "value": "fnlp/MOSS-TTSD-v0.5:david"},
+ {"label": "diana", "value": "fnlp/MOSS-TTSD-v0.5:diana"},
+ ],
+ )
class SiliconCloudTTSModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
-
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
- return SiliconCloudTTSModelGeneralParams()
\ No newline at end of file
+ return SiliconCloudTTSModelGeneralParams()
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/embedding.py b/apps/models_provider/impl/siliconCloud_model_provider/model/embedding.py
index 6e315cacbc4..28c7c6f5b15 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/embedding.py
@@ -1,19 +1,23 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/16 16:34
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/16 16:34
+@desc:
"""
-from typing import Dict, List
+
+from typing import Dict
from common.utils.logger import maxkb_logger
import requests
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class SiliconCloudEmbeddingModel(MaxKBBaseEmbeddingModel):
+ def supports_image_embedding(self) -> bool:
+ return False
-class SiliconCloudEmbeddingModel(MaxKBBaseModel):
model_name: str
openai_api_key: str
base_url: str
@@ -30,29 +34,22 @@ def is_cache_model(self):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return SiliconCloudEmbeddingModel(
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
model_name=model_name,
optional_params=optional_params,
- base_url=model_credential.get('api_base'),
+ base_url=model_credential.get("api_base"),
)
def embed_query(self, text: str) -> list:
- payload = {
- "model": self.model_name,
- "input": text,
- **self.optional_params
- }
- headers = {
- "Authorization": f"Bearer {self.openai_api_key}",
- "Content-Type": "application/json"
- }
-
- response = requests.post(self.base_url + '/embeddings', json=payload, headers=headers)
+ payload = {"model": self.model_name, "input": text, **self.optional_params}
+ headers = {"Authorization": f"Bearer {self.openai_api_key}", "Content-Type": "application/json"}
+
+ response = requests.post(self.base_url + "/embeddings", json=payload, headers=headers)
data = response.json()
if isinstance(data, dict):
- if data['data'] is None or 'code' in data:
+ if data["data"] is None or "code" in data:
raise ValueError(f"Embedding API returned no data: {data}")
# 假设返回结构中有 'data[0].embedding'
return data["data"][0]["embedding"]
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/image.py b/apps/models_provider/impl/siliconCloud_model_provider/model/image.py
index 29cc2e10b20..02c85a26a29 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/image.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/image.py
@@ -5,7 +5,6 @@
class SiliconCloudImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -15,8 +14,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return SiliconCloudImage(
model_name=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/llm.py b/apps/models_provider/impl/siliconCloud_model_provider/model/llm.py
index 6fbed53c997..afdf3e28b17 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/llm.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/llm.py
@@ -1,15 +1,14 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/18 15:28
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/4/18 15:28
+@desc:
"""
-from typing import List, Dict
-from langchain_core.messages import BaseMessage, get_buffer_string
-from langchain_openai.chat_models import ChatOpenAI
+from typing import Dict
+
from common.config.tokenizer_manage_config import TokenizerManage
from models_provider.base_model_provider import MaxKBBaseModel
@@ -22,7 +21,6 @@ def custom_get_token_ids(text: str):
class SiliconCloudChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -32,7 +30,7 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return SiliconCloudChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/reranker.py b/apps/models_provider/impl/siliconCloud_model_provider/model/reranker.py
index 4ff71b9f9db..715de9ae7a4 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/reranker.py
@@ -1,20 +1,19 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: siliconcloud_reranker.py
- @date:2024/9/10 9:45
- @desc: SiliconCloud 文档重排封装
+@project: MaxKB
+@Author:虎
+@file: siliconcloud_reranker.py
+@date:2024/9/10 9:45
+@desc: SiliconCloud 文档重排封装
"""
-from typing import Sequence, Optional, Any, Dict
+from typing import Sequence, Optional, Dict
import requests
from langchain_core.callbacks import Callbacks
from langchain_core.documents import BaseDocumentCompressor, Document
from models_provider.base_model_provider import MaxKBBaseModel
-from django.utils.translation import gettext as _
class SiliconCloudReranker(MaxKBBaseModel, BaseDocumentCompressor):
@@ -30,14 +29,15 @@ class SiliconCloudReranker(MaxKBBaseModel, BaseDocumentCompressor):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return SiliconCloudReranker(
- api_base=model_credential.get('api_base'),
+ api_base=model_credential.get("api_base"),
model=model_name,
- api_key=model_credential.get('api_key'),
- top_n=model_kwargs.get('top_n', 3)
+ api_key=model_credential.get("api_key"),
+ top_n=model_kwargs.get("top_n", 3),
)
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if not documents:
return []
@@ -45,10 +45,7 @@ def compress_documents(self, documents: Sequence[Document], query: str, callback
texts = [doc.page_content for doc in documents]
# 发送请求到 SiliconCloud API
- headers = {
- "Authorization": f"Bearer {self.api_key}",
- "Content-Type": "application/json"
- }
+ headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}
payload = {
"model": self.model,
"query": query,
@@ -67,8 +64,8 @@ def compress_documents(self, documents: Sequence[Document], query: str, callback
# 解析返回结果
return [
Document(
- page_content=item.get('document', {}).get('text', ''),
- metadata={'relevance_score': item.get('relevance_score')}
+ page_content=item.get("document", {}).get("text", ""),
+ metadata={"relevance_score": item.get("relevance_score")},
)
- for item in res.get('results', [])
+ for item in res.get("results", [])
]
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/stt.py b/apps/models_provider/impl/siliconCloud_model_provider/model/stt.py
index b5eb1012860..c49b183d8e8 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/stt.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/stt.py
@@ -1,4 +1,3 @@
-import asyncio
import io
from typing import Dict
@@ -22,21 +21,21 @@ class SiliconCloudSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.params = kwargs.get("params")
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return SiliconCloudSpeechToText(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
params=model_kwargs,
**optional_params,
)
@@ -46,28 +45,18 @@ def is_cache_model():
return False
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def speech_to_text(self, audio_file):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
audio_data = audio_file.read()
buffer = io.BytesIO(audio_data)
buffer.name = "file.mp3" # this is the important line
- filter_params = {k: v for k, v in self.params.items() if k not in {'model_id', 'use_local', 'streaming'}}
- transcription_params = {
- 'model': self.model,
- 'file': buffer,
- 'language': 'zh'
- }
+ filter_params = {k: v for k, v in self.params.items() if k not in {"model_id", "use_local", "streaming"}}
+ transcription_params = {"model": self.model, "file": buffer, "language": "zh"}
- res = client.audio.transcriptions.create(**transcription_params,extra_body=filter_params)
+ res = client.audio.transcriptions.create(**transcription_params, extra_body=filter_params)
return res.text
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/tti.py b/apps/models_provider/impl/siliconCloud_model_provider/model/tti.py
index 7cd5a5d9b88..3ef765c2aff 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/tti.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/tti.py
@@ -20,10 +20,10 @@ class SiliconCloudTextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -31,14 +31,14 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024x1024', 'quality': 'standard', 'n': 1}}
+ optional_params = {"params": {"size": "1024x1024", "quality": "standard", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return SiliconCloudTextToImage(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/model/tts.py b/apps/models_provider/impl/siliconCloud_model_provider/model/tts.py
index fecfe66945a..ae23177f630 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/model/tts.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/model/tts.py
@@ -21,42 +21,34 @@ class SiliconCloudTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice': 'alloy'}}
+ optional_params = {"params": {"voice": "alloy"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return SiliconCloudTextToSpeech(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def text_to_speech(self, text):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
text = _remove_empty_lines(text)
with client.audio.speech.with_streaming_response.create(
- model=self.model,
- input=text,
- **self.params
+ model=self.model, input=text, **self.params
) as response:
return response.read()
diff --git a/apps/models_provider/impl/siliconCloud_model_provider/siliconCloud_model_provider.py b/apps/models_provider/impl/siliconCloud_model_provider/siliconCloud_model_provider.py
index 5059a20e25e..8a38325edd2 100644
--- a/apps/models_provider/impl/siliconCloud_model_provider/siliconCloud_model_provider.py
+++ b/apps/models_provider/impl/siliconCloud_model_provider/siliconCloud_model_provider.py
@@ -1,24 +1,28 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: openai_model_provider.py
- @date:2024/3/28 16:26
- @desc:
+@project: maxkb
+@Author:虎
+@file: openai_model_provider.py
+@date:2024/3/28 16:26
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
-from models_provider.impl.siliconCloud_model_provider.credential.embedding import \
- SiliconCloudEmbeddingCredential
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
+from models_provider.impl.siliconCloud_model_provider.credential.embedding import SiliconCloudEmbeddingCredential
from models_provider.impl.siliconCloud_model_provider.credential.image import SiliconCloudImageModelCredential
from models_provider.impl.siliconCloud_model_provider.credential.llm import SiliconCloudLLMModelCredential
from models_provider.impl.siliconCloud_model_provider.credential.reranker import SiliconCloudRerankerCredential
from models_provider.impl.siliconCloud_model_provider.credential.stt import SiliconCloudSTTModelCredential
-from models_provider.impl.siliconCloud_model_provider.credential.tti import \
- SiliconCloudTextToImageModelCredential
+from models_provider.impl.siliconCloud_model_provider.credential.tti import SiliconCloudTextToImageModelCredential
from models_provider.impl.siliconCloud_model_provider.credential.tts import SiliconCloudTTSModelCredential
from models_provider.impl.siliconCloud_model_provider.model.embedding import SiliconCloudEmbeddingModel
from models_provider.impl.siliconCloud_model_provider.model.image import SiliconCloudImage
@@ -37,121 +41,154 @@
openai_image_model_credential = SiliconCloudImageModelCredential()
openai_tts_model_credential = SiliconCloudTTSModelCredential()
model_info_list = [
- ModelInfo('deepseek-ai/DeepSeek-R1-Distill-Llama-8B', '', ModelTypeConst.LLM,
- openai_llm_model_credential, SiliconCloudChatModel
- ),
- ModelInfo('deepseek-ai/DeepSeek-R1-Distill-Qwen-7B', '', ModelTypeConst.LLM,
- openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('Qwen/Qwen2.5-7B-Instruct',
- '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('Qwen/Qwen2.5-Coder-7B-Instruct', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('internlm/internlm2_5-7b-chat', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('Qwen/Qwen2-1.5B-Instruct', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('THUDM/glm-4-9b-chat', '',
- ModelTypeConst.LLM, openai_llm_model_credential,
- SiliconCloudChatModel),
- ModelInfo('FunAudioLLM/SenseVoiceSmall', '',
- ModelTypeConst.STT, openai_stt_model_credential,
- SiliconCloudSpeechToText),
+ ModelInfo(
+ "deepseek-ai/DeepSeek-R1-Distill-Llama-8B",
+ "",
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ SiliconCloudChatModel,
+ ),
+ ModelInfo(
+ "deepseek-ai/DeepSeek-R1-Distill-Qwen-7B",
+ "",
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ SiliconCloudChatModel,
+ ),
+ ModelInfo(
+ "deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B",
+ "",
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ SiliconCloudChatModel,
+ ),
+ ModelInfo("Qwen/Qwen2.5-7B-Instruct", "", ModelTypeConst.LLM, openai_llm_model_credential, SiliconCloudChatModel),
+ ModelInfo(
+ "Qwen/Qwen2.5-Coder-7B-Instruct", "", ModelTypeConst.LLM, openai_llm_model_credential, SiliconCloudChatModel
+ ),
+ ModelInfo(
+ "internlm/internlm2_5-7b-chat", "", ModelTypeConst.LLM, openai_llm_model_credential, SiliconCloudChatModel
+ ),
+ ModelInfo("Qwen/Qwen2-1.5B-Instruct", "", ModelTypeConst.LLM, openai_llm_model_credential, SiliconCloudChatModel),
+ ModelInfo("THUDM/glm-4-9b-chat", "", ModelTypeConst.LLM, openai_llm_model_credential, SiliconCloudChatModel),
+ ModelInfo(
+ "FunAudioLLM/SenseVoiceSmall", "", ModelTypeConst.STT, openai_stt_model_credential, SiliconCloudSpeechToText
+ ),
]
open_ai_embedding_credential = SiliconCloudEmbeddingCredential()
model_info_embedding_list = [
- ModelInfo('netease-youdao/bce-embedding-base_v1', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- SiliconCloudEmbeddingModel),
- ModelInfo('BAAI/bge-m3', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- SiliconCloudEmbeddingModel),
- ModelInfo('BAAI/bge-large-en-v1.5', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- SiliconCloudEmbeddingModel),
- ModelInfo('BAAI/bge-large-zh-v1.5', '',
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- SiliconCloudEmbeddingModel),
+ ModelInfo(
+ "netease-youdao/bce-embedding-base_v1",
+ "",
+ ModelTypeConst.EMBEDDING,
+ open_ai_embedding_credential,
+ SiliconCloudEmbeddingModel,
+ ),
+ ModelInfo("BAAI/bge-m3", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, SiliconCloudEmbeddingModel),
+ ModelInfo(
+ "BAAI/bge-large-en-v1.5", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, SiliconCloudEmbeddingModel
+ ),
+ ModelInfo(
+ "BAAI/bge-large-zh-v1.5", "", ModelTypeConst.EMBEDDING, open_ai_embedding_credential, SiliconCloudEmbeddingModel
+ ),
]
model_info_tti_list = [
- ModelInfo('deepseek-ai/Janus-Pro-7B', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- SiliconCloudTextToImage),
- ModelInfo('stabilityai/stable-diffusion-3-5-large', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- SiliconCloudTextToImage),
- ModelInfo('black-forest-labs/FLUX.1-schnell', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- SiliconCloudTextToImage),
- ModelInfo('stabilityai/stable-diffusion-3-medium', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- SiliconCloudTextToImage),
- ModelInfo('stabilityai/stable-diffusion-xl-base-1.0', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- SiliconCloudTextToImage),
- ModelInfo('stabilityai/stable-diffusion-2-1', '',
- ModelTypeConst.TTI, openai_tti_model_credential,
- SiliconCloudTextToImage),
+ ModelInfo("deepseek-ai/Janus-Pro-7B", "", ModelTypeConst.TTI, openai_tti_model_credential, SiliconCloudTextToImage),
+ ModelInfo(
+ "stabilityai/stable-diffusion-3-5-large",
+ "",
+ ModelTypeConst.TTI,
+ openai_tti_model_credential,
+ SiliconCloudTextToImage,
+ ),
+ ModelInfo(
+ "black-forest-labs/FLUX.1-schnell", "", ModelTypeConst.TTI, openai_tti_model_credential, SiliconCloudTextToImage
+ ),
+ ModelInfo(
+ "stabilityai/stable-diffusion-3-medium",
+ "",
+ ModelTypeConst.TTI,
+ openai_tti_model_credential,
+ SiliconCloudTextToImage,
+ ),
+ ModelInfo(
+ "stabilityai/stable-diffusion-xl-base-1.0",
+ "",
+ ModelTypeConst.TTI,
+ openai_tti_model_credential,
+ SiliconCloudTextToImage,
+ ),
+ ModelInfo(
+ "stabilityai/stable-diffusion-2-1", "", ModelTypeConst.TTI, openai_tti_model_credential, SiliconCloudTextToImage
+ ),
]
model_rerank_list = [
- ModelInfo('netease-youdao/bce-reranker-base_v1', '', ModelTypeConst.RERANKER,
- openai_reranker_model_credential, SiliconCloudReranker
- ),
- ModelInfo('BAAI/bge-reranker-v2-m3', '', ModelTypeConst.RERANKER,
- openai_reranker_model_credential, SiliconCloudReranker
- ),
+ ModelInfo(
+ "netease-youdao/bce-reranker-base_v1",
+ "",
+ ModelTypeConst.RERANKER,
+ openai_reranker_model_credential,
+ SiliconCloudReranker,
+ ),
+ ModelInfo(
+ "BAAI/bge-reranker-v2-m3", "", ModelTypeConst.RERANKER, openai_reranker_model_credential, SiliconCloudReranker
+ ),
]
model_tts_list = [
- ModelInfo('FunAudioLLM/CosyVoice2-0.5B', '',
- ModelTypeConst.TTS, openai_tts_model_credential,
- SiliconCloudTextToSpeech),
+ ModelInfo(
+ "FunAudioLLM/CosyVoice2-0.5B", "", ModelTypeConst.TTS, openai_tts_model_credential, SiliconCloudTextToSpeech
+ ),
]
model_image_info_list = [
- ModelInfo('Qwen/Qwen3-VL-32B-Instruct', '',
- ModelTypeConst.IMAGE, openai_image_model_credential,
- SiliconCloudImage),
+ ModelInfo("Qwen/Qwen3-VL-32B-Instruct", "", ModelTypeConst.IMAGE, openai_image_model_credential, SiliconCloudImage),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
.append_default_model_info(
- ModelInfo('gpt-3.5-turbo', _('The latest gpt-3.5-turbo, updated with OpenAI adjustments'), ModelTypeConst.LLM,
- openai_llm_model_credential, SiliconCloudChatModel
- ))
+ ModelInfo(
+ "gpt-3.5-turbo",
+ _("The latest gpt-3.5-turbo, updated with OpenAI adjustments"),
+ ModelTypeConst.LLM,
+ openai_llm_model_credential,
+ SiliconCloudChatModel,
+ )
+ )
.append_model_info_list(model_info_embedding_list)
.append_default_model_info(model_info_embedding_list[0])
.append_model_info_list(model_info_tti_list)
.append_default_model_info(model_info_tti_list[0])
- .append_default_model_info(ModelInfo('whisper-1', '',
- ModelTypeConst.STT, openai_stt_model_credential,
- SiliconCloudSpeechToText))
+ .append_default_model_info(
+ ModelInfo("whisper-1", "", ModelTypeConst.STT, openai_stt_model_credential, SiliconCloudSpeechToText)
+ )
.append_model_info_list(model_rerank_list)
.append_default_model_info(model_rerank_list[0])
.append_model_info_list(model_tts_list)
.append_default_model_info(model_tts_list[0])
.append_model_info_list(model_image_info_list)
.append_default_model_info(model_image_info_list[0])
-
.build()
)
class SiliconCloudModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_siliconCloud_provider', name='SILICONFLOW', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'siliconCloud_model_provider',
- 'icon',
- 'siliconCloud_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_siliconCloud_provider",
+ name="SILICONFLOW",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "impl",
+ "siliconCloud_model_provider",
+ "icon",
+ "siliconCloud_icon_svg",
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/__init__.py b/apps/models_provider/impl/tencent_cloud_model_provider/__init__.py
deleted file mode 100644
index 2dc4ab10db4..00000000000
--- a/apps/models_provider/impl/tencent_cloud_model_provider/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/3/28 16:25
- @desc:
-"""
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/credential/llm.py b/apps/models_provider/impl/tencent_cloud_model_provider/credential/llm.py
deleted file mode 100644
index 422e6372660..00000000000
--- a/apps/models_provider/impl/tencent_cloud_model_provider/credential/llm.py
+++ /dev/null
@@ -1,78 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:32
- @desc:
-"""
-from typing import Dict
-
-from django.utils.translation import gettext_lazy as _, gettext
-from langchain_core.messages import HumanMessage
-
-from common import forms
-from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, TooltipLabel
-from models_provider.base_model_provider import BaseModelCredential, ValidCode
-from common.utils.logger import maxkb_logger
-
-class TencentCloudLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
-
- max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
- _min=1,
- _max=100000,
- _step=1,
- precision=0)
-
-
-class TencentCloudLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
-
- for key in ['api_base', 'api_key']:
- if key not in model_credential:
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
- else:
- return False
- try:
-
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
- except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- if isinstance(e, AppApiException):
- raise e
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
- else:
- return False
- return True
-
- def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
-
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
-
- def get_model_params_setting_form(self, model_name):
- return TencentCloudLLMModelParams()
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/icon/tencent_cloud_icon_svg b/apps/models_provider/impl/tencent_cloud_model_provider/icon/tencent_cloud_icon_svg
deleted file mode 100644
index ff559eaff44..00000000000
--- a/apps/models_provider/impl/tencent_cloud_model_provider/icon/tencent_cloud_icon_svg
+++ /dev/null
@@ -1,15 +0,0 @@
-
-
-
\ No newline at end of file
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/model/__init__.py b/apps/models_provider/impl/tencent_cloud_model_provider/model/__init__.py
deleted file mode 100644
index e69de29bb2d..00000000000
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/model/llm.py b/apps/models_provider/impl/tencent_cloud_model_provider/model/llm.py
deleted file mode 100644
index 101fbba50e9..00000000000
--- a/apps/models_provider/impl/tencent_cloud_model_provider/model/llm.py
+++ /dev/null
@@ -1,38 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/18 15:28
- @desc:
-"""
-from typing import Dict
-
-from common.config.tokenizer_manage_config import TokenizerManage
-from models_provider.base_model_provider import MaxKBBaseModel
-from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
-
-
-def custom_get_token_ids(text: str):
- tokenizer = TokenizerManage.get_tokenizer()
- return tokenizer.encode(text)
-
-
-class TencentCloudChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
- @staticmethod
- def is_cache_model():
- return False
-
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- azure_chat_open_ai = TencentCloudChatModel(
- model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
- custom_get_token_ids=custom_get_token_ids,
- **optional_params,
- )
- return azure_chat_open_ai
-
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/tencent_cloud_model_provider.py b/apps/models_provider/impl/tencent_cloud_model_provider/tencent_cloud_model_provider.py
deleted file mode 100644
index 3a6bd9c2041..00000000000
--- a/apps/models_provider/impl/tencent_cloud_model_provider/tencent_cloud_model_provider.py
+++ /dev/null
@@ -1,61 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: openai_model_provider.py
- @date:2024/3/28 16:26
- @desc:
-"""
-import os
-
-from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, \
- ModelTypeConst, ModelInfoManage
-from models_provider.impl.openai_model_provider.credential.embedding import OpenAIEmbeddingCredential
-from models_provider.impl.openai_model_provider.credential.image import OpenAIImageModelCredential
-from models_provider.impl.openai_model_provider.credential.llm import OpenAILLMModelCredential
-from models_provider.impl.openai_model_provider.credential.stt import OpenAISTTModelCredential
-from models_provider.impl.openai_model_provider.credential.tti import OpenAITextToImageModelCredential
-from models_provider.impl.openai_model_provider.credential.tts import OpenAITTSModelCredential
-from models_provider.impl.openai_model_provider.model.embedding import OpenAIEmbeddingModel
-from models_provider.impl.openai_model_provider.model.image import OpenAIImage
-from models_provider.impl.openai_model_provider.model.llm import OpenAIChatModel
-from models_provider.impl.openai_model_provider.model.stt import OpenAISpeechToText
-from models_provider.impl.openai_model_provider.model.tti import OpenAITextToImage
-from models_provider.impl.openai_model_provider.model.tts import OpenAITextToSpeech
-from models_provider.impl.tencent_cloud_model_provider.credential.llm import TencentCloudLLMModelCredential
-from models_provider.impl.tencent_cloud_model_provider.model.llm import TencentCloudChatModel
-from maxkb.conf import PROJECT_DIR
-from django.utils.translation import gettext_lazy as _
-
-openai_llm_model_credential = TencentCloudLLMModelCredential()
-model_info_list = [
- ModelInfo('deepseek-v3', '', ModelTypeConst.LLM,
- openai_llm_model_credential, TencentCloudChatModel
- ),
- ModelInfo('deepseek-r1', '', ModelTypeConst.LLM,
- openai_llm_model_credential, TencentCloudChatModel
- ),
-]
-
-model_info_manage = (
- ModelInfoManage.builder()
- .append_model_info_list(model_info_list)
- .append_default_model_info(
- ModelInfo('deepseek-v3', '', ModelTypeConst.LLM,
- openai_llm_model_credential, TencentCloudChatModel
- ))
- .build()
-)
-
-
-class TencentCloudModelProvider(IModelProvider):
-
- def get_model_info_manage(self):
- return model_info_manage
-
- def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_tencent_cloud_provider', name=_('Tencent Cloud'), icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'tencent_cloud_model_provider',
- 'icon',
- 'tencent_cloud_icon_svg')))
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/embedding.py b/apps/models_provider/impl/tencent_model_provider/credential/embedding.py
index 4f31cc11066..b71630af869 100644
--- a/apps/models_provider/impl/tencent_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/tencent_model_provider/credential/embedding.py
@@ -1,40 +1,55 @@
+# coding=utf-8
+
from typing import Dict
from django.utils.translation import gettext as _
from common import forms
from common.exception.app_exception import AppApiException
-from common.forms import BaseForm
+from common.forms import BaseForm, TooltipLabel
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
-class TencentEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True) -> bool:
+class TencentEmbeddingCredential(BaseForm, BaseModelCredential):
+ def is_valid(
+ self, model_type, model_name, model_credential: Dict[str, object], model_params, provider, raise_exception=True
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
- self.valid_form(model_credential)
+ if not any(mt.get("value") == model_type for mt in model_type_list):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
+
+ if "api_key" not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, _("api_key is required"))
+ return False
+
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
- def encryption_dict(self, model: Dict[str, object]) -> Dict[str, object]:
- encrypted_secret_key = super().encryption(model.get('SecretKey', ''))
- return {**model, 'SecretKey': encrypted_secret_key}
+ def encryption_dict(self, model: Dict[str, object]):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- SecretId = forms.PasswordInputField('SecretId', required=True)
- SecretKey = forms.PasswordInputField('SecretKey', required=True)
+ base_url = forms.TextInputField(
+ label=TooltipLabel(_("API URL"), _("TokenHub OpenAI compatible embeddings endpoint")),
+ required=False,
+ default_value="https://tokenhub.tencentmaas.com/v1",
+ )
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/image.py b/apps/models_provider/impl/tencent_model_provider/credential/image.py
index 4c2f6f83048..1ca90803a4b 100644
--- a/apps/models_provider/impl/tencent_model_provider/credential/image.py
+++ b/apps/models_provider/impl/tencent_model_provider/credential/image.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 18:41
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 18:41
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -19,61 +20,79 @@
class TencentModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=1.0,
- _min=0.1,
- _max=1.9,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=1.0,
+ _min=0.1,
+ _max=1.9,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class TencentVisionModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['api_key', 'api_base']:
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True, default_value='https://api.hunyuan.cloud.tencent.com/v1')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://tokenhub.tencentmaas.com/v1")
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return TencentModelParams()
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/llm.py b/apps/models_provider/impl/tencent_model_provider/credential/llm.py
index b4d254ee020..534bc2d5d73 100644
--- a/apps/models_provider/impl/tencent_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/tencent_model_provider/credential/llm.py
@@ -1,5 +1,7 @@
# coding=utf-8
+from typing import Dict
+
from django.utils.translation import gettext_lazy as _, gettext
from langchain_core.messages import HumanMessage
@@ -9,61 +11,84 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class TencentLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.5,
- _min=0.1,
- _max=2.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.5,
+ _min=0.1,
+ _max=2.0,
+ _step=0.01,
+ precision=2,
+ )
+ max_tokens = forms.SliderField(
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
+ _min=1,
+ _max=100000,
+ _step=1,
+ precision=0,
+ )
-class TencentLLMModelCredential(BaseForm, BaseModelCredential):
- REQUIRED_FIELDS = ['hunyuan_app_id', 'hunyuan_secret_id', 'hunyuan_secret_key']
- @classmethod
- def _validate_model_type(cls, model_type, provider, raise_exception=False):
- if not any(mt['value'] == model_type for mt in provider.get_model_type_list()):
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
- return False
- return True
-
- @classmethod
- def _validate_credential_fields(cls, model_credential, raise_exception=False):
- missing_keys = [key for key in cls.REQUIRED_FIELDS if key not in model_credential]
- if missing_keys:
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{keys} is required').format(keys=", ".join(missing_keys)))
- return False
- return True
+class TencentLLMModelCredential(BaseForm, BaseModelCredential):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
+ model_type_list = provider.get_model_type_list()
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- def is_valid(self, model_type, model_name, model_credential, model_params, provider, raise_exception=False):
- if not (self._validate_model_type(model_type, provider, raise_exception) and
- self._validate_credential_fields(model_credential, raise_exception)):
- return False
+ for key in ["api_base", "api_key"]:
+ if key not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
+ else:
+ return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if isinstance(e, AppApiException):
+ raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
- return False
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ else:
+ return False
return True
- def encryption_dict(self, model):
- return {**model, 'hunyuan_secret_key': super().encryption(model.get('hunyuan_secret_key', ''))}
+ def encryption_dict(self, model: Dict[str, object]):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- hunyuan_app_id = forms.TextInputField('APP ID', required=True)
- hunyuan_secret_id = forms.PasswordInputField('SecretId', required=True)
- hunyuan_secret_key = forms.PasswordInputField('SecretKey', required=True)
+ api_base = forms.TextInputField(
+ label=TooltipLabel(_("API URL"), _("TokenHub OpenAI compatible endpoint")),
+ required=True,
+ default_value="https://tokenhub.tencentmaas.com/v1",
+ )
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
def get_model_params_setting_form(self, model_name):
return TencentLLMModelParams()
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/stt.py b/apps/models_provider/impl/tencent_model_provider/credential/stt.py
index a03684cb40d..9e667eedc36 100644
--- a/apps/models_provider/impl/tencent_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/tencent_model_provider/credential/stt.py
@@ -1,4 +1,3 @@
-
from common import forms
from common.exception.app_exception import AppApiException
from common.forms import BaseForm, TooltipLabel
@@ -7,11 +6,12 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class TencentSSTModelParams(BaseForm):
EngSerViceType = forms.SingleSelect(
- TooltipLabel(_('Engine model type'), _('If not passed, the default value is 16k_zh (Chinese universal)')),
+ TooltipLabel(_("Engine model type"), _("If not passed, the default value is 16k_zh (Chinese universal)")),
required=True,
- default_value='16k_zh',
+ default_value="16k_zh",
option_list=[
{"value": "8k_zh", "label": _("Chinese telephone universal")},
{"value": "8k_en", "label": _("English telephone universal")},
@@ -34,21 +34,24 @@ class TencentSSTModelParams(BaseForm):
{"value": "16k_hi", "label": _("Hindi")},
{"value": "16k_fr", "label": _("French")},
{"value": "16k_de", "label": _("German")},
- {"value": "16k_zh_dialect", "label": _("Multiple dialects, supporting 23 dialects")}
+ {"value": "16k_zh_dialect", "label": _("Multiple dialects, supporting 23 dialects")},
],
- value_field='value',
- text_field='label'
+ value_field="value",
+ text_field="label",
)
+
class TencentSTTModelCredential(BaseForm, BaseModelCredential):
REQUIRED_FIELDS = ["SecretId", "SecretKey"]
@classmethod
def _validate_model_type(cls, model_type, provider, raise_exception=False):
- if not any(mt['value'] == model_type for mt in provider.get_model_type_list()):
+ if not any(mt["value"] == model_type for mt in provider.get_model_type_list()):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
return False
return True
@@ -57,33 +60,38 @@ def _validate_credential_fields(cls, model_credential, raise_exception=False):
missing_keys = [key for key in cls.REQUIRED_FIELDS if key not in model_credential]
if missing_keys:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{keys} is required').format(keys=", ".join(missing_keys)))
+ raise AppApiException(
+ ValidCode.valid_error.value, gettext("{keys} is required").format(keys=", ".join(missing_keys))
+ )
return False
return True
def is_valid(self, model_type, model_name, model_credential, model_params, provider, raise_exception=False):
- if not (self._validate_model_type(model_type, provider, raise_exception) and
- self._validate_credential_fields(model_credential, raise_exception)):
+ if not (
+ self._validate_model_type(model_type, provider, raise_exception)
+ and self._validate_credential_fields(model_credential, raise_exception)
+ ):
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
return False
return True
def encryption_dict(self, model):
- return {**model, 'SecretKey': super().encryption(model.get('SecretKey', ''))}
+ return {**model, "SecretKey": super().encryption(model.get("SecretKey", ""))}
- SecretId = forms.PasswordInputField('SecretId', required=True)
- SecretKey = forms.PasswordInputField('SecretKey', required=True)
+ SecretId = forms.PasswordInputField("SecretId", required=True)
+ SecretKey = forms.PasswordInputField("SecretKey", required=True)
def get_model_params_setting_form(self, model_name):
return TencentSSTModelParams()
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py b/apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py
new file mode 100644
index 00000000000..c4051f9ee2d
--- /dev/null
+++ b/apps/models_provider/impl/tencent_model_provider/credential/tokenhub_stt.py
@@ -0,0 +1,83 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@desc: Tencent Tokenhub ASR sync_transcribe credential (model: wand-asr-v1 / hy-asr-3.0-preview)
+"""
+
+from django.utils.translation import gettext_lazy as _, gettext
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, TooltipLabel
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class TencentTokenhubSTTModelParams(BaseForm):
+ source = forms.SingleSelect(
+ label=TooltipLabel(_("Recognition language"), _("Recognition language: zh / en, auto detected when omitted")),
+ text_field="value",
+ value_field="value",
+ option_list=[
+ {"value": "", "label": _("Auto detect")},
+ {"value": "zh", "label": _("Chinese")},
+ {"value": "en", "label": _("English")},
+ ],
+ required=False,
+ default_value="",
+ )
+ voice_encode_format = forms.SingleSelect(
+ label=TooltipLabel(_("Audio encoding"), _("pcm / wav / ogg / mp3, auto detected when omitted")),
+ text_field="value",
+ value_field="value",
+ option_list=[
+ {"value": "", "label": _("Auto")},
+ {"value": "pcm", "label": "pcm"},
+ {"value": "wav", "label": "wav"},
+ {"value": "ogg", "label": "ogg"},
+ {"value": "mp3", "label": "mp3"},
+ ],
+ required=False,
+ default_value="",
+ )
+
+
+class TencentTokenhubSTTModelCredential(BaseForm, BaseModelCredential):
+ def is_valid(self, model_type, model_name, model_credential, model_params, provider, raise_exception=False):
+ model_type_list = provider.get_model_type_list()
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
+ if "api_key" not in model_credential:
+ if raise_exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key="api_key"))
+ return False
+ try:
+ model = provider.get_model(model_type, model_name, model_credential, **model_params)
+ model.check_auth()
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ return False
+ return True
+
+ def encryption_dict(self, model):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
+
+ base_url = forms.TextInputField(
+ label=TooltipLabel(_("API URL"), _("Tokenhub sync_transcribe endpoint")),
+ required=False,
+ default_value="https://tokenhub.tencentmaas.com/v1/wand/asrproxy/sync_transcribe",
+ )
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
+
+ def get_model_params_setting_form(self, model_name):
+ return TencentTokenhubSTTModelParams()
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/tti.py b/apps/models_provider/impl/tencent_model_provider/credential/tti.py
index 98df630b4d7..4d63943bcde 100644
--- a/apps/models_provider/impl/tencent_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/tencent_model_provider/credential/tti.py
@@ -5,76 +5,96 @@
from common import forms
from common.exception.app_exception import AppApiException
from common.forms import BaseForm, TooltipLabel
-from models_provider.base_model_provider import BaseModelCredential, ValidCode
+from common.forms.switch_field import SwitchField
from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+# 37 preset sizes from the TokenHub Hy-Image docs (width x height, area <= 1024x1024).
+_HY_IMAGE_SIZES = [
+ "2048x512",
+ "1984x512",
+ "1920x512",
+ "1856x512",
+ "1792x512",
+ "1728x512",
+ "1664x512",
+ "1600x512",
+ "1536x512",
+ "1472x576",
+ "1408x640",
+ "1344x704",
+ "1280x768",
+ "1216x832",
+ "1152x896",
+ "1088x960",
+ "1024x1024",
+ "960x1088",
+ "896x1152",
+ "832x1216",
+ "768x1280",
+ "704x1344",
+ "640x1408",
+ "576x1472",
+ "512x1536",
+ "512x1600",
+ "512x1664",
+ "512x1728",
+ "512x1792",
+ "512x1856",
+ "512x1920",
+ "512x1984",
+ "512x2048",
+ "768x1024",
+ "720x1280",
+ "1024x768",
+ "1280x720",
+]
+
class TencentTTIModelParams(BaseForm):
- Style = forms.SingleSelect(
- TooltipLabel(_('painting style'), _('If not passed, the default value is 201 (Japanese anime style)')),
- required=True,
- default_value='201',
- option_list=[
- {'value': '000', 'label': _('Not limited to style')},
- {'value': '101', 'label': _('ink painting')},
- {'value': '102', 'label': _('concept art')},
- {'value': '103', 'label': _('Oil painting 1')},
- {'value': '118', 'label': _('Oil Painting 2 (Van Gogh)')},
- {'value': '104', 'label': _('watercolor painting')},
- {'value': '105', 'label': _('pixel art')},
- {'value': '106', 'label': _('impasto style')},
- {'value': '107', 'label': _('illustration')},
- {'value': '108', 'label': _('paper cut style')},
- {'value': '109', 'label': _('Impressionism 1 (Monet)')},
- {'value': '119', 'label': _('Impressionism 2')},
- {'value': '110', 'label': '2.5D'},
- {'value': '111', 'label': _('classical portraiture')},
- {'value': '112', 'label': _('black and white sketch')},
- {'value': '113', 'label': _('cyberpunk')},
- {'value': '114', 'label': _('science fiction style')},
- {'value': '115', 'label': _('dark style')},
- {'value': '116', 'label': '3D'},
- {'value': '117', 'label': _('vaporwave')},
- {'value': '201', 'label': _('Japanese animation')},
- {'value': '202', 'label': _('monster style')},
- {'value': '203', 'label': _('Beautiful ancient style')},
- {'value': '204', 'label': _('retro anime')},
- {'value': '301', 'label': _('Game cartoon hand drawing')},
- {'value': '401', 'label': _('Universal realistic style')},
- ],
- value_field='value',
- text_field='label'
+ size = forms.SingleSelect(
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "Width and height must be in [512, 2048] and the area must not exceed 1024x1024. If not passed, the "
+ "model auto-selects the closest preset size."
+ ),
+ ),
+ required=False,
+ default_value="1024x1024",
+ option_list=[{"value": value, "label": value} for value in _HY_IMAGE_SIZES],
+ value_field="value",
+ text_field="label",
)
- Resolution = forms.SingleSelect(
- TooltipLabel(_('Generate image resolution'), _('If not transmitted, the default value is 768:768.')),
- required=True,
- default_value='768:768',
- option_list=[
- {'value': '768:768', 'label': '768:768(1:1)'},
- {'value': '768:1024', 'label': '768:1024(3:4)'},
- {'value': '1024:768', 'label': '1024:768(4:3)'},
- {'value': '1024:1024', 'label': '1024:1024(1:1)'},
- {'value': '720:1280', 'label': '720:1280(9:16)'},
- {'value': '1280:720', 'label': '1280:720(16:9)'},
- {'value': '768:1280', 'label': '768:1280(3:5)'},
- {'value': '1280:768', 'label': '1280:768(5:3)'},
- {'value': '1080:1920', 'label': '1080:1920(9:16)'},
- {'value': '1920:1080', 'label': '1920:1080(16:9)'},
- ],
- value_field='value',
- text_field='label'
+ revise = SwitchField(
+ TooltipLabel(
+ _("Prompt rewrite"), _("Whether the model should rewrite and optimize the prompt before generation.")
+ ),
+ attrs={"active-value": True, "inactive-value": False},
+ default_value=True,
+ )
+
+ footnote = forms.TextInputField(
+ TooltipLabel(
+ _("Watermark footnote"), _("Custom watermark content, at most 16 characters, drawn in the bottom-right.")
+ ),
+ required=False,
+ default_value="",
)
class TencentTTIModelCredential(BaseForm, BaseModelCredential):
- REQUIRED_FIELDS = ['hunyuan_secret_id', 'hunyuan_secret_key']
+ REQUIRED_FIELDS = ["api_key"]
@classmethod
def _validate_model_type(cls, model_type, provider, raise_exception=False):
- if not any(mt['value'] == model_type for mt in provider.get_model_type_list()):
+ if not any(mt["value"] == model_type for mt in provider.get_model_type_list()):
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
return False
return True
@@ -83,33 +103,42 @@ def _validate_credential_fields(cls, model_credential, raise_exception=False):
missing_keys = [key for key in cls.REQUIRED_FIELDS if key not in model_credential]
if missing_keys:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{keys} is required').format(keys=", ".join(missing_keys)))
+ raise AppApiException(
+ ValidCode.valid_error.value, gettext("{keys} is required").format(keys=", ".join(missing_keys))
+ )
return False
return True
def is_valid(self, model_type, model_name, model_credential, model_params, provider, raise_exception=False):
- if not (self._validate_model_type(model_type, provider, raise_exception) and
- self._validate_credential_fields(model_credential, raise_exception)):
+ if not (
+ self._validate_model_type(model_type, provider, raise_exception)
+ and self._validate_credential_fields(model_credential, raise_exception)
+ ):
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
return False
return True
def encryption_dict(self, model):
- return {**model, 'hunyuan_secret_key': super().encryption(model.get('hunyuan_secret_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- hunyuan_secret_id = forms.PasswordInputField('SecretId', required=True)
- hunyuan_secret_key = forms.PasswordInputField('SecretKey', required=True)
+ base_url = forms.TextInputField(
+ label=TooltipLabel(_("API URL"), _("TokenHub Hy-Image v3-generation endpoint")),
+ required=False,
+ default_value="https://tokenhub.tencentmaas.com/v1/wand/hunyuan-image/v3-generation",
+ )
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
def get_model_params_setting_form(self, model_name):
return TencentTTIModelParams()
diff --git a/apps/models_provider/impl/tencent_model_provider/credential/ttv.py b/apps/models_provider/impl/tencent_model_provider/credential/ttv.py
new file mode 100644
index 00000000000..48400feff94
--- /dev/null
+++ b/apps/models_provider/impl/tencent_model_provider/credential/ttv.py
@@ -0,0 +1,107 @@
+# coding=utf-8
+
+from django.utils.translation import gettext_lazy as _, gettext
+
+from common import forms
+from common.exception.app_exception import AppApiException
+from common.forms import BaseForm, TooltipLabel
+from common.forms.switch_field import SwitchField
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import BaseModelCredential, ValidCode
+
+
+class TencentVideoModelParams(BaseForm):
+ resolution = forms.SingleSelect(
+ TooltipLabel(_("Resolution"), _("Output video resolution: 480p, 720p, 1080p.")),
+ required=False,
+ default_value="720p",
+ option_list=[{"value": value, "label": value} for value in ["480p", "720p", "1080p"]],
+ value_field="value",
+ text_field="label",
+ )
+
+ fps = forms.SingleSelect(
+ TooltipLabel(_("Frame rate"), _("Output video frame rate: 16, 24, 30.")),
+ required=False,
+ default_value="30",
+ option_list=[{"value": value, "label": value} for value in ["16", "24", "30"]],
+ value_field="value",
+ text_field="label",
+ )
+
+ logo_add = SwitchField(
+ TooltipLabel(
+ _("Add logo"),
+ _(
+ "Whether to add the AI-generated logo to the video. 1: add logo; 0: no logo "
+ "(requires console approval for independent control)."
+ ),
+ ),
+ attrs={"active-value": 1, "inactive-value": 0},
+ default_value=1,
+ )
+
+
+class TencentTTVModelCredential(BaseForm, BaseModelCredential):
+ REQUIRED_FIELDS = ["api_key"]
+
+ @classmethod
+ def _validate_model_type(cls, model_type, provider, raise_exception=False):
+ if not any(mt["value"] == model_type for mt in provider.get_model_type_list()):
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
+ return False
+ return True
+
+ @classmethod
+ def _validate_credential_fields(cls, model_credential, raise_exception=False):
+ missing_keys = [key for key in cls.REQUIRED_FIELDS if key not in model_credential]
+ if missing_keys:
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value, gettext("{keys} is required").format(keys=", ".join(missing_keys))
+ )
+ return False
+ return True
+
+ def is_valid(self, model_type, model_name, model_credential, model_params, provider, raise_exception=False):
+ if not (
+ self._validate_model_type(model_type, provider, raise_exception)
+ and self._validate_credential_fields(model_credential, raise_exception)
+ ):
+ return False
+ try:
+ model = provider.get_model(model_type, model_name, model_credential, **model_params)
+ model.check_auth()
+ except Exception as e:
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ if raise_exception:
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
+ return False
+ return True
+
+ def encryption_dict(self, model):
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
+
+ base_url = forms.TextInputField(
+ label=TooltipLabel(
+ _("API URL"),
+ _(
+ "TokenHub video endpoint. Use the base (e.g. https://tokenhub.tencentmaas.com/v1) or a full submit/query URL."
+ ),
+ ),
+ required=False,
+ default_value="https://tokenhub.tencentmaas.com/v1",
+ )
+ api_key = forms.PasswordInputField(_("API Key"), required=True)
+
+ def get_model_params_setting_form(self, model_name):
+ return TencentVideoModelParams()
diff --git a/apps/models_provider/impl/tencent_model_provider/icon/tencent_icon_svg b/apps/models_provider/impl/tencent_model_provider/icon/tencent_icon_svg
index 6cec08b74c2..ff559eaff44 100644
--- a/apps/models_provider/impl/tencent_model_provider/icon/tencent_icon_svg
+++ b/apps/models_provider/impl/tencent_model_provider/icon/tencent_icon_svg
@@ -1,5 +1,15 @@
-
+
-
+
\ No newline at end of file
diff --git a/apps/models_provider/impl/tencent_model_provider/model/embedding.py b/apps/models_provider/impl/tencent_model_provider/model/embedding.py
index 6392ca3e64f..5b97568032c 100644
--- a/apps/models_provider/impl/tencent_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/tencent_model_provider/model/embedding.py
@@ -1,41 +1,96 @@
-
+# coding=utf-8
+
from typing import Dict, List
-from langchain_core.embeddings import Embeddings
-from tencentcloud.common import credential
-from tencentcloud.hunyuan.v20230901.hunyuan_client import HunyuanClient
-from tencentcloud.hunyuan.v20230901.models import GetEmbeddingRequest
+import requests
-from models_provider.base_model_provider import MaxKBBaseModel
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
-class TencentEmbeddingModel(MaxKBBaseModel, Embeddings):
- def embed_documents(self, texts: List[str]) -> List[List[float]]:
- return [self.embed_query(text) for text in texts]
+class TencentEmbeddingModel(MaxKBBaseEmbeddingModel):
+ """腾讯 TokenHub 向量模型(OpenAI Embeddings 兼容接口)。
- def embed_query(self, text: str) -> List[float]:
- request = GetEmbeddingRequest()
- request.Input = text
- res = self.client.GetEmbedding(request)
- return res.Data[0].Embedding
-
- def __init__(self, secret_id: str, secret_key: str, model_name: str):
- self.secret_id = secret_id
- self.secret_key = secret_key
+ 文本向量:POST /v1/embeddings
+ 多模态向量:POST /v1/embeddings/multimodal(kinfra-vl-embedding-* 支持文本、图片、视频)
+ """
+
+ DEFAULT_BASE_URL: str = "https://tokenhub.tencentmaas.com/v1"
+ REQUEST_TIMEOUT: tuple = (10, 60)
+
+ def __init__(self, api_key: str, model_name: str, base_url: str, params: dict = None):
+ self.api_key = api_key
self.model_name = model_name
- cred = credential.Credential(
- secret_id, secret_key
- )
- self.client = HunyuanClient(cred, "")
+ self.base_url = (base_url or self.DEFAULT_BASE_URL).rstrip("/")
+ self.params = params or {}
@staticmethod
- def new_instance(model_type: str, model_name: str, model_credential: Dict[str, str], **model_kwargs):
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type: str, model_name: str, model_credential: Dict[str, object], **model_kwargs):
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return TencentEmbeddingModel(
- secret_id=model_credential.get('SecretId'),
- secret_key=model_credential.get('SecretKey'),
+ api_key=model_credential.get("api_key"),
model_name=model_name,
+ base_url=model_credential.get("base_url") or TencentEmbeddingModel.DEFAULT_BASE_URL,
+ params=optional_params,
)
- def _generate_auth_token(self):
- # Example method to generate an authentication token for the model API
- return f"{self.secret_id}:{self.secret_key}"
+ def supports_image_embedding(self) -> bool:
+ return "vl-embedding" in self.model_name
+
+ def _embedding_url(self) -> str:
+ if self.supports_image_embedding():
+ return f"{self.base_url}/embeddings/multimodal"
+ return f"{self.base_url}/embeddings"
+
+ def _post(self, payload: dict) -> dict:
+ headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}
+ response = requests.post(self._embedding_url(), headers=headers, json=payload, timeout=self.REQUEST_TIMEOUT)
+ response.raise_for_status()
+ return response.json()
+
+ @staticmethod
+ def _extract_embedding(result: dict) -> List[float]:
+ data = result.get("data") or []
+ if not data:
+ maxkb_logger.error(f"Tencent TokenHub embedding returned no data: {result}")
+ raise RuntimeError("Tencent TokenHub embedding API returned no embedding")
+ return data[0].get("embedding", [])
+
+ def embed_documents(self, texts: List[str]) -> List[List[float]]:
+ if self.supports_image_embedding():
+ # 多模态接口单次请求融合为一个向量,逐条处理
+ return [self._embed_multimodal([{"type": "text", "text": text}]) for text in texts]
+ payload = {"model": self.model_name, "input": texts, "encoding_format": "float", **self.params}
+ result = self._post(payload)
+ return [item.get("embedding", []) for item in result.get("data", [])]
+
+ def embed_query(self, text: str) -> List[float]:
+ if self.supports_image_embedding():
+ return self._embed_multimodal([{"type": "text", "text": text}])
+ payload = {"model": self.model_name, "input": text, "encoding_format": "float", **self.params}
+ return self._extract_embedding(self._post(payload))
+
+ def embed_images(self, images: List[str]) -> List[List[float]]:
+ if not self.supports_image_embedding():
+ return []
+ return [
+ self._embed_multimodal([{"type": "image_url", "image_url": {"url": self._to_base64_content(url)}}])
+ for url in images
+ ]
+
+ @staticmethod
+ def _to_base64_content(url: str) -> str:
+ """TokenHub 的 image_url.url 接受 URL 或 base64 内容。
+
+ MaxKB 传入的图片是 data:image/...;base64,xxx 形式的 data URL,
+ 这里剥掉 data: 前缀,转换为纯 base64 内容再交给接口。
+ """
+ return MaxKBBaseEmbeddingModel.normalize_image_input(url, keep_data_prefix=False)
+
+ def _embed_multimodal(self, items: list) -> List[float]:
+ payload = {"model": self.model_name, "input": items, "encoding_format": "float", **self.params}
+ return self._extract_embedding(self._post(payload))
diff --git a/apps/models_provider/impl/tencent_model_provider/model/hunyuan.py b/apps/models_provider/impl/tencent_model_provider/model/hunyuan.py
deleted file mode 100644
index 9055c4cb1be..00000000000
--- a/apps/models_provider/impl/tencent_model_provider/model/hunyuan.py
+++ /dev/null
@@ -1,280 +0,0 @@
-import json
-import logging
-from typing import Any, Dict, Iterator, List, Mapping, Optional, Type
-
-from langchain_core.callbacks import CallbackManagerForLLMRun
-from langchain_core.language_models.chat_models import (
- BaseChatModel,
- generate_from_stream,
-)
-from langchain_core.messages import (
- AIMessage,
- AIMessageChunk,
- BaseMessage,
- BaseMessageChunk,
- ChatMessage,
- ChatMessageChunk,
- HumanMessage,
- HumanMessageChunk, SystemMessage,
-)
-from langchain_core.outputs import ChatGeneration, ChatGenerationChunk, ChatResult
-from pydantic import Field, SecretStr, root_validator
-from langchain_core.utils import (
- convert_to_secret_str,
- get_from_dict_or_env,
- get_pydantic_field_names,
- pre_init,
-)
-
-logger = logging.getLogger(__name__)
-
-
-def _convert_message_to_dict(message: BaseMessage) -> dict:
- message_dict: Dict[str, Any]
- if isinstance(message, ChatMessage):
- message_dict = {"Role": message.role, "Content": message.content}
- elif isinstance(message, HumanMessage):
- message_dict = {"Role": "user", "Content": message.content}
- elif isinstance(message, AIMessage):
- message_dict = {"Role": "assistant", "Content": message.content}
- elif isinstance(message, SystemMessage):
- message_dict = {"Role": "system", "Content": message.content}
- else:
- raise TypeError(f"Got unknown type {message}")
-
- return message_dict
-
-
-def _convert_dict_to_message(_dict: Mapping[str, Any]) -> BaseMessage:
- role = _dict["Role"]
- if role == "user":
- return HumanMessage(content=_dict["Content"])
- elif role == "assistant":
- return AIMessage(content=_dict.get("Content", "") or "")
- else:
- return ChatMessage(content=_dict["Content"], role=role)
-
-
-def _convert_delta_to_message_chunk(
- _dict: Mapping[str, Any], default_class: Type[BaseMessageChunk]
-) -> BaseMessageChunk:
- role = _dict.get("Role")
- content = _dict.get("Content") or ""
-
- if role == "user" or default_class == HumanMessageChunk:
- return HumanMessageChunk(content=content)
- elif role == "assistant" or default_class == AIMessageChunk:
- return AIMessageChunk(content=content)
- elif role or default_class == ChatMessageChunk:
- return ChatMessageChunk(content=content, role=role) # type: ignore[arg-type]
- else:
- return default_class(content=content) # type: ignore[call-arg]
-
-
-def _create_chat_result(response: Mapping[str, Any]) -> ChatResult:
- generations = []
- for choice in response["Choices"]:
- message = _convert_dict_to_message(choice["Message"])
- generations.append(ChatGeneration(message=message))
-
- token_usage = response["Usage"]
- llm_output = {"token_usage": token_usage}
- return ChatResult(generations=generations, llm_output=llm_output)
-
-
-class ChatHunyuan(BaseChatModel):
- """Tencent Hunyuan chat models API by Tencent.
-
- For more information, see https://cloud.tencent.com/document/product/1729
- """
-
- @property
- def lc_secrets(self) -> Dict[str, str]:
- return {
- "hunyuan_app_id": "HUNYUAN_APP_ID",
- "hunyuan_secret_id": "HUNYUAN_SECRET_ID",
- "hunyuan_secret_key": "HUNYUAN_SECRET_KEY",
- }
-
- @property
- def lc_serializable(self) -> bool:
- return True
-
- hunyuan_app_id: Optional[int] = None
- """Hunyuan App ID"""
- hunyuan_secret_id: Optional[str] = None
- """Hunyuan Secret ID"""
- hunyuan_secret_key: Optional[SecretStr] = None
- """Hunyuan Secret Key"""
- streaming: bool = False
- """Whether to stream the results or not."""
- request_timeout: int = 60
- """Timeout for requests to Hunyuan API. Default is 60 seconds."""
- temperature: float = 1.0
- """What sampling temperature to use."""
- top_p: float = 1.0
- """What probability mass to use."""
- model: str = "hunyuan-lite"
- """What Model to use.
- Optional model:
- - hunyuan-lite、
- - hunyuan-standard
- - hunyuan-standard-256K
- - hunyuan-pro
- - hunyuan-code
- - hunyuan-role
- - hunyuan-functioncall
- - hunyuan-vision
- """
- stream_moderation: bool = False
- """Whether to review the results or not when streaming is true."""
- enable_enhancement: bool = True
- """Whether to enhancement the results or not."""
-
- model_kwargs: Dict[str, Any] = Field(default_factory=dict)
- """Holds any model parameters valid for API call not explicitly specified."""
-
- class Config:
- """Configuration for this pydantic object."""
-
- validate_by_name = True
-
- @root_validator(pre=True)
- def build_extra(cls, values: Dict[str, Any]) -> Dict[str, Any]:
- """Build extra kwargs from additional params that were passed in."""
- all_required_field_names = get_pydantic_field_names(cls)
- extra = values.get("model_kwargs", {})
- for field_name in list(values):
- if field_name in extra:
- raise ValueError(f"Found {field_name} supplied twice.")
- if field_name not in all_required_field_names:
- logger.warning(
- f"""WARNING! {field_name} is not default parameter.
- {field_name} was transferred to model_kwargs.
- Please confirm that {field_name} is what you intended."""
- )
- extra[field_name] = values.pop(field_name)
-
- invalid_model_kwargs = all_required_field_names.intersection(extra.keys())
- if invalid_model_kwargs:
- raise ValueError(
- f"Parameters {invalid_model_kwargs} should be specified explicitly. "
- f"Instead they were passed in as part of `model_kwargs` parameter."
- )
-
- values["model_kwargs"] = extra
- return values
-
- @pre_init
- def validate_environment(cls, values: Dict) -> Dict:
- values["hunyuan_app_id"] = get_from_dict_or_env(
- values,
- "hunyuan_app_id",
- "HUNYUAN_APP_ID",
- )
- values["hunyuan_secret_id"] = get_from_dict_or_env(
- values,
- "hunyuan_secret_id",
- "HUNYUAN_SECRET_ID",
- )
- values["hunyuan_secret_key"] = convert_to_secret_str(
- get_from_dict_or_env(
- values,
- "hunyuan_secret_key",
- "HUNYUAN_SECRET_KEY",
- )
- )
- return values
-
- @property
- def _default_params(self) -> Dict[str, Any]:
- """Get the default parameters for calling Hunyuan API."""
- normal_params = {
- "Temperature": self.temperature,
- "TopP": self.top_p,
- "Model": self.model,
- "Stream": self.streaming,
- "StreamModeration": self.stream_moderation,
- "EnableEnhancement": self.enable_enhancement,
- }
- return {**normal_params, **self.model_kwargs}
-
- def _generate(
- self,
- messages: List[BaseMessage],
- stop: Optional[List[str]] = None,
- run_manager: Optional[CallbackManagerForLLMRun] = None,
- **kwargs: Any,
- ) -> ChatResult:
- if self.streaming:
- stream_iter = self._stream(
- messages=messages, stop=stop, run_manager=run_manager, **kwargs
- )
- return generate_from_stream(stream_iter)
-
- res = self._chat(messages, **kwargs)
- return _create_chat_result(json.loads(res.to_json_string()))
-
- usage_metadata: dict = {}
-
- def _stream(
- self,
- messages: List[BaseMessage],
- stop: Optional[List[str]] = None,
- run_manager: Optional[CallbackManagerForLLMRun] = None,
- **kwargs: Any,
- ) -> Iterator[ChatGenerationChunk]:
- res = self._chat(messages, **kwargs)
-
- default_chunk_class = AIMessageChunk
- for chunk in res:
- chunk = chunk.get("data", "")
- if len(chunk) == 0:
- continue
- response = json.loads(chunk)
- if "error" in response:
- raise ValueError(f"Error from Hunyuan api response: {response}")
-
- for choice in response["Choices"]:
- chunk = _convert_delta_to_message_chunk(
- choice["Delta"], default_chunk_class
- )
- default_chunk_class = chunk.__class__
- # FinishReason === stop
- if choice.get("FinishReason") == "stop":
- self.usage_metadata = response.get("Usage", {})
- cg_chunk = ChatGenerationChunk(message=chunk)
- if run_manager:
- run_manager.on_llm_new_token(chunk.content, chunk=cg_chunk)
- yield cg_chunk
-
- def _chat(self, messages: List[BaseMessage], **kwargs: Any) -> Any:
- if self.hunyuan_secret_key is None:
- raise ValueError("Hunyuan secret key is not set.")
-
- try:
- from tencentcloud.common import credential
- from tencentcloud.hunyuan.v20230901 import hunyuan_client, models
- except ImportError:
- raise ImportError(
- "Could not import tencentcloud python package. "
- "Please install it with `pip install tencentcloud-sdk-python`."
- )
-
- parameters = {**self._default_params, **kwargs}
- cred = credential.Credential(
- self.hunyuan_secret_id, str(self.hunyuan_secret_key.get_secret_value())
- )
- client = hunyuan_client.HunyuanClient(cred, "")
- req = models.ChatCompletionsRequest()
- params = {
- "Messages": [_convert_message_to_dict(m) for m in messages],
- **parameters,
- }
- req.from_json_string(json.dumps(params))
- resp = client.ChatCompletions(req)
- return resp
-
- @property
- def _llm_type(self) -> str:
- return "hunyuan-chat"
diff --git a/apps/models_provider/impl/tencent_model_provider/model/image.py b/apps/models_provider/impl/tencent_model_provider/model/image.py
index 42b11723e98..617a2361ac0 100644
--- a/apps/models_provider/impl/tencent_model_provider/model/image.py
+++ b/apps/models_provider/impl/tencent_model_provider/model/image.py
@@ -5,14 +5,13 @@
class TencentVision(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return TencentVision(
model_name=model_name,
- openai_api_base=model_credential.get('api_base') or 'https://api.hunyuan.cloud.tencent.com/v1',
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base") or "https://tokenhub.tencentmaas.com/v1",
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/tencent_model_provider/model/llm.py b/apps/models_provider/impl/tencent_model_provider/model/llm.py
index e86edd54b9a..151e0973ec8 100644
--- a/apps/models_provider/impl/tencent_model_provider/model/llm.py
+++ b/apps/models_provider/impl/tencent_model_provider/model/llm.py
@@ -1,45 +1,54 @@
# coding=utf-8
-from typing import List, Dict, Optional, Any
+from typing import Dict, List
-from langchain_core.messages import BaseMessage
+from langchain_core.messages import BaseMessage, get_buffer_string
+from common.config.tokenizer_manage_config import TokenizerManage
from models_provider.base_model_provider import MaxKBBaseModel
-from models_provider.impl.tencent_model_provider.model.hunyuan import ChatHunyuan
+from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
-class TencentModel(MaxKBBaseModel, ChatHunyuan):
- @staticmethod
- def is_cache_model():
- return False
-
- def __init__(self, model_name: str, credentials: Dict[str, str], streaming: bool = False, **kwargs):
- hunyuan_app_id = credentials.get('hunyuan_app_id')
- hunyuan_secret_id = credentials.get('hunyuan_secret_id')
- hunyuan_secret_key = credentials.get('hunyuan_secret_key')
+def custom_get_token_ids(text: str):
+ tokenizer = TokenizerManage.get_tokenizer()
+ return tokenizer.encode(text)
- optional_params = MaxKBBaseModel.filter_optional_params(kwargs)
- if not all([hunyuan_app_id, hunyuan_secret_id, hunyuan_secret_key]):
- raise ValueError(
- "All of 'hunyuan_app_id', 'hunyuan_secret_id', and 'hunyuan_secret_key' must be provided in credentials.")
+class TencentModel(MaxKBBaseModel, BaseChatOpenAI):
+ """Tencent TokenHub LLM model.
- super().__init__(model=model_name, hunyuan_app_id=hunyuan_app_id, hunyuan_secret_id=hunyuan_secret_id,
- hunyuan_secret_key=hunyuan_secret_key, streaming=streaming,
- temperature=optional_params.get('temperature', 1.0)
- )
+ TokenHub aggregates Tencent Hunyuan and other providers behind an
+ OpenAI Chat Completions compatible API, see
+ https://cloud.tencent.com/document/product/1823/132252
+ """
@staticmethod
- def new_instance(model_type: str, model_name: str, model_credential: Dict[str, object],
- **model_kwargs) -> 'TencentModel':
- streaming = model_kwargs.pop('streaming', False)
- return TencentModel(model_name=model_name, credentials=model_credential, streaming=streaming, **model_kwargs)
+ def is_cache_model():
+ return False
- def get_last_generation_info(self) -> Optional[Dict[str, Any]]:
- return self.usage_metadata
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ streaming = model_kwargs.get("streaming", False)
+ return TencentModel(
+ model=model_name,
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
+ streaming=streaming,
+ custom_get_token_ids=custom_get_token_ids,
+ **optional_params,
+ )
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
- return self.usage_metadata.get('PromptTokens', 0)
+ try:
+ return super().get_num_tokens_from_messages(messages)
+ except Exception:
+ tokenizer = TokenizerManage.get_tokenizer()
+ return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
- return self.usage_metadata.get('CompletionTokens', 0)
+ try:
+ return super().get_num_tokens(text)
+ except Exception:
+ tokenizer = TokenizerManage.get_tokenizer()
+ return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/tencent_model_provider/model/stt.py b/apps/models_provider/impl/tencent_model_provider/model/stt.py
index f8157735c71..6240c1c2394 100644
--- a/apps/models_provider/impl/tencent_model_provider/model/stt.py
+++ b/apps/models_provider/impl/tencent_model_provider/model/stt.py
@@ -2,7 +2,9 @@
import json
import os
import traceback
-from typing import Dict
+
+import requests
+from typing import Dict, Optional
from tencentcloud.asr.v20190614 import asr_client, models
from tencentcloud.common import credential
@@ -23,10 +25,10 @@ class TencentSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.hunyuan_secret_id = kwargs.get('hunyuan_secret_id')
- self.hunyuan_secret_key = kwargs.get('hunyuan_secret_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.hunyuan_secret_id = kwargs.get("hunyuan_secret_id")
+ self.hunyuan_secret_key = kwargs.get("hunyuan_secret_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -35,16 +37,16 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return TencentSpeechToText(
- hunyuan_secret_id=model_credential.get('SecretId'),
- hunyuan_secret_key=model_credential.get('SecretKey'),
+ hunyuan_secret_id=model_credential.get("SecretId"),
+ hunyuan_secret_key=model_credential.get("SecretKey"),
model=model_name,
params=model_kwargs,
- **model_kwargs
+ **model_kwargs,
)
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as f:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as f:
self.speech_to_text(f)
def speech_to_text(self, audio_file):
@@ -65,11 +67,11 @@ def speech_to_text(self, audio_file):
# 实例化一个请求对象,每个接口都会对应一个request对象
req = models.SentenceRecognitionRequest()
params = {
- "EngSerViceType": self.params.get('EngSerViceType'),
+ "EngSerViceType": self.params.get("EngSerViceType"),
"SourceType": 1,
"VoiceFormat": "mp3",
"Data": _v.decode(),
- **self.params
+ **self.params,
}
req.from_json_string(json.dumps(params))
@@ -78,7 +80,75 @@ def speech_to_text(self, audio_file):
# 输出json格式的字符串回包
return resp.Result
-
except TencentCloudSDKException as err:
maxkb_logger.error(f":Error: {str(err)}: {traceback.format_exc()}")
raise err
+
+
+DEFAULT_WAND_BASE_URL = "https://tokenhub.tencentmaas.com/v1/wand/asrproxy/sync_transcribe"
+
+
+class TencentWandSpeechToText(MaxKBBaseModel, BaseSpeechToText):
+ api_key: str
+ model: str
+ params: dict
+ base_url: Optional[str] = DEFAULT_WAND_BASE_URL
+
+ def __init__(self, **kwargs):
+ super().__init__(**kwargs)
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params") or {}
+ self.base_url = kwargs.get("base_url") or DEFAULT_WAND_BASE_URL
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
+ instance_kwargs = {
+ "api_key": model_credential.get("api_key"),
+ "model": model_name,
+ "params": model_kwargs,
+ **model_kwargs,
+ }
+ base_url = model_credential.get("base_url")
+ if base_url:
+ instance_kwargs["base_url"] = base_url
+ return TencentWandSpeechToText(**instance_kwargs)
+
+ def check_auth(self):
+ cwd = os.path.dirname(os.path.abspath(__file__))
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as f:
+ self.speech_to_text(f)
+
+ def speech_to_text(self, audio_file):
+ try:
+ payload = {"model": self.model}
+ # 仅使用上传音频文件的 base64 data,不提供 input_url 兜底
+ audio_data = audio_file.read()
+ payload["data"] = base64.b64encode(audio_data).decode("utf-8")
+ for key in ("source", "voice_encode_format"):
+ if self.params.get(key):
+ payload[key] = self.params[key]
+
+ headers = {
+ "Authorization": f"Bearer {self.api_key}",
+ "Content-Type": "application/json",
+ }
+ response = requests.post(self.base_url, headers=headers, json=payload, timeout=300)
+ response.raise_for_status()
+ result = response.json()
+ if result.get("status") != "completed":
+ maxkb_logger.error(f"WAND ASR task not completed: {result}")
+ raise Exception(f"WAND ASR task not completed: {result}")
+ output = result.get("output") or {}
+ text = output.get("text")
+ if not text:
+ sentences = output.get("sentences") or []
+ text = " ".join([s.get("text", "") for s in sentences if s.get("text")])
+ return text
+ except Exception as e:
+ maxkb_logger.error(f"WAND ASR Error: {str(e)}: {traceback.format_exc()}")
+ raise e
diff --git a/apps/models_provider/impl/tencent_model_provider/model/tti.py b/apps/models_provider/impl/tencent_model_provider/model/tti.py
index 4e2c080d830..8dcc73dd2c9 100644
--- a/apps/models_provider/impl/tencent_model_provider/model/tti.py
+++ b/apps/models_provider/impl/tencent_model_provider/model/tti.py
@@ -1,93 +1,79 @@
# coding=utf-8
-import json
-import logging
-from typing import Dict
+import traceback
+from typing import Dict, Optional
+import requests
from django.utils.translation import gettext as _
-from tencentcloud.common import credential
-from tencentcloud.common.exception.tencent_cloud_sdk_exception import TencentCloudSDKException
-from tencentcloud.common.profile.client_profile import ClientProfile
-from tencentcloud.common.profile.http_profile import HttpProfile
-from tencentcloud.hunyuan.v20230901 import hunyuan_client, models
from common.utils.logger import maxkb_logger
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.impl.base_tti import BaseTextToImage
-from models_provider.impl.tencent_model_provider.model.hunyuan import ChatHunyuan
+
+
+DEFAULT_WAND_IMAGE_BASE_URL = "https://tokenhub.tencentmaas.com/v1/wand/hunyuan-image/v3-generation"
class TencentTextToImageModel(MaxKBBaseModel, BaseTextToImage):
- hunyuan_secret_id: str
- hunyuan_secret_key: str
+ api_key: str
model: str
params: dict
+ base_url: Optional[str] = DEFAULT_WAND_IMAGE_BASE_URL
+
+ def __init__(self, **kwargs):
+ super().__init__(**kwargs)
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params") or {}
+ self.base_url = kwargs.get("base_url") or DEFAULT_WAND_IMAGE_BASE_URL
@staticmethod
def is_cache_model():
return False
- def __init__(self, **kwargs):
- super().__init__(**kwargs)
- self.hunyuan_secret_id = kwargs.get('hunyuan_secret_id')
- self.hunyuan_secret_key = kwargs.get('hunyuan_secret_key')
- self.model = kwargs.get('model_name')
- self.params = kwargs.get('params')
-
@staticmethod
- def new_instance(model_type: str, model_name: str, model_credential: Dict[str, object],
- **model_kwargs) -> 'TencentTextToImageModel':
- optional_params = {'params': {'Style': '201', 'Resolution': '768:768'}}
+ def new_instance(
+ model_type: str, model_name: str, model_credential: Dict[str, object], **model_kwargs
+ ) -> "TencentTextToImageModel":
+ optional_params = {"params": {"size": "1024x1024"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
- return TencentTextToImageModel(
- model=model_name,
- hunyuan_secret_id=model_credential.get('hunyuan_secret_id'),
- hunyuan_secret_key=model_credential.get('hunyuan_secret_key'),
- **optional_params
- )
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ instance_kwargs = {
+ "api_key": model_credential.get("api_key"),
+ "model": model_name,
+ "params": optional_params["params"],
+ **optional_params,
+ }
+ base_url = model_credential.get("base_url")
+ if base_url:
+ instance_kwargs["base_url"] = base_url
+ return TencentTextToImageModel(**instance_kwargs)
def check_auth(self):
- chat = ChatHunyuan(hunyuan_app_id='111111',
- hunyuan_secret_id=self.hunyuan_secret_id,
- hunyuan_secret_key=self.hunyuan_secret_key,
- model="hunyuan-standard")
- res = chat.invoke(_('Hello'))
- # print(res)
+ self.generate_image(_("Hello"), None)
def generate_image(self, prompt: str, negative_prompt: str = None):
try:
- # 实例化一个认证对象,入参需要传入腾讯云账户 SecretId 和 SecretKey,此处还需注意密钥对的保密
- # 代码泄露可能会导致 SecretId 和 SecretKey 泄露,并威胁账号下所有资源的安全性。以下代码示例仅供参考,建议采用更安全的方式来使用密钥,请参见:https://cloud.tencent.com/document/product/1278/85305
- # 密钥可前往官网控制台 https://console.cloud.tencent.com/cam/capi 进行获取
- cred = credential.Credential(self.hunyuan_secret_id, self.hunyuan_secret_key)
- # 实例化一个http选项,可选的,没有特殊需求可以跳过
- httpProfile = HttpProfile()
- httpProfile.endpoint = "hunyuan.tencentcloudapi.com"
-
- # 实例化一个client选项,可选的,没有特殊需求可以跳过
- clientProfile = ClientProfile()
- clientProfile.httpProfile = httpProfile
- # 实例化要请求产品的client对象,clientProfile是可选的
- client = hunyuan_client.HunyuanClient(cred, "ap-guangzhou", clientProfile)
-
- # 实例化一个请求对象,每个接口都会对应一个request对象
- req = models.TextToImageLiteRequest()
- params = {
- "Prompt": prompt,
- "NegativePrompt": negative_prompt,
- "RspImgType": "url",
- **self.params
+ payload = {"model": self.model, "prompt": prompt}
+ payload.update({key: value for key, value in self.params.items() if value not in (None, "")})
+ headers = {
+ "Authorization": f"Bearer {self.api_key}",
+ "Content-Type": "application/json",
}
- req.from_json_string(json.dumps(params))
-
- # 返回的resp是一个TextToImageLiteResponse的实例,与请求对象对应
- resp = client.TextToImageLite(req)
+ response = requests.post(self.base_url, headers=headers, json=payload, timeout=300)
+ response.raise_for_status()
+ result = response.json()
+ data = result.get("data") or []
file_urls = []
-
- file_urls.append(resp.ResultImage)
+ for item in data:
+ url = item.get("url")
+ if url:
+ file_urls.append(url)
+ if not file_urls:
+ maxkb_logger.error(f"Tencent Text to Image API returned no urls: {result}")
+ raise RuntimeError("Tencent Text to Image API returned no image urls")
return file_urls
- except TencentCloudSDKException as err:
- maxkb_logger.error(f"Tencent Text to Image API call failed: {err}")
+ except requests.RequestException as err:
+ maxkb_logger.error(f"Tencent Text to Image API call failed: {err}: {traceback.format_exc()}")
raise RuntimeError(f"Tencent Text to Image API call failed: {err}") from err
diff --git a/apps/models_provider/impl/tencent_model_provider/model/ttv.py b/apps/models_provider/impl/tencent_model_provider/model/ttv.py
new file mode 100644
index 00000000000..d01709bf18f
--- /dev/null
+++ b/apps/models_provider/impl/tencent_model_provider/model/ttv.py
@@ -0,0 +1,152 @@
+# coding=utf-8
+
+import time
+from typing import ClassVar, Dict
+
+import requests
+
+from common.utils.logger import maxkb_logger
+from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_ttv import BaseGenerationVideo
+
+
+class TencentVideoModel(MaxKBBaseModel, BaseGenerationVideo):
+ """腾讯混元/优图视频生成模型(TokenHub OpenAI 兼容视频接口)。
+
+ 同时兼容文生视频(HY-Video-1.5)与图生视频/首尾帧(YT-Video-2.0):
+ - 提交任务:POST /v1/api/video/submit
+ - 查询任务:POST /v1/api/video/query
+ """
+
+ DEFAULT_BASE_URL: ClassVar[str] = "https://tokenhub.tencentmaas.com/v1"
+ REQUEST_TIMEOUT: ClassVar[tuple] = (10, 120) # (连接超时, 读取超时)
+ MAX_POLL_ATTEMPTS: ClassVar[int] = 120 # 最多轮询 120 次(约 6 分钟)
+ POLL_INTERVAL: ClassVar[int] = 3 # 秒
+ COMPLETED_STATUS: ClassVar[str] = "completed"
+ FAILED_STATUSES: ClassVar[frozenset] = frozenset({"failed", "error", "cancelled", "canceled"})
+
+ api_key: str
+ model_name: str
+ params: dict = {}
+ base_url: str = DEFAULT_BASE_URL
+
+ def __init__(self, **kwargs):
+ super().__init__(**kwargs)
+ self.api_key = kwargs.get("api_key")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params") or {}
+ self.base_url = (kwargs.get("base_url") or self.DEFAULT_BASE_URL).rstrip("/")
+
+ @staticmethod
+ def is_cache_model():
+ return False
+
+ @staticmethod
+ def new_instance(
+ model_type: str, model_name: str, model_credential: Dict[str, object], **model_kwargs
+ ) -> "TencentVideoModel":
+ optional_params = {"params": {}}
+ for key, value in model_kwargs.items():
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
+ return TencentVideoModel(
+ api_key=model_credential.get("api_key"),
+ model_name=model_name,
+ base_url=model_credential.get("base_url") or TencentVideoModel.DEFAULT_BASE_URL,
+ **optional_params,
+ )
+
+ def _endpoints(self) -> tuple:
+ """根据 base_url 推导 submit/query 地址。
+
+ base_url 可以是根地址(如 https://tokenhub.tencentmaas.com/v1),
+ 也可以是完整的 submit 或 query 地址,均能正确推导出两个接口地址。
+ """
+ base = self.base_url.rstrip("/")
+ if "/api/video/submit" in base:
+ submit = base
+ query = base[: base.index("/api/video/submit")] + "/api/video/query"
+ elif "/api/video/query" in base:
+ query = base
+ submit = base[: base.index("/api/video/query")] + "/api/video/submit"
+ else:
+ submit = f"{base}/api/video/submit"
+ query = f"{base}/api/video/query"
+ return submit, query
+
+ @property
+ def submit_url(self) -> str:
+ return self._endpoints()[0]
+
+ @property
+ def query_url(self) -> str:
+ return self._endpoints()[1]
+
+ def check_auth(self):
+ if not self.api_key:
+ raise RuntimeError("api_key is required")
+ return True
+
+ def _headers(self) -> dict:
+ return {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}
+
+ def _build_payload(self, prompt: str, first_frame_url=None, last_frame_url=None) -> dict:
+ payload = {"model": self.model_name, "prompt": prompt}
+ # 图生视频/首尾帧模式:优先使用首帧,其次使用尾帧作为输入图片
+ image_url = first_frame_url or last_frame_url
+ if image_url:
+ payload["image"] = {"url": image_url}
+ # 合并模型参数(resolution、fps、logo_add 等),过滤空值
+ for key, value in self.params.items():
+ if value not in (None, ""):
+ payload[key] = value
+ return payload
+
+ def _submit(self, prompt: str, first_frame_url=None, last_frame_url=None):
+ payload = self._build_payload(prompt, first_frame_url, last_frame_url)
+ maxkb_logger.info(f"提交腾讯视频生成任务,模型: {self.model_name}, url: {self.submit_url}")
+ response = requests.post(self.submit_url, headers=self._headers(), json=payload, timeout=self.REQUEST_TIMEOUT)
+ response.raise_for_status()
+ result = response.json()
+ task_id = result.get("id")
+ if not task_id:
+ raise RuntimeError(f"腾讯视频提交任务失败,未获取到 id: {result}")
+ return task_id, result.get("status")
+
+ def _query(self, task_id: str) -> dict:
+ payload = {"model": self.model_name, "id": task_id}
+ response = requests.post(self.query_url, headers=self._headers(), json=payload, timeout=self.REQUEST_TIMEOUT)
+ response.raise_for_status()
+ return response.json()
+
+ def _wait_for_result(self, task_id: str) -> dict:
+ for attempt in range(1, self.MAX_POLL_ATTEMPTS + 1):
+ result = self._query(task_id)
+ status = result.get("status")
+ maxkb_logger.info(
+ f"查询腾讯视频任务 {task_id} 状态: {status}, 进度: {result.get('progress')}, 第 {attempt} 次"
+ )
+ if status == self.COMPLETED_STATUS:
+ return result
+ if status in self.FAILED_STATUSES:
+ message = (
+ result.get("message")
+ or result.get("error_message")
+ or result.get("error")
+ or result.get("msg")
+ or "未知错误"
+ )
+ raise RuntimeError(f"腾讯视频任务 {task_id} 执行失败: {message}")
+ time.sleep(self.POLL_INTERVAL)
+ raise RuntimeError(f"腾讯视频任务 {task_id} 轮询超时({self.MAX_POLL_ATTEMPTS * self.POLL_INTERVAL} 秒)")
+
+ def generate_video(
+ self, prompt: str, negative_prompt: str = None, first_frame_url=None, last_frame_url=None, **kwargs
+ ):
+ task_id, _ = self._submit(prompt, first_frame_url, last_frame_url)
+ result = self._wait_for_result(task_id)
+ data = result.get("data") or {}
+ video_url = data.get("url")
+ if not video_url:
+ raise RuntimeError(f"腾讯视频任务完成但未获取到视频 URL: {result}")
+ return video_url
diff --git a/apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py b/apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
index 1b4877f9242..d99678c2e7a 100644
--- a/apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
+++ b/apps/models_provider/impl/tencent_model_provider/tencent_model_provider.py
@@ -4,116 +4,219 @@
import os
from common.utils.common import get_file_content
from models_provider.base_model_provider import (
- IModelProvider, ModelProvideInfo, ModelInfo, ModelTypeConst, ModelInfoManage
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
)
from models_provider.impl.tencent_model_provider.credential.embedding import TencentEmbeddingCredential
from models_provider.impl.tencent_model_provider.credential.image import TencentVisionModelCredential
from models_provider.impl.tencent_model_provider.credential.llm import TencentLLMModelCredential
from models_provider.impl.tencent_model_provider.credential.stt import TencentSTTModelCredential
+from models_provider.impl.tencent_model_provider.credential.tokenhub_stt import TencentTokenhubSTTModelCredential
from models_provider.impl.tencent_model_provider.credential.tti import TencentTTIModelCredential
+from models_provider.impl.tencent_model_provider.credential.ttv import TencentTTVModelCredential
from models_provider.impl.tencent_model_provider.model.embedding import TencentEmbeddingModel
from models_provider.impl.tencent_model_provider.model.image import TencentVision
from models_provider.impl.tencent_model_provider.model.llm import TencentModel
-from models_provider.impl.tencent_model_provider.model.stt import TencentSpeechToText
+from models_provider.impl.tencent_model_provider.model.stt import TencentSpeechToText, TencentWandSpeechToText
from models_provider.impl.tencent_model_provider.model.tti import TencentTextToImageModel
+from models_provider.impl.tencent_model_provider.model.ttv import TencentVideoModel
from maxkb.conf import PROJECT_DIR
from django.utils.translation import gettext as _
+
def _create_model_info(model_name, description, model_type, credential_class, model_class):
return ModelInfo(
name=model_name,
desc=description,
model_type=model_type,
model_credential=credential_class(),
- model_class=model_class
+ model_class=model_class,
)
def _get_tencent_icon_path():
- return os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'tencent_model_provider',
- 'icon', 'tencent_icon_svg')
+ return os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "tencent_model_provider", "icon", "tencent_icon_svg"
+ )
def _initialize_model_info():
- model_info_list = [_create_model_info(
- 'hunyuan-pro',
- _('The most effective version of the current hybrid model, the trillion-level parameter scale MOE-32K long article model. Reaching the absolute leading level on various benchmarks, with complex instructions and reasoning, complex mathematical capabilities, support for function call, and application focus optimization in fields such as multi-language translation, finance, law, and medical care'),
- ModelTypeConst.LLM,
- TencentLLMModelCredential,
- TencentModel
- ),
- _create_model_info(
- 'hunyuan-standard',
- _('A better routing strategy is adopted to simultaneously alleviate the problems of load balancing and expert convergence. For long articles, the needle-in-a-haystack index reaches 99.9%'),
+ model_info_list = [
+ _create_model_info(
+ "hy4-preview",
+ _("The latest generation productivity model with upgraded Agent and complex task execution capabilities."),
+ ModelTypeConst.LLM,
+ TencentLLMModelCredential,
+ TencentModel,
+ ),
+ _create_model_info(
+ "hy3",
+ _(
+ "Tuned on real business scenarios, balancing effectiveness and cost-effectiveness, with reinforced Coding, long-text, reasoning and Agent capabilities."
+ ),
+ ModelTypeConst.LLM,
+ TencentLLMModelCredential,
+ TencentModel,
+ ),
+ _create_model_info(
+ "hy3-preview",
+ _(
+ "Designed for Agent workloads, using a MoE architecture that supports interleaved thinking, structured output, Function Calling and Cache caching."
+ ),
+ ModelTypeConst.LLM,
+ TencentLLMModelCredential,
+ TencentModel,
+ ),
+ _create_model_info(
+ "hy-mt2-pro",
+ _("Tencent Hybrid multilingual translation model."),
ModelTypeConst.LLM,
TencentLLMModelCredential,
- TencentModel),
+ TencentModel,
+ ),
_create_model_info(
- 'hunyuan-lite',
- _('Upgraded to MOE structure, the context window is 256k, leading many open source models in multiple evaluation sets such as NLP, code, mathematics, industry, etc.'),
+ "hy-mt2-plus",
+ _("Tencent Hybrid multilingual translation model."),
ModelTypeConst.LLM,
TencentLLMModelCredential,
- TencentModel),
+ TencentModel,
+ ),
_create_model_info(
- 'hunyuan-role',
- _("Hunyuan's latest version of the role-playing model, a role-playing model launched by Hunyuan's official fine-tuning training, is based on the Hunyuan model combined with the role-playing scene data set for additional training, and has better basic effects in role-playing scenes."),
+ "hy-mt2-lite",
+ _("Tencent Hybrid multilingual translation model."),
ModelTypeConst.LLM,
TencentLLMModelCredential,
- TencentModel),
+ TencentModel,
+ ),
_create_model_info(
- 'hunyuan-functioncall',
- _("Hunyuan's latest MOE architecture FunctionCall model has been trained with high-quality FunctionCall data and has a context window of 32K, leading in multiple dimensions of evaluation indicators."),
+ "hunyuan-role-latest",
+ _("Hunyuan's latest role-playing model based on the Hunyuan model with role-playing scene fine-tuning."),
ModelTypeConst.LLM,
TencentLLMModelCredential,
- TencentModel),
+ TencentModel,
+ ),
_create_model_info(
- 'hunyuan-code',
- _("Hunyuan's latest code generation model, after training the base model with 200B high-quality code data, and iterating on high-quality SFT data for half a year, the context long window length has been increased to 8K, and it ranks among the top in the automatic evaluation indicators of code generation in the five major languages; the five major languages In the manual high-quality evaluation of 10 comprehensive code tasks that consider all aspects, the performance is in the first echelon."),
+ "hy-role",
+ _("Hunyuan's role-playing model with better basic effects in role-playing scenarios."),
ModelTypeConst.LLM,
TencentLLMModelCredential,
- TencentModel),
+ TencentModel,
+ ),
_create_model_info(
- 'asr-sentence',
- _("This interface is used to recognize short audio files within 60 seconds. Supports Mandarin Chinese, English, Cantonese, Japanese, Vietnamese, Malay, Indonesian, Filipino, Thai, Portuguese, Turkish, Arabic, Hindi, French, German, and 23 Chinese dialects."),
+ "asr-sentence",
+ _(
+ "This interface is used to recognize short audio files within 60 seconds. Supports Mandarin Chinese, English, Cantonese, Japanese, Vietnamese, Malay, Indonesian, Filipino, Thai, Portuguese, Turkish, Arabic, Hindi, French, German, and 23 Chinese dialects."
+ ),
ModelTypeConst.STT,
TencentSTTModelCredential,
- TencentSpeechToText),
+ TencentSpeechToText,
+ ),
+ _create_model_info(
+ "wand-asr-v1", _(""), ModelTypeConst.STT, TencentTokenhubSTTModelCredential, TencentWandSpeechToText
+ ),
+ _create_model_info(
+ "hy-asr-3.0-preview", _(""), ModelTypeConst.STT, TencentTokenhubSTTModelCredential, TencentWandSpeechToText
+ ),
]
- tencent_embedding_model_info = _create_model_info(
- 'hunyuan-embedding',
- _("Tencent's Hunyuan Embedding interface can convert text into high-quality vector data. The vector dimension is 1024 dimensions."),
- ModelTypeConst.EMBEDDING,
- TencentEmbeddingCredential,
- TencentEmbeddingModel
- )
+ model_info_embedding_list = [
+ _create_model_info(
+ "kinfra-text-embedding-0.6b",
+ _("Tencent TokenHub text embedding model, 1024 dimensions."),
+ ModelTypeConst.EMBEDDING,
+ TencentEmbeddingCredential,
+ TencentEmbeddingModel,
+ ),
+ _create_model_info(
+ "kinfra-text-embedding-4b",
+ _("Tencent TokenHub text embedding model, 2560 dimensions."),
+ ModelTypeConst.EMBEDDING,
+ TencentEmbeddingCredential,
+ TencentEmbeddingModel,
+ ),
+ _create_model_info(
+ "kinfra-vl-embedding-2b",
+ _("Tencent TokenHub multimodal embedding model, 2048 dimensions."),
+ ModelTypeConst.EMBEDDING,
+ TencentEmbeddingCredential,
+ TencentEmbeddingModel,
+ ),
+ _create_model_info(
+ "kinfra-vl-embedding-8b",
+ _("Tencent TokenHub multimodal embedding model, 4096 dimensions."),
+ ModelTypeConst.EMBEDDING,
+ TencentEmbeddingCredential,
+ TencentEmbeddingModel,
+ ),
+ ]
+ tencent_embedding_model_info = model_info_embedding_list[0]
- model_info_embedding_list = [tencent_embedding_model_info]
-
- model_info_vision_list = [_create_model_info(
- 'hunyuan-vision',
- _('Mixed element visual model'),
- ModelTypeConst.IMAGE,
- TencentVisionModelCredential,
- TencentVision)]
-
- model_info_tti_list = [_create_model_info(
- 'hunyuan-dit',
- _('Hunyuan graph model'),
- ModelTypeConst.TTI,
- TencentTTIModelCredential,
- TencentTextToImageModel)]
-
- model_info_manage = ModelInfoManage.builder() \
- .append_model_info_list(model_info_list) \
- .append_model_info_list(model_info_embedding_list) \
- .append_model_info_list(model_info_vision_list) \
- .append_default_model_info(model_info_vision_list[0]) \
- .append_model_info_list(model_info_tti_list) \
- .append_default_model_info(model_info_tti_list[0]) \
- .append_default_model_info(model_info_list[0]) \
- .append_default_model_info(tencent_embedding_model_info) \
+ model_info_vision_list = [
+ _create_model_info(
+ "hunyuan-vision",
+ _("Mixed element visual model"),
+ ModelTypeConst.IMAGE,
+ TencentVisionModelCredential,
+ TencentVision,
+ )
+ ]
+
+ model_info_tti_list = [
+ _create_model_info(
+ "hy-image-v3",
+ _("Hunyuan Hy-Image 3.0 text-to-image model."),
+ ModelTypeConst.TTI,
+ TencentTTIModelCredential,
+ TencentTextToImageModel,
+ )
+ ]
+
+ model_info_ttv_list = [
+ _create_model_info(
+ "hy-video-1.5",
+ _("Hunyuan HY-Video 1.5 text-to-video model."),
+ ModelTypeConst.TTV,
+ TencentTTVModelCredential,
+ TencentVideoModel,
+ )
+ ]
+
+ model_info_itv_list = [
+ _create_model_info(
+ "hy-video-1.5",
+ _("Hunyuan HY-Video 1.5 image-to-video model."),
+ ModelTypeConst.ITV,
+ TencentTTVModelCredential,
+ TencentVideoModel,
+ ),
+ _create_model_info(
+ "yt-video-2.0",
+ _("Tencent YT-Video 2.0 image-to-video model."),
+ ModelTypeConst.ITV,
+ TencentTTVModelCredential,
+ TencentVideoModel,
+ ),
+ ]
+
+ model_info_manage = (
+ ModelInfoManage.builder()
+ .append_model_info_list(model_info_list)
+ .append_model_info_list(model_info_embedding_list)
+ .append_model_info_list(model_info_vision_list)
+ .append_default_model_info(model_info_vision_list[0])
+ .append_model_info_list(model_info_tti_list)
+ .append_default_model_info(model_info_tti_list[0])
+ .append_model_info_list(model_info_ttv_list)
+ .append_default_model_info(model_info_ttv_list[0])
+ .append_model_info_list(model_info_itv_list)
+ .append_default_model_info(model_info_itv_list[0])
+ .append_default_model_info(model_info_list[0])
+ .append_default_model_info(tencent_embedding_model_info)
.build()
+ )
return model_info_manage
@@ -125,11 +228,13 @@ def __init__(self):
def get_model_info_manage(self):
return self._model_info_manage
+ def get_model(self, model_type, model_name, model_credential, **model_kwargs):
+ # STT 模型:模型名不以 asr- 开头的一律走 Tencent Tokenhub WAND 识别
+ if model_type == ModelTypeConst.STT.name and not model_name.startswith("asr-"):
+ return TencentWandSpeechToText.new_instance(model_type, model_name, model_credential, **model_kwargs)
+ return super().get_model(model_type, model_name, model_credential, **model_kwargs)
+
def get_model_provide_info(self):
icon_path = _get_tencent_icon_path()
icon_data = get_file_content(icon_path)
- return ModelProvideInfo(
- provider='model_tencent_provider',
- name=_('Tencent Hunyuan'),
- icon=icon_data
- )
+ return ModelProvideInfo(provider="model_tencent_provider", name=_("Tencent Cloud"), icon=icon_data)
diff --git a/apps/models_provider/impl/vllm_model_provider/credential/embedding.py b/apps/models_provider/impl/vllm_model_provider/credential/embedding.py
index 89a4f19e332..cc80d268b66 100644
--- a/apps/models_provider/impl/vllm_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/vllm_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,37 +17,49 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class VllmEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/vllm_model_provider/credential/image.py b/apps/models_provider/impl/vllm_model_provider/credential/image.py
index d8a0b235ae8..d47479a448b 100644
--- a/apps/models_provider/impl/vllm_model_provider/credential/image.py
+++ b/apps/models_provider/impl/vllm_model_provider/credential/image.py
@@ -12,39 +12,56 @@
class VllmImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class VllmImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
@@ -53,20 +70,22 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return VllmImageModelParams()
diff --git a/apps/models_provider/impl/vllm_model_provider/credential/llm.py b/apps/models_provider/impl/vllm_model_provider/credential/llm.py
index e15d858e236..f4dfd23563c 100644
--- a/apps/models_provider/impl/vllm_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/vllm_model_provider/credential/llm.py
@@ -10,63 +10,84 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class VLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class VLLMModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'), model_credential.get('api_key'))
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, gettext('API domain name is invalid'))
+ model_list = provider.get_base_model_list(model_credential.get("api_base"), model_credential.get("api_key"))
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("API domain name is invalid"))
exist = provider.get_model_info_by_name(model_list, model_name)
if len(exist) == 0:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('The model does not exist, please download the model first'))
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
+ raise AppApiException(
+ ValidCode.valid_error.value, gettext("The model does not exist, please download the model first")
+ )
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
try:
- res = model.invoke([HumanMessage(content=gettext('Hello'))])
+ res = model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
return True
def encryption_dict(self, model_info: Dict[str, object]):
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
def build_model(self, model_info: Dict[str, object]):
- for key in ['api_key', 'model']:
+ for key in ["api_key", "model"]:
if key not in model_info:
- raise AppApiException(500, gettext('{key} is required').format(key=key))
- self.api_key = model_info.get('api_key')
+ raise AppApiException(500, gettext("{key} is required").format(key=key))
+ self.api_key = model_info.get("api_key")
return self
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return VLLMModelParams()
diff --git a/apps/models_provider/impl/vllm_model_provider/credential/reranker.py b/apps/models_provider/impl/vllm_model_provider/credential/reranker.py
index d092704a71a..d9c3a6891e7 100644
--- a/apps/models_provider/impl/vllm_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/vllm_model_provider/credential/reranker.py
@@ -13,52 +13,63 @@
class VllmRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class VllmRerankerCredential(BaseForm, BaseModelCredential):
- api_url = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_url = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_url', 'api_key']:
+ for key in ["api_url", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model: VllmBgeReranker = provider.get_model(model_type, model_name, model_credential)
- test_text = str(_('Hello'))
+ test_text = str(_("Hello"))
model.compress_documents([Document(page_content=test_text)], test_text)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
raise AppApiException(
ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e))
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
)
return False
return True
def encryption_dict(self, model_info: Dict[str, object]):
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
def get_model_params_setting_form(self, model_name: str) -> VllmRerankerModelParams:
return VllmRerankerModelParams()
diff --git a/apps/models_provider/impl/vllm_model_provider/credential/whisper_stt.py b/apps/models_provider/impl/vllm_model_provider/credential/whisper_stt.py
index 5844d0a4d4f..996c3bd97ff 100644
--- a/apps/models_provider/impl/vllm_model_provider/credential/whisper_stt.py
+++ b/apps/models_provider/impl/vllm_model_provider/credential/whisper_stt.py
@@ -1,9 +1,7 @@
# coding=utf-8
-import traceback
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
-from langchain_core.messages import HumanMessage
from common import forms
from common.exception.app_exception import AppApiException
@@ -13,50 +11,54 @@
class VLLMWhisperModelParams(BaseForm):
Language = forms.TextInputField(
- TooltipLabel(_('language'),
- _("If not passed, the default value is 'zh'")),
+ TooltipLabel(_("language"), _("If not passed, the default value is 'zh'")),
required=True,
- default_value='zh',
+ default_value="zh",
)
class VLLMWhisperModelCredential(BaseForm, BaseModelCredential):
- api_url = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_url = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self,
- model_type: str,
- model_name,
- model_credential: Dict[str, object],
- model_params,
- provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_url'), model_credential.get('api_key'))
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, gettext('API domain name is invalid'))
+ model_list = provider.get_base_model_list(model_credential.get("api_url"), model_credential.get("api_key"))
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("API domain name is invalid"))
exist = provider.get_model_info_by_name(model_list, model_name)
if len(exist) == 0:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('The model does not exist, please download the model first'))
+ raise AppApiException(
+ ValidCode.valid_error.value, gettext("The model does not exist, please download the model first")
+ )
model = provider.get_model(model_type, model_name, model_credential, **model_params)
return True
def encryption_dict(self, model_info: Dict[str, object]):
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
def build_model(self, model_info: Dict[str, object]):
- for key in ['api_key', 'model']:
+ for key in ["api_key", "model"]:
if key not in model_info:
- raise AppApiException(500, gettext('{key} is required').format(key=key))
- self.api_key = model_info.get('api_key')
+ raise AppApiException(500, gettext("{key} is required").format(key=key))
+ self.api_key = model_info.get("api_key")
return self
def get_model_params_setting_form(self, model_name):
- return VLLMWhisperModelParams()
\ No newline at end of file
+ return VLLMWhisperModelParams()
diff --git a/apps/models_provider/impl/vllm_model_provider/model/embedding.py b/apps/models_provider/impl/vllm_model_provider/model/embedding.py
index 98280b2b000..894af047fe2 100644
--- a/apps/models_provider/impl/vllm_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/vllm_model_provider/model/embedding.py
@@ -1,19 +1,23 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 17:44
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 17:44
+@desc:
"""
+
from typing import Dict, List
import openai
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+
+class VllmEmbeddingModel(MaxKBBaseEmbeddingModel):
+ def supports_image_embedding(self) -> bool:
+ return False
-class VllmEmbeddingModel(MaxKBBaseModel):
model_name: str
optional_params: dict
@@ -27,25 +31,22 @@ def is_cache_model(self):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return VllmEmbeddingModel(
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
model_name=model_name,
- base_url=model_credential.get('api_base'),
- optional_params=optional_params
+ base_url=model_credential.get("api_base"),
+ optional_params=optional_params,
)
def embed_query(self, text: str):
res = self.embed_documents([text])
return res[0]
- def embed_documents(
- self, texts: List[str], chunk_size: int | None = None
- ) -> List[List[float]]:
+ def embed_documents(self, texts: List[str], chunk_size: int | None = None) -> List[List[float]]:
if len(self.optional_params) > 0:
res = self.client.create(
- input=texts, model=self.model_name, encoding_format="float",
- **self.optional_params
+ input=texts, model=self.model_name, encoding_format="float", **self.optional_params
)
else:
res = self.client.create(input=texts, model=self.model_name, encoding_format="float")
diff --git a/apps/models_provider/impl/vllm_model_provider/model/image.py b/apps/models_provider/impl/vllm_model_provider/model/image.py
index 450567bf76a..105b612f81f 100644
--- a/apps/models_provider/impl/vllm_model_provider/model/image.py
+++ b/apps/models_provider/impl/vllm_model_provider/model/image.py
@@ -8,14 +8,13 @@
class VllmImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return VllmImage(
model_name=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
@@ -29,10 +28,10 @@ def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
- return self.usage_metadata.get('input_tokens', 0)
+ return self.usage_metadata.get("input_tokens", 0)
def get_num_tokens(self, text: str) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
- return self.get_last_generation_info().get('output_tokens', 0)
+ return self.get_last_generation_info().get("output_tokens", 0)
diff --git a/apps/models_provider/impl/vllm_model_provider/model/llm.py b/apps/models_provider/impl/vllm_model_provider/model/llm.py
index 7b7e861125c..d977e8da029 100644
--- a/apps/models_provider/impl/vllm_model_provider/model/llm.py
+++ b/apps/models_provider/impl/vllm_model_provider/model/llm.py
@@ -12,14 +12,13 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
class VllmChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -29,8 +28,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
vllm_chat_open_ai = VllmChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
streaming=True,
stream_usage=True,
**optional_params,
@@ -41,10 +40,10 @@ def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
- return self.usage_metadata.get('input_tokens', 0)
+ return self.usage_metadata.get("input_tokens", 0)
def get_num_tokens(self, text: str) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
- return self.get_last_generation_info().get('output_tokens', 0)
+ return self.get_last_generation_info().get("output_tokens", 0)
diff --git a/apps/models_provider/impl/vllm_model_provider/model/reranker.py b/apps/models_provider/impl/vllm_model_provider/model/reranker.py
index 0b64f0479ba..5008377c7e9 100644
--- a/apps/models_provider/impl/vllm_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/vllm_model_provider/model/reranker.py
@@ -17,12 +17,13 @@ class VllmBgeReranker(MaxKBBaseModel, BaseDocumentCompressor):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
- self.api_url = kwargs.get('api_url')
- self.top_n = kwargs.get('top_n', 3)
- self.client = cohere.ClientV2(kwargs.get('api_key'), base_url=kwargs.get('api_url'))
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = dict(kwargs.get("params") or {})
+ self.api_url = kwargs.get("api_url")
+ self.top_n = kwargs.get("top_n", 3)
+ self.params.pop("top_n", None)
+ self.client = cohere.Client(kwargs.get("api_key"), base_url=kwargs.get("api_url"))
@staticmethod
def is_cache_model():
@@ -30,21 +31,42 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- r_url = model_credential.get('api_url')[:-3] if model_credential.get('api_url').endswith('/v1') else model_credential.get('api_url')
+ r_url = (
+ model_credential.get("api_url")[:-3]
+ if model_credential.get("api_url").endswith("/v1")
+ else model_credential.get("api_url")
+ )
+ optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ top_n = optional_params.pop("top_n", 3)
return VllmBgeReranker(
model=model_name,
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
api_url=r_url,
- params=model_kwargs,
- **model_kwargs
+ top_n=top_n,
+ params=optional_params,
)
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if documents is None or len(documents) == 0:
return []
ds = [d.page_content for d in documents]
- result = self.client.rerank(model=self.model, query=query, documents=ds, top_n=self.top_n, **self.params)
- return [Document(page_content=d.document.get('text'), metadata={'relevance_score': d.relevance_score}) for d in
- result.results]
+ try:
+ result = self.client.v2.rerank(model=self.model, query=query, documents=ds, top_n=self.top_n)
+ except cohere.NotFoundError:
+ result = self.client.rerank(model=self.model, query=query, documents=ds, top_n=self.top_n)
+
+ reranked_documents = []
+ for item in result.results:
+ if item.index < 0 or item.index >= len(documents):
+ raise ValueError(f'Rerank result index {item.index} is out of range')
+ source = documents[item.index]
+ reranked_documents.append(
+ Document(
+ page_content=source.page_content,
+ metadata={**source.metadata, 'relevance_score': item.relevance_score},
+ )
+ )
+ return reranked_documents
diff --git a/apps/models_provider/impl/vllm_model_provider/model/whisper_sst.py b/apps/models_provider/impl/vllm_model_provider/model/whisper_sst.py
index 12e01a98400..856c895ace6 100644
--- a/apps/models_provider/impl/vllm_model_provider/model/whisper_sst.py
+++ b/apps/models_provider/impl/vllm_model_provider/model/whisper_sst.py
@@ -1,4 +1,3 @@
-import base64
import os
import traceback
from typing import Dict
@@ -10,7 +9,6 @@
from models_provider.impl.base_stt import BaseSpeechToText
-
class VllmWhisperSpeechToText(MaxKBBaseModel, BaseSpeechToText):
api_key: str
api_url: str
@@ -19,10 +17,10 @@ class VllmWhisperSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
- self.api_url = kwargs.get('api_url')
+ self.api_key = kwargs.get("api_key")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
+ self.api_url = kwargs.get("api_url")
@staticmethod
def is_cache_model():
@@ -32,39 +30,34 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return VllmWhisperSpeechToText(
model=model_name,
- api_key=model_credential.get('api_key'),
- api_url=model_credential.get('api_url'),
+ api_key=model_credential.get("api_key"),
+ api_url=model_credential.get("api_url"),
params=model_kwargs,
- **model_kwargs
+ **model_kwargs,
)
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as audio_file:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as audio_file:
self.speech_to_text(audio_file)
def speech_to_text(self, audio_file):
-
- base_url = self.api_url if self.api_url.endswith('v1') else f"{self.api_url}/v1"
+ base_url = self.api_url.rstrip("/")
+ base_url = base_url if base_url.endswith("/v1") else f"{base_url}/v1"
try:
- client = OpenAI(
- api_key=self.api_key,
- base_url=base_url
- )
+ client = OpenAI(api_key=self.api_key, base_url=base_url)
buf = audio_file.read()
- filter_params = {k: v for k, v in self.params.items() if k not in {'model_id', 'use_local', 'streaming'}}
+ filter_params = {k: v for k, v in self.params.items() if k not in {"model_id", "use_local", "streaming"}}
transcription_params = {
- 'model': self.model,
- 'file': buf,
- 'language': 'zh',
+ "model": self.model,
+ "file": buf,
+ "language": "zh",
}
- result = client.audio.transcriptions.create(
- **transcription_params, extra_body=filter_params
- )
+ result = client.audio.transcriptions.create(**transcription_params, extra_body=filter_params)
return result.text
except Exception as err:
maxkb_logger.error(f":Error: {str(err)}: {traceback.format_exc()}")
- raise err
\ No newline at end of file
+ raise err
diff --git a/apps/models_provider/impl/vllm_model_provider/vllm_model_provider.py b/apps/models_provider/impl/vllm_model_provider/vllm_model_provider.py
index ffe544081d6..f0ccd21e620 100644
--- a/apps/models_provider/impl/vllm_model_provider/vllm_model_provider.py
+++ b/apps/models_provider/impl/vllm_model_provider/vllm_model_provider.py
@@ -5,8 +5,13 @@
import requests
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, ModelTypeConst, \
- ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.vllm_model_provider.credential.embedding import VllmEmbeddingCredential
from models_provider.impl.vllm_model_provider.credential.image import VllmImageModelCredential
from models_provider.impl.vllm_model_provider.credential.llm import VLLMModelCredential
@@ -28,41 +33,58 @@
rerank_model_credential = VllmRerankerCredential()
model_info_list = [
- ModelInfo('facebook/opt-125m', _('Facebook’s 125M parameter model'), ModelTypeConst.LLM, v_llm_model_credential,
- VllmChatModel),
- ModelInfo('BAAI/Aquila-7B', _('BAAI’s 7B parameter model'), ModelTypeConst.LLM, v_llm_model_credential,
- VllmChatModel),
- ModelInfo('BAAI/AquilaChat-7B', _('BAAI’s 13B parameter mode'), ModelTypeConst.LLM, v_llm_model_credential,
- VllmChatModel),
-
+ ModelInfo(
+ "facebook/opt-125m",
+ _("Facebook’s 125M parameter model"),
+ ModelTypeConst.LLM,
+ v_llm_model_credential,
+ VllmChatModel,
+ ),
+ ModelInfo(
+ "BAAI/Aquila-7B", _("BAAI’s 7B parameter model"), ModelTypeConst.LLM, v_llm_model_credential, VllmChatModel
+ ),
+ ModelInfo(
+ "BAAI/AquilaChat-7B", _("BAAI’s 13B parameter mode"), ModelTypeConst.LLM, v_llm_model_credential, VllmChatModel
+ ),
]
image_model_info_list = [
- ModelInfo('Qwen/Qwen2-VL-2B-Instruct', '', ModelTypeConst.IMAGE, image_model_credential, VllmImage),
+ ModelInfo("Qwen/Qwen2-VL-2B-Instruct", "", ModelTypeConst.IMAGE, image_model_credential, VllmImage),
]
embedding_model_info_list = [
- ModelInfo('HIT-TMG/KaLM-embedding-multilingual-mini-instruct-v1.5', '', ModelTypeConst.EMBEDDING,
- embedding_model_credential, VllmEmbeddingModel),
+ ModelInfo(
+ "HIT-TMG/KaLM-embedding-multilingual-mini-instruct-v1.5",
+ "",
+ ModelTypeConst.EMBEDDING,
+ embedding_model_credential,
+ VllmEmbeddingModel,
+ ),
]
whisper_model_info_list = [
- ModelInfo('whisper-tiny', '', ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
- ModelInfo('whisper-large-v3-turbo', '', ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
- ModelInfo('whisper-small', '', ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
- ModelInfo('whisper-large-v3', '', ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
+ ModelInfo("whisper-tiny", "", ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
+ ModelInfo("whisper-large-v3-turbo", "", ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
+ ModelInfo("whisper-small", "", ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
+ ModelInfo("whisper-large-v3", "", ModelTypeConst.STT, whisper_model_credential, VllmWhisperSpeechToText),
]
reranker_model_info_list = [
- ModelInfo('BAAI/bge-reranker-v2-m3', '', ModelTypeConst.RERANKER, rerank_model_credential, VllmBgeReranker),
+ ModelInfo("BAAI/bge-reranker-v2-m3", "", ModelTypeConst.RERANKER, rerank_model_credential, VllmBgeReranker),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
- .append_default_model_info(ModelInfo('facebook/opt-125m',
- _('Facebook’s 125M parameter model'),
- ModelTypeConst.LLM, v_llm_model_credential, VllmChatModel))
+ .append_default_model_info(
+ ModelInfo(
+ "facebook/opt-125m",
+ _("Facebook’s 125M parameter model"),
+ ModelTypeConst.LLM,
+ v_llm_model_credential,
+ VllmChatModel,
+ )
+ )
.append_model_info_list(image_model_info_list)
.append_default_model_info(image_model_info_list[0])
.append_model_info_list(embedding_model_info_list)
@@ -77,9 +99,9 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
@@ -88,23 +110,29 @@ def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_vllm_provider', name='vLLM', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'vllm_model_provider', 'icon',
- 'vllm_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_vllm_provider",
+ name="vLLM",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "vllm_model_provider", "icon", "vllm_icon_svg"
+ )
+ ),
+ )
@staticmethod
def get_base_model_list(api_base, api_key):
base_url = get_base_url(api_base)
- base_url = base_url if base_url.endswith('/v1') else (base_url + '/v1')
+ base_url = base_url if base_url.endswith("/v1") else (base_url + "/v1")
headers = {}
if api_key:
- headers['Authorization'] = f"Bearer {api_key}"
+ headers["Authorization"] = f"Bearer {api_key}"
r = requests.request(method="GET", url=f"{base_url}/models", headers=headers, timeout=5)
r.raise_for_status()
- return r.json().get('data')
+ return r.json().get("data")
@staticmethod
def get_model_info_by_name(model_list, model_name):
if model_list is None:
return []
- return [model for model in model_list if model.get('id') == model_name]
+ return [model for model in model_list if model.get("id") == model_name]
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/bigModel_stt.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/bigModel_stt.py
index beb6c903a6b..eb0e678d2ff 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/bigModel_stt.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/bigModel_stt.py
@@ -12,48 +12,60 @@
class VolcanicEngineBigModelSTTModelParams(BaseForm):
uid = forms.TextInputField(
- TooltipLabel(_('User ID'), _('If not passed, the default value is streaming_asr_demo')),
+ TooltipLabel(_("User ID"), _("If not passed, the default value is streaming_asr_demo")),
required=True,
- default_value='streaming_asr_demo'
+ default_value="streaming_asr_demo",
)
class VolcanicEngineBigModelSTTModelCredential(BaseForm, BaseModelCredential):
- volcanic_app_id = forms.TextInputField('App ID', required=True)
- volcanic_token = forms.PasswordInputField('Access Token', required=True)
- volcanic_api_url = forms.TextInputField('API URL', required=True,
- default_value='https://openspeech.bytedance.com/api/v3/auc/bigmodel/recognize/flash')
+ volcanic_app_id = forms.TextInputField("App ID", required=True)
+ volcanic_token = forms.PasswordInputField("Access Token", required=True)
+ volcanic_api_url = forms.TextInputField(
+ "API URL", required=True, default_value="https://openspeech.bytedance.com/api/v3/auc/bigmodel/recognize/flash"
+ )
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['volcanic_api_url', 'volcanic_app_id', 'volcanic_token']:
+ for key in ["volcanic_api_url", "volcanic_app_id", "volcanic_token"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'volcanic_token': super().encryption(model.get('volcanic_token', ''))}
+ return {**model, "volcanic_token": super().encryption(model.get("volcanic_token", ""))}
def get_model_params_setting_form(self, model_name):
return VolcanicEngineBigModelSTTModelParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/embedding.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/embedding.py
index 5cda8fd880d..75d56dcba12 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/7/12 16:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/7/12 16:45
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,37 +17,49 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class VolcanicEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/image.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/image.py
index 0801ff62edb..7c44f60ca9d 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/image.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/image.py
@@ -12,61 +12,80 @@
class VolcanicEngineImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.95,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.95,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class VolcanicEngineImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return VolcanicEngineImageModelParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/llm.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/llm.py
index 7d330fa9821..557d73a0d4e 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/11 17:57
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/11 17:57
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,61 +18,80 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class VolcanicEngineLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.3,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.3,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class VolcanicEngineLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['access_key_id', 'secret_access_key']:
+ for key in ["access_key_id", "secret_access_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ res = model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'access_key_id': super().encryption(model.get('access_key_id', ''))}
+ return {**model, "access_key_id": super().encryption(model.get("access_key_id", ""))}
- access_key_id = forms.PasswordInputField('Access Key ID', required=True)
- secret_access_key = forms.PasswordInputField('Secret Access Key', required=True)
+ access_key_id = forms.PasswordInputField("Access Key ID", required=True)
+ secret_access_key = forms.PasswordInputField("Secret Access Key", required=True)
def get_model_params_setting_form(self, model_name):
return VolcanicEngineLLMModelParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/stt.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/stt.py
index 60fed88d0a5..942dfadd7fd 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/stt.py
@@ -9,52 +9,64 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class VolcanicEngineSTTModelParams(BaseForm):
uid = forms.TextInputField(
- TooltipLabel(_('User ID'),_('If not passed, the default value is streaming_asr_demo')),
+ TooltipLabel(_("User ID"), _("If not passed, the default value is streaming_asr_demo")),
required=True,
- default_value='streaming_asr_demo'
+ default_value="streaming_asr_demo",
)
-
class VolcanicEngineSTTModelCredential(BaseForm, BaseModelCredential):
- volcanic_api_url = forms.TextInputField('API URL', required=True,
- default_value='wss://openspeech.bytedance.com/api/v2/asr')
- volcanic_app_id = forms.TextInputField('App ID', required=True)
- volcanic_token = forms.PasswordInputField('Access Token', required=True)
- volcanic_cluster = forms.TextInputField('Cluster ID', required=True)
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ volcanic_api_url = forms.TextInputField(
+ "API URL", required=True, default_value="wss://openspeech.bytedance.com/api/v2/asr"
+ )
+ volcanic_app_id = forms.TextInputField("App ID", required=True)
+ volcanic_token = forms.PasswordInputField("Access Token", required=True)
+ volcanic_cluster = forms.TextInputField("Cluster ID", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['volcanic_api_url', 'volcanic_app_id', 'volcanic_token', 'volcanic_cluster']:
+ for key in ["volcanic_api_url", "volcanic_app_id", "volcanic_token", "volcanic_cluster"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'volcanic_token': super().encryption(model.get('volcanic_token', ''))}
+ return {**model, "volcanic_token": super().encryption(model.get("volcanic_token", ""))}
def get_model_params_setting_form(self, model_name):
return VolcanicEngineSTTModelParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/tti.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/tti.py
index 139325bfb76..bca8f3fa6d1 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/tti.py
@@ -12,61 +12,78 @@
class VolcanicEngineTTIModelGeneralParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('If the gap between width, height and 512 is too large, the picture rendering effect will be poor and the probability of excessive delay will increase significantly. Recommended ratio and corresponding width and height before super score: width*height')),
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "If the gap between width, height and 512 is too large, the picture rendering effect will be poor and the probability of excessive delay will increase significantly. Recommended ratio and corresponding width and height before super score: width*height"
+ ),
+ ),
required=True,
- default_value='512x512',
+ default_value="512x512",
option_list=[
- {'label': '512x512', 'value': '512x512'},
- {'label': '1024x1024', 'value': '1024x1024'},
- {'label': '864x1152', 'value': '864x1152'},
- {'label': '1152x864', 'value': '1152x864'},
- {'label': '1280x720', 'value': '1280x720'},
- {'label': '720x1280', 'value': '720x1280'},
- {'label': '832x1248', 'value': '832x1248'},
- {'label': '1248x832', 'value': '1248x832'},
- {'label': '1512x648', 'value': '1512x648'},
-
+ {"label": "512x512", "value": "512x512"},
+ {"label": "1024x1024", "value": "1024x1024"},
+ {"label": "864x1152", "value": "864x1152"},
+ {"label": "1152x864", "value": "1152x864"},
+ {"label": "1280x720", "value": "1280x720"},
+ {"label": "720x1280", "value": "720x1280"},
+ {"label": "832x1248", "value": "832x1248"},
+ {"label": "1248x832", "value": "1248x832"},
+ {"label": "1512x648", "value": "1512x648"},
],
- text_field='label',
- value_field='value')
+ text_field="label",
+ value_field="value",
+ )
class VolcanicEngineTTIModelCredential(BaseForm, BaseModelCredential):
- volcanic_api_url = forms.TextInputField('API URL', required=True,
- default_value='https://ark.cn-beijing.volces.com/api/v3')
- api_key = forms.PasswordInputField('Api key', required=True)
+ volcanic_api_url = forms.TextInputField(
+ "API URL", required=True, default_value="https://ark.cn-beijing.volces.com/api/v3"
+ )
+ api_key = forms.PasswordInputField("Api key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key']:
+ for key in ["api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return VolcanicEngineTTIModelGeneralParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/tts.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/tts.py
index 2fda2db37ad..1f208e7e5c2 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/tts.py
@@ -9,69 +9,123 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class VolcanicEngineTTSModelGeneralParams(BaseForm):
voice_type = forms.SingleSelect(
- TooltipLabel(_('timbre'), _('Chinese sounds can support mixed scenes of Chinese and English')),
- required=True, default_value='zh_female_cancan_mars_bigtts',
- text_field='value',
- value_field='value',
+ TooltipLabel(_("timbre"), _("Chinese sounds can support mixed scenes of Chinese and English")),
+ required=True,
+ default_value="zh_female_cancan_mars_bigtts",
+ text_field="label",
+ value_field="value",
+ option_list=[
+ {"label": "灿灿/Shiny", "value": "zh_female_cancan_mars_bigtts"},
+ {"label": "清新女声", "value": "zh_female_qingxinnvsheng_mars_bigtts"},
+ {"label": "爽快思思/Skye", "value": "zh_female_shuangkuaisisi_moon_bigtts"},
+ {"label": "湾区大叔", "value": "zh_female_wanqudashu_moon_bigtts"},
+ {"label": "呆萌川妹", "value": "zh_female_daimengchuanmei_moon_bigtts"},
+ {"label": "广州德哥", "value": "zh_male_guozhoudege_moon_bigtts"},
+ {"label": "北京小爷", "value": "zh_male_beijingxiaoye_moon_bigtts"},
+ {"label": "少年梓辛/Brayan", "value": "zh_male_shaonianzixin_moon_bigtts"},
+ {"label": "魅力女友", "value": "zh_female_meilinvyou_moon_bigtts"},
+ ],
+ )
+ format = forms.SingleSelect(
+ TooltipLabel(_("audio format"), _("The streaming scenario recommends pcm")),
+ required=True,
+ default_value="mp3",
+ text_field="label",
+ value_field="value",
+ option_list=[
+ {"label": "mp3", "value": "mp3"},
+ {"label": "pcm", "value": "pcm"},
+ {"label": "ogg_opus", "value": "ogg_opus"},
+ {"label": "wav", "value": "wav"},
+ ],
+ )
+ sample_rate = forms.SingleSelect(
+ TooltipLabel(_("sample rate"), _("ogg_opus only supports 48000")),
+ required=True,
+ default_value=24000,
+ text_field="label",
+ value_field="value",
option_list=[
- {'text': '灿灿/Shiny', 'value': 'zh_female_cancan_mars_bigtts'},
- {'text': '清新女声', 'value': 'zh_female_qingxinnvsheng_mars_bigtts'},
- {'text': '爽快思思/Skye', 'value': 'zh_female_shuangkuaisisi_moon_bigtts'},
- {'text': '湾区大叔', 'value': 'zh_female_wanqudashu_moon_bigtts' },
- {'text': '呆萌川妹', 'value': 'zh_female_daimengchuanmei_moon_bigtts'},
- {'text': '广州德哥', 'value': 'zh_male_guozhoudege_moon_bigtts'},
- {'text': '北京小爷', 'value': 'zh_male_beijingxiaoye_moon_bigtts'},
- {'text': '少年梓辛/Brayan', 'value': 'zh_male_shaonianzixin_moon_bigtts'},
- {'text': '魅力女友', 'value': 'zh_female_meilinvyou_moon_bigtts'},
- ])
- speed_ratio = forms.SliderField(
- TooltipLabel(_('speaking speed'), _('[0.2,3], the default is 1, usually one decimal place is enough')),
- required=True, default_value=1,
- _min=0.2,
- _max=3,
- _step=0.1,
- precision=1)
+ {"label": "8000", "value": 8000},
+ {"label": "16000", "value": 16000},
+ {"label": "22050", "value": 22050},
+ {"label": "24000", "value": 24000},
+ {"label": "32000", "value": 32000},
+ {"label": "44100", "value": 44100},
+ {"label": "48000", "value": 48000},
+ ],
+ )
+ speech_rate = forms.SliderField(
+ TooltipLabel(_("speaking speed"), _("[-50,100], 100 means 2x speed, -50 means 0.5x speed")),
+ required=True,
+ default_value=0,
+ _min=-50,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
+ loudness_rate = forms.SliderField(
+ TooltipLabel(_("volume"), _("[-50,100], 100 means 2x volume, -50 means 0.5x volume")),
+ required=True,
+ default_value=0,
+ _min=-50,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class VolcanicEngineTTSModelCredential(BaseForm, BaseModelCredential):
- volcanic_api_url = forms.TextInputField('API URL', required=True,
- default_value='wss://openspeech.bytedance.com/api/v1/tts/ws_binary')
- volcanic_app_id = forms.TextInputField('App ID', required=True)
- volcanic_token = forms.PasswordInputField('Access Token', required=True)
- volcanic_cluster = forms.TextInputField('Cluster ID', required=True)
+ api_url = forms.TextInputField(
+ "API URL", required=True, default_value="https://openspeech.bytedance.com/api/v3/tts/unidirectional"
+ )
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['volcanic_api_url', 'volcanic_app_id', 'volcanic_token', 'volcanic_cluster']:
+ for key in ["api_url", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'volcanic_token': super().encryption(model.get('volcanic_token', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return VolcanicEngineTTSModelGeneralParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/credential/ttv.py b/apps/models_provider/impl/volcanic_engine_model_provider/credential/ttv.py
index 3dfb143c003..ea6f5f7574b 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/credential/ttv.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/credential/ttv.py
@@ -13,79 +13,91 @@
class VolcanicEngineTTVModelGeneralParams(BaseForm):
resolution = SingleSelect(
- TooltipLabel(_('Resolution'), _('Resolution')),
+ TooltipLabel(_("Resolution"), _("Resolution")),
required=True,
- default_value='480P',
+ default_value="480p",
option_list=[
- {'value': '480P', 'label': '480P'},
- {'value': '720P', 'label': '720P'},
- {'value': '1080P', 'label': '1080P'},
+ {"value": "480p", "label": "480p"},
+ {"value": "720p", "label": "720p"},
+ {"value": "1080p", "label": "1080p"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
ratio = SingleSelect(
- TooltipLabel(_('Ratio'), _('Ratio')),
+ TooltipLabel(_("Ratio"), _("Ratio")),
required=True,
- default_value='16:9',
+ default_value="16:9",
option_list=[
- {'value': '16:9', 'label': '16:9'},
- {'value': '9:16', 'label': '9:16'},
- {'value': '1:1', 'label': '1:1'},
- {'value': '4:3', 'label': '4:3'},
- {'value': '3:4', 'label': '3:4'},
- {'value': '21:9', 'label': '21:9'},
+ {"value": "16:9", "label": "16:9"},
+ {"value": "9:16", "label": "9:16"},
+ {"value": "1:1", "label": "1:1"},
+ {"value": "4:3", "label": "4:3"},
+ {"value": "3:4", "label": "3:4"},
+ {"value": "21:9", "label": "21:9"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
duration = TextInputField(
- TooltipLabel(_('Duration'), _('Duration')),
+ TooltipLabel(_("Duration"), _("Duration")),
required=True,
default_value=5,
)
watermark = SwitchField(
- TooltipLabel(_('Watermark'), _('Whether to add watermark')),
+ TooltipLabel(_("Watermark"), _("Whether to add watermark")),
attrs={"active-value": True, "inactive-value": False},
default_value=False,
)
class VolcanicEngineTTVModelCredential(BaseForm, BaseModelCredential):
- base_url = forms.TextInputField('Base URL', required=True, default_value='https://ark.cn-beijing.volces.com/api/v3')
- api_key = forms.PasswordInputField('Api key', required=True)
+ base_url = forms.TextInputField("Base URL", required=True, default_value="https://ark.cn-beijing.volces.com/api/v3")
+ api_key = forms.PasswordInputField("Api key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'base_url']:
+ for key in ["api_key", "base_url"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return VolcanicEngineTTVModelGeneralParams()
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/bigModel_stt.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/bigModel_stt.py
index 2bc00d50817..d2d56c4c730 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/bigModel_stt.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/bigModel_stt.py
@@ -28,14 +28,14 @@ def determine_api_mode(url):
"""
根据URL判断API模式
"""
- if '/recognize/flash' in url:
- return 'sync'
- elif '/submit' in url:
- return 'async_submit'
- elif '/query' in url:
- return 'async_query'
+ if "/recognize/flash" in url:
+ return "sync"
+ elif "/submit" in url:
+ return "async_submit"
+ elif "/query" in url:
+ return "async_query"
else:
- return 'unknown'
+ return "unknown"
class VolcanicASRClient:
@@ -52,35 +52,41 @@ def _build_headers(self, url, task_id=None, x_tt_logid=None):
"X-Api-Access-Key": self.token,
}
- if mode == 'sync':
- headers.update({
- "X-Api-Resource-Id": "volc.bigasr.auc_turbo",
- "X-Api-Request-Id": str(uuid.uuid4()),
- "X-Api-Sequence": "-1",
- })
- elif mode == 'async_submit':
- headers.update({
- "X-Api-Resource-Id": "volc.bigasr.auc",
- "X-Api-Request-Id": task_id or str(uuid.uuid4()),
- "X-Api-Sequence": "-1",
- })
- elif mode == 'async_query':
- headers.update({
- "X-Api-Resource-Id": "volc.bigasr.auc",
- "X-Api-Request-Id": task_id or str(uuid.uuid4()),
- "X-Tt-Logid": x_tt_logid or "",
- })
+ if mode == "sync":
+ headers.update(
+ {
+ "X-Api-Resource-Id": "volc.bigasr.auc_turbo",
+ "X-Api-Request-Id": str(uuid.uuid4()),
+ "X-Api-Sequence": "-1",
+ }
+ )
+ elif mode == "async_submit":
+ headers.update(
+ {
+ "X-Api-Resource-Id": "volc.bigasr.auc",
+ "X-Api-Request-Id": task_id or str(uuid.uuid4()),
+ "X-Api-Sequence": "-1",
+ }
+ )
+ elif mode == "async_query":
+ headers.update(
+ {
+ "X-Api-Resource-Id": "volc.bigasr.auc",
+ "X-Api-Request-Id": task_id or str(uuid.uuid4()),
+ "X-Tt-Logid": x_tt_logid or "",
+ }
+ )
return headers
- def _create_request_body(self, audio_data, mode='sync'):
+ def _create_request_body(self, audio_data, mode="sync"):
"""创建请求体"""
base_request = {
- "user": {"uid": self.appid if mode == 'sync' else "fake_uid"},
+ "user": {"uid": self.appid if mode == "sync" else "fake_uid"},
"audio": audio_data,
}
- if mode == 'sync':
+ if mode == "sync":
base_request["request"] = {
"model_name": "bigmodel",
"enable_itn": True,
@@ -95,10 +101,7 @@ def _create_request_body(self, audio_data, mode='sync'):
"enable_speaker_info": True,
"enable_punc": True,
"enable_itn": True,
- "corpus": {
- "correct_table_name": "",
- "context": ""
- }
+ "corpus": {"correct_table_name": "", "context": ""},
}
return base_request
@@ -114,9 +117,9 @@ def process_audio(self, audio_file=None, submit_url=None):
# 根据URL判断API模式
mode = determine_api_mode(submit_url)
- if mode == 'sync':
+ if mode == "sync":
return self._sync_recognize(audio_data, submit_url)
- elif mode == 'async_submit':
+ elif mode == "async_submit":
return self._async_process(audio_data, submit_url)
else:
raise ValueError(f"Unsupported URL pattern: {submit_url}")
@@ -129,7 +132,7 @@ def _get_audio_data(self, audio_file):
def _sync_recognize(self, audio_data, submit_url):
"""同步识别模式"""
headers = self._build_headers(submit_url)
- request_body = self._create_request_body(audio_data, mode='sync')
+ request_body = self._create_request_body(audio_data, mode="sync")
response = requests.post(submit_url, json=request_body, headers=headers)
return self._handle_response(response, "sync_recognize")
@@ -139,7 +142,7 @@ def _async_process(self, audio_data, submit_url):
# 提交任务
task_id = str(uuid.uuid4())
headers = self._build_headers(submit_url, task_id=task_id)
- request_body = self._create_request_body(audio_data, mode='async')
+ request_body = self._create_request_body(audio_data, mode="async")
submit_response = requests.post(submit_url, data=json.dumps(request_body), headers=headers)
@@ -157,11 +160,11 @@ def _poll_for_result(self, task_id, x_tt_logid):
while True:
query_response = self._query_task(task_id, x_tt_logid, query_url)
- code = query_response.headers.get('X-Api-Status-Code', "")
+ code = query_response.headers.get("X-Api-Status-Code", "")
- if code == '20000000': # 任务完成
+ if code == "20000000": # 任务完成
return query_response
- elif code != '20000001' and code != '20000002': # 任务失败
+ elif code != "20000001" and code != "20000002": # 任务失败
print(f"Async task failed with code: {code}")
return None
time.sleep(1)
@@ -174,18 +177,18 @@ def _query_task(self, task_id, x_tt_logid, query_url):
def _handle_response(self, response, operation, silent=False):
"""处理响应"""
- if 'X-Api-Status-Code' in response.headers:
+ if "X-Api-Status-Code" in response.headers:
if not silent:
- print(f'{operation} response header X-Api-Status-Code: {response.headers["X-Api-Status-Code"]}')
- print(f'{operation} response header X-Api-Message: {response.headers["X-Api-Message"]}')
- print(f'{operation} response header X-Tt-Logid: {response.headers["X-Tt-Logid"]}')
+ print(f"{operation} response header X-Api-Status-Code: {response.headers['X-Api-Status-Code']}")
+ print(f"{operation} response header X-Api-Message: {response.headers['X-Api-Message']}")
+ print(f"{operation} response header X-Tt-Logid: {response.headers['X-Tt-Logid']}")
if operation == "sync_recognize":
- print(f'sync response content: {response.json()}\n')
+ print(f"sync response content: {response.json()}\n")
return response
else:
- print(f'{operation} failed: {response.headers}\n')
+ print(f"{operation} failed: {response.headers}\n")
return None
@@ -197,10 +200,10 @@ class VolcanicEngineBigModelSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.volcanic_api_url = kwargs.get('volcanic_api_url')
- self.volcanic_token = kwargs.get('volcanic_token')
- self.volcanic_app_id = kwargs.get('volcanic_app_id')
- self.params = kwargs.get('params')
+ self.volcanic_api_url = kwargs.get("volcanic_api_url")
+ self.volcanic_token = kwargs.get("volcanic_token")
+ self.volcanic_app_id = kwargs.get("volcanic_app_id")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -209,20 +212,20 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return VolcanicEngineBigModelSpeechToText(
- volcanic_api_url=model_credential.get('volcanic_api_url'),
- volcanic_token=model_credential.get('volcanic_token'),
- volcanic_app_id=model_credential.get('volcanic_app_id'),
+ volcanic_api_url=model_credential.get("volcanic_api_url"),
+ volcanic_token=model_credential.get("volcanic_token"),
+ volcanic_app_id=model_credential.get("volcanic_app_id"),
params=model_kwargs,
)
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as audio_file:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as audio_file:
self.speech_to_text(audio_file)
def speech_to_text(self, audio_file):
@@ -230,6 +233,6 @@ def speech_to_text(self, audio_file):
client = VolcanicASRClient(self.volcanic_app_id, self.volcanic_token)
result = client.process_audio(audio_file, self.volcanic_api_url)
if result.status_code == 200:
- return result.json().get('result').get('text')
+ return result.json().get("result").get("text")
except Exception as e:
- maxkb_logger.error(f'Error getting speech to text: {e}')
+ maxkb_logger.error(f"Error getting speech to text: {e}")
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/embedding.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/embedding.py
index c4474871667..a208a8be41f 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/embedding.py
@@ -1,20 +1,17 @@
from typing import Dict, List
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
from volcenginesdkarkruntime import Ark
-class VolcanicEngineEmbeddingModel(MaxKBBaseModel):
+class VolcanicEngineEmbeddingModel(MaxKBBaseEmbeddingModel):
api_key: str
model_name: str
api_base: str
params: Dict[str, object]
def __init__(self, api_key: str, model: str, api_base: str, **params):
- self.client = Ark(
- api_key=api_key,
- base_url=api_base
- )
+ self.client = Ark(api_key=api_key, base_url=api_base)
self.model_name = model
self.params = params
@@ -24,42 +21,52 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
+ optional_params = MaxKBBaseEmbeddingModel.filter_optional_params(model_kwargs)
return VolcanicEngineEmbeddingModel(
api_key=model_credential.get("api_key"),
model=model_name,
api_base=model_credential.get("api_base"),
- **optional_params
+ **optional_params,
)
def embed_query(self, text: str):
res = self.embed_documents([text])
return res[0]
- def embed_documents(
- self, texts: List[str]
- ) -> List[List[float]]:
+ def embed_documents(self, texts: List[str]) -> List[List[float]]:
if self.model_name.startswith("doubao-embedding-vision-"):
embeddings = []
for text in texts:
multimodal_input = {"type": "text", "text": text}
resp = self.client.multimodal_embeddings.create(
- model=self.model_name,
- input=[multimodal_input],
- encoding_format="float",
- **(self.params or {})
+ model=self.model_name, input=[multimodal_input], encoding_format="float", **(self.params or {})
)
embedding = self._extract_embedding(resp.data)
if embedding is not None:
embeddings.append(embedding)
return embeddings
else:
- resp = self.client.embeddings.create(
+ resp = self.client.embeddings.create(model=self.model_name, input=texts, **(self.params or {}))
+ return [e.embedding for e in resp.data]
+
+ def supports_image_embedding(self) -> bool:
+ return self.model_name.startswith("doubao-embedding-vision-")
+
+ def embed_images(self, images: List[str]) -> List[List[float]]:
+ if not self.supports_image_embedding():
+ return []
+ embeddings = []
+ for image in images:
+ resp = self.client.multimodal_embeddings.create(
model=self.model_name,
- input=texts,
- **(self.params or {})
+ input=[{"type": "image_url", "image_url": {"url": image}}],
+ encoding_format="float",
+ **(self.params or {}),
)
- return [e.embedding for e in resp.data]
+ value = self._extract_embedding(resp.data)
+ if value is not None:
+ embeddings.append(value)
+ return embeddings
def _extract_embedding(self, data):
if isinstance(data, list) and len(data) > 0:
@@ -67,10 +74,10 @@ def _extract_embedding(self, data):
else:
item = data
- if hasattr(item, 'embedding'):
+ if hasattr(item, "embedding"):
return item.embedding
elif isinstance(item, dict):
- return item.get('embedding')
+ return item.get("embedding")
elif isinstance(item, list):
return item
return None
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/image.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/image.py
index 57300637de1..0e63bb88325 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/image.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/image.py
@@ -1,5 +1,3 @@
-import base64
-import mimetypes
from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
@@ -7,14 +5,13 @@
class VolcanicEngineImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return VolcanicEngineImage(
model_name=model_name,
- openai_api_key=model_credential.get('api_key'),
- openai_api_base=model_credential.get('api_base'),
+ openai_api_key=model_credential.get("api_key"),
+ openai_api_base=model_credential.get("api_base"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
@@ -24,6 +21,3 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
@staticmethod
def is_cache_model():
return False
-
-
-
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/llm.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/llm.py
index fd2e8852df6..22f2e4e1a06 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/llm.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/llm.py
@@ -1,4 +1,4 @@
-from typing import List, Dict
+from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
@@ -15,7 +15,7 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return VolcanicEngineChatModel(
model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
**optional_params,
)
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/stt.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/stt.py
index bc0e5128f49..83b2ca04c71 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/stt.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/stt.py
@@ -6,12 +6,12 @@
pip install asyncio
pip install websockets
"""
+
import asyncio
import base64
import gzip
import hmac
import json
-import logging
import os
import ssl
import uuid_utils.compat as uuid
@@ -70,13 +70,13 @@
def generate_header(
- version=PROTOCOL_VERSION,
- message_type=CLIENT_FULL_REQUEST,
- message_type_specific_flags=NO_SEQUENCE,
- serial_method=JSON,
- compression_type=GZIP,
- reserved_data=0x00,
- extension_header=bytes()
+ version=PROTOCOL_VERSION,
+ message_type=CLIENT_FULL_REQUEST,
+ message_type_specific_flags=NO_SEQUENCE,
+ serial_method=JSON,
+ compression_type=GZIP,
+ reserved_data=0x00,
+ extension_header=bytes(),
):
"""
protocol_version(4 bits), header_size(4 bits),
@@ -100,16 +100,11 @@ def generate_full_default_header():
def generate_audio_default_header():
- return generate_header(
- message_type=CLIENT_AUDIO_ONLY_REQUEST
- )
+ return generate_header(message_type=CLIENT_AUDIO_ONLY_REQUEST)
def generate_last_audio_default_header():
- return generate_header(
- message_type=CLIENT_AUDIO_ONLY_REQUEST,
- message_type_specific_flags=NEG_SEQUENCE
- )
+ return generate_header(message_type=CLIENT_AUDIO_ONLY_REQUEST, message_type_specific_flags=NEG_SEQUENCE)
def parse_response(res):
@@ -122,14 +117,14 @@ def parse_response(res):
payload 类似与http 请求体
"""
protocol_version = res[0] >> 4
- header_size = res[0] & 0x0f
+ header_size = res[0] & 0x0F
message_type = res[1] >> 4
- message_type_specific_flags = res[1] & 0x0f
+ message_type_specific_flags = res[1] & 0x0F
serialization_method = res[2] >> 4
- message_compression = res[2] & 0x0f
+ message_compression = res[2] & 0x0F
reserved = res[3]
- header_extensions = res[4:header_size * 4]
- payload = res[header_size * 4:]
+ header_extensions = res[4 : header_size * 4]
+ payload = res[header_size * 4 :]
result = {}
payload_msg = None
payload_size = 0
@@ -138,13 +133,13 @@ def parse_response(res):
payload_msg = payload[4:]
elif message_type == SERVER_ACK:
seq = int.from_bytes(payload[:4], "big", signed=True)
- result['seq'] = seq
+ result["seq"] = seq
if len(payload) >= 8:
payload_size = int.from_bytes(payload[4:8], "big", signed=False)
payload_msg = payload[8:]
elif message_type == SERVER_ERROR_RESPONSE:
code = int.from_bytes(payload[:4], "big", signed=False)
- result['code'] = code
+ result["code"] = code
payload_size = int.from_bytes(payload[4:8], "big", signed=False)
payload_msg = payload[8:]
maxkb_logger.error(f"Error code: {code}, message: {payload_msg}")
@@ -156,14 +151,14 @@ def parse_response(res):
payload_msg = json.loads(str(payload_msg, "utf-8"))
elif serialization_method != NO_SERIALIZATION:
payload_msg = str(payload_msg, "utf-8")
- result['payload_msg'] = payload_msg
- result['payload_size'] = payload_size
+ result["payload_msg"] = payload_msg
+ result["payload_size"] = payload_size
return result
def read_wav_info(data: bytes = None) -> (int, int, int, int, int):
with BytesIO(data) as _f:
- wave_fp = wave.open(_f, 'rb')
+ wave_fp = wave.open(_f, "rb")
nchannels, sampwidth, framerate, nframes = wave_fp.getparams()[:4]
wave_bytes = wave_fp.readframes(nframes)
return nchannels, sampwidth, framerate, nframes, len(wave_bytes)
@@ -196,11 +191,11 @@ class VolcanicEngineSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.volcanic_api_url = kwargs.get('volcanic_api_url')
- self.volcanic_token = kwargs.get('volcanic_token')
- self.volcanic_app_id = kwargs.get('volcanic_app_id')
- self.volcanic_cluster = kwargs.get('volcanic_cluster')
- self.params = kwargs.get('params')
+ self.volcanic_api_url = kwargs.get("volcanic_api_url")
+ self.volcanic_token = kwargs.get("volcanic_token")
+ self.volcanic_app_id = kwargs.get("volcanic_app_id")
+ self.volcanic_cluster = kwargs.get("volcanic_cluster")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -209,49 +204,47 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return VolcanicEngineSpeechToText(
- volcanic_api_url=model_credential.get('volcanic_api_url'),
- volcanic_token=model_credential.get('volcanic_token'),
- volcanic_app_id=model_credential.get('volcanic_app_id'),
- volcanic_cluster=model_credential.get('volcanic_cluster'),
+ volcanic_api_url=model_credential.get("volcanic_api_url"),
+ volcanic_token=model_credential.get("volcanic_token"),
+ volcanic_app_id=model_credential.get("volcanic_app_id"),
+ volcanic_cluster=model_credential.get("volcanic_cluster"),
params=model_kwargs,
**model_kwargs,
- **optional_params
+ **optional_params,
)
def construct_request(self, reqid):
params = self.params or {}
req = {
- 'app': {
- 'appid': self.volcanic_app_id,
- 'cluster': self.volcanic_cluster,
- 'token': self.volcanic_token,
+ "app": {
+ "appid": self.volcanic_app_id,
+ "cluster": self.volcanic_cluster,
+ "token": self.volcanic_token,
},
- 'user': {
- 'uid': params.get("uid", "streaming_asr_demo")
+ "user": {"uid": params.get("uid", "streaming_asr_demo")},
+ "request": {
+ "reqid": reqid,
+ "nbest": params.get("nbest", self.nbest),
+ "workflow": params.get("workflow", self.workflow),
+ "show_language": params.get("show_language", self.show_language),
+ "show_utterances": params.get("show_utterances", self.show_utterances),
+ "result_type": params.get("result_type", self.result_type),
+ "sequence": params.get("sequence", 1),
},
- 'request': {
- 'reqid': reqid,
- 'nbest': params.get('nbest', self.nbest),
- 'workflow': params.get('workflow', self.workflow),
- 'show_language': params.get('show_language', self.show_language),
- 'show_utterances': params.get('show_utterances', self.show_utterances),
- 'result_type': params.get('result_type', self.result_type),
- 'sequence': params.get('sequence', 1)
+ "audio": {
+ "format": params.get("format", self.format),
+ "rate": params.get("rate", self.rate),
+ "language": params.get("language", self.language),
+ "bits": params.get("bits", self.bits),
+ "channel": params.get("channel", self.channel),
+ "codec": params.get("codec", self.codec),
},
- 'audio': {
- 'format': params.get('format', self.format),
- 'rate': params.get('rate', self.rate),
- 'language': params.get('language', self.language),
- 'bits': params.get('bits', self.bits),
- 'channel': params.get('channel', self.channel),
- 'codec': params.get('codec', self.codec)
- }
}
return req
@@ -266,34 +259,33 @@ def slice_data(data: bytes, chunk_size: int) -> (list, bool):
data_len = len(data)
offset = 0
while offset + chunk_size < data_len:
- yield data[offset: offset + chunk_size], False
+ yield data[offset : offset + chunk_size], False
offset += chunk_size
else:
- yield data[offset: data_len], True
+ yield data[offset:data_len], True
def _real_processor(self, request_params: dict) -> dict:
pass
def token_auth(self):
- return {'Authorization': 'Bearer; {}'.format(self.volcanic_token)}
+ return {"Authorization": "Bearer; {}".format(self.volcanic_token)}
def signature_auth(self, data):
header_dicts = {
- 'Custom': 'auth_custom',
+ "Custom": "auth_custom",
}
url_parse = urlparse(self.volcanic_api_url)
- input_str = 'GET {} HTTP/1.1\n'.format(url_parse.path)
- auth_headers = 'Custom'
- for header in auth_headers.split(','):
- input_str += '{}\n'.format(header_dicts[header])
- input_data = bytearray(input_str, 'utf-8')
+ input_str = "GET {} HTTP/1.1\n".format(url_parse.path)
+ auth_headers = "Custom"
+ for header in auth_headers.split(","):
+ input_str += "{}\n".format(header_dicts[header])
+ input_data = bytearray(input_str, "utf-8")
input_data += data
- mac = base64.urlsafe_b64encode(
- hmac.new(self.secret.encode('utf-8'), input_data, digestmod=sha256).digest())
- header_dicts['Authorization'] = 'HMAC256; access_token="{}"; mac="{}"; h="{}"'.format(self.volcanic_token,
- str(mac, 'utf-8'),
- auth_headers)
+ mac = base64.urlsafe_b64encode(hmac.new(self.secret.encode("utf-8"), input_data, digestmod=sha256).digest())
+ header_dicts["Authorization"] = 'HMAC256; access_token="{}"; mac="{}"; h="{}"'.format(
+ self.volcanic_token, str(mac, "utf-8"), auth_headers
+ )
return header_dicts
async def segment_data_processor(self, wav_data: bytes, segment_size: int):
@@ -303,41 +295,43 @@ async def segment_data_processor(self, wav_data: bytes, segment_size: int):
payload_bytes = str.encode(json.dumps(request_params))
payload_bytes = gzip.compress(payload_bytes)
full_client_request = bytearray(generate_full_default_header())
- full_client_request.extend((len(payload_bytes)).to_bytes(4, 'big')) # payload size(4 bytes)
+ full_client_request.extend((len(payload_bytes)).to_bytes(4, "big")) # payload size(4 bytes)
full_client_request.extend(payload_bytes) # payload
header = None
if self.auth_method == "token":
header = self.token_auth()
elif self.auth_method == "signature":
header = self.signature_auth(full_client_request)
- async with websockets.connect(self.volcanic_api_url, additional_headers=header, max_size=1000000000,
- ssl=ssl_context) as ws:
+ async with websockets.connect(
+ self.volcanic_api_url, additional_headers=header, max_size=1000000000, ssl=ssl_context
+ ) as ws:
# 发送 full client request
await ws.send(full_client_request)
res = await ws.recv()
result = parse_response(res)
- if 'payload_msg' in result and result['payload_msg']['code'] != self.success_code:
+ if "payload_msg" in result and result["payload_msg"]["code"] != self.success_code:
raise Exception(
- f"Error code: {result['payload_msg']['code']}, message: {result['payload_msg']['message']}")
+ f"Error code: {result['payload_msg']['code']}, message: {result['payload_msg']['message']}"
+ )
for seq, (chunk, last) in enumerate(VolcanicEngineSpeechToText.slice_data(wav_data, segment_size), 1):
# if no compression, comment this line
payload_bytes = gzip.compress(chunk)
audio_only_request = bytearray(generate_audio_default_header())
if last:
audio_only_request = bytearray(generate_last_audio_default_header())
- audio_only_request.extend((len(payload_bytes)).to_bytes(4, 'big')) # payload size(4 bytes)
+ audio_only_request.extend((len(payload_bytes)).to_bytes(4, "big")) # payload size(4 bytes)
audio_only_request.extend(payload_bytes) # payload
# 发送 audio-only client request
await ws.send(audio_only_request)
res = await ws.recv()
result = parse_response(res)
- if 'payload_msg' in result and result['payload_msg']['code'] != self.success_code:
+ if "payload_msg" in result and result["payload_msg"]["code"] != self.success_code:
return result
- return result['payload_msg']['result'][0]['text']
+ return result["payload_msg"]["result"][0]["text"]
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as f:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as f:
self.speech_to_text(f)
def speech_to_text(self, file):
@@ -348,8 +342,7 @@ def speech_to_text(self, file):
return asyncio.run(self.segment_data_processor(audio_data, segment_size))
if self.format != "wav":
raise Exception("format should in wav or mp3")
- nchannels, sampwidth, framerate, nframes, wav_len = read_wav_info(
- audio_data)
+ nchannels, sampwidth, framerate, nframes, wav_len = read_wav_info(audio_data)
size_per_sec = nchannels * sampwidth * framerate
segment_size = int(size_per_sec * self.seg_duration / 1000)
return asyncio.run(self.segment_data_processor(audio_data, segment_size))
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/tti.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/tti.py
index d0d26e32b47..432d002da9e 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/tti.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/tti.py
@@ -1,12 +1,13 @@
# coding=utf-8
-'''
+"""
requires Python 3.6 or later
pip install asyncio
pip install websockets
-'''
+"""
+
from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.impl.base_tti import BaseTextToImage
@@ -22,10 +23,10 @@ class VolcanicEngineTextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model_version = kwargs.get('model_version')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model_version = kwargs.get("model_version")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -33,15 +34,15 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return VolcanicEngineTextToImage(
model_version=model_name,
- api_key=model_credential.get('api_key'),
- api_base=model_credential.get('volcanic_api_url') or 'https://ark-api.volcengine.com',
- **optional_params
+ api_key=model_credential.get("api_key"),
+ api_base=model_credential.get("volcanic_api_url") or "https://ark.cn-beijing.volces.com/api/v3",
+ **optional_params,
)
def check_auth(self):
@@ -55,25 +56,21 @@ def generate_image(self, prompt: str, negative_prompt: str = None):
api_key=self.api_key,
)
file_urls = []
- imagesResponse = client.images.generate(
- model=self.model_version,
- prompt=prompt,
- **self.params
- )
+ imagesResponse = client.images.generate(model=self.model_version, prompt=prompt, **self.params)
# 如果 data 是列表,遍历所有图片
if isinstance(imagesResponse.data, list):
for item in imagesResponse.data:
# 优先使用 URL,其次使用 base64
- if hasattr(item, 'url') and item.url:
+ if hasattr(item, "url") and item.url:
file_urls.append(item.url)
- elif hasattr(item, 'b64_json') and item.b64_json:
+ elif hasattr(item, "b64_json") and item.b64_json:
file_urls.append(item.b64_json)
else:
# 如果 data 是单个对象
item = imagesResponse.data
- if hasattr(item, 'url') and item.url:
+ if hasattr(item, "url") and item.url:
file_urls.append(item.url)
- elif hasattr(item, 'b64_json') and item.b64_json:
+ elif hasattr(item, "b64_json") and item.b64_json:
file_urls.append(item.b64_json)
return file_urls
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/tts.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/tts.py
index 5dd02f0b2d6..ba28788f218 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/tts.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/tts.py
@@ -1,184 +1,164 @@
# coding=utf-8
+"""
+单向流式语音合成 HTTP 接口。
-'''
-requires Python 3.6 or later
+接口文档: https://docs.volcengine.com/docs/6561/2528925
+"""
-pip install asyncio
-pip install websockets
-
-'''
-
-import asyncio
-import copy
-import gzip
+import base64
+import codecs
import json
-import re
-import ssl
-
-import requests
-import uuid_utils.compat as uuid
from typing import Dict
+from uuid import uuid4
-import websockets
+import requests
from django.utils.translation import gettext as _
from common.utils.common import _remove_empty_lines
+from common.utils.logger import maxkb_logger
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.impl.base_tts import BaseTextToSpeech
-MESSAGE_TYPES = {11: "audio-only server response", 12: "frontend server response", 15: "error message from server"}
-MESSAGE_TYPE_SPECIFIC_FLAGS = {0: "no sequence number", 1: "sequence number > 0",
- 2: "last message from server (seq < 0)", 3: "sequence number < 0"}
-MESSAGE_SERIALIZATION_METHODS = {0: "no serialization", 1: "JSON", 15: "custom type"}
-MESSAGE_COMPRESSIONS = {0: "no compression", 1: "gzip", 15: "custom compression method"}
+DEFAULT_API_URL = "https://openspeech.bytedance.com/api/v3/tts/unidirectional"
+DEFAULT_VOICE_TYPE = "zh_female_cancan_mars_bigtts"
+DEFAULT_FORMAT = "mp3"
+DEFAULT_SAMPLE_RATE = 24000
+
+# audio_params 中仅在用户显式设置时才透传的字段
+OPTIONAL_AUDIO_PARAM_KEYS = ("bit_rate",)
-# version: b0001 (4 bits)
-# header size: b0001 (4 bits)
-# message type: b0001 (Full client request) (4bits)
-# message type specific flags: b0000 (none) (4bits)
-# message serialization method: b0001 (JSON) (4 bits)
-# message compression: b0001 (gzip) (4bits)
-# reserved data: 0x00 (1 byte)
-default_header = bytearray(b'\x11\x10\x11\x00')
+# 音频发送完毕后服务端返回该结束码,属于正常结束
+STREAM_END_CODE = 20000000
-ssl_context = ssl.SSLContext(ssl.PROTOCOL_TLS_CLIENT)
-ssl_context.check_hostname = False
-ssl_context.verify_mode = ssl.CERT_NONE
+REQUEST_TIMEOUT = (10, 600)
class VolcanicEngineTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
- volcanic_app_id: str
- volcanic_cluster: str
- volcanic_api_url: str
- volcanic_token: str
+ api_url: str
+ api_key: str
+ model_name: str
params: dict
def __init__(self, **kwargs):
+ kwargs["api_url"] = kwargs.get("api_url") or DEFAULT_API_URL
+ kwargs["params"] = kwargs.get("params") or {}
super().__init__(**kwargs)
- self.volcanic_api_url = kwargs.get('volcanic_api_url')
- self.volcanic_token = kwargs.get('volcanic_token')
- self.volcanic_app_id = kwargs.get('volcanic_app_id')
- self.volcanic_cluster = kwargs.get('volcanic_cluster')
- self.params = kwargs.get('params')
+ self.api_url = kwargs.get("api_url")
+ self.api_key = kwargs.get("api_key")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params")
+
+ @staticmethod
+ def is_cache_model():
+ return False
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice_type': 'zh_female_cancan_mars_bigtts', 'speed_ratio': 1.0}}
+ optional_params = {
+ "params": {
+ "voice_type": DEFAULT_VOICE_TYPE,
+ "format": DEFAULT_FORMAT,
+ "sample_rate": DEFAULT_SAMPLE_RATE,
+ "speech_rate": 0,
+ "loudness_rate": 0,
+ }
+ }
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return VolcanicEngineTextToSpeech(
- volcanic_api_url=model_credential.get('volcanic_api_url'),
- volcanic_token=model_credential.get('volcanic_token'),
- volcanic_app_id=model_credential.get('volcanic_app_id'),
- volcanic_cluster=model_credential.get('volcanic_cluster'),
- **optional_params
+ api_url=model_credential.get("api_url"),
+ api_key=model_credential.get("api_key"),
+ model_name=model_name,
+ **optional_params,
)
def check_auth(self):
- self.text_to_speech(_('Hello'))
+ self.text_to_speech(_("Hello"))
+
+ def _build_audio_params(self) -> dict:
+ params = self.params or {}
+ audio_params = {
+ "format": params.get("format") or DEFAULT_FORMAT,
+ "sample_rate": int(params.get("sample_rate") or DEFAULT_SAMPLE_RATE),
+ "speech_rate": int(params.get("speech_rate") or 0),
+ "loudness_rate": int(params.get("loudness_rate") or 0),
+ }
+ for key in OPTIONAL_AUDIO_PARAM_KEYS:
+ value = params.get(key)
+ if value:
+ audio_params[key] = int(value)
+ return audio_params
+
+ def _build_req_params(self, text: str) -> dict:
+ params = self.params or {}
+ req_params = {
+ "text": text,
+ "speaker": params.get("voice_type") or DEFAULT_VOICE_TYPE,
+ "audio_params": self._build_audio_params(),
+ }
+ # 仅当 speaker 为复刻音色时需要指定模型版本
+ if params.get("model"):
+ req_params["model"] = params["model"]
+ return req_params
def text_to_speech(self, text):
- request_json = {
- "app": {
- "appid": self.volcanic_app_id,
- "token": "access_token",
- "cluster": self.volcanic_cluster
- },
- "user": {
- "uid": "uid"
- },
- "audio": {
- "encoding": "mp3",
- "volume_ratio": 1.0,
- "pitch_ratio": 1.0,
- } | self.params,
- "request": {
- "reqid": str(uuid.uuid7()),
- "text": '',
- "text_type": "plain",
- "operation": "xxx"
- }
+ headers = {
+ "X-Api-Key": self.api_key,
+ # 模型ID 即接口要求的 resource id(seed-tts-2.0 / seed-icl-2.0)
+ "X-Api-Resource-Id": self.model_name,
+ "X-Api-Request-Id": str(uuid4()),
+ "Content-Type": "application/json",
+ "Connection": "keep-alive",
}
- text = _remove_empty_lines(text)
-
- return asyncio.run(self.submit(request_json, text))
-
- def is_cache_model(self):
- return False
-
- def token_auth(self):
- return {'Authorization': 'Bearer; {}'.format(self.volcanic_token)}
-
- async def submit(self, request_json, text):
- submit_request_json = copy.deepcopy(request_json)
- submit_request_json["request"]["operation"] = "submit"
- header = {"Authorization": f"Bearer; {self.volcanic_token}"}
- result = b''
- async with websockets.connect(self.volcanic_api_url, additional_headers=header, ping_interval=None,
- ssl=ssl_context) as ws:
- lines = [text[i:i + 200] for i in range(0, len(text), 200)]
- for line in lines:
- if self.is_table_format_chars_only(line):
+ payload = {"req_params": self._build_req_params(_remove_empty_lines(text))}
+ audio = bytearray()
+ buffer = ""
+ decoder = codecs.getincrementaldecoder("utf-8")()
+ with requests.post(
+ self.api_url, json=payload, headers=headers, stream=True, timeout=REQUEST_TIMEOUT
+ ) as response:
+ if response.status_code != 200:
+ raise Exception(f"语音合成请求失败: HTTP {response.status_code}, {response.text[:500]}")
+ for chunk in response.iter_content(chunk_size=None):
+ if not chunk:
continue
- submit_request_json["request"]["reqid"] = str(uuid.uuid7())
- submit_request_json["request"]["text"] = line
- payload_bytes = str.encode(json.dumps(submit_request_json))
- payload_bytes = gzip.compress(payload_bytes) # if no compression, comment this line
- full_client_request = bytearray(default_header)
- full_client_request.extend((len(payload_bytes)).to_bytes(4, 'big')) # payload size(4 bytes)
- full_client_request.extend(payload_bytes) # payload
- await ws.send(full_client_request)
- result += await self.parse_response(ws)
- return result
-
- @staticmethod
- def is_table_format_chars_only(s):
- # 检查是否仅包含 "|", "-", 和空格字符
- return bool(s) and re.fullmatch(r'[|\-\s]+', s)
+ buffer += decoder.decode(chunk)
+ buffer, finished = self._consume(buffer, audio)
+ if finished:
+ break
+ if buffer.strip():
+ maxkb_logger.warning(f"语音合成响应存在未解析内容: {buffer[:200]}")
+ if not audio:
+ raise Exception("No audio data received")
+ return bytes(audio)
@staticmethod
- async def parse_response(ws):
- result = b''
- while True:
- res = await ws.recv()
- protocol_version = res[0] >> 4
- header_size = res[0] & 0x0f
- message_type = res[1] >> 4
- message_type_specific_flags = res[1] & 0x0f
- serialization_method = res[2] >> 4
- message_compression = res[2] & 0x0f
- reserved = res[3]
- header_extensions = res[4:header_size * 4]
- payload = res[header_size * 4:]
- if header_size != 1:
- # print(f" Header extensions: {header_extensions}")
- pass
- if message_type == 0xb: # audio-only server response
- if message_type_specific_flags == 0: # no sequence number as ACK
- continue
- else:
- sequence_number = int.from_bytes(payload[:4], "big", signed=True)
- payload_size = int.from_bytes(payload[4:8], "big", signed=False)
- payload = payload[8:]
- result += payload
- if sequence_number < 0:
- break
- else:
- continue
- elif message_type == 0xf:
- code = int.from_bytes(payload[:4], "big", signed=False)
- msg_size = int.from_bytes(payload[4:8], "big", signed=False)
- error_msg = payload[8:]
- if message_compression == 1:
- error_msg = gzip.decompress(error_msg)
- error_msg = str(error_msg, "utf-8")
- raise Exception(f"Error code: {code}, message: {error_msg}")
- elif message_type == 0xc:
- msg_size = int.from_bytes(payload[:4], "big", signed=False)
- payload = payload[4:]
- if message_compression == 1:
- payload = gzip.decompress(payload)
- else:
+ def _consume(content: str, audio: bytearray) -> tuple:
+ """解析缓冲区中已完整的 JSON 分片,把 base64 音频累加到 audio。
+
+ 返回 (未解析完的剩余内容, 是否已收到结束标记)
+ """
+ decoder = json.JSONDecoder()
+ index = 0
+ length = len(content)
+ while index < length:
+ while index < length and content[index] in " \r\n\t":
+ index += 1
+ if index >= length:
+ break
+ try:
+ chunk, end = decoder.raw_decode(content, index)
+ except ValueError:
+ # 分片不完整,等待后续内容
break
- return result
+ code = chunk.get("code", 0)
+ if code == STREAM_END_CODE:
+ return "", True
+ if code > 0:
+ raise Exception(f"Error code: {code}, message: {chunk.get('message')}")
+ data = chunk.get("data")
+ if data:
+ audio.extend(base64.b64decode(data))
+ index = end
+ return content[index:], False
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/model/ttv.py b/apps/models_provider/impl/volcanic_engine_model_provider/model/ttv.py
index 1ee6cf39aed..7693dbca331 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/model/ttv.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/model/ttv.py
@@ -1,11 +1,32 @@
-import base64
import time
-from typing import Dict, Optional
+from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.base_ttv import BaseGenerationVideo
from common.utils.logger import maxkb_logger
from volcenginesdkarkruntime import Ark
+# 视频生成接口支持的直接传参字段
+# 文档: https://www.volcengine.com/docs/82379/1520758
+VIDEO_PARAM_KEYS = (
+ "resolution",
+ "ratio",
+ "duration",
+ "frames",
+ "watermark",
+ "camera_fixed",
+ "seed",
+ "generate_audio",
+ "draft",
+ "return_last_frame",
+ "service_tier",
+ "callback_url",
+ "execution_expires_after",
+ "priority",
+ "safety_identifier",
+)
+
+INT_PARAM_KEYS = ("duration", "frames", "seed", "execution_expires_after", "priority")
+
class GenerationVideoModel(MaxKBBaseModel, BaseGenerationVideo):
api_key: str
@@ -17,10 +38,10 @@ class GenerationVideoModel(MaxKBBaseModel, BaseGenerationVideo):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.base_url = kwargs.get('base_url')
- self.model_name = kwargs.get('model_name')
- self.params = kwargs.get('params', {})
+ self.api_key = kwargs.get("api_key")
+ self.base_url = kwargs.get("base_url")
+ self.model_name = kwargs.get("model_name")
+ self.params = kwargs.get("params", {})
self.retry_delay = 5
@staticmethod
@@ -29,34 +50,37 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {}}
+ optional_params = {"params": {}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return GenerationVideoModel(
model_name=model_name,
- api_key=model_credential.get('api_key'),
- base_url=model_credential.get('base_url', "https://ark.cn-beijing.volces.com/api/v3"),
+ api_key=model_credential.get("api_key"),
+ base_url=model_credential.get("base_url", "https://ark.cn-beijing.volces.com/api/v3"),
**optional_params,
)
def check_auth(self):
return True
- def _build_prompt(self, prompt: str) -> str:
- """拼接参数到 prompt 文本"""
- param_map = {
- "ratio": "rt",
- "duration": "dur",
- "framespersecond": "fps",
- "resolution": "rs",
- "watermark": "wm",
- "camerafixed": "cf",
- }
- for key, value in self.params.items():
- if key in param_map:
- prompt += f" --{param_map[key]} {value}"
- return prompt
+ def _build_params(self) -> dict:
+ """把参数转换为视频生成接口的顶层字段,接口不支持的字段放入 extra_body"""
+ params = {}
+ extra_body = {}
+ for key, value in (self.params or {}).items():
+ if value is None or value == "":
+ continue
+ name = str(key).replace(" ", "_").lower()
+ if name == "camerafixed":
+ name = "camera_fixed"
+ if name in VIDEO_PARAM_KEYS:
+ params[name] = int(value) if name in INT_PARAM_KEYS else value
+ else:
+ extra_body[name] = value
+ if extra_body:
+ params["extra_body"] = extra_body
+ return params
def _poll_task(self, client: Ark, task_id: str, interval: int = 30):
"""轮询任务状态,直到完成"""
@@ -73,29 +97,14 @@ def _poll_task(self, client: Ark, task_id: str, interval: int = 30):
# --- 通用异步生成函数 ---
def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, last_frame_url=None, **kwargs):
client = Ark(api_key=self.api_key, base_url=self.base_url)
- # 根据params设置其他参数 豆包的参数和别的不一样 需要拼接在text里
- # --rt 16:9 --dur 5 --fps 24 --rs 720p --wm true --cf false
- prompt = self._build_prompt(prompt)
content = [{"type": "text", "text": prompt}]
if first_frame_url:
- content.append({
- "type": "image_url",
- "image_url": {
- "url": first_frame_url
- },
- "role": "first_frame"
- })
+ content.append({"type": "image_url", "image_url": {"url": first_frame_url}, "role": "first_frame"})
if last_frame_url:
- content.append({
- "type": "image_url",
- "image_url": {
- "url": last_frame_url
- },
- "role": "last_frame"
- })
-
- task = client.content_generation.tasks.create(model=self.model_name, content=content)
+ content.append({"type": "image_url", "image_url": {"url": last_frame_url}, "role": "last_frame"})
+
+ task = client.content_generation.tasks.create(model=self.model_name, content=content, **self._build_params())
task_id = task.id
maxkb_logger.info(f"[ArkVideo] Created task {task_id}")
@@ -111,5 +120,5 @@ def generate_video(self, prompt, negative_prompt=None, first_frame_url=None, las
except Exception as e:
maxkb_logger.error(f"[ArkVideo] Failed to delete task {task_id}: {e}")
raise e
- maxkb_logger.info("视频地址", result.content.video_url)
+ maxkb_logger.info(f"[ArkVideo] 视频地址 {result.content.video_url}")
return result.content.video_url
diff --git a/apps/models_provider/impl/volcanic_engine_model_provider/volcanic_engine_model_provider.py b/apps/models_provider/impl/volcanic_engine_model_provider/volcanic_engine_model_provider.py
index dc6f8fb23e5..f486d4e446e 100644
--- a/apps/models_provider/impl/volcanic_engine_model_provider/volcanic_engine_model_provider.py
+++ b/apps/models_provider/impl/volcanic_engine_model_provider/volcanic_engine_model_provider.py
@@ -1,22 +1,28 @@
#!/usr/bin/env python
# -*- coding: UTF-8 -*-
"""
-@Project :MaxKB
+@Project :MaxKB
@File :gemini_model_provider.py
@Author :Brian Yang
-@Date :5/13/24 7:47 AM
+@Date :5/13/24 7:47 AM
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, ModelTypeConst, \
- ModelInfoManage
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
from models_provider.impl.openai_model_provider.credential.llm import OpenAILLMModelCredential
-from models_provider.impl.volcanic_engine_model_provider.credential.bigModel_stt import \
- VolcanicEngineBigModelSTTModelCredential
+from models_provider.impl.volcanic_engine_model_provider.credential.bigModel_stt import (
+ VolcanicEngineBigModelSTTModelCredential,
+)
from models_provider.impl.volcanic_engine_model_provider.credential.embedding import VolcanicEmbeddingCredential
-from models_provider.impl.volcanic_engine_model_provider.credential.image import \
- VolcanicEngineImageModelCredential
+from models_provider.impl.volcanic_engine_model_provider.credential.image import VolcanicEngineImageModelCredential
from models_provider.impl.volcanic_engine_model_provider.credential.tti import VolcanicEngineTTIModelCredential
from models_provider.impl.volcanic_engine_model_provider.credential.tts import VolcanicEngineTTSModelCredential
from models_provider.impl.volcanic_engine_model_provider.credential.ttv import VolcanicEngineTTVModelCredential
@@ -42,83 +48,78 @@
volcanic_engine_tti_model_credential = VolcanicEngineTTIModelCredential()
model_info_list = [
- ModelInfo('ep-xxxxxxxxxx-yyyy',
- _('The user goes to the model inference page of Volcano Ark to create an inference access point. Here, you need to enter ep-xxxxxxxxxx-yyyy to call it.'),
- ModelTypeConst.LLM,
- volcanic_engine_llm_model_credential, VolcanicEngineChatModel
- ),
- ModelInfo('ep-xxxxxxxxxx-yyyy',
- _('The user goes to the model inference page of Volcano Ark to create an inference access point. Here, you need to enter ep-xxxxxxxxxx-yyyy to call it.'),
- ModelTypeConst.IMAGE,
- volcanic_engine_image_model_credential, VolcanicEngineImage
- ),
- ModelInfo('asr',
- '',
- ModelTypeConst.STT,
- volcanic_engine_stt_model_credential, VolcanicEngineSpeechToText
- ),
- ModelInfo('bigmodel',
- '',
- ModelTypeConst.STT,
- volcanic_engine_big_stt_model_credential, VolcanicEngineBigModelSpeechToText
- ),
- ModelInfo('tts',
- '',
- ModelTypeConst.TTS,
- volcanic_engine_tts_model_credential, VolcanicEngineTextToSpeech
- ),
- ModelInfo('doubao-seedream-3-0-t2i-250415',
- _(''),
- ModelTypeConst.TTI,
- volcanic_engine_tti_model_credential, VolcanicEngineTextToImage
- ),
+ ModelInfo(
+ "ep-xxxxxxxxxx-yyyy",
+ _(
+ "The user goes to the model inference page of Volcano Ark to create an inference access point. Here, you need to enter ep-xxxxxxxxxx-yyyy to call it."
+ ),
+ ModelTypeConst.LLM,
+ volcanic_engine_llm_model_credential,
+ VolcanicEngineChatModel,
+ ),
+ ModelInfo(
+ "ep-xxxxxxxxxx-yyyy",
+ _(
+ "The user goes to the model inference page of Volcano Ark to create an inference access point. Here, you need to enter ep-xxxxxxxxxx-yyyy to call it."
+ ),
+ ModelTypeConst.IMAGE,
+ volcanic_engine_image_model_credential,
+ VolcanicEngineImage,
+ ),
+ ModelInfo("asr", "", ModelTypeConst.STT, volcanic_engine_stt_model_credential, VolcanicEngineSpeechToText),
+ ModelInfo(
+ "bigmodel", "", ModelTypeConst.STT, volcanic_engine_big_stt_model_credential, VolcanicEngineBigModelSpeechToText
+ ),
+ ModelInfo(
+ "doubao-seedream-3-0-t2i-250415",
+ _(""),
+ ModelTypeConst.TTI,
+ volcanic_engine_tti_model_credential,
+ VolcanicEngineTextToImage,
+ ),
+]
+
+# TTS 的模型ID 即接口的 resource id
+model_info_tts_list = [
+ ModelInfo(
+ "seed-tts-2.0",
+ _(""),
+ ModelTypeConst.TTS,
+ volcanic_engine_tts_model_credential,
+ VolcanicEngineTextToSpeech,
+ ),
+ ModelInfo(
+ "seed-icl-2.0",
+ _(""),
+ ModelTypeConst.TTS,
+ volcanic_engine_tts_model_credential,
+ VolcanicEngineTextToSpeech,
+ ),
]
open_ai_embedding_credential = VolcanicEmbeddingCredential()
model_info_embedding_list = [
- ModelInfo('ep-xxxxxxxxxx-yyyy',
- _('The user goes to the model inference page of Volcano Ark to create an inference access point. Here, you need to enter ep-xxxxxxxxxx-yyyy to call it.'),
- ModelTypeConst.EMBEDDING, open_ai_embedding_credential,
- VolcanicEngineEmbeddingModel)
+ ModelInfo(
+ "ep-xxxxxxxxxx-yyyy",
+ _(
+ "The user goes to the model inference page of Volcano Ark to create an inference access point. Here, you need to enter ep-xxxxxxxxxx-yyyy to call it."
+ ),
+ ModelTypeConst.EMBEDDING,
+ open_ai_embedding_credential,
+ VolcanicEngineEmbeddingModel,
+ )
]
ttv_credential = VolcanicEngineTTVModelCredential()
model_info_ttv_list = [
- ModelInfo('doubao-seedance-1-0-pro-250528',
- _(''),
- ModelTypeConst.TTV,
- ttv_credential, GenerationVideoModel)
- ,
- ModelInfo('doubao-seedance-1-0-lite-t2v-250428',
- _(''),
- ModelTypeConst.TTV,
- ttv_credential, GenerationVideoModel)
- ,
- ModelInfo('wan2-1-14b-t2v-250225',
- _(''),
- ModelTypeConst.TTV,
- ttv_credential, GenerationVideoModel)
+ ModelInfo("doubao-seedance-1-0-pro-250528", _(""), ModelTypeConst.TTV, ttv_credential, GenerationVideoModel),
+ ModelInfo("doubao-seedance-1-0-lite-t2v-250428", _(""), ModelTypeConst.TTV, ttv_credential, GenerationVideoModel),
+ ModelInfo("wan2-1-14b-t2v-250225", _(""), ModelTypeConst.TTV, ttv_credential, GenerationVideoModel),
]
model_info_itv_list = [
- ModelInfo('doubao-seedance-1-0-pro-250528',
- _(''),
- ModelTypeConst.ITV,
- ttv_credential,
- GenerationVideoModel),
- ModelInfo('doubao-seedance-1-0-lite-i2v-250428',
- _(''),
- ModelTypeConst.ITV,
- ttv_credential,
- GenerationVideoModel),
- ModelInfo('wan2-1-14b-i2v-250225',
- _(''),
- ModelTypeConst.ITV,
- ttv_credential,
- GenerationVideoModel),
- ModelInfo('wan2-1-14b-flf2v-250417',
- _(''),
- ModelTypeConst.ITV,
- ttv_credential,
- GenerationVideoModel),
+ ModelInfo("doubao-seedance-1-0-pro-250528", _(""), ModelTypeConst.ITV, ttv_credential, GenerationVideoModel),
+ ModelInfo("doubao-seedance-1-0-lite-i2v-250428", _(""), ModelTypeConst.ITV, ttv_credential, GenerationVideoModel),
+ ModelInfo("wan2-1-14b-i2v-250225", _(""), ModelTypeConst.ITV, ttv_credential, GenerationVideoModel),
+ ModelInfo("wan2-1-14b-flf2v-250417", _(""), ModelTypeConst.ITV, ttv_credential, GenerationVideoModel),
]
model_info_manage = (
@@ -129,7 +130,8 @@
.append_default_model_info(model_info_list[2])
.append_default_model_info(model_info_list[3])
.append_default_model_info(model_info_list[4])
- .append_default_model_info(model_info_list[5])
+ .append_model_info_list(model_info_tts_list)
+ .append_default_model_info(model_info_tts_list[0])
.append_model_info_list(model_info_embedding_list)
.append_default_model_info(model_info_embedding_list[0])
.append_model_info_list(model_info_ttv_list)
@@ -141,14 +143,22 @@
class VolcanicEngineModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_volcanic_engine_provider', name=_('volcano engine'),
- icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl',
- 'volcanic_engine_model_provider',
- 'icon',
- 'volcanic_engine_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_volcanic_engine_provider",
+ name=_("volcano engine"),
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "impl",
+ "volcanic_engine_model_provider",
+ "icon",
+ "volcanic_engine_icon_svg",
+ )
+ ),
+ )
diff --git a/apps/models_provider/impl/wenxin_model_provider/__init__.py b/apps/models_provider/impl/wenxin_model_provider/__init__.py
deleted file mode 100644
index 53b7001e589..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/__init__.py
+++ /dev/null
@@ -1,8 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2023/10/31 17:16
- @desc:
-"""
diff --git a/apps/models_provider/impl/wenxin_model_provider/credential/__init__.py b/apps/models_provider/impl/wenxin_model_provider/credential/__init__.py
deleted file mode 100644
index e69de29bb2d..00000000000
diff --git a/apps/models_provider/impl/wenxin_model_provider/credential/embedding.py b/apps/models_provider/impl/wenxin_model_provider/credential/embedding.py
deleted file mode 100644
index b250dffe9c4..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/credential/embedding.py
+++ /dev/null
@@ -1,81 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/17 15:40
- @desc:
-"""
-from typing import Dict
-
-from django.utils.translation import gettext as _
-
-from common import forms
-from common.exception.app_exception import AppApiException
-from common.forms import BaseForm
-from models_provider.base_model_provider import BaseModelCredential, ValidCode
-from common.utils.logger import maxkb_logger
-
-class QianfanEmbeddingCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- api_version = model_credential.get('api_version', 'v1')
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- if api_version == 'v1':
- model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
- model_info = [model.lower() for model in model.client.models()]
- if not model_info.__contains__(model_name.lower()):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_name} The model does not support').format(model_name=model_name))
- required_keys = ['qianfan_ak', 'qianfan_sk']
- if api_version == 'v2':
- required_keys = ['api_base', 'qianfan_ak']
-
- for key in required_keys:
- if key not in model_credential:
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
- else:
- return False
- try:
- model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
- except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- if isinstance(e, AppApiException):
- raise e
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
- else:
- return False
- return True
-
- def encryption_dict(self, model: Dict[str, object]):
- api_version = model.get('api_version', 'v1')
- if api_version == 'v1':
- return {**model, 'qianfan_sk': super().encryption(model.get('qianfan_sk', ''))}
- else: # v2
- return {**model, 'qianfan_ak': super().encryption(model.get('qianfan_ak', ''))}
-
- api_version = forms.Radio('API Version', required=True, text_field='label', value_field='value',
- option_list=[
- {'label': 'v1', 'value': 'v1'},
- {'label': 'v2', 'value': 'v2'}
- ],
- default_value='v1',
- provider='',
- method='', )
-
- # v2版本字段
- api_base = forms.TextInputField("API URL", required=True, relation_show_field_dict={"api_version": ["v2"]})
-
- # v1版本字段
- qianfan_ak = forms.PasswordInputField('API Key', required=True)
- qianfan_sk = forms.PasswordInputField("Secret Key", required=True,
- relation_show_field_dict={"api_version": ["v1"]})
diff --git a/apps/models_provider/impl/wenxin_model_provider/credential/llm.py b/apps/models_provider/impl/wenxin_model_provider/credential/llm.py
deleted file mode 100644
index 0f30adc6b90..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/credential/llm.py
+++ /dev/null
@@ -1,116 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/12 10:19
- @desc:
-"""
-from typing import Dict
-
-from django.utils.translation import gettext_lazy as _, gettext
-from langchain_core.messages import HumanMessage
-
-from common import forms
-from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, TooltipLabel
-from models_provider.base_model_provider import BaseModelCredential, ValidCode
-from common.utils.logger import maxkb_logger
-
-class WenxinLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.95,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
-
- max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
- _min=2,
- _max=100000,
- _step=1,
- precision=0)
-
-
-class WenxinLLMModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
- # 根据api_version检查必需字段
- api_version = model_credential.get('api_version', 'v1')
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- if api_version == 'v1':
- model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
- model_info = [model.lower() for model in model.client.models()]
- if not model_info.__contains__(model_name.lower()):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_name} The model does not support').format(model_name=model_name))
- required_keys = ['api_key', 'secret_key']
- if api_version == 'v2':
- required_keys = ['api_base', 'api_key']
-
- for key in required_keys:
- if key not in model_credential:
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
- else:
- return False
- try:
- model.invoke(
- [HumanMessage(content=gettext('Hello'))])
- except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- raise e
- return True
-
- def encryption_dict(self, model_info: Dict[str, object]):
- # 根据api_version加密不同字段
- api_version = model_info.get('api_version', 'v1')
- if api_version == 'v1':
- return {**model_info, 'secret_key': super().encryption(model_info.get('secret_key', ''))}
- else: # v2
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
-
- def build_model(self, model_info: Dict[str, object]):
- api_version = model_info.get('api_version', 'v1')
- # 根据api_version检查必需字段
- if api_version == 'v1':
- for key in ['api_version', 'api_key', 'secret_key', 'model']:
- if key not in model_info:
- raise AppApiException(500, gettext('{key} is required').format(key=key))
- self.api_key = model_info.get('api_key')
- self.secret_key = model_info.get('secret_key')
- else: # v2
- for key in ['api_version', 'api_base', 'api_key', 'model', ]:
- if key not in model_info:
- raise AppApiException(500, gettext('{key} is required').format(key=key))
- self.api_base = model_info.get('api_base')
- self.api_key = model_info.get('api_key')
- return self
-
- # 动态字段定义 - 根据api_version显示不同字段
- api_version = forms.Radio('API Version', required=True, text_field='label', value_field='value',
- option_list=[
- {'label': 'v1', 'value': 'v1'},
- {'label': 'v2', 'value': 'v2'}
- ],
- default_value='v1',
- provider='',
- method='', )
-
- # v2版本字段
- api_base = forms.TextInputField("API URL", required=True, relation_show_field_dict={"api_version": ["v2"]})
-
- # v1版本字段
- api_key = forms.PasswordInputField('API Key', required=True)
- secret_key = forms.PasswordInputField("Secret Key", required=True,
- relation_show_field_dict={"api_version": ["v1"]})
-
- def get_model_params_setting_form(self, model_name):
- return WenxinLLMModelParams()
diff --git a/apps/models_provider/impl/wenxin_model_provider/credential/reranker.py b/apps/models_provider/impl/wenxin_model_provider/credential/reranker.py
deleted file mode 100644
index 874644bb167..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/credential/reranker.py
+++ /dev/null
@@ -1,63 +0,0 @@
-from typing import Dict
-
-from langchain_core.documents import Document
-
-from common import forms
-from common.exception.app_exception import AppApiException
-from common.forms import BaseForm, TooltipLabel
-from models_provider.base_model_provider import BaseModelCredential, ValidCode
-from django.utils.translation import gettext_lazy as _
-from common.utils.logger import maxkb_logger
-from models_provider.impl.wenxin_model_provider.model.reranker import QfBgeReranker
-
-
-class QfRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
-
-
-class QfRerankerCredential(BaseForm, BaseModelCredential):
- api_url = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
- model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
-
- for key in ['api_url', 'api_key']:
- if key not in model_credential:
- if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
- else:
- return False
- try:
- model: QfBgeReranker = provider.get_model(model_type, model_name, model_credential)
- test_text = str(_('Hello'))
- model.compress_documents([Document(page_content=test_text)], test_text)
- except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
- if isinstance(e, AppApiException):
- raise e
- if raise_exception:
- raise AppApiException(
- ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e))
- )
- return False
-
- return True
-
- def encryption_dict(self, model_info: Dict[str, object]):
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
-
- def get_model_params_setting_form(self, model_name: str) -> QfRerankerModelParams:
- return QfRerankerModelParams()
diff --git a/apps/models_provider/impl/wenxin_model_provider/icon/__init__.py b/apps/models_provider/impl/wenxin_model_provider/icon/__init__.py
deleted file mode 100644
index e69de29bb2d..00000000000
diff --git a/apps/models_provider/impl/wenxin_model_provider/model/__init__.py b/apps/models_provider/impl/wenxin_model_provider/model/__init__.py
deleted file mode 100644
index e69de29bb2d..00000000000
diff --git a/apps/models_provider/impl/wenxin_model_provider/model/embedding.py b/apps/models_provider/impl/wenxin_model_provider/model/embedding.py
deleted file mode 100644
index cfa555d92b7..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/model/embedding.py
+++ /dev/null
@@ -1,65 +0,0 @@
-# coding=utf-8
-"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/17 16:48
- @desc:
-"""
-from typing import Dict, List
-from langchain_community.embeddings import QianfanEmbeddingsEndpoint
-import openai
-from models_provider.base_model_provider import MaxKBBaseModel
-
-
-class QianfanV1Embeddings(MaxKBBaseModel, QianfanEmbeddingsEndpoint):
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return QianfanV1Embeddings(
- model=model_name,
- qianfan_ak=model_credential.get('qianfan_ak'),
- qianfan_sk=model_credential.get('qianfan_sk'),
- )
-
-
-class QianfanV2EmbeddingModel(MaxKBBaseModel):
- model_name: str
-
- @staticmethod
- def is_cache_model():
- return False
-
- def __init__(self, api_key, base_url, model_name: str):
- self.client = openai.OpenAI(api_key=api_key, base_url=base_url).embeddings
- self.model_name = model_name
-
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return QianfanV2EmbeddingModel(
- api_key=model_credential.get('qianfan_ak'),
- model_name=model_name,
- base_url=model_credential.get('api_base'),
- )
-
- def embed_query(self, text: str):
- res = self.embed_documents([text])
- return res[0]
-
- def embed_documents(
- self, texts: List[ str],
- ) -> List[List[float]]:
- res = self.client.create(input=texts, model=self.model_name, encoding_format="float")
- return [e.embedding for e in res.data]
-
-
-class QianfanEmbeddings(MaxKBBaseModel):
-
-
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- api_version = model_credential.get('api_version', 'v1')
-
- if api_version == "v1":
- return QianfanV1Embeddings.new_instance(model_type, model_name, model_credential, **model_kwargs)
- elif api_version == "v2":
- return QianfanV2EmbeddingModel.new_instance(model_type, model_name, model_credential, **model_kwargs)
diff --git a/apps/models_provider/impl/wenxin_model_provider/model/llm.py b/apps/models_provider/impl/wenxin_model_provider/model/llm.py
deleted file mode 100644
index 688530136d3..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/model/llm.py
+++ /dev/null
@@ -1,104 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2023/11/10 17:45
- @desc:
-"""
-from typing import List, Dict, Optional, Any, Iterator
-
-from langchain_community.chat_models.baidu_qianfan_endpoint import _convert_dict_to_message, QianfanChatEndpoint
-from langchain_core.callbacks import CallbackManagerForLLMRun
-from langchain_core.messages import (
- AIMessageChunk,
- BaseMessage,
-)
-from langchain_core.outputs import ChatGenerationChunk
-
-from models_provider.base_model_provider import MaxKBBaseModel
-from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
-
-
-class QianfanChatModelQianfan(MaxKBBaseModel, QianfanChatEndpoint):
- @staticmethod
- def is_cache_model():
- return False
-
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- return QianfanChatModelQianfan(model=model_name,
- qianfan_ak=model_credential.get('api_key'),
- qianfan_sk=model_credential.get('secret_key'),
- streaming=model_kwargs.get('streaming', False),
- init_kwargs=optional_params)
-
- usage_metadata: dict = {}
-
- def get_last_generation_info(self) -> Optional[Dict[str, Any]]:
- return self.usage_metadata
-
- def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
- return self.usage_metadata.get('prompt_tokens', 0)
-
- def get_num_tokens(self, text: str) -> int:
- return self.usage_metadata.get('completion_tokens', 0)
-
- def _stream(
- self,
- messages: List[BaseMessage],
- stop: Optional[List[str]] = None,
- run_manager: Optional[CallbackManagerForLLMRun] = None,
- **kwargs: Any,
- ) -> Iterator[ChatGenerationChunk]:
- kwargs = {**self.init_kwargs, **kwargs}
- params = self._convert_prompt_msg_params(messages, **kwargs)
- params["stop"] = stop
- params["stream"] = True
- for res in self.client.do(**params):
- if res:
- msg = _convert_dict_to_message(res)
- additional_kwargs = msg.additional_kwargs.get("function_call", {})
- if msg.content == "" or res.get("body").get("is_end"):
- token_usage = res.get("body").get("usage")
- self.usage_metadata = token_usage
- chunk = ChatGenerationChunk(
- text=res["result"],
- message=AIMessageChunk( # type: ignore[call-arg]
- content=msg.content,
- role="assistant",
- additional_kwargs=additional_kwargs,
- ),
- generation_info=msg.additional_kwargs,
- )
- if run_manager:
- run_manager.on_llm_new_token(chunk.text, chunk=chunk)
- yield chunk
-
-
-class QianfanChatModelOpenai(MaxKBBaseModel, BaseChatOpenAI):
- @staticmethod
- def is_cache_model():
- return False
-
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
- return QianfanChatModelOpenai(
- model=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
- extra_body=optional_params
- )
-
-
-class QianfanChatModel(MaxKBBaseModel):
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- api_version = model_credential.get('api_version', 'v1')
-
- if api_version == "v1":
- return QianfanChatModelQianfan.new_instance(model_type, model_name, model_credential, **model_kwargs)
- elif api_version == "v2":
- return QianfanChatModelOpenai.new_instance(model_type, model_name, model_credential, **model_kwargs)
diff --git a/apps/models_provider/impl/wenxin_model_provider/model/reranker.py b/apps/models_provider/impl/wenxin_model_provider/model/reranker.py
deleted file mode 100644
index ad5e76c3370..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/model/reranker.py
+++ /dev/null
@@ -1,75 +0,0 @@
-import json
-from typing import Sequence, Optional, Dict, Any
-
-import requests
-from langchain_core.callbacks import Callbacks
-from langchain_core.documents import BaseDocumentCompressor, Document
-
-from models_provider.base_model_provider import MaxKBBaseModel
-
-
-class QfBgeReranker(MaxKBBaseModel, BaseDocumentCompressor):
- api_key: str
- api_url: str
- model: str
- params: dict
- top_n: int = 3
-
- def __init__(self, **kwargs):
- super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params', {})
- self.api_url = kwargs.get('api_url')
- self.top_n = self.params.get('top_n', 3)
-
- @staticmethod
- def is_cache_model():
- return False
-
- @staticmethod
- def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return QfBgeReranker(
- model=model_name,
- api_key=model_credential.get('api_key'),
- api_url=model_credential.get('api_url'),
- params=model_kwargs,
- )
-
- def compress_documents(
- self,
- documents: Sequence[Document],
- query: str,
- callbacks: Optional[Callbacks] = None
- ) -> Sequence[Document]:
- if not documents:
- return []
-
- texts = [doc.page_content for doc in documents]
-
- headers = {
- "Authorization": f"Bearer {self.api_key}",
- "Content-Type": "application/json"
- }
- top_n = min(self.top_n, len(texts))
- payload = {
- "model": self.model,
- "query": query,
- "documents": texts,
- "top_n": top_n
- }
-
- response = requests.post(f"{self.api_url}/rerank", json=payload, headers=headers)
-
- if response.status_code != 200:
- raise RuntimeError(f"千帆 API 请求失败:{response.text}")
-
- res = response.json()
-
- return [
- Document(
- page_content=item.get('document', ''),
- metadata={'relevance_score': item.get('relevance_score')}
- )
- for item in res.get('results', [])
- ]
diff --git a/apps/models_provider/impl/wenxin_model_provider/wenxin_model_provider.py b/apps/models_provider/impl/wenxin_model_provider/wenxin_model_provider.py
deleted file mode 100644
index 9c936a729e4..00000000000
--- a/apps/models_provider/impl/wenxin_model_provider/wenxin_model_provider.py
+++ /dev/null
@@ -1,78 +0,0 @@
-# coding=utf-8
-"""
- @project: maxkb
- @Author:虎
- @file: wenxin_model_provider.py
- @date:2023/10/31 16:19
- @desc:
-"""
-import os
-
-from common.utils.common import get_file_content
-from models_provider.base_model_provider import ModelProvideInfo, ModelTypeConst, ModelInfo, IModelProvider, \
- ModelInfoManage
-from models_provider.impl.wenxin_model_provider.credential.embedding import QianfanEmbeddingCredential
-from models_provider.impl.wenxin_model_provider.credential.llm import WenxinLLMModelCredential
-from models_provider.impl.wenxin_model_provider.credential.reranker import QfRerankerCredential
-from models_provider.impl.wenxin_model_provider.model.embedding import QianfanEmbeddings
-from models_provider.impl.wenxin_model_provider.model.llm import QianfanChatModel
-from maxkb.conf import PROJECT_DIR
-from django.utils.translation import gettext as _
-
-from models_provider.impl.wenxin_model_provider.model.reranker import QfBgeReranker
-
-win_xin_llm_model_credential = WenxinLLMModelCredential()
-qianfan_embedding_credential = QianfanEmbeddingCredential()
-qf_reranker_credential = QfRerankerCredential()
-model_info_list = [ModelInfo('ERNIE-Bot-4',
- _('ERNIE-Bot-4 is a large language model independently developed by Baidu. It covers massive Chinese data and has stronger capabilities in dialogue Q&A, content creation and generation.'),
- ModelTypeConst.LLM, win_xin_llm_model_credential, QianfanChatModel),
- ModelInfo('ERNIE-Bot',
- _('ERNIE-Bot is a large language model independently developed by Baidu. It covers massive Chinese data and has stronger capabilities in dialogue Q&A, content creation and generation.'),
- ModelTypeConst.LLM, win_xin_llm_model_credential, QianfanChatModel),
- ModelInfo('ERNIE-Bot-turbo',
- _('ERNIE-Bot-turbo is a large language model independently developed by Baidu. It covers massive Chinese data, has stronger capabilities in dialogue Q&A, content creation and generation, and has a faster response speed.'),
- ModelTypeConst.LLM, win_xin_llm_model_credential, QianfanChatModel),
- ModelInfo('qianfan-chinese-llama-2-13b',
- '',
- ModelTypeConst.LLM, win_xin_llm_model_credential, QianfanChatModel),
- ModelInfo('ernie-4.5-turbo-32k', '', ModelTypeConst.LLM, win_xin_llm_model_credential,
- QianfanChatModel),
- ModelInfo('ernie-speed-8k', '', ModelTypeConst.LLM, win_xin_llm_model_credential, QianfanChatModel),
- ModelInfo('ernie-4.5-0.3b', '', ModelTypeConst.LLM, win_xin_llm_model_credential, QianfanChatModel)
-
- ]
-embedding_model_info_list = [ModelInfo('Embedding-V1',
- _('Embedding-V1 is a text representation model based on Baidu Wenxin large model technology. It can convert text into a vector form represented by numerical values and can be used in text retrieval, information recommendation, knowledge mining and other scenarios. Embedding-V1 provides the Embeddings interface, which can generate corresponding vector representations based on input content. You can call this interface to input text into the model and obtain the corresponding vector representation for subsequent text processing and analysis.'),
- ModelTypeConst.EMBEDDING, qianfan_embedding_credential, QianfanEmbeddings),
- ModelInfo('tao-8k', '', ModelTypeConst.EMBEDDING, qianfan_embedding_credential,
- QianfanEmbeddings),
- ModelInfo('bge-large-zh', '', ModelTypeConst.EMBEDDING, qianfan_embedding_credential,
- QianfanEmbeddings)
- ]
-rerank_model_info_list = [ModelInfo('bce-reranker-base',
- _(''),
- ModelTypeConst.RERANKER, qf_reranker_credential, QfBgeReranker),
- ]
-model_info_manage = (ModelInfoManage.builder().append_model_info_list(model_info_list).append_default_model_info(
- ModelInfo('ERNIE-Bot-4',
- _('ERNIE-Bot-4 is a large language model independently developed by Baidu. It covers massive Chinese data and has stronger capabilities in dialogue Q&A, content creation and generation.'),
- ModelTypeConst.LLM,
- win_xin_llm_model_credential,
- QianfanChatModel)).append_model_info_list(embedding_model_info_list).append_default_model_info(
- embedding_model_info_list[0]).
- append_model_info_list(rerank_model_info_list).append_default_model_info(
- rerank_model_info_list[0]).build())
-
-
-class WenxinModelProvider(IModelProvider):
-
- def get_model_info_manage(self):
- return model_info_manage
-
- def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_wenxin_provider', name=_('Thousand sails large model'),
- icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl',
- 'wenxin_model_provider', 'icon',
- 'azure_icon_svg')))
diff --git a/apps/models_provider/impl/xf_model_provider/__init__.py b/apps/models_provider/impl/xf_model_provider/__init__.py
index c743b4e183a..f0d334c6324 100644
--- a/apps/models_provider/impl/xf_model_provider/__init__.py
+++ b/apps/models_provider/impl/xf_model_provider/__init__.py
@@ -1,8 +1,8 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/04/19 15:55
- @desc:
-"""
\ No newline at end of file
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/04/19 15:55
+@desc:
+"""
diff --git a/apps/models_provider/impl/xf_model_provider/credential/embedding.py b/apps/models_provider/impl/xf_model_provider/credential/embedding.py
index 4227f29f82e..f0f1b00f489 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/embedding.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/17 15:40
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/17 15:40
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -16,34 +17,45 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
-class XFEmbeddingCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+class XFEmbeddingCredential(BaseForm, BaseModelCredential):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
self.valid_form(model_credential)
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.embed_query(_('Hello'))
+ model.embed_query(_("Hello"))
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
- base_url = forms.TextInputField('API URL', required=True, default_value="https://emb-cn-huabei-1.xf-yun.com/")
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ base_url = forms.TextInputField("API URL", required=True, default_value="https://emb-cn-huabei-1.xf-yun.com/")
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
diff --git a/apps/models_provider/impl/xf_model_provider/credential/image.py b/apps/models_provider/impl/xf_model_provider/credential/image.py
index 7336d135503..e9ba61f62f8 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/image.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/image.py
@@ -13,47 +13,62 @@
from models_provider.impl.xf_model_provider.model.image import ImageMessage
from common.utils.logger import maxkb_logger
+
class XunFeiImageModelCredential(BaseForm, BaseModelCredential):
- spark_api_url = forms.TextInputField('API URL', required=True,
- default_value='wss://spark-api.cn-huabei-1.xf-yun.com/v2.1/image')
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ spark_api_url = forms.TextInputField(
+ "API URL", required=True, default_value="wss://spark-api.cn-huabei-1.xf-yun.com/v2.1/image"
+ )
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']:
+ for key in ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/img_1.png', 'rb') as f:
- message_list = [ImageMessage(str(base64.b64encode(f.read()), 'utf-8')),
- HumanMessage(_('Please outline this picture'))]
+ with open(f"{cwd}/img_1.png", "rb") as f:
+ message_list = [
+ ImageMessage(str(base64.b64encode(f.read()), "utf-8")),
+ HumanMessage(_("Please outline this picture")),
+ ]
model.stream(message_list)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
def get_model_params_setting_form(self, model_name):
pass
diff --git a/apps/models_provider/impl/xf_model_provider/credential/llm.py b/apps/models_provider/impl/xf_model_provider/credential/llm.py
index 5fa6b2bbdba..b23077c4815 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/12 10:29
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/12 10:29
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,84 +18,111 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class XunFeiLLMModelGeneralParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.5,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.5,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=4096,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=4096,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class XunFeiLLMModelProParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.5,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.5,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=4096,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=4096,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class XunFeiLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']:
+ for key in ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
- spark_api_url = forms.TextInputField('API URL', required=True)
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ spark_api_url = forms.TextInputField("API URL", required=True)
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
def get_model_params_setting_form(self, model_name):
- if model_name == 'general' or model_name == 'pro-128k':
+ if model_name == "general" or model_name == "pro-128k":
return XunFeiLLMModelGeneralParams()
return XunFeiLLMModelProParams()
diff --git a/apps/models_provider/impl/xf_model_provider/credential/stt.py b/apps/models_provider/impl/xf_model_provider/credential/stt.py
index e9cee6a4f71..e5e2d3c265e 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/stt.py
@@ -9,60 +9,70 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class XunFeiSTTModelParams(BaseForm):
language = forms.TextInputField(
- TooltipLabel(_('language'), _('If not passed, the default value is zh_cn')),
+ TooltipLabel(_("language"), _("If not passed, the default value is zh_cn")),
required=True,
- default_value='zh_cn'
+ default_value="zh_cn",
)
domain = forms.TextInputField(
- TooltipLabel(_('domain'), _('If not passed, the default value is iat')),
- required=True,
- default_value='iat'
+ TooltipLabel(_("domain"), _("If not passed, the default value is iat")), required=True, default_value="iat"
)
accent = forms.TextInputField(
- TooltipLabel(_('accent'), _('If not passed, the default value is mandarin')),
+ TooltipLabel(_("accent"), _("If not passed, the default value is mandarin")),
required=True,
- default_value='mandarin'
+ default_value="mandarin",
)
class XunFeiSTTModelCredential(BaseForm, BaseModelCredential):
- spark_api_url = forms.TextInputField('API URL', required=True, default_value='wss://iat-api.xfyun.cn/v2/iat')
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ spark_api_url = forms.TextInputField("API URL", required=True, default_value="wss://iat-api.xfyun.cn/v2/iat")
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']:
+ for key in ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
def get_model_params_setting_form(self, model_name):
return XunFeiSTTModelParams()
diff --git a/apps/models_provider/impl/xf_model_provider/credential/tts/__init__.py b/apps/models_provider/impl/xf_model_provider/credential/tts/__init__.py
index 18197d857fc..24bdcbf7e24 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/tts/__init__.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/tts/__init__.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/12/10 14:13
- @desc:
+@project: MaxKB
+@Author:niu
+@file: __init__.py.py
+@date:2025/12/10 14:13
+@desc:
"""
+
from .tts import *
from .default_tts import *
-from .super_humanoid_tts import *
\ No newline at end of file
+from .super_humanoid_tts import *
diff --git a/apps/models_provider/impl/xf_model_provider/credential/tts/default_tts.py b/apps/models_provider/impl/xf_model_provider/credential/tts/default_tts.py
index 7c65b18736c..0c25b42eec0 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/tts/default_tts.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/tts/default_tts.py
@@ -2,6 +2,7 @@
"""
讯飞 TTS 工厂类 Credential,根据 api_version 路由到具体 Credential
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,53 +18,66 @@ class XunFeiDefaultTTSModelCredential(BaseForm, BaseModelCredential):
"""讯飞 TTS 工厂类 Credential,根据 api_version 参数路由到具体实现"""
api_version = forms.SingleSelect(
- _("API Version"), required=True,
- text_field='label',
- value_field='value',
- default_value='online',
+ _("API Version"),
+ required=True,
+ text_field="label",
+ value_field="value",
+ default_value="online",
option_list=[
- {'label': _('Online TTS'), 'value': 'online'},
- {'label': _('Super Humanoid TTS'), 'value': 'super_humanoid'}
- ])
+ {"label": _("Online TTS"), "value": "online"},
+ {"label": _("Super Humanoid TTS"), "value": "super_humanoid"},
+ ],
+ )
- spark_api_url = forms.TextInputField(_('API URL'), required=True)
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ spark_api_url = forms.TextInputField(_("API URL"), required=True)
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- api_version = model_credential.get('api_version', 'online')
+ api_version = model_credential.get("api_version", "online")
- for key in ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']:
+ for key in ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
def get_model_params_setting_form(self, model_name):
# params 只包含通用参数,vcn 已在 credential 中
@@ -74,9 +88,11 @@ class XunFeiDefaultTTSModelParams(BaseForm):
"""工厂类的参数表单,只包含通用参数"""
speed = forms.SliderField(
- TooltipLabel(_('speaking speed'), _('Speech speed, optional value: [0-100], default is 50')),
- required=True, default_value=50,
+ TooltipLabel(_("speaking speed"), _("Speech speed, optional value: [0-100], default is 50")),
+ required=True,
+ default_value=50,
_min=1,
_max=100,
_step=5,
- precision=1)
+ precision=1,
+ )
diff --git a/apps/models_provider/impl/xf_model_provider/credential/tts/super_humanoid_tts.py b/apps/models_provider/impl/xf_model_provider/credential/tts/super_humanoid_tts.py
index 741b9845489..a993cb2d32d 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/tts/super_humanoid_tts.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/tts/super_humanoid_tts.py
@@ -2,6 +2,7 @@
"""
讯飞超拟人语音合成 (Super Humanoid TTS) Credential
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -14,61 +15,77 @@
class XunFeiSuperHumanoidTTSModelParams(BaseForm):
"""超拟人语音合成参数"""
+
vcn = forms.SingleSelect(
- TooltipLabel(_('Speaker'), _('Speaker selection for super-humanoid TTS service')),
- required=True, default_value='x5_lingxiaoxuan_flow',
- text_field='label',
- value_field='value',
+ TooltipLabel(_("Speaker"), _("Speaker selection for super-humanoid TTS service")),
+ required=True,
+ default_value="x5_lingxiaoxuan_flow",
+ text_field="label",
+ value_field="value",
option_list=[
- {'label': _('Super-humanoid: Lingxiaoxuan Flow'), 'value': 'x5_lingxiaoxuan_flow'},
- {'label': _('Super-humanoid: Lingyuyan Flow'), 'value': 'x5_lingyuyan_flow'},
- {'label': _('Super-humanoid: Lingfeiyi Flow'), 'value': 'x5_lingfeiyi_flow'},
- {'label': _('Super-humanoid: Lingxiaoyue Flow'), 'value': 'x5_lingxiaoyue_flow'},
- {'label': _('Super-humanoid: Sun Dasheng Flow'), 'value': 'x5_sundasheng_flow'},
- {'label': _('Super-humanoid: Lingyuzhao Flow'), 'value': 'x5_lingyuzhao_flow'},
- {'label': _('Super-humanoid: Lingxiaotang Flow'), 'value': 'x5_lingxiaotang_flow'},
- {'label': _('Super-humanoid: Lingxiaorong Flow'), 'value': 'x5_lingxiaorong_flow'},
- {'label': _('Super-humanoid: Xinyun Flow'), 'value': 'x5_xinyun_flow'},
- {'label': _('Super-humanoid: Grant (EN)'), 'value': 'x5_EnUs_Grant_flow'},
- {'label': _('Super-humanoid: Lila (EN)'), 'value': 'x5_EnUs_Lila_flow'},
- {'label': _('Super-humanoid: Lingwanwan Pro'), 'value': 'x6_lingwanwan_pro'},
- {'label': _('Super-humanoid: Yiyi Pro'), 'value': 'x6_yiyi_pro'},
- {'label': _('Super-humanoid: Huifangnv Pro'), 'value': 'x6_huifangnv_pro'},
- {'label': _('Super-humanoid: Lingxiaoying Pro'), 'value': 'x6_lingxiaoying_pro'},
- {'label': _('Super-humanoid: Lingfeibo Pro'), 'value': 'x6_lingfeibo_pro'},
- {'label': _('Super-humanoid: Lingyuyan Pro'), 'value': 'x6_lingyuyan_pro'},
- ])
+ {"label": _("Super-humanoid: Lingxiaoxuan Flow"), "value": "x5_lingxiaoxuan_flow"},
+ {"label": _("Super-humanoid: Lingyuyan Flow"), "value": "x5_lingyuyan_flow"},
+ {"label": _("Super-humanoid: Lingfeiyi Flow"), "value": "x5_lingfeiyi_flow"},
+ {"label": _("Super-humanoid: Lingxiaoyue Flow"), "value": "x5_lingxiaoyue_flow"},
+ {"label": _("Super-humanoid: Sun Dasheng Flow"), "value": "x5_sundasheng_flow"},
+ {"label": _("Super-humanoid: Lingyuzhao Flow"), "value": "x5_lingyuzhao_flow"},
+ {"label": _("Super-humanoid: Lingxiaotang Flow"), "value": "x5_lingxiaotang_flow"},
+ {"label": _("Super-humanoid: Lingxiaorong Flow"), "value": "x5_lingxiaorong_flow"},
+ {"label": _("Super-humanoid: Xinyun Flow"), "value": "x5_xinyun_flow"},
+ {"label": _("Super-humanoid: Grant (EN)"), "value": "x5_EnUs_Grant_flow"},
+ {"label": _("Super-humanoid: Lila (EN)"), "value": "x5_EnUs_Lila_flow"},
+ {"label": _("Super-humanoid: Lingwanwan Pro"), "value": "x6_lingwanwan_pro"},
+ {"label": _("Super-humanoid: Yiyi Pro"), "value": "x6_yiyi_pro"},
+ {"label": _("Super-humanoid: Huifangnv Pro"), "value": "x6_huifangnv_pro"},
+ {"label": _("Super-humanoid: Lingxiaoying Pro"), "value": "x6_lingxiaoying_pro"},
+ {"label": _("Super-humanoid: Lingfeibo Pro"), "value": "x6_lingfeibo_pro"},
+ {"label": _("Super-humanoid: Lingyuyan Pro"), "value": "x6_lingyuyan_pro"},
+ ],
+ )
speed = forms.SliderField(
- TooltipLabel(_('speaking speed'), _('Speech speed, optional value: [0-100], default is 50')),
- required=True, default_value=50,
+ TooltipLabel(_("speaking speed"), _("Speech speed, optional value: [0-100], default is 50")),
+ required=True,
+ default_value=50,
_min=1,
_max=100,
_step=5,
- precision=1)
+ precision=1,
+ )
class XunFeiSuperHumanoidTTSModelCredential(BaseForm, BaseModelCredential):
"""讯飞超拟人语音合成 Credential"""
- spark_api_url = forms.TextInputField('API URL', required=True,
- default_value='wss://cbm01.cn-huabei-1.xf-yun.com/v1/private/mcd9m97e6')
- spark_app_id = forms.TextInputField('APP ID', required=True)
+
+ spark_api_url = forms.TextInputField(
+ "API URL", required=True, default_value="wss://cbm01.cn-huabei-1.xf-yun.com/v1/private/mcd9m97e6"
+ )
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- required_keys = ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']
+ required_keys = ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]
for key in required_keys:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
@@ -78,16 +95,18 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
def get_model_params_setting_form(self, model_name):
return XunFeiSuperHumanoidTTSModelParams()
diff --git a/apps/models_provider/impl/xf_model_provider/credential/tts/tts.py b/apps/models_provider/impl/xf_model_provider/credential/tts/tts.py
index 121c7be919c..a6121f31ec7 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/tts/tts.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/tts/tts.py
@@ -9,66 +9,86 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class XunFeiTTSModelGeneralParams(BaseForm):
vcn = forms.SingleSelect(
- TooltipLabel(_('Speaker'),
- _('Speaker, optional value: Please go to the console to add a trial or purchase speaker. After adding, the speaker parameter value will be displayed.')),
- required=True, default_value='xiaoyan',
- text_field='value',
- value_field='value',
+ TooltipLabel(
+ _("Speaker"),
+ _(
+ "Speaker, optional value: Please go to the console to add a trial or purchase speaker. After adding, the speaker parameter value will be displayed."
+ ),
+ ),
+ required=True,
+ default_value="xiaoyan",
+ text_field="value",
+ value_field="value",
option_list=[
- {'text': _('iFlytek Xiaoyan'), 'value': 'xiaoyan'},
- {'text': _('iFlytek Xujiu'), 'value': 'aisjiuxu'},
- {'text': _('iFlytek Xiaoping'), 'value': 'aisxping'},
- {'text': _('iFlytek Xiaojing'), 'value': 'aisjinger'},
- {'text': _('iFlytek Xuxiaobao'), 'value': 'aisbabyxu'},
- ])
+ {"text": _("iFlytek Xiaoyan"), "value": "xiaoyan"},
+ {"text": _("iFlytek Xujiu"), "value": "aisjiuxu"},
+ {"text": _("iFlytek Xiaoping"), "value": "aisxping"},
+ {"text": _("iFlytek Xiaojing"), "value": "aisjinger"},
+ {"text": _("iFlytek Xuxiaobao"), "value": "aisbabyxu"},
+ ],
+ )
speed = forms.SliderField(
- TooltipLabel(_('speaking speed'), _('Speech speed, optional value: [0-100], default is 50')),
- required=True, default_value=50,
+ TooltipLabel(_("speaking speed"), _("Speech speed, optional value: [0-100], default is 50")),
+ required=True,
+ default_value=50,
_min=1,
_max=100,
_step=5,
- precision=1)
+ precision=1,
+ )
class XunFeiTTSModelCredential(BaseForm, BaseModelCredential):
- spark_api_url = forms.TextInputField('API URL', required=True, default_value='wss://tts-api.xfyun.cn/v2/tts')
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ spark_api_url = forms.TextInputField("API URL", required=True, default_value="wss://tts-api.xfyun.cn/v2/tts")
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']:
+ for key in ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
def get_model_params_setting_form(self, model_name):
return XunFeiTTSModelGeneralParams()
diff --git a/apps/models_provider/impl/xf_model_provider/credential/zh_en_stt.py b/apps/models_provider/impl/xf_model_provider/credential/zh_en_stt.py
index b4f90e72ee4..7eda9879325 100644
--- a/apps/models_provider/impl/xf_model_provider/credential/zh_en_stt.py
+++ b/apps/models_provider/impl/xf_model_provider/credential/zh_en_stt.py
@@ -11,45 +11,52 @@
class ZhEnXunFeiSTTModelCredential(BaseForm, BaseModelCredential):
- spark_api_url = forms.TextInputField('API URL', required=True, default_value='wss://iat.xf-yun.com/v1')
- spark_app_id = forms.TextInputField('APP ID', required=True)
+ spark_api_url = forms.TextInputField("API URL", required=True, default_value="wss://iat.xf-yun.com/v1")
+ spark_app_id = forms.TextInputField("APP ID", required=True)
spark_api_key = forms.PasswordInputField("API Key", required=True)
- spark_api_secret = forms.PasswordInputField('API Secret', required=True)
-
- def is_valid(self,
- model_type: str,
- model_name,
- model_credential: Dict[str, object],
- model_params, provider,
- raise_exception=False):
+ spark_api_secret = forms.PasswordInputField("API Secret", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['spark_api_url', 'spark_app_id', 'spark_api_key', 'spark_api_secret']:
+ for key in ["spark_api_url", "spark_app_id", "spark_api_key", "spark_api_secret"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'spark_api_secret': super().encryption(model.get('spark_api_secret', ''))}
+ return {**model, "spark_api_secret": super().encryption(model.get("spark_api_secret", ""))}
def get_model_params_setting_form(self, model_name):
- pass
\ No newline at end of file
+ pass
diff --git a/apps/models_provider/impl/xf_model_provider/model/embedding.py b/apps/models_provider/impl/xf_model_provider/model/embedding.py
index a2120b57688..fd9893ea67b 100644
--- a/apps/models_provider/impl/xf_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/xf_model_provider/model/embedding.py
@@ -1,25 +1,24 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: embedding.py
- @date:2024/10/17 15:29
- @desc:
+@project: MaxKB
+@Author:虎
+@file: embedding.py
+@date:2024/10/17 15:29
+@desc:
"""
-import base64
-import json
+import queue
+import threading
+import time
from typing import Dict, Optional
-from langchain_community.embeddings import SparkLLMTextEmbeddings
-from numpy import ndarray
-from models_provider.base_model_provider import MaxKBBaseModel
-import time
-import json
import base64
+import json
import numpy as np
-import threading
-import queue
+from numpy import ndarray
+
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+from models_provider.langchain_compat.sparkllm import SparkLLMTextEmbeddings
_task_queue = queue.Queue()
@@ -54,7 +53,6 @@ def _worker():
break
except Exception as e:
-
if i == 2:
future["error"] = e
future["event"].set()
@@ -67,25 +65,24 @@ def _worker():
threading.Thread(target=_worker, daemon=True).start()
-class XFEmbedding(MaxKBBaseModel, SparkLLMTextEmbeddings):
+class XFEmbedding(MaxKBBaseEmbeddingModel, SparkLLMTextEmbeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
+
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return XFEmbedding(
- base_url=model_credential.get('base_url'),
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret')
+ base_url=model_credential.get("base_url"),
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
)
@staticmethod
def _parser_message(
- message: str,
+ message: str,
) -> Optional[ndarray]:
- future = {
- "event": threading.Event(),
- "result": None,
- "error": None
- }
+ future = {"event": threading.Event(), "result": None, "error": None}
_task_queue.put((message, future))
diff --git a/apps/models_provider/impl/xf_model_provider/model/image.py b/apps/models_provider/impl/xf_model_provider/model/image.py
index 1bd808105e6..2e14a55715c 100644
--- a/apps/models_provider/impl/xf_model_provider/model/image.py
+++ b/apps/models_provider/impl/xf_model_provider/model/image.py
@@ -3,8 +3,8 @@
import os
from typing import Dict, Any, List, Optional, Iterator
-#from docutils.utils import SystemMessage
-from langchain_community.chat_models.sparkllm import ChatSparkLLM, _convert_delta_to_message_chunk
+# from docutils.utils import SystemMessage
+from models_provider.langchain_compat.sparkllm import ChatSparkLLM, _convert_delta_to_message_chunk
from langchain_core.callbacks import CallbackManagerForLLMRun
from langchain_core.messages import BaseMessage, ChatMessage, HumanMessage, AIMessage, AIMessageChunk
from langchain_core.outputs import ChatGenerationChunk
@@ -54,28 +54,28 @@ class XFSparkImage(MaxKBBaseModel, ChatSparkLLM):
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return XFSparkImage(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
- **optional_params
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
+ **optional_params,
)
@staticmethod
def generate_message(prompt: str, image) -> list[BaseMessage]:
if image is None:
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/img_1.png', 'rb') as f:
+ with open(f"{cwd}/img_1.png", "rb") as f:
base64_image = base64.b64encode(f.read()).decode("utf-8")
- return [ImageMessage(f'data:image/jpeg;base64,{base64_image}'), HumanMessage(prompt)]
+ return [ImageMessage(f"data:image/jpeg;base64,{base64_image}"), HumanMessage(prompt)]
return [HumanMessage(prompt)]
def _stream(
- self,
- messages: List[BaseMessage],
- stop: Optional[List[str]] = None,
- run_manager: Optional[CallbackManagerForLLMRun] = None,
- **kwargs: Any,
+ self,
+ messages: List[BaseMessage],
+ stop: Optional[List[str]] = None,
+ run_manager: Optional[CallbackManagerForLLMRun] = None,
+ **kwargs: Any,
) -> Iterator[ChatGenerationChunk]:
default_chunk_class = AIMessageChunk
diff --git a/apps/models_provider/impl/xf_model_provider/model/llm.py b/apps/models_provider/impl/xf_model_provider/model/llm.py
index db46a12a7a3..6eb6c463a52 100644
--- a/apps/models_provider/impl/xf_model_provider/model/llm.py
+++ b/apps/models_provider/impl/xf_model_provider/model/llm.py
@@ -1,15 +1,19 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: __init__.py.py
- @date:2024/04/19 15:55
- @desc:
+@project: maxkb
+@Author:虎
+@file: __init__.py.py
+@date:2024/04/19 15:55
+@desc:
"""
+
from typing import List, Optional, Any, Iterator, Dict
-from langchain_community.chat_models.sparkllm import \
- ChatSparkLLM, convert_message_to_dict, _convert_delta_to_message_chunk
+from models_provider.langchain_compat.sparkllm import (
+ ChatSparkLLM,
+ _convert_delta_to_message_chunk,
+ convert_message_to_dict,
+)
from langchain_core.callbacks import CallbackManagerForLLMRun
from langchain_core.messages import BaseMessage, AIMessageChunk
from langchain_core.outputs import ChatGenerationChunk
@@ -26,13 +30,13 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return XFChatSparkLLM(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
spark_llm_domain=model_name,
- streaming=model_kwargs.get('streaming', False),
- **optional_params
+ streaming=model_kwargs.get("streaming", False),
+ **optional_params,
)
usage_metadata: dict = {}
@@ -41,17 +45,17 @@ def get_last_generation_info(self) -> Optional[Dict[str, Any]]:
return self.usage_metadata
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
- return self.usage_metadata.get('prompt_tokens', 0)
+ return self.usage_metadata.get("prompt_tokens", 0)
def get_num_tokens(self, text: str) -> int:
- return self.usage_metadata.get('completion_tokens', 0)
+ return self.usage_metadata.get("completion_tokens", 0)
def _stream(
- self,
- messages: List[BaseMessage],
- stop: Optional[List[str]] = None,
- run_manager: Optional[CallbackManagerForLLMRun] = None,
- **kwargs: Any,
+ self,
+ messages: List[BaseMessage],
+ stop: Optional[List[str]] = None,
+ run_manager: Optional[CallbackManagerForLLMRun] = None,
+ **kwargs: Any,
) -> Iterator[ChatGenerationChunk]:
default_chunk_class = AIMessageChunk
diff --git a/apps/models_provider/impl/xf_model_provider/model/stt.py b/apps/models_provider/impl/xf_model_provider/model/stt.py
index cbff1f4bb67..2511a845e78 100644
--- a/apps/models_provider/impl/xf_model_provider/model/stt.py
+++ b/apps/models_provider/impl/xf_model_provider/model/stt.py
@@ -8,7 +8,6 @@
import hashlib
import hmac
import json
-import logging
import os
import ssl
from datetime import datetime, UTC
@@ -39,12 +38,12 @@ class XFSparkSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.spark_api_url = kwargs.get('spark_api_url')
- self.spark_app_id = kwargs.get('spark_app_id')
- self.spark_api_key = kwargs.get('spark_api_key')
- self.spark_api_secret = kwargs.get('spark_api_secret')
- self.params = kwargs.get('params')
- self.model_name = kwargs.get('model_name')
+ self.spark_api_url = kwargs.get("spark_api_url")
+ self.spark_app_id = kwargs.get("spark_app_id")
+ self.spark_api_key = kwargs.get("spark_api_key")
+ self.spark_api_secret = kwargs.get("spark_api_secret")
+ self.params = kwargs.get("params")
+ self.model_name = kwargs.get("model_name")
@staticmethod
def is_cache_model():
@@ -53,18 +52,18 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return XFSparkSpeechToText(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
params=model_kwargs,
model_name=model_name,
- **optional_params
+ **optional_params,
)
# 生成url
@@ -72,7 +71,7 @@ def create_url(self):
url = self.spark_api_url
host = urlparse(url).hostname
# 生成RFC1123格式的时间戳
- gmt_format = '%a, %d %b %Y %H:%M:%S GMT'
+ gmt_format = "%a, %d %b %Y %H:%M:%S GMT"
date = datetime.now(UTC).strftime(gmt_format)
# 拼接字符串
@@ -80,21 +79,22 @@ def create_url(self):
signature_origin += "date: " + date + "\n"
signature_origin += "GET " + "/v2/iat " + "HTTP/1.1"
# 进行hmac-sha256进行加密
- signature_sha = hmac.new(self.spark_api_secret.encode('utf-8'), signature_origin.encode('utf-8'),
- digestmod=hashlib.sha256).digest()
- signature_sha = base64.b64encode(signature_sha).decode(encoding='utf-8')
-
- authorization_origin = "api_key=\"%s\", algorithm=\"%s\", headers=\"%s\", signature=\"%s\"" % (
- self.spark_api_key, "hmac-sha256", "host date request-line", signature_sha)
- authorization = base64.b64encode(authorization_origin.encode('utf-8')).decode(encoding='utf-8')
+ signature_sha = hmac.new(
+ self.spark_api_secret.encode("utf-8"), signature_origin.encode("utf-8"), digestmod=hashlib.sha256
+ ).digest()
+ signature_sha = base64.b64encode(signature_sha).decode(encoding="utf-8")
+
+ authorization_origin = 'api_key="%s", algorithm="%s", headers="%s", signature="%s"' % (
+ self.spark_api_key,
+ "hmac-sha256",
+ "host date request-line",
+ signature_sha,
+ )
+ authorization = base64.b64encode(authorization_origin.encode("utf-8")).decode(encoding="utf-8")
# 将请求的鉴权参数组合为字典
- v = {
- "authorization": authorization,
- "date": date,
- "host": host
- }
+ v = {"authorization": authorization, "date": date, "host": host}
# 拼接鉴权参数,生成url
- url = url + '?' + urlencode(v)
+ url = url + "?" + urlencode(v)
# print("date: ",date)
# print("v: ",v)
# 此处打印出建立连接时候的url,参考本demo的时候可取消上方打印的注释,比对相同参数时生成的url与自己代码生成的url是否一致
@@ -103,7 +103,7 @@ def create_url(self):
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as f:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as f:
self.speech_to_text(f)
def speech_to_text(self, file):
@@ -138,17 +138,32 @@ async def send(self, ws, file):
frameSize = 8000 # 每一帧的音频大小
status = STATUS_FIRST_FRAME # 音频的状态信息,标识音频是第一帧,还是中间帧、最后一帧
- allowed_params = {'language', 'domain', 'accent', 'vad_eos', 'dwa', 'pd', 'ptt',
- 'pcm', 'ltc', 'rlang', 'vinfo', 'nunum', 'speex_size', 'nbest', 'wbest'}
+ allowed_params = {
+ "language",
+ "domain",
+ "accent",
+ "vad_eos",
+ "dwa",
+ "pd",
+ "ptt",
+ "pcm",
+ "ltc",
+ "rlang",
+ "vinfo",
+ "nunum",
+ "speex_size",
+ "nbest",
+ "wbest",
+ }
business_params = {k: v for k, v in self.params.items() if k in allowed_params}
if not business_params:
business_params = {
- "domain": f'{self.model_name}',
+ "domain": f"{self.model_name}",
"language": "zh_cn",
"accent": "mandarin",
"vinfo": 1,
- "vad_eos": 10000
+ "vad_eos": 10000,
}
while True:
buf = file.read(frameSize)
@@ -161,27 +176,37 @@ async def send(self, ws, file):
if status == STATUS_FIRST_FRAME:
d = {
"common": {"app_id": self.spark_app_id},
- "business": {
- **business_params
- },
+ "business": {**business_params},
"data": {
- "status": 0, "format": "audio/L16;rate=16000",
- "audio": str(base64.b64encode(buf), 'utf-8'),
- "encoding": "lame"}
+ "status": 0,
+ "format": "audio/L16;rate=16000",
+ "audio": str(base64.b64encode(buf), "utf-8"),
+ "encoding": "lame",
+ },
}
d = json.dumps(d)
await ws.send(d)
status = STATUS_CONTINUE_FRAME
# 中间帧处理
elif status == STATUS_CONTINUE_FRAME:
- d = {"data": {"status": 1, "format": "audio/L16;rate=16000",
- "audio": str(base64.b64encode(buf), 'utf-8'),
- "encoding": "lame"}}
+ d = {
+ "data": {
+ "status": 1,
+ "format": "audio/L16;rate=16000",
+ "audio": str(base64.b64encode(buf), "utf-8"),
+ "encoding": "lame",
+ }
+ }
await ws.send(json.dumps(d))
# 最后一帧处理
elif status == STATUS_LAST_FRAME:
- d = {"data": {"status": 2, "format": "audio/L16;rate=16000",
- "audio": str(base64.b64encode(buf), 'utf-8'),
- "encoding": "lame"}}
+ d = {
+ "data": {
+ "status": 2,
+ "format": "audio/L16;rate=16000",
+ "audio": str(base64.b64encode(buf), "utf-8"),
+ "encoding": "lame",
+ }
+ }
await ws.send(json.dumps(d))
break
diff --git a/apps/models_provider/impl/xf_model_provider/model/tts/__init__.py b/apps/models_provider/impl/xf_model_provider/model/tts/__init__.py
index ee1091982c2..8b4d767bbfe 100644
--- a/apps/models_provider/impl/xf_model_provider/model/tts/__init__.py
+++ b/apps/models_provider/impl/xf_model_provider/model/tts/__init__.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: __init__.py.py
- @date:2025/12/10 14:14
- @desc:
+@project: MaxKB
+@Author:niu
+@file: __init__.py.py
+@date:2025/12/10 14:14
+@desc:
"""
+
from .super_humanoid_tts import *
from .tts import *
-from .default_tts import *
\ No newline at end of file
+from .default_tts import *
diff --git a/apps/models_provider/impl/xf_model_provider/model/tts/default_tts.py b/apps/models_provider/impl/xf_model_provider/model/tts/default_tts.py
index 3b6439dc9fc..54fb3c4c7ba 100644
--- a/apps/models_provider/impl/xf_model_provider/model/tts/default_tts.py
+++ b/apps/models_provider/impl/xf_model_provider/model/tts/default_tts.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:
- @file: default_tts.py
- @date:2025/12/9
- @desc: 讯飞 TTS 工厂类,根据 api_version 路由到具体实现
+@project: MaxKB
+@Author:
+@file: default_tts.py
+@date:2025/12/9
+@desc: 讯飞 TTS 工厂类,根据 api_version 路由到具体实现
"""
+
from typing import Dict
from models_provider.base_model_provider import MaxKBBaseModel
@@ -30,25 +31,28 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
from models_provider.impl.xf_model_provider.model.tts import XFSparkTextToSpeech
from models_provider.impl.xf_model_provider.model.tts.super_humanoid_tts import XFSparkSuperHumanoidTextToSpeech
- api_version = model_credential.get('api_version', 'online')
+ api_version = model_credential.get("api_version", "online")
- if api_version == 'super_humanoid':
+ if api_version == "super_humanoid":
return XFSparkSuperHumanoidTextToSpeech(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
- params = model_kwargs,
- **model_kwargs
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
+ params=model_kwargs,
+ **model_kwargs,
)
else:
# 在线语音:从 credential 获取 vcn_online
return XFSparkTextToSpeech(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
- params={key: v for key, v in model_kwargs.items() if
- not ['parameter', 'streaming', 'model_id', 'use_local'].__contains__(key)},
- **model_kwargs
- )
\ No newline at end of file
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
+ params={
+ key: v
+ for key, v in model_kwargs.items()
+ if not ["parameter", "streaming", "model_id", "use_local"].__contains__(key)
+ },
+ **model_kwargs,
+ )
diff --git a/apps/models_provider/impl/xf_model_provider/model/tts/super_humanoid_tts.py b/apps/models_provider/impl/xf_model_provider/model/tts/super_humanoid_tts.py
index a210729d292..67ab03116c2 100644
--- a/apps/models_provider/impl/xf_model_provider/model/tts/super_humanoid_tts.py
+++ b/apps/models_provider/impl/xf_model_provider/model/tts/super_humanoid_tts.py
@@ -28,6 +28,7 @@
class XFSparkSuperHumanoidTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
"""讯飞超拟人语音合成 (Super Humanoid TTS)"""
+
spark_app_id: str
spark_api_key: str
spark_api_secret: str
@@ -36,11 +37,11 @@ class XFSparkSuperHumanoidTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.spark_api_url = kwargs.get('spark_api_url')
- self.spark_app_id = kwargs.get('spark_app_id')
- self.spark_api_key = kwargs.get('spark_api_key')
- self.spark_api_secret = kwargs.get('spark_api_secret')
- self.params = kwargs.get('params') or {}
+ self.spark_api_url = kwargs.get("spark_api_url")
+ self.spark_app_id = kwargs.get("spark_app_id")
+ self.spark_api_key = kwargs.get("spark_api_key")
+ self.spark_api_secret = kwargs.get("spark_api_secret")
+ self.params = kwargs.get("params") or {}
@staticmethod
def is_cache_model():
@@ -52,23 +53,23 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
params = {}
for k, v in model_kwargs.items():
- if k not in ['model_id', 'use_local', 'streaming']:
+ if k not in ["model_id", "use_local", "streaming"]:
params[k] = v
return XFSparkSuperHumanoidTextToSpeech(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
params=params,
- **model_kwargs
+ **model_kwargs,
)
def create_url(self):
url = self.spark_api_url
host = urlparse(url).hostname
- gmt_format = '%a, %d %b %Y %H:%M:%S GMT'
+ gmt_format = "%a, %d %b %Y %H:%M:%S GMT"
date = datetime.now(UTC).strftime(gmt_format)
signature_origin = f"host: {host}\n"
@@ -76,29 +77,22 @@ def create_url(self):
signature_origin += f"GET {urlparse(url).path} HTTP/1.1"
signature_sha = hmac.new(
- self.spark_api_secret.encode('utf-8'),
- signature_origin.encode('utf-8'),
- digestmod=hashlib.sha256
+ self.spark_api_secret.encode("utf-8"), signature_origin.encode("utf-8"), digestmod=hashlib.sha256
).digest()
- signature_sha = base64.b64encode(signature_sha).decode('utf-8')
+ signature_sha = base64.b64encode(signature_sha).decode("utf-8")
- authorization_origin = \
- f'api_key="{self.spark_api_key}", algorithm="hmac-sha256", headers="host date request-line", signature="{signature_sha}"'
+ authorization_origin = f'api_key="{self.spark_api_key}", algorithm="hmac-sha256", headers="host date request-line", signature="{signature_sha}"'
- authorization = base64.b64encode(authorization_origin.encode('utf-8')).decode('utf-8')
+ authorization = base64.b64encode(authorization_origin.encode("utf-8")).decode("utf-8")
- v = {
- "authorization": authorization,
- "date": date,
- "host": host
- }
+ v = {"authorization": authorization, "date": date, "host": host}
- url = url + '?' + urlencode(v)
+ url = url + "?" + urlencode(v)
return url
def check_auth(self):
- self.text_to_speech(_('Hello'))
+ self.text_to_speech(_("Hello"))
def text_to_speech(self, text):
text = _remove_empty_lines(text)
@@ -111,10 +105,12 @@ async def handle():
except websockets.exceptions.InvalidStatus as e:
if e.response.status_code == 401:
raise Exception(
- _("Authentication failed (HTTP 401). Please check: "
- "1) API URL is correct for TTS service; "
- "2) APP ID, API Key, and API Secret are correct; "
- "3) Your iFlytek account has TTS service enabled.")
+ _(
+ "Authentication failed (HTTP 401). Please check: "
+ "1) API URL is correct for TTS service; "
+ "2) APP ID, API Key, and API Secret are correct; "
+ "3) Your iFlytek account has TTS service enabled."
+ )
)
else:
raise Exception(f"WebSocket connection failed: HTTP {e.response.status_code}")
@@ -127,7 +123,7 @@ async def handle():
@staticmethod
async def handle_message(ws):
- audio_bytes: bytes = b''
+ audio_bytes: bytes = b""
while True:
res = await ws.recv()
message = json.loads(res)
@@ -160,27 +156,30 @@ async def send(self, ws, text):
"sample_rate": self.params.get("sample_rate", 24000),
"channels": self.params.get("channels", 1),
"bit_depth": self.params.get("bit_depth", 16),
- "frame_size": self.params.get("frame_size", 0)
+ "frame_size": self.params.get("frame_size", 0),
}
tts_params = {
- **{key: v for key, v in self.params.items() if
- not ['parameter', 'streaming', 'model_id', 'use_local'].__contains__(key)},
+ **{
+ key: v
+ for key, v in self.params.items()
+ if not ["parameter", "streaming", "model_id", "use_local"].__contains__(key)
+ },
"vcn": self.params.get("vcn") or "x5_lingxiaoxuan_flow",
"audio": audio_params,
"volume": self.params.get("volume", 50),
"speed": self.params.get("speed", 50),
- "pitch": self.params.get("pitch", 50)
+ "pitch": self.params.get("pitch", 50),
}
- encoded_text = base64.b64encode(text.encode('utf-8')).decode('utf-8')
+ encoded_text = base64.b64encode(text.encode("utf-8")).decode("utf-8")
payload_text_obj = {
"encoding": "utf8",
"compress": "raw",
"format": "plain",
"status": 2,
"seq": 0,
- "text": encoded_text
+ "text": encoded_text,
}
s = {"tts": tts_params}
# "parameter": {"oar":"xxxx"}
@@ -189,7 +188,7 @@ async def send(self, ws, text):
d = {
"header": {"app_id": self.spark_app_id, "status": 2},
"parameter": {"tts": tts_params} | parameter,
- "payload": {"text": payload_text_obj}
+ "payload": {"text": payload_text_obj},
}
await ws.send(json.dumps(d))
diff --git a/apps/models_provider/impl/xf_model_provider/model/tts/tts.py b/apps/models_provider/impl/xf_model_provider/model/tts/tts.py
index 8a6132b8f44..7a812b20360 100644
--- a/apps/models_provider/impl/xf_model_provider/model/tts/tts.py
+++ b/apps/models_provider/impl/xf_model_provider/model/tts/tts.py
@@ -10,7 +10,6 @@
import hashlib
import hmac
import json
-import logging
import ssl
from datetime import datetime, UTC
from typing import Dict
@@ -41,11 +40,11 @@ class XFSparkTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.spark_api_url = kwargs.get('spark_api_url')
- self.spark_app_id = kwargs.get('spark_app_id')
- self.spark_api_key = kwargs.get('spark_api_key')
- self.spark_api_secret = kwargs.get('spark_api_secret')
- self.params = kwargs.get('params')
+ self.spark_api_url = kwargs.get("spark_api_url")
+ self.spark_app_id = kwargs.get("spark_app_id")
+ self.spark_api_key = kwargs.get("spark_api_key")
+ self.spark_api_secret = kwargs.get("spark_api_secret")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -53,16 +52,16 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'vcn': 'xiaoyan', 'speed': 50}}
+ optional_params = {"params": {"vcn": "xiaoyan", "speed": 50}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return XFSparkTextToSpeech(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
- **optional_params
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
+ **optional_params,
)
# 生成url
@@ -70,7 +69,7 @@ def create_url(self):
url = self.spark_api_url
host = urlparse(url).hostname
# 生成RFC1123格式的时间戳
- gmt_format = '%a, %d %b %Y %H:%M:%S GMT'
+ gmt_format = "%a, %d %b %Y %H:%M:%S GMT"
date = datetime.now(UTC).strftime(gmt_format)
# 拼接字符串
@@ -78,21 +77,22 @@ def create_url(self):
signature_origin += "date: " + date + "\n"
signature_origin += "GET " + "/v2/tts " + "HTTP/1.1"
# 进行hmac-sha256进行加密
- signature_sha = hmac.new(self.spark_api_secret.encode('utf-8'), signature_origin.encode('utf-8'),
- digestmod=hashlib.sha256).digest()
- signature_sha = base64.b64encode(signature_sha).decode(encoding='utf-8')
-
- authorization_origin = "api_key=\"%s\", algorithm=\"%s\", headers=\"%s\", signature=\"%s\"" % (
- self.spark_api_key, "hmac-sha256", "host date request-line", signature_sha)
- authorization = base64.b64encode(authorization_origin.encode('utf-8')).decode(encoding='utf-8')
+ signature_sha = hmac.new(
+ self.spark_api_secret.encode("utf-8"), signature_origin.encode("utf-8"), digestmod=hashlib.sha256
+ ).digest()
+ signature_sha = base64.b64encode(signature_sha).decode(encoding="utf-8")
+
+ authorization_origin = 'api_key="%s", algorithm="%s", headers="%s", signature="%s"' % (
+ self.spark_api_key,
+ "hmac-sha256",
+ "host date request-line",
+ signature_sha,
+ )
+ authorization = base64.b64encode(authorization_origin.encode("utf-8")).decode(encoding="utf-8")
# 将请求的鉴权参数组合为字典
- v = {
- "authorization": authorization,
- "date": date,
- "host": host
- }
+ v = {"authorization": authorization, "date": date, "host": host}
# 拼接鉴权参数,生成url
- url = url + '?' + urlencode(v)
+ url = url + "?" + urlencode(v)
# print("date: ",date)
# print("v: ",v)
# 此处打印出建立连接时候的url,参考本demo的时候可取消上方打印的注释,比对相同参数时生成的url与自己代码生成的url是否一致
@@ -100,7 +100,7 @@ def create_url(self):
return url
def check_auth(self):
- self.text_to_speech(_('Hello'))
+ self.text_to_speech(_("Hello"))
def text_to_speech(self, text):
@@ -121,7 +121,7 @@ def is_cache_model(self):
@staticmethod
async def handle_message(ws):
- audio_bytes: bytes = b''
+ audio_bytes: bytes = b""
while True:
res = await ws.recv()
message = json.loads(res)
@@ -146,7 +146,7 @@ async def send(self, ws, text):
d = {
"common": {"app_id": self.spark_app_id},
"business": business | self.params,
- "data": {"status": 2, "text": str(base64.b64encode(text.encode('utf-8')), "UTF8")},
+ "data": {"status": 2, "text": str(base64.b64encode(text.encode("utf-8")), "UTF8")},
}
d = json.dumps(d)
await ws.send(d)
diff --git a/apps/models_provider/impl/xf_model_provider/model/zh_en_stt.py b/apps/models_provider/impl/xf_model_provider/model/zh_en_stt.py
index e770a0a6c82..22f7e54738e 100644
--- a/apps/models_provider/impl/xf_model_provider/model/zh_en_stt.py
+++ b/apps/models_provider/impl/xf_model_provider/model/zh_en_stt.py
@@ -7,7 +7,7 @@
import traceback
from typing import Dict
from urllib.parse import urlencode
-from datetime import datetime, timezone, UTC
+from datetime import datetime, UTC
import websockets
import os
@@ -44,11 +44,11 @@ class XFZhEnSparkSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.spark_api_url = kwargs.get('spark_api_url')
- self.spark_app_id = kwargs.get('spark_app_id')
- self.spark_api_key = kwargs.get('spark_api_key')
- self.spark_api_secret = kwargs.get('spark_api_secret')
- self.params = kwargs.get('params')
+ self.spark_api_url = kwargs.get("spark_api_url")
+ self.spark_app_id = kwargs.get("spark_app_id")
+ self.spark_api_key = kwargs.get("spark_api_key")
+ self.spark_api_secret = kwargs.get("spark_api_secret")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -58,12 +58,12 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return XFZhEnSparkSpeechToText(
- spark_app_id=model_credential.get('spark_app_id'),
- spark_api_key=model_credential.get('spark_api_key'),
- spark_api_secret=model_credential.get('spark_api_secret'),
- spark_api_url=model_credential.get('spark_api_url'),
+ spark_app_id=model_credential.get("spark_app_id"),
+ spark_api_key=model_credential.get("spark_api_key"),
+ spark_api_secret=model_credential.get("spark_api_secret"),
+ spark_api_url=model_credential.get("spark_api_url"),
params=model_kwargs,
- **model_kwargs
+ **model_kwargs,
)
# 生成url
@@ -71,7 +71,7 @@ def create_url(self):
url = self.spark_api_url
host = urlparse(url).hostname
- gmt_format = '%a, %d %b %Y %H:%M:%S GMT'
+ gmt_format = "%a, %d %b %Y %H:%M:%S GMT"
date = datetime.now(UTC).strftime(gmt_format)
# 拼接字符串
signature_origin = "host: " + host + "\n"
@@ -79,29 +79,23 @@ def create_url(self):
signature_origin += "GET " + "/v1 HTTP/1.1"
# 进行hmac-sha256进行加密
signature_sha = hmac.new(
- self.spark_api_secret.encode('utf-8'),
- signature_origin.encode('utf-8'),
- hashlib.sha256
+ self.spark_api_secret.encode("utf-8"), signature_origin.encode("utf-8"), hashlib.sha256
).digest()
- signature = base64.b64encode(signature_sha).decode(encoding='utf-8')
+ signature = base64.b64encode(signature_sha).decode(encoding="utf-8")
authorization_origin = (
f'api_key="{self.spark_api_key}", algorithm="hmac-sha256", '
f'headers="host date request-line", signature="{signature}"'
)
- authorization = base64.b64encode(authorization_origin.encode('utf-8')).decode(encoding='utf-8')
+ authorization = base64.b64encode(authorization_origin.encode("utf-8")).decode(encoding="utf-8")
- params = {
- 'authorization': authorization,
- 'date': date,
- 'host': host
- }
- auth_url = url + '?' + urlencode(params)
+ params = {"authorization": authorization, "date": date, "host": host}
+ auth_url = url + "?" + urlencode(params)
return auth_url
def check_auth(self):
cwd = os.path.dirname(os.path.abspath(__file__))
- with open(f'{cwd}/iat_mp3_16k.mp3', 'rb') as f:
+ with open(f"{cwd}/iat_mp3_16k.mp3", "rb") as f:
self.speech_to_text(f)
def speech_to_text(self, audio_file_path):
@@ -112,13 +106,14 @@ async def handle():
await self.send_audio(ws, audio_file_path)
# 接收识别结果
return await self.handle_message(ws)
+
try:
return asyncio.run(handle())
except Exception as err:
maxkb_logger.error(f"语音识别错误: {str(err)}: {traceback.format_exc()}")
raise
- def merge_params_to_frame(self, frame,params):
+ def merge_params_to_frame(self, frame, params):
return deep_merge_dict(frame, params)
@@ -132,7 +127,7 @@ async def send_audio(self, ws, audio_file):
if not chunk or seq > max_chunks:
break
- chunk_base64 = base64.b64encode(chunk).decode('utf-8')
+ chunk_base64 = base64.b64encode(chunk).decode("utf-8")
# 第一帧
if seq == 1:
frame = {
@@ -144,18 +139,29 @@ async def send_audio(self, ws, audio_file):
"accent": "mandarin",
"eos": 10000,
"vinfo": 1,
- "result": {"encoding": "utf8", "compress": "raw", "format": "json"}
+ "result": {"encoding": "utf8", "compress": "raw", "format": "json"},
}
},
"payload": {
"audio": {
- "encoding": "lame", "sample_rate": 16000, "channels": 1,
- "bit_depth": 16, "seq": seq, "status": 0, "audio": chunk_base64
+ "encoding": "lame",
+ "sample_rate": 16000,
+ "channels": 1,
+ "bit_depth": 16,
+ "seq": seq,
+ "status": 0,
+ "audio": chunk_base64,
}
- }
+ },
}
- frame = self.merge_params_to_frame(frame,{key: value for key, value in self.params.items() if
- not ['model_id', 'use_local', 'streaming'].__contains__(key)})
+ frame = self.merge_params_to_frame(
+ frame,
+ {
+ key: value
+ for key, value in self.params.items()
+ if not ["model_id", "use_local", "streaming"].__contains__(key)
+ },
+ )
# 中间帧
else:
@@ -163,14 +169,25 @@ async def send_audio(self, ws, audio_file):
"header": {"app_id": self.spark_app_id, "status": 1},
"payload": {
"audio": {
- "encoding": "lame", "sample_rate": 16000, "channels": 1,
- "bit_depth": 16, "seq": seq, "status": 1, "audio": chunk_base64
+ "encoding": "lame",
+ "sample_rate": 16000,
+ "channels": 1,
+ "bit_depth": 16,
+ "seq": seq,
+ "status": 1,
+ "audio": chunk_base64,
}
- }
+ },
}
- frame = self.merge_params_to_frame(frame,{key: value for key, value in self.params.items() if
- not ['model_id', 'use_local', 'streaming','parameter'].__contains__(key)})
+ frame = self.merge_params_to_frame(
+ frame,
+ {
+ key: value
+ for key, value in self.params.items()
+ if not ["model_id", "use_local", "streaming", "parameter"].__contains__(key)
+ },
+ )
await ws.send(json.dumps(frame))
seq += 1
@@ -180,14 +197,25 @@ async def send_audio(self, ws, audio_file):
"header": {"app_id": self.spark_app_id, "status": 2},
"payload": {
"audio": {
- "encoding": "lame", "sample_rate": 16000, "channels": 1,
- "bit_depth": 16, "seq": seq, "status": 2, "audio": ""
+ "encoding": "lame",
+ "sample_rate": 16000,
+ "channels": 1,
+ "bit_depth": 16,
+ "seq": seq,
+ "status": 2,
+ "audio": "",
}
- }
+ },
}
- end_frame = self.merge_params_to_frame(end_frame,{key: value for key, value in self.params.items() if
- not ['model_id', 'use_local', 'streaming','parameter'].__contains__(key)})
+ end_frame = self.merge_params_to_frame(
+ end_frame,
+ {
+ key: value
+ for key, value in self.params.items()
+ if not ["model_id", "use_local", "streaming", "parameter"].__contains__(key)
+ },
+ )
await ws.send(json.dumps(end_frame))
@@ -198,20 +226,20 @@ async def handle_message(self, ws):
try:
message = await asyncio.wait_for(ws.recv(), timeout=30.0)
data = json.loads(message)
- if data['header']['code'] != 0:
+ if data["header"]["code"] != 0:
raise Exception("")
- if 'payload' in data and 'result' in data['payload']:
- result = data['payload']['result']
- text = result.get('text', '')
+ if "payload" in data and "result" in data["payload"]:
+ result = data["payload"]["result"]
+ text = result.get("text", "")
if text:
- text_data = json.loads(base64.b64decode(text).decode('utf-8'))
- for ws_item in text_data.get('ws', []):
- for cw in ws_item.get('cw', []):
- for sw in cw.get('w', []):
+ text_data = json.loads(base64.b64decode(text).decode("utf-8"))
+ for ws_item in text_data.get("ws", []):
+ for cw in ws_item.get("cw", []):
+ for sw in cw.get("w", []):
result_text += sw
- if data['header'].get('status') == 2:
+ if data["header"].get("status") == 2:
break
except asyncio.TimeoutError:
break
diff --git a/apps/models_provider/impl/xf_model_provider/xf_model_provider.py b/apps/models_provider/impl/xf_model_provider/xf_model_provider.py
index 0876ca3f6a3..46eaea200d9 100644
--- a/apps/models_provider/impl/xf_model_provider/xf_model_provider.py
+++ b/apps/models_provider/impl/xf_model_provider/xf_model_provider.py
@@ -1,23 +1,31 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: xf_model_provider.py
- @date:2024/04/19 14:47
- @desc:
+@project: maxkb
+@Author:虎
+@file: xf_model_provider.py
+@date:2024/04/19 14:47
+@desc:
"""
+
import os
import ssl
from common.utils.common import get_file_content
-from models_provider.base_model_provider import ModelProvideInfo, ModelTypeConst, ModelInfo, IModelProvider, \
- ModelInfoManage
+from models_provider.base_model_provider import (
+ ModelProvideInfo,
+ ModelTypeConst,
+ ModelInfo,
+ IModelProvider,
+ ModelInfoManage,
+)
from models_provider.impl.xf_model_provider.credential.embedding import XFEmbeddingCredential
from models_provider.impl.xf_model_provider.credential.image import XunFeiImageModelCredential
from models_provider.impl.xf_model_provider.credential.llm import XunFeiLLMModelCredential
from models_provider.impl.xf_model_provider.credential.stt import XunFeiSTTModelCredential
from models_provider.impl.xf_model_provider.credential.tts import XunFeiTTSModelCredential
-from models_provider.impl.xf_model_provider.credential.tts.super_humanoid_tts import XunFeiSuperHumanoidTTSModelCredential
+from models_provider.impl.xf_model_provider.credential.tts.super_humanoid_tts import (
+ XunFeiSuperHumanoidTTSModelCredential,
+)
from models_provider.impl.xf_model_provider.credential.tts.default_tts import XunFeiDefaultTTSModelCredential
from models_provider.impl.xf_model_provider.credential.zh_en_stt import ZhEnXunFeiSTTModelCredential
from models_provider.impl.xf_model_provider.model.embedding import XFEmbedding
@@ -44,44 +52,58 @@
embedding_model_credential = XFEmbeddingCredential()
model_info_list = [
- ModelInfo('generalv3.5', '', ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM),
- ModelInfo('generalv3', '', ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM),
- ModelInfo('generalv2', '', ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM),
- ModelInfo('iat', _('Chinese and English recognition'), ModelTypeConst.STT, stt_model_credential,
- XFSparkSpeechToText),
- ModelInfo('slm', _('Chinese and English recognition'), ModelTypeConst.STT, zh_en_stt_credential,
- XFZhEnSparkSpeechToText),
+ ModelInfo("generalv3.5", "", ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM),
+ ModelInfo("generalv3", "", ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM),
+ ModelInfo("generalv2", "", ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM),
+ ModelInfo(
+ "iat", _("Chinese and English recognition"), ModelTypeConst.STT, stt_model_credential, XFSparkSpeechToText
+ ),
+ ModelInfo(
+ "slm", _("Chinese and English recognition"), ModelTypeConst.STT, zh_en_stt_credential, XFZhEnSparkSpeechToText
+ ),
# 具体 TTS 模型
- ModelInfo('tts', _('Online TTS'), ModelTypeConst.TTS, tts_model_credential, XFSparkTextToSpeech),
- ModelInfo('tts-super-humanoid', _('Super Humanoid TTS'), ModelTypeConst.TTS, super_humanoid_tts_credential,
- XFSparkSuperHumanoidTextToSpeech),
- ModelInfo('embedding', '', ModelTypeConst.EMBEDDING, embedding_model_credential, XFEmbedding)
+ ModelInfo("tts", _("Online TTS"), ModelTypeConst.TTS, tts_model_credential, XFSparkTextToSpeech),
+ ModelInfo(
+ "tts-super-humanoid",
+ _("Super Humanoid TTS"),
+ ModelTypeConst.TTS,
+ super_humanoid_tts_credential,
+ XFSparkSuperHumanoidTextToSpeech,
+ ),
+ ModelInfo("embedding", "", ModelTypeConst.EMBEDDING, embedding_model_credential, XFEmbedding),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
.append_default_model_info(
- ModelInfo('generalv3.5', '', ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM))
+ ModelInfo("generalv3.5", "", ModelTypeConst.LLM, xunfei_model_credential, XFChatSparkLLM)
+ )
.append_default_model_info(
- ModelInfo('iat', _('Chinese and English recognition'), ModelTypeConst.STT, stt_model_credential,
- XFSparkSpeechToText),
+ ModelInfo(
+ "iat", _("Chinese and English recognition"), ModelTypeConst.STT, stt_model_credential, XFSparkSpeechToText
+ ),
)
# default TTS 工厂入口
.append_default_model_info(
- ModelInfo('default', _('default'), ModelTypeConst.TTS, default_tts_credential, XFSparkDefaultTextToSpeech))
+ ModelInfo("default", _("default"), ModelTypeConst.TTS, default_tts_credential, XFSparkDefaultTextToSpeech)
+ )
.append_default_model_info(
- ModelInfo('embedding', '', ModelTypeConst.EMBEDDING, embedding_model_credential, XFEmbedding))
+ ModelInfo("embedding", "", ModelTypeConst.EMBEDDING, embedding_model_credential, XFEmbedding)
+ )
.build()
)
class XunFeiModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_xf_provider', name=_('iFlytek Spark'), icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'xf_model_provider', 'icon',
- 'xf_icon_svg')))
\ No newline at end of file
+ return ModelProvideInfo(
+ provider="model_xf_provider",
+ name=_("iFlytek Spark"),
+ icon=get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "models_provider", "impl", "xf_model_provider", "icon", "xf_icon_svg")
+ ),
+ )
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/embedding.py b/apps/models_provider/impl/xinference_model_provider/credential/embedding.py
index 1ca79e40af7..e1a41d91518 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/embedding.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/embedding.py
@@ -11,34 +11,44 @@
class XinferenceEmbeddingModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'), model_credential.get('api_key'),
- 'embedding')
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, _('API domain name is invalid'))
+ model_list = provider.get_base_model_list(
+ model_credential.get("api_base"), model_credential.get("api_key"), "embedding"
+ )
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, _("API domain name is invalid"))
exist = provider.get_model_info_by_name(model_list, model_name)
model: LocalEmbedding = provider.get_model(model_type, model_name, model_credential)
if len(exist) == 0:
model.start_down_model_thread()
- raise AppApiException(ValidCode.model_not_fount,
- _('The model does not exist, please download the model first'))
- model.embed_query(_('Hello'))
+ raise AppApiException(
+ ValidCode.model_not_fount, _("The model does not exist, please download the model first")
+ )
+ model.embed_query(_("Hello"))
return True
def encryption_dict(self, model_info: Dict[str, object]):
return model_info
def build_model(self, model_info: Dict[str, object]):
- for key in ['model']:
+ for key in ["model"]:
if key not in model_info:
- raise AppApiException(500, _('{key} is required').format(key=key))
+ raise AppApiException(500, _("{key} is required").format(key=key))
return self
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/image.py b/apps/models_provider/impl/xinference_model_provider/credential/image.py
index 83f1d0f321a..38cae811b8b 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/image.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/image.py
@@ -12,60 +12,79 @@
class XinferenceImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class XinferenceImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return XinferenceImageModelParams()
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/llm.py b/apps/models_provider/impl/xinference_model_provider/credential/llm.py
index aee80fee76a..378dec8d557 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/llm.py
@@ -12,56 +12,75 @@
class XinferenceLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.7,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.7,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=800,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=8192,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class XinferenceLLMModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
try:
- model_list = provider.get_base_model_list(model_credential.get('api_base'), model_credential.get('api_key'),
- model_type)
- except Exception as e:
- raise AppApiException(ValidCode.valid_error.value, gettext('API domain name is invalid'))
+ model_list = provider.get_base_model_list(
+ model_credential.get("api_base"), model_credential.get("api_key"), model_type
+ )
+ except Exception:
+ raise AppApiException(ValidCode.valid_error.value, gettext("API domain name is invalid"))
exist = provider.get_model_info_by_name(model_list, model_name)
if len(exist) == 0:
- raise AppApiException(ValidCode.valid_error.value,
- gettext('The model does not exist, please download the model first'))
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ raise AppApiException(
+ ValidCode.valid_error.value, gettext("The model does not exist, please download the model first")
+ )
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
return True
def encryption_dict(self, model_info: Dict[str, object]):
- return {**model_info, 'api_key': super().encryption(model_info.get('api_key', ''))}
+ return {**model_info, "api_key": super().encryption(model_info.get("api_key", ""))}
def build_model(self, model_info: Dict[str, object]):
- for key in ['api_key', 'model']:
+ for key in ["api_key", "model"]:
if key not in model_info:
- raise AppApiException(500, gettext('{key} is required').format(key=key))
- self.api_key = model_info.get('api_key')
+ raise AppApiException(500, gettext("{key} is required").format(key=key))
+ self.api_key = model_info.get("api_key")
return self
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return XinferenceLLMModelParams()
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/reranker.py b/apps/models_provider/impl/xinference_model_provider/credential/reranker.py
index 94291f10549..35c13836802 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/reranker.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/reranker.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: reranker.py
- @date:2024/9/10 9:46
- @desc:
+@project: MaxKB
+@Author:虎
+@file: reranker.py
+@date:2024/9/10 9:46
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext as _
@@ -18,37 +19,50 @@
class XInferenceRerankerModelParams(BaseForm):
- top_n = forms.SliderField(TooltipLabel(_('Top N'),
- _('Number of top documents to return after reranking')),
- required=True, default_value=3,
- _min=1,
- _max=100,
- _step=1,
- precision=0)
+ top_n = forms.SliderField(
+ TooltipLabel(_("Top N"), _("Number of top documents to return after reranking")),
+ required=True,
+ default_value=3,
+ _min=1,
+ _max=100,
+ _step=1,
+ precision=0,
+ )
class XInferenceRerankerModelCredential(BaseForm, BaseModelCredential):
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=True):
- if not model_type == 'RERANKER':
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['server_url']:
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=True,
+ ):
+ if not model_type == "RERANKER":
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
+ for key in ["server_url"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential)
- model.compress_documents([Document(page_content=_('Hello'))], _('Hello'))
+ model.compress_documents([Document(page_content=_("Hello"))], _("Hello"))
except Exception as e:
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
@@ -56,9 +70,9 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
def encryption_dict(self, model_info: Dict[str, object]):
return model_info
- server_url = forms.TextInputField('API URL', required=True)
+ server_url = forms.TextInputField("API URL", required=True)
- api_key = forms.PasswordInputField('API Key', required=False)
+ api_key = forms.PasswordInputField("API Key", required=False)
def get_model_params_setting_form(self, model_name: str) -> XInferenceRerankerModelParams:
return XInferenceRerankerModelParams()
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/stt.py b/apps/models_provider/impl/xinference_model_provider/credential/stt.py
index e4a389fd476..bb6613e6b46 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/stt.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/stt.py
@@ -10,20 +10,28 @@
class XInferenceSTTModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
+
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- _('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value, _("{model_type} Model type is not supported").format(model_type=model_type)
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, _('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, _("{key} is required").format(key=key))
else:
return False
try:
@@ -33,15 +41,18 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- _('Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ _("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
pass
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/tti.py b/apps/models_provider/impl/xinference_model_provider/credential/tti.py
index 2abc4f69183..9f3cae18a29 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/tti.py
@@ -11,57 +11,80 @@
class XinferenceTTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('The image generation endpoint allows you to create raw images based on text prompts. The dimensions of the image can be 1024x1024, 1024x1792, or 1792x1024 pixels.')),
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "The image generation endpoint allows you to create raw images based on text prompts. The dimensions of the image can be 1024x1024, 1024x1792, or 1792x1024 pixels."
+ ),
+ ),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '1024x1792', 'label': '1024x1792'},
- {'value': '1792x1024', 'label': '1792x1024'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "1024x1792", "label": "1024x1792"},
+ {"value": "1792x1024", "label": "1792x1024"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
quality = forms.SingleSelect(
- TooltipLabel(_('Picture quality'),
- _('By default, images are generated in standard quality, you can set quality: "hd" to enhance detail. Square, standard quality images are generated fastest.')),
+ TooltipLabel(
+ _("Picture quality"),
+ _(
+ 'By default, images are generated in standard quality, you can set quality: "hd" to enhance detail. Square, standard quality images are generated fastest.'
+ ),
+ ),
required=True,
- default_value='standard',
+ default_value="standard",
option_list=[
- {'value': 'standard', 'label': 'standard'},
- {'value': 'hd', 'label': 'hd'},
+ {"value": "standard", "label": "standard"},
+ {"value": "hd", "label": "hd"},
],
- text_field='label',
- value_field='value'
+ text_field="label",
+ value_field="value",
)
n = forms.SliderField(
- TooltipLabel(_('Number of pictures'),
- _('You can request 1 image at a time (requesting more images by making parallel requests), or up to 10 images at a time using the n parameter.')),
- required=True, default_value=1,
+ TooltipLabel(
+ _("Number of pictures"),
+ _(
+ "You can request 1 image at a time (requesting more images by making parallel requests), or up to 10 images at a time using the n parameter."
+ ),
+ ),
+ required=True,
+ default_value=1,
_min=1,
_max=10,
_step=1,
- precision=0)
+ precision=0,
+ )
class XinferenceTextToImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
@@ -71,16 +94,18 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return XinferenceTTIModelParams()
diff --git a/apps/models_provider/impl/xinference_model_provider/credential/tts.py b/apps/models_provider/impl/xinference_model_provider/credential/tts.py
index b1dc2f885ca..ec7d20a9cd1 100644
--- a/apps/models_provider/impl/xinference_model_provider/credential/tts.py
+++ b/apps/models_provider/impl/xinference_model_provider/credential/tts.py
@@ -12,36 +12,47 @@
class XInferenceTTSModelGeneralParams(BaseForm):
# ['中文女', '中文男', '日语男', '粤语女', '英文女', '英文男', '韩语女']
voice = forms.SingleSelect(
- TooltipLabel(_('timbre'), ''),
- required=True, default_value='中文女',
- text_field='value',
- value_field='value',
+ TooltipLabel(_("timbre"), ""),
+ required=True,
+ default_value="中文女",
+ text_field="value",
+ value_field="value",
option_list=[
- {'text': _('Chinese female'), 'value': '中文女'},
- {'text': _('Chinese male'), 'value': '中文男'},
- {'text': _('Japanese male'), 'value': '日语男'},
- {'text': _('Cantonese female'), 'value': '粤语女'},
- {'text': _('English female'), 'value': '英文女'},
- {'text': _('English male'), 'value': '英文男'},
- {'text': _('Korean female'), 'value': '韩语女'},
- ])
+ {"text": _("Chinese female"), "value": "中文女"},
+ {"text": _("Chinese male"), "value": "中文男"},
+ {"text": _("Japanese male"), "value": "日语男"},
+ {"text": _("Cantonese female"), "value": "粤语女"},
+ {"text": _("English female"), "value": "英文女"},
+ {"text": _("English male"), "value": "英文男"},
+ {"text": _("Korean female"), "value": "韩语女"},
+ ],
+ )
class XInferenceTTSModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True)
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True)
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_base', 'api_key']:
+ for key in ["api_base", "api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
@@ -51,16 +62,18 @@ def is_valid(self, model_type: str, model_name, model_credential: Dict[str, obje
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return XInferenceTTSModelGeneralParams()
diff --git a/apps/models_provider/impl/xinference_model_provider/model/embedding.py b/apps/models_provider/impl/xinference_model_provider/model/embedding.py
index 923971958aa..a85e594a872 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/embedding.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/embedding.py
@@ -4,10 +4,21 @@
from langchain_core.embeddings import Embeddings
-from models_provider.base_model_provider import MaxKBBaseModel
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel
+try:
+ from xinference.client import RESTfulClient
+except ImportError:
+ try:
+ from xinference_client import RESTfulClient
+ except ImportError:
+ RESTfulClient = None
+
+
+class XinferenceEmbedding(MaxKBBaseEmbeddingModel, Embeddings):
+ def supports_image_embedding(self) -> bool:
+ return False
-class XinferenceEmbedding(MaxKBBaseModel, Embeddings):
client: Any
server_url: Optional[str]
"""URL of the xinference server"""
@@ -18,8 +29,8 @@ class XinferenceEmbedding(MaxKBBaseModel, Embeddings):
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
return XinferenceEmbedding(
model_uid=model_name,
- server_url=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ server_url=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
)
def down_model(self):
@@ -31,19 +42,13 @@ def start_down_model_thread(self):
thread.start()
def __init__(
- self, server_url: Optional[str] = None, model_uid: Optional[str] = None,
- api_key: Optional[str] = None
+ self, server_url: Optional[str] = None, model_uid: Optional[str] = None, api_key: Optional[str] = None
):
- try:
- from xinference.client import RESTfulClient
- except ImportError:
- try:
- from xinference_client import RESTfulClient
- except ImportError as e:
- raise ImportError(
- "Could not import RESTfulClient from xinference. Please install it"
- " with `pip install xinference` or `pip install xinference_client`."
- ) from e
+ if RESTfulClient is None:
+ raise ImportError(
+ "Could not import RESTfulClient from xinference. Please install it"
+ " with `pip install xinference` or `pip install xinference_client`."
+ )
if server_url is None:
raise ValueError("Please provide server URL")
@@ -69,9 +74,7 @@ def embed_documents(self, texts: List[str]) -> List[List[float]]:
model = self.client.get_model(self.model_uid)
- embeddings = [
- model.create_embedding(text)["data"][0]["embedding"] for text in texts
- ]
+ embeddings = [model.create_embedding(text)["data"][0]["embedding"] for text in texts]
return [list(map(float, e)) for e in embeddings]
def embed_query(self, text: str) -> List[float]:
diff --git a/apps/models_provider/impl/xinference_model_provider/model/image.py b/apps/models_provider/impl/xinference_model_provider/model/image.py
index 5029afc03bb..e8c7b1c0d51 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/image.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/image.py
@@ -8,7 +8,6 @@
class XinferenceImage(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -18,8 +17,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return XinferenceImage(
model_name=model_name,
- openai_api_base=model_credential.get('api_base'),
- openai_api_key=model_credential.get('api_key'),
+ openai_api_base=model_credential.get("api_base"),
+ openai_api_key=model_credential.get("api_key"),
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
@@ -30,10 +29,10 @@ def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
- return self.usage_metadata.get('input_tokens', 0)
+ return self.usage_metadata.get("input_tokens", 0)
def get_num_tokens(self, text: str) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
- return self.get_last_generation_info().get('output_tokens', 0)
+ return self.get_last_generation_info().get("output_tokens", 0)
diff --git a/apps/models_provider/impl/xinference_model_provider/model/llm.py b/apps/models_provider/impl/xinference_model_provider/model/llm.py
index ab3d77abef5..7d60d2ccba0 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/llm.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/llm.py
@@ -12,28 +12,27 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
class XinferenceChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- api_base = model_credential.get('api_base', '')
+ api_base = model_credential.get("api_base", "")
base_url = get_base_url(api_base)
- base_url = base_url if base_url.endswith('/v1') else (base_url + '/v1')
+ base_url = base_url if base_url.endswith("/v1") else (base_url + "/v1")
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return XinferenceChatModel(
model=model_name,
openai_api_base=base_url,
- openai_api_key=model_credential.get('api_key'),
+ openai_api_key=model_credential.get("api_key"),
**optional_params,
)
@@ -41,10 +40,10 @@ def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
- return self.usage_metadata.get('input_tokens', 0)
+ return self.usage_metadata.get("input_tokens", 0)
def get_num_tokens(self, text: str) -> int:
if self.usage_metadata is None or self.usage_metadata == {}:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
- return self.get_last_generation_info().get('output_tokens', 0)
+ return self.get_last_generation_info().get("output_tokens", 0)
diff --git a/apps/models_provider/impl/xinference_model_provider/model/reranker.py b/apps/models_provider/impl/xinference_model_provider/model/reranker.py
index 405e8322474..43f4dda7160 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/reranker.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/reranker.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: reranker.py
- @date:2024/9/10 9:45
- @desc:
+@project: MaxKB
+@Author:虎
+@file: reranker.py
+@date:2024/9/10 9:45
+@desc:
"""
+
from typing import Sequence, Optional, Any, Dict
from langchain_core.callbacks import Callbacks
@@ -24,13 +25,18 @@ class XInferenceReranker(MaxKBBaseModel, BaseDocumentCompressor):
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- return XInferenceReranker(server_url=model_credential.get('server_url'), model_uid=model_name,
- api_key=model_credential.get('api_key'), top_n=model_kwargs.get('top_n', 3))
+ return XInferenceReranker(
+ server_url=model_credential.get("server_url"),
+ model_uid=model_name,
+ api_key=model_credential.get("api_key"),
+ top_n=model_kwargs.get("top_n", 3),
+ )
top_n: Optional[int] = 3
- def compress_documents(self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None) -> \
- Sequence[Document]:
+ def compress_documents(
+ self, documents: Sequence[Document], query: str, callbacks: Optional[Callbacks] = None
+ ) -> Sequence[Document]:
if documents is None or len(documents) == 0:
return []
client: Any
@@ -50,5 +56,9 @@ def compress_documents(self, documents: Sequence[Document], query: str, callback
client = RESTfulClient(self.server_url, self.api_key)
model: RESTfulRerankModelHandle = client.get_model(self.model_uid)
res = model.rerank([document.page_content for document in documents], query, self.top_n, return_documents=True)
- return [Document(page_content=d.get('document', {}).get('text'),
- metadata={'relevance_score': d.get('relevance_score')}) for d in res.get('results', [])]
+ return [
+ Document(
+ page_content=d.get("document", {}).get("text"), metadata={"relevance_score": d.get("relevance_score")}
+ )
+ for d in res.get("results", [])
+ ]
diff --git a/apps/models_provider/impl/xinference_model_provider/model/stt.py b/apps/models_provider/impl/xinference_model_provider/model/stt.py
index 5c6179cd06f..b61f13001be 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/stt.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/stt.py
@@ -21,10 +21,10 @@ class XInferenceSpeechToText(MaxKBBaseModel, BaseSpeechToText):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -33,42 +33,31 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = {}
- if 'max_tokens' in model_kwargs and model_kwargs['max_tokens'] is not None:
- optional_params['max_tokens'] = model_kwargs['max_tokens']
- if 'temperature' in model_kwargs and model_kwargs['temperature'] is not None:
- optional_params['temperature'] = model_kwargs['temperature']
+ if "max_tokens" in model_kwargs and model_kwargs["max_tokens"] is not None:
+ optional_params["max_tokens"] = model_kwargs["max_tokens"]
+ if "temperature" in model_kwargs and model_kwargs["temperature"] is not None:
+ optional_params["temperature"] = model_kwargs["temperature"]
return XInferenceSpeechToText(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
params=model_kwargs,
**optional_params,
)
def check_auth(self):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
response_list = client.models.with_raw_response.list()
# print(response_list)
def speech_to_text(self, audio_file):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
audio_data = audio_file.read()
buffer = io.BytesIO(audio_data)
buffer.name = "file.mp3" # this is the important line
- filter_params = {k: v for k, v in self.params.items() if k not in {'model_id', 'use_local', 'streaming'}}
- transcription_params = {
- 'model': self.model,
- 'file': buffer,
- 'language': 'zh',
- **filter_params
- }
+ filter_params = {k: v for k, v in self.params.items() if k not in {"model_id", "use_local", "streaming"}}
+ transcription_params = {"model": self.model, "file": buffer, "language": "zh", **filter_params}
res = client.audio.transcriptions.create(**transcription_params)
return res.text
diff --git a/apps/models_provider/impl/xinference_model_provider/model/tti.py b/apps/models_provider/impl/xinference_model_provider/model/tti.py
index f0d929eca2d..53a57059ba1 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/tti.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/tti.py
@@ -4,12 +4,10 @@
from openai import OpenAI
from common.config.tokenizer_manage_config import TokenizerManage
-from common.utils.common import bytes_to_uploaded_file
-from knowledge.models import FileSourceType
+
# from dataset.serializers.file_serializers import FileSerializer
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.impl.base_tti import BaseTextToImage
-from oss.serializers.file import FileSerializer
def custom_get_token_ids(text: str):
@@ -25,10 +23,10 @@ class XinferenceTextToImage(MaxKBBaseModel, BaseTextToImage):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -36,23 +34,23 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'size': '1024x1024', 'quality': 'standard', 'n': 1}}
+ optional_params = {"params": {"size": "1024x1024", "quality": "standard", "n": 1}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return XinferenceTextToImage(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- self.generate_image('生成一个小猫图片')
+ self.generate_image("生成一个小猫图片")
def generate_image(self, prompt: str, negative_prompt: str = None):
chat = OpenAI(api_key=self.api_key, base_url=self.api_base)
- res = chat.images.generate(model=self.model, prompt=prompt, response_format='b64_json', **self.params)
+ res = chat.images.generate(model=self.model, prompt=prompt, response_format="b64_json", **self.params)
file_urls = []
# 临时文件
for img in res.data:
diff --git a/apps/models_provider/impl/xinference_model_provider/model/tts.py b/apps/models_provider/impl/xinference_model_provider/model/tts.py
index 1dd22244876..3b510cad825 100644
--- a/apps/models_provider/impl/xinference_model_provider/model/tts.py
+++ b/apps/models_provider/impl/xinference_model_provider/model/tts.py
@@ -22,10 +22,10 @@ class XInferenceTextToSpeech(MaxKBBaseModel, BaseTextToSpeech):
def __init__(self, **kwargs):
super().__init__(**kwargs)
- self.api_key = kwargs.get('api_key')
- self.api_base = kwargs.get('api_base')
- self.model = kwargs.get('model')
- self.params = kwargs.get('params')
+ self.api_key = kwargs.get("api_key")
+ self.api_base = kwargs.get("api_base")
+ self.model = kwargs.get("model")
+ self.params = kwargs.get("params")
@staticmethod
def is_cache_model():
@@ -33,30 +33,25 @@ def is_cache_model():
@staticmethod
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
- optional_params = {'params': {'voice': '中文女'}}
+ optional_params = {"params": {"voice": "中文女"}}
for key, value in model_kwargs.items():
- if key not in ['model_id', 'use_local', 'streaming']:
- optional_params['params'][key] = value
+ if key not in ["model_id", "use_local", "streaming"]:
+ optional_params["params"][key] = value
return XInferenceTextToSpeech(
model=model_name,
- api_base=model_credential.get('api_base'),
- api_key=model_credential.get('api_key'),
+ api_base=model_credential.get("api_base"),
+ api_key=model_credential.get("api_key"),
**optional_params,
)
def check_auth(self):
- self.text_to_speech(_('Hello'))
+ self.text_to_speech(_("Hello"))
def text_to_speech(self, text):
- client = OpenAI(
- base_url=self.api_base,
- api_key=self.api_key
- )
+ client = OpenAI(base_url=self.api_base, api_key=self.api_key)
# ['中文女', '中文男', '日语男', '粤语女', '英文女', '英文男', '韩语女']
text = _remove_empty_lines(text)
with client.audio.speech.with_streaming_response.create(
- model=self.model,
- input=text,
- **self.params
+ model=self.model, input=text, **self.params
) as response:
- return response.read()
\ No newline at end of file
+ return response.read()
diff --git a/apps/models_provider/impl/xinference_model_provider/xinference_model_provider.py b/apps/models_provider/impl/xinference_model_provider/xinference_model_provider.py
index 749dcbeb9d2..7a3bd0523a3 100644
--- a/apps/models_provider/impl/xinference_model_provider/xinference_model_provider.py
+++ b/apps/models_provider/impl/xinference_model_provider/xinference_model_provider.py
@@ -5,10 +5,14 @@
import requests
from common.utils.common import get_file_content
-from models_provider.base_model_provider import IModelProvider, ModelProvideInfo, ModelInfo, ModelTypeConst, \
- ModelInfoManage
-from models_provider.impl.xinference_model_provider.credential.embedding import \
- XinferenceEmbeddingModelCredential
+from models_provider.base_model_provider import (
+ IModelProvider,
+ ModelProvideInfo,
+ ModelInfo,
+ ModelTypeConst,
+ ModelInfoManage,
+)
+from models_provider.impl.xinference_model_provider.credential.embedding import XinferenceEmbeddingModelCredential
from models_provider.impl.xinference_model_provider.credential.image import XinferenceImageModelCredential
from models_provider.impl.xinference_model_provider.credential.llm import XinferenceLLMModelCredential
from models_provider.impl.xinference_model_provider.credential.reranker import XInferenceRerankerModelCredential
@@ -33,512 +37,249 @@
model_info_list = [
ModelInfo(
- 'code-llama',
- _('Code Llama is a language model specifically designed for code generation.'),
+ "code-llama",
+ _("Code Llama is a language model specifically designed for code generation."),
ModelTypeConst.LLM,
xinference_llm_model_credential,
- XinferenceChatModel
+ XinferenceChatModel,
),
ModelInfo(
- 'code-llama-instruct',
- _('''
+ "code-llama-instruct",
+ _("""
Code Llama Instruct is a fine-tuned version of Code Llama's instructions, designed to perform specific tasks.
- '''),
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'code-llama-python',
- _('Code Llama Python is a language model specifically designed for Python code generation.'),
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'codeqwen1.5',
- _('CodeQwen 1.5 is a language model for code generation with high performance.'),
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'codeqwen1.5-chat',
- _('CodeQwen 1.5 Chat is a chat model version of CodeQwen 1.5.'),
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'deepseek',
- _('Deepseek is a large-scale language model with 13 billion parameters.'),
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'deepseek-chat',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'deepseek-coder',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'deepseek-coder-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'deepseek-vl-chat',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'gpt-3.5-turbo',
- '',
+ """),
ModelTypeConst.LLM,
xinference_llm_model_credential,
- XinferenceChatModel
+ XinferenceChatModel,
),
ModelInfo(
- 'gpt-4',
- '',
+ "code-llama-python",
+ _("Code Llama Python is a language model specifically designed for Python code generation."),
ModelTypeConst.LLM,
xinference_llm_model_credential,
- XinferenceChatModel
+ XinferenceChatModel,
),
ModelInfo(
- 'gpt-4-vision-preview',
- '',
+ "codeqwen1.5",
+ _("CodeQwen 1.5 is a language model for code generation with high performance."),
ModelTypeConst.LLM,
xinference_llm_model_credential,
- XinferenceChatModel
+ XinferenceChatModel,
),
ModelInfo(
- 'gpt4all',
- '',
+ "codeqwen1.5-chat",
+ _("CodeQwen 1.5 Chat is a chat model version of CodeQwen 1.5."),
ModelTypeConst.LLM,
xinference_llm_model_credential,
- XinferenceChatModel
+ XinferenceChatModel,
),
ModelInfo(
- 'llama2',
- '',
+ "deepseek",
+ _("Deepseek is a large-scale language model with 13 billion parameters."),
ModelTypeConst.LLM,
xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'llama2-chat',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'llama2-chat-32k',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen-chat',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen-chat-32k',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen-code',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen-code-chat',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen-vl',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen-vl-chat',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2-72b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2-57b-a14b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2-7b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-72b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-32b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-14b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-7b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-1.5b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-0.5b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'qwen2.5-3b-instruct',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
- ),
- ModelInfo(
- 'minicpm-llama3-v-2_5',
- '',
- ModelTypeConst.LLM,
- xinference_llm_model_credential,
- XinferenceChatModel
+ XinferenceChatModel,
),
+ ModelInfo("deepseek-chat", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("deepseek-coder", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("deepseek-coder-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("deepseek-vl-chat", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("gpt-3.5-turbo", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("gpt-4", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("gpt-4-vision-preview", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("gpt4all", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("llama2", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("llama2-chat", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("llama2-chat-32k", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen-chat", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen-chat-32k", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen-code", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen-code-chat", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen-vl", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen-vl-chat", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2-72b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2-57b-a14b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2-7b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-72b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-32b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-14b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-7b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-1.5b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-0.5b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("qwen2.5-3b-instruct", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
+ ModelInfo("minicpm-llama3-v-2_5", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel),
]
voice_model_info = [
+ ModelInfo("CosyVoice-300M-SFT", "", ModelTypeConst.TTS, xinference_tts_model_credential, XInferenceTextToSpeech),
ModelInfo(
- 'CosyVoice-300M-SFT',
- '',
- ModelTypeConst.TTS,
- xinference_tts_model_credential,
- XInferenceTextToSpeech
- ),
- ModelInfo(
- 'Belle-whisper-large-v3-zh',
- '',
- ModelTypeConst.STT,
- xinference_stt_model_credential,
- XInferenceSpeechToText
+ "Belle-whisper-large-v3-zh", "", ModelTypeConst.STT, xinference_stt_model_credential, XInferenceSpeechToText
),
]
image_model_info = [
+ ModelInfo("qwen-vl-chat", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("deepseek-vl-chat", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("yi-vl-chat", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("omnilmm", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("internvl-chat", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("cogvlm2", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("MiniCPM-Llama3-V-2_5", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("GLM-4V", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("MiniCPM-V-2.6", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("internvl2", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("qwen2-vl-instruct", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo("llama-3.2-vision", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+ ModelInfo(
+ "llama-3.2-vision-instruct", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage
+ ),
+ ModelInfo("glm-edge-v", "", ModelTypeConst.IMAGE, xinference_image_model_credential, XinferenceImage),
+]
+
+tti_model_info = [
+ ModelInfo("sd-turbo", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage),
+ ModelInfo("sdxl-turbo", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage),
+ ModelInfo("stable-diffusion-v1.5", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage),
ModelInfo(
- 'qwen-vl-chat',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
- ),
- ModelInfo(
- 'deepseek-vl-chat',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
- ),
- ModelInfo(
- 'yi-vl-chat',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
- ),
- ModelInfo(
- 'omnilmm',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "stable-diffusion-xl-base-1.0", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage
),
+ ModelInfo("sd3-medium", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage),
+ ModelInfo("FLUX.1-schnell", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage),
+ ModelInfo("FLUX.1-dev", "", ModelTypeConst.TTI, xinference_tti_model_credential, XinferenceTextToImage),
+]
+
+xinference_embedding_model_credential = XinferenceEmbeddingModelCredential()
+
+# 生成embedding_model_info列表
+embedding_model_info = [
ModelInfo(
- 'internvl-chat',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bce-embedding-base_v1",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
+ ModelInfo("bge-base-en", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'cogvlm2',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-base-en-v1.5", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding
),
+ ModelInfo("bge-base-zh", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'MiniCPM-Llama3-V-2_5',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-base-zh-v1.5", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding
),
+ ModelInfo("bge-large-en", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'GLM-4V',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-large-en-v1.5", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding
),
+ ModelInfo("bge-large-zh", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'MiniCPM-V-2.6',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-large-zh-noinstruct",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'internvl2',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-large-zh-v1.5", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding
),
+ ModelInfo("bge-m3", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'qwen2-vl-instruct',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-small-en-v1.5", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding
),
+ ModelInfo("bge-small-zh", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'llama-3.2-vision',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "bge-small-zh-v1.5", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding
),
+ ModelInfo("e5-large-v2", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
+ ModelInfo("gte-base", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
+ ModelInfo("gte-large", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'llama-3.2-vision-instruct',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "jina-embeddings-v2-base-en",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'glm-edge-v',
- '',
- ModelTypeConst.IMAGE,
- xinference_image_model_credential,
- XinferenceImage
+ "jina-embeddings-v2-base-zh",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
-]
-
-tti_model_info = [
ModelInfo(
- 'sd-turbo',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "jina-embeddings-v2-small-en",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
+ ModelInfo("m3e-base", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
+ ModelInfo("m3e-large", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
+ ModelInfo("m3e-small", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding),
ModelInfo(
- 'sdxl-turbo',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "multilingual-e5-large",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'stable-diffusion-v1.5',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "text2vec-base-chinese",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'stable-diffusion-xl-base-1.0',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "text2vec-base-chinese-paraphrase",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'sd3-medium',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "text2vec-base-chinese-sentence",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'FLUX.1-schnell',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "text2vec-base-multilingual",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
ModelInfo(
- 'FLUX.1-dev',
- '',
- ModelTypeConst.TTI,
- xinference_tti_model_credential,
- XinferenceTextToImage
+ "text2vec-large-chinese",
+ "",
+ ModelTypeConst.EMBEDDING,
+ xinference_embedding_model_credential,
+ XinferenceEmbedding,
),
]
-
-xinference_embedding_model_credential = XinferenceEmbeddingModelCredential()
-
-# 生成embedding_model_info列表
-embedding_model_info = [
- ModelInfo('bce-embedding-base_v1', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-base-en', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-base-en-v1.5', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-base-zh', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-base-zh-v1.5', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-large-en', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-large-en-v1.5', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-large-zh', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-large-zh-noinstruct', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-large-zh-v1.5', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-m3', '', ModelTypeConst.EMBEDDING, xinference_embedding_model_credential,
- XinferenceEmbedding),
- ModelInfo('bge-small-en-v1.5', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-small-zh', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('bge-small-zh-v1.5', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('e5-large-v2', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('gte-base', '', ModelTypeConst.EMBEDDING, xinference_embedding_model_credential,
- XinferenceEmbedding),
- ModelInfo('gte-large', '', ModelTypeConst.EMBEDDING, xinference_embedding_model_credential,
- XinferenceEmbedding),
- ModelInfo('jina-embeddings-v2-base-en', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('jina-embeddings-v2-base-zh', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('jina-embeddings-v2-small-en', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('m3e-base', '', ModelTypeConst.EMBEDDING, xinference_embedding_model_credential,
- XinferenceEmbedding),
- ModelInfo('m3e-large', '', ModelTypeConst.EMBEDDING, xinference_embedding_model_credential,
- XinferenceEmbedding),
- ModelInfo('m3e-small', '', ModelTypeConst.EMBEDDING, xinference_embedding_model_credential,
- XinferenceEmbedding),
- ModelInfo('multilingual-e5-large', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('text2vec-base-chinese', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('text2vec-base-chinese-paraphrase', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('text2vec-base-chinese-sentence', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('text2vec-base-multilingual', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
- ModelInfo('text2vec-large-chinese', '', ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding),
+rerank_list = [
+ ModelInfo(
+ "bce-reranker-base_v1", "", ModelTypeConst.RERANKER, XInferenceRerankerModelCredential(), XInferenceReranker
+ )
]
-rerank_list = [ModelInfo('bce-reranker-base_v1',
- '',
- ModelTypeConst.RERANKER, XInferenceRerankerModelCredential(), XInferenceReranker)]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
.append_model_info_list(voice_model_info)
.append_default_model_info(voice_model_info[0])
.append_default_model_info(voice_model_info[1])
- .append_default_model_info(ModelInfo('phi3',
- '',
- ModelTypeConst.LLM, xinference_llm_model_credential,
- XinferenceChatModel))
+ .append_default_model_info(
+ ModelInfo("phi3", "", ModelTypeConst.LLM, xinference_llm_model_credential, XinferenceChatModel)
+ )
.append_model_info_list(embedding_model_info)
- .append_default_model_info(ModelInfo('',
- '',
- ModelTypeConst.EMBEDDING,
- xinference_embedding_model_credential, XinferenceEmbedding))
+ .append_default_model_info(
+ ModelInfo("", "", ModelTypeConst.EMBEDDING, xinference_embedding_model_credential, XinferenceEmbedding)
+ )
.append_model_info_list(rerank_list)
.append_model_info_list(image_model_info)
.append_default_model_info(image_model_info[0])
@@ -551,9 +292,9 @@
def get_base_url(url: str):
parse = urlparse(url)
- result_url = ParseResult(scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params='',
- query='',
- fragment='').geturl()
+ result_url = ParseResult(
+ scheme=parse.scheme, netloc=parse.netloc, path=parse.path, params="", query="", fragment=""
+ ).geturl()
return result_url[:-1] if result_url.endswith("/") else result_url
@@ -562,24 +303,36 @@ def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_xinference_provider', name='Xorbits Inference', icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'xinference_model_provider', 'icon',
- 'xinference_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_xinference_provider",
+ name="Xorbits Inference",
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "impl",
+ "xinference_model_provider",
+ "icon",
+ "xinference_icon_svg",
+ )
+ ),
+ )
@staticmethod
def get_base_model_list(api_base, api_key, model_type):
base_url = get_base_url(api_base)
- base_url = base_url if base_url.endswith('/v1') else (base_url + '/v1')
+ base_url = base_url if base_url.endswith("/v1") else (base_url + "/v1")
headers = {}
if api_key:
- headers['Authorization'] = f"Bearer {api_key}"
+ headers["Authorization"] = f"Bearer {api_key}"
r = requests.request(method="GET", url=f"{base_url}/models", headers=headers, timeout=5)
r.raise_for_status()
- model_list = r.json().get('data')
- return [model for model in model_list if model.get('model_type') == model_type]
+ model_list = r.json().get("data")
+ return [model for model in model_list if model.get("model_type") == model_type]
@staticmethod
def get_model_info_by_name(model_list, model_name):
if model_list is None:
return []
- return [model for model in model_list if model.get('model_name') == model_name or model.get('id') == model_name]
+ return [model for model in model_list if model.get("model_name") == model_name or model.get("id") == model_name]
diff --git a/apps/models_provider/impl/zhipu_model_provider/credential/image.py b/apps/models_provider/impl/zhipu_model_provider/credential/image.py
index af2d31a5bd9..8145cb7c133 100644
--- a/apps/models_provider/impl/zhipu_model_provider/credential/image.py
+++ b/apps/models_provider/impl/zhipu_model_provider/credential/image.py
@@ -12,61 +12,80 @@
class ZhiPuImageModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.95,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.95,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class ZhiPuImageModelCredential(BaseForm, BaseModelCredential):
- api_base = forms.TextInputField('API URL', required=True, default_value='https://open.bigmodel.cn/api/paas/v4')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://open.bigmodel.cn/api/paas/v4")
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'api_base']:
+ for key in ["api_key", "api_base"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
- res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext('Hello')}])])
+ res = model.stream([HumanMessage(content=[{"type": "text", "text": gettext("Hello")}])])
for chunk in res:
maxkb_logger.info(chunk)
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return ZhiPuImageModelParams()
diff --git a/apps/models_provider/impl/zhipu_model_provider/credential/llm.py b/apps/models_provider/impl/zhipu_model_provider/credential/llm.py
index 6f4b3dbfeb1..46f5197a86f 100644
--- a/apps/models_provider/impl/zhipu_model_provider/credential/llm.py
+++ b/apps/models_provider/impl/zhipu_model_provider/credential/llm.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: llm.py
- @date:2024/7/12 10:46
- @desc:
+@project: MaxKB
+@Author:虎
+@file: llm.py
+@date:2024/7/12 10:46
+@desc:
"""
+
from typing import Dict
from django.utils.translation import gettext_lazy as _, gettext
@@ -17,60 +18,79 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class ZhiPuLLMModelParams(BaseForm):
- temperature = forms.SliderField(TooltipLabel(_('Temperature'),
- _('Higher values make the output more random, while lower values make it more focused and deterministic')),
- required=True, default_value=0.95,
- _min=0.1,
- _max=1.0,
- _step=0.01,
- precision=2)
+ temperature = forms.SliderField(
+ TooltipLabel(
+ _("Temperature"),
+ _("Higher values make the output more random, while lower values make it more focused and deterministic"),
+ ),
+ required=True,
+ default_value=0.95,
+ _min=0.1,
+ _max=1.0,
+ _step=0.01,
+ precision=2,
+ )
max_tokens = forms.SliderField(
- TooltipLabel(_('Output the maximum Tokens'),
- _('Specify the maximum number of tokens that the model can generate')),
- required=True, default_value=1024,
+ TooltipLabel(
+ _("Output the maximum Tokens"), _("Specify the maximum number of tokens that the model can generate")
+ ),
+ required=True,
+ default_value=1024,
_min=1,
_max=100000,
_step=1,
- precision=0)
+ precision=0,
+ )
class ZhiPuLLMModelCredential(BaseForm, BaseModelCredential):
-
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
- for key in ['api_key']:
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
+ for key in ["api_key"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
- model = provider.get_model(model_type, model_name, model_credential, **model_params)
- model.invoke([HumanMessage(content=gettext('Hello'))])
+ model = provider.get_model(model_type, model_name, model_credential, **{**model_params, "max_tokens": 1})
+ model.invoke([HumanMessage(content="1")])
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
- api_base = forms.TextInputField('API URL', required=True, default_value='https://open.bigmodel.cn/api/paas/v4')
- api_key = forms.PasswordInputField('API Key', required=True)
+ api_base = forms.TextInputField("API URL", required=True, default_value="https://open.bigmodel.cn/api/paas/v4")
+ api_key = forms.PasswordInputField("API Key", required=True)
def get_model_params_setting_form(self, model_name):
return ZhiPuLLMModelParams()
diff --git a/apps/models_provider/impl/zhipu_model_provider/credential/tti.py b/apps/models_provider/impl/zhipu_model_provider/credential/tti.py
index f890b4dff44..a12d1f5337f 100644
--- a/apps/models_provider/impl/zhipu_model_provider/credential/tti.py
+++ b/apps/models_provider/impl/zhipu_model_provider/credential/tti.py
@@ -9,60 +9,77 @@
from models_provider.base_model_provider import BaseModelCredential, ValidCode
from common.utils.logger import maxkb_logger
+
class ZhiPuTTIModelParams(BaseForm):
size = forms.SingleSelect(
- TooltipLabel(_('Image size'),
- _('Image size, only cogview-3-plus supports this parameter. Optional range: [1024x1024,768x1344,864x1152,1344x768,1152x864,1440x720,720x1440], the default is 1024x1024.')),
+ TooltipLabel(
+ _("Image size"),
+ _(
+ "Image size, only cogview-3-plus supports this parameter. Optional range: [1024x1024,768x1344,864x1152,1344x768,1152x864,1440x720,720x1440], the default is 1024x1024."
+ ),
+ ),
required=True,
- default_value='1024x1024',
+ default_value="1024x1024",
option_list=[
- {'value': '1024x1024', 'label': '1024x1024'},
- {'value': '768x1344', 'label': '768x1344'},
- {'value': '864x1152', 'label': '864x1152'},
- {'value': '1344x768', 'label': '1344x768'},
- {'value': '1152x864', 'label': '1152x864'},
- {'value': '1440x720', 'label': '1440x720'},
- {'value': '720x1440', 'label': '720x1440'},
+ {"value": "1024x1024", "label": "1024x1024"},
+ {"value": "768x1344", "label": "768x1344"},
+ {"value": "864x1152", "label": "864x1152"},
+ {"value": "1344x768", "label": "1344x768"},
+ {"value": "1152x864", "label": "1152x864"},
+ {"value": "1440x720", "label": "1440x720"},
+ {"value": "720x1440", "label": "720x1440"},
],
- text_field='label',
- value_field='value')
+ text_field="label",
+ value_field="value",
+ )
class ZhiPuTextToImageModelCredential(BaseForm, BaseModelCredential):
- base_url = forms.TextInputField('Base URL', required=True, default_value='https://open.bigmodel.cn/api/paas/v4')
- api_key = forms.PasswordInputField('API Key', required=True)
+ base_url = forms.TextInputField("Base URL", required=True, default_value="https://open.bigmodel.cn/api/paas/v4")
+ api_key = forms.PasswordInputField("API Key", required=True)
- def is_valid(self, model_type: str, model_name, model_credential: Dict[str, object], model_params, provider,
- raise_exception=False):
+ def is_valid(
+ self,
+ model_type: str,
+ model_name,
+ model_credential: Dict[str, object],
+ model_params,
+ provider,
+ raise_exception=False,
+ ):
model_type_list = provider.get_model_type_list()
- if not any(list(filter(lambda mt: mt.get('value') == model_type, model_type_list))):
- raise AppApiException(ValidCode.valid_error.value,
- gettext('{model_type} Model type is not supported').format(model_type=model_type))
+ if not any(list(filter(lambda mt: mt.get("value") == model_type, model_type_list))):
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("{model_type} Model type is not supported").format(model_type=model_type),
+ )
- for key in ['api_key', 'base_url']:
+ for key in ["api_key", "base_url"]:
if key not in model_credential:
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value, gettext('{key} is required').format(key=key))
+ raise AppApiException(ValidCode.valid_error.value, gettext("{key} is required").format(key=key))
else:
return False
try:
model = provider.get_model(model_type, model_name, model_credential, **model_params)
res = model.check_auth()
except Exception as e:
- maxkb_logger.error(f'Exception: {e}', exc_info=True)
+ maxkb_logger.error(f"Exception: {e}", exc_info=True)
if isinstance(e, AppApiException):
raise e
if raise_exception:
- raise AppApiException(ValidCode.valid_error.value,
- gettext(
- 'Verification failed, please check whether the parameters are correct: {error}').format(
- error=str(e)))
+ raise AppApiException(
+ ValidCode.valid_error.value,
+ gettext("Verification failed, please check whether the parameters are correct: {error}").format(
+ error=str(e)
+ ),
+ )
else:
return False
return True
def encryption_dict(self, model: Dict[str, object]):
- return {**model, 'api_key': super().encryption(model.get('api_key', ''))}
+ return {**model, "api_key": super().encryption(model.get("api_key", ""))}
def get_model_params_setting_form(self, model_name):
return ZhiPuTTIModelParams()
diff --git a/apps/models_provider/impl/zhipu_model_provider/model/image.py b/apps/models_provider/impl/zhipu_model_provider/model/image.py
index 7d31ae04bbf..0ee50a8dfa0 100644
--- a/apps/models_provider/impl/zhipu_model_provider/model/image.py
+++ b/apps/models_provider/impl/zhipu_model_provider/model/image.py
@@ -3,8 +3,8 @@
from models_provider.base_model_provider import MaxKBBaseModel
from models_provider.impl.base_chat_open_ai import BaseChatOpenAI
-class ZhiPuImage(MaxKBBaseModel, BaseChatOpenAI):
+class ZhiPuImage(MaxKBBaseModel, BaseChatOpenAI):
@staticmethod
def is_cache_model():
return False
@@ -14,8 +14,8 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
return ZhiPuImage(
model_name=model_name,
- openai_api_key=model_credential.get('api_key'),
- openai_api_base=model_credential.get('api_base') or 'https://open.bigmodel.cn/api/paas/v4',
+ openai_api_key=model_credential.get("api_key"),
+ openai_api_base=model_credential.get("api_base") or "https://open.bigmodel.cn/api/paas/v4",
# stream_options={"include_usage": True},
streaming=True,
stream_usage=True,
diff --git a/apps/models_provider/impl/zhipu_model_provider/model/llm.py b/apps/models_provider/impl/zhipu_model_provider/model/llm.py
index 64259373df3..e7261db7b2e 100644
--- a/apps/models_provider/impl/zhipu_model_provider/model/llm.py
+++ b/apps/models_provider/impl/zhipu_model_provider/model/llm.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: llm.py
- @date:2024/4/28 11:42
- @desc:
+@project: maxkb
+@Author:虎
+@file: llm.py
+@date:2024/4/28 11:42
+@desc:
"""
from typing import Dict, List
@@ -22,7 +22,6 @@ def custom_get_token_ids(text: str):
class ZhipuChatModel(MaxKBBaseModel, BaseChatOpenAI):
-
@staticmethod
def is_cache_model():
return False
@@ -31,10 +30,10 @@ def is_cache_model():
def new_instance(model_type, model_name, model_credential: Dict[str, object], **model_kwargs):
optional_params = MaxKBBaseModel.filter_optional_params(model_kwargs)
zhipuai_chat = ZhipuChatModel(
- api_key=model_credential.get('api_key'),
+ api_key=model_credential.get("api_key"),
model=model_name,
- base_url=model_credential.get('api_base') or 'https://open.bigmodel.cn/api/paas/v4',
- streaming=model_kwargs.get('streaming', False),
+ base_url=model_credential.get("api_base") or "https://open.bigmodel.cn/api/paas/v4",
+ streaming=model_kwargs.get("streaming", False),
custom_get_token_ids=custom_get_token_ids,
**optional_params,
)
@@ -43,13 +42,13 @@ def new_instance(model_type, model_name, model_credential: Dict[str, object], **
def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
try:
return super().get_num_tokens_from_messages(messages)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return sum([len(tokenizer.encode(get_buffer_string([m]))) for m in messages])
def get_num_tokens(self, text: str) -> int:
try:
return super().get_num_tokens(text)
- except Exception as e:
+ except Exception:
tokenizer = TokenizerManage.get_tokenizer()
return len(tokenizer.encode(text))
diff --git a/apps/models_provider/impl/zhipu_model_provider/zhipu_model_provider.py b/apps/models_provider/impl/zhipu_model_provider/zhipu_model_provider.py
index 4d4c0825a98..6c966360a1e 100644
--- a/apps/models_provider/impl/zhipu_model_provider/zhipu_model_provider.py
+++ b/apps/models_provider/impl/zhipu_model_provider/zhipu_model_provider.py
@@ -1,16 +1,22 @@
# coding=utf-8
"""
- @project: maxkb
- @Author:虎
- @file: zhipu_model_provider.py
- @date:2024/04/19 13:5
- @desc:
+@project: maxkb
+@Author:虎
+@file: zhipu_model_provider.py
+@date:2024/04/19 13:5
+@desc:
"""
+
import os
from common.utils.common import get_file_content
-from models_provider.base_model_provider import ModelProvideInfo, ModelTypeConst, ModelInfo, IModelProvider, \
- ModelInfoManage
+from models_provider.base_model_provider import (
+ ModelProvideInfo,
+ ModelTypeConst,
+ ModelInfo,
+ IModelProvider,
+ ModelInfoManage,
+)
from models_provider.impl.zhipu_model_provider.credential.image import ZhiPuImageModelCredential
from models_provider.impl.zhipu_model_provider.credential.llm import ZhiPuLLMModelCredential
from models_provider.impl.zhipu_model_provider.credential.tti import ZhiPuTextToImageModelCredential
@@ -25,39 +31,65 @@
zhipu_tti_model_credential = ZhiPuTextToImageModelCredential()
model_info_list = [
- ModelInfo('glm-4', '', ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel),
- ModelInfo('glm-4v', '', ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel),
- ModelInfo('glm-3-turbo', '', ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel)
+ ModelInfo("glm-4", "", ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel),
+ ModelInfo("glm-4v", "", ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel),
+ ModelInfo("glm-3-turbo", "", ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel),
]
model_info_image_list = [
- ModelInfo('glm-4v-plus', _('Have strong multi-modal understanding capabilities. Able to understand up to five images simultaneously and supports video content understanding'),
- ModelTypeConst.IMAGE, zhipu_image_model_credential,
- ZhiPuImage),
- ModelInfo('glm-4v', _('Focus on single picture understanding. Suitable for scenarios requiring efficient image analysis'),
- ModelTypeConst.IMAGE, zhipu_image_model_credential,
- ZhiPuImage),
- ModelInfo('glm-4v-flash', _('Focus on single picture understanding. Suitable for scenarios requiring efficient image analysis (free)'),
- ModelTypeConst.IMAGE, zhipu_image_model_credential,
- ZhiPuImage),
+ ModelInfo(
+ "glm-4v-plus",
+ _(
+ "Have strong multi-modal understanding capabilities. Able to understand up to five images simultaneously and supports video content understanding"
+ ),
+ ModelTypeConst.IMAGE,
+ zhipu_image_model_credential,
+ ZhiPuImage,
+ ),
+ ModelInfo(
+ "glm-4v",
+ _("Focus on single picture understanding. Suitable for scenarios requiring efficient image analysis"),
+ ModelTypeConst.IMAGE,
+ zhipu_image_model_credential,
+ ZhiPuImage,
+ ),
+ ModelInfo(
+ "glm-4v-flash",
+ _("Focus on single picture understanding. Suitable for scenarios requiring efficient image analysis (free)"),
+ ModelTypeConst.IMAGE,
+ zhipu_image_model_credential,
+ ZhiPuImage,
+ ),
]
model_info_tti_list = [
- ModelInfo('cogview-3', _('Quickly and accurately generate images based on user text descriptions. Resolution supports 1024x1024'),
- ModelTypeConst.TTI, zhipu_tti_model_credential,
- ZhiPuTextToImage),
- ModelInfo('cogview-3-plus', _('Generate high-quality images based on user text descriptions, supporting multiple image sizes'),
- ModelTypeConst.TTI, zhipu_tti_model_credential,
- ZhiPuTextToImage),
- ModelInfo('cogview-3-flash', _('Generate high-quality images based on user text descriptions, supporting multiple image sizes (free)'),
- ModelTypeConst.TTI, zhipu_tti_model_credential,
- ZhiPuTextToImage),
+ ModelInfo(
+ "cogview-3",
+ _("Quickly and accurately generate images based on user text descriptions. Resolution supports 1024x1024"),
+ ModelTypeConst.TTI,
+ zhipu_tti_model_credential,
+ ZhiPuTextToImage,
+ ),
+ ModelInfo(
+ "cogview-3-plus",
+ _("Generate high-quality images based on user text descriptions, supporting multiple image sizes"),
+ ModelTypeConst.TTI,
+ zhipu_tti_model_credential,
+ ZhiPuTextToImage,
+ ),
+ ModelInfo(
+ "cogview-3-flash",
+ _("Generate high-quality images based on user text descriptions, supporting multiple image sizes (free)"),
+ ModelTypeConst.TTI,
+ zhipu_tti_model_credential,
+ ZhiPuTextToImage,
+ ),
]
model_info_manage = (
ModelInfoManage.builder()
.append_model_info_list(model_info_list)
- .append_default_model_info(ModelInfo('glm-4', '', ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel))
+ .append_default_model_info(ModelInfo("glm-4", "", ModelTypeConst.LLM, zhipu_model_credential, ZhipuChatModel))
.append_model_info_list(model_info_image_list)
.append_default_model_info(model_info_image_list[0])
.append_model_info_list(model_info_tti_list)
@@ -67,11 +99,16 @@
class ZhiPuModelProvider(IModelProvider):
-
def get_model_info_manage(self):
return model_info_manage
def get_model_provide_info(self):
- return ModelProvideInfo(provider='model_zhipu_provider', name=_('zhipu AI'), icon=get_file_content(
- os.path.join(PROJECT_DIR, "apps", 'models_provider', 'impl', 'zhipu_model_provider', 'icon',
- 'zhipuai_icon_svg')))
+ return ModelProvideInfo(
+ provider="model_zhipu_provider",
+ name=_("zhipu AI"),
+ icon=get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "models_provider", "impl", "zhipu_model_provider", "icon", "zhipuai_icon_svg"
+ )
+ ),
+ )
diff --git a/apps/models_provider/langchain_compat/__init__.py b/apps/models_provider/langchain_compat/__init__.py
new file mode 100644
index 00000000000..a2b80dea0f2
--- /dev/null
+++ b/apps/models_provider/langchain_compat/__init__.py
@@ -0,0 +1,13 @@
+from .sparkllm import (
+ ChatSparkLLM,
+ SparkLLMTextEmbeddings,
+ _convert_delta_to_message_chunk,
+ convert_message_to_dict,
+)
+
+__all__ = [
+ "ChatSparkLLM",
+ "SparkLLMTextEmbeddings",
+ "_convert_delta_to_message_chunk",
+ "convert_message_to_dict",
+]
diff --git a/apps/models_provider/langchain_compat/sparkllm.py b/apps/models_provider/langchain_compat/sparkllm.py
new file mode 100644
index 00000000000..4e93f773d00
--- /dev/null
+++ b/apps/models_provider/langchain_compat/sparkllm.py
@@ -0,0 +1,513 @@
+import base64
+import hashlib
+import hmac
+import json
+import logging
+import queue
+import threading
+from datetime import datetime
+from queue import Queue
+from time import mktime
+from typing import Any, Dict, Generator, Iterator, List, Mapping, Optional, Type, cast
+from urllib.parse import urlencode, urlparse, urlunparse
+from wsgiref.handlers import format_date_time
+
+import numpy as np
+import requests
+from langchain_core.callbacks import CallbackManagerForLLMRun
+from langchain_core.embeddings import Embeddings
+from langchain_core.language_models.chat_models import BaseChatModel, generate_from_stream
+from langchain_core.messages import (
+ AIMessage,
+ AIMessageChunk,
+ BaseMessage,
+ BaseMessageChunk,
+ ChatMessage,
+ ChatMessageChunk,
+ FunctionMessageChunk,
+ HumanMessage,
+ HumanMessageChunk,
+ SystemMessage,
+ ToolMessageChunk,
+)
+from langchain_core.output_parsers.openai_tools import make_invalid_tool_call, parse_tool_call
+from langchain_core.outputs import ChatGeneration, ChatGenerationChunk, ChatResult
+from langchain_core.utils import get_from_dict_or_env, get_pydantic_field_names
+from langchain_core.utils.pydantic import get_fields
+from numpy import ndarray
+from pydantic import BaseModel, ConfigDict, Field, model_validator
+
+logger = logging.getLogger(__name__)
+
+SPARK_API_URL = "wss://spark-api.xf-yun.com/v3.5/chat"
+SPARK_LLM_DOMAIN = "generalv3.5"
+
+
+def convert_message_to_dict(message: BaseMessage) -> dict:
+ message_dict: Dict[str, Any]
+ if isinstance(message, ChatMessage):
+ message_dict = {"role": "user", "content": message.content}
+ elif isinstance(message, HumanMessage):
+ message_dict = {"role": "user", "content": message.content}
+ elif isinstance(message, AIMessage):
+ message_dict = {"role": "assistant", "content": message.content}
+ if "function_call" in message.additional_kwargs:
+ message_dict["function_call"] = message.additional_kwargs["function_call"]
+ if message_dict["content"] == "":
+ message_dict["content"] = None
+ if "tool_calls" in message.additional_kwargs:
+ message_dict["tool_calls"] = message.additional_kwargs["tool_calls"]
+ if message_dict["content"] == "":
+ message_dict["content"] = None
+ elif isinstance(message, SystemMessage):
+ message_dict = {"role": "system", "content": message.content}
+ else:
+ raise ValueError(f"Got unknown type {message}")
+ return message_dict
+
+
+def convert_dict_to_message(_dict: Mapping[str, Any]) -> BaseMessage:
+ msg_role = _dict["role"]
+ msg_content = _dict["content"]
+ if msg_role == "user":
+ return HumanMessage(content=msg_content)
+ if msg_role == "assistant":
+ invalid_tool_calls = []
+ additional_kwargs: Dict[str, Any] = {}
+ if function_call := _dict.get("function_call"):
+ additional_kwargs["function_call"] = dict(function_call)
+ tool_calls = []
+ if raw_tool_calls := _dict.get("tool_calls"):
+ additional_kwargs["tool_calls"] = raw_tool_calls
+ for raw_tool_call in raw_tool_calls:
+ try:
+ tool_calls.append(parse_tool_call(raw_tool_call, return_id=True))
+ except Exception as exc:
+ invalid_tool_calls.append(make_invalid_tool_call(raw_tool_call, str(exc)))
+ else:
+ additional_kwargs = {}
+ return AIMessage(
+ content=msg_content or "",
+ additional_kwargs=additional_kwargs,
+ tool_calls=tool_calls,
+ invalid_tool_calls=invalid_tool_calls,
+ )
+ if msg_role == "system":
+ return SystemMessage(content=msg_content)
+ return ChatMessage(content=msg_content, role=msg_role)
+
+
+def _convert_delta_to_message_chunk(
+ _dict: Mapping[str, Any], default_class: Type[BaseMessageChunk]
+) -> BaseMessageChunk:
+ msg_role = cast(str, _dict.get("role"))
+ msg_content = cast(str, _dict.get("content") or "")
+ additional_kwargs: Dict[str, Any] = {}
+ if _dict.get("function_call"):
+ function_call = dict(_dict["function_call"])
+ if "name" in function_call and function_call["name"] is None:
+ function_call["name"] = ""
+ additional_kwargs["function_call"] = function_call
+ if _dict.get("tool_calls"):
+ additional_kwargs["tool_calls"] = _dict["tool_calls"]
+ if msg_role == "user" or default_class == HumanMessageChunk:
+ return HumanMessageChunk(content=msg_content)
+ if msg_role == "assistant" or default_class == AIMessageChunk:
+ return AIMessageChunk(content=msg_content, additional_kwargs=additional_kwargs)
+ if msg_role == "function" or default_class == FunctionMessageChunk:
+ return FunctionMessageChunk(content=msg_content, name=_dict["name"])
+ if msg_role == "tool" or default_class == ToolMessageChunk:
+ return ToolMessageChunk(content=msg_content, tool_call_id=_dict["tool_call_id"])
+ if msg_role or default_class == ChatMessageChunk:
+ return ChatMessageChunk(content=msg_content, role=msg_role)
+ return default_class(content=msg_content) # type: ignore[call-arg]
+
+
+class ChatSparkLLM(BaseChatModel):
+ client: Any = None
+ spark_app_id: Optional[str] = Field(default=None, alias="app_id")
+ spark_api_key: Optional[str] = Field(default=None, alias="api_key")
+ spark_api_secret: Optional[str] = Field(default=None, alias="api_secret")
+ spark_api_url: Optional[str] = Field(default=None, alias="api_url")
+ spark_llm_domain: Optional[str] = Field(default=None, alias="model")
+ spark_user_id: str = "lc_user"
+ streaming: bool = False
+ request_timeout: int = Field(30, alias="timeout")
+ temperature: float = 0.5
+ top_k: int = 4
+ model_kwargs: Dict[str, Any] = Field(default_factory=dict)
+
+ model_config = ConfigDict(populate_by_name=True)
+
+ @model_validator(mode="before")
+ @classmethod
+ def build_extra(cls, values: Dict[str, Any]) -> Dict[str, Any]:
+ extra = values.get("model_kwargs", {})
+ all_required_field_names = get_pydantic_field_names(cls)
+ for field_name in list(values):
+ if field_name in extra:
+ raise ValueError(f"Found {field_name} supplied twice.")
+ if field_name not in all_required_field_names:
+ extra[field_name] = values.pop(field_name)
+ invalid_model_kwargs = all_required_field_names.intersection(extra.keys())
+ if invalid_model_kwargs:
+ raise ValueError(
+ f"Parameters {invalid_model_kwargs} should be specified explicitly. "
+ "Instead they were passed in as part of `model_kwargs` parameter."
+ )
+ values["model_kwargs"] = extra
+ return values
+
+ @model_validator(mode="before")
+ @classmethod
+ def validate_environment(cls, values: Dict[str, Any]) -> Dict[str, Any]:
+ values["spark_app_id"] = get_from_dict_or_env(values, ["spark_app_id", "app_id"], "IFLYTEK_SPARK_APP_ID")
+ values["spark_api_key"] = get_from_dict_or_env(
+ values, ["spark_api_key", "api_key"], "IFLYTEK_SPARK_API_KEY"
+ )
+ values["spark_api_secret"] = get_from_dict_or_env(
+ values, ["spark_api_secret", "api_secret"], "IFLYTEK_SPARK_API_SECRET"
+ )
+ values["spark_api_url"] = get_from_dict_or_env(
+ values, "spark_api_url", "IFLYTEK_SPARK_API_URL", SPARK_API_URL
+ )
+ values["spark_llm_domain"] = get_from_dict_or_env(
+ values, "spark_llm_domain", "IFLYTEK_SPARK_LLM_DOMAIN", SPARK_LLM_DOMAIN
+ )
+
+ model_kwargs = values.setdefault("model_kwargs", {})
+ field_values = {name: field.default for name, field in get_fields(cls).items() if field.default is not None}
+ field_values.update(values)
+ model_kwargs["temperature"] = field_values.get("temperature")
+ model_kwargs["top_k"] = field_values.get("top_k")
+
+ values["client"] = _SparkLLMClient(
+ app_id=values["spark_app_id"],
+ api_key=values["spark_api_key"],
+ api_secret=values["spark_api_secret"],
+ api_url=values["spark_api_url"],
+ spark_domain=values["spark_llm_domain"],
+ model_kwargs=model_kwargs,
+ )
+ return values
+
+ def _stream(
+ self,
+ messages: List[BaseMessage],
+ stop: Optional[List[str]] = None,
+ run_manager: Optional[CallbackManagerForLLMRun] = None,
+ **kwargs: Any,
+ ) -> Iterator[ChatGenerationChunk]:
+ default_chunk_class = AIMessageChunk
+ self.client.arun(
+ [convert_message_to_dict(message) for message in messages],
+ self.spark_user_id,
+ self.model_kwargs,
+ streaming=True,
+ )
+ for content in self.client.subscribe(timeout=self.request_timeout):
+ if "data" not in content:
+ continue
+ delta = content["data"]
+ generation_info = {}
+ if "reasoning_content" in delta:
+ generation_info["reasoning_content"] = delta.pop("reasoning_content")
+ chunk = _convert_delta_to_message_chunk(delta, default_chunk_class)
+ generation_chunk = ChatGenerationChunk(message=chunk, generation_info=generation_info or None)
+ if run_manager:
+ run_manager.on_llm_new_token(str(chunk.content), chunk=generation_chunk)
+ yield generation_chunk
+
+ def _generate(
+ self,
+ messages: List[BaseMessage],
+ stop: Optional[List[str]] = None,
+ run_manager: Optional[CallbackManagerForLLMRun] = None,
+ stream: Optional[bool] = None,
+ **kwargs: Any,
+ ) -> ChatResult:
+ if stream or self.streaming:
+ return generate_from_stream(self._stream(messages=messages, stop=stop, run_manager=run_manager, **kwargs))
+
+ self.client.arun(
+ [convert_message_to_dict(message) for message in messages],
+ self.spark_user_id,
+ self.model_kwargs,
+ False,
+ )
+ completion: Dict[str, Any] = {}
+ llm_output: Dict[str, Any] = {}
+ for content in self.client.subscribe(timeout=self.request_timeout):
+ if "usage" in content:
+ llm_output["token_usage"] = content["usage"]
+ if "data" in content:
+ completion = content["data"]
+
+ generation_info = {}
+ if "reasoning_content" in completion:
+ generation_info["reasoning_content"] = completion.pop("reasoning_content")
+ return ChatResult(
+ generations=[ChatGeneration(message=convert_dict_to_message(completion), generation_info=generation_info or None)],
+ llm_output=llm_output,
+ )
+
+ @property
+ def _llm_type(self) -> str:
+ return "spark-llm-chat"
+
+
+class _SparkLLMClient:
+ def __init__(
+ self,
+ app_id: str,
+ api_key: str,
+ api_secret: str,
+ api_url: Optional[str] = None,
+ spark_domain: Optional[str] = None,
+ model_kwargs: Optional[dict] = None,
+ ):
+ import websocket
+
+ self.websocket_client = websocket
+ self.api_url = api_url or SPARK_API_URL
+ self.app_id = app_id
+ self.model_kwargs = model_kwargs
+ self.spark_domain = spark_domain or SPARK_LLM_DOMAIN
+ self.queue: Queue[Dict[str, Any]] = Queue()
+ self.blocking_message = {"content": "", "role": "assistant"}
+ self.api_key = api_key
+ self.api_secret = api_secret
+
+ @staticmethod
+ def _create_url(api_url: str, api_key: str, api_secret: str) -> str:
+ date = format_date_time(mktime(datetime.now().timetuple()))
+ parsed_url = urlparse(api_url)
+ host = parsed_url.netloc
+ path = parsed_url.path
+ signature_origin = f"host: {host}\ndate: {date}\nGET {path} HTTP/1.1"
+ signature_sha = hmac.new(
+ api_secret.encode("utf-8"),
+ signature_origin.encode("utf-8"),
+ digestmod=hashlib.sha256,
+ ).digest()
+ signature_sha_base64 = base64.b64encode(signature_sha).decode(encoding="utf-8")
+ authorization_origin = (
+ f'api_key="{api_key}", algorithm="hmac-sha256", headers="host date request-line", '
+ f'signature="{signature_sha_base64}"'
+ )
+ authorization = base64.b64encode(authorization_origin.encode("utf-8")).decode(encoding="utf-8")
+ return urlunparse(
+ (
+ parsed_url.scheme,
+ parsed_url.netloc,
+ parsed_url.path,
+ parsed_url.params,
+ urlencode({"authorization": authorization, "date": date, "host": host}),
+ parsed_url.fragment,
+ )
+ )
+
+ def run(
+ self,
+ messages: List[Dict[str, Any]],
+ user_id: str,
+ model_kwargs: Optional[dict] = None,
+ streaming: bool = False,
+ ) -> None:
+ self.websocket_client.enableTrace(False)
+ ws = self.websocket_client.WebSocketApp(
+ self._create_url(self.api_url, self.api_key, self.api_secret),
+ on_message=self.on_message,
+ on_error=self.on_error,
+ on_close=self.on_close,
+ on_open=self.on_open,
+ )
+ ws.messages = messages # type: ignore[attr-defined]
+ ws.user_id = user_id # type: ignore[attr-defined]
+ ws.model_kwargs = self.model_kwargs if model_kwargs is None else model_kwargs # type: ignore[attr-defined]
+ ws.streaming = streaming # type: ignore[attr-defined]
+ ws.run_forever()
+
+ def arun(
+ self,
+ messages: List[Dict[str, Any]],
+ user_id: str,
+ model_kwargs: Optional[dict] = None,
+ streaming: bool = False,
+ ) -> threading.Thread:
+ thread = threading.Thread(target=self.run, args=(messages, user_id, model_kwargs, streaming))
+ thread.start()
+ return thread
+
+ def on_error(self, ws: Any, error: Optional[Any]) -> None:
+ self.queue.put({"error": error})
+ ws.close()
+
+ def on_close(self, ws: Any, close_status_code: int, close_reason: str) -> None:
+ logger.debug({"close_status_code": close_status_code, "close_reason": close_reason})
+ self.queue.put({"done": True})
+
+ def on_open(self, ws: Any) -> None:
+ self.blocking_message = {"content": "", "role": "assistant"}
+ ws.send(json.dumps(self.gen_params(messages=ws.messages, user_id=ws.user_id, model_kwargs=ws.model_kwargs)))
+
+ def on_message(self, ws: Any, message: str) -> None:
+ data = json.loads(message)
+ code = data["header"]["code"]
+ if code != 0:
+ self.queue.put({"error": f"Code: {code}, Error: {data['header']['message']}"})
+ ws.close()
+ return
+
+ choices = data["payload"]["choices"]
+ status = choices["status"]
+ text_chunk = choices["text"][0]
+ content = text_chunk.get("content", "")
+ if ws.streaming:
+ self.queue.put({"data": text_chunk})
+ else:
+ self.blocking_message["content"] += content
+ if "reasoning_content" in text_chunk:
+ self.blocking_message["reasoning_content"] = text_chunk["reasoning_content"]
+ if status == 2:
+ if not ws.streaming:
+ self.queue.put({"data": self.blocking_message})
+ usage_data = data.get("payload", {}).get("usage", {}).get("text", {})
+ self.queue.put({"usage": usage_data})
+ ws.close()
+
+ def gen_params(
+ self, messages: List[Dict[str, Any]], user_id: str, model_kwargs: Optional[dict] = None
+ ) -> Dict[str, Any]:
+ data: Dict[str, Any] = {
+ "header": {"app_id": self.app_id, "uid": user_id},
+ "parameter": {"chat": {"domain": self.spark_domain}},
+ "payload": {"message": {"text": messages}},
+ }
+ if model_kwargs:
+ data["parameter"]["chat"].update(model_kwargs)
+ return data
+
+ def subscribe(self, timeout: Optional[int] = 30) -> Generator[Dict[str, Any], None, None]:
+ while True:
+ try:
+ content = self.queue.get(timeout=timeout)
+ except queue.Empty as exc:
+ raise TimeoutError(f"SparkLLMClient wait LLM api response timeout {timeout} seconds") from exc
+ if "error" in content:
+ raise ConnectionError(content["error"])
+ if "usage" in content:
+ yield content
+ continue
+ if "done" in content or "data" not in content:
+ break
+ yield content
+
+
+class Url:
+ def __init__(self, host: str, path: str, schema: str) -> None:
+ self.host = host
+ self.path = path
+ self.schema = schema
+
+
+class SparkLLMTextEmbeddings(BaseModel, Embeddings):
+ spark_app_id: Optional[str] = Field(default=None, alias="app_id")
+ spark_api_key: Optional[str] = Field(default=None, alias="api_key")
+ spark_api_secret: Optional[str] = Field(default=None, alias="api_secret")
+ base_url: str = "https://emb-cn-huabei-1.xf-yun.com/"
+ domain: str = "para"
+
+ model_config = ConfigDict(populate_by_name=True)
+
+ @model_validator(mode="before")
+ @classmethod
+ def validate_environment(cls, values: Dict[str, Any]) -> Dict[str, Any]:
+ values["spark_app_id"] = get_from_dict_or_env(values, ["spark_app_id", "app_id"], "SPARK_APP_ID")
+ values["spark_api_key"] = get_from_dict_or_env(values, ["spark_api_key", "api_key"], "SPARK_API_KEY")
+ values["spark_api_secret"] = get_from_dict_or_env(
+ values, ["spark_api_secret", "api_secret"], "SPARK_API_SECRET"
+ )
+ return values
+
+ def _embed(self, texts: List[str], host: str) -> List[List[float]]:
+ url = self._assemble_ws_auth_url(
+ request_url=host,
+ method="POST",
+ api_key=self.spark_api_key or "",
+ api_secret=self.spark_api_secret or "",
+ )
+ embedding_result: List[List[float]] = []
+ for text in texts:
+ response = requests.post(
+ url,
+ json=self._get_body(self.spark_app_id or "", {"messages": [{"content": text, "role": "user"}]}),
+ headers={"content-type": "application/json"},
+ timeout=30,
+ )
+ response.raise_for_status()
+ parsed = self._parser_message(response.text)
+ if parsed is None:
+ raise ValueError("Failed to parse Spark embedding response")
+ embedding_result.append(parsed.tolist())
+ return embedding_result
+
+ def embed_documents(self, texts: List[str]) -> List[List[float]]:
+ return self._embed(texts, self.base_url)
+
+ def embed_query(self, text: str) -> List[float]:
+ return self._embed([text], self.base_url)[0]
+
+ @staticmethod
+ def _assemble_ws_auth_url(
+ request_url: str, method: str = "GET", api_key: str = "", api_secret: str = ""
+ ) -> str:
+ url = SparkLLMTextEmbeddings._parse_url(request_url)
+ date = format_date_time(mktime(datetime.now().timetuple()))
+ signature_origin = f"host: {url.host}\ndate: {date}\n{method} {url.path} HTTP/1.1"
+ signature_sha = hmac.new(
+ api_secret.encode("utf-8"),
+ signature_origin.encode("utf-8"),
+ digestmod=hashlib.sha256,
+ ).digest()
+ signature_sha_str = base64.b64encode(signature_sha).decode(encoding="utf-8")
+ authorization_origin = (
+ 'api_key="%s", algorithm="%s", headers="%s", signature="%s"'
+ % (api_key, "hmac-sha256", "host date request-line", signature_sha_str)
+ )
+ authorization = base64.b64encode(authorization_origin.encode("utf-8")).decode(encoding="utf-8")
+ return request_url + "?" + urlencode({"host": url.host, "date": date, "authorization": authorization})
+
+ @staticmethod
+ def _parse_url(request_url: str) -> Url:
+ stidx = request_url.index("://")
+ host = request_url[stidx + 3 :]
+ schema = request_url[: stidx + 3]
+ edidx = host.index("/")
+ if edidx <= 0:
+ raise AssembleHeaderException("invalid request url:" + request_url)
+ return Url(host[:edidx], host[edidx:], schema)
+
+ def _get_body(self, appid: str, text: dict) -> Dict[str, Any]:
+ return {
+ "header": {"app_id": appid, "uid": "39769795890", "status": 3},
+ "parameter": {"emb": {"domain": self.domain, "feature": {"encoding": "utf8"}}},
+ "payload": {"messages": {"text": base64.b64encode(json.dumps(text).encode("utf-8")).decode()}},
+ }
+
+ @staticmethod
+ def _parser_message(message: str) -> Optional[ndarray]:
+ data = json.loads(message)
+ code = data["header"]["code"]
+ if code != 0:
+ logger.warning("Request error: %s, %s", code, data)
+ return None
+ text_data = base64.b64decode(data["payload"]["feature"]["text"])
+ float_dtype = np.dtype(np.float32).newbyteorder("<")
+ text = np.frombuffer(text_data, dtype=float_dtype)
+ return text[:2560] if len(text) > 2560 else text
+
+
+class AssembleHeaderException(Exception):
+ def __init__(self, msg: str) -> None:
+ self.message = msg
diff --git a/apps/models_provider/migrations/0002_rename_wenxin_provider_to_qianfan.py b/apps/models_provider/migrations/0002_rename_wenxin_provider_to_qianfan.py
new file mode 100644
index 00000000000..33b974a5845
--- /dev/null
+++ b/apps/models_provider/migrations/0002_rename_wenxin_provider_to_qianfan.py
@@ -0,0 +1,24 @@
+from django.db import migrations
+
+OLD_PROVIDER = "model_wenxin_provider"
+NEW_PROVIDER = "model_qianfan_provider"
+
+
+def forwards(apps, schema_editor):
+ Model = apps.get_model("models_provider", "Model")
+ Model.objects.filter(provider=OLD_PROVIDER).update(provider=NEW_PROVIDER)
+
+
+def backwards(apps, schema_editor):
+ Model = apps.get_model("models_provider", "Model")
+ Model.objects.filter(provider=NEW_PROVIDER).update(provider=OLD_PROVIDER)
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("models_provider", "0001_initial"),
+ ]
+
+ operations = [
+ migrations.RunPython(forwards, backwards),
+ ]
diff --git a/apps/models_provider/serializers/model_apply_serializers.py b/apps/models_provider/serializers/model_apply_serializers.py
index 30c33147f1e..c069cb56a96 100644
--- a/apps/models_provider/serializers/model_apply_serializers.py
+++ b/apps/models_provider/serializers/model_apply_serializers.py
@@ -1,76 +1,81 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: model_apply_serializers.py
- @date:2024/8/20 20:39
- @desc:
+@project: MaxKB
+@Author:虎
+@file: model_apply_serializers.py
+@date:2024/8/20 20:39
+@desc:
"""
-from django.db import connection
-from django.db.models import QuerySet
-from langchain_core.documents import Document
-from rest_framework import serializers
from common.config.embedding_config import ModelManage
+from django.db import connection
+from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
-
+from langchain_core.documents import Document
from models_provider.models import Model
from models_provider.tools import get_model
+from rest_framework import serializers
def get_embedding_model(model_id):
model = QuerySet(Model).filter(id=model_id).first()
# 手动关闭数据库连接
connection.close()
- embedding_model = ModelManage.get_model(model_id,
- lambda _id: get_model(model, use_local=True))
+ embedding_model = ModelManage.get_model(model_id, lambda _id: get_model(model, use_local=True))
return embedding_model
class EmbedDocuments(serializers.Serializer):
- texts = serializers.ListField(required=True,
- child=serializers.CharField(required=True, label=_('vector text')),
- label=_('vector text list'))
+ texts = serializers.ListField(
+ required=True, child=serializers.CharField(required=True, label=_("vector text")), label=_("vector text list")
+ )
class EmbedQuery(serializers.Serializer):
- text = serializers.CharField(required=True, label=_('vector text'))
+ text = serializers.CharField(required=True, label=_("vector text"))
class CompressDocument(serializers.Serializer):
- page_content = serializers.CharField(required=True, label=_('text'))
- metadata = serializers.DictField(required=False, label=_('metadata'))
+ page_content = serializers.CharField(required=True, label=_("text"))
+ metadata = serializers.DictField(required=False, label=_("metadata"))
class CompressDocuments(serializers.Serializer):
documents = CompressDocument(required=True, many=True)
- query = serializers.CharField(required=True, label=_('query'))
+ query = serializers.CharField(required=True, label=_("query"))
class ModelApplySerializers(serializers.Serializer):
- model_id = serializers.UUIDField(required=True, label=_('model id'))
+ model_id = serializers.UUIDField(required=True, label=_("model id"))
def embed_documents(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
EmbedDocuments(data=instance).is_valid(raise_exception=True)
- model = get_embedding_model(self.data.get('model_id'))
- return model.embed_documents(instance.getlist('texts'))
+ model = get_embedding_model(self.data.get("model_id"))
+ return model.embed_documents(instance.getlist("texts"))
def embed_query(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
EmbedQuery(data=instance).is_valid(raise_exception=True)
- model = get_embedding_model(self.data.get('model_id'))
- return model.embed_query(instance.get('text'))
+ model = get_embedding_model(self.data.get("model_id"))
+ return model.embed_query(instance.get("text"))
def compress_documents(self, instance, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
CompressDocuments(data=instance).is_valid(raise_exception=True)
- model = get_embedding_model(self.data.get('model_id'))
- return [{'page_content': d.page_content, 'metadata': d.metadata} for d in model.compress_documents(
- [Document(page_content=document.get('page_content'), metadata=document.get('metadata')) for document in
- instance.get('documents')], instance.get('query'))]
+ model = get_embedding_model(self.data.get("model_id"))
+ return [
+ {"page_content": d.page_content, "metadata": d.metadata}
+ for d in model.compress_documents(
+ [
+ Document(page_content=document.get("page_content"), metadata=document.get("metadata"))
+ for document in instance.get("documents")
+ ],
+ instance.get("query"),
+ )
+ ]
diff --git a/apps/models_provider/serializers/model_serializer.py b/apps/models_provider/serializers/model_serializer.py
index 7e866eda128..d528f483c3f 100644
--- a/apps/models_provider/serializers/model_serializer.py
+++ b/apps/models_provider/serializers/model_serializer.py
@@ -6,26 +6,25 @@
from typing import Dict
import uuid_utils.compat as uuid
-from django.core.cache import cache
-from django.db import transaction
-from django.db.models import QuerySet
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
from common.config.embedding_config import ModelManage
from common.constants.cache_version import Cache_Version
-from common.constants.permission_constants import ResourcePermission, ResourceAuthType
+from common.constants.resource_permission_constants import ResourceAuthType
from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.db.search import native_search
from common.exception.app_exception import AppApiException
from common.utils.common import get_file_content
-from common.utils.rsa_util import rsa_long_encrypt, rsa_long_decrypt
+from common.utils.rsa_util import rsa_long_decrypt, rsa_long_encrypt
+from django.core.cache import cache
+from django.db import transaction
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
from maxkb.conf import PROJECT_DIR
-from models_provider.base_model_provider import ValidCode, DownModelChunkStatus
+from models_provider.base_model_provider import DownModelChunkStatus, ValidCode
from models_provider.constants.model_provider_constants import ModelProvideConstants
from models_provider.models import Model, Status
from models_provider.tools import get_model_credential
-from system_manage.models import WorkspaceUserResourcePermission, AuthTargetType
+from rest_framework import serializers
+from system_manage.models import AuthTargetType, WorkspaceUserResourcePermission, WorkspaceUserGroupResourcePermission
from system_manage.models.resource_mapping import ResourceMapping
from system_manage.serializers.resource_mapping_serializers import ResourceMappingSerializer
from system_manage.serializers.user_resource_permission import UserResourcePermissionSerializer
@@ -44,9 +43,19 @@ class ModelModelSerializer(serializers.ModelSerializer):
class Meta:
model = Model
fields = [
- 'id', 'name', 'status', 'model_type', 'model_name',
- 'user', 'provider', 'credential', 'meta',
- 'model_params_form', 'workspace_id', 'create_time', 'update_time'
+ "id",
+ "name",
+ "status",
+ "model_type",
+ "model_name",
+ "user",
+ "provider",
+ "credential",
+ "meta",
+ "model_params_form",
+ "workspace_id",
+ "create_time",
+ "update_time",
]
@@ -83,19 +92,15 @@ def pull(model: Model, credential: Dict):
status = Status.ERROR
message = ""
for chunk in down_model_chunk.values():
- if chunk.get('status') == DownModelChunkStatus.success.value:
+ if chunk.get("status") == DownModelChunkStatus.success.value:
status = Status.SUCCESS
- elif chunk.get('status') == DownModelChunkStatus.error.value:
+ elif chunk.get("status") == DownModelChunkStatus.error.value:
message = chunk.get("digest")
- QuerySet(Model).filter(id=model.id).update(
- meta={"down_model_chunk": [], "message": message},
- status=status
- )
+ QuerySet(Model).filter(id=model.id).update(meta={"down_model_chunk": [], "message": message}, status=status)
except Exception as e:
QuerySet(Model).filter(id=model.id).update(
- meta={"down_model_chunk": [], "message": str(e)},
- status=Status.ERROR
+ meta={"down_model_chunk": [], "message": str(e)}, status=Status.ERROR
)
@@ -104,19 +109,19 @@ class ModelSerializer(serializers.Serializer):
def model_to_dict(model: Model):
credential = json.loads(rsa_long_decrypt(model.credential))
return {
- 'id': str(model.id),
- 'provider': model.provider,
- 'name': model.name,
- 'model_type': model.model_type,
- 'model_name': model.model_name,
- 'status': model.status,
- 'meta': model.meta,
- 'credential': ModelProvideConstants[model.provider].value.get_model_credential(
- model.model_type, model.model_name
- ).encryption_dict(credential),
- 'workspace_id': model.workspace_id,
- 'nick_name': model.user.nick_name if model.user else '',
- 'username': model.user.username if model.user else ''
+ "id": str(model.id),
+ "provider": model.provider,
+ "name": model.name,
+ "model_type": model.model_type,
+ "model_name": model.model_name,
+ "status": model.status,
+ "meta": model.meta,
+ "credential": ModelProvideConstants[model.provider]
+ .value.get_model_credential(model.model_type, model.model_name)
+ .encryption_dict(credential),
+ "workspace_id": model.workspace_id,
+ "nick_name": model.user.nick_name if model.user else "",
+ "username": model.user.username if model.user else "",
}
class Operate(serializers.Serializer):
@@ -132,45 +137,52 @@ def is_valid(self, *, raise_exception=False):
model_query = model_query.filter(workspace_id=workspace_id)
model = model_query.first()
if model is None:
- raise AppApiException(500, _('Model does not exist'))
- if model.workspace_id == 'None':
- raise AppApiException(500, _('Shared models cannot be deleted or modified'))
+ raise AppApiException(500, _("Model does not exist"))
+ if model.workspace_id == "None":
+ raise AppApiException(500, _("Shared models cannot be deleted or modified"))
def one(self, with_valid=False):
if with_valid:
super().is_valid(raise_exception=True)
- model = QuerySet(Model).get(
- id=self.data.get('id'), workspace_id=self.data.get('workspace_id', 'None')
- )
+ model = QuerySet(Model).get(id=self.data.get("id"), workspace_id=self.data.get("workspace_id", "None"))
return ModelSerializer.model_to_dict(model)
def one_meta(self, with_valid=False):
model = None
if with_valid:
super().is_valid(raise_exception=True)
- model = QuerySet(Model).filter(id=self.data.get("id"),
- workspace_id=self.data.get('workspace_id', 'None')).first()
+ model = (
+ QuerySet(Model)
+ .filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id", "None"))
+ .first()
+ )
if model is None:
- raise AppApiException(500, _('Model does not exist'))
- return {'id': str(model.id), 'provider': model.provider, 'name': model.name, 'model_type': model.model_type,
- 'model_name': model.model_name,
- 'status': model.status,
- 'meta': model.meta,
- 'workspace_id': model.workspace_id,
- }
+ raise AppApiException(500, _("Model does not exist"))
+ return {
+ "id": str(model.id),
+ "provider": model.provider,
+ "name": model.name,
+ "model_type": model.model_type,
+ "model_name": model.model_name,
+ "status": model.status,
+ "meta": model.meta,
+ "workspace_id": model.workspace_id,
+ }
def pause_download(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- QuerySet(Model).filter(id=self.data.get('id')).update(status=Status.PAUSE_DOWNLOAD)
+ QuerySet(Model).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).update(
+ status=Status.PAUSE_DOWNLOAD
+ )
return True
@transaction.atomic
def delete(self, with_valid=True):
if with_valid:
- super().is_valid(raise_exception=True)
- model_id = self.data.get('id')
- model = Model.objects.filter(id=model_id).first()
+ self.is_valid(raise_exception=True)
+ model_id = self.data.get("id")
+ model = Model.objects.filter(id=model_id, workspace_id=self.data.get("workspace_id")).first()
if model is None:
return True
QuerySet(WorkspaceUserResourcePermission).filter(target=model_id).delete()
@@ -197,31 +209,29 @@ def delete(self, with_valid=True):
def edit(self, instance: Dict, user_id: str, with_valid=True):
if with_valid:
- super().is_valid(raise_exception=True)
- model = QuerySet(Model).filter(id=self.data.get('id')).first()
+ self.is_valid(raise_exception=True)
+ model = QuerySet(Model).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).first()
- credential, model_credential, provider_handler = ModelSerializer.Edit(
- data={**instance}).is_valid(
- model=model)
+ credential, model_credential, provider_handler = ModelSerializer.Edit(data={**instance}).is_valid(
+ model=model
+ )
try:
model.status = Status.SUCCESS
- default_params = {item['field']: item['default_value'] for item in model.model_params_form}
+ default_params = {item["field"]: item["default_value"] for item in model.model_params_form}
# 校验模型认证数据
- provider_handler.is_valid_credential(model.model_type,
- instance.get("model_name"),
- credential,
- default_params,
- raise_exception=True)
+ provider_handler.is_valid_credential(
+ model.model_type, instance.get("model_name"), credential, default_params, raise_exception=True
+ )
except AppApiException as e:
if e.code == ValidCode.model_not_fount:
model.status = Status.DOWNLOAD
else:
raise e
- update_keys = ['credential', 'name', 'model_type', 'model_name']
+ update_keys = ["credential", "name", "model_type", "model_name"]
for update_key in update_keys:
if update_key in instance and instance.get(update_key) is not None:
- if update_key == 'credential':
+ if update_key == "credential":
model_credential_str = json.dumps(credential)
model.__setattr__(update_key, rsa_long_encrypt(model_credential_str))
else:
@@ -235,38 +245,35 @@ def edit(self, instance: Dict, user_id: str, with_valid=True):
return self.one(with_valid=False)
class Edit(serializers.Serializer):
- user_id = serializers.CharField(required=False, label=(_('user id')))
+ user_id = serializers.CharField(required=False, label=(_("user id")))
- name = serializers.CharField(required=False, max_length=64,
- label=(_("model name")))
+ name = serializers.CharField(required=False, max_length=64, label=(_("model name")))
model_type = serializers.CharField(required=False, label=(_("model type")))
model_name = serializers.CharField(required=False, label=(_("base model")))
- credential = serializers.DictField(required=False,
- label=(_("certification information")))
+ credential = serializers.DictField(required=False, label=(_("certification information")))
workspace_id = serializers.CharField(required=False, label=(_("workspace id")))
def is_valid(self, model=None, raise_exception=False):
super().is_valid(raise_exception=True)
- filter_params = {'workspace_id': model.workspace_id}
- if 'name' in self.data and self.data.get('name') is not None:
- filter_params['name'] = self.data.get('name')
+ filter_params = {"workspace_id": model.workspace_id}
+ if "name" in self.data and self.data.get("name") is not None:
+ filter_params["name"] = self.data.get("name")
if QuerySet(Model).exclude(id=model.id).filter(**filter_params).exists():
- raise AppApiException(500, _('base model【{model_name}】already exists').format(
- model_name=self.data.get("name")))
+ raise AppApiException(
+ 500, _("base model【{model_name}】already exists").format(model_name=self.data.get("name"))
+ )
ModelSerializer.model_to_dict(model)
provider = model.provider
- model_type = self.data.get('model_type')
- model_name = self.data.get(
- 'model_name')
- credential = self.data.get('credential')
+ model_type = self.data.get("model_type")
+ model_name = self.data.get("model_name")
+ credential = self.data.get("credential")
provider_handler = ModelProvideConstants[provider].value
- model_credential = ModelProvideConstants[provider].value.get_model_credential(model_type,
- model_name)
+ model_credential = ModelProvideConstants[provider].value.get_model_credential(model_type, model_name)
source_model_credential = json.loads(rsa_long_decrypt(model.credential))
source_encryption_model_credential = model_credential.encryption_dict(source_model_credential)
if credential is not None:
@@ -276,7 +283,7 @@ def is_valid(self, model=None, raise_exception=False):
return credential, model_credential, provider_handler
class Create(serializers.Serializer):
- user_id = serializers.UUIDField(required=True, label=_('user id'))
+ user_id = serializers.UUIDField(required=True, label=_("user id"))
name = serializers.CharField(required=True, max_length=64, label=_("model name"))
provider = serializers.CharField(required=True, label=_("provider"))
model_type = serializers.CharField(required=True, label=_("model type"))
@@ -287,21 +294,21 @@ class Create(serializers.Serializer):
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- if QuerySet(Model).filter(
- name=self.data.get('name'),
- workspace_id=self.data.get('workspace_id', 'None')
- ).exists():
+ if (
+ QuerySet(Model)
+ .filter(name=self.data.get("name"), workspace_id=self.data.get("workspace_id", "None"))
+ .exists()
+ ):
raise AppApiException(
- 500,
- _('base model【{model_name}】already exists').format(model_name=self.data.get("name"))
+ 500, _("base model【{model_name}】already exists").format(model_name=self.data.get("name"))
)
- default_params = {item['field']: item['default_value'] for item in self.data.get('model_params_form')}
- ModelProvideConstants[self.data.get('provider')].value.is_valid_credential(
- self.data.get('model_type'),
- self.data.get('model_name'),
- self.data.get('credential'),
+ default_params = {item["field"]: item["default_value"] for item in self.data.get("model_params_form")}
+ ModelProvideConstants[self.data.get("provider")].value.is_valid_credential(
+ self.data.get("model_type"),
+ self.data.get("model_name"),
+ self.data.get("credential"),
default_params,
- raise_exception=True
+ raise_exception=True,
)
def insert(self, workspace_id, with_valid=True):
@@ -315,28 +322,30 @@ def insert(self, workspace_id, with_valid=True):
else:
raise e
- credential = self.data.get('credential')
+ credential = self.data.get("credential")
model_data = {
- 'id': uuid.uuid7(),
- 'status': status,
- 'user_id': self.data.get('user_id'),
- 'name': self.data.get('name'),
- 'credential': rsa_long_encrypt(json.dumps(credential)),
- 'provider': self.data.get('provider'),
- 'model_type': self.data.get('model_type'),
- 'model_name': self.data.get('model_name'),
- 'model_params_form': self.data.get('model_params_form'),
- 'workspace_id': workspace_id
+ "id": uuid.uuid7(),
+ "status": status,
+ "user_id": self.data.get("user_id"),
+ "name": self.data.get("name"),
+ "credential": rsa_long_encrypt(json.dumps(credential)),
+ "provider": self.data.get("provider"),
+ "model_type": self.data.get("model_type"),
+ "model_name": self.data.get("model_name"),
+ "model_params_form": self.data.get("model_params_form"),
+ "workspace_id": workspace_id,
}
model = Model(**model_data)
try:
model.save()
- if workspace_id != 'None':
- UserResourcePermissionSerializer(data={
- 'workspace_id': workspace_id,
- 'user_id': self.data.get('user_id'),
- 'auth_target_type': AuthTargetType.MODEL.value
- }).auth_resource(str(model.id))
+ if workspace_id != "None":
+ UserResourcePermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "user_id": self.data.get("user_id"),
+ "auth_target_type": AuthTargetType.MODEL.value,
+ }
+ ).auth_resource(str(model.id))
except Exception as save_error:
# 可添加日志记录
raise AppApiException(500, _("Model saving failed")) from save_error
@@ -349,12 +358,12 @@ def insert(self, workspace_id, with_valid=True):
class Query(serializers.Serializer):
user_id = serializers.CharField(required=True, label=_("User ID"))
- name = serializers.CharField(required=False, max_length=64, label=_('model name'))
- model_type = serializers.CharField(required=False, label=_('model type'))
- model_name = serializers.CharField(required=False, label=_('base model'))
- provider = serializers.CharField(required=False, label=_('provider'))
- create_user = serializers.CharField(required=False, label=_('create user'))
- workspace_id = serializers.CharField(required=False, label=_('workspace id'))
+ name = serializers.CharField(required=False, max_length=64, label=_("model name"))
+ model_type = serializers.CharField(required=False, label=_("model type"))
+ model_name = serializers.CharField(required=False, label=_("base model"))
+ provider = serializers.CharField(required=False, label=_("provider"))
+ create_user = serializers.CharField(required=False, label=_("create user"))
+ workspace_id = serializers.CharField(required=False, label=_("workspace id"))
@staticmethod
def is_x_pack_ee():
@@ -362,19 +371,35 @@ def is_x_pack_ee():
role_permission_mapping_model = DatabaseModelManage.get_model("role_permission_mapping_model")
return workspace_user_role_mapping_model is not None and role_permission_mapping_model is not None
+ @staticmethod
+ def get_workspace_user_group_resource_permission_query_set(workspace_id, user_id):
+ return QuerySet(WorkspaceUserGroupResourcePermission).filter(
+ auth_target_type="MODEL",
+ workspace_id=workspace_id,
+ user_group__user_relations__user_id=user_id,
+ )
+
def list(self, workspace_id, with_valid):
if with_valid:
self.is_valid(raise_exception=True)
user_id = self.data.get("user_id")
- workspace_manage = is_workspace_manage_permission_read(user_id, workspace_id, 'MODEL:READ')
+ workspace_manage = is_workspace_manage_permission_read(user_id, workspace_id, "MODEL:READ")
query_params = self._build_query_params(workspace_id, workspace_manage, user_id)
is_x_pack_ee = self.is_x_pack_ee()
- result = native_search(query_params,
- select_string=get_file_content(
- os.path.join(PROJECT_DIR, "apps", "models_provider", 'sql',
- 'list_model.sql' if workspace_manage else (
- 'list_model_user_ee.sql' if is_x_pack_ee else 'list_model_user.sql')
- )))
+ result = native_search(
+ query_params,
+ select_string=get_file_content(
+ os.path.join(
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "sql",
+ "list_model.sql"
+ if workspace_manage
+ else ("list_model_user_ee.sql" if is_x_pack_ee else "list_model_user.sql"),
+ )
+ ),
+ )
return ResourceMappingSerializer().get_resource_count(result)
def share_list(self, workspace_id, with_valid=True):
@@ -382,24 +407,20 @@ def share_list(self, workspace_id, with_valid=True):
self.is_valid(raise_exception=True)
user_id = self.data.get("user_id")
query_params = self._build_query_params(workspace_id, False, user_id)
- result = [
- self._build_model_data(
- model
- ) for model in query_params.get('model_query_set')
- ]
+ result = [self._build_model_data(model) for model in query_params.get("model_query_set")]
return ResourceMappingSerializer().get_resource_count(result)
def model_list(self, workspace_id, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
user_id = self.data.get("user_id")
- workspace_manage = is_workspace_manage_permission_read(user_id, workspace_id, 'MODEL:READ')
+ workspace_manage = is_workspace_manage_permission_read(user_id, workspace_id, "MODEL:READ")
queryset = self._build_query_params(workspace_id, workspace_manage, user_id)
get_authorized_model = DatabaseModelManage.get_model("get_authorized_model")
shared_queryset = QuerySet(Model).none()
if get_authorized_model is not None:
- shared_queryset = self._build_query_params('None', False, user_id)['model_query_set']
+ shared_queryset = self._build_query_params("None", False, user_id)["model_query_set"]
shared_queryset = get_authorized_model(shared_queryset, workspace_id)
# 构建共享模型和普通模型列表
@@ -410,95 +431,122 @@ def model_list(self, workspace_id, with_valid=True):
queryset,
select_string=get_file_content(
os.path.join(
- PROJECT_DIR, "apps", "models_provider", 'sql',
- 'list_model.sql' if workspace_manage else (
- 'list_model_user_ee.sql' if is_x_pack_ee else 'list_model_user.sql')
+ PROJECT_DIR,
+ "apps",
+ "models_provider",
+ "sql",
+ "list_model.sql"
+ if workspace_manage
+ else ("list_model_user_ee.sql" if is_x_pack_ee else "list_model_user.sql"),
)
- )
+ ),
)
- return {
- "shared_model": shared_model,
- "model": normal_model
- }
+ return {"shared_model": shared_model, "model": normal_model}
def _build_query_params(self, workspace_id, workspace_manage: bool, user_id):
queryset = QuerySet(Model)
if workspace_id:
queryset = queryset.filter(workspace_id=workspace_id)
- for field in ['name', 'model_type', 'model_name', 'provider', 'create_user']:
+ for field in ["name", "model_type", "model_name", "provider", "create_user"]:
value = self.data.get(field)
if value is not None:
- if field == 'name':
- queryset = queryset.filter(**{f'{field}__icontains': value})
- elif field == 'create_user':
+ if field == "name":
+ queryset = queryset.filter(**{f"{field}__icontains": value})
+ elif field == "create_user":
queryset = queryset.filter(user_id=value)
else:
queryset = queryset.filter(**{field: value})
queryset = queryset.order_by("-create_time")
- return {
- 'model_query_set': queryset,
- 'workspace_user_resource_permission_query_set': QuerySet(WorkspaceUserResourcePermission).filter(
- auth_target_type="MODEL",
- workspace_id=workspace_id,
- user_id=user_id)} if (
- not workspace_manage) else {
- 'model_query_set': queryset,
- }
+ return (
+ {
+ "model_query_set": queryset,
+ "workspace_user_resource_permission_query_set": QuerySet(WorkspaceUserResourcePermission).filter(
+ auth_target_type="MODEL", workspace_id=workspace_id, user_id=user_id
+ ),
+ "workspace_user_group_resource_permission_query_set": self.get_workspace_user_group_resource_permission_query_set(
+ workspace_id, user_id
+ ),
+ }
+ if (not workspace_manage)
+ else {
+ "model_query_set": queryset,
+ }
+ )
def _build_model_data(self, model):
return {
- 'id': str(model.id),
- 'provider': model.provider,
- 'name': model.name,
- 'model_type': model.model_type,
- 'model_name': model.model_name,
- 'status': model.status,
- 'meta': model.meta,
- 'user_id': model.user_id,
- 'username': model.user.username,
- 'nick_name': model.user.nick_name,
+ "id": str(model.id),
+ "provider": model.provider,
+ "name": model.name,
+ "model_type": model.model_type,
+ "model_name": model.model_name,
+ "status": model.status,
+ "meta": model.meta,
+ "user_id": model.user_id,
+ "username": model.user.username,
+ "nick_name": model.user.nick_name,
}
def page(self, current_page, page_size):
pass
class ModelParams(serializers.Serializer):
- id = serializers.UUIDField(required=True, label=_('model id'))
+ id = serializers.UUIDField(required=True, label=_("model id"))
+ workspace_id = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("workspace id"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- model = QuerySet(Model).filter(id=self.data.get("id")).first()
+
+ validated_data = self.validated_data
+ model = (
+ QuerySet(Model)
+ .filter(
+ id=validated_data["id"],
+ )
+ .first()
+ )
+
if model is None:
raise AppApiException(500, _("Model does not exist"))
+ if model.workspace_id == "None":
+ return model
+
+ if model.workspace_id != validated_data["workspace_id"]:
+ raise AppApiException(500, _("Model does not exist"))
+
+ return model
+
def get_model_params(self, with_valid=True):
+ model = None
if with_valid:
- self.is_valid(raise_exception=True)
- model_id = self.data.get('id')
- model = QuerySet(Model).filter(id=model_id).first()
+ model = self.is_valid(raise_exception=True)
return model.model_params_form
def save_model_params_form(self, model_params_form, with_valid=True):
+ model = None
if with_valid:
- self.is_valid(raise_exception=True)
+ model = self.is_valid(raise_exception=True)
if model_params_form is None:
model_params_form = []
- model_id = self.data.get('id')
- model = QuerySet(Model).filter(id=model_id).first()
if not isinstance(model_params_form, list):
- raise AppApiException(500, _('model_params_form must be a list'))
+ raise AppApiException(500, _("model_params_form must be a list"))
# 还需要校验几个字段:label required default_value
# 校验每个配置项的必要字段
for index, param in enumerate(model_params_form):
if not isinstance(param, dict):
- raise AppApiException(500, _('The {index}th item in model_params_form must be a dictionary').format(
- index=index))
+ raise AppApiException(
+ 500, _("The {index}th item in model_params_form must be a dictionary").format(index=index)
+ )
# 校验 label 字段
- if 'label' not in param or param['label'] is None:
- raise AppApiException(500,
- _('The label field is required for the {index}th item in model_params_form').format(
- index=index))
+ if "label" not in param or param["label"] is None:
+ raise AppApiException(
+ 500,
+ _("The label field is required for the {index}th item in model_params_form").format(
+ index=index
+ ),
+ )
model.model_params_form = model_params_form
model.save()
@@ -506,31 +554,31 @@ def save_model_params_form(self, model_params_form, with_valid=True):
class WorkspaceSharedModelSerializer(serializers.Serializer):
- workspace_id = serializers.CharField(required=True, label=_('workspace id'))
- name = serializers.CharField(required=False, max_length=64, label=_('model name'))
- model_type = serializers.CharField(required=False, label=_('model type'))
- model_name = serializers.CharField(required=False, label=_('base model'))
- provider = serializers.CharField(required=False, label=_('provider'))
- create_user = serializers.CharField(required=False, label=_('create user'))
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ name = serializers.CharField(required=False, max_length=64, label=_("model name"))
+ model_type = serializers.CharField(required=False, label=_("model type"))
+ model_name = serializers.CharField(required=False, label=_("base model"))
+ provider = serializers.CharField(required=False, label=_("provider"))
+ create_user = serializers.CharField(required=False, label=_("create user"))
def get_share_model_list(self):
self.is_valid(raise_exception=True)
- workspace_id = self.data.get('workspace_id')
+ workspace_id = self.data.get("workspace_id")
queryset = self._build_queryset(workspace_id)
return [
{
- 'id': str(model.id),
- 'provider': model.provider,
- 'name': model.name,
- 'model_type': model.model_type,
- 'model_name': model.model_name,
- 'status': model.status,
- 'meta': model.meta,
- 'user_id': model.user_id,
- 'nick_name': model.user.nick_name,
- 'username': model.user.username
+ "id": str(model.id),
+ "provider": model.provider,
+ "name": model.name,
+ "model_type": model.model_type,
+ "model_name": model.model_name,
+ "status": model.status,
+ "meta": model.meta,
+ "user_id": model.user_id,
+ "nick_name": model.user.nick_name,
+ "username": model.user.username,
}
for model in queryset.order_by("-create_time")
]
@@ -542,12 +590,12 @@ def _build_queryset(self, workspace_id):
if get_authorized_model is not None:
queryset = get_authorized_model(queryset, workspace_id)
- for field in ['name', 'model_type', 'model_name', 'provider', 'create_user']:
+ for field in ["name", "model_type", "model_name", "provider", "create_user"]:
value = self.data.get(field)
if value is not None:
- if field == 'name':
- queryset = queryset.filter(**{f'{field}__icontains': value})
- elif field == 'create_user':
+ if field == "name":
+ queryset = queryset.filter(**{f"{field}__icontains": value})
+ elif field == "create_user":
queryset = queryset.filter(user_id=value)
else:
queryset = queryset.filter(**{field: value})
diff --git a/apps/models_provider/sql/list_model_user.sql b/apps/models_provider/sql/list_model_user.sql
index df50d538a96..6fb334bca0a 100644
--- a/apps/models_provider/sql/list_model_user.sql
+++ b/apps/models_provider/sql/list_model_user.sql
@@ -15,4 +15,12 @@ FROM (SELECT model."id"::text, model."name",
left join "user" on user_id = "user".id
where model."id"::text in (select target
from workspace_user_resource_permission ${workspace_user_resource_permission_query_set}
- and 'VIEW' = any (permission_list)) ) temp ${model_query_set}
+ and 'VIEW' = any (permission_list)
+ union
+ select distinct target
+ from workspace_user_group_resource_permission
+ inner join system_user_group_relation
+ on system_user_group_relation.group_id =
+ workspace_user_group_resource_permission.user_group_id
+ ${workspace_user_group_resource_permission_query_set}
+ and 'VIEW' = any (permission_list)) ) temp ${model_query_set}
diff --git a/apps/models_provider/sql/list_model_user_ee.sql b/apps/models_provider/sql/list_model_user_ee.sql
index 88590546ee5..052aca197ad 100644
--- a/apps/models_provider/sql/list_model_user_ee.sql
+++ b/apps/models_provider/sql/list_model_user_ee.sql
@@ -32,6 +32,33 @@ FROM (SELECT model."id"::text, model."name",
else
'VIEW' = any (permission_list)
- end) ) temp ${model_query_set}
-
+ end
+ union
+ select distinct target
+ from workspace_user_group_resource_permission
+ inner join system_user_group_relation
+ on system_user_group_relation.group_id =
+ workspace_user_group_resource_permission.user_group_id
+ ${workspace_user_group_resource_permission_query_set}
+ and (
+ 'VIEW' = any (permission_list)
+ or (
+ auth_type = 'ROLE'
+ and 'ROLE' = any (permission_list)
+ and 'MODEL:READ' in (select (case
+ when user_role_relation.role_id =
+ any (array['USER'])
+ then 'MODEL:READ'
+ else
+ role_permission.permission_id end)
+ from role_permission role_permission
+ right join user_role_relation user_role_relation
+ on user_role_relation.role_id =
+ role_permission.role_id
+ where user_role_relation.user_id =
+ system_user_group_relation.user_id
+ and user_role_relation.workspace_id =
+ workspace_user_group_resource_permission.workspace_id)
+ )
+ ) ) temp ${model_query_set}
diff --git a/apps/models_provider/tests.py b/apps/models_provider/tests.py
index 7ce503c2dd9..b7f81022575 100644
--- a/apps/models_provider/tests.py
+++ b/apps/models_provider/tests.py
@@ -1,3 +1,52 @@
-from django.test import TestCase
+import inspect
+
+from django.test import SimpleTestCase
+
+from common.exception.app_exception import AppApiException
+from models_provider.base_model_provider import MaxKBBaseEmbeddingModel, ModelTypeConst
+from models_provider.constants.model_provider_constants import ModelProvideConstants
+
+
+class MissingImageCapabilityEmbedding(MaxKBBaseEmbeddingModel):
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential, **model_kwargs):
+ return MissingImageCapabilityEmbedding()
+
+
+class TextOnlyEmbedding(MaxKBBaseEmbeddingModel):
+ @staticmethod
+ def new_instance(model_type, model_name, model_credential, **model_kwargs):
+ return TextOnlyEmbedding()
+
+ def supports_image_embedding(self) -> bool:
+ return False
+
+
+class EmbeddingCapabilityContractTests(SimpleTestCase):
+ def test_capability_declaration_is_abstract(self):
+ self.assertTrue(inspect.isabstract(MissingImageCapabilityEmbedding))
+
+ def test_unsupported_provider_uses_consistent_image_embedding_error(self):
+ model = TextOnlyEmbedding()
+
+ self.assertFalse(model.supports_image_embedding())
+ with self.assertRaises(AppApiException):
+ model.embed_images(["data:image/png;base64,AA=="])
+
+ def test_every_registered_embedding_provider_declares_image_capability(self):
+ embedding_classes = {
+ model_info.model_class
+ for provider in ModelProvideConstants
+ for model_info in provider.value.get_model_info_manage().model_list
+ if model_info.model_type == ModelTypeConst.EMBEDDING.name
+ }
+
+ self.assertTrue(embedding_classes)
+ for embedding_class in embedding_classes:
+ with self.subTest(embedding_class=embedding_class.__name__):
+ self.assertTrue(issubclass(embedding_class, MaxKBBaseEmbeddingModel))
+ self.assertIn("supports_image_embedding", embedding_class.__dict__)
+ self.assertFalse(inspect.isabstract(embedding_class))
+
# Create your tests here.
diff --git a/apps/models_provider/tools.py b/apps/models_provider/tools.py
index 9bdb8b8d261..4ec31303a03 100644
--- a/apps/models_provider/tools.py
+++ b/apps/models_provider/tools.py
@@ -1,25 +1,24 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: tools.py
- @date:2024/7/22 11:18
- @desc:
+@project: MaxKB
+@Author:虎
+@file: tools.py
+@date:2024/7/22 11:18
+@desc:
"""
-from django.db import connection
-from django.db.models import QuerySet
-
-from common.config.embedding_config import ModelManage
-from common.database_model_manage.database_model_manage import DatabaseModelManage
-from models_provider.base_model_provider import ModelTypeConst
-from models_provider.models import Model
-from django.utils.translation import gettext_lazy as _
import json
from typing import Dict
+from common.config.embedding_config import ModelManage
+from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.utils.rsa_util import rsa_long_decrypt
+from django.db import connection
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from models_provider.base_model_provider import ModelTypeConst
from models_provider.constants.model_provider_constants import ModelProvideConstants
+from models_provider.models import Model
def get_model_(provider, model_type, model_name, credential, model_id, use_local=False, **kwargs):
@@ -33,12 +32,15 @@ def get_model_(provider, model_type, model_name, credential, model_id, use_local
@param use_local: 是否调用本地模型 只适用于本地供应商
@return: 模型实例
"""
- model = get_provider(provider).get_model(model_type, model_name,
- json.loads(
- rsa_long_decrypt(credential)),
- model_id=model_id,
- use_local=use_local,
- streaming=True, **kwargs)
+ model = get_provider(provider).get_model(
+ model_type,
+ model_name,
+ json.loads(rsa_long_decrypt(credential)),
+ model_id=model_id,
+ use_local=use_local,
+ streaming=True,
+ **kwargs,
+ )
return model
@@ -90,8 +92,9 @@ def get_model_type_list(provider):
return get_provider(provider).get_model_type_list()
-def is_valid_credential(provider, model_type, model_name, model_credential: Dict[str, object], model_params,
- raise_exception=False):
+def is_valid_credential(
+ provider, model_type, model_name, model_credential: Dict[str, object], model_params, raise_exception=False
+):
"""
校验模型认证参数
@param provider: 供应商字符串
@@ -101,8 +104,9 @@ def is_valid_credential(provider, model_type, model_name, model_credential: Dict
@param raise_exception: 是否抛出错误
@return: True|False
"""
- return get_provider(provider).is_valid_credential(model_type, model_name, model_credential, model_params,
- raise_exception)
+ return get_provider(provider).is_valid_credential(
+ model_type, model_name, model_credential, model_params, raise_exception
+ )
def get_model_by_id(_id, workspace_id):
@@ -126,10 +130,7 @@ def convert_to_int(value):
return value
return value
- return {
- p.get('field'): convert_to_int(p.get('default_value'))
- for p in model.model_params_form
- }
+ return {p.get("field"): convert_to_int(p.get("default_value")) for p in model.model_params_form}
def reset_model_params(default_model_params, **kwargs):
@@ -151,6 +152,6 @@ def get_model_instance_by_model_workspace_id(model_id, workspace_id, **kwargs):
model = get_model_by_id(model_id, workspace_id)
default_model_params = get_model_default_params(model)
if model.model_type == ModelTypeConst.RERANKER.name:
- default_model_params.setdefault('top_n', 3)
+ default_model_params.setdefault("top_n", 3)
model_params = reset_model_params(default_model_params, **kwargs)
return ModelManage.get_model(model_id, lambda _id: get_model(model, **model_params))
diff --git a/apps/models_provider/views/model.py b/apps/models_provider/views/model.py
index fe498b20ac1..61a12a15633 100644
--- a/apps/models_provider/views/model.py
+++ b/apps/models_provider/views/model.py
@@ -1,28 +1,30 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: user.py
- @date:2025/4/14 19:25
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: user.py
+@date:2025/4/14 19:25
+@desc:
"""
-from django.db.models import QuerySet
-from drf_spectacular.utils import extend_schema
-from rest_framework.views import APIView
-from django.utils.translation import gettext_lazy as _
-from rest_framework.request import Request
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import result
from common.utils.common import query_params_to_single_dict
-from models_provider.api.model import ModelCreateAPI, GetModelApi, ModelEditApi, ModelListResponse, DefaultModelResponse
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from models_provider.api.model import DefaultModelResponse, GetModelApi, ModelCreateAPI, ModelEditApi, ModelListResponse
from models_provider.api.provide import ProvideApi
from models_provider.models import Model
-from models_provider.serializers.model_serializer import ModelSerializer, \
- WorkspaceSharedModelSerializer
+from models_provider.serializers.model_serializer import ModelSerializer, WorkspaceSharedModelSerializer
+from rest_framework.request import Request
+from rest_framework.views import APIView
from system_manage.views import encryption_str
@@ -36,47 +38,49 @@ def get_edit_model_details(request):
path = request.path
body = request.data
query = request.query_params
- credential = body.get('credential', {})
+ credential = body.get("credential", {})
credential_encryption_ed = encryption_credential(credential)
- return {
- 'path': path,
- 'body': {**body, 'credential': credential_encryption_ed},
- 'query': query
- }
+ return {"path": path, "body": {**body, "credential": credential_encryption_ed}, "query": query}
def get_model_operation_object(model_id):
model_model = QuerySet(model=Model).filter(id=model_id).first()
if model_model is not None:
- return {
- "name": model_model.name
- }
+ return {"name": model_model.name}
return {}
class ModelSetting(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- summary=_("Create model"),
- description=_("Create model"),
- operation_id=_("Create model"), # type: ignore
- tags=[_("Model")], # type: ignore
- parameters=ModelCreateAPI.get_parameters(),
- request=ModelCreateAPI.get_request(),
- responses=ModelCreateAPI.get_response())
- @has_permissions(PermissionConstants.MODEL_CREATE.get_workspace_permission(),
- PermissionConstants.MODEL_EDIT.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role())
- @log(menu='model', operate='Create model',
- get_operation_object=lambda r, k: {'name': r.date.get('name')},
- get_details=get_edit_model_details,
- )
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Create model"),
+ description=_("Create model"),
+ operation_id=_("Create model"), # type: ignore
+ tags=[_("Model")], # type: ignore
+ parameters=ModelCreateAPI.get_parameters(),
+ request=ModelCreateAPI.get_request(),
+ responses=ModelCreateAPI.get_response(),
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_CREATE.get_workspace_permission(),
+ PermissionConstants.MODEL_EDIT.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
+ )
+ @log(
+ menu="model",
+ operate="Create model",
+ get_operation_object=lambda r, k: {"name": r.date.get("name")},
+ get_details=get_edit_model_details,
+ )
def post(self, request: Request, workspace_id: str):
return result.success(
ModelSerializer.Create(
- data={**request.data, 'user_id': request.user.id, 'workspace_id': workspace_id}).insert(workspace_id,
- with_valid=True))
+ data={**request.data, "user_id": request.user.id, "workspace_id": workspace_id}
+ ).insert(workspace_id, with_valid=True)
+ )
# @extend_schema(methods=['PUT'],
# summary=_('Update model'),
@@ -90,193 +94,251 @@ def post(self, request: Request, workspace_id: str):
# ModelSerializer.Create(data={**request.data, 'user_id': str(request.user.id)}).insert(request.user.id,
# with_valid=True))
- @extend_schema(methods=['GET'],
- summary=_('Query model list'),
- description=_('Query model list'),
- operation_id=_('Query model list'), # type: ignore
- parameters=ModelListResponse.get_parameters(),
- responses=ModelListResponse.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_READ.get_workspace_permission(),
- PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Query model list"),
+ description=_("Query model list"),
+ operation_id=_("Query model list"), # type: ignore
+ parameters=ModelListResponse.get_parameters(),
+ responses=ModelListResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_READ.get_workspace_permission(),
+ PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str):
return result.success(
ModelSerializer.Query(
- data={**query_params_to_single_dict(request.query_params), 'user_id': str(request.user.id)}).list(
- workspace_id=workspace_id,
- with_valid=True))
+ data={**query_params_to_single_dict(request.query_params), "user_id": str(request.user.id)}
+ ).list(workspace_id=workspace_id, with_valid=True)
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['PUT'],
- summary=_('Update model'),
- description=_('Update model'),
- operation_id=_('Update model'), # type: ignore
- request=ModelEditApi.get_request(),
- parameters=GetModelApi.get_parameters(),
- responses=ModelEditApi.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_EDIT.get_workspace_model_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- PermissionConstants.MODEL_EDIT.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.MODEL.get_workspace_model_permission()],
- CompareConstants.AND), )
- @log(menu='model', operate='Update model',
- get_operation_object=lambda r, k: get_model_operation_object(k.get('model_id')),
- get_details=get_edit_model_details,
- )
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Update model"),
+ description=_("Update model"),
+ operation_id=_("Update model"), # type: ignore
+ request=ModelEditApi.get_request(),
+ parameters=GetModelApi.get_parameters(),
+ responses=ModelEditApi.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_EDIT.get_workspace_model_permission(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ PermissionConstants.MODEL_EDIT.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.MODEL.get_workspace_model_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ @log(
+ menu="model",
+ operate="Update model",
+ get_operation_object=lambda r, k: get_model_operation_object(k.get("model_id")),
+ get_details=get_edit_model_details,
+ )
def put(self, request: Request, workspace_id, model_id: str):
return result.success(
ModelSerializer.Operate(
- data={'id': model_id, 'user_id': request.user.id, 'workspace_id': workspace_id}).edit(request.data,
- str(request.user.id)))
+ data={"id": model_id, "user_id": request.user.id, "workspace_id": workspace_id}
+ ).edit(request.data, str(request.user.id))
+ )
- @extend_schema(methods=['DELETE'],
- summary=_('Delete model'),
- description=_('Delete model'),
- operation_id=_('Delete model'), # type: ignore
- parameters=GetModelApi.get_parameters(),
- responses=DefaultModelResponse.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_DELETE.get_workspace_model_permission(),
- PermissionConstants.MODEL_DELETE.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.MODEL.get_workspace_model_permission()],
- CompareConstants.AND), )
- @log(menu='model', operate='Delete model',
- get_operation_object=lambda r, k: get_model_operation_object(k.get('model_id')),
- )
+ @extend_schema(
+ methods=["DELETE"],
+ summary=_("Delete model"),
+ description=_("Delete model"),
+ operation_id=_("Delete model"), # type: ignore
+ parameters=GetModelApi.get_parameters(),
+ responses=DefaultModelResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_DELETE.get_workspace_model_permission(),
+ PermissionConstants.MODEL_DELETE.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.MODEL.get_workspace_model_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ @log(
+ menu="model",
+ operate="Delete model",
+ get_operation_object=lambda r, k: get_model_operation_object(k.get("model_id")),
+ )
def delete(self, request: Request, workspace_id: str, model_id: str):
return result.success(
ModelSerializer.Operate(
- data={'id': model_id, 'user_id': request.user.id, 'workspace_id': workspace_id}).delete())
+ data={"id": model_id, "user_id": request.user.id, "workspace_id": workspace_id}
+ ).delete()
+ )
- @extend_schema(methods=['GET'],
- summary=_('Query model details'),
- description=_('Query model details'),
- operation_id=_('Query model details'), # type: ignore
- parameters=GetModelApi.get_parameters(),
- responses=GetModelApi.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_READ.get_workspace_model_permission(),
- PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.MODEL.get_workspace_model_permission()],
- CompareConstants.AND), )
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Query model details"),
+ description=_("Query model details"),
+ operation_id=_("Query model details"), # type: ignore
+ parameters=GetModelApi.get_parameters(),
+ responses=GetModelApi.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_READ.get_workspace_model_permission(),
+ PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.MODEL.get_workspace_model_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
def get(self, request: Request, workspace_id: str, model_id: str):
return result.success(
ModelSerializer.Operate(
- data={'id': model_id, 'user_id': request.user.id, 'workspace_id': workspace_id}).one(
- with_valid=True))
+ data={"id": model_id, "user_id": request.user.id, "workspace_id": workspace_id}
+ ).one(with_valid=True)
+ )
class ModelParamsForm(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Get model parameter form'),
- description=_('Get model parameter form'),
- operation_id=_('Get model parameter form'), # type: ignore
- parameters=GetModelApi.get_parameters(),
- responses=ProvideApi.ModelParamsForm.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_READ.get_workspace_model_permission(),
- PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission(),
- PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.MODEL_READ.get_workspace_permission(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- RoleConstants.USER.get_workspace_role(),)
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get model parameter form"),
+ description=_("Get model parameter form"),
+ operation_id=_("Get model parameter form"), # type: ignore
+ parameters=GetModelApi.get_parameters(),
+ responses=ProvideApi.ModelParamsForm.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_READ.get_workspace_model_permission(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission(),
+ PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.MODEL_READ.get_workspace_permission(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, model_id: str):
return result.success(
- ModelSerializer.ModelParams(data={'id': model_id}).get_model_params())
+ ModelSerializer.ModelParams(data={"id": model_id, "workspace_id": workspace_id}).get_model_params()
+ )
- @extend_schema(methods=['PUT'],
- summary=_('Save model parameter form'),
- description=_('Save model parameter form'),
- operation_id=_('Save model parameter form'), # type: ignore
- parameters=GetModelApi.get_parameters(),
- request=GetModelApi.get_request(),
- responses=ProvideApi.ModelParamsForm.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_EDIT.get_workspace_model_permission(),
- PermissionConstants.MODEL_EDIT.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- PermissionConstants.MODEL_READ.get_workspace_permission(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.MODEL.get_workspace_model_permission()],
- CompareConstants.AND), )
- @log(menu='model', operate='Save model parameter form',
- get_operation_object=lambda r, k: get_model_operation_object(k.get('model_id')),
- )
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Save model parameter form"),
+ description=_("Save model parameter form"),
+ operation_id=_("Save model parameter form"), # type: ignore
+ parameters=GetModelApi.get_parameters(),
+ request=GetModelApi.get_request(),
+ responses=ProvideApi.ModelParamsForm.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_EDIT.get_workspace_model_permission(),
+ PermissionConstants.MODEL_EDIT.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ PermissionConstants.MODEL_READ.get_workspace_permission(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.MODEL.get_workspace_model_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
+ @log(
+ menu="model",
+ operate="Save model parameter form",
+ get_operation_object=lambda r, k: get_model_operation_object(k.get("model_id")),
+ )
def put(self, request: Request, workspace_id: str, model_id: str):
return result.success(
- ModelSerializer.ModelParams(data={'id': model_id}).save_model_params_form(request.data))
+ ModelSerializer.ModelParams(data={"id": model_id, "workspace_id": workspace_id}).save_model_params_form(
+ request.data
+ )
+ )
class ModelMeta(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_(
- 'Query model meta information, this interface does not carry authentication information'),
- description=_(
- 'Query model meta information, this interface does not carry authentication information'),
- operation_id=_(
- 'Query model meta information, this interface does not carry authentication information'),
- parameters=GetModelApi.get_parameters(),
- responses=GetModelApi.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_READ.get_workspace_model_permission(),
- PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- PermissionConstants.MODEL_READ.get_workspace_permission(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.MODEL.get_workspace_model_permission()],
- CompareConstants.AND), )
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Query model meta information, this interface does not carry authentication information"),
+ description=_("Query model meta information, this interface does not carry authentication information"),
+ operation_id=_("Query model meta information, this interface does not carry authentication information"), # type: ignore
+ parameters=GetModelApi.get_parameters(),
+ responses=GetModelApi.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_READ.get_workspace_model_permission(),
+ PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ PermissionConstants.MODEL_READ.get_workspace_permission(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.MODEL.get_workspace_model_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
def get(self, request: Request, workspace_id: str, model_id: str):
return result.success(
- ModelSerializer.Operate(data={'id': model_id, 'workspace_id': workspace_id}).one_meta(with_valid=True))
+ ModelSerializer.Operate(data={"id": model_id, "workspace_id": workspace_id}).one_meta(with_valid=True)
+ )
class PauseDownload(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['PUT'],
- summary=_('Pause model download'),
- description=_('Pause model download'),
- operation_id=_('Pause model download'), # type: ignore
- parameters=GetModelApi.get_parameters(),
- request=GetModelApi.get_request(),
- responses=DefaultModelResponse.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_CREATE.get_workspace_model_permission(),
- PermissionConstants.MODEL_CREATE.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.MODEL.get_workspace_model_permission()],
- CompareConstants.AND), )
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Pause model download"),
+ description=_("Pause model download"),
+ operation_id=_("Pause model download"), # type: ignore
+ parameters=GetModelApi.get_parameters(),
+ request=GetModelApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_CREATE.get_workspace_model_permission(),
+ PermissionConstants.MODEL_CREATE.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.MODEL.get_workspace_model_permission()],
+ compare=CompareConstants.AND,
+ ),
+ )
def put(self, request: Request, workspace_id: str, model_id: str):
return result.success(
- ModelSerializer.Operate(data={'id': model_id, 'workspace_id': workspace_id}).pause_download())
+ ModelSerializer.Operate(data={"id": model_id, "workspace_id": workspace_id}).pause_download()
+ )
class WorkspaceSharedModelSetting(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['Get'],
- summary=_('Get Share model by workspace id'),
- description=_('Get Share model by workspace id'),
- operation_id=_('Get Share model by workspace id'), # type: ignore
+ methods=["Get"],
+ summary=_("Get Share model by workspace id"),
+ description=_("Get Share model by workspace id"),
+ operation_id=_("Get Share model by workspace id"), # type: ignore
parameters=ModelListResponse.get_parameters(),
responses=DefaultModelResponse.get_response(),
- tags=[_('Shared Model')]
- ) # type: ignore
+ tags=[_("Shared Model")], # type: ignore
+ )
@has_permissions(
PermissionConstants.MODEL_READ.get_workspace_permission(),
PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
@@ -285,30 +347,37 @@ class WorkspaceSharedModelSetting(APIView):
)
def get(self, request: Request, workspace_id: str):
return result.success(
- WorkspaceSharedModelSerializer(data={**query_params_to_single_dict(request.query_params),
- 'workspace_id': workspace_id}).get_share_model_list())
+ WorkspaceSharedModelSerializer(
+ data={**query_params_to_single_dict(request.query_params), "workspace_id": workspace_id}
+ ).get_share_model_list()
+ )
class ModelList(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Query all model list'),
- description=_('Query all model list'),
- operation_id=_('Query all model list'), # type: ignore
- parameters=ModelListResponse.get_parameters(),
- responses=ModelListResponse.get_response(),
- tags=[_('Model')]) # type: ignore
- @has_permissions(PermissionConstants.MODEL_READ.get_workspace_permission(),
- PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission(),
- PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Query all model list"),
+ description=_("Query all model list"),
+ operation_id=_("Query all model list"), # type: ignore
+ parameters=ModelListResponse.get_parameters(),
+ responses=ModelListResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.MODEL_READ.get_workspace_permission(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission(),
+ PermissionConstants.MODEL_READ.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.KNOWLEDGE_READ.get_workspace_permission_workspace_manage_role(),
+ PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str):
return result.success(
ModelSerializer.Query(
- data={**query_params_to_single_dict(request.query_params), 'user_id': str(request.user.id)}).model_list(
- workspace_id=workspace_id,
- with_valid=True))
+ data={**query_params_to_single_dict(request.query_params), "user_id": str(request.user.id)}
+ ).model_list(workspace_id=workspace_id, with_valid=True)
+ )
diff --git a/apps/models_provider/views/model_apply.py b/apps/models_provider/views/model_apply.py
index d7e691c336f..d9231457541 100644
--- a/apps/models_provider/views/model_apply.py
+++ b/apps/models_provider/views/model_apply.py
@@ -1,57 +1,54 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎
- @file: model_apply.py
- @date:2024/8/20 20:38
- @desc:
+@project: MaxKB
+@Author:虎
+@file: model_apply.py
+@date:2024/8/20 20:38
+@desc:
"""
-from urllib.request import Request
+from urllib.request import Request
+from common.result import result
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
-from rest_framework.views import APIView
-
-from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants
-from common.result import result
from models_provider.api.model import DefaultModelResponse
from models_provider.serializers.model_apply_serializers import ModelApplySerializers
+from rest_framework.views import APIView
class ModelApply(APIView):
class EmbedDocuments(APIView):
- @extend_schema(methods=['POST'],
- summary=_('Vectorization documentation'),
- description=_('Vectorization documentation'),
- operation_id=_('Vectorization documentation'), # type: ignore
- responses=DefaultModelResponse.get_response(),
- tags=[_('Model')] # type: ignore
- )
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Vectorization documentation"),
+ description=_("Vectorization documentation"),
+ operation_id=_("Vectorization documentation"), # type: ignore
+ responses=DefaultModelResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).embed_documents(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).embed_documents(request.data))
class EmbedQuery(APIView):
- @extend_schema(methods=['POST'],
- summary=_('Vectorization documentation'),
- description=_('Vectorization documentation'),
- operation_id=_('Vectorization documentation'), # type: ignore
- responses=DefaultModelResponse.get_response(),
- tags=[_('Model')] # type: ignore
- )
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Vectorization documentation"),
+ description=_("Vectorization documentation"),
+ operation_id=_("Vectorization documentation"), # type: ignore
+ responses=DefaultModelResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).embed_query(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).embed_query(request.data))
class CompressDocuments(APIView):
- @extend_schema(methods=['POST'],
- summary=_('Reorder documents'),
- description=_('Reorder documents'),
- operation_id=_('Reorder documents'), # type: ignore
- responses=DefaultModelResponse.get_response(),
- tags=[_('Model')] # type: ignore
- )
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Reorder documents"),
+ description=_("Reorder documents"),
+ operation_id=_("Reorder documents"), # type: ignore
+ responses=DefaultModelResponse.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def post(self, request: Request, model_id):
- return result.success(
- ModelApplySerializers(data={'model_id': model_id}).compress_documents(request.data))
+ return result.success(ModelApplySerializers(data={"model_id": model_id}).compress_documents(request.data))
diff --git a/apps/models_provider/views/provide.py b/apps/models_provider/views/provide.py
index 70b916ca19d..7e7ce5aadcb 100644
--- a/apps/models_provider/views/provide.py
+++ b/apps/models_provider/views/provide.py
@@ -1,103 +1,122 @@
# coding=utf-8
-from django.utils.translation import gettext_lazy as _
-from drf_spectacular.utils import extend_schema
-from rest_framework.request import Request
-from rest_framework.views import APIView
-
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
from models_provider.api.provide import ProvideApi
from models_provider.constants.model_provider_constants import ModelProvideConstants
from models_provider.serializers.model_serializer import get_default_model_params_setting
+from rest_framework.request import Request
+from rest_framework.views import APIView
class Provide(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Get a list of model suppliers'),
- description=_('Get a list of model suppliers'),
- operation_id=_('Get a list of model suppliers'), # type: ignore
- responses=ProvideApi.get_response(),
- tags=[_('Model')]) # type: ignore
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get a list of model suppliers"),
+ description=_("Get a list of model suppliers"),
+ operation_id=_("Get a list of model suppliers"), # type: ignore
+ responses=ProvideApi.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def get(self, request: Request):
- model_type = request.query_params.get('model_type')
+ model_type = request.query_params.get("model_type")
if model_type:
providers = []
for key in ModelProvideConstants.__members__:
- if len([item for item in ModelProvideConstants[key].value.get_model_type_list() if
- item['value'] == model_type]) > 0:
+ if (
+ len(
+ [
+ item
+ for item in ModelProvideConstants[key].value.get_model_type_list()
+ if item["value"] == model_type
+ ]
+ )
+ > 0
+ ):
providers.append(ModelProvideConstants[key].value.get_model_provide_info().to_dict())
return result.success(providers)
return result.success(
- [ModelProvideConstants[key].value.get_model_provide_info().to_dict() for key in
- ModelProvideConstants.__members__])
+ [
+ ModelProvideConstants[key].value.get_model_provide_info().to_dict()
+ for key in ModelProvideConstants.__members__
+ ]
+ )
class ModelTypeList(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Get a list of model types'),
- description=_('Get a list of model types'),
- operation_id=_('Get a list of model types'), # type: ignore
- parameters=ProvideApi.ModelTypeList.get_query_params_api(),
- responses=ProvideApi.ModelTypeList.get_response(),
- tags=[_('Model')]) # type: ignore
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get a list of model types"),
+ description=_("Get a list of model types"),
+ operation_id=_("Get a list of model types"), # type: ignore
+ parameters=ProvideApi.ModelTypeList.get_query_params_api(),
+ responses=ProvideApi.ModelTypeList.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def get(self, request: Request):
- provider = request.query_params.get('provider')
+ provider = request.query_params.get("provider")
return result.success(ModelProvideConstants[provider].value.get_model_type_list())
class ModelList(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Example of obtaining model list'),
- description=_('Example of obtaining model list'),
- operation_id=_('Example of obtaining model list'), # type: ignore
- parameters=ProvideApi.ModelList.get_query_params_api(),
- responses=ProvideApi.ModelList.get_response(),
- tags=[_('Model')]) # type: ignore
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Example of obtaining model list"),
+ description=_("Example of obtaining model list"),
+ operation_id=_("Example of obtaining model list"), # type: ignore
+ parameters=ProvideApi.ModelList.get_query_params_api(),
+ responses=ProvideApi.ModelList.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def get(self, request: Request):
- provider = request.query_params.get('provider')
- model_type = request.query_params.get('model_type')
+ provider = request.query_params.get("provider")
+ model_type = request.query_params.get("model_type")
- return result.success(
- ModelProvideConstants[provider].value.get_model_list(
- model_type))
+ return result.success(ModelProvideConstants[provider].value.get_model_list(model_type))
class ModelParamsForm(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Get model default parameters'),
- description=_('Get model default parameters'),
- operation_id=_('Get model default parameters'), # type: ignore
- parameters=ProvideApi.ModelParamsForm.get_query_params_api(),
- responses=ProvideApi.ModelParamsForm.get_response(),
- tags=[_('Model')]) # type: ignore
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get model default parameters"),
+ description=_("Get model default parameters"),
+ operation_id=_("Get model default parameters"), # type: ignore
+ parameters=ProvideApi.ModelParamsForm.get_query_params_api(),
+ responses=ProvideApi.ModelParamsForm.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def get(self, request: Request):
- provider = request.query_params.get('provider')
- model_type = request.query_params.get('model_type')
- model_name = request.query_params.get('model_name')
+ provider = request.query_params.get("provider")
+ model_type = request.query_params.get("model_type")
+ model_name = request.query_params.get("model_name")
return result.success(get_default_model_params_setting(provider, model_type, model_name))
class ModelForm(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_('Get the model creation form'),
- description=_('Get the model creation form'),
- operation_id=_('Get the model creation form'), # type: ignore
- parameters=ProvideApi.ModelParamsForm.get_query_params_api(),
- responses=ProvideApi.ModelParamsForm.get_response(),
- tags=[_('Model')]) # type: ignore
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get the model creation form"),
+ description=_("Get the model creation form"),
+ operation_id=_("Get the model creation form"), # type: ignore
+ parameters=ProvideApi.ModelParamsForm.get_query_params_api(),
+ responses=ProvideApi.ModelParamsForm.get_response(),
+ tags=[_("Model")], # type: ignore
+ )
def get(self, request: Request):
- provider = request.query_params.get('provider')
- model_type = request.query_params.get('model_type')
- model_name = request.query_params.get('model_name')
+ provider = request.query_params.get("provider")
+ model_type = request.query_params.get("model_type")
+ model_name = request.query_params.get("model_name")
return result.success(
- ModelProvideConstants[provider].value.get_model_credential(model_type, model_name).to_form_list())
+ ModelProvideConstants[provider].value.get_model_credential(model_type, model_name).to_form_list()
+ )
diff --git a/apps/ops/celery/signal_handler.py b/apps/ops/celery/signal_handler.py
index 43038c6cd1a..08d9ff3088f 100644
--- a/apps/ops/celery/signal_handler.py
+++ b/apps/ops/celery/signal_handler.py
@@ -10,7 +10,6 @@
)
from django.core.cache import cache
from django_apscheduler.models import DjangoJob
-from django_celery_beat.models import PeriodicTask
from common.utils.logger import maxkb_logger
from .decorator import get_after_app_ready_tasks, get_after_app_shutdown_clean_tasks
@@ -76,10 +75,6 @@ def on_app_ready(sender=None, headers=None, **kwargs):
logger.debug("Work ready signal recv")
logger.debug("Start need start task: [{}]".format(", ".join(tasks)))
for task in tasks:
- periodic_task = PeriodicTask.objects.filter(task=task).first()
- if periodic_task and not periodic_task.enabled:
- logger.debug("Periodic task [{}] is disabled!".format(task))
- continue
subtask(task).delay()
@@ -99,7 +94,6 @@ def after_app_shutdown_periodic_tasks(sender=None, **kwargs):
tasks = get_after_app_shutdown_clean_tasks()
logger.debug("Worker shutdown signal recv")
logger.debug("Clean period tasks: [{}]".format(', '.join(tasks)))
- PeriodicTask.objects.filter(name__in=tasks).delete()
@after_setup_logger.connect
diff --git a/apps/ops/celery/utils.py b/apps/ops/celery/utils.py
index d14f9e1f4db..8e3f569af4a 100644
--- a/apps/ops/celery/utils.py
+++ b/apps/ops/celery/utils.py
@@ -5,9 +5,6 @@
import uuid
from django.conf import settings
-from django_celery_beat.models import (
- PeriodicTasks
-)
from common.utils.logger import maxkb_logger
from maxkb.const import PROJECT_DIR
@@ -15,24 +12,6 @@
logger = logging.getLogger(__file__)
-def disable_celery_periodic_task(task_name):
- from django_celery_beat.models import PeriodicTask
- PeriodicTask.objects.filter(name=task_name).update(enabled=False)
- PeriodicTasks.update_changed()
-
-
-def delete_celery_periodic_task(task_name):
- from django_celery_beat.models import PeriodicTask
- PeriodicTask.objects.filter(name=task_name).delete()
- PeriodicTasks.update_changed()
-
-
-def get_celery_periodic_task(task_name):
- from django_celery_beat.models import PeriodicTask
- task = PeriodicTask.objects.filter(name=task_name).first()
- return task
-
-
def make_dirs(name, mode=0o700, exist_ok=False):
""" 默认权限设置为 0o700 """
return os.makedirs(name, mode=mode, exist_ok=exist_ok)
diff --git a/apps/oss/retrieval_urls.py b/apps/oss/retrieval_urls.py
index 816c242eefc..201b6c63ed6 100644
--- a/apps/oss/retrieval_urls.py
+++ b/apps/oss/retrieval_urls.py
@@ -13,11 +13,11 @@
app_name = 'oss'
urlpatterns = [
- re_path(rf'^(.*)/oss/file/(?P[\w-]+)/?$',
+ re_path(r'^(.*)/oss/file/(?P[\w-]+)/?$',
views.FileRetrievalView.as_view()),
- re_path(rf'oss/file/(?P[\w-]+)/?$',
+ re_path(r'oss/file/(?P[\w-]+)/?$',
views.FileRetrievalView.as_view()),
- re_path(rf'^/oss/get_url/(?P[\w-]+)?$',
+ re_path(r'^oss/get_url/(?P[\w-]+)/?$',
views.GetUrlView.as_view()),
]
diff --git a/apps/oss/serializers/file.py b/apps/oss/serializers/file.py
index 63ae28eedaa..bf6a1eafb03 100644
--- a/apps/oss/serializers/file.py
+++ b/apps/oss/serializers/file.py
@@ -1,140 +1,425 @@
# coding=utf-8
-import base64
-import ipaddress
import re
-import socket
import urllib
-from urllib.parse import urlparse, urlunparse
-import requests
import uuid_utils.compat as uuid
-from django.db.models import QuerySet
+from django.db.models.functions import Cast
+
+from application.models import Application, ApplicationAccessToken, ChatShareLink
+from common.auth.common import parse_token
+from common.auth.constants.chat_permission_constants import ChatPermissionConstants
+from common.auth.constants.operate_constants import Operate
+from common.auth.handle.impl.user_token import get_auth
+from common.auth.handle.impl.chat_user_token import get_auth as get_chat_auth
+from common.constants.authentication_type import AuthenticationType
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.exception.app_exception import AppApiException, AppUnauthorizedFailed, NotFound404
+from django.db.models import QuerySet, CharField
from django.http import HttpResponse
+from django.utils.translation import gettext
from django.utils.translation import gettext_lazy as _
+from homepage.serializers.homepage import (
+ has_extends_workspace_manage_permission,
+ hasPermission,
+ is_extends_workspace_manage,
+ is_workspace_manage,
+)
+from knowledge.models import Document, File, FileSourceType, Knowledge, PublicFileAccess
+from maxkb.const import CONFIG
from rest_framework import serializers
-
-from application.models import Application
-from common.exception.app_exception import NotFound404, AppApiException
-from knowledge.models import File, FileSourceType
+from system_manage.models import WorkspaceUserResourcePermission
+from system_manage.models.resource_mapping import ResourceMapping, ResourceType
from tools.serializers.tool import UploadedFileField
+from users.models import User
mime_types = {
- "html": "text/html", "htm": "text/html", "shtml": "text/html", "css": "text/css", "xml": "text/xml",
- "gif": "image/gif", "jpeg": "image/jpeg", "jpg": "image/jpeg", "js": "application/javascript",
- "atom": "application/atom+xml", "rss": "application/rss+xml", "mml": "text/mathml", "txt": "text/plain",
- "jad": "text/vnd.sun.j2me.app-descriptor", "wml": "text/vnd.wap.wml", "htc": "text/x-component",
- "avif": "image/avif", "png": "image/png", "svg": "image/svg+xml", "svgz": "image/svg+xml",
- "tif": "image/tiff", "tiff": "image/tiff", "wbmp": "image/vnd.wap.wbmp", "webp": "image/webp",
- "ico": "image/x-icon", "jng": "image/x-jng", "bmp": "image/x-ms-bmp", "woff": "font/woff",
- "woff2": "font/woff2", "jar": "application/java-archive", "war": "application/java-archive",
- "ear": "application/java-archive", "json": "application/json", "hqx": "application/mac-binhex40",
- "doc": "application/msword", "pdf": "application/pdf", "ps": "application/postscript",
+ "html": "text/html",
+ "htm": "text/html",
+ "shtml": "text/html",
+ "css": "text/css",
+ "xml": "text/xml",
+ "gif": "image/gif",
+ "jpeg": "image/jpeg",
+ "jpg": "image/jpeg",
+ "js": "application/javascript",
+ "atom": "application/atom+xml",
+ "rss": "application/rss+xml",
+ "mml": "text/mathml",
+ "txt": "text/plain",
+ "jad": "text/vnd.sun.j2me.app-descriptor",
+ "wml": "text/vnd.wap.wml",
+ "htc": "text/x-component",
+ "avif": "image/avif",
+ "png": "image/png",
+ "svg": "image/svg+xml",
+ "svgz": "image/svg+xml",
+ "tif": "image/tiff",
+ "tiff": "image/tiff",
+ "wbmp": "image/vnd.wap.wbmp",
+ "webp": "image/webp",
+ "ico": "image/x-icon",
+ "jng": "image/x-jng",
+ "bmp": "image/x-ms-bmp",
+ "woff": "font/woff",
+ "woff2": "font/woff2",
+ "jar": "application/java-archive",
+ "war": "application/java-archive",
+ "ear": "application/java-archive",
+ "json": "application/json",
+ "hqx": "application/mac-binhex40",
+ "doc": "application/msword",
+ "pdf": "application/pdf",
+ "ps": "application/postscript",
"docx": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
"xlsx": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
"pptx": "application/vnd.openxmlformats-officedocument.presentationml.presentation",
- "eps": "application/postscript", "ai": "application/postscript", "rtf": "application/rtf",
- "m3u8": "application/vnd.apple.mpegurl", "kml": "application/vnd.google-earth.kml+xml",
- "kmz": "application/vnd.google-earth.kmz", "xls": "application/vnd.ms-excel",
- "eot": "application/vnd.ms-fontobject", "ppt": "application/vnd.ms-powerpoint",
+ "eps": "application/postscript",
+ "ai": "application/postscript",
+ "rtf": "application/rtf",
+ "m3u8": "application/vnd.apple.mpegurl",
+ "kml": "application/vnd.google-earth.kml+xml",
+ "kmz": "application/vnd.google-earth.kmz",
+ "xls": "application/vnd.ms-excel",
+ "eot": "application/vnd.ms-fontobject",
+ "ppt": "application/vnd.ms-powerpoint",
"odg": "application/vnd.oasis.opendocument.graphics",
"odp": "application/vnd.oasis.opendocument.presentation",
- "ods": "application/vnd.oasis.opendocument.spreadsheet", "odt": "application/vnd.oasis.opendocument.text",
- "wmlc": "application/vnd.wap.wmlc", "wasm": "application/wasm", "7z": "application/x-7z-compressed",
- "cco": "application/x-cocoa", "jardiff": "application/x-java-archive-diff",
- "jnlp": "application/x-java-jnlp-file", "run": "application/x-makeself", "pl": "application/x-perl",
- "pm": "application/x-perl", "prc": "application/x-pilot", "pdb": "application/x-pilot",
- "rar": "application/x-rar-compressed", "rpm": "application/x-redhat-package-manager",
- "sea": "application/x-sea", "swf": "application/x-shockwave-flash", "sit": "application/x-stuffit",
- "tcl": "application/x-tcl", "tk": "application/x-tcl", "der": "application/x-x509-ca-cert",
- "pem": "application/x-x509-ca-cert", "crt": "application/x-x509-ca-cert",
- "xpi": "application/x-xpinstall", "xhtml": "application/xhtml+xml", "xspf": "application/xspf+xml",
- "zip": "application/zip", "bin": "application/octet-stream", "exe": "application/octet-stream",
- "dll": "application/octet-stream", "deb": "application/octet-stream", "dmg": "application/octet-stream",
- "iso": "application/octet-stream", "img": "application/octet-stream", "msi": "application/octet-stream",
- "msp": "application/octet-stream", "msm": "application/octet-stream", "mid": "audio/midi",
- "midi": "audio/midi", "kar": "audio/midi", "mp3": "audio/mp3", "ogg": "audio/ogg", "m4a": "audio/x-m4a",
- "ra": "audio/x-realaudio", "3gpp": "video/3gpp", "3gp": "video/3gpp", "ts": "video/mp2t",
- "mp4": "video/mp4", "mpeg": "video/mpeg", "mpg": "video/mpeg", "mov": "video/quicktime",
- "webm": "video/webm", "flv": "video/x-flv", "m4v": "video/x-m4v", "mng": "video/x-mng",
- "asx": "video/x-ms-asf", "asf": "video/x-ms-asf", "wmv": "video/x-ms-wmv", "avi": "video/x-msvideo",
- "wav": "audio/wav", "flac": "audio/flac", "aac": "audio/aac", "opus": "audio/opus",
- "csv": "text/csv", "tsv": "text/tab-separated-values", "ics": "text/calendar",
+ "ods": "application/vnd.oasis.opendocument.spreadsheet",
+ "odt": "application/vnd.oasis.opendocument.text",
+ "wmlc": "application/vnd.wap.wmlc",
+ "wasm": "application/wasm",
+ "7z": "application/x-7z-compressed",
+ "cco": "application/x-cocoa",
+ "jardiff": "application/x-java-archive-diff",
+ "jnlp": "application/x-java-jnlp-file",
+ "run": "application/x-makeself",
+ "pl": "application/x-perl",
+ "pm": "application/x-perl",
+ "prc": "application/x-pilot",
+ "pdb": "application/x-pilot",
+ "rar": "application/x-rar-compressed",
+ "rpm": "application/x-redhat-package-manager",
+ "sea": "application/x-sea",
+ "swf": "application/x-shockwave-flash",
+ "sit": "application/x-stuffit",
+ "tcl": "application/x-tcl",
+ "tk": "application/x-tcl",
+ "der": "application/x-x509-ca-cert",
+ "pem": "application/x-x509-ca-cert",
+ "crt": "application/x-x509-ca-cert",
+ "xpi": "application/x-xpinstall",
+ "xhtml": "application/xhtml+xml",
+ "xspf": "application/xspf+xml",
+ "zip": "application/zip",
+ "bin": "application/octet-stream",
+ "exe": "application/octet-stream",
+ "dll": "application/octet-stream",
+ "deb": "application/octet-stream",
+ "dmg": "application/octet-stream",
+ "iso": "application/octet-stream",
+ "img": "application/octet-stream",
+ "msi": "application/octet-stream",
+ "msp": "application/octet-stream",
+ "msm": "application/octet-stream",
+ "mid": "audio/midi",
+ "midi": "audio/midi",
+ "kar": "audio/midi",
+ "mp3": "audio/mp3",
+ "ogg": "audio/ogg",
+ "m4a": "audio/x-m4a",
+ "ra": "audio/x-realaudio",
+ "3gpp": "video/3gpp",
+ "3gp": "video/3gpp",
+ "ts": "video/mp2t",
+ "mp4": "video/mp4",
+ "mpeg": "video/mpeg",
+ "mpg": "video/mpeg",
+ "mov": "video/quicktime",
+ "webm": "video/webm",
+ "flv": "video/x-flv",
+ "m4v": "video/x-m4v",
+ "mng": "video/x-mng",
+ "asx": "video/x-ms-asf",
+ "asf": "video/x-ms-asf",
+ "wmv": "video/x-ms-wmv",
+ "avi": "video/x-msvideo",
+ "wav": "audio/wav",
+ "flac": "audio/flac",
+ "aac": "audio/aac",
+ "opus": "audio/opus",
+ "csv": "text/csv",
+ "tsv": "text/tab-separated-values",
+ "ics": "text/calendar",
}
# 如果是音频文件并且有range请求,处理部分内容
-audio_types = ['mp3', 'wav', 'ogg', 'flac', 'aac', 'opus', 'm4a']
+audio_types = ["mp3", "wav", "ogg", "flac", "aac", "opus", "m4a"]
+
+_PUBLIC_SOURCE_TYPES = (
+ FileSourceType.TEMPORARY_120_MINUTE,
+ FileSourceType.TEMPORARY_30_MINUTE,
+ FileSourceType.TEMPORARY_1_DAY,
+ FileSourceType.SYSTEM,
+ FileSourceType.TOOL,
+)
+
+
+def _deny():
+ raise AppUnauthorizedFailed(403, gettext("No permission to access"))
+
+
+def auth(file, mk_file_auth):
+ if CONFIG.get("FILE_AUTH", "1") != "1":
+ return
+ # 公共/临时文件无需鉴权
+ if file.source_type in _PUBLIC_SOURCE_TYPES:
+ return
+ # PublicFileAccess 中记录的文件允许公开访问
+ if QuerySet(PublicFileAccess).filter(source_type="FILE", source_id=str(file.id)).exists():
+ return
+ if file.source_type == FileSourceType.APPLICATION_SETTINGS:
+ return
+
+ # 非公共文件,直接拒绝
+ if mk_file_auth is None:
+ _deny()
+ token = parse_token(mk_file_auth)
+ user_type = AuthenticationType(token.type)
+
+ if user_type == AuthenticationType.CHAT_USER:
+ _auth_chat(file, token)
+ elif user_type == AuthenticationType.SYSTEM_USER:
+ _auth_system(file, token.id)
+ else:
+ # 默认拒绝,避免枚举扩展后静默放行
+ _deny()
+
+
+def _auth_chat(file, token):
+ user_id = token.id
+ application_id = token.kwargs.get("application_id")
+ if file.source_type == FileSourceType.APPLICATION:
+ if application_id:
+ if not token.application_id == file.source_id:
+ _deny()
+ else:
+ user_auth = get_chat_auth(token.login_type, token.id, application_id)
+ if not any(
+ [
+ hasPermission(
+ user_auth,
+ _permission._build_workspace_permission("application_id")({"application_id": file.source_id}),
+ )
+ for _permission in ChatPermissionConstants
+ ]
+ ):
+ _deny()
+ if file.source_type == FileSourceType.CHAT:
+ if file.meta.get("user_id") == user_id:
+ return
+ # 非本人:存在分享链接才允许
+ if not QuerySet(ChatShareLink).filter(chat_id=file.source_id).exists():
+ _deny()
+ # 匿名用户还需满足应用的登录要求
+ if token.login_type.upper() == str(Operate.ANNOTATION_AUTH):
+ _check_anonymous_login(file.source_id)
+ return
+
+ # DOCUMENT / KNOWLEDGE
+ if file.source_type == FileSourceType.DOCUMENT:
+ knowledge_id = QuerySet(Document).filter(id=file.source_id).values_list("knowledge_id", flat=True).first()
+ if knowledge_id is None:
+ _deny()
+ elif file.source_type == FileSourceType.KNOWLEDGE:
+ knowledge_id = file.source_id
+ else:
+ _deny()
+ return
+ ## 如果是匿名的就要看可访问的应用是否
+ if token.login_type.upper() == str(Operate.ANNOTATION_AUTH):
+ _check_knowledge_mapped_to_application(knowledge_id)
+ return
+
+ get_authorized = DatabaseModelManage.get_model("get_knowledge_list_of_authorized")
+ if knowledge_id not in get_authorized(user_id, [knowledge_id]):
+ _deny()
+
+
+def _check_anonymous_login(chat_id):
+ access_token = ApplicationAccessToken.objects.filter(
+ application__chat__id=chat_id,
+ application__chat__is_deleted=False,
+ ).first()
+ if access_token and access_token.authentication and access_token.authentication_value.get("type") == "login":
+ _deny()
+
+
+def _check_knowledge_mapped_to_application(knowledge_id):
+ if knowledge_id is None:
+ _deny()
+ exists = (
+ QuerySet(ResourceMapping)
+ .filter(
+ source_type=ResourceType.APPLICATION,
+ source_id__in=QuerySet(ApplicationAccessToken)
+ .filter(is_active=True, authentication=False)
+ .values_list(Cast("application_id", output_field=CharField()), flat=True),
+ target_type=ResourceType.KNOWLEDGE,
+ target_id=str(knowledge_id),
+ )
+ .exists()
+ )
+ if not exists:
+ _deny()
+
+
+def _auth_system(file, user_id):
+ user = QuerySet(User).filter(id=user_id).first()
+ if not user:
+ _deny()
+ user_auth = get_auth(user)
+
+ if file.source_type == FileSourceType.CHAT:
+ application = QuerySet(Application).filter(chat__id=file.source_id).first()
+ if application is None:
+ _deny()
+ _check_workspace_resource_permission(
+ user_auth,
+ user_id,
+ workspace_id=application.workspace_id,
+ target_id=application.id,
+ auth_target_type="APPLICATION",
+ read_permission="APPLICATION:READ",
+ )
+ elif file.source_type == FileSourceType.APPLICATION:
+ application = QuerySet(Application).filter(id=file.source_id).first()
+ if application is None:
+ _deny()
+ _check_workspace_resource_permission(
+ user_auth,
+ user_id,
+ workspace_id=application.workspace_id,
+ target_id=application.id,
+ auth_target_type="APPLICATION",
+ read_permission="APPLICATION:READ",
+ )
+ elif file.source_type in (FileSourceType.DOCUMENT, FileSourceType.KNOWLEDGE):
+ if file.source_type == FileSourceType.DOCUMENT:
+ knowledge_id = QuerySet(Document).filter(id=file.source_id).values_list("knowledge_id", flat=True).first()
+ else:
+ knowledge_id = file.source_id
+ knowledge = QuerySet(Knowledge).filter(id=knowledge_id).first() if knowledge_id else None
+ if knowledge is None:
+ _deny()
+ _check_workspace_resource_permission(
+ user_auth,
+ user_id,
+ workspace_id=knowledge.workspace_id,
+ target_id=knowledge.id,
+ auth_target_type="KNOWLEDGE",
+ read_permission="KNOWLEDGE:READ",
+ )
+ else:
+ _deny()
+
+
+def _check_workspace_resource_permission(
+ user_auth, user_id, *, workspace_id, target_id, auth_target_type, read_permission
+):
+ if is_workspace_manage(user_auth, workspace_id):
+ return
+ if is_extends_workspace_manage(user_auth, workspace_id) and has_extends_workspace_manage_permission(
+ user_auth, read_permission, workspace_id
+ ):
+ return
+
+ permission_list = ["VIEW", "MANAGE", "ROLE"] if hasPermission(user_auth, read_permission) else ["VIEW", "MANAGE"]
+ if (
+ not QuerySet(WorkspaceUserResourcePermission)
+ .filter(
+ target=target_id,
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_target_type=auth_target_type,
+ permission_list__overlap=permission_list,
+ )
+ .exists()
+ ):
+ _deny()
class FileSerializer(serializers.Serializer):
- file = UploadedFileField(required=True, label=_('file'))
+ file = UploadedFileField(required=True, label=_("file"))
meta = serializers.JSONField(required=False, allow_null=True)
source_id = serializers.CharField(
- required=False, allow_null=True, label=_('source id'), default=FileSourceType.TEMPORARY_120_MINUTE.value
+ required=False, allow_null=True, label=_("source id"), default=FileSourceType.TEMPORARY_120_MINUTE.value
)
source_type = serializers.ChoiceField(
- choices=FileSourceType.choices, required=False, allow_null=True, label=_('source type'),
- default=FileSourceType.TEMPORARY_120_MINUTE
+ choices=FileSourceType.choices,
+ required=False,
+ allow_null=True,
+ label=_("source type"),
+ default=FileSourceType.TEMPORARY_120_MINUTE,
)
- def upload(self, with_valid=True):
+ def upload(self, with_valid=True, user_id=None):
if with_valid:
self.is_valid(raise_exception=True)
- meta = self.data.get('meta', None)
+ meta = self.data.get("meta", None)
if not meta:
- meta = {'debug': True}
- file_id = meta.get('file_id', uuid.uuid7())
+ meta = {"debug": True}
+ if user_id:
+ meta["user_id"] = user_id
+ file_id = meta.get("file_id", uuid.uuid7())
file = File(
id=file_id,
- file_name=self.data.get('file').name,
+ file_name=self.data.get("file").name,
meta=meta,
- source_id=self.data.get('source_id') or FileSourceType.TEMPORARY_120_MINUTE.value,
- source_type=self.data.get('source_type') or FileSourceType.TEMPORARY_120_MINUTE
+ source_id=self.data.get("source_id") or FileSourceType.TEMPORARY_120_MINUTE.value,
+ source_type=self.data.get("source_type") or FileSourceType.TEMPORARY_120_MINUTE,
)
- file.save(self.data.get('file').read())
- return f'./oss/file/{file_id}'
+ file.save(self.data.get("file").read())
+ return f"./oss/file/{file_id}"
class Operate(serializers.Serializer):
id = serializers.UUIDField(required=True)
http_range = serializers.CharField(
- required=False, allow_blank=True, allow_null=True, label=_('HTTP Range'),
- help_text=_('HTTP Range header for partial content requests, e.g., "bytes=0-1023"')
+ required=False,
+ allow_blank=True,
+ allow_null=True,
+ label=_("HTTP Range"),
+ help_text=_('HTTP Range header for partial content requests, e.g., "bytes=0-1023"'),
)
- def get(self, with_valid=True):
+ def get(self, mk_file_auth=None, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- file_id = self.data.get('id')
+ file_id = self.data.get("id")
file = QuerySet(File).filter(id=file_id).first()
if file is None:
- raise NotFound404(404, _('File not found'))
+ raise NotFound404(404, _("File not found"))
+ auth(file, mk_file_auth)
file_type = file.file_name.split(".")[-1].lower()
- content_type = mime_types.get(file_type, 'application/octet-stream')
+ content_type = mime_types.get(file_type, "application/octet-stream")
encoded_filename = urllib.parse.quote(file.file_name)
# 获取文件内容
file_bytes = file.get_bytes()
file_size = len(file_bytes)
response = None
- if file_type in audio_types and self.data.get('http_range'):
+ if file_type in audio_types and self.data.get("http_range"):
response = self.handle_audio(file_size, file_bytes, content_type, encoded_filename)
if response:
return response
# 对于非范围请求或其他类型文件,返回完整内容
- headers = {
- 'Content-Type': content_type,
- 'Content-Disposition': f'attachment; filename={encoded_filename}'
- }
- return HttpResponse(
- file_bytes,
- status=200,
- headers=headers
- )
+ headers = {"Content-Type": content_type, "Content-Disposition": f"attachment; filename={encoded_filename}"}
+ return HttpResponse(file_bytes, status=200, headers=headers)
def handle_audio(self, file_size, file_bytes, content_type, encoded_filename):
# 解析range请求 (格式如 "bytes=0-1023")
- range_match = re.match(r'bytes=(\d+)-(\d*)', self.data.get('http_range', ''))
+ range_match = re.match(r"bytes=(\d+)-(\d*)", self.data.get("http_range", ""))
if range_match:
start = int(range_match.group(1))
end = int(range_match.group(2)) if range_match.group(2) else file_size - 1
@@ -144,230 +429,65 @@ def handle_audio(self, file_size, file_bytes, content_type, encoded_filename):
length = end - start + 1
# 创建部分响应
- response = HttpResponse(
- file_bytes[start:start + length],
- status=206,
- content_type=content_type
- )
+ response = HttpResponse(file_bytes[start : start + length], status=206, content_type=content_type)
# 设置部分内容响应头
- response['Content-Range'] = f'bytes {start}-{end}/{file_size}'
- response['Accept-Ranges'] = 'bytes'
- response['Content-Length'] = str(length)
- response['Content-Disposition'] = f'inline; filename={encoded_filename}'
+ response["Content-Range"] = f"bytes {start}-{end}/{file_size}"
+ response["Accept-Ranges"] = "bytes"
+ response["Content-Length"] = str(length)
+ response["Content-Disposition"] = f"inline; filename={encoded_filename}"
return response
- def delete(self):
+ def delete(self, mk_file_auth=None):
self.is_valid(raise_exception=True)
- file_id = self.data.get('id')
+ file_id = self.data.get("id")
file = QuerySet(File).filter(id=file_id).first()
if file is not None:
+ auth(file, mk_file_auth)
file.delete()
return True
-from requests.adapters import HTTPAdapter
-
-
-class SafeHTTPAdapter(HTTPAdapter):
- """
- 安全的 HTTP 适配器,防止 DNS 重绑定攻击
- 在建立连接前验证目标 IP 地址
- """
-
- def send(self, request, **kwargs):
- # 解析 URL 获取主机名
- parsed_url = urlparse(request.url)
- host = parsed_url.hostname
-
- if host:
- # 验证目标 IP 是否安全
- self._validate_host_ip(host)
-
- return super().send(request, **kwargs)
-
- def _validate_host_ip(self, host: str):
- """验证主机解析的 IP 地址是否安全"""
- try:
- # 获取所有 IP 地址(包括 IPv4 和 IPv6)
- addr_infos = socket.getaddrinfo(host, None, socket.AF_UNSPEC, socket.SOCK_STREAM)
-
- for addr_info in addr_infos:
- ip = addr_info[4][0]
- if self._is_unsafe_ip(ip):
- raise AppApiException(500, _('Access to internal IP addresses is blocked'))
- except AppApiException:
- raise
- except Exception as e:
- raise AppApiException(500, _('Failed to resolve host: {error}').format(error=str(e)))
-
- def _is_unsafe_ip(self, ip: str) -> bool:
- """检查 IP 地址是否属于不安全的范围"""
- try:
- ip_addr = ipaddress.ip_address(ip)
- return (
- ip_addr.is_private or
- ip_addr.is_loopback or
- ip_addr.is_reserved or
- ip_addr.is_link_local or
- ip_addr.is_multicast
- )
- except Exception:
- return True
-
-
def get_url_content(url, application_id: str):
application = Application.objects.filter(id=application_id).first()
if application is None:
- raise AppApiException(500, _('Application does not exist'))
+ raise AppApiException(500, _("Application does not exist"))
if not application.file_upload_enable:
- raise AppApiException(500, _('File upload is not enabled'))
+ raise AppApiException(500, _("File upload is not enabled"))
file_limit = 50 * 1024 * 1024
- if application.file_upload_setting and application.file_upload_setting.get('fileLimit'):
- file_limit = application.file_upload_setting.get('fileLimit') * 1024 * 1024
- parsed = validate_url(url)
-
- # 创建带有安全检查的 session
- session = requests.Session()
- safe_adapter = SafeHTTPAdapter()
- session.mount('http://', safe_adapter)
- session.mount('https://', safe_adapter)
-
+ if application.file_upload_setting and application.file_upload_setting.get("fileLimit"):
+ file_limit = application.file_upload_setting.get("fileLimit") * 1024 * 1024
try:
- response = session.get(
- url,
- timeout=3,
- allow_redirects=False
+ from common.utils.tool_code import ToolExecutor
+
+ response = ToolExecutor().exec_code(
+ """
+ def get_url_content(url):
+ import requests
+ requests.packages.urllib3.disable_warnings()
+ response = requests.get(url, verify=False, allow_redirects=False)
+ content_type = response.headers.get('Content-Type', '')
+ if 'text' in content_type or 'json' in content_type:
+ content = response.text
+ else:
+ import base64
+ content = base64.b64encode(response.content).decode('utf-8')
+ return {
+ "status_code": response.status_code,
+ "Content-Type": content_type,
+ "Content-Length": response.headers.get('Content-Length', 0),
+ "content": content,
+ }
+ """,
+ {"url": url},
)
- finally:
- session.close()
-
- final_host = urlparse(response.url).hostname
- if is_private_ip(final_host):
- raise ValueError("Blocked unsafe redirect to internal host")
- # 判断文件大小
- if int(response.headers.get('Content-Length', 0)) > file_limit:
- raise AppApiException(500, _('File size exceeds limit'))
- # 返回状态码 响应内容大小 响应的contenttype 还有字节流
- content_type = response.headers.get('Content-Type', '')
- # 根据内容类型决定如何处理
- if 'text' in content_type or 'json' in content_type:
- content = response.text
- else:
- # 二进制内容使用Base64编码
- content = base64.b64encode(response.content).decode('utf-8')
-
+ except Exception as e:
+ raise AppApiException(500, str(e))
+ if int(response.get("Content-Length")) > file_limit:
+ raise AppApiException(500, _("File size exceeds limit"))
return {
- 'status_code': response.status_code,
- 'Content-Length': response.headers.get('Content-Length', 0),
- 'Content-Type': content_type,
- 'content': content,
+ "status_code": response.get("status_code"),
+ "Content-Type": response.get("Content-Type"),
+ "Content-Length": response.get("Content-Length"),
+ "content": response.get("content"),
}
-
-
-def is_private_ip(host: str) -> bool:
- """检测 IP 是否属于内网、环回、云 metadata 的危险地址"""
- try:
- ip = ipaddress.ip_address(socket.gethostbyname(host))
- return (
- ip.is_private or
- ip.is_loopback or
- ip.is_reserved or
- ip.is_link_local or
- ip.is_multicast
- )
- except Exception:
- return True
-
-
-def validate_and_normalize_url(url: str) -> str:
- """
- 严格验证并规范化 URL,防止 URL 解析绕过攻击
-
- 防御场景:
- - http://127.0.0.1:6666\@1.1.1.1/ (反斜杠绕过)
- - http://127.0.0.1:6666@1.1.1.1/ (认证信息混淆)
- - http://1.1.1.1#@127.0.0.1:6666/ (片段注入)
- """
- if not url:
- raise ValueError("URL is required")
-
- # 1. 拒绝包含危险字符的 URL
- dangerous_patterns = [
- r'\\', # 反斜杠
- r'\s', # 空白字符
- r'%00', # 空字节
- r'%0a', # 换行符
- r'%0d', # 回车符
- ]
-
- url_lower = url.lower()
- for pattern in dangerous_patterns:
- if re.search(pattern, url_lower):
- raise ValueError("URL contains dangerous characters")
-
- # 2. 解析 URL
- parsed = urlparse(url)
-
- # 3. 仅允许 http / https
- if parsed.scheme not in ("http", "https"):
- raise ValueError("Only http and https are allowed")
-
- # 4. 提取主机名(从 netloc 中)
- netloc = parsed.netloc
-
- # 5. 如果 netloc 中包含 @,说明有认证信息,需要特别处理
- if '@' in netloc:
- # 分离认证信息和主机
- auth_part, host_part = netloc.rsplit('@', 1)
-
- # 检查认证部分是否包含危险的 IP 或端口信息
- # 攻击者可能在认证部分放置内网地址
- if ':' in auth_part or '.' in auth_part:
- raise ValueError("Authentication part contains suspicious content")
-
- # 使用真实的主机部分
- actual_host = host_part.split(':')[0] if ':' in host_part else host_part
- else:
- # 没有认证信息,直接提取主机
- actual_host = parsed.hostname
-
- # 6. 验证主机名不为空
- if not actual_host:
- raise ValueError("Invalid URL: missing hostname")
-
- # 7. 验证主机不是 IP 地址形式的内网地址
- # 这样可以防止直接在 URL 中使用内网 IP
- try:
- # 尝试解析为 IP 地址
- ip_addr = ipaddress.ip_address(actual_host)
- if is_private_ip(actual_host):
- raise ValueError("Access to internal IP addresses is blocked")
- except ValueError as e:
- # 如果不是 IP 地址(是域名),则继续检查
- if "internal IP" in str(e):
- raise
- # 对于域名,检查其解析结果
- if is_private_ip(actual_host):
- raise ValueError("Access to internal IP addresses is blocked")
-
- # 8. 重新构建干净的 URL,移除可能的认证信息
- clean_netloc = actual_host
- if parsed.port:
- clean_netloc = f"{actual_host}:{parsed.port}"
-
- clean_url = urlunparse((
- parsed.scheme,
- clean_netloc,
- parsed.path,
- parsed.params,
- parsed.query,
- '' # 移除 fragment,防止片段注入
- ))
-
- return clean_url
-
-
-def validate_url(url: str):
- """验证 URL 是否安全(保留向后兼容)"""
- return validate_and_normalize_url(url)
diff --git a/apps/oss/tests.py b/apps/oss/tests.py
index 7ce503c2dd9..4703c42b873 100644
--- a/apps/oss/tests.py
+++ b/apps/oss/tests.py
@@ -1,3 +1,54 @@
-from django.test import TestCase
+from django.test import SimpleTestCase
+from django.urls import resolve
-# Create your tests here.
+from maxkb.const import CONFIG
+from oss.views import FileRetrievalView, FileView, GetUrlView
+
+
+class OssUrlTestCase(SimpleTestCase):
+ def assert_resolves(self, path, view_class, namespace, kwargs=None):
+ match = resolve(path)
+
+ self.assertIs(match.func.view_class, view_class)
+ self.assertEqual(match.namespace, namespace)
+ self.assertEqual(match.kwargs, kwargs or {})
+
+ def test_file_api_routes_use_unique_namespaces(self):
+ self.assert_resolves(
+ f'{CONFIG.get_admin_path()}/api/oss/file',
+ FileView,
+ 'admin_oss',
+ )
+ self.assert_resolves(
+ f'{CONFIG.get_chat_path()}/api/oss/file',
+ FileView,
+ 'chat_oss',
+ )
+
+ def test_file_retrieval_routes_use_unique_namespaces(self):
+ self.assert_resolves(
+ f'{CONFIG.get_admin_path()}/oss/file/file-id',
+ FileRetrievalView,
+ 'admin_oss_retrieval',
+ {'file_id': 'file-id'},
+ )
+ self.assert_resolves(
+ f'{CONFIG.get_chat_path()}/oss/file/file-id',
+ FileRetrievalView,
+ 'chat_oss_retrieval',
+ {'file_id': 'file-id'},
+ )
+
+ def test_get_url_retrieval_routes_pass_application_id(self):
+ self.assert_resolves(
+ f'{CONFIG.get_admin_path()}/oss/get_url/application-id',
+ GetUrlView,
+ 'admin_oss_retrieval',
+ {'application_id': 'application-id'},
+ )
+ self.assert_resolves(
+ f'{CONFIG.get_chat_path()}/oss/get_url/application-id',
+ GetUrlView,
+ 'chat_oss_retrieval',
+ {'application_id': 'application-id'},
+ )
diff --git a/apps/oss/views/file.py b/apps/oss/views/file.py
index fa08734aa24..7abe6e0a73e 100644
--- a/apps/oss/views/file.py
+++ b/apps/oss/views/file.py
@@ -1,32 +1,39 @@
# coding=utf-8
+
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
from rest_framework.parsers import MultiPartParser
-from rest_framework.views import APIView
-from rest_framework.views import Request
+from rest_framework.views import APIView, Request
+
from common.auth import TokenAuth, AllTokenAuth
-from common.constants.permission_constants import ChatAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.role_constants import RoleConstants
+from common.exception.app_exception import AppUnauthorizedFailed
from common.log.log import log
from common.result import result
-from knowledge.api.file import FileUploadAPI, FileGetAPI, GetUrlContentAPI
+from knowledge.api.file import FileGetAPI, FileUploadAPI, GetUrlContentAPI
+from knowledge.models import FileSourceType
+from maxkb.const import CONFIG
from oss.serializers.file import FileSerializer, get_url_content
class FileRetrievalView(APIView):
@extend_schema(
- methods=['GET'],
- summary=_('Get file'),
- description=_('Get file'),
- operation_id=_('Get file'), # type: ignore
+ methods=["GET"],
+ summary=_("Get file"),
+ description=_("Get file"),
+ operation_id=_("Get file"), # type: ignore
parameters=FileGetAPI.get_parameters(),
responses=FileGetAPI.get_response(),
- tags=[_('File')] # type: ignore
+ tags=[_("File")], # type: ignore
)
def get(self, request: Request, file_id: str):
- return FileSerializer.Operate(data={
- 'id': file_id,
- 'http_range': request.headers.get('Range', ''),
- }).get()
+ return FileSerializer.Operate(
+ data={
+ "id": file_id,
+ "http_range": request.headers.get("Range", ""),
+ }
+ ).get(mk_file_auth=request.COOKIES.get("mk_file_auth"))
class FileView(APIView):
@@ -34,55 +41,74 @@ class FileView(APIView):
parser_classes = [MultiPartParser]
@extend_schema(
- methods=['POST'],
- summary=_('Upload file'),
- description=_('Upload file'),
- operation_id=_('Upload file'), # type: ignore
+ methods=["POST"],
+ summary=_("Upload file"),
+ description=_("Upload file"),
+ operation_id=_("Upload file"), # type: ignore
parameters=FileUploadAPI.get_parameters(),
request=FileUploadAPI.get_request(),
responses=FileUploadAPI.get_response(),
- tags=[_('File')] # type: ignore
+ tags=[_("File")], # type: ignore
)
- @log(menu='file', operate='Upload file')
+ @log(menu="file", operate="Upload file")
def post(self, request: Request):
- return result.success(FileSerializer(data={
- 'file': request.FILES.get('file'),
- 'source_id': request.data.get('source_id'),
- 'source_type': request.data.get('source_type'),
- }).upload())
+ source_id = request.data.get("source_id")
+ source_type = request.data.get("source_type") or FileSourceType.TEMPORARY_120_MINUTE.value
+ # 聊天路径(/chat/...)或匿名会话下只能上传聊天文件,禁止将文件归属到
+ # Application/Knowledge 等其他受保护资源,无论调用者是否登录。
+ is_chat_path = request.path.startswith(CONFIG.get_chat_path())
+ if request.user is None or is_chat_path:
+ if source_type != FileSourceType.CHAT.value:
+ raise AppUnauthorizedFailed(403, _("No permission"))
+ return result.success(
+ FileSerializer(
+ data={
+ "file": request.FILES.get("file"),
+ "source_id": source_id,
+ "source_type": source_type,
+ }
+ ).upload(user_id=str(request.user.id))
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['DELETE'],
- summary=_('Delete file'),
- description=_('Delete file'),
- operation_id=_('Delete file'), # type: ignore
+ methods=["DELETE"],
+ summary=_("Delete file"),
+ description=_("Delete file"),
+ operation_id=_("Delete file"), # type: ignore
parameters=FileGetAPI.get_parameters(),
responses=FileGetAPI.get_response(),
- tags=[_('File')] # type: ignore
+ tags=[_("File")], # type: ignore
)
- @log(menu='file', operate='Delete file')
+ @log(menu="file", operate="Delete file")
+ @has_permissions(RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE, RoleConstants.USER)
def delete(self, request: Request, file_id: str):
- return result.success(FileSerializer.Operate(data={'id': file_id}).delete())
+ return result.success(
+ FileSerializer.Operate(
+ data={
+ "id": file_id,
+ "http_range": request.headers.get("Range", ""),
+ }
+ ).delete(mk_file_auth=request.COOKIES.get("mk_file_auth"))
+ )
class GetUrlView(APIView):
authentication_classes = [AllTokenAuth]
@extend_schema(
- methods=['GET'],
- summary=_('Get url'),
+ methods=["GET"],
+ summary=_("Get url"),
parameters=GetUrlContentAPI.get_parameters(),
- description=_('Get url'),
- operation_id=_('Get url'), # type: ignore
- tags=[_('Chat')] # type: ignore
+ description=_("Get url"),
+ operation_id=_("Get url"), # type: ignore
+ tags=[_("Chat")], # type: ignore
)
def get(self, request: Request, application_id: str):
- if isinstance(request.auth, ChatAuth) and request.auth.application_id and str(
- request.auth.application_id) != application_id:
- return result.error(_('No permission'))
- url = request.query_params.get('url')
+ if "application_id" in request.user.kwargs and str(request.user.kwargs.get("application_id")) != application_id:
+ return result.error(_("No permission"))
+ url = request.query_params.get("url")
result_data = get_url_content(url, application_id)
return result.success(result_data)
diff --git a/apps/models_provider/impl/qwen_model_provider/model/__init__.py b/apps/portal/__init__.py
similarity index 100%
rename from apps/models_provider/impl/qwen_model_provider/model/__init__.py
rename to apps/portal/__init__.py
diff --git a/apps/portal/admin.py b/apps/portal/admin.py
new file mode 100644
index 00000000000..8c38f3f3dad
--- /dev/null
+++ b/apps/portal/admin.py
@@ -0,0 +1,3 @@
+from django.contrib import admin
+
+# Register your models here.
diff --git a/apps/portal/api/__init__.py b/apps/portal/api/__init__.py
new file mode 100644
index 00000000000..2740e7b78b6
--- /dev/null
+++ b/apps/portal/api/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .portal import *
diff --git a/apps/portal/api/portal.py b/apps/portal/api/portal.py
new file mode 100644
index 00000000000..0728331a600
--- /dev/null
+++ b/apps/portal/api/portal.py
@@ -0,0 +1,128 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:MaxKB
+@file: portal.py
+@date:2026/8/3
+@desc: 门户API文档
+"""
+
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+
+from common.mixins.api_mixin import APIMixin
+from common.result import DefaultResultSerializer
+from users.serializers.login import LoginRequest
+
+
+class PortalAPI(APIMixin):
+ class Get(APIMixin):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Save(APIMixin):
+ @staticmethod
+ def get_request():
+ return {
+ "multipart/form-data": {
+ "type": "object",
+ "properties": {
+ "name": {"type": "string", "description": "门户名称"},
+ "description": {"type": "string", "description": "门户描述"},
+ "logo": {"type": "string", "format": "binary", "description": "门户Logo"},
+ "tab_logo": {"type": "string", "format": "binary", "description": "浏览器Tab Logo"},
+ "enable_public_access": {"type": "boolean", "description": "是否开启公开访问"},
+ "enable_api": {"type": "boolean", "description": "是否开启API服务"},
+ "enable_auth": {"type": "boolean", "description": "是否开启身份认证"},
+ "auth_config": {"type": "object", "description": "身份认证配置"},
+ "enable_cors": {"type": "boolean", "description": "是否开启跨域设置"},
+ "cors_config": {"type": "object", "description": "跨域配置"},
+ },
+ }
+ }
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Application(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name="current_page",
+ description="当前页码",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="page_size",
+ description="每页数量",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="name",
+ description="应用名称搜索",
+ type=OpenApiTypes.STR,
+ location="query",
+ required=False,
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Login(APIMixin):
+ @staticmethod
+ def get_request():
+ return LoginRequest
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Info(APIMixin):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Logout(APIMixin):
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
+
+ class Conversation(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name="current_page",
+ description="当前页码",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="page_size",
+ description="每页数量",
+ type=OpenApiTypes.INT,
+ location="path",
+ required=True,
+ ),
+ OpenApiParameter(
+ name="name",
+ description="应用名称搜索",
+ type=OpenApiTypes.STR,
+ location="query",
+ required=False,
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer
diff --git a/apps/portal/apps.py b/apps/portal/apps.py
new file mode 100644
index 00000000000..811caa82b8d
--- /dev/null
+++ b/apps/portal/apps.py
@@ -0,0 +1,5 @@
+from django.apps import AppConfig
+
+
+class PortalConfig(AppConfig):
+ name = 'portal'
diff --git a/apps/portal/migrations/0001_initial.py b/apps/portal/migrations/0001_initial.py
new file mode 100644
index 00000000000..4269916ad39
--- /dev/null
+++ b/apps/portal/migrations/0001_initial.py
@@ -0,0 +1,63 @@
+# Generated by Django 6.0.7 on 2026-08-03 06:20
+
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+def create_default_portal(apps, schema_editor):
+ Portal = apps.get_model("portal", "Portal")
+
+ Portal.objects.create(
+ id="019fca92-0371-7a03-a7bb-445ebeb1314c",
+ name="智能体门户",
+ description="默认门户",
+ enable_public_access=True,
+ enable_api=True,
+ enable_auth=False,
+ auth_config={},
+ enable_cors=False,
+ cors_config={},
+ )
+
+
+class Migration(migrations.Migration):
+ initial = True
+
+ dependencies = []
+
+ operations = [
+ migrations.CreateModel(
+ name="Portal",
+ fields=[
+ (
+ "id",
+ models.UUIDField(
+ default=uuid_utils.compat.uuid7,
+ editable=False,
+ primary_key=True,
+ serialize=False,
+ verbose_name="主键id",
+ ),
+ ),
+ ("create_time", models.DateTimeField(auto_now_add=True, db_index=True, verbose_name="创建时间")),
+ ("update_time", models.DateTimeField(auto_now=True, db_index=True, verbose_name="修改时间")),
+ ("name", models.CharField(default="智能体门户", max_length=64, verbose_name="门户名称")),
+ ("description", models.TextField(blank=True, max_length=256, null=True, verbose_name="门户描述")),
+ ("logo", models.CharField(blank=True, max_length=512, null=True, verbose_name="门户Logo地址")),
+ ("enable_public_access", models.BooleanField(default=True, verbose_name="是否开启公开访问")),
+ ("enable_api", models.BooleanField(default=True, verbose_name="是否开启API服务")),
+ ("enable_knowledge_base_api", models.BooleanField(default=True, verbose_name="是否开启知识库API")),
+ ("enable_auth", models.BooleanField(default=False, verbose_name="是否开启身份认证")),
+ ("auth_config", models.JSONField(blank=True, default=dict, verbose_name="身份认证配置")),
+ ("enable_cors", models.BooleanField(default=False, verbose_name="是否开启跨域设置")),
+ ("cors_config", models.JSONField(blank=True, default=dict, verbose_name="跨域配置")),
+ ],
+ options={
+ "db_table": "portal",
+ },
+ ),
+ migrations.RunPython(
+ create_default_portal,
+ migrations.RunPython.noop,
+ ),
+ ]
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/credential/__init__.py b/apps/portal/migrations/__init__.py
similarity index 100%
rename from apps/models_provider/impl/tencent_cloud_model_provider/credential/__init__.py
rename to apps/portal/migrations/__init__.py
diff --git a/apps/portal/models/__init__.py b/apps/portal/models/__init__.py
new file mode 100644
index 00000000000..599f93561da
--- /dev/null
+++ b/apps/portal/models/__init__.py
@@ -0,0 +1 @@
+from .portal import *
diff --git a/apps/portal/models/portal.py b/apps/portal/models/portal.py
new file mode 100644
index 00000000000..e7d42ecd538
--- /dev/null
+++ b/apps/portal/models/portal.py
@@ -0,0 +1,38 @@
+# coding=utf-8
+
+import uuid_utils.compat as uuid
+from common.mixins.app_model_mixin import AppModelMixin
+from django.db import models
+
+
+class Portal(AppModelMixin):
+ """
+ 门户配置
+ """
+
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+
+ # 基础信息
+ name = models.CharField(max_length=64, verbose_name="门户名称", default="智能体门户")
+
+ description = models.TextField(null=True, blank=True, max_length=256, verbose_name="门户描述")
+
+ logo = models.CharField(max_length=512, null=True, blank=True, verbose_name="门户Logo地址")
+
+ enable_public_access = models.BooleanField(default=True, verbose_name="是否开启公开访问")
+ # API服务配置
+ enable_api = models.BooleanField(default=True, verbose_name="是否开启API服务")
+
+ enable_knowledge_base_api = models.BooleanField(default=True, verbose_name="是否开启知识库API")
+
+ # 身份认证配置
+ enable_auth = models.BooleanField(default=False, verbose_name="是否开启身份认证")
+
+ auth_config = models.JSONField(default=dict, blank=True, verbose_name="身份认证配置")
+
+ enable_cors = models.BooleanField(default=False, verbose_name="是否开启跨域设置")
+
+ cors_config = models.JSONField(default=dict, blank=True, verbose_name="跨域配置")
+
+ class Meta:
+ db_table = "portal"
diff --git a/apps/portal/serializers/__init__.py b/apps/portal/serializers/__init__.py
new file mode 100644
index 00000000000..9bad5790a57
--- /dev/null
+++ b/apps/portal/serializers/__init__.py
@@ -0,0 +1 @@
+# coding=utf-8
diff --git a/apps/portal/serializers/portal.py b/apps/portal/serializers/portal.py
new file mode 100644
index 00000000000..d5797024b35
--- /dev/null
+++ b/apps/portal/serializers/portal.py
@@ -0,0 +1,301 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:MaxKB
+@file: portal.py
+@date:2026/8/3
+@desc: 门户配置序列化器
+"""
+
+import json
+import uuid_utils.compat as uuid
+from django.core.cache import cache
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from common.auth.common import ChatToken
+from common.auth.constants.operate_constants import Operate
+from common.constants.authentication_type import AuthenticationType
+from common.constants.cache_version import Cache_Version
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.exception.app_exception import AppApiException
+from common.log.log import record_log
+from common.utils.common import password_verify, needs_password_upgrade, password_encrypt
+from common.utils.rsa_util import decrypt, get_key_pair_by_sql
+from knowledge.models import File, FileSourceType
+from maxkb.const import CONFIG
+from portal.models import Portal
+from system_manage.models.chat_user import (
+ ChatUser,
+)
+from users.serializers.login import LoginRequest
+
+system_version, system_get_key = Cache_Version.SYSTEM.value
+
+
+class PortalSerializer(serializers.Serializer):
+ name = serializers.CharField(required=False, label=_("portal name"), help_text=_("portal name"))
+ description = serializers.CharField(
+ required=False,
+ allow_null=True,
+ allow_blank=True,
+ label=_("portal description"),
+ help_text=_("portal description"),
+ )
+ logo = serializers.CharField(
+ required=False, allow_null=True, allow_blank=True, label=_("portal logo"), help_text=_("portal logo")
+ )
+ enable_public_access = serializers.BooleanField(
+ required=False, label=_("enable public access"), help_text=_("enable public access")
+ )
+ enable_api = serializers.BooleanField(required=False, label=_("enable api"), help_text=_("enable api"))
+ enable_knowledge_base_api = serializers.BooleanField(
+ required=False, label=_("enable knowledge base api"), help_text=_("enable knowledge base api")
+ )
+ enable_auth = serializers.BooleanField(required=False, label=_("enable auth"), help_text=_("enable auth"))
+ auth_config = serializers.JSONField(required=False, label=_("auth config"), help_text=_("auth config"))
+ enable_cors = serializers.BooleanField(required=False, label=_("enable cors"), help_text=_("enable cors"))
+ cors_config = serializers.JSONField(required=False, label=_("cors config"), help_text=_("cors config"))
+
+ class Model(serializers.ModelSerializer):
+ class Meta:
+ model = Portal
+ fields = "__all__"
+
+ def one(self):
+ portal = Portal.objects.first()
+ if portal is None:
+ raise AppApiException(500, _("Portal configuration does not exist"))
+ return PortalSerializer.Model(portal).data
+
+ def _upload_file(self, file_obj):
+ file_id = uuid.uuid7()
+ file = File(
+ id=file_id,
+ file_name=file_obj.name,
+ source_type=FileSourceType.SYSTEM,
+ meta={"debug": False},
+ )
+ file.save(file_obj.read())
+ return f"./oss/file/{file_id}"
+
+ def _handle_file_field(self, portal, field_name, value):
+ if hasattr(value, "read"):
+ old_url = getattr(portal, field_name)
+ if old_url:
+ old_file_id = old_url.split("/")[-1]
+ File.objects.filter(id=old_file_id).delete()
+ new_url = self._upload_file(value)
+ setattr(portal, field_name, new_url)
+ else:
+ setattr(portal, field_name, value)
+
+ def edit(self, instance, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ portal = Portal.objects.first()
+ if portal is None:
+ raise AppApiException(500, _("Portal configuration does not exist"))
+ file_fields = ["logo", "id", "create_time", "update_time"]
+ for field, value in instance.items():
+ if hasattr(portal, field) and field not in file_fields:
+ setattr(portal, field, value)
+ for field_name in ["logo"]:
+ if field_name in instance:
+ self._handle_file_field(portal, field_name, instance.get(field_name))
+ portal.save()
+ return PortalSerializer.Model(portal).data
+
+
+class PortalLoginSerializer(serializers.Serializer):
+ @staticmethod
+ def login(instance):
+ username = instance.get("username", "")
+ encrypted_data = instance.get("encryptedData", "")
+
+ if encrypted_data:
+ try:
+ decrypted_raw = decrypt(encrypted_data)
+ decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
+ if isinstance(decrypted_data, dict):
+ instance.update(decrypted_data)
+ except Exception:
+ raise AppApiException(500, _("Invalid encrypted data"))
+
+ try:
+ request_serializer = LoginRequest(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ except serializers.ValidationError:
+ raise
+ except Exception as e:
+ raise AppApiException(500, str(e))
+
+ validated_data = request_serializer.validated_data
+ username = validated_data.get("username", "")
+ password = validated_data.get("password", "")
+ captcha = validated_data.get("captcha", "")
+
+ portal = Portal.objects.first()
+ if portal is None or not portal.enable_auth:
+ raise AppApiException(500, _("Portal authentication is not enabled"))
+ auth_config = portal.auth_config or {}
+ login_value = auth_config.get("login_value", [])
+ if "LOCAL" not in login_value:
+ raise AppApiException(500, _("Portal local login is not enabled"))
+
+ max_attempts = auth_config.get("max_attempts", 1)
+
+ license_validator = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
+ is_license_valid = license_validator() if license_validator() is not None else False
+
+ if is_license_valid:
+ failed_attempts = auth_config.get("failed_attempts", 5)
+ lock_time = auth_config.get("lock_time", 10)
+ else:
+ failed_attempts = 5
+ lock_time = 10
+
+ cache_key = system_get_key(f"portal_{username}")
+
+ if PortalLoginSerializer._is_account_locked(username, failed_attempts):
+ raise AppApiException(
+ 1005, _("This account has been locked for %s minutes, please try again later") % lock_time
+ )
+ if PortalLoginSerializer._need_captcha(username, max_attempts):
+ PortalLoginSerializer._validate_captcha(username, captcha, failed_attempts, lock_time)
+
+ user = ChatUser.objects.filter(username=username).first()
+
+ if not user or not password_verify(password, user.password):
+ PortalLoginSerializer._handle_failed_login(username, failed_attempts, lock_time)
+ raise AppApiException(500, _("The username or password is incorrect"))
+
+ if needs_password_upgrade(user.password):
+ user.password = password_encrypt(password)
+ user.save(update_fields=["password"])
+
+ if not user.is_active:
+ raise AppApiException(1005, _("The user has been disabled, please contact the administrator!"))
+
+ cache.delete(cache_key, version=system_version)
+ cache.delete(system_get_key(f"portal_{username}_lock"), version=system_version)
+
+ token = ChatToken(str(user.id), AuthenticationType.CHAT_USER, str(Operate.LOCAL)).to_token()
+ version, get_key = Cache_Version.CHAT_USER_TOKEN.value
+ timeout = CONFIG.get_session_timeout()
+ cache.set(get_key(token), user, timeout=timeout, version=version)
+ record_log(
+ menu="Portal",
+ operate="Log in",
+ request=None,
+ user={"username": user.username},
+ status=200,
+ operation_object={"name": user.username},
+ workspace_id="default",
+ )
+ return {"token": token}
+
+ @staticmethod
+ def get_login_profile():
+ portal = Portal.objects.first()
+ if portal is None:
+ raise AppApiException(500, _("Portal configuration does not exist"))
+ auth_config = portal.auth_config or {}
+ return {
+ "name": portal.name,
+ "description": portal.description or "",
+ "logo": portal.logo or "",
+ "enable_auth": portal.enable_auth,
+ "authentication_type": auth_config.get("type", "password") if portal.enable_auth else "",
+ "login_value": auth_config.get("login_value", []) if portal.enable_auth else [],
+ "max_attempts": auth_config.get("max_attempts", 1) if portal.enable_auth else 1,
+ "rsa_key": get_key_pair_by_sql().get("key", ""),
+ }
+
+ @staticmethod
+ def _is_account_locked(username: str, failed_attempts: int) -> bool:
+ if failed_attempts == -1:
+ return False
+ lock_cache = cache.get(system_get_key(f"portal_{username}_lock"), version=system_version)
+ return bool(lock_cache)
+
+ @staticmethod
+ def _need_captcha(username: str, max_attempts: int) -> bool:
+ cache_key = system_get_key(f"portal_{username}")
+ if max_attempts == -1:
+ return False
+ if max_attempts > 0:
+ fail_count = cache.get(cache_key, version=system_version) or 0
+ return fail_count >= max_attempts
+ return True
+
+ @staticmethod
+ def _validate_captcha(username: str, captcha: str, failed_attempts: int = 5, lock_time: int = 10) -> None:
+ if not captcha:
+ raise AppApiException(1005, _("Captcha is required"))
+ captcha_key = Cache_Version.CAPTCHA.get_key(captcha=f"portal_{username}")
+ captcha_cache = cache.get(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+ if captcha_cache is None or captcha.lower() != captcha_cache:
+ # 校验失败与口令失败共用同一失败计数与锁定机制,防止"识别-试错"循环绕过验证码
+ PortalLoginSerializer._record_login_failure(username, failed_attempts, lock_time)
+ raise AppApiException(1005, _("Captcha code error or expiration"))
+ # 校验通过即销毁,保证验证码一次性使用
+ cache.delete(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+
+ @staticmethod
+ def _record_login_failure(username: str, failed_attempts: int, lock_time: int) -> int:
+ """记录一次认证失败(口令或验证码),累计计数并在达到阈值时创建锁键;不抛异常。"""
+ try:
+ _record_login_fail(username)
+ except Exception:
+ pass
+ lock_fail_count = 0
+ try:
+ lock_fail_count = _record_login_fail_lock(username, lock_time)
+ except Exception:
+ pass
+ if failed_attempts > 0 and lock_fail_count >= failed_attempts:
+ try:
+ cache.add(system_get_key(f"portal_{username}_lock"), 1, timeout=lock_time * 60, version=system_version)
+ except Exception:
+ pass
+ return lock_fail_count
+
+ @staticmethod
+ def _handle_failed_login(username: str, failed_attempts: int, lock_time: int) -> None:
+ lock_fail_count = PortalLoginSerializer._record_login_failure(username, failed_attempts, lock_time)
+ # 仅由失败次数配置控制(CE/PE 同样生效);计数在此之前已记录
+ if failed_attempts <= 0:
+ return
+ if lock_fail_count < failed_attempts:
+ remain_attempts = failed_attempts - lock_fail_count
+ raise AppApiException(
+ 1005,
+ _("Login failed %s times, account will be locked, you have %s more chances !")
+ % (failed_attempts, remain_attempts),
+ )
+ raise AppApiException(
+ 1005, _("This account has been locked for %s minutes, please try again later") % lock_time
+ )
+
+
+def _record_login_fail(username: str, expire: int = 600):
+ if not username:
+ return
+ fail_key = system_get_key(f"portal_{username}")
+ try:
+ cache.incr(fail_key, 1, version=system_version)
+ except ValueError:
+ cache.set(fail_key, 1, timeout=expire, version=system_version)
+
+
+def _record_login_fail_lock(username: str, expire: int = 10):
+ if not username:
+ return 0
+ lock_key = system_get_key(f"portal_{username}_lock_count")
+ try:
+ fail_count = cache.incr(lock_key, 1, version=system_version)
+ except ValueError:
+ cache.set(lock_key, 1, timeout=expire * 60, version=system_version)
+ fail_count = 1
+ return fail_count
diff --git a/apps/portal/tests.py b/apps/portal/tests.py
new file mode 100644
index 00000000000..7ce503c2dd9
--- /dev/null
+++ b/apps/portal/tests.py
@@ -0,0 +1,3 @@
+from django.test import TestCase
+
+# Create your tests here.
diff --git a/apps/portal/urls.py b/apps/portal/urls.py
new file mode 100644
index 00000000000..36fdce98d2c
--- /dev/null
+++ b/apps/portal/urls.py
@@ -0,0 +1,12 @@
+from django.urls import path
+
+from . import views
+
+app_name = "portal"
+
+urlpatterns = [
+ path("portal", views.PortalView.as_view()),
+ path("portal/info", views.PortalInfoView.as_view()),
+ path("portal/login", views.PortalLoginView.as_view()),
+ path("portal/logout", views.PortalLogoutView.as_view()),
+]
diff --git a/apps/portal/views/__init__.py b/apps/portal/views/__init__.py
new file mode 100644
index 00000000000..2740e7b78b6
--- /dev/null
+++ b/apps/portal/views/__init__.py
@@ -0,0 +1,2 @@
+# coding=utf-8
+from .portal import *
diff --git a/apps/portal/views/portal.py b/apps/portal/views/portal.py
new file mode 100644
index 00000000000..a1fe30365a7
--- /dev/null
+++ b/apps/portal/views/portal.py
@@ -0,0 +1,114 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:MaxKB
+@file: portal.py
+@date:2026/8/3
+@desc: 门户配置视图
+"""
+
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.parsers import MultiPartParser, JSONParser
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from common import result
+from common.auth import TokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.constants.cache_version import Cache_Version
+from common.log.log import log
+from django.core.cache import cache
+from portal.api.portal import PortalAPI
+from portal.serializers.portal import (
+ PortalSerializer,
+ PortalLoginSerializer,
+)
+
+
+class PortalView(APIView):
+ authentication_classes = [TokenAuth]
+ parser_classes = [JSONParser, MultiPartParser]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get portal configuration"),
+ summary=_("Get portal configuration"),
+ operation_id=_("Get portal configuration"), # type: ignore
+ responses=PortalAPI.Get.get_response(),
+ tags=[_("Portal")], # type: ignore
+ )
+ @has_permissions(PermissionConstants.PORTAL_EDIT, RoleConstants.ADMIN)
+ def get(self, request: Request):
+ return result.success(PortalSerializer().one())
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Save portal configuration"),
+ summary=_("Save portal configuration"),
+ operation_id=_("Save portal configuration"), # type: ignore
+ request=PortalAPI.Save.get_request(),
+ responses=PortalAPI.Save.get_response(),
+ tags=[_("Portal")], # type: ignore
+ )
+ @log(menu="Portal", operate="Save portal configuration")
+ @has_permissions(PermissionConstants.PORTAL_EDIT, RoleConstants.ADMIN)
+ def put(self, request: Request):
+ return result.success(PortalSerializer(data=request.data).edit(request.data))
+
+
+class PortalLoginView(APIView):
+ @extend_schema(
+ methods=["POST"],
+ description=_("Portal login"),
+ summary=_("Portal login"),
+ operation_id=_("Portal login"), # type: ignore
+ tags=[_("Portal")], # type: ignore
+ request=PortalAPI.Login.get_request(),
+ responses=PortalAPI.Login.get_response(),
+ )
+ def post(self, request: Request):
+ token_data = PortalLoginSerializer.login(request.data)
+ response = result.success(token_data)
+ secure = request.is_secure()
+ response.set_cookie(
+ "mk_file_auth",
+ value=token_data.get("token"),
+ max_age=7 * 24 * 3600,
+ path="/portal/",
+ domain=None,
+ secure=secure,
+ httponly=True,
+ samesite="Lax",
+ )
+ return response
+
+
+class PortalInfoView(APIView):
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get portal login info"),
+ summary=_("Get portal login info"),
+ operation_id=_("Get portal login info"), # type: ignore
+ tags=[_("Portal")], # type: ignore
+ )
+ def get(self, request: Request):
+ return result.success(PortalLoginSerializer.get_login_profile())
+
+
+class PortalLogoutView(APIView):
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Portal logout"),
+ description=_("Portal logout"),
+ operation_id=_("Portal logout"), # type: ignore
+ tags=[_("Portal")], # type: ignore
+ responses=PortalAPI.Logout.get_response(),
+ )
+ @log(menu="Portal", operate="Log out")
+ def post(self, request: Request):
+ version, get_key = Cache_Version.TOKEN.value
+ cache.delete(get_key(token=request.META.get("HTTP_AUTHORIZATION")[7:]), version=version)
+ return result.success(True)
diff --git a/apps/system_manage/api/chat_user.py b/apps/system_manage/api/chat_user.py
new file mode 100644
index 00000000000..3ff2e893ea9
--- /dev/null
+++ b/apps/system_manage/api/chat_user.py
@@ -0,0 +1,179 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: user.py
+ @date:2025/4/14 19:23
+ @desc:
+"""
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+
+from common.mixins.api_mixin import APIMixin
+from common.result import ResultSerializer
+from users.serializers.user import CreateUserSerializer
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from system_manage.serializers.chat_user import ChatUserInstanceSerializer, ChatUserSerializer
+
+
+class ChatUserResponse(ResultSerializer):
+ def get_data(self):
+ return ChatUserInstanceSerializer()
+
+
+class CreateChatUserRequestSerializer(CreateUserSerializer):
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User Group IDs')
+ )
+
+
+class ChatUserAPI(APIMixin):
+
+ @staticmethod
+ def get_response():
+ return ChatUserResponse
+
+ @staticmethod
+ def get_request():
+ return CreateChatUserRequestSerializer
+
+ @staticmethod
+ def get_parameters():
+ return [OpenApiParameter(
+ name="user_id",
+ description=_('User ID'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH,
+ required=True,
+ )]
+
+
+class BatchAddGroupApi(APIMixin):
+
+ @staticmethod
+ def get_request():
+ return ChatUserSerializer.BatchAddGroup
+
+
+class UserPasswordResponse(APIMixin):
+
+ @staticmethod
+ def get_response():
+ return PasswordResponse
+
+
+class Password(serializers.Serializer):
+ password = serializers.CharField(required=True, label=_('Password'))
+
+
+class PasswordResponse(ResultSerializer):
+ def get_data(self):
+ return Password()
+
+
+class EditChatUserRequestSerializer(ChatUserSerializer.UserEditInstance):
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User Group IDs')
+ )
+
+
+class EditUserApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [OpenApiParameter(
+ name="user_id",
+ description=_('User ID'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH,
+ required=True,
+ )]
+
+ @staticmethod
+ def get_request():
+ return EditChatUserRequestSerializer
+
+
+class ChatUserListResponse(serializers.Serializer):
+ id = serializers.CharField(required=True, label=_('ID'))
+ username = serializers.CharField(required=True, label=_('Username'))
+ nick_name = serializers.CharField(required=True, label=_('Nickname'))
+ email = serializers.EmailField(required=False, allow_blank=True, label=_('Email'))
+ phone = serializers.CharField(required=False, allow_blank=True, label=_('Phone'))
+ is_active = serializers.BooleanField(required=False, default=True, label=_('Is Active'))
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User Group IDs')
+ )
+ user_group_names = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User Group Names')
+ )
+
+
+class ChatUsersListResponse(ResultSerializer):
+ def get_data(self):
+ return ChatUserListResponse(many=True)
+
+
+class ChatUserPageApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [OpenApiParameter(
+ name="username",
+ description=_('Username'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ ),
+ OpenApiParameter(
+ name="nick_name",
+ description=_('Nickname'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ ),
+ OpenApiParameter(
+ name="source",
+ description=_('Source'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ ),
+ OpenApiParameter(
+ name="is_active",
+ description=_('Is Active'),
+ type=OpenApiTypes.BOOL,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ ),
+ OpenApiParameter(
+ name='current_page',
+ type=OpenApiTypes.INT,
+ description=_('Current page'),
+ required=True,
+ location=OpenApiParameter.PATH,
+ ),
+ OpenApiParameter(
+ name='page_size',
+ type=OpenApiTypes.INT,
+ description=_('Page size'),
+ required=True,
+ location=OpenApiParameter.PATH,
+ ),
+
+ ]
+
+ @staticmethod
+ def get_response():
+ return ChatUsersListResponse
+
+
+
diff --git a/apps/system_manage/api/user_group.py b/apps/system_manage/api/user_group.py
new file mode 100644
index 00000000000..9203f7fb8e0
--- /dev/null
+++ b/apps/system_manage/api/user_group.py
@@ -0,0 +1,128 @@
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+from rest_framework import serializers
+
+from common.mixins.api_mixin import APIMixin
+from common.result import ResultSerializer, DefaultResultSerializer
+from system_manage.serializers.chat_user import UserGroupCreateSerializer, UserGroupModelSerializer
+from django.utils.translation import gettext_lazy as _
+
+
+class UserGroupResponse(ResultSerializer):
+ def get_data(self):
+ return UserGroupModelSerializer()
+
+
+class CreateUserGroupApi(APIMixin):
+ @staticmethod
+ def get_request():
+ return UserGroupCreateSerializer
+
+ @staticmethod
+ def get_response():
+ return UserGroupResponse
+
+
+class DeleteUserGroupApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [OpenApiParameter(
+ name="user_group_id",
+ description=_("User Group ID"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH,
+ required=True,
+ )]
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer()
+
+
+class UserGroupListResponse(ResultSerializer):
+ def get_data(self):
+ return UserGroupModelSerializer(many=True)
+
+
+class UserGroupListApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name='user_group_id',
+ type=OpenApiTypes.STR,
+ description=_('Group ID'),
+ required=True,
+ location=OpenApiParameter.PATH,
+ ),
+ OpenApiParameter(
+ name='current_page',
+ type=OpenApiTypes.INT,
+ description=_('Current page'),
+ required=True,
+ location=OpenApiParameter.PATH,
+ ),
+ OpenApiParameter(
+ name='page_size',
+ type=OpenApiTypes.INT,
+ description=_('Page size'),
+ required=True,
+ location=OpenApiParameter.PATH,
+ ),
+ OpenApiParameter(
+ name='username',
+ type=OpenApiTypes.STR,
+ description=_('Username'),
+ required=False,
+ location=OpenApiParameter.QUERY,
+ ),
+ OpenApiParameter(
+ name='nick_name',
+ type=OpenApiTypes.STR,
+ description=_('Nickname'),
+ required=False,
+ location=OpenApiParameter.QUERY,
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return UserGroupListResponse
+
+
+class AddMemberRequest(serializers.Serializer):
+ user_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User IDs')
+ )
+
+
+class AddMemberApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [OpenApiParameter(
+ name="user_group_id",
+ description=_("User Group ID"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH,
+ required=True,
+ )]
+
+ @staticmethod
+ def get_request():
+ return AddMemberRequest
+
+
+class RemoveMemberRequest(serializers.Serializer):
+ group_relation_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User group relation IDs')
+ )
+
+
+class RemoveMemberApi(APIMixin):
+ @staticmethod
+ def get_request():
+ return RemoveMemberRequest
diff --git a/apps/system_manage/migrations/0003_alter_workspaceuserresourcepermission_target.py b/apps/system_manage/migrations/0003_alter_workspaceuserresourcepermission_target.py
index 42b2630428e..d1acf040386 100644
--- a/apps/system_manage/migrations/0003_alter_workspaceuserresourcepermission_target.py
+++ b/apps/system_manage/migrations/0003_alter_workspaceuserresourcepermission_target.py
@@ -5,7 +5,6 @@
from django.db import migrations, models
from django.db.models import QuerySet
-from common.constants.permission_constants import WorkspaceUserRoleMapping
from common.utils.common import group_by
@@ -16,22 +15,34 @@ def workspace_user_role_mapping_model_exists(workspace_user_role_mapping_model):
return False
return False
-def delete_auth(apps,folder_model):
+
+def delete_auth(apps, folder_model):
workspace_user_resource_permission_model = apps.get_model('system_manage', 'WorkspaceUserResourcePermission')
- QuerySet(workspace_user_resource_permission_model).filter(target__in=QuerySet(folder_model).values_list('id')).delete()
+ QuerySet(workspace_user_resource_permission_model).filter(
+ target__in=QuerySet(folder_model).values_list('id')).delete()
-def get_workspace_user_resource_permission_list(apps, auth_target_type, workspace_user_role_mapping_model_workspace_dict,
+def get_workspace_user_resource_permission_list(apps, auth_target_type,
+ workspace_user_role_mapping_model_workspace_dict,
folder_model):
workspace_user_resource_permission_model = apps.get_model('system_manage', 'WorkspaceUserResourcePermission')
return reduce(lambda x, y: [*x, *y], [
[workspace_user_resource_permission_model(target=f.id, workspace_id=f.workspace_id, user_id=wurm.user_id,
- auth_target_type=auth_target_type, auth_type="RESOURCE_PERMISSION_GROUP",
- permission_list=['VIEW','MANAGE'] if wurm.user_id == f.user_id else ['VIEW']) for wurm in
+ auth_target_type=auth_target_type,
+ auth_type="RESOURCE_PERMISSION_GROUP",
+ permission_list=['VIEW', 'MANAGE'] if wurm.user_id == f.user_id else [
+ 'VIEW']) for wurm in
workspace_user_role_mapping_model_workspace_dict.get(f.workspace_id, [])] for f in
QuerySet(folder_model).all()], [])
+class WorkspaceUserRoleMapping:
+ def __init__(self, workspace_id, role_id, user_id):
+ self.workspace_id = workspace_id
+ self.role_id = role_id
+ self.user_id = user_id
+
+
def auth_folder(apps, schema_editor):
from common.database_model_manage.database_model_manage import DatabaseModelManage
DatabaseModelManage.init()
@@ -59,20 +70,20 @@ def auth_folder(apps, schema_editor):
QuerySet(workspace_user_role_mapping_model)}.values()],
lambda item: item.workspace_id)
- workspace_user_resource_permission_list = get_workspace_user_resource_permission_list(apps,"APPLICATION",
+ workspace_user_resource_permission_list = get_workspace_user_resource_permission_list(apps, "APPLICATION",
workspace_user_role_mapping_model_workspace_dict,
application_folder_model)
- workspace_user_resource_permission_list += get_workspace_user_resource_permission_list(apps,"TOOL",
+ workspace_user_resource_permission_list += get_workspace_user_resource_permission_list(apps, "TOOL",
workspace_user_role_mapping_model_workspace_dict,
tool_folder_model)
- workspace_user_resource_permission_list += get_workspace_user_resource_permission_list(apps,"KNOWLEDGE",
+ workspace_user_resource_permission_list += get_workspace_user_resource_permission_list(apps, "KNOWLEDGE",
workspace_user_role_mapping_model_workspace_dict,
knowledge_folder_model)
- delete_auth(apps,application_folder_model)
- delete_auth(apps,knowledge_folder_model)
- delete_auth(apps,tool_folder_model)
+ delete_auth(apps, application_folder_model)
+ delete_auth(apps, knowledge_folder_model)
+ delete_auth(apps, tool_folder_model)
QuerySet(workspace_user_resource_permission_model).bulk_create(workspace_user_resource_permission_list)
diff --git a/apps/system_manage/migrations/0005_resourcemapping.py b/apps/system_manage/migrations/0005_resourcemapping.py
index bafecc4a8d5..36d6737731c 100644
--- a/apps/system_manage/migrations/0005_resourcemapping.py
+++ b/apps/system_manage/migrations/0005_resourcemapping.py
@@ -10,56 +10,74 @@
def get_initialization_resource_mapping():
from django.db.models import QuerySet
- from application.flow.tools import get_workflow_resource, get_node_handle_callback, \
- get_instance_resource
+ from system_manage.services.resource_mapping import (
+ get_workflow_resource,
+ get_node_handle_callback,
+ get_instance_resource,
+ )
from system_manage.models.resource_mapping import ResourceType
from application.models import Application
from knowledge.models import KnowledgeWorkflow
- from application.flow.tools import application_instance_field_call_dict, knowledge_instance_field_call_dict
+ from system_manage.services.resource_mapping import (
+ application_instance_field_call_dict,
+ knowledge_instance_field_call_dict,
+ )
from application.models.application import ApplicationKnowledgeMapping
from system_manage.models.resource_mapping import ResourceMapping
+
resource_mapping_list = []
- ids = list(Application.objects.values_list('id', flat=True))
+ ids = list(Application.objects.values_list("id", flat=True))
for app_id in ids:
try:
application = Application.objects.get(id=app_id)
- workflow_mapping = get_workflow_resource(application.work_flow,
- get_node_handle_callback(ResourceType.APPLICATION,
- application.id))
- instance_mapping = get_instance_resource(application, ResourceType.APPLICATION, str(application.id),
- application_instance_field_call_dict)
+ workflow_mapping = get_workflow_resource(
+ application.work_flow, get_node_handle_callback(ResourceType.APPLICATION, application.id)
+ )
+ instance_mapping = get_instance_resource(
+ application, ResourceType.APPLICATION, str(application.id), application_instance_field_call_dict
+ )
resource_mapping_list += workflow_mapping
resource_mapping_list += instance_mapping
except:
pass
- knowledge_ids = list(Knowledge.objects.values_list('id', flat=True))
+ knowledge_ids = list(Knowledge.objects.values_list("id", flat=True))
for knowledge_id in knowledge_ids:
try:
knowledge = Knowledge.objects.get(id=knowledge_id)
if knowledge.type == 4:
knowledge_workflow = QuerySet(KnowledgeWorkflow).filter(knowledge_id=knowledge_id).first()
if knowledge_workflow:
- workflow_mapping = get_workflow_resource(knowledge_workflow.work_flow,
- get_node_handle_callback(ResourceType.KNOWLEDGE,
- str(knowledge_workflow.knowledge_id)))
+ workflow_mapping = get_workflow_resource(
+ knowledge_workflow.work_flow,
+ get_node_handle_callback(ResourceType.KNOWLEDGE, str(knowledge_workflow.knowledge_id)),
+ )
resource_mapping_list += workflow_mapping
- instance_mapping = get_instance_resource(knowledge, ResourceType.KNOWLEDGE, str(knowledge.id),
- knowledge_instance_field_call_dict)
+ instance_mapping = get_instance_resource(
+ knowledge, ResourceType.KNOWLEDGE, str(knowledge.id), knowledge_instance_field_call_dict
+ )
resource_mapping_list += instance_mapping
except:
pass
application_knowledge_mapping = [
- ResourceMapping(source_type=ResourceType.APPLICATION, target_type=ResourceType.KNOWLEDGE,
- source_id=str(akm.application_id), target_id=str(akm.knowledge_id)) for akm in
- QuerySet(ApplicationKnowledgeMapping).all()]
+ ResourceMapping(
+ source_type=ResourceType.APPLICATION,
+ target_type=ResourceType.KNOWLEDGE,
+ source_id=str(akm.application_id),
+ target_id=str(akm.knowledge_id),
+ )
+ for akm in QuerySet(ApplicationKnowledgeMapping).all()
+ ]
resource_mapping_list += application_knowledge_mapping
- return {(str(item.target_type) + str(item.target_id) + str(item.source_type) + str(item.source_id)): item for item
- in resource_mapping_list}.values()
+ return {
+ (str(item.target_type) + str(item.target_id) + str(item.source_type) + str(item.source_id)): item
+ for item in resource_mapping_list
+ }.values()
def resource_mapping(apps, schema_editor):
from system_manage.models.resource_mapping import ResourceMapping
+
with ThreadPoolExecutor(max_workers=3) as executor:
future = executor.submit(get_initialization_resource_mapping)
resource_mapping_list = future.result()
@@ -68,32 +86,49 @@ def resource_mapping(apps, schema_editor):
class Migration(migrations.Migration):
dependencies = [
- ('system_manage', '0004_alter_systemsetting_type_and_more'),
- ('knowledge', '0007_remove_knowledgeworkflowversion_workflow_and_more'),
- ('application', '0003_application_stt_model_params_setting_and_more'),
+ ("system_manage", "0004_alter_systemsetting_type_and_more"),
+ ("knowledge", "0007_remove_knowledgeworkflowversion_workflow_and_more"),
+ ("application", "0003_application_stt_model_params_setting_and_more"),
]
operations = [
migrations.CreateModel(
- name='ResourceMapping',
+ name="ResourceMapping",
fields=[
- ('create_time', models.DateTimeField(auto_now_add=True, db_index=True, verbose_name='创建时间')),
- ('update_time', models.DateTimeField(auto_now=True, db_index=True, verbose_name='修改时间')),
- ('id',
- models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False,
- verbose_name='主键id')),
- ('source_type', models.CharField(
- choices=[('KNOWLEDGE', '知识库'), ('APPLICATION', '应用'), ('TOOL', '工具'), ('MODEL', '模型')],
- db_index=True, verbose_name='关联资源类型')),
- ('target_type', models.CharField(
- choices=[('KNOWLEDGE', '知识库'), ('APPLICATION', '应用'), ('TOOL', '工具'), ('MODEL', '模型')],
- db_index=True, verbose_name='被关联资源类型')),
- ('source_id', models.CharField(db_index=True, max_length=128, verbose_name='关联资源id')),
- ('target_id', models.CharField(db_index=True, max_length=128, verbose_name='被关联资源id')),
+ ("create_time", models.DateTimeField(auto_now_add=True, db_index=True, verbose_name="创建时间")),
+ ("update_time", models.DateTimeField(auto_now=True, db_index=True, verbose_name="修改时间")),
+ (
+ "id",
+ models.UUIDField(
+ default=uuid_utils.compat.uuid7,
+ editable=False,
+ primary_key=True,
+ serialize=False,
+ verbose_name="主键id",
+ ),
+ ),
+ (
+ "source_type",
+ models.CharField(
+ choices=[("KNOWLEDGE", "知识库"), ("APPLICATION", "应用"), ("TOOL", "工具"), ("MODEL", "模型")],
+ db_index=True,
+ verbose_name="关联资源类型",
+ ),
+ ),
+ (
+ "target_type",
+ models.CharField(
+ choices=[("KNOWLEDGE", "知识库"), ("APPLICATION", "应用"), ("TOOL", "工具"), ("MODEL", "模型")],
+ db_index=True,
+ verbose_name="被关联资源类型",
+ ),
+ ),
+ ("source_id", models.CharField(db_index=True, max_length=128, verbose_name="关联资源id")),
+ ("target_id", models.CharField(db_index=True, max_length=128, verbose_name="被关联资源id")),
],
options={
- 'db_table': 'resource_mapping',
+ "db_table": "resource_mapping",
},
),
- migrations.RunPython(resource_mapping, atomic=False)
+ migrations.RunPython(resource_mapping, atomic=False),
]
diff --git a/apps/system_manage/migrations/0006_alter_chatuser_nick_name_chatuserapikey.py b/apps/system_manage/migrations/0006_alter_chatuser_nick_name_chatuserapikey.py
new file mode 100644
index 00000000000..b6631fcba9b
--- /dev/null
+++ b/apps/system_manage/migrations/0006_alter_chatuser_nick_name_chatuserapikey.py
@@ -0,0 +1,33 @@
+# Generated by Django 6.0.7 on 2026-08-03 02:04
+
+import django.db.models.deletion
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('system_manage', '0005_resourcemapping'),
+ ]
+
+ operations = [
+ migrations.AlterField(
+ model_name='chatuser',
+ name='nick_name',
+ field=models.CharField(db_index=True, max_length=150, verbose_name='昵称'),
+ ),
+ migrations.CreateModel(
+ name='ChatUserApiKey',
+ fields=[
+ ('id', models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False, verbose_name='主键id')),
+ ('secret_key', models.CharField(max_length=1024, unique=True, verbose_name='秘钥')),
+ ('is_active', models.BooleanField(default=True, verbose_name='是否开启')),
+ ('create_time', models.DateTimeField(auto_now_add=True, db_index=True, null=True, verbose_name='创建时间')),
+ ('user', models.ForeignKey(on_delete=django.db.models.deletion.CASCADE, to='system_manage.chatuser', verbose_name='用户')),
+ ],
+ options={
+ 'db_table': 'chat_user_api_key',
+ },
+ ),
+ ]
diff --git a/apps/system_manage/migrations/0007_workspaceusergroupresourcepermission.py b/apps/system_manage/migrations/0007_workspaceusergroupresourcepermission.py
new file mode 100644
index 00000000000..e81ae7c6255
--- /dev/null
+++ b/apps/system_manage/migrations/0007_workspaceusergroupresourcepermission.py
@@ -0,0 +1,35 @@
+# Generated by Django 5.2.14 on 2026-08-05 07:06
+
+import django.contrib.postgres.fields
+import django.db.models.deletion
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('system_manage', '0006_alter_chatuser_nick_name_chatuserapikey'),
+ ('users', '0003_systemusergroup_systemusergrouprelation'),
+ ]
+
+ operations = [
+ migrations.CreateModel(
+ name='WorkspaceUserGroupResourcePermission',
+ fields=[
+ ('id', models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False, verbose_name='主键id')),
+ ('workspace_id', models.CharField(db_index=True, default='default', max_length=128, verbose_name='工作空间id')),
+ ('auth_target_type', models.CharField(choices=[('KNOWLEDGE', '知识库'), ('APPLICATION', '应用'), ('TOOL', '工具'), ('MODEL', '模型')], db_index=True, default='KNOWLEDGE', max_length=128, verbose_name='授权目标')),
+ ('target', models.CharField(db_index=True, max_length=128, verbose_name='知识库/应用id')),
+ ('auth_type', models.CharField(choices=[('ROLE', 'Role'), ('RESOURCE_PERMISSION_GROUP', 'Resource Permission Group')], db_default='ROLE', db_index=True, default=False, verbose_name='授权类型')),
+ ('permission_list', django.contrib.postgres.fields.ArrayField(base_field=models.CharField(blank=True, choices=[('VIEW', 'View'), ('MANAGE', 'Manage'), ('ROLE', 'Role')], default='VIEW', max_length=256), default=list, size=None, verbose_name='权限列表')),
+ ('create_time', models.DateTimeField(auto_now_add=True, db_index=True, verbose_name='创建时间')),
+ ('update_time', models.DateTimeField(auto_now=True, db_index=True, verbose_name='修改时间')),
+ ('user_group', models.ForeignKey(on_delete=django.db.models.deletion.CASCADE, to='users.systemusergroup', verbose_name='用户组id')),
+ ],
+ options={
+ 'db_table': 'workspace_user_group_resource_permission',
+ 'unique_together': {('workspace_id', 'user_group', 'auth_target_type', 'target')},
+ },
+ ),
+ ]
diff --git a/apps/system_manage/migrations/0008_add_chat_user_token_quota.py b/apps/system_manage/migrations/0008_add_chat_user_token_quota.py
new file mode 100644
index 00000000000..3a78cbf1ef7
--- /dev/null
+++ b/apps/system_manage/migrations/0008_add_chat_user_token_quota.py
@@ -0,0 +1,86 @@
+# Generated by Django 6.0.7 on 2026-08-06 02:40
+
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+def migrate_historical_tokens(apps, schema_editor):
+ ChatRecord = apps.get_model("application", "ChatRecord")
+ Chat = apps.get_model("application", "Chat")
+ ChatUserTokenQuota = apps.get_model("system_manage", "ChatUserTokenQuota")
+
+ chat_user_map = {str(c["id"]): str(c["chat_user_id"]) for c in Chat.objects.values("id", "chat_user_id").iterator()}
+ user_totals = {}
+ queryset = ChatRecord.objects.filter(message_tokens__isnull=False) | ChatRecord.objects.filter(
+ answer_tokens__isnull=False
+ )
+ for record in queryset.values("chat_id", "message_tokens", "answer_tokens").iterator(chunk_size=5000):
+ user_id = chat_user_map.get(str(record["chat_id"]))
+ if not user_id:
+ continue
+ tokens = (record["message_tokens"] or 0) + (record["answer_tokens"] or 0)
+ user_totals[user_id] = user_totals.get(user_id, 0) + tokens
+
+ objs = [
+ ChatUserTokenQuota(user_id=uid, total_tokens=total, used_tokens=total) for uid, total in user_totals.items()
+ ]
+ if objs:
+ ChatUserTokenQuota.objects.bulk_create(objs, batch_size=500)
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("system_manage", "0007_workspaceusergroupresourcepermission"),
+ ]
+
+ operations = [
+ migrations.CreateModel(
+ name="ChatUserTokenQuota",
+ fields=[
+ ("create_time", models.DateTimeField(auto_now_add=True, db_index=True, verbose_name="创建时间")),
+ ("update_time", models.DateTimeField(auto_now=True, db_index=True, verbose_name="修改时间")),
+ (
+ "id",
+ models.UUIDField(
+ default=uuid_utils.compat.uuid7,
+ editable=False,
+ primary_key=True,
+ serialize=False,
+ verbose_name="主键id",
+ ),
+ ),
+ ("user_id", models.CharField(db_index=True, max_length=128, unique=True, verbose_name="用户id")),
+ (
+ "quota_type",
+ models.CharField(
+ choices=[("UNLIMITED", "不限额"), ("PERIODIC", "按周期限制")],
+ default="UNLIMITED",
+ max_length=20,
+ verbose_name="配额模式",
+ ),
+ ),
+ (
+ "period_type",
+ models.CharField(
+ blank=True,
+ choices=[("DAY", "天"), ("WEEK", "周"), ("MONTH", "月")],
+ max_length=10,
+ null=True,
+ verbose_name="周期单位",
+ ),
+ ),
+ ("period_value", models.PositiveIntegerField(blank=True, null=True, verbose_name="周期数量")),
+ ("token_limit", models.BigIntegerField(blank=True, null=True, verbose_name="Tokens上限")),
+ ("used_tokens", models.BigIntegerField(default=0, verbose_name="当前周期已使用Tokens")),
+ ("total_tokens", models.BigIntegerField(default=0, verbose_name="累计Tokens")),
+ ("period_end", models.DateTimeField(blank=True, null=True, verbose_name="当前周期结束时间")),
+ ],
+ options={
+ "db_table": "chat_user_token_quota",
+ },
+ ),
+ migrations.RunPython(
+ migrate_historical_tokens,
+ migrations.RunPython.noop,
+ ),
+ ]
diff --git a/apps/system_manage/models/__init__.py b/apps/system_manage/models/__init__.py
index de01c428b10..32c2a7507bc 100644
--- a/apps/system_manage/models/__init__.py
+++ b/apps/system_manage/models/__init__.py
@@ -7,6 +7,8 @@
@desc:
"""
from .workspace_user_permission import *
+from .workspace_user_group_permission import *
from .system_setting import *
from .log_management import *
-from .chat_user import *
\ No newline at end of file
+from .chat_user import *
+from .chat_user_token_quota import *
\ No newline at end of file
diff --git a/apps/system_manage/models/chat_user.py b/apps/system_manage/models/chat_user.py
index 2d5cd1a4884..9d1d28ed3c1 100644
--- a/apps/system_manage/models/chat_user.py
+++ b/apps/system_manage/models/chat_user.py
@@ -9,14 +9,12 @@
import uuid_utils.compat as uuid
from django.db import models
-from common.constants.permission_constants import Group
-
class ChatUser(models.Model):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
email = models.EmailField(null=True, blank=True, verbose_name="邮箱", db_index=True)
phone = models.CharField(max_length=20, verbose_name="电话", default="")
- nick_name = models.CharField(max_length=150, verbose_name="昵称", unique=True, db_index=True)
+ nick_name = models.CharField(max_length=150, verbose_name="昵称", db_index=True)
username = models.CharField(max_length=150, unique=True, verbose_name="用户名", db_index=True)
password = models.CharField(max_length=150, verbose_name="密码")
source = models.CharField(max_length=10, verbose_name="来源", default="LOCAL", db_index=True)
@@ -50,8 +48,8 @@ class Meta:
class ResourceType(models.TextChoices):
"""资源类型"""
- KNOWLEDGE = Group.KNOWLEDGE.value, '知识库'
- APPLICATION = Group.APPLICATION.value, '应用'
+ KNOWLEDGE = 'KNOWLEDGE', '知识库'
+ APPLICATION = 'APPLICATION', '应用'
class ResourceChatUserAuthorize(models.Model):
@@ -87,3 +85,14 @@ class ResourceChatUserGroupAuthorize(models.Model):
class Meta:
db_table = "resource_chat_user_group_authorize"
unique_together = ('user_group_id', 'resource_type', 'resource_id')
+
+
+class ChatUserApiKey(models.Model):
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+ user = models.ForeignKey(ChatUser, on_delete=models.CASCADE, verbose_name="用户")
+ secret_key = models.CharField(max_length=1024, verbose_name="秘钥", unique=True)
+ is_active = models.BooleanField(default=True, verbose_name="是否开启")
+ create_time = models.DateTimeField(verbose_name="创建时间", auto_now_add=True, null=True, db_index=True)
+
+ class Meta:
+ db_table = "chat_user_api_key"
diff --git a/apps/system_manage/models/chat_user_token_quota.py b/apps/system_manage/models/chat_user_token_quota.py
new file mode 100644
index 00000000000..70956c129d2
--- /dev/null
+++ b/apps/system_manage/models/chat_user_token_quota.py
@@ -0,0 +1,93 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@file: chat_user_token_quota.py
+@desc: 对话用户Token配额模型
+"""
+
+import uuid_utils.compat as uuid
+from django.db import models
+
+from common.exception.app_exception import AppApiException
+from common.mixins.app_model_mixin import AppModelMixin
+from dateutil.relativedelta import relativedelta
+from django.utils import timezone
+
+
+class QuotaType(models.TextChoices):
+ UNLIMITED = "UNLIMITED", "不限额"
+ PERIODIC = "PERIODIC", "按周期限制"
+
+
+class PeriodType(models.TextChoices):
+ DAY = "DAY", "天"
+ WEEK = "WEEK", "周"
+ MONTH = "MONTH", "月"
+
+
+class ChatUserTokenQuota(AppModelMixin):
+ """
+ 对话用户Token配额
+ """
+
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+
+ user_id = models.CharField(max_length=128, unique=True, verbose_name="用户id", db_index=True)
+
+ quota_type = models.CharField(
+ max_length=20, choices=QuotaType.choices, default=QuotaType.UNLIMITED, verbose_name="配额模式"
+ )
+
+ period_type = models.CharField(
+ max_length=10, choices=PeriodType.choices, null=True, blank=True, verbose_name="周期单位"
+ )
+
+ period_value = models.PositiveIntegerField(null=True, blank=True, verbose_name="周期数量")
+
+ token_limit = models.BigIntegerField(null=True, blank=True, verbose_name="Tokens上限")
+
+ # 统计字段
+ used_tokens = models.BigIntegerField(default=0, verbose_name="当前周期已使用Tokens")
+ total_tokens = models.BigIntegerField(default=0, verbose_name="累计Tokens")
+
+ period_end = models.DateTimeField(null=True, blank=True, verbose_name="当前周期结束时间")
+
+ class Meta:
+ db_table = "chat_user_token_quota"
+
+ def check_and_reset(self):
+ if self.quota_type != QuotaType.PERIODIC or self.period_end is None:
+ return
+ now = timezone.now()
+ if now < self.period_end:
+ return
+ while self.period_end <= now:
+ self.period_end += relativedelta(**{f"{self.period_type.lower()}s": self.period_value})
+ self.used_tokens = 0
+ self.save(update_fields=["used_tokens", "period_end"])
+
+ @classmethod
+ def consume(cls, user_id, amount):
+ if amount <= 0:
+ return
+ quota = cls.objects.filter(user_id=user_id).first()
+ if quota is None:
+ # 所有消费用户都创建统计行,匿名用户也累计使用量
+ quota, _ = cls.objects.get_or_create(
+ user_id=user_id,
+ defaults={"quota_type": QuotaType.UNLIMITED},
+ )
+ if quota.quota_type == QuotaType.UNLIMITED:
+ # 不限额:只累计使用量,不校验上限
+ quota.used_tokens += amount
+ quota.total_tokens += amount
+ quota.save(update_fields=["used_tokens", "total_tokens"])
+ return
+ quota.check_and_reset()
+ if quota.used_tokens + amount > quota.token_limit:
+ raise AppApiException(
+ 500, _("The token quota for the current period has been exhausted. Please contact the administrator.")
+ )
+ quota.used_tokens += amount
+ quota.total_tokens += amount
+ quota.save(update_fields=["used_tokens", "total_tokens"])
diff --git a/apps/system_manage/models/resource_mapping.py b/apps/system_manage/models/resource_mapping.py
index 5d38092a886..03cbedbb7ae 100644
--- a/apps/system_manage/models/resource_mapping.py
+++ b/apps/system_manage/models/resource_mapping.py
@@ -9,7 +9,7 @@
from django.db import models
import uuid_utils.compat as uuid
-from common.constants.permission_constants import Group
+from common.auth.constants.group_constants import Group
from common.mixins.app_model_mixin import AppModelMixin
diff --git a/apps/system_manage/models/workspace_user_group_permission.py b/apps/system_manage/models/workspace_user_group_permission.py
new file mode 100644
index 00000000000..033f48e4c1d
--- /dev/null
+++ b/apps/system_manage/models/workspace_user_group_permission.py
@@ -0,0 +1,53 @@
+# coding=utf-8
+"""
+ @project: MaxKB
+ @Author:虎虎
+ @file: workspace_permission.py
+ @date:2025/4/16 18:25
+ @desc:
+"""
+
+import uuid_utils.compat as uuid
+from django.contrib.postgres.fields import ArrayField
+from django.db import models
+
+from common.constants.resource_permission_constants import ResourceAuthType, ResourcePermissionConstants, \
+ AuthTargetType
+
+from users.models.user_group import SystemUserGroup
+
+
+class WorkspaceUserGroupResourcePermission(models.Model):
+ """
+ 工作空间用户组资源权限表
+ 用于管理当前工作空间下用户组对某一个应用或者知识库的操作权限
+ """
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+
+ workspace_id = models.CharField(max_length=128, verbose_name="工作空间id", default="default", db_index=True)
+
+ user_group = models.ForeignKey(SystemUserGroup, on_delete=models.CASCADE, verbose_name="用户组id", db_index=True)
+
+ auth_target_type = models.CharField(verbose_name='授权目标', max_length=128, choices=AuthTargetType.choices,
+ default=AuthTargetType.KNOWLEDGE, db_index=True)
+ # 授权的知识库或者应用的id
+ target = models.CharField(max_length=128, verbose_name="知识库/应用id", db_index=True)
+
+ # 授权类型 如果是Role那么就是角色的权限 如果是PERMISSION
+ auth_type = models.CharField(default=False, verbose_name="授权类型", choices=ResourceAuthType.choices,
+ db_default=ResourceAuthType.ROLE, db_index=True)
+ # 资源权限列表
+ permission_list = ArrayField(verbose_name="权限列表",
+ default=list,
+ base_field=models.CharField(max_length=256,
+ blank=True,
+ choices=ResourcePermissionConstants.choices,
+ default=ResourcePermissionConstants.VIEW))
+
+ create_time = models.DateTimeField(verbose_name="创建时间", auto_now_add=True, db_index=True)
+
+ update_time = models.DateTimeField(verbose_name="修改时间", auto_now=True, db_index=True)
+
+ class Meta:
+ db_table = "workspace_user_group_resource_permission"
+ unique_together = ('workspace_id', 'user_group', 'auth_target_type', 'target')
diff --git a/apps/system_manage/models/workspace_user_permission.py b/apps/system_manage/models/workspace_user_permission.py
index d20bfa6ed97..973c3188407 100644
--- a/apps/system_manage/models/workspace_user_permission.py
+++ b/apps/system_manage/models/workspace_user_permission.py
@@ -11,19 +11,11 @@
from django.contrib.postgres.fields import ArrayField
from django.db import models
-from common.constants.permission_constants import Group, ResourcePermissionGroup, ResourceAuthType, \
- ResourcePermissionRole, ResourcePermission
+from common.constants.resource_permission_constants import ResourceAuthType, ResourcePermissionConstants, \
+ AuthTargetType
from users.models import User
-class AuthTargetType(models.TextChoices):
- """授权目标"""
- KNOWLEDGE = Group.KNOWLEDGE.value, '知识库'
- APPLICATION = Group.APPLICATION.value, '应用'
- TOOL = Group.TOOL.value, '工具'
- MODEL = Group.MODEL.value, '模型'
-
-
class WorkspaceUserResourcePermission(models.Model):
"""
工作空间用户资源权限表
@@ -48,8 +40,8 @@ class WorkspaceUserResourcePermission(models.Model):
default=list,
base_field=models.CharField(max_length=256,
blank=True,
- choices=ResourcePermission.choices + ResourcePermissionRole.choices,
- default=ResourcePermission.VIEW))
+ choices=ResourcePermissionConstants.choices,
+ default=ResourcePermissionConstants.VIEW))
create_time = models.DateTimeField(verbose_name="创建时间", auto_now_add=True, db_index=True)
diff --git a/apps/system_manage/serializers/chat_user.py b/apps/system_manage/serializers/chat_user.py
new file mode 100644
index 00000000000..256050c506d
--- /dev/null
+++ b/apps/system_manage/serializers/chat_user.py
@@ -0,0 +1,702 @@
+# coding=utf-8
+import json
+import re
+from collections import defaultdict
+
+from dateutil.relativedelta import relativedelta
+
+import uuid_utils.compat as uuid
+from django.core import validators
+from django.db import transaction
+from django.db.models import Q, QuerySet
+from django.utils import timezone
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from common.constants.exception_code_constants import ExceptionCodeConstants
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.db.search import page_search
+from common.exception.app_exception import AppApiException
+from common.utils.common import password_encrypt
+from common.utils.rsa_util import decrypt
+from system_manage.models import ChatUser, UserGroup, UserGroupRelation
+from system_manage.models.chat_user_token_quota import ChatUserTokenQuota, QuotaType
+from users.serializers.user import PASSWORD_REGEX
+
+
+class ChatUserInstanceSerializer(serializers.ModelSerializer):
+ class Meta:
+ model = ChatUser
+ fields = ["id", "username", "email", "phone", "is_active", "nick_name", "create_time", "update_time", "source"]
+
+
+@transaction.atomic
+def add_or_edit_user_group_relation(user, user_group_ids):
+ UserGroupRelation.objects.filter(user=user).delete()
+ if not user_group_ids:
+ return
+ groups = UserGroup.objects.filter(id__in=user_group_ids)
+ if groups.count() != len(user_group_ids):
+ raise AppApiException(500, _("Some user groups do not exist"))
+
+ UserGroupRelation.objects.bulk_create([UserGroupRelation(user=user, group=group) for group in groups])
+
+
+def build_token_quota(quota: ChatUserTokenQuota, now=None) -> dict:
+ """
+ 将配额记录投影为前端使用的 token_quota 结构
+ 按周期配额在读取时滚动计算有效值,不落库
+ """
+ now = now or timezone.now()
+ effective_used = quota.used_tokens
+ effective_period_end = quota.period_end
+ if quota.quota_type == QuotaType.PERIODIC and quota.period_end and now >= quota.period_end:
+ effective_used = 0
+ delta_kwargs = {f"{quota.period_type.lower()}s": quota.period_value}
+ while effective_period_end <= now:
+ effective_period_end += relativedelta(**delta_kwargs)
+ return {
+ "quota_type": quota.quota_type,
+ "used_tokens": effective_used,
+ "token_limit": quota.token_limit,
+ "total_tokens": quota.total_tokens,
+ "period_end": effective_period_end.isoformat() if effective_period_end else None,
+ }
+
+
+class ChatUserSerializer(serializers.Serializer):
+ class UserInstance(serializers.Serializer):
+ email = serializers.EmailField(
+ required=False,
+ label=_("Email"),
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
+ allow_null=True,
+ allow_blank=True,
+ )
+ username = serializers.CharField(
+ required=True,
+ label=_("Username"),
+ max_length=64,
+ min_length=4,
+ validators=[
+ validators.RegexValidator(
+ regex=re.compile("^.{4,64}$"), message=_("Username must be 4-64 characters long")
+ )
+ ],
+ )
+ password = serializers.CharField(
+ required=True,
+ label=_("Password"),
+ max_length=20,
+ min_length=6,
+ validators=[
+ validators.RegexValidator(
+ regex=PASSWORD_REGEX,
+ message=_(
+ "The password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
+ ),
+ )
+ ],
+ )
+ nick_name = serializers.CharField(
+ required=True,
+ label=_("Nick name"),
+ max_length=64,
+ )
+ phone = serializers.CharField(
+ required=False, label=_("Phone"), max_length=20, allow_null=True, allow_blank=True
+ )
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=True), required=False, label=_("User Group IDs")
+ )
+ source = serializers.CharField(required=False, label=_("Source"), max_length=20, default="LOCAL")
+
+ def is_valid(self, *, raise_exception=True):
+ super().is_valid(raise_exception=True)
+ self._check_unique_username_and_email()
+
+ def _check_unique_username_and_email(self):
+ username = self.data.get("username")
+ nick_name = self.data.get("nick_name")
+ user = ChatUser.objects.filter(Q(username=username) | Q(nick_name=nick_name)).first()
+ if user:
+ if user.username == username:
+ raise ExceptionCodeConstants.USERNAME_IS_EXIST.value.to_app_api_exception()
+ if user.nick_name == nick_name:
+ raise ExceptionCodeConstants.NICKNAME_IS_EXIST.value.to_app_api_exception()
+
+ class Query(serializers.Serializer):
+ username = serializers.CharField(required=False, label=_("Username"), allow_null=True, allow_blank=True)
+ nick_name = serializers.CharField(required=False, label=_("Nickname"), allow_null=True, allow_blank=True)
+ source = serializers.CharField(required=False, label=_("Source"), allow_null=True, allow_blank=True)
+ is_active = serializers.BooleanField(required=False, label=_("Is active"), allow_null=True)
+
+ def get_query_set(self):
+ username = self.data.get("username")
+ query_set = QuerySet(ChatUser)
+ if username is not None:
+ query_set = query_set.filter(Q(username__contains=username))
+ nick_name = self.data.get("nick_name")
+ if nick_name is not None:
+ query_set = query_set.filter(Q(nick_name__contains=nick_name))
+ source = self.data.get("source")
+ if source is not None:
+ query_set = query_set.filter(source=source)
+ is_active = self.data.get("is_active", None)
+ if is_active is not None:
+ query_set = query_set.filter(is_active=is_active)
+ query_set = query_set.order_by("-create_time")
+ return query_set
+
+ def page(self, current_page: int, page_size: int, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ result = page_search(
+ current_page,
+ page_size,
+ self.get_query_set(),
+ post_records_handler=lambda u: ChatUserInstanceSerializer(u).data,
+ )
+ user_ids = [user["id"] for user in result["records"]]
+ user_groups = UserGroupRelation.objects.filter(user__id__in=user_ids).select_related("group")
+
+ user_groups_map = defaultdict(lambda: {"user_group_ids": [], "user_group_names": []})
+
+ for relation in user_groups:
+ user_groups_map[str(relation.user_id)]["user_group_ids"].append(str(relation.group_id))
+ user_groups_map[str(relation.user_id)]["user_group_names"].append(relation.group.name)
+
+ for user in result["records"]:
+ user.update(user_groups_map.get(str(user["id"]), {"user_group_ids": [], "user_group_names": []}))
+
+ # 合并 Token 配额数据
+ license_is_valid = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
+ license_is_valid = license_is_valid() if license_is_valid() is not None else False
+ if license_is_valid:
+ quotas = ChatUserTokenQuota.objects.filter(user_id__in=user_ids)
+ now = timezone.now()
+ quota_map = {str(q.user_id): build_token_quota(q, now) for q in quotas}
+ for user in result["records"]:
+ user["token_quota"] = quota_map.get(str(user["id"]))
+
+ return result
+
+ class BatchDeleteInstance(serializers.Serializer):
+ ids = serializers.ListField(child=serializers.UUIDField(required=True), required=True, label=_("User IDs"))
+
+ def batch_delete(self):
+ user_ids = self.data.get("ids")
+ if not user_ids:
+ raise AppApiException(1004, _("User IDs cannot be empty"))
+ ChatUser.objects.filter(id__in=user_ids).delete()
+ return True
+
+ class BatchAddGroup(serializers.Serializer):
+ ids = serializers.ListField(child=serializers.UUIDField(required=True), required=True, label=_("User IDs"))
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=True), required=True, label=_("User Group IDs")
+ )
+ is_append = serializers.BooleanField(required=False, label=_("Is Append"), default=False)
+
+ @transaction.atomic
+ def batch_add_group(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ user_ids = self.data.get("ids")
+ original_group_ids = self.data.get("user_group_ids")
+ is_append = self.data.get("is_append", False)
+
+ if not user_ids:
+ raise AppApiException(1004, _("User IDs cannot be empty"))
+ if not original_group_ids:
+ raise AppApiException(1004, _("User Group IDs cannot be empty"))
+
+ users = ChatUser.objects.filter(id__in=user_ids)
+ if users.count() != len(user_ids):
+ raise AppApiException(1004, _("Some users do not exist"))
+
+ groups_count = UserGroup.objects.filter(id__in=original_group_ids).count()
+ if groups_count != len(original_group_ids):
+ raise AppApiException(1004, _("Some user groups do not exist"))
+
+ if is_append:
+ # 获取现有关系
+ existing_relations = UserGroupRelation.objects.filter(user_id__in=user_ids).values_list(
+ "user_id", "group_id"
+ )
+
+ existing_groups_map = defaultdict(set)
+ for user_id, group_id in existing_relations:
+ existing_groups_map[str(user_id)].add(group_id)
+
+ # 准备要创建的新关系
+ relations_to_create = []
+ for user_id in user_ids:
+ # 只添加不在现有关系中的组
+ new_group_ids = set(original_group_ids) - existing_groups_map.get(user_id, set())
+
+ for group_id in new_group_ids:
+ relations_to_create.append(
+ UserGroupRelation(id=uuid.uuid7(), user_id=user_id, group_id=group_id)
+ )
+
+ # 只创建不存在的关系,不删除现有关系
+ if relations_to_create:
+ UserGroupRelation.objects.bulk_create(relations_to_create, batch_size=1000)
+
+ else:
+ # 非追加模式:直接批量删除旧关系,批量创建新关系
+ UserGroupRelation.objects.filter(user_id__in=user_ids).delete()
+
+ relations_to_create = [
+ UserGroupRelation(id=uuid.uuid7(), user_id=user_id, group_id=group_id)
+ for user_id in user_ids
+ for group_id in original_group_ids
+ ]
+
+ if relations_to_create:
+ UserGroupRelation.objects.bulk_create(relations_to_create, batch_size=1000)
+
+ @transaction.atomic
+ def save(self, instance, with_valid=True):
+ if with_valid:
+ if instance.get("encrypted"):
+ instance["password"] = decrypt(instance.get("password"))
+ self.UserInstance(data=instance).is_valid(raise_exception=True)
+
+ user = ChatUser(
+ id=uuid.uuid7(),
+ email=instance.get("email"),
+ phone=instance.get("phone", ""),
+ nick_name=instance.get("nick_name", ""),
+ username=instance.get("username"),
+ password=password_encrypt(instance.get("password")),
+ source=instance.get("source", "LOCAL"),
+ is_active=True,
+ )
+ user.save()
+ add_or_edit_user_group_relation(user, instance.get("user_group_ids", []))
+ return ChatUserInstanceSerializer(user).data
+
+ class UserEditInstance(serializers.Serializer):
+ email = serializers.EmailField(
+ required=False,
+ label=_("Email"),
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
+ allow_null=True,
+ allow_blank=True,
+ )
+ nick_name = serializers.CharField(
+ required=False,
+ label=_("Name"),
+ max_length=64,
+ )
+ phone = serializers.CharField(
+ required=False, label=_("Phone"), max_length=20, allow_null=True, allow_blank=True
+ )
+ is_active = serializers.BooleanField(required=False, label=_("Is Active"))
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=True), required=False, label=_("User Group IDs")
+ )
+
+ def is_valid(self, *, user_id=None, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ self._check_unique_nick_name(user_id)
+
+ def _check_unique_nick_name(self, user_id):
+ nick_name = self.data.get("nick_name")
+ if nick_name and ChatUser.objects.filter(nick_name=nick_name).exclude(id=user_id).exists():
+ raise AppApiException(1008, _("Nickname is already in use"))
+
+ class RePasswordInstance(serializers.Serializer):
+ password = serializers.CharField(
+ required=True,
+ label=_("Password"),
+ max_length=20,
+ min_length=6,
+ validators=[
+ validators.RegexValidator(
+ regex=PASSWORD_REGEX,
+ message=_(
+ "The password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
+ ),
+ )
+ ],
+ )
+ re_password = serializers.CharField(
+ required=True,
+ label=_("Re Password"),
+ validators=[
+ validators.RegexValidator(
+ regex=PASSWORD_REGEX,
+ message=_(
+ "The confirmation password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
+ ),
+ )
+ ],
+ )
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ self._check_passwords_match()
+
+ def _check_passwords_match(self):
+ if self.data.get("password") != self.data.get("re_password"):
+ raise ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.to_app_api_exception()
+
+ class Operate(serializers.Serializer):
+ id = serializers.UUIDField(required=True, label=_("User ID"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ self._check_user_exists()
+
+ def _check_user_exists(self):
+ if not ChatUser.objects.filter(id=self.data.get("id")).exists():
+ raise AppApiException(1004, _("User does not exist"))
+
+ @transaction.atomic
+ def delete(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ user_id = self.data.get("id")
+ ChatUser.objects.filter(id=user_id).delete()
+ return True
+
+ def edit(self, instance, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ ChatUserSerializer.UserEditInstance(data=instance).is_valid(
+ user_id=self.data.get("id"), raise_exception=True
+ )
+ user = ChatUser.objects.filter(id=self.data.get("id")).first()
+ self._update_user_fields(user, instance)
+ user.save()
+ add_or_edit_user_group_relation(user, instance.get("user_group_ids", []))
+ return ChatUserInstanceSerializer(user).data
+
+ @staticmethod
+ def _update_user_fields(user, instance):
+ update_keys = ["email", "nick_name", "phone", "is_active"]
+ for key in update_keys:
+ if key in instance and instance.get(key) is not None:
+ setattr(user, key, instance.get(key))
+
+ def one(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ user = ChatUser.objects.filter(id=self.data.get("id")).first()
+ user_data = ChatUserInstanceSerializer(user).data
+ # 补充用户组信息
+ user_data["user_group_ids"] = list(
+ UserGroupRelation.objects.filter(user=user).values_list("group_id", flat=True)
+ )
+ return user_data
+
+ def re_password(self, instance, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ encrypted_data = instance.get("encryptedData", "")
+ if encrypted_data:
+ try:
+ decrypted_raw = decrypt(encrypted_data)
+ # decrypt 可能返回非 JSON 字符串,防护解析异常
+ decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
+ if isinstance(decrypted_data, dict):
+ instance.update(decrypted_data)
+ except Exception:
+ raise AppApiException(500, _("Invalid encrypted data"))
+ ChatUserSerializer.RePasswordInstance(data=instance).is_valid(raise_exception=True)
+ user = ChatUser.objects.filter(id=self.data.get("id")).first()
+ user.password = password_encrypt(instance.get("password"))
+ user.save()
+ return True
+
+ class GetUserListByGroup(serializers.Serializer):
+ group_id = serializers.UUIDField(required=True, label=_("Group ID"))
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ group_id = self.data.get("group_id")
+ if not UserGroup.objects.filter(id=group_id).exists():
+ raise AppApiException(1004, _("User group does not exist"))
+
+ def get_user_list(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ group_id = self.data.get("group_id")
+ user_ids = UserGroupRelation.objects.filter(group_id=group_id).values_list("user_id", flat=True)
+ users = ChatUser.objects.exclude(id__in=user_ids)
+ return ChatUserInstanceSerializer(users, many=True).data
+
+ @classmethod
+ def list(cls):
+ users = ChatUser.objects.all().order_by("-create_time")
+ return ChatUserInstanceSerializer(users, many=True).data
+
+
+class UserGroupModelSerializer(serializers.ModelSerializer):
+ class Meta:
+ model = UserGroup
+ fields = ["id", "name"]
+
+
+class UserGroupCreateSerializer(serializers.Serializer):
+ id = serializers.CharField(required=False, label="ID")
+ name = serializers.CharField(required=True, label="User Group Name")
+
+ def validate(self, data):
+ id = data.get("id")
+ name = data.get("name")
+ if id:
+ group = UserGroup.objects.filter(id=id).first()
+ if not group:
+ raise AppApiException(500, _("User group does not exist"))
+ if name:
+ queryset = UserGroup.objects.filter(name=name)
+ if id:
+ # 排除当前用户组自身
+ queryset = queryset.exclude(id=id)
+ if queryset.exists():
+ raise AppApiException(500, _("User group name already exists"))
+ return data
+
+ def create_or_update_group(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ id = self.data.get("id")
+ name = self.data.get("name")
+
+ if id:
+ group = UserGroup.objects.get(id=id)
+ group.name = name
+ group.save()
+ else:
+ group = UserGroup.objects.create(id=uuid.uuid7(), name=name)
+ group.save()
+ return UserGroupModelSerializer(group).data
+
+ def get_user_group_list(self):
+ groups = UserGroup.objects.all().order_by("name")
+ return UserGroupModelSerializer(groups, many=True).data
+
+ class UserGroupDeleteSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label="ID")
+
+ def validate(self, data):
+ id = data.get("id")
+ group = UserGroup.objects.filter(id=id).first()
+ if not group:
+ raise AppApiException(500, _("User group does not exist"))
+ if group.id == "default":
+ raise AppApiException(500, _("Default user group cannot be deleted"))
+ return data
+
+ def delete(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ id = self.data.get("id")
+ UserGroupRelation.objects.filter(group_id=id).delete()
+ UserGroup.objects.filter(id=id).delete()
+ return True
+
+
+class UserGroupAddMemberSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label="ID")
+ user_ids = serializers.ListField(child=serializers.CharField(required=True), required=True, label=_("User IDs"))
+
+ def validate(self, data):
+ id = data.get("id")
+ user_ids = data.get("user_ids")
+ group = UserGroup.objects.filter(id=id).first()
+ if not group:
+ raise AppApiException(500, _("User group does not exist"))
+ if not user_ids:
+ raise AppApiException(500, _("User IDs cannot be empty"))
+ return data
+
+ def add_member(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ user_ids = self.data.get("user_ids")
+ current_user_group_ids = set(
+ str(user_id)
+ for user_id in UserGroupRelation.objects.filter(group__id=self.data.get("id")).values_list(
+ "user_id", flat=True
+ )
+ )
+ to_add = set(user_ids).difference(current_user_group_ids)
+ if to_add:
+ UserGroupRelation.objects.bulk_create(
+ [
+ UserGroupRelation(id=uuid.uuid7(), user_id=user_id, group_id=self.data.get("id"))
+ for user_id in to_add
+ ]
+ )
+ return True
+
+
+class UserGroupRemoveMemberSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label="ID")
+ group_relation_ids = serializers.ListField(
+ child=serializers.CharField(required=True), required=True, label=_("User group relation IDs")
+ )
+
+ def validate(self, data):
+ id = data.get("id")
+ user_ids = data.get("group_relation_ids")
+ if UserGroup.objects.filter(id=id).count() == 0:
+ raise AppApiException(500, _("User group does not exist"))
+ if not user_ids:
+ raise AppApiException(500, _("User group relation IDs cannot be empty"))
+ return data
+
+ def remove_member(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ group_relation_ids = self.data.get("group_relation_ids")
+ UserGroupRelation.objects.filter(id__in=group_relation_ids).delete()
+ return True
+
+
+class UserGroupListPageSerializer(serializers.Serializer):
+ class Query(serializers.Serializer):
+ group_id = serializers.CharField(required=True, label=_("Group ID"))
+ username = serializers.CharField(required=False, label=_("Username"), allow_null=True)
+ nick_name = serializers.CharField(required=False, label=_("Nick Name"), allow_null=True)
+ source = serializers.CharField(required=False, label=_("Source"), allow_null=True)
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=raise_exception)
+ group_id = self.data.get("group_id")
+ if not UserGroup.objects.filter(id=group_id).exists():
+ raise AppApiException(500, _("User group does not exist"))
+
+ def page(self, current_page, page_size):
+ self.is_valid()
+ query_set = self.get_query_set()
+ result = page_search(
+ current_page,
+ page_size,
+ query_set,
+ post_records_handler=lambda relation: {
+ **ChatUserInstanceSerializer(relation.user).data,
+ "user_group_relation_id": relation.id,
+ },
+ )
+ return result
+
+ def get_query_set(self):
+ group_id = self.data.get("group_id")
+
+ username = self.data.get("username")
+ nick_name = self.data.get("nick_name")
+ source = self.data.get("source")
+ query_set = UserGroupRelation.objects.filter(group_id=group_id).select_related("user")
+
+ if username is not None:
+ query_set = query_set.filter(user__username__contains=username)
+ if nick_name is not None:
+ query_set = query_set.filter(user__nick_name__contains=nick_name)
+ if source is not None:
+ query_set = query_set.filter(user__source=source)
+ return query_set.order_by("-user__create_time")
+
+
+class RePasswordSerializer(serializers.Serializer):
+ password = serializers.CharField(
+ required=True,
+ label=_("Password"),
+ validators=[
+ validators.RegexValidator(
+ regex=re.compile(
+ "^(?![a-zA-Z]+$)(?![A-Z0-9]+$)(?![A-Z_!@#$%^&*`~.()-+=]+$)(?![a-z0-9]+$)(?![a-z_!@#$%^&*`~()-+=]+$)"
+ "(?![0-9_!@#$%^&*`~()-+=]+$)[a-zA-Z0-9_!@#$%^&*`~.()-+=]{6,20}$"
+ ),
+ message=_(
+ "The confirmation password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
+ ),
+ )
+ ],
+ )
+
+ re_password = serializers.CharField(
+ required=True,
+ label=_("Confirm Password"),
+ validators=[
+ validators.RegexValidator(
+ regex=re.compile(
+ "^(?![a-zA-Z]+$)(?![A-Z0-9]+$)(?![A-Z_!@#$%^&*`~.()-+=]+$)(?![a-z0-9]+$)(?![a-z_!@#$%^&*`~()-+=]+$)"
+ "(?![0-9_!@#$%^&*`~()-+=]+$)[a-zA-Z0-9_!@#$%^&*`~.()-+=]{6,20}$"
+ ),
+ message=_(
+ "The confirmation password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
+ ),
+ )
+ ],
+ )
+
+ class Meta:
+ model = ChatUser
+ fields = "__all__"
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ if self.data.get("password") != self.data.get("re_password"):
+ raise AppApiException(
+ ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.code,
+ ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.message,
+ )
+ return True
+
+ def reset_password(self, user_id):
+ """
+ 修改密码
+ :return: 是否成功
+ """
+ if self.is_valid():
+ QuerySet(ChatUser).filter(id=user_id).update(password=password_encrypt(self.data.get("password")))
+ return True
+
+
+class ChatUserProfileSerializer(serializers.Serializer):
+ @staticmethod
+ def profile(user: ChatUser):
+ """
+ 获取对话用户详情
+ @param user: 用户对象
+ @return:
+ """
+ if not user:
+ return {}
+ license_is_valid = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
+ license_is_valid = license_is_valid() if license_is_valid() is not None else False
+ token_quota = None
+ if license_is_valid:
+ quota = ChatUserTokenQuota.objects.filter(user_id=str(user.id)).first()
+ if quota:
+ quota_detail = build_token_quota(quota)
+ token_quota = {
+ "quota_type": quota_detail["quota_type"],
+ "used_tokens": quota_detail["used_tokens"],
+ "token_limit": quota_detail["token_limit"],
+ "total_tokens": quota_detail["total_tokens"],
+ }
+ return {
+ "id": user.id,
+ "username": user.username,
+ "nick_name": user.nick_name,
+ "email": user.email,
+ "source": user.source,
+ "token_quota": token_quota,
+ }
diff --git a/apps/system_manage/serializers/chat_user_serializer.py b/apps/system_manage/serializers/chat_user_serializer.py
new file mode 100644
index 00000000000..22f10810c8f
--- /dev/null
+++ b/apps/system_manage/serializers/chat_user_serializer.py
@@ -0,0 +1,158 @@
+import json
+
+from django.core.cache import cache
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.models import ApplicationAccessToken, ChatUserType
+from common.auth.common import ChatToken
+from common.auth.constants.operate_constants import Operate
+from common.constants.authentication_type import AuthenticationType
+from common.constants.cache_version import Cache_Version
+from common.exception.app_exception import AppApiException
+from common.log.log import record_log
+from common.utils.common import password_encrypt
+from common.utils.common import password_verify, needs_password_upgrade
+from common.utils.rsa_util import decrypt
+from system_manage.models import (
+ ResourceChatUserGroupAuthorize,
+ ResourceType,
+ UserGroupRelation,
+ ResourceChatUserAuthorize,
+ ChatUser,
+)
+from users.serializers.login import LoginRequest
+
+system_version, system_get_key = Cache_Version.SYSTEM.value
+
+
+class ChatUserAccessTokenSerializer(serializers.Serializer):
+ @staticmethod
+ def create_token_and_cache(access_token, user, request):
+ status = 500 # 默认失败状态
+ workspace_id = "default"
+ try:
+ application_access_token = ApplicationAccessToken.objects.filter(access_token=access_token).first()
+
+ if not application_access_token:
+ raise AppApiException(1005, _("Invalid access token"))
+
+ application_id = application_access_token.application_id
+ workspace_id = application_access_token.application.workspace_id
+ # 检查用户是否有权限访问该应用
+ is_authorized = ResourceChatUserAuthorize.objects.filter(
+ resource_id=application_id, resource_type=ResourceType.APPLICATION.value, is_auth=True, user_id=user.id
+ ).exists()
+ if not is_authorized:
+ # 获取资源组授权的用户组ID
+ resource_group_ids = ResourceChatUserGroupAuthorize.objects.filter(
+ resource_id=application_id,
+ resource_type=ResourceType.APPLICATION.value,
+ is_auth=True,
+ ).values_list("user_group_id", flat=True)
+
+ # 如果有资源组授权,则检查用户是否属于这些用户组
+ if resource_group_ids.exists():
+ is_authorized = UserGroupRelation.objects.filter(
+ user_id=user.id, group_id__in=resource_group_ids
+ ).exists()
+
+ if not is_authorized:
+ raise AppApiException(1005, _("The user does not have permission to access the application"))
+ token = ChatToken(
+ user.id, AuthenticationType.CHAT_USER, str(Operate.LOCAL).lower(), application_id=application_id
+ ).to_token()
+ status = 200
+ return token
+ finally:
+ record_log(
+ menu="Chat User/login",
+ operate="Log in",
+ request=request,
+ user={"username": user.username},
+ status=status,
+ operation_object={"name": user.username},
+ workspace_id=workspace_id,
+ )
+
+ @staticmethod
+ def get_auth_setting(access_token):
+ auth_setting = {}
+ application_access_token = ApplicationAccessToken.objects.filter(access_token=access_token).first()
+
+ if not application_access_token:
+ raise AppApiException(1005, _("Invalid access token"))
+ if application_access_token:
+ auth_setting = application_access_token.authentication_value
+
+ return auth_setting
+
+ @staticmethod
+ def local_login(instance, access_token):
+ username = instance.get("username", "")
+ encryptedData = instance.get("encryptedData", "")
+ if encryptedData:
+ json_data = json.loads(decrypt(encryptedData))
+ instance.update(json_data)
+ try:
+ LoginRequest(data=instance).is_valid(raise_exception=True)
+ except Exception as e:
+ raise e
+ auth_setting = ChatUserAccessTokenSerializer.get_auth_setting(access_token)
+
+ max_attempts = auth_setting.get("max_attempts", 1)
+ password = instance.get("password")
+ captcha = instance.get("captcha", "")
+
+ # 判断是否需要验证码
+ need_captcha = True
+ if max_attempts == -1:
+ need_captcha = False
+ elif max_attempts > 0:
+ fail_count = cache.get(system_get_key(f"chat_{username}"), version=system_version) or 0
+ need_captcha = fail_count >= max_attempts
+
+ if need_captcha:
+ ChatUserAccessTokenSerializer._validate_captcha(username, captcha)
+
+ user = ChatUser.objects.filter(username=username).first()
+
+ if not user or not password_verify(password, user.password):
+ record_login_fail(username)
+ raise AppApiException(500, _("The username or password is incorrect"))
+
+ if needs_password_upgrade(user.password):
+ user.password = password_encrypt(password)
+ user.save(update_fields=["password"])
+ if not user.is_active:
+ raise AppApiException(1005, _("The user has been disabled, please contact the administrator!"))
+ cache.delete(system_get_key(f"chat_{username}"), version=system_version)
+ return user
+
+ @staticmethod
+ def _validate_captcha(username: str, captcha: str) -> None:
+ """验证验证码(一次性消费)"""
+ if not captcha:
+ raise AppApiException(1005, _("Captcha is required"))
+
+ captcha_key = Cache_Version.CAPTCHA.get_key(captcha=f"chat_{username}")
+ captcha_cache = cache.get(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+
+ if captcha_cache is None or captcha.lower() != captcha_cache:
+ # 校验失败也计入失败计数,防止"识别-试错"循环绕过验证码
+ record_login_fail(username)
+ raise AppApiException(1005, _("Captcha code error or expiration"))
+
+ # 校验通过即销毁,保证验证码一次性使用
+ cache.delete(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+
+
+def record_login_fail(username: str, expire: int = 600):
+ """记录登录失败次数(原子递增)"""
+ if not username:
+ return
+ fail_key = system_get_key(f"chat_{username}")
+ try:
+ cache.incr(fail_key, 1, version=system_version)
+ except ValueError:
+ cache.set(fail_key, 1, timeout=expire, version=system_version)
diff --git a/apps/system_manage/serializers/user_group_resource_permission.py b/apps/system_manage/serializers/user_group_resource_permission.py
new file mode 100644
index 00000000000..3932518ec32
--- /dev/null
+++ b/apps/system_manage/serializers/user_group_resource_permission.py
@@ -0,0 +1,520 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: workspace_user_resource_permission.py
+@date:2025/4/28 17:17
+@desc:
+"""
+
+import json
+import os
+
+from django.core.cache import cache
+from django.db import models
+from django.db.models import QuerySet, Q, TextField
+from django.db.models.functions import Cast
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from application.models import Application
+from common.constants.cache_version import Cache_Version
+from common.auth.constants.role_constants import RoleConstants
+from common.constants.resource_permission_constants import ResourceAuthType, ResourcePermissionConstants
+from common.db.search import native_search, native_page_search, get_dynamics_model
+from common.db.sql_execute import select_list
+from common.exception.app_exception import AppApiException
+from common.utils.common import get_file_content
+from knowledge.models import Knowledge
+from maxkb.conf import PROJECT_DIR
+from maxkb.settings import edition
+from models_provider.models import Model
+from system_manage.models import WorkspaceUserResourcePermission, WorkspaceUserGroupResourcePermission
+from tools.models import Tool
+from users.models.user_group import SystemUserGroupRelation
+
+
+class PermissionSerializer(serializers.Serializer):
+ VIEW = serializers.BooleanField(required=True, label="可读")
+ MANAGE = serializers.BooleanField(required=True, label="管理")
+ ROLE = serializers.BooleanField(required=True, label="跟随角色")
+
+
+class UserResourcePermissionItemResponse(serializers.Serializer):
+ id = serializers.UUIDField(required=True, label="主键id")
+ name = serializers.CharField(required=True, label="资源名称")
+ auth_target_type = serializers.CharField(required=True, label="授权资源")
+ user_id = serializers.UUIDField(required=True, label="用户id")
+ icon = serializers.CharField(required=True, label="资源图标")
+ auth_type = serializers.CharField(required=True, label="授权类型")
+ permission = serializers.ChoiceField(
+ required=False,
+ allow_null=True,
+ allow_blank=True,
+ choices=["NOT_AUTH", "MANAGE", "VIEW", "ROLE"],
+ label=_("permission"),
+ )
+
+
+class UserResourcePermissionResponse(serializers.Serializer):
+ KNOWLEDGE = UserResourcePermissionItemResponse(many=True)
+
+
+class UpdateTeamMemberItemPermissionSerializer(serializers.Serializer):
+ target_id = serializers.CharField(required=True, label=_("target id"))
+ permission = serializers.ChoiceField(
+ required=False,
+ allow_null=True,
+ allow_blank=True,
+ choices=["NOT_AUTH", "MANAGE", "VIEW", "ROLE"],
+ label=_("permission"),
+ )
+
+
+class UpdateUserResourcePermissionRequest(serializers.Serializer):
+ user_resource_permission_list = UpdateTeamMemberItemPermissionSerializer(required=True, many=True)
+
+ def is_valid(self, *, auth_target_type=None, workspace_id=None, raise_exception=False):
+ super().is_valid(raise_exception=True)
+ user_resource_permission_list = [
+ {"target_id": urp.get("target_id"), "auth_target_type": auth_target_type}
+ for urp in self.data.get("user_resource_permission_list")
+ ]
+ illegal_target_id_list = select_list(
+ get_file_content(
+ os.path.join(PROJECT_DIR, "apps", "system_manage", "sql", "check_member_permission_target_exists.sql")
+ ),
+ [
+ json.dumps(user_resource_permission_list),
+ workspace_id,
+ workspace_id,
+ workspace_id,
+ workspace_id,
+ workspace_id,
+ workspace_id,
+ workspace_id,
+ ],
+ )
+ if illegal_target_id_list is not None and len(illegal_target_id_list) > 0:
+ raise AppApiException(500, _("Non-existent id") + "[" + str(illegal_target_id_list) + "]")
+
+
+m_map = {
+ "KNOWLEDGE": Knowledge,
+ "TOOL": Tool,
+ "MODEL": Model,
+ "APPLICATION": Application,
+}
+
+sql_map = {
+ "KNOWLEDGE": "get_knowledge_user_group_resource_permission.sql",
+ "TOOL": "get_tool_user_group_resource_permission.sql",
+ "MODEL": "get_model_user_group_resource_permission.sql",
+ "APPLICATION": "get_application_user_group_resource_permission.sql",
+}
+
+
+class UserResourcePermissionUserListRequest(serializers.Serializer):
+ name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("resource name"))
+ permission = serializers.MultipleChoiceField(
+ required=False,
+ allow_null=True,
+ allow_blank=True,
+ choices=["NOT_AUTH", "MANAGE", "VIEW", "ROLE"],
+ label=_("permission"),
+ )
+
+
+class UserGroupResourcePermissionSerializer(serializers.Serializer):
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ user_group_id = serializers.CharField(required=True, label=_("User Group id"))
+ auth_target_type = serializers.CharField(required=True, label=_("resource"))
+
+ def get_queryset(self, instance):
+ resource_query_set = QuerySet(
+ model=get_dynamics_model(
+ {
+ "name": models.CharField(),
+ "permission": models.CharField(),
+ }
+ )
+ )
+ name = instance.get("name")
+ permission = instance.get("permission")
+ query_p_list = [None if p == "NOT_AUTH" else p for p in permission]
+
+ if name:
+ resource_query_set = resource_query_set.filter(name__contains=name)
+ if permission:
+ if all([p is None for p in query_p_list]):
+ resource_query_set = resource_query_set.filter(permission=None)
+ else:
+ if any([p is None for p in query_p_list]):
+ resource_query_set = resource_query_set.filter(Q(permission__in=query_p_list) | Q(permission=None))
+ else:
+ resource_query_set = resource_query_set.filter(permission__in=query_p_list)
+ return {
+ "query_set": QuerySet(m_map.get(self.data.get("auth_target_type"))).filter(
+ workspace_id=self.data.get("workspace_id")
+ ),
+ "folder_query_set": QuerySet(m_map.get(self.data.get("auth_target_type"))).filter(
+ workspace_id=self.data.get("workspace_id")
+ ),
+ "workspace_user_group_resource_permission_query_set": QuerySet(WorkspaceUserGroupResourcePermission).filter(
+ workspace_id=self.data.get("workspace_id"),
+ user_group_id=self.data.get("user_group_id"),
+ auth_target_type=self.data.get("auth_target_type"),
+ ),
+ "resource_query_set": resource_query_set,
+ }
+
+ def auth_resource_batch(self, resource_id_list: list):
+ self.is_valid(raise_exception=True)
+ auth_target_type = self.data.get("auth_target_type")
+ workspace_id = self.data.get("workspace_id")
+ user_id = self.data.get("user_id")
+ wurp = (
+ QuerySet(WorkspaceUserResourcePermission)
+ .filter(auth_target_type=auth_target_type, workspace_id=workspace_id, user_id=user_id)
+ .first()
+ )
+ auth_type = (
+ wurp.auth_type
+ if wurp
+ else (ResourceAuthType.RESOURCE_PERMISSION_GROUP if edition == "CE" else ResourceAuthType.ROLE)
+ )
+ workspace_user_resource_permission = [
+ WorkspaceUserResourcePermission(
+ target=resource_id,
+ auth_target_type=auth_target_type,
+ permission_list=[ResourcePermissionConstants.VIEW, ResourcePermissionConstants.MANAGE]
+ if auth_type == ResourceAuthType.RESOURCE_PERMISSION_GROUP
+ else [ResourcePermissionConstants.ROLE],
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_type=auth_type,
+ )
+ for resource_id in resource_id_list
+ ]
+ QuerySet(WorkspaceUserResourcePermission).bulk_create(workspace_user_resource_permission)
+ # 刷新缓存
+ version = Cache_Version.PERMISSION_LIST.get_version()
+ key = Cache_Version.PERMISSION_LIST.get_key(user_id=user_id)
+ cache.delete(key, version=version)
+ return True
+
+ def auth_resource(self, resource_id: str, is_folder=False):
+ self.is_valid(raise_exception=True)
+ auth_target_type = self.data.get("auth_target_type")
+ workspace_id = self.data.get("workspace_id")
+ user_id = self.data.get("user_id")
+
+ WorkspaceUserResourcePermission(
+ target=resource_id,
+ auth_target_type=auth_target_type,
+ permission_list=[ResourcePermissionConstants.VIEW, ResourcePermissionConstants.MANAGE],
+ workspace_id=workspace_id,
+ user_id=user_id,
+ auth_type=ResourceAuthType.RESOURCE_PERMISSION_GROUP,
+ ).save()
+ # 刷新缓存
+ version = Cache_Version.PERMISSION_LIST.get_version()
+ key = Cache_Version.PERMISSION_LIST.get_key(user_id=user_id)
+ cache.delete(key, version=version)
+ return True
+
+ def list(self, instance, user, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ UserResourcePermissionUserListRequest(data=instance).is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ user_group_id = self.data.get("user_group_id")
+ # 用户权限列表
+ user_resource_permission_list = native_search(
+ self.get_queryset(instance),
+ get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "system_manage", "sql", sql_map.get(self.data.get("auth_target_type"))
+ )
+ ),
+ )
+
+ return [{**user_resource_permission} for user_resource_permission in user_resource_permission_list]
+
+ def page(self, instance, current_page: int, page_size: int, user, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ UserResourcePermissionUserListRequest(data=instance).is_valid(raise_exception=True)
+ workspace_id = self.data.get("workspace_id")
+ user_group_id = self.data.get("user_group_id")
+ # 用户组对应的资源权限分页列表
+ user_resource_permission_page_list = native_page_search(
+ current_page,
+ page_size,
+ self.get_queryset(instance),
+ get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "system_manage", "sql", sql_map.get(self.data.get("auth_target_type"))
+ )
+ ),
+ )
+
+ return user_resource_permission_page_list
+
+ def edit(self, instance, user, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ UpdateUserResourcePermissionRequest(data={"user_resource_permission_list": instance}).is_valid(
+ raise_exception=True,
+ auth_target_type=self.data.get("auth_target_type"),
+ workspace_id=self.data.get("workspace_id"),
+ )
+ workspace_id = self.data.get("workspace_id")
+ user_group_id = self.data.get("user_group_id")
+ update_list = []
+ save_list = []
+ targets = [item["target_id"] for item in instance]
+ QuerySet(WorkspaceUserGroupResourcePermission).filter(
+ workspace_id=workspace_id,
+ user_group_id=user_group_id,
+ auth_target_type=self.data.get("auth_target_type"),
+ target__in=targets,
+ ).delete()
+ workspace_user_resource_permission_exist_list = []
+ for user_resource_permission in instance:
+ permission = user_resource_permission["permission"]
+ auth_type, permission_list = permission_map[permission]
+ exist_list = [
+ user_resource_permission_exist
+ for user_resource_permission_exist in workspace_user_resource_permission_exist_list
+ if user_resource_permission.get("target_id") == str(user_resource_permission_exist.target)
+ ]
+ if len(exist_list) > 0:
+ exist_list[0].permission_list = [
+ key
+ for key in user_resource_permission.get("permission").keys()
+ if user_resource_permission.get("permission").get(key)
+ ]
+ exist_list[0].auth_type = user_resource_permission.get("auth_type")
+ update_list.append(exist_list[0])
+ else:
+ save_list.append(
+ WorkspaceUserGroupResourcePermission(
+ target=user_resource_permission.get("target_id"),
+ auth_target_type=self.data.get("auth_target_type"),
+ permission_list=permission_list,
+ workspace_id=workspace_id,
+ user_group_id=user_group_id,
+ auth_type=auth_type,
+ )
+ )
+ # 批量更新
+ QuerySet(WorkspaceUserGroupResourcePermission).bulk_update(
+ update_list, ["permission_list", "auth_type"]
+ ) if len(update_list) > 0 else None
+ # 批量插入
+ QuerySet(WorkspaceUserGroupResourcePermission).bulk_create(save_list) if len(save_list) > 0 else None
+ version = Cache_Version.PERMISSION_LIST.get_version()
+ member_user_ids = (
+ QuerySet(SystemUserGroupRelation).filter(group_id=user_group_id).values_list("user_id", flat=True)
+ )
+ for user_id in member_user_ids:
+ cache.delete(Cache_Version.PERMISSION_LIST.get_key(user_id=user_id), version=version)
+ return instance
+
+
+class ResourceUserPermissionUserListRequest(serializers.Serializer):
+ name = serializers.CharField(required=False, allow_null=True, allow_blank=True, label=_("Name"))
+ permission = serializers.MultipleChoiceField(
+ required=False,
+ allow_null=True,
+ allow_blank=True,
+ choices=["NOT_AUTH", "MANAGE", "VIEW", "ROLE"],
+ label=_("permission"),
+ )
+
+
+class ResourceUserPermissionEditRequest(serializers.Serializer):
+ user_group_id = serializers.CharField(required=True, label=_("User Group id"))
+ permission = serializers.ChoiceField(
+ required=True, choices=["NOT_AUTH", "MANAGE", "VIEW", "ROLE"], label=_("permission")
+ )
+
+
+permission_map = {
+ "ROLE": ("ROLE", ["ROLE"]),
+ "MANAGE": ("RESOURCE_PERMISSION_GROUP", ["MANAGE", "VIEW"]),
+ "VIEW": ("RESOURCE_PERMISSION_GROUP", ["VIEW"]),
+ "NOT_AUTH": ("RESOURCE_PERMISSION_GROUP", []),
+}
+
+
+class ResourceUserGroupPermissionSerializer(serializers.Serializer):
+ workspace_id = serializers.CharField(required=True, label=_("workspace id"))
+ target = serializers.CharField(required=True, label=_("resource id"))
+ auth_target_type = serializers.CharField(required=True, label=_("resource"))
+ users_permission = ResourceUserPermissionEditRequest(required=False, many=True, label=_("users_permission"))
+
+ RESOURCE_MODEL_MAP = {"APPLICATION": Application, "KNOWLEDGE": Knowledge, "TOOL": Tool}
+
+ def get_queryset(self, instance):
+
+ user_query_set = QuerySet(
+ model=get_dynamics_model(
+ {
+ "name": models.CharField(),
+ "permission": models.CharField(),
+ "u.id": models.UUIDField(),
+ }
+ )
+ )
+ name = instance.get("name")
+ permission = instance.get("permission")
+ query_p_list = [None if p == "NOT_AUTH" else p for p in permission]
+
+ workspace_user_group_resource_permission_query_set = QuerySet(WorkspaceUserGroupResourcePermission).filter(
+ workspace_id=self.data.get("workspace_id"),
+ auth_target_type=self.data.get("auth_target_type"),
+ target=self.data.get("target"),
+ )
+ if name:
+ user_query_set = user_query_set.filter(name__contains=name)
+ if permission:
+ if all([p is None for p in query_p_list]):
+ user_query_set = user_query_set.filter(permission=None)
+ else:
+ if any([p is None for p in query_p_list]):
+ user_query_set = user_query_set.filter(Q(permission__in=query_p_list) | Q(permission=None))
+ else:
+ user_query_set = user_query_set.filter(permission__in=query_p_list)
+ return {
+ "workspace_user_group_resource_permission_query_set": workspace_user_group_resource_permission_query_set,
+ "user_query_set": user_query_set,
+ }
+
+ def list(self, instance, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ ResourceUserPermissionUserListRequest(data=instance).is_valid(raise_exception=True)
+ # 资源的用户授权列表
+ resource_user_permission_list = native_search(
+ self.get_queryset(instance),
+ get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "system_manage", "sql", "get_resource_user_group_permission_detail.sql"
+ )
+ ),
+ )
+ return resource_user_permission_list
+
+ def page(self, instance, current_page: int, page_size: int, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ ResourceUserPermissionUserListRequest(data=instance).is_valid(raise_exception=True)
+ resource_user_permission_page_list = native_page_search(
+ current_page,
+ page_size,
+ self.get_queryset(instance),
+ get_file_content(
+ os.path.join(
+ PROJECT_DIR, "apps", "system_manage", "sql", "get_resource_user_group_permission_detail.sql"
+ )
+ ),
+ )
+ return resource_user_permission_page_list
+
+ def get_has_manage_permission_resource_under_folders(self, current_user_id, folder_ids):
+
+ workspace_id = self.data.get("workspace_id")
+ auth_target_type = self.data.get("auth_target_type")
+ resource_model = self.RESOURCE_MODEL_MAP[auth_target_type]
+
+ from folders.serializers.folder import has_exact_permission_by_role
+
+ permission_id = f"{auth_target_type}:READ+AUTH"
+
+ role_type = RoleConstants.USER.value.__str__()
+ has_user_role_exact_permission = has_exact_permission_by_role(
+ current_user_id, workspace_id, permission_id, role_type
+ )
+
+ permission_list = ["MANAGE"]
+ if has_user_role_exact_permission:
+ permission_list = ["MANAGE", "ROLE"]
+
+ current_user_managed_resources_ids = (
+ QuerySet(WorkspaceUserGroupResourcePermission)
+ .filter(
+ workspace_id=workspace_id,
+ user_id=current_user_id,
+ auth_target_type=auth_target_type,
+ target__in=QuerySet(resource_model)
+ .filter(workspace_id=workspace_id, folder__in=folder_ids)
+ .annotate(id_str=Cast("id", TextField()))
+ .values_list("id_str", flat=True),
+ permission_list__overlap=permission_list,
+ )
+ .values_list("target", flat=True)
+ )
+
+ return current_user_managed_resources_ids
+
+ def edit(self, instance, with_valid=True, current_user_id=None):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ ResourceUserPermissionEditRequest(data=instance, many=True).is_valid(raise_exception=True)
+
+ workspace_id = self.data.get("workspace_id")
+ target = self.data.get("target")
+ auth_target_type = self.data.get("auth_target_type")
+ users_permission = instance
+
+ user_group_ids = [item["user_group_id"] for item in users_permission]
+ include_children = users_permission[0].get("include_children")
+ folder_ids = users_permission[0].get("folder_ids")
+ # 删除已存在的对应的用户在该资源下的权限
+
+ if include_children:
+ managed_resource_ids = (
+ list(
+ self.get_has_manage_permission_resource_under_folders(
+ current_user_id,
+ folder_ids,
+ )
+ )
+ + folder_ids
+ )
+
+ else:
+ managed_resource_ids = [target]
+ QuerySet(WorkspaceUserGroupResourcePermission).filter(
+ workspace_id=workspace_id,
+ target__in=managed_resource_ids,
+ auth_target_type=auth_target_type,
+ user_group_id__in=user_group_ids,
+ ).delete()
+
+ save_list = [
+ WorkspaceUserGroupResourcePermission(
+ target=resource_id,
+ auth_target_type=auth_target_type,
+ workspace_id=workspace_id,
+ auth_type=permission_map[item["permission"]][0],
+ user_group_id=item["user_group_id"],
+ permission_list=permission_map[item["permission"]][1],
+ )
+ for resource_id in managed_resource_ids
+ for item in users_permission
+ ]
+
+ if save_list:
+ QuerySet(WorkspaceUserResourcePermission).bulk_create(save_list)
+
+ version = Cache_Version.PERMISSION_LIST.get_version()
+ for user_group_id in user_group_ids:
+ member_user_ids = (
+ QuerySet(SystemUserGroupRelation).filter(group_id=user_group_id).values_list("user_id", flat=True)
+ )
+ for user_id in member_user_ids:
+ cache.delete(Cache_Version.PERMISSION_LIST.get_key(user_id=user_id), version=version)
+ return instance
diff --git a/apps/system_manage/serializers/user_resource_permission.py b/apps/system_manage/serializers/user_resource_permission.py
index ac6a232a42b..a95d1f0c53a 100644
--- a/apps/system_manage/serializers/user_resource_permission.py
+++ b/apps/system_manage/serializers/user_resource_permission.py
@@ -19,8 +19,8 @@
from application.models import Application
from common.constants.cache_version import Cache_Version
-from common.constants.permission_constants import get_default_workspace_user_role_mapping_list, RoleConstants, \
- ResourcePermission, ResourcePermissionRole, ResourceAuthType
+from common.auth.constants.role_constants import RoleConstants
+from common.constants.resource_permission_constants import ResourceAuthType, ResourcePermissionConstants
from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.db.search import native_search, native_page_search, get_dynamics_model
from common.db.sql_execute import select_list
@@ -167,7 +167,7 @@ def is_auth(self, resource_id: str):
else:
return False
else:
- return wurp.permission_list.__contains__(ResourcePermission.VIEW.value)
+ return wurp.permission_list.__contains__(ResourcePermissionConstants.VIEW.value)
def auth_resource_batch(self, resource_id_list: list):
self.is_valid(raise_exception=True)
@@ -181,9 +181,9 @@ def auth_resource_batch(self, resource_id_list: list):
workspace_user_resource_permission = [WorkspaceUserResourcePermission(
target=resource_id,
auth_target_type=auth_target_type,
- permission_list=[ResourcePermission.VIEW,
- ResourcePermission.MANAGE] if auth_type == ResourceAuthType.RESOURCE_PERMISSION_GROUP else [
- ResourcePermissionRole.ROLE],
+ permission_list=[ResourcePermissionConstants.VIEW,
+ ResourcePermissionConstants.MANAGE] if auth_type == ResourceAuthType.RESOURCE_PERMISSION_GROUP else [
+ ResourcePermissionConstants.ROLE],
workspace_id=workspace_id,
user_id=user_id,
auth_type=auth_type
@@ -204,8 +204,8 @@ def auth_resource(self, resource_id: str, is_folder=False):
WorkspaceUserResourcePermission(
target=resource_id,
auth_target_type=auth_target_type,
- permission_list=[ResourcePermission.VIEW,
- ResourcePermission.MANAGE],
+ permission_list=[ResourcePermissionConstants.VIEW,
+ ResourcePermissionConstants.MANAGE],
workspace_id=workspace_id,
user_id=user_id,
auth_type=ResourceAuthType.RESOURCE_PERMISSION_GROUP
diff --git a/apps/models_provider/impl/tencent_cloud_model_provider/icon/__init__.py b/apps/system_manage/services/__init__.py
similarity index 100%
rename from apps/models_provider/impl/tencent_cloud_model_provider/icon/__init__.py
rename to apps/system_manage/services/__init__.py
diff --git a/apps/system_manage/services/resource_mapping.py b/apps/system_manage/services/resource_mapping.py
new file mode 100644
index 00000000000..4462b489fc9
--- /dev/null
+++ b/apps/system_manage/services/resource_mapping.py
@@ -0,0 +1,200 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author: 虎虎虎
+@file: resource_mapping.py
+@desc: 资源映射工具集(唯一来源)。
+
+这些函数只解析 work_flow 的 JSON 结构(nodes/properties/node_data)或实例字段,
+据此推导它引用的目标资源并登记到 system_manage.ResourceMapping。与执行引擎无关,
+故归属于 ResourceMapping 所在的 system_manage,不放在工作流引擎(flow / workflow)里。
+"""
+
+from functools import reduce
+
+from django.db.models import QuerySet
+
+from tools.models import Tool, ToolScope, ToolType, ToolWorkflow
+
+# 节点类型 -> 其引用的目标资源 id 提取函数(按资源类型分组),供资源映射登记使用
+target_source_node_mapping = {
+ "TOOL": {
+ "tool-lib-node": lambda n: [n.get("properties").get("node_data").get("tool_lib_id")],
+ "ai-chat-node": lambda n: [
+ *(n.get("properties").get("node_data").get("mcp_tool_ids") or []),
+ *(n.get("properties").get("node_data").get("tool_ids") or []),
+ *(n.get("properties").get("node_data").get("skill_tool_ids") or []),
+ ],
+ "mcp-node": lambda n: [n.get("properties").get("node_data").get("mcp_tool_id")],
+ "tool-workflow-lib-node": lambda n: [n.get("properties").get("node_data").get("tool_lib_id")],
+ },
+ "MODEL": {
+ "ai-chat-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "question-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "speech-to-text-node": lambda n: [n.get("properties").get("node_data").get("stt_model_id")],
+ "text-to-speech-node": lambda n: [n.get("properties").get("node_data").get("tts_model_id")],
+ "image-to-video-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "image-generate-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "intent-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "image-understand-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "parameter-extraction-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "video-understand-node": lambda n: [n.get("properties").get("node_data").get("model_id")],
+ "reranker-node": lambda n: [n.get("properties").get("node_data").get("reranker_model_id")],
+ },
+ "KNOWLEDGE": {
+ "search-knowledge-node": lambda n: n.get("properties").get("node_data").get("knowledge_id_list"),
+ "search-document-node": lambda n: n.get("properties").get("node_data").get("knowledge_id_list"),
+ },
+ "APPLICATION": {
+ "application-node": lambda n: [n.get("properties").get("node_data").get("application_id")],
+ "ai-chat-node": lambda n: [*(n.get("properties").get("node_data").get("application_ids") or [])],
+ },
+}
+
+
+def get_node_handle_callback(source_type, source_id):
+ def node_handle_callback(node):
+ from system_manage.models.resource_mapping import ResourceMapping
+
+ response = []
+ for key, value in target_source_node_mapping.items():
+ if node.get("type") in value:
+ call = value.get(node.get("type"))
+ target_source_id_list = call(node)
+ for target_source_id in target_source_id_list:
+ if target_source_id:
+ response.append(
+ ResourceMapping(
+ source_type=source_type,
+ target_type=key,
+ source_id=source_id,
+ target_id=target_source_id,
+ )
+ )
+ return response
+
+ return node_handle_callback
+
+
+def get_workflow_resource(workflow, node_handle):
+ response = []
+ if "nodes" in workflow:
+ for node in workflow.get("nodes"):
+ rs = node_handle(node)
+ if rs:
+ for r in rs:
+ response.append(r)
+ if node.get("type") == "loop-node":
+ r = get_workflow_resource(node.get("properties", {}).get("node_data", {}).get("loop_body"), node_handle)
+ for rn in r:
+ response.append(rn)
+ return list({(str(item.target_type) + str(item.target_id)): item for item in response}.values())
+ return []
+
+
+application_instance_field_call_dict = {
+ "TOOL": [
+ lambda instance: instance.mcp_tool_ids or [],
+ lambda instance: instance.skill_tool_ids or [],
+ lambda instance: instance.tool_ids or [],
+ ],
+ "APPLICATION": [
+ lambda instance: instance.application_ids or [],
+ ],
+ "MODEL": [
+ lambda instance: [instance.model_id] if instance.model_id else [],
+ lambda instance: [instance.long_term_model_id] if instance.long_term_model_id else [],
+ lambda instance: [instance.tts_model_id] if instance.tts_model_id else [],
+ lambda instance: [instance.stt_model_id] if instance.stt_model_id else [],
+ ],
+}
+knowledge_instance_field_call_dict = {
+ "MODEL": [lambda instance: [instance.embedding_model_id] if instance.embedding_model_id else []],
+}
+
+
+def get_instance_resource(instance, source_type, source_id, instance_field_call_dict):
+ response = []
+ from system_manage.models.resource_mapping import ResourceMapping
+
+ for target_type, call_list in instance_field_call_dict.items():
+ target_id_list = reduce(lambda x, y: [*x, *y], [call(instance) for call in call_list], [])
+ if target_id_list:
+ for target_id in target_id_list:
+ response.append(
+ ResourceMapping(
+ source_type=source_type, target_type=target_type, source_id=source_id, target_id=target_id
+ )
+ )
+ return response
+
+
+def save_workflow_mapping(workflow, source_type, source_id, other_resource_mapping=None):
+ if not other_resource_mapping:
+ other_resource_mapping = []
+ from system_manage.models.resource_mapping import ResourceMapping
+
+ QuerySet(ResourceMapping).filter(source_type=source_type, source_id=source_id).delete()
+ resource_mapping_list = get_workflow_resource(workflow, get_node_handle_callback(source_type, source_id))
+ resource_mapping_list += other_resource_mapping
+ if resource_mapping_list:
+ QuerySet(ResourceMapping).bulk_create(
+ {(str(item.target_type) + str(item.target_id)): item for item in resource_mapping_list}.values()
+ )
+
+
+def get_tool_id_list(workflow, with_deep=False):
+ _result = []
+ for node in workflow.get("nodes", []):
+ if node.get("type") == "tool-lib-node":
+ tool_id = node.get("properties", {}).get("node_data", {}).get("tool_lib_id")
+ if tool_id:
+ _result.append(tool_id)
+ elif node.get("type") == "loop-node":
+ r = get_tool_id_list(node.get("properties", {}).get("node_data", {}).get("loop_body", {}))
+ for item in r:
+ _result.append(item)
+ elif node.get("type") == "tool-workflow-lib-node":
+ tool_id = node.get("properties", {}).get("node_data", {}).get("tool_lib_id")
+ if tool_id:
+ _result.append(tool_id)
+ elif node.get("type") == "ai-chat-node":
+ node_data = node.get("properties", {}).get("node_data", {})
+ mcp_tool_ids = node_data.get("mcp_tool_ids") or []
+ skill_tool_ids = node_data.get("skill_tool_ids") or []
+ tool_ids = node_data.get("tool_ids") or []
+ for _id in mcp_tool_ids + tool_ids + skill_tool_ids:
+ _result.append(_id)
+ elif node.get("type") == "mcp-node":
+ mcp_tool_id = node.get("properties", {}).get("node_data", {}).get("mcp_tool_id")
+ if mcp_tool_id:
+ _result.append(mcp_tool_id)
+ if with_deep:
+ workflow_list = QuerySet(Tool).filter(id__in=_result, tool_type=ToolType.WORKFLOW)
+ tool_work_flow_list = QuerySet(ToolWorkflow).filter(tool_id__in=[wl.id for wl in workflow_list])
+ for tool_work_flow in tool_work_flow_list:
+ child_tool_id_list = get_child_tool_id_list(tool_work_flow.work_flow, [])
+ for c in child_tool_id_list:
+ _result.append(c)
+ return _result
+
+
+def get_child_tool_id_list(work_flow, response):
+ tool_id_list = get_tool_id_list(work_flow, False)
+ tool_id_list = [tool_id for tool_id in tool_id_list if len([r for r in response if r == tool_id]) == 0]
+ tool_list = []
+ if len(tool_id_list) > 0:
+ tool_list = QuerySet(Tool).filter(id__in=tool_id_list).exclude(scope=ToolScope.SHARED)
+ work_flow_tools = [tool for tool in tool_list if tool.tool_type == ToolType.WORKFLOW]
+ if len(work_flow_tools) > 0:
+ work_flow_tool_dict = {
+ tw.tool_id: tw for tw in QuerySet(ToolWorkflow).filter(tool_id__in=[t.id for t in work_flow_tools])
+ }
+ for tool in tool_list:
+ response.append(str(tool.id))
+ if tool.tool_type == ToolType.WORKFLOW:
+ get_child_tool_id_list(work_flow_tool_dict.get(tool.id).work_flow, response)
+ else:
+ for tool in tool_list:
+ response.append(str(tool.id))
+ return response
diff --git a/apps/system_manage/sql/get_application_user_group_resource_permission.sql b/apps/system_manage/sql/get_application_user_group_resource_permission.sql
new file mode 100644
index 00000000000..dd0ca8b8cac
--- /dev/null
+++ b/apps/system_manage/sql/get_application_user_group_resource_permission.sql
@@ -0,0 +1,47 @@
+SELECT resource_or_folder.*,
+ CASE
+ WHEN wurp.permission IS NULL THEN 'NOT_AUTH'
+ ELSE wurp.permission
+ END
+FROM (
+ SELECT id::text,
+ "name",
+ 'APPLICATION' AS "auth_target_type",
+ 'application' AS "resource_type",
+ user_id,
+ workspace_id,
+ icon,
+ folder_id,
+ create_time
+ FROM application
+ ${query_set}
+ UNION
+ SELECT application_folder."id"::text,
+ application_folder."name",
+ 'APPLICATION' AS "auth_target_type",
+ 'folder' AS "resource_type",
+ application_folder."user_id",
+ application_folder."workspace_id",
+ NULL AS "icon",
+ application_folder."parent_id" AS "folder_id",
+ application_folder."create_time"
+ FROM application_folder
+ ${folder_query_set}
+ ) resource_or_folder
+LEFT JOIN (
+ SELECT target,
+ CASE
+ WHEN auth_type = 'ROLE'
+ AND 'ROLE' = ANY (permission_list) THEN 'ROLE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'MANAGE' = ANY (permission_list) THEN 'MANAGE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'VIEW' = ANY (permission_list) THEN 'VIEW'
+ ELSE NULL
+ END AS permission
+ FROM workspace_user_group_resource_permission
+ ${workspace_user_group_resource_permission_query_set}
+) wurp
+ON wurp.target::text = resource_or_folder.id
+${resource_query_set}
+ORDER BY resource_or_folder.create_time DESC
diff --git a/apps/system_manage/sql/get_knowledge_user_group_resource_permission.sql b/apps/system_manage/sql/get_knowledge_user_group_resource_permission.sql
new file mode 100644
index 00000000000..400ddae5dac
--- /dev/null
+++ b/apps/system_manage/sql/get_knowledge_user_group_resource_permission.sql
@@ -0,0 +1,50 @@
+SELECT resource_or_folder.*,
+ CASE
+ WHEN wurp.permission IS NULL THEN 'NOT_AUTH'
+ ELSE wurp.permission
+ END
+FROM (
+ SELECT
+ id::text,
+ "name",
+ 'KNOWLEDGE' AS "auth_target_type",
+ 'knowledge' AS "resource_type",
+ user_id,
+ workspace_id,
+ "type"::varchar AS "icon",
+ folder_id,
+ create_time
+ FROM knowledge
+ ${query_set}
+ UNION
+ SELECT knowledge_folder."id"::text,
+ knowledge_folder."name",
+ 'KNOWLEDGE' AS "auth_target_type",
+ 'folder' AS "resource_type",
+ knowledge_folder."user_id",
+ knowledge_folder."workspace_id",
+ NULL AS "icon",
+ knowledge_folder."parent_id" AS "folder_id",
+ knowledge_folder."create_time"
+ FROM knowledge_folder
+ ${folder_query_set}
+ ) resource_or_folder
+LEFT JOIN (
+ SELECT
+ target,
+ CASE
+ WHEN auth_type = 'ROLE'
+ AND 'ROLE' = ANY(permission_list) THEN 'ROLE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'MANAGE' = ANY(permission_list) THEN 'MANAGE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'VIEW' = ANY(permission_list) THEN 'VIEW'
+ ELSE null
+ END AS permission
+ FROM
+ workspace_user_group_resource_permission
+ ${workspace_user_group_resource_permission_query_set}
+) wurp
+ON wurp.target::text = resource_or_folder.id
+${resource_query_set}
+ORDER BY resource_or_folder.create_time DESC
\ No newline at end of file
diff --git a/apps/system_manage/sql/get_model_user_group_resource_permission.sql b/apps/system_manage/sql/get_model_user_group_resource_permission.sql
new file mode 100644
index 00000000000..532646c7ffe
--- /dev/null
+++ b/apps/system_manage/sql/get_model_user_group_resource_permission.sql
@@ -0,0 +1,55 @@
+SELECT
+ resource_or_folder.*,
+ CASE
+ WHEN
+ wurp."permission" is null then 'NOT_AUTH'
+ ELSE wurp."permission"
+ END
+FROM (
+ SELECT
+ "id"::text,
+ "name",
+ 'MODEL' AS "auth_target_type",
+ 'model' AS "resource_type",
+ user_id,
+ workspace_id,
+ provider as icon,
+ 'default' as folder_id,
+ create_time
+ FROM
+ model
+ ${query_set}
+ UNION
+ SELECT
+ "id"::text,
+ "name",
+ 'MODEL' AS "auth_target_type",
+ 'folder' AS "resource_type",
+ user_id,
+ workspace_id,
+ provider as icon,
+ 'default' as folder_id,
+ create_time
+ FROM model
+ ${folder_query_set}
+ AND 1=0
+) resource_or_folder
+LEFT JOIN (
+ SELECT
+ target,
+ CASE
+ WHEN auth_type = 'ROLE'
+ AND 'ROLE' = ANY(permission_list) THEN 'ROLE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'MANAGE' = ANY(permission_list) THEN 'MANAGE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'VIEW' = ANY(permission_list) THEN 'VIEW'
+ ELSE null
+ END AS permission
+ FROM
+ workspace_user_group_resource_permission
+ ${workspace_user_group_resource_permission_query_set}
+) wurp
+ON wurp.target = resource_or_folder."id"
+${resource_query_set}
+ORDER BY resource_or_folder.create_time DESC
\ No newline at end of file
diff --git a/apps/system_manage/sql/get_resource_user_group_permission_detail.sql b/apps/system_manage/sql/get_resource_user_group_permission_detail.sql
new file mode 100644
index 00000000000..0f5a2b34ccd
--- /dev/null
+++ b/apps/system_manage/sql/get_resource_user_group_permission_detail.sql
@@ -0,0 +1,41 @@
+SELECT
+ u.id,
+ u.name,
+ COALESCE(ugr."count", 0) AS "count",
+ case
+ when
+ wurp."permission" is null then 'NOT_AUTH'
+ else wurp."permission"
+ end
+FROM
+ public."system_user_group" u
+LEFT JOIN (
+ SELECT
+ user_group_id ,
+ (case
+ when auth_type = 'ROLE'
+ and 'ROLE' = any( permission_list) then 'ROLE'
+ when auth_type = 'RESOURCE_PERMISSION_GROUP'
+ and 'MANAGE'= any(permission_list) then 'MANAGE'
+ when auth_type = 'RESOURCE_PERMISSION_GROUP'
+ and 'VIEW' = any( permission_list) then 'VIEW'
+ else null
+ end) as "permission"
+ FROM
+ workspace_user_group_resource_permission
+ ${workspace_user_group_resource_permission_query_set}
+ ) wurp
+ON
+ u.id = wurp.user_group_id
+LEFT JOIN (
+ SELECT
+ group_id,
+ COUNT(*) AS "count"
+ FROM
+ public."system_user_group_relation"
+ GROUP BY
+ group_id
+) ugr
+ON
+ u.id = ugr.group_id
+${user_query_set}
\ No newline at end of file
diff --git a/apps/system_manage/sql/get_tool_user_group_resource_permission.sql b/apps/system_manage/sql/get_tool_user_group_resource_permission.sql
new file mode 100644
index 00000000000..46297832842
--- /dev/null
+++ b/apps/system_manage/sql/get_tool_user_group_resource_permission.sql
@@ -0,0 +1,51 @@
+SELECT resource_or_folder.*,
+ CASE
+ WHEN wurp."permission" IS NULL THEN 'NOT_AUTH'
+ ELSE wurp."permission"
+ END
+FROM (
+ SELECT "id"::text,
+ "name",
+ 'TOOL' AS "auth_target_type",
+ 'tool' AS "resource_type",
+ user_id,
+ workspace_id,
+ icon,
+ folder_id,
+ tool_type,
+ create_time
+ FROM tool
+ ${query_set}
+ UNION
+ SELECT tool_folder."id"::text,
+ tool_folder."name",
+ 'TOOL' AS "auth_target_type",
+ 'folder' AS "resource_type",
+ tool_folder."user_id",
+ tool_folder."workspace_id",
+ NULL AS "icon",
+ tool_folder."parent_id" AS "folder_id",
+ NULL AS "tool_type",
+ tool_folder."create_time"
+ FROM tool_folder
+ ${folder_query_set}
+ ) resource_or_folder
+LEFT JOIN (
+ SELECT target,
+ CASE
+ WHEN auth_type = 'ROLE'
+ AND 'ROLE' = ANY(permission_list) THEN 'ROLE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'MANAGE' = ANY(permission_list) THEN 'MANAGE'
+ WHEN auth_type = 'RESOURCE_PERMISSION_GROUP'
+ AND 'VIEW' = ANY(permission_list) THEN 'VIEW'
+ ELSE null
+ END AS permission
+ FROM
+ workspace_user_group_resource_permission
+ ${workspace_user_group_resource_permission_query_set}
+) wurp
+ON wurp.target::text = resource_or_folder."id"
+${resource_query_set}
+ORDER BY resource_or_folder.create_time DESC
+
diff --git a/apps/system_manage/urls.py b/apps/system_manage/urls.py
index 078da32f922..eba3e147583 100644
--- a/apps/system_manage/urls.py
+++ b/apps/system_manage/urls.py
@@ -8,11 +8,27 @@
urlpatterns = [
path('workspace//user_resource_permission/user//resource/', views.WorkSpaceUserResourcePermissionView.as_view()),
path('workspace//user_resource_permission/user//resource///', views.WorkSpaceUserResourcePermissionView.Page.as_view()),
+ path('workspace//user_group_resource_permission/user_group//resource/', views.WorkSpaceUserGroupResourcePermissionView.as_view()),
+ path('workspace//user_group_resource_permission/user_group//resource///', views.WorkSpaceUserGroupResourcePermissionView.Page.as_view()),
path('workspace//resource_user_permission/resource//resource/', views.WorkspaceResourceUserPermissionView.as_view()),
path('workspace//resource_user_permission/resource//resource///', views.WorkspaceResourceUserPermissionView.Page.as_view()),
+ path('workspace//resource_user_group_permission/resource//resource/', views.WorkspaceResourceUserGroupPermissionView.as_view()),
+ path('workspace//resource_user_group_permission/resource//resource///', views.WorkspaceResourceUserGroupPermissionView.Page.as_view()),
path('workspace//resource_mapping////', views.ResourceMappingView.as_view()),
path('workspace//mapping_resource////', views.MappingResourceView.as_view()),
path('email_setting', views.SystemSetting.Email.as_view()),
path('profile', views.SystemProfile.as_view()),
- path('valid//', views.Valid.as_view())
+ path('system/chat_user', views.SystemChatUserView.as_view()),
+ path('system/chat_user/list', views.SystemChatUserView.List.as_view()),
+ path('system/chat_user/batch_delete', views.SystemChatUserView.BatchDelete.as_view()),
+ path("system/chat_user/batch_add_group", views.SystemChatUserView.BatchAddGroup.as_view()),
+ path("system/chat_user/", views.SystemChatUserView.Operate.as_view()),
+ path("system/chat_user//re_password", views.SystemChatUserView.RePassword.as_view()),
+ path("system/chat_user/user_manage//", views.SystemChatUserView.Page.as_view()),
+ path('system/chat_user/group/', views.SystemChatUserView.GetUserListByGroup.as_view()),
+ path('system/group', views.SystemChatUserGroupView.as_view()),
+ path('system/group/', views.SystemChatUserGroupView.Delete.as_view()),
+ path('system/group//add_member', views.SystemChatUserGroupView.AddMember.as_view()),
+ path('system/group//remove_member', views.SystemChatUserGroupView.RemoveMember.as_view()),
+ path('system/group//user_list//', views.SystemChatUserGroupView.UserList.as_view()),
]
diff --git a/apps/system_manage/views/__init__.py b/apps/system_manage/views/__init__.py
index b8af19c4b5e..d78a56454bf 100644
--- a/apps/system_manage/views/__init__.py
+++ b/apps/system_manage/views/__init__.py
@@ -11,3 +11,5 @@
from .system_profile import *
from .valid import *
from .resource_mapping import *
+from .system_chat_user import *
+from .user_group_resource_permission import *
diff --git a/apps/system_manage/views/email_setting.py b/apps/system_manage/views/email_setting.py
index f386bb6e816..0dc281b8828 100644
--- a/apps/system_manage/views/email_setting.py
+++ b/apps/system_manage/views/email_setting.py
@@ -12,7 +12,8 @@
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
from django.utils.translation import gettext_lazy as _
diff --git a/apps/system_manage/views/resource_mapping.py b/apps/system_manage/views/resource_mapping.py
index ff3c71d303d..b012e2b8f3e 100644
--- a/apps/system_manage/views/resource_mapping.py
+++ b/apps/system_manage/views/resource_mapping.py
@@ -1,10 +1,10 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: resource_mapping.py
- @date:2025/12/25 15:28
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: resource_mapping.py
+@date:2025/12/25 15:28
+@desc:
"""
from django.utils.translation import gettext_lazy as _
@@ -15,8 +15,10 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import Permission, Group, Operate, RoleConstants, ViewPermission, \
- CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from system_manage.api.resource_mapping import ResourceMappingAPI
from system_manage.serializers.resource_mapping_serializers import ResourceMappingSerializer, MappingResourceSerializer
@@ -25,65 +27,83 @@ class ResourceMappingView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Retrieve the pagination list of resource relationships'),
- operation_id=_('Retrieve the pagination list of resource relationships'), # type: ignore
+ methods=["GET"],
+ description=_("Retrieve the pagination list of resource relationships"),
+ operation_id=_("Retrieve the pagination list of resource relationships"), # type: ignore
responses=ResourceMappingAPI.get_response(),
parameters=ResourceMappingAPI.get_parameters(),
- tags=[_('Resources mapping')] # type: ignore
+ tags=[_("Resources mapping")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.RELATE_VIEW,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"),
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.RELATE_VIEW,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource')}/{kwargs.get('resource_id')}"),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource')}/{kwargs.get('resource_id')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('resource')}_RELATE_RESOURCE_VIEW"
+ ].get_workspace_permission_workspace_manage_role()(r, kwargs),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('resource')}_RELATE_RESOURCE_VIEW"
+ ]._build_workspace_permission(resource_id_key="resource_id")(r, kwargs),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("resource")]._build_workspace_permission(
+ resource_id_key="resource_id"
+ )(r, kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, resource: str, resource_id: str, current_page, page_size):
- return result.success(ResourceMappingSerializer({
- 'resource': resource,
- 'resource_id': resource_id,
- 'resource_name': request.query_params.get('resource_name'),
- 'user_name': request.query_params.get('user_name'),
- 'source_type': request.query_params.getlist('source_type[]'),
- }).page(current_page, page_size))
+ return result.success(
+ ResourceMappingSerializer(
+ {
+ "resource": resource,
+ "resource_id": resource_id,
+ "resource_name": request.query_params.get("resource_name"),
+ "user_name": request.query_params.get("user_name"),
+ "source_type": request.query_params.getlist("source_type[]"),
+ }
+ ).page(current_page, page_size)
+ )
class MappingResourceView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Retrieve the pagination list of resource relationships'),
- operation_id=_('Retrieve the pagination list of resource relationships'), # type: ignore
+ methods=["GET"],
+ description=_("Retrieve the pagination list of resource relationships"),
+ operation_id=_("Retrieve the pagination list of resource relationships"), # type: ignore
responses=ResourceMappingAPI.get_response(),
parameters=ResourceMappingAPI.get_parameters(),
- tags=[_('Mapping Resource')] # type: ignore
+ tags=[_("Mapping Resource")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.RELATE_VIEW,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"),
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.RELATE_VIEW,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource')}/{kwargs.get('resource_id')}"),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource')}/{kwargs.get('resource_id')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('resource')}_RELATE_RESOURCE_VIEW"
+ ].get_workspace_permission_workspace_manage_role()(r, kwargs),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('resource')}_RELATE_RESOURCE_VIEW"
+ ]._build_workspace_permission(resource_id_key="resource_id")(r, kwargs),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("resource")]._build_workspace_permission(
+ resource_id_key="resource_id"
+ )(r, kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, resource: str, resource_id: str, current_page, page_size):
- return result.success(MappingResourceSerializer({
- 'resource': resource,
- 'resource_id': resource_id,
- 'resource_name': request.query_params.get('resource_name'),
- 'user_name': request.query_params.get('user_name'),
- 'target_type': request.query_params.getlist('target_type[]'),
- }).page(current_page, page_size))
\ No newline at end of file
+ return result.success(
+ MappingResourceSerializer(
+ {
+ "resource": resource,
+ "resource_id": resource_id,
+ "resource_name": request.query_params.get("resource_name"),
+ "user_name": request.query_params.get("user_name"),
+ "target_type": request.query_params.getlist("target_type[]"),
+ }
+ ).page(current_page, page_size)
+ )
diff --git a/apps/system_manage/views/system_chat_user.py b/apps/system_manage/views/system_chat_user.py
new file mode 100644
index 00000000000..bc8bfd11000
--- /dev/null
+++ b/apps/system_manage/views/system_chat_user.py
@@ -0,0 +1,399 @@
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from common.auth import TokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.log.log import log
+from common.result import result
+from models_provider.api.model import DefaultModelResponse
+from system_manage.api.chat_user import BatchAddGroupApi, ChatUserAPI, ChatUserPageApi, EditUserApi
+from system_manage.api.user_group import (
+ AddMemberApi,
+ CreateUserGroupApi,
+ DeleteUserGroupApi,
+ RemoveMemberApi,
+ UserGroupListApi,
+)
+from system_manage.models import ChatUser, UserGroup
+from system_manage.serializers.chat_user import (
+ ChatUserSerializer,
+ UserGroupAddMemberSerializer,
+ UserGroupCreateSerializer,
+ UserGroupListPageSerializer,
+ UserGroupRemoveMemberSerializer,
+)
+from users.api.user import ChangeUserPasswordApi, DeleteUserApi, UserPageApi, UserProfileAPI
+
+
+def get_user_operation_object(user_id):
+ user_model = QuerySet(model=ChatUser).filter(id=user_id).first()
+ if user_model is not None:
+ return {"name": user_model.username}
+ return {}
+
+
+def get_batch_delete_user_operation_object(user_ids):
+ user_models = QuerySet(model=ChatUser).filter(id__in=user_ids)
+ if user_models.exists():
+ return {"name": ", ".join([user.username for user in user_models])}
+ return {}
+
+
+def get_user_group_operation_object(user_group_id):
+ user_group_model = QuerySet(model=UserGroup).filter(id=user_group_id).first()
+ if user_group_model is not None:
+ return {"name": user_group_model.name}
+ return {}
+
+
+class SystemChatUserView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Create chat user"),
+ description=_("Create chat user"),
+ operation_id=_("Create chat user"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ request=ChatUserAPI.get_request(),
+ responses=ChatUserAPI.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_CREATE, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="User management",
+ operate="Add user",
+ get_operation_object=lambda r, k: {"name": r.data.get("username", None)},
+ )
+ def post(self, request: Request):
+ return result.success(ChatUserSerializer().save(request.data))
+
+ class List(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get chat user list"),
+ description=_("Get chat user list"),
+ operation_id=_("Get chat user list"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ responses=ChatUserPageApi.get_response(),
+ )
+ @has_permissions(
+ PermissionConstants.CHAT_USER_READ,
+ PermissionConstants.USER_GROUP_READ,
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE,
+ )
+ def get(self, request: Request):
+ return result.success(ChatUserSerializer.list())
+
+ class Operate(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Delete chat user"),
+ summary=_("Delete chat user"),
+ operation_id=_("Delete chat user"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ parameters=DeleteUserApi.get_parameters(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_DELETE, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="User management",
+ operate="Delete user",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ )
+ def delete(self, request: Request, user_id):
+ return result.success(ChatUserSerializer.Operate(data={"id": user_id}).delete(with_valid=True))
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get chat user information"),
+ description=_("Get chat user information"),
+ operation_id=_("Get chat user information"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ request=DeleteUserApi.get_parameters(),
+ responses=UserProfileAPI.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_READ, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ def get(self, request: Request, user_id):
+ return result.success(ChatUserSerializer.Operate(data={"id": user_id}).one(with_valid=True))
+
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Update chat user information"),
+ description=_("Update chat user information"),
+ operation_id=_("Update chat user information"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ parameters=DeleteUserApi.get_parameters(),
+ request=EditUserApi.get_request(),
+ responses=UserProfileAPI.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_EDIT, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="Chat user",
+ operate="Update user information",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ )
+ def put(self, request: Request, user_id):
+ return result.success(ChatUserSerializer.Operate(data={"id": user_id}).edit(request.data, with_valid=True))
+
+ class GetUserListByGroup(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user list by group"),
+ description=_("Get user list by group"),
+ operation_id=_("Get user list by group"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ request=AddMemberApi.get_parameters(),
+ responses=UserProfileAPI.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_READ, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ def get(self, request: Request, user_group_id):
+ return result.success(
+ ChatUserSerializer.GetUserListByGroup(data={"group_id": user_group_id}).get_user_list()
+ )
+
+ class BatchDelete(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Batch delete chat user"),
+ description=_("Batch delete chat user"),
+ operation_id=_("Batch delete chat user"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ request=DeleteUserApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_DELETE, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="Chat user",
+ operate="Batch delete user",
+ get_operation_object=lambda r, k: get_batch_delete_user_operation_object(r.data.get("ids", [])),
+ )
+ def post(self, request: Request):
+ return result.success(ChatUserSerializer.BatchDeleteInstance({"ids": request.data}).batch_delete())
+
+ class BatchAddGroup(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Batch add chat user to group"),
+ description=_("Batch add chat user to group"),
+ operation_id=_("Batch add chat user to group"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ request=BatchAddGroupApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_GROUP, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="Chat user",
+ operate="Batch add user to group",
+ get_operation_object=lambda r, k: get_batch_delete_user_operation_object(r.data.get("user_group_ids", [])),
+ )
+ def post(self, request: Request):
+ return result.success(ChatUserSerializer.BatchAddGroup(data=request.data).batch_add_group(with_valid=True))
+
+ class RePassword(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Change chat user password"),
+ description=_("Change chat user password"),
+ operation_id=_("Change chat user password"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ parameters=DeleteUserApi.get_parameters(),
+ request=ChangeUserPasswordApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_EDIT, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="Chat user",
+ operate="Change password",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ )
+ def put(self, request: Request, user_id):
+ return result.success(
+ ChatUserSerializer.Operate(data={"id": user_id}).re_password(request.data, with_valid=True)
+ )
+
+ class Page(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user paginated list"),
+ description=_("Get user paginated list"),
+ operation_id=_("Get user paginated list"), # type: ignore
+ tags=[_("System/Chat user")], # type: ignore
+ parameters=ChatUserPageApi.get_parameters(),
+ responses=UserPageApi.get_response(),
+ )
+ @has_permissions(PermissionConstants.CHAT_USER_READ, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ def get(self, request: Request, current_page, page_size):
+ d = ChatUserSerializer.Query(
+ data={
+ "username": request.query_params.get("username", None),
+ "nick_name": request.query_params.get("nick_name", None),
+ "source": request.query_params.get("source", None),
+ "is_active": request.query_params.get("is_active", None),
+ "user_id": str(request.user.id),
+ }
+ )
+ return result.success(d.page(current_page, page_size))
+
+
+class SystemChatUserGroupView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Create or update Chat User Group"),
+ description=_("Create or update Chat User Group"),
+ operation_id=_("Create or update Chat User Group"), # type: ignore
+ request=CreateUserGroupApi.get_request(),
+ responses=CreateUserGroupApi.get_response(),
+ tags=[_("System/User Group")], # type: ignore
+ ) # type: ignore
+ @has_permissions(
+ PermissionConstants.USER_GROUP_CREATE,
+ PermissionConstants.USER_GROUP_EDIT,
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE,
+ )
+ @log(
+ menu="User group",
+ operate="Create or update user group",
+ get_operation_object=lambda r, k: {"name": r.data.get("name", None)},
+ )
+ def post(self, request: Request):
+ return result.success(UserGroupCreateSerializer(data=request.data).create_or_update_group(with_valid=True))
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user group list"),
+ description=_("Get user group list"),
+ operation_id=_("Get user group list"), # type: ignore
+ responses=UserGroupListApi.get_response(),
+ tags=[_("System/User Group")], # type: ignore
+ )
+ @has_permissions(PermissionConstants.USER_GROUP_READ, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ def get(self, request: Request):
+ return result.success(UserGroupCreateSerializer().get_user_group_list())
+
+ class Delete(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ summary=_("Delete chat user group"),
+ description=_("Delete chat user group"),
+ operation_id=_("Delete chat user group"), # type: ignore
+ parameters=DeleteUserGroupApi.get_parameters(),
+ responses=DefaultModelResponse,
+ tags=[_("System/User Group")], # type: ignore
+ )
+ @has_permissions(PermissionConstants.USER_GROUP_DELETE, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="User group",
+ operate="Delete user group",
+ get_operation_object=lambda r, k: get_user_group_operation_object(k.get("user_group_id")),
+ )
+ def delete(self, request: Request, user_group_id: str):
+ return result.success(
+ UserGroupCreateSerializer.UserGroupDeleteSerializer(data={"id": user_group_id}).delete()
+ )
+
+ class AddMember(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Add member to chat user group"),
+ description=_("Add member to chat user group"),
+ operation_id=_("Add member to chat user group"), # type: ignore
+ parameters=AddMemberApi.get_parameters(),
+ request=AddMemberApi.get_request(),
+ responses=DefaultModelResponse,
+ tags=[_("System/User Group")], # type: ignore
+ )
+ @has_permissions(PermissionConstants.USER_GROUP_ADD_MEMBER, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ @log(
+ menu="User group",
+ operate="Add member to user group",
+ get_operation_object=lambda r, k: get_user_group_operation_object(k.get("user_group_id")),
+ get_user=lambda r: {"user_name": None, "email": None},
+ get_details=lambda r: {"user_ids": r.data.get("user_ids", [])},
+ )
+ def post(self, request: Request, user_group_id: str):
+ return result.success(
+ UserGroupAddMemberSerializer(
+ data={"id": user_group_id, "user_ids": request.data.get("user_ids", [])}
+ ).add_member()
+ )
+
+ class RemoveMember(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Remove member from chat user group"),
+ description=_("Remove member from chat user group"),
+ operation_id=_("Remove member from chat user group"), # type: ignore
+ parameters=AddMemberApi.get_parameters(),
+ request=RemoveMemberApi.get_request(),
+ responses=DefaultModelResponse,
+ tags=[_("System/User Group")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.USER_GROUP_REMOVE_MEMBER, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE
+ )
+ @log(
+ menu="User group",
+ operate="Remove member from user group",
+ get_operation_object=lambda r, k: get_user_group_operation_object(k.get("user_group_id")),
+ get_user=lambda r: {"user_name": None, "email": None},
+ get_details=lambda r: {"group_relation_ids": r.data.get("group_relation_ids", [])},
+ )
+ def post(self, request: Request, user_group_id: str):
+ return result.success(
+ UserGroupRemoveMemberSerializer(
+ data={"id": user_group_id, "group_relation_ids": request.data.get("group_relation_ids", [])}
+ ).remove_member()
+ )
+
+ class UserList(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user list by group"),
+ description=_("Get user list by group"),
+ operation_id=_("Get user list by group"), # type: ignore
+ tags=[_("System/User Group")], # type: ignore
+ parameters=UserGroupListApi.get_parameters(),
+ responses=UserGroupListApi.get_response(),
+ )
+ @has_permissions(PermissionConstants.USER_GROUP_READ, RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE)
+ def get(self, request: Request, user_group_id: str, current_page: int, page_size: int):
+ d = UserGroupListPageSerializer.Query(
+ data={
+ "username": request.query_params.get("username", None),
+ "nick_name": request.query_params.get("nick_name", None),
+ "source": request.query_params.get("source", None),
+ "group_id": user_group_id,
+ }
+ )
+ return result.success(d.page(current_page, page_size))
diff --git a/apps/system_manage/views/user_group_resource_permission.py b/apps/system_manage/views/user_group_resource_permission.py
new file mode 100644
index 00000000000..8d2fe9f9243
--- /dev/null
+++ b/apps/system_manage/views/user_group_resource_permission.py
@@ -0,0 +1,284 @@
+# coding=utf-8
+"""
+@project: MaxKB
+@Author:虎虎
+@file: workspace_user_resource_permission.py
+@date:2025/4/28 16:38
+@desc:
+"""
+
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from common import result
+from common.auth import TokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.group_constants import Group
+from common.auth.constants.operate_constants import Operate
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.auth.struct.permission import Permission
+from common.log.log import log
+from system_manage.api.user_resource_permission import (
+ UserResourcePermissionAPI,
+ EditUserResourcePermissionAPI,
+ ResourceUserPermissionAPI,
+ ResourceUserPermissionPageAPI,
+ ResourceUserPermissionEditAPI,
+ UserResourcePermissionPageAPI,
+)
+from system_manage.serializers.user_group_resource_permission import (
+ UserGroupResourcePermissionSerializer,
+ ResourceUserGroupPermissionSerializer,
+)
+from users.models.user_group import SystemUserGroup
+
+
+def get_user_operation_object(user_group_id):
+ user_group = QuerySet(model=SystemUserGroup).filter(id=user_group_id).first()
+ if user_group is not None:
+ return {"name": user_group.name}
+ return {}
+
+
+class WorkSpaceUserGroupResourcePermissionView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Obtain resource authorization list"),
+ operation_id=_("Obtain resource authorization list"), # type: ignore
+ parameters=UserResourcePermissionAPI.get_parameters(),
+ responses=UserResourcePermissionAPI.get_response(),
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @has_permissions(
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource") + "_RESOURCE_PERMISSION_READ"
+ ]._build_workspace_permission(),
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(self, request: Request, workspace_id: str, user_group_id: str, resource: str):
+ return result.success(
+ UserGroupResourcePermissionSerializer(
+ data={"workspace_id": workspace_id, "user_group_id": user_group_id, "auth_target_type": resource}
+ ).list(
+ {"name": request.query_params.get("name"), "permission": request.query_params.getlist("permission[]")},
+ request.user,
+ )
+ )
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Modify the resource authorization list"),
+ operation_id=_("Modify the resource authorization list"), # type: ignore
+ parameters=EditUserResourcePermissionAPI.get_parameters(),
+ request=EditUserResourcePermissionAPI.get_request(),
+ responses=EditUserResourcePermissionAPI.get_response(),
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @log(
+ menu="System",
+ operate="Modify the resource authorization list",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_group_id")),
+ )
+ @has_permissions(
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource") + "_RESOURCE_PERMISSION_EDIT"
+ ]._build_workspace_permission(),
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def put(self, request: Request, workspace_id: str, user_group_id: str, resource: str):
+ return result.success(
+ UserGroupResourcePermissionSerializer(
+ data={"workspace_id": workspace_id, "user_group_id": user_group_id, "auth_target_type": resource}
+ ).edit(request.data, request.user)
+ )
+
+ class Page(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Obtain resource authorization list by page"),
+ summary=_("Obtain resource authorization list by page"),
+ operation_id=_("Obtain resource authorization list by page"), # type: ignore
+ request=None,
+ parameters=UserResourcePermissionPageAPI.get_parameters(),
+ responses=UserResourcePermissionPageAPI.get_response(),
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @has_permissions(
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource") + "_RESOURCE_PERMISSION_READ"
+ ]._build_workspace_permission(),
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(
+ self,
+ request: Request,
+ workspace_id: str,
+ user_group_id: str,
+ resource: str,
+ current_page: str,
+ page_size: str,
+ ):
+ return result.success(
+ UserGroupResourcePermissionSerializer(
+ data={"workspace_id": workspace_id, "user_group_id": user_group_id, "auth_target_type": resource}
+ ).page(
+ {
+ "name": request.query_params.get("name"),
+ "permission": request.query_params.getlist("permission[]"),
+ },
+ current_page,
+ page_size,
+ request.user,
+ )
+ )
+
+
+class WorkspaceResourceUserGroupPermissionView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get user group authorization status of resource"),
+ summary=_("Get user group authorization status of resource"),
+ operation_id=_("Get user group authorization status of resource"), # type: ignore
+ parameters=ResourceUserPermissionAPI.get_parameters(),
+ responses=ResourceUserPermissionAPI.get_response(),
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @has_permissions(
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ].get_workspace_permission_workspace_manage_role(),
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ]._build_workspace_permission(resource_id_key="target"),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "")
+ ]._build_workspace_permission(resource_id_key="target")(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(self, request: Request, workspace_id: str, target: str, resource: str):
+ return result.success(
+ UserGroupResourcePermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "target": target,
+ "auth_target_type": resource.replace("_FOLDER", ""),
+ }
+ ).list(
+ {"name": request.query_params.get("name"), "permission": request.query_params.getlist("permission[]")}
+ )
+ )
+
+ @extend_schema(
+ methods=["PUT"],
+ description=_("Edit user group authorization status of resource"),
+ summary=_("Edit user group authorization status of resource"),
+ operation_id=_("Edit user group authorization status of resource"), # type: ignore
+ parameters=ResourceUserPermissionEditAPI.get_parameters(),
+ request=ResourceUserPermissionEditAPI.get_request(),
+ responses=ResourceUserPermissionEditAPI.get_response(),
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @log(
+ menu="System",
+ operate="Edit user group authorization status of resource",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ )
+ @has_permissions(
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ].get_workspace_permission_workspace_manage_role(),
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ]._build_workspace_permission(resource_id_key="target"),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "")
+ ]._build_workspace_permission(resource_id_key="target")(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def put(self, request: Request, workspace_id: str, target: str, resource: str):
+ return result.success(
+ ResourceUserGroupPermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "target": target,
+ "auth_target_type": resource.replace("_FOLDER", ""),
+ }
+ ).edit(instance=request.data, current_user_id=request.user.id)
+ )
+
+ class Page(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ description=_("Get user group authorization status of resource by page"),
+ summary=_("Get user group authorization status of resource by page"),
+ operation_id=_("Get user group authorization status of resource by page"), # type: ignore
+ parameters=ResourceUserPermissionPageAPI.get_parameters(),
+ responses=ResourceUserPermissionPageAPI.get_response(),
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @has_permissions(
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ].get_workspace_permission_workspace_manage_role(),
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ]._build_workspace_permission(resource_id_key="target"),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "")
+ ]._build_workspace_permission(resource_id_key="target")(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(
+ self, request: Request, workspace_id: str, target: str, resource: str, current_page: int, page_size: int
+ ):
+ return result.success(
+ ResourceUserGroupPermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "target": target,
+ "auth_target_type": resource.replace("_FOLDER", ""),
+ }
+ ).page(
+ {
+ "name": request.query_params.get("name"),
+ "permission": request.query_params.getlist("permission[]"),
+ },
+ current_page,
+ page_size,
+ )
+ )
diff --git a/apps/system_manage/views/user_resource_permission.py b/apps/system_manage/views/user_resource_permission.py
index 8f03327eaff..68d6cbab04d 100644
--- a/apps/system_manage/views/user_resource_permission.py
+++ b/apps/system_manage/views/user_resource_permission.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: workspace_user_resource_permission.py
- @date:2025/4/28 16:38
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: workspace_user_resource_permission.py
+@date:2025/4/28 16:38
+@desc:
"""
+
from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
@@ -15,23 +16,33 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import RoleConstants, Permission, Group, Operate, ViewPermission, \
- CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.group_constants import Group
+from common.auth.constants.operate_constants import Operate
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.auth.struct.permission import Permission
from common.log.log import log
-from system_manage.api.user_resource_permission import UserResourcePermissionAPI, EditUserResourcePermissionAPI, \
- ResourceUserPermissionAPI, ResourceUserPermissionPageAPI, ResourceUserPermissionEditAPI, \
- UserResourcePermissionPageAPI
-from system_manage.serializers.user_resource_permission import UserResourcePermissionSerializer, \
- ResourceUserPermissionSerializer
+from system_manage.api.user_resource_permission import (
+ UserResourcePermissionAPI,
+ EditUserResourcePermissionAPI,
+ ResourceUserPermissionAPI,
+ ResourceUserPermissionPageAPI,
+ ResourceUserPermissionEditAPI,
+ UserResourcePermissionPageAPI,
+)
+from system_manage.serializers.user_resource_permission import (
+ UserResourcePermissionSerializer,
+ ResourceUserPermissionSerializer,
+)
from users.models import User
def get_user_operation_object(user_id):
user_model = QuerySet(model=User).filter(id=user_id).first()
if user_model is not None:
- return {
- "name": user_model.username
- }
+ return {"name": user_model.username}
return {}
@@ -39,166 +50,236 @@ class WorkSpaceUserResourcePermissionView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Obtain resource authorization list'),
- operation_id=_('Obtain resource authorization list'), # type: ignore
+ methods=["GET"],
+ description=_("Obtain resource authorization list"),
+ operation_id=_("Obtain resource authorization list"), # type: ignore
parameters=UserResourcePermissionAPI.get_parameters(),
responses=UserResourcePermissionAPI.get_response(),
- tags=[_('Resources authorization')] # type: ignore
+ tags=[_("Resources authorization")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource') + '_WORKSPACE_USER_RESOURCE_PERMISSION'),
- operate=Operate.READ),
- RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource") + "_RESOURCE_PERMISSION_READ"
+ ]._build_workspace_permission(),
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, user_id: str, resource: str):
- return result.success(UserResourcePermissionSerializer(
- data={'workspace_id': workspace_id, 'user_id': user_id, 'auth_target_type': resource}
- ).list({'name': request.query_params.get('name'),
- 'permission': request.query_params.getlist('permission[]')}, request.user))
+ return result.success(
+ UserResourcePermissionSerializer(
+ data={"workspace_id": workspace_id, "user_id": user_id, "auth_target_type": resource}
+ ).list(
+ {"name": request.query_params.get("name"), "permission": request.query_params.getlist("permission[]")},
+ request.user,
+ )
+ )
@extend_schema(
- methods=['PUT'],
- description=_('Modify the resource authorization list'),
- operation_id=_('Modify the resource authorization list'), # type: ignore
+ methods=["PUT"],
+ description=_("Modify the resource authorization list"),
+ operation_id=_("Modify the resource authorization list"), # type: ignore
parameters=EditUserResourcePermissionAPI.get_parameters(),
request=EditUserResourcePermissionAPI.get_request(),
responses=EditUserResourcePermissionAPI.get_response(),
- tags=[_('Resources authorization')] # type: ignore
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @log(
+ menu="System",
+ operate="Modify the resource authorization list",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
)
- @log(menu='System', operate='Modify the resource authorization list',
- get_operation_object=lambda r, k: get_user_operation_object(k.get('user_id'))
- )
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource') + '_WORKSPACE_USER_RESOURCE_PERMISSION'),
- operate=Operate.EDIT),
- RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource") + "_RESOURCE_PERMISSION_EDIT"
+ ]._build_workspace_permission(),
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def put(self, request: Request, workspace_id: str, user_id: str, resource: str):
- return result.success(UserResourcePermissionSerializer(
- data={'workspace_id': workspace_id, 'user_id': user_id, 'auth_target_type': resource}
- ).edit(request.data, request.user))
+ return result.success(
+ UserResourcePermissionSerializer(
+ data={"workspace_id": workspace_id, "user_id": user_id, "auth_target_type": resource}
+ ).edit(request.data, request.user)
+ )
class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Obtain resource authorization list by page'),
- summary=_('Obtain resource authorization list by page'),
- operation_id=_('Obtain resource authorization list by page'), # type: ignore
+ methods=["GET"],
+ description=_("Obtain resource authorization list by page"),
+ summary=_("Obtain resource authorization list by page"),
+ operation_id=_("Obtain resource authorization list by page"), # type: ignore
request=None,
parameters=UserResourcePermissionPageAPI.get_parameters(),
responses=UserResourcePermissionPageAPI.get_response(),
- tags=[_('Resources authorization')] # type: ignore
+ tags=[_("Resources authorization")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource') + '_WORKSPACE_USER_RESOURCE_PERMISSION'),
- operate=Operate.READ),
- RoleConstants.ADMIN, RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
- def get(self, request: Request, workspace_id: str, user_id: str, resource: str, current_page: str,
- page_size: str):
- return result.success(UserResourcePermissionSerializer(
- data={'workspace_id': workspace_id, 'user_id': user_id, 'auth_target_type': resource}
- ).page({'name': request.query_params.get('name'),
- 'permission': request.query_params.getlist('permission[]')}, current_page, page_size, request.user))
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource") + "_RESOURCE_PERMISSION_READ"
+ ]._build_workspace_permission(),
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(
+ self, request: Request, workspace_id: str, user_id: str, resource: str, current_page: str, page_size: str
+ ):
+ return result.success(
+ UserResourcePermissionSerializer(
+ data={"workspace_id": workspace_id, "user_id": user_id, "auth_target_type": resource}
+ ).page(
+ {
+ "name": request.query_params.get("name"),
+ "permission": request.query_params.getlist("permission[]"),
+ },
+ current_page,
+ page_size,
+ request.user,
+ )
+ )
class WorkspaceResourceUserPermissionView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get user authorization status of resource'),
- summary=_('Get user authorization status of resource'),
- operation_id=_('Get user authorization status of resource'), # type: ignore
+ methods=["GET"],
+ description=_("Get user authorization status of resource"),
+ summary=_("Get user authorization status of resource"),
+ operation_id=_("Get user authorization status of resource"), # type: ignore
parameters=ResourceUserPermissionAPI.get_parameters(),
responses=ResourceUserPermissionAPI.get_response(),
- tags=[_('Resources authorization')] # type: ignore
+ tags=[_("Resources authorization")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.AUTH,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"),
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.AUTH,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource').replace('_FOLDER','')}/{kwargs.get('target')}"),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('resource').replace('_FOLDER','')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource').replace('_FOLDER','')}/{kwargs.get('target')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ].get_workspace_permission_workspace_manage_role(),
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ]._build_workspace_permission(resource_id_key="target"),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "")
+ ]._build_workspace_permission(resource_id_key="target")(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, target: str, resource: str):
- return result.success(ResourceUserPermissionSerializer(
- data={'workspace_id': workspace_id, "target": target, 'auth_target_type': resource.replace('_FOLDER',''),
- }).list(
- {'username': request.query_params.get("username"),
- 'role': request.query_params.get("role"),
- 'nick_name': request.query_params.get("nick_name"),
- 'permission': request.query_params.getlist("permission[]")
- }))
+ return result.success(
+ ResourceUserPermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "target": target,
+ "auth_target_type": resource.replace("_FOLDER", ""),
+ }
+ ).list(
+ {
+ "username": request.query_params.get("username"),
+ "role": request.query_params.get("role"),
+ "nick_name": request.query_params.get("nick_name"),
+ "permission": request.query_params.getlist("permission[]"),
+ }
+ )
+ )
@extend_schema(
- methods=['PUT'],
- description=_('Edit user authorization status of resource'),
- summary=_('Edit user authorization status of resource'),
- operation_id=_('Edit user authorization status of resource'), # type: ignore
+ methods=["PUT"],
+ description=_("Edit user authorization status of resource"),
+ summary=_("Edit user authorization status of resource"),
+ operation_id=_("Edit user authorization status of resource"), # type: ignore
parameters=ResourceUserPermissionEditAPI.get_parameters(),
request=ResourceUserPermissionEditAPI.get_request(),
responses=ResourceUserPermissionEditAPI.get_response(),
- tags=[_('Resources authorization')] # type: ignore
+ tags=[_("Resources authorization")], # type: ignore
+ )
+ @log(
+ menu="System",
+ operate="Edit user authorization status of resource",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
)
- @log(menu='System', operate='Edit user authorization status of resource',
- get_operation_object=lambda r, k: get_user_operation_object(k.get('user_id'))
- )
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.AUTH,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"),
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.AUTH,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource').replace('_FOLDER','')}/{kwargs.get('target')}"),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('resource').replace('_FOLDER','')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource').replace('_FOLDER','')}/{kwargs.get('target')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ].get_workspace_permission_workspace_manage_role(),
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ]._build_workspace_permission(resource_id_key="target"),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "")
+ ]._build_workspace_permission(resource_id_key="target")(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def put(self, request: Request, workspace_id: str, target: str, resource: str):
- return result.success(ResourceUserPermissionSerializer(
- data={'workspace_id': workspace_id, "target": target, 'auth_target_type': resource.replace('_FOLDER',''), })
- .edit(instance=request.data, current_user_id=request.user.id))
+ return result.success(
+ ResourceUserPermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "target": target,
+ "auth_target_type": resource.replace("_FOLDER", ""),
+ }
+ ).edit(instance=request.data, current_user_id=request.user.id)
+ )
class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get user authorization status of resource by page'),
- summary=_('Get user authorization status of resource by page'),
- operation_id=_('Get user authorization status of resource by page'), # type: ignore
+ methods=["GET"],
+ description=_("Get user authorization status of resource by page"),
+ summary=_("Get user authorization status of resource by page"),
+ operation_id=_("Get user authorization status of resource by page"), # type: ignore
parameters=ResourceUserPermissionPageAPI.get_parameters(),
responses=ResourceUserPermissionPageAPI.get_response(),
- tags=[_('Resources authorization')] # type: ignore
+ tags=[_("Resources authorization")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.AUTH,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"),
- lambda r, kwargs: Permission(group=Group(kwargs.get('resource')),
- operate=Operate.AUTH,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource').replace('_FOLDER','')}/{kwargs.get('target')}"),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('resource').replace('_FOLDER','')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('resource').replace('_FOLDER','')}/{kwargs.get('target')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
- def get(self, request: Request, workspace_id: str, target: str, resource: str, current_page: int,
- page_size: int):
- return result.success(ResourceUserPermissionSerializer(
- data={'workspace_id': workspace_id, "target": target, 'auth_target_type': resource.replace('_FOLDER',''), }
- ).page({'username': request.query_params.get("username"),
- 'role': request.query_params.get("role"),
- 'nick_name': request.query_params.get("nick_name"),
- 'permission': request.query_params.getlist("permission[]")}, current_page, page_size,
- ))
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ].get_workspace_permission_workspace_manage_role(),
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "") + "_RESOURCE_AUTHORIZATION"
+ ]._build_workspace_permission(resource_id_key="target"),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[
+ kwargs.get("resource").replace("_FOLDER", "")
+ ]._build_workspace_permission(resource_id_key="target")(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
+ def get(
+ self, request: Request, workspace_id: str, target: str, resource: str, current_page: int, page_size: int
+ ):
+ return result.success(
+ ResourceUserPermissionSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "target": target,
+ "auth_target_type": resource.replace("_FOLDER", ""),
+ }
+ ).page(
+ {
+ "username": request.query_params.get("username"),
+ "role": request.query_params.get("role"),
+ "nick_name": request.query_params.get("nick_name"),
+ "permission": request.query_params.getlist("permission[]"),
+ },
+ current_page,
+ page_size,
+ )
+ )
diff --git a/apps/tools/migrations/0008_toolworkflow_default_model_setting_and_more.py b/apps/tools/migrations/0008_toolworkflow_default_model_setting_and_more.py
new file mode 100644
index 00000000000..9082399b91b
--- /dev/null
+++ b/apps/tools/migrations/0008_toolworkflow_default_model_setting_and_more.py
@@ -0,0 +1,55 @@
+# Generated by Django 6.1 on 2026-09-10 07:58
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+ dependencies = [
+ ("tools", "0007_alter_tool_tool_type_toolworkflow_and_more"),
+ ]
+
+ operations = [
+ migrations.AddField(
+ model_name="toolworkflow",
+ name="default_model_setting",
+ field=models.JSONField(default=dict, verbose_name="默认模型"),
+ ),
+ migrations.AddField(
+ model_name="toolworkflowversion",
+ name="default_model_setting",
+ field=models.JSONField(default=dict, verbose_name="默认模型"),
+ ),
+ migrations.AlterField(
+ model_name="tool",
+ name="tool_type",
+ field=models.CharField(
+ choices=[
+ ("INTERNAL", "内置"),
+ ("CUSTOM", "自定义"),
+ ("SKILL", "技能"),
+ ("MCP", "MCP工具"),
+ ("DATA_SOURCE", "数据源"),
+ ("WORKFLOW", "工作流"),
+ ],
+ db_index=True,
+ default="CUSTOM",
+ max_length=20,
+ verbose_name="工具类型",
+ ),
+ ),
+ migrations.AlterField(
+ model_name="toolrecord",
+ name="source_type",
+ field=models.CharField(
+ choices=[
+ ("APPLICATION", "Application"),
+ ("KNOWLEDGE", "Knowledge"),
+ ("TOOL", "Tool"),
+ ("TRIGGER", "Trigger"),
+ ],
+ default="APPLICATION",
+ max_length=256,
+ verbose_name="触发器任务类型",
+ ),
+ ),
+ ]
diff --git a/apps/tools/models/tool_workflow.py b/apps/tools/models/tool_workflow.py
index 4f070cebd6c..8ca45c8c549 100644
--- a/apps/tools/models/tool_workflow.py
+++ b/apps/tools/models/tool_workflow.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: tool_workflow.py
- @date:2026/3/3 13:59
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: tool_workflow.py
+@date:2026/3/3 13:59
+@desc:
"""
+
from django.db import models
from common.mixins.app_model_mixin import AppModelMixin
@@ -18,13 +19,16 @@ class ToolWorkflow(AppModelMixin):
"""
知识库工作流表
"""
+
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
- tool = models.OneToOneField(Tool, on_delete=models.CASCADE, verbose_name="工具",
- db_constraint=False, related_name='workflow')
+ tool = models.OneToOneField(
+ Tool, on_delete=models.CASCADE, verbose_name="工具", db_constraint=False, related_name="workflow"
+ )
workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", default="default", db_index=True)
work_flow = models.JSONField(verbose_name="工作流数据", default=dict)
is_publish = models.BooleanField(verbose_name="是否发布", default=False, db_index=True)
publish_time = models.DateTimeField(verbose_name="发布时间", null=True, blank=True)
+ default_model_setting = models.JSONField(verbose_name="默认模型", default=dict)
class Meta:
db_table = "tool_workflow"
@@ -34,6 +38,7 @@ class ToolWorkflowVersion(AppModelMixin):
"""
知识库工作流版本表 - 记录工作流历史版本
"""
+
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
tool = models.ForeignKey(Tool, on_delete=models.CASCADE, verbose_name="工具", db_constraint=False)
workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", default="default", db_index=True)
@@ -41,6 +46,7 @@ class ToolWorkflowVersion(AppModelMixin):
work_flow = models.JSONField(verbose_name="工作流数据", default=dict)
publish_user_id = models.UUIDField(verbose_name="发布者id", max_length=128, default=None, null=True)
publish_user_name = models.CharField(verbose_name="发布者名称", max_length=128, default="")
+ default_model_setting = models.JSONField(verbose_name="默认模型", default=dict)
class Meta:
db_table = "tool_workflow_version"
diff --git a/apps/tools/serializers/tool.py b/apps/tools/serializers/tool.py
index 0d1cadd7444..8761275b9ca 100644
--- a/apps/tools/serializers/tool.py
+++ b/apps/tools/serializers/tool.py
@@ -26,6 +26,7 @@
from common.utils.logger import maxkb_logger
from common.utils.rsa_util import rsa_long_decrypt, rsa_long_encrypt
from common.utils.tool_code import ToolExecutor
+from common.utils.url_validator import ALLOWED_CALLBACK_HOSTS, ALLOWED_DOWNLOAD_HOSTS, validate_trusted_url
from django.core import validators
from django.core.cache import cache
from django.db import transaction
@@ -35,7 +36,7 @@
from django.utils.translation import gettext_lazy as _
from knowledge.models import File, FileSourceType, Knowledge
from langchain_core.messages import AIMessage, HumanMessage
-from langchain_mcp_adapters.client import MultiServerMCPClient
+from application.workflow.backend.sandbox_mcp import SandboxMCPBackend
from maxkb.const import CONFIG, PROJECT_DIR
from models_provider.models import Model
from rest_framework import serializers, status
@@ -43,11 +44,11 @@
from system_manage.models.resource_mapping import ResourceMapping
from system_manage.serializers.resource_mapping_serializers import ResourceMappingSerializer
from system_manage.serializers.user_resource_permission import UserResourcePermissionSerializer
-from trigger.models import Trigger, TriggerTask
-from users.serializers.user import is_workspace_manage, is_workspace_manage_permission_read
-
from tools.models import Tool, ToolFolder, ToolRecord, ToolScope, ToolType
from tools.models.tool_workflow import ToolWorkflow
+from tools.serializers.tool_icon import delete_tool_icon, download_tool_icon
+from trigger.models import Trigger, TriggerTask
+from users.serializers.user import is_workspace_manage, is_workspace_manage_permission_read
tool_executor = ToolExecutor()
@@ -158,13 +159,13 @@ def encryption(message: str):
def validate_mcp_config(servers: Dict):
async def validate():
- client = MultiServerMCPClient(servers)
- await client.get_tools()
+ backend = SandboxMCPBackend(servers)
+ await backend.get_tools()
try:
asyncio.run(validate())
except Exception as e:
- maxkb_logger.error(f"validate mcp config error: {e}, servers: {servers}")
+ maxkb_logger.error(f"validate mcp config error: {e}")
raise serializers.ValidationError(_("MCP configuration is invalid"))
@@ -477,10 +478,10 @@ def insert(self, instance, with_valid=True):
if instance.get("work_flow_template") is not None:
template_instance = instance.get("work_flow_template")
download_url = template_instance.get("downloadUrl")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
tool = ToolSerializer.Import(
data={
"file": bytes_to_uploaded_file(res.content, "file.tool"),
@@ -492,9 +493,9 @@ def insert(self, instance, with_valid=True):
try:
download_callback_url = template_instance.get("downloadCallbackUrl", "")
- if not download_callback_url.startswith("https://apps.fit2cloud.com"):
- raise AppApiException(500, _("Illegal download callback url"))
- requests.get(download_callback_url, timeout=5)
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
+ raise AppApiException(500, _("Illegal download callback url"))
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
return tool
@@ -569,6 +570,7 @@ def debug(self, debug_instance):
input_field_list = debug_instance.get("input_field_list")
code = debug_instance.get("code")
debug_field_list = debug_instance.get("debug_field_list")
+ init_field_list = debug_instance.get("init_field_list", [])
init_params = debug_instance.get("init_params")
params = {
field.get("name"): self.convert_value(
@@ -582,11 +584,13 @@ def debug(self, debug_instance):
for field in input_field_list
]
}
+ # 合并初始化参数(默认值 → 已保存的启动参数 → 运行时入参)
+ init_params_default_value = {i["field"]: i.get("default_value") for i in init_field_list}
# 合并初始化参数
if init_params is not None:
- all_params = init_params | params
+ all_params = init_params_default_value | init_params | params
else:
- all_params = params
+ all_params = init_params_default_value | params
return tool_executor.exec_code(code, all_params)
@staticmethod
@@ -646,7 +650,7 @@ def edit(self, instance, with_valid=True):
if instance.get("tool_type") == ToolType.MCP:
ToolExecutor().validate_mcp_transport(instance.get("code", ""))
- if not QuerySet(Tool).filter(id=self.data.get("id")).exists():
+ if not QuerySet(Tool).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).exists():
raise serializers.ValidationError(_("Tool not found"))
edit_field_list = [
@@ -666,9 +670,9 @@ def edit(self, instance, with_valid=True):
if (field in instance and instance.get(field) is not None)
}
- tool = QuerySet(Tool).filter(id=self.data.get("id")).first()
+ tool = QuerySet(Tool).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).first()
if "init_params" in edit_dict:
- if edit_dict["init_field_list"] is not None:
+ if edit_dict.get("init_field_list") is not None:
rm_key = []
for key in edit_dict["init_params"]:
if key not in [field["field"] for field in edit_dict["init_field_list"]]:
@@ -683,7 +687,9 @@ def edit(self, instance, with_valid=True):
edit_dict["init_params"] = rsa_long_encrypt(json.dumps(edit_dict["init_params"]))
edit_dict["update_time"] = timezone.now()
- QuerySet(Tool).filter(id=self.data.get("id")).update(**edit_dict)
+ QuerySet(Tool).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).update(
+ **edit_dict
+ )
if "is_active" in instance:
QuerySet(TriggerTask).filter(source_type="TOOL", source_id=self.data.get("id")).update(
is_active=instance.get("is_active")
@@ -705,13 +711,14 @@ def delete(self):
from trigger.serializers.trigger import TriggerModelSerializer
self.is_valid(raise_exception=True)
- tool = QuerySet(Tool).filter(id=self.data.get("id")).first()
- if tool.template_id is None and tool.icon != "":
- QuerySet(File).filter(id=tool.icon.split("/")[-1]).delete()
+ tool = QuerySet(Tool).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).first()
+ if tool is None:
+ raise serializers.ValidationError(_("Tool not found"))
+ delete_tool_icon(tool.icon, tool.id)
if tool.tool_type == ToolType.SKILL:
QuerySet(File).filter(id=tool.code).delete()
QuerySet(WorkspaceUserResourcePermission).filter(target=tool.id).delete()
- QuerySet(Tool).filter(id=self.data.get("id")).delete()
+ QuerySet(Tool).filter(id=self.data.get("id"), workspace_id=self.data.get("workspace_id")).delete()
ResourceMapping.objects.filter(Q(target_id=self.data.get("id")) | Q(source_id=self.data.get("id"))).delete()
QuerySet(ToolRecord).filter(tool_id=self.data.get("id")).delete()
trigger_ids = list(
@@ -766,7 +773,7 @@ def one(self):
}
def get_child_tool_list(self, work_flow, response):
- from application.flow.tools import get_tool_id_list
+ from system_manage.services.resource_mapping import get_tool_id_list
tool_id_list = get_tool_id_list(work_flow, False)
tool_id_list = [
@@ -872,9 +879,9 @@ def run(self, instance, is_valid=True):
{
"type": "error"
if (
- item.get("code") == "E999"
- or str(item.get("code") or "").startswith("E9")
- or item.get("code") in ["F821", "F822", "F823"]
+ item.get("code") == "E999"
+ or str(item.get("code") or "").startswith("E9")
+ or item.get("code") in ["F821", "F822", "F823"]
)
else "warning",
"module": "",
@@ -1000,7 +1007,7 @@ def import_workflow_tools(self, tool, workspace_id, user_id, folder_id, new_chil
{**tool, "id": update_tool_map.get(tool.get("id"))}
for tool in tool_list
if not exits_tool_id_list.__contains__(tool.get("id"))
- and not exits_tool_id_list.__contains__(
+ and not exits_tool_id_list.__contains__(
new_uuid.generate_uuid(tool.get("id"))
if new_child_policy == 2
else generate_uuid((tool.get("id") + workspace_id or ""))
@@ -1158,6 +1165,7 @@ def is_valid(self, *, raise_exception=False):
if not query_set.exists():
raise AppApiException(500, _("Tool id does not exist"))
+ @transaction.atomic
def edit(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
@@ -1165,8 +1173,7 @@ def edit(self, with_valid=True):
if tool is None:
raise AppApiException(500, _("Function does not exist"))
# 删除旧的图片
- if tool.icon != "":
- QuerySet(File).filter(id=tool.icon.split("/")[-1]).delete()
+ delete_tool_icon(tool.icon, tool.id)
if self.data.get("image") is None:
tool.icon = ""
else:
@@ -1212,7 +1219,7 @@ def add(self, instance, with_valid=True):
self.is_valid(raise_exception=True)
AddInternalToolRequest(data=instance).is_valid(raise_exception=True)
- internal_tool = QuerySet(Tool).filter(id=self.data.get("tool_id")).first()
+ internal_tool = QuerySet(Tool).filter(id=self.data.get("tool_id"), scope=ToolScope.INTERNAL).first()
if internal_tool is None:
raise AppApiException(500, _("Tool does not exist"))
@@ -1305,6 +1312,7 @@ class AddStoreTool(serializers.Serializer):
workspace_id = serializers.CharField(required=True, label=_("workspace id"))
tool_id = serializers.CharField(required=True, label=_("tool id"))
+ @transaction.atomic
def add(self, instance: Dict, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
@@ -1312,13 +1320,13 @@ def add(self, instance: Dict, with_valid=True):
versions = instance.get("versions", [])
download_url = instance.get("download_url")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
version_name = next(
(version.get("name") for version in versions if version.get("downloadUrl") == download_url),
)
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
tool_data = RestrictedUnpickler(io.BytesIO(res.content)).load().tool
tool_id = uuid.uuid7()
# 如果是SKILL类型的工具,保存文件内容到file表,并将code替换为file_id
@@ -1339,7 +1347,7 @@ def add(self, instance: Dict, with_valid=True):
desc=tool_data.get("desc"),
code=tool_data.get("code"),
user_id=self.data.get("user_id"),
- icon=instance.get("icon", ""),
+ icon=download_tool_icon(instance.get("icon"), tool_id),
workspace_id=self.data.get("workspace_id"),
input_field_list=tool_data.get("input_field_list", []),
init_field_list=tool_data.get("init_field_list", []),
@@ -1362,7 +1370,10 @@ def add(self, instance: Dict, with_valid=True):
}
).auth_resource(str(tool_id))
try:
- requests.get(instance.get("download_callback_url"), timeout=5)
+ download_callback_url = instance.get("download_callback_url")
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
+ raise AppApiException(500, _("Illegal download callback url"))
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
return ToolModelSerializer(tool).data
@@ -1376,10 +1387,15 @@ class UpdateStoreTool(serializers.Serializer):
icon = serializers.CharField(required=True, label=_("icon"), allow_null=True, allow_blank=True)
versions = serializers.ListField(required=True, label=_("versions"), child=serializers.DictField())
+ @transaction.atomic
def update_tool(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- tool = QuerySet(Tool).filter(id=self.data.get("tool_id")).first()
+ if not validate_trusted_url(self.data.get("download_url"), ALLOWED_DOWNLOAD_HOSTS):
+ raise AppApiException(500, _("Illegal download url"))
+ tool = (
+ QuerySet(Tool).filter(id=self.data.get("tool_id"), workspace_id=self.data.get("workspace_id")).first()
+ )
if tool is None:
raise AppApiException(500, _("Tool does not exist"))
# 查找匹配的版本名称
@@ -1390,7 +1406,7 @@ def update_tool(self, with_valid=True):
if version.get("downloadUrl") == self.data.get("download_url")
),
)
- res = requests.get(self.data.get("download_url"), timeout=5)
+ res = requests.get(self.data.get("download_url"), timeout=5, allow_redirects=False)
tool_data = RestrictedUnpickler(io.BytesIO(res.content)).load().tool
# 如果是SKILL类型的工具,保存文件内容到file表,并将code替换为file_id
if tool_data.get("tool_type") == ToolType.SKILL:
@@ -1408,12 +1424,17 @@ def update_tool(self, with_valid=True):
tool.code = tool_data.get("code")
tool.input_field_list = tool_data.get("input_field_list", [])
tool.init_field_list = tool_data.get("init_field_list", [])
- tool.icon = self.data.get("icon", tool.icon)
+ old_icon = tool.icon
+ tool.icon = download_tool_icon(self.data.get("icon"), tool.id)
+ delete_tool_icon(old_icon, tool.id)
tool.version = version_name
# tool.is_active = False
tool.save()
try:
- requests.get(self.data.get("download_callback_url"), timeout=5)
+ download_callback_url = self.data.get("download_callback_url")
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
+ raise AppApiException(500, _("Illegal download callback url"))
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
return ToolModelSerializer(tool).data
@@ -1437,7 +1458,11 @@ def one(self):
Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=self.data.get("id")),
version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version(),
)
- if tool_record:
+ if (
+ tool_record
+ and str(tool_record.get("tool_id")) == str(self.data.get("tool_id"))
+ and tool_record.get("workspace_id") == self.data.get("workspace_id")
+ ):
return tool_record
tool_record = (
QuerySet(ToolRecord)
@@ -1503,7 +1528,7 @@ def get_tool_records(self, current_page: int, page_size: int):
if self.data.get("state"):
query_set = query_set.filter(Q(state=self.data.get("state", "")))
if self.data.get("source_name"):
- query_set = query_set.filter(Q(tool_name__icontains=self.data.get("source_name", "")))
+ query_set = query_set.filter(Q(source_name__icontains=self.data.get("source_name", "")))
if self.data.get("record_id"):
query_set = query_set.filter(Q(id=self.data.get("record_id")))
if self.data.get("workspace_id"):
@@ -1516,7 +1541,7 @@ def get_tool_records(self, current_page: int, page_size: int):
query_set,
lambda record: {
**ToolRecordModelSerializer(record).data,
- "source_name": record.tool_name,
+ "source_name": record.source_name,
"tool_icon": record.tool_icon,
"trigger_type": record.trigger_type,
},
@@ -1572,7 +1597,7 @@ class GenerateCodeSerializer(serializers.Serializer):
input_field_list = serializers.ListField(required=False, default=list, label=_("Input Field List"))
def generate_code(self):
- from application.flow.tools import to_stream_response_simple
+ from common.utils.common import to_stream_response_simple
from models_provider.tools import get_model_instance_by_model_workspace_id
self.is_valid(raise_exception=True)
@@ -1604,15 +1629,15 @@ def process():
)
try:
for r in model.stream(
- [
- # SystemMessage(content=SYSTEM_ROLE),
- *[
- HumanMessage(content=m.get("content"))
- if m.get("role") == "user"
- else AIMessage(content=m.get("content"))
- for m in messages
- ]
+ [
+ # SystemMessage(content=SYSTEM_ROLE),
+ *[
+ HumanMessage(content=m.get("content"))
+ if m.get("role") == "user"
+ else AIMessage(content=m.get("content"))
+ for m in messages
]
+ ]
):
yield "data: " + json.dumps({"content": r.content}) + "\n\n"
except Exception as e:
@@ -1642,8 +1667,7 @@ def batch_delete(self, instance: Dict, with_valid=True):
tool_query_set = QuerySet(Tool).filter(id__in=id_list, workspace_id=workspace_id)
for tool in tool_query_set:
- if tool.template_id is None and tool.icon != "":
- QuerySet(File).filter(id=tool.icon.split("/")[-1]).delete()
+ delete_tool_icon(tool.icon, tool.id)
if tool.tool_type == ToolType.SKILL:
QuerySet(File).filter(id=tool.code).delete()
@@ -1776,8 +1800,9 @@ def is_x_pack_ee():
def page_tool_with_folders(self, current_page: int, page_size: int):
self.is_valid(raise_exception=True)
- workspace_manage = is_workspace_manage_permission_read(self.data.get("user_id"),
- self.data.get("workspace_id"), 'TOOL:READ')
+ workspace_manage = is_workspace_manage_permission_read(
+ self.data.get("user_id"), self.data.get("workspace_id"), "TOOL:READ"
+ )
is_x_pack_ee = self.is_x_pack_ee()
result = native_page_search(
current_page,
@@ -1805,8 +1830,9 @@ def page_tool_with_folders(self, current_page: int, page_size: int):
def get_tools(self):
self.is_valid(raise_exception=True)
- workspace_manage = is_workspace_manage_permission_read(self.data.get("user_id"),
- self.data.get("workspace_id"), 'TOOL:READ')
+ workspace_manage = is_workspace_manage_permission_read(
+ self.data.get("user_id"), self.data.get("workspace_id"), "TOOL:READ"
+ )
is_x_pack_ee = self.is_x_pack_ee()
results = native_search(
self.get_query_set(workspace_manage, is_x_pack_ee),
diff --git a/apps/tools/serializers/tool_icon.py b/apps/tools/serializers/tool_icon.py
new file mode 100644
index 00000000000..74b8274a797
--- /dev/null
+++ b/apps/tools/serializers/tool_icon.py
@@ -0,0 +1,61 @@
+"""Persist store icons using the same file storage as uploaded tool icons."""
+
+import os
+from urllib.parse import urlparse
+from uuid import UUID
+
+import requests
+import uuid_utils.compat as uuid
+from common.exception.app_exception import AppApiException
+from common.utils.url_validator import ALLOWED_DOWNLOAD_HOSTS, validate_trusted_url
+from django.db.models import QuerySet
+from django.utils.translation import gettext_lazy as _
+from knowledge.models import File, FileSourceType
+
+MAX_ICON_BYTES = 10 * 1024 * 1024
+
+
+def download_tool_icon(icon, tool_id):
+ if not icon:
+ return ""
+ if not validate_trusted_url(icon, ALLOWED_DOWNLOAD_HOSTS):
+ raise AppApiException(500, _("Illegal download url"))
+ try:
+ with requests.get(icon, timeout=5, allow_redirects=False, stream=True) as response:
+ response.raise_for_status()
+ # requests does not treat redirects as HTTP errors.
+ if response.status_code != 200:
+ raise ValueError("Unexpected icon response")
+ if not response.headers.get("Content-Type", "").lower().startswith("image/"):
+ raise ValueError("Invalid icon content type")
+ content = bytearray()
+ for chunk in response.iter_content(chunk_size=64 * 1024):
+ content.extend(chunk)
+ if len(content) > MAX_ICON_BYTES:
+ raise ValueError("Icon is too large")
+ if not content:
+ raise ValueError("Empty icon")
+ except (requests.RequestException, ValueError) as exc:
+ raise AppApiException(500, _("Failed to download tool icon")) from exc
+
+ file_id = uuid.uuid7()
+ file = File(
+ id=file_id,
+ file_name=os.path.basename(urlparse(icon).path)[:256] or "icon",
+ source_type=FileSourceType.TOOL,
+ source_id=tool_id,
+ meta={"debug": False},
+ )
+ file.save(bytes(content))
+ return f"./oss/file/{file_id}"
+
+
+def delete_tool_icon(icon, tool_id):
+ """Delete only local icons owned by this tool, preserving shared template icons."""
+ if not icon or not icon.startswith("./oss/file/"):
+ return
+ try:
+ file_id = UUID(icon.removeprefix("./oss/file/"))
+ except ValueError:
+ return
+ QuerySet(File).filter(id=file_id, source_type=FileSourceType.TOOL, source_id=tool_id).delete()
diff --git a/apps/tools/serializers/tool_workflow.py b/apps/tools/serializers/tool_workflow.py
index ab1c71d6cda..3212b3315a8 100644
--- a/apps/tools/serializers/tool_workflow.py
+++ b/apps/tools/serializers/tool_workflow.py
@@ -13,33 +13,44 @@
# coding=utf-8
import pickle
+import queue
import tempfile
+import time
import zipfile
from functools import reduce
from typing import Dict, List
import requests
import uuid_utils.compat as uuid
-from application.flow.common import Workflow, WorkflowMode
-from application.flow.i_step_node import ToolWorkflowPostHandler
-from application.flow.tool_workflow_manage import ToolWorkflowManage
-from application.models import ChatRecord
-from application.serializers.application import McpServersSerializer, get_mcp_tools
-from application.serializers.common import ToolExecute
+from common.utils.common import to_stream_response_simple
+from application.workflow.common import WorkflowType, new_instance
+from application.workflow.message.aggregator import AggregationManager
+from application.workflow.nodes import get_node_class
+from application.workflow.status import Status
+from application.workflow.workflow_manage import CallBack, WorkflowManage
+from application.serializers.application import (
+ McpServersSerializer,
+ get_mcp_tools,
+ validate_bound_tool_permissions,
+)
+from common.constants.cache_version import Cache_Version
from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.handle.impl.response.system_to_response import SystemToResponse
from common.exception.app_exception import AppApiException
from common.field.common import UploadedFileField
from common.result import result
from common.utils.common import bytes_to_uploaded_file, generate_uuid, restricted_loads
from common.utils.logger import maxkb_logger
from common.utils.tool_code import ToolExecutor
+from common.utils.url_validator import ALLOWED_CALLBACK_HOSTS, ALLOWED_DOWNLOAD_HOSTS, validate_trusted_url
+from django.core.cache import cache
from django.db import transaction
from django.db.models import Q, QuerySet
from django.http import HttpResponse
from django.utils import timezone
-from django.utils.translation import gettext
-from django.utils.translation import gettext_lazy as _
+from django.utils.translation import gettext_lazy as _, gettext
from knowledge.models import Knowledge, KnowledgeScope, KnowledgeWorkflow
+from knowledge.models.knowledge_action import State
from knowledge.serializers.knowledge import KnowledgeModelSerializer, KnowledgeSerializer
from maxkb.const import CONFIG
from rest_framework import serializers, status
@@ -159,38 +170,178 @@ def debug(self, instance: Dict, user, with_valid=True):
self.is_valid(raise_exception=True)
tool_workflow = QuerySet(ToolWorkflow).filter(tool_id=self.data.get("tool_id")).first()
workspace_id = tool_workflow.workspace_id
+ default_model_setting = tool_workflow.default_model_setting
tool_record_id = instance.get("chat_record_id") or str(uuid.uuid7())
- took_execute = ToolExecute(self.data.get("tool_id"), tool_record_id, workspace_id, None, None, True)
- record = took_execute.get_record()
- work_flow_manage = ToolWorkflowManage(
- Workflow.new_instance(tool_workflow.work_flow, WorkflowMode.TOOL),
- {
- "chat_record_id": tool_record_id,
- "tool_id": self.data.get("tool_id"),
- "stream": True,
- "workspace_id": workspace_id,
- **instance,
+ # 表单节点等断点续跑:position 指向要从其恢复执行的节点,机制与 chat 一致
+ position = instance.get("position")
+ # 运行身份取自认证上下文(DB 工作空间 + 登录用户),请求体不得覆盖,
+ # 防止低权限用户伪造 workspace_id/user_id 绕过工具引用授权;
+ # chat_record_id 仅用于沿用同一条执行记录,工具工作流本身不作为运行参数
+ identity_keys = {"workspace_id", "user_id", "chat_user_id", "chat_user_type", "chat_record_id"}
+ # 对齐旧引擎 get_body():输入字段值 + 执行身份,不含对话语义字段(question/chat_record_id)
+ parameters = {
+ "tool_id": self.data.get("tool_id"),
+ "stream": True,
+ "debug": True,
+ "workspace_id": workspace_id,
+ "user_id": self.data.get("user_id"),
+ "default_model_setting": default_model_setting,
+ **{k: v for k, v in instance.items() if k not in identity_keys},
+ }
+
+ workflow = new_instance(tool_workflow.work_flow, WorkflowType.TOOL)
+ aggregation = AggregationManager()
+ result_queue = queue.Queue()
+ base_to_response = SystemToResponse()
+ start_time = time.time()
+
+ def on_next(wf_manage, content):
+ aggregation.aggregate(content)
+ result_queue.put(("chunk", content.to_dict()))
+
+ def on_complete(wf_manage, error):
+ try:
+ self.save_tool_record(
+ tool_record_id,
+ self.data.get("tool_id"),
+ workspace_id,
+ wf_manage,
+ aggregation,
+ parameters,
+ start_time,
+ error,
+ position,
+ )
+ finally:
+ result_queue.put(("error", error) if error else ("done", None))
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_node_parameters(node):
+ return node.properties.get("node_data", {})
+
+ def get_start_node_fn(wf, wm):
+ # 有 position:从指定节点续跑(表单节点等),与 chat 的 position 机制一致
+ if position and position.get("id"):
+ node = wf.get_node(position.get("id"))
+ if node:
+ node_class = get_node_class(node.type, WorkflowType.TOOL)
+ return node_class(node, wm, get_node_parameters)
+ # 默认从工具起始节点开始
+ start_node = wf.get_node("tool-start-node")
+ if start_node is None:
+ raise AppApiException(500, gettext("The start node does not exist"))
+ node_class = get_node_class(start_node.type, WorkflowType.TOOL)
+ return node_class(start_node, wm, get_node_parameters)
+
+ # 有 position 且有记录 id:从历史 context 恢复(position 机制与 chat 一致);恢复失败回退为全新执行。
+ # 工具无 ChatRecord,context 来源是 debug 专用缓存——通过 get_context 回调提供,from_context 只负责重建
+ if position and instance.get("chat_record_id"):
+
+ def get_tool_context():
+ return cache.get(Cache_Version.DEBUG_WORKFLOW_CONTEXT.get_key(chat_record_id=str(tool_record_id)))
+
+ work_flow_manage = WorkflowManage.from_context(
+ get_context=get_tool_context,
+ workflow=workflow,
+ parameters=parameters,
+ workflow_type=WorkflowType.TOOL,
+ call_back=call_back,
+ get_start_node=get_start_node_fn,
+ )
+ if work_flow_manage is None:
+ work_flow_manage = WorkflowManage(
+ workflow, parameters, WorkflowType.TOOL, call_back, get_start_node_fn
+ )
+ else:
+ work_flow_manage = WorkflowManage(workflow, parameters, WorkflowType.TOOL, call_back, get_start_node_fn)
+ work_flow_manage.start_node.workflow_manage = work_flow_manage
+
+ def generate():
+ work_flow_manage.run()
+ while True:
+ msg_type, data = result_queue.get()
+ if msg_type == "done":
+ yield "data: [DONE]\n\n"
+ break
+ if msg_type == "error":
+ error_block = {"id": str(uuid.uuid7()), "type": "FAILURE", "content": str(data)}
+ frame = base_to_response.to_stream(tool_record_id, tool_record_id, error_block)
+ if frame is not None:
+ yield "data: " + frame + "\n\n"
+ yield "data: [DONE]\n\n"
+ break
+ if msg_type == "chunk":
+ frame = base_to_response.to_stream(tool_record_id, tool_record_id, data)
+ if frame is not None:
+ yield "data: " + frame + "\n\n"
+
+ return to_stream_response_simple(generate())
+
+ @staticmethod
+ def save_tool_record(
+ tool_record_id, tool_id, workspace_id, wf_manage, aggregation, parameters, start_time, error, position=None
+ ):
+ """
+ 工具调试执行结束后写执行记录缓存(替代旧引擎 ToolWorkflowPostHandler)。
+ debug 只写 30 分钟 Redis 缓存、不落库,前端据此拉取 meta.output/details 展示;
+ 缓存 shape 与 tool 记录查询端点(ToolSerializer...one)读取的字段保持一致。
+ 同时把运行 context 写入 DEBUG_WORKFLOW_CONTEXT,供下次 position 续跑时 from_context 恢复。
+ """
+ workflow = wf_manage.workflow
+ base_node = workflow.get_node("tool-base-node")
+ input_field_list = base_node.properties.get("user_input_field_list", []) if base_node else []
+ output_field_list = base_node.properties.get("user_output_field_list", []) if base_node else []
+ input_data = {f.get("field"): parameters.get(f.get("field")) for f in input_field_list}
+ # 新引擎工具输出收口于全局 output 上下文(tool-start-node 初始化、变量赋值节点写入)
+ output = wf_manage.context.get("output", {})
+ # 续跑(有 position):合并上一次的节点详情,与 chat 的 get_details 用法一致
+ old_details = None
+ if position:
+ prev_record = cache.get(
+ Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=tool_record_id),
+ version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version(),
+ )
+ if prev_record:
+ old_details = (prev_record.get("meta") or {}).get("details")
+ details = wf_manage.get_details(position=position, old_details=old_details)
+ tool_record = {
+ "id": tool_record_id,
+ "tool_id": tool_id,
+ "workspace_id": workspace_id,
+ "source_type": None,
+ "source_id": None,
+ "state": ToolWorkflowSerializer.Operate.compute_tool_state(details, error),
+ "run_time": time.time() - start_time,
+ "meta": {
+ "input_field_list": input_field_list,
+ "output_field_list": output_field_list,
+ "input": input_data,
+ "output": output,
+ "details": details,
+ "answer_text_list": aggregation.get_contents(),
},
- ToolWorkflowPostHandler(took_execute, self.data.get("tool_id")),
- is_the_task_interrupted=lambda: False,
- child_node=instance.get("child_node"),
- start_node_id=instance.get("runtime_node_id"),
- start_node_data=instance.get("node_data"),
- chat_record=self.to_chat_record(record),
+ }
+ cache.set(
+ Cache_Version.TOOL_WORKFLOW_EXECUTE.get_key(key=tool_record_id),
+ tool_record,
+ version=Cache_Version.TOOL_WORKFLOW_EXECUTE.get_version(),
+ timeout=60 * 30,
+ )
+ # 持久化运行 context,供 position 续跑时恢复(工具无 ChatRecord,故写 debug 专用缓存)。
+ # 读写都用 cache.get/set(key) 不带 version,两侧须一致,否则 Django version 命名空间对不上会命中不到。
+ cache.set(
+ Cache_Version.DEBUG_WORKFLOW_CONTEXT.get_key(chat_record_id=str(tool_record_id)),
+ wf_manage.context,
+ timeout=60 * 30,
)
-
- r = work_flow_manage.run()
- return r
@staticmethod
- def to_chat_record(record):
- if record is None:
- return None
- return ChatRecord(
- answer_text_list=record.meta.get("answer_text_list"),
- details=record.meta.get("details"),
- answer_text="",
- )
+ def compute_tool_state(details, error):
+ if error:
+ return State.FAILURE
+ has_fail = any((d or {}).get("status") == Status.FAIL.value for d in (details or []))
+ return State.FAILURE if has_fail else State.SUCCESS
def publish(self, with_valid=True):
if with_valid:
@@ -207,6 +358,7 @@ def publish(self, with_valid=True):
publish_user_id=user_id,
publish_user_name=user.username,
workspace_id=workspace_id,
+ default_model_setting=tool_workflow.default_model_setting,
)
work_flow_version.save()
QuerySet(ToolWorkflow).filter(tool_id=self.data.get("tool_id")).update(
@@ -280,6 +432,9 @@ def edit(self, instance: Dict):
tool = QuerySet(Tool).filter(id=self.data.get("tool_id")).first()
workflow_id = tool.workspace_id
if instance.get("work_flow"):
+ # 校验工作流中引用的工具(mcp-node 的 mcp_tool_id 等)当前用户是否有权使用,
+ # 防止低权限用户绑定他人工具并通过工作流执行绕过工具的单独授权控制
+ validate_bound_tool_permissions(self.data.get("user_id"), workflow_id, instance)
dependency = is_valid_tool_workflow_circular_dependency(
workflow=instance.get("work_flow"), _id=str(tool.id)
)
@@ -292,11 +447,13 @@ def edit(self, instance: Dict):
"tool_id": self.data.get("tool_id"),
"workspace_id": workflow_id,
"work_flow": instance.get("work_flow", {}),
+ "default_model_setting": instance.get("default_model_setting", {}),
},
defaults={
"tool_id": self.data.get("tool_id"),
"workspace_id": workflow_id,
"work_flow": instance.get("work_flow"),
+ "default_model_setting": instance.get("default_model_setting", {}),
},
)
# 当前用户可修改关联的知识库列表
@@ -342,10 +499,10 @@ def edit(self, instance: Dict):
if instance.get("work_flow_template"):
template_instance = instance.get("work_flow_template")
download_url = template_instance.get("downloadUrl")
- if not download_url.startswith("https://apps-assets.fit2cloud.com/"):
+ if not validate_trusted_url(download_url, ALLOWED_DOWNLOAD_HOSTS):
raise AppApiException(500, _("Illegal download url"))
# 查找匹配的版本名称
- res = requests.get(download_url, timeout=5)
+ res = requests.get(download_url, timeout=5, allow_redirects=False)
tool = QuerySet(Tool).filter(id=self.data.get("tool_id")).first()
ToolSerializer.Import(
data={
@@ -358,9 +515,9 @@ def edit(self, instance: Dict):
try:
download_callback_url = template_instance.get("downloadCallbackUrl", "")
- if not download_callback_url.startswith("https://apps.fit2cloud.com"):
+ if not validate_trusted_url(download_callback_url, ALLOWED_CALLBACK_HOSTS):
raise AppApiException(500, _("Illegal download callback url"))
- requests.get(download_callback_url, timeout=5)
+ requests.get(download_callback_url, timeout=5, allow_redirects=False)
except Exception as e:
maxkb_logger.error(f"callback appstore tool download error: {e}")
@@ -391,9 +548,7 @@ def get_mcp_servers(self, instance, with_valid=True):
self.is_valid(raise_exception=True)
McpServersSerializer(data=instance).is_valid(raise_exception=True)
servers = json.loads(instance.get("mcp_servers"))
- for server, config in servers.items():
- if config.get("transport") not in ["sse", "streamable_http"]:
- raise AppApiException(500, _("Only support transport=sse or transport=streamable_http"))
+ ToolExecutor().validate_mcp_transport(json.dumps(servers))
tools = []
for server in servers:
tools += [
@@ -465,7 +620,7 @@ def get_appstore_templates(self):
def update_resource_mapping_by_tool(tool_id: str, other_resource_mapping=None):
- from application.flow.tools import get_instance_resource, save_workflow_mapping
+ from system_manage.services.resource_mapping import get_instance_resource, save_workflow_mapping
from system_manage.models.resource_mapping import ResourceType
if other_resource_mapping is None:
diff --git a/apps/tools/tests.py b/apps/tools/tests.py
index 7ce503c2dd9..6a9c58dd379 100644
--- a/apps/tools/tests.py
+++ b/apps/tools/tests.py
@@ -1,3 +1,78 @@
-from django.test import TestCase
+from unittest.mock import patch
+from uuid import UUID
-# Create your tests here.
+import requests
+from django.test import SimpleTestCase
+
+from common.exception.app_exception import AppApiException
+from tools.serializers.tool_icon import delete_tool_icon, download_tool_icon
+
+
+class ToolIconTests(SimpleTestCase):
+ def test_download_saves_bytes_and_returns_local_url(self):
+ with (
+ patch("tools.serializers.tool_icon.requests.get") as get,
+ patch("tools.serializers.tool_icon.File") as file,
+ ):
+ response = get.return_value.__enter__.return_value
+ response.status_code = 200
+ response.headers = {"Content-Type": "image/png"}
+ response.iter_content.return_value = [b"image", b" data"]
+ icon = download_tool_icon("https://apps-assets.fit2cloud.com/tool/icon.png?v=1", "tool-id")
+ self.assertEqual(icon, f"./oss/file/{file.call_args.kwargs['id']}")
+ self.assertEqual(file.call_args.kwargs["source_id"], "tool-id")
+ self.assertEqual(file.call_args.kwargs["file_name"], "icon.png")
+ file.return_value.save.assert_called_once_with(b"image data")
+ self.assertFalse(get.call_args.kwargs["allow_redirects"])
+
+ def test_empty_icon_does_not_download(self):
+ with patch("tools.serializers.tool_icon.requests.get") as get:
+ self.assertEqual(download_tool_icon(None, "tool-id"), "")
+ self.assertEqual(download_tool_icon("", "tool-id"), "")
+ get.assert_not_called()
+
+ def test_untrusted_url_does_not_download(self):
+ with patch("tools.serializers.tool_icon.requests.get") as get:
+ with self.assertRaises(AppApiException):
+ download_tool_icon("http://127.0.0.1/icon.png", "tool-id")
+ get.assert_not_called()
+
+ def test_bad_responses_do_not_save_files(self):
+ for status, content_type, chunks in [
+ (302, "image/png", [b"image"]),
+ (200, "text/html", [b"html"]),
+ (200, "image/png", []),
+ (200, "image/png", [b"12345"]),
+ ]:
+ with self.subTest(status=status, content_type=content_type, chunks=chunks):
+ with (
+ patch("tools.serializers.tool_icon.requests.get") as get,
+ patch("tools.serializers.tool_icon.File") as file,
+ patch("tools.serializers.tool_icon.MAX_ICON_BYTES", 4),
+ ):
+ response = get.return_value.__enter__.return_value
+ response.status_code = status
+ response.headers = {"Content-Type": content_type}
+ response.iter_content.return_value = chunks
+ with self.assertRaises(AppApiException):
+ download_tool_icon("https://apps-assets.fit2cloud.com/icon.png", "tool-id")
+ file.assert_not_called()
+
+ def test_timeout_is_reported(self):
+ with patch("tools.serializers.tool_icon.requests.get", side_effect=requests.Timeout):
+ with self.assertRaises(AppApiException):
+ download_tool_icon("https://apps-assets.fit2cloud.com/icon.png", "tool-id")
+
+ def test_remote_and_static_icons_are_not_deleted(self):
+ with patch("tools.serializers.tool_icon.QuerySet") as query:
+ for icon in ["", None, "https://example.com/icon.png", "./tool/icon.png", "./oss/file/invalid"]:
+ delete_tool_icon(icon, "tool-id")
+ query.assert_not_called()
+
+ def test_local_icon_deletion_is_scoped_to_owner(self):
+ file_id = UUID("00000000-0000-0000-0000-000000000001")
+ with patch("tools.serializers.tool_icon.QuerySet") as query:
+ delete_tool_icon(f"./oss/file/{file_id}", "tool-id")
+ self.assertEqual(query.return_value.filter.call_args.kwargs["id"], file_id)
+ self.assertEqual(query.return_value.filter.call_args.kwargs["source_id"], "tool-id")
+ query.return_value.filter.return_value.delete.assert_called_once()
diff --git a/apps/tools/views/tool.py b/apps/tools/views/tool.py
index 79d5aa2617d..346ee7eeb31 100644
--- a/apps/tools/views/tool.py
+++ b/apps/tools/views/tool.py
@@ -1,28 +1,41 @@
+from common import result
+from common.auth import TokenAuth
+from common.auth.authentication import check_batch_permissions, has_permissions
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
+from common.log.log import log
from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
from rest_framework.parsers import MultiPartParser
from rest_framework.request import Request
from rest_framework.views import APIView
-
-from common import result
-from common.auth import TokenAuth
-from common.auth.authentication import has_permissions, check_batch_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
-from common.log.log import log
-from tools.api.tool import ToolCreateAPI, ToolEditAPI, ToolReadAPI, ToolDeleteAPI, ToolTreeReadAPI, ToolDebugApi, \
- ToolExportAPI, ToolImportAPI, ToolPageAPI, PylintAPI, EditIconAPI, GetInternalToolAPI, AddInternalToolAPI, \
- ToolBatchOperateAPI
-from tools.models import ToolScope, Tool
-from tools.serializers.tool import ToolSerializer, ToolTreeSerializer, ToolBatchOperateSerializer
+from tools.api.tool import (
+ AddInternalToolAPI,
+ EditIconAPI,
+ GetInternalToolAPI,
+ PylintAPI,
+ ToolBatchOperateAPI,
+ ToolCreateAPI,
+ ToolDebugApi,
+ ToolDeleteAPI,
+ ToolEditAPI,
+ ToolExportAPI,
+ ToolImportAPI,
+ ToolPageAPI,
+ ToolReadAPI,
+ ToolTreeReadAPI,
+)
+from tools.models import Tool, ToolScope
+from tools.serializers.tool import ToolBatchOperateSerializer, ToolSerializer, ToolTreeSerializer
def get_tool_operation_object(tool_id):
tool_model = QuerySet(model=Tool).filter(id=tool_id).first()
if tool_model is not None:
- return {
- "name": tool_model.name
- }
+ return {"name": tool_model.name}
return {}
@@ -30,8 +43,8 @@ def get_tool_operation_object_batch(tool_id_list):
tool_model_list = QuerySet(model=Tool).filter(id__in=tool_id_list)
if tool_model_list is not None:
return {
- "name": f'[{",".join([t.name for t in tool_model_list])}]',
- 'tool_list': [{'name': t.name} for t in tool_model_list]
+ "name": f"[{','.join([t.name for t in tool_model_list])}]",
+ "tool_list": [{"name": t.name} for t in tool_model_list],
}
return {}
@@ -40,198 +53,218 @@ class ToolView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Create tool'),
- summary=_('Create tool'),
- operation_id=_('Create tool'), # type: ignore
+ methods=["POST"],
+ description=_("Create tool"),
+ summary=_("Create tool"),
+ operation_id=_("Create tool"), # type: ignore
parameters=ToolCreateAPI.get_parameters(),
request=ToolCreateAPI.get_request(),
responses=ToolCreateAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_CREATE.get_workspace_permission(),
PermissionConstants.TOOL_CREATE.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
@log(
- menu="Tool", operate="Create tool",
- get_operation_object=lambda r, k: r.data.get('name'),
+ menu="Tool",
+ operate="Create tool",
+ get_operation_object=lambda r, k: r.data.get("name"),
)
def post(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.Create(
- data={'user_id': request.user.id, 'workspace_id': workspace_id}
- ).insert({**request.data, 'scope': ToolScope.WORKSPACE}))
+ return result.success(
+ ToolSerializer.Create(data={"user_id": request.user.id, "workspace_id": workspace_id}).insert(
+ {**request.data, "scope": ToolScope.WORKSPACE}
+ )
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get tool by folder'),
- summary=_('Get tool by folder'),
- operation_id=_('Get tool by folder'), # type: ignore
+ methods=["GET"],
+ description=_("Get tool by folder"),
+ summary=_("Get tool by folder"),
+ operation_id=_("Get tool by folder"), # type: ignore
parameters=ToolTreeReadAPI.get_parameters(),
responses=ToolTreeReadAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_READ.get_workspace_permission(),
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
- return result.success(ToolTreeSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'folder_id': request.query_params.get('folder_id'),
- 'name': request.query_params.get('name'),
- 'scope': request.query_params.get('scope', ToolScope.WORKSPACE),
- 'tool_type': request.query_params.get('tool_type'),
- 'tool_type_list': request.query_params.getlist('tool_type_list[]'),
- 'user_id': request.user.id,
- 'create_user': request.query_params.get('create_user'),
- }
- ).get_tools())
+ return result.success(
+ ToolTreeSerializer.Query(
+ data={
+ "workspace_id": workspace_id,
+ "folder_id": request.query_params.get("folder_id"),
+ "name": request.query_params.get("name"),
+ "scope": request.query_params.get("scope", ToolScope.WORKSPACE),
+ "tool_type": request.query_params.get("tool_type"),
+ "tool_type_list": request.query_params.getlist("tool_type_list[]"),
+ "user_id": request.user.id,
+ "create_user": request.query_params.get("create_user"),
+ }
+ ).get_tools()
+ )
class Debug(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Debug Tool'),
- summary=_('Debug Tool'),
- operation_id=_('Debug Tool'), # type: ignore
+ methods=["POST"],
+ description=_("Debug Tool"),
+ summary=_("Debug Tool"),
+ operation_id=_("Debug Tool"), # type: ignore
request=ToolDebugApi.get_request(),
responses=ToolDebugApi.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_EDIT.get_workspace_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def post(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.Debug(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}
- ).debug(request.data))
+ return result.success(
+ ToolSerializer.Debug(data={"workspace_id": workspace_id, "user_id": request.user.id}).debug(
+ request.data
+ )
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- description=_('Update tool'),
- summary=_('Update tool'),
- operation_id=_('Update tool'), # type: ignore
+ methods=["PUT"],
+ description=_("Update tool"),
+ summary=_("Update tool"),
+ operation_id=_("Update tool"), # type: ignore
parameters=ToolEditAPI.get_parameters(),
request=ToolEditAPI.get_request(),
responses=ToolEditAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_EDIT.get_workspace_tool_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Tool', operate='Update tool',
- get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
-
+ menu="Tool",
+ operate="Update tool",
+ get_operation_object=lambda r, k: get_tool_operation_object(k.get("tool_id")),
)
def put(self, request: Request, workspace_id: str, tool_id: str):
- return result.success(ToolSerializer.Operate(
- data={'id': tool_id, 'workspace_id': workspace_id}
- ).edit(request.data))
+ return result.success(
+ ToolSerializer.Operate(data={"id": tool_id, "workspace_id": workspace_id}).edit(request.data)
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get tool'),
- summary=_('Get tool'),
- operation_id=_('Get tool'), # type: ignore
+ methods=["GET"],
+ description=_("Get tool"),
+ summary=_("Get tool"),
+ operation_id=_("Get tool"), # type: ignore
parameters=ToolReadAPI.get_parameters(),
responses=ToolReadAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_READ.get_workspace_tool_permission(),
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission(),
- PermissionConstants.APPLICATION_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.USER.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
- @log(menu='Tool', operate='Get tool')
+ @log(menu="Tool", operate="Get tool")
def get(self, request: Request, workspace_id: str, tool_id: str):
- return result.success(ToolSerializer.Operate(
- data={'id': tool_id, 'workspace_id': workspace_id}
- ).one())
+ return result.success(ToolSerializer.Operate(data={"id": tool_id, "workspace_id": workspace_id}).one())
@extend_schema(
- methods=['DELETE'],
- description=_('Delete tool'),
- summary=_('Delete tool'),
- operation_id=_('Delete tool'), # type: ignore
+ methods=["DELETE"],
+ description=_("Delete tool"),
+ summary=_("Delete tool"),
+ operation_id=_("Delete tool"), # type: ignore
parameters=ToolDeleteAPI.get_parameters(),
responses=ToolDeleteAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_DELETE.get_workspace_tool_permission(),
PermissionConstants.TOOL_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Tool', operate="Delete tool",
- get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
-
+ menu="Tool",
+ operate="Delete tool",
+ get_operation_object=lambda r, k: get_tool_operation_object(k.get("tool_id")),
)
def delete(self, request: Request, workspace_id: str, tool_id: str):
- return result.success(ToolSerializer.Operate(
- data={'id': tool_id, 'workspace_id': workspace_id}
- ).delete())
+ return result.success(ToolSerializer.Operate(data={"id": tool_id, "workspace_id": workspace_id}).delete())
class BatchDelete(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
description=_("Batch delete tools"),
summary=_("Batch delete tools"),
- operation_id=_("Batch delete tools"),
+ operation_id=_("Batch delete tools"), # type: ignore
parameters=ToolBatchOperateAPI.get_parameters(),
request=ToolBatchOperateAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Tool')]
+ tags=[_("Tool")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.TOOL_BATCH_DELETE.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.TOOL_BATCH_DELETE.get_workspace_permission(),
- RoleConstants.USER.get_workspace_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
- )
def put(self, request: Request, workspace_id: str):
- id_list = request.data.get('id_list', [])
+ id_list = request.data.get("id_list", [])
permitted_ids = check_batch_permissions(
- request, id_list, 'tool_id',
- (PermissionConstants.TOOL_DELETE.get_workspace_tool_permission(),
- PermissionConstants.TOOL_DELETE.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()), workspace_id=workspace_id
+ request,
+ id_list,
+ "tool_id",
+ (
+ PermissionConstants.TOOL_DELETE.get_workspace_tool_permission(),
+ PermissionConstants.TOOL_DELETE.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ),
+ workspace_id=workspace_id,
)
- @log(menu='Tool', operate='Batch delete tools',
- get_operation_object=lambda r, k: get_tool_operation_object_batch(permitted_ids))
+ @log(
+ menu="Tool",
+ operate="Batch delete tools",
+ get_operation_object=lambda r, k: get_tool_operation_object_batch(permitted_ids),
+ )
def inner(view, r, **kwargs):
- return ToolBatchOperateSerializer(
- data={'workspace_id': workspace_id}
- ).batch_delete({'id_list': permitted_ids})
+ return ToolBatchOperateSerializer(data={"workspace_id": workspace_id}).batch_delete(
+ {"id_list": permitted_ids}
+ )
return result.success(inner(self, request, workspace_id=workspace_id))
@@ -239,38 +272,48 @@ class BatchMove(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
description=_("Batch move tools"),
summary=_("Batch move tools"),
- operation_id=_("Batch move tools"),
+ operation_id=_("Batch move tools"), # type: ignore
parameters=ToolBatchOperateAPI.get_parameters(),
request=ToolBatchOperateAPI.get_move_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Tool')]
+ tags=[_("Tool")], # type: ignore
+ )
+ @has_permissions(
+ PermissionConstants.TOOL_BATCH_MOVE.get_workspace_permission(),
+ RoleConstants.USER.get_workspace_role(),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
- @has_permissions(PermissionConstants.TOOL_BATCH_MOVE.get_workspace_permission(),
- RoleConstants.USER.get_workspace_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()
- )
def put(self, request: Request, workspace_id: str):
- id_list = request.data.get('id_list', [])
+ id_list = request.data.get("id_list", [])
permitted_ids = check_batch_permissions(
- request, id_list, 'tool_id',
- (PermissionConstants.TOOL_EDIT.get_workspace_tool_permission(),
- PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role()),
- workspace_id=workspace_id
+ request,
+ id_list,
+ "tool_id",
+ (
+ PermissionConstants.TOOL_EDIT.get_workspace_tool_permission(),
+ PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ ),
+ workspace_id=workspace_id,
)
- @log(menu='Tool', operate='Batch move tools',
- get_operation_object=lambda r, k: get_tool_operation_object_batch(permitted_ids))
+ @log(
+ menu="Tool",
+ operate="Batch move tools",
+ get_operation_object=lambda r, k: get_tool_operation_object_batch(permitted_ids),
+ )
def inner(view, r, **kwargs):
- return ToolBatchOperateSerializer(
- data={'workspace_id': workspace_id}
- ).batch_move({'id_list': permitted_ids, 'folder_id': request.data.get('folder_id')})
+ return ToolBatchOperateSerializer(data={"workspace_id": workspace_id}).batch_move(
+ {"id_list": permitted_ids, "folder_id": request.data.get("folder_id")}
+ )
return result.success(inner(self, request, workspace_id=workspace_id))
@@ -278,232 +321,258 @@ class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get tool list by pagination'),
- summary=_('Get tool list by pagination'),
- operation_id=_('Get tool list by pagination'), # type: ignore
+ methods=["GET"],
+ description=_("Get tool list by pagination"),
+ summary=_("Get tool list by pagination"),
+ operation_id=_("Get tool list by pagination"), # type: ignore
parameters=ToolPageAPI.get_parameters(),
responses=ToolPageAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_READ.get_workspace_permission(),
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
- @log(menu='Tool', operate='Get tool list')
+ @log(menu="Tool", operate="Get tool list")
def get(self, request: Request, workspace_id: str, current_page: int, page_size: int):
- return result.success(ToolTreeSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'folder_id': request.query_params.get('folder_id'),
- 'name': request.query_params.get('name'),
- 'scope': request.query_params.get('scope'),
- 'tool_type': request.query_params.get('tool_type'),
- 'user_id': request.user.id,
- 'create_user': request.query_params.get('create_user'),
- }
- ).page_tool_with_folders(current_page, page_size))
+ return result.success(
+ ToolTreeSerializer.Query(
+ data={
+ "workspace_id": workspace_id,
+ "folder_id": request.query_params.get("folder_id"),
+ "name": request.query_params.get("name"),
+ "scope": request.query_params.get("scope", ToolScope.WORKSPACE),
+ "tool_type": request.query_params.get("tool_type"),
+ "user_id": request.user.id,
+ "create_user": request.query_params.get("create_user"),
+ }
+ ).page_tool_with_folders(current_page, page_size)
+ )
class Query(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get tool list '),
- summary=_('Get tool list'),
- operation_id=_('Get tool list'), # type: ignore
+ methods=["GET"],
+ description=_("Get tool list "),
+ summary=_("Get tool list"),
+ operation_id=_("Get tool list"), # type: ignore
parameters=ToolReadAPI.get_parameters(),
responses=ToolReadAPI.get_response(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_READ.get_workspace_permission(),
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
- @log(menu='Tool', operate='Get tool list')
+ @log(menu="Tool", operate="Get tool list")
def get(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.Query(
- data={
- 'workspace_id': workspace_id,
- 'folder_id': request.query_params.get('folder_id'),
- 'name': request.query_params.get('name'),
- 'scope': request.query_params.get('scope'),
- 'tool_type': request.query_params.get('tool_type'),
- 'user_id': request.user.id,
- 'create_user': request.query_params.get('create_user'),
- }
- ).get_tools())
+ return result.success(
+ ToolSerializer.Query(
+ data={
+ "workspace_id": workspace_id,
+ "folder_id": request.query_params.get("folder_id"),
+ "name": request.query_params.get("name"),
+ "scope": request.query_params.get("scope", ToolScope.WORKSPACE),
+ "tool_type": request.query_params.get("tool_type"),
+ "user_id": request.user.id,
+ "create_user": request.query_params.get("create_user"),
+ }
+ ).get_tools()
+ )
class Import(APIView):
authentication_classes = [TokenAuth]
parser_classes = [MultiPartParser]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Import tool"),
summary=_("Import tool"),
operation_id=_("Import tool"), # type: ignore
parameters=ToolImportAPI.get_parameters(),
request=ToolImportAPI.get_request(),
responses=ToolImportAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_IMPORT.get_workspace_permission(),
PermissionConstants.TOOL_IMPORT.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
+ )
+ @log(
+ menu="Tool",
+ operate="Import tool",
)
- @log(menu='Tool', operate='Import tool', )
def post(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.Import(
- data={
- 'workspace_id': workspace_id,
- 'file': request.FILES.get('file'),
- 'user_id': request.user.id,
- 'folder_id': request.data.get('folder_id')
- }
- ).import_(ToolScope.WORKSPACE))
+ return result.success(
+ ToolSerializer.Import(
+ data={
+ "workspace_id": workspace_id,
+ "file": request.FILES.get("file"),
+ "user_id": request.user.id,
+ "folder_id": request.data.get("folder_id"),
+ }
+ ).import_(ToolScope.WORKSPACE)
+ )
class Export(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Export tool"),
summary=_("Export tool"),
operation_id=_("Export tool"), # type: ignore
parameters=ToolExportAPI.get_parameters(),
responses=ToolExportAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_EXPORT.get_workspace_tool_permission(),
PermissionConstants.TOOL_EXPORT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
@log(
- menu='Tool', operate="Export tool",
- get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
+ menu="Tool",
+ operate="Export tool",
+ get_operation_object=lambda r, k: get_tool_operation_object(k.get("tool_id")),
)
def get(self, request: Request, tool_id: str, workspace_id: str):
- return ToolSerializer.Operate(
- data={'id': tool_id, 'workspace_id': workspace_id}
- ).export()
+ return ToolSerializer.Operate(data={"id": tool_id, "workspace_id": workspace_id}).export()
class Pylint(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- summary=_('Check code'),
- operation_id=_('Check code'), # type: ignore
- description=_('Check code'),
+ methods=["POST"],
+ summary=_("Check code"),
+ operation_id=_("Check code"), # type: ignore
+ description=_("Check code"),
request=PylintAPI.get_request(),
responses=PylintAPI.get_response(),
parameters=PylintAPI.get_parameters(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_READ.get_workspace_permission(),
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- RoleConstants.USER.get_workspace_role()
+ RoleConstants.USER.get_workspace_role(),
)
def post(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.Pylint(
- data={'workspace_id': workspace_id}
- ).run(request.data))
+ return result.success(ToolSerializer.Pylint(data={"workspace_id": workspace_id}).run(request.data))
class EditIcon(APIView):
authentication_classes = [TokenAuth]
parser_classes = [MultiPartParser]
@extend_schema(
- methods=['PUT'],
- summary=_('Edit tool icon'),
- operation_id=_('Edit tool icon'), # type: ignore
- description=_('Edit tool icon'),
+ methods=["PUT"],
+ summary=_("Edit tool icon"),
+ operation_id=_("Edit tool icon"), # type: ignore
+ description=_("Edit tool icon"),
request=EditIconAPI.get_request(),
responses=EditIconAPI.get_response(),
parameters=EditIconAPI.get_parameters(),
- tags=[_('Tool')] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_EDIT.get_workspace_tool_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
def put(self, request: Request, tool_id: str, workspace_id: str):
- return result.success(ToolSerializer.IconOperate(data={
- 'id': tool_id,
- 'workspace_id': workspace_id,
- 'user_id': request.user.id,
- 'image': request.FILES.get('file')
- }).edit(request.data))
+ return result.success(
+ ToolSerializer.IconOperate(
+ data={
+ "id": tool_id,
+ "workspace_id": workspace_id,
+ "user_id": request.user.id,
+ "image": request.FILES.get("file"),
+ }
+ ).edit(request.data)
+ )
class TestConnection(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Test tool connection"),
summary=_("Test tool connection"),
operation_id=_("Test tool connection"), # type: ignore
request=ToolReadAPI.get_request(),
responses=ToolReadAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_CREATE.get_workspace_permission(),
PermissionConstants.TOOL_CREATE.get_workspace_permission_workspace_manage_role(),
PermissionConstants.TOOL_EDIT.get_workspace_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def post(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.TestConnection(data={
- 'workspace_id': workspace_id,
- 'code': request.data.get('code'),
- }).test_connection())
+ return result.success(
+ ToolSerializer.TestConnection(
+ data={
+ "workspace_id": workspace_id,
+ "code": request.data.get("code"),
+ }
+ ).test_connection()
+ )
class InternalTool(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get internal tool"),
summary=_("Get internal tool"),
operation_id=_("Get internal tool"), # type: ignore
parameters=GetInternalToolAPI.get_parameters(),
responses=GetInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
def get(self, request: Request):
- return result.success(ToolSerializer.InternalTool(data={
- 'user_id': request.user.id,
- 'name': request.query_params.get('name', ''),
- }).get_internal_tools())
+ return result.success(
+ ToolSerializer.InternalTool(
+ data={
+ "user_id": request.user.id,
+ "name": request.query_params.get("name", ""),
+ }
+ ).get_internal_tools()
+ )
class AddInternalTool(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Add internal tool"),
summary=_("Add internal tool"),
operation_id=_("Add internal tool"), # type: ignore
parameters=AddInternalToolAPI.get_parameters(),
request=AddInternalToolAPI.get_request(),
responses=AddInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_CREATE.get_workspace_permission(),
@@ -512,45 +581,50 @@ class AddInternalTool(APIView):
RoleConstants.USER.get_workspace_role(),
)
@log(
- menu='Tool', operate="Add internal tool",
- get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
+ menu="Tool",
+ operate="Add internal tool",
+ get_operation_object=lambda r, k: get_tool_operation_object(k.get("tool_id")),
)
def post(self, request: Request, tool_id: str, workspace_id: str):
- return result.success(ToolSerializer.AddInternalTool(data={
- 'tool_id': tool_id,
- 'user_id': request.user.id,
- 'workspace_id': workspace_id
- }).add(request.data))
+ return result.success(
+ ToolSerializer.AddInternalTool(
+ data={"tool_id": tool_id, "user_id": request.user.id, "workspace_id": workspace_id}
+ ).add(request.data)
+ )
class StoreTool(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get Appstore tools"),
summary=_("Get Appstore tools"),
operation_id=_("Get Appstore tools"), # type: ignore
responses=GetInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
def get(self, request: Request):
- return result.success(ToolSerializer.StoreTool(data={
- 'user_id': request.user.id,
- 'name': request.query_params.get('name', ''),
- }).get_appstore_tools())
+ return result.success(
+ ToolSerializer.StoreTool(
+ data={
+ "user_id": request.user.id,
+ "name": request.query_params.get("name", ""),
+ }
+ ).get_appstore_tools()
+ )
class AddStoreTool(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Add Appstore tool"),
summary=_("Add Appstore tool"),
operation_id=_("Add Appstore tool"), # type: ignore
parameters=AddInternalToolAPI.get_parameters(),
request=AddInternalToolAPI.get_request(),
responses=AddInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_CREATE.get_workspace_permission(),
@@ -559,28 +633,33 @@ class AddStoreTool(APIView):
RoleConstants.USER.get_workspace_role(),
)
@log(
- menu='Tool', operate="Add Appstore tool",
- get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
+ menu="Tool",
+ operate="Add Appstore tool",
+ get_operation_object=lambda r, k: get_tool_operation_object(k.get("tool_id")),
)
def post(self, request: Request, tool_id: str, workspace_id: str):
- return result.success(ToolSerializer.AddStoreTool(data={
- 'tool_id': tool_id,
- 'user_id': request.user.id,
- 'workspace_id': workspace_id,
- }).add(request.data))
+ return result.success(
+ ToolSerializer.AddStoreTool(
+ data={
+ "tool_id": tool_id,
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ }
+ ).add(request.data)
+ )
class UpdateStoreTool(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
+ methods=["POST"],
description=_("Update Appstore tool"),
summary=_("Update Appstore tool"),
operation_id=_("Update Appstore tool"), # type: ignore
parameters=AddInternalToolAPI.get_parameters(),
request=AddInternalToolAPI.get_request(),
responses=AddInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_CREATE.get_workspace_permission(),
@@ -589,119 +668,147 @@ class UpdateStoreTool(APIView):
RoleConstants.USER.get_workspace_role(),
)
@log(
- menu='Tool', operate="Update Appstore tool",
- get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
+ menu="Tool",
+ operate="Update Appstore tool",
+ get_operation_object=lambda r, k: get_tool_operation_object(k.get("tool_id")),
)
def post(self, request: Request, tool_id: str, workspace_id: str):
- return result.success(ToolSerializer.UpdateStoreTool(data={
- 'tool_id': tool_id,
- 'user_id': request.user.id,
- 'workspace_id': workspace_id,
- 'download_url': request.data.get('download_url'),
- 'download_callback_url': request.data.get('download_callback_url'),
- 'icon': request.data.get('icon'),
- 'versions': request.data.get('versions'),
- }).update_tool(request.data))
+ return result.success(
+ ToolSerializer.UpdateStoreTool(
+ data={
+ "tool_id": tool_id,
+ "user_id": request.user.id,
+ "workspace_id": workspace_id,
+ "download_url": request.data.get("download_url"),
+ "download_callback_url": request.data.get("download_callback_url"),
+ "icon": request.data.get("icon"),
+ "versions": request.data.get("versions"),
+ }
+ ).update_tool(request.data)
+ )
class PageToolRecord(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get tool records"),
summary=_("Get tool records"),
operation_id=_("Get tool records"), # type: ignore
parameters=AddInternalToolAPI.get_parameters(),
responses=AddInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_EXECUTE_RECORD.get_workspace_tool_permission(),
PermissionConstants.TOOL_EXECUTE_RECORD.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
def get(self, request: Request, tool_id: str, workspace_id: str, current_page: int, page_size: int):
- return result.success(ToolSerializer.ToolRecord(data={
- 'tool_id': tool_id,
- 'workspace_id': workspace_id,
- 'source_name': request.query_params.get('source_name'),
- 'source_type': request.query_params.get('source_type'),
- 'state': request.query_params.get('state'),
- }).get_tool_records(current_page, page_size))
+ return result.success(
+ ToolSerializer.ToolRecord(
+ data={
+ "tool_id": tool_id,
+ "workspace_id": workspace_id,
+ "source_name": request.query_params.get("source_name"),
+ "source_type": request.query_params.get("source_type"),
+ "state": request.query_params.get("state"),
+ }
+ ).get_tool_records(current_page, page_size)
+ )
class ToolRecord(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
+ methods=["GET"],
description=_("Get tool record"),
summary=_("Get tool record"),
operation_id=_("Get tool record"), # type: ignore
parameters=AddInternalToolAPI.get_parameters(),
responses=AddInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_EXECUTE_RECORD.get_workspace_tool_permission(),
PermissionConstants.TOOL_EXECUTE_RECORD.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
def get(self, request: Request, tool_id: str, workspace_id: str, record_id: str):
- return result.success(ToolSerializer.ToolRecord.Operate(data={
- 'tool_id': tool_id,
- 'workspace_id': workspace_id,
- 'id': record_id,
- }).one())
+ return result.success(
+ ToolSerializer.ToolRecord.Operate(
+ data={
+ "tool_id": tool_id,
+ "workspace_id": workspace_id,
+ "id": record_id,
+ }
+ ).one()
+ )
class UploadSkillFile(APIView):
authentication_classes = [TokenAuth]
parser_classes = [MultiPartParser]
@extend_schema(
- methods=['PUT'],
+ methods=["PUT"],
description=_("Upload skill file"),
summary=_("Upload skill file"),
operation_id=_("Upload skill file"), # type: ignore
parameters=AddInternalToolAPI.get_parameters(),
request=AddInternalToolAPI.get_request(),
responses=AddInternalToolAPI.get_response(),
- tags=[_("Tool")] # type: ignore
+ tags=[_("Tool")], # type: ignore
)
@has_permissions(
PermissionConstants.TOOL_CREATE.get_workspace_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
PermissionConstants.TOOL_CREATE.get_workspace_permission_workspace_manage_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role(), RoleConstants.USER.get_workspace_role()
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ RoleConstants.USER.get_workspace_role(),
)
def put(self, request: Request, workspace_id: str):
- return result.success(ToolSerializer.UploadSkillFile(data={
- 'workspace_id': workspace_id,
- 'user_id': request.user.id,
- 'file': request.FILES.get('file'),
- }).upload())
+ return result.success(
+ ToolSerializer.UploadSkillFile(
+ data={
+ "workspace_id": workspace_id,
+ "user_id": request.user.id,
+ "file": request.FILES.get("file"),
+ }
+ ).upload()
+ )
class DownloadSkillFile(APIView):
authentication_classes = [TokenAuth]
@has_permissions(
- PermissionConstants.TOOL_EDIT.get_workspace_permission(),
+ PermissionConstants.TOOL_EDIT.get_workspace_tool_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- RoleConstants.USER.get_workspace_role()
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [PermissionConstants.TOOL.get_workspace_tool_permission()],
+ compare=CompareConstants.AND,
+ ),
)
def get(self, request: Request, workspace_id: str, tool_id: str):
- return ToolSerializer.DownloadSkillFile(data={
- 'workspace_id': workspace_id,
- 'user_id': request.user.id,
- 'tool_id': tool_id,
- }).download()
+ return ToolSerializer.DownloadSkillFile(
+ data={
+ "workspace_id": workspace_id,
+ "user_id": request.user.id,
+ "tool_id": tool_id,
+ }
+ ).download()
class GenerateCode(APIView):
authentication_classes = [TokenAuth]
@@ -712,10 +819,9 @@ class GenerateCode(APIView):
PermissionConstants.TOOL_EDIT.get_workspace_permission(),
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
- RoleConstants.USER.get_workspace_role()
+ RoleConstants.USER.get_workspace_role(),
)
def post(self, request: Request, workspace_id: str):
- return ToolSerializer.GenerateCodeSerializer(data={
- 'workspace_id': workspace_id,
- **request.data
- }).generate_code()
+ return ToolSerializer.GenerateCodeSerializer(
+ data={"workspace_id": workspace_id, **request.data}
+ ).generate_code()
diff --git a/apps/tools/views/tool_workflow.py b/apps/tools/views/tool_workflow.py
index 7bad1926c92..d0e38441b4b 100644
--- a/apps/tools/views/tool_workflow.py
+++ b/apps/tools/views/tool_workflow.py
@@ -3,7 +3,10 @@
from application.api.application_api import SpeechToTextAPI
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import CompareConstants, PermissionConstants, RoleConstants, ViewPermission
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import DefaultResultSerializer, result
from django.utils.translation import gettext_lazy as _
@@ -40,7 +43,7 @@ class Publish(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@@ -80,7 +83,7 @@ class Operate(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
@log(
@@ -111,7 +114,7 @@ def put(self, request: Request, workspace_id: str, tool_id: str):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def get(self, request: Request, workspace_id: str, tool_id: str):
@@ -141,7 +144,7 @@ class ToolWorkflowDebugView(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
)
def post(self, request: Request, workspace_id: str, tool_id: str):
@@ -169,7 +172,7 @@ class McpServers(APIView):
ViewPermission(
[RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND,
+ compare=CompareConstants.AND,
),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
diff --git a/apps/tools/views/tool_workflow_version.py b/apps/tools/views/tool_workflow_version.py
index d3f8a319d7e..7c6547bb9f5 100644
--- a/apps/tools/views/tool_workflow_version.py
+++ b/apps/tools/views/tool_workflow_version.py
@@ -15,7 +15,10 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from knowledge.api.knowledge_version import KnowledgeVersionListAPI, KnowledgeVersionPageAPI, \
KnowledgeVersionOperateAPI
@@ -49,7 +52,7 @@ class ToolWorkflowVersionView(APIView):
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id, tool_id: str):
return result.success(
@@ -73,7 +76,7 @@ class Page(APIView):
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, tool_id: str, current_page: int, page_size: int):
return result.success(
@@ -98,7 +101,7 @@ class Operate(APIView):
PermissionConstants.TOOL_READ.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
def get(self, request: Request, workspace_id: str, tool_id: str, tool_version_id: str):
return result.success(
@@ -120,7 +123,7 @@ def get(self, request: Request, workspace_id: str, tool_id: str, tool_version_id
PermissionConstants.TOOL_EDIT.get_workspace_permission_workspace_manage_role(),
ViewPermission([RoleConstants.USER.get_workspace_role()],
[PermissionConstants.TOOL.get_workspace_tool_permission()],
- CompareConstants.AND),
+ compare=CompareConstants.AND),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
@log(menu='Tool', operate="Modify tool version information",
get_operation_object=lambda r, k: get_tool_operation_object(k.get('tool_id')),
diff --git a/apps/trigger/handler/impl/task/application_task.py b/apps/trigger/handler/impl/task/application_task.py
index 16cfed8b49a..b88b302a470 100644
--- a/apps/trigger/handler/impl/task/application_task.py
+++ b/apps/trigger/handler/impl/task/application_task.py
@@ -32,10 +32,10 @@ def get_reference(fields, obj):
def conversion_custom_value(value, _type):
- if _type in ('array', 'dict', 'float', 'int', 'boolean', 'any'):
+ if ['array', 'dict', 'float', 'int', 'boolean', 'any'].__contains__(_type):
try:
return json.loads(value)
- except Exception:
+ except Exception as e:
pass
return value
@@ -48,11 +48,9 @@ def valid_value_type(value, _type):
if _type == 'float':
return isinstance(value, float)
if _type == 'int':
- return isinstance(value, int) and not isinstance(value, bool)
+ return isinstance(value, int)
if _type == 'boolean':
return isinstance(value, bool)
- if _type == 'any':
- return True
return isinstance(value, str)
@@ -62,17 +60,15 @@ def get_field_value(value, kwargs, _type, required, default_value, field):
_value = value.get('value')
if _value:
_value = conversion_custom_value(_value, _type)
+ else:
+ if default_value or (_type == 'boolean' and default_value == False):
+ return default_value
+ if required:
+ raise Exception(f'{field} is required')
+ else:
+ return None
else:
_value = get_reference(value.get('value'), kwargs)
-
- if _value is None:
- if default_value:
- return default_value
- if required:
- raise Exception(f'{field} is required')
- else:
- return None
-
valid = valid_value_type(_value, _type)
if not valid:
raise Exception(f'{field} type error')
@@ -173,7 +169,7 @@ def get_application_parameters_setting(application):
v = file_upload_setting.get(field)
if v:
application_parameter_setting[field + '_list'] = {'required': False, 'default_value': [],
- 'type': 'array'}
+ 'type': 'array'}
return application_parameter_setting
diff --git a/apps/trigger/handler/impl/task/tool_task/workflow_tool_task.py b/apps/trigger/handler/impl/task/tool_task/workflow_tool_task.py
index 9ef050fb92d..26968f687fe 100644
--- a/apps/trigger/handler/impl/task/tool_task/workflow_tool_task.py
+++ b/apps/trigger/handler/impl/task/tool_task/workflow_tool_task.py
@@ -1,20 +1,23 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: workflow_tool_task.py.py
- @date:2026/3/27 18:47
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: workflow_tool_task.py.py
+@date:2026/3/27 18:47
+@desc:
"""
+
+import threading
import time
import traceback
import uuid_utils.compat as uuid
from django.db.models import QuerySet
-from application.flow.common import WorkflowMode, Workflow
-from application.flow.i_step_node import ToolWorkflowPostHandler, get_tool_workflow_state
-from application.serializers.common import ToolExecute
+from application.workflow.common import WorkflowType, get_node_parameters, new_instance
+from application.workflow.nodes import get_node_class
+from application.workflow.status import Status
+from application.workflow.workflow_manage import CallBack, WorkflowManage
from common.utils.common import common_convert_value
from common.utils.logger import maxkb_logger
from common.utils.tool_code import ToolExecutor
@@ -37,11 +40,12 @@ def get_reference(fields, obj):
def get_field_value(value, kwargs):
- source = value.get('source')
- if source == 'custom':
- return value.get('value')
+ source = value.get("source")
+ if source == "custom":
+ return value.get("value")
else:
- return get_reference(value.get('value'), kwargs)
+ return get_reference(value.get("value"), kwargs)
+
def get_tool_execute_parameters(input_field_list, parameter_setting, kwargs):
type_map = {f.get("name"): f.get("type") for f in (input_field_list or []) if f.get("name")}
@@ -59,79 +63,97 @@ def support(self, tool, trigger_task, **kwargs):
return tool.tool_type == ToolType.WORKFLOW
def execute(self, tool, trigger_task, **kwargs):
- parameter_setting = trigger_task.get('parameter')
- tool_id = trigger_task.get('source_id')
+ parameter_setting = trigger_task.get("parameter")
+ tool_id = trigger_task.get("source_id")
task_record_id = uuid.uuid7()
start_time = time.time()
try:
TaskRecord(
id=task_record_id,
- trigger_id=trigger_task.get('trigger'),
- trigger_task_id=trigger_task.get('id'),
+ trigger_id=trigger_task.get("trigger"),
+ trigger_task_id=trigger_task.get("id"),
source_type="TOOL",
source_id=tool_id,
task_record_id=task_record_id,
- meta={'input': parameter_setting, 'output': {}},
- state=State.STARTED
+ meta={"input": parameter_setting, "output": {}},
+ state=State.STARTED,
).save()
ToolRecord(
id=task_record_id,
workspace_id=tool.workspace_id,
tool_id=tool.id,
source_type=ToolTaskTypeChoices.TRIGGER,
- source_id=trigger_task.get('trigger'),
- meta={'input': parameter_setting, 'output': {}},
- state=State.STARTED
+ source_id=trigger_task.get("trigger"),
+ meta={"input": parameter_setting, "output": {}},
+ state=State.STARTED,
).save()
- tool_workflow_version = QuerySet(ToolWorkflowVersion).filter(tool_id=tool.id).order_by(
- '-create_time')[0:1].first()
+ tool_workflow_version = (
+ QuerySet(ToolWorkflowVersion).filter(tool_id=tool.id).order_by("-create_time")[0:1].first()
+ )
if not tool_workflow_version:
maxkb_logger.info(f"Tool with id {tool_id} not found or inactive.")
return
- flow = Workflow.new_instance(tool_workflow_version.work_flow, WorkflowMode.TOOL)
- base_node = flow.get_node('tool-base-node')
+ workflow = new_instance(tool_workflow_version.work_flow, WorkflowType.TOOL)
+ base_node = workflow.get_node("tool-base-node")
user_input_field_list = base_node.properties.get("user_input_field_list") or []
- parameters = get_tool_execute_parameters(user_input_field_list,
- parameter_setting.get('user_input_field_list'), kwargs)
- took_execute = ToolExecute(tool_id, str(task_record_id),
- tool.workspace_id,
- ToolTaskTypeChoices.TRIGGER,
- trigger_task.get('trigger'),
- False)
- from application.flow.tool_workflow_manage import ToolWorkflowManage
- work_flow_manage = ToolWorkflowManage(
- flow,
- {
- 'chat_record_id': task_record_id,
- 'tool_id': tool_id,
- 'stream': True,
- 'workspace_id': tool.workspace_id,
- **parameters},
- ToolWorkflowPostHandler(took_execute, tool_id),
- is_the_task_interrupted=lambda: False,
- child_node=None,
- start_node_id=None,
- start_node_data=None,
- chat_record=None
+ field_parameters = get_tool_execute_parameters(
+ user_input_field_list, parameter_setting.get("user_input_field_list"), kwargs
)
- res = work_flow_manage.run()
- for r in res:
+ # 对齐旧引擎 body:输入字段值 + 运行身份;新引擎 tool-start-node 按 field 从这里取值
+ parameters = {
+ "tool_id": tool_id,
+ "stream": True,
+ "workspace_id": tool.workspace_id,
+ **field_parameters,
+ }
+
+ # 后台任务:非流式,run() 起线程异步执行,完成后经 on_complete 通知,这里阻塞等结果
+ done_event = threading.Event()
+ run_result = {"error": None}
+
+ def on_next(wf_manage, content):
pass
- state = get_tool_workflow_state(work_flow_manage)
+
+ def on_complete(wf_manage, error):
+ run_result["error"] = error
+ done_event.set()
+
+ call_back = CallBack(on_next, on_complete)
+
+ def get_start_node_fn(wf, wm):
+ start_node = wf.get_node("tool-start-node")
+ if start_node is None:
+ raise Exception("The start node does not exist")
+ node_class = get_node_class(start_node.type, WorkflowType.TOOL)
+ return node_class(start_node, wm, get_node_parameters)
+
+ work_flow_manage = WorkflowManage(workflow, parameters, WorkflowType.TOOL, call_back, get_start_node_fn)
+ work_flow_manage.run()
+ done_event.wait()
+
+ if run_result["error"]:
+ raise run_result["error"]
+
+ # 新引擎工具输出收口于全局 output 上下文(tool-start-node 初始化、变量赋值节点写入)
+ output = work_flow_manage.context.get("output", {})
+ details = work_flow_manage.get_details()
+ has_fail = any((d or {}).get("status") == Status.FAIL.value for d in (details or []))
+ state = State.FAILURE if has_fail else State.SUCCESS
QuerySet(TaskRecord).filter(id=task_record_id).update(
- state=state,
- run_time=time.time() - start_time,
- meta={'input': parameter_setting, 'output': work_flow_manage.out_context}
+ state=state, run_time=time.time() - start_time, meta={"input": parameter_setting, "output": output}
+ )
+ QuerySet(ToolRecord).filter(id=task_record_id).update(
+ state=state, run_time=time.time() - start_time, meta={"input": parameter_setting, "output": output}
)
except Exception as e:
maxkb_logger.error(f"Tool execution error: {traceback.format_exc()}")
QuerySet(TaskRecord).filter(id=task_record_id).update(
state=State.FAILURE,
run_time=time.time() - start_time,
- meta={'input': parameter_setting, 'output': 'Error: ' + str(e), 'err_message': 'Error: ' + str(e)}
+ meta={"input": parameter_setting, "output": "Error: " + str(e), "err_message": "Error: " + str(e)},
)
QuerySet(ToolRecord).filter(id=task_record_id).update(
state=State.FAILURE,
run_time=time.time() - start_time,
- meta={'input': parameter_setting, 'output': 'Error: ' + str(e), 'err_message': 'Error: ' + str(e)}
+ meta={"input": parameter_setting, "output": "Error: " + str(e), "err_message": "Error: " + str(e)},
)
diff --git a/apps/trigger/serializers/trigger.py b/apps/trigger/serializers/trigger.py
index 94673ad3154..f5494934036 100644
--- a/apps/trigger/serializers/trigger.py
+++ b/apps/trigger/serializers/trigger.py
@@ -463,6 +463,11 @@ def batch_delete(self, instance: Dict, with_valid=True):
self.is_valid(raise_exception=True)
workspace_id = self.data.get("workspace_id")
trigger_id_list = instance.get("id_list")
+ trigger_id_list = list(
+ QuerySet(Trigger)
+ .filter(id__in=trigger_id_list, workspace_id=workspace_id)
+ .values_list("id", flat=True)
+ )
for trigger_id in trigger_id_list:
trigger = QuerySet(Trigger).filter(id=trigger_id).first()
undeploy(TriggerModelSerializer(trigger).data, **{})
diff --git a/apps/trigger/sql/get_trigger_page_list.sql b/apps/trigger/sql/get_trigger_page_list.sql
index 79c6094bad3..ec33d6fa6d9 100644
--- a/apps/trigger/sql/get_trigger_page_list.sql
+++ b/apps/trigger/sql/get_trigger_page_list.sql
@@ -1,8 +1,25 @@
WITH scheduler AS (SELECT SPLIT_PART(id, ':', 2) as trigger_id,
- id,
next_run_time
FROM django_apscheduler_djangojob
- WHERE id LIKE 'trigger:%%')
+ WHERE id LIKE 'trigger:%%'),
+ scheduler_summary AS (SELECT trigger_id,
+ (ARRAY_AGG(next_run_time ORDER BY next_run_time))[1] AS next_run_time
+ FROM scheduler
+ GROUP BY trigger_id),
+ trigger_task_summary AS (SELECT tt.trigger_id,
+ JSON_AGG(
+ JSON_BUILD_OBJECT(
+ 'type', tt.source_type,
+ 'name', COALESCE(app.name, tool.name),
+ 'icon', COALESCE(app.icon, tool.icon)
+ )
+ ) AS trigger_task,
+ STRING_AGG(COALESCE(app.name, tool.name), ' ') AS trigger_task_str
+ FROM event_trigger_task tt
+ LEFT JOIN application app
+ ON tt.source_type = 'APPLICATION' AND tt.source_id = app.id
+ LEFT JOIN tool ON tt.source_type = 'TOOL' AND tt.source_id = tool.id
+ GROUP BY tt.trigger_id)
SELECT *
FROM (SELECT t.id,
t.workspace_id,
@@ -13,31 +30,16 @@ FROM (SELECT t.id,
t.meta::JSON,
t.is_active,
t.create_time,
- t.update_time,
- t.user_id,
- (SELECT nick_name FROM "user" WHERE id = t.user_id) AS create_user,
- COALESCE(
- (ARRAY_AGG(sj.next_run_time ORDER BY sj.next_run_time))[1],
- NULL
- ) as next_run_time,
- COALESCE(
- JSON_AGG(
- JSON_BUILD_OBJECT(
- 'type', tt.source_type,
- 'name', COALESCE(app.name, tool.name),
- 'icon', COALESCE(app.icon, tool.icon)
- )
- ), '[]'::JSON
- ) AS trigger_task,
- STRING_AGG(COALESCE(app.name, tool.name), ' ') AS trigger_task_str
+ t.update_time,
+ t.user_id,
+ (SELECT nick_name FROM "user" WHERE id = t.user_id) AS create_user,
+ ss.next_run_time,
+ COALESCE(tts.trigger_task, '[]'::JSON) AS trigger_task,
+ tts.trigger_task_str
FROM event_trigger t
- LEFT JOIN scheduler sj ON sj.trigger_id=t.id::text
- LEFT JOIN event_trigger_task tt ON t.id = tt.trigger_id
- LEFT JOIN application app ON tt.source_type = 'APPLICATION' AND tt.source_id = app.id
- LEFT JOIN tool ON tt.source_type = 'TOOL' AND tt.source_id = tool.id
+ LEFT JOIN scheduler_summary ss ON ss.trigger_id = t.id::text
+ LEFT JOIN trigger_task_summary tts ON t.id = tts.trigger_id
${trigger_query_set}
- GROUP BY t.id, t.workspace_id, t.name, t.desc, t.trigger_type, t.trigger_setting, t.meta, t.is_active,
- t.create_time,
- t.update_time, t.user_id) AS sub
+ ) AS sub
${task_query_set}
ORDER BY sub.create_time DESC
\ No newline at end of file
diff --git a/apps/trigger/views/trigger.py b/apps/trigger/views/trigger.py
index 2cfcd3bab05..a8699d51305 100644
--- a/apps/trigger/views/trigger.py
+++ b/apps/trigger/views/trigger.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:niu
- @file: trigger.py
- @date:2026/1/14 11:44
- @desc:
+@project: MaxKB
+@Author:niu
+@file: trigger.py
+@date:2026/1/14 11:44
+@desc:
"""
+
from django.db.models import QuerySet
from django.utils.translation import gettext_lazy as _
from drf_spectacular.utils import extend_schema
@@ -16,36 +17,49 @@
from common import result
from common.auth import TokenAuth
from common.auth.authentication import has_permissions
-from common.constants.permission_constants import PermissionConstants, RoleConstants, ViewPermission, CompareConstants, \
- Permission, Group, Operate
+from common.auth.constants.compare_constants import CompareConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.aggregate_permission import ViewPermission
from common.log.log import log
from common.result import DefaultResultSerializer
from trigger.models import Trigger
-from trigger.serializers.task_source_trigger import TaskSourceTriggerListSerializer, TaskSourceTriggerOperateSerializer, \
- TaskSourceTriggerSerializer
+from trigger.serializers.task_source_trigger import (
+ TaskSourceTriggerListSerializer,
+ TaskSourceTriggerOperateSerializer,
+ TaskSourceTriggerSerializer,
+)
from trigger.serializers.trigger import TriggerQuerySerializer, TriggerOperateSerializer
-from trigger.api.trigger import TriggerCreateAPI, TriggerOperateAPI, TriggerEditAPI, TriggerBatchDeleteAPI, \
- TriggerBatchActiveAPI, TaskSourceTriggerOperateAPI, TaskSourceTriggerAPI, TaskSourceTriggerCreateAPI, \
- TriggerQueryAPI, TriggerQueryPageAPI
+from trigger.api.trigger import (
+ TriggerCreateAPI,
+ TriggerOperateAPI,
+ TriggerEditAPI,
+ TriggerBatchDeleteAPI,
+ TriggerBatchActiveAPI,
+ TaskSourceTriggerOperateAPI,
+ TaskSourceTriggerAPI,
+ TaskSourceTriggerCreateAPI,
+ TriggerQueryAPI,
+ TriggerQueryPageAPI,
+)
from trigger.serializers.trigger import TriggerSerializer
def get_trigger_operation_object(trigger_id):
trigger_model = QuerySet(model=Trigger).filter(id=trigger_id).first()
if trigger_model is not None:
- return {
- "name": trigger_model.name
- }
+ return {"name": trigger_model.name}
def get_trigger_operation_object_batch(trigger_id_list):
trigger_model_list = QuerySet(model=Trigger).filter(id__in=trigger_id_list)
if trigger_model_list is not None:
return {
- "name": f'[{",".join([trigger_model.name for trigger_model in trigger_model_list])}]',
- "trigger_list": [{'name': trigger_model.name, 'type': trigger_model.type} for trigger_model in
- trigger_model_list]
+ "name": f"[{','.join([trigger_model.name for trigger_model in trigger_model_list])}]",
+ "trigger_list": [
+ {"name": trigger_model.name, "type": trigger_model.type} for trigger_model in trigger_model_list
+ ],
}
@@ -53,351 +67,422 @@ class TriggerView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Create trigger'),
- summary=_('Create trigger'),
- operation_id=_('Create trigger'), # type: ignore
+ methods=["POST"],
+ description=_("Create trigger"),
+ summary=_("Create trigger"),
+ operation_id=_("Create trigger"), # type: ignore
parameters=TriggerCreateAPI.get_parameters(),
request=TriggerCreateAPI.get_request(),
responses=TriggerCreateAPI.get_response(),
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_CREATE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu="Trigger", operate="Create trigger",
- get_operation_object=lambda r, k: r.data.get('name'),
+ menu="Trigger",
+ operate="Create trigger",
+ get_operation_object=lambda r, k: r.data.get("name"),
)
def post(self, request: Request, workspace_id: str):
- return result.success(TriggerSerializer(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}).insert(request.data))
+ return result.success(
+ TriggerSerializer(data={"workspace_id": workspace_id, "user_id": request.user.id}).insert(request.data)
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get the trigger list'),
- summary=_('Get the trigger list'),
- operation_id=_('Get the trigger list'), # type: ignore
+ methods=["GET"],
+ description=_("Get the trigger list"),
+ summary=_("Get the trigger list"),
+ operation_id=_("Get the trigger list"), # type: ignore
parameters=TriggerQueryAPI.get_parameters(),
responses=TriggerQueryAPI.get_response(),
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str):
- return result.success(TriggerQuerySerializer(data={
- 'workspace_id': workspace_id,
- 'name': request.query_params.get('name'),
- 'type': request.query_params.get('type'),
- 'task': request.query_params.get('task'),
- 'is_active': request.query_params.get('is_active'),
- 'create_user': request.query_params.get('create_user'),
- }).list())
+ return result.success(
+ TriggerQuerySerializer(
+ data={
+ "workspace_id": workspace_id,
+ "name": request.query_params.get("name"),
+ "type": request.query_params.get("type"),
+ "task": request.query_params.get("task"),
+ "is_active": request.query_params.get("is_active"),
+ "create_user": request.query_params.get("create_user"),
+ }
+ ).list()
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get trigger details'),
- summary=_('Get trigger details'),
- operation_id=_('Get trigger details'), # type: ignore
+ methods=["GET"],
+ description=_("Get trigger details"),
+ summary=_("Get trigger details"),
+ operation_id=_("Get trigger details"), # type: ignore
parameters=TriggerOperateAPI.get_parameters(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu="Trigger", operate="Get trigger details",
- get_operation_object=lambda r, k: get_trigger_operation_object(k.get('trigger_id')),
+ menu="Trigger",
+ operate="Get trigger details",
+ get_operation_object=lambda r, k: get_trigger_operation_object(k.get("trigger_id")),
)
def get(self, request: Request, workspace_id: str, trigger_id: str):
- return result.success(TriggerOperateSerializer(
- data={'trigger_id': trigger_id, 'workspace_id': workspace_id, 'user_id': request.user.id}
- ).one())
+ return result.success(
+ TriggerOperateSerializer(
+ data={"trigger_id": trigger_id, "workspace_id": workspace_id, "user_id": request.user.id}
+ ).one()
+ )
@extend_schema(
- methods=['PUT'],
- description=_('Modify the trigger'),
- summary=_('Modify the trigger'),
- operation_id=_('Modify the trigger'), # type: ignore
+ methods=["PUT"],
+ description=_("Modify the trigger"),
+ summary=_("Modify the trigger"),
+ operation_id=_("Modify the trigger"), # type: ignore
parameters=TriggerOperateAPI.get_parameters(),
request=TriggerEditAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu="Trigger", operate="Modify the trigger",
- get_operation_object=lambda r, k: get_trigger_operation_object(k.get('trigger_id')),
+ menu="Trigger",
+ operate="Modify the trigger",
+ get_operation_object=lambda r, k: get_trigger_operation_object(k.get("trigger_id")),
)
def put(self, request: Request, workspace_id: str, trigger_id: str):
- return result.success(TriggerOperateSerializer(
- data={'trigger_id': trigger_id, 'workspace_id': workspace_id, 'user_id': request.user.id}
- ).edit(request.data))
+ return result.success(
+ TriggerOperateSerializer(
+ data={"trigger_id": trigger_id, "workspace_id": workspace_id, "user_id": request.user.id}
+ ).edit(request.data)
+ )
@extend_schema(
- methods=['DELETE'],
- description=_('Delete the trigger'),
- summary=_('Delete the trigger'),
- operation_id=_('Delete the trigger'), # type: ignore
+ methods=["DELETE"],
+ description=_("Delete the trigger"),
+ summary=_("Delete the trigger"),
+ operation_id=_("Delete the trigger"), # type: ignore
parameters=TriggerOperateAPI.get_parameters(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu="Trigger", operate="Delete the trigger",
- get_operation_object=lambda r, k: get_trigger_operation_object(k.get('trigger_id')),
+ menu="Trigger",
+ operate="Delete the trigger",
+ get_operation_object=lambda r, k: get_trigger_operation_object(k.get("trigger_id")),
)
def delete(self, request: Request, workspace_id: str, trigger_id: str):
- return result.success(TriggerOperateSerializer(
- data={'trigger_id': trigger_id, 'workspace_id': workspace_id, 'user_id': request.user.id}
- ).delete())
+ return result.success(
+ TriggerOperateSerializer(
+ data={"trigger_id": trigger_id, "workspace_id": workspace_id, "user_id": request.user.id}
+ ).delete()
+ )
class BatchDelete(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- description=_('Delete trigger in batches'),
- summary=_('Delete trigger in batches'),
- operation_id=_('Delete trigger in batches'), # type: ignore
+ methods=["PUT"],
+ description=_("Delete trigger in batches"),
+ summary=_("Delete trigger in batches"),
+ operation_id=_("Delete trigger in batches"), # type: ignore
parameters=TriggerBatchDeleteAPI.get_parameters(),
request=TriggerBatchDeleteAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_DELETE.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu="Trigger", operate="Delete trigger in batches",
- get_operation_object=lambda r, k: get_trigger_operation_object_batch(r.data.get('id_list')),
+ menu="Trigger",
+ operate="Delete trigger in batches",
+ get_operation_object=lambda r, k: get_trigger_operation_object_batch(r.data.get("id_list")),
)
def put(self, request: Request, workspace_id: str):
- return result.success(TriggerSerializer.Batch(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}
- ).batch_delete(request.data))
+ return result.success(
+ TriggerSerializer.Batch(data={"workspace_id": workspace_id, "user_id": request.user.id}).batch_delete(
+ request.data
+ )
+ )
class BatchActivate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['PUT'],
- description=_('Activate trigger in batches'),
- summary=_('Activate trigger in batches'),
- operation_id=_('Activate trigger in batches'), # type: ignore
+ methods=["PUT"],
+ description=_("Activate trigger in batches"),
+ summary=_("Activate trigger in batches"),
+ operation_id=_("Activate trigger in batches"), # type: ignore
parameters=TriggerBatchDeleteAPI.get_parameters(),
request=TriggerBatchActiveAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_EDIT.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
@log(
- menu="Trigger", operate="Activate trigger in batches",
- get_operation_object=lambda r, k: get_trigger_operation_object_batch(r.data.get('id_list')),
+ menu="Trigger",
+ operate="Activate trigger in batches",
+ get_operation_object=lambda r, k: get_trigger_operation_object_batch(r.data.get("id_list")),
)
def put(self, request: Request, workspace_id: str):
- return result.success(TriggerSerializer.Batch(
- data={'workspace_id': workspace_id, 'user_id': request.user.id}
- ).batch_switch(request.data))
+ return result.success(
+ TriggerSerializer.Batch(data={"workspace_id": workspace_id, "user_id": request.user.id}).batch_switch(
+ request.data
+ )
+ )
class Page(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get the trigger list by page'),
- summary=_('Get the trigger list by page'),
- operation_id=_('Get the trigger list by page'), # type: ignore
+ methods=["GET"],
+ description=_("Get the trigger list by page"),
+ summary=_("Get the trigger list by page"),
+ operation_id=_("Get the trigger list by page"), # type: ignore
parameters=TriggerQueryPageAPI.get_parameters(),
responses=TriggerQueryPageAPI.get_response(),
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
PermissionConstants.TRIGGER_READ.get_workspace_permission_workspace_manage_role(),
RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
)
def get(self, request: Request, workspace_id: str, current_page: int, page_size: int):
- return result.success(TriggerQuerySerializer(data={
- 'workspace_id': workspace_id,
- 'name': request.query_params.get('name'),
- 'task': request.query_params.get('task'),
- 'type': request.query_params.get('type'),
- 'is_active': request.query_params.get('is_active'),
- 'create_user': request.query_params.get('create_user'),
- }).page(current_page, page_size))
+ return result.success(
+ TriggerQuerySerializer(
+ data={
+ "workspace_id": workspace_id,
+ "name": request.query_params.get("name"),
+ "task": request.query_params.get("task"),
+ "type": request.query_params.get("type"),
+ "is_active": request.query_params.get("is_active"),
+ "create_user": request.query_params.get("create_user"),
+ }
+ ).page(current_page, page_size)
+ )
class TaskSourceTriggerView(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['POST'],
- description=_('Create trigger in source'),
- summary=_('Create trigger in source'),
- operation_id=_('Create trigger in source'), # type: ignore
+ methods=["POST"],
+ description=_("Create trigger in source"),
+ summary=_("Create trigger in source"),
+ operation_id=_("Create trigger in source"), # type: ignore
parameters=TaskSourceTriggerCreateAPI.get_parameters(),
request=TaskSourceTriggerCreateAPI.get_request(),
responses=TaskSourceTriggerCreateAPI.get_response(),
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_CREATE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_CREATE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}"
- ),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('source_type')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_CREATE"
+ ]._build_workspace_permission(resource_id_key="source_id"),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_CREATE"
+ ].get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("source_type")]._build_workspace_permission(
+ resource_id_key="source_id"
+ )(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
@log(
- menu="Trigger", operate="Create trigger in source",
- get_operation_object=lambda r, k: r.data.get('name'),
+ menu="Trigger",
+ operate="Create trigger in source",
+ get_operation_object=lambda r, k: r.data.get("name"),
)
def post(self, request: Request, workspace_id: str, source_type: str, source_id: str):
- return result.success(TaskSourceTriggerSerializer(data={
- 'workspace_id': workspace_id,
- 'user_id': request.user.id
- }).insert({**request.data, 'source_id': source_id,
- 'workspace_id': workspace_id,
- 'is_active': True,
- 'source_type': source_type}))
+ return result.success(
+ TaskSourceTriggerSerializer(data={"workspace_id": workspace_id, "user_id": request.user.id}).insert(
+ {
+ **request.data,
+ "source_id": source_id,
+ "workspace_id": workspace_id,
+ "is_active": True,
+ "source_type": source_type,
+ }
+ )
+ )
@extend_schema(
- methods=['GET'],
- description=_('Get the trigger list of source'),
- summary=_('Get the trigger list of source'),
- operation_id=_('Get the trigger list of source'), # type: ignore
+ methods=["GET"],
+ description=_("Get the trigger list of source"),
+ summary=_("Get the trigger list of source"),
+ operation_id=_("Get the trigger list of source"), # type: ignore
parameters=TaskSourceTriggerAPI.get_parameters(),
responses=DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}"
- ),
+ lambda r, kwargs: PermissionConstants[f"{kwargs.get('source_type')}_TRIGGER_READ"]._build_workspace_permission(
+ resource_id_key="source_id"
+ ),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_READ"
+ ].get_workspace_permission_workspace_manage_role(),
RoleConstants.USER.get_workspace_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, source_type: str, source_id: str):
- return result.success(TaskSourceTriggerListSerializer(data={
- 'workspace_id': workspace_id,
- 'source_id': source_id,
- 'source_type': source_type,
- }).list())
+ return result.success(
+ TaskSourceTriggerListSerializer(
+ data={
+ "workspace_id": workspace_id,
+ "source_id": source_id,
+ "source_type": source_type,
+ }
+ ).list()
+ )
class Operate(APIView):
authentication_classes = [TokenAuth]
@extend_schema(
- methods=['GET'],
- description=_('Get Task source trigger details'),
- summary=_('Get Task source trigger details'),
- operation_id=_('Get Task source trigger details'), # type: ignore
+ methods=["GET"],
+ description=_("Get Task source trigger details"),
+ summary=_("Get Task source trigger details"),
+ operation_id=_("Get Task source trigger details"), # type: ignore
parameters=TaskSourceTriggerOperateAPI.get_parameters(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_READ,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}"
- ),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_READ"
+ ]._build_workspace_permission(resource_id_key="source_id"),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_READ"
+ ].get_workspace_permission_workspace_manage_role(),
RoleConstants.USER.get_workspace_role(),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
def get(self, request: Request, workspace_id: str, source_type: str, source_id: str, trigger_id: str):
- return result.success(TaskSourceTriggerOperateSerializer(
- data={'trigger_id': trigger_id, 'workspace_id': workspace_id,
- 'source_id': source_id, 'source_type': source_type}
- ).one())
+ return result.success(
+ TaskSourceTriggerOperateSerializer(
+ data={
+ "trigger_id": trigger_id,
+ "workspace_id": workspace_id,
+ "source_id": source_id,
+ "source_type": source_type,
+ }
+ ).one()
+ )
@extend_schema(
- methods=['PUT'],
- description=_('Modify the task source trigger'),
- summary=_('Modify the task source trigger'),
- operation_id=_('Modify the task source trigger'), # type: ignore
+ methods=["PUT"],
+ description=_("Modify the task source trigger"),
+ summary=_("Modify the task source trigger"),
+ operation_id=_("Modify the task source trigger"), # type: ignore
parameters=TaskSourceTriggerOperateAPI.get_parameters(),
request=TaskSourceTriggerOperateAPI.get_request(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_EDIT,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_EDIT,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}"
- ),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('source_type')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_EDIT"
+ ]._build_workspace_permission(resource_id_key="source_id"),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_EDIT"
+ ].get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("source_type")]._build_workspace_permission(
+ resource_id_key="source_id"
+ )(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
@log(
- menu="Trigger", operate="Modify the source point trigger",
- get_operation_object=lambda r, k: get_trigger_operation_object(k.get('trigger_id')),
+ menu="Trigger",
+ operate="Modify the source point trigger",
+ get_operation_object=lambda r, k: get_trigger_operation_object(k.get("trigger_id")),
)
def put(self, request: Request, workspace_id: str, source_type: str, source_id: str, trigger_id: str):
- return result.success(TaskSourceTriggerOperateSerializer(
- data={'trigger_id': trigger_id, 'workspace_id': workspace_id,
- 'source_id': source_id, 'source_type': source_type}
- ).edit(request.data))
+ return result.success(
+ TaskSourceTriggerOperateSerializer(
+ data={
+ "trigger_id": trigger_id,
+ "workspace_id": workspace_id,
+ "source_id": source_id,
+ "source_type": source_type,
+ }
+ ).edit(request.data)
+ )
@extend_schema(
- methods=['DELETE'],
- description=_('Delete the task source trigger'),
- summary=_('Delete the task source trigger'),
- operation_id=_('Delete the task source trigger'), # type: ignore
+ methods=["DELETE"],
+ description=_("Delete the task source trigger"),
+ summary=_("Delete the task source trigger"),
+ operation_id=_("Delete the task source trigger"), # type: ignore
parameters=TaskSourceTriggerOperateAPI.get_parameters(),
responses=result.DefaultResultSerializer,
- tags=[_('Trigger')] # type: ignore
+ tags=[_("Trigger")], # type: ignore
)
@has_permissions(
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_DELETE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}:ROLE/WORKSPACE_MANAGE"
- ),
- lambda r, kwargs: Permission(group=Group(kwargs.get("source_type")), operate=Operate.TRIGGER_DELETE,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}"
- ),
- ViewPermission([RoleConstants.USER.get_workspace_role()],
- [lambda r, kwargs: Permission(group=Group(kwargs.get('source_type')),
- operate=Operate.SELF,
- resource_path=f"/WORKSPACE/{kwargs.get('workspace_id')}/{kwargs.get('source_type')}/{kwargs.get('source_id')}")],
- CompareConstants.AND),
- RoleConstants.WORKSPACE_MANAGE.get_workspace_role())
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_DELETE"
+ ]._build_workspace_permission(resource_id_key="source_id"),
+ lambda r, kwargs: PermissionConstants[
+ f"{kwargs.get('source_type')}_TRIGGER_DELETE"
+ ].get_workspace_permission_workspace_manage_role(),
+ ViewPermission(
+ [RoleConstants.USER.get_workspace_role()],
+ [
+ lambda r, kwargs: PermissionConstants[kwargs.get("source_type")]._build_workspace_permission(
+ resource_id_key="source_id"
+ )(r, **kwargs)
+ ],
+ compare=CompareConstants.AND,
+ ),
+ RoleConstants.WORKSPACE_MANAGE.get_workspace_role(),
+ )
@log(
- menu="Trigger", operate="Delete the source point trigger",
- get_operation_object=lambda r, k: get_trigger_operation_object(k.get('trigger_id')),
+ menu="Trigger",
+ operate="Delete the source point trigger",
+ get_operation_object=lambda r, k: get_trigger_operation_object(k.get("trigger_id")),
)
def delete(self, request: Request, workspace_id: str, source_type: str, source_id: str, trigger_id: str):
- return result.success(TaskSourceTriggerOperateSerializer(
- data={'trigger_id': trigger_id, 'workspace_id': workspace_id,
- 'source_id': source_id, 'source_type': source_type}
- ).delete())
+ return result.success(
+ TaskSourceTriggerOperateSerializer(
+ data={
+ "trigger_id": trigger_id,
+ "workspace_id": workspace_id,
+ "source_id": source_id,
+ "source_type": source_type,
+ }
+ ).delete()
+ )
diff --git a/apps/trigger/views/trigger_task.py b/apps/trigger/views/trigger_task.py
index 27758fe8c48..3abcfa432aa 100644
--- a/apps/trigger/views/trigger_task.py
+++ b/apps/trigger/views/trigger_task.py
@@ -17,7 +17,8 @@
from trigger.api.trigger_task import TriggerTaskRecordExecutionDetailsAPI, TriggerTaskRecordPageAPI, TriggerTaskAPI
from trigger.serializers.trigger_task import TriggerTaskQuerySerializer, TriggerTaskRecordQuerySerializer, \
TriggerTaskRecordOperateSerializer
-from common.constants.permission_constants import PermissionConstants, RoleConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
class TriggerTaskView(APIView):
diff --git a/apps/users/api/user.py b/apps/users/api/user.py
index 399d75b281b..0474d09c2ce 100644
--- a/apps/users/api/user.py
+++ b/apps/users/api/user.py
@@ -6,15 +6,15 @@
@date:2025/4/14 19:23
@desc:
"""
+from django.utils.translation import gettext_lazy as _
from drf_spectacular.types import OpenApiTypes
from drf_spectacular.utils import OpenApiParameter
+from rest_framework import serializers
from common.mixins.api_mixin import APIMixin
from common.result import ResultSerializer, DefaultResultSerializer
from users.serializers.user import UserProfileResponse, CreateUserSerializer, UserManageSerializer, \
UserInstanceSerializer, RePasswordSerializer, CheckCodeSerializer, SendEmailSerializer
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
class ApiUserProfileResponse(ResultSerializer):
@@ -59,13 +59,22 @@ def get_parameters():
class WorkspaceUserAPI(APIMixin):
@staticmethod
def get_parameters():
- return [OpenApiParameter(
- name="workspace_id",
- description=_('Workspace ID'),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.PATH,
- required=True,
- )]
+ return [
+ OpenApiParameter(
+ name="workspace_id",
+ description=_('Workspace ID'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH,
+ required=True,
+ ),
+ OpenApiParameter(
+ name="nick_name",
+ description=_('Nick name'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ )
+ ]
@staticmethod
def get_response():
@@ -165,13 +174,15 @@ def get_response():
class UserListApi(APIMixin):
@staticmethod
def get_parameters():
- return [OpenApiParameter(
- name="workspace_id",
- description=_('Workspace ID'),
- type=OpenApiTypes.STR,
- location=OpenApiParameter.PATH,
- required=False,
- )]
+ return [
+ OpenApiParameter(
+ name="nick_name",
+ description=_('Nick name'),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.QUERY,
+ required=False,
+ )
+ ]
@staticmethod
def get_response():
diff --git a/apps/users/api/user_group.py b/apps/users/api/user_group.py
new file mode 100644
index 00000000000..fd5d77333f3
--- /dev/null
+++ b/apps/users/api/user_group.py
@@ -0,0 +1,198 @@
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.types import OpenApiTypes
+from drf_spectacular.utils import OpenApiParameter
+from rest_framework import serializers
+
+from common.mixins.api_mixin import APIMixin
+from common.result import ResultSerializer, DefaultResultSerializer
+from users.serializers.user_group import SystemUserGroupModelSerializer, SystemUserGroupCreateSerializer
+
+
+class UserGroupResponse(ResultSerializer):
+ def get_data(self):
+ return SystemUserGroupModelSerializer()
+
+
+class CreateUserGroupApi(APIMixin):
+ @staticmethod
+ def get_request():
+ return SystemUserGroupCreateSerializer
+
+ @staticmethod
+ def get_response():
+ return UserGroupResponse
+
+
+class DeleteUserGroupApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [OpenApiParameter(
+ name='workspace_id',
+ type=OpenApiTypes.STR,
+ description=_('Workspace ID'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name="user_group_id",
+ description=_("User Group ID"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ )]
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer()
+
+
+class UserGroupListResponse(ResultSerializer):
+ def get_data(self):
+ return SystemUserGroupModelSerializer(many=True)
+
+
+class UserGroupListApi(APIMixin):
+ @staticmethod
+ def get_response():
+ return UserGroupListResponse
+
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name='workspace_id',
+ type=OpenApiTypes.STR,
+ description=_('Workspace ID'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ )]
+
+
+class UserGroupListPageResponse(ResultSerializer):
+ def get_data(self):
+ return SystemUserGroupModelSerializer(many=True)
+
+
+class UserGroupListPageApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name='workspace_id',
+ type=OpenApiTypes.STR,
+ description=_('Workspace ID'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name='user_group_id',
+ type=OpenApiTypes.STR,
+ description=_('Group ID'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name='current_page',
+ type=OpenApiTypes.INT,
+ description=_('Current page'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name='page_size',
+ type=OpenApiTypes.INT,
+ description=_('Page size'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name='username',
+ type=OpenApiTypes.STR,
+ description=_('Username'),
+ required=False,
+ location=OpenApiParameter.QUERY, # type: ignore
+ ),
+ OpenApiParameter(
+ name='nick_name',
+ type=OpenApiTypes.STR,
+ description=_('Nickname'),
+ required=False,
+ location=OpenApiParameter.QUERY, # type: ignore
+ ),
+ ]
+
+ @staticmethod
+ def get_response():
+ return UserGroupListPageResponse
+
+
+class AddMemberRequest(serializers.Serializer):
+ user_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User IDs')
+ )
+
+
+class AddMemberApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name='workspace_id',
+ type=OpenApiTypes.STR,
+ description=_('Workspace ID'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name="user_group_id",
+ description=_("User Group ID"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ )]
+
+ @staticmethod
+ def get_request():
+ return AddMemberRequest
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer()
+
+
+class RemoveMemberRequest(serializers.Serializer):
+ group_relation_ids = serializers.ListField(
+ child=serializers.CharField(required=True),
+ required=True,
+ label=_('User group relation IDs')
+ )
+
+
+class RemoveMemberApi(APIMixin):
+ @staticmethod
+ def get_parameters():
+ return [
+ OpenApiParameter(
+ name='workspace_id',
+ type=OpenApiTypes.STR,
+ description=_('Workspace ID'),
+ required=True,
+ location=OpenApiParameter.PATH, # type: ignore
+ ),
+ OpenApiParameter(
+ name="user_group_id",
+ description=_("User Group ID"),
+ type=OpenApiTypes.STR,
+ location=OpenApiParameter.PATH, # type: ignore
+ required=True,
+ )]
+
+ @staticmethod
+ def get_request():
+ return RemoveMemberRequest
+
+ @staticmethod
+ def get_response():
+ return DefaultResultSerializer()
diff --git a/apps/users/migrations/0001_initial.py b/apps/users/migrations/0001_initial.py
index 6291d6e5fc6..732b0b13015 100644
--- a/apps/users/migrations/0001_initial.py
+++ b/apps/users/migrations/0001_initial.py
@@ -3,7 +3,7 @@
import uuid_utils.compat
from django.db import migrations, models
-from common.constants.permission_constants import RoleConstants
+from common.auth.constants.role_constants import RoleConstants
from common.utils.common import password_encrypt
from maxkb.const import CONFIG
@@ -20,7 +20,6 @@ def insert_default_data(apps, schema_editor):
class Migration(migrations.Migration):
-
initial = True
dependencies = [
@@ -30,8 +29,11 @@ class Migration(migrations.Migration):
migrations.CreateModel(
name='User',
fields=[
- ('id', models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False, verbose_name='主键id')),
- ('email', models.EmailField(blank=True, db_index=True, max_length=254, null=True, unique=True, verbose_name='邮箱')),
+ ('id',
+ models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False,
+ verbose_name='主键id')),
+ ('email', models.EmailField(blank=True, db_index=True, max_length=254, null=True, unique=True,
+ verbose_name='邮箱')),
('phone', models.CharField(db_index=True, default='', max_length=20, verbose_name='电话')),
('nick_name', models.CharField(db_index=True, max_length=150, unique=True, verbose_name='昵称')),
('username', models.CharField(db_index=True, max_length=150, unique=True, verbose_name='用户名')),
@@ -40,7 +42,8 @@ class Migration(migrations.Migration):
('source', models.CharField(db_index=True, default='LOCAL', max_length=10, verbose_name='来源')),
('is_active', models.BooleanField(db_index=True, default=True)),
('language', models.CharField(default=None, max_length=10, null=True, verbose_name='语言')),
- ('create_time', models.DateTimeField(auto_now_add=True, db_index=True, null=True, verbose_name='创建时间')),
+ ('create_time',
+ models.DateTimeField(auto_now_add=True, db_index=True, null=True, verbose_name='创建时间')),
('update_time', models.DateTimeField(auto_now=True, db_index=True, null=True, verbose_name='修改时间')),
],
options={
diff --git a/apps/users/migrations/0002_alter_user_nick_name.py b/apps/users/migrations/0002_alter_user_nick_name.py
new file mode 100644
index 00000000000..0486dd18de2
--- /dev/null
+++ b/apps/users/migrations/0002_alter_user_nick_name.py
@@ -0,0 +1,18 @@
+# Generated by Django 6.0.6 on 2026-07-07 01:46
+
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('users', '0001_initial'),
+ ]
+
+ operations = [
+ migrations.AlterField(
+ model_name='user',
+ name='nick_name',
+ field=models.CharField(db_index=True, max_length=150, verbose_name='昵称'),
+ ),
+ ]
diff --git a/apps/users/migrations/0003_systemusergroup_systemusergrouprelation.py b/apps/users/migrations/0003_systemusergroup_systemusergrouprelation.py
new file mode 100644
index 00000000000..951c1192f83
--- /dev/null
+++ b/apps/users/migrations/0003_systemusergroup_systemusergrouprelation.py
@@ -0,0 +1,41 @@
+# Generated by Django 5.2.14 on 2026-08-05 07:06
+
+import django.db.models.deletion
+import uuid_utils.compat
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('users', '0002_alter_user_nick_name'),
+ ]
+
+ operations = [
+ migrations.CreateModel(
+ name='SystemUserGroup',
+ fields=[
+ ('id', models.CharField(default=uuid_utils.compat.uuid7, editable=False, max_length=128, primary_key=True, serialize=False, verbose_name='主键id')),
+ ('name', models.CharField(db_index=True, max_length=150, unique=True, verbose_name='名称')),
+ ('workspace_id', models.CharField(db_index=True, default='default', max_length=64, verbose_name='工作空间id')),
+ ('create_time', models.DateTimeField(auto_now_add=True, db_index=True, null=True, verbose_name='创建时间')),
+ ('update_time', models.DateTimeField(auto_now=True, db_index=True, null=True, verbose_name='修改时间')),
+ ],
+ options={
+ 'db_table': 'system_user_group',
+ 'unique_together': {('workspace_id', 'name')},
+ },
+ ),
+ migrations.CreateModel(
+ name='SystemUserGroupRelation',
+ fields=[
+ ('id', models.UUIDField(default=uuid_utils.compat.uuid7, editable=False, primary_key=True, serialize=False, verbose_name='主键id')),
+ ('group', models.ForeignKey(on_delete=django.db.models.deletion.CASCADE, to='users.systemusergroup', verbose_name='用户组')),
+ ('user', models.ForeignKey(on_delete=django.db.models.deletion.CASCADE, to='users.user', verbose_name='用户')),
+ ],
+ options={
+ 'db_table': 'system_user_group_relation',
+ 'constraints': [models.UniqueConstraint(fields=('user', 'group'), name='uniq_user_group_relation')],
+ },
+ ),
+ ]
diff --git a/apps/users/migrations/0004_alter_systemusergrouprelation_group.py b/apps/users/migrations/0004_alter_systemusergrouprelation_group.py
new file mode 100644
index 00000000000..5bce7cc1b5a
--- /dev/null
+++ b/apps/users/migrations/0004_alter_systemusergrouprelation_group.py
@@ -0,0 +1,19 @@
+# Generated by Django 6.0.7 on 2026-08-06 02:13
+
+import django.db.models.deletion
+from django.db import migrations, models
+
+
+class Migration(migrations.Migration):
+
+ dependencies = [
+ ('users', '0003_systemusergroup_systemusergrouprelation'),
+ ]
+
+ operations = [
+ migrations.AlterField(
+ model_name='systemusergrouprelation',
+ name='group',
+ field=models.ForeignKey(on_delete=django.db.models.deletion.CASCADE, related_name='user_relations', to='users.systemusergroup', verbose_name='用户组'),
+ ),
+ ]
diff --git a/apps/users/models/user.py b/apps/users/models/user.py
index 0f480d89fde..d68130c242c 100644
--- a/apps/users/models/user.py
+++ b/apps/users/models/user.py
@@ -17,7 +17,7 @@ class User(models.Model):
id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
email = models.EmailField(unique=True, null=True, blank=True, verbose_name="邮箱", db_index=True)
phone = models.CharField(max_length=20, verbose_name="电话", default="", db_index=True)
- nick_name = models.CharField(max_length=150, verbose_name="昵称", unique=True, db_index=True)
+ nick_name = models.CharField(max_length=150, verbose_name="昵称", db_index=True)
username = models.CharField(max_length=150, unique=True, verbose_name="用户名", db_index=True)
password = models.CharField(max_length=150, verbose_name="密码")
role = models.CharField(max_length=150, verbose_name="角色")
diff --git a/apps/users/models/user_group.py b/apps/users/models/user_group.py
new file mode 100644
index 00000000000..138f0e4a91d
--- /dev/null
+++ b/apps/users/models/user_group.py
@@ -0,0 +1,35 @@
+# coding=utf-8
+import uuid_utils.compat as uuid
+
+from django.db import models
+
+from users.models import User
+
+
+class SystemUserGroup(models.Model):
+ id = models.CharField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+ name = models.CharField(max_length=150, verbose_name="名称", unique=True, db_index=True)
+ workspace_id = models.CharField(max_length=64, verbose_name="工作空间id", default="default", db_index=True)
+ create_time = models.DateTimeField(verbose_name="创建时间", auto_now_add=True, null=True, db_index=True)
+ update_time = models.DateTimeField(verbose_name="修改时间", auto_now=True, null=True, db_index=True)
+
+ class Meta:
+ db_table = "system_user_group"
+ unique_together = ("workspace_id", "name")
+
+
+class SystemUserGroupRelation(models.Model):
+ id = models.UUIDField(primary_key=True, max_length=128, default=uuid.uuid7, editable=False, verbose_name="主键id")
+ user = models.ForeignKey(User, on_delete=models.CASCADE, verbose_name="用户")
+ group = models.ForeignKey(SystemUserGroup, on_delete=models.CASCADE, verbose_name="用户组",
+ related_name="user_relations")
+
+ class Meta:
+ db_table = "system_user_group_relation"
+ constraints = [
+ models.UniqueConstraint(
+ fields=["user", "group"],
+ name="uniq_user_group_relation"
+ )
+ ]
+
diff --git a/apps/users/serializers/login.py b/apps/users/serializers/login.py
index 1cf29668d37..4cdd9d31bec 100644
--- a/apps/users/serializers/login.py
+++ b/apps/users/serializers/login.py
@@ -10,73 +10,61 @@
import base64
import json
-from captcha.image import ImageCaptcha
-from django.core import signing
-from django.core.cache import cache
-from django.utils.translation import gettext_lazy as _
-from rest_framework import serializers
-
from application.models import ApplicationAccessToken
+from captcha.image import ImageCaptcha
+from common.auth.common import SystemToken
from common.constants.authentication_type import AuthenticationType
from common.constants.cache_version import Cache_Version
from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.exception.app_exception import AppApiException
-from common.utils.common import password_encrypt, password_verify, needs_password_upgrade, get_random_chars
+from common.utils.common import get_random_chars, needs_password_upgrade, password_encrypt, password_verify
+from common.utils.logger import maxkb_logger
from common.utils.rsa_util import decrypt
+from django.core import signing
+from django.core.cache import cache
+from django.utils.translation import gettext_lazy as _
from maxkb.const import CONFIG
+from rest_framework import serializers
from users.models import User
-from common.utils.logger import maxkb_logger
+
+system_version, system_get_key = Cache_Version.SYSTEM.value
class LoginRequest(serializers.Serializer):
- username = serializers.CharField(required=True, max_length=64, help_text=_("Username"), label=_("Username"))
+ username = serializers.CharField(required=True, max_length=64, label=_("Username"))
password = serializers.CharField(required=True, max_length=128, label=_("Password"))
- captcha = serializers.CharField(
- required=False, max_length=64, label=_("captcha"), allow_null=True, allow_blank=True
- )
- encryptedData = serializers.CharField(required=False, label=_("encryptedData"), allow_null=True, allow_blank=True)
-
-
-system_version, system_get_key = Cache_Version.SYSTEM.value
+ captcha = serializers.CharField(required=False, max_length=64, allow_null=True, allow_blank=True)
+ encryptedData = serializers.CharField(required=False, allow_null=True, allow_blank=True)
class LoginResponse(serializers.Serializer):
- """
- 登录响应对象
- """
-
token = serializers.CharField(required=True, label=_("token"))
-def record_login_fail(username: str, expire: int = 600):
+def _incr_fail_count(cache_key: str, expire: int) -> int:
+ """原子递增失败计数,key 不存在时初始化并返回当前值"""
+ try:
+ return cache.incr(cache_key, 1, version=system_version)
+ except ValueError:
+ cache.set(cache_key, 1, timeout=expire, version=system_version)
+ return 1
+
+
+def record_login_fail(username: str, expire: int = 600) -> int:
"""记录登录失败次数(原子)返回当前失败计数"""
if not username:
return 0
- fail_key = system_get_key(f"system_{username}")
- try:
- fail_count = cache.incr(fail_key, 1, version=system_version)
- except ValueError:
- # key 不存在,初始化并设置过期
- cache.set(fail_key, 1, timeout=expire, version=system_version)
- fail_count = 1
- return fail_count
+ return _incr_fail_count(system_get_key(f"system_{username}"), expire)
-def record_login_fail_lock(username: str, expire: int = 10):
+def record_login_fail_lock(username: str, expire: int = 10) -> int:
"""
使用 cache.incr 保证原子递增,并在不存在时初始化计数器并返回当前值。
这里的计数器用于判断是否应当进入"锁定"分支,避免依赖非原子 get -> set 的组合。
"""
if not username:
return 0
- fail_key = system_get_key(f"system_{username}_lock_count")
- try:
- fail_count = cache.incr(fail_key, 1, version=system_version)
- except ValueError:
- # key 不存在,初始化并设置过期(分钟转秒)
- cache.set(fail_key, 1, timeout=expire * 60, version=system_version)
- fail_count = 1
- return fail_count
+ return _incr_fail_count(system_get_key(f"system_{username}_lock_count"), expire * 60)
class LoginSerializer(serializers.Serializer):
@@ -84,94 +72,103 @@ class LoginSerializer(serializers.Serializer):
def get_auth_setting():
"""获取认证设置"""
auth_setting_model = DatabaseModelManage.get_model("auth_setting")
- auth_setting = {}
- if auth_setting_model:
- setting_obj = auth_setting_model.objects.filter(param_key="auth_setting").first()
- if setting_obj:
- try:
- auth_setting = json.loads(setting_obj.param_value) or {}
- except Exception:
- auth_setting = {}
- return auth_setting
+ if not auth_setting_model:
+ return {}
+ setting_obj = auth_setting_model.objects.filter(param_key="auth_setting").first()
+ if not setting_obj:
+ return {}
+ try:
+ return json.loads(setting_obj.param_value) or {}
+ except Exception:
+ return {}
@staticmethod
- def login(instance):
- # 解密数据
+ def _decrypt_request_data(instance: dict) -> dict:
+ """解密并合并 encryptedData,返回更新后的请求数据"""
username = instance.get("username", "")
encrypted_data = instance.get("encryptedData", "")
-
- if encrypted_data:
- try:
- decrypted_raw = decrypt(encrypted_data)
- # decrypt 可能返回非 JSON 字符串,防护解析异常
- decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
- if isinstance(decrypted_data, dict):
- instance.update(decrypted_data)
- except Exception as e:
- maxkb_logger.exception("Failed to decrypt/parse encryptedData for user %s: %s", username, e)
- raise AppApiException(500, _("Invalid encrypted data"))
+ if not encrypted_data:
+ return instance
try:
- LoginRequest(data=instance).is_valid(raise_exception=True)
- except serializers.ValidationError:
- raise
+ decrypted_raw = decrypt(encrypted_data)
+ # decrypt 可能返回非 JSON 字符串,防护解析异常
+ decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
+ if isinstance(decrypted_data, dict):
+ instance.update(decrypted_data)
except Exception as e:
- raise AppApiException(500, str(e))
+ maxkb_logger.exception("Failed to decrypt/parse encryptedData for user %s: %s", username, e)
+ raise AppApiException(500, _("Invalid encrypted data"))
+ return instance
- password = instance.get("password")
- captcha = instance.get("captcha", "")
+ @staticmethod
+ def _authenticate(username: str, password: str) -> User | None:
+ """校验用户名密码,失败记录计数并抛异常"""
+ user = User.objects.filter(username=username).first()
+ if not user or not password_verify(password, user.password):
+ return None
+
+ # Transparently upgrade legacy MD5 hash to PBKDF2
+ if needs_password_upgrade(user.password):
+ user.password = password_encrypt(password)
+ user.save(update_fields=["password"])
+ return user
+
+ @staticmethod
+ def _issue_token(user: User) -> str:
+ """签发登录 token 并写入缓存"""
+ token = SystemToken(str(user.id), AuthenticationType.SYSTEM_USER).to_token()
+ version, get_key = Cache_Version.TOKEN.value
+ cache.set(get_key(token), user, timeout=CONFIG.get_session_timeout(), version=version)
+ return token
+
+ @staticmethod
+ def login(instance):
+ # 解密数据
+ instance = LoginSerializer._decrypt_request_data(instance)
+
+ request_serializer = LoginRequest(data=instance)
+ request_serializer.is_valid(raise_exception=True)
+ validated_data = request_serializer.validated_data
+ username = validated_data["username"]
+ password = validated_data["password"]
+ captcha = validated_data.get("captcha", "")
# 获取认证配置
auth_setting = LoginSerializer.get_auth_setting()
max_attempts = auth_setting.get("max_attempts", 1)
- failed_attempts = auth_setting.get("failed_attempts", 5)
- lock_time = auth_setting.get("lock_time", 10)
- # 检查许可证有效性
license_validator = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
is_license_valid = license_validator() if license_validator() is not None else False
if is_license_valid:
- # 检查账户是否被锁定
- if LoginSerializer._is_account_locked(username, failed_attempts):
- raise AppApiException(
- 1005, _("This account has been locked for %s minutes, please try again later") % lock_time
- )
+ failed_attempts = auth_setting.get("failed_attempts", 5)
+ lock_time = auth_setting.get("lock_time", 10)
+ else:
+ failed_attempts = 5
+ lock_time = 10
- # 验证验证码
+ if LoginSerializer._is_account_locked(username, failed_attempts):
+ raise AppApiException(
+ 1005, _("This account has been locked for %s minutes, please try again later") % lock_time
+ )
if LoginSerializer._need_captcha(username, max_attempts):
- LoginSerializer._validate_captcha(username, captcha)
+ # 验证验证码
+ LoginSerializer._validate_captcha(username, captcha, failed_attempts, lock_time)
# 验证用户凭据:先按用户名查找,再用 password_verify 验证密码
- user = User.objects.filter(username=username).first()
-
- if not user or not password_verify(password, user.password):
- LoginSerializer._handle_failed_login(username, is_license_valid, failed_attempts, lock_time)
+ user = LoginSerializer._authenticate(username, password)
+ if user is None:
+ LoginSerializer._handle_failed_login(username, failed_attempts, lock_time)
raise AppApiException(500, _("The username or password is incorrect"))
- # Transparently upgrade legacy MD5 hash to PBKDF2
- if needs_password_upgrade(user.password):
- user.password = password_encrypt(password)
- user.save(update_fields=["password"])
-
if not user.is_active:
raise AppApiException(1005, _("The user has been disabled, please contact the administrator!"))
# 清除失败计数并生成令牌
cache.delete(system_get_key(f"system_{username}"), version=system_version)
cache.delete(system_get_key(f"system_{username}_lock"), version=system_version)
- token = signing.dumps(
- {
- "username": user.username,
- "id": str(user.id),
- "email": user.email,
- "type": AuthenticationType.SYSTEM_USER.value,
- }
- )
-
- version, get_key = Cache_Version.TOKEN.value
- timeout = CONFIG.get_session_timeout()
- cache.set(get_key(token), user, timeout=timeout, version=version)
+ token = LoginSerializer._issue_token(user)
return {"token": token}
@@ -185,36 +182,49 @@ def _is_account_locked(username: str, failed_attempts: int) -> bool:
@staticmethod
def _need_captcha(username: str, max_attempts: int) -> bool:
+ return LoginSerializer._need_captcha_by_key(system_get_key(f"system_{username}"), max_attempts)
+
+ @staticmethod
+ def _need_captcha_by_key(cache_key: str, max_attempts: int) -> bool:
"""判断是否需要验证码"""
if max_attempts == -1:
return False
- elif max_attempts > 0:
- fail_count = cache.get(system_get_key(f"system_{username}"), version=system_version) or 0
+ if max_attempts > 0:
+ fail_count = cache.get(cache_key, version=system_version) or 0
return fail_count >= max_attempts
return True
@staticmethod
- def _validate_captcha(username: str, captcha: str) -> None:
- """验证验证码"""
+ def _validate_captcha(username: str, captcha: str, failed_attempts: int = 5, lock_time: int = 10) -> None:
+ """验证验证码(一次性消费)"""
if not captcha:
raise AppApiException(1005, _("Captcha is required"))
- captcha_cache = cache.get(
- Cache_Version.CAPTCHA.get_key(captcha=f"system_{username}"), version=Cache_Version.CAPTCHA.get_version()
- )
+ captcha_key = Cache_Version.CAPTCHA.get_key(captcha=f"system_{username}")
+ captcha_cache = cache.get(captcha_key, version=Cache_Version.CAPTCHA.get_version())
if captcha_cache is None or captcha.lower() != captcha_cache:
+ # 校验失败与口令失败共用同一失败计数与锁定机制,防止"识别-试错"循环绕过验证码
+ LoginSerializer._record_login_failure(username, failed_attempts, lock_time)
+ if LoginSerializer._is_account_locked(username, failed_attempts):
+ raise AppApiException(
+ 1005, _("This account has been locked for %s minutes, please try again later") % lock_time
+ )
raise AppApiException(1005, _("Captcha code error or expiration"))
+ # 校验通过即销毁,保证验证码一次性使用
+ cache.delete(captcha_key, version=Cache_Version.CAPTCHA.get_version())
+
@staticmethod
- def _handle_failed_login(username: str, is_license_valid: bool, failed_attempts: int, lock_time: int) -> None:
- """处理登录失败
+ def _record_login_failure(username: str, failed_attempts: int, lock_time: int) -> int:
+ """记录一次认证失败(口令或验证码),累计失败/锁定计数,达到阈值时创建锁键。
修复要点:
- 使用 record_login_fail / record_login_fail_lock 两个原子 incr 来记录失败;
- 不再依赖精确等于 0 的比较来触发锁,而是基于原子计数 >= 阈值来决定进入锁定分支;
- 使用 cache.add 原子创建锁键,cache.add 保证只有第一个成功创建者可写入该键;
其他并发到达的请求若发现计数已到达阈值也应当返回"已锁定"响应,避免出现绕过。
+ - 不抛异常,返回当前锁定计数,供口令校验与验证码校验共用。
"""
# 记录普通失败计数(供验证码触发使用)
try:
@@ -229,8 +239,29 @@ def _handle_failed_login(username: str, is_license_valid: bool, failed_attempts:
except Exception:
maxkb_logger.exception("Failed to record lock fail count for user %s", username)
- # 如果不是企业版或禁用锁定功能,直接返回(但计数已经记录)
- if not is_license_valid or failed_attempts <= 0:
+ # 当计数达到或超过阈值时,尝试原子创建锁键;无论 cache.add 返回 True/False 都视为已锁定,
+ # 因为若为 False 说明其他并发请求已将账户标记为锁定,行为应一致。
+ if failed_attempts > 0 and lock_fail_count >= failed_attempts:
+ try:
+ locked = cache.add(
+ system_get_key(f"system_{username}_lock"), 1, timeout=lock_time * 60, version=system_version
+ )
+ if locked:
+ maxkb_logger.info("Account %s locked by setting cache key", username)
+ else:
+ maxkb_logger.info("Account %s lock key already present (another request set it)", username)
+ except Exception:
+ maxkb_logger.exception("Failed to set lock key for user %s", username)
+
+ return lock_fail_count
+
+ @staticmethod
+ def _handle_failed_login(username: str, failed_attempts: int, lock_time: int) -> None:
+ """处理口令校验失败:记录失败计数并抛出对应提示"""
+ lock_fail_count = LoginSerializer._record_login_failure(username, failed_attempts, lock_time)
+
+ # 仅由失败次数配置控制(CE/PE 同样生效);计数在此之前已记录
+ if failed_attempts <= 0:
return
# 当计数小于阈值,告知剩余尝试次数
@@ -242,29 +273,12 @@ def _handle_failed_login(username: str, is_license_valid: bool, failed_attempts:
% (failed_attempts, remain_attempts),
)
- # 当计数达到或超过阈值时,尝试原子创建锁键;无论 cache.add 返回 True/False,都返回已锁定响应,
- # 因为若为 False 说明其他并发请求已将账户标记为锁定,行为应一致。
- try:
- locked = cache.add(
- system_get_key(f"system_{username}_lock"), 1, timeout=lock_time * 60, version=system_version
- )
- if locked:
- maxkb_logger.info("Account %s locked by setting cache key", username)
- else:
- maxkb_logger.info("Account %s lock key already present (another request set it)", username)
- except Exception:
- maxkb_logger.exception("Failed to set lock key for user %s", username)
-
raise AppApiException(
1005, _("This account has been locked for %s minutes, please try again later") % lock_time
)
class CaptchaResponse(serializers.Serializer):
- """
- 登录响应对象
- """
-
captcha = serializers.CharField(required=True, label=_("captcha"))
@@ -273,13 +287,7 @@ class CaptchaSerializer(serializers.Serializer):
def generate(username: str, type: str = "system"):
auth_setting = LoginSerializer.get_auth_setting()
max_attempts = auth_setting.get("max_attempts", 1)
-
- need_captcha = True
- if max_attempts == -1:
- need_captcha = False
- elif max_attempts > 0:
- fail_count = cache.get(system_get_key(f"system_{username}"), version=system_version) or 0
- need_captcha = fail_count >= max_attempts
+ need_captcha = LoginSerializer._need_captcha_by_key(system_get_key(f"system_{username}"), max_attempts)
return CaptchaSerializer._generate_captcha_if_needed(username, type, need_captcha)
@@ -292,25 +300,16 @@ def chat_generate(username: str, type: str = "chat", access_token: str = ""):
auth_setting = application_access_token.authentication_value
max_attempts = auth_setting.get("max_attempts", 1)
-
- need_captcha = True
- if max_attempts == -1:
- need_captcha = False
- elif max_attempts > 0:
- fail_count = cache.get(system_get_key(f"{type}_{username}"), version=system_version) or 0
- need_captcha = fail_count >= max_attempts
+ need_captcha = LoginSerializer._need_captcha_by_key(system_get_key(f"{type}_{username}"), max_attempts)
return CaptchaSerializer._generate_captcha_if_needed(username, type, need_captcha)
@staticmethod
def _generate_captcha_if_needed(username: str, type: str, need_captcha: bool):
- """
- 提取的公共验证码生成方法
- """
+ """提取的公共验证码生成方法"""
if need_captcha:
chars = get_random_chars()
- image = ImageCaptcha()
- data = image.generate(chars)
+ data = ImageCaptcha().generate(chars)
captcha = base64.b64encode(data.getbuffer())
cache.set(
Cache_Version.CAPTCHA.get_key(captcha=f"{type}_{username}"),
diff --git a/apps/users/serializers/user.py b/apps/users/serializers/user.py
index e49291e1bb9..37353c96ec0 100644
--- a/apps/users/serializers/user.py
+++ b/apps/users/serializers/user.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: user.py
- @date:2025/4/14 19:18
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: user.py
+@date:2025/4/14 19:18
+@desc:
"""
+
import datetime
import json
import os
@@ -13,32 +14,31 @@
import re
from collections import defaultdict
+import uuid_utils.compat as uuid
+from django.core import validators
from django.core.cache import cache
+from django.core.mail import send_mail
from django.core.mail.backends.smtp import EmailBackend
from django.db import transaction
from django.db.models import Q, QuerySet
-from django.utils import translation
+from django.utils.translation import get_language
+from django.utils.translation import gettext_lazy as _
from rest_framework import serializers
-import uuid_utils.compat as uuid
+from common.auth.constants.role_constants import RoleConstants
+from common.auth.struct.auth import Auth
from common.constants.cache_version import Cache_Version
from common.constants.exception_code_constants import ExceptionCodeConstants
-from common.constants.permission_constants import RoleConstants, Auth, ResourceAuthType, ResourcePermissionRole, \
- ResourcePermission
from common.database_model_manage.database_model_manage import DatabaseModelManage
from common.db.search import page_search
from common.exception.app_exception import AppApiException
-from common.utils.common import valid_license, password_encrypt, password_verify, get_random_chars
+from common.utils.common import password_encrypt, password_verify
from common.utils.rsa_util import decrypt
-from maxkb import settings
from maxkb.conf import PROJECT_DIR
from maxkb.const import CONFIG
-from system_manage.models import SystemSetting, SettingType, AuthTargetType, WorkspaceUserResourcePermission
+from system_manage.models import SettingType, SystemSetting
from users.models import User
-from django.utils.translation import gettext_lazy as _, to_locale
-from django.core import validators
-from django.core.mail import send_mail
-from django.utils.translation import get_language
+from users.models.user_group import SystemUserGroup, SystemUserGroupRelation
PASSWORD_REGEX = re.compile(
r"^" # 开始
@@ -50,25 +50,126 @@
)
version, get_key = Cache_Version.SYSTEM.value
+EMAIL_CODE_TYPE_REGEX = re.compile(r"^(register|reset_password)$")
+
+
+MAX_VERIFY_CODE_ATTEMPTS = 5
+VERIFY_CODE_EXPIRE_SECONDS = 10 * 60
+# 达到错误上限后的锁定冷却时长
+VERIFY_CODE_LOCKOUT_SECONDS = 10 * 60
+
+
+def _raise_verify_code_limit():
+ raise AppApiException(500, _("Too many verification code attempts, please try again later"))
+
+
+def check_verify_code_lockout(email: str, type_code: str):
+ """
+ 检查验证码是否处于锁定冷却期
+ """
+ lock_cache_key = get_key(email + ":" + type_code + "_locked")
+ if cache.get(lock_cache_key, version=version):
+ _raise_verify_code_limit()
+
+
+def check_verify_code_attempts(email: str, type_code: str, submitted_code: str) -> bool:
+ """
+ 校验验证码并限制错误尝试次数,防止验证码被暴力破解(CWE-307)。
+ 失败计数按邮箱累计且不随重新发送验证码清零:连续错误达到上限后,进入固定冷却期的
+ 锁定,锁定期间即使验证码正确也一律拒绝,必须等待冷却期结束才能重新尝试,从而
+ 避免通过反复发送验证码维持无限猜解节奏。
+ 校验通过时返回 True,否则抛出校验异常。
+ """
+ code_cache_key = email + ":" + type_code
+ failed_cache_key = code_cache_key + "_failed_attempts"
+ lock_cache_key = code_cache_key + "_locked"
+ cached_code = cache.get(get_key(code_cache_key), version=version)
+ failed_attempts = int(cache.get(get_key(failed_cache_key), version=version) or 0)
+ # 已进入锁定冷却期(独立锁 key,固定 10 分钟):无论验证码是否正确都拒绝,
+ # 且不刷新锁定时长
+ if cache.get(get_key(lock_cache_key), version=version):
+ cache.delete(get_key(code_cache_key), version=version)
+ _raise_verify_code_limit()
+ if cached_code is None:
+ raise ExceptionCodeConstants.CODE_ERROR.value.to_app_api_exception()
+ if cached_code != submitted_code:
+ failed_attempts += 1
+ cache.set(
+ get_key(failed_cache_key),
+ failed_attempts,
+ timeout=VERIFY_CODE_LOCKOUT_SECONDS,
+ version=version,
+ )
+ if failed_attempts >= MAX_VERIFY_CODE_ATTEMPTS:
+ # 错满 5 次:验证码立即失效,并写入独立锁 key 进入固定 10 分钟锁定
+ cache.delete(get_key(code_cache_key), version=version)
+ cache.set(get_key(lock_cache_key), True, timeout=VERIFY_CODE_LOCKOUT_SECONDS, version=version)
+ _raise_verify_code_limit()
+ raise ExceptionCodeConstants.CODE_ERROR.value.to_app_api_exception()
+ # 校验通过,清除错误尝试计数与锁定
+ cache.delete(get_key(failed_cache_key), version=version)
+ cache.delete(get_key(lock_cache_key), version=version)
+ return True
class UserProfileResponse(serializers.ModelSerializer):
- is_edit_password = serializers.BooleanField(required=True, label=_('Is Edit Password'))
- permissions = serializers.ListField(required=True, label=_('permissions'))
+ is_edit_password = serializers.BooleanField(required=True, label=_("Is Edit Password"))
+ permissions = serializers.ListField(required=True, label=_("permissions"))
class Meta:
model = User
- fields = ['id', 'username', 'nick_name', 'email', 'role', 'permissions', 'language', 'is_edit_password']
+ fields = ["id", "username", "nick_name", "email", "role", "permissions", "language", "is_edit_password"]
class CreateUserSerializer(serializers.Serializer):
- username = serializers.CharField(required=True, label=_('Username'))
- password = serializers.CharField(required=True, label=_('Password'))
- email = serializers.EmailField(required=True, label=_('Email'))
- nick_name = serializers.CharField(required=False, label=_('Nick name'))
- phone = serializers.CharField(required=False, label=_('Phone'))
- source = serializers.CharField(required=False, label=_('Source'), default='LOCAL')
- defaultPermission = serializers.CharField(required=False, label=_('defaultPermission'))
+ username = serializers.CharField(required=True, label=_("Username"))
+ password = serializers.CharField(required=True, label=_("Password"))
+ email = serializers.EmailField(required=True, label=_("Email"))
+ nick_name = serializers.CharField(required=False, label=_("Nick name"))
+ phone = serializers.CharField(required=False, label=_("Phone"))
+ source = serializers.CharField(required=False, label=_("Source"), default="LOCAL")
+ user_group_ids = serializers.ListField(
+ child=serializers.CharField(required=False), required=False, label=_("User Group IDs")
+ )
+
+
+def _get_workspace_name_mapping():
+ workspace_model = DatabaseModelManage.get_model("workspace_model")
+ if not workspace_model:
+ return {}
+ return {str(workspace.id): workspace.name for workspace in workspace_model.objects.all()}
+
+
+def _get_user_group_workspace_mapping(user_ids):
+ user_group_relations = SystemUserGroupRelation.objects.filter(user_id__in=user_ids).select_related("group")
+ workspace_mapping = _get_workspace_name_mapping()
+ user_group_mapping = defaultdict(
+ lambda: {
+ "user_group_ids": [],
+ "user_group_names": [],
+ "user_group_workspace": defaultdict(list),
+ }
+ )
+
+ for relation in user_group_relations:
+ user_id = str(relation.user_id)
+ group_name = relation.group.name
+ workspace_name = workspace_mapping.get(relation.group.workspace_id, relation.group.workspace_id)
+ user_group_mapping[user_id]["user_group_ids"].append(str(relation.group_id))
+ user_group_mapping[user_id]["user_group_names"].append(group_name)
+ user_group_mapping[user_id]["user_group_workspace"][workspace_name].append(group_name)
+
+ return {
+ user_id: {
+ "user_group_ids": data["user_group_ids"],
+ "user_group_names": data["user_group_names"],
+ "user_group_workspace": [
+ {"workspace": workspace_name, "user_group_names": group_names}
+ for workspace_name, group_names in data["user_group_workspace"].items()
+ ],
+ }
+ for user_id, data in user_group_mapping.items()
+ }
def is_workspace_manage(user_id: str, workspace_id: str):
@@ -76,9 +177,14 @@ def is_workspace_manage(user_id: str, workspace_id: str):
role_permission_mapping_model = DatabaseModelManage.get_model("role_permission_mapping_model")
is_x_pack_ee = workspace_user_role_mapping_model is not None and role_permission_mapping_model is not None
if is_x_pack_ee:
- return QuerySet(workspace_user_role_mapping_model).select_related('role', 'user').filter(
- workspace_id=workspace_id, user_id=user_id,
- role__type=RoleConstants.WORKSPACE_MANAGE.value.__str__()).exists()
+ return (
+ QuerySet(workspace_user_role_mapping_model)
+ .select_related("role", "user")
+ .filter(
+ workspace_id=workspace_id, user_id=user_id, role__type=RoleConstants.WORKSPACE_MANAGE.value.__str__()
+ )
+ .exists()
+ )
return QuerySet(User).filter(id=user_id, role=RoleConstants.ADMIN.value.__str__()).exists()
@@ -88,30 +194,34 @@ def is_workspace_manage_permission_read(user_id: str, workspace_id: str, permiss
is_x_pack_ee = workspace_user_role_mapping_model is not None and role_permission_mapping_model is not None
if is_x_pack_ee:
# 内置工作空间管理员(role_id 固定为 'WORKSPACE_MANAGE')拥有全量权限,直接放行
- is_builtin_manage = QuerySet(workspace_user_role_mapping_model).filter(
- user_id=user_id,
- workspace_id=workspace_id,
- role_id=RoleConstants.WORKSPACE_MANAGE.value.__str__()
- ).exists()
+ is_builtin_manage = (
+ QuerySet(workspace_user_role_mapping_model)
+ .filter(user_id=user_id, workspace_id=workspace_id, role_id=RoleConstants.WORKSPACE_MANAGE.value.__str__())
+ .exists()
+ )
if is_builtin_manage:
return True
# 继承(自定义)工作空间管理员:需被显式授予对应权限
- has_permission = QuerySet(role_permission_mapping_model).filter(
- role__userrolerelation__user_id=user_id,
- role__userrolerelation__workspace_id=workspace_id,
- permission_id=permission_id,
- role__type=RoleConstants.WORKSPACE_MANAGE.value.__str__()
- ).exists()
+ has_permission = (
+ QuerySet(role_permission_mapping_model)
+ .filter(
+ role__userrolerelation__user_id=user_id,
+ role__userrolerelation__workspace_id=workspace_id,
+ permission_id=permission_id,
+ role__type=RoleConstants.WORKSPACE_MANAGE.value.__str__(),
+ )
+ .exists()
+ )
return has_permission
return QuerySet(User).filter(id=user_id, role=RoleConstants.ADMIN.value.__str__()).exists()
def get_workspace_list_by_user(user_id):
- get_workspace_list = DatabaseModelManage.get_model('get_workspace_list_by_user')
- license_is_valid = DatabaseModelManage.get_model('license_is_valid') or (lambda: False)
+ get_workspace_list = DatabaseModelManage.get_model("get_workspace_list_by_user")
+ license_is_valid = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
if get_workspace_list is not None and license_is_valid():
return get_workspace_list(user_id)
- return [{'id': 'default', 'name': 'default'}]
+ return [{"id": "default", "name": "default"}]
class UserProfileSerializer(serializers.Serializer):
@@ -128,34 +238,49 @@ def profile(user: User, auth: Auth):
role_name = [user.role]
if user_role_relation_model:
user_role_relations = (
- user_role_relation_model.objects
- .filter(user_id=user.id)
- .select_related('role')
- .distinct('role_id')
+ user_role_relation_model.objects.filter(user_id=user.id, workspace_id="None")
+ .select_related("role")
+ .distinct("role_id")
)
- role_name = [relation.role.role_name for relation in user_role_relations]
+ role_name = [
+ role.role_name
+ for role in sorted(
+ (relation.role for relation in user_role_relations), key=lambda role: not role.internal
+ )
+ ]
return {
- 'id': user.id,
- 'username': user.username,
- 'nick_name': user.nick_name,
- 'email': user.email,
- 'source': user.source,
- 'role': auth.role_list,
- 'permissions': auth.permission_list,
- 'is_edit_password': password_verify(CONFIG.get('DEFAULT_PASSWORD', 'MaxKB@123..'),
- user.password) if user.source == 'LOCAL' else False,
- 'language': user.language,
- 'workspace_list': workspace_list,
- 'role_name': role_name
+ "id": user.id,
+ "username": user.username,
+ "nick_name": user.nick_name,
+ "email": user.email,
+ "source": user.source,
+ "role": list(auth.roles),
+ "permissions": auth.permissions,
+ "is_edit_password": password_verify(CONFIG.get("DEFAULT_PASSWORD", "MaxKB@123.."), user.password)
+ if user.source == "LOCAL"
+ else False,
+ "language": user.language,
+ "workspace_list": workspace_list,
+ "role_name": role_name,
}
class UserInstanceSerializer(serializers.ModelSerializer):
class Meta:
model = User
- fields = ['id', 'username', 'email', 'phone', 'is_active', 'role', 'nick_name', 'create_time', 'update_time',
- 'source']
+ fields = [
+ "id",
+ "username",
+ "email",
+ "phone",
+ "is_active",
+ "role",
+ "nick_name",
+ "create_time",
+ "update_time",
+ "source",
+ ]
class UserManageSerializer(serializers.Serializer):
@@ -163,10 +288,12 @@ class UserInstance(serializers.Serializer):
email = serializers.EmailField(
required=True,
label=_("Email"),
- validators=[validators.EmailValidator(
- message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
- code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code
- )]
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
)
username = serializers.CharField(
required=True,
@@ -175,10 +302,9 @@ class UserInstance(serializers.Serializer):
min_length=4,
validators=[
validators.RegexValidator(
- regex=re.compile("^.{4,64}$"),
- message=_('Username must be 4-64 characters long')
+ regex=re.compile("^.{4,64}$"), message=_("Username must be 4-64 characters long")
)
- ]
+ ],
)
password = serializers.CharField(
required=True,
@@ -190,9 +316,9 @@ class UserInstance(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
nick_name = serializers.CharField(
required=True,
@@ -200,49 +326,27 @@ class UserInstance(serializers.Serializer):
max_length=64,
)
phone = serializers.CharField(
- required=False,
- label=_("Phone"),
- max_length=20,
- allow_null=True,
- allow_blank=True
- )
- source = serializers.CharField(
- required=False,
- label=_("Source"),
- max_length=20,
- default="LOCAL"
+ required=False, label=_("Phone"), max_length=20, allow_null=True, allow_blank=True
)
+ source = serializers.CharField(required=False, label=_("Source"), max_length=20, default="LOCAL")
def is_valid(self, *, raise_exception=True):
super().is_valid(raise_exception=True)
self._check_unique_username_and_email()
def _check_unique_username_and_email(self):
- username = self.data.get('username')
- email = self.data.get('email')
- nick_name = self.data.get('nick_name')
- user = User.objects.filter(Q(username=username) | Q(email=email) | Q(nick_name=nick_name)).first()
+ username = self.data.get("username")
+ email = self.data.get("email")
+ user = User.objects.filter(Q(username=username) | Q(email=email)).first()
if user:
if user.email == email:
raise ExceptionCodeConstants.EMAIL_IS_EXIST.value.to_app_api_exception()
if user.username == username:
raise ExceptionCodeConstants.USERNAME_IS_EXIST.value.to_app_api_exception()
- if user.nick_name == nick_name:
- raise ExceptionCodeConstants.NICKNAME_IS_EXIST.value.to_app_api_exception()
class Query(serializers.Serializer):
- username = serializers.CharField(
- required=False,
- label=_("Username"),
- max_length=64,
- allow_blank=True
- )
- nick_name = serializers.CharField(
- required=False,
- label=_("Nick Name"),
- max_length=64,
- allow_blank=True
- )
+ username = serializers.CharField(required=False, label=_("Username"), max_length=64, allow_blank=True)
+ nick_name = serializers.CharField(required=False, label=_("Nick Name"), max_length=64, allow_blank=True)
email = serializers.CharField(
required=False,
label=_("Email"),
@@ -259,11 +363,11 @@ class Query(serializers.Serializer):
)
def get_query_set(self):
- username = self.data.get('username')
- nick_name = self.data.get('nick_name')
- email = self.data.get('email')
- is_active = self.data.get('is_active', None)
- source = self.data.get('source', None)
+ username = self.data.get("username")
+ nick_name = self.data.get("nick_name")
+ email = self.data.get("email")
+ is_active = self.data.get("is_active", None)
+ source = self.data.get("source", None)
query_set = QuerySet(User)
if username is not None:
query_set = query_set.filter(username__contains=username)
@@ -281,15 +385,34 @@ def get_query_set(self):
def list(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- return [{'id': user_model.id, 'username': user_model.username, 'email': user_model.email} for user_model in
- self.get_query_set()]
+ return [
+ {"id": user_model.id, "username": user_model.username, "email": user_model.email}
+ for user_model in self.get_query_set()
+ ]
def page(self, current_page: int, page_size: int, user_id: str, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- result = page_search(current_page, page_size,
- self.get_query_set(),
- post_records_handler=lambda u: UserInstanceSerializer(u).data)
+ result = page_search(
+ current_page,
+ page_size,
+ self.get_query_set(),
+ post_records_handler=lambda u: UserInstanceSerializer(u).data,
+ )
+ user_group_mapping = _get_user_group_workspace_mapping([user["id"] for user in result["records"]])
+
+ for user in result["records"]:
+ user_group_data = user_group_mapping.get(
+ str(user["id"]),
+ {
+ "user_group_ids": [],
+ "user_group_names": [],
+ "user_group_workspace": [],
+ },
+ )
+ user["user_group_ids"] = user_group_data["user_group_ids"]
+ user["user_group_names"] = user_group_data["user_group_names"]
+ user["user_group_workspace"] = user_group_data["user_group_workspace"]
role_model = DatabaseModelManage.get_model("role_model")
user_role_relation_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
@@ -298,15 +421,15 @@ def _get_user_roles(user_ids, is_admin=True):
if not (role_model and user_role_relation_model and workspace_model):
return {}
- workspace_mapping = {str(workspace_model.id): workspace_model.name for workspace_model in
- workspace_model.objects.all()}
+ workspace_mapping = {
+ str(workspace_model.id): workspace_model.name for workspace_model in workspace_model.objects.all()
+ }
# 获取所有相关角色关系,并预加载角色信息
user_role_relations = (
- user_role_relation_model.objects
- .filter(user_id__in=user_ids)
- .select_related('role')
- .distinct('user_id', 'role_id', 'workspace_id') # 确保组合唯一性
+ user_role_relation_model.objects.filter(user_id__in=user_ids)
+ .select_related("role")
+ .distinct("user_id", "role_id", "workspace_id") # 确保组合唯一性
)
# 构建用户ID到角色名称列表的映射
@@ -324,20 +447,24 @@ def _get_user_roles(user_ids, is_admin=True):
user_role_mapping[user_id].add(relation.role.role_name)
user_role_setting_mapping[user_id][role_id].append(workspace_id)
user_role_workspace_mapping[user_id][relation.role.role_name].append(
- workspace_mapping.get(workspace_id, workspace_id))
+ workspace_mapping.get(workspace_id, workspace_id)
+ )
# 将 set 转换为 list 以符合返回格式
user_role_mapping = {uid: list(roles) for uid, roles in user_role_mapping.items()}
# 转换为所需的结构
result_user_role_setting_mapping = {
- user_id: [{"role_id": role_id, "workspace_ids": workspace_ids}
- for role_id, workspace_ids in roles.items()]
+ user_id: [
+ {"role_id": role_id, "workspace_ids": workspace_ids} for role_id, workspace_ids in roles.items()
+ ]
for user_id, roles in user_role_setting_mapping.items()
}
result_user_role_workspace_mapping = {
- user_id: {role_name: workspace_names
- for role_name, workspace_names in roles.items()}
+ user_id: [
+ {"role_name": role_name, "workspace": workspace_names}
+ for role_name, workspace_names in roles.items()
+ ]
for user_id, roles in user_role_workspace_mapping.items()
}
@@ -345,40 +472,44 @@ def _get_user_roles(user_ids, is_admin=True):
if role_model and user_role_relation_model:
# 获取当前用户的所有角色 判断是不是内置的系统管理员
- is_admin = user_role_relation_model.objects.filter(user_id=user_id,
- role_id=RoleConstants.ADMIN.name).exists()
- user_ids = [user['id'] for user in result['records']]
- user_role_mapping, user_role_setting_mapping, user_role_workspace_mapping = _get_user_roles(user_ids,
- is_admin)
+ is_admin = user_role_relation_model.objects.filter(
+ user_id=user_id, role_id=RoleConstants.ADMIN.name
+ ).exists()
+ user_ids = [user["id"] for user in result["records"]]
+ user_role_mapping, user_role_setting_mapping, user_role_workspace_mapping = _get_user_roles(
+ user_ids, is_admin
+ )
# 将角色信息添加回用户数据中
- for user in result['records']:
- user_id = str(user['id'])
- user['role_name'] = user_role_mapping.get(user_id, [])
- user['role_setting'] = user_role_setting_mapping.get(user_id, [])
- user['role_workspace'] = user_role_workspace_mapping.get(user_id, [])
+ for user in result["records"]:
+ user_id = str(user["id"])
+ user["role_name"] = user_role_mapping.get(user_id, [])
+ user["role_setting"] = user_role_setting_mapping.get(user_id, [])
+ user["role_workspace"] = user_role_workspace_mapping.get(user_id, [])
+
+ # 用户设置用户组
return result
@transaction.atomic
def save(self, instance, user_id, with_valid=True):
if with_valid:
- if instance.get('encrypted'):
- instance['password'] = decrypt(instance.get('password'))
+ if instance.get("encrypted"):
+ instance["password"] = decrypt(instance.get("password"))
self.UserInstance(data=instance).is_valid(raise_exception=True)
user = User(
id=uuid.uuid7(),
- email=instance.get('email'),
- phone=instance.get('phone', ''),
- nick_name=instance.get('nick_name', ''),
- username=instance.get('username'),
- password=password_encrypt(instance.get('password')),
+ email=instance.get("email"),
+ phone=instance.get("phone", ""),
+ nick_name=instance.get("nick_name", ""),
+ username=instance.get("username"),
+ password=password_encrypt(instance.get("password")),
role=RoleConstants.USER.name,
- source=instance.get('source', 'LOCAL'),
- is_active=True
+ source=instance.get("source", "LOCAL"),
+ is_active=True,
)
update_user_role(instance, user, user_id)
- set_default_permission(user.id, instance)
+ set_user_groups(user.id, instance)
user.save()
return UserInstanceSerializer(user).data
@@ -386,10 +517,12 @@ class UserEditInstance(serializers.Serializer):
email = serializers.EmailField(
required=False,
label=_("Email"),
- validators=[validators.EmailValidator(
- message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
- code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code
- )]
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
)
nick_name = serializers.CharField(
required=False,
@@ -397,31 +530,18 @@ class UserEditInstance(serializers.Serializer):
max_length=64,
)
phone = serializers.CharField(
- required=False,
- label=_("Phone"),
- max_length=20,
- allow_null=True,
- allow_blank=True
- )
- is_active = serializers.BooleanField(
- required=False,
- label=_("Is Active")
+ required=False, label=_("Phone"), max_length=20, allow_null=True, allow_blank=True
)
+ is_active = serializers.BooleanField(required=False, label=_("Is Active"))
def is_valid(self, *, user_id=None, raise_exception=False):
super().is_valid(raise_exception=True)
self._check_unique_email(user_id)
- self._check_unique_nick_name(user_id)
-
- def _check_unique_nick_name(self, user_id):
- nick_name = self.data.get('nick_name')
- if nick_name and User.objects.filter(nick_name=nick_name).exclude(id=user_id).exists():
- raise AppApiException(1008, _('Nickname is already in use'))
def _check_unique_email(self, user_id):
- email = self.data.get('email')
+ email = self.data.get("email")
if email and User.objects.filter(email=email).exclude(id=user_id).exists():
- raise AppApiException(1004, _('Email is already in use'))
+ raise AppApiException(1004, _("Email is already in use"))
class RePasswordInstance(serializers.Serializer):
password = serializers.CharField(
@@ -434,9 +554,9 @@ class RePasswordInstance(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
re_password = serializers.CharField(
required=True,
@@ -446,9 +566,9 @@ class RePasswordInstance(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The confirmation password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
def is_valid(self, *, raise_exception=False):
@@ -456,56 +576,61 @@ def is_valid(self, *, raise_exception=False):
self._check_passwords_match()
def _check_passwords_match(self):
- if self.data.get('password') != self.data.get('re_password'):
+ if self.data.get("password") != self.data.get("re_password"):
raise ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.to_app_api_exception()
class Operate(serializers.Serializer):
- id = serializers.UUIDField(required=True, label=_('User ID'))
+ id = serializers.UUIDField(required=True, label=_("User ID"))
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
self._check_user_exists()
def _check_user_exists(self):
- if not User.objects.filter(id=self.data.get('id')).exists():
- raise AppApiException(1004, _('User does not exist'))
+ if not User.objects.filter(id=self.data.get("id")).exists():
+ raise AppApiException(1004, _("User does not exist"))
@transaction.atomic
def delete(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
self._check_not_admin()
- user_id = self.data.get('id')
+ user_id = self.data.get("id")
# TODO 需要删除授权关系
User.objects.filter(id=user_id).delete()
return True
def _check_not_admin(self):
- user = User.objects.filter(id=self.data.get('id')).first()
- if user.role == RoleConstants.ADMIN.name or str(user.id) == 'f0dd8f71-e4ee-11ee-8c84-a8a1595801ab':
- raise AppApiException(1004, _('Unable to delete administrator'))
+ user = User.objects.filter(id=self.data.get("id")).first()
+ if user.role == RoleConstants.ADMIN.name or str(user.id) == "f0dd8f71-e4ee-11ee-8c84-a8a1595801ab":
+ raise AppApiException(1004, _("Unable to delete administrator"))
def edit(self, instance, user_id, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- UserManageSerializer.UserEditInstance(data=instance).is_valid(user_id=self.data.get('id'),
- raise_exception=True)
- user = User.objects.filter(id=self.data.get('id')).first()
+ UserManageSerializer.UserEditInstance(data=instance).is_valid(
+ user_id=self.data.get("id"), raise_exception=True
+ )
+ user = User.objects.filter(id=self.data.get("id")).first()
self._check_admin_modification(user, instance)
self._update_user_fields(user, instance)
update_user_role(instance, user, user_id)
+ set_user_groups(user.id, instance)
user.save()
return UserInstanceSerializer(user).data
@staticmethod
def _check_admin_modification(user, instance):
- if user.role == RoleConstants.ADMIN.name and 'is_active' in instance and instance.get(
- 'is_active') is not None:
- raise AppApiException(1004, _('Cannot modify administrator status'))
+ if (
+ user.role == RoleConstants.ADMIN.name
+ and "is_active" in instance
+ and instance.get("is_active") is not None
+ ):
+ raise AppApiException(1004, _("Cannot modify administrator status"))
@staticmethod
def _update_user_fields(user, instance):
- update_keys = ['email', 'nick_name', 'phone', 'is_active']
+ update_keys = ["email", "nick_name", "phone", "is_active"]
for key in update_keys:
if key in instance and instance.get(key) is not None:
setattr(user, key, instance.get(key))
@@ -513,12 +638,11 @@ def _update_user_fields(user, instance):
def one(self, with_valid=True):
if with_valid:
self.is_valid(raise_exception=True)
- user = User.objects.filter(id=self.data.get('id')).first()
+ user = User.objects.filter(id=self.data.get("id")).first()
workspace_user_role_mapping_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
if workspace_user_role_mapping_model:
role_setting = {}
- workspace_user_role_mapping_list = QuerySet(workspace_user_role_mapping_model).filter(
- user_id=user.id)
+ workspace_user_role_mapping_list = QuerySet(workspace_user_role_mapping_model).filter(user_id=user.id)
for workspace_user_role_mapping in workspace_user_role_mapping_list:
role_id = workspace_user_role_mapping.role_id
workspace_id = workspace_user_role_mapping.workspace_id
@@ -526,13 +650,13 @@ def one(self, with_valid=True):
role_setting[role_id] = []
role_setting[role_id].append(workspace_id)
return {
- 'id': user.id,
- 'username': user.username,
- 'email': user.email,
- 'phone': user.phone,
- 'nick_name': user.nick_name,
- 'is_active': user.is_active,
- 'role_setting': role_setting
+ "id": user.id,
+ "username": user.username,
+ "email": user.email,
+ "phone": user.phone,
+ "nick_name": user.nick_name,
+ "is_active": user.is_active,
+ "role_setting": role_setting,
}
return UserInstanceSerializer(user).data
@@ -547,15 +671,15 @@ def re_password(self, instance, with_valid=True):
decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
if isinstance(decrypted_data, dict):
instance.update(decrypted_data)
- except Exception as e:
+ except Exception:
raise AppApiException(500, _("Invalid encrypted data"))
UserManageSerializer.RePasswordInstance(data=instance).is_valid(raise_exception=True)
- user = User.objects.filter(id=self.data.get('id')).first()
- user.password = password_encrypt(instance.get('password'))
+ user = User.objects.filter(id=self.data.get("id")).first()
+ user.password = password_encrypt(instance.get("password"))
user.save()
return True
- def get_user_list(self, workspace_id, nick_name):
+ def get_user_list(self, user_id, workspace_id, nick_name):
"""
获取用户列表
:param workspace_id: 工作空间ID
@@ -563,122 +687,126 @@ def get_user_list(self, workspace_id, nick_name):
"""
workspace_user_role_mapping_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
if workspace_user_role_mapping_model:
- user_ids = (
- workspace_user_role_mapping_model.objects
- .filter(workspace_id=workspace_id)
- .values_list('user_id', flat=True)
- .distinct()
- )
+ # 判断当前用户是否属于该空间,不属于直接返回空
+ if not workspace_user_role_mapping_model.objects.filter(
+ workspace_id=workspace_id, user_id=user_id
+ ).exists():
+ query_set = User.objects.none()
+ else:
+ query_set = User.objects.filter(
+ id__in=workspace_user_role_mapping_model.objects.filter(workspace_id=workspace_id).values("user_id")
+ )
+
else:
- user_ids = User.objects.values_list('id', flat=True)
+ if user_id == "f0dd8f71-e4ee-11ee-8c84-a8a1595801ab":
+ query_set = User.objects.all()
+ else:
+ query_set = User.objects.filter(role=RoleConstants.USER.name)
- query_set = User.objects.filter(id__in=user_ids)
if nick_name:
query_set = query_set.filter(nick_name__contains=nick_name)
- users = query_set.values('id', 'nick_name')[:200]
+ users = query_set.values("id", "nick_name")[:200]
+
return list(users)
- def get_user_members(self, workspace_id):
+ def get_user_members(self, workspace_id, nick_name=None):
"""
获取工作空间成员列表
:param workspace_id: 工作空间ID
+ :param nick_name: 昵称模糊查询
:return: 成员列表
"""
role_model = DatabaseModelManage.get_model("role_model")
user_role_relation_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
if user_role_relation_model and role_model:
- user_role_relations = (
- user_role_relation_model.objects
- .filter(workspace_id=workspace_id, role__type='USER')
- .select_related('role', 'user')
- )
+ user_role_relations = user_role_relation_model.objects.filter(
+ workspace_id=workspace_id, role__type="USER"
+ ).select_related("role", "user")
+ if nick_name:
+ user_role_relations = user_role_relations.filter(user__nick_name__contains=nick_name)
user_dict = {}
for relation in user_role_relations:
user_id = relation.user.id
if user_id not in user_dict:
user_dict[user_id] = {
- 'id': user_id,
- 'nick_name': relation.user.nick_name,
- 'email': relation.user.email,
- 'roles': [relation.role.role_name]
+ "id": user_id,
+ "nick_name": relation.user.nick_name,
+ "roles": [relation.role.role_name],
}
else:
- user_dict[user_id]['roles'].append(relation.role.role_name)
+ user_dict[user_id]["roles"].append(relation.role.role_name)
# 将字典值转换为列表形式
- return list(user_dict.values())
+ return list(user_dict.values())[:200]
user_list = User.objects.exclude(role=RoleConstants.ADMIN.name)
+ if nick_name:
+ user_list = user_list.filter(nick_name__contains=nick_name)
return [
- {
- 'id': user.id,
- 'nick_name': user.nick_name,
- 'email': user.email,
- 'roles': [RoleConstants.USER.name]
- } for user in user_list
+ {"id": user.id, "nick_name": user.nick_name, "roles": [RoleConstants.USER.name]} for user in user_list[:200]
]
class BatchDelete(serializers.Serializer):
- ids = serializers.ListField(required=True, label=_('User IDs'))
+ ids = serializers.ListField(required=True, label=_("User IDs"))
def batch_delete(self, with_valid=True):
- user_ids = self.data.get('ids')
+ user_ids = self.data.get("ids")
if not user_ids:
- raise AppApiException(1004, _('User IDs cannot be empty'))
- User.objects.filter(id__in=user_ids).exclude(id='f0dd8f71-e4ee-11ee-8c84-a8a1595801ab').delete()
+ raise AppApiException(1004, _("User IDs cannot be empty"))
+ User.objects.filter(id__in=user_ids).exclude(id="f0dd8f71-e4ee-11ee-8c84-a8a1595801ab").delete()
return True
def get_all_user_list(self, nick_name=None):
query_set = User.objects.all()
if nick_name:
query_set = query_set.filter(nick_name__contains=nick_name)
- users = query_set.values('id', 'nick_name', 'username')[:200]
+ users = query_set.values("id", "nick_name", "username")[:200]
return list(users)
def update_user_role(instance, user, user_id=None):
workspace_user_role_mapping_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
if workspace_user_role_mapping_model:
- role_setting = instance.get('role_setting')
- license_is_valid = DatabaseModelManage.get_model('license_is_valid') or (lambda: False)
+ role_setting = instance.get("role_setting")
+ license_is_valid = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
license_is_valid = license_is_valid() if license_is_valid() is not None else False
- if not role_setting or (len(role_setting) == 1
- and role_setting[0].get('role_id') == ''
- and len(role_setting[0].get('workspace_ids', [])) == 0):
+ if not role_setting or (
+ len(role_setting) == 1
+ and role_setting[0].get("role_id") == ""
+ and len(role_setting[0].get("workspace_ids", [])) == 0
+ ):
if not license_is_valid:
workspace_user_role_mapping_model.objects.create(
- id=uuid.uuid7(),
- user_id=user.id,
- role_id=RoleConstants.USER.name,
- workspace_id='default'
+ id=uuid.uuid7(), user_id=user.id, role_id=RoleConstants.USER.name, workspace_id="default"
)
return
- is_admin = workspace_user_role_mapping_model.objects.filter(user_id=user_id,
- role_id=RoleConstants.ADMIN.name).exists()
+ is_admin = workspace_user_role_mapping_model.objects.filter(
+ user_id=user_id, role_id=RoleConstants.ADMIN.name
+ ).exists()
- if str(user.id) == 'f0dd8f71-e4ee-11ee-8c84-a8a1595801ab':
+ if str(user.id) == "f0dd8f71-e4ee-11ee-8c84-a8a1595801ab":
# 需要判断当前角色的权限 不能删除系统管理员 空间管理员 普通管理员等角色
# role_setting是一个数组 结构式 [{role_id:1,workspace_ids:[1,2]}]
# 如果role_id不包含ADMIN 就直接报错 如果WORKSPACE_MANAGE 或者USER 必须判断workspace_ids是否包含默认工作空间 不包含就报错
admin_role_id = RoleConstants.ADMIN.name
workspace_manage_role_id = RoleConstants.WORKSPACE_MANAGE.name
# 判断内置的三个角色是不是不在
- current_role_ids = {item['role_id'] for item in role_setting}
+ current_role_ids = {item["role_id"] for item in role_setting}
initial_role = [admin_role_id, workspace_manage_role_id, RoleConstants.USER.name]
if not set(initial_role).issubset(current_role_ids):
raise AppApiException(1004, _("Cannot delete built-in role"))
- if not any(item['role_id'] == str(admin_role_id) for item in role_setting):
+ if not any(item["role_id"] == str(admin_role_id) for item in role_setting):
raise AppApiException(1004, _("Cannot delete built-in role"))
# 验证 WORKSPACE_MANAGE 或 USER 是否包含默认工作空间
- default_workspace_id = 'default'
+ default_workspace_id = "default"
for item in role_setting:
- role_id = item['role_id']
- workspace_ids = item.get('workspace_ids', [])
+ role_id = item["role_id"]
+ workspace_ids = item.get("workspace_ids", [])
if role_id == str(workspace_manage_role_id) or role_id == str(RoleConstants.USER.value):
if default_workspace_id not in workspace_ids:
@@ -687,20 +815,18 @@ def update_user_role(instance, user, user_id=None):
workspace_user_role_mapping_model.objects.filter(user_id=user.id).delete()
else:
workspace_user_role_mapping_model.objects.filter(user_id=user.id).exclude(
- role__type=RoleConstants.ADMIN.name).delete()
+ role__type=RoleConstants.ADMIN.name
+ ).delete()
relations = set()
for item in role_setting:
- role_id = item['role_id']
- workspace_ids = item['workspace_ids'] if item['workspace_ids'] else ['None']
+ role_id = item["role_id"]
+ workspace_ids = item["workspace_ids"] if item["workspace_ids"] else ["None"]
for workspace_id in workspace_ids:
relations.add((role_id, workspace_id))
for role_id, workspace_id in relations:
workspace_user_role_mapping_model.objects.create(
- id=uuid.uuid7(),
- role_id=role_id,
- workspace_id=workspace_id,
- user_id=user.id
+ id=uuid.uuid7(), role_id=role_id, workspace_id=workspace_id, user_id=user.id
)
permission_version, permission_get_key = Cache_Version.PERMISSION_LIST.value
cache.delete(permission_get_key(str(user.id)), version=permission_version)
@@ -708,268 +834,39 @@ def update_user_role(instance, user, user_id=None):
cache.delete(role_get_key(str(user.id)), version=role_version)
-def set_default_permission(user_id, instance):
- """
- 为用户设置默认权限
- """
- default_permission = instance.get('defaultPermission', 'NOT_AUTH')
-
- # 获取工作空间ID列表
- workspace_ids = _get_workspace_ids(instance, default_permission)
- if not workspace_ids:
- return
-
- # 根据权限类型确定认证类型
- auth_type = (ResourceAuthType.ROLE
- if default_permission == ResourceAuthType.ROLE
- else ResourceAuthType.RESOURCE_PERMISSION_GROUP)
-
- # 设置根目录权限
- _set_root_permissions(user_id, workspace_ids)
-
- # 如果是无权限设置,直接返回
- if default_permission == 'NOT_AUTH':
- return
-
- # 设置具体资源权限
- _set_resource_permissions(user_id, workspace_ids, default_permission, auth_type)
-
-
-def _get_workspace_ids(instance, default_permission):
- """
- 获取工作空间ID列表
- """
- role_setting_model = DatabaseModelManage.get_model("role_model")
-
- if not role_setting_model:
- return ['default']
-
- # 检查许可证有效性
- license_is_valid = DatabaseModelManage.get_model('license_is_valid') or (lambda: False)
- if default_permission == ResourceAuthType.ROLE and not license_is_valid():
- return []
-
- role_setting = instance.get('role_setting')
- if not role_setting:
- return ['default']
-
- # 获取用户角色的工作空间ID
- all_role_ids = [item['role_id'] for item in role_setting]
- user_role_ids = set(role_setting_model.objects.filter(
- id__in=all_role_ids,
- type=RoleConstants.USER.name
- ).values_list('id', flat=True))
+def set_user_groups(user_id, instance):
+ user_group_ids = instance.get("user_group_ids") or []
- workspace_ids = set()
- for item in role_setting:
- role_id = item['role_id']
- if role_id in user_role_ids:
- workspace_ids.update(item.get('workspace_ids', []))
-
- return list(workspace_ids) if workspace_ids else []
-
-
-def _set_root_permissions(user_id, workspace_ids):
- """
- 设置根目录权限(默认为查看权限)
- """
- root_permissions = []
- for ws in workspace_ids:
- root_permissions.extend([
- WorkspaceUserResourcePermission(
- target=ws,
- auth_target_type=auth_target_type,
- permission_list=[ResourcePermission.VIEW],
- workspace_id=ws,
+ if SystemUserGroup.objects.filter(id__in=user_group_ids).count() != len(user_group_ids):
+ raise AppApiException(
+ 1004,
+ _("One or more user groups do not exist"),
+ )
+ SystemUserGroupRelation.objects.filter(user_id=user_id).delete()
+ if user_group_ids:
+ SystemUserGroupRelation.objects.bulk_create(
+ SystemUserGroupRelation(
+ id=uuid.uuid7(),
user_id=user_id,
- auth_type=ResourceAuthType.RESOURCE_PERMISSION_GROUP
+ group_id=group_id,
)
- for auth_target_type in [
- AuthTargetType.APPLICATION.value,
- AuthTargetType.KNOWLEDGE.value,
- AuthTargetType.TOOL.value
- ]
- ])
-
- _batch_create_permissions(root_permissions)
-
-
-def _set_resource_permissions(user_id, workspace_ids, default_permission, auth_type):
- """
- 设置具体资源权限
- """
- # 批量查询资源并按工作空间分组
- resource_maps = _get_resource_maps(workspace_ids)
-
- # 构造权限实例
- instances = []
- for ws in workspace_ids:
- instances.extend(_create_resource_permission_instances(
- ws, resource_maps, user_id, default_permission, auth_type))
-
- # 批量创建权限
- _batch_create_permissions(instances)
-
-
-def _get_resource_maps(workspace_ids):
- """
- 获取各类型资源按工作空间的映射
- """
- from application.models import Application, ApplicationFolder
- from knowledge.models import Knowledge, KnowledgeFolder
- from tools.models import Tool, ToolFolder
- from models_provider.models import Model
- from collections import defaultdict
-
- resource_maps = {
- 'apps': defaultdict(list),
- 'app_folders': defaultdict(list),
- 'knowledge': defaultdict(list),
- 'knowledge_folders': defaultdict(list),
- 'tools': defaultdict(list),
- 'tool_folders': defaultdict(list),
- 'models': defaultdict(list)
- }
-
- # 查询应用资源
- for ws, rid in Application.objects.filter(workspace_id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['apps'][ws].append(rid)
-
- for ws, fid in ApplicationFolder.objects.filter(workspace_id__in=workspace_ids).exclude(
- id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['app_folders'][ws].append(fid)
-
- # 查询知识库资源
- for ws, kid in Knowledge.objects.filter(workspace_id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['knowledge'][ws].append(kid)
-
- for ws, kfid in KnowledgeFolder.objects.filter(workspace_id__in=workspace_ids).exclude(
- id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['knowledge_folders'][ws].append(kfid)
-
- # 查询工具资源
- for ws, tid in Tool.objects.filter(workspace_id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['tools'][ws].append(tid)
-
- for ws, tfid in ToolFolder.objects.filter(workspace_id__in=workspace_ids).exclude(
- id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['tool_folders'][ws].append(tfid)
-
- # 查询模型资源
- for ws, mid in Model.objects.filter(workspace_id__in=workspace_ids).values_list('workspace_id', 'id'):
- resource_maps['models'][ws].append(mid)
-
- return resource_maps
-
-
-def _create_resource_permission_instances(workspace_id, resource_maps, user_id, permission, auth_type):
- """
- 创建资源权限实例列表
- """
- instances = []
- if permission == ResourcePermission.MANAGE:
- permission = [ResourcePermission.VIEW, ResourcePermission.MANAGE]
- else:
- permission = [permission]
-
- # 应用权限
- for rid in resource_maps['apps'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=rid,
- auth_target_type=AuthTargetType.APPLICATION.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- # 应用文件夹权限
- for fid in resource_maps['app_folders'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=fid,
- auth_target_type=AuthTargetType.APPLICATION.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- # 知识库权限
- for kid in resource_maps['knowledge'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=kid,
- auth_target_type=AuthTargetType.KNOWLEDGE.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- # 知识库文件夹权限
- for kf in resource_maps['knowledge_folders'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=kf,
- auth_target_type=AuthTargetType.KNOWLEDGE.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- # 工具权限
- for tid in resource_maps['tools'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=tid,
- auth_target_type=AuthTargetType.TOOL.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- # 工具文件夹权限
- for tf in resource_maps['tool_folders'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=tf,
- auth_target_type=AuthTargetType.TOOL.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- # 模型权限
- for mid in resource_maps['models'].get(workspace_id, []):
- instances.append(WorkspaceUserResourcePermission(
- target=mid,
- auth_target_type=AuthTargetType.MODEL.value,
- permission_list=permission,
- workspace_id=workspace_id,
- user_id=user_id,
- auth_type=auth_type
- ))
-
- return instances
-
-
-def _batch_create_permissions(instances, batch_size=500):
- """
- 批量创建权限实例
- """
- if not instances:
- return
+ for group_id in user_group_ids
+ )
- objs = WorkspaceUserResourcePermission.objects
- for i in range(0, len(instances), batch_size):
- objs.bulk_create(instances[i:i + batch_size])
+ return None
class RePasswordSerializer(serializers.Serializer):
email = serializers.EmailField(
required=True,
label=_("Email"),
- validators=[validators.EmailValidator(message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
- code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code)])
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
+ )
code = serializers.CharField(required=True, label=_("Code"))
password = serializers.CharField(
@@ -982,9 +879,9 @@ class RePasswordSerializer(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
re_password = serializers.CharField(
required=True,
@@ -994,25 +891,24 @@ class RePasswordSerializer(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The confirmation password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
class Meta:
model = User
- fields = '__all__'
+ fields = "__all__"
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
email = self.data.get("email")
- cache_code = cache.get(get_key(email + ':reset_password'), version=version)
- if self.data.get('password') != self.data.get('re_password'):
- raise AppApiException(ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.code,
- ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.message)
- if cache_code != self.data.get('code'):
- raise AppApiException(ExceptionCodeConstants.CODE_ERROR.value.code,
- ExceptionCodeConstants.CODE_ERROR.value.message)
+ if self.data.get("password") != self.data.get("re_password"):
+ raise AppApiException(
+ ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.code,
+ ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.message,
+ )
+ check_verify_code_attempts(email, "reset_password", self.data.get("code"))
return True
def reset_password(self):
@@ -1022,8 +918,7 @@ def reset_password(self):
"""
if self.is_valid():
email = self.data.get("email")
- QuerySet(User).filter(email=email).update(
- password=password_encrypt(self.data.get('password')))
+ QuerySet(User).filter(email=email).update(password=password_encrypt(self.data.get("password")))
code_cache_key = email + ":reset_password"
cache.delete(get_key(code_cache_key), version=version)
return True
@@ -1040,9 +935,9 @@ class ResetCurrentUserPassword(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
re_password = serializers.CharField(
required=True,
@@ -1052,20 +947,22 @@ class ResetCurrentUserPassword(serializers.Serializer):
regex=PASSWORD_REGEX,
message=_(
"The confirmation password must be 6-20 characters long and must be a combination of letters, numbers, and special characters."
- )
+ ),
)
- ]
+ ],
)
class Meta:
model = User
- fields = '__all__'
+ fields = "__all__"
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=True)
- if self.data.get('password') != self.data.get('re_password'):
- raise AppApiException(ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.code,
- ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.message)
+ if self.data.get("password") != self.data.get("re_password"):
+ raise AppApiException(
+ ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.code,
+ ExceptionCodeConstants.PASSWORD_NOT_EQ_RE_PASSWORD.value.message,
+ )
return True
def reset_password(self, user_id: str):
@@ -1074,35 +971,48 @@ def reset_password(self, user_id: str):
:return: 是否成功
"""
if self.is_valid():
- QuerySet(User).filter(id=user_id).update(
- password=password_encrypt(self.data.get('password')))
+ QuerySet(User).filter(id=user_id).update(password=password_encrypt(self.data.get("password")))
return True
class SendEmailSerializer(serializers.Serializer):
email = serializers.EmailField(
- required=True
- , label=_("Email"),
- validators=[validators.EmailValidator(message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
- code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code)])
+ required=True,
+ label=_("Email"),
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
+ )
- type = serializers.CharField(required=True, label=_("Type"), validators=[
- validators.RegexValidator(regex=re.compile("^register|reset_password$"),
- message=_("The type only supports register|reset_password"), code=500)
- ])
+ type = serializers.CharField(
+ required=True,
+ label=_("Type"),
+ validators=[
+ validators.RegexValidator(
+ regex=EMAIL_CODE_TYPE_REGEX,
+ message=_("The type only supports register|reset_password"),
+ code=500,
+ )
+ ],
+ )
class Meta:
model = User
- fields = '__all__'
+ fields = "__all__"
def is_valid(self, *, raise_exception=False):
super().is_valid(raise_exception=raise_exception)
- code_cache_key = self.data.get('email') + ":" + self.data.get("type")
+ code_cache_key = self.data.get("email") + ":" + self.data.get("type")
code_cache_key_lock = code_cache_key + "_lock"
ttl = cache.ttl(code_cache_key_lock, version=version)
- if ttl is not None and ttl > 0:
- raise AppApiException(500, _("Do not send emails again within {seconds} seconds").format(
- seconds=int(ttl.total_seconds())))
+ seconds = ttl.total_seconds() if isinstance(ttl, datetime.timedelta) else ttl
+ if seconds is not None and seconds > 0:
+ raise AppApiException(
+ 500, _("Do not send emails again within {seconds} seconds").format(seconds=int(seconds))
+ )
return True
def send(self):
@@ -1113,87 +1023,99 @@ def send(self):
"""
email = self.data.get("email")
state = self.data.get("type")
- # 生成随机验证码
- code = "".join(list(map(lambda i: random.choice(['1', '2', '3', '4', '5', '6', '7', '8', '9', '0'
- ]), range(6))))
- # 获取邮件模板
+ check_verify_code_lockout(email, state)
+ code = "".join(random.choices("0123456789", k=6))
language = get_language()
- file = open(
- os.path.join(PROJECT_DIR, "apps", "common", 'template', f'email_template_{language}.html'), "r",
- encoding='utf-8')
- content = file.read()
- file.close()
+ template_path = os.path.join(PROJECT_DIR, "apps", "common", "template", f"email_template_{language}.html")
+ with open(template_path, "r", encoding="utf-8") as template_file:
+ content = template_file.read()
code_cache_key = email + ":" + state
code_cache_key_lock = code_cache_key + "_lock"
- # 设置缓存
cache.set(get_key(code_cache_key_lock), code, timeout=60, version=version)
system_setting = QuerySet(SystemSetting).filter(type=SettingType.EMAIL.value).first()
if system_setting is None:
cache.delete(get_key(code_cache_key_lock), version=version)
- raise AppApiException(1004,
- _("The email service has not been set up. Please contact the administrator to set up the email service in [Email Settings]."))
+ raise AppApiException(
+ 1004,
+ _(
+ "The email service has not been set up. Please contact the administrator to set up the email service in [Email Settings]."
+ ),
+ )
try:
- connection = EmailBackend(system_setting.meta.get("email_host"),
- system_setting.meta.get('email_port'),
- system_setting.meta.get('email_host_user'),
- system_setting.meta.get('email_host_password'),
- system_setting.meta.get('email_use_tls'),
- False,
- system_setting.meta.get('email_use_ssl')
- )
+ connection = EmailBackend(
+ system_setting.meta.get("email_host"),
+ system_setting.meta.get("email_port"),
+ system_setting.meta.get("email_host_user"),
+ system_setting.meta.get("email_host_password"),
+ system_setting.meta.get("email_use_tls"),
+ False,
+ system_setting.meta.get("email_use_ssl"),
+ )
# 发送邮件
- send_mail(_('【Intelligent knowledge base question and answer system-{action}】').format(
- action=_('User registration') if state == 'register' else _('Change password')),
- '',
- html_message=f'{content.replace("${code}", code)}',
- from_email=system_setting.meta.get('from_email'),
- recipient_list=[email], fail_silently=False, connection=connection)
- except Exception as e:
- cache.delete(get_key(code_cache_key_lock))
- return True
- cache.set(get_key(code_cache_key), code, timeout=60 * 30, version=version)
+ send_mail(
+ _("【Intelligent knowledge base question and answer system-{action}】").format(
+ action=_("User registration") if state == "register" else _("Change password")
+ ),
+ "",
+ html_message=f"{content.replace('${code}', code)}",
+ from_email=system_setting.meta.get("from_email"),
+ recipient_list=[email],
+ fail_silently=False,
+ connection=connection,
+ )
+ except Exception:
+ cache.delete(get_key(code_cache_key_lock), version=version)
+ raise AppApiException(500, _("Failed to send email. Please try again later."))
+ cache.set(get_key(code_cache_key), code, timeout=VERIFY_CODE_EXPIRE_SECONDS, version=version)
return True
class CheckCodeSerializer(serializers.Serializer):
"""
- 校验验证码
+ 校验验证码
"""
+
email = serializers.EmailField(
required=True,
label=_("Email"),
- validators=[validators.EmailValidator(message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
- code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code)])
+ validators=[
+ validators.EmailValidator(
+ message=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.message,
+ code=ExceptionCodeConstants.EMAIL_FORMAT_ERROR.value.code,
+ )
+ ],
+ )
code = serializers.CharField(required=True, label=_("Verification code"))
- type = serializers.CharField(required=True,
- label=_("Type"),
- validators=[
- validators.RegexValidator(regex=re.compile("^register|reset_password$"),
- message=_(
- "The type only supports register|reset_password"),
- code=500)
- ])
+ type = serializers.CharField(
+ required=True,
+ label=_("Type"),
+ validators=[
+ validators.RegexValidator(
+ regex=EMAIL_CODE_TYPE_REGEX,
+ message=_("The type only supports register|reset_password"),
+ code=500,
+ )
+ ],
+ )
def is_valid(self, *, raise_exception=False):
- super().is_valid()
- value = cache.get(get_key(self.data.get("email") + ":" + self.data.get("type")), version=version)
- if value is None or value != self.data.get("code"):
- raise ExceptionCodeConstants.CODE_ERROR.value.to_app_api_exception()
+ super().is_valid(raise_exception=raise_exception)
+ check_verify_code_attempts(self.data.get("email"), self.data.get("type"), self.data.get("code"))
return True
class SwitchLanguageSerializer(serializers.Serializer):
- user_id = serializers.UUIDField(required=True, label=_('user id'))
- language = serializers.CharField(required=True, label=_('language'))
+ user_id = serializers.UUIDField(required=True, label=_("user id"))
+ language = serializers.CharField(required=True, label=_("language"))
def switch(self):
self.is_valid(raise_exception=True)
- language = self.data.get('language')
+ language = self.data.get("language")
support_language_list = CONFIG.get_languages()
# 这个是一个list 完事是对象 key是语言的key value是语言的value 我只需要提取语言的key就行
support_keys = [lang[0] for lang in support_language_list]
# support_language_list = ['zh-CN', 'zh-Hant', 'en-US'] en_US,ja,zh_CN,zh_Hant
- if not support_keys.__contains__(language):
- raise AppApiException(500, _('language only support:') + ','.join(support_keys))
- QuerySet(User).filter(id=self.data.get('user_id')).update(language=language)
+ if language not in support_keys:
+ raise AppApiException(500, _("language only support:") + ",".join(support_keys))
+ QuerySet(User).filter(id=self.data.get("user_id")).update(language=language)
diff --git a/apps/users/serializers/user_group.py b/apps/users/serializers/user_group.py
new file mode 100644
index 00000000000..a9f5c873d71
--- /dev/null
+++ b/apps/users/serializers/user_group.py
@@ -0,0 +1,284 @@
+# coding=utf-8
+
+import uuid_utils.compat as uuid
+from collections import defaultdict
+from django.db import transaction
+from django.db.models import Count
+from django.utils.translation import gettext_lazy as _
+from rest_framework import serializers
+
+from common.auth.constants.role_constants import RoleConstants
+from common.database_model_manage.database_model_manage import DatabaseModelManage
+from common.db.search import page_search
+from common.exception.app_exception import AppApiException
+from system_manage.models import UserGroup, UserGroupRelation
+from users.models.user_group import SystemUserGroup, SystemUserGroupRelation
+
+
+@transaction.atomic
+def add_or_edit_user_group_relation(user, user_group_ids):
+ UserGroupRelation.objects.filter(user=user).delete()
+ if not user_group_ids:
+ return
+ groups = UserGroup.objects.filter(id__in=user_group_ids)
+ if groups.count() != len(user_group_ids):
+ raise AppApiException(500, _("Some user groups do not exist"))
+
+ UserGroupRelation.objects.bulk_create([UserGroupRelation(user=user, group=group) for group in groups])
+
+
+class SystemUserGroupModelSerializer(serializers.ModelSerializer):
+ count = serializers.SerializerMethodField()
+
+ def get_count(self, obj):
+ return getattr(obj, "count", 0)
+
+ class Meta:
+ model = SystemUserGroup
+ fields = ["id", "name", "workspace_id", "count"]
+
+
+class SystemUserGroupCreateSerializer(serializers.Serializer):
+ id = serializers.CharField(required=False, label="ID")
+ name = serializers.CharField(required=True, label="User Group Name")
+ workspace_id = serializers.CharField(required=True, label="Workspace ID")
+
+ def validate(self, data):
+ group_id = data.get("id")
+ name = data.get("name")
+ workspace_id = data.get("workspace_id")
+ if group_id:
+ if not SystemUserGroup.objects.filter(id=group_id, workspace_id=workspace_id).exists():
+ raise AppApiException(500, _("User group does not exist"))
+ if name:
+ queryset = SystemUserGroup.objects.filter(name=name, workspace_id=workspace_id)
+ if group_id:
+ queryset = queryset.exclude(id=group_id)
+ if queryset.exists():
+ raise AppApiException(500, _("User group name already exists"))
+ return data
+
+ def create_or_update_group(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.validated_data
+ group_id = data.get("id")
+ name = data["name"]
+ workspace_id = data["workspace_id"]
+
+ if group_id:
+ SystemUserGroup.objects.filter(id=group_id, workspace_id=workspace_id).update(name=name)
+ group = SystemUserGroup.objects.get(id=group_id, workspace_id=workspace_id)
+ else:
+ group = SystemUserGroup.objects.create(
+ id=uuid.uuid7(),
+ name=name,
+ workspace_id=workspace_id,
+ )
+ return SystemUserGroupModelSerializer(group).data
+
+ class UserGroupDeleteSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label="ID")
+ workspace_id = serializers.CharField(required=True, label="Workspace ID")
+
+ group = None
+
+ def validate(self, attrs):
+ self.group = SystemUserGroup.objects.filter(
+ id=attrs["id"],
+ workspace_id=attrs["workspace_id"],
+ ).first()
+
+ if self.group is None:
+ raise AppApiException(500, _("User group does not exist"))
+
+ return attrs
+
+ @transaction.atomic
+ def delete(self, *, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+
+ self.group.delete()
+ return True
+
+ class Query(serializers.Serializer):
+ workspace_id = serializers.CharField(required=True, label="Workspace ID")
+
+ def get_query_set(self):
+ return (
+ SystemUserGroup.objects.filter(workspace_id=self.data.get("workspace_id"))
+ .annotate(count=Count("user_relations"))
+ .order_by("name")
+ )
+
+ def list(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ return SystemUserGroupModelSerializer(self.get_query_set(), many=True).data
+
+
+class UserGroupAddMemberSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label="ID")
+ workspace_id = serializers.CharField(required=True, label="Workspace ID")
+ user_ids = serializers.ListField(child=serializers.CharField(required=True), required=True, label=_("User IDs"))
+
+ def validate_normal_users(self, workspace_id: str, user_ids: list[str]):
+ if not user_ids:
+ return
+
+ license_is_valid = DatabaseModelManage.get_model("license_is_valid") or (lambda: False)
+ license_is_valid = license_is_valid() if license_is_valid() is not None else False
+ if not license_is_valid:
+ return
+
+ user_id_set = set(user_ids)
+
+ mapping_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
+ valid_user_ids = set(
+ str(uid)
+ for uid in mapping_model.objects.filter(
+ workspace_id=workspace_id,
+ user_id__in=user_id_set,
+ role__type=RoleConstants.USER.name,
+ ).values_list("user_id", flat=True)
+ )
+
+ invalid_user_ids = user_id_set - valid_user_ids
+ if invalid_user_ids:
+ raise AppApiException(500, _("Unauthorized users are present"))
+
+ def validate(self, data):
+ id = data.get("id")
+ workspace_id = data.get("workspace_id")
+ user_ids = data.get("user_ids")
+ group = SystemUserGroup.objects.filter(id=id, workspace_id=workspace_id).first()
+ if not group:
+ raise AppApiException(500, _("User group does not exist"))
+ if not user_ids:
+ raise AppApiException(500, _("User IDs cannot be empty"))
+
+ self.validate_normal_users(workspace_id, user_ids)
+ return data
+
+ def add_member(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ user_ids = self.data.get("user_ids")
+ workspace_id = self.data.get("workspace_id")
+
+ current_user_group_ids = set(
+ str(user_id)
+ for user_id in SystemUserGroupRelation.objects.filter(
+ group__id=self.data.get("id"), group__workspace_id=workspace_id
+ ).values_list("user_id", flat=True)
+ )
+ to_add = set(user_ids).difference(current_user_group_ids)
+ if to_add:
+ SystemUserGroupRelation.objects.bulk_create(
+ [
+ SystemUserGroupRelation(id=uuid.uuid7(), user_id=user_id, group_id=self.data.get("id"))
+ for user_id in to_add
+ ]
+ )
+ return True
+
+
+class UserGroupRemoveMemberSerializer(serializers.Serializer):
+ id = serializers.CharField(required=True, label="ID")
+ workspace_id = serializers.CharField(required=True, label="Workspace ID")
+ group_relation_ids = serializers.ListField(
+ child=serializers.CharField(required=True), required=True, label=_("User group relation IDs")
+ )
+
+ def validate(self, data):
+ group_id = data.get("id")
+ workspace_id = data.get("workspace_id")
+ relation_ids = data.get("group_relation_ids")
+ if not SystemUserGroup.objects.filter(id=group_id, workspace_id=workspace_id).exists():
+ raise AppApiException(500, _("User group does not exist"))
+ if not relation_ids:
+ raise AppApiException(500, _("User group relation IDs cannot be empty"))
+ return data
+
+ def remove_member(self, with_valid=True):
+ if with_valid:
+ self.is_valid(raise_exception=True)
+ data = self.validated_data
+ relation_ids = data["group_relation_ids"]
+ SystemUserGroupRelation.objects.filter(
+ id__in=relation_ids,
+ group_id=data["id"],
+ group__workspace_id=data["workspace_id"],
+ ).delete()
+ return True
+
+
+class UserGroupListPageSerializer(serializers.Serializer):
+ class Query(serializers.Serializer):
+ workspace_id = serializers.CharField(required=True, label="Workspace ID")
+ group_id = serializers.CharField(required=True, label=_("Group ID"))
+ username = serializers.CharField(required=False, label=_("Username"), allow_null=True)
+ nick_name = serializers.CharField(required=False, label=_("Nick Name"), allow_null=True)
+ source = serializers.CharField(required=False, label=_("Source"), allow_null=True)
+
+ def is_valid(self, *, raise_exception=False):
+ super().is_valid(raise_exception=raise_exception)
+ group_id = self.data.get("group_id")
+ workspace_id = self.data.get("workspace_id")
+ if not SystemUserGroup.objects.filter(id=group_id, workspace_id=workspace_id).exists():
+ raise AppApiException(500, _("User group does not exist"))
+
+ def page(self, current_page, page_size):
+ self.is_valid()
+ query_set = self.get_query_set()
+ result = page_search(
+ current_page,
+ page_size,
+ query_set,
+ post_records_handler=lambda relation: {
+ "id": str(relation.user.id),
+ "username": relation.user.username,
+ "nick_name": relation.user.nick_name,
+ "system_user_group_relation_id": str(relation.id),
+ "source": relation.user.source,
+ },
+ )
+
+ # 补充用户在指定工作空间的角色
+ role_map = self._get_user_role_map(self.data.get("workspace_id"), result["records"])
+ for user in result["records"]:
+ user["roles"] = role_map.get(str(user["id"]), [])
+ return result
+
+ def _get_user_role_map(self, workspace_id, records):
+ """查询 records 中用户在指定工作空间的角色列表"""
+ role_model = DatabaseModelManage.get_model("role_model")
+ user_role_relation_model = DatabaseModelManage.get_model("workspace_user_role_mapping")
+ if not role_model or not user_role_relation_model:
+ return {}
+
+ user_ids = [str(user["id"]) for user in records]
+ user_role_relations = user_role_relation_model.objects.filter(
+ workspace_id=workspace_id, user_id__in=user_ids, role__type="USER"
+ ).select_related("role", "user")
+
+ role_map = defaultdict(list)
+ for relation in user_role_relations:
+ role_map[str(relation.user_id)].append(relation.role.role_name)
+ return role_map
+
+ def get_query_set(self):
+ group_id = self.data.get("group_id")
+ username = self.data.get("username")
+ nick_name = self.data.get("nick_name")
+ source = self.data.get("source")
+ query_set = SystemUserGroupRelation.objects.filter(group_id=group_id).select_related("user")
+
+ if username is not None:
+ query_set = query_set.filter(user__username__contains=username)
+ if nick_name is not None:
+ query_set = query_set.filter(user__nick_name__contains=nick_name)
+ if source is not None:
+ query_set = query_set.filter(user__source=source)
+ return query_set.order_by("-user__create_time")
diff --git a/apps/users/urls.py b/apps/users/urls.py
index 27d7f914946..b159f23fb15 100644
--- a/apps/users/urls.py
+++ b/apps/users/urls.py
@@ -13,7 +13,6 @@
path('user/logout', views.Logout.as_view(), name='logout'),
path('user/language', views.SwitchUserLanguageView.as_view(), name='language'),
path("user/send_email", views.SendEmail.as_view(), name='send_email'),
- path("user/check_code", views.CheckCode.as_view(), name='check_code'),
path("user/re_password", views.RePasswordView.as_view(), name='re_password'),
path("user/current/send_email", views.SendEmailToCurrentUserView.as_view(), name="send_email_current"),
path("user/current/reset_password", views.ResetCurrentUserPasswordView.as_view(), name="reset_password_current"),
@@ -27,4 +26,9 @@
path("user_manage/", views.UserManage.Operate.as_view(), name="user_manage_operate"),
path("user_manage//re_password", views.UserManage.RePassword.as_view(), name="user_manage_re_password"),
path("user_manage//", views.UserManage.Page.as_view(), name="user_manage_page"),
+ path('system/workspace//user_group', views.SystemUserGroupView.as_view()),
+ path('system/workspace//user_group/', views.SystemUserGroupView.Delete.as_view()),
+ path('system/workspace//user_group//add_member', views.SystemUserGroupView.AddMember.as_view()),
+ path('system/workspace//user_group//remove_member', views.SystemUserGroupView.RemoveMember.as_view()),
+ path('system/workspace//user_group//user_list//', views.SystemUserGroupView.UserList.as_view()),
]
diff --git a/apps/users/views/__init__.py b/apps/users/views/__init__.py
index 9ef4e79ce76..9b93c142583 100644
--- a/apps/users/views/__init__.py
+++ b/apps/users/views/__init__.py
@@ -8,3 +8,4 @@
"""
from .login import *
from .user import *
+from .system_user_group import *
diff --git a/apps/users/views/login.py b/apps/users/views/login.py
index 03bf8a0a4f2..817a65c25d3 100644
--- a/apps/users/views/login.py
+++ b/apps/users/views/login.py
@@ -1,77 +1,96 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: user.py
- @date:2025/4/14 10:22
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: user.py
+@date:2025/4/14 10:22
+@desc:
"""
-from django.core.cache import cache
-from django.utils.translation import gettext_lazy as _
-from drf_spectacular.utils import extend_schema
-from rest_framework.request import Request
-from rest_framework.views import APIView
from common import result
from common.auth import TokenAuth
from common.constants.cache_version import Cache_Version
from common.log.log import log
from common.utils.common import encryption
+from django.core.cache import cache
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from maxkb.const import CONFIG
from models_provider.api.model import DefaultModelResponse
-from users.api.login import LoginAPI, CaptchaAPI
-from users.serializers.login import LoginSerializer, CaptchaSerializer
+from rest_framework.request import Request
+from rest_framework.views import APIView
+from users.api.login import CaptchaAPI, LoginAPI
+from users.serializers.login import CaptchaSerializer, LoginSerializer
def _get_details(request):
path = request.path
body = request.data
query = request.query_params
- return {
- 'path': path,
- 'body': {**body, 'password': encryption(body.get('password', ''))},
- 'query': query
- }
+ return {"path": path, "body": {**body, "password": encryption(body.get("password", ""))}, "query": query}
class LoginView(APIView):
- @extend_schema(methods=['POST'],
- description=_("Log in"),
- summary=_("Log in"),
- operation_id=_("Log in"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=LoginAPI.get_request(),
- responses=LoginAPI.get_response())
- @log(menu='User management', operate='Log in', get_user=lambda r: {'username': r.data.get('username', None)},
- get_details=_get_details,
- get_operation_object=lambda r, k: {'name': r.data.get('username')})
+ @extend_schema(
+ methods=["POST"],
+ description=_("Log in"),
+ summary=_("Log in"),
+ operation_id=_("Log in"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=LoginAPI.get_request(),
+ responses=LoginAPI.get_response(),
+ )
+ @log(
+ menu="User management",
+ operate="Log in",
+ get_user=lambda r: {"username": r.data.get("username", None)},
+ get_details=_get_details,
+ get_operation_object=lambda r, k: {"name": r.data.get("username")},
+ )
def post(self, request: Request):
- return result.success(LoginSerializer().login(request.data))
+ token = LoginSerializer().login(request.data)
+ response = result.success(token)
+
+ is_https = request.scheme == "https"
+ response.set_cookie(
+ key="mk_file_auth",
+ value=token.get("token"),
+ max_age=7 * 24 * 3600,
+ path=CONFIG.get_admin_path(),
+ secure=is_https,
+ httponly=True,
+ samesite="None" if is_https else "Lax",
+ )
+ return response
class Logout(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- summary=_("Sign out"),
- description=_("Sign out"),
- operation_id=_("Sign out"), # type: ignore
- tags=[_("User Management")], # type: ignore
- responses=DefaultModelResponse.get_response())
- @log(menu='User management', operate='Sign out',
- get_operation_object=lambda r, k: {'name': r.user.username})
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Sign out"),
+ description=_("Sign out"),
+ operation_id=_("Sign out"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(menu="User management", operate="Sign out", get_operation_object=lambda r, k: {"name": r.user.username})
def post(self, request: Request):
version, get_key = Cache_Version.TOKEN.value
- cache.delete(get_key(token=request.META.get('HTTP_AUTHORIZATION')[7:]), version=version)
+ cache.delete(get_key(token=request.META.get("HTTP_AUTHORIZATION")[7:]), version=version)
return result.success(True)
class CaptchaView(APIView):
- @extend_schema(methods=['GET'],
- summary=_("Get captcha"),
- description=_("Get captcha"),
- operation_id=_("Get captcha"), # type: ignore
- tags=[_("User Management")], # type: ignore
- responses=CaptchaAPI.get_response())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get captcha"),
+ description=_("Get captcha"),
+ operation_id=_("Get captcha"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ responses=CaptchaAPI.get_response(),
+ )
def get(self, request: Request):
- username = request.query_params.get('username', None)
+ username = request.query_params.get("username", None)
return result.success(CaptchaSerializer().generate(username))
diff --git a/apps/users/views/system_user_group.py b/apps/users/views/system_user_group.py
new file mode 100644
index 00000000000..cf2582cffcf
--- /dev/null
+++ b/apps/users/views/system_user_group.py
@@ -0,0 +1,187 @@
+# coding=utf-8
+
+from django.utils.translation import gettext_lazy as _
+from drf_spectacular.utils import extend_schema
+from rest_framework.request import Request
+from rest_framework.views import APIView
+
+from common import result
+from common.auth import TokenAuth
+from common.auth.authentication import has_permissions
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
+from common.log.log import log
+from models_provider.api.model import DefaultModelResponse
+from users.api.user_group import (
+ AddMemberApi, CreateUserGroupApi, DeleteUserGroupApi,
+ RemoveMemberApi, UserGroupListApi, UserGroupListPageApi
+)
+from users.models.user_group import SystemUserGroup
+from users.serializers.user_group import (
+ SystemUserGroupCreateSerializer,
+ UserGroupAddMemberSerializer,
+ UserGroupRemoveMemberSerializer,
+ UserGroupListPageSerializer
+)
+
+
+def _get_operation_object(request, kwargs):
+ try:
+ return {"name": request.data.get("name", None)}
+ except Exception:
+ return {}
+
+
+def _get_group_operation_object(group_id):
+ try:
+ group = SystemUserGroup.objects.filter(id=group_id).values("name").first()
+ return group or {}
+ except Exception:
+ return {}
+
+
+class SystemUserGroupView(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Create or update System User Group"),
+ description=_("Create or update System User Group"),
+ operation_id=_("Create or update System User Group"), # type: ignore
+ request=CreateUserGroupApi.get_request(),
+ responses=CreateUserGroupApi.get_response(),
+ tags=["IAM/System User Group"],
+ )
+ @has_permissions(PermissionConstants.SYSTEM_USER_GROUP_CREATE,
+ PermissionConstants.SYSTEM_USER_GROUP_EDIT,
+ RoleConstants.ADMIN)
+ @log(
+ menu="IAM/System User Group",
+ operate="Create or update System User Group",
+ get_operation_object=_get_operation_object,
+ )
+ def post(self, request: Request, workspace_id: str):
+ serializer = SystemUserGroupCreateSerializer(
+ data={
+ **request.data,
+ "workspace_id": workspace_id,
+ }
+ )
+ data = serializer.create_or_update_group(with_valid=True)
+ return result.success(data)
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get System User Group list by workspace id"),
+ description=_("Get System User Group list by workspace id"),
+ operation_id=_("Get System User Group list by workspace id"), # type: ignore
+ request=UserGroupListApi.get_parameters(),
+ responses=UserGroupListApi.get_response(),
+ tags=["IAM/System User Group"],
+ )
+ @has_permissions(PermissionConstants.SYSTEM_USER_GROUP_READ, RoleConstants.ADMIN)
+ def get(self, request: Request, workspace_id: str):
+ return result.success(SystemUserGroupCreateSerializer.Query(
+ data={'workspace_id': workspace_id}
+ ).list())
+
+ class Delete(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ summary=_("Delete System User Group"),
+ description=_("Delete System User Group"),
+ operation_id=_("Delete System User Group"), # type: ignore
+ parameters=DeleteUserGroupApi.get_parameters(),
+ responses=DefaultModelResponse.get_response(),
+ tags=["IAM/System User Group"],
+ )
+ @has_permissions(PermissionConstants.SYSTEM_USER_GROUP_DELETE, RoleConstants.ADMIN)
+ @log(
+ menu="IAM/System User Group",
+ operate="Delete System User Group",
+ get_operation_object=lambda r, k: _get_group_operation_object(k.get("user_group_id")),
+ )
+ def delete(self, request: Request, workspace_id, user_group_id: str):
+ return result.success(
+ SystemUserGroupCreateSerializer.UserGroupDeleteSerializer(
+ data={"id": user_group_id, "workspace_id": workspace_id}).delete()
+ )
+
+ class AddMember(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Add members to System User Group"),
+ description=_("Add members to System User Group"),
+ operation_id=_("Add members to System User Group"), # type: ignore
+ parameters=AddMemberApi.get_parameters(),
+ request=AddMemberApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ tags=["IAM/System User Group"],
+ )
+ @has_permissions(PermissionConstants.SYSTEM_USER_GROUP_ADD_MEMBER, RoleConstants.ADMIN)
+ @log(
+ menu="IAM/System User Group",
+ operate="Add members to System User Group",
+ )
+ def post(self, request: Request, workspace_id: str, user_group_id: str):
+ return result.success(
+ UserGroupAddMemberSerializer(
+ data={"id": user_group_id, "workspace_id": workspace_id,
+ "user_ids": request.data.get("user_ids", [])}
+ ).add_member()
+ )
+
+ class RemoveMember(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["DELETE"],
+ summary=_("Remove members from System User Group"),
+ description=_("Remove members from System User Group"),
+ operation_id=_("Remove members from System User Group"), # type: ignore
+ parameters=RemoveMemberApi.get_parameters(),
+ request=RemoveMemberApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ tags=["IAM/System User Group"],
+ )
+ @has_permissions(PermissionConstants.SYSTEM_USER_GROUP_REMOVE_MEMBER, RoleConstants.ADMIN)
+ @log(
+ menu="IAM/System User Group",
+ operate="Remove members from System User Group",
+ )
+ def delete(self, request: Request, workspace_id: str, user_group_id: str):
+ return result.success(
+ UserGroupRemoveMemberSerializer(
+ data={"id": user_group_id, "workspace_id": workspace_id,
+ "group_relation_ids": request.data.get("group_relation_ids", [])}
+ ).remove_member()
+ )
+
+ class UserList(APIView):
+ authentication_classes = [TokenAuth]
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user list by group"),
+ description=_("Get user list by group"),
+ operation_id=_("Get user list by group"), # type: ignore
+ tags=[_("IAM/System User Group")], # type: ignore
+ parameters=UserGroupListPageApi.get_parameters(),
+ responses=UserGroupListPageApi.get_response(),
+ )
+ @has_permissions(PermissionConstants.SYSTEM_USER_GROUP_READ, RoleConstants.ADMIN)
+ def get(self, request: Request, workspace_id: str, user_group_id: str, current_page: int, page_size: int):
+ d = UserGroupListPageSerializer.Query(
+ data={
+ "username": request.query_params.get("username", None),
+ "nick_name": request.query_params.get("nick_name", None),
+ "source": request.query_params.get("source", None),
+ "group_id": user_group_id,
+ "workspace_id": workspace_id,
+ }
+ )
+ return result.success(d.page(current_page, page_size))
diff --git a/apps/users/views/user.py b/apps/users/views/user.py
index b2de2c78b49..046d4dec933 100644
--- a/apps/users/views/user.py
+++ b/apps/users/views/user.py
@@ -1,11 +1,12 @@
# coding=utf-8
"""
- @project: MaxKB
- @Author:虎虎
- @file: user.py
- @date:2025/4/14 19:25
- @desc:
+@project: MaxKB
+@Author:虎虎
+@file: user.py
+@date:2025/4/14 19:25
+@desc:
"""
+
import json
from django.core.cache import cache
@@ -18,7 +19,8 @@
from common.auth.authenticate import TokenAuth
from common.auth.authentication import has_permissions
from common.constants.cache_version import Cache_Version
-from common.constants.permission_constants import PermissionConstants, Permission, Group, Operate, RoleConstants
+from common.auth.constants.permission_constants import PermissionConstants
+from common.auth.constants.role_constants import RoleConstants
from common.exception.app_exception import AppApiException
from common.log.log import log
from common.result import result
@@ -26,23 +28,39 @@
from common.utils.rsa_util import decrypt
from maxkb.const import CONFIG
from models_provider.api.model import DefaultModelResponse
-from tools.serializers.tool import encryption
-from users.api.user import UserProfileAPI, TestWorkspacePermissionUserApi, DeleteUserApi, EditUserApi, \
- ChangeUserPasswordApi, UserPageApi, UserListApi, UserPasswordResponse, WorkspaceUserAPI, ResetPasswordAPI, \
- SendEmailAPI, CheckCodeAPI, SwitchUserLanguageAPI
+from users.api.user import (
+ UserProfileAPI,
+ TestWorkspacePermissionUserApi,
+ DeleteUserApi,
+ EditUserApi,
+ ChangeUserPasswordApi,
+ UserPageApi,
+ UserListApi,
+ UserPasswordResponse,
+ WorkspaceUserAPI,
+ ResetPasswordAPI,
+ SendEmailAPI,
+ CheckCodeAPI,
+ SwitchUserLanguageAPI,
+)
from users.models import User
-from users.serializers.user import UserProfileSerializer, UserManageSerializer, CheckCodeSerializer, \
- SendEmailSerializer, RePasswordSerializer, SwitchLanguageSerializer, ResetCurrentUserPassword
+from users.serializers.user import (
+ UserProfileSerializer,
+ UserManageSerializer,
+ CheckCodeSerializer,
+ SendEmailSerializer,
+ RePasswordSerializer,
+ SwitchLanguageSerializer,
+ ResetCurrentUserPassword,
+)
-default_password = CONFIG.get('DEFAULT_PASSWORD', 'MaxKB@123..')
+default_password = CONFIG.get("DEFAULT_PASSWORD", "MaxKB@123..")
def get_user_operation_object(user_id):
user_model = QuerySet(model=User).filter(id=user_id).first()
if user_model is not None:
- return {
- "name": user_model.username
- }
+ return {"name": user_model.username}
return {}
@@ -50,319 +68,384 @@ def get_re_password_details(request):
path = request.path
body = request.data
query = request.query_params
- body_copy = dict(body) if hasattr(body, 'items') else body
+ body_copy = dict(body) if hasattr(body, "items") else body
if isinstance(body_copy, dict):
- body_copy.pop('password', None)
- body_copy.pop('re_password', None)
- return {
- "path": path,
- "body": body_copy,
- "query": query
- }
+ body_copy.pop("password", None)
+ body_copy.pop("re_password", None)
+ return {"path": path, "body": body_copy, "query": query}
class UserProfileView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_("Get current user information"),
- description=_("Get current user information"),
- operation_id=_("Get current user information"), # type: ignore
- tags=[_("User Management")], # type: ignore
-
- responses=UserProfileAPI.get_response())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get current user information"),
+ description=_("Get current user information"),
+ operation_id=_("Get current user information"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ responses=UserProfileAPI.get_response(),
+ )
def get(self, request: Request):
- return result.success(UserProfileSerializer().profile(request.user, request.auth))
+ return result.success(UserProfileSerializer().profile(request.user.profile, request.auth))
class TestPermissionsUserView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_("Get current user information"),
- description=_("Get current user information"),
- operation_id="测试",
- tags=[_("User Management")], # type: ignore
- responses=UserProfileAPI.get_response())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get current user information"),
+ description=_("Get current user information"),
+ operation_id="测试",
+ tags=[_("User Management")], # type: ignore
+ responses=UserProfileAPI.get_response(),
+ )
@has_permissions(PermissionConstants.USER_EDIT, RoleConstants.ADMIN)
def get(self, request: Request):
- return result.success(UserProfileSerializer().profile(request.user, request.auth))
+ return result.success(UserProfileSerializer().profile(request.user.profile, request.auth))
class SwitchUserLanguageView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- summary=_("Switch Language"),
- description=_("Switch Language"),
- operation_id=_("Switch Language"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=SwitchUserLanguageAPI.get_request(),
- )
- @log(menu='User management', operate='Switch Language',
- get_operation_object=lambda r, k: {'name': r.user.username})
- @has_permissions(PermissionConstants.SWITCH_LANGUAGE, RoleConstants.ADMIN, RoleConstants.USER,
- RoleConstants.WORKSPACE_MANAGE)
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Switch Language"),
+ description=_("Switch Language"),
+ operation_id=_("Switch Language"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=SwitchUserLanguageAPI.get_request(),
+ )
+ @log(menu="User management", operate="Switch Language", get_operation_object=lambda r, k: {"name": r.user.username})
+ @has_permissions(
+ PermissionConstants.SWITCH_LANGUAGE, RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE
+ )
def post(self, request: Request):
- data = {**request.data, 'user_id': request.user.id}
+ data = {**request.data, "user_id": request.user.id}
return result.success(SwitchLanguageSerializer(data=data).switch())
class TestWorkspacePermissionUserView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary="针对工作空间下权限校验",
- description="针对工作空间下权限校验",
- operation_id="针对工作空间下权限校验",
- tags=[_("User Management")], # type: ignore
- responses=UserProfileAPI.get_response(),
- parameters=TestWorkspacePermissionUserApi.get_parameters())
+ @extend_schema(
+ methods=["GET"],
+ summary="针对工作空间下权限校验",
+ description="针对工作空间下权限校验",
+ operation_id="针对工作空间下权限校验",
+ tags=[_("User Management")], # type: ignore
+ responses=UserProfileAPI.get_response(),
+ parameters=TestWorkspacePermissionUserApi.get_parameters(),
+ )
@has_permissions(PermissionConstants.USER_EDIT.get_workspace_permission(), RoleConstants.ADMIN)
def get(self, request: Request, workspace_id):
- return result.success(UserProfileSerializer().profile(request.user, request.auth))
+ return result.success(UserProfileSerializer().profile(request.user.profile, request.auth))
class UserList(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_("Get all user"),
- description=_("Get all user"),
- operation_id=_("Get all user"), # type: ignore
- tags=[_("User Management")], # type: ignore
- responses=UserListApi.get_response())
- @has_permissions(RoleConstants.WORKSPACE_MANAGE, RoleConstants.ADMIN, RoleConstants.EXTENDS_ADMIN,
- RoleConstants.EXTENDS_WORKSPACE_MANAGE, RoleConstants.USER, RoleConstants.EXTENDS_USER)
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get all user"),
+ description=_("Get all user"),
+ operation_id=_("Get all user"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=UserListApi.get_parameters(),
+ responses=UserListApi.get_response(),
+ )
+ @has_permissions(
+ RoleConstants.WORKSPACE_MANAGE,
+ RoleConstants.ADMIN,
+ RoleConstants.EXTENDS_ADMIN,
+ RoleConstants.EXTENDS_WORKSPACE_MANAGE,
+ RoleConstants.USER,
+ RoleConstants.EXTENDS_USER,
+ )
def get(self, request: Request):
- nick_name = request.query_params.get('nick_name', None)
+ nick_name = request.query_params.get("nick_name", None)
return result.success(UserManageSerializer().get_all_user_list(nick_name))
class WorkspaceUserListView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_("Get user list under workspace"),
- description=_("Get user list under workspace"),
- operation_id=_("Get user list under workspace"), # type: ignore
- tags=[_("User Management")], # type: ignore
- parameters=WorkspaceUserAPI.get_parameters(),
- responses=WorkspaceUserAPI.get_response())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user list under workspace"),
+ description=_("Get user list under workspace"),
+ operation_id=_("Get user list under workspace"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=WorkspaceUserAPI.get_parameters(),
+ responses=WorkspaceUserAPI.get_response(),
+ )
+ @has_permissions(
+ RoleConstants.WORKSPACE_MANAGE,
+ RoleConstants.ADMIN,
+ RoleConstants.EXTENDS_ADMIN,
+ RoleConstants.EXTENDS_WORKSPACE_MANAGE,
+ RoleConstants.USER,
+ RoleConstants.EXTENDS_USER,
+ )
def get(self, request: Request, workspace_id):
- nick_name = request.query_params.get('nick_name', None)
- return result.success(UserManageSerializer().get_user_list(workspace_id, nick_name))
+ nick_name = request.query_params.get("nick_name", None)
+ return result.success(UserManageSerializer().get_user_list(str(request.user.id), workspace_id, nick_name))
class WorkspaceUserMemberView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_("Get user member under workspace"),
- description=_("Get user member under workspace"),
- operation_id=_("Get user member under workspace"), # type: ignore
- tags=[_("User Management")], # type: ignore
- parameters=WorkspaceUserAPI.get_parameters(),
- responses=WorkspaceUserAPI.get_response())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user member under workspace"),
+ description=_("Get user member under workspace"),
+ operation_id=_("Get user member under workspace"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=WorkspaceUserAPI.get_parameters(),
+ responses=WorkspaceUserAPI.get_response(),
+ )
+ @has_permissions(
+ RoleConstants.WORKSPACE_MANAGE,
+ RoleConstants.ADMIN,
+ RoleConstants.EXTENDS_ADMIN,
+ RoleConstants.EXTENDS_WORKSPACE_MANAGE,
+ RoleConstants.USER,
+ RoleConstants.EXTENDS_USER,
+ )
def get(self, request: Request, workspace_id):
- return result.success(UserManageSerializer().get_user_members(workspace_id))
+ nick_name = request.query_params.get("nick_name", None)
+ return result.success(UserManageSerializer().get_user_members(workspace_id, nick_name))
class UserManage(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- summary=_("Create user"),
- description=_("Create user"),
- operation_id=_("Create user"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=UserProfileAPI.get_request(),
- responses=UserProfileAPI.get_response())
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Create user"),
+ description=_("Create user"),
+ operation_id=_("Create user"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=UserProfileAPI.get_request(),
+ responses=UserProfileAPI.get_response(),
+ )
@has_permissions(PermissionConstants.USER_CREATE, RoleConstants.ADMIN)
- @log(menu='User management', operate='Add user',
- get_operation_object=lambda r, k: {'name': r.data.get('username', None)})
+ @log(
+ menu="User management",
+ operate="Add user",
+ get_operation_object=lambda r, k: {"name": r.data.get("username", None)},
+ )
def post(self, request: Request):
return result.success(UserManageSerializer().save(request.data, str(request.user.id)))
class Password(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['Get'],
- summary=_("Get default password"),
- description=_("Get default password"),
- operation_id=_("Get default password"), # type: ignore
- tags=[_("User Management")], # type: ignore
- responses=UserPasswordResponse.get_response())
- @has_permissions(PermissionConstants.USER_CREATE, PermissionConstants.CHAT_USER_CREATE,
- PermissionConstants.WORKSPACE_CHAT_USER_CREATE, RoleConstants.ADMIN,
- RoleConstants.WORKSPACE_MANAGE)
+ @extend_schema(
+ methods=["Get"],
+ summary=_("Get default password"),
+ description=_("Get default password"),
+ operation_id=_("Get default password"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ responses=UserPasswordResponse.get_response(),
+ )
+ @has_permissions(
+ PermissionConstants.USER_CREATE,
+ PermissionConstants.CHAT_USER_CREATE,
+ RoleConstants.ADMIN,
+ RoleConstants.WORKSPACE_MANAGE,
+ )
def get(self, request: Request):
- return result.success(data={'password': default_password})
+ return result.success(data={"password": default_password})
class Operate(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['DELETE'],
- description=_("Delete user"),
- summary=_("Delete user"),
- operation_id=_("Delete user"), # type: ignore
- tags=[_("User Management")], # type: ignore
- parameters=DeleteUserApi.get_parameters(),
- responses=DefaultModelResponse.get_response())
+ @extend_schema(
+ methods=["DELETE"],
+ description=_("Delete user"),
+ summary=_("Delete user"),
+ operation_id=_("Delete user"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=DeleteUserApi.get_parameters(),
+ responses=DefaultModelResponse.get_response(),
+ )
@has_permissions(PermissionConstants.USER_DELETE, RoleConstants.ADMIN)
- @log(menu='User management', operate='Delete user',
- get_operation_object=lambda r, k: get_user_operation_object(k.get('user_id')))
+ @log(
+ menu="User management",
+ operate="Delete user",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ )
def delete(self, request: Request, user_id):
- return result.success(UserManageSerializer.Operate(data={'id': user_id}).delete(with_valid=True))
-
- @extend_schema(methods=['GET'],
- summary=_("Get user information"),
- description=_("Get user information"),
- operation_id=_("Get user information"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=DeleteUserApi.get_parameters(),
- responses=UserProfileAPI.get_response())
+ return result.success(UserManageSerializer.Operate(data={"id": user_id}).delete(with_valid=True))
+
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user information"),
+ description=_("Get user information"),
+ operation_id=_("Get user information"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=DeleteUserApi.get_parameters(),
+ responses=UserProfileAPI.get_response(),
+ )
@has_permissions(PermissionConstants.USER_READ, RoleConstants.ADMIN)
def get(self, request: Request, user_id):
- return result.success(UserManageSerializer.Operate(data={'id': user_id}).one(with_valid=True))
-
- @extend_schema(methods=['PUT'],
- summary=_("Update user information"),
- description=_("Update user information"),
- operation_id=_("Update user information"), # type: ignore
- tags=[_("User Management")], # type: ignore
- parameters=DeleteUserApi.get_parameters(),
- request=EditUserApi.get_request(),
- responses=UserProfileAPI.get_response())
+ return result.success(UserManageSerializer.Operate(data={"id": user_id}).one(with_valid=True))
+
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Update user information"),
+ description=_("Update user information"),
+ operation_id=_("Update user information"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=DeleteUserApi.get_parameters(),
+ request=EditUserApi.get_request(),
+ responses=UserProfileAPI.get_response(),
+ )
@has_permissions(PermissionConstants.USER_EDIT, RoleConstants.ADMIN)
- @log(menu='User management', operate='Update user information',
- get_operation_object=lambda r, k: get_user_operation_object(k.get('user_id')))
+ @log(
+ menu="User management",
+ operate="Update user information",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ )
def put(self, request: Request, user_id):
return result.success(
- UserManageSerializer.Operate(data={'id': user_id}).edit(request.data, str(request.user.id),
- with_valid=True))
+ UserManageSerializer.Operate(data={"id": user_id}).edit(
+ request.data, str(request.user.id), with_valid=True
+ )
+ )
class BatchDelete(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- description=_("Batch delete user"),
- summary=_("Batch delete user"),
- operation_id=_("Batch delete user"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=DeleteUserApi.get_request(),
- responses=DefaultModelResponse.get_response())
+ @extend_schema(
+ methods=["POST"],
+ description=_("Batch delete user"),
+ summary=_("Batch delete user"),
+ operation_id=_("Batch delete user"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=DeleteUserApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
@has_permissions(PermissionConstants.USER_DELETE, RoleConstants.ADMIN)
- @log(menu='User management', operate='Batch delete user',
- get_operation_object=lambda r, k: get_user_operation_object(r.data.get('ids', [])))
+ @log(
+ menu="User management",
+ operate="Batch delete user",
+ get_operation_object=lambda r, k: get_user_operation_object(r.data.get("ids", [])),
+ )
def post(self, request: Request):
- return result.success(UserManageSerializer.BatchDelete({'ids': request.data}).batch_delete(with_valid=True))
+ return result.success(UserManageSerializer.BatchDelete({"ids": request.data}).batch_delete(with_valid=True))
class RePassword(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['PUT'],
- summary=_("Change password"),
- description=_("Change password"),
- operation_id=_("Change password"), # type: ignore
- tags=[_("User Management")], # type: ignore
- parameters=DeleteUserApi.get_parameters(),
- request=ChangeUserPasswordApi.get_request(),
- responses=DefaultModelResponse.get_response())
- @log(menu='User management', operate='Change password',
- get_operation_object=lambda r, k: get_user_operation_object(k.get('user_id')),
- get_details=get_re_password_details)
+ @extend_schema(
+ methods=["PUT"],
+ summary=_("Change password"),
+ description=_("Change password"),
+ operation_id=_("Change password"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=DeleteUserApi.get_parameters(),
+ request=ChangeUserPasswordApi.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(
+ menu="User management",
+ operate="Change password",
+ get_operation_object=lambda r, k: get_user_operation_object(k.get("user_id")),
+ get_details=get_re_password_details,
+ )
@has_permissions(PermissionConstants.USER_EDIT, RoleConstants.ADMIN)
def put(self, request: Request, user_id):
return result.success(
- UserManageSerializer.Operate(data={'id': user_id}).re_password(request.data, with_valid=True))
+ UserManageSerializer.Operate(data={"id": user_id}).re_password(request.data, with_valid=True)
+ )
class Page(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['GET'],
- summary=_("Get user paginated list"),
- description=_("Get user paginated list"),
- operation_id=_("Get user paginated list"), # type: ignore
- tags=[_("User Management")], # type: ignore
- parameters=UserPageApi.get_parameters(),
- responses=UserPageApi.get_response())
+ @extend_schema(
+ methods=["GET"],
+ summary=_("Get user paginated list"),
+ description=_("Get user paginated list"),
+ operation_id=_("Get user paginated list"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ parameters=UserPageApi.get_parameters(),
+ responses=UserPageApi.get_response(),
+ )
@has_permissions(PermissionConstants.USER_READ, RoleConstants.ADMIN)
def get(self, request: Request, current_page, page_size):
- d = UserManageSerializer.Query(
- data={**query_params_to_single_dict(request.query_params)})
+ d = UserManageSerializer.Query(data={**query_params_to_single_dict(request.query_params)})
return result.success(d.page(current_page, page_size, str(request.user.id)))
class RePasswordView(APIView):
-
- @extend_schema(methods=['POST'],
- summary=_("Change password"),
- description=_("Change password"),
- operation_id=_("Change password"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=ResetPasswordAPI.get_request(),
- responses=DefaultModelResponse.get_response())
- @log(menu='User management', operate='Change password',
- get_operation_object=lambda r, k: {'name': r.user.username},
- get_details=get_re_password_details)
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Change password"),
+ description=_("Change password"),
+ operation_id=_("Change password"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=ResetPasswordAPI.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(
+ menu="User management",
+ operate="Change password",
+ get_operation_object=lambda r, k: {"name": r.user.username},
+ get_details=get_re_password_details,
+ )
def post(self, request: Request):
request_data = request.data
if request_data.get("encrypted", False):
- request_data['password'] = decrypt(request_data.get('password'))
- request_data['re_password'] = decrypt(request_data.get('re_password'))
+ request_data["password"] = decrypt(request_data.get("password"))
+ request_data["re_password"] = decrypt(request_data.get("re_password"))
serializer_obj = RePasswordSerializer(data=request_data)
return result.success(serializer_obj.reset_password())
class SendEmail(APIView):
-
- @extend_schema(methods=['POST'],
- summary=_("Send email"),
- description=_("Send email"),
- operation_id=_("Send email"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=SendEmailAPI.get_request(),
- responses=SendEmailAPI.get_response())
- @log(menu='User management', operate='Send email',
- get_operation_object=lambda r, k: {'name': r.data.get('email', None)},
- get_user=lambda r: {'user_name': None, 'email': r.data.get('email', None)})
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Send email"),
+ description=_("Send email"),
+ operation_id=_("Send email"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=SendEmailAPI.get_request(),
+ responses=SendEmailAPI.get_response(),
+ )
+ @log(
+ menu="User management",
+ operate="Send email",
+ get_operation_object=lambda r, k: {"name": r.data.get("email", None)},
+ get_user=lambda r: {"user_name": None, "email": r.data.get("email", None)},
+ )
def post(self, request: Request):
serializer_obj = SendEmailSerializer(data=request.data)
if serializer_obj.is_valid(raise_exception=True):
return result.success(serializer_obj.send())
-class CheckCode(APIView):
-
- @extend_schema(methods=['POST'],
- summary=_("Check whether the verification code is correct"),
- description=_("Check whether the verification code is correct"),
- operation_id=_("Check whether the verification code is correct"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=CheckCodeAPI.get_request(),
- responses=CheckCodeAPI.get_response())
- @log(menu='User management', operate='Check whether the verification code is correct',
- get_operation_object=lambda r, k: {'name': r.data.get('email', None)},
- get_user=lambda r: {'user_name': None, 'email': r.data.get('email', None)})
- def post(self, request: Request):
- return result.success(CheckCodeSerializer(data=request.data).is_valid(raise_exception=True))
-
-
class SendEmailToCurrentUserView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- summary=_("Send email to current user"),
- description=_("Send email to current user"),
- operation_id=_("Send email to current user"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=SendEmailAPI.get_request(),
- responses=SendEmailAPI.get_response())
- @log(menu='User management', operate='Send email to current user',
- get_operation_object=lambda r, k: {'name': r.user.username})
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Send email to current user"),
+ description=_("Send email to current user"),
+ operation_id=_("Send email to current user"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=SendEmailAPI.get_request(),
+ responses=SendEmailAPI.get_response(),
+ )
+ @log(
+ menu="User management",
+ operate="Send email to current user",
+ get_operation_object=lambda r, k: {"name": r.user.username},
+ )
def post(self, request: Request):
- serializer_obj = SendEmailSerializer(data={'email': request.user.email, 'type': "reset_password"})
+ serializer_obj = SendEmailSerializer(data={"email": request.user.email, "type": "reset_password"})
if serializer_obj.is_valid(raise_exception=True):
return result.success(serializer_obj.send())
@@ -370,18 +453,24 @@ def post(self, request: Request):
class ResetCurrentUserPasswordView(APIView):
authentication_classes = [TokenAuth]
- @extend_schema(methods=['POST'],
- summary=_("Modify current user password"),
- description=_("Modify current user password"),
- operation_id=_("Modify current user password"), # type: ignore
- tags=[_("User Management")], # type: ignore
- request=ResetPasswordAPI.get_request(),
- responses=DefaultModelResponse.get_response())
- @log(menu='User management', operate='Modify current user password',
- get_operation_object=lambda r, k: {'name': r.user.username},
- get_details=get_re_password_details)
- @has_permissions(PermissionConstants.CHANGE_PASSWORD, RoleConstants.ADMIN, RoleConstants.USER,
- RoleConstants.WORKSPACE_MANAGE)
+ @extend_schema(
+ methods=["POST"],
+ summary=_("Modify current user password"),
+ description=_("Modify current user password"),
+ operation_id=_("Modify current user password"), # type: ignore
+ tags=[_("User Management")], # type: ignore
+ request=ResetPasswordAPI.get_request(),
+ responses=DefaultModelResponse.get_response(),
+ )
+ @log(
+ menu="User management",
+ operate="Modify current user password",
+ get_operation_object=lambda r, k: {"name": r.user.username},
+ get_details=get_re_password_details,
+ )
+ @has_permissions(
+ PermissionConstants.CHANGE_PASSWORD, RoleConstants.ADMIN, RoleConstants.USER, RoleConstants.WORKSPACE_MANAGE
+ )
def post(self, request: Request):
request_data = request.data
encrypted_data = request_data.get("encryptedData", "")
@@ -392,7 +481,7 @@ def post(self, request: Request):
decrypted_data = json.loads(decrypted_raw) if decrypted_raw else {}
if isinstance(decrypted_data, dict):
request_data = decrypted_data
- except Exception as e:
+ except Exception:
raise AppApiException(500, _("Invalid encrypted data"))
serializer_obj = ResetCurrentUserPassword(data=request_data)
if serializer_obj.reset_password(request.user.id):
diff --git a/installer/Dockerfile b/installer/Dockerfile
index ff890c6dbdf..b57bd2e188d 100644
--- a/installer/Dockerfile
+++ b/installer/Dockerfile
@@ -6,7 +6,7 @@ RUN cd ui && ls -la && if [ -d "dist" ]; then exit 0; fi && \
NODE_OPTIONS="--max-old-space-size=4096" npx concurrently "npm run build" "npm run build-chat" && \
find . -maxdepth 1 ! -name '.' ! -name 'dist' ! -name 'public' -exec rm -rf {} +
-FROM ghcr.io/1panel-dev/maxkb-base:python3.11-pg17.10-20260525 AS stage-build
+FROM ghcr.io/1panel-dev/maxkb-base:python3.13-pg17.11-20260902 AS stage-build
COPY --chmod=700 . /opt/maxkb-app
RUN apt-get update && \
apt-get install -y --no-install-recommends gcc g++ gettext libexpat1-dev libffi-dev && \
@@ -24,7 +24,7 @@ RUN gcc -shared -fPIC -o ${MAXKB_SANDBOX_HOME}/lib/sandbox.so /opt/maxkb-app/ins
rm -rf /opt/maxkb-app/installer
COPY --from=web-build --chmod=700 ui /opt/maxkb-app/ui
-FROM ghcr.io/1panel-dev/maxkb-base:python3.11-pg17.10-20260525
+FROM ghcr.io/1panel-dev/maxkb-base:python3.13-pg17.11-20260902
ARG DOCKER_IMAGE_TAG=dev \
BUILD_AT \
GITHUB_COMMIT
@@ -45,6 +45,10 @@ ENV MAXKB_VERSION="${DOCKER_IMAGE_TAG} (build at ${BUILD_AT}, commit: ${GITHUB_C
MAXKB_LOCAL_MODEL_HOST=127.0.0.1 \
MAXKB_LOCAL_MODEL_PORT=11636 \
MAXKB_LOCAL_MODEL_PROTOCOL=http \
+ MAXKB_S3_ACCESS_KEY=${SEAWEEDFS_ACCESS_KEY} \
+ MAXKB_S3_SECRET_KEY=${SEAWEEDFS_SECRET_KEY} \
+ MAXKB_S3_ENDPOINT=${SEAWEEDFS_S3_ENDPOINT} \
+ MAXKB_S3_BUCKET=${SEAWEEDFS_S3_BUCKET} \
PIP_TARGET=/opt/maxkb/python-packages
WORKDIR /opt/maxkb-app
diff --git a/installer/Dockerfile-base b/installer/Dockerfile-base
index e739618cbf8..d4feee79de5 100644
--- a/installer/Dockerfile-base
+++ b/installer/Dockerfile-base
@@ -1,9 +1,11 @@
-FROM python:3.11-slim-trixie AS python-stage
+FROM python:3.13-slim-trixie AS python-stage
RUN python3 -m venv /opt/py3
FROM ghcr.io/1panel-dev/maxkb-vector-model:v2.0.3 AS vector-model
-FROM postgres:17.10-trixie
+FROM chrislusf/seaweedfs:4.36 AS seaweedfs-stage
+
+FROM postgres:17.11-trixie
COPY --from=python-stage /usr/local /usr/local
COPY --from=python-stage /opt/py3 /opt/py3
COPY --chmod=500 installer/*.sh /usr/bin/
@@ -34,6 +36,7 @@ RUN ln -sf /usr/share/zoneinfo/Asia/Shanghai /etc/localtime && \
apt-get clean all && \
rm -rf /var/lib/postgresql /var/lib/apt/lists/* /usr/share/doc/* /usr/share/man/* /usr/share/info/* /usr/share/locale/* /usr/share/lintian/* /usr/share/linda/* /var/cache/* /var/log/* /var/tmp/* /tmp/*
COPY --from=vector-model --chmod=700 /opt/maxkb-app/model /opt/maxkb-app/model
+COPY --from=seaweedfs-stage --chmod=755 /usr/bin/weed /usr/local/bin/weed
ENV PATH=/opt/py3/bin:$PATH \
PGDATA=/opt/maxkb/data/postgresql/pgdata \
@@ -47,8 +50,11 @@ ENV PATH=/opt/py3/bin:$PATH \
MAXKB_LOG_LEVEL=INFO \
MAXKB_SANDBOX=1 \
MAXKB_SANDBOX_HOME=/opt/maxkb-app/sandbox \
- MAXKB_SANDBOX_PYTHON_PACKAGE_PATHS="/opt/py3/lib/python3.11/site-packages,/opt/maxkb-app/sandbox/python-packages,/opt/maxkb/python-packages" \
+ MAXKB_SANDBOX_PYTHON_PACKAGE_PATHS="/opt/py3/lib/python3.13/site-packages,/opt/maxkb-app/sandbox/python-packages,/opt/maxkb/python-packages" \
MAXKB_SANDBOX_PYTHON_BANNED_HOSTS="127.0.0.0/8,localhost,host.docker.internal,172.17.0.0/16,maxkb,pgsql,redis,172.31.250.192/26,0.0.0.0/32,::/0" \
- MAXKB_ADMIN_PATH=/admin
-
-EXPOSE 6379
\ No newline at end of file
+ MAXKB_ADMIN_PATH=/admin \
+ SEAWEEDFS_ACCESS_KEY=seaweedfsadmin \
+ SEAWEEDFS_SECRET_KEY=seaweedfsadmin \
+ SEAWEEDFS_VOLUMES=/opt/maxkb/data/seaweedfs \
+ SEAWEEDFS_S3_BUCKET=maxkb \
+ SEAWEEDFS_S3_ENDPOINT=http://127.0.0.1:8333
diff --git a/installer/Dockerfile-vector-model b/installer/Dockerfile-vector-model
index 6001ace553e..4de711c9fcb 100644
--- a/installer/Dockerfile-vector-model
+++ b/installer/Dockerfile-vector-model
@@ -1,4 +1,4 @@
-#FROM python:3.11-slim-bookworm AS vector-model
+#FROM python:3.13-slim-bookworm AS vector-model
#COPY installer/install_model.py install_model.py
#RUN pip3 install --upgrade pip setuptools && \
# pip install pycrawlers && \
@@ -10,7 +10,7 @@
# 不知道为什么用上面的脚本重新拉一遍向量模型比之前的大很多,所以还是用下面的脚本复用原来已经构建好的向量模型
-FROM python:3.11-slim-bookworm AS tmp-stage1
+FROM python:3.13-slim-bookworm AS tmp-stage1
COPY installer/install_model_bert_base_cased.py install_model_bert_base_cased.py
RUN pip3 install --upgrade pip setuptools && \
pip install pycrawlers && \
diff --git a/installer/sandbox.c b/installer/sandbox.c
index cd652f8dc27..e255d4f7e6e 100644
--- a/installer/sandbox.c
+++ b/installer/sandbox.c
@@ -325,6 +325,11 @@ int execve(const char *filename, char *const argv[], char *const envp[]) {
int __execve(const char *filename, char *const argv[], char *const envp[]) {
return execve(filename, argv, envp);
}
+int fexecve(int fd, char *const argv[], char *const envp[]) {
+ RESOLVE_REAL(fexecve);
+ if (!allow_create_subprocess()) return throw_permission_denied_err(true, "create subprocess");
+ return real_fexecve(fd, argv, envp);
+}
int execveat(int dirfd, const char *pathname,
char *const argv[], char *const envp[], int flags) {
RESOLVE_REAL(execveat);
@@ -472,7 +477,6 @@ static int allow_access_syscall() {
ensure_config_loaded();
return allow_syscall || !is_sandbox_user();
}
-long (*real_syscall)(long, ...) = NULL;
long syscall(long number, ...) {
RESOLVE_REAL(syscall);
va_list ap;
@@ -553,25 +557,12 @@ long syscall(long number, ...) {
/**
* 限制加载动态链接库
*/
-static int called_from_python_import() {
- if (allow_dl_open) return 1;
- void *buf[32];
- int n = backtrace(buf, 32);
- for (int i = 0; i < n; i++) {
- Dl_info info;
- if (dladdr(buf[i], &info) && info.dli_sname) {
- if (strstr(info.dli_sname, "PyImport") || strstr(info.dli_sname, "_PyImport")) {
- return 1;
- }
- }
- }
- throw_permission_denied_err(true, "open dynamic link library");
- return 0;
-}
static int is_allow_dl(const char *filename) {
ensure_config_loaded();
- if (!called_from_python_import()) return 0;
if (!filename || !*filename) return 1;
+ if (!allow_dl_open && strstr(filename, "_ctypes")) { // 不允许使用ctypes
+ throw_permission_denied_err(true, "open dynamic link library");
+ }
if (!allow_dl_paths || !*allow_dl_paths) return 0;
char real_file[PATH_MAX];
if (strchr(filename, '/') == NULL) {
diff --git a/installer/start-all.sh b/installer/start-all.sh
index 0011e9e04d8..00ffee24ec0 100644
--- a/installer/start-all.sh
+++ b/installer/start-all.sh
@@ -25,6 +25,14 @@ if [ "$MAXKB_REDIS_HOST" = "127.0.0.1" ]; then
wait-for-it 127.0.0.1:6379 --timeout=60 --strict -- echo -e "\033[1;32mRedis started.\033[0m"
fi
+if [ "$MAXKB_S3_ENDPOINT" = "http://127.0.0.1:8333" ]; then
+ echo -e "\033[1;32mSeaweedFS starting...\033[0m"
+ /usr/bin/start-seaweedfs.sh &
+ seaweedfs_pid=$!
+ sleep 3
+ wait-for-it 127.0.0.1:8333 --timeout=60 --strict -- echo -e "\033[1;32mSeaweedFS started.\033[0m"
+fi
+
echo -e "\033[1;32mMaxKB starting...\033[0m"
/usr/bin/start-maxkb.sh &
maxkb_pid=$!
@@ -33,5 +41,5 @@ wait-for-it 127.0.0.1:8080 --timeout=180 --strict -- echo -e "\033[1;32mMaxKB st
wait -n
echo -e "\033[1;31mSystem is shutting down.\033[0m"
-kill $postgres_pid $redis_pid $maxkb_pid 2>/dev/null
+kill $postgres_pid $redis_pid $seaweedfs_pid $maxkb_pid 2>/dev/null
wait
\ No newline at end of file
diff --git a/installer/start-seaweedfs.sh b/installer/start-seaweedfs.sh
new file mode 100644
index 00000000000..aa0f4197dd9
--- /dev/null
+++ b/installer/start-seaweedfs.sh
@@ -0,0 +1,15 @@
+#!/bin/bash
+
+set -e
+
+mkdir -p "${SEAWEEDFS_VOLUMES:-/opt/maxkb/data/seaweedfs}"
+
+S3_ENDPOINT="${SEAWEEDFS_S3_ENDPOINT:-http://127.0.0.1:8333}"
+S3_PORT="${S3_ENDPOINT##*:}"
+
+AWS_ACCESS_KEY_ID="${SEAWEEDFS_ACCESS_KEY:-seaweedfsadmin}" \
+AWS_SECRET_ACCESS_KEY="${SEAWEEDFS_SECRET_KEY:-seaweedfsadmin}" \
+S3_BUCKET="${SEAWEEDFS_S3_BUCKET:-maxkb}" \
+/usr/local/bin/weed mini \
+ -dir="${SEAWEEDFS_VOLUMES:-/opt/maxkb/data/seaweedfs}" \
+ -s3.port="$S3_PORT"
diff --git a/main.py b/main.py
index a3458e0a04c..8bc9e3e711c 100644
--- a/main.py
+++ b/main.py
@@ -6,14 +6,24 @@
import django
from django.core import management
+from django.core.management.utils import get_random_secret_key
+
+import warnings
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
-APP_DIR = os.path.join(BASE_DIR, 'apps')
+APP_DIR = os.path.join(BASE_DIR, "apps")
os.chdir(BASE_DIR)
sys.path.insert(0, APP_DIR)
os.environ.setdefault("DJANGO_SETTINGS_MODULE", "maxkb.settings")
+# 忽略 pydub / jieba / celery 等依赖的语法警告, 3.14中已经是Error
+# 注意: module= 对编译期触发的 SyntaxWarning 不生效, 需按 message 匹配
+# 用 PYTHONWARNINGS 而不仅是 warnings.filterwarnings, 因为 celery worker
+# 是独立子进程, 只有环境变量才能被继承, filterwarnings 只对当前进程生效
+os.environ.setdefault("PYTHONWARNINGS", "ignore::SyntaxWarning")
+warnings.filterwarnings("ignore", category=SyntaxWarning, message="invalid escape sequence")
+
def collect_static():
"""
@@ -23,7 +33,7 @@ def collect_static():
"""
logging.info("Collect static files")
try:
- management.call_command('collectstatic', '--no-input', '-c', verbosity=0, interactive=False)
+ management.call_command("collectstatic", "--no-input", "-c", verbosity=0, interactive=False)
logging.info("Collect static files done")
except:
pass
@@ -41,24 +51,24 @@ def perform_db_migrate():
retry_interval = 5 # seconds
for attempt in range(1, max_retries + 1):
try:
- management.call_command('migrate')
+ management.call_command("migrate")
return
except Exception as e:
err_msg = str(e)
# 判断是否为数据库仍在启动中(崩溃恢复场景)
is_db_starting = (
- 'the database system is starting up' in err_msg
- or 'starting up' in err_msg
- or 'Connection refused' in err_msg
+ "the database system is starting up" in err_msg
+ or "starting up" in err_msg
+ or "Connection refused" in err_msg
)
if is_db_starting and attempt < max_retries:
logging.warning(
- f'Database is not ready yet (attempt {attempt}/{max_retries}), '
- f'retrying in {retry_interval}s... Error: {err_msg}'
+ f"Database is not ready yet (attempt {attempt}/{max_retries}), "
+ f"retrying in {retry_interval}s... Error: {err_msg}"
)
time.sleep(retry_interval)
else:
- logging.error('Perform migrate failed, exit', exc_info=True)
+ logging.error("Perform migrate failed, exit", exc_info=True)
sys.exit(11)
@@ -66,20 +76,20 @@ def start_services():
services = args.services if isinstance(args.services, list) else [args.services]
start_args = []
if args.daemon:
- start_args.append('--daemon')
+ start_args.append("--daemon")
if args.force:
- start_args.append('--force')
+ start_args.append("--force")
if args.worker:
- start_args.extend(['--worker', str(args.worker)])
+ start_args.extend(["--worker", str(args.worker)])
else:
- worker = os.environ.get('MAXKB_CORE_WORKER')
+ worker = os.environ.get("MAXKB_CORE_WORKER")
if isinstance(worker, str) and worker.isdigit():
- start_args.extend(['--worker', worker])
+ start_args.extend(["--worker", worker])
try:
management.call_command(action, *services, *start_args)
except KeyboardInterrupt:
- logging.info('Cancel ...')
+ logging.info("Cancel ...")
time.sleep(2)
except Exception as exc:
logging.error("Start service error {}: {}".format(services, exc))
@@ -88,19 +98,22 @@ def start_services():
def dev():
services = args.services if isinstance(args.services, list) else args.services
- if services.__contains__('web'):
- management.call_command('runserver', "0.0.0.0:8080")
- elif services.__contains__('celery'):
- management.call_command('celery', 'celery')
- elif services.__contains__('local_model'):
+ if services.__contains__("web"):
+ management.call_command("runserver", "0.0.0.0:8080")
+ elif services.__contains__("celery"):
+ management.call_command("celery", "celery")
+ elif services.__contains__("local_model"):
from maxkb.const import CONFIG
- bind = f'{CONFIG.get("LOCAL_MODEL_HOST")}:{CONFIG.get("LOCAL_MODEL_PORT")}'
- management.call_command('runserver', bind)
+
+ bind = f"{CONFIG.get('LOCAL_MODEL_HOST')}:{CONFIG.get('LOCAL_MODEL_PORT')}"
+ management.call_command("runserver", bind)
-if __name__ == '__main__':
- os.environ['HF_HOME'] = '/opt/maxkb-app/model/base'
- os.environ['TMPDIR'] = '/opt/maxkb-app/tmp'
+if __name__ == "__main__":
+ os.environ["HF_HOME"] = "/opt/maxkb-app/model/base"
+ os.environ["TMPDIR"] = "/opt/maxkb-app/tmp"
+ if not os.environ.get('MAXKB_SECRET_KEY'):
+ os.environ['MAXKB_SECRET_KEY'] = get_random_secret_key()
parser = argparse.ArgumentParser(
description="""
qabot service control tools;
@@ -111,33 +124,34 @@ def dev():
"""
)
parser.add_argument(
- 'action', type=str,
- choices=("start", "dev", "upgrade_db", "collect_static"),
- help="Action to run"
+ "action", type=str, choices=("start", "dev", "upgrade_db", "collect_static"), help="Action to run"
)
args, e = parser.parse_known_args()
parser.add_argument(
- "services", type=str, default='all' if args.action == 'start' else 'web', nargs="*",
- choices=("all", "web", "task") if args.action == 'start' else ("web", "celery", 'local_model'),
+ "services",
+ type=str,
+ default="all" if args.action == "start" else "web",
+ nargs="*",
+ choices=("all", "web", "task") if args.action == "start" else ("web", "celery", "local_model"),
help="The service to start",
)
- parser.add_argument('-d', '--daemon', nargs="?", const=True)
- parser.add_argument('-w', '--worker', type=int, nargs="?")
- parser.add_argument('-f', '--force', nargs="?", const=True)
+ parser.add_argument("-d", "--daemon", nargs="?", const=True)
+ parser.add_argument("-w", "--worker", type=int, nargs="?")
+ parser.add_argument("-f", "--force", nargs="?", const=True)
args = parser.parse_args()
action = args.action
services = args.services if isinstance(args.services, list) else args.services
- if services.__contains__('web'):
- os.environ.setdefault('SERVER_NAME', 'web')
- elif services.__contains__('local_model'):
- os.environ.setdefault('SERVER_NAME', 'local_model')
+ if services.__contains__("web"):
+ os.environ.setdefault("SERVER_NAME", "web")
+ elif services.__contains__("local_model"):
+ os.environ.setdefault("SERVER_NAME", "local_model")
django.setup()
if action == "upgrade_db":
perform_db_migrate()
elif action == "collect_static":
collect_static()
- elif action == 'dev':
+ elif action == "dev":
collect_static()
perform_db_migrate()
dev()
diff --git a/pyproject.toml b/pyproject.toml
index bc0e07139df..0a856b7d707 100644
--- a/pyproject.toml
+++ b/pyproject.toml
@@ -3,69 +3,83 @@ name = "maxkb"
version = "2.0.0"
description = "强大易用的开源企业级智能体平台"
authors = [{ name = "shaohuzhang1", email = "shaohu.zhang@fit2cloud.com" }]
-requires-python = "~=3.11.0"
+requires-python = "~=3.13.0"
readme = "README.md"
dependencies = [
- "django==5.2.14",
- "drf-spectacular[sidecar]==0.28.0",
- "django-redis==6.0.0",
+ # Web framework & API
+ "django==6.1.1",
+ "djangorestframework==3.18.1",
+ "drf-spectacular[sidecar]==0.30.0",
+
+ # Django ecosystem
+ "django-apscheduler==0.7.0",
"django-db-connection-pool==1.2.6",
- "django-mptt==0.17.0",
- "djangorestframework==3.17.1",
- "psycopg[binary]==3.2.9",
- "python-dotenv==1.2.2",
- "uuid-utils==0.14.0",
- "captcha==0.7.1",
- "pytz==2025.2",
- "psutil==7.0.0",
- "beautifulsoup4==4.13.4",
- "jieba==0.42.1",
- "langchain==1.3.10",
- "langchain-core==1.4.8",
- "langchain-openai==1.3.2",
- "langchain-anthropic==1.4.6",
- "langchain-community==0.4.2",
- "langchain-deepseek==1.1.0",
- "langchain-google-genai==4.2.5",
- "langchain-mcp-adapters==0.3.0",
+ "django-mptt==0.18.0",
+ "django-redis==7.0.0",
+
+ # AI orchestration & model frameworks
+ "deepagents==0.7.15",
+ "langchain==1.4.1",
+ "langchain-anthropic==1.7.2",
+ "langchain-aws==1.7.8",
+ "langchain-core==1.6.3",
+ "langchain-google-genai==4.4.0",
"langchain-huggingface==1.2.2",
+ "langchain-mcp-adapters==0.3.2",
"langchain-ollama==1.1.0",
- "langchain-aws==1.6.0",
- "langgraph==1.2.6",
- "deepagents==0.6.11",
- "torch==2.12.1",
- "numpy==1.26.4",
- "sentence-transformers==5.0.0",
+ "langchain-openai==1.6.2",
+ "langgraph==1.2.11",
+ "torch==2.13.0",
+ "sentence-transformers==6.0.1",
+ "xinference-client==3.4.0",
+
+ # Model providers & cloud SDKs
+ "boto3==1.43.96",
+ "cohere==7.1.1",
+ "dashscope==1.27.5",
"qianfan==0.4.12.3",
+ "tencentcloud-sdk-python-common==3.1.176",
+ "tencentcloud-sdk-python-hunyuan==3.1.56",
+ "tencentcloud-sdk-python-asr==3.1.172",
+ "volcengine-python-sdk[ark]==5.0.49",
"zai-sdk==0.2.3",
- "volcengine-python-sdk[ark]==5.0.24",
- "boto3==1.42.46",
- "tencentcloud-sdk-python==3.0.1420",
- "xinference-client==1.7.1.post1",
- "anthropic==0.96.0",
- "dashscope==1.25.16",
- "celery[sqlalchemy]==5.5.3",
- "django-celery-beat==2.8.1",
+
+ # Database, cache & async task queue
+ "celery[sqlalchemy]==5.6.3",
"celery-once==3.0.1",
- "django-apscheduler==0.7.0",
+ "psycopg[binary]==3.3.5",
+
+ # Document & media processing
+ "audioop-lts==0.2.2",
+ "beautifulsoup4==4.15.0",
+ "jieba==0.42.1",
+ "markdownify==1.2.3",
"openpyxl==3.1.5",
+ "pydub==0.25.1",
+ "pypdf==6.19.0",
+ "pysilk==0.0.1",
"python-docx==1.2.0",
"xlrd==2.0.2",
"xlwt==1.3.0",
- "pypdf==6.13.3",
- "pydub==0.25.1",
- "pysilk==0.0.1",
- "gunicorn==23.0.0",
- "python-daemon==3.1.2",
- "websockets==15.0.1",
- "ruff==0.15.12",
- "cohere==5.17.0",
+
+ # Runtime, utility & security
+ "captcha==0.7.1",
+ "cryptography==50.0.1",
"jsonpath-ng==1.8.0",
- "markdownify==1.2.2",
"polib==1.2.0",
- "cryptography==48.0.1"
+ "psutil==7.2.2",
+ "python-daemon==3.1.2",
+ "python-dotenv==1.2.3",
+ "pytz==2026.3.post1",
+
+ # Server & development tools
+ "gunicorn==26.2.0",
+ "ruff==0.15.21",
]
+[dependency-groups]
+dev = ["pre-commit==4.6.2"]
+
[tool.uv]
package = false
@@ -82,7 +96,7 @@ explicit = true
[tool.uv.sources]
torch = [
{ index = "pytorch", marker = "sys_platform == 'linux'" },
- { index = "pytorch", marker = "sys_platform == 'win'" },
+ { index = "pytorch", marker = "sys_platform == 'win32'" },
{ index = "macpytorch", marker = "sys_platform == 'darwin'" },
]
diff --git a/ui/.editorconfig b/ui/.editorconfig
index 5a5809dbeff..0ab3c174e72 100644
--- a/ui/.editorconfig
+++ b/ui/.editorconfig
@@ -4,6 +4,5 @@ indent_size = 2
indent_style = space
insert_final_newline = true
trim_trailing_whitespace = true
-
end_of_line = lf
-max_line_length = 100
+max_line_length = 150
diff --git a/ui/.gitignore b/ui/.gitignore
index 8ee54e8d343..901380290e0 100644
--- a/ui/.gitignore
+++ b/ui/.gitignore
@@ -14,9 +14,6 @@ dist-ssr
coverage
*.local
-/cypress/videos/
-/cypress/screenshots/
-
# Editor directories and files
.vscode/*
!.vscode/extensions.json
@@ -28,3 +25,16 @@ coverage
*.sw?
*.tsbuildinfo
+
+.eslintcache
+
+# Cypress
+/cypress/videos/
+/cypress/screenshots/
+
+# Vitest
+__screenshots__/
+
+# Vite
+*.timestamp-*-*.mjs
+
diff --git a/ui/.oxlintrc.json b/ui/.oxlintrc.json
new file mode 100644
index 00000000000..d5648b966b8
--- /dev/null
+++ b/ui/.oxlintrc.json
@@ -0,0 +1,10 @@
+{
+ "$schema": "./node_modules/oxlint/configuration_schema.json",
+ "plugins": ["eslint", "typescript", "unicorn", "oxc", "vue"],
+ "env": {
+ "browser": true
+ },
+ "categories": {
+ "correctness": "error"
+ }
+}
diff --git a/ui/.prettierignore b/ui/.prettierignore
new file mode 100644
index 00000000000..e34ce3480e9
--- /dev/null
+++ b/ui/.prettierignore
@@ -0,0 +1,2 @@
+src/assets/iconfont.js
+src/components.d.ts
diff --git a/ui/.prettierrc.json b/ui/.prettierrc.json
index 29a2402ef05..cd3e24731f3 100644
--- a/ui/.prettierrc.json
+++ b/ui/.prettierrc.json
@@ -2,5 +2,5 @@
"$schema": "https://json.schemastore.org/prettierrc",
"semi": false,
"singleQuote": true,
- "printWidth": 100
+ "printWidth": 150
}
diff --git a/ui/AGENTS.md b/ui/AGENTS.md
new file mode 100644
index 00000000000..ebcc08e79ce
--- /dev/null
+++ b/ui/AGENTS.md
@@ -0,0 +1,228 @@
+# MaxKB v3 Frontend
+
+This document is for frontend agents working in the `ui/` project.
+
+## Documentation Workflow
+
+`AGENTS.md` is the Codex-maintained entry point for project-wide instructions. It provides the project overview, shared conventions, and an index of topic-specific rule documents; it does not replace the detailed rules owned by those documents.
+
+Before making changes, determine which areas the task touches and read the corresponding rule documents:
+
+- Styles: `src/styles/STYLE_README.md` is the source of truth for styling rules.
+- Router: `src/router/ROUTE_README.md` is the source of truth for routing rules.
+- Components: `src/components/COMPONENT_README.md` is the source of truth for component rules.
+- Constants: `src/constants/CONSTANT_README.md` is the source of truth for shared constant rules.
+- Utilities: `src/utils/UTILS_README.md` is the source of truth for shared utility rules.
+- API: `src/api/API_README.md` is the source of truth for request infrastructure, business API
+ organization, and API type ownership.
+- Views: `src/views/VIEW_README.md` is the source of truth for page responsibilities and
+ feature-local code organization.
+- Workflow canvas: `src/workflow-canvas/WORKFLOW_README.md` is the source of truth for LogicFlow canvas
+ responsibilities, configuration boundaries, node maintenance, and View integration.
+
+Follow this maintenance flow:
+
+1. Use `AGENTS.md` to understand the project-wide context and locate applicable rule documents.
+2. Read every applicable rule document before implementing or reviewing changes in that area.
+3. Keep detailed, area-specific guidance in its owning README; keep only the summary and document index in `AGENTS.md`.
+4. When a new area-specific rule README is added, append it to the list above and reference it in the relevant project-structure or responsibility section of `AGENTS.md`.
+5. When a rule changes, update its owning README and adjust the summary in `AGENTS.md` only when the project-wide guidance or index also changes.
+
+## Stack
+
+- Vue 3.5 with `
+
+
-
+
+
+
diff --git a/ui/src/api/API_README.md b/ui/src/api/API_README.md
new file mode 100644
index 00000000000..e5069812ed6
--- /dev/null
+++ b/ui/src/api/API_README.md
@@ -0,0 +1,424 @@
+# API 目录说明
+
+`src/api` 负责前端与服务端之间的通信,按照应用入口隔离 Admin 与 Chat 请求体系。
+Admin 与 Chat 分别维护请求客户端和业务接口。
+
+```text
+src/api/
+├── constants.ts # Admin 与 Chat 的 API base 路径常量
+├── admin/
+│ ├── file.ts # 通用文件上传、进度与取消
+│ ├── auth/ # Admin 登录认证与当前用户接口
+│ │ └── types.ts # 认证 API 与认证 Store 共用类型
+│ ├── core/ # Admin 请求基础能力
+│ │ ├── request.ts # Axios 实例、HTTP 方法与统一响应解包
+│ │ └── types.ts # Admin 请求协议类型
+│ ├── system/ # 系统管理业务接口
+│ │ ├── chat-user/ # 对话用户、用户组及认证接口
+│ │ ├── settings/ # 登录认证、邮件与外观设置接口
+│ │ ├── shared-resources/ # System 共享资源接口
+│ │ └── .ts # 其他 System 单资源接口
+│ ├── workspace/ # 工作空间业务接口
+│ │ ├── conversation.ts # 调试对话、历史会话与语音接口
+│ │ ├── application/ # 智能体接口
+│ │ ├── knowledge/ # 知识库接口
+│ │ ├── model/ # 模型接口
+│ │ ├── trigger/ # 触发器查询及维护接口
+│ │ ├── tool/ # 工具、工具工作流及工具商店接口
+│ │ └── .ts # 工作空间公共资源接口
+│ └── provider.ts # Workspace 与 System 共用的模型供应商接口
+├── chat/ # Chat 独立请求体系
+│ ├── core/request.ts # JSON 与流式请求
+│ ├── core/types.ts # Chat 请求协议类型
+│ ├── file.ts # Chat 文件上传、进度与取消
+│ ├── conversation.ts # 正式对话、历史会话与语音接口
+│ └── README.md # Chat API 边界说明
+├── enums/ # 后端固定枚举值
+│ ├── index.ts # API 枚举值的唯一导入入口
+│ └── .ts # 按明确业务域拆分的枚举值
+├── types/ # API 与 View/Component 共用的业务类型
+│ ├── index.ts # API 公共类型的唯一导入入口
+│ ├── common.ts # 多个 API 业务域共用的基础类型
+│ └── .ts # 按明确业务域拆分的共享类型
+└── API_README.md
+```
+
+## 分层职责
+
+- `admin/core` 处理请求发送、协议解析和全局传输错误,通过 Admin Pinia Store 获取 token 与
+ 语言,并统一处理超时、404、401、403 的提示或跳转。
+- `admin/auth`、`admin/workspace` 和 `admin/system` 描述具体业务接口,不管理页面 loading、
+ 消息提示或路由跳转。
+- 页面或 Store 负责 loading、成功提示、特殊业务错误以及请求成功后的状态变更。
+- Chat 的 base URL、鉴权和错误处理独立实现,不复用 Admin 请求客户端。
+
+## 请求版本控制
+
+除 `components/global/mk-infinite-scroll/index.vue` 的滚动加载外,未经用户明确要求,
+不添加 `requestVersion`、请求序号、递增 ID、代次标记等用于忽略旧响应的请求版本控制,
+也不通过改名或封装工具引入同类逻辑。普通请求直接维护数据、loading 和错误处理。
+
+## 业务接口组织
+
+`admin/system/chat-management/portal-setting.ts` 通过 Admin `/portal` 读取和局部保存门户配置,
+公共类型维护在 `types/portal.ts`。JSON 用于访问开关和认证、跨域配置,门户名称与 Logo 使用
+FormData;保存返回完整配置,页面以该返回值作为唯一数据来源。
+认证配置保留未编辑字段,仅提交后端读取的 `login_value`、`max_attempts`、`failed_attempts`、
+`lock_time`;跨域配置写入 `cross_domain_list`(对齐后端 `ApplicationApiKey.cross_domain_list`),
+并保留 `cors_config` 中的其他字段。
+
+- 业务 API 先按 Admin 入口下的 `auth`、`workspace`、`system` 等一级业务域归类。Workspace 和
+ System 内部可继续按明确的功能域建立子目录,例如 `workspace/application/`、
+ `workspace/tool/`、`system/chat-user/` 和 `system/settings/`;不需要分组的单资源接口直接放在
+ 所属一级业务域下。
+- 一类资源的增删改查放在同一个最终资源文件中。调用方直接导入该文件,不为业务目录创建聚合
+ 入口,也不创建汇总所有业务接口的 `api.ts`。
+- 工具基础信息和工具工作流使用后端不同资源接口:`workspace/tool/tool.ts` 维护工具增删改查,
+ `workspace/tool/workflow.ts` 维护工具工作流的加载、保存、发布与调试。
+ 工具工作流保存请求的 `default_model_setting` 与详情响应统一复用 `DefaultModelSettingPayload`。
+- 每个业务接口函数必须添加简短的 JSDoc,说明接口的业务作用;注释应描述“获取什么”“保存什么”
+ 或“对哪个资源执行什么操作”,不重复参数类型、请求方法等代码已经清楚表达的信息。
+- 每个业务接口使用 `const` 声明的箭头函数,不单独具名导出;在文件末尾通过
+ `export default { ... }` 直接默认导出接口对象,不为默认导出声明中间变量。调用方统一按
+ “文件名 PascalCase + `Api`”命名默认导入并通过该对象调用,不创建只做二次转发的聚合入口。
+ 该规则适用于 `admin/auth`、`admin/workspace`、`admin/system` 等业务 API;
+ `admin/core/request.ts` 等请求基础设施可按职责提供具名导出。
+ 例如从 `login.ts` 使用 `import LoginApi from '@/api/admin/auth/login'`,再调用
+ `LoginApi.postLogin()`;System Workspace API 使用
+ `import WorkspaceApi from '@/api/admin/system/workspace'`;System 登录设置使用
+ `import AuthSettingApi from '@/api/admin/system/settings/auth-setting'`。
+
+### 当前账号密码
+
+`admin/auth/current-user.ts` 的 `postCurrentUserPassword` 向 `/user/current/reset_password`
+提交 RSA 加密的 `{ encryptedData }`。头像菜单的 `layout/avatar-dropdown/ChangePasswordDialog.vue`
+负责新密码与确认密码校验、加密和提交,成功后清除本地登录凭据并跳转登录页。
+
+### 四类特殊资源 API
+
+`application`、`knowledge`、`model`、`tool` 是需要同时考虑 Workspace、System 资源管理和
+System 共享资源的四类特殊资源。其接口按真实后端边界分别维护在 `admin/workspace/` 与
+`admin/system/` 下,不把不同范围的 URL 合并为页面侧 API Map,也不让卡片或 Action 根据路由拼接
+System 接口地址。
+
+页面根据路由 `resourceScope` 选择当前范围的完整业务 API 对象,并将其传给需要请求的 Card
+Action、Drawer 或 Dialog。复用方直接使用 `typeof XxxApi` 约束完整 API 对象;不要为每组 Action
+额外维护逐方法接口,例如 `ModelActionApi`,也不要使用不断扩展的 `Pick`。
+完整 API 对象的方法集合不同时,共用组件使用完整对象类型的联合,例如
+`typeof ModelApi | typeof SystemSharedModelApi`,不为凑齐类型添加其他范围不存在的接口。
+仅展示数据的组件不接收 API。
+
+### 工作流发布历史
+
+`workspace/application/workflow.ts` 维护智能体 `application_version` 资源:
+`getWorkflowVersions(applicationId)` 返回按创建时间倒序的完整 `WorkflowVersion[]`;
+`putWorkflowVersion(applicationId, versionId, payload)` 编辑标题与更新说明,返回更新后的版本。
+共用类型 `WorkflowVersion` 和 `WorkflowVersionPayload` 位于 `types/workflow-version.ts`,
+通过 `@/api/types` 导出。`ButtonApplicationPublishHistory` 内部调用智能体版本 API,公共发布历史
+UI 组件只接收数据和事件,不接收 API 或推测其他工作流的接口地址。
+`workspace/tool/workflow.ts` 同时维护工具 `tool_version` 资源,提供
+`getWorkflowVersions(toolId)` 和 `putWorkflowVersion(toolId, versionId, payload)`,
+复用上述版本类型,由 `views/workflow/tool/ButtonPublishHistory.vue` 调用。
+工具版本接口同样尚未支持 `description`,且未返回版本的默认模型配置。
+`workspace/knowledge/workflow.ts` 维护知识库 `knowledge_version` 资源,提供同名查询与编辑方法,
+由知识库 `ButtonPublishHistory.vue` 调用;知识库版本也尚未支持更新说明和默认模型配置。
+
+v3 编辑表单提交 `{ name, description }`,标题上限 64、更新说明上限 1000。
+当前仓库后端的版本编辑序列化器只处理 `name`,列表和详情也未返回 `description`;
+更新说明的持久化与回显需要后端补齐,前端不将智能体自身的 `desc` 当作版本更新说明。
+
+### 智能体模板中心
+
+`admin/store.ts` 的 `getStoreApplicationList(query)` 查询智能体模板,直接返回
+`ApplicationStoreResponse`,不再返回 `unknown`。公共模板元数据为 `api/types/workflow-template.ts` 的 `WorkflowStoreTemplate`,
+智能体 `ApplicationStoreTemplate` 为其类型别名,响应结构仍由 `api/types/application.ts` 维护。
+类型统一经 `@/api/types` 导入;各资源业务入口整理响应字段,公共 UI 不调用接口。
+创建或覆盖工作流时通过已有智能体 API 提交 `work_flow_template`,成功后的刷新与导航由 View 负责。
+
+### 模型选项查询
+
+`workspace/model/model.ts` 的 `getModelListWithShared(query)` 请求
+`/workspace//model_list`,支持 `name`、`model_type`、`model_name` 筛选。
+将 `shared_model` 与 `model` 按共享在前的顺序合并为 `ModelItem[]`,分别标记
+`source: 'shared'` 与 `source: 'workspace'`。`SelectModel` 的接口选项统一通过此方法查询,
+工作流通过 Store 同名方法使用缓存或强制刷新。模型管理列表继续使用 `getModelList`。
+
+### 工具列表查询
+
+`workspace/tool/tool.ts` 的 `getAllTool(query)` 查询支持 `folder_id` 筛选的工作空间工具
+非分页列表,用于文件夹菜单和工具选择弹窗。`getToolListWithShared(query)` 请求 `tool/tool_list`,
+将响应的 `tools` 与 `shared_tools` 合并为 `ToolItem[]`,用于包含已授权共享工具的选项查询;
+按工具类型筛选时使用 `tool_type`。`workspace/shared.ts` 的 `getAllTool(query)` 仅查询共享工具。
+
+### 知识库维护
+
+`getKnowledgeMcpConfig(knowledgeId)` 与 `postKnowledgeKeywordIndex(knowledgeId)` 为预留接口方法,
+目前不发送 HTTP 请求:前者返回空配置文本,后者模拟成功。后续确认后端协议后替换方法内部实现。
+MCP 入口加载配置后打开只读及复制弹窗;分词索引入口仅调用方法并在成功后提示“操作成功”。
+
+`exportKnowledgeExcel`、`exportKnowledgeZip`、`exportKnowledge` 分别通过 GET 请求知识库
+`//export`、`export_zip`、`export_knowledge`,复用 `getExportFile` 下载。
+三种结果分别为文档 Excel、包含图片的文档 ZIP 和可导入创建的知识库 ZIP;优先使用服务端文件名。
+
+`postKnowledgeImport(file, folderId)` 将文件与 `folder_id` 组装为 FormData,POST 到
+`/workspace//knowledge/import_knowledge`,响应为 `{ knowledge_id, type }`。
+后端校验知识库导出包并创建资源;导入成功后的用户权限和列表刷新由调用页面负责。
+
+`workspace/knowledge/knowledge.ts` 与 `workspace/shared.ts` 的 `getAllKnowledge(query)`
+分别查询工作空间及共享知识库的非分页列表,返回 `KnowledgeItem[]`,用于关联知识库选择等
+需要全量选项的场景。原有 `getKnowledgePage` 继续用于分页列表。
+
+`workspace/knowledge/knowledge.ts` 的 `putKnowledge` 更新普通知识库,`putLarkKnowledge`
+更新飞书知识库;单项转移提交 `folder_id`。`putBatchMoveKnowledge` 将知识库 ID 数组和目标目录
+组装为 `{ id_list, folder_id }`,`putBatchDeleteKnowledge` 将 ID 数组组装为 `{ id_list }`,
+分别使用 PUT 请求 `batch_move` 和 `batch_delete`。页面和 Action 负责类型判断及 loading。
+
+`putReEmbeddingKnowledge` 使用 PUT 请求 `//embedding` 重新向量化。
+设置页更换向量模型时先确认、保存,再调用该接口;Web、飞书配置通过 `meta` 提交,保留未编辑的
+已有配置,文件数量与大小限制仍作为知识库顶层字段提交。
+
+知识库创建通过 `postKnowledge`、`postWebKnowledge` 分别提交到 `/base`、`/web`;
+`postLarkKnowledge` 沿用飞书扩展接口 `/lark/save`,当前开源后端未包含该实现。
+基础创建字段由 `KnowledgeCreatePayload` 统一维护,Web、飞书请求扩展对应类型;工作流创建
+复用基础字段并附加 `work_flow` 及可选的 `KnowledgeWorkflowTemplate` 商店模板。
+成功后的用户资料刷新、列表刷新和路由跳转由创建弹窗负责。
+
+## 枚举与类型组织
+
+`enums/state.ts` 的 `STATE_TYPES` 维护跨业务复用的任务状态,联合类型 `State` 定义在
+`types/state.ts`。触发器及后续文件等业务直接引用公共状态,新增状态时保持已有接口值不变。
+
+API 枚举与类型统一在 `src/api` 范围内管理,相关规则由本文档统一维护。
+
+后端字段的固定枚举值放在 `src/api/enums/.ts`,使用 `as const` 对象声明,并通过
+`src/api/enums/index.ts` 统一导出。业务代码统一从 `@/api/enums` 导入运行时枚举值,不直接
+引用领域文件;不得重复使用裸字符串或另建同值常量。
+
+`src/api/enums` 按明确业务域拆分文件,不创建收集无关枚举的通用文件。枚举的联合类型在对应的
+`src/api/types/.ts` 中由枚举对象派生,并继续通过 `@/api/types` 对外提供。例如
+`TOOL_TYPE` 从 `@/api/enums` 导入,`ToolType` 从 `@/api/types` 导入。
+
+触发器参数来源、间隔单位和请求字段类型直接在对应接口字段中声明字符串联合类型,
+不单独导出运行时枚举;表单选项使用对应字符串值。触发周期继续复用 `TRIGGER_SCHEDULE_TYPE`。
+
+新增或移动类型时按以下顺序判断:
+
+1. 只在一个文件中使用:直接在该文件中声明,不导出。
+2. 只在同一个 API 业务边界内跨文件使用:放在该边界的 `types.ts`;出现重复声明时,提取到
+ 最近共同目录的 `common.ts`。
+3. 同一个业务类型同时被 API 和 View 或 Component 使用:放入 `src/api/types/.ts`,
+ 通过 `src/api/types/index.ts` 导出。
+4. Router、Layout、View 或 Component 专属类型保留在所属目录或实现文件,不放入
+ `src/api/types`。
+
+具体规则:
+
+- API 专用的请求参数、响应包装、请求配置和基础设施类型,放在对应 API 文件、资源目录的
+ `types.ts`,或该 API 业务域的 `common.ts`。
+- 字符串键字典统一使用 `@/api/types` 导出的 `Dict`;未收窄值类型的请求查询参数使用
+ `Dict`,不再为相同结构声明额外别名。
+- `src/api/types` 只存放 API 与 View 或 Component 跨层共用的业务类型,使用方统一通过
+ `import type { ... } from '@/api/types'` 导入,不写 `/index.ts`。
+- `src/api/types/index.ts` 只负责导出各业务域类型,不直接声明类型。
+- 新增类型前先搜索是否已有等价声明,优先复用或扩展已有类型。
+- `src/api/types/index.ts` 只使用 `export type *` 导出类型,运行时值不得从 `@/api/types` 暴露。
+- 同一业务边界内的重复类型提取到最近共同目录的 `common.ts`;`common.ts` 不得成为无关类型
+ 的集合。
+- API 与 View 或 Component 使用同一业务类型时只保留一份声明,不得在两层分别定义。
+- 智能体详情及保存参数中的 `default_model_setting` 使用 `DefaultModelSettingPayload`;该类型由
+ `DefaultModelType` 和单项配置 `ModelConfig` 组合而成(`types/model.ts`),工作流页面及设置抽屉
+ 从 `@/api/types` 引用。
+- 名称相同但业务含义或字段约束不同的类型不要强行合并,应使用明确的领域名称区分。
+- 使用 `interface` 描述对象结构,使用 `type` 描述联合类型、交叉类型、工具类型结果或别名。
+- 类型名称必须体现业务含义,避免使用 `Data`、`Item`、`Info` 等脱离领域后含义不清的名称。
+
+## 接口命名
+
+- 业务接口函数使用“HTTP 方法 + 业务名称”的 camelCase 名称,使调用处能直接识别请求方式,
+ 例如 `getCaptcha`、`postLogin`、`postLogout`、`getWorkspaceDetail`、`postTool`、
+ `putRole` 和 `deleteKnowledge`。
+- 前缀与实际请求方法保持一致:查询使用 `get`,创建和业务动作使用 `post`,完整更新使用
+ `put`,删除使用 `delete`。局部更新接口真实采用 PATCH 时使用 `patch`。
+- 文件导出是直接触发浏览器下载的业务动作,使用 `exportXxx` 命名,例如 `exportTool`。
+- HTTP 方法前缀后必须带有明确的业务名称,不导出 `get`、`post`、`list`、`detail`、`login`
+ 或 `logout` 等缺少请求方式或业务含义的名称。
+- 函数名不追加 `Api` 后缀,所属业务域由目录和文件名表达。
+
+## 请求约定
+
+- `constants.ts` 统一导出 `ADMIN_API_BASE_PATH` 和 `CHAT_API_BASE_PATH`,分别优先读取
+ `window.MaxKB.prefix` 和 `window.MaxKB.chatPrefix`,再回退到 `VITE_BASE_PATH` 和各自默认路径;
+ 去掉末尾斜杠后追加 `/api`。Admin、Chat 请求客户端和会话流式请求复用这些常量。
+- Admin 普通业务接口只声明相对资源路径,由 `core/request.ts` 的 Axios baseURL 处理部署前缀;
+ 流式接口显式传入对应的 API base 常量。
+- Admin Router 直接读取 `window.MaxKB` 运行时路径配置,请求客户端通过上述常量读取;`Window` 和
+ `MaxKBRuntimeConfig` 的全局类型统一声明在根目录 `env.d.ts`。
+- Admin 普通 JSON 请求使用 Axios;`request.ts` 导出 Axios 实例以及 `promise`、`get`、
+ `post`、`put`、`del`、流式响应 `postStream` 和 Blob 文件 `downloadRequest` 请求封装。
+- 正常 JSON 接口返回 `Promise`,请求层负责解包后端 `{ code, message, data }` 响应。
+- GET 文件导出使用 `getExportFile`;需要通过 POST 同时传递查询参数和可选请求体的 Excel 导出
+ 使用 `postExportExcel`;Skill 压缩包等指定请求方法的文件下载使用 `downloadRequest`。请求层统一
+ 获取 Blob、解析 `Content-Disposition` 文件名并触发浏览器下载;业务 API 只需传入接口地址及业务参数。
+- 业务代码通过 `api.method().then(...)` 处理接口成功后的状态变化;通用接口错误由请求层统一
+ 提示,不在调用处重复使用 `try/catch` 或 `.catch()` 提示相同错误。只有业务降级、状态恢复等
+ 非提示类失败处理可以按需保留失败分支。
+- token 和平台公开档案由 `stores/auth.ts` 管理,语言由 `stores/user.ts` 管理;Router、Axios 等业务代码通过
+ `stores/index.ts` 导出的 `useStore()` 按需访问 Store;401 响应统一清除 token 并跳转 Admin
+ 登录页。
+- loading 不作为业务 API 或 Admin、Chat 底层请求封装的参数;JSON 请求、文件上传和下载均遵循此规则。
+ 由调用接口的页面、组件或 Store 在请求前开启 loading,并在 Promise 的 `finally` 中释放,确保成功和失败都恢复状态。
+- 流式 POST 请求使用 `postStream` 返回原始 `Response`,由业务组件按具体协议解析数据块;
+ 参数顺序为 `postStream(base, path, data?, config?)`,`config.signal` 用于取消请求。
+ 鉴权、语言请求头和错误状态仍由请求基础设施统一处理。
+- 上传、下载和其他特殊请求在真实需求出现时独立设计,不提前塞入普通 JSON 请求客户端。
+
+### 资源用户授权
+
+`admin/workspace/resource-authorization.ts` 按指定资源查询和更新用户权限,使用
+`resource_user_permission/resource//resource/`;与 System 用户视角的
+`user_resource_permission` 区分。分页使用 `ParamsPage`,直接返回
+`ResponsePage`;提交 `ResourceUserPermissionPayload[]`。
+用户及用户组的查询和更新接口均以必填的 `workspaceId` 为首个参数,由调用方从资源或文件夹
+接口数据的 `workspace_id` 传入,不读取或回退到路由工作空间。
+`ResourceAuthorizationTargetType` 包含资源类型和三个 `_FOLDER` 类型,文件夹类型用于后端
+鉴权。包含子资源时传 `include_children: true` 及经过管理权限筛选的 `folder_ids`,
+普通资源或仅当前文件夹不传子文件夹 ID。loading、刷新及成功提示由抽屉负责。
+
+用户组视角使用同文件的 `getResourceUserGroupAuthorization` 和
+`putResourceUserGroupAuthorization`,请求路径为
+`resource_user_group_permission/resource//resource/`。分页返回
+`ResponsePage`(`id`、`name`、`count`、`permission`),
+名称查询参数为 `name`,提交 `ResourceUserGroupPermissionPayload[]`,对象 ID 字段为
+`user_group_id`;文件夹生效范围参数与用户授权一致。
+
+System 资源管理的用户授权维护在 `admin/system/resource-management/resource-authorization.ts`,
+使用 `/system/workspace//resource_management/resource//resource/